redis从入门到实践
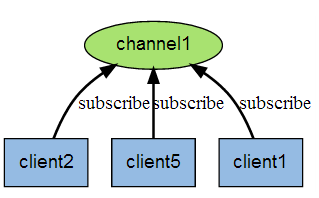
一. Redis安装使用 1.介绍 redis是一个key-value存储系统。和Memcached类似,它支持存储的value类型相对更多, 包括string(字符串)、list(链表)、set(集合)、zset(sorted set--有序集合)和hash(哈希类型)。 这些数据类型都支持push/pop、add/remove及取交集并集和差集及更丰富的操作,而且 这些操作都是原子性的。在此基础上,redis支持各种不同方式的排序。与memcached一样, 为了保证效率,数据都是缓存在内存中。区别的是redis会周期性的把更新的数据写入磁盘 或者把修改操作写入追加的记录文件,并且在此基础上实现了master-slave(主从)同步。 2.安装redis 1.下载官网最新redis安装包 http://download.redis.io/releases/redis-4.0.0.tar.gz 2.在/usr/local下创建文件redis cd /usr/local mkdir redis 3.将下载的redis-4.0.2.tar.gz安装包解压到redis文件夹中 cd ~ tar -zxvf redis-4.0.2.tar.gz -C /usr/local/redis 4.进入解压后的目录进行编译 cd /usr/local/redis/redis-4.0.2 make 5.安装到指定目录,如 /usr/local/redis cd /usr/local/redis/redis-4.0.2 make PREFIX=/usr/local/redis install 6.拷贝配置文件redis.conf到安装目录下 cp /usr/local/redis/redis-4.0.2/redis.conf /usr/local/redis/bin 7.修改redis.conf配置文件,这里使用默认端口6379,有需要的可以更改。 把daemonize改为yes(这里推荐以后端模式启动) vi /usr/local/redis/bin/redis.conf ----------------------------------- 以后端模式启动redis cd /usr/local/redis ./bin/redis-server ./bin/redis.conf 8.测试redis cd /usr/local/redis ./bin/redis-cli set name zhangsan get name 9.Linux开启关闭redis 1.启动:./redis-server(redis-server redis.conf) 2.登陆:./redis-cli(redis-cli -p 6379) 3.关闭:./redis-cli shutdown 10.Linux 为redis配置密码 1.第一种方式(临时密码,Linux重启后会消失) (1) [root@localhost bin]# redis-cli -p 6379 127.0.0.1:6379> (2)查看当前redis有没有设置密码: 127.0.0.1:6379> config get requirepass 1) "requirepass" 2) "" (3)为以上显示说明没有密码,那么现在来设置密码: 127.0.0.1:6379> config set requirepass abcdefg OK 127.0.0.1:6379> (4)再次查看当前redis就提示需要密码: 127.0.0.1:6379> config get requirepass (error) NOAUTH Authentication required. 127.0.0.1:6379> 2.第二种方式 (永久方式) 需要永久配置密码的话就去redis.conf的配置文件中找到requirepass这个参数,如下配置: 修改redis.conf配置文件 # requirepass foobared requirepass 123 指定密码123 保存后重启redis就可以了 11.Jedis连接redis java 代码方式 //连接redis服务器,192.168.0.100:6379 jedis = new Jedis("ip", 6379); //权限认证 jedis.auth("password"); 配置文件方式 <bean id=”jedisConnectionFactory” class=”org.springframework.data.redis.connection.jedis.JedisConnectionFactory”> <property name=”hostName” value=”${redis.host}” /> <property name=”port” value=”${redis.port}” /> <property name=”password” value=”${redis.pass}” /> </bean> redis的其他命令 如果需要关闭redis: [root@localhost bin]# pkill redis 如果需要开启redis: [root@localhost bin]# redis-server & 加&符号的作用是为了让此进程转换为后台进程,不占用shell的服务。 注意事项 1.提示time out错误 需要在iptables防火墙上添加6379端口并重启防火墙服务 2.提示connection refuse错误 需要注释掉redis.conf 文件中的bind 127.0.0.1 3.提示J edisDataException错误 需要将redis.conf文件中的protect-mode 置为no最后重启redis 应用场景 1.缓存 2.聊天室,秒杀,任务队列(list结构,pop(弹出),push(插入)) 3.数据存储(add,del,update,select)定期持久化到硬盘中 4.网站统计 5.数据过期处理 6.分布式集群架构中的session分离 主要内容 NoSQL(非关系型数据库) redis:key/value键值dui存储数据库 mongodb:文档型数据库 hbase:列式数据库 neo4j:图式数据库,存储的是图关系而非行或列。主要用于社交网络的存储 redis数据结构:String Hash Set SortedSet List redis事务:multi exec discard redis持久化:rbd内存快照,aof命令日志 二.Redis快速入门 1.redis 配置说明 1\. Redis默认不是以守护进程的方式运行,可以通过该配置项修改,使用yes启用守护进程 daemonize no 2\. 当Redis以守护进程方式运行时,Redis默认会把pid写入/var/run/redis.pid文件,可以通过pidfile指定 pidfile /var/run/redis.pid 3\. 指定Redis监听端口,默认端口为6379,作者在自己的一篇博文中解释了为什么选用6379作为默认端口,因为6379在手机按键上MERZ对应的号码,而MERZ取自意大利歌女Alessia Merz的名字 port 6379 4\. 绑定的主机地址 bind 127.0.0.1 5.当 客户端闲置多长时间后关闭连接,如果指定为0,表示关闭该功能 timeout 300 6\. 指定日志记录级别,Redis总共支持四个级别:debug、verbose、notice、warning,默认为verbose loglevel verbose 7\. 日志记录方式,默认为标准输出,如果配置Redis为守护进程方式运行,而这里又配置为日志记录方式为标准输出,则日志将会发送给/dev/null logfile stdout 8\. 设置数据库的数量,默认数据库为0,可以使用SELECT <dbid>命令在连接上指定数据库id databases 16 9\. 指定在多长时间内,有多少次更新操作,就将数据同步到数据文件,可以多个条件配合 save <seconds> <changes> Redis默认配置文件中提供了三个条件: save 900 1 save 300 10 save 60 10000 分别表示900秒(15分钟)内有1个更改,300秒(5分钟)内有10个更改以及60秒内有10000个更改。 10\. 指定存储至本地数据库时是否压缩数据,默认为yes,Redis采用LZF压缩,如果为了节省CPU时间,可以关闭该选项,但会导致数据库文件变的巨大 rdbcompression yes 11\. 指定本地数据库文件名,默认值为dump.rdb dbfilename dump.rdb 12\. 指定本地数据库存放目录 dir ./ 13\. 设置当本机为slav服务时,设置master服务的IP地址及端口,在Redis启动时,它会自动从master进行数据同步 slaveof <masterip> <masterport> 14\. 当master服务设置了密码保护时,slav服务连接master的密码 masterauth <master-password> 15\. 设置Redis连接密码,如果配置了连接密码,客户端在连接Redis时需要通过AUTH <password>命令提供密码,默认关闭 requirepass foobared 16\. 设置同一时间最大客户端连接数,默认无限制,Redis可以同时打开的客户端连接数为Redis进程可以打开的最大文件描述符数,如果设置 maxclients 0,表示不作限制。当客户端连接数到达限制时,Redis会关闭新的连接并向客户端返回max number of clients reached错误信息 maxclients 128 17\. 指定Redis最大内存限制,Redis在启动时会把数据加载到内存中,达到最大内存后,Redis会先尝试清除已到期或即将到期的Key,当此方法处理 后,仍然到达最大内存设置,将无法再进行写入操作,但仍然可以进行读取操作。Redis新的vm机制,会把Key存放内存,Value会存放在swap区 maxmemory <bytes> 18\. 指定是否在每次更新操作后进行日志记录,Redis在默认情况下是异步的把数据写入磁盘,如果不开启,可能会在断电时导致一段时间内的数据丢失。因为 redis本身同步数据文件是按上面save条件来同步的,所以有的数据会在一段时间内只存在于内存中。默认为no appendonly no 19\. 指定更新日志文件名,默认为appendonly.aof appendfilename appendonly.aof 20\. 指定更新日志条件,共有3个可选值: no:表示等操作系统进行数据缓存同步到磁盘(快) always:表示每次更新操作后手动调用fsync()将数据写到磁盘(慢,安全) everysec:表示每秒同步一次(折衷,默认值) appendfsync everysec 21\. 指定是否启用虚拟内存机制,默认值为no,简单的介绍一下,VM机制将数据分页存放,由Redis将访问量较少的页即冷数据swap到磁盘上,访问多的页面由磁盘自动换出到内存中(在后面的文章我会仔细分析Redis的VM机制) vm-enabled no 22\. 虚拟内存文件路径,默认值为/tmp/redis.swap,不可多个Redis实例共享 vm-swap-file /tmp/redis.swap 23\. 将所有大于vm-max-memory的数据存入虚拟内存,无论vm-max-memory设置多小,所有索引数据都是内存存储的(Redis的索引数据 就是keys),也就是说,当vm-max-memory设置为0的时候,其实是所有value都存在于磁盘。默认值为0 vm-max-memory 0 24\. Redis swap文件分成了很多的page,一个对象可以保存在多个page上面,但一个page上不能被多个对象共享,vm-page-size是要根据存储的 数据大小来设定的,作者建议如果存储很多小对象,page大小最好设置为32或者64bytes;如果存储很大大对象,则可以使用更大的page,如果不 确定,就使用默认值 vm-page-size 32 25\. 设置swap文件中的page数量,由于页表(一种表示页面空闲或使用的bitmap)是在放在内存中的,,在磁盘上每8个pages将消耗1byte的内存。 vm-pages 134217728 26\. 设置访问swap文件的线程数,最好不要超过机器的核数,如果设置为0,那么所有对swap文件的操作都是串行的,可能会造成比较长时间的延迟。默认值为4 vm-max-threads 4 27\. 设置在向客户端应答时,是否把较小的包合并为一个包发送,默认为开启 glueoutputbuf yes 28\. 指定在超过一定的数量或者最大的元素超过某一临界值时,采用一种特殊的哈希算法 hash-max-zipmap-entries 64 hash-max-zipmap-value 512 29\. 指定是否激活重置哈希,默认为开启(后面在介绍Redis的哈希算法时具体介绍) activerehashing yes 30\. 指定包含其它的配置文件,可以在同一主机上多个Redis实例之间使用同一份配置文件,而同时各个实例又拥有自己的特定配置文件 include /path/to/local.conf Redis 键(key) Redis 键命令用于管理 redis 的键。 语法 Redis 键命令的基本语法如下: redis 127.0.0.1:6379> COMMAND KEY_NAME 实例 redis 127.0.0.1:6379> SET runoobkey redis OK redis 127.0.0.1:6379> DEL runoobkey (integer) 1 在以上实例中 DEL 是一个命令, runoobkey 是一个键。 如果键被删除成功,命令执行后输出 (integer) 1,否则将输出 (integer) 0 Redis keys 命令 下表给出了与 Redis 键相关的基本命令: 1 DEL key 该命令用于在 key 存在时删除 key。 2 DUMP key 序列化给定 key ,并返回被序列化的值。 3 EXISTS key 检查给定 key 是否存在。 4 EXPIRE key seconds 为给定 key 设置过期时间。 5 EXPIREAT key timestamp EXPIREAT 的作用和 EXPIRE 类似,都用于为 key 设置过期时间。 不同在于 EXPIREAT 命令接受的时间参数是 UNIX 时间戳(unix timestamp)。 6 PEXPIRE key milliseconds 设置 key 的过期时间以毫秒计。 7 PEXPIREAT key milliseconds-timestamp 设置 key 过期时间的时间戳(unix timestamp) 以毫秒计 8 KEYS pattern 查找所有符合给定模式( pattern)的 key 。 9 MOVE key db 将当前数据库的 key 移动到给定的数据库 db 当中。 10 PERSIST key 移除 key 的过期时间,key 将持久保持。 11 PTTL key 以毫秒为单位返回 key 的剩余的过期时间。 12 TTL key 以秒为单位,返回给定 key 的剩余生存时间(TTL, time to live)。 13 RANDOMKEY 从当前数据库中随机返回一个 key 。 14 RENAME key newkey 修改 key 的名称 15 RENAMENX key newkey 仅当 newkey 不存在时,将 key 改名为 newkey 。 16 TYPE key 返回 key 所储存的值的类型 Redis 数据类型 Redis支持五种数据类型: string(字符串), hash(哈希), list(列表), set(集合) zset(sorted set:有序集合)。 String(字符串) string是redis最基本的类型,你可以理解成与Memcached一模一样的类型,一个key对应一个value。 string类型是二进制安全的。意思是redis的string可以包含任何数据。比如jpg图片或者序列化的对象 。 string类型是Redis最基本的数据类型,一个键最大能存储512MB。 实例 redis 127.0.0.1:6379> SET name "runoob" OK redis 127.0.0.1:6379> GET name "runoob" 在以上实例中我们使用了 Redis 的 SET 和 GET 命令。键为 name,对应的值为 runoob。 注意:一个键最大能存储512MB。 Redis 字符串命令 1 SET key value 设置指定 key 的值 2 GET key 获取指定 key 的值。 3 GETRANGE key start end 返回 key 中字符串值的子字符 4 GETSET key value 将给定 key 的值设为 value ,并返回 key 的旧值(old value)。 5 GETBIT key offset 对 key 所储存的字符串值,获取指定偏移量上的位(bit)。 6 MGET key1 [key2..] 获取所有(一个或多个)给定 key 的值。 7 SETBIT key offset value 对 key 所储存的字符串值,设置或清除指定偏移量上的位(bit)。 8 SETEX key seconds value 将值 value 关联到 key ,并将 key 的过期时间设为 seconds (以秒为单位)。 9 SETNX key value 只有在 key 不存在时设置 key 的值。 10 SETRANGE key offset value 用 value 参数覆写给定 key 所储存的字符串值,从偏移量 offset 开始。 11 STRLEN key 返回 key 所储存的字符串值的长度。 12 MSET key value [key value ...] 同时设置一个或多个 key-value 对。 13 MSETNX key value [key value ...] 同时设置一个或多个 key-value 对,当且仅当所有给定 key 都不存在。 14 PSETEX key milliseconds value 这个命令和 SETEX 命令相似,但它以毫秒为单位设置 key 的生存时间,而不是像 SETEX 命令那样,以秒为单位。 15 INCR key 将 key 中储存的数字值增一。 16 INCRBY key increment 将 key 所储存的值加上给定的增量值(increment) 。 17 INCRBYFLOAT key increment 将 key 所储存的值加上给定的浮点增量值(increment) 。 18 DECR key 将 key 中储存的数字值减一。 19 DECRBY key decrement key 所储存的值减去给定的减量值(decrement) 。 20 APPEND key value 如果 key 已经存在并且是一个字符串, APPEND 命令将 value 追加到 key 原来的值的末尾。 Hash(哈希) Redis hash 是一个键值(key=>value)对集合。 Redis hash是一个string类型的field和value的映射表,hash特别适合用于存储对象。 实例 redis> HMSET myhash field1 "Hello" field2 "World" "OK" redis> HGET myhash field1 "Hello" redis> HGET myhash field2 "World" 以上实例中 hash 数据类型存储了包含用户脚本信息的用户对象。 实例中我们使用了 Redis HMSET, HGETALL 命令,user:1 为键值。 每个 hash 可以存储 232 -1 键值对(40多亿)。 Redis hash 命令 1 HDEL key field1 [field2] 删除一个或多个哈希表字段 2 HEXISTS key field 查看哈希表 key 中,指定的字段是否存在。 3 HGET key field 获取存储在哈希表中指定字段的值。 4 HGETALL key 获取在哈希表中指定 key 的所有字段和值 5 HINCRBY key field increment 为哈希表 key 中的指定字段的整数值加上增量 increment 。 6 HINCRBYFLOAT key field increment 为哈希表 key 中的指定字段的浮点数值加上增量 increment 。 7 HKEYS key 获取所有哈希表中的字段 8 HLEN key 获取哈希表中字段的数量 9 HMGET key field1 [field2] 获取所有给定字段的值 10 HMSET key field1 value1 [field2 value2 ] 同时将多个 field-value (域-值)对设置到哈希表 key 中。 11 HSET key field value 将哈希表 key 中的字段 field 的值设为 value 。 12 HSETNX key field value 只有在字段 field 不存在时,设置哈希表字段的值。 13 HVALS key 获取哈希表中所有值 14 HSCAN key cursor [MATCH pattern] [COUNT count] 迭代哈希表中的键值对。 List(列表) Redis 列表是简单的字符串列表,按照插入顺序排序。你可以添加一个元素到列表的头部(左边)或者尾部(右边)。 实例 redis 127.0.0.1:6379> lpush runoob redis (integer) 1 redis 127.0.0.1:6379> lpush runoob mongodb (integer) 2 redis 127.0.0.1:6379> lpush runoob rabitmq (integer) 3 redis 127.0.0.1:6379> lrange runoob 0 10 1) "rabitmq" 2) "mongodb" 3) "redis" redis 127.0.0.1:6379> 列表最多可存储 232 - 1 元素 (4294967295, 每个列表可存储40多亿)。 Redis 列表命令 1 BLPOP key1 [key2 ] timeout 移出并获取列表的第一个元素, 如果列表没有元素会阻塞列表直到等待超时或发现可弹出元素为止。 2 BRPOP key1 [key2 ] timeout 移出并获取列表的最后一个元素, 如果列表没有元素会阻塞列表直到等待超时或发现可弹出元素为止。 3 BRPOPLPUSH source destination timeout 从列表中弹出一个值,将弹出的元素插入到另外一个列表中并返回它; 如果列表没有元素会阻塞列表直到等待超时或发现可弹出元素为止。 4 LINDEX key index 通过索引获取列表中的元素 5 LINSERT key BEFORE|AFTER pivot value 在列表的元素前或者后插入元素 6 LLEN key 获取列表长度 7 LPOP key 移出并获取列表的第一个元素 8 LPUSH key value1 [value2] 将一个或多个值插入到列表头部 9 LPUSHX key value 将一个值插入到已存在的列表头部 10 LRANGE key start stop 获取列表指定范围内的元素 11 LREM key count value 移除列表元素 12 LSET key index value 通过索引设置列表元素的值 13 LTRIM key start stop 对一个列表进行修剪(trim),就是说,让列表只保留指定区间内的元素,不在指定区间之内的元素都将被删除。 14 RPOP key 移除并获取列表最后一个元素 15 RPOPLPUSH source destination 移除列表的最后一个元素,并将该元素添加到另一个列表并返回 16 RPUSH key value1 [value2] 在列表中添加一个或多个值 17 RPUSHX key value 为已存在的列表添加值 Set(集合) Redis的Set是string类型的无序集合。 集合是通过哈希表实现的,所以添加,删除,查找的复杂度都是O(1)。 sadd 命令 添加一个string元素到,key对应的set集合中,成功返回1,如果元素已经在集合中返回0,key对应的set不存在返回错误。 sadd key member 实例 redis 127.0.0.1:6379> sadd runoob redis (integer) 1 redis 127.0.0.1:6379> sadd runoob mongodb (integer) 1 redis 127.0.0.1:6379> sadd runoob rabitmq (integer) 1 redis 127.0.0.1:6379> sadd runoob rabitmq (integer) 0 redis 127.0.0.1:6379> smembers runoob 1) "rabitmq" 2) "mongodb" 3) "redis" 注意:以上实例中 rabitmq 添加了两次,但根据集合内元素的唯一性,第二次插入的元素将被忽略。 集合中最大的成员数为 232 - 1(4294967295, 每个集合可存储40多亿个成员)。 Redis 集合命令 1 SADD key member1 [member2] 向集合添加一个或多个成员 2 SCARD key 获取集合的成员数 3 SDIFF key1 [key2] 返回给定所有集合的差集 4 SDIFFSTORE destination key1 [key2] 返回给定所有集合的差集并存储在 destination 中 5 SINTER key1 [key2] 返回给定所有集合的交集 6 SINTERSTORE destination key1 [key2] 返回给定所有集合的交集并存储在 destination 中 7 SISMEMBER key member 判断 member 元素是否是集合 key 的成员 8 SMEMBERS key 返回集合中的所有成员 9 SMOVE source destination member 将 member 元素从 source 集合移动到 destination 集合 10 SPOP key 移除并返回集合中的一个随机元素 11 SRANDMEMBER key [count] 返回集合中一个或多个随机数 12 SREM key member1 [member2] 移除集合中一个或多个成员 13 SUNION key1 [key2] 返回所有给定集合的并集 14 SUNIONSTORE destination key1 [key2] 所有给定集合的并集存储在 destination 集合中 15 SSCAN key cursor [MATCH pattern] [COUNT count] 迭代集合中的元素 zset(sorted set:有序集合) Redis zset 和 set 一样也是string类型元素的集合,且不允许重复的成员。 不同的是每个元素都会关联一个double类型的分数。redis正是通过分数来为集合中的成员进行从小到大的排序。 zset的成员是唯一的,但分数(score)却可以重复。 zadd 命令 添加元素到集合,元素在集合中存在则更新对应score zadd key score member 实例 redis 127.0.0.1:6379> zadd runoob 0 redis (integer) 1 redis 127.0.0.1:6379> zadd runoob 0 mongodb (integer) 1 redis 127.0.0.1:6379> zadd runoob 0 rabitmq (integer) 1 redis 127.0.0.1:6379> zadd runoob 0 rabitmq (integer) 0 redis 127.0.0.1:6379> ZRANGEBYSCORE runoob 0 1000 1) "redis" 2) "mongodb" 3) "rabitmq" Redis 有序集合命令 1 ZADD key score1 member1 [score2 member2] 向有序集合添加一个或多个成员,或者更新已存在成员的分数 2 ZCARD key 获取有序集合的成员数 3 ZCOUNT key min max 计算在有序集合中指定区间分数的成员数 4 ZINCRBY key increment member 有序集合中对指定成员的分数加上增量 increment 5 ZINTERSTORE destination numkeys key [key ...] 计算给定的一个或多个有序集的交集并将结果集存储在新的有序集合 key 中 6 ZLEXCOUNT key min max 在有序集合中计算指定字典区间内成员数量 7 ZRANGE key start stop [WITHSCORES] 通过索引区间返回有序集合成指定区间内的成员 8 ZRANGEBYLEX key min max [LIMIT offset count] 通过字典区间返回有序集合的成员 9 ZRANGEBYSCORE key min max [WITHSCORES] [LIMIT] 通过分数返回有序集合指定区间内的成员 10 ZRANK key member 返回有序集合中指定成员的索引 11 ZREM key member [member ...] 移除有序集合中的一个或多个成员 12 ZREMRANGEBYLEX key min max 移除有序集合中给定的字典区间的所有成员 13 ZREMRANGEBYRANK key start stop 移除有序集合中给定的排名区间的所有成员 14 ZREMRANGEBYSCORE key min max 移除有序集合中给定的分数区间的所有成员 15 ZREVRANGE key start stop [WITHSCORES] 返回有序集中指定区间内的成员,通过索引,分数从高到底 16 ZREVRANGEBYSCORE key max min [WITHSCORES] 返回有序集中指定分数区间内的成员,分数从高到低排序 17 ZREVRANK key member 返回有序集合中指定成员的排名,有序集成员按分数值递减(从大到小)排序 18 ZSCORE key member 返回有序集中,成员的分数值 19 ZUNIONSTORE destination numkeys key [key ...] 计算给定的一个或多个有序集的并集,并存储在新的 key 中 20 ZSCAN key cursor [MATCH pattern] [COUNT count] 迭代有序集合中的元素(包括元素成员和元素分值) HyperLogLog Redis 在 2.8.9 版本添加了 HyperLogLog 结构。 Redis HyperLogLog 是用来做基数统计的算法,HyperLogLog 的优点是,在输入元素的数量或者体积非常非常大时,计算基数所需的空间总是固定 的、并且是很小的。 在 Redis 里面,每个 HyperLogLog 键只需要花费 12 KB 内存,就可以计算接近 2^64 个不同元素的基 数。这和计算基数时,元素越多耗费内存就越多的集合形成鲜明对比。 但是,因为 HyperLogLog 只会根据输入元素来计算基数,而不会储存输入元素本身,所以 HyperLogLog 不能像集合那样,返回输入的各个元素。 什么是基数? 比如数据集 {1, 3, 5, 7, 5, 7, 8}, 那么这个数据集的基数集为 {1, 3, 5 ,7, 8}, 基数(不重复元素)为5。 基数估计就是在误差可接受的范围内,快速计算基数。 实例 redis 127.0.0.1:6379> PFADD runoobkey "redis" 1) (integer) 1 redis 127.0.0.1:6379> PFADD runoobkey "mongodb" 1) (integer) 1 redis 127.0.0.1:6379> PFADD runoobkey "mysql" 1) (integer) 1 redis 127.0.0.1:6379> PFCOUNT runoobkey (integer) 3 Redis HyperLogLog 命令 1 PFADD key element [element ...] 添加指定元素到 HyperLogLog 中。 2 PFCOUNT key [key ...] 返回给定 HyperLogLog 的基数估算值。 3 PFMERGE destkey sourcekey [sourcekey ...] 将多个 HyperLogLog 合并为一个 HyperLogLog 发布订阅 Redis 发布订阅(pub/sub)是一种消息通信模式:发送者(pub)发送消息,订阅者(sub)接收消息。 Redis 客户端可以订阅任意数量的频道。 下图展示了频道 channel1 , 以及订阅这个频道的三个客户端 —— client2 、 client5 和 client1 之间的关系: image 当有新消息通过 PUBLISH 命令发送给频道 channel1 时, 这个消息就会被发送给订阅它的三个客户端: image 实例 redis 127.0.0.1:6379> SUBSCRIBE redisChat Reading messages... (press Ctrl-C to quit) 1) "subscribe" 2) "redisChat" 3) (integer) 1 现在,我们先重新开启个 redis 客户端,然后在同一个频道 redisChat 发布两次消息,订阅者就能接收到消息。 redis 127.0.0.1:6379> PUBLISH redisChat "Redis is a great caching technique" (integer) 1 redis 127.0.0.1:6379> PUBLISH redisChat "Learn redis by runoob.com" (integer) 1 # 订阅者的客户端会显示如下消息 1) "message" 2) "redisChat" 3) "Redis is a great caching technique" 1) "message" 2) "redisChat" 3) "Learn redis by runoob.com" Redis 发布订阅命令 1 PSUBSCRIBE pattern [pattern ...] 订阅一个或多个符合给定模式的频道。 2 PUBSUB subcommand [argument [argument ...]] 查看订阅与发布系统状态。 3 PUBLISH channel message 将信息发送到指定的频道。 4 PUNSUBSCRIBE [pattern [pattern ...]] 退订所有给定模式的频道。 5 SUBSCRIBE channel [channel ...] 订阅给定的一个或多个频道的信息。 6 UNSUBSCRIBE [channel [channel ...]] 指退订给定的频道。 Redis 事务 Redis 事务可以一次执行多个命令, 并且带有以下两个重要的保证: 事务是一个单独的隔离操作:事务中的所有命令都会序列化、按顺序地执行。事务在执行的过程中,不会被其他客户端发送来的命令请求所打断。 事务是一个原子操作:事务中的命令要么全部被执行,要么全部都不执行。 一个事务从开始到执行会经历以下三个阶段: 开始事务。 命令入队。 执行事务。 实例 `` txt 以下是一个事务的例子, 它先以 MULTI 开始一个事务, 然后将多个命令入队到事务中, 最后由 EXEC 命令触发事务, 一并执行事务中的所有命令: redis 127.0.0.1:6379> MULTI OK redis 127.0.0.1:6379> SET book-name "Mastering C++ in 21 days" QUEUED redis 127.0.0.1:6379> GET book-name QUEUED redis 127.0.0.1:6379> SADD tag "C++" "Programming" "Mastering Series" QUEUED redis 127.0.0.1:6379> SMEMBERS tag QUEUED redis 127.0.0.1:6379> EXEC OK "Mastering C++ in 21 days" (integer) 3 "Mastering Series" "C++" "Programming" ##### Redis 事务命令 ``` txt 1 DISCARD 取消事务,放弃执行事务块内的所有命令。 2 EXEC 执行所有事务块内的命令。 3 MULTI 标记一个事务块的开始。 4 UNWATCH 取消 WATCH 命令对所有 key 的监视。 5 WATCH key [key ...] 监视一个(或多个) key ,如果在事务执行之前这个(或这些) key 被其他命令所改动,那么事务将被打断。 Redis 连接 Redis 连接命令主要是用于连接 redis 服务。 实例 以下实例演示了客户端如何通过密码验证连接到 redis 服务,并检测服务是否在运行: redis 127.0.0.1:6379> AUTH "password" OK redis 127.0.0.1:6379> PING PONG Redis 连接命令 1 AUTH password 验证密码是否正确 2 ECHO message 打印字符串 3 PING 查看服务是否运行 4 QUIT 关闭当前连接 5 SELECT index 切换到指定的数据库 Redis 服务器 Redis 服务器命令主要是用于管理 redis 服务。 实例 以下实例演示了如何获取 redis 服务器的统计信息: redis 127.0.0.1:6379> INFO Redis 服务器命令 1 BGREWRITEAOF 异步执行一个 AOF(AppendOnly File) 文件重写操作 2 BGSAVE 在后台异步保存当前数据库的数据到磁盘 3 CLIENT KILL [ip:port] [ID client-id] 关闭客户端连接 4 CLIENT LIST 获取连接到服务器的客户端连接列表 5 CLIENT GETNAME 获取连接的名称 6 CLIENT PAUSE timeout 在指定时间内终止运行来自客户端的命令 7 CLIENT SETNAME connection-name 设置当前连接的名称 8 CLUSTER SLOTS 获取集群节点的映射数组 9 COMMAND 获取 Redis 命令详情数组 10 COMMAND COUNT 获取 Redis 命令总数 11 COMMAND GETKEYS 获取给定命令的所有键 12 TIME 返回当前服务器时间 13 COMMAND INFO command-name [command-name ...] 获取指定 Redis 命令描述的数组 14 CONFIG GET parameter 获取指定配置参数的值 15 CONFIG REWRITE 对启动 Redis 服务器时所指定的 redis.conf 配置文件进行改写 16 CONFIG SET parameter value 修改 redis 配置参数,无需重启 17 CONFIG RESETSTAT 重置 INFO 命令中的某些统计数据 18 DBSIZE 返回当前数据库的 key 的数量 19 DEBUG OBJECT key 获取 key 的调试信息 20 DEBUG SEGFAULT 让 Redis 服务崩溃 21 FLUSHALL 删除所有数据库的所有key 22 FLUSHDB 删除当前数据库的所有key 23 INFO [section] 获取 Redis 服务器的各种信息和统计数值 24 LASTSAVE 返回最近一次 Redis 成功将数据保存到磁盘上的时间,以 UNIX 时间戳格式表示 25 MONITOR 实时打印出 Redis 服务器接收到的命令,调试用 26 ROLE 返回主从实例所属的角色 27 SAVE 异步保存数据到硬盘 28 SHUTDOWN [NOSAVE] [SAVE] 异步保存数据到硬盘,并关闭服务器 29 SLAVEOF host port 将当前服务器转变为指定服务器的从属服务器(slave server) 30 SLOWLOG subcommand [argument] 管理 redis 的慢日志 31 SYNC 用于复制功能(replication)的内部命令 Redis 数据备份与恢复 Redis SAVE 命令用于创建当前数据库的备份。 语法 redis Save 命令基本语法如下: redis 127.0.0.1:6379> SAVE 实例 redis 127.0.0.1:6379> SAVE OK 该命令将在 redis 安装目录中创建dump.rdb文件。 恢复数据 如果需要恢复数据,只需将备份文件 (dump.rdb) 移动到 redis 安装目录并启动服务即可。获取 redis 目录可以使用 CONFIG 命令,如下所示: redis 127.0.0.1:6379> CONFIG GET dir 1) "dir" 2) "/usr/local/redis/bin" 以上命令 CONFIG GET dir 输出的 redis 安装目录为 /usr/local/redis/bin。 Bgsave 创建 redis 备份文件也可以使用命令 BGSAVE,该命令在后台执行。 实例 127.0.0.1:6379> BGSAVE Background saving started Redis 客户端连接 Redis 通过监听一个 TCP 端口或者 Unix socket 的方式来接收来自客户端的连接,当一个连接建立后,Redis 内部会进行以下一些操作: 首先,客户端 socket 会被设置为非阻塞模式,因为 Redis 在网络事件处理上采用的是非阻塞多路复用模型。 然后为这个 socket 设置 TCP_NODELAY 属性,禁用 Nagle 算法 然后创建一个可读的文件事件用于监听这个客户端 socket 的数据发送 最大连接数 在 Redis2.4 中,最大连接数是被直接硬编码在代码里面的,而在2.6版本中这个值变成可配置的。 maxclients 的默认值是 10000,你也可以在 redis.conf 中对这个值进行修改。 config get maxclients 1) "maxclients" 2) "10000" 实例 以下实例我们在服务启动时设置最大连接数为 100000: redis-server --maxclients 100000 客户端命令 1 CLIENT LIST 返回连接到 redis 服务的客户端列表 2 CLIENT SETNAME 设置当前连接的名称 3 CLIENT GETNAME 获取通过 CLIENT SETNAME 命令设置的服务名称 4 CLIENT PAUSE 挂起客户端连接,指定挂起的时间以毫秒计 5 CLIENT KILL 关闭客户端连接 三.Java 使用 Redis 下载jedis.jar 连接到 redis 服务 import redis.clients.jedis.Jedis; public class RedisJava { public static void main(String[] args) { //连接本地的 Redis 服务 Jedis jedis = new Jedis("localhost"); System.out.println("连接成功"); //查看服务是否运行 System.out.println("服务正在运行: "+jedis.ping()); } } 编译以上 Java 程序,确保驱动包的路径是正确的。 连接成功 服务正在运行: PONG Redis Java String(字符串) 实例 import redis.clients.jedis.Jedis; public class RedisStringJava { public static void main(String[] args) { //连接本地的 Redis 服务 Jedis jedis = new Jedis("localhost"); System.out.println("连接成功"); //设置 redis 字符串数据 jedis.set("runoobkey", "www.runoob.com"); // 获取存储的数据并输出 System.out.println("redis 存储的字符串为: "+ jedis.get("runoobkey")); } } 编译以上程序。 连接成功 redis 存储的字符串为: www.runoob.com Redis Java List(列表) 实例 import java.util.List; import redis.clients.jedis.Jedis; public class RedisListJava { public static void main(String[] args) { //连接本地的 Redis 服务 Jedis jedis = new Jedis("localhost"); System.out.println("连接成功"); //存储数据到列表中 jedis.lpush("site-list", "Runoob"); jedis.lpush("site-list", "Google"); jedis.lpush("site-list", "Taobao"); // 获取存储的数据并输出 List<String> list = jedis.lrange("site-list", 0 ,2); for(int i=0; i<list.size(); i++) { System.out.println("列表项为: "+list.get(i)); } } } 编译以上程序。 连接成功 列表项为: Taobao 列表项为: Google 列表项为: Runoob Redis Java Keys 实例 import java.util.Iterator; import java.util.Set; import redis.clients.jedis.Jedis; public class RedisKeyJava { public static void main(String[] args) { //连接本地的 Redis 服务 Jedis jedis = new Jedis("localhost"); System.out.println("连接成功"); // 获取数据并输出 Set<String> keys = jedis.keys("*"); Iterator<String> it=keys.iterator() ; while(it.hasNext()){ String key = it.next(); System.out.println(key); } } } 编译以上程序。 连接成功 runoobkey site-list Maven依赖 <dependency> <groupId>redis.clients</groupId> <artifactId>jedis</artifactId> <version>2.1.0</version> </dependency> java 代码 package com.shier.common.test; import org.junit.Before; import org.junit.Test; import redis.clients.jedis.Jedis; import java.util.HashMap; import java.util.Iterator; import java.util.List; import java.util.Map; public class RedisTest { private Jedis jedis; @Before public void setup() { //连接redis服务器,192.168.0.100:6379 jedis = new Jedis("172.16.57.150", 6379); //权限认证 jedis.auth("shier@ixiye.com"); jedis.select(1); } /** * redis存储字符串 */ @Test public void testString() { //-----添加数据---------- jedis.set("name", "xinxin");//向key-->name中放入了value-->xinxin System.out.println(jedis.get("name"));//执行结果:xinxin jedis.append("name", " is my lover"); //拼接 System.out.println(jedis.get("name")); //jedis.del("name"); //删除某个键 System.out.println(jedis.get("name")); //设置多个键值对 //jedis.mset("name", "liuling", "age", "23", "qq", "476777XXX"); //jedis.incr("age"); //进行加1操作 System.out.println(jedis.get("name") + "-" + jedis.get("age") + "-" + jedis.get("qq")); } /** * redis操作Map */ @Test public void testMap() { //-----添加数据---------- Map<String, String> map = new HashMap<String, String>(); map.put("name", "xinxin"); map.put("age", "22"); map.put("qq", "123456"); jedis.hmset("user", map); //取出user中的name,执行结果:[minxr]-->注意结果是一个泛型的List //第一个参数是存入redis中map对象的key,后面跟的是放入map中的对象的key,后面的key可以跟多个,是可变参数 List<String> rsmap = jedis.hmget("user", "name", "age", "qq"); System.out.println(rsmap); //删除map中的某个键值 jedis.hdel("user", "age"); System.out.println(jedis.hmget("user", "age")); //因为删除了,所以返回的是null System.out.println(jedis.hlen("user")); //返回key为user的键中存放的值的个数2 System.out.println(jedis.exists("user"));//是否存在key为user的记录 返回true System.out.println(jedis.hkeys("user"));//返回map对象中的所有key System.out.println(jedis.hvals("user"));//返回map对象中的所有value Iterator<String> iter = jedis.hkeys("user").iterator(); while (iter.hasNext()) { String key = iter.next(); System.out.println(key + ":" + jedis.hmget("user", key)); } } /** * jedis操作List */ @Test public void testList() { //开始前,先移除所有的内容 jedis.del("java framework"); System.out.println(jedis.lrange("java framework", 0, -1)); //先向key java framework中存放三条数据 jedis.lpush("java framework", "spring"); jedis.lpush("java framework", "struts"); jedis.lpush("java framework", "hibernate"); //再取出所有数据jedis.lrange是按范围取出, // 第一个是key,第二个是起始位置,第三个是结束位置,jedis.llen获取长度 -1表示取得所有 System.out.println(jedis.lrange("java framework", 0, -1)); jedis.del("java framework"); jedis.rpush("java framework", "spring"); jedis.rpush("java framework", "struts"); jedis.rpush("java framework", "hibernate"); System.out.println(jedis.lrange("java framework", 0, -1)); } /** * jedis操作Set */ @Test public void testSet() { //添加 jedis.sadd("user", "liuling"); jedis.sadd("user", "xinxin"); jedis.sadd("user", "ling"); jedis.sadd("user", "zhangxinxin"); jedis.sadd("user", "who"); //移除noname jedis.srem("user", "who"); System.out.println(jedis.smembers("user"));//获取所有加入的value System.out.println(jedis.sismember("user", "who"));//判断 who 是否是user集合的元素 System.out.println(jedis.srandmember("user")); System.out.println(jedis.scard("user"));//返回集合的元素个数 } @Test public void test() throws InterruptedException { //jedis 排序 //注意,此处的rpush和lpush是List的操作。是一个双向链表(但从表现来看的) jedis.del("a");//先清除数据,再加入数据进行测试 jedis.rpush("a", "1"); jedis.lpush("a", "6"); jedis.lpush("a", "3"); jedis.lpush("a", "9"); System.out.println(jedis.lrange("a", 0, -1));// [9, 3, 6, 1] System.out.println(jedis.sort("a")); //[1, 3, 6, 9] //输入排序后结果 System.out.println(jedis.lrange("a", 0, -1)); } } RedisUtil package com.shier.common.util; import redis.clients.jedis.Jedis; import redis.clients.jedis.JedisPool; import redis.clients.jedis.JedisPoolConfig; public final class RedisUtil { //Redis服务器IP private static String ADDR = "172.16.57.150"; //Redis的端口号 private static int PORT = 6379; //访问密码 private static String AUTH = "shier@ixiye.com"; //可用连接实例的最大数目,默认值为8; //如果赋值为-1,则表示不限制;如果pool已经分配了maxActive个jedis实例,则此时pool的状态为exhausted(耗尽)。 private static int MAX_ACTIVE = 1024; //控制一个pool最多有多少个状态为idle(空闲的)的jedis实例,默认值也是8。 private static int MAX_IDLE = 200; //等待可用连接的最大时间,单位毫秒,默认值为-1,表示永不超时。如果超过等待时间,则直接抛出JedisConnectionException; private static int MAX_WAIT = 10000; private static int TIMEOUT = 10000; //在borrow一个jedis实例时,是否提前进行validate操作;如果为true,则得到的jedis实例均是可用的; private static boolean TEST_ON_BORROW = true; private static JedisPool jedisPool = null; /** * 初始化Redis连接池 */ static { try { JedisPoolConfig config = new JedisPoolConfig(); config.setMaxActive(MAX_ACTIVE); config.setMaxIdle(MAX_IDLE); config.setMaxWait(MAX_WAIT); config.setTestOnBorrow(TEST_ON_BORROW); jedisPool = new JedisPool(config, ADDR, PORT, TIMEOUT, AUTH); } catch (Exception e) { e.printStackTrace(); } } /** * 获取Jedis实例 * * @return */ public synchronized static Jedis getJedis() { try { if (jedisPool != null) { Jedis resource = jedisPool.getResource(); return resource; } else { return null; } } catch (Exception e) { e.printStackTrace(); return null; } } /** * 释放jedis资源 * * @param jedis */ public static void returnResource(final Jedis jedis) { if (jedis != null) { jedisPool.returnResource(jedis); } } } ----------------------------------------------------------------- package com.shier.common.test; import com.shier.common.util.RedisUtil; import org.junit.Test; import redis.clients.jedis.Jedis; public class RedisTest { @Test public void testRedisPool() { RedisUtil.getJedis().set("newname", "中文测试"); System.out.println(RedisUtil.getJedis().get("newname")); } } 四.Spring整合Redis 添加Redis Maven依赖 <span style="white-space:pre;"> </span><!-- redis --> <dependency> <groupId>redis.clients</groupId> <artifactId>jedis</artifactId> <version>2.6.2</version> </dependency> <dependency> <groupId>org.springframework.data</groupId> <artifactId>spring-data-redis</artifactId> <version>1.7.1.RELEASE</version> </dependency> config.properties redis.host=192.168.0.254 redis.port=6379 redis.password=jedis21tb redis.maxIdle=300 redis.maxWait=1000 redis.testOnBorrow=true redis.timeout=3000 spring配置文件(applicationContext.xml) <!--引入配置属性文件 --> <context:property-placeholder location="classpath:config.properties" /> <!-- redis --> <!-- jedis 配置 --> <bean id="poolConfig" class="redis.clients.jedis.JedisPoolConfig" > <property name="maxIdle" value="${redis.maxIdle}" /> <property name="maxWaitMillis" value="${redis.maxWait}" /> <property name="testOnBorrow" value="${redis.testOnBorrow}" /> </bean > <!-- redis服务器中心 --> <bean id="connectionFactory" class="org.springframework.data.redis.connection.jedis.JedisConnectionFactory" > <property name="poolConfig" ref="poolConfig" /> <property name="port" value="${redis.port}" /> <property name="hostName" value="${redis.host}" /> <property name="password" value="${redis.password}" /> <property name="timeout" value="${redis.timeout}" ></property> </bean > <bean id="redisTemplate" class="org.springframework.data.redis.core.RedisTemplate" > <property name="connectionFactory" ref="connectionFactory" /> <property name="keySerializer" > <bean class="org.springframework.data.redis.serializer.StringRedisSerializer" /> </property> <!-- <property name="valueSerializer" > <bean class="org.springframework.data.redis.serializer.JdkSerializationRedisSerializer" /> </property> --> </bean > <bean id="redisUtil" class="com.kttx.common.RedisUtil" > <property name="redisTemplate" ref="redisTemplate" /> </bean > java代码 package com.kttx.common; import java.io.Serializable; import java.util.Set; import java.util.concurrent.TimeUnit; import org.apache.log4j.Logger; import org.springframework.data.redis.core.RedisTemplate; import org.springframework.data.redis.core.ValueOperations; /** * redis * @author txs * */ public class RedisUtil { private static Logger logger = Logger.getLogger(RedisUtil.class); private static RedisTemplate<Serializable, Object> redisTemplate; /** * 写入或更新缓存 * @param key * @param value * @return */ public static boolean set(final String key, Object value) { boolean result = false; try { ValueOperations<Serializable, Object> operations = redisTemplate .opsForValue(); operations.set(key, value); result = true; } catch (Exception e) { logger.error("write redis is faill"); e.printStackTrace(); } return result; } /** * 写入缓存 * 设置失效时间 * @param key * @param value * @return */ public static boolean set(final String key, Object value, Long expireTime) { boolean result = false; try { ValueOperations<Serializable, Object> operations = redisTemplate .opsForValue(); operations.set(key, value); redisTemplate.expire(key, expireTime, TimeUnit.SECONDS); result = true; } catch (Exception e) { e.printStackTrace(); } return result; } /** * 读取缓存 * @param key * @return */ public static Object get(final String key) { Object result = null; ValueOperations<Serializable, Object> operations = redisTemplate .opsForValue(); result = operations.get(key); return result; } /** * 删除对应的value * @param key */ public static void remove(final String key) { if (exists(key)) { redisTemplate.delete(key); } } /** * 批量删除对应的value * * @param keys */ public static void remove(final String... keys) { for (String key : keys) { remove(key); } } /** * 批量删除key * * @param pattern 正则表达式 */ public static void removePattern(final String pattern) { Set<Serializable> keys = redisTemplate.keys(pattern); if (keys.size() > 0) redisTemplate.delete(keys); } /** * 判断缓存中是否有对应的value * * @param key * @return */ public static boolean exists(final String key) { return redisTemplate.hasKey(key); } public void setRedisTemplate( RedisTemplate<Serializable, Object> redisTemplate) { this.redisTemplate = redisTemplate; } } 五.Spring boot整合Redis 添加maveny依赖 <dependency> <groupId>redis.clients</groupId> <artifactId>jedis</artifactId> <version>2.6.2</version> </dependency> <dependency> <groupId>org.springframework.data</groupId> <artifactId>spring-data-redis</artifactId> <version>1.7.1.RELEASE</version> </dependency> 配置属性: # database name spring.redis.database=0 # server host spring.redis.host=127.0.0.1 # server password spring.redis.password=123456 #connection port spring.redis.port=6379 # pool settings ... spring.redis.pool.max-idle=8 spring.redis.pool.min-idle=0 spring.redis.pool.max-active=8 spring.redis.pool.max-wait=-1 redis配置 package com.ming.config; import java.lang.reflect.Method; import java.util.HashMap; import java.util.Map; import org.springframework.cache.CacheManager; import org.springframework.cache.annotation.CachingConfigurerSupport; import org.springframework.cache.annotation.EnableCaching; import org.springframework.cache.interceptor.KeyGenerator; import org.springframework.context.annotation.Bean; import org.springframework.context.annotation.Configuration; import org.springframework.data.redis.cache.RedisCacheManager; import org.springframework.data.redis.connection.RedisConnectionFactory; import org.springframework.data.redis.core.RedisTemplate; import org.springframework.data.redis.core.StringRedisTemplate; import org.springframework.data.redis.serializer.Jackson2JsonRedisSerializer; import com.fasterxml.jackson.annotation.JsonAutoDetect; import com.fasterxml.jackson.annotation.PropertyAccessor; import com.fasterxml.jackson.databind.ObjectMapper; @Configuration @EnableCaching // 启用缓存,这个注解很重要; public class RedisCacheConfig extends CachingConfigurerSupport { /** * 生成key的策略 * * @return */ @Bean public KeyGenerator keyGenerator() { return new KeyGenerator() { @Override public Object generate(Object target, Method method, Object... params) { StringBuilder sb = new StringBuilder(); sb.append(target.getClass().getName()); sb.append(method.getName()); for (Object obj : params) { sb.append(obj.toString()); } return sb.toString(); } }; } /** * 管理缓存 * * @param redisTemplate * @return */ @SuppressWarnings("rawtypes") @Bean public CacheManager cacheManager(RedisTemplate redisTemplate) { RedisCacheManager rcm = new RedisCacheManager(redisTemplate); //设置缓存过期时间 // rcm.setDefaultExpiration(60);//秒 //设置value的过期时间 Map<String,Long> map=new HashMap<String, Long>(); map.put("test",60L); rcm.setExpires(map); return rcm; } /** * RedisTemplate配置 * @param factory * @return */ @Bean public RedisTemplate<String, String> redisTemplate(RedisConnectionFactory factory) { StringRedisTemplate template = new StringRedisTemplate(factory); Jackson2JsonRedisSerializer jackson2JsonRedisSerializer = new Jackson2JsonRedisSerializer(Object.class); ObjectMapper om = new ObjectMapper(); om.setVisibility(PropertyAccessor.ALL, JsonAutoDetect.Visibility.ANY); om.enableDefaultTyping(ObjectMapper.DefaultTyping.NON_FINAL); jackson2JsonRedisSerializer.setObjectMapper(om); template.setValueSerializer(jackson2JsonRedisSerializer);//如果key是String 需要配置一下StringSerializer,不然key会乱码 /XX/XX template.afterPropertiesSet(); return template; } } package com.ming.config; import java.io.Serializable; import java.util.Set; import java.util.concurrent.TimeUnit; import org.springframework.beans.factory.annotation.Autowired; import org.springframework.data.redis.core.RedisTemplate; import org.springframework.data.redis.core.ValueOperations; import org.springframework.stereotype.Component; /** * redicache 工具类 * */ @SuppressWarnings("unchecked") @Component public class RedisUtils { @SuppressWarnings("rawtypes") @Autowired private RedisTemplate redisTemplate; /** * 批量删除对应的value * * @param keys */ public void remove(final String... keys) { for (String key : keys) { remove(key); } } /** * 批量删除key * * @param pattern */ public void removePattern(final String pattern) { Set<Serializable> keys = redisTemplate.keys(pattern); if (keys.size() > 0) redisTemplate.delete(keys); } /** * 删除对应的value * * @param key */ public void remove(final String key) { if (exists(key)) { redisTemplate.delete(key); } } /** * 判断缓存中是否有对应的value * * @param key * @return */ public boolean exists(final String key) { return redisTemplate.hasKey(key); } /** * 读取缓存 * * @param key * @return */ public Object get(final String key) { Object result = null; ValueOperations<Serializable, Object> operations = redisTemplate.opsForValue(); result = operations.get(key); return result; } /** * 写入缓存 * * @param key * @param value * @return */ public boolean set(final String key, Object value) { boolean result = false; try { ValueOperations<Serializable, Object> operations = redisTemplate.opsForValue(); operations.set(key, value); result = true; } catch (Exception e) { e.printStackTrace(); } return result; } /** * 写入缓存 * * @param key * @param value * @return */ public boolean set(final String key, Object value, Long expireTime) { boolean result = false; try { ValueOperations<Serializable, Object> operations = redisTemplate.opsForValue(); operations.set(key, value); redisTemplate.expire(key, expireTime, TimeUnit.SECONDS); result = true; } catch (Exception e) { e.printStackTrace(); } return result; } } 测试 package com.ming.web.controller; import org.springframework.beans.factory.annotation.Autowired; import org.springframework.web.bind.annotation.RequestMapping; import org.springframework.web.bind.annotation.RestController; import com.ming.config.RedisUtils; @RestController @RequestMapping("/caches") public class CacheController { @Autowired private RedisUtils redisUtils; @RequestMapping("/test") public String test(){ redisUtils.set("123", "hello world"); System.out.println("进入了方法"); String string= redisUtils.get("123").toString(); return string; } }