首页 文章 精选 留言 我的

精选列表

搜索[鸿蒙实践],共10000篇文章
优秀的个人博客,低调大师

ECS实例RAM角色实践

ECS实例RAM角色快速入门 概述 以往部署在ECS实例中的应用程序如果需要访问阿里云其他云产品的API,通常需要借助于AccessKeyId和AccessKeySecret(下文简称AK)来实现。AK是用户访问阿里云API的密钥,具有相应账户的完整权限。但是为了方便应用程序对AK的管理,用户通常需要将AK保存在应用程序的配置文件中或以其他方式保存在实例中。这在一定程度上增加了AK管理上的复杂性且降低了AK的保密性,尤其是对有多地域一致性部署需求的用户,AK将随着镜像及镜像创建的实例扩散出去。在需要更换AK时,也需要逐台实例(和镜像)进行更新和重新部署。此外,使用AK虽然简单,但AK的权限过大,无法做到精细的权限控制。 现在借助于ECS实例RAM角色,我们可以将RAM角色和ECS实例关联起来,实例内部的应用程序则通过STS临时凭证访问其

优秀的个人博客,低调大师

深入实践Spring Boot导读

Preface?前 言 Spring Boot作为Java编程语言的一个全新开发框架,在国内外才刚刚兴起,还未得到普及使用。相比于以往的一些开发框架,Spring Boot不但使用更加简单,而且功能更加丰富,性能更加稳定而健壮。使用Spring Boot开发框架,不仅能提高开发速度,增强生产效率,从某种意义上,可以说是解放了程序员的劳动,而且一种新技术的使用,更能增强系统的稳定性和扩展系统的性能指标。本书就是本着提高开发效率,增强系统性能,促进新技术的普及使用这一目的而写的。 Spring Boot是在Spring框架基础上创建的一个全新框架,其设计目的是简化Spring应用的搭建和开发过程,它不但具有Spring的所有优秀特性,而且具有如下显著的特点: 为Spring开发提供更加简单的使用和快速开发的技巧。 具有开箱即用的默认配置功能

优秀的个人博客,低调大师

Sqoop 数据导入导出实践

Sqoop是一个用来将hadoop和关系型数据库中的数据相互转移的工具,可以将一个关系型数据库(例如:mysql,oracle,等)中的数据导入到hadoop的HDFS中,也可以将HDFS的数据导入到关系型数据库中。 1.简介 首先切换到到hadoop用户:su - hadoop 温馨提示:oracle的所有表名列名都要大写!!! 下面的代码,在命令行输入的时候,可能要写成一行 比如第一条需要写成: sqoop export --table Oracle_table_name --connect jdbc:oracle:thin:@ip:1521:数据库名 --username 用户名 --password 密码 --export-dir hdfs:/user/hive/warehouse/XXX --columns COLUMN1,2,3 --input-fields-terminated-by '\001' --input-lines-terminated-by '\n' 1.导hive表到Oracle sqoop export --table Oracle_table_name --connect jdbc:oracle:thin:@ip:1521:数据库名 --username 用户名 --password 密码 --export-dir hdfs:/user/hive/warehouse/XXX --columns COLUMN1,2,3, --input-fields-terminated-by '\001' #或者其他分隔符,比如逗号等 --input-lines-terminated-by '\n' 注意:导hive表是“\001” –解释: sqoop export –table Oracle_table_name(// 数据库Oracle的表名) –connect jdbc:oracle:thin:@ip:1521:数据库名 (//数据库的地址,其中1521为端口号,默认都为1521,ibd为数据库实例名) –username用户名(//数据库用户名) –password用户名(//数据库密码) –export-dir hdfs:/user/hive/warehouse/XXX (//hdfs上Hive表的绝对路径) –columns column1, column2… (//数据库表的所有列名) –input-fields-terminated-by ‘\001’(列分隔符) –input-lines-terminated-by ‘\n’ (行分隔符) 2. 查询数据导入到Oracle的数据是否成功 sqoop eval --connect jdbc:oracle:thin:@YOUR-IP-ADDRESS:1521:database-name --username XXX --password XXX --query "select * from table_name" 3.导Oracle表到hive表 sqoop import --connect jdbc:oracle:thin:@YOUR-IP-ADDRESS:1521:database-name --username xxx --password xxx --table TABLE_NAME --columns COLUMN1,2,3... --hive-import --hive-table hive_table_name -m 1 —解释: TABLE_NAME为oracle表名(切忌:Oracle个表名在命令中必须是大写,不然会报错) hive_test为hive表名(hive中的这个表可以不用提前建,只用给表名即可,导成功后列名和Oracle表的列名相同) 4. 连接oracle数据库,列出数据库中的表 sqoop list-tables --connect jdbc:oracle:thin:@YOUR-IP-ADDRESS:1521:database-name --username xxx --password xxx 5.从数据库导出表的数据到HDFS文件(这个比较实用) sqoop import --connect jdbc:oracle:thin:@YOUR-IP-ADDRESS:1521:database-name --username xxx --password xxx --table DD --m 1 --target-dir /home/dpt 解释: DD为oracle表名(切忌:Oracle表名在命令中必须是大写,不然会报错); /home/dpt为目的目录,如果没有这个目录则会在hdfs上自动创建这个目录. 导成功后可以用命令查看: hadoop fs -text /home/dpt/part-m-00000 6.分区表的导入 通过sqoop将hive中的表导入到oracle中 sqoop export --table t_amap_all --connect jdbc:oracle:thin:@YOUR-IP-ADDRESS:1521:database-name --username xxx --password xxx --export-dir hdfs://user/hive/warehouse/ --columns 1,2,3... --input-fields-terminated-by '\t' --input-lines-terminated-by '\n'; 导入分区表需要指定到具体分区目录,不然会找不到数据,在oracle表中能指定分区这个字段! 分隔符要遵循hive表的具体分隔符 导致任务失败有可能是表名不一致,字段不一致,oracle中的字段大小不够 2.可能遇到的问题 连接oracle数据库,列出数据库中的表时 sqoop list-tables --connect jdbc:oracle:thin:@YOUR-IP-ADDRESS:1521:database-name --username xxx --password xxx 报错: 16/01/28 09:27:15 ERROR sqoop.Sqoop: Got exception running Sqoop: java.lang.RuntimeException: Could not load db driver class: oracle.jdbc.OracleDriver 则 1)发现sqoop的安装目录 /usr/lib/sqoop/lib中缺ojdbc驱动包,然后将驱动包(ojdbc6-11.2.0.1.0.jar)复制到your-ip的sqoop安装目录就可以了: scp ./ojdbc6-11.2.0.1.0.jar root@your-ip:/usr/lib/sqoop/lib 参考链接 1.下载链接: https://github.com/apache/sqoop 2.官方文档: http://sqoop.apache.org/docs/1.4.6/SqoopUserGuide.html#_introduction 3.官网: http://sqoop.apache.org/

优秀的个人博客,低调大师

技术实践的主流方向

1、嵌入式开发 传统的arm linux开发、新兴的智能硬件、物联网等技术的发展,都让整个方向成为热门领域。 2、游戏开发 cocos2d-x、unity3d、html5,都可以用来开发游戏。 3、移动开发 当前移动开发领域主流的三大平台: [1].iOS:开发语言为Objective-C/Swift,开发工具为Xcode,背后巨头为Apple公司。 [2].Android:开发语言为Java,开发工具为eclipse/Android Studio,背后巨头为Google公司。 [3].Windows Phone :首选开发语言为C#,开发工具为Visual Studio,背后巨头为Microsoft公司。 经过这几年的发展,移动开发领域又有了一些变化,正所谓唯一不变的就是变。 IOS开发出了新的编程语言swift,它比原先的Objective-C更加容易掌握,语法上类似于JavaScript。 Android开发由于使用了Java语言,使得很多原先熟悉Java的程序员很容易转到Android开发上面来。为此Oracle还向Google提起了诉讼,认为Google使用了Oracle的Java是侵权行为。未来Google是否会使用新的编程语言(比如:Go)来取代Java的位置呢?让我们共同期待。但是值得一提的是,Google在虚拟机层次上并没有使用jvm,而是自行实现了一套虚拟机dalvik。 Windows Phone的市场份额实在不容乐观,据说Android+IOS=96%以上的市场份额,所以Windows Phone暂时还没有像Android和IOS那样风靡全球。 最后提一下,最近在各大社区经常看到移动跨平台解决方案Xamarin的广告,其基本概念就是利用C#一门语言就可以开发Android、IOS、Windows Phone(本来就支持)等移动app,听起来很有吸引力,但是毕竟不是原生语言开发,是否成熟是个问题。而且还是收费的,在国内环境下很难有大批的开发者会使用这项技术。 4、应用开发 c++(vc++、qt)、java(javaee)、c#(asp.net/wpf)等等是目前就业人员最多的技术领域。 5、前端开发 html、css、javascript、jquery、bootstrap、extjs、angularjs、reactjs...,还有一堆库、框架等你去尝试。在这个强调用户体验的互联网时代,前端开发显得尤为重要。 6、数据库 oracle、sqlserver、mysql、nosql(mongodb、redis)是目前数据库领域的主流。 当前流行的主流数据库:1)Oracle 2)MS Sql Server 3)MySQL 4)DB2 5)SQLite [1].Oracle由Oracle公司开发,是当前的大型数据库管理系统,公认为当前数据库领域第一王牌。 [2].MS-Sql Server 由Microsoft公司开发,成为当前使用最广泛的数据库管理系统,适合于大、中、小型项目的数据库管理系统。版本从2000、2005到2008再到2012,完全适合各类层次的用户和企业使用。由于其秉持了微软一贯的操作方便、界面友好等特点,使得其得到了大多数企业的肯定。尤其适合作为Windows平台的项目的系统数据库。 [3].MySQL 原来由SUN公司(发明了Java)以10亿美元收购,后Oracle公司以74亿美元收购SUN,自然投入了Oracle阵营。它最大的特点就是免费开源,但是被SUN收购后,变为了商业化数据库。但是其性能不是很好,而且稳定性不够,适合小型项目,尤其适合作为php的网站数据库管理系统。 [4].DB2由IBM公司开发,但是其受操作系统的制约,只能用于AIX操作系统,因此使用面不如上面3个数据库。 [5].其他还有SqLite(基于C语言开发的文件型数据库,用于手机等嵌入式开发)、VFP(Visual Fox Pro)、access(Office套件)等。 7、系统集成 这个领域会比较杂(运维、硬件、网络、服务器、存储),要熟悉各种公司的产品以及开源工具,具备二次开发的能力更好。 8、云计算、虚拟化、大数据 目前最热门的方向,机器学习、深度学习都属于大数据领域的范畴,知识的广度和深度要求都比较高。 像嵌入式跟大数据比较适合硕士以上学历从事,其它6个方向本科都可以。 嵌入式开发涉及到硬件、电路等相对专业的知识,有一定门槛。非计算机或电子专业的想从事这个方向的工作,需要去额外的学习很多底层的知识,而且这部分知识难度稍高,需要付出很大的精力才能胜任。 大数据(机器学习、深度学习)方向如果搞纯应用不用太高学历,但是如果要进阶的话则适合搞学术的人从事,因为机器学习等都涉及到大量的数学知识,难度较大。 援引:http://www.cnblogs.com/guwei4037/p/5600036.html墨匠

优秀的个人博客,低调大师

Hive Tunning(三) 最佳实践

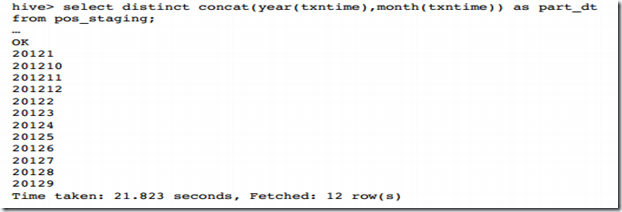
在上一讲的基础上,我们来做来一个实际的例子来展示如何在实操中进行高效的hive查询作业。 (1)首先我们建立一个表 CREATE EXTERNAL TABLE pos_staging( txnid STRING, txntime STRING, givenname STRING, lastname STRING, postalcode STRING, storeid STRING, indl STRING, productid STRING, purchaseamount FLOAT, creditcard STRING )ROW FORMAT DELIMITED FIELDS TERMINATED BY '|' LOCATION '/user/hdfs/staging_data/pos_staging'; 我们建立一张外部表是为了初始化或者加载mapreduce或者pig作业产生的元数据,然后我们自己建立一张优化的表。 (2)建立调优表的时候,我们就要考虑使用哪种分区模式,比如按时间分区。 以下是两个关于动态分区的参数: 所有节点的动态分区的最大数以及每个节点的动态分区的最大数 hive.exec.max.dynamic.partitions=1000 hive.exec.max.dynamic.partitions.pernode=100 (3)建立调优表 CREATE TABLE fact_pos ( txnid STRING, txntime STRING, givenname STRING, lastname STRING, postalcode STRING, storeidSTRING, indl STRING, productid STRING, purchaseamountFLOAT, creditcardSTRING ) PARTITIONED BY (part_dt STRING)! CLUSTERED BY (txnid) SORTED BY (txnid) INTO 24 BUCKETS STORED AS ORC tblproperties("orc.compress"="SNAPPY"); CLUSTERED 和SORTED 使用都是同一个字段,它就是连接的时候需要使用的字段。 BUCKETS也出现了,前面一直不理解的概念,现在出现了还分了24个。 (4)把数据插入到调优表中 FROM pos_staging INSERT OVERWRITE TABLE fact_pos PARTITION (part_dt) SELECT txnid, txntime, givenname, lastname, postalcode, storeid, indl, productid, purchaseamount, creditcard, concat(year(txntime),month(txntime)) as part_dt SORT BY productid; 语句中使用了前面教的自动分区的语句,按照年月自动分区。 hadoop fs-setrep-R –w 5 /apps/hive/warehouse/fact_pos 上面的命令当中是个hdfs中存数的fact_pos表增加备份,因为hdfs的数据是存得很分散的,增加备份因为会使得节点上的数据增多,然后查询的时候,hive 从本地直接就可以获取到的数据的几率提高,增快查询速度。 当然考虑到空间的问题,可以减少一下备份的数量。 上述流程我们也可以把它放到oozie中自动执行。 。。。又一个熟悉的词出现了。 在hdfs-site.xml或者Ambari settings for HDFS, 设置完要重启。 dfs.block.local-path-access.user=hdfs dfs.client.read.shortcircuit=true dfs.client.read.shortcircuit.skip.checksum=false 开启了这个东东有什么作用呢?当数据块在本地的时候,它可以不需要开启一个端口来读,可以直接访问,就像图中的闪电那样。 (5)执行查询 set hive.mapred.reduce.tasks.speculative.execution=false; set io.sort.mb=300; set mapreduce.reduce.input.limit=-1; select productid, ROUND(SUM(purchaseamount),2) as total from fact_pos where part_dt between ‘201210’ and ‘201212’ group by productid order by total desc limit 100; 查询之前先对查询设置相应的运行参数。

优秀的个人博客,低调大师

Docker实践--部署Nodejs应用

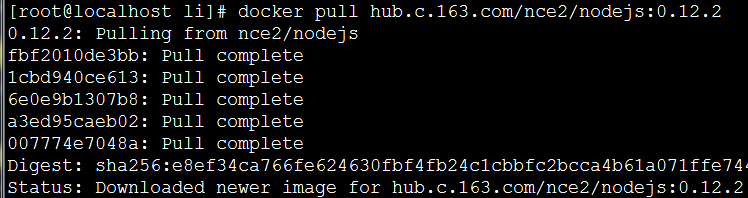
这个例子的目标是为了向大家展示如何在Docker的container里运行Node.js程序。我会先创建一个简单的Node.js web app,来构建一个镜像。然后基于这个Image运行一个container。从而实现快速部署。 由于网络的原因我的Node.js镜像从国内的镜像库下载,而不是Docker Hub。 先从国内的镜像网站上pull下一下nodejs镜像。 docker pull hub.c.163.com/nce2/nodejs:0.12.2 下载完后查看我们的镜像,找到他的名称,等会我们会用到 创建Node.js 程序 创建package.json,并写入相关信息和依赖 vi package.json { "name": "webtest", "version": "1.0.0", "description": "Node.js on Docker", "author": "lpxxn", "main": "server.js", "scripts": { "start": "node server.js" }, "dependencies": { "express": "^4.13.3" } } 创建server.js vi server.js 写一个最简单web 这个web基于express框架,返回Hello word.注意我们监听的是8888端口 'use strict'; var express = require('express'); var PORT = 8888; var app = express(); app.get('/', function (req, res) { res.send('Hello world\n'); }); app.listen(PORT); console.log('Running on http://localhost:' + PORT); 创建Dockerfile 接下来主角上场了创建Dockerfile文件 这个文件是创建镜像所必须的文件 vi Dockerfile Docker会依照Dockerfile的内容来构建一个镜像。我先给出完整的代码,再一行一行的给出解释 FROM hub.c.163.com/nce2/nodejs:0.12.2 # Create app directory RUN mkdir -p /home/Service WORKDIR /home/Service # Bundle app source COPY . /home/Service RUN npm install EXPOSE 8888 CMD [ "npm", "start" ] 我们来一句一句的解释 FROM hub.c.163.com/nce2/nodejs:0.12.2 FROM是构建镜像的基础源镜像,hub.c.163.com/nce2/nodejs:0.12.2 这个是镜像的名称,也就是我们一开始从国内服务器上拉下来的那个Image。如果本地没有Docker 会自己pull镜像。 # Create app directory RUN mkdir -p /home/Service WORKDIR /home/Service 第一句RUN 用于在Image里创建一个文件夹,将来用于保存我们的代码。 第二句WORKDIR是将我们创建的文件夹做为工作目录。 # Bundle app source COPY . /home/Service RUN npm install 第一句的COPY是把本机当前目录下的所有文件拷贝到Image的/home/Service文件夹下。 第二句的RUN 使用npm 安装我们的app据需要的所有依赖。 EXPOSE 8888 由于我们的web app监听的是8888端口,我们把这个端口暴露给主机,这样我就能从外部访问web了。 CMD [ "npm", "start" ] 这个我相信我不用解释你也能看出来他是做什么的。运行npm start命令,这个命令会运行 node service.js来 启动我们的web app。 构建Image 在你Dockerfile文件所在的目录下运行下面的命令来构建一个Image. docker build -t mynodeapp . 别忘了最的的那个点 构建完后查看一下我们的镜像 运行镜像 docker run -d -p 8888:8888 ac5 -d 表明容器会在后台运行,-p 表示端口映射,把本机的8888商品映射到container的8888端口这样外网就能通过本机的8888商品访问我们的web了。 后面的ac5是我们Image的ID因为前3个就已经能定位出这个Image所以我就没有把后边的再写出来。 通过docker ps查看我们刚运行的Container的ID 打印log 7370就是我们的Container ID,和Image ID一样,你也可以全写出来,我比较懒就写前4位,已经足够标识出这个Container了 docker logs 7350 如果你想到Container里可以执行下面的命令,进入到里边后就可以像操作普通的linux 一样。如果想退出可执行exit命令。 测试 我们先通过curl 看能不能访问我们的web。 curl -i localhost:8888 也可以通过浏览器来看一下 好了,这个小教程到此就结束了,希望能帮助你入门。

优秀的个人博客,低调大师

MapReduce、Hbase接口API实践

读取hdfs中文件并做处理,取出卡号,通过卡号连接hbase查询出对应客户号,写入redis,因为不用输出,所以不调用context.write方法,整个操作在一个map中便可完成 protected HTable connect //setup方法被MapReduce框架仅且执行一次,在执行Map任务前,进行相关变量或者资源的集中初始化工作。若是将资源初始化工作放在方法map()中,导致Mapper任务在解析每一行输入时都会进行资源初始化工作,导致重复,程序运行效率不高! protected void setup(Context context) throws IOExcption,InterruptedException{ super.setup(context) String jobName = context.getJobName(); //文件索引值 cartNoIndex = conf.get(jobName + "source.key","7"); //创建hbase连接,hbase-site.xml配置文件需要在jar包中 Configuration config = HBaseConfiguration.create(); connect = new HTable(config,"tableName") } protected void map(writable key,Text value,Context context){ if(value == null || value.toString().trim().isEmpty()){ //计数器,记录处理的条数 context.getCounter(....).increment(1); }else{ String[] values = Utils.split(value,separator,true); //业务逻辑处理 int i = Integer.parseInt(cartNoIndex); if(i<values.length){ cardNo = values[i]; }else{ logger.error("cardNo cannot find"); } //从hbase中查询出对应客户号 String rowkey = HTableManager.generatRowkey(cardNo); Get getResult = new Get(rowkey.getBytes()); Result rs = connect.get(getResult); String curNo = Bytes.toString(rs.getValue("f1".getBytes(),"column_name".getBtes());RedisClient.getRedisClient().zincrbyset("spending:rank",countNum,custNo);protected void cleanup(context context)throws IOException,InterruptedException{ super.cleanup(context); connect.close();} public static String[] split(String value,String separator,boolean trimSpace){ String[] rtn = split(value.separator); if(trimSpace && rtn != null){ for(int i=0;i<rtn.length;i++){ rtn[i] = rtn[i].trim(); } } return rtn; } public static String[] split(String value,String separator){ String[] rtn = null; if(value != null){ boolean endBlank = false; if(value.endsWith(separator)){ value +=" "; endBlank = true; } separator = escapeExprSpecialWord(deparator); if(endBlank){ rtn(rtn.length-1) = ""; } } return rtn; } public static String escapeExprSpecialWord(String keyWord){ if(keyword != null && !keyword.isEmpty()){ String[] fbsArr = {"\\","|","(",")"}; for(String key : fbsArr){ if(keyword.contains(key){ keyword = keyword.replace(key,"\\"+key); } } } return keyword; }

优秀的个人博客,低调大师

Zigbee透传驱动开发—【万物智能之开源鸿蒙OpenHarmony系统实战开发系列教程】

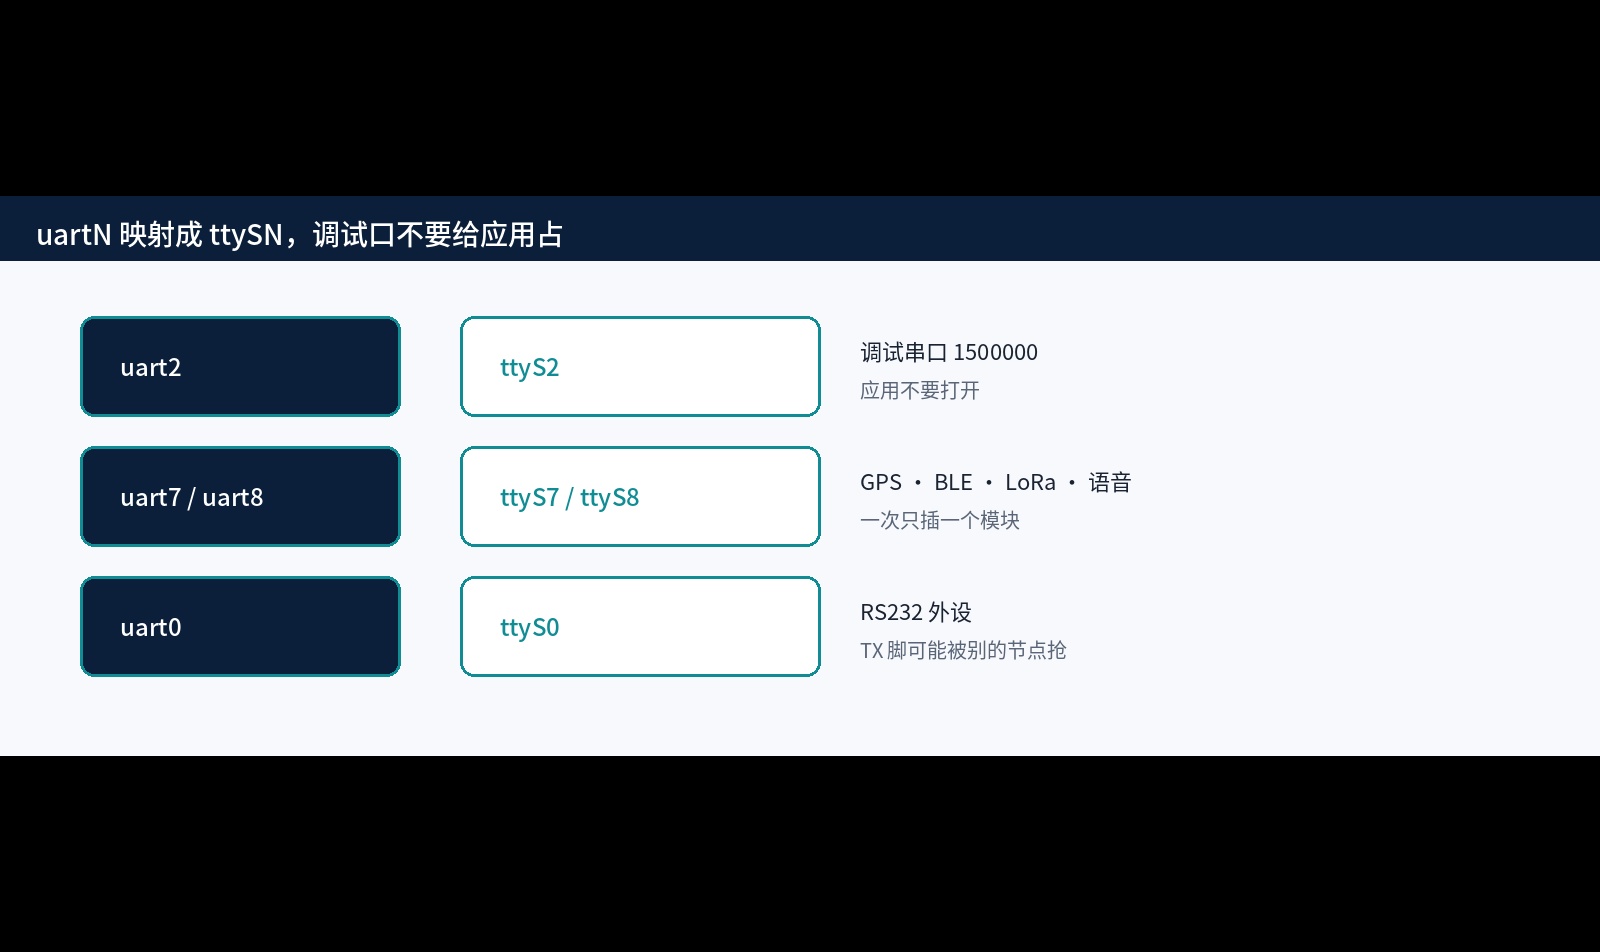
LoRa 的验收口径清楚了。今天是 Zigbee,同样是串口透传。真组网需要协调器和终端,一颗模组当不了两头。 第 41 章把 UART 打开了,第 44、45 章在同一根排针上做过 BLE 和 LoRa。这一章还是 `/dev/ttyS7`,115200 8N1,换上一颗 **Zigbee 透传模组**。 板上这一侧看起来和 LoRa 几乎没区别:`write` 几个字节,射频侧发出去;空中收到的字节,从 UART 读回来。没有 Zigbee 协议栈要你在用户态跑,没有 AF_INET,没有 socket。应用写的是串口。 先把三扇错门焊死: 1. **一块板、一颗模组,组不了网。** `write` 返回成功,只说明 UART FIFO 吃进了字节。对面没有协调器或终端,空中没有人接,读回来就是空。这不是驱动坏了。 2. **模组上的 USB 口常常只供电。** 没有 D+ / D-,插电脑认不出串口设备。通信走排针上的 TX/RX。 3. **波特率不是 9600。** GPS、六轴、LoRa 是 9600,这边默认 **115200**。写错,配置帧的 `FE` 头永远对不上。 一次能通的路径:板上打开 `ttyS7` @ 115200,十六进制发取 ID 命令,模组回 `FE` 开头的帧,串口活着。然后第二套:一颗协调器、一颗终端,同一信道,A 发 `hello`,B 在一秒内读到。 --- ![uart-map.png](https://developer.qcloudimg.com/http-save/yehe-12803057/46de1053107caf6cbd59e59791e79ac4.png) ![UART两线连接.png](https://developer.qcloudimg.com/http-save/yehe-12803057/9faf7ea4b749b1e704bbaac78d50d8ec.png) ## 1. 板上这一侧就是串口 ``` 应用 write("/dev/ttyS7") │ 115200 8N1 原始模式 ▼ RK3568 uart7 (GPIO3_C4 TX / GPIO3_C5 RX) │ ▼ Zigbee 透传模组 UART │ 射频,自组网 ▼ 另一颗模组 UART → 另一块板的 ttyS7 ``` 透传的意思:你写什么,对端读什么,字节不解释。组网、信道、短地址,模组固件自己管。用户态最多发几条厂商配置帧查 ID、查信道,不在应用里实现 IEEE 802.15.4。 和 BLE 那章的差别:BLE 对端是手机 GATT;Zigbee 对端是另一颗同协议模组。手机 nRF Connect 在这里没用。 和 LoRa 那章的共同点:单模块只能证明「UART 通了」。无线电要两套。 排针和 GPS / BLE / LoRa / 六轴 / 语音共用 uart7。一次插一颗。插着 GPS 再插 Zigbee,两颗 TX 短在一起,谁都别想通。 --- ## 2. 设备树:uart7 用 m1,不是 SoC 默认的 m0 ```dts &uart7 { status = "okay"; pinctrl-0 = ; /* GPIO3_C4 TX / GPIO3_C5 RX */ }; ``` SoC 默认 `uart7m0` 是另一组球。板级必须覆盖成 m1,否则排针是死的,`/dev/ttyS7` 节点还在,`write` 也成功——字节发到空气里的另一对脚上。 核对: ```bash hdc shell "ls -l /dev/ttyS7" hdc shell "cat /proc/tty/driver/serial" hdc shell "cat /proc/device-tree/serial@fe6b0000/status" ``` 要看到字符设备 `crw`、`7: uart:16550A`、status 里 `okay`。`ttyS2` 是 1500000 调试口,应用禁止占用。 HAP 不是 root。开机脚本: ```bash chmod 0666 /dev/ttyS7 /dev/ttyS8 /dev/ttyS3 ``` 路径按教程约定放在 `device/board/rk/rk3568_evb/board_perm/board-perm.sh`,打进 vendor。hdc 临时 chmod,重启丢掉。 --- ## 3. 打开串口:115200,关硬件流控,不要 select 第 41 章的结论这里直接用。RK3568 的 `dw-apb-uart`,DMA 请求失败会回退中断模式。这条回退路径上 **`select` 的就绪不可靠**:内核 rx 计数在涨,`cat /dev/ttyS7 | od` 能看到字节,应用 `select` 却永远不返回可读。 `VTIME` 在这份内核上也不老实,阻塞 `read` 可能永不返回,ArkTS 主线程一起冻。 现在这套打开方式: ```c int fd = open(path, O_RDWR | O_NOCTTY | O_NONBLOCK); struct termios t; tcgetattr(fd, &t); cfsetispeed(&t, B115200); cfsetospeed(&t, B115200); t.c_cflag = (t.c_cflag & ~CSIZE) | CS8 | CLOCAL | CREAD; t.c_cflag &= ~(PARENB | CSTOPB | CRTSCTS); /* 模组没有 RTS/CTS,开了会卡死 */ t.c_lflag &= ~(ICANON | ECHO | ECHOE | ISIG); t.c_iflag &= ~(IXON | IXOFF | IXANY | INLCR | ICRNL); t.c_oflag &= ~OPOST; t.c_cc[VMIN] = 0; t.c_cc[VTIME] = 0; tcflush(fd, TCIOFLUSH); tcsetattr(fd, TCSANOW, &t); ``` 读用 `poll(POLLIN, timeout)`,就绪再 `read`。写之前 `tcflush(fd, TCIFLUSH)`,丢掉模组上电乱吐的半帧,否则配置帧对不齐。 NAPI 封装成 `libboard.so` 的 `uartOpen` / `uartWrite` / `uartRead` / `uartReadAsync`。ArkTS 主线程不要跑同步 `uartRead` 的长超时,六轴那章会把这个坑放大。 --- ## 4. 配置帧:单模块能验的那几字节 常见 UART-Zigbee 透传模组,配置包以 `FE 05` 开头、`FF` 结尾。三句够用: 作用十六进制 取 ID`FE059021000002FF` 取短地址`FE059021000001FF` 取信道`FE059021000003FF` 模组在线会回一帧同样以 `FE` 开头的数据。回了 = UART 通、模组活、波特率对。没回,先换 tty、换 115200,再查 TX/RX 是否交叉。 外设测试应用 Zigbee 页默认十六进制、设备 `/dev/ttyS7`、波特 115200。把取 ID 贴进发送框,点发送,再点读取。看到 `FE` 就算单模块过关。 不要在这一步要求「发出去的 hello 自己读回来」。无线不会从自己的天线绕一圈进自己的 RX。那是 RS485 A/B 短接才有的戏,第 50 章。 --- ## 5. 组网:协调器 + 终端,两套 Zigbee 最小闭合是两颗模组: - 一颗工作在 **协调器**(建网、分配短地址) - 一颗工作在 **终端**(入网、收发) 两颗上电后固件通常会自组网,只要信道一致、距离几米内。用户态两边都当普通串口: ``` 板 A uart_tool send "hello\n" │ ▼ 空中 板 B uart_tool recv → 读到 hello ``` 角色怎么切,看模组说明书:有的上电就是透传、自动入网;有的要先发进配置态的 AT 或 `FE` 帧设角色。应用层不要假设自己在跑一个完整的 Zigbee stack。 验收我只认这一条:**A 发出的那几个字节,B 原样读到**。短地址、信道能读出来是加分,不是组网的判据。 只有一颗模组时,把验收口径写成「配置帧有应答」,不要写成「Zigbee 不通」。口径写错,人会在 UART 驱动里翻三天。 --- ## 6. 命令行工具 和第 41、44 章同一把 `uart_tool`,32 位 musl。交叉编译: ```bash CLANG=/prebuilts/clang/ohos/linux-x86_64/llvm/bin/clang SYSROOT=/prebuilts/ohos-sdk/linux/11/native/sysroot $CLANG --target=arm-linux-ohos --sysroot=$SYSROOT \ -Wl,--dynamic-linker=/system/lib/ld-musl-arm.so.1 \ -O2 -o uart_tool uart_tool.c hdc file send uart_tool /data/local/tmp/uart_tool hdc shell "chmod +x /data/local/tmp/uart_tool" ``` 取 ID: ```bash hdc shell "/data/local/tmp/uart_tool /dev/ttyS7 115200 hex FE059021000002FF" hdc shell "/data/local/tmp/uart_tool /dev/ttyS7 115200 recv 2" ``` `recv` 那一下应打出 `FE...`。空的话把命令换成 9600 试一次——如果 9600 出字,模组被设过波特,应用默认 115200 就要改。出厂这块我用的是 115200。 两板对发,文本模式即可: ```bash # 板 A hdc shell "/data/local/tmp/uart_tool /dev/ttyS7 115200 send hello" # 板 B hdc shell "/data/local/tmp/uart_tool /dev/ttyS7 115200 recv 3" ``` `dmesg` 里出现 `path="/dev/ttyS7"` 和 `ioctl 0x5401`(TCGETS),说明 `uartOpen` 真的打开了,不是应用自己报了个假成功。 --- ## 7. ArkTS 页:透传控制台就够 协议解析留给 GPS、指纹、语音。Zigbee 页复用串口控制台:设备、波特、十六进制开关、发送、单次读、连续读。 ```ts import board from 'libboard.so'; @State curDev: string = '/dev/ttyS7'; @State curBaud: string = '115200'; @State hex: boolean = true; @State tx: string = 'FE059021000002FF'; @State rx: string = '(未打开)'; @State opened: boolean = false; toggle() { if (this.opened) { board.uartClose(); this.opened = false; this.rx = '(已关闭)'; return; } let b: number = parseInt(this.curBaud); if (board.uartOpen(this.curDev, b) !== 0) { this.rx = '打开失败:节点、权限、DTS、是不是占用了 ttyS2'; return; } this.opened = true; this.rx = '已打开 ' + this.curDev + ' @' + b; } send() { if (!this.opened) { this.rx = '先打开'; return; } let n: number = board.uartWrite(this.tx, this.hex ? 1 : 0); this.rx = 'TX ' + n + ' 字节'; } readOnce() { if (!this.opened) { this.rx = '先打开'; return; } let s: string = board.uartRead(500, this.hex ? 1 : 0); this.rx = s.length > 0 ? ('RX: ' + s) : '(500ms 空)'; } ``` 连续读用 `setInterval` 调 `uartRead(200, 1)` 可以,超时别超过间隔。更稳的是 `await board.uartReadAsync(200, 1)`,读放进 NAPI 工作线程,停按钮还能点。 `isHex=1` 时 C 层把 `FE0590...` 收成二进制再 `write`。文本模式会把 `FE` 当两个 ASCII 字母发出去,模组当垃圾。配置帧必须勾十六进制。 --- ## 8. NAPI 写十六进制的那几行 ```c static int hexval(char c) { if (c >= '0' && c = 'a' && c = 'A' && c 模组tty波特这一侧在干什么 GPSttyS79600收 NMEA BLE 透传ttyS7115200对手机 GATT LoRattyS79600对另一颗 LoRa ZigbeettyS7115200对另一颗 Zigbee 六轴ttyS79600收 0x55 帧 语音ttyS7115200收 ASR 帧 RS485常见 ttyS8115200收发器,不是 uart7 应用里设备框能改。插错排针、选错 tty,`write` 仍然成功——成功的是另一颗 UART 控制器。Zigbee 页如果默认 ttyS7 没回 `FE`,先改 ttyS3 / ttyS8 试,不要先改内核。 全局一个 `g_uart`。打开 Zigbee 页等于关掉六轴页的 fd。这是 NAPI 实现的限制,不是硬件限制。 --- ## 11. 我踩过的 **单模块当回环。** 发 hello,连续读空。当时把 termios、DMA、权限全查了一遍。后来拿第二颗模组,第一秒就通。单模块只验配置帧。 **USB 当数据口。** 插电脑没有 COM,以为模组坏了。量排针 TX,上电有波形,UART 是好的。 **9600。** 手顺,从 GPS 页抄过来。内核 rx 在涨,全是错位字节,拼不出 `FE`。改回 115200,取 ID 立刻回。 **select。** 和第 47 章同一根控制器。`cat` 看得到,应用看不到。改 `poll`。 **CRTSCTS。** 抄了某份 8250 示例。CTS 悬空,`write` 卡住。关硬件流控。 **占用 ttyS2。** 应用误填 `/dev/ttyS2`,调试窗口雪花,板子还活着。断电,1500000 回来。 **两颗模组信道不同。** 配置帧能回,对发空。先两边都读信道,不一致就按说明书拉到同一信道。自动入网的模组,靠近上电一次。 **HAP 打开失败、工具成功。** 权限。`ls -l /dev/ttyS7` 不是 0666。 --- ## 12. 排障顺序 ```text 1. ls -l /dev/ttyS7 字符设备?0666? 2. cat /proc/tty/driver/serial 有 7: 16550A? 3. 排针上只留这一颗 UART 模组 4. 115200 hex 发 FE059021000002FF,2 秒内有没有 FE 应答 5. 第 4 步空:换 ttyS3 / ttyS8,换 9600 对比一次,查 TX/RX 6. 第 4 步成功、对发失败:第二套在不在、角色、信道、距离 7. 工具成功、HAP 失败:chmod、32 位 so、是不是勾了十六进制 ``` 第 4 步切开「UART」和「射频」。这一刀值回半天。 --- ## 路径清单 用途路径 板级 DTS uart7`device/board/rk/rk3568_evb/kernel/rk3568-evb-linux.dts` 节点`/dev/ttyS7` 内核串口表`/proc/tty/driver/serial` 开机放权`device/board/rk/rk3568_evb/board_perm/board-perm.sh` NAPI`entry/src/main/cpp/napi_init.cpp`(`libboard.so`) ArkTS`entry/src/main/ets/pages/Zigbee.ets` 工具`/data/local/tmp/uart_tool` 调试口(勿占)`/dev/ttyS2`,1500000 --- 系列第 46 篇 · 芯片:瑞芯微 RK3568 · OpenHarmony 4.1(API 11) · Linux 5.10

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册