首页 文章 精选 留言 我的

精选列表

搜索[world],共5280篇文章
优秀的个人博客,低调大师

九步构建自己的hello world Docker镜像

构建 Docker 镜像 Docker镜像构建是通过 Dockerfile来构建的,里面运行的程序是可以自定的,从编写程序到安装Docker镜像,可以一气呵成。接下来我们就通过九步实现一个自定义的镜像的制作、构建及运行。 编写在Docker中要运行的程序 该部分主要是镜像中程序的编写及编译 1. 创建目录 # 创建应用程序目录 mkdir hello-docker # 进入该目录 cd hello-docker 2. 编写程序 vim hello.c 3. 源码 #include<stdio.h> Int main (){ Printf("hello docker\n"); } 4. 编译 将编写的c程序编译在hello-docker根目录 gcc --static hello.c -o hello Dockerfile文件编写 5. 在hello-docker文件夹下新建Dockerfile文件 vim Dockerfile 6. 编写Dockerfile中的内容 FROM scatch ADD hello / RUN yun update CMD ["/hello"] 注: FROM:从哪构建镜像,是基础镜像的地址或者名称;ADD: 添加文件到镜像执行位置,如上是根目录;RUN: 镜像的操作指令;CMD: 容器启动时执行指令 编译及运行 7. 在hello-docker 根目录编译镜像 docker build -t guzhongren/test . 8. 编译完成后,在命令行中查看镜像是否存在 docker images 9. 运行镜像 docker run guzhongren/test 总结 知其然,知其所以然。

优秀的个人博客,低调大师

Hello World, S/4HANA for Customer Management 1.0

SAP CRM的前世今生 在我之前的微信公众号文章SAP的这三款CRM解决方案,您能区分清楚么我曾经提到过我作为成都SAP研究院CRM产品开发团队的一员工作过一段时间。 我向在SAP德国总部工作的德国老前辈们请教SAP CRM最早的版本是何时问世的,得到的答复是上世纪末本世纪初。 作为一个PC游戏迷,我联想到了供我领略众多国内外游戏大作的微软操作系统DOS, Windows 95, 98, 2000, Me和XP, 20年转瞬即逝,如今它们已经远离我们的视线了。 再回到我曾经工作的SAP CRM。每当Jerry在SAPGUI里调试着SAP CRM那些Created字段显示为本世纪初的ABAP代码时,脑子里情不自禁地浮现出曹老板和他神作里的千里马形象: * 同样,SAP的这三款CRM解决方案,您能区分清楚么里也提到了另一款SAP成都研究院的开发团队参与开发的产品:S/4HANA for Customer Management 1.0 今天(2018年2月28日),这款产品终于揭开了TA的神秘面纱 : 在SAP成都研究院开发团队和SAP全球其他部门同事们的共同努力下,S/4HANA for Customer Management 1.0问世了! SAP CRM On-Premises(下文简称为SAP CRM)的部分销售和服务功能已经成功集成到了S/4HANA里, 成为了S/4HANA的一部分。对于SAP的旗舰级产品S/4HANA来说,可以用"如虎添翼"四个字来形容这一融合。作者本人也是这个产品开发团队的一份子,贡献了部分代码和一些技术难题的攻关和原型开发,为此我感到自豪。 在传统的SAP系统集成部署架构下,SAP ERP和SAP CRM通过中间件进行数据同步,其间若是配置不当,数据同步可能会出现形形色色的问题。好在SAP CRM中间件在全球有着众多用户,这个产品本身又非常成熟,因此SAP生态圈内有着众多中间件相关文档,让您在遇到问题时不会一筹莫展。 一个好消息是,在S/4HANA for Customer Management里,原本CRM和ERP数据同步过程中种种令人头痛的问题已经从设计层面上得以避免了,因为在这款产品里运行的CRM销售和服务业务,使用和生成的业务数据当然是直接存储在S/4HANA系统里的,根本就不再需要使用中间件进行数据同步了。 关于S/4HANA for Customer Management 1.0 支持的销售和服务功能细节,请参阅SAP官方帮助文档。 先看看这个产品颜值如何。点击Fiori Launchpad里下图所示的tile开启S/4HANA for Customer Management的旅程: 对于使用过SAP CRM的朋友来说,接下来都是熟悉的味道。如果后台用户profile里将参数CRM_UI_PROFILE的值维护为*,就能够在下图的登录界面里看到所有可供选择的业务角色: 现在我用角色S4C_SRV_ICAG登入系统, 跑一个呼叫中心相关的场景。 假设一位名叫Jerry的客户打电话到呼叫中心,就他购买的一款ID为11的产品提出了服务请求。 座席接到电话,首先确认Jerry的身份:可以根据Jerry提供的在系统中的Account ID或是其他的联系方式,比如手机号码,邮箱地址等等(支持的所有方式如下图Identify Account区域内的字段所示)。这里座席采用的方式是根据Account ID来确认身份。 座席输入Jerry提供的Account ID,点击Search Account按钮: 选中搜索结果,点击Confirm按钮。 然后根据Jerry提供的产品ID 11, 将这个产品搜索出来,点击工具栏的创建按钮,基于该产品创建一个服务订单。 这是最终生成的订单一览: 我的公众号后台收到很多朋友的留言,询问关于这个产品的种种细节。这里就我能够回答的问题一一解答。 1. S/4HANA for Customer Management的UI是用什么技术开发的? 答:用的仍然是SAP CRM WebClient UI,而不是SAP UI5。对于熟悉CRM WebClient UI开发技术的朋友们来说,这是一个好消息,意味着大家以前在这项开发技能上投入的时间没有白费,可以继续在S/4HANA上发光发热。而对那些想学习新的UI开发技术的朋友们来说,S/4HANA的CDS View+Smart Template这一组合,也给大家充分提供了使用新技术的机会。大家如果想尝试Smart Template,可以参考我的微信公众号文章:Jerry的通过CDS view + Smart Template 开发Fiori应用的blog合集, 里面包含了一些具体的例子。 2. S/4HANA for Customer Management里的销售和服务流程,和SAP CRM的对应流程相比有何区别? 答: 至少在目前已经发布的1.0版本里,前者是后者的一个子集。后续版本会在S/4HANA里引入更多在SAP CRM里支持的销售和服务功能。 3. 接问题2: 同样的业务流程,S/4HANA for Customer Management里的技术实现,和SAP CRM相比有何区别? 答: 同一个功能,比如物料主数据的搜索,虽然从最终用户眼中看起来都是在同样的UI上点击搜索按钮而已,但技术上的实现在这两个产品里是不同的。差异主要体现在下图中绿色区域的Generic Interaction层和更底层的数据模型,以及围绕这些数据模型进行CRUD(增删读改)操作的API。 数据库表的更改最易理解,在这两个产品里有很多从业务上说实际上描述的是同一概念的模型,比如SAP CRM的Product(产品)和S/4HANA里的Material(物料)。在CRM里我们用事务码COMMPR01创建产品, 其相关数据存储在以COMM_开头的一系列表里。而S/4HANA则是在事务码MM01里创建物料, 数据存储在主表MARA和一系列从表里。 上述描述反映了这样一种情况:在SAP CRM和S/4HANA分别用不同的技术模式描述业务上同一个概念。针对这种情况,在将SAP CRM的销售和服务流程引入S/4HANA的过程中,我们面临着模型的取舍问题。我们采用的准则是:使用S/4HANA的模型。 这就意味着在S/4HANA for Customer Management里,之前SAP CRM里使用的API也需要做相应的调整,这些API里对SAP CRM数据模型的操作需要重定向到S/4HANA对应的数据模型。 举一个具体的例子: 以存储物料的数据库表为例。本文前部在介绍S/4HANA for Customer Management的外观部分提到了ID为11的产品,在SAP CRM里我们是去表COMM_PRODUCT里根据PRODUCT_ID来找到该产品。而在S/4HANA里则需要去表MARA里找。 值得一提的是,在这款新产品的开发过程中,我们并不是简单地将代码里所有使用到SAP CRM数据模型的地方都找出来,替换成S/4HANA的数据模型而已。我们做了很多基于S/4HANA架构的优化,目的是充分发挥S/4HANA系统底层提供的强大功能和各种创新技术。 一个具体例子就是本文开头提到的产品搜索功能。这个功能是SAP成都研究院开发团队负责实现的。SAP CRM产品搜索的底层实现是基于数据库表COMM_PRODUCT的。而在S/4HANA for Customer Management里,我的同事们并没有简单照搬思路直接去查S/4HANA物料数据库表MARA,而是采用了S/4HANA的新的建模方式,设计了一个CDS view。当用户点击了搜索按钮后,底层的执行会搜索下图这个CDS view。 借助CDS view,我们遵循了S/4HANA建模领域里耳熟能详的准则"Code Push Down", 确保了尽可能多的逻辑直接在数据库层面执行, 充分发挥SAP HANA强大的数据处理能力。 如果大家对S/4HANA里CDS view这一重要的建模方式感兴趣的话,可以阅读这篇SAP Community上访问量过2万的CDS View概述文章: ABAP Core Data Services – Introduction (ABAP CDS view) https://blogs.sap.com/2017/09/09/abap-core-data-services-introduction-abap-cds-view/ 如果想深入了解CDS view的一些技术细节,请参考我的微信公众号文章:Jerry的CDS view自学系列,里面包含了14篇文章,全是我自己通过阅读CDS框架源代码和调试的方式了解到的一些技术实现细节,以及我做过的一些例子和工具。 4. S/4HANA for Customer Management里的One Order模型,和SAP CRM里的模型相比有何改进? 答:有很多改进,Jerry去年在德国SAP总部吃了3个月的土豆+面包,就是在做这件事情。 在SAP CRM里,一个订单的数据散落在不同的数据库表里,大家最熟知的,就是存放抬头信息的CRMD_ORDERADM_H和存放行项目信息的CRMD_ORDERADM_I这两张表。其名称中的ADM(Administration)是一个提示:订单的绝大部分业务数据并没有存储在这两张表里,而是位于其他的专属表里。 如下图所示,图中不同颜色的矩形框代表One Order模型里不同类型的节点,每个节点拥有一个专属的数据库表,这些节点之间可能包含从属关系,这些从属关系又维护在下图正中的数据库表CRMD_LINK里。 所有这些数据库表加起来有200多个。这套数据模型在传统的Transaction应用领域里被证明是非常成功的:SAP CRM广泛应用于全球众多客户群的事实说明了一切。而在Analytics使用场景下,上述数据模型需要和另一个模型,就是CRM顾问们熟知的索引表CRMD_ORDER_INDEX协同工作。 顾名思义,这张表的引入是一个以空间换时间的策略——索引表存放了部分来自业务数据表里的数据,以部分冗余的存储空间为代价来减少进行Analytics计算所花费的时间。 而在S/4HANA for Customer Management里,One Order的底层存储模型得到了大幅简化。一个订单所有的抬头级别的数据,例如订单编号,描述信息,类型,创建者,创建时间,发货方,收货方等等都存储在一个新的数据库表CRMS4D_SERV_H里。 而对应的行项目信息,则存放于表CRMS4D_SERV_I里。 基于这种扁平结构的数据表上构造出来的CDS view,能够最大程度上减少为了抽取数据用于Analytics场景所需要进行的数据库表之间的连接操作,充分发挥出S/4HANA强劲的数据处理能力,也从根本上避免了索引表的引入造成的存储空间浪费。 从用户的角度上说,S/4HANA加上CDS view这对组合,就是Analytics场景下最好的性能保证。 从架构的角度上说,S/4HANA的销售和服务这块业务的Transaction和Analytics应用,使用了同一套新的数据模型,相比SAP CRM On Premise的众多业务专属表+CRMD_LINK+CRMD_ORDER_INDEX的设计有了大幅简化。更重要的是,CDS view的引入,使得S/4HANA for Customer Management能够受益于SAP在CDS view这一领域内的持续创新。 从Partner的角度上说,底层模型的简化,也降低了Partner排错的复杂度。同时,感谢之前SAP CRM里One Order API优雅的分层设计——上文描述的底层存储模型的改动,没有影响到One Order API的接口。这意味着如果之前您已经能够在SAP CRM里熟练运行CRM_ORDER_MAINTAIN和CRM_ORDER_SAVE这些API进行二次开发,那么您在S/4HANA for Customer Management从事和One Order相关的二次开发也没有任何问题——这些API的用法没有任何改变。 5. 我是一位SAP CRM开发顾问。我将来会失业么? 答:如果您有耐心读到这里,相信您心中已经有了答案。 一方面,在S/4HANA for Customer Management里,二次开发使用到的技术, 前台仍然是CRM WebClient UI,加上后台的One Order系列的API,这使得大家之前在这一领域多年的技术积累没有白费。另一方面,这个新的产品因为是运行在S/4HANA这一SAP旗舰级产品上,这就给每一位希望学习S/4HANA的CRM顾问打开了一扇门。 我自己有一个感受,学习一项新技术,或是一个新产品,在工作和实战中学习,其效率和知识掌握的深度都要超过在业余时间看看资料这种学习方式。S/4HANA for Customer Management的问世,给每一位CRM顾问提供了更大的舞台,让大家不仅能继续在销售和服务领域深耕,同时也能在工作中学习S/4HANA,我个人认为这是一个很好的发展机会。

优秀的个人博客,低调大师

一个最简单的WebSocket hello world demo

服务器端代码不超过42行: const WSServer = require("./server.js"); var counter = 0; function createWebsocket() { var host = "127.0.0.1"; var port = "9999"; var wsServer = WSServer.startServer(host, port); console.log("WebSocket server listens to: " + host + ":" + port); wsServer.on('open', (data) => { console.log('WS Client has connected: ' + data); setInterval(function(){ counter++; WSServer.broadcast("Jerry: " + counter ); }, 3000); }); wsServer.on('dataWS', (data) => { console.log('Receive Data from WebUI : ' + data); }); wsServer.on('disconnect', (data) => { console.log('WSServer disconnect:' + data.name); }); wsServer.on('close', (data) => { console.log('WSServer close: ' + data.name); }); wsServer.on('end', (data) => { console.log('WSServer Close: '+data.name); }); wsServer.on('error', (data) => { }); } createWebsocket(); </pre> 代码第10行创建一个WebSocket服务器,监听在9999端口上: 第15~18行每隔3秒发送一个字符串到浏览器,用一个计数器标识每次发送的请求。 代码里所需的server.js我已经上传到我的Github上了: https://github.com/i042416/KnowlegeRepository/blob/master/practice/nodejs/server.js 使用nodejs启动这个服务器: 网页端代码: <html> <script src="socket.io.dev.js"> </script> <script> console.log("1"); var socket = io('ws://127.0.0.1:9999'); socket.on('connect', function(){ console.log("connected!"); }); socket.on('event', function(data){ console.log("event: " + data); }); socket.on('news', function(data){ console.log("data from server: " + JSON.stringify(data,2,2)); }); socket.on('disconnect', function(){ console.log("disconnect..."); }); </script> </html> </pre> 浏览器端每隔三秒收到服务器推送的消息,打印在console上: 本文来自云栖社区合作伙伴“汪子熙”

优秀的个人博客,低调大师

hadoop实战–搭建eclipse开发环境及编写Hello World

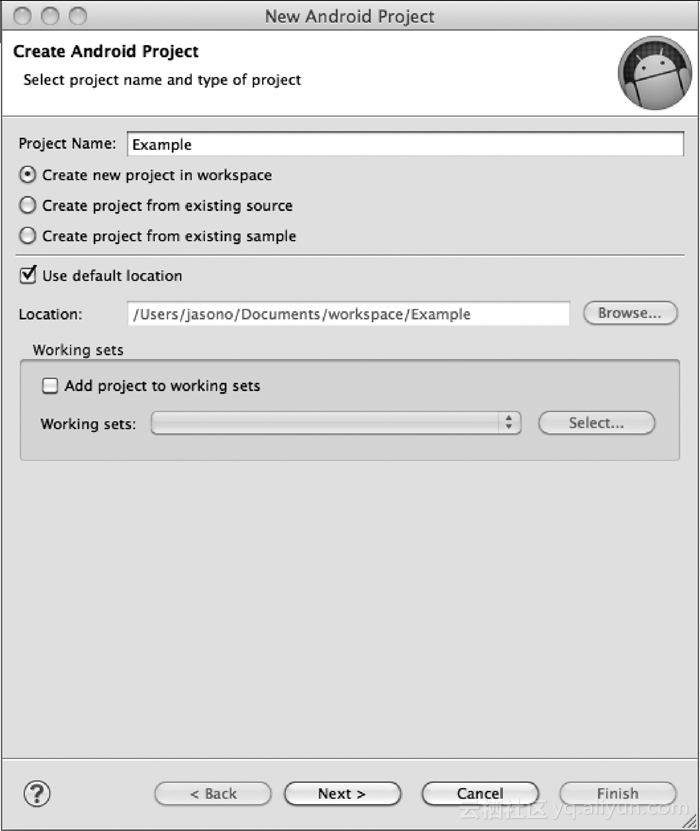
1、在eclise中安装hadoop的插件并配置 在上篇文章《编译hadoop eclipse的插件(hadoop1.0)》,已经介绍过怎样编译基于hadoop1.0的eclipse插件 将jar包放在eclipse安装目录下的plugins文件夹下。然后启动eclipse 进入后,在菜单window->Rreferences下打开设置: 点击“Ant” 出现: 点击browse选择hadoop的源码下的build目录,然后点OK 打开Window->Show View->Other 选择Map/Reduce Tools,单击Map/Reduce Locations,会打开一个View: 添加Hadoop Loacation,其中Host和Port的内容这里的host和port对应mapred-site.xml中mapred.job.tracker的值,UserName 是用户名,我配置的是localhost和9001 但是出现如下问题,eclipse的左侧看不到project explorer,更看不到其中的dfs 解决办法: 应该在菜单栏 选择:Window->Open pespective-><Map/Reduce>。然后就能看到HDFS文件系统已经所创建得一些项目。 添加Hadoop Loacation,其中Host和Port的内容跟据conf/hadoop-site.xml的配置填写,UserName 是用户名,如下图 成功添加Hadoop Loacation后还可能出现如下错误: 解决办法: 这时候,需要对namenode进行格式化:bin/hadoop namenode -format 执行命令:bin/start-all.sh 如果test下面的文件夹显示(1)而不是(2)也是正常的,如果要显示(2),运行《安装并运行hadoop》一文中最后的那几个命令。 在配置完后,在Project Explorer中就可以浏览到DFS中的文件,一级级展开,可以看到之前我们上传的in文件夹,以及当是存放的2个txt文件,同时看到一个在计算完后的out文件夹。 现在我们要准备自己写个Hadoop 程序了,所以我们要把这个out文件夹删除,有两种方式,一是可以在这树上,执行右健删除。 二是可以用命令行: $ bin/hadoop fs -rmr out 用$bin/hadoop fs -ls 查看 2、编写HelloWorld 环境搭建好了,之前运行Hadoop时,直接用了examples中的示例程序跑了下,现在可以自己来写这个HelloWorld了。在eclipse菜单下 new Project 可以看到,里面增加了Map/Reduce选项: 选中,点下一步: 输入项目名称后,继续(next), 再点Finish 然后在Project Explorer中就可以看到该项目了,展开,src发现里面啥也没有,于是右健菜单,新建类(new->new class): 然后点击Finish,就可以看到创建了一个java类了: 然后在这个类中填入下面代码: public static class TokenizerMapper extends Mapper<Object, Text, Text, IntWritable>{ private final static IntWritable one = new IntWritable(1); private Text word = new Text(); public void map(Object key, Text value, Context context ) throws IOException, InterruptedException { StringTokenizer itr = new StringTokenizer(value.toString()); while (itr.hasMoreTokens()) { word.set(itr.nextToken()); context.write(word, one); } } } public static class IntSumReducer extends Reducer<Text,IntWritable,Text,IntWritable> { private IntWritable result = new IntWritable(); public void reduce(Text key, Iterable<IntWritable> values, Context context ) throws IOException, InterruptedException { int sum = 0; for (IntWritable val : values) { sum += val.get(); } result.set(sum); context.write(key, result); } } public static void main(String[] args) throws Exception { Configuration conf = new Configuration(); String[] otherArgs = new GenericOptionsParser(conf, args).getRemainingArgs(); if (otherArgs.length != 2) { System.err.println("Usage: wordcount <in> <out>"); System.exit(2); } Job job = new Job(conf, "word count"); job.setJarByClass(wordCount.class); job.setMapperClass(TokenizerMapper.class); job.setCombinerClass(IntSumReducer.class); job.setReducerClass(IntSumReducer.class); job.setOutputKeyClass(Text.class); job.setOutputValueClass(IntWritable.class); FileInputFormat.addInputPath(job, new Path(otherArgs[0])); FileOutputFormat.setOutputPath(job, new Path(otherArgs[1])); System.exit(job.waitForCompletion(true) ? 0 : 1); } 填入代码后,会看到一些错误,没关系,点击边上的红叉,然后选择里面的import即可: import java.io.IOException; import java.util.StringTokenizer; import org.apache.hadoop.conf.Configuration; import org.apache.hadoop.fs.Path; import org.apache.hadoop.io.IntWritable; import org.apache.hadoop.io.Text; import org.apache.hadoop.mapreduce.Job; import org.apache.hadoop.mapreduce.Mapper; import org.apache.hadoop.mapreduce.Reducer; import org.apache.hadoop.mapreduce.lib.input.FileInputFormat; import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat; import org.apache.hadoop.util.GenericOptionsParser; 这里,如果直接用源码来操作,可能会GenericOptionsParser这个类找不到定义,还是红叉,添加commons-cli- 1.2.jar这个jar包,在build/ivy/lib/Hadoop/Common下,右健Project Explorer中的MyHelloWorld工程,选择Build Path->Config Build Path 在Liberaries Tab页下,点击Add External JARs 在弹出窗口中,跟据前面说的目录,找到这个jar包,点确定后,回到工程,可以看到红叉消失,说明编译都通过了。 在确保整个工程没有错误后,点击上面的小绿箭头,然后在弹出的小窗口上,选择Run On Hadoop: 点OK后,会弹出小窗口: 然手中选择Choose an existing server from the list below。然后找到之前配置的地址项,选中后,点Finish,然后系统不会Run起来,在控制台(双击可最大化)中可以看到运行结果: 运行完后,可以看到多了一个out文件夹,双击打开out文件可以看到单词的统计结果来 3、可能出现的问题: 问题1: 运行后,如果Console里只输出Usage :wordcount<in> <out>, 则需要修改下参数,在运行菜单边上小箭头,下拉,点击Run Configuration,: 左边选中 JavaApplication中的 WordCount,右边,在Arguments中输入 in out。然后再点Run 就可以看到结果了。 左边选中 JavaApplication中的 WordCount,右边,在Arguments中输入 in out。然后再点Run 就可以看到结果了。 问题2: 第二次运行会报错,仔细看提示,可以看到报错的是out目录已经存在,所以需要手动来删除一下。 更进一步 上面我们写了一个MapReduce的HelloWorld程序,现在,我们就也学一学HDFS程序的编写。HDFS是什么,它是一个分布式文件存 储系统。一般常用操作有哪些? 当然我们可以从编程角度来:创建、读、写一个文件,列出文件夹中的文件及文件夹列表,删除文件夹,删除目录,移动文件或文件夹,重命名文件或文件夹。 启动eclipse,新建Hadoop项目,名称MyHDFSTest,新建类HDFSTest,点击确定,然后同样工程属性Configure BuildPath中把 build/ivy/lib/Hadoop下的所有jar包都引用进来(不详细说明了,可参考上面的步骤) 在类中,添加main函数: public static void main(String[] args) { } 或者也可以在添加类时,勾选上创建main,则会自动添加上。 在mian函数中添加以下内容: try { Configuration conf = new Configuration(); conf.set("fs.default.name", "hdfs://localhost:9000"); FileSystem hdfs = FileSystem.get(conf); Path path = new Path("in/test3.txt"); FSDataOutputStream outputStream = hdfs.create(path); byte[] buffer = "Hello".getBytes(); outputStream.write(buffer, 0, buffer.length); outputStream.flush(); outputStream.close(); System.out.println("Create OK"); } catch (IOException e) { e.printStackTrace(); } 直接添加进来会报错,然后需要添加一些引用才行: import org.apache.hadoop.conf.Configuration; import org.apache.hadoop.fs.FSDataOutputStream; import org.apache.hadoop.fs.FileSystem; import org.apache.hadoop.fs.Path; 在没有错误后,点击工具条上的运行, 但这次跟前次不一样,选择Run as Java Application。然后,就可以在输出框中看到Create OK的字样了,表明程序运行成功。 这段代码的意思是在in文件夹下,创建test3.txt,里面的内容是”Hello”。 在运行完后,我们可以到eclipse的Project Explorer中查看是否有这文件以及内容。同样也可以用命令行查看$bin/hadoop fs -ls in。 ok,第一个操作HDFS的程序跑起来了,那其它功能只要套上相应的处理类就可以了。为了方便查找操作,我们列举了张表: 操作说明 操作本地文件 操作DFS文件 主要命名空间 java.io.File java.io.FileInputStream java.io.FileOutputStream org.apache.hadoop.conf.Configuration org.apache.hadoop.fs.FileSystem org.apache.hadoop.fs.Path org.apache.hadoop.fs.FSDataInputStream; org.apache.hadoop.fs.FSDataOutputStream 初使化对象 new File(路径); Configuration FileSystem hdfs 创建文件 File.createNewFile(); FSDataOutputStream = hdfs.create(path) FSDataOutputStream.write( buffer, 0, buffer.length); 创建文件夹 File.mkdir() hdfs.mkdirs(Path); 读文件 new FileInputStream(); FileInputStream.read(buffer) FSDataInputStream = hdfs.open(path); FSDataInputStream.read(buffer); 写文件 FileOutputStream.write( buffer, 0, buffer.length); FSDataOutputStream = hdfs.append(path) FSDataOutputStream.write( buffer, 0, buffer.length); 删除文件(夹) File.delete() FileSystem.delete(Path) 列出文件夹内容 File.list(); FileSystem.listStatus() 重命令文件(夹) File.renameTo(File) FileSystem.rename(Path, Path) 有了这张表,以后在需要的时候就可以方便查询了。

资源下载

更多资源
优质分享App

优质分享App

近一个月的开发和优化,本站点的第一个app全新上线。该app采用极致压缩,本体才4.36MB。系统里面做了大量数据访问、缓存优化。方便用户在手机上查看文章。后续会推出HarmonyOS的适配版本。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册