首页 文章 精选 留言 我的

精选列表

搜索[world],共5280篇文章
优秀的个人博客,低调大师

函数计算入门示例 - hello world

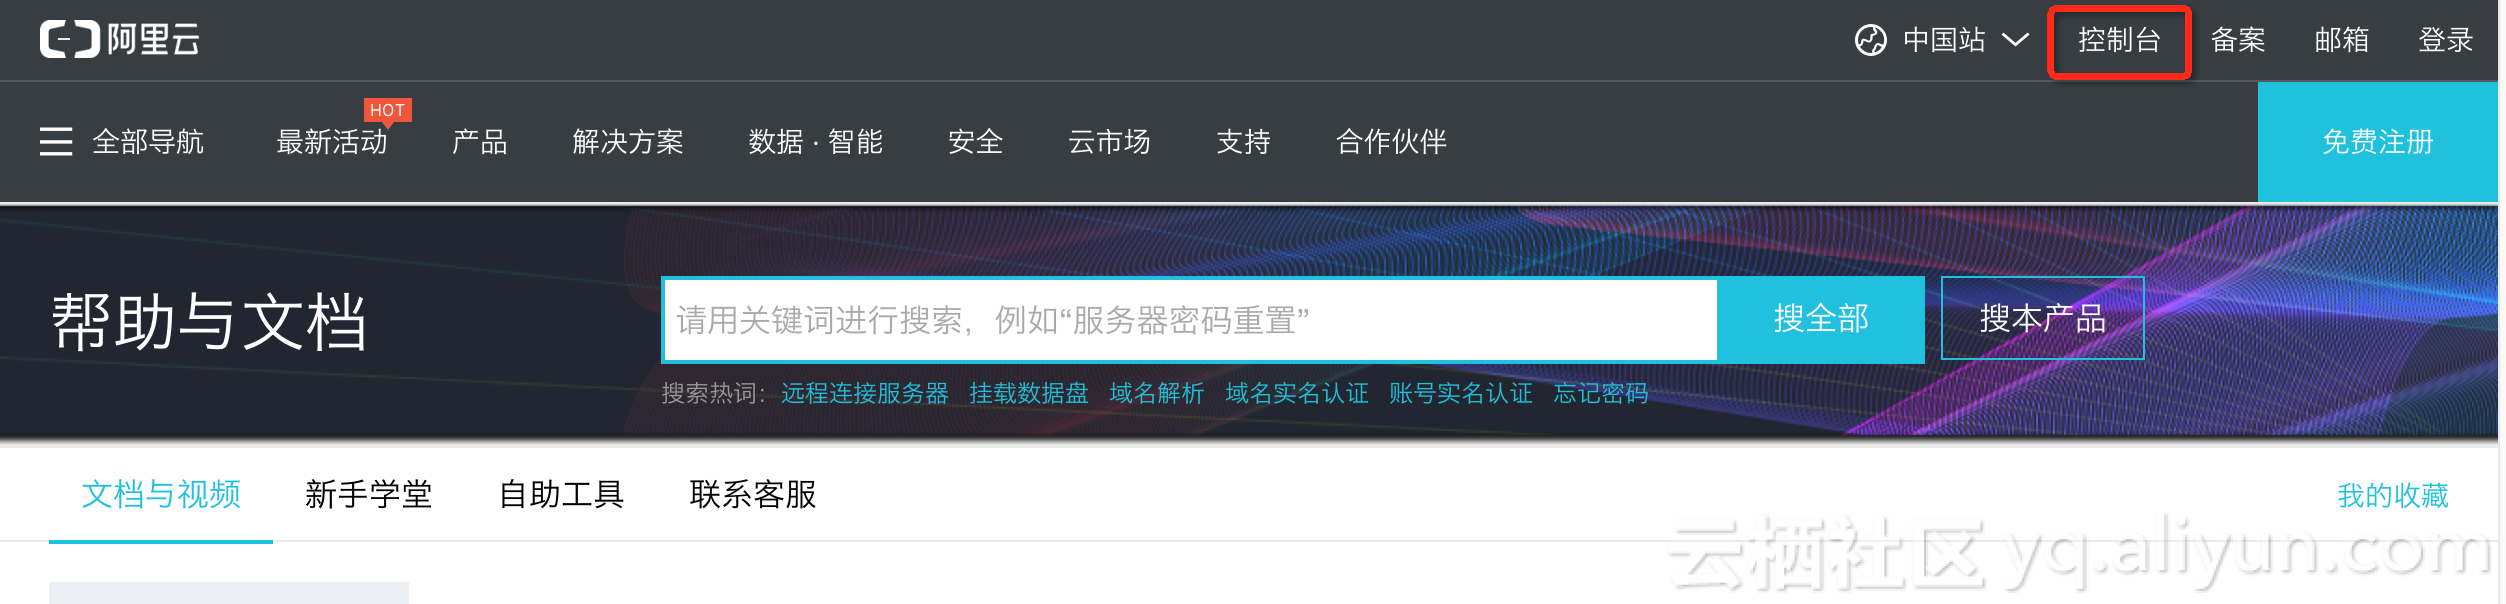
前言 在函数计算中,用户除了使用命令行的工具来管理和操作函数计算服务,还可以使用可视化的控制台工具来查看和管理自己的函数,这边以一个简单的例子来简单介绍下函数计算控制台的使用。 控制台使用 - 1,登录阿里云函数计算官方帮助网址,点击下图的控制台进行登录 - 2, 成功登录后,进入阿里云管理控制台页面,可以通过下图两种方式的任意一种进入函数计算的控制台管理页面 1 如果你把函数计算控制台配置到管理控制台 2 万能入口方式 注:创建服务的时候注意下区域,区域详情 -3, 进入函数计算控制台管理页面之后,新建一个服务 -4, 创建服务成功后,在服务下面创建一个函数 step1:创建函数过程中有响应的模板,这边选择最简单的空白函数模板,语言选择python step2:这边示例不创建触发器 step3:给函数取名,编辑代码相关,这边默认的代码是经典的hello

优秀的个人博客,低调大师

Bridge to the digital world —— AR算法技术分享

什么是AR? 为什么AR? Augmented reality译作增强现实。顾名思义,现实就是我们所在的物理世界,而增强则指由计算机所编辑进而与真实世界相融合重新呈现给我们的增强世界。 图1:AR即将改变我们的生活模式,如:出行、阅读、生活、工作、购物和娱乐 AR可以发挥计算机的优势进而强化人自身传感处理能力的不足,可以通过增强世界提供进入虚拟世界的入口,也可以产生人与人、人与世界的全新连通与互动方式。就像图1所示的那样,它即将深刻改变我们的出行、阅读、生活、工作、购物和娱乐等模式。 从集团角度讲,AR可能成为一种为新零售新生活打造的高效连接线上线下的纽带,也可通过其对物理世界与虚拟世界的双重连接更好地形成社区,亦可通过其提供的虚拟世界编辑能力更有效地“生产快乐”以打造生活化平台而不仅仅是电商平台。更重要的是,谁抢占了未来AR的app入口,谁就更有能力获得更多真实物理世界的数字化信息,而这些数据本身将带来更大价值。 AR的核心问题有哪些? 既然AR如此有潜力,那么AR所面对的核心问题都有哪些呢? AR的核心要素: AR系统有相互联系、密不可分的三个核心要素: 对世界的感知:逆向工程物理世界,将其数字化; 对世界的编辑:正向创造一个虚拟世界,并与真实世界融合为增强世界; 互动:用户与世界、用户与用户的互动。 AR的核心需求: 在上述核心要素的基础上,AR的核心需求是实时性,因此需要足够高效的算法以及充足的硬件计算处理能力。 AR的研究边际: 真实物理世界的信息维度过高,因此AR只关注那些能被人体传感器系统所截获并呈现在人脑中的方式,例如:可见光(390-700nm)视觉,(20Hz-20KHz)听觉等,因为如果创造的增强世界不能被人所接收和呈现也是意义有限的。 AR核心问题描述: 1. 流程概述: 图2:AR流程图与核心问题描述 首先,我们先跟大家解释下这几个名词的含义以便后续理解:物理世界是真实世界,虚拟世界是在电脑中产生的世界(比如:游戏魔兽世界),增强世界是真实和虚拟融合在一起并呈现给用户的世界。 现在,我们将用图2来阐述对AR的理解并描述其核心问题。 AR设备用起来很简单,但这个“黑盒子”里究竟发生了什么呢?下面是AR的大致工作流程:①利用AR设备中的传感器系统,去完成对物理世界的感知并将其数字化;②这些数字化信息进入“世界编辑”流程,用以创造一个和物理世界相关的虚拟世界;③最后,物理世界和虚拟世界相融合,形成增强世界。 用户可以通过与增强世界的在线互动,进而改变虚拟世界,如:在虚拟世界中给家里的沙发换色以搭配家装。用户也可通过与增强世界的交互改变物理世界,如:利用AR设备的无线通信功能打开电器。用户又可通过世界编辑提供的虚拟世界创造功能离线添加虚拟世界的内容。当然也可正常与物理世界进行交互。 通过世界感知这个桥梁,AR连通了物理世界和虚拟世界。通过这两个世界,继而可以跨时空建立起更多用户与用户的联系。世界编辑则提供了建立虚拟世界的基础能力,决定了日后AR社区能否更容易让用户创造内容。用户和世界、用户和用户的可交互维度和便利性,将决定AR最终的成败。 下面,我们将就图2中的世界感知和世界编辑问题进行展开。由于不同的感官呈现方式对世界感知的需求存在很强的共性,下面我们将仅仅以视觉为例。 2. 世界感知: 世界感知,按所感知类别可分为对人、物、场的感知。按照问题描述,又可分为重建、定位、识别和分割问题。其中,重建和定位问题绝大部分属于基于物理模型的传统计算机视觉范畴,而识别和分割问题则随着AI大潮一起被更多地采用数据驱动的方式去解决。下面针对图2中所列的问题,从视觉的角度,简要说明其含义: 2.1 对场景的感知 1) 场景能量源重建:主要指用图像去推断光源的信息。例如:光源的方向,位置,强度以及颜色等。这些信息可帮助还原场景中光度不变性信息(photometric invariant)以获得场景本体反射图(intrinsic image),继而在编辑世界(渲染)的过程中辅助数字化重打光(digital relighting)以达到更加真实的渲染效果。 图3:技术实例:场景本体反射图分解。左:原图;中:分解的本体反射图(若已知场景法向量场,可数字化重打光);右:分解的影调图(若已知场景法向量场,可推断光源) 2) 场景几何形态重建:主要指构建三维世界的空间几何形态,解决空间中有没有物体的问题。构建起的几何形态,可被用来当作空间地图使用以完成精确定位,可渲染生成可视化三维模型进行展示,也可利用几何形态信息完成对三维场景的空间分割。 图4:技术实例:左:空间定位;中:可视化三维模型; 右:三维场景分割 3) 场景物理特性重建:主要用来还原场景中区域的反射性质(如BRDF)。可利用材质库反射信息推断物体材质,渲染替换真实物体中特定材质的区域。对物体材质的推测,也可帮助更好地完成物体识别等视觉任务。 图5:技术实例:对材质信息进行感知,根据材质的不同对场景区域进行分割,并将真实物体中的特定材质渲染成为新材质并呈现 4) 场景识别:主要可用在分辨当前场景最有可能出现的地点,筛选后可完成基于视觉的粗定位。2.2 对人的感知 1)观察者几何定位:主要感知人与场景的相对位置关系,通常和场景几何形态重建共同完成(如SLAM,VO)。 2)观察者识别:包括人脸识别相关的应用场景,主要解决人是谁的问题,也可识别人的心情等。同时,也包括手势、动作识别等以更有效地进行人机交互。2.3 对目标物的感知 1) 目标物识别:主要识别图像中的目标物体并定位其在二维图像中的位置。如果有场景额外三维信息,可推测目标物在三维空间中的位置。目标物的位置又可辅助完成基于high-level语义信息的定位。 图6:技术实例:左:2D目标物识别和定位;右:3D目标物识别和定位 2)目标物提取:主要识别并提取图像中的目标物,可将目标物传送到任意其他场景,或将其他物体渲染到目标物位置。这个提取过程可能在二维图像中完成,若有三维几何信息,也可在三维世界中完成。 图7:技术实例:上:2D目标物提取;右:3D目标物提取 3) 目标物跟踪:通常识别到目标物后,需要跟踪目标在图像中的位置。跟踪的意义主要在于其快速性和稳定性。 4) 目标物重建:与场景几何形态和物理特性重建类似,但目标物重建额外需要目标物从场景中的分割提取。重建目标物,可生成三维渲染模型,将其以最简化的表达任意传送至其他渲染目的地。建立起的三维模型库也将对三维物体识别等问题产生深远影响。 3.世界编辑: 在世界感知过程中,我们得到了场景、目标物和人的数字化信息。在世界编辑过程中,我们可以利用这些信息,按照真实世界的物理规则和人眼作为受众去创造(渲染)虚拟世界并呈现给人们。我们也可以改变观察者特性,呈现给人一个完全不同的对真实世界的感知体验,例如提供小动物眼睛的模拟器去看世界。 更有意思的是,这个计算机所生成世界的运行法则可以由我们来制定,我们就是这个世界的上帝。就像黑客帝国中所描绘的那样,可以扭曲虚拟世界中的物理定律。随着AR技术的进步,我们将来很可能傻傻分不清什么才是真实,要不要从违反物理定律角度开个后门呢?~ 对于世界编辑来说,上帝级开发者编辑虚拟世界中事物的运行法则,而开放给普通用户一些基础世界编辑能力也很必要,靠大众去创造更多的内容。小编想起了很早以前流行的一款叫《孢子》的游戏,其中所有事物都可以由玩家所创造,玩家间也可以共享创造,这样就形成了社区。据游戏发行公司EA统计,创造器发布18天,玩家群体一共上传了1,589,000种生物。设计师莱特曾幽默地说,玩家已经高效地完成了上帝38%的工作。可见用户参与编辑设计的力量。若加之一些合理的主干引导和支线剧情,游戏本身可以说就有千变万化的玩法。回想Pokemon go,是不是离成功就差了更多用户参与的内容迭代机制呢?我们可不可以借鉴类似的思路用在我们AR内容的创造上呢? 图8:《孢子》生物创造器 AR已有哪些技术落地?业务场景有哪些? 前面讲了这么多对AR的理解,想必大家要问:AR目前真正落地的技术有哪些,业务场景又有哪些呢?由于小编来自算法团队,主要做利用视觉进行世界感知部分,因此只适合从这方面介绍。虽然技术是为业务需求服务的,但是如果按照业务线梳理过于庞杂,很难有系统性,因此我们按照技术线去梳理,从视觉AR基础技术的角度出发,进而讲述哪些业务应用到了这些技术。由于篇幅有限,主要介绍两类关键技术:1)自然特征检测和跟踪;2)SLAM。其他技术,比如LBS AR,三维物体识别与跟踪等技术均已落地一些业务场景(如:双十一寻找狂欢猫),但在此不做展开。 自然特征检测和跟踪 自然特征(nature feature)通常是指一个平面图案(marker),比如是公司的logo等。借助这个marker,可以帮助我们建立起相机和三维世界的(6自由度)相对姿态关系,如图9所示。 图9:通过Marker建立相机与世界相对姿态原理图 要将自然特征有效运用,就需要完成两项基本任务:检测和跟踪。检测解决的是判断目标marker是否出现在画面中并且初始化世界坐标系(marker坐标系)的问题。而跟踪则解决在初始化完成后,如何稳定跟踪marker的位置并实时算出相机相对世界坐标系的姿态(camera pose)。 Marker的检测主要通过存储的marker特征点描述和场景中的特征点描述进行匹配来完成。若匹配成功,则代表已检测到marker。随即,通过在二维图像中特征点的对应关系,在已知相机内参(camera intrinsics)的情况下,可以利用解决perspective-n-point (PnP) 问题的各种算法解算camera pose以完成初始化。 关于marker检测环节,还有一些额外的技术考量。首先,marker检测可能要求同时检测多种不同的marker,如果对于每一种marker都进行一次匹配显然是不可行的,因为这种方式不scalable。这就要求我们建立起marker的索引树,例如应用Bag-of-Words(BoW)方法。这样可以让我们像查字典一样快速检索,让同时在线检测多个marker成为可能。其次,之所以选用特征匹配方式(feature-based matching)而不是图像块匹配(patch-based matching,又通常叫direct method),因为相比patch而言,feature拥有更好的尺度不变性和方向不变性,而且对光照变化更加不敏感,因此可以提供更加鲁棒的特征点。然而feature相比patch的缺点也十分明显,即其计算代价相对较高。对于实时性要求很高的AR应用来说,有些特征描述的计算代价甚至是不可接受的(如SIFT)。平衡计算代价和准确程度,我们最终倾向采用Freak或ORB。在实际操作中,我们采用了Freak特征。 第二个基本任务是marker的跟踪。有人可能要问,为什么不对每一帧marker都做检测,那样不就不用跟踪了吗?之所以用跟踪,主要有三点考虑:其一,跟踪较之识别,计算代价更小;其二,应用跟踪可以防止相机姿态的跳变;其三,利用跟踪,可以建立起相机的运动模型,若突然哪一帧图像质量不好,还可以通过相机运动模型进行预测(prediction),例如应用卡尔曼或粒子滤波等,以减少跟丢概率。 在marker跟踪过程中,由于特征提取很耗费计算资源,因此对于当前帧,只提取上一帧Freak位置一个特定大小neighborhood内的特征点并进行特征匹配以找到两个相邻帧Freak特征的对应点关系。在前一帧图像中,每一个Freak特征都对应了一个世界坐标系下的三维点坐标,这些点映射回当前帧画面的点的坐标是我们之前找到的对应点,我们的优化目标是计算当前帧相机相对世界坐标系的姿态。我们可以利用reprojection error最小作为目标建立起最优化目标函数,初始化前一帧相机姿态作为当前相机姿态,利用梯度下降等数值方法求解最优解。这个求解过程转化为了求解典型的bundle adjustment问题。这样做的优点相较于已知二维特征对应点关系直接应用PnP来讲,可以减少相机姿态跳变的概率,这也是很多主流Visual Odometry (VO) 算法所采取的方式。 Marker的检测和跟踪作为AR的一种基础能力,对手淘的多种业务产生了影响,例如:AR互动营销,双十一跨屏抢星衣和AR Shoes等。手淘的AR MagicEye互动平台就是以此技术为原点建立起来的。 AR互动营销落地的业务有中秋抢月饼。扫一下一个淘公仔的形象,一个动态的淘公仔就展现在你手机里。上传一张照片,它就可以拿着这照片到处抖起来了~ 类似的业务还有扫五环,哈根达斯logo等出各种AR效果并和用户产生互动。 图10:AR互动营销案例 双十一抢星衣活动也是主要依赖marker快速检测技术完成的。如图11所示,在林志玲准备抛衣服前一刻,电视屏幕上会显示出marker,当然这个marker只占电视屏幕的一小部分。这就要求当marker在手机屏幕占比足够小时,算法仍需要快速准确检测出来。用户打开手机瞄准电视,检测到了这个marker也就完成了抢星衣过程。 图11:双十一跨屏抢星衣 AR Shoes主要目的是提供一种视觉测量手段使用户能够方便测量自己脚的尺寸以买合适大小的鞋。如图12所示,用户将身份证作为Marker去定基准面。身份证大小已知,假设脚在基准面上,这样就有了绝对尺寸信息。用户在图像中框出自己的脚,已知相机内参,也就可以计算出在基准面上所框区域的长宽,而这就是脚的尺寸。这里之所以选择身份证,是因为人人都有,能让更多人用起这个功能。 图12:AR Shoes 视觉测量 Simultaneous Localization and Mapping (SLAM) SLAM(同时定位并建图)技术是除marker外另一项AR的基础能力。顾名思义,它的目的是同时计算相机姿态和环境三维几何信息。 我们关注的是基于视觉的SLAM(VSLAM),因此不关注利用其它传感器(如激光雷达)的SLAM问题。在VSLAM中,我们只关注基于单目摄像头的SLAM,因为我们的传感器主要依赖用户手机的摄像头。对于手机AR应用来说,SLAM的侧重点在其定位而不是建图功能,因此我们暂时不关注那些semi-dense或者dense的SLAM算法,只用稀疏点云(sparse point cloud)来描述三维地图。 VSLAM(又作structure from motion)的原理类似于双目视觉,采用的是三角定位(triangulation)原理。VSLAM需要两张有足够视差的图像帧去还原图像中对应特征点在三维空间中的坐标,同时算出这两帧图像所对应的相对相机姿态。严格上说,VSLAM只能还原3个转动自由度和2个平移自由度信息(一个normalized的3维平移向量),无法获得绝对距离信息,因此需要额外融合手机IMU提供的信息,以获得真正的三维空间。对类似双目视觉基础原理感兴趣的同学可以参考这个领域的经典书籍《Multiple View Geometry in Computer Vision》。随着相机的移动,SLAM观测到了更多环境中的特征点并加入三维地图,同时可以计算出此时相对前一帧的相机姿态。此外,VSLAM还涉及关键帧筛选(key-frame selection),闭环检测(loop-detection),光束优化(bundle-adjustment)等技术点。 结合已有的大量VSLAM领域文献和我们的工程实践,针对移动端AR的具体需求,我们总结了一套针对移动端AR的VSLAM算法流程(AliSLAM),如图13所示。由于各中细节考量众多,篇幅有限,在此就不一一赘述。 图13:AliSLAM算法流程图 AliSLAM针对移动端AR需求已完成的优化,包括但不限于:缩小BoW词库大小以降低分发成本,并行框架加速和GPU加速,IMU传感器融合以防抖防丢,基于patch取代基于feature的跟踪以提速等。优化后性能参数如下表所示。与PC端SLAM的优化目标不同,AliSLAM的主要优化目标是在精度可接受范围内尽可能提高其快速性以提升用户流畅性体验和降低用户应用门槛。 AliSLAM已集成到手淘并应用在多个业务场景,如极有家AR Detail,AR电器说明书。 极有家AR Detail是利用用户操作,通过SLAM在三维世界中的定位功能,放置一个虚拟物体在实际三维世界的某个位置。当放置成功后,用户可从各个角度观察这个虚拟物体的细节,并仿佛它就摆在你面前一样。这个功能将为以后的各种虚拟或增强购物打底。想象一下,以SLAM技术为基础,我们可以提供操纵图14中这台虚拟手机的能力,是不是很有意思~ 图14:AR Detail案例展示 AR说明书是利用AR的方式展示实际生活、生产环节中一些器械的使用方式或是工作原理。比如家电(洗衣机、电饭煲等)的3D形式说明书(如图15),工厂内一些机器的虚拟操作指南等。这项业务主要依托于三维物体跟踪和SLAM技术。 图15:AR说明书示例图 其他技术 AR已落地的其他技术还有很多,如:三维物体识别和跟踪,LBS AR。双十一寻找狂欢猫作为不得不提的典型案例成为了应用LBS AR技术的经典。作为2016双十一最火爆的线上线下造势和预热活动,总PV为16亿,日均PV 3亿多,UV 3100万,同时支持星巴克、KFC等60多款品牌猫。 如果您已经耐心看到这里,说明您是我们的知音。无论您对AR有哪些思考,想到了哪些新玩法,或是想和我们讨论一些技术层面的问题,非常欢迎您致信hexa_ar@list.alibaba-inc.com。发挥您的想象力,一不小心,未来生活的方式将因您这封邮件而改变,why not? 本文主要由阿里AI LAB源方执笔。文中涉及的技术是全组人共同的结晶@方如@烁凡@水源@紫炎@煦深,我们是阿里AI LAB AR算法团队。 本文部分图片取自互联网,在此鸣谢所有原图分享者。

优秀的个人博客,低调大师

基于Android Studio 的NDK之 “Hello,World!”

环境 Android Studio:1.3.2 JRE:1.7.0 Android SDK Tools:24.3.4 Android NDK:r10e Android Studio安装步骤略,下载地址:http://developer.android.com/tools/studio/index.html 找到下载地址后,复制到迅雷下载后安装,Studio很好用的一个地方就是有更新直接下载安装,不用像Eclipse那样重新下载新版。 Android NDK下载地址:https://developer.android.com/tools/sdk/ndk/index.html 同样迅雷下载安装,唯一提醒一点,先把安装包拷贝到要安装的目录,exe文件自动提取到当前目录下,害的我又拷贝了一般,3个多G呐! 上述环境安装完毕,启动Android SDK Manager更新好Android SDK,进入正题; 首先Studio中新建一个工程,默认就是这个样子: 在Project的local.properties文件中告知Android Studio你的ndk所在目录: 注意':'和'\'要进行转义 ndk.dir=D\:\\Android\\android-ndk-r10e 创建一个JNI文件(我放在一个单独的jni包中),简单的一个native方法add,计算两个整数相加的值: 接着我们就要写C层的代码了,在main文件夹下建立一个jni的子文件夹(跟java文件夹并列,Android会默认知道这事底层的代码源文件夹),声明头文件和源码文件: tips:可以使用javah -jni 'your jni java class with package name'来自动生成.h文件 用法:打开命令行,切换到..\your project path\app\build\intermediates\classes\debug目录下,执行上述命令,然后把这个生成的.h文件拷贝到刚建立的jni目录下 建一个cpp文件,名称自己起名,我起名为math.cpp,实现头文件中声明的方法: 1 2 3 4 5 6 7 8 9 10 // //Createdbydellon2015/9/10. // #include"math.h" JNIEXPORTjintJNICALLJava_com_lbrant_jni_MathJNI_add (JNIEnv*env,jobject,jinta,jintb){ return a+b; } 在gradle.properties中添加如下,不然编译器会提示错误: android.useDeprecatedNdk=true 在app module中(注意不是项目根目录),配置ndk编译(这里只配置了moduleName和平台): 1 2 3 4 5 6 7 8 9 10 11 12 defaultConfig{ applicationId"com.lbrant.x_project" minSdkVersion15 targetSdkVersion23 versionCode1 versionName"1.0" ndk{ moduleName"math" abiFilters"armeabi","armeabi-v7a","x86" } } 由于是JNI和应用层是在同一个工程中,直接运行系统会自动编译,生成Android.mk和对于so: 本文转自 breezy_yuan 51CTO博客,原文链接:http://blog.51cto.com/lbrant/1693389,如需转载请自行联系原作者

优秀的个人博客,低调大师

MySQL · 社区见闻 · Oracle Open World 2016 见闻

高能预警:这不是一篇纯技术月报,这不是一篇纯技术月报!(不善拍照,外景图片有从朋友的FB和Twitter中截取) 申请主题 今年的OOW依然在旧金山召开,有了去年参会的经验,感觉以我们的工作水平,放在国际上也是可以出去讲一番的,因此在收到 Oracle ACE 主题邀请之后,就果断把我们去年最大的成果之一——《Double Sync Replication》提交上去了。 不过多久,收到会务组通知主题竟然通过了,第一次在国外用英文公开讲Topic,内心还是有点小激动和小紧张的,好好练了一番英语,当然现场最终还是Chinglish,这是后话了…… 参会 9.16到会场Checkin,拿到了自己的小卡片,作为今年唯一来自国内的数据库Speaker,还是很自豪的。(忽略JavaOne,我也不知道为何工作人员给我贴一个JavaOne,我对Java只会

优秀的个人博客,低调大师

ZooKeeper 笔记(1) 安装部署及hello world

先给一堆学习文档,方便以后查看 官网文档地址大全: OverView(概述) http://zookeeper.apache.org/doc/r3.4.6/zookeeperOver.html Getting Started(开始入门) http://zookeeper.apache.org/doc/r3.4.6/zookeeperStarted.html Tutorial(教程) http://zookeeper.apache.org/doc/r3.4.6/zookeeperTutorial.html Java Example(Java示例) http://zookeeper.apache.org/doc/r3.4.6/javaExample.html Programmer's Guide(开发人员指南) http://zookeeper.apache.org/doc/r3.4.6/zookeeperProgrammers.html Recipes and Solutions(技巧及解决方案) http://zookeeper.apache.org/doc/r3.4.6/recipes.html 3.4.6 API online(在线API速查) http://zookeeper.apache.org/doc/r3.4.6/api/index.html 另外推荐园友sunddenly的zookeeper系列 http://www.cnblogs.com/sunddenly/category/620563.html 一、安装部署 本文在一台机器上模拟3个 zk server的集群安装 1.1下载解压 解压到3个目录(模拟3台zk server): /home/hadoop/zookeeper-1 /home/hadoop/zookeeper-2 /home/hadoop/zookeeper-3 1.2创建每个目录下conf/zoo.cfg配置文件 /home/hadoop/zookeeper-1/conf/zoo.cfg 内容如下: tickTime=2000 initLimit=10 syncLimit=5 dataDir=/home/hadoop/tmp/zk1/data dataLogDir=/home/hadoop/tmp/zk1/log clientPort=2181 server.1=localhost:2287:3387 server.2=localhost:2288:3388 server.3=localhost:2289:3389 /home/hadoop/zookeeper-2/conf/zoo.cfg 内容如下: tickTime=2000 initLimit=10 syncLimit=5 dataDir=/home/hadoop/tmp/zk2/data dataLogDir=/home/hadoop/tmp/zk2/log clientPort=2182 server.1=localhost:2287:3387 server.2=localhost:2288:3388 server.3=localhost:2289:3389 /home/hadoop/zookeeper-3/conf/zoo.cfg 内容如下: tickTime=2000 initLimit=10 syncLimit=5 dataDir=/home/hadoop/tmp/zk3/data dataLogDir=/home/hadoop/tmp/zk3/log clientPort=2183 server.1=localhost:2287:3387 server.2=localhost:2288:3388 server.3=localhost:2289:3389 注:因为是在一台机器上模拟集群,所以端口不能重复,这里用2181~2183,2287~2289,以及3387~3389相互错开。另外每个zk的instance,都需要设置独立的数据存储目录、日志存储目录,所以dataDir、dataLogDir这二个节点对应的目录,需要手动先创建好。 另外还有一个灰常关键的设置,在每个zk server配置文件的dataDir所对应的目录下,必须创建一个名为myid的文件,其中的内容必须与zoo.cfg中server.x 中的x相同,即: /home/hadoop/tmp/zk1/data/myid 中的内容为1,对应server.1中的1/home/hadoop/tmp/zk2/data/myid 中的内容为2,对应server.2中的2/home/hadoop/tmp/zk3/data/myid 中的内容为3,对应server.3中的3 生产环境中,分布式集群部署的步骤与上面基本相同,只不过因为各zk server分布在不同的机器,上述配置文件中的localhost换成各服务器的真实Ip即可。分布在不同的机器后,不存在端口冲突问题,可以让每个服务器的zk均采用相同的端口,这样管理起来比较方便。 1.3 启动验证 /home/hadoop/zookeeper-1/bin/zkServer.sh start /home/hadoop/zookeeper-2/bin/zkServer.sh start /home/hadoop/zookeeper-3/bin/zkServer.sh start 启用成功后,输入 jps 看下进程 20351 ZooKeeperMain20791 QuorumPeerMain20822 QuorumPeerMain20865 QuorumPeerMain 应该至少能看到以上几个进程。 可以启动客户端测试下: bin/zkCli.sh -server localhost:2181 (注:如果是远程连接,把localhost换成指定的IP即可) 成功后,应该会进到提示符下,类似下面这样: [zk: localhost:2181(CONNECTED) 0] 然后,就可以用一些基础命令,比如 ls ,create ,delete ,get 来测试了(关于这些命令,大家可以查看文档),特别提一个很有用的命令rmr 用来递归删除某个节点及其所有子节点 二、java 与 zk的连接示例 2.1maven项目的pom.xml中先添加以下依赖项 <!--zk--> <dependency> <groupId>org.apache.zookeeper</groupId> <artifactId>zookeeper</artifactId> <version>3.4.6</version> </dependency> 2.2最基本的示例程序 package yjmyzz; import java.io.IOException; import org.apache.zookeeper.*; import org.apache.zookeeper.data.Stat; public class ZooKeeperHello { public static void main(String[] args) throws IOException, InterruptedException, KeeperException { ZooKeeper zk = new ZooKeeper("172.28.20.102:2181", 300000, new DemoWatcher());//连接zk server String node = "/app1"; Stat stat = zk.exists(node, false);//检测/app1是否存在 if (stat == null) { //创建节点 String createResult = zk.create(node, "test".getBytes(), ZooDefs.Ids.OPEN_ACL_UNSAFE, CreateMode.PERSISTENT); System.out.println(createResult); } //获取节点的值 byte[] b = zk.getData(node, false, stat); System.out.println(new String(b)); zk.close(); } static class DemoWatcher implements Watcher { @Override public void process(WatchedEvent event) { System.out.println("----------->"); System.out.println("path:" + event.getPath()); System.out.println("type:" + event.getType()); System.out.println("stat:" + event.getState()); System.out.println("<-----------"); } } } 2.3 与zk集群的连接 zk的优点之一,就是高可用性,上面的代码连接的是单台zk server,如果这台server挂了,自然代码就会出错,事实上zk的API考虑到了这一点,把连接代码改成下面这样: ZooKeeper zk = new ZooKeeper("172.28.20.102:2181,172.28.20.102:2182,172.28.20.102:2183", 300000, new DemoWatcher());//连接zk server 即:IP1:port1,IP2:port2,IP3:port3... 用这种方式连接集群就行了,只要有超过半数的zk server还活着,应用一般就没问题。但是也有一种极罕见的情况,比如这行代码执行时,刚初始化完成,正准备连接ip1时,因为网络故障ip1对应的server挂了,仍然会报错(此时,zk还来不及选出新leader),这个问题详见:http://segmentfault.com/q/1010000002506725/a-1020000002507402,参考该文的做法,改成: 1 ZooKeeper zk = new ZooKeeper("172.28.20.102:2181,172.28.20.102:2182,172.28.20.102:2183", 300000, new DemoWatcher());//连接zk server 2 if (!zk.getState().equals(ZooKeeper.States.CONNECTED)) { 3 while (true) { 4 if (zk.getState().equals(ZooKeeper.States.CONNECTED)) { 5 break; 6 } 7 try { 8 TimeUnit.SECONDS.sleep(5); 9 } catch (InterruptedException e) { 10 e.printStackTrace(); 11 } 12 } 13 } 但是这样代码未免太冗长,建议用开源的zkClient,官方地址:https://github.com/sgroschupf/zkclient,使用方法很简单: <!--zkclient--> <dependency> <groupId>com.github.sgroschupf</groupId> <artifactId>zkclient</artifactId> <version>0.1</version> </dependency> pom.xml先加这一坨,然后这样用: 1 @Test 2 public void testZkClient() { 3 ZkClient zkClient = new ZkClient("172.28.20.102:2181,172.28.20.102:2182,172.28.20.102:2183"); 4 String node = "/app2"; 5 if (!zkClient.exists(node)) { 6 zkClient.createPersistent(node, "hello zk"); 7 } 8 System.out.println(zkClient.readData(node)); 9 }
优秀的个人博客,低调大师

Solon AI 开发学习 - 2chat - Hello World

1、部署本地大语言模型(llm) 借用 ollama 部署 llama3.2 模式(这个比较小,1G大小左右) ollama run llama3.2 # 或 deepseek-r1:7b 具体可参考:ollama 部署本地环境 2、开始新建项目(通过 solon-ai 使用 llm) 可以用Solon Initializr生成一个模板项目。新建项目之后,添加依赖: <dependency> <groupId>org.noear</groupId> <artifactId>solon-ai</artifactId> </dependency> 3、添加应用配置 在app.yml应用配置文件里,添加如下内容: solon.ai.chat: demo: apiUrl: "http://127.0.0.1:11434/api/chat" # 使用完整地址(而不是 api_base) provider: "ollama" # 使用 ollama 服务时,需要配置 provider model: "llama3.2" # 或 deepseek-r1:7b 4、添加配置类和测试代码 在项目里,添加一个 DemoConfig。概构建 ChatModel,也做测试。 import org.noear.solon.ai.chat.ChatConfig; import org.noear.solon.ai.chat.ChatModel; import org.noear.solon.ai.chat.ChatResponse; import org.noear.solon.annotation.Bean; import org.noear.solon.annotation.Configuration; import org.noear.solon.annotation.Inject; import java.io.IOException; @Configuration public class DemoConfig { @Bean public ChatModel build(@Inject("${solon.ai.chat.demo}") ChatConfig config) { return ChatModel.of(config).build(); } @Bean public void test(ChatModel chatModel) throws IOException { //一次性返回 ChatResponse resp = chatModel.prompt("hello").call(); //打印消息 System.out.println(resp.getMessage()); } } 5、程序启动后

资源下载

更多资源
优质分享App

优质分享App

近一个月的开发和优化,本站点的第一个app全新上线。该app采用极致压缩,本体才4.36MB。系统里面做了大量数据访问、缓存优化。方便用户在手机上查看文章。后续会推出HarmonyOS的适配版本。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册