首页 文章 精选 留言 我的

精选列表

搜索[中国数据库前世今生],共10024篇文章
优秀的个人博客,低调大师

聊聊云原生的前世今生

云原生这词在这几年突然火了,在很多人还不了解她是什么的时候频频被她刷屏。所以我经常说技术人是一个容易焦虑的群体,每天被一堆新的概念拉着走,扯着学。新语言多,新概念多,新技术多,没什么安全感。对于新概念,我喜欢从三个层次去理解,一个是这技术名词被提出的历史背景,一个是技术名词概念的演化,一个是结合比较主流的话语体系的解读。关于云原生,我也会从这三个方面来解读。 云原生(Cloud Native)的由来 云原生的概念最早开始于2010年,在当时 Paul Fremantle 的一篇博客中被提及,他主要将其描述为一种和云一样的系统行为的应用的编写,比如分布式的、松散的、自服务的、持续部署与测试的。当时提出云原生是为了能构建一种符合云计算特性的标准来指导云计算应用的编写。 后来到2013年 Matt Stine在推特上迅速推广云原生概念,并在2015年《迁移到云原生架构》一书中定义了符合云原生架构的特征:12因素、微服务、自服务、基于API协作、扛脆弱性。而由于这本书的推广畅销,这也成了很多人对云原生的早期印象,同时这时云原生也被12要素变成了一个抽象的概念。 CNCF基金会成立及云原生概念的演化 2015年由Linux基金会发起了一个 The Cloud Native Computing Foundation(CNCF) 基金组织,CNCF基金会的成立标志着云原生正式进入高速发展轨道,google、Cisco、Docker各大厂纷纷加入,并逐步构建出围绕 Cloud Native 的具体工具,而云原生这个的概念也逐渐变得更具体化。因此,CNCF基金最初对云原生定义是也是深窄的,当时把云原生定位为容器化封装+自动化管理+面向微服务: The CNCF defines “cloud-native” a little more narrowly, to mean using open source software stack to be containerized, where each part of the app is packaged in its own container, dynamically orchestrated so each part is actively scheduled and managed to optimize resource utilization, and microservices-oriented to increase the overall agility and maintainability of applications. 这主要因为CNCF基金会在当时的核心拳头软件就是 k8s,因此在概念定义上主要是围绕着容器编排建立起来的生态。其实这也是为什么我们可以看到 CNCF 定义云原生的时候有时感觉就是再说容器生态。 到了2017年, 云原生应用的提出者之一的Pivotal在其官网上将云原生的定义概况为DevOps、持续交付、微服务、容器这四大特征,这也成了很多人对 Cloud Native的基础印象。 而到了2018年,随着Service Mesh的加入,CNCF对云原生的定义发生了改变,而这也逐渐作为被大家认可的官方定义: Cloud native technologies empower organizations to build and run scalable applications in modern, dynamic environments such as public, private, and hybrid clouds. Containers, service meshes, microservices, immutable infrastructure, and declarative APIs exemplify this approach.These techniques enable loosely coupled systems that are resilient, manageable, and observable. Combined with robust automation, they allow engineers to make high-impact changes frequently and predictably with minimal toil.The Cloud Native Computing Foundation seeks to drive adoption of this paradigm by fostering and sustaining an ecosystem of open source, vendor-neutral projects. We democratize state-of-the-art patterns to make these innovations accessible for everyone. 总结一下就是: (1)基于容器、服务网格、微服务、不可变基础设施和声明式API构建的可弹性扩展的应用; (2)基于自动化技术构建具备高容错性、易管理和便于观察的松耦合系统; (3)构建一个统一的开源云技术生态,能和云厂商提供的服务解耦, 可以看出这一阶段CNCF对云原生的定义加上服务网格和声明式API,同时为这一概念阐述更深一层的意义,也就是建立一个统一中立的开源云生态(至于是否中立嘛这里就不谈了:)。这对云原生的生态定位会是很重要的一点,也算CNCF最初成立的宗旨之一吧,打破云巨头的垄断。 对云原生的解构 对一个词的解读,除了看其历史发展背景,还有一种偏向于语言学的方法解读,也就是我们常说的从“字面意思”来理解为何这些理念的集合体。 Cloud Native,从词面上拆解其实就是 Cloud 和 Native,也就是云计算和土著的意思——云计算上的原生居民,即天生具备云计算的亲和力。 那怎么理解“云的原生居民”呢? 首先从云的角度来理解,云本质可以看作是一种提供稳定计算存储资源的对象,为了实现这点,像虚拟化、弹性扩展、高可用、高容错性、自恢复这些都是云的基本属性,云原生作为一种云计算,这是所具备的第一层含义。 第二层要从 Native 来看,云原生和传统的在云上跑的应用是不同。比如一些基于公有云搭建的应用,是基于传统的SOA架构来搭建的,然后再移植到云上去运行,那么他和云得整合是非常低得。为什么低呢?云作为一种分布式架构,其“土著居民”也应该是基于分布式架构设计出来得,而微服务或者Serverless这种将服务或函数拆分成一个个模块的松耦合系统天然就具备分布式设计得属性。这是Native的第一种表现。 其次云作为一种PaaS服务,这位“土著居民”从出生(设计)到成长(开发),再到生活(部署)都应该是基于云的理念来实现的,那么就需要一套自动化的开发流程CI/CD来实现。这是Native的第二种表现。 而最后“土著居民”的特点希望做到能在所有的云端都是适应的,不管是各厂商的公有云 像AWS、Azure、阿里云,还是各企业自己搭建的私有云,云原生的应用都能做到无缝的运行和连接。 参考文献 Paul Fremantle's Blog Cloud-Native: What It Is and How It All Started The Twelve Factor App shikanon's Blog Migrating to Cloud Native Application Architectures 迁移到云原生应用架构 微软技术文档: 云原生的定义 CNCF官网

优秀的个人博客,低调大师

Webwork 学习之路【01】Webwork与 Struct 的前世今生

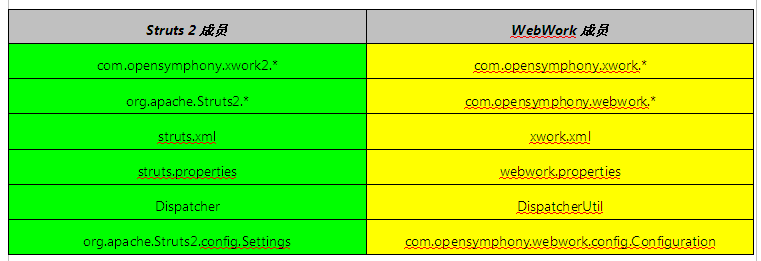
Struts 1是全世界第一个发布的MVC框架,它由Craig McClanahan在2001年发布,该框架一经推出,就得到了世界上Java Web开发者的拥护,经过长达6年时间的锤炼,Struts 1框架更加成熟、稳定,性能也有了很好的保证。 到目前为止,Struts 1依然是世界上使用最广泛的MVC框架。目前,基于Web的MVC框架非常多,发展也很快,每隔一段时间就有一个新的MVC框架发布。 虽然Struts 2号称是一个全新的框架,但这仅仅是相对Struts 1而言。Struts 2与 Struts 1相比,确实有很多革命性的改进,但它并不是新发布的新框架,而是在另一个赫赫有名的框架:WebWork基础上发展起来的。从某种程度上来讲,Strut2没有继承Struts 1的血统,而是继承了WebWork的血统。或者说,WebWork衍生出了Struts 2,而不是Struts 1衍生了Struts 2。因为Struts 2是WebWork的升级,而不是一个全新的框架,因此稳定性、性能等各方面都有很好的保证;而且吸收了Struts 1和WebWork两者的优势。 Struts 2以WebWork为核心,采用拦截器的机制来处理用户的请求,这样的设计也使得业务逻辑控制器能够与Servlet API完全脱离开。在很多方面Struts仅仅是改变了WebWork下的名称。Struts2对应的有自己的标签,并且功能强大。Webwork也有自己的标签。Struts 2和WebWork成员名称(命名上存在的改变)的对应表: 除此之外,Struts 2也删除了WebWork中少量特性: AroundInterceptor:Struts 2不再支持WebWork中的AroundInterceptor。如果应用程序中需要使用AroundInterceptor,则应该自己手动导入WebWork中的AroundInterceptor类。 富文本编辑器标签:Struts 2不再支持WebWork的富文本编辑器,如果应用中需要使用富文本编辑器,则应该使用Dojo的富文本编辑器。 IoC容器支持:Struts 2不再支持内建的IoC容器,而改为全面支持Spring的IoC容器,以Spring的IoC容器作为默认的Object工厂。 WebWork 框架流转图: WebWork的网站上提供了一个完整的WebWork架构图。它描述了从客户端的一次请求到最后服务器端响应的的整个执行过程。架构图如下: 此架构图一个分为五个部分,其中五个部分分别有五中不同颜色表示。 1、浅灰色方框。分别代表了客户端的一次Http请求,和服务器端运算结束之后的一次响应。 2、浅红色方框。表示一次Action请求所要经过的Servlet filters(Servlet过滤器)。我们可以看到最后一个filter就是我们前面介绍的WebWork的前端控制器。 3、蓝色方框。这是WebWork框架的核心部分。 1)一次请求到了WebWork的前端控制器,它首先会根据请求的URL解析出对应的action名称,然后去咨询ActionMapper这个action是否需要被执行。 2)如果ActionMapper决定这个action需要被执行,前端控制器就把工作委派给ActionProxy。接着她们会咨询WebWork的配置管理器,并读取在web.xml文件中定义的配置信息。接下来ActionProxy会创建ActionInvocation对象。 3)ActionInvocation是Xwork原理的(Command模式)实现部分。它会调用这个Action已定义的拦截器(before方法),Action方法,Result方法。 4)最后,看上面流程的图的方向,它会再执行拦截器(after方法),再回到Servlet Filter部分,最后结束并传给用户一个结果响应。 4、靛色方框。这是拦截器部分,在上面的拦截器章节我们已经有了详细的介绍。 5、黄色方框。这是我们在开发Web应用时,需要自己开发的程序。其中包括:Action类,页面模板,配置文件xwork.xml。 本文转自Orson博客园博客,原文链接:http://www.cnblogs.com/java-class/p/5016415.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

人工智能在深度学习领域的前世今生

雷锋网(公众号:雷锋网)按:本文作者兰彻, 文章详细介绍了1)人工智能发展的七个重要阶段;2)深度学习在人工智能的发展;3)最后也提出作者对于深度学习挑战和未来发展的看法。 这两年人工智能热闹非凡,不仅科技巨头发力AI取得技术与产品的突破,还有众多初创企业获得风险资本的青睐,几乎每周都可以看到相关领域初创公司获得投资的报道,而最近的一次春雷毫无疑问是Google旗下Deepmind开发的人工智能AlphaGo与南韩李世石的围棋之战,AiphaGo大比分的获胜让人们对AI刮目相看的同时也引发了对AI将如何改变我们生活的思考。其实,人工智能从上世纪40年代诞生至今,经历了一次又一次的繁荣与低谷,首先我们来回顾下过去半个世纪里人工智能的各个发展历程。 |人工智能发展的七大篇章 人工智能的起源:人工智能真正诞生于20世纪的40 - 50年代,这

优秀的个人博客,低调大师

三问云原生,有哪些绕不开的前世今生

2013年,一位来自著名PaaS云服务公司Pivotal的程序员Matt Stine提出“CloudNative”概念,云原生这个小众且深刻的名字从此流传开来。 经过两年的积累,2015年云原生计算基金会(CNCF)成立。这个由Google等大公司牵头成立的厂商中立基金会,在云原生应用推广普及方面起到不可或缺的作用。随着云原生概念不断演进,整个云计算市场对它关注度逐渐提升。 业内普遍认为2020年应被看作云原生的元年,大量云服务厂商对外声称可以对企业进行云原生应用的迭代更新,从而实现云平台设施弹性伸缩、动态调度、优化资源利用率等优势,然而事实真的如此吗? 感性来看,云原生是基于“未来的软件一定生长于云上”这一理念,对未来云平台发展路径提出的美好畅想。但是作为产业观察者,我们需要进行一系列问题的思考: 首先,云原生到底应该被定义为一项技术,还是一种方法论抑或是多项技术总和的体系? 其次,云原生改革更新背后的动力和原因具体是什么?而我们应该如何去对现有的云平台进行云原生化布局? 最后,是否涉及具体赛道布局云原生的优先级顺序? 在思考这些问题之前,我们可以回溯历史长河中技术革新事件,用来和当下云原生的火热市场情况进行类比。 一 回到1866年的德国,西门子制成发电机。实际可用的发电机在19世纪70年代问世,这标志着电能转为机械能已成为现实,电力可以被用来带动机器,成为补充或取代蒸汽动力的“新能源”。 有趣的是直到1900年,全美仍然只有不到5%的工厂使用电力作为主要能源,坚持使用蒸汽能源和配套设备成为业内常态。对于工厂来说,电气时代的开始依旧属于蒸汽时代。 与当下现代化工厂截然不同,当时以蒸汽机为主的工厂,所有的动力传输都依靠一根长度超过厂房的巨大传动轴实现。传动轴系统除分配动力的主轴外,副轴、皮带和齿轮的协同作用不可或缺,此外锤子、冲床、压床等设备相互配合才能完成动力系统的整体组成。 这样一种高度耦合化的系统,造成了只要有一台设备需要运行、作为动力源头的蒸汽机就不能停下的窘境。同时复杂系统带来的是使用成本提高和危险性增加,由于遇险时蒸汽机无法及时停下,19世纪后叶丧生于工厂制造流程的工人不计其数。 在这样的内因外压下,小部分工厂注意到市场上存在更加清洁和现代化的电气机器。他们付出高额置换成本后,将蒸汽机换成电动机,然而令人遗憾的是,这并没有带来相对应的收益。因此绝大多数工厂依然坚持使用蒸汽机,这也造就了之前提到1900年“电气时代中的蒸汽时代”这一情况。 究其原因,想要发挥电动机的全部优势,单单把原来的蒸汽机替换为电动机是远远不够的,更要求工厂转换运营的思维模式。 在蒸汽时代中人服务于机器,只要机器运行状态良好,工人的资质技术以及数量都对产出效率影响有限;电气时代恰恰相反,电气化设备允许工厂将视线从围绕传动轴的动力系统,逐渐转向工人工作效率和合作能力的提升。蒸汽时代中,动力源泉蒸汽机和巨大传动轴是核心;而在新式的电气工厂中,优秀工人才是核心。 我们时常会将生产效率或幸福程度的巨大提升归功于新技术的生产应用,但历史结论反复验证——真正的进步常常晚于新技术的诞生,我们需要更长的时间去思考这样的新技术对既有规则的冲击与影响。如何在信息乱流中找到改革的真正价值所在,是达到并超过预期的基础条件。 回到云原生的讨论上,早期“云”这个概念吸引了大量来自学术界、企业的视线。为了降低企业上云的难度,使上云流程标准化,云服务厂商通常会采用直接迁移(Lift and Shift)的方式。这种方式实施成本低、风险小、流程短,为早期上云策略提供了发展的基础环境。 将本地数据的精准副本搬运上云的底层逻辑,就如同100多年前电动机替代蒸汽机的复刻。 在这种相对简单的上云方式下,云计算的收益并不能最大化体现,公有云的使用成本相比本地部署的服务器并没有显著下降。这样的迭代问题和云服务商当前所谓的解决方案,在呼吁企业向云原生进发的路程中,以似曾相识的方式显现出来。 二 云原生时代,产业、企业在云原生体系搭建过程中是否应该遵循某些先后顺序呢?一拥而上的更新部署是否真的可以达到企业降本增效的目的呢?想去回答这个问题,不得不回到云原生的核心优势上。 云原生CloudNative是组合词,Cloud指是以云计算为基础,Native指为云而设计,Cloud Native指充分利用、发挥云平台的弹性与分布式优势。亿欧智库认为,云原生是一种构建和运行应用程序的技术体系和方法论,云原生特质可以被简单概括为容器化+微服务+DevOps+持续交付。 由此我们会发现,单单把它看作一项技术是不准确的。既然不是单纯的技术更新,简单粗暴地用电气机代替蒸汽机的方式是不可行的。云原生在合理利用云计算作为底层技术后,应该从重点技术出发,挖掘平台云原生化的步骤逻辑。 平台云原生化的布局不能成为无根之水,在着手更新之前企业应当了解云原生化的平台到底和原先的平台有什么的区别与改进。 从产业效用方面来看,云原生极大释放云的红利、充分继承云的设计思想,未来应用将更多基于云上进行本土应用开发,即云原生应用更加适合云的架构。而云计算也为云原生应用提供较好的基础支撑,如资源隔离、分布式、高可用等,云计算的拐点已至,云原生成为驱动业务增长的重要引擎。 同时云原生作为支撑数字化转型的重要技术,逐渐在人工智能、大数据、边缘计算、5G 等新兴领域崭露头角,成为驱动数字基础设施的强大引擎。伴随全行业上云的逐步深化,企业云原生化转型进程将进一步加速。 从技术特征方面来看,云原生技术架构具备以下典型特征:极致的弹性能力,不同于虚拟机分钟级的弹性响应,以容器云技术为基础的云原生技术架构可实现秒级甚至毫秒级的弹性响应;服务自治故障自愈能力,基于云原生技术栈构建的平台具有高度自动化的分发调度调谐机制,可实现应用故障的自动摘除与重构,具有极强的自愈能力及随意处置性;大规模可复制能力,可实现跨区域、跨平台甚至跨服务商的规模化复制部署能力。 从应用价值方面来看,异构资源标准化,容器技术有效解决了异构环境的部署一致性问题,为服务化、自动化提供了基础;加速数字基础设施升级并解放生产力,降低用户数字化技术的使用门槛,提高资源的复合利用率,变革研发运营的生产方式,打破组织壁垒,实现研发与运维的跨域协同,提升交付效率;提升业务应用的迭代速度,赋能业务创新。 云原生技术实现了应用的敏捷开发,大幅提升交付速度,降低业务试错成本,高效响应用户需求,增强用户体验加速业务创新。以上几点,使得云原生这一技术体系正受到市场的广泛欢迎。 至于如何对云平台进行云原生化的部署更新,亿欧智库认为可以从这几项技术和理念入手。 容器云技术催生云原生应用,它便于调试、开发、部署、运维、迁移、扩容的优势,可以很好地与云弹性能力相结合,最大化发挥云的效能和价值。 作为SaaS模式呈现,且可被客户获取的微服务,它的特点是可以独立修改、更新、迭代,多个微服务之间不会相互干扰,总体来说是种松耦合的架构。由此看出微服务的特性和容器技术优势相辅相成,容器化成为微服务成长发展的温床。 企业想要进行云原生改革,单从技术角度出发是不够全面的,企业开发及运维团队也必须同时进行多项变革,以便更加快速高效地构建和部署应用。通过切实遵循DevOps的原则和文化价值,周全考虑各种活动、技术、团队和流程,企业最终可以实现从瀑布式发布向持续发布的积极转变。 三 最后一个问题,在企业布局云原生改革期间,哪些具体赛道有更强的优先级?亿欧智库发现,优先级最高的应该是硬件架构异质化严重、对于平台更新与弹性扩容需求高的金融赛道,原因有方面。 其一,过去二十多年间,金融机构经历多次硬件架构升级改造,异类硬件设备串联使用导致系统内部资源异质化严重,资源利用效率有限。而容器云可以实现跨网络、设备的节点管理,强大的兼容能力使得金融机构更好的统筹兼顾开发、测试、生产以及信息管理环境。 其二,云原生可以很好地解决金融行业出现的集中成交金融产品导致并发场景失衡情况。不难看出金融机构会经历集中抢购、集中交易的高频率高并发场景,扩容问题难以避免。云原生弹性扩容一方面满足峰谷效应带来的波动性影响,同时最大程度上减少金融企业在扩容成本上的消耗。 总体来看,云原生体系的优势毋庸置疑。 从底层技术来看,云原生天身继承云的设计理念,且更加适合云的架构。在云计算已经相对成熟的今天,云原生配合5G、人工智能、云边端协同等新兴领域技术,也将成为支撑数字化转型的重要技术体系基石之一。 从应用价值来看,峰谷效应的有效缓解、微服务的体验升级、开发运维一体化的文化形成都将成为云原生体系在金融行业进一步发光发热的体现。 【责任编辑:赵宁宁 TEL:(010)68476606】

优秀的个人博客,低调大师

Citrix VDI-in-a-Box 第一篇:前世今生

前言:目前虚拟桌面市场如火如荼,很多企业都在咨询虚拟桌面,到底什么样的桌面才适合企业,但是高昂的费用和复杂的架构让很多企业望而却步,看过了本文,也许很多中小企业会发现原来可以这么简单。 笔者最近研究了一下这款产品,发现这款产品也许是中小企业桌面市场未来的趋势。 不久前,Citrix收购了Kaviza,随后发布了Citrix VDI-in-a-Box。 为什么Citrix会收购这家企业? 笔者分析了一下 原先有四: 一、Kaviza的VDI-in-a-Box架构比较简单,只需要一些基础的硬件,部署比较方便。 二、VDI-in-a-Box是一个虚拟化设备,一个一体化产品,管理和维护比较方便。 三、相对于XenDesktop,产品成本和所需要的硬件成本都比较低。 四、Citrix的XenDesktop市场效果不太明显,Citrix希望通过Kaviza占领中小企业市场。 个人觉得,第四个原因才是根本原因。Kaviza的VDI-in-a-Box的产品透露出了六个字: 简单才是王道。 Citrix VDI-in-a-box 5功能 Citrix VDI-in-a-box 5 VDI-in-a-Box是一个虚拟设备,包括Windows管理员交付虚拟桌面给使用任何设备的终端用户的所有工具。VDI-in-a-Box通过整合了Citrix HDX,可以获得高清晰桌面。也可以与Citrix Receiver软件客户端工作,得到VDI安全性与高可用性功能。 VDI-in-a-Box是一个一体化产品,管理者只需要通过它和一个存储设备,就可以实现VDI架构提供了动态配置和负载均衡功能,几个小时就可以运行起来。 VDI-in-a-Box并支持三大主要的hypervisor:Microsoft Hyper-V、Citrix XenServer与VMware vSphere、ESX和ESXi。 kaviza的架构如下:从图中可以看出,不需要太复杂的设备 本文转自shj1985122951CTO博客,原文链接:http://blog.51cto.com/shenhj/715049,如需转载请自行联系原作者

优秀的个人博客,低调大师

性能追求之路——MaxCompute2.0(原ODPS)的前世今生

在2017云栖大会大数据专场,阿里云高级专家云郎分享了《大数据计算服务MaxCompute产品最新动态》。他首先介绍了MaxCompute的发展历程和技术架构,然后对MaxCompute 2.0版本新特性和新技术进行了详细介绍。最后,分享了基于MaxCompute平台构建完整大数据应用架构、构建新型数据仓库、实现个性化推荐的实践。 本文根据直播视频整理而成。 首先看三个简单的问题。在阿里内部已经有了30多个业务单元,是一个典型的数据驱动公司。数据在整个业务创新、业务变更的过程中起了非常重要的作用。所以,是什么技术支撑了阿里巴巴集团内部的数据计算要求?经历了很多次双十一,双11背后的大数据平台是什么?在阿里云,第1个运行在阿里云飞天平台上的云服务是什么?答案非常简单,就是阿里云大数据平台MaxCompute(原名ODPS,https

优秀的个人博客,低调大师

一文讲透Cluster API的前世今生与未来

Cluster API是一个Kubernetes项目,它将声明式Kubernetes风格的API用于集群的创建、配置和管理。它通过使用时CustomResourceDefinitions(CRDs)来扩展被Kubernetes API Server暴露的API来实现这些功能,从而允许用户创建新资源,例如集群(指Kubernetes集群)和Machine(指组成集群的节点的Machine)。然后每个资源的控制器负责对这些资源的更改做出反应,以启动集群。API的设计可以让不同的基础架构提供程序可以与其集成,进而提供针对其环境的特定逻辑。 Cluster API项目仍处于早期阶段,但是当前的情况已经证明了它能带来强大的功能。这篇文章的目的是总结迄今为止该项目的功能,并展望后续版本的功能。 过去、现在和未来 撰写这篇文章的时候,Cluster API最新发布的版本实现了v1alpha2。在这里,我们将讨论该API的转换以及提供程序如何与之集成。 过去:v1alpha1 最初,Cluster API的v1alpha1实现要求提供程序需要在其项目中包含Cluster API控制器代码,并实现actuator(接口)以处理其环境的特定逻辑(例如,对云提供程序API的调用)。该代码作为特定于某个提供程序的管理器二进制文件运行,该二进制文件可以为管理集群所需的每个资源管理一个控制器。 现在:v1alpha2 使用Cluster API 的v1alpha1方法存在一个痛点,即它要求每个提供程序都实现一定数量的bootstrap boilerplate code,即代码不灵活并且冗长。为了解决这个问题,v1alpha2引入了bootstrap provider,它们负责生成将Machine转变为Kubernetes节点所需的数据。Kubeadm bootstrap provider则通过使用kubedam在所有环境中处理此任务。它的默认行为是为每台Machine生成一个可用于bootstrap节点的cloud-config脚本。 v1alpha2引入的另一个更改是,提供程序不再需要将Cluster API控制器代码包含在其项目中。而且Cluster API提供了对核心类型负责的独立控制器。有关这些更改的更多信息,请参阅Github上的信息。 对于此版本,现在需要部署3个管理器(而不是此前的1个): Cluster API manager:用于管理核心v1alpha2资源 Bootstrap provider manager:用于管理资源以生成将Machine转变为Kubernetes节点的数据 Infrastructure provider manager:用于管理提供运行集群所需基础架构的资源 例如,如果我想使用kubedam在配置好的GCP上创建一个集群,我应该部署Cluster API manager(用于调和核心资源,例如集群和Machine资源),kubeadm bootstrap provider(例如,用于调和KubeadmConfig资源)以及GCP infrastructure provider(用于调和环境的特定资源,如GCPClusters和GCPMachines)。 为了了解如何应用这些资源,我们将使用我编写的Kubernetes基础架构提供程序实现来进行集群部署,即由Kubernetes本身提供基础架构的提供程序。Kubernetes节点使用kind镜像作为Kubernetes Pod运行。 首先,我们需要创建一个基础集群来为我们的Cluster API集群提供基础架构。我们将使用GKE。以下命令假定你已安装gcloud和GCP项目并设置了帐户。 警告:gcloud命令将产生一些花费,你也可以考虑使用GCP免费套餐。 Calico将作为Cluster API集群的CNI解决方案。在配置GKE集群以路由IPv4封装的数据包时,需要一些特殊的配置。为了不分散本文关于Cluster API行为的描述,我们将在此处直接运行它们,不做详细解释。有关详细信息,可以参考Kubernetes基础架构提供程序代码库。 gcloud container clusters create management-cluster --cluster-version=1.14 --image-type=UBUNTU CLUSTER_CIDR=$(gcloud container clusters describe management-cluster --format="value(clusterIpv4Cidr)") gcloud compute firewall-rules create allow-management-cluster-pods-ipip --source-ranges=$CLUSTER_CIDR --allow=ipip kubectl apply -f <(cat <<EOF apiVersion: apps/v1 kind: DaemonSet metadata: name: forward-ipencap namespace: kube-system labels: app: forward-ipencap spec: selector: matchLabels: name: forward-ipencap template: metadata: labels: name: forward-ipencap spec: hostNetwork: true initContainers: - name: forward-ipencap command: - sh - -c - | apk add iptables iptables -C FORWARD -p ipencap -j ACCEPT || iptables -A FORWARD -p ipencap -j ACCEPT image: alpine:3.11 securityContext: capabilities: add: ["NET_ADMIN"] containers: - name: sleep-forever image: alpine:3.11 command: ["tail"] args: ["-f", "/dev/null"] EOF ) 配置了GKE集群后,我们现在可以开始部署必要的管理器(manager)。 # Install cluster api manager kubectl apply -f https://github.com/kubernetes-sigs/cluster-api/releases/download/v0.2.8/cluster-api-components.yaml # Install kubeadm bootstrap provider kubectl apply -f https://github.com/kubernetes-sigs/cluster-api-bootstrap-provider-kubeadm/releases/download/v0.1.5/bootstrap-components.yaml # Install kubernetes infrastructure provider kubectl apply -f https://github.com/dippynark/cluster-api-provider-kubernetes/releases/download/v0.2.1/provider-components.yaml # Allow cluster api controller to interact with kubernetes infrastructure resources # If the kubernetes provider were SIG-sponsored this would not be necesarry ;) # https://cluster-api.sigs.k8s.io/providers/v1alpha1-to-v1alpha2.html#the-new-api-groups kubectl apply -f https://github.com/dippynark/cluster-api-provider-kubernetes/releases/download/v0.2.1/capi-kubernetes-rbac.yaml 现在,我们可以部署我们的集群。 kubectl apply -f <(cat <<EOF apiVersion: infrastructure.lukeaddison.co.uk/v1alpha2 kind: KubernetesCluster metadata: name: example spec: controlPlaneServiceType: LoadBalancer --- apiVersion: cluster.x-k8s.io/v1alpha2 kind: Cluster metadata: name: example spec: clusterNetwork: services: cidrBlocks: ["172.16.0.0/12"] pods: cidrBlocks: ["192.168.0.0/16"] serviceDomain: "cluster.local" infrastructureRef: apiVersion: infrastructure.lukeaddison.co.uk/v1alpha2 kind: KubernetesCluster name: example EOF ) 在这里,我们定义了特定于环境的KubernetesCluster资源。这将为运行Kubernetes集群提供必要的基础架构组件。例如,GCPCluster可能会提供VPC、防火墙规则和负载均衡器以访问API Server。而我们的KubernetesCluster只为API Server设置了LoadBalancer类型的Kubernetes服务。我们可以查询KubernetesCluster来查看其状态。 $ kubectl get kubernetescluster NAME PHASE HOST PORT AGE example Provisioned 35.205.255.206 443 51s 我们从核心集群资源中引用特定于提供程序的集群资源,该资源提供了集群的网络详细信息。KubernetesCluster将被修改为由集群资源所拥有。 现在,我们准备部署我们的Machine。在这里,我们创建一个controller Machine,它引用infrastructure provider中特定的KubernetesMachine资源以及bootstrap provider中特定的KubeadmConfig资源。 kubectl apply -f <(cat <<EOF apiVersion: bootstrap.cluster.x-k8s.io/v1alpha2 kind: KubeadmConfig metadata: name: controller spec: initConfiguration: nodeRegistration: kubeletExtraArgs: eviction-hard: nodefs.available<0%,nodefs.inodesFree<0%,imagefs.available<0% cgroups-per-qos: "false" enforce-node-allocatable: "" clusterConfiguration: controllerManager: extraArgs: enable-hostpath-provisioner: "true" --- apiVersion: infrastructure.lukeaddison.co.uk/v1alpha2 kind: KubernetesMachine metadata: name: controller --- apiVersion: cluster.x-k8s.io/v1alpha2 kind: Machine metadata: name: controller labels: cluster.x-k8s.io/cluster-name: example cluster.x-k8s.io/control-plane: "true" spec: version: "v1.17.0" bootstrap: configRef: apiVersion: bootstrap.cluster.x-k8s.io/v1alpha2 kind: KubeadmConfig name: controller infrastructureRef: apiVersion: infrastructure.lukeaddison.co.uk/v1alpha2 kind: KubernetesMachine name: controller EOF ) kubeadm bootstrap provider将KubeadmConfig资源转换为cloud-config脚本,Kubernetes infrastructure provider使用该脚本来bootstrap Kubernetes Pod以形成新集群的控制平面。 Kubernetes infrastructure provider通过依靠systemd(它作为kind镜像的一部分运行)来实现这一目的。然后从cloud-config脚本生成一个bash脚本,以创建和运行指定的文件和命令。使用Kubernetes Secret将脚本安装到Pod中,当containerd socket可以使用之后,就使用systemd路径单元触发该脚本。你可以到controller pod中执行,并运行journalctl -u cloud-init来查看此脚本的输出。cat /opt/cloud-init/bootstrap.sh将显示完整脚本。 Kubelet运行之后,它将通过在etcd中创建controller Node对象(也在controller Pod上运行)向集群注册自己。 现在,我们可以部署我们的worker Machine了。这看起来与controller Machine 配置非常类似,但我们还会利用MachineDeployment、KubeadmConfigTemplate和KubernetesMachineTemplate来请求worker节点的多个副本。 kubectl apply -f <(cat <<EOF apiVersion: infrastructure.lukeaddison.co.uk/v1alpha2 kind: KubernetesMachineTemplate metadata: name: worker spec: template: spec: {} --- apiVersion: bootstrap.cluster.x-k8s.io/v1alpha2 kind: KubeadmConfigTemplate metadata: name: worker spec: template: spec: joinConfiguration: nodeRegistration: kubeletExtraArgs: eviction-hard: nodefs.available<0%,nodefs.inodesFree<0%,imagefs.available<0% cgroups-per-qos: "false" enforce-node-allocatable: "" --- apiVersion: cluster.x-k8s.io/v1alpha2 kind: MachineDeployment metadata: name: worker labels: cluster.x-k8s.io/cluster-name: example nodepool: default spec: replicas: 3 selector: matchLabels: cluster.x-k8s.io/cluster-name: example nodepool: default template: metadata: labels: cluster.x-k8s.io/cluster-name: example nodepool: default spec: version: "v1.17.0" bootstrap: configRef: apiVersion: bootstrap.cluster.x-k8s.io/v1alpha2 kind: KubeadmConfigTemplate name: worker infrastructureRef: apiVersion: infrastructure.lukeaddison.co.uk/v1alpha2 kind: KubernetesMachineTemplate name: worker EOF ) MachineDeployments与Kubernetes Deployment工作方式十分相似,因为它们管理MachineSets,后者还管理所需数量的Machines副本。 现在,我们应该能够查询已经配置的Machine,以查看其状态。 $ kubectl get machines NAME PROVIDERID PHASE controller kubernetes://871cde5a-3159-11ea-a1c6-42010a840084 provisioning worker-6c498c48db-4grxq pending worker-6c498c48db-66zk7 pending worker-6c498c48db-k5kkp pending 我们还可以看到相应的KubernetesMachines。 $ kubectl get kubernetesmachines NAME PROVIDER-ID PHASE AGE controller kubernetes://871cde5a-3159-11ea-a1c6-42010a840084 Provisioning 53s worker-cs95w Pending 35s worker-kpbhm Pending 35s worker-pxsph Pending 35s 不久,所有KubernetesMachines都应处于运行状态。 $ kubectl get kubernetesmachines NAME PROVIDER-ID PHASE AGE controller kubernetes://871cde5a-3159-11ea-a1c6-42010a840084 Running 2m worker-cs95w kubernetes://bcd10f28-3159-11ea-a1c6-42010a840084 Running 1m worker-kpbhm kubernetes://bcd4ef33-3159-11ea-a1c6-42010a840084 Running 1m worker-pxsph kubernetes://bccd1af4-3159-11ea-a1c6-42010a840084 Running 1m 我们还可以看到与你的KubernetesMachines相对应的Pod。 $ kubectl get pods NAME READY STATUS RESTARTS AGE controller 1/1 Running 0 2m11s worker-cs95w 1/1 Running 0 111s worker-kpbhm 1/1 Running 0 111s worker-pxsph 1/1 Running 0 111s Cluster API manager生成一个kubeconfig并将其保存为一个Kubernetes Secret,名为<clusterName>-kubeconfig。我们可以检索它并访问集群。 $ kubectl get secret example-kubeconfig -o jsonpath='{.data.value}' | base64 --decode > example-kubeconfig $ export KUBECONFIG=example-kubeconfig $ kubectl get nodes NAME STATUS ROLES AGE VERSION controller NotReady master 3m16s v1.17.0 worker-cs95w NotReady <none> 2m34s v1.17.0 worker-kpbhm NotReady <none> 2m32s v1.17.0 worker-pxsph NotReady <none> 2m34s v1.17.0 最后,可以应用我们的Calico CNI解决方案。节点应该很快就准备就绪。 $ kubectl apply -f https://docs.projectcalico.org/v3.11/manifests/calico.yaml $ kubectl get nodes NAME STATUS ROLES AGE VERSION controller Ready master 5m8s v1.17.0 worker-cs95w Ready <none> 4m26s v1.17.0 worker-kpbhm Ready <none> 4m24s v1.17.0 worker-pxsph Ready <none> 4m26s v1.17.0 现在,我们可以在全新的集群上运行工作负载: kubectl run nginx --image=nginx --replicas=3 对于其他基础设施提供程序,流程类似。你还可以在Cluster API文档中的快速入门部分找到许多其他示例。 未来:v1alpha3以及更高级的版本 我们仅仅是根据当前的情况进行延展,探讨Cluster API可能提供的功能。此外,我们还将讨论roadmap上的其他一些有趣的事情。 机器健康检查(MachineHealthCheck) 在v1alpha2中,特定于基础架构的Machine可以将其自身标记为故障,并且状态将上升到owning Machine,但是owning MachineSet不执行任何操作。这样做是因为,除了MachineSet之外的其他资源都可以拥有Machine,因此将Machine修复逻辑与MachineSet分离是有意义的。 MachineHealthCheck是一种建议的资源,用于描述节点的故障情况并在发生故障时删除相应的Machine。这将触发适当的删除行为(例如,驱散)和任何控制资源来启动替换Machine。 Kubeadm控制平面(KubeadmControlPlane) 当前,创建一个高可用控制平面并管理它通常需要使用正确的bootstrap配置(需要以正确的顺序启动)仔细配置独立的controller Machine。v1alpha3则希望通过初始的kubeadm控制平面实现来支持控制平台提供程序。从infrastructure provider的角度来看,这机会不需要进行任何更改,但是将允许用户管理控制平面的实例化和弹性伸缩,而无需手动创建相应的Machine。关于此功能,你可以查看Github上相关页面获取更多信息。 与MachineHealthChecks一起使用,可以使用Cluster API进行控制平面自动修复。 集群自动伸缩(Cluster Autoscaler) Cluster Autoscaler是可以利用Cluster API的项目的一个示例。当前的实现要求每个受支持的云提供程序都实现扩展其环境中的实例组所需的CloudProvider和NodeGroup接口。随着Cluster API的出现,可以通过与Cluster API资源交互而不是直接与提供程序特定的API交互,来实现自动弹性伸缩逻辑,并且没有厂商锁定。 总 结 我们已经对Cluster API的当前功能以及不久的将来进行了深入的研究。该项目看起来十分强大并且完整,这令人激动。作为一个与Kubernetes相关的开源项目,Cluster API也是十分开放的,你可以通过各种渠道提出建议或是做出自己的贡献。

优秀的个人博客,低调大师

阿里研究员华先胜:图像搜索的前世今生

以下内容为由4月27日由将门主办的“计算机视觉”主题技术专家微信群分享嘉宾实录。 自我介绍 我在2001年北大数学系十年寒窗博士毕业以后加入了微软亚洲研究院在之后9年半的时间在研究院一直从事图像和视频的分析工作。2010年底我突然变得有点迷盲虽然一直也在做产品但实际上还没有真正地上过“战场”所以当时就做了一个大家都不太看好的决定——我觉得应该真正地到“战场上打仗”看看我们实际当中的图像搜索的困难到底在哪里用户的需求和痛点到底在哪里因此之后我去了微软美国总部必应产品组做了两年的图像搜索也发现很多东西需要深入研究。当时微软的图像搜索在这两年之内也发生了很大的变化从比Google差到很多地方都胜过了Google。 两年后我转到微软雷德蒙研究院做图像识别方面的研究。又做了两年多后渐渐发觉需要更多的资源来实现自己的想法于是我又选择回到了国内

优秀的个人博客,低调大师

分布式服务治理框架Dubbo的前世今生及应用实战

Dubbo的出现背景 Dubbo从开源到现在,已经出现了接近10年时间,在国内各大企业被广泛应用。 它到底有什么魔力值得大家去追捧呢?本篇文章给大家做一个详细的说明。 大规模服务化对于服务治理的要求 当企业开始大规模的服务化以后,远程通信带来的弊端就越来越明显了。比如说 服务链路变长了,如何实现对服务链路的跟踪和监控呢? 服务的大规模集群使得服务之间需要依赖第三方注册中心来解决服务的发现和服务的感知问题 服务通信之间的异常,需要有一种保护机制防止一个节点故障引发大规模的系统故障,所以要有容错机制 服务大规模集群会是的客户端需要引入负载均衡机制实现请求分发 而这些对于服务治理的要求,传统的RPC技术在这样的场景中显得有点力不从心,因此很多企业开始研发自己的RPC框架,比如阿里的HSF、Dubbo;京东的JSF框架、当当的dubbox、新浪的motan、蚂蚁金服的sofa等等 有技术输出能力的公司,都会研发适合自己场景的rpc框架,要么是从0到1开发,要么是基于现有的思想结合公司业务特色进行改造。而没有技术输出能力的公司,遇到服务治理的需求时,会优先选择那些比较成熟的开源框架。而Dubbo就是其中一个 dubbo主要是一个分布式服务治理解决方案,那么什么是服务治理?服务治理主要是针对大规模服务化以后,服务之间的路由、负载均衡、容错机制、服务降级这些问题的解决方案,而Dubbo实现的不仅仅是远程服务通信,并且还解决了服务路由、负载、降级、容错等功能。 Dubbo的发展历史 Dubbo是阿里巴巴内部使用的一个分布式服务治理框架,2012年开源,因为Dubbo在公司内部经过了很多的验证相对来说比较成熟,所以在很短的的还是件就被很多互联网公司使用,再加上阿里出来的很多技术大牛进入各个创业公司担任技术架构以后,都以Dubbo作为主推的RPC框架使得dubbo很快成为了很多互联网公司的首要选择。并且很多公司在应用dubbo时,会基于自身业务特性进行优化和改进,所以也衍生了很多版本,比如京东的JSF、比如新浪的Motan、比如当当的dubbox. 在2014年10月份,Dubbo停止了维护。后来在2017年的9月份,阿里宣布重启Dubbo,并且对于Dubbo做好了长期投入的准备,并且在这段时间Dubbo进行了非常多的更新,目前的版本已经到了2.7. 2018年1月8日,Dubbo创始人之一梁飞在Dubbo交流群里透露了Dubbo 3.0正在动工的消息。Dubbo 3.0内核与Dubbo2.0完全不同,但兼容Dubbo 2.0。Dubbo 3.0将支持可选Service Mesh 2018年2月份, Dubbo捐给了Apache。另外,阿里巴巴对于Spring Cloud Alibaba生态的完善,以及Spring Cloud团队对于alibaba整个服务治理生态的支持,所以Dubbo未来依然是国内绝大部分公司的首要选择。 Dubbo的整体架构 Dubbo的使用 首先,构建两个maven项目 user-service user-service-api user-service-provider user-service-consumer user-service-api user-service提供服务的公共契约,里面提供了user-service对外的服务。 public interface ILoginService { String login(String username,String password); } user-service-provider 在user-service-provider服务中,提供ILoginService的实现 public class LoginServiceImpl implements ILoginService{ @Override public String login(String username, String password) { if(username.equals("admin")&&password.equals("admin")){ return "SUCCESS"; } return "FAILED"; } } user-service-consumer public class App { public static void main( String[] args ){ ILoginService loginService=null; System.out.println(loginService.login("admin","admin")); } } 问题来了,现在user-service-consumer作为服务消费者,如何去调用远程服务user-service-provider呢? 按照前面对于服务远程通信的原理来说,服务提供方必然需要将服务发布到网络上,并且提供对应的访问协议。而服务消费端必然需要基于这个协议来进行访问。 这个时候,dubbo这个中间件就派上用场了,它的最基本作用就是提供服务的发布和服务的远程访问。 引入Dubbo发布服务 引入dubbo依赖包 <dependency> <groupId>org.apache.dubbo</groupId> <artifactId>dubbo</artifactId> <version>2.7.8</version> </dependency> 在/src/main/resource/META-INF/spring目录下添加application.xml文件 <?xml version="1.0" encoding="UTF-8"?> <beans xmlns="http://www.springframework.org/schema/beans" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance" xmlns:dubbo="http://code.alibabatech.com/schema/dubbo" xsi:schemaLocation="http://www.springframework.org/schema/beans http://www.springframework.org/schema/beans/spring-beans.xsd http://code.alibabatech.com/schema/dubbo http://code.alibabatech.com/schema/dubbo/dubbo.xsd"> <!-- 提供方应用信息,用于计算依赖关系 --> <dubbo:application name="user-service"/> <!-- 使用multicast广播注册中心暴露服务地址 --> <dubbo:registry address="N/A" /> <!-- 用dubbo协议在20880端口暴露服务 --> <dubbo:protocol name="dubbo" port="20880" /> <!-- 声明需要暴露的服务接口 --> <dubbo:service interface="com.gupaoedu.demo.ILoginService" ref="loginService" /> <!-- 和本地bean一样实现服务 --> <bean id="loginService" class="com.gupaoedu.demo.LoginServiceImpl" /> </beans> 启动服务 public class App { public static void main( String[] args ){ Main.main(args); } } 启动成功后,会在控制台看到如下日志 信息: [DUBBO] Export dubbo service com.gupaoedu.demo.ILoginService to url dubbo://192.168.1.104:20880/com.gupaoedu.demo.ILoginService?anyhost=true&application=user-service&bind.ip=192.168.1.104&bind.port=20880&deprecated=false&dubbo=2.0.2&dynamic=true&generic=false&interface=com.gupaoedu.demo.ILoginService&methods=login&pid=24280&release=2.7.8&side=provider&timestamp=1596550697070, dubbo version: 2.7.8, current host: 192.168.152.1 八月 04, 2020 10:18:17 下午 org.apache.dubbo.remoting.transport.AbstractServer info 信息: [DUBBO] Start NettyServer bind /0.0.0.0:20880, export /192.168.1.104:20880, dubbo version: 2.7.8, current host: 192.168.152.1 通过上述步骤,就表示ILoginService已经发布到了网络上,基于NettyServer的形式,默认监听20880端口 服务消费者引入dubbo 添加jar包依赖 <dependency> <groupId>org.apache.dubbo</groupId> <artifactId>dubbo</artifactId> <version>2.7.8</version> </dependency> 在/src/main/resources/META-INF/spring目录下添加application.xml文件 <?xml version="1.0" encoding="UTF-8"?> <beans xmlns="http://www.springframework.org/schema/beans" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance" xmlns:dubbo="http://code.alibabatech.com/schema/dubbo" xsi:schemaLocation="http://www.springframework.org/schema/beans http://www.springframework.org/schema/beans/spring-beans.xsd http://code.alibabatech.com/schema/dubbo http://code.alibabatech.com/schema/dubbo/dubbo.xsd"> <!-- 提供方应用信息,用于计算依赖关系 --> <dubbo:application name="user-service-consumer"/> <!-- 使用multicast广播注册中心暴露服务地址 --> <dubbo:registry address="N/A" /> <dubbo:reference id="loginService" interface="com.gupaoedu.demo.ILoginService"/> </beans> 修改main方法 通过ApplicationContext加载spring的配置文件 从容器中获得一个ILoginService的bean public class App { public static void main( String[] args ){ ILoginService loginService=null; ApplicationContext applicationContext=new ClassPathXmlApplicationContext("classpath:META-INF/spring/application.xml"); loginService=applicationContext.getBean(ILoginService.class); System.out.println(loginService.login("admin","admin")); } } 指定服务提供端的url 在上述的配置完成之后,运行项目后发现会提示如下错误 IllegalStateException: No such any registry to reference com.gupaoedu.demo.ILoginService on the consumer 192.168.152.1 use dubbo version 2.7.8, please config <dubbo:registry address="..." /> to your spring config. 原因是,我们配置的dubbo:registry指定的注册中心是N/A,表示没有配置注册中心。 其次,我们也没有明确的指明服务提供者在什么位置。因此解决这个问题的方法有两种 指向服务提供者的地址 配置服务注册中心,把服务提供者注册到注册中心,然后服务消费者指向注册中心从注册中心获取服务地址 修改方式如下,修改服务消费者中application.xml中的dubbo:reference。 <dubbo:reference id="loginService" interface="com.gupaoedu.demo.ILoginService" url="dubbo://192.168.1.104:20880/com.gupaoedu.demo.ILoginService"/> 总结 简单总结一下上面的整个过程,其实不难发现,Dubbo这个中间件为我们提供了服务远程通信的解决方案。通过dubbo这个框架,可以开发者快速高效的构建微服务架构下的远程通信实现。 不知道大家是否发现,我们在使用dubbo发布服务,或者消费服务的时候,全程都是采用spring的配置来完成的,这样的好处是我们在学习或者使用dubbo时,如果你用过spring这个框架,那么对于它的学习难度会大大的降低。而且我们也可以看到,dubbo是完全集成Spring 的,因此后续我们去分析dubbo的源码时,还是会有一些和spring有关的内容。 而且如果大家之前学习过我手写RPC的那节课,也基本能猜测到它的整个实现结构,大家不妨大胆的去猜测dubbo的一些实现细节,以助于后续在深度学习dubbo时更好的理解。 引入注册中心 Dubbo并不仅仅只是一个RPC框架,他还是一个服务治理框架,它提供了对服务的统一管理、以及服务的路由等功能。 在上面的案例中,我们只是掩饰了Dubbo作为RPC通信的点对点服务,但是就像咱们前面在学习spring cloud的内容一样,服务多了以后,如何管理和维护,以及动态发现呢? 而且,从Dubbo的架构图中可以看到,Dubbo天然就支持服务注册与发现,官方最早推荐的服务注册中心是zookeeper,当然,目前dubbo能够支持的注册中心已经非常多了,比如 consul、etcd、nacos、sofa、zookeeper、eureka、redis等等,很显然,Dubbo已经在往一个独立微服务解决方案的生态在发展。 集成Zookeeper作为服务注册中心 添加zookeeper的jar包依赖 <dependency> <groupId>org.apache.dubbo</groupId> <artifactId>dubbo-dependencies-zookeeper</artifactId> <version>2.7.8</version> </dependency> 修改服务提供者和服务消费者的配置 <dubbo:registry address="zookeeper://192.168.216.128:2181" /> 集成Nacos作为服务注册中心 启动nacos docker run --name nacos -d -p 8848:8848 --privileged=true --restart=always -e JVM_XMS=512m -e JVM_XMX=2048m -e MODE=standalone -e PREFER_HOST_MODE=hostname -v /home/nacos/logs:/home/nacos/logs nacos/nacos-server privileged: 使用该参数,container内的root拥有真正的root权限。否则,container内的root只是外部的一个普通用户权限。 当 Docker 重启时,容器自动重启 PREFER_HOST_MODE: ip #如果支持主机名可以使用hostname,否则使用ip,默认也是ip 添加依赖 <dependency> <groupId>com.alibaba.nacos</groupId> <artifactId>nacos-client</artifactId> <version>1.2.1</version> </dependency> 修改配置 <dubbo:registry address="nacos://192.168.216.128:8848" timeout="10000" /> Dubbo Spring Cloud 既然我们讲的是Spring Cloud Alibaba这个专题,那么我们就有必要去了解一下Dubbo是如何集成Spring Cloud去使用的。 Dubbo Spring Cloud是构建在原生的Spring Cloud之上,涵盖了Spring Cloud原生特性,而且相对于Spring Cloud原生治理来说,Dubbo Spring Cloud提供了更加稳定和成熟的实现。 具体的特性对比如下: ![image-20200804224645852](E:\教研-课件\vip课程\第四轮\分布式微服务\5 第五章 Spring Cloud Alibaba微服务生态\01 第一节 微服务治理之Dubbo的基本认识\第一节 微服务治理之Dubbo的基本认识.assets\image-20200804224645852.png) 为什么叫Dubbo Spring Cloud,而不是Spring Cloud Dubbo呢,在我看来,Dubbo本身是自成一个生态体系,并且在本身的服务治理以及成熟度上要比Spring cloud 更加突出。 所以实际上Dubbo整合Spring Cloud,是Dubbo这个成熟的生态去拥抱spring cloud的标准体系。 Dubbo Spring Cloud 基于 Dubbo Spring Boot 2.7.1[1] 和 Spring Cloud 2.x 开发,无论开发人员是 Dubbo 用户还是 Spring Cloud 用户, 都能轻松地驾驭,并以接近“零”成本的代价使应用向上迁移 从 2.7.0 开始,Dubbo Spring Boot 与 Dubbo 在版本上保持一致 接下来,我们可以去利用Dubbo Spring Cloud来做一个简单的案例实现 创建一个项目 创建一个spring-cloud-dubbo-example的maven工程 分别添加三个模块 spring-cloud-dubbo-sample-api spring-cloud-dubbo-sample-provider spring-cloud-dubbo-sample-consumer 其中后面两个模块都是spring boot的应用。 修改spring-cloud-dubbo-sample-provider这个模块中。 将dependencyManagement部分的依赖移动到parent pom.xml 修改spring-cloud-dubbo-sample-provider中的pom.xml,增加parent模块的依赖 <parent> <groupId>com.gupaoedu.dubbo</groupId> <artifactId>spring-cloud-dubbo-example</artifactId> <version>1.0-SNAPSHOT</version> </parent> 添加maven依赖 <dependency> <groupId>com.alibaba.cloud</groupId> <artifactId>spring-cloud-starter-dubbo</artifactId> </dependency> <dependency> <groupId>com.gupaoedu.dubbo</groupId> <version>1.0-SNAPSHOT</version> <artifactId>spring-cloud-dubbo-sample-api</artifactId> </dependency> <dependency> <groupId>com.alibaba.cloud</groupId> <artifactId>spring-cloud-starter-alibaba-nacos-discovery</artifactId> </dependency> 定义服务接口 在spring-boot-dubbo-sample-api模块中,定义接口 public interface IHelloService { String sayHello(); } 实现服务 在spring-boot-dubbo-sample-provider中,实现IHelloService接口 public class HelloServiceImpl implements IHelloService{ @Override public String sayHello() { return "Hello GuPao"; } } 添加@EnableDiscoveryClient注解 @EnableDiscoveryClient @SpringBootApplication public class SpringCloudDubboSampleProviderApplication { public static void main(String[] args) { SpringApplication.run(SpringCloudDubboSampleProviderApplication.class, args); } } 配置dubbo服务发布 在服务实现类中添加@Service注解 @Service public class HelloServiceImpl implements IHelloService{ @Override public String sayHello() { return "Hello GuPao"; } } 配置dubbo提供方信息 # dubbo 服务扫描基础包路径 dubbo.scan.base-packages=com.gupaoedu.dubbo.springclouddubbosampleprovider dubbo.protocol.id=dubbo # Dubbo 服务暴露的协议配置,其中子属性 name 为协议名称,port 为协议端口( -1 表示自增端口,从 20880 开始) dubbo.protocol.name=dubbo dubbo.protocol.port=-1 spring.cloud.nacos.discovery.server-addr=192.168.216.128:8848 dubbo.scan.base-packages : 指定 Dubbo 服务实现类的扫描基准包 dubbo.protocol : Dubbo 服务暴露的协议配置,其中子属性 name 为协议名称,port 为协议端口( -1 表示自增端口,从 20880 开始) dubbo.registry : Dubbo 服务注册中心配置,其中子属性 address 的值 "spring-cloud://localhost",说明挂载到 Spring Cloud 注册中心 spring.cloud.nacos.discovery : Nacos 服务发现与注册配置,其中子属性 server-addr 指定 Nacos 服务器主机和端口 版本规范 项目的版本号格式为 x.x.x 的形式,其中 x 的数值类型为数字,从 0 开始取值,且不限于 0~9 这个范围。项目处于孵化器阶段时,第一位版本号固定使用 0,即版本号为 0.x.x 的格式。 由于 Spring Boot 1 和 Spring Boot 2 在 Actuator 模块的接口和注解有很大的变更,且 spring-cloud-commons 从 1.x.x 版本升级到 2.0.0 版本也有较大的变更,因此我们采取跟 SpringBoot 版本号一致的版本: 1.5.x 版本适用于 Spring Boot 1.5.x 2.0.x 版本适用于 Spring Boot 2.0.x 2.1.x 版本适用于 Spring Boot 2.1.x 2.2.x 版本适用于 Spring Boot 2.2.x 构建服务消费者 添加jar包依赖 <dependency> <groupId>com.alibaba.cloud</groupId> <artifactId>spring-cloud-starter-dubbo</artifactId> </dependency> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-actuator</artifactId> </dependency> <dependency> <groupId>com.gupaoedu.dubbo</groupId> <version>1.0-SNAPSHOT</version> <artifactId>spring-cloud-dubbo-sample-api</artifactId> </dependency> <dependency> <groupId>com.alibaba.cloud</groupId> <artifactId>spring-cloud-starter-alibaba-nacos-discovery</artifactId> </dependency> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-web</artifactId> </dependency> 添加配置文件 spring.application.name=spring-cloud-dubbo-sample-consumer dubbo.application.name=spring-cloud-dubbo-sample-consumer dubbo.cloud.subscribed-services=spring-cloud-dubbo-sample-provider spring.cloud.nacos.discovery.server-addr=192.168.216.128:8848 除应用名称 spring.application.name 存在差异外,spring-cloud-dubbo-client-sample 新增了属性 dubbo.cloud.subscribed-services 的设置。并且该值为服务提供方应用 "spring-cloud-dubbo-sample-provider"。 它的主要作用是服务消费方订阅服务提供方的应用名称的列表,若需订阅多应用,使用 "," 分割。 不推荐使用默认值为 "*",它将订阅所有应用。 编写测试代码 @RestController @EnableDiscoveryClient @SpringBootApplication public class SpringCloudDubboSampleConsumerApplication { public static void main(String[] args) { SpringApplication.run(SpringCloudDubboSampleConsumerApplication.class, args); } @Reference IHelloService helloService; @GetMapping("/say") public String say(){ return helloService.sayHello(); } } 多注册中心的支持 dubbo相对于spring cloud来说,它的强大之处在于,提供了很多不同场景的功能支持,比如多注册中心的支持。 所谓的多注册中心,就是指dubbo可以同时配置多个注册中心的地址,然后针对于不同类型的服务注册到不同的注册中心上。 Dubbo多注册中心可以支持几种场景 一个服务部署到多个注册中心 基于spring cloud的配置方式 添加jar包依赖 <dependency> <groupId>org.apache.dubbo</groupId> <artifactId>dubbo-dependencies-zookeeper</artifactId> <version>2.7.8</version> <exclusions> <exclusion> <groupId>org.slf4j</groupId> <artifactId>slf4j-log4j12</artifactId> </exclusion> <exclusion> <artifactId>log4j</artifactId> <groupId>log4j</groupId> </exclusion> </exclusions> </dependency> 修改application配置 dubbo.registries.registry1.address=nacos://192.168.216.128:8848 dubbo.registries.registry1.timeout=10000 dubbo.registries.registry2.address=zookeeper://192.168.216.128:2181 dubbo.registries.registry2.timeout=10000 #spring.cloud.nacos.discovery.server-addr=192.168.216.128:8848 spring.cloud.nacos.discovery.register-enabled=false spring.cloud.nacos.discovery.watch.enabled=false spring.cloud.service-registry.auto-registration.enabled=false spring.cloud.service-registry.auto-registration.enabled 关闭spring cloud的自动注册 spring.cloud.nacos.discovery.watch.enabled/spring.cloud.nacos.discovery.register-enabled关闭nacos的服务注册和监听 这么做的目的是,规避spring cloud本身的服务注册发现机制,走dubbo本身的服务注册与发现 修改服务配置 @Service(registry = {"registry1","registry2"}) public class HelloServiceImpl implements IHelloService{ @Override public String sayHello() { return "Hello GuPao"; } } 多注册中心的引用 修改消费端的application.properties dubbo.registries.registry1.address=nacos://192.168.216.128:8848 dubbo.registries.registry1.timeout=10000 dubbo.registries.registry2.address=zookeeper://192.168.216.128:2181 dubbo.registries.registry2.timeout=10000 spring.cloud.nacos.discovery.register-enabled=false spring.cloud.nacos.discovery.watch.enabled=false spring.cloud.service-registry.auto-registration.enabled=false 添加jar包依赖 <dependency> <groupId>org.apache.dubbo</groupId> <artifactId>dubbo-dependencies-zookeeper</artifactId> <version>2.7.8</version> <exclusions> <exclusion> <groupId>org.slf4j</groupId> <artifactId>slf4j-log4j12</artifactId> </exclusion> <exclusion> <artifactId>log4j</artifactId> <groupId>log4j</groupId> </exclusion> </exclusions> </dependency> 基于spring boot集成Dubbo方式 实际上,在dubbo spring cloud的使用方式中,对于配置多个服务注册中心不是很友好而且还有一些潜在的问题, 毕竟dubbo和spring cloud两个本质上是属于完全不同的生态耦合在一起,必然会导致一些兼容问题。比如刚刚我们去配置的这些多注册中心的支持,它需要去关闭spring cloud本身的服务自动注册和发现的支持,本质上就是在两个生态中选择其中一个生态作为主要方式来使用。 所以,如果是在spring cloud的生态中,可以尽量减少对于dubbo本身灵活性的使用,拥抱spring cloud的标准生态,当然如果希望以dubbo作为独立的生态来使用,大家可以采用spring boot+Dubbo来集成, 这里同样也给大家快速构建一下。 另外,dubbo集成到spring boot中还有一个好处,就是它可以继承spring boot本身的特性 自动装配(注解驱动、自动装配) production-ready(安全机制、健康检测、外部化配置) 创建项目结构 创建基础的项目结构 spring-boot-dubbo-example [maven] spring-boot-dubbo-sample-api [maven] spring-boot-dubbo-sample-provider [spring boot] spring-boot-dubbo-sample-consumerp [spring-boot] 添加jar包依赖 从2.7开始,dubbo的版本和dubbo-spring-boot的版本是保持一致的,所以大家不用再去担心版本的问题。 <dependency> <groupId>org.apache.dubbo</groupId> <artifactId>dubbo-spring-boot-starter</artifactId> <version>2.7.7</version> </dependency> <dependency> <groupId>com.alibaba.nacos</groupId> <artifactId>nacos-client</artifactId> <version>1.2.1</version> </dependency> 添加服务以及发布 @DubboService public class SayHelloServiceImpl implements ISayHelloService{ @Override public String sayHello() { return "Hello GuPaoEdu.com"; } } spring.application.name=spring-boot-dubbo-sample-provider dubbo.registry.address=nacos://192.168.216.128:8848 dubbo.scan.base-packages=com.gupaoedu.springboot.dubbo.springbootdubbosampleprovider.service dubbo.protocol.name=dubbo dubbo.protocol.port=-1 编写服务引用代码 添加jar包依赖 <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-web</artifactId> </dependency> <dependency> <groupId>com.gupaoedu.com</groupId> <version>1.0-SNAPSHOT</version> <artifactId>spring-boot-dubbo-sample-api</artifactId> </dependency> <dependency> <groupId>org.apache.dubbo</groupId> <artifactId>dubbo-spring-boot-starter</artifactId> <version>2.7.7</version> </dependency> <dependency> <groupId>com.alibaba.nacos</groupId> <artifactId>nacos-client</artifactId> <version>1.2.1</version> </dependency> 添加web测试类 @DubboReference ISayHelloService sayHelloService; @GetMapping("/get") public String get(){ return sayHelloService.sayHello(); } dubbo.registry.address=nacos://192.168.216.128:8848 不同服务注册到不同的注册中心 从上面的配置可以发现,我们开可以针对不同的服务配置到不同的注册中心,这个就不再浪费时间去演示了。 多个注册中心的集群 如果一个服务消费者引用了多个注册中心,那么这个时候服务消费者首先要做的就是先针对注册中心的负载均衡,然后得到一个目标注册中心之后,再从目标注册中心上获得服务提供者的地址列表再进行集群访问,实现原理如下图所示 当然,有三种方式来指定注册中心的负载均衡配置 指定优先级 <!-- 来自 preferred=“true” 注册中心的地址将被优先选择,只有该中心无可用地址时才 Fallback 到其他注册中心 --> <dubbo:registry address="zookeeper://${zookeeper.address1}" preferred="true" /> 同zone优先 <!-- 选址时会和流量中的 zone key 做匹配,流量会优先派发到相同 zone 的地址 --> <dubbo:registry address="zookeeper://${zookeeper.address1}" zone="beijing" /> 权重轮询 <!-- 来自北京和上海集群的地址,将以 10:1 的比例来分配流量 --> <dubbo:registry id="beijing" address="zookeeper://${zookeeper.address1}" weight=”100“ /> <dubbo:registry id="shanghai" address="zookeeper://${zookeeper.address2}" weight=”10“ /> 接口多版本支持 平时我们在开发接口的时候,可能会面临到一个接口的修改,但是这个时候因为线上会有一些项目正在使用这个接口,如果直接修改,很可能会对线上的服务造成比较大的影响。 因此对于这种情况,dubbo提供了接口版本的支持。 具体的配置方式 服务端针对同一个接口提供不同版本的实现 并在dubboservice注解中配置版本的声明 @DubboService(registry = {"registry1","registry2"},version = "1.0") 服务消费端指定消费版本号 @DubboReference(registry = {"registry1","registry2"},version = "2.0") ISayHelloService sayHelloService; 多协议的支持 当公司原本采用其他的rpc框架,这个时候如果想迁移到dubbo这个框架上来,那么Dubbo提供的多协议支持就能够提供几乎零成本的迁移。 对于一个服务,可以同时发布多种不同协议的接口,也可以针对不同的接口发布不同的协议类型。并且从2.7开始,dubbo对于一些主流的协议做了支持,目前已经支持的协议有 dubbo协议、hessian协议、http协议、thrift、rmi、webservice、grpc、rest等。初次之外,dubbo还提供了非常灵活的可扩展性机制,对于有定制化需求或者目前正在使用的协议,dubbo不支持的公司,是可以自己去进行扩展。 整体的灵活性以及可插拔性的特性,相比spring cloud来说,更加强大。 JAX-RS协议说明 Dubbo中的REST(表述性资源转移)支持,是基于JAX-RS2.0(Java API for RESTful Web Services)来实现的。 REST是一种架构风格,简单来说就是对于api接口的约束,基于URL定位资源,使用http动词(GET/POST/DELETE)来描述操作 REST很早就提出来了,在早期开发人员为了实现REST,会使用各种工具来实现,比如Servlets就经常用来开发RESTful的程序。随着REST被越来越多的开发人员采用,所以JCP(Java community process)提出了JAX-RS规范,并且提供了一种新的基于注解的方式来开发RESTful服务。有了这样的一个规范,使得开发人员不需要关心通讯层的东西,只需要关注资源以以及数据对象。 JAX-RS规范的实现有:Apache CXF、Jersey(由Sun公司提供的JAX-RS的参考实现)、RESTEasy(jboss实现)等。 而Dubbo里面实现的REST就是基于Jboss提供的RESTEasy框架来实现的 SpringMVC中的RESTful实现我们用得比较多,它也是JAX-RS规范的一种实现 添加REST支持 添加jar包依赖 <dependency> <groupId>org.jboss.resteasy</groupId> <artifactId>resteasy-jaxrs</artifactId> <version>3.13.0.Final</version> </dependency> <dependency> <groupId>org.jboss.resteasy</groupId> <artifactId>resteasy-client</artifactId> <version>3.13.0.Final</version> </dependency> <dependency> <groupId>org.eclipse.jetty</groupId> <artifactId>jetty-server</artifactId> <version>9.4.19.v20190610</version> </dependency> <dependency> <groupId>org.eclipse.jetty</groupId> <artifactId>jetty-servlet</artifactId> <version>9.4.19.v20190610</version> </dependency> 修改配置文件 dubbo.protocols.dubbo.name=dubbo dubbo.protocols.dubbo.port=-1 dubbo.protocols.rest.name=rest dubbo.protocols.rest.port=8888 dubbo.protocols.rest.server=jetty 修改api的接口定义 @Path("/") public interface ISayHelloService { @GET @Path("say") String sayHello(); } 版权声明:本博客所有文章除特别声明外,均采用 CC BY-NC-SA 4.0 许可协议。转载请注明来自 Mic带你学架构! 如果本篇文章对您有帮助,还请帮忙点个关注和赞,您的坚持是我不断创作的动力。欢迎关注「跟着Mic学架构」公众号公众号获取更多技术干货!

优秀的个人博客,低调大师

「前端工程四部曲」模块化的前世今生

前言 在日益复杂和多元的Web业务背景下,前端工程化这个概念经常被提及。“说说你对Web工程化的理解?” 相信很多初学者在面试时会经常遇到,而大多数人脑子会直接浮现出 Webpack,认为工程化就是 Webpack 做的那些事情儿,当然也不能说不对,准确说 Webpack 只是工程化背景下产生的工具。 工程化的目的是高性能、是稳定性、是可用性、是可维护性、是高效协同,只要是以这几个角度为目标所做的操作,都可称为工程化的一部分。工程化其实是软件工程中的一种思想。当下的前端工程化可以分为四个方面:模块化、组件化、规范化、自动化 。 工程四部曲为题,此文我们以 模块化 为始来剖析前端工程化的概念,码字不易,先赞后看,养成习惯! 什么是模块化 模块化其实是指解决一个复杂问题时 自顶向下逐层把系统划分成若干模块 的过程,每个模块完成一个特定的子功能(单一职责),所有的模块按某种方法组装起来,成为一个整体,从而完成整个系统所要求的功能,不理解没关系,接着往下看。 为什么需要模块化 早期在网页这个东西刚出现的时候,页面、样式都很简单,极少有交互以及设计元素,一个页面也不会依赖很多文件,逻辑代码非常少,就是静态页面那种,那个时候的前端叫网页设计。 随着 Web 技术的发展,各种交互以及新技术等使网页变得越来越丰富,逐渐我们前端工程师登上了舞台,同时也使得我们前端同学的代码量急速上涨、复杂度在逐步增高,越来越多的业务逻辑和交互都放在 Web 层实现,代码一多,各种命名冲突、代码冗余、文件间依赖变大等等一系列的问题就出来了,甚至导致后期难以维护。 在这些问题上,其他如 java、php 等后端语言中早已有了很多实践经验,那就是模块化,因为小的、组织良好的代码远比庞大的代码更易理解和维护,于是前端也开启了模块化历程。 JS模块化 说到JS模块化,肯定少不了CommonJS、AMD、CMD、UMD、ESM,相信很多前端新同学甚至有些喜好摸鱼的老同学经常把它们搞混,如果你知道这些概念却不知道它们之间的联系,或者知道它们之间的联系却不了解核心实现,那请好好看此文。 早期前端三剑客中占据主导地位的 JS 不是一种模块化编程语言,规范中也没有模块(即module)的概念,所以模块的实现就显得很麻烦了,不过早期的前端工程师通过 JS 的语言特性来模拟实现了模块化。 早期JS模块化方案 普通函数 首先考虑到函数实现,因为 JS 中函数是有独立作用域的,并且函数中可以放任何代码,只需要在需要使用的地方调用即可,就比如下面代码: function fn1(){ //... } function fn2(){ //... } function fn3() { fn1() fn2() } 复制代码 可以看到这样做实现了代码分离及组织,看着挺清晰,其实是因为代码量小,如果函数过多,并且在多个文件中,还是无法保证它们不与其它模块发生命名冲突,而且模块成员之间看不出直接关系,还是会给后期的维护造成麻烦。 命名空间 在上面普通函数的方式中,很多变量和函数会直接在全局作用域下面声明,很容易产生命名冲突,于是,命名空间模式(namespace)就被提出了。 因为对象可以有属性,而它的属性既可以是数据,也可以是方法,刚好能够很好地满足需求,而且对象的属性通过对象名字来访问,相当于设定了一个命名空间。 我们来看看把模块写成一个对象,所有的模块成员都放到这个对象里面是怎么样的: var myModule = { name: "isboyjc", getName: function (){ console.log(this.name) } } // 使用 myModule.getName() 复制代码 显然这是可行的,但是很快我们又发现了其缺点,对象内部属性全部会暴露出来,内部状态可以被外部更改,如下: myModule.name = "哈哈哈" myModule.getName() // 哈哈哈 复制代码 立即执行函数(IIFE) 尽管命名空间模式一定程度上解决了全局命名空间上的变量污染问题,但是它没办法解决代码和数据隔离的问题,大概在 2003 年,立即执行函数简称 IIFE 出现了 ,它其实是利用函数闭包的特性来实现私有数据和共享方法,如下: var myModule = (function() { var name = 'isboyjc' function getName() { console.log(name) } return { getName } })() 复制代码 这样我们就可以通过 myModule.getName() 来获取 name,并且实现 name 属性的私有化,即外部调用不到: myModule.getName() // isboyjc myModule.name // undefined 复制代码 那假如我们这个模块需要依赖其他模块呢?这时候就用到了引入依赖,即函数传参: // otherModule.js模块文件 var otherModule = (function(){ return { a: 1, b: 2 } })() // myModule.js模块文件 - 依赖 otherModule 模块 var myModule = (function(other) { var name = 'isboyjc' function getName() { console.log(name) console.log(other.a, other.b) } return { getName } })(otherModule) 复制代码 通过这种传参的形式,我们就可以在 myModule 模块中使用其他模块,从而解决了很多问题,这也是现代模块化规范的思想来源。 依赖注入 模块化发展的历程中还有模版定义依赖、注释定义依赖等方案,这些我觉得并不具有很强的学习性质,不再赘述。我们下面说说依赖注入(Dependency Indection, DI),说到这个,不得不提起三大框架之一的 Angular,它诞生于 2009 年,其核心特性之一就是依赖注入。 假如我们有两个原始模块 fnA 和 fnB : // 模块fnA let fnA = function(){ return {name: '我是fnA'} } // 模块fnB let fnB = function(){ return {name: '我是fnB'} } 复制代码 我们编写一个函数 fnC,想要使用上面两个模块,我们可以通过下面这种方式: let fnC = function(){ let a = fnA() let b = fnB() console.log(a, b) } 复制代码 我们也知道,上面这样的代码无论从哪个角度看都很不灵活,我们不知道这段代码中有哪些依赖,也不能对引入的依赖进行二次修改因为会造成原函数的更改,这个时候我们要做的就是将依赖的函数作为参数显式的传入: let fnC = function(fnA, fnB){ let a = fnA() let b = fnB() console.log(a, b) } 复制代码 问题又来了,如果我们在很多地方都调用了函数 fnC,后面突然有需求需要调用第三个依赖项怎么办呢?难道要去修改调用处函数传入参吗?这样做也可以,但很不明智,那这里就需要一段代码帮助我们做这个事情,也就是所谓的依赖注入器,它需要帮我们解决下面这几个问题: 可以实现依赖的注册 依赖注入器应该可以接收依赖(函数等),注入成功后给我们返回一个可以获取所有资源的函数 依赖注入器要能够保持传递函数的作用域 传递的函数能够接收自定义的参数,而不仅仅是被描述的依赖项 我们来简单实现一个依赖注册器,我们新建一个 injector 对象,它是独立的,以便它能够在我们应用的各个部分都拥有同样的功能。 let injector = { dependencies: {}, register: function(key, value) { this.dependencies[key] = value; }, resolve: function(deps, func, scope) { var args = []; for(var i = 0; i < deps.length, d = deps[i]; i++) { if(this.dependencies[d]) { // 存在此依赖 args.push(this.dependencies[d]); } else { // 不存在 throw new Error('不存在依赖:' + d); } } return function() { func.apply(scope || {}, args.concat(Array.prototype.slice.call(arguments, 0))); } } } 复制代码 可以看到,这个对象非常简单,只有三个属性,dependencies 用来保存依赖,register 用来添加依赖,最后的 resolve 用来注入依赖。 resolve 函数需要做的事情很简单,先检查 deps 数组,然后在 dependencies 对象种寻找依赖,依次添加至 args 数组中, scope 参数存在则指定其作用域,返回的函数中将其参数使用 .apply 的方法传入我们传递回去的 func 回调。 再来看使用: // 添加 injector.register('fnA', fnA) injector.register('fnB', fnB) // 注入 (injector.resolve(['fnA', 'fnB'], function(fnA, fnB){ let a = fnA() let b = fnB() console.log(a, b) }))() 复制代码 调用时,我们也可以传入额外的参数: (injector.resolve(['fnA', 'fnB'], function(fnA, fnB, str){ let a = fnA() let b = fnB() console.log(a, b, str) }))('isboyjc') 复制代码 由此,我们实现了一个简单的依赖注入,依赖注入并不是一个新的东西,它在其他语言中存在已久,它是一种设计模式,也可以说是一种风格。 早期的模块化演变过程中还有很多方案,就不一一写了。我们所说的模块化方案,并不是相互独立的,每种方案之间可能相互借鉴,就像依赖注入这种方式也用到了 IIFE ,一个好的模块化方案,无非就像是解决我们上面依赖注入提出的几个问题一样解决实际问题而存在。 随着前端发展对模块需求越来越大,社区中逐渐出现了一些优秀且被大多数人认同的模块化解决方案,慢慢演变成了通用的社区模块化规范,它们不仅解决了依赖注入的这些问题,还具备了很多独有的模块化特性,再到后面 ES6 的出现,也意味着官方(语言层面)的模块化规范 ESM 的落地。 JS模块化规范演进 CommonJS规范 简介 JS 标准定义的 API 只是为了构建基于浏览器的应用程序,并没有制定一个用于更广泛的应用程序的标准库。 而 CommonJS 规范的提出主要是为了弥补 JS 没有标准的缺陷,它由社区提出,终极目标就是提供一个类似 Python 或 Ruby 或 Java语言的标准库,而不只是停留在脚本程序的阶段。 即用 CommonJS API 编写出的应用不仅可利用 JS 来开发客户端应用,还可编写服务器端 JS 应用程序、命令行工具、桌面图形界面应用程序等。 2009 年,美国程序员 Ryan Dahl 以 CommonJs 规范为基础创造了 node.js 项目,将 JS 语言用于服务器端编程,为前端奠基,从此之后 nodejs 就成为了 CommonJs 的代名词。 CommonJS 规范中规定每个文件就是一个独立的模块,有自己的作用域,模块的变量、函数、类都是私有的,外部想要调用,必须使用 module.exports 主动暴露,而在另一个文件中引用则直接使用 require(path) 即可,如下: // num.js var a = 1 var b = 2 var add = function (){ return a + b } // 导出 module.exports.a = a module.exports.b = b module.exports.add = add 复制代码 引用如下: var num = require('./num.js') console.log(num.a) // 1 console.log(num.b) // 2 console.log(num.add(a,b)) // 3 复制代码 require 命令则负责读取并执行一个 JS 文件,并返回该模块的 exports 对象,没找到的话就抛出一个错误。 上面也说过,CommonJS 规范适用于服务端,也就是只适用于 NodeJS ,其实简单来说就是 Node 内部提供一个构造函数 Module,所有模块都是构造函数 Module 的实例,如下: function Module(id, parent) { this.id = id this.exports = {} this.parent = parent // ... } 复制代码 每个模块内部,都有一个 module 实例,该对象就会有下面几个属性: module.id 模块的识别符,通常是带有绝对路径的模块文件名 module.filename 模块的文件名,带有绝对路径 module.loaded 返回一个布尔值,表示模块是否已经完成加载 module.parent 返回一个对象,表示调用该模块的模块 module.children 返回一个数组,表示该模块要用到的其他模块 module.exports 表示模块对外输出的值 总的来说 CommonJS 规范的特点有下面几个方面: 所有代码都运行在模块作用域,不会污染全局作用域 模块可以多次加载,但是只会在第一次加载时运行一次,然后运行结果就被缓存了,以后再加载,就直接读取缓存结果,要想让模块再次运行,必须清除缓存 模块加载的顺序,按照其在代码中出现的顺序 说了这么多,不如我们直接实现一个简单的。 核心实现 不多说,先上代码为敬,简单几十行代码,带大家体会一下 commonJS。 首先,我们创建一个 test.js,写如下代码: module.exports = { a:1, b:2, c(){ return 3 } } 复制代码 有人会问: module.exports 明明是原生的,不是要手写实现吗?接着看。 新建一个 commonJS.js 文件,全部代码如下,看一遍注释,后面再略微介绍下就 OK 了。 let path = require('path'); let fs = require('fs'); let vm = require('vm'); let n = 0 // 构造函数Module function Module(filename){ this.id = n++; // 唯一ID this.filename = filename; // 文件的绝对路径 this.exports = {}; // 模块对应的导出结果 } // 存放可解析的文件模块扩展名 Module._extensions = ['.js']; // 缓存 Module._cache = {}; // 拼凑成闭包的数组 Module.wrapper = ['(function(exports,require,module){','\r\n})']; // 没写扩展名,默认添加扩展名 Module._resolveFilename = function (p) { p = path.join(__dirname, p); if(!/\.\w+$/.test(p)){ //如果没写扩展名,尝试添加扩展名 for(let i = 0; i < Module._extensions.length; i++){ //拼接出一个路径 let filePath = p + Module._extensions[i]; // 判断文件是否存在 try{ fs.accessSync(filePath); return filePath; }catch (e) { throw new Error('module not found') } } }else { return p } } // 加载模块本身 Module.prototype.load = function () { // 解析文件后缀名 isboyjc.js -> .js let extname = path.extname(this.filename); // 调用对应后缀文件加载方法 Module._extensions[extname](this); }; // 后缀名为js的加载方法 Module._extensions['.js'] = function (module) { // 读文件 let content = fs.readFileSync(module.filename, 'utf8'); // 形成闭包函数字符串 let script = Module.wrapper[0] + content + Module.wrapper[1]; // 创建沙箱环境,运行并返回结果 let fn = vm.runInThisContext(script); // 执行闭包函数,将被闭包函数包裹的加载内容 fn.call(module, module.exports, req, module) }; // 仿require方法, 实现加载模块 function req(path) { // 根据输入的路径 转换绝对路径 let filename = Module._resolveFilename(path); // 查看缓存是否存在,存在直接返回缓存 if(Module._cache[filename]){ return Module._cache[filename].exports; } // 通过文件名创建一个Module实例 let module = new Module(filename); // 加载文件,执行对应加载方法 module.load(); // 入缓存 Module._cache[filename] = module; return module.exports } let str = req('./test'); console.log(str); 复制代码 如上,附带注释也不过 80 行代码。 首先我们写了一个构造函数 Module,其中 id 是唯一ID,filename 存文件的绝对路径,exports 存模块对应的导出结果。 我们还为 Module 添加了几个静态属性,其中 _extensions 存放可解析模块扩展名,而在后面将扩展名作为 key,添加其解析方法。_cache 则是缓存加载过的模块,wrapper 是一个数组,包含两个字符串项,两个字符串合起来就是一个函数字符串,它作为我们后面拼凑函数的数组。 其次还添加了一个静态方法 _resolveFilename 用于解析文件完整路径,还有一个比较核心的原型方法 load ,用于加载模块。 平常我们使用 node 加载模块时,使用的是 require 方法,而我们手写则是用 req 方法,该方法传入一个文件路径(可省略后缀),方法中我们首先调用构造函数 Module 的 _resolveFilename 方法把传入的路径解析成一个绝对路径 filename,接着校验 _cache 对象中是否存在以 filename 路径为 key 的值,如果有,直接读取缓存。 如果缓存中没有,new 一个 Module 实例,再调用 load 方法加载模块。 最重要的是 load 的过程,load 首先解析 filename 字符串,拿到文件的后缀名,通过调用 _extensions 中后缀名对应的方法加载对应文件,我们在代码中,已经为 Module._extensions['.js'] 添加了对应解析方法,也就是解析 js 后缀的文件。 文中的文件是 test.js,其后缀是 .js,正好对应,调用该方法,传入 this(即 module 实例)。 目光来到 Module._extensions['.js'] 方法,其实也简单,首先通过 filename 读取该文件内容,接着,开始拼凑一个方法,也就是下面这行代码: let script = Module.wrapper[0] + content + Module.wrapper[1]; 复制代码 此行代码拼凑出来的字符串 script 其实就是一个方法,只不过是字符串方法,如下: 'function(exports,require,module){ test.js文件内容 }' 复制代码 再接下来,就是大家不太理解的 vm.runInThisContext 方法了,这里简单介绍下: vm.runInThisContext(code) 会创建一个独立的沙箱环境,执行对参数代码 code 的编译,运行并返回结果。该方法运行的代码没有权限访问本地作用域,但是可以访问 Global 全局对象。 这样说不理解的话,那大家总知道 eval 吧!其实它和 eval 类似,来看示例: var vm = require('vm'); var str = '111'; //在runInThisContext创建的沙箱环境中执行 var vmRes = vm.runInThisContext('str = "vm222";'); console.log('vmRes: ', vmRes); // vmRes: vm222 console.log('str: ', str); // str: 111 //在eval中执行 var evalRes = eval('str = "eval222";'); console.log('evalRes: ', evalRes); // evalRes: eval222 console.log('str: ', str); // str: eval222 复制代码 如上,使用 vm.runInThisContext 执行的字符串 code 并不会改变当前作用域,而 eval 可以,仅此而已。 思绪回来,vm.runInThisContext(script) 把我们拼成的字符串方法,变成了一个可执行的方法,随后调用并传入参数: fn.call(module, module.exports, req, module) 复制代码 由于使用了 call 方法,所以第一个参数是将转换后的 script 也就是函数 fn 的 this 指向变为 当前 module 实例,剩余三个即函数调用参数,回顾当时拼函数时这个函数的形参与当前函数调时传入值的对比: // 原来函数 fn = function(exports, require, module){ // test.js文件内容 } // 调用 fn(module.exports, req, module) 复制代码 三个参数分别是: module 实例的 exports 对象 req 模块导入方法 module 实例本身 看到这里我想大家应该明白示例最开始的 test.js 中我们为什么可以直接使用 module.exports 导出了,很明显因为在加载过程中,我们把整个 test 文件作为一块代码塞进了匿名的加载方法中,而这个加载方法在执行时,形参中存在 module 实例,所以我们就可以直接操作 module 实例,向其 exports 属性中塞数据了!!!如此,一个非常简单的 commonJS 手写例子就结束了,你 Get 了吗? 最后总结,简单点说,CommonJs 就是模块化的社区标准,而 Nodejs 就是 CommonJs 模块化规范的实现,它对模块的加载是同步的,也就是说,只有引入的模块加载完成,才会执行后面的操作,在 Node 服务端应用当中,模块一般存在本地,加载较快,同步问题不大,在浏览器中就不太合适了,你试想一下,如果一个很大的项目,所有的模块都同步加载,那体验是极差的,所以还需要异步模块化方案,所以 AMD规范 就此诞生。 AMD规范 简介 AMD(异步模块定义)是专门为浏览器环境设计的,它定义了一套异步加载标准来解决同步的问题 语法如下: define(id?: String, dependencies?: String[], factory: Function|Object) 复制代码 id 即模块的名字,字符串,可选 dependencies 指定了所要依赖的模块列表,它是一个数组,也是可选的参数,每个依赖的模块的输出将作为参数一次传入 factory 中。如果没有指定 dependencies,那么它的默认值是 ["require", "exports", "module"] factory 包裹了模块的具体实现,可为函数或对象,如果是函数,返回值就是模块的输出接口或者值 我们简单列举一些用法,如下,我们定义一个名为 myModule 的模块,依赖于 jQuery 模块: // 定义依赖 myModule,该模块依赖 JQ 模块 define('myModule', ['jquery'], function($) { // $ 是 jquery 模块的输出 $('body').text('isboyjc') }) // 引入依赖 require(['myModule'], function(myModule) { // todo... }) 复制代码 没有 ID 值的匿名模块,此时文件名就是它的标识名,通常都作为启动模块: define(['jquery'], function($) { $('body').text('isboyjc') }) 复制代码 依赖多个模块: define(['jquery', './math.js'], function($, math) {}) 复制代码 模块输出: define(['jquery'], function($) { var writeName = function(selector){ $(selector).text('isboyjc') } // writeName 是该模块输出的对外接口 return writeName }) 复制代码 模块内部引用依赖: define(function(require) { // 引入依赖 var $ = require('jquery') $('body').text('isboyjc') }) 复制代码 大家应该都知道 RequireJS ,一个遵守 AMD 规范的工具库,用于客户端的模块管理。 它就是通过 define 方法,将代码定义为模块,通过 require 方法,实现代码的模块加载,使用时需要下载和导入,也就是说我们在浏览器中想要使用 AMD 规范时先在页面中引入 require.js 就可以了。 可以说 RequireJS 就是 AMD 的标准化实现 。 核心实现 上面的用法大家可能都知道,我们接下来来简单实现一个 AMD 规范的模块加载器,类似 RequireJS 。 写之前,我们先把使用的例子写出来: index.html 入口文件: <!DOCTYPE html> <html lang="en"> <head> <meta charset="UTF-8"> <meta name="viewport" content="width=device-width, initial-scale=1.0"> <title>Document</title> </head> <body> <script src="./requireJS.js"></script> <script> require(['a', 'b'], function (a, b) { console.log(b + a) }); </script> </body> </html> 复制代码 如上所示,大概就是引入 requireJS.js 文件,然后使用它引入 a 和 b 两个依赖项并返回其相加的和。 我们自来看模块 a 和 b : // a.js define([], function () { return 1 }) // b.js define(['c'], function (c) { return 2 + c }) // c.js define([], function () { return 2 }) 复制代码 可以看到,a.js 文件中返回或者说导出了变量 1。 而 b.js 文件确又依赖了模块 c ,返回 2 + c 的和。 最后的 c.js 模块文件则是直接返回了变量 2。 我们要做到的效果就是执行 index.html 文件,最终输出 5 即可。 接下来我们来手写,其实最主要的就是两个方法 require & define ,还是先放代码再解释,requireJS.js 文件如下: (function () { // 缓存 const cache = {} let moudle = null const tasks = [] // 创建script标签,用来加载文件模块 const createNode = function (depend) { let script = document.createElement("script"); script.src = `./${depend}.js`; // 嵌入自定义 data-moduleName 属性,后可由dataset获取 script.setAttribute("data-moduleName", depend); let fs = document.getElementsByTagName('script')[0]; fs.parentNode.insertBefore(script, fs); return script; } // 校验所有依赖是否都已经解析完成 const hasAlldependencies = function (dependencies) { let hasValue = true dependencies.forEach(depd => { if (!cache.hasOwnProperty(depd)) { hasValue = false } }) return hasValue } // 递归执行callback const implementCallback = function (callbacks) { if (callbacks.length) { callbacks.forEach((callback, index) => { // 所有依赖解析都已完成 if (hasAlldependencies(callback.dependencies)) { const returnValue = callback.callback(...callback.dependencies.map(it => cache[it])) if (callback.name) { cache[callback.name] = returnValue } tasks.splice(index, 1) implementCallback(tasks) } }) } } // 根据依赖项加载js文件 const require = function (dependencies, callback) { if (!dependencies.length) { // 此文件没有依赖项 moudle = { value: callback() } } else { //此文件有依赖项 moudle = { dependencies, callback } tasks.push(moudle) dependencies.forEach(function (item) { if (!cache[item]) { // script表亲加载文件结束 createNode(item).onload = function () { // 获取嵌入属性值,即module名 let modulename = this.dataset.modulename console.log(moudle) // 校验module中是否存在value属性 if (moudle.hasOwnProperty('value')) { // 存在,将其module value(模块返回值|导出值)存入缓存 cache[modulename] = moudle.value } else { // 不存在 moudle.name = modulename if (hasAlldependencies(moudle.dependencies)) { // 所有依赖解析都已完成,执行回调,抛出依赖返回(导出)值 cache[modulename] = callback(...moudle.dependencies.map(v => cache[v])) } } // 递归执行callback implementCallback(tasks) } } }) } } window.require = require window.define = require })(window) 复制代码 同样这也是简化版本,不超过 90 行代码,附带注释,大部分同学看一遍应该就懂了。不过分讲解,简单介绍一下流程。 调用 require 或者 define 方法,首先是根据依赖数组加载 js 文件,不同于 commonJS,AMD 基于浏览器,要读文件,我们只能动态创建 script 标签,所以 createNode 即创建script标签,用来加载文件模块。 script 引入文件加载完成后会触发 onload 事件,我们以此控制依赖的加载顺序。只有在 JS 模块加载完成后,才能执行其 callback 回调,但是我们引入的 JS 依赖项中都是使用 define 方法定义的,而 define 方法还可能会依赖某些 js 文件模块,但总有一个源头是不存在依赖的,如此,递归便派上了用场。 我们的目的是模块加载完成后执行 callbck 回调,但如果是 A 依赖 B,B 又依赖 C 等等的关系,我们想要执行 A 回调,那必须等 B 和 C 都加载完,所以我们使用一个栈(数组) tasks 来存储 callback 回调,等所有依赖都加载完了,再依次执行,就和 Node 框架 koa 的洋葱模型一样。这是为了让 callback 回调函数的执行顺序正确。 大致如上,剩下还有一些校验,因为代码简单,不细说了。但可不要以为 requireJS 源码真的这么简单,并不是,真正的源码考虑了太多的东西,此代码只是为了方便大家理解,有兴趣自己看源码吧~ CMD规范 简介 CMD 的出现较为晚一些,它汲取了 CommonJS 和 AMD 规范的优点,也是专门用于浏览器的异步模块加载。 在 CMD 规范中,一个模块就是一个文件,define 是一个全局函数,用来定义模块。 define 接受 factory 参数,factory 可以是一个函数,也可以是一个对象或字符串。 factory 为对象和字符串时,表示模块的接口就是该对象、字符串,如下: // factory 为JSON数据对象 define({'name': 'isboyjc'}) // factory 为字符串模版 define('my name is {{name}}!!!') 复制代码 factory 为函数时,表示是模块的构造方法,执行该构造方法,可以得到模块向外提供的接口,即 function(require, exports, module) : require 是一个方法,接受模块标识作为唯一参数,用来获取其他模块提供的接口 exports 是一个对象,用来向外提供模块接口 module 是一个对象,上面存储了与当前模块相关联的一些属性和方法 factory 为函数时,如下: define(function(require, exports, module) { var a = require('./a') a.doSomething() // 依赖就近原则:依赖就近书写,什么时候用到什么时候引入 var b = require('./b') b.doSomething() }) 复制代码 再来看看更多用法: define(function(require, exports, module) { // 同步引入 var a = require('./a') // 异步引入 require.async('./b', function (b) { }) // 条件引入 if (status) { var c = requie('./c') } // 暴露模块 exports.aaa = 'hahaha' }) 复制代码 和上面 CommonJS 、 AMD 类似,CMD 是 SeaJS 在推广过程中对模块定义的规范化产出 ,而 CMD 规范以及 SeaJS 在国内曾经十分被推崇,原因不只是因为它足够简单方便,更是因为 SeaJS 的作者是阿里的 玉伯 大佬所写,同 Vue 一样的国人作者,堪称国人之光。 核心实现 对于 CMD 规范下的 SeaJS,同 AMD 规范下的 RequireJS 一样,都是浏览器端模块加载器,两者很相似,但又有明显不同,个人认为 SeaJS 的实现相对来说更精美一些,一度风靡前端圈,碍于篇幅,放在这里肯定是不合适的,后面有机会单独来介绍 SeaJS 的实现,此文我们先了解 CMD 与 AMD 区别即可。 CMD 与 AMD 规范 推崇 代表作 AMD 依赖前置 requirejs CMD 依赖就近 seajs CMD 对比 AMD 来说,CMD 比较推崇 as lazy as possible(尽可能的懒加载,也称为延迟加载,即在需要的时候才加载)。 对于依赖的模块,AMD 是提前执行,CMD 是延迟执行,两者执行方式不一样,AMD 执行过程中会将所有依赖前置执行,也就是在自己的代码逻辑开始前全部执行,而 CMD 如果 require 引入了但整个逻辑并未使用这个依赖或未执行到逻辑使用它的地方前是不会执行的,不过 RequireJS 从 2.0 开始,也能改成延迟执行(根据写法不同,处理方式不同),另外一方面 CMD 推崇依赖就近,而 AMD 推崇依赖前置。 UMD规范 简介 UMD(Universal Module Definition),即通用模块定义,从名字就可以看出来,这东西是做大一统的。 它随着大前端的趋势所诞生,可以通过运行时或者编译时让同一个代码模块在使用 CommonJs、CMD 甚至是 AMD 的项目中运行,也就是说同一个 JavaScript 包运行在浏览器端、服务区端甚至是 APP 端都只需要遵守同一个写法就行了,那它是怎样实现的呢? 核心实现 我们来看看这样一段代码 ((root, factory) => { if (typeof define === 'function' && define.amd) { // AMD define(factory); } else if (typeof exports === 'object') { // CommonJS module.exports = factory(); } else if (typeof define === 'function' && define.cmd){ // CMD define(function(require, exports, module) { module.exports = factory() }) } else { // 都不是 root.umdModule = factory(); } })(this, () => { console.log('我是UMD') // todo... }); 复制代码 可以看到,define 是 AMD/CMD 语法,而 exports 只在 CommonJS 中存在,你会发现它在定义模块的时候会检测当前使用环境和模块的定义方式,如果匹配就使用其规范语法,全部不匹配则挂载再全局对象上,我们看到传入的是一个 this ,它在浏览器中指的就是 window ,在服务端环境中指的就是 global ,使用这样的方式将各种模块化定义都兼容。 其实社区形成的的规范还有很多,目的都是为了 JS 的模块化开发,只是我们上面说的这几个是最常用的。 截止到目前为止我们说的 CommonJS 、AMD 、 CMD 等都只是社区比较认可的统一模块化规范,但并不是官方(JS语言层面)的,那接下来要说的这个就是 JS 的官方模块化规范了。 ES Module 2015年6月,ECMAScript2015 也就是我们说的 ES6 发布了,JS 终于在语言标准的层面上,实现了模块功能,使得在编译时就能确定模块的依赖关系,以及其输入和输出的变量,不像 CommonJS 、AMD 之类的需要在运行时才能确定(例如 FIS 这样的工具只能预处理依赖关系,本质上还是运行时解析),成为浏览器和服务器通用的模块解决方案。 所以说在 ES6 之前 JS 是没有官方的模块机制的,ES6在语言标准的层面上,实现了模块化功能,而且实现的相当简单,旨在成为浏览器和服务器通用的模块化解决方案,其模块化功能主要由俩个命令构成:exports和import,export命令由于规定模块的对外接口,import命令用于输入其他模块的功能。ES6还提供了export default的命令。为模块指定默认输出。对应的import语句不需要大括号。这也更接近AMD的引用写法。 ES6 Module不是对象,import命令被JavaScript引擎静态分析,在编译的时候就引入模块代码。而不是在代码运行时加载,所以无法实现条件加载。也就使得静态分析成为可能。 export export可以导出的是对象中包含多个属性、方法,export default只能导出一个可以不具名的函数。我们可以输用import引入。同时我们也可以直接使用require使用,原因是webpack启用了server相关。 import import { fn } from './xxx' // export导出的方式 import fn from 'xx' // export default方式 复制代码 ES6模块运行机制与commonjs运行机制不一样。js引擎对脚本静态分析的时候,遇到模块加载指令后会生成一个只读引用。等到脚本真正执行的时候。才会通过引用模块中获取值,在引用到执行的过程中,模块中的值发生变化,导入的这里也会跟着发生变化。ES6模块是动态引入的。并不会缓存值。模块里总是绑定其所在的模块。 最后 其实说白了,对于 JS 模块化,上述这些方案都在解决几个同样的问题: 谜一样的全局变量污染 恼人的命名冲突 繁琐的文件依赖 不同的模块化手段都在致力于解决这些问题。前两个问题其实很好解决,使用闭包配合立即执行函数,高级一点使用沙箱编译,缓存输出等等。难点在于文件依赖关系梳理以及加载。CommonJS 在服务端使用 fs 模块同步读取文件,而在浏览器中,不管是 AMD 规范的 RequireJs 还是 CMD 规范的 SeaJs,其实都是使用动态创建 script 标签方式加载,在依赖加载完毕之后再执行,以此省去开发手动书写 script 标签还需关注加载顺序这一烦恼。 ESM 作为语言标准层面的模块化方案,不需要我们额外引入用于模块化的三方包,抛开兼容问题,绝对是最好的选择,也是未来趋势,这点在 Vite 上就足以证明。 读到这里,你是不是对模块化了解有了更清晰的认识呢?此文我们主要讲 JS 模块化,当然模块化并不是只有 JS。 如果你觉得这篇文章对你有点用的话,麻烦请给我们的开源项目点点star:http://github.crmeb.net/u/defu不胜感激!

优秀的个人博客,低调大师

一文读懂边缘计算与云原生结合的前世今生

云栖号资讯:【点击查看更多行业资讯】在这里您可以找到不同行业的第一手的上云资讯,还在等什么,快来! 边缘计算的发展趋势 全球产业数字化正在快速的前进,数字化的应用不仅需要强大的算力完成大数据分析和AI建模,还需要满足现场对处理延迟和网络条件的苛刻要求,满足高度的隐私性和安全性要求,以及能在复杂的IT环境中提供统一且一致的管理能力。 产业对边缘计算的核心需求在于适配性、可编程性和可管理性。其技术趋势可以总结为如下几点: 环境标准,基于标准的API环境开发和移植应用程序; 统一编排,由单一的控制面系统管理云和边缘的应用; 可伸缩性,同一套架构能够支持不同性能、不同规模的设施; 去中心化,模糊边缘和中心的边界,实现应用和数据的全局分布式协作。 本文将深入分析边缘计算从容器化到云原生化的技术演进,进一步提升应用的开发体验和敏捷性。 边缘计算的容器化 边缘计算引入容器化技术能带来以下优势: 解耦运行依赖:容器模式实现了依赖封装,不在需要本地安装; 标准化应用分发:统一使用标准的容器格式和容器仓库; 扩展应用类型:边缘平台使用统一的容器控制面接口。 下图是LFEdge基金会开源项目“Baetyl”的1.0版本架构图,展示了一个典型的容器化边缘: 上图左侧是Baetyl的主进程,该进程位于容器外直接运行于本地操作系统上,负责控制Docker。中间位置是多个Baetyl功能服务,这些服务均以容器的形式运行于Docker内。尽管服务的具体功能、使用资源和开发语言都不相同,但Baetyl只需以标准容器方式启动和监控即可。 容器化已经是主流边缘计算产品的默认选择,但随着生产环境的逐渐增多,也暴露出了不足: 单机限制:Docker缺乏有效的多机通信网络,这限制了边缘的总算力规模; 编排限制:Docker Compose缺乏多实例和跨机器连接能力,这限制了对复杂业务的描述能力; 更新限制:位于容器外的主程序仍然需要手工升级,这限制了无人值守设备的普及。 管理限制:边缘应用的定义和管理模式与云应用分离,这限制了业务的敏捷性。 为解决上述问题,边缘计算平台开始走向与云原生相结合的模式。 边缘计算在本地设备上的云原生化 云原生模式的关键技术是对底层设施的切换,通过使用Kubernetes带来了更精细的应用组织能力。 下图是Baetyl 2.0的架构图,展示了一个典型的云原生边缘: 可见Baetyl 2.0不仅支持了更复杂的Pod应用,还将主程序也一并纳入自身管理,这种变化能带来多方面的收益: 可更新的主程序。新的模式将“系统更新”看作 Baetyl OTA 的一部分,这将让边缘计算设备总能第一时间获得安全更新和Bug修复。 可独立更新的多容器应用。新的模式充分利用的 Kubernetes 丰富的应用定义,并且使每个服务都能被独立的部署和升级,这将让边缘计算拥有更加多样的功能。 对边缘集群的支持。新的模式基于 Kubernetes 的编排能力,可以让一个 Baetyl 实例分布在多个不同的计算节点上,这既能提升总的计算能力,又能获得更高的可用性。 边缘计算在远程管理上云原生化 根据LFEdge的定义,边缘计算会覆盖了多种不同的网络区域,实现与云的无缝融合。 不同的网络之间并没有绝对的边缘和云的区分,而是根据各自的特点承担不同程度的计算负载,双方存在应用和数据的广泛交换。基于这样的原因,边缘计算需要与云计算共享同一套控制面机制,也就是都纳入云原生的形态范围内,统一使用Kubernetes进行管理。 边缘计算的云原生化管理最核心的问题就是如何实现一套在不稳定网络下保证Kubernetes稳定编排的机制。综合业界不同的实现,解决编排的稳定性问题一般分为三个流派。 虚拟节点模式虚拟节点即为每个边缘计算设备创建一个逻辑上的、虚拟的Kubernetes工作节点。虚拟节点本身与Kubernetes位于同一个网络内以保证稳定的工作负载编排。物理边缘设备接收虚拟节点的数据实现间接的稳定编排。 虚拟节点的缺点本地信息被简单抽象为一个工作节点,难以实现本地负载均衡和故障转移。 同步状态复制对虚拟节点的一种改造思路是将本地边缘计算系统视为一个单独的Kubernetes集群,边缘直接复制云上etcd的数据。这种方法能够保证本地拥有足够的编排灵活性,其难点在于保证复制的一致性,且etcd属于Kubernetes的“内部数据”不适合直接操作。 Shadow CRDCustom Resource Definition是Kubernetes社区推荐的功能扩展机制。CRD提供了标准的编程接口,能够在不改变Kubernetes内部机制的前提下引入可自编排的边缘计算节点。Device Shadow是来自物联网的概念,即每一个物理设备(Device)都有对等的影子对象(Shadow)。影子提供了一套完整的一致性数据同步机制。 由Baetyl 2.0引入的Shadow CRD是一种灵活、高效且不损失信息的边云同步技术,未来通过与Operator的结合会进一步提升全局自动化管理的能力。 总结 边缘计算在过去几年经历的极为快速的技术演进,与云原生模式的结合将能让边缘计算更好的吸收云、大数据和AI的成果,并让后者进一步扩展应用范围。 尽管边缘计算仍然处在发展的初期,但随着全球开源社区的蓬勃发展,边缘计算必然会将更多的创新带入各行各业,成为推动智能化时代的关键力量。 【云栖号在线课堂】每天都有产品技术专家分享!课程地址:https://yqh.aliyun.com/live 立即加入社群,与专家面对面,及时了解课程最新动态!【云栖号在线课堂 社群】https://c.tb.cn/F3.Z8gvnK 原文发布时间:2020-07-08本文作者:51CTO技术栈本文来自:“51CTO技术栈”,了解相关信息可以关注“51CTO技术栈”

优秀的个人博客,低调大师

一个优秀的Push平台,需要经历怎样的前世今生

作者:闲鱼技术-剑辛 对闲鱼的用户来说,Push更是与用户息息相关,因为闲鱼商品库存只有一件,商品的时效性很强,所以当用户关注的卖家上新、浏览的商品发生降价或者是平台为用户找到一批高性价比商品时,用户都期望尽快被通知。Push已经成为用户与闲鱼平台联系的重要纽带。 本文将以技术同学视角,介绍闲鱼Push从离线手工投放的1.0版本进化到智能个性化的2.0版本的发展过程,详细说明遇到的问题和技术方案选型,以期给读者带来一些思考和解决类似问题的思路。 一、闲鱼Push1.0 当闲鱼开始all in无线后,平台需要把与用户相关的优质内容推送给用户,便于用户快速找到想购买的商品和感兴趣的内容。平台亟需一个Push产品化方案保证将优质内容以Push的形式触达到用户,提升用户体验。基于这样的前提,闲鱼Push1.0方案的主要思路如下: 计算Push用户名

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册