首页 文章 精选 留言 我的

精选列表

搜索[中国数据库前世今生],共10024篇文章
优秀的个人博客,低调大师

阿里移动技术Overview,详解阿里云移动云Apsara Mobile前世今生

2017杭州云栖大会阿里移动云峰会暨Apsara Mobile品牌发布会上,阿里资深技术专家天施带来《阿里移动技术Overview》的演讲。本文主要对移动十年进行总结,进而回顾了阿里这几年的移动技术变迁,包括Mobile First & Super APP基本原则、技术创新推动组织升级和阿里云移动云Apsara Mobile整个体系介绍和专有云EMAX服务的开启,最后对移动未来进行了展望。 以下是精彩内容整理: 去年阿里做了一年的Weex开源,业界也有很多声音,一直到今天,大家都说移动到了下半场,我们也有很多感受,接下来移动技术应该怎样走?作为走在业界前沿的团队,我们和阿里云移动云思考怎样把更好的产品带给世界,以及移动未来会是什么样子? 移动十年总结 回顾过去移动10年,图为Gartner创新技术曲线,分为几个阶段:第一

优秀的个人博客,低调大师

从网络文件系统到对象存储,聊聊对象存储的前世今生

云栖号资讯:【点击查看更多行业资讯】在这里您可以找到不同行业的第一手的上云资讯,还在等什么,快来! 每种技术的产生都有其原因,也有其渊源。网络文件系统的产生有几十年的历史了,但是由于在互联网盛行的当下无法满足某些需求,于是对象存储产生了。今天我们就从从网络文件系统说起。 早些时候的企业级架构普遍采用网络文件系统,这其中最为著名的就是Sum的NFS了。微软也有类似的网络文件系统,也就是SMB。网络文件系统的原理很简单,其目的就是将存储系统上的文件系统映射到计算节点(比如Web服务器)。这样可以实现存储资源的共享,提高存储资源的利用率。具体映射方式如下所示。 但是文件系统有个天然的缺点。由于文件系统空间组织的特点,导致对文件访问的时候需要比较多次的磁盘访问。 以Ext4文件系统为例,文件系统将磁盘空间分为两个主要的区域,一个是元数据区,用于存储文件inode等信息;另外一个是数据区,用于存储文件的数据,也就是用户数据,具体如下图所示。 这样,当我们访问一个文件的时候,首先需要找到文件对应的inode,然后根据inode信息找到数据的位置,并读取数据。这个过程可能要涉及到2-3次的磁盘访问。对于互联网应用来说,多次磁盘访问会显著降低性能,影响用户的体验。 当然,除此之外还有其它一些问题,比如横向扩展能力等。其实本质上来说,文件系统的目的是一个通用的存储形态,其目的是为了适用大多数的应用场景(比如文件锁,扩展属性,ACL等等)。而网络文件系统为了保证与文件系统语义的一致性,也需要实现这些特性,这就导致网络文件系统比较臃肿。 对象存储解决的问题 由于上述缺点,传统的网络文件系统是完全无法满足互联网领域应用的。我们举一个例子,以FaceBook为例,其每秒钟都有几十万次的照片检索请求。其存储的照片总量每天新增3.5亿张,对应的存储增量大概在300TB左右。如果对应物理设备,每天大概需要新增上百块硬盘。 这种问题在任何互联网公司都会遇到的问题。比如国内的头条,淘宝或者京东等等,在它们的平台上每天也要产生海量的图片访问。传统存储很难满足其性能和扩展性的要求。 虽然互联网应用对性能和容量的要求极高,但是对其它特性却没什么特别的要求。甚至可以说它对其它特性基本上没有太多要求。由于其存储的主要是图片,而且对图片的存储是一次存储,多次访问,没有修改。 为了解决上述问题,对象存储应运而生。可以看出对象存储解决的问题很集中,如何保证横向扩展能力、降低访问延时。而不需要实现文件系统的其它额外特性(后面我们会介绍对象存储还有一些高级特性)。下面是维基百科对对象存储的定义。 Object storage (also known as object-based storage) is a computer data storage architecture that manages data as objects 从定义可以看出,对象存储在数据处理层面的特点是将待处理的数据看做一个整体,这也就是为什么把它称为对象,而不是文件了。 其实对象存储也并非全部如此简单,很多对象存储也实现了比较复杂的功能特性。比如S3对象存储可以支持大数据处理、扩展属性和二次处理(比如照片的转换,水印等)等特性。 对象存储的常见架构 为了让大家对对象存储有更加深刻的理解,我们介绍一下常见对象存储的架构。虽然亚马逊的S3非常出名,但是并没有公开太多技术信息,其架构也无从了解。今天本文将介绍一下比较流行的其它对象存储的架构。 Swift对象存储 首先介绍一下开源对象存储Swift的架构。Swift是OpenStack的一个子项目,是非常流行的开源对象存储软件。Swift在OpenStack中主要用作虚拟机镜像,其特点也是存储大对象。对于小对象则想多弱势。 Swift最主要的是实现横向扩展能力,其前端有一个Proxy组件,该组件实现了数据的分发服务。该组件可以具备多个实例,每个实例可以安装在一台物理服务器。由于Proxy可以横向扩展,因此不会成为性能瓶颈。 在Proxy中最核心的算法是进行数据放置的一致性哈希算法。该算法实现了将一个对象映射到物理设备的过程。为了保证整个系统的可靠性和可用性,Swift将设备划分为若干等级,比如Zone,Host和Disk。通过不同设备的分发,实现故障域的隔离。 如上图哈希算法,首先将物理设备映射到哈希环上;当有对象访问的时候根据对象名称计算出哈希值,然后将对象映射到具体的物理设备上。 Haystack对象存储 Facebook这对其照片应用开发了Haystack对象存储。Haystack与前面Switf的差异是其存储的是小对象。因为图片通常在10MB以下,大部分在KB级别。因此Haystack除了保证系统的横向扩展能力外,其最主要的是实现对小文件的处理。 前面我们说过,对于小文件的性能问题,普通文件系统的问题在于多次读盘操作。而Haystack正式解决了该问题。 Haystack的做法非常简单,它将多个小文件作为一个大文件的局部数据,这个局部数据称为needle。同时Haystack构建了一个描述needle在大文件中位置的索引文件。由于索引文件比较小,因此可以一次性的加载到内存当中。 通过这种方式,当客户端需要访问数据的时候,在存储节点可以直接从内存中得到数据的位置,并一次从磁盘上读取数据。这样访问存储的性能得到大幅的提升。 由于篇幅有限,本文先介绍到这里,关于存储技术的更多细节,还请关注本号。本号后续还会步步深入,介绍关于存储技术的诸多细节。 【云栖号在线课堂】每天都有产品技术专家分享!课程地址:https://yqh.aliyun.com/live 立即加入社群,与专家面对面,及时了解课程最新动态!【云栖号在线课堂 社群】https://c.tb.cn/F3.Z8gvnK 原文发布时间:2020-07-28本文作者:SunnyZhang的IT世界本文来自:“51CTO”,了解相关信息可以关注“51CTO”

优秀的个人博客,低调大师

前端技术及开发模式的演进,带你了解前端技术的前世今生

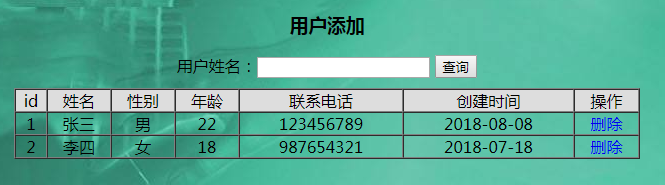
先声明,本篇不会讲带有年代性的前端发展史,不讲故事,想了解的读者可以去查阅一些其他的资料和文章,本篇仅仅从技术发展角度结合案例分析,说明前端技术的发展和开发模式的演进变化。本篇内容重点说明PC端技术,移动端、桌面端本篇不涉及,防止读者看到后面有疑惑,这里强调一下。 这里先讲一个需求,有一个系统需要实现一个模块,用户管理,模块的功能很简单,就是查询、删除。基于这个需求,南风哥会使用几代不同的前端技术分别予以实现,让读者感受其中的变化和奥秘。界面大概是这个样子。 非常老土,非常简单,这都不是重点,重点是能说明问题就行。 第一代:单文件模式 何为单文件模式,解释一下就是一个模块所有的代码都集中在一个文件中,实现上面说的需求,目录大概是这个样子的。 然后看「user.html」具体里面的内容。 <!DOCTYPE html> <html lang="en"> <head> <meta charset="UTF-8"> <title>用户管理</title> <style> .bg{ background-image: url("../img/bg.jpg"); } .text-center{ text-align: center; } .condition-box{ margin-bottom: 10px; } table{ width:90%; } .table-header{ background-color: #dddddd; } .delete{ text-decoration: none; } </style> </head> <body class="bg"> <div class="text-center"> <h3>用户添加</h3> </div> <div class="text-center"> <!-- 查询条件 --> <div class="condition-box"> 用户姓名:<input id="name" type="text"> <button id="search" onclick="search()">查询</button> </div> <!-- 用户列表 --> <table align="center" border="1" cellpadding="0" cellspacing="0"> <tr class="table-header"> <td>id</td> <td>姓名</td> <td>性别</td> <td>年龄</td> <td>联系电话</td> <td>创建时间</td> <td>操作</td> </tr> <tr> <td>1</td> <td>张三</td> <td>男</td> <td>22</td> <td>123456789</td> <td>2018-08-08</td> <td><a class="delete" href="javascript:void(0);" onclick="deleteUser(this,1)">删除</a></td> </tr> <tr id="5"> <td>2</td> <td>李四</td> <td>女</td> <td>18</td> <td>987654321</td> <td>2018-07-18</td> <td><a class="delete" href="javascript:void(0);" onclick="deleteUser(this,2)">删除</a></td> </tr> </table> </div> </body> <script src="../js/jquery-2.1.1.min.js"></script> <script type="text/javascript"> function deleteUser(e,id){ // 调用控制器删除方法 // 后端逻辑是,控制器调用删除业务方法后,返回到user.html页面,即当前页面 location.href = "/userDelete?id=" + id; } function search(){ var name = $("#name").val(); // 调用控制器搜索方法 // 后端逻辑是,控制器调用删除业务方法后,返回到user.html页面,即当前页面 location.href = "/userList?name=" + name; } </script> </html> 我们会发现,所有的样式声明,js代码以及html代码都会集中在一个文件中。这样一个功能如果较为复杂,页面代码看起来会非常复杂,久而久之就会变得不易维护。 当然有一些优化的方式。就是目录划分更友好一些,剥离css和js脚本,采用外部引入的方式,这种方式也是后来采用的比较多的方式,像下面这样,看起来就清爽多了。 <!DOCTYPE html> <html lang="en"> <head> <meta charset="UTF-8"> <title>用户管理</title> <!-- 用户样式 --> <link type="text/css" rel="stylesheet" href="../css/user.css" /> </head> <body class="bg"> <div class="text-center"> <h3>用户添加</h3> </div> <div class="text-center"> <!-- 查询条件 --> <div class="condition-box"> 用户姓名:<input id="name" type="text"> <button id="search" onclick="search()">查询</button> </div> <!-- 用户列表 --> <table align="center" border="1" cellpadding="0" cellspacing="0"> <tr class="table-header"> <td>id</td> <td>姓名</td> <td>性别</td> <td>年龄</td> <td>联系电话</td> <td>创建时间</td> <td>操作</td> </tr> <tr> <td>1</td> <td>张三</td> <td>男</td> <td>22</td> <td>123456789</td> <td>2018-08-08</td> <td><a class="delete" href="javascript:void(0);" onclick="deleteUser(this,1)">删除</a></td> </tr> <tr id="5"> <td>2</td> <td>李四</td> <td>女</td> <td>18</td> <td>987654321</td> <td>2018-07-18</td> <td><a class="delete" href="javascript:void(0);" onclick="deleteUser(this,2)">删除</a></td> </tr> </table> </div> </body> <script src="../js/jquery-2.1.1.min.js"></script> <script src="../js/user.js"></script> </html> 以上两种形式,本质上没有什么区别,所以就放在一起说明,以上方式的优点就是简单粗暴,代码开发的速度较高。 与后端的交互都是后端建立一个Controller或Servlet 这么一个控制器,请求到达控制器,处理完逻辑,然后控制器中跳转到一个页面,页面进行数据渲染展示。每次交互过程目标跳转页面的内容都需要全部刷新加载,即使多次交互跳转的是同一个页面。 这种有什么问题吗?我们来看一下,在用户管理中的用户列表页我们有个查询功能,我们输入一个姓名,点击查询,如果采用上面的方式,想想看,点一下查询,到控制器,后端执行完SQL拿到数据后,又会跳转到用户列表页,我点5次查询,整个列表页就会加载5次,而且整个页面只有用户表格这个部分是变化的,其他部分是没有变化的,这样资源(背景图、jquery库、css)每次就是重复加载,带来的问题就是一、体验不好,二、资源重复加载,给web服务器带来一定的请求压力。 这里补充多说一点内容,就是jsp这个东西,虽然现在用的不多,但还是说一下,之前南风哥面试问过很多面试者,前端都会什么技术,面试者张口就来,jsp .... 什么什么,这里南风哥想说,jsp不属于前端技术,为什么 ? 因为jsp本身执行前是需要编译的,编程成class文件,是在服务端执行的,而真正的前端技术一定是在浏览器或相关前端技术执行引擎上(类Chrome V8)解释执行的。像jsp里写的css、html、js这些东西属于前端技术的范畴,这些都是由浏览器解释执行的,很多人被jsp这种表象迷惑了,看到jsp里面写的都是页面展现相关的代码,认为jsp就是前端技术。 回到上面的问题,我们再来看如何解决上面的问题,这就是第二代技术。 第一代代表技术:html、css、javascript、jquery 第二代:SPA 单页Web应用(single page web application,SPA),简称SPA,由于ajax技术的兴起,使得局部加载变得流行,单页应用页得到了广大开发者和用户的青睐。 简单理解单页应用,就是整个应用加载都在一个页面当中,做的就是局部替换,比如点击一个菜单,系统整个头部,底部,菜单部分都不变化,只变化中间区域的模块内容。 再比如上面说到的查询需求,点击查询后,用户列表整体内容不变,通过ajax请求,数据回来后,通过js仅仅修改表格部分的数据内容。 这样就解决了上面说的一、体验的问题,二、资源重复加载的问题。 大部分情况下,我们只需要在整体页面中引入需要的所有资源,模块中就不需要在引入资源,只处理模块自身的内容和业务即可。 这种方式与后端的交互都是就是建立一个Controller或Servlet 这么一个控制器,请求到达控制器,处理完逻辑,然后返回局部页面片段或者json数据,页面进行渲染展示。每次交互过程只刷新局部,整体页面不做刷新。 这里的数据渲染,一种是通过jquery或js的方式,字符串拼接,然后设置到对应的dom中,像这样。 页面Dom <!-- 用户列表 --> <table id="userList" align="center" border="1" cellpadding="0" cellspacing="0"></table> Ajax加载渲染 function search(){ var name = $("#name").val(); // 调用控制器搜索方法,返回json数据 $.get('/userList?name=' + name,{},function(data){ var userList = data.userList; var row = ''; row += '<tr class="table-header">'; row += ' <td>id</td>'; row += ' <td>姓名</td>'; row += ' <td>性别</td>'; row += ' <td>年龄</td>'; row += ' <td>联系电话</td>'; row += ' <td>创建时间</td>'; row += ' <td>操作</td> '; row += ' </tr>'; for(var i = 0 ; i < userList.length; i++){ var user = userList[i]; row += '<tr>'; row += ' <td>' + user.id + '</td>'; row += ' <td>' + user.name +'</td>'; row += ' <td>' + user.sex + '</td>'; row += ' <td>' + user.age +' '</td>'; row += ' <td>' + user.phone + '</td>'; row += ' <td>' + user.createDate + '</td>'; row += ' <td><a class="delete" href="javascript:void(0);" onclick="deleteUser(this,1)">删除</a></td>'; row += '</tr>'; } $("#userList").html(row); },'json'); } 另一种方式模板引擎 <!-- 定义模板 --> <script id="userListTpl" type="text/html"> <tr class="table-header"> <td>id</td> <td>姓名</td> <td>性别</td> <td>年龄</td> <td>联系电话</td> <td>创建时间</td> <td>操作</td> </tr> {{each list as user i}} <tr> <td>{{user.id}}</td> <td>{{user.name}}</td> <td>{{user.sex}}</td> <td>{{user.age}}</td> <td>{{user.phone}}</td> <td>{{user.createDate}}</td> <td><a class="delete" href="javascript:void(0);" onclick="deleteUser(this,{{user.id}})">删除</a></td> </tr> {{/each}} </script> 使用 function search(){ var name = $("#name").val(); // 调用控制器搜索方法,返回json数据 $.get('/userList?name=' + name,{},function(data){ var userList = data.userList; var html = template('userListTpl', userList); document.getElementById('userList').innerHTML = html; },'json'); } 复杂页面建议使用模板引擎的方式,代码结构更清晰,更容易维护。 这种方式的优点,显而易见可以解决第一代技术的问题,那它有问题吗 ? 显然有,一、破坏浏览器的后退、前进功能(异步加载,地址栏不发生变化,所以是无法后退前进),当然有一些解决办法,下面再说 ,二、SEO不友好。 所以比较常见的做法是,后端管理系统一般会整体采用SPA方式,包括现在的很多系统也是,有强SEO需求的仍然会采用上面第一代方式,然后结合一点点ajax的内容,这便是第二代前端的开发模式。 局部加载的实现方式: 1、ajax 局部请求加载 2、前端hash路由,也是现在的主流方式,这种方式可以解决浏览器的前进、后退问题,通过地址栏hash值的变化,但历史页面状态无法保持,回退的页面数据仍需要重新加载、初始化,但随着前端数据持久化的逐步流行,回退历史页面状态的保存也渐渐不是问题。 3、iframe、frameset 也可以实现,但是不建议。 第二代代表技术:ajax、artTemplate 第三代:模块化 随着系统功能越来越多,代码文件也越来越多,相互之间的依赖调用关系变得异常复杂。这时候两个问题变得十分突出,一是js中的命名冲突问题,二是资源的加载问题。 先看js的命名问题,看一个简单的js文件 function deleteUser(e,id){ // 调用控制器删除方法 // 后端逻辑是,控制器调用删除业务方法后,返回到user.html页面,即当前页面 location.href = "/userDelete?id=" + id; } function search(){ var name = $("#name").val(); // 调用控制器搜索方法 // 后端逻辑是,控制器调用删除业务方法后,返回到user.html页面,即当前页面 location.href = "/userList?name=" + name; } 这是上面user模块的js文件,user.js,有两个方法,这个js会被在user.html中引入 但是一个稍微复杂点的系统或功能,不可能只引入这么几个外部js,常常有几十个甚至上百个js需要引入,还有我们自己封装的组件,通用方法等。这样的大量引入,如果都是user.js 这种全局命名形式,很容易就发生命名上的冲突,就是你定了一个search函数,另一个开发者或者插件里面也定义了一个search方法,这就会带来莫名奇妙的BUG和问题。 在来看一下资源加载的问题,同样是用户模块,引入了比如说50个js文件,但是有40个文件是点击搜索时才需要使用,加载列表时不需要,如果每次加载列表都去加载全部的js文件,那将需要多大的带宽资源和带来多大的请求压力(这里先不考虑CDN等优化方式)。能不能让资源在真正需要的时候再去加载 ? 那么前端模块化技术就是重点解决以上两个问题。我们的代码结构就会变成这个样子。 定义模块 define(function(require, exports, module) { var $ = require('jquery'); var tpl = require('template'); var user = {} // 初始化 user.init = function(){ user.deleteUser(); user.search(); } user.deleteUser = function() { $(".delete").click(function(){ $.get('/userDelete?id=' + id,{},function(data){ user.reloadData(); },'json'); }); }; user.search = function() { $("#search").click(function () { var name = $("#name").val(); // 调用控制器搜索方法,返回json数据 $.get('/userList?name=' + name,{},function(data){ var userList = data.userList; var html = template('userListTpl', userList); document.getElementById('userList').innerHTML = html; },'json'); }); }; exports user; }); 使用模块 完整页面代码 <!DOCTYPE html> <html lang="en"> <head> <meta charset="UTF-8"> <title>用户管理</title> <!-- 用户样式 --> <link type="text/css" rel="stylesheet" href="../css/user.css" /> </head> <body class="bg"> <div class="text-center"> <h3>用户添加</h3> </div> <div class="text-center"> <!-- 查询条件 --> <div class="condition-box"> 用户姓名:<input id="name" type="text"> <button id="search">查询</button> </div> <!-- 用户列表 --> <table id="userList" align="center" border="1" cellpadding="0" cellspacing="0"> </table> </div> </body> <script src="../js/jquery-2.1.1.min.js"></script> <script src="../js/sea.js"></script> <script> seajs.use(['./js/user', 'jquery'], function(user, $) { user.init(); }); </script> <!-- 定义模板 --> <script id="userListTpl" type="text/html"> <tr class="table-header"> <td>id</td> <td>姓名</td> <td>性别</td> <td>年龄</td> <td>联系电话</td> <td>创建时间</td> <td>操作</td> </tr> {{each list as user i}} <tr> <td>{{user.id}}</td> <td>{{user.name}}</td> <td>{{user.sex}}</td> <td>{{user.age}}</td> <td>{{user.phone}}</td> <td>{{user.createDate}}</td> <td><a class="delete" href="javascript:void(0);" onclick="deleteUser(this,{{user.id}})">删除</a></td> </tr> {{/each}} </script> </html> 第三代代表技术:seajs、requirejs、kissy 第四代:前端MVC MVC开始是存在于桌面程序中的,作者意图解决桌面端GUI的开发耦合问题,后来被结合后端技术,整体又组成了一个MVC模式以及纯前端的MVC模式。但思想是一致的,就是包含 控制器、模型、视图三个部分。 当一个系统的模块越来越多之后,模块内部的代码维护便是个大问题,为了让模块代码变得清晰,更易维护,相互之间没有紧密的耦合关系,技术先驱者们想了很多解决办法,MVC便是其中一种,像还有MVP模式,以及后面将提到的MVVM。 第四代代表技术:Extjs、backbone.js Extjs不是UI框架吗?,实际上它不只有UI控件,Extjs4开始有了MVC模式,南风哥之前所在公司使用的便是Extjs,充分使用了其中的MVC模式。虽说现在收费了,用的人不怎么多了,但在当年还是有一席之地的。 如何将一个前端模块使用MVC的方式就行构建,以Extjs的为例构建用户管理就是如下。 UserController 注册用户管理的交互事件和方法定义 UserModel 数据模型,配置Store使用 UserStore 异步请求,负责交互后台数据 UserGrid 表格视图,负责展示Store请求回来的数据,绑定渲染 将各层分离,使代码整体结构更清晰,耦合度更低,可维护性更强,感觉很复杂?没错,这样本来一个简单的模块开发起来就会变得看起来复杂,需要分离,需要遵循一定的规范,但长远看这么做是有好处的,代码的可维护性和可读性会有不小的提升。 第五代: MVVM 这里就不在提MVP这种模式了,没有太流行起来,直接看MVVM模式。拆解一下,实际上是 M-V-VM(即模型-视图-视图模型)三个部分 ,M和V还是原来的M和V,唯一不同的是VM这个东西,通过VM(ViewModel)完全将M和V分离,是M和V的连接纽带。实现了双向数据绑定,简单理解一下就是,模型发生变化,视图会自动更新,视图数据发生变化,模型会自动感知也发生变化,当然这是直观的使用感受,底层是有比较复杂的实现逻辑支撑。 对开发者来说,就可以从以前的dom操作中解放出来,想想以前的操作模式,接收到后台的数据,jquery开干,选择dom,拿到数据,拼接字符串,填充到dom中。视图数据变化了,js 每次需要主动重新取值,有了MVVM这都不需要了,做好了双向绑定。只要将数据绑定到M,V自动更新,V层表单或其他视图组件状态发生变化,M自动更新,没有了中间的DOM操作和控制。一切都变得简单。相互之间也没有耦合,自己干自己的事情。 相比前端模板引擎,它又少了模板定义这个部分,也是简单不少,省了不少事情。 使用MVVM后,代码会变成这样。 定义 new Vue({ el: '#app', data: { name:'', userList:[] }, methods:{ deleteUser:function(){ }, search:function(){ var _this = this; $.get('/userList?name=' + name,{},function(data){ var userList = data.userList; // 赋值,视图自动更新 _this.userList = userList; },'json'); } } }) 使用 <!DOCTYPE html> <html lang="en"> <head> <meta charset="UTF-8"> <title>用户管理</title> <!-- 用户样式 --> <link type="text/css" rel="stylesheet" href="../css/user.css" /> </head> <body class="bg"> <div class="text-center"> <h3>用户添加</h3> </div> <div class="text-center"> <!-- 查询条件 --> <div class="condition-box"> 用户姓名:<input v-model="name" type="text"> <button v-on:click="search()">查询</button> </div> <!-- 用户列表 --> <table id="userList" align="center" border="1" cellpadding="0" cellspacing="0"> <tr class="table-header"> <td>id</td> <td>姓名</td> <td>性别</td> <td>年龄</td> <td>联系电话</td> <td>创建时间</td> <td>操作</td> </tr> <tr v-for="user in userList"> <td>{{user.id}}</td> <td>{{user.name}}</td> <td>{{user.sex}}</td> <td>{{user.age}}</td> <td>{{user.phone}}</td> <td>{{user.createDate}}</td> <td><a class="delete" href="javascript:void(0);" onclick="deleteUser(this,{{user.id}})">删除</a></td> </tr> </table> </div> </body> <script src="../js/jquery-2.1.1.min.js"></script> <script src="../js/vue.js"></script> <script src="../js/user.js"></script> </html> 第五代代表技术: Angularjs、Vue 第六代:nodejs 为基础的大前端 关于nodejs引用网上的一句解释 “Node.js是一个基于 Chrome V8 引擎的 JavaScript 运行环境。”,简单的说Node.js就是运行在服务端的 JavaScript。What ?js 能运行在服务端了 ?对的。 先说下为什么出现了nodejs这个东西,nodejs作者的初衷是设计一个高性能的Web服务器,让前端开发人员通过javascript也可以进行服务端的开发,不可否认,事件驱动 + 非阻塞 + Chrome v8 引擎,nodejs的性能表现确实优异。 发展至今,纯使用nodejs作为后端开发的企业,显然不多。但是却在另外两个方面大放异彩。 一、开发时,打破前后端协作的壁垒,即使在后端没有按时提供接口的情况下,前端依旧可以按照自己的节奏完成开发任务。是大前端开发的基石。 二、生产环境中,借助其高性能,更多作为一层网关或代理,转发请求到真正的后端服务上。 随着nodejs的流行,前端变得更加独立,产生了以vue和react为代表的两大阵营,结合其他插件模块,前端也有模块依赖了,也可以管理依赖了,前端也需要打包编译了,对,没错,前端需要学的东西也越来越多了,体系也越来越庞大了,这是真正完全的前后端分离,大前端来了。 第六代代表技术:nodejs、Vue、React、Webpack 通过以上几代技术的演进,前端技术发展一直在朝着解耦、可维护、高性能的目标不懈的努力着,致力于良好的用户体验,未来还会出现哪些NB的技术,让我们拭目以待吧。 南风哥对以上几种方式都经历过,体验过,现在每种方式肯定都有企业在用或者组合使用,技术这个东西本身就是为解决问题而存在的,不能为了技术而技术,为了追求潮流而不管不顾,立足企业的痛点和需求,结合企业的实际情况,选择合适的技术解决问题才是王道。 文章篇幅较长,能坚持看完着实不易,给自己点个赞吧。 创作也不易,给作者点个赞。

优秀的个人博客,低调大师

一个前端大佬的十年回顾 | 漫画前端的前世今生

作者:京东科技 胡骏 引言 岁月如梭,十载流年 前端技术,蓬勃向前 HTML,CSS,JavaScript 演绎出璀璨夺目的技术画卷 回到十年前,前端技术就像一名戴着厚重眼镜的书呆子,总是小心翼翼,被各种各样的浏览器兼容性问题欺负(就像在小学被欺负一样)。 但随着时间的推移,这个书呆子开始锻炼,变得越来越强壮,终于能够对抗那些讨厌的兼容性问题 进入中学时期,前端技术遇到了那个改变它一生的朋友——jQuery。在jQuery的帮助下,前端技术变得更加自信,能够在各种浏览器之间轻松穿梭(就像找到了武林秘籍,功力大增)。 随后,前端技术开始追求更高的境界。它遇到了三位美丽的姑娘:Angular、React和Vue。这三位姑娘带给了前端技术无尽的魅力,让它迅速崛起,成为了技术江湖中的一股新兴力量。 如今,前端技术已经变得越来越强大,像一个熟练掌握各种武功的高手。它的发展速度之快,令人瞠目结舌,仿佛在短短十年内成为了武林盟主。它带领着一群忠诚的拜金党(程序员),在技术江湖中闯荡,创造了一个又一个的传奇。 而现在,前端技术正在为未来的挑战做准备,它还能带给我们多少惊喜,以及如何抵抗那些不断涌现的挑战者?让我们一起拭目以待,看这场武林大戏如何演绎。 一、历程 前端技术开发在过去的十年里经历了从HTML、CSS到JavaScript的演变。在这个历程中,前端工程师的角色也发生了变化,他们不再只是单纯的代码开发者,还需要与设计师、产品经理、运营人员等其他团队成员协作,共同完成网站的开发。 • _2010年以前,_前端工程师主要负责网站的静态页面开发,如网页设计、图片处理等。在这个阶段,前端工程师的技能主要包括HTML、CSS和JavaScript等基本技术。 • _2010年,_JavaScript成为了前端开发的主要语言。随着JavaScript的普及和发展,越来越多的前端工程师开始关注JavaScript的应用和开发。 • _2011年,_jQuery成为了前端开发的主流库,并且HTML5和CSS3开始受到重视。这也是前端开发变得更加动态和交互性的开始。 • _2012年,_响应式设计和移动设备优先的设计理念开始流行,前端开发在移动端上崭露头角。 • _2013年,_Angular引入了模块化和数据绑定的概念,Bootstrap实现了响应式框架,前端开发变得更加简单和高效。 • _2014年,_React发布,革新出组件化的思想,前端开发变得更加灵活和可维护。 • _2015年,_ES6发布,带来了诸如箭头函数、模板字符串和解构赋值等语言的改进,使JavaScript变得更加易用和现代化。同年,Vue的发布迅速获得了广泛应用。 • _2016年,_前端工具链的发展得到了加速,例如Webpack和Babel等工具的普及使得前端工程化得到了广泛推广。 • _2017年,_JavaScript库和框架更加多样,Angular、React和Vue等都在不断地演进和优化。PWA技术的普及使得网页更接近原生应用的用户体验。 • _2018年,_JavaScript框架的选择更加复杂,同时CSS预处理器(例如Sass和Less)和CSS-in-JS的技术也逐渐成熟。 • _2019年,_前端技术继续保持快速发展的趋势,更加注重用户体验和开发效率。例如,React Hooks和Vue 3等技术的推出使得前端代码更简洁并可维护。 • _2020年,_因新冠疫情影响,居家办公及远程工作成为新趋势。虚拟会议和在线教育等普及推动了前端技术的发展,也更加重视了访问性和用户体验。 • _2021年,_新技术和工具不断推陈出新。Web Assembly使得前端代码获得更高的效率,而预渲染和静态站点生成等技术让前端应用可以获得更快的加载速度。 • _2022年,_VR(虚拟现实)和AR(增强现实)技术的不断发展,前端开发者需要开发出更加适合VR/AR场景的应用程序。 • _2023年至今,_AI(人工智能)技术的突破性进展,前端技术将在AI 技术的加持下得到更广泛的应用,从而带来更智能和更高效的前端开发体验。 二、HTML5和CSS3的普及 HTML5和CSS3,这两个神秘代码世界的统治者,它们的名字听起来像是一对科学家的昵称,但它们的影响力却是无与伦比的:让我们的网页从普通变得绚丽多彩。 作为一名网页开发者,我们经常需要面对一些令人头疼的问题:浏览器兼容性、页面加载速度缓慢等。但是,当HTML5和CSS3出现在我们的视野中时,一切都变得不一样了。 HTML5是一种用于网页开发的语言,它具有更强的多媒体功能,比如说可以轻松地嵌入音频和视频。它还具有更强的语义,使我们可以更容易地描述页面内容。 而CSS3则是一种用于美化网页的语言,它提供了更多的样式选项,比如说可以实现圆角、阴影等效果。它还支持响应式设计,可以让我们的网页在不同的设备上都能得到最佳的展示效果。 用HTML5和CSS3开发的网页不仅美观,而且更快。我们不再需要使用大量的JavaScript代码来实现一些简单的功能,因为HTML5和CSS3已经帮我们完成了这些工作。 不仅如此,HTML5和CSS3还使得网页开发变得更有趣。我们可以创造出各种各样的动画效果,比如说滚动、旋转等,而不需要依赖任何第三方工具。这不仅让我们的网页更具吸引力,也使我们的用户更容易理解和使用。 HTML5就像一个网页的“建造师”,它负责把网页的框架建造出来,而CSS3则是一个“装饰师”,它负责把网页的外观和感觉打造出来。这对搭档携手合作,把一栋美丽的大厦(网站)拔地而起。 三、JavaScript框架的崛起 JavaScript框架,从这个词语中我们就能感受到它的强大和威力,如同统治世界的巨龙,横行天下,让所有的开发者都震撼不已。 在过去的十年里,我们见证了许多JavaScript框架的诞生和发展。最早的Angular和Backbone逐渐被React和Vue等框架所取代。这些框架不仅简化了开发者的工作流程,还引入了组件化的开发思想,提升了Web应用的可维护性和可扩展性。 另外,JavaScript框架也推动了Web前端技术的进步,引入了许多新的概念和理念,如组件化、数据驱动等等,使得Web前端开发变得更加简单而清晰。 3.1 React:让你的用户界面如此简单 React,这是一个神奇的JavaScript框架,它可以让你的用户界面变得如此简单,以至于你会想:“这就是魔法吗?” React的核心思想是组件化,它把用户界面拆分成许多小的组件,每个组件都可以独立运行,并且可以方便地复用。这样,你就可以更加简单高效地开发出高质量的用户界面。 React的另一个优秀特性是Virtual DOM,它可以帮助你更快速地渲染用户界面,并且不会影响用户体验。这就像是一个超级快速的缓存,让你的用户界面飞快地呈现在用户面前。 React还提供了一些非常实用的功能,比如说React Router,它可以帮助你管理路由,让用户界面更加流畅;而React Redux可以帮助你管理应用状态,让你的代码更加整洁。 此外,React是一个非常活跃的开源项目,它的开发者们一直在不断改进和完善,值得每一个前端开发者去学习和使用。 3.2 Vue:充满了年轻的活力和智慧 Vue是另一个JavaScript框架,可以让你快速构建网页,就像是一个魔术师,把一堆杂乱无章的东西变成了一个美丽的魔术。 Vue的核心思想是数据驱动+组件化。这听起来很高大上,但其实就像是你在做一道数学题,先把问题分解成若干小问题,再一步步解决。 Vue有一个很酷的特性:双向绑定。这听起来很神秘,但实际上就像是你和你的好朋友之间的对话,你说了什么,他就知道了。 学习和使用Vue的过程中,你会发现开发变得更加简单和有趣,就像是在做一道神奇的拼图,一步步把图片拼出来,比如说它有很多组件,就像是一个工具箱,你可以随时随地使用。组件的好处在于,它可以把复杂的功能分解成若干个简单的部分,这样就可以很容易地管理和维护你的代码。 同时,Vue有很多很多的插件,可以让你的开发体验更加顺畅。插件的好处在于,它可以帮助你实现一些复杂的功能,这样就不必自己写一坨代码。 Vue还有一个很棒的社区,可以帮助你解决一些棘手的问题,也方便了你与其他开发者交流经验,编码世界有了朋友,永远不会孤单。 3.3 谨慎:利剑具有两面性 JavaScript框架是一个非常重要的工具,就像一把利剑帮助开发者切开困难,让开发者更加简便高效地开发前端应用,也推动了前端技术的进步,并抵达成功的彼岸。 但是,请记住,刀刃朝向你,也有可能伤到自己,因此请开发者在使用JavaScript框架时要谨慎小心。 四、Node.js和前后端分离 首先,让我们回顾一下过去,那时候前后端是紧密结合在一起的,像一对结婚多年的夫妇。它们有着许多共同的爱好,但是有时它们也会产生冲突,就像夫妇间的争吵一样,前后端争吵也是不可避免。 但是,随着技术的发展,我们发现了一个新的解决方案:前后端分离。就像夫妇分居一样,前后端也可以分开,以避免冲突,Node.js就是这个分离的功臣。 Node.js可以帮助前端和后端分开,各自独立工作。前端可以专注于用户界面的开发,后端可以专注于数据的处理,就像夫妇分别在各自的工作岗位上工作一样,前后端也可以分别在各自的领域里工作。 Node.js的出现让JavaScript可以在服务器端运行,为前后端分离的架构模式提供了可能。前后端分离使开发者可以更加专注于前端应用的开发,提高开发效率。同时,Node.js的诞生也带来了诸如npm、yarn等包管理器的出现,开发者可以轻松地引入和管理第三方库。 4.1 npm:被忽视的少年 首先,让我们了解一下npm的历史。它曾经是一个年轻的少年,总是被忽视。但是随着它长大,它变得越来越强大,并且成为了Node.js开发的重要组成部分。 以前,如果我们想要安装一个库,需要手动下载,并且手动安装它。这是一件非常繁琐的事情,而且很容易出错。但是,随着npm的出现,一切都变得更简单了。只需要运行一条命令(如:npm install),就可以轻松地安装任何库。 npm还提供了一个巨大的软件仓库,其中包含了数以千计的库和工具。它就像一个图书馆,你可以随心所欲地查阅和使用。 但是,npm不仅仅是一个简单的安装工具。它还像一个管家,辅助我们管理依赖关系,并帮助我们发布代码和维护代码库。它还有许多其他功能,例如构建工具,测试工具等。因此,如果你想充分利用npm,请不要仅仅停留在它的基础功能上。 4.2 yarn:少年的替身 首先,让我们了解一下yarn的由来。它的诞生是为了解决npm的一些问题,就像是一个少年的替身,它试图取代npm并成为新的领导者。 yarn可以帮助我们快速安装依赖包,并管理依赖关系,像一个组织者可以帮助我们维护代码库,以此节省时间并提高开发效率。 yarn还提供了一个更好的版本控制系统,可以帮助我们管理依赖项的版本。如果你在多个项目中使用相同的依赖项,可以确保所有项目使用相同的版本,从而避免了版本冲突,譬如一个和平协调员。 除了管理依赖关系和解决依赖冲突外,yarn还可以帮助我们更快地进行安装,因为它可以在本地缓存安装过的依赖项。这意味着,如果你在多个项目中使用相同的依赖项,它们将不会再次下载,从而减少了安装时间。 此外,yarn支持并行安装,这意味着它可以同时安装多个依赖项,从而加快安装速度。这是一个非常有用的功能,特别是当你需要安装大量依赖项时。 yarn也有一个很棒的社区,可以帮助你解决任何问题。如果你在使用yarn时遇到问题,可以在社区中寻求帮助。这是一个非常有价值的资源,可以帮助你更快地解决问题。 五、构建工具和自动化 构建工具和自动化是现代软件开发的重要组成部分,就像给你的代码加上糖衣一样,帮助我们提高开发效率,并且可以让我们更专注于代码本身。 Grunt、Gulp、Webpack等工具的出现,使得开发者可以方便地实现代码压缩、合并、优化以及模块化等功能。而随着CI/CD的普及,自动化测试和部署变得更加便捷,大大提高了软件开发的质量和开发速度。 5.1 Grunt:猪叫的声音? Grunt,这不是一个军人,也不是一个猪叫的声音。实际上,它是个非常酷的JavaScript任务运行器,可以帮助你自动化各种任务,如代码构建,单元测试和文件合并。它的目的是让你的工作变得更轻松、更有效率,而且不需要你不停地敲代码。 想象一下,每次你修改了一个文件,你就需要手动编译、压缩、合并、测试等等。这听起来很枯燥,对吧?但是,如果有一个工具能帮你自动完成这些任务,那该有多好!这就是Grunt的作用。 Grunt的核心思想是使用插件(plugins)来完成各种任务。有数以百计的插件可以帮助你实现从编译Sass到压缩JavaScript的各种任务。插件是通过npm安装的。Grunt有许多内置任务,例如:文件压缩,CSS预处理,JavaScript检查等。此外,还有大量第三方插件,也可以助你完成更多任务。 Grunt的配置文件是Gruntfile.js,用于定义任务和任务的配置。Grunt使用JavaScript代码配置任务,因此对JavaScript基础知识的了解是使用Grunt的必备条件。 Grunt的任务可以在命令行中通过运行以下命令执行:grunt task-name。如果你想要实时监控文件的变化,并在文件变化时自动执行任务,你可以使用grunt watch命令。 如果你是一个JavaScript开发者,那么Grunt是一个不可或缺的工具。它可以让你的工作变得更快捷、更高效,让你有更多的时间去做其他有趣的事情,比如喝咖啡、写文章或者是找对象。 5.2 Gulp:古老的咒语? 让我们来说说Gulp的名字。它的名字听起来有点像一个古老的魔法咒语,你想:“Gulp!” 然后你的代码就会变得更快、更简洁、更酷。不过,实际上Gulp并不是魔法,而是非常实用的构建工具。 Gulp的工作原理很简单:它通过创建一系列的任务,来自动完成你的工作流程。比如说,你可以创建一个任务,来自动编译你的Sass文件,或者压缩你的JavaScript文件。这样,你就不需要手动执行这些步骤了,Gulp会帮你完成。 Gulp还有一个非常酷的功能:它可以实时监控你的文件,并在你修改了文件后立即执行相应的任务。这样,你就可以实时看到更改的内容,而不需要手动重新执行。 Gulp如何使用呢?首先,你需要安装Node.js和npm,因为Gulp是基于Node.js的。其次,安装Gulp的命令行工具,只需在终端中运行以下命令即可:npm install gulp-cli -g。接下来,你需要在项目目录中创建一个package.json文件,这是npm的配置文件,用于管理项目依赖。你可以通过运行以下命令来创建一个package.json文件:npm init。然后,你需要安装Gulp,只需在项目目录中运行以下命令即可:npm install gulp--save-dev。最后,创建一个gulpfile.js文件,这是Gulp的配置文件,用于编写你的任务。 现在,你已经准备好使用Gulp了。开始编写你的任务,并运行以下命令来执行吧:gulp task-name。 5.3 Webpack:订制的包包? Webpack可以帮你把代码压缩成小而美的包,就像私人订制的收纳柜,它可以装下你所有的包包,并且把它们整齐地放在一起,使你的“奢侈”更加有序! 但是,如果你犯了错误,它就像一个恶魔般出现在你面前,吼叫着告诉你:“Error: This is error!”所以,请小心使用Webpack。 不过,只要你已经掌握了Webpack的使用方法,那么它将成为你的最佳伙伴,因为它可以为你节省大量的时间,并且让你的代码变得更加整洁。 你可以告诉Webpack:“嘿,Webpack!帮我处理图片和字体!” 然后Webpack就会用它的魔力,将它们变成小小的Data URL或文件。你不会相信,Webpack的魔力是如此的强大,它甚至可以帮你处理模块依赖。 那么,如何使用Webpack呢?首先,你需要安装它(就像是奢侈品店要先开门才能买包)。安装很简单,只需要在终端中输入:npm install webpack;然后,创建一个配置文件(就像是奢侈品店的导览图,告诉你每样包包在哪里)。配置文件一般命名为webpack.config.js,内容如下:module.exports = {entry:'./src/index.js',output: {filename:'bundle.js',path: __dirname +'/dist'}};。接下来,只需要在终端中输入打包命令:npx webpack;最后,引用打包后的文件bundle.js就可以了(背起新包包,开启一场冒险之旅)。 六、PWA和Web性能优化 在这个快节奏的数字化时代,越来越多的用户转向使用移动设备和Web应用程序。 PWA成为了一个重要的技术趋势,它的全称是“Progressive Web App”,翻译成中文就是“渐进式Web应用程序”。简单来说,PWA是一个既可以在浏览器上运行的Web应用程序,同时也可以像原生应用一样在离线时使用。它的最大优点就是可靠性,因为PWA可以像原生应用一样缓存数据和资源,这意味着它可以在离线时运行,而不会像普通的Web应用程序一样无法使用。 此外,Web性能优化也成为了开发者关注的重点。我们需要知道一个简单的事实,那就是用户喜欢快速的网站。如果你的网站速度太慢,那就会让你的用户感觉像一头正在沙漠里跑步的骆驼一样疲惫不堪,感到痛苦和沮丧,这会让他们不得不离开,去寻找新的绿洲。 所以,为了确保你的网站速度足够快,你需要采取一些优化措施。以下是一些可以提高Web应用性能的技巧: **使用CDN(内容分发网络):**CDN是一组分布在世界各地的服务器,它们可以缓存你的网站内容,并将其分发到全球各地的用户。这可以大大加快你的网站加载速度,因为用户可以从离他们最近的服务器获取内容。 **压缩文件大小:**压缩你的HTML、CSS和JavaScript文件可以减少它们的大小,从而加快它们的加载速度。你可以使用像Gzip这样的压缩算法来实现这一点。 **使用缓存:**缓存是一种将网站数据存储的技术。例如浏览器缓存:在响应头中设置缓存策略来控制缓存时间;以及服务器端缓存:使用Memcached或Redis等缓存服务器,以减少响应时间。这样一来,当用户再次访问你的网站时,它们可以从缓存中加载数据,而不必重新下载,大大加快你的网站加载速度。 **减少HTTP请求:**有一个叫做“夹心饼干法则”的说法。这个法则认为,在一次HTTP请求中,中间的响应部分应该像夹心饼干一样短,而请求和响应头和尾应该像饼干的两端一样长。这听起来很有趣,但其实它也是有道理的,因为请求和响应头和尾中包含的信息比较少,而响应中间部分则包含了网页的实际内容,因此应该尽可能地减少其大小。你可以通过将HTML和CSS以及JavaScript文件合并成一个文件,或者通过使用CSS Sprites将多个图像合并成一个文件来减少HTTP请求的数量。 **使用响应式图片:**图片是网站加载速度最慢的资源之一。为了提高网站加载速度,你可以使用响应式图片,这些图片可以根据用户的设备屏幕大小来动态地调整大小。这样一来,用户只会下载他们所需的图像大小,而不是下载整个大图像。 **使用懒加载技术:**懒加载是一种延迟加载技术,它可以延迟加载页面上的图像、视频和其他资源,直到它们真正需要时才出现。这可以减少页面的初始加载时间,因为只有当用户滚动到需要加载的部分时,它们才会被加载。 你知道吗,Google Chrome浏览器可以使用一个名为“Lighthouse”的工具来检查网站的PWA和性能方面的指标。但你可能不知道的是,这个工具还有一个有趣的功能,就是可以为你的网站生成一份“独家报告”,这样你就可以像读报纸一样轻松地查看网站的PWA和性能状况了。但是,要牢记的是,优化Web应用性能是一个不断发展的过程,需要持续监测和调整以确保最佳体验。 七、Web组件和跨平台框架 Web组件和跨平台框架是现代Web开发中的两个热门话题,它们就像是现代Web开发的两座巨大城堡,吸引着无数开发者前来探索和征服。 首先,我们来谈谈Web组件。Web组件是一种现代的Web开发技术,它允许开发者将Web应用程序分解成可重用的组件,这些组件可以在不同的Web应用程序中共享和重用。比如,你可以将一个搜索框组件用于多个Web页面,而不必每次都重新编写。 Web组件的好处不仅在于可重用性,还在于它们的灵活性。你可以根据需要自定义Web组件,为你的Web应用程序添加新的功能和样式。 但是,Web组件并不是“银弹”,它们在某些方面仍然有限制。比如,Web组件难以处理动态数据,因为它们是静态的。此外,Web组件也不是完美的跨平台解决方案,因为它们可能无法兼容不同的Web浏览器和设备。 这就引出了我们的下一个话题:跨平台框架。跨平台框架是一种可以在多个平台上运行的软件框架,包括Web、移动和桌面应用程序。它们允许开发者编写一次代码,然后在不同的平台上运行,无需进行任何额外的修改。 跨平台框架的好处显而易见:它们可以大大减少开发时间和开发成本。但是,跨平台框架并非完美无缺。它们可能会受到不同平台的限制,从而无法充分利用每个平台的功能和性能。此外,跨平台框架还可能会导致性能问题和代码质量问题。 现在,我们来看看如何将这两种技术结合起来。使用Web组件和跨平台框架可以让你搭建你的虚拟王国,充分利用Web组件的可重用性和灵活性,同时充分利用跨平台框架的跨平台能力和效率。 当然,这并不是说将Web组件和跨平台框架混合在一起就是万无一失的。你需要仔细考虑你的应用场景,确保使用这两种技术的方式是最优的。 比如,你可以使用Web组件来构建你的用户界面,然后使用跨平台框架来将Web应用程序转换为移动应用程序。这样,你就可以在多个平台上运行相同的代码,而且用户体验也会更加一致。 或者,你可以使用跨平台框架来编写你的应用程序逻辑,然后使用Web组件来定制你的用户界面。这样,你可以在不同的Web应用程序中重用你的用户界面,而且你的应用程序逻辑也可以在多个平台上运行。 再者,你也可以将这两种技术都使用在同一个应用程序中。这样,你可以充分利用Web组件的可重用性和灵活性,同时充分利用跨平台框架的跨平台能力和效率。只要你能合理地使用这些技术,就可以打造出更好的Web应用程序。 Web组件和跨平台框架都是非常有前途的技术,它们可以为现代Web开发带来很多好处,为我们带来更加灵活、高效和强大的Web开发工具和平台。无论是Web组件还是跨平台框架,它们都是我们构建虚拟王国的重要基石。 八、前端安全问题 在当今数字化时代,前端安全已成为互联网世界中的重要一环。不管是个人用户,还是企业机构,前端安全都需要被高度重视。尽管我们已经发展出了各种各样的安全技术和防御手段,但是前端安全问题仍然是一个不断增长的挑战。 8.1 XSS攻击:你的网站很容易被攻击 你听说过XSS攻击吗?这种攻击方式是通过篡改网页的HTML并在用户浏览器中注入恶意代码的一种攻击方式。这些恶意代码通常是JavaScript脚本,它们可以被用来窃取用户的敏感信息,如用户名、密码、银行账户信息等等。 如果你的网站存在XSS漏洞,那么恶意攻击者就可以在你的网站上注入一些不良代码,这些代码可能会窃取用户的登录凭证或者其他敏感信息。所以,尽管你的网站已经被SSL加密保护,你的用户仍然面临着被XSS攻击的风险。 如何防御XSS攻击呢?其实非常简单,你只需要在所有的输入框中过滤掉所有的HTML标签和JavaScript脚本即可。但是,如果你认为这么做会影响用户体验,那么你可以考虑使用HTML的特殊字符转义功能来替换这些标签和脚本。 8.2 CSRF攻击:请勿相信恶意链接 现在让我们来谈谈CSRF攻击。这种攻击方式是通过篡改用户的HTTP请求来伪造用户的身份,从而进行一些非法的操作。这种攻击方式通常是通过欺骗用户点击一个恶意链接来实现的。一旦用户点击了这个链接,攻击者就可以获得用户的凭证,然后模拟用户的请求,从而执行一些非法的操作。 假设,你的网站有一个删除账户的功能,攻击者就可以利用CSRF攻击来让用户误删除自己的账户。这听起来非常可怕,但是不要担心,我们可以通过一些简单的方法来防御这种攻击。 首先,我们可以在所有的表单提交中添加一个随机的Token值。这个Token值可以通过后台生成,然后在前端将其嵌入到表单中。当用户提交表单时,我们可以检查这个Token值是否匹配,如果不匹配,则拒绝这个请求。这样就可以简单的避免CSRF攻击了。 8.3 CSP策略:请勿允许不信任的资源 CSP策略是一种非常有用的前端安全措施。CSP策略可以帮助我们限制网页中可加载的资源,从而减少被攻击的风险。例如,我们可以限制只允许加载来自指定域名的JavaScript文件,这样就可以避免恶意代码的注入。 但是,如果你不小心将不信任的资源允许加载到你的网页中,那么你的网站就可能面临被攻击的风险。假设你的网站允许用户上传文件,并在网页中显示这些文件,如果你没有限制文件的类型和内容,那么攻击者就可能上传恶意文件,并在用户浏览器中注入恶意代码。 所以,如果你想保证你的网站的安全性,那么你应该始终谨慎地过滤用户上传的文件,只允许加载来自可信任来源的资源。 我们可以认识到,前端安全是一项非常重要的技术挑战。如果你是一位前端开发人员,那么应该始终将前端安全作为开发过程中的一个重要考虑因素。只有这样,我们才能够为用户提供安全可靠的Web服务。 九、前端工程师的多元化技能 作为一名前端工程师,一定是个充满多元化技能的大神。不仅仅要会写代码,还要会与设计师沟通,管理版本控制,解决兼容性,甚至还要有点艺术细胞。 **代码技能:**前端工程师最基本的技能,也是最重要的技能。不仅需要掌握 HTML、CSS、JavaScript,还需要掌握一些前端框架和库,比如 React、Vue、Angular 等。当然,这些都不是问题,对于一名优秀的前端工程师来说,这只是小菜一碟。 **与设计师沟通:**设计师们总是有各种奇怪的想法,然后她们会告诉你:“我要实现这个效果,你帮我写一下”。但是,很快会发现这个效果并不现实,于是你需要与设计师进行沟通,告诉她们这个效果无法实现。当然,你不能用技术术语来向她们解释,否则她们会摆出一副“我听不懂”的表情。所以,你需要用她们喜欢听的语言,比如“我理解你的设计需求,并深刻认识到其对于网站效果的重要性。不过,由于技术和浏览器的限制,我们需要寻找其他的可行方案来实现类似的效果,以保证网站的性能和可访问性,我会尽最大的努力提供最佳的解决方案。” **管理版本控制:**代码管理是一个很重要的问题,特别是当你和其他人合作的时候。你需要使用Git进行版本控制,这样才能确保代码的稳定性和可靠性。当然,你也需要了解一些Git的命令,比如 commit、push、pull 等等。不过,如果你不小心把代码弄挂了,那也不用担心,只要跟团队的其他成员说“我不小心把代码弄挂了”,他们就会告诉你怎么做了。 **解决兼容性:**不同的浏览器之间有很多不兼容,而前端工程师需要解决这些问题。比如,IE浏览器总是出现各种奇怪的bug,但是你不能告诉用户:“你用的是IE,这不是我的问题”。相反,你需要找到问题的根源,然后解决它。这是一个非常重要的技能,因为它涉及到用户体验和网站的稳定性。 **有点艺术细胞:**前端工程师不仅仅是一个代码的机器,还需要有一点艺术细胞。毕竟,好的界面设计是网站的关键之一。所以需要了解一些基本的设计原则,比如颜色搭配、排版等等。当然并不需要成为一个设计师,但是需要知道如何运用这些原则来改进网站的设计。 **学习新技能:**前端工程师是一个不断学习的过程。每天都有新的技术和框架出现,并且要不断学习并掌握这些技能。但是,并不需要成为一个全栈工程师,只要掌握所需要的技能,然后专注于自己的领域即可。当然,这也意味着要学会如何筛选有用的信息,因为不可能学习完所有的技术和框架。 **解决问题:**前端工程师是一个解决问题的岗位。当网站出现问题时,需要迅速找到问题的根源,并解决它。但是,也不一定要独自解决所有的问题,可以向同事寻求帮助,或者参加一些开发者社区来寻找解决方案。最终要记住的是,解决问题是前端工程师最重要的技能之一。 **与团队合作:**前端工程师需要和设计师、后端工程师、测试人员等等进行合作,以确保网站的成功。在与团队合作中,要学会如何与不同的人合作,并且尽力避免出现冲突。 前端工程师需要掌握很多不同的技能,但这并不意味着要成为一个万能的人。相反,只需要专注于自己的领域在不断地技术学习过程中成长。 十、AI与前端技术结合 回顾过去,畅想未来,立足当下,来讲个故事吧。 在一个遥远的星球上,有一个叫做前端技术的孤独王国。这个王国的居民们都是非常优秀的程序员,他们用HTML、CSS和JavaScript这三种神奇的武器来构建网站,为用户带来无尽的愉悦。然而,这个王国有一个问题,那就是他们一直无法征服一个名为AI的神秘国度。 终于有一天,一个勇敢的前端战士——HTML骑士,决定向AI国度发起挑战。他带着两个小伙伴:CSS猎人和JavaScript法师,踏上了一段充满挑战的探险之旅。 他们沿着神秘的网络海洋航行,一路上遇到了各种令人捧腹大笑的趣事。先是在一个叫做布局的洲际,他们被一群叫做“浮动”的怪兽困扰,CSS猎人拔出了他的弹性盒子弓箭,一箭穿心,解决了怪兽。接下来,他们来到了一个充满奇特生物的动画之地,JavaScript法师用他的神奇魔法,让这些生物如同表演马戏团一般,给他们带来了一场场精彩绝伦的表演。 然后,他们终于来到了AI国度的边境。在那里,他们遇到了一个脾气古怪的巨人,他叫做机器学习。这个巨人用一种叫做数学的强大力量来支配着这片土地。HTML骑士认为,要征服这个国度,就必须挑战巨人,并将他的力量与前端技术融合。 于是,在他们与巨人大战三百回合后,JavaScript法师从中意外领悟了神奇魔法,召唤出一个叫做TensorFlow.js的强大法宝。这个法宝让前端技术也能够掌握机器学习的力量。HTML骑士和CSS猎人纷纷表示赞叹,他们觉得自己终于找到了一种将AI与前端技术结合的方法。 在这之后,他们三人一起用TensorFlow.js建立了一个名为“智能前端”的新城堡。这座城堡里,前端技术与AI融合得天衣无缝,为用户带来前所未有的体验。 城堡的大门上,HTML骑士精心设计了一个智能问答系统。这个系统可以回答用户关于前端技术的各种问题,让新手程序员们感叹不已。而这一切,都得益于TensorFlow.js和机器学习的神奇力量。 城堡的内部,CSS猎人则利用AI技术打造了一套全新的自适应布局。这套布局能够根据用户的喜好和设备自动调整,让每个访问者都能享受到最佳的浏览体验。他还研发了一种名为“智能配色”的神奇法术,能够根据用户的喜好自动调整网页的颜色搭配,让网站变得更加美观大方。 而在城堡的核心区域,JavaScript法师则运用AI技术开发了一系列令人惊叹的交互功能。比如,他创造了一种可以根据用户行为自动优化的推荐算法,将用户感兴趣的内容精准推送。此外,他还设计了一款智能聊天机器人,可以与用户进行即时互动,解答他们的疑问。 在“智能前端”城堡的建设过程中,他们三人不仅发挥出了各自的特长,还不断地学习AI技术,将其与前端技术相互融合。这让他们的作品充满了趣味与智慧,吸引了无数程序员和用户前来参观。 在这段充满挑战的探险之旅中,HTML骑士、CSS猎人和JavaScript法师用他们的智慧和勇气,成功地将AI技术引入前端领域。他们的故事传遍了整个网络世界,成为了程序员们争相传颂的佳话。 如今,前端技术和AI的结合已经成为了一种趋势,越来越多的开发者开始探索这个领域的无限可能。而在这个探索过程中,他们总是能从HTML骑士、CSS猎人和JavaScript法师的故事中汲取勇气与智慧,勇往直前,为未来的网络世界描绘出一个更加美好、充满创意和智慧的蓝图。 有人说,前端技术与AI的结合就像一场狂欢。程序员们欢笑着跳动,发挥着自己的想象力,创造出一个又一个令人叹为观止的作品。在这场狂欢中,每个人都是舞者,每个人都是艺术家,每个人都在为这个美丽的网络世界贡献着自己的力量。 如同那个遥远的星球上,那个欢呼雀跃的前端王国,如今我们所生活的这个网络世界也充满了欢声笑语。而在这片欢乐的土地上,那些勇敢的前端战士们正携手AI,共同书写着属于他们的传奇! 随着技术的不断发展,我们相信前端技术与AI的结合将会走得更远,创造出更多不可思议的奇迹。也许有一天,我们的网络世界将变得如同童话般美好,充满智慧的光辉。而在那个时候,我们将不禁想起那个勇敢的HTML骑士、CSS猎人和JavaScript法师,怀念他们当年那段充满挑战的探险之旅,为他们的勇气与智慧而感慨不已。 在探险的道路上,我们将一路欢笑并肩前行,勇敢地追求那个梦寐以求的未来。也许在某个不经意的瞬间,我们会发现,那个童话般的前端王国,其实就在我们心中,等待着我们去探索、去发现、去唤醒它,让它绽放出最耀眼的光芒。 后记 前端技术的演进从未停歇,仍然充满了机遇与挑战…… 让我们一起期待下一个十年,见证前端技术的更多精彩!

优秀的个人博客,低调大师

生成对抗网络(GANs)最新家谱:为你揭秘GANs的前世今生

生成对抗网络(GAN)一经提出就风光无限,更是被Yann Lecun誉为“十年来机器学习领域最有趣的想法”。 GAN“左右互搏”的理念几乎众所周知,但正如卷积神经网络(CNN)一样,GAN发展至今已经衍生出了诸多变化形态。 今天,文摘菌就来为大家盘点一下GAN大家庭中各具特色的成员们。 他们的名单如下: 1.DCGANs 2.Improved DCGANs 3.Conditional GANs 4.InfoGANs 5.Wasserstein GANs 6.Improved WGANs 7.BEGANs 8.ProGANs 9.CycleGANs 注意,这篇文章不会包含以下内容 • 复杂的技术分析 • 代码(但有代码链接) • 详细的研究清单 (你可以点击以下链接https://github.com/zhangqianhui/AdversarialNetsPapers) 想要了解更多GANs相关内容的也可以留言告诉文摘菌哦~ 编辑器"> GANs概论 如果你对GANs很熟悉的话,你可以跳过这部分的内容。 .6687979539641944"> 请点击此处输入图片描述 GANs最早由Ian Goodfellow提出,由两个网络构成,一个生成器和一个鉴别器。他们在同一时间训练并且在极小化极大算法(minimax)中进行竞争。生成器被训练来欺骗鉴别器以产生逼真的图像,鉴别器则在训练中学会不被生成器愚弄。 GAN 训练原理概览.43510506798516685"> 请点击此处输入图片描述 首先,生成器通过从一个简单分布(例如正态分布)中抽取一个噪音向量Z,并且上行采样(upsample)这个向量来生成图像。在最初的循环中,这些图像看起来非常嘈杂。然后,鉴别器得到真伪图像并学习去识别它们。随后生成器通过反向传播算法(backpropagation)收到鉴别器的反馈,渐渐在生成图像时做得更好。我们最终希望伪图像的分布尽可能地接近真图像。或者,简单来说,我们想要伪图像尽可能看起来像真的一样。 值得一提的是,因为GANs是用极小化极大算法做优化的,所以训练过程可能会很不稳定。不过你可以使用一些“小技巧”来获得更稳健的训练过程。 在下面这个视频中,你可以看到GANs所生成图片的训练演变过程。 编辑器"> 代码 如果对GANs的基本实现感兴趣,可以参见代码的链接: Tensorflow(https://github.com/ericjang/genadv_tutorial/blob/master/genadv1.ipynb) Torch 和 Python (PyTorch)(https://github.com/devnag/pytorch-generative-adversarial-networks;https://medium.com/@devnag/generative-adversarial-networks-gans-in-50-lines-of-code-pytorch-e81b79659e3f) Torch 和 Lua(https://github.com/lopezpaz/metal) 虽然这些不是最前沿的内容,但它们对于掌握理念很有帮助。 接下来我将按照粗略的时间顺序描述最近这些年来出现的GANs相关的一些进展和类型。 编辑器"> 深度卷积生成式对抗网络(Deep Convolutional GANs, DCGANs) DCGANs是GAN结构的最早的重要发展。就训练和生成更高质量的样本来说,DCGANs更加稳定。 论文链接:https://arxiv.org/abs/1511.06434 DCGAN的作者们专注于提升初代GAN的框架结构。他们发现: 批次(Batch)的正态化在两个网络中都是必须要做的。 完全隐藏的连接层不是一个好的想法。 避免池化,只需卷积 修正线性单元(ReLU)激活函数非常有用。 DCGANs截至目前任然被时常提起,因为它们成为了实践和使用GANs的主要基准之一。 在这篇论文发布后不久,就在Theano, Torch, Tensorflow和Chainer中出现了不同的可使用的实现方法,这些方法可以在你感兴趣的任何数据集上测试。所以,如果你遇到了生成后奇怪的数据集,你完全可以归咎于这些家伙。 DCGANs的使用场景如下: 你想要比基础GANs表现更好(这是必须的)。基础GANs适用于简单的数据集,然而DCGANs比这要强得多。 你在寻找一种稳固的基准方法来比较你的新GAN算法。 从现在开始,除非特别说明,我接下来将要描述的所有GANs的类型都被假定为有DCGAN的结构。 编辑器"> 提升深度卷积生成式对抗网络(Improved DCGANs) 一系列提升先前的DCGAN的技术。例如,这一提升后的基准方法能够生成更好的高分辨率图像。 论文链接:https://arxiv.org/abs/1606.03498 GANs的主要问题之一是收敛性。收敛性不是一定的,而且尽管DCGAN做了结构细化,训练过程仍可能非常不稳定。 在这篇论文里,作者们针对GAN训练过程提出了不同的增强方法。以下是其中一部分: 特征匹配:他们提出了一种新的目标函数,而不是让生成器尽可能地去蒙骗鉴别器。这个目标函数需要生成器生成的数据能够跟真实数据的统计量相匹配。在这种情况下,鉴别器只被用来指定哪些才是值得去匹配的统计量。 历史平均:在更新参数值时,把它们过去的值也纳入考虑。 单侧标签平滑:这一项非常简单:只要把你的鉴别器的目标输出值从[0=假图像,1=真图像]改成[0=假图像,0.9=真图像]。不错,这样就提升了训练效果。 虚拟批次正态化:通过使用从其他批次计算的统计量来避免依赖于同一批次的数据。这样的计算成本很高,所以它仅仅被用在生成器当中。 所有这些技术都使得模型在生成高分辨率图像时能表现得更好,而这正是GANs的弱项之一。 作为对比,请看在128x128图像上原始DCGAN和提升后的DCGAN的表现差异: .5043370508054523"> 请点击此处输入图片描述 这些本来都是狗的图片。正如你看到的,DCGAN表现很糟糕,而用improved DCGAN你至少可以看到一些包含狗的特征的内容。这也说明了GANs的另一局限——生成结构性的内容。 Improved DCGANs的使用场景如下 生成更高分辨率的图像 编辑器"> 条件生成式对抗网络(Conditional GANs, cGANs) 条件式生成式对抗网络使用额外的标签信息用于生成更高质量图片,并且使图片的呈现可控制。 论文链接:https://arxiv.org/abs/1411.1784 CGANs是GAN框架的扩展。我们用条件信息Y来描述数据的某些特征。假设我们要处理面部图像,Y则可以用来描述头发颜色或者性别。然后这些属性被插入生成器和鉴别器。 .3488843813387424"> 请点击此处输入图片描述 使用脸部特征信息的条件生成网络如上图所示 条件式生成对抗网络有两个很有意思的地方: 1、随着你不断给模型提供更多信息,GAN学习探索这些信息,然后产生更好的样本。 2、我们用两种方法来控制图片的呈现,在没有CGAN的时候所有图片信息使用Z编码。在CGAN下,我们加入了条件信息Y,于是Z和Y对不同信息进行编码。 例如,我们假设Y对手写数字0-9进行编码。Z对其他变量编码,这些变量可以是数字的风格比如(大小,粗细,旋转角度等。) .4322981366459627"> 请点击此处输入图片描述 MNIST(MixedNational Institute of Standards and Technologydatabase,简单机器视觉数据集)样本中Z和Y的区别如上图。Z是行,Y是列;Z对数字的风格编码,Y对数字本身编码。 最近的研究成果编辑器"> 在这个领域有很多有趣的文章,我介绍2个: 1、使用生成对抗网络学习在指定位置画画 (论文:https://arxiv.org/abs/1610.02454;代码:https://github.com/reedscot/nips2016):这篇论文里作者设计了一个本文描述的方法来告诉GAN画什么,同时使用方框和标记告诉GAN绘画主体的位置。如下图示: .772264631043257"> 请点击此处输入图片描述 堆栈式GAN (原文:https://arxiv.org/abs/1612.03242;代码:https://github.com/hanzhanggit/StackGAN) 这篇文章和上一篇比较类似,这里作者同时使用2个GAN网络(阶段1和阶段2)用于提升图片的质量。第1阶段用来获得包含图片“基本”概念的低分辨率图片。第2阶段用更多的细节和更高的分辨率提炼第1阶段的图片。 这篇文章据我所知是生成高质量图片最好的模型之一,不信请看下图。 .6143011917659805"> 请点击此处输入图片描述 条件式生成网络的使用场景如下: 1、你有一个带标签的训练集,想提高生成图片的质量 2、你想对图片的某些特征进行精细的控制,比如在某个设定的位置生成特定大小的一只红色小鸟。 编辑器"> 最大信息化生成对抗网络(InfoGANs) GANs可以在无监督模式下对噪声向量Z的一部分有意义的图像特征进行编码。比如对某一数字的旋转编码。 论文链接:https://arxiv.org/abs/1606.03657 你是否曾想过GAN里输入噪声Z对哪些信息进行编码?一般来说它对图片的不同类型的特征使用一种非常“嘈杂”的方式编码。例如,取Z向量的一个位置 并且插入一个-1到1之间的值。这是下图所示的MNIST数据集的训练模型。 左上图像是对Z插值取-1的时候,右下是插值为1的时候.995"> 请点击此处输入图片描述 上图中,生成的图片看似是从4慢慢变成“Y”(很像是4和9的混合体)。 这就是我之前所说的使用一种“嘈杂”的方式进行编码:Z的一个位置是图像多个特征的一个参数。 这种情况下,这个位置改变了数字自己(某种程度,从4变成9)和他的风格(从粗体变成斜体)。 然而,你无法定义Z的位置的确切含义。 如果使用Z的一些位置来代表唯一且受限的信息,正如CGAN里的条件信息Y呢? 例如,第一个位置是0-9之间的数值来控制数字,第二个位置来控制数字的旋转,这就是文中作者想要表达的。 有意思的是,与CGANS不同,他们使用无监督的方法实现并不需要标签信息。 他们是这么做的,把Z向量拆分成两部分:C和Z C对数据分布的语义特征进行编码 Z对分布的所有非结构化噪声进行编码 如何用C对这些特征编码呢? 通过改变损失函数避免C被GAN简单地忽略掉。所以他们使用一种信息论正则化确保C与生成器分布之间的互信息[z1](mutual information)。 也就是说,如果C变化,生成的图像也会变化。这导致你不能明确的控制什么类型的信息将被引入C中。但是C的每一个位置都有独特的含义。 如下图所示:.2864983534577388"> 请点击此处输入图片描述 C的第一位置编码数字的类别,第二位置编码旋转方向。 然而,不使用标签信息的代价是,这些编码仅对非常简单的数据集有效比如MNIST库里的数字。 并且,你还需要手工设定C的每个位置。例如文章中作者需要定义C的第一位置是介于0-9的整数以对应数据集的十类数字。你会认为这样不是百分百的无监督,因为需要手动给模型提供一些细节。 你可能需要用到infoGANs的场景如下: 1、数据集不太复杂 2、你想训练一个CGAN模型但是缺少标签信息 3、你想知道数据集主要有意义的图像特征并且对他们进行控制 编辑器"> 生成式对抗网络(Wasserstein GANs) 修改损失函数以引入Wasserstein距离,这样以来WassGANs 的损失函数同图片质量建立联系。同时训练的稳定性有所提升而并非依赖于架构。 论文链接:https://arxiv.org/abs/1701.07875 GANs 经常存在收敛问题,所以你并不知道什么时候该停止训练。换句话说损失函数同图像质量无关,这可是个大难题。 因为: 你需要不断的查看样本来确认模型训练是否正确 因为不收敛,你不知道何时该停止训练 也没有数值指示你调参的效果如何 举个例子,看下面DCGAN的两个无信息损失函数完美的生成MNIST样本的迭代图[z2] .46494464944649444"> 请点击此处输入图片描述 仅看上图你知道什么时候该停止训练吗? 这种可解释性的问题也是Wasserstein GANs要解决的。 怎样解决呢? 如果真实和伪造样本的分布不重叠(一般都是这样)GANs可以用来最小化JS散度(Jensen-Shannon divergence)直到0。 所以与其最小化JS散度,作者使用Wasserstein距离来描述不同分布中点之间的距离。 思路大概如此,如果你想了解更多,我强烈建议你看这篇文章(https://paper.dropbox.com/doc/Wasserstein-GAN-GvU0p2V9ThzdwY3BbhoP7)或者更深入分析或者阅读本论文。 WassGAN有和图像质量关联的损失函数并且能够收敛。同时他更加稳定而不依赖GAN的结构。比如,就算你去掉批标准化或者使用怪异的结构,它仍能很好的工作。 .665158371040724"> 请点击此处输入图片描述 这就是他的损失函数图,损失越低,图像质量越好。完美! Wasserstein GANs的应用场景如下: 你需要寻找最先进的且有最高训练稳定性的GAN 你想要一个有信息量且可以解读的损失函数。 编辑器"> 加强版WGANs(Improved WGANs , WGAN-GP) 这个模型使用的是Wasserstein GANs,并应用了梯度惩罚(gradient penalty)来代替权重剪辑(weight clipping)及其带来的一些不需要的行为。这个方法可以带来更高的聚合度、更高质量的样本和更稳定的训练。 论文:https://arxiv.org/abs/1704.00028 代码:https://github.com/igul222/improved_wgan_training 针对问题:WGANs有时候会生成一些质量不佳的样本,或者是无法在某些集合中生成聚集。这种现象主要是由于为了满足Lipschitz限制而在WGANs中应用权重剪辑(即把所有权重限制在一个由最小值和最大值组成的范围内)所造成的。如果你对这个限制不太了解,那么你只需要记住它是WGANs正常运行的一个必要条件。那么为什么权重剪辑会造成如上问题呢?这是因为它会使WGANs偏向于使用那些过于简单的函数,这意味着当WGANs想要模拟复杂的数据时,简单地估算近似值令其无法得到准确的结果(如下图所示)。另外,权重剪辑也使得梯度爆炸与消失更容易发生。 .4889502762430939"> 请点击此处输入图片描述 左图是使用了简单的函数导致无法正确模拟高斯为8的WGANs运行后的结果,而右图则是经过使用了更复杂的函数的WGAN-GP矫正后的图像。 梯度惩罚(Gradient penalty):所以我们该如何摆脱权重剪辑带来的不良效果呢? WGAN-GP的作者(GP表示梯度惩罚)提出了使用另一种叫梯度惩罚的办法来加强Lipschitz限制的建议。原则上,梯度惩罚的原理是对某些梯度实行了均值为1的限制。对于那些均值偏离于1的梯度将会实施惩罚(减少权重),这也是为什么它被称为梯度惩罚的原因。 优点:由于在训练中使用了梯度惩罚而不是权重剪辑,WGANs获得了更快的聚合。另外,因为不再必须对超参数进行调整,而且网络架构的使用也不再像之前那么重要,训练在某种程度上变得更加稳定。虽然很难说清楚到底有多少,但这些WGAN-GP确实产生了更高质量的样本。在已验证并测试的结构上,这些样本的质量和作为基线的WGANs产出的结果非常相似。 .8425720620842572"> 请点击此处输入图片描述 基于同一个网络架构,WGANs-GP明显在生成高质量样本上更有优势,而GANs则不然。 比如,据作者所知,这是首次GANs能够在残差网络的结构上运行: .8425720620842572"> 请点击此处输入图片描述 为了不超出本篇博文的范畴,还有许多其他有趣的细节我这里就不一一阐述了。如果你对这个训练方式有兴趣想要了解更多(例如,为什么梯度惩罚只应用于“某些”特定梯度,又或者怎样才能把这个模型用于文本数据样本),我会建议你自行阅读一下该论文。 强化版的WGAN的优点如下: l 更快的聚合 l 可以在各种各样的网络架构和数据集中使用 l 不像其他的GANs一样需要太多的超参数调整 编辑器"> 边界均衡GANs(Boundary Equilibrium GANs,BEGANs) GANs使用一个自动编码器作为均衡判别器。它们可在一个简单的架构上被训练出来,且合成一个动态的可以使得均衡器和生成器在训练中两者平衡的阶段。 论文:https://arxiv.org/abs/1703.10717 一个有趣的事实:BEGANs 和WGAN-GP几乎是同一天在论文上发表。 理念:让BEGAN区别于其他GANs的原因有两个,一是它们使用了一个自动编码器作为均衡判别器(这一点和EBGANs类似),二是为了适用于这个情境的一个特别的损失函数。这种选择背后的理由是什么呢?强迫我们使用像素重建损失函数来制造模糊生成样本的自动编码器是否也不是传说中那么“邪恶”呢? 要回答这些问题,我们需要考虑以下两点: 1. 为什么要重建像素损失?作者解释说这么做的原因是,对于那些符合对像素损失的重建分布模式的假设,我们可以依赖它们去匹配样本的分布模式。 2. 而这又引出了下一个问题:如何才可以达到这一目的呢?一个重要的观点是,从自动编码器/均衡判别器形成的像素重建损失(换言之,就是基于某个图像输入,输出最优化的像素重建)并不是经BEGANs最小化后生成的最终损失。可以说,这个重建损失不过是为了计算最终损失的其中一个步骤。而最终损失的计算这是通过衡量基于真实数据的重建损失和基于生成数据的重建损失之间的Wasserstein距离(是的,现在它无处不在)。 这么一看似乎这其中的信息量非常大,但我可以保证,一旦我们看清损失函数是如何作用于生成器和判别器,这一切将会变得再明白不过了。 生成器专注于生成那些能够让判别器良好重建的图像 而判别器则致力于尽可能良好地重建真实图像,同时重建那些误差最大化的生成图像。 差异因数:另一个有趣的成分是所谓的差异因数。通过这个因子你能控制判别器不同程度的表现,决定它能只专注于形成对真实图像的完美重建(注重质量),又或是更侧重在区分真实图像和生成图像(注重多样性)。然后,它们就能更进一步地利用这个差异因数去保持生成器和判别器在训练中的平衡。如同WGANs,这一模型同样应用均衡状态作为调整和图像质量相关的聚合度的方法。然而,和WGANs (与 WGANs-GP)不尽相同的是,它们利用了Wasserstein 距离,而非Lipschitz限制,去测量均衡水平。 结论:BEGANs并不需要任何花里胡哨的网络架构就可以训练得当。如同在论文中所述的,“不批量标准化,不丢弃神经网络元,无反卷积,也没有卷积滤镜的指数化增长”,这些生成样本(128x128)的质量已经相当好了。 .6028708133971292"> 请点击此处输入图片描述 然而,在这篇论文中有一个重要的细节值得我们注意:论文中使用的未发表数据集的样本量是目前广为使用的CelebA数据集的两倍之大。因此,为了得到更具有现实意义的定性比较,我邀请大家去查看那些使用了CelebA的公开模型(https://github.com/carpedm20/BEGAN-tensorflow),并看看那些由此生成的样本。 最后,如果你对BEGANs感兴趣想要了解更多,我建议你阅读一下这篇博文(https://blog.heuritech.com/2017/04/11/began-state-of-the-art-generation-of-faces-with-generative-adversarial-networks/),里面对BEGANs有更多详细的介绍。 你需要BEGANs的原因一般会和需要使用WGANs-GP的情况差不多。这两个模型的结果往往非常相似(稳定的训练、简单的架构、和图像质量相关的损失函数),而两者的不同主要在于过程中使用的手段。由于评估生成式模型本身就不是一件容易的事,我们很难去说清楚孰优孰劣。但就像Theisetal在他们的论文(https://arxiv.org/abs/1511.01844)中所说的,选择一个评估的方法,不然就依据实际情况来做判定。在这种情况下,WGANs-GP具有更高的初始分数(Inception score)而BEGANs则能生成非常优质的图像,两者都是未来最值得研究和最具有革新意义的模型。 编辑器"> 渐进式发展生成对抗网络(Progressive growing of GANs,ProGANs) 在训练过程中,逐步嵌入新的高分辨率的层次,来生成相当逼真的图像。更多的进步以及新兴的考核机制也相继涌现。新生成的图片质量高得惊人。 论文:https://arxiv.org/abs/1710.10196 代码:https://github.com/tkarras/progressive_growing_of_gans 生成高分辨率的图像是个大挑战。图片越大,对生成对抗网络来说越可能失败。因为它要求模型学习辨别更细微、复杂的细节。为了使大家更好理解,在这篇文章发表之前,GANs产出图像的合理尺寸大概是256x256。渐进式生成对抗网络(ProGANs)将它提升到了一个全新水准-生成尺寸为1024x1024的图片。我们来看看它是如何实现的: 理念:ProGANs-建立于WFGANs-GP-引入了一种灵活地将新层次逐渐嵌入到训练时间的方式。每一层都利用上采样增强了生成器和判别器里的图像分辨率。 步骤分解如下: 1 首先,利用低像素图片训练生成器和判别器。 2 在一定时间点(开始聚合的时候),提高分辨率。这是通过“迁移阶段”/“平滑技术”非常完美地实现的。 .5040840140023337"> 请点击此处输入图片描述 新的层次是借助α控制的一系列细微的线性步骤添加,而不是简单粗暴地加上一层。 我们看看生成器里都发生了什么。最初,当α = 0,无变化。产出主要来自于前一低分辨率层(16x16)的贡献。 当提升α的值,新一层(32x32)开始通过反向传播调整它的权重。最后,当α趋近于1,我们几乎可以跳过32x32这一层的操作。同理适用于判别器,当然是以完全相反的方式:不是使图片更大,而是更小。 3 一旦转化完成,继续训练生成器与判别器。假如得到的图片质量分辨率不达标,请回到步骤2。 不过,等等……对新的高分辨率图像的上采样与串联不是已经在StackGANs(还有新StackGANs++)里实现了么?没错,也不全对。首先,StackGANs是将文字翻译为图像的条件GANs,它引入文字描述作为额外输入值。而ProGANs没有使用任何假定式的信息。更加有趣的是,尽管StackGANs和ProGANs都对更高分辨率的图片串联,StackGANs需要尽量多的根据上采样独立配对的GANs-需单独训练,你想进行上采样3次么?那你要训练3个GANs。另一方面,在ProGANs模型中只有一个单一的GAN被训练。在这一训练中,更多的上采样层被逐步叠加至上采样的图片,上采样3次的尝试只是增加更多的层在训练时间上,而不是抓3个新的GANs逐次训练。总而言之,ProGANs采用一种与StackGANs相似的理念,它完美地完成,而且在没有额外信息的情况下产出更好的结果。 结果。作为渐进训练的结果,ProGANs生成的图片有更高的质量,而针对1024x1024图像的训练时间也缩减了5.4倍。背后的理由是,ProGAN不需要一次性学习所有大、小规模的典型图片。在ProGAN模型里,小规模的图像最先被学习(低分辨率层次聚合),然后模型可以自行聚焦在完善大尺寸图片的结构上(新的高分辨率层次聚合)。 其他的提升。 另外,该论文提出了新的设计决策来更进一步提升模型的性能。概述如下: 小批量标准差:将标准差运用于这些小批量的所有特征属性,允许每个小批量有相似的统计数据。然后,总结为一个新的层的单一值,嵌入至网络尾端。 均衡的学习速率:通过在训练过程中持续地将每个权重除以一个常量,确保所有权重的学习速度一致。 像素标准化:在生成器上,每一个矢量的特征是根据其卷基层标准化的(论文里的精确公式)。这是为了防止生成器和判别器的梯度量级的逐步上涨。 CelebA-HQ(CelebA高级版)。 值得一提的是,作者为了实现高分辨率训练,改进了原始的CelebA,从而得到了CelebA-HQ,简单来说,它们移除原像,应用高斯滤波器来生成一种景深效果,然后探测到人脸图像,得到一个1024x1024尺寸的裁剪图片,在这一流程之后,他们从202k张图片里保留了最优质的30k张图片。 评估编辑器"> 最后,我们介绍一种新的评估方式: 背后的理念是:生成图像的本地图形结构应该与训练图像的结构匹配。 那么如何测量本地结构? 使用Laplacian pyramid算法,你可以得到不同的空间频段,来作为描述符。 最后,我们从生成图像和原始图像中提取描述符,将其规范化,然后使用著名的Wasserstein距离检测它们有多接近。距离越近越好。 你可能会想在以下场景使用ProGANs的使用场景如下: 假如你希望获得最完美的结果。但是考虑到… 你需要花大量时间搭建模型:我们需要在一个单一的NVIDIA Tesla P100 GPU上花20天训练网络 如果你开始怀疑世界的真实性。GANs的下一轮迭代可能会给你一些比现实生活还真实的样本参考。 编辑器"> 循环生成对抗网络(Cycle GANs) 论文:https://arxiv.org/pdf/1703.10593.pdf ​ 代码:https://github.com/junyanz/CycleGAN 循环GANs是目前最先进的用于图片互译的生成对抗网络。 请点击此处输入图片描述 这些GANs并不需要配对的数据集来学习不同领域之间的转译,这点很棒,因为配对数据集很难获取。然而CycleGANs仍然需要通过两个不同领域的数据X和Y(例如X是普通的马匹,Y是斑马)来训练。为了将转换限制于从一个领域到另一领域的范畴,他们使用所谓的“循环一致性损失”。大意是,如果可以将马匹A转化成斑马A,那么当你将斑马A逆转化,应该能得到马匹A才对。 这种从一个领域到另一领域的变换与另一热门概念“神经风格转换”是有区别的。后者结合了一副图像的“内容”与另一图像的“样式”。循环GANs则是在一个领域转换至另一领域的过程中学习总结非常高层次的特征。因此,循环GANs更笼统,并且适用于多种映射关系,例如将一个速写转化为真实物品。 总结一下,生成对抗网络在近期取得了两大显著进步: WGANS-GP和BEGANs 尽管理论研究方向不同,但它们提供了相似的优点。其次,我们有ProGANs(基于WGANS-GP),它打开了一条通往生成高清图像的清晰路径。同时,循环GANs让我们看到了GANs从数据集提取有用信息的潜力以及这些信息如何转入至另一非关联的数据分布。 转载。原文:https://www.jiqizhixin.com/articles/2017-12-04-22

优秀的个人博客,低调大师

语音识别的前世今生 | 深度学习彻底改变对话式人工智能

CNET科技行者 8月21日 北京消息:“语音识别”的终极梦想,是真正能够理解人类语言甚至是方言环境的系统。但几十年来,人们并没有一个有效的策略来创建这样一个系统,直到人工智能技术的爆发。 在过去几年中,人们在人工智能和深度学习领域的突破,让语音识别的探索跨了一大步。市面上玲琅满目的产品也反映了这种飞跃式发展,例如亚马逊Echo、苹果Siri 等等。本文将回顾语音识别技术领域的最新进展,研究促进其迅猛发展进程的元素,并探讨其未来以及我们距离可以完全解决这个问题还有多远。 背景:人机交互 多年来,理解人类一直都是人工智能的最重要任务之一。人们不仅希望机器能够理解他们在说些什么,还希望它们能够理解他们所要表达的意思,并基于这些信息采取特定的行动。而这一目标正是对话式人工智能(AI)的精髓。 对话式AI包含有两个主要类别:人机界面,以及人与人沟通的界面。在人机界面中,人类与机器往往通过语音或文本交互,届时机器会理解人类 (尽管这种理解方式是有限的) 并采取相应的一些措施。图1表明,这台机器可以是一个私人助理 ( Siri、Alexa之类的产品 ) 或某种聊天机器人。 图1:人机交互AI 在人与人之间的互动中,人工智能会在两个或两个以上进行会话、互动或提出见解的人类用户之间构建一座桥梁 ( 参见图2 ) 。例如,一个AI在听取电话会议后,能够创立出一段简要的电话记录摘要,并跟进相关人员。 图2:人与人之间互动的人工智能 对话式AI背后:机器感知与机器识别 为了理解对话式AI背后的挑战与技术,我们必须研究人工智能的基本概念:机器感知与机器识别。 机器感知是指机器能够采用类似于人类自己凭感觉感知周围世界来分析数据的能力;换句话说,其本质上就是为机器赋予人类的感知能力。近来很多的人工智能算法都需要使用电脑摄像头,如目标检测和识别,都归属于机器感知范畴——主要涉及视觉处理。语音识别和分析则是那些利用听觉的机器感知技术。 机器识别是在机器感知所生成的元数据之上的推理运算。机器识别包括决策制定、专家系统、行动执行以及用户的意图等方面。一般情况下,如果没有机器识别,对AI的感知系统不会产生任何影响,而机器感知会提供适当的元数据信息来令其做出决策与执行行动。 在对话式AI中,机器感知包括所有的语音分析技术,如识别和性能分析;机器识别则包括所有与语言理解能力相关的技术,而这也是自然语言处理 ( NLP ) 的一部分。 语音识别的发展 语音识别的研究和发展情况基本分为三个主要时期: 2011年之前 人们对语音识别的活跃研究已经进行了几十年,而事实上,即使是在二十世纪50年代和60年代,人们也一直在试图构建语音识别系统。然而,在2011年以及深度学习、大数据和云计算出现以前,这些解决方案还远远不足以被大规模采用以及商业使用。从本质上来说,其算法还不够好,当时也没有足够的数据可以用于算法的训练,而且无法进行高性能计算机也阻碍了研究人员运行更复杂的实验。 2011年-2014年 深度学习产生的第一个重大影响发生在2011年,当时有一个研究小组一同创造了第一个基于深度学习的语音识别系统,而这个研究小组成员包括来自微软的研究人员、李登(Li Deng)、董玉(Dong Yu)和亚历克斯·阿赛罗(Alex Acero),以及杰弗里·希尔顿(Geoffrey Hinton)和他的学生乔治·达尔(George Dahl)。效果很即时:其相对错误率降低了25%以上。而这个系统也是深度学习领域进行大规模发展和改进的切入点。 此后,在有了更多数据、云计算可用后,苹果(Siri)、亚马逊 (Alexa) 和谷歌这类的大公司均采用了深度学习技术,而且对其产品性能有着显著的改善,并将其产品发布到了市场上。 2015至今 在2014年底,递归神经网络获得了更多的关注。与此同时,递归神经网络与注意力模型、记忆网络以及其他技术一起,掀起了这个领域发展的第三次浪潮。如今,几乎每一种算法或者解决方案都采用了某种类型的神经模型,而且实际上,几乎所有的关于语音的研究都已转向深度学习。 语音识别领域,神经模型的最新进展 过去六年中,语音识别在此前40多年的基础上创造了更多的突破。这种非凡的新进展主要归功于神经网络。要理解深度学习所带来的影响以及它所扮演的角色,我们首先需要理解语音识别是如何工作的。 尽管近50年来语音识别一直属于热门研究领域,然而构建能够理解人类语言的及其仍旧是人工智能最具挑战性的问题之一,要实现这一目标非常困难。语音识别由不少明确的任务组成:给出某种制定的人类语言,然后尝试将其语音转换成文字。然而,机器所识别的语音中可能包括一部分噪音,所以就要求其能够从噪声中提取出与对话相关的部分并将其转换成有意义的文字。 语音识别系统的基本构造块 语音识别基本分为三个主要部分: 信号位准:信号为准的目的是提取语音信号并增强信号(如果有必要的话),或是进行适当的预处理、清理和特征提取。这非常类似于每一项机器学习任务,换句话说,如果给定一些数据,我们需要做适当的数据预处理和特征提取。 噪音位准:噪音位准的目的在于将不同的特征划分成不同的声音。换句话说,声音本身并不能提供出一个足够精确的标准,而有时我们将次于原声的声音称为声学标准。 语言位准:因为我们假设这些声音都是人类所产生而且是有意义的,因此我们可以把这些声音组合成词语,然后把这些词语组合成句子。在语言位准中,这些技术通常属于不同类型的NLP技术。 基于深度学习的改进 深入学习对语音识别领域产生了巨大的影响。其影响非常深远,即使在今天,几乎每一个语音识别领域的解决方案都可能包含有一个或多个基于神经模型的嵌入算法。 通常而言,人们对语音识别系统的评价都基于一个名为配电盘(SWBD)的行业标准。SWBD是一个语音语料库,整合了电话中的即兴对话,包含音频和人声的副本。 语音识别系统的评估标准主要基于其误字率(WER),误字率是指语音识别系统识别错误的单词有多少。图3展示了从2008年到2017的误字率改进情况。 图3:误字率改进情况 从2008年到2011年,误字率一直都处于一个稳定的状态,位于23%至24%之间;而深度学习从2011年开始出现时起,误字率从23.6%降低至5.5%。这一重大发展对语音识别开发而言是一种变革,其误字率的改进相对提高了近77%。误字率的改善也产生了广泛应用,例如苹果Siri、亚马逊 Alexa、微软 Cortana 和 Google Now,这些应用也可以通过语音识别激活各种家居,如亚马逊Echo 和 Google Home。 秘密武器 那么,系统产生如此大幅度改善的原因是什么呢?是不是有什么技术可以使得误字率从23.6%减少到了5.5%呢?遗憾的是,并没有其他单独的技术、方法。 然而,深入学习和语音识别息息相关,构造出了一个可以涉及各种不同技术和方法的先进系统。 例如,在信号位准中,有着不同的基于神经模型从信号中提取和增强语音本身的技术 (图4) 。同时,还有能够用更加复杂高效的基于神经模型的方法取代经典特征提取方法的技术。 图4:信号位准的分析 声音和语言位准中也包含有各种各样不同的深度学习技术,无论是声音等级分类还是语言等级分类,都采用了不同类型基于神经模型的架构(见图5)。 图5:声音和语言位准分析 总而言之,建立一个先进的系统并不是一项容易的工作,而实现将所有涉及的这些不同技术集成为一个系统的过程也不轻松。 前沿研究 近来在语音识别领域有这么多的突破,那么我们自然要问,语音识别接下来的突破口在哪?未来聚焦的研究点或将从以下三个主要领域展开:算法、数据和可扩展性。 算法 随着亚马逊Echo 与 Google Home 的成功,许多公司正在发布能够识别理解语音的智能扬声器和家庭设备。然而,这些设备的推出又带来了一个新问题:用户说话时往往距离麦克风不是很近,例如用户用手机对话时的状态。而处理远距离语音识别又是一个具有挑战性的问题,很多研究小组也正在积极研究这个问题。如今,创新的深度学习和信号处理技术已经可以提高语音识别的质量了。 数据 语音识别系统的关键问题之一是缺乏现实生活的数据。例如,很难获得高质量的远程通话数据。但是,有很多来自其他来源的数据可用。一个问题是:我们可以创建合适的合成器来生成培训用的数据吗?今天,生成合成数据并培训系统正在受到重视。 为了训练语音识别系统,我们需要同时具备音频和转录的数据集。人工转录是繁琐的工作,有时会导致大量音频的问题。因此,就有了对半监督培训的积极研究,并为识别者建立了适当程度的信心。 由于深度学习与语音识别相结合,因此对CPU和内存的占用量不容小觑。随着用户大量采用语音识别系统,构建经济高效的云解决方案是一个具有挑战性的重要问题。对如何降低计算成本并开发更有效的解决方案的研究一直在进行。今天,大多数语音识别系统都是基于云的,并且具有必须解决的两个具体问题:延迟和持续连接。延迟是需要立即响应的设备(如机器人)的关键问题。在长时间监听的系统中,由于带宽成本,持续连接是一个问题。因此,还需要对边缘语音识别的研究,它必须保持基于云的系统的质量。 解决语音识别问题 近年来,语音识别的表现和应用出现了巨大的飞跃。我们离完全解决这个问题还有多远?答案也许五年、也许十年,但仍然有一些挑战性的问题需要时间来解决。 第一个问题是对噪音的敏感性问题。一个语音识别系统在非常接近麦克风而且不嘈杂的环境中运行得很好——然而,如果说话的声音比较远或者环境很嘈杂能迅速降低系统的效能。 第二个必须解决的问题是语言扩展:世界上大约有7000种语言,绝大多数语音识别系统能够支持的语言数量大约是八十种。扩展系统带来了巨大的挑战。 此外,我们缺少许多语言的数据,而且匮乏数据资源则难以创建语音识别系统。 结论 深度学习在语音识别和对话式AI领域刻下了深深的印记。而鉴于该技术最近获得的突破,我们真的正处于一场革命的边缘。 而最大的问题在于,我们是否准备赢得语音识别领域的技术挑战,并像其他商品化技术一样开始运用它呢?或者说,是否还有另一个新的解决方案正等待着我们去发现?毕竟,语音识别的最新进展只是未来科技蓝图的一小块:语言理解本身就是一个复杂而且或许更加强大的一个领域。 原文发布时间为:2017-8-21 本文作者:周雅 本文来自云栖社区合作伙伴至顶网,了解相关信息可以关注至顶网。

优秀的个人博客,低调大师

小程序的前世今生与未来,关于小程序看完这篇就全明白了

2017 年 12 月 28 日,一款叫做《跳一跳》的微信小游戏横空出世,为微信小程序跳出一片繁华;2018 年 5 月,研究公司 QuestMobile 发布了微信小游戏《跳一跳》的数据,这款只有 4MB 大小的游戏截至 2018 年 3 月份已经积累了 3.9 亿玩家。除了本身平台用户基数的优势,微信还认为,微信小游戏的加载速度比 HTML5 快 30%也是其成功的原因。 据微信游戏产品总监孙春光分享: 《跳一跳》的 次日留存为 65% ,三日留存为 60%,七日留存为 52%,“这已经可以媲美一款非常活跃的 APP 大作了…… 和 H5 游戏行业 20%左右的留存相比更是有翻天覆地的变化。我们做过对比,同样品质的 H5 游戏,做成小游戏,留存率有 10%的提升。” 而跳一跳发布的这一天,距离微信声势浩大的提出“小程序”的概念已经比较久了,一直不温不火、没有广泛群众基础的“小程序”,在《跳一跳》中让普通用户感受到了它的魅力,也让商业开发者嗅到了真正的商机。 全文脉络大体如下图所示: 小程序 小程序的诞生 如果我们将时间拨回到 2017 年 1 月 9 日 0 点:万众瞩目的微信第一批微信小程序正式低调上线,用户可以体验到各种各样微信小程序提供的服务。 小程序类似传统的 Hybrid 架构,对渲染性能要求较高的组件,通过 Native 组件来实现,以弥补传统 Web 页面性能上的不足。而小程序主要有以下一些优势和特点: 小程序的特点 而微信小程序,从某种意义上来说,并不算是小程序理念的第一次提出。 2013 年 8 月 22 日,百度 CEO 李彦宏在百度世界大会上正式宣布推出轻应用开放平台,提出“移动搜索+轻应用”是满足海量中长尾应用开发者需求的最佳模式。当时的轻应用主要有以下特点: 第一,无需下载,即搜即用:以往,开发者付出高昂成本拉动用户下载应用,每隔十天半月还要推送更新版本,一不小心就遭用户卸载,通过轻应用,开发者后端的每一处更新在前端都自动呈现,无需骚扰用户; 第二,破壳检索,智能分发:开发者开发的应用不再是信息孤岛,里面的内容都可以被索引,这跟原生应用形成明显的差别。在应用商店里,只有用户输入明确的 App 名称,例如“滴滴打车”,这个应用才能够被分发。而现在,移动搜索中自然表达的所有与打车有关的需求,比如“我要打车”、“从国贸到雍和宫”等,都将导向开发者开发的打车类应用,大大增加应用的曝光量和使用率,从源头解决分发难题; 第三,功能强大,全能体验:轻应用能够帮应用调起语音、摄像头、定位、存储等手机本地或云端的多种能力,让应用的功能更强大; 第四,订阅推送,沉淀用户:轻应用不仅支持用户搜索时实现调用,还支持用户主动订阅。如果用户有订阅需求并添加应用,相关开发者就能够将用户沉淀下来,并对用户进行持续、精准的信息和服务推送。 以上内容摘自维基百科。 2016 年 Google 提出的 PWA 的概念,于 2017 年正式落地,2018 年迎来重大突破,全球顶级的浏览器厂商,Google、Microsoft、Apple 已经全数宣布支持 PWA 技术,但是由于国内技术环境的特殊性,PWA 可算籍籍无名。 小程序界的先行者 —— 轻应用、PWA 的结局,想必你已经清楚,最终在国内成功的,只有微信推出的小程序,这不禁使人感叹:赤兔无人用,当须吕布骑。 小程序的技术原理 小程序的运行环境 小程序通常是依附于特定 App 而存在的,根据设备进行分类,小程序通常有以下四种运行环境: Operating environment 双线程模型 我们都知道,微信小程序采用双线程模型,将逻辑层与渲染层分开,其中 WXML 模板和 WXSS 样式工作在渲染层,JS 脚本工作在逻辑层,如下图所示: 逻辑层与渲染层 小程序开发框架的逻辑层使用 JavaScript 引擎为小程序提供开发者 JavaScript 代码的运行环境以及微信小程序的特有功能。逻辑层将数据进行处理后发送给视图层,同时接受视图层的事件反馈。开发者写的所有代码最终将会打包成一份 JavaScript 文件,并在小程序启动的时候运行,直到小程序销毁。这一行为类似 ServiceWorker,所以逻辑层也称之为 App Service。 逻辑层与渲染层 双线程的特点 双线程 双线层交互的生命周期 双线程交互的生命周期,一图胜千言: 双线程生命周期 前文提到,小程序是基于双线程模型的,所以在小程序视图层和逻辑层之间的数据传递会存在一定延时。渲染层需要有逻辑层的数据才能把界面渲染出来。 下面对双线程交互的生命周期做简要解释说明: start 阶段: View 线程初始化渲染,包括页面层级等; AppService 线程初始化数据,进入 钩子; 初始化完成 View 线程:通知逻辑层,等待逻辑层数据 AppService 线程:进入 onShow 钩子,等待渲染层通知 渲染层渲染初始数据 View 线程:渲染数据 AppService 线程:等待渲染层通知 渲染层渲染初始数据完成 View 线程:通知逻辑层初始化数据完成 AppService 线程:进入 onReady 钩子 数据变化 AppService 线程:重新把数据发送给渲染层 View 线程:接收到数据并渲染 切到后台 AppService 线程:进入 onHide 钩子 切到前台 AppService 线程:进入 onShow 钩子,发送数据到渲染层 View 线程:接收到数据并渲染 调用 navigateBack(从页面栈删除) AppService 线程:进入 onUnload 钩子 View 线程:清除层级渲染 小程序运行机制 下图从启动、更新、运行、通信等角度简单总结了小程序运行机制: 小程序运行机制 页面生命周期 前文描述了双线程交互的生命周期,而页面的生命周期则更加直观明了: 页面生命周期 页面路由 在小程序中所有页面的路由全部由框架进行管理; 框架以栈的形式维护了当前的所有页面,开发者可以使用 getCurrentPages() 函数获取当前页面栈; 小程序不允许打开超过五个层级的页面。 API 小程序开发框架提供丰富的微信原生 API,可以方便的调起微信提供的能力,如获取用户信息,本地存储,支付功能等,类别上主要可以分为: 事件监听 API; 同步 API; 异步 API(支持 callback & promise 两种调用方式); 云开发 API,开通并使用微信云开发,即可使用云开发 API,在小程序端直接调用服务端的云函数。 云开发 微信云开发是微信团队联合腾讯云推出的专业的小程序开发服务。开发者可以使用云开发快速开发小程序、小游戏、公众号网页等,并且原生打通微信开放能力。开发者无需搭建服务器,可免鉴权直接使用平台提供的 API 进行业务开发。 小程序前景 手机上那些僵尸 App 现在进入六月份了,一年一度的综合所得税汇算也进入最后阶段,每一个普通的我们默默打开个人所得税 App,体味着补税与退税的悲喜;这个一年中只会使用那么几次,却没法真的卸载的 App,承载着我们的悲喜,也诠释着我们在信息化时代的无奈,最先抗议的,也许是手机的内存了。 是的,作为普通人,每天在自己的手机上会使用的 App 有几个?社交电商、衣食住行、银行服务、视频娱乐等较为高频的场景日益聚合在互联网大平台所提供的“超级 App”中,独立第三方 App 即便聚焦细分领域的特定群体,依然不得不与大量其他竞争者激烈争夺消费者掌中那方寸之屏。 我们的手机上满屏满屏的 App,绝大部分都是僵尸 App;作为消费者,我们日常使用的都是超级 App,而且数量不会超过十根手指,剩下的都是墙上的一抹蚊子血。 小程序在未来生活中,将承担越来越多的角色,而这得益于小程序“无需下载、用完即走”的理念,也得益于小程序在技术上制作成本低、内存小、运行快、敏捷迭代、易部署、具有丰富的延展性等技术优势。 百花齐放的小程序 为什么要做小程序?用张小龙的话说是因为越来越多的人通过微信公众号来宣传、推广和销售产品,因为公众号的开发、获取用户和传播成本更低,并且为了更好的服务客户,拆分出来的服务号却没能提供更好的服务,所以微信有必要再研究出一个新的形态,来满足商家直接通过微信服务顾客的需求。这也是一些自带场景属性的平台化 App 涉足小程序的一个重要原因。 随着微信小程序的推出,一些的大厂也纷纷提供了小程序开放平台,一时间,小程序生态百花齐放,好不热闹。而这些大厂才有的小程序能力,我称之为“王谢堂前燕”。 百花齐放的小程序 从上图不难发现,目前主流 App 利用他们的高流量,在自己的生态下提供一种开放能力,每种 App 都有相应的优势和政策,帮助开发者更有效的宣传和营销。比如: QQ 小程序,连接年轻用户的新方式,覆盖 8 亿新生代活跃网民; 百度智能小程序,智能连接人与信息、人与服务、人与万物的开放生态,依托以百度 App 为代表的全域流量,通过百度 AI 开放式赋能, 精准连接用户,无需下载安装便可享受智慧超前的使用体验; 支付宝小程序是一种全新的开放模式,让合作伙伴有机会分享支付宝及阿里集团多端流量和商业能力,为用户提供更好的体验,助力商家经营升级; 字节跳动系小程序(抖音+头条新闻+西瓜视频),广大开发者以字节小程序为载体,利用小程序提供的丰富基础能力完成服务搭建,为字节跳动旗下 App 用户提供优质服务,同时也让自身业务完成流量与转化升级。 小程序行业前景 据 「中研网数据」 显示,2021 年微信小程序日活超过 4.5 亿,全网小程序数量突破 700 万个,小程序开发者突破 300 万,微信为开发者支付的广告分成接近百亿,小程序服务在加速普及。 小程序行业前景 综上,小程序看起来市场广阔,前景无限,但是似乎有能力提供开放平台的都是一些超级 App。 在当前传统大型企业转型、互联网生态逐渐趋于政策性开放的背景下,普通 App 难道就没法分一杯羹,获得运行小程序的能力吗?数字化时代, 普通 App 最终又将何去何从? 让你App接入小程序 也许大家潜意识里一直觉得,只有那些超级 APP 才具备运行小程序的能力,而且日常生活中使用小程序场景最多的无非就是微信、支付宝、抖音、头条、百度这几个 APP,那你们有没有想过「自己的 APP 也可以具备小程序的运行能力」呢? 虽然互联网大厂并未将这部分小程序运行能力开放出来,但是我们也不必望而生羡,因为小程序技术不再是 BAT 的专属,市面上早就推出了类似技术能力,我们一般称之为小程序容器技术。 目前在 Github 很热门的前端容器技术 —— FinClip,一个可以让任何 APP 都能具备小程序运行能力的前端容器技术,只需简单集成 FinClip SDK ,即可在 iPhone、Android、Windows、Linux、macOS、统信等平台下的应用中运行你的小程序,这意味着,移动端、PC 端、车载设备、智能电视、智能手表都能运行小程序了。同时,它还提供一个后台管理系统,统一管理小程序的上架和下架。 FinClip小程序容器技术主要有以下几点技术优势: 多平台终端兼容:自带多终端小程序 SDK,简单集成后即可在 iPhone,Android,Windows,Linux,macOS 平台下的应用中运行你的小程序。 SDK 体积小:移动 App 集成 FinClip SDK 后,安装包的体积仅仅增大了不到 3MB; FinClip 完全遵循兼容微信小程序的开发标准与规范:如果你有现成的微信小程序,可以不改一行代码直接放进你的 App 里面,运行效果和在微信上面保持一致,不必额外二次开发和改造,大大节省了人力成本。此外,在 FinClip 上架的小程序不需要修改一行代码也能具备用微信登录能力,可基于微信生态建立对应的用户登录体系。 支持灰度发布功能:FinClip 提供了面向业务与运营的灰度发布功能,您可以针对不同人群、不同地域设置不同条件,具备超级 APP 才拥有的“千人千面”灵活效果 提供小程序 IDE 开发工具 —— FIDE:界面与微信小程序的开发工具类似,自带调试和真机预览,简单易上手,同时支持小程序生成 APP,可以将已有小程序代码导出为 IOS 与 Android 中可用的工程文件(也是近期开发者最喜欢的功能)。 Generate app 你可以在这个 FIDE 里面,对现有项目进行二次开发,扩展功能和接口,同时它们还支持「小程序一键转换成 APP」,可以将已有小程序代码导出为 IOS 与 Android 中可用的工程文件,由于导出的工程文件已经集成了 FinClip SDK ,所以直接拥有小程序的运行能力,后续可在这个 APP 上继续上架更多小程序,自建自己的小程序生态。 并且 FIDE 中还包含各类扩展插件和接口(支付、人脸识别、音视频、OCR 等),开发者可自主勾选所需的支持插件,从而增强所生成 App 原生能力。 最后,通过一个脑图简单总结一下: 本文转载至公众号前端印象。

优秀的个人博客,低调大师

伯克利AI研究所:新型元学习法MAML的前世今生

雷锋网 AI科技评论按:伯克利AI研究所带来了他们的最新研究——未知模型元学习法(MAML)。它不会对模型的形式做任何假设,也没有为元学习引入额外的参数,极易应用于许多领域,包括分类、回归和强化学习。这种方法非常简单,并且优于已知的很多方法。 雷锋网(公众号:雷锋网) AI科技评论将其编译如下: 智能的一个关键层面是多才多艺——即拥有做许多不同事情的能力。目前的人工智能系统擅长掌握单一技能,如精通围棋的Go、深度回答能力超强的Watson,甚至还有自动控制直升机系统。但是,当你让人工智能系统去做不同种类看似简单的问题时,它就会举步维艰。在《Jeopardy》中的智力问答冠军Watson不能交谈,一个能熟练操控直升机飞行的系统不能应用于其他新的、简单的情形,比如为了扑灭火灾,进行定位、飞行和悬停操作。相比之下,人类可以做很多事,智能地适

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册