首页 文章 精选 留言 我的

精选列表

搜索[中国数据库前世今生],共10024篇文章
优秀的个人博客,低调大师

你未必知道的 WebRTC – 前世今生、未来

不是解决方案,也不是某种代码库。但却有可能帮助我们在业务上实现新的突破,让我们一起来聊聊,WebRTC 是什么? 如果你是一位工程师,想必听过 WebRTC,就算没有开发过;如果你是一位互联网用户,大概率使用过 WebRTC,虽然可能没有意识到。在这个视频为王的时代,我们漫谈一下这个技术的来龙去脉以及一些有趣的应用。 WebRTC 关卿底事? 文言“底”也表示疑问,是”何“、”什么“的意思。如南唐中主李璟在调侃冯延巳时所写「风乍起,吹皱一池春水,干卿底事?」 如果说 20 世纪人类的书写工具是笔、通讯方式是邮局寄信,那么 21 世纪初人类的书写工具就变成键盘、通讯方式就是电子邮件/短信/即时通信聊天,而从现在开始的可见未来,手机摄像头/VR 设备就是你的书写记录这个世界的工具、实时网络通讯就是你的通讯方式。 视频成了娱乐、学习、商务会议、社交、电商的载体,人们逐渐不再有耐心阅读文字性的信息,现在连购买一件自安装的家具,它都附带二维码,用户只要一扫即打开安装指南的视频,再也不用反复研究纸质说明书里那往往画的非常蹩脚的安装图。 视频不仅是信息的展现方式,它从一部部的 mov、jpeg4、wmv(你硬盘上熟悉而又陌生的文件对不对?)变成一个个的播放器,再变成一个个的 App,然后又从这种单向的“录制-上传 -下载-找播放器打开- 播放”,变成了“现场录制-边录边播- 实时收看”,再变成视频与即时通讯工具、会议工具融合的双向“录制与播放”。 远程视频会议已经成为如今办公的标配 传说中的“实况直播”终于发展到一个“平民化”的阶段。WebRTC,全称 Web Real-Time Communication,就是这么一种基础技术,它促进你用新的“笔”(智能视频设备,例如你的手机)以影像而非文字方式去记录与沟通。 它的奥妙在两部分,自然就是:Web + RTC!这不是显而易见的废话吗?还真不是… 但我们先聊一下RTC,实时网络通讯。 “感觉上很快”就是实时? WebRTC 强调“实时通讯网络”。网络早已无处不在了,但是否“实时”呢?大部分情况下不是。 首先,当前互联网上最重要最基本的 HTTP 协议并不是为“实时”应用设计的,当你访问一个网站的时候,你发起请求,等候网站的服务器把内容应答送回到你的PC或者手机设备,虽然这个应答可以非常快,但本质上是“请求-等候-应答”,这个“等候”,往往是一个不易控制的时间变量。 电子邮件是不是“实时”的呢?显然也不是,虽然相比传统的邮递快了十万八千倍,但是它本质上是“存储-转发”(Store-and-Forward)的机制,是由互联网上很多的邮件服务器以接力的方式,在某个最优网络路径上把电邮从某甲的设备送到某乙的设备,任何中间环节都可能延迟。 聊天工具是不是实时?它相比电子邮件而言,有更加“在线”的会话感 – 一个群里聊天信息来来回回、这边发那边看,好像很“实时”,但它的技术本质依然是“存储-转发”,消息接收方不在线没关系,只要“上线”(打开 App)就能收到,也不需要马上回复。 事实上,对快慢的感觉不能定义实时。网络的低延迟、高带宽固然是实时性的一些保障,但不等同于实时。 用大白话来描述的话,实时视频的目标,是把正在某个地方A发生的人和事,以几乎零延迟、不失真的方式“同步”到另外一个地方 B,让 B 的人瞬间看到、听到,并且反之亦然。人和事都是在不断的变化中,视频需要以“流”的方式源源不断的向远端推送更新,A、B 两地的人虽然隔着十万八千里,但是他们之间的网络能把“视频流”瞬间同步,让彼此感觉近在咫尺,这就是“实时”。 那么现在我们的“实时通讯网络”,距离真正的实时还有多远? 构建元宇宙?无限追求实时 上述问题的简单答案是,有点远。 我们对“实时”的追求是无限的,详细一点的解释,可以借最近热炒的“元宇宙”作为例子。元宇宙,是一个“仿真”或者说“全真”的互联网,它的特点之一,是利用极其强大的实时网络,把物理世界里事物的无限细节信息化并瞬间传播给接收者,使其通过一些特殊设备去复原这些信息并最大程度感受到在原发地事物的原本样子。 这些信息能包括些什么呢?例如有空间感的立体声效(Spatial Audio),让你在一个线上会议室里能听到讲话的人在自己的什么方位,让你在一个虚拟社交沙龙里能听到轻微的背景音乐、左边一群人的闲言碎语、右边吧台上酒保的调酒声;例如能足以让远端设备渲染还原成逼真 3D 效果的人或物的特征数据,大至街景建筑小至毛发与脸部表情,让你在虚拟空间里与其中的物品或人进行互动,像真的一样; 假如有一天我们发明出能收集味道并信息化并在远端通过刺激大脑皮层还原味道的设备,那么这又是一种需要传送的数据。一句话,我们希望把任何物理距离以外的东西,色香味俱全的“同步”到自己的大脑。 如果说我们现在的互联网是 2D 的话(即你只能面对一个屏幕这样的二维平面去交互感知),元宇宙就是下一代 3D 互联网,你“沉浸”在其中,你被实时送达的数据包裹,你的眼耳鼻舌身意“六根”都在里面。不要以为这是科幻,一些技术已经看的到摸得着,简单者如hubhub,复杂花哨者如 Google 的Starline。 有兴趣的小伙伴可以去看看 Metaverse Primer 在 Matthew Ball 的“元宇宙入门”( Metaverse Primer)中,提到实时网络是让这一代沉浸式互联网成为可能的8种最核心技术之一。海量数据的极低延迟实时传输能力,目前技术上还是有点遥远。 虽然元宇宙还在“炒作曲线”的不知道哪个点上,可是一些实实在在的商业应用场景确实已经可以基于实时的视频技术进行构建。除了大家熟悉的直播带货、娱乐互动,还有虚拟展会、实时教练培训、远程医疗(Telehealth)等等应用,相信任何线下的场景,只要技术允许,都会有产生线上仿真的一天。 去中心化的通讯方式? WebRTC 的里的“Web”部分,并非简单无意义的泛指,而是特指Web Browser(浏览器)。这个标准以及实现它的技术,目前均已内置在各主流浏览器中,理论上让任何用户通过任何 PC、Mac、iPhone、Android 甚至车载系统的浏览器,即可发起彼此之间的直接视频语音通讯。 也就是说,张三和李四,不管人在何方,理论上只要各自有一台设备运行一个支持 HTML5 标准的浏览器,即可以无需经过“中间商”(互联网大平台、电信运营商等等)的通讯服务或渠道而建立这两个浏览器之间的直接连接,实现传说中的“点对点”(Peer-to-Peer)视频通讯和文件分享!如果还有王五、陈六、何七几位呢?欢迎加入,组成一个完全无障碍的、无服务器的、自组织的对等网络,每个人的浏览器都是这个网络的节点,共同进行视频会议、文件分享。 有点像 VR Pro Max 的感觉 无中间商赚差价、无互联网大平台收集通讯各方的隐私数据,个人掌握自己的信息安全,也不依赖任何第三方,是不是忽然有一种自由飞翔的感觉?去中心化、点对点、对等网络,让我们回忆到互联网美好的蛮荒时代 – BT、电驴、迅雷… the good old days… 可惜暂时来说,上述情形只是一种理想,因为互联网的实际环境复杂,例如我们每个人的上网设备实际上都是在某个小区宽带、移动运营商网络、酒店 WiFi、公司局域网等等的后面,互联网实际上是由无数这样大大小小的局部网络通过一系列的网络设备、网络协议进行互联互通的,链路上信息的传递通过不同网络的设备进行层层转发和网络地址/端口的“翻译”转换,最终才到达某个个体设备。 在深圳南山区科技园某公司的员工张某,如何让其浏览器发现并连接北京朝阳区某小区的群众李某的浏览器设备地址,从而建立起点对点直连?没有直接办法。 现有的技术实现方案,依然是中心化的,即张某与李某,不得不通过一个第三方的服务来“发现”彼此的地址,这个环节叫做 Signaling(信令)。 “去中心化”临门一脚,暂时没有现成技术,比较可惜。 区块链+ WebRTC 有没有的搞? 有一些这方面的研究探索,待有志者进一步深入。 首先是关于技术本身的优化与扩展。例如有人提出利用 Kademlia(一种 DHT/分布式哈希表的算法,被以太坊、Storj 等区块链用于组网)实现信令服务的去中心化。一篇 IEEE 的研究论文则探讨了通过区块链智能合约去提高 WebRTC 的安全性。 区块链能借助 WebRtc 实现新的突破吗 其次在应用方面,有一种方案提出,在疫情以来远程办公比重日益增加的情况下,出于企业信息安全、合规留痕、工作效率管控等等原因,需要对例如销售、服务等各种发生在公司外部的远程通讯活动进行记录,依靠现有的基础设施提供商的 CDR(Call Detail Record)难以确立单一可信来源、追踪上下文,可以结合区块链与智能合约,对 WebRTC 的通讯记录数据出块,实现单一可信源拷贝、不可篡改以及分布式存储等好处。 很多金融机构的服务,例如开户或者购买理财产品等,需要远程视频见证,也许是区块链+WebRTC 的一个很好的应用场景。 WebRTC的未来与Google的算盘 讲到未来,我们不得不先回顾一下这个技术的历史。 2021 年 1 月 26 日,W3C 正式宣告 1.0 标准(“WebRTC 1.0:Real-Time Communication Between Browser”)。此前 WebRTC 经历了整整 10 年的发展:2011-2014 是这个技术的探索期,大家的主要疑问是:我是否应该尝试这个技术?2015-2019 是这个技术的成长期,随着所有主流浏览器对 WebRTC 的支持,业界的问题变成:我该如何利用这个标准技术?有些什么应用场景?2020 年开始迄今,是这个技术应用的差异化时期。 WebRtc 的标识具有典型的 Google 配色 2020 年的新冠疫情,被认为对 WebRTC 技术产生直接促进性影响。视频会议无处不在,Zoom 变成一个家喻户晓的品牌(在国内市场自然是某些互联网巨头的相应品牌),可以说大众对云端视频会议的认知与接受度得到史无前例的加强。 同样是 W3C 的标准,WebRTC 有没有机会像 HTTP 之于“古典互联网”一样,成为下一代互联网(无论你称它为“实时通讯网络”、“Web3.0”还是“元宇宙”)的基础协议?回答这个问题,得了解一下 WebRTC 背后的真正“操盘手”。 操盘手是 Google – 它不仅推动 WebRTC 成为一个互联网标准,也贡献了大部分的底层开源技术。十年前 Google 干这事的动机是什么呢?大概有这么几个原因: 押注这十年的技术发展,让视频编码技术、视频质量、网络带宽、运算资源都有重大发展,视频成为网上最最重要的应用载体; 很多企业当时的视频会议还是企业内部的、设置使用繁复的、需要专用设备的那种技术。随着云计算的发展,视频会议会不会变成云服务?很有可能; 视频应用需要专门的软件工具(回忆一下十年前五花八门的视频播放器?),Google 不控制计算机操作系统,但是它的 Chrome 浏览器已经开始击败微软和火狐,成为无处不在的存在。把一个视频技术内置于浏览器,给用户带来极大便利,视频内容与网页内容随时交织在一起,打开即看,下载什么视频播放器呢? 最重要一点来了,当年 Google 在视频会议这个领域,毫无优势可言,领先的技术平台提供商并不是 Google。所以,开个源、搅个局,完全没有坏处。 WebRTC 标准与技术,最终赢得了 Firefox、Opera、Apple Safari、Microsoft Edge 以及各种 Chrome 变种浏览器的支持,从这个角度看,是取得巨大的成功。但比较讽刺的是,Google 自己的产品中涉及视频的,似乎都没有太取得商业上的成功。例如视频会议方面,大家甚至都不太想起 Google 也有这方面的产品(而且质量不错),反而 Google 的竞争者们不少都采用 WebRTC 却取得竞争优势。 WebRtc 在各浏览器中的支持程度超过 90% 当 WebRTC 成为公共标准后,Google自己貌似在开始与 WebRTC “脱钩”,开始投资到另一个全新的技术栈:WebTransport + WebCodecs + WebAssembly。其中 WebTransport 主要基于 QUIC(HTTP/3的传输层协议),带来更低的网络延迟,更适合视频类应用。WebCodecs 内置于浏览器,让其有独立的音视频编码解码能力。WebAssembly,一个已经发展了相当长时间、进入成熟期的开源技术,它不仅让浏览器渲染执行 JavaScript 代码的性能获得“原生”级别的提升,更重要的是它可能支持机器学习方面的结合。 如果 Google 作为 WebRTC 开源技术的主要推手,不再投资到其中,那么 WebRTC 1.0 之后,除了修修补补的小版本,还有持续发展的未来吗?我们基于 WebRTC 打造应用,是否得担心一下? WebRTC 成为下一代互联网的实时应用基石,估计有点悬,因为确实有潜在的更优解在那里。但是,对于应用开发者,未来几年内,WebRTC可能就是我们的最优解,原因有三: 不要说 HTTP/3,到了今天互联网的主体还是依赖古老过时的 HTTP/1.1,HTTP/2 还在缓慢的增长中。替换一个积累10年而成熟的标准不容易; 虽然 Apple 有它的 FaceTime、Zoom(以及国内外的视频服务巨头们)有自己的封闭技术,未必在意 WebRTC,但是对于独立开发者,一个标准的、开放的、互联互通的、工业品质的开源技术,依然是我们最好的选择; 标准与开源的好处就是,只要有企业能利用它做出杀手级应用、商业成功,就会有人去继续支持维护与创新,接过 Google 的枪。例如会不会有人把 WebRTC 更彻底的去中心化?利用 QUIC 去优化 WebRTC 的低延迟?总是有人会去琢磨。 作为应用开发者,可以做的事情是应用场景的创意发掘与创新,是促进一个标准/技术繁荣有生命力的最佳保证。 杀手级WebRTC应用有哪些? Alexa,亚马逊的智能音箱 Echo 里的智能助手,采用 WebRTC。 Facebook Messenger、Discord、Amazon Chime、Google Meet/Hangout/Duo,都是基于 WebRTC 的视频通讯工具、视频会议应用。 Clubhouse,2021 年现象级的语音社交工具。 Chrome Remote Desktop,远程桌面工具。对于一般商务人士例如市场、销售等等来说,可能过于技术,难以驾驭。但这种工具为什么没有人深入研究借鉴一下,发展出实时远程销售培训、实时远程机器维修人员培训、实时远程医疗人员培训这样的东西呢? 最后必须特别推荐三个值得关注的 WebRTC 相关公司及其应用场景: peer5.com Peer 5,一个基于 WebRTC 的 eCDN(企业内容分发网络),对内容进行网络加速,充分利用到 WebRTC 内置在浏览器中的 P2P 能力。今年8月份被微软收购。这是一个借力新标准、开源技术成就一家创业公司的成功故事。 hopin.com Hopin,一家英国的独角兽公司,采用 WebRTC 打造“虚拟活动平台”,成立两年成功融资 5 亿 7 千万美元、收购 4 家公司。 stadia.com Stadia,这是 Google 尝试进军游戏行业的一大尝试,能否成功不去讨论。其有趣的地方是开启 Cloud Gaming 这一领域,也可以称之为“Gaming As A Service”(游戏即服务)或者“On-Demand Gaming”。怎么理解它呢,一直以来我们打 Xbox、任天堂的游戏,都是需要买一个游戏机,打不同的游戏就放进去不同的游戏光盘。 Cloud Gaming,就是你不需要本地的光盘了,游戏在云端运行,然后通过流媒体的方式传输到你的屏幕上,就像你在电视上点播电影一样,但你用游戏手柄可以与“电影”互动。 你怎么看待 WebRtc 在未来的发展? 本文转载至FinClip博客,更多有趣的文章欢迎点击FinClip博客。

优秀的个人博客,低调大师

用户操作系统Unix的前世今生

【前言】 Brain Kernighan,加拿大计算机科学家,曾就职于贝尔实验室,目前为普林斯顿大学教授。他曾参与 Unix 的研发,也是 AMPL 与 AWK 的共同创造者之一,他和 Dennis Ritchie 共同写作了C语言的第一本著作《C程序设计语言》,他是大名鼎鼎的 K & R 里面的 K,当然也是 AWK 里面的 K 。作为 Unix 的开发者之一、Unix 命名者,亲眼见证了 Unix 的诞生。 关于 Kernighan,还有一个有趣的定律——柯林汉定律。 柯林汉定律:调试一段代码的难度是编写它们的两倍,因此如果你的代码写的尽可能巧妙,按照定义而言,你可能没有能力来调试它了。 关于 Unix ,除了 Kernighan,有三个人的名字需要记住:美国计算机科学学者和工程师、B语言发明人 Ken Thompson,美国计算机科学家C语言的创造者、Unix操作系统的关键开发者Dennis Ritchie 以及 达特茅斯学院的兼职教授、著名数学家、工程师以及程序员 Doug Mcllory。 Unix 的诞生地贝尔实验室真的是大神云集,自己好几天才能做出来的东西别人可能一顿饭工夫就能解决。这种自由的环境令人不禁想起来著名物理学家费恩曼介绍自己在 Caltech 的有趣故事。在 Unix 的诞生之路上,有哪些人和事给 Kernighan 留下了深刻印象呢? 在贝尔实验室的第一天就遇到了 Richard Hamming ! 1967 年,当 Kernighan 还是一个研究生的时候,就拿到了贝尔实验室的实习,贝尔实验室可真大,三千多人在此工作,Kernighan 虽然是实习生,也配置了独立办公室,让我等打工人羡慕不已。令人更酸的是,Kernighan 后来去贝尔实验室都没有面试,只要完成博士论文就可以了。和我们一样,快到中午的时候,也会思考“我中午要吃点什么才好呢?。就像电视剧当中的剧情一样,真的就有一位绅士来邀请共进午餐。他介绍说自己是 Dick(英文名 Richard 的简写和昵称),Kernighan 当时也没有记住他的名字,只能偷偷去他的办公室看门口的牌牌,他就是 Richard Hamming! Hamming 的英文维基百科页面特别的长,随便哪个都是碾压级别的:参与曼哈顿计划为核武器发射编写程序、图灵奖得主、纠错码发明人,为了表彰他的贡献,IEEE 还特意设立以他的名字命名的奖项。和费恩曼一样,Hamming 在实验室里面也不喜欢当团队的领导者。 将 Kernighan 对于 Hamming 的描述概括起来就是两个字——伟大。这可不是高帽,Hamming 真的是这样要求自己的,这个天赋异丙而又有趣的人,在很多方面对世界做出了深刻的影响。Hamming 说过,他会把周五的下午用来思考伟大的事情。他还会去找其他方向的人聊天,发出灵魂拷问:“你的研究是否有可能获得诺贝尔奖?”如果得到否定回答的话,就会化身教鞭“那你为什么要做?这个研究连获得诺贝尔奖的可能都没有,肯定没那么重要了,你为什么要把时间浪费在不重要的事情上呢?”退休几年之后,他还发表了关于如何获得成功职业生涯建议的演讲,题目为《你和你的研究》。 Fortran 那么难 话题说回 Kernighan,他听从了 Hamming 的建议,论文研究的课题是图分割,这个跟著名的旅行商问题比较像。不过他还得用普林斯顿的电脑,要知道,1967年的电脑跟今天的可大不一样,和段子里面中用针刻光盘类似,那时候的程序员编程还是喜欢用打孔卡,比如 Fortran 和 Combol 语言。Fortran 是用于科学计算的编程语言,现在也有很多科学家的课题组或者专业软件在使用Fortran语言编程。 Kernighan 其实也是个有趣的家伙,有一次他们参与了一条广告的拍摄,他反常地打了一条领带,结果几周后对方表示照片丢失了,需要再拍一张,结果 Kernighan 坚决表示不打领带拍摄,后来发现刊登的还是打领带的照片,因为那张照片居然被他们找到了。 现在连小学生都会玩电脑和平板,但是大部分见到软盘的话应该会当成“保存按钮”,就更不用说古老的打孔卡了。感兴趣的朋友可以搜索一下关于打孔卡的历史。编写一个程序真的太费功夫了。做好的打孔卡装在盒子里面,去计算机房,计算机操作人员给你们处理,你就只能等结果,而且可不会给你显示什么报错,就算这样,在那个时候真的是足够快、且昂贵了。 【关于打孔卡】19世纪80年代,美国人口调查局职员发明了用于人口普查的穿孔卡片和机器,用于90年的人口普查,用了六周就完成了之前需要7年的工程。何乐礼创建的公司发展成了今天的 IBM ,1928 年(算到这边就是民国十七年),IBM 发现矩形孔更省空间,发明了 80 列的矩阵孔卡片。它的设计是这样的,最下面的 10 行命名为 0-9 行,顶部两行为 11、12 行,每列的孔代表一个字符,一些特殊的字符用了额外的单孔双孔表示。 后来 IBM 又对打孔卡进行了一系列的改进。 80 孔打孔卡 分时系统和 Multics 的诞生 在 Unix 分时系统出现之前,人工和机器的交互简直就像《疯狂动物城》里面的树懒一样,慢是真慢,而且毫无交互体验,和现在相同的是,提交者都不希望有 bug 出现,即使多提交几张打孔卡的代码也无妨。 Kernighan 讲到,他注意到 Jerry Saltzer写的给博士论文排版的程序,自己也写了一个代码来给自己的论文进行排版。但是 Fortran 对于字符的处理实在是不太好,以至于最后论文居然有 3 盒打孔卡,每盒 5000 张,大概 5 公斤那么重,其中 1000 张是程序代码,等了两三个小时之后才打出来这份论文。 贝尔实验室的 Ken Thompson 和 Dennis Ritchie 开始了一个新的项目——Multics。这是个分时操作系统,在交互式方面有着重要的突破。它允许多人连接到计算机上,每个人都可以获得一部分时间,给用户一个独占整个计算机的感觉,不过计算机实际上还会在他们之间来回切换。如果你可以“独享”的话,你就可以使用电传打字机而不需要打孔卡了。电传打字机这个东西是打字机、打印机和电话线的结合体,你可以输入命令,通过电话线传给计算机,然后输出。这种原理和现在的 SSH 其实比较类似, 打孔卡的环境其实叫做批处理环境,这个提交脚本作业、Windows 当中的 bat 比较像,如果代码完正确的话,其实效率还是挺高的,就比如我们现在利用超算提交作业,往往就是用的批处理脚本,例如著名的竞赛网站 Kaggle 平台就会分别提供 Notebook 交互环境和 Scripts 的模式。有了分时系统,用户就可以进行及时的人机交互,对于较小的不成熟的作业就能够及时获得反馈。 了不起的 Ken Thompson 不过,Multics 实在是太贵了,尽管它能提供很好的计算环境,很多针对它的描述用到了”过度工程“这个词。 因此,贝尔实验室在 1969 年退出了项目,只有 MIT 和 AT&T 还在支持。虽然贝尔实验室退出了 Multics计划,Ken 可没闲着,实验室有一台 PDP-7,说是一台微型机,实际上也是需要一件屋子才能放得下,不过还好已经有显示器了。他就用这台 PDP-7 机器,把自己写的《Space Travel》 游戏在上面运行了。游戏当中玩家可以互相射击,而且还加入了引力效果,让玩家对轨道动力学有了简单了解。 总是有那么多巧合,Ken 的爱人带着一岁的孩子去加州呆了三周度假。利用这三周的时间,Ken 完成了可以正常运行的系统,他命名为“Uniplexed Information and Computing System”,缩写为 UNICS ,这可以说是 Unix 的初代机了。 对于文档处理软件,Ken 也很感兴趣,为了论文格式之类的问题,他们买了一台排字机,这个东西有点像现在的激光打印机,打印到感光纸上,然后洗成照片。不过机器本身的软件很容易出错,两人商量了决定逆向一下这个软件,设计自己的软件来运行。一台机器、使用手册,汇编语言的代码,这就是他们目前手头上有的东西。Kernighan 想着太难了还是先吃个晚饭,等他回来的时候,Ken 已经写出了反汇编程序看到裸机当中代码了,第二天他甚至还用 B 语言写了一个解释器。Kernighan 表示说这些事情你我都可以完成,但绝对不是几个小时就能搞定的。对 Ken 来说简直就是砍瓜切菜,手到擒来。 文件系统、shell 和管道 早期的计算机,例如 IBM,实际上没有什么文件系统,虽然存储信息的方式比较多,但是都比较局限于特定设备和场景,但访问辅助存储的信息是,你就得记住注入光盘柱面等等奇怪的属性。而 Ken 在 Unix 当中就实现了更加简单整洁的文件系统。只要 6 个系统调用就能获得处理信息需要的所有东西。 关于 Unix 另外一个伟大的点在于交互式 shell,也就是我们喜欢的命令行。这个想法最初在 Multics 上就有体现,只是 Unix 上更加清晰。早期的管道概念也是在这里萌生的,你不用经过中间件,就能将程序的输出放到另一个的输入当中,大概 1973 年,Doug Mcllory 希望把程序接在一起,就像花园里面的水管连接起来一样,后来反复提及,他想到了用竖线,也就是我们今天的管道符号。Ken 也将管道符号添加到了 Unix 系统。这个有点像函数式编程,Unix 程序似乎一下子变成了积木,有了拼接的可能。 Unix 文化 Unix 系统后来被移植到了 PDP-11 上面,放置这台机器的地方在贝尔实验室的 6 层,这就是 Unix 房间,房间很大,但是走廊光线很差,还有些二战时期的垃圾设备。不过房间本身不错,就像现在开放式环境一样,大家可以闲聊,虽然有点嘈杂,毕竟大家的工作一致,有时候很容易得到启发。 你可以在办公室里面思考程序,也可以写在黑板上,需要的时候在放回公共区域,有些人就喜欢一直在公共区域里。比如 Ken,他从来不在自己的办公室里面,Kernighan 就喜欢在办公室里面,然和每隔一两个小时就去冲个咖啡,和别人交流一下。整栋大楼的人都很愿意和别人交流,楼里面的走廊里面贴着很多东西。计算机方向的人在两个小走廊直接办公,他们很愿意来回走动。不过 Unix 房间某个时期在走廊的一端,后来又到了六楼,空间非常紧凑,不过这种布局也更方便了大家交谈。这种友善的环境当中,经常能发现一些有趣的东西。 据 Kernighan 讲,当时他们还搬来了 10kg 的巧克力,人们用刀切一两块带走,搞得满地都是渣渣,估计负责清洁的人都要炸了。有时候你走进 Unix 房间,走到旁边的屋子里面,听到人们会讨论 Unix 多么强大或者给别人介绍我们做的其他东西,有时候还会有一些名人到访。整个氛围轻松愉快。Ritchie 经常会把他姐姐送给他的英国讽刺刊物《私家侦探》放在桌子上,一般就在巧克力旁边,我有时候也会翻一下看看里面有趣的卡通画,不过有些东西真的是英式幽默,没有在英国生活过可能无法理解。 给 CIA 演示 Unix 的强大引来参观者无数,70年代中后期,Kernighan 他们就要给许多名人展示 Unix 系统, 陪同人员还都是贝尔实验室的高层。不过最有意思的还是中情局局长,William Colby。 展示的内容主要基于 Unix 的组合思想,比如管道,多个程序组合就能比写一个专用程序容易得多。常见的展示就是拼写检查,可以把文档分割成单词,然后都变成小写,获得一片叫好。不过,由于当时的机器比较慢,知道 Colby 要来的时候,提前运行了管道,然后把结果存在文件里面当天直接打印,毕竟不能让大人物等三四十秒。这就是一个经典的“演示工程”。不过比今天很多"PPT 项目”已经好很多了。 如果对于程序谁有新的想法,也可以写一个新版本来改进,不过这里有个特别的规则,最后修改这拥有程序的所有权,Kernighan 后来成为了 ed 文本编辑器的所有者。这时候,其实计算机也是一个社区,只是你们看不到谁在线而已。那么还有个命令就是 who,不仅能看到谁在线,还能知道他最后做了什么。这种方式方便了信息共享和共同交流。 编程很难,如何变得简单? 我们今天用的一切,比如分享代码树、审查 PR 等等,其机制在四五十年前就出现了。后来 Unix 传到了贝尔实验室之外,包括源码,人们开始给 Unix 贡献代码,虽然这不是开源,但是和开源非常相似。 在 Kernighan 看来,今天的代码编写太难了,比起某个不知道多少层代码的文档中去找需要的函数,自己写程序逻辑这种创作的行为更加容易。Ken 的电子游戏或者类旅行商问题哪个更重要其实说不好,那么如何打造一个提升程序员工作效率的环境?如何让编程变得更加容易呢?如果做出了一些能对自己有帮助的事情,对他人的工作可能也会有所改善,何乐而不为呢? 【责任编辑: 未丽燕 TEL:(010)68476606】

优秀的个人博客,低调大师

一文领略 HTTP 的前世今生

每个时代,都不会亏待会学习的人。 大家好,我是 yes。 HTTP 协议在当今的互联网可谓是随处可见,一直默默的在背后支持着网络世界的运行,对于我们程序员来说 HTTP 更是熟悉不过了。 平日里我们都说架构是演进的,需求推动着技术的迭代、更新和进步,对于 HTTP 协议来说也是如此。 不知你是否有想过 HTTP 协议是如何诞生的,一开始是怎样的,又是怎么一步一步发展到今天的 HTTP/3 ? 其中经历了哪些不为人知的秘密? 今天我就想和大家一起来看一看 HTTP 的演进之路,来看看它是如何从一个小宝宝成长为现在统治互联网的存在。 不过在此之前,我们先简单的看看互联网的始祖-阿帕网的一段小历史,还是很有趣的。 互联网的始祖-阿帕网 在 1950 年代,通信研究者们认识到不同计算机用户和网络之间的需要通信,这促使了分布式网络、排队论和封包交互的研究。 在1958 年2月7日,美国国防部长尼尔 · 麦克尔罗伊发布了国防部 5105.15 号指令,建立了高级研究计划局(ARPA) 。 ARPA 的核心机构之一 IPTO(信息处理处)赞助的一项研究导致了阿帕网的开发。 我们来看看这段历史。 在 1962 年,ARPA 的主任聘请约瑟夫·利克莱德担任 IPTO 的第一任主任,他是最早预见到现代交互计算及其在各种应用的人之一。 IPTO 资助了先进的计算机和网络技术的研究,并委托十三个研究小组对人机交互和分布式系统相关技术进行研究。每个小组获得的预算是正常研究补助金的三十至四十倍。 这就是财大气粗啊,研究人员肯定是干劲十足! 在 1963 年利克莱德资助了一个名为 MAC 的研究项目,该项目旨在探索在分时计算机上建立社区的可能性。 这个项目对 IPTO 和更广泛的研究界产生了持久的影响,成为广泛联网的原型。 并且利克莱德的全球网络愿景极大地影响了他在 IPTO 的继任者们。 1964 年利克莱德跳槽到了 IBM,第二任主任萨瑟兰上线,他创建了革命性的 Sketchpad 程序,用于存储计算机显示器的内存,在 1965 年他与麻省理工学院的劳伦斯 · 罗伯茨签订了 IPTO 合同,以进一步发展计算机网络技术。 随后,罗伯茨和托马斯 · 梅里尔在麻省理工学院的 TX-2 计算机和加利福尼亚的 Q-32 计算机之间,通过拨号电话连接实现了第一个数据包交换。 1966 年第三任主任鲍勃 · 泰勒上任,他深受利克莱德的影响,巧的是泰勒和利克莱德一样也是个心理声学家。 在泰勒的 IPTO 办公室里有三个不同的终端连接到三个不同的研究站点,他意识到这种架构将严重限制他扩展访问多个站点的能力。 于是他想着把一个终端连接到一个可以访问多个站点的网络上,并且从他在五角大楼的职位来说,他有这个能力去实现这个愿景。 美国国防部高级研究计划局局长查理 · 赫茨菲尔德向泰勒承诺,如果 IPTO 能够组织起来,他将提供 100 万美元用于建立一个分布式通信网络。 泰勒一听舒服了,然后他对罗伯茨的工作印象很深刻,邀请他加入并领导这项工作,然后罗伯茨却不乐意。 泰勒不高兴了,于是要求赫茨菲尔德让林肯实验室的主任向罗伯茨施压,要求他重新考虑,这最终促使罗伯茨缓和了态度,于1966年12月加入 IPTO 担任首席科学家。 在 1968 年6月3日,罗伯茨向泰勒描述了建立阿帕网的计划,18 天后,也就是 6 月 21 日,泰勒批准了这个计划,14 个月后阿帕网建立。 当阿帕网顺利发展时,泰勒于 1969 年9月将 IPTO 的管理权移交给罗伯茨。 随后罗伯茨离开 ARPA 成为 Telenet 的 CEO ,而利克莱德再次回到 IPTO 担任董事,以完成该组织的生命周期。 至此,这段历史暂告一段落,可以看到阿帕网之父罗伯茨还是被施压的才接受这项任务,最终创建了阿帕网,互联网的始祖。 也多亏了利克莱德的远见和砸钱促进了技术的发展,ARPA 不仅成为网络诞生地,同样也是电脑图形、平行过程、计算机模拟飞行等重要成果的诞生地。 历史就是这么的巧合和有趣。 互联网的历史 在 1973 年 ARPA 网扩展成互联网,第一批接入的有英国和挪威计算机,逐渐地成为网络连接的骨干。 1974 年 ARPA 的罗伯特·卡恩和斯坦福的文顿·瑟夫提出TCP/IP 协议。 1986 年,美国国家科学基金会(National Science Foundation,NSF)建立了大学之间互联的骨干网络 NSFNET ,这是互联网历史上重要的一步,NSFNET 成为新的骨干,1990 年 ARPANET 退役。 在 1990 年 ,蒂姆·伯纳斯-李(下文我就称李老) 创建了运行万维网所需的所有工具:超文本传输协议(HTTP)、超文本标记语言(HTML)、第一个网页浏览器、第一个网页服务器和第一个网站。 至此,互联网开启了快速发展之路,HTTP 也开始了它的伟大征途。 还有很多有趣的历史,比如第一次浏览器大战等等,之后有机会再谈,今天我们的主角是 HTTP。 接下来我们就看看 HTTP 各大版本的演进,来看看它是如何成长到今天这个样子的。 HTTP / 0.9 时代 在 1989 年,李老发表了一篇论文,文中提出了三项现在看来很平常的三个概念。 URI,统一资源标识符,作为互联网上的唯一标识。 HTML,超文本标记语言,描述超文本。 HTTP ,超文本传输协议,传输超文本。 随后李老就付之于行动,把这些都搞出来了,称之为万维网(World Wide Web)。 那时候是互联网初期,计算机的处理能力包括网速等等都很弱,所以 HTTP 也逃脱不了那个时代的约束,因此设计的非常简单,而且也是纯文本格式。 李老当时的想法是文档存在服务器里面,我们只需要从服务器获取文档,因此只有 “GET”,也不需要啥请求头,并且拿完了就结束了,因此请求响应之后连接就断了。 这就是为什么 HTTP 设计为文本协议,并且一开始只有“GET”、响应之后连接就断了的原因了。 在我们现在看来这协议太简陋了,但是在当时这是互联网发展的一大步!一个东西从无到有是最困难的。 这时候的 HTTP 还没有版本号的,之所以称之为 HTTP / 0.9 是后人加上去了,为了区别之后的版本。 HTTP 1.0 时代 人们的需求是无止尽的,随着图像和音频的发展,浏览器也在不断的进步予以支持。 在 1995 年又开发出了 Apache,简化了 HTTP 服务器的搭建,越来越多的人用上了互联网,这也促进了 HTTP 协议的修改。 需求促使添加各种特性来满足用户的需求,经过了一系列的草案 HTTP/1.0 于 1996 年正式发布。 Dave Raggett 在1995年领导了 HTTP 工作组,他希望通过扩展操作、扩展协商、更丰富的元信息以及与安全协议相关的安全协议来扩展协议,这种安全协议通过添加额外的方法和头字段来提高效率。 所以在 HTTP/1.0 版本主要增加以下几点: 增加了 HEAD、POST 等新方法。 增加了响应状态码。 引入了头部,即请求头和响应头。 在请求中加入了 HTTP 版本号。 引入了 Content-Type ,使得传输的数据不再限于文本。 可以看到引入了新的方法,填充了操作的语义,像 HEAD 还可以只拿元信息不必传输全部内容,提高某些场景下的效率。 引入的响应状态码让请求方可以得知服务端的情况,可以区分请求出错的原因,不会一头雾水。 引入了头部,使得请求和响应更加的灵活,把控制数据和业务实体进行了拆分,也是一种解耦。 新增了版本号表明这是一种工程化的象征,说明走上了正途,毕竟没版本号无法管理。 引入了 Content-Type,支持传输不同类型的数据,丰富了协议的载体,充实了用户的眼球。 但是那时候 HTTP/1.0 还不是标准,没有实际的约束力,各方势力不吃这一套,大白话就是你算老几。 HTTP 1.1 时代 HTTP/1.1 版本在 1997 的 RFC 2068 中首次被记录,从 1995 年至 1999 年间的第一次浏览器大战,极大的推动了 Web 的发展。 随着发展 HTTP/1.0 演进成了 HTTP/1.1,并且在 1999 年废弃了之前的 RFC 2068,发布了 RFC 2616。 从版本号可以得知这是一个小版本的更新,更新主要是因为 HTTP/1.0 很大的性能问题,就是每请求一个资源都得新建一个 TCP 连接,而且只能串行请求。 所以在 HTTP/1.1 版本主要增加以下几点: 新增了连接管理即 keepalive ,允许持久连接。 支持 pipeline,无需等待前面的请求响应,即可发送第二次请求。 允许响应数据分块(chunked),即响应的时候不标明Content-Length,客户端就无法断开连接,直到收到服务端的 EOF ,利于传输大文件。 新增缓存的控制和管理。 加入了 Host 头,用在你一台机子部署了多个主机,然后多个域名解析又是同一个 IP,此时加入了 Host 头就可以判断你到底是要访问哪个主机。 可以看到浏览器大战推进了 Web 的发展,也暴露出 HTTP/1.0 的不足之处,毕竟网络带宽等等都在进步,总不能让协议限制了硬件的发展。 因此提出了 HTTP/1.1 ,主要是为了解决性能的问题,包括支持持久连接、pipeline、缓存管理等等,也添加了一些特性。 再后来到 2014 年对 HTTP/1.1 又做了一次修订,因为其太过庞大和复杂,因此进行了拆分,弄成了六份小文档 RFC7230 - RFC7235 这时候 HTTP/1.1 已经成了标准,其实标准往往是在各大强力竞争对手相对稳定之后建立的,因为标准意味着统一,统一就不用费劲心思去兼容各种玩意。 只有强大的势力才能定标准,当你足够强大的时候你也可以定标准,去挑战老标准。 HTTP 2 时代 随着 HTTP/1.1 的发布,互联网也开始了爆发式的增长,这种增长暴露出 HTTP 的不足,主要还是性能问题,而 HTTP/1.1 无动于衷。 这就是人的惰性,也符合平日里我们对产品的演进,当你足够强大又安逸的时候,任何的改动你是不想理会的。 别用咯。 这时候 Google 看不下去了,你不搞是吧?我自己搞我的,我自己和我自己玩,我用户群体大,我有 Chrome,我服务多了去了。 Google 推出了 SPDY 协议,凭借着它全球的占有率超过了 60% 的底气,2012年7月,开发 SPDY 的小组公开表示,它正在努力实现标准化。 HTTP 坐不住了,之后互联网标准化组织以 SPDY 为基础开始制定新版本的 HTTP 协议,最终在 2015 年发布了 HTTP/2。 HTTP/2 版本主要增加以下几点: 是二进制协议,不再是纯文本。 支持一个 TCP 连接发起多请求,移除了 pipeline。 利用 HPACK 压缩头部,减少数据传输量。 允许服务端主动推送数据。 从文本到二进制其实简化了整齐的复杂性,解析数据的开销更小,数据更加紧凑,减少了网络的延迟,提升了整体的吞吐量。 支持一个 TCP 连接发起多请求,即支持多路复用,像 HTTP/1.1 pipeline 还是有阻塞的情况,需要等前面的一个响应返回了后面的才能返回。 而多路复用就是完全异步化,这减少了整体的往返时间(RTT),解决了 HTTP 队头阻塞问题,也规避了 TCP 慢启动带来的影响。 HPACK 压缩头部,采用了静态表、动态表和哈夫曼编码,在客户端和服务器都维护请求头的列表,所以只需要增量和压缩过的头部信息,服务端拿到之后组装一下就能得到完整的头部信息。 形象一点就是如下图所示: 再具体一点就是下图这样: 服务端主动推送数据,这个其实就是减少了请求的次数,比如客户端请求 1.html,我把 1.html 需要的 js 和 css 也一块送过去,省的之后客户端再请求我要 js ,我要这个 css。 可以看到 HTTP/2 的整体演进都是往性能优化的角度发展,因为此时的性能就是痛点,任何东西的演进都是哪里痛医哪里。 当然有一些例外,比如一些意外,或者就是“闲的蛋疼”的那种捯饬。 这次推进属于用户揭竿而起为之,你再不给我升级我自己搞了,我有着资本,你自己掂量。 最终结果是好的,Google 后来放弃了 SPDY ,拥抱标准,而 HTTP/1.1 这个历史包袱太重了,所以 HTTP/2 到现在也只有大致一半的网站使用它。 HTTP 3 时代 这 HTTP/2 还没捂热, HTTP/3 怎么就来了? 这次又是 Google,它自己突破自己,主要也是源自于痛点,这次的痛点来自于 HTTP 依赖的 TCP。 TCP 是面向可靠的、有序的传输协议,因此会有失败重传和按序机制,而 HTTP/2 是所有流共享一个 TCP 连接,所以会有 TCP 层面的队头阻塞,当发生重传时会影响多个请求响应。 并且 TCP 是基于四元组(源IP,源端口,目标IP,目标端口)来确定连接的,而在移动网络的情况下 IP 地址会频繁的换,这会导致反复的建连。 还有 TCP 与 TLS 的叠加握手,增加了延时。 问题就出在 TCP 身上,所以 Google 就把目光瞄向了 UDP。 UDP 我们知道是无连接的,不管什么顺序,也不管你什么丢包,而 TCP 我在之前的文章说的很清楚了TCP疑难杂症解析不了解的同学可以去看看。 简单的说就是 TCP 太无私了,或者说太保守了,现在需要一种更激进的做法。 那怎么搞? TCP 改不动我就换!然后把 TCP 可靠、有序的功能提到应用层来实现,因此 Google 就研究出了 QUIC 协议。 QUIC 层来实现自己的丢包重传和拥塞控制,还有出于安全的考虑我们都会用 HTTPS ,所以需要多次握手。 上面我也已经提到了关于四元组的情况,所以在移动互联网时代这握手的消耗就更加放大了,于是 QUIC 引入了个叫 Connection ID 来标识一个链接,所以切换网络之后可以复用这个连接,达到 0 RTT 就能开始传输。 注意上图是在已经和服务端握过手之后的,由于网络切换等原因才有 0 RTT ,也就是 Connection ID 在之前生成过了。 如果是第一次建连还是需要多次握手的,我们来看一下简化的握手对比图。 所以所谓的 0RTT 是在之前已经建连的情况下。 当然还有 HTTP/2 提到的 HPACK,这个是依赖 TCP 的可靠、有序传输的,于是 QUIC 得搞了个 QPACK,也采用了静态表、动态表和哈夫曼编码。 它丰富了 HTTP/2 的静态表,从 61 项加到了 98 项。 上面提到的动态表,是用来存储未包含在静态表中的头部项,假设动态表还未收到,后面来解头部的时候肯定要被阻塞的。 所以 QPACK 就另开一条路,在单向的 Stream 里传输动态表的编解码,单向传输好了,接受端到才能开始解码,也就是说还没好你就先别管,防止做一半卡住了。 那还有前面提到的 TCP 队头阻塞, QUIC 是怎么解决的呢?毕竟它也要保证有序和可靠啊。 因为 TCP 不认识每个流分别是哪个请求的,所以它只能全部阻塞住,而 QUIC 知道,因此比如请求 A 丢包了,我就把 A 卡住了就行,请求 B 完全可以全部放行,丝毫不受影响。 可以看到基于 UDP 的 QUIC 还是很强大的,而且人家用户多,在 2018 年,互联网标准化组织 IETF 提议将 HTTP over QUIC 更名为 HTTP/3 并获得批准。 可以看到需求又推动技术的进步,由于 TCP 自身机制的限制,我们的目光已经往 UDP 上靠了,那 TCP 会不会成为历史呢? 我们拭目以待。 最后 今天我们大致过了一遍 HTTP 发展的历史和它的演进之路,可以看到技术是源于需求,需求推动着技术的发展。 本质上就是人的惰性,只有痛了才会成长。 而且标准其实也是巨头们为了他们的利益推动的,不过标准确实能减轻对接的开销,统一而方便。 当然就 HTTP 来说还是有很多内容的,有很多细节,很多算法,比如拿 Connection ID 来说,不同的四元组你如何保证请求一定会转发到之前的服务器上? 所以今天我只是浅显的谈了谈大致的演进,具体的实现还是得靠各位自己摸索,或者之后有机会我再写一些。 不过相对于这些实现细节我更感兴趣的是历史的演进,这能让我从时代背景等一些约束来得知,为什么这东西一开始是这么设计的,从而更深刻的理解这玩意。 而且历史还是很有趣的,不是么? 最后的最后 个人能力有限,如有纰漏请赶紧联系鞭挞我,如果想进群就备注下进群,我拉你。 如果觉得文章不错还望点个在看支持一下哟。 我是 yes,从一点点到亿点点,我们下篇见。 巨人的肩膀 https://www.livinginternet.com/i/ii_ipto.htm https://jacobianengineering.com/blog/2016/11/1543/ https://w3techs.com/technologies/details/ce-http2 https://www.verizondigitalmedia.com/blog/how-quic-speeds-up-all-web-applications/ https://www.oreilly.com/content/http2-a-new-excerpt/ https://www.darpa.mil/about-us/timeline/dod-establishes-arpa https://en.wikipedia.org/wiki/ARPANET https://en.wikipedia.org/wiki/Internet 深入剖析HTTP/3协议 ,陶辉 透视HTTP协议 ,罗剑锋 本文分享自微信公众号 - yes的练级攻略(yes_java)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

一文了解Kubernetes的前世今生

近十几年来,IT领域新技术、新概念层出不穷,例如DevOps、微服务(Microservice)、容器(Container)、云计算(Cloud Computing)和区块链(Blockchain)等,直有“乱花渐欲迷人眼”之势。另外,出于业务的需要,IT应用模型也在不断地变革,例如,开发模式从瀑布式(Waterfall)到敏捷(Agile)再到精益(Lean),甚至是与QA和Operations融合的DevOps,应用程序架构从单体(monolithic)模型到分层模型再到微服务,部署及打包方式从面向物理机到虚拟机再到容器,应用程序的基础架构从自建机房到托管再到云计算,等等,这些变革使得IT技术应用的效率大大提升,同时却以更低的成本交付更高质量的产品。尤其是以Docker为代表的容器技术的出现,终结了DevOps中交付和部署环节

优秀的个人博客,低调大师

视觉回顾智能手表的前世今生

2014年:LG G Watch R LG G Watch R于2014年上市,搭载Android Wear系统,属于G Watch的后续版本。它配备1.2 GHz处理器、4GB的内部存储空间以及320x320像素显示屏。LG G Watch R不仅仅能够跟相配的Android智能手机通讯,还能够通过Google Now处理语音指令。它还拥有现代智能手表的一些常见功能,如心率监测、脉搏监测和运动追踪。 该设备的零售价为295美元。其最令人称道的地方是时尚大气的设计,不过它面临的市场竞争非常激烈。 2014年:摩托罗拉Moto 360 摩托罗拉Moto 360于2014年进入市场。它采用谷歌的Android Wear系统,配备1.56英寸的320x290像素显示屏、心率监测器和计步器。该设备受到了业界的一致好评。它有三种不同的款色选择

优秀的个人博客,低调大师

每日一博 | Redis 线程模型的前世今生

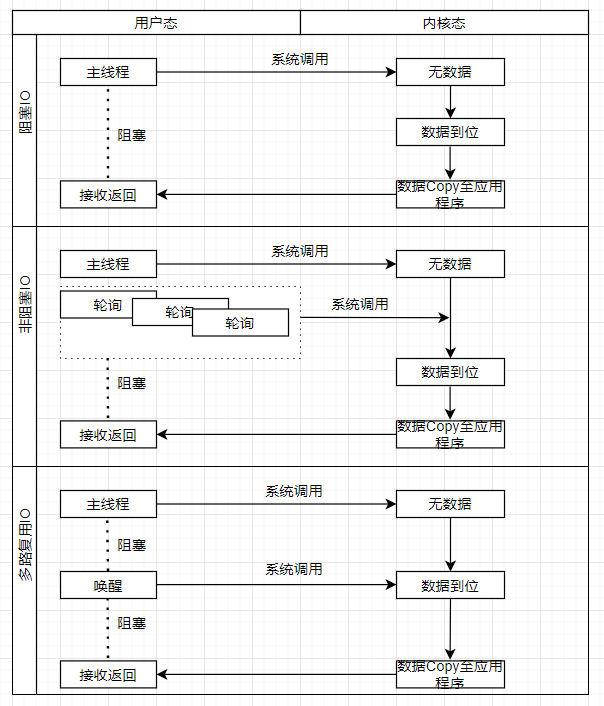
一、概述 众所周知,Redis是一个高性能的数据存储框架,在高并发的系统设计中,Redis也是一个比较关键的组件,是我们提升系统性能的一大利器。深入去理解Redis高性能的原理显得越发重要,当然Redis的高性能设计是一个系统性的工程,涉及到很多内容,本文重点关注Redis的IO模型,以及基于IO模型的线程模型。 我们从IO的起源开始,讲述了阻塞IO、非阻塞IO、多路复用IO。基于多路复用IO,我们也梳理了几种不同的Reactor模型,并分析了几种Reactor模型的优缺点。基于Reactor模型我们开始了Redis的IO模型和线程模型的分析,并总结出Redis线程模型的优点、缺点,以及后续的Redis多线程模型方案。本文的重点是对Redis线程模型设计思想的梳理,捋顺了设计思想,就是一通百通的事了。 注:本文的代码都是伪代码,主要是为了示意,不可用于生产环境。 二、网络IO模型发展史 我们常说的网络IO模型,主要包含阻塞IO、非阻塞IO、多路复用IO、信号驱动IO、异步IO,本文重点关注跟Redis相关的内容,所以我们重点分析阻塞IO、非阻塞IO、多路复用IO,帮助大家后续更好的理解Redis网络模型。 我们先看下面这张图; 2.1 阻塞IO 我们经常说的阻塞IO其实分为两种,一种是单线程阻塞,一种是多线程阻塞。这里面其实有两个概念,阻塞和线程。 阻塞:指调用结果返回之前,当前线程会被挂起,调用线程只有在得到结果之后才会返回; 线程:系统调用的线程个数。 像建立连接、读、写都涉及到系统调用,本身是一个阻塞的操作。 2.1.1 单线程阻塞 服务端单线程来处理,当客户端请求来临时,服务端用主线程来处理连接、读取、写入等操作。 以下用代码模拟了单线程的阻塞模式; import java.net.Socket; public class BioTest { public static void main(String[] args) throws IOException { ServerSocket server=new ServerSocket(8081); while(true) { Socket socket=server.accept(); System.out.println("accept port:"+socket.getPort()); BufferedReader in=new BufferedReader(new InputStreamReader(socket.getInputStream())); String inData=null; try { while ((inData = in.readLine()) != null) { System.out.println("client port:"+socket.getPort()); System.out.println("input data:"+inData); if("close".equals(inData)) { socket.close(); } } } catch (IOException e) { e.printStackTrace(); } finally { try { socket.close(); } catch (IOException e) { e.printStackTrace(); } } } } } 我们准备用两个客户端同时发起连接请求、来模拟单线程阻塞模式的现象。同时发起连接,通过服务端日志,我们发现此时服务端只接受了其中一个连接,主线程被阻塞在上一个连接的read方法上。 我们尝试关闭第一个连接,看第二个连接的情况,我们希望看到的现象是,主线程返回,新的客户端连接被接受。 从日志中发现,在第一个连接被关闭后,第二个连接的请求被处理了,也就是说第二个连接请求在排队,直到主线程被唤醒,才能接收下一个请求,符合我们的预期。 此时不仅要问,为什么呢? 主要原因在于accept、read、write三个函数都是阻塞的,主线程在系统调用的时候,线程是被阻塞的,其他客户端的连接无法被响应。 通过以上流程,我们很容易发现这个过程的缺陷,服务器每次只能处理一个连接请求,CPU没有得到充分利用,性能比较低。如何充分利用CPU的多核特性呢?自然而然的想到了——多线程逻辑。 2.1.2 多线程阻塞 对工程师而言,代码解释一切,直接上代码。 BIO多线程 package net.io.bio; import java.io.BufferedReader; import java.io.IOException; import java.io.InputStreamReader; import java.net.ServerSocket; import java.net.Socket; public class BioTest { public static void main(String[] args) throws IOException { final ServerSocket server=new ServerSocket(8081); while(true) { new Thread(new Runnable() { public void run() { Socket socket=null; try { socket = server.accept(); System.out.println("accept port:"+socket.getPort()); BufferedReader in=new BufferedReader(new InputStreamReader(socket.getInputStream())); String inData=null; while ((inData = in.readLine()) != null) { System.out.println("client port:"+socket.getPort()); System.out.println("input data:"+inData); if("close".equals(inData)) { socket.close(); } } } catch (IOException e) { e.printStackTrace(); } finally { } } }).start(); } } } 同样,我们并行发起两个请求; 两个请求,都被接受,服务端新增两个线程来处理客户端的连接和后续请求。 我们用多线程解决了,服务器同时只能处理一个请求的问题,但同时又带来了一个问题,如果客户端连接比较多时,服务端会创建大量的线程来处理请求,但线程本身是比较耗资源的,创建、上下文切换都比较耗资源,又如何去解决呢? 2.2 非阻塞 如果我们把所有的Socket(文件句柄,后续用Socket来代替fd的概念,尽量减少概念,减轻阅读负担)都放到队列里,只用一个线程来轮训所有的Socket的状态,如果准备好了就把它拿出来,是不是就减少了服务端的线程数呢? 一起看下代码,单纯非阻塞模式,我们基本上不用,为了演示逻辑,我们模拟了相关代码如下; package net.io.bio; import java.io.BufferedReader; import java.io.IOException; import java.io.InputStreamReader; import java.net.ServerSocket; import java.net.Socket; import java.net.SocketTimeoutException; import java.util.ArrayList; import java.util.List; import org.apache.commons.collections4.CollectionUtils; public class NioTest { public static void main(String[] args) throws IOException { final ServerSocket server=new ServerSocket(8082); server.setSoTimeout(1000); List<Socket> sockets=new ArrayList<Socket>(); while (true) { Socket socket = null; try { socket = server.accept(); socket.setSoTimeout(500); sockets.add(socket); System.out.println("accept client port:"+socket.getPort()); } catch (SocketTimeoutException e) { System.out.println("accept timeout"); } //模拟非阻塞:轮询已连接的socket,每个socket等待10MS,有数据就处理,无数据就返回,继续轮询 if(CollectionUtils.isNotEmpty(sockets)) { for(Socket socketTemp:sockets ) { try { BufferedReader in=new BufferedReader(new InputStreamReader(socketTemp.getInputStream())); String inData=null; while ((inData = in.readLine()) != null) { System.out.println("input data client port:"+socketTemp.getPort()); System.out.println("input data client port:"+socketTemp.getPort() +"data:"+inData); if("close".equals(inData)) { socketTemp.close(); } } } catch (SocketTimeoutException e) { System.out.println("input client loop"+socketTemp.getPort()); } } } } } } 系统初始化,等待连接; 发起两个客户端连接,线程开始轮询两个连接中是否有数据。 两个连接分别输入数据后,轮询线程发现有数据准备好了,开始相关的逻辑处理(单线程、多线程都可)。 再用一张流程图辅助解释下(系统实际采用文件句柄,此时用Socket来代替,方便大家理解)。 服务端专门有一个线程来负责轮询所有的Socket,来确认操作系统是否完成了相关事件,如果有则返回处理,如果无继续轮询,大家一起来思考下?此时又带来了什么问题呢。 CPU的空转、系统调用(每次轮询到涉及到一次系统调用,通过内核命令来确认数据是否准备好),造成资源的浪费,那有没有一种机制,来解决这个问题呢? 2.3 IO多路复用 server端有没专门的线程来做轮询操作(应用程序端非内核),而是由事件来触发,当有相关读、写、连接事件到来时,主动唤起服务端线程来进行相关逻辑处理。模拟了相关代码如下; IO多路复用 import java.net.InetSocketAddress; import java.nio.ByteBuffer; import java.nio.channels.SelectionKey; import java.nio.channels.Selector; import java.nio.channels.ServerSocketChannel; import java.nio.channels.SocketChannel; import java.nio.charset.Charset; import java.util.Iterator; import java.util.Set; public class NioServer { private static Charset charset = Charset.forName("UTF-8"); public static void main(String[] args) { try { Selector selector = Selector.open(); ServerSocketChannel chanel = ServerSocketChannel.open(); chanel.bind(new InetSocketAddress(8083)); chanel.configureBlocking(false); chanel.register(selector, SelectionKey.OP_ACCEPT); while (true){ int select = selector.select(); if(select == 0){ System.out.println("select loop"); continue; } System.out.println("os data ok"); Set<SelectionKey> selectionKeys = selector.selectedKeys(); Iterator<SelectionKey> iterator = selectionKeys.iterator(); while (iterator.hasNext()){ SelectionKey selectionKey = iterator.next(); if(selectionKey.isAcceptable()){ ServerSocketChannel server = (ServerSocketChannel)selectionKey.channel(); SocketChannel client = server.accept(); client.configureBlocking(false); client.register(selector, SelectionKey.OP_READ); //继续可以接收连接事件 selectionKey.interestOps(SelectionKey.OP_ACCEPT); }else if(selectionKey.isReadable()){ //得到SocketChannel SocketChannel client = (SocketChannel)selectionKey.channel(); //定义缓冲区 ByteBuffer buffer = ByteBuffer.allocate(1024); StringBuilder content = new StringBuilder(); while (client.read(buffer) > 0){ buffer.flip(); content.append(charset.decode(buffer)); } System.out.println("client port:"+client.getRemoteAddress().toString()+",input data: "+content.toString()); //清空缓冲区 buffer.clear(); } iterator.remove(); } } } catch (Exception e) { e.printStackTrace(); } } } 同时创建两个连接; 两个连接无阻塞的被创建; 无阻塞的接收读写; 再用一张流程图辅助解释下(系统实际采用文件句柄,此时用Socket来代替,方便大家理解)。 当然操作系统的多路复用有好几种实现方式,我们经常使用的select(),epoll模式这里不做过多的解释,有兴趣的可以查看相关文档,IO的发展后面还有异步、事件等模式,我们在这里不过多的赘述,我们更多的是为了解释Redis线程模式的发展。 三、NIO线程模型解释 我们一起来聊了阻塞、非阻塞、IO多路复用模式,那Redis采用的是哪种呢? Redis采用的是IO多路复用模式,所以我们重点来了解下多路复用这种模式,如何在更好的落地到我们系统中,不可避免的我们要聊下Reactor模式。 首先我们做下相关的名词解释; Reactor:类似NIO编程中的Selector,负责I/O事件的派发; Acceptor:NIO中接收到事件后,处理连接的那个分支逻辑; Handler:消息读写处理等操作类。 3.1 单Reactor单线程模型 处理流程 Reactor监听连接事件、Socket事件,当有连接事件过来时交给Acceptor处理,当有Socket事件过来时交个对应的Handler处理。 优点 模型比较简单,所有的处理过程都在一个连接里; 实现上比较容易,模块功能也比较解耦,Reactor负责多路复用和事件分发处理,Acceptor负责连接事件处理,Handler负责Scoket读写事件处理。 缺点 只有一个线程,连接处理和业务处理共用一个线程,无法充分利用CPU多核的优势。 在流量不是特别大、业务处理比较快的时候系统可以有很好的表现,当流量比较大、读写事件比较耗时情况下,容易导致系统出现性能瓶颈。 怎么去解决上述问题呢?既然业务处理逻辑可能会影响系统瓶颈,那我们是不是可以把业务处理逻辑单拎出来,交给线程池来处理,一方面减小对主线程的影响,另一方面利用CPU多核的优势。这一点希望大家要理解透彻,方便我们后续理解Redis由单线程模型到多线程模型的设计的思路。 3.2 单Reactor多线程模型 这种模型相对单Reactor单线程模型,只是将业务逻辑的处理逻辑交给了一个线程池来处理。 处理流程 Reactor监听连接事件、Socket事件,当有连接事件过来时交给Acceptor处理,当有Socket事件过来时交个对应的Handler处理。 Handler完成读事件后,包装成一个任务对象,交给线程池来处理,把业务处理逻辑交给其他线程来处理。 优点 让主线程专注于通用事件的处理(连接、读、写),从设计上进一步解耦; 利用CPU多核的优势。 缺点 貌似这种模型已经很完美了,我们再思考下,如果客户端很多、流量特别大的时候,通用事件的处理(读、写)也可能会成为主线程的瓶颈,因为每次读、写操作都涉及系统调用。 有没有什么好的办法来解决上述问题呢?通过以上的分析,大家有没有发现一个现象,当某一个点成为系统瓶颈点时,想办法把他拿出来,交个其他线程来处理,那这种场景是否适用呢? 3.3 多Reactor多线程模型 这种模型相对单Reactor多线程模型,只是将Scoket的读写处理从mainReactor中拎出来,交给subReactor线程来处理。 处理流程 mainReactor主线程负责连接事件的监听和处理,当Acceptor处理完连接过程后,主线程将连接分配给subReactor; subReactor负责mainReactor分配过来的Socket的监听和处理,当有Socket事件过来时交个对应的Handler处理; Handler完成读事件后,包装成一个任务对象,交给线程池来处理,把业务处理逻辑交给其他线程来处理。 优点 让主线程专注于连接事件的处理,子线程专注于读写事件吹,从设计上进一步解耦; 利用CPU多核的优势。 缺点 实现上会比较复杂,在极度追求单机性能的场景中可以考虑使用。 四、Redis的线程模型 4.1 概述 以上我们聊了,IO网路模型的发展历史,也聊了IO多路复用的reactor模式。那Redis采用的是哪种reactor模式呢?在回答这个问题前,我们先梳理几个概念性的问题。 Redis服务器中有两类事件,文件事件和时间事件。 文件事件:在这里可以把文件理解为Socket相关的事件,比如连接、读、写等; 时间时间:可以理解为定时任务事件,比如一些定期的RDB持久化操作。 本文重点聊下Socket相关的事件。 4.2 模型图 首先我们来看下Redis服务的线程模型图; IO多路复用负责各事件的监听(连接、读、写等),当有事件发生时,将对应事件放入队列中,由事件分发器根据事件类型来进行分发; 如果是连接事件,则分发至连接应答处理器;GET、SET等redis命令分发至命令请求处理器。 命令处理完后产生命令回复事件,再由事件队列,到事件分发器,到命令回复处理器,回复客户端响应。 4.3 一次客户端和服务端的交互流程 4.3.1 连接流程 连接过程 Redis服务端主线程监听固定端口,并将连接事件绑定连接应答处理器。 客户端发起连接后,连接事件被触发,IO多路复用程序将连接事件包装好后丢人事件队列,然后由事件分发处理器分发给连接应答处理器。 连接应答处理器创建client对象以及Socket对象,我们这里关注Socket对象,并产生ae_readable事件,和命令处理器关联,标识后续该Socket对可读事件感兴趣,也就是开始接收客户端的命令操作。 当前过程都是由一个主线程负责处理。 4.3.2 命令执行流程 SET命令执行过程 客户端发起SET命令,IO多路复用程序监听到该事件后(读事件),将数据包装成事件丢到事件队列中(事件在上个流程中绑定了命令请求处理器); 事件分发处理器根据事件类型,将事件分发给对应的命令请求处理器; 命令请求处理器,读取Socket中的数据,执行命令,然后产生ae_writable事件,并绑定命令回复处理器; IO多路复用程序监听到写事件后,将数据包装成事件丢到事件队列中,事件分发处理器根据事件类型分发至命令回复处理器; 命令回复处理器,将数据写入Socket中返回给客户端。 4.4 模型优缺点 以上流程分析我们可以看出Redis采用的是单线程Reactor模型,我们也分析了这种模式的优缺点,那Redis为什么还要采用这种模式呢? Redis本身的特性 命令执行基于内存操作,业务处理逻辑比较快,所以命令处理这一块单线程来做也能维持一个很高的性能。 优点 Reactor单线程模型的优点,参考上文。 缺点 Reactor单线程模型的缺点也同样在Redis中来体现,唯一不同的地方就在于业务逻辑处理(命令执行)这块不是系统瓶颈点。 随着流量的上涨,IO操作的的耗时会越来越明显(read操作,内核中读数据到应用程序。write操作,应用程序中的数据到内核),当达到一定阀值时系统的瓶颈就体现出来了。 Redis又是如何去解的呢? 哈哈~将耗时的点从主线程拎出来呗?那Redis的新版本是这么做的吗?我们一起来看下。 4.5 Redis多线程模式 Redis的多线程模型跟”多Reactor多线程模型“、“单Reactor多线程模型有点区别”,但同时用了两种Reactor模型的思想,具体如下; Redis的多线程模型是将IO操作多线程化,本身逻辑处理过程(命令执行过程)依旧是单线程,借助了单Reactor思想,实现上又有所区分。 将IO操作多线程化,又跟单Reactor衍生出多Reactor的思想一致,都是将IO操作从主线程中拎出来。 命令执行大致流程 客户端发送请求命令,触发读就绪事件,服务端主线程将Socket(为了简化理解成本,统一用Socket来代表连接)放入一个队列,主线程不负责读; IO 线程通过Socket读取客户端的请求命令,主线程忙轮询,等待所有 I/O 线程完成读取任务,IO线程只负责读不负责执行命令; 主线程一次性执行所有命令,执行过程和单线程一样,然后需要返回的连接放入另外一个队列中,有IO线程来负责写出(主线程也会写); 主线程忙轮询,等待所有 I/O 线程完成写出任务。 五、总结 了解一个组件,更多的是要去了解他的设计思路,要去思考为什么要这么设计,做这种技术选型的背景是啥,对后续做系统架构设计有什么参考意义等等。一通百通,希望对大家有参考意义。 作者:vivo互联网服务器团队-Wang Shaodong

优秀的个人博客,低调大师

最强整理:微信小程序的前世今生

微信小程序 一、小程序介绍 背景与趋势 小程序技术方案 公众平台注册及配置 开发工具的使用 MINA框架架构剖析 应用程序配置详解 逻辑与界面分离架构 单向数据流 二、UI开发 复杂的页面布局 文字图片等内容的呈现 用户交互表单开发 对话框等交互元素开发 下拉刷新和上拉加载 图形与动画操作 页面之间的跳转过渡 用户界面事件处理 三、小程序项目实战 3.1 微信小程序的文件结构 —— 教程系列(1) 微信小程序的生命周期实例演示 —— 微信小程序教程系列(2) 微信小程序的动态修改视图层的数据 —— 微信小程序教程系列(3) 微信小程序如何新建页面 —— 微信小程序教程系列(4) 微信小程序的如何使用全局属性 —— 微信小程序教程系列(5) 微信小程序的页面跳转和参数传递 —— 微信小程序教程系列(6) 微信小程序标题栏和导航栏的设置 —— 微信小程序教程系列(7) 微信小程序的作用域和模块化 —— 微信小程序教程系列(8) 微信小程序视图层的数据绑定 —— 微信小程序教程系列(9) 微信小程序之wx:if视图层的条件渲染 —— 微信小程序教程系列(10) 微信小程序视图层的列表渲染 —— 微信小程序教程系列(11) 微信小程序视图层的模板 —— 微信小程序教程系列(12) 微信小程序之wxss —— 微信小程序教程系列(13) 微信小程序的网络请求 —— 微信小程序教程系列(14) 微信小程序的百度地图获取地理位置 —— 微信小程序教程系列(15) 微信小程序使用百度api获取天气信息 —— 微信小程序教程系列(16) 微信小程序获取系统日期和时间 —— 微信小程序教程系列(17) 微信小程序之上拉加载和下拉刷新 —— 微信小程序教程系列(18) 微信小程序之组件 —— 微信小程序教程系列(19) 微信小程序之微信登陆 —— 微信小程序教程系列(20) 微信小程序之顶部导航栏(选项卡)实例 —— 微信小程序实战系列(21) 微信小程序之加载更多(分页加载)实例 —— 微信小程序实战系列(22) 微信小程序之自定义轮播图实例 —— 微信小程序实战系列(23) 微信小程序之仿android fragment之可滑动的底部导航栏实例 —— 微信小程序实战系列(24) 微信小程序之登录页实例 —— 微信小程序实战系列(25) 微信小程序之自定义toast实例 —— 微信小程序实战系列(26) 微信小程序之自定义抽屉菜单(从下拉出)实例 —— 微信小程序实战系列(27) 微信小程序之自定义模态弹窗(带动画)实例 —— 微信小程序实战系列(28) 微信小程序之侧栏分类 —— 微信小程序实战商城系列(29) 微信小程序之仿淘宝分类入口 —— 微信小程序实战商城系列(30) 微信小程序之购物数量加减 —— 微信小程序实战商城系列(31) 微信小程序之商品属性分类 —— 微信小程序实战商城系列(32) 微信小程序之购物车 —— 微信小程序实战商城系列(33) 最后 Alvin老师已经将精品网课、书籍、BAT面试文档、项目专题源码等资料已分享在网盘中,并在持续更新中。欢迎关注Alvin老师微信号VX:Android-Alvin 前往领取!

优秀的个人博客,低调大师

人工智能和机器学习的前世今生

如果正确的利用模式识别进行商业预测和决策,那么会为企业带来巨大的利益。机器学习(ML)研究这些模式,并将人类决策过程编码成算法。这些算法可以被应用到几个实例以得出有意义的结论。在这篇文章中,我们将了解一些机器学习的基础、工作原理及特点。 举例来了解机器学习 经研究预测,截至到2020年,企业采用机器学习、人工智能和深度学习、物联网(IOT)以及大数据将从他们那些不太知情的同行那里带走超过1兆2000亿美元。 数据是机器学习的关键。算法从一定数量的数据中学习,然后应用这种学习来做出明智的决策。Netflix有一个很好的关于下一个你想看的节目的想法,Facebook可以在照片中识别你和你的朋友,这要感谢机器学习.。 机器学习是关于自动执行任务的,它的应用跨越了广泛的行业领域。数据安全公司可以使用机器学习来追踪恶意软件,而金融公司可以使用它来增强其盈利能力这里有个例子,让我们考虑一个手电筒,无论什么时候,当“黑暗”一词出现在一个短语中的时候,它就会被程序打开。我们将使用的几个短语作为关于手电筒的机器学习算法的输入数据。 用程序语言来表达机器学习 为了解决业务的复杂性,并带来机器学习的技术创新,编程语言和框架技术不断地被引入和更新。一些编程语言来来往往,而一些被相关的、保留的还在经历着考验。这两个编程语言在机器学习和人工智能的圈子里是最强大的。还有其他语言如java、C++、Julia、SAS、MATLAB、Scala,还有很多。然而,我们讨论的仅限于Python和R这两个语言. Python不仅流行,还很简单,并且功能众多。它是一种能在所有主流平台上使用的便携式编程语言,如Linux、Windows、MAC和UNIX。Python不仅作为Web应用开发的通用语言,而且还可以作为科学计算、数据挖掘和分析的专用语言。如果有一种在招聘人员中最喜欢的机器学习和AI的编程技术,那就肯定是Python了。 R语言是适用于机器学习的另一种编程语言,并且它与统计学家和数学家有着密切的联系。现在,虽然机器学习本身与统计学的原理密切相关,但是R作为机器学习语言可以带来巨大的好处。如果你希望在大数据中解决模式问题,R语言是最佳选择,它是由统计学家和科学家设计的,很方便地用于数据分析。 机器学习算法的工作原理 机器学习算法评估一个用一种特殊的数据来泛化的预测模型。因此,必须有大量的实例,以供机器学习算法用来理解系统的行为。现在,当机器学习算法与新类型的数据一起出现时,系统将能够生成类似的预测。了解机器学习算法的不同组成部分和它们之间的相互关系,可以使机器学习任务变得更加容易。 机器学习算法有一个结构化的学习组件,使他们有能力理解输入数据中的模式,从而导致输出。 输入数据 -> 模式 -> 机器学习算法 -> 推断/输出 这里让"Y"表示未来的预测结果,让"X"表示输入的实例.那么,我们得出这个表达式: Y=f (X) 其中“Y”也称为映射函数,“f”称为目标函数。“f”总是未知的,因为它在数学上是无法确定的。因此,机器学习被用来获得目标函数的近似值,“f”。机器学习算法考虑到关于目标函数的几个假设,并用一个带有评估的假设来开始。为了得到输出的最佳估值,进行了大量的假设迭代。正是这种假设使得机器学习算法能够在短时间内得到一个更好地逼近目标函数的近似值。 人工智能vs机器学习vs深度学习 你的愿望永远不会被模糊所混淆。人工智能、机器学习和深度学习是经常可以交替使用的概念,这或多或少地加重了与这些概念相关联的已经存在的混淆程度。让我们领会这些概念,直截了当地理解它们的内涵和之间的细微差别。 人工智能是一个比机器学习更广泛的概念。它是关于将人类的认知智能如何传授给计算机的过程。任何机器使用算法以智能方式执行任务,这就是展现的人工智能。 机器学习是人工智能的一个子集。它是关于机器从一组数据中学习的能力。通过信息处理的这种学习增强了算法,从而提供更好的评估和对未来的预测。 深度学习深入机器学习,可以被认为是机器学习的一个子集。神经网络允许计算机模仿人类的大脑。就像我们的大脑天生的具有识别归类和分类信息的模式一样,神经网络也为计算机实现了同样的功能。深度学习有时也被称为深度神经网络,因为决策树的嵌套层次结构的层数是数以百万计的数据节点。 让你的机器学习人工智能认证计数 自从第一次工业革命以来,机器就一直驱动着我们的生活方式,使之成为当今工业4.0的趋势。因此,在某种程度上有必要通过让你很好地了解一个强大的技术平台,如机器学习、人工智能和深度学习,成为这一革命的一个组成部分。一旦你完成了它的来龙去脉,成功就在眼前拥抱你! 数十款阿里云产品限时折扣中,赶紧点击领劵开始云上实践吧! 以上为译文。 本文由北邮@爱可可-爱生活老师推荐,阿里云云栖社区组织翻译。 文章原标题《Machines at Work: Understanding the Ins and Outs of AI and Machine Learning》,译者:Mags,审校:袁虎。 文章为简译,更为详细的内容,请查看原文。

优秀的个人博客,低调大师

时空穿梭 探寻高端存储架构的前世今生

低端存储拼价格,中端存储拼功能,那么高端存储拼什么?当然是架构。5月8日,浪潮正式推出新一代高端存储AS18000,满足了关键业务对高性能、高可靠性、高可扩展性的核心需求,而这一切的基础就是其独特的架构——业内领先的全共享交换架构iMatrix。 架构设计对于高端存储系统来说,就像摩天大楼的建筑结构设计,不同的结构决定了建筑的安全性、耐久性和适用性。所以,高端存储的架构设计将对产品的性能、可靠性、可扩展性起到决定性作用。 俗话说,外行看热闹,内行看门道。对于高端存储来说,这个门道就是架构。高性能、高可靠和可扩展性是所有高端存储面临的“三角”难题,也是成为衡量高端存储技术领先性的重要指标。如何在三者之间取得均衡,对于厂商和用户来说都是一道难题。那么,高端存储架构经历了怎样的演进呢?浪潮全共享交换架构iMatrix又是如何重新定义新一代高端存储架构的领先性呢?且看下文分解。 (图示:黄色方块代表控制器,浅蓝色方块代表缓存,深蓝色方块代表存储介质,白色方块代表交换,线条代表线缆) 多控高端存储演进 先回顾一下存储架构过去几十年的发展历史。高端存储是在大型机、小型机出现后,随着数据规模的持续增长需求开始出现,自从问世就一直承担着IT应用中的最核心的业务数据的存储、管理。其中,基于开放系统的高端存储系统出现的时间已接近20年。按时间顺序,高端存储架构经历了从总线架构到交换式架构、矩阵直连架构、分布式架构、全共享交换式架构的演进历程。今天,浪潮AS18000的推出将高端存储架构定格在新一代全共享交换架构。可以这样说,浪潮AS18000采用的新一代全共享交换架构的iMatrix融合了前几代架构的优势,既充分发挥了交换架构的高可靠优势,又使得分布式架构的高扩展优势得以全面施展。浪潮AS18000为高端存储的可靠性、扩展性、性能、延迟等指标树立了新杆杆。 1. 总线架构:扩展性差,总线资源争用 总线架构图示 目前,已经没有厂家再采用总线交换式的架构。EMC和HDS的早期产品都曾经采用过这种架构。该架构的缺点是可扩展性不强,且由于基于总线,存在总线争用,造成数据访问效率受到影响。 2. 交换式架构:时延大,资源争用 交换式架构 交换式的架构通过交换ASIC将前端和后端连接进行数据交换。交换式架构具有更好的可扩展性,但要解决减少交换时延和交换争用等问题。目前,在全球仍有高端存储厂商在采用该架构。 3. 矩阵直连架构:不易扩展,布线复杂 矩阵直连式架构 该架构的前端和后端采取矩阵式直接连接方式,缺点是可扩展性很差,同时由于连接信号线数目众多,在一定程度上给布线和维护带来了困难。EMC的DMX-4就是采用基于矩阵直连式的存储阵列架构。目前,EMC在VMAX高端存储上已经弃用该架构。 关于矩阵直连式架构的诞生,在这里给大家讲个小故事,据说当年研发出交换式架构的厂商对该架构申请了技术专利。这样就让竞争厂商没有办法采用,只得放弃交换式架构另辟蹊径,转而将每个需要通信的部件全部用线连起来,确保架构的应用能力,并且规避专利版权问题。这就是矩阵直连式架构的由来。 矩阵直连架构的优点是:数据响应敏捷、时延低,因为不用经过交换机。缺点也显而易见:扩展性差。可以想象,每增加一个控制器,都会带来线缆的大量增加,给产品设计带来不小的挑战,也增加了项目实施和运维的复杂度。 4. 分布式架构:非全共享模式 分布式架构 分布式架构将串行延迟降至了最低,使得系统获得了理论上最高的加速比。由于该系统的所有资源,包括计算资源、内存资源、磁盘资源都足够分散,因此资源争用的可能性极小。分布式系统具有更好的性能、可扩展性,同时也拥有更低的成本。 然而,这种架构也存在一些不足,分布式架构在系统内部保持了一个较高的数据冗余保证,但是在主机到存储的链路层,缺少更高层次的可靠性保证机制;在关键业务应用环境中,只保证了数据的高性能、高可靠的内部存储,没有提供更高可靠性的数据IO服务。 目前,市场上最新一代高端存储阵列HP P10000、EMC的VMAX等高端存储都在采用这种全分布式架构。 5. 全共享交换架构iMatrix:定义新一代高端架构,高可靠、高性能、高扩展 全共享交换式架构 在“互联网+”的影响下,用户要迎接新时期的“关键业务+”的挑战,首先就需要一个高可靠、高性能和灵活可扩展的核心业务架构。浪潮新一代全共享交换架构iMatrix,包括主机层、控制器层、存储层三层全共享交换,提供了领先的高可靠、高性能、高扩展等关键存储特性,代表着高端存储架构设计未来的发展方向。 基于iMatrix架构的浪潮AS18000高端存储与天梭K1构成浪潮“计算+”战略的核心应用引擎。浪潮AS18000为客户提供“7个9”的方案级可靠性、600万IOPS(约每秒承载60万笔业务)的高性能、16个控制器和7680个硬盘驱动器的高扩展能力。 目前,iMatrix具有业界最强的容错能力,提供了从容忍三控制器故障、三引擎故障到容忍三站点故障的系统架构保障。基于新一代高端存储架构的AS18000毫无疑问将成为用户核心业务的强大支撑,让用户的核心数据系统能够轻松应对关键业务带来的诸多挑战。 浪潮AS18000通过32路存储冗余链路和智能化的IO调度策略,可实现高端存储链路、控制器、存储资源的自动负载均衡。基于前端PCIe 3.0全交换,浪潮AS18000可构建全局缓存资源池,充分发挥每个控制器的性能,达到目前业界最高的600万IOPS和小于1ms延迟。通过后端SAS 3.0全交换,浪潮AS18000可构建统一的数据共享资源池,实现每一块数据对每个前端控制器可视。 iMatrix架构让浪潮AS18000充分发挥了前后端交换组件的最大性能,可实现768GB/s的双向均衡带宽,达到小于1ms的低延迟,满足关键业务对数据响应速度和数据一致性的高要求。 在极端情况下,16个控制器只要还有一个控制器“存活”,也可确保数据的可访问性。可以说,iMatrix具有数倍于其他厂商高端存储的容错能力,能够实现“6个9”的系统可靠性和“7个9”的方案级可靠性。 作者:佚名 来源:51CTO

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册