首页 文章 精选 留言 我的

精选列表

搜索[中国数据库前世今生],共10024篇文章
优秀的个人博客,低调大师

MySQL数据库中FOR UPDATE的使用

在MySQL中,FOR UPDATE是一个非常重要的锁机制,主要用于在事务中锁定查询到的数据行,防止其他事务修改这些数据。 基本语法 sql 复制代码 SELECT * FROM table_name WHERE condition FOR UPDATE; 主要作用 1. 行级排他锁 对查询结果集加排他锁(X锁) 其他事务无法对这些行加任何锁,包括读锁和写锁 其他事务可以普通读取(取决于隔离级别),但不能修改 2. 防止数据竞争 在并发环境下,防止多个事务同时修改同一数据: sql 复制代码 -- 事务1 START TRANSACTION; SELECT balance FROM accounts WHERE id = 1 FOR UPDATE; -- 此时其他事务无法修改id=1的记录 UPDATE accounts SET balance = balance - 100 WHERE id = 1; COMMIT; 使用场景 1. 库存扣减 sql 复制代码 START TRANSACTION; SELECT stock FROM products WHERE id = 1001 FOR UPDATE; -- 检查库存并扣减 UPDATE products SET stock = stock - 1 WHERE id = 1001; COMMIT; 2. 账户余额操作 sql 复制代码 START TRANSACTION; SELECT balance FROM accounts WHERE user_id = 123 FOR UPDATE; -- 确保余额充足后进行转账 UPDATE accounts SET balance = balance - 500 WHERE user_id = 123; COMMIT; 3. 订单处理 sql 复制代码 START TRANSACTION; SELECT * FROM orders WHERE status = 'pending' FOR UPDATE; -- 处理待处理订单 UPDATE orders SET status = 'processing' WHERE status = 'pending'; COMMIT; 注意事项 1. 必须在事务中使用 sql 复制代码 -- 错误用法(不在事务中) SELECT * FROM table FOR UPDATE; -- 正确用法 START TRANSACTION; SELECT * FROM table FOR UPDATE; -- ... 其他操作 COMMIT; 2. 锁的释放 锁在事务提交或回滚时自动释放 长时间持有锁会影响并发性能 3. 索引的重要性 sql 复制代码 -- 使用主键索引(高效) SELECT * FROM users WHERE id = 1 FOR UPDATE; -- 无索引字段可能导致表锁(性能差) SELECT * FROM users WHERE name = 'John' FOR UPDATE; 4. 与其他锁的区别 锁类型 说明 其他事务能否读取 其他事务能否修改 FOR UPDATE 排他锁 可以(READ COMMITTED) 不可以 LOCK IN SHARE MODE 共享锁 可以 不可以 实际示例 sql 复制代码 -- 银行转账场景 START TRANSACTION; -- 锁定转出账户 SELECT balance FROM accounts WHERE account_no = 'A001' FOR UPDATE; -- 锁定转入账户 SELECT balance FROM accounts WHERE account_no = 'B002' FOR UPDATE; -- 执行转账操作 UPDATE accounts SET balance = balance - 1000 WHERE account_no = 'A001'; UPDATE accounts SET balance = balance + 1000 WHERE account_no = 'B002'; COMMIT; 性能建议 尽量缩短锁持有时间 确保查询条件使用索引 避免在高峰期对热点数据使用 考虑使用乐观锁替代 FOR UPDATE是保证数据一致性的重要工具,但需要谨慎使用以避免死锁和性能问题。
优秀的个人博客,低调大师

InfiniBand 的前世今生

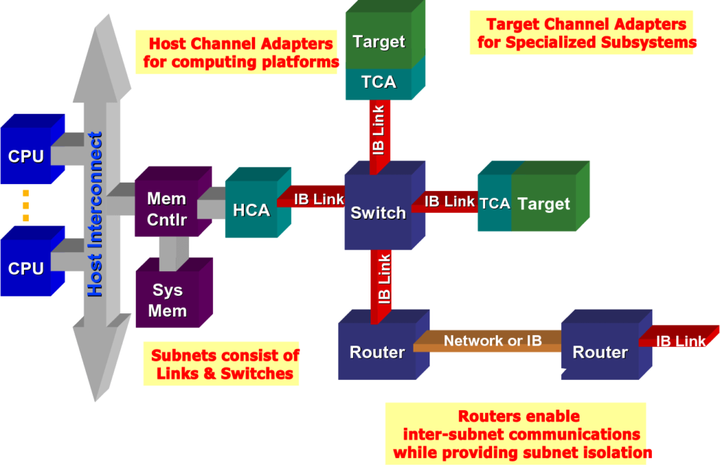
今年,以 ChatGPT 为代表的 AI 大模型强势崛起,而 ChatGPT 所使用的网络,正是 InfiniBand,这也让 InfiniBand 大火了起来。那么,到底什么是 InfiniBand 呢?下面,我们就来带你深入了解 InfiniBand。 InfiniBand的发展历史 InfiniBand(也称为“无限带宽”,缩写为 IB)是一个用于高性能计算的计算机网络通信标准,它具有极高的吞吐量和极低的延迟,用于计算机与计算机之间的数据互连。InfiniBand 也用作服务器与存储系统之间的直接或交换互连,以及存储系统之间的互连。随着人工智能的兴起,它也是 GPU 服务器的首选网络互连技术。 我们来看下 InfiniBand 的发展历程: 1999 年,一家名为 InfiniBand Trade Association(IBTA)的组织发布了 InfiniBand 架构,该架构的目的是为了取代 PCI 总线,旨在提供一种高性能、低延迟的计算和存储互连技术。 2000年,InfiniBand架构规范的 1.0 版本正式发布。紧接着在 20021 年,首批 InfiniBand 产品问世,多家厂商也开始推出支持 InfiniBand 的产品,包括服务器、存储系统和网络设备等。 2003 年,InfiniBand 转向一个新的应用领域——计算机集群互联,并在当时的 TOP500 超级计算机中得到了广泛应用。 在接下来的几年中,InfiniBand 多次引入新的特性和改进,支持双倍带宽的 DDR(Double Date Rate)、远程直接内存访问和更好的虚拟化支持,这些新特性为高性能计算和存储系统提供了更多的灵活性和性能优势。 到 2019 年的 TOP500 超级计算机中,已经有 181 个采用了 InfiniBand 技术,当时的 Ethernet(以太网)仍然是主流。而到了 2015 年,InfiniBand 技术在 TOP500 超级计算机中的占比首次超过了50%,达到 51.4%。这标志着 InfiniBand 技术首次实现了对以太网技术的逆袭,成为超级计算机中最受欢迎的内部连接技术。 InfiniBand的架构 InfiniBand 是处理器和 I/O 设备之间数据流的通信链路,支持多达 64,000 个可寻址设备。InfiniBand 架构 (IBA) 是一种行业标准规范,定义了用于互连服务器、通信基础设施、存储设备和嵌入式系统的点对点交换输入/输出框架。 InfiniBand的网络架构 InfiniBand 具有普遍性、低延迟、高带宽和低管理成本,非常适合在单个连接中连接多个数据流(集群、通信、存储、管理),具有数千个互连节点。最小的完整 IBA 单元是子网,多个子网通过路由器连接起来形成一个大的 IBA 网络。 InfiniBand 系统由通道适配器、交换机、路由器、电缆和连接器组成。CA 分为主机通道适配器(HCA)和目标通道适配器(TCA)。IBA 交换机在原理上与其他标准网络交换机类似,但必须满足 InfiniBand 的高性能和低成本要求。HCA 是 IB 端节点(例如服务器或存储设备)连接到 IB 网络的设备点。TCA 是一种特殊形式的通道适配器,主要用于存储设备等嵌入式环境。 △ InfiniBand 的网络拓扑结构 InfiniBand的分层架构 InfiniBand 架构分为多个层,每个层彼此独立运行。InfiniBand 分为以下几层:物理层、链路层、网络层、传输层和上层。 物理层:物理层服务于链路层并提供这两层之间的逻辑接口。物理层由端口信号连接器、物理连接(电和光)、硬件管理、电源管理、编码线等模块组成, 链路层:链路层负责处理分组中链路数据的发送和接收,提供寻址、缓冲、流量控制、错误检测和数据交换等服务。服务质量(QoS)主要由这一层体现。 网络层:网络层负责在 IBA 子网之间路由数据包,包括单播和多播操作。网络层不指定多协议路由(例如,非 IBA 类型上的 IBA 路由),也不指定原始数据包如何在 IBA 子网之间路由。 传输层:每个 IBA 数据都包含一个传输头。传输头包含端节点执行指定操作所需的信息。通过操纵 QP,传输层的 IBA 通道适配器通信客户端形成“发送”工作队列和“接收”工作队列。 上层:上层协议和应用层负责处理更高级别的通信功能和应用需求。上层协议可以包括诸如TCP/IP(传输控制协议/互联网协议)、UDP(用户数据报协议)、MPI(消息传递接口)等常见的网络协议。它们利用底层提供的基础通信能力,通过InfiniBand网络进行数据传输和通信,用于实现应用程序之间的通信和数据交换。此外,上层还包括运行在 InfiniBand 网络上的应用程序。 InfiniBand的特点及优势 InfiniBand 最突出的一个优势,就是率先引入了 RDMA (Remote Direct Memory Access)协议。RDMA 是一种绕过远程主机而访问其内存中数据的技术,解决网络传输中数据处理延迟而产生的一种远端内存直接访问技术。 在传统的 TCP/IP 网络通信中,数据发送方需要将数据进行多次内存拷贝,并经过一系列的网络协议的数据包处理工作;数据接收方在应用程序中处理数据前,也需要经过多次内存拷贝和一系列的网络协议的数据包处理工作。 而 RDMA 允许应用与网卡之间的直接数据读写,允许接收端直接从发送端的内存读取数据,RDMA 可以显著降低传输延迟,加快数据交换速度,并可以减轻 CPU 负载,释放 CPU 的计算能力。 △ 传统传输 VS RDMA 除了 InfiniBand 对 RDMA 协议的支持,还有以下优势: 低延迟:InfiniBand 网络以其极低的延迟而著称。RDMA 零拷贝网络减少了操作系统开销,使得数据能够在网络中快速移动,InfiniBand 网络延迟可达到 0.7 微秒。 高带宽:InfiniBand 网络提供高带宽的数据传输能力。它通常支持数十Gb/s甚至更高的带宽,取决于网络设备和配置。高带宽使得节点之间可以以高速进行数据交换,适用于大规模数据传输、并行计算和存储系统等应用。 可扩展性:IB网络具有出色的可扩展性,适用于构建大规模计算集群和数据中心。它支持多级拓扑结构,如全局互连网络、树状结构和扁平结构,可以根据应用需求和规模进行灵活配置和扩展。此外,IB网络还支持多个子网的互连,使得不同子网之间的节点可以进行通信和数据交换。这种可扩展性使得IB网络能够应对不断增长的计算和存储需求。 高吞吐量:由于低延迟和高带宽的特性,IB网络能够实现高吞吐量的数据传输。它支持大规模数据流的并行传输,同时减少了中间处理和拷贝操作,提高了系统的整体性能。高吞吐量对于需要大规模数据共享和并行计算的应用非常重要,如科学模拟、大数据分析和机器学习。 在看了上文后,相信你对 InfiniBand 已经有了一定的了解。根据行业机构的预测,InfiniBand 的市场规模在 2029 年将达到 983.7 亿美元,相比 2021 年的66.6亿美元,增长 14.7 倍。在高性能计算和 AI 的强力推动下,InfiniBand 的发展前景令人期待。

优秀的个人博客,低调大师

Docker 的前世今生

虚拟化 要解释清楚 Docker,首先要解释清楚容器(Container)的概念。要解释容器的话,就需要从操作系统说起。操作系统太底层,细说的话一两本书都说不清楚。这里就一句话来总结一下:操作系统(Operating System,简称OS)是管理计算机硬件与软件资源的计算机程序,并且为软件运行提供通用服务的系统软件。 随着硬件的性能提升,软件种类的丰富,有两种情况变得很常见: 硬件性能过剩——很多计算机的硬件配置,往往会有大量时间处于硬件资源闲置的状态。例如一般家用电脑,已经是四核、六核的配置了,除了3A游戏、视频制作、3D渲染、高性能计算等特殊应用外,通常有 90% 以上时间 CPU 是闲置的; 软件冲突——因为业务需要,两个或者多个软件之间冲突,或者需要同一个软件的不同版本。例如早几年做 Web 前端的,要测试网页在不同版本的 IE 上是否能正常显示,然而 Windows 只能装一个版本的 IE。 为了解决软件冲突,只能配置多台计算机,或者很麻烦的在同一台电脑上安装多个操作系统。显然这两个方案都有其缺点:多台计算机成本太高,多操作系统的安装、切换都很麻烦。在硬件性能过剩的时候,硬件虚拟化的普及就很自然而然的提出来了。 所谓硬件虚拟化,就是某个特殊的软件,仿真出一台或者多台计算机的各种硬件,用户可以在这一台虚拟机上安装、运行操作系统(一般叫来宾操作系统,Guest OS)和各种应用,并且把 Guest OS 和上面应用软件对硬件资源的访问转发到底层的硬件上来实现。 对于 Guest OS 和上面的应用程序来说,这台虚拟机和普通物理计算机是完全一样没有任何区别的——除了性能可能差一点。全球第一人气的 VMware Workstation 就是这么一个软件,Oracle 的 VirtualBox 以及 Microsoft 的 Virtual PC 都是。这类软件英语有一个专用的单词是 Hypervisor(虚拟机管理程序)。 虚拟机的优点 可以把资源分配到不同的虚拟机,达到硬件资源的最大化利用; 相比直接在物理机上部署应用,虚拟机更容易扩展应用; 云服务:通过虚拟机虚拟出不同的物理资源,可以快速搭建云服务。 虚拟化技术主要用来解决高性能的物理硬件产能过剩和老旧的硬件硬件产品产能过低的重组重用,透明化底层物理硬件,从而最大化的利用物理硬件。 虚拟机的缺点 虚拟机的缺点在于 Guest OS 通常会占用不少硬件资源。例如 Windows 安装 VMware 并开机 Guest OS,不运行任何应用的情况下,就需要占用 2 ~ 3G 内存,20 ~ 30G 硬盘空间。而且为了应用系统运行的性能,往往还要给每台虚拟机留出更多的内存容量。虽然不少 Hypervisor 支持动态内存,但基本上都会降低虚拟机的性能。在这样的资源占用情况下,少量的虚拟机还是可以接受的,如果同时运行十多台或数十台虚拟机,硬件资源的浪费就会成倍递增。通常来说,其中相当大一部分甚至全部 Guest OS 都是相同的。 能不能所有应用使用同一个操作系统减少硬件资源的浪费,但是又能避免包括运行库在内的软件冲突呢?操作系统层虚拟化——容器概念的提出,就是为了解决这个问题。Docker 就是一个容器的标准化实现。 容器化 容器技术已经发展了很长一段时间了,例如:LXC,BSD Jails,Solaris Zones... 容器化就是应用程序级别的虚拟化技术。容器提供了将应用程序的代码、运行时、系统工具、系统库和配置打包到一个实例中的标准方法。容器共享一个内核(操作系统),它安装在硬件上。 和虚拟机相比,容器有以下优点: 启动迅速:没有虚拟机硬件的初始化,没有 Guest OS 的启动过程,可以节约很多启动时间,这就是容器的“开箱即用”; 占用资源少:没有运行 Guest OS 所需的内存开销,无需为虚拟机预留运行内存,无需安装、运行 App 不需要的运行库/操作系统服务,内存占用、存储空间占用都小的多。相同配置的服务器,如果运行虚拟机能运行十多台的,通常可以运行上百个容器毫无压力——当然前提是单个容器应用本身不会消耗太多资源。 Docker 历史 2010 年,几个搞 IT 的年轻人,在美国旧金山成立了一家名叫 dotCloud 的公司。dotCloud 的平台即服务(Platform-as-a-Service, PaaS)提供商。底层技术上,dotCloud 平台利用了 Linux 的 LXC 容器技术。 为了方便创建和管理这些容器,dotCloud 基于 Google 公司推出的 Go 语言开发了一套内部工具,之后被命名为 Docker。Docker 就是这样诞生的。 LXC 是 Docker 的底层基石,但是在 Docker 0.9 版本的时候,Docker 见异思迁了,引入了基于 Go 语言构建的 Libcontainer 的 execution driver。有了 Libcontainer 这个项目,Docker 不再需要依赖于 Linux 部件(LXC,libvirt,systemd-nspawn...)就可以处理 namespaces、control groups、capabilities、apparmor profiles、network interfaces。这下,LXC 沦为可选项。 在 Docker 1.8 中 LXC 被 deprecated,在 Docker 1.10,LXC 彻底出局。Docker 推出 Libcontainer 自己集成了 Linux 内核中的很多特性,作为一个独特、稳定且不受制于 Linux 的 Library,独立的时代终于到来了。 如同 Docker 的 Logo 一样,Docker 的思想来源于集装箱。集装箱解决了什么问题?在一艘大船上,可以把货物规整的摆放起来,并且各种各样的货物被集装箱标准化,集装箱与集装箱之间互不影响。那么就不需要专门运送水果的船和专门运送化学用品的船了。只要这些货物封装在不同的集装箱里,就可以用一艘大船把它们都运走。 Docker 技术诞生之后,并没有引起行业的关注。而 dotCloud 公司,作为一家小型创业企业,在激烈的竞争之下,也步履维艰。 正当他们快要坚持不下去的时候,脑子里蹦出了“开源”的想法。什么是“开源”?开源,就是开放源代码。也就是将原来内部保密的程序源代码开放给所有人,然后让大家一起参与进来,贡献代码和意见。 有的软件一开始就是开源的。也有的软件,是混不下去,创造者又不想放弃,所以选择开源。自己养不活,就吃“百家饭”嘛。2013 年 3 月,dotCloud 公司的创始人之一,Docker 之父,28 岁的 Solomon Hykes 正式决定,将 Docker 项目开源。 不开则已,一开惊人。越来越多的 IT 工程师发现了 Docker 的优点,然后蜂拥而至,加入 Docker 开源社区。Docker 的人气迅速攀升,速度之快,令人瞠目结舌。 开源当月, Docker 0.1 版本发布。此后的每一个月, Docker 都会发布一个版本。到 2014 年 6 月 9 日, Docker 1.0 版本正式发布。 此时的 Docker,已经成为行业里人气最火爆的开源技术,没有之一。甚至像 Google、微软、Amazon、 VMware 这样的巨头们都对它青睐有加,表示将全力支持。 Docker 火了之后, dotCloud 公司干脆把公司名字也改成了 Docker Inc. 。 为什么选择 Docker 更高效的利用系统资源 由于容器不需要进行硬件虚拟以及运行完整操作系统等额外开销,Docker 对系统资源的利用率更高。无论是应用执行速度、内存损耗或者文件存储速度,都要比传统虚拟机技术更高效。因此,相比虚拟机技术,一个相同配置的主机,往往可以运行更多数量的应用。 更快速的启动时间 传统的虚拟机技术启动应用服务往往需要数分钟,而 Docker 容器应用,由于直接运行于宿主内核,无需启动完整的操作系统,因此可以做到秒级、甚至毫秒级的启动时间。大大的节约了开发、测试、部署的时间。 一致的运行环境 开发过程中一个常见的问题是环境一致性问题。由于开发环境、测试环境、生产环境不一致,导致有些 bug 并未在开发过程中被发现。而 Docker 的镜像提供了除内核外完整的运行时环境,确保了应用运行环境一致性,从而不会再出现「这段代码在我机器上没问题啊」 这类问题。 持续交付和部署 对开发和运维(DevOps)人员来说,最希望的就是一次创建或配置,可以在任意地方正常运行。 使用 Docker 可以通过定制应用镜像来实现持续集成、持续交付、部署。开发人员可以通过 Dockerfile 来进行镜像构建,并结合持续集成(Continuous Integration)系统进行集成测试,而运维人员则可以直接在生产环境中快速部署该镜像,甚至结合持续部署(Continuous Delivery/Deployment)系统进行自动部署。 而且使用 Dockerfile 使镜像构建透明化,不仅仅开发团队可以理解应用运行环境,也方便运维团队理解应用运行所需条件,帮助更好的在生产环境中部署该镜像。 更轻松的迁移 由于 Docker 确保了执行环境的一致性,使得应用的迁移更加容易。Docker 可以在很多平台上运行,无论是物理机、虚拟机、公有云、私有云,甚至是笔记本,其运行结果是一致的。因此用户可以很轻易的将在一个平台上运行的应用,迁移到另一个平台上,而不用担心运行环境的变化导致应用无法正常运行的情况。 更轻松的维护和扩展 Docker 使用的分层存储以及镜像的技术,使得应用重复部分的复用更为容易,也使得应用的维护更新更加简单,基于基础镜像进一步扩展镜像也变得非常简单。此外,Docker 团队同各个开源项目团队一起维护了一大批高质量的 官方镜像,既可以直接在生产环境使用,又可以作为基础进一步定制,大大的降低了应用服务的镜像制作成本。 容器与虚拟机的比较 下面的图片比较了 Docker 和传统虚拟化方式的不同之处,可见容器是在操作系统层面上实现虚拟化,直接复用本地主机的操作系统,而传统方式则是在硬件层面实现。 与传统的虚拟机相比,Docker 优势体现为启动速度快、占用体积小。 至此 Docker 概念性相关内容就介绍到这里,下文我们聊聊 Docker 架构及其工作原理。 本文采用 知识共享「署名-非商业性使用-禁止演绎 4.0 国际」许可协议。 大家可以通过 分类 查看更多关于 Docker 的文章。 🤗 您的点赞和转发是对我最大的支持。 📢 扫码关注 哈喽沃德先生「文档 + 视频」每篇文章都配有专门视频讲解,学习更轻松噢 ~

优秀的个人博客,低调大师

TypeScript的前世今生

(本文首发于ayqy.net,用️原创系列。) 一.背景 2010 – 微软团队开始开发 2012 – 第一个公开版本发布(TypeScript 0.8) 2013 – TypeScript 0.9 发布,支持泛型了 2014 – TypeScript 1.0 发布,Visual Studio 2013 默认支持 TypeScript 了。同时,源码从 CodePlex 迁移到 Github 2017 – TypeScript 2.1 发布 2018 – TypeScript 3.2 发布 TypeScript 最初是个微软内部项目,叫 Strada,致力于提升大型 JS 项目(当时内部需求是 Bing Maps、 Office Web Apps 甚至 Windows 8 apps)的可靠性和可维护性。2010 年开始开发,2012 年 10 月

优秀的个人博客,低调大师

Promise的前世今生

原作者:@洗影 Promise 的历史 Promise 是一个古老的概念(最初提出于 1976 年),通常与 future 结合在一起。Future 指的是未来的值,通常在 Promise 里被作为参数和返回值传来传去(但是在有的语境下 Future 又被用来指代类似 Promise 的东西。下文中,我们所说的 future 表示第一种概念)。 Promise 只是一个概念,很多常见语言的标准库都有 Promise 关联的特性(比如 C++ 11 的 std::promise 和 std::future、Java 8 的 java.util.concurrent.Future、Python 3.2+ 的 concurrent.futures等)。即使标准库里没有,大部分语言里也有第三方实现的 Promise(比如 Ruby 的 Prom

优秀的个人博客,低调大师

RocketMQ的前世今生

一、前言 阿里巴巴消息中间件起源于2001年的五彩石项目,Notify在这期间应运而生,用于交易核心消息的流转。 至2010年,B2B开始大规模使用ActiveMQ作为消息内核,随着阿里业务的快速发展,急需一款支持顺序消息,拥有海量消息堆积能力的消息中间件,MetaQ 1.0在2011年诞生。 到2012年,MetaQ已经发展到了MetaQ 3.0,并抽象出了通用的消息引擎RocketMQ。随后,将RocketMQ进行了开源,阿里的消息中间件正式走入了公众的视野。 到2015年,RocketMQ已经经历了多年双十一的洗礼,在可用性、可靠性以及稳定性等方面都有出色的表现。与此同时,云计算大行其道,阿里消息中间件基于RocketMQ推出了Aliware MQ 1.0,开始为阿里云上成千上万家企业提供消息服务。 到今年,MetaQ在2016年双十

优秀的个人博客,低调大师

Docker Swarm的前世今生

概述 在我的《Docker Swarm集群初探》一文中,我们实际体验了Docker Swarm容器集群技术的魅力,与《Kubernetes实践录》一文中提到的Kubernetes集群技术相比,Docker Swarm没有Kubernetes显得那么厚重,因此可以认为是更加轻量级的容器集群技术,这也就意味着上手更加方便快捷,使用起来也要省事很多。作为Docker集群技术三(或“四”)架马车之一的Docker Swarm,它从一开始便是Docker官方的“亲儿子”,发展到现在也经历了很多阶段和迭代。作者在学习的过程中也了解了一点其发展历史,发现有几个概念还是挺容易混淆的,因此撰写成文,是梳理,也是总结。 初出茅庐之:经典Swarm 早在2014年底,Docker公司就设计了容器集群的方案组合:Machine + Swarm + Compose。其中Machine主要用于快速创建Docker运行环境,其支持在创建出来的节点上自动部署Swarm,此时的Swarm我们称为 “经典Swarm”,它是一款整合跨节点网络的集群式容器服务,其利用Docker守护进程的API,将多节点的计算资源进行汇总,并提供兼容Docker的运行API,使用者只需要在执行Docker命令工具时,用--host参数将目标设置为Swarm服务的IP和端口,即可操作整个容器集群。 当然此时的Swarm局限性较大,比如: 没有副本和负载均衡的概念,这导致服务无法高可用 当然也更不存在什么服务网络管理和跨节点数据存储这些东西 没有服务模型:集群中服务间关系和启动顺序编排也很复杂 于是就有了下面的SwarmKit的诞生。 发展壮大之:SwarmKit 在2016年2月,Docker公司开始了一个名叫 SwarmKit 的项目。而恰在Docker 1.12 RC之前的一段时间,Docker 发布了 Swarmkit,这是一个独立的、开源的容器编排项目。SwarmKit不同于一开始的经典Swarm,它从一开始就重新设计了一套独立的API和模型体系,并且采用独立的客户端命令行工具:swarmctl 和上面的经典Swarm模型相比,它加入了如下特性: 重新设计的一套独立的API和模型体系 使用了自己的CLI(swarmd命令负责管理,swarmctl命令用于控制) 节点管理、服务模型更加自然,提供编排和调度服务 将过去Swarm依赖的外部集群一致性存储组件Etcd的核心部分内置化 然而此时的SwarmKit并没有提供诸如服务发现、负载均衡和路由等功能。尽管如此,SwarmKit其实已经是我们今天广泛使用的Docker Swarm集群技术的基石。 厚积薄发之:Swarm Mode Swarm Mode则更进一步,它在Docker 1.12版本开始为大家所周知,一个 docker swarm命令 红遍大江南北,这个所谓的Swarm Mode其实就是我们今天所广泛使用的Docker Swarm集群技术。 然而Swarm Mode并不是一个全新的东西,也并不是一个全新的模式,而是站在SwarmKit的巨人肩膀上发展起来的,是Docker中的一组与集群相关功能的统称而已。Docker将SwarmKit的核心模块内嵌于Docker的后台服务之中,通过不同的命令允许使用者同时以“本节点”和“本集群”这两种视角来操作整个集群,增加了集群的管理、节点的管理、服务的管理和编排等等一系列高级特性,就像在我的《Docker Swarm集群初探》一文中体验的那样。 因此总结一下Swarm Mode就是: 基于Swarmkit编写 支持服务模型以及服务发现、路由和负载均衡等新功能 使用Docker原生态的CLI命令 集成到了Docker engine中(强大的 docker swarm 命令) 对比总结 如果用一张图来表示 Docker、经典Swarm、SwarmKit、Swarm Mode 四个概念之间的关系,则大致可以如下图所示: 正如图中所示,SwarmKit 和 Swarm Mode 重叠的部分表示的是相应的项目之间存在代码层面的互相引用或组件形式的依赖,其实 Swarm Mode 所创建的集群本质上并无异于 SwarmKit 集群。 更细致一点,我们从SwarmKit和Swarm Mode二者在一些常用命令操作上的比较来看看二者的区别和联系: 1. 创建集群 SwarmKit方式:swarmd SwarmMode方式:docker swarm init 2. 往集群中添加节点 SwarmKit方式:swarmd --hostname worknode --join-addr [IP:端口] --join-token [Token] SwarmMode方式:docker swarm join --token [token] [IP:端口] 3. 查看集群节点信息 SwarmKit方式:swarmctl node ls SwarmMode方式:docker node ls 4. 创建服务 SwarmKit方式:swarmctl service create --name [服务名] --image [镜像名] SwarmMode方式:docker service create --name [服务名] [镜像名] 5. 服务扩容 SwarmKit方式:swarmctl service update [服务名] --replicas [副本数目] SwarmMode方式:docker service scale [服务名]=[副本数目] 6. 服务(镜像)升级 SwarmKit方式:swarmctl service update [服务名] --image [镜像名] SwarmMode方式:docker service update [服务名] --image [镜像名] 从命令行操作来看,Swarm Mode其实非常类似于SwarmKit,然而前者更加靠近 Docker 原生态圈的命令,因此更加人性化。 后记 作者更多的原创文章在此 如果有兴趣,也可以抽点时间看看作者一些关于容器化、微服务化方面的文章: Docker容器可视化监控中心搭建 利用ELK搭建Docker容器化应用日志中心 利用K8S技术栈打造个人私有云系列连载文章 Docker容器跨主机通信 Spring Boot应用监控实战 RPC框架实践之:Google gRPC RPC框架实践之:Apache Thrift 微服务调用链追踪中心搭建

优秀的个人博客,低调大师

Redis线程模型的前世今生

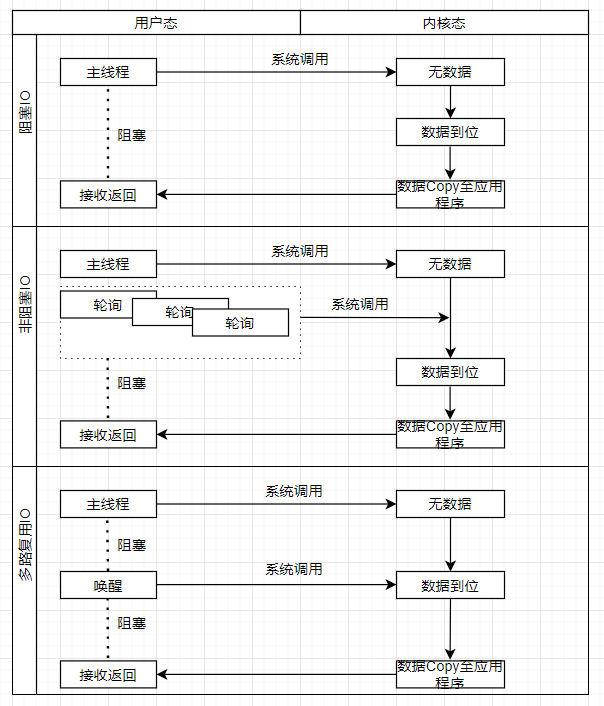
一、概述 众所周知,Redis是一个高性能的数据存储框架,在高并发的系统设计中,Redis也是一个比较关键的组件,是我们提升系统性能的一大利器。深入去理解Redis高性能的原理显得越发重要,当然Redis的高性能设计是一个系统性的工程,涉及到很多内容,本文重点关注Redis的IO模型,以及基于IO模型的线程模型。 我们从IO的起源开始,讲述了阻塞IO、非阻塞IO、多路复用IO。基于多路复用IO,我们也梳理了几种不同的Reactor模型,并分析了几种Reactor模型的优缺点。基于Reactor模型我们开始了Redis的IO模型和线程模型的分析,并总结出Redis线程模型的优点、缺点,以及后续的Redis多线程模型方案。本文的重点是对Redis线程模型设计思想的梳理,捋顺了设计思想,就是一通百通的事了。 注:本文的代码都是伪代码,主要是为了示意,不可用于生产环境。 二、网络IO模型发展史 我们常说的网络IO模型,主要包含阻塞IO、非阻塞IO、多路复用IO、信号驱动IO、异步IO,本文重点关注跟Redis相关的内容,所以我们重点分析阻塞IO、非阻塞IO、多路复用IO,帮助大家后续更好的理解Redis网络模型。 我们先看下面这张图; 2.1 阻塞IO 我们经常说的阻塞IO其实分为两种,一种是单线程阻塞,一种是多线程阻塞。这里面其实有两个概念,阻塞和线程。 阻塞:指调用结果返回之前,当前线程会被挂起,调用线程只有在得到结果之后才会返回; 线程:系统调用的线程个数。 像建立连接、读、写都涉及到系统调用,本身是一个阻塞的操作。 2.1.1 单线程阻塞 服务端单线程来处理,当客户端请求来临时,服务端用主线程来处理连接、读取、写入等操作。 以下用代码模拟了单线程的阻塞模式; import java.net.Socket; public class BioTest { public static void main(String[] args) throws IOException { ServerSocket server=new ServerSocket(8081); while(true) { Socket socket=server.accept(); System.out.println("accept port:"+socket.getPort()); BufferedReader in=new BufferedReader(new InputStreamReader(socket.getInputStream())); String inData=null; try { while ((inData = in.readLine()) != null) { System.out.println("client port:"+socket.getPort()); System.out.println("input data:"+inData); if("close".equals(inData)) { socket.close(); } } } catch (IOException e) { e.printStackTrace(); } finally { try { socket.close(); } catch (IOException e) { e.printStackTrace(); } } } } } 我们准备用两个客户端同时发起连接请求、来模拟单线程阻塞模式的现象。同时发起连接,通过服务端日志,我们发现此时服务端只接受了其中一个连接,主线程被阻塞在上一个连接的read方法上。 我们尝试关闭第一个连接,看第二个连接的情况,我们希望看到的现象是,主线程返回,新的客户端连接被接受。 从日志中发现,在第一个连接被关闭后,第二个连接的请求被处理了,也就是说第二个连接请求在排队,直到主线程被唤醒,才能接收下一个请求,符合我们的预期。 此时不仅要问,为什么呢? 主要原因在于accept、read、write三个函数都是阻塞的,主线程在系统调用的时候,线程是被阻塞的,其他客户端的连接无法被响应。 通过以上流程,我们很容易发现这个过程的缺陷,服务器每次只能处理一个连接请求,CPU没有得到充分利用,性能比较低。如何充分利用CPU的多核特性呢?自然而然的想到了——多线程逻辑。 2.1.2 多线程阻塞 对工程师而言,代码解释一切,直接上代码。 BIO多线程 package net.io.bio; import java.io.BufferedReader; import java.io.IOException; import java.io.InputStreamReader; import java.net.ServerSocket; import java.net.Socket; public class BioTest { public static void main(String[] args) throws IOException { final ServerSocket server=new ServerSocket(8081); while(true) { new Thread(new Runnable() { public void run() { Socket socket=null; try { socket = server.accept(); System.out.println("accept port:"+socket.getPort()); BufferedReader in=new BufferedReader(new InputStreamReader(socket.getInputStream())); String inData=null; while ((inData = in.readLine()) != null) { System.out.println("client port:"+socket.getPort()); System.out.println("input data:"+inData); if("close".equals(inData)) { socket.close(); } } } catch (IOException e) { e.printStackTrace(); } finally { } } }).start(); } } } 同样,我们并行发起两个请求; 两个请求,都被接受,服务端新增两个线程来处理客户端的连接和后续请求。 我们用多线程解决了,服务器同时只能处理一个请求的问题,但同时又带来了一个问题,如果客户端连接比较多时,服务端会创建大量的线程来处理请求,但线程本身是比较耗资源的,创建、上下文切换都比较耗资源,又如何去解决呢? 2.2 非阻塞 如果我们把所有的Socket(文件句柄,后续用Socket来代替fd的概念,尽量减少概念,减轻阅读负担)都放到队列里,只用一个线程来轮训所有的Socket的状态,如果准备好了就把它拿出来,是不是就减少了服务端的线程数呢? 一起看下代码,单纯非阻塞模式,我们基本上不用,为了演示逻辑,我们模拟了相关代码如下; package net.io.bio; import java.io.BufferedReader; import java.io.IOException; import java.io.InputStreamReader; import java.net.ServerSocket; import java.net.Socket; import java.net.SocketTimeoutException; import java.util.ArrayList; import java.util.List; import org.apache.commons.collections4.CollectionUtils; public class NioTest { public static void main(String[] args) throws IOException { final ServerSocket server=new ServerSocket(8082); server.setSoTimeout(1000); List<Socket> sockets=new ArrayList<Socket>(); while (true) { Socket socket = null; try { socket = server.accept(); socket.setSoTimeout(500); sockets.add(socket); System.out.println("accept client port:"+socket.getPort()); } catch (SocketTimeoutException e) { System.out.println("accept timeout"); } //模拟非阻塞:轮询已连接的socket,每个socket等待10MS,有数据就处理,无数据就返回,继续轮询 if(CollectionUtils.isNotEmpty(sockets)) { for(Socket socketTemp:sockets ) { try { BufferedReader in=new BufferedReader(new InputStreamReader(socketTemp.getInputStream())); String inData=null; while ((inData = in.readLine()) != null) { System.out.println("input data client port:"+socketTemp.getPort()); System.out.println("input data client port:"+socketTemp.getPort() +"data:"+inData); if("close".equals(inData)) { socketTemp.close(); } } } catch (SocketTimeoutException e) { System.out.println("input client loop"+socketTemp.getPort()); } } } } } } 系统初始化,等待连接; 发起两个客户端连接,线程开始轮询两个连接中是否有数据。 两个连接分别输入数据后,轮询线程发现有数据准备好了,开始相关的逻辑处理(单线程、多线程都可)。 再用一张流程图辅助解释下(系统实际采用文件句柄,此时用Socket来代替,方便大家理解)。 服务端专门有一个线程来负责轮询所有的Socket,来确认操作系统是否完成了相关事件,如果有则返回处理,如果无继续轮询,大家一起来思考下?此时又带来了什么问题呢。 CPU的空转、系统调用(每次轮询到涉及到一次系统调用,通过内核命令来确认数据是否准备好),造成资源的浪费,那有没有一种机制,来解决这个问题呢? 2.3 IO多路复用 server端有没专门的线程来做轮询操作(应用程序端非内核),而是由事件来触发,当有相关读、写、连接事件到来时,主动唤起服务端线程来进行相关逻辑处理。模拟了相关代码如下; IO多路复用 import java.net.InetSocketAddress; import java.nio.ByteBuffer; import java.nio.channels.SelectionKey; import java.nio.channels.Selector; import java.nio.channels.ServerSocketChannel; import java.nio.channels.SocketChannel; import java.nio.charset.Charset; import java.util.Iterator; import java.util.Set; public class NioServer { private static Charset charset = Charset.forName("UTF-8"); public static void main(String[] args) { try { Selector selector = Selector.open(); ServerSocketChannel chanel = ServerSocketChannel.open(); chanel.bind(new InetSocketAddress(8083)); chanel.configureBlocking(false); chanel.register(selector, SelectionKey.OP_ACCEPT); while (true){ int select = selector.select(); if(select == 0){ System.out.println("select loop"); continue; } System.out.println("os data ok"); Set<SelectionKey> selectionKeys = selector.selectedKeys(); Iterator<SelectionKey> iterator = selectionKeys.iterator(); while (iterator.hasNext()){ SelectionKey selectionKey = iterator.next(); if(selectionKey.isAcceptable()){ ServerSocketChannel server = (ServerSocketChannel)selectionKey.channel(); SocketChannel client = server.accept(); client.configureBlocking(false); client.register(selector, SelectionKey.OP_READ); //继续可以接收连接事件 selectionKey.interestOps(SelectionKey.OP_ACCEPT); }else if(selectionKey.isReadable()){ //得到SocketChannel SocketChannel client = (SocketChannel)selectionKey.channel(); //定义缓冲区 ByteBuffer buffer = ByteBuffer.allocate(1024); StringBuilder content = new StringBuilder(); while (client.read(buffer) > 0){ buffer.flip(); content.append(charset.decode(buffer)); } System.out.println("client port:"+client.getRemoteAddress().toString()+",input data: "+content.toString()); //清空缓冲区 buffer.clear(); } iterator.remove(); } } } catch (Exception e) { e.printStackTrace(); } } } 同时创建两个连接; 两个连接无阻塞的被创建; 无阻塞的接收读写; 再用一张流程图辅助解释下(系统实际采用文件句柄,此时用Socket来代替,方便大家理解)。 当然操作系统的多路复用有好几种实现方式,我们经常使用的select(),epoll模式这里不做过多的解释,有兴趣的可以查看相关文档,IO的发展后面还有异步、事件等模式,我们在这里不过多的赘述,我们更多的是为了解释Redis线程模式的发展。 三、NIO线程模型解释 我们一起来聊了阻塞、非阻塞、IO多路复用模式,那Redis采用的是哪种呢? Redis采用的是IO多路复用模式,所以我们重点来了解下多路复用这种模式,如何在更好的落地到我们系统中,不可避免的我们要聊下Reactor模式。 首先我们做下相关的名词解释; Reactor:类似NIO编程中的Selector,负责I/O事件的派发; Acceptor:NIO中接收到事件后,处理连接的那个分支逻辑; Handler:消息读写处理等操作类。 3.1 单Reactor单线程模型 处理流程 Reactor监听连接事件、Socket事件,当有连接事件过来时交给Acceptor处理,当有Socket事件过来时交个对应的Handler处理。 优点 模型比较简单,所有的处理过程都在一个连接里; 实现上比较容易,模块功能也比较解耦,Reactor负责多路复用和事件分发处理,Acceptor负责连接事件处理,Handler负责Scoket读写事件处理。 缺点 只有一个线程,连接处理和业务处理共用一个线程,无法充分利用CPU多核的优势。 在流量不是特别大、业务处理比较快的时候系统可以有很好的表现,当流量比较大、读写事件比较耗时情况下,容易导致系统出现性能瓶颈。 怎么去解决上述问题呢?既然业务处理逻辑可能会影响系统瓶颈,那我们是不是可以把业务处理逻辑单拎出来,交给线程池来处理,一方面减小对主线程的影响,另一方面利用CPU多核的优势。这一点希望大家要理解透彻,方便我们后续理解Redis由单线程模型到多线程模型的设计的思路。 3.2 单Reactor多线程模型 这种模型相对单Reactor单线程模型,只是将业务逻辑的处理逻辑交给了一个线程池来处理。 处理流程 Reactor监听连接事件、Socket事件,当有连接事件过来时交给Acceptor处理,当有Socket事件过来时交个对应的Handler处理。 Handler完成读事件后,包装成一个任务对象,交给线程池来处理,把业务处理逻辑交给其他线程来处理。 优点 让主线程专注于通用事件的处理(连接、读、写),从设计上进一步解耦; 利用CPU多核的优势。 缺点 貌似这种模型已经很完美了,我们再思考下,如果客户端很多、流量特别大的时候,通用事件的处理(读、写)也可能会成为主线程的瓶颈,因为每次读、写操作都涉及系统调用。 有没有什么好的办法来解决上述问题呢?通过以上的分析,大家有没有发现一个现象,当某一个点成为系统瓶颈点时,想办法把他拿出来,交个其他线程来处理,那这种场景是否适用呢? 3.3 多Reactor多线程模型 这种模型相对单Reactor多线程模型,只是将Scoket的读写处理从mainReactor中拎出来,交给subReactor线程来处理。 处理流程 mainReactor主线程负责连接事件的监听和处理,当Acceptor处理完连接过程后,主线程将连接分配给subReactor; subReactor负责mainReactor分配过来的Socket的监听和处理,当有Socket事件过来时交个对应的Handler处理; Handler完成读事件后,包装成一个任务对象,交给线程池来处理,把业务处理逻辑交给其他线程来处理。 优点 让主线程专注于连接事件的处理,子线程专注于读写事件吹,从设计上进一步解耦; 利用CPU多核的优势。 缺点 实现上会比较复杂,在极度追求单机性能的场景中可以考虑使用。 四、Redis的线程模型 4.1 概述 以上我们聊了,IO网路模型的发展历史,也聊了IO多路复用的reactor模式。那Redis采用的是哪种reactor模式呢?在回答这个问题前,我们先梳理几个概念性的问题。 Redis服务器中有两类事件,文件事件和时间事件。 文件事件:在这里可以把文件理解为Socket相关的事件,比如连接、读、写等; 时间时间:可以理解为定时任务事件,比如一些定期的RDB持久化操作。 本文重点聊下Socket相关的事件。 4.2 模型图 首先我们来看下Redis服务的线程模型图; IO多路复用负责各事件的监听(连接、读、写等),当有事件发生时,将对应事件放入队列中,由事件分发器根据事件类型来进行分发; 如果是连接事件,则分发至连接应答处理器;GET、SET等redis命令分发至命令请求处理器。 命令处理完后产生命令回复事件,再由事件队列,到事件分发器,到命令回复处理器,回复客户端响应。 4.3 一次客户端和服务端的交互流程 4.3.1 连接流程 连接过程 Redis服务端主线程监听固定端口,并将连接事件绑定连接应答处理器。 客户端发起连接后,连接事件被触发,IO多路复用程序将连接事件包装好后丢人事件队列,然后由事件分发处理器分发给连接应答处理器。 连接应答处理器创建client对象以及Socket对象,我们这里关注Socket对象,并产生ae_readable事件,和命令处理器关联,标识后续该Socket对可读事件感兴趣,也就是开始接收客户端的命令操作。 当前过程都是由一个主线程负责处理。 4.3.2 命令执行流程 SET命令执行过程 客户端发起SET命令,IO多路复用程序监听到该事件后(读事件),将数据包装成事件丢到事件队列中(事件在上个流程中绑定了命令请求处理器); 事件分发处理器根据事件类型,将事件分发给对应的命令请求处理器; 命令请求处理器,读取Socket中的数据,执行命令,然后产生ae_writable事件,并绑定命令回复处理器; IO多路复用程序监听到写事件后,将数据包装成事件丢到事件队列中,事件分发处理器根据事件类型分发至命令回复处理器; 命令回复处理器,将数据写入Socket中返回给客户端。 4.4 模型优缺点 以上流程分析我们可以看出Redis采用的是单线程Reactor模型,我们也分析了这种模式的优缺点,那Redis为什么还要采用这种模式呢? Redis本身的特性 命令执行基于内存操作,业务处理逻辑比较快,所以命令处理这一块单线程来做也能维持一个很高的性能。 优点 Reactor单线程模型的优点,参考上文。 缺点 Reactor单线程模型的缺点也同样在Redis中来体现,唯一不同的地方就在于业务逻辑处理(命令执行)这块不是系统瓶颈点。 随着流量的上涨,IO操作的的耗时会越来越明显(read操作,内核中读数据到应用程序。write操作,应用程序中的数据到内核),当达到一定阀值时系统的瓶颈就体现出来了。 Redis又是如何去解的呢? 哈哈~将耗时的点从主线程拎出来呗?那Redis的新版本是这么做的吗?我们一起来看下。 4.5 Redis多线程模式 Redis的多线程模型跟”多Reactor多线程模型“、“单Reactor多线程模型有点区别”,但同时用了两种Reactor模型的思想,具体如下; Redis的多线程模型是将IO操作多线程化,本身逻辑处理过程(命令执行过程)依旧是单线程,借助了单Reactor思想,实现上又有所区分。 将IO操作多线程化,又跟单Reactor衍生出多Reactor的思想一致,都是将IO操作从主线程中拎出来。 命令执行大致流程 客户端发送请求命令,触发读就绪事件,服务端主线程将Socket(为了简化理解成本,统一用Socket来代表连接)放入一个队列,主线程不负责读; IO 线程通过Socket读取客户端的请求命令,主线程忙轮询,等待所有 I/O 线程完成读取任务,IO线程只负责读不负责执行命令; 主线程一次性执行所有命令,执行过程和单线程一样,然后需要返回的连接放入另外一个队列中,有IO线程来负责写出(主线程也会写); 主线程忙轮询,等待所有 I/O 线程完成写出任务。 五、总结 了解一个组件,更多的是要去了解他的设计思路,要去思考为什么要这么设计,做这种技术选型的背景是啥,对后续做系统架构设计有什么参考意义等等。一通百通,希望对大家有参考意义。 作者:vivo互联网服务器团队-Wang Shaodong

优秀的个人博客,低调大师

《Java 开发手册》的前世今生

《Java 开发手册》始发于阿里巴巴内部规约,涵盖编程规约、异常日志、单元测试、安全规约等七大维度。从 2017 年上线至今整整四年,共发布了七个版本,在全球 Java 开发者共同努力下,这本手册已经成为业界普遍遵循的开发规范,感谢大家一直和我们在码出高效、码出质量的路上并肩同行。 本文将介绍每个版本手册更新的亮点,文末可以下载所有版本的合集。 第七版:泰山版《Java 开发手册》 更新日期:2020/04/22 更新亮点: 新增 5 条日期时间规约 新增 2 条表别名 sql 规约 新增统一错误码规约 新增的规约细则如下: OOP 规约 1.【强制】任何货币金额,均以最小货币单位且整型类型来进行存储。 2.【推荐】当某个方法的代码行数超过 10 行时,return / throw 等中断逻辑的右大括号后加一个空行。 说明:这样做逻辑清晰,有利于代码阅读

优秀的个人博客,低调大师

机器翻译的前世今生

不久前,一个实时翻译视频风靡网络,视频中两名分别说着英语和西班牙语的人借助Skype软件的实时翻译功能竟然实现了无障碍交流。这种之前只在科幻片中存在的场景如今已成现实,而这一切都得益于机器翻译技术。 那么什么是机器翻译呢?机器翻译(machine translation),又称为自动翻译,是利用计算机把一种自然语言转变为另一种自然语言的过程。 机器翻译的实现方法 随着科技和社会经济的快速发展,全世界的互联互通已经成为不可阻挡的发展趋势,那么不同国家之间如何实现低成本的有效交流呢?人工翻译所耗费的成本巨大,也许最好的解决方法就是:充分利用机器翻译技术提供智能自动翻译服务。机器不会累、学习快,一个系统同时掌握十几种语言互译也不是问题,也许永远不会像人一样出现翻译盲点。 但是语言的复杂性众所周知,人尚且会有误解的时候,那么冰冷的机器究竟是怎么翻

优秀的个人博客,低调大师

【综述】情感计算的“前世今生

作者:郭晴、刘伟 摘要:情感计算作为一个全世界范围内的学术热点,研究方向遍及心理学、生理学、神经科学、语言学、医学、社会学等学科。情感计算的研究使形式化的机器更加形象化,是实现自然人机交互的前提。本文结合近几年情感计算的国内外研究,基于新的层面对主要研究以及最新应用进行了归纳总结,并就情感计算进行深度探究,使更多研究人员了解情感计算最新研究方向。 一.引言 大约半个世纪前,美国心理学家“认知心理学之父” 奈瑟尔(Neisser Ulrich)描述了人类思维的三个基本和相互联系的特征,这些特征在计算机程序中也明显存在着: 1.人类的思维总是随着成长和发展过程积累,并且能对该过程产生积极作用; 2.人的思想开始于情绪和情感的永远不会完全消失的密切关系中; 3.几乎所有的人类活动,包括思维,在同一时间的动机具有多样性而不是单一的。 Herbert A

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册