首页 文章 精选 留言 我的

精选列表

搜索[腾讯云双十一抄作业],共10000篇文章
优秀的个人博客,低调大师

【Java orm 框架比较】十一 新增 原生 jdbc 对比

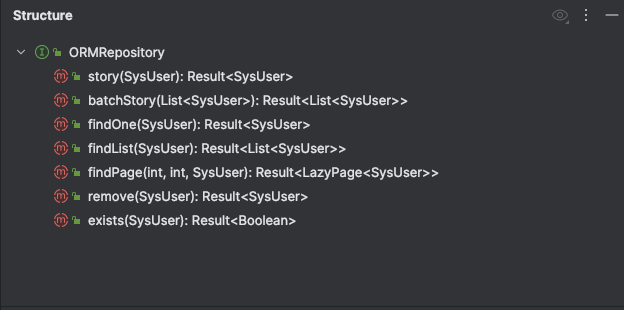
迁移到(https://gitee.com/wujiawei1207537021/spring-orm-integration-compare) orm框架使用性能比较 比较mybatis-plus、lazy、sqltoy、mybatis-flex、easy-query、mybatis-mp、jpa、dbvisitor、beetlsql、dream_orm、wood、hammer_sql_db、原生jdbc 操作数据 环境: idea jdk17 spring boot 3.0.7 mysql 8.0 测试条件常规对象 orm 框架 是否支持xml 是否支持 Lambda 对比版本 编码方式 mybatis ☑️ ☑️ 3.5.4 lambda +xml 优化 sqltoy ☑️ ☑️ 5.2.98 lambda lazy ✖️ ☑️ 1.2.4-JDK17-SNAPSHOT lambda mybatis-flex ☑️ ☑️ 1.8.0 lambda +xml 优化 easy-query ✖️ ☑️ 1.10.31 lambda mybatis-mp ☑️ ☑️ 1.4.1 xml 优化 jpa ☑️ ☑️ 3.0.7 ---------------------- dbvisitor ☑️ ☑️ 5.4.1 xml 优化 beetlsql 支持md ☑️ 3.26.0-RELEASE insert ignore into 优化 dream_orm ✖️ ☑️ 1.3.0 insert ignore into (当前版本不支持) wood ☑️ ☑️ 1.2.9 insert ignore into (当前版本不支持) hammer_sql_db ☑️ ☑️ 0.7.0 insert ignore into (当前版本不支持) jdbc ✖️ ✖️ 数据库表(含有唯一性索引s_u) CREATE TABLE `sys_user` ( `column_name` varchar(255) COLLATE utf8mb4_general_ci DEFAULT NULL COMMENT '额外字段', `create_time` datetime DEFAULT CURRENT_TIMESTAMP ON UPDATE CURRENT_TIMESTAMP COMMENT '创建时间', `id` bigint NOT NULL AUTO_INCREMENT COMMENT '用户ID', `is_deleted` tinyint(1) DEFAULT NULL COMMENT 'null', `password` varchar(255) COLLATE utf8mb4_general_ci DEFAULT NULL COMMENT '密码', `scope` varchar(255) COLLATE utf8mb4_general_ci DEFAULT NULL COMMENT 'null', `status` tinyint(1) DEFAULT NULL COMMENT '状态', `update_time` datetime DEFAULT CURRENT_TIMESTAMP ON UPDATE CURRENT_TIMESTAMP COMMENT '更新时间', `username` varchar(255) COLLATE utf8mb4_general_ci DEFAULT NULL COMMENT '用户名', PRIMARY KEY (`id`) USING BTREE, UNIQUE KEY `s_u` (`scope`,`username`) ) ENGINE=InnoDB AUTO_INCREMENT=9223371632070323791 DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_general_ci; 比较方法:增加、修改、删除、分页查询(当前项目暂时只比较批量新增和分页) 项目设计 声明 ORMRepository 接口提供对应增删改查方法 声明 ORMComparisonRepository接口 继承 ORMRepository 下游由不同ORM实现 声明 SysUserRepository 接口 继承 ORMRepository 用于循环调用不同orm实现方法执行方法测试产生测试结果 声明抽象类 SysUserRepositoryAbstractRecord 继承 ORMComparisonRepository 并且提供对应的框架执行结果存储 不同ORM框架mybatis-plus、sqltoy、Lazy、easy-query、mybatis-mp、jpa、dbvisitor、beetlsql、dream_orm、wood、hammer_sql_db、原生jdbc 创建 ORMComparisonRepository 的实现 不同 ORM 操作数据的实现 测试条件 批量插入数据 10、100、1000、10000、100000 ,分页查询数据 10、100、1000、10000、100000 项目启动后使用浏览器打开 http://localhost:1003/sys/user/run-compare 测试条件(细节比较) 批量插入数据 1~10000,分页查询数据 1~10000 项目启动后使用浏览器打开 http://localhost:1003/sys/user/run-particulars-compare 导出测试数据为MD 项目启动后使用浏览器打开 http://localhost:1003/sys/user/export-compare-result 测试执行过程 清空需要插入表中所有数据 通过ORM框架进行数据批量新增、而后进行分页查询,记录消耗时间,输出md文档 查看结果曲线图 测试结果(结果只提供参考) MYBATIS_FLEX(batchStory) 影响行数:10 影响行数:100 影响行数:1000 影响行数:10000 影响行数:100000 执行时间: 94毫秒 25毫秒 133毫秒 1119毫秒 9376毫秒 WOOD(batchStory) 影响行数:10 影响行数:100 影响行数:1000 影响行数:10000 影响行数:100000 执行时间: 13毫秒 18毫秒 100毫秒 400毫秒 4305毫秒 MYBATIS_MP(batchStory) 影响行数:10 影响行数:100 影响行数:1000 影响行数:10000 影响行数:100000 执行时间: 12毫秒 24毫秒 116毫秒 1021毫秒 8646毫秒 MYBATIS_PLUS(batchStory) 影响行数:10 影响行数:100 影响行数:1000 影响行数:10000 影响行数:100000 执行时间: 43毫秒 21毫秒 195毫秒 871毫秒 8578毫秒 SQLTOY(batchStory) 影响行数:10 影响行数:100 影响行数:1000 影响行数:10000 影响行数:100000 执行时间: 34毫秒 19毫秒 122毫秒 839毫秒 6994毫秒 LAZY(batchStory) 影响行数:10 影响行数:100 影响行数:1000 影响行数:10000 影响行数:100000 执行时间: 8毫秒 16毫秒 75毫秒 530毫秒 4223毫秒 JDBC(batchStory) 影响行数:10 影响行数:100 影响行数:1000 影响行数:10000 影响行数:100000 执行时间: 12毫秒 11毫秒 68毫秒 415毫秒 3750毫秒 DB_VISITOR(batchStory) 影响行数:10 影响行数:100 影响行数:1000 影响行数:10000 影响行数:100000 执行时间: 21毫秒 14毫秒 120毫秒 404毫秒 4763毫秒 JPA(batchStory) 影响行数:10 影响行数:100 影响行数:1000 影响行数:10000 影响行数:100000 执行时间: 78毫秒 72毫秒 1162毫秒 9891毫秒 87352毫秒 EASY_QUERY(batchStory) 影响行数:10 影响行数:100 影响行数:1000 影响行数:10000 影响行数:100000 执行时间: 89毫秒 317毫秒 3192毫秒 1167毫秒 10696毫秒 HAMMER_SQL_DB(batchStory) 影响行数:10 影响行数:100 影响行数:1000 影响行数:10000 影响行数:100000 执行时间: 99毫秒 18毫秒 147毫秒 937毫秒 7454毫秒 DREAM_ORM(batchStory) 影响行数:10 影响行数:100 影响行数:1000 影响行数:10000 影响行数:100000 执行时间: 48毫秒 15毫秒 117毫秒 1059毫秒 9139毫秒 BEETL_SQL(batchStory) 影响行数:10 影响行数:100 影响行数:1000 影响行数:10000 影响行数:100000 执行时间: 155毫秒 19毫秒 132毫秒 861毫秒 8667毫秒 MYBATIS_FLEX(findPage) 影响行数:10 影响行数:100 影响行数:1000 影响行数:10000 影响行数:100000 执行时间: 29毫秒 17毫秒 31毫秒 170毫秒 1529毫秒 WOOD(findPage) 影响行数:10 影响行数:100 影响行数:1000 影响行数:10000 影响行数:100000 执行时间: 10毫秒 10毫秒 40毫秒 148毫秒 1691毫秒 MYBATIS_MP(findPage) 影响行数:10 影响行数:100 影响行数:1000 影响行数:10000 影响行数:100000 执行时间: 32毫秒 24毫秒 39毫秒 173毫秒 1433毫秒 MYBATIS_PLUS(findPage) 影响行数:10 影响行数:100 影响行数:1000 影响行数:10000 影响行数:100000 执行时间: 33毫秒 10毫秒 30毫秒 178毫秒 1639毫秒 SQLTOY(findPage) 影响行数:10 影响行数:100 影响行数:1000 影响行数:10000 影响行数:100000 执行时间: 25毫秒 11毫秒 48毫秒 166毫秒 976毫秒 LAZY(findPage) 影响行数:10 影响行数:100 影响行数:1000 影响行数:10000 影响行数:100000 执行时间: 5毫秒 11毫秒 25毫秒 142毫秒 1103毫秒 JDBC(findPage) 影响行数:10 影响行数:100 影响行数:1000 影响行数:10000 影响行数:100000 执行时间: 4毫秒 6毫秒 57毫秒 329毫秒 2372毫秒 DB_VISITOR(findPage) 影响行数:10 影响行数:100 影响行数:1000 影响行数:10000 影响行数:100000 执行时间: 10毫秒 9毫秒 15毫秒 159毫秒 1044毫秒 JPA(findPage) 影响行数:10 影响行数:100 影响行数:1000 影响行数:10000 影响行数:100000 执行时间: 135毫秒 25毫秒 81毫秒 166毫秒 1601毫秒 EASY_QUERY(findPage) 影响行数:10 影响行数:100 影响行数:1000 影响行数:10000 影响行数:100000 执行时间: 57毫秒 13毫秒 15毫秒 137毫秒 1516毫秒 HAMMER_SQL_DB(findPage) 影响行数:10 影响行数:100 影响行数:1000 影响行数:10000 影响行数:100000 执行时间: 162毫秒 11毫秒 39毫秒 174毫秒 1886毫秒 DREAM_ORM(findPage) 影响行数:10 影响行数:100 影响行数:1000 影响行数:10000 影响行数:100000 执行时间: 40毫秒 8毫秒 31毫秒 145毫秒 1213毫秒 BEETL_SQL(findPage) 影响行数:10 影响行数:100 影响行数:1000 影响行数:10000 影响行数:100000 执行时间: 53毫秒 19毫秒 47毫秒 182毫秒 1264毫秒 写在最后 经过不间断时间的框架收集、学习、实验、编码、测试市面上常见的ORM框架,过程中拜读了很多作者的博文、样例,学习很多收获很多。 重新梳理下整理的框架:mybatis-plus、lazy、sqltoy、mybatis-flex、easy-query、mybatis-mp、jpa、dbvisitor、beetlsql、dream_rom、wood、hammer_sql_db、原生jdbc 下面从一下几点出发作出总结 文档方面:学习过程中mybatis-plus、jpa、db_visitor提供的文档资料是比较全和完善,经得住市场的考验 技术方面:beetlsql、easy-query、mybatis、wood、db_visitor系列 三类框架都已经支持spring 和solon生态 其技术架构设计可以推荐大家学习 并发方面:jpa、db_visitor 还需要开发时候深度优化处理 大数据存储方面: Lazy 、原生jdbc具有一定优势 大数据查询方面:sqltoy、dream_orm、Easy_query、lazy、db_visitor 反射处理的比较优秀 小数据量下各ORM框架处理时间大体相近或者通过优化后趋于一致,重点看一万数据以后框架处理能力体现价值 以上是个人整理的观点,如果大家有不同的想法和意见可以在gitee或者个人博客留言CSDN 细节数据对比(一万以内基本相差不大) 细节数据对比,数据属于并发行测试数据,如果测试总数是一百,那么会执行一百次batchStory,一百次findPage 每次执行的条数在之前数据的基础上+1 从形成的折线图看(具体趋势看排名与测试结果) 存储性能对比: lazy、原生jdbc、mybatis-flex、mybatis-mp、mybatis-plus、dream_rom、sqltoy、beetlSql、hammer_sql_db、db_visitor 更适合并发性数据存储。jpa、easy-query 处理耗时较长波动较大 分页查询性能对比: lazy、mybatis-flex、mybatis-mp、mybatis-plus、 dream_rom、easy-query、sqltoy、db_visitor、beetlSql 、jpa、hammer_sql_db、原生jdbc都比较稳定。 批量保存: 一万条数据以内 原生jdbc、lazy、mybatis-flex、mybatis-mp、mybatis-plus、easy-query、sqltoy、beetlSql、jpa、db_visitor、wood、hammer_sql_db 性能趋于一致 十万数据时,处理时间由快到慢依次是: 八千毫秒以内:原生jdbc、lazy、dream_rom、easy-query、hammer_sql_db、sqltoy、wood、db_visitor 八千毫秒以上: mybatis-flex、mybatis-mp、mybatis-plus、beetlSql、jpa,其中 jpa 处理时间明显起伏 分页查询: 一万条数据以内 几款ORM均保持在200毫秒内 十万数据时,处理时间由快到慢依次是: 一千毫秒以内:sqltoy、dream_rom、db_visitor、easy-query、lazy、beetlSql、mybatis-plus 一千毫秒以上:mybatis-mp、jpa、mybatis-flex、wood、hammer_sql_db、原生jdbc 快速数据对比(大数据曲线图) 优化项 时间 2024年5月7日 添加 wood框架对比测试数据库存储和查询 测试结果容易上手快速集成,但是内部使用了大量字符串不易于编写 时间 2024年5月8日 针对mysql 配置 rewriteBatchedStatements=true 保存时间明显提高 时间:2024年5月9日 事件 新增hammer_sql_db框架对比测试,该框架上手比较简单比较灵活 测试结果hammer_sql_db 批量存储做的很优秀,但当分页获取数据量超过一万后分页查询性能开始下降 时间:2024年5月11日 事件 新增原生jdbc测试 测试结果 因为未对jdbc过分优化,从结果过上看insertBatch 存在一定优势但是不大、分页查询结果集映射单纯for循环迭代会很慢 当前项目地址 lazy-orm地址 mybatis地址 sqltoy地址 mybatis-flex地址 easy-query地址 mybatis-mp地址 dbvisitor地址 beetlsql地址 dream-orm地址 wood地址 hammer_sql_db地址

优秀的个人博客,低调大师

ES7学习笔记(十一)与SpringBoot结合

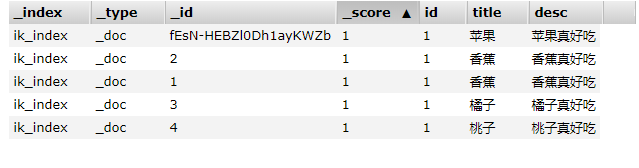
在前面的章节中,我们把ES的基本功能都给大家介绍完了,从ES的搭建、创建索引、分词器、到数据的查询,大家发现,我们都是通过ES的API去进行调用,那么,我们在项目当中怎么去使用ES呢?这一节,我们就看看ES如何与我们的SpringBoot项目结合。 版本依赖 SpringBoot默认是有ElasticSearch的Starter,但是它依赖的ES客户端的版本比较低,跟不上ES的更新速度,所以我们在SpringBoot项目中要指定ES的最新版本,如下: <properties> <elasticsearch.version>7.6.1</elasticsearch.version> </properties> <dependency> <groupId>org.elasticsearch.client</groupId> <artifactId>elasticsearch-rest-high-level-client</artifactId> </dependency> 我们在项目中指定ES客户端的版本为7.6.1。 配置文件 然后我们在SpringBoot的配置文件application.properties当中,配置ES集群的地址,如下: spring.elasticsearch.rest.uris=http://192.168.73.130:9200,http://192.168.73.131:9200,http://192.168.73.132:9200 多个地址之间我们使用,隔开即可。 与ES交互 所有配置的东西都准备好了,下面我们看看在程序当中如何交互,还记得前面咱们提到的动态映射吗?这个东西是非常的好用的,简化了我们不少的工作量。在这里我们还用前面的索引ik_index举例,我们先看看目前ik_index索引中有哪些字段, 在索引中只有3个字段,id、title和desc。接下来我们在创建索引ik_index对应的实体类,内容也很简单,具体如下: @Setter@Getter public class IkIndex { private Long id; private String title; private String desc; private String category; } 在实体类中,我们新添加了一个字段category表示分类,我们可以联想一下,category字段动态映射到ES当中会是什么类型?对了,就是text类型,我们再深入想一步,text类型会用到全文索引,会用到分词器,而在索引ik_index当中,我们配置了默认的分词器是IK中文分词器。能够想到这里,我觉得你对ES了解的比较深入了。 接下来,我们就要编写service了,并向ik_index索引中添加一条新的数据,如下: @Service public class EService { @Autowired private RestHighLevelClient client; /** * 添加索引数据 * @throws IOException */ public void insertIkIndex() throws IOException { IkIndex ikIndex = new IkIndex(); ikIndex.setId(10l); ikIndex.setTitle("足球"); ikIndex.setDesc("足球是世界第一运动"); ikIndex.setCategory("体育"); IndexRequest request = new IndexRequest("ik_index"); // request.id("1"); request.source(JSON.toJSONString(ikIndex), XContentType.JSON); IndexResponse indexResponse = client.index(request, RequestOptions.DEFAULT); System.out.println(indexResponse.status()); System.out.println(indexResponse.toString()); } } 首先,我们要引入ES的高等级的客户端RestHighLevelClient,由于我们在配置文件中配置了ES集群的地址,所以SpringBoot自动为我们创建了RestHighLevelClient的实例,我们直接自动注入就可以了。然后在添加索引数据的方法中,我们先把索引对应的实体创建好,并设置对应的值。 接下来我们就要构建索引的请求了,在IndexRequest的构造函数中,我们指定了索引的名称ik_index,索引的id被我们注释掉了,ES会给我们默认生成id,当然自己指定也可以。大家需要注意的是,这个id和IkIndex类里的id不是一个id,这个id是数据在ES索引里的唯一标识,而IkIndex实体类中的id只是一个数据而已,大家一定要区分开。然后我们使用request.source方法将实体类转化为JSON对象并封装到request当中,最后我们调用client的index方法完成数据的插入。我们看看执行结果吧。 CREATED IndexResponse[index=ik_index,type=_doc,id=f20EVHIBK8kOanEwfXbW,version=1,result=created,seqNo=9,primaryTerm=6,shards={"total":2,"successful":2,"failed":0}] status返回的值是CREATED,说明数据添加成功,而后面的响应信息中,包含了很多具体的信息,像每个分片是否成功都已经返回了。我们再用elasticsearch-head插件查询一下,结果如下: 数据插入成功,并且新添加的字段category也有了对应的值,这是我们期望的结果。下面我们再看看查询怎么使用。代码如下: public void searchIndex() throws IOException { SearchRequest searchRequest = new SearchRequest("ik_index"); SearchSourceBuilder ssb = new SearchSourceBuilder(); QueryBuilder qb = new MatchQueryBuilder("desc","香蕉好吃"); ssb.query(qb); searchRequest.source(ssb); SearchResponse response = client.search(searchRequest, RequestOptions.DEFAULT); SearchHit[] hits = response.getHits().getHits(); for (SearchHit hit : hits) { String record = hit.getSourceAsString(); System.out.println(record); } } 我们先创建一个查询请求,并指定索引为ik_index; 然后我们创建一个请求体SearchSourceBuilder,再构建我们的查询请求QueryBuilder,QueryBuilder是一个接口,它的实现类有很多,对应着ES中的不同种类的查询,比如咱们前面介绍的bool和boosting查询,都有对应的实现类。在这里,咱们使用MatchQueryBuilder并查询desc包含香蕉好吃的数据,这个查询咱们在前面通过API的方式也查询过。 最后我们封装好请求,并通过client.search方法进行查询,返回的结构是SearchResponse。 在返回的结果中,我们获取对应的数据,咦?这个为什么调用了两次Hits方法?咱们可以从API的返回值看出端倪,如下: 我们可以看到返回的结果中确实有两个hits,第一个hits中包含了数据的条数,第二个hits中才是我们想要的查询结果,所以在程序中,我们调用了两次hits。 在每一个hit当中,我们调用getSourceAsString方法,获取JSON格式的结果,我们可以用这个字符串通过JSON工具映射为实体。 我们看看程序运行的结果吧, {"id":1,"title":"香蕉","desc":"香蕉真好吃"} {"id":1,"title":"香蕉","desc":"香蕉真好吃"} {"id":1,"title":"橘子","desc":"橘子真好吃"} {"id":1,"title":"桃子","desc":"桃子真好吃"} {"id":1,"title":"苹果","desc":"苹果真好吃"} 查询出了5条数据,和我们的预期是一样的,由于使用IK中文分词器,所以desc中包含好吃的都被查询了出来,而我们新添加的足球数据并没有查询出来,这也是符合预期的。我们再来看看聚合查询怎么用, public void searchAggregation() throws IOException { SearchRequest searchRequest = new SearchRequest("ik_index"); SearchSourceBuilder ssb = new SearchSourceBuilder(); TermsAggregationBuilder category = AggregationBuilders.terms("category").field("category.keyword"); ssb.aggregation(category); searchRequest.source(ssb); SearchResponse response = client.search(searchRequest, RequestOptions.DEFAULT); Terms terms = response.getAggregations().get("category"); for (Terms.Bucket bucket : terms.getBuckets()) { System.out.println(bucket.getKey()); System.out.println(bucket.getDocCount()); } } 同样,我们创建一个SearchRequest,然后再创建一个TermsAggregationBuilder,TermsAggregationBuilder我们指定了name叫做category,这个name对应着上一节中的那个自定义的名称,大家还有印象吗? 后面的field是我们要聚合的字段,注意这里因为category字段是text类型,默认是不能够做聚合查询的,我们指定的是category.keyword,还记得这个keyword类型吗?它是不使用分词器的,我们使用这个keyword类型是可以的。 最后把AggregationBuilder封装到查询请求中,进行查询。 查询后,我们怎么去取这个aggregation呢?取查询结果我们是通过hits,取聚合查询,我们要使用aggregation了,然后再get我们的自定义名称response.getAggregations().get("category")。至于前面的类型,它是和AggregationBuilder对应的,在咱们的例子中使用的是TermsAggregationBuilder,那么我们在取结果时就要用Terms;如果查询时使用的是AvgAggregationBuilder,取结果时就要用Avg。 在取得Terms后,我们可以获取里边的值了。运行一下,看看结果。 体育 1 key是体育,doc_count是1,说明分类体育的数据只有1条。完全符合我们的预期,这个聚合查询的功能非常重要,在电商平台中,商品搜索页通常列出所有的商品类目,并且每个类目后面都有这个商品的数量,这个功能就是基于聚合查询实现的。 好了,到这里,ES已经结合到我们的SpringBoot项目中了,并且最基础的功能也已经实现了,大家放心的使用吧~


优秀的个人博客,低调大师

Spring Boot(十一):Spring Boot如何测试打包部署

一、开发阶段 (一)单元测试 在开发阶段的时候最重要的是单元测试,Spring Boot对单元测试的支持已经很完善了。 1、在pom.xml文件中添加依赖 <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-test</artifactId> <scope>test</scope> </dependency> 2、开发测试类 以最简单的helloworld为例,在测试类的类头部需要添加:@RunWith(SpringRunner.class)和@SpringBootTest注解,在测试方法的顶端添加@Test即可,最后在方法上点击右键run就可以运行了。 @RunWith(SpringRunner.class) @SpringBootTest public class ApplicationTests { @Test public void hello() { System.out.println("hello world"); } } 实际使用中,可以按照项目的正常使用去注入数据层代码或者service层代码进行测试验证,spring-boot-starter-test提供很多基础用法,更难得的是增加了对controller层测试的支持。 //简单的验证结果集是否正确 Assert.assertEquals(3,userMapper.getAll().size); //验证结果集,提升 Assert.assertTrue("错误,正确的返回值为200",status==200); Assert.assertFalse("错误,正确的返回值为200",status!=200); 引入了MockMvc支持了对controller层的测试,简单示例如下: public class HelloControlerTests { private MockMvc mvc; //初始化执行 @Before public void setUp() throws Exception { mvc = MockMvcBuilders.standaloneSetup(new HelloController()).build(); } //验证controller是否正常响应并打印返回结果 @Test public void getHello() throws Exception { mvc.perform(MockMvcRequestBuilders.get("/hello").accept(MediaType.APPLICATION_JSON)) .andExpect(MockMvcResultMatchers.status().isOk()) .andDo(MockMvcResultHandlers.print()) .andReturn(); } //验证controller是否正常响应并判断返回结果是否正确 @Test public void testHello() throws Exception { mvc.perform(MockMvcRequestBuilders.get("/hello").accept(MediaType.APPLICATION_JSON)) .andExpect(status().isOk()) .andExpect(content().string(equalTo("Hello World"))); } } 单元测试是验证你代码第一道屏障,要养成每写一部分代码就进行单元测试的习惯,不要等到全部集成后再进行测试,集成后因为更关注整体运行效果,很容易遗漏掉代码底层的bug。 (二)集成测试 整体开发完成之后进入集成测试,Spring Boot项目的启动入口在application类中,直接运行run方法就可以启动项目,但是在调试的过程中我们肯定需要不断的去调试代码,如果每修改一次代码就需要手动启动一次服务很麻烦,Spring Boot非常贴心的给出了热部署的支持,很方便在web项目中调试使用。 pom.xml中添加一下依赖即可: <dependencies> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-devtools</artifactId> <optional>true</optional> </dependency> </dependencies> <build> <plugins> <plugin> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-maven-plugin</artifactId> <configuration> <fork>true</fork> </configuration> </plugin> </plugins> </build> 添加以上配置后,项目就支持了热部署,非常方便集成测试。 二、上线 其实我觉得这个阶段,应该还是比较简单,一般分为两种,一种是打包成jar包直接执行,另一种是打包成war包放到tomcat服务器下。 (一)打包成jar包 如果你使用的是maven来管理项目,执行以下命令 cd 项目跟目录(和pom.xml同级) maven clear package //或者执行下面的命令 //排除测试代码后进行打包 mvn clean package -Dmaven.test.skip=true 打包完成后jar包会生成到target目录下,命名一般是项目名+版本号.jar 启动jar包命令 java -jar target/spring-boot-scheduler-1.0.0.jar 这种方式,只要控制台关闭,服务就不能访问了。下面我们使用在后台运行的方式来启动: nohup java -jar target/spring-boot-scheduler-1.0.0.jar & 也可以在启动的时候选择读取不同的配置文件 java -jar app.jar --spring.profiles.active=dev 也可以在启动的时候设置 jvm 参数 java -Xms10m -Xmx80m -jar app.jar & 如果使用的是 gradle,使用下面命令打包 gradle build java -jar build/libs/mymodule-0.0.1-SNAPSHOT.jar (二)打成war包 打成war包一般可以分两种方式实现,第一种可以通过eclipse这种开发工具来导出war包,另外一种是使用命令来完成,这里主要介绍后一种 1、maven项目,修改pom.xml <packaging>war</packaging> 2、打包时排除tomcat <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-web</artifactId> </dependency> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-tomcat</artifactId> <scope>provided</scope> </dependency> 在这里将scope属性设置为provided,这样在最终形成的war中不会包含这个jar包,因为tomcat或jetty等服务器在运行时将会提供相关的API类。 3、注册启动类 创建 ServletInitializer.java,继承 SpringBootServletInitializer ,覆盖 configure(),把启动类 Application 注册进去。外部 Web 应用服务器构建 Web Application Context 的时候,会把启动类添加进去。 public class ServletInitializer extends SpringBootServletInitializer { @Override protected SpringApplicationBuilder configure(SpringApplicationBuilder application) { return application.sources(Application.class); } } 最后执行 mvn clean package -Dmaven.test.skip=true 会在 target 目录下生成:项目名+版本号.war文件,拷贝到 tomcat 服务器中启动即可。 如果使用的是 Gradle,基本步奏一样,build.gradle中 添加 war 的支持,排除 spring-boot-starter-tomcat: ... apply plugin: 'war' ... dependencies { compile("org.springframework.boot:spring-boot-starter-web:1.4.2.RELEASE"){ exclude mymodule:"spring-boot-starter-tomcat" } } ... 再使用构建命令 gradle build war 会生成在 build\libs 目录下。 三、生产运维 1、查看JVM参数的值 可以根据java自带的jinfo命令: jinfo -flags pid 来查看 jar 启动后使用的是什么 gc、新生代、老年代分批的内存都是多少,示例如下: -XX:CICompilerCount=3 -XX:InitialHeapSize=234881024 -XX:MaxHeapSize=3743416320 -XX:MaxNewSize=1247805440 -XX:MinHeapDeltaBytes=524288 -XX:NewSize=78118912 -XX:OldSize=156762112 -XX:+UseCompressedClassPointers -XX:+UseCompressedOops -XX:+UseFastUnorderedTimeStamps -XX:+UseParallelGC -XX:CICompilerCount:最大的并行编译数 -XX:InitialHeapSize和-XX:MaxHeapSize:指定JVM的初始和最大堆内存大小 -XX:MaxNewSize:JVM堆区域新生代内存的最大可分配大小 -XX:+UseParallelGC:垃圾回收使用 Parallel 收集器 2、如何重启 (1)直接 kill 掉进程再次启动 jar 包 ps -ef|grep java ##拿到对于Java程序的pid kill -9 pid ## 再次重启 Java -jar xxxx.jar 当然这种方式比较传统和暴力,所以建议大家使用下面的方式来管理 (2)脚本执行 如果使用的是maven,需要包含以下的配置 <plugin> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-maven-plugin</artifactId> <configuration> <executable>true</executable> </configuration> </plugin> 如果使用是 gradle,需要包含下面配置 springBoot { executable = true } 启动方式: 可以直接./yourapp.jar来启动 注册为服务 也可以做一个链接指向你的jar包并加入到init.d中,然后用命令来启动。 init.d例子 ln -s /var/yourapp/yourapp.jar /etc/init.d/yourapp chmod +x /etc/init.d/yourapp 这样就可以使用stop和restart命令来管理你的应用。 /etc/init.d/yourapp start|stop|restart 或者 service yourapp start|stop|restart 到此Spring Boot项目如何测试、联调和打包投产已经介绍完了,以后可以研究一下spring boot的自动化运维,以及spring boot和docker相结合的使用。 更多精彩内容,首发公众号【素小暖】,欢迎关注。

优秀的个人博客,低调大师

Sping Boot(十一):Spring Boot如何测试打包部署

一、开发阶段 (一)单元测试 在开发阶段的时候最重要的是单元测试,Spring Boot对单元测试的支持已经很完善了。 1、在pom.xml文件中添加依赖 <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-test</artifactId> <scope>test</scope> </dependency> 2、开发测试类 以最简单的helloworld为例,在测试类的类头部需要添加:@RunWith(SpringRunner.class)和@SpringBootTest注解,在测试方法的顶端添加@Test即可,最后在方法上点击右键run就可以运行了。 @RunWith(SpringRunner.class) @SpringBootTest public class ApplicationTests { @Test public void hello() { System.out.println("hello world"); } } 实际使用中,可以按照项目的正常使用去注入数据层代码或者service层代码进行测试验证,spring-boot-starter-test提供很多基础用法,更难得的是增加了对controller层测试的支持。 //简单的验证结果集是否正确 Assert.assertEquals(3,userMapper.getAll().size); //验证结果集,提升 Assert.assertTrue("错误,正确的返回值为200",status==200); Assert.assertFalse("错误,正确的返回值为200",status!=200); 引入了MockMvc支持了对controller层的测试,简单示例如下: public class HelloControlerTests { private MockMvc mvc; //初始化执行 @Before public void setUp() throws Exception { mvc = MockMvcBuilders.standaloneSetup(new HelloController()).build(); } //验证controller是否正常响应并打印返回结果 @Test public void getHello() throws Exception { mvc.perform(MockMvcRequestBuilders.get("/hello").accept(MediaType.APPLICATION_JSON)) .andExpect(MockMvcResultMatchers.status().isOk()) .andDo(MockMvcResultHandlers.print()) .andReturn(); } //验证controller是否正常响应并判断返回结果是否正确 @Test public void testHello() throws Exception { mvc.perform(MockMvcRequestBuilders.get("/hello").accept(MediaType.APPLICATION_JSON)) .andExpect(status().isOk()) .andExpect(content().string(equalTo("Hello World"))); } } 单元测试是验证你代码第一道屏障,要养成每写一部分代码就进行单元测试的习惯,不要等到全部集成后再进行测试,集成后因为更关注整体运行效果,很容易遗漏掉代码底层的bug。 (二)集成测试 整体开发完成之后进入集成测试,Spring Boot项目的启动入口在application类中,直接运行run方法就可以启动项目,但是在调试的过程中我们肯定需要不断的去调试代码,如果每修改一次代码就需要手动启动一次服务很麻烦,Spring Boot非常贴心的给出了热部署的支持,很方便在web项目中调试使用。 pom.xml中添加一下依赖即可: <dependencies> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-devtools</artifactId> <optional>true</optional> </dependency> </dependencies> <build> <plugins> <plugin> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-maven-plugin</artifactId> <configuration> <fork>true</fork> </configuration> </plugin> </plugins> </build> 添加以上配置后,项目就支持了热部署,非常方便集成测试。 二、上线 其实我觉得这个阶段,应该还是比较简单,一般分为两种,一种是打包成jar包直接执行,另一种是打包成war包放到tomcat服务器下。 (一)打包成jar包 如果你使用的是maven来管理项目,执行以下命令 cd 项目跟目录(和pom.xml同级) maven clear package //或者执行下面的命令 //排除测试代码后进行打包 mvn clean package -Dmaven.test.skip=true 打包完成后jar包会生成到target目录下,命名一般是项目名+版本号.jar 启动jar包命令 java -jar target/spring-boot-scheduler-1.0.0.jar 这种方式,只要控制台关闭,服务就不能访问了。下面我们使用在后台运行的方式来启动: nohup java -jar target/spring-boot-scheduler-1.0.0.jar & 也可以在启动的时候选择读取不同的配置文件 java -jar app.jar --spring.profiles.active=dev 也可以在启动的时候设置 jvm 参数 java -Xms10m -Xmx80m -jar app.jar & 如果使用的是 gradle,使用下面命令打包 gradle build java -jar build/libs/mymodule-0.0.1-SNAPSHOT.jar (二)打成war包 打成war包一般可以分两种方式实现,第一种可以通过eclipse这种开发工具来导出war包,另外一种是使用命令来完成,这里主要介绍后一种 1、maven项目,修改pom.xml <packaging>war</packaging> 2、打包时排除tomcat <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-web</artifactId> </dependency> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-tomcat</artifactId> <scope>provided</scope> </dependency> 在这里将scope属性设置为provided,这样在最终形成的war中不会包含这个jar包,因为tomcat或jetty等服务器在运行时将会提供相关的API类。 3、注册启动类 创建 ServletInitializer.java,继承 SpringBootServletInitializer ,覆盖 configure(),把启动类 Application 注册进去。外部 Web 应用服务器构建 Web Application Context 的时候,会把启动类添加进去。 public class ServletInitializer extends SpringBootServletInitializer { @Override protected SpringApplicationBuilder configure(SpringApplicationBuilder application) { return application.sources(Application.class); } } 最后执行 mvn clean package -Dmaven.test.skip=true 会在 target 目录下生成:项目名+版本号.war文件,拷贝到 tomcat 服务器中启动即可。 如果使用的是 Gradle,基本步奏一样,build.gradle中 添加 war 的支持,排除 spring-boot-starter-tomcat: ... apply plugin: 'war' ... dependencies { compile("org.springframework.boot:spring-boot-starter-web:1.4.2.RELEASE"){ exclude mymodule:"spring-boot-starter-tomcat" } } ... 再使用构建命令 gradle build war 会生成在 build\libs 目录下。 三、生产运维 1、查看JVM参数的值 可以根据java自带的jinfo命令: jinfo -flags pid 来查看 jar 启动后使用的是什么 gc、新生代、老年代分批的内存都是多少,示例如下: -XX:CICompilerCount=3 -XX:InitialHeapSize=234881024 -XX:MaxHeapSize=3743416320 -XX:MaxNewSize=1247805440 -XX:MinHeapDeltaBytes=524288 -XX:NewSize=78118912 -XX:OldSize=156762112 -XX:+UseCompressedClassPointers -XX:+UseCompressedOops -XX:+UseFastUnorderedTimeStamps -XX:+UseParallelGC -XX:CICompilerCount:最大的并行编译数 -XX:InitialHeapSize和-XX:MaxHeapSize:指定JVM的初始和最大堆内存大小 -XX:MaxNewSize:JVM堆区域新生代内存的最大可分配大小 -XX:+UseParallelGC:垃圾回收使用 Parallel 收集器 2、如何重启 (1)直接 kill 掉进程再次启动 jar 包 ps -ef|grep java ##拿到对于Java程序的pid kill -9 pid ## 再次重启 Java -jar xxxx.jar 当然这种方式比较传统和暴力,所以建议大家使用下面的方式来管理 (2)脚本执行 如果使用的是maven,需要包含以下的配置 <plugin> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-maven-plugin</artifactId> <configuration> <executable>true</executable> </configuration> </plugin> 如果使用是 gradle,需要包含下面配置 springBoot { executable = true } 启动方式: 可以直接./yourapp.jar来启动 注册为服务 也可以做一个链接指向你的jar包并加入到init.d中,然后用命令来启动。 init.d例子 ln -s /var/yourapp/yourapp.jar /etc/init.d/yourapp chmod +x /etc/init.d/yourapp 这样就可以使用stop和restart命令来管理你的应用。 /etc/init.d/yourapp start|stop|restart 或者 service yourapp start|stop|restart 到此Spring Boot项目如何测试、联调和打包投产已经介绍完了,以后可以研究一下spring boot的自动化运维,以及spring boot和docker相结合的使用。 更多精彩内容,首发公众号【素小暖】,欢迎关注。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册