首页 文章 精选 留言 我的

精选列表

搜索[移动解析],共10000篇文章
优秀的个人博客,低调大师

Lock 解析,如何避免死锁?

Lock 前面聊了聊 synchronized,今天再聊聊 Lock。Lock 接口是 Java 5 引入的,最常见的实现类是 ReentrantLock、ReadLock、WriteLock,可以起到 “锁” 的作用。 PS:篇幅原因,这章不聊实现类,后面再聊,只专注于 Lock 以及它与 synchronized 的区别。 Lock.png Lock 和 synchronized 是 java 中两种最常见的锁,"锁" 是一种工具。它用于控制对共享资源的访问。需要注意的是 Lock 设计的初衷并不是为了取代 synchronized ,而是一种升级。当 synchronized 不合适或者不能满足需求时(后面会说两者区别),Lock 顶上。 一般情况下,Lock 同一时间只允许一个线程来访问这个共享资源。但是也有特殊的时候允许并发访问。比如读写锁(ReadWriteLock)里面的读锁(ReadLock)。PS:这就是其中一个 synchronized 不能满足的场景。 Lock 的方法 如下图所示,Lock 有 5 个方法,1 个条件: publicinterfaceLock{voidlock();voidlockInterruptibly()throwsInterruptedException;booleantryLock();booleantryLock(longtime,TimeUnitunit)throwsInterruptedException;voidunlock();ConditionnewCondition();} lock 加锁主要有 4 个方法:lock、lockInterruptibly、tryLock、tryLock (long time, TimeUnit unit) 。解锁只有一个 unlock 方法。此外,还有一个线程间通信的条件(Condition)。下面逐一讲解: lock Lock 有 4 种加锁方法,其中 lock 是最基础的。Lock 获取锁和释放锁都是显式的,不像 synchronized 是隐式的。所以 synchronized 会在抛异常时自动释放锁,而 Lock 只能是主动释放,加解锁都必须有显式的代码控制。所以就有了以下伪代码: Locklock=...;//代码显式加锁lock.lock();try{//获取到了被本锁保护的资源,处理任务//捕获异常}finally{//代码显式释放锁lock.unlock();} 这种 lock 的写法才是最安全的,先获取 lock,然后在 try 中操作资源,最后 finally 中释放锁,以保证绝对释放(这一步非常重要,它防止代码走不到这里,导致跳过了 unlock () 语句,使得这个锁永远不能被释放)。 此外,lock () 方法有个缺点就是它不能被中断,一旦陷入死锁,lock () 就会陷入永久等待。所以,一般来说我们会用 tryLock 来代替 lock。 tryLock tryLock 顾名思义是尝试获取锁的意思,返回值是 boolean,获取成功返回 true,获取失败返回 false*。使用方法如下: Locklock=...;if(lock.tryLock()){try{//操作资源}finally{//释放锁lock.unlock();}}else{//如果不能获取锁,则做其他事情} 使用 if 判断是否获取锁,成功获取则去操作共享资源,失败则去干别的事(比如,几秒之后重试,或者跳过此任务),最后还是记得要在 finally 中释放锁。 tryLock 解决死锁问题 想象这样一个场景:比如有两个线程同时调用以下这个方法,传入的 lock1 和 lock2 恰好是相反的。如果第一个线程获取了 lock1,第二个线程获取了 lock2,两个线程都需要获取对方的锁才能工作。如果用 lock 这就很容易陷入死锁,原因前面也说了。 这个时候 tryLock 就发挥作用了:其中一个线程尝试获取锁 lock1,获取不到,则去隔段时间重试(这样做的目的在于等另一个获取到锁的线程在这段时间内完成任务,释放锁)。获取到了,则继续获取 lock2 ,获取到就操作共享资源,获取不到则释放 lock1,继续进入重试。 publicvoidtryLock(Locklock1,Locklock2)throwsInterruptedException{while(true){if(lock1.tryLock()){try{if(lock2.tryLock()){try{System.out.println("获取到了两把锁,完成业务逻辑");return;}finally{lock2.unlock();}}}finally{lock1.unlock();}}else{Thread.sleep(newRandom().nextInt(1000));}}} tryLock(long time, TimeUnit unit) 这个方法是 tryLock 的重载,区别在于 tryLock (long time, TimeUnit unit) 方法会有一个超时时间。在拿不到锁时会等待指定的时间,在指定时间内获取不到锁返回 false;获取到锁或者等待期间内获取到锁,返回 true。 此外,超时之后,它将放弃主动获取锁。它还可以响应中断,抛出 InterruptException,避免死锁的产生。 lockInterruptibly lockInterruptibly 去获取锁,获取到了马上返回 true。它非常执拗,如果获取不到锁就会一直尝试获取直到获取到为止,除非当前线程在获取锁期间被中断。可以把它理解为不限时的 tryLock (long time, TimeUnit unit)。 publicvoidlockInterruptibly()throwsInterruptException{lock.lockInterruptibly();try{System.out.println("操作资源");}finally{lock.unlock();}} unlock unlock 顾名思义就是释放锁。就 ReentrantLock 而言,调用 unlock 方法时,内部会把锁的 “被持有计数器” 减 1,减到 0 代表当前线程已经完全释放这把锁。 newCondition() Condition 的用法就不说了,不会的看之前这篇文章:线程之生产者消费者模式。它有两个主要的方法 await 和 signal 分别用于阻塞线程和唤醒线程。对应于 Object 的 wait 和 notify。 -END- 如果看到这里,喜欢这篇文章的话,请帮点个好看。微信搜索「一个优秀的废人」,关注后回复「1024」送你一套完整的 java 教程(包括视频)。回复「电子书」送你全编程领域电子书(不只Java)。 教程节选 本文分享自微信公众号 - 一个优秀的废人(feiren_java)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

TensorFlow On Flink 原理解析

作者:陈戊超(仲卓),阿里巴巴技术专家 深度学习技术在当代社会发挥的作用越来越大。目前深度学习被广泛应用于个性化推荐、商品搜索、人脸识别、机器翻译、自动驾驶等多个领域,此外还在向社会各个领域迅速渗透。 背景 当前,深度学习的应用越来越多样化,随之涌现出诸多优秀的计算框架。其中 TensorFlow,PyTorch,MXNeT 作为广泛使用的框架更是备受瞩目。在将深度学习应用于实际业务的过程中,往往需要结合数据处理相关的计算框架如:模型训练之前需要对训练数据进行加工生成训练样本,模型预测过程中需要对处理数据的一些指标进行监控等。在这样的情况下,数据处理和模型训练分别需要使用不同的计算引擎,增加了用户使用的难度。 本文将分享如何使用一套引擎搞定机器学习全流程的解决方案。先介绍一下典型的机器学习工作流程。如图所示,整个流程包含特征工程、模型训练、离线或者是在线预测等环节。 在此过程中,无论是特征工程、模型训练还是模型预测,中间都会产生日志。需要先用数据处理引擎比如 Flink 对这些日志进行分析,然后进入特征工程。再使用深度学习的计算引擎 TensorFlow 进行模型训练和模型预测。当模型训练好了以后再用 tensor serving 做在线的打分。 上述流程虽然可以跑通,但也存在一定的问题,比如: 同一个机器学习项目在做特征工程、模型训练、模型预测时需要用到 Flink 和 TensorFlow 两个计算引擎,部署相对而言更复杂。 TensorFlow 在分布式的支持上还不够友好,运行过程中需要指定机器的 IP 地址和端口号;而实际生产过程经常是运行在一个调度系统上比如 Yarn,需要动态分配 IP 地址和端口号。 TensorFlow 的分布式运行缺乏自动的 failover 机制。 针对以上问题,我们通过结合 Flink 和 TensorFlow,将 TensorFlow 的程序跑在 Flink 集群上的这种方式来解决,整体流程如下: 特征工程用 Flink 去执行,模型训练和模型的准实时预测目标使 TensorFlow 计算引擎可以跑在 Flink 集群上。这样就可以用 Flink 一套计算引擎去支持模型训练和模型的预测,部署上更简单的同时也节约了资源。 Flink 计算简介 Flink 是一款开源大数据分布式计算引擎,在 Flink 里所有的计算都抽象成 operator,如上图所示,数据读取的节点叫 source operator,输出数据的节点叫 sink operator。source 和 sink 中间有多种多样的 Flink operator 去处理,上图的计算拓扑包含了三个 source 和两个 sink。 机器学习分布式拓扑 机器学习分布式运行拓扑如下图所示: 在一个机器学习的集群当中,经常会对一组节点(node)进行分组,如上图所示,一组节点可以是 worker(运行算法),也可以是 ps(更新参数)。 如何将 Flink 的 operator 结构与 Machine Learning 的 node、Application Manager 角色结合起来?下面将详细讲解 flink-ai-extended 的抽象。 Flink-ai-extended 抽象 首先,对机器学习的 cluster 进行一层抽象,命名为 ML framework,同时机器学习也包含了 ML operator。通过这两个模块,可以把 Flink 和 Machine Learning Cluster 结合起来,并且可以支持不同的计算引擎,包括 TensorFlow。 如下图所示: 在 Flink 运行环境上,抽象了 ML Framework 和 ML Operator 模块,负责连接 Flink 和其他计算引擎。 ML Framework ML Framework 分为 2 个角色。 Application Manager(以下简称 am) 角色,负责管理所有 node 的节点的生命周期。 node 角色,负责执行机器学习的算法程序。 在上述过程中,还可以对 Application Manager 和 node 进行进一步的抽象,Application Manager 里面我们单独把 state machine 的状态机做成可扩展的,这样就可以支持不同类型的作业。 深度学习引擎,可以自己定义其状态机。从 node 的节点抽象 runner 接口,这样用户就可以根据不同的深度学习引擎去自定义运行算法程序。 ML Operator ML Operator 模块提供了两个接口: addAMRole,这个接口的作用是在 Flink 的作业里添加一个 Application Manager 的角色。Application Manager 角色如上图所示就是机器学习集群的管理节点。 addRole,增加的是机器学习的一组节点。 利用 ML Operator 提供的接口,可以实现 Flink Operator 中包含一个Application Manager 及 3 组 node 的角色,这三组 node 分别叫 role a、 role b,、role c,三个不同角色组成机器学习的一个 cluster。如上图代码所示。Flink 的 operator 与机器学习作业的 node 一一对应。 机器学习的 node 节点运行在 Flink 的 operator 里,需要进行数据交换,原理如下图所示: Flink operator 是 java 进程,机器学习的 node 节点一般是 python 进程,java 和 python 进程通过共享内存交换数据。 TensorFlow On Flink TensorFlow 分布式运行 TensorFlow 分布式训练一般分为 worker 和 ps 角色。worker 负责机器学习计算,ps 负责参数更新。下面将讲解 TensorFlow 如何运行在 Flink 集群中。 TensorFlow Batch 训练运行模式 Batch 模式下,样本数据可以是放在 HDFS 上的,对于 Flink 作业而言,它会起一个source 的 operator,然后 TensorFlow 的 work 角色就会启动。如上图所示,如果 worker 的角色有三个节点,那么 source 的并行度就会设为 3。同理下面 ps 角色有 2 个,所以 ps source 节点就会设为 2。而 Application Manager 和别的角色并没有数据交换,所以 Application Manager 是单独的一个节点,因此它的 source 节点并行度始终为 1。这样 Flink 作业上启动了三个 worker 和两个 ps 节点,worker 和 ps 之间的通讯是通过原始的 TensorFlow 的 GRPC 通讯来实现的,并不是走 Flink 的通信机制。 TensorFlow stream 训练运行模式 如上图所示,前面有两个 source operator,然后接 join operator,把两份数据合并为一份数据,再加自定义处理的节点,生成样本数据。在 stream 模式下,worker 的角色是通过 UDTF 或者 flatmap 来实现的。 同时,TensorFlow worker node 有3 个,所以 flatmap 和 UDTF 相对应的 operator 的并行度也为 3, 由于ps 角色并不去读取数据,所以是通过 flink source operator 来实现。 下面我们再讲一下,如果已经训练好的模型,如何去支持实时的预测。 使用 Python 进行预测 使用 Python 进行预测流程如图所示,如果 TensorFlow 的模型是分布式训练出来的模型,并且这个模型非常大,比如说单机放不下的情况,一般出现在推荐和搜索的场景下。那么实时预测和实时训练原理相同,唯一不同的地方是多了一个加载模型的过程。 在预测的情况下,通过读取模型,将所有的参数加载到 ps 里面去,然后上游的数据还是经过和训练时候一样的处理形式,数据流入到 worker 这样一个角色中去进行处理,将预测的分数再写回到 flink operator,并且发送到下游 operator。 使用 Java 进行预测 如图所示,模型单机进行预测时就没必要再去起 ps 节点,单个 worker 就可以装下整个模型进行预测,尤其是使用 TensorFlow 导出 save model。同时,因为 saved model 格式包含了整个深度学习预测的全部计算逻辑和输入输出,所以不需要运行 Python 的代码就可以进行预测。 此外,还有一种方式可以进行预测。前面 source、join、UDTF 都是对数据进行加工处理变成预测模型可以识别的数据格式,在这种情况下,可以直接在 Java 进程里面通过 TensorFlow Java API,将训练好的模型 load 到内存里,这时会发现并不需要 ps 角色, worker 角色也都是 Java 进程,并不是 Python 的进程,所以我们可以直接在 Java 进程内进行预测,并且可以将预测结果继续发给 Flink 的下游。 总结 在本文中,我们讲解了 flink-ai-extended 原理,以及Flink 结合 TensorFlow 如何进行模型训练和预测。希望通过本文大分享,大家能够使用 flink-ai-extended, 通过 Flink 作业去支持模型训练和模型的预测。

优秀的个人博客,低调大师

AnalyticDB for MySQL技术架构解析

企业数据需求不断变化,近年来变化趋势日益明显,从数据的3V特性看:体积,速度和变化;Big Data强调数据量,PB级以上,是静态数据。而Fast Data在数据量的基础上,意味着速度和和变化,意味着客户可以更加实时化、更加快速地进行数据处理。 在Forrester最近的一项研究中,超过75%的受访公司已经使用Fast Data解决方案。 在接受调查的人中,88%表示他们需要近乎实时地对数据执行分析。 AnalyticDB是阿里巴巴自主研发、唯一经过超大规模以及核心业务验证的PB级实时数据仓库,是FastData的最佳代表。自2012年第一次在集团发布上线以来,至今已累计迭代发布近百个版本,支撑起集团内的电商、广告、菜鸟、文娱、飞猪等众多在线分析业务。AnalyticDB于2014年在阿里云开始正式对外输出,支撑行业既包括传统的大中型

优秀的个人博客,低调大师

ConcurrentHashMap 1.8原理解析

JDK 1.8中,Hash家族有这么一些存在,HashMap,HashTable,LinkedHashMap,ConcurrentHashMap。这里面支持线程安全的有HashTable以及ConcurrentHashMap。对Hash有一个基本了解可以参考本人的从Hash到一致性Hash原理(深度好文) 。 那既然说到ConcurrentHashMap,自然要讨论的就是它的线程安全性和效能。我们先来看一下HashTable的线程安全性以及效能的低下。 public synchronized V put(K key, V value) { // Make sure the value is not null if (value == null) { throw new NullPointerException(); } // Makes sure the key is not already in the hashtable. Entry<?,?> tab[] = table; int hash = key.hashCode(); int index = (hash & 0x7FFFFFFF) % tab.length; @SuppressWarnings("unchecked") Entry<K,V> entry = (Entry<K,V>)tab[index]; for(; entry != null ; entry = entry.next) { if ((entry.hash == hash) && entry.key.equals(key)) { V old = entry.value; entry.value = value; return old; } } addEntry(hash, key, value, index); return null; } public synchronized V get(Object key) { Entry<?,?> tab[] = table; int hash = key.hashCode(); int index = (hash & 0x7FFFFFFF) % tab.length; for (Entry<?,?> e = tab[index] ; e != null ; e = e.next) { if ((e.hash == hash) && e.key.equals(key)) { return (V)e.value; } } return null; } 我们对比一下HashMap 1.7的这两个方法(因为1.8点HashMap会生成红黑树,我们暂时先不考虑红黑树的问题) public V put(K key, V value) { if (key == null) return putForNullKey(value); int hash = hash(key); int i = indexFor(hash, table.length); for (Entry<K,V> e = table[i]; e != null; e = e.next) { Object k; if (e.hash == hash && ((k = e.key) == key || key.equals(k))) { V oldValue = e.value; e.value = value; e.recordAccess(this); return oldValue; } } modCount++; addEntry(hash, key, value, i); return null; } public V get(Object key) { if (key == null) return getForNullKey(); Entry<K,V> entry = getEntry(key); return null == entry ? null : entry.getValue(); } final int hash(Object k) { int h = 0; if (useAltHashing) { if (k instanceof String) { return sun.misc.Hashing.stringHash32((String) k); } h = hashSeed; } h ^= k.hashCode(); // This function ensures that hashCodes that differ only by // constant multiples at each bit position have a bounded // number of collisions (approximately 8 at default load factor). //一种算法,进行4次位移,得到相对比较分散的链表 h ^= (h >>> 20) ^ (h >>> 12); return h ^ (h >>> 7) ^ (h >>> 4); } 在这里我们可以看到,他们除了key的hash算法不同,HashTable的比较简单,只是用key的哈希值与0x7FFFFFFF(十进制2147483647,二进制1111111111111111111111111111111)进行一次与运算,即为只要相同二进制位上不论0,1全部都变成1,再对table数组的长度取模。而HashMap 1.7则为key的哈希值进行各位无符号位移加异或运算,取得最终哈希值。然后是HashTable不接收null的key,而HashMap接受。他们最大的区别就在于synchronized显示器锁了。 synchronized的本质是所有对象的字节码中有一个monitor的对象头,任何线程拿到了这个monitor的对象头就可以对这个对象进行操作,而拿不到monitor对象头的线程就只能等待,直到拿到了monitor的线程放弃,其他线程才能争夺这个对象头来对对象进行操作。那么问题来了,当大量线程高并发的时候,只要有一个线程拿到了这个对象头,其他线程对这个对象是既不能读也不能写。而对于HashMap来说,如果多线程对其进行操作,那么任意线程都可以胡乱修改里面值的内容造成脏读,所以HashMap是线程不安全的。 那么我们今天的主角登场了ConcurrentHashMap。我们同样来看一下这两个方法。以下是1.8的源码,首先我们要清楚的是1.8跟1.7已经完全不同,1.7是使用segements(16个segement),每个segement都有一个table(Map.Entry数组),相当于16个HashMap,同步机制为分段锁,每个segment继承ReentrantLock;而1.8只有1个table(Map.Entry数组),同步机制为CAS + synchronized保证并发更新。如果不搞清楚这个问题,那么你看1.8的源码可能会很懵逼。 public V put(K key, V value) { return putVal(key, value, false); } final V putVal(K key, V value, boolean onlyIfAbsent) { //无论key还是value,不允许空 if (key == null || value == null) throw new NullPointerException(); //此处获取hash值的方法与HashTable类似 int hash = spread(key.hashCode()); int binCount = 0; //无限循环 for (Node<K,V>[] tab = table;;) { Node<K,V> f; int n, i, fh; //如果节点数组为null,或者长度为0,初始化节点数组 if (tab == null || (n = tab.length) == 0) tab = initTable(); //如果节点数组的某个节点为null,则put的时候就会采用无锁竞争来获取该节点的头把交椅 else if ((f = tabAt(tab, i = (n - 1) & hash)) == null) { if (casTabAt(tab, i, null, new Node<K,V>(hash, key, value, null))) break; // no lock when adding to empty bin } //需要扩容的时候先扩容,再写入 else if ((fh = f.hash) == MOVED) tab = helpTransfer(tab, f); else { //如果hash冲突的时候,即多线程操作时,大家都有一样的hash值 V oldVal = null; synchronized (f) { //锁定节点数组的该节点 if (tabAt(tab, i) == f) { //如果当前该节点为链表形态 if (fh >= 0) { binCount = 1; for (Node<K,V> e = f;; ++binCount) { K ek; //找链表中找到相同的key,把新value替代老value if (e.hash == hash && ((ek = e.key) == key || (ek != null && key.equals(ek)))) { oldVal = e.val; if (!onlyIfAbsent) e.val = value; break; } Node<K,V> pred = e; //如果找不到key,就添加到链表到末尾 if ((e = e.next) == null) { pred.next = new Node<K,V>(hash, key, value, null); break; } } } //如果当前为红黑树形态,进行红黑树到查找和替代(存在相同的key),或者放入红黑树到新叶节点上(key不存在) else if (f instanceof TreeBin) { Node<K,V> p; binCount = 2; if ((p = ((TreeBin<K,V>)f).putTreeVal(hash, key, value)) != null) { oldVal = p.val; if (!onlyIfAbsent) p.val = value; } } } } if (binCount != 0) { //如果链表长度超过了8,链表转红黑树 if (binCount >= TREEIFY_THRESHOLD) treeifyBin(tab, i); if (oldVal != null) return oldVal; break; } } } //统计节点个数,检查是否需要扩容 addCount(1L, binCount); return null; } public V get(Object key) { Node<K,V>[] tab; Node<K,V> e, p; int n, eh; K ek; int h = spread(key.hashCode()); if ((tab = table) != null && (n = tab.length) > 0 && (e = tabAt(tab, (n - 1) & h)) != null) { if ((eh = e.hash) == h) { if ((ek = e.key) == key || (ek != null && key.equals(ek))) return e.val; } else if (eh < 0) return (p = e.find(h, key)) != null ? p.val : null; while ((e = e.next) != null) { if (e.hash == h && ((ek = e.key) == key || (ek != null && key.equals(ek)))) return e.val; } } return null; } 读取的时候,我们没有看见锁到存在,说明读不受多线程影响。 对比ConcurrentHashMap和HashTable,我们可以明显的看到,ConcurrentHashMap在写的时候,并没有锁住整个节点数组,在新节点上使用的是无锁竞争,在老节点上锁住的仅仅是一个节点,读的时候如果不是恰好读到写线程写入相同Hash值的位置,不受影响(可以认为我们的操作一般是读多写少,这种几率也比较低)。而HashTable是对整个节点数组进行锁定,读到时候不能写,写的时候不能读,这么一对比就可以明显感觉到性能差距是巨大的。 虽然ConcurrentHashMap的并发性能还算比较优异,但在亿级计算中,却依然会成为性能瓶颈,具体可以参考本人的Fork/Join框架原理和使用探秘 至于这里为什么会慢,我认为在这种超高并发下,节点数组的单节点的的写写竞争是互斥的,其次,由于红黑树具有读快写慢的特性,它要不断保持树的平衡而不断返转,所以才会使得高并发写的性能急剧下降。

优秀的个人博客,低调大师

Redis radix tree源码解析

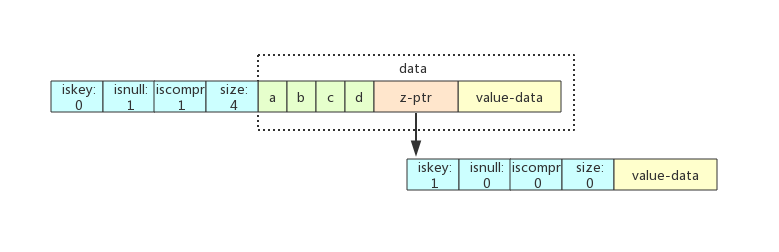
Redis实现了不定长压缩前缀的radix tree,用在集群模式下存储slot对应的的所有key信息。本文将详述在Redis中如何实现radix tree。 核心数据结构 raxNode是radix tree的核心数据结构,其结构体如下代码所示: typedef struct raxNode { uint32_t iskey:1; uint32_t isnull:1; uint32_t iscompr:1; uint32_t size:29; unsigned char data[]; } raxNode; iskey:表示这个节点是否包含key 0:没有key 1:表示从头部到其父节点的路径完整的存储了key,查找的时候按子节点iskey=1来判断key是否存在 isnull:是否有存储value值,比如存储元数据就只有key,没有value值。value值也是存储在data中 iscompr:是否有前缀压缩,决定了data存储的数据结构 size:该节点存储的字符个数 data:存储子节点的信息 iscompr=0:非压缩模式下,数据格式是:[header strlen=0][abc][a-ptr][b-ptr][c-ptr](value-ptr?),有size个字符,紧跟着是size个指针,指向每个字符对应的下一个节点。size个字符之间互相没有路径联系。 iscompr=1:压缩模式下,数据格式是:[header strlen=3][xyz][z-ptr](value-ptr?),只有一个指针,指向下一个节点。size个字符是压缩字符片段 Rax Insert 以下用几个示例来详解rax tree插入的流程。假设j是遍历已有节点的游标,i是遍历新增节点的游标。 场景一:只插入abcd z-ptr指向的叶子节点iskey=1,使用了压缩前缀。 场景二:在abcd之后插入abcdef 从abcd父节点的每个压缩前缀字符比较,遍历完所有abcd节点后指向了其空子节点,j = 0, i < len(abcded)。 查找到abcd的空子节点,直接将ef赋值到子节点上,成为abcd的子节点。ef节点被标记为iskey=1,用来标识abcd这个key。ef节点下再创建一个空子节点,iskey=1来表示abcdef这个key。 场景三:在abcd之后插入ab ab在abcd能找到前两位的前缀,也就是i=len(ab),j < len(abcd)。 将abcd分割成ab和cd两个子节点,cd也是一个压缩前缀节点,cd同时被标记为iskey=1,来表示ab这个key。 cd下挂着一个空子节点,来标记abcd这个key。 场景四:在abcd之后插入abABC abcABC在abcd中只找到了ab这个前缀,即i < len(abcABC),j < len(abcd)。这个步骤有点复杂,分解一下: step 1:将abcd从ab之后拆分,拆分成ab、c、d 三个节点。 step 2:c节点是一个非压缩的节点,c挂在ab子节点上。 step 3:d节点只有一个字符,所以也是一个非压缩节点,挂在c子节点上。 step 4:将ABC 拆分成了A和BC, A挂在ab子节点上,和c节点属于同一个节点,这样A就和c同属于父节点ab。 step 5:将BC作为一个压缩前缀的节点,挂在A子节点下。 step 6:d节点和BC节点都挂一个空子节点分别标识abcd和abcABC这两个key。 场景五:在abcd之后插入Aabc abcd和Aabc没有前缀匹配,i = 0,j = 0。 将abcd拆分成a、bcd两个节点,a节点是一个非压缩前缀节点。 将Aabc拆分成A、abc两个节点,A节点也是一个非压缩前缀节点。 将A节点挂在和a相同的父节点上。 同上,在bcd和abc这两个节点下挂空子节点来分别表示两个key。 Rax Remove 删除 删除一个key的流程比较简单,找到iskey的节点后,向上遍历父节点删除非iskey的节点。如果是非压缩的父节点并且size > 1,表示还有其他非相关的路径存在,则需要按删除子节点的模式去处理这个父节点,主要是做memove和realloc。 合并 删除一个key之后需要尝试做一些合并,以收敛树的高度。 合并的条件是: iskey=1的节点不能合并 子节点只有一个字符 父节点只有一个子节点(如果父节点是压缩前缀的节点,那么只有一个子节点,满足条件。如果父节点是非压缩前缀的节点,那么只能有一个字符路径才能满足条件) 结束语 云数据库Redis版(ApsaraDB for Redis)是一种稳定可靠、性能卓越、可弹性伸缩的数据库服务。基于飞天分布式系统和全SSD盘高性能存储,支持主备版和集群版两套高可用架构。提供了全套的容灾切换、故障迁移、在线扩容、性能优化的数据库解决方案。欢迎各位购买使用:云数据库 Redis 版 作者:羽洵 原文链接 本文为云栖社区原创内容,未经允许不得转载。

优秀的个人博客,低调大师

Android Handler原理实践解析

前言 Handler消息处理机制在Android开发中起着举足轻重的作用,我们有必要好好理解下其原理,下面我们先从一个简单的例子出发 一、日常使用 假设我们有这么一个需要,请求网络然后将图片展示出来,我们知道网络请求是不允许在主线程执行的,而UI是不能在子线程(具体是不允许在非创建UI的原始线程)更新的,因此我们需要在子线程请求网络获得了数据以后再切换回主线程更新UI,这个例子中Handler就是起着切换线程的作用,下面的代码演示了这个例子 classMainActivity : AppCompatActivity() { private lateinit var mImageView: ImageView override fun onCreate(savedInstanceState: Bundle?){

优秀的个人博客,低调大师

Helm源码解析 资料下载

Helm 是Kubernetes 集群的包管理器(charts), charts 是Kubernetes资源的一个打包集合。 Helm之于Kubernetes好比yum之于RHEL,或者apt-get之于Ubuntu。Helm使用Chart帮助我们管理应用,Chart就好像RPM一样,里面描述了应用及其依赖关系。这篇分享会简单介绍 Helm 的用法 以及chart 的介绍,随后会针对Helm 源码以一个简单的chart 创建为示例,从源码级别分析Helm 的创建流程。最后会简单介绍一下Helm v3的进展以及改变。 本次分享专家:阿里云技术专家 陈显鹭 直播视频全程链接:https://yq.aliyun.com/live/826 PPT精彩内容一览: PPT下载地址:https://yq.aliyun.com/download/32

优秀的个人博客,低调大师

应用基础框架全面解析

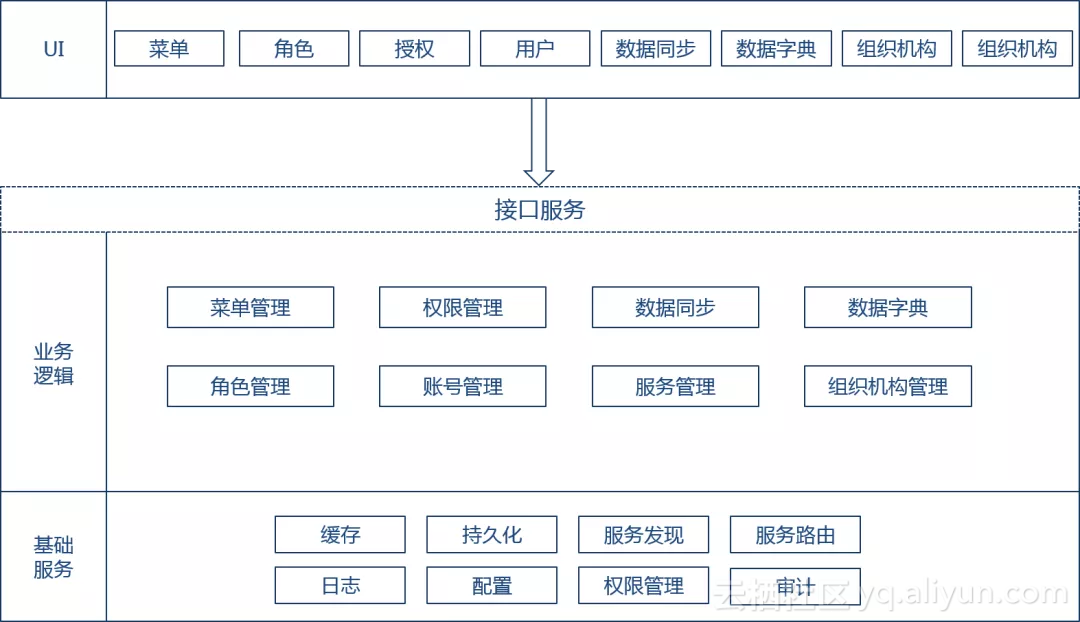
引言: 应用基础框架Coframe是EOS产品自带的开源应用基础框架,提供了资源管理、权限管理、用户以及角色管理等业务应用基础能力,用户可以根据自己的需要进行二次开发与扩展。本文向大家分享Coframe的主要功能和设计实现方案。 目录: 一、简介 二、系统资源 三、权限管理 四、组织管理 一、简介 应用基础框架也叫Coframe,是产品自带的开源应用基础框架,提供了一些基础功能,用户可以根据自己的需要进行二次开发与扩展。 Coframe提供3大核心功能: 系统资源:提供了功能菜单管理、字典码表、应用管理折几个应用框架基础能力。 权限管理:提供了基于Party(参与者) 的复杂权限计算模型和授权模型。 基于参与者、资源与授权等概念可扩展开发出符合用户个性化需求的参与者模型。 组织管理:提供了机构、岗位、员工、 用户、工作组等组织机构相关管理功能,支持与已有业务系统对接,使得基于普元EOS Platform 8.0开发的应用可方便地使用同一套组织机构。 逻辑架构逻辑架构图展示了基础应用框架的基本功能模块,前端Restful形式接口调用后端服务。进程架构应用基础框架有两种部署模式:微服务架构Coframe集成模式和单应用架构Coframe集成模式。 单应用架构很好理解,即直接使用Coframe源码或者jar包开发应用,后端只有一个server,而集成模式可以将应用要对外暴露的服务封装在Coframe中,这样Coframe可以对应用进行权限管理。前端使用VUE开发,可以很方便的使用源码进行二次开发。 数据模型应用基础框架的数据模型即DB表结构,展示了主要的一些表结构,包括权限表,用户表等。用户可以很方便的进行二次开发扩展应用。 二、系统资源 菜单管理 菜单框架支持两级菜单,用户可以自定义菜单的路径和打开方式等。应用基础框架提供了几个基础的菜单,用户可以在页面编辑菜单或者直接在数据库端编辑菜单。目前应用基础框架前端Ui支持二级菜单,用户可以根据自己的需求扩展到三级菜单。 字典码表 字典码表即为系统内部定义的具有业务属性的数据字典。系统管理员可以配置字典类型和字典项,用于管理系统中的枚举类型的基础数据,并且支持excel导入导出。字典类型和字典数据均支持一级子项。 字典类型:对数据进行分类管理 字典数据项:需要管理的枚举数据 应用管理 应用管理又叫服务权限控制,是指在多应用系统以及单应用系统下,实现对应用的服务功能的权限控制。实现角色、用户、功能的灵活绑定。在需要进行权限管理的功能接口方法定义上添加@TarestOperation注解,发布服务。 @RequestMapping("/say-hello") @TarestService(group = "SP1", displayName = "服务提供组1", version = "1.0.0.0", groupName = "服务提供组1", name = "ISampleAppHello") public interface ISampleAppHello { @GetMapping @TarestOperation(checkPermission=false,name="DEMO_001",displayName="功能1") String sayHello(); /** * @TarestOperation 在@TarestOperation中默认是不进行权限管理的 * 通过设置checkPermission = true,打开权限控制功能 * **/ @GetMapping(value = "/user") @TarestOperation(checkPermission =true,name="DEMO_002",displayName="功能2") String insertDemo(@RequestParam String name, @RequestParam Integer age); } 单应用系统即只有一个后端应用的系统,(直接以嵌入方式集成Coframe)无需新建应用。 多应用系统即有多个后端应用的系统,Coframe作为一个独立的应用部署的系统,需要在coframe中新建应用。如图所示: 三、权限管理 提供了基于Party(参与者) 的复杂权限计算模型和授权模型。 基于参与者、资源与授权等概念可扩展开发出符合用户个性化需求的参与者模型。 角色:角色是Coframe一个重要的对象,也可以成为权限集,表示系统中权限一个子集,用于控制用户可以使用的功能集合,赋予用户一个角色表示给用户一定功能的使用权限。Coframe中角色的分配本身赋予某些用户,员工,机构等之外,还要向角色授予可访问某些功能,模块,表单,视图等资源的权限。拥有某角色的用户可访问角色被授予的资源的权限。 用户:所有能登录系统的用户都是系统中的用户,需要增加登录账号有两种方式。一种是在用户管理中新增用户,第二种是在组织管理中新增员工时关联一个用户,如果用户的登录名不存在会创建一个新的用户。 用户管理所有能登录系统的用户都是系统中的用户,需要增加登录账号有两种方式。一种是在用户管理中新增用户,第二种是在组织管理中新增员工时关联一个用户,如果用户的登录名不存在会创建一个新的用户。当Coframe使用IAM的统一认证登录的时候能够同步IAM端的同一租户下的用户信息。 Coframe的用户账号由其登录认证方式决定是本地创建的还是又IAM即同一认真平台同步过来的用户信息。 本地登录:用户账号及其认证密码在本地存储,本地认证配置可以参考:http://t.cn/EUrzEtL 单点登录:即与IAM集成的sso方式登录,可以参考:http://t.cn/EUrZPOs 授权管理 目前提供了菜单授权与服务授权,授权管理即将资源与参与者之间建立关系。如下图所示,菜单和应用: 即可以视为资源,而账号、角色、组织机构、工作中等,即可以视为参与者。授权表结构如下图所示: 此注解用来标志一个数据实体为授权实体,授权实体需要指定类型:资源、授权主体,比如: @Entity // 此实体名称为order,类型为resource @AuthEntity(name = "order", type = AuthEntityType.RESOURCE) @Table(name = "SAMPLE_ORDER") public class SampleOrder { @Id @GeneratedValue private Long id; private String name; private Date date; } 四、组织管理 机构管理机构指企业的组织机构,一般包含机构、岗位、员工等信息。 机构管理通过对一棵机构人员树的维护把机构、岗位、人员等信息和关系维护好,并可设置这些组织对象的角色。工作组管理工作组与机构类似,是为了将项目组、工作组等临时性的组织机构管理起来,业务上通常工作组有一定的时效性,是一个非常设机构。 工作组是企业动态创建的组织机构分组,工作组下可以有子工作组、员工信息。总结: 以上介绍了应用基础框架的主要基础功能,以及设计过程中的一些理念,比如授权模型等。 作为开源应用基础框架会随着规划发展不断完善,用户可以根据自身的需求来更改适配。也非常欢迎大家能够更多参与使其更加健壮。 原文发布时间为:2018-12-19本文作者:许方杰本文来自云栖社区合作伙伴“ EAWorld”,了解相关信息可以关注“eaworld”微信公众号

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册