首页 文章 精选 留言 我的

精选列表

搜索[移动解析],共10000篇文章
优秀的个人博客,低调大师

Hystrix降级技术解析-Fallback

一、降级 所谓降级,就是指在在Hystrix执行非核心链路功能失败的情况下,我们如何处理,比如我们返回默认值等。如果我们要回退或者降级处理,代码上需要实现HystrixCommand.getFallback()方法或者是HystrixObservableCommand. HystrixObservableCommand()。 publicclassCommandHelloFailureextendsHystrixCommand<String>{ privatefinalStringname; publicCommandHelloFailure(Stringname){ super(HystrixCommandGroupKey.Factory.asKey("ExampleGroup")); this.name=name; } @Override protectedStringrun(){ thrownewRuntimeException("thiscommandalwaysfails"); } @Override protectedStringgetFallback(){ return"HelloFailure"+name+"!"; } } 二、Hystrix的降级回退方式 Hystrix一共有如下几种降级回退模式: 1、Fail Fast 快速失败 @Override protectedStringrun(){ if(throwException){ thrownewRuntimeException("failurefromCommandThatFailsFast"); }else{ return"success"; } } 如果我们实现的是HystrixObservableCommand.java则 重写 resumeWithFallback方法 @Override protectedObservable<String>resumeWithFallback(){ if(throwException){ returnObservable.error(newThrowable("failurefromCommandThatFailsFast")); }else{ returnObservable.just("success"); } } 2、Fail Silent 无声失败 返回null,空Map,空List fail silent.png @Override protectedStringgetFallback(){ returnnull; } @Override protectedList<String>getFallback(){ returnCollections.emptyList(); } @Override protectedObservable<String>resumeWithFallback(){ returnObservable.empty(); } 3、Fallback: Static 返回默认值 回退的时候返回静态嵌入代码中的默认值,这样就不会导致功能以Fail Silent的方式被清楚,也就是用户看不到任何功能了。而是按照一个默认的方式显示。 @Override protectedBooleangetFallback(){ returntrue; } @Override protectedObservable<Boolean>resumeWithFallback(){ returnObservable.just(true); } 4、Fallback: Stubbed 自己组装一个值返回 当我们执行返回的结果是一个包含多个字段的对象时,则会以Stubbed 的方式回退。Stubbed 值我们建议在实例化Command的时候就设置好一个值。以countryCodeFromGeoLookup为例,countryCodeFromGeoLookup的值,是在我们调用的时候就注册进来初始化好的。CommandWithStubbedFallback command = new CommandWithStubbedFallback(1234, "china");主要代码如下: publicclassCommandWithStubbedFallbackextendsHystrixCommand<UserAccount>{ protectedCommandWithStubbedFallback(intcustomerId,StringcountryCodeFromGeoLookup){ super(HystrixCommandGroupKey.Factory.asKey("ExampleGroup")); this.customerId=customerId; this.countryCodeFromGeoLookup=countryCodeFromGeoLookup; } @Override protectedUserAccountgetFallback(){ /** *Returnstubbedfallbackwithsomestaticdefaults,placeholders, *andaninjectedvalue'countryCodeFromGeoLookup'thatwe'lluse *insteadofwhatwewouldhaveretrievedfromtheremoteservice. */ returnnewUserAccount(customerId,"UnknownName", countryCodeFromGeoLookup,true,true,false); } 5、Fallback: Cache via Network 利用远程缓存 通过远程缓存的方式。在失败的情况下再发起一次remote请求,不过这次请求的是一个缓存比如redis。由于是又发起一起远程调用,所以会重新封装一次Command,这个时候要注意,执行fallback的线程一定要跟主线程区分开,也就是重新命名一个ThreadPoolKey。 Cache via Network.png publicclassCommandWithFallbackViaNetworkextendsHystrixCommand<String>{ privatefinalintid; protectedCommandWithFallbackViaNetwork(intid){ super(Setter.withGroupKey(HystrixCommandGroupKey.Factory.asKey("RemoteServiceX")) .andCommandKey(HystrixCommandKey.Factory.asKey("GetValueCommand"))); this.id=id; } @Override protectedStringrun(){ //RemoteServiceXClient.getValue(id); thrownewRuntimeException("forcefailureforexample"); } @Override protectedStringgetFallback(){ returnnewFallbackViaNetwork(id).execute(); } privatestaticclassFallbackViaNetworkextendsHystrixCommand<String>{ privatefinalintid; publicFallbackViaNetwork(intid){ super(Setter.withGroupKey(HystrixCommandGroupKey.Factory.asKey("RemoteServiceX")) .andCommandKey(HystrixCommandKey.Factory.asKey("GetValueFallbackCommand")) //useadifferentthreadpoolforthefallbackcommand //sosaturatingtheRemoteServiceXpoolwon'tprevent //fallbacksfromexecuting .andThreadPoolKey(HystrixThreadPoolKey.Factory.asKey("RemoteServiceXFallback"))); this.id=id; } @Override protectedStringrun(){ MemCacheClient.getValue(id); } @Override protectedStringgetFallback(){ //thefallbackalsofailed //sothisfallback-of-a-fallbackwill //failsilentlyandreturnnull returnnull; } } } 6、Primary + Secondary with Fallback 主次方式回退(主要和次要) 这个有点类似我们日常开发中需要上线一个新功能,但为了防止新功能上线失败可以回退到老的代码,我们会做一个开关比如使用zookeeper做一个配置开关,可以动态切换到老代码功能。那么Hystrix它是使用通过一个配置来在两个command中进行切换。 Primary + Secondary with Fallback.png /** *Sample{@linkHystrixCommand}patternusingasemaphore-isolatedcommand *thatconditionallyinvokesthread-isolatedcommands. */ publicclassCommandFacadeWithPrimarySecondaryextendsHystrixCommand<String>{ privatefinalstaticDynamicBooleanPropertyusePrimary=DynamicPropertyFactory.getInstance().getBooleanProperty("primarySecondary.usePrimary",true); privatefinalintid; publicCommandFacadeWithPrimarySecondary(intid){ super(Setter .withGroupKey(HystrixCommandGroupKey.Factory.asKey("SystemX")) .andCommandKey(HystrixCommandKey.Factory.asKey("PrimarySecondaryCommand")) .andCommandPropertiesDefaults( //wewanttodefaulttosemaphore-isolationsincethiswraps //2otherscommandsthatarealreadythreadisolated //采用信号量的隔离方式 HystrixCommandProperties.Setter() .withExecutionIsolationStrategy(ExecutionIsolationStrategy.SEMAPHORE))); this.id=id; } //通过DynamicPropertyFactory来路由到不同的command @Override protectedStringrun(){ if(usePrimary.get()){ returnnewPrimaryCommand(id).execute(); }else{ returnnewSecondaryCommand(id).execute(); } } @Override protectedStringgetFallback(){ return"static-fallback-"+id; } @Override protectedStringgetCacheKey(){ returnString.valueOf(id); } privatestaticclassPrimaryCommandextendsHystrixCommand<String>{ privatefinalintid; privatePrimaryCommand(intid){ super(Setter .withGroupKey(HystrixCommandGroupKey.Factory.asKey("SystemX")) .andCommandKey(HystrixCommandKey.Factory.asKey("PrimaryCommand")) .andThreadPoolKey(HystrixThreadPoolKey.Factory.asKey("PrimaryCommand")) .andCommandPropertiesDefaults( //wedefaulttoa600mstimeoutforprimary HystrixCommandProperties.Setter().withExecutionTimeoutInMilliseconds(600))); this.id=id; } @Override protectedStringrun(){ //performexpensive'primary'servicecall return"responseFromPrimary-"+id; } } privatestaticclassSecondaryCommandextendsHystrixCommand<String>{ privatefinalintid; privateSecondaryCommand(intid){ super(Setter .withGroupKey(HystrixCommandGroupKey.Factory.asKey("SystemX")) .andCommandKey(HystrixCommandKey.Factory.asKey("SecondaryCommand")) .andThreadPoolKey(HystrixThreadPoolKey.Factory.asKey("SecondaryCommand")) .andCommandPropertiesDefaults( //wedefaulttoa100mstimeoutforsecondary HystrixCommandProperties.Setter().withExecutionTimeoutInMilliseconds(100))); this.id=id; } @Override protectedStringrun(){ //performfast'secondary'servicecall return"responseFromSecondary-"+id; } } publicstaticclassUnitTest{ @Test publicvoidtestPrimary(){ HystrixRequestContextcontext=HystrixRequestContext.initializeContext(); try{ //将属性"primarySecondary.usePrimary"设置为true,则走PrimaryCommand;设置为false,则走SecondaryCommand ConfigurationManager.getConfigInstance().setProperty("primarySecondary.usePrimary",true); assertEquals("responseFromPrimary-20",newCommandFacadeWithPrimarySecondary(20).execute()); }finally{ context.shutdown(); ConfigurationManager.getConfigInstance().clear(); } } @Test publicvoidtestSecondary(){ HystrixRequestContextcontext=HystrixRequestContext.initializeContext(); try{ //将属性"primarySecondary.usePrimary"设置为true,则走PrimaryCommand;设置为false,则走SecondaryCommand ConfigurationManager.getConfigInstance().setProperty("primarySecondary.usePrimary",false); assertEquals("responseFromSecondary-20",newCommandFacadeWithPrimarySecondary(20).execute()); }finally{ context.shutdown(); ConfigurationManager.getConfigInstance().clear(); } } } } 三、总结 降级的处理方式,返回默认值,返回缓存里面的值(包括远程缓存比如redis和本地缓存比如jvmcache)。 但回退的处理方式也有不适合的场景: 1、写操作 2、批处理 3、计算 以上几种情况如果失败,则程序就要将错误返回给调用者。 参考资料:https://github.com/Netflix/Hystrix/wiki

优秀的个人博客,低调大师

Dubbo (二) ——- 项目结构解析

本文主要说明点 概述 背景 需求 架构 Dubbo源代码项目结构 概述 分享Dubbo 的项目结构,通过本文可以大致了解到Dubbo整个项目的结构 背景 将一个项目进行拆分, 进行分布式架构。 需要解决下面的问题 单一应用架构 网站流量少时单一架构,简化开发。此时,用于简化增删改查工作量的数据访问框架(ORM)是关键。 垂直应用架构 访问大时单一应用速度过小,需要进行应用拆分。此时,用于加速前端页面开发的Web框架(MVC)是关键。 分布式服务架构 当垂直应用过多,将核心业务独立服务。然后提供给其他项目内部调用。此时,用于提高业务复用及整合的分布式服务框架(RPC)是关键。 流动计算架构 当服务更多的时候,对流量的控制,服务的限流,熔断等操作。而且还需要管理集群容量,提供集群利用率。此时,用于提高机器利用率的资源调度和治理中心(SOA)是关键。 需求 dubbo解决下面几个需求 当服务越来越多时,服务 URL 配置管理变得非常困难,F5 硬件负载均衡器的单点压力也越来越大 服务间依赖关系变得错踪复杂,甚至分不清哪个应用要在哪个应用之前启动 服务的调用量越来越大,服务的容量问题就暴露出来机器管理,流量的控制等 架构 节点角色说明 节点角色说明 Provider暴露服务的服务提供方 Consumer调用远程服务的服务消费方 Registry服务注册与发现的注册中心 Monitor统计服务的调用次数和调用时间的监控中心 Container服务运行容器 调用关系说明 服务容器负责启动,加载,运行服务提供者 服务提供者在启动时,向注册中心注册自己提供的服务 服务消费者在启动时,向注册中心订阅自己所需的服务。 注册中心返回服务提供者地址列表给消费者,如果有变更,注册中心将基于长连接推送变更数据给消费者。 服务消费者,从提供者地址列表中,基于软负载均衡算法,选一台提供者进行调用,如果调用失败,再选另一台调用。 服务消费者和提供者,在内存中累计调用次数和调用时间,定时每分钟发送一次统计数据到监控中心。 Dubbo 架构 下面特点 连通性、健壮性、伸缩性、以及向未来架构的升级性 连通性 注册中心负责服务地址的注册与查找,相当于目录服务,服务提供者和消费者只在启动时与注册中心交互,注册中心不转发请求,压力较小 监控中心负责统计各服务调用次数,调用时间等,统计先在内存汇总后每分钟一次发送到监控中心服务器,并以报表展示 服务提供者向注册中心注册其提供的服务,并汇报调用时间到监控中心,此时间不包含网络开销 服务消费者向注册中心获取服务提供者地址列表,并根据负载算法直接调用提供者,同时汇报调用时间到监控中心,此时间包含网络开销 注册中心,服务提供者,服务消费者三者之间均为长连接,监控中心除外 注册中心通过长连接感知服务提供者的存在,服务提供者宕机,注册中心将立即推送事件通知消费者 注册中心和监控中心全部宕机,不影响已运行的提供者和消费者,消费者在本地缓存了提供者列表 注册中心和监控中心都是可选的,服务消费者可以直连服务提供者 健壮性 监控中心宕掉不影响使用,只是丢失部分采样数据 数据库宕掉后,注册中心仍能通过缓存提供服务列表查询,但不能注册新服务 注册中心对等集群,任意一台宕掉后,将自动切换到另一台 注册中心全部宕掉后,服务提供者和服务消费者仍能通过本地缓存通讯 服务提供者无状态,任意一台宕掉后,不影响使用 服务提供者全部宕掉后,服务消费者应用将无法使用,并无限次重连等待服务提供者恢复 伸缩性 注册中心为对等集群,可动态增加机器部署实例,所有客户端将自动发现新的注册中心 服务提供者无状态,可动态增加机器部署实例,注册中心将推送新的服务提供者信息给消费者 升级性 需要实现动态部署,进行流动计算 下图是未来可能的一种架构 节点角色说明 节点角色说明 Deployer自动部署服务的本地代理 Repository仓库用于存储服务应用发布包 Scheduler调度中心基于访问压力自动增减服务提供者 Admin统一管理控制台 Registry服务注册与发现的注册中心 Monitor统计服务的调用次数和调用时间的监控中心 Dubbo源代码项目结构 **模块分包 ** 每个模块都是相互隔离的,可插拔的。下面的这个图是模块引用图 下面对着这些模块做个简单介绍 **dubbo-common ** 公共逻辑模块:包括 Util 类和通用模型。 **dubbo-remoting ** 远程通讯模块:相当于 Dubbo 协议的实现,如果 RPC 用 RMI协议则不需要使用此包。 dubbo-rpc ** 远程调用模块**:抽象各种协议,以及动态代理,只包含一对一的调用,不关心集群的管理。 dubbo-cluster ** 集群模块**:将多个服务提供方伪装为一个提供方, 包括:负载均衡, 容错,路由等,集群的地址列表可以是静态配置的,也可以是由注册中心下发。 **dubbo-registry ** 注册中心模块:基于注册中心下发地址的集群方式,以及对各种注册中心的抽象 dubbo-monitor ** 监控模块**:统计服务调用次数,调用时间的,调用链跟踪的服务。 **dubbo-config ** 配置模块:是 Dubbo 对外的 API,用户通过 Config 使用D ubbo,隐藏 Dubbo 所有细节。 **dubbo-container ** 容器模块:是一个 Standlone 的容器,以简单的 Main 加载 Spring 启动, 因为服务通常不需要 Tomcat/JBoss 等 Web 容器的特性,没必要用 Web 容器去加载服务。 整体上按照分层结构进行分包,与分层的不同点在于: container 为服务容器,用于部署运行服务,没有在层中画出。 protocol 层和 proxy 层都放在 rpc 模块中,这两层是 rpc 的核心,在不需要集群也就是只有一个提供者时,可以只使用这两层完成 rpc 调用。 transport 层和 exchange 层都放在 remoting 模块中,为 rpc 调用的通讯基础。 serialize 层放在 common 模块中,以便更大程度复用。 依赖关系 图例说明: 图中小方块 Protocol, Cluster, Proxy, Service, Container, Registry, Monitor 代表层或模块,蓝色的表示与业务有交互,绿色的表示只对 Dubbo 内部交互。 图中背景方块 Consumer, Provider, Registry, Monitor 代表部署逻辑拓扑节点。 图中蓝色虚线为初始化时调用,红色虚线为运行时异步调用,红色实线为运行时同步调用。 图中只包含 RPC 的层,不包含 Remoting 的层,Remoting 整体都隐含在 Protocol 中。 下面对各个模块进行分解介绍 dubbo-common 公共逻辑模块:包括 Util 类和通用模型。 作用提供一些工具类和通用模型例如com.alibaba.dubbo.common.URL: dubbo-remoting 远程通讯模块:相当于 Dubbo 协议的实现,如果 RPC 用 RMI协议则不需要使用此包。 dubbo-remoting-zookeeper 相当于 Zookeeper 客户端,与ZK 服务器通信 dubbo-remoting-api 定义Dubbo CLient和 Dubbo Server的接口规则 实现dubbo-remoting-api dubbo-remoting-grizzly,基于Grizzly实现。 dubbo-remoting-http,基于Jetty或Tomcat实现。 dubbo-remoting-mina,基于Mina实现。 dubbo-remoting-netty,基于Netty 3实现。 dubbo-remoting-netty4,基于Netty 4实现。 dubbo-remoting-p2p,P2P 服务器。注册中心dubbo-registry-multicast项目的使用该项目。 dubbo-rpc 远程调用模块:抽象各种协议,以及动态代理,只包含一对一的调用,不关心集群的管理 集群相关的管理,由dubbo-cluster提供特性 dubbo-rpc-api 抽象各种协议以及动态代理,实现了一对一的调用。 其他模块,实现dubbo-rpc-api,提供对应的协议实现 协议参考手册 dubbo-rpc-default 对应dubbo://协议。 dubbo-cluster 集群模块:将多个服务提供方伪装为一个提供方,包括:负载均衡, 集群容错,路由,分组聚合等。集群的地址列表可以是静态配置的,也可以是由注册中心下发。 ​ 注册中心下发,由dubbo-registry提供特性。 容错 com.alibaba.dubbo.rpc.cluster.Cluster接口 +com.alibaba.dubbo.rpc.cluster.support包。 Cluster 将 Directory 中的多个 Invoker 伪装成一个 Invoker,对上层透明,伪装过程包含了容错逻辑,调用失败后,重试另一个。 拓展参见《Dubbo 用户指南 —— 集群容错》和《Dubbo 开发指南 —— 集群扩展》文档。 目录 com.alibaba.dubbo.rpc.cluster.Directory接口 +com.alibaba.dubbo.rpc.cluster.directory包。 Directory 代表了多个 Invoker ,可以把它看成 List ,但与 List 不同的是,它的值可能是动态变化的,比如注册中心推送变更。 路由 com.alibaba.dubbo.rpc.cluster.Router接口 +com.alibaba.dubbo.rpc.cluster.router包。 负责从多个Invoker中按路由规则选出子集,比如读写分离,应用隔离等。 拓展参见《Dubbo 用户指南 —— 路由规则》和《Dubbo 开发指南 —— 路由拓展》文档。 配置 com.alibaba.dubbo.rpc.cluster.Configurator接口 +com.alibaba.dubbo.rpc.cluster.configurator包。 拓展参见《Dubbo 用户指南 —— 配置规则》文档。 负载均衡 com.alibaba.dubbo.rpc.cluster.LoadBalance接口 +com.alibaba.dubbo.rpc.cluster.loadbalance包。 LoadBalance 负责从多个 Invoker 中选出具体的一个用于本次调用,选的过程包含了负载均衡算法,调用失败后,需要重选。 拓展参见《Dubbo 用户指南 —— 负载均衡》和《Dubbo 开发指南 —— 负载均衡拓展》文档。 合并结果 com.alibaba.dubbo.rpc.cluster.Merger接口 +com.alibaba.dubbo.rpc.cluster.merger包。 合并返回结果,用于分组聚合。 拓展参见《Dubbo 用户指南 —— 分组聚合》和《Dubbo 开发指南 —— 合并结果扩展》文档。 整体流程如下: dubbo-registry 注册中心模块:基于注册中心下发地址的集群方式,以及对各种注册中心的抽象。 dubbo-registry-api,抽象注册中心的注册与发现接口。 其他模块,实现dubbo-registry-api,提供对应的注册中心实现。在《用户指南 —— 注册中心参考手册》中,可以看到每种注册中心的介绍。 另外,dubbo-registry-default对应 Simple 注册中心。 拓展参见《Dubbo 开发指南 —— 注册中心扩展》文档。 dubbo-monitor 监控模块:统计服务调用次数,调用时间的,调用链跟踪的服务 拓展参见《Dubbo 开发指南 —— 监控中心扩展》。 dubbo-config 配置模块:是 Dubbo 对外的 API,用户通过 Config 使用Dubbo,隐藏 Dubbo 所有细节。 dubbo-config-api,实现了API 配置和属性配置功能。 dubbo-config-spring,实现了XML 配置和注解配置功能。 dubbo-container 容器模块:是一个 Standlone 的容器,以简单的 Main 加载 Spring 启动, 因为服务通常不需要 Tomcat/JBoss 等 Web 容器的特性,没必要用 Web 容器去加载服务。 dubbo-container-api:定义了com.alibaba.dubbo.container.Container接口,并提供 加载所有容器启动的 Main 类。 实现 dubbo-container-api dubbo-container-spring,提供了com.alibaba.dubbo.container.spring.SpringContainer。 dubbo-container-log4j,提供了com.alibaba.dubbo.container.log4j.Log4jContainer。 dubbo-container-logback,提供了com.alibaba.dubbo.container.logback.LogbackContainer。 拓展参考《Dubbo 用户指南 —— 服务容器》和《Dubbo 开发指南 —— 容器扩展》文档。 dubbo-filter 过滤器模块:提供了内置的过滤器。 dubbo-filter-cache ,缓存过滤器。 拓展参考《Dubbo 用户指南 —— 结果缓存》和《Dubbo 开发指南 —— 缓存拓展》文档。 dubbo-filter-validation ,参数验证过滤器。 拓展参考《Dubbo 用户指南 —— 参数验证》和《Dubbo 开发指南 —— 验证扩展》文档。 dubbo-plugin 过滤器模块:提供了内置的插件。 dubbo-qos ,提供在线运维命令。 拓展参考《Dubbo 用户指南 —— 新版本 telnet 命令使用说明》和《Dubbo 开发指南 —— Telnet 命令扩展》文档。 hessian-lite hessian-lite:Dubbo 对Hessian 2的序列化部分的精简、改进、BugFix 。 提交历史如下: dubbo-demo dubbo-demo快速启动示例。 参见《Dubbo 用户指南 —— 快速启动》文档。 dubbo-test dubbo-test测试模块。 在此我向大家推荐一个架构学习交流群。交流学习群号:821169538 里面会分享一些资深架构师录制的视频录像:有Spring,MyBatis,Netty源码分析,高并发、高性能、分布式、微服务架构的原理,JVM性能优化、分布式架构等这些成为架构师必备的知识体系。还能领取免费的学习资源,目前受益良多。 dubbo-test-benchmark ,性能测试。 dubbo-test-compatibility ,兼容性测试。 dubbo-test-spring3,测试对 Spring 3 的兼容性。 dubbo-test-example,使用示例。 Maven POM dubbo-dependencies-bom dubbo-dependencies-bom/pom.xml,Maven BOM(Bill Of Materials) ,统一定义了 Dubbo 依赖的三方库的版本号: dubbo-parent会引入该 BOM : dubbo-bom dubbo-bom/pom.xml,Maven BOM(Bill Of Materials) ,统一定义了 Dubbo 的版本号: dubbo-parent dubbo/pom.xml,Dubbo Parent Pom 。 Dubbo 的 Maven 模块,都会引入该 pom 文件。以dubbo-cluster举例子: 出处:http://wsccoder.top/2018/10/15/Dubb

优秀的个人博客,低调大师

深度解析volatile—底层实现

我们都知道,Java关键字volatile的作用 1、内存可见性 2、禁止指令重排序 可见性是指,在多线程环境,共享变量的操作对于每个线程来说,都是内存可见的,也就是每个线程获取的volatile变量都是最新值;并且每个线程对volatile变量的修改,都直接刷新到主存。 下面重点介绍指令重排序。 为什么要指令重排序? 为了提高程序执行的性能,编译器和执行器(处理器)通常会对指令做一些优化(重排序) 1、编译器重排序。编译器在不改变单线程程序语义的前提下,可以重新安排语句的执行顺序; 2、处理器重排序。如果不存在数据依赖性,处理器可以改变语句对应机器指令的执行顺序; 学过《编译原理》同学应该知道,现代高级编程语言的编译器,实现都很复杂。 编译器基本构造包括:语法分析、词法分析、语义分析、中间代码生成、指令优化、目标代码产生。 第一阶段:编译器优化,就是发生在编译阶段,就Java而言,就是java源码编译生成class字节码的时候,对编译生成的中间代码进行的一次指令优化。Java的编译器是javac.exe。 第二阶段:执行器(处理器)优化,和不同的处理器硬件厂商的实现有关,也和Java的执行器(java.exe,也称Java解释器)有关。执行器优化,是对于机器指令在目标平台的机器上运行,做的一层优化。 我们知道,现代高级编程语言,经过编译后,产生目标代码,如.java的源文件编译后生成.class字节码文件,.cpp源文件经过C++编译器编译后生成.o对象文件。 这些编译后生成的文件,不能直接在机器上运行,而是需要转化成特定平台的机器指令。机器能够运行的指令,是需要这个平台、这个机器能正确识别的。 相同的一份源码,最终转化成不同平台上的机器指令,是不同的。 这也更容易理解:汇编指令,并不是跨平台的。Windows下通常使用Intel汇编,而Linux下多用AT&T汇编,它们在语法上存在差异,运行效果也依赖于各自平台的实现。 在Java中,为了提高运行效率,javac编译器,和java解释器,在2个阶段分别对指令进行了优化,也就是重排序。 Java重排序的前提:在不影响 单线程运行结果的前提下进行重排序。也就是在单线程环境运行,重排序后的结果和重排序之前按代码顺序运行的结果相同。 指令重排序对单线程没有什么影响,它不会影响程序的运行结果,但是会影响多线程的正确性。 Java因为指令重排序,优化我们的代码,让程序运行更快,也随之带来了多线程下,指令执行顺序的不可控。既然指令重排序会影响到多线程执行的正确性,那么我们就需要某些情景下禁止重排序。Java提供给我们禁止重排序能力的操作——就是volatile。 那么JVM的volatile是如何禁止重排序的呢? 在具体探究之前,我们先看另一个原则happens-before,happen-before原则保证了程序的“有序性”,它规定如果两个操作的执行顺序无法从happens-before原则中推到出来,那么他们就不能保证有序性,可以随意进行重排序。其定义如下: 1、同一个线程中的,前面的操作 happen-before 后续的操作。(即单线程内按代码顺序执行。但是,在不影响在单线程环境执行结果的前提下,编译器和处理器可以进行重排序,这是合法的。换句话说,这一是规则无法保证编译重排和指令重排)。 2、监视器上的解锁操作 happen-before 其后续的加锁操作。(Synchronized 规则) 3、对volatile变量的写操作 happen-before 后续的读操作。(volatile 规则) 4、线程的start() 方法 happen-before 该线程所有的后续操作。(线程启动规则) 5、线程所有的操作 happen-before 其他线程在该线程上调用 join 返回成功后的操作。 6、如果 a happen-before b,b happen-before c,则a happen-before c(传递性)。 在JVM中,将Happens-Before的程序顺序规则与其他某个顺序规则(通常是监视器锁规则、volatile变量规则)结合起来,从而对某个未被锁保护的变量的访问操作进行排序。 我们着重看第三点volatile规则:对volatile变量的写操作 happen-before 后续的读操作。为了实现volatile内存语义,JMM会重排序,其规则如下: 是否重排序 第二个操作 第一个操作 普通读/写 volatile读 volatile写 普通读/写 volatile读 NO NO NO volatile写 NO NO 为了探究volatile底层的实现原理,进行了如下探究。 通过javap 命令,将字节码文件反编译。观察反编译的结果,对于volatile修饰的变量,发现反编译得到的代码并没有什么帮助,和不加volatile修饰的变量没有任何区别。也就是说,字节码层面volatile变量并没有什么不同。 下面通过查看Java的汇编指令,查看Java代码最真实的运行细节。 如何查看Java的汇编指令,可以阅读:https://www.jianshu.com/p/93821b08e774 通过使用-XX:+UnlockDiagnosticVMOptions -XX:+PrintAssembly IDEA打印出了源代码的汇编指令。我们看到红色线框里面的那行指令:putstatic a ,将静态变量a入栈,注意观察add指令前面有一个lock前缀指令。 加入volatile关键字和没有加入volatile关键字时所生成的汇编代码发现,加入volatile关键字时,会多出一个lock前缀指令。我们发现,volatile变量在字节码级别没有任何区别,在汇编级别使用了lock指令前缀。 lock是一个指令前缀,Intel的手册上对其的解释是: Causes the processor's LOCK# signal to be asserted during execution of the accompanying instruction (turns the instruction into an atomic instruction). In a multiprocessor environment, the LOCK# signal insures that the processor has exclusive use of any shared memory while the signal is asserted. 简单理解也就是说,lock后就是一个原子操作。原子操作是指不会被线程调度机制打断的操作;这种操作一旦开始,就一直运行到结束,中间不会有任何 context switch (切换到另一个线程)。 当使用 LOCK 指令前缀时,它会使 CPU 宣告一个 LOCK# 信号,这样就能确保在多处理器系统或多线程竞争的环境下互斥地使用这个内存地址。当指令执行完毕,这个锁定动作也就会消失。 是不是感觉有点像Java的synchronized锁。但volatile底层使用多核处理器实现的lock指令,更底层,消耗代价更小。 因此有人将Java的synchronized看作重量级的锁,而volatile看作轻量级的锁 并不是全无道理。 lock前缀指令其实就相当于一个内存屏障。内存屏障是一组CPU处理指令,用来实现对内存操作的顺序限制。volatile的底层就是通过内存屏障来实现的。 编译器和执行器 可以在保证输出结果一样的情况下对指令重排序,使性能得到优化。插入一个内存屏障,相当于告诉CPU和编译器先于这个命令的必须先执行,后于这个命令的必须后执行。正如去西藏途中各个站点的先后顺序在你心中都一清二楚。 内存屏障另一个作用是强制更新一次不同CPU的缓存。例如,一个写屏障会把这个屏障前写入的数据刷新到缓存,这样任何试图读取该数据的线程将得到最新值,而不用考虑到底是被哪个cpu核心或者哪个CPU执行的。这正是volatile实现内存可见性的基础。 内存屏障细说来有写屏障、读屏障、读写屏障,而且内存屏障的实现依赖于编译器和机器两部分。 编译器在编译过程中可能会对指令重排序,这样开发者通过显式地标注告知编译器,避免编译器最终生成的代码行为违背预期,对于 Java 而言,不光生成的 bytecode 需要保存 volatile 的语义,连运行时的 JIT 代码的行为也要遵守相应的约束;即插入内存屏障后,告诉CPU和编译器先于这个命令的必须先执行,后于这个命令的必须后执行,从而实现了禁止重排序。 关于内存屏障的一些具体细节,大佬Martin写了一篇文章《going into memory barriers》介绍,外网可以看看。 小结: 1、Java重排序的前提:在不影响 单线程运行结果的前提下进行重排序。也就是在单线程环境运行,重排序后的结果和重排序之前按代码顺序运行的结果相同。 2、指令重排序对单线程没有什么影响,它不会影响程序的运行结果,反而会优化执行性能,但会影响多线程的正确性。 3、Java因为指令重排序,优化我们的代码,让程序运行更快,也随之带来了多线程下,指令执行顺序的不可控。 4、volatile的底层是通过lock前缀指令、内存屏障来实现的。 存档文章 查看Java的汇编指令 终于有人把Java内存模型(JMM)说清楚了 JVM体系结构-----深入理解内存结构 从多核硬件架构,看Java内存模型

优秀的个人博客,低调大师

Java Hashtable类源码解析

老生常谈的问题——Hashtable和HashMap有什么区别 大家一般都能说出几条,比如Hashtable是线程安全的,不支持null作为key和value值等等。那么,要仔细了解这个问题还是直接从Hashtable的源码入手。 先列一下我找到的区别: 继承类不同,Hashtable继承的是Dictionary这是一个废弃类,而HashMap继承的是AbstractMap 产生时间不同,Hashtable自JDK1.0版本就有了,而HashMap是JDK1.2才加入的,同时Hashtable可能因为历史原因并不是我们习惯的驼峰法命名的 Hashtable比HashMap多提供了elments()方法用于返回此Hashtable中的value的枚举 Hashtable既不支持null key也不支持null value Hashtable的默认大小是11,扩大的逻辑是*2+1,对于给定大小不会做扩展。而HashMap是16,扩大时*2,初始大小会转换成恰好大于等于的2的指数次幂 Hashtable中的遍历操作是从高位开始的,而HashMap是从低位开始 Hashtable处理冲突元素时插入到链表头部,而HashMap是插入到链表尾部 Hashtable的hashcode方法计算所有entry的hashcode总和,HashMap没有这样的方法,同时HashMap在计算hash值时会用高位右移16位与低位异或来打散散列值,避免位与操作造成冲突过多 Hashtable每一次定位都要做一次完整的除法取余数,而HashMap使用的是与数组大小-1的位与计算,效率高很多 Hashtable的方法都加上了synchronized是线程安全的方法,而HashMap不是,所以单线程时前者额外开销很大。JDK8以后Hashtable也用了modCount来保证在遍历过程中其他线程修改对象的fast-fail机制。但是,即使是多线程环境下,依然应该优先选择对HashMap进行一些特殊处理而不是用Hashtable,因为所有方法都加上synchronized的程序并发性很差。实际上就我个人经验而言,在一些特定的具体情况下,比如大规模写入key值连续数据(出自今年的第四届阿里中间件性能挑战赛复赛题),链表法解决冲突性能可能不如开放地址法,即使加上了红黑树。所以说对于一些对极致压榨性能的情况下,适当的可以抛弃一些通用的集合而尝试自由发挥造轮子。 首先从最上方的注释中可以看到Hashtable自JDK1.0版本就有了,而HashMap是JDK1.2才加入的。观察一下类的声明,我们可以看到他们继承的类也是不同的,Hashtable继承的是Dictionary, Dictionary这个类从注释上写着已经是obsolete被废弃了,所以连带Hashtable也基本不用了 。 Hashtable 也有元素个数,数组大小,负载因子这些属性,不用元素个数用的是 count 不是 size 。也是使用链表法来解决冲突。 public class Hashtable<K,V> extends Dictionary<K,V> implements Map<K,V>, Cloneable, java.io.Serializable public class HashMap<K,V> extends AbstractMap<K,V> implements Map<K,V>, Cloneable, Serializable 构造函数可以看出默认大小是 11,同时初始大小给定多少初始数组就多大,不会做扩展到2的指数次幂这样的操作。 threshold=initialCapacity*loadFactor 这点和 HashMap 相同。 public Hashtable(int initialCapacity, float loadFactor) { if (initialCapacity < 0) throw new IllegalArgumentException("Illegal Capacity: "+ initialCapacity); if (loadFactor <= 0 || Float.isNaN(loadFactor)) throw new IllegalArgumentException("Illegal Load: "+loadFactor); if (initialCapacity==0) initialCapacity = 1; this.loadFactor = loadFactor; table = new Entry<?,?>[initialCapacity]; threshold = (int)Math.min(initialCapacity * loadFactor, MAX_ARRAY_SIZE + 1); } public Hashtable() { this(11, 0.75f); } contains 这个方法是从表尾开始向前搜索的,同时也没有使用 ==来比较 public synchronized boolean contains(Object value) { if (value == null) { throw new NullPointerException(); } Entry<?,?> tab[] = table; for (int i = tab.length ; i-- > 0 ;) { for (Entry<?,?> e = tab[i] ; e != null ; e = e.next) { if (e.value.equals(value)) { return true; } } } return false; } 从 containsKey 可以看出, Hashtable的index计算逻辑是使用key.hashCode()的后31位然后除以tab.length 取余数。 HashMap 的那种按位与的操作仅当操作数低位全是 1 时才等价为取余操作,也就是 2 的指数次幂 -1 才可成立,这样做计算速度比除法快很多,不过冲突数量会增加,所以加入了一些打散的设计比如hashCode高位与低位异或。 public synchronized boolean containsKey(Object key) { Entry<?,?> tab[] = table; int hash = key.hashCode(); int index = (hash & 0x7FFFFFFF) % tab.length; for (Entry<?,?> e = tab[index] ; e != null ; e = e.next) { if ((e.hash == hash) && e.key.equals(key)) { return true; } } return false; } 扩展方法rehash的 扩大方式是旧数组大小*2+1 ,而HashMap是*2,要重新计算每一个的index所以效率低,同时冲突时将 后面的元素插入到前面元素的前一位 ,所以会改变顺序 protected void rehash() { int oldCapacity = table.length; Entry<?,?>[] oldMap = table; // overflow-conscious code int newCapacity = (oldCapacity << 1) + 1;//新大小=旧大小*2+1 if (newCapacity - MAX_ARRAY_SIZE > 0) { if (oldCapacity == MAX_ARRAY_SIZE) // Keep running with MAX_ARRAY_SIZE buckets return; newCapacity = MAX_ARRAY_SIZE; } Entry<?,?>[] newMap = new Entry<?,?>[newCapacity];//创建一个新的数组 modCount++; threshold = (int)Math.min(newCapacity * loadFactor, MAX_ARRAY_SIZE + 1); table = newMap; for (int i = oldCapacity ; i-- > 0 ;) { for (Entry<K,V> old = (Entry<K,V>)oldMap[i] ; old != null ; ) { Entry<K,V> e = old; old = old.next; int index = (e.hash & 0x7FFFFFFF) % newCapacity;//重新计算每一个元素的index e.next = (Entry<K,V>)newMap[index];//前后元素有冲突时,后面的元素插入到前面元素的前面 newMap[index] = e; } } } 对于插入结点同样要先检查是否存在key值相同的点,存在则不插入,然后检查是否需要扩展数组,插入时如果发生冲突,也是将要 插入的元素放在链表的首位 ,而putVal方法是放入尾部的。同时,可以看到Hashtable是 不支持null作为key或value值的 public synchronized V put(K key, V value) { // Make sure the value is not null if (value == null) {//value为null直接报错 throw new NullPointerException(); } // Makes sure the key is not already in the hashtable. Entry<?,?> tab[] = table; int hash = key.hashCode();//若key为null这里会报错 int index = (hash & 0x7FFFFFFF) % tab.length; @SuppressWarnings("unchecked") Entry<K,V> entry = (Entry<K,V>)tab[index]; for(; entry != null ; entry = entry.next) { if ((entry.hash == hash) && entry.key.equals(key)) { V old = entry.value; entry.value = value; return old; } } addEntry(hash, key, value, index); return null; } private void addEntry(int hash, K key, V value, int index) { modCount++; Entry<?,?> tab[] = table; if (count >= threshold) { // Rehash the table if the threshold is exceeded rehash(); tab = table; hash = key.hashCode(); index = (hash & 0x7FFFFFFF) % tab.length; } // Creates the new entry. @SuppressWarnings("unchecked") Entry<K,V> e = (Entry<K,V>) tab[index]; tab[index] = new Entry<>(hash, key, value, e); count++; }Hashtable的 hashcode方法计算所有entry的hash值总和 public synchronized int hashCode() { int h = 0; if (count == 0 || loadFactor < 0) return h; // Returns zero loadFactor = -loadFactor; // Mark hashCode computation in progress Entry<?,?>[] tab = table; for (Entry<?,?> entry : tab) { while (entry != null) { h += entry.hashCode(); entry = entry.next; } } loadFactor = -loadFactor; // Mark hashCode computation complete return h; } elements 这个方法是Hashtable多出来的, 返回所有value值的枚举 public synchronized Enumeration<V> elements() { return this.<V>getEnumeration(VALUES); }我们可以注意到,Hashtable的 方法都加上了synchronized,他们是线程安全的,但是对于本身是线程安全的情况就会大幅度影响性能,JDK8开始引入modCount来作为fast-fail机制,防止其他线程的非synchronzied方法对Hashtable进行修改。

优秀的个人博客,低调大师

Java LinkedList类源码解析

LinkedList底层为双向链表同样继承了AbstractSequentialList<E>,跟ArrayList的数组相比读取效率低,不支持随机读取,碎片化空间利用率高,平均随机插入效率相对高。同时可以用来实现queue。属性有: transient int size = 0;list大小 transient Node<E> first;头指针 transient Node<E> last;尾指针 private void linkFirst(E e) void linkLast(E e) 将e添加到链表的头部和尾部,size与modCount加一 void linkBefore(E e, Node<E> succ)将e插入到succ结点之前 private E unlinkFirst(Node<E> f) private E unlinkLast(Node<E> l) 移除头部或尾部结点,size减1,modCount加1,将移除结点的next prev item值都设为null以触发gc E unlink(Node<E> x)移除结点x,需要再判断有无前驱和后驱结点,若没有则要改变头尾指针,同样将移除结点的next prev item值都设为null以触发gc public E getFirst() public E getLast() 返回first或last指向的结点,链表为空时抛错 public E removeFirst() public E removeLast() 调用unlinkLast移除并返回头部或尾部的结点,链表为空时抛错 public void addFirst(E e)调用linkFirst(e),将元素插入到头部 public void addLast(E e) public boolean add(E e) 两个方法都是调用linkLast(e),除了返回值外是等价的 public boolean remove(Object o)o==null时,通过unlink方法移除所有x==null的元素,否则移除o.equals(x)的元素,每有一个符合的元素就调用一次unlink所以modCount的增加值为移除元素的个数 public boolean addAll(int index, Collection<? extends E> c)将c中的集合插入到index位置。首先检查index是否符合链表长度范围,若c中没有元素则直接返回false,否则遍历c中的元素产生新的结点并链接到index指向位置,检查是否需要修改first和last的位置,最后修改size和modCount++ public void clear()遍历所有结点,将last prev item全部设为null,size为0,modCount++ public E set(int index, E element)检查index范围后设置为item=element,不会改变modCount public void add(int index, E element)检查index范围,若index==size即插入再末尾,调用linkLast(element),否则调用linkBefore(element, node(index))因此会造成modCount++ public E remove(int index) 检查index范围,index >= 0 && index < size则调用unlink(node(index))移除元素,modCount++ Node<E> node(int index)返回index下标的结点,若index超过size的一半则从last开始向头寻找,否则从first开始向后寻找 public int indexOf(Object o)寻找与o相等的下标最小的链表元素,若没有则返回-1,比较逻辑依然根据o是否是null来区分 public int lastIndexOf(Object o)从尾部开始搜索第一个符合条件的元素下标,和上面一个方法类似 public E peek()返回first指向结点的item,若为空则返回null public E element()也是返回first.item,区别是为空会抛错 public E poll()在peek()的基础上,若不为null会删除第一个元素 public boolean offer(E e)同add(e) public boolean offerFirst(E e)同addFirst public boolean offerLast(E e)同addLast public E peekFirst()同peek() public E peekLast()返回尾部元素,为空则返回null public E pollFirst()同poll() public E pollLast()返回尾部元素,为空则返回null,不为空移除尾部元素 public void push(E e)将e添加到头部 public E pop()移除头部元素 public boolean removeFirstOccurrence(Object o)同remove(o) public boolean removeLastOccurrence(Object o)移除最后一个与o相等的元素 public Object[] toArray()新建一个数组,遍历链表将元素复制到数组中 private void writeObject(java.io.ObjectOutputStream s) private void readObject(java.io.ObjectInputStream s) 序列化的方式和ArrayList相同,是通过对象输入输出流来完成,输入时调用linkLast将读取到的元素加入链表末尾个人GitHub地址: https://github.com/GrayWind33

优秀的个人博客,低调大师

Java String类源码解析

String直接继承Object 含有一个char[] value,还有一个int hash默认值为0 new String()的构造产生的是一个值为””的字符数组 String(char value[], int offset, int count)当count=0且offset<=value.length时构造一个值为””的字符串。offset>0且offset+count<=value.length时复制该部分子串。其余情况都会抛错。 字符数据类型是一个采用UTF-16编码表示Unicode代码点的代码单元。大多数的常用Unicode字符使用一个代码单元就可以表示,而辅助字符需要一对代码单元表示。而length返回的是UTF-16下的代码单元的数量,而codePointCount返回的是代码点的数量。对于大部分人工输入的字符,这两者是相等的,会出现length比codePointCount长的通常是某些数学或者机器符号,需要两个代码单元来表示一个代码点。 对于返回char[]的方法,底层调用的是System.arraycopy方法,这也是高效的数组拷贝函数。 getBytes方法会调用StringCoding.encode返回序列化后的byte[] 关于String a == String b的判断,是指a和b指向内存中的同一个对象,凡是new String初始化的对象,都不会产生a==b的情况,因为他会新开辟一个对象空间,然后复制value的值,仅当b=a初始化时a==b成立。 public static void main(String args[]) { String a, b; a = "123"; b = "123"; System.out.println(a==b);//true a = "123"; b = new String("123"); System.out.println(a==b);//false a = new String("123"); b = new String("123"); System.out.println(a==b);//false a = "123"; b = new String(a); System.out.println(a==b);//false a = new String("123"); b = a; System.out.println(a==b);//true } 而a.equals(b)先判断a == b是否成立,再判断b是否是String类,然后逐个比较value数组的值是否相等。equalsIgnoreCase在此基础上忽略大小写的区别 a.compareTo(b)比较a和b第一个不相等字符的差值,若都相等则比较长度差值。compareToIgnoreCase多一个忽略大小写的区别。regionMatches(int toffset, String other, int ooffset, int len)则是比较a从toffset开始和other从ooffset开始长度为len的部分是否相等。 startsWith(String prefix, int toffset)字符串从tooffset位置开始和prefix是否相等。endsWith(String suffix)字符串结尾和suffix等长部分是否相等。 hashCode()调用时,若hash值为0且字符串长度不为0,则要计算hash值,方法是value数组化为31进制 indexOf是返回第一个出现的指定值的位置,可以通过fromIndex来指定开始查找的位置,而indexOfSupplementary是忽略大小写的该方法。lastIndexOf则是从尾部开始查找最后一个。 substring根据指定的位置返回一个新的子字符串,若指定位置不符合原字符串的长度,则抛错。 a.concat(String str)新建一个字符串内容是a+str并返回,不会修改a原本的值 public static void main(String args[]) { String a, b; a = "123"; b = "123"; a.concat(b); System.out.println(a);//123 System.out.println(a.concat(b));//123123 a = a.concat(b); System.out.println(a);//123123 } replace(char oldChar, char newChar)生成一个新的字符串,将原字符串中的oldChar字符全部替换为newChar,不会改变原字符串的值。replaceAll(String regex, String replacement)和前一个方法相比,参数regex是正则表达式,其余相同。 public static void main(String args[]) { String a; a = "12131"; a.replace("1", "a"); System.out.println(a);//12131 a = a.replace("1", "a"); System.out.println(a);//a2a3a } split(String regex, int limit)将字符串按照给定的正则表达式分割为字符串组,limit是分割产生的数组最大数量,对于多余部分不做分割全部保留在最后一个字符串中。 public static void main(String args[]) { String a; a = "1,2,3,4"; String[] b = a.split(","); for(String t : b){ System.out.print(t + " ");//1 2 3 4 } System.out.println(""); String[] c = a.split(",", 3); for(String t : c){ System.out.print(t + " ");//1 2 3,4 } } toCharArray()复制出一个新的char[]而不是直接返回value trim()生成一个新的字符串,去掉头部的所有空格 public native String intern()这个方法的作用是在常量池当中寻找是否已经存在该字符串,若已存在则返回该引用,若不存在则在常量池新建。从上面的源码分析中,我们可以看出String的所有操作都是返回一个新的字符串,对自身是没有修改的,String被设计为一个不可变的final对象,理由有以下几点: 1. 字符串常量池的需要。字符串常量池的诞生是为了提升效率和减少内存分配。、因为String的不可变性,常量池很容易被管理和优化。 2. 安全性考虑。正因为使用字符串的场景如此之多,所以设计成不可变可以有效的防止字符串被有意或者无意的篡改。(通过反射或者Unsafe直接操作内存的手段也可以实现对所谓不可变String的修改)。 3. 作为HashMap、HashTable等hash型数据key的必要。因为不可变的设计,jvm底层很容易在缓存String对象的时候缓存其hashcode,这样在执行效率上会大大提升。 public static void main(String args[]) { String a, b; a = "123"; b = new String(a).intern(); System.out.println(a == b);//true a = "12" + "3"; b = "123"; System.out.println(a == b);//true a = "12" + "3"; b = new String("123"); System.out.println(a == b);//false a = "12" + "3"; b = new String("123").intern(); System.out.println(a == b);//true a = new String("123"); b = a.intern(); System.out.println(a == b);//false } 从上面一段代码的运行结果我们可以看到,intern()会从常量池寻找指定的字符串,指向同一个常量池对象的时候,a==b就是成立的。这里说明一下最后一个case,首先常量池存在了”123”,然后a获得的引用是另一个”123”(因为是new String得到的对象),而b得到的是常量池中第一个”123”的引用,所以a!=b。对于字符串相加的操作"12" + "3",操作过后常量池内会有3个字符串,"12" "3" “123” 个人GitHub地址: https://github.com/GrayWind33

优秀的个人博客,低调大师

JDK动态代理源码解析

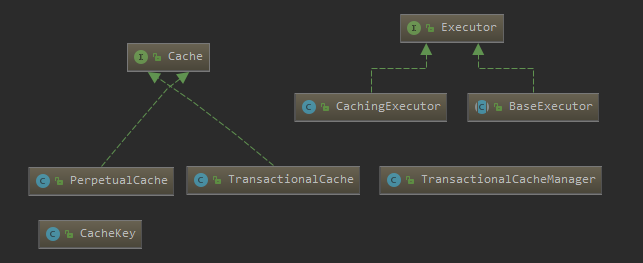
版权声明:本文为博主原创文章,未经博主允许不得转载。 https://blog.csdn.net/qq_34173549/article/details/80557290 分析版本jdk1.8 在分析jdk动态代理之前,先来了解java WeakReference弱引用的使用。运行期创建目标对象的代理非常耗时,使用缓存来存储生成的代理类显得尤为重要。jdk动态代理使用弱引用指向cache中的代理类,以便代理类对象能够被GC回收。 在java中,当一个对象O被创建时,它被放在Heap里,当GC运行的时候,如果发现没有任何引用指向O,O就会被回收以腾出内存空间,或者说,一个对象被回收,必须满足两个条件:1)没有任何引用指向它;2)GC被运行。在现实情况写代码的时候, 我们往往通过把所有指向某个对象的referece置空来保证这个对象在下次GC运行的时候被回收 (可以用java -verbose:gc来观察gc的行为)。 [java] view plain copy Objectc=newCar(); c=null; 但是, 手动置空对象对于程序员来说, 是一件繁琐且违背自动回收的理念的. 对于简单的情况, 手动置空是不需要程序员来做的, 因为在java中, 对于简单对象, 当调用它的方法执行完毕后, 指向它的引用会被从stack中popup, 所以他就能在下一次GC执行时被回收了. 但是, 也有特殊例外. 当使用cache的时候, 由于cache的对象正是程序运行需要的, 那么只要程序正在运行, cache中的引用就不会被GC给(或者说, cache中的reference拥有了和主程序一样的life cycle). 那么随着cache中的reference越来越多, GC无法回收的object也越来越多, 无法被自动回收. 当这些object需要被回收时, 回收这些object的任务只有交给程序编写者了. 然而这却违背了GC的本质(自动回收可以回收的objects).所以, java中引入了weak reference. 相对于前面举例中的strong reference: [java] view plain copy Objectc=newCar();//只要c还指向carobject,carobject就不会被回收 当一个对象仅仅被weak reference指向, 而没有任何其他strong reference指向的时候, 如果GC运行, 那么这个对象就会被回收. weak reference的语法是: [java] view plain copy WeakReference<Car>weakCar=newWeakReference(Car)(car); 当要获得weak reference引用的object时, 首先需要判断它是否已经被回收: [java] view plain copy weakCar.get(); 如果此方法为空, 那么说明weakCar指向的对象已经被回收了,下面来看一个例子: [java] view plain copy packageweakreference; /** *@authorywchen */ publicclassCar{ privatedoubleprice; privateStringcolour; publicCar(doubleprice,Stringcolour){ this.price=price; this.colour=colour; } publicdoublegetPrice(){ returnprice; } publicvoidsetPrice(doubleprice){ this.price=price; } publicStringgetColour(){ returncolour; } publicvoidsetColour(Stringcolour){ this.colour=colour; } publicStringtoString(){ returncolour+"carcosts$"+price; } } packageweakreference; importjava.lang.ref.WeakReference; /** *@authorywchen */ publicclassTestWeakReference{ publicstaticvoidmain(String[]args){ Carcar=newCar(22000,"silver"); WeakReference<Car>weakCar=newWeakReference<Car>(car); inti=0; while(true){ if(weakCar.get()!=null){ i++; System.out.println("Objectisalivefor"+i+"loops-"+weakCar); }else{ System.out.println("Objecthasbeencollected."); break; } } } } 在上例中, 程序运行一段时间后, 程序打印出"Object has been collected." 说明, weak reference指向的对象的被回收了. ReferenceQueue在weak reference指向的对象被回收后, weak reference本身其实也就没有用了. java提供了一个ReferenceQueue来保存这些所指向的对象已经被回收的reference. 用法是在定义WeakReference的时候将一个ReferenceQueue的对象作为参数传入构造函数. jdk动态代理 面向对象编程(OOP)有一些弊端,为多个不具有继承关系的对象引入同一个公共行为,例如日志、安全监测等,需要在每个对象里引入公共行为,导致程序中产生大量重复代码。不便于维护。所以就有了一个面向对象编程的补充,即面向切面编程(AOP),AOP所关注的是横向,OOP关注的是纵向。AOP的实现,可采用JDK动态代理、CGLIB代理。 JDK动态代理:其代理对象必须是某个接口的实现,它是通过在运行期间创建一个接口的实现来完成目标对象的代理。 CBLIB代理:实现原理类似于JDK动态代理,它在运行期间生成的代理对象是针对目标类扩展的子类。CGLIB是高效的代码生成包,底层依靠ASM(开源的字节码编辑类库)操作字节码实现,性能比JDK强。 jdk动态代理实现示例 1.新建委托类 [java] view plain copy /** *目标对象实现的接口,用JDK来生成代理对象一定要实现一个接口 *@authoryawenchen *@since2016-11-15 * */ publicinterfaceUserService{ /** *目标方法 */ publicabstractvoidadd(); } [java] view plain copy /** *目标对象 *@authoryawenchen *@since2016-11-15 * */ publicclassUserServiceImplimplementsUserService{ /*(non-Javadoc) *@seedynamic.proxy.UserService#add() */ publicvoidadd(){ System.out.println("--------------------add---------------"); } } UserService 是一个接口,UserServiceImpl 接口的实现类,也称委托类。动态代理要求代理对象必须是接口的实现类。因此UserServiceImpl 实现了UserService 。 2.实现InvocationHandlerj接口 [java] view plain copy importjava.lang.reflect.InvocationHandler; importjava.lang.reflect.Method; importjava.lang.reflect.Proxy; /** *实现自己的InvocationHandler *@authorywchen *@since2016-11-15 * */ publicclassMyInvocationHandlerimplementsInvocationHandler{ //目标对象 privateObjecttarget; /** *构造方法 *@paramtarget目标对象 */ publicMyInvocationHandler(Objecttarget){ super(); this.target=target; } /** *执行目标对象的方法 */ publicObjectinvoke(Objectproxy,Methodmethod,Object[]args)throwsThrowable{ //在目标对象的方法执行之前简单的打印一下 System.out.println("------------------before------------------"); //执行目标对象的方法 Objectresult=method.invoke(target,args); //在目标对象的方法执行之后简单的打印一下 System.out.println("-------------------after------------------"); returnresult; } /** *获取目标对象的代理对象 *@return代理对象 */ publicObjectgetProxy(){ returnProxy.newProxyInstance(Thread.currentThread().getContextClassLoader(), target.getClass().getInterfaces(),this); } } target属性,表示代理的目标对象。InvocationHandler是负责连接代理对象与目标对象的自定义中间类MyInvocationHandler必须实现的接口,只有一个方法。 public Object invoke(Object proxy, Method method, Object[] args) 参数说明:Proxy表示通过Proxy.newProxyInstance()生成的代理类对象。Method表示目标对象被调用的方法。Args表示目标对象被调用方法的输入参数。 3.通过Proxy类静态函数生成代理对象 [java] view plain copy publicclassProxyTest{ publicstaticvoidmain(String[]args){ //实例化目标对象 UserServiceuserService=newUserSericeImpl(); //实例化InvocationHander MyInvocationHandlerinvocationHandler=newMyInvocationHandler(userService); //根据目标对象生成代理对象 UserServiceproxy=(UserService)invocationHandler.getProxy(); //调用代理对象的方法 proxy.add(); } } 执行结果 ------------------before------------------ --------------------add--------------- -------------------after------------------ 动态代理原理 [java] view plain copy /** *loader:类加载器 *interfaces:目标对象实现的接口 *h:InvocationHandler的实现类 */ publicstaticObjectnewProxyInstance(ClassLoaderloader, Class<?>[]interfaces, InvocationHandlerh) throwsIllegalArgumentException { Objects.requireNonNull(h); finalClass<?>[]intfs=interfaces.clone(); finalSecurityManagersm=System.getSecurityManager(); if(sm!=null){ checkProxyAccess(Reflection.getCallerClass(),loader,intfs); } /* *Lookuporgeneratethedesignatedproxyclass.从缓存中查找或生成目标对象的代理类 */ Class<?>cl=getProxyClass0(loader,intfs); /* *Invokeitsconstructorwiththedesignatedinvocationhandler. */ try{ if(sm!=null){ checkNewProxyPermission(Reflection.getCallerClass(),cl); } //调用代理对象的构造函数(代理对象的构造函数$Proxy0(InvocationHandlerh),通过字节码反编译可以查看生成的代理类) finalConstructor<?>cons=cl.getConstructor(constructorParams); finalInvocationHandlerih=h; if(!Modifier.isPublic(cl.getModifiers())){ AccessController.doPrivileged(newPrivilegedAction<Void>(){ publicVoidrun(){ cons.setAccessible(true); returnnull; } }); } //生成代理类的实例,并把MyInvocationHander的实例作为构造函数参数传入 returncons.newInstance(newObject[]{h}); }catch(IllegalAccessException|InstantiationExceptione){ thrownewInternalError(e.toString(),e); }catch(InvocationTargetExceptione){ Throwablet=e.getCause(); if(tinstanceofRuntimeException){ throw(RuntimeException)t; }else{ thrownewInternalError(t.toString(),t); } }catch(NoSuchMethodExceptione){ thrownewInternalError(e.toString(),e); } } 进到getProxyClass0方法 [java] view plain copy privatestaticClass<?>getProxyClass0(ClassLoaderloader, Class<?>...interfaces){ if(interfaces.length>65535){ thrownewIllegalArgumentException("interfacelimitexceeded"); } //Iftheproxyclassdefinedbythegivenloaderimplementing //thegiveninterfacesexists,thiswillsimplyreturnthecachedcopy; //otherwise,itwillcreatetheproxyclassviatheProxyClassFactory returnproxyClassCache.get(loader,interfaces); } proxyClassCache为WeakCache的实例化对象,在Proxy类中定义,表示代理类的缓存。定义如下: [java] view plain copy privatestaticfinalWeakCache<ClassLoader,Class<?>[],Class<?>>proxyClassCache=newWeakCache<>(newKeyFactory(),newProxyClassFactory()); KeyFactory、ProxyClassFactory是WeakCache的内部静态类。实现了BiFunction接口。WeakCache实例化时作为构造函数参数传入,继承关系如下: 主要的代码如下: [java] view plain copy publicinterfaceBiFunction<T,U,R>{ Rapply(Tt,Uu); } [java] view plain copy privatestaticfinalclassProxyClassFactory implementsBiFunction<ClassLoader,Class<?>[],Class<?>> { //prefixforallproxyclassnames代理类的前缀 privatestaticfinalStringproxyClassNamePrefix="$Proxy"; //nextnumbertouseforgenerationofuniqueproxyclassnames //生成唯一的代理类名称 privatestaticfinalAtomicLongnextUniqueNumber=newAtomicLong(); @Override publicClass<?>apply(ClassLoaderloader,Class<?>[]interfaces){ Map<Class<?>,Boolean>interfaceSet=newIdentityHashMap<>(interfaces.length); for(Class<?>intf:interfaces){ /* *Verifythattheclassloaderresolvesthenameofthis *interfacetothesameClassobject. */ //确保接口的类对象与类加载器加载的类对象相同,且由同一个加载器加载。《深入理解java虚拟机》提到,类加载器虽然只用于实现类的加载动作,但在java程序起的作用远不止于类的加载。对于任何一个类,都需要由加载它的的类加载器和这个类本身一同确立其在java虚拟机中的唯一性,每一个类加载器,都拥有一个独立的类名称空间,通俗点,比较两个类是否相等,只有在这两个类是由同一个类加载器加载的前提下才有意义,否则,即使这两个类来源于同一个class文件,被同一个虚拟机加载,只要加载它们的类加载器不同,那这两个类就必定不相等。interfaceClass=Class.forName(intf.getName(),false,loader);验证类是否相等,实现原理如上所述。 Class<?>interfaceClass=null; try{ interfaceClass=Class.forName(intf.getName(),false,loader); }catch(ClassNotFoundExceptione){ } if(interfaceClass!=intf){ thrownewIllegalArgumentException( intf+"isnotvisiblefromclassloader"); } /* *VerifythattheClassobjectactuallyrepresentsan *interface.验证类对象表示的是接口 */ if(!interfaceClass.isInterface()){ thrownewIllegalArgumentException( interfaceClass.getName()+"isnotaninterface"); } /* *Verifythatthisinterfaceisnotaduplicate.验证接口未重复 */ if(interfaceSet.put(interfaceClass,Boolean.TRUE)!=null){ thrownewIllegalArgumentException( "repeatedinterface:"+interfaceClass.getName()); } } StringproxyPkg=null;//packagetodefineproxyclassin定义待生成的代理类所在包名 intaccessFlags=Modifier.PUBLIC|Modifier.FINAL; /* *Recordthepackageofanon-publicproxyinterfacesothatthe *proxyclasswillbedefinedinthesamepackage.Verifythat *allnon-publicproxyinterfacesareinthesamepackage.非public修饰的代理接口,需要定义在相同的包中,如果非public修饰的接口不在相同包,会因访问权限的限制而无法访问。intf.getModifiers()返回的是一个整数,用不同的位开关表示接口中public/final修饰符的使用情况。 */ for(Class<?>intf:interfaces){ intflags=intf.getModifiers(); if(!Modifier.isPublic(flags)){ accessFlags=Modifier.FINAL; Stringname=intf.getName(); intn=name.lastIndexOf('.'); Stringpkg=((n==-1)?"":name.substring(0,n+1)); if(proxyPkg==null){ proxyPkg=pkg;//代理对象的包名,如com.aop }elseif(!pkg.equals(proxyPkg)){ thrownewIllegalArgumentException( "non-publicinterfacesfromdifferentpackages"); } } } if(proxyPkg==null){ //ifnonon-publicproxyinterfaces,usecom.sun.proxypackage proxyPkg=ReflectUtil.PROXY_PACKAGE+"."; } /* *Chooseanamefortheproxyclasstogenerate. */ longnum=nextUniqueNumber.getAndIncrement(); StringproxyName=proxyPkg+proxyClassNamePrefix+num; /* *Generatethespecifiedproxyclass. *生成目标对象的代理类的字节码,并保存到硬盘中。 */ byte[]proxyClassFile=ProxyGenerator.generateProxyClass( proxyName,interfaces,accessFlags); try{ //返回代理类对象,将字节码加载到内存中 returndefineClass0(loader,proxyName, proxyClassFile,0,proxyClassFile.length); }catch(ClassFormatErrore){ /* *AClassFormatErrorheremeansthat(barringbugsinthe *proxyclassgenerationcode)therewassomeother *invalidaspectoftheargumentssuppliedtotheproxy *classcreation(suchasvirtualmachinelimitations *exceeded). */ thrownewIllegalArgumentException(e.toString()); } } } [java] view plain copy /** *映射接口数组到最后键的函数 *接口数组映射到最优键对象上(如实例化Key1时,接口作为Key1的构造函数参数,保存到Key1中),同时,Key1/Key2/KeyX继承了WeakReference弱引用类类,因此接口所在的类对象被弱引用 */ privatestaticfinalclassKeyFactory implementsBiFunction<ClassLoader,Class<?>[],Object> { @Override publicObjectapply(ClassLoaderclassLoader,Class<?>[]interfaces){ switch(interfaces.length){ case1:returnnewKey1(interfaces[0]);//themostfrequent case2:returnnewKey2(interfaces[0],interfaces[1]); case0:returnkey0; default:returnnewKeyX(interfaces); } } } WeakCache类中定义的map变量如下: [java] view plain copy privatefinalConcurrentMap<Object,ConcurrentMap<Object,Supplier<V>>>map=newConcurrentHashMap<>(); 双层map映射,第一层key为ClassLoader,第二层key为接口的弱引用对象,value为代理类的Class对象。怎么看出是弱引用的呢,value中存放的值是一个类,该类继承了弱引用类WeakReference,我们的代理类在对象实例化时,通过构造函数传入。为对象添加引用,可看WeakReference用法。第一层是类加载器,第二层才是类对象,为什么不用一层,代理类对象作为键呢,这里就涉及到类加载器的使用。记住一点,类的唯一性是由类加载器和类本身共同决定的。 对Supplier接口,Factory类进行说明,接下来的代码中会用到。 调用proxyClassCache.get(loader, interfaces),进入WeakCache的get方法。代码如下: [java] view plain copy publicVget(Kkey,Pparameter){ Objects.requireNonNull(parameter); expungeStaleEntries(); //refQueue的类型为ReferenceQueue,存放对象的弱引用,CacheKey继承了WeakReference,因此key(ClassLoader)所在对象被弱引用,对象的应用存放在队列refQueue中。 ObjectcacheKey=CacheKey.valueOf(key,refQueue); //lazilyinstallthe2ndlevelvaluesMapfortheparticularcacheKey //生成第一层key,从缓存中获取valuesMap,如果为空,则新建ConcurrentHashMap实例,把当前加载器和ConcurrentHashMap实例放到缓存中。 ConcurrentMap<Object,Supplier<V>>valuesMap=map.get(cacheKey); if(valuesMap==null){ ConcurrentMap<Object,Supplier<V>>oldValuesMap =map.putIfAbsent(cacheKey, valuesMap=newConcurrentHashMap<>()); if(oldValuesMap!=null){ valuesMap=oldValuesMap; } } //createsubKeyandretrievethepossibleSupplier<V>storedbythat //subKeyfromvaluesMap //subKeyFactory是Proxy类的内部静态类KeyFactory的实例对象 //valueFactory是Proxy类的内容静态类ProxyClassFactory的实例对象 //subKeyFactory.apply(key,parameter)返回接口的弱引用对象。subKey,即接口的弱引用对象作为第二层映射的键 ObjectsubKey=Objects.requireNonNull(subKeyFactory.apply(key,parameter)); Supplier<V>supplier=valuesMap.get(subKey); Factoryfactory=null; while(true){ if(supplier!=null){ //suppliermightbeaFactoryoraCacheValue<V>instance,supplier不为空,缓存中存在代理类 Vvalue=supplier.get(); if(value!=null){//value不为空,即代理类存在,将代理类返回。 returnvalue; } } //elsenosupplierincache //orasupplierthatreturnednull(couldbeaclearedCacheValue //oraFactorythatwasn'tsuccessfulininstallingtheCacheValue) //lazilyconstructaFactory if(factory==null){ factory=newFactory(key,parameter,subKey,valuesMap); } if(supplier==null){ supplier=valuesMap.putIfAbsent(subKey,factory); if(supplier==null){ //successfullyinstalledFactory supplier=factory; } //elseretrywithwinningsupplier }else{ if(valuesMap.replace(subKey,supplier,factory)){ //successfullyreplaced //clearedCacheEntry/unsuccessfulFactory //withourFactory supplier=factory; }else{ //retrywithcurrentsupplier supplier=valuesMap.get(subKey); } } } } 上面执行流程中,主要的两个步骤为: Object subKey = Objects.requireNonNull(subKeyFactory.apply(key, parameter)); subKey为接口对象的弱引用。 进入Proxy类的内部静态类KeyFactory,查看apply方法(本文前面提到的KeyFactory类)。 V value = supplier.get(); value为缓存中的代理类对象,Supplier是个接口,实现代码是在接口的实现类Factory中, 进入WeakCache类的内部类Factory,查看get方法。如下: Supplier是接口 [java] view plain copy publicinterfaceSupplier<T>{ /** *Getsaresult. * *@returnaresult */ Tget(); } } Factory是WeakCache的内部类, Factory实现了接口Supplier [java] view plain copy privatefinalclassFactoryimplementsSupplier<V>{ privatefinalKkey; privatefinalPparameter; privatefinalObjectsubKey; privatefinalConcurrentMap<Object,Supplier<V>>valuesMap; Factory(Kkey,Pparameter,ObjectsubKey, ConcurrentMap<Object,Supplier<V>>valuesMap){ this.key=key; this.parameter=parameter; this.subKey=subKey; this.valuesMap=valuesMap; } @Override publicsynchronizedVget(){//serializeaccess //re-check Supplier<V>supplier=valuesMap.get(subKey); if(supplier!=this){ //somethingchangedwhilewewerewaiting: //mightbethatwewerereplacedbyaCacheValue //orwereremovedbecauseoffailure-> //returnnulltosignalWeakCache.get()toretry //theloop returnnull; } //elsestillus(supplier==this) //createnewvalue Vvalue=null; try{ //valueFactory.apply(key,parameter)返回代理类对象,即Class对象。 //如果value不为空,说明缓存中已经存在代理类,可以直接返回。 //通过前面的判断,已经能确定缓存中存在代理类,否则,程序是走不到这里来的。 value=Objects.requireNonNull(valueFactory.apply(key,parameter)); }finally{ if(value==null){//removeusonfailure valuesMap.remove(subKey,this); } } //theonlypathtoreachhereiswithnon-nullvalue assertvalue!=null; //wrapvaluewithCacheValue(WeakReference) CacheValue<V>cacheValue=newCacheValue<>(value); //tryreplacinguswithCacheValue(thisshouldalwayssucceed) if(valuesMap.replace(subKey,this,cacheValue)){ //putalsoinreverseMap reverseMap.put(cacheValue,Boolean.TRUE); }else{ thrownewAssertionError("Shouldnotreachhere"); } //successfullyreplaceduswithnewCacheValue->returnthevalue //wrappedbyit returnvalue; } } 在Facotry类的get方法中,value是由valueFactory.apply(key, parameter)生成,返回代理类Class对象。具体的实现可在本文前面提到的ValueFactory中查看。 JDK动态代理实现原理 Java WeakReference的理解与使用

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册