首页 文章 精选 留言 我的

精选列表

搜索[AIOps最佳实践],共10000篇文章
优秀的个人博客,低调大师

🔥🔥🔥Oinone 工作流动态表单最佳实践

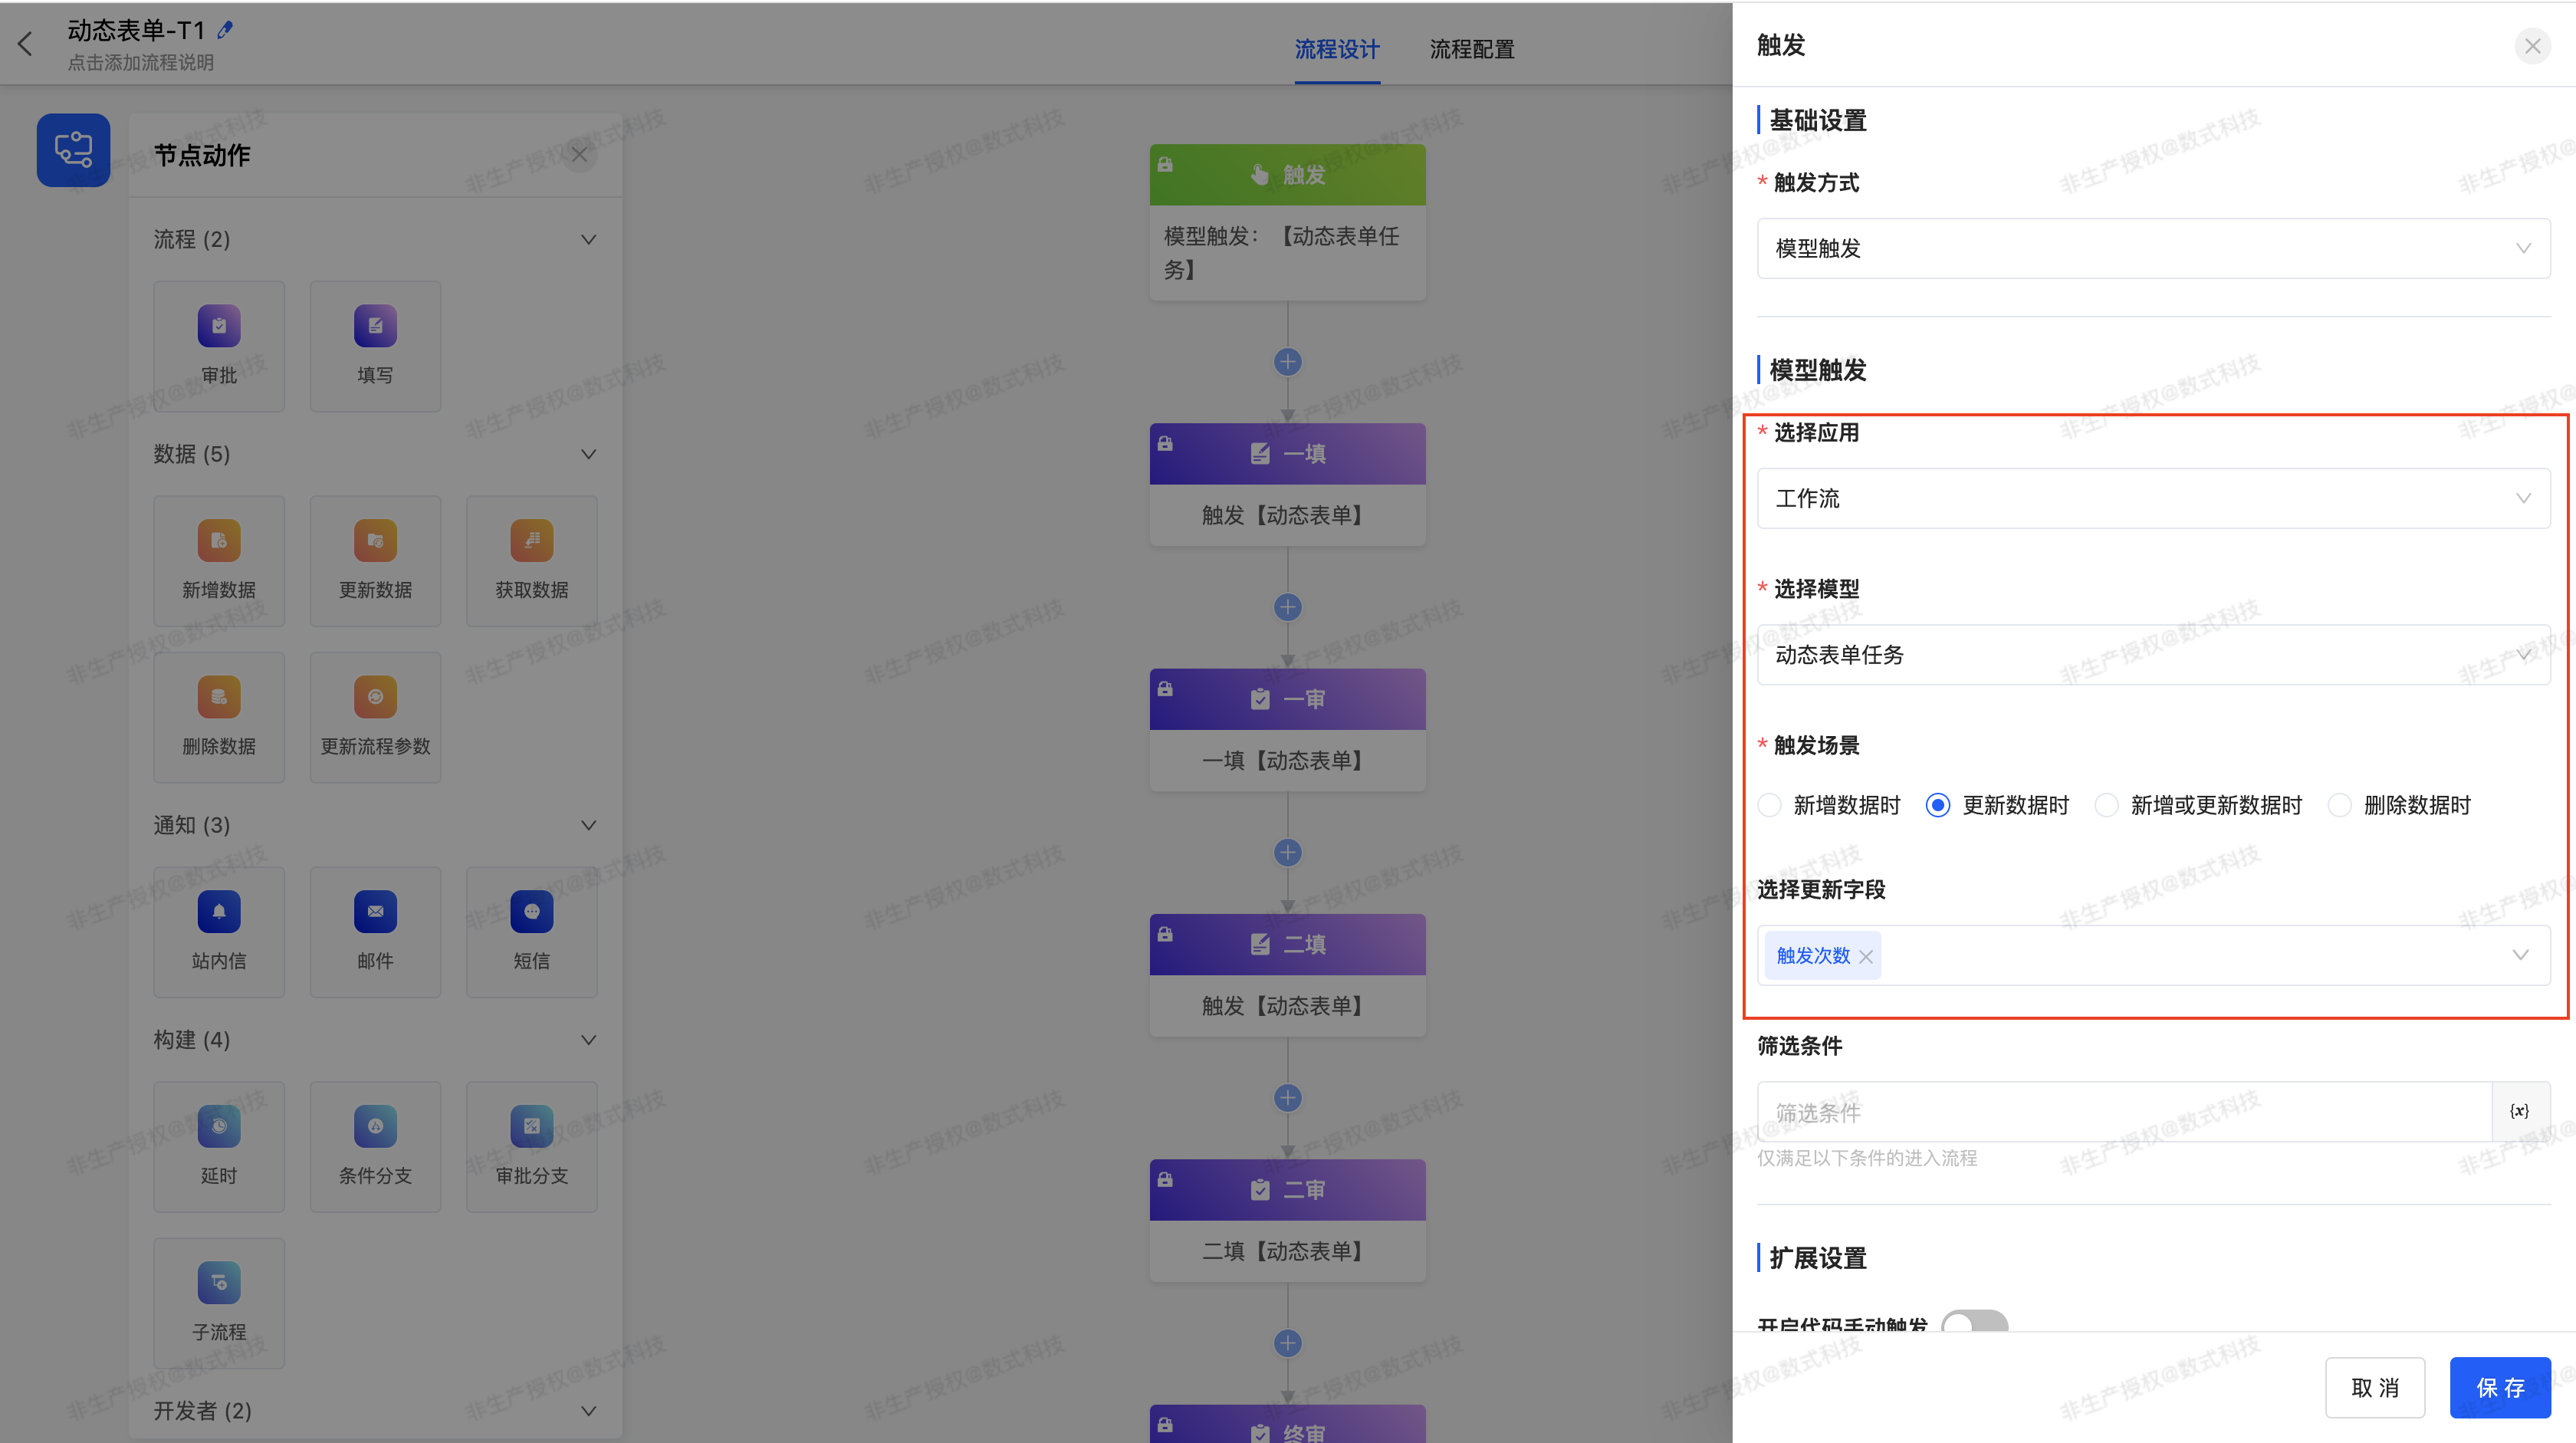
点击查看体验 需求背景 为了提高操作效率并简化流程设计过程,应对伙伴们反映的在流程设计器中,即使填写/审批流程相同,不同模型也需重新配置的问题,我们引入了"动态表单"功能。此功能旨在减少重复配置的需求,通过设置节点名称和绑定视图,便可实现审批流程相同而视图不同,从而使得相同的审批流程可以被高效重复利用。 为确保伙伴们能够更加方便的使用动态表单,我们将典型示例整合至"工作流"中。本节将结合这些示例详细阐述"动态表单"功能的应用方法。 使用主要分为两个步骤:流程设计和动态表单配置。 流程设计 触发节点配置 应用:工作流 选择模型:动态表单任务 触发场景:更新数据时 选择更新字段:触发次数 填写/审批节点配置 动态表单按钮设置为启用状态。 数据来源设置为触发节点。 动态表单函数默认有一条内置函数,选中即可。 数据保存方式、填写人等信息,同从前使用方式。 在动态表单模式下,数据权限的管理将不再由流程设计器控制,而是由用户所填写的视图进行控制。 例如,若希望用户在"一审"阶段不能修改某字段,则应在设计视图时将相关字段设为只读模式。同样,若某些信息不宜在"一审"阶段展示给客户,相应字段应在设计过程中被设置为隐藏状态。 若需在"一审"节点接收"一填"阶段的结果,数据来源设置为"一填[动态表单]"。其他配置项保持不变,按照上述说明进行设置。 若希望"二填"节点的数据由用户填写,并希望内容处于空白状态,可将数据来源设置为"触发"节点。 通过这种配置,"二填"节点的数据将不会受到"一填"和"一审"节点数据的影响。 二审节点的配置同一审,此处省略。 "终审"节点希望接收到"一审"节点的数据,可以将数据来源设置为一审。 动态表单配置 首先创建动态表单任务:工作流->动态表单任务->创建,给流程起个名字。 节点任务配置 流程名:通过下拉菜单选择,数据为动态表单任务中,创建的流程信息。 节点名称:【强制】确保与流程设计中的节点名称完全一致,否则将无法正确匹配到对应节点的视图。 模型:选定用于绑定节点视图的模型。 视图:选择视图前须先确定模型,系统将自动列出所选模型下的通过UI创建的视图供选择。 查看配置效果 在工作流模块->动态表单->动态表单任务,点击"详情",可以看到该流程所配置的节点信息。 动态表单任务详情页 流程触发 点击"触发"按钮将使触发次数自动递增。在流程设计器中配置触发节点时,我们已设定"触发次数"字段的变化作为流程启动的条件。 触发节点配置筛选条件 通过完成上述操作,我们已成功配置动态表单。现在可以利用触发节点的筛选条件,来确定触发按钮被点击后,所启动的流程。 自定义动态表单函数 如果所提供的示例未能满足您的需求,您可以根据自身的需求,对触发条件和动态表单函数进行相应的定制与调整。 动态表单函数定义规则如下: namespace:强制为 WorkflowFunctionConstant.FUNCTION_NAMESPACE。 fun:强制以 WorkflowFunctionConstant.WORKFLOW_CUSTOM_VIEW_FUNCTION_PREFIX 为前缀。 入参说明: 参数1:节点数据,例如,配合instanceof可以判断当前是填写节点(WriteNode)还是审批节点(ApprovalNode)。 参数2:触发节点的模型数据,如果您的触发节点不确定,可以通过Map接收参数。 参数3:该节点所配置数据来源的数据。 出参说明:视图,如果出参为null,流程终止运行,错误信息提示为"流程节点执行失败,动态表单函数获取视图为空"。 @Slf4j @Component @Fun(WorkflowFunctionConstant.FUNCTION_NAMESPACE) public class DynamicFormCustom { /** * 根据动态表单任务获取视图 * * @param node 节点数据 * @param dynamicFormTask 触发节点数据 * @param dataObj 源数据 */ @Function.fun(WorkflowFunctionConstant.WORKFLOW_CUSTOM_VIEW_FUNCTION_PREFIX + "fetchDynamicFormFunction") @Function.Advanced(displayName = "[内置]获取动态表单函数") @Function(name = "fetchDynamicFormFunction") public View fetchDynamicFormFunction(Node node, DynamicFormTask dynamicFormTask, Map<String, Object> dataObj) { DynamicFormTaskNode dynamicFormTaskNode = fetchDynamicFormTaskNode(node, dynamicFormTask); if (dynamicFormTaskNode == null) { return null; } dynamicFormTaskNode.fieldQuery(DynamicFormTaskNode::getView); return dynamicFormTaskNode.getView(); } private DynamicFormTaskNode fetchDynamicFormTaskNode(Node node, DynamicFormTask dynamicFormTask) { List<DynamicFormTaskNode> dynamicFormTaskNodeList = Models.origin().queryListByWrapper(Pops.<DynamicFormTaskNode>lambdaQuery() .from(DynamicFormTaskNode.MODEL_MODEL) .eq(DynamicFormTaskNode::getNodeName, node.getNodeName()) .eq(DynamicFormTaskNode::getTaskCode, dynamicFormTask.getCode()) ); if (CollectionUtils.isEmpty(dynamicFormTaskNodeList)) { return null; } if (dynamicFormTaskNodeList.size() > 1) { log.error("工作流动态获取表单函数视图匹配多个,{}", JsonUtils.toJSONString(dynamicFormTaskNodeList)); } return dynamicFormTaskNodeList.get(0); } } 动态表单使用说明

优秀的个人博客,低调大师

AI加速引擎PAI-TorchAcc:OLMo训练加速最佳实践

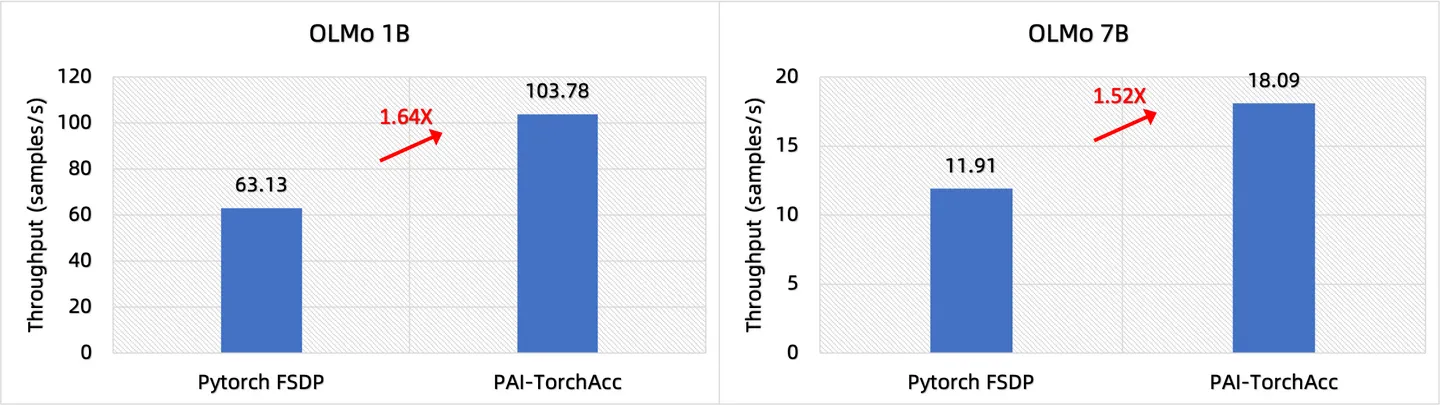
作者:黄奕桐、沈雯婷、艾宝乐、王昂、李永 摘要 阿里云机器学习平台PAI开发的Pytorch训练加速框架PAI-TorchAcc已接入最新开源的大语言模型 OLMo。 在保证模型效果和易用性的前提下,PAI-TorchAcc相对 PyTorch 性能在 OLMo 1B 上加速比达到 1.64X,在 OLMo 7B 上加速比达到 1.52X。 本文分析了 PAI-TorchAcc 的性能收益来源。 1、PAI-TorchAcc 简介 PAI-TorchAcc(Torch Accelerator)是阿里云机器学习平台开发的Pytorch上的大模型训练加速框架。 PAI-TorchAcc借助社区PyTorch/XLA,通过 GraphCapture 技术将 Pytorch 动态图转换为静态计算图,基于计算图进行分布式优化、计算优化、显存优化等,为包括大语言模型在内的Pytorch上的模型提供高效训练支持。相比于社区Pytorch/XLA,PAI-TorchAcc具有更好的易用性、更高的性能和更丰富的功能。更详细的介绍可以见文章:AI加速引擎PAI-TorchAcc:整体介绍与性能概述。 2、完全开源的 OLMo 模型 OLMo (Open Language Model) 是由艾伦人工智能研究所等机构发表的完全开源的大语言模型。OLMo 模型提供了完整的训练数据集、代码、checkpoint 等,几乎完全开源了一个大语言模型从零开始训练所需的代码和数据。不仅如此,OLMo 模型在多项核心指标上接近而且部分超过 LLAMA2 模型。 3、如何使用 PAI-TorchAcc 加速 OLMo 模型训练? 通过 PAI-TorchAcc 加速模型训练一般需要三个步骤: 定义 torchacc.Config,并指定加速选项。 调用 torchacc.accelerate,并传入model和config,完成加速训练的准备。 通过torchacc.AsyncLoader对 torch dataset_loader 进行封装,加速数据加载。 # 定义 model 和 dataloader model = AutoModelForCausalLM.from_pretrained("allenai/OLMo-1B", trust_remote_code=True) tokenizer = AutoTokenizer.from_pretrained("allenai/OLMo-1B", use_fast=False, trust_remote_code=True) train_loader = get_dataloader(tokenizer) # 定义 TorchAcc Config config = torchacc.Config() config.compute.bf16 = True # 开启 bf16 config.compute.acc_scaled_dot_attn = True # 自动替换 Torch ScaledDot 为torchacc flash attn 版本 config.dist.fsdp.size = torchacc.dist.world_size() # 开启 FSDP,设置 FSDP 数目 config.dist.fsdp.wrap_layer_cls = {"OlmoSequentialBlock"} # 将OLMo模型的decoder layer进行FSDP封装 # 一行代码加速模型 model = torchacc.accelerate(model, config) # 异步加速数据加载 train_loader = torchacc.AsyncLoader(train_loader, model.device) # training loop ... 阿里云 DSW Gallery 现在有更完整的 OLMo 模型加速示例:TorchAcc加速OLMo模型训练。 4、PAI-TorchAcc 的性能表现 以单机 8 卡 A100 为例,在 OLMo 1B 上,PAI-TorchAcc 相比 PyTorch FSDP 加速比为 1.64X;在 OLMo 7B 上,PAI-TorchAcc 相比 PyTorch FSDP 加速比为 1.52X。 图 1: PAI-TorchAcc 相比 PyTorch FSDP 在 OLMo 模型上的性能提升 5、PAI-TorchAcc 为何这么快? 在 OLMo 模型的性能对比中,PAI-TorchAcc和 PyTorch 都采用相同的分布式策略 FSDP(ZeRO-3)。PAI-TorchAcc 通过计算优化、通信优化、显存优化等,在 OLMo 7B 上相比 PyTorch 达到了 1.52X 的加速比。下面我们以 OLMo 7B 为例分析 PAI-TorchAcc 的性能收益来源。 计算优化&通信优化 为了方便对比,我们将 PAI-TorchAcc和 PyTorch 的 micro batch size都设置为 2 进行对比。 从图 2 中可以看出,通过计算优化,PAI-TorchAcc 将访存密集型算子的时间优化为 PyTorch 对应算子时间的 45.56%,整体的加速比约为 1.25X。通过通信优化,PAI-TorchAcc 能够将计算和通信更好进行 overlap,将没有 overlap 的通信占整体时间的占比从 8.19%降低到 2.43%。 通过计算优化&通信优化,PAI-TorchAcc 相比PyTorch达到了 1.32X 的加速比。 图 2: micro batch size=2 时,PAI-TorchAcc 相比 PyTorch FSDP 在 OLMo 7B 上的性能提升 显存优化 在 PAI-TorchAcc 中,由于 PyTorch 模型已经转换为静态计算图,所以可以使用比较多的显存优化方法。例如,通过对算子的执行顺序进行调整,可以得到更小的显存峰值;通过更优的显存分配算法,可以让显存碎片更少,减少显存使用;通过 patten match 等方式将 attention 替换为使用显存更少的 flash attention 等等。 通过显存优化,PAI-TorchAcc 的最大 micro batch size 能够达到 4,而 PyTorch 的最大 micro batch size 只能达到 2,这使得PAI-TorchAcc 能够获得更高的性能加速比,这一部分的性能收益主要来自于计算密集型算子。 如图 3 所示,PAI-TorchAcc micro batch size=4 相比 micro batch size=2 的吞吐加速比为 1.15X,这使得PAI-TorchAcc 相比 PyTorch 最终达到了 1.52X 的加速比。 图 3: 在不同 micro batch size 下,PAI-TorchAcc 相比 PyTorch FSDP 在 OLMo 7B 上的性能提升 6 总结 本文介绍了如何使用 PAI-TorchAcc 加速 OLMo 模型训练,分析了PAI-TorchAcc 的性能收益来源。实际上,PAI-TorchAcc可以通过并行化策略、显存优化、计算优化和调度优化等方法来加速更多的大语言模型训练,目前已接入常见的开源大模型,包括LLaMA、LLaMA-2、BaiChuan、ChatGLM、QWen等。除了大语言模型之外,PAI-TorchAcc也易于接入视觉类、语音类模型,并大幅度提升训练性能。欢迎在阿里云上使用该产品。

优秀的个人博客,低调大师

大数据调度最佳实践 | 从Airflow迁移到Apache DolphinScheduler

迁移背景 有部分用户原来是使用 Airflow 作为调度系统的,但是由于 Airflow 只能通过代码来定义工作流,并且没有对资源、项目的粒度划分,导致在部分需要较强权限控制的场景下不能很好的贴合客户需求,所以部分用户需要将调度系统从 Airflow 迁移到 Apache Dolphinscheduler。 秉承着解决用户实际需求的角度出发,Whaleops 研发了 Air2phin 迁移工具,协助用户更好的迁移到 DolphinScheduler 中。由于 Airflow 是通过 python code 来定义工作流的,并且有部分元数据信息仅仅在 python code 中而不会持久化到数据库中,所以我们需要通过解析 python code 来完成分析和迁移的步骤 为什么要迁移到 DolphinScheduler Airflow 和 DolphinScheduler 都是任务调度系统,都解决了任务编排的问题。两者各有优势,这个章节中我们仅介绍 DolphinScheduler 相对 Airflow 的优势,两者的对比文章我们会在以后详细对比的文章中描述: 两者都是成熟的开源工作流调度系统,都有成熟的社区,细微的区别是 **Apache DolphinScheduler:**以可视化为主,API为辅,有更细粒度的权限管理,工作流层级更多,使用成本更加低,数据平民化 **Airflow:**以代码定义工作流, 编写工作流为高级研发,灵活性较高,但是使用成本更高,基本上是面向研发人员 DolphinScheduler 因为将工作流定义、任务定义、任务关系都存储到原数据库中,所以 在增减 master worker 节点时没有额外的操作,airflow 在增加 master 和 worker 节点时,需要将 dags 文件复制到新的节点中 同时由于存在解析文件获取工作流、任务的过程,没有新增、更改任务的延时,自然也不需要为了降低延时而牺牲 CPU 性能的说法。airflow 是使用 loop 的方式发现和调度 DAGs 的,所以在 loop 的时候 scheduler 会消耗较多的 cpu 资源 能保留完整的历史工作流、任务运行状态。airflow 如果最新的定义中删除了部分任务,则不能找到这些任务的历史状态和日志 原生支持版本的信息。airflow 的 DAGs 定义需要在 git log 中查找,revert 也需要通过 git DolphinScheduler 支持资源中心,更加方便用户管理、组织包括本地和远程的资源文件。airflow 如果有外部资源的话,一般需要和git 一起托管在版本控制中 除开离线调度任务的工作外,DolphinScheduler 还支持实时任务、数据资料、对物理机器资源的监控等调度相关的实用功能。airflow 目前来说更加专注的是离线工作流调度 DolphinScheduler 是一个分布式,无中心的系统,master 的服务器资源利用率更高,Airflow 由于通过 scheduler 扫描并发现可调度任务,CPU 利用率没有 DolphinScheduler 高。详见 AWS 性能测评 诉求及挑战 诉求 作为一个迁移工具,其核心诉求就是希望能在人为介入尽可能少的情况下,实现将 Airflow DAGs 转化成 DolphinScheduler 中工作流的迁移。 但是这需要有一个较好平衡,不能一味追求自动化,不然可能会导致程序复杂、可维护性降低、泛化能力变弱等情况,特别是我们需要去兼容不同 Airflow 版本的时候,如何取舍就是是 air2phin 必须面对的一个问题。 挑战 语法差异:Airflow 和 DolphinScheduler Python SDK 在基础的 Python 语法(for、if、else)上都是一样的,但是在具体的任务名称和参数上稍有不同,如 airflow 中的 bash operator 对应到 DolphinScheduler Python SDK 的名称是 Shell, 同时两者的参数也不一样,迁移需要兼容这部分逻辑 任务类型差异:Airflow 和 DolphinScheduler 可能都允许用户进行一定程度的定制化扩展,如自定义插件。但是两者在在任务类型的数量和对任务的封装抽象是有差异,有部分任务类型仅在 airflow 存在,有部分任务类型仅在 DolphinScheduler 中存在,转换的时候需要处理这部分差异 定时调度差异:Airflow 定义调度周期的时候使用 Cron 表达式(如 5 4 * * *)或者 Python 的 datetime.timedelta ,DolphinScheduler 使用的是更加精细化的 Cron 表达式,如 0 5 4 * * ? * 所以这部分的转换也是挑战 内置时间参数差异:Airflow 的内置时间参数是通过 macro 来处理的,并且提供了 jinja2 模版作为时间的计算,如 ds_add('2015-01-06', -5)。DolphinScheduler 有自己的内置时间定义和计算规则,如运行时间使用 yyyy-MM-dd,需要时间增减使用 yyyy-MM-dd+1 迁移规则的扩展:不管是 Airflow 和 DolphinScheduler Python SDK 都会随着时间而修改对应的 API,只有有不兼容的修改就会导致迁移工具失效,所以迁移工具规则的修改和新增需要尽可能简单,尽量减少维护成本 不同版本的Airflow:Airflow 的不同版本之间可能也有差异,如在 2.0.0 之前有 airflow.operators.bash_operator 但是到2.0.0 后我们只有 airflow.operators.bash 迁移工具介绍 Air2phin 是什么 Air2phin 是一个基于规则的 AST 转换器,提供了从 Airflow dag 文件转成 pydolphinscheudler 定义文件的功能。其使用 LibCST 解析和转换 Python 代码,并使用 Yaml 文件定义转换规则。他是一个协助用户完成转化的工具,并非是一键转化工具。 Air2phin 的数据流转图 从标准输入或者文件中获取原来 airflow DAGs 的定义 将转换规则从 YAML 文件加载到 air2phin 将 airflow DAGs 内容解析为 CST 树 根据转换规则改变 CST 树 将转换后的结果输出到标准输出或者文件 Air2phin 如何使用 由于 Air2phin 是 Python 的包,所以需要通过 pip 安装,安装结束后可以通过命令 air2phin migrate ~/airflow/dags 将 airflow 全部的 dags 转换成 DolphinScheduler Python SDK 的定义到了这一步 air2phin 的使命已经完成了,最后只需要使用 Python 执行这部分 SDK 的代码就能将转化后的工作流提交到 DolphinScheduler # Install package python -m pip install --upgrade air2phin # Migrate airflow‘s dags air2phin migrate -i ~/airflow/dags 在实际生产中, ~/airflow/dags 下面可能有非常多的 DAG, 而 air2phin 默认是串行处理这部分 DAG 的,如果你想要更加高效的处理,可以使用 --multiprocess <core-num> 让 air2phin 可以多进程执行转换。 # use multiprocess to convert the airflow dags files air2phin migrate -i --multiprocess 12 ~/airflow/dags 完成了上述的转化后,你就完成了从 Airflow dags 文件到 DolphinScheduler python sdk 定义脚本的转化,只需要将 DolphinScheduler python sdk 提交到 DolphinSchedeuler 中即可完成 # Install apache-dolphinscheduler according to apache DolphinScheduler server you use, ref: https://dolphinscheduler.apache.org/python/main/#version python -m pip install apache-dolphinscheduler # Submit your dolphinscheduler python sdk definition python ~/airflow/dags/tutorial.py Air2phin 如何定义自己的转换规则 大部分 Airflow 的用户都会自定义部分 operator,想要转化这部分的 operator 需要用户自定义规则,幸运的 Air2phin 的规则是基于 YAML 文件的,意味用户可以较为简单的新增规则。下面是一个用户客户自定义的 Redshift operator 转化成 DolphinScheduler SQL 任务类型的规则转换 YAML 文件。 这里假设用户基于 airflow.providers.postgres.operators.postgres 自定义了一个 redshift operator,其 operator 的代码如下 from airflow.providers.postgres.operators.postgres import PostgresOperator class RedshiftOperator(PostgresOperator): def __init__( self, *, sql: str | Iterable[str], my_custom_conn_id: str = 'postgres_default', autocommit: bool = False, parameters: Iterable | Mapping | None = None, database: str | None = None, runtime_parameters: Mapping | None = None, **kwargs, ) -> None: super().__init__( sql=sql, postgres_conn_id=my_custom_conn_id, autocommit=autocommit, parameters=parameters, database=database, runtime_parameters=runtime_parameters, **kwargs, ) 由于这是用户自定义的 operator,他肯定不在 air2phin 内置的转换规则中,所以我们需要自定义一个转换规则的 YAML 文件 name: RedshiftOperator migration: module: - action: replace src: utils.operator.RedshiftOperator.RedshiftOperator dest: pydolphinscheduler.tasks.sql.Sql - action: add module: pydolphinscheduler.resources_plugin.Local parameter: - action: replace src: task_id dest: name - action: add arg: datasource_name default: type: str value: "redshift_read_conn" - action: add arg: resource_plugin default: type: code value: Local(prefix="/path/to/dir/") 客户只需要将这个文件加入 air2phin 的规则路径下,就能实现该自定义 operator 的转化动作了。 air2phin migrate --custom-rules /path/to/RedshiftOperator.yaml ~/airflow/dags Air2phin 如何解决迁移的挑战 前面提到了 Airflow 到 Dolophinscheduler 可能面临的挑战,下面来看看 Air2phin 是如何解决的 语法差异 由于 Airflow 和 DolphinScheduler Python SDK 都是使用 Python 编写的。所以 Python 相关的基础语法是相似。但是由于 Airflow 和 DolphinScheduler Python SDK是两套无关联的 API, 所以两者在特定参数、类和函数等方面存在一些不同之处。air2phin 就是用来解决这个问题的,他通过定义适当的 YAML 这部分差异的转换规则,解决差异并实现从一个平台迁移到另一个平台的流程。 YAML文件转换规则: 参数映射: 对于参数的不同命名或结构,可以在 YAML 文件中定义映射规则,将 Airflow 的参数名称映射到 DolphinScheduler Python SDK 的对应参数。 类和函数转换: 如果 Airflow 和 DolphinScheduler Python SDK 使用不同的类名或函数,可以在YAML文件中定义类和函数的转换规则,将 Airflow 的类名和函数映射到 DolphinScheduler Python SDK的等效项。 错误处理和告警: 鉴于两个平台可能有不同的错误处理和告警机制,可以在YAML文件中定义如何映射Airflow的错误处理到DolphinScheduler的等效机制。 通过制定这些转换规则,可以确保在迁移过程中,根据 YAML 文件的定义,将 Airflow 的任务代码转换成DolphinScheduler Python SDK 平台所需的代码,以适应平台之间的差异,并确保新增和修改任务的灵活性。任务类型差异 定时调度差异 在定时调度配置方面,Airflow 和 DolphinScheduler Python SDK 也存在一些区别。Airflow 使用标准的 Cron 表达式来定义任务的定时调度,而 DolphinScheduler Python SDK 采用了更加精确的 Cron 调度策略。这种差异可能会影响任务的精确调度和执行频率。 Airflow的Cron表达式: Airflow使用通用的Cron表达式来定义任务的调度频率。Cron表达式由五个或六个字段组成,分别表示分钟、小时、日期、月份、星期。它允许用户定义相对宽松的调度规则,例如每小时一次、每天一次等。 DolphinScheduler Python SDK 的精确Cron调度: DolphinScheduler则引入了更加精确的Cron调度策略。它将Cron表达式分成两部分:基本Cron和高级Cron。基本Cron用于定义任务的粗略调度规则,如分钟、小时、日期等。而高级Cron则用于定义更精确的调度规则,包括秒级精度等。这使得DolphinScheduler可以实现更细粒度的任务调度,适用于对执行时间要求更高的场景,如金融领域等。 由于 DolphinScheduler Python SDK 的精度比 Airflow 的精度高,所以转化的时候不会存在精度丢失的问题,这个问题也就迎刃而解了。 内置时间参数差异 内置时间参数差异指的是 Airflow 和 DolphinScheduler Python SDK 在任务调度中使用内置时间参数的不同方式。Airflow使用Jinja2的宏(macros)功能来实现内置时间参数,而DolphinScheduler的Python SDK 使用自定义的方式来实现这些参数。这两种实现方法可能会导致使用和理解上的差异。 Airflow的Jinja2宏: Airflow的内置时间参数是通过Jinja2宏来实现的。Jinja2宏允许在DAGs文件中使用特殊的占位符和函数,用于动态地生成调度时间。例如,可以使用{{ macros.ds_add(ds, 1) }}来在调度时间上加一天。 DolphinScheduler Python SDK的自定义实现: DolphinScheduler的Python SDK在实现内置时间参数时,可能会使用一些自定义的函数或类,而不是直接使用Jinja2宏。这些自定义的实现方法可能需要在DolphinScheduler平台上进行特定的配置和处理。 所以迁移的时候需要注意: 语法和方式不同: Airflow 的 Jinja2 宏在语法和使用方式上与 DolphinScheduler Python SDK 的自定义实现有很大的区别,可能导致部分时间参数不能被正确迁移。Air2phin 对于部分不能自动迁移的参数会保留其原本的值 功能相似性: 尽管实现方式不同,但两者都旨在为任务调度提供内置时间参数。确保迁移后的任务能够正确地使用新平台的内置时间参数。 迁移规则的扩展 Airflow允许用户根据需要定义和使用自定义Operator、Hook、Sensor等,以满足特定的任务需求。这些自定义组件可能在 DAGs 中使用,而且它们的实现和调用方式可能在迁移过程中需要特殊处理。最简单的处理方式是使用上问提到的 “Air2phin 如何定义自己的转换规则” 的方式处理。只要自定义的任务在 DolphinScheduler 中可以被定义,那就能将任务从 Airflow 迁移到 DolphinScheduler 不同版本的 Airflow 迁移 不同版本的 Airflow 在 operator 的语法中有所不同,在 2.0.0 之前的版本中,Airflow 对 bash 的支持仅拥有 airflow.operators.bash_operator.BashOperator 这个类,但是在 2.0.0 及之后的版本,Airflow 对 bash 更加推荐的是 airflow.operators.bash.BashOperator 这里类,同时兼容 Airflow.operators.bash_operator.BashOperator。类似的情况还有很多,所以 Air2phin 需要同时兼容上述两种类型转换成 DolphinScheduler 的 shell 任务类型。我们通过在 YAML 中支持列表的方式实现对多个类转化,详见下面的 migration.module.* 节点 migration: module: - action: replace src: - airflow.operators.bash.BashOperator - airflow.operators.bash_operator.BashOperator dest: pydolphinscheduler.tasks.shell.Shell parameter: - action: replace src: task_id dest: name - action: replace src: bash_command dest: command 用户收益 Air2phin迁移工具可以通过简单的配置实现用户从 Airflow 的 DAGs 代码转换为 DolphinScheduler Python SDK, 给用户带来了很多收益 简化迁移过程: 迁移工具可以自动处理代码转换,避免手动逐行迁移的复杂过程,大大减轻了开发人员的工作负担。 节省时间和成本: 手动迁移代码需要投入大量时间和人力资源。使用迁移工具可以快速、高效地完成迁移,从而节省时间和成本。 减少错误: 手动迁移容易引入错误,而迁移工具可以基于预定义规则自动进行转换,减少了潜在的人为错误。 规范代码风格: 迁移工具可以根据预定义的规则和模板生成代码,确保代码风格一致,降低维护成本。 降低技术门槛: 迁移工具可以隐藏底层技术细节,使得不熟悉 DolphinScheduler 的开发人员也能够轻松迁移任务。 灵活性和可定制性: 好的迁移工具通常会提供一些可定制的选项,以满足不同项目的需求,同时保持灵活性。 总的来说,使用 Air2phin 可以显著提升迁移过程的效率和质量,降低风险,同时减轻了开发人员的工作负担,为团队带来了时间和资源的节省,以及更好的开发体验。 Air2phin 目前还不能解决的问题 Air2phin 是一个协助用户更简单从 Airflow 迁移到Apache DolphinScheduler 。这个的关键词是“协助”,意味着他能减少用户的迁移成本,但是并不能完全自动化。目前已知的不能解决的问题如下: 不能迁移在 DolphinScheduler 不存在的任务类型:部分任务类型仅在 Airflow 中存在,但是在 DolphinScheduler 不存在,这部分任务不能被自动迁移,需要手动处理。如 Discord operator 中在 DolphinScheduler 中不存在,所以原来 Discord operator 定义会被保留,需要用户手动处理 部分任务属性不能被迁移到 DolphinScheduler:Airflow 中部分任务属性在 DolphinScheduler 中不存在,如 successc_callback 和 retry_callback,这部分属性在迁移过程中会被直接遗弃 REF air2phin 使用文档:https://air2phin.readthedocs.io/en/latest/index.html air2phin in PyPI: https://pypi.org/project/air2phin/ air2phin GitHub repository: https://github.com/WhaleOps/air2phin 本文由 白鲸开源科技 提供发布支持!

优秀的个人博客,低调大师

实现基于 GitLab 的数据库 CI/CD 最佳实践

数据库变更一直是整个应用发布过程中效率最低、流程最复杂、风险最高的环节,也是 DevOps 流程中最难以攻克的阵地。那我们是否能在具体的 CI/CD 流程中,像处理代码那样处理数据库变更呢? DORA 调研报告 DORA(DevOps Research & Assessment)是一家专注于 DevOps 的研究机构, 在该领域以专业与客观著称。自 2014 年以来,DevOps 调研了全球范围内超过 32,000 名专业人员,并以年度报告的形式对外发布研究成果。DORA 明确指出,将数据库变更纳入应用发布流程将显著提升整体发布效率。 这一结论并不令人意外。问题是,该怎么做? 一个完整的基于 GitLab 的数据库 CI/CD 工作流 通过 Bytebase,我们将实现一个完整的基于 GitLab 的数据库 CI/CD 工作流: 开发者将变更 SQL 脚本提交到代码分支; 触发 Bytebase 提供的 SQL 审核 CI 进行自动化 SQL 审核,并给出修改建议; 修改完成后的 SQL 脚本合并入主分支; 自动触发发布流程,脚本将被推送到 Bytebase 工具中; Bytebase 内置的自动审核将对变更语句进行二次确认,根据变更风险等级自动匹配审批流,根据审批流审批; 审批后的语句可以通过手动或自动触发在目标库中执行; 变更完成后的数据库最新 schema 结构将被自动回写入代码仓库; 确认变更完成后,触发下一阶段的应用发布流程。 通过 Bytebase 社区版实现 让我们一步一步看看这个过程怎样实现的。 第一步 通过 Docker 启动 Bytebase,并配置外部 URL ngrok 是一个反向代理工具,我们需要它的公网地址,以便从 GitHub 接收 webhooks。这里使用 ngrok 是出于测试目的;生产环境建议使用 Caddy。 登录 ngrok Dashboard,并按照 Getting Started 步骤进行安装和配置。 在 Docker 中运行 Bytebase: docker run --init \ --name bytebase \ --restart always \ --publish 5678:8080 \ --health-cmd "curl --fail http://localhost:5678/healthz || exit 1" \ --health-interval 5m \ --health-timeout 60s \ --volume ~/.bytebase/data:/var/opt/bytebase \ bytebase/bytebase:2.8.0 \ --data /var/opt/bytebase \ --port 8080 Bytebase 通过 Docker 成功启动,你可以通过 localhost:5678 来访问。注册一个管理员账号。 在命令行运行 ngrok http 5678 ,并获得公共 URL。 登录 Bytebase,点击右上角的齿轮,将公共 URL 填入到网络部分的外部 URL,点击更新。 第二步 在 Bytebase 种添加 GitLab.com 作为 Git Provider 通过公共 URL 来访问 Bytebase,点击右上角的齿轮 > 集成 > GitOps,选择 gitlab.com,点击下一步。你会进入到第二步,拷贝 Redirect URI。 访问 GitLab,点击头像,选择下拉菜单中的偏好设置,在左侧栏中选择应用。填写表格如下并保存: Name: Bytebase Redirect URI: 从 Bytebase GitOps 配置里步骤 2 里复制 Confidential: Yes Scope: api 从 GitLab 的应用页面复制 Application ID 和 Secret,然后粘贴到 Bytebase 的 GitOps 配置页面步骤 2 里。 第三步 在 Bytebase 中配置一个 GitOps 工作流 访问 GitLab,并建立一个新项目 bytebase-gitlabcom-demo。将 Visibility Level(可见级别)设置为公共。点击建立项目。 访问 Bytebase,进入项目 Sample Project。点击 GitOps 标签,选择 GitOps 工作流。点击 配置 GitOps。 选择 GitLab.com(就是你在上一步配置的),然后选择 bytebase-gitlabcom-demo 这个项目。你会来到步骤三,保持其它参数不变,滑动到页面底部,勾选 基于 GitLab CI 开启 SQL 审核。点击完成。 Image 系统会自动在 GitLab 中建立实现 CI 的 MR,跳转到 GitLab 中手动合并。 回到 Bytebase,你会见到 GitOps 工作流已设置成功。 第四步 建立一个 MR(合并请求)去触发 SQL 审核 CI 点击界面顶端环境,你可以看到在 Prod 最下方有连接了一个 SQL 审核策略,点击编辑,你会看到有 3 条开启的规则。它们将通过 CI 应用。 为了测试 SQL 审核 CI,我们将创建一个合并请求来更改 Prod 数据库 schema。不过,我们会让它先违反下 SQL 审核策略。转到 GitLab 上的 bytebase-gitlabcom-demo。单击新建分支,命名为 add-nickname-table-employee,点击创建分支。 在新分支上创建子目录 bytebase,并创建子子目录 prod。在 prod 目录中创建文件 employee##202309262500##ddl##add_nickname_table_employee.sql。将以下 SQL 脚本复制到文件中,并提交更改。 ALTER TABLE "public"."employee" ADD COLUMN "nick_name" text; 创建包含上述提交的合并请求。SQL 审核 CI 将自动运行并显示失败消息。不过,无论 CI 结果如何,你仍然可以合并它。 更新 SQL 脚本并提交到当前分支。SQL 审核 CI 将再次运行并显示通过信息。单击合并。 ALTER TABLE "public"."employee" ADD COLUMN "nick_name" text NOT NULL DEFAULT ''; 6. 返回 Bytebase 中的 Sample Project,你会看到推送事件产生了一个工单。 7. 点击 issue/102 到问题详情页面。因为没有配置审批流或手动发布,此工单会自动发布。您可以点击查看变更来查看差异。 通过 Bytebase 企业版解锁更多功能 您可以升级到企业版,解锁更多功能。点击左下角的开始免费试用并升级到企业版,点击顶部实例,为现有的两个实例分配证书。 手动发布 在环境 > 2.Prod,找到发布策略,然后选择 人工发布 > 需要 DBA 或者 Bytebase 实例所有者发布。 自定义审批 访问设置 > 安全性 & 策略 > 自定义审批。将项目 Project Owner -> DBA 设置为 DDL > 高风险的审批流。 访问设置 > 安全性 & 策略 > 风险中心。点击添加规则,然后点击加载第一个模板,点击添加。 最新 schema 写回 Schema 变更完成后,Bytebase 会将最新 schema 写回 Git 代码库。这样,团队在 Git 中就始终有一个数据库 schema 的标准真实源。 返回 GitLab,新建一个分支 add-country-table-employee。在 bytebase/prod 目录下创建文件 employee##202309261700##ddl##add_country_table_employee.sql。将以下 SQL 脚本复制到文件中并提交更改。 ALTER TABLE "public"."employee" ADD COLUMN "country" text NOT NULL DEFAULT ''; 返回 Bytebase,转到新创建的工单,它符合 Project Owner -> DBA 的审批流程。 按照审批流程点击批准后,横幅将显示等待发布。然后,负责人就可以点击 发布了。 回到 GitLab,在 bytebase/prod/ 下有一个新的文件 .employee##LATEST.sql,包含了 Bytebase 写回的最新 schema。 Schema 漂移 Bytebase 内置了 schema 漂移检测功能,可以检测到意外的 schema 变更。让我们使用 SQL 编辑器管理员模式来模拟一下。 点击右上角的终端图标(SQL 编辑器)。你将跳转到 SQL 编辑器。点击管理员模式。在此模式下所做的一切与直接连接服务器相同,Bytebase 不会记录。 选择左侧的 (Prod) Employee,粘贴并运行以下脚本: ALTER TABLE "public"."employee" ADD COLUMN "city" text NOT NULL DEFAULT ''; 返回 Bytebase 主页,点击顶部的数据库, 选择 Prod 下的 employee。点击现在同步。看到成功消息后,刷新页面。你将看到 schema 漂移。你可以在实例详情页配置自动扫描,以避免手动同步。 访问异常中心,也会看到 schema 漂移。 总结 有了 Bytebase,你就有了一套完整的 GitLab 数据库 CI/CD 工作流程。您可以将此工作流程应用到自己的项目中,并根据自己的需要进行定制。 Bytebase 也支持 GitHub,Bitbucket 以及 Azure DevOps。具体的配置步骤可以查看文档。 💡 你可以访问官网,免费注册云账号,立即体验 Bytebase。

优秀的个人博客,低调大师

每日一博 | 京东短网址高可用提升最佳实践

作者:京东零售郝彦军 什么是短网址? 短网址,是在长度上比较短的网址。简单来说就是帮您把冗长的URL地址缩短成8个字符以内的短网址。 当我们在腾讯、新浪发微博时,有时发很长的网址连接,但由于微博只限制140个字,所以微博就自动把您发的长网址给转换成短网址了。在微博和手机短信提醒等限制字数的地方来使用短网址,的确是一个不错的方案。 短网址通常使用“短域名/短码”的形式,打开短网址网页会直接跳转到长网址页面。例:3.cn/CdEyF2、t.cn/RlB2PdD、dwz.cn/134128 等短网址,分别是由以下短网址服务缩短后的网址 京东短网址:http://s.3.cn/, 新浪短网址:https://sina.lt/ ,百度短网址:http://dwz.cn/。 短网址服务主要包含功能: 生成短网址(长网址缩短)、二维码简化、修改短网址、短网址跳转(访问短网址跳转到长网址)、唤醒APP、短网址统计 等。 短网址能解决什么问题? 长网址存在的问题: 1、长网址的长度太长,下面的长网址,共记312个字符,在微博场景中,限制140字符,已无法发布出去。在短信场景中,限制70字符,会产生5条短信费用,被拆分后还无法访问,严重影响用户体验。http://wjorder-http.jd.com/scan/np?encodePrcode=2hP_lwNr&encodeShcode=2-S83&businessSource=1&scanSkuType=2&ec=1&salerId=167916&discountsUrl=%2F%2Fcoupon.m.jd.com%2Fcoupons%2Fshow.action%3FlinkKey%3DAAROH_xIpeffAs_-naABEFoePLd7eC4GJgwsPUkFtDqklu805DO1cEqFyTHVT7fbD12AHD7DElAKgh0pfvQpX-E5PbgwLQ&unionId=1001465750 2、长网址生成的二维码,极其复杂 ,导致手机扫描识别极其困难,低端手机甚至无法识别,严重影响用户体验。 短网址则完美解决了上述问题: 1、使用短网址服务缩短上面长网址后的短网址(3.cn/1jK-CDAE),仅有13个字符,在微博、短信等场景中发送十分容易,而且简洁清晰,用户体验极好。 2、短网址生成的二维码,极其简洁 ,非常容易识别,用户体验良好。 京东短网址的业务场景: 京东短网址http://s.3.cn/,是京东唯一的短网址服务平台,已应用到京东体系的各个业务场景中,日均产生1亿条带有3.cn的短消息,点击短网址还可直接唤起对应的APP和小程序。 如下图1-2是来自七鲜、金龙鱼、京东金融、蒙牛、京东等业务的营销消息,下图3-4是唤起七鲜小程序、京东APP、金融APP并跳转至落地页的截图。 图1 图2 图3 图4 京东短网址服务的架构优化: 改造前短网址生成流程图说明: 1、系统首先查询长网址(长链)是否已存在于redis(jimdb)或hbase中, 2、如果长链已存在,则表示该长网址已经生成过,可直接返回查到的短网址,流程结束。 3、如果长链不存在,则使用长网址进行MD5随机算法生成一个长串,并分成3段,转化成62进制短码,拼装成短网址,然后查询短网址(短链)是否存在于redis或hbase中 4、如果短链不存在,则保存长网址到短网址的映射、以及短网址到长网址的映射,到redis或hbase中,返回短网址,流程结束。 5、如果短链已存在,说明随机算法生成的短码发生了冲突碰撞,需要循环回到步骤3,加盐重新生成一个短码,直到生成的短码检测没有冲突后,走到步骤4结束。 从原流程图分析原系统优劣势: 优势:采用随机算法,同一长链在同一账号下始终唯一,适用于长网址大量重复生成的情景,可以在步骤2快速返回,且随机算法遍历难度相对较高。 劣势:外部操作太多,性能影响较大,每次生成短网址涉及的网络请求次数至少8次(2次查redis、2次写redis、2次查hbase、2次写hbase)。 且从上面步骤5可以看出,系统存在一个碰撞循环,随着短码数据量日益增加,碰撞率也会大大增加,每次碰撞都要额外增加1次redis与1次hbase查询,导致性能越来越差。 分析原流程&历史数据,寻找原流程优化点: 1、 从原流程可以看出,如果继续采用随机算法,很难进行优化,因此,想到了可以采用自增算法,因为自增不存在碰撞,就不需要进行双向检索存储,能够极大的降低外部请求数。 2、 分析历史数据发现,很少存在长网址被大量重复生成的情况,也就是说,可以采用自增算法的单向存储(仅存储短网址到长网址的映射),并不会增加存储量,反而会比随机算法的双向存储(存储短到长的映射,及长到短的映射,即双倍存储)节省存储量。 3、 分析历史数据发现,90%超过1个月的短网址都不再有访问量了,同时调研业务也发现,43%用户1个月有效期就够了,46%用户3个月,10%用户1年,极少有用户需要短网址永久有效。 4、 分析历史数据发现,生成的数据量很大,日均1亿+,且大多数短网址并不需要永久保存,需要做好清理规划 5、 分析历史数据发现,生成量远大于跳转量,跳转服务流程简单仅做查询,优化空间不大,倒是对生成服务性能要求极高,优化重点在于生成服务。 优化后的短码生成流程说明: 1、 系统直接采用自增算法生成了一个短码,因为自增算法没有了随机碰撞,也就不需要再检索短网址是否存在redis或hbase中。 2、 直接保存短网址到长网址的映射到redis中,因为没有了检索长网址是否存在于redis或hbase,也就不再需要保存长网址到短网址的映射,也就可以把hbase的写入改成异步写入,然后直接返回短网址,流程结束。(可以看到系统仅剩下1次同步的redis操作,流程极大简化,可以预见接口性能将得到极大提升) 自研专利算法介绍 细心的同学可能会有疑问,上面的分布式自增算法是怎么实现的呢? 目前市面上已知方案,1、通过数据库自增(并发QPS数有限)2、通过redis自增(存在单key热点问题,也就是所有的发号请求都会打到同一分片上),两种方案均会增加性能损耗,且存在扩展瓶颈,无法满足京东的海量业务请求。3、雪花算法(长度太长不符合,短网址要求长度一般在7个字符) 因此设计了下面的专利自增算法:(性能近乎于内存,损耗可忽略) 下面介绍一下核心的自增算法原理:主要采用缓存发号加内存自增方式,既无碰撞率又性能极高,主要体现在下图的三条彩色通道上面。 1、绿色通道:内存发号,速度极快,每次从缓存取出10000个无重复号码,然后在内存中便可连续生成10000个短码,因此速度比传统基于数据库及缓存自增发号方式快万倍。 2、蓝色通道:缓存取号,依赖缓存保证分布式发号无碰撞,批量发号,每1万次内存绿色通道才走一次蓝色缓存通道取号,因此性能极高 3、红色通道:保障机制,保障生成的号码都在短网址对应长度的号码总容量范围内,仅在初始化及总容量用尽时执行,性能损耗可忽略不计。 长度&有效期规划: • 有访问会自动延期N天(7位短码总容量3万亿,过期时间30天,每天有1000亿短码可用,30天内有1次访问就会重置30天有效期,也就是说保持“热数据”始终在redis中) • 连续N天无访问自动回收(7位短码,连续30天没有访问的情况下,才会过期回收,也就是说“冷数据”无访问N天后会自动过期清理回收) 以下统计了最近6天的各短码长度的使用分布占比情况,目前使用最多的是7位与8位短码,占比总和近90%。其中43%的用户选择了30天有效期,46%的用户选择来了100天有效期。 提效成果: Ø 接口性能极大提升:tp999:从150+ms ->7ms,解决了业务调用缓慢及超时的痛点 Ø 单机承载量极大提升:单机QPS:从497->10184,提升了20倍+,无扩容支撑了日生成量:从1千万->2亿+ Ø 按百度短网址费用核算,1年可节约2700万元(证明短网址产生价值很大 Ø redis缓存30天热数据,缓存量 1.2TB Ø Hbase存储全量数据,存储量 4TB Ø 6月18日生成量4.7亿、6月日均1亿、峰值QPS 7.2万 Ø 6月1日跳转量1600万、6月日均800万 Ø 线上仅8台4核docker(优化后日常节约了760核机器,618节约3572核) Ø 有访问自动延期,无访问自动过期回收,避免了死码长期占用资源消耗费用,避免短码越积越多导致的数据量太大及性能下降,系统可长期稳定运行 创新性: Ø 产出技术发明 专利1篇,编号:JDZL2019N5022 Ø 技术关键点是分布式 无碰撞 高效 短码生成算法: Ø 该算法利用redis的incrby实现分布式号段发放(5位短码每次发放1000个号,当然6、7位短码可设置更大步长值10000个),利用本机原子id自增减少redis请求(每10000个id自增后请求1次redis),因为id始终自增所以短码无碰撞概率(id可以直接转化为62进制短码),避免了因短码碰撞带来的循环生成检索的性能开销。利用redis.set原子检测key不存在时才能设置成功实现分布式加锁,解决多线程并发重置问题,最终实现比传统自增方案快万倍的高性能无碰撞短码自增算法。 Ø 利用容量规划及过期时间机制(5位短码总容量9亿,有效期10天,每天有9千万可用),实现号段循环重复利用(10天后第1天的号段过期,可以再次使用)(当然如果是6位短码、总容量有550亿,有效期也可以更长。7位短码总容量3万亿,基本可以不用过期了),保障了系统的长期稳定运行。 影响力: Ø 宙斯平台-京麦服务市场中上架,有**470+**京东商户应用使用。3.cn/1-jMkHBf Ø 3.cn作为京东唯一的短网址服务平台,合作的应用50+(京东APP、京东金融、京东云、京东保险、七鲜、京东健康、京东物流等等)、小程序20+、合作的二级部门80+

优秀的个人博客,低调大师

好未来基于北极星的注册中心最佳实践

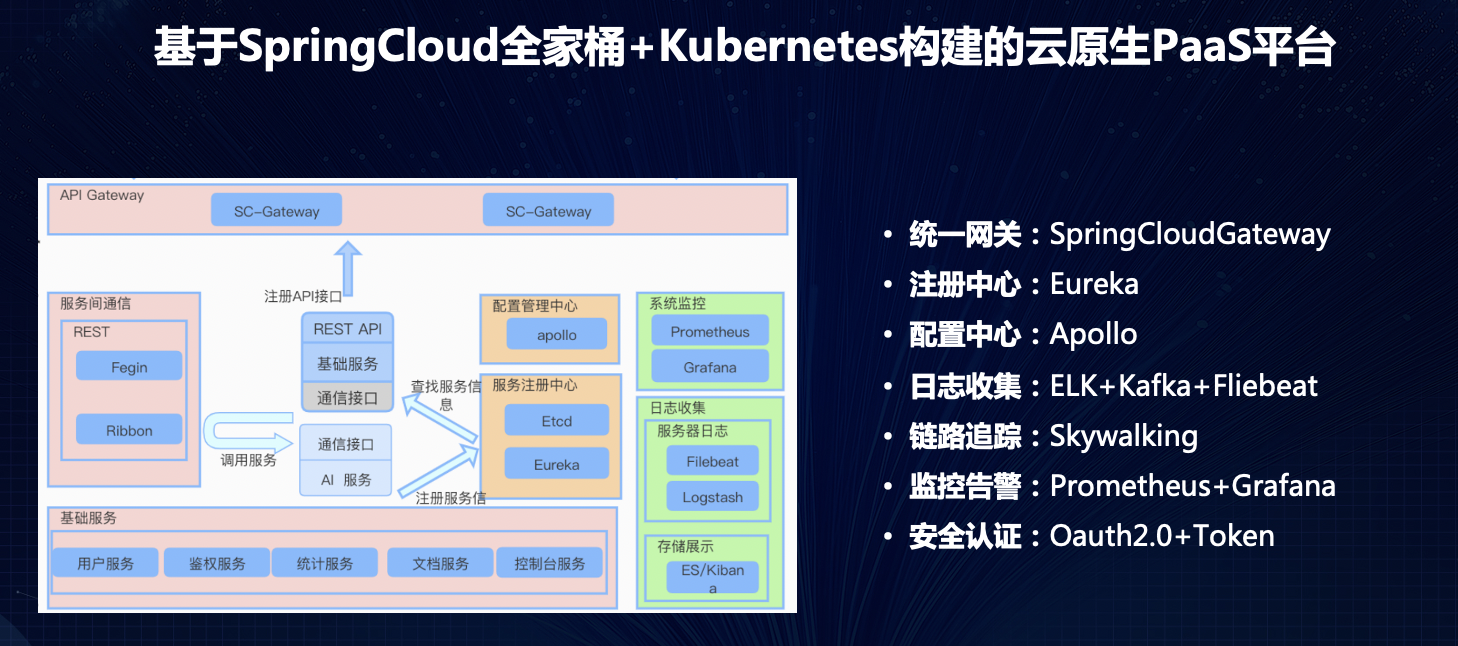
业务背景 好未来是一家以智慧教育和开放平台为主体,在全球范围内服务公办教育,助力民办教育,探索未来教育新模式的科技教育公司,旗下拥有学而思素养、学而思网校等品牌。作为国家新一代人工智能开放创新平台在教育行业的代表,好未来深耕教育场景,目前已积累15大类共计170余种AI能力,覆盖视觉、语音、自然语言处理等多个方向,引领教育+AI发展的同时,助力中小行业伙伴的成长,推动教育新生态建设。 2021年好未来 AI 中台业务规模激增,日调用量超6亿,总调用量上千亿。相比2020年增长约9倍,并持续呈现增长趋势。业务规模井喷式增长,给平台带来的稳定性技术挑战也越发强烈,好未来AI中台的现有架构,无论是业务支撑还是架构设计,均存在一定的风险和隐患。 痛点分析与解决方案 好未来采用SpringCloud全家桶和Kubernetes构建云原生的 AI 中台。整体采用单集群部署。这种部署架构随着业务规模的激增,带来资源和性能瓶颈,如 VPC 中的 IP 资源、Node节点、apiserver性能等问题进而影响现网业务。另一方面,也带来集群层面的单点问题,如:完全依赖某一家云厂商、没有灾备集群、升级困难等挑战 。 除此之外 ,因历史遗留问题导致的技术债也日益严重,如:技术栈不统一 (java、python、go、c++)、服务注册sdk使用不规范 、服务负载不均衡等问题。整体架构升级与改造中,涉及模块众多,本文将重点聚焦于注册中心模块遇到的痛点与解决方案 。 服务负载不均衡 业务规模激增,注册中心瓶颈显著 技术栈多且杂,迁移难 现有服务注册发现方案 首先,我们先来看一下好未来现有的服务注册发现方案。 好未来选择Eureka组件作为AI中台的注册中心。Eureka是Netflix开源的一款基于Java语言的服务发现框架,2014年发布了第一个版本,现在业界广泛使用的是与Spring Cloud结合的Spring Cloud Neflix的版本。 Eureka主要功能是为应用之间跨进程的RPC调用提供服务注册发现,以及故障实例剔除的功能,其工作原理如下图所示: Eureka Server:提供基于最终一致性的服务数据管理,服务发现,异常节点剔除等能力。 Provider:服务被调方,启动时候将自身注册到Eureka server,运行过程中定时发送心跳续约请求进行保活,在进程结束时将自身从Eureka server反注册。 Consumer:服务主调方,基于Eureka服务发现接口,从eureka拉取服务列表,并根据一定负载均衡算法,选出一个IP地址与被调方进行远程调用。 Eureka支持多语言客户端SDK,官方提供了Java版本的SDK(spring-cloud-netflix-eureka-client),社区提供了其他语言的SDK(Go,Python等)。 好未来为多语言应用,同时使用了官方提供的Java SDK、社区版Go/Python SDK,与此同时,还自研了C++ SDK。具体架构如下图所示 : 2、核心的痛点与解决方案 痛点一 :服务负载不均衡 好未来将每个服务配置的k8s service name注册至Eureka server服务列表中。通过Eureka + Ribbon 实现轮询(round-robin)负载算法的客户端负载均衡,Ribbon负载均衡器缓存了从Eureka Server中获取的所有服务信息。 由于同一个服务不同实例的k8s service name是同一个,导致在长链接场景下,客户端负载不均衡。如下图所示: 解决方案: 将注册服务信息由k8s clusterIP替换成每个实例的pod ip。 痛点二:注册中心注册瓶颈 好未来有4000左右的服务数,平均每个服务3节点。将service(cluster ip)注册改为pod ip注册后,客户端注册量由4000,增长至超过1万。 Eureka各个server之间是通过异步请求的方式进行写请求的同步,写请求包括注册/反注册/心跳续约的请求,同步失败会进行重试。这种异步同步模式,在客户端集群规模较大、或者网络情况不好触发了重试风暴的情况下,容易因为处理过多的同步续约请求,导致server端高负载。 以下是好未来出现的现网场景,一个可用区的Eureka server出现网络异常,续约的同步请求都重试到其他区的服务端,导致服务端高负载,出现大量请求超时,超时情况下会继续重试,从而导致高负载问题蔓延到其他区。 在1小时内,服务端平均负载飙升到80%,续约请求的时延也出现10s的峰值,导致大量服务健康状态出现异常,严重影响了现网的服务运营质量。 解决方案: 性能、可扩展性与迁移成本是好未来进行注册中心选型时重点考虑的因素。在对比了开源和业内其他厂商的注册中心之后,决定选择腾讯云提供的TSE微服务引擎(Polaris)。 Polaris(北极星)是腾讯开源的服务发现和治理组件,在服务注册发现基础上,提供了流量调度,故障剔除等治理能力,其功能可完整覆盖Eureka的使用场景。Polaris(北极星)很好的解决了Eureka带来的性能瓶颈和容量瓶颈。Polaris服务端采用计算存储分离的架构,计算层可以随着接入节点的增加平行扩展,轻松支持百万节点。 在5万服务注册节点的场景下,性能数据如下: 服务注册:成功率100%,最大延时<1s 上报心跳:成功率100%,最大延时<15ms 服务发现:成功率100%,最大延时<8ms 通过监控曲线可以看到,5W注册实例,并发进行全量数据拉取及实时心跳续约的场景下,北极星(Eureka)的整体CPU使用情况稳定在2.29核,并且整体的**CPU利用率稳定在57%**左右。 痛点三:技术栈多且杂,迁移难 因历史遗留问题导致的技术栈也日益严重,技术栈不统一 、服务注册sdk使用不规范。好未来为多语言应用,同时使用了官方提供的Java SDK、社区版Go/Python SDK,与此同时,还自研了C++ SDK。因此,迁移成本是重要的考虑因素: 问题一:用户程序代码需要改造吗? 好未来当前程序已经集成了Eureka的客户端,如果切换成北极星客户端的话,需要做代码变更,成本较高。 解决方案: 北极星实现了Eureka Server API的全兼容,做到支持各个语言、不同版本的Eureka Client进行直接接入。完全无需代码改造。 问题二:数据如何平滑迁移 ? 用户现网已经注册到Eureka上的存量数据,如何平滑迁移到北极星上,过程中不能出现业务的中断。 解决方案: 北极星在服务端通过服务数据单向同步,以及关联查询的方式,实现了新老服务的互访,好未来可以按自己的节奏将服务从Eureka注册中心迁移到北极星。 3、总结与收益 从定位上来说,Eureka是服务注册中心,只提供服务发现、服务注册和健康检查功能。北极星是服务发现和治理中心,除服务发现、服务注册和健康检查之外,还提供流量控制、故障容错和安全能力。 从架构上来说,Eureka集群采用异步复制的方式同步数据,每个Server将收到的写请求异步复制给集群内的其他Server。当Client越来越多时,需要扩容Server。但是,增加Server也会增加Server之间的复制请求,导致扩容效果不明显。北极星服务端计算存储分离,计算层节点可以随着客户端节点的增加平行扩展,轻松支持百万级节点接入。 好未来AI中台零代码修改,将注册中心由Eureka迁移至北极星,并发注册服务数有极大的提升,由7k提升至5w。解决了业务规模激增场景下开源注册中心瓶颈问题,有效避免线上再次故障。北极星计算存储分离、控制面无状态,可以随着未来业务规模的继续扩大,高效方便的继续扩容。除此之外,好未来还获得了服务治理、可视化控制台、服务治理监控等方面的收益。 服务治理:北极星提供熔断功能,根据实时采集的错误率等指标,及时熔断异常的服务、接口、实例或者实例分组,降低请求失败率。 当负载已经超过了系统的最大处理能力时,北极星提供服务限流功能,可针对不同的请求来源和系统资源进行访问限流,避免服务被压垮。有效提升业务系统的健壮性。 可视化控制台:北极星提供简单易用的可视化控制台,用户可通过控制台界面简化服务管理、配置管理、以及服务治理规则管理等相关的操作。 服务治理监控:北极星提供可视化的服务治理监控能力,基于Prometheus和Grafana,提供服务路由、故障熔断、访问限流等曲线监控以及告警的能力。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册