首页 文章 精选 留言 我的

精选列表

搜索[AIOps最佳实践],共10000篇文章
优秀的个人博客,低调大师

云数据库ClickHouse二级索引 - 最佳实践

引言 阿里云数据库ClickHouse二级索引功能近日已正式发布上线,主要弥补了ClickHouse在海量数据分析场景下,多维度点查能力不足的短板。在以往服务用户的过程中,作者发现绝大部分用户对ClickHouse单表查询性能优化问题感到无从下手,借此机会,本文会先为大家展开介绍ClickHouse在单表分析查询性能优化上的几个方法,基本涵盖了OLAP领域存储层扫描加速的所有常用手段。在解决过各种各样业务场景下的性能优化问题后,作者发现目前ClickHouse在解决多维搜索问题上确实能力不足,一条点查常常浪费巨大的IO、CPU资源,于是云数据库ClickHouse自研了二级索引功能来彻底解决问题,本文会详细介绍二级索引的DDL语法、几个典型适用场景和特色功能。希望可以通过本文让大家对ClickHouse在OLAP场景下的能力有更深的理解,同时阐述清楚二级索引适用的搜索场景。 存储扫描性能优化 在介绍各类OLAP存储扫描性能优化技术之前,作者先在这里申明一个简单的代价模型和一些OLAP的背景知识。本文使用最简单的代价模型来计算OLAP存储扫描阶段的开销:磁盘扫描读取的数据量。在类似ClickHouse这样纯列式的存储和计算引擎中,数据的压缩、计算、流转都是以列块为单位按列进行的。在ClickHouse中,只能对数据列以块为单位进行定位读取,虽然用户的查询是按照uid查询确定的某一条记录,但是从磁盘读取的数据量会被放大成块大小 * 列数。本文中不考虑数据缓存(BlockCache / PageCache)这些优化因素,因为Cache可以达到的优化效果不是稳定的。 排序键优化-跳跃扫描 排序键是ClickHouse最主要依赖的存储扫描加速技术,它的含义是让存储层每个DataPart里的数据按照排序键进行严格有序存储。正是这种有序存储的模式,构成了ClickHouse "跳跃"扫描的基础和重复数据高压缩比的能力(对于ClickHouse的MergeTree存储结构不熟悉的同学可以参考往期文章《ClickHouse内核分析-MergeTree的存储结构和查询加速》)。 CREATE TABLE order_info ( `oid` UInt64, --订单ID `buyer_nick` String, --买家ID `seller_nick` String, --店铺ID `payment` Decimal64(4), --订单金额 `order_status` UInt8, --订单状态 ... `gmt_order_create` DateTime, --下单时间 `gmt_order_pay` DateTime, --付款时间 `gmt_update_time` DateTime, --记录变更时间 INDEX oid_idx (oid) TYPE minmax GRANULARITY 32 ) ENGINE = MergeTree() PARTITION BY toYYYYMMDD(gmt_order_create) --以天为单位分区 ORDER BY (seller_nick, gmt_order_create, oid) --排序键 PRIMARY KEY (seller_nick, gmt_order_create) --主键 SETTINGS index_granularity = 8192; 以一个简单的订单业务场景为例(表结构如上),order by定义了数据文件中的记录会按照店铺ID , 下单时间以及订单号组合排序键进行绝对有序存储,而primary key和index_granularity两者则定义了排序键上的索引结构长什么样子,ClickHouse为每一个有序的数据文件构造了一个"跳跃数组"作为索引,这个"跳跃数组"中的记录是从原数据中按一定间隔抽取出来得到的(简化理解就是每隔index_granularity抽取一行记录),同时只保留primary key定义里的seller_nick, gmt_order_create两个前缀列。如下图所示,有了这个全内存的"跳跃数组"作为索引,优化器可以快速排除掉和查询无关的行号区间,大大减少磁盘扫描的数据量。至于为何不把oid列放到primary key中,读者可以仔细思考一下原因,和index_granularity设定值大小也有关。 作者碰到过很多用户在把mysql的binlog数据迁移到ClickHouse上做分析时,照搬照抄mysql上的主键定义,导致ClickHouse的排序键索引基本没有发挥出任何作用,查询性能主要就是靠ClickHouse牛逼的数据并行扫描能力和高效的列式计算引擎在硬抗,这也从侧面反应出ClickHouse在OLAP场景下的绝对性能优势,没有任何索引依旧可以很快。业务系统中的mysql主要侧重单条记录的事务更新,主键是可以简单明了定义成oid,但是在OLAP场景下查询都需要做大数据量的扫描分析,ClickHouse需要用排序键索引来进行"跳跃"扫描,用户建表时应尽量把业务记录生命周期中不变的字段都放入排序键(一般distinct count越小的列放在越前)。 分区键优化-MinMax裁剪 继续上一节中的业务场景,当业务需要查询某一段时间内所有店铺的全部订单量时,primary key中定义的"跳跃"数组索引效用就不那么明显了,查询如下: select count(*) from order_info where gmt_order_create > '2020-0802 00:00:00' and gmt_order_create < '2020-0804 15:00:00' ClickHouse中的primary key索引有一个致命问题是,当前缀列的离散度(distinct value count)非常大时,在后续列上的过滤条件起到的"跳跃"加速作用就很微弱了。这个其实很好理解,当"跳跃数组"中相邻的两个元组是('a', 1)和('a', 10086)时,我们可以推断出第二列在对应的行号区间内值域是[1, 10086];若相邻的元素是('a', 1)和('b', 10086),则第二列的值域范围就变成(-inf, +inf)了,无法依据第二列的过滤条件进行跳过。 这时候就需要用到partition by优化了,ClickHouse中不同分区的数据是在物理上隔离开的,同时在数据生命管理上也是独立的。partition by就好像是多个DataPart文件集合(数据分区)之间的"有序状态",而上一节中的order by则是单个DataPart文件内部记录的"有序状态"。每一个DataPart文件只属于一个数据分区,同时在内存里保有partition by列的MinMax值记录。上述查询case中,优化器根据每个DataPart的gmt_order_create最大值最小值可以快速裁剪掉不相关的DataPart,这中裁剪方式对数据的筛选效率比排序键索引更高。 这里教大家一个小技巧,如果业务方既要根据下单时间范围聚合分析,又要根据付款时间范围聚合分析,该如何设计分区键呢?像这类有业务相关性的两个时间列,同时时间差距上又是有业务约束的情况下,我们可以把partition by定义成: (toYYYYMMDD(gmt_order_create), (gmt_order_pay - gmt_order_create)/3600/240) 这样一来DataPart在gmt_order_create和gmt_order_pay两列上就都有了MinMax裁剪索引。在设计数据分区时,大家需要注意两点: 1)partition by会对DataPart起到物理隔离,所以数据分区过细的情况下会导致底层的DataPart数量膨胀,一定程度影响那种大范围的查询性能,要控制partition by的粒度; 2)partition by和order by都是让数据存放达到"有序状态"的技术,定义的时候应当尽量错开使用不同的列来定义两者,order by的第一个列一定不要重复放到partition by里,一般来说时间列更适合放在partition by上。 Skipping index优化-MetaScan 在ClickHouse开源版本里,用户就可以通过自定义index来加速分析查询。但是实际使用中,绝大部分用户都不理解这个文档上写的"skipping index"是个什么原理?为什么创建index之后查询一点都没有变快或者反而变慢了???因为"skipping index"并不是真正意义上的索引,正常的索引都是让数据按照索引key进行聚集,或者把行号按照索引key聚集起来。而ClickHouse的"skipping index"并不会做任何聚集的事情,它只是加速筛选Block的一种手段。以 INDEX oid_idx (oid) TYPE minmax GRANULARITY 32 这个索引定义为例,它会对oid列的每32个列存块做一个minmax值统计,统计结果存放在单独的索引文件里。下面的查询在没有oid skipping index的情况下,至少需要扫描5天的数据文件,才能找到对应的oid行。有了索引后,数据扫描的逻辑变成了先扫描oid索引文件,检查oid的minmax区间是否覆盖目标值,后续扫描主表的时候可以跳过不相关的Block,这其实就是在OLAP里常用的Block Meta Scan技术。 select * from order_info where gmt_order_create > '2020-0802 00:00:00' and gmt_order_create < '2020-0807 00:00:00' and oid = 726495; 当oid列存块的minmax区间都很大时,这个skipping index就无法起到加速作用,甚至会让查询更慢。实际在这个业务场景下oid的skipping idex是有作用的。上一节讲过在同一个DataPart内数据主要是按照店铺ID和下单时间进行排序,所有在同一个DataPart内的oid列存块minmax区间基本都是重叠的。但是ClickHouse的MergeTree还有一个隐含的有序状态:那就是同一个partition下的多个DataPart是处于按写入时间排列的有序状态,而业务系统里的oid是一个自增序列,刚好写入ClickHouse的数据oid基本也是按照时间递增的趋势,不同DataPart之间的oid列存块minmax就基本是错开的。 不难理解,skipping index对查询的加速效果是一个常数级别的,索引扫描的时间是和数据量成正比的。除了minmax类型的skipping index,还有set类型索引,它适用的场景也是要求列值随着写入时间有明显局部性。剩下的bloom_filter、ngrambf_v1、tokenbf_v1则是通过把完整的字符串列或者字符串列分词后的token用bloom_filter生成高压缩比的签名来进行排除Block,在长字符串的场景下有一定加速空间。 Prewhere优化-两阶段扫描 前面三节讲到的所有性能优化技术基本都是依赖数据的"有序性"来加速扫描满足条件的Block,这也意味着满足查询条件的数据本身就是存在某种"局部性"的。正常的业务场景中只要满足条件的数据本身存在"局部性"就一定能通过上面的三种方法来加速查询。在设计业务系统时,我们甚至应该刻意去创造出更多的"局部性",例如本文例子中的oid如果是设计成"toYYYYMMDDhh(gmt_order_create)+店铺ID+递增序列",那就可以在DataPart内部筛选上获得"局部性",查询会更快,读者们可以深入思考下这个问题。 在OLAP场景下最难搞定的问题就是满足查询条件的数据没有任何"局部性":查询条件命中的数据可能性数不多,但是分布非常散乱,每一个列存块中都有一两条记录满足条件。这种情况下因为列式存储的关系,只要块中有一条记录命中系统就需要读取完整的块,最后几百上千倍的数据量需要从磁盘中读取。当然这是个极端情况,很多时候情况是一部分列存块中没有满足条件的记录,一部分列存块中包含少量满足条件的记录,整体呈现随机无序。这种场景下当然可以对查询条件列加上类似lucene的倒排索引快速定位到命中记录的行号集合,但索引是有额外存储、构建成本的,更好的方法是采用两阶段扫描来加速。 以下面的查询为例,正常的执行逻辑中存储层扫描会把5天内的全部列数据从磁盘读取出来,然后计算引擎再按照order_status列过滤出满足条件的行。在两阶段扫描的框架下,prewhere表达式会下推到存储扫描过程中执行,优先扫描出order_status列存块,检查是否有记录满足条件,再把满足条件行的其他列读取出来,当没有任何记录满足条件时,其他列的块数据就可以跳过不读了。 --常规 select * from order_info where where order_status = 2 --订单取消 and gmt_order_create > '2020-0802 00:00:00' and gmt_order_create < '2020-0807 00:00:00'; --两阶段扫描 select * from order_info where prewhere order_status = 2 --订单取消 where gmt_order_create > '2020-0802 00:00:00' and gmt_order_create < '2020-0807 00:00:00'; 这种两阶段扫描的思想就是优先扫描筛选率高的列进行过滤,再按需扫描其他列的块。在OLAP几百列的大宽表分析场景下,这种加速方式减少的IO效果是非常明显的。但是瓶颈也是确定的,至少需要把某个单列的数据全部扫描出来。目前大家在使用prewhere加速的时候最好是根据数据分布情况来挑选最有筛选率同时扫描数据量最少的过滤条件。当遇上那种每个Block中都有一两条记录满足查询条件的极端情况时,尝试使用ClickHouse的物化视图来解决吧。物化视图的作用不光是预聚合计算,也可以让数据换个排序键重新有序存储一份。还有一种zorder的技术也能缓解一部分此类问题,有兴趣的同学可以自己了解一下。 小结 前面四节分别介绍了ClickHouse中四种不同的查询加速技术,当满足查询条件的数据有明显的"局部性"时,大家可以通过前三种低成本的手段来加速查询。最后介绍了针对数据分布非常散乱的场景下,prewhere可以缓解多列分析的IO压力。实际上这四种优化手段都是可以结合使用的,本文拆开阐述只是为了方便大家理解它们的本质。延续上一节的问题,当数据分布非常散乱,同时查询命中的记录又只有若干条的场景下,就算使用prewhere进行两阶段扫描,它的IO放大问题也依旧是非常明显的。简单的例子就是查询某个特定买家id(buyer_nick)的购买记录,买家id在数据表中的分布是完全散乱的,同时买家id列全表扫描的代价过大。所以阿里云ClickHouse推出了二级索引功能,专门来解决这种少量结果的搜索问题。这里如何定义结果的少呢?一般列存系统中一个列存块包括接近10000行记录,当满足搜索条件的记录数比列存块小一个数量级时(筛选率超过100000:1),二级索引才能发挥比较明显的性能优势。 二级索引多维搜索 ClickHouse的二级索引在设计的时候对标的就是ElasticSearch的多维搜索能力,支持多索引列条件交并差检索。同时对比ElasticSearch又有更贴近ClickHouse的易用性优化,总体特点概括如下: 多列联合索引 & 表达式索引 函数下推 In Set Clause下推 多值索引 & 字典索引 高压缩比 1:1 vs lucene 8.7 向量化构建 4X vs lucene 8.7 常规索引 二级索引在创建表时的定义语句示例如下: CREATE TABLE index_test ( id UInt64, d DateTime, x UInt64, y UInt64, tag String, KEY tag_idx tag TYPE range, --单列索引 KEY d_idx toStartOfHour(d) TYPE range, --表达式索引 KEY combo_idx (toStartOfHour(d),x, y) TYPE range, --多列联合索引 ) ENGINE = MergeTree() ORDER BY id; 其他二级索引相关的修改DDL如下: --删除索引定义 Alter table index_test DROP KEY tag_idx; --增加索引定义 Alter table index_test ADD KEY tag_idx tag TYPE range; --清除数据分区下的索引文件 Alter table index_test CLEAR KEY tag_idx tag in partition partition_expr; --重新构建数据分区下的索引文件 Alter table index_test MATERIALIZE KEY tag_idx tag in partition partition_expr; 支持多列索引的目的是减少特定查询pattern下的索引结果归并,针对QPS要求特别高的查询用户可以创建针对性的多列索引达到极致的检索性能。而表达式索引主要是方便用户进行自由的检索粒度变换,考虑以下两个典型场景: 1)索引中的时间列在搜索条件中,只会以小时粒度进行过滤,这种情况下用户可以对toStartOfHour(time)表达式创建索引,可以一定程度加速索引构建,同时对time列的时间过滤条件都可以自动转换下推索引。 2)索引中的id列是由UUID构成,UUID几乎是可以保证永久distinct的字符串序列,直接对id构建索引会导致索引文件太大。这时用户可以使用前缀函数截取UUID来构建索引,如prefix8(id)是截取8个byte的前缀,对应的还有prefix4和prefix16,prefixUTF4、prefixUTF8、prefixUTF16则是用来截取UTF编码的。 值得注意的是,用户对表达式构建索引后,原列上的查询条件也可以正常下推索引,不需要特意改写查询。同样用户对原列构建索引,过滤条件上对原列加了表达式的情况下,优化器也都可以正常下推索引。 In Set Clause下推则是一个关联搜索的典型场景,作者经常碰到此类场景:user的属性是一张单独的大宽表,user的行为记录又是另一张单独的表,对user的搜索需要先从user行为记录表中聚合过滤出满足条件的user id,再用user ids从属性表中取出明细记录。这种in subquery的场景下,ClickHouse也可以自动下推索引进行加速。 多值索引 多值索引主要针对的是array类型列上has()/hasAll()/hasAny()条件的搜索加速,array列时标签分析里常用的数据类型,每条记录会attach对个标签,存放在一个array列里。对这个标签列的过滤以往只能通过暴力扫描过滤,ClickHouse二级索引专门扩展了多值索引类型解决此类问题,索引定义示例如下: CREATE TABLE index_test ( id UInt64, tags Array(String), KEY tag_idx tag TYPE array --多值索引 ) ENGINE = MergeTree() ORDER BY id; --包含单个标签 select * from index_test where has(tags, 'aaa'); --包含所有标签 select * from index_test where hasAll(tags, ['aaa', 'bbb']); --包含任意标签 select * from index_test where has(tags, ['aaa', 'ccc']); 字典索引 字典索引主要是针对那种使用两个array类型列模拟Map的场景进行检索加速,key和value是两个单独的array列,通过元素的position一一对应进行kv关联。ClickHouse二级索引专门为这种场景扩展了检索函数和索引类型支持,索引定义示例如下: CREATE TABLE index_test ( id UInt64, keys Array(String), vals Array(UInt32), KEY kv_idx (keys, vals) TYPE map --字典索引 ) ENGINE = MergeTree() ORDER BY id; --指定key的value等值条件 map['aaa'] = 32 select * from index_test where hasPairEQ(keys, vals, ('aaa', 32)); --指定key的value大于条件 map['aaa'] > 32 select * from index_test where hasPairGT(keys, vals, ('aaa', 32)); --指定key的value大于等于条件 map['aaa'] >= 32 select * from index_test where hasPairGTE(keys, vals, ('aaa', 32)); --指定key的value小于条件 map['aaa'] < 32 select * from index_test where hasPairLT(keys, vals, ('aaa', 32)); --指定key的value小于等于条件 map['aaa'] <= 32 select * from index_test where hasPairLTE(keys, vals, ('aaa', 32)); 索引构建性能 作者对ClickHouse的二级索引构建性能和索引压缩率做了全方位多场景下的测试,主要对比的是lucene 8.7的倒排索引和BKD索引。ElasticSearch底层的索引就是采用的lucene,这里的性能数据读者可以作个参考,但并不代表ElasticSearch和ClickHouse二级索引功能端到端的性能水平。因为ClickHouse的二级索引是在DataPart merge的时候进行构建,了解ClickHouse MergeTree存储引擎的同学应该明白MergeTree存在写放大的情况(一条记录merge多次),同时merge又完全是异步的行为。 日志trace_id场景 mock数据方法: substringUTF8(cast (generateUUIDv4() as String), 1, 16) 数据量:1E (ClickHouse数据文件1.5G) 构建耗时: ClickHouse 65.32s vs Lucene 487.255s 索引文件大小: ClickHouse 1.4G vs Lucene 1.3G 字符串枚举场景 mock数据方法: cast((10000000 + rand(number) % 1000) as String) 数据量:1E (ClickHouse数据文件316M) 构建耗时: ClickHouse 37.19s vs Lucene 46.279s 索引文件大小: ClickHouse 160M vs Lucene 163M 数值散列场景 mock数据方法: toFloat64(rand(100000000)) 数据量:1E (ClickHouse数据文件564M) 构建耗时: ClickHouse 32.20s vs Lucene BKD 86.456s 索引文件大小: ClickHouse 801M vs Lucene BKD 755M 数值枚举场景 mock数据方法: rand(1000) 数据量:1E (ClickHouse数据文件275M) 构建耗时: ClickHouse 12.81s vs Lucene BKD 78.0s 索引文件大小: ClickHouse 160M vs Lucene BKD 184M 结语 二级索引功能的主要目的是为了弥补ClickHouse在搜索场景下的不足,在分析场景下ClickHouse目前原有的技术已经比较丰富。希望通过本文大家对OLAP查询优化有更深的理解,欢迎大家尝试使用二级索引来解决多维搜索问题,积极反馈使用体验问题。 原文链接 本文为阿里云原创内容,未经允许不得转载。


优秀的个人博客,低调大师

【最佳实践】大数据时代,通过OSS快照迁移Elasticsearch数据

当您需要在Elasticsearch集群间迁移数据,或者需要恢复Elasticsearch中的数据时,可通过OSS快照的方式来实现。OSS快照方式的数据迁移,适用于数据量比较大的场景,简单流程如下。 本文以将自建Elasticsearch迁移至阿里云Elasticsearch中为例,为您介绍通过OSS快照迁移数据的具体方法。阿里云Elasticsearch兼容开源Elasticsearch的功能,以及Security、Machine Learning、Graph、APM等商业功能,致力于数据分析、数据搜索等场景服务。支持5.5.3、6.3.2、6.7.0、6.8.0和7.4.0等版本,并提供了商业插件X-Pack服务。在开源Elasticsearch的基础上提供企业级权限管控、安全监控告警、自动报表生成等功能。阿里云Elasticsearch为您提供1个月的免费试用活动,单击此处即可免费试用。与开源Elasticsearch相比,阿里云Elasticsearch提供了高可用性、高可靠性、高安全性等功能特性。并且提供Elasticsearch和Kibana的全托管服务,您可以按需付费,即买即用。在此基础上,还对内核性能进行了优化,提供独立的index build服务、存储计算分离、智能运维、达摩院分词器、商业插件等功能。 操作流程 准备工作 完成搭建自建Elasticsearch集群、创建OSS Bucket、创建阿里云Elasticsearch集群。 步骤一:安装elasticsearch-repository-oss插件 在自建Elasticsearch各节点中安装elasticsearch-repository-oss插件,插件安装后才可在自建Elasticsearch中创建OSS仓库。 步骤二:在自建Elasticsearch集群中创建仓库 使用snapshot API在自建Elasticsearch中创建快照备份仓库。 步骤三:为指定索引创建快照 为需要迁移的索引创建快照,并将快照备份到已创建的仓库中。 步骤四:在阿里云Elasticsearch上创建相同仓库 在阿里云Elasticsearch的Kibana控制台中,使用snapshot API创建一个与自建Elasticsearch相同的快照备份仓库。 步骤五:在阿里云Elasticsearch上恢复快照 将仓库中已备份的自建Elasticsearch的快照恢复到阿里云Elasticsearch中,完成数据迁移。 步骤六:查看快照恢复结果 快照恢复后,查看恢复的索引和索引数据。 准备工作 准备自建Elasticsearch集群。 如果您还没有自建Elasticsearch集群,建议您使用阿里云ECS进行搭建,具体操作步骤请参见[安装并运行Elasticsearch](https://www.elastic.co/guide/cn/elasticsearch/guide/current/running-elasticsearch.html)。 本文以单节点的Elasticsearch集群为例进行演示,版本为6.7.0。实际生产中您可以购买多个相同专有网络VPC(Virtual Private Cloud)的ECS搭建Elasticsearch集群,购买ECS的具体步骤请参见[使用向导创建实例](https://help.aliyun.com/document_detail/87190.html?spm=a2c4g.11186623.2.29.6739639dydpjkZ#task-vwq-5g4-r2b)。 开通OSS服务,并创建与自建Elasticsearch所在ECS相同区域的Bucket。 具体操作步骤请参见[开通OSS服务](https://help.aliyun.com/document_detail/31884.html?spm=a2c4g.11186623.2.30.7275639dbLtjau#task-njz-hf4-tdb)和[创建存储空间](https://help.aliyun.com/document_detail/31885.html?spm=a2c4g.11186623.2.31.7275639dbLtjau#task-u3p-3n4-tdb)。 **说明:** 请创建标准存储类型的OSS Bucket,不支持归档存储类型。 创建目标阿里云Elasticsearch实例,所选区域与您创建的Bucket相同。 具体操作步骤请参见[创建阿里云Elasticsearch实例](https://help.aliyun.com/document_detail/69055.html?spm=a2c4g.11186623.2.32.7275639dbLtjau#task-2444429)。 步骤一:安装elasticsearch-repository-oss插件 连接自建Elasticsearch集群所在的ECS。说明: 连接ECS的方式请参见连接Linux实例。 下载elasticsearch-repository-oss插件。 本文使用6.7.0版本的插件,要求JDK为11.0及以上版本。 wget https://github.com/aliyun/elasticsearch-repository-oss/releases/download/v6.7.0/elasticsearch-repository-oss-6.7.0.zip 将安装包解压到自建Elasticsearch各节点安装路径的plugins目录下。 unzip -d /home/elastic/app/elasticsearch-6.7.0/plugins elasticsearch-repository-oss-6.7.0.zip **说明:** 请将`/home/app/elasticsearch-6.7.0`替换为您自建Elasticsearch的安装路径。 修改插件的plugin-descriptor.properties文件中Elasticsearch集群的版本号,将其设置为当前Elasticsearch集群的版本。 说明: 如果您使用的elasticsearch-repository-oss插件的版本与您自建Elasticsearch集群的版本相同,可忽略此步骤。 使用以下命令打开plugin-descriptor.properties文件,将elasticsearch.version设置为当前Elasticsearch集群的版本。 vim /home/elastic/app/elasticsearch-6.7.0/plugins/plugin-descriptor.properties 启动自建Elasticsearch集群各节点。 cd /home/app/elasticsearch-6.7.0/bin ./elasticsearch -d **说明:** 请将`/home/app/elasticsearch-6.7.0`替换为您自建Elasticsearch的安装路径。 步骤二:在自建Elasticsearch集群中创建仓库 连接自建Elasticsearch所在的ECS,执行如下命令创建仓库。 curl -H "Content-Type: application/json" -XPUT localhost:9200/_snapshot/es_backup -d' {"type": "oss", "settings": { "endpoint": "http://oss-cn-hangzhou-internal.aliyuncs.com", "access_key_id": "your_accesskeyid", "secret_access_key":"your_accesskeysecret", "bucket": "es-backup-es", "compress": true }}' 参数 说明 es_backup 仓库名称,可自定义。 type 仓库类型,请设置为oss。 endpoint OSS Bucket的访问地址,请参见访问域名和数据中心获取。说明: 如果自建Elasticsearch所在ECS与您的OSS在同一区域,请使用内网地址,否则请使用外网地址。 access_key_id 创建OSS Bucket的账号的AccessKey ID,获取方式请参见如何获取AccessKeyId和AccessKeySecret。 secret_access_key 创建OSS Bucket的账号的AccessKey Secret,获取方式请参见如何获取AccessKeyId和AccessKeySecret。 bucket 您创建的OSS Bucket名称。 compress 是否压缩。 创建成功后,返回"acknowledge":true。 步骤三:为指定索引创建快照 在自建Elasticsearch中创建一个快照,用来备份您需要迁移的索引数据。创建快照时,默认会备份所有打开的索引。如果您不想备份系统索引,例如以.kibana、.security、.monitoring等开头的索引,可在快照时指定需要备份的索引。 注意: 建议您不要备份系统索引,因为系统索引会占用较大空间。 curl -H "Content-Type: application/json" -XPUT localhost:9200/_snapshot/es_backup/snapshot_1?pretty -d' { "indices": "index1,index2" }' index1和index2为您需要备份的索引名称。快照创建成功后,返回"accepted" : true。 步骤四:在阿里云Elasticsearch上创建相同仓库 登录阿里云Elasticsearch的Kibana控制台。 登录控制台的具体步骤请参见[t615643.md\#](t615643.md#)。 在左侧导航栏单击Dev Tools。 在Console中执行以下命令,创建与自建Elasticsearch相同的仓库。 PUT _snapshot/es_backup { "type": "oss", "settings": { "endpoint": "oss-cn-hangzhou-internal.aliyuncs.com", "access_key_id": "your_accesskeyid", "secret_access_key": "your_accesskeysecret", "bucket": "es-backup-es", "compress": true } } 步骤五:在阿里云Elasticsearch上恢复快照 参见步骤四:在阿里云Elasticsearch上创建相同仓库,在Kibana控制台上执行以下命令,恢复快照中的所有索引(除过.开头的系统索引)。 POST _snapshot/es_backup/snapshot_1/_restore {"indices":"*,-.monitoring*,-.security_audit*","ignore_unavailable":"true"} 命令执行成功,返回"accepted" : true。 以上命令会恢复快照中的所有索引,您也可以选择需要恢复的索引。同时如果阿里云Elasticsearch集群中有同名索引,而您想在不替换现有数据的前提下,恢复旧数据来验证内容,或者处理其他任务,可在恢复过程中重命名索引。 POST _snapshot/es_backup/snapshot_1/_restore { "indices":"index1", "rename_pattern": "index(.+)", "rename_replacement": "restored_index_$1" } 说明: 更多快照和恢复命令请参见快照备份与恢复命令。 步骤六:查看快照恢复结果 参见步骤四:在阿里云ES上创建相同仓库,在Kibana控制台上执行以下命令,查看恢复结果。 查看恢复的索引 GET /_cat/indices?v 查看恢复的索引数据 GET /index1/_search 执行成功后,返回结果如下。 { "took" : 2, "timed_out" : false, "_shards" : { "total" : 5, "successful" : 5, "skipped" : 0, "failed" : 0 }, "hits" : { "total" : 1, "max_score" : 1.0, "hits" : [ { "_index" : "index1", "_type" : "_doc", "_id" : "1", "_score" : 1.0, "_source" : { "productName" : "testpro", "annual_rate" : "3.22%", "describe" : "testpro" } } ] } } 相关活动 更多折扣活动,请访问阿里云 Elasticsearch 官网。 阿里云 Elasticsearch 商业通用版,1核2G ,SSD 20G首月免费阿里云 Logstash 2核4G首月免费

优秀的个人博客,低调大师

【最佳实践】通过Elasticsearch和rsbeat实时分析Redis slowlog

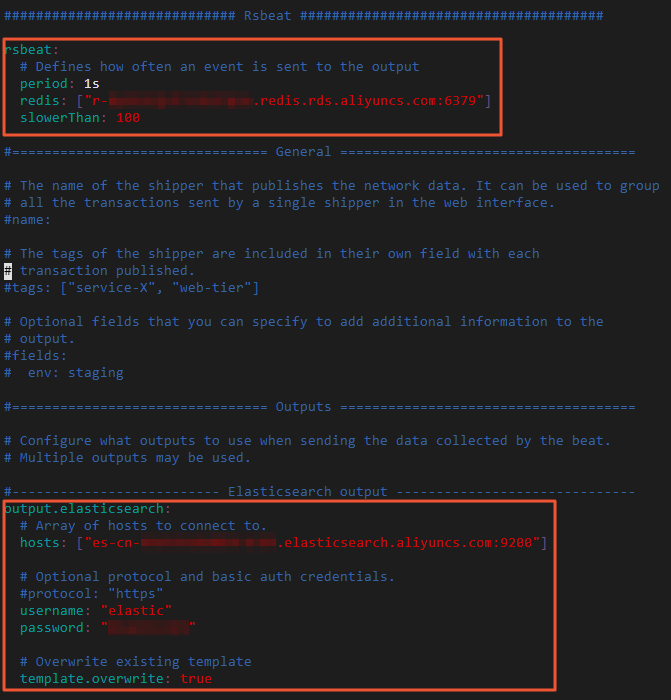
背景信息 通过Elasticsearch和rsbeat实时分析Redis slowlog的原理为:使用rsbeat将Redis slowlog采集到Elasticsearch中,然后在Kibana中进行图形化分析。 相关概念说明如下: Elasticsearch:是一个基于Lucene的实时分布式的搜索与分析引擎,是遵从Apache开源条款的一款开源产品,是当前主流的企业级搜索引擎。它提供了一个分布式服务,可以使您快速的近乎于准实时的存储、查询和分析超大数据集,通常被用来作为构建复杂查询特性和需求强大应用的基础引擎或技术。 阿里云Elasticsearch兼容开源Elasticsearch的功能,以及Security、Machine Learning、Graph、APM等商业功能,致力于数据分析、数据搜索等场景服务。支持5.5.3、6.3.2、6.7.0、6.8.0和7.4.0等版本,并提供了商业插件X-Pack服务。在开源Elasticsearch的基础上提供企业级权限管控、安全监控告警、自动报表生成等功能。本文使用阿里云Elasticsearch进行演示,单击即可免费试用。 rsbeat:用来收集和分析Redis慢日志的采集器,详情请参见rsbeat官方文档。 Redis:是一个开源的、基于内存的数据结构存储器,可以用作数据库、缓存和消息中间件,详情请参见Redis官方说明。 云数据库Redis版(ApsaraDB for Redis)是兼容开源Redis协议标准、提供内存加硬盘的混合存储方式的数据库服务,基于高可靠双机热备架构及可平滑扩展的集群架构,满足高读写性能场景及弹性变配的业务需求。本文使用云数据库Redis版进行演示,更多详情请参见什么是云数据库Redis版。 操作流程 准备工作 创建阿里云Elasticsearch实例、云数据库Redis版实例(以下简称Redis实例)和ECS实例,三者在同一专有网络VPC(Virtual Private Cloud)下。 步骤一:配置Redis慢查询参数 根据需求设置Redis slowlog生成的条件,以及可记录的slowlog的最大条数。 步骤二:安装并配置rsbeat 在ECS中安装rsbeat,并在其配置文件中指定Redis和Elasticsearch服务。 步骤三:通过Kibana图形化分析slowlog 通过Kibana查看日志详细信息,并根据需求进行统计分析。 准备工作 创建阿里云Elasticsearch实例,并开启自动创建索引功能。 具体操作步骤请参见创建阿里云Elasticsearch实例和开启自动创建索引。本文使用的实例版本为通用商业版6.7。 创建Redis实例。 具体操作步骤请参见步骤1:创建实例。本文使用的实例版本为Redis 5.0社区版,并且与阿里云Elasticsearch实例在同一VPC下,便于内网访问。 创建ECS实例。 具体操作步骤请参见使用向导创建实例。本文使用的实例镜像为CentOS 7.6 64位,并且与Redis和Elasticsearch实例在同一VPC下。 配置Redis实例的访问白名单。 将ECS实例的内网IP地址添加到Redis实例的白名单中,具体操作步骤请参见设置IP白名单。 步骤一:配置Redis慢查询参数 登录Redis管理控制台。 在顶部菜单栏处,选择地域。 在 实例列表 页,单击目标实例ID或者其右侧 操作 栏的 管理 。 在左侧导航栏,单击 参数设置 。 在参数设置列表中,找到 slowlog-log-slower-than 和 slowlog-max-len 参数,将其修改为您期望的值。 | 参数 | 说明 | 示例 | |-----------------------------|----------------------------------------------------------------------------------------------------------|---------------------------------------------| | slowlog-log-slower-than | 当命令执行时间(不包括排队时间)超过该参数值时,该命令会被定义为慢查询,并记录到slowlog中。单位为微秒,默认为10000,即10毫秒。 注意 负数表示关闭慢查询日志功能,0表示记录所有命令操作。 | 本文将该参数值设置为20000。表示在slowlog中记录执行时长超过20ms的命令。 | | slowlog-max-len | slowlog中可以记录的最大慢查询命令的条数。当slowlog中的记录数超过最大值后,Redis会将最早的slowlog删除。 | 本文将该参数值设置为100。表示在slowlog中记录最近100条慢查询命令。 | 步骤二:安装并配置rsbeat 连接ECS实例。 具体操作步骤请参见连接实例。 安装rsbeat。 本文使用5.3.2版本。 wget https://github.com/Yourdream/rsbeat/archive/master.zip unzip master.zip 修改rsbeat配置。 执行以下命令打开rsbeat.yml文件。cd rsbeat-mastervim rsbeat.yml 按照以下说明修改rsbeat和output.elasticsearch参数配置,并保存。 rebeat配置 | 参数 | 说明 | |------------|----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------| | period | 每隔多久将slowlog输出到Elasticsearch。 | | redis | Redis实例的连接地址,获取方式请参见[查看连接地址](https://help.aliyun.com/document_detail/107717.html?spm=a2c4g.11186623.2.33.3b4c96e9lemsfi#concept-apt-fkl-5gb)。 **注意** 由于配置文件中没有定义Redis实例的密码,因此在获取连接地址后,您还需要开启免密访问,才能确保rsbeat能够访问Redis实例,开启方法请参见[开启免密访问](https://help.aliyun.com/document_detail/85168.html?spm=a2c4g.11186623.2.34.3b4c96e9lemsfi#concept-ttq-dst-j2b)。 | | slowerThan | 定义将`config set slowlog-log-slower-than`命令发送到Redis服务器的时间。单位为微秒。 | output.elasticsearch配置 | 参数 | 说明 | |--------------------|------------------------------------------------------------------------------------------------------------------| | hosts | 阿里云Elasticsearch实例的连接地址,可在实例的基本信息页面获取,详情请参见[查看实例的基本信息](https://help.aliyun.com/document_detail/67804.html?spm=a2c4g.11186623.2.35.3b4c96e9lemsfi#task-2449896)。 | | username | 阿里云Elasticsearch实例的访问用户名,默认为elastic。 | | password | 对应用户的密码。elastic用户的密码在创建实例时设定,如果忘记可重置,重置密码的注意事项和操作步骤请参见[重置实例访问密码](https://help.aliyun.com/document_detail/159883.html?spm=a2c4g.11186623.2.36.3b4c96e9lemsfi#task-2458093)。 | | template.overwrite | 是否覆盖已存在的同名模板,默认为true。 | 启动rsbeat服务。 ./rsbeat.linux.amd64 -c rsbeat.yml -e -d "*" 步骤三:通过Kibana图形化分析slowlog 登录目标阿里云Elasticsearch实例的Kibana控制台。 具体操作步骤请参见登录Kibana控制台。 创建索引模式。 在左侧导航栏,单击 Management 。 在 Kibana 区域,单击 Index Patterns 。 单击 Create index pattern 。 输入 Index pattern 名称,单击 Next step 。 ![[外链图片转存失败,源站可能有防盗链机制,建议将图片保存下来直接上传(img-Aknn8zZ5-1597031007638)(../images/p132004.png)] {#substep-itn-drq-4lu}{#substep-itn-drq-4lu}](https://img-blog.csdnimg.cn/20200810120441327.png?x-oss-process=image/watermark,type_ZmFuZ3poZW5naGVpdGk,shadow_10,text_aHR0cHM6Ly9ibG9nLmNzZG4ubmV0L3FxXzQ2Mzk2NTYz,size_16,color_FFFFFF,t_70) 从 Time Filter field name 中,选择时间过滤器字段名(本文选择 @timestamp )。 单击 Create index pattern 。 查看slowlog的详细信息。 在左侧导航栏,单击 Discover 。 在 Discover 页面左侧,选择目标索引模式rsbeat-*。 在页面右上角,选择一段时间,查看该时间段内的slowlog信息。 ![[外链图片转存失败,源站可能有防盗链机制,建议将图片保存下来直接上传(img-23WUpcRG-1597031007646)(../images/p132012.png)] {#substep-zhe-81c-3wu}{#substep-zhe-81c-3wu}](https://img-blog.csdnimg.cn/20200810120529291.png?x-oss-process=image/watermark,type_ZmFuZ3poZW5naGVpdGk,shadow_10,text_aHR0cHM6Ly9ibG9nLmNzZG4ubmV0L3FxXzQ2Mzk2NTYz,size_16,color_FFFFFF,t_70) 统计slowlog数量最多的前10个key,并以降序排列展示。 在左侧导航栏,单击 Visualize 。 在 Visualize 页面,单击+图标。 在 New Visualization 对话框中,单击 Pie 。 ![[外链图片转存失败,源站可能有防盗链机制,建议将图片保存下来直接上传(img-Ec0YpMUX-1597031007669)(../images/p132052.png)] {#substep-wto-vkb-ldr}{#substep-wto-vkb-ldr}](https://img-blog.csdnimg.cn/20200810120611317.png?x-oss-process=image/watermark,type_ZmFuZ3poZW5naGVpdGk,shadow_10,text_aHR0cHM6Ly9ibG9nLmNzZG4ubmV0L3FxXzQ2Mzk2NTYz,size_16,color_FFFFFF,t_70) 选择索引模式rsbeat-*。 ![[外链图片转存失败,源站可能有防盗链机制,建议将图片保存下来直接上传(img-ViBUg24X-1597031007673)(../images/p132051.png)] {#substep-5o7-tza-7qw}{#substep-5o7-tza-7qw}](https://img-blog.csdnimg.cn/20200810120732837.png?x-oss-process=image/watermark,type_ZmFuZ3poZW5naGVpdGk,shadow_10,text_aHR0cHM6Ly9ibG9nLmNzZG4ubmV0L3FxXzQ2Mzk2NTYz,size_16,color_FFFFFF,t_70) 按照下图配置Metrics和Buckets。 ![[外链图片转存失败,源站可能有防盗链机制,建议将图片保存下来直接上传(img-FrVP5JiM-1597031007680)(../images/p132049.png)] {#substep-65j-4ex-ri9}{#substep-65j-4ex-ri9}](https://img-blog.csdnimg.cn/20200810120721181.png?x-oss-process=image/watermark,type_ZmFuZ3poZW5naGVpdGk,shadow_10,text_aHR0cHM6Ly9ibG9nLmNzZG4ubmV0L3FxXzQ2Mzk2NTYz,size_16,color_FFFFFF,t_70) 单击运行图标,查看结果。 说明 更多Kibana的使用方法,请参见Kibana官方文档。

优秀的个人博客,低调大师

【最佳实践】Elasticsearch 运用 shard filtering 实现冷热节点索引分配

简介 在我们的实际部署中,我们的各个 node(节点)的能力是不一样的。比如有的节点的计算能力比较强,而且配有高性能的存储,速度也比较快,同时我们可能有一些 node 的能力稍微差一点,比如计算能力及存储器的速度都比较差一点。针对这两种情况,我们其实可以把这两种节点用来做不同的用途:运算能力较强的节点可以用来做 indexing(建立索引表格)的工作,而那些能力较差一点的节点,我们可以用来做搜索用途。我们可以把这两种节点分别叫做: • hot node:用于支持索引并写入新文档• warm node:用于处理不太频繁查询的只读索引 这种架构在 Elasticsearch 中,我们称之为 hot/warm 架构。 Hot node 我们可以使用 hot node 来做 indexing:• indexing 是 CPU 和 IO 的密集操作,

优秀的个人博客,低调大师

【最佳实践】阿里云 Elasticsearch 索引数据生命周期管理

索引生命周期管理(ILM)是指:ES数据索引从设置,创建,打开,关闭,删除的全生命周期过程的管理;为了降低索引存储成本,提升集群性能和执行效率,我们可以通过对存储在阿里云 Elasticsearch 的数据做生命周期管理。 本文作者:阿里云 Elasticsearch团队—Lettie 阿里云 Elasticsearch (>=6.6) 提供 ILM 功能,同时将索引生命周期分为 Hot,Warm、Cold、Delete 4个阶段。 阶段 描述 Hot 主要处理时序数据的实时写入,根据索引的文档数大小时长决定是否调用 Rollover API 来滚动索引。 Warm 主要用来提供查询,索引不再写入。 Cold 查询较少,查询速度变慢,索引不再被更新。 Delete 删除数据 说明:Rollover 配置归档,目前仅支持三种策略,分别是:max_doc

优秀的个人博客,低调大师

夯实Java基础系列15:Java注解简介和最佳实践

Java注解简介 注解如同标签 Java 注解概述 什么是注解? 注解的用处 注解的原理 元注解 JDK里的注解 注解处理器实战 不同类型的注解 类注解 方法注解 参数注解 变量注解 Java注解相关面试题 什么是注解?他们的典型用例是什么? 描述标准库中一些有用的注解。 可以从注解方法声明返回哪些对象类型? 哪些程序元素可以注解? 有没有办法限制可以应用注解的元素? 什么是元注解? 下面的代码会编译吗? 参考文章 微信公众号 Java技术江湖 个人公众号:黄小斜 - Java注解 本系列文章将整理到我在GitHub上的《Java面试指南》仓库,更多精彩内容请到我的仓库里查看 https://github.com/h2pl/Java-Tutorial 喜欢的话麻烦点下Star哈 文章首发于我的个人博客: www.how2playlife.com 本文是微信公众号【Java技术江湖】的《夯实Java基础系列博文》其中一篇,本文部分内容来源于网络,为了把本文主题讲得清晰透彻,也整合了很多我认为不错的技术博客内容,引用其中了一些比较好的博客文章,如有侵权,请联系作者。该系列博文会告诉你如何从入门到进阶,一步步地学习Java基础知识,并上手进行实战,接着了解每个Java知识点背后的实现原理,更完整地了解整个Java技术体系,形成自己的知识框架。为了更好地总结和检验你的学习成果,本系列文章也会提供每个知识点对应的面试题以及参考答案。 如果对本系列文章有什么建议,或者是有什么疑问的话,也可以关注公众号【Java技术江湖】联系作者,欢迎你参与本系列博文的创作和修订。 Java注解简介 Annotation 中文译过来就是注解、标释的意思,在 Java 中注解是一个很重要的知识点,但经常还是有点让新手不容易理解。 我个人认为,比较糟糕的技术文档主要特征之一就是:用专业名词来介绍专业名词。比如: Java 注解用于为 Java 代码提供元数据。作为元数据,注解不直接影响你的代码执行,但也有一些类型的注解实际上可以用于这一目的。Java 注解是从 Java5 开始添加到 Java 的。这是大多数网站上对于 Java 注解,解释确实正确,但是说实在话,我第一次学习的时候,头脑一片空白。这什么跟什么啊?听了像没有听一样。因为概念太过于抽象,所以初学者实在是比较吃力才能够理解,然后随着自己开发过程中不断地强化练习,才会慢慢对它形成正确的认识。 我在写这篇文章的时候,我就在思考。如何让自己或者让读者能够比较直观地认识注解这个概念?是要去官方文档上翻译说明吗?我马上否定了这个答案。 后来,我想到了一样东西————墨水,墨水可以挥发、可以有不同的颜色,用来解释注解正好。 不过,我继续发散思维后,想到了一样东西能够更好地代替墨水,那就是印章。印章可以沾上不同的墨水或者印泥,可以定制印章的文字或者图案,如果愿意它也可以被戳到你任何想戳的物体表面。 但是,我再继续发散思维后,又想到一样东西能够更好地代替印章,那就是标签。标签是一张便利纸,标签上的内容可以自由定义。常见的如货架上的商品价格标签、图书馆中的书本编码标签、实验室中化学材料的名称类别标签等等。 并且,往抽象地说,标签并不一定是一张纸,它可以是对人和事物的属性评价。也就是说,标签具备对于抽象事物的解释。 所以,基于如此,我完成了自我的知识认知升级,我决定用标签来解释注解。 注解如同标签 之前某新闻客户端的评论有盖楼的习惯,于是 “乔布斯重新定义了手机、罗永浩重新定义了傻X” 就经常极为工整地出现在了评论楼层中,并且广大网友在相当长的一段时间内对于这种行为乐此不疲。这其实就是等同于贴标签的行为。在某些网友眼中,罗永浩就成了傻X的代名词。 广大网友给罗永浩贴了一个名为“傻x”的标签,他们并不真正了解罗永浩,不知道他当教师、砸冰箱、办博客的壮举,但是因为“傻x”这样的标签存在,这有助于他们直接快速地对罗永浩这个人做出评价,然后基于此,罗永浩就可以成为茶余饭后的谈资,这就是标签的力量。 而在网络的另一边,老罗靠他的人格魅力自然收获一大批忠实的拥泵,他们对于老罗贴的又是另一种标签。 老罗还是老罗,但是由于人们对于它贴上的标签不同,所以造成对于他的看法大相径庭,不喜欢他的人整天在网络上评论抨击嘲讽,而崇拜欣赏他的人则会愿意挣钱购买锤子手机的发布会门票。 我无意于评价这两种行为,我再引个例子。 《奇葩说》是近年网络上非常火热的辩论节目,其中辩手陈铭被另外一个辩手马薇薇攻击说是————“站在宇宙中心呼唤爱”,然后贴上了一个大大的标签————“鸡汤男”,自此以后,观众再看到陈铭的时候,首先映入脑海中便是“鸡汤男”三个大字,其实本身而言陈铭非常优秀,为人师表、作风正派、谈吐举止得体,但是在网络中,因为娱乐至上的环境所致,人们更愿意以娱乐的心态来认知一切,于是“鸡汤男”就如陈铭自己所说成了一个撕不了的标签。 我们可以抽象概括一下,标签是对事物行为的某些角度的评价与解释。 到这里,终于可以引出本文的主角注解了。 初学者可以这样理解注解:想像代码具有生命,注解就是对于代码中某些鲜活个体的贴上去的一张标签。简化来讲,注解如同一张标签。 在未开始学习任何注解具体语法而言,你可以把注解看成一张标签。这有助于你快速地理解它的大致作用。如果初学者在学习过程有大脑放空的时候,请不要慌张,对自己说: 注解,标签。注解,标签。 Java 注解概述 什么是注解? 对于很多初次接触的开发者来说应该都有这个疑问?Annontation是Java5开始引入的新特征,中文名称叫注解。它提供了一种安全的类似注释的机制,用来将任何的信息或元数据(metadata)与程序元素(类、方法、成员变量等)进行关联。为程序的元素(类、方法、成员变量)加上更直观更明了的说明,这些说明信息是与程序的业务逻辑无关,并且供指定的工具或框架使用。Annontation像一种修饰符一样,应用于包、类型、构造方法、方法、成员变量、参数及本地变量的声明语句中。 Java注解是附加在代码中的一些元信息,用于一些工具在编译、运行时进行解析和使用,起到说明、配置的功能。注解不会也不能影响代码的实际逻辑,仅仅起到辅助性的作用。包含在 java.lang.annotation 包中。 注解的用处 1、生成文档。这是最常见的,也是java 最早提供的注解。常用的有@param @return 等 2、跟踪代码依赖性,实现替代配置文件功能。比如Dagger 2依赖注入,未来java开发,将大量注解配置,具有很大用处; 3、在编译时进行格式检查。如@override 放在方法前,如果你这个方法并不是覆盖了超类方法,则编译时就能检查出。 注解的原理 注解本质是一个继承了Annotation的特殊接口,其具体实现类是Java运行时生成的动态代理类。而我们通过反射获取注解时,返回的是Java运行时生成的动态代理对象$Proxy1。通过代理对象调用自定义注解(接口)的方法,会最终调用AnnotationInvocationHandler的invoke方法。该方法会从memberValues这个Map中索引出对应的值。而memberValues的来源是Java常量池。 元注解 java.lang.annotation提供了四种元注解,专门注解其他的注解(在自定义注解的时候,需要使用到元注解): @Documented –注解是否将包含在JavaDoc中 @Retention –什么时候使用该注解 @Target –注解用于什么地方 @Inherited – 是否允许子类继承该注解 1.)@Retention– 定义该注解的生命周期 ● RetentionPolicy.SOURCE : 在编译阶段丢弃。这些注解在编译结束之后就不再有任何意义,所以它们不会写入字节码。@Override, @SuppressWarnings都属于这类注解。 ● RetentionPolicy.CLASS : 在类加载的时候丢弃。在字节码文件的处理中有用。注解默认使用这种方式 ● RetentionPolicy.RUNTIME : 始终不会丢弃,运行期也保留该注解,因此可以使用反射机制读取该注解的信息。我们自定义的注解通常使用这种方式。 2.)Target – 表示该注解用于什么地方。默认值为任何元素,表示该注解用于什么地方。可用的ElementType参数包括 ● ElementType.CONSTRUCTOR:用于描述构造器 ● ElementType.FIELD:成员变量、对象、属性(包括enum实例) ● ElementType.LOCAL_VARIABLE:用于描述局部变量 ● ElementType.METHOD:用于描述方法 ● ElementType.PACKAGE:用于描述包 ● ElementType.PARAMETER:用于描述参数 ● ElementType.TYPE:用于描述类、接口(包括注解类型) 或enum声明 3.)@Documented–一个简单的Annotations标记注解,表示是否将注解信息添加在java文档中。 4.)@Inherited – 定义该注释和子类的关系 @Inherited 元注解是一个标记注解,@Inherited阐述了某个被标注的类型是被继承的。如果一个使用了@Inherited修饰的annotation类型被用于一个class,则这个annotation将被用于该class的子类。 JDK里的注解 JDK 内置注解先来看几个 Java 内置的注解,让大家热热身。 @Override 演示 class Parent { public void run() { } } class Son extends Parent { /** * 这个注解是为了检查此方法是否真的是重写父类的方法 * 这时候就不用我们用肉眼去观察到底是不是重写了 */ @Override public void run() { } } @Deprecated 演示class Parent { /** * 此注解代表过时了,但是如果可以调用到,当然也可以正常使用 * 但是,此方法有可能在以后的版本升级中会被慢慢的淘汰 * 可以放在类,变量,方法上面都起作用 */ @Deprecated public void run() { } } public class JDKAnnotationDemo { public static void main(String[] args) { Parent parent = new Parent(); parent.run(); // 在编译器中此方法会显示过时标志 } } @SuppressWarnings 演示class Parent { // 因为定义的 name 没有使用,那么编译器就会有警告,这时候使用此注解可以屏蔽掉警告 // 即任意不想看到的编译时期的警告都可以用此注解屏蔽掉,但是不推荐,有警告的代码最好还是处理一下 @SuppressWarnings("all") private String name; } @FunctionalInterface 演示/** 此注解是 Java8 提出的函数式接口,接口中只允许有一个抽象方法 加上这个注解之后,类中多一个抽象方法或者少一个抽象方法都会报错 */ @FunctionalInterface interface Func { void run(); } 注解处理器实战 注解处理器注解处理器才是使用注解整个流程中最重要的一步了。所有在代码中出现的注解,它到底起了什么作用,都是在注解处理器中定义好的。概念:注解本身并不会对程序的编译方式产生影响,而是注解处理器起的作用;注解处理器能够通过在运行时使用反射获取在程序代码中的使用的注解信息,从而实现一些额外功能。前提是我们自定义的注解使用的是 RetentionPolicy.RUNTIME 修饰的。这也是我们在开发中使用频率很高的一种方式。 我们先来了解下如何通过在运行时使用反射获取在程序中的使用的注解信息。如下类注解和方法注解。 类注解 Class aClass = ApiController.class; Annotation[] annotations = aClass.getAnnotations(); for(Annotation annotation : annotations) { if(annotation instanceof ApiAuthAnnotation) { ApiAuthAnnotation apiAuthAnnotation = (ApiAuthAnnotation) annotation; System.out.println("name: " + apiAuthAnnotation.name()); System.out.println("age: " + apiAuthAnnotation.age()); } } 方法注解 Method method = ... //通过反射获取方法对象 Annotation[] annotations = method.getDeclaredAnnotations(); for(Annotation annotation : annotations) { if(annotation instanceof ApiAuthAnnotation) { ApiAuthAnnotation apiAuthAnnotation = (ApiAuthAnnotation) annotation; System.out.println("name: " + apiAuthAnnotation.name()); System.out.println("age: " + apiAuthAnnotation.age()); } } 此部分内容可参考: 通过反射获取注解信息 注解处理器实战接下来我通过在公司中的一个实战改编来演示一下注解处理器的真实使用场景。需求: 网站后台接口只能是年龄大于 18 岁的才能访问,否则不能访问前置准备: 定义注解(这里使用上文的完整注解),使用注解(这里使用上文中使用注解的例子)接下来要做的事情: 写一个切面,拦截浏览器访问带注解的接口,取出注解信息,判断年龄来确定是否可以继续访问。 在 dispatcher-servlet.xml 文件中定义 aop 切面 <aop:config> <!--定义切点,切的是我们自定义的注解--> <aop:pointcut id="apiAuthAnnotation" expression="@annotation(cn.caijiajia.devops.aspect.ApiAuthAnnotation)"/> <!--定义切面,切点是 apiAuthAnnotation,切面类即注解处理器是 apiAuthAspect,主处理逻辑在方法名为 auth 的方法中--> <aop:aspect ref="apiAuthAspect"> <aop:around method="auth" pointcut-ref="apiAuthAnnotation"/> </aop:aspect> </aop:config> 切面类处理逻辑即注解处理器代码如 @Component("apiAuthAspect") public class ApiAuthAspect { public Object auth(ProceedingJoinPoint pjp) throws Throwable { Method method = ((MethodSignature) pjp.getSignature()).getMethod(); ApiAuthAnnotation apiAuthAnnotation = method.getAnnotation(ApiAuthAnnotation.class); Integer age = apiAuthAnnotation.age(); if (age > 18) { return pjp.proceed(); } else { throw new RuntimeException("你未满18岁,禁止访问"); } } } 不同类型的注解 类注解 你可以在运行期访问类,方法或者变量的注解信息,下是一个访问类注解的例子: Class aClass = TheClass.class; Annotation[] annotations = aClass.getAnnotations(); for(Annotation annotation : annotations){ if(annotation instanceof MyAnnotation){ MyAnnotation myAnnotation = (MyAnnotation) annotation; System.out.println("name: " + myAnnotation.name()); System.out.println("value: " + myAnnotation.value()); } } 你还可以像下面这样指定访问一个类的注解: Class aClass = TheClass.class; Annotation annotation = aClass.getAnnotation(MyAnnotation.class); if(annotation instanceof MyAnnotation){ MyAnnotation myAnnotation = (MyAnnotation) annotation; System.out.println("name: " + myAnnotation.name()); System.out.println("value: " + myAnnotation.value()); } 方法注解 下面是一个方法注解的例子: public class TheClass { @MyAnnotation(name="someName", value = "Hello World") public void doSomething(){} } 你可以像这样访问方法注解: Method method = ... //获取方法对象 Annotation[] annotations = method.getDeclaredAnnotations(); for(Annotation annotation : annotations){ if(annotation instanceof MyAnnotation){ MyAnnotation myAnnotation = (MyAnnotation) annotation; System.out.println("name: " + myAnnotation.name()); System.out.println("value: " + myAnnotation.value()); } } 你可以像这样访问指定的方法注解: Method method = ... // 获取方法对象 Annotation annotation = method.getAnnotation(MyAnnotation.class); if(annotation instanceof MyAnnotation){ MyAnnotation myAnnotation = (MyAnnotation) annotation; System.out.println("name: " + myAnnotation.name()); System.out.println("value: " + myAnnotation.value()); } 参数注解 方法参数也可以添加注解,就像下面这样: public class TheClass { public static void doSomethingElse( @MyAnnotation(name="aName", value="aValue") String parameter){ } } 你可以通过 Method对象来访问方法参数注解: Method method = ... //获取方法对象 Annotation[][] parameterAnnotations = method.getParameterAnnotations(); Class[] parameterTypes = method.getParameterTypes(); int i=0; for(Annotation[] annotations : parameterAnnotations){ Class parameterType = parameterTypes[i++]; for(Annotation annotation : annotations){ if(annotation instanceof MyAnnotation){ MyAnnotation myAnnotation = (MyAnnotation) annotation; System.out.println("param: " + parameterType.getName()); System.out.println("name : " + myAnnotation.name()); System.out.println("value: " + myAnnotation.value()); } } } 需要注意的是 Method.getParameterAnnotations()方法返回一个注解类型的二维数组,每一个方法的参数包含一个注解数组。 变量注解 下面是一个变量注解的例子: public class TheClass { @MyAnnotation(name="someName", value = "Hello World") public String myField = null; } 你可以像这样来访问变量的注解: Field field = ... //获取方法对象</pre> <pre>Annotation[] annotations = field.getDeclaredAnnotations(); for(Annotation annotation : annotations){ if(annotation instanceof MyAnnotation){ MyAnnotation myAnnotation = (MyAnnotation) annotation; System.out.println("name: " + myAnnotation.name()); System.out.println("value: " + myAnnotation.value()); } } 你可以像这样访问指定的变量注解: Field field = ...//获取方法对象</pre> <pre> Annotation annotation = field.getAnnotation(MyAnnotation.class); if(annotation instanceof MyAnnotation){ MyAnnotation myAnnotation = (MyAnnotation) annotation; System.out.println("name: " + myAnnotation.name()); System.out.println("value: " + myAnnotation.value()); } Java注解相关面试题 什么是注解?他们的典型用例是什么? 注解是绑定到程序源代码元素的元数据,对运行代码的操作没有影响。 他们的典型用例是: 编译器的信息 - 使用注解,编译器可以检测错误或抑制警告 编译时和部署时处理 - 软件工具可以处理注解并生成代码,配置文件等。 运行时处理 - 可以在运行时检查注解以自定义程序的行为 描述标准库中一些有用的注解。 java.lang和java.lang.annotation包中有几个注解,更常见的包括但不限于此: @Override -标记方法是否覆盖超类中声明的元素。如果它无法正确覆盖该方法,编译器将发出错误 @Deprecated - 表示该元素已弃用且不应使用。如果程序使用标有此批注的方法,类或字段,编译器将发出警告 @SuppressWarnings - 告诉编译器禁止特定警告。在与泛型出现之前编写的遗留代码接口时最常用的 @FunctionalInterface - 在Java 8中引入,表明类型声明是一个功能接口,可以使用Lambda Expression提供其实现 可以从注解方法声明返回哪些对象类型? 返回类型必须是基本类型,String,Class,Enum或数组类型之一。否则,编译器将抛出错误。 这是一个成功遵循此原则的示例代码: enum Complexity { LOW, HIGH } public @interface ComplexAnnotation { Class<? extends Object> value(); int[] types(); Complexity complexity(); } 下一个示例将无法编译,因为Object不是有效的返回类型: public @interface FailingAnnotation { Object complexity(); } 哪些程序元素可以注解? 注解可以应用于整个源代码的多个位置。它们可以应用于类,构造函数和字段的声明: @SimpleAnnotation public class Apply { @SimpleAnnotation private String aField; @SimpleAnnotation public Apply() { // ... } } 方法及其参数: @SimpleAnnotation public void aMethod(@SimpleAnnotation String param) { // ... } 局部变量,包括循环和资源变量: @SimpleAnnotation int i = 10; for (@SimpleAnnotation int j = 0; j < i; j++) { // ... } try (@SimpleAnnotation FileWriter writer = getWriter()) { // ... } catch (Exception ex) { // ... } 其他注解类型: @SimpleAnnotation public @interface ComplexAnnotation { // ... } 甚至包,通过package-info.java文件: @PackageAnnotation package com.baeldung.interview.annotations; 从Java 8开始,它们也可以应用于类型的使用。为此,注解必须指定值为ElementType.USE的@Target注解: @Target(ElementType.TYPE_USE) public @interface SimpleAnnotation { // ... } 现在,注解可以应用于类实例创建: new @SimpleAnnotation Apply(); 类型转换: aString = (@SimpleAnnotation String) something; 接口中: public class SimpleList<T> implements @SimpleAnnotation List<@SimpleAnnotation T> { // ... } 抛出异常上: void aMethod() throws @SimpleAnnotation Exception { // ... } 有没有办法限制可以应用注解的元素? 有,@ Target注解可用于此目的。如果我们尝试在不适用的上下文中使用注解,编译器将发出错误。 以下是仅将@SimpleAnnotation批注的用法限制为字段声明的示例: @Target(ElementType.FIELD) public @interface SimpleAnnotation { // ... } 如果我们想让它适用于更多的上下文,我们可以传递多个常量: @Target({ ElementType.FIELD, ElementType.METHOD, ElementType.PACKAGE }) 我们甚至可以制作一个注解,因此它不能用于注解任何东西。当声明的类型仅用作复杂注解中的成员类型时,这可能会派上用场: @Target({}) public @interface NoTargetAnnotation { // ... } 什么是元注解? 元注解适用于其他注解的注解。 所有未使用@Target标记或使用它标记但包含ANNOTATION_TYPE常量的注解也是元注解: @Target(ElementType.ANNOTATION_TYPE) public @interface SimpleAnnotation { // ... } 下面的代码会编译吗? @Target({ ElementType.FIELD, ElementType.TYPE, ElementType.FIELD }) public @interface TestAnnotation { int[] value() default {}; } 不能。如果在@Target注解中多次出现相同的枚举常量,那么这是一个编译时错误。 删除重复常量将使代码成功编译: @Target({ ElementType.FIELD, ElementType.TYPE}) 参考文章 https://blog.fundodoo.com/2018/04/19/130.htmlhttps://blog.csdn.net/qq_37939251/article/details/83215703https://blog.51cto.com/4247649/2109129https://www.jianshu.com/p/2f2460e6f8e7https://blog.csdn.net/yuzongtao/article/details/83306182 微信公众号 Java技术江湖 如果大家想要实时关注我更新的文章以及分享的干货的话,可以关注我的公众号【Java技术江湖】一位阿里 Java 工程师的技术小站,作者黄小斜,专注 Java 相关技术:SSM、SpringBoot、MySQL、分布式、中间件、集群、Linux、网络、多线程,偶尔讲点Docker、ELK,同时也分享技术干货和学习经验,致力于Java全栈开发! Java工程师必备学习资源: 一些Java工程师常用学习资源,关注公众号后,后台回复关键字 “Java” 即可免费无套路获取。 个人公众号:黄小斜 作者是 985 硕士,蚂蚁金服 JAVA 工程师,专注于 JAVA 后端技术栈:SpringBoot、MySQL、分布式、中间件、微服务,同时也懂点投资理财,偶尔讲点算法和计算机理论基础,坚持学习和写作,相信终身学习的力量! 程序员3T技术学习资源: 一些程序员学习技术的资源大礼包,关注公众号后,后台回复关键字 “资料” 即可免费无套路获取。

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册