首页 文章 精选 留言 我的

精选列表

搜索[AIOps最佳实践],共10000篇文章
优秀的个人博客,低调大师

夯实Java基础系列15:Java注解简介和最佳实践

Java注解简介 注解如同标签 Java 注解概述 什么是注解? 注解的用处 注解的原理 元注解 JDK里的注解 注解处理器实战 不同类型的注解 类注解 方法注解 参数注解 变量注解 Java注解相关面试题 什么是注解?他们的典型用例是什么? 描述标准库中一些有用的注解。 可以从注解方法声明返回哪些对象类型? 哪些程序元素可以注解? 有没有办法限制可以应用注解的元素? 什么是元注解? 下面的代码会编译吗? 参考文章 微信公众号 Java技术江湖 个人公众号:黄小斜 - Java注解 本系列文章将整理到我在GitHub上的《Java面试指南》仓库,更多精彩内容请到我的仓库里查看 https://github.com/h2pl/Java-Tutorial 喜欢的话麻烦点下Star哈 文章首发于我的个人博客: www.how2playlife.com 本文是微信公众号【Java技术江湖】的《夯实Java基础系列博文》其中一篇,本文部分内容来源于网络,为了把本文主题讲得清晰透彻,也整合了很多我认为不错的技术博客内容,引用其中了一些比较好的博客文章,如有侵权,请联系作者。该系列博文会告诉你如何从入门到进阶,一步步地学习Java基础知识,并上手进行实战,接着了解每个Java知识点背后的实现原理,更完整地了解整个Java技术体系,形成自己的知识框架。为了更好地总结和检验你的学习成果,本系列文章也会提供每个知识点对应的面试题以及参考答案。 如果对本系列文章有什么建议,或者是有什么疑问的话,也可以关注公众号【Java技术江湖】联系作者,欢迎你参与本系列博文的创作和修订。 Java注解简介 Annotation 中文译过来就是注解、标释的意思,在 Java 中注解是一个很重要的知识点,但经常还是有点让新手不容易理解。 我个人认为,比较糟糕的技术文档主要特征之一就是:用专业名词来介绍专业名词。比如: Java 注解用于为 Java 代码提供元数据。作为元数据,注解不直接影响你的代码执行,但也有一些类型的注解实际上可以用于这一目的。Java 注解是从 Java5 开始添加到 Java 的。这是大多数网站上对于 Java 注解,解释确实正确,但是说实在话,我第一次学习的时候,头脑一片空白。这什么跟什么啊?听了像没有听一样。因为概念太过于抽象,所以初学者实在是比较吃力才能够理解,然后随着自己开发过程中不断地强化练习,才会慢慢对它形成正确的认识。 我在写这篇文章的时候,我就在思考。如何让自己或者让读者能够比较直观地认识注解这个概念?是要去官方文档上翻译说明吗?我马上否定了这个答案。 后来,我想到了一样东西————墨水,墨水可以挥发、可以有不同的颜色,用来解释注解正好。 不过,我继续发散思维后,想到了一样东西能够更好地代替墨水,那就是印章。印章可以沾上不同的墨水或者印泥,可以定制印章的文字或者图案,如果愿意它也可以被戳到你任何想戳的物体表面。 但是,我再继续发散思维后,又想到一样东西能够更好地代替印章,那就是标签。标签是一张便利纸,标签上的内容可以自由定义。常见的如货架上的商品价格标签、图书馆中的书本编码标签、实验室中化学材料的名称类别标签等等。 并且,往抽象地说,标签并不一定是一张纸,它可以是对人和事物的属性评价。也就是说,标签具备对于抽象事物的解释。 所以,基于如此,我完成了自我的知识认知升级,我决定用标签来解释注解。 注解如同标签 之前某新闻客户端的评论有盖楼的习惯,于是 “乔布斯重新定义了手机、罗永浩重新定义了傻X” 就经常极为工整地出现在了评论楼层中,并且广大网友在相当长的一段时间内对于这种行为乐此不疲。这其实就是等同于贴标签的行为。在某些网友眼中,罗永浩就成了傻X的代名词。 广大网友给罗永浩贴了一个名为“傻x”的标签,他们并不真正了解罗永浩,不知道他当教师、砸冰箱、办博客的壮举,但是因为“傻x”这样的标签存在,这有助于他们直接快速地对罗永浩这个人做出评价,然后基于此,罗永浩就可以成为茶余饭后的谈资,这就是标签的力量。 而在网络的另一边,老罗靠他的人格魅力自然收获一大批忠实的拥泵,他们对于老罗贴的又是另一种标签。 老罗还是老罗,但是由于人们对于它贴上的标签不同,所以造成对于他的看法大相径庭,不喜欢他的人整天在网络上评论抨击嘲讽,而崇拜欣赏他的人则会愿意挣钱购买锤子手机的发布会门票。 我无意于评价这两种行为,我再引个例子。 《奇葩说》是近年网络上非常火热的辩论节目,其中辩手陈铭被另外一个辩手马薇薇攻击说是————“站在宇宙中心呼唤爱”,然后贴上了一个大大的标签————“鸡汤男”,自此以后,观众再看到陈铭的时候,首先映入脑海中便是“鸡汤男”三个大字,其实本身而言陈铭非常优秀,为人师表、作风正派、谈吐举止得体,但是在网络中,因为娱乐至上的环境所致,人们更愿意以娱乐的心态来认知一切,于是“鸡汤男”就如陈铭自己所说成了一个撕不了的标签。 我们可以抽象概括一下,标签是对事物行为的某些角度的评价与解释。 到这里,终于可以引出本文的主角注解了。 初学者可以这样理解注解:想像代码具有生命,注解就是对于代码中某些鲜活个体的贴上去的一张标签。简化来讲,注解如同一张标签。 在未开始学习任何注解具体语法而言,你可以把注解看成一张标签。这有助于你快速地理解它的大致作用。如果初学者在学习过程有大脑放空的时候,请不要慌张,对自己说: 注解,标签。注解,标签。 Java 注解概述 什么是注解? 对于很多初次接触的开发者来说应该都有这个疑问?Annontation是Java5开始引入的新特征,中文名称叫注解。它提供了一种安全的类似注释的机制,用来将任何的信息或元数据(metadata)与程序元素(类、方法、成员变量等)进行关联。为程序的元素(类、方法、成员变量)加上更直观更明了的说明,这些说明信息是与程序的业务逻辑无关,并且供指定的工具或框架使用。Annontation像一种修饰符一样,应用于包、类型、构造方法、方法、成员变量、参数及本地变量的声明语句中。 Java注解是附加在代码中的一些元信息,用于一些工具在编译、运行时进行解析和使用,起到说明、配置的功能。注解不会也不能影响代码的实际逻辑,仅仅起到辅助性的作用。包含在 java.lang.annotation 包中。 注解的用处 1、生成文档。这是最常见的,也是java 最早提供的注解。常用的有@param @return 等 2、跟踪代码依赖性,实现替代配置文件功能。比如Dagger 2依赖注入,未来java开发,将大量注解配置,具有很大用处; 3、在编译时进行格式检查。如@override 放在方法前,如果你这个方法并不是覆盖了超类方法,则编译时就能检查出。 注解的原理 注解本质是一个继承了Annotation的特殊接口,其具体实现类是Java运行时生成的动态代理类。而我们通过反射获取注解时,返回的是Java运行时生成的动态代理对象$Proxy1。通过代理对象调用自定义注解(接口)的方法,会最终调用AnnotationInvocationHandler的invoke方法。该方法会从memberValues这个Map中索引出对应的值。而memberValues的来源是Java常量池。 元注解 java.lang.annotation提供了四种元注解,专门注解其他的注解(在自定义注解的时候,需要使用到元注解): @Documented –注解是否将包含在JavaDoc中 @Retention –什么时候使用该注解 @Target –注解用于什么地方 @Inherited – 是否允许子类继承该注解 1.)@Retention– 定义该注解的生命周期 ● RetentionPolicy.SOURCE : 在编译阶段丢弃。这些注解在编译结束之后就不再有任何意义,所以它们不会写入字节码。@Override, @SuppressWarnings都属于这类注解。 ● RetentionPolicy.CLASS : 在类加载的时候丢弃。在字节码文件的处理中有用。注解默认使用这种方式 ● RetentionPolicy.RUNTIME : 始终不会丢弃,运行期也保留该注解,因此可以使用反射机制读取该注解的信息。我们自定义的注解通常使用这种方式。 2.)Target – 表示该注解用于什么地方。默认值为任何元素,表示该注解用于什么地方。可用的ElementType参数包括 ● ElementType.CONSTRUCTOR:用于描述构造器 ● ElementType.FIELD:成员变量、对象、属性(包括enum实例) ● ElementType.LOCAL_VARIABLE:用于描述局部变量 ● ElementType.METHOD:用于描述方法 ● ElementType.PACKAGE:用于描述包 ● ElementType.PARAMETER:用于描述参数 ● ElementType.TYPE:用于描述类、接口(包括注解类型) 或enum声明 3.)@Documented–一个简单的Annotations标记注解,表示是否将注解信息添加在java文档中。 4.)@Inherited – 定义该注释和子类的关系 @Inherited 元注解是一个标记注解,@Inherited阐述了某个被标注的类型是被继承的。如果一个使用了@Inherited修饰的annotation类型被用于一个class,则这个annotation将被用于该class的子类。 JDK里的注解 JDK 内置注解先来看几个 Java 内置的注解,让大家热热身。 @Override 演示 class Parent { public void run() { } } class Son extends Parent { /** * 这个注解是为了检查此方法是否真的是重写父类的方法 * 这时候就不用我们用肉眼去观察到底是不是重写了 */ @Override public void run() { } } @Deprecated 演示class Parent { /** * 此注解代表过时了,但是如果可以调用到,当然也可以正常使用 * 但是,此方法有可能在以后的版本升级中会被慢慢的淘汰 * 可以放在类,变量,方法上面都起作用 */ @Deprecated public void run() { } } public class JDKAnnotationDemo { public static void main(String[] args) { Parent parent = new Parent(); parent.run(); // 在编译器中此方法会显示过时标志 } } @SuppressWarnings 演示class Parent { // 因为定义的 name 没有使用,那么编译器就会有警告,这时候使用此注解可以屏蔽掉警告 // 即任意不想看到的编译时期的警告都可以用此注解屏蔽掉,但是不推荐,有警告的代码最好还是处理一下 @SuppressWarnings("all") private String name; } @FunctionalInterface 演示/** 此注解是 Java8 提出的函数式接口,接口中只允许有一个抽象方法 加上这个注解之后,类中多一个抽象方法或者少一个抽象方法都会报错 */ @FunctionalInterface interface Func { void run(); } 注解处理器实战 注解处理器注解处理器才是使用注解整个流程中最重要的一步了。所有在代码中出现的注解,它到底起了什么作用,都是在注解处理器中定义好的。概念:注解本身并不会对程序的编译方式产生影响,而是注解处理器起的作用;注解处理器能够通过在运行时使用反射获取在程序代码中的使用的注解信息,从而实现一些额外功能。前提是我们自定义的注解使用的是 RetentionPolicy.RUNTIME 修饰的。这也是我们在开发中使用频率很高的一种方式。 我们先来了解下如何通过在运行时使用反射获取在程序中的使用的注解信息。如下类注解和方法注解。 类注解 Class aClass = ApiController.class; Annotation[] annotations = aClass.getAnnotations(); for(Annotation annotation : annotations) { if(annotation instanceof ApiAuthAnnotation) { ApiAuthAnnotation apiAuthAnnotation = (ApiAuthAnnotation) annotation; System.out.println("name: " + apiAuthAnnotation.name()); System.out.println("age: " + apiAuthAnnotation.age()); } } 方法注解 Method method = ... //通过反射获取方法对象 Annotation[] annotations = method.getDeclaredAnnotations(); for(Annotation annotation : annotations) { if(annotation instanceof ApiAuthAnnotation) { ApiAuthAnnotation apiAuthAnnotation = (ApiAuthAnnotation) annotation; System.out.println("name: " + apiAuthAnnotation.name()); System.out.println("age: " + apiAuthAnnotation.age()); } } 此部分内容可参考: 通过反射获取注解信息 注解处理器实战接下来我通过在公司中的一个实战改编来演示一下注解处理器的真实使用场景。需求: 网站后台接口只能是年龄大于 18 岁的才能访问,否则不能访问前置准备: 定义注解(这里使用上文的完整注解),使用注解(这里使用上文中使用注解的例子)接下来要做的事情: 写一个切面,拦截浏览器访问带注解的接口,取出注解信息,判断年龄来确定是否可以继续访问。 在 dispatcher-servlet.xml 文件中定义 aop 切面 <aop:config> <!--定义切点,切的是我们自定义的注解--> <aop:pointcut id="apiAuthAnnotation" expression="@annotation(cn.caijiajia.devops.aspect.ApiAuthAnnotation)"/> <!--定义切面,切点是 apiAuthAnnotation,切面类即注解处理器是 apiAuthAspect,主处理逻辑在方法名为 auth 的方法中--> <aop:aspect ref="apiAuthAspect"> <aop:around method="auth" pointcut-ref="apiAuthAnnotation"/> </aop:aspect> </aop:config> 切面类处理逻辑即注解处理器代码如 @Component("apiAuthAspect") public class ApiAuthAspect { public Object auth(ProceedingJoinPoint pjp) throws Throwable { Method method = ((MethodSignature) pjp.getSignature()).getMethod(); ApiAuthAnnotation apiAuthAnnotation = method.getAnnotation(ApiAuthAnnotation.class); Integer age = apiAuthAnnotation.age(); if (age > 18) { return pjp.proceed(); } else { throw new RuntimeException("你未满18岁,禁止访问"); } } } 不同类型的注解 类注解 你可以在运行期访问类,方法或者变量的注解信息,下是一个访问类注解的例子: Class aClass = TheClass.class; Annotation[] annotations = aClass.getAnnotations(); for(Annotation annotation : annotations){ if(annotation instanceof MyAnnotation){ MyAnnotation myAnnotation = (MyAnnotation) annotation; System.out.println("name: " + myAnnotation.name()); System.out.println("value: " + myAnnotation.value()); } } 你还可以像下面这样指定访问一个类的注解: Class aClass = TheClass.class; Annotation annotation = aClass.getAnnotation(MyAnnotation.class); if(annotation instanceof MyAnnotation){ MyAnnotation myAnnotation = (MyAnnotation) annotation; System.out.println("name: " + myAnnotation.name()); System.out.println("value: " + myAnnotation.value()); } 方法注解 下面是一个方法注解的例子: public class TheClass { @MyAnnotation(name="someName", value = "Hello World") public void doSomething(){} } 你可以像这样访问方法注解: Method method = ... //获取方法对象 Annotation[] annotations = method.getDeclaredAnnotations(); for(Annotation annotation : annotations){ if(annotation instanceof MyAnnotation){ MyAnnotation myAnnotation = (MyAnnotation) annotation; System.out.println("name: " + myAnnotation.name()); System.out.println("value: " + myAnnotation.value()); } } 你可以像这样访问指定的方法注解: Method method = ... // 获取方法对象 Annotation annotation = method.getAnnotation(MyAnnotation.class); if(annotation instanceof MyAnnotation){ MyAnnotation myAnnotation = (MyAnnotation) annotation; System.out.println("name: " + myAnnotation.name()); System.out.println("value: " + myAnnotation.value()); } 参数注解 方法参数也可以添加注解,就像下面这样: public class TheClass { public static void doSomethingElse( @MyAnnotation(name="aName", value="aValue") String parameter){ } } 你可以通过 Method对象来访问方法参数注解: Method method = ... //获取方法对象 Annotation[][] parameterAnnotations = method.getParameterAnnotations(); Class[] parameterTypes = method.getParameterTypes(); int i=0; for(Annotation[] annotations : parameterAnnotations){ Class parameterType = parameterTypes[i++]; for(Annotation annotation : annotations){ if(annotation instanceof MyAnnotation){ MyAnnotation myAnnotation = (MyAnnotation) annotation; System.out.println("param: " + parameterType.getName()); System.out.println("name : " + myAnnotation.name()); System.out.println("value: " + myAnnotation.value()); } } } 需要注意的是 Method.getParameterAnnotations()方法返回一个注解类型的二维数组,每一个方法的参数包含一个注解数组。 变量注解 下面是一个变量注解的例子: public class TheClass { @MyAnnotation(name="someName", value = "Hello World") public String myField = null; } 你可以像这样来访问变量的注解: Field field = ... //获取方法对象</pre> <pre>Annotation[] annotations = field.getDeclaredAnnotations(); for(Annotation annotation : annotations){ if(annotation instanceof MyAnnotation){ MyAnnotation myAnnotation = (MyAnnotation) annotation; System.out.println("name: " + myAnnotation.name()); System.out.println("value: " + myAnnotation.value()); } } 你可以像这样访问指定的变量注解: Field field = ...//获取方法对象</pre> <pre> Annotation annotation = field.getAnnotation(MyAnnotation.class); if(annotation instanceof MyAnnotation){ MyAnnotation myAnnotation = (MyAnnotation) annotation; System.out.println("name: " + myAnnotation.name()); System.out.println("value: " + myAnnotation.value()); } Java注解相关面试题 什么是注解?他们的典型用例是什么? 注解是绑定到程序源代码元素的元数据,对运行代码的操作没有影响。 他们的典型用例是: 编译器的信息 - 使用注解,编译器可以检测错误或抑制警告 编译时和部署时处理 - 软件工具可以处理注解并生成代码,配置文件等。 运行时处理 - 可以在运行时检查注解以自定义程序的行为 描述标准库中一些有用的注解。 java.lang和java.lang.annotation包中有几个注解,更常见的包括但不限于此: @Override -标记方法是否覆盖超类中声明的元素。如果它无法正确覆盖该方法,编译器将发出错误 @Deprecated - 表示该元素已弃用且不应使用。如果程序使用标有此批注的方法,类或字段,编译器将发出警告 @SuppressWarnings - 告诉编译器禁止特定警告。在与泛型出现之前编写的遗留代码接口时最常用的 @FunctionalInterface - 在Java 8中引入,表明类型声明是一个功能接口,可以使用Lambda Expression提供其实现 可以从注解方法声明返回哪些对象类型? 返回类型必须是基本类型,String,Class,Enum或数组类型之一。否则,编译器将抛出错误。 这是一个成功遵循此原则的示例代码: enum Complexity { LOW, HIGH } public @interface ComplexAnnotation { Class<? extends Object> value(); int[] types(); Complexity complexity(); } 下一个示例将无法编译,因为Object不是有效的返回类型: public @interface FailingAnnotation { Object complexity(); } 哪些程序元素可以注解? 注解可以应用于整个源代码的多个位置。它们可以应用于类,构造函数和字段的声明: @SimpleAnnotation public class Apply { @SimpleAnnotation private String aField; @SimpleAnnotation public Apply() { // ... } } 方法及其参数: @SimpleAnnotation public void aMethod(@SimpleAnnotation String param) { // ... } 局部变量,包括循环和资源变量: @SimpleAnnotation int i = 10; for (@SimpleAnnotation int j = 0; j < i; j++) { // ... } try (@SimpleAnnotation FileWriter writer = getWriter()) { // ... } catch (Exception ex) { // ... } 其他注解类型: @SimpleAnnotation public @interface ComplexAnnotation { // ... } 甚至包,通过package-info.java文件: @PackageAnnotation package com.baeldung.interview.annotations; 从Java 8开始,它们也可以应用于类型的使用。为此,注解必须指定值为ElementType.USE的@Target注解: @Target(ElementType.TYPE_USE) public @interface SimpleAnnotation { // ... } 现在,注解可以应用于类实例创建: new @SimpleAnnotation Apply(); 类型转换: aString = (@SimpleAnnotation String) something; 接口中: public class SimpleList<T> implements @SimpleAnnotation List<@SimpleAnnotation T> { // ... } 抛出异常上: void aMethod() throws @SimpleAnnotation Exception { // ... } 有没有办法限制可以应用注解的元素? 有,@ Target注解可用于此目的。如果我们尝试在不适用的上下文中使用注解,编译器将发出错误。 以下是仅将@SimpleAnnotation批注的用法限制为字段声明的示例: @Target(ElementType.FIELD) public @interface SimpleAnnotation { // ... } 如果我们想让它适用于更多的上下文,我们可以传递多个常量: @Target({ ElementType.FIELD, ElementType.METHOD, ElementType.PACKAGE }) 我们甚至可以制作一个注解,因此它不能用于注解任何东西。当声明的类型仅用作复杂注解中的成员类型时,这可能会派上用场: @Target({}) public @interface NoTargetAnnotation { // ... } 什么是元注解? 元注解适用于其他注解的注解。 所有未使用@Target标记或使用它标记但包含ANNOTATION_TYPE常量的注解也是元注解: @Target(ElementType.ANNOTATION_TYPE) public @interface SimpleAnnotation { // ... } 下面的代码会编译吗? @Target({ ElementType.FIELD, ElementType.TYPE, ElementType.FIELD }) public @interface TestAnnotation { int[] value() default {}; } 不能。如果在@Target注解中多次出现相同的枚举常量,那么这是一个编译时错误。 删除重复常量将使代码成功编译: @Target({ ElementType.FIELD, ElementType.TYPE}) 参考文章 https://blog.fundodoo.com/2018/04/19/130.htmlhttps://blog.csdn.net/qq_37939251/article/details/83215703https://blog.51cto.com/4247649/2109129https://www.jianshu.com/p/2f2460e6f8e7https://blog.csdn.net/yuzongtao/article/details/83306182 微信公众号 Java技术江湖 如果大家想要实时关注我更新的文章以及分享的干货的话,可以关注我的公众号【Java技术江湖】一位阿里 Java 工程师的技术小站,作者黄小斜,专注 Java 相关技术:SSM、SpringBoot、MySQL、分布式、中间件、集群、Linux、网络、多线程,偶尔讲点Docker、ELK,同时也分享技术干货和学习经验,致力于Java全栈开发! Java工程师必备学习资源: 一些Java工程师常用学习资源,关注公众号后,后台回复关键字 “Java” 即可免费无套路获取。 个人公众号:黄小斜 作者是 985 硕士,蚂蚁金服 JAVA 工程师,专注于 JAVA 后端技术栈:SpringBoot、MySQL、分布式、中间件、微服务,同时也懂点投资理财,偶尔讲点算法和计算机理论基础,坚持学习和写作,相信终身学习的力量! 程序员3T技术学习资源: 一些程序员学习技术的资源大礼包,关注公众号后,后台回复关键字 “资料” 即可免费无套路获取。

优秀的个人博客,低调大师

日志服务数据加工最佳实践: 解析syslog各种标准格式

概况 syslog是一种工业标准的协议,可用来记录设备的日志。在UNIX系统,路由器、交换机等网络设备中,系统日志(System Log)记录系统中任何时间发生的大小事件。管理者可以通过查看系统记录,随时掌握系统状况。UNIX的系统日志是通过syslogd这个进程记录系统有关事件记录,也可以记录应用程序运作事件。通过适当的配置,还可以实现运行syslog协议的机器间通信,通过分析这些网络行为日志,藉以追踪掌握与设备和网络有关的状况。 问题 在Unix类操作系统上,syslog广泛应用于系统日志。syslog日志消息既可以记录在本地文件中,也可以通过网络发送到接收syslog的服务器。接收syslog的服务器可以对多个设备的syslog消息进行统一的存储,或者解析其中的内容做相应的处理。常见的应用场景是网络管理工具、安全管理系统、日志审计

优秀的个人博客,低调大师

日志服务数据加工最佳实践: 解析CSV格式的日志

本案例是根据客户实际应用需求中产生,以下将详细从原始数据到需求再到解决方案等几个方面向读者解答如何使用LOG DSL加工语法,解决实际生产中的问题。 原始日志 _program_:error _severity_:6 _priority_:14 _facility_:1 topic:syslog-forwarder content:10.64.10.20|10/Jun/2019:11:32:16 +0800|m.zf.cn|GET /zf/11874.html HTTP/1.1|200|0.077|6404|10.11.186.82:8001|200|0.060|https://yz.m.sm.cn/s?q=%E8%9B%8B%E8%8A%B1%E9%BE%99%E9%A1%BB%E9%9D%A2%E7%9A%84%E5%81%9A%

优秀的个人博客,低调大师

【ECS最佳实践】使用多块云硬盘构建RAID组

1.RAID简介 RAID是将多个独立的磁盘按照一定的方式组成1个磁盘阵列组,相比单个磁盘能够有效的提高磁盘的容量、带宽以及可靠性和可用性。 说明: 1.不建议对云盘采用RAID5 和RAID6模式,这些RAID模式的奇偶校验数据会占用一定的IOPS,从而造成性能的损失 2.建议创建RAID0,RAID1模式,并使用相同分区大小,以减少云盘空间的浪费 如下是常见的RAID配置选项: 配置 优点 劣势 使用场景 RAID0 I/O在卷内以条带化的方式分布在各个磁盘上。增加云盘空间会直接增加吞吐量。存储空间等于各个云盘之和 没有数据冗余能力,单个云盘的损坏有可能造成整个虚拟盘数据丢失 对 I/O 性能要求很高,并且已通过其他方式对数据进行备份处理或者不需要进行数据备份的场景 RAID1 数据以镜像的方式存储在各个磁盘上。虚拟盘的存储空间大小取决于RAID组内容

优秀的个人博客,低调大师

【最佳实践】如何限制用户仅通过HTTPS方式访问OSS?

一、当前存在的问题 当前OSS支持用户使用HTTPS/HTTP协议访问Bucket。但由于HTTP存在安全漏洞。大型企业客户都要求使用HTTPS方式访问OSS,并且拒绝HTTP访问请求。 目前OSS可以通过RAM policy方式实现:限制某个用户、角色拒绝通过HTTP协议访问指定的Bucket和对象。但是RAM Policy是一种基于用户的授权方式,无法针对资源进行授权。也就是说无法针对Bucket或者对象级别,拒绝所有用户的HTTP请求。目前我们正在基于Bucket Policy开发该功能,后续用户可以直接通过Bucket Policy设置HTTPS访问策略。 二、通过RAM Policy实现“限制用户仅通过HTTPS方式访问OSS” 阿里云RAM Policy有丰富的Condition参数,可以限制对资源的访问。这里我们

优秀的个人博客,低调大师

最佳实践:阿里云VPC、ECS支持IPv6啦!

12月6日,阿里云宣布为企业提供全栈IPv6解决方案。 阿里云专有网络VPC、云服务器ECS,作为阿里云的核心产品,也于2018年11月底上线双栈VPC、双栈ECS,目前正在对外公测中。 那么如何在阿里云拥有IPv4/IPv6双栈VPC、双栈ECS呢,请看下文详解。 操作概览 操作详情 (一)VPC开通IPv6 前提:您已经获取阿里云IPv6使用资格,点我申请公测资格 1.1、登录阿里云专有网络VPC控制台,地域选择“华北5(呼和浩特)”。 说明:当前VPC双栈、ECS双栈,只在阿里云中国站华北5(呼和浩特)地域开服。更多地域即将支持VPC IPv6、ECS IPv6功能,敬请期待。 1.2、点击创建专有网络,在右滑页面按照提示进行操作。 创建专有网络的同时,您还需要创建一个交换机。 交换机的IPv6网段支持用户自定义后8比特位,您可以在输入框输入0-

优秀的个人博客,低调大师

我用 Zabbix 的最佳实践,战胜各种不确定挑战

VUCA 这个词在高效运维社区好几个分享当中都有提到过,现在是变幻莫测的时代,有很多不确定性、易变性、复杂性、模糊性,我们现在的需求变得越来越模糊不确定。以前开发使用瀑布型的模型,完成一个交付可能需要几个月的时间,需求是固定的。但是现在面对越来越多的竞争对手,越来越多的新需求,我们会有很多的不确定性。比如上线一个类似拼多多的拼团业务模型,业务部门往往希望在几周内进行需求交付。 因此,VUCA 带来的持续不断的变化,对于底层的监控系统造成了非常大的挑战,包括技术栈的挑战,包括人员的专业能力上的挑战。所以很多时候,VUCA带来的变化也意味着各种不确定的挑战。 一. Fintech的挑战 大家认为运维的第一要务是什么? 从表面看,运维是一个消耗的部门,会消耗很多金钱和资源,所以对于我们来说运维的第一要务是止损。只有保证线上系统的高可用性,保证业

优秀的个人博客,低调大师

MSSQL · 最佳实践 · 使用非对称秘钥实现列加密

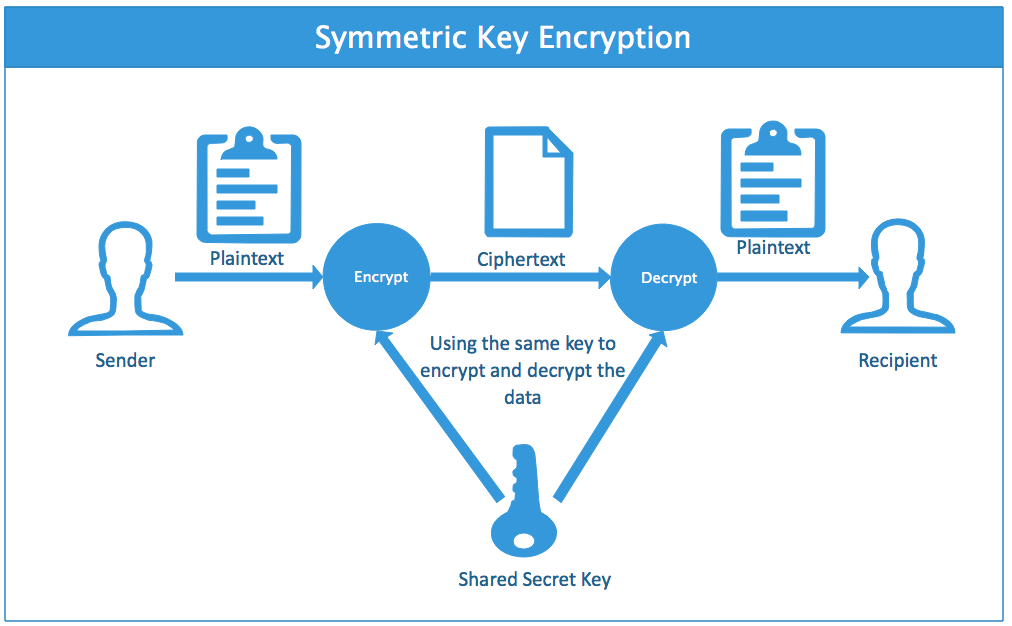
摘要 上一篇月报,我们分享了SQL Server使用对称秘钥实现列加密的方法。为了解决对称加密安全性低的问题,本期月报我们分享使用非对称秘钥加密方式实现SQL Server列加密方法,保护用户的关键、核心隐私数据列信息。 场景引入 对称加密是指加密和解密过程使用同一个密钥的加密算法,而非对称加密方法加密和解密过程使用不同的秘钥进行。因此,通常来说对称加密安全性较弱,非对象加密安全性相对较高。以下是关于对称加密和非对称加密的过程介绍。 对称加密过程 对称加密算法使用相同的秘钥对数据进行加密,如下图所示: 对称加密数据整个流转过程包括: 数据发送者使用秘钥将数据明文加密为密文 通过网络将数据密文和秘钥发送给接受者 接受者使用相同秘钥对密文进行解密,获取到最终的明文数据 从数据整个流转过程来看,很可能用于加密的秘钥会被窃取,比如: 网络传输过程中,

优秀的个人博客,低调大师

Spring Boot 最佳实践(五)Spring Data JPA 操作 MySQL 8

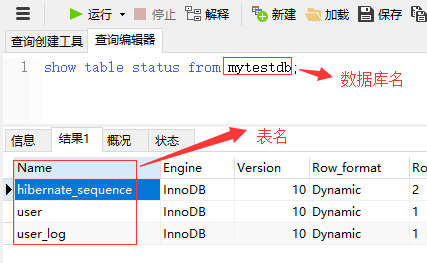
一、Spring Data JPA 介绍 JPA(Java Persistence API)Java持久化API,是 Java 持久化的标准规范,Hibernate是持久化规范的技术实现,而Spring Data JPA是在 Hibernate 基础上封装的一款框架。 开发环境 Spring Boot 2.0.4 Spring Data JPA 2.0.4 MySQL 8.0.12 JDK 8 IDEA 2018.2 Windows 10 二、集成步骤 2.1 配置依赖 添加Spring Data JPA 和 MySQL Connector,配置pom.xml文件,代码如下: <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-data-jpa</artifactId> <version>2.0.4.RELEASE</version> </dependency> <dependency> <groupId>mysql</groupId> <artifactId>mysql-connector-java</artifactId> <version>8.0.12</version> </dependency> 更多JPA版本:http://mvnrepository.com/artifact/org.springframework.boot/spring-boot-starter-data-jpa 更多Mysql版本:http://mvnrepository.com/artifact/mysql/mysql-connector-java 2.2 application.properties 设置配置文件 ## 数据源配置 spring.datasource.url=jdbc:mysql://172.16.10.79:3306/mytestdb?serverTimezone=UTC&useSSL=false&allowPublicKeyRetrieval=true spring.datasource.username=root spring.datasource.password=123456 spring.datasource.driver-class-name=com.mysql.cj.jdbc.Driver spring.jpa.hibernate.ddl-auto=update spring.jpa.database-platform=org.hibernate.dialect.MySQL5InnoDBDialect spring.jpa.show-sql=true hbm2ddl.auto:自动创建|更新|验证数据库表结构 dialect:设置数据库引擎为InnoDB show-sql:打印sql语句,方便调试 hbm2ddl.auto有四个属性: create:每次加载 hibernate 时都会删除上一次的生成的表,然后根据你的 model 类再重新来生成新表,哪怕两次没有任何改变也要这样执行,这就是导致数据库表数据丢失的一个重要原因。[删除-创建-操作] create-drop :每次加载 hibernate 时根据 model 类生成表,但是 sessionFactory 一关闭,表就自动删除。[删除-创建-操作-再删除] update:最常用的属性,第一次加载 hibernate 时根据 model 类会自动建立起表的结构(前提是先建立好数据库),以后加载 hibernate 时根据 model 类自动更新表结构,即使表结构改变了,但表中的行仍然存在,不会删除以前的行。要注意的是当部署到服务器后,表结构是不会被马上建立起来的,是要等应用第一次运行起来后才会。[没表-创建-操作 | 有表-更新没有的属性列-操作] validate:每次加载 hibernate 时,验证创建数据库表结构,只会和数据库中的表进行比较,不会创建新表,但是会插入新值。[启动验证表结构,验证不成功,项目启动失败] 2.3 增加实体类(Entity) @Entity public class User implements Serializable { @Id @GeneratedValue private Long id; @Column(name = "name", nullable = false) private String name; @Column(nullable = false) private int age; @Column(nullable = false) private String pwd; public User(){} public User(String name, int age, String pwd) { this.name = name; this.age = age; this.pwd = pwd; } //...忽略set、get方法 } @GeneratedValue 自动生成id @Column 设置列属性(name="数据库列名") @Transient 不会映射到数据库 2.4 创建 Repository 接口构建业务方法 public interface UserRepository extends JpaRepository<User,Long> { public User findByName(String name); } 继承JpaRepository之后就继承了: Repository.save(user); // 插入或保存 Repository.saveFlush(user); // 保存并刷新 Repository.exists(1) // 主键查询是否存在 Repository.findOne(1); // 主键查询单条 Repository.delete(1); // 主键删除 Repository.findByUsername("stone"); // 查询单条 Repository.findAll(pageable); // 带排序和分页的查询列表 Repository.saveState(1, 0); // 更新单个字段 这些方法,可以不写一行代码就可以实现对一个表的操作,当然你也可以扩展一些自己的方法,只需要在UserRepository里面添加方法即可。 2.5 添加、查询数据库 @Controller @RequestMapping("/") public class UserController { @Autowired private UserRepository userRepository; @RequestMapping("/") public ModelAndView index() { userRepository.save(new User("老王",18,"123456")); ModelAndView modelAndView = new ModelAndView("/index"); modelAndView.addObject("dataSize", userRepository.findAll().size()); return modelAndView; } } 到现在为止,集成 Spring Data JPA 已经全部完成了,启动调试,查看运行效果吧。 三、高级使用 本节高级使用将会涉及的知识点如下: 事务实现 根据名称自动生成SQL 自定义Sql语句查询 3.1 事务实现 3.1.1 Spring事务实现步骤 实现事务,只需要两步即可: 步骤一、在application.properties配置数据库引擎为InnoDB: spring.jpa.database-platform=org.hibernate.dialect.MySQL5InnoDBDialect 步骤二、在方法或类上标识事务@Transactional 示例代码: @Transactional public void saveGroup(){ userRepository.save(user); userRepository.save(user2); } 如果出现错误,就会进行事务回滚。 3.1.2 事务不生效的原因 3.1.2.1 确认数据库引擎 在application.properties配置数据库引擎为InnoDB: spring.jpa.database-platform=org.hibernate.dialect.MySQL5InnoDBDialect 3.1.2.2 查看表的引擎必须为InnoDB 通过命令: show table status from mytestdb; 修改表的引擎: alter table table_name engine=innodb; 3.1.2.3 注意引入@Transactional的命名空间 @Transactional注解来自org.springframework.transaction.annotation包,而不是javax.transaction. 3.2 根据名称自动生成SQL JPA支持根据简单的关键字自动生成Sql查询的方法,比如根据name和age的组合查询,代码如下: public User findByNameAndAge(String name,int age); 使用关键字“And”即可,或者查询时间区间的: public User findByStartDateBetween(Long startDate); 使用关键字“Between”即可。 更多内部支持的关键字,如下表: Keyword Sample JPQL snippet And findByLastnameAndFirstname … where x.lastname = ?1 and x.firstname = ?2 Or findByLastnameOrFirstname … where x.lastname = ?1 or x.firstname = ?2 Is,Equals findByFirstname,findByFirstnameIs … where x.firstname = ?1 Between findByStartDateBetween … where x.startDate between ?1 and ?2 LessThan findByAgeLessThan … where x.age < ?1 LessThanEqual findByAgeLessThanEqual … where x.age <= ?1 GreaterThan findByAgeGreaterThan … where x.age > ?1 GreaterThanEqual findByAgeGreaterThanEqual … where x.age >= ?1 After findByStartDateAfter … where x.startDate > ?1 Before findByStartDateBefore … where x.startDate < ?1 IsNull findByAgeIsNull … where x.age is null IsNotNull,NotNull findByAge(Is)NotNull … where x.age not null Like findByFirstnameLike … where x.firstname like ?1 NotLike findByFirstnameNotLike … where x.firstname not like ?1 StartingWith findByFirstnameStartingWith … where x.firstname like ?1(parameter bound with appended %) EndingWith findByFirstnameEndingWith … where x.firstname like ?1(parameter bound with prepended %) Containing findByFirstnameContaining … where x.firstname like ?1(parameter bound wrapped in %) OrderBy findByAgeOrderByLastnameDesc … where x.age = ?1 order by x.lastname desc Not findByLastnameNot … where x.lastname <> ?1 In findByAgeIn(Collection ages) … where x.age in ?1 NotIn findByAgeNotIn(Collection ages) … where x.age not in ?1 True findByActiveTrue() … where x.active = true False findByActiveFalse() … where x.active = false IgnoreCase findByFirstnameIgnoreCase … where UPPER(x.firstame) = UPPER(?1) 官方文档:https://docs.spring.io/spring-data/jpa/docs/2.0.9.RELEASE/reference/html/#jpa.repositories 3.3 自定义Sql语句查询 对于用户自己编写sql,Spring Boot JPA也有很好的支持,只需要添加@Query(sql)即可。 示例代码: @Transactional @Modifying @Query("update User set name=?1 where id=?2") public int modifyName(String name,Long id); 注意:在执行修改和删除的时候必须添加@Modifying注解,ORM才知道要执行写操作,update/delete query 的时候,也必须需要加上@Transactional(事务)才能正常操作。 四、常见错误 在 Spring Data JPA 的使用当中,可能会遇到如下的一些错误。 1.No default constructor for entity 实体类Entity没有空参数的默认构造函数,新增即可解决。 2.java.sql.SQLException: Access denied for user ''@'172.17.0.1' (using password: NO) 启动项目报错,用户名和密码配置的key有误,MySQL8的用户名和密码配置和之前的不一样,MySQL 8 正确的用户名密码配置如下: spring.datasource.username=root spring.datasource.password=123456 # 以下为配置老数据库驱动配置 #spring.datasource.data-username=root #spring.datasource.data-password=123456 3.Caused by: java.lang.IllegalStateException: Cannot load driver class: com.mysql.jdbc.Driver MySQL 8 的spring.datasource.driver-class-name配置需要改为“com.mysql.cj.jdbc.Driver”而不是“com.mysql.jdbc.Driver”,正确配置如下: spring.datasource.driver-class-name=com.mysql.cj.jdbc.Driver

优秀的个人博客,低调大师

K8S有状态服务-StatefulSet使用最佳实践

介绍 StatefulSet是一种给Pod提供唯一标志的控制器,它可以保证部署和扩展的顺序。 Pod一致性:包含次序(启动、停止次序)、网络一致性。此一致性与Pod相关,与被调度到哪个node节点无关。 稳定的次序:对于N个副本的StatefulSet,每个Pod都在[0,N)的范围内分配一个数字序号,且是唯一的。 稳定的网络:Pod的hostname模式为$(statefulset名称)-$(序号)。 稳定的存储:通过VolumeClaimTemplate为每个Pod创建一个PV。删除、减少副本,不会删除相关的卷。 阿里云云盘支持动态挂载的功能,可以通过VolumeClaimTemplate方式部署statefulset应用。 部署Statefulset服务 volumeClaimTemplates:表示一类PVC的模板,系统会根据Statef

优秀的个人博客,低调大师

最佳实践系列丨Docker EE 服务发现参考架构(一)

本文首发自“Docker公司”公众号(ID:docker-cn)编译丨小东每周一、三、五 与您不见不散! 服务发现对服务进行注册并发布其连接信息,以使其他服务了解如何连接到服务。随着应用向微服务和面向服务的架构转变,服务发现已经成为所有分布式系统的必要组成部分,增加了这些环境的运维复杂性。 Docker 企业版 (Docker EE) 包含服务发现和负载均衡功能,可为整个组织的开发运维计划提供助力。服务发现和负载均衡可以方便开发人员创建可动态互相发现的应用。另外,这些功能还简化了运维工程师扩展应用的过程。 Docker 使用称作服务的概念来部署应用。服务由基于相同的镜像创建的容器组成。每个服务都由在工作节点上执行并且会定义应用的状态的任务组成。部署服务时,服务定义在创建服务时完成。服务定义包含很多信息,其中包括,服务包含的容器、发布的端口、连接的网络和从节点的数量。所有这些任务共同组成服务的理想状态。如果某个节点未通过运行状况检查或服务定义中某个特定的服务任务未通过运行状况检查,那么集群将调整服务状态,使其与另一个运行状况良好的节点的服务状态一致。Docker EE 包含服务发现、负载均衡、扩展和调整事件,以使该编排可以无缝工作。 学习内容 此参考架构涵盖 Docker EE 提供的服务发现和负载均衡领域的解决方案。创建服务时,Docker 使用 DNS 实现服务发现,而且 Docker 内置了不同的网格路由,可确保应用高度可用。UCP 2.0 发行版引入了新的应用层网格路由,称为 HTTP 网格路由 (HRM),它基于 DNS 主机名路由 HTTP 流量。阅读完本文档之后,您将充分了解 HRM 的工作原理以及它如何与其他 Docker 服务发现和负载均衡功能集成。 使用 DNS 的服务发现 Docker 使用嵌入的 DNS 来为在单个 Docker 引擎上运行的容器和在 Docker Swarm 中运行的任务提供服务发现功能。Docker 引擎具备内部 DNS 服务器,可为用户定义的 bridge、overlay 和 MACVLAN 网络中的主机上的所有容器提供名称解析。每个 Docker 容器(或任务(swarm mode 中))都具备一个可将 DNS 查询转发到 Docker 引擎的 DNS 解析器,它充当 DNS 服务器。然后,Docker 引擎将在发送请求的容器所属的每个网络上检查 DNS 查询是否属于容器或服务。如果属于,Docker 引擎将在其键值存储中查找与容器、任务、或服务的名称匹配的 IP 地址,并将 IP 或服务虚拟 IP (VIP) 返回给请求方。 服务发现将网络作为范围,这意味着只有在相同网络上的容器或任务才可使用嵌入的 DNS 功能。不在相同网络上的容器无法解析彼此的地址。而且,只有在特定网络上具备容器或任务的节点才会存储该网络的 DNS 条目。这有助于提高安全性和性能。 如果目标容器或服务和源容器位于不同的网络上,Docker 引擎会将 DNS 查询转发到默认 DNS 服务器。 本示例中,有一个具有两个容器的服务,称为 myservice。在相同的网络上还存在第二个服务 (client)。client 运行两个 curl 操作(为 docker.com 和 myservice)。以下为因此发生的操作: client 为 docker.com 和 myservice发起 DNS 查询; 容器的内置解析器在 127.0.0.11:53 上拦截 DNS 查询,并将其发送到 Docker 引擎的 DNS 服务器; myservice 解析到服务的虚拟 IP (VIP),并在内部均衡分配到各个任务 IP 地址。容器名也将被解析,只不过是直接解析到其 IP 地址; docker.com 没有作为服务名称存在于 mynet 网络中,所以请求被转发给已配置的默认 DNS 服务器; 内部负载均衡 当在 Docker Swarm 集群中创建服务时,将自动向其分配虚拟 IP (VIP),它是服务的网络的一部分。解析服务的名称时将返回 VIP。流向 VIP 的流量将被自动发送到整个 overlay 网络上该服务的所有运行状况良好的任务。此方法可避免由于在客户端进行任何负载均衡,因为仅有一个 IP 返回到客户端。Docker 会处理所有路由并将流量平均分发给运行状况良好的服务任务。 要获取服务的 VIP,请按以下方式运行 docker service inspect myservice 命令: # Create an overlay network called mynet $ docker network create -d overlay mynet a59umzkdj2r0ua7x8jxd84dhr # Create myservice with 2 replicas as part of that network $ docker service create --network mynet --name myservice --replicas 2 busybox ping localhost 8t5r8cr0f0h6k2c3k7ih4l6f5 # Get the VIP that was created for that service $ docker service inspect myservice ... “VirtualIPs":[ { "NetworkID":"a59umzkdj2r0ua7x8jxd84dhr", "Addr":“10.0.0.3/24" }, ] DNS 轮询 (DNS RR) 负载均衡是适用于服务(使用 --endpoint-mode配置)的另外一个负载均衡选项。在 DNS RR 模式下,不为每个服务单独创建 VIP。Docker DNS 服务器通过轮询方式将服务名称解析到各个容器 IP。 外部负载均衡(Swarm Mode 网格路由) 创建或更新服务时,您可以使用 --publish 标志在外部公开服务。在 Docker swarm mode 下公开端口意味着集群中的每个节点都将侦听端口。但是,如果服务的任务不在侦听该端口的节点上应该怎么办呢? 在这种情况下需要使用网格路由。网格路由是 Docker 引擎 1.12 中的一项新功能,它将 ipvs 和 iptables 相结合以创建功能强大的全集群传输层 (L4) 负载均衡器。它允许所有 swarm 节点接受服务发布的端口上的连接。任何 swarm 节点收到发往运行中服务的已发布 TCP/UDP 端口的流量时,它会使用称为入口的预定义 overlay 网络将流量转发到服务的 VIP。入口网络的行为方式与其他 overlay 网络相似,但是其唯一的目标是将网格路由流量从外部客户端传输给集群服务。它使用与前一部分中所述相同的基于 VIP 的内部负载均衡功能。 启动服务后,您就可以为应用创建外部 DNS 记录,并将其映射到任何或所有 Docker swarm 节点。您无需担心容器在哪里运行,因为有了网格路由路由功能,集群中的所有节点就像一个整体。 #Create a service with two replicas and export port 8000 on the cluster $ docker service create --name app --replicas 2 --network appnet --publish 8000:80 nginx 该图表对网格路由的工作原理进行了说明。 创建带有两个从节点的服务,并将其端口映射到外部端口 8000; 网格路由在集群中的每个主机上公开端口 8000; 发往应用的流量可从任何主机进入。在这种情况下,外部 LB 无需通过服务从节点就可将流量发送到主机; 内核的 IPVS 负载均衡器将入口 overlay 网络上的流量重定向到运行状况良好的服务从节点;

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册