首页 文章 精选 留言 我的

精选列表

搜索[AIOps最佳实践],共10000篇文章
优秀的个人博客,低调大师

Android应用性能优化最佳实践.2.5 启动优化

2.5 启动优化 随着应用的功能越来越丰富、启动时需要初始化的工作多、界面的元素复杂等,启动速度不可避免地受到影响,比如一开始单击时出现黑屏或者白屏,甚至在低端机型上出现假死的现象,本节通过学习应用的启动流程、启动速度的监控,发现影响启动速度的问题所在,并优化启动的逻辑,提高应用的启动速度。 2.5.1 应用启动流程 Android应用程序的载体是APK文件,其中包含了组件和资源,APK文件可能运行在一个独立的进程中,也有可能产生多个进程,还可以多个APK运行在同一个进程中,可以通过不同的方式来实现。但有两点需要注意,第一,每个应用只对应一个Application对象,并且启动应用一定会产生一个Application对象;第二,应用程序可视化组件Activity是应用的基本组成之一,因此要分析启动的性能,就有必要了解这两个对象的工作流程

优秀的个人博客,低调大师

Android应用性能优化最佳实践.2.3 布局优化

2.3 布局优化 布局是否合理主要影响的是页面测量时间的多少,我们知道一个页面的显示测量和绘制过程都是通过递归来完成的,多叉树遍历的时间与树的高度h相关,其时间复杂度为O(h),如果层级太深,每增加一层则会增加更多的页面显示时间。 任何时候View中的绘制内容发生变化时,都需要重新创建DisplayList、渲染DisplayList,更新到屏幕上等一系列操作。这个流程的表现性能取决于View的复杂程度、View的状态变化以及渲染管道的执行性能。例如,假设某个Button的大小需要增大到目前的两倍,在增大Button大小之前,需要通过父View重新计算并摆放其他子View的位置。修改View的大小会触发整个HierarcyView的重新计算大小的操作。如果是修改View的位置,则会触发HierarchView重新计算其他View的位置

优秀的个人博客,低调大师

Android应用性能优化最佳实践.1.4 本章小结

1.4 本章小结 Android Studio的安装并不复杂,首次使用可能会不适应并觉得效率甚至低于以前使用的其他IDE,但相信使用一段时间后,一定能体验到它的灵活和强大之处,同时Android Studio的技巧非常多,大家可以多从网上找到各种技巧。 古人云,“工欲善其事,必先利其器”,Android应用开发者的“器”则是指Android Studio,熟练运用开发工具,能极大程度提高开发效率。在掌握Android Studio这个开发神器后,再通过接下来的章节的学习,从UI性能、内存、稳定性等多个维度的优化,使Android应用程序更加高效、流畅地运行,从而打造出一款高质量的Android应用。

优秀的个人博客,低调大师

Redis · 最佳实践 · 阿里云Redis助力双11业务

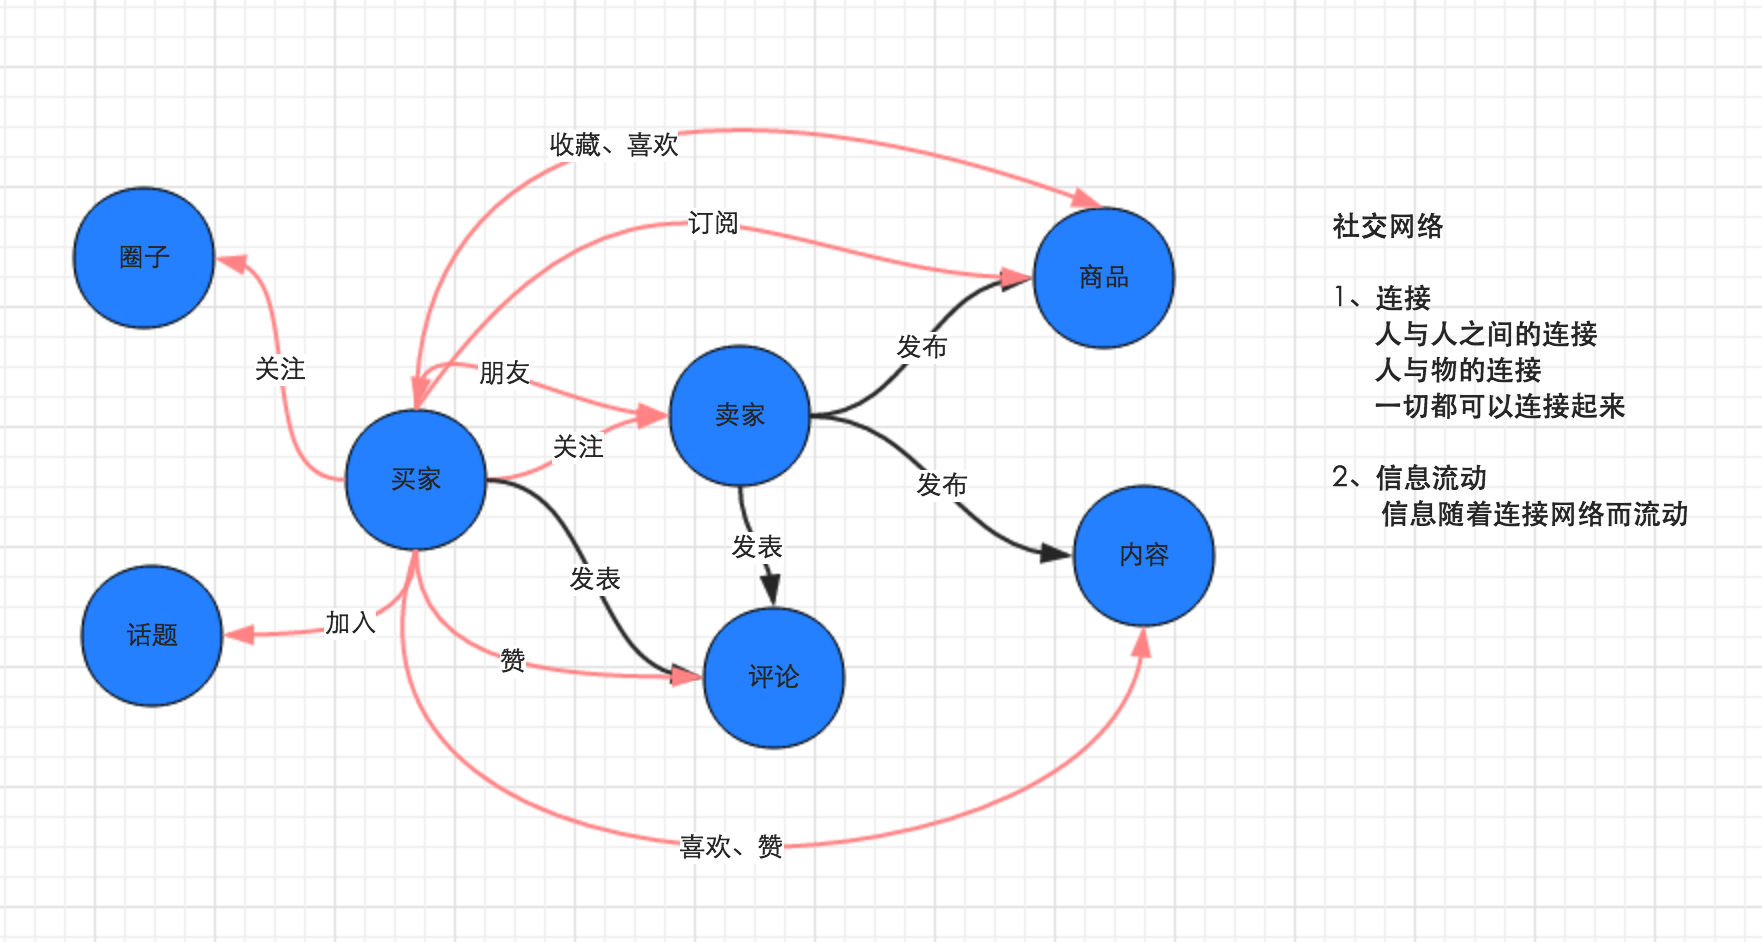
双11如火如荼的结束了,阿里云Redis(ApsaraDB for Redis原KVStore)也圆满完成了双11Redis的保障工作。目前阿里云Redis提供了单机版本和集群版本的Redis。 单机版本Redis具有很高的兼容性,并且支持Lua脚本及地理位置计算。 集群版本具有大容量、高性能的特性,能够突破Redis单线程的单机性能极限。 阿里云Redis默认双机热备并提供了备份恢复支持,同时阿里云Redis源码团队持续对Redis进行优化升级,提供了强大的安全防护能力。本文将选取双11的一些业务场景简化之后进行介绍,实际业务场景会比本文复杂。 微淘社区之亿级关系链存储 微淘社区承载了亿级淘宝用户的社交关系链,对于每个用户都有自己的关注列表,每个商家有自己的粉丝信息,整个微淘社区承载的关系链如下图所示。 如果选用传统的关系型数据库模型表达如

优秀的个人博客,低调大师

阿里云上搭建Docker Swarm模式集群最佳实践

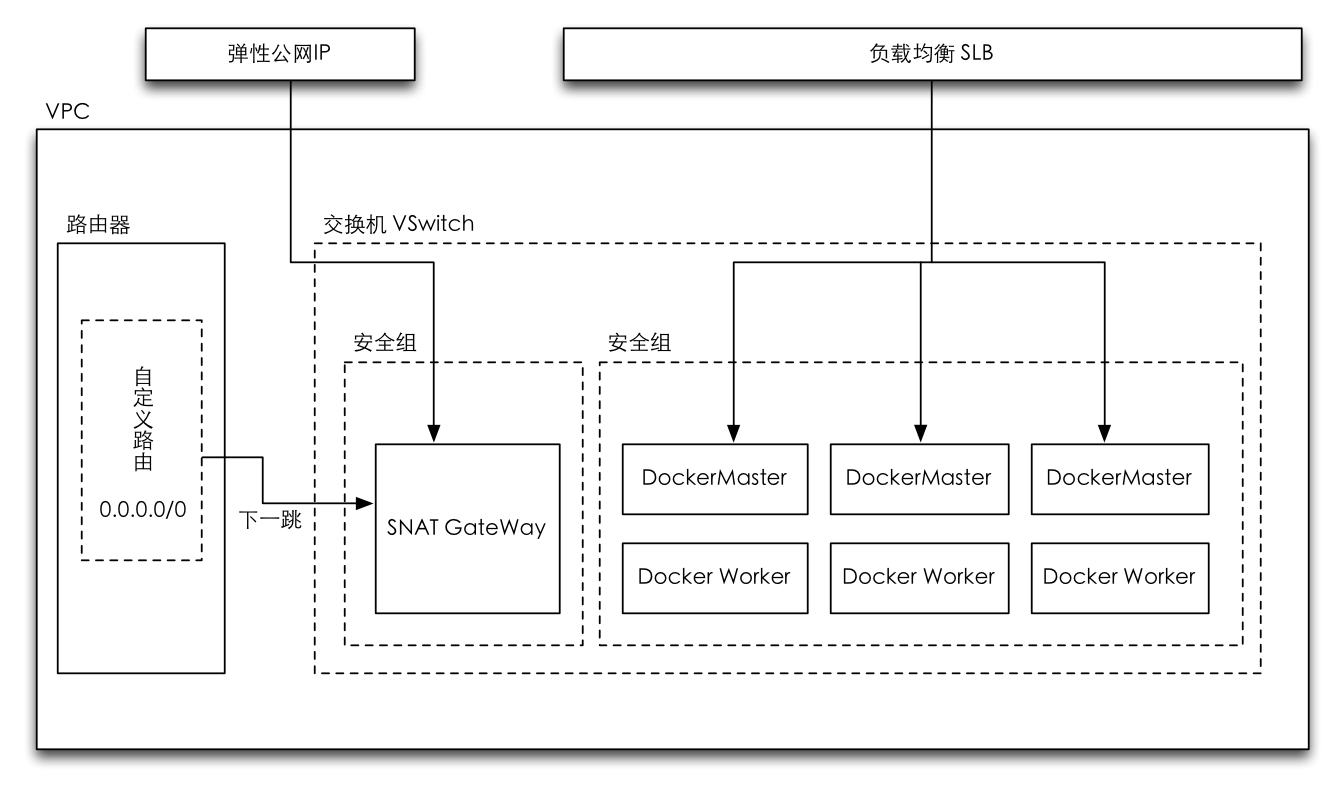
Docker技术体系和生态在2016年得到飞速发展、成熟,在2016中国容器技术调研报告中也发现了国内绝大部分用户都在关注Docker,80%的用户都会考虑使用容器技术。那如何能快速的在阿里云上搭建Docker集群呢?本文将讲解如何利用资源编排快速搭建Docker Swarm 模式集群,本例子中将安装Docker1.12,在Docker1.12中提供了Swarm模式,将一组Docker Engine构成一个集群统一管理、调度。 集群架构图如下: 如果已有VPC网络和NAT网关,可以跳过第一步,直接到第二步。 第一步:创建VPC网络,以及NAT网关。创建NAT网关有多种方法,您可以根据实际业务场景搭建自己的网关,本文使用ECS绑定EIP,并且增加自定义路由的方式搭建的SNAT网关。VPC即将推出一款企业级的VPC公网网关,详细介绍请参见

优秀的个人博客,低调大师

【最佳实践】实时计算Flink在IoT行业的实时数仓建设实践

行业背景 行业现状: 物联网(Internet of Things,以下简写为 IoT)是互联网、传统电信网等资讯的承载体,让所有具备独立功能的普通物体实现互联互通的网络。物联网广泛应用于运输和物流、健康医疗、智慧环境(家庭、办公、工厂)等领域, 具有十分广阔的市场和应用前景。物联网将智能感知、识别技术、网络通信与普适计算等技术融合起来,被认为是继计算机、互联网、智能手机之后世界信息产业发展的下一个风口。 据 IDC 估计,到 2020 年物联网将在全球范围内产生 1.46 万亿美元的价值。据预测,届时中国的物联网市场规模将超过 1.8 万亿人民币。得益于庞大的人口基数和低廉的芯片制造成本,中国将成为物联网行业的主要参与者,并在推动全球物联网市场增长上发挥重要的作用。 大数据在其行业中的作用: 数以百万计的物联网设备连接到物联网,产生了大量的数据,通过大规模分析这些数据了解影响业务的上下文关系和模式,从而做出更加实时决策,因此,可以说大数据和物联网密切相关。 物联网大数据分析可以帮助人们更好地理解数据,从而做出更有效、明智的决定。大数据分析使数据挖掘者和科学家能够利用传统工具分析非结构化数据。此外,大数据分析的目的是利用数据挖掘技术,提取知识信息,这些信息有助于进行预测,识别趋势,发现隐藏的信息,并做出决定。 业务场景 某公司开发了一套针对商场的人流量管理和分析系统。当顾客进入商场后,固定部署的WIFI探针将实时探测并采集顾客手机或PC终端的WIFI信息。这些顾客WIFI信息经过Flink实时统计和分析后获得商场中客流量、客流量的高峰期、顾客喜欢哪些商店、新客与常客的比例、商场的成交额、顾客的实时位置等等指标。客流量指标可用于数据大屏,顾客的实时位置指标可用于展示顾客实时密度图,顾客喜欢的商店指标可用于个性化的广告推送应用等。 技术架构 架构解析:数据采集:该场景中,数仓的数据来源于WIFI探针探测到的顾客手机和PC终端的WIFI信息,实时采集至DataHub作为Flink的输入数据。实时数仓架构:该场景中,整个实时数仓的ETL和BI部分的构建,全部通过Flink完成,Flink实时读取DataHub的数据进行处理,并与维表进行关联查询等操作,统计和分析结果最终输出到RDS和TableStore等存储系统,以供业务系统使用。 业务指标 场景一:客流量统计 每日商场客流量 每日商店客流量 顾客的实时位置 每日商场新增顾客人数 每日商场中顾客数量前5的商店 每日商场中顾客最多的时间段及顾客数量 场景二:顾客喜好分析 单日顾客最喜欢的商店 单日顾客进入超过一次的商店 业务代码 场景一:客流量统计 每日商场客流量 对顾客WIFI信息按天维度进行分组,使用count distinct语法去重统计得到商场中顾客人数。 输入表 --顾客WIFI信息 CREATE TABLE user_wifidata ( id varchar, shop_code varchar, --商店编码 ap_ip varchar, --WIFI的ip地址 occur_time varchar, --记录时间 user_device_mac varchar, --终端mac地址 rssi varchar, --接收信号强度 ap_mac varchar, --WIFI的MAC地址 pt varchar, --pt ts_occur_time AS TO_TIMESTAMP(cast(cast(occur_time as bigint)*1000 as bigint)), WATERMARK FOR ts_occur_time AS withOffset(ts_occur_time, 60000) ) WITH ( type = 'datahub',... ); 输出表 --每日商场客流量 CREATE TABLE trading_area_daily_people ( count_date varchar, --日期 people_sum bigint, --客流量 primary key (count_date) ) WITH ( type='rds',... ); 业务代码 --每日商场可流量统计 INSERT into trading_area_daily_people select DATE_FORMAT(data.ts_occur_time,'yyyy-MM-dd') count_date, count(distinct data.user_device_mac) from user_wifidata data group by DATE_FORMAT(data.ts_occur_time,'yyyy-MM-dd') ; 每日商店的客流量 顾客WIFI信息通过关联商场中的商店维表获得商店名称,在此基础上按照商店名称和按天维度时间字段进行分组,使用count distinct语法去重统计每日商店的顾客人数。 输入表 --顾客WIFI信息:使用场景一“每日商场客流量”的输入表:user_wifidata 输出表 --每日商店的客流量 CREATE TABLE shop_area_daily_people ( count_date varchar, --日期 shop_name varchar, --商店名 people_sum bigint, --客流量 primary key (count_date) ) WITH ( type='rds',... ); 维表 --商店维表 CREATE TABLE area_shop ( id bigint, shop_code varchar, --商店编码 shop_name varchar, --商店名 PRIMARY KEY (shop_code), PERIOD FOR SYSTEM_TIME ) WITH ( type='rds',... ); 业务代码 --每日商店的客流量统计 INSERT into shop_area_daily_people select DATE_FORMAT(data.ts_occur_time,'yyyy-MM-dd') count_date, mas.shop_name, count(distinct data.user_device_mac) from user_wifidata data left outer join area_shop FOR SYSTEM_TIME AS OF PROCTIME() mas on data.shop_code=mas.shop_code group by DATE_FORMAT(data.ts_occur_time,'yyyy-MM-dd'),mas.shop_name ; 顾客的实时位置 顾客WIFI信息通过关联探测顾客位置维表(place_info),获取到顾客的实时位置信息,通过1秒钟的滚动窗口实现每秒钟上报一次位置信息,实时投放到数据大屏上,从而实现顾客实时密度图功能。 输入表 --顾客WIFI信息:使用场景一“每日商场客流量”的输入表:user_wifidata 输出表 --顾客来店数据表 CREATE TABLE area_customer_info_allday ( user_device_mac varchar, --终端mac地址 come_time varchar, --到来的时间 ap_mac varchar, --WIFI的MAC地址 occur_time varchar, --记录时间 used_x bigint, --顾客的经度 used_y bigint, --顾客的维度 first_come_flag varchar, --是否是第一次 rssi varchar, --接收信号强度 save_time varchar, --时间 pt varchar, --pt PRIMARY KEY (user_device_mac) ) WITH ( type='ots' ); 维表 --探测设备可以获取到顾客的位置 CREATE TABLE place_info ( user_device_mac varchar, --终端mac地址 used_x bigint, --顾客的经度 used_y bigint, --顾客的维度 min_rssi bigint, --最小的接收信号强度 PRIMARY KEY (user_device_mac), PERIOD FOR SYSTEM_TIME ) WITH ( type='rds',... ); 业务代码 --通过1秒钟的滚动窗口实现每秒钟上报一次位置信息 CREATE view record_sec ( user_device_mac , come_time , ap_mac , occur_time , user_loca_x , user_loca_y , first_come_flag , rssi , save_time , shop_code , pt ) as select data.user_device_mac , DATE_FORMAT(TUMBLE_START(data.ts_occur_time, INTERVAL '1' SECOND),'yyyy-MM-dd HH:mm:ss') , data.ap_mac, data.occur_time, '', '', '', min(data.rssi), FROM_UNIXTIME(unix_timestamp()), grd.shop_code, max(data.pt) from user_wifidata data GROUP BY TUMBLE(ts_occur_time, INTERVAL '1' SECOND),ap_mac,user_device_mac,shop_code,occur_time ; CREATE view view1 as select a0.user_device_mac, a0.come_time, a0.ap_mac, a0.occur_time, mai.used_x , mai.used_y , a0.first_come_flag, a0.rssi, a0.save_time, a0.pt from record_sec a0 left OUTER join place_info FOR SYSTEM_TIME AS OF PROCTIME() mai on mai.user_device_mac=a0.user_device_mac; INSERT into area_customer_info_allday select * from view1 ; 每日商场新增顾客人数 顾客WIFI信息通过关联探测顾客位置维表(place_info),获取到顾客的实时位置信息,然后通过关联顾客来店记录维表,获取到顾客是否是新顾客信息,统计新顾客的人数。同时将新顾客信息更新到顾客来店记录表中标注成常客。此场景下,顾客来店记录表在同一个作业中即作为结果表又作为维表。 输入表 --顾客WIFI信息:使用场景一“每日商场客流量”的输入表:user_wifidata 输出表 --每日商场新增顾客人数 CREATE TABLE customer_info_people_sum ( people_sum bigint, --新增顾客人数 come_time varchar, --日期 PRIMARY KEY (come_time) ) WITH ( type='rds',... ); --顾客来店记录表 CREATE TABLE shop_user_record_update ( user_device_mac varchar, --终端mac地址 first_come_flag varchar , --是否是第一次来 first_coming_time varchar, --进店时间 last_coming_time varchar , --离开时间 PRIMARY KEY (user_device_mac), PERIOD FOR SYSTEM_TIME ) WITH ( type='ots', tableName='shop_user_record'... ); 维表 --使用场景一“商店中顾客的实时位置”的维表:place_info CREATE TABLE place_info ( user_device_mac varchar, --终端mac地址 used_x bigint, --顾客的经度 used_y bigint, --顾客的维度 min_rssi bigint, --最小的接收信号强度 PRIMARY KEY (user_device_mac), PERIOD FOR SYSTEM_TIME ) WITH ( type='rds',... ); --顾客来店记录 CREATE TABLE shop_user_record ( user_device_mac varchar, --终端mac地址 first_come_flag varchar, --是否是第一次来 first_coming_time varchar, --进店时间 last_coming_time varchar, --离开时间 PRIMARY KEY (user_device_mac), PERIOD FOR SYSTEM_TIME ) WITH ( type='ots', tableName='shop_user_record'... ); 业务代码 --通过1秒钟的滚动窗口实现每秒钟上报一次位置信息 CREATE view record_sec ( user_device_mac, come_time , ap_mac , occur_time , user_loca_x , user_loca_y , first_come_flag, rssi , save_time , shop_code , pt ) as select data.user_device_mac , DATE_FORMAT(TUMBLE_START(data.ts_occur_time, INTERVAL '1' SECOND),'yyyy-MM-dd HH:mm:ss') , data.ap_mac, data.occur_time, '', '', '', min(data.rssi), FROM_UNIXTIME(unix_timestamp()), grd.shop_code, max(data.pt) from user_wifidata data GROUP BY TUMBLE(ts_occur_time, INTERVAL '1' SECOND),ap_mac,user_device_mac,shop_code,occur_time ; CREATE view view1 as select a0.user_device_mac, a0.come_time, a0.ap_mac, a0.occur_time, mai.used_x , mai.used_y , a0.first_come_flag, a0.rssi, a0.save_time, a0.pt from record_sec a0 left OUTER join place_infomst_buynoplace_infow_ap_info FOR SYSTEM_TIME AS OF PROCTIME() mai on mai.user_device_mac=a0.user_device_mac; CREATE view view2 as select a1.user_device_mac, a1.come_time, a1.ap_mac, a1.occur_time, cast(a1.used_x as varchar) as used_x, cast(a1.used_y as varchar) as used_y, mci.first_come_flag as first_come_flag, a1.rssi, a1.save_time, a1.pt, mci.first_coming_time, mci.last_coming_time from view1 a1 left OUTER join shop_user_record FOR SYSTEM_TIME AS OF PROCTIME() mci on mci.user_device_mac = a1.user_device_mac ; CREATE view record_out as select a2.user_device_mac as user_device_mac, a2.come_time as come_time, a2.occur_time as occur_time, a2.ap_mac as ap_mac, a2.used_x as used_x, a2.used_y as used_y, if(a2.first_come_flag is null ,'1','0') as first_come_flag,--first_come_flag, a2.rssi as rssi, a2.save_time as save_time, a2.pt as pt, a2.first_coming_time as first_coming_time, a2.last_coming_time as last_coming_time from view2 a2 ; --更新shop_user_record维表的顾客来店记录 INSERT into shop_user_record_update select user_device_mac , first_come_flag,first_coming_time, last_coming_time from record_out ; --统计每日商店新顾客数 insert into customer_info_people_sum select t1.people_sum,t1.come_time from (select count(distinct dt1.user_device_mac) as people_sum, DATE_FORMAT(dt1.come_time,'yyyy-MM-dd') as come_time from record_out dt1 where dt1.first_come_flag='1' group by DATE_FORMAT(dt1.come_time,'yyyy-MM-dd')) t1 每日商场中顾客数量前5的商店 顾客WIFI信息按照天维度和商店分组后,统计每日商店顾客数量,通过topn语句获取到每日顾客数量前5的商店信息,再通过关联商场店铺表得到商店名。 输入表 --顾客WIFI信息:使用场景一“每日商场客流量”的输入表:user_wifidata 输出表 --每日商场中顾客数量前5的商店 CREATE TABLE top5_shop ( shop_code varchar, --商店编码 shop_name varchar, --商店名 date_time varchar, --记录顾客进入商店的时间(天维度) people_sum bigint, --顾客数量 PRIMARY KEY (shop_code) ) WITH ( type='rds'... ); 维表 --商场店铺表:使用场景一“每日商店的客流量”的维表:area_shop CREATE TABLE area_shop ( id bigint, shop_code varchar, --商店编码 shop_name varchar, --商店名 PRIMARY KEY (shop_code), PERIOD FOR SYSTEM_TIME ) WITH ( type='rds',... ); 业务代码 --按天、商店分组统计商店的顾客数 CREATE VIEW Window1 AS SELECT shop_code, DATE_FORMAT(data.ts_occur_time,'yyyy-MM-dd') AS date_time, count(distinct user_device_mac) AS people_sum FROM user_wifidata data GROUP BY shop_code, DATE_FORMAT(data.ts_occur_time,'yyyy-MM-dd'); -- 统计每天top5客流量的商店 CREATE VIEW top5_view AS SELECT shop_code, date_time, people_sum, rownum FROM ( SELECT shop_code, date_time, people_sum, ROW_NUMBER() OVER (PARTITION BY shop_code,date_time ORDER BY people_sum DESC) as rownum FROM Window1 ) WHERE rownum <= 5; INSERT into top5_shop select top5.shop_code , mas.shop_name , top5.date_time , top5.people_sum from top5_view top5 inner join area_shop FOR SYSTEM_TIME AS OF PROCTIME() mas on top5.shop_code=mas.shop_code 每日商场中顾客最多的时间段及顾客数量 顾客WIFI信息按照1小时滚动窗口统计商场顾客数量,使用topn语句获取到每日商场中顾客最多的时间段。 输入表 --顾客WIFI信息:使用场景一“每日商场客流量”的输入表:user_wifidata 输出表 --商场中顾客最多的时间段及顾客数量 CREATE TABLE top1_time ( start_time timestamp, --时间段 people_sum bigint , --顾客数量 PRIMARY KEY (start_time) ) WITH ( type='rds',... ); 业务代码 --1小时滚动窗口统计每小时商场的顾客数 CREATE VIEW Window1 AS SELECT shop_code, TUMBLE_START(ts_occur_time, INTERVAL '1' hour) AS start_time, count(distinct user_device_mac) AS people_sum FROM user_wifidata GROUP BY shop_code, TUMBLE(ts_occur_time, INTERVAL '1' hour); INSERT into top1_time SELECT start_time, people_sum FROM ( SELECT start_time, people_sum, ROW_NUMBER() OVER (PARTITION BY start_time ORDER BY people_sum DESC) as rownum FROM Window1 ) WHERE rownum <= 1; 场景二:顾客喜好分析 每日单个顾客最喜欢的商店 顾客WIFI信息按照商店、顾客、天维度进行分组得到每日顾客进入商店的次数,使用topn语句获取到每日顾客去过最多的商店,通过关联商店名维表获取商店名,从而统计每日单个顾客最喜欢的商店。 输入表 --顾客WIFI信息:使用场景一“每日商场客流量”的输入表:user_wifidata 输出表 --单个顾客最喜欢的商店输出表 CREATE TABLE favorite_shop ( user_device_mac varchar, --终端mac地址 date_time varchar, --记录顾客进入商店的时间(天维度) shop_code varchar, --商店编码 shop_name varchar, --商店名 shop_number bigint , --进店次数 PRIMARY KEY (shop_code) ) WITH ( type='rds'... ); 维表 --商场店铺表:使用场景一“每日商店的客流量”的维表:area_shop CREATE TABLE area_shop ( id bigint, shop_code varchar, --商店编码 shop_name varchar, --商店名 PRIMARY KEY (shop_code), PERIOD FOR SYSTEM_TIME ) WITH ( type='rds',... ); 业务代码 --按天、顾客和商店分组统计单个客户当天进入单个商店的次数 CREATE VIEW Window1 AS SELECT user_device_mac, shop_code, DATE_FORMAT(data.ts_occur_time,'yyyy-MM-dd') AS date_time, count(shop_code) AS shop_number FROM user_wifidata data GROUP BY user_device_mac,shop_code, DATE_FORMAT(data.ts_occur_time,'yyyy-MM-dd'); -- 统计一天中顾客进入次数最多的商店,并输出 CREATE VIEW top1_view AS SELECT user_device_mac,shop_code, date_time, shop_number, rownum FROM ( SELECT user_device_mac,shop_code, date_time, shop_number, ROW_NUMBER() OVER (PARTITION BY user_device_mac,shop_code,date_time ORDER BY shop_number DESC) as rownum FROM Window1 ) WHERE rownum <= 1; --关联商店名维表并输出 INSERT into favorite_shop select top1.user_device_mac, top1.date_time , top1.shop_code , mas.shop_name , top1.shop_number from top1_view top1 inner join area_shop FOR SYSTEM_TIME AS OF PROCTIME() mas on top1.shop_code=mas.shop_code 单日单个顾客进入超过一次的商店 顾客WIFI信息按照商店、顾客、天维度进行分组获取到每日顾客进入商店的次数,通过where语句获取到每日顾客进入超过一次的商店,再通过关联商店名维表得到商店名,从而得到单日单个顾客进入超过一次的商店信息。 输入表 --顾客WIFI信息:使用场景一“每日商场客流量”的输入表:user_wifidata 输出表 --单日单个顾客进入超过一次的商店 CREATE TABLE morethanonce_shop ( user_device_mac varchar, --终端mac地址 date_time varchar, --记录顾客进入商店的时间(天维度) shop_code varchar, --商店编码 shop_name varchar, --商店名 shop_number bigint, --进店次数 PRIMARY KEY (user_device_mac) ) WITH ( type='rds',... ); 维表 --商场店铺表:使用场景一“每日商店的客流量”的维表:area_shop CREATE TABLE area_shop ( id bigint, shop_code varchar, --商店编码 shop_name varchar, --商店名 PRIMARY KEY (shop_code), PERIOD FOR SYSTEM_TIME ) WITH ( type='rds',... ); 业务代码 --按天、顾客和商店分组统计单个客户当天进入单个商店的次数 CREATE VIEW Window1 AS SELECT user_device_mac, shop_code, DATE_FORMAT(data.ts_occur_time,'yyyy-MM-dd')AS date_time, count(shop_code) AS shop_number FROM user_wifidata data GROUP BY user_device_mac,shop_code, DATE_FORMAT(data.ts_occur_time,'yyyy-MM-dd'); -- 1天中顾客进入超过两次的商店 CREATE VIEW exceed2_view AS SELECT user_device_mac,shop_code, date_time, shop_number FROM Window1 WHERE shop_number >= 2; INSERT into morethanonce_shop select exceed2.user_device_mac, exceed2.date_time , exceed2.shop_code , mas.shop_name , exceed2.shop_number from exceed2_view exceed2 inner join area_shop FOR SYSTEM_TIME AS OF PROCTIME() mas on exceed2.shop_code=mas.shop_code 实时计算 Flink 版产品交流群 阿里云实时计算Flink - 解决方案: https://developer.aliyun.com/article/765097 阿里云实时计算Flink - 场景案例: https://ververica.cn/corporate-practice 阿里云实时计算Flink - 产品详情页: https://www.aliyun.com/product/bigdata/product/sc


优秀的个人博客,低调大师

【最佳实践】实时计算Flink在游戏行业的实时数仓建设实践

行业背景 行业现状: 随着互联网和移动互联网的相互促进与融合,以及PC终端和各类移动终端在智能化和便携性上的趋同,游戏产品跨平台运行于各类终端的需求逐步显现,特别是互联网页面游戏中的社交类游戏等产品跨平台运行于各类移动终端已经出现,随着版权价值意识的增强,游戏开发商和运营商在取得版权后,加强了对文化内容的开发利用,力图以多形式多媒介的产品实现版权价值的最大化。 大数据在游戏行业中的作用: 根据游戏数据分析游戏产品趋势,实现精准营销 根据玩家付费和活跃度等进行玩家画像,针对不同的玩家设计不同的商业化活动方案,提升付费玩家的体验,提升游戏消费额 业务场景 某游戏公司开发了个游戏APP,该公司在APP中会发布一些游戏场景、游戏角色、装备、精美皮肤等内容,玩家在线娱乐,产生充值购买等行为。业务的构建涉及到几个端: APP:应用程序,玩家访问入口,玩家主要进行如下操作: 注册账号 在线娱乐 游戏充值 后台系统:对玩家行为数据进行分析,提供给运营/运维人员,用于辅助公司决策。 实时归档日志:用于OLAP查询或离线数据分析 实时KPI统计:统计不同时间段的游戏点击量,作为确定游戏活动开启、版本升级、服务器维护等操作时间的依据;根据游戏收益金额,制定更合理的商业化活动方式 实时统计TopN游戏:辅助公司对游戏APP开发资源、运营资源的分配决策 技术架构 架构解析:数据采集:该场景中,数仓的数据来源有两部分:用户操作日志采集至日志服务(SLS),用户的购买充值等信息则通过RDS Binlog日志同步至DataHub。实时数仓架构:该场景中,整个实时数仓的聚合统计,全部通过Flink完成,Flink实时读取SLS和DataHub的数据进行处理,并与维表进行关联查询等操作,最终实时统计的结果输入到下游数据库ODPS和RDS中。 业务指标 日志归档 KPI统计 游戏UV 新增角色累积收益总额 游戏评论次数 热门游戏TOP3 说明:该案例中仅包含以上场景及指标,在实际的应用场景下还包括游戏账号异地登录、玩家画像等其他指标。 业务代码 场景一:日志归档 本场景将用户点击游戏APP产生的日志,实时同步至ODPS进行日志归档,并提取日志产生的时间(按天、小时维度)等信息,用于运营人员进行离线分析。 输入表 CREATE TABLE game_log_source ( log_t BIGINT, app_id VARCHAR , app_ver VARCHAR, body VARCHAR, param1 VARCHAR, param2 VARCHAR, param3 VARCHAR, param4 VARCHAR, param5 VARCHAR, device_id VARCHAR, lcmid BIGINT ) WITH ( type= 'sls', ... ); 输出表 CREATE TABLE game_log ( log_t bigint, app_ver VARCHAR, device_id VARCHAR, mbga_uid bigint, param1 VARCHAR, param2 VARCHAR, param3 VARCHAR, param4 VARCHAR, param5 VARCHAR, `user_id` VARCHAR, a_typ VARCHAR, `zone` VARCHAR, `ahour` bigint, `dt` bigint ) with ( type = 'odps', ... ); 业务代码 INSERT INTO game_log SELECT log_t, app_ver, device_id, lcmid as mbga_uid, param1, param2, param3, param4, param5, SPLIT_INDEX (JSON_VALUE (body, '$.a_usr'), '@', 1) AS user_id, JSON_VALUE (body, '$.a_typ') AS a_typ, concat ('', SPLIT_INDEX (JSON_VALUE (body, '$.a_usr'), '@', 0)) AS `zone`, cast (from_unixtime (log_t, 'yyyyMMddHH') as bigint) AS `ahour`, cast (from_unixtime (log_t, 'yyyyMMdd') as bigint) AS `dt` FROM game_log_source; 场景二:KPI统计 游戏UV 本场景统计每天每小时的游戏UV。以server_date_day和game_id分组,然后与维表进行join扩展玩家信息,使用类似count(distinct user_id) filter (where reg_hour=0)的方法求得00:00—00:59时间段的游戏UV,从而统计每天每小时的游戏UV。 输入表 CREATE TABLE agent_login ( user_id VARCHAR, user_name VARCHAR, gender VARCHAR, birth VARCHAR, age VARCHAR, game_id VARCHAR, game_name VARCHAR, channel_id VARCHAR, game_channel_id VARCHAR, os_type VARCHAR, server_date_day VARCHAR, reg_date VARCHAR, reg_hour BIGINT, ad_id VARCHAR, reg_via VARCHAR, dt VARCHAR )WITH ( type='datahub', ... ); 维度表 CREATE TABLE advertising ( id INT, ad_name VARCHAR, game_id INT, game_name VARCHAR, media_id INT, media_account_id INT, package_id INT, ad_resource_id INT, ad_media_params VARCHAR, admin_id INT, create_time TIMESTAMP, PRIMARY KEY (package_id,ad_media_params), PERIOD FOR SYSTEM_TIME )WITH ( type='rds', ... ); 输出表 CREATE TABLE hour_uv( `date` VARCHAR, ad_game_id VARCHAR, channel_id VARCHAR, package_id VARCHAR, ad_media_params VARCHAR, hour_active_nuv_0 BIGINT, hour_active_nuv_1 BIGINT, hour_active_nuv_2 BIGINT, hour_active_nuv_3 BIGINT, hour_active_nuv_4 BIGINT, hour_active_nuv_5 BIGINT, hour_active_nuv_6 BIGINT, hour_active_nuv_7 BIGINT, hour_active_nuv_8 BIGINT, hour_active_nuv_9 BIGINT, hour_active_nuv_10 BIGINT, hour_active_nuv_11 BIGINT, hour_active_nuv_12 BIGINT, hour_active_nuv_13 BIGINT, hour_active_nuv_14 BIGINT, hour_active_nuv_15 BIGINT, hour_active_nuv_16 BIGINT, hour_active_nuv_17 BIGINT, hour_active_nuv_18 BIGINT, hour_active_nuv_19 BIGINT, hour_active_nuv_20 BIGINT, hour_active_nuv_21 BIGINT, hour_active_nuv_22 BIGINT, hour_active_nuv_23 BIGINT, create_time VARCHAR, via VARCHAR, media_id BIGINT, media_account_id BIGINT, ad_resource_id BIGINT, game_id BIGINT, admin_id BIGINT, ad_id BIGINT, os_type VARCHAR )WITH ( type='rds', ... ); 业务代码 INSERT INTO hour_uv select server_date_day as server_date, o.game_id, o.channel_id, o.game_channel_id, o.ad_id, count(distinct user_id) filter (where reg_hour=0) as hour_active_nuv_0, count(distinct user_id) filter (where reg_hour=1) as hour_active_nuv_1, count(distinct user_id) filter (where reg_hour=2) as hour_active_nuv_2, count(distinct user_id) filter (where reg_hour=3) as hour_active_nuv_3, count(distinct user_id) filter (where reg_hour=4) as hour_active_nuv_4, count(distinct user_id) filter (where reg_hour=5) as hour_active_nuv_5, count(distinct user_id) filter (where reg_hour=6) as hour_active_nuv_6, count(distinct user_id) filter (where reg_hour=7) as hour_active_nuv_7, count(distinct user_id) filter (where reg_hour=8) as hour_active_nuv_8, count(distinct user_id) filter (where reg_hour=9) as hour_active_nuv_9, count(distinct user_id) filter (where reg_hour=10) as hour_active_nuv_10, count(distinct user_id) filter (where reg_hour=11) as hour_active_nuv_11, count(distinct user_id) filter (where reg_hour=12) as hour_active_nuv_12, count(distinct user_id) filter (where reg_hour=13) as hour_active_nuv_13, count(distinct user_id) filter (where reg_hour=14) as hour_active_nuv_14, count(distinct user_id) filter (where reg_hour=15) as hour_active_nuv_15, count(distinct user_id) filter (where reg_hour=16) as hour_active_nuv_16, count(distinct user_id) filter (where reg_hour=17) as hour_active_nuv_17, count(distinct user_id) filter (where reg_hour=18) as hour_active_nuv_18, count(distinct user_id) filter (where reg_hour=19) as hour_active_nuv_19, count(distinct user_id) filter (where reg_hour=20) as hour_active_nuv_20, count(distinct user_id) filter (where reg_hour=21) as hour_active_nuv_21, count(distinct user_id) filter (where reg_hour=22) as hour_active_nuv_22, count(distinct user_id) filter (where reg_hour=23) as hour_active_nuv_23, dt, reg_via, cast(min(ad.media_id) as bigint), cast(min(ad.media_account_id) as bigint), cast(min(ad.ad_resource_id) as bigint), cast(min(ad.game_id) as bigint), cast(min(ad.admin_id) as bigint), cast(min(ad.id) as bigint), COALESCE((case when o.os_type = 'h5' then 'android' else o.os_type end),'android') from agent_login AS o LEFT JOIN advertising FOR SYSTEM_TIME AS OF PROCTIME() AS ad on (o.ad_id=ad.ad_media_params and o.game_channel_id=ad.package_id) where server_date_day=reg_date group by server_date_day,o.game_id,o.channel_id,o.game_channel_id,o.ad_id,dt,reg_via,COALESCE((case when o.os_type = 'h5' then 'android' else o.os_type end),'android'); 新增角色累积收益总额 输入表 本场景统计新增游戏角色在不同时间段内(新增日、新增日和次日、新增日至新增第3日)产生的收益总额。以reg_date和game_id分组,与维表join扩展玩家信息,通过TopN进行去重,然后比如使用sum(money) filter (where reg_date>=server_date_day-14),得到新增角色后15天内的收益金额。从而得到新增游戏角色后不同时间段的收益总额。 CREATE TABLE `order` ( `server` VARCHAR, os_type VARCHAR, create_time VARCHAR, update_time VARCHAR, money DOUBLE, user_id VARCHAR, id VARCHAR, channel_id VARCHAR, order_sn VARCHAR, status VARCHAR, game_id VARCHAR, game_channel_id VARCHAR, first_order_date VARCHAR, server_date_day VARCHAR, --角色登录时间 reg_date VARCHAR, --角色发布时间 ad_id VARCHAR, via VARCHAR, reg_via VARCHAR, server_ts VARCHAR, game_name VARCHAR, package_name VARCHAR, dt VARCHAR ) WITH ( type = 'datahub', ... ); 维度A表 CREATE TABLE advertising ( id INT, channel_id INT, game_id INT, game_name VARCHAR, media_id INT, media_account_id INT, package_id INT, package_name VARCHAR, ad_resource_id INT, ad_media_params VARCHAR, `type` TINYINT, status TINYINT, admin_id INT, create_time TIMESTAMP, update_time TIMESTAMP, PRIMARY KEY (package_id,ad_media_params), PERIOD FOR SYSTEM_TIME ) WITH ( type= 'rds', ... ); 维度B表 CREATE TABLE advertising_divided ( id INT, ad_id INT, media_id INT, media_account_id INT, ad_resource_id INT, game_id INT, package_id INT, ad_media_params VARCHAR, ratio decimal(10,2), divide_date VARCHAR, create_time TIMESTAMP, update_time TIMESTAMP, PRIMARY KEY (package_id,ad_media_params,divide_date), PERIOD FOR SYSTEM_TIME ) WITH ( type= 'rds', ... ); 输出表 CREATE TABLE total_revenue ( `date` VARCHAR, ad_game_id VARCHAR, channel_id VARCHAR, package_id VARCHAR, ad_media_params VARCHAR, pay_people_yet BIGINT, pay_amount_yet DECIMAL, pay_amount_1 DECIMAL, pay_amount_2 DECIMAL, pay_amount_3 DECIMAL, split_share_rate decimal(10,2), create_time VARCHAR, via VARCHAR, media_id BIGINT, media_account_id BIGINT, ad_resource_id BIGINT, game_id BIGINT, admin_id BIGINT, ad_id BIGINT, os_type VARCHAR, PRIMARY KEY (`date`,ad_game_id,channel_id,package_id,ad_media_params,create_time,via,os_type) ) WITH ( type= 'rds', ... ); 业务代码 INSERT INTO total_revenue select reg_date,o.game_id,o.channel_id,o.game_channel_id,o.ad_id, count(distinct user_id) filter (where server_date_day=first_order_date) as pay_people_yet, cast(sum(money) as decimal), --某日新增的角色中,每个角色在接下来1天内(新增日)为游戏带来的收入 cast(sum(money) filter (where reg_date>=server_date_day) as decimal)as pay_amount_1, --某日新增的角色中,每个角色在接下来2天内(新增日和之后的2日)为游戏带来的收入 cast(sum(money) filter (where reg_date>=DATE_SUB(server_date_day,1)) as decimal) as pay_amount_2, --某日新增的角色中,每个角色在接下来3天内(新增日和之后的3日)为游戏带来的收入 cast(sum(money) filter (where reg_date>=DATE_SUB(server_date_day,2)) as decimal) as pay_amount_3, cast(max(COALESCE(ra.ratio,0)) as decimal(10,2)),dt,reg_via,cast(min(ad.media_id) as bigint),cast(min(ad.media_account_id) as bigint),cast(min(ad.ad_resource_id) as bigint),cast(min(ad.game_id) as bigint),cast(min(ad.admin_id) as bigint),cast(min(ad.id) as bigint),COALESCE((case when o.os_type = 'h5' then 'android' else o.os_type end),'android') from ( SELECT *, ROW_NUMBER() OVER (PARTITION BY order_sn ORDER BY server_date_day ASC) as rowNum FROM `order` ) AS o LEFT JOIN advertising FOR SYSTEM_TIME AS OF PROCTIME() AS ad on (o.ad_id=ad.ad_media_params and o.game_channel_id=ad.package_id) LEFT JOIN advertising_divided FOR SYSTEM_TIME AS OF PROCTIME() AS ra on (o.ad_id=ra.ad_media_params and o.game_channel_id=ra.package_id and DATE_FORMAT(o.server_date_day,'yyyy-MM-dd','yyyy-MM')=ra.`divide_date`) WHERE rowNum = 1 group by reg_date,o.game_id,o.channel_id,o.game_channel_id,o.ad_id,dt,reg_via,COALESCE((case when o.os_type = 'h5' then 'android' else o.os_type end),'android'); 游戏评论用户数 本场景按照三分钟维度的滚动窗口统计评论游戏的用户数。用户评论游戏后产生日志数据,Flink对Json格式的日志数据进行解析并清洗,获取app_id、游戏评论时间day、游戏评论的用户id等信息,以app_id和day进行分组,通过三分钟的滚动窗口函数进行聚合,统计得到对应的游戏评论用户数。 埋点数据样例 { "app_id":"", "body":{ "lid":"", "affcode":"", } "app_table":"", "log_t":"", } 输入表 CREATE TABLE log_input ( `message` VARCHAR, ts AS case when JSON_VALUE(`message`, '$.log_t') is NULL then TO_TIMESTAMP('1970-01-01 00:00:00') else TO_TIMESTAMP(cast(JSON_VALUE(`message`, '$.log_t') as BIGINT)) end, WATERMARK wk1 FOR ts as withOffset(ts, 180000) --Watermark计算方法,偏移1分钟 ) WITH ( type='sls', ... ); 输出表 create table total_comments ( app_id VARCHAR, comment_name VARCHAR, comment_type VARCHAR, kpi_type_val VARCHAR, comment_value bigint, `day` VARCHAR, createtime timestamp, PRIMARY KEY (app_id,comment_name,comment_type,kpi_type_val,`day`) ) with ( type = 'rds', ... ); 业务代码 解析Json数据并进行清洗 CREATE VIEW user_session AS SELECT CAST(TO_DATE(cast(now() as VARCHAR),'yyyyMMdd') as VARCHAR) as `day`,ts, JSON_VALUE(`message`, '$.app_id') as app_id, JSON_VALUE(JSON_VALUE(`message`, '$.body'), '$.lid') as lid, --游戏评论的用户id JSON_VALUE(JSON_VALUE(`message`, '$.body'), '$.affcode') as affcode from log_input where JSON_VALUE(`message`, '$.app_table') = 'user_session' and JSON_VALUE(`message`, '$.body') is not null and JSON_VALUE(`message`, '$.body') <> '' and CHAR_LENGTH(cast(JSON_VALUE(`message`, '$.log_t') as varchar)) = 13 and JSON_VALUE(`message`, '$.app_id') is not NULL and JSON_VALUE(`message`, '$.app_id') <> '' and JSON_VALUE(JSON_VALUE(`message`, '$.body'), '$.affcode') is not null and JSON_VALUE(JSON_VALUE(`message`, '$.body'), '$.affcode') <> 'PRESSURE_TEST' and JSON_VALUE(JSON_VALUE(`message`, '$.body'), '$.lid') is not null and JSON_VALUE(JSON_VALUE(`message`, '$.body'), '$.lid') <> ''; 统计3分钟维度的评论次数 INSERT INTO total_comments SELECT app_id, 'comment_name' as comment_name, 'comment' as comment_type, affcode as comment_type_val, count(DISTINCT lid) as comment_value, `day`, CURRENT_TIMESTAMP as createtime from user_session GROUP BY `day`,TUMBLE(ts, INTERVAL '3' MINUTE),app_id,affcode; 场景三:热门游戏TOP3 本场景是用于计算每天的热门游戏的排行榜。在游戏商城前端下载页面进行埋点,将埋点数据同步至DataHub,以time和game_app分组,计算单天内每个游戏的总下载次数。对下载次数进行topn排序,得到下载次数最多的三个游戏作为最热门游戏。 输入表 CREATE TABLE source_table( game_app VARCHAR ,--游戏名称 `time` VARCHAR --时间(本场景为天) )WITH ( TYPE='datahub', ... ); 输出表 CREATE TABLE result_table( Ranking BIGINT, `time` VARCHAR, game_app VARCHAR, number BIGINT, primary key(`time`,game_app) )WITH ( TYPE='rds', ... ); 业务代码 INSERT INTO result_table SELECT Ranking, `time`, game_app, number FROM ( SELECT *, ROW_NUMBER() OVER (PARTITION BY `time` ORDER BY number desc) AS Ranking FROM ( SELECT `time` AS `time`, COUNT(game_app) AS number, game_app FROM source_table GROUP BY `time`,game_app )a ) WHERE Ranking <= 3 实时计算 Flink 版产品交流群 阿里云实时计算Flink - 解决方案: https://developer.aliyun.com/article/765097 阿里云实时计算Flink - 场景案例: https://ververica.cn/corporate-practice 阿里云实时计算Flink - 产品详情页: https://www.aliyun.com/product/bigdata/product/sc

优秀的个人博客,低调大师

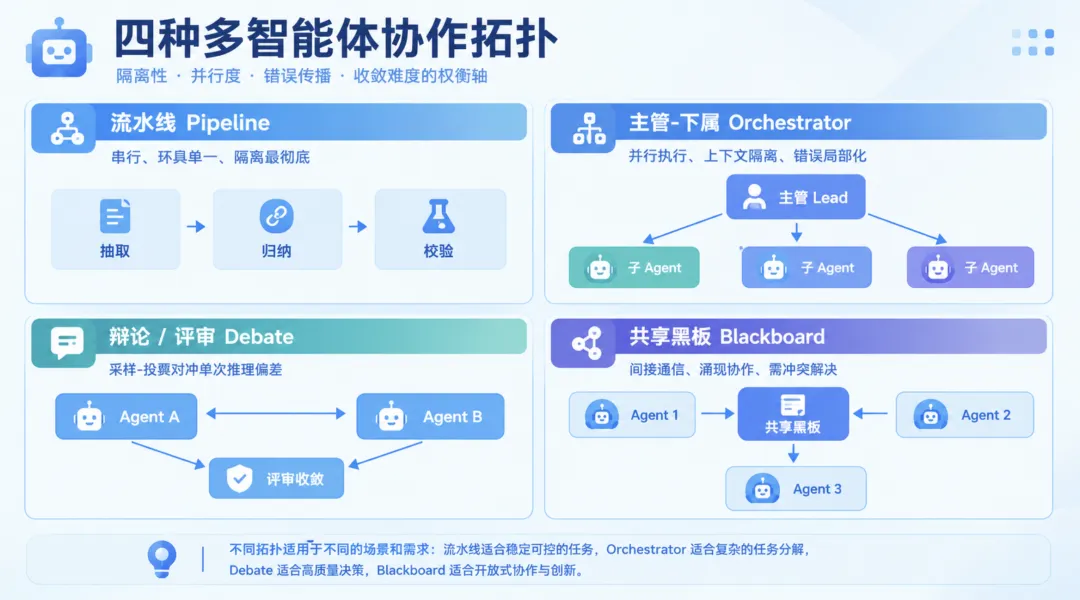
Loop Engineering:多智能体协作架构内幕与最佳实践

把多个大模型塞进一个系统里,让它彼此对话、分工、反复确认,这几乎是当下所有"高级 Agent"产品背后的真实形态。但你如果真的动手搭过一套多智能体系统,很快就会撞上几个很朴素的问题:怎么把任务切给不同的 Agent?它们之间的上下文怎么传?谁来判定"这件事做完了"?出错的时候错误是在哪一层被放大的?

优秀的个人博客,低调大师

Claude Code 工程最佳实践 | 主数据平台 1.5.0 震撼来袭

​ 更新周期:2026-07-06 ~ 2026-08-21,前端 132 次提交、后端 43 次提交 项目地址: github:https://github.com/henhen6/mdp gitee:https://gitee.com/henhen6/mddata gitcode:https://gitcode.com/henhen6/mdp ✨ 亮点特性 📊 统计大屏 新增统计大屏,覆盖系统概览、接口成功率、请求日志概览与排行、临时文件统计、用户增长趋势、开放平台统计(含退回应用数)及站内未读通知 后端拆分接口监控与请求日志模块,百分比统计统一 BigDecimal、日期参数统一 LocalDate,保证数据精度 前端同步完善大屏页面,API 调用、文件增长、消息发送、用户增长四类趋势均支持任意日期区间查询 📁 文件管理 新增控制台文件管理模块:文件类型筛选、侧边栏导航、文件统计展示(含类型分布饼图) 实现文件分片上传,支持断点合并、进度管理、指定存储平台及上传对象类型动态设置 支持单文件、批量下载及多选 ZIP 打包下载,完善文件名非法字符校验与编码处理 文件预览接入 vue-office,支持多种文件类型在线预览 🔐 开放平台 重构 IP 访问控制,支持白名单校验 新增签名校验令牌、AES 加密密钥字段及 RSA 秘钥生成与重置功能 支持开放平台统计按日期区间查询 🔄 重构与优化 业务表单体系按最新 vben 代码逻辑重构,合并 vben 上游代码 6 次 消息任务状态、组织类型等常量统一改为枚举,分布数据转换逻辑优化 请求日志注解的日志类型配置统一完善 前端三端 TypeScript 类型检查报错清零 🐛 缺陷修复 修复合并 vben 后布局内容区域高度计算不正确的问题 修复角色模板删除后数据清空、树节点选中及切换 Tab 加载问题 修复压缩包文件名重复、非法字符及文件下载接口响应类型处理问题 修复字典管理 IconPicker、地图数据跨域、消息行拖拽等前端问题 修改密码正则校验提示信息 📦 其他 更新 mdp.sql 全量脚本,新增统计大屏相关表结构 发布 1.5.0 版本号(md-build、md-bom、mdp-parent) 新增统计业务设计文档及单表代码生成规范文档 🌟 关注我们 MDP(Master Data Platform)主数据平台—— 基于 Java 17、SpringBoot 3.x、SpringCloud、Vue3 + TypeScript 的企业级中后台快速开发平台,内置权限管理、单点登录、代码生成、数据同步、监控审计等核心能力,开箱即用,助力企业数字化建设。 项目持续迭代中,欢迎 Star、Fork、提 Issue 参与共建! github:https://github.com/henhen6/mdp gitee:https://gitee.com/henhen6/mddata gitcode:https://gitcode.com/henhen6/mdp 📎 更多实战干货、架构分享、版本动态,请关注公众号《灯灯快速开发》,一起交流快速开发那些事!

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册