首页 文章 精选 留言 我的

精选列表

搜索[磐石100],共10000篇文章
优秀的个人博客,低调大师

加密了100个小姐姐的PDF文档,1行代码搞定,网友:快男!

大家好,这里是程序员晚枫,今天给大家分享一个PDF的搞笑技能:1行代码,批量给PDF加密。 别人拿到加密的PDF开心不开心我不知道,反正你肯定开心了。 1、上代码 下载Python自动化办公的专用库:python-office,下载命令如下。 pip install python-office -i https://pypi.python.org/simple -U 注意,最近清华镜像和阿里镜像都不怎么更新国外源了,不知道是什么原因。 所以,建议大家在条件允许的情况下,像上面的代码那样,使用国外源来下载第三方库,才是最新版~ # pip install python-office 一定要成功哦~ import office office.pdf.encrypt4pdf(path=r'D:\程序员晚枫的文件夹\input_pdf', password='程序员晚枫的密码', output_path=r'D:\程序员晚枫的文件夹\output_pdf') 2、使用说明 有以下几点使用技巧: path:可以填单个文件,也可以填一个路径,会自动搜索路径下所有pdf文件,包括子文件夹里的。 有加密就有解密。需要批量解密功能,请点赞本文后,在留言区告诉我~ 进阶功能:有些朋友想根据文件名筛选pdf文档,或者更高阶的想通过正则来筛选。

优秀的个人博客,低调大师

MetInfo 7.1.0 正式发布,产品支持视频展示,同步上线 100 套免费模板数据

MetInfo V7.1.0,产品模块支持视频展示,优化若干细节,更安全,更稳定! 米拓企业建站系统,1个网站内容轻松同步到10种终端展示(电脑、手机、平板、微官网、微信小程序、百度小程序、支付宝小程序、字节跳动小程序[今日头条、抖音]、360小程序、QQ小程序),适合专业建站! 下载地址:https://www.metinfo.cn 演示地址:http://demo.metinfo.cn/ 免费模板:https://www.metcms.cn/ 升级方法:登录网站后台,可视化编辑后台请点击“常用功能-检测更新”;传统后台请点击“设置-检测更新”。 技术支持:安装升级过程中如有问题,技术支持范围内的用户可到用户中心提交工单,无技术支持服务的用户可到米拓问答提问获得帮助。 10合1建站:https://www.mituo.cn/10he1/ 升级必读: 1、7.1.0修改了后台编辑器路径,开启伪静态的站点升级后必须更新伪静态规则文件才能正常使用内容编辑器(具体方法为:升级成功后,请在网站后台点击“SEO-伪静态”,关闭“伪静态化”,保存,再开启“伪静态化”保存,从而完成伪静态规则文件更新,nginx服务器需要重新加载伪静态规则文件才能生效。); 2、升级到7.1.0后,部分插件需要升级后才能正常使用,请在网站后台的插件管理界面中升级相关插件,如商城模块升级后才能支持商品视频展示功能; 3、若网站已购买版权标识修改许可并修改了版权,强烈建议你在可视化编辑后台中升级,并建议升级“去版权”插件检测相关版权修改是否正常,如通过传统后台升级,升级后请务必退出管理员账号重新登录检测版权修改是否生效。 更新日志: 1、新增:产品详情页视频展示功能; 2、新增:网站前台版权标识样式切换功能; 3、优化:会员中心社会化登陆功能,用户可通过扫码关注设定的公众号登录; 4、优化:安装商城模块后,可在网站后台内容管理中直接添加和编辑商品; 5、优化:用户购买版权标识修改许可后,后台版权修改相关细节功能; 6、优化:非创始管理员登录后台隐藏后台文件夹修改功能; 7、修复:sql注入漏洞问题; 8、修复:允许php后缀文件上传的漏洞问题; 9、修复:页面title 拼接多 “-”的问题; 10、修复:当详情页有tag标签的时候动态链接跳转静态链接失效问题; 11、修复:手动添加tag后内容详情再添加同名tag ,tag链接跳转404错误问题; 12、修复:搜索关键词中带有 + - 特殊字符无法在前台的整站中展示搜索结果问题; 13、修复:手动添加tags不能更新网站地图的问题; 14、修复:自定义管理员取消可视化权限后,在后台添加或编辑产品时设置选项卡的设置页面打不开问题; 15、修复:文章设置了定时发布,但是前台页面显示的是文章更新时间,不是定时发布时间的问题; 16、修复:前台表单提交文件类型必填属性验证错误问题; 17、修复:部分页面调用分页标签报错问题; 18、修复:编辑器内编辑时图片变形的问题; 19、修复:会员中心页面统一设置背景问题; 20、修复:当数据库类型为sqlite的时候,部分插件应用的配置数据保存失败问题; 21、修复:回收站批量删除失败问题; 22、修复:手机菜单图标在详情页路径错误问题; 23、修复:当一个页面添加相同的TAG标签的时候,会重复生成tags问题; 24、修复:产品按销量筛选不生效的问题; 25、修复:sqlite数据库切换不成功问题; 26、修复:可视化界面打开应用切换界面时部分情况下标题显示不正确的问题; 27、修复:商城管理后台添加产品报错的问题; 28、修复:系统可视化模式src属性数据填充不正确的问题; 29、修复:可视化界面里内容编辑器弹框第一次弹出时js报错的问题; 30、修复:百度编辑器video标签muted参数编辑无效的问题; 31、修复:首页购物车里的商品图片显示空白的问题; 32、修复:导航栏购物车里商品删除后没反应的问题; 33、修复:商城编辑商品-批量编辑价格保存后无效的问题; 34、修复:前台语言列表-编辑插件语言-编辑应用参数时,搜索参数请求地址没有提交应用编号的问题; 35、修复:栏目过多时,友情链接编辑、banner编辑选择所属栏目显示不全的问题; 36、修复:后台产品列表复制内容时,栏目列表过多无法显示完全的问题; 37、修复:nginx服务器环境二级目录网站开启伪静态后页面不能访问的问题; 38、修复:多语言国旗图标显示错误问题; 39、修复:banner排序前后台不一致的问题; 40、修复:在线客服和页面可以随鼠标一直往下滚动的问题; 41、修复:手机菜单栏当设置电话类型,在详情页显示地址错误问题; 42、修复:后台会员设置等页面的按钮中有多个加号的问题; 43、修复:编辑器中的表格内的英文无法按单词换行的问题; 44、修复:编辑器里设置了尺寸的图片在编辑器中尺寸无效的问题; 45、修复:反馈表单关联了产品栏目,回收站里面的产品依然会展示在反馈栏目表单的问题; 46、修复:“年月日+ID”的静态页面包含小时的BUG; 47、修复:metv7图片模块详情页排版问题; 48、修复:添加多语言时国旗显示错误问题; 49、修复:tag聚合页面空白问题; 50、修复:百度编辑器预览模式页面的图片显示不出来的问题

优秀的个人博客,低调大师

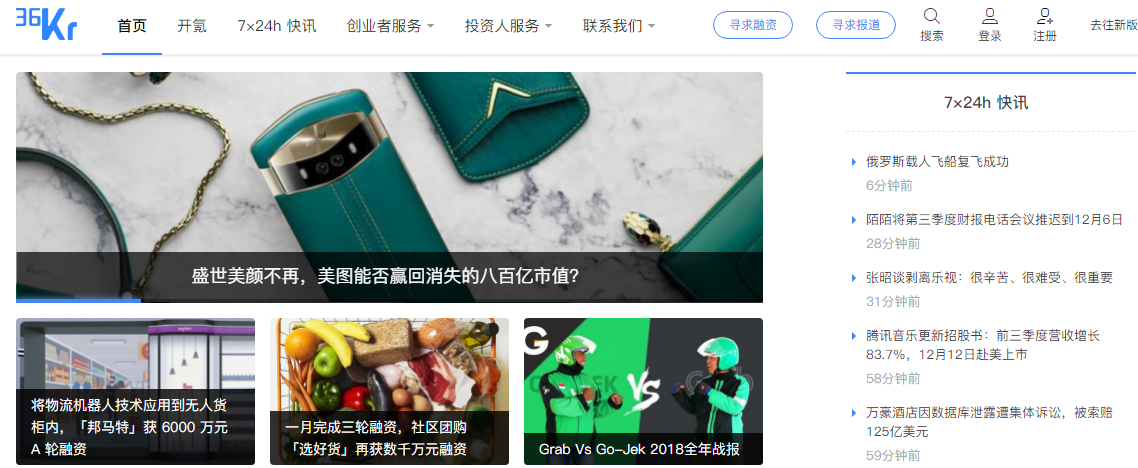
Python爬虫入门教程 31-100 36氪(36kr)数据抓取 scrapy

1. 36氪(36kr)数据----写在前面 今天抓取一个新闻媒体,36kr的文章内容,也是为后面的数据分析做相应的准备的,预计在12月底,爬虫大概写到50篇案例的时刻,将会迎来一个新的内容,系统的数据分析博文,记得关注哦~ 36kr 让一部分人先看到未来,而你今天要做的事情确实要抓取它的过去。 网址 https://36kr.com/ 2. 36氪(36kr)数据----数据分析 36kr的页面是一个瀑布流的效果,当你不断的下拉页面的时候,数据从后台追加过来,基于此,基本可以判断它是ajax异步的数据,只需要打开开发者工具,就能快速的定位到想要的数据,我们尝试一下! 捕获链接如下 https://36kr.com/api/search-column/mainsite?per_page=20&page=1&_=15438401

优秀的个人博客,低调大师

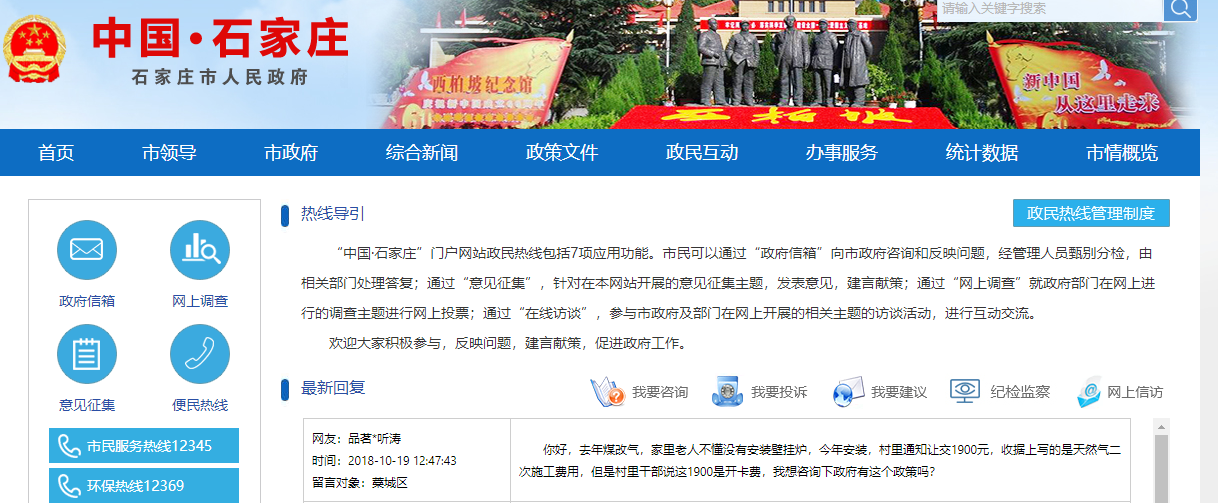
Python爬虫入门教程 15-100 石家庄政民互动数据爬取

1. 石家庄政民互动数据爬取-写在前面 今天,咱抓取一个网站,这个网站呢,涉及的内容就是 网友留言和回复,特别简单,但是网站是gov的。网址为http://www.sjz.gov.cn/col/1490066682000/index.html 首先声明,为了学习,绝无恶意抓取信息,不管你信不信,数据我没有长期存储,预计存储到重装操作系统就删除。 2. 石家庄政民互动数据爬取-网页分析 点击更多回复 ,可以查看到相应的数据。 数据量很大14万条,,数据爬完,还可以用来学习数据分析,真是nice 经过分析之后,找到了列表页面。数据的爬取这次我们采用的是 selenium ,解析页面采用lxml,数据存储采用pymongo ,关于selenium 你可以去搜索引擎搜索相关的教程,好多的,主要就是打开一个浏览器,然后模拟用户的操作,你可以去系统的学习一下。 3. 石家庄政民互动数据爬取-撸代码 导入必备模块 from selenium import webdriver from selenium.common.exceptions import TimeoutException from selenium.webdriver.common.by import By from selenium.webdriver.support.ui import WebDriverWait from selenium.webdriver.support import expected_conditions as EC from lxml import etree import pymongo import time 打开浏览器,获取总页码 这个操作最重要的步骤,你搜索之后就会知道,需要提前下载一个叫做 chromedriver.exe 的东东,然后把他配置好,自行解决去吧~ # 加载浏览器引擎,需要提前下载好 chromedriver.exe 。 browser = webdriver.Chrome() wait = WebDriverWait(browser,10) def get_totle_page(): try: # 浏览器跳转 browser.get("http://www.sjz.gov.cn/zfxxinfolist.jsp?current=1&wid=1&cid=1259811582187") # 等待元素加载到 totle_page = wait.until( EC.presence_of_element_located((By.CSS_SELECTOR,'input[type="hidden"]:nth-child(4)')) ) # 获取属性 totle = totle_page.get_attribute('value') # 获取首页数据,这个地方先不必须 ############################## #get_content() ############################## return totle except TimeoutError: return get_totle_page() 上面的代码在测试之后,你会得到如下结果 这时候,你已经得到20565这个总页码数目了,只需要进行一系列循环的操作即可,接下来有一个重要的函数,叫做next_page 这个函数里面,需要进行一个模拟用户行为的操作,输入一个页码,然后点击跳转。 def main(): totle = int(get_totle_page()) # 获取完整页码 for i in range(2,totle+1): print("正在加载第{}页数据".format(i)) # 获取下一页 next_page(i) if __name__ == '__main__': print(main()) 输入页码,点击跳转 def next_page(page_num): try: input = wait.until( EC.presence_of_element_located((By.CSS_SELECTOR,"#pageto")) ) submit = wait.until( EC.element_to_be_clickable((By.CSS_SELECTOR,"#goPage")) ) input.clear() # 清空文本框 input.send_keys(page_num) # 发送页码 submit.click() # 点击跳转 #get_content(page_num) except TimeoutException: next_page(page_num) 以上代码实现的效果动态演示为 4. 石家庄政民互动数据爬取-解析页面 可以进行翻页之后,通过browser.page_source 获取网页源码,网页源码通过lxml进行解析。编写相应的方法为 def get_content(page_num=None): try: wait.until( EC.presence_of_element_located((By.CSS_SELECTOR, "table.tably")) ) html = browser.page_source # 获取网页源码 tree = etree.HTML(html) # 解析 tables = tree.xpath("//table[@class='tably']") for table in tables: name = table.xpath("tbody/tr[1]/td[1]/table/tbody/tr[1]/td")[0].text public_time = table.xpath("tbody/tr[1]/td[1]/table/tbody/tr[2]/td")[0].text to_people = table.xpath("tbody/tr[1]/td[1]/table/tbody/tr[3]/td")[0].text content = table.xpath("tbody/tr[1]/td[2]/table/tbody/tr[1]/td")[0].text repl_time = table.xpath("tbody/tr[2]/td[1]/table/tbody/tr[1]/td")[0].text repl_depart = table.xpath("tbody/tr[2]/td[1]/table/tbody/tr[2]/td")[0].text repl_content = table.xpath("tbody/tr[2]/td[2]/table/tbody/tr[1]/td")[0].text # 清理数据 consult = { "name":name.replace("网友:",""), "public_time":public_time.replace("时间:",""), "to_people":to_people.replace("留言对象:",""), "content":content, "repl_time":repl_time.replace("时间:",""), "repl_depart":repl_depart.replace("回复部门:",""), "repl_content":repl_content } # 数据存储到mongo里面 #save_mongo(consult) except Exception: # 这个地方需要特殊说明一下 print("异常错误X1") print("浏览器休息一下") time.sleep(60) browser.get("http://www.sjz.gov.cn/zfxxinfolist.jsp?current={}&wid=1&cid=1259811582187".format(page_num)) get_content() 在实际的爬取过程中发现,经过几百页之后,就会限制一下IP,所以当我们捕获页面信息出错,需要暂停一下,等待页面正常之后,在继续爬取数据。 5. 石家庄政民互动数据爬取-数据存储到mongodb里面 爬取到的最终数据,我存储到了mongodb里面,这个就没有什么难度了,我们按照常规的套路编写即可。 6. 石家庄政民互动数据爬取-写在最后 由于这次爬取的网站是gov的,所以建议不要用多线程,源码也不发送到github上去了,要不惹祸,如果有任何疑问,请评论。nice boy她专科学历27岁从零开始学习c,c++,python编程语言29岁编写百例教程30岁掌握10种编程语言,用自学的经历告诉你,学编程就找梦想橡皮擦

优秀的个人博客,低调大师

Python爬虫入门教程 7-100 蜂鸟网图片爬取之二

1. 蜂鸟网图片-简介 今天玩点新鲜的,使用一个新库 aiohttp ,利用它提高咱爬虫的爬取速度。 安装模块常规套路 pip install aiohttp 运行之后等待,安装完毕,想要深造,那么官方文档必备 :https://aiohttp.readthedocs.io/en/stable/ 接下来就可以开始写代码了。 我们要爬取的页面,这一次选取的是 http://bbs.fengniao.com/forum/forum_101_1_lastpost.html 打开页面,我们很容易就获取到了页码 好久没有这么方便的看到页码了。 尝试用 aiohttp 访问这个页面吧,模块的引入,没有什么特殊的,采用 import 即可 如果我们需要 使用 Asyncio + Aiohttp异步IO 编写爬虫,那么需要注意,你需要异步的方法前面加上 async 接下来

优秀的个人博客,低调大师

Python爬虫入门教程 8-100 蜂鸟网图片爬取之三

1. 蜂鸟网图片-啰嗦两句 前几天的教程内容量都比较大,今天写一个相对简单的,爬取的还是蜂鸟,依旧采用aiohttp 希望你喜欢爬取页面https://tu.fengniao.com/15/ 本篇教程还是基于学习的目的,为啥选择蜂鸟,没办法,我瞎选的。 一顿熟悉的操作之后,我找到了下面的链接https://tu.fengniao.com/ajax/ajaxTuPicList.php?page=2&tagsId=15&action=getPicLists 这个链接返回的是JSON格式的数据 page =2页码,那么从1开始进行循环就好了 tags=15 标签名称,15是儿童,13是美女,6391是私房照,只能帮助你到这了,毕竟我这是专业博客 ヾ(◍°∇°◍)ノ゙ action=getPicLists接口地址,不变的地方 2.

优秀的个人博客,低调大师

Python爬虫入门教程 6-100 蜂鸟网图片爬取之一

1. 蜂鸟网图片简介 国庆假日结束了,新的工作又开始了,今天我们继续爬取一个网站,这个网站为 http://image.fengniao.com/ ,蜂鸟一个摄影大牛聚集的地方,本教程请用来学习,不要用于商业目的,不出意外,蜂鸟是有版权保护的网站。 2. 蜂鸟网图片网站分析 第一步,分析要爬取的网站有没有方法爬取,打开页面,找分页 http://image.fengniao.com/index.php?action=getList&class_id=192&sub_classid=0&page=1&not_in_id=5352384,5352410 http://image.fengniao.com/index.php?action=getList&class_id=192&sub_classid=0&page=2&not_in_id=5352384,5352410 http://image.fengniao.com/index.php?action=getList&class_id=192&sub_classid=0&page=3&not_in_id=5352384,5352410 http://image.fengniao.com/index.php?action=getList&class_id=192&sub_classid=0&page=4&not_in_id=5352384,5352410 上面的页面发现一个关键的参数page=1这个就是页码了,但是另一个比较头疼的问题是,他没有最后的页码,这样我们没有办法确定循环次数,所以后面的代码编写中,只能使用while了 这个地址返回的是JSON格式的数据,这个对爬虫来说,非常友好!省的我们用正则表达式分析了。 分析这个页面的头文件,查阅是否有反爬措施 发现除了HOST和User-Agent以外,没有特殊的点,大网站就是任性,没啥反爬,可能压根不在乎这个事情。 第二步,分析图片详情页面,在我们上面获取到的JSON中,找到关键地址 关键地址打开之后,这个地方有一个比较骚的操作了,上面图片中标注的URL选的不好,恰好是一个文章了,我们要的是组图,重新提供一个新链接 http://image.fengniao.com/slide/535/5352130_1.html#p=1 打开页面,你可能直接去找规律了,找到下面的一堆链接,但是这个操作就有点复杂了,我们查阅上述页面的源码 http://image.fengniao.com/slide/535/5352130_1.html#p=1 http://image.fengniao.com/slide/535/5352130_1.html#p=2 http://image.fengniao.com/slide/535/5352130_1.html#p=3 .... 网页源码中发现了,这么一块区域 大胆的猜测一下,这个应该是图片的JSON,只是他打印在了HTML中,我们只需要用正则表达式进行一下匹配就好了,匹配到之后,然后进行下载。 第三步,开始撸代码。 3. 蜂鸟网图片写代码 from http_help import R # 这个文件自己去上篇博客找,或者去github找 import threading import time import json import re img_list = [] imgs_lock = threading.Lock() #图片操作锁 # 生产者类 class Product(threading.Thread): def __init__(self): threading.Thread.__init__(self) self.__headers = {"Referer":"http://image.fengniao.com/", "Host": "image.fengniao.com", "X-Requested-With":"XMLHttpRequest" } #链接模板 self.__start = "http://image.fengniao.com/index.php?action=getList&class_id=192&sub_classid=0&page={}&not_in_id={}" self.__res = R(headers=self.__headers) def run(self): # 因为不知道循环次数,所有采用while循环 index = 2 #起始页码设置为1 not_in = "5352384,5352410" while True: url = self.__start.format(index,not_in) print("开始操作:{}".format(url)) index += 1 content = self.__res.get_content(url,charset="gbk") if content is None: print("数据可能已经没有了====") continue time.sleep(3) # 睡眠3秒 json_content = json.loads(content) if json_content["status"] == 1: for item in json_content["data"]: title = item["title"] child_url = item["url"] # 获取到链接之后 代码来源,公众号:非本科程序员 img_content = self.__res.get_content(child_url,charset="gbk") pattern = re.compile('"pic_url_1920_b":"(.*?)"') imgs_json = pattern.findall(img_content) if len(imgs_json) > 0: if imgs_lock.acquire(): img_list.append({"title":title,"urls":imgs_json}) # 这个地方,我用的是字典+列表的方式,主要是想后面生成文件夹用,你可以进行改造 imgs_lock.release() 上面的链接已经生成,下面就是下载图片了,也非常简单 # 消费者 class Consumer(threading.Thread): def __init__(self): threading.Thread.__init__(self) self.__res = R() def run(self): while True: if len(img_list) <= 0: continue # 进入下一次循环 if imgs_lock.acquire(): data = img_list[0] del img_list[0] # 删除第一项 imgs_lock.release() urls =[url.replace("\\","") for url in data["urls"]] # 创建文件目录 for item_url in urls: try: file = self.__res.get_file(item_url) # 记得在项目根目录先把fengniaos文件夹创建完毕,代码来源,公众号:非本科程序员 with open("./fengniaos/{}".format(str(time.time())+".jpg"), "wb+") as f: f.write(file) except Exception as e: print(e) 代码走起,结果

优秀的个人博客,低调大师

Python爬虫入门教程 4-100 美空网未登录图片爬取

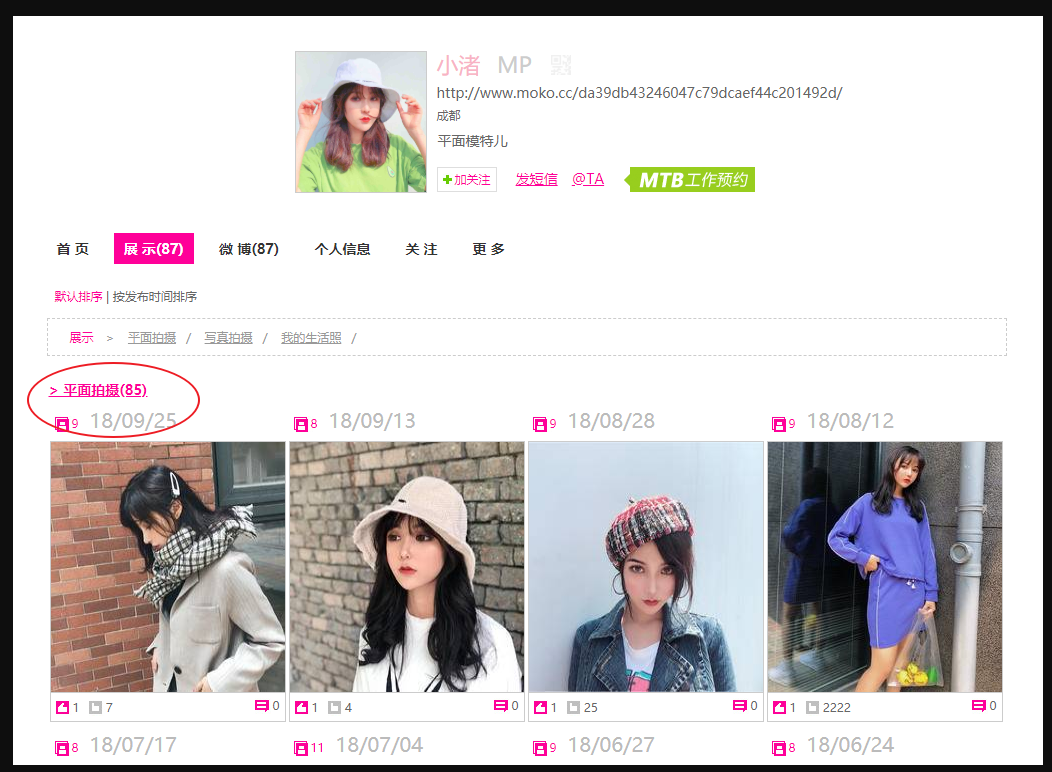
简介 上一篇写的时间有点长了,接下来继续把美空网的爬虫写完,这套教程中编写的爬虫在实际的工作中可能并不能给你增加多少有价值的技术点,因为它只是一套入门的教程,老鸟你自动绕过就可以了,或者带带我也行。 爬虫分析 首先,我们已经爬取到了N多的用户个人主页,我通过链接拼接获取到了 http://www.moko.cc/post/da39db43246047c79dcaef44c201492d/list.html 在这个页面中,咱们要找几个核心的关键点,发现平面拍摄点击进入的是图片列表页面。接下来开始代码走起。 获取所有列表页面 我通过上篇博客已经获取到了70000(实际测试50000+)用户数据,读取到python中。 这个地方,我使用了一个比较好用的python库pandas,大家如果不熟悉,先模仿我的代码就可以了,我把注释都写完整。 import pandas as pd # 用户图片列表页模板 user_list_url = "http://www.moko.cc/post/{}/list.html" # 存放所有用户的列表页 user_profiles = [] def read_data(): # pandas从csv里面读取数据 df = pd.read_csv("./moko70000.csv") #文件在本文末尾可以下载 # 去掉昵称重复的数据 df = df.drop_duplicates(["nikename"]) # 按照粉丝数目进行降序 profiles = df.sort_values("follows", ascending=False)["profile"] for i in profiles: # 拼接链接 user_profiles.append(user_list_url.format(i)) if __name__ == '__main__': read_data() print(user_profiles) 数据已经拿到,接下来我们需要获取图片列表页面,找一下规律,看到重点的信息如下所示,找对位置,就是正则表达式的事情了。 快速的编写一个正则表达式<p class="title"><a hidefocus="ture".*?href="(.*?)" class="mwC u">.*?\((\d+?)\)</a></p> 引入re,requests模块 import requests import re # 获取图片列表页面 def get_img_list_page(): # 固定一个地址,方便测试 test_url = "http://www.moko.cc/post/da39db43246047c79dcaef44c201492d/list.html" response = requests.get(test_url,headers=headers,timeout=3) page_text = response.text pattern = re.compile('<p class="title"><a hidefocus="ture".*?href="(.*?)" class="mwC u">.*?\((\d+?)\)</a></p>') # 获取page_list page_list = pattern.findall(page_text) 运行得到结果 [('/post/da39db43246047c79dcaef44c201492d/category/304475/1.html', '85'), ('/post/da39db43246047c79dcaef44c201492d/category/304476/1.html', '2'), ('/post/da39db43246047c79dcaef44c201492d/category/304473/1.html', '0')] 继续完善代码,我们发现上面获取的数据,有"0"的产生,需要过滤掉 # 获取图片列表页面 def get_img_list_page(): # 固定一个地址,方便测试 test_url = "http://www.moko.cc/post/da39db43246047c79dcaef44c201492d/list.html" response = requests.get(test_url,headers=headers,timeout=3) page_text = response.text pattern = re.compile('<p class="title"><a hidefocus="ture".*?href="(.*?)" class="mwC u">.*?\((\d+?)\)</a></p>') # 获取page_list page_list = pattern.findall(page_text) # 过滤数据 for page in page_list: if page[1] == '0': page_list.remove(page) print(page_list) 获取到列表页的入口,下面就要把所有的列表页面全部拿到了,这个地方需要点击下面的链接查看一下 http://www.moko.cc/post/da39db43246047c79dcaef44c201492d/category/304475/1.html 本页面有分页,4页,每页显示数据4*7=28条所以,基本计算公式为 math.ceil(85/28)接下来是链接生成了,我们要把上面的链接,转换成 http://www.moko.cc/post/da39db43246047c79dcaef44c201492d/category/304475/1.html http://www.moko.cc/post/da39db43246047c79dcaef44c201492d/category/304475/2.html http://www.moko.cc/post/da39db43246047c79dcaef44c201492d/category/304475/3.html http://www.moko.cc/post/da39db43246047c79dcaef44c201492d/category/304475/4.html page_count = math.ceil(int(totle)/28)+1 for i in range(1,page_count): # 正则表达式进行替换 pages = re.sub(r'\d+?\.html',str(i)+".html",start_page) all_pages.append(base_url.format(pages)) 当我们回去到足够多的链接之后,对于初学者,你可以先干这么一步,把这些链接存储到一个csv文件中,方便后续开发 # 获取所有的页面 def get_all_list_page(start_page,totle): page_count = math.ceil(int(totle)/28)+1 for i in range(1,page_count): pages = re.sub(r'\d+?\.html',str(i)+".html",start_page) all_pages.append(base_url.format(pages)) print("已经获取到{}条数据".format(len(all_pages))) if(len(all_pages)>1000): pd.DataFrame(all_pages).to_csv("./pages.csv",mode="a+") all_pages.clear() 让爬虫飞一会,我这边拿到了80000+条数据 好了,列表数据有了,接下来,我们继续操作这个数据,是不是感觉速度有点慢,代码写的有点LOW,好吧,我承认这是给新手写的其实就是懒,我回头在用一篇文章把他给改成面向对象和多线程的 我们接下来基于爬取到的数据再次进行分析 例如 http://www.moko.cc/post/nimusi/category/31793/1.html 这个页面中,我们需要获取到,红色框框的地址,为什么要或者这个?因为点击这个图片之后进入里面才是完整的图片列表。 我们还是应用爬虫获取几个步骤 循环我们刚才的数据列表 抓取网页源码 正则表达式匹配所有的链接 def read_list_data(): # 读取数据 img_list = pd.read_csv("./pages.csv",names=["no","url"])["url"] # 循环操作数据 for img_list_page in img_list: try: response = requests.get(img_list_page,headers=headers,timeout=3) except Exception as e: print(e) continue # 正则表达式获取图片列表页面 pattern = re.compile('<a hidefocus="ture" alt="(.*?)".*? href="(.*?)".*?>VIEW MORE</a>') img_box = pattern.findall(response.text) need_links = [] # 待抓取的图片文件夹 for img in img_box: need_links.append(img) # 创建目录 file_path = "./downs/{}".format(str(img[0]).replace('/', '')) if not os.path.exists(file_path): os.mkdir(file_path) # 创建目录 for need in need_links: # 获取详情页面图片链接 get_my_imgs(base_url.format(need[1]), need[0]) 上面代码几个重点地方 pattern = re.compile('<a hidefocus="ture" alt="(.*?)".*? href="(.*?)".*?>VIEW MORE</a>') img_box = pattern.findall(response.text) need_links = [] # 待抓取的图片文件夹 for img in img_box: need_links.append(img) 获取到抓取目录,这个地方,我匹配了两个部分,主要用于创建文件夹创建文件夹需要用到 os 模块,记得导入一下 # 创建目录 file_path = "./downs/{}".format(str(img[0]).replace('/', '')) if not os.path.exists(file_path): os.mkdir(file_path) # 创建目录 获取到详情页面图片链接之后,在进行一次访问抓取所有图片链接 #获取详情页面数据 def get_my_imgs(img,title): print(img) headers = { "User-Agent": "Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/68.0.3440.106 Safari/537.36"} response = requests.get(img, headers=headers, timeout=3) pattern = re.compile('<img src2="(.*?)".*?>') all_imgs = pattern.findall(response.text) for download_img in all_imgs: downs_imgs(download_img,title) 最后编写一个图片下载的方法,所有的代码完成,图片保存本地的地址,用的是时间戳。 def downs_imgs(img,title): headers ={"User-Agent": "Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/68.0.3440.106 Safari/537.36"} response = requests.get(img,headers=headers,timeout=3) content = response.content file_name = str(int(time.time()))+".jpg" file = "./downs/{}/{}".format(str(title).replace('/','').strip(),file_name) with open(file,"wb+") as f: f.write(content) print("完毕") 运行代码,等着收图 代码运行一下,发现报错了 原因是路径的问题,在路径中出现了...这个特殊字符,我们需要类似上面处理/的方式处理一下。自行处理一下吧。 数据获取到,就是这个样子的 代码中需要完善的地方 代码分成了两部分,并且是面向过程的,非常不好,需要改进 网络请求部分重复代码过多,需要进行抽象,并且加上错误处理,目前是有可能报错的 代码单线程,效率不高,可以参照前两篇文章进行改进 没有模拟登录,最多只能爬取6个图片,这也是为什么先把数据保存下来的原因,方便后期直接改造

优秀的个人博客,低调大师

100行Python代码理解深度学习关键概念:从头构建恶性肿瘤检测网络

在构建乳腺癌预测神经网络过程中,我们主要分为3大部分: 1.用Python从零开始创建一个神经网络,并使用梯度下降算法训练模型。 2.在该神经网络中使用威斯康星乳腺癌数据集,根据9种不同的特征,预测肿瘤是良性还是恶性的。 3.探索反向传播和梯度下降算法的工作原理。 在这个领域中,有很多大牛都通过视频和博文分享了自己掌握的专业知识,如fast.ai的Jeremy Howard、吴恩达、Andrej Karpathy、Yann Lecun等等。 他们一致认为,深度学习的关键之一就是,尽快亲自动手编写一个深度学习的模型。当前,深度学习领域中有很多强大的库可供我们使用,如Tensorflow、 PyTorch、 Fast.ai、 Keras、 Mxnett、 Nctk、DL4J 等。如果仅仅直接使用这些强大的库,我们可能会错过很多关键的东西,因此,

优秀的个人博客,低调大师

六个方向关于iOS100个面试题,你都会了吗?

常见问题 你昨天/这周学习了什么? 你为什么热衷于软件开发? 你对哪一种控制系统比较熟悉? 是否参与过GitHub项目? 是否参与过GitHub或其他同类型网站的iOS开源项目? 请描述一下你的iOS应用开发流程。 是否熟知CocoaPods?它是什么?如何运行的? 请概括一下你对软件授权的理解,及其对软件开发的影响。 请概括一下你在构建iOS应用时的测试过程。iOS应用如何实现对其他语言、日期格式以及货币单位的支持? 请描述一下Instruments及其作用。 关于iOS技术 请解释一下Handoff是什么,并简述它是如何实现iOS、Mac/网页应用互通的。 iCloud包含了哪些技术与服务? iOS扩展是指?能否列举一些热门或常见的范例? HealthKit是什么? HomeKit是什么? Apple Pay是什么?能否描述一下如何在应用中使用Apple Pay? 请解释一下iOS应用沙盒机制。 VoiceOver是什么?请举例解释一下iOS中的辅助功能(Accessibility)。开发者如何使用这些功能? iOS应用是如何实现后台多任务处理(Multitasking)的? Game Center针对iOS游戏有哪些功能? iBeacons是什么? Cocoa/Cocoa Touch是什么? 请概括一下Core Audio,Core Data以及Core Location各是什么。它们对iOS应用有何意义? 请描述SpriteKit和SceneKit的作用。 Metal是什么? 响应链(Responder Chain)是什么?它是如何发挥作用的? 按钮和其他控制方式对哪些操作做出回应? AppDelegate扮演着什么样的角色? 请解释一下NSUserDefaults。就你而言,你会如何在磁盘中对数组对象进行序列化? 你会如何储存用户的认证信息? 请问何为Keychain服务? 为什么移动设备上的缓存和压缩是不可或缺的? 请解释一下~/Documents,~/Library和~/tmp。 iOS中的~属于什么目录? AirPlay是如何运行的?换做是你,你会如何通过编程提高应用的实用性以及演示效果? 传感器,IO以及WiFi、拨号等连接方式如何在iOS平台上运作?它们有何利用价值?请扼要地谈谈你的观点。 iPad 2,iPad mini 1-3,iPad Retina,iPad Air 2,iPhone 5、5S、6以及6+在硬件性能方面有何差异?这对注重性能的应用有何限制? 关于编程 Cocoa Touch包含什么?不包含什么? 为什么Cocoa Touch的类名称是以两个大写字母开头的? Swift和Objective-C分别是什么?两者相比有何不同之处,又有何联系? 为什么Optional在Swift语言中非常重要? 请解释一下NSError。在Swift中,什么情况下能使用NSError ,什么情况下不能? 请说明如何使用Instancetype及其重要性。 在Swift中,什么时候该用let,什么时候该用var? 为什么map函数必不可少?该在什么情况下使用它? 你会选择什么工具来追踪Bug? 如果在Cocoa中发现一个Bug,你会如何处理? 如果应用的新版本出现了Regression的情况,该如何补救?如何防止用户在使用过程中遇到新的Bug? Objective-C的类是怎么执行的?Objective-C Runtime是如何实现的? iOS是如何提高安全性,保护用户隐私信息的? 应用可以下载并即刻显示数据。如何根据MVC来判断下载的最佳位置? MVC对代码库(Codebase)的设计有何影响? Controller Life-Cycle以及View Life-cycle分别有哪些调试方法? iOS使用的是哪些设计模式(Design Patterns)?你的代码库使用的是哪些设计模式? iOS提供哪些线程?如何充分利用这些线程? 请简要描述一下UIScrollView的执行过程。它是如何响应手势识别(Gesture Recognizer)、多点触控(Multi-Touch)和Run Loop的? 你认为iOS需要添加或改进哪些API? 关于界面 iPhone5、6、6+以及iPad Air 2的屏幕分辨率分别是多少? 分辨率的计算单位是什么? 请解释一下Interface Builder的作用以及NIB文件的概念。 iOS UI的图像储存类型是什么? 请描述一下Storyboard和标准NIB文件的差别。 设备状态栏(Device Status Bar)是什么?高度如何?是否透明?在手机通话或者导航状态下,它是如何显示的? 导航栏(Navigation Bar)是什么?能否拿出你的iPhone,指出你下载的哪些应用运用了导航栏? 选项卡(Tab Bar)和工具栏(Toolbar)分别是什么?两者之间有何共同点和不同点? 表视图(Table View)是什么?集合视图(Collection View)又是什么? 什么时候用“弹出(Popover)”属性最为合适? Split-view Controller是什么? 选取器视图(Picker View)适合存放哪类内容? 应该在什么情况下使用标签、文本域和文本视图? 分段控件(Segmented Control)的作用是什么? 模态视图(Modal View)是什么? iOS通知属于什么类型? 关于设计 iOS应用图标是指什么?请尽可能详细地描述一下。 最小尺寸和最大尺寸的应用图标分别是什么样子的? 应用图标能否包含透明的部分? Newsstand的图标与常规应用有何不同? 请解释一下启动画面(Launch Images)。 自动布局(Auto Layout)的作用是什么?请概括一下它是如何运行的。 设计软件时为什么要加上动画? 请描述一下软件设计中的交互和Feedback有什么作用。 设计iPhone和iPad应用时,应分别考虑哪些因素? 请描述一下原型设计对于软件开发的意义。其作用是什么? 关于App Store 应用内购买(In-App Purchases)是怎么回事?IAP能够为用户带来哪些新体验? 你是否在App Store上发布过应用?能否概括一下过程? iTunes Connect是什么? Provisioning Profiles是指? App ID是什么? iOS的开发和发布签名证书有何异同? 如何使用TestFlight?通过Ad-hoc发布应用的话,该如何使用UUID? 应何时验证购买收据? 发布iAds(苹果平台广告)有哪些要求? 趣味问答 最近有没有开发什么好玩的东西?你最引以为豪的作品是什么? 谈一谈你常用的开发工具都有哪些优势? 你最敬佩的独立Mac或者iOS应用开发者是谁? 最喜欢什么项目?哪种类型的? 你觉得Xcode有哪些需要改进的地方? iOS上你最喜欢哪些API? 是否有最中意的错误报告? 你最爱以哪种方式来检验一项新技术是否好用? 为什么词典被称作Dictionaries,而不是HashTable或HashMap?

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册