首页 文章 精选 留言 我的

精选列表

搜索[产业分析],共10000篇文章
优秀的个人博客,低调大师

Hi-Fi 无线 SONOS吹响云音乐产业号角

关于音乐,有一个问题时常在我脑海转悠,到底是追求无底洞似的音质,还是追求无拘束的音乐?不同经历的人们也许有不同的选择,爸爸常常拿着一台连MP3功能都没有的收音机,陶醉在50年前的音乐中;女朋友总喜欢在手机上听歌,仿佛在喧闹的车厢中只有她孤身一人;而我,则偏好孤独,一个人在房间内听着Bee Gees,感觉回到高中青涩年代。 音乐,总能给人带来感触,但心灵要和音乐共鸣,需要回归到音乐的本质,如今这个年代,能够听音乐的设备总是太多,如何能尽可能简单听音乐,是大多数人追求的梦想,但在太多的播放器中,我们总是难以选择。 要摆脱束缚,当然需要去掉线材,SONOS推出了一种无线音响系统,分别是Play3和Play5,可以把移动设备和音响之间使用无线连接,我使用手机或者平板电脑,就能很简单,很轻松地操作它。在没有线材的情况下,它能带给我们什么?最终要的,其实还是音乐本身。 没有音频线,将带来什么革命? 所谓“智能”的含义的最大程度的方便消费者使用,抛弃那些复杂的连接方式,最大限度地回归本源。play3 play5均支持无线连接的方式。网络传输的标准为Wi-Fi,相比蓝牙更加稳定,传输距离更远。 以前用的音乐设备,我总是要把很多精力花在那些莫名其妙的数据线上,众多的线材让人有些无所适从,等都搞定了又没有听音乐的兴致了。所以无线是我们爱听音乐发烧友的终极追求,没有数据线接口的要求,只要你的手机或平板为Android或者iOS系统,就能使用。同时Wi-Fi这种数字化的传输方式可以有效地提高音质。这是因为很多便携式设备和音响系统的连接采用3.5mm模拟输出方式,音响再播放出来,这种方式对音质本身有一定影响。 不需依靠就能“自我解码” 以前用CD听音乐,虽然那些碟片的质感能够吸引我,但这小小碟片本身也是一种拘束,遥控也是一大问题,必须使用红外线遥控器。方便,自由的音乐似乎比音质更加重要。SONOS的这两套无线系统采用了自解码的方式,实际上,SONOS的play3、play5本身就是一个高品质的音频播放中心,具备嵌入式的Linux系统,支持各种音频解码功能,包括FLAC等无损格式,可以最大限度地利用其他设备上的音乐资源,不需要花费时间去转码。同时play3、play5内嵌的Linux本身也是一个服务器端,我们可以通过SONOS官方发布的应用程序对play3、play5系统进行远程控制,由于了连接方式是Wi-Fi,所以即便家里环境比较大,也能够毫无压力地控制, 实际上,遥控端本身只是发送一个信号,要求音响系统播放某一首音乐或者打开电源,真正的处理工作,都是在音响系统本身完成。这样一来,play3、play5的实用性就得到了大大提高,这种遥控方式,也是智能家居的重要组成部分。另外,play3、play5对苹果的AIR PLAY也提供了良好的支持,堪称全能。实际上,笔者也注意到play3、play5本身属于Hi-Fi音箱范畴。所以在音质方面,SONOS同样花了很大的功夫。每个扬声器都搭配了独立放大器,声音浑厚能够满足大多数用户的需求。 是网络播放,更是云未来 在一些朋友聚会,或者小型派对上,SONOS的音乐系统能让所有人满意,这不仅是因为它们出众的音质,还在于它能够提供的音乐数量,远超我们的想象,即便你的手机或者平板里面没有音乐,“云存储”也能帮助我们解决问题, 其实这套系统要是只能够播放计算机、手机或者平板内的音乐,这样的产品确实比较极客化,极客化的最大问题就是受众面小,要面对普罗大众,面对那些需要音乐本身的用户,SONOS的产品就必须拥有更好的实用性。在SONOS的系统中,我可以直接访问QQ音乐库。通过play3或play5系统直接在浩如烟海的音乐库中寻找我们需要的感觉,最大的方便,来自于SONOS本身是一套Linux系统的设备,搜索音乐神马的,确实十分简单。 有人告诉我,SONOS音响就是“无需线缆并且可以用手机平板电脑控制的无线HiFi音响系统”。但我本身并非很技术范,对我来说,如何能够方便快捷地听到我要的音乐,才是最为重要的。SONOS这套产品最优秀之处在于,无论是我身边的音乐,还是云端的节奏,都能胜任,而且还没有了线材的困扰。同时SONOS也是智能家居的一部分,它的开放标准能够和我的很多其他设备兼容,如苹果的AIRPLAY,它将Hi-Fi+无线的重新结合,又将会孕育出另一片音箱行业的“云海”。(科幻星系/文)

优秀的个人博客,低调大师

腾讯研究院发布《中美两国人工智能产业发展全面解读》:中国AI产业将迎来泡沫?(附全文PDF下载)

雷锋网AI科技评论按:谈起AI,中国有理由感到自豪,在人工智能领域发表的论文数量排名世界第一;在数理基础研究领域,集聚了大量人才;在语音识别、人脸识别,以及自然语音识别等技术,我们已经走在了世界前列。但这些已经够了么? 当下,中美两国虽同属AI领域第一梯队,但美国AI整体实力却是公认的全球第一。中国和美国的差距又是在哪里? 顶层战略和美相似,基础研究和应用落后 美国和中国政府都把人工智能当作未来战略的主导,出台发展战略规划,从国家战略层面进行整体推进。美国人工智能报告体现了美国政府对新时代维持自身领先优势的战略导向。中国新一代人工智能发展规划,也在战略引导和项目实施上做了整体部署。虽然美国和中国都在国家层面建立了相对完整的研发促进机制,整体推进人工智能发展。但在应用系统中,美国走的较远,已经开始将AI装备到军事领域。 美国在人工智能基础研

优秀的个人博客,低调大师

混合事务分析处理“HTAP”的技术要点分析

HTAP是近些年来比较火的一个概念,本文将聊聊HTAP的前世今生及技术特点。 一、数据应用类别 根据数据的使用特征,可简单做如下划分。在选择技术平台之前,我们需要做好这样的定位。 1.1 OLTP 联机事务处理OLTP(On-Line Transaction Processing) OLTP是事件驱动、面向应用的,也称为面向交易的处理过程。其基本特征是前台接收的用户数据可以立即传送到计算中心进行处理,并在很短的时间内给出处理结果,是对用户操作的快速响应。例如银行类、电子商务类的交易系统就是典型的OLTP系统。 OLTP具备以下特点: 直接面向应用,数据在系统中产生。 基于交易的处理系统。 每次交易牵涉的数据量很小;对响应时间要求非常高。 用户数量非常庞大,其用户是操作人员,并发度很高。 数据库的各种操作主要基于索引进行。 以SQL作为交互载体。 总体数据

优秀的个人博客,低调大师

WorkBuddy竞争分析

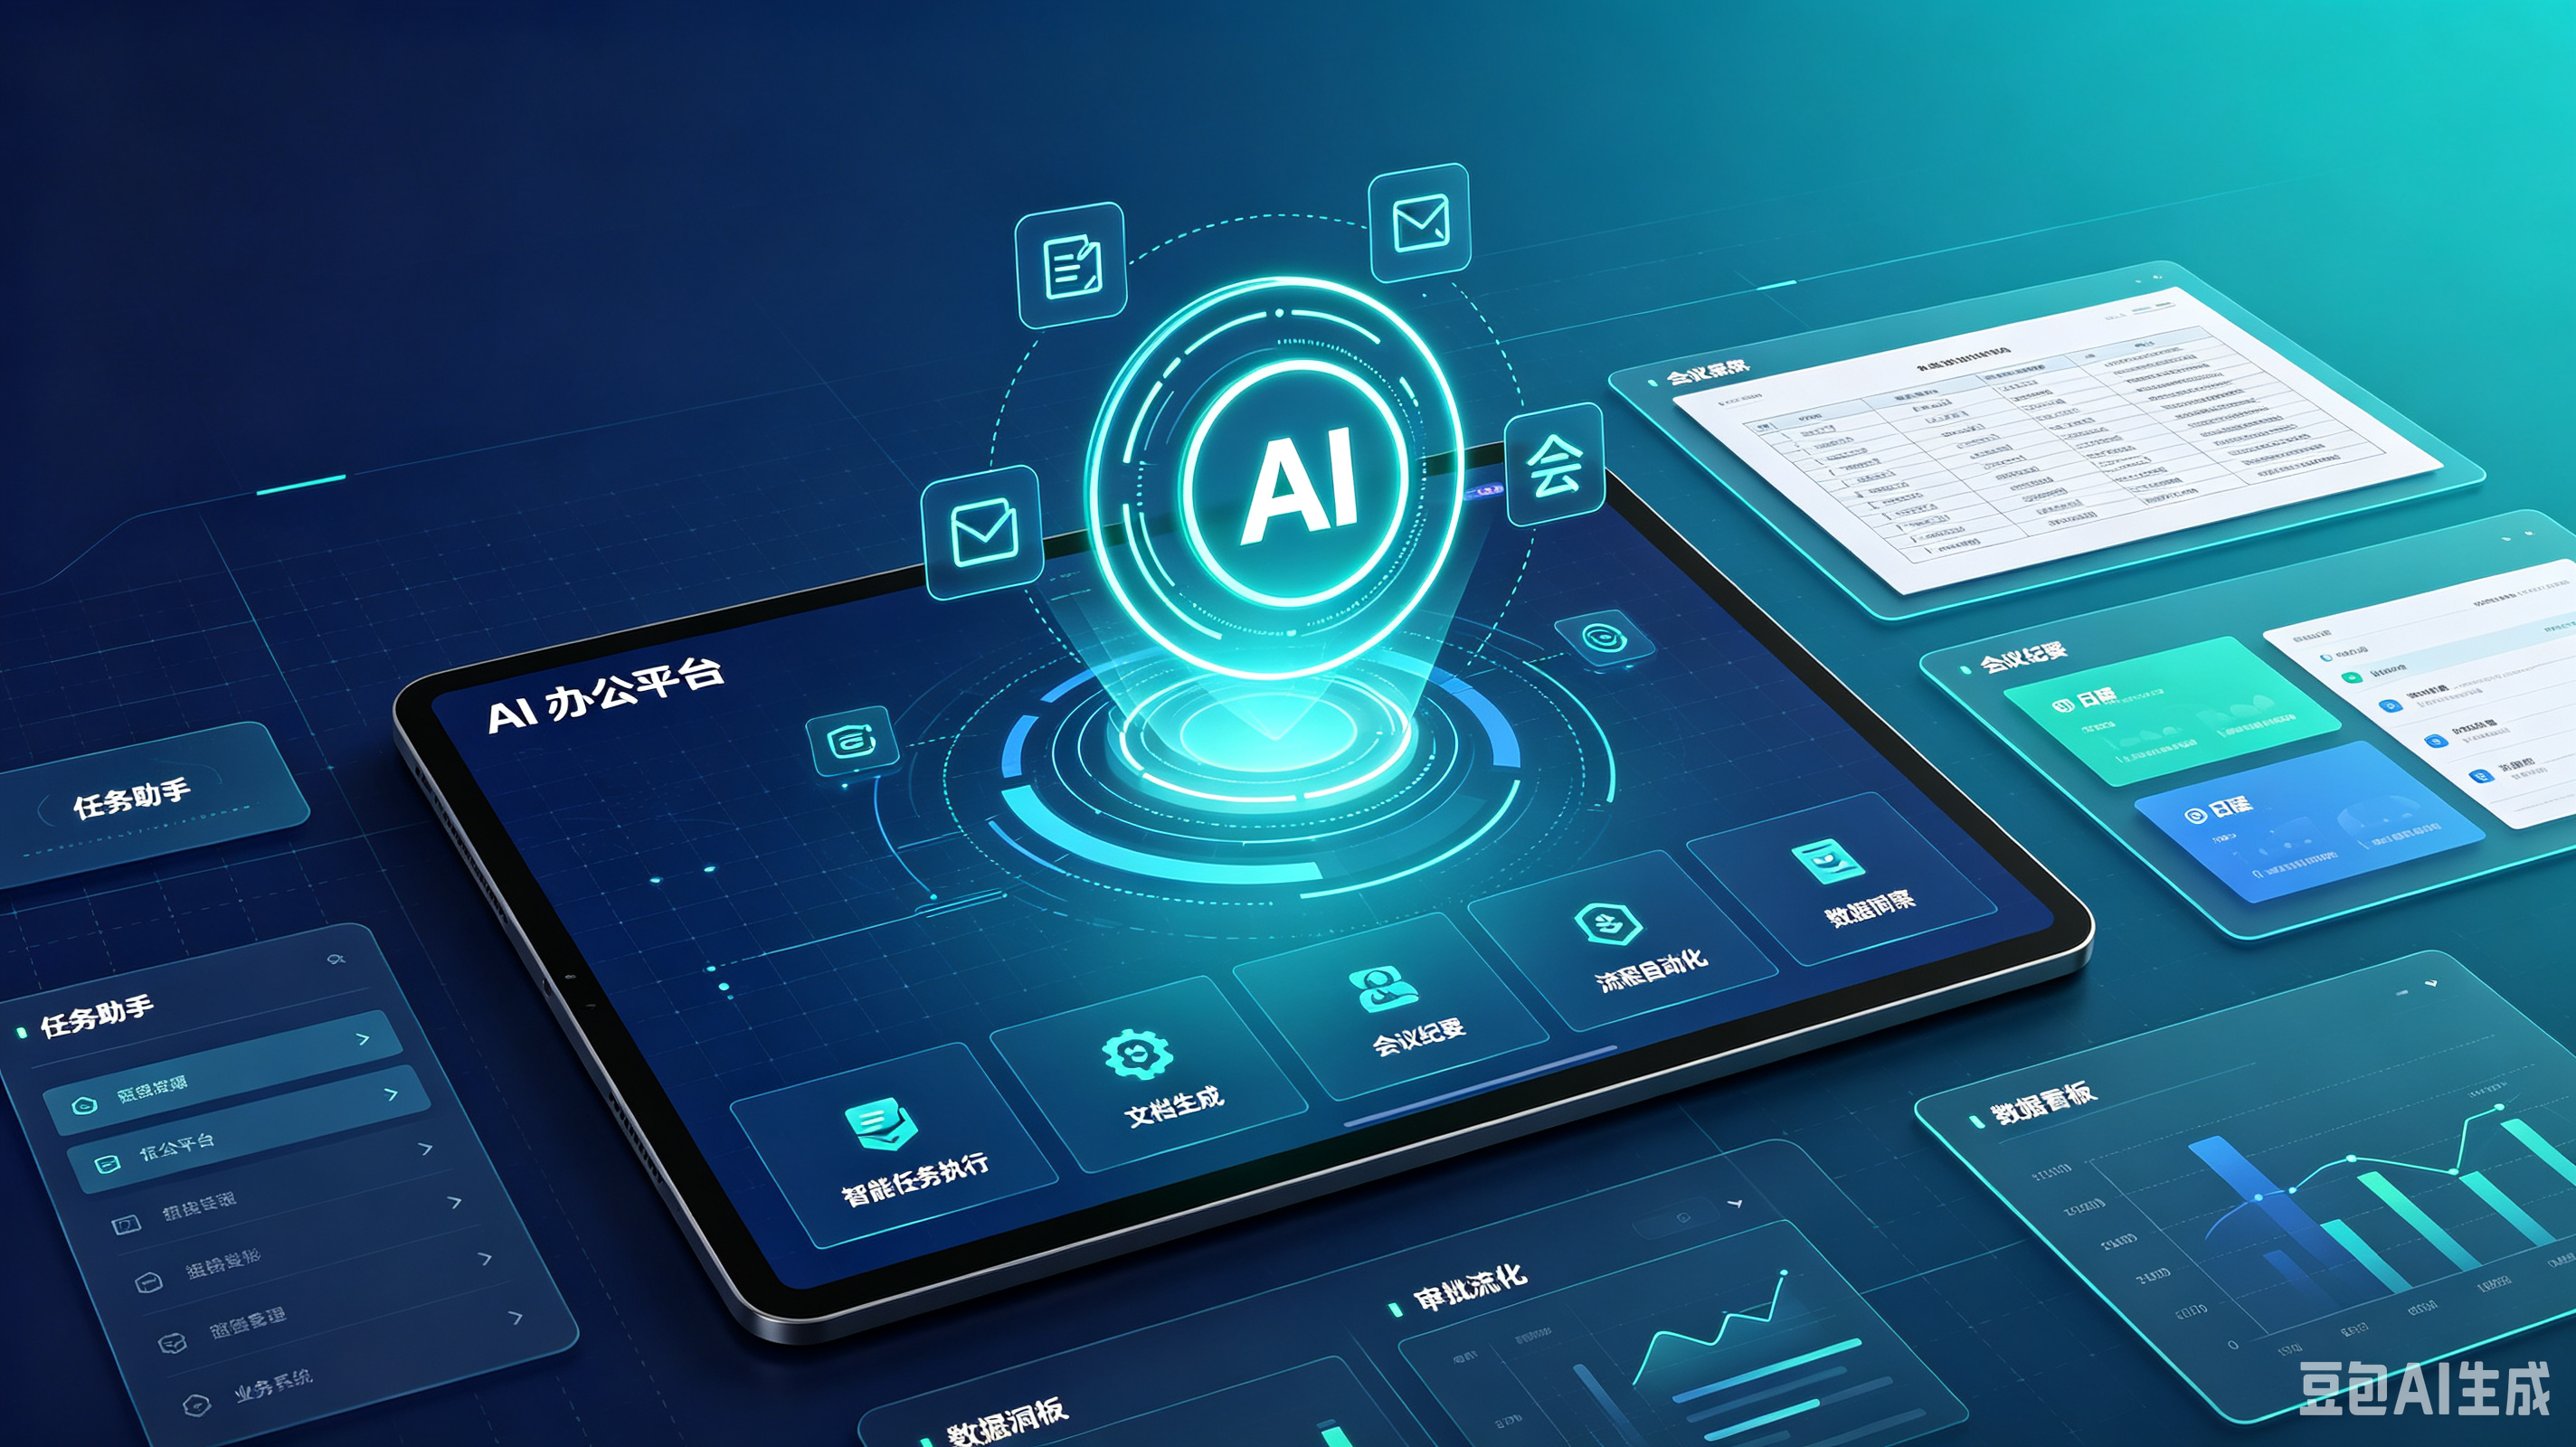
7月21日至22日多方消息披露,阿里巴巴即将推出面向企业级市场的AI智能体产品"千问办公",该产品由钉钉新任CEO陈宇森主导,整合了旗下QoderWork、悟空、MuleRun三款智能体,定位独立于通义千问之外的 B 端深度办公产品线,主打跨系统审批、多角色协同、法务、财务、HR 垂直场景的智能体自治执行,目前已启动内部小范围测试,预计近期正式发布,将与通义千问形成 "C 端通用 + B 端办公" 的双引擎格局。智能办公领域又来了新的硬核玩家。但国内PC端AI原生办公智能体老大目前还是WorkBuddy !那我们一起来看看WorkBuddy。

优秀的个人博客,低调大师

ReetrantLock源码分析

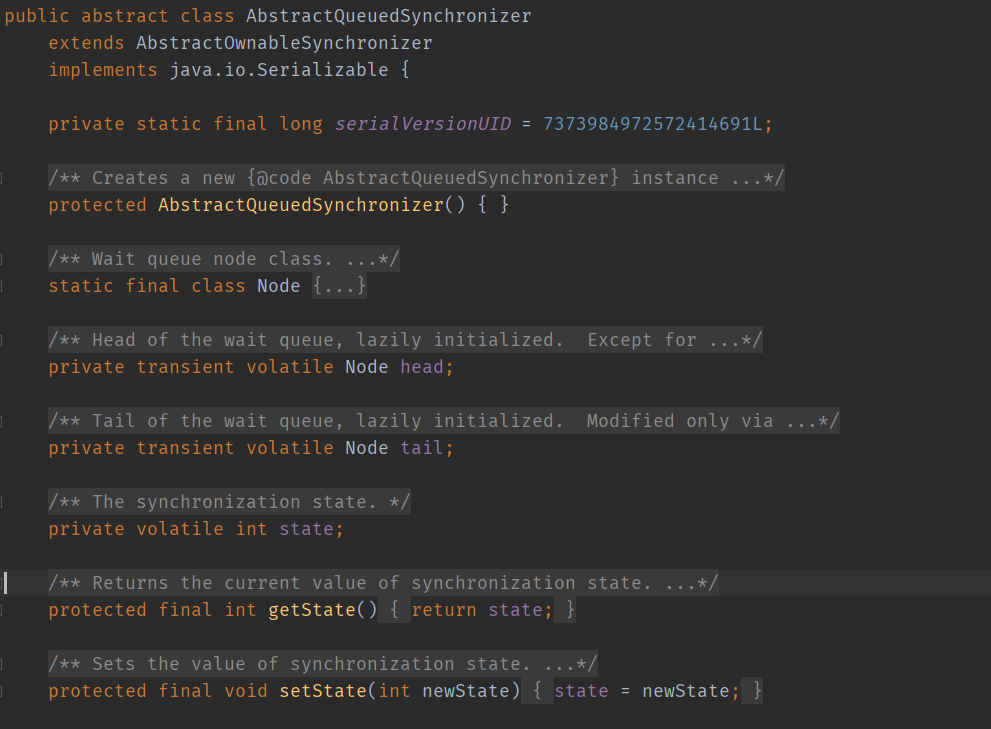
ReentrantLock类的大部分逻辑,都是其均继承自AQS的内部类Sync实现的 啥是AQS: Java并发编程核心在于java.concurrent.util包而juc当中的大多数同步器实现都是围绕着共同的基础行为,比如「等待队列、条件队列、独占获取、共享获取」等,而这个行为的抽象就是基于AbstractQueuedSynchronizer简称AQS 它定义了一套多线程访问共享资源的同步器框架,是一个「依赖状态(state)的同步器」。 以公平锁为例子: publicstaticvoidmain(String[]args){ ReentrantLocklock=newReentrantLock(true); lock.lock();//加锁断点处 try{ Thread.sleep(5000); }catch(InterruptedExceptione){ e.printStackTrace(); }finally{ lock.unlock(); } 公平锁、非公平锁 publicReentrantLock(booleanfair){//ReetrantLock的有参构造函数 sync=fair?newFairSync():newNonfairSync(); } 在加锁行打断点运行, 我们可以看到参数: image-20201105163128535 ​ 记住这几个值,后面会用到. 单步步入 F7 image-20201105163427610 看到lock()调用了Sync实例中的lock()方法 我们可以看到Sync是在ReentrantLock类中的一个抽象内部类 继承于AbstractQueuedSynchronizer (AQS)(抽象队列同步器) 点击Sync类中lock抽象接口方法 我们可以发现ReetrantLock有公平和非公平锁两种方式实现方式.由于本章我们使用公平锁讲解所以我们选择公平锁的实现方式继续向下调试代码 /** *Syncobjectforfairlocks */ staticfinalclassFairSyncextendsSync{//公平锁实现方式继承于Sync privatestaticfinallongserialVersionUID=-3000897897090466540L; finalvoidlock(){ acquire(1);//获取锁传入参数1 } .. 向下⬇️ publicfinalvoidacquire(intarg){//acquire方法接收参数1 if(!tryAcquire(arg)&&acquireQueued(addWaiter(Node.EXCLUSIVE),arg)) //这里有两个操作使用短路与如果第一个操作成功第二个操作不执行 //1.尝试以独占模式获取锁,在成功时返回 //2.线程进入队列排队 selfInterrupt(); } 方式1 首先尝试获取锁 /** *FairversionoftryAcquire.Don'tgrantaccessunless *recursivecallornowaitersorisfirst. */ protectedfinalbooleantryAcquire(intacquires){//参数:1 finalThreadcurrent=Thread.currentThread();//获取当前线程 intc=getState();//还记得我们第一个断点截图的state值是0 if(c==0){//是0说明我们是第一次获取锁,如果不是0说明是重入,会进入else if(!hasQueuedPredecessors()&& //公平锁和非公平锁,主要是在方法tryAcquire中,是否有!hasQueuedPredecessors()判断。 compareAndSetState(0,acquires)){//通过cas操作state更新,期望值是0,新值是1 setExclusiveOwnerThread(current);//设置当前拥有独占访问的线程。 returntrue; } } elseif(current==getExclusiveOwnerThread()){//如果是重入情况会进入这里. //进入前会判断是否是当前线程拿的锁 intnextc=c+acquires;//假设重入次数为2那么nextc=2+1=3 if(nextc<0) thrownewError("Maximumlockcountexceeded"); setState(nextc);//更新state值 returntrue; } returnfalse; } 先判断state是否为0,「如果为0就执行上面提到的lock方法的前半部分」,通过CAS操作将state的值从0变为1,否则判断当前线程是否为exclusiveOwnerThread,然后把state++,也就是重入锁的体现,「我们注意前半部分是通过CAS来保证同步,后半部分并没有同步的体现」,原因是:后半部分是线程重入,再次获得锁时才触发的操作,此时当前线程拥有锁,所以对ReentrantLock的属性操作是无需加锁的。「如果tryAcquire()获取失败,则要执行addWaiter()向等待队列中添加一个独占模式的节点。」 publicfinalbooleanhasQueuedPredecessors(){ Nodet=tail;//根据初始化顺序倒序获取字段 Nodeh=head; Nodes; returnh!=t&& ((s=h.next)==null||s.thread!=Thread.currentThread()); } //在这个判断中主要就是看当前线程是不是同步队列的首位,是:true、否:false //这部分涉及公平锁的实现,CLH(Craig,LandinandHagersten)。三个作者的首字母组合 啥是CLH CLH锁即Craig, Landin, and Hagersten (CLH) locks。CLH锁是一个自旋锁。能确保无饥饿性。提供先来先服务的公平性。 为什么说JUC中的实现是基于CLH的“变种”,因为原始CLH队列,一般用于实现自旋锁。而JUC中的实现,获取不到锁的线程,一般会时而阻塞,时而唤醒。 1.获取不到锁的线程,会进入队尾,然后自旋,直到其前驱线程释放锁,具体位置是放在tail后的null位置,并让新对象的next指向Null 2.如果head成功拿到了锁 此时 把head中包含的线程指向为Null并将head的前任设置为head后清除现任head 方式2 没获取到锁,需要进入队列排队: 进入方式需要改造项目让多个线程进行抢占资源改造如下: importjava.util.concurrent.locks.ReentrantLock; classScratch{ publicstaticvoidmain(String[]args){ ReentrantLocklock=newReentrantLock(true); for(inti=0;i<5;i++){ newThread(()->{ lock.lock(); try{ Thread.sleep(100); System.out.println(Thread.currentThread().getName()+"工作结束...."); }catch(InterruptedExceptione){ e.printStackTrace(); }finally{ lock.unlock(); } }).start(); } } } 回到这里发现等待队列addWaiter方法添加了一个Null 将自己加入CLH队列的尾部 关注公众号:[JAVA宝典] image-20201105171529838 发现等待队列addWaiter方法添加了一个Null null的含义是: 使用null是私有占用资源模式,使用new Node()是 共享模式.(顺带一提,writelock不互斥,就是使用的共享模式) Node还有几个等待状态: /** *Statusfield,takingononlythevalues: *SIGNAL:Thesuccessorofthisnodeis(orwillsoonbe) *blocked(viapark),sothecurrentnodemust *unparkitssuccessorwhenitreleasesor *cancels.Toavoidraces,acquiremethodsmust *firstindicatetheyneedasignal, *thenretrytheatomicacquire,andthen, *onfailure,block. *CANCELLED:Thisnodeiscancelledduetotimeoutorinterrupt. *Nodesneverleavethisstate.Inparticular, *athreadwithcancellednodeneveragainblocks. *CONDITION:Thisnodeiscurrentlyonaconditionqueue. *Itwillnotbeusedasasyncqueuenode *untiltransferred,atwhichtimethestatus *willbesetto0.(Useofthisvalueherehas *nothingtodowiththeotherusesofthe *field,butsimplifiesmechanics.) *PROPAGATE:AreleaseSharedshouldbepropagatedtoother *nodes.Thisisset(forheadnodeonly)in *doReleaseSharedtoensurepropagation *continues,evenifotheroperationshave *sinceintervened. *0:Noneoftheabove * *Thevaluesarearrangednumericallytosimplifyuse. *Non-negativevaluesmeanthatanodedoesn'tneedto *signal.So,mostcodedoesn'tneedtocheckforparticular *values,justforsign. * *Thefieldisinitializedto0fornormalsyncnodes,and *CONDITIONforconditionnodes.ItismodifiedusingCAS *(orwhenpossible,unconditionalvolatilewrites). */ volatileintwaitStatus; 在addWaiter(Node.EXCLUSIVE)处断点: /** *根据给定的模式为当前节点创建一个Node * *@parammodeNode.EXCLUSIVEforexclusive,Node.SHAREDforshared // *@returnthenewnode */ privateNodeaddWaiter(Nodemode){ //线程对应的Node Nodenode=newNode(Thread.currentThread(),mode); //Trythefastpathofenq;backuptofullenqonfailure Nodepred=tail; //尾节点不为空 if(pred!=null){ //当前node的前驱指向尾节点 node.prev=pred; //将当前node设置为新的尾节点 //如果cas操作失败,说明线程竞争 if(compareAndSetTail(pred,node)){ pred.next=node; returnnode; } } //lockfree的方式插入队尾 enq(node);//只有在tail==null时才进入 returnnode; } 先找到等待队列的tail节点pred,如果pred!=null,就把当前线程添加到pred后面进入等待队列,如果不存在tail节点执行enq() privateNodeenq(finalNodenode){ //经典的lockfree算法:循环+CAS for(;;){ Nodet=tail; //尾节点为空 if(t==null){//Mustinitialize //初始化头节点 if(compareAndSetHead(newNode())) tail=head; }else{ node.prev=t; if(compareAndSetTail(t,node)){ t.next=node; returnt; } } } } 这里进行了循环,「如果此时存在了tail就执行同上一步骤的添加队尾操作,如果依然不存在,就把当前线程作为head结点。」 插入节点后,调用acquireQueued()进行阻塞 /** *Acquiresinexclusiveuninterruptiblemodeforthreadalreadyin *queue.Usedbyconditionwaitmethodsaswellasacquire. * *@paramnodethenode *@paramargtheacquireargument *@return{@codetrue}ifinterruptedwhilewaiting */ finalbooleanacquireQueued(finalNodenode,intarg){ booleanfailed=true; try{ booleaninterrupted=false; for(;;){ finalNodep=node.predecessor(); if(p==head&&tryAcquire(arg)){ setHead(node); p.next=null;//helpGC failed=false; returninterrupted; } if(shouldParkAfterFailedAcquire(p,node)&& parkAndCheckInterrupt()) interrupted=true; } }finally{ if(failed) cancelAcquire(node); } } 先获取当前节点的前一节点p,如果p是head的话就再进行一次tryAcquire(arg)操作,如果成功就返回,否则就执行「shouldParkAfterFailedAcquire、parkAndCheckInterrupt来达到阻塞效果;」 unlock 在unlock处打断点 进入了 publicvoidunlock(){ sync.release(1); } image-20201106142501425 继续跟进发现进入release方法,继续查看tryRelease(arg)方法 尝试释放锁有三种实现 我们点ReetrantLock实现方式 源码: protectedfinalbooleantryRelease(intreleases){//最后进入到实际解锁源码中 intc=getState()-releases; if(Thread.currentThread()!=getExclusiveOwnerThread())//判断持有线程和当前执行线程是否是同一个,否则报错 thrownewIllegalMonitorStateException(); booleanfree=false; if(c==0){//判断释放掉releases参数后是否是0如果为0设置当前排他锁的占有线程为Null free=true; setExclusiveOwnerThread(null); } setState(c);//更新state为0 returnfree;//返回解锁是否成功 }

优秀的个人博客,低调大师

ConcurrentHashMap 源码分析

和 HashMap 不同的是,ConcurrentHashMap 采用分段加锁的方式保障线程安全,JDK 1.8 之后,ConcurrentHashMap 的底层数据结构从 1.8 开始跟 HashMap 差不多。 HashTable 也是线程安全的,存储 Key-Value 键值对的数据结构,Key 和 Value 都不能为空,但不推荐使用,因为其所有的方法采用 synchronized 修饰,效率低。 Key 和 Value 都不能为 Null 的原因是:如果 map.get(key) 返回 null,可以认为是 value 的值本来就是 null,也可以认为 map 中不存在 key 的存储数据,因此具有二义性,但 HashMap 在单线程环境,可以通过 map.containsKey(key) 判断,消除而已性。 但在多线程环境中,map.get(key) 和 map.containsKey(key) 是非原子的操作,可能在线程 A 的两个语句运行之间,其他线程 B 运行 map.put(key,value),导致线程 A 无法消除上面的二义性。 参考 https://www.cnblogs.com/thisiswhy/p/12059240.html 下图是 ConcurrentHashMap 的 UML 关系图。 1、底层存储结构 1.1、JDK 1.7 的存储结构,了解即可 在 JDK 1.7 ,ConcurrentHashMap 通过对 Segment 的分段加锁实现线程安全。一个 Segment 里面就是 HashMap 的存储结构,可以扩容。Segment 的数据量初始化以后不可以更改,默认值 16,因此默认支持 16 个线程同时操作 ConcurrentHashMap。 1.2 JDK 1.8 的存储结构 JDK 1.8 之后,存储结构变化比较大,跟 HashMap 类似。红黑树节点小于某个数(默认值 6) 又会转换为链表。 [ ] ConcurrentHashMap的主要成员变量,类似 HashMap,补上注释 2、ConcurrentHashMap 的构造方法 ConcurrentHashMap 的默认构造容量为 16,在初始化的时候并不会初始化 table 数组。同 HashMap 一样,在 put 第一个元素的时候才会 initTable() 初始化数组。 /** Creates a new, empty map with the default initial table size (16). */ public ConcurrentHashMap() { } // 设置初始化大小的构造函数 public ConcurrentHashMap(int initialCapacity) { this(initialCapacity, LOAD_FACTOR, 1); } // 根据传入的 map 初始化 public ConcurrentHashMap(Map<? extends K, ? extends V> m) { this.sizeCtl = DEFAULT_CAPACITY; putAll(m); } // 设置初始容量和加载因子的大小 public ConcurrentHashMap(int initialCapacity, float loadFactor) { this(initialCapacity, loadFactor, 1); } // 初始容量、加载因子、并发级别 public ConcurrentHashMap(int initialCapacity, float loadFactor, int concurrencyLevel) { // 数据校验 if (!(loadFactor > 0.0f) || initialCapacity < 0 || concurrencyLevel <= 0) throw new IllegalArgumentException(); // 如果初始容量小于并发级别 if (initialCapacity < concurrencyLevel) // Use at least as many bins initialCapacity = concurrencyLevel; // as estimated threads // 一些比较 long size = (long)(1.0 + (long)initialCapacity / loadFactor); int cap = (size >= (long)MAXIMUM_CAPACITY) ? MAXIMUM_CAPACITY : tableSizeFor((int)size); this.sizeCtl = cap; } 3、get、put 方法 3.1 get 方法,根据 key 找 value,没有返回 null get 的流程总体和 HashMap 差不多,只不过是通过头结点的 hash 值判断是红黑树还是链表。 static final int MOVED = -1; // 转发节点? TODO 作用? static final int TREEBIN = -2; // 跟节点 static final int RESERVED = -3; // 临时保留的节点? TODO 作用? static final int HASH_BITS = 0x7fffffff; // hash 的扰动函数 spread() 计算用的 // 根据 key 获取 value 值 public V get(Object key) { Node<K,V>[] tab; Node<K,V> e, p; int n, eh; K ek; // 计算 hash 值 int h = spread(key.hashCode()); // 集散所在的 hash 桶 if ((tab = table) != null && (n = tab.length) > 0 && (e = tabAt(tab, (n - 1) & h)) != null) { if ((eh = e.hash) == h) { // 头结点,刚好是要找的节点 if ((ek = e.key) == key || (ek != null && key.equals(ek))) return e.val; } else if (eh < 0) // 头结点 hash 值小于 0,说明正在扩容或者是红黑树,find 查找 return (p = e.find(h, key)) != null ? p.val : null; while ((e = e.next) != null) { // 链表遍历查找 if (e.hash == h && ((ek = e.key) == key || (ek != null && key.equals(ek)))) return e.val; } } return null; } 3.2、put 方法 put 方法的流程跟 HashMap 的流程差不多,不同点在于线程安全,自旋,CAS,synchronized onlyIfAbsent 如果为 true ,如果已经存在了 key,不会替换旧的值。 public V put(K key, V value) { return putVal(key, value, false); } /** Implementation for put and putIfAbsent */ final V putVal(K key, V value, boolean onlyIfAbsent) { // key 和 value 都不能为 null if (key == null || value == null) throw new NullPointerException(); // 计算 hash(key) 的扰动函数 int hash = spread(key.hashCode()); // 离岸边的长度 int binCount = 0; for (Node<K,V>[] tab = table;;) { Node<K,V> f; int n, i, fh; K fk; V fv; // 如果 table 还没有初始化,就初始化 table (自旋+CAS) if (tab == null || (n = tab.length) == 0) tab = initTable(); else if ((f = tabAt(tab, i = (n - 1) & hash)) == null) { // 如果当前 hash 桶为 null,直接放入,CAS 加入,成功了就直接 break if (casTabAt(tab, i, null, new Node<K,V>(hash, key, value))) break; // no lock when adding to empty bin } // TODO : else if ((fh = f.hash) == MOVED) tab = helpTransfer(tab, f); else if (onlyIfAbsent // check first node without acquiring lock && fh == hash && ((fk = f.key) == key || (fk != null && key.equals(fk))) && (fv = f.val) != null) return fv; else { // 旧的值 V oldVal = null; // 加锁 synchronized (f) { if (tabAt(tab, i) == f) { if (fh >= 0) { binCount = 1; for (Node<K,V> e = f;; ++binCount) { K ek; // 如果存在 hash(key) 和 key 对应的节点,直接更改 value 值 if (e.hash == hash && ((ek = e.key) == key || (ek != null && key.equals(ek)))) { oldVal = e.val; if (!onlyIfAbsent) e.val = value; break; } Node<K,V> pred = e; if ((e = e.next) == null) { // 不存在直接放入,因为前面加锁了 pred.next = new Node<K,V>(hash, key, value); break; } } } // 如果是红黑树,红黑树插入 else if (f instanceof TreeBin) { Node<K,V> p; binCount = 2; if ((p = ((TreeBin<K,V>)f).putTreeVal(hash, key, value)) != null) { oldVal = p.val; if (!onlyIfAbsent) p.val = value; } } else if (f instanceof ReservationNode) throw new IllegalStateException("Recursive update"); } } if (binCount != 0) { // 是否要转为红黑树 if (binCount >= TREEIFY_THRESHOLD) treeifyBin(tab, i); // 旧的值 if (oldVal != null) return oldVal; break; } } } addCount(1L, binCount); return null; } 4、TODO ConcurrentHashMap 的扩容方法 ConcurrentHashMap 也是默认扩容 2 倍,扩容的方法 transfer() Node<K,V>[] nt = (Node<K,V>[])new Node<?,?>[n << 1]; 5、总结 ConcurrentHashMap 在 JDK 1.7 和 1.8 变化很大,在 JDK 1.7 中,采用 Segment 分段存储数据,也通过 Segment 分段加锁。 而在 JDK 1.8 中,使用 synchronized 锁定 hash 桶的链表的首节点/红黑树的根节点,只要 hash(key) 不冲突,就不会影响其他线程。
优秀的个人博客,低调大师

ArrayList源码分析

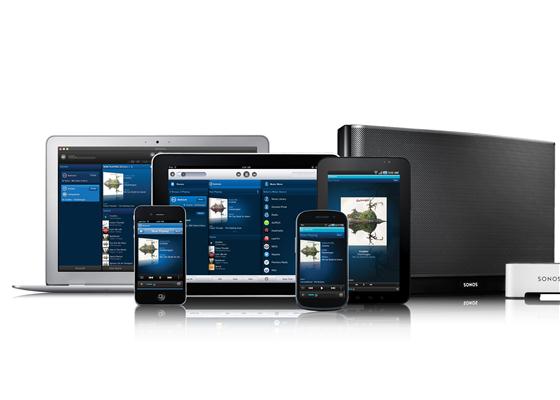
一、核心变量 // 序列化ID private static final long serialVersionUID = 8683452581122892189L; // 默认初始化容量 private static final int DEFAULT_CAPACITY = 10; // 空数组 private static final Object[] EMPTY_ELEMENTDATA = {}; // 空数组 private static final Object[] DEFAULTCAPACITY_EMPTY_ELEMENTDATA = {}; // 存储数据元素的数组 transient Object[] elementData; // non-private to simplify nested class access // 当前arraylist集合的大小,也就是elementData数组中数据元素的个数 private int size; 二、构造函数 /** * 一:无参构造方法 */ public ArrayList() { this.elementData = DEFAULTCAPACITY_EMPTY_ELEMENTDATA; } /** * 二:携带一个int类型的参数,指定arraylist的初始容量 */ public ArrayList(int initialCapacity) { if (initialCapacity > 0) { this.elementData = new Object[initialCapacity]; } else if (initialCapacity == 0) { this.elementData = EMPTY_ELEMENTDATA; } else { throw new IllegalArgumentException("Illegal Capacity: "+ initialCapacity); } } 1、无参构造 可以看到,在构造方法中直接将 elementData 指向 DEFAULTCAPACITY_EMPTY_ELEMENTDATA空数组,这个时候该ArrayList的size为初始值0。 1、有参构造 进行参数校验: 参数大于0,则指定数组长度; 参数等于0,则为空数组; 参数小于0,则抛异常。 三、add方法 /** * 一:直接添加数据元素到arraylist的尾部 */ public boolean add(E e) { //是否扩容、记录modCount ensureCapacityInternal(size + 1); // Increments modCount!! //把值添加到数组尾部 elementData[size++] = e; return true; } ---------------------------------------------------------------------- private void ensureCapacityInternal(int minCapacity) { //minCapacity=size+1; //minCapacity表示如果添加成功后,数组的最小长度 //如果为无参构造 if (elementData == DEFAULTCAPACITY_EMPTY_ELEMENTDATA) { //取默认长度和minCapacity的最大值,即10 minCapacity = Math.max(DEFAULT_CAPACITY, minCapacity); } //是否扩容 ensureExplicitCapacity(minCapacity); } ---------------------------------------------------------------------- private void ensureExplicitCapacity(int minCapacity) { modCount++; // 如果添加后最小长度大于 数组长度 if (minCapacity - elementData.length > 0) //扩容 grow(minCapacity); } ---------------------------------------------------------------------- private void grow(int minCapacity) { //获取数组长度 int oldCapacity = elementData.length; //1.5倍扩容 int newCapacity = oldCapacity + (oldCapacity >> 1); //1.5倍扩容也不够用 if (newCapacity - minCapacity < 0) //扩容后长度=minCapacity newCapacity = minCapacity; //简直最大长度 if (newCapacity - MAX_ARRAY_SIZE > 0) newCapacity = hugeCapacity(minCapacity); // 复制 elementData = Arrays.copyOf(elementData, newCapacity); } 代码中已经有注释了,很清晰。 四、remove方法 /* * 一:根据角标进行remove操作 */ public E remove(int index) { // 1. 对角标越界进行判断 if (index >= size) throw new IndexOutOfBoundsException(outOfBoundsMsg(index)); // 2.modCount自增1 modCount++; // 3.获取到指定下角标位置的数据 E oldValue = (E) elementData[index]; // 4.计算需要移动的元素个数 int numMoved = size - index - 1; if (numMoved > 0) // 5. 指定角标位置后的元素前移一位,效率低 System.arraycopy(elementData, index+1, elementData, index, numMoved); // 6.将size自减1,并将数组末尾置为null,便于垃圾回收 elementData[--size] = null; // clear to let GC do its work // 7.最后将所要删除的数据元素return掉 return oldValue; } /* * 二:根据数据元素进行remove操作 */ public boolean remove(Object o) { if (o == null) { for (int index = 0; index < size; index++) if (elementData[index] == null) { fastRemove(index); return true; } } else { for (int index = 0; index < size; index++) if (o.equals(elementData[index])) { fastRemove(index); return true; } } return false; } ---------------------------------------------------------------------- private void fastRemove(int index) { // 1.modCount的值自增1 modCount++; // 2.计算需要移动的元素个数 int numMoved = size - index - 1; if (numMoved > 0) // 3. 指定角标位置后的元素前移一位 System.arraycopy(elementData, index+1, elementData, index, numMoved); // 4.将size自减1,并将数组末尾置为null,便于垃圾回收 elementData[--size] = null; // clear to let GC do its work } 五、set方法 public void set(E e) { if (lastRet < 0) throw new IllegalStateException(); //检查modCount checkForComodification(); try { ArrayList.this.set(lastRet, e); } catch (IndexOutOfBoundsException ex) { throw new ConcurrentModificationException(); } } ---------------------------------------------------------------------- public E set(int index, E element) { rangeCheck(index); E oldValue = elementData(index); elementData[index] = element; return oldValue; } ---------------------------------------------------------------------- final void checkForComodification() { if (expectedModCount != ArrayList.this.modCount) throw new ConcurrentModificationException(); } 六、get方法 public E get(int index) { rangeCheck(index); checkForComodification(); return ArrayList.this.elementData(offset + index); } ---------------------------------------------------------------------- E elementData(int index) { return (E) elementData[index]; } 七、clear方法 public void clear() { modCount++; // clear to let GC do its work for (int i = 0; i < size; i++) elementData[i] = null; size = 0; } 八、contains方法 public boolean contains(Object o) { return indexOf(o) >= 0; } ---------------------------------------------------------------------- public int indexOf(Object o) { if (o == null) { for (int i = 0; i < size; i++) if (elementData[i]==null) return i; } else { for (int i = 0; i < size; i++) if (o.equals(elementData[i])) return i; } return -1; } 未命名文件.jpg 九、fail-fast机制 ail-fast机制是集合中的一种错误检测机制,我们在操作集合中经常会遇到 java.util.ConcurrentModificationException异常,产生该异常的原因就是fail-fast机制。 实现:如果在迭代期间计数器被修改,那么hasNext或next将抛出concurrentModificationException 缺点:这种检查是没有同步的情况下进行的,因此可能会看到失效的计数值,而迭代器可能并没有意识到已经发生了修改。这是一种设计上的权衡,从而降低了并发修改操作的检测代码对程序性能带来的影响。 十、可能的并发问题 add() EX:a、100个元素,可能最后数组长度不到100。 两个线程并发add,对索引位置5的地方几乎同时赋值,第二个线程会覆盖第一个线程的值,并且size少了1个。 b、假设有两个线程在操作同一个ArrayList,线程一执行step1(容量足够)后被挂起,线程二执行add()方法后,线程一被唤醒,这时线程一因为已经不再判断容量是否足够(已经判断过),执行step2就会出现数组越界 数组容量检测的并发问题 remove 两个线程有可能会想要删除同一个内容,一个线程先完成的时候第二个线程再删,就找不到这个内容了

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册