首页 文章 精选 留言 我的

精选列表

搜索[产业分析],共10000篇文章
优秀的个人博客,低调大师

CAS原理分析

版权声明:本文为博主原创文章,未经博主允许不得转载。 https://blog.csdn.net/qq_34173549/article/details/79917850 一、锁机制 常用的锁机制有两种: 1、悲观锁:假定会发生并发冲突,屏蔽一切可能违反数据完整性的操作。悲观锁的实现,往往依靠底层提供的锁机制;悲观锁会导致其它所有需要锁的线程挂起,等待持有锁的线程释放锁。 2、乐观锁:假设不会发生并发冲突,每次不加锁而是假设没有冲突而去完成某项操作,只在提交操作时检查是否违反数据完整性。如果因为冲突失败就重试,直到成功为止。乐观锁大多是基于数据版本记录机制实现。为数据增加一个版本标识,比如在基于数据库表的版本解决方案中,一般是通过为数据库表增加一个 “version” 字段来实现。读取出数据时,将此版本号一同读出,之后更新时,对此版本号加一。此时,将提交数据的版本数据与数据库表对应记录的当前版本信息进行比对,如果提交的数据版本号大于数据库表当前版本号,则予以更新,否则认为是过期数据。 乐观锁的缺点是不能解决脏读的问题。 在实际生产环境里边,如果并发量不大且不允许脏读,可以使用悲观锁解决并发问题;但如果系统的并发非常大的话,悲观锁定会带来非常大的性能问题,所以我们就要选择乐观锁定的方法. 锁机制存在以下问题: (1)在多线程竞争下,加锁、释放锁会导致比较多的上下文切换和调度延时,引起性能问题。 (2)一个线程持有锁会导致其它所有需要此锁的线程挂起。 (3)如果一个优先级高的线程等待一个优先级低的线程释放锁会导致优先级倒置,引起性能风险。 二、CAS 操作 JDK 5之前Java语言是靠synchronized关键字保证同步的,这是一种独占锁,也是是悲观锁。java.util.concurrent(J.U.C)种提供的atomic包中的类,使用的是乐观锁,用到的机制就是CAS,CAS(Compare and Swap)有3个操作数,内存值V,旧的预期值A,要修改的新值B。当且仅当预期值A和内存值V相同时,将内存值V修改为B,否则什么都不做。 现代的CPU提供了特殊的指令,允许算法执行读-修改-写操作,而无需害怕其他线程同时修改变量,因为如果其他线程修改变量,那么CAS会检测它(并失败),算法可以对该操作重新计算。而 compareAndSet() 就用这些代替了锁定。 以AtomicInteger为例,研究在没有锁的情况下是如何做到数据正确性的。 [java] view plain copy publicclassAtomicIntegerextendsNumberimplementsjava.io.Serializable{ privatevolatileintvalue; publicfinalintget(){ returnvalue; } publicfinalintgetAndIncrement(){ for(;;){ intcurrent=get(); intnext=current+1; if(compareAndSet(current,next)) returncurrent; } } publicfinalbooleancompareAndSet(intexpect,intupdate){ returnunsafe.compareAndSwapInt(this,valueOffset,expect,update); } 字段value需要借助volatile原语,保证线程间的数据是可见的(共享的)。这样在获取变量的值的时候才能直接读取。然后来看看++i是怎么做到的。getAndIncrement采用了CAS操作,每次从内存中读取数据然后将此数据和+1后的结果进行CAS操作,如果成功就返回结果,否则重试直到成功为止。而compareAndSet利用JNI来完成CPU指令的操作。 [java] view plain copy publicfinalbooleancompareAndSet(intexpect,intupdate){ returnunsafe.compareAndSwapInt(this,valueOffset,expect,update); } 整体的过程就是这样子的,利用CPU的CAS指令,同时借助JNI来完成Java的非阻塞算法。其它原子操作都是利用类似的特性完成的。 而整个J.U.C都是建立在CAS之上的,因此对于synchronized阻塞算法,J.U.C在性能上有了很大的提升。 CAS第一个问题是会导致“ABA问题”。aba实际上是乐观锁无法解决脏数据读取的一种体现。CAS算法实现一个重要前提需要取出内存中某时刻的数据,而在下时刻比较并替换,那么在这个时间差类会导致数据的变化。比如说一个线程one从内存位置V中取出A,这时候另一个线程two也从内存中取出A,并且two进行了一些操作变成了B,然后two又将V位置的数据变成A,这时候线程one进行CAS操作发现内存中仍然是A,然后one操作成功。尽管线程one的CAS操作成功,但是不代表这个过程就是没有问题的。如果链表的头在变化了两次后恢复了原值,但是不代表链表就没有变化。因此AtomicStampedReference/AtomicMarkableReference就很有用了。 AtomicMarkableReference 类描述的一个<Object,Boolean>的对,可以原子的修改Object或者Boolean的值,这种数据结构在一些缓存或者状态描述中比较有用。这种结构在单个或者同时修改Object/Boolean的时候能够有效的提高吞吐量。AtomicStampedReference 类维护带有整数“标志”的对象引用,可以用原子方式对其进行更新。对比AtomicMarkableReference 类的<Object,Boolean>,AtomicStampedReference 维护的是一种类似<Object,int>的数据结构,其实就是对对象(引用)的一个并发计数(标记版本戳stamp)。但是与AtomicInteger 不同的是,此数据结构可以携带一个对象引用(Object),并且能够对此对象和计数同时进行原子操作。 [java] view plain copy

优秀的个人博客,低调大师

分析Java AtomicInteger

为了解决多线程访问Integer变量导致结果不正确所设计的一个基于多线程并且支持原子操作的Integer类 AtomicInteger内部有一个变量UnSafe: Unsafe类是一个可以执行不安全、容易犯错的操作的一个特殊类 虽然Unsafe类中所有方法都是public的,但是这个类只能在一些被信任的代码中使用。 Unsafe类可以执行以下几种操作 分配内存,释放内存:在方法allocateMemory,reallocateMemory,freeMemory中,有点类似c中的malloc,free方法 可以定位对象的属性在内存中的位置,可以修改对象的属性值。使用objectFieldOffset方法 挂起和恢复线程,被封装在LockSupport类中供使用 AtomicInteger中用的就是Unsafe的CAS操作 Unsafe中的int类型的CAS操作方法 public final native boolean compareAndSwapInt(Object o, long offset,int expected,int x); 如果我把1这个数字属性更新到2的话,需要这样调用: compareAndSwapInt(this, valueOffset, 1, 2) valueOffset字段表示内存位置,可以在AtomicInteger对象中使用unsafe得到: ` value表示当前的整型值,这个整型变量还是volatile的,保证内存可见 AI内部还封装了一下CAS,定义了一个compareAndSet方法,只需要2个参数 addAndGet方法 内部使用一个死循环,先得到当前的值value,然后再把当前的值加一,加完之后使用cas原子操作让当前值加一处理正确。当然cas原子操作不一定是成功的,所以做了一个死循环,当cas操作成功的时候返回数据。这里由于使用了cas原子操作,所以不会出现多线程处理错误的问题。 比如线程A得到current为1,线程B也得到current为1 线程A的next值为2,进行cas操作并且成功的时候,将value修改成了2 这个时候线程B也得到next值为2,当进行cas操作的时候由于expected值已经是2,而不是1了 所以cas操作会失败,下一次循环的时候得到的current就变成了2 也就不会出现多线程处理问题了 incrementAndGet方法 跟addAndGet方法类似,只不过next值变成了current+1: getAndAdd方法 跟addAndGet方法一样,返回值变成了current: 缺点 虽然AtomicInteger中的cas操作可以实现非阻塞的原子操作,但是会产生ABA问题,

优秀的个人博客,低调大师

GCD源码分析

背景 最近在浏览React Native代码的时候发现有提到Main Queue和Main Thread的区别,很早就有阅读GCD源码的冲动,这回总算找到机会了。 阅读源码之前先给个结论:Main Thread 和 Main Queue是两个不同的东西。 Main Queue IS bound to Main Thread. Main Thread IS NOT bound to Main Queue. 源码剖析 关键点 queue和线程的关系 JUST REMEMBER THIS PNG!! slowpath vs fastpath 可能大家对__builtin_expect比较熟悉,这是编译器可以用来优化执行速度的函数。程序员在写if条件的时候,可能知道比较的值更可能是哪种情况,因此就可以使用fastpath或者slowpath来告诉编译器,让编

优秀的个人博客,低调大师

openstack 源码分析

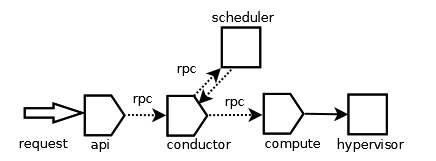
Nova对于底层Hypervisor(如KVM/QEMU等)的调用与管理主要通过LibvirtDriver类,nova/virt/libvirt/driver.py Libvirt对Hypervisor的连接有两种方式:一种是只读式,用于管理;另一种是认证式,用于操作; 创建实例过程:/nova/api/ec2/cloud.py/L1193, run_instances(),获取创建数目,kernal_id,ramdisk_id,镜像uuid等通过self.compute_api.create() 发送实例的信息和要运行实例的请求消息到远程调度器scheduler. 从用户发送请求(创建新实例)的工作流程: 上图是一个全局的流程图,图中每个服务是一个单独的进程实例,他们之间通过rpc调用(广播或者调用)另一个服务。 nova-api服务是一个wsgi服务实例,创建新instance的入口代码是在nova /api/openstack/compute/servers.py,处理函数为create(self, req, body); 参数验证之后,调用compute api的create 函数(代码在nova/compute/api.py中): http://www.infoq.com/cn/articles/openstack-access-request-calling-process eclipse快捷键: 注释:ctrl+/ 跳转函数定义:F3 显示outline:ctrl+o 自己用c++实现c++反射机制;类比java反射机制

优秀的个人博客,低调大师

Shuffle相关分析

Shuffle描述是一个过程,表现出的是多对多的依赖关系。Shuffle是连接map阶段和Reduce阶段的纽带,每个Reduce Task都会从Map Task产生的数据里读取其中的一片数据。Shuffle通常分为两个部分:Map阶段的数据准备和Reduce阶段的数据副本。 Map阶段根据Reduce阶段的Task数量来决定每个Map Task输出的数据分片的个数,这些数据分片可能保存在内存中或者磁盘上,这些分片的存在形式可能是每个分片一个文件,也可能是多个分片放在一个数据文件中,外加一个索引来记录每个分片在数据文件中的偏移量。(RDD中的窄依赖除外,恰好是一对一的) 1、 Shuffle写 Spark中Shuffle输出的ShuffleMapTask会为每个ResultTask创建对应的Bucket,ShuffleMapTask产生的结果会根据设置的partitionner得到对应的BucketId.然后填充到对应的Bucket中去,所以每个ShuffleMapTask创建Bucket的数据是和ResultTask的数目相等的。 ShuffleMapTask创建的Bucket对应磁盘上的一个文件,用于存储结果,此文件也被成为BlockFile.通过spark.shuffle.file.buffer.kb属性配置的缓冲区就是用来创建FastBufferedOutputStream输出流的。如果在配置文件中设置了spark.shuffle.consolidateFiles属性为true,则ShuffleMapTask所产生的Bucket就不一定单独对应一个文件了,而是对应文件的一部分,这样做会大大减少产生的BlockFile文件数量。 2、 Shuffle读 Spark可以通过两种方式读数据,一种是普通的socket方式,另一种是使用Netty框架。Netty方式可以通过配置spark.shuffle.use.netty属性为true启动。Netty框架时,BlockManager会创建ShuffleSender专门用于发送数据,如果ResultTask所需要的数据恰好在本节点,则直接去磁盘上读即可,不再通过网络获取。MapReduce取数据时,即使数据在本地还是要走一遍网络传输。

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册