首页 文章 精选 留言 我的

精选列表

搜索[深度集成],共10000篇文章
优秀的个人博客,低调大师

深度解密Python单例模式

认识单例模式认识单例模式 1 单例模式含义2 单例模式优点3 单例模式缺点4 单例模式应用 Python实现单例模式Python实现单例模式 1 多种实现方法2 实例分析 总结总结 认识单例模式1.1 单例模式含义单例模式,也叫单子模式,是一种常用的软件设计模式。在应用这个模式时,单例对象的类必须保证只有一个实例存在。许多时候整个系统只需要拥有一个的全局对象,这样有利于我们协调系统整体的行为。比如在某个服务器程序中,该服务器的配置信息存放在一个文件中,这些配置数据由一个单例对象统一读取,然后服务进程中的其他对象再通过这个单例对象获取这些配置信息。这种方式简化了在复杂环境下的配置管理。 实现单例模式的思路是:一个类能返回对象一个引用(永远是同一个)和一个获得该实例的方法(必须是静态方法,通常使用getInstance这个名称);当我们调用这个方法时,如果类持有的引用不为空就返回这个引用,如果类保持的引用为空就创建该类的实例并将实例的引用赋予该类保持的引用;同时我们还将该类的构造函数定义为私有方法,这样其他处的代码就无法通过调用该类的构造函数来实例化该类的对象,只有通过该类提供的静态方法来得到该类的唯一实例。 单例模式在多线程的应用场合下必须小心使用。如果当唯一实例尚未创建时,有两个线程同时调用创建方法,那么它们同时没有检测到唯一实例的存在,从而同时各自创建了一个实例,这样就有两个实例被构造出来,从而违反了单例模式中实例唯一的原则。 解决这个问题的办法是为指示类是否已经实例化的变量提供一个互斥锁(虽然这样会降低效率)。 1.2 单例模式优点单例模式的优点:1、由于单例模式要求在全局内只有一个实例,因而可以节省比较多的内存空间;2、全局只有一个接入点,可以更好地进行数据同步控制,避免多重占用;3、单例可长驻内存,减少系统开销。 1.3 单例模式缺点单例模式的缺点1、单例模式的扩展是比较困难的;2、赋于了单例以太多的职责,某种程度上违反单一职责原则(六大原则后面会讲到);3、单例模式是并发协作软件模块中需要最先完成的,因而其不利于测试;4、单例模式在某种情况下会导致“资源瓶颈”。 1.4 单例模式应用单例模式的应用举例:1、生成全局惟一的序列号;2、访问全局复用的惟一资源,如磁盘、总线等;3、单个对象占用的资源过多,如数据库等;4、系统全局统一管理,如Windows下的Task Manager;5、网站计数器。 Python实现单例模式2.1 多种实现方法2.1.1.使用模块其实,Python 的模块就是天然的单例模式,因为模块在第一次导入时,会生成 .pyc 文件,当第二次导入时,就会直接加载 .pyc 文件,而不会再次执行模块代码。因此,我们只需把相关的函数和数据定义在一个模块中,就可以获得一个单例对象了。如果我们真的想要一个单例类,可以考虑这样做: singleton_by_module.py class Singleton(object): def foo(self): pass singleton = Singleton()将上面的代码保存在文件 singleton_by_module.py 中,要使用时,直接在其他文件中导入此文件中的对象,这个对象即是单例模式的对象test_singleton_by_module.py from singleton_by_module import Singleton t = Singleton()这样我们一旦调用到singleton_by_module.py就会产生一个singleton_by_module.pyc,以后我们每次调用都会直接引用这里面的代码。 2.1.2.使用装饰器singleton_by_decorator.py def Singleton(cls): _instance = {} count = 0 def _singleton(*args, **kargs): nonlocal count if cls not in _instance: print(f"count: {count}: {cls.__name__} not init") _instance[cls] = cls(*args, **kargs) else: print(f"count: {count}: {cls.__name__} alreay init") count+=1 return _instance[cls] return _singleton @Singletonclass A(object): a = 1 def __init__(self, x=0): self.x = x a1 = A(2)a2 = A(3) print(f"a1 id: {id(a1)}, a1 value: {a1.x}")print(f"a2 id: {id(a2)}, a2 value: {a2.x}") output count: 0: A not initcount: 1: A alreay inita1 id: 140536039677232, a1 value: 2a2 id: 140536039677232, a2 value: 2根据上面的运行情况,我们可以发现,当a1被创建后调用的是正常的产生实例的过程,当a2被创建的时候,由于之前实例已经被存储下来,所以直接引用了a1的实例,所以他们的id是一样的,也就是他们引用了同一个内存实例。 2.1.3.使用类singleton_by_class.py class Singleton: def __init__(self): pass @classmethod def instance(cls, *args, **kwargs): if not hasattr(Singleton, "_instance"): Singleton._instance = Singleton(*args, **kwargs) return Singleton._instance a1 = Singleton.instance()a2 = Singleton.instance() print(f"a1 id: {id(a1)}")print(f"a2 id: {id(a2)}") output a1 id: 140419818871776a2 id: 140419818871776一般情况,大家以为这样就完成了单例模式,但是这样当使用多线程时会存在问题 singleton_by_class_mutli_threading.py class Singleton(object): def __init__(self): pass @classmethod def instance(cls, *args, **kwargs): if not hasattr(Singleton, "_instance"): Singleton._instance = Singleton(*args, **kwargs) return Singleton._instance import threading def task(arg): obj = Singleton.instance() print(obj) for i in range(10): t = threading.Thread(target=task,args=[i,]) t.start() 程序执行后,打印结果如下: <__main__.Singleton object at 0x02C933D0><__main__.Singleton object at 0x02C933D0><__main__.Singleton object at 0x02C933D0><__main__.Singleton object at 0x02C933D0><__main__.Singleton object at 0x02C933D0><__main__.Singleton object at 0x02C933D0><__main__.Singleton object at 0x02C933D0><__main__.Singleton object at 0x02C933D0><__main__.Singleton object at 0x02C933D0><__main__.Singleton object at 0x02C933D0>看起来也没有问题,那是因为执行速度过快,如果在init方法中有一些IO操作,就会发现问题了,下面我们通过time.sleep模拟 我们在上面init方法中加入以下代码: singleton_by_class_mutli_threading_sleep.py def __init__(self): import time time.sleep(1) 重新执行程序后,结果如下 <__main__.Singleton object at 0x034A3410><__main__.Singleton object at 0x034BB990><__main__.Singleton object at 0x034BB910><__main__.Singleton object at 0x034ADED0><__main__.Singleton object at 0x034E6BD0><__main__.Singleton object at 0x034E6C10><__main__.Singleton object at 0x034E6B90><__main__.Singleton object at 0x034BBA30><__main__.Singleton object at 0x034F6B90><__main__.Singleton object at 0x034E6A90>问题出现了!按照以上方式创建的单例,无法支持多线程 解决办法:加锁!未加锁部分并发执行,加锁部分串行执行,速度降低,但是保证了数据安全 singleton_by_class_mutli_threading_lock.py import timeimport threadingclass Singleton: _instance_lock = threading.Lock() def __init__(self): time.sleep(1) @classmethod def instance(cls, *args, **kwargs): with Singleton._instance_lock: if not hasattr(Singleton, "_instance"): Singleton._instance = Singleton(*args, **kwargs) return Singleton._instance def task(arg): obj = Singleton.instance() print(obj) for i in range(10): t = threading.Thread(target=task,args=[i,]) t.start() time.sleep(20)obj = Singleton.instance()print(obj)打印结果如下: <__main__.Singleton object at 0x02D6B110><__main__.Singleton object at 0x02D6B110><__main__.Singleton object at 0x02D6B110><__main__.Singleton object at 0x02D6B110><__main__.Singleton object at 0x02D6B110><__main__.Singleton object at 0x02D6B110><__main__.Singleton object at 0x02D6B110><__main__.Singleton object at 0x02D6B110><__main__.Singleton object at 0x02D6B110><__main__.Singleton object at 0x02D6B110>这样就差不多了,但是还是有一点小问题,就是当程序执行时,执行了time.sleep(20)后,下面实例化对象时,此时已经是单例模式了,但我们还是加了锁,这样不太好,再进行一些优化,把intance方法,改成下面的这样就行: @classmethod def instance(cls, *args, **kwargs): if not hasattr(Singleton, "_instance"): with Singleton._instance_lock: if not hasattr(Singleton, "_instance"): Singleton._instance = Singleton(*args, **kwargs) return Singleton._instance 这样,一个可以支持多线程的单例模式就完成了 singleton_by_class_mutli_threading_safe.py import timeimport threadingclass Singleton: _instance_lock = threading.Lock() def __init__(self): time.sleep(1) @classmethod def instance(cls, *args, **kwargs): if not hasattr(Singleton, "_instance"): with Singleton._instance_lock: if not hasattr(Singleton, "_instance"): Singleton._instance = Singleton(*args, **kwargs) return Singleton._instance def task(arg): obj = Singleton.instance() print(obj) for i in range(10): t = threading.Thread(target=task,args=[i,]) t.start() time.sleep(20)obj = Singleton.instance()print(obj) 完整代码这种方式实现的单例模式,使用时会有限制,以后实例化必须通过 obj = Singleton.instance() 如果用 obj=Singleton() ,这种方式得到的不是单例 2.1.4基于new方法实现(推荐使用,方便)通过上面例子,我们可以知道,当我们实现单例时,为了保证线程安全需要在内部加入锁 我们知道,当我们实例化一个对象时,是先执行了类的new方法(我们没写时,默认调用type.new),实例化对象;然后再执行类的init方法,对这个对象进行初始化,所有我们可以基于这个,实现单例模式 singleton_by_new.py import threadingclass Singleton: _instance_lock = threading.Lock() def __init__(self): pass def __new__(cls, *args, **kwargs): if not hasattr(Singleton, "_instance"): with Singleton._instance_lock: if not hasattr(Singleton, "_instance"): Singleton._instance = super(Singleton,cls).__new__(cls,*args, **kwargs) return Singleton._instance obj1 = Singleton()obj2 = Singleton()print(obj1,obj2) def task(arg): obj = Singleton() print(obj) for i in range(10): t = threading.Thread(target=task,args=[i,]) t.start() 打印结果如下: <__main__.Singleton object at 0x038B33D0> <__main__.Singleton object at 0x038B33D0><__main__.Singleton object at 0x038B33D0><__main__.Singleton object at 0x038B33D0><__main__.Singleton object at 0x038B33D0><__main__.Singleton object at 0x038B33D0><__main__.Singleton object at 0x038B33D0><__main__.Singleton object at 0x038B33D0><__main__.Singleton object at 0x038B33D0><__main__.Singleton object at 0x038B33D0><__main__.Singleton object at 0x038B33D0><__main__.Singleton object at 0x038B33D0>采用这种方式的单例模式,以后实例化对象时,和平时实例化对象的方法一样 obj = Singleton() 2.1.5.基于metaclass方式实现相关知识 """1.类由type创建,创建类时,type的init方法自动执行,类() 执行type的 call方法(类的new方法,类的init方法)2.对象由类创建,创建对象时,类的init方法自动执行,对象()执行类的 call 方法""" class Foo: def __init__(self): pass def __call__(self, *args, **kwargs): pass obj = Foo() 执行type的 call 方法,调用 Foo类(是type的对象)的 __new__方法,用于创建对象,然后调用 Foo类(是type的对象)的 __init__方法,用于对对象初始化。 obj() # 执行Foo的 call 方法元类的使用metaclass_ex.py class SingletonType(type): def __init__(self,*args,**kwargs): super(SingletonType,self).__init__(*args,**kwargs) def __call__(cls, *args, **kwargs): # 这里的cls,即Foo类 print('cls',cls) obj = cls.__new__(cls,*args, **kwargs) cls.__init__(obj,*args, **kwargs) # Foo.__init__(obj) return obj class Foo(metaclass=SingletonType): # 指定创建Foo的type为SingletonType def __init__(self,name): self.name = name def __new__(cls, *args, **kwargs): return object.__new__(cls) obj = Foo('xx')实现单例模式 singleton_by_metaclass.py import threading class SingletonType(type): _instance_lock = threading.Lock() def __call__(cls, *args, **kwargs): if not hasattr(cls, "_instance"): with SingletonType._instance_lock: if not hasattr(cls, "_instance"): cls._instance = super(SingletonType,cls).__call__(*args, **kwargs) return cls._instance class Foo(metaclass=SingletonType): def __init__(self,name): self.name = name obj1 = Foo('name')obj2 = Foo('name')print(obj1,obj2)2.2 实例分析总线是计算机各种功能部件或者设备之间传送数据、控制信号等信息的公共通信解决方案之一。现假设有如下场景:某中央处理器(CPU)通过某种协议总线与一个信号灯相连,信号灯有64种颜色可以设置,中央处理器上运行着三个线程,都可以对这个信号灯进行控制,并且可以独立设置该信号灯的颜色。抽象掉协议细节(用打印表示),如何实现线程对信号等的控制逻辑。加线程锁进行控制,无疑是最先想到的方法,但各个线程对锁的控制,无疑加大了模块之间的耦合。下面,我们就用设计模式中的单例模式,来解决这个问题。 代码如下: import threadingimport time 这里使用方法__new__来实现单例模式 class Singleton(object):#抽象单例 def __new__(cls, *args, **kw): if not hasattr(cls, '_instance'): orig = super(Singleton, cls) cls._instance = orig.__new__(cls, *args, **kw) return cls._instance 总线 class Bus(Singleton): lock = threading.RLock() def sendData(self,data): self.lock.acquire() time.sleep(3) print "Sending Signal Data...",data self.lock.release() 线程对象,为更加说明单例的含义,这里将Bus对象实例化写在了run里 class VisitEntity(threading.Thread): my_bus="" name="" def getName(self): return self.name def setName(self, name): self.name=name def run(self): self.my_bus=Bus() self.my_bus.sendData(self.name) if __name__=="__main__": for i in range(3): print "Entity %d begin to run..."%i my_entity=VisitEntity() my_entity.setName("Entity_"+str(i)) my_entity.start() 运行结果如下:Entity 0 begin to run...Entity 1 begin to run...Entity 2 begin to run...Sending Signal Data... Entity_0Sending Signal Data... Entity_1Sending Signal Data... Entity_2在程序运行过程中,三个线程同时运行(运行结果的前三行先很快打印出来),而后分别占用总线资源(后三行每隔3秒打印一行)。虽然看上去总线Bus被实例化了三次,但实际上在内存里只有一个实例。 总结因为单例模式在设计模式中算是最基础且最简单的一个模式,因此在一般初级面试的时候,面试官都会通过这个问题来考察,一个很重要的原因是单例模式实现方法多种且优化的方式也有很多,所以也很能考察应聘者的水平,所以,大家要好好学这个最基础的设计模式啊!另外,在Java中单例模式常说的饱汉饿汉模式,其实和Python中的利用__new__和利用class来创建是一样的,也就是在什么时候创建实例的区别。
优秀的个人博客,低调大师

深度剖析Spring Cloud底层原理

毫无疑问,Spring Cloud 是目前微服务架构领域的翘楚,无数的书籍博客都在讲解这个技术。 不过大多数讲解还停留在对 Spring Cloud 功能使用的层面,其底层的很多原理,很多人可能并不知晓。 实际上,Spring Cloud 是一个全家桶式的技术栈,它包含了很多组件。本文先从最核心的几个组件,也就是 Eureka、Ribbon、Feign、Hystrix、Zuul 入手,来剖析其底层的工作原理。 业务场景介绍 先来给大家说一个业务场景,假设咱们现在开发一个电商网站,要实现支付订单的功能。 流程如下: 创建一个订单后,如果用户立刻支付了这个订单,我们需要将订单状态更新为“已支付”。 扣减相应的商品库存。 通知仓储中心,进行发货。 给用户的这次购物增加相应的积分。 针对上述流程,我们需要有订单服务、库存服务、仓储服务、积分服务。 整个流程的大体思路如下: 用户针对一个订单完成支付之后,就会去找订单服务,更新订单状态。 订单服务调用库存服务,完成相应功能。 订单服务调用仓储服务,完成相应功能。 订单服务调用积分服务,完成相应功能。 至此,整个支付订单的业务流程结束。下面这张图,清晰表明了各服务间的调用过程: 好!有了业务场景之后,咱们就一起来看看 Spring Cloud 微服务架构中,这几个组件如何相互协作,各自发挥的作用以及其背后的原理。 Spring Cloud 核心组件:Eureka 咱们来考虑第一个问题:订单服务想要调用库存服务、仓储服务,或者积分服务,怎么调用? 订单服务压根儿就不知道人家库存服务在哪台机器上啊!它就算想要发起一个请求,都不知道发送给谁,有心无力! 这时候,就轮到 Spring Cloud Eureka 出场了。Eureka 是微服务架构中的注册中心,专门负责服务的注册与发现。 咱们来看看下面的这张图,结合图来仔细剖析一下整个流程: 如上图所示,库存服务、仓储服务、积分服务中都有一个 Eureka Client 组件,这个组件专门负责将这个服务的信息注册到 Eureka Server 中。 说白了,就是告诉 Eureka Server,自己在哪台机器上,监听着哪个端口。 而 Eureka Server 是一个注册中心,里面有一个注册表,保存了各服务所在的机器和端口号。 订单服务里也有一个 Eureka Client 组件,这个 Eureka Client 组件会找 Eureka Server 问一下:库存服务在哪台机器啊?监听着哪个端口啊?仓储服务呢?积分服务呢? 然后就可以把这些相关信息从 Eureka Server 的注册表中拉取到自己的本地缓存中来。 这时如果订单服务想要调用库存服务,不就可以找自己本地的 Eureka Client 问一下库存服务在哪台机器?监听哪个端口吗? 收到响应后,紧接着就可以发送一个请求过去,调用库存服务扣减库存的那个接口!同理,如果订单服务要调用仓储服务、积分服务,也是如法炮制。 总结一下: Eureka Client:负责将这个服务的信息注册到 Eureka Server 中。 Eureka Server:注册中心,里面有一个注册表,保存了各个服务所在的机器和端口号。 Spring Cloud 核心组件:Feign 现在订单服务确实知道库存服务、积分服务、仓库服务在哪里了,同时也监听着哪些端口号了。 但是新问题又来了:难道订单服务要自己写一大堆代码,跟其他服务建立网络连接,然后构造一个复杂的请求,接着发送请求过去,最后对返回的响应结果再写一大堆代码来处理吗? 这是上述流程翻译的代码片段,咱们一起来看看,体会一下这种绝望而无助的感受!!! 友情提示,前方高能: 看完上面那一大段代码,有没有感到后背发凉、一身冷汗?实际上你进行服务间调用时,如果每次都手写代码,代码量比上面那段要多至少几倍,所以这个事压根儿就不是地球人能干的。 既然如此,那怎么办呢?别急,Feign 早已为我们提供好了优雅的解决方案。来看看如果用 Feign 的话,你的订单服务调用库存服务的代码会变成啥样? 看完上面的代码什么感觉?是不是感觉整个世界都干净了,又找到了活下去的勇气! 没有底层的建立连接、构造请求、解析响应的代码,直接就是用注解定义一个 Feign Client 接口,然后调用那个接口就可以了。 人家 Feign Client 会在底层根据你的注解,跟你指定的服务建立连接、构造请求、发起请求、获取响应、解析响应,等等。这一系列脏活累活,人家 Feign 全给你干了。 那么问题来了,Feign 是如何做到这么神奇的呢?很简单,Feign 的一个关键机制就是使用了动态代理。 咱们一起来看看上面的图,结合图来分析: 首先,如果你对某个接口定义了 @FeignClient 注解,Feign 就会针对这个接口创建一个动态代理。 接着你要是调用那个接口,本质就是会调用 Feign 创建的动态代理,这是核心中的核心。 Feign的动态代理会根据你在接口上的 @RequestMapping 等注解,来动态构造出你要请求的服务的地址。 最后针对这个地址,发起请求、解析响应。 Spring Cloud 核心组件:Ribbon 说完了 Feign,还没完。现在新的问题又来了,如果人家库存服务部署在了 5 台机器上。 如下所示: 192.168.169:9000 192.168.170:9000 192.168.171:9000 192.168.172:9000 192.168.173:9000 这下麻烦了!人家 Feign 怎么知道该请求哪台机器呢?这时 Spring Cloud Ribbon 就派上用场了。 Ribbon 就是专门解决这个问题的。它的作用是负载均衡,会帮你在每次请求时选择一台机器,均匀的把请求分发到各个机器上。 Ribbon 的负载均衡默认使用的最经典的 Round Robin 轮询算法。这是啥? 简单来说,就是如果订单服务对库存服务发起 10 次请求,那就先让你请求第 1 台机器、然后是第 2 台机器、第 3 台机器、第 4 台机器、第 5 台机器,接着再来—个循环,第 1 台机器、第 2 台机器。。。以此类推。 此外,Ribbon 是和 Feign 以及 Eureka 紧密协作,完成工作的,具体如下: 首先 Ribbon 会从 Eureka Client 里获取到对应的服务注册表,也就知道了所有的服务都部署在了哪些机器上,在监听哪些端口号。 然后 Ribbon 就可以使用默认的 Round Robin 算法,从中选择一台机器。 Feign 就会针对这台机器,构造并发起请求。 对上述整个过程,再来一张图,帮助大家更深刻的理解: Spring Cloud 核心组件:Hystrix 在微服务架构里,一个系统会有很多的服务。以本文的业务场景为例:订单服务在一个业务流程里需要调用三个服务。 现在假设订单服务自己最多只有 100 个线程可以处理请求,然后呢,积分服务不幸的挂了,每次订单服务调用积分服务的时候,都会卡住几秒钟,然后抛出—个超时异常。 咱们一起来分析一下,这样会导致什么问题?如果系统处于高并发的场景下,大量请求涌过来的时候,订单服务的 100 个线程都会卡在请求积分服务这块,导致订单服务没有一个线程可以处理请求。 然后就会导致别人请求订单服务的时候,发现订单服务也挂了,不响应任何请求了。 上面这个,就是微服务架构中恐怖的服务雪崩问题,如下图所示: 如上图,这么多服务互相调用,要是不做任何保护的话,某一个服务挂了,就会引起连锁反应,导致别的服务也挂。 比如积分服务挂了,会导致订单服务的线程全部卡在请求积分服务这里,没有一个线程可以工作,瞬间导致订单服务也挂了,别人请求订单服务全部会卡住,无法响应。 但是我们思考一下,就算积分服务挂了,订单服务也可以不用挂啊!为什么? 我们结合业务来看:支付订单的时候,只要把库存扣减了,然后通知仓库发货就 OK 了。 如果积分服务挂了,大不了等它恢复之后,慢慢人肉手工恢复数据!为啥一定要因为一个积分服务挂了,就直接导致订单服务也挂了呢?不可以接受! 现在问题分析完了,如何解决?这时就轮到 Hystrix 闪亮登场了。Hystrix 是隔离、熔断以及降级的一个框架。啥意思呢? 说白了,Hystrix 会搞很多个小小的线程池,比如订单服务请求库存服务是一个线程池,请求仓储服务是一个线程池,请求积分服务是一个线程池。每个线程池里的线程就仅仅用于请求那个服务。 打个比方:现在很不幸,积分服务挂了,会咋样?当然会导致订单服务里那个用来调用积分服务的线程都卡死不能工作了啊! 但由于订单服务调用库存服务、仓储服务的这两个线程池都是正常工作的,所以这两个服务不会受到任何影响。 这个时候如果别人请求订单服务,订单服务还是可以正常调用库存服务扣减库存,调用仓储服务通知发货。 只不过调用积分服务的时候,每次都会报错。但是如果积分服务都挂了,每次调用都要去卡住几秒钟干啥呢?有意义吗?当然没有! 所以我们直接对积分服务熔断不就得了,比如在 5 分钟内请求积分服务直接就返回了,不要去走网络请求卡住几秒钟,这个过程,就是所谓的熔断! 那人家又说,兄弟,积分服务挂了你就熔断,好歹你干点儿什么啊!别啥都不干就直接返回啊? 没问题,咱们就来个降级:每次调用积分服务,你就在数据库里记录一条消息,说给某某用户增加了多少积分,因为积分服务挂了,导致没增加成功! 这样等积分服务恢复了,你可以根据这些记录手工加一下积分。这个过程,就是所谓的降级。 为帮助大家更直观的理解,接下来用一张图,梳理一下 Hystrix 隔离、熔断和降级的全流程: Spring Cloud 核心组件:Zuul 说完了 Hystrix,接着给大家说说最后一个组件:Zuul,也就是微服务网关。这个组件是负责网络路由的。 不懂网络路由?行,那我给你说说,如果没有 Zuul 的日常工作会怎样? 假设你后台部署了几百个服务,现在有个前端兄弟,人家请求是直接从浏览器那儿发过来的。 打个比方:人家要请求一下库存服务,你难道还让人家记着这服务的名字叫做 inventory-service?部署在 5 台机器上? 就算人家肯记住这一个,你后台可有几百个服务的名称和地址呢?难不成人家请求一个,就得记住一个?你要这样玩儿,那真是友谊的小船,说翻就翻! 上面这种情况,压根儿是不现实的。所以一般微服务架构中都必然会设计一个网关在里面。 像 Android、iOS、PC 前端、微信小程序、H5 等等,不用去关心后端有几百个服务,就知道有一个网关,所有请求都往网关走,网关会根据请求中的一些特征,将请求转发给后端的各个服务。 而且有一个网关之后,还有很多好处,比如可以做统一的降级、限流、认证授权、安全,等等。 如果想免费学习Java工程化、高性能及分布式、深入浅出。微服务、Spring,MyBatis,Netty源码分析的朋友可以加我的Java进阶群:705127209,群里有阿里大牛直播讲解技术,以及Java大型互联网技术的视频免费分享给大家。 总结 最后再来总结一下,上述几个 Spring Cloud 核心组件,在微服务架构中,分别扮演的角色: Eureka:各个服务启动时,Eureka Client 都会将服务注册到 Eureka Server,并且 Eureka Client 还可以反过来从 Eureka Server 拉取注册表,从而知道其他服务在哪里。 Ribbon:服务间发起请求的时候,基于 Ribbon 做负载均衡,从一个服务的多台机器中选择一台。 Feign:基于 Feign 的动态代理机制,根据注解和选择的机器,拼接请求 URL 地址,发起请求。 Hystrix:发起请求是通过 Hystrix 的线程池来走的,不同的服务走不同的线程池,实现了不同服务调用的隔离,避免了服务雪崩的问题。 Zuul:如果前端、移动端要调用后端系统,统一从 Zuul 网关进入,由 Zuul 网关转发请求给对应的服务。 以上就是我们通过一个电商业务场景,阐述了 Spring Cloud 微服务架构几个核心组件的底层原理。 文字总结还不够直观?没问题!我们将 Spring Cloud 的 5 个核心组件通过一张图串联起来,再来直观的感受一下其底层的架构原理: 如果想免费学习Java工程化、高性能及分布式、深入浅出。微服务、Spring,MyBatis,Netty源码分析的朋友可以加我的Java进阶群:705127209,群里有阿里大牛直播讲解技术,以及Java大型互联网技术的视频免费分享给大家。

优秀的个人博客,低调大师

利用深度学习建立流失模型

客户流失分析 失去一个老用户会带来巨大的损失,大概需要公司拉新10个新用户才能予以弥补。如何预测客户即将流失,让公司采取合适的挽回措施,是每个公司都要关注的重点问题。 目标 利用类神经网络构建用户流失分析模型,以预测用户是否有流失的可能。 工具 Jupyter Notebook :一个对于数据分析师来说特别合适的Python编辑器,强烈推荐大家去使用。 Python:在机器学习时代,Python是最受欢迎的机器学习语言。有很多机器学习的库,可以方便高效的去实现机器学习。 主要用到的Python包 pandas:是基于 Numpy 构建的含有更高级数据结构和工具的数据分析包。能很方便的进行各种数据清洗。是每个数据分析师必学的Python包之一。 sklearn:是机器学习中一个常用的第三方包,里面对一些常用那个的机器学习方法进行了封装,使得大家能够更

优秀的个人博客,低调大师

实战深度学习(下)OpenCV库

在上一节中,我们讲到了OpenCV库的安装,现在我们来进行实战,看如何利用Python来调用OpenCV库。 一: 如果您的电脑是win10的系统,那么请您按下win键,再按下空格键,输入Python,进入Python的IDEA shell界面。这个时候您也可以直接进入CMD进行民命令行模式的编辑,因为第一次可我们并不会很多的代码需要您去编辑。在后期您可以使用轻量级的IDEA,比如sublime test3 或者重量级的Pycharm IDEA进行编辑,它们都是现在世界上十分常用的Python编译器,用它们进行编辑,会给你们一种视觉上的清新之感以及灵魂上的愉悦之感呢。 二:如果您的电脑是linux操作系统,这是一个主流的选择。很好,笔者现在还没有为我的linux操作系统配置上Python环境,因此具体方法您可以百度一下。 三:如果您的电脑是苹果电脑,请您赶紧卖了,因为配置太低,系统难用,价格昂贵。完全不适合编写程序搞事情。 四:开始编写代码: 现在我们输入以下代码: import cv2 #表示您引入了opencv库 import numpy as np #表示您引入了用于计算矩阵的库并且将numpy简写为了np 现在,如果您按下F5运行,编译器没有报错的话,那么把您的库文件肯定是安装好的了,嘿嘿 五:读入图片,保存图片: 在opencv库当中,最基本的一步就是读入图片和保存图片了。我们可以在读入和保存图片的时候改变图片的格式,因为里面的库函数对Python的文件读写已经进行了一定的操作。现在我们键入以下代码: # Load an color image in grayscale img = cv2.imread('呵呵.jpg',0) #表示您所读入的图片的名称和路径 cv2.imshow('image',img) #显示图像 cv2.waitKey(0) #等待键盘事件,这和我们的单片机相同 cv2.destroyAllWindows() #意思和上面的英文代码相同 六:保存图片文件: 请输入以下代码: cv2.imwrite('呵呵.png',img) #即可保存以上图片为png格式了,十分方便。 七,笔者已经自己用OpenCV尝试成功进行人脸识别的项目,其结果如下所示:(由于这是在我的公众号上复制的,本人性别男,性格:懒。因此就懒得把图片复制过来了额)

优秀的个人博客,低调大师

【原】iOS触摸事件深度解析

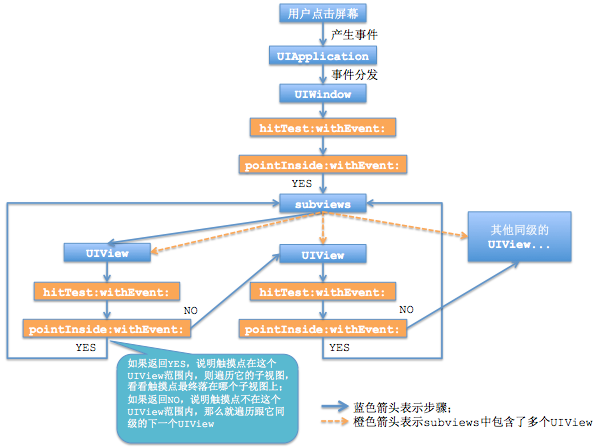
概述 本文主要解析从我们的手指触摸苹果设备到最终响应事件的整个处理机制。本质上讲,整个过程可以分为两个步骤: 步骤1:找目标。在iOS视图层次结构中找到触摸事件的最终接受者; 步骤2:事件响应。基于iOS响应者链(Responder Chain)处理触摸事件 找目标 在找目标阶段所使用到的两大利器是UIView的hitTest:withEvent:以及pointInside:withEvent:方法。找目标的过程也称为hit-Testing。先来看一张图(注: 图来自MJ)比较直观: 下面解释一下处理原理: 1、手指触摸屏幕,这个动作被包装成一个UIEvent对象发送给当前活跃的UIApplication (Active Application),Application将该Event对象插到任务队列的末尾等待处理(先进先出,先来的先处理); 2、UIApplication单例将事件发送给APP的主Window(所有显示的view都添加在Window上); 3、主Window调用视图层次结构上逐级使用hit-Testing确认最终的响应目标,这个目标也称为hitTesting view。 在没有做任何重载操作的前提下,系统默认的hit-Testing的处理机制如下: 当前view调用自身的pointInside: withEvent:方法判断触摸点是否在自己范围内: 若pointInside: withEvent:方法返回NO,则说明触摸点不在自己范围内,则 当前view的hitTest: withEvent:方法返回nil,当前view上的所有subview都不做判断。有点领导的意见一票否决的味道。 若pointInside: withEvent:方法返回YES,则说明触摸点在自己的范围内。但无法判断是否在自己身上还是在subview的身上。此时,遍历所有的subviews,对每个subview调用hitTest方法。这里要注意,遍历的顺序是从当前view的subviews数组的尾部开始遍历。因此离用户最近的上层的subview会优先被调用hitTest方法。 一旦hitTest方法返回非空的view,则被返回的view就是最终相应触摸事件的view,寻找hitTesting view的阶段到此结束,不再遍历。 若当前view的所有subviews的hitTest方法都返回nil,则当前view的hitTest方法返回self作为最终的hitTesting view,处理结束。 以上就是第一阶段寻找响应view的机制。这里我们结合一个具体的例子再过一遍(图片引自技术哥的博客): 当用户点击ViewD所在的区域时会进行以下hit-Testing: ViewA的pointInside返回YES,因为触摸点在其bounds内。遍历ViewA的两个subview; ViewB的pointInside返回NO,因为触摸点不在其bounds内,ViewB的hitTest方法返回nil。而且发生一票否决,在ViewB上的所有subviews受到牵连将不再进行hit-Testing处理。ViewC的pointInside返回YES,因为触摸点在其bounds范围内,ViewC的hitTest方法返回默认处理,也就是return[super hitTest:point withEvent:event];遍历ViewC的两个subview; ViewD的pointInside返回YES,因为触摸点在其bounds范围内,且ViewD没有subview,因此hitTest方法返回其自己。hitTesting view找到,结束处理。 这里有几点需要强调: 1、hitTest方法调用pointInside方法; 2、hit-Testing过程是从superView向subView逐级传递,也就是从层次树的根节点向叶子节点传递; 3、遇到以下设置时,view的pointInside将返回NO,hitTest方法返回nil: view.isHidden=YES; view.alpah<=0.01; view.userInterfaceEnable=NO; control.enable=NO;(UIControl的属性) hit-Testing过程用代码可以描述如下: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 - (UIView *)hitTest:(CGPoint)point withEvent:(UIEvent *)event { if ( self .alpha <= 0.01 || ! self .userInteractionEnabled || self .hidden) { return nil ; } BOOL inside = [ self pointInside:point withEvent:event]; UIView *hitView = nil ; if (inside) { NSEnumerator *enumerator = [ self .subviews reverseObjectEnumerator]; for (UIView *subview in enumerator) { hitView = [subview hitTest:point withEvent:event]; if (hitView) { break ; } } if (!hitView) { hitView = self ; } return hitView; } else { return nil ; } } 事件响应 上一部分我们通过hit-Testing机制找到了hitTesting View,这个hitTesting View就是触摸事件的响应者Responder。在iOS系统中,能够响应并处理事件的对象称之为Responder Object,而UIResponder是所有responder的最顶层基类。当hitTesting view做完自己该做的动作后,可以根据需要将消息传给下一级响应者。那下一级响应者会是什么呢?这取决于iOS中的响应者链Responder Chain,如下图所示: UIView的nextResponder属性,如果有管理此view的UIViewController对象,则为此UIViewController对象;否则nextResponder即为其superview。 UIViewController的nextResponder属性为其管理view的superview. UIWindow的nextResponder属性为UIApplication对象。 UIApplication的nextResponder属性为nil。 更具体的: 如果hit-test view或first responder不处理此事件,则将事件传递给其nextResponder处理,若有UIViewController对象则传递给UIViewController,传递给其superView。 如果view的viewController也不处理事件,则viewController将事件传递给其管理view的superView。 视图层级结构的顶级为UIWindow对象,如果window仍不处理此事件,传递给UIApplication. 若UIApplication对象不处理此事件,则事件被丢弃。 了解响应者链有时候可以帮我解决一些实际问题。我举个例子,我们知道,当提供给你一个ViewController你可以很容易得到它的view,一句代码的事情: 1 viewWanted = someViewController.view; 但如果反过来呢?当给你一个view,让你找到其所在的ViewController呢?这时候响应者链可以帮上忙了,代码如下: 1 2 3 4 5 6 7 8 9 10 11 12 @implementation UIView (FindController) -(UIViewController*)parentController{ UIResponder *responder = [ self nextResponder]; while (responder) { if ([responder isKindOfClass:[UIViewController class ]]) { return (UIViewController*)responder; } responder = [responder nextResponder]; } return nil ; } @end 写在最后 这篇文章解析了iOS响应触摸事件的机制。或许你现在找不到这个知识的应用点,但是一旦你理解了,可以帮助你实现一些特别的需求,比如点击某个按钮,响应的却是另一个按钮;穿透某个view点击到view下面的view... 更有甚者,你可以用上面的知识解决不规则区域触摸问题(看我之前的文章)、不添加任何view就能扩大控件的可触摸区域等。天马行空,任我翱翔! 本文转自编程小翁博客园博客,原文链接:http://www.cnblogs.com/wengzilin/p/4720550.html,如需转载请自行联系原作者

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册