首页 文章 精选 留言 我的

精选列表

搜索[深度集成],共10000篇文章
优秀的个人博客,低调大师

深度推荐模型之Wide & Deep

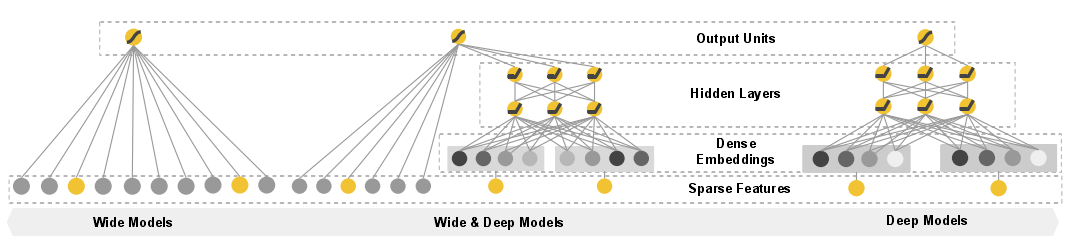
1 背景 在CTR预估任务中, 线性模型仍占有半壁江山。利用手工构造的交叉组合特征来使线性模型具有“记忆性”,使模型记住共现频率较高的特征组合,往往也能达到一个不错的baseline,而且可解释性强。但这种方式有着较为明显的缺点:首先,特征工程需要耗费太多精力。其次,因为模型是强行记住这些组合特征的,所以对于未曾出现过的特征组合,权重系数为0,无法进行泛化。 为了加强模型的泛化能力,研究者引入了DNN结构,将高维稀疏特征编码为低维稠密的Embedding vector,这种基于Embedding的方式减轻了特征工程的负担,而且能够有效提高模型的泛化能力。但是,基于Embedding的方式可能因为数据长尾分布,导致长尾的一些特征值无法被充分学习,其对应的嵌入向量是不准确的,这便会造成模型泛化过度,当基础query-item矩阵稀疏且评分较高时,例如具有特定偏好的用户或具有狭窄吸引力的商品,很难学习有效的query和item的低维表示形式。在这种情况下,大多数query-item对之间不应存在任何交互,但是密集的嵌入向量将导致所有query-item组合的预测都不为零,因此可能泛化过度,做出的推荐的相关性也比较小。 2016年,Google提出Wide&Deep模型,将线性模型与DNN很好的结合起来,在提高模型泛化能力的同时,兼顾模型的记忆性。Wide&Deep这种线性模型与DNN的并行连接模式,后来成为推荐领域的经典模式。 2 模型结构及原理 图中最左边是模型的Wide部分,这个部分可以使用广义线性模型来替代,如LR便是最简单的一种。模型的Deep部分是一个简单的基于Embedding的全连接网络,结构与FNN一致。 2.1 Wide部分 这部分是一个广义线性模型,其中 是 维特征向量,特征集合包括原始输入特征和转换后的特征。最常用的特征转换函数便是特征交叉函数 , 当且仅当 是第 个特征变换的一部分时, 。否则为0。例如,对于一个二值特征,特征交叉函数为 ,当且仅当构成特征中 和时该函数值为1,否则为0,即同时具有这两个特征,那么转换后的新特征才为1。这捕获了二元特征之间的相互作用,并为广义线性模型增加了非线性。 Wide部分只能学习这些模式的权重,做一些筛选,而不能自己发现新的模式,需要根据人工经验、业务背景,来将我们认为有价值的、显而易见的特征及特征组合喂入Wide部分。 2.2 Deep部分 Deep部分是全连接网络: 。输入的特征分为两类:一类是数值特征(可直接输入DNN);一类是类别特征(需要经过Embedding之后才能输入到DNN中)。通过增加模型的层数,使要素发生更深层次的交互,提高模型的泛化能力。 2.3 Wide与Deep的结合 将两部分的输出结合起来联合训练,将Wide和Deep部分的输出使用逻辑回归模型做最终的预测: 。 需要注意的是,因为Wide侧的数据是高维稀疏的,所以作者使用了FTRL算法优化,而Deep侧使用的是Adagrad。 3 思考 适用于Wide部分的特征:高维稀疏特征、人工手动交叉特征;适用于Deep部分的特征:数值类特征、类别特征等 使用L1 FTRL是应对稀疏性一种很好的方法,方法非常注重稀疏性,采用L1 FTRL可以让Wide部分更加稀疏。 Deep部分的输入要么是数值型特征,要么是嵌入向量,不存在严重的稀疏性问题,所以不用特别考虑Deep部分的稀疏性问题。 4 代码实现 模型的实现与模型结构类似由deep和wide两部分组成,这两部分结构所需要的特征在上面已经说过了,针对当前数据集实现,我们在wide部分加入了所有可能的一阶特征,包括数值特征和类别特征的onehot都加进去了,其实也可以加入一些与wide&deep原论文中类似交叉特征。只要能够发现高频、常见模式的特征都可以放在wide侧,对于Deep部分,在本数据中放入了数值特征和类别特征的embedding特征,实际应用也需要根据需求进行选择。 # Wide&Deep 模型的wide部分及Deep部分的特征选择,应该根据实际的业务场景去确定哪些特征应该放在Wide部分,哪些特征应该放在Deep部分 def WideNDeep(linear_feature_columns, dnn_feature_columns): # 构建输入层,即所有特征对应的Input()层,这里使用字典的形式返回,方便后续构建模型 dense_input_dict, sparse_input_dict = build_input_layers(linear_feature_columns + dnn_feature_columns) # 将linear部分的特征中sparse特征筛选出来,后面用来做1维的embedding linear_sparse_feature_columns = list(filter(lambda x: isinstance(x, SparseFeat), linear_feature_columns)) # 构建模型的输入层,模型的输入层不能是字典的形式,应该将字典的形式转换成列表的形式 # 注意:这里实际的输入与Input()层的对应,是通过模型输入时候的字典数据的key与对应name的Input层 input_layers = list(dense_input_dict.values()) + list(sparse_input_dict.values()) # Wide&Deep模型论文中Wide部分使用的特征比较简单,并且得到的特征非常的稀疏,所以使用了FTRL优化Wide部分(这里没有实现FTRL) # 但是是根据他们业务进行选择的,我们这里将所有可能用到的特征都输入到Wide部分,具体的细节可以根据需求进行修改 linear_logits = get_linear_logits(dense_input_dict, sparse_input_dict, linear_sparse_feature_columns) # 构建维度为k的embedding层,这里使用字典的形式返回,方便后面搭建模型 embedding_layers = build_embedding_layers(dnn_feature_columns, sparse_input_dict, is_linear=False) dnn_sparse_feature_columns = list(filter(lambda x: isinstance(x, SparseFeat), dnn_feature_columns)) # 在Wide&Deep模型中,deep部分的输入是将dense特征和embedding特征拼在一起输入到dnn中 dnn_logits = get_dnn_logits(dense_input_dict, sparse_input_dict, dnn_sparse_feature_columns, embedding_layers) # 将linear,dnn的logits相加作为最终的logits output_logits = Add()([linear_logits, dnn_logits]) # 这里的激活函数使用sigmoid output_layer = Activation("sigmoid")(output_logits) model = Model(input_layers, output_layer) return model 参考资料 Cheng H T, Koc L, Harmsen J, et al. Wide & deep learning for recommender systems[C]//Proceedings of the 1st workshop on deep learning for recommender systems. 2016: 7-10. DataWhalehttps://github.com/datawhalechina/team-learning-rs/blob/master/DeepRecommendationModel/Wide%26Deep.md 见微知著,你真的搞懂Google的Wide&Deep模型了吗? 推荐系统系列(六):Wide&Deep理论与实践
优秀的个人博客,低调大师

基于synchronized锁的深度解析

1. 问题引入 小伙伴们都接触过线程,也都会使用线程,今天我们要讲的是线程安全相关的内容,在这之前我们先来看一个简单的代码案例。 代码案例: /** * @url: i-code.online * @author: AnonyStar * @time: 2020/10/14 15:39 */ public class ThreadSafaty { //共享变量 static int count = 0; public static void main(String[] args) { //创建线程 Runnable runnable = () -> { for (int i = 0; i < 5; i++) { count ++; try { Thread.sleep(1); } catch (InterruptedException e) { e.printStackTrace(); } } }; for (int i = 0; i < 100; i++) { new Thread(runnable,"Thread-"+i).start(); } try { Thread.sleep(5000); } catch (InterruptedException e) { e.printStackTrace(); } System.out.println("count = "+ count); } } 执行结果: 问题说明 在上面的代码中我们可以看到,定义了一个线程 runnable 里面对公共成员变量进行 ++ 操作,并循环五次,每次睡眠一毫秒,之后我们在主线程 main 方法中创建一百个线程并且启动,然后主线程睡眠等待五秒以此来等所有的线程执行结束。我们预期结果应该是 500 。但是实际执行后我们发现 count 的值是不固定的 ,是小于 500 的,这里就是多线程并行导致的数据安全性问题! 通过上述案例我们可以清楚的看到线程安全的问题,那么我们想想是否有什么办法来避免这种安全问题尼 ?我们可以想到导致这种安全问题的原因是因为我们访问了共享数据,那么我们是否能将线程访问共享数据的过程变成串行的过程那么不就是不存在这个问题了。这里我们可以想到之前说的**锁** ,我们知道锁是处理并发的一种同步方式,同时他也具备互斥性,在Java中实现加锁是通过 synchronized 关键字 2. 锁的基本认识 2.1 Synchronized 的认识 在Java 中我们知道有一个元老级的关键字 synchronized ,它是实现加锁的关键,但是我们一直都认为它是一个重量级锁,其实早在 jdk1.6 时就对其进行了大量的优化,让它已经变成非常灵活。也不再一直是重量级锁了,而是引入了 **偏向锁 **和 **轻量级锁。 **关于这些内容我们将详细介绍。 synchronized的基础使用 synchronized 修饰实例方法,作用于当前实例加锁 synchronized 修饰静态方法,作用于当前类对象加锁, synchronized 修饰代码块,指定加锁对象,对给定对象加锁, 在上述情况中,我们要进入被 synchronized 修饰的同步代码前,必须获得相应的锁,其实这也体现出来针对不同的修饰类型,代表的是锁的控制粒度 我们修改一下前面我们写的案例,通过使用 synchronized 关键字让其实现线程安全 //创建线程 Runnable runnable = () -> { synchronized (ThreadSafaty.class){ for (int i = 0; i < 5; i++) { count ++; try { Thread.sleep(1); } catch (InterruptedException e) { e.printStackTrace(); } } } }; 只需要添加 synchronized (ThreadSafaty.class) 的修饰,将操作的内容放入代码块中,那么就会实现线程安全 通过上面的实践我们可以直观感受 synchronized 的作用,这是我们平时开发中常规使用,大家有没有过疑问,这个锁到底是怎么存储实现的?那么下面我们将对探索其中的奥秘 Java中锁的实现 我们知道锁是具有互斥性(Mutual Exclusion)的 ,那么它是在什么地方标记存在的尼? 我们也知道多个线程都可以获取锁,那么锁必然是可以共享的 我们最熟悉的 synchronized 它获取锁的过程到底是怎么样的呢?它的锁是如何存储的呢? 我们可以注意观察 synchronized 的语法,可以看到 **synchronized(lock) 是基于 lock 的生命周期来实现控制锁粒度的,**这里一定要理解,我们获得锁时都时一个对象,那么锁是不是会和这个对象有关系呢? 到这里为止,我们将所有的关键信息都指向了对象,那么我们有必要以此为切入点,来首先了解对象在 jvm 中的分布形式,再来看锁是怎么被实现的。 对象的内存布局 这里我们只谈论对象在 Heap 中的布局,而不会涉及过多的关于对象的创建过程等细节,这些内容我们再单独文章详细阐述,可以关注 i-code.online 博客或wx "云栖简码" 在我们最常用的虚拟机 hotspot 中对象在内存中的分布可以分为三个部分:对象头(Header)、实列数据(Instance Data)、对其填充(Padding) 通过上述的图示我们可以看到,对象在内存中,包含三个部分, 其中对象头内分为 对象标记与类元信息,在对象标记中主要包含如图所示 hashcode、GC分代年龄、锁标记状态、偏向锁持有线程id、线程持有的锁(monitor)等六个内容,这部分数据的长度在 32 位和64位的虚拟机中分别为32bit 和 64bit,在官方将这部分称为 Mark Word 。 Mark Word 实际是一中可以动态定义的数据结构,这样可以让极小的空间存储尽量多的数据,根据对象的状态复用自己的内存空间,比如在32位的虚拟机中,如果对象未被同步锁锁定的状态下, Mark Word 的32个比特存储单元中,25个用于存储哈希码,4个用于存储GC分代年龄,2个存锁标记位,1个固定位0,针对各个状态下的分布可以直观的参看下面的图表 32位HotSpot虚拟机对象头Mark Word 锁状态 25bit 4bit 1bit(是否是偏向锁) 2bit(锁标志位) 23bit 2bit 无锁 对象的HashCode 分代年龄 0 01 偏向锁 线程ID Epoch(偏向时间戳) 分代年龄 1 01 轻量级锁 指向栈中锁记录的指针 00 重量级锁 指向重量级锁的指针 10 GC标记 空 11 上述说的是32位虚拟机,需要注意。关于对象头的另一部分是类型指针,这里我们不展开再细说了,想了解的关注 i-code.online ,会持续更新相关内容😁😊 下面内容会涉及到源码的查看,需要提前下载源码,如果你不知道如何来下载,可以参看《下载JDK 与 Hotspot 虚拟机源码》这篇文章,或者关注 云栖简码。 在我们熟悉的虚拟机 Hotspot 中实现 Mark Word 的代码在 markOop.cpp 中,我们可以看下面片段,这是描述了虚拟机中MarkWord 的存储布局: 当我们在 new 一个对象时,虚拟机层面实际会创建一个 instanceOopDesc 对象,我们熟悉的 Hotspot 虚拟机采用了 OOP-Klass 模型来描述 Java 对象实例,其中 OOP 就是我们熟悉的普通对象指针,而 Klass 则是描述对象的具体类型,在Hotspot 中分别用 instanceOopDesc 和 arrayOopDesc 来描述,其中arrayOopDesc 用来描述数组类型, 对于 instanceOopDesc 的实现我们可以从 Hotspot 源码中找到。对应在 instanceOop.hpp 文件中,而相应的 arrayOopDesc 在 arrayOop.hpp 中,下面我们来看一下相关的内容: 我们可以看到 instanceOopDesc 继承了 oopDesc,而 oopDesc 则定义在 oop.hpp 中, 上述图示中我们可以看到相关信息,具体也注释了文字,那么接下来我们要探索一下 _mark 的实现定义了,如下,我们看到它是markOopDesc 通过代码跟进我们可以在找到 markOopDesc 的定义在 markOop.hpp 文件中,如下图所示: 在上述图片中我们可以看到,内部有一个枚举。记录了 markOop 中存储项,所以在我们实际开发时,当 synchronized 将某个对象作为锁时那么之后的一系列锁的信息都和 markOop 相关。如上面表格中 mark word的分布记录所示具体的各个部分的含义 因为我们创建对象时实际在jvm层面都会生成一个native 的c++ 对象 oop/oopdesc 来映射的,而每个对象都带有一个 monitor 的监视器对象,可以在 markOop.hpp 中看到,其实在多线程中抢夺锁就是在争夺 monitor 来修改相应的标记 Synchronized 的深入 在 Java 中 synchronized 是实现互斥同步最基本的方法,它是一个块结构(Block Structured)的同步语法,在经过javac 编译后会在块的前后分别形成 monitorrenter 和 monitorexit 两个字节码指令,而它们又都需要一个 reference 类型的参数来指明锁对象,具体锁对象取决于 synchronized 修饰的内容,上面已经说过不在阐述。 《深入理解Java虚拟机》中有这样的描述: 根据《Java虚拟机规范》的要求,在执行monitorenter指令时,首先要去尝试获取对象的锁。如果 这个对象没被锁定,或者当前线程已经持有了那个对象的锁,就把锁的计数器的值增加一,而在执行 monitorexit指令时会将锁计数器的值减一。一旦计数器的值为零,锁随即就被释放了。如果获取对象 锁失败,那当前线程就应当被阻塞等待,直到请求锁定的对象被持有它的线程释放为止 所以被 synchronized 修饰的代码块对同一个线程是可重入的,这也就避免了同线程反复进入导致死锁的可能 在synchronized 修饰的代码块直接结束释放锁之前,会阻塞后面的其他线程 为什么说synchronized是重量级锁 从执行成本来说,持有锁是一个重量级(Heavy-Weight)的操作过程,因为在Java中线程都是映射到操作系统的原生内核线程上的,如果要阻塞和唤醒某一个线程都需要经过操作系统来调度,而这就不可避免的会进行用户态和内核态的转换,但是这种转换是非常耗费处理器时间的,尤其对于本身业务代码简单的程序,可能在这里耗费的时间比业务代码自身执行的时间还长,所以说synchronized 是一个重量级的操作,不过在 jdk6 后对其做了大量的优化,让它不再显得那么重 锁的优化 在 JDK5 升级到 JDK6 后进行一系列关于锁的改进,通过多种技术手段来优化锁,让 synchronized 不再像以前一样显的很重,这其中涉及到适应性自旋(Adaptive Spinning)、锁消除(Lock Elimination)、锁膨胀(Lock Coarsening)、轻量级锁(LightWeight Locking)、偏向锁(Biased Locking)等,这些都是用来优化和提高多线程访问共享数据的竞争问题。 锁消除 锁消除是虚拟机在即时编译器运行时对一些代码要求同步,但是被检测到不可能存在共享数据竞争的锁进行消除,其中主要的判定依据是基于逃逸分析技术来实现的,关于这块内容不在这里展开,后续相关文章介绍。这里我们简单理解就是,如果一段代码中,在堆上的数据都不会逃逸出去被其他线程访问到,那么就可以把它们当作栈上的数据来对来,认为它们都是线程私有的,从而也就不需要同步加锁了, 关于代码中变量是否逃逸,对虚拟机来说需要通过复杂分析才能得到,但是对我们开发人员来说还是相对直观的,那可能有人会疑惑既然开发人员能清楚还为什么要多余的加锁同步呢?,其实实际上,程序上非常多的同步措施并不是我们开发人员自己加入的,而是 java 内部就有大量的存在,比如下面这个典型的例子,下面展示的是字符串的相加 private String concatString(String s1,String s2,String s3){ return s1 + s2 + s3; } 我们知道String 类是被 final 修饰的不可变类,所以对于字符串的相加都是通过生成新的String 对象来试试先的,因此编译器会对这种操作做优化处理,在JDK5 之前会转换为 StringBuffer 对象的append() 操作,而在JDK5 及其之后则转换为StringBuilder 对象来操作。所以上述代码在jdk5可能会变成如下: private String concatString(String s1,String s2,String s3){ StringBuffer sb = new StringBuffer(); sb.append(s1); sb.append(s2); sb.append(s3); return sb.toString(); } 这时候,就可以看到,对于StringBuffer。append() 方法是一个同步方法,带有同步快,锁对象就是 sb ,这时候虚拟机通过分析发现 sb 的作用域被限制在方法内部,而不可能逃逸出方法外让其他线程访问到,所以这是在经过服务端编译器的即时编译后,这段代码的所有同步措施都会失效而直接执行。 上述代码是为了方便演示而选择了String,实际来说在jdk5之后都是转换为Stringbuilder ,也就不存在这个问题了,但是在jdk中类似这种还是非常多的。 锁粗化 关于锁的粗话其实也是很简单的理解,我们在开发时总是推荐同步代码块要作用范围尽量小,尽量只在共享数据的实际作用域中才进行同步,这样的目的是为了尽可能减少同步的操作,让其他线程能更快的拿到锁 这是多大多数情况,但是总有一些特殊情况,比如在某个系列连续操作的都是对同一个对象反复的加锁和解锁,那么这会导致不必要的性能损耗 也如同上面String 的案例,在连续的append 操作都是零碎的同步块,而且都是同一个锁对象,这时候会将锁的范围扩展,到整个操作序列外部,也就是第一个append 之前到最后一个append 操作之后,将这些全部放入一个同步锁中就可以了,这样就避免了多次的锁获取和释放。 自旋锁 通过之前的了解,我们知道挂起线程和恢复线程都是会涉及到用户态和内核态的转换,而这些都是非常耗时的,这会直接影响虚拟机的并发性能。 在我们平时开发中,如果共享数据的锁定状态只会持续很短的时间,那么为了这很短的时间而去挂起阻塞线程是非常浪费资源的。尤其现在的电脑都基本是多核处理器,所以在这种前提下,我们是是否可以让另一个请求锁对象的线程不去挂起,而是稍微等一下,这个等待并不会放弃CPU 的执行时间。等待观察持有锁的线程是否能很快的释放锁,其实这个等待就好比是一个空的循环,这种技术就是一个所谓的自旋锁 自旋锁在JDK6 中及已经是默认开启的了,在jdk4时就引入了。自旋锁并不是阻塞也代替不了阻塞。 自旋锁对处理器数量有一定的要求,同时它是会占用CPU 时间的,虽然它避免了线程切换的开销,但是这之间时存在平衡关系的,假如锁被占用的时间很短那么自旋就非常有价值,会节省大量的时间开销,但是相反,如果锁占用的时间很长,那么自旋的线程就会白白消耗处理器资源,造成性能的浪费。 所以自旋锁必须有一个限度,也就是它自旋的次数,规定一个自旋次数,如果超过这个次数则不再自旋转而用传统方式挂起线程, 自旋的次数默认时十次。但是我们也可以通过 -XX: PreBlockSpin 参数来自定义设置 自适应自旋锁 在前面我们知道可以自定义自旋次数,但是这个很难有个合理的值,毕竟在程序中怎么样的情况都有,我们不可能通过全局设置一个。所以在JDK6 之后引入了自适应自旋锁,也就是对原有的自旋锁进行了优化 自适应自旋的时间不再是固定的,而是由前一次在同一个锁上的自旋时间及锁的拥有者的状态决定的,如果在同一个锁对象上,自旋等待刚刚成功获得过锁,并且支持有锁的线程正在运行中,那么虚拟机就会任务这次自旋也极有再次获得锁,那么就会允许自旋的持续时间更长 相应的 ,如果对于某个锁,自旋获得锁的次数非常少,那么在之后要获取锁的时候将直接忽略掉自旋的过程进而直接阻塞线程避免浪费处理器资源 轻量级锁 轻量级锁也是 JDK6 时加入的新的锁机制,它的轻量级是相对于通过操作系统互斥量来实现的传统锁而言的,轻量级锁也是一种优化,而不是能替代重量级锁,轻量级锁的涉及初衷就是在没有多线程竞争下减少传统重量级锁使用操作系统互斥量产生的性能消耗。 要想了解轻量级锁我们必须对对象在Heap 中的分布了解,也就是上面说到的内容。 轻量级锁加锁 当代码执行到同步代码块时,如果同步对象没有被锁定也就是锁标志位为01 状态,那么虚拟机首先将在当前线程的栈帧中建立一个名为锁记录Lock Record 的空间 这块锁记录空间用来存储锁对象目前的 Mark Word 的拷贝,官方给其加了个Displaced 的前缀,即 Displaced Mark Word ,如下图所示,这是在CAS 操作之前堆栈与对象的状态 当复制结束后虚拟机会通过CAS 操作尝试把对象的Mark Word 更新为指向Lock Record 的指针,如果更新成功则代表该线程拥有了这个对象的锁,并且将Mark Word 的锁标志位(最后两个比特)转变为 “00”,此时表示对象处于轻量级锁定状态,此时的堆栈与对象头的状态如下: 如果上述操作失败了,那说明至少存在一条线程与当前线程竞争获取该对象的锁,虚拟机会首先检查对象的Mark Word 是否指向当前线程的栈帧,如果是,则说明当前线程已经拥有了这个对象的锁,那么直接进入同步代码块执行即可。否则则说明这个对象已经被其他线程抢占了。 如果有超过两条以上的线程争夺同一个锁的情况,那么轻量级锁就不再有效,必须膨胀为重量级锁,锁的标记位也变为“10”,此时Mark Word 中存储的就是指向重量级锁的指针,等待的线程也必须进入阻塞状态 轻量级锁的解锁 轻量级锁的解锁同样是通过CAS 操作来进行的 如果对象的 Mark Word 仍然指向线程的锁记录,那么就用CAS 操作把对象当前的 Mark Word 和线程中复制的 Displaced Mark Word 替换回来 如果替换成功则整个同步过程结束,若失败则说明有其他线程正在尝试获取该锁,那就要在释放锁的同时,唤醒被挂起的线程 轻量级锁适用的场景是对于绝大部分锁在整个同步周期内都是不存在竞争的,因为如果没有竞争,轻量级锁便可以通过CAS 操作成功避免了使用互斥量的开销,但是如果确实存在锁竞争,那么除了互斥量本身的开销外还得额外发生了CAS 操作的开销,这种情况下反而比重量级锁更慢 下面通过完整的流程图来直观看一下轻量级锁的加锁解锁及膨胀过程 偏向锁 偏向锁也是JDK6 引入的一种锁优化技术,如果说轻量级锁是在无竞争情况下通过CAS 操作消除了同步使用的互斥量,那么偏向锁则是再无竞争情况下把整个同步都给消除掉了,连CAS 操作都不再去做了,可以看出这比轻量级锁更加轻 从对象头的分布上看,偏向锁中是没有哈希值的而是多了线程ID与Epoch 两个内容 偏向锁的意思就是锁会偏向第一个获得它的线程,如果接下来的执行过程中该锁一直没有被其他线程获取,那么只有偏向锁的线程将永远不需要再进行同步 偏向锁的获取和撤销 当代码执行到同步代码块时,在第一次被线程执行到时,锁对象是第一次被线程获取,此时虚拟机会将对象头中的锁标志改为“01”,同时把偏向锁标志位改为“1”,表示当前锁对象进入偏向锁模式。 接下来线程通过CAS 操作来将这个帧的线程ID记录到对象头中,如果CAS 成功了。则持有锁对象的线程再之后进入同步代码不再进行任何同步操作(如获取锁解锁等操作)。每次都会通过判断当前线程与锁对象中记录的线程id是否一致。 如果 上述的 CAS 操作失败了,那说明肯定存在另外一个线程在获取这个锁,并且获取成功了。这种情况下说明存在锁竞争,则偏向模式马上结束,偏向锁的撤销,需要等待全局安全点(在这个时间点上没有正在执行的字节码)。它会首先暂停拥有偏向锁的线程,会根据锁对象是否处于锁定状态来决定是否撤销偏向也就是将偏向锁标志位改为“0”,如果撤销则会变为未锁定(“01”)或者轻量级锁(“00”) 如果锁对象未锁定,则撤销偏向锁(设置偏向锁标志位为“0”),此时锁处于未锁定不可以偏向状态,因为具有哈希值,进而变为轻量级锁 如果锁对象还在锁定状态则直接进入轻量级锁状态 偏向锁的开关 偏向锁在JDK6 及其之后是默认启用的。由于偏向锁适用于无锁竞争的场景,如果我们应用程序里所有的锁通常情况下处于竞争状态,可以通过JVM参数关闭偏向锁:-XX:-UseBiasedLocking=false,那么程序默认会进入轻量级锁状态。 如果要开启偏向锁可以用: -XX:+UseBiasedLocking -XX:BiasedLockingStartupDelay=0 重量级锁 重量级锁也就是上述几种优化都无效后,膨胀为重量级锁,通过互斥量来实现,我们先来看下面的代码 上面代码是一个简单使用了synchronized 的代码,我们通过字节码工具可以看到右侧窗口。我们发现,在同步代码块的前后分别形成了monitorenter 和 monitorexit 两条指令 在Java对现中都会有一个monitor 的监视器,这里的monitorenter 指令就是去获取一个对象的监视器。而相应的monitorexit 则表示释放监视器monitor 的所有权,允许被其他线程来获取 monitor 是依赖于系统的 MutexLock (互斥锁) 来实现的,当线程阻塞后进入内核态事,就会造成系统在用户态和内核态之间的切换,进而影响性能 总结 上面是阐述了关于synchronized 锁的一些优化与转换,在我们开启偏向锁和自旋时,锁的转变是 无锁 -> 偏向锁 -> 轻量级锁 -> 重量级锁, 自旋锁实际是一种锁的竞争机制,而不是一种状态。在偏向锁和轻量级锁中都使用到了自旋 偏向锁适用于无锁竞争的场景,轻量级锁适合无多个线程竞争的场景 偏向锁和轻量级锁都依赖与CAS操作,但是偏向锁中只有在第一次时才会CAS操作 当一个对象已经被计算过一致性哈希值时,那么这个对象就再也不无法进入到偏向锁状态了,如果对象正处于偏向锁状态,而接收到计算哈希值的请求,那么他的偏向锁状态会被立即撤销,并且会膨胀为重量级锁。这要是为什么偏向锁状态时MarkWord 中没有哈希值 本文由 AnonyStar 发布,可转载但需声明原文出处。 欢迎关注微信公账号 :云栖简码 获取更多优质文章 更多文章关注笔者博客 :云栖简码 i-code.online

优秀的个人博客,低调大师

再谈测试浮躁论——深度好文!

目前来说软件测试人员都有这么些问题吧,这大概已经成为中国目前测试的瓶颈了。人心浮躁大概不是某些职业人特有的,其实是我们这些年轻人的通病了。但身为测试人员,当你在应聘找工作的时候是否发现过自己的不足呢?浮躁的测试人还是占大多数。 一、根基不牢 问题:利用等价类划分的方法,对某问题设计测试用例。 分析:98%以上的应聘者只知道按照有效等价类和无效等价类进行划分,殊不知此种分类方法只是等价类划分的一个典型应用而已,等价类划分远非只能划分为有效和无效两类。根据种种划分依据,还可以进一步划分很多其他类别。 问题:根据事件描述,画出对应的因果图。 分析:标准答案中只画了两条恒等,两条非,一个与,一个或。如此简单的问题,上百名应聘者中竟然无一人答对,痛心啊。黑盒测试方法就那么几种,既然你已知这个名,怎么就不知道多看几眼。 小结: 上面提到的是软件测试的最基本的方法,作为从业测试实际工作已经有1-2年的应聘人员,未能真正领悟,实属不应该,心浮气躁,忽视了你身边最简单,也是最厉害的技能。根基不牢,怎么可能把测试做深。 二、专业不精 问题:音视频文件都有哪些格式,这些格式之间有什么差别? 分析:此问题是问那些做过多媒体方面测试的,但是我们的应聘者向来都是拿来主义,别人给我什么媒体文件我就用什么做测试,而根本不管不问。为什么 MIDI文件比WAV文件小那么多?我们如何知道扩展名是.Mpeg的文件是Mpeg1格式的还是Mpeg2格式的?,面对这些问题,应聘者默默无语,只是无奈的笑笑。不去看别人,想想自己测试涉及的专业,是否把那个行业知识搞清楚了呢? 问题:测试脚本运行不畅如何调试? 分析:此问题是问那些标明自己熟练掌握WinRunner、Robot、QTP等测试工具的应聘人员,但是当真正问到他们关于脚本的具体调试时,有7成以上人员表示他们只是参加测试培训时老师讲过,或者自己在网上看过相关资料,另外有2成以上人员表示他们虽然用过,但是只是简单的录制回放,根本不会自己调试。可能是迫于无奈吧,简历里面什么都不写,可能面试的机会都没有,但是简历如此夸大的来写,终归是浪费自己的面试时间和路费。 小结: 从事测试仅1-2年时间,要想测试也精通,专业也精通确实不易,但是不说精通,至少也该知道个60%才对的起你的测试工作。一两年时光如此荒废,静下心来反思一下,身边还有哪些技能我们应该掌握扎实一点呢。(1079636098)推荐软件测试学习技术交流群 三、无测试体系概念,忽视理论 问题:请说出软件测试的定义,BUG的定义。 分析:99%的人不能说出这两个测试名词的定义,只是在给我解释测试是为了发现bug之类的片面理解,残留的几个人也说得不够准确。这两个词目前尚不能说业内已经有了成熟统一的定义,但是无论是对是错,身为测试人员已经数年,自己竟然说不出这两个词的概念,多少也说不过去啊。有些人和我说,理论名词概念不重要,我会做测试就是了。想想金庸老先生早就告诉我们,武功仅有招式是不够的,必须配合上什么心法口诀才能行。你只会测试执行的招式,却不懂测试理论的心法,怎么能够修炼成上乘的软件测试呢? 问题:请介绍一下你们的测试流程,流程和过程有什么不同,为什么好的测试需要好的流程? 分析:但凡做过1、2年测试的人都能给我说出他们先做什么后做什么,但是当我继续问这是否可以叫做过程?流程和过程有什么差别,应聘者一棒子被打晕,继续追问为什么好的测试需要好的流程的时候,早已经找不到东南西北了。每天公司各项制度叫你做什么你就做什么,让你怎么做你就怎么做,完全不管不顾为什么,那么自己岂不成了没头脑的工具。这样你能干的工作别人也能做,自己的优势不就没有了吗。 小结: 目前测试业内流传着学院派和实践派的说法,学院派的理论给人的感觉往往是好听但不实用,而实践派的知识,往往能够立即见效。所以眼下测试培训往往实践派的更受欢迎。继续引用金庸先生的观点,练武分练内气宗,练外剑宗,但是真正的高手是内外兼修。如果我们不想只做普通的测试小弟子的话,就要理论实践并重,方能有所作为。 四、周边知识知之甚少 问题:能给我介绍一下软件工程中的瀑布模型吗? 分析:又是8成应聘者不会回答,都是曾在遥远的学生时代有所耳闻,现今早已忘得一干二净了。软件测试因何而生——软件危机,软件危机导致软件工程的兴起,软件工程中又包含软件测试,就好像鱼儿活在水里,如果没有软件工程这个水,哪里能够养活这软件测试的鱼,如果我们对于身边的软件工程不够了解,怎么可能在里面自由的畅游呢。 问题:用你最熟悉的开发语言实现sum=1+2+3+。。。+100 分析:保守统计7成以上的应聘者写出来的程序无法执行或者运行结果错误,更少有人能够一气呵成,而且精准。这道编程题难吗?肯定不难,那么为何答错,自己没有真正写过程序,即使写过几行,也早就是如烟往事了。做测试一定需要懂开发吗?这个问题讨论以久,当然不一定,但是如果要做好测试,做深测试,分析问题原因,提出问题解决方案,编写测试脚本或工具,哪一个又能离开软件开发呢? 小结: 我们学习测试也应该有个先后顺序,有步骤。掌握周边知识的紧迫程度可能不如测试知识和行业知识。但是对于我们已经从业1-2年的测试人员来说,学校里面学到的知识不应该丢,之后的发展中,周边知识的学习也应该开始了。周边知识的范畴其实很广,还包括各种其他测试理念的学习,机械工业出版社翻译的那套测试丛书就很不错,观点众多而新颖,博众家之长,集大成,向来都是大家风范。 五、缺乏必要的责任心、细心、耐心、虚心等 问题:请数出下图中三角形的个数(平面图,有几根弧线做干扰) 分析:我总是问自己,这道题真有这么难吗?连中小学生都能数对的十几个三角形,到了我们这二十几岁的年轻人手中,正确率才1%,为什么?其实就是现在我们已经很少有人能够静下心来,耐心细致的去做事情了。很多应聘者告诉我她的优点就是踏实,坐的住,正适合这繁琐的测试工作”。我需要的不是坐在那里不做事或者做错事的人,而是需要能够按时保质量完成测试工作的测试人员。 问题:你离职的原因? 分析:这是面试中最常见的问题了。应聘者往往也是充分准备,理由多种多样,但是看看应聘者的工作记录统计,70%应聘者平均跳槽频率是1年/次(实习情况除外),不会都那么凑巧吧,赶上什么公司倒闭,每隔一年就会想一次自己学不到东西,需要去外面看看。而在我看来,真正的原因更多的应该是希望通过跳槽提高工资,或者因为自身水平不足被公司炒鱿鱼吧。 小结: 我并不认为所有的人都适合做测试。非技术素质方面,这点或者那点不足够优秀也很正常,心浮气躁也可以理解。但是作为用人单位,理解归理解,却也不会用不胜任岗位,或性价比不高的人员。那么对于此类应聘者,我的忠告就是,要么你另谋高就,要么你就放低姿态,培养好你必备的素质后再谈。 六、缺乏诚信 这一点本应该被归在上一条素质中,但是这点的重要性我认为远超过了上一条所列各项,因此单独提出。相关表现主要体现在:1、虚报自己历史工薪;2、笔试题目作弊;3、编造离职原因;4、虚报学历,工作经验;5、夸大自己工作技能等。对于严重缺乏诚信的,一旦发现,其他表现再好,也无济于事了。 另外其实还有个大家都爱犯的通病,不知道如何问问题,言之无物,有的时候自己都不知道想问什么,但却心里总觉得自己是好学的是在请教,殊不知你并没有真正的在做事情,你并没有搞清楚事物的根本。 想学好一个东西,首要的就是要学好如何问问题。 最近在繁忙而复杂的找工作过程中,遇到问题无数,今日阅读若干文章感触颇深。自己的成败荣辱仿佛一瞬间集中在眼前。自己审视自己,真的,我还差的很多。 最后: 欢迎大家关注公众号:程序员一凡,获取软件测试技术进阶、大厂面试资料。

优秀的个人博客,低调大师

Android GC原理探究(深度好文)

相信大家都遇到过手机图片滑动卡顿问题,由于不断的GC导致的丢帧卡顿的问题让我们想了很多方案去解决,所以就打算详细的看看内存分配和GC的原理,为什么会不断的GC,GC ALLOC和GC COCURRENT有什么区别,能不能想办法扩大堆内存减少GC的频次等等。 1、JVM内存回收机制 1.1 回收算法 标记回收算法(Mark and Sweep GC) 从"GC Roots"集合开始,将内存整个遍历一次,保留所有可以被GC Roots直接或间接引用到的对象,而剩下的对象都当作垃圾对待并回收,这个算法需要中断进程内其它组件的执行并且可能产生内存碎片 复制算法 (Copying) 将现有的内存空间分为两快,每次只使用其中一块,在垃圾回收时将正在使用的内存中的存活对象复制到未被使用的内存块中,之后,清除正在使用的内存块中的所有对象,交换两个内存的角色,完成垃圾回收。 标记-压缩算法 (Mark-Compact) 先需要从根节点开始对所有可达对象做一次标记,但之后,它并不简单地清理未标记的对象,而是将所有的存活对象压缩到内存的一端。之后,清理边界外所有的空间。这种方法既避免了碎片的产生,又不需要两块相同的内存空间,因此,其性价比比较高。 分代 将所有的新建对象都放入称为年轻代的内存区域,年轻代的特点是对象会很快回收,因此,在年轻代就选择效率较高的复制算法。当一个对象经过几次回收后依然存活,对象就会被放入称为老生代的内存空间。对于新生代适用于复制算法,而对于老年代则采取标记-压缩算法。 1.2 复制和标记-压缩算法的区别 乍一看这两个算法似乎并没有多大的区别,都是标记了然后挪到另外的内存地址进行回收,那为什么不同的分代要使用不同的回收算法呢? 其实2者最大的区别在于前者是用空间换时间后者则是用时间换空间。 前者的在工作的时候是不没有独立的“mark”与“copy”阶段的,而是合在一起做一个动作,就叫scavenge(或evacuate,或者就叫copy)。也就是说,每发现一个这次收集中尚未访问过的活对象就直接copy到新地方,同时设置forwarding pointer。这样的工作方式就需要多一份空间。 后者在工作的时候则需要分别的mark与compact阶段,mark阶段用来发现并标记所有活的对象,然后compact阶段才移动对象来达到compact的目的。如果compact方式是sliding compaction,则在mark之后就可以按顺序一个个对象“滑动”到空间的某一侧。因为已经先遍历了整个空间里的对象图,知道所有的活对象了,所以移动的时候就可以在同一个空间内而不需要多一份空间。 所以新生代的回收会更快一点,老年代的回收则会需要更长时间,同时压缩阶段是会暂停应用的,所以给我们应该尽量避免对象出现在老年代。 2、Dalvik虚拟机 2.1 java堆 Java堆实际上是由一个Active堆和一个Zygote堆组成的,其中,Zygote堆用来管理Zygote进程在启动过程中预加载和创建的各种对象,而Active堆是在Zygote进程fork第一个子进程之前创建的。以后启动的所有应用程序进程是被Zygote进程fork出来的,并都持有一个自己的Dalvik虚拟机。在创建应用程序的过程中,Dalvik虚拟机采用COW策略复制Zygote进程的地址空间。 COW策略:一开始的时候(未复制Zygote进程的地址空间的时候),应用程序进程和Zygote进程共享了同一个用来分配对象的堆。当Zygote进程或者应用程序进程对该堆进行写操作时,内核就会执行真正的拷贝操作,使得Zygote进程和应用程序进程分别拥有自己的一份拷贝,这就是所谓的COW。因为copy是十分耗时的,所以必须尽量避免copy或者尽量少的copy。 为了实现这个目的,当创建第一个应用程序进程时,会将已经使用了的那部分堆内存划分为一部分,还没有使用的堆内存划分为另外一部分。前者就称为Zygote堆,后者就称为Active堆。这样只需把zygote堆中的内容复制给应用程序进程就可以了。以后无论是Zygote进程,还是应用程序进程,当它们需要分配对象的时候,都在Active堆上进行。这样就可以使得Zygote堆尽可能少地被执行写操作,因而就可以减少执行写时拷贝的操作。在Zygote堆里面分配的对象其实主要就是Zygote进程在启动过程中预加载的类、资源和对象了。这意味着这些预加载的类、资源和对象可以在Zygote进程和应用程序进程中做到长期共享。这样既能减少拷贝操作,还能减少对内存的需求。 2.2 和GC有关的一些指标 记得我们之前在优化魅族某手机的gc卡顿问题时,发现他很容易触发GC_FOR_MALLOC,这个GC类别后续会说到,是分配对象内存不足时导致的。可是我们又设置了很大的堆Size为什么还会内存不够呢,这里需要了解以下几个概念:分别是Java堆的起始大小(Starting Size)、最大值(Maximum Size)和增长上限值(Growth Limit)。 在启动Dalvik虚拟机的时候,我们可以分别通过-Xms、-Xmx和-XX:HeapGrowthLimit三个选项来指定上述三个值,以上三个值分别表示表示 Starting Size : Dalvik虚拟机启动的时候,会先分配一块初始的堆内存给虚拟机使用。 Growth Limit:是系统给每一个程序的最大堆上限,超过这个上限,程序就会OOM Maximum Size:不受控情况下的最大堆内存大小,起始就是我们在用largeheap属性的时候,可以从系统获取的最大堆大小 同时除了上面的这个三个指标外,还有几个指标也是值得我们关注的,那就是堆最小空闲值(Min Free)、堆最大空闲值(Max Free)和堆目标利用率(Target Utilization)。假设在某一次GC之后,存活对象占用内存的大小为LiveSize,那么这时候堆的理想大小应该为(LiveSize / U)。但是(LiveSize / U)必须大于等于(LiveSize + MinFree)并且小于等于(LiveSize + MaxFree),每次GC后垃圾回收器都会尽量让堆的利用率往目标利用率靠拢。所以当我们尝试手动去生成一些几百K的对象,试图去扩大可用堆大小的时候,反而会导致频繁的GC,因为这些对象的分配会导致GC,而GC后会让堆内存回到合适的比例,而我们使用的局部变量很快会被回收理论上存活对象还是那么多,我们的堆大小也会缩减回来无法达到扩充的目的。 与此同时这也是产生CONCURRENT GC的一个因素,后文我们会详细讲到。 2.3 GC的类型 GC_FOR_MALLOC: 表示是在堆上分配对象时内存不足触发的GC。 GC_CONCURRENT: 当我们应用程序的堆内存达到一定量,或者可以理解为快要满的时候,系统会自动触发GC操作来释放内存。 GC_EXPLICIT: 表示是应用程序调用System.gc、VMRuntime.gc接口或者收到SIGUSR1信号时触发的GC。 GC_BEFORE_OOM: 表示是在准备抛OOM异常之前进行的最后努力而触发的GC。 实际上,GC_FOR_MALLOC、GC_CONCURRENT和GC_BEFORE_OOM三种类型的GC都是在分配对象的过程触发的。而并发和非并发GC的区别主要在于前者在GC过程中,有条件地挂起和唤醒非GC线程,而后者在执行GC的过程中,一直都是挂起非GC线程的。并行GC通过有条件地挂起和唤醒非GC线程,就可以使得应用程序获得更好的响应性。但是同时并行GC需要多执行一次标记根集对象以及递归标记那些在GC过程被访问了的对象的操作,所以也需要花费更多的CPU资源。后文在Art的并发和非并发GC中我们也会着重说明下这两者的区别。 2.4 对象的分配和GC触发时机 1. 调用函数dvmHeapSourceAlloc在Java堆上分配指定大小的内存。如果分配成功,那么就将分配得到的地址直接返回给调用者了。函数dvmHeapSourceAlloc在不改变Java堆当前大小的前提下进行内存分配,这是属于轻量级的内存分配动作。 2. 如果上一步内存分配失败,这时候就需要执行一次GC了。不过如果GC线程已经在运行中,即gDvm.gcHeap->gcRunning的值等于true,那么就直接调用函数dvmWaitForConcurrentGcToComplete等到GC执行完成就是了。否则的话,就需要调用函数gcForMalloc来执行一次GC了,参数false表示不要回收软引用对象引用的对象。 3. GC执行完毕后,再次调用函数dvmHeapSourceAlloc尝试轻量级的内存分配操作。如果分配成功,那么就将分配得到的地址直接返回给调用者了。 4. 如果上一步内存分配失败,这时候就得考虑先将Java堆的当前大小设置为Dalvik虚拟机启动时指定的Java堆最大值,再进行内存分配了。这是通过调用函数dvmHeapSourceAllocAndGrow来实现的。 5. 如果调用函数dvmHeapSourceAllocAndGrow分配内存成功,则直接将分配得到的地址直接返回给调用者了。 6. 如果上一步内存分配还是失败,这时候就得出狠招了。再次调用函数gcForMalloc来执行GC。参数true表示要回收软引用对象引用的对象。 7. GC执行完毕,再次调用函数dvmHeapSourceAllocAndGrow进行内存分配。这是最后一次努力了,成功与事都到此为止。 示例图如下: 通过这个流程可以看到,在对象的分配中会导致GC,第一次分配对象失败我们会触发GC但是不回收Soft的引用,如果再次分配还是失败我们就会将Soft的内存也给回收,前者触发的GC是GC_FOR_MALLOC类型的GC,后者是GC_BEFORE_OOM类型的GC。而当内存分配成功后,我们会判断当前的内存占用是否是达到了GC_CONCURRENT的阀值,如果达到了那么又会触发GC_CONCURRENT。 那么这个阀值又是如何来的呢,上面我们说到的一个目标利用率,GC后我们会记录一个目标值,这个值理论上需要再上述的范围之内,如果不在我们会选取边界值做为目标值。虚拟机会记录这个目标值,当做当前允许总的可以分配到的内存。同时根据目标值减去固定值(200~500K),当做触发GC_CONCURRENT事件的阈值。 2.5 回收算法和内存碎片 主流的大部分Davik采取的都是标注与清理(Mark and Sweep)回收算法,也有实现了拷贝GC的,这一点和HotSpot是不一样的,具体使用什么算法是在编译期决定的,无法在运行的时候动态更换。如果在编译dalvik虚拟机的命令中指明了"WITH_COPYING_GC"选项,则编译"/dalvik/vm/alloc/Copying.cpp"源码 – 此是Android中拷贝GC算法的实现,否则编译"/dalvik/vm/alloc/HeapSource.cpp" – 其实现了标注与清理GC算法。 由于Mark and Sweep算法的缺点,容易导致内存碎片,所以在这个算法下,当我们有大量不连续小内存的时候,再分配一个较大对象时,还是会非常容易导致GC,比如我们在该手机上decode图片,具体情况如下: 所以对于Dalvik虚拟机的手机来说,我们首先要尽量避免掉频繁生成很多临时小变量(比如说:getView,onDraw等函数),另一个又要尽量去避免产生很多长生命周期的大对象。 3、ART内存回收机制 3.1 Java堆 ART运行时内部使用的Java堆的主要组成包括Image Space、Zygote Space、Allocation Space和Large Object Space四个Space,Image Space用来存在一些预加载的类, Zygote Space和Allocation Space与Dalvik虚拟机垃圾收集机制中的Zygote堆和Active堆的作用是一样的, Large Object Space就是一些离散地址的集合,用来分配一些大对象从而提高了GC的管理效率和整体性能,类似如下图: 在下文的GC Log中,我们也能看到在art的GC Log中包含了LOS的信息,方便我们查看大内存的情况。 3.2 GC的类型 kGcCauseForAlloc ,当要分配内存的时候发现内存不够的情况下引起的GC,这种情况下的GC会stop world kGcCauseBackground,当内存达到一定的阀值的时候会去出发GC,这个时候是一个后台gc,不会引起stop world kGcCauseExplicit,显示调用的时候进行的gc,如果art打开了这个选项的情况下,在system.gc的时候会进行gc 其他更多 3.3 对象的分配和GC触发时机 由于Art下内存分配和Dalvik下基本没有任何区别,我直接贴图带过了。 3.4 并发和非并发GC Art在GC上不像Dalvik仅有一种回收算法,Art在不同的情况下会选择不同的回收算法,比如Alloc内存不够的时候会采用非并发GC,而在Alloc后发现内存达到一定阀值的时候又会触发并发GC。同时在前后台的情况下GC策略也不尽相同,后面我们会一一给大家说明。 非并发GC 步骤1. 调用子类实现的成员函数InitializePhase执行GC初始化阶段。 步骤2. 挂起所有的ART运行时线程。 步骤3. 调用子类实现的成员函数MarkingPhase执行GC标记阶段。 步骤4. 调用子类实现的成员函数ReclaimPhase执行GC回收阶段。 步骤5. 恢复第2步挂起的ART运行时线程。 步骤6. 调用子类实现的成员函数FinishPhase执行GC结束阶段。 并发GC 步骤1. 调用子类实现的成员函数InitializePhase执行GC初始化阶段。 步骤2. 获取用于访问Java堆的锁。 步骤3. 调用子类实现的成员函数MarkingPhase执行GC并行标记阶段。 步骤4. 释放用于访问Java堆的锁。 步骤5. 挂起所有的ART运行时线程。 步骤6. 调用子类实现的成员函数HandleDirtyObjectsPhase处理在GC并行标记阶段被修改的对象。。 步骤7. 恢复第4步挂起的ART运行时线程。 步骤8. 重复第5到第7步,直到所有在GC并行阶段被修改的对象都处理完成。 步骤9. 获取用于访问Java堆的锁。 步骤10. 调用子类实现的成员函数ReclaimPhase执行GC回收阶段。 步骤11. 释放用于访问Java堆的锁。 步骤12. 调用子类实现的成员函数FinishPhase执行GC结束阶段。 所以不论是并发还是非并发,都会引起stopworld的情况出现,并发的情况下单次stopworld的时间会更短,基本区别和。 3.5 Art并发和Dalvik并发GC的差异 首先可以通过如下2张图来对比下 Dalvik GC: Art GC Art的并发GC和Dalvik的并发GC有什么区别呢,初看好像2者差不多,虽然没有一直挂起线程,但是也会有暂停线程去执行标记对象的流程。通过阅读相关文档可以了解到Art并发GC对于Dalvik来说主要有三个优势点: 1、标记自身 Art在对象分配时会将新分配的对象压入到Heap类的成员变量allocation_stack_描述的Allocation Stack中去,从而可以一定程度缩减对象遍历范围。 2、预读取 对于标记Allocation Stack的内存时,会预读取接下来要遍历的对象,同时再取出来该对象后又会将该对象引用的其他对象压入栈中,直至遍历完毕。 3、减少Pause时间 在Mark阶段是不会Block其他线程的,这个阶段会有脏数据,比如Mark发现不会使用的但是这个时候又被其他线程使用的数据,在Mark阶段也会处理一些脏数据而不是留在最后Block的时候再去处理,这样也会减少后面Block阶段对于脏数据的处理的时间。 3.6 前后台GC 前台Foreground指的就是应用程序在前台运行时,而后台Background就是应用程序在后台运行时。因此,Foreground GC就是应用程序在前台运行时执行的GC,而Background就是应用程序在后台运行时执行的GC。 应用程序在前台运行时,响应性是最重要的,因此也要求执行的GC是高效的。相反,应用程序在后台运行时,响应性不是最重要的,这时候就适合用来解决堆的内存碎片问题。因此,Mark-Sweep GC适合作为Foreground GC,而Mark-Compact GC适合作为Background GC。 由于有Compact的能力存在,碎片化在Art上可以很好的被避免,这个也是Art一个很好的能力。 3.7 Art大法好 总的来看,art在gc上做的比dalvik好太多了,不光是gc的效率,减少pause时间,而且还在内存分配上对大内存的有单独的分配区域,同时还能有算法在后台做内存整理,减少内存碎片。对于开发者来说art下我们基本可以避免很多类似gc导致的卡顿问题了。另外根据谷歌自己的数据来看,Art相对Dalvik内存分配的效率提高了10倍,GC的效率提高了2-3倍。 4、GC Log 当我们想要根据GC日志来追查一些GC可能造成的卡顿时,我们需要了解GC日志的组成,不同信息代表了什么含义。 4.1 Dalvik GC日志 dalvik的日志格式基本如下: D/dalvikvm: , , , gc_reason:就是我们上文提到的,是gc_alloc还是gc_concurrent,了解到不同的原因方便我们做不同的处理。 amount_freed:表示系统通过这次GC操作释放了多少内存 Heap_stats:中会显示当前内存的空闲比例以及使用情况(活动对象所占内存 / 当前程序总内存) Pause_time:表示这次GC操作导致应用程序暂停的时间。关于这个暂停的时间,在2.3之前GC操作是不能并发进行的,也就是系统正在进行GC,那么应用程序就只能阻塞住等待GC结束。而自2.3之后,GC操作改成了并发的方式进行,就是说GC的过程中不会影响到应用程序的正常运行,但是在GC操作的开始和结束的时候会短暂阻塞一段时间,所以还有后续的一个total_time。 Total_time:表示本次GC所花费的总时间和上面的Pause_time,也就是stop all是不一样的,卡顿时间主要看上面的pause_time。 4.2 Art GC日志 I/art: , , , , 基本情况和Dalvik没有什么差别,GC的Reason更多了,还多了一个OS_Space_Status LOS_Space_Status:Large Object Space,大对象占用的空间,这部分内存并不是分配在堆上的,但仍属于应用程序内存空间,主要用来管理 bitmap 等占内存大的对象,避免因分配大内存导致堆频繁 GC。 **推荐阅读:字节跳动面试题 —— 水壶问题2017-2020历年字节跳动Android面试真题解析(累计下载1082万次,持续更新中)** 原文作者:Tmacchen原文链接:https://zhuanlan.zhihu.com/p/24835977

优秀的个人博客,低调大师

深度剖析如何实现事务消息

这是一篇从去年写到今年的文章,希望大家会喜欢 1.背景 分布式事务一直是一个老生常谈的一个话题,在我的公众号下面下面已经写过很多篇分布式事务相关的文章了,但是依旧没有将其完全剖析。在之前的文章中我也多次提到我们可以使用消息队列来实现我们的分布式事务,但是大多都是一笔带过,很多读者都对这一块产生了很多疑问,希望读完这篇文章能让你理解如何用消息队列实现分布式事务。 当然首先要回顾一下我们的一些基本概念: CAP CAP定理,又被叫作布鲁尔定理。对于设计分布式系统来说(不仅仅是分布式事务)的架构师来说,CAP就是你的入门理论。 C (一致性):对某个指定的客户端来说,读操作能返回最新的写操作。对于数据分布在不同节点上的数据上来说,如果在某个节点更新了数据,那么在其他节点如果都能读取到这个最新的数据,那么就称为强一致,如果有某个节点没有读取到,那就是分布式不一致。 A (可用性):非故障的节点在合理的时间内返回合理的响应(不是错误和超时的响应)。可用性的两个关键一个是合理的时间,一个是合理的响应。合理的时间指的是请求不能无限被阻塞,应该在合理的时间给出返回。合理的响应指的是系统应该明确返回结果并且结果是正确的,这里的正确指的是比如应该返回50,而不是返回40。 P (分区容错性):当出现网络分区后,系统能够继续工作。打个比方,这里个集群有多台机器,有台机器网络出现了问题,但是这个集群仍然可以正常工作。 熟悉CAP的人都知道,三者不能共有,如果感兴趣可以搜索CAP的证明,在分布式系统中,网络无法100%可靠,分区其实是一个必然现象,如果我们选择了CA而放弃了P,那么当发生分区现象时,为了保证一致性,这个时候必须拒绝请求,但是A又不允许,所以分布式系统理论上不可能选择CA架构,只能选择CP或者AP架构。 对于CP来说,放弃可用性,追求一致性和分区容错性,我们的zookeeper其实就是追求的强一致。 对于AP来说,放弃一致性(这里说的一致性是强一致性),追求分区容错性和可用性,这是很多分布式系统设计时的选择,后面的BASE也是根据AP来扩展。 顺便一提,CAP理论中是忽略网络延迟,也就是当事务提交时,从节点A复制到节点B,但是在现实中这个是明显不可能的,所以总会有一定的时间是不一致。同时CAP中选择两个,比如你选择了CP,并不是叫你放弃A。因为P出现的概率实在是太小了,大部分的时间你仍然需要保证CA。就算分区出现了你也要为后来的A做准备,比如通过一些日志的手段,是其他机器回复至可用。 BASE BASE 是 Basically Available(基本可用)、Soft state(软状态)和 Eventually consistent (最终一致性)三个短语的缩写。是对CAP中AP的一个扩展 基本可用:分布式系统在出现故障时,允许损失部分可用功能,保证核心功能可用。 软状态:允许系统中存在中间状态,这个状态不影响系统可用性,这里指的是CAP中的不一致。 最终一致:最终一致是指经过一段时间后,所有节点数据都将会达到一致。 BASE解决了CAP中理论没有网络延迟,在BASE中用软状态和最终一致,保证了延迟后的一致性。BASE和 ACID 是相反的,它完全不同于ACID的强一致性模型,而是通过牺牲强一致性来获得可用性,并允许数据在一段时间内是不一致的,但最终达到一致状态。 事务消息 我们的所有事务消息都可以看作是BASE模型的实现。在业界中有事务消息功能比较有代表性的就是阿里开源的RocketMQ和去哪儿开源的QMQ,他们两个消息队列都实现了事务消息功能,但是实现的方式却各有不同,接下来也会分别剖析这两个消息队列是如何实现事务消息。 2. RocketMQ-事务消息 RocketMQ事务消息到底是怎么一回事呢? 基本流程如下: 第一阶段Prepared消息,会拿到消息的地址。 第二阶段执行本地事务。 第三阶段通过第一阶段拿到的地址去访问消息,并修改状态。消息接受者就能使用这个消息。 如果确认消息失败,在RocketMq Broker中提供了定时扫描没有更新状态的消息,如果有消息没有得到确认,会向消息发送者发送消息,来判断是否提交,在rocketmq中是以listener的形式给发送者,用来处理。 如果确认消息失败,在RocketMq Broker中提供了定时扫描没有更新状态的消息,如果有消息没有得到确认,会向消息发送者发送消息,来判断是否提交,在rocketmq中是以listener的形式给发送者,用来处理。 如果消费超时,则需要一直重试,消息接收端需要保证幂等。如果消息消费失败,这个就需要人工进行处理,因为这个概率较低,如果为了这种小概率时间而设计这个复杂的流程反而得不偿失 这个图大家想必再其他地方已经看见过很多次了,很多时候从看这个图只能一知半解,那接下来看看代码是如何实现的吧。 2.1 使用事务消息 在RocketMQ的事务消息中有个很重要的监听器叫TransactionListener,我们需要实现他 其中有两个方法: executeLocalTransaction:顾名思义执行我们的本地事务方法,一般来说我们的本地事务方法是由上层的业务顺序推进调用,但是在rocketMQ的事务消息中是需要由Listener来进行驱动,如果要使用RocketMQ的事务消息需要对我们的业务进行一定的改造。并且这里还需要注意的是,我们在事务中还需要保存消息的事务ID和当前事务的对应关系。 checkLocalTransaction:根据我们之前的事务ID来检查我们的本地事务状态,这里的状态有三种: 事务消息共有三种状态,提交状态、回滚状态、中间状态: TransactionStatus.CommitTransaction: 提交事务,它允许消费者消费此消息。 TransactionStatus.RollbackTransaction: 回滚事务,它代表该消息将被删除,不允许被消费。 TransactionStatus.Unknown: 中间状态,它代表需要检查消息队列来确定状态。返回这个状态的时候RocketMQ会进行重试检查,为了防止频繁检查,默认将单个消息的检查次数限制为15 次。 对于我们的消息发送有如下代码: 我们发现在代码中我们将我们之前的listener以及一个线程池来和我们的producer进行绑定,这里线程池的作用是我们checkLocalTransaction所使用的线程池。 2.2 实现原理 2.2.1 客户端 这里的代码比较简单,主要分下面几个步骤 Step 1: 先发送消息至Broker. Step 2: 根据发送的结果,判断是否执行本地事务,如果发送成功,则执行本地事务。 Step 3: 记录本地事务状态,这里的状态也就是上面我们所讲的提交事务,回滚事务,中间状态三个状态。 Step 4: 结束事务,根据本地事务状态决定是提交或者回滚。 对于checkLocalTransaction: 在RocketMQ中会接收RocketMQ-Broker发送的CHECK_TRANSACTION_STATE请求,来执行检查本地事务状态。 2.3.1 服务端 在Broker上会对事务消息进行特殊判断: 如果是事务消息那么就需要走prepareMessage这个逻辑,prepareMessage这个逻辑如下: 主要是将当前消息的topic替换成RMQ_SYS_TRANS_HALF_TOPIC。我们的一阶段发送半消息到这里就完成了,接下来就是Broker处理我们事务的commit或者rollback: 图中红色方框表示我们的核心步骤,对于commit的一共有三步: 获取需要commit的半消息 将消息发送到原来的topic 删除半消息 对于rollback一共有两步: 获取需要rollback的半消息 删除半消息 对于获取消息这个比较简单,通过记录的offset直接查询就好,对于将消息发送到原来的topic逻辑基本上可以复用,这里要重点讨论的是如何删除半消息,我们都知道RocketMQ是顺序写入,我们不可能去真正的删除消息,那么就只能依靠一些其他的途径,我们可以想到消息消费了之后,只要offset不重置,这个消息就不会再被消费,那么其实就实现了删除的功能。RocketMQ也是通过这样的思路,自己实现了一个消费者,去消费RMQ_SYS_TRANS_HALF_TOPIC这个Topic,如果消息需要删除的话消费了之后就不需要做其他操作,如果不需要删除的话,消费了之后又会重新投递。 那其实核心就在于怎么去记录半消息是否应该删除呢?对于这个问题RocketMQ采用了新的TopicRMQ_SYS_TRANS_OP_HALF_TOPIC来保存半消息是否删除,其实在上面的删除半消息的流程中其实也是对RMQ_SYS_TRANS_OP_HALF_TOPIC投递了一个op_message,然后由后台任务去进行操作。 整个流程原理图如下面所示: Step1: 发送事务消息,这里也叫做halfMessage,会将Topic替换为HalfMessage的Topic。 Step2: 发送commit或者rollback,如果是commit这里会查询出之前的消息,然后将消息复原成原Topic,并且发送一个OpMessage用于记录当前消息可以删除。如果是rollback这里会直接发送一个OpMessage删除。 Step3: 在Broker有个处理事务消息的定时任务,定时对比halfMessage和OpMessage,如果有OpMessage且状态为删除,那么该条消息必定commit或者rollback,所以就可以删除这条消息。 Step4: 如果事务超时(默认是6s),还没有opMessage,那么很有可能commit信息丢了,这里会去反查我们的Producer本地事务状态。 Step5: 根据查询出来的信息做Step2。 2.3 小结 上面已经讲了如何使用RocketMQ的事务消息和实现原理,想必大家已经对RocketMQ事务消息有自己的认识了。但是RocketMQ的事务消息目前在我的一些业务实战中是从来没有使用过的,主要原因有几个方面: 改造成本大,比如一个下单的操作,创建订单的本地事务一般来说是同步进行的,创建之后会获取到订单ID,但是在RocketMQ中这个本地事务变成了在Listener里面的操作了,那么就不能通过返回参数来进行,只能通过一些其他方法来完成这个业务逻辑,比如ThreadLocal等等。 需要记录TransactionId和本地事务状态的关系 只支持单个事务消息,如果我创建订单需要发送10种消息,如果都想保持事务一致,那么RocketMQ是不支持的。 综上所述,RocketMQ的事务消息在我看来的确属于比较鸡肋,很难去适应于老业务。那么怎么去接下来讲一下QMQ的事务消息的解决方案,看看这种方案能否解决我们所说的这种问题呢? 3. QMQ事务消息 QMQ的事务消息没有RocketMQ那么的复杂,对于消息中间件的本身改造是很小的,其依赖了数据库自身的本地事务,比如一个创建订单,需要发送两种消息,分别是A和B,那么有如下的伪代码: begin transaction; createOrder(); commit transaction; sendMessageA(); snedMessageB(); 这个时候我们发现消息A和消息B都在事务之外,其一致性得不到保证,那么其实我们发送消息的时候不一定要真正的和消息中间件打交道,我们可以做一个本地的存储,保存我们的消息: begin transaction; createOrder(); saveMessageA(); saveMessageB(); commit transaction; // 发送消息 sendMessageA(); snedMessageB(); 可以看见其实我们只是增加两个保存消息的操作,那么我们是如何保证一致性呢,如果发送MessageA的时候挂了,那么我们就可以通过定时任务去拉去我们数据库中保存的并没有发送的消息,然后再次进行发送。 其实这种方法同样的可以扩展至其他的消息队列,因为对于消息中间件本身是没有入侵的,如果RocketMQ或者Kafka也想使用这种方法来保证事务消息,也是可以的。 我们来看看这种方法能否解决RocketMQ事务消息带来的问题呢? 改造成本,只需要改造一次Client,在QMQ中重写了spring的TransactionSynchronization,可以直接把代码简化成如下面所示: begin transaction; createOrder(); sendMessageA(); snedMessageB(); commit transaction; 这里的send其实内部逻辑是saveMessage,在commit之后会自动进行发送,并且后台有定时任务会补偿发送。 不需要额外做transactionId和message的绑定 支持发送多个事务消息 RocketMQ事务消息带来的问题基本可以解决,但是其同样也有缺点,因为其引入了额外的数据库写,如果事务消息较多,那么就会多出很多写数据库的操作,对于响应时间比较敏感的服务需要仔细考虑 4.总结 介绍了两种事务消息,对于我个人而言,QMQ实现的方案能更加适应于大多数业务。但是这里要注意事务消息并不是所有的分布式一致性都能使用,事务消息使用的场景只能是发出这个消息就能代表这个操作成功的场景,什么意思呢?举个例子,比如我们支付的时候会扣积分,扣券等等,如果我发一个扣积分的消息能代表一定成功吗?这个肯定是不行的,因为用户的积分可能不够,就会导致扣除失败。如果是发送一个赠送积分的消息那么就可以代表成功,因为赠送积分是属于加法,并没有太多的限制。 如果发现事务消息不能很好的满足的满足业务场景,那么你就可以考虑其他的一些事务策略,比如TCC,saga等,这些在我之前的文章都有讲述。 如果大家觉得这篇文章对你有帮助,你的关注和转发是对我最大的支持,O(∩_∩)O:

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册