源码级深度理解 Java SPI
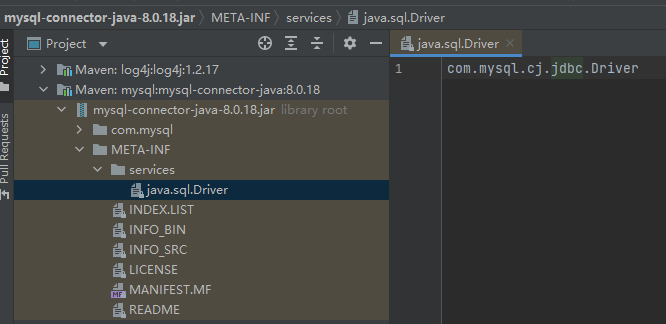
作者:vivo 互联网服务器团队- Zhang Peng SPI 是一种用于动态加载服务的机制。它的核心思想就是解耦,属于典型的微内核架构模式。SPI 在 Java 世界应用非常广泛,如:Dubbo、Spring Boot 等框架。本文从源码入手分析,深入探讨 Java SPI 的特性、原理,以及在一些比较经典领域的应用。 一、SPI 简介 SPI 全称 Service Provider Interface,是 Java 提供的,旨在由第三方实现或扩展的 API,它是一种用于动态加载服务的机制。Java 中 SPI 机制主要思想是将装配的控制权移到程序之外,在模块化设计中这个机制尤其重要,其核心思想就是解耦。 Java SPI 有四个要素: SPI 接口:为服务提供者实现类约定的的接口或抽象类。 SPI 实现类:实际提供服务的实现类。 SPI 配置:Java SPI 机制约定的配置文件,提供查找服务实现类的逻辑。配置文件必须置于 META-INF/services 目录中,并且,文件名应与服务提供者接口的完全限定名保持一致。文件中的每一行都有一个实现服务类的详细信息,同样是服务提供者类的完全限定名称。 ServiceLoader:Java SPI 的核心类,用于加载 SPI 实现类。ServiceLoader 中有各种实用方法来获取特定实现、迭代它们或重新加载服务。 二、SPI 示例 正所谓,实践出真知,我们不妨通过一个具体的示例来看一下,如何使用 Java SPI。 2.1 SPI 接口 首先,需要定义一个 SPI 接口,和普通接口并没有什么差别。 package io.github.dunwu.javacore.spi;public interface DataStorage { String search(String key);} 2.2 SPI 实现类 假设,我们需要在程序中使用两种不同的数据存储——MySQL 和 Redis。因此,我们需要两个不同的实现类去分别完成相应工作。 MySQL查询 MOCK 类 package io.github.dunwu.javacore.spi;public class MysqlStorage implements DataStorage { @Override public String search(String key) { return "【Mysql】搜索" + key + ",结果:No"; }} Redis 查询 MOCK 类 package io.github.dunwu.javacore.spi;public class RedisStorage implements DataStorage { @Override public String search(String key) { return "【Redis】搜索" + key + ",结果:Yes"; }} service 传入的是期望加载的 SPI 接口类型 到目前为止,定义接口,并实现接口和普通的 Java 接口实现没有任何不同。 2.3 SPI 配置 如果想通过 Java SPI 机制来发现服务,就需要在 SPI 配置中约定好发现服务的逻辑。配置文件必须置于 META-INF/services 目录中,并且,文件名应与服务提供者接口的完全限定名保持一致。文件中的每一行都有一个实现服务类的详细信息,同样是服务提供者类的完全限定名称。以本示例代码为例,其文件名应该为 io.github.dunwu.javacore.spi.DataStorage, 文件中的内容如下: io.github.dunwu.javacore.spi.MysqlStorageio.github.dunwu.javacore.spi.RedisStorage 2.4 ServiceLoader 完成了上面的步骤,就可以通过 ServiceLoader 来加载服务。示例如下: import java.util.ServiceLoader;public class SpiDemo { public static void main(String[] args) { ServiceLoader<DataStorage> serviceLoader = ServiceLoader.load(DataStorage.class); System.out.println("============ Java SPI 测试============"); serviceLoader.forEach(loader -> System.out.println(loader.search("Yes Or No"))); }} 输出: ============ Java SPI 测试============【Mysql】搜索Yes Or No,结果:No【Redis】搜索Yes Or No,结果:Yes 三、SPI 原理 上文中,我们已经了解 Java SPI 的要素以及使用 Java SPI 的方法。你有没有想过,Java SPI 和普通 Java 接口有何不同,Java SPI 是如何工作的。实际上,Java SPI 机制依赖于 ServiceLoader 类去解析、加载服务。因此,掌握了 ServiceLoader 的工作流程,就掌握了 SPI 的原理。ServiceLoader 的代码本身很精练,接下来,让我们通过走读源码的方式,逐一理解 ServiceLoader 的工作流程。 3.1 ServiceLoader 的成员变量 先看一下 ServiceLoader 类的成员变量,大致有个印象,后面的源码中都会使用到。 public final class ServiceLoader<S> implements Iterable<S> { // SPI 配置文件目录 private static final String PREFIX = "META-INF/services/"; // 将要被加载的 SPI 服务 private final Class<S> service; // 用于加载 SPI 服务的类加载器 private final ClassLoader loader; // ServiceLoader 创建时的访问控制上下文 private final AccessControlContext acc; // SPI 服务缓存,按实例化的顺序排列 private LinkedHashMap<String,S> providers = new LinkedHashMap<>(); // 懒查询迭代器 private LazyIterator lookupIterator; // ...} 3.2 ServiceLoader 的工作流程 (1)ServiceLoader.load静态方法 应用程序加载 Java SPI 服务,都是先调用 ServiceLoader.load 静态方法。 ServiceLoader.load 静态方法的作用是: ① 指定类加载 ClassLoader 和访问控制上下文; ② 然后,重新加载 SPI 服务 清空缓存中所有已实例化的 SPI 服务 根据ClassLoader和 SPI 类型,创建懒加载迭代器 这里,摘录 ServiceLoader.load 相关源码,如下: // service 传入的是期望加载的 SPI 接口类型// loader 是用于加载 SPI 服务的类加载器public static <S> ServiceLoader<S> load(Class<S> service, ClassLoader loader) { return new ServiceLoader<>(service, loader);}public void reload() { // 清空缓存中所有已实例化的 SPI 服务 providers.clear(); // 根据 ClassLoader 和 SPI 类型,创建懒加载迭代器 lookupIterator = new LazyIterator(service, loader);}// 私有构造方法// 重新加载 SPI 服务private ServiceLoader(Class<S> svc, ClassLoader cl) { service = Objects.requireNonNull(svc, "Service interface cannot be null"); // 指定类加载 ClassLoader 和访问控制上下文 loader = (cl == null) ? ClassLoader.getSystemClassLoader() : cl; acc = (System.getSecurityManager() != null) ? AccessController.getContext() : null; // 然后,重新加载 SPI 服务 reload();} (2)应用程序通过ServiceLoader的iterator方法遍历 SPI 实例 ServiceLoader 的类定义,明确了 ServiceLoader 类实现了 Iterable<T>接口,所以,它是可以迭代遍历的。实际上,ServiceLoader 类维护了一个缓存 providers( LinkedHashMap 对象),缓存 providers 中保存了已经被成功加载的 SPI 实例,这个 Map 的 key 是 SPI 接口实现类的全限定名,value 是该实现类的一个实例对象。 当应用程序调用 ServiceLoader 的 iterator 方法时,ServiceLoader 会先判断缓存 providers 中是否有数据:如果有,则直接返回缓存 providers 的迭代器;如果没有,则返回懒加载迭代器的迭代器。 public Iterator<S> iterator() { return new Iterator<S>() { // 缓存 SPI providers Iterator<Map.Entry<String,S>> knownProviders = providers.entrySet().iterator(); // lookupIterator 是 LazyIterator 实例,用于懒加载 SPI 实例 public boolean hasNext() { if (knownProviders.hasNext()) return true; return lookupIterator.hasNext(); } public S next() { if (knownProviders.hasNext()) return knownProviders.next().getValue(); return lookupIterator.next(); } public void remove() { throw new UnsupportedOperationException(); } };} (3)懒加载迭代器的工作流程 上面的源码中提到了,lookupIterator 是 LazyIterator 实例,而 LazyIterator 用于懒加载 SPI 实例。那么, LazyIterator 是如何工作的呢? 这里,摘取LazyIterator关键代码 hasNextService 方法: 拼接META-INF/services/+ SPI 接口全限定名 通过类加载器,尝试加载资源文件 解析资源文件中的内容,获取 SPI 接口的实现类的全限定名nextName nextService 方法: hasNextService()方法解析出了 SPI 实现类的的全限定名 nextName,通过反射,获取 SPI 实现类的类定义 Class。 然后,尝试通过 Class 的 newInstance 方法实例化一个 SPI 服务对象。如果成功,则将这个对象加入到缓存 providers 中并返回该对象。 private boolean hasNextService() { if (nextName != null) { return true; } if (configs == null) { try { // 1.拼接 META-INF/services/ + SPI 接口全限定名 // 2.通过类加载器,尝试加载资源文件 // 3.解析资源文件中的内容 String fullName = PREFIX + service.getName(); if (loader == null) configs = ClassLoader.getSystemResources(fullName); else configs = loader.getResources(fullName); } catch (IOException x) { fail(service, "Error locating configuration files", x); } } while ((pending == null) || !pending.hasNext()) { if (!configs.hasMoreElements()) { return false; } pending = parse(service, configs.nextElement()); } nextName = pending.next(); return true;}private S nextService() { if (!hasNextService()) throw new NoSuchElementException(); String cn = nextName; nextName = null; Class<?> c = null; try { c = Class.forName(cn, false, loader); } catch (ClassNotFoundException x) { fail(service, "Provider " + cn + " not found"); } if (!service.isAssignableFrom(c)) { fail(service, "Provider " + cn + " not a s"); } try { S p = service.cast(c.newInstance()); providers.put(cn, p); return p; } catch (Throwable x) { fail(service, "Provider " + cn + " could not be instantiated", x); } throw new Error(); // This cannot happen} 3.3 SPI 和类加载器 通过上面两个章节中,走读 ServiceLoader 代码,我们已经大致了解 Java SPI 的工作原理,即通过 ClassLoader 加载 SPI 配置文件,解析 SPI 服务,然后通过反射,实例化 SPI 服务实例。我们不妨思考一下,为什么加载 SPI 服务时,需要指定类加载器 ClassLoader 呢? 学习过 JVM 的读者,想必都了解过类加载器的双亲委派模型(Parents Delegation Model)。双亲委派模型要求除了顶层的 BootstrapClassLoader 外,其余的类加载器都应有自己的父类加载器。这里类加载器之间的父子关系一般通过组合(Composition)关系来实现,而不是通过继承(Inheritance)的关系实现。 双亲委派机制约定了:一个类加载器首先将类加载请求传送到父类加载器,只有当父类加载器无法完成类加载请求时才尝试加载。 双亲委派的好处:使得 Java 类伴随着它的类加载器,天然具备一种带有优先级的层次关系,从而使得类加载得到统一,不会出现重复加载的问题: 系统类防止内存中出现多份同样的字节码 保证 Java 程序安全稳定运行 例如:java.lang.Object 存放在 rt.jar 中,如果编写另外一个 java.lang.Object 的类并放到 classpath 中,程序可以编译通过。因为双亲委派模型的存在,所以在 rt.jar 中的 Object 比在 classpath 中的 Object 优先级更高,因为 rt.jar 中的 Object 使用的是启动类加载器,而 classpath 中的 Object 使用的是应用程序类加载器。正因为 rt.jar 中的 Object 优先级更高,因为程序中所有的 Object 都是这个 Object。 双亲委派的限制:子类加载器可以使用父类加载器已经加载的类,而父类加载器无法使用子类加载器已经加载的。——这就导致了双亲委派模型并不能解决所有的类加载器问题。Java SPI 就面临着这样的问题: SPI 的接口是 Java 核心库的一部分,是由 BootstrapClassLoader 加载的; 而 SPI 实现的 Java 类一般是由 AppClassLoader 来加载的。BootstrapClassLoader 是无法找到 SPI 的实现类的,因为它只加载 Java 的核心库。它也不能代理给 AppClassLoader,因为它是最顶层的类加载器。这也解释了本节开始的问题——为什么加载 SPI 服务时,需要指定类加载器 ClassLoader 呢?因为如果不指定 ClassLoader,则无法获取 SPI 服务。 如果不做任何的设置,Java 应用的线程的上下文类加载器默认就是 AppClassLoader。在核心类库使用 SPI 接口时,传递的类加载器使用线程上下文类加载器,就可以成功的加载到 SPI 实现的类。线程上下文类加载器在很多 SPI 的实现中都会用到。 通常可以通过 Thread.currentThread().getClassLoader() 和 Thread.currentThread().getContextClassLoader()获取线程上下文类加载器。 3.4 Java SPI 的不足 Java SPI 存在一些不足: 不能按需加载,需要遍历所有的实现,并实例化,然后在循环中才能找到我们需要的实现。如果不想用某些实现类,或者某些类实例化很耗时,它也被载入并实例化了,这就造成了浪费。 获取某个实现类的方式不够灵活,只能通过 Iterator 形式获取,不能根据某个参数来获取对应的实现类。 多个并发多线程使用 ServiceLoader 类的实例是不安全的。 四、SPI 应用场景 SPI 在 Java 开发中应用十分广泛。首先,在 Java 的 java.util.spi package 中就约定了很多 SPI 接口。下面,列举一些 SPI 接口: TimeZoneNameProvider:为 TimeZone 类提供本地化的时区名称。 DateFormatProvider:为指定的语言环境提供日期和时间格式。 NumberFormatProvider:为 NumberFormat 类提供货币、整数和百分比值。 Driver:从 4.0 版开始,JDBC API 支持 SPI 模式。旧版本使用 Class.forName() 方法加载驱动程序。 PersistenceProvider:提供 JPA API 的实现。 等等 除此以外,SPI 还有很多应用,下面列举几个经典案例。 4.1 SPI 应用案例之 JDBC DriverManager 作为 Java 工程师,尤其是 CRUD 工程师,相必都非常熟悉 JDBC。众所周知,关系型数据库有很多种,如:MySQL、Oracle、PostgreSQL 等等。JDBC 如何识别各种数据库的驱动呢? 4.1.1创建数据库连接 我们先回顾一下,JDBC 如何创建数据库连接的呢? 在JDBC4.0 之前,连接数据库的时候,通常会用 Class.forName(XXX)方法来加载数据库相应的驱动,然后再获取数据库连接,继而进行 CRUD 等操作。 Class.forName("com.mysql.jdbc.Driver") 而 JDBC4.0 之后,不再需要用 Class.forName(XXX)方法来加载数据库驱动,直接获取连接就可以了。显然,这种方式很方便,但是如何做到的呢? (1)JDBC 接口:首先,Java 中内置了接口 java.sql.Driver。 (2)JDBC 接口实现:各个数据库的驱动自行实现 java.sql.Driver 接口,用于管理数据库连接。 ① MySQL:在 MySQL的 Java 驱动包 mysql-connector-java-XXX.jar 中,可以找到 META-INF/services 目录,该目录下会有一个名字为java.sql.Driver 的文件,文件内容是com.mysql.cj.jdbc.Driver。 com.mysql.cj.jdbc.Driver 正是 MySQL 版的 java.sql.Driver 实现。如下图所示: ②PostgreSQL 实现:在 PostgreSQL 的 Java 驱动包 postgresql-42.0.0.jar 中,也可以找到同样的配置文件,文件内容是 org.postgresql.Driver,org.postgresql.Driver 正是 PostgreSQL 版的 java.sql.Driver 实现。 (3)创建数据库连接 以 MySQL 为例,创建数据库连接代码如下: final String DB_URL = String.format("jdbc:mysql://%s:%s/%s", DB_HOST, DB_PORT, DB_SCHEMA);connection = DriverManager.getConnection(DB_URL, DB_USER, DB_PASSWORD); 4.1.2 DriverManager 从前文,我们已经知道 DriverManager 是创建数据库连接的关键。它究竟是如何工作的呢? 可以看到是加载实例化驱动的,接着看 loadInitialDrivers 方法: private static void loadInitialDrivers() { String drivers; try { drivers = AccessController.doPrivileged(new PrivilegedAction<String>() { public String run() { return System.getProperty("jdbc.drivers"); } }); } catch (Exception ex) { drivers = null; } // 通过 classloader 获取所有实现 java.sql.Driver 的驱动类 AccessController.doPrivileged(new PrivilegedAction<Void>() { public Void run() { // 利用 SPI,记载所有 Driver 服务 ServiceLoader<Driver> loadedDrivers = ServiceLoader.load(Driver.class); // 获取迭代器 Iterator<Driver> driversIterator = loadedDrivers.iterator(); try{ // 遍历迭代器 while(driversIterator.hasNext()) { driversIterator.next(); } } catch(Throwable t) { // Do nothing } return null; } }); // 打印数据库驱动信息 println("DriverManager.initialize: jdbc.drivers = " + drivers); if (drivers == null || drivers.equals("")) { return; } String[] driversList = drivers.split(":"); println("number of Drivers:" + driversList.length); for (String aDriver : driversList) { try { println("DriverManager.Initialize: loading " + aDriver); // 尝试实例化驱动 Class.forName(aDriver, true, ClassLoader.getSystemClassLoader()); } catch (Exception ex) { println("DriverManager.Initialize: load failed: " + ex); } }} 上面的代码主要步骤是: 从系统变量中获取驱动的实现类。 利用 SPI 来获取所有驱动的实现类。 遍历所有驱动,尝试实例化各个实现类。 根据第 1 步获取到的驱动列表来实例化具体的实现类。 需要关注的是下面这行代码: ServiceLoader<Driver> loadedDrivers = ServiceLoader.load(Driver.class); 这里实际获取的是 java.util.ServiceLoader.LazyIterator 迭代器。调用其 hasNext 方法时,会搜索 classpath 下以及 jar 包中的 META-INF/services 目录,查找 java.sql.Driver 文件,并找到文件中的驱动实现类的全限定名。调用其 next 方法时,会根据驱动类的全限定名去尝试实例化一个驱动类的对象。 4.2SPI 应用案例之 Common-Loggin common-logging(也称 Jakarta Commons Logging,缩写 JCL)是常用的日志门面工具包。 common-logging 的核心类是入口是 LogFactory,LogFatory 是一个抽象类,它负责加载具体的日志实现。 其入口方法是 LogFactory.getLog 方法,源码如下: public static Log getLog(Class clazz) throws LogConfigurationException { return getFactory().getInstance(clazz);}public static Log getLog(String name) throws LogConfigurationException { return getFactory().getInstance(name);} 从以上源码可知,getLog 采用了工厂设计模式,是先调用 getFactory 方法获取具体日志库的工厂类,然后根据类名称或类型创建日志实例。 LogFatory.getFactory 方法负责选出匹配的日志工厂,其源码如下: public static LogFactory getFactory() throws LogConfigurationException { // 省略... // 加载 commons-logging.properties 配置文件 Properties props = getConfigurationFile(contextClassLoader, FACTORY_PROPERTIES); // 省略... // 决定创建哪个 LogFactory 实例 // (1)尝试读取全局属性 org.apache.commons.logging.LogFactory if (isDiagnosticsEnabled()) { logDiagnostic("[LOOKUP] Looking for system property [" + FACTORY_PROPERTY + "] to define the LogFactory subclass to use..."); } try { // 如果指定了 org.apache.commons.logging.LogFactory 属性,尝试实例化具体实现类 String factoryClass = getSystemProperty(FACTORY_PROPERTY, null); if (factoryClass != null) { if (isDiagnosticsEnabled()) { logDiagnostic("[LOOKUP] Creating an instance of LogFactory class '" + factoryClass + "' as specified by system property " + FACTORY_PROPERTY); } factory = newFactory(factoryClass, baseClassLoader, contextClassLoader); } else { if (isDiagnosticsEnabled()) { logDiagnostic("[LOOKUP] No system property [" + FACTORY_PROPERTY + "] defined."); } } } catch (SecurityException e) { // 异常处理 } catch (RuntimeException e) { // 异常处理 } // (2)利用 Java SPI 机制,尝试在 classpatch 的 META-INF/services 目录下寻找 org.apache.commons.logging.LogFactory 实现类 if (factory == null) { if (isDiagnosticsEnabled()) { logDiagnostic("[LOOKUP] Looking for a resource file of name [" + SERVICE_ID + "] to define the LogFactory subclass to use..."); } try { final InputStream is = getResourceAsStream(contextClassLoader, SERVICE_ID); if( is != null ) { // This code is needed by EBCDIC and other strange systems. // It's a fix for bugs reported in xerces BufferedReader rd; try { rd = new BufferedReader(new InputStreamReader(is, "UTF-8")); } catch (java.io.UnsupportedEncodingException e) { rd = new BufferedReader(new InputStreamReader(is)); } String factoryClassName = rd.readLine(); rd.close(); if (factoryClassName != null && ! "".equals(factoryClassName)) { if (isDiagnosticsEnabled()) { logDiagnostic("[LOOKUP] Creating an instance of LogFactory class " + factoryClassName + " as specified by file '" + SERVICE_ID + "' which was present in the path of the context classloader."); } factory = newFactory(factoryClassName, baseClassLoader, contextClassLoader ); } } else { // is == null if (isDiagnosticsEnabled()) { logDiagnostic("[LOOKUP] No resource file with name '" + SERVICE_ID + "' found."); } } } catch (Exception ex) { // note: if the specified LogFactory class wasn't compatible with LogFactory // for some reason, a ClassCastException will be caught here, and attempts will // continue to find a compatible class. if (isDiagnosticsEnabled()) { logDiagnostic( "[LOOKUP] A security exception occurred while trying to create an" + " instance of the custom factory class" + ": [" + trim(ex.getMessage()) + "]. Trying alternative implementations..."); } // ignore } } // (3)尝试从 classpath 目录下的 commons-logging.properties 文件中查找 org.apache.commons.logging.LogFactory 属性 if (factory == null) { if (props != null) { if (isDiagnosticsEnabled()) { logDiagnostic( "[LOOKUP] Looking in properties file for entry with key '" + FACTORY_PROPERTY + "' to define the LogFactory subclass to use..."); } String factoryClass = props.getProperty(FACTORY_PROPERTY); if (factoryClass != null) { if (isDiagnosticsEnabled()) { logDiagnostic( "[LOOKUP] Properties file specifies LogFactory subclass '" + factoryClass + "'"); } factory = newFactory(factoryClass, baseClassLoader, contextClassLoader); // TODO: think about whether we need to handle exceptions from newFactory } else { if (isDiagnosticsEnabled()) { logDiagnostic("[LOOKUP] Properties file has no entry specifying LogFactory subclass."); } } } else { if (isDiagnosticsEnabled()) { logDiagnostic("[LOOKUP] No properties file available to determine" + " LogFactory subclass from.."); } } } // (4)以上情况都不满足,实例化默认实现类 org.apache.commons.logging.impl.LogFactoryImpl if (factory == null) { if (isDiagnosticsEnabled()) { logDiagnostic( "[LOOKUP] Loading the default LogFactory implementation '" + FACTORY_DEFAULT + "' via the same classloader that loaded this LogFactory" + " class (ie not looking in the context classloader)."); } factory = newFactory(FACTORY_DEFAULT, thisClassLoader, contextClassLoader); } if (factory != null) { /** * Always cache using context class loader. */ cacheFactory(contextClassLoader, factory); if (props != null) { Enumeration names = props.propertyNames(); while (names.hasMoreElements()) { String name = (String) names.nextElement(); String value = props.getProperty(name); factory.setAttribute(name, value); } } } return factory;} 从 getFactory 方法的源码可以看出,其核心逻辑分为 4 步: 首先,尝试查找全局属性org.apache.commons.logging.LogFactory,如果指定了具体类,尝试创建实例。 利用 Java SPI 机制,尝试在 classpatch 的 META-INF/services 目录下寻找org.apache.commons.logging.LogFactory 的实现类。 尝试从 classpath 目录下的 commons-logging.properties 文件中查找org.apache.commons.logging.LogFactory 属性,如果指定了具体类,尝试创建实例。 以上情况如果都不满足,则实例化默认实现类,即org.apache.commons.logging.impl.LogFactoryImpl。 4.3 SPI 应用案例之 Spring Boot Spring Boot 是基于 Spring 构建的框架,其设计目的在于简化 Spring 应用的配置、运行。在 Spring Boot 中,大量运用了自动装配来尽可能减少配置。 下面是一个 Spring Boot 入口示例,可以看到,代码非常简洁。 import org.springframework.boot.SpringApplication;import org.springframework.boot.autoconfigure.SpringBootApplication;import org.springframework.web.bind.annotation.GetMapping;import org.springframework.web.bind.annotation.RequestParam;import org.springframework.web.bind.annotation.RestController;@SpringBootApplication@RestControllerpublic class DemoApplication { public static void main(String[] args) { SpringApplication.run(DemoApplication.class, args); } @GetMapping("/hello") public String hello(@RequestParam(value = "name", defaultValue = "World") String name) { return String.format("Hello %s!", name); }} 那么,Spring Boot 是如何做到寥寥几行代码,就可以运行一个 Spring Boot 应用的呢。我们不妨带着疑问,从源码入手,一步步探究其原理。 4.3.1 @SpringBootApplication 注解 首先,Spring Boot 应用的启动类上都会标记一个 @SpringBootApplication 注解。 @SpringBootApplication 注解定义如下: @Target({ElementType.TYPE})@Retention(RetentionPolicy.RUNTIME)@Documented@Inherited@SpringBootConfiguration@EnableAutoConfiguration@ComponentScan( excludeFilters = {@Filter( type = FilterType.CUSTOM, classes = {TypeExcludeFilter.class}), @Filter( type = FilterType.CUSTOM, classes = {AutoConfigurationExcludeFilter.class})})public @interface SpringBootApplication { // 略} 除了@Target、@Retention、@Documented、@Inherited 这几个元注解, @SpringBootApplication 注解的定义中还标记了@SpringBootConfiguration、 @EnableAutoConfiguration、@ComponentScan 三个注解。 4.3.2 @SpringBootConfiguration 注解 从@SpringBootConfiguration 注解的定义来看,@SpringBootConfiguration 注解本质上就是一个@Configuration 注解,这意味着被@SpringBootConfiguration 注解修饰的类会被 Spring Boot 识别为一个配置类。 @Target({ElementType.TYPE})@Retention(RetentionPolicy.RUNTIME)@Documented@Configurationpublic @interface SpringBootConfiguration { @AliasFor( annotation = Configuration.class ) boolean proxyBeanMethods() default true;} 4.3.3 @EnableAutoConfiguration 注解 @EnableAutoConfiguration 注解定义如下: @Target({ElementType.TYPE})@Retention(RetentionPolicy.RUNTIME)@Documented@Inherited@AutoConfigurationPackage@Import({AutoConfigurationImportSelector.class})public @interface EnableAutoConfiguration { String ENABLED_OVERRIDE_PROPERTY = "spring.boot.enableautoconfiguration"; Class<?>[] exclude() default {}; String[] excludeName() default {};} @EnableAutoConfiguration 注解包含了@AutoConfigurationPackage 与@Import({AutoConfigurationImportSelector.class})两个注解。 4.3.4 @AutoConfigurationPackage 注解 @AutoConfigurationPackage 会将被修饰的类作为主配置类,该类所在的 package 会被视为根路径,Spring Boot 默认会自动扫描根路径下的所有 Spring Bean(被@Component 以及继承@Component 的各个注解所修饰的类)。——这就是为什么 Spring Boot 的启动类一般要置于根路径的原因。这个功能等同于在 Spring xml 配置中通过 context:component-scan 来指定扫描路径。@Import 注解的作用是向 Spring 容器中直接注入指定组件。@AutoConfigurationPackage 注解中注明了@Import({Registrar.class})。Registrar 类用于保存 Spring Boot 的入口类、根路径等信息。 4.3.5 SpringFactoriesLoader.loadFactoryNames 方法 @Import(AutoConfigurationImportSelector.class)表示直接注入 AutoConfigurationImportSelector。 AutoConfigurationImportSelector 有一个核心方法 getCandidateConfigurations 用于获取候选配置。该方法调用了 SpringFactoriesLoader.loadFactoryNames 方法,这个方法即为 Spring Boot SPI 的关键,它负责加载所有 META-INF/spring.factories 文件,加载的过程由 SpringFactoriesLoader 负责。 Spring Boot 的 META-INF/spring.factories 文件本质上就是一个 properties 文件,数据内容就是一个个键值对。 SpringFactoriesLoader.loadFactoryNames 方法的关键源码: // spring.factories 文件的格式为:key=value1,value2,value3// 遍历所有 META-INF/spring.factories 文件// 解析文件,获得 key=factoryClass 的类名称public static List<String> loadFactoryNames(Class<?> factoryType, @Nullable ClassLoader classLoader) { String factoryTypeName = factoryType.getName(); return loadSpringFactories(classLoader).getOrDefault(factoryTypeName, Collections.emptyList());}private static Map<String, List<String>> loadSpringFactories(@Nullable ClassLoader classLoader) { // 尝试获取缓存,如果缓存中有数据,直接返回 MultiValueMap<String, String> result = cache.get(classLoader); if (result != null) { return result; } try { // 获取资源文件路径 Enumeration<URL> urls = (classLoader != null ? classLoader.getResources(FACTORIES_RESOURCE_LOCATION) : ClassLoader.getSystemResources(FACTORIES_RESOURCE_LOCATION)); result = new LinkedMultiValueMap<>(); // 遍历所有路径 while (urls.hasMoreElements()) { URL url = urls.nextElement(); UrlResource resource = new UrlResource(url); // 解析文件,得到对应的一组 Properties Properties properties = PropertiesLoaderUtils.loadProperties(resource); // 遍历解析出的 properties,组装数据 for (Map.Entry<?, ?> entry : properties.entrySet()) { String factoryTypeName = ((String) entry.getKey()).trim(); for (String factoryImplementationName : StringUtils.commaDelimitedListToStringArray((String) entry.getValue())) { result.add(factoryTypeName, factoryImplementationName.trim()); } } } cache.put(classLoader, result); return result; } catch (IOException ex) { throw new IllegalArgumentException("Unable to load factories from location [" + FACTORIES_RESOURCE_LOCATION + "]", ex); }} 归纳上面的方法,主要作了这些事: 加载所有 META-INF/spring.factories 文件,加载过程有 SpringFactoriesLoader 负责。 在 CLASSPATH 中搜寻所有 META-INF/spring.factories 配置文件。 然后,解析 spring.factories 文件,获取指定自动装配类的全限定名。 4.3.6 Spring Boot 的 AutoConfiguration 类 Spring Boot 有各种 starter 包,可以根据实际项目需要,按需取材。在项目开发中,只要将 starter 包引入,我们就可以用很少的配置,甚至什么都不配置,即可获取相关的能力。通过前面的 Spring Boot SPI 流程,只完成了自动装配工作的一半,剩下的工作如何处理呢 ? 以 spring-boot-starter-web 的 jar 包为例,查看其 maven pom,可以看到,它依赖于 spring-boot-starter,所有 Spring Boot 官方 starter 包都会依赖于这个 jar 包。而 spring-boot-starter 又依赖于 spring-boot-autoconfigure,Spring Boot 的自动装配秘密,就在于这个 jar 包。 从 spring-boot-autoconfigure 包的结构来看,它有一个 META-INF/spring.factories ,显然利用了 Spring Boot SPI,来自动装配其中的配置类。 下图是 spring-boot-autoconfigure 的 META-INF/spring.factories 文件的部分内容,可以看到其中注册了一长串会被自动加载的 AutoConfiguration 类。 以 RedisAutoConfiguration 为例,这个配置类中,会根据@ConditionalXXX 中的条件去决定是否实例化对应的 Bean,实例化 Bean 所依赖的重要参数则通过 RedisProperties 传入。 RedisProperties 中维护了 Redis 连接所需要的关键属性,只要在 yml 或 properties 配置文件中,指定 spring.redis 开头的属性,都会被自动装载到 RedisProperties 实例中。 通过以上分析,已经一步步解读出 Spring Boot 自动装载的原理。 五、SPI 应用案例之 Dubbo Dubbo 并未使用 Java SPI,而是自己封装了一套新的 SPI 机制。Dubbo SPI 所需的配置文件需放置在 META-INF/dubbo 路径下,配置内容形式如下: optimusPrime = org.apache.spi.OptimusPrimebumblebee = org.apache.spi.Bumblebee 与 Java SPI 实现类配置不同,Dubbo SPI 是通过键值对的方式进行配置,这样可以按需加载指定的实现类。Dubbo SPI 除了支持按需加载接口实现类,还增加了 IOC 和 AOP 等特性。 5.1 ExtensionLoader 入口 Dubbo SPI 的相关逻辑被封装在了 ExtensionLoader 类中,通过 ExtensionLoader,可以加载指定的实现类。 ExtensionLoader 的 getExtension 方法是其入口方法,其源码如下: public T getExtension(String name) { if (name == null || name.length() == 0) throw new IllegalArgumentException("Extension name == null"); if ("true".equals(name)) { // 获取默认的拓展实现类 return getDefaultExtension(); } // Holder,顾名思义,用于持有目标对象 Holder<Object> holder = cachedInstances.get(name); if (holder == null) { cachedInstances.putIfAbsent(name, new Holder<Object>()); holder = cachedInstances.get(name); } Object instance = holder.get(); // 双重检查 if (instance == null) { synchronized (holder) { instance = holder.get(); if (instance == null) { // 创建拓展实例 instance = createExtension(name); // 设置实例到 holder 中 holder.set(instance); } } } return (T) instance;} 可以看出,这个方法的作用就是:首先检查缓存,缓存未命中则调用 createExtension 方法创建拓展对象。那么,createExtension 是如何创建拓展对象的呢,其源码如下: private T createExtension(String name) { // 从配置文件中加载所有的拓展类,可得到“配置项名称”到“配置类”的映射关系表 Class<?> clazz = getExtensionClasses().get(name); if (clazz == null) { throw findException(name); } try { T instance = (T) EXTENSION_INSTANCES.get(clazz); if (instance == null) { // 通过反射创建实例 EXTENSION_INSTANCES.putIfAbsent(clazz, clazz.newInstance()); instance = (T) EXTENSION_INSTANCES.get(clazz); } // 向实例中注入依赖 injectExtension(instance); Set<Class<?>> wrapperClasses = cachedWrapperClasses; if (wrapperClasses != null && !wrapperClasses.isEmpty()) { // 循环创建 Wrapper 实例 for (Class<?> wrapperClass : wrapperClasses) { // 将当前 instance 作为参数传给 Wrapper 的构造方法,并通过反射创建 Wrapper 实例。 // 然后向 Wrapper 实例中注入依赖,最后将 Wrapper 实例再次赋值给 instance 变量 instance = injectExtension( (T) wrapperClass.getConstructor(type).newInstance(instance)); } } return instance; } catch (Throwable t) { throw new IllegalStateException("..."); }} createExtension 方法的的工作步骤可以归纳为: 通过getExtensionClasses获取所有的拓展类 通过反射创建拓展对象 向拓展对象中注入依赖 将拓展对象包裹在相应的Wrapper对象中 以上步骤中,第一个步骤是加载拓展类的关键,第三和第四个步骤是 Dubbo IOC 与 AOP 的具体实现。 5.2获取所有的拓展类 Dubbo 在通过名称获取拓展类之前,首先需要根据配置文件解析出拓展项名称到拓展类的映射关系表(Map<名称, 拓展类>),之后再根据拓展项名称从映射关系表中取出相应的拓展类即可。相关过程的代码分析如下: private Map<String, Class<?>> getExtensionClasses() { // 从缓存中获取已加载的拓展类 Map<String, Class<?>> classes = cachedClasses.get(); // 双重检查 if (classes == null) { synchronized (cachedClasses) { classes = cachedClasses.get(); if (classes == null) { // 加载拓展类 classes = loadExtensionClasses(); cachedClasses.set(classes); } } } return classes;} 这里也是先检查缓存,若缓存未命中,则通过 synchronized 加锁。加锁后再次检查缓存,并判空。此时如果 classes 仍为 null,则通过 loadExtensionClasses 加载拓展类。下面分析 loadExtensionClasses 方法的逻辑。 private Map<String, Class<?>> loadExtensionClasses() { // 获取 SPI 注解,这里的 type 变量是在调用 getExtensionLoader 方法时传入的 final SPI defaultAnnotation = type.getAnnotation(SPI.class); if (defaultAnnotation != null) { String value = defaultAnnotation.value(); if ((value = value.trim()).length() > 0) { // 对 SPI 注解内容进行切分 String[] names = NAME_SEPARATOR.split(value); // 检测 SPI 注解内容是否合法,不合法则抛出异常 if (names.length > 1) { throw new IllegalStateException("more than 1 default extension name on extension..."); } // 设置默认名称,参考 getDefaultExtension 方法 if (names.length == 1) { cachedDefaultName = names[0]; } } } Map<String, Class<?>> extensionClasses = new HashMap<String, Class<?>>(); // 加载指定文件夹下的配置文件 loadDirectory(extensionClasses, DUBBO_INTERNAL_DIRECTORY); loadDirectory(extensionClasses, DUBBO_DIRECTORY); loadDirectory(extensionClasses, SERVICES_DIRECTORY); return extensionClasses;} loadExtensionClasses 方法总共做了两件事情,一是对 SPI 注解进行解析,二是调用 loadDirectory 方法加载指定文件夹配置文件。SPI 注解解析过程比较简单,无需多说。下面我们来看一下 loadDirectory 做了哪些事情。 private void loadDirectory(Map<String, Class<?>> extensionClasses, String dir) { // fileName = 文件夹路径 + type 全限定名 String fileName = dir + type.getName(); try { Enumeration<java.net.URL> urls; ClassLoader classLoader = findClassLoader(); // 根据文件名加载所有的同名文件 if (classLoader != null) { urls = classLoader.getResources(fileName); } else { urls = ClassLoader.getSystemResources(fileName); } if (urls != null) { while (urls.hasMoreElements()) { java.net.URL resourceURL = urls.nextElement(); // 加载资源 loadResource(extensionClasses, classLoader, resourceURL); } } } catch (Throwable t) { logger.error("..."); }} loadDirectory 方法先通过 classLoader 获取所有资源链接,然后再通过 loadResource 方法加载资源。我们继续跟下去,看一下 loadResource 方法的实现。 private void loadResource(Map<String, Class<?>> extensionClasses, ClassLoader classLoader, java.net.URL resourceURL) { try { BufferedReader reader = new BufferedReader( new InputStreamReader(resourceURL.openStream(), "utf-8")); try { String line; // 按行读取配置内容 while ((line = reader.readLine()) != null) { // 定位 # 字符 final int ci = line.indexOf('#'); if (ci >= 0) { // 截取 # 之前的字符串,# 之后的内容为注释,需要忽略 line = line.substring(0, ci); } line = line.trim(); if (line.length() > 0) { try { String name = null; int i = line.indexOf('='); if (i > 0) { // 以等于号 = 为界,截取键与值 name = line.substring(0, i).trim(); line = line.substring(i + 1).trim(); } if (line.length() > 0) { // 加载类,并通过 loadClass 方法对类进行缓存 loadClass(extensionClasses, resourceURL, Class.forName(line, true, classLoader), name); } } catch (Throwable t) { IllegalStateException e = new IllegalStateException("Failed to load extension class..."); } } } } finally { reader.close(); } } catch (Throwable t) { logger.error("Exception when load extension class..."); }} loadResource 方法用于读取和解析配置文件,并通过反射加载类,最后调用 loadClass 方法进行其他操作。loadClass 方法用于主要用于操作缓存,该方法的逻辑如下: private void loadClass(Map<String, Class<?>> extensionClasses, java.net.URL resourceURL, Class<?> clazz, String name) throws NoSuchMethodException { if (!type.isAssignableFrom(clazz)) { throw new IllegalStateException("..."); } // 检测目标类上是否有 Adaptive 注解 if (clazz.isAnnotationPresent(Adaptive.class)) { if (cachedAdaptiveClass == null) { // 设置 cachedAdaptiveClass缓存 cachedAdaptiveClass = clazz; } else if (!cachedAdaptiveClass.equals(clazz)) { throw new IllegalStateException("..."); } // 检测 clazz 是否是 Wrapper 类型 } else if (isWrapperClass(clazz)) { Set<Class<?>> wrappers = cachedWrapperClasses; if (wrappers == null) { cachedWrapperClasses = new ConcurrentHashSet<Class<?>>(); wrappers = cachedWrapperClasses; } // 存储 clazz 到 cachedWrapperClasses 缓存中 wrappers.add(clazz); // 程序进入此分支,表明 clazz 是一个普通的拓展类 } else { // 检测 clazz 是否有默认的构造方法,如果没有,则抛出异常 clazz.getConstructor(); if (name == null || name.length() == 0) { // 如果 name 为空,则尝试从 Extension 注解中获取 name,或使用小写的类名作为 name name = findAnnotationName(clazz); if (name.length() == 0) { throw new IllegalStateException("..."); } } // 切分 name String[] names = NAME_SEPARATOR.split(name); if (names != null && names.length > 0) { Activate activate = clazz.getAnnotation(Activate.class); if (activate != null) { // 如果类上有 Activate 注解,则使用 names 数组的第一个元素作为键, // 存储 name 到 Activate 注解对象的映射关系 cachedActivates.put(names[0], activate); } for (String n : names) { if (!cachedNames.containsKey(clazz)) { // 存储 Class 到名称的映射关系 cachedNames.put(clazz, n); } Class<?> c = extensionClasses.get(n); if (c == null) { // 存储名称到 Class 的映射关系 extensionClasses.put(n, clazz); } else if (c != clazz) { throw new IllegalStateException("..."); } } } }} 如上,loadClass 方法操作了不同的缓存,比如 cachedAdaptiveClass、 cachedWrapperClasses 和 cachedNames 等等。除此之外,该方法没有其他什么逻辑了。 参考资料 Java SPI 思想梳理 Dubbo SPI springboot 中 SPI 机制 SpringBoot 的自动装配原理、自定义 starter 与 spi 机制,一网打尽 END 猜你喜欢 vivo平台化实践探索之旅-平台产品系列01 探究Presto SQL引擎(4)-统计计数 本文分享自微信公众号 - vivo互联网技术(vivoVMIC)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。