首页 文章 精选 留言 我的

精选列表

搜索[笔记工具],共10000篇文章
优秀的个人博客,低调大师

js的基础知识笔记

目录 一、基本数据类型 二、函数 三、面向对象 一、基本数据类型 1、使用var声明变量、使用;结尾、使用{}表示代码块、使用驼峰式命名 2、变量是弱类型的,即并不严格要求声明变量的类型,一个变量可以在运行期间动态的指向不同类型的数据 3、变量声明后可以不定义(或叫赋值、初始化),此时它的值是undefined 4、符号$可以作为命名开头的特殊字母,jQuery使用它作为jquery函数的别名 5、数据分为两大类:原始数据和引用数据,所以一个变量中保存的值自然也有两类 原始数据:直接存放在栈中, 变量中保存着此数据的直接值 引用数据:存放在堆中,并把内存地址存放在栈中,即变量中存放着此对象的指针 6、原始类型:undefined、boolean、number、string、null 7、引用类型:即对象object,其他array、function等对象都是在object基础上进一步封装的对象 二、函数 1、函数也是一个对象,构造函数在功能上还类似于一个类 2、函数如果没有显式说明返回值,则默认return undefined 3、函数对输入参数的要求并不严格(数量、类型),可以使用arguments来获得一个函数的输入参数数组 4、函数也是一个对象意味着,函数可以被当做输入参数、也可以被return,这就意味着可以实现闭包 5、函数的toString()方法可以得到函数的源代码 6、闭包,保存了函数定义时上下文的执行环境,当函数执行时,可以获取到这些数据 闭包的支持意味着可以完成装饰器模式 7、函数声明和函数表达式在某些环境下有非常大的区别 函数声明: function show(){} 函数表达式: var show = function(){} 函数声明有很高的优先级,会被解释器提前解析并释放到执行环境中() console.log(show) // 可以正常的打印出show函数对象 function show(){} 以上两句语句可以正常执行而不报错,全局代码被扫描的时候通过词法分析会在当前函数的AO对象中设定show变量的值为对应函数 而函数表达式等价于一个赋值语句,只有在运行此句代码时才执行,一下语句会报错 console.log(show) var show = function(){} 8、词法分析,一个函数在被真正执行内部代码前,解释器会先扫描函数源代码并执行词法分析,目的是提前完成函数作用域的生成, 函数作用域通过一个AO对象来保存,后续在逐行执行函数代码时,所有的变量查询都通过AO对象,词法分析步骤: a、分析函数输入参数,若函数源代码出现输入参数,则发生此步骤。解释器在AO对象中添加此属性,值为undefined,若有接收实参,则覆盖原有的值 b、分析变量,若函数源代码中出现变量定义,则发生此步骤。解释器寻找AO对象中是否有此属性,若无则增加,值为undefined,若有,什么也不做 c、分析函数声明,若函数源代码中出现函数声明(函数表达式会被定义为步骤b),则发生此步骤。解释器寻找AO对象是否有此属性,若无则增加,若有,则覆盖 换句话说,如果在一个函数func1内部有另一个函数声明func2,此func1函数在真正被执行内部代码前就已经生成了AO对象并且func2函数已经在func1函数的作用域中 三、面向对象 1、js对象类似于Python中的字典,里面存放着无序的键值对 2、对象中的属性(数据属性、函数属性)权限均为公开的(和Python一样),使用_xxx_的方式约定俗成的表示成私有数据(Python中使用__xxx) 3、this指代当前对象,尤其在构造函数中使用时,指代当前被初始化的对象(类似Python的__init__中的self) 4、如何定义一个类(实际是构造函数) a、构造函数定义数据+原型定义函数(我个人比较常用此种方式,代码清晰) function Stu(stuName, stuAge){ this.stuName = stuName; this.stuAge = stuAge; } Stu.prototype.goToSchool = function(schoolName){ console.log(this.stuName + ' is going to school: ' + schoolName); } b、构造函数定义数据+函数(这种模型也可以用于处理单例模式) function Stu(stuName, stuAge){ this.stuName = stuName; this.stuAge = stuAge; if(!Stu.__definedFlag){ //实际上此函数被当做单例模式 Stu.prototype.goToSchool = function(schoolName){ console.log(this.stuName + ' is going to school: ' + schoolName); } var Stu.__definedFlag = true; } }

优秀的个人博客,低调大师

AndroidStudio笔记(1)快捷键

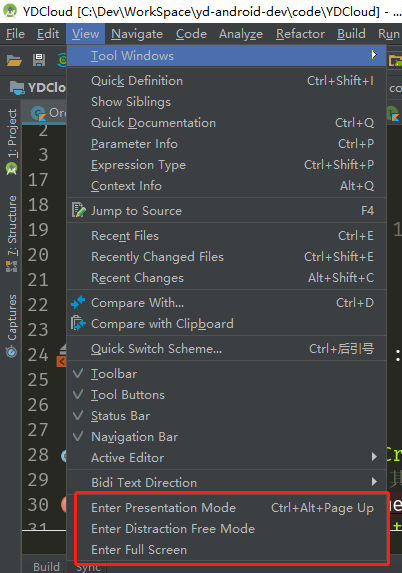
前言 记录一些常用的快捷键键位和小技巧,能够极大的提高开发效率和逼格,最终目的是成为一个 Full Screen Developer,远离鼠标。 正式内容 本套快捷键基于 ==Android Studio 3.1.3==,非常常用和比较有意思的快捷键会单独独立出来讲解,其它的就列一个表格。 全屏模式/勿扰模式 三种模式 Presentation mode 演示模式(全屏专注模式),在这个模式下,只有代码编辑区,什么菜单栏等乱七八糟的东西都没有。来看看效果: Toggle Presentation mode 如何进入该模式? 点击 View - > Toggle Presentation mode 就能进入勿扰模式,在点击一次就能退出。 当然,既然要远离鼠标,我们就可以设置快捷键了,好像在3.1.3之前的版本默认就有个快捷键 ==Ctrl + Alt + PageUp==,那么久直接设置这个快捷键吧。 快捷键1 另外两种模式就不详细讲了,看看截图吧 Distraction Free mode Distraction Free mode Full Screen Full Screen 缺省键 更改==缺省(提示)==键,避免与win10的 ==输入法切换== 冲突 缺省键 定位当前文件 定位当前文件在项目文件夹中的位置。 快捷键 ==Alt + F1==,选择第一个菜单选项 Select In 快速导航到错误代码行 这个快捷键看上去没什么作用,但事实上作用可大了,就好比一个几百行的代码报错了,有可能是因为没写分号,而你又死活找不到错误的位置,那么就可以直接用这个快捷键,它能够让你快速定位到 错误位置 和切换 错误位置。 AS 3.1以下 Alt + E AS 3.1以上 F2 其它常用 键位含义 对应键位 编译并启动 Shift + F10 查看引用 Ctrl +B 编译并调试 Shift + F9 打开菜单栏 Alt + 菜单栏首字母 打开侧边栏 - Project Alt +1 查看注释 Ctrl + Q 查看方法参数提示 Ctrl + P 抽取方法 Ctrl + Alt + M 局部变量变为成员变量 Ctrl + Alt + F 提交仓库 Ctrl + K 打开logcat Alt + 6 打开文件 Ctrl + Shift + N 搜索文件 双击 Shift 当前文件内搜索 Ctrl + F 全局搜索 Ctrl + Shift + F 重命名-文件名、变量名等 Shift +F6 Show Action Ctrl + Shift + A 是 Android Studio中最强大的快捷键,它提供了所有的快捷键搜索方式,可以不用记住键位,只需要要模糊的记得几个单词,比如下面的例子; 抽取样式 抽取样式 创建新的layout 创建新的layout 等等.....很多很多,只要你能熟用 Show Action ,那么平常的开发效率将会大大提升。 最后 未完待续、敬请期待!我的博客地址 FullScreenDeveloper

优秀的个人博客,低调大师

2018-09-02学习笔记

Content Provider 总结: 跨程序共享数据——Content Provider 之 运行时权限解析以及申请的实现(可完美解决java.lang.SecurityException:Permission Denial 问题) 跨程序共享数据——Content Provider 之 ContentResolver基本用法 & 一个读取系统联系人的Demo 跨程序共享数据——Content Provider 之 创建自己的内容提供器 Content Provider 之 最终弹 实战体验跨程序数据共享(结合SQLiteDemo)(即本文) Java回顾: Java基础知识的全面巩固_note1(附各种demo code) Java知识详细巩固_note2(数组 _ 附demo code) 受腾讯云+社区的运营小编陈子龙前辈邀请, 我的博客即将搬运同步至腾讯云+社区,邀请大家一同入驻:https://cloud.tencent.com/developer/support-plan?invite_code=2iitqqr04f408 ——2018.9.3

优秀的个人博客,低调大师

ElasticSearch学习笔记之原理介绍

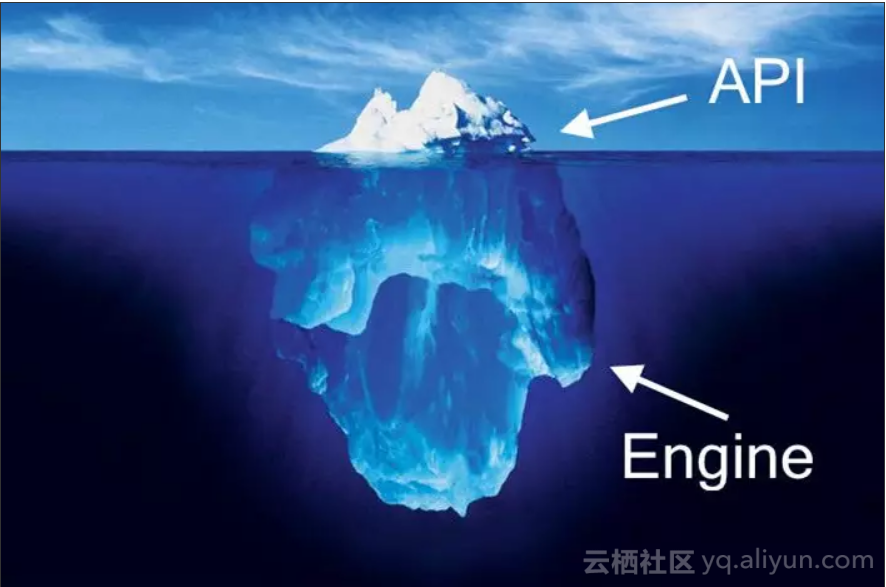
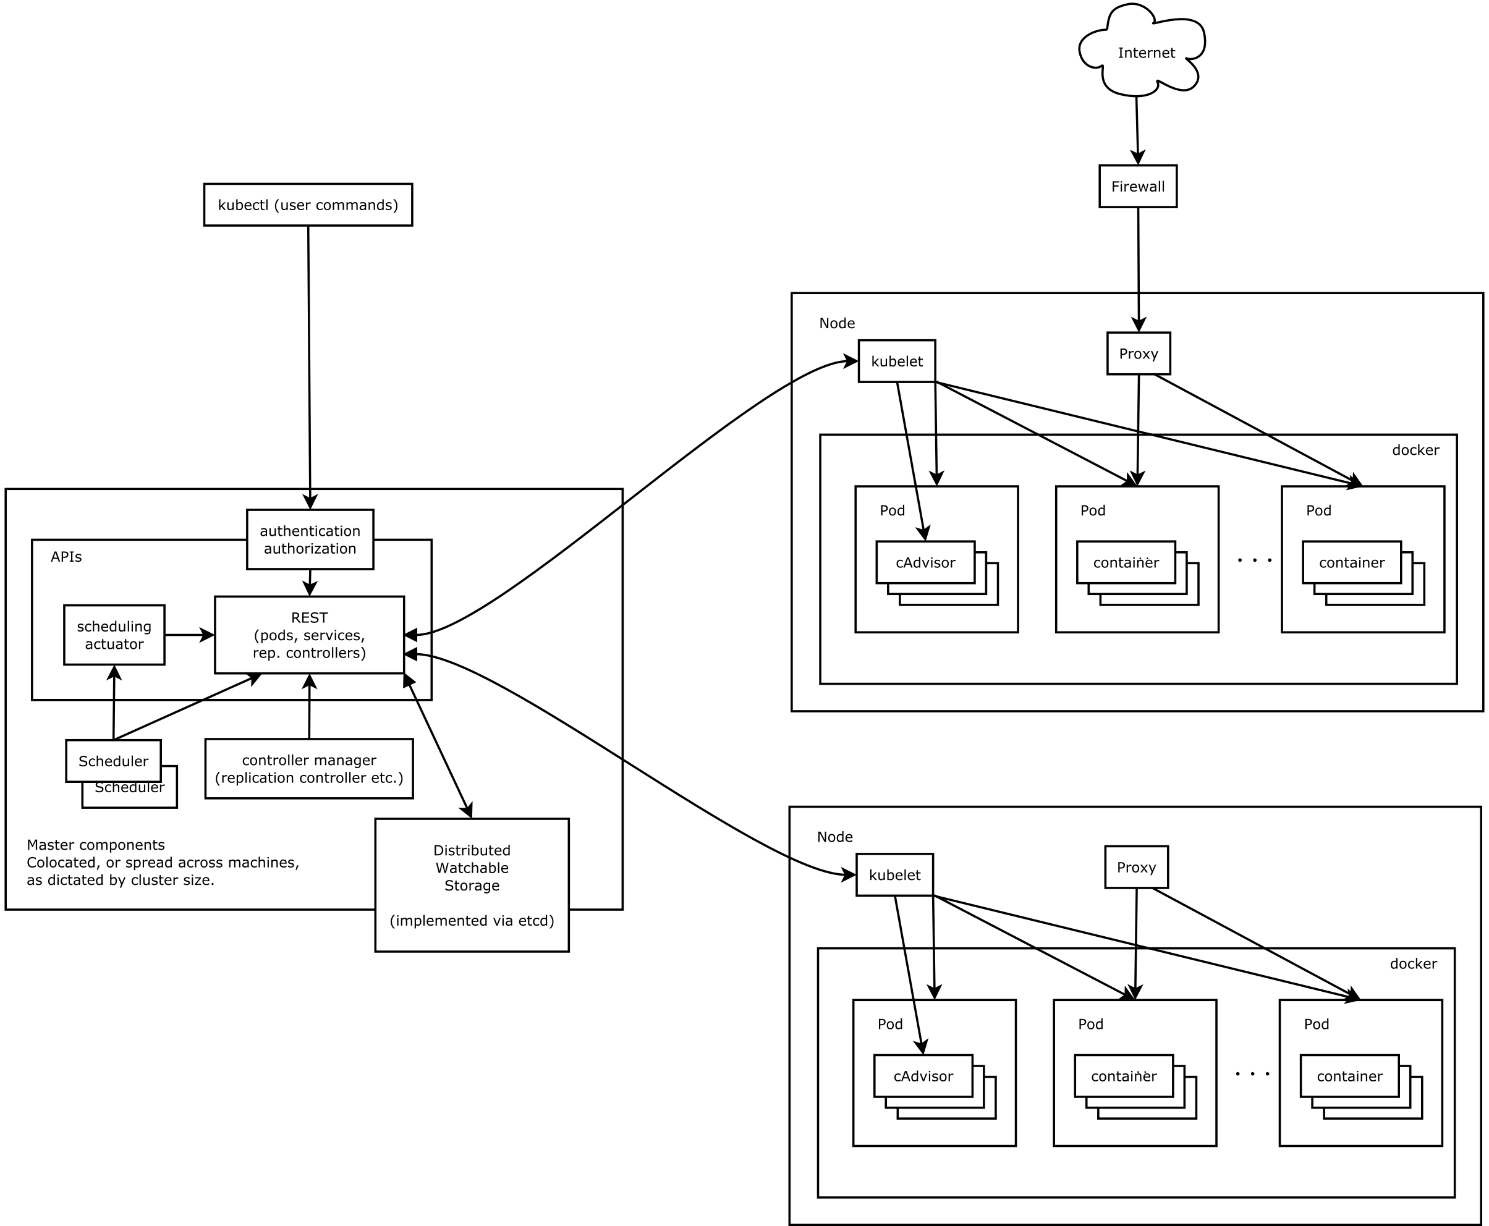
ElasticSearch是一个基于Lucene的搜索服务器。它提供了一个分布式多用户能力的全文搜索引擎,基于RESTful web接口。Elasticsearch是用Java开发的,并作为Apache许可条款下的开放源码发布,是当前流行的企业级搜索引擎。设计用于云计算中,能够达到实时搜索,稳定,可靠,快速,安装使用方便。 揭面: 架构图: 架构各模块介绍: Lucence Directory:是lucene的框架服务发现以及选主 ZenDiscovery: 用来实现节点自动发现,还有Master节点选取,假如Master出现故障,其它的这个节点会自动选举,产生一个新的Master; Plugins:插件可以通过自定的方式扩展加强Elasticsearch的基本功能,比如可以自定义类型映射,分词器,本地脚本,自动发现等; Scripting:使用脚本语言可以计算自定义表达式的值,比如计算自定义查询相关度评分。支持的脚本语言有groovy,js,mvel(1.3.0废弃),python等; Disovery:该模块主要负责集群中节点的自动发现和Master节点的选举。节点之间使用p2p的方式进行直接通信,不存在单点故障的问题。Elasticsearch中,Master节点维护集群的全局状态,比如节点加入和离开时进行shard的重新分配; River:代表es的一个数据源,也是其它存储方式(如:数据库)同步数据到es的一个方法。它是以插件方式存在的一个es服务,通过读取river中的数据并把它索引到es中; Gateway:模块用于存储es集群的元数据信息; Zen Discovery:zen发现机制是elasticsearch默认的内建模块。它提供了多播和单播两种发现方式,能够很容易的扩展至云环境。zen发现机制是和其他模块集成的,例如所有节点间通讯必须用trasport模块来完成。 核心概念: 集群(Cluster):ES集群是一个或多个节点的集合,它们共同存储了整个数据集,并提供了联合索引以及可跨所有节点的搜索能力。多节点组成的集群拥有冗余能力,它可以在一个或几个节点出现故障时保证服务的整体可用性。 集群靠其独有的名称进行标识,默认名称为“elasticsearch”。节点靠其集群名称来决定加入哪个ES集群,一个节点只能属一个集群; 节点(node):一个节点是一个逻辑上独立的服务,可以存储数据,并参与集群的索引和搜索功能, 一个节点也有唯一的名字,群集通过节点名称进行管理和通信; 主节点:主节点的主要职责是和集群操作相关的内容,如创建或删除索引,跟踪哪些节点是群集的一部分,并决定哪些分片分配给相关的节点。稳定的主节点对集群的健康是非常重要的。虽然主节点也可以协调节点,路由搜索和从客户端新增数据到数据节点,但最好不要使用这些专用的主节点。一个重要的原则是,尽可能做尽量少的工作。 对于大型的生产集群来说,推荐使用一个专门的主节点来控制集群,该节点将不处理任何用户请求。 数据节点:持有数据和倒排索引。 客户端节点:它既不能保持数据也不能成为主节点,该节点可以响应用户的情况,把相关操作发送到其他节点;客户端节点会将客户端请求路由到集群中合适的分片上。对于读请求来说,协调节点每次会选择不同的分片处理请求,以实现负载均衡。 部落节点:部落节点可以跨越多个集群,它可以接收每个集群的状态,然后合并成一个全局集群的状态,它可以读写所有节点上的数据。 索引(Index): ES将数据存储于一个或多个索引中,索引是具有类似特性的文档的集合。类比传统的关系型数据库领域来说,索引相当于SQL中的一个数据库,或者一个数据存储方案(schema)。索引由其名称(必须为全小写字符)进行标识,并通过引用此名称完成文档的创建、搜索、更新及删除操作。一个ES集群中可以按需创建任意数目的索引。 文档类型(Type):类型是索引内部的逻辑分区(category/partition),然而其意义完全取决于用户需求。因此,一个索引内部可定义一个或多个类型(type)。一般来说,类型就是为那些拥有相同的域的文档做的预定义。例如,在索引中,可以定义一个用于存储用户数据的类型,一个存储日志数据的类型,以及一个存储评论数据的类型。类比传统的关系型数据库领域来说,类型相当于“表”。 文档(Document) :文档是Lucene索引和搜索的原子单位,它是包含了一个或多个域的容器,基于JSON格式进行表示。文档由一个或多个域组成,每个域拥有一个名字及一个或多个值,有多个值的域通常称为“多值域”。每个文档可以存储不同的域集,但同一类型下的文档至应该有某种程度上的相似之处。相当于数据库的“记录” Mapping: 相当于数据库中的schema,用来约束字段的类型,不过 Elasticsearch 的 mapping 可以自动根据数据创建。 ES中,所有的文档在存储之前都要首先进行分析。用户可根据需要定义如何将文本分割成token、哪些token应该被过滤掉,以及哪些文本需要进行额外处理等等。 分片(shard) :ES的“分片(shard)”机制可将一个索引内部的数据分布地存储于多个节点,它通过将一个索引切分为多个底层物理的Lucene索引完成索引数据的分割存储功能,这每一个物理的Lucene索引称为一个分片(shard)。 每个分片其内部都是一个全功能且独立的索引,因此可由集群中的任何主机存储。创建索引时,用户可指定其分片的数量,默认数量为5个。 Shard有两种类型:primary和replica,即主shard及副本shard。 Primary shard用于文档存储,每个新的索引会自动创建5个Primary shard,当然此数量可在索引创建之前通过配置自行定义,不过,一旦创建完成,其Primary shard的数量将不可更改。 Replica shard是Primary Shard的副本,用于冗余数据及提高搜索性能。 每个Primary shard默认配置了一个Replica shard,但也可以配置多个,且其数量可动态更改。ES会根据需要自动增加或减少这些Replica shard的数量。 ES集群可由多个节点组成,各Shard分布式地存储于这些节点上。 ES可自动在节点间按需要移动shard,例如增加节点或节点故障时。简而言之,分片实现了集群的分布式存储,而副本实现了其分布式处理及冗余功能。 创建索引: 过程:当分片所在的节点接收到来自协调节点的请求后,会将该请求写入translog,并将文档加入内存缓存。如果请求在主分片上成功处理,该请求会并行发送到该分片的副本上。当translog被同步到全部的主分片及其副本上后,客户端才会收到确认通知。 内存缓冲会被周期性刷新(默认是1秒),内容将被写到文件系统缓存的一个新段(segment)上。虽然这个段并没有被同步(fsync),但它是开放的,内容可以被搜索到。 每30分钟,或者当translog很大的时候,translog会被清空,文件系统缓存会被同步。这个过程在Elasticsearch中称为冲洗(flush)。在冲洗过程中,内存中的缓冲将被清除,内容被写入一个新段。段的fsync将创建一个新的提交点,并将内容刷新到磁盘。旧的translog将被删除并开始一个新的translog。 ES如何做到实时检索? 由于在buffer中的索引片先同步到文件系统缓存,再刷写到磁盘,因此在检索时可以直接检索文件系统缓存,保证了实时性。 这一步刷到文件系统缓存的步骤,在 Elasticsearch 中,是默认设置为 1 秒间隔的,对于大多数应用来说,几乎就相当于是实时可搜索了。 不过对于 ELK 的日志场景来说,并不需要如此高的实时性,而是需要更快的写入性能。我们可以通过 /_settings接口或者定制 template 的方式,加大 refresh_interval 参数。 当segment从文件系统缓存同步到磁盘时发生了错误怎么办? 数据会不会丢失? 由于Elasticsearch 在把数据写入到内存 buffer 的同时,其实还另外记录了一个 translog日志,如果在这期间故障发生时,Elasticsearch会从commit位置开始,恢复整个translog文件中的记录,保证数据的一致性。 等到真正把 segment 刷到磁盘,且 commit 文件进行更新的时候, translog 文件才清空。这一步,叫做flush。同样,Elasticsearch 也提供了 /_flush 接口。 索引数据的一致性通过 translog 保证,那么 translog 文件自己呢? Elasticsearch 2.0 以后为了保证不丢失数据,每次 index、bulk、delete、update 完成的时候,一定触发刷新translog 到磁盘上,才给请求返回 200 OK。这个改变在提高数据安全性的同时当然也降低了一点性能 检索文档: 搜索相关性 相关性是由搜索结果中Elasticsearch打给每个文档的得分决定的。默认使用的排序算法是tf/idf(词频/逆文档频率)。词频衡量了一个词项在文档中出现的次数 (频率越高 == 相关性越高),逆文档频率衡量了词项在全部索引中出现的频率,是一个索引中文档总数的百分比(频率越高 == 相关性越低)。最后的得分是tf-idf得分与其他因子比如(短语查询中的)词项接近度、(模糊查询中的)词项相似度等的组合 更新删除索引: 删除和更新也都是写操作。但是Elasticsearch中的文档是不可变的,因此不能被删除或者改动以展示其变更。那么,该如何删除和更新文档呢? 磁盘上的每个段都有一个相应的.del文件。当删除请求发送后,文档并没有真的被删除,而是在.del文件中被标记为删除。该文档依然能匹配查询,但是会在结果中被过滤掉。当段合并(我们将在本系列接下来的文章中讲到)时,在.del文件中被标记为删除的文档将不会被写入新段。 接下来我们看更新是如何工作的。在新的文档被创建时,Elasticsearch会为该文档指定一个版本号。当执行更新时,旧版本的文档在.del文件中被标记为删除,新版本的文档被索引到一个新段。旧版本的文档依然能匹配查询,但是会在结果中被过滤掉。 物理删除索引:当索引数据不断增长时,对应的segment也会不断的增多,查询性能可能就会下降。因此,Elasticsearch会触发segment合并的线程,把很多小的segment合并成更大的segment,然后删除小的segment,当这些标记为删除的segment不会被复制到新的索引段中。 Elasticseach查询: Elasticseach查询分为两种,结构化查询和全文查询; 尽管统一称之为query DSL,事实上Elasticsearch中存在两种DSL:查询DSL(query DSL)和过滤DSL(filter DSL)。 查询子句和过滤子句的自然属性非常相近,但在使用目的上略有区别。 简单来讲,当执行full-text查询或查询结果依赖于相关度分值时应该使用查询DSL,当执行精确值(extac-value)查询或查询结果仅有“yes”或“no”两种结果时应该使用过滤DSL。 Filter DSL计算及过滤速度较快,且适于缓存,因此可有效提升后续查询请求的执行速度。而query DSL不仅要查找匹配的文档,还需要计算每个文件的相关度分值,因此为更重量级的查询,其查询结果不会被缓存。 不过,得益于倒排索引,一个仅返回少量文档的简单query或许比一个跨数百万文档的filter执行起来并得显得更慢。 Elasticsearch支持许多的query和filter,但最常用的也不过几种。 Filter DSL中常见的有term Filter、terms Filter、range Filter、exists and missing Filters和bool Filter。 而Query DSL中常见的有match_all、match 、multi_match及bool Query。鉴于时间关系,这里不再细述,朋友们可参考官方文档学习。 Queries用于查询上下文,而filters用于过滤上下文,不过,Elasticsearch的API也支持此二者合并运行。 组合查询可用于合并查询子句,组合过滤用于合并过滤子句,然而,Elasticsearch的使用习惯中,也常会把filter用于query上进行过滤。不过,很少有机会需要把query用于filter上的。 结构化搜索:是指查询包含内部结构的数据。日期,时间,和数字都是结构化的:它们有明确的格式给你执行逻辑操作。一般包括比较数字或日期的范围,或确定两个值哪个大。 文本也可以被结构化。一包蜡笔有不同的颜色:红色,绿色,蓝色。一篇博客可能被打上 分布式 和 搜索的标签。电子商务产品有商品统一代码(UPCs) 或其他有着严格格式的标识。 通过结构化搜索,你的查询结果始终是 是或非;是否应该属于集合。结构化搜索不关心文档的相关性或分数,它只是简单的包含或排除文档。 这必须是有意义的逻辑,一个数字不能比同一个范围中的其他数字更多。它只能包含在一个范围中,或不在其中。类似的,对于结构化文本,一个值必须相等或不等。这里没有 更匹配 的概念。 所谓的全文搜索查询通常是指在给定的文本域内部搜索指定的关键字,但搜索操作该需要真正理解查询者的目的,例如: (1) 搜索“UK”应该返回包含“United Kingdom”的相关文档; (2) 搜索“jump”应该返回包含“JUMP”、“jumped”、“jumps”、“jumping”甚至是“leap”的文档; 为了完成此类全文搜域的搜索,ES必须首先分析文本并将其构建成为倒排索引(inverted index),倒排索引由各文档中出现的单词列表组成,列表中的各单词不能重复且需要指向其所在的各文档。 因此,为了创建倒排索引,需要先将各文档中域的值切分为独立的单词(也称为term或token),而后将之创建为一个无重复的有序单词列表。这个过程称之为“分词(tokenization)”。 其次,为了完成此类full-text域的搜索,倒排索引中的数据还需进行“正规化(normalization)”为标准格式,才能评估其与用户搜索请求字符串的相似度。 这里的“分词”及“正规化”操作也称为“分析(analysis)”。 Analysis过程由两个步骤的操作组成:首先将文本切分为terms(词项)以适合构建倒排索引,其次将各terms正规化为标准形式以提升其“可搜索度”。这两个步骤由分析器(analyzers)完成。 一个分析器通常需要由三个组件构成:字符过滤器(Character filters)、分词器(Tokenizer)和分词过滤器(Token filters)组成。 字符过滤器:在文本被切割之前进行清理操作,例如移除HTML标签,将&替换为字符等; 分词器:将文本切分为独立的词项;简单的分词器通常是根据空白及标点符号进行切分; 分词过滤器:转换字符(如将大写转为小写)、移除词项(如移除a、an、of及the等)或者添加词项(例如,添加同义词); Elasticsearch内置了许多字符过滤器、分词器和分词过滤器,用户可按需将它们组合成“自定义”的分析器。 与SOLR比对: 三种使用方式: 使用案例: 1)维基百科,类似百度百科,牙膏,牙膏的维基百科,全文检索,高亮,搜索推荐; 2)The Guardian(国外新闻网站),类似搜狐新闻,用户行为日志(点击,浏览,收藏,评论)+社交网络数据(对某某新闻的相关看法),数据分析,给到每篇新闻文章的作者,让他知道他的文章的公众反馈(好,坏,热门,垃圾,鄙视,崇拜); 3)Stack Overflow(国外的程序异常讨论论坛),IT问题,程序的报错,提交上去,有人会跟你讨论和回答,全文检索,搜索相关问题和答案,程序报错了,就会将报错信息粘贴到里面去,搜索有没有对应的答案; 4)GitHub(开源代码管理),搜索上千亿行代码; 5)电商网站,检索商品; 6)日志数据分析,logstash采集日志,ES进行复杂的数据分析(ELK技术,elasticsearch+logstash+kibana); 7)商品价格监控网站,用户设定某商品的价格阈值,当低于该阈值的时候,发送通知消息给用户,比如说订阅牙膏的监控,如果高露洁牙膏的家庭套装低于50块钱,就通知我,我就去买; 8)BI系统,商业智能,Business Intelligence。比如说有个大型商场集团,BI,分析一下某某区域最近3年的用户消费金额的趋势以及用户群体的组成构成,产出相关的数张报表,最近3年,每年消费金额呈现100%的增长,而且用户群体85%是高级白领,开一个新商场。ES执行数据分析和挖掘,Kibana进行数据可视化; 9)国内:站内搜索(电商,招聘,门户,等等),IT系统搜索(OA,CRM,ERP,等等),数据分析(ES热门的一个使用场景) 原文发布时间为:2018-08-22 本文作者:等待九月 本文来自云栖社区合作伙伴“我的小碗汤”,了解相关信息可以关注“我的小碗汤”。

优秀的个人博客,低调大师

Python多线程threading进阶笔记

1.创建threading.Thread对象实现多线程: 创建一个threading.Thread对象,在它的初始化函数(__init__)中将可调用对象作为参数传入 引入threadring来同时播放音乐和视频: #coding=utf-8 import threading from time import ctime,sleep def music(func): for i in range(2): print ("I was listening to %s. %s\n" %(func,ctime())) sleep(1) def move(func): for i in range(2): print ("I was at the %s! %s\n" %(func,ctime())) sleep(5) threads = [] t1 = threading.Thread(target=music,args=(u'爱情买卖',)) threads.append(t1) t2 = threading.Thread(target=move,args=(u'阿凡达',)) threads.append(t2) if __name__ == '__main__': for t in threads: t.setDaemon(True) t.start() print ("all over %s" %ctime()) import threading 首先导入threading 模块,这是使用多线程的前提。 threads = [] t1 = threading.Thread(target=music,args=(u'爱情买卖',)) threads.append(t1) 创建了threads数组,创建线程t1,使用threading.Thread()方法,在这个方法中调用music方法target=music,args方法对music进行传参。 把创建好的线程t1装到threads数组中。 接着以同样的方式创建线程t2,并把t2也装到threads数组。 for t in threads: t.setDaemon(True) t.start() 最后通过for循环遍历数组。(数组被装载了t1和t2两个线程) setDaemon() setDaemon(True)将线程声明为守护线程,必须在start() 方法调用之前设置,如果不设置为守护线程程序会被无限挂起。子线程启动后,父线程也继续执行下去,当父线程执行完最后一条语句print "all over %s" %ctime()后,没有等待子线程,直接就退出了,同时子线程也一同结束。 start() 开始线程活动。 运行结果: >>> ========================= RESTART ================================ >>> I was listening to 爱情买卖. Thu Apr 17 12:51:45 2014 I was at the 阿凡达! Thu Apr 17 12:51:45 2014 all over Thu Apr 17 12:51:45 2014 从执行结果来看,子线程(muisc、move)和主线程(print"allover%s"%ctime())都是同一时间启动,但由于主线程执行完结束,所以导致子线程也终止。 继续调整程序: ... if __name__ == '__main__': for t in threads: t.setDaemon(True) t.start() t.join() print "all over %s" %ctime() 我们只对上面的程序加了个join()方法,用于等待线程终止。join()的作用是,在子线程完成运行之前,这个子线程的父线程将一直被阻塞。 注意: join()方法的位置是在for循环外的,也就是说必须等待for循环里的两个进程都结束后,才去执行主进程。 运行结果: >>> ========================= RESTART ================================ >>> I was listening to 爱情买卖. Thu Apr 17 13:04:11 2014 I was at the 阿凡达! Thu Apr 17 13:04:11 2014 I was listening to 爱情买卖. Thu Apr 17 13:04:12 2014 I was at the 阿凡达! Thu Apr 17 13:04:16 2014 all over Thu Apr 17 13:04:21 2014 从执行结果可看到,music和move是同时启动的。 开始时间4分11秒,直到调用主进程为4分22秒,总耗时为10秒。从单线程时减少了2秒,我们可以把music的sleep()的时间调整为4秒。 ... def music(func): for i in range(2): print "I was listening to %s. %s" %(func,ctime()) sleep(4) ... 执行结果: >>> ====================== RESTART ================================ >>> I was listening to 爱情买卖. Thu Apr 17 13:11:27 2014 I was at the 阿凡达! Thu Apr 17 13:11:27 2014 I was listening to 爱情买卖. Thu Apr 17 13:11:31 2014 I was at the 阿凡达! Thu Apr 17 13:11:32 2014 all over Thu Apr 17 13:11:37 2014 子线程启动11分27秒,主线程运行11分37秒。 虽然music每首歌曲从1秒延长到了4,但通多程线的方式运行脚本,总的时间没变化。 2.继承Thread类实现多线程 下面分别举例说明。先来看看通过继承threading.Thread类来创建线程的例子: #coding=utf-8 import threading, time count = 0 class Counter(threading.Thread): def __init__(self, lock, threadName): ''' @summary: 初始化对象。 @param lock: 琐对象。 @param threadName: 线程名称。 ''' super(Counter, self).__init__(name = threadName) #注意:一定要显式的调用父类的初始化函数。 self.lock = lock def run(self): ''' @summary: 重写父类run方法,在线程启动后执行该方法内的代码。 ''' global count self.lock.acquire() for i in range(10000): count = count + 1 self.lock.release() lock = threading.Lock() for i in range(5): Counter(lock, "thread-" + str(i)).start() time.sleep(2) #确保线程都执行完毕 print (count) 在代码中,我们创建了一个Counter类,它继承了threading.Thread。初始化函数接收两个参数,一个是琐对象,另一个是线程的名称。在Counter中,重写了从父类继承的run方法,run方法将一个全局变量逐一的增加10000。在接下来的代码中,创建了五个Counter对象,分别调用其start方法。最后打印结果。这里要说明一下run方法 和start方法: 它们都是从Thread继承而来的,run()方法将在线程开启后执行,可以把相关的逻辑写到run方法中;start()方法用于启动线程。 3.Thread类 Thread类还定义了以下常用方法与属性: Thread.getName() Thread.setName() Thread.name 用于获取和设置线程的名称。 Thread.ident 获取线程的标识符。线程标识符是一个非零整数,只有在调用了start()方法之后该属性才有效,否则它只返回None。 Thread.is_alive() Thread.isAlive() 判断线程是否是激活的(alive)。从调用start()方法启动线程,到run()方法执行完毕或遇到未处理异常而中断 这段时间内,线程是激活的。 Thread.join([timeout]) 调用Thread.join将会使主调线程堵塞,直到被调用线程运行结束或超时。参数timeout是一个数值类型,表示超时时间,如果未提供该参数,那么主调线程将一直堵塞到被调线程结束。下面举个例子说明join()的使用: import threading, time def doWaiting(): print ('start waiting:', time.strftime('%H:%M:%S')) time.sleep(3) print ('stop waiting', time.strftime('%H:%M:%S')) thread1 = threading.Thread(target = doWaiting) thread1.start() time.sleep(1) #确保线程thread1已经启动 print ('start join') thread1.join() #将一直堵塞,直到thread1运行结束。 print ('end join') threading.RLock和threading.Lock 在threading模块中,定义两种类型的琐:threading.Lock和threading.RLock。它们之间有一点细微的区别,通过比较下面两段代码来说明: import threading lock = threading.Lock() #Lock对象 lock.acquire() lock.acquire() #产生了死琐。 lock.release() lock.release() import threading rLock = threading.RLock() #RLock对象 rLock.acquire() rLock.acquire() #在同一线程内,程序不会堵塞。 rLock.release() rLock.release() 这两种琐的主要区别是:RLock允许在同一线程中被多次acquire。而Lock却不允许这种情况。注意:如果使用RLock,那么acquire和release必须成对出现,即调用了n次acquire,必须调用n次的release才能真正释放所占用的琐。 threading.Condition 可以把Condiftion理解为一把高级的琐,它提供了比Lock, RLock更高级的功能,允许我们能够控制复杂的线程同步问题。threadiong.Condition在内部维护一个琐对象(默认是RLock),可以在创建Condigtion对象的时候把琐对象作为参数传入。Condition也提供了acquire, release方法,其含义与琐的acquire, release方法一致,其实它只是简单的调用内部琐对象的对应的方法而已。Condition还提供了如下方法(特别要注意:这些方法只有在占用琐(acquire)之后才能调用,否则将会报RuntimeError异常。): Condition.wait([timeout]): wait方法释放内部所占用的琐,同时线程被挂起,直至接收到通知被唤醒或超时(如果提供了timeout参数的话)。当线程被唤醒并重新占有琐的时候,程序才会继续执行下去。 Condition.notify(): 唤醒一个挂起的线程(如果存在挂起的线程)。注意:notify()方法不会释放所占用的琐。 Condition.notify_all() Condition.notifyAll() 唤醒所有挂起的线程(如果存在挂起的线程)。注意:这些方法不会释放所占用的琐。 现在写个捉迷藏的游戏来具体介绍threading.Condition的基本使用。假设这个游戏由两个人来玩,一个藏(Hider),一个找(Seeker)。游戏的规则如下:1. 游戏开始之后,Seeker先把自己眼睛蒙上,蒙上眼睛后,就通知Hider;2. Hider接收通知后开始找地方将自己藏起来,藏好之后,再通知Seeker可以找了; 3. Seeker接收到通知之后,就开始找Hider。Hider和Seeker都是独立的个体,在程序中用两个独立的线程来表示,在游戏过程中,两者之间的行为有一定的时序关系,我们通过Condition来控制这种时序关系。 #---- Condition #---- 捉迷藏的游戏 import threading, time class Hider(threading.Thread): def __init__(self, cond, name): super(Hider, self).__init__() self.cond = cond self.name = name def run(self): time.sleep(1) #确保先运行Seeker中的方法 self.cond.acquire() #b print (self.name + ': 我已经把眼睛蒙上了') self.cond.notify() self.cond.wait() #c #f print (self.name + ': 我找到你了 ~_~') self.cond.notify() self.cond.release() #g print (self.name + ': 我赢了') #h class Seeker(threading.Thread): def __init__(self, cond, name): super(Seeker, self).__init__() self.cond = cond self.name = name def run(self): self.cond.acquire() self.cond.wait() #a #释放对琐的占用,同时线程挂起在这里,直到被notify并重新占有琐。 #d print (self.name + ': 我已经藏好了,你快来找我吧') self.cond.notify() self.cond.wait() #e #h self.cond.release() print (self.name + ': 被你找到了,哎~~~') cond = threading.Condition() seeker = Seeker(cond, 'seeker') hider = Hider(cond, 'hider') seeker.start() hider.start() threading.Event Event实现与Condition类似的功能,不过比Condition简单一点。它通过维护内部的标识符来实现线程间的同步问题。(threading.Event和.NET中的System.Threading.ManualResetEvent类实现同样的功能。) Event.wait([timeout]) 堵塞线程,直到Event对象内部标识位被设为True或超时(如果提供了参数timeout)。 Event.set() 将标识位设为Ture Event.clear() 将标识伴设为False。 Event.isSet() 判断标识位是否为Ture。 下面使用Event来实现捉迷藏的游戏(可能用Event来实现不是很形象) #---- Event #---- 捉迷藏的游戏 import threading, time class Hider(threading.Thread): def __init__(self, cond, name): super(Hider, self).__init__() self.cond = cond self.name = name def run(self): time.sleep(1) #确保先运行Seeker中的方法 print (self.name + ': 我已经把眼睛蒙上了') self.cond.set() time.sleep(1) self.cond.wait() print (self.name + ': 我找到你了 ~_~') self.cond.set() print (self.name + ': 我赢了') class Seeker(threading.Thread): def __init__(self, cond, name): super(Seeker, self).__init__() self.cond = cond self.name = name def run(self): self.cond.wait() print (self.name + ': 我已经藏好了,你快来找我吧') self.cond.set() time.sleep(1) self.cond.wait() print (self.name + ': 被你找到了,哎~~~') cond = threading.Event() seeker = Seeker(cond, 'seeker') hider = Hider(cond, 'hider') seeker.start() hider.start() threading.Timer threading.Timer是threading.Thread的子类,可以在指定时间间隔后执行某个操作。下面是Python手册上提供的一个例子: def hello(): print ("hello, world") t = Timer(3, hello) t.start() # 3秒钟之后执行hello函数。 threading常用的方法: threading.active_count() threading.activeCount() 获取当前活动的(alive)线程的个数。 threading.current_thread() threading.currentThread() 获取当前的线程对象(Thread object)。 threading.enumerate() 获取当前所有活动线程的列表。 threading.settrace(func) 设置一个跟踪函数,用于在run()执行之前被调用。 threading.setprofile(func) 设置一个跟踪函数,用于在run()执行完毕之后调用。 threading模块的内容很多,更多内容可以参考官方,猛戳这里!

优秀的个人博客,低调大师

ES6学习笔记(一)

一、let 命令 1、let命令 1.1基本用法 1.1.1 let用于声明变量 类似var,但是let声明的变量只在当前代码块内有效 { let a = 10; var b = 1; } a // ReferenceError: a is not defined. b // 1 let命令在for 循环的计数器中很实用。 1.1.2 let不存在变量提升 var命令会发送“变量提升”,即变量可以在声明之前使用,值为undefined 正常来说变量使用一定要在声明之后。 1.1.3 暂时性死区 只要块级作用域内存在let命令,它所生命的变量就绑定(binding)这个区域,不受外部影响。 ES6明确规定,在区块中存在let 和 const命令,这个区块对这些命令声明的变量都是 不能提前使用的,会报错。 总之在代码块之内,Let声明的变量不可提前使用。 1.1.4不允许重复声明 let不允许在相同作用域内重复声明同一个变量。所以不能在函数内部重新声明参数。 function func(arg) { let arg; // 报错 } function func(arg) { { let arg; // 不报错 } } 1.1.5 ES6的块级作用域 let为JavaScript新增了块级作用域,允许块级作用域的任意嵌套。 {{{{{let insane = 'Hello World'}}}}}; 外层作用域无法读取内层作用域内的变量。 {{{{ {let insane = 'Hello World'} console.log(insane); // 报错 }}}}; 内层作用域可以定义外层作用域的同名变量。 {{{{ let insane = 'Hello World'; {let insane = 'Hello World'} }}}}; 1.1.6 允许块级作用域中声明函数 // 浏览器的 ES6 环境 function f() { console.log('I am outside!'); } (function () { if (false) { // 重复声明一次函数f function f() { console.log('I am inside!'); } } f(); }()); // Uncaught TypeError: f is not a function ES6的块级作用域允许声明函数的规则只在使用大括号的前提下成立,否则就会报错。 1.1.7 do表达式 块级作用域是一个语句,将多个操作封装在一起,没有返回值。 使得块级作用域可以变为表达式,也就是说可以返回值,办法就是在块级作用域之前加上do,使它变为do表达式。 let x = do { let t = f(); t * t + 1; }; 上面代码中,变量x会得到整个块级作用域的返回值。

优秀的个人博客,低调大师

深度学习入门笔记系列 ( 一 )

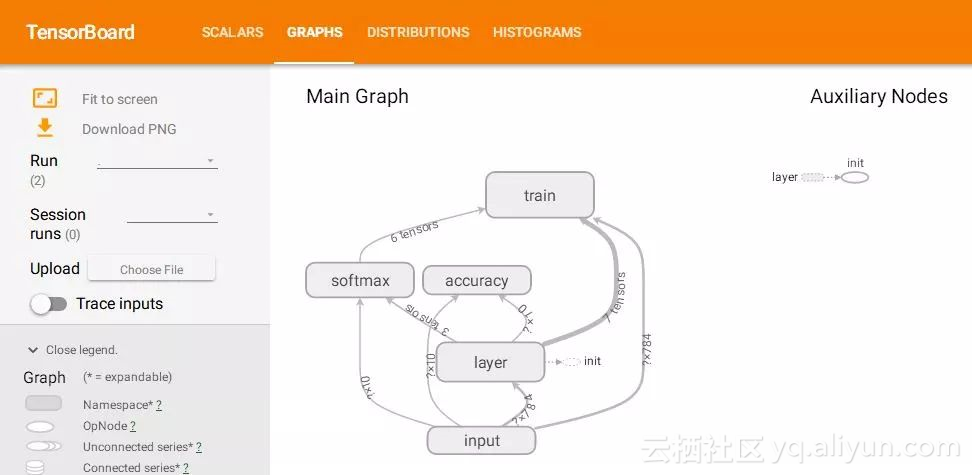
本系列将分为 8 篇 。今天是第一篇 ,工欲善其事必先利其器 ,先简单讲讲当前的主流深度学习框架 TensorFlow 及其安装方法 。 我们知道 ,深度学习研究的热潮持续高涨 ,许多的开源深度学习框架也层出不穷 ,比如 TensorFlow、Caffe、Keras、Theano、Torch7……其中 ,TensorFlow 由强大的谷歌研发 ,应用也十分广泛 ,从 GitHub 上的数据统计可以看出来其有着大一统之势头 。 关于 TensorFlow 的安装 ,我们首先得知道 : Window 、MacOS 、Linux 都已支持 TensorFlow Window用户只能使用python3.5+ ,MacOS,Linux支持python2.7和python3.3+ 有GPU可以安装带GPU版本的,没有GPU就安装CPU版本的。 关于 TensorFlow 的安装 ,这里推荐使用 pip 方式安装 ,简单粗暴 !这里小詹安利一款神器 ,谁用谁说好哈哈 !Anaconda ,你可以试试 ,自带python3.5 ,也包含了很多模块 ,配置其他模块的时候也很好用 。 首先是 windows 下的 pip 安装 :(命令窗口执行) CPU 版本 :pip install tensorflow GPU 版本 :pip install tensorflow-gpu 如果要更新 ,可以选择先pip uninstall tensorflow 再执行pip install tensorflow 至于 Linux 和 MacOS 安装 Tensorflow : CPU版本:Python 2.7 用户:pip install tensorflow Python 3.3+ 用户:pip3 install tensorflow GPU版本:Python 2.7用户:pip install tensorflow-gpu Python3.3+用户:pip3 install tensorflow-gpu 磨刀不误砍柴工 ,花较少的篇幅汇总下如何安装 TensorFlow 在我看来还是很有必要的 ! 原文发布时间为:2018-07-25本文作者: 小詹学Python本文来自云栖社区合作伙伴“小詹学Python”,了解相关信息可以关注“小詹学Python”

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册