首页 文章 精选 留言 我的

精选列表

搜索[笔记工具],共10000篇文章
优秀的个人博客,低调大师

《Hive编程指南》读书笔记

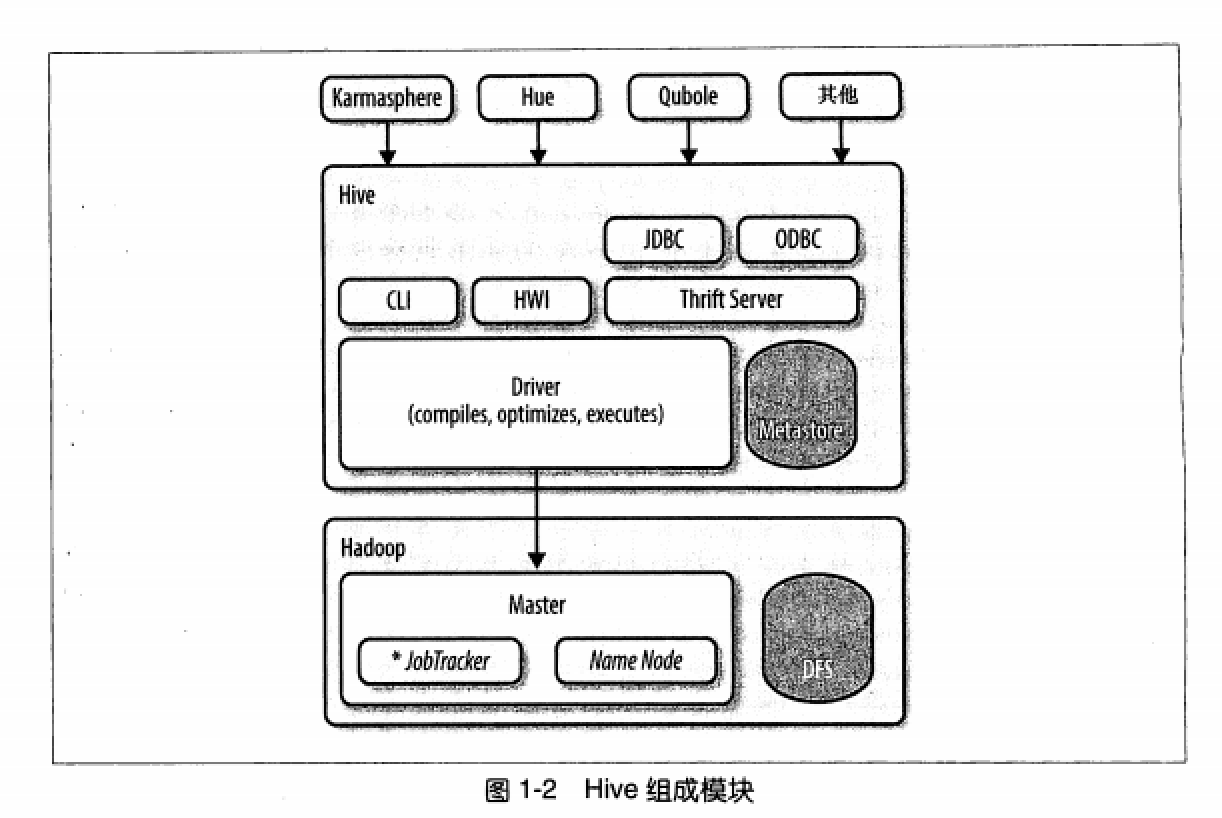
前言: 最近刚接触写Hive SQL,却发现许多查询的执行速度远不如预期。为了提升查询效率,我去阅读了《Hive编程指南》,希望通过理解其底层机制来找到优化的方式,并为未来能编写出高效的SQL奠定基础。谨以此文做个记录。 一、Hive因何而生 先有Hadoop再有Hive Hadoop实现了一个计算模型——MapReduce,它可以将计算任务分割成多个处理单元然后分散到一群家用的或服务器级别的硬件机器上,从而降低计算成本并提供水平可伸缩性。但是这套编程模型对于大多数数据分析分析师较为复杂和地销,即便是Java开发编写MapReduce程序也需要很多时间和精力。基于此,Hive提供了基于SQL的查询语言(HiveQL),这边能够让拥有SQL知识的用户能够轻松使用Hadoop进行大数据分析,因为Hive的底层会自动将这些查询转换为MapReduce任务。 二、Hive组成模块   所有的命令和查询都会进入Driver,通过该模块对输入进行解析编译,对需求的计算进行优化,然后按照指定的步骤执行。 Hive通过JobTracker通信来初始化MapReduce任务,需要处理的数据文件是存储在HDFS中的,而HDFS是由NameNode进行管理的。 Metastore(元数据存储)是一个独立的关系型数据库,Hive会在其中保存表模式和其他系统元数据。 三、HQL执行流程   简单来说,Hive会从Hadoop分布式文件系统(HDFS)中读取原始数据,然后根据查询定义,在单节点(本地模式)或者Hadoop集群上(集群模式)执行数据处理。处理完成后,Hive会将结果输出到HDFS或者其他指定的存储位置。 那么,Hive的执行时间主要花费在哪儿呢?我们可优化的部分是哪部分? Hive的执行时间主要花费在以下几个阶段: 1. 查询编译:Hive 将 HiveQL 查询编译成一个逻辑执行计划,这个计划描述了如何执行查询。此阶段包括语法分析、语义分析、生成逻辑计划、逻辑计划优化和生成物理计划(通常是 MapReduce 作业)。 2. 任务调度:编译生成的 MapReduce 作业被提交到 Hadoop 集群的资源管理器(如 YARN),等待资源调度和作业执行。 3. 数据读写:读取存储在 HDFS 上的数据以及写入最终结果到 HDFS,这个过程涉及大量的磁盘 I/O 操作,尤其是在处理大量数据集时。 4. MapReduce 作业执行:包括 1. Map 阶段:执行过滤、投影等操作; 2. Shuffle 阶段:Map 任务输出的中间数据在网络上传输并在 Reduce 节点上进行排序和合并; 3. Reduce 阶段:执行聚合、排序等操作; 5. 网络传输:在 MapReduce 的 Shuffle 阶段,中间数据需要在集群节点之间传输,这可能导致显著的网络延迟。 通常,MapReduce 作业的执行时间(尤其是 Shuffle 和 Reduce 阶段)以及数据的读写操作是 Hive 查询中最耗时的部分,也是我们优化过程中主要关注的部分,接下来我们看下有哪些常见的优化方式。 四、Hive常见的优化方式 本地模式 -- 开启本地模式,默认为false hive.exec.mode.local.auto=true 原理:有时Hive的输入数据量是非常小的。在这种情况下,为查询触发执行任务的时间消耗可能会比实际job的执行时间要多得多。对于大多数这种情况,Hive可以通过本地模式在单台机器上处理所有的任务。对于小数据集,执行时间可以明显被缩短。用户可以通过设计属性 hive.exec.mode.local.auto的值为true,来让Hive在适当的时候自动启动这个优化。实践有效,但如果并行执行的SQL过多,容易造成本地内存溢出。  map-side JOIN优化 #-- Hive v0.7之前需要通过添加标记 /*+ MAPJOIN(X) */ 触发,如下图   -- Hive v0.7版本开始之后,通过设置hive.auto.convert.JOIN的值为true开启 set hive.auto.convert.JOIN=true -- 设置小表的大下,单位为字节 set hive.mapjoin.smalltable.filesize=25000000 原理:如果所有表中有一个表足够得小,是可以完成载入内存中的,那么这时Hive可以执行一个map-side JOIN,将小表完全放到内存,Hive便可以直接和内存中的小表进行逐一匹配,从而减少所需要的reduce过程,有时甚至可以减少某些map task任务。 并发执行 -- 通过设置参数hive.exec.parallel值为true,开启并发执行,默认为false set hive.exec.parallel=true 原理:Hive会将一个查询转化成一个或者多个阶段。这样的阶段可以是MapReduce阶段、抽样阶段、合并阶段、limit阶段等。默认情况下,Hive一次只会执行一个阶段。但是有些阶段并非完全互相依赖的,也就是说这些阶段是可以并行执行的,这样可以使得整个job的执行时间缩短。 通过设置参数hive.exec.parallel值为true,就可以开启并发执行。 动态分区调整 -- 启用动态分区,默认为false; SET hive.exec.dynamic.partition=true; -- 启用动态分区模式为非严格模式。开启严格模式时们必须保证至少有一个分区时静态的。 SET hive.exec.dynamic.partition.mode=nonstrict; -- 设置在一个动态分区插入操作中可以创建的最大分区数量 SET hive.exec.max.dynamic.partitions=1000; -- 设置每个节点可以创建的最大分区数量 SET hive.exec.max.dynamic.partitions.pernode=100; 当执行查询时,如果查询条件包含分区键,Hive可以仅扫描相关分区的数据,从而减少了扫描的数据量,提高查询效率;在执行动态分区的插入时,这些分区也可以并行写入,从而提高了数据写入的并行度和性能。通过以上参数,可更好的使用动态分区。 合并小文件 --是否和并Map输出文件,默认true SET hive.merge.mapfiles=true; --是否合并 Reduce 输出文件,默认false SET hive.merge.mapredfiles=true; -- 设置合并文件的大小阈值 SET hive.merge.size.per.task=256000000; -- 设置小文件的平均大小阈值 SET hive.merge.smallfiles.avgsize=128000000; 由于一些小批量的写入、MapReduce作业切割、数据倾斜等原因,Hive中可能会产生大量小文件,通过以上参数可进行小文件合并以减少读取文件时的开销、降低NameNode压力,提升查询效率。 数据倾斜优化 数据倾斜指的是在分布式处理过程中,数据不均匀地分配给各个节点处理,导致部分节点负载过重,而其他节点负载轻松,从而影响整体计算效率。数据倾斜出现的原因主要如下: 1. 键值分布不均匀:有些键值对应的数据远多于其他键值; 2. 量相同键值:大量数据使用相同的键(如null或者特定的默认值)进行分组; 3. 不合理的JOIN操作:在JOIN大表时,如果小表的某个键值在大表中分布不均,导致JOIN后的结果倾斜; 4. 不合理的分区策略:数据分区时没有考虑数据的实际分布,导致分区不均匀。 主要解决方案有: 1. 自定义分区策略:实现自定义分区期,根据数据的特点进行更合理的分区; 2. 扩展键值:对倾斜的键添加随机前缀或编号,使其分散到多个分区; 3. 过滤大键值数据:识别出倾斜的键值(如null、空值)进行单独处理或过滤掉不重要的数据。  最后就是我们关系型数据库常用的优化方式同样也适用与Hive。例如通过使用小表关联大表的方式减少查询数据量,提高查询效率;Hive同样也有索引的概念,通过建立索引减少MapReduce的输入数据量,但同样和关系型数据库一样,是否使用索引需要进行仔细评估,因为维护索引也需要额外的存储空间,而且创建索引同样消耗计算资源;Hive同样也有EXPLAIN关键字,用于查询Hive时如何将查询转化为MapReduce任务的,使用EXPLAIN EXTENDED语句可以产生更多的输出信息,有兴趣大家可自行查看。 总体而言,这本书对于刚入门学习写HQL的我来说收获很大,让我初步对Hive有了基本的认知,也让我对我写的SQL有了更深入的了解。但是该书中的Hive应该版本比较低了,和我们现在所使用的可能有所偏差,不过入个门足够了。本文除了书中内容还有些我个人理解,如有错误,欢迎指正。 作者: 马壮 来源:京东云开发者社区 转载请注明来源 

优秀的个人博客,低调大师

Kubernetes笔记(8) - ConfigMap和Secret

ConfigMap 创建ConfigMap对象 基于字面值创建 基于文件创建 基于目录创建 使用配置清单创建 通过环境变量传递ConfigMap数据 envFrom 通过ConfigMap存储卷传递数据 挂载整个存储卷 挂载存储卷中的部分键值 Secret 创建Secret资源 命令式创建 基于配置清单创建 Secret存储卷 imagePullSecret资源对象 <!-- /code_chunk_output --> ConfigMap和Secret是Kubernetes系统上两种特殊类型的存储卷,ConfigMap对象用于为容器中的应用提供配置数据,Secret对象则用于提供密钥、证书等敏感的配置信息。它们将相应的配置信息保存于对象中,而后在Pod资源上以存储卷的形式将其挂载并获取相关的配置,以实现配置与镜像文件的解耦。 ConfigMap 配置本身源于代码,是为了提高代码的灵活性而提取出来的一些经常变化的或需要定制的内容。已有一些开源的分布式系统配置管理系统如Apollo、Diamond、Disconf等。ConfigMap则是Kubernetes提供的统一配置管理方案,一个ConfigMap对象就是一系列配置数据的集合,这些数据可“注入”到Pod对象中,并为容器应用所使用,注入方式有两种 挂载为存储卷 传递为环境变量 创建ConfigMap对象 ConfigMap对象将配置数据以键值对的形式进行存储,可以使用kubectl create命令创建 kubectl create configmap <map-name> <data-source> map-name为ConfigMap对象的名称,而data-source是数据源,它可以通过这几种方式来获取 字面值 文件 目录 配置清单 无论采用哪一种方式,都要被转换为ConfigMap对象中的Key-Value数据。 基于字面值创建 使用--from-literal选项可在命令行直接提供键值对: kubectl create configmap literal-config --from-literal=key1=value1 创建后可以使用kubectl get configmaps dir-config -o yaml命令查看。 基于文件创建 基于文件创建时要使用--from-file选项: kubectl create configmap file-config --from-file=8_config_file.txt 这种方式创建的ConfigMap对象,其数据存储的键为文件名,值为文件内容 apiVersion: v1 data: 8_config_file.txt: |- test config from file kind: ConfigMap 自定义键名的方式: kubectl create configmap file-config --from-file=file-key1=8_config_file.txt 基于目录创建 使用--from-file选项时,如果指定的是文件目录,kubectl会将目录下的文件分别创建为键值数据。 kubectl create configmap dir-config --from-file=. 使用配置清单创建 配置清单需要指定apiVersion、kind、metadata、data字段,data字段用于存储键值数据: apiVersion: v1 kind: ConfigMap metadata: name: yaml-config data: key1: value1 key2: value2 通过环境变量传递ConfigMap数据 ConfigMap是名称空间级别的资源,它必须与引用它的Pod资源在同一空间中; 通过环境变量传递ConfigMap的格式为: env: - name: <env-name> valueFrom: configMapKeyRef: name: <configmap-name> key: <key-name> optional: <bool> 如果optional指定为false,则创建引用了ConfigMap资源的Pod对象时,被引用的资源必须事先存在,否则将无法启动容器,直到被依赖的资源创建完成为止。 示例: apiVersion: v1 kind: Pod metadata: name: env-test-pod labels: app: label-env-test-pod spec: containers: - name: env-test-container image: busybox command: ["/bin/sh", "-c", "env"] env: - name: MY_KEY1 valueFrom: configMapKeyRef: name: yaml-config key: key3 optional: true - name: MY_KEY2 valueFrom: configMapKeyRef: name: yaml-config key: key4 optional: true envFrom 有时容器需要引用很多ConfigMap资源中的键值数据,这种情况下如果为容器逐一配置环境变量会非常繁琐,而且不好维护。使用envFrom字段可以直接将ConfigMap资源中的所有键值一次性导入。格式为: envFrom: - prefix: <prefix> configMapRef: name: <configmap-name> optional: <bool> 通过ConfigMap存储卷传递数据 如果在ConfigMap中的值体积较大,比如存放的是给容器应用提供的配置文件,那么使用环境变量将其导入会使得变量值占据过多的内存空间而且不易处理。这时建议通过ConfigMap存储卷的方式可以将内容直接作为文件进行引用。 挂载整个存储卷 关联为Pod资源的存储卷时,ConfigMap对象中的每个键都对应地表现为一个文件,键名为文件名 apiVersion: v1 kind: Pod metadata: name: configmap-vol labels: app: configmap-vol spec: containers: - name: configmap-vol image: busybox command: ["/bin/sh", "-c", "sleep 3600"] volumeMounts: - name: config-vol mountPath: /etc/test readOnly: true volumes: - name: config-vol configMap: name: file-config 挂载后可以将键名作为文件名来查看内容: kubectl exec configmap-vol -- cat /etc/test/file-key1 挂载存储卷中的部分键值 有时并不希望挂载ConfigMap中的所有内容,可以只挂载存储卷中的部分键值。 格式为: volumes: - name: config-vol configMap: name: file-config items: - key: file-key1 path: file-key1 Secret Secret资源的功能类似于ConfigMap,但它专用于存放敏感数据,例如密码、数字证书、私钥、令牌和SSH key等。 与ConfigMap类似,Secret以键值方式存储数据,在Pod资源中通过环境变量或存储卷进行数据访问。 Secret对象的数据的存储及打印格式为Base64编码的字符串,在容器中以环境变量或存储卷的方式访问时,它们会被自动解码为明文格式。 Secret对象主要有两种用途: 作为存储卷注入到Pod上由容器应用程序所使用 用于kubelet为Pod里的容器拉取镜像时向私有仓库提供认证信息 Secret资源分为四种类型: Opaque:自定义数据内容;base64编码,用来存储密码、密钥、信息、证书等数据,类型标识符为generic。‰ kubernetes.io/service-account-token:Service Account的认证信息,可在创建Service Accout时由Kubernetes自动创建。‰ kubernetes.io/dockerconfigjson:用来存储Docker镜像仓库的认证信息,类型标识为docker-registry。‰ kubernetes.io/tls:用于为SSL通信模式存储证书和私钥文件,命令式创建时类型标识为tls。 创建Secret资源 命令式创建 直接使用字面值创建: kubectl create secret generic mysql-auth --from-literal=username=root --from-literal=password=password1 查看base64编码后的内容: ✗ kubectl get secret mysql-auth -o yaml apiVersion: v1 data: password: cGFzc3dvcmQx username: cm9vdA== 使用generic标识创建的Secret为Opaque类型。下面的示例使用了tls标识来创建tls类型的Secret: kubectl create secret tls nginx-ssl --key=./nginx.key --cert=./nginx.crt 创建成功后名称固定为tls.key和tls.crt,不受证书和私钥文件的名称的影响。 基于配置清单创建 基于配置清单创建的示例: apiVersion: v1 kind: Secret metadata: name: yaml-secret stringData: username: redis password: password1 type: Opaqu 这里使用了stringData,可以用明文的形式设置secret数据,然后在创建为Secret对象时会自动进行Base64编码并保存于data字段中;stringData字段中的明文不会被API Server输出,但如果使用“kubectl apply”命令进行的创建,那么注解信息中还是可以看到明文信息的。如果用data字段,则必须直接提供Base64编码后的数据。 Secret存储卷 虽然Secret数据也可以痛殴环境变量注入,但并不推荐这样做,因为容器应用通常会在发生错误时将所有环境变量保存于日志信息中,甚至有些应用在启动时即会将运行环境打印到日志中;另外,容器应用调用第三方程序为子进程时,这些子进程能够继承并使用父进程的所有环境变量。 所以建议使用Secret存储卷来传递数据,使用方式与configMap基本相同,但字段为secret和secretName: volumes: - name: secret-vol secret: secretName: yaml-secret items: - key: username path: username - key: password path: password imagePullSecret资源对象 imagePullSecret资源可用于将Secret提供的密码传递给kubelet从而在拉取镜像前完成认证。 创建imagePullSecret的标识为docker-registry,有两种使用方式: 在定义Pod资源时通过“imagePullSecrets”字段指定 将其添加到某特定的ServiceAccount对象中 采用第一张方式,创建docker-registry: kubectl create secret docker-registry local-registry --docker-username=user1 --docker-password=password1 然后在创建Pod的配置清单中,通过spec.imagePullSecrets字段为kubelet提供Secret信息: spec: imagePullSecrets: - name: local-registry 但这种方式需要为每个Pod资源显式定义imagePullSecrets,基于ServiceAccount的的方式可以避免这个问题,后续再做详细了解。 学习资料 《Kubernetes实战进阶》 马永亮著

优秀的个人博客,低调大师

Golang学习笔记--slice使用总结

切片对数组进行包装,为数据序列提供了更通用、更强大和更方便的接口。Go中的大多数数组编程都是用切片而不是简单的数组来完成的 slice(切片)代表变长的序列,序列中每个元素都有相同的类型。一个slice类型一般写作[]T,其中T代表slice中元素的类型。 1.slice创建 直接通过初始化参数创建 slice0 := []int{1,3,7,5,2,3,4} fmt.Println(slice0,len(slice0),cap(slice0)) // [1 3 7 5 2 3 4] 7 7 使用内置函数make创建。使用默认值进行初始化 slice1 := make([]int,5,10) fmt.Println(slice1,len(slice1),cap(slice1)) // [0 0 0 0 0] 5 10 从指定下标创建。没指定的将使用默认值进行初始化,比如int类型是0值,string类型是空串。 slice2 := [...]int{1:1,12:12} fmt.Println(slice2) // [0 1 0 0 0 0 0 0 0 0 0 0 12] fmt.Println(slice2[0],len(slice2),cap(slice2)) // 0 13 13 2.slice的操作 下标索引操作 slice3 := []int{1,3,7,5,2,3,4} fmt.Println(slice3[1]) // 3 fmt.Println(slice3[10]) // 运行时报panic: runtime error: index out of range [10] with length 7 for循环操作 slice3 := []int{1,3,7,5,2,3,4} for _,val := range slice3{ fmt.Println(val) } 切片操作。跟python里面切片一样 slice3 := []int{1,3,7,5,2,3,4} fmt.Println(slice3[2:4]) // [7 5] 两个slice不能直接使用 ==进行比较。slice唯一合法的比较操作是和nil比较 slice4 := []int{1,3,7,5,2,3,4} slice5 := slice4[2:4] fmt.Println(slice4 == slice5) // 提示:Invalid operation: slice4 == slice5 (operator == is not defined on []int) fmt.Println(slice4 != nil) // true 内置函数的len和cap函数分别返回slice的长度和容量 内置函数append进行添加操作 slice6 := []int{1,3,7,5,2,3,4} slice7 := append(slice6,0) slice8 := append(slice7,9,8) fmt.Println(slice7) // [1 3 7 5 2 3 4 0] fmt.Println(slice8) // [1 3 7 5 2 3 4 0 9 8] fmt.Println(append(slice6,slice7...)) // 两个slice进行添加 // [1 3 7 5 2 3 4 1 3 7 5 2 3 4 0] 内置函数copy进行拷贝操作 slice10 := []int{1,3,7,5,2,3,4} var slice9 = make([]int,len(slice10)) fmt.Println(slice9,len(slice9),cap(slice9)) // [0 0 0 0 0 0 0] 7 7 copy(slice9,slice10) fmt.Println(slice9,len(slice9),cap(slice9)) // [1 3 7 5 2 3 4] 7 7 3.slice的使用注意点 切片保存对底层数组的引用,如果将一个切片分配给另一个切片,则两个切片都引用同一个数组。修改切片的值,会同时影响到源切片的数据 slice11 := []int{1,3,7,5,2,3,4} slice12 := slice11[2:5] slice12[1] = 10 fmt.Println(slice11) // [1 3 7 10 2 3 4] fmt.Println(slice12) // [7 10 2] 如果函数接受slice参数,则调用者可以看到它对slice元素所做的更改,类似于传递指向底层数组的指针。 slice13 := []int{1,3,7,5,2,3,4} reverse(slice13) fmt.Println(slice13) // [4 3 2 5 7 3 1] func reverse(input_slice []int){ slice_len := len(input_slice) for i := 0 ; i < slice_len / 2; i++ { input_slice[i], input_slice[slice_len - i - 1] = input_slice[slice_len - i -1], input_slice[i] } } slice没有提供直接删除的切片某个元素的内置函数,可以自己组合切片来实现 slice13 := []int{1,3,7,5,2,3,4} slice14 := append(slice13[:2],slice13[4:len(slice13)]...) fmt.Println(slice14) // [4 3 7 3 1] 删除下标为3的元素 在边界处拷贝 Slices 和 Maps(uber_go_guide) 接收 Slices的时候注意拷贝。当 map 或 slice 作为函数参数传入时,如果您存储了对它们的引用,则用户可以对其进行修改。 func (d *Driver) SetTrips(trips []Trip) { d.trips = make([]Trip, len(trips)) copy(d.trips, trips) } trips := ... d1.SetTrips(trips) // 这里我们修改 trips[0],但不会影响到 d1.trips trips[0] = ... 返回 slices的时候注意拷贝。同样,请注意用户对暴露内部状态的 map 或 slice 的修改。 type Stats struct { mu sync.Mutex counters map[string]int } func (s *Stats) Snapshot() map[string]int { s.mu.Lock() defer s.mu.Unlock() result := make(map[string]int, len(s.counters)) for k, v := range s.counters { result[k] = v } return result } // snapshot 现在是一个拷贝 snapshot := stats.Snapshot() 4.slice的runtime的部分实现 // slice.go package runtime // slice的底层的实现结构 type slice struct { array unsafe.Pointer // 一个数组的指针 len int cap int } ... // slice的创建 func makeslice(et *_type, len, cap int) unsafe.Pointer { mem, overflow := math.MulUintptr(et.size, uintptr(cap)) // uintptr的type的大小 * cap大小的uint指针类型 if overflow || mem > maxAlloc || len < 0 || len > cap { // 计算有没有溢出 mem, overflow := math.MulUintptr(et.size, uintptr(len)) if overflow || mem > maxAlloc || len < 0 { panicmakeslicelen() } panicmakeslicecap() } return mallocgc(mem, et, true)// 使用mallockgc进行内存分配, 并返回unsafe.Pointer指针,指向数组 } // append超过容量的时候,进行容量扩展 func growslice(et *_type, old slice, cap int) slice { if raceenabled { callerpc := getcallerpc() racereadrangepc(old.array, uintptr(old.len*int(et.size)), callerpc, funcPC(growslice)) } if msanenabled { msanread(old.array, uintptr(old.len*int(et.size))) } if cap < old.cap { panic(errorString("growslice: cap out of range")) } if et.size == 0 { // append不应该创建一个带有nil指针但有非零len的切片 return slice{unsafe.Pointer(&zerobase), old.len, cap} } // 计算容量扩容后新的容量 newcap := old.cap doublecap := newcap + newcap if cap > doublecap { // 新建的容量大于旧容量的两倍,直接使用当前的容量 newcap = cap } else { if old.len < 1024 { // 如果就长度小于1024,直接使用旧的2倍容量 newcap = doublecap } else { // 如果旧的容量小于当前容量,则按25%的幅度循环进行增长,直到大于当前容量 for 0 < newcap && newcap < cap { newcap += newcap / 4 } if newcap <= 0 { newcap = cap } } } var overflow bool var lenmem, newlenmem, capmem uintptr switch { case et.size == 1: lenmem = uintptr(old.len) newlenmem = uintptr(cap) capmem = roundupsize(uintptr(newcap)) overflow = uintptr(newcap) > maxAlloc newcap = int(capmem) case et.size == sys.PtrSize: lenmem = uintptr(old.len) * sys.PtrSize newlenmem = uintptr(cap) * sys.PtrSize capmem = roundupsize(uintptr(newcap) * sys.PtrSize) overflow = uintptr(newcap) > maxAlloc/sys.PtrSize newcap = int(capmem / sys.PtrSize) case isPowerOfTwo(et.size): var shift uintptr if sys.PtrSize == 8 { // Mask shift for better code generation. shift = uintptr(sys.Ctz64(uint64(et.size))) & 63 } else { shift = uintptr(sys.Ctz32(uint32(et.size))) & 31 } lenmem = uintptr(old.len) << shift newlenmem = uintptr(cap) << shift capmem = roundupsize(uintptr(newcap) << shift) overflow = uintptr(newcap) > (maxAlloc >> shift) newcap = int(capmem >> shift) default: lenmem = uintptr(old.len) * et.size newlenmem = uintptr(cap) * et.size capmem, overflow = math.MulUintptr(et.size, uintptr(newcap)) capmem = roundupsize(capmem) newcap = int(capmem / et.size) } if overflow || capmem > maxAlloc { panic(errorString("growslice: cap out of range")) } // 创建新的slice的数组 var p unsafe.Pointer if et.ptrdata == 0 { p = mallocgc(capmem, nil, false) memclrNoHeapPointers(add(p, newlenmem), capmem-newlenmem) } else { p = mallocgc(capmem, et, true) if lenmem > 0 && writeBarrier.enabled { bulkBarrierPreWriteSrcOnly(uintptr(p), uintptr(old.array), lenmem-et.size+et.ptrdata) } } // 将旧的数组复制到新的数组 memmove(p, old.array, lenmem) // 返回新的slice结构 return slice{p, old.len, newcap} } // slice的copy操作 func slicecopy(toPtr unsafe.Pointer, toLen int, fmPtr unsafe.Pointer, fmLen int, width uintptr) int { if fmLen == 0 || toLen == 0 { return 0 } n := fmLen if toLen < n { n = toLen } if width == 0 { return n } if raceenabled { callerpc := getcallerpc() pc := funcPC(slicecopy) racereadrangepc(fmPtr, uintptr(n*int(width)), callerpc, pc) racewriterangepc(toPtr, uintptr(n*int(width)), callerpc, pc) } if msanenabled { msanread(fmPtr, uintptr(n*int(width))) msanwrite(toPtr, uintptr(n*int(width))) } size := uintptr(n) * width if size == 1 { // common case worth about 2x to do here // 长度为1表示只是一个字节,直接进行赋值 *(*byte)(toPtr) = *(*byte)(fmPtr) } else { // 否则使用内存内存拷贝,将源地址数据拷贝到新的数组 memmove(toPtr, fmPtr, size) } return n }

优秀的个人博客,低调大师

Spring学习笔记(六):MyBatis集成

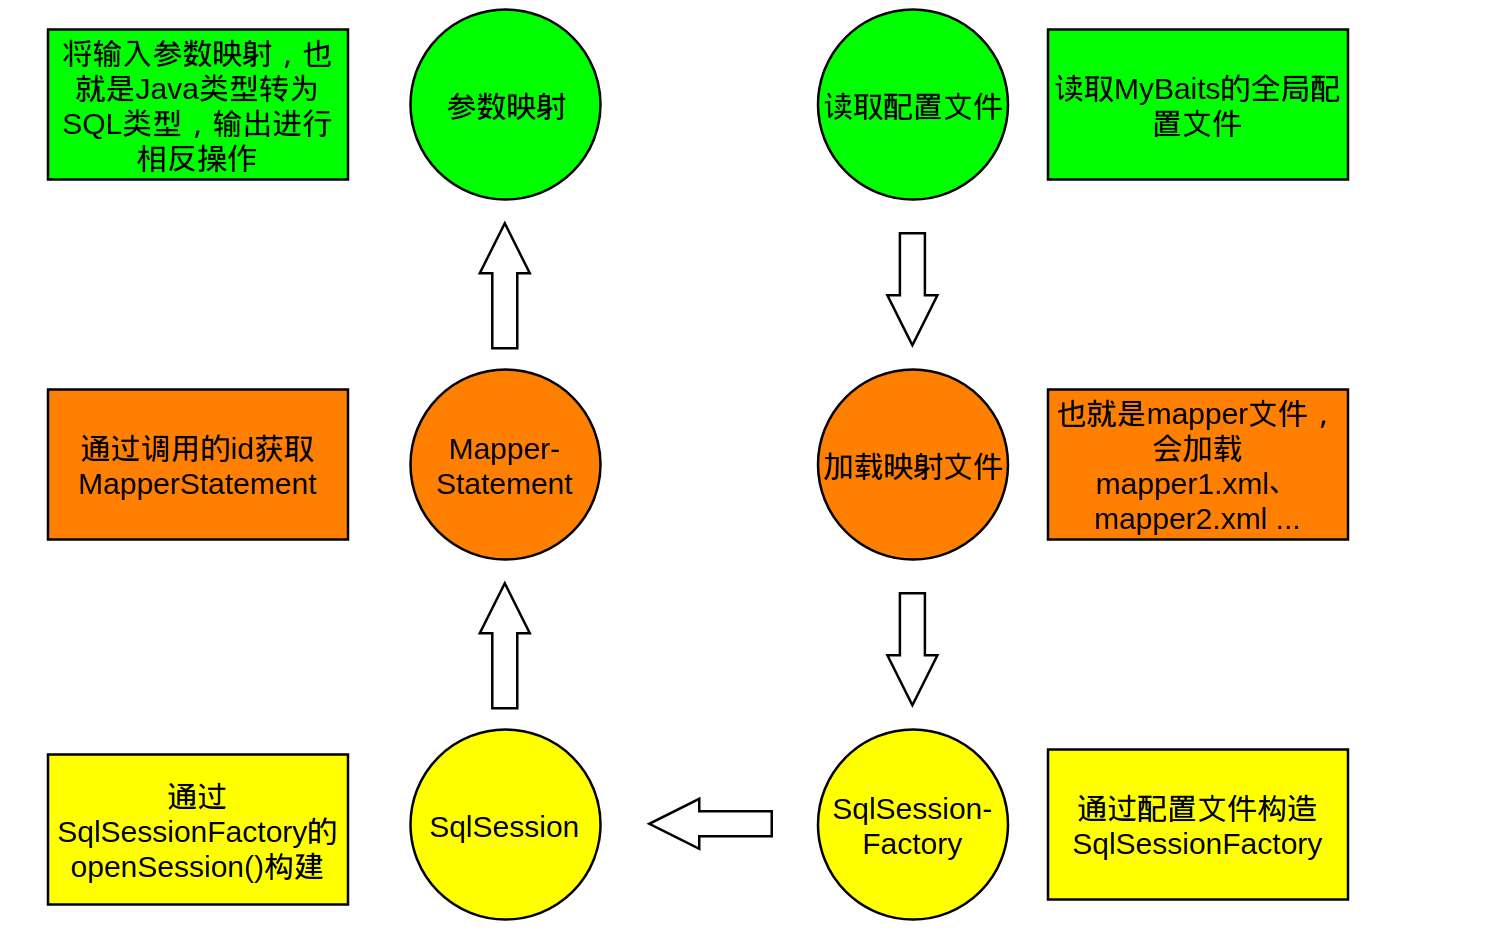
1 概述 MyBaits是一个著名的持久层框架,本文首先介绍了MyBatis的简单使用,接着与Spring进行整合,最后简单地使用了Generator去自动生成代码。 2 MyBatis简介 MyBatis本来是Apache的一个开源项目——iBatis,2010年由Apaceh Software Foundation迁移到了Google Code,并改名为MyBatis。 MyBatis是一个基于Java的持久层框架,提供的持久层框架包括SQL Maps和Data Access Objects,使用简单的XML或者注解用于配置映射,将接口和POJO映射成数据库中的记录,是一个小巧、方便、高效、简单、直接、半自动化的持久层框架。 3 工作原理 上图: 读取配置文件:mybatis-config.xml是全局MyBatis配置文件,配置了MyBatis运行环境信息 加载映射文件:也就是SQL映射文件,配置了操作数据库的SQL语句 构造会话工厂:通过配置文件构造会话工厂SqlSessionFactory 创建会话对象:由上一步的会话工厂创建会话对象SqlSession 获取MapperStatement:通过用户调用的api的Statement ID获取MapperStatement对象 输入参数映射:通过Executor对MapperStatement进行解析,将各种Java基本类型转化为SQL操作语句中的类型 输出结果映射:JDBC执行SQL后,借助MapperStatement的映射关系将返回结果转化为Java基本类型并返回 4 MyBatis示例 首先先来看一下纯MyBaits的示例,没有整合Spring,一个简单的Maven工程,项目结构如下: 4.1 依赖 <dependency> <groupId>org.mybatis</groupId> <artifactId>mybatis</artifactId> <version>3.5.5</version> </dependency> <dependency> <groupId>org.projectlombok</groupId> <artifactId>lombok</artifactId> <version>1.18.12</version> </dependency> <!--驱动用的是MySQL,版本请自行修改--> <dependency> <groupId>mysql</groupId> <artifactId>mysql-connector-java</artifactId> <version>8.0.21</version> </dependency> Gradle: compile group: 'org.mybatis', name: 'mybatis', version: '3.5.5' compile group: 'mysql', name: 'mysql-connector-java', version: '8.0.21' 4.2 实体类 @Setter @Getter @Builder public class User { private Integer id; private String name; @Override public String toString() { return "id:"+id+"\tname:"+name; } } 4.3 映射文件 新建一个叫UserMapper.xml的映射文件: <?xml version="1.0" encoding="UTF-8"?> <!DOCTYPE mapper PUBLIC "-//mybatis.org//DTD Mapper 3.0//EN" "http://mybatis.org/dtd/mybatis-3-mapper.dtd"> <mapper namespace="UserMapper"> <select id="selectById" parameterType="Integer" resultType="pers.entity.User"> select * from user where id=#{id} </select> <select id="selectAll" resultType="pers.entity.User"> select * from user </select> <insert id="insert" parameterType="pers.entity.User"> INSERT INTO `user` (`id`,`name`) VALUES (#{id},#{name}) </insert> <update id="update" parameterType="pers.entity.User"> UPDATE `user` set `name`=#{name} where id=#{id} </update> <delete id="delete" parameterType="Integer"> DELETE FROM `user` WHERE `id` = #{id} </delete> </mapper> 映射文件是一个XML文件,根元素为<mapper>,需要注意其中的namespace属性,调用的时候通过该namespace调用。其中的子元素表示SQL语句: <select>:查询,id指定了这条语句的id号,调用时通过namespace.id的方式调用,比如该条select需要通过UserMapper.selectById调用,parameterType指定参数类型,这里是一个Integer的参数,resultType指定返回类型,实体类 <insert>/<update>/<delete>:对应的插入/修改/删除语句 关于占位符:#{}表示是占位符,相当于传统JDBC中的?,#{id}表示该占位符等待接收的参数名称为id 4.4 配置文件 MyBatis的配置文件,叫mybatis-config.xml: <?xml version="1.0" encoding="UTF-8"?> <!DOCTYPE configuration PUBLIC "-//mybatis.org//DTD Config 3.0//EN" "http://mybatis.org/dtd/mybatis-3-config.dtd"> <configuration> <environments default="development"> <environment id="development"> <transactionManager type="JDBC" /> <dataSource type="POOLED"> <property name="driver" value="com.mysql.cj.jdbc.Driver"/> <property name="url" value="jdbc:mysql://localhost:3306/test"/> <property name="username" value="test"/> <property name="password" value="test"/> </dataSource> </environment> </environments> <mappers> <mapper resource="mapper/UserMapper.xml" /> </mappers> </configuration> 指定了数据库的一些连接属性还有mapper的位置。 4.5 测试 public class Main { public static void main(String[] args) { try { InputStream inputStream = Resources.getResourceAsStream("config/mybatis-config.xml"); SqlSessionFactory factory = new SqlSessionFactoryBuilder().build(inputStream); SqlSession session = factory.openSession(); User user = session.selectOne("UserMapper.selectById",1); System.out.println(user); User user1 = User.builder().name("test").build(); session.insert("UserMapper.insert",user1); user1.setName("222"); session.update("UserMapper.update",user1); List<User> list = session.selectList("UserMapper.selectAll"); list.forEach(System.out::println); session.delete("UserMapper.delete",1); session.commit(); session.close(); } catch (Exception e) { e.printStackTrace(); } } } 主要流程如下: 读取配置文件:根据org.apache.ibatis.io.Resources读取配置文件mybatis-config.xml,请注意配置文件的位置正确,这里的配置文件都放在resources下,mybatis-config.xml放在其中的config下 构建Session:根据配置文件构建SqlSessionFactory后,通过openSession创建Session 业务操作:通过session的selectOne/insert/update等进行业务操作,这类操作带两个参数,第一个参数是String,表示配置文件中的SQL语句,采用namespace.id的形式,比如这里的UserMapper.xml中声明namespace为UserMapper,其中带有一条id为selectById的select语句,因此调用时使用UserMapper.selectById的形式,第二个参数是一个Object,表示要传递的参数,也就是绑定到配置文件中对应占位符的值 提交与关闭:业务操作完成后提交事务并关闭session 示例测试结果: 5 Spring整合示例 上面的例子只是为了演示MyBatis的基本使用,没有整合Spring,这里的例子是把Spring整合进来,流程也大概差不多,项目结构如下: 5.1 依赖 分为5类JAR: MyBatis需要的JAR Spring需要的JAR MyBatis与Spring整合的中间JAR 数据库驱动JAR 数据源JAR 完整依赖如下: <dependency> <groupId>org.springframework</groupId> <artifactId>spring-context</artifactId> <version>5.2.9.RELEASE</version> </dependency> <dependency> <groupId>org.springframework</groupId> <artifactId>spring-core</artifactId> <version>5.2.9.RELEASE</version> </dependency> <dependency> <groupId>org.springframework</groupId> <artifactId>spring-beans</artifactId> <version>5.2.9.RELEASE</version> </dependency> <dependency> <groupId>org.springframework</groupId> <artifactId>spring-web</artifactId> <version>5.2.9.RELEASE</version> </dependency> <dependency> <groupId>org.projectlombok</groupId> <artifactId>lombok</artifactId> <version>1.18.12</version> </dependency> <dependency> <groupId>org.springframework</groupId> <artifactId>spring-jdbc</artifactId> <version>5.2.9.RELEASE</version> </dependency> <dependency> <groupId>mysql</groupId> <artifactId>mysql-connector-java</artifactId> <version>8.0.21</version> </dependency> <dependency> <groupId>org.springframework</groupId> <artifactId>spring-tx</artifactId> <version>5.2.9.RELEASE</version> </dependency> <dependency> <groupId>org.mybatis</groupId> <artifactId>mybatis</artifactId> <version>3.5.5</version> </dependency> <dependency> <groupId>org.mybatis</groupId> <artifactId>mybatis-spring</artifactId> <version>2.0.5</version> </dependency> <dependency> <groupId>org.apache.commons</groupId> <artifactId>commons-dbcp2</artifactId> <version>2.8.0</version> </dependency> Gradle: compile group: 'org.springframework', name: 'spring-beans', version: '5.2.9.RELEASE' compile group: 'org.springframework', name: 'spring-context', version: '5.2.9.RELEASE' compile group: 'org.springframework', name: 'spring-core', version: '5.2.9.RELEASE' compile group: 'org.springframework', name: 'spring-tx', version: '5.2.9.RELEASE' compile group: 'org.springframework', name: 'spring-jdbc', version: '5.2.9.RELEASE' compile group: 'mysql', name: 'mysql-connector-java', version: '8.0.21' compile group: 'org.apache.commons', name: 'commons-dbcp2', version: '2.8.0' compile group: 'org.mybatis', name: 'mybatis', version: '3.5.5' compile group: 'org.mybatis', name: 'mybatis-spring', version: '2.0.5' 5.2 配置文件 配置文件分为三类: MyBatis映射文件:编写mapper的地方,也就是业务需要的SQL语句 MyBatis全局配置文件:由于整合了Spring,数据源的配置放在了Spring的配置文件中,而只需要保留mapper的查找位置 Spring配置文件:配置数据源+事务管理+MyBaits的sqlSssionFactory+组件扫描 5.2.1 MyBatis映射文件 与上面的例子差不多,只是修改了namespace为包名.类名的形式: <?xml version="1.0" encoding="UTF-8"?> <!DOCTYPE mapper PUBLIC "-//mybatis.org//DTD Mapper 3.0//EN" "http://mybatis.org/dtd/mybatis-3-mapper.dtd"> <mapper namespace="pers.dao.UserDao"> <select id="selectById" parameterType="Integer" resultType="pers.entity.User"> select * from user where id=#{id} </select> <select id="selectAll" resultType="pers.entity.User"> select * from user </select> <insert id="insert" parameterType="pers.entity.User"> INSERT INTO `user` (`id`,`name`) VALUES (#{id},#{name}) </insert> <update id="update" parameterType="pers.entity.User"> UPDATE `user` set `name`=#{name} where id=#{id} </update> <delete id="delete" parameterType="Integer"> DELETE FROM `user` WHERE `id` = #{id} </delete> </mapper> namespace需要与对应包名的带有@Mapper的类配置一致。 5.2.2 MyBatis配置文件 <?xml version="1.0" encoding="UTF-8"?> <!DOCTYPE configuration PUBLIC "-//mybatis.org//DTD Config 3.0//EN" "http://mybatis.org/dtd/mybatis-3-config.dtd"> <configuration> <mappers> <mapper resource="mapper/UserMapper.xml" /> </mappers> </configuration> 5.2.3 Spring配置文件 <?xml version="1.0" encoding="utf-8" ?> <beans xmlns="http://www.springframework.org/schema/beans" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance" xmlns:context="http://www.springframework.org/schema/context" xmlns:tx="http://www.springframework.org/schema/tx" xsi:schemaLocation="http://www.springframework.org/schema/beans http://www.springframework.org/schema/beans/spring-beans.xsd http://www.springframework.org/schema/tx http://www.springframework.org/schema/tx/spring-tx.xsd http://www.springframework.org/schema/context https://www.springframework.org/schema/context/spring-context.xsd" > <context:component-scan base-package="pers.dao"/> <context:component-scan base-package="pers.service"/> <!--数据源--> <bean id="dataSource" class="org.apache.commons.dbcp2.BasicDataSource"> <property name="driverClassName" value="com.mysql.cj.jdbc.Driver"/> <property name="url" value="jdbc:mysql://localhost:3306/test"/> <property name="username" value="test"/> <property name="password" value="test"/> <!--最大连接数+最大空闲数+初始连接数--> <property name="maxTotal" value="30"/> <property name="maxIdle" value="10"/> <property name="initialSize" value="5"/> </bean> <!--事务管理--> <bean id="txManager" class="org.springframework.jdbc.datasource.DataSourceTransactionManager"> <property name="dataSource" ref="dataSource"/> </bean> <!--开启事务注解--> <tx:annotation-driven transaction-manager="txManager" /> <!--创建SqlSessionFactory Bean--> <bean id="sqlSessionFactory" class="org.mybatis.spring.SqlSessionFactoryBean"> <property name="dataSource" ref="dataSource"/> <property name="configLocation" value="classpath:config/mybatis-config.xml"/> </bean> <!--注解扫描,主要用于@Mapper,会扫描basePackge下的@Mapper注解的接口并自动装配为MyBatis的映射接口--> <bean class="org.mybatis.spring.mapper.MapperScannerConfigurer"> <property name="basePackage" value="pers.dao"/> <property name="sqlSessionFactoryBeanName" value="sqlSessionFactory"/> </bean> </beans> 5.3 持久层 需要加上@Mapper注解,表示自动装配为MyBatis的映射接口,注意: 映射文件中的namespace需要与包名.类名对应,比如这里的包为pers.dao,类名为UserDao,那么映射文件中的namespace为pers.dao.UserDao id需要与方法名对应,比如映射文件中的有一条select语句的id为selectById,那么方法就需要命名为selectById,且参数类型需要对应一致 @Repository @Mapper public interface UserDao { User selectById(Integer id); List<User> selectAll(); int insert(User user); int update(User user); int delete(Integer id); } 5.4 业务层 @Service @Transactional @RequiredArgsConstructor(onConstructor = @__(@Autowired)) public class MyBatisService { private final UserDao dao; public void test(){ User user = dao.selectById(13); System.out.println(user); dao.insert(User.builder().name("333").build()); dao.update(User.builder().name("88888").id(13).build()); dao.selectAll().forEach(System.out::println); dao.delete(12); dao.selectAll().forEach(System.out::println); } } 注入UserDao后进行简单的测试,结果如下: 6 自动生成代码 相信很多程序员也讨厌写又长又麻烦的XML配置文件,因此,MyBatis也提供了一个生成器插件,可以直接从表中生成实体类、dao接口以及映射文件,可以省去很多操作。 步骤如下: 导入依赖 编写Generator配置文件 生成代码 6.1 依赖 其实就是加入一个插件: <build> <plugins> <plugin> <groupId>org.mybatis.generator</groupId> <artifactId>mybatis-generator-maven-plugin</artifactId> <version>1.4.0</version> <configuration> <!-- 在控制台打印执行日志 --> <verbose>true</verbose> <!-- 重复生成时会覆盖之前的文件--> <overwrite>true</overwrite> <configurationFile>src/main/resources/generatorConfig.xml</configurationFile> </configuration> <dependencies> <dependency> <groupId>mysql</groupId> <artifactId>mysql-connector-java</artifactId> <version>8.0.21</version> </dependency> </dependencies> </plugin> </plugins> </build> 数据库驱动请对应修改。 至于Gradle版请看Kotlin版源码。 6.2 配置文件 这里是参考别人的配置文件,修改数据库连接、表名、包名即可: <?xml version="1.0" encoding="UTF-8"?> <!DOCTYPE generatorConfiguration PUBLIC "-//mybatis.org//DTD MyBatis Generator Configuration 1.0//EN" "http://mybatis.org/dtd/mybatis-generator-config_1_0.dtd"> <generatorConfiguration> <!-- context 是逆向工程的主要配置信息 --> <!-- id:起个名字 --> <!-- targetRuntime:设置生成的文件适用于那个 mybatis 版本 --> <context id="default" targetRuntime="MyBatis3"> <!--optional,指在创建class时,对注释进行控制--> <commentGenerator> <property name="suppressDate" value="true"/> <!-- 是否去除自动生成的注释 true:是 : false:否 --> <property name="suppressAllComments" value="true"/> </commentGenerator> <!--jdbc的数据库连接 wg_insert 为数据库名字--> <jdbcConnection driverClass="com.mysql.cj.jdbc.Driver" connectionURL="jdbc:mysql://localhost:3306/test" userId="test" password="test" /> <!--非必须,类型处理器,在数据库类型和java类型之间的转换控制--> <javaTypeResolver> <!-- 默认情况下数据库中的 decimal,bigInt 在 Java 对应是 sql 下的 BigDecimal 类 --> <!-- 不是 double 和 long 类型 --> <!-- 使用常用的基本类型代替 sql 包下的引用类型 --> <property name="forceBigDecimals" value="false"/> </javaTypeResolver> <!-- targetPackage:生成的实体类所在的包 --> <!-- targetProject:生成的实体类所在的硬盘位置 --> <javaModelGenerator targetPackage="pers.entity" targetProject="src/main/java"> <!-- 是否允许子包 --> <property name="enableSubPackages" value="false"/> <!-- 是否对modal添加构造函数 --> <property name="constructorBased" value="true"/> <!-- 是否清理从数据库中查询出的字符串左右两边的空白字符 --> <property name="trimStrings" value="true"/> <!-- 建立modal对象是否不可改变 即生成的modal对象不会有setter方法,只有构造方法 --> <property name="immutable" value="false"/> </javaModelGenerator> <!-- targetPackage 和 targetProject:生成的 mapper 文件的包和位置 --> <sqlMapGenerator targetPackage="mapper" targetProject="src/main/resources"> <!-- 针对数据库的一个配置,是否把 schema 作为字包名 --> <property name="enableSubPackages" value="false"/> </sqlMapGenerator> <!-- targetPackage 和 targetProject:生成的 interface 文件的包和位置 --> <javaClientGenerator type="XMLMAPPER" targetPackage="pers.dao" targetProject="src/main/java"> </javaClientGenerator> <!-- tableName是数据库中的表名,domainObjectName是生成的JAVA模型名,后面的参数不用改,要生成更多的表就在下面继续加table标签 --> <table tableName="user" domainObjectName="User" enableCountByExample="false" enableUpdateByExample="false" enableDeleteByExample="false" enableSelectByExample="false" selectByExampleQueryId="false" /> </context> </generatorConfiguration> 6.3 生成代码 双击生成即可: 生成了实体类、dao接口以及mapper文件。 7 参考源码 Java版: Github 码云 CODE.CHINA Kotlin版: Github 码云 CODE.CHINA 8 参考链接 简书-IDEA使用mybatis-generator Github-mybatis-generator-plugin

优秀的个人博客,低调大师

RocketMQ-笔记,简介整体架构

1. RocketMQ的理念: rocketMQ同大多数的消息中间件类似,都是基于主体消息的发布和订阅模式,其最核心的就是消息的发送,消息的存储,消息的接收,路由信息四部分组成,他的设计有一下几个特点: nameSrv的出现摒弃了以前需要依赖zookeeper作为注册中心,使用namesrv来保存元数据,设计简单,namesrv之间不相互通信,降低网络消耗,不追求像zookeeper一样的强一致性,而是保证了其最终一致性。 namesrv的高性能io存储,RocketMQ追求的是高性能消息发送,其内部存储采用了文件组的形式,组内的每个文件有固定的大小,方便引用内存映射机制,所有主题的消息都是按顺序写入,极大的提高了写的性能,同时为了兼顾消息的消费和消息的查找引入了消息消费的队列文件和索引文件 容忍设计上的缺陷,让用户去解决一些问题,给予用户最大限度的自由发挥,比如消息重复消费的问题。 2. RocketMQ作为一款高性能消息中间件需要解决的问题有以下几个方面 架构模式 架构模式与普通的消息中间件类似都是基于发布订阅的模式,核心是消息的发送,消息的存储,消息的接收,消息路由 顺序消息 严格保证消息的顺序性,消费者消费的消息严格按照到达消息服务器存储的消息顺序。 消息过滤 消费者在消费的时候过滤,消费者在订阅某一个主体的消息的时候可以按照一定规则注册自己感兴趣的消息,一种是broker端过滤,只推送给消费者感兴趣的消息,一种是在消费者端过滤,这种会有很多无用消息需要过滤。 消息存储 RocketMQ 追求消息存储的高性能,引人内存映射机制,所有主题的消息顺序存储在同一个文件中 同时为了避免消息无限在消息存储服务器中累积,引入了消息文件过期机制与文件存储报警机制 消息到达低延迟 RocketMQ 在消息不发生消息堆积时,以长轮询模式实现准实时的消息推送模式。 定时消息 消息发送之后不要求消费者立即消费需要在某个特定的时间点或者任意精度的时间被消费者消费,如果要支持任意精度,势必要在消息的服务端就消息进行排序,性能消耗很大,所以rocketMQ不支持任意精度的定时,而是支持特定的延时级别 消息的高可用 1,Broker正常关机 2,Broker异常关机 3,OS Crash 4,机器断电,但 能立即恢复供电情况 5,机器无法开机 6,磁盘设备损坏 情况 1~4 RocketMQ 在同步刷盘机制下可以确保不丢失消息,在异步刷盘的时候会丢失少量消息,5-6属于单点故障,一旦发生,消息全部丢失,如果开启可异步复制,会丢失少量的数据,但是够来rocketMq开启了双鞋机制,满足可用性极高的场景 保证每个消息被消费一次 保证每个消息至少被消费一次,但由于ack消息丢失等原因造成的重复消费需要用户自己去处理 回溯消息 消息消费之后还可以再次消费 消息的堆积能力 应对洪峰数据,提高系统的可用性,必然要求我们有一定的消息堆积能力,RocketMQ采用了磁盘文件(内存映射机制),并且在物理布局上为多个大小相等的文件组成一个逻辑组,可无限循环使用,还提供了过期机制,默认是保留3天的消息。 消息的重试机制 消息在消费的时候,如果消费失败,消息中间件支持重新发送消费 3. 整体架构 rocketMQ的流程,首先启动namesrv,然后broke服务器在启动的时候会向所有的namesrv服务器注册,消息生产者在发送消息之前先从namesrv中根据topic找到对应的namesrv地址列表,然后根据负载均衡算法从列表中选取一个namesrv发送消息,namesrv和broker之间保持长连接,每隔30sbroker会向namesrv发送心跳检测信息,namesrv定时任务会每120秒扫描一次列表如果有超过120秒没有收到消息那么就认为其故障然后移除列表了,,但是这个路由消息不会立马同步给其他namesrv,也不会立马通知生产者需要生产者自己拉取,因为namesrv之间是不同步信息的,会造成短暂的不一致的情况,这是为了降低namesrv的设计复杂度,我们可以从消息的发送端解决这个问题保证消息的高可用,消息到达broker之后,broker会将其存储,并且推送给订阅这个消息的消费者。 下面会根据章节介绍rocketMQ的重要组件namesrv,生产者,存储,消费者,过滤,主从同步,事务

优秀的个人博客,低调大师

前端学习笔记(6) - JavaScript数组

在最新的TypeScript 3.6中实现了更准确的数组扩展。借此机会聊一下我对js中数组的一点理解。 使用Array()初始化数组 先来看一下下面的两行代码 1 in [undefined, undefined, undefined] // true 1 in Array(3) // false 再看一下接下来代码 let arr=new Array(3).map(()=>{return 3}) console.log(arr) //(3)[empty × 3] 可见使用无论使用Array方法还是使用Array构造器所生成的数组均为没有索引与元素单存在length属性的空数组。(参数为单个非负整数时)map方法对于没有赋值或者被delete删除的索引不会调用 初始化数组 以下三种方法都可以得到一个[undefined, undefined, undefined]数组 Array(...Array(3)) Array.apply(null,Array(3)) Array.apply(null,{length:3}) 第一种第二种方法比较好理解,但是第三种apply方法的第二个参数为数组为什么传入一个对象同样可以执行。据我测试后发现ie8及以下版本中会直接报错,chrome、firefox、edge、ie9-11中可以执行。目前大部分浏览器都支持apply传入一个类数组对象。有些文章中称是因为{length:3}为一个可迭代方法,实际上是错误的说法,对象是否可迭代实际上是由对象及其原型链上是否存在[Symbol.iterator]方法决定的。调用该方法可以得到一个对象的迭代器,调用对象的keys方法也可以得到一个相同的迭代器 [1,2,3][Symbol.iterator]() [1,2,3].keys() 另外enumerable为false的属性无法被keys、for in 、entries枚举。 let tempArr=[1,2,3] Object.defineProperty(tempArr,'0',{enumerable:false}) for(let i in tempArr){ console.log(tempArr[i]) } //2 3 Object.keys(tempArr) //(2)["1", "2"] Object.entries(tempArr) //(2) [["1", 2],["2", 3]]

优秀的个人博客,低调大师

前端学习笔记(1) - JavaScript类型

背景介绍 我从事前端工作只能有短短的一年,工作要求使我接触到了前端这个领域。起初对于前端的理解就是html、css、js,但是随着对前端这个领域的不断了解,我发现前端远不止这些。虽然目前我已经能够根据需求写出不错的前端代码,但是我所掌握度前端知识实际上过于零散,基础知识的欠缺限制了我解决问题的思路。重新系统的学习一遍前端知识对我来说是非常必要的。此文章主要用来记录学习中的问题,希望能帮助到同我一样的前端学习者。 undefined undefined在JavaScript中是一个变量而非一个关键字,这其实是JavaScript的设计失误之一。在某些浏览器中允许你重写undefined,建议使用void 0来获取undefined值。 0.1+0.2===0.3??? 根据双精度浮点数的定义Number 类型中有效的整数范围是-0x1fffffffffffff 至 0x1fffffffffffff,也就说JavaScript无法表示此范围之外的整数。对于64位浮点数(double)来说,大于1的最小浮点数相当于二进制的1.00..001小数点后面有连续51个零。这个值减去1 之后,就等于2的-52 次方。所以非整数的Number类型数字无法使用==或者===进行比较。正确的比较方法为:Math.abs(0.1 + 0.2 - 0.3) <= Number.EPSILON “类”===“类型”??? 由于C++、java等语言中每一个类都有一个类型一一对应,所以很多人将JavaScript中的“类”与类型混淆。实际上JavaScript中无法自定义类型。3与new Number(3)是完全不同的值,一个是number类型,一个是对象类型。Number、Boolean、String跟new配合可以生成对象,直接调用则是强制类型转换。Symbol函数比较特殊无法使用new。 装箱操作 那为什么number类型数据可以调用Number对象类型中定义的方法?实际上.运算符进行了一个封箱操作,根据基础数据类型构造一个临时对象类型,使得我们可以在基础数据类型之上调用对象方法。频繁的装箱操作会产生大量临时对象,所以在要求高性能的场景应尽量避免使用装箱操作。 拆箱转换 JavaScript中规定了ToPrimitive函数它是对象到基本类型的转换 var o = { valueOf : () => {console.log("valueOf"); return {}}, toString : () => {console.log("toString"); return {}} } o * 2 // valueOf // toString // TypeError 类型转换的内部实现是通过ToPrimitive ( input [ , PreferredType ] )方法进行转换的,这个方法的作用就是将input转换成一个非对象类型。参数preferredType是可选的,它的作用是,指出了input被期待转成的类型。如果不传preferredType进来,默认的是'number'。如果preferredType的值是"string",那就先执行"toString", 后执行"valueOf"。否则,先执行"valueOf", 后执行"toString"。由此可见,"toString", "valueOf"的执行顺序,取决于preferred的值。

优秀的个人博客,低调大师

python算法学习笔记1

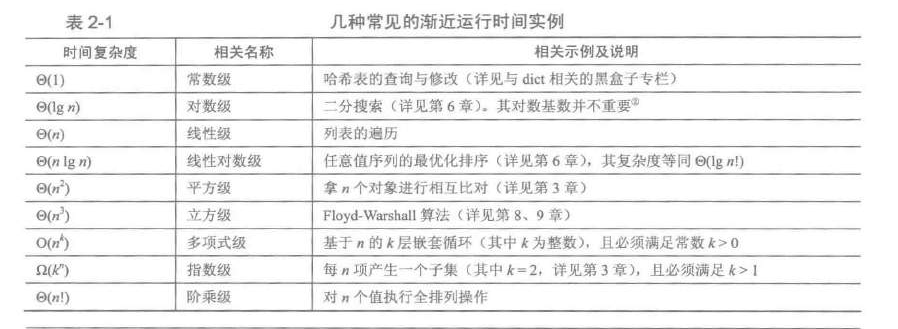
python中array 是一整块单一连续的内存区域,根据索引值访问的话可以直接计算出目标元素在内存中的位置,对于链表要从头开始遍历链表插入代价小,数值插入代价大,要移动右边所有的元素这边的数组指动态数组复杂度O 构建排序算法之前先对序列进行检查,如果目标已经排过序则直接返回 def sort_w_check(): n=len(seq) for i in range(n-1): if seq[i] >seq[i+1]: break else: return .... 排序的三种情况:1.最好情况,已经排好序,线性时间2.最坏情况3.平均情况,期望时间算法评估:用timeit模块 import timeit t1=timeit.timeit("x=2+2") print(t1) t2=timeit.timeit("x=sum(range(10))") print(t2) 计算时间,但对于多次迭代时timeit会通过多次运行相关代码的方式来提高计时精度图结构:图的要点主要包括: 散列(hashing)可以通过python中的hash函数提供 print(hash("hello,world!")) print(hash("Hello,world!")) python中字典类型dict就是常说的散列表,集合类型也是通过这种机制完成的,对于散列的访问平局时间为O(1),最坏为O(n)邻接列表及类似的结构示意图 示意图转换为邻接集表示方法 a,b,c,d,e,f,g,h=range(8) N=[ {b,c,d,e,f}, {c,e}, {d}, {e}, {f}, {c,g,h}, {f,h}, {f,g} ] 加权的邻接列表 a,b,c,d,e,f,g,h=range(8) N=[ {b:2,c:1,d:3,e:9,f:4}, {c:4,e:3}, {d:8}, {e:7}, {f:5}, {c:2,g:2,h:2}, {f:1,h:6}, {f:9,g:8} ] 邻接集的字典表示法: N={ 'a':set('bcdef'), 'b':set('ce'), 'c':set('d'), 'e':set('e'), 'f':set('cgh'), 'g':set('fh'), 'h':set('fg') } 树二叉树 class Tree(object): """docstring for Tree""" def __init__(self, left,right): self.left=left self.right=right t=Tree(Tree("a","b"),Tree("c","d")) print(t.right.left) 多路搜索树 class True: def __init__(self,kids,next=None): self.kids=self.val=kids self.next=next t=Tree(Tree("a",Tree("b",Tree("c",Tree("d"))))) print(t.kids.next.next.val) 隐性平方级操作例子 import time from random import randrange L=[randrange(10000) for i in range(1000)] t1=time.time() print(42 in L) t2=time.time() print(t2-t1) S=set(L) t3=time.time() print(42 in S) t4=time.time() print(t4-t3) 对list的搜索是线性数量级的,set的搜索是常数级的

优秀的个人博客,低调大师

Golang学习笔记之方法(method)

法总是绑定对象实例,并隐式将实例作为第⼀实参 (receiver)。• 只能为当前包内命名类型定义⽅法。• 参数 receiver 可任意命名。如⽅法中未曾使⽤,可省略参数名。• 参数 receiver 类型可以是 T 或 *T。基类型 T 不能是接⼝或指针。• 不⽀持⽅法重载, receiver 只是参数签名的组成部分。• 可⽤实例 value 或 pointer 调⽤全部⽅法,编译器⾃动转换。• Go 不允许同名函数,但是同名方法可以定义在不同的类型上• method和receiver必须在同一个包里定义• 作为函数参数,值类型就是值类型,指针类型就是指针类型• 方法有一个值类型和指针类型的接受者时,都可以直接调用,内部会自动进行语法的转换。 一个方法只是一个函数,它有一个特殊的接收者(receiver)类型,该接收者放在 fu

优秀的个人博客,低调大师

Scala学习笔记(1)-环境搭建

Scala是一种多范式的编程语言,设计初衷是要集成面向对象编程和函数式编程的各种特性。scala可以和java程序无缝拼接,因为scala文件编译后也是成为.class文件,并且在JVM上运行,有下下一代Java之称,当然要有Java今天的阵势还有很长很长的一段路要走。 Scala的几个主要特性 1.面向风格:Scala中的每个值都是一个对象,包括基本数据类型(java中基本类型不是对象)在内,连函数也是对象。 2.函数式风格:高阶函数(Higher-Order Function)、局部套用(Currying)、嵌套函数(Nested Function)、序列解读(Sequence Comprehensions)等等。 3.Scala是静态类型的,这就允许它提供泛型类、内部类、甚至多态方法(Polymorphic Method) 4.Scala可以与Java互操作:它用scalac这个编译器把源文件编译成Java的class文件(即在JVM上运行的字节码)。你可以从Scala中调用所有的Java类库,也同样可以从Java应用程序中调用Scala的代码。它也可以访问现存的数之不尽的Java类库,这让(潜在地)迁移到Scala更加容易。 1.安装Scala,这个不用多说 Scala目前最新的版本为2.11.8,下载地址http://www.scala-lang.org/,我下载的.msi文件,直接安装完毕自动添加了path 2.安装IDE (1)直接下载ScalaIDE,安装完后就可以直接使用。 (2)已安装有Eclipse的,可以安装scala支持插件,支持的eclipse版本是3.8-4.3(Juno and Kepler) 插件地址 http://download.scala-ide.org/sdk/helium/e38/scala211/stable/site 其他版本:http://scala-ide.org/download/prev-stable.html 3.写一段代码测试一下 package com.demo object Demo {//注意这里是object 不是 class 喔,两者区别后面会讲到。 def main(args: Array[String]): Unit = { println("hello scala!") println("hello world!");//分号可选要不要 } } 本文来自云栖社区合作伙伴“开源中国” 本文作者:山海经 原文链接

优秀的个人博客,低调大师

Scala学习笔记(2)-基础语法

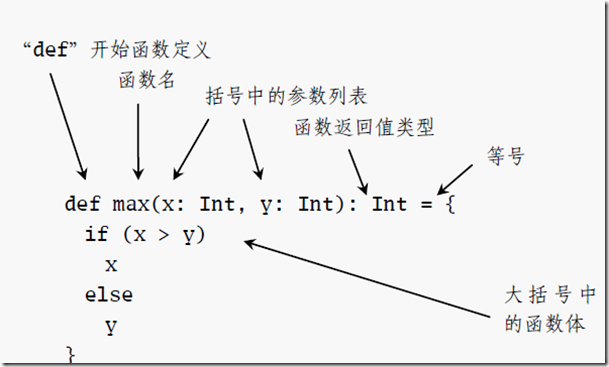
秉着简洁而不失完整的的原则,这章只把Scala主要语法和与Java不同的内容列出来,以后章节也如此,内容以简洁为主,太长了自己都被吓着了,也没耐心看下去。 1.Scala解释器使用,这里不做介绍,有IDE这玩意一般用不着。 2.基本数据类型 Java原始类型在scala包里都有对应的类。例如,scala.Boolean对应着Java的boolean。scala.Float对应着Java的float。当你把你的Scala代码编译成Java字节码,Scala编译器将使用Java的原始类型以便获得其带来的性能益处。 3.定义变量 Scala有两种变量,val和var。val类似于Java里的final变量。一旦初始化了,val就不能再赋值了。与之对应的,var如同Java里面的非final变量。var可以在它生命周期中被多次赋值。 val msg1=”hello scala” var msg2=”hello world” 仔细看上面定义的2个变量好像都没有类型声明,这是怎么回事呢?这就要说到Scala的类型推断(type inference),因为你用了一个字符串来初始化msg变量,Scala推断msg的类型是String。你也可以显式地定义类型,有些时候也应该这么做。显式的类型标注不但可以确保Scala编译器推断你倾向的类型,还有助于以后代码的阅读。 val msg : String=”hello scala” 与Java不同的是类型声明在变量后面,用一个”:”分隔。 4.定义函数 上面已经定义了变量,现在开始学习怎么定义一个函数 def max(x: Int, y: Int): Int = { //定义函数 if (x > y) x else y } max(3,7) //调用函数 自己对照看与 java函数有什么不同,函数体只有一句的大括号可以省略写成 : def max(x: Int, y: Int) = if (x > y) x else y 结果类型也去掉了,编译器类型推断可得出,尽管如此带上结果类型也是一个好习惯,便于其他人阅读代码。 Scala的Unit结果类型指的是函数没有返回有用的值。Scala的Unit类型比较接近Java的void类型,而且实际上Java里每一个返回void的方法都被映射为Scala里返回Unit的方法。因此结果类型为Unit的方法,仅仅是为了它们的副作用而运行 注:java里的i++和++i在scala里是行不通的。 本文来自云栖社区合作伙伴“开源中国” 本文作者:山海经 原文链接

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册