首页 文章 精选 留言 我的

精选列表

搜索[笔记工具],共10000篇文章
优秀的个人博客,低调大师

ElasticSearch + Logstash + Kibana 搭建笔记

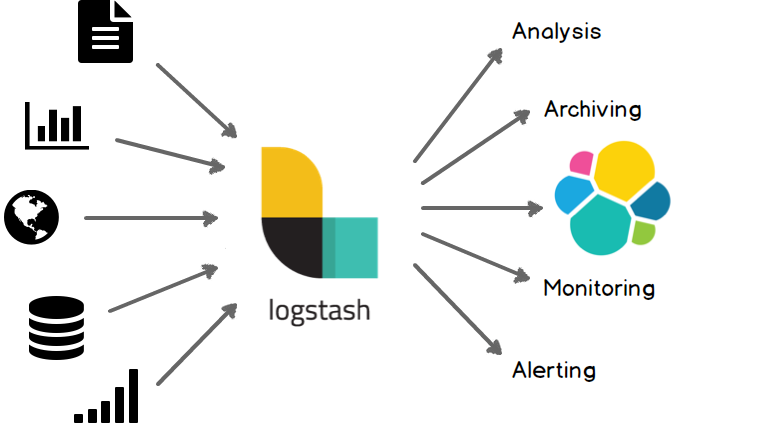
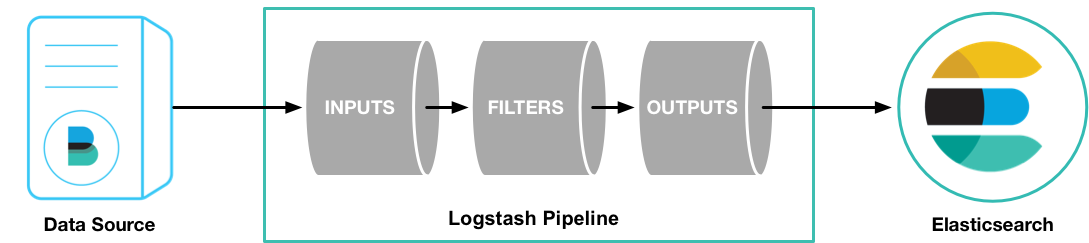
ElasticSearch 安装 1、下载 ElasticSearch,本文使用的版本为 5.5.1。 2、配置 path.data: /data/es #数据路径 path.logs: /data/logs/es #日志路径 network.host: 本机地址 #服务器地址 http.port: 9200 #端口 如果不修改配置的话,默认的数据和日志都位于elasticsearch文件夹下。 默认地址会使用 192.168.0.1 的地址,此时ElasticSearch运行于开发模式,只能从本机访问。如果修改为生产地址,就会进入生产模式,并且运行 bootstrap check 。 3、启动 ./bin/elasticsearch 注意,elasticsearch 不能使用 root 用户启动,使用其他用户启动,要注意有文件夹的读写权限。 我在安装过程中还出现了下面几个警告信息 [2017-08-07T09:13:59,951][WARN ][o.e.b.JNANatives ] unable to install syscall filter: java.lang.UnsupportedOperationException: seccomp unavailable: requires kernel 3.5+ with CONFIG_SECCOMP and CONFIG_SECCOMP_FILTER compiled in at org.elasticsearch.bootstrap.SystemCallFilter.linuxImpl(SystemCallFilter.java:350) ~[elasticsearch-5.5.1.jar:5.5.1] at org.elasticsearch.bootstrap.SystemCallFilter.init(SystemCallFilter.java:638) ~[elasticsearch-5.5.1.jar:5.5.1] at org.elasticsearch.bootstrap.JNANatives.tryInstallSystemCallFilter(JNANatives.java:245) [elasticsearch-5.5.1.jar:5.5.1] at org.elasticsearch.bootstrap.Natives.tryInstallSystemCallFilter(Natives.java:113) [elasticsearch-5.5.1.jar:5.5.1] at org.elasticsearch.bootstrap.Bootstrap.initializeNatives(Bootstrap.java:111) [elasticsearch-5.5.1.jar:5.5.1] at org.elasticsearch.bootstrap.Bootstrap.setup(Bootstrap.java:194) [elasticsearch-5.5.1.jar:5.5.1] at org.elasticsearch.bootstrap.Bootstrap.init(Bootstrap.java:351) [elasticsearch-5.5.1.jar:5.5.1] at org.elasticsearch.bootstrap.Elasticsearch.init(Elasticsearch.java:123) [elasticsearch-5.5.1.jar:5.5.1] at org.elasticsearch.bootstrap.Elasticsearch.execute(Elasticsearch.java:114) [elasticsearch-5.5.1.jar:5.5.1] at org.elasticsearch.cli.EnvironmentAwareCommand.execute(EnvironmentAwareCommand.java:67) [elasticsearch-5.5.1.jar:5.5.1] at org.elasticsearch.cli.Command.mainWithoutErrorHandling(Command.java:122) [elasticsearch-5.5.1.jar:5.5.1] at org.elasticsearch.cli.Command.main(Command.java:88) [elasticsearch-5.5.1.jar:5.5.1] at org.elasticsearch.bootstrap.Elasticsearch.main(Elasticsearch.java:91) [elasticsearch-5.5.1.jar:5.5.1] at org.elasticsearch.bootstrap.Elasticsearch.main(Elasticsearch.java:84) [elasticsearch-5.5.1.jar:5.5.1] [2017-08-01T14:10:57,843][WARN ][o.e.b.BootstrapChecks ] [VAfWGGZ] max file descriptors [65535] for elasticsearch process is too low, increase to at least [65536] [2017-08-01T14:10:57,844][WARN ][o.e.b.BootstrapChecks ] [VAfWGGZ] max number of threads [1024] for user [maserati] is too low, increase to at least [2048] [2017-08-01T14:10:57,844][WARN ][o.e.b.BootstrapChecks ] [VAfWGGZ] max virtual memory areas vm.max_map_count [65530] is too low, increase to at least [262144] [2017-08-01T14:10:57,844][WARN ][o.e.b.BootstrapChecks ] [VAfWGGZ] system call filters failed to install; check the logs and fix your configuration or disable system call filters at your own risk 针对文件描述符,调成 65536 ulimit -n 65536,如果提示没有权限,则可以在用户的 .bash_profile 中增加一行,退出用户重新登陆就可以。 针对 max number of threads 问题,修改 /etc/security/limits.d/90-nproc.conf 。 * soft nproc 2048 root soft nproc unlimited 针对 max virtual memory areas ,修改 /etc/sysctl.conf。如果没有,就新增一行。 vm.max_map_count = 262144 针对 system_call_filter 可以,通过修改配置文件(elasticsearch.yml)关掉这个参数。 bootstrap.system_call_filter: false 4、访问,出现下面的结果表示启动成功。 [root@iZ627x15h6pZ cloud]# curl http://localhost:9200 { "name" : "VAfWGGZ", "cluster_name" : "elasticsearch", "cluster_uuid" : "J9Tm5R2zRt2PkOSwtXj5Wg", "version" : { "number" : "5.5.1", "build_hash" : "19c13d0", "build_date" : "2017-07-18T20:44:24.823Z", "build_snapshot" : false, "lucene_version" : "6.6.0" }, "tagline" : "You Know, for Search" } Logstash 安装 1、下载并解压 Logstash,本文用的 Logstash-5.5.1 版本 2、创建一个简单的配置文件 logstash_test.conf input { stdin { } } output { stdout { codec => rubydebug } } 3、启动 logstash ./bin/logstash -f logstash_test.conf 出现这些信息,表示启动成功了。 [2017-08-01T13:58:38,437][INFO ][logstash.pipeline ] Pipeline main started The stdin plugin is now waiting for input: [2017-08-01T13:58:38,532][INFO ][logstash.agent ] Successfully started Logstash API endpoint {:port=>9600} 4、与ElasticSearch配合。 Kibana 安装 1、下载 Kibana 2、修改配置 //启动端口 因为端口受限 所以变更了默认端口 server.port: 5601 //启动服务的ip server.host: "本机ip" //elasticsearch地址 elasticsearch.url: "http://localhost:9200” 3、启动程序 ./bin/kibana 4、访问查看Kibana启动是否成功,并检索查看数据 http://localhost:5601 参考资料: 1、Download Logstash 2、ElasticSearch Download 3、ElasticSearch 5.0启动出现的错误 4、Ulimit详解 5、ELK+Filebeat 安装配置入门

优秀的个人博客,低调大师

网络及Web学习笔记

IT人一提到说到网络,必定且首先就要提到的就是TCP/IP协议了。这是基本的网络通信层的协议。而这个协议,是网路平台七层网络协议中的一个点。网路协议定义了从用户数据和请求的处理打包/解包的TCP,UDP协议,到分包发送数据的IP协议,再到物理层的实现。一大堆的概念,一本本大砖头般的书,就是学这方面的人都受不了,更不用说只是想了解下网络过程的一般用户了。而更为人熟知的,该是伯纳斯李及其万维网了。万维网乃是现在最大的网络了,而一开始,网络是一点点连接起来的。 那么网络到底是什么呢?计算机刚兴起时,其主要工作就是用来做大规模计算的。其服务方式也是由大型服务机To客户机的形式。客户端进行数据请求,服务机响应处理然后再由客户机显示结果。后来,才有了机器与机器之间需要数据共享的问题。如果就那么几台机器,那么拷贝一份数据也没什么。但是当一个集群的机器需要共享数据,特别是涉及到实时数据时,显然,用拷贝的方式不能满足需求了。所以才有了计算机之间的通信。 而在一开始,不同硬件厂商——IBM, HP, SUN都定义了自己的通信协议和实现。同一个硬件厂商的硬件通信没问题,但是不同厂商的硬件却不能通信。所以才有了后来的标准化的通信协议。而万维网的兴起是在个人计算机兴起后,伯纳斯李的创造性发明。由此,计算机不再是一个个单独的存在,而是通过网络互通互联在一起的一个网络了。 首次接触到通信协议这种东西,往往茫然不知其所谓。记得我第一次了解到这些协议的时候就总是想不通,通过这些协议性的规定就可以实现数据的传输了吗?这是莫名其妙。后来才理解了,传输数据是由物理层的介质——光纤、无线网络——来实现的。而协议是通信双方约定好的,数据传输的格式。以约定好的格式来传输,双方都方便。数据发送方按照协议规定格式进行数据打包然后发送,而接收方就可以按照这个格式进行快速解包了。或者,可以这么去理解,协议就是一个双方都知道的其格式的空表格,发送方往表格空白处填充数据,而接收方,从表格中取出数据。由于双方都知道表格的格式,所以,要发什么数据,要取什么数据,直接去找所需的栏目就可以了。 现在的网络,是一个去中心化的网络。网络中的一个个节点通过IP地址定位。主要通信则发生在服务器与普通网络入口(pc机,手机)之间。所谓网络应用程序就是客户端(Client)软件与服务器端(Server)的通信了。这就是所谓的CS架构模型。而当下大热的Web,提倡用浏览器(Browser)代替客户端(Client)的新模型——BS架构模型。其中,最主要的通信就是浏览器与服务器程序的通信。也就是HTTP通信协议。这些整个过程中,HTTP协议负责对请求和响应的打包与解包。TCP协议负责的是机器与机器之间的通信连接,即用户端机器与服务器端机器的连接。而IP协议负责了用户机器与客户端机器见通信路径的选择,数据的分包发送等。TCP协议是建立在IP协议的基础上的。 作者:何妍 来源:51CTO

优秀的个人博客,低调大师

MySQL Group Replication 学习笔记

作者简介 刘伟 云和开创高级顾问 题记:group replication作为mysql官方,在5.7版本阶段开发的,innodb的分布式数据库架构,从发布开始就有很多关注,下文是我对目前为止的材料以及实验的一些总结。 主要资料来源是官方blog:http://mysqlhighavailability.com/ group replication架构 group replication(后文简称GR)实现的分布式数据库架构,底层的分布式基础是Paxos(出于行文限制,此处不单独交代Paxos)。通过Paxos来保证分布式数据库系统中,事务的提交顺序。 每次一个事务在一个节点提交的时候,就会发送所修改的数据到所有节点,检查期间是否有修改冲突(比如修改了别的节点已经修改并提交成功的事务的数据),如果发现冲突,本事务回滚。如果没有冲突,则可以直接提交成功。 对于非执行事务的远程节点,如果事务判断为执行成功,远程发送过来的数据,会被保存在本地的一个relay log里面(注意,与常规主从同步使用的relay log不是同一组),之后由从库的applier线程采用正常主从同步(目前已经支持LOGICAL_CLOCK并行执行)的方式执行掉对应的relay log。 这里有一个临界点,如果一个事务刚刚被写入relay log,还没有来得及执行掉,这时候有一个事务的执行涉及了相关的数据,那么后来的这个事务在执行阶段可以执行成功,但是必定会在提交阶段失败的。 使用建议 根据目前的状况看,GR使用的时候,应该做到以下几点以对性能优化以及减少分布式冲突。 节点分区 虽然是分布式,但并非采用纯粹的随机或者轮询来对节点访问,而是采用一些分区算法,保证指定的主键必定发生指定的实例上。 这点主要目的是避免出现事务在分布式系统中的冲突,导致不可控的事务回滚。 建议的分区算法是一致性哈希,方便节点的添加删除,以及负载均衡。 控制单次事务操作数据量 即控制事务所涉及修改(增,删,改)的数据,主要原因有两点: 一是,多节点之间的冲突检验需要传输相关的数据,如果单次事务量过大,会导致单次事务的检查时间增长,由于分布式事务的全局序列性,单个慢事务会导致全局的低速。 二是,由于最终多节点的同步,还是通过每个节点自己的relay线程来执行的,如果有大事务,会导致relay线程执行不到后面的事务,导致事务延迟,并导致可能会产生的分布式事务回滚。 周边功能介绍 主要组件简介 capture 追踪当前正在执行的事务的上下文 applier 执行远程事务传输到本地的日志到本地数据库 recovery 负责分布式环境下的节点恢复,以及相关的数据回追,失败处理等 失败节点检测 只有认为无法连接的节点才会从集群中自动踢走。 机制如下: 不可用本身的发觉,是依赖消息通讯的超时决定的。即如果节点对另外的节点的消息发送超时,则认为远程节点不可用。 对于正常节点,如果认为一个其他节点不可用了,首先会标记为不可用,之后与其他节点沟通,如果确认这个节点确实其他节点都认为不可用,则实际设置为不可用节点。 如果一个节点发现自生连接不到其他所有的实例(认为其他节点全部死亡),则这个节点本身之后的事务执行,就不会采用分布式算法而是退回传统的单节点事务模式。 另外,如果同时失败节点数过多(超过一半),为了避免脑裂,分布式算法会拒绝运行,需要人工介入恢复,这也是需要注意的一点。 节点状态 ONLINE 节点状态正常,可以正常执行事务 RECOVERING 正在接收种子节点的日志 OFFLINE 节点之前注册了,但并不属于当前集群(可能节点已经失败) ERROR 恢复阶段,阶段1或者阶段2失败 UNREACHABLE 节点不可达,一般出现在通讯超时的情况 失败恢复 这里说的,主要把一个节点,加入到已有集群的过程,而非单实例的崩溃恢复。 -->阶段1 第一阶段,新实例选择集群中的一个实例作为种子实例,这个种子实例会发送所有新实例到加入集群为止缺失的日志数据到新实例,这个的执行,是通过简单的主从同步日志的方式做的。 执行阶段1的期间,新实例还会一直持续接收当前正在活跃(实例加入集群后)的事务的日志,补全从种子实例没有传输的增量日志。 当种子实例传输日志完成之后,第一阶段就完毕了。 这一阶段,如果种子实例出现问题崩溃或者失败了,新实例会自动选取实例里面别的实例替代。 -->阶段2 这一阶段,新实例合并之前的活跃事务到当前数据库,当残余的事务量接近0(新事务一直在别的实例发生,只能非常接近0而很难完全追上)的时候,实例在集群中的状态,就会被修改为ONLINE了。 流量控制 mysql的GR,全局所有的实例都拥有所有的数据,也实际上需要运行所有的写入流量,如果有某一个实例相对较慢,如果时间持续下去,这个节点可能出现延迟,极端情况下,可能越追越远。 流量控制试图做到的事情是,保障整个集群节点之间,最快的节点和最慢的节点之间的事务差距不要太大。 实际需要控制的,有两个队列,一个是事务提交时候的冲突检查队列,一个是事务实际执行的relay日志队列 DDL执行 DDL先天上并不支持事务化,也就是多节点执行的时候,如果有几个节点失败,并不会导致已经执行成功的节点回滚DDL,对于DDL的执行结果需要单独验证,以避免多节点表不一致。 IP白名单 这个主要是安全方面的考虑,之允许指定来源的ip作为复制节点与集群通讯。 一些限制 使用group replication有以下一些限制。 所有涉及的数据都必须发生在InnoDB存储引擎的表内。 所有的表必须有明确的主键定义。 网络地址只支持IPv4。 需要低延迟,高带宽的网络。 目前集群限制最多允许9个节点。 必须启用binlog。 binlog 格式必须是row格式。 必须打开gtid模式。 复制相关信息必须使用表存储。 事务写集合(Transaction write set extraction)必须打开。(这个目前与savepoint冲突,这也是导致mysqldump无法备份GR实例的原因) log slave updates必须打开。 binlog的checksum目前不支持。 由于事务写集合的干扰,无法使用savepoint。 SERIALIZABLE 隔离级别目前不支持。 对同一个对象,在集群中不同的实例上,并行地执行DDL(哪怕是相互冲突的DDL)是可行的,但会导致数据一致性等方面的错误,目前阶段不支持在多节点同时执行同一对象的DDL。 外键的级联约束操作目前的实现并不完全支持,不推荐使用。 几个名词 Donor:用于节点恢复时候,传输历史binlog的节点。Group Configuration:集群里已经配置的实例列表。Group Membership Service:维护一致性view变更的服务,作用于节点的新增,退出,以及当前视图的维护工作。Joiner:将要加入到集群但状态尚未恢复到ONLINE的新节点。Seed:负责触发新节点加入集群动作的实例。View:当前集群活跃实例的列表。 本文出自数据和云公众号,原文链接

优秀的个人博客,低调大师

Android Drawable绘图学习笔记

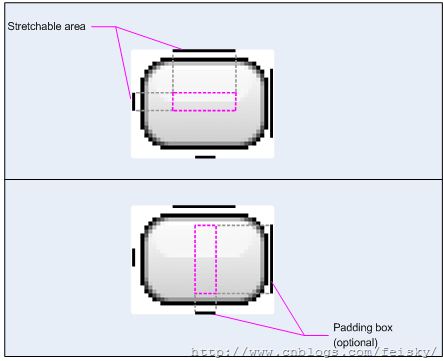
如何获取 res 中的资源 数据包package:android.content.res 主要类:Resources Android SDK中的简介:Class for accessing an application’s resources.Class for accessing an application’s resources. This sits on top of the asset manager of the application (accessible through getAssets()) and provides a higher-level API for getting typed data from the assets. 其主要接口按照功能,划分为以下三部分: getXXXX() 例如: int getColor(int id) Drawable getDrawable(int id) String getString(int id) 直接获取res中存放的资源 InputStream openRawResource(int id) 获取资源的数据流,读取资源数据 void parseBundleExtras(XmlResourceParser parser, Bundle outBundle) 从XML文件中获取数据 Resource为每种资源提供了相应的接口来获取这种资源,除了可以直接获取资源外,还额外提供了以数据流的方式获取资源,这在以后的应用程序开发中会经常使用,那么如何获取Resources了,如下:Resources r = this.getContext().getResources(); 如何获取资源中的画图对象 数据包package:android.graphics.drawable 主要类:Drawable Android SDK中的简介:A Drawable is a general abstraction for “something that can be drawn.” Most often you will deal with Drawable as the type of resource retrieved for drawing things to the screen; the Drawable class provides a generic API for dealing with an underlying visual resource that may take a variety of forms. 看了以上简介,发现Drawable是个virtual class,具体如何画图,需要具体分析Drawable的子类,例如:BitmapDrawable Android SDK中的简介:A Drawable that wraps a bitmap and can be tiled, stretched, or aligned. You can create a BitmapDrawable from a file path, an input stream, through XML inflation, or from a Bitmap object. It can be defined in an XML file with the<bitmap>element. 其主要接口如下: BitmapDrawable() BitmapDrawable(Bitmap bitmap) BitmapDrawable(String filepath) BitmapDrawable(InputStream is) void draw(Canvas canvas) Draw in its bounds (set via setBounds) respecting optional effects such as alpha (set via setAlpha) and color filter (set via setColorFilter). final Bitmap getBitmap() final Paint getPaint() Drawable是个抽象类,在BitmapDrawable中我们就看到位图的具体操作,在仔细看下BitmapDrawable的构造函数,我们就会发现与Resource中的openRawResource()接口是相对应的,就可以通过以下方法来获取位图: Resources r = this.getContext().getResources(); Inputstream is = r.openRawResource(R.drawable.my_background_image); BitmapDrawable bmpDraw = new BitmapDrawable(is); Bitmap bmp = bmpDraw.getBitmap(); Paint 数据包package:android.graphics Android SDK中的简介:The Paint class holds the style and color information about how to draw geometries, text and bitmaps. 主要就是定义:画刷的样式,画笔的大小/颜色等。 Typeface 数据包 package:android.graphics Android SDK中的简介:The Typeface class specifies the typeface and intrinsic style of a font. 主要就是定义:字体。 核心类显示资源 数据包package:android.graphics 主要类:Canvas Android SDK中的简介:The Canvas class holds the “draw” calls. To draw something, you need 4 basic components: A Bitmap to hold the pixels, a Canvas to host the draw calls (writing into the bitmap), a drawing primitive (e.g. Rect, Path, text, Bitmap), and a paint (to describe the colors and styles for the drawing). 按照结构的功能,将主要接口分为以下3部分: boolean clipXXXX() Region区域操作:DIFFERENCE INTERSECT REPLACE REVERSE_DIFFERENCE UNION XOR void drawXXXX()画图函数 void rotate() void scale() void skew() void translate() 画布操作函数 Region在这里需要特殊说明下:Region就是一个区域,也就是画布(Canvas)中的有效区域,在无效区域上draw,对画布没有任何改变。 Drawable类 Drawable是一个通用的抽象类,它的目的是告诉你什么东西是可以画的。你会发现基于Drawable类扩展出各种绘图的类,见下面的表格,当然你可以继承它来创建你自己的绘图类. Interfaces Animatable Interface that drawables suporting animations should implement. Drawable.Callback Implement this interface if you want to create an animated drawable that extendsDrawable. Classes AnimationDrawable An object used to create frame-by-frame animations, defined by a series of Drawable objects, which can be used as a View object's background. BitmapDrawable A Drawable that wraps a bitmap and can be tiled, stretched, or aligned. ClipDrawable A Drawable that clips another Drawable based on this Drawable's current level value. ColorDrawable A specialized Drawable that fills the Canvas with a specified color, with respect to the clip region. Drawable A Drawable is a general abstraction for "something that can be drawn." Most often you will deal with Drawable as the type of resource retrieved for drawing things to the screen; the Drawable class provides a generic API for dealing with an underlying visual resource that may take a variety of forms. Drawable.ConstantState DrawableContainer DrawableContainer.DrawableContainerState GradientDrawable A Drawable with a color gradient for buttons, backgrounds, etc. InsetDrawable A Drawable that insets another Drawable by a specified distance. LayerDrawable A Drawable that manages an array of other Drawables. LevelListDrawable A resource that manages a number of alternate Drawables, each assigned a maximum numerical value. NinePatchDrawable A resizeable bitmap, with stretchable areas that you define. PaintDrawable Drawable that draws its bounds in the given paint, with optional rounded corners. PictureDrawable Drawable subclass that wraps a Picture, allowing the picture to be used whereever a Drawable is supported. RotateDrawable A Drawable that can rotate another Drawable based on the current level value. ScaleDrawable A Drawable that changes the size of another Drawable based on its current level value. ShapeDrawable A Drawable object that draws primitive shapes. ShapeDrawable.ShaderFactory Base class defines a factory object that is called each time the drawable is resized (has a new width or height). StateListDrawable Lets you assign a number of graphic images to a single Drawable and swap out the visible item by a string ID value. TransitionDrawable An extension of LayerDrawables that is intended to cross-fade between the first and second layer. 有三种方法可以定义和实例化一个Drawable:保存一个图片到你工程资源中,使用XML文件来描述Drawable属性或者用一个正常的类去构造。下面我们将讨论两种技术(对一个有开发经验的开发者来说构造并不是最新的技术)。 从资源图像文件中创建 一个比较简单的方法是添加一个图片到你的程序中,然后通过资源文件引用这个文件,支持的文件类型有PNG(首选的) JPG(可接受的)GIF(不建议),显然这种对于显示应用程序的图标跟来说是首选的方法,也可以用来显示LOGO,其余的图片可以用在例如游戏中。 把一个图片资源,添加你的文件到你工程中res/drawable/目录中去,从这里,你就可以引用它到你的代码或你的XML布局中,也就是说,引用它也可以用资源编号,比如你选择一个文件只要去掉后缀就可以了(例如:my_image.png 引用它是就是my_image)。 注意:SDK指出,为了缩小图片的存储空间,在Build的时候又可能对图片进行压缩,如果不想被压缩,可以将图片放在res/raw/目录中。 SDK给出的例子: LinearLayout mLinearLayout; protected void onCreate(Bundle savedInstanceState) { super.onCreate(savedInstanceState); // Create a LinearLayout in which to add the ImageView mLinearLayout = new LinearLayout(this); // Instantiate an ImageView and define its properties ImageView i = new ImageView(this); i.setImageResource(R.drawable.my_image); i.setAdjustViewBounds(true); // set the ImageView bounds to match the Drawable's dimensions i.setLayoutParams(new Gallery.LayoutParams(LayoutParams.WRAP_CONTENT, LayoutParams.WRAP_CONTENT)); // Add the ImageView to the layout and set the layout as the content view mLinearLayout.addView(i); setContentView(mLinearLayout); } 获取Drawable对象: Resources res = mContext.getResources(); Drawable myImage = res.getDrawable(R.drawable.my_image); 注意:保持每个资源类型的一至,可以保证你项目状态的一致性,就不用担心有许多不同类型的对象来实例化它。例如:如果使用相同的图像资源来实例化两个Drawable对象。然后修改一个Drawables的属性(例如alpha),然后不幸得是这个效果也会出现在另一个对象上去。所以当处理同一个资源的多个实例对象时,不是直接转换为Drawable,而是应该执行tween animation 如何添加资源到ImageView: <ImageView android:layout_width="wrap_content" android:layout_height="wrap_content" android:tint="#55ff0000" android:src="@drawable/my_image"/> 从XML文件中创建 到如今,你应该比较熟悉按Android的原则去开发一个用户接口,因此,你也应该理解了定义一个XML文件对于对象的作用与灵活的重要性。这个理念无数次用于Drawables. 如果你想创建一个Drawable对象,而这个对象并不依赖于变量或用户的交换,把它定义到XML中去应该是一个不错的方法。即使你期望在你的应用程序中改变其属性来增加用户体验。你应该考虑把对象放入XML中,因为你可以随时修改其属性。 当你在你的XML中定义了一个Drawable,保存这个XML文件到你工程目录下res/drawable目录中,然后通过调用Resource.getDrawable()来检索并实例化,传递给它XML文件中的资源ID号。任何Drawable的子类都支持inflate这个方法,这个方法会通过XML来实例化你的程序。任何Drawable都支持XML的扩展来利用特殊的XML属性来帮助定义对象的属性,可以查看任何Drawable子类文档来看如何定义XML文件。 如下定义了一个TransitionDrawable:An extension of LayerDrawables that is intended to cross-fade between the first and second layer. It can be defined in an XML file with the<transition>element. Each Drawable in the transition is defined in a nested<item>. 有关TransitionDrawable的详细信息查看http://androidappdocs.appspot.com/reference/android/graphics/drawable/TransitionDrawable.html。 将其定义在res/drawable/expand_collapse.xml: <?xml version="1.0" encoding="utf-8"?> <transition xmlns:android="http://schemas.android.com/apk/res/android"> <item android:drawable="@drawable/pic1"/> <item android:drawable="@drawable/pic2"/> </transition> 下面实例化并处理: public class MainActivity extends Activity { /** Called when the activity is first created. */ @Override public void onCreate(Bundle savedInstanceState) { super.onCreate(savedInstanceState); setContentView(R.layout.main); Resources res=getResources(); TransitionDrawable trans=(TransitionDrawable )res.getDrawable(R.drawable.expand_collapse); ImageView image = (ImageView)findViewById(R.id.ImageView01); image.setImageDrawable(trans); trans.startTransition(3000); } } ShapeDrawable 当你想去画一些动态的二维图片,一个ShapeDrawable对象可能会对你有很大的帮助。通过ShapeDrawable,你可以通过编程画出任何你想到的图像与样式。 ShapeDrawable继承了Drawable, 所以你可以调用Drawable里有的函数,比如视图的背景,通过setBackgroundDrawable()设置。当然,你可以在自定义的视图布局中画你的图形,因为ShapeDrawable有自己的draw()方法。你可以在View.OnDraw()方法期间创建一个视图的子类去画ShapeDrawable。 ShapeDrawable类(像很多其他Drawable类型在android.graphics.drawable包)允许你定义drawable公共方法的各种属性。有些属性你可以需要调整,包括透明度,颜色过滤,不透明度,颜色。 例子: public class CustomDrawableView extends View { private ShapeDrawable mDrawable; public CustomDrawableView(Context context) { super(context); int x = 10; int y = 10; int width = 300; int height = 50; mDrawable = new ShapeDrawable(new OvalShape()); mDrawable.getPaint().setColor(0xff74AC23); mDrawable.setBounds(x, y, x + width, y + height); } protected void onDraw(Canvas canvas) { mDrawable.draw(canvas); } 显示: CustomDrawableView mCustomDrawableView;protected void onCreate(Bundle savedInstanceState) { super.onCreate(savedInstanceState); mCustomDrawableView = new CustomDrawableView(this); setContentView(mCustomDrawableView);} 在XML中定义方法:如果你想用XML文件配置来取代原有布局来画自定义的drawable,于是你自定义的Drawable类必须重载view (Context, AttributeSet) 构造函数。 <com.example.shapedrawable.CustomDrawableView android:layout_width="fill_parent" android:layout_height="wrap_content" /> NinePatchDrawable NinePatchDrawable 绘画的是一个可以伸缩的位图图像,Android会自动调整大小来容纳显示的内容。一个例子就是NinePatch为背景,使用标准的Android按钮,按钮必须伸缩来容纳长度变化的字符 NinePatchDrawable是一个标准的PNG图像,它包括额外的1个像素的边界,你必须保存它后缀为.9.png,并且保持到工程的res/drawable目录中。 这个边界是用来确定图像的可伸缩和静态区域。你可以在左边和上边的线上画一个或多个黑色的1个像素指出可伸缩的部分(你可以需要很多可伸缩部分),它的相对位置在可伸缩部分相同,所以大的部分总是很大的。 你还有可以在图像的右边和下边画一条可选的drawable区域(有效的,内边距线)。如果你的视图对象设置NinePath为背景然后指定特殊的视图字体,它将自行伸缩使所有的文本来适应根据右线与底部线设计好的区域(如果有的话),当然内边距线不包括其中,Android可以使用左边的线与上面的线来定义一个drawable区域。 我们来澄清一下这两条不同的线,左边跟顶部的线来定义哪些图像的像素允许在伸缩时被复制。底部与右边的线用来定义一个相对位置内的图像,视图的内容就放入其中。 使用方法: <Button id="@+id/tiny" android:layout_width="wrap_content" android:layout_height="wrap_content" android:layout_alignParentTop="true" android:layout_centerInParent="true" android:text="Tiny" android:textSize="8sp" android:background="@drawable/my_button_background"/><Button id="@+id/big" android:layout_width="wrap_content" android:layout_height="wrap_content" android:layout_alignParentBottom="true" android:layout_centerInParent="true" android:text="Biiiiiiig text!" android:textSize="30sp" android:background="@drawable/my_button_background"/> 本文转自feisky博客园博客,原文链接:http://www.cnblogs.com/feisky/archive/2010/01/08/1642567.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

人工智能学习笔记

1、什么是人工智能?简单地讲,人工智能就是为机器赋予人类的智能。人类的智能体现在何处?学习、创造、归纳、演绎 2、人工智能的应用领域:a)自然语言处理(机器翻译、机器写作、机器问答)b)计算机视觉(图像识别、视频识别、人脸识别、自动驾驶)c)语音识别(语音转文字、文字转语音)d)机器人(扫地机器人、工业机器人) 3、机器学习机器学习是实现人工智能的一种方法,具体的实现技术有:深度学习、有监督学习和无监督学习。 什么是机器学习?给定某个任务(T),通过机器不断积累经验(E)来完善,提升性能(P) 人类的知识在两个维度上可分成四类:(不)可统计/(不)可推理 机器学习要想做得好,需要走好三大步:(1) 如何找一系列函数来实现预期的功能,这是建模问题。(2) 如何找出一组合理的评价标准,来评估函数的好坏,这是评价问题。(3) 如何快速找到性能最佳的函数,这是优化问题(比如说,机器学习中梯度下降法干的就是这个活) 5、深度学习(Deep learning)深度学习:依靠机器对数据的分析和学习,自己学习如何抓取数据的特征,得出想要的结果。深度学习,是把由人工选取对象特征,变更为通过神经网络自己选取特征,为了提升学习的性能,采用多层次的特征表示学习。 深度学习是高度数据依赖型的算法,它的性能通常随着数据量的增加而不断增强 6、神经网络(ANN)深度学习来源于神经网络学习。 根据芬兰计算机科学家Teuvo Kohonen的定义(这老爷子以提出“自组织神经网络”而名扬人工智能领域):“神经网络,是一种由具有自适应性的简单单元构成的广泛并行互联的网络,它的组织结构能够模拟生物神经系统对真实世界所作出的交互反应。” 人工智能研究领域的两个学派:符号主义(重规则和推理),连接主义(重模型)。连接主义认为,人的思维就是某些神经元的组合。因此,可以在网络层次上模拟人的认知功能,用人脑的并行处理模式,来表征认知过程。这种受神经科学的启发的网络,被称之人工神经网络(Artificial Neural Network,简称ANN)。目前,这个网络的升级版,就是目前非常流行的深度学习。 理论上来讲,只需一个包含足够多神经元的隐藏层,多层前馈网络能以任意精度逼近任意复杂度的连续函数。(收敛函数) M-P模型,Sigmoid函数和卷积函数所谓卷积,就是一个功能和另一个功能在时间的维度上的“叠加”作用。

优秀的个人博客,低调大师

hiveql函数笔记(二)

1、数据查询 //提高聚合的性能 SET hive.map.aggr=true; SELECT count(*),avg(salary) FROM employees; //木匾不允许在一个查询语句中使用多于一个的函数(DISTINCT。。。)表达式 SELECT count(DISTINCT symbol) FROM stocks; 表生成函数: explode(APPAY array) 返回0到多行结果,每行都对应输入的array数组中的一个元素 explode(ARRAY<TYPE> a) 对于a中的每个元素,explode()会生成一个记录包含这个元素 explode(ARRAY<TYPE> a) 对于a中的每个元素,explode()会生成一行记录包含这个元素 inline(ARRAY<STRUCT[,STRUCT]>) 将结构体数组提取出来并插入到表中 json_tuple(STRING jsonStr,p1,p2,..,pn) 对输入的JSON字符串进行处理,合格get_json_object这个UDF类似,不过更高效,其通过一次调用就可以获取多个键值。 parse_url_tuple(url,partname1,partname2,..,partNameN) 其中N>=1,从URL中解析出N个部分信息。其输入参数是:URL,以及多个要抽取的部分的名称。部分名称是大小写敏感的,而且不应该包含有空格:HOST,PATH,QUERY,REF,PROTOCOL,AUTHORITY,FILE,USERINFO,QUERY:<KEY_NAME> 其他内置函数: ascii(STRING s) 返回字符串s中首个ASCII字符的整数值 base64(BINARY bin) 将二进制值bin转换成基于64位的字符串 cast(<expr> as <type>) 将expr转换成type类型的。例如:cast('1' as BIGINT)将会将字符串'1'转换成BIGINT数值类型。如果转换失败,则返回NULL concat(BINARY s1,BINARY s2,..) 将二进制字节码按次序拼接成一个字符串 concat(STRING s1,STRING s2,..) 将字符串s1,s2等拼接成一个字符串。例如:concat('ab','cd')的结果是'abcd' concat)ws(STRING separator,STRING s1,STRING s2,...) 和concat类似,不过是使用指定的分隔符进行拼接. decode(BINARY bin,STRING charset) 使用指定的字符集charset将二进制值bin解码成字符串(支持的字符集有:'UTF-16')。如果任一输入参数为NULL,则结果返回NULL encode(STRING src,STRING charset) 使用指定的字符集charset将字符串src编码成二进制值(支持的字符集有:'US-ASCII','ISO-8859-1','UTF-8',UTF-16BE','UTF-16LE','UTF-16')),如果任一输入参数为NULL,则结果为NULL find_in_set(STRING s,STRING commaSeparatedString) 返回在以逗号分隔的字符串中s出现的位置,如果没有找到则返回NULL format_number(NUMBER X,INT d) 将数值x转换成'#,###,###,##'格式字符串,并博保留d位小数。如果d为0,那么输出值就没有小数点后面的值。 get_json_object(STRING json_string,STRING path) 从给定路径上的JSON字符串中抽取JSON对象,并返回这个对象的JSON字符串形式。如果输入的JSON字符串是非法的,则返回NULL in_file(STRING s,STRING filename) 如果文件名为filename的文件中有完整一行数据和字符串s完全匹配的话,则返回true instr(STRING str,STRING substr) 查找字符串str中子字符串substr第一次出现的位置 length(STRING s) 计算字符串s的长度 locate(STRING substr,STRING [,INT pos]) 查找在字符串str中的pos位置后字符串substr第一次出现的位置 lpad(STRING s,INT len,STRING pad) 从左边开始对字符串s使用字符串pad进行填充,最终达到len长度为止。如果字符串s本身长度比len大的话,那么多余的部分被去除掉。 rpad(STRING s,INT len,STRING pad) 从右边开始对字符串s...... ltrim(STRING s) 将字符串s前面出现的空格全部去除掉。例如trim(' hive ')的结果是'hive ' regexp_replace(STRING s,STRING regex,STRING replacement) 按照JAVA正则表达式regex将字符串s中符合条件的部分替换成replacement所指定的字符串a.如果replacement部分是空的话,那么符合正则的部门就会背去除掉。例如regexp_replace('hive','[ie]','z')的 结果是'hzvz' repeat(STRING s,INT n) 重复输出n次字符串s reverse(STRING s) 反转字符串 rtrim(STRING s) 将字符串s后面出现的空格全部去除掉。例如trim('hive')的结果是'hive' split(STRING s,STRING pattern) 按照正则表达式pattern分隔字符串s,并将分割后的部分以字符串数组的方式返回。 str_to_map(STRING s,STRING delim1,STRING delim2) 将字符串s按照按指定分隔符转换成map,第一个参数是输入的字符串,第二个参数是键值对之间的分隔符,第三个分隔符是键和值之间的分隔符 substr(STRING s,STRING start_index) 对于字符串s,从start位置开始截取length长度的字符串,作为字符串。例如:substr('abcdefgh',3,2)的结果是'cd' unix_timestamp(STRING date,STRING pattern) 将指定时间字符串格式字符串转换成Unix时间戳,如果格式不对则返回0,例如unix_timestamp('2009-03-20','yyyy-MM-dd')=1237532400 to_date(STRING timestamp) 返回时间字符串的日期部分,例如:to_date("1970-01-01 00:00:00")="1970-01-01" year(STRING date) 返回时间字符串中的年份并使用INT类型表示。例如:year("1970-01-01") = 1970 month....day...hour...minute...second...weekofyear同理 datediff(STRING enddate,STRING startdate) 计算开始时间startdata到结束时间enddata相差的天数。例如:datediff('2009-03-01','2009-02-27')=2 date_add(STRING startdate,INT days) 为开始时间startdata增加days天,例如data_sub('2008-12-31',1)='2008-12-30' 谓词操作符 A<=>B 如果A和B都为NULL则返回TRUE,其他的和等号(=)操作符的结果一致,如果任一为NULL则结果为NULL A<>B,A!=B A或者B为NULL则返回NULL,如果A不等于B则返回TRUE,反之返回FALSE A[NOT] BETWEEN B AND C 如果A的值大于或等于B而且小于或等于C,则结果为TRUE A[NOT] like B B是一个SQL下的简单正则表达式 A RLIKE B,A REGEXP B B是一个正则表达式,如果A与其相匹配,则返回TRUE。 参考文献:《Hive编程指南》

优秀的个人博客,低调大师

虚拟化技术学习笔记

ECS 用的KVM。 任何计算机的问题都可以通过另一层的重定向解决。 虚拟技术:Xen, KVM, Hyper-V, Vmware ESX Server, VMware workstation, VirtualBox Binary Translation: 因为一开始X86不支持虚拟化, 实现复杂,性能损失 硬件辅助虚拟化:2004年 Intel和AMD 发布新的CPU规范,支持虚拟化。 问题: 1,ECS主要就是用的虚拟化技术吧,ECS产品本身和盘古有什么关系呢?这张图感觉有点需要推敲。 2,一个特定的ECS在阿里云里面,如果相应的物理机发生故障,如何切换?

优秀的个人博客,低调大师

Learning ELK stack 学习笔记

不错的入门书Learning ELK stack 第三章: Logstash插件类型分为四类: Input Filter Output Codec Logstash input类的file插件维护了一个sincedb文件追踪监控操作文件的当前位置。默认写入$HOME/.sincedb*,游标及读取频率可以通过配置修改。 file的两个配置属性:sincedb_path,sincedb_write_interval(默认15秒读取一次文件) 这里还涉及另一个配置 start_position => "beginning" 或"end"(默认),使用beginning,如果移除了.sincedb,将重新读取历史数据,造成数据重复。 lumberjack和logstash forwarder(轻量化的logstash)使用lumberjack协议打包日志 redis经常做为logstash forwarder 与logstash的中间人角色,在高负载系统上提供获取日志的服务。 Logstash outpu类型插件: 重点是elasticsearch,email,kafka,lumberjack,redis, Logstash filter类型插件: date,drop,grok解析非结构化的日志转换成结构化,mutate重命名,移除,替换,修改字段,转换字段类型,合并字段等 Logstash codec类型插件:编码解码日志 json,mutliline 第五章节: elasticsearch > indices > documents(json) > fields(_type,mapping) pattern=>"logstash-%{+YYYY.MM.dd}"(默认index) shard:index的物理存储位置,支持Primary shard and replica shard, 默认每个document使用5个shard replica shard分布在各个节点上,可以failover与平均负载 cluster > nodes :三种角色 =>data node =>master node =>routing node & load banlancer node elasticsearch api $curl -X '://://?'d '' VERB:GET, POST, PUT,DELETE, HEAD PROTOCAL:http,https PATH:/index/type/id OPERATION_NAME:_search, _count, and so on QUERY_STRING:?pretty for pretty print of JSON documents BODY:This makes a request for body text. 查看指定index的document thinkt@linux-pw37:~> curl -XGET 'http://192.168.56.101:9200/logstash-2016.09.09/_search?pretty' { "took" : 107, "timed_out" : false, "_shards" : { "total" : 5, "successful" : 5, "failed" : 0 }, "hits" : { "total" : 1, "max_score" : 1.0, "hits" : [ { "_index" : "logstash-2016.09.09", "_type" : "logs", "_id" : "AVf3tVjYndkMLGPlmtnx", "_score" : 1.0, "_source" : { "message" : "2016-09-09,770.099976,773.244995,759.659973,759.659973,1812200,759.659973", "@version" : "1", "@timestamp" : "2016-09-09T00:00:00.000Z", "path" : "/home/vagrant/table.csv", "host" : "localhost.localdomain", "Date" : "2016-09-09", "Open" : 770.099976, "High" : 773.244995, "Low" : 759.659973, "Close" : 759.659973, "Volume" : 1812200, "Adj_close" : 759.659973 } } ] } } 查看所有index thinkt@linux-pw37:~> curl -XGET 'http://192.168.56.101:9200/_cat/indices?v' health status index pri rep docs.count docs.deleted store.size pri.store.size yellow open logstash-2016.03.18 5 1 1 0 7.9kb 7.9kb yellow open logstash-2016.03.17 5 1 1 0 7.9kb 7.9kb yellow open logstash-2016.03.16 5 1 1 0 7.9kb 7.9kb yellow open logstash-2016.03.15 5 1 1 0 7.9kb 7.9kb yellow open logstash-2016.06.07 5 1 1 0 7.9kb 7.9kb yellow open logstash-2016.06.08 5 1 1 0 7.9kb 7.9kb yellow open logstash-2016.06.09 5 1 1 0 7.9kb 7.9kb yellow open logstash-2016.08.31 5 1 1 0 8kb 8kb yellow open logstash-2016.09.01 5 1 1 0 7.9kb 7.9kb yellow open logstash-2016.08.30 5 1 1 0 8kb 8kb yellow open logstash-2016.03.21 5 1 1 0 7.9kb 7.9kb yellow open logstash-2016.06.14 5 1 1 0 7.9kb 7.9kb yellow open logstash-2016.09.08 5 1 1 0 8kb 8kb yellow open logstash-2016.06.15 5 1 1 0 7.9kb 7.9kb yellow open logstash-2016.09.09 5 1 1 0 7.9kb 7.9kb yellow open logstash-2016.06.16 5 1 1 0 7.9kb 7.9kb yellow open logstash-2016.09.06 5 1 1 0 7.9kb 7.9kb 查看集群中所有nodes thinkt@linux-pw37:~> curl -XGET 'http://192.168.56.101:9200/_cat/nodes?v' host ip heap.percent ram.percent load node.role master name 10.0.2.15 10.0.2.15 13 56 0.00 d * node-1 logstash 的elasticsearch 插件会自动创建index kibana4特性: 搜索关键字高亮 聚合类型:桶,度量 可脚本化的字段 动态展示 kibana的主项: discover,visualize,dashboard,settings discover的search box搜索记录默认最多显示500条index documents time filter支持quick,absolute,relative三种时间过滤方式,并支持定义自动刷新间隔,也可以使用histogram直方图拖动选择时间。 查询语法使用lucene语法 Lucene n. Lucene是一个非常优秀的开源的全文搜索引擎; 我们可以在它的上面开发出各种全文搜索的应用来。Lucene在国外有很高的知名度; 现在已经是Apache的顶级项目; 在国内; 搜索方式:search box 文本查询,field查询 visualize,dashboard 阻止数据丢失 logs > borker(redis,rabbit mq,amqp,zeroMQ) > logstash > elasticsearch > kibana > nginx 加固数据访问 elasticsearch,kibana使用SSL认证访问elasticsearch browser-(ssl_key_file,ssl_cert_file)->kibana->elasticsearch Elasticsearch shield(收费) Search guard(free) 系统伸缩性 horizontally scalable fast,quick,realtime inexpensive便宜的 flexable弹性灵活的 用户量及支持力度 开源的 数据保留策略 elasticsearch curator管理indeices

优秀的个人博客,低调大师

hadoop学习笔记--集群搭建

注:大家常说的ssh其实就是一个免密码访问的东西,为了简化操作的,不用每次访问其他节点重新输入密码。但是要想配置如下: 1.在每台机器上执行 ssh-keygen -t rsa,连敲三次回车键(即设置空密码) 2.然后在每台机器上都执行cd ~/.ssh,并分别把id_rsa.pub复制到authorized_keys中, 即执行 cp id_rsa.pub authorized_keys 3.然后分别把slave0,slave1的authorized_keys都复制到master主节点的authorized_keys中, 即分别在两个从节点slave0和slave1中执行 ssh-copy-id -i master 4.再分别复制到slave0,slave1中(即每一个节点的authorized_keys中都有这三个节点的密钥) 即在主节点master上执行 scp -r ~/.ssh/authorized_keys slave0:~/.ssh/ scp -r ~/.ssh/authorized_keys slave1:~/.ssh/ 此时成功。 简单测试:比如说在master上执行ssh slave0,这时候发现不需要输入密码即可转 到slave0从节点上,这时成功 hadoop-0.20.2的配置文件 hadoop-0.20.0的配置文件: core-site.xml <property> <name>fs.default.name</name> <value>hdfs://cMaster:9000</value> </property> <property> <name>hadoop.tmp.dir</name> <value>/home/joe/cloudData</value> </property> hdfs-site.xml <property> <name>dfs.name.dir</name> <value>/home/joe/hdfs/name</value> </property> <property> <name>dfs.data.dir</name> <value>/home/joe/hdfs/data</value> </property> <property> <name>dfs.replication</name> <value>1</value> </property> mapred-site.xml <property> <name>mapred.job.tracker</name> <value>cMaster:9001</value> </property> hadoop-0.20.2集群操作命令: hadoop-0.20.2的集群操作命令 上传本地文件至hdfs:[rio@cMaster hadoop-0.20.2]#bin/hadoop dfs -put /home/rio/input/* /in 用WordCount计算数据:[rio@cMaster hadoop-2.2.0]#bin/hadoop jar hadoop-0.20.2-examples.jar wordcount /in /out/wc-01 hadoop-2.2.0的配置文件: hadoop-2.2.0的配置文件: core-site.xml <property> <name>fs.defaultFS</name> <value>hdfs://cMaster:8020</value> </property> <property> <name>hadoop.tmp.dir</name> <value>/home/joe/cloudData</value> </property> yarn-site.xml <property> <name>yarn.resourcemanager.hostname</name> <value>cMaster</value> </property> <property> <name>yarn.nodemanager.aux-services</name> <value>mapreduce_shuffle</value> </property> mapred-site.xml(注:将mapred-site.xml.template重命名为mapred-site.xml) <property> <name>mapreduce.framework.name</name> <value>yarn</value> </property> hadoop-2.2.0进程启动命令: 启动(或关闭)全部服务:[rio@cMaster hadoop-2.2.0]#sbin/start-all.sh [rio@cMaster hadoop-2.2.0]#sbin/stop-all.sh 格式化主节点:[rio@cMaster hadoop-2.2.0]#bin/hdfs namenode -format(注:仅格式化一次) 启动主节点上的namenode:[rio@cMaster hadoop-2.2.0]#sbin/hadoop-daemon.sh start namenode 启动主节点上的resourcemanager:[rio@cMaster hadoop-2.2.0]#sbin/yarn-daemon.sh start resourcemanager 启动从节点上的datanode:[rio@cMaster hadoop-2.2.0]#sbin/hadoop-daemon.sh start datanode 启动从节点上的nodemanager:[rio@cMaster hadoop-2.2.0]#sbin/yarn-daemon.sh start nodemanager 启动日志历史查询:[rio@cMaster hadoop-2.2.0]#sbin/mr-jobhistory-daemon.sh start historyserver 查看服务是否启动:[rio@cMaster hadoop-2.2.0]#/usr/java/jdk1.8.0_71/bin/jps hadoop-2.2.0集群操作命令: 创建目录:[rio@cMaster hadoop-2.2.0]#bin/hdfs dfs -mkidr /in 删除文件及目录:[rio@cMaster hadoop-2.2.0]#bin/hdfs dfs -rmr /out/input 上传本地文件至hdfs:[rio@cMaster hadoop-2.2.0]#bin/hdfs dfs -put /home/rio/input/* /in 查看hdfs里的文件:[rio@cMaster hadoop-2.2.0]#bin/hdfs dfs -cat /in/* [rio@cMaster hadoop-2.2.0]#bin/hdfs dfs -cat /out/wc-01/* 用WordCount计算数据:[rio@cMaster hadoop-2.2.0]#bin/hadoop jar share/hadoop/mapreduce/hadoop-mapreduce-example-2.2.0.jar wordcount /in /out/wc-01 当神已无能为力,那便是魔渡众生

优秀的个人博客,低调大师

Hive数据压缩笔记

Hive数据压缩 本文介绍Hadoop系统中Hive数据压缩方案的比较结果及具体压缩方法。 一、压缩方案比较 关于Hadoop HDFS文件的压缩格式选择,我们通过多个真实的Track数据做测试,得出结论如下: 1. 系统的默认压缩编码方式 DefaultCodec 无论在压缩性能上还是压缩比上,都优于GZIP 压缩编码。这一点与网上的一些观点不大一致,网上不少人认为GZIP的压缩比要高一些,估计和Cloudera的封装及我们Track的数据类型有关。 2. Hive文件的RCFile 的在压缩比,压缩效率,及查询效率上都优于SEQENCE FILE (包括RECORD, BLOCK 级别) 。 3. 所有压缩文件均可以正常解压为TEXT 文件,但比原始文件略大,可能是行列重组造成的。 关于压缩文件对于其他组件是适用性如下: 1. Pig 不支持任何形式的压缩文件。 2. Impala 目前支持SequenceFile的压缩格式,但还不支持RCFile的压缩格式。 综上所述: 从压缩及查询的空间和时间性能上来说,DefaultCodeC + RCFile的压缩方式均为最优,但使用该方式,会使得Pig 和Impala 无法使用(Impala的不兼容不确定是否是暂时的)。 而DefaultCodeC+ SequenceFile 在压缩比,查询性能上略差于RCFile (压缩比约 6:5), 但可以支持 Impala实时查询。 推荐方案: 采用RCFile 方式压缩历史数据。FackBook全部hive表都用RCFile存数据。 二、局部压缩方法 只需要两步: 1.创建表时指定压缩方式,默认不压缩,以下为示例: create external table track_hist( id bigint, url string, referer string, keyword string, type int, gu_idstring, …/*此处省略中间部分字段*/ …, string,ext_field10 string) partitioned by (ds string) stored as RCFile location '/data/share/track_histk' ; 2. 插入数据是设定立即压缩 SET hive.exec.compress.output=true; insert overwrite table track_histpartition(ds='2013-01-01') select id,url, …/*此处省略中间部分字段*/ …, ext_field10 fromtrackinfo where ds='2013-01-01'; 三、全局方式,修改属性文件 在hive-site.xml中设置: <property> <name>hive.default.fileformat</name> <value>RCFile</value> <description>Default file format for CREATE TABLE statement.Options are TextFile and SequenceFile. Users can explicitly say CREAT E TABLE ... STORED AS&lt;TEXTFILE|SEQUENCEFILE&gt; to override</description> </property> <property> <name>hive.exec.compress.output</name> <value>true</value> <description> This controls whether the final outputs of a query(to a local/hdfs file or a hive table) is compressed. The compres sion codec and other options are determinedfrom hadoop config variables mapred.output.compress* </description> </property> 四、注意事项 1、Map阶段输出不进行压缩 2、对输出文本进行处理时不压缩

优秀的个人博客,低调大师

深入mysql的视图复习笔记

## 1.4 视图 > 视图是一个虚拟表,是sql的查询结果,其内容由查询定义。同真实的表一样,视图包含一系列带有名称的列和行数据,在使用视图时动态生成。视图的数据变化会影响到基表,基表的数据变化也会影响到视图[insert update delete ] ; 创建视图需要create view 权限,并且对于查询涉及的列有select权限;使用create or replace 或者 alter修改视图,那么还需要改视图的drop权限。 ### 1.4.1 创建视图 1. create view 视图名 AS select 来自多个表的字段 where 条件 1. create view stu_info as select s.name,s.grade,f.father_name,f.mather_name,f.phone from student as s ,family as f where s.name = f.child_name; ### 1.4.2 视图使用场景 1. 计算列的需要,数据库设计范式要求我们减少冗余字段,因此现在很多数据表都没有计算列字段,如采购单:有价格、数量、税率、含税金额,多半没有不含税金额、税额,而这些字段在很多报表中有都会用到,所以我们可以创建一个含有计算列字段的视图来解决这个问题。 1. 不同表字段聚合,信息重组,如:经销商通常有业务员,业务员通常有上下级关系(客户经理、区域经理、大区经理等),因此查看经销商业务员时我们需要看到直管业务员是谁?该业务员对应的区域经理、大区经理是谁(可能NULL)?因此我们可以联合经销商表、业务员信息表、业务员上下级关系表定义一个经销商视图。 1. 安全性需要,主要是早期遗留系统集成需要,如:需要xx系统数据,又没接口,怎么办?直接操作数据库,这时就涉及数据安全性,合理利用视图则可以减少很多授权工作和保证数据安全性。当下新构建的系统几乎都是暴露api接口,因此数据安全性更多关注在接口的身份认证和数据粒度方面。 1. 兼容老的数据表,曾经碰到过这么个问题。公司自主研发的进销存管理系统,一开始自用的,后来合作伙伴企业也要用,所以打算Saas化,当初做了一个最大的变动就是几乎所有表增加了一个使用单位(co_id)字段。悲催的是另外一个外购系统用到了采购单表,该系统已经停止维护、又继续在用。于是就创建了一个co_id=自有公司的视图,命名为原采购单表,而原采购单表改成新表名。这样一来外购系统可以继续使用,而且数据也没问题。 1. 大数据分表时可以用到.比如,表的行数超过1000万行时,就会变慢,可以把一张的表的数据拆成4张表来存放.还可以用视图, 把4张表形成一张视图.Create view news as select from n1 union select from n2 union......... ### 1.4.3 删除视图 1. drop view view_name; 1. drop view if exists view_name;

优秀的个人博客,低调大师

笔记应用 Evernote 订阅涨价 1391%

BornCity 报道称,有公司发现,其年度订阅到期后自动续订的费用出现了惊人的1391%涨幅,原本包含6名用户的公司仅需1199.94欧元(约9811元人民币),在续订时竟高达17900欧元(约14.6万元人民币),吓得其立马取消订阅。 出现如此夸张涨幅的原因在于,Evernote 今年对产品线进行了精简,取消了Team团队订阅方案,将原有公司客户强制升级至Enterprise企业订阅。 Enterprise企业订阅分为“灵活版(Flexible)”和“无限版(Unlimited)”两种方案,其中灵活版的年订阅费为5810欧元(约47508元人民币),而无限版则高达17900欧元(约14.6万元人民币)。 问题就在于 Evernote 自动续订时,直接将Team团队订阅升级至价格最昂贵的无限版方案,而没有提前通知用户。如果用户没有查看自动续订通知,就可能被收取天价年度订阅费用。 事实上,这并非Evernote第一次使用类似的策略,2025年,Evernote也曾因自动续订问题引发争议,当时将个人版和专业版合并升级为新的高级版,导致个人版月费从9.99欧元直接上调至18.99欧元,许多不常查看电子邮件的用户因此中招。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册