首页 文章 精选 留言 我的

精选列表

搜索[视频解析],共10000篇文章
优秀的个人博客,低调大师

HashMap 源码解析(二)

上篇文章介绍了hashMap 的基本数据结构和put() get() resize()流程 传送门 现在我们来介绍 hashmap 剩下的一些方法hashMap 有些情况下会进行遍历操作,hashMap 支持提供了三种遍历方法 1 keySet() 官方注释是@return a set view of the keys contained in this map(返回map的key set) public Set<K> keySet() { Set<K> ks = keySet; if (ks == null) { ks = new KeySet(); keySet = ks; } return ks; } 这个方法反回了一个KeySet类 看看这个KetSet是个什么啥 final class KeySet extends AbstractSet<K> { public final int size() { return size; } public final void clear() { HashMap.this.clear(); } public final Iterator<K> iterator() { return new KeyIterator(); } public final boolean contains(Object o) { return containsKey(o); } public final boolean remove(Object key) { return removeNode(hash(key), key, null, false, true) != null; } public final Spliterator<K> spliterator() { return new KeySpliterator<>(HashMap.this, 0, -1, 0, 0); } public final void forEach(Consumer<? super K> action) { Node<K,V>[] tab; if (action == null) throw new NullPointerException(); if (size > 0 && (tab = table) != null) { int mc = modCount; for (int i = 0; i < tab.length; ++i) { for (Node<K,V> e = tab[i]; e != null; e = e.next) action.accept(e.key); } if (modCount != mc) throw new ConcurrentModificationException(); } } } KeySet是hashMap的内部类,没有没有写任何逻辑,如何去遍历这个KeySet的关键在于iterator() 不管是使用迭代器还是使用for加强循环,核心的东西都是这个迭代器下面继续看KeyIterator.class 是个什么东西 final class KeyIterator extends HashIterator implements Iterator<K> { public final K next() { return nextNode().key; } } 可以看到 这个迭代器继承于HashIterator ,仅重写了next() 方法,结合HashIterator代码一起分析 abstract class HashIterator { Node<K,V> next; // next entry to return Node<K,V> current; // current entry int expectedModCount; // for fast-fail int index; } 首先在迭代器初始化时 HashIterator() { expectedModCount = modCount; //将hashMap操作次数赋值给expectedModCount, //在其他线程操作该hashMap后 预期值和实际值不同直接抛出异常,类似于cas Node<K,V>[] t = table; //将hashMap的数据集赋值给 t current = next = null; //设置迭代器的当前节点和下一个节点为空 index = 0; //hashMap table 游标设置为0 if (t != null && size > 0) { // advance to first entry 判断是不是空map //获取table数组中第一个不为空的链表头节点 do {} while (index < t.length && (next = t[index++]) == null); } } ok,现在迭代器初始化完成,迭代器的两大核心方法为hasNext() 判断是否存在下一条数据 和next() 获取下一条数据并将next指向下一条数据1 hashNext(),很简单,判断next是不是为空就可以 public final boolean hasNext() { return next != null; } 2 next():抽象类HashIterator 没有定义该方法,是因为next() 有返回值,需要子类去自己定义返回值,HashIterator 将公用操作定义为nextNode方法 KeySet的迭代器KeyIterator 定义的方法为 public final K next() { return nextNode().key; } HashIterator.nextNode()方法如下,方法很短,但是操作很多 final Node<K,V> nextNode() { Node<K,V>[] t; Node<K,V> e = next; //获取next if (modCount != expectedModCount) //判断 hashMap是否被其他线程修改过 throw new ConcurrentModificationException(); if (e == null)//判断下一个节点是不是为空 throw new NoSuchElementException(); // 下面的操作比较复杂我们拆成多步操作 /** current = e;// 将current next = current.next; //next赋值为current的下一个节点 t=table; if(next == null&&t != null){//如果next为链表最后一个节点 do {} while (index < t.length && (next = t[index++]) == null); // 数组游标++ 一直找到数组的下一个有数据的节点的头节点,假如是最后一个节点则跳出循环,next =null }**/ if ((next = (current = e).next) == null && (t = table) != null) { do {} while (index < t.length && (next = t[index++]) == null); } return e; } 2 values() values().iterator() 返回了一个ValueIterator() final class ValueIterator extends HashIterator implements Iterator<V> { public final V next() { return nextNode().value; } } next() 方法也是调用HashIterator.nextNode()方法,只不过是去的value; 3 entrySet() 上代码 final class EntryIterator extends HashIterator implements Iterator<Map.Entry<K,V>> { public final Map.Entry<K,V> next() { return nextNode(); } } 直接返回了整个node节点 hashMap遍历顺序 从nextNode()方法可以看出,hashMap在通过上述三种方法遍历时,都是从table数组 从小下标到大下标,如果发生hash冲突导致链表的,优先遍历链表,因此hashMap的遍历和插入顺序是不同的,和hashCode()有关 ,按照插入顺序遍历hashMap可以使用LinkedHashMap ,具体用法后面会继续写

优秀的个人博客,低调大师

python Kmeans算法解析

一. 概述 首先需要先介绍一下无监督学习,所谓无监督学习,就是训练样本中的标记信息是位置的,目标是通过对无标记训练样本的学习来揭示数据的内在性质以及规律。通俗得说,就是根据数据的一些内在性质,找出其内在的规律。而这一类算法,应用最为广泛的就是“聚类”。 聚类算法可以对数据进行数据归约,即在尽可能保证数据完整的前提下,减少数据的量级,以便后续处理。也可以对聚类数据结果直接应用或分析。 而Kmeans 算法可以说是聚类算法里面较为基础的一种算法。 二. 从样例开始 我们现在在二维平面上有这样一些点 x y 1.658985 4.285136 -3.453687 3.424321 4.838138 -1.151539 -5.379713 -3.362104 0.972564 2.924086 -3.567919 1.531611 0.450614 -3.302219 -3.487105 -1.724432 2.668759 1.594842 -3.156485 3.191137 3.165506 -3.999838 -2.786837 -3.099354 4.208187 2.984927 -2.123337 2.943366 0.704199 -0.479481 -0.392370 -3.963704 2.831667 1.574018 -0.790153 3.343144 2.943496 -3.357075 ... 它在二维平面上的分布大概是这样的: 好,这些点看起来隐约分成4个“簇”,那么我们可以假定它就是要分成4个“簇”。(虽然我们可以“看”出来是要分成4个“簇”,但实际上也可以分成其他个,比如说5个。)这里分成“4个簇“是我们看出来的。而在实际应用中其实应该由机器算得,下面也会有介绍的。 找出4个”簇”之后,就要找出每个“簇”的中心了,我们可以“看出”大概的中心点,但机器不知道啊。那么机器是如何知道的呢?答案是通过向量距离,也叫向量相似性。这个相似性计算有多种方法,比如欧式距离,曼哈顿距离,切比雪夫距离等等。 我们这里使用的是欧式距离,欧式距离其实就是反应空间中两点的直线距离。 知道这些后,我们就可以开始让机器计算出4个“簇”了。 主要做法是这样,先随机生成4个点,假设这4个点就是4个“簇”的中心。计算平面中每个点到4个中心点的距离,平面中每个点选取距离最近的那个中心作为自己的中心。 此时我们就完成第一步,将平面中所有点分成4个”簇“。但是刚刚那几个中心都是随机的,这样分成的4个簇明显不是我们想要的结果。怎么办呢?做法如下: 现在有4个簇,根据每个簇中所有点计算出每个簇的新中心点。这个新中心点就会比上一个旧的中心点更优,因为它更加中心。然后使用新中心点重复第一步的步骤。即再对平面中所有点算距离,然后分发到4个新簇中。不断迭代,直到误差较小。 这就是 Kmeans 算法的过程了。 三. 知识点浅析 3.1 确定“簇”的个数 上面所说的分成 4 个簇,这个 4 其实就是 Kmeans 中的K。要使用 Kmeans 首先就是要选取一个 K 作为聚类个数。而上面的例子其实是我们主观”看“出来的,但多数情况下我们是无法直观”看“出分多少个 K 比较好。那怎么办呢? 我们可以从较低的 K 值开始。使用较简单的 Kmeans 算法的结果(即较少的迭代次数,不求最佳结果,但求最快)。计算每个点到其归属的“簇”的中心点的距离,然后求和,求和结果就是误差值。然后再增加 K 值,再计算误差值。比如上面的例子,我们可以从 K=2 开始,计算 K 值从 2 到 7 的 Kmeans 算法的误差值。这样会得到类似这样一张图: 里面的 Error 可以理解未 Kmeans 的误差,而当分成越多“簇”的适合,误差肯定是越来越小。 但是不是“簇”越多越好呢?答案是否定的,有时候“簇”过多的话是不利于我们得到想要的结果或是做下一步操作的。 所以我们通常会选择误差减小速度比较平缓的那个临界点,比如上图中的 4。 可以发现,在分成 4 个簇之后,再增加簇的数量,误差也不会有很大的减少。而取 4 个簇也和我们所看到的相符。 3.2 欧式距离 3.2 欧式距离 欧氏距离是一个通常采用的距离定义,指在m维空间中两个点之间的真实距离,计算公式如下: 而本例种的是在二维空间种,故而本例的计算公式如下: 四. 代码和结果 加载数据的代码,使用了 numpy ,先是将代码加载成 matrix 类型。 import numpy as np def loadDataSet(fileName): ''' 加载数据集 :param fileName: :return: ''' # 初始化一个空列表 dataSet = [] # 读取文件 fr = open(fileName) # 循环遍历文件所有行 for line in fr.readlines(): # 切割每一行的数据 curLine = line.strip().split('\t') # 将数据转换为浮点类型,便于后面的计算 # fltLine = [float(x) for x in curLine] # 将数据追加到dataMat fltLine = list(map(float,curLine)) # 映射所有的元素为 float(浮点数)类型 dataSet.append(fltLine) # 返回dataMat return np.matrix(dataSet) 接下来需要生成 K 个初始的质点,即中心点。这里采用随机生成的方法生成 k 个“簇”。 def randCent(dataMat, k): ''' 为给定数据集构建一个包含K个随机质心的集合, 随机质心必须要在整个数据集的边界之内,这可以通过找到数据集每一维的最小和最大值来完成 然后生成0到1.0之间的随机数并通过取值范围和最小值,以便确保随机点在数据的边界之内 :param dataMat: :param k: :return: ''' # 获取样本数与特征值 m, n = np.shape(dataMat) # 初始化质心,创建(k,n)个以零填充的矩阵 centroids = np.mat(np.zeros((k, n))) # 循环遍历特征值 for j in range(n): # 计算每一列的最小值 minJ = min(dataMat[:, j]) # 计算每一列的范围值 rangeJ = float(max(dataMat[:, j]) - minJ) # 计算每一列的质心,并将值赋给centroids centroids[:, j] = np.mat(minJ + rangeJ * np.random.rand(k, 1)) # 返回质心 return centroids 欧式距离计算 def distEclud(vecA, vecB): ''' 欧氏距离计算函数 :param vecA: :param vecB: :return: ''' return np.sqrt(sum(np.power(vecA - vecB, 2))) cost 方法将执行一个简化的 kMeans ,即较少次数的迭代,计算出其中的误差(即当前点到簇质心的距离,后面会使用该误差来评价聚类的效果) def cost(dataMat, k, distMeas=distEclud, createCent=randCent,iterNum=300): ''' 计算误差的多少,通过这个方法来确定 k 为多少比较合适,这个其实就是一个简化版的 kMeans :param dataMat: 数据集 :param k: 簇的数目 :param distMeans: 计算距离 :param createCent: 创建初始质心 :param iterNum:默认迭代次数 :return: ''' # 获取样本数和特征数 m, n = np.shape(dataMat) # 初始化一个矩阵来存储每个点的簇分配结果 # clusterAssment包含两个列:一列记录簇索引值,第二列存储误差(误差是指当前点到簇质心的距离,后面会使用该误差来评价聚类的效果) clusterAssment = np.mat(np.zeros((m, 2))) # 创建质心,随机K个质心 centroids = createCent(dataMat, k) clusterChanged = True while iterNum > 0: clusterChanged = False # 遍历所有数据找到距离每个点最近的质心, # 可以通过对每个点遍历所有质心并计算点到每个质心的距离来完成 for i in range(m): minDist = np.inf minIndex = -1 for j in range(k): # 计算数据点到质心的距离 # 计算距离是使用distMeas参数给出的距离公式,默认距离函数是distEclud distJI = distMeas(centroids[j, :], dataMat[i, :]) # print(distJI) # 如果距离比minDist(最小距离)还小,更新minDist(最小距离)和最小质心的index(索引) if distJI < minDist: minDist = distJI minIndex = j # 更新簇分配结果为最小质心的index(索引),minDist(最小距离)的平方 clusterAssment[i, :] = minIndex, minDist ** 2 iterNum -= 1; # print(centroids) # 遍历所有质心并更新它们的取值 for cent in range(k): # 通过数据过滤来获得给定簇的所有点 ptsInClust = dataMat[np.nonzero(clusterAssment[:, 0].A == cent)[0]] # 计算所有点的均值,axis=0表示沿矩阵的列方向进行均值计算 centroids[cent, :] = np.mean(ptsInClust, axis=0) # 返回给定迭代次数后误差的值 return np.mat(clusterAssment[:,1].sum(0))[0,0] 最后可以调用 Kmeans 算法来进行计算。 def kMeans(dataMat, k, distMeas=distEclud, createCent=randCent): ''' 创建K个质心,然后将每个店分配到最近的质心,再重新计算质心。 这个过程重复数次,直到数据点的簇分配结果不再改变为止 :param dataMat: 数据集 :param k: 簇的数目 :param distMeans: 计算距离 :param createCent: 创建初始质心 :return: ''' # 获取样本数和特征数 m, n = np.shape(dataMat) # 初始化一个矩阵来存储每个点的簇分配结果 # clusterAssment包含两个列:一列记录簇索引值,第二列存储误差(误差是指当前点到簇质心的距离,后面会使用该误差来评价聚类的效果) clusterAssment = np.mat(np.zeros((m, 2))) # 创建质心,随机K个质心 centroids = createCent(dataMat, k) # 初始化标志变量,用于判断迭代是否继续,如果True,则继续迭代 clusterChanged = True while clusterChanged: clusterChanged = False # 遍历所有数据找到距离每个点最近的质心, # 可以通过对每个点遍历所有质心并计算点到每个质心的距离来完成 for i in range(m): minDist = np.inf minIndex = -1 for j in range(k): # 计算数据点到质心的距离 # 计算距离是使用distMeas参数给出的距离公式,默认距离函数是distEclud distJI = distMeas(centroids[j, :], dataMat[i, :]) # 如果距离比minDist(最小距离)还小,更新minDist(最小距离)和最小质心的index(索引) if distJI < minDist: minDist = distJI minIndex = j # 如果任一点的簇分配结果发生改变,则更新clusterChanged标志 if clusterAssment[i, 0] != minIndex: clusterChanged = True # 更新簇分配结果为最小质心的index(索引),minDist(最小距离)的平方 clusterAssment[i, :] = minIndex, minDist ** 2 # print(centroids) # 遍历所有质心并更新它们的取值 for cent in range(k): # 通过数据过滤来获得给定簇的所有点 ptsInClust = dataMat[np.nonzero(clusterAssment[:, 0].A == cent)[0]] # 计算所有点的均值,axis=0表示沿矩阵的列方向进行均值计算 centroids[cent, :] = np.mean(ptsInClust, axis=0) # 返回所有的类质心与点分配结果 return centroids, clusterAssment 选取不同的 k 值对结果影响有多大呢?我们来看看就知道了,下面给出的是 k 值为 2 到 6 的效果。图中红色方块即为“簇”的中心点,每个“簇”所属的点用不同的颜色表示。K = 2 K = 3 K = 4 K = 5 K = 6

优秀的个人博客,低调大师

NGINX配置PHP解析

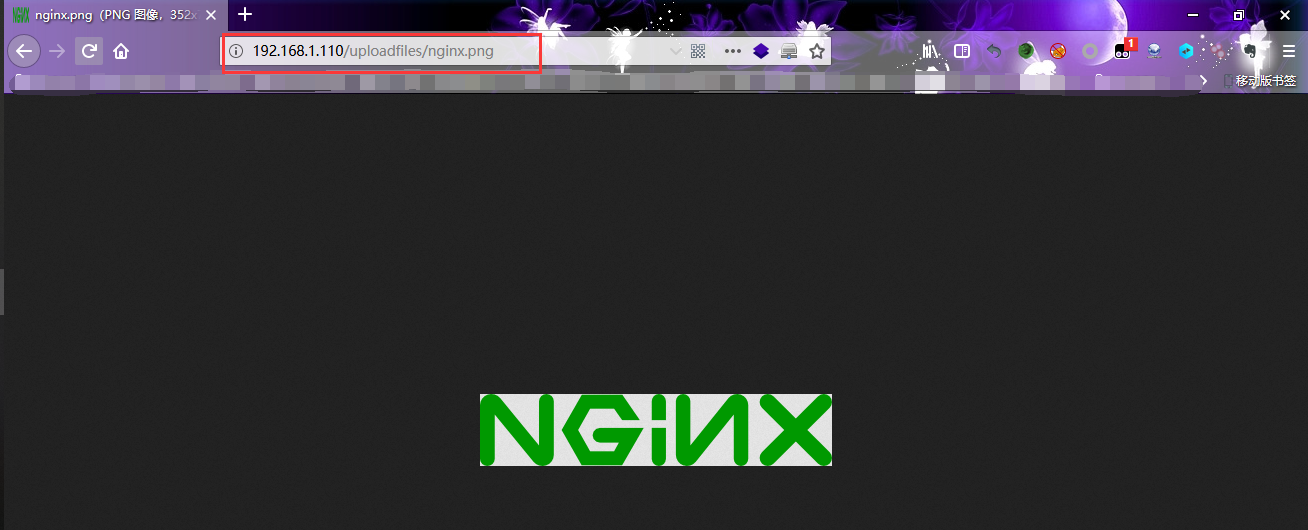
<?php phpinfo(); ?> location ~ \.php$ { root html; fastcgi_pass 127.0.0.1:9000; fastcgi_index index.php; fastcgi_param SCRIPT_FILENAME usr/local/nginx/html$fastcgi_script_name; include fastcgi_params; } ------------------------------------------------------------- 作者: 罗穆瑞 出处: http://www.cnblogs.com/kazihuo/ 转载请保留此段声明,且在文章页面明显位置给出原文链接,谢谢! ------------------------------------------------------------------------------ 如果觉得这篇文章对你有小小的帮助的话,记得在右下角点个“推荐”哦,博主在此感谢! ------------------------------------------------------------------------------

优秀的个人博客,低调大师

springboot源码解析(一)

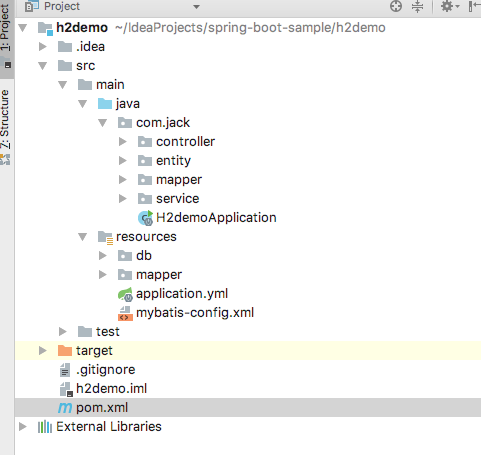
SpringBoot应用基础结构 我们每创建一个springboot应用就会发现,其目录结构中都会有一个以应用名为首的Application类(下文中都直接称为Application类),而其他包都是在这个类的同级或子级下面,结构如图: Application类作为应用的启动类,位于项目源码的根目录中,至于为什么结构会这么安排,我们下面会说。 Application类的结构 如上图所示,我们可以看到,最关键的地方有两个: @SpringBootApplication注解 SpringApplication.run()方法 任何的springboot应用都会由这两个部分组成。接下来我就来就这两个地方分析源码。 @SpringBootApplication注解 打开注解的源码我们可以看到,主要由以下几个注解组成: @SpringBootConfiguration @EnableAutoConfiguration @ComponentScan @SpringBootConfiguration @SpringBootConfiguration注解是由@Configuration来注解的,因此也就表示Application类本身就是一个bean。虽然@SpringBootConfiguration注释中说该注解一个应用中只能用一次,但是配置多个也不会报错,只是建议在一个应用中只用一次,并且该注解也可以与@Configuration互换。 @ComponentScan @ComponentScan注解的功能与我们之前在xml文件配置的的功能是一样的,而上面也提到Application类放在源码的根目录下,其实就是与这个注解有关。@ComponentScan在没有指明basePackages忏属性的时候,默认会扫描该注解所在的类的包及其子包下的所有@Component注解过的类,包括@Controller,@Service,@Configuration这些注解。这也就是为什么我们不用做任何配置,就可以将springboot应用中的类扫描为bean。 @EnableAutoConfiguration @EnableAutoConfiguration注解,从名字我们也可以看出,是开启自配置配置的。从源码中我们可以看到,该注解中有一个@Import(AutoConfigurationImportSelector.class),而其中发挥自动配置作用就是AutoConfigurationImportSelector类。 从AutoConfigurationImportSelector的源码中可以知道,该类是通过SpringFactoriesLoader来加载自动配置的类的,从而进一步通过这些自动配置的类来完成默认配置。从而这也就解决了,为什么我们使用springboot的时候压根就不需要配置太多,原因就是因为SpringBoot通过自动配置将已经封装在jar包中的自动配置类加载进来生成了bean。而对于SpringFactoriesLoader的原理我们下面会说。 SpringApplication类 Application类是通过SpringApplication类的静态run方法来启动应用的。打开这个静态方法,该表态方法真正执行的是两部分: new SpringApplication() 执行对象run()方法 在SpringApplication的构造方法中,我们可以看到有如下几个步骤: 推断当前的环境是否是web环境,其中springboot2.0中又添加了reactive环境。 初始化ApplicationContextInitilizer,其中的原理也是通过SpringFactoriesLoader来实现的。 初始化ApplicationListener,原理同上。 推断当前启动的main方法所在的类。 推断当前应用环境 springboot在启动时需要推断当前的应用环境,springboot2.0当中一共定义了三种环境:none, servlet, reactive。none表示当前的应用即不是一个web应用也不是一个reactive应用,是一个纯后台的应用。servlet表示当前应用是一个标准的web应用。reactive是spring5当中的新特性,表示是一个响应式的web应用。而判断的依据就是根据Classloader中加载的类。如果是servlet,则表示是web,如果是DispatcherHandler,则表示是一个reactive应用,如果两者都不存在,则表示是一个非web环境的应用。 初始化ApplicationContextInitializer 在介绍初始化之前,先介绍一下SpringFactoiesLoader的原理。 SpringFactoiesLoader会扫描所有jar包中的META-INF/spring.factoies文件,该文件的格式都是key=value的格式。key是一个接口的名字,value是实现类的名字,如果value有多个值,则用逗号分隔。而我们上面提到的@EnableAutoConfiguration也是利用这个原理去扫描所有的自动配置类,以该注解的全限定类名作为key,所有的默认配置类为值。SpringFactoiesLoader内部有一个静态的双层ConcurrentMap,用来存储这些key-value,第一层map的key是classloader,springboot默认的classloader是appClassLoader,value则是一个MultiValueMap,是spring自己实现的一个hashmap。而这个MultiValueMap的key就是spring.factoies文件中的key,value是一个list,即spring.factoies文件中的value。SpringFactoiesLoader利用缓存机制,只在第一次扫描所有的META-INF/spring.factoies文件时,就把所有的key-value都加载到这个map中,后面再进从中获取值时,直接从map中取就可以了,就不需要再重新扫描了。 把ApplicationContextInitializer都加载了之后,还要进行一项工作就是会对所有的ApplicationContextInitializer实现类生成对象,SpringApplication中有一个属性,List类型的initializers,用来存储这些实例化后的对象,这些对象存储之后,会在后面的启动过程中初始化ApplicationContext。 初始化ApplicationListener ApplicationListener的过程与ApplicationContextInitializer是一样的,不过因为SpringFactoiesLoader已经扫描过一次了,所以这次执行的时候,就会直接从SpringFactoiesLoader中的静态map中取出值即可。同样的,也需要将所有的实现类生成对象,并保存在SpringApplication对象的listener list属性中。 注:springboot初始化过程中主要是扫描两个spring.factoies文件,其中定义的key-value中的类,是整个启动过程中要用到的。一个是spring-boot-2.0.3.RELEASE中的,一个是spring-boot-autoconfigure包中的。这两个jar包中的文件定义整个启动流程中要执行的所有默认配置好的类。 推断整个应用的main方法所在的类 其实我们已经从main方法中启动了,为什么后面还要再推断一下呢?其实这样做的目的,主要是为了将该类的对象存储在SpringApplication的对象中,创建日志Logger和打印日志用的。我们在启动时会看到主类的类名以及其他的打印信息,都是通过该对象来创建logger和打印日志的。 总结:从上面几个步骤中我们可以看出,前期的new SpringApplication()方法中主要是起到了一个预加载的功能,将前期的环境判断,后面要用到的对象都准备好,到run执行的时候就直接拿出来用就好了,也是大大方便了后面run方法执行的过程。

优秀的个人博客,低调大师

消息队列深入解析

消息队列和消息 “消息队列”(Message queue)是在消息的传输过程中保存消息的容器。“消息” 是在两台计算机间传送的数据单位。消息可以非常简单,例如只包含文本字符串;也可以更复杂,可能包含嵌入对象。 常见的消息队列有那些? 当前使用较多的消息队列有RabbitMQ、ActiveMQ、RocketMQ、Kafka等等,我们之前提高的redis数据库也可以实现消息队列,不过不推荐,redis本身设计就不是用来做消息队列的。 使用消息队列的场景和好处 《大型网站技术架构》第四章和第七章均有提到消息队列对应用性能及扩展性的提升。 1.通过异步处理提高系统性能 如上图,在不使用消息队列服务器的时候,用户的请求数据直接写入数据库,在高并发的情况下数据库压力剧增,使得响应速度变慢。但是在使用消息队列之后,用户的请求数据发送给消息队列之后立即 返回,再由消息队列的消费者进程从消息队列中获取数据,异步写入数据库。由于消息队列服务器处理速度快于数据库(消息队列也比数据库有更好的伸缩性),因此响应速度得到大幅改善。 通过以上分析我们可以得出消息队列具有很好的削峰作用的功能——即通过异步处理,将短时间高并发产生的事务消息存储在消息队列中,从而削平高峰期的并发事务。 举例:在电子商务一些秒杀、促销活动中,合理使用消息队列可以有效抵御促销活动刚开始大量订单涌入对系统的冲击。如下图所示:因为用户请求数据写入消息队列之后就立即返回给用户了,但是请求数据在后续的业务校验、写数据库等操作中可能失败。因此使用消息队列进行异步处理之后,需要适当修改业务流程进行配合,比如用户在提交订单之后,订单数据写入消息队列,不能立即返回用户订单提交成功,需要在消息队列的订单消费者进程真正处理完该订单之后,甚至出库后,再通过电子邮件或短信通知用户订单成功,以免交易纠纷。这就类似我们平时手机订火车票和电影票。 2.降低系统耦合性 我们知道模块分布式部署以后聚合方式通常有两种:1.分布式消息队列和2.分布式服务。 先来简单说一下分布式服务: 目前使用比较多的用来构建SOA(Service Oriented Architecture面向服务体系结构)的分布式服务框架是阿里巴巴开源的Dubbo.如果想深入了解Dubbo的可以看我写的关于Dubbo的这一篇文章:《高性能优秀的服务框架-dubbo介绍》:https://juejin.im/post/5acadeb1f265da2375072f9c 再来谈我们的分布式消息队列: 我们知道如果模块之间不存在直接调用,那么新增模块或者修改模块就对其他模块影响较小,这样系统的可扩展性无疑更好一些。 我们最常见的事件驱动架构类似生产者消费者模式,在大型网站中通常用利用消息队列实现事件驱动结构。如下图所示:消息队列使利用发布-订阅模式工作,消息发送者(生产者)发布消息,一个或多个消息接受者(消费者)订阅消息。 从上图可以看到消息发送者(生产者)和消息接受者(消费者)之间没有直接耦合,消息发送者将消息发送至分布式消息队列即结束对消息的处理,消息接受者从分布式消息队列获取该消息后进行后续处理,并不需要知道该消息从何而来。对新增业务,只要对该类消息感兴趣,即可订阅该消息,对原有系统和业务没有任何影响,从而实现网站业务的可扩展性设计。 消息接受者对消息进行过滤、处理、包装后,构造成一个新的消息类型,将消息继续发送出去,等待其他消息接受者订阅该消息。因此基于事件(消息对象)驱动的业务架构可以是一系列流程。 另外为了避免消息队列服务器宕机造成消息丢失,会将成功发送到消息队列的消息存储在消息生产者服务器上,等消息真正被消费者服务器处理后才删除消息。在消息队列服务器宕机后,生产者服务器会选择分布式消息队列服务器集群中的其他服务器发布消息。 备注: 不要认为消息队列只能利用发布-订阅模式工作,只不过在解耦这个特定业务环境下是使用发布-订阅模式的,比如在我们的ActiveMQ消息队列中还有点对点工作模式,具体的会在后面的文章给大家详细介绍,这一篇文章主要还是让大家对消息队列有一个更透彻的了解。 常见的消息队列介绍 1.ActiveMQ 官网:http://activemq.apache.org/ 简介: ActiveMQ 是Apache出品,最流行的,能力强劲的开源消息总线。ActiveMQ 是一个完全支持JMS1.1和J2EE 1.4规范的 JMS Provider实现,尽管JMS规范出台已经是很久的事情了,但是JMS在当今的J2EE应用中间仍然扮演着特殊的地位。 特点: 支持来自Java,C,C ++,C#,Ruby,Perl,Python,PHP的各种跨语言客户端和协议 完全支持JMS客户端和Message Broker中的企业集成模式 支持许多高级功能,如消息组,虚拟目标,通配符和复合目标 完全支持JMS 1.1和J2EE 1.4,支持瞬态,持久,事务和XA消息 Spring支持,以便ActiveMQ可以轻松嵌入到Spring应用程序中,并使用Spring的XML配置机制进行配置 专为高性能集群,客户端 - 服务器,基于对等的通信而设计 CXF和Axis支持,以便ActiveMQ可以轻松地放入这些Web服务堆栈中以提供可靠的消息传递 可以用作内存JMS提供程序,非常适合单元测试JMS 支持可插拔传输协议,例如in-VM,TCP,SSL,NIO,UDP,多播,JGroups和JXTA传输 使用JDBC和高性能日志支持非常快速的持久性 2.RabbitMQ 官网:http://www.rabbitmq.com/ 简介: RabbitMQ 是一个由 Erlang 语言开发的 AMQP 的开源实现。RabbitMQ轻巧且易于部署在云端。 它支持多种消息传递协议。 RabbitMQ可以部署在分布式和联合配置中,以满足高规模,高可用性需求。RabbitMQ可运行在许多操作系统和云环境中,并为大多数流行语言提供广泛的开发工具。(来自官网翻译) AMQP (Advanced MessageQueue):高级消息队列协议。它是应用层协议的一个开放标准,为面向消息的中间件设计,基于此协议的客户端与消息中间件可传递消息,并不受产品、开发语言等条件的限制。 RabbitMQ最初广泛应用于金融行业,根据官网描述,它具有如下特点: 特点: 异步消息传递:支持多种消息协议,消息队列,传送确认,灵活的路由到队列,多种交换类型; 支持几乎所有最受欢迎的编程语言:Java,C,C ++,C#,Ruby,Perl,Python,PHP等等; 可以部署为高可用性和吞吐量的集群; 跨多个可用区域和区域进行联合; 可插入的身份验证,授权,支持TLS和LDAP。; 提供了一个易用的用户界面,使得用户可以监控和管理消息 Broker 的许多方面; 提供了许多插件,来从多方面进行扩展,也可以编写自己的插件。 3. Kafka 官网:http://kafka.apache.org/ 简介: Kafka是由Apache软件基金会开发的一个开源流处理平台,由Scala和Java编写。Kafka是一种高吞吐量的分布式发布订阅消息系统,它可以处理消费者规模的网站中的所有动作流数据。 这种动作(网页浏览,搜索和其他用户的行动)是在现代网络上的许多社会功能的一个关键因素。 这些数据通常是由于吞吐量的要求而通过处理日志和日志聚合来解决。 对于像Hadoop的一样的日志数据和离线分析系统,但又要求实时处理的限制,这是一个可行的解决方案。Kafka的目的是通过Hadoop的并行加载机制来统一线上和离线的消息处理,也是为了通过集群来提供实时的消息。 Kafka它主要用于处理活跃的流式数据,因此Kafaka在大数据系统中使用较多。 特点: 同时为发布和订阅提供高吞吐量。据了解,Kafka每秒可以生产约25万消息(50 MB),每秒处理55万消息(110 MB)。 可进行持久化操作。将消息持久化到磁盘,因此可用于批量消费,例如ETL,以及实时应用程序。通过将数据持久化到硬盘以及replication防止数据丢失。 分布式系统,易于向外扩展。所有的producer、broker和consumer都会有多个,均为分布式的。无需停机即可扩展机器。 消息被处理的状态是在consumer端维护,而不是由server端维护。当失败时能自动平衡。 支持online和offline的场景。 4. RocketMQ 官网:http://rocketmq.apache.org/ 简介: RocketMQ是阿里开源的消息中间件,目前在Apache孵化,使用纯Java开发,具有高吞吐量、高可用性、适合大规模分布式系统应用的特点。RocketMQ思路起源于Kafka,但并不是简单的复制,它对消息的可靠传输及事务性做了优化,目前在阿里集团被广泛应用于交易、充值、流计算、消息推送、日志流式处理、binglog分发等场景,支撑了阿里多次双十一活动。 特点: 支持发布/订阅(Pub/Sub)和点对点(P2P)消息模型 在一个队列中可靠的先进先出(FIFO)和严格的顺序传递 支持拉(pull)和推(push)两种消息模式 单一队列百万消息的堆积能力 支持多种消息协议,如 JMS、MQTT 等 分布式高可用的部署架构,满足至少一次消息传递语义 提供 docker 镜像用于隔离测试和云集群部署 提供配置、指标和监控等功能丰富的 Dashboard 区别(图片来源慕课网):其实对于这些消息队列的产品,每一种都在某一领域占有一席,虽然ActiveMQ目前在社区已经不是很活跃,但是其下一代产品Apollo已经问世。ZeroMQ小而美,RabbitMQ大而稳,Kakfa和RocketMQ快而强劲。RocketMQ虽然目前还很多不完善,但是一旦在Apache孵化成为顶级项目,全球程序猿开始贡献,前途也是不可限量的。 下一篇文章我会详细介绍ActiveMQ以及相关使用方法。 欢迎关注我的微信公众号:"Java面试通关手册"(一个有温度的微信公众号,期待与你共同进步~~~坚持原创,分享美文,分享各种Java学习资源):。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册