首页 文章 精选 留言 我的

精选列表

搜索[视频解析],共10000篇文章
优秀的个人博客,低调大师

python 装饰器解析

一般来说,装饰器是一个函数,接受一个函数(或者类)作为参数,返回值也是也是一个函数(或者类)。首先来看一个简单的例子: -- coding: utf-8 -- def log_cost_time(func): def wrapped(*args, **kwargs): import time begin = time.time() try: return func(*args, **kwargs) finally: print 'func %s cost %s' % (func.__name__, time.time() - begin) return wrapped @log_cost_time def complex_func(num): ret = 0 for i in xrange(num): ret += i * i return ret complex_func = log_cost_time(complex_func) if name == '__main__': print complex_func(100000) code snippet 0 代码中,函数log_cost_time就是一个装饰器,其作用也很简单,打印被装饰函数运行时间。 装饰器的语法如下: @dec def func():pass 本质上等同于: func = dec(func)。 在上面的代码(code snippet 0)中,把line12注释掉,然后把line18的注释去掉,是一样的效果。另外staticmethod和classmethod是两个我们经常在代码中用到的装饰器,如果对pyc反编译,得到的代码一般也都是 func = staticmthod(func)这种模式。当然,@符号的形式更受欢迎些,至少可以少拼写一次函数名。 装饰器是可以嵌套的,如 @dec0 @dec1 def func():pass 等将于 func = dec0(dec1(fun))。 装饰器也有“副作用“”,对于被log_cost_time装饰的complex_calc, 我们查看一下complex_func.__name__,输出是:”wrapped“”。额,这个是log_cost_time里面inner function(wrapped)的名字,调用者当然希望输出是”complex_func”,为了解决这个问题,python提供了两个函数。 functools.update_wrapper 原型: functools.update_wrapper(wrapper, wrapped, assigned) 第三个参数,将wrapped的值直接复制给wrapper,默认为(__doc__, __name__, __module__) 第四个参数,update,默认为(__dict__) functools.wraps: update_wrapper的封装 This is a convenience function for invoking partial(update_wrapper,wrapped=wrapped,assigned=assigned,updated=updated) as a function decorator when defining a wrapper function. 简单改改代码: import functools def log_cost_time(func): @functools.wraps(func) def wrapped(*args, **kwargs): import time begin = time.time() try: return func(*args, **kwargs) finally: print 'func %s cost %s' % (func.__name__, time.time() - begin) return wrapped 再查看complex_func.__name__ 输出就是 “complex_func” 装饰器也是可以带参数的。我们将上面的代码略微修改一下: def log_cost_time(stream): def inner_dec(func): def wrapped(*args, **kwargs): import time begin = time.time() try: return func(*args, **kwargs) finally: stream.write('func %s cost %s \n' % (func.__name__, time.time() - begin)) return wrapped return inner_dec import sys @log_cost_time(sys.stdout) def complex_func(num): ret = 0 for i in xrange(num): ret += i * i return ret if name == '__main__': print complex_func(100000) code snippet 1 log_cost_time函数也接受一个参数,该参数用来指定信息的输出流,对于带参数的decorator @dec(dec_args) def func(args, *kwargs):pass 等价于 func = dec(dec_args)(args, *kwargs)。 装饰器对类的修饰也是很简单的,只不过平时用得不是很多。举个例子,我们需要给修改类的__str__方法,代码很简单。 def Haha(clz): clz.__str__ = lambda s: "Haha" return clz @Haha class Widget(object): ''' class Widget ''' if name == '__main__': w = Widget() print w 那什么场景下有必要使用decorator呢,设计模式中有一个模式也叫装饰器。我们先简单回顾一下设计模式中的装饰器模式,简单的一句话概述 动态地为某个对象增加额外的责任 由于装饰器模式仅从外部改变组件,因此组件无需对它的装饰有任何了解;也就是说,这些装饰对该组件是透明的。 下图来自《设计模式Java手册》或者GOF的《设计模式》 回到Python中来,用decorator语法实现装饰器模式是很自然的,比如文中的示例代码,在不改变被装饰对象的同时增加了记录函数执行时间的额外功能。当然,由于Python语言的灵活性,decorator是可以修改被装饰的对象的(比如装饰类的例子)。decorator在python中用途非常广泛,下面列举几个方面: (1)修改被装饰对象的属性或者行为 (2)处理被函数对象执行的上下文,比如设置环境变量,加log之类 (3)处理重复的逻辑,比如有N个函数都可能跑出异常,但是我们不关心这些异常,只要不向调用者传递异常就行了,这个时候可以写一个catchall的decorator,作用于所用可能跑出异常的函数 def catchall(func): @functools.wraps(func) def wrapped(*args, **kwargs): try: return func(*args, **kwargs) except: pass return wrapped (4)框架代码,如flask, bottle等等,让使用者很方便就能使用框架,本质上也避免了重复代码。 decorator的奇妙应用往往超出相应,经常在各种源码中看到各种神奇的用法,酷壳这篇文章举的例子也不错。 参考文献 [2]H. Berenson, P. Bernstein, J. Gray, J.Melton, E. O’Neil,and P. O’Neil. A critique of ANSI SQL isolation levels. InProceedings of the SIGMOD International Conference on Management of Data, pages1–10, May 1995. [3]Michael J. Cahill, Uwe Röhm, and Alan D.Fekete. 2008. Serializable isolation for snapshot databases. In SIGMOD ’08:Proceedings of the 2008 ACM SIGMOD international conference on Management of data, pages 729–738, New York, NY, USA. ACM. [4]Michael James Cahill. 2009. Serializable Isolation for Snapshot Databases. Sydney Digital Theses. University of Sydney, School of Information Technologies [5] A. Fekete, D. Liarokapis, E. O’Neil, P.O’Neil, andD. Shasha. Making snapshot isolation serializable. www.codexueyuan.com In ACM transactions on database systems, volume 39(2), pages 492–528, June 2005.

优秀的个人博客,低调大师

Android Fragment完全解析

转载请注明出处:http://blog.csdn.net/guolin_blog/article/details/8881711 我们都知道,Android上的界面展示都是通过Activity实现的,Activity实在是太常用了,我相信大家都已经非常熟悉了,这里就不再赘述。 但是Activity也有它的局限性,同样的界面在手机上显示可能很好看,在平板上就未必了,因为平板的屏幕非常大,手机的界面放在平板上可能会有过分被拉长、控件间距过大等情况。这个时候更好的体验效果是在Activity中嵌入"小Activity",然后每个"小Activity"又可以拥有自己的布局。因此,我们今天的主角Fragment登场了。 Fragment初探 为了让界面可以在平板上更好地展示,Android在3.0版本引入了Fragment(碎片)功能,它非常类似于Activity,可以像Activity一样包含布局。Fragment通常是嵌套在Activity中使用的,现在想象这种场景:有两个Fragment,Fragment 1包含了一个ListView,每行显示一本书的标题。Fragment 2包含了TextView和ImageView,来显示书的详细内容和图片。 如果现在程序运行竖屏模式的平板或手机上,Fragment 1可能嵌入在一个Activity中,而Fragment 2可能嵌入在另一个Activity中,如下图所示: 而如果现在程序运行在横屏模式的平板上,两个Fragment就可以嵌入在同一个Activity中了,如下图所示: 由此可以看出,使用Fragment可以让我们更加充分地利用平板的屏幕空间,下面我们一起来探究下如何使用Fragment。 首先需要注意,Fragment是在3.0版本引入的,如果你使用的是3.0之前的系统,需要先导入android-support-v4的jar包才能使用Fragment功能。 新建一个项目叫做Fragments,然后在layout文件夹下新建一个名为fragment1.xml的布局文件: <LinearLayoutxmlns:android="http://schemas.android.com/apk/res/android" android:layout_width="match_parent" android:layout_height="match_parent" android:background="#00ff00"> <TextView android:layout_width="wrap_content" android:layout_height="wrap_content" android:text="Thisisfragment1" android:textColor="#000000" android:textSize="25sp"/> </LinearLayout> 可以看到,这个布局文件非常简单,只有一个LinearLayout,里面加入了一个TextView。我们如法炮制再新建一个fragment2.xml : <LinearLayoutxmlns:android="http://schemas.android.com/apk/res/android" android:layout_width="match_parent" android:layout_height="match_parent" android:background="#ffff00"> <TextView android:layout_width="wrap_content" android:layout_height="wrap_content" android:text="Thisisfragment2" android:textColor="#000000" android:textSize="25sp"/> </LinearLayout> 然后新建一个类Fragment1,这个类是继承自Fragment的: publicclassFragment1extendsFragment{ @Override publicViewonCreateView(LayoutInflaterinflater,ViewGroupcontainer,BundlesavedInstanceState){ returninflater.inflate(R.layout.fragment1,container,false); } } 我们可以看到,这个类也非常简单,主要就是加载了我们刚刚写好的fragment1.xml布局文件并返回。同样的方法,我们再写好Fragment2 : publicclassFragment2extendsFragment{ @Override publicViewonCreateView(LayoutInflaterinflater,ViewGroupcontainer,BundlesavedInstanceState){ returninflater.inflate(R.layout.fragment2,container,false); } } 然后打开或新建activity_main.xml作为主Activity的布局文件,在里面加入两个Fragment的引用,使用android:name前缀来引用具体的Fragment: <LinearLayoutxmlns:android="http://schemas.android.com/apk/res/android" android:layout_width="match_parent" android:layout_height="match_parent" android:baselineAligned="false"> <fragment android:id="@+id/fragment1" android:name="com.example.fragmentdemo.Fragment1" android:layout_width="0dip" android:layout_height="match_parent" android:layout_weight="1"/> <fragment android:id="@+id/fragment2" android:name="com.example.fragmentdemo.Fragment2" android:layout_width="0dip" android:layout_height="match_parent" android:layout_weight="1"/> </LinearLayout> 最后打开或新建MainActivity作为程序的主Activity,里面的代码非常简单,都是自动生成的: publicclassMainActivityextendsActivity{ @Override protectedvoidonCreate(BundlesavedInstanceState){ super.onCreate(savedInstanceState); setContentView(R.layout.activity_main); } } 现在我们来运行一次程序,就会看到,一个Activity很融洽地包含了两个Fragment,这两个Fragment平分了整个屏幕,效果图如下: 动态添加Fragment 你已经学会了如何在XML中使用Fragment,但是这仅仅是Fragment最简单的功能而已。Fragment真正的强大之处在于可以动态地添加到Activity当中,因此这也是你必须要掌握的东西。当你学会了在程序运行时向Activity添加Fragment,程序的界面就可以定制的更加多样化。下面我们立刻来看看,如何动态添加Fragment。 还是在上一节代码的基础上修改,打开activity_main.xml,将其中对Fragment的引用都删除,只保留最外层的LinearLayout,并给它添加一个id,因为我们要动态添加Fragment,不用在XML里添加了,删除后代码如下: <LinearLayoutxmlns:android="http://schemas.android.com/apk/res/android" android:id="@+id/main_layout" android:layout_width="match_parent" android:layout_height="match_parent" android:baselineAligned="false"> </LinearLayout> 然后打开MainActivity,修改其中的代码如下所示: publicclassMainActivityextendsActivity{ @Override protectedvoidonCreate(BundlesavedInstanceState){ super.onCreate(savedInstanceState); setContentView(R.layout.activity_main); Displaydisplay=getWindowManager().getDefaultDisplay(); if(display.getWidth()>display.getHeight()){ Fragment1fragment1=newFragment1(); getFragmentManager().beginTransaction().replace(R.id.main_layout,fragment1).commit(); }else{ Fragment2fragment2=newFragment2(); getFragmentManager().beginTransaction().replace(R.id.main_layout,fragment2).commit(); } } } 首先,我们要获取屏幕的宽度和高度,然后进行判断,如果屏幕宽度大于高度就添加fragment1,如果高度大于宽度就添加fragment2。动态添加Fragment主要分为4步: 1.获取到FragmentManager,在Activity中可以直接通过getFragmentManager得到。 2.开启一个事务,通过调用beginTransaction方法开启。 3.向容器内加入Fragment,一般使用replace方法实现,需要传入容器的id和Fragment的实例。 4.提交事务,调用commit方法提交。 现在运行一下程序,效果如下图所示: 如果你是在使用模拟器运行,按下ctrl + F11切换到竖屏模式。效果如下图所示: Fragment的生命周期 和Activity一样,Fragment也有自己的生命周期,理解Fragment的生命周期非常重要,我们通过代码的方式来瞧一瞧Fragment的生命周期是什么样的: publicclassFragment1extendsFragment{ publicstaticfinalStringTAG="Fragment1"; @Override publicViewonCreateView(LayoutInflaterinflater,ViewGroupcontainer,BundlesavedInstanceState){ Log.d(TAG,"onCreateView"); returninflater.inflate(R.layout.fragment1,container,false); } @Override publicvoidonAttach(Activityactivity){ super.onAttach(activity); Log.d(TAG,"onAttach"); } @Override publicvoidonCreate(BundlesavedInstanceState){ super.onCreate(savedInstanceState); Log.d(TAG,"onCreate"); } @Override publicvoidonActivityCreated(BundlesavedInstanceState){ super.onActivityCreated(savedInstanceState); Log.d(TAG,"onActivityCreated"); } @Override publicvoidonStart(){ super.onStart(); Log.d(TAG,"onStart"); } @Override publicvoidonResume(){ super.onResume(); Log.d(TAG,"onResume"); } @Override publicvoidonPause(){ super.onPause(); Log.d(TAG,"onPause"); } @Override publicvoidonStop(){ super.onStop(); Log.d(TAG,"onStop"); } @Override publicvoidonDestroyView(){ super.onDestroyView(); Log.d(TAG,"onDestroyView"); } @Override publicvoidonDestroy(){ super.onDestroy(); Log.d(TAG,"onDestroy"); } @Override publicvoidonDetach(){ super.onDetach(); Log.d(TAG,"onDetach"); } } 可以看到,上面的代码在每个生命周期的方法里都打印了日志,然后我们来运行一下程序,可以看到打印日志如下: 这时点击一下home键,打印日志如下: 如果你再重新进入进入程序,打印日志如下: 然后点击back键退出程序,打印日志如下: 看到这里,我相信大多数朋友已经非常明白了,因为这和Activity的生命周期太相似了。只是有几个Activity中没有的新方法,这里需要重点介绍一下: onAttach方法:Fragment和Activity建立关联的时候调用。 onCreateView方法:为Fragment加载布局时调用。 onActivityCreated方法:当Activity中的onCreate方法执行完后调用。 onDestroyView方法:Fragment中的布局被移除时调用。 onDetach方法:Fragment和Activity解除关联的时候调用。 Fragment之间进行通信 通常情况下,Activity都会包含多个Fragment,这时多个Fragment之间如何进行通信就是个非常重要的问题了。我们通过一个例子来看一下,如何在一个Fragment中去访问另一个Fragment的视图。 还是在第一节代码的基础上修改,首先打开fragment2.xml,在这个布局里面添加一个按钮: <LinearLayoutxmlns:android="http://schemas.android.com/apk/res/android" android:layout_width="match_parent" android:layout_height="match_parent" android:orientation="vertical" android:background="#ffff00"> <TextView android:layout_width="wrap_content" android:layout_height="wrap_content" android:text="Thisisfragment2" android:textColor="#000000" android:textSize="25sp"/> <Button android:id="@+id/button" android:layout_width="wrap_content" android:layout_height="wrap_content" android:text="Getfragment1text" /> </LinearLayout> 然后打开fragment1.xml,为TextView添加一个id: <LinearLayoutxmlns:android="http://schemas.android.com/apk/res/android" android:layout_width="match_parent" android:layout_height="match_parent" android:background="#00ff00"> <TextView android:id="@+id/fragment1_text" android:layout_width="wrap_content" android:layout_height="wrap_content" android:text="Thisisfragment1" android:textColor="#000000" android:textSize="25sp"/> </LinearLayout> 接着打开Fragment2.java,添加onActivityCreated方法,并处理按钮的点击事件: publicclassFragment2extendsFragment{ @Override publicViewonCreateView(LayoutInflaterinflater,ViewGroupcontainer,BundlesavedInstanceState){ returninflater.inflate(R.layout.fragment2,container,false); } @Override publicvoidonActivityCreated(BundlesavedInstanceState){ super.onActivityCreated(savedInstanceState); Buttonbutton=(Button)getActivity().findViewById(R.id.button); button.setOnClickListener(newOnClickListener(){ @Override publicvoidonClick(Viewv){ TextViewtextView=(TextView)getActivity().findViewById(R.id.fragment1_text); Toast.makeText(getActivity(),textView.getText(),Toast.LENGTH_LONG).show(); } }); } } 现在运行一下程序,并点击一下fragment2上的按钮,效果如下图所示: 我们可以看到,在fragment2中成功获取到了fragment1中的视图,并弹出Toast。这是怎么实现的呢?主要都是通过getActivity这个方法实现的。getActivity方法可以让Fragment获取到关联的Activity,然后再调用Activity的findViewById方法,就可以获取到和这个Activity关联的其它Fragment的视图了。 好了,以上就是关于Fragment你所须知道的一切。如果想要切身体验一下Fragment的实战,请继续阅读Android手机平板两不误,使用Fragment实现兼容手机和平板的程序以及Android Fragment应用实战,使用碎片向ActivityGroup说再见 本文转自欢醉博客园博客,原文链接http://www.cnblogs.com/zhangs1986/p/3676372.html如需转载请自行联系原作者 欢醉

优秀的个人博客,低调大师

Xamarin 技术全解析

Xamarin 是一套基于C#语言的跨平台移动应用开发工具,今年2月份微软宣布收购Xamarin,而后在4月份进行的Build大会上微软宣布将会在各个版本的Visual Studio中免费提供Xamarin,并且宣布Xamarin SDK开源。 本文主要阐述Xamarin是什么,它能做什么以及它是如何跨平台的。 1. 什么是Xamarin Xamarin 是一个跨平台的移动开发工具,由 Mono 发展而来。开发人员可以使用 C# 为iOS,Android, Mac以及Windows Phone开发原生应用。 Xamarin 的跨平台开发思路是:使用 C# 来完成所有平台共用的,和平台无关的 app 逻辑部分;由于各个平台的 UI 和交互不同,再使用由 Xamarin 封装好的 C# API 来访问和操控 native 的控件,分别进行不同平台的 UI 开发。 如下图: 另外Xamarin还提供了Xamarin.Forms UI工具包,Xamarin.Forms可以帮助开发人员快速的构建跨平台的UI,通过一次编码,生成多个平台的原生UI界面,稍后本文会讲述Xamarin.Forms的使用方法以及实现原理。 2. Xamarin能做什么 Xamarin主要由Xamarin.iOS,Xamarin.Android以及Xamarin.Forms组成,主要功能也有着三部分组成: 2.1 使用Xamarin.iOS来构建iOS原生应用 下面会使用Mac OS X上的Xamarin Studio来演示如何构建iOS应用: - 打开Xamarin Studio - 新建一个项目,选择iOS - App - Single View App - 点击下一步,输入App 名称, 例如:FirstXamariniOS,一路点击下一步,工程创建完成。 下面是生成的iOS工程结构截图: 如果有Xcode使用经验的话会发现,这个Xamarin iOS工程的项目结构与Xcode的结构很类似,都包含了AppDelegate类,默认的ViewController以及Main StoryBoard文件,基本的类名称都是一致的。 打开Main.storyboard 文件,可以从Toolbox上拖拽一些原生控件到View Controller上,与Xcode中使用方式一致,但是有一些功能没有Xcode 强大,比如设置View的Auto layout等等,如下图: 运行上面的工程,就可以在模拟器中查看效果了。 从上面来看来说使用Xamarin进行iOS编程需要有一定的iOS App开发知识,需要熟悉iOS UI框架(Cocoa Touch)等等,即便使用Xamarin开发应用,也绕不过原生底层的这些东西。 2.2 使用Xamarin.Android来构建Android原生应用 下面会使用Mac OS X上的Xamarin Studio来演示如何构建iOS应用: - 打开Xamarin Studio - 新建一个项目,选择Android - App - Android App - 点击下一步,输入App 名称, 例如:FirstXamarinAndroid,一路点击下一步,工程创建完成。 下面是生成的Android工程结构截图: 如果有Eclipse进行Android编程经验的话会发现,这个Xamarin Android工程的项目结构与Eclipse的结构很类似,都包含了默认的MainActivity以及布局文件,基本的类名称都是一致的。 打开Main.axml文件,可以从Toolbox上拖拽一些原生控件到View Controller上,与Eclipse的体验类似,也可以通过编辑XML的方式更改界面。 同样从上面来看来说使用Xamarin进行Android编程需要有一定的Android App开发知识,需要熟悉Android UI框架等等,原生底层的东西还是需要熟悉的。 2.3 使用Xamarin.Forms来构建跨平台的应用 Xamarin.Forms 是一个创建跨平台用户界面的库,通过Xamarin.Forms 可以一次编码生成基于各个移动平台(iOS, Android, Windows Phone)的应用界面。 Xamarin.Forms提供了更高层次的一层UI组件抽象,这些组件在进行最终呈现的时候,会以原生控件的方式表现出来,也就是说每一个Xmarin.Forms的控件最终会有多个平台的原生呈现逻辑,如下图中,Xamarin.Forms的Entry控件,对应的原生呈现为: 使用Xamarin.Forms构建跨平台应用的一个缺陷就是只能使用Xamarin.Forms包中的控件,会有一些限制。 如果先了解更多关于如何使用Xamarin.Forms构建跨平台应用,请参见文章:Xamarin.Forms入门-使用 Xamarin.Forms 来创建跨平台的用户界面。 3. Xamarin实现原理 3.1 Xamarin.Android 实现原理 在讲述Xamarin.Android架构之前,需要先了解一些Android应用程序的背景知识: - Android应用程序试运行在Dalvik虚拟机中的,每一个应用程序对应一个单独的虚拟机实例,其代码在虚拟机的解释下得以执行。 -Dalvik主要是完成对象生命周期管理,堆栈管理,线程管理,安全和异常管理,以及垃圾回收等等重要功能。 -不同于Java虚拟机运行java字节码,Dalvik虚拟机运行的是其专有的文件格式 Xamarin.Android架构图(ART 是Android 虚拟机Dalvik): Android Callable Wrappers(ACW) 使用C#开发的Android应用程序在运行的时候,C#代码是在Mono虚拟机中执行的,而Mono虚拟机是寄宿在Dalvik虚拟机中运行的,所有的C#代码都通过ACW的方式被调用。 由于需要打包Mono环境,使用C#开发的Android应用的APK文件会比原生开发的大,执行效率也会差一些。 Managed Callable Wrapper(MCW) 如果需要在C#中调用一些系统的功能或者Java实现的类库,该如何调用那? 答案就是MCW,MCW就是一个JNI桥梁,可以使用托管代码调用Android的代码。MCW将整个Android.* 以及相关的命名空间通过jar绑定的方式暴露出来,是的C#可以调用。 3.2 Xamarin.iOS 实现原理 对于开发者来说,Xamarin.IOS相对于Xamarin.Android就要简单很多了,我们用C#开发的iOS应用程序在被编译成IL代码之后,然后转交给Apple complier直接编译成iOS的本地机器码,也就是说C#写的iOS应用程序和Objective-C 写的是一样的。 透过 Ahead-of-Time (AOT) 编译程序,直接将Xamarin.iOS程序编译为ARM的执行档。编译封装完成的应用程序被直接编译为原生的二进制执行文件。 3.3 Xamarin.Forms实现原理 在Xamarin Studio中构建Xamarin.Forms跨平台的应用的时候,会生成Android以及iOS单独的项目工程,两者共享业务逻辑以及一些UI界面,在打包生成App的时候,是分开进行的,两者互不影响。每个平台的实现原理与上面讲的是一样的。 本文转自 powertoolsteam 51CTO博客,原文链接:http://blog.51cto.com/powertoolsteam/1782877,如需转载请自行联系原作者

优秀的个人博客,低调大师

系统必要进程 解析

系统必要进程: 1.system process :页面内存管理进程 2.alg.exe: 应用层网关服务用于网络共享 3.csrss.exe: 客户端服务子系统,用于控制windows图形相关子系统 4.explorer.exe: 程序管理,显示系统桌面上的图标以及任务栏 5.lsass.exe: 本地安全权限服务(震荡波利用这个漏洞),这个是系统的核心进程. 6.services.exe:管理windows服务 7.smss.exe:该进程为会话管理子系统用以初始化系统变量,MS-DOS驱动名称类似LPT1以及COM,调用Win32壳子系统和运行在Windows登陆过程. 8.svchost.exe: 标准的动态链接库主机处理服务. 查找中毒:搜索svchost.exe文件,就可以发现,一般只会找到一个在:c:\windowssystem32 目录下的svchost.exechengxu.ruguo在其他目录下发现,很可能就是中毒了. 9.tastkmgr.exe:任务管理器 10.winlogon.exe windows nt用户登陆程序. 11.ctfmon.exe:语音识别,手写识别,键盘,翻译和其他用户输入技术的支持. 本文转自wzhj132 51CTO博客,原文链接:http://blog.51cto.com/wzhj132/188414

优秀的个人博客,低调大师

Kafka consumer rebalance解析

线上使用Kafka0.72+Flume-ng 1.4的消息架构;流入到HDFS使用的Flume根据容量分析使用率太低了,决定从8个实例缩减到4个实例,在down实例的过程中的消息流入量per sec如下图: 这个Kafka的Topic共有10个partitions;在down实例的时候发生了一些抖动,不过是十分有规律并且可以预测的. kafka的rebalance assigment是固定的;将partition按照consumer的label排序,然后进行取模分配:即第m个partition,如果一个consumer group有n个consumers,则分配到给第(m mod n)个consumer;其实根据这个算法完全可以预测出上图的波动了.另外,根据该算法,如果consumer的个数大于partition的数目那么多余的consumer不会消费到消息(https://issues.apache.org/jira/browse/KAFKA-687https://issues.apache.org/jira/browse/KAFKA-564); 不过,kafka的rebalance算法在0.8还是不成熟的:最明显的当属herd effect了;每当一个consumer加入或者删除,或者partition增加或者减少都会导致所有的consumer进行一次rebalance操作;0.9对rebalance做了新的design(https://issues.apache.org/jira/browse/KAFKA-264)引入了consumer co-ordination. 本文转自MIKE老毕 51CTO博客,原文链接:http://blog.51cto.com/boylook/1300306,如需转载请自行联系原作者

优秀的个人博客,低调大师

Android AIDL实例解析

AIDL这项技术在我们的开发中一般来说并不是很常用,虽然自己也使用新浪微博的SSO登录,其原理就是使用AIDL,但是自己一直没有动手完整的写过AIDL的例子,所以就有了这篇简单的文章。 AIDL(AndRoid接口描述语言)是一种借口描述语言; 编译器可以通过aidl文件生成一段代码,通过预先定义的接口达到两个进程内部通信进程的目的. 如果需要在一个Activity中, 访问另一个Service中的某个对象, 需要先将对象转化成 AIDL可识别的参数(可能是多个参数), 然后使用AIDL来传递这些参数, 在消息的接收端, 使用这些参数组装成自己需要的对象. 说白了,AIDL就是定义一个接口,客户端(调用端)通过bindService来与远程服务端简历一个连接,在该连接建立时会将返回一个IBinder对象,该对象是服务端Binder的BinderProxy,在建立连接时,客户端通过asInterface函数将该BinderProxy对象包装成本地的Proxy,并将远程服务端的BinderProxy对象赋值给Proxy类的mRemote字段,就是通过mRemote执行远程方法调用。需要对Binder机制有更深的理解,请转到老罗的系列文字吧,Android系统进程间通信Binder机制在应用程序框架层的Java接口源代码分析。下面我们看一个AIDL实例。 AIDL接口声明 在src目录下创建一个com.example.advanceandroid.aidl包,然后在该包下创建一个ILogin.aidl文件,注意是创建文件而不是类或者接口类型。在ILogin.aidl中声明接口,实例如下 : package com.example.advanceandroid.aidl; interface ILogin { String login(); } 注意看,接口和方法声明都不用public,方法加入public会提示错误。编写完后如果eclipse开启了自动编译则会在gen/com.example.advanceandroid.aidl下生成一个ILogin.java类,内容大致如下: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 package com.example.advanceandroid.aidl; public interface ILogin extends android.os.IInterface { /** Local-side IPC implementation stub class. */ public static abstract class Stub extends android.os.Binder implements com.example.advanceandroid.aidl.ILogin { private static final java.lang.String DESCRIPTOR = "com.example.advanceandroid.aidl.ILogin" ; /** Construct the stub at attach it to the interface. */ public Stub() { this .attachInterface( this , DESCRIPTOR); } /** * Cast an IBinder object into an com.example.advanceandroid.aidl.ILogin * interface, generating a proxy if needed. */ public static com.example.advanceandroid.aidl.ILogin asInterface(android.os.IBinder obj) { if ((obj == null )) { return null ; } android.os.IInterface iin = obj.queryLocalInterface(DESCRIPTOR); if (((iin != null ) && (iin instanceof com.example.advanceandroid.aidl.ILogin))) { return ((com.example.advanceandroid.aidl.ILogin) iin); } return new com.example.advanceandroid.aidl.ILogin.Stub.Proxy(obj); } @Override public android.os.IBinder asBinder() { return this ; } @Override public boolean onTransact( int code, android.os.Parcel data, android.os.Parcel reply, int flags) throws android.os.RemoteException { switch (code) { case INTERFACE_TRANSACTION: { reply.writeString(DESCRIPTOR); return true ; } case TRANSACTION_login: { // 1、登录请求,执行的是this.login(); data.enforceInterface(DESCRIPTOR); java.lang.String _result = this .login(); reply.writeNoException(); reply.writeString(_result); return true ; } } return super .onTransact(code, data, reply, flags); } private static class Proxy implements com.example.advanceandroid.aidl.ILogin { private android.os.IBinder mRemote; Proxy(android.os.IBinder remote) { mRemote = remote; } @Override public android.os.IBinder asBinder() { return mRemote; } public java.lang.String getInterfaceDescriptor() { return DESCRIPTOR; } @Override public java.lang.String login() throws android.os.RemoteException // 2、Proxy中的login,通过Binder机制实现IPC { android.os.Parcel _data = android.os.Parcel.obtain(); android.os.Parcel _reply = android.os.Parcel.obtain(); java.lang.String _result; try { _data.writeInterfaceToken(DESCRIPTOR); mRemote.transact(Stub.TRANSACTION_login, _data, _reply, 0 ); _reply.readException(); _result = _reply.readString(); } finally { _reply.recycle(); _data.recycle(); } return _result; } } static final int TRANSACTION_login = (android.os.IBinder.FIRST_CALL_TRANSACTION + 0 ); } public java.lang.String login() throws android.os.RemoteException; } 可以看到,该类中自动生成了ILogin接口,该接口中又一个login()函数。但最重要的是里面生成了一个Stub类,该类集成子Binder类,并且实现了ILogin接口。Stub里面最重要的就是asInterface()这个函数,在这个函数中会判断obj参数的类型,如果是该obj是本地的接口类似,则认为不是IPC,会将该obj转换成ILogin类型;否则会通过自动生成的另一个内部类Proxy来包装obj,将其赋值给Proxy中的mRemote属性。Proxy类也实现了ILogin接口,在login()函数中,Proxy将通过Binder机制向服务端传递请求和数据,如上面代码中的注释2。这是客户端的工作算是完成了。 服务端AIDL接口 服务端也需要在相同的包下创建同名的aidl文件,我们直接将客户端的com.example.advanceandroid.aidl包下的ILogin.aidl拷贝到服务端即可,如果用到了自定义的类型,那么该自定义类型也需要在客户端、服务端都有。拷贝完aidl后,在服务端程序中也会在gen中生成对应的ILogin.java文件,内容同客户端一样。这里的重点我们要看onTransact函数,即上述代码中的注释1处,可以看到,在case TRANSACTION_login处执行了this.login()函数,意思是当接收到客户端的TRANSACTION_login请求时,执行this.login()函数,通过客户端的分析我们知道,当我们调用login()时实际上就是通过mRemote向服务端提交了一个TRANSACTION_login请求,因此就两端通过Binder机制就对接上了,我们可以简单的理解为C/S模式。 服务端还没有完,最重要的一步时建立一个Service,内容大致如下 : 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 /** * AIDL服务端接口,LoginStubImpl实现了ILogin接口. * * @author mrsimple */ public class LoginService extends Service { /** * */ IBinder mBinder = new LoginStubImpl(); /** * @author mrsimple */ class LoginStubImpl extends Stub { @Override public String login() throws RemoteException { return "这是从 " + this .getClass().getName() + " 返回的字符串" ; } } /* * 返回Binder实例,即实现了ILogin接口的Stub的子类,这里为LoginStubImpl * [url=home.php?mod=space&uid=133757]@see[/url] android.app.Service#onBind(android.content.Intent) */ @Override public IBinder onBind(Intent intent) { return mBinder; } } 该Service我们这里命名为LoginService,继承自Service,然后建一个名为LoginServiceImpl的内部类,该类继承自自动生成的Stub,然后实现login()方法。在LoginService中声明一个IBinder字段mBinder : IBinder mBinder = new LoginStubImpl(); 并且在LoginService的onBind函数中将mBinder对象返回。即在客户端建立与服务端的连接时,会调用onBind方法将mBinder对象返回,在客户端的ServiceConnection类的onServiceConnected函数中得到的对象IBinder就是经过BinderProxy包装的LoginService中的mBinder对象。因此在服务端中的onTransact中调用的this.login()函数实际上就是调用的LoginStubImpl中的login()函数。 在服务端程序的AndroidManifest.xml中注册LoginService,如下 : 1 2 3 4 5 6 <!-- aidl server service --> <service android:name= "com.example.advanceandroid.aidl.LoginService" > <intent-filter> </action></intent-filter> </service> 客户端建立连接 在Activity中加入如下代码 : 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 ServiceConnection mLoginConnection = new ServiceConnection() { @Override public void onServiceDisconnected(ComponentName name) { Log.d( "" , "### aidl disconnected." ); } @Override public void onServiceConnected(ComponentName name, IBinder service) { Log.d( "" , "### aidl onServiceConnected. service : " + service.getClass().getName()); ILogin login = Stub.asInterface(service); Log.d( "" , "### after asInterface : " + login.getClass().getName()); try { Log.d( "" , "### login : " + login.login()); // Toast.makeText(MainActivity.this, "onServiceConnected : " + // login.login(), // Toast.LENGTH_SHORT).show(); } catch (RemoteException e) { e.printStackTrace(); } } }; @Override protected void onResume() { super .onResume(); // 服务端的action Intent aidlIntent = new Intent( "com.example.advanceandroid.aidl.LoginService" ); bindService(aidlIntent, mLoginConnection, Context.BIND_AUTO_CREATE); } @Override protected void onStop() { super .onStop(); // unbind unbindService(mLoginConnection); } 运行 先运行服务端程序,然后在启动客户端程序,可以看到客户端输出如下Log: 1 2 3 09 - 02 10 : 40 : 54.662 : D/( 9589 ): ### aidl onServiceConnected. service : android.os.BinderProxy 09 - 02 10 : 40 : 54.662 : D/( 9589 ): ### after asInterface : com.example.advanceandroid.aidl.ILogin$Stub$Proxy 09 - 02 10 : 40 : 54.662 : D/( 9589 ): ### login : 这是从 com.example.advanceandroid.aidl.LoginService$LoginStubImpl 返回的字符串 可以看淡onServiceConnected(ComponentName name, IBinder service)中的service对象是BinderProxy类型,经过asInterface转换后被包装成了Proxy类型,但是调用的时候,执行的是服务端LoginStubImpl中的login()函数。因此,LoginStubImpl实例mBinder被服务端包装成BinderProxy类型,再经过客户端的Proxy进行包装,通过Binder机制进行数据传输,实现IPC。 本文转自 一点点征服 博客园博客,原文链接:http://www.cnblogs.com/ldq2016/p/7306173.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

fragment和fragmentactivity解析

一、为什么要使用Fragment 1、当我们须要动态的多界面切换的时候,就须要将UI元素和Activity融合成一个模块。在2.3中我们一般通过各种Activity中进行跳转来实现多界面的跳转和单个界面动态改变。在4.0或以上系统中就能够使用新的特性来方便的达到这个效果--Fragment类。Fragment类似一个嵌套Activity,能够定义自己的layout和自己的生命周期。 2、 多个Fragment能够放在一个Activity中(所以上面讲到类似一个嵌套Activity)。而这个类能够对这些Fragment进行配置以适应不同的屏幕尺寸(比方平板和手机)。 二、使用Fragment 1、Fragment 是 activity 的界面中的一部分或一种行为。 能够把多个 Fragment 组合到一个 activity 中来创建一 个多面界面而且能够在多个 activity 中重用一个 Fragment。 能够把 Fragment 觉得模块化的一段 activity,它具 有自己的生命周期,接收它自己的事件,并能够在 activity 执行时被加入或删除。 2、Fragment 不能独立存在,它必须嵌入到 activity 中,并且 Fragment 的生命周期直接受所在的 activity 的影 响。 3、当向 activity 中加入一个 Fragment 时,它须置于 ViewGroup 控件中,而且需定义 Fragment 自己的界面。 可 以在 layoutxml 文件里声明 Fragment,元素为:<fragment>;也能够在代码中创建 Fragment,然后把它加入到 ViewGroup 控件中。 然而,Fragment 不一定非要放在 activity 的界面中,它能够隐藏在后台为 actvitiy 工作。 三、 生命周期 通常, 应当至少实现例如以下的生命周期方法: onCreate() 当创建fragment时, 系统调用该方法. 在实现代码中,应当初始化想要在fragment中保持的必要组件, 当fragment被暂停或者停止后能够恢复. onCreateView() fragment第一次绘制它的用户界面的时候, 系统会调用此方法. 为了绘制fragment的UI,此方法必须返回一个View, 这个view是你的fragment布局的根view. 假设fragment不提供UI, 能够返回null. onPause() 用户将要离开fragment时,系统调用这种方法作为第一个指示(然而它不总是意味着fragment将被销毁.) 在当前用户会话结束之前,通常应当在这里提交不论什么应该持久化的变化(由于用户有可能不会返回). 大多数程序应最少对 fragment 实现这三个方法。 当然还有其他几个回调方法可应该按情况实现之。 下图为 fragment 的生命周期(它所在的 activity 处于执行状态)。 四、怎样使用Fragment 1、加入一个用户界面 fragment通经常使用来作为一个activity的用户界面的一部分,并将它的layout提供给activity.为了给一个fragment提供一 个layout,你必须实现 onCreateView()回调方法, 当到了fragment绘制它自己的layout的时候,Android系统调用它.你的此方法的实现代码必须返回一个你的fragment的 layout的根view. 从onCreateView()返回的View, 也能够从一个layout的xml资源文件里读取并生成. 为了帮助你这么做, onCreateView() 提供了一个LayoutInflater 对象. 举个样例, 这里有一个Fragment的子类, 从文件 frament_main.xml 载入了一个layout: @Override public View onCreateView(LayoutInflater inflater, ViewGroup container, Bundle savedInstanceState) { View view = inflater.inflate(R.layout.frament_main, container, false); return view; } PS 传入onCreateView()的container參数是你的fragmentlayout将被插入的父ViewGroup(来自activity的layout) savedInstanceState 參数是一个Bundle, 假设fragment是被恢复的,它提供关于fragment的之前的实例的数据, inflate() 方法有3个參数: a、想要载入的layout的resource ID. b、载入的layout的父ViewGroup.传入container是非常重要的, 目的是为了让系统接受所要载入的layout的根view的layout參数,由它将挂靠的父view指定. c、布尔值指示在载入期间, 展开的layout是否应当附着到ViewGroup (第二个參数). 2、将fragment加入到activity 通常地, fragment为宿主activity提供UI的一部分, 被作为activity的整个viewhierarchy的一部分被嵌入. 有2种方法你能够加入一个fragment到activity layout:2.1、使用XML将Fragment加入到一个Activity中 在这样的情况下。你能够像为View一样, 为fragment指定layout属性。 <?xml version="1.0" encoding="utf-8"?> <LinearLayout xmlns:android="http://schemas.android.com/apk/res/android" android:orientation="horizontal" android:layout_width="match_parent" android:layout_height="match_parent"> <fragment android:name="com.example.news.ArticleListFragment" android:id="@+id/list" android:layout_weight="1" android:layout_width="0dp" android:layout_height="match_parent" /> <fragment android:name="com.example.news.ArticleReaderFragment" android:id="@+id/viewer" android:layout_weight="2" android:layout_width="0dp" android:layout_height="match_parent" /> </LinearLayout> PS 1、<fragment> 中的 android:name属性指定了在layout中实例化的Fragment类. 当系统创建这个activity layout时,它实例化每个在layout中指定的fragment,并调用每个上的onCreateView()方法,来获取每个 fragment的layout.系统将从fragment返回的 View直接插入到<fragment>元素所在的地方. 2、通过在xml中定义fragment的方式。我们不能在执行时移除fragment。假设我们想要通过切换fragments来跟用户有更好的互动。那么就须要在activity启动的时候定义fragment了。 2.2、在执行时加入一个Fragment到Activity 上面一节的在activity的布局文件(layout xml)中加入Fragment的方法我们已经知道了。 如今我们将学习第二种方式。这样的方式同意我们在执行时动态的显示和隐藏fragment。为了达到在activity中动态管理Fragment,我们须要用到FragmentManager,而且通过它创建FragmentTransaction。 activity同意移除或者替换fragment须要有例如以下条件: 1、activity的onCreate()方法中加入初始化的fragment 2、fragment放置位置的布局中必须有一个视图容器 比方:res/layout/news_articles.xml文件提供了视图容器。 <FrameLayout xmlns:android="http://schemas.android.com/apk/res/android" android:id="@+id/fragment_container" android:layout_width="match_parent" android:layout_height="match_parent" /> Activity中使用getSupportFragmentManager()获取FragmentManager,之后调用beginTransaction去创建一个FragmentTransaction对象, 再调用add()方法就可以加入一个fragment。 在activity中能够使用同一个FragmentTransaction对象去运行多个fragment事务,当做这样操作时。必须调用commint()方法。 以下的代码演示如何加入一个fragment到res/layout/news_articles.xml的layout: import android.os.Bundle; import android.support.v4.app.FragmentActivity; public class MainActivity extends FragmentActivity { @Override public void onCreate(Bundle savedInstanceState) { super.onCreate(savedInstanceState); setContentView(R.layout.news_articles); if (findViewById(R.id.fragment_container) != null) { if (savedInstanceState != null) { return; } HeadlinesFragment firstFragment = new HeadlinesFragment(); firstFragment.setArguments(getIntent().getExtras()); // Add the fragment to the 'fragment_container' FrameLayout getSupportFragmentManager().beginTransaction() .add(R.id.fragment_container, firstFragment).commit(); } } } add()的第一个參数是fragment要放入的ViewGroup, 由resource ID指定,第二个參数是须要加入的fragment.一旦用FragmentTransaction做了改变,为了使改变生效,必须调用commit(). PS 如今再来说明另外一个实例,实例图例如以下。我要在四个标签页面切换(主页。手机,配件,购物车) 代码例如以下,详细就是通过影藏和显示fragment来实现切换 import android.os.Bundle; import android.support.v4.app.Fragment; import android.support.v4.app.FragmentActivity; import android.view.View; import android.view.Window; public class FramentMainActivity extends FragmentActivity { private Fragment[] fragments; @Override protected void onCreate(Bundle savedInstanceState) { super.onCreate(savedInstanceState); requestWindowFeature(Window.FEATURE_NO_TITLE); setContentView(R.layout.activity_frament_main); fragments = new Fragment[4]; fragments[0] = getSupportFragmentManager().findFragmentById(R.id.farment_main); fragments[1] = getSupportFragmentManager().findFragmentById(R.id.farment_phone); fragments[2] = getSupportFragmentManager().findFragmentById(R.id.farment_accessory); fragments[3] = getSupportFragmentManager().findFragmentById(R.id.farment_cart); getSupportFragmentManager().beginTransaction(). hide(fragments[1]).hide(fragments[2]).hide(fragments[3]).show(fragments[0]).commit(); } public void mainClick(View view){ getSupportFragmentManager().beginTransaction().hide(fragments[1]).hide(fragments[2]).hide(fragments[3]).show(fragments[0]).commit(); } public void phoneClick(View view){ getSupportFragmentManager().beginTransaction().hide(fragments[0]).hide(fragments[2]).hide(fragments[3]).show(fragments[1]).commit(); } public void accessoryClick(View view){ getSupportFragmentManager().beginTransaction().hide(fragments[0]).hide(fragments[1]).hide(fragments[3]).show(fragments[2]).commit(); } public void cartClick(View view){ getSupportFragmentManager().beginTransaction().hide(fragments[0]).hide(fragments[1]).hide(fragments[2]).show(fragments[3]).commit(); } } 3、Frament 管理 要管理 fragment,需使用 FragmentManager,要获取它,需在 activity 中调用方法 getFragmentManager()。 能够用 FragmentManager 来做以上事情: 用法 findFragmentById()或 findFragmentByTag(),获取 activity 中已存在的 fragment 用法 popBackStack()从 activity 的后退栈中弹出 fragment(这能够模拟后退键引发的动作) 用方法 addOnBackStackChangedListerner()注冊一个侦听器以监视后退栈的变化 还能够使用 FragmentManager 打开一个 FragmentTransaction 来运行 fragment 的事务,比方加入或删除 fragment。 在 activity 中使用 fragment 的一个伟大的优点是能跟据用户的输入对 fragment 进行加入、删除、替换以及运行 其他动作的能力。 提交的一组 fragment 的变化叫做一个事务。 事务通过 FragmentTransaction 来运行。还能够把每一个 事务保存在 activity 的后退栈中,这样就能够让用户在 fragment 变化之间导航(跟在 activity 之间导航一样)。 能够通过 FragmentManager 来取得 FragmentTransaction 的实例,例如以下: FragmentManagerfragmentManager = getFragmentManager(); FragmentTransactionfragmentTransaction =fragmentManager.beginTransaction(); 一个事务是在同一时刻运行的一组动作(非常像数据库中的事务)。 能够用 add(),remove(),replace()等方法构成事务,最后使用 commit()方法提交事务。在调用 commint()之前,能够用addToBackStack()把事务加入到一个后退栈中, 这个后退栈属于所在的 activity。有了它,就能够在用户按下返回键时,返回到 fragment 运行事务之前的状态。如 下例:演示了怎样用一个 fragment 取代还有一个 fragment,同一时候在后退栈中保存被取代的 fragment 的状态。 4、为Activity创建事件回调方法 在一些情况下, 你可能须要一个fragment与activity分享事件. 一个好的方法是在fragment中定义一个回调的interface, 并要求宿主activity实现它.当activity通过interface接收到一个回调, 必要时它能够和在layout中的其它fragment分享信息. 比如, 假设一个新的应用在activity中有2个fragment – 一个用来显示文章列表(framgent A), 还有一个显示文章内容(fragment B) – 然后 framgent A必须告诉activity何时一个list item被选中,然后它能够告诉fragmentB去显示文章. PS 最后在简单说说一个项目的大致实现,比方在手机上面实现了一个FragmentActivity + 多个fragment(登录。菜单,具体,账户等页面)。 1、每个项目包含非常多活动,每个活动(FragmentActivity)相互不影响,每个活动(FragmentActivity)包含非常多子活动(fragment,一个页面),每个子活动也相互不影响. 2、每个活动(FragmentActivity)用FrameLayout来显示子活动,而且对活动进行堆栈管理,实现数据不用反复拉取。就跟搜狐新闻一样的效果. 3、登录(FragmentActivity):logo页面,登录页面 4、菜单(FragmentActivity):菜单选择页面(側边栏,滑动),子菜单功能(每个新闻页面) 5、其它(FragmentActivity):上传页面,下载页面等 每个活动(FragmentActivity)实现了相互不影响。 本文转自mfrbuaa博客园博客,原文链接:http://www.cnblogs.com/mfrbuaa/p/5393911.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

Hbase原理解析

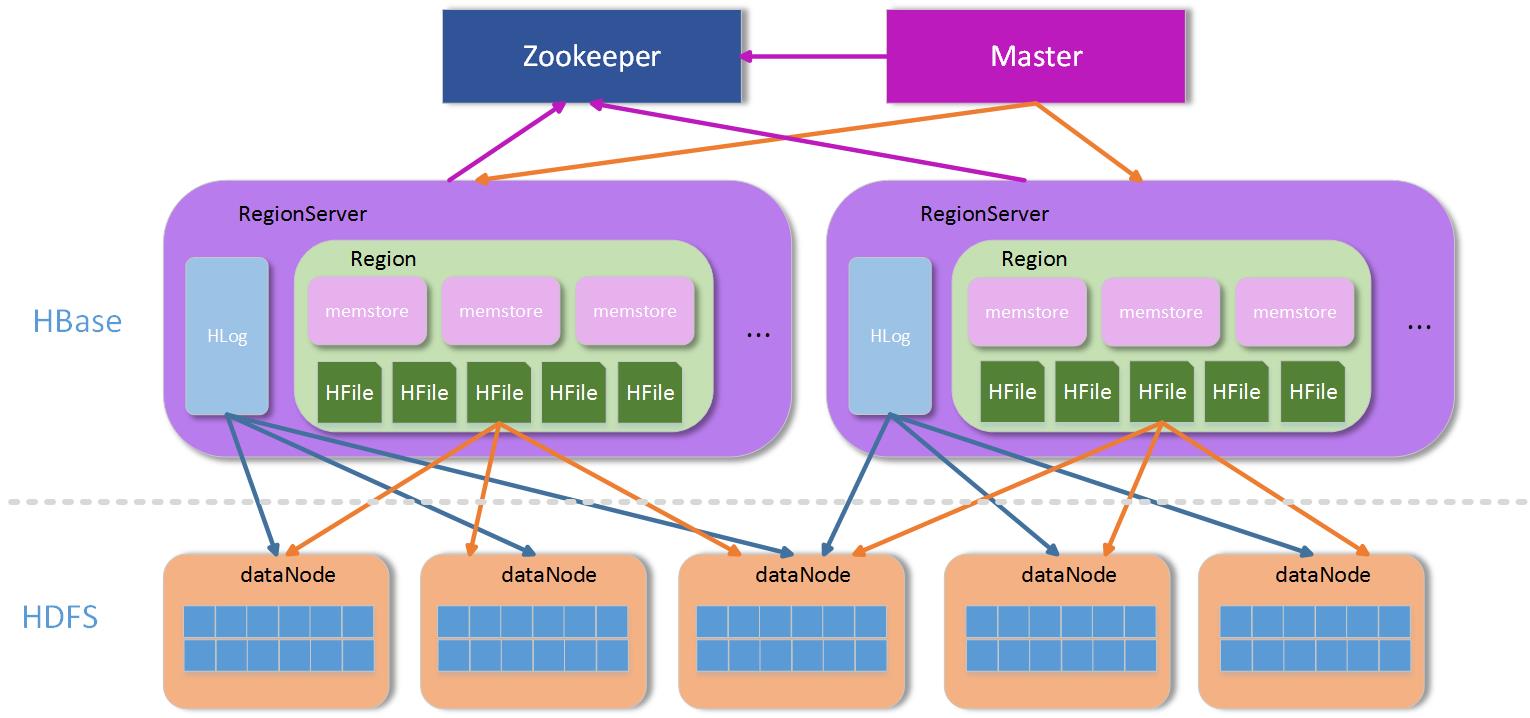
原文网站已经打不开了,其他都是转载地址,在此就不列了 简介 [HBase]——Hadoop Database的简称,Google BigTable的另一种开源实现方式,从问世之初,就为了解决用大量廉价的机器高速存取海量数据、实现数据分布式存储提供可靠的方案。从功能上来讲,HBase不折不扣是一个数据库,与我们熟悉的Oracle、MySQL、MSSQL等一样,对外提供数据的存储和读取服务。而从应用的角度来说,HBase与一般的数据库又有所区别,HBase本身的存取接口相当简单,不支持复杂的数据存取,更不支持SQL等结构化的查询语言;HBase也没有除了rowkey以外的索引,所有的数据分布和查询都依赖rowkey。 所以HBase在表的设计上会有很严格的要求。 架构上,HBase是分布式数据库的典范,这点比较像MongoDB的sharding模式,能根据键值的大小,把数据分布到不同的存储节点上,MongoDB根据configserver来定位数据落在哪个分区上,HBase通过访问Zookeeper来获取-ROOT-表所在地址,通过-ROOT-表得到相应.META.表信息,从而获取数据存储的region位置。 架构 上面提到,HBase是一个分布式的架构,除去底层存储的HDFS外,HBase本身从功能上可以分为三块:Zookeeper群、Master群和RegionServer群。 Zookeeper群:HBase集群中不可缺少的重要部分,主要用于存储Master地址、协调Master和RegionServer等上下线、存储临时数据等等。 Master群:Master主要是做一些管理操作,如:region的分配,手动管理操作下发等等,一般数据的读写操作并不需要经过Master集群,所以Master一般不需要很高的配置即可。 RegionServer群:RegionServer群是真正数据存储的地方,每个RegionServer由若干个region组成,而一个region维护了一定区间rowkey值的数据,整个结构如下图: HBase结构图 上图中,Zookeeper(简称ZK)是一个集群,通常有奇数个ZK服务组成。Master为了服务可用性,也建议部署成集群方式,因为Master是整个管理操作的发起者,如果Master一旦发生意外停机,整个集群将会无法进行管理操作,所以Master也必须有多个,当然多个Master也有主从之分,如何区分哪个是主,哪个是从?关键看哪个Master能竞争到ZK上对应Master目录下的锁,持有该目录锁的Master为主Master,其他从Master轮询竞争该锁,所以一旦主Master发生意外停机,从Master很快会因为竞争到Master文件夹上的锁而接管服务。 RegionServer(简称RS)在非Replication模式下,整个系统中都是唯一的,也就是说,在整个非Replication的HBase集群中,每台RS上保存的数据都不一样,所以相对于前面两者,该模式下的RS并不是高可用的,至少RS可能存在单点故障的问题,但是由于HBase内部数据分region存储和region可以迁移的机制,RS服务的单点故障可能会在极小代价下很快恢复,但是一旦停掉的RS上有-ROOT-或者.META.表的region,那后果还是比较严重,因为数据节点的RS停机,只会在短时间内影响该台RS上的region不可访问,等到region迁移完成后即可恢复,如果是-ROOT-、.META.所在的RS停机,整个HBase的新的求情都将受到影响,因为需要通过.META.表来路由,从而寻找到region所在RS的地址。 数据组织 整个架构中,ZK用于服务协调和整个集群运行过程中部分信息的保存和-ROOT-表地址定位,Master用于集群内部管理,所以剩下的RS主要用于处理数据。 RS是处理数据的主要场所,那么在RS内部的数据是怎么分布的?其实RS本身只是一个容器,其定义了一些功能线程,比如:数据合并线程(compact thread)、storeFile分割线程(split thread)等等。容器中的主要对象就是region,region是一个表根据自身rowkey范围划分的一部分,一个表可以被划分成若干部分,也就是若干个region,region可以根据rowkey范围不同而被分布在不同的RS上(当然也可以在同一个RS上,但不建议这么做)。一个RS上可以包含多个表的region,也可以只包含一个表的部分region,RS和表是两个不同的概念。 这里还有一个概念——列簇。对HBase有一些了解的人,或多或少听说过:HBase是一个列式存储的数据库,而这个列式存储中的列,其实是区别于一般数据库的列,这里的列的概念,就是列簇。列簇,顾名思义就是很多列的集合,而在数据存储上来讲,不同列簇的数据,一定是分开存储的,即使是在同一个region内部,不同的列簇也存储在不同的文件夹中,这样做的好处是,一般我们定义列簇的时候,通常会把类似的数据放入同一个列簇,不同的列簇分开存储,有利于数据的压缩,并且HBase本身支持多种压缩方式。 原理 前面介绍了HBase的一般架构,我们知道了HBase有ZK、Master和RS等组成,本节我们来介绍下HBase的基本原理,从数据访问、RS路由到RS内部缓存、数据存储和刷写再到region的合并和拆分等等功能。 RegionServer定位 访问HBase通过HBase客户端(或API)进行,整个HBase提供给外部的地址,其实是ZK的入口,前面也介绍了,ZK中有保存-ROOT-所在的RS地址,从-ROOT-表可以获取.META.表信息,根据.META.表可以获取region在RS上的分布,整个region寻址过程大致如下: RS定位过程 首先,Client通过访问ZK来请求目标数据的地址。 ZK中保存了-ROOT-表的地址,所以ZK通过访问-ROOT-表来请求数据地址。同样,-ROOT-表中保存的是.META.的信息,通过访问.META.表来获取具体的RS。.META.表查询到具体RS信息后返回具体RS地址给Client。Client端获取到目标地址后,然后直接向该地址发送数据请求。 上述过程其实是一个三层索引结构,从ZK获取-ROOT-信息,再从-ROOT-获取.META.表信息,最后从.META.表中查到RS地址后缓存。这里有几个问题: 既然ZK中能保存-ROOT-信息,那么为什么不把.META.信息直接保存在ZK中,而需要通过-ROOT-表来定位? Client查找到目标地址后,下一次请求还需要走ZK —> -ROOT- —> .META.这个流程么? 先来回答第一个问题:为什么不直接把.META.表信息直接保存到ZK中?主要是为了保存的数据量考虑,ZK中不宜保存大量数据,而.META.表主要是保存Region和RS的映射信息,region的数量没有具体约束,只要在内存允许的范围内,region数量可以有很多,如果保存在ZK中,ZK的压力会很大。所以通过一个-ROOT-表来转存到RS中是一个比较理想的方案,相比直接保存在ZK中,也就多了一层-ROOT-表的查询,对性能来说影响不大。 第二个问题:每次访问都需要走ZK –> -ROOT- —> .META.的流程么?当然不需要,Client端有缓存,第一次查询到相应region所在RS后,这个信息将被缓存到Client端,以后每次访问都直接从缓存中获取RS地址即可。当然这里有个意外:访问的region若果在RS上发生了改变,比如被balancer迁移到其他RS上了,这个时候,通过缓存的地址访问会出现异常,在出现异常的情况下,Client需要重新走一遍上面的流程来获取新的RS地址。总体来说,region的变动只会在极少数情况下发生,一般变动不会很大,所以在整个集群访问过程中,影响可以忽略。 Region数据写入 HBase通过ZK —> -ROOT- —> .META.的访问获取RS地址后,直接向该RS上进行数据写入操作,整个过程如下图: RegionServer数据操作过程 Client通过三层索引获得RS的地址后,即可向指定RS的对应region进行数据写入,HBase的数据写入采用WAL(write ahead log)的形式,先写log,后写数据。HBase是一个append类型的数据库,没有关系型数据库那么复杂的操作,所以记录HLog的操作都是简单的put操作(delete/update操作都被转化为put进行) HLog HLog写入 HLog是HBase实现WAL方式产生的日志信息,其内部是一个简单的顺序日志,每个RS上的region都共享一个HLog,所有对于该RS上的region数据写入都被记录到该HLog中。HLog的主要作用就是在RS出现意外崩溃的时候,可以尽量多的恢复数据,这里说是尽量多,因为在一般情况下,客户端为了提高性能,会把HLog的auto flush关掉,这样HLog日志的落盘全靠操作系统保证,如果出现意外崩溃,短时间内没有被fsync的日志会被丢失。 HLog过期 HLog的大量写入会造成HLog占用存储空间会越来越大,HBase通过HLog过期的方式进行HLog的清理,每个RS内部都有一个HLog监控线程在运行,其周期可以通过hbase.master.cleaner.interval进行配置。 HLog在数据从memstore flush到底层存储上后,说明该段HLog已经不再被需要,就会被移动到.oldlogs这个目录下,HLog监控线程监控该目录下的HLog,当该文件夹下的HLog达到hbase.master.logcleaner.ttl设置的过期条件后,监控线程立即删除过期的HLog。 Memstore 数据存储 memstore是region内部缓存,其大小通过HBase参数hbase.hregion.memstore.flush.size进行配置。RS在写完HLog以后,数据写入的下一个目标就是region的memstore,memstore在HBase内部通过LSM-tree结构组织,所以能够合并大量对于相同rowkey上的更新操作。 正是由于memstore的存在,HBase的数据写入都是异步的,而且性能非常不错,写入到memstore后,该次写入请求就可以被返回,HBase即认为该次数据写入成功。这里有一点需要说明,写入到memstore中的数据都是预先按照rowkey的值进行排序的,这样有利于后续数据查找。 数据刷盘 memstore中的数据在一定条件下会进行刷写操作,使数据持久化到相应的存储设备上,触发memstore刷盘的操作有多种不同的方式如下图: Memstore刷写流程以上1,2,3都可以触发memstore的flush操作,但是实现的方式不同: 1、通过全局内存控制,触发memstore刷盘操作memstore整体内存占用上限通过参数hbase.regionserver.global.memstore.upperLimit进行设置,当然在达到上限后,memstore的刷写也不是一直进行,在内存下降到hbase.regionserver.global.memstore.lowerLimit配置的值后,即停止memstore的刷盘操作。这样做,主要是为了防止长时间的memstore刷盘,会影响整体的性能。在该种情况下,RS中所有region的memstore内存占用都没达到刷盘条件,但整体的内存消耗已经到一个非常危险的范围,如果持续下去,很有可能造成RS的OOM,这个时候,需要进行memstore的刷盘,从而释放内存。 2、手动触发memstore刷盘操作HBase提供API接口,运行通过外部调用进行memstore的刷盘 3、memstore上限触发数据刷盘前面提到memstore的大小通过hbase.hregion.memstore.flush.size进行设置,当region中memstore的数据量达到该值时,会自动触发memstore的刷盘操作。 刷盘影响 memstore在不同的条件下会触发数据刷盘,那么整个数据在刷盘过程中,对region的数据写入等有什么影响?memstore的数据刷盘,对region的直接影响就是:在数据刷盘开始到结束这段时间内,该region上的访问都是被拒绝的,这里主要是因为在数据刷盘结束时,RS会对改region做一个snapshot,同时HLog做一个checkpoint操作,通知ZK哪些HLog可以被移到.oldlogs下。从前面图上也可以看到,在memstore写盘开始,相应region会被加上UpdateLock锁,写盘结束后该锁被释放。 StoreFile memstore在触发刷盘操作后会被写入底层存储,每次memstore的刷盘就会相应生成一个存储文件HFile,storeFile即HFile在HBase层的轻量级分装。数据量的持续写入,造成memstore的频繁flush,每次flush都会产生一个HFile,这样底层存储设备上的HFile文件数量将会越来越多。不管是HDFS还是Linux下常用的文件系统如Ext4、XFS等,对小而多的文件上的管理都没有大文件来的有效,比如小文件打开需要消耗更多的文件句柄;在大量小文件中进行指定rowkey数据的查询性能没有在少量大文件中查询来的快等等。 Compact 大量HFile的产生,会消耗更多的文件句柄,同时会造成RS在数据查询等的效率大幅度下降,HBase为解决这个问题,引入了compact操作,RS通过compact把大量小的HFile进行文件合并,生成大的HFile文件。RS上的compact根据功能的不同,可以分为两种不同类型,即:minor compact和major compact。 Minor Compact minor compact又叫small compact,在RS运行过程中会频繁进行,主要通过参数hbase.hstore.compactionThreshold进行控制,该参数配置了HFile数量在满足该值时,进行minor compact,minor compact只选取region下部分HFile进行compact操作,并且选取的HFile大小不能超过hbase.hregion.max.filesize参数设置。 Major Compact 相反major compact也被称之为large compact,major compact会对整个region下相同列簇的所有HFile进行compact,也就是说major compact结束后,同一个列簇下的HFile会被合并成一个。major compact是一个比较长的过程,对底层I/O的压力相对较大。 major compact除了合并HFile外,另外一个重要功能就是清理过期或者被删除的数据。前面提到过,HBase的delete操作也是通过append的方式写入,一旦某些数据在HBase内部被删除了,在内部只是被简单标记为删除,真正在存储层面没有进行数据清理,只有通过major compact对HFile进行重组时,被标记为删除的数据才能被真正的清理。 compact操作都有特定的线程进行,一般情况下不会影响RS上数据写入的性能,当然也有例外:在compact操作速度跟不上region中HFile增长速度时,为了安全考虑,RS会在HFile达到一定数量时,对写入进行锁定操作,直到HFile通过compact降到一定的范围内才释放锁。 Split compact将多个HFile合并单个HFile文件,随着数据量的不断写入,单个HFile也会越来越大,大量小的HFile会影响数据查询性能,大的HFile也会,HFile越大,相对的在HFile中搜索的指定rowkey的数据花的时间也就越长,HBase同样提供了region的split方案来解决大的HFile造成数据查询时间过长问题。 一个较大的region通过split操作,会生成两个小的region,称之为Daughter,一般Daughter中的数据是根据rowkey的之间点进行切分的,region的split过程大致如下图: region split流程 1、region先更改ZK中该region的状态为SPLITING。 2、Master检测到region状态改变。 3、region会在存储目录下新建.split文件夹用于保存split后的daughter region信息。 4、Parent region关闭数据写入并触发flush操作,保证所有写入Parent region的数据都能持久化。 5、在.split文件夹下新建两个region,称之为daughter A、daughter B。 6、Daughter A、Daughter B拷贝到HBase根目录下,形成两个新的region。 7、Parent region通知修改.META.表后下线,不再提供服务。 8、Daughter A、Daughter B上线,开始向外提供服务。 9、如果开启了balance_switch服务,split后的region将会被重新分布。 上面1 ~ 9就是region split的整个过程,split过程非常快,速度基本会在秒级内,那么在这么快的时间内,region中的数据怎么被重新组织的? 其实,split只是简单的把region从逻辑上划分成两个,并没有涉及到底层数据的重组,split完成后,Parent region并没有被销毁,只是被做下线处理,不再对外部提供服务。而新产生的region Daughter A和Daughter B,内部的数据只是简单的到Parent region数据的索引,Parent region数据的清理在Daughter A和Daughter B进行major compact以后,发现已经没有到其内部数据的索引后,Parent region才会被真正的清理。 HBase设计 HBase是一个分布式数据库,其性能的好坏主要取决于内部表的设计和资源的分配是否合理。 Rowkey设计 rowkey是HBase实现分布式的基础,HBase通过rowkey范围划分不同的region,分布式系统的基本要求就是在任何时候,系统的访问都不要出现明显的热点现象,所以rowkey的设计至关重要,一般我们建议rowkey的开始部分以hash或者MD5进行散列,尽量做到rowkey的头部是均匀分布的。禁止采用时间、用户id等明显有分段现象的标志直接当作rowkey来使用。 列簇设计 HBase的表设计时,根据不同需求有不同选择,需要做在线查询的数据表,尽量不要设计多个列簇,我们知道,不同的列簇在存储上是被分开的,多列簇设计会造成在数据查询的时候读取更多的文件,从而消耗更多的I/O。 TTL设计 选择合适的数据过期时间也是表设计中需要注意的一点,HBase中允许列簇定义数据过期时间,数据一旦超过过期时间,可以被major compact进行清理。大量无用历史数据的残余,会造成region体积增大,影响查询效率。 Region设计 一般地,region不宜设计成很大,除非应用对阶段性性能要求很多,但是在将来运行一段时间可以接受停服处理。region过大会导致major compact调用的周期变长,而单次major compact的时间也相应变长。major compact对底层I/O会造成压力,长时间的compact操作可能会影响数据的flush,compact的周期变长会导致许多删除或者过期的数据不能被及时清理,对数据的读取速度等都有影响。 相反,小的region意味着major compact会相对频繁,但是由于region比较小,major compact的相对时间较快,而且相对较多的major compact操作,会加速过期数据的清理。 当然,小region的设计意味着更多的region split风险,region容量过小,在数据量达到上限后,region需要进行split来拆分,其实split操作在整个HBase运行过程中,是被不怎么希望出现的,因为一旦发生split,涉及到数据的重组,region的再分配等一系列问题。所以我们在设计之初就需要考虑到这些问题,尽量避免region的运行过程中发生split。 HBase可以通过在表创建的时候进行region的预分配来解决运行过程中region的split产生,在表设计的时候,预先分配足够多的region数,在region达到上限前,至少有部分数据会过期,通过major compact进行清理后, region的数据量始终维持在一个平衡状态。 region数量的设计还需要考虑内存上的限制,通过前面的介绍我们知道每个region都有memstore,memstore的数量与region数量和region下列簇的数量成正比,一个RS下memstore内存消耗 Memory = memstore大小 * region数量 * 列簇数量 如果不进行前期数据量估算和region的预分配,通过不断的split产生新的region,容易导致因为内存不足而出现OOM现象。 个人介绍: 高广超:多年一线互联网研发与架构设计经验,擅长设计与落地高可用、高性能互联网架构。 本文首发在 高广超的简书博客 转载请注明! image.png

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册