首页 文章 精选 留言 我的

精选列表

搜索[视频解析],共10000篇文章
优秀的个人博客,低调大师

WKWebView代理方法解析

一.前言 上一篇文章已经对WKWebView做了一个简单的介绍,主要对它的一些方法和属性做了一个简单的介绍,今天看一下WKWebView的两个协议:WKNavigationDelegate 和 WKUIDelegate。 二.WKNavigationDelegate 根据字面意思,它的作用是用于导航(navigation)的代理。其实里面定义了n多个方法,用于处理网页接受、加载和导航请求等自定义的行为。直接拿下面的例子来看: #pragma mark - WKWebView NavigationDelegate //WKNavigationDelegate - (void)webView:(WKWebView *)webView decidePolicyForNavigationAction:(WKNavigationAction *)navigationAction decisionHandler:(void (^)(WKNavigationActionPolicy))decisionHandler { NSLog(@"是否允许这个导航"); decisionHandler(WKNavigationActionPolicyAllow); } - (void)webView:(WKWebView *)webView decidePolicyForNavigationResponse:(WKNavigationResponse *)navigationResponse decisionHandler:(void (^)(WKNavigationResponsePolicy))decisionHandler { // Decides whether to allow or cancel a navigation after its response is known. NSLog(@"知道返回内容之后,是否允许加载,允许加载"); decisionHandler(WKNavigationResponsePolicyAllow); } - (void)webView:(WKWebView *)webView didStartProvisionalNavigation:(null_unspecified WKNavigation *)navigation { NSLog(@"开始加载"); self.progress.alpha = 1; [UIApplication sharedApplication].networkActivityIndicatorVisible = YES; } - (void)webView:(WKWebView *)webView didReceiveServerRedirectForProvisionalNavigation:(null_unspecified WKNavigation *)navigation { NSLog(@"跳转到其他的服务器"); } - (void)webView:(WKWebView *)webView didFailProvisionalNavigation:(null_unspecified WKNavigation *)navigation withError:(NSError *)error { NSLog(@"网页由于某些原因加载失败"); self.progress.alpha = 0; [UIApplication sharedApplication].networkActivityIndicatorVisible = NO; } - (void)webView:(WKWebView *)webView didCommitNavigation:(null_unspecified WKNavigation *)navigation { NSLog(@"网页开始接收网页内容"); } - (void)webView:(WKWebView *)webView didFinishNavigation:(null_unspecified WKNavigation *)navigation { NSLog(@"网页导航加载完毕"); [UIApplication sharedApplication].networkActivityIndicatorVisible = NO; self.title = webView.title; [webView evaluateJavaScript:@"document.title" completionHandler:^(id _Nullable ss, NSError * _Nullable error) { NSLog(@"----document.title:%@---webView title:%@",ss,webView.title); }]; self.progress.alpha = 0; } - (void)webView:(WKWebView *)webView didFailNavigation:(null_unspecified WKNavigation *)navigation withError:(NSError *)error { NSLog(@"加载失败,失败原因:%@",[error description]); self.progress.alpha = 0; } - (void)webViewWebContentProcessDidTerminate:(WKWebView *)webView { NSLog(@"网页加载内容进程终止"); } //- (void)webView:(WKWebView *)webView didReceiveAuthenticationChallenge:(NSURLAuthenticationChallenge *)challenge completionHandler:(void (^)(NSURLSessionAuthChallengeDisposition, NSURLCredential * _Nullable))completionHandler { // NSLog(@"receive"); //} 首先看一下(WKN1): - (void)webView:(WKWebView *)webView decidePolicyForNavigationAction:(WKNavigationAction *)navigationAction decisionHandler:(void (^)(WKNavigationActionPolicy))decisionHandler { NSLog(@"是否允许这个导航"); decisionHandler(WKNavigationActionPolicyAllow); } 这个方法是加载网页第一个执行的方法,因为它要确定是否允许或者取消加载这个导航。这里有一个枚举WKNavigationActionPolicy,其结构如下: typedef NS_ENUM(NSInteger, WKNavigationActionPolicy) { WKNavigationActionPolicyCancel, WKNavigationActionPolicyAllow, } API_AVAILABLE(macosx(10.10), ios(8.0)); 这里的两个枚举确定了这个网页是否加载,我们只需要在decisionHandler回调里面传入相应的枚举值即可。这里可以用来处理自己不允许加载的网页,比如你的app里面的网页很多,但是domain只有两个,如果你只想加载这两个domain里面的网页,其他的domain不加载,那么可以在这里进行处理。(可以用来屏蔽移动或联通运营商推送的网页,让其不在app中展示) 这里还有一个WKNavigationAction。它是一个导航动作, 包含了点击之后的导航动作,我们做过滤的时候可以通过该动作决定是否允许加载。它有两个关键的FrameInfo: sourceFrame targetFrame 他们都是WKFrameInfo的实例。该类包含了网页加载的frame的信息。该类有一个重要的属性:mainFrame。它是一个Bool值,用于标识该frame是不是当前网页的主frame或者是子frame。举个例子: 当我们第一次打开百度的时候,navigationAction是这样的: <WKNavigationAction: 0x100410fa0; navigationType = -1; syntheticClickType = 0; request = <NSMutableURLRequest: 0x170019a10> { URL: https://www.baidu.com/ }; sourceFrame = (null); targetFrame = <WKFrameInfo: 0x100401200; isMainFrame = YES; request = (null)>> 它的request url是https://www.baidu.com/。它的sourceFrame是nil,也就是请求导航的frame是空的。它的targetFrame是: <WKFrameInfo: 0x100401200; isMainFrame = YES; request = (null)> 这里是在当前的frame打开,也就是目的的frame。当我点击新闻那个链接的时候,其navigationAction是这样的: <WKNavigationAction: 0x1004120b0; navigationType = -1; syntheticClickType = 0; request = <NSMutableURLRequest: 0x17001af30> { URL: http://m.news.baidu.com/news?fr=mohome&ssid=0&from=844b&uid=&pu=sz%401320_2001%2Cta%40iphone_1_10.2_3_602&bd_page_type=1 }; sourceFrame = (null); targetFrame = <WKFrameInfo: 0x100414ff0; isMainFrame = YES; request = <NSMutableURLRequest: 0x17001b080> { URL: https://www.baidu.com/ }>> 可以看到,此时的导航动作是要请求的 http://m.news.baidu.com/news?fr=mohome&ssid=0&from=844b&uid=&pu=sz%401320_2001%2Cta%40iphone_1_10.2_3_602&bd_page_type=1 也就是网页版百度新闻的链接。此时它的sourceFrame是nil,它的targetFrame是: <WKFrameInfo: 0x100414ff0; isMainFrame = YES; request = <NSMutableURLRequest: 0x17001b080> { URL: https://www.baidu.com/ }> 它的目标frame的request是baidu。其中的isMainFrame属性是YES,说明是主的frame,所以还是在当前的网页中打开一个新链接。 此时我们也许会遇到另外一种情况,就是sourceFrame不为空,但是targetFrame为空,这里如果targetFrame为空,那么这个就是新建一个window 导航。用我们自己的话来说就是重新打开了一个tab页面。 就类似这样,我点击了PC版的网页链接,然后新开了一个tab,这样的话sourceFrame就是当前的百度,而targetFrame就是空的。此时(我用这个网页测试)你会发现这个代理方法不执行了,好尴尬。。。。处理都不知道怎么处理了。由于新打开了tab,也就意味着我们的请求不在当前的网页加载了,那么也无法调用到这个代理方法了。因此我们需要重新配置这个新打开的网页,这里就会调用: - (nullable WKWebView *)webView:(WKWebView *)webView createWebViewWithConfiguration:(WKWebViewConfiguration *)configuration forNavigationAction:(WKNavigationAction *)navigationAction windowFeatures:(WKWindowFeatures *)windowFeatures; 这个代理方法是WKUIDelegate的代理方法,可在下面查看。 接着就是开始加载(WKN2): - (void)webView:(WKWebView *)webView didStartProvisionalNavigation:(null_unspecified WKNavigation *)navigation; 这个方法比较好理解,就是当网页内容开始加载到web view的时候调用,这里的navigation没有其他特殊含义,看一下WKNavigation这个类可以知道,他就是NSObject的一个子类,而且里面没有任何新增的其他方法或者属性。我想仅仅是为了名字上能够好理解才这样写的吧。 再接着就是(WKN3): - (void)webView:(WKWebView *)webView decidePolicyForNavigationResponse:(WKNavigationResponse *)navigationResponse decisionHandler:(void (^)(WKNavigationResponsePolicy))decisionHandler; 这个代理方法了。我们知道了网页是否允许加载,那么一旦不允许,那么这个加载过程就已经结束了,不会再执行其他的代理方法;如果允许,那么就会执行开始加载的代理方法,执行完开始加载的代理方法的时候再执行这个代理方法。 根据意思可知,它的作用就是要根据导航的返回信息来判断是否加载网页。我们首先打印出navigationResponse的信息: <WKNavigationResponse: 0x100323e50; response = <NSHTTPURLResponse: 0x170226780> { URL: https://www.baidu.com/ } { status code: 200, headers { "Cache-Control" = "no-cache"; Connection = "keep-alive"; "Content-Encoding" = gzip; "Content-Length" = 20059; "Content-Type" = "text/html;charset=utf-8"; Date = "Mon, 27 Mar 2017 05:29:56 GMT"; Server = "bfe/1.0.8.18"; "Set-Cookie" = "H_WISE_SIDS=108266_100186_114821_114654_114743_109815_103550_114996_114701_112106_107314_114132_115245_115109_115056_115244_115043_114797_114513_114998_115227_114329_114534_115032_114276_114975_110085; path=/; domain=.baidu.com, BDSVRTM=182; path=/, __bsi=11762462753482193024_00_281_N_N_189_0303_C02F_N_N_Y_0; expires=Mon, 27-Mar-17 05:30:01 GMT; domain=www.baidu.com; path=/"; "Strict-Transport-Security" = "max-age=172800"; Traceid = 149059259607016350822661639119137312881; } }> 这个response有个属性叫做forMainFrame,用于标识导航的frame是不是主frame。 navigationResponse的canShowMIMEType属性用于表示WebKit是否能够展示返回的MIME类型。 如果我们拿到了返回的信息,发现这些信息我们不需要,我们可以在此方法里面进行处理,然后决定是否加载该网页。 接下来执行的是(WKN4): - (void)webView:(WKWebView *)webView didCommitNavigation:(null_unspecified WKNavigation *)navigation; 这个代理方法是在网页开始接受网络内容的时候调用,也就是网络内容开始要往网页中加载。 再接着就是(WKN5): - (void)webView:(WKWebView *)webView didFinishNavigation:(null_unspecified WKNavigation *)navigation; 意思就是这个导航我们已经加载完成了。我的理解就是这个当前网页加载完毕。 还有剩下的三个方法,一个加载网页失败的方法,一个接收服务器跳转方法和一个网页加载进程终止的方法。 网页加载失败方法: - (void)webView:(WKWebView *)webView didFailProvisionalNavigation:(null_unspecified WKNavigation *)navigation withError:(NSError *)error; 当网页由于error加载失败就会调用这个代理方法,它会将具体的error信息给抛出,然后供开发者具体情况具体处理。这里的error code具体在NSURLError.h里面定义。 这里有个小小的问题需要说明一下: 当我是用这个URL来进行加载的时候。我点击进去一个连接,然后再返回上一个页面的时候,发现会执行加载失败,查看原因是-999,也就是NSURLErrorCancelled。我理解的应该是因为之前上一个网页已经加载过了,再次加载的时候发现已经加载过了,所以这次返回上一个页面会报一个加载取消,应该是webview发现要加载的这个网页之前已经加载过,然后就取消了这个加载,加载了缓存。 另外两个代理方法: - (void)webView:(WKWebView *)webView didReceiveServerRedirectForProvisionalNavigation:(null_unspecified WKNavigation *)navigation; 和 - (void)webViewWebContentProcessDidTerminate:(WKWebView *)webView API_AVAILABLE(macosx(10.11), ios(9.0)); 前者重定向跳转我们也许会经常遇到,但是一般不怎么去处理其内容,这里就不在介绍了,后者进程终止这个我也不太清楚怎么去触发,也就不再介绍了。 接下来就来看一下各个代理方法的执行顺序(直接跑百度): 2017-03-27 14:16:22.028051 WKWebViewDemo[561:39556] 是否允许这个导航 2017-03-27 14:16:22.028486 WKWebViewDemo[561:39556] 开始加载 2017-03-27 14:16:24.102160 WKWebViewDemo[561:39556] 知道返回内容之后,是否允许加载,允许加载 2017-03-27 14:16:24.106276 WKWebViewDemo[561:39556] 网页开始接收网页内容 2017-03-27 14:16:29.156518 WKWebViewDemo[561:39556] 网页导航加载完毕 2017-03-27 14:16:29.177006 WKWebViewDemo[561:39556] ----document.title:百度一下---webView title:百度一下 这就是顺序了。 忘了还有一个身份验证的: - (void)webView:(WKWebView *)webView didReceiveAuthenticationChallenge:(NSURLAuthenticationChallenge *)challenge completionHandler:(void (^)(NSURLSessionAuthChallengeDisposition disposition, NSURLCredential * _Nullable credential))completionHandler; 具体没做了解,以后如果用到会进一步补充,这里感兴趣的也可以自己看一下。 二.WKUIDelegate 该协议的代理方法的作用是使用原生的用户界面来代表网页。 说白了就是我们去手动写新加载页面的UI、alert框的样式、对话框的样式等等。直接拿下面的例子来看: #pragma mark - WKWebView WKUIDelegate - (nullable WKWebView *)webView:(WKWebView *)webView createWebViewWithConfiguration:(WKWebViewConfiguration *)configuration forNavigationAction:(WKNavigationAction *)navigationAction windowFeatures:(WKWindowFeatures *)windowFeatures { NSLog(@"创建一个新的webView"); if (!navigationAction.targetFrame.isMainFrame) { [webView loadRequest:navigationAction.request]; } return nil; } - (void)webView:(WKWebView *)webView runJavaScriptAlertPanelWithMessage:(NSString *)message initiatedByFrame:(WKFrameInfo *)frame completionHandler:(void (^)(void))completionHandler { UIAlertController *alert = [UIAlertController alertControllerWithTitle:@"alert" message:message preferredStyle:UIAlertControllerStyleAlert]; [alert addAction:[UIAlertAction actionWithTitle:@"确定1" style:UIAlertActionStyleDefault handler:^(UIAlertAction * _Nonnull action) { completionHandler(); }]]; [self presentViewController:alert animated:YES completion:nil]; } - (void)webViewDidClose:(WKWebView *)webView { } - (void)webView:(WKWebView *)webView runJavaScriptConfirmPanelWithMessage:(NSString *)message initiatedByFrame:(WKFrameInfo *)frame completionHandler:(void (^)(BOOL result))completionHandler { completionHandler(YES); } - (void)webView:(WKWebView *)webView runJavaScriptTextInputPanelWithPrompt:(NSString *)prompt defaultText:(nullable NSString *)defaultText initiatedByFrame:(WKFrameInfo *)frame completionHandler:(void (^)(NSString * _Nullable result))completionHandler { completionHandler(@"oc对象"); } - (BOOL)webView:(WKWebView *)webView shouldPreviewElement:(WKPreviewElementInfo *)elementInfo { return YES; } - (void)webView:(WKWebView *)webView commitPreviewingViewController:(UIViewController *)previewingViewController { NSLog(@"Called when the user performs a pop action on the preview."); } 首先来看一下: - (nullable WKWebView *)webView:(WKWebView *)webView createWebViewWithConfiguration:(WKWebViewConfiguration *)configuration forNavigationAction:(WKNavigationAction *)navigationAction windowFeatures:(WKWindowFeatures *)windowFeatures; 在上面也提到了,如果我们新打开了一个tab,就会调用此方法。如果我们打开tab但是没有实现这个方法,那么网页就会取消这个导航,也就是没有做出任何反应。所以使用WKWebView的时候一定要记得对这个方法进行处理,如果没有处理也许就会导致点击网页没有任何反应。此时可以这样处理: - (nullable WKWebView *)webView:(WKWebView *)webView createWebViewWithConfiguration:(WKWebViewConfiguration *)configuration forNavigationAction:(WKNavigationAction *)navigationAction windowFeatures:(WKWindowFeatures *)windowFeatures { NSLog(@"创建一个新的webView"); if (!navigationAction.targetFrame.isMainFrame) { [webView loadRequest:navigationAction.request]; } return nil; } 这样做就是说如果是新打开的网页,那么我们可以直接在当前网页去加载要load的请求,然后返回nil,这样就是在当前的网页去打开新的tab页面了。也可以直接判断targetFrame是否空来进行loadRequest。 当我们的网页中调用alert()方法的时候,我们就要去实现: - (void)webView:(WKWebView *)webView runJavaScriptAlertPanelWithMessage:(NSString *)message initiatedByFrame:(WKFrameInfo *)frame completionHandler:(void (^)(void))completionHandler; 如果我们没有实现这个方法,那么alert是没有办法弹出来的(我这边测试的是弹不出来)。因此我们可以这样实现此代理方法: - (void)webView:(WKWebView *)webView runJavaScriptAlertPanelWithMessage:(NSString *)message initiatedByFrame:(WKFrameInfo *)frame completionHandler:(void (^)(void))completionHandler { UIAlertController *alert = [UIAlertController alertControllerWithTitle:@"alert" message:message preferredStyle:UIAlertControllerStyleAlert]; [alert addAction:[UIAlertAction actionWithTitle:@"确定" style:UIAlertActionStyleDefault handler:^(UIAlertAction * _Nonnull action) { completionHandler(); }]]; [self presentViewController:alert animated:YES completion:nil]; } 我们将alert的UI设置为我们系统的UIAlertController。这里的message就是要alert出来的数据信息。 接下来是: - (void)webView:(WKWebView *)webView runJavaScriptConfirmPanelWithMessage:(NSString *)message initiatedByFrame:(WKFrameInfo *)frame completionHandler:(void (^)(BOOL result))completionHandler { completionHandler(YES); } 此方法的作用是展示一个js确认框。这里的completionHandler的回调是确认框的yes or no。例如一个网页的按钮处理操作如下: // confirm选择框 function firm() { var r=confirm("Press a button") if (r==true) { document.write("You pressed OK!") } else { document.write("You pressed Cancel!") } } 如果我们传入的是YES,那么就会执行“You pressed OK”,否则就是执行“You pressed Cancel”。 接下来是: - (void)webView:(WKWebView *)webView runJavaScriptTextInputPanelWithPrompt:(NSString *)prompt defaultText:(nullable NSString *)defaultText initiatedByFrame:(WKFrameInfo *)frame completionHandler:(void (^)(NSString * _Nullable result))completionHandler; 这里如果我们不去手动实现该方法,那么点击的动作就像我们点击取消,是一样的效果。 例如 在HTML中button的click方法如下: function prom() { var result = prompt("演示一个带输入的对话框", "请输入内容"); if(result) { alert("谢谢使用,你输入的是:" + result) } } 那么这个result就是我们在上面的代理方法里面传入的result。例如: - (void)webView:(WKWebView *)webView runJavaScriptTextInputPanelWithPrompt:(NSString *)prompt defaultText:(nullable NSString *)defaultText initiatedByFrame:(WKFrameInfo *)frame completionHandler:(void (^)(NSString * _Nullable result))completionHandler { completionHandler(@"oc对象"); } 那么他就会弹出:“谢谢使用,你输入的是oc对象”。 其实这里我们可以对上面的三个代理方法进行深度定制UI,那么就能按照我们原生的UI显示出来效果。 当我们设置WKWebView的属性allowsLinkPreview为YES的时候,那么我们就可以进行3D touch预览。默认的值是NO。如果我们设置YES,但是: - (BOOL)webView:(WKWebView *)webView shouldPreviewElement:(WKPreviewElementInfo *)elementInfo { return NO; } 此代理方法中返回NO,那么依然无法展示预览视图,因为该代理方法的作用就是决定是否允许加载预览视图。(safari默认是支持3D touch预览的)。而: - (nullable UIViewController *)webView:(WKWebView *)webView previewingViewControllerForElement:(WKPreviewElementInfo *)elementInfo defaultActions:(NSArray<id <WKPreviewActionItem>> *)previewActions { return nil; } 这个方法就是用于我们自己定义预览界面。另外还有: - (void)webViewDidClose:(WKWebView *)webView API_AVAILABLE(macosx(10.11), ios(9.0)); 和 - (void)webView:(WKWebView *)webView commitPreviewingViewController:(UIViewController *)previewingViewController API_AVAILABLE(ios(10.0)); 前者是DOM window成功关闭的时候调用。后者是当用户在预览中执行弹出操作时调用。 四.总结 简单就对WKWebView的代理介绍这么多,在后面如果有其他需要补充的再补充。

优秀的个人博客,低调大师

Android AsyncTask 源码解析

AsyncTask中的几个方法才能完成对任务的定制。经常需要去重写的方法有以下四个: 1.onPreExecute() 这个方法会在后台任务开始执行之间调用,用于进行一些界面上的初始化操作,比如显示一个进度条对话框等。 2.doInBackground(Params...) 这个方法中的所有代码都会在子线程中运行,我们应该在这里去处理所有的耗时任务。任务一旦完成就可以通过return语句来将任务的执行结果进行返回,如果AsyncTask的第三个泛型参数指定的是Void,就可以不返回任务执行结果。注意,在这个方法中是不可以进行UI操作的,如果需要更新UI元素,比如说反馈当前任务的执行进度,可以调用publishProgress(Progress...)方法来完成。 3.onProgressUpdate(Progress...) 当在后台任务中调

优秀的个人博客,低调大师

docker存储结构解析

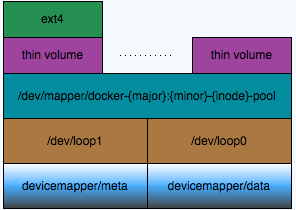
由于aufs并未并入内核,故而目前只有Ubuntu系统上能够使用aufs作为docker的存储引擎,而其他系统上使用lvm thin provisioning(overlayfs是一个和aufs类似的union filesystem,未来有可能进入内核,但目前还没有;Lvm snapshot are useful for doing e.g. backup of a snapshot, but regress badly in performance when you start having many snapshots of the same device.)。为了实现lvm thin provisioning,docker启动时会设置一个100G的sparse文件( /var/lib/docker/devicemapper/devicemapper/data,元数据为/var/lib/docker/devicemapper/devicemapper/metadata),并将其作为devicemapper的存储池,而所有容器都从该存储池中分配默认10G的存储空间使用,如下图所示: 比如创建一个apache容器时devicemapper处理流程如下所示: Create a snapshot of the base device. Mount it and apply the changes in the fedora image. Create a snapshot based on the fedora device. Mount it and apply the changes in the apache image. Create a snapshot based on the apache device. Mount it and use as the root in the new container. thin provisioning管理 使用lvm工具来创建一个thin pool: dd if=/dev/zero of=lvm.img bs=1M count=100 losetup /dev/loop7 lvm.img losetup -a pvcreate /dev/loop7 vgcreate lvm_pool /dev/loop7 # create thin pool lvcreate -L 80M -T lvm_pool/thin_pool # create volume in thin pool lvcreate -T lvm_pool/thin_pool -V 500M -n first_lv docker启动时创建的默认存储池: #dmsetup table docker-253:1-138011042-pool 0 209715200 thin-pool 7:2 7:1 128 32768 1 skip_block_zeroing #209715200*512/1024/1024/1024=100GB 当启动容器后,会从该池中分配10G出来: #dmsetup table docker-253:1-138011042-641cdebd22b55f2656a560cd250e661ab181dcf2f5c5b78dc306df7ce62231f2 0 20971520 thin 253:2 166 # 20971520*512/1024/1024/1024=10GB 该10G存储的分配过程为: dmsetup message /dev/mapper/docker-253:1-138011042-pool 0 "create_thin 166" dmsetup create docker-253:1-138011042-641cdebd22b55f2656a560cd250e661ab181dcf2f5c5b78dc306df7ce62231f3 --table "020971520thin /dev/mapper/docker-253:1-138011042-pool 166" 创建快照: dmsetup suspend /dev/mapper/thin dmsetup message /dev/mapper/yy_thin_pool 0 "create_snap 1 0" dmsetup resume /dev/mapper/thin dmsetup create snap --table "0 40960 thin /dev/mapper/yy_thin_pool 1" docker服务在启动的时候可以配置devicemapper的启动参数,docker -d --storage-opt dm.foo=bar,可选参数有以下几个: dm.basesize 默认为10G,限制容器和镜像的大小 dm.loopdatasize 存储池大小,默认为100G dm.datadev 存储池设备,默认生成一个/var/lib/docker/devicemapper/devicemapper/data文件 dm.loopmetadatasize 元数据大小,默认为2G dm.metadatadev 元数据设备,默认生成一个/var/lib/docker/devicemapper/devicemapper/metadata文件 dm.fs 文件系统,默认ext4 dm.blocksize blocksize默认64K dm.blkdiscard 默认true 最后看看启动一个容器后,该容器的配置是如何组织的。 每个容器创建后都会将其基本配置写入到/var/lib/docker/containers/中: #ls /var/lib/docker/containers/49f19ee979f6bf125c62779dcabf3bdce310b13d22e5c826752db202e509154e -l total 20 -rw------- 1 root root 0 Nov 18 16:31 49f19ee979f6bf125c62779dcabf3bdce310b13d22e5c826752db202e509154e-json.log -rw-r--r-- 1 root root 1741 Nov 18 16:31 config.json -rw-r--r-- 1 root root 368 Nov 18 16:31 hostconfig.json -rw-r--r-- 1 root root 13 Nov 18 16:31 hostname -rw-r--r-- 1 root root 175 Nov 18 16:31 hosts -rw-r--r-- 1 root root 325 Nov 18 16:31 resolv.conf 分配10G空间后会将容器存储配置写入到以下两个文件中: # cd /var/lib/docker #cat ./devicemapper/metadata/49f19ee979f6bf125c62779dcabf3bdce310b13d22e5c826752db202e509154e-init {"device_id":174,"size":10737418240,"transaction_id":731,"initialized":false} #cat ./devicemapper/metadata/49f19ee979f6bf125c62779dcabf3bdce310b13d22e5c826752db202e509154e {"device_id":175,"size":10737418240,"transaction_id":732,"initialized":false} 而容器的rootfs会mount到/var/lib/docker/devicemapper/mnt/container_id下: #mount | grep 49f1 /dev/mapper/docker-253:1-138011042-49f19ee979f6bf125c62779dcabf3bdce310b13d22e5c826752db202e509154e on /var/lib/docker/devicemapper/mnt/49f19ee979f6bf125c62779dcabf3bdce310b13d22e5c826752db202e509154e type ext4 (rw,relatime,discard,stripe=16,data=ordered) 本文转自feisky博客园博客,原文链接:http://www.cnblogs.com/feisky/p/4106212.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

Spark on Yarn 架构解析

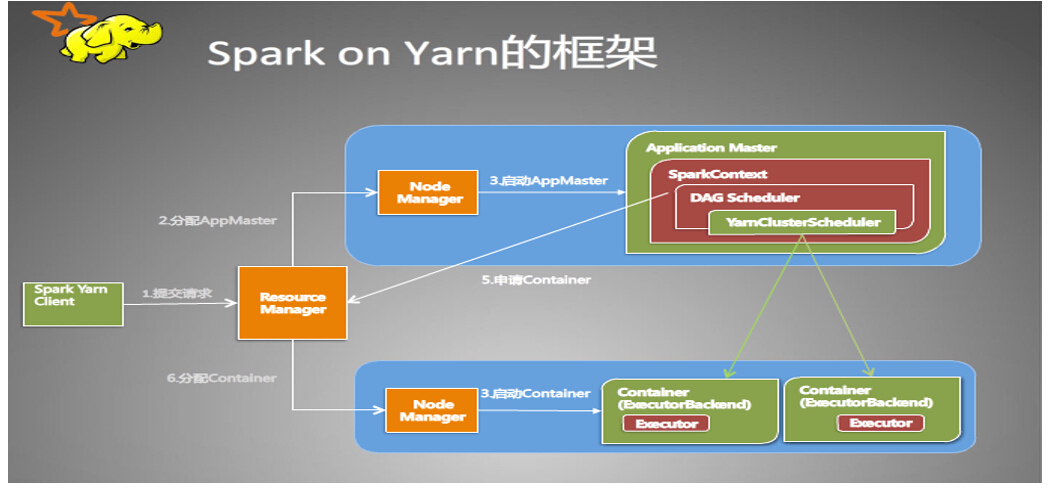
。 一、Hadoop Yarn组件介绍: 我们都知道yarn重构根本的思想,是将原有的JobTracker的两个主要功能资源管理器 和 任务调度监控 分离成单独的组件。新的架构使用全局管理所有应用程序的计算资源分配。 主要包含三个组件ResourceManager 、NodeManager和ApplicationMaster以及一个核心概念Container. 1.ResourceManager(RM) 就是所谓的资源管理器,每个集群一个,实现全局的资源管理和任务调度。它可以处理客户端提交计算作业的请求,启动并监听ApplicationMaster,监控NodeManager,进行资源分配与调度。每一个应用程序需要不同类型的资源,因此就需要不同的容器。这里的资源包括内存、CPU、磁盘、网络等。(比如使用spark-submit 执行程序jar包,就需要向ResourceManager注册,申请相应的容器,资源),其中该ResourceManager提供一个调度策略的插件,负责将集群资源分配给多个队列和应用程序.(可以基于现有的能力调度和公平调度模型) 2.NodeManager(NM) 节点管理器,每个节点一个,实现节点的监控与报告。处理来自ResourceManager的命令,也处理来自ApplicationMaster的命令,同时监控资源可用性,报告错误,管理资源的生命周期。NodeManager是每一台机器框架的代理,是执行应用程序的容器,监控应用程序的资源使用情况(CPU、内存、硬盘、网络)并向调度器汇报。 3.ApplicationMaster(AM) 应用控制器,每个作业或应用一个,实现应用的调度和资源协调。具体来说呢,它进行数据的切分,为应用申请资源并分配给任务,完成任务监控与容错。实际上,每个应用的ApplicationMaster是一个详细的框架库。它结合从ResourceManager获得的资源和NodeManager协同工作来运行和监听任务。ApplicationMaster负责向ResourceManager索要适当的资源容器(containter)来运行任务,跟踪应用程序的状态和监控她们的进程,处理任务的失败原因。 4.Container 容器,封装了及其资源,包括内存、CPU、磁盘、网络等。每个任务会被分配一个容器,该任务只能在该容器中执行,并使用该容器封装的资源。当应用程序发出资源请求时,ResourceManager并不会立刻返回满足要求的资源,需要ApplicationMaster与ResourceManager不断地通信,检测分配到的资源足够,才会进行分配。一旦分配完毕,ApplicationMaster便可从ResourceManager处获取以Container表示的资源。(Container可以看做一个可序列化的Java对象,包含字段信息)一般来说,每个Container可用于执行一个任务。ApplicationMaster在收到一个或多个Container后,再将该Container进一步分配给内部的某个任务,确定该任务后,ApplicationMaster将该任务运行环境(包含运行命令、环境变量、依赖的外部文件等)连同Container中的资源信息封装到ContainerLaunchContext对象中,进而与对应的NodeManager通信,启动该任务。 二、Spark on Yarn 1.当提交一个spark-submit任务时,spark将在startUserClass函数专门启动了一个线程(名称为Driver的线程)来启动用户提交的Application,也就是启动了Driver。在Driver中将会初始化SparkContext。 2.等待SparkContext初始化完成,最多等待spark.yarn.applicationMaster.waitTries次数(默认为10),如果等待了的次数超过了配置的,程序将会退出;否则用SparkContext初始化yarnAllocator. 3.当SparkContext、Driver初始化完成的时候,通过ApplicationMasterClient向ResourceManager注册ApplicationMaster. 4.分配并启动Executeors。在启动Executeors之前,先要通过yarnAllocator获取到numExecutors个Container,然后在Container中启动Executeors。(启动Executeors是通过ExecutorRunnable实现的,而ExecutorRunnable内部是启动CoarseGrainedExecutorBackend的) 5.最后,Task将在CoarseGrainedExecutorBackend里面运行,然后运行状况会通过Akka通知CoarseGrainedScheduler,直到作业运行完成。 Spark on Yarn只需要部署一份spark,当应用程序启动时,spark会将相关的jar包上传注册给ResoureManager,任务的执行由ResourceManager来调度,并执行spark的代码。

优秀的个人博客,低调大师

Flink 源码解析 —— 深度解析 Flink 是如何管理好内存的?

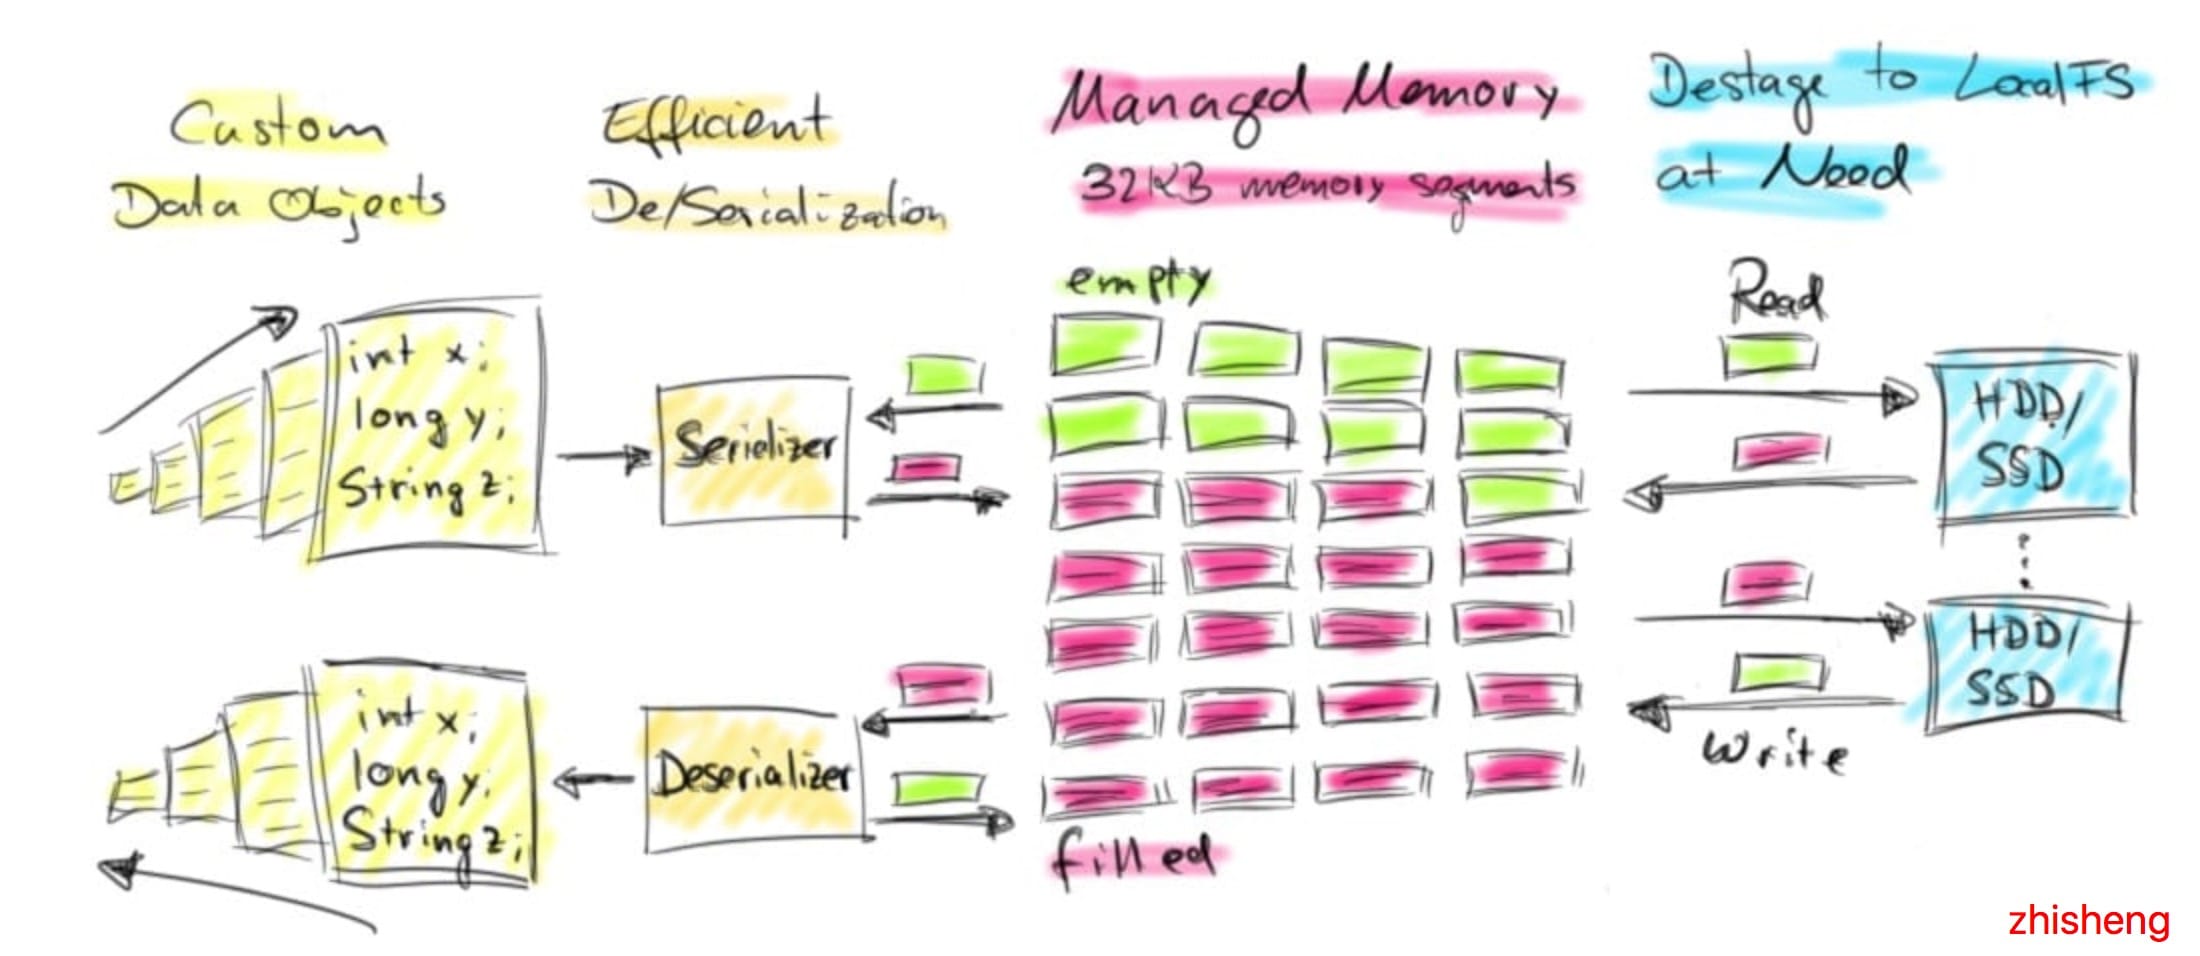
前言如今,许多用于分析大型数据集的开源系统都是用 Java 或者是基于 JVM 的编程语言实现的。最着名的例子是 Apache Hadoop,还有较新的框架,如 Apache Spark、Apache Drill、Apache Flink。基于 JVM 的数据分析引擎面临的一个常见挑战就是如何在内存中存储大量的数据(包括缓存和高效处理)。合理的管理好 JVM 内存可以将 难以配置且不可预测的系统 与 少量配置且稳定运行的系统区分开来。在这篇文章中,我们将讨论 Apache Flink 如何管理内存,讨论其自定义序列化与反序列化机制,以及它是如何操作二进制数据的。数据对象直接放在堆内存中在 JVM 中处理大量数据最直接的方式就是将这些数据做为对象存储在堆内存中,然后直接在内存中操作这些数据,如果想进行排序则就是对对象列表进行排序。然而这种方法有一些明显的缺点,首先,在频繁的创建和销毁大量对象的时候,监视和控制堆内存的使用并不是一件很简单的事情。如果对象分配过多的话,那么会导致内存过度使用,从而触发 OutOfMemoryError,导致 JVM 进程直接被杀死。 另一个方面就是因为这些对象大都是生存在新生代,当 JVM 进行垃圾回收时,垃圾收集的开销很容易达到 50% 甚至更多。最后就是 Java 对象具有一定的空间开销(具体取决于 JVM 和平台)。对于具有许多小对象的数据集,这可以显著减少有效可用的内存量。如果你精通系统设计和系统调优,你可以根据系统进行特定的参数调整,可以或多或少的控制出现 OutOfMemoryError 的次数和避免堆内存的过多使用,但是这种设置和调优的作用有限,尤其是在数据量较大和执行环境发生变化的情况下。Flink 是怎么做的?Apache Flink 起源于一个研究项目,该项目旨在结合基于 MapReduce 的系统和并行数据库系统的最佳技术。在此背景下,Flink 一直有自己的内存数据处理方法。Flink 将对象序列化为固定数量的预先分配的内存段,而不是直接把对象放在堆内存上。它的 DBMS 风格的排序和连接算法尽可能多地对这个二进制数据进行操作,以此将序列化和反序列化开销降到最低。如果需要处理的数据多于可以保存在内存中的数据,Flink 的运算符会将部分数据溢出到磁盘。事实上,很多Flink 的内部实现看起来更像是 C / C ++,而不是普通的 Java。下图概述了 Flink 如何在内存段中存储序列化数据并在必要时溢出到磁盘: Flink 的主动内存管理和操作二进制数据有几个好处:1、内存安全执行和高效的核外算法 由于分配的内存段的数量是固定的,因此监控剩余的内存资源是非常简单的。在内存不足的情况下,处理操作符可以有效地将更大批的内存段写入磁盘,后面再将它们读回到内存。因此,OutOfMemoryError 就有效的防止了。2、减少垃圾收集压力 因为所有长生命周期的数据都是在 Flink 的管理内存中以二进制表示的,所以所有数据对象都是短暂的,甚至是可变的,并且可以重用。短生命周期的对象可以更有效地进行垃圾收集,这大大降低了垃圾收集的压力。现在,预先分配的内存段是 JVM 堆上的长期存在的对象,为了降低垃圾收集的压力,Flink 社区正在积极地将其分配到堆外内存。这种努力将使得 JVM 堆变得更小,垃圾收集所消耗的时间将更少。3、节省空间的数据存储 Java 对象具有存储开销,如果数据以二进制的形式存储,则可以避免这种开销。4、高效的二进制操作和缓存敏感性 在给定合适的二进制表示的情况下,可以有效地比较和操作二进制数据。此外,二进制表示可以将相关值、哈希码、键和指针等相邻地存储在内存中。这使得数据结构通常具有更高效的缓存访问模式。主动内存管理的这些特性在用于大规模数据分析的数据处理系统中是非常可取的,但是要实现这些功能的代价也是高昂的。要实现对二进制数据的自动内存管理和操作并非易事,使用 java.util.HashMap 比实现一个可溢出的 hash-table (由字节数组和自定义序列化支持)。当然,Apache Flink 并不是唯一一个基于 JVM 且对二进制数据进行操作的数据处理系统。例如 Apache Drill、Apache Ignite、Apache Geode 也有应用类似技术,最近 Apache Spark 也宣布将向这个方向演进。下面我们将详细讨论 Flink 如何分配内存、如果对对象进行序列化和反序列化以及如果对二进制数据进行操作。我们还将通过一些性能表现数据来比较处理堆内存上的对象和对二进制数据的操作。Flink 如何分配内存?Flink TaskManager 是由几个内部组件组成的:actor 系统(负责与 Flink master 协调)、IOManager(负责将数据溢出到磁盘并将其读取回来)、MemoryManager(负责协调内存使用)。在本篇文章中,我们主要讲解 MemoryManager。MemoryManager 负责将 MemorySegments 分配、计算和分发给数据处理操作符,例如 sort 和 join 等操作符。MemorySegment 是 Flink 的内存分配单元,由常规 Java 字节数组支持(默认大小为 32 KB)。MemorySegment 通过使用 Java 的 unsafe 方法对其支持的字节数组提供非常有效的读写访问。你可以将 MemorySegment 看作是 Java 的 NIO ByteBuffer 的定制版本。为了在更大的连续内存块上操作多个 MemorySegment,Flink 使用了实现 Java 的 java.io.DataOutput 和 java.io.DataInput 接口的逻辑视图。MemorySegments 在 TaskManager 启动时分配一次,并在 TaskManager 关闭时销毁。因此,在 TaskManager 的整个生命周期中,MemorySegment 是重用的,而不会被垃圾收集的。在初始化 TaskManager 的所有内部数据结构并且已启动所有核心服务之后,MemoryManager 开始创建 MemorySegments。默认情况下,服务初始化后,70% 可用的 JVM 堆内存由 MemoryManager 分配(也可以配置全部)。剩余的 JVM 堆内存用于在任务处理期间实例化的对象,包括由用户定义的函数创建的对象。下图显示了启动后 TaskManager JVM 中的内存分布: Flink 如何序列化对象? Java 生态系统提供了几个库,可以将对象转换为二进制表示形式并返回。常见的替代方案是标准 Java 序列化,Kryo,Apache Avro,Apache Thrift 或 Google 的 Protobuf。Flink 包含自己的自定义序列化框架,以便控制数据的二进制表示。这一点很重要,因为对二进制数据进行操作需要对序列化布局有准确的了解。此外,根据在二进制数据上执行的操作配置序列化布局可以显著提升性能。Flink 的序列化机制利用了这一特性,即在执行程序之前,要序列化和反序列化的对象的类型是完全已知的。Flink 程序可以处理表示为任意 Java 或 Scala 对象的数据。在优化程序之前,需要识别程序数据流的每个处理步骤中的数据类型。对于 Java 程序,Flink 提供了一个基于反射的类型提取组件,用于分析用户定义函数的返回类型。Scala 程序可以在 Scala 编译器的帮助下进行分析。Flink 使用 TypeInformation 表示每种数据类型。 Flink 有如下几种数据类型的 TypeInformations:BasicTypeInfo:所有 Java 的基础类型或 java.lang.StringBasicArrayTypeInfo:Java 基本类型构成的数组或 java.lang.StringWritableTypeInfo:Hadoop 的 Writable 接口的任何实现TupleTypeInfo:任何 Flink tuple(Tuple1 到 Tuple25)。Flink tuples 是具有类型化字段的固定长度元组的 Java 表示CaseClassTypeInfo:任何 Scala CaseClass(包括 Scala tuples)PojoTypeInfo:任何 POJO(Java 或 Scala),即所有字段都是 public 的或通过 getter 和 setter 访问的对象,遵循通用命名约定GenericTypeInfo:不能标识为其他类型的任何数据类型 每个 TypeInformation 都为它所代表的数据类型提供了一个序列化器。例如,BasicTypeInfo 返回一个序列化器,该序列化器写入相应的基本类型;WritableTypeInfo 的序列化器将序列化和反序列化委托给实现 Hadoop 的 Writable 接口的对象的 write() 和 readFields() 方法;GenericTypeInfo 返回一个序列化器,该序列化器将序列化委托给 Kryo。对象将自动通过 Java 中高效的 Unsafe 方法来序列化到 Flink MemorySegments 支持的 DataOutput。对于可用作键的数据类型,例如哈希值,TypeInformation 提供了 TypeComparators,TypeComparators 比较和哈希对象,并且可以根据具体的数据类型有效的比较二进制并提取固定长度的二进制 key 前缀。Tuple,Pojo 和 CaseClass 类型是复合类型,它们可能嵌套一个或者多个数据类型。因此,它们的序列化和比较也都比较复杂,一般将其成员数据类型的序列化和比较都交给各自的 Serializers(序列化器) 和 Comparators(比较器)。下图说明了 Tuple3<Integer, Double, Person>对象的序列化,其中Person 是 POJO 并定义如下: public class Person { public int id; public String name;} 通过提供定制的 TypeInformations、Serializers(序列化器) 和 Comparators(比较器),可以方便地扩展 Flink 的类型系统,从而提高序列化和比较自定义数据类型的性能。Flink 如何对二进制数据进行操作?与其他的数据处理框架的 API(包括 SQL)类似,Flink 的 API 也提供了对数据集进行分组、排序和连接等转换操作。这些转换操作的数据集可能非常大。关系数据库系统具有非常高效的算法,比如 merge-sort、merge-join 和 hash-join。Flink 建立在这种技术的基础上,但是主要分为使用自定义序列化和自定义比较器来处理任意对象。在下面文章中我们将通过 Flink 的内存排序算法示例演示 Flink 如何使用二进制数据进行操作。Flink 为其数据处理操作符预先分配内存,初始化时,排序算法从 MemoryManager 请求内存预算,并接收一组相应的 MemorySegments。这些 MemorySegments 变成了缓冲区的内存池,缓冲区中收集要排序的数据。下图说明了如何将数据对象序列化到排序缓冲区中: 排序缓冲区在内部分为两个内存区域:第一个区域保存所有对象的完整二进制数据,第二个区域包含指向完整二进制对象数据的指针(取决于 key 的数据类型)。将对象添加到排序缓冲区时,它的二进制数据会追加到第一个区域,指针(可能还有一个 key)被追加到第二个区域。分离实际数据和指针以及固定长度的 key 有两个目的:它可以有效的交换固定长度的 entries(key 和指针),还可以减少排序时需要移动的数据。如果排序的 key 是可变长度的数据类型(比如 String),则固定长度的排序 key 必须是前缀 key,比如字符串的前 n 个字符。 请注意:并非所有数据类型都提供固定长度的前缀排序 key。将对象序列化到排序缓冲区时,两个内存区域都使用内存池中的 MemorySegments 进行扩展。一旦内存池为空且不能再添加对象时,则排序缓冲区将会被完全填充并可以进行排序。Flink 的排序缓冲区提供了比较和交换元素的方法,这使得实际的排序算法是可插拔的。默认情况下, Flink 使用了 Quicksort(快速排序)实现,可以使用 HeapSort(堆排序)。下图显示了如何比较两个对象: 排序缓冲区通过比较它们的二进制固定长度排序 key 来比较两个元素。如果元素的完整 key(不是前缀 key) 或者二进制前缀 key 不相等,则代表比较成功。如果前缀 key 相等(或者排序 key 的数据类型不提供二进制前缀 key),则排序缓冲区遵循指向实际对象数据的指针,对两个对象进行反序列化并比较对象。根据比较结果,排序算法决定是否交换比较的元素。排序缓冲区通过移动其固定长度 key 和指针来交换两个元素,实际数据不会移动,排序算法完成后,排序缓冲区中的指针被正确排序。下图演示了如何从排序缓冲区返回已排序的数据: 通过顺序读取排序缓冲区的指针区域,跳过排序 key 并按照实际数据的排序指针返回排序数据。此数据要么反序列化并作为对象返回,要么在外部合并排序的情况下复制二进制数据并将其写入磁盘。基准测试数据那么,对二进制数据进行操作对性能意味着什么?我们将运行一个基准测试,对 1000 万个Tuple2<Integer, String>对象进行排序以找出答案。整数字段的值从均匀分布中采样。String 字段值的长度为 12 个字符,并从长尾分布中进行采样。输入数据由返回可变对象的迭代器提供,即返回具有不同字段值的相同 Tuple 对象实例。Flink 在从内存,网络或磁盘读取数据时使用此技术,以避免不必要的对象实例化。基准测试在具有 900 MB 堆大小的 JVM 中运行,在堆上存储和排序 1000 万个 Tuple 对象并且不会导致触发 OutOfMemoryError 大约需要这么大的内存。我们使用三种排序方法在Integer 字段和 String 字段上对 Tuple 对象进行排序:1、对象存在堆中:Tuple 对象存储在常用的 java.util.ArrayList 中,初始容量设置为 1000 万,并使用 Java 中常用的集合排序进行排序。2、Flink 序列化:使用 Flink 的自定义序列化程序将 Tuple 字段序列化为 600 MB 大小的排序缓冲区,如上所述排序,最后再次反序列化。在 Integer 字段上进行排序时,完整的 Integer 用作排序 key,以便排序完全发生在二进制数据上(不需要对象的反序列化)。对于 String 字段的排序,使用 8 字节前缀 key,如果前缀 key 相等,则对 Tuple 对象进行反序列化。 3、Kryo 序列化:使用 Kryo 序列化将 Tuple 字段序列化为 600 MB 大小的排序缓冲区,并在没有二进制排序 key 的情况下进行排序。这意味着每次比较需要对两个对象进行反序列化。所有排序方法都使用单线程实现。结果的时间是十次运行结果的平均值。在每次运行之后,我们调用System.gc()请求垃圾收集运行,该运行不会进入测量的执行时间。下图显示了将输入数据存储在内存中,对其进行排序并将其作为对象读回的时间。 我们看到 Flink 使用自己的序列化器对二进制数据进行排序明显优于其他两种方法。与存储在堆内存上相比,我们看到将数据加载到内存中要快得多。因为我们实际上是在收集对象,没有机会重用对象实例,但必须重新创建每个 Tuple。这比 Flink 的序列化器(或Kryo序列化)效率低。另一方面,与反序列化相比,从堆中读取对象是无性能消耗的。在我们的基准测试中,对象克隆比序列化和反序列化组合更耗性能。 查看排序时间,我们看到对二进制数据的排序也比 Java 的集合排序更快。使用没有二进制排序 key 的 Kryo 序列化的数据排序比其他方法慢得多。这是因为反序列化带来很大的开销。在String 字段上对 Tuple 进行排序比在 Integer 字段上排序更快,因为长尾值分布显着减少了成对比较的数量。为了更好地了解排序过程中发生的状况,我们使用 VisualVM 监控执行的 JVM。以下截图显示了执行 10次 运行时的堆内存使用情况、垃圾收集情况和 CPU 使用情况。 测试是在 8 核机器上运行单线程,因此一个核心的完全利用仅对应 12.5% 的总体利用率。截图显示,对二进制数据进行操作可显著减少垃圾回收活动。对于对象存在堆中,垃圾收集器在排序缓冲区被填满时以非常短的时间间隔运行,并且即使对于单个处理线程也会导致大量 CPU 使用(排序本身不会触发垃圾收集器)。 JVM 垃圾收集多个并行线程,解释了高CPU 总体利用率。另一方面,对序列化数据进行操作的方法很少触发垃圾收集器并且 CPU 利用率低得多。实际上,如果使用 Flink 序列化的方式在 Integer 字段上对 Tuple 进行排序,则垃圾收集器根本不运行,因为对于成对比较,不需要反序列化任何对象。Kryo 序列化需要比较多的垃圾收集,因为它不使用二进制排序 key 并且每次排序都要反序列化两个对象。内存使用情况上图显示 Flink 序列化和 Kryo 序列化不断的占用大量内存存使用情况图表显示flink-serialized和kryo-serialized不断占用大量内存。这是由于 MemorySegments 的预分配。实际内存使用率要低得多,因为排序缓冲区并未完全填充。下表显示了每种方法的内存消耗。1000 万条数据产生大约 280 MB 的二进制数据(对象数据、指针和排序 key),具体取决于使用的序列化程序以及二进制排序 key 的存在和大小。将其与数据存储在堆上的方法进行比较,我们发现对二进制数据进行操作可以显著提高内存效率。在我们的基准测试中,如果序列化为排序缓冲区而不是将其作为堆上的对象保存,则可以在内存中对两倍以上的数据进行排序。 总而言之,测试验证了文章前面说的对二进制数据进行操作的好处。展望未来Apache Flink 具有相当多的高级技术,可以通过有限的内存资源安全有效地处理大量数据。但是有几点可以使 Flink 更有效率。Flink 社区正在努力将管理内存移动到堆外内存。这将允许更小的 JVM,更低的垃圾收集开销,以及更容易的系统配置。使用 Flink 的 Table API,所有操作(如 aggregation 和 projection)的语义都是已知的(与黑盒用户定义的函数相反)。因此,我们可以为直接对二进制数据进行操作的 Table API 操作生成代码。进一步的改进包括序列化设计,这些设计针对应用于二进制数据的操作和针对序列化器和比较器的代码生成而定制。总结Flink 的主动内存管理减少了因触发 OutOfMemoryErrors 而杀死 JVM 进程和垃圾收集开销的问题。Flink 具有高效的数据序列化和反序列化机制,有助于对二进制数据进行操作,并使更多数据适合内存。Flink 的 DBMS 风格的运算符本身在二进制数据上运行,在必要时可以在内存中高性能地传输到磁盘。本文地址: http://www.54tianzhisheng.cn/2019/03/24/Flink-code-memory-management/

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册