首页 文章 精选 留言 我的

精选列表

搜索[bat],共2195篇文章
优秀的个人博客,低调大师

Taro 3.0.0 RC6 发布,BAT 小程序、H5 与 RN 端统一框架

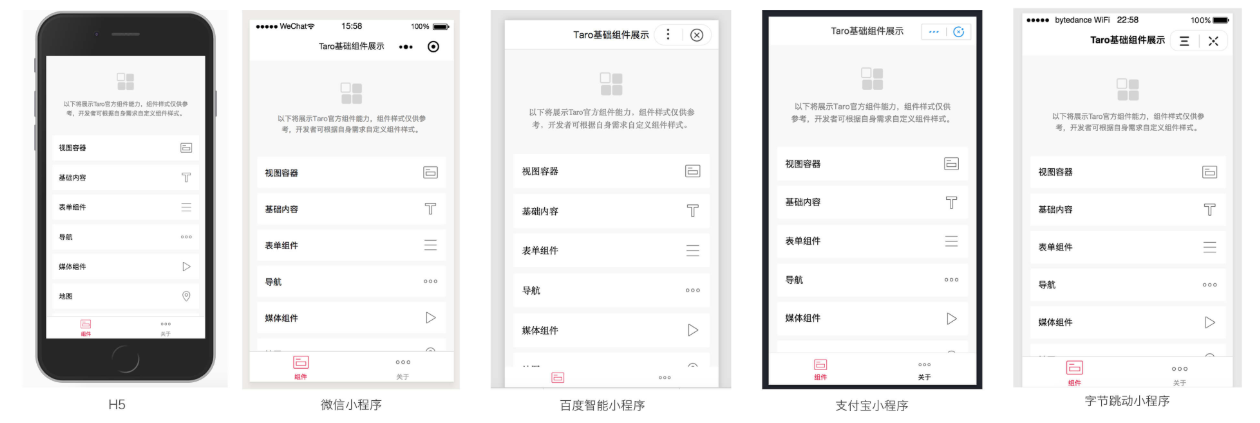
Taro 发布了 3.0.0 RC6 版本。Taro 是一套遵循 React 语法规范的多端统一开发框架,支持用 React 的方式编写一次代码,生成能运行在微信小程序/百度智能小程序/支付宝小程序、H5 与 React Native 等端的应用。 此版本更新内容如下: 修复 @tarojs/taro未导出getCurrentInstance,by@vdfor 虚拟列表 scrollTo 方法无效,close#6751 无法使用 require.context,fix#6720 H5 路由无法跳转参数不同的同一页面, close#6612 navigateBack API支持配置 delta,close#6740 小程序 自定义 tabbar key 报错, close#6297 input 组件光标位置初次聚焦在最左边,#6632 QQ 小程序bindLongTab事件不存在,by@disflyer 类型 修复false拼写错误, by@kokororin 自定义 Hooks 不准确,by@fjc0k CLI 修复 sass 配置校验,close#6745 重构 开发模式现在也会打开tree-shaking, close#6705 nextTick 函数一定会在 onReady 之后运行 , close#6501 更新说明: https://github.com/NervJS/taro/releases/tag/v3.0.0-rc.6

优秀的个人博客,低调大师

Taro 3.0.0-rc.3 发布,BAT 小程序、H5 与 RN 端统一框架

Taro 3.0.0-rc.3现已发布。Taro 是一套遵循 React 语法规范的多端统一开发框架,支持用 React 的方式编写一次代码,生成能运行在微信小程序/百度智能小程序/支付宝小程序、H5 与 React Native 等端的应用。 此版本更新内容如下: 修复 修复 vue 虚拟列表 this 指向不正确的问题,fix#6467 修复选择模板逻辑,fix#6457 修复 html 解析 className 不正确的问题 修复 taro doctor 命令 更新说明:https://github.com/NervJS/taro/releases/tag/v3.0.0-rc.3

优秀的个人博客,低调大师

Taro 2.0.0-beta.13 发布,BAT 小程序、H5 与 RN 端统一框架

Taro 2.0.0-beta.13发布了。Taro 是一套遵循 React 语法规范的多端统一开发框架,支持用 React 的方式编写一次代码,生成能运行在微信小程序/百度智能小程序/支付宝小程序、H5 与 React Native 等端的应用。 此版本更新内容包括: Features taro-runner-utils:添加单元测试和优化注释 (97a1642) webpack-runner 和 mini-runner 代码优化 (d799097) cli:cli 支持事件 && 小程序编译配置向 H5 看齐 (13ab8b0) cli:借助 tapable 改造 (b77f00a) cli:增加 tapable 包 (413f9f7) cli:将 app/页面/组件 添加到入口文件进行编译 (97cc0e1) cli:尝试接入 webpack 来编译各端小程序 (338650a) cli:拆分逻辑到 loader (e5a9fca) cli:调整文件编译 (f209936) components-qa:增强快应用button组件,增加属性判断及点击变色等 (#4882) (83322ec) docs:更新 2.0 版本使用 async-await 的文档#4837(6ccfe83) mini-runner:优化 watch (07134d7) mini-runner:保证快应用文件生成正确 (236ebaa) mini-runner:加入 watch (678ddd4) mini-runner:增加 Taro 模块专有处理插件 (2ea3205) mini-runner:支持与原生小程序代码混写 (56369d4) mini-runner:支持分包 (6abb72b) mini-runner:支持编译 tabBar 上引用的资源编译 (43a129a) mini-runner:生成快应用页面及组件 (4fd3152) taro:cli 配合 mini-runner 重构 && 支持使用 mini-runner 编译插件 (f80016f) taro-cli:配置文件分开存放,优化 taro config 输出 (860c3b9) taro-runner-utils:添加@tarojs/runner-utils 包 (201a991) audio context (2796e46) mock for quickapp (a26c41a) stop trans asset for quickapp (dbc27c5) taro:加入快应用编译支持 (0d7e5c8) taro:调整小程序和 H5 的编译配置 (0b47af5) taro-cli:调整 rn 编译配置 (8578d17) taro-mini-runner:优化文件生成 (65c699d) taro-mini-runner:如果是组件需要补充 component:true 配置 (302e878) taro-mini-runner:引入拆分的公共 chunks (1041ffe) taro-mini-runner:拆分文件编译成为 plugin (8eb3d43) taro-mini-runner:生成多端类型文件 (9029d25) taro-mini-runner:生成页面以及组件的 usingComponents 配置 (15dede3) checkout from auto-docs (b0ec706) 此外还有大量 bug 修复,详情查看更新日志: https://github.com/NervJS/taro/blob/2.x/CHANGELOG.md

优秀的个人博客,低调大师

如果你不了解Java的JVM,那真的很难进BAT一线大厂!

前言 对于开发人员来说,如果不了解Java的JVM,那真的是很难写得一手好代码,很难查得一手好bug。同时,JVM也是面试环节的中重灾区。我们不能为了面试而面试,但是学习会这些核心知识你必定会成为面试与工作中“最亮的一颗星”。 思考一下 学习一项知识总该知道为什么学习吧。有人会说,这些写代码好像又用不上,貌似所有的事情JVM都替我们做好了。那就,思考一下为什么要学习JVM虚拟机结构。那你是否遇到这样的困惑:堆内存该设置多大?OutOfMemoryError异常到底是怎么引起的?如何进行JVM调优?JVM的垃圾回收是如何?甚至创建一个String对象,JVM都做了些什么?这些疑问随着学习的深入都会慢慢得到解答,而要解决这些问题的第一步,就是先了解JVM的构成。 JVM内存结构 java虚拟机在执行程序的过程中会将内存划分为不同的数据区域,看一下下图。 如果理解了上图,JVM的内存结构基本上掌握了一半。通过上图我们可以看到什么?外行看热闹,内行看门道。从图中可以得到如下信息。第一,JVM分为五个区域:虚拟机栈、本地方法栈、方法区、堆、程序计数器。PS:大家不要排斥英语,此处用英文记忆反而更容易理解。第二,JVM五个区中虚拟机栈、本地方法栈、程序计数器为线程私有,方法区和堆为线程共享区。图中已经用颜色区分,绿色表示“通行”,橘黄色表示停一停(需等待)。第三,JVM不同区域的占用内存大小不同,一般情况下堆最大,程序计数器较小。那么最大的区域会放什么?当然就是Java中最多的“对象”了。学习延伸:如果你记住了这张图,是不是就可以说出关于JVM的内存结构了呢?可以尝试一下,切记不用死记硬背,发挥你的想象。 堆(Heap) 上面已经得出结论,堆内存最大,堆是被线程共享,堆的目的就是存放对象。几乎所有的对象实例都在此分配。当然,随着优化技术的更新,某些数据也会被放在栈上等。枪打出头鸟,树大招风。因为堆占用内存空间最大,堆也是Java垃圾回收的主要区域(重点对象),因此也称作“GC堆”(Garbage Collected Heap)。关于GC的操作,我们后面章节会详细讲,但正因为GC的存在,而现代收集器基本都采用分代收集算法,堆又被细化了。 同样,对上图呈现内容汇总分析。第一,堆的GC操作采用分代收集算法。第二,堆区分了新生代和老年代;第三,新生代又分为:Eden空间、From Survivor(S0)空间、To Survivor(S1)空间。欢迎大家关注我的公种浩【程序员追风】,文章都会在里面更新,整理的资料也会放在里面。Java虚拟机规范规定,Java堆可以处于物理上不连续的内存空间中,只要逻辑上是连续的即可。也就是说堆的内存是一块块拼凑起来的。要增加堆空间时,往上“拼凑”(可扩展性)即可,但当堆中没有内存完成实例分配,并且堆也无法再扩展时,将会抛出OutOfMemoryError异常。 方法区(Method Area) 方法区与堆有很多共性:线程共享、内存不连续、可扩展、可垃圾回收,同样当无法再扩展时会抛出OutOfMemoryError异常。正因为如此相像,Java虚拟机规范把方法区描述为堆的一个逻辑部分,但目前实际上是与Java堆分开的(Non-Heap)。方法区个性化的是,它存储的是已被虚拟机加载的类信息、常量、静态变量、即时编译器编译后的代码等数据。方法区的内存回收目标主要是针对常量池的回收和对类型的卸载,一般来说这个区域的回收“成绩”比较难以令人满意,尤其是类型的卸载,条件相当苛刻,但是回收确实是有必要的。 程序计数器(Program Counter Register) 关于程序计数器我们已经得知:占用内存较小,现成私有。它是唯一没有OutOfMemoryError异常的区域。程序计数器的作用可以看做是当前线程所执行的字节码的行号指示器,字节码解释器工作时就是通过改变计数器的值来选取下一条字节码指令。其中,分支、循环、跳转、异常处理、线程恢复等基础功能都需要依赖计数器来完成。 Java虚拟机的多线程是通过线程轮流切换并分配处理器执行时间的方式来实现的,在任何一个确定的时刻,一个处理器(对于多核处理器来说是一个内核)只会执行一条线程中的指令。 因此,为了线程切换后能恢复到正确的执行位置,每条线程都需要有一个独立的程序计数器,各条线程之间的计数器互不影响,独立存储,我们称这类内存区域为“线程私有”的内存。如果线程正在执行的是一个Java方法,这个计数器记录的是正在执行的虚拟机字节码指令的地址;如果正在执行的是Natvie方法,这个计数器值则为空(Undefined)。 虚拟机栈(JVM Stacks) 虚拟机栈线程私有,生命周期与线程相同。栈帧(Stack Frame)是用于支持虚拟机进行方法调用和方法执行的数据结构。栈帧存储了方法的局部变量表、操作数栈、动态连接和方法返回地址等信息。每一个方法从调用至执行完成的过程,都对应着一个栈帧在虚拟机栈里从入栈到出栈的过程。 局部变量表(Local Variable Table)是一组变量值存储空间,用于存放方法参数和方法内定义的局部变量。包括8种基本数据类型、对象引用(reference类型)和returnAddress类型(指向一条字节码指令的地址)。其中64位长度的long和double类型的数据会占用2个局部变量空间(Slot),其余的数据类型只占用1个。如果线程请求的栈深度大于虚拟机所允许的深度,将抛出StackOverflowError异常;如果虚拟机栈动态扩展时无法申请到足够的内存时会抛出OutOfMemoryError异常。操作数栈(Operand Stack)也称作操作栈,是一个后入先出栈(LIFO)。随着方法执行和字节码指令的执行,会从局部变量表或对象实例的字段中复制常量或变量写入到操作数栈,再随着计算的进行将栈中元素出栈到局部变量表或者返回给方法调用者,也就是出栈/入栈操作。动态链接:Java虚拟机栈中,每个栈帧都包含一个指向运行时常量池中该栈所属方法的符号引用,持有这个引用的目的是为了支持方法调用过程中的动态链接(Dynamic Linking)。方法返回:无论方法是否正常完成,都需要返回到方法被调用的位置,程序才能继续进行。 本地方法栈(Native Method Stacks) 本地方法栈(Native Method Stacks)与虚拟机栈作用相似,也会抛出StackOverflowError和OutOfMemoryError异常。欢迎大家关注我的公种浩【程序员追风】,文章都会在里面更新,整理的资料也会放在里面。区别在于虚拟机栈为虚拟机执行Java方法(字节码)服务,而本地方法栈是为虚拟机使用到的Native方法服务。 总结 经过上面的讲解,想必大家已经了解到JVM内存结构的基本情况。下面对照脑图,归纳总结一下,看你能说出来多少。 最后欢迎大家一起交流,喜欢文章记得点个赞哟,感谢支持!

优秀的个人博客,低调大师

20道BAT面试官最喜欢问的JVM+MySQL面试题(含答案解析)

1. 内存模型以及分区,需要详细到每个区放什么。JVM 分为堆区和栈区,还有方法区,初始化的对象放在堆里面,引用放在栈里面,class 类信息常量池(static 常量和 static 变量)等放在方法区new: 方法区:主要是存储类信息,常量池(static 常量和 static 变量),编译后的代码(字节码)等数据 堆:初始化的对象,成员变量 (那种非 static 的变量),所有的对象实例和数组都要在堆上分配 栈:栈的结构是栈帧组成的,调用一个方法就压入一帧,帧上面存储局部变量表,操作数栈,方法出口等信息,局部变量表存放的是 8 大基础类型加上一个应用类型,所以还是一个指向地址的指针 本地方法栈:主要为 Native 方法服务 程序计数器:记录当前线程执行的行号 2. 堆里面的分区:Eden,survival (from+ to),老年代,各自的特点。堆里面分为新生代和老生代(java8 取消了永久代,采用了 Metaspace),新生代包含 Eden+Survivor 区,survivor 区里面分为 from 和 to 区,内存回收时,如果用的是复制算法,从 from 复制到 to,当经过一次或者多次 GC 之后,存活下来的对象会被移动到老年区,当 JVM 内存不够用的时候,会触发 Full GC,清理 JVM 老年区当新生区满了之后会触发 YGC,先把存活的对象放到其中一个 Survice区,然后进行垃圾清理。因为如果仅仅清理需要删除的对象,这样会导致内存碎片,因此一般会把 Eden 进行完全的清理,然后整理内存。那么下次 GC 的时候,就会使用下一个 Survive,这样循环使用。如果有特别大的对象,新生代放不下,就会使用老年代的担保,直接放到老年代里面。因为 JVM 认为,一般大对象的存活时间一般比较久远。 3. 对象创建方法,对象的内存分配,对象的访问定位。new 一个对象 4. GC 的两种判定方法:引用计数法:指的是如果某个地方引用了这个对象就+1,如果失效了就-1,当为 0 就会回收但是 JVM 没有用这种方式,因为无法判定相互循环引用(A 引用 B,B 引用 A)的情况引用链法: 通过一种 GC ROOT 的对象(方法区中静态变量引用的对象等-static 变量)来判断,如果有一条链能够到达 GC ROOT 就说明,不能到达 GC ROOT 就说明可以回收 5. SafePoint 是什么比如 GC 的时候必须要等到 Java 线程都进入到 safepoint 的时候 VMThread 才能开始执行 GC, 循环的末尾 (防止大循环的时候一直不进入 safepoint,而其他线程在等待它进入safepoint) 方法返回前 调用方法的 call 之后 抛出异常的位置 **6. GC 的三种收集方法:标记清除、标记整理、复制算法的原理与特点,分别用在什么地方,如果让你优化收集方法,有什么思路?**先标记,标记完毕之后再清除,效率不高,会产生碎片复制算法:分为 8:1 的 Eden 区和 survivor 区,就是上面谈到的 YGC标记整理:标记完毕之后,让所有存活的对象向一端移动 7. GC 收集器有哪些?CMS 收集器与 G1 收集器的特点。并行收集器:串行收集器使用一个单独的线程进行收集,GC 时服务有停顿时间串行收集器:次要回收中使用多线程来执行CMS 收集器是基于“ 标记— 清除”算法实现的,经过多次标记才会被清除G1 从 整体来看是基于“ 标记— 整理”算法实现的收集器,从 局部(两个 Region 之间)上来看是基于“ 复制”算法实现的 8. Minor GC 与 Full GC 分别在什么时候发生?新生代内存不够用时候发生 MGC 也叫 YGC,JVM 内存不够的时候发生 FGC 9. 几种常用的内存调试工具:jmap、jstack、jconsole、jhatjstack 可以看当前栈的情况,jmap 查看内存,jhat 进行 dump 堆的信息mat(eclipse 的也要了解一下) 10. 类加载的几个过程:加载、验证、准备、解析、初始化。然后是使用和卸载了通过全限定名来加载生成 class 对象到内存中,然后进行验证这个 class 文件,包括文件格式校验、元数据验证,字节码校验等。准备是对这个对象分配内存。解析是将符号引用转化为直接引用(指针引用),初始化就是开始执行构造器的代码 1. 数据库三范式是什么? 第一范式(1NF):字段具有原子性,不可再分。(所有关系型数据库系统都满足第一范式数据库表中的字段都是单一属性的,不可再分) 第二范式(2NF)是在第一范式(1NF)的基础上建立起来的,即满足第二范式(2NF)必须先满足第一范式(1NF)。要求数据库表中的每 个实例或行必须可以被惟一地区分。通常需要为表加上一个列,以存储各个实例的惟一标识。这个惟一属性列被称为主关键字或主键。 满足第三范式(3NF)必须先满足第二范式(2NF)。简而言之,第三范式(3NF)要求一个数据库表中不包含已在其它表中已包含的非主关 键字信息。 >所以第三范式具有如下特征: >>1. 每一列只有一个值 >>2. 每一行都能区分。 >>3. 每一个表都不包含其他表已经包含的非主关键字信息。 2. 有哪些数据库优化方面的经验? 用 PreparedStatement, 一般来说比 Statement 性能高:一个 sql发给服务器去执行,涉及步骤:语法检查、语义分析, 编译,缓存。 有外键约束会影响插入和删除性能,如果程序能够保证数据的完整性,那在设计数据库时就去掉外键。 表中允许适当冗余,譬如,主题帖的回复数量和最后回复时间等 UNION ALL 要比 UNION 快很多,所以,如果可以确认合并的两个结果集中不包含重复数据且不需要排序时的话,那么就使用 UNION ALL。 >>UNION 和 UNION ALL 关键字都是将两个结果集合并为一个,但这两者从使用和效率上来说都有所不同。 >1. 对重复结果的处理:UNION 在进行表链接后会筛选掉重复的记录,Union All 不会去除重复记录。 >2. 对排序的处理:Union 将会按照字段的顺序进行排序;UNION ALL 只是简单的将两个结果合并后就返回。 3. 请简述常用的索引有哪些种类? 普通索引: 即针对数据库表创建索引 唯一索引: 与普通索引类似,不同的就是:MySQL 数据库索引列的值必须唯一,但允许有空值 主键索引: 它是一种特殊的唯一索引,不允许有空值。一般是在建表的时候同时创建主键索引 组合索引: 为了进一步榨取 MySQL 的效率,就要考虑建立组合索引。即将数据库表中的多个字段联合起来作为一个组合索引。 4. 以及在 mysql 数据库中索引的工作机制是什么?数据库索引,是数据库管理系统中一个排序的数据结构,以协助快速查询、更新数据库表中数据。索引的实现通常使用 B 树及其变种 B+树 5.MySQL 的基础操作命令: MySQL 是否处于运行状态:Debian 上运行命令 service mysqlstatus,在 RedHat 上运行命令 service mysqld status 开启或停止 MySQL 服务 :运行命令 service mysqld start 开启服务;运行命令 service mysqld stop 停止服务 Shell 登入 MySQL: 运行命令 mysql -u root -p 列出所有数据库:运行命令 show databases; 切换到某个数据库并在上面工作:运行命令 use databasename; 进入名为 databasename 的数据库 列出某个数据库内所有表: show tables; 获取表内所有 Field 对象的名称和类型 :describe table_name; 6.mysql 的复制原理以及流程。Mysql 内建的复制功能是构建大型,高性能应用程序的基础。将 Mysql 的数据分布到多个系统上去,这种分布的机制,是通过将 Mysql 的某一台主机的数据复制到其它主机(slaves)上,并重新执行一遍来实现的。 * 复制过程中一个服务器充当主服务器,而一个或多个其它服务器充当从服务器。主服务器将更新写入二进制日志文件,并维护文件的一个索引以跟踪日志循环。这些日志可以记录发送到从服务器的更新。 当一个从服务器连接主服务器时,它通知主服务器在日志中读取的最后一次成功更新的位置。从服务器接收从那时起发生的任何更新,然后封锁并等待主服务器通知新的更新。 过程如下 1. 主服务器把更新记录到二进制日志文件中。 2. 从服务器把主服务器的二进制日志拷贝到自己的中继日志(replay log)中。 3. 从服务器重做中继日志中的时间,把更新应用到自己的数据库上。 7.mysql 支持的复制类型? 基于语句的复制: 在主服务器上执行的 SQL 语句,在从服务器上执行同样的语句。MySQL 默认采用基于语句的复制,效率比较高。 一旦发 现没法精确复制时,会自动选着基于行的复制。 基于行的复制:把改变的内容复制过去,而不是把命令在从服务器上执行一遍. 从 mysql5.0 开始支持 混合类型的复制: 默认采用基于语句的复制,一旦发现基于语句的无法精确的复制时,就会采用基于行的复制。 **8.mysql 中 中 varchar 与 与 char 的区别以及 varchar(50) 中的 50 代表的涵义?** varchar 与 char 的区别: char 是一种固定长度的类型,varchar 则是一种可变长度的类型. varchar(50)中 50 的涵义 : 最多存放 50 个字节 int(20)中 20 的涵义: int(M)中的 M indicates the maximum width (最大显示宽度)for integer types. The maximum legal display width is 255. **9. 表中有大字段 X (例如:text 类型),且字段 X 不会经常更新,以读为为主,将该字段拆成子表好处是什么?**如果字段里面有大字段(text,blob)类型的,而且这些字段的访问并不多,这时候放在一起就变成缺点了。 MYSQL 数据库的记录存储是按行存储的,数据块大小又是固定的(16K),每条记录越小,相同的块存储的记录就越多。此时应该把大字段拆走,这样应付大部分小字段的查询时,就能提高效率。当需要查询大字段时,此时的关联查询是不可避免的,但也是值得的。拆分开后,对字段的 UPDAE 就要 UPDATE 多个表了 **10.MySQL 中 中 InnoDB 引擎的行锁是通过加在什么上完成(或称实现)的?**InnoDB 行锁是通过给索引上的索引项加锁来实现的,这一点 MySQL 与Oracle 不同,后者是通过在数据块中对相应数据行加锁来实现的。InnoDB 这种行锁实现特点意味着:只有通过索引条件检索数据,InnoDB 才使用行级锁,否则,InnoDB 将使用表锁! 欢迎大家一起交流,喜欢文章记得点个赞哟,感谢支持!

优秀的个人博客,低调大师

【Github 5K星】BAT头条滴滴小米等笔试面经+深度学习/算法/NLP资源汇总!

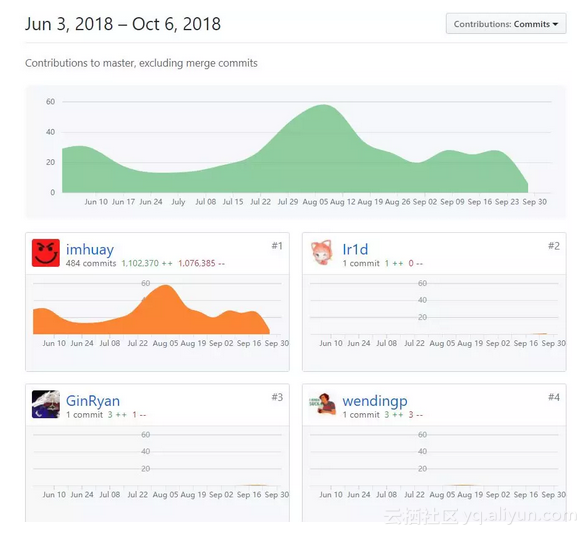
最近,在GitHub上有位id为imhuay的热心人带头建立了一个关于国内知名互联网企业笔试和面试经验的资源库,光从名称上就能看出其内容有多丰富:《2018/2019/校招/春招/秋招/算法/机器学习(MachineLearning)/深度学习(Deep Learning)/自然语言处理(NLP)/C/C++/Python/面试笔记》。 其中除了初步梳理和介绍的机器学习领域重要的基础知识和脉络结构之外,还总结了一些国内互联网名企网招、校招笔试面试时的内容和套路,非常值得立志进入这些企业的小伙伴们参考,而且是纯中文的哦! 目前,该资源库在Github上已经获得5100+的星,可以说是很火热了。 Github资源库地址: https://github.com/imhuay/Algorithm_Interview_Notes-Chinese 这个库目前有四个贡献者,多亏他们,才能集聚如此丰富的题库。在此,首先向这四位开发者致谢。 下面我们一起来看看,这个资源库收集了哪些宝贵资源。 主页面很简洁,就是一份按内容划分的主目录。除了最后一项“笔试面经”之外,其他的目录标题都是和计算机相关的热门主题词。里面是相关主题词下的一些知识介绍和技术资料,同样值得参考。 计算机相关热门话题知识介绍和总结 比如“机器学习”这个条目,点击进去可以看到一些子目录,包括“机器学习基础”、“机器学习算法”、“机器学习实践”、“集成学习”。 继续点击可以看到相关主题下的资料,比如下面就是“机器学习基础”子目录下关于“生成模型与判别模型”的介绍。 其他目录结构与此类似,比如下图是“机器学习算法”子目录下对支持向量机(SVM)的介绍。 再来看看同样热门的“自然语言处理”,子目录分别为:自然语言处理基础、词向量、句向量。 里面内容同样相当丰富,以“自然语言处理基础”为例,下图分别为Seq2Seq模型和语言模型的介绍。 除了知识总结与资料介绍,相信小伙伴们最关心的还是国内互联网名企的笔试面经了。 百度、腾讯、头条等名企笔试面经:一面二面三面 点击主目录下的“笔试面经”,百度、腾讯、360、字节跳动等互联网名企赫然在列,我们来看看这些大牛企业笔试面试都考点啥。 先看腾讯的笔试,更新时间为9月16日,主目录中给出了3道笔试题,分别是字符串系数、小Q与牛牛的游戏、三元组。 每道题的下方都给出了相应的代码和解法,涉及Python和C++语言。下图为第二题的解法代码。 再来看看百度的笔试,更新时间为9月14日。呈现形式基本一致,收录两道笔试题,字符串计数、寻寻觅觅。 主目录下还有不少企业的笔试题收录,感兴趣的小伙伴可以自行食用。 https://github.com/imhuay/Algorithm_Interview_Notes-Chinese/tree/master/D-%E7%AC%94%E8%AF%95%E9%9D%A2%E7%BB%8F 互联网名企笔试面经:面试部分 接下来看面试,这里给出了一位小伙伴面试字节跳动深度学习/NLP方向职位的面试流程,一共四面,全程第一视角,生动形象,简直有身临其境之感!其中还不时穿插面试人自己的内心OS(“不会、瞎说的、尬聊”什么的,小编也是服气),可以说是很耿直了! 不过面试时这再正常不过了,不信你去试试,毕竟你跺你也麻! 来看看这位老兄的面试经历吧!不容易啊! 一面: 自我介绍,聊项目,深度学习基本问题 【算法】手写 K-Means。磕磕绊绊算是写出来一个框架,内部细节全是问题,面试官比较宽容,勉强算过了 二面: 自我介绍,聊项目,深度学习基本问题 【算法】找数组中前 k 大的数字。我说了两个思路:最小堆和快排中的 partition 方法;让我选一个实现,我选的堆方法,然后又让我实现调整堆的方法。 三面: 自我介绍。为什么会出现梯度消失和梯度爆炸。 分别说了下前馈网络和 RNN 出现梯度消失的情况,有哪些解决方法。 因为提到了残差和门机制,所以又问,分别说下它们为什么能缓解梯度消失 因为说残差的时候提到了 ResNet,让我介绍下 ResNet(没用过,随便说了几句) 其他加速网络收敛的方法(除了残差和门机制) 我从优化方法的角度说了一点(SGB 的改进:动量方法、Adam) 提示我 BN,然后我就把 BN 的做法说了一下 然后问 BN 为什么能加速网络的收敛(从数据分布的角度随便说了几句) 传统的机器学习方法(简历上写用过 GBDT),简单介绍下 XGBoost CART 树怎么选择切分点(基尼系数) 基尼系数的动机、原理(不会) 【算法】直方图蓄水问题,LeetCode 42. 接雨水; 当时太紧张没想出 O(N) 解法,面试一结束就想出来了,哎~ 附 AC 代码 class Solution { public: int trap(vector<int>& H) { int n = H.size(); vector<int> dp_fw(H); vector<int> dp_bw(H); for(int i=1; i<n; i++) // 记录每个位置左边的最高点 dp_fw[i] = max(dp_fw[i-1], dp_fw[i]); for(int i=n-2; i>=0; i--) // 记录每个位置右边的最高点 dp_bw[i] = max(dp_bw[i+1], dp_bw[i]); int ret = 0; for (int i=1; i<n-1; i++) // 取两侧较矮的点 ret += min(dp_fw[i], dp_bw[i]) - H[i]; return ret; } }; 四面(非加面) 因为流程出了问题,其实还是三面 【算法】和为 K 的连续子数组,返回首尾位置 LeetCode 560. 和为K的子数组 很熟悉的题,但就是没想出来;然后面试官降低了难度,数组改成有序且为正整数,用双指针勉强写了出来;但是边界判断有问题,被指了出来;然后又问无序的情况或者有负数的情况能不能也用双指针做,尬聊了几分钟,没说出个所以然。 如何无监督的学习句子表示 我说 Self-Attention,让我把公式写出来,因为写的不清楚,让我写原始的 Attention 然后问怎么训练,损失函数是什么(没说出来,除了词向量我基本没碰过无监督任务,而且我认为词向量也算不上无监督...) 如何无监督的学习一个短视频的特征表示 抽取关键帧,然后通过 ResNet 等模型对每一帧转化为特征表示,然后对各帧的特征向量做拼接或者直接保存为二维特征(瞎说的,别说视频,我连图像都没做过) 再来看一个今日头条算法工程实习生岗位的面试: 一面: 自我介绍;二分查找; Algorithm_for_Interview/常用子函数/二分查找模板.hpp 判断链表是否有环; Algorithm_for_Interview/链表/链表中环的入口结点.hpp 将数组元素划分成两部分,使两部分和的差最小,数组顺序可变; Algorithm_for_Interview/查找与排序/暴力搜索_划分数组使和之差最小.hpp 智力题,在一个圆环上随机添加3个点,三个点组成一个锐角三角形的概率; ../数学问题/#1 推导逻辑斯蒂回归、线性支持向量机算法; ../机器学习/逻辑斯蒂回归推导 ../机器学习/线性支持向量机推导 二面: 在一个圆环上随机添加3点,三个点组成一个锐角三角形的概率,用积分计算上述概率。用程序解决上述问题。 多次采样求概率,关键是如何判断采样的三个点能否构成锐角三角形,不同的抽象会带来不同的复杂度。 最直接的想法是,根据边长关系,此时需要采样三个 x 坐标值,相应的 y 坐标通过计算得出,然后计算三边长度,再判断,循环以上过程,计算形成锐角的比例。 更简单的,根据 ../数学/#1 中提到的简单思路,原问题可以等价于“抛两次硬币,求两次均为正面的概率”——此时,只需要采样两个(0, 1)之间的值,当两个值都小于 0.5 意味着能构成锐角三角形。 深度学习,推导反向传播算法,知道什么激活函数,不用激活函数会怎么样,ROC与precesion/recall评估模型的手段有何区别,什么情况下应该用哪一种?深度学习如何参数初始化? 介绍kaggle项目,titanic,用到了哪些框架,用到了哪些算法; 三面: 自我介绍。分层遍历二叉树,相邻层的遍历方向相反,如第一层从左到右遍历,下一层从右向左遍历; 介绍AdaBoost算法。介绍梯度下降,随机梯度下降。写出逻辑斯蒂回归的损失函数。C++,虚函数,虚析构函数。 先说到这里,Github库中还有更多资料,只待你去探索。当然,也欢迎你把自己的面试经验简单总结,留给后来的小伙伴们参考哦~ 原文发布时间为:2018-09-7 本文作者: AI派 本文来自云栖社区合作伙伴“ ”,了解相关信息可以关注“ ”。

优秀的个人博客,低调大师

看看BAT这类的公司是正确使用Redis的!!

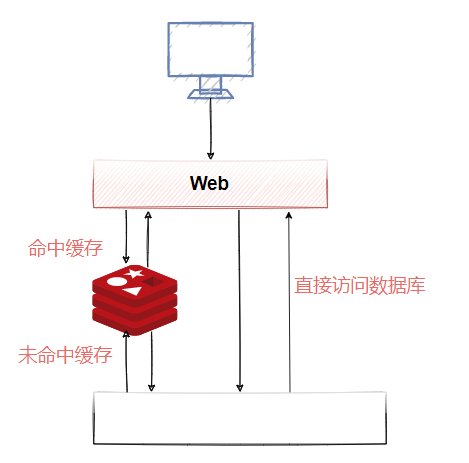
Redis使用过程中要注意的事项 Redis使用起来很简单,但是在实际应用过程中,一定会碰到一些比较麻烦的问题,常见的问题有 redis和数据库数据的一致性 缓存雪崩 缓存穿透 热点数据发现 下面逐一来分析这些问题的原理及解决方案。 数据一致性 针对读多写少的高并发场景,我们可以使用缓存来提升查询速度。当我们使用Redis作为缓存的时候,一般流程如图3-4所示。 如果数据在Redis存在,应用就可以直接从Redis拿到数据,不用访问数据库。 如果Redis里面没有,先到数据库查询,然后写入到Redis,再返回给应用。 <center>图3-4</center> 因为这些数据是很少修改的,所以在绝大部分的情况下可以命中缓存。但是,一旦被缓存的数据发生变化的时候,我们既要操作数据库的数据,也要操作Redis的数据,所以问题来了。现在我们有两种选择: 先操作Redis的数据再操作数据库的数据 先操作数据库的数据再操作Redis的数据 到底选哪一种? 首先需要明确的是,不管选择哪一种方案, 我们肯定是希望两个操作要么都成功,要么都一个都不成功。不然就会发生Redis跟数据库的数据不一致的问题。但是,Redis的数据和数据库的数据是不可能通过事务达到统一的,我们只能根据相应的场景和所需要付出的代价来采取一些措施降低数据不一致的问题出现的概率,在数据一致性和性能之间取得一个权衡。 对于数据库的实时性一致性要求不是特别高的场合,比如T+1的报表,可以采用定时任务查询数据库数据同步到Redis的方案。由于我们是以数据库的数据为准的,所以给缓存设置一个过期时间,是保证最终一致性的解决方案。 Redis:删除还是更新? 这里我们先要补充一点,当存储的数据发生变化,Redis的数据也要更新的时候,我们有两种方案,一种就是直接更新,调用set;还有一种是直接删除缓存,让应用在下次查询的时候重新写入。 这两种方案怎么选择呢?这里我们主要考虑更新缓存的代价。 更新缓存之前,判断是不是要经过其他表的查询、接口调用、计算才能得到最新的数据,而不是直接从数据库拿到的值,如果是的话,建议直接删除缓存,这种方案更加简单,一般情况下也推荐删除缓存方案。 这一点明确之后,现在我们就剩一个问题: 到底是先更新数据库,再删除缓存 还是先删除缓存,再更新数据库 先更新数据库,再删除缓存 正常情况:更新数据库,成功。删除缓存,成功。 异常情况: 1、更新数据库失败,程序捕获异常,不会走到下一步,所以数据不会出现不一致。 2、更新数据库成功,删除缓存失败。数据库是新数据,缓存是旧数据,发生了不一致的情况。 这种问题怎么解决呢?我们可以提供一个重试的机制。 比如:如果删除缓存失败,我们捕获这个异常,把需要删除的key发送到消息队列。然后自己创建一个消费者消费,尝试再次删除这个key,如图3-5所示。 <center>图3-5</center> 另外一种方案,异步更新缓存: 因为更新数据库时会往binlog写入日志,所以我们可以通过一个服务来监听binlog的变化(比如阿里的canal),然后在客户端完成删除key的操作。如果删除失败的话,再发送到消息队列。 总之,对于后删除缓存失败的情况,我们的做法是不断地重试删除,直到成功。无论是重试还是异步删除,都是最终一致性的思想,如图3-6所示。 基于数据库增量日志解析,提供增量数据订阅&消费,目前主要支持了mysql。 <center>图3-6</center> 先删除缓存,再更新数据库 正常情况:删除缓存,成功。更新数据库,成功。 异常情况: 删除缓存,程序捕获异常,不会走到下一步,所以数据不会出现不一致。 删除缓存成功,更新数据库失败。 因为以数据库的数据为准,所以不存在数据不一致的情况。 看起来好像没问题,但是如果有程序并发操作的情况下: 线程A需要更新数据,首先删除了Redis缓存 线程B查询数据,发现缓存不存在,到数据库查询旧值,写入Redis,返回 线程A更新了数据库 这个时候,Redis是旧的值,数据库是新的值,发生了数据不一致的情况,如图3-7所示,这种情况就比较难处理了,只有针对同一条数据进行串行化访问,才能解决这个问题,但是这种实现起来对性能影响较大,因此一般情况下不会采用这种做法。 <center>图3-7</center> 缓存雪崩 缓存雪崩就是Redis的大量热点数据同时过期(失效),因为设置了相同的过期时间,刚好这个时候Redis请求的并发量又很大,就会导致所有的请求落到数据库。 关于缓存过期 在实际开发中,我们经常会,比如限时优惠、缓存、验证码有效期等。一旦过了指定的有效时间就需要自动删除这些数据,否则这些无效数据会一直占用内存但是缺没有任何价值,因此在Redis中提供了Expire命令设置一个键的过期时间,到期以后Redis会自动删除它。这个在我们实际使用过程中用得非常多。 expire key seconds # 设置键在给定秒后过期 pexpire key milliseconds # 设置键在给定毫秒后过期 expireat key timestamp # 到达指定秒数时间戳之后键过期 pexpireat key timestamp # 到达指定毫秒数时间戳之后键过期 EXPIRE 返回值为1表示设置成功,0表示设置失败或者键不存在,如果向知道一个键还有多久时间被删除,可以使用TTL命令 ttl key # 返回键多少秒后过期 pttl key # 返回键多少毫秒后过期 当键不存在时,TTL命令会返回-2,而对于没有给指定键设置过期时间的,通过TTL命令会返回-1。 除此之外,针对String类型的key的过期时间,我们还可以通过下面这个方法来设置,其中可选参数ex表示设置过期时间。 set key value [ex seconds] 如果向取消键的过期时间设置(使该键恢复成为永久的),可以使用PERSIST命令,如果该命令执行成功或者成功清除了过期时间,则返回1 。 否则返回0(键不存在或者本身就是永久的) SET expire.demo 1 ex 20 TTL expire.demo PERSIST expire.demo TTL expire 除了PERSIST命令,使用set命令为键赋值的操作也会导致过期时间失效。 关于key过期的实现原理 Redis使用一个过期字典(Redis字典使用哈希表实现,可以将字典看作哈希表)存储键的过期时间,字典的键是指向数据库键的指针(使用指针可以避免浪费内存空间),字典的值是一个毫秒时间戳,所以在当前时间戳大于字典值的时候这个键就过期了,就可以对这个键进行删除(删除一个键不仅要删除数据库中的键,也要删除过期字典中的键)。 设置过期时间的命令都是使用pexpireat命令实现的,其他命令也会转换成pexpireat。给一个键设置过期时间,就是将这个键的指针以及给定的到期时间戳添加到过期字典中。比如,执行命令pexpireat key 1608290696843,那么过期字典结构将如图3-8所示。 <center>图3-8</center> 过期键的删除 过期键的删除有两种方法。 被动方式删除 被动方式的核心原理是,当客户端尝试访问某个key时,发现当前key已经过期了,就直接删除这个key。 当然,有可能会存在一些key,一直没有客户端访问,就会导致这部分key一直占用内存,因此加了一个主动删除方式。 主动方式删除 主动删除就是Redis定期扫描国期间中的key进行删除,它的删除策略是: 从过期键中随机获取20个key,删除这20个key中已经过期的key。 如果在这20个key中有超过25%的key过期,则重新执行当前步骤。实际上这是利用了一种概率算法。 Redis结合这两种设计很好的解决了过期key的处理问题。 如何解决缓存雪崩 了解了过期key的删除后,再来分析缓存雪崩问题。缓存雪崩有几个方面的原因导致。 Redis的大量热点数据同时过期(失效) Redis服务器出现故障, 这种情况,我们需要考虑到redis的高可用集群,这块后面再说。 我们来分析第一种情况,这种情况无非就是程序再去查一次数据库,再把数据库中的数据保存到缓存中就行,问题也不大。可是一旦涉及大数据量的需求,比如一些商品抢购的情景,或者是主页访问量瞬间较大的时候,单一使用数据库来保存数据的系统会因为面向磁盘,磁盘读/写速度比较慢的问题而存在严重的性能弊端,一瞬间成千上万的请求到来,需要系统在极短的时间内完成成千上万次的读/写操作,这个时候往往不是数据库能够承受的,极其容易造成数据库系统瘫痪,最终导致服务宕机的严重生产问题。 解决这类问题的方法有几个。 对过期时间增加一个随机值,避免同一时刻大量key失效。 对于热点数据,不设置过期时间。 当从redis中获取数据为空时,去数据库查询数据的地方互斥锁,这种方式会造成性能下降。 增加二级缓存,以及缓存和二级缓存的过期时间不同,当一级缓存失效后,可以再通过二级缓存获取。 缓存穿透 缓存穿透,一般是指当前访问的数据在redis和mysql中都不存在的情况,有可能是一次错误的查询,也可能是恶意攻击。 在这种情况下,因为数据库值不存在,所以肯定不会写入Redis,那么下一次查询相同的key的时候,肯定还是会再到数据库查一次。试想一下,如果有人恶意设置大量请求去访问一些不存在的key,这些请求同样最终会访问到数据库中,有可能导致数据库的压力过大而宕机。 这种情况一般有两种处理方法。 缓存空值 我们可以在数据库缓存一个空字符串,或者缓存一个特殊的字符串,那么在应用里面拿到这个特殊字符串的时候,就知道数据库没有值了,也没有必要再到数据库查询了。 但是这里需要设置一个过期时间,不然的会数据库已经新增了这一条记录,应用也还是拿不到值。 这个是应用重复查询同一个不存在的值的情况,如果应用每一次查询的不存在的值是不一样的呢?即使你每次都缓存特殊字符串也没用,因为它的值不一样,比如我们的用户系统登录的场景,如果是恶意的请求,它每次都生成了一个符合ID规则的账号,但是这个账号在我们的数据库是不存在的,那Redis就完全失去了作用,因此我们有另外一种方法,布隆过滤器。 布隆过滤器解决缓存穿透 先来了解一下布隆过滤器的原理, 首先,项目在启动的时候,把所有的数据加载到布隆过滤器中。 然后,当客户端有请求过来时,先到布隆过滤器中查询一下当前访问的key是否存在,如果布隆过滤器中没有该key,则不需要去数据库查询直接反馈即可 <center>图3-9</center> 下面我们通过一个案例来演示一下布隆过滤器的工作机制。 注意,该案例是在[springboot-redis-example]这个工程中进行演示。 添加guava依赖,guava中提供了布隆过滤器的api <dependency> <groupId>com.google.guava</groupId> <artifactId>guava</artifactId> <version>21.0</version> </dependency> 增加一个ApplicationRunner实现,当spring boot启动完成后执行初始化 @Slf4j @Component public class BloomFilterDataLoadApplicationRunner implements ApplicationRunner { @Autowired ICityService cityService; @Override public void run(ApplicationArguments args) throws Exception { List<City> cityList=cityService.list(); // expectedInsertions: 预计添加的元素个数 // fpp: 误判率(后续再讲) BloomFilter<String> bloomFilter=BloomFilter.create(Funnels.stringFunnel(Charsets.UTF_8),10000000,0.03); cityList.parallelStream().forEach(city -> { bloomFilter.put(RedisKeyConstants.CITY_KEY+":"+city.getId()); }); BooleanFilterCache.bloomFilter=bloomFilter; } } 添加一个controller用来访问测试 @RestController public class BloomFilterController { @Autowired RedisTemplate redisTemplate; @GetMapping("/bloom/{id}") public String filter(@PathVariable("id")Integer id){ String key=RedisKeyConstants.CITY_KEY+":"+id; if(BooleanFilterCache.bloomFilter.mightContain(key)){ //判断当前数据在布隆过滤器中是否存在,如果存在则从缓存中加载 return redisTemplate.opsForValue().get(key).toString(); } return "数据不存在"; } } 布隆过滤器存储空间大小计算: https://hur.st/bloomfilter/?n=1000000&p=0.03&m=&k= 布隆过滤器原理分析 完成上述实验过程后,很多同学会产生疑问, 老师,如果我的数据量有上千万,那不会很占内存啊? 老师,布隆过滤器的实现原理是什么呀? 什么是布隆过滤器 布隆过滤器是Burton Howard Bloom在1970年提出来的,一种空间效率极高的概率型算法和数据结构,主要用来判断一个元素是否在集合中存在。因为他是一个概率型的算法,所以会存在一定的误差,如果传入一个值去布隆过滤器中检索,可能会出现检测存在的结果但是实际上可能是不存在的,但是肯定不会出现实际上不存在然后反馈存在的结果。因此,Bloom Filter不适合那些“零错误”的应用场合。而在能容忍低错误率的应用场合下,Bloom Filter通过极少的错误换取了存储空间的极大节省 BitMap(位图) 所谓的Bit-map就是用一个bit位来标记某个元素对应的Value,通过Bit为单位来存储数据,可以大大节省存储空间. ps:比特是一个二进制数的最小单元,就像我们现在金额的最小单位是分。只不过比特是二进制数而已,一个比特只能拥有一个值,不是0就是1,所以如果我给你一个值0,你可以说它就是一个比特,如果我给你两个(00),你就可以说它们是两个比特了。如果你将八个0或者1组合在一起,我们可以说说是8比特或者1个字节。在32位的机器上,一个int类型的数据会占用4个字节,也就是32个比特位。 在java中,一个int类型占32个比特,我们用一个int数组来表示时未new int[32],总计占用内存32*32bit,现假如我们用int字节码的每一位表示一个数字的话,那么32个数字只需要一个int类型所占内存空间大小就够了,这样在大数据量的情况下会节省很多内存。 如果要存储n个数字,那么具体思路如下。 1个int占4字节即4*8=32位,那么我们只需要申请一个int数组长度为 int tmp[1+N/32]即可存储完这些数据,其中N代表要进行查找的总数,tmp中的每个元素在内存在占32位可以对应表示十进制数0~31,所以可得到BitMap表: tmp[0]:可表示0~31 tmp[1]:可表示32~63 tmp[2]可表示64~95 ....... 接着,我们只需要把对应的数字存储到指定数组元素的bit中即可,如何判断int数字在tmp数组的哪个下标,这个其实可以通过直接除以32取整数部分,例如:整数8除以32取整等于0,那么8就在tmp[0]上。另外,我们如何知道了8在tmp[0]中的32个位中的哪个位,这种情况直接mod上32就ok,又如整数8,在tmp[0]中的8 mod 32等于8,那么整数8就在tmp[0]中的第八个bit位(从右边数起) 比如我们要存储5**(101)、9(1001)、3(11)、1(1)**四个数字,那么我们申请int型的内存空间,会有32个比特位。这四个数字的二进制分别对应如下。 从右往左开始数,比如第一个数字是5,对应的二进制数据是101, 那么从有往左数到第5位,把对应的二进制数据存储到32个比特位上。 第一个5就是 00000000000000000000000000101000 而输入9的时候 00000000000000000000001001000000 输入3时候 00000000000000000000000000001100 输入1的时候 00000000000000000000000000000010 思想比较简单,关键是十进制和二进制bit位需要一个map映射表,把10进制映射到bit位上,这样的好处是内存占用少、效率很高(不需要比较和位移)。 布隆过滤器原理 有了对位图的理解以后,我们对布隆过滤器的原理理解就会更容易了,基于前面的例子,我们把数据库中的一张表的数据全部先保存到布隆过滤器中,用来判断当前访问的key是否存在于数据库。 假设我们需要把id=1这个key保存到布隆过滤器中,并且该布隆过滤器中的hash函数个数为3{x、y、z},它的具体实现原理如下: 首先将位数组进行初始化,将里面每个位都设置位0。 对于集合里面的每一个元素,将元素依次通过3个哈希函数{x、y、z}进行映射,每次映射都会产生一个哈希值,这个值对应位数组上面的一个点,然后将位数组对应的位置标记为1。 查询id=1元素是否存在集合中的时候,同样的方法将W通过哈希映射到位数组上的3个点。 如果3个点的其中有一个点不为1,则可以判断该元素一定不存在集合中。 反之,如果3个点都为1,则该元素可能存在集合中。 <center>图3-10</center> 接下来按照该方法处理所有的输入对象,每个对象都可能把bitMap中一些白位置涂黑,也可能会遇到已经涂黑的位置,遇到已经为黑的让他继续为黑即可。处理完所有的输入对象之后,在bitMap中可能已经有相当多的位置已经被涂黑。至此,一个布隆过滤器生成完成,这个布隆过滤器代表之前所有输入对象组成的集合。 如何去判断一个元素是否存在bit array中呢? 原理是一样,根据k个哈希函数去得到的结果,如果所有的结果都是1,表示这个元素可能(假设某个元素通过映射对应下标为4,5,6这3个点。虽然这3个点都为1,但是很明显这3个点是不同元素经过哈希得到的位置,因此这种情况说明元素虽然不在集合中,也可能对应的都是1)存在。 如果一旦发现其中一个比特位的元素是0,表示这个元素一定不存在 至于k个哈希函数的取值为多少,能够最大化的降低错误率(因为哈希函数越多,映射冲突会越少),这个地方就会涉及到最优的哈希函数个数的一个算法逻辑。 fpp表示允许的错误概率 expectedInsertions: 预期插入的数量 public static void main(String[] args) { BloomFilter<String> bloomFilter=BloomFilter.create(Funnels.stringFunnel(Charsets.UTF_8),10000000,0.03); bloomFilter.put("Mic"); System.out.println(bloomFilter.mightContain("Mic")); } 关注[跟着Mic学架构]公众号,获取更多精品原创

优秀的个人博客,低调大师

Java程序员2018最新面试题,想进BAT企业的必看(含答案解析)为2019做准备

以下2018阿里巴巴最新面试题可自由收藏,文末有福利放送,感谢大家支持。 1、String,StringBuffer, StringBuilder 的区别是什么?String为什么是不可变的? 答: 1、String是字符串常量,StringBuffer和StringBuilder都是字符串变量。后两者的字符内容可变,而前者创建后内容不可变。 2、String不可变是因为在JDK中String类被声明为一个final类。 3、StringBuffer是线程安全的,而StringBuilder是非线程安全的。 ps:线程安全会带来额外的系统开销,所以StringBuilder的效率比StringBuffer高。如果对系统中的线程是否安全很掌握,可用StringBuffer,在线程不安全处加上关键字Synchronize。 2、Vector,ArrayList, LinkedList的区别是什么? 答: 1、Vector、ArrayList都是以类似数组的形式存储在内存中,LinkedList则以链表的形式进行存储。 2、List中的元素有序、允许有重复的元素,Set中的元素无序、不允许有重复元素。 3、Vector线程同步,ArrayList、LinkedList线程不同步。 4、LinkedList适合指定位置插入、删除操作,不适合查找;ArrayList、Vector适合查找,不适合指定位置的插入、删除操作。 5、ArrayList在元素填满容器时会自动扩充容器大小的50%,而Vector则是100%,因此ArrayList更节省空间。 3、HashTable, HashMap,TreeMap区别? 答: 1、HashTable线程同步,HashMap非线程同步。 2、HashTable不允许<键,值>有空值,HashMap允许<键,值>有空值。 3、HashTable使用Enumeration,HashMap使用Iterator。 4、HashTable中hash数组的默认大小是11,增加方式的old*2+1,HashMap中hash数组的默认大小是16,增长方式一定是2的指数倍。 5、TreeMap能够把它保存的记录根据键排序,默认是按升序排序。 详见:链接 小编注:为什么没有第四题不要问我...学姐没写 5、Tomcat,Apache,JBoss的区别? 答: 1、Apache是Http服务器,Tomcat是web服务器,JBoss是应用服务器。 2、Apache解析静态的html文件;Tomcat可解析jsp动态页面、也可充当servlet容器。 详见:链接 6、GET,POST区别? 答: 基础知识:Http的请求格式如下。 <request line> 主要包含三个信息:1、请求的类型(GET或POST),2、要访问的资源(如 esimga.jif),3、Http版本(http/1.1) <header> 用来说明服务器要使用的附加信息 <blank line> 这是Http的规定,必须空一行 [<request-body>] 请求的内容数据 区别: 1、Get是从服务器端获取数据,Post则是向服务器端发送数据。 2、在客户端,Get方式通过URL提交数据,在URL地址栏可以看到请求消息,该消息被编码过;Post数据则是放在Html header内提交。 3、对于Get方式,服务器端用Request.QueryString获取变量的值;对用Post方式,服务器端用Request.Form获取提交的数据值。 4、Get方式提交的数据最多1024字节,而Post则没有限制。 5、Get方式提交的参数及参数值会在地址栏显示,不安全,而Post不会,比较安全。 详见:链接 7、Session, Cookie区别 答: 1、Session由应用服务器维护的一个服务器端的存储空间;Cookie是客户端的存储空间,由浏览器维护。 2、用户可以通过浏览器设置决定是否保存Cookie,而不能决定是否保存Session,因为Session是由服务器端维护的。 3、Session中保存的是对象,Cookie中保存的是字符串。 4、Session和Cookie不能跨窗口使用,每打开一个浏览器系统会赋予一个SessionID,此时的SessionID不同,若要完成跨浏览器访问数据,可以使用 Application。 5、Session、Cookie都有失效时间,过期后会自动删除,减少系统开销。 详见:链接 8、Servlet的生命周期 答: 大致分为4部:Servlet类加载-->实例化-->服务-->销毁 下图是Tomcat中Servlet时序图。 1、Web Client向Servlet容器(Tomcat)发出Http请求。 2、Servlet容器接收Client端的请求。 3、Servlet容器创建一个HttpRequest对象,将Client的请求信息封装到这个对象中。 4、Servlet创建一个HttpResponse对象。 5、Servlet调用HttpServlet对象的service方法,把HttpRequest对象和HttpResponse对象作为参数传递给HttpServlet对象中。 6、HttpServlet调用HttpRequest对象的方法,获取Http请求,并进行相应处理。 7、处理完成HttpServlet调用HttpResponse对象的方法,返回响应数据。 8、Servlet容器把HttpServlet的响应结果传回客户端。 其中的3个方法说明了Servlet的生命周期: 1、init():负责初始化Servlet对象。 2、service():负责响应客户端请求。 3、destroy():当Servlet对象推出时,负责释放占用资源。 详见:链接 9、HTTP 报文包含内容 答: 主要包含四部分: 1、request line 2、header line 3、blank line 4、request body 详见:链接 10、Statement与PreparedStatement的区别,什么是SQL注入,如何防止SQL注入 答: 1、PreparedStatement支持动态设置参数,Statement不支持。 2、PreparedStatement可避免如类似 单引号 的编码麻烦,Statement不可以。 3、PreparedStatement支持预编译,Statement不支持。 4、在sql语句出错时PreparedStatement不易检查,而Statement则更便于查错。 5、PreparedStatement可防止Sql助于,更加安全,而Statement不行。 详见:链接 什么是SQL注入: 通过sql语句的拼接达到无参数查询数据库数据目的的方法。 如将要执行的sql语句为 select * from table where name = "+appName+",利用appName参数值的输入,来生成恶意的sql语句,如将['or'1'='1'] 传入可在数据库中执行。 因此可以采用PrepareStatement来避免Sql注入,在服务器端接收参数数据后,进行验证,此时PrepareStatement会自动检测,而Statement不行,需要手工检测。 11、sendRedirect, foward区别 答: 1、foward是服务器端控制页面转向,在客户端的浏览器地址中不会显示转向后的地址;sendRedirect则是完全的跳转,浏览器中会显示跳转的地址并重新发送请求链接。 原理:forward是服务器请求资源,服务器直接访问目标地址的URL,把那个URL的响应内容读取过来,然后再将这些内容返回给浏览器,浏览器根本不知道服务器发送的这些内容是从哪来的,所以地址栏还是原来的地址。 redirect是服务器端根据逻辑,发送一个状态码,告诉浏览器重新去请求的那个地址,浏览器会用刚才的所有参数重新发送新的请求。 详见:链接 12、关于JAVA内存模型,一个对象(两个属性,四个方法)实例化100次,现在内存中的存储状态,几个对象,几个属性,几个方法。 答: 由于JAVA中new出来的对象都是放在堆中,所以如果要实例化100次,将在堆中产生100个对象,一般对象与其中的属性、方法都属于一个整体,但如果 属性和方法是静态的,就是用static关键字声明的,那么属于类的属性和方法永远只在内存中存在一份。 详见:链接 13、谈谈Hibernate的理解,一级和二级缓存的作用,在项目中Hibernate都是怎么使用缓存的。 答: Hibernate是一个开发的对象关系映射框架(ORM)。它对JDBC进行了非常对象封装,Hibernate允许程序员采用面向对象的方式来操作关系数据库。 Hibernate的优点: 1、程序更加面向对象 2、提高了生产率 3、方便移植 4、无入侵性。 缺点: 1、效率比JDBC略差 2、不适合批量操作 3、只能配置一种关联关系 Hibernate有四种查询方式: 1、get、load方法,根据id号查询对象。 2、Hibernate query language 3、标准查询语言 4、通过sql查询 Hibernage工作原理: 1、配置hibernate对象关系映射文件、启动服务器 2、服务器通过实例化Configuration对象,读取hibernate.cfg.xml文件的配置内容,并根据相关的需求建好表以及表之间的映射关系。 3、通过实例化的Configuration对象建立SeesionFactory实例,通过SessionFactory实例创建Session对象。 4、通过Seesion对象完成数据库的增删改查操作。 Hibernate中的状态转移 临时状态(transient) 1、不处于session缓存中 2、数据库中没有对象记录 java是如何进入临时状态的:1、通过new语句创建一个对象时。2、刚调用session的delete方法时,从seesion缓存中删除一个对象时。 持久化状态(persisted) 1、处于session缓存中 2、持久化对象数据库中没有对象记录 3、seesion在特定的时刻会保存两者同步 java如何进入持久化状态:1、seesion的save()方法。2、seesion的load().get()方法返回的对象。3、seesion的find()方法返回的list集合中存放的对象。4、Session的update().save()方法。 流离状态(detached) 1、不再位于session缓存中 2、游离对象由持久化状态转变而来,数据库中还没有相应记录。 java如何进入流离状态:1、Session的close()。Session的evict()方法,从缓存中删除一个对象。 Hibernate中的缓存主要有Session缓存(一级缓存)和SessionFactory缓存(二级缓存,一般由第三方提供)。 详见:链接1链接2 14、反射讲一讲,主要是概念,都在哪需要反射机制,反射的性能,如何优化 答: 反射机制的定义: 是在运行状态中,对于任意的一个类,都能够知道这个类的所有属性和方法,对任意一个对象都能够通过反射机制调用一个类的任意方法,这种动态获取类信息及动态调用类对象方法的功能称为java的反射机制。 反射的作用: 1、动态地创建类的实例,将类绑定到现有的对象中,或从现有的对象中获取类型。 2、应用程序需要在运行时从某个特定的程序集中载入一个特定的类 详见:链接 15、谈谈Hibernate与Ibatis的区别,哪个性能会更高一些 答: 1、Hibernate偏向于对象的操作达到数据库相关操作的目的;而ibatis更偏向于sql语句的优化。 2、Hibernate的使用的查询语句是自己的hql,而ibatis则是标准的sql语句。 3、Hibernate相对复杂,不易学习;ibatis类似sql语句,简单易学。 性能方面: 1、如果系统数据处理量巨大,性能要求极为苛刻时,往往需要人工编写高性能的sql语句或存错过程,此时ibatis具有更好的可控性,因此性能优于Hibernate。 2、同样的需求下,由于hibernate可以自动生成hql语句,而ibatis需要手动写sql语句,此时采用Hibernate的效率高于ibatis。 详见:链接1链接2 16、对Spring的理解,项目中都用什么?怎么用的?对IOC、和AOP的理解及实现原理 答: Spring是一个开源框架,处于MVC模式中的控制层,它能应对需求快速的变化,其主要原因它有一种面向切面编程(AOP)的优势,其次它提升了系统性能,因为通过依赖倒置机制(IOC),系统中用到的对象不是在系统加载时就全部实例化,而是在调用到这个类时才会实例化该类的对象,从而提升了系统性能。这两个优秀的性能使得Spring受到许多J2EE公司的青睐,如阿里里中使用最多的也是Spring相关技术。 Spring的优点: 1、降低了组件之间的耦合性,实现了软件各层之间的解耦。 2、可以使用容易提供的众多服务,如事务管理,消息服务,日志记录等。 3、容器提供了AOP技术,利用它很容易实现如权限拦截、运行期监控等功能。 Spring中AOP技术是设计模式中的动态代理模式。只需实现jdk提供的动态代理接口InvocationHandler,所有被代理对象的方法都由InvocationHandler接管实际的处理任务。面向切面编程中还要理解切入点、切面、通知、织入等概念。 Spring中IOC则利用了Java强大的反射机制来实现。所谓依赖注入即组件之间的依赖关系由容器在运行期决定。其中依赖注入的方法有两种,通过构造函数注入,通过set方法进行注入。 详见:链接1链接2 17、线程同步,并发操作怎么控制 答: Java中可在方法名前加关键字syschronized来处理当有多个线程同时访问共享资源时候的问题。syschronized相当于一把锁,当有申请者申请该 资源时,如果该资源没有被占用,那么将资源交付给这个申请者使用,在此期间,其他申请者只能申请而不能使用该资源,当该资源被使用完成后将释放该资源上的锁,其他申请者可申请使用。 并发控制主要是为了多线程操作时带来的资源读写问题。如果不加以空间可能会出现死锁,读脏数据、不可重复读、丢失更新等异常。 并发操作可以通过加锁的方式进行控制,锁又可分为乐观锁和悲观锁。 悲观锁: 悲观锁并发模式假定系统中存在足够多的数据修改操作,以致于任何确定的读操作都可能会受到由个别的用户所制造的数据修改的影响。也就是说悲观锁假定冲突总会发生,通过独占正在被读取的数据来避免冲突。但是独占数据会导致其他进程无法修改该数据,进而产生阻塞,读数据和写数据会相互阻塞。 乐观锁: 乐观锁假定系统的数据修改只会产生非常少的冲突,也就是说任何进程都不大可能修改别的进程正在访问的数据。乐观并发模式下,读数据和写数据之间不会发生冲突,只有写数据与写数据之间会发生冲突。即读数据不会产生阻塞,只有写数据才会产生阻塞。 详见:链接1链接2 18、描述struts的工作流程 答: 1、在web应用启动时,加载并初始化ActionServlet,ActionServlet从struts-config.xml文件中读取配置信息,将它们存放到各个配置对象中。 2、当ActionServlet接收到一个客户请求时,首先检索和用户请求相匹配的ActionMapping实例,如果不存在,就返回用户请求路径无效信息。 3、如果ActionForm实例不存在,就创建一个ActionForm对象,把客户提交的表单数据保存到ActionForm对象中。 4、根据配置信息决定是否需要验证表单,如果需要,就调用ActionForm的validate()方法,如果ActionForm的validate()方法返回null或返回一个不包含ActionMessage的ActionErrors对象,就表示表单验证成功。 5、ActionServlet根据ActionMapping实例包含的映射信息决定请求转发给哪个Action,如果相应的Action实例不存在,就先创建一个实例,然后调用Action的execute()方法。 6、Action的execute()方法返回一个ActionForward对象,ActionServlet再把客户请求转发给ActionForward对象指向的JSP组件。 7、ActionForward对象指向的JSP组件生成动态网页,返回给客户。 19、Tomcat的session处理,如果让你实现一个tomcatserver,如何实现session机制 答: 没有找到合适的答案。 20、关于Cache(Ehcache,Memcached) 答: 最近研究了一下缓存技术,主要比较了一下memcached和ehcache。 ehcache是纯java编写的,通信是通过RMI方式,适用于基于java技术的项目。 memcached服务器端是c编写的,客户端有多个语言的实现,如c,php(淘宝,sina等各大门户网站),python(豆瓣网),java(Xmemcached,spymemcached)。memcached服务器端是使用文本或者二进制通信的。memcached的 python客户端没有开源,其他语言的好像都开源了。另外我以前不明白为什么各大互联网公司都是使用memcached缓存,后来我明白了原因:因为各大门户网站以及淘宝是使用php编写的网站,memcached有php客户端,而ehcache是纯java。 21、sql的优化相关问题 答: 这篇文章写的真心不错,值得仔细拜读,所以将其转载过来了。 近期因工作需要,希望比较全面的总结下SQL SERVER数据库性能优化相关的注意事项,在网上搜索了一下,发现很多文章,有的都列出了上百条,但是仔细看发现,有很多似是而非或者过时(可能对SQL SERVER6.5以前的版本或者ORACLE是适用的)的信息,只好自己根据以前的经验和测试结果进行总结了。 我始终认为,一个系统的性能的提高,不单单是试运行或者维护阶段的性能调优的任务,也不单单是开发阶段的事情,而是在整个软件生命周期都需要注意,进行有效工作才能达到的。所以我希望按照软件生命周期的不同阶段来总结数据库性能优化相关的注意事项。 一、分析阶段 一 般来说,在系统分析阶段往往有太多需要关注的地方,系统各种功能性、可用性、可靠性、安全性需求往往吸引了我们大部分的注意力,但是,我们必须注意,性能 是很重要的非功能性需求,必须根据系统的特点确定其实时性需求、响应时间的需求、硬件的配置等。最好能有各种需求的量化的指标。 另一方面,在分析阶段应该根据各种需求区分出系统的类型,大的方面,区分是OLTP(联机事务处理系统)和OLAP(联机分析处理系统)。 二、设计阶段 设计阶段可以说是以后系统性能的关键阶段,在这个阶段,有一个关系到以后几乎所有性能调优的过程—数据库设计。 在数据库设计完成后,可以进行初步的索引设计,好的索引设计可以指导编码阶段写出高效率的代码,为整个系统的性能打下良好的基础。 以下是性能要求设计阶段需要注意的: 1、 数据库逻辑设计的规范化 数据库逻辑设计的规范化就是我们一般所说的范式,我们可以这样来简单理解范式: 第1规范:没有重复的组或多值的列,这是数据库设计的最低要求。 第2规范: 每个非关键字段必须依赖于主关键字,不能依赖于一个组合式主关键字的某些组成部分。消除部分依赖,大部分情况下,数据库设计都应该达到第二范式。 第3规范: 一个非关键字段不能依赖于另一个非关键字段。消除传递依赖,达到第三范式应该是系统中大部分表的要求,除非一些特殊作用的表。 更高的范式要求这里就不再作介绍了,个人认为,如果全部达到第二范式,大部分达到第三范式,系统会产生较少的列和较多的表,因而减少了数据冗余,也利于性能的提高。 2、 合理的冗余 完全按照规范化设计的系统几乎是不可能的,除非系统特别的小,在规范化设计后,有计划地加入冗余是必要的。 冗余可以是冗余数据库、冗余表或者冗余字段,不同粒度的冗余可以起到不同的作用。 冗余可以是为了编程方便而增加,也可以是为了性能的提高而增加。从性能角度来说,冗余数据库可以分散数据库压力,冗余表可以分散数据量大的表的并发压力,也可以加快特殊查询的速度,冗余字段可以有效减少数据库表的连接,提高效率。 3、 主键的设计 主键是必要的,SQL SERVER的主键同时是一个唯一索引,而且在实际应用中,我们往往选择最小的键组合作为主键,所以主键往往适合作为表的聚集索引。聚集索引对查询的影响是比较大的,这个在下面索引的叙述。 在有多个键的表,主键的选择也比较重要,一般选择总的长度小的键,小的键的比较速度快,同时小的键可以使主键的B树结构的层次更少。 主键的选择还要注意组合主键的字段次序,对于组合主键来说,不同的字段次序的主键的性能差别可能会很大,一般应该选择重复率低、单独或者组合查询可能性大的字段放在前面。 4、 外键的设计 外键作为数据库对象,很多人认为麻烦而不用,实际上,外键在大部分情况下是很有用的,理由是: 外键是最高效的一致性维护方法,数据库的一致性要求,依次可以用外键、CHECK约束、规则约束、触发器、客户端程序,一般认为,离数据越近的方法效率越高。 谨慎使用级联删除和级联更新,级联删除和级联更新作为SQL SERVER 2000当年的新功能,在2005作 了保留,应该有其可用之处。我这里说的谨慎,是因为级联删除和级联更新有些突破了传统的关于外键的定义,功能有点太过强大,使用前必须确定自己已经把握好 其功能范围,否则,级联删除和级联更新可能让你的数据莫名其妙的被修改或者丢失。从性能看级联删除和级联更新是比其他方法更高效的方法。 5、 字段的设计 字段是数据库最基本的单位,其设计对性能的影响是很大的。需要注意如下: A、数据类型尽量用数字型,数字型的比较比字符型的快很多。 B、 数据类型尽量小,这里的尽量小是指在满足可以预见的未来需求的前提下的。 C、 尽量不要允许NULL,除非必要,可以用NOT NULL+DEFAULT代替。 D、少用TEXT和IMAGE,二进制字段的读写是比较慢的,而且,读取的方法也不多,大部分情况下最好不用。 E、 自增字段要慎用,不利于数据迁移。 6、 数据库物理存储和环境的设计 在设计阶段,可以对数据库的物理存储、操作系统环境、网络环境进行必要的设计,使得我们的系统在将来能适应比较多的用户并发和比较大的数据量。 这里需要注意文件组的作用,适用文件组可以有效把I/O操作分散到不同的物理硬盘,提高并发能力。 7、 系统设计 整个系统的设计特别是系统结构设计对性能是有很大影响的,对于一般的OLTP系统,可以选择C/S结构、三层的C/S结构等,不同的系统结构其性能的关键也有所不同。 系统设计阶段应该归纳一些业务逻辑放在数据库编程实现,数据库编程包括数据库存储过程、触发器和函数。用数据库编程实现业务逻辑的好处是减少网络流量并可更充分利用数据库的预编译和缓存功能。 8、 索引的设计 在设计阶段,可以根据功能和性能的需求进行初步的索引设计,这里需要根据预计的数据量和查询来设计索引,可能与将来实际使用的时候会有所区别。 关于索引的选择,应改主意: 根据数据量决定哪些表需要增加索引,数据量小的可以只有主键。 根据使用频率决定哪些字段需要建立索引,选择经常作为连接条件、筛选条件、聚合查询、排序的字段作为索引的候选字段。 把经常一起出现的字段组合在一起,组成组合索引,组合索引的字段顺序与主键一样,也需要把最常用的字段放在前面,把重复率低的字段放在前面。 一个表不要加太多索引,因为索引影响插入和更新的速度。 三、 编码阶段 编码阶段是本文的重点,因为在设计确定的情况下,编码的质量几乎决定了整个系统的质量。 编码阶段首先是需要所有程序员有性能意识,也就是在实现功能同时有考虑性能的思想,数据库是能进行集合运算的工具,我们应该尽量的利用这个工具,所谓集合运算实际是批量运算,就是尽量减少在客户端进行大数据量的循环操作,而用SQL语句或者存储过程代替。关于思想和意识,很难说得很清楚,需要在编程过程中来体会。 下面罗列一些编程阶段需要注意的事项: 1、 只返回需要的数据 返回数据到客户端至少需要数据库提取数据、网络传输数据、客户端接收数据以及客户端处理数据等环节,如果返回不需要的数据,就会增加服务器、网络和客户端的无效劳动,其害处是显而易见的,避免这类事件需要注意: A、横向来看,不要写SELECT *的语句,而是选择你需要的字段。 B、 纵向来看,合理写WHERE子句,不要写没有WHERE的SQL语句。 C、 注意SELECT INTO后的WHERE子句,因为SELECT INTO把数据插入到临时表,这个过程会锁定一些系统表,如果这个WHERE子句返回的数据过多或者速度太慢,会造成系统表长期锁定,诸塞其他进程。 D、对于聚合查询,可以用HAVING子句进一步限定返回的行。 2、 尽量少做重复的工作 这一点和上一点的目的是一样的,就是尽量减少无效工作,但是这一点的侧重点在客户端程序,需要注意的如下: A、控制同一语句的多次执行,特别是一些基础数据的多次执行是很多程序员很少注意的。 B、减少多次的数据转换,也许需要数据转换是设计的问题,但是减少次数是程序员可以做到的。 C、杜绝不必要的子查询和连接表,子查询在执行计划一般解释成外连接,多余的连接表带来额外的开销。 D、 合并对同一表同一条件的多次UPDATE,比如 UPDATE EMPLOYEE SET FNAME=’HAIWER’ WHERE EMP_ID=’ VPA30890F’ UPDATE EMPLOYEE SET LNAME=’YANG’ WHERE EMP_ID=’ VPA30890F’ 这两个语句应该合并成以下一个语句 UPDATE EMPLOYEE SET FNAME=’HAIWER’,LNAME=’YANG’ WHERE EMP_ID=’ VPA30890F’ E、 UPDATE操作不要拆成DELETE操作+INSERT操作的形式,虽然功能相同,但是性能差别是很大的。 F、不要写一些没有意义的查询,比如 SELECT * FROM EMPLOYEE WHERE 1=2 3、 注意事务和锁 事务是数据库应用中和重要的工具,它有原子性、一致性、隔离性、持久性这四个属性,很多操作我们都需要利用事务来保证数据的正确性。在使用事务中我们需要做到尽量避免死锁、尽量减少阻塞。具体以下方面需要特别注意: A、事务操作过程要尽量小,能拆分的事务要拆分开来。 B、 事务操作过程不应该有交互,因为交互等待的时候,事务并未结束,可能锁定了很多资源。 C、 事务操作过程要按同一顺序访问对象。 D、提高事务中每个语句的效率,利用索引和其他方法提高每个语句的效率可以有效地减少整个事务的执行时间。 E、 尽量不要指定锁类型和索引,SQL SERVER允许我们自己指定语句使用的锁类型和索引,但是一般情况下,SQL SERVER优化器选择的锁类型和索引是在当前数据量和查询条件下是最优的,我们指定的可能只是在目前情况下更有,但是数据量和数据分布在将来是会变化的。 F、 查询时可以用较低的隔离级别,特别是报表查询的时候,可以选择最低的隔离级别(未提交读)。 4、 注意临时表和表变量的用法 在复杂系统中,临时表和表变量很难避免,关于临时表和表变量的用法,需要注意: A、如果语句很复杂,连接太多,可以考虑用临时表和表变量分步完成。 B、 如果需要多次用到一个大表的同一部分数据,考虑用临时表和表变量暂存这部分数据。 C、 如果需要综合多个表的数据,形成一个结果,可以考虑用临时表和表变量分步汇总这多个表的数据。 D、其他情况下,应该控制临时表和表变量的使用。 E、 关于临时表和表变量的选择,很多说法是表变量在内存,速度快,应该首选表变量,但是在实际使用中发现,这个选择主要考虑需要放在临时表的数据量,在数据量较多的情况下,临时表的速度反而更快。 F、 关于临时表产生使用SELECT INTO和CREATE TABLE + INSERT INTO的选择,我们做过测试,一般情况下,SELECT INTO会比CREATE TABLE + INSERT INTO的方法快很多,但是SELECT INTO会锁定TEMPDB的系统表SYSOBJECTS、SYSINDEXES、SYSCOLUMNS,在多用户并发环境下,容易阻塞其他进程,所以我的建议是,在并发系统中,尽量使用CREATE TABLE + INSERT INTO,而大数据量的单个语句使用中,使用SELECT INTO。 G、 注意排序规则,用CREATE TABLE建立的临时表,如果不指定字段的排序规则,会选择TEMPDB的默认排序规则,而不是当前数据库的排序规则。如果当前数据库的排序规则和TEMPDB的排序规则不同,连接的时候就会出现排序规则的冲突错误。一般可以在CREATE TABLE建立临时表时指定字段的排序规则为DATABASE_DEFAULT来避免上述问题。 5、 子查询的用法 子查询是一个 SELECT 查询,它嵌套在 SELECT、INSERT、UPDATE、DELETE 语句或其它子查询中。任何允许使用表达式的地方都可以使用子查询。 子查询可以使我们的编程灵活多样,可以用来实现一些特殊的功能。但是在性能上,往往一个不合适的子查询用法会形成一个性能瓶颈。 如果子查询的条件中使用了其外层的表的字段,这种子查询就叫作相关子查询。相关子查询可以用IN、NOT IN、EXISTS、NOT EXISTS引入。 关于相关子查询,应该注意: A、NOT IN、NOT EXISTS的相关子查询可以改用LEFT JOIN代替写法。比如: SELECT PUB_NAME FROM PUBLISHERS WHERE PUB_ID NOT IN (SELECT PUB_ID FROM TITLES WHERE TYPE = ’BUSINESS’) 可以改写成: SELECT A.PUB_NAME FROM PUBLISHERS A LEFT JOIN TITLES B ON B.TYPE = ’BUSINESS’ AND A.PUB_ID=B. PUB_ID WHERE B.PUB_ID IS NULL SELECT TITLE FROM TITLES WHERE NOT EXISTS (SELECT TITLE_ID FROM SALES WHERE TITLE_ID = TITLES.TITLE_ID) 可以改写成: SELECT TITLE FROM TITLES LEFT JOIN SALES ON SALES.TITLE_ID = TITLES.TITLE_ID WHERE SALES.TITLE_ID IS NULL B、 如果保证子查询没有重复 ,IN、EXISTS的相关子查询可以用INNER JOIN 代替。比如: SELECT PUB_NAME FROM PUBLISHERS WHERE PUB_ID IN (SELECT PUB_ID FROM TITLES WHERE TYPE = ’BUSINESS’) 可以改写成: SELECT DISTINCT A.PUB_NAME FROM PUBLISHERS A INNER JOIN TITLES B ON B.TYPE = ’BUSINESS’ AND A.PUB_ID=B. PUB_ID C、 IN的相关子查询用EXISTS代替,比如 SELECT PUB_NAME FROM PUBLISHERS WHERE PUB_ID IN (SELECT PUB_ID FROM TITLES WHERE TYPE = ’BUSINESS’) 可以用下面语句代替: SELECT PUB_NAME FROM PUBLISHERS WHERE EXISTS (SELECT 1 FROM TITLES WHERE TYPE = ’BUSINESS’ AND PUB_ID= PUBLISHERS.PUB_ID) D、不要用COUNT(*)的子查询判断是否存在记录,最好用LEFT JOIN或者EXISTS,比如有人写这样的语句: SELECT JOB_DESC FROM JOBS WHERE (SELECT COUNT(*) FROM EMPLOYEE WHERE JOB_ID=JOBS.JOB_ID)=0 应该改成: SELECT JOBS.JOB_DESC FROM JOBS LEFT JOIN EMPLOYEE ON EMPLOYEE.JOB_ID=JOBS.JOB_ID WHERE EMPLOYEE.EMP_ID IS NULL SELECT JOB_DESC FROM JOBS WHERE (SELECT COUNT(*) FROM EMPLOYEE WHERE JOB_ID=JOBS.JOB_ID)<>0 应该改成: SELECT JOB_DESC FROM JOBS WHERE EXISTS (SELECT 1 FROM EMPLOYEE WHERE JOB_ID=JOBS.JOB_ID) 6、 慎用游标 数据库一般的操作是集合操作,也就是对由WHERE子句和选择列确定的结果集作集合操作,游标是提供的一个非集合操作的途径。一般情况下,游标实现的功能往往相当于客户端的一个循环实现的功能,所以,大部分情况下,我们把游标功能搬到客户端。 游标是把结果集放在服务器内存,并通过循环一条一条处理记录,对数据库资源(特别是内存和锁资源)的消耗是非常大的,所以,我们应该只有在没有其他方法的情况下才使用游标。 另外,我们可以用SQL SERVER的一些特性来代替游标,达到提高速度的目的。 A、字符串连接的例子 这是论坛经常有的例子,就是把一个表符合条件的记录的某个字符串字段连接成一个变量。比如需要把JOB_ID=10的EMPLOYEE的FNAME连接在一起,用逗号连接,可能最容易想到的是用游标: DECLARE @NAME VARCHAR(20) DECLARE @NAME VARCHAR(1000) DECLARE NAME_CURSOR CURSOR FOR SELECT FNAME FROM EMPLOYEE WHERE JOB_ID=10 ORDER BY EMP_ID OPEN NAME_CURSOR FETCH NEXT FROM RNAME_CURSOR INTO @NAME WHILE @@FETCH_STATUS = 0 BEGIN SET @NAMES = ISNULL(@NAMES+’,’,’’)+@NAME FETCH NEXT FROM NAME_CURSOR INTO @NAME END CLOSE NAME_CURSOR DEALLOCATE NAME_CURSOR 可以如下修改,功能相同: DECLARE @NAME VARCHAR(1000) SELECT @NAMES = ISNULL(@NAMES+’,’,’’)+FNAME FROM EMPLOYEE WHERE JOB_ID=10 ORDER BY EMP_ID B、 用CASE WHEN 实现转换的例子 很多使用游标的原因是因为有些处理需要根据记录的各种情况需要作不同的处理,实际上这种情况,我们可以用CASE WHEN语句进行必要的判断处理,而且CASE WHEN是可以嵌套的。比如: 表结构: CREATE TABLE 料件表( 料号 VARCHAR(30), 名称 VARCHAR(100), 主单位 VARCHAR(20), 单位1 VARCHAR(20), 单位1参数 NUMERIC(18,4), 单位2 VARCHAR(20), 单位2参数 NUMERIC(18,4) ) GO CREATE TABLE 入库表( 时间 DATETIME, 料号 VARCHAR(30), 单位 INT, 入库数量 NUMERIC(18,4), 损坏数量 NUMERIC(18,4) ) GO 其中,单位字段可以是0,1,2,分别代表主单位、单位1、单位2,很多计算需要统一单位,统一单位可以用游标实现: DECLARE @料号 VARCHAR(30), @单位 INT, @参数 NUMERIC(18,4), DECLARE CUR CURSOR FOR SELECT 料号,单位 FROM 入库表 WHERE 单位 <>0 OPEN CUR FETCH NEXT FROM CUR INTO @料号,@单位 WHILE @@FETCH_STATUS<>-1 BEGIN IF @单位=1 BEGIN SET @参数=(SELECT 单位1参数 FROM 料件表 WHERE 料号 =@料号) UPDATE 入库表 SET 数量=数量*@参数,损坏数量=损坏数量*@参数,单位=1 WHERE CURRENT OF CUR END IF @单位=2 BEGIN SET @参数=(SELECT 单位1参数 FROM 料件表 WHERE 料号 =@料号) UPDATE 入库表 SET 数量=数量*@参数,损坏数量=损坏数量*@参数,单位=1 WHERE CURRENT OF CUR END FETCH NEXT FROM CUR INTO @料号,@单位 END CLOSE CUR DEALLOCATE CUR 可以改写成: UPDATE A SET 数量=CASE A.单位 WHEN 1 THEN A.数量*B. 单位1参数 WHEN 2 THEN A.数量*B. 单位2参数 ELSE A.数量 END, 损坏数量= CASE A.单位 WHEN 1 THEN A. 损坏数量*B. 单位1参数 WHEN 2 THEN A. 损坏数量*B. 单位2参数 ELSE A. 损坏数量 END, 单位=1 FROM入库表 A, 料件表 B WHERE A.单位<>1 AND A.料号=B.料号 C、 变量参与的UPDATE语句的例子 SQL ERVER的语句比较灵活,变量参与的UPDATE语句可以实现一些游标一样的功能,比如: 在SELECT A,B,C,CAST(NULL AS INT) AS 序号 INTO #T FROM 表 ORDER BY A ,NEWID() 产生临时表后,已经按照A字段排序,但是在A相同的情况下是乱序的,这时如果需要更改序号字段为按照A字段分组的记录序号,就只有游标和变量参与的UPDATE语句可以实现了,这个变量参与的UPDATE语句如下: DECLARE @A INT DECLARE @序号 INT UPDATE #T SET @序号=CASE WHEN A=@A THEN @序号+1 ELSE 1 END, @A=A, 序号=@序号 D、如果必须使用游标,注意选择游标的类型,如果只是循环取数据,那就应该用只进游标(选项FAST_FORWARD),一般只需要静态游标(选项STATIC)。 E、 注意动态游标的不确定性,动态游标查询的记录集数据如果被修改,会自动刷新游标,这样使得动态游标有了不确定性,因为在多用户环境下,如果其他进程或者本身更改了纪录,就可能刷新游标的记录集。 7、 尽量使用索引 建立索引后,并不是每个查询都会使用索引,在使用索引的情况下,索引的使用效率也会有很大的差别。只要我们在查询语句中没有强制指定索引,索引的选择和使用方法是SQLSERVER的优化器自动作的选择,而它选择的根据是查询语句的条件以及相关表的统计信息,这就要求我们在写SQL语句的时候尽量使得优化器可以使用索引。 为了使得优化器能高效使用索引,写语句的时候应该注意: A、不要对索引字段进行运算,而要想办法做变换,比如 SELECT ID FROM T WHERE NUM/2=100 应改为: SELECT ID FROM T WHERE NUM=100*2 SELECT ID FROM T WHERE NUM/2=NUM1 如果NUM有索引应改为: SELECT ID FROM T WHERE NUM=NUM1*2 如果NUM1有索引则不应该改。 发现过这样的语句: SELECT 年,月,金额 FROM 结余表 WHERE 100*年+月=2007*100+10 应该改为: SELECT 年,月,金额 FROM 结余表 WHERE 年=2007 AND 月=10 B、 不要对索引字段进行格式转换 日期字段的例子: WHERE CONVERT(VARCHAR(10), 日期字段,120)=’2008-08-15’ 应该改为 WHERE日期字段〉=’2008-08-15’ AND 日期字段<’2008-08-16’ ISNULL转换的例子: WHERE ISNULL(字段,’’)<>’’应改为:WHERE字段<>’’ WHERE ISNULL(字段,’’)=’’不应修改 WHERE ISNULL(字段,’F’) =’T’应改为: WHERE字段=’T’ WHERE ISNULL(字段,’F’)<>’T’不应修改 C、 不要对索引字段使用函数 WHERE LEFT(NAME, 3)=’ABC’ 或者WHERE SUBSTRING(NAME,1, 3)=’ABC’ 应改为: WHERE NAME LIKE ‘ABC%’ 日期查询的例子: WHERE DATEDIFF(DAY, 日期,’2005-11-30′)=0应改为:WHERE 日期 >=’2005-11-30′ AND 日期 <’2005-12-1‘ WHERE DATEDIFF(DAY, 日期,’2005-11-30′)>0应改为:WHERE 日期 <’2005-11-30‘ WHERE DATEDIFF(DAY, 日期,’2005-11-30′)>=0应改为:WHERE 日期 <’2005-12-01‘ WHERE DATEDIFF(DAY, 日期,’2005-11-30′)<0应改为:WHERE 日期>=’2005-12-01‘ WHERE DATEDIFF(DAY, 日期,’2005-11-30′)<=0应改为:WHERE 日期>=’2005-11-30‘ D、不要对索引字段进行多字段连接 比如: WHERE FAME+ ’.’+LNAME=‘HAIWEI.YANG’ 应改为: WHERE FNAME=‘HAIWEI’ AND LNAME=‘YANG’ 8、 注意连接条件的写法 多表连接的连接条件对索引的选择有着重要的意义,所以我们在写连接条件条件的时候需要特别的注意。 A、多表连接的时候,连接条件必须写全,宁可重复,不要缺漏。 B、 连接条件尽量使用聚集索引 C、 注意ON部分条件和WHERE部分条件的区别 9、 其他需要注意的地方 经验表明,问题发现的越早解决的成本越低,很多性能问题可以在编码阶段就发现,为了提早发现性能问题,需要注意: A、程序员注意、关心各表的数据量。 B、 编码过程和单元测试过程尽量用数据量较大的数据库测试,最好能用实际数据测试。 C、 每个SQL语句尽量简单 D、不要频繁更新有触发器的表的数据 E、 注意数据库函数的限制以及其性能 10、学会分辩SQL语句的优劣 自己分辨SQL语句的优劣非常重要,只有自己能分辨优劣才能写出高效的语句。 A、查看SQL语句的执行计划,可以在查询分析其使用CTRL+L图形化的显示执行计划,一般应该注意百分比最大的几个图形的属性,把鼠标移动到其上面会显示这个图形的属性,需要注意预计成本的数据,也要注意其标题,一般都是CLUSTERED INDEX SEEK 、INDEX SEEK 、CLUSTERED INDEX SCAN 、INDEX SCAN 、TABLE SCAN等,其中出现SCAN说明语句有优化的余地。也可以用语句 SET SHOWPLAN_ALL ON 要执行的语句 SET SHOWPLAN_ALL OFF 查看执行计划的文本详细信息。 B、用事件探查器跟踪系统的运行,可疑跟踪到执行的语句,以及所用的时间,CPU用量以及I/O数据,从而分析语句的效率。 C、可以用WINDOWS的系统性能检测器,关注CPU、I/O参数 四、测试、试运行、维护阶段 测试的主要任务是发现并修改系统的问题,其中性能问题也是一个重要的方面。重点应该放在发现有性能问题的地方,并进行必要的优化。主要进行语句优化、索引优化等。 试运行和维护阶段是在实际的环境下运行系统,发现的问题范围更广,可能涉及操作系统、网络以及多用户并发环境出现的问题,其优化也扩展到操作系统、网络以及数据库物理存储的优化。 这个阶段的优花方法在这里不再展开,只说明下索引维护的方法: A、可以用DBCC DBREINDEX语句或者SQL SERVER维护计划设定定时进行索引重建,索引重建的目的是提高索引的效能。 B、可以用语句UPDATE STATISTICS或者SQL SERVER维护计划设定定时进行索引统计信息的更新,其目的是使得统计信息更能反映实际情况,从而使得优化器选择更合适的索引。 C、可以用DBCC CHECKDB或者DBCC CHECKTABLE语句检查数据库表和索引是否有问题,这两个语句也能修复一般的问题。 五、网上资料中一些说法的个人不同意见 1、 “应尽量避免在 WHERE 子句中对字段进行 NULL 值判断,否则将导致引擎放弃使用索引而进行全表扫描,如: SELECT ID FROM T WHERE NUM IS NULL 可以在NUM上设置默认值0,确保表中NUM列没有NULL值,然后这样查询: SELECT ID FROM T WHERE NUM=0” 个人意见:经过测试,IS NULL也是可以用INDEX SEEK查找的,0和NULL是不同概念的,以上说法的两个查询的意义和记录数是不同的。 2、 “应尽量避免在 WHERE 子句中使用!=或<>操作符,否则将引擎放弃使用索引而进行全表扫描。” 个人意见:经过测试,<>也是可以用INDEX SEEK查找的。 3、 “应尽量避免在 WHERE 子句中使用 OR 来连接条件,否则将导致引擎放弃使用索引而进行全表扫描,如: SELECT ID FROM T WHERE NUM=10 OR NUM=20 可以这样查询: SELECT ID FROM T WHERE NUM=10 UNION ALL SELECT ID FROM T WHERE NUM=20” 个人意见:主要对全表扫描的说法不赞同。 4、 “IN 和 NOT IN 也要慎用,否则会导致全表扫描,如: SELECT ID FROM T WHERE NUM IN(1,2,3) 对于连续的数值,能用 BETWEEN 就不要用 IN 了: SELECT ID FROM T WHERE NUM BETWEEN 1 AND 3” 个人意见:主要对全表扫描的说法不赞同。 5、“如果在 WHERE 子句中使用参数,也会导致全表扫描。因为SQL只有在运行时才会解析局部变量,但优化程序不能将访问计划的选择推迟到运行时;它必须在编译时进行选择。然而,如果在编译时建立访问计划,变量的值还是未知的,因而无法作为索引选择的输入项。如下面语句将进行全表扫描: SELECT ID FROM T WHERE NUM=@NUM 可以改为强制查询使用索引: SELECT ID FROM T WITH(INDEX(索引名)) WHERE NUM=@NUM” 个人意见:关于局部变量的解释比较奇怪,使用参数如果会影响性能,那存储过程就该校除了,我坚持我上面对于强制索引的看法。 6、 “尽可能的使用 VARCHAR/NVARCHAR 代替 CHAR/NCHAR ,因为首先变长字段存储空间小,可以节省存储空间,其次对于查询来说,在一个相对较小的字段内搜索效率显然要高些。” 个人意见:“在一个相对较小的字段内搜索效率显然要高些”显然是对的,但是字段的长短似乎不是由变不变长决定,而是业务本身决定。在SQLSERVER6.5或者之前版本,不定长字符串字段的比较速度比定长的字符串字段的比较速度慢很多,所以对于那些版本,我们都是推荐使用定长字段存储一些关键字段。而在2000版本,修改了不定长字符串字段的比较方法,与定长字段的比较速度差别不大了,这样为了方便,我们大量使用不定长字段。 7、 关于连接表的顺序或者条件的顺序的说法,经过测试,在SQL SERVER,这些顺序都是不影响性能的,这些说法可能是对ORACLE有效。 22、oracle中 rownum与rowid的理解,一千条记录我查200到300的记录怎么查? 答:详见:链接 如何查200到300行的记录,可以通过top关键字辅助:select top 100 * from table where id is not in (select top 200 id from table); 查询n到m行记录的通用公式:select top m * from table where id is not in (select top n * from table) 23、如何分析ORACLE的执行计划? 答: 详见:链接 24、 DB中索引原理,种类,使用索引的好处和问题是什么? 答: 经常需要修改的表不易对改变建立索引,因为数据库对索引进行维护需要额外的开销。对经常需要查询的大数据表需要建立索引,这样会增加 查询的效率。 索引的原理:没有找到合适的答案。 索引的种类:B*Tree、反向索引、降序索引、位图索引、函数索引。详见:链接 25、JVM垃圾回收实现原理。垃圾回收的线程优先级。 答: 详见:链接 26、jvm 最大内存设置。设置的原理。结合垃圾回收讲讲。 答: 详见:链接 对于技术我们有自己的高清思维方向导图以及阿里架构师讲解的架构视频分享(包括高可用,高并发,spring源码,mybatis源码,JVM,大数据,Netty等多个技术知识的架构视频资料和各种电子书籍阅读)视频资料获取方式加入Java进阶之路即可免费获取:878—249—276 精讲架构视频资料获取方式加入Java进阶之路即可免费获取:878—249—276 以及一些一线互联网公司的面试题解析含答案

优秀的个人博客,低调大师

阿里P8十年Java架构师分享,会了这个知识点的人都去BAT了

蓦然回首,从毕业到现在做后台开发已经十年了,这十年中我获得了很多,技术能力、培训、出国、大公司的经历,还有很多志同道合的朋友。但再仔细一想,这十年码农路上我至少浪费了五年时间,这五年可以足够让自己成长为一个优秀的程序员,可惜我错过了,我用这五年时间和很多程序员一样在困惑和迷茫中找不到出路! “ 路上本没有坑,走的人多了,路就烂了。 ” 在大公司做事情有一个特征,你只需要在工作时间做好公司给你安排的那份工作,你就会做的很好,这也就是说每个人都是一颗螺丝钉。所以,我在一进入大公司后,由于自己经历不够,再加上刚毕业就作为大学班上进入大公司的佼佼者,所以有点飘,不能沉下心来研究技术,所以浪费了一段时间。 后来在和在贝尔实验室(上海)工作的研究生同学的一次交流中,让我严重的意识到,做为程序员除了做好公司安排的工作只是为了自己“活着”,而程序员的“生活”应该是体现在自己对技术的追求和对源码的执着之上。 虽然自己经常和周围的朋友进行程序生涯的交流,唯独这次交流才真正影响了我的程序人生。回想起来,影响程序员明天困局的往往就是一直挂着我们嘴边的小事,那些源码啊,框架啊,实战,造轮子,开源这一切都需要我们实实在在亲力亲为的一行行代码去解决。 今天,就为大家整理一份目前互联网公司Java后台最主流的技术选型↓ 01 阅读源码 程序员每天都和代码打交道。经过数年的基础教育和职业培训,大部分程序员都会「写」代码,或者至少会抄代码和改代码。但是,会读代码的并不在多数,会读代码又真正读懂一些大项目的源码的,少之又少。这也造成了很多错误看源码的方式。 那要如何正确的分析源码呢? 我们的目标应该放在最常用的框架上面,下面就介绍两个:一个是Spring,另一个是大家用来觉得一直不怎么出问题的Mybatis。 △spring源码 △mybatis源码 02 分布式架构 随着我们的业务量越来越大和越重要,单体的架构模式已经无法对应大规模的应用场景,而且系统中决不能存在单点故障导致整体不可用,所以只有垂直或是水平拆分业务系统,使其形成一个分布式的架构,利用分布式架构来冗余系统消除单点的故障,从而提高整个系统的可用性。同时分布式系统的模块重用度更高,速度更快,扩展性更高是大型的项目必不可少的环节。 03 微服务 关于微服务架构的取舍 在合适的项目,合适的团队,采用微服务架构收益会大于成本。微服务架构有很多吸引人的地方,但在拥抱微服务之前,也需要认清它所带来的挑战。需要避免为了“微服务”而“微服务”。微服务架构引入策略 – 对传统企业而言,开始时可以考虑引入部分合适的微服务架构原则对已有系统进行改造或新建微服务应用,逐步探索及积累微服务架构经验,而非全盘实施微服务架构。 04 性能调优 我们不仅仅对项目要运筹帷幄,还要能解决一切性能问题。只有深入学习JVM底层原理,Mysql底层优化以及Tomcat调优,才能达到知其然,知其所以然的效果。除了性能优化之外,也能提供通用的常见思路以及方案选型的考虑点,帮助大家培养在方案选型时的意识、思维以及做各种权衡的能力。 05 开发工具工程化 通过一小段描述信息来管理项目的构建,报告和文档的软件项目管理工具。程序员的战斗,往往不是一个人的战斗,我们如何在一个平台下高效的去重,进行代码review,对功能进行调整,debug,做到在统一的规划下步步为营,混乱的堆代码的过程中找到自己的记录。这一切都依赖于有效的工具。 06 项目实战 要想立足于互联网公司,且能在互联网浪潮中不被淹没,对于项目的开发实战演练是不必可少的技能,也是对自身能力的一个衡量,有多少的量对等于获得多少的回报。看似简单的一个项目需求图谱,其中的底层原理,实现原理又能知道多少?你搭建一个完整的B2C项目平台到底需要多少知识?这一切都是需要我们考量的。 1、具有1-5工作经验的,面对目前流行的技术不知从何下手, 需要突破技术瓶颈的。 2、在公司待久了,过得很安逸, 但跳槽时面试碰壁。需要在短时间内进修、跳槽拿高薪的。 3、如果没有工作经验,但基础非常扎实,对java工作机制, 常用设计思想,常用java开发框架掌握熟练的。 4、觉得自己很牛B,一般需求都能搞定。 但是所学的知识点没有系统化,很难在技术领域继续突破的。 5. 群号:468947140高级架构群备注好信息!

资源下载

更多资源
优质分享App

优质分享App

近一个月的开发和优化,本站点的第一个app全新上线。该app采用极致压缩,本体才4.36MB。系统里面做了大量数据访问、缓存优化。方便用户在手机上查看文章。后续会推出HarmonyOS的适配版本。

Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册