首页 文章 精选 留言 我的

精选列表

搜索[bat],共2195篇文章
优秀的个人博客,低调大师

BAT面试必备——Java 集合类

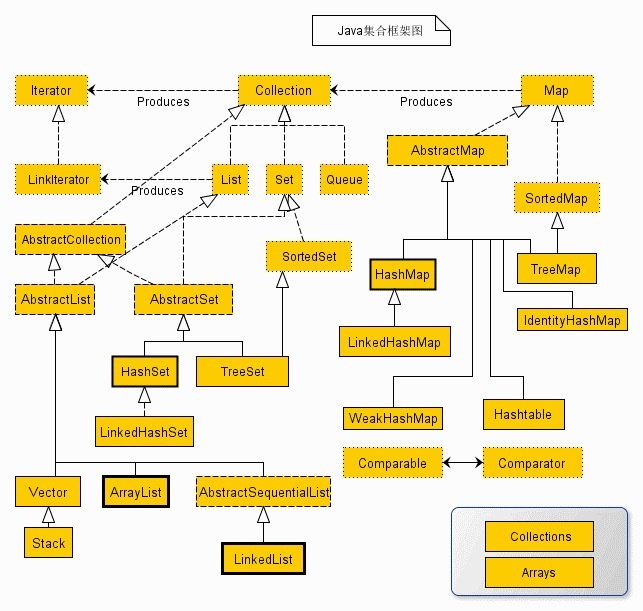
本文首发于我的个人博客:尾尾部落 来源:http://www.runoob.com/java/java-collections.html 来源:https://www.cnblogs.com/jing99/p/7057245.html 1. Iterator接口 Iterator接口,这是一个用于遍历集合中元素的接口,主要包含hashNext(),next(),remove()三种方法。它的一个子接口LinkedIterator在它的基础上又添加了三种方法,分别是add(),previous(),hasPrevious()。也就是说如果是先Iterator接口,那么在遍历集合中元素的时候,只能往后遍历,被遍历后的元素不会在遍历到,通常无序集合实现的都是这个接口,比如HashSet,HashMap;而那些元素有序的集合,实现的一般都是LinkedIterator接口,实现这个接口的集合可以双向遍历,既可以通过next()访问下一个元素,又可以通过previous()访问前一个元素,比如ArrayList。 2. List List是元素有序并且可以重复的集合。 List的主要实现:ArrayList, LinkedList, Vector。 image 2. ArrayList、LinkedList、Vector 的区别 ArrayList LinkedList Vector 底层实现 数组 双向循环链表 数组 同步性及效率 不同步,非线程安全,效率高 不同步,非线程安全,效率高 同步,线程安全,效率低 特点 查询快,增删慢 查询慢,增删快 查询快,增删慢 默认容量 10 / 10 扩容机制 int newCapacity = oldCapacity + (oldCapacity >> 1); //1.5 倍 / 2 倍 总结: ArrayList 和 Vector 基于数组实现,对于随机访问get和set,ArrayList优于LinkedList,因为LinkedList要移动指针。 LinkedList 不会出现扩容的问题,所以比较适合随机位置增、删。但是其基于链表实现,所以在定位时需要线性扫描,效率比较低。 当操作是在一列数据的后面添加数据而不是在前面或中间,并且需要随机地访问其中的元素时,使用ArrayList会提供比较好的性能; 当你的操作是在一列数据的前面或中间添加或删除数据,并且按照顺序访问其中的元素时,就应该使用LinkedList了。 3. Set Set集合中的对象不按特定的方式排序(存入和取出的顺序不一定一致),并且没有重复对象。 Set的主要实现类:HashSet, TreeSet。 image HashSet TreeSet LinkedHashSet 底层实现 HashMap 红黑树 LinkedHashMap 重复性 不允许重复 不允许重复 不允许重复 有/无序 无序 有序,支持两种排序方式,自然排序和定制排序,其中自然排序为默认的排序方式。 有序,以元素插入的顺序来维护集合的链接表 时间复杂度 add(),remove(),contains()方法的时间复杂度是O(1) add(),remove(),contains()方法的时间复杂度是O(logn) LinkedHashSet在迭代访问Set中的全部元素时,性能比HashSet好,但是插入时性能稍微逊色于HashSet,时间复杂度是 O(1)。 同步性 不同步,线程不安全 不同步,线程不安全 不同步,线程不安全 null值 允许null值 不支持null值,会抛出 java.lang.NullPointerException 异常。因为TreeSet应用 compareTo() 方法于各个元素来比较他们,当比较null值时会抛出 NullPointerException异常。 允许null值 比较 equals() compareTo() equals() HashSet如何检查重复 当你把对象加入HashSet时,HashSet会先计算对象的hashcode值来判断对象加入的位置,同时也会与其他加入的对象的hashcode值作比较,如果没有相符的hashcode,HashSet会假设对象没有重复出现。但是如果发现有相同hashcode值的对象,这时会调用equals()方法来检查hashcode相等的对象是否真的相同。如果两者相同,HashSet就不会让加入操作成功。 hashCode()与equals()的相关规定: 如果两个对象相等,则hashcode一定也是相同的 两个对象相等,对两个equals方法返回true 两个对象有相同的hashcode值,它们也不一定是相等的 综上,equals方法被覆盖过,则hashCode方法也必须被覆盖 hashCode()的默认行为是对堆上的对象产生独特值。如果没有重写hashCode(),则该class的两个对象无论如何都不会相等(即使这两个对象指向相同的数据)。 总结: HashSet是一个通用功能的Set,而LinkedHashSet 提供元素插入顺序保证,TreeSet是一个SortedSet实现,由Comparator 或者 Comparable指定的元素顺序存储元素。 4. Map Map 是一种把键对象和值对象映射的集合,它的每一个元素都包含一对键对象和值对象。 Map没有继承于Collection接口从Map集合中检索元素时,只要给出键对象,就会返回对应的值对象。 Map 的常用实现类:HashMap、TreeMap、HashTable、LinkedHashMap、ConcurrentHashMap image HashMap HashTable 底层实现 数组+链表 数组+链表 同步性 线程不同步 同步 null值 允许 key 和 Vale 是 null,但是只允许一个 key 为 null,且这个元素存放在哈希表 0 角标位置 不允许key、value 是 null hash 使用hash(Object key)扰动函数对 key 的 hashCode 进行扰动后作为 hash 值 直接使用 key 的 hashCode() 返回值作为 hash 值 容量 容量为 2^4 且容量一定是 2^n 默认容量是11,不一定是 2^n 扩容 两倍,且哈希桶的下标使用 &运算代替了取模 2倍+1,取哈希桶下标是直接用模运算 几个问题: 1. HashMap 的工作原理? 通过hash的方法,通过put和get存储和获取对象。存储对象时,我们将K/V传给put方法时,它调用hashCode计算hash从而得到bucket位置,进一步存储,HashMap会根据当前bucket的占用情况自动调整容量(超过Load Facotr则resize为原来的2倍)。获取对象时,我们将K传给get,它调用hashCode计算hash从而得到bucket位置,并进一步调用equals()方法确定键值对。如果发生碰撞的时候,Hashmap通过链表将产生碰撞冲突的元素组织起来,在Java 8中,如果一个bucket中碰撞冲突的元素超过某个限制(默认是8),则使用红黑树来替换链表,从而提高效率。2.get和put的原理吗?equals()和hashCode()的都有什么作用? 通过对key的hashCode()进行hashing,并计算下标( n-1 & hash),从而获得buckets的位置。如果产生碰撞,则利用key.equals()方法去链表或树中去查找对应的节点3. HashMap 的长度为什么是2的幂次方? 为了能让 HashMap 存取高效,尽量较少碰撞,也就是要尽量把数据分配均匀,每个链表/红黑树长度大致相同。这个实现就是把数据存到哪个链表/红黑树中的算法。 HashMap 和 LinkedHashMap 的区别 LinkedHashMap 拥有与 HashMap 相同的底层哈希表结构,即数组 + 单链表 + 红黑树,也拥有相同的扩容机制。 LinkedHashMap 相比 HashMap 的拉链式存储结构,内部额外通过 Entry 维护了一个双向链表。 HashMap 元素的遍历顺序不一定与元素的插入顺序相同,而 LinkedHashMap 则通过遍历双向链表来获取元素,所以遍历顺序在一定条件下等于插入顺序。 LinkedHashMap 可以通过构造参数 accessOrder 来指定双向链表是否在元素被访问后改变其在双向链表中的位置。 HashMap & TreeMap 的区别 HashMap实现了Map接口,不保障元素顺序。 TreeMap实现了SortedMap接口,是一个有序的Map。内部采用红黑树实现,红黑树是一种维护有序数据的高效数据结构 ConcurrentHashMap 和 Hashtable 的区别 ConcurrentHashMap 和 Hashtable 的区别主要体现在实现线程安全的方式上不同。 底层数据结构: JDK1.7的 ConcurrentHashMap 底层采用 分段的数组+链表 实现,JDK1.8 采用的数据结构跟HashMap1.8的结构一样,数组+链表/红黑二叉树。Hashtable 和 JDK1.8 之前的 HashMap 的底层数据结构类似都是采用 数组+链表 的形式,数组是 HashMap 的主体,链表则是主要为了解决哈希冲突而存在的; 实现线程安全的方式(重要): ① 在JDK1.7的时候,ConcurrentHashMap(分段锁) 对整个桶数组进行了分割分段(Segment),每一把锁只锁容器其中一部分数据,多线程访问容器里不同数据段的数据,就不会存在锁竞争,提高并发访问率。(默认分配16个Segment,比Hashtable效率提高16倍。) 到了 JDK1.8 的时候已经摒弃了Segment的概念,而是直接用 Node 数组+链表+红黑树的数据结构来实现,并发控制使用 synchronized 和 CAS 来操作。(JDK1.6以后 对 synchronized锁做了很多优化) 整个看起来就像是优化过且线程安全的 HashMap,虽然在JDK1.8中还能看到 Segment 的数据结构,但是已经简化了属性,只是为了兼容旧版本;② Hashtable(同一把锁) :使用 synchronized 来保证线程安全,效率非常低下。当一个线程访问同步方法时,其他线程也访问同步方法,可能会进入阻塞或轮询状态,如使用 put 添加元素,另一个线程不能使用 put 添加元素,也不能使用 get,竞争会越来越激烈效率越低。 image JDK1.7的ConcurrentHashMap: image JDK1.8的ConcurrentHashMap(TreeBin: 红黑二叉树节点 Node: 链表节点): image 参考 这几道Java集合框架面试题在面试中几乎必问 搞懂 HashSet & LinkedHashSet 源码以及集合常见面试题目 获取最新资讯,请关注微信公众号:南强说晚安 image

优秀的个人博客,低调大师

BAT技术面dubbo还能这么问?

1、为什么要用 Dubbo? 随着服务化的进一步发展,服务越来越多,服务之间的调用和依赖关系也越来越复杂,诞生了面向服务的架构体系(SOA),也因此衍生出了一系列相应的技术,如对服务提供、服务调用、连接处理、通信协议、序列化方式、服务发现、服务路由、日志输出等行为进行封装的服务框架。就这样为分布式系统的服务治理框架就出现了,Dubbo 也就这样产生了。 2、Dubbo 的整体架构设计有哪些分层? 接口服务层(Service): 该层与业务逻辑相关,根据 provider 和 consumer 的业务设计对应的接口和实现配置层(Config): 对外配置接口,以 ServiceConfig 和 ReferenceConfig 为中心服务代理层(Proxy): 服务接口透明代理,生成服务的客户端 Stub 和 服务端的Skeleton,以 ServiceProxy 为中心,扩展接口为 ProxyFactory服务注册层(Registry): 封装服务地址的注册和发现,以服务 URL 为中心,扩展接口为 RegistryFactory、Registry、RegistryService路由层(Cluster): 封装多个提供者的路由和负载均衡,并桥接注册中心,以 Invoker为中心,扩展接口为 Cluster、Directory、Router 和 LoadBlancce监控层(Monitor):RPC 调用次数和调用时间监控,以 Statistics 为中心,扩展接口为 MonitorFactory、Monitor 和 MonitorService远程调用层(Protocal): 封装 RPC 调用,以 Invocation 和 Result 为中心,扩展接口为 Protocal、Invoker 和 Exporter信息交换层(Exchange): 封装请求响应模式,同步转异步。以 Request 和Response 为中心,扩展接口为 Exchanger、ExchangeChannel、ExchangeClient 和 ExchangeServer网络传输层(Transport): 抽象 mina 和 netty 为统一接口,以 Message 为中心,扩展接口为 Channel、Transporter、Client、Server 和 Codec数据序列化层(Serialize): 可复用的一些工具,扩展接口为 Serialization、ObjectInput、ObjectOutput 和 ThreadPool3、默认使用的是什么通信框架,还有别的选择吗? 默认也推荐使用 netty 框架,还有 mina。 4、服务调用是阻塞的吗? 默认是阻塞的,可以异步调用,没有返回值的可以这么做。Dubbo 是基于 NIO 的非阻塞实现并行调用,客户端不需要启动多线程即可完成并行调用多个远程服务,相对多线程开销较小,异步调用会返回一个 Future 对象。 5、一般使用什么注册中心?还有别的选择吗? 推荐使用 Zookeeper 作为注册中心,还有 Redis、Multicast、Simple 注册中心,但不推荐。 6、默认使用什么序列化框架,你知道的还有哪些? 推荐使用 Hessian 序列化,还有 Duddo、FastJson、Java 自带序列化。 7、服务提供者能实现失效踢出是什么原理? 服务失效踢出基于 zookeeper 的临时节点原理。 8、服务上线怎么不影响旧版本? 采用多版本开发,不影响旧版本。 9、如何解决服务调用链过长的问题? 可以结合 zipkin 实现分布式服务追踪。 10、说说核心的配置有哪些? 11、Dubbo 推荐用什么协议? 12、同一个服务多个注册的情况下可以直连某一个服务吗? 13、画一画服务注册与发现的流程图? 14、Dubbo 集群容错有几种方案? 15、Dubbo 服务降级,失败重试怎么做? 16、Dubbo 使用过程中都遇到了些什么问题? 17、Dubbo Monitor 实现原理? 18、Dubbo 用到哪些设计模式? 19、Dubbo 配置文件是如何加载到 Spring 中的? 20、Dubbo SPI 和 Java SPI 区别? 21、Dubbo 支持分布式事务吗? 22、Dubbo 可以对结果进行缓存吗? 23、服务上线怎么兼容旧版本? 24、Dubbo 必须依赖的包有哪些? 25、Dubbo telnet 命令能做什么? 26、Dubbo 支持服务降级吗? 27、Dubbo 如何优雅停机? 28、Dubbo 和 Dubbox 之间的区别? 29、Dubbo 和 Spring Cloud 的区别? 30、你还了解别的分布式框架吗? 需要其余问题答案的关注gzh“程序员小x”私信领取哦!另外喜欢这篇文章的可以给笔者点个赞,关注一下,每天都会分享Java相关文章!还有不定时的福利赠送,包括整理的学习资料,面试题,源码等~~

优秀的个人博客,低调大师

BAT面试必问HashMap源码分析

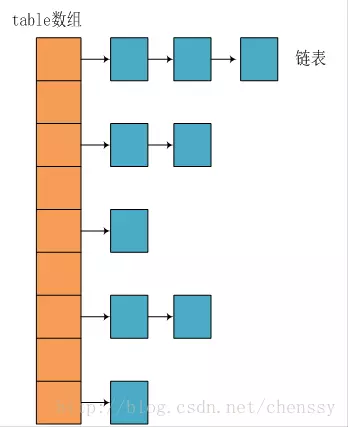
HashMap 简介 HashMap 主要用来存放键值对,它基于哈希表的Map接口实现,是常用的Java集合之一。 JDK1.8 之前 HashMap 由 数组+链表 组成的,数组是 HashMap 的主体,链表则是主要为了解决哈希冲突而存在的(“拉链法”解决冲突).JDK1.8 以后在解决哈希冲突时有了较大的变化,当链表长度大于阈值(默认为 8)时,将链表转化为红黑树,以减少搜索时间。 底层数据结构分析 JDK1.8之前 JDK1.8 之前 HashMap 底层是数组和链表结合在一起使用也就是链表散列。HashMap 通过 key 的 hashCode 经过扰动函数处理过后得到 hash 值,然后通过(n - 1) & hash判断当前元素存放的位置(这里的 n 指的是数组的长度),如果当前位置存在元素的话,就判断该元素与要存入的元素的 hash 值以及 key 是否相同,如果相同的话,直接覆盖,不相同就通过拉链法解决冲突。 所谓扰动函数指的就是 HashMap 的 hash 方法。使用 hash 方法也就是扰动函数是为了防止一些实现比较差的 hashCode() 方法 换句话说使用扰动函数之后可以减少碰撞。 JDK 1.8 HashMap 的 hash 方法源码: JDK 1.8 的 hash方法 相比于 JDK 1.7 hash 方法更加简化,但是原理不变。 1 2 3 4 5 6 7 static final int hash(Object key) { int h; // key.hashCode():返回散列值也就是hashcode // ^ :按位异或 // >>>:无符号右移,忽略符号位,空位都以0补齐 return (key == null) ? 0 : (h = key.hashCode()) ^ (h >>> 16); } 对比一下 JDK1.7的 HashMap 的 hash 方法源码. 1 2 3 4 5 6 7 8 static int hash(int h) { // This function ensures that hashCodes that differ only by // constant multiples at each bit position have a bounded // number of collisions (approximately 8 at default load factor). h ^= (h >>> 20) ^ (h >>> 12); return h ^ (h >>> 7) ^ (h >>> 4); } 相比于 JDK1.8 的 hash 方法 ,JDK 1.7 的 hash 方法的性能会稍差一点点,因为毕竟扰动了 4 次。 所谓“拉链法”就是:将链表和数组相结合。也就是说创建一个链表数组,数组中每一格就是一个链表。若遇到哈希冲突,则将冲突的值加到链表中即可。 JDK1.8之后 相比于之前的版本,jdk1.8在解决哈希冲突时有了较大的变化,当链表长度大于阈值(默认为8)时,将链表转化为红黑树,以减少搜索时间。 类的属性: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 public class HashMap<K,V> extends AbstractMap<K,V> implements Map<K,V>, Cloneable, Serializable { // 序列号 private static final long serialVersionUID = 362498820763181265L; // 默认的初始容量是16 static final int DEFAULT_INITIAL_CAPACITY = 1 << 4; // 最大容量 static final int MAXIMUM_CAPACITY = 1 << 30; // 默认的填充因子 static final float DEFAULT_LOAD_FACTOR = 0.75f; // 当桶(bucket)上的结点数大于这个值时会转成红黑树 static final int TREEIFY_THRESHOLD = 8; // 当桶(bucket)上的结点数小于这个值时树转链表 static final int UNTREEIFY_THRESHOLD = 6; // 桶中结构转化为红黑树对应的table的最小大小 static final int MIN_TREEIFY_CAPACITY = 64; // 存储元素的数组,总是2的幂次倍 transient Node<k,v>[] table; // 存放具体元素的集 transient Set<map.entry<k,v>> entrySet; // 存放元素的个数,注意这个不等于数组的长度。 transient int size; // 每次扩容和更改map结构的计数器 transient int modCount; // 临界值 当实际大小(容量*填充因子)超过临界值时,会进行扩容 int threshold; // 填充因子 final float loadFactor; } loadFactor加载因子 loadFactor加载因子是控制数组存放数据的疏密程度,loadFactor越趋近于1,那么 数组中存放的数据(entry)也就越多,也就越密,也就是会让链表的长度增加,load Factor越小,也就是趋近于0, loadFactor太大导致查找元素效率低,太小导致数组的利用率低,存放的数据会很分散。loadFactor的默认值为0.75f是官方给出的一个比较好的临界值。 threshold threshold = capacity * loadFactor,当Size>=threshold的时候,那么就要考虑对数组的扩增了,也就是说,这个的意思就是衡量数组是否需要扩增的一个标准。 Node节点类源码: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 // 继承自 Map.Entry<K,V> static class Node<K,V> implements Map.Entry<K,V> { final int hash;// 哈希值,存放元素到hashmap中时用来与其他元素hash值比较 final K key;//键 V value;//值 // 指向下一个节点 Node<K,V> next; Node(int hash, K key, V value, Node<K,V> next) { this.hash = hash; this.key = key; this.value = value; this.next = next; } public final K getKey() { return key; } public final V getValue() { return value; } public final String toString() { return key + "=" + value; } // 重写hashCode()方法 public final int hashCode() { return Objects.hashCode(key) ^ Objects.hashCode(value); } public final V setValue(V newValue) { V oldValue = value; value = newValue; return oldValue; } // 重写 equals() 方法 public final boolean equals(Object o) { if (o == this) return true; if (o instanceof Map.Entry) { Map.Entry<?,?> e = (Map.Entry<?,?>)o; if (Objects.equals(key, e.getKey()) && Objects.equals(value, e.getValue())) return true; } return false; } } 树节点类源码: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 static final class TreeNode<K,V> extends LinkedHashMap.Entry<K,V> { TreeNode<K,V> parent; // 父 TreeNode<K,V> left; // 左 TreeNode<K,V> right; // 右 TreeNode<K,V> prev; // needed to unlink next upon deletion boolean red; // 判断颜色 TreeNode(int hash, K key, V val, Node<K,V> next) { super(hash, key, val, next); } // 返回根节点 final TreeNode<K,V> root() { for (TreeNode<K,V> r = this, p;;) { if ((p = r.parent) == null) return r; r = p; } HashMap源码分析 构造方法 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 // 默认构造函数。 public More ...HashMap() { this.loadFactor = DEFAULT_LOAD_FACTOR; // all other fields defaulted } // 包含另一个“Map”的构造函数 public More ...HashMap(Map<? extends K, ? extends V> m) { this.loadFactor = DEFAULT_LOAD_FACTOR; putMapEntries(m, false);//下面会分析到这个方法 } // 指定“容量大小”的构造函数 public More ...HashMap(int initialCapacity) { this(initialCapacity, DEFAULT_LOAD_FACTOR); } // 指定“容量大小”和“加载因子”的构造函数 public More ...HashMap(int initialCapacity, float loadFactor) { if (initialCapacity < 0) throw new IllegalArgumentException("Illegal initial capacity: " + initialCapacity); if (initialCapacity > MAXIMUM_CAPACITY) initialCapacity = MAXIMUM_CAPACITY; if (loadFactor <= 0 || Float.isNaN(loadFactor)) throw new IllegalArgumentException("Illegal load factor: " + loadFactor); this.loadFactor = loadFactor; this.threshold = tableSizeFor(initialCapacity); } putMapEntries方法: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 final void putMapEntries(Map<? extends K, ? extends V> m, boolean evict) { int s = m.size(); if (s > 0) { // 判断table是否已经初始化 if (table == null) { // pre-size // 未初始化,s为m的实际元素个数 float ft = ((float)s / loadFactor) + 1.0F; int t = ((ft < (float)MAXIMUM_CAPACITY) ? (int)ft : MAXIMUM_CAPACITY); // 计算得到的t大于阈值,则初始化阈值 if (t > threshold) threshold = tableSizeFor(t); } // 已初始化,并且m元素个数大于阈值,进行扩容处理 else if (s > threshold) resize(); // 将m中的所有元素添加至HashMap中 for (Map.Entry<? extends K, ? extends V> e : m.entrySet()) { K key = e.getKey(); V value = e.getValue(); putVal(hash(key), key, value, false, evict); } } } put方法 HashMap只提供了put用于添加元素,putVal方法只是给put方法调用的一个方法,并没有提供给用户使用。 对putVal方法添加元素的分析如下: ①如果定位到的数组位置没有元素 就直接插入。 ②如果定位到的数组位置有元素就和要插入的 key 比较,如果key相同就直接覆盖,如果 key 不相同,就判断 p 是否是一个树节点,如果是就调用e = ((TreeNode<K,V>)p).putTreeVal(this, tab, hash, key, value)将元素添加进入。如果不是就遍历链表插入。 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 public V put(K key, V value) { return putVal(hash(key), key, value, false, true); } final V putVal(int hash, K key, V value, boolean onlyIfAbsent, boolean evict) { Node<K,V>[] tab; Node<K,V> p; int n, i; // table未初始化或者长度为0,进行扩容 if ((tab = table) == null || (n = tab.length) == 0) n = (tab = resize()).length; // (n - 1) & hash 确定元素存放在哪个桶中,桶为空,新生成结点放入桶中(此时,这个结点是放在数组中) if ((p = tab[i = (n - 1) & hash]) == null) tab[i] = newNode(hash, key, value, null); // 桶中已经存在元素 else { Node<K,V> e; K k; // 比较桶中第一个元素(数组中的结点)的hash值相等,key相等 if (p.hash == hash && ((k = p.key) == key || (key != null && key.equals(k)))) // 将第一个元素赋值给e,用e来记录 e = p; // hash值不相等,即key不相等;为红黑树结点 else if (p instanceof TreeNode) // 放入树中 e = ((TreeNode<K,V>)p).putTreeVal(this, tab, hash, key, value); // 为链表结点 else { // 在链表最末插入结点 for (int binCount = 0; ; ++binCount) { // 到达链表的尾部 if ((e = p.next) == null) { // 在尾部插入新结点 p.next = newNode(hash, key, value, null); // 结点数量达到阈值,转化为红黑树 if (binCount >= TREEIFY_THRESHOLD - 1) // -1 for 1st treeifyBin(tab, hash); // 跳出循环 break; } // 判断链表中结点的key值与插入的元素的key值是否相等 if (e.hash == hash && ((k = e.key) == key || (key != null && key.equals(k)))) // 相等,跳出循环 break; // 用于遍历桶中的链表,与前面的e = p.next组合,可以遍历链表 p = e; } } // 表示在桶中找到key值、hash值与插入元素相等的结点 if (e != null) { // 记录e的value V oldValue = e.value; // onlyIfAbsent为false或者旧值为null if (!onlyIfAbsent || oldValue == null) //用新值替换旧值 e.value = value; // 访问后回调 afterNodeAccess(e); // 返回旧值 return oldValue; } } // 结构性修改 ++modCount; // 实际大小大于阈值则扩容 if (++size > threshold) resize(); // 插入后回调 afterNodeInsertion(evict); return null; } 我们再来对比一下 JDK1.7 put方法的代码 对于put方法的分析如下: ①如果定位到的数组位置没有元素 就直接插入。 ②如果定位到的数组位置有元素,遍历以这个元素为头结点的链表,依次和插入的key比较,如果key相同就直接覆盖,不同就采用头插法插入元素。 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 public V put(K key, V value) if (table == EMPTY_TABLE) { inflateTable(threshold); } if (key == null) return putForNullKey(value); int hash = hash(key); int i = indexFor(hash, table.length); for (Entry<K,V> e = table[i]; e != null; e = e.next) { // 先遍历 Object k; if (e.hash == hash && ((k = e.key) == key || key.equals(k))) { V oldValue = e.value; e.value = value; e.recordAccess(this); return oldValue; } } modCount++; addEntry(hash, key, value, i); // 再插入 return null; } get方法 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 public V get(Object key) { Node<K,V> e; return (e = getNode(hash(key), key)) == null ? null : e.value; } final Node<K,V> getNode(int hash, Object key) { Node<K,V>[] tab; Node<K,V> first, e; int n; K k; if ((tab = table) != null && (n = tab.length) > 0 && (first = tab[(n - 1) & hash]) != null) { // 数组元素相等 if (first.hash == hash && // always check first node ((k = first.key) == key || (key != null && key.equals(k)))) return first; // 桶中不止一个节点 if ((e = first.next) != null) { // 在树中get if (first instanceof TreeNode) return ((TreeNode<K,V>)first).getTreeNode(hash, key); // 在链表中get do { if (e.hash == hash && ((k = e.key) == key || (key != null && key.equals(k)))) return e; } while ((e = e.next) != null); } } return null; } resize方法 进行扩容,会伴随着一次重新hash分配,并且会遍历hash表中所有的元素,是非常耗时的。在编写程序中,要尽量避免resize。 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 final Node<K,V>[] resize() { Node<K,V>[] oldTab = table; int oldCap = (oldTab == null) ? 0 : oldTab.length; int oldThr = threshold; int newCap, newThr = 0; if (oldCap > 0) { // 超过最大值就不再扩充了,就只好随你碰撞去吧 if (oldCap >= MAXIMUM_CAPACITY) { threshold = Integer.MAX_VALUE; return oldTab; } // 没超过最大值,就扩充为原来的2倍 else if ((newCap = oldCap << 1) < MAXIMUM_CAPACITY && oldCap >= DEFAULT_INITIAL_CAPACITY) newThr = oldThr << 1; // double threshold } else if (oldThr > 0) // initial capacity was placed in threshold newCap = oldThr; else { signifies using defaults newCap = DEFAULT_INITIAL_CAPACITY; newThr = (int)(DEFAULT_LOAD_FACTOR * DEFAULT_INITIAL_CAPACITY); } // 计算新的resize上限 if (newThr == 0) { float ft = (float)newCap * loadFactor; newThr = (newCap < MAXIMUM_CAPACITY && ft < (float)MAXIMUM_CAPACITY ? (int)ft : Integer.MAX_VALUE); } threshold = newThr; @SuppressWarnings({"rawtypes","unchecked"}) Node<K,V>[] newTab = (Node<K,V>[])new Node[newCap]; table = newTab; if (oldTab != null) { // 把每个bucket都移动到新的buckets中 for (int j = 0; j < oldCap; ++j) { Node<K,V> e; if ((e = oldTab[j]) != null) { oldTab[j] = null; if (e.next == null) newTab[e.hash & (newCap - 1)] = e; else if (e instanceof TreeNode) ((TreeNode<K,V>)e).split(this, newTab, j, oldCap); else { Node<K,V> loHead = null, loTail = null; Node<K,V> hiHead = null, hiTail = null; Node<K,V> next; do { next = e.next; // 原索引 if ((e.hash & oldCap) == 0) { if (loTail == null) loHead = e; else loTail.next = e; loTail = e; } // 原索引+oldCap else { if (hiTail == null) hiHead = e; else hiTail.next = e; hiTail = e; } } while ((e = next) != null); // 原索引放到bucket里 if (loTail != null) { loTail.next = null; newTab[j] = loHead; } // 原索引+oldCap放到bucket里 if (hiTail != null) { hiTail.next = null; newTab[j + oldCap] = hiHead; } } } } } return newTab; } HashMap常用方法测试 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 package map; import java.util.Collection; import java.util.HashMap; import java.util.Set; public class HashMapDemo { public static void main(String[] args) { HashMap<String, String> map = new HashMap<String, String>(); // 键不能重复,值可以重复 map.put("san", "张三"); map.put("si", "李四"); map.put("wu", "王五"); map.put("wang", "老王"); map.put("wang", "老王2");// 老王被覆盖 map.put("lao", "老王"); System.out.println("-------直接输出hashmap:-------"); System.out.println(map); /** * 遍历HashMap */ // 1.获取Map中的所有键 System.out.println("-------foreach获取Map中所有的键:------"); Set<String> keys = map.keySet(); for (String key : keys) { System.out.print(key+" "); } System.out.println();//换行 // 2.获取Map中所有值 System.out.println("-------foreach获取Map中所有的值:------"); Collection<String> values = map.values(); for (String value : values) { System.out.print(value+" "); } System.out.println();//换行 // 3.得到key的值的同时得到key所对应的值 System.out.println("-------得到key的值的同时得到key所对应的值:-------"); Set<String> keys2 = map.keySet(); for (String key : keys2) { System.out.print(key + ":" + map.get(key)+" "); } /** * 另外一种不常用的遍历方式 */ // 当我调用put(key,value)方法的时候,首先会把key和value封装到 // Entry这个静态内部类对象中,把Entry对象再添加到数组中,所以我们想获取 // map中的所有键值对,我们只要获取数组中的所有Entry对象,接下来 // 调用Entry对象中的getKey()和getValue()方法就能获取键值对了 Set<java.util.Map.Entry<String, String>> entrys = map.entrySet(); for (java.util.Map.Entry<String, String> entry : entrys) { System.out.println(entry.getKey() + "--" + entry.getValue()); } /** * HashMap其他常用方法 */ System.out.println("after map.size():"+map.size()); System.out.println("after map.isEmpty():"+map.isEmpty()); System.out.println(map.remove("san")); System.out.println("after map.remove():"+map); System.out.println("after map.get(si):"+map.get("si")); System.out.println("after map.containsKey(si):"+map.containsKey("si")); System.out.println("after containsValue(李四):"+map.containsValue("李四")); System.out.println(map.replace("si", "李四2")); System.out.println("after map.replace(si, 李四2):"+map); } }

优秀的个人博客,低调大师

最全的BAT大厂面试题整理

版权声明:本文为博主原创文章,未经博主允许不得转载。https://www.jianshu.com/p/c70989bd5f29 转载请标明出处:https://www.jianshu.com/p/c70989bd5f29 本文出自 AWeiLoveAndroid的博客 临近年关,又到了面试求职高峰期,最近有很多网友都在求大厂面试题。正好我之前电脑里面有这方面的整理,于是就发上来分享给大家。 这些题目是网友去百度、小米、乐视、美团、58、猎豹、360、新浪、搜狐等一线互联网公司面试被问到的题目。熟悉本文中列出的知识点会大大增加通过前两轮技术面试的几率。 网上的都是按照公司划分的,想找具体某一方面的知识点有点不好找,我这里就根据知识点分门别类的整理了一下,想看哪一块可以快速找到,希望可以帮助大家,祝大家求职顺利。 本文同步发布在github上,想要md文件的,有兴趣的可以去github下载下来研究,同时也欢迎网友提交面试题库,欢迎点赞和留言。 https://github.com/AweiLoveAndroid/CommonDevKnowledge 【好消息】我的微信公众号正式开通了,关注一下吧! 关注一下我的公众号吧 主要分为以下几部分: (1)java面试题 (2)Android面试题 (3)混合开发面试题 (4)高端技术面试题 (5)非技术性问题&HR问题汇总 一、java面试题 熟练掌握java是很关键的,大公司不仅仅要求你会使用几个api,更多的是要你熟悉源码实现原理,甚至要你知道有哪些不足,怎么改进,还有一些java有关的一些算法,设计模式等等。 (一) java基础面试知识点 java中==和equals和hashCode的区别 int、char、long各占多少字节数 int与integer的区别 谈谈对java多态的理解 String、StringBuffer、StringBuilder区别 什么是内部类?内部类的作用 抽象类和接口区别 抽象类的意义 抽象类与接口的应用场景 抽象类是否可以没有方法和属性? 接口的意义 泛型中extends和super的区别 父类的静态方法能否被子类重写 进程和线程的区别 final,finally,finalize的区别 序列化的方式 Serializable 和Parcelable 的区别 静态属性和静态方法是否可以被继承?是否可以被重写?以及原因? 静态内部类的设计意图 成员内部类、静态内部类、局部内部类和匿名内部类的理解,以及项目中的应用 谈谈对kotlin的理解 闭包和局部内部类的区别 string 转换成 integer的方式及原理 (二) java深入源码级的面试题(有难度) 哪些情况下的对象会被垃圾回收机制处理掉? 讲一下常见编码方式? utf-8编码中的中文占几个字节;int型几个字节? 静态代理和动态代理的区别,什么场景使用? Java的异常体系 谈谈你对解析与分派的认识。 修改对象A的equals方法的签名,那么使用HashMap存放这个对象实例的时候,会调用哪个equals方法? Java中实现多态的机制是什么? 如何将一个Java对象序列化到文件里? 说说你对Java反射的理解 说说你对Java注解的理解 说说你对依赖注入的理解 说一下泛型原理,并举例说明 Java中String的了解 String为什么要设计成不可变的? Object类的equal和hashCode方法重写,为什么? (三) 数据结构 常用数据结构简介 并发集合了解哪些? 列举java的集合以及集合之间的继承关系 集合类以及集合框架 容器类介绍以及之间的区别(容器类估计很多人没听这个词,Java容器主要可以划分为4个部分:List列表、Set集合、Map映射、工具类(Iterator迭代器、Enumeration枚举类、Arrays和Collections),具体的可以看看这篇博文 Java容器类) List,Set,Map的区别 List和Map的实现方式以及存储方式 HashMap的实现原理 HashMap数据结构? HashMap源码理解 HashMap如何put数据(从HashMap源码角度讲解)? HashMap怎么手写实现? ConcurrentHashMap的实现原理 ArrayMap和HashMap的对比 HashTable实现原理 TreeMap具体实现 HashMap和HashTable的区别 HashMap与HashSet的区别 HashSet与HashMap怎么判断集合元素重复? 集合Set实现Hash怎么防止碰撞 ArrayList和LinkedList的区别,以及应用场景 数组和链表的区别 二叉树的深度优先遍历和广度优先遍历的具体实现 堆的结构 堆和树的区别 堆和栈在内存中的区别是什么(解答提示:可以从数据结构方面以及实际实现方面两个方面去回答)? 什么是深拷贝和浅拷贝 手写链表逆序代码 讲一下对树,B+树的理解 讲一下对图的理解 判断单链表成环与否? 链表翻转(即:翻转一个单项链表) 合并多个单有序链表(假设都是递增的) (四) 线程、多线程和线程池 开启线程的三种方式? 线程和进程的区别? 为什么要有线程,而不是仅仅用进程? run()和start()方法区别 如何控制某个方法允许并发访问线程的个数? 在Java中wait和seelp方法的不同; 谈谈wait/notify关键字的理解 什么导致线程阻塞? 线程如何关闭? 讲一下java中的同步的方法 数据一致性如何保证? 如何保证线程安全? 如何实现线程同步? 两个进程同时要求写或者读,能不能实现?如何防止进程的同步? 线程间操作List Java中对象的生命周期 Synchronized用法 synchronize的原理 谈谈对Synchronized关键字,类锁,方法锁,重入锁的理解 static synchronized 方法的多线程访问和作用 同一个类里面两个synchronized方法,两个线程同时访问的问题 volatile的原理 谈谈volatile关键字的用法 谈谈volatile关键字的作用 谈谈NIO的理解 synchronized 和volatile 关键字的区别 synchronized与Lock的区别 ReentrantLock 、synchronized和volatile比较 ReentrantLock的内部实现 lock原理 死锁的四个必要条件? 怎么避免死锁? 对象锁和类锁是否会互相影响? 什么是线程池,如何使用? Java的并发、多线程、线程模型 谈谈对多线程的理解 多线程有什么要注意的问题? 谈谈你对并发编程的理解并举例说明 谈谈你对多线程同步机制的理解? 如何保证多线程读写文件的安全? 多线程断点续传原理 断点续传的实现 (五)并发编程有关知识点(这个是一般Android开发用的少的,所以建议多去看看): 平时Android开发中对并发编程可以做得比较少,Thread这个类经常会用到,但是我们想提升自己的话,一定不能停留在表面,,我们也应该去了解一下java的关于线程相关的源码级别的东西。 学习的参考资料如下: Java 内存模型 java线程安全总结 深入理解java内存模型系列文章 线程状态: 一张图让你看懂JAVA线程间的状态转换 锁: 锁机制:synchronized、Lock、Condition Java 中的锁 并发编程: Java并发编程:Thread类的使用 Java多线程编程总结 Java并发编程的总结与思考 Java并发编程实战-----synchronized 深入分析ConcurrentHashMap 二、Android面试题 Android面试题包括Android基础,还有一些源码级别的、原理这些等。所以想去大公司面试,一定要多看看源码和实现方式,常用框架可以试试自己能不能手写实现一下,锻炼一下自己。 (一)Android基础知识点 四大组件是什么 四大组件的生命周期和简单用法 Activity之间的通信方式 Activity各种情况下的生命周期 横竖屏切换的时候,Activity 各种情况下的生命周期 Activity与Fragment之间生命周期比较 Activity上有Dialog的时候按Home键时的生命周期 两个Activity 之间跳转时必然会执行的是哪几个方法? 前台切换到后台,然后再回到前台,Activity生命周期回调方法。弹出Dialog,生命值周期回调方法。 Activity的四种启动模式对比 Activity状态保存于恢复 fragment各种情况下的生命周期 Fragment状态保存startActivityForResult是哪个类的方法,在什么情况下使用? 如何实现Fragment的滑动? fragment之间传递数据的方式? Activity 怎么和Service 绑定? 怎么在Activity 中启动自己对应的Service? service和activity怎么进行数据交互? Service的开启方式 请描述一下Service 的生命周期 谈谈你对ContentProvider的理解 说说ContentProvider、ContentResolver、ContentObserver 之间的关系 请描述一下广播BroadcastReceiver的理解 广播的分类 广播使用的方式和场景 在manifest 和代码中如何注册和使用BroadcastReceiver? 本地广播和全局广播有什么差别? BroadcastReceiver,LocalBroadcastReceiver 区别 AlertDialog,popupWindow,Activity区别 Application 和 Activity 的 Context 对象的区别 Android属性动画特性 如何导入外部数据库? LinearLayout、RelativeLayout、FrameLayout的特性及对比,并介绍使用场景。 谈谈对接口与回调的理解 回调的原理 写一个回调demo 介绍下SurfView RecycleView的使用 序列化的作用,以及Android两种序列化的区别 差值器 估值器 Android中数据存储方式 (二)Android源码相关分析 Android动画框架实现原理 Android各个版本API的区别 Requestlayout,onlayout,onDraw,DrawChild区别与联系 invalidate和postInvalidate的区别及使用 Activity-Window-View三者的差别 谈谈对Volley的理解 如何优化自定义View 低版本SDK如何实现高版本api? 描述一次网络请求的流程 HttpUrlConnection 和 okhttp关系 Bitmap对象的理解 looper架构 ActivityThread,AMS,WMS的工作原理 自定义View如何考虑机型适配 自定义View的事件 AstncTask+HttpClient 与 AsyncHttpClient有什么区别? LaunchMode应用场景 AsyncTask 如何使用? SpareArray原理 请介绍下ContentProvider 是如何实现数据共享的? AndroidService与Activity之间通信的几种方式 IntentService原理及作用是什么? 说说Activity、Intent、Service 是什么关系 ApplicationContext和ActivityContext的区别 SP是进程同步的吗?有什么方法做到同步? 谈谈多线程在Android中的使用 进程和 Application 的生命周期 封装View的时候怎么知道view的大小 RecycleView原理 AndroidManifest的作用与理解 (三)常见的一些原理性问题 Handler机制和底层实现 Handler、Thread和HandlerThread的差别 handler发消息给子线程,looper怎么启动? 关于Handler,在任何地方new Handler 都是什么线程下? ThreadLocal原理,实现及如何保证Local属性? 请解释下在单线程模型中Message、Handler、Message Queue、Looper之间的关系 请描述一下View事件传递分发机制 Touch事件传递流程 事件分发中的onTouch 和onTouchEvent 有什么区别,又该如何使用? View和ViewGroup分别有哪些事件分发相关的回调方法 View刷新机制 View绘制流程 自定义控件原理 自定义View如何提供获取View属性的接口? Android代码中实现WAP方式联网 AsyncTask机制 AsyncTask原理及不足 如何取消AsyncTask? 为什么不能在子线程更新UI? ANR产生的原因是什么? ANR定位和修正 oom是什么? 什么情况导致oom? 有什么解决方法可以避免OOM? Oom 是否可以try catch?为什么? 内存泄漏是什么? 什么情况导致内存泄漏? 如何防止线程的内存泄漏? 内存泄露场的解决方法 内存泄漏和内存溢出区别? LruCache默认缓存大小 ContentProvider的权限管理(解答:读写分离,权限控制-精确到表级,URL控制) 如何通过广播拦截和abort一条短信? 广播是否可以请求网络? 广播引起anr的时间限制是多少? 计算一个view的嵌套层级 Activity栈 Android线程有没有上限? 线程池有没有上限? ListView重用的是什么? Android为什么引入Parcelable? 有没有尝试简化Parcelable的使用? (四)开发中常见的一些问题 ListView 中图片错位的问题是如何产生的? 混合开发有了解吗? 知道哪些混合开发的方式?说出它们的优缺点和各自使用场景?(解答:比如:RN,weex,H5,小程序,WPA等。做Android的了解一些前端js等还是很有好处的); 屏幕适配的处理技巧都有哪些? 服务器只提供数据接收接口,在多线程或多进程条件下,如何保证数据的有序到达? 动态布局的理解 怎么去除重复代码? 画出 Android 的大体架构图 Recycleview和ListView的区别 ListView图片加载错乱的原理和解决方案 动态权限适配方案,权限组的概念 Android系统为什么会设计ContentProvider? 下拉状态栏是不是影响activity的生命周期 如果在onStop的时候做了网络请求,onResume的时候怎么恢复? Bitmap 使用时候注意什么? Bitmap的recycler() Android中开启摄像头的主要步骤 ViewPager使用细节,如何设置成每次只初始化当前的Fragment,其他的不初始化? 点击事件被拦截,但是想传到下面的View,如何操作? 微信主页面的实现方式 微信上消息小红点的原理 CAS介绍(这是阿里巴巴的面试题,我不是很了解,可以参考博客: CAS简介) 三、混合开发面试题 大厂除了技术深度之外,还要求你具备一些广度的知识,比如你要会前端知识,会混合开发,至少会一种脚本语言,C c++更不用说了,也是必会的。 Hybrid做过吗? Hybrid通信原理是什么,有做研究吗? react native有多少了解?讲一下原理。 weex了解吗?如何自己实现类似技术? flutter了解吗?内部是如何实现跨平台的? Dart语言有研究贵吗? 快应用了解吗?跟其她方式相比有什么优缺点? 说说你用过的混合开发技术有哪些?各有什么优缺点? Python会吗? 会不会PHP? Gradle了解多少?groovy语法会吗? 四、高端技术面试题 这里讲的是大公司需要用到的一些高端Android技术,这里专门整理了一个文档,希望大家都可以看看。这些题目有点技术含量,需要好点时间去研究一下的。 (一)图片 图片库对比 图片库的源码分析 图片框架缓存实现 LRUCache原理 图片加载原理 自己去实现图片库,怎么做? Glide源码解析 Glide使用什么缓存? Glide内存缓存如何控制大小? (二)网络和安全机制 网络框架对比和源码分析 自己去设计网络请求框架,怎么做? okhttp源码 网络请求缓存处理,okhttp如何处理网络缓存的 从网络加载一个10M的图片,说下注意事项 TCP的3次握手和四次挥手 TCP与UDP的区别 TCP与UDP的应用 HTTP协议 HTTP1.0与2.0的区别 HTTP报文结构 HTTP与HTTPS的区别以及如何实现安全性 如何验证证书的合法性? https中哪里用了对称加密,哪里用了非对称加密,对加密算法(如RSA)等是否有了解? client如何确定自己发送的消息被server收到? 谈谈你对WebSocket的理解 WebSocket与socket的区别 谈谈你对安卓签名的理解。 请解释安卓为啥要加签名机制? 视频加密传输 App 是如何沙箱化,为什么要这么做? 权限管理系统(底层的权限是如何进行 grant 的)? (三)数据库 sqlite升级,增加字段的语句 数据库框架对比和源码分析 数据库的优化 数据库数据迁移问题 (四)算法 排序算法有哪些? 最快的排序算法是哪个? 手写一个冒泡排序 手写快速排序代码 快速排序的过程、时间复杂度、空间复杂度 手写堆排序 堆排序过程、时间复杂度及空间复杂度 写出你所知道的排序算法及时空复杂度,稳定性 二叉树给出根节点和目标节点,找出从根节点到目标节点的路径 给阿里2万多名员工按年龄排序应该选择哪个算法? GC算法(各种算法的优缺点以及应用场景) 蚁群算法与蒙特卡洛算法 子串包含问题(KMP 算法)写代码实现 一个无序,不重复数组,输出N个元素,使得N个元素的和相加为M,给出时间复杂度、空间复杂度。手写算法 万亿级别的两个URL文件A和B,如何求出A和B的差集C(提示:Bit映射->hash分组->多文件读写效率->磁盘寻址以及应用层面对寻址的优化) 百度POI中如何试下查找最近的商家功能(提示:坐标镜像+R树)。 两个不重复的数组集合中,求共同的元素。 两个不重复的数组集合中,这两个集合都是海量数据,内存中放不下,怎么求共同的元素? 一个文件中有100万个整数,由空格分开,在程序中判断用户输入的整数是否在此文件中。说出最优的方法 一张Bitmap所占内存以及内存占用的计算 2000万个整数,找出第五十大的数字? 烧一根不均匀的绳,从头烧到尾总共需要1个小时。现在有若干条材质相同的绳子,问如何用烧绳的方法来计时一个小时十五分钟呢? 求1000以内的水仙花数以及40亿以内的水仙花数 5枚硬币,2正3反如何划分为两堆然后通过翻转让两堆中正面向上的硬8币和反面向上的硬币个数相同 时针走一圈,时针分针重合几次 N*N的方格纸,里面有多少个正方形 x个苹果,一天只能吃一个、两个、或者三个,问多少天可以吃完? (五)插件化、模块化、组件化、热修复、增量更新、Gradle 对热修复和插件化的理解 插件化原理分析 模块化实现(好处,原因) 热修复,插件化 项目组件化的理解 描述清点击 Android Studio 的 build 按钮后发生了什么 (六)架构设计和设计模式 谈谈你对Android设计模式的理解 MVC MVP MVVM原理和区别 你所知道的设计模式有哪些? 项目中常用的设计模式 手写生产者/消费者模式 写出观察者模式的代码 适配器模式,装饰者模式,外观模式的异同? 用到的一些开源框架,介绍一个看过源码的,内部实现过程。 谈谈对RxJava的理解 RxJava的功能与原理实现 RxJava的作用,与平时使用的异步操作来比的优缺点 说说EventBus作用,实现方式,代替EventBus的方式 从0设计一款App整体架构,如何去做? 说一款你认为当前比较火的应用并设计(比如:直播APP,P2P金融,小视频等) 谈谈对java状态机理解 Fragment如果在Adapter中使用应该如何解耦? Binder机制及底层实现 对于应用更新这块是如何做的?(解答:灰度,强制更新,分区域更新)? 实现一个Json解析器(可以通过正则提高速度) 统计启动时长,标准 (七)性能优化 如何对Android 应用进行性能分析以及优化? ddms 和 traceView 性能优化如何分析systrace? 用IDE如何分析内存泄漏? Java多线程引发的性能问题,怎么解决? 启动页白屏及黑屏解决? 启动太慢怎么解决? 怎么保证应用启动不卡顿? App启动崩溃异常捕捉 自定义View注意事项 现在下载速度很慢,试从网络协议的角度分析原因,并优化(提示:网络的5层都可以涉及)。 Https请求慢的解决办法(提示:DNS,携带数据,直接访问IP) 如何保持应用的稳定性 RecyclerView和ListView的性能对比 ListView的优化 RecycleView优化 View渲染 Bitmap如何处理大图,如一张30M的大图,如何预防OOM java中的四种引用的区别以及使用场景 强引用置为null,会不会被回收? (八)NDK、jni、Binder、AIDL、进程通信有关 请介绍一下NDK 什么是NDK库? jni用过吗? 如何在jni中注册native函数,有几种注册方式? Java如何调用c、c++语言? jni如何调用java层代码? 进程间通信的方式? Binder机制 简述IPC? 什么是AIDL? AIDL解决了什么问题? AIDL如何使用? Android 上的 Inter-Process-Communication 跨进程通信时如何工作的? 多进程场景遇见过么? Android进程分类? 进程和 Application 的生命周期? 进程调度 谈谈对进程共享和线程安全的认识 谈谈对多进程开发的理解以及多进程应用场景 什么是协程? (九)framework层、ROM定制、Ubuntu、Linux之类的问题 java虚拟机的特性 谈谈对jvm的理解 JVM内存区域,开线程影响哪块内存 对Dalvik、ART虚拟机有什么了解? Art和Dalvik对比 虚拟机原理,如何自己设计一个虚拟机(内存管理,类加载,双亲委派) 谈谈你对双亲委派模型理解 JVM内存模型,内存区域 类加载机制 谈谈对ClassLoader(类加载器)的理解 谈谈对动态加载(OSGI)的理解 内存对象的循环引用及避免 内存回收机制、GC回收策略、GC原理时机以及GC对象 垃圾回收机制与调用System.gc()区别 Ubuntu编译安卓系统 系统启动流程是什么?(提示:Zygote进程 –> SystemServer进程 –> 各种系统服务 –> 应用进程) 大体说清一个应用程序安装到手机上时发生了什么 简述Activity启动全部过程 App启动流程,从点击桌面开始 逻辑地址与物理地址,为什么使用逻辑地址? Android为每个应用程序分配的内存大小是多少? Android中进程内存的分配,能不能自己分配定额内存? 进程保活的方式 如何保证一个后台服务不被杀死?(相同问题:如何保证service在后台不被kill?)比较省电的方式是什么? App中唤醒其他进程的实现方式 五、非技术性问题&HR问题汇总 这里整理的是一些与技术没有直接关系的面试题,但是能够考察你的综合水平,所以不要以为不是技术问题,就不看,往往有时候就是这样一些细节的题目被忽视,而错过了一次次面试机会。 (一)非技术问题 介绍你做过的哪些项目 都使用过哪些框架、平台? 都使用过哪些自定义控件? 研究比较深入的领域有哪些? 对业内信息的关注渠道有哪些? 最近都读哪些书? 有没有什么开源项目? 自己最擅长的技术点,最感兴趣的技术领域和技术点 项目中用了哪些开源库,如何避免因为引入开源库而导致的安全性和稳定性问题 实习过程中做了什么,有什么产出? (二)HR提出的面试问题 您在前一家公司的离职原因是什么? 讲一件你印象最深的一件事情 介绍一个你影响最深的项目 介绍你最热爱最擅长的专业领域 公司实习最大的收获是什么? 与上级意见不一致时,你将怎么办? 自己的优点和缺点是什么?并举例说明? 你的学习方法是什么样的?实习过程中如何学习?实习项目中遇到的最大困难是什么以及如何解决的? 说一件最能证明你能力的事情 针对你你申请的这个职位,你认为你还欠缺什么 如果通过这次面试我们单位录用了你,但工作一段时间却发现你根本不适合这个职位,你怎么办? 项目中遇到最大的困难是什么?如何解决的? 你的职业规划以及个人目标、未来发展路线及求职定位 如果你在这次面试中没有被录用,你怎么打算? 评价下自己,评价下自己的技术水平,个人代码量如何? 通过哪些渠道了解的招聘信息,其他同学都投了哪些公司? 业余都有哪些爱好? 你做过的哪件事最令自己感到骄傲? 假如你晚上要去送一个出国的同学去机场,可单位临时有事非你办不可,你怎么办? 就你申请的这个职位,你认为你还欠缺什么? 当前的offer状况;如果BATH都给了offer该如何选? 你对一份工作更看重哪些方面?平台,技术,氛围,城市,还是money? 理想薪资范围;杭州岗和北京岗选哪个? 理想中的工作环境是什么? 谈谈你对跳槽的看法 说说你对行业、技术发展趋势的看法 实习过程中周围同事/同学有哪些值得学习的地方? 家人对你的工作期望及自己的工作期望 如果你的工作出现失误,给本公司造成经济损失,你认为该怎么办? 若上司在公开会议上误会你了,该如何解决? 是否可以实习,可以实习多久? 在五年的时间内,你的职业规划 你看中公司的什么?或者公司的那些方面最吸引你? 引用声明: 文章开头图片来自于 https://mini.eastday.com/a/160420175508810.html?btype=listpage&idx=37&ishot=0&subtype=news 本文参考相关博文如下: 阿里、腾讯、百度、华为、京东、搜狗和滴滴最新面试题汇集2017下半年,一二线互联网公司Android面试题汇总2017 年初、阿里、腾讯、百度、华为、京东、搜狗和滴滴面试题汇集(更新篇)android_interviewAndroidInterview-Q-A 相关文章: 【面试经验】那些年面试遇到的“坑”老程序员的10条中肯建议一个十几年程序员给所有新老程序员的忠告

优秀的个人博客,低调大师

盘点互有增减的2015 BAT 校招

【大咖・来了 第7期】10月24日晚8点观看《智能导购对话机器人实践》 又到一年开学季,也是毕业生开始被各种招聘、宣讲所围绕的时节。 在众多行业中,互联网在过往几年,也属于较热门的***梯队之中。不过,在2015年的经济形势下,大家不由地疑问,互联网企业的招聘还会持续吗? 《***财经日报》记者多方了解到,目前互联网企业对人才的渴求依然明显,校园招聘也在紧锣密鼓地展开。不过,企业们对人才的要求可能会更加严格,除了优中选优,技术类人才2015年更受青睐。 阿里:名额缩减 9月7日,阿里校招团队负责人曲洋向《***财经日报》记者表示,目前阿里2016年校招已经发放1407份录用意向书,此外,加上正在进行中的实习生转正及专场面试,还将陆续发出几百份offer。 《***财经日报》记者从几位阿里内部人士了解,2015年9月1日阿里巴巴内部召开了一个人才策略调整的会议,这实际上成为左右2015年校招变化的直接因素。据称会上的总体思路是,为应对阿里巴巴组织变革,需要对人才战略进行调整,优中取优,从“平凡人做非凡事”的口号变成“非凡人做非凡事”。校招名额缩减是执行该政策的结果之一。9月1日下午,在开完上述人才策略调整会议后,阿里在其校招官网和官微上发布了说明,其解释称:由于集团人才战略调整,阿里巴巴2016校招名额确定将要缩减,各岗位将执行更加严格的“择优录取”标准,也就是说,按原定名额有很大几率被录取的同学,现在不得不面临更加激烈的竞争。 百度:略有上浮 “2016年百度校园招聘人数将突破1500人,预计比2014年略有上浮。”9月8日,百度方面对《***财经日报》记者透露了2015年的校招规模。 在扩大2016年校园招聘规模的同时,百度也扩大了职位招聘范围。以往百度校园招聘大部分职位为技术岗等,而此次百度校园招聘在以技术为主要岗位上,增加了HR、商务拓展、商业分析师等职位,旨在吸纳多元化的人才。 有业内人士认为,百度“大手笔”招揽优秀人才,是为了深化其连接3600行的O2O战略储备人才队伍。在这背后,百度它已把***一笔投资(三年200亿)押注在糯米上,此外,百度2015年上半年的投资主要围绕O2O展开。 值得一提的是,除了常规的校园宣讲之外,百度的“百赴美计划”和“4S计划”是百度校园招聘吸引人才的重磅项目之一。 其中,“4S计划”(Super Search Shining Star),是百度专为培育优秀搜索技术人才而推出的,要求专业能力上在某一个或多个互联网搜索技术上,百度会提供高于一般校招标准的Special offer,将参与***的技术和平台;“百赴美”计划将技术能力超群的学生直接派往百度在美国硅谷的研发中心,相信这应当是百度对未来核心研发智囊的培育计划之一。 腾讯:与往年持平 在腾讯校园招聘的官网上,记者了解到,在2014年2015年校园招聘中,腾讯公司的招聘团队覆盖了全国多个城市,并录用1000多名学生。 2015年3月,腾讯校园招聘官网曾发布的一条针对2016届毕业生的校园招聘信息显示,腾讯有1000多个岗位虚席以待,招聘岗位涉及技术、视觉设计、策划、商业分析等众多岗位。当被问及腾讯的2016校园招聘与其他竞争对手相比***的优势是什么?腾讯方面的回答称,丰富的实习岗位提供了多元化的发展平台,尊重个性、轻松自由的工作环境、有趣的实习工作让毕业生更明确未来的职业发展方向。 京东:将招超过3000个岗位 9月8日,京东方面向《***财经日报》记者透露,2015年京东开放给应届毕业生的岗位种类超过80个,岗位数量超过3000个,从岗位类型上,有技术研发类、金融类、物流类、营销类、职能类,运营类等等,工作地点覆盖了北京、上海、广州、成都、武汉、西安、南京、沈阳等各大城市。 网易:扩招至2000人 在网易的官方网站的Q&A部分,提到“2015年网易互联网全面扩招,预计将发出近2000份offer”,并特别提到,“对于技术类、产品类岗位更是不限人数”。值得一提的是,网易校招启动的也很早,从8月中旬就开始,足足比大部分企业提前了一个月,也显示出其抢人的决心。 58同城:增招23% 9月8日,58同城方面向《***财经日报》记者透露2013届实际入职92人,2014届实际入职152人,2015届实际入职566人,新一年校招,我们预计招收700人。按这一比例计算,2015年其招聘人数较2014年上涨了23%。 还有哪些企业在进行校园招聘? 以上企业的招聘计划,只是互联网企业的“人才圈地运动”的冰山一角。《***财经日报》记者查阅多家互联网企业网站,发现搜狐、滴滴快的、爱奇艺等互联网企业都拟定了详细的校园招聘行程和计划。虽然没有公布人数,但声势都不小。 众多招聘企业中,大部分将日程安排在9月中旬开始,例如,滴滴快的***场宣讲选在9月14日;美团的***场宣讲在9月9日开始,等等。不过,在简历截止时间上,大家紧迫程度各不相同,例如,大众点评的首批简历(南京、武汉、西安)就截止到9月15日,但上海和“隐藏批”截止到11月1日;而滴滴快的则将全部截止日期都定在10月31日,备足了两个月的宣传期。更晚一些的,像酷派,则将整个宣讲流程从10月开始持续到11月。 职位方面,互联网企业2015年不约而同地更多放出了大量技术类的职位。这也许是目前市场状况下,大家选择“练内功”的结果。 【责任编辑: chenqingxiang TEL:(010)68476606】

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册