首页 文章 精选 留言 我的

精选列表

搜索[bat],共2195篇文章
优秀的个人博客,低调大师

字节今年 AI 研发投入接近 BAT 三家总和

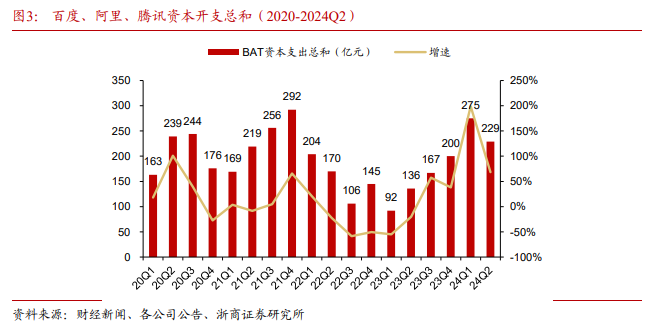
浙商证券在其报告中指出,字节跳动在AI上加大流量投放、扩大资本开支、大力扩张团队,研发投入显著领先同行。在资金上,字节跳动在AI上投入巨大,2024年资本开支达到800亿元,接近百度、阿里、腾讯三家的总和(约1000亿元)。 2025年,字节跳动资本开支有望达到1600亿元,其中约900亿元将用于AI算力的采购,700 亿元用于IDC基建以及网络设备。 浙商证券表示,类比于微软加力投资OpenAI,字节之于中国或可类比OpenAI之于美国。报告指出,海外大模型蓬勃发展离不开巨大的算力投入,而字节巨量的算力开支有望带动整体中国AI产业的发展。 在AI人才方面,浙商证券表示:据证券时报,公司创始人张一鸣多次在内部强调追求"通用人工智能"的目标。大模型成员来自字节的核心部门,语言部分由搜索团队牵头,图像部分由产品研发与工程架构部下属的智能创作团队牵头。

优秀的个人博客,低调大师

美国突然宣布“清网”措施,明确点名华为及BAT

本文经AI新媒体量子位(公众号ID:QbitAI)授权转载,转载请联系出处。 美东时间8月5日,美国国务院公布了国务卿蓬佩奥签发的美国“清网”(Clean Network)命令的补充条令。 在这个条令中,还明确点名了华为、百度、阿里、腾讯等中国公司。 从App、云、运营等等方面,给出了更直白、更具针对性的举措。 甚至放话:不受信任的App,就要直接从美国应用商店中删掉。 5大方向,点名HBAT 蓬佩奥签发的命令中,要求把美国的网络“打扫干净”,总共有五条措施,原文翻译如下: 运营商:确保不受信任的中国运营商未与美国电信网络连接。此类公司对美国国家安全构成威胁,因此禁止提供往返美国的国际电信服务。 应用商店:从美国移动应用商店中删除不受信任的APP。来自中国的APP威胁美国的隐私,传播病毒,并传播宣传和虚假信息。 应用程序App:防止不受信任的中国智能手机制造商,在其应用商店中预安装(或以其他方式使之可供下载)受信任的应用程序。华为是中国的公司,利用美国和外国领先企业的创新和声誉进行交易。这些公司应从华为的应用程序商店中删除其应用程序。 云:防止美国公民最敏感的个人信息和企业的知识产权(包括COVID-19疫苗研究),在阿里巴巴、百度和腾讯等云端系统存储或处理。 光缆:确保世界各地的海底电缆不受到破坏。 特朗普的清网行动 Clean Network计划是特朗普政府采取的综合措施,保护美国公民的隐私和公司敏感信息免受侵扰。 这些计划以美国政府在2020年4月29日宣布的5G倡议路径为基础。 而蓬佩奥昨天签署的命令中,说到目前全世界大概有30多个国家和地区,是这届美国政府认为的“Clean Country”,这些“Clean Country”和很多大公司已经向美国政府承诺,使用所谓美国认可的“Clean Network”。

优秀的个人博客,低调大师

Android大厂面试题锦集(BAT TMD JD 小米)

1.android事件分发机制,请详细说下整个流程 事件分发(面试).png 2.android view绘制机制和加载过程,请详细说下整个流程 1.ViewRootImpl会调用performTraversals(),其内部会调用performMeasure()、performLayout、performDraw()。 2.performMeasure()会调用最外层的ViewGroup的measure()-->onMeasure(),ViewGroup的onMeasure()是抽象方法,但其提供了measureChildren(),这之中会遍历子View然后循环调用measureChild()这之中会用getChildMeasureSpec()+父View的MeasureSpec+子View的LayoutParam一起获取本View的MeasureSpec,然后调用子View的measure()到View的onMeasure()-->setMeasureDimension(getDefaultSize(),getDefaultSize()),getDefaultSize()默认返回measureSpec的测量数值,所以继承View进行自定义的wrap_content需要重写。 3.performLayout()会调用最外层的ViewGroup的layout(l,t,r,b),本View在其中使用setFrame()设置本View的四个顶点位置。在onLayout(抽象方法)中确定子View的位置,如LinearLayout会遍历子View,循环调用setChildFrame()-->子View.layout()。 4.performDraw()会调用最外层ViewGroup的draw():其中会先后调用background.draw()(绘制背景)、onDraw()(绘制自己)、dispatchDraw()(绘制子View)、onDrawScrollBars()(绘制装饰)。 5.MeasureSpec由2位SpecMode(UNSPECIFIED、EXACTLY(对应精确值和match_parent)、AT_MOST(对应warp_content))和30位SpecSize组成一个int,DecorView的MeasureSpec由窗口大小和其LayoutParams决定,其他View由父View的MeasureSpec和本View的LayoutParams决定。ViewGroup中有getChildMeasureSpec()来获取子View的MeasureSpec。 6.三种方式获取measure()后的宽高: 1.Activity#onWindowFocusChange()中调用获取 2.view.post(Runnable)将获取的代码投递到消息队列的尾部。 3.ViewTreeObservable. 3.android四大组件的加载过程,请详细介绍下 1.android四大组件的加载过程:这是我总结的一篇博客 4.Activity的启动模式 1.standard:默认标准模式,每启动一个都会创建一个实例, 2.singleTop:栈顶复用,如果在栈顶就调用onNewIntent复用,从onResume()开始 3.singleTask:栈内复用,本栈内只要用该类型Activity就会将其顶部的activity出栈 4.singleInstance:单例模式,除了3中特性,系统会单独给该Activity创建一个栈, 5.A、B、C、D分别是四种Activity的启动模式,那么A->B->C->D->A->B->C->D分别启动,最后的activity栈是怎么样的 1.这个题目需要深入了解activity的启动模式 2.最后的答案是:两个栈,前台栈是只有D,后台栈从底至上是A、B、C 6.Activity缓存方法 1.配置改变导致Activity被杀死,横屏变竖屏:在onStop之前会调用onSaveInstanceState()保存数据在重建Activity之后,会在onStart()之后调用onRestoreInstanceState(),并把保存下来的Bundle传给onCreate()和它会默认重建Activity当前的视图,我们可以在onCreate()中,回复自己的数据。 2.内存不足杀掉Activity,优先级分别是:前台可见,可见非前台,后台。 7.Service的生命周期,两种启动方法,有什么区别 1.context.startService() ->onCreate()- >onStart()->Service running-->(如果调用context.stopService() )->onDestroy() ->Service shut down 1.如果Service还没有运行,则调用onCreate()然后调用onStart(); 2.如果Service已经运行,则只调用onStart(),所以一个Service的onStart方法可能会重复调用多次。 3.调用stopService的时候直接onDestroy, 4.如果是调用者自己直接退出而没有调用stopService的话,Service会一直在后台运行。该Service的调用者再启动起来后可以通过stopService关闭Service。 2.context.bindService()->onCreate()->onBind()->Service running-->onUnbind() -> onDestroy() ->Service stop 1.onBind将返回给客户端一个IBind接口实例,IBind允许客户端回调服务的方法,比如得到Service运行的状态或其他操作。 2.这个时候会把调用者和Service绑定在一起,Context退出了,Service就会调用onUnbind->onDestroy相应退出。 3.所以调用bindService的生命周期为:onCreate --> onBind(只一次,不可多次绑定) --> onUnbind --> onDestory。 8.怎么保证service不被杀死 1.提升service优先级 2.提升service进程优先级 3.onDestroy方法里重启service 9.静态的Broadcast 和动态的有什么区别 1.动态的比静态的安全 2.静态在app启动的时候就初始化了 动态使用代码初始化 3.静态需要配置 动态不需要 4.生存期,静态广播的生存期可以比动态广播的长很多 5.优先级动态广播的优先级比静态广播高 10.Intent可以传递哪些数据类型 1.Serializable 2.charsequence: 主要用来传递String,char等 3.parcelable 4.Bundle 11.Json有什么优劣势、解析的原理 1.JSON的速度要远远快于XML 2.JSON相对于XML来讲,数据的体积小 3.JSON对数据的描述性比XML较差 4.解析的基本原理是:词法分析 12.一个语言的编译过程 1.词法分析:将一串文本按规则分割成最小的结构,关键字、标识符、运算符、界符和常量等。一般实现方法是自动机和正则表达式 2.语法分析:将一系列单词组合成语法树。一般实现方法有自顶向下和自底向上 3.语义分析:对结构上正确的源程序进行上下文有关性质的审查 4.目标代码生成 5.代码优化:优化生成的目标代码, 13.动画有哪几类,各有什么特点 1.动画的基本原理:其实就是利用插值器和估值器,来计算出各个时刻View的属性,然后通过改变View的属性来,实现View的动画效果。 2.View动画:只是影像变化,view的实际位置还在原来的地方。 3.帧动画是在xml中定义好一系列图片之后,使用AnimationDrawable来播放的动画。 4.View的属性动画: 1.插值器:作用是根据时间的流逝的百分比来计算属性改变的百分比 2.估值器:在1的基础上由这个东西来计算出属性到底变化了多少数值的类 14.Handler、Looper消息队列模型,各部分的作用 1.MessageQueue:读取会自动删除消息,单链表维护,在插入和删除上有优势。在其next()中会无限循环,不断判断是否有消息,有就返回这条消息并移除。 2.Looper:Looper创建的时候会创建一个MessageQueue,调用loop()方法的时候消息循环开始,loop()也是一个死循环,会不断调用messageQueue的next(),当有消息就处理,否则阻塞在messageQueue的next()中。当Looper的quit()被调用的时候会调用messageQueue的quit(),此时next()会返回null,然后loop()方法也跟着退出。 3.Handler:在主线程构造一个Handler,然后在其他线程调用sendMessage(),此时主线程的MessageQueue中会插入一条message,然后被Looper使用。 4.系统的主线程在ActivityThread的main()为入口开启主线程,其中定义了内部类Activity.H定义了一系列消息类型,包含四大组件的启动停止。 5.MessageQueue和Looper是一对一关系,Handler和Looper是多对一 15.怎样退出终止App 1.自己设置一个Activity的栈,然后一个个finish() 16.Android IPC:Binder原理 1.在Activity和Service进行通讯的时候,用到了Binder。 1.当属于同个进程我们可以继承Binder然后在Activity中对Service进行操作 2.当不属于同个进程,那么要用到AIDL让系统给我们创建一个Binder,然后在Activity中对远端的Service进行操作。 2.系统给我们生成的Binder: 1.Stub类中有:接口方法的id,有该Binder的标识,有asInterface(IBinder)(让我们在Activity中获取实现了Binder的接口,接口的实现在Service里,同进程时候返回Stub否则返回Proxy),有onTransact()这个方法是在不同进程的时候让Proxy在Activity进行远端调用实现Activity操作Service 2.Proxy类是代理,在Activity端,其中有:IBinder mRemote(这就是远端的Binder),两个接口的实现方法不过是代理最终还是要在远端的onTransact()中进行实际操作。 3.哪一端的Binder是副本,该端就可以被另一端进行操作,因为Binder本体在定义的时候可以操作本端的东西。所以可以在Activity端传入本端的Binder,让Service端对其进行操作称为Listener,可以用RemoteCallbackList这个容器来装Listener,防止Listener因为经历过序列化而产生的问题。 4.当Activity端向远端进行调用的时候,当前线程会挂起,当方法处理完毕才会唤醒。 5.如果一个AIDL就用一个Service太奢侈,所以可以使用Binder池的方式,建立一个AIDL其中的方法是返回IBinder,然后根据方法中传入的参数返回具体的AIDL。 6.IPC的方式有:Bundle(在Intent启动的时候传入,不过是一次性的),文件共享(对于SharedPreference是特例,因为其在内存中会有缓存),使用Messenger(其底层用的也是AIDL,同理要操作哪端,就在哪端定义Messenger),AIDL,ContentProvider(在本进程中继承实现一个ContentProvider,在增删改查方法中调用本进程的SQLite,在其他进程中查询),Socket 17.描述一次跨进程通讯 1.client、proxy、serviceManager、BinderDriver、impl、service 2.client发起一个请求service信息的Binder请求到BinderDriver中,serviceManager发现BinderDiriver中有自己的请求 然后将clinet请求的service的数据返回给client这样完成了一次Binder通讯 3.clinet获取的service信息就是该service的proxy,此时调用proxy的方法,proxy将请求发送到BinderDriver中,此时service的 Binder线程池循环发现有自己的请求,然后用impl就处理这个请求最后返回,这样完成了第二次Binder通讯 4.中间client可挂起,也可以不挂起,有一个关键字oneway可以解决这个 18.android重要术语解释 1.ActivityManagerServices,简称AMS,服务端对象,负责系统中所有Activity的生命周期 2.ActivityThread,App的真正入口。当开启App之后,会调用main()开始运行,开启消息循环队列,这就是传说中的UI线程或者叫主线程。与ActivityManagerServices配合,一起完成Activity的管理工作 3.ApplicationThread,用来实现ActivityManagerService与ActivityThread之间的交互。在ActivityManagerService需要管理相关Application中的Activity的生命周期时,通过ApplicationThread的代理对象与ActivityThread通讯。 4.ApplicationThreadProxy,是ApplicationThread在服务器端的代理,负责和客户端的ApplicationThread通讯。AMS就是通过该代理与ActivityThread进行通信的。 5.Instrumentation,每一个应用程序只有一个Instrumentation对象,每个Activity内都有一个对该对象的引用。Instrumentation可以理解为应用进程的管家,ActivityThread要创建或暂停某个Activity时,都需要通过Instrumentation来进行具体的操作。 6.ActivityStack,Activity在AMS的栈管理,用来记录已经启动的Activity的先后关系,状态信息等。通过ActivityStack决定是否需要启动新的进程。 7.ActivityRecord,ActivityStack的管理对象,每个Activity在AMS对应一个ActivityRecord,来记录Activity的状态以及其他的管理信息。其实就是服务器端的Activity对象的映像。 8.TaskRecord,AMS抽象出来的一个“任务”的概念,是记录ActivityRecord的栈,一个“Task”包含若干个ActivityRecord。AMS用TaskRecord确保Activity启动和退出的顺序。如果你清楚Activity的4种launchMode,那么对这个概念应该不陌生。 19.理解Window和WindowManager 1.Window用于显示View和接收各种事件,Window有三种类型:应用Window(每个Activity对应一个Window)、子Window(不能单独存在,附属于特定Window)、系统window(Toast和状态栏) 2.Window分层级,应用Window在1-99、子Window在1000-1999、系统Window在2000-2999.WindowManager提供了增删改View三个功能。 3.Window是个抽象概念:每一个Window对应着一个View和ViewRootImpl,Window通过ViewRootImpl来和View建立联系,View是Window存在的实体,只能通过WindowManager来访问Window。 4.WindowManager的实现是WindowManagerImpl其再委托给WindowManagerGlobal来对Window进行操作,其中有四个List分别储存对应的View、ViewRootImpl、WindowManger.LayoutParams和正在被删除的View 5.Window的实体是存在于远端的WindowMangerService中,所以增删改Window在本端是修改上面的几个List然后通过ViewRootImpl重绘View,通过WindowSession(每个应用一个)在远端修改Window。 6.Activity创建Window:Activity会在attach()中创建Window并设置其回调(onAttachedToWindow()、dispatchTouchEvent()),Activity的Window是由Policy类创建PhoneWindow实现的。然后通过Activity#setContentView()调用PhoneWindow的setContentView。 20.Bitmap的处理 1.当使用ImageView的时候,可能图片的像素大于ImageView,此时就可以通过BitmapFactory.Option来对图片进行压缩,inSampleSize表示缩小2^(inSampleSize-1)倍。 2.BitMap的缓存: 1.使用LruCache进行内存缓存。 2.使用DiskLruCache进行硬盘缓存。 3.实现一个ImageLoader的流程:同步异步加载、图片压缩、内存硬盘缓存、网络拉取 1.同步加载只创建一个线程然后按照顺序进行图片加载 2.异步加载使用线程池,让存在的加载任务都处于不同线程 3.为了不开启过多的异步任务,只在列表静止的时候开启图片加载 21.如何实现一个网络框架(参考Volley) 1.缓存队列,以url为key缓存内容可以参考Bitmap的处理方式,这里单独开启一个线程。 2.网络请求队列,使用线程池进行请求。 3.提供各种不同类型的返回值的解析如String,Json,图片等等。 22.ClassLoader的基础知识 1.双亲委托:一个ClassLoader类负责加载这个类所涉及的所有类,在加载的时候会判断该类是否已经被加载过,然后会递归去他父ClassLoader中找。 2.可以动态加载Jar通过URLClassLoader 3.ClassLoader 隔离问题 JVM识别一个类是由:ClassLoader id+PackageName+ClassName。 4.加载不同Jar包中的公共类: 1.让父ClassLoader加载公共的Jar,子ClassLoader加载包含公共Jar的Jar,此时子ClassLoader在加载公共Jar的时候会先去父ClassLoader中找。(只适用Java) 2.重写加载包含公共Jar的Jar的ClassLoader,在loadClass中找到已经加载过公共Jar的ClassLoader,也就是把父ClassLoader替换掉。(只适用Java) 3.在生成包含公共Jar的Jar时候把公共Jar去掉。 23.插件化框架描述:dynamicLoadApk为例子 1.可以通过DexClassLoader来对apk中的dex包进行加载访问 2.如何加载资源是个很大的问题,因为宿主程序中并没有apk中的资源,所以调用R资源会报错,所以这里使用了Activity中的实现ContextImpl的getAssets()和getResources()再加上反射来实现。 3.由于系统启动Activity有很多初始化动作要做,而我们手动反射很难完成,所以可以采用接口机制,将Activity的大部分生命周期提取成接口,然后通过代理Activity去调用插件Activity的生命周期。同时如果像增加一个新生命周期方法的时候,只需要在接口中和代理中声明一下就行。 4.缺点: 1.慎用this,因为在apk中使用this并不代表宿主中的activity,当然如果this只是表示自己的接口还是可以的。除此之外可以使用that代替this。 2.不支持Service和静态注册的Broadcast 3.不支持LaunchMode和Apk中Activity的隐式调用。 24.热修复:Andfix为例子 1.大致原理:apkpatch将两个apk做一次对比,然后找出不同的部分。可以看到生成的apatch了文件,后缀改成zip再解压开,里面有一个dex文件。通过jadx查看一下源码,里面就是被修复的代码所在的类文件,这些更改过的类都加上了一个_CF的后缀,并且变动的方法都被加上了一个叫@MethodReplace的annotation,通过clazz和method指定了需要替换的方法。然后客户端sdk得到补丁文件后就会根据annotation来寻找需要替换的方法。最后由JNI层完成方法的替换。 2.无法添加新类和新的字段、补丁文件很容易被反编译、加固平台可能会使热补丁功能失效 25.线程同步的问题,常用的线程同步 1.sycn:保证了原子性、可见性、有序性 2.锁:保证了原子性、可见性、有序性 1.自旋锁:可以使线程在没有取得锁的时候,不被挂起,而转去执行一个空循环。 1.优点:线程被挂起的几率减少,线程执行的连贯性加强。用于对于锁竞争不是很激烈,锁占用时间很短的并发线程。 2.缺点:过多浪费CPU时间,有一个线程连续两次试图获得自旋锁引起死锁 2.阻塞锁:没得到锁的线程等待或者挂起,Sycn、Lock 3.可重入锁:一个线程可多次获取该锁,Sycn、Lock 4.悲观锁:每次去拿数据的时候都认为别人会修改,所以会阻塞全部其他线程 Sycn、Lock 5.乐观锁:每次去拿数据的时候都认为别人不会修改,所以不会上锁,但是在更新的时候会判断一下在此期间别人有没有去更新这个数据,可以使用版本号等机制。cas 6.显示锁和内置锁:显示锁用Lock来定义、内置锁用synchronized。 7.读-写锁:为了提高性能,Java提供了读 3.volatile 1.只能保证可见性,不能保证原子性 2.自增操作有三步,此时多线程写会出现问题 4.cas 1.操作:内存值V、旧的预期值A、要修改的值B,当且仅当预期值A和内存值V相同时,将内存值修改为B并返回true,否则什么都不做并返回false。 2.解释:本地副本为A,共享内存为V,线程A要把V修改成B。某个时刻线程A要把V修改成B,如果A和V不同那么就表示有其他线程在修改V,此时就表示修改失败,否则表示没有其他线程修改,那么把V改成B。 3.局限:如果V被修改成V1然后又被改成V,此时cas识别不出变化,还是认为没有其他线程在修改V,此时就会有问题 4.局限解决:将V带上版本。 5.线程不安全到底是怎么回事: 1.一个线程写,多个线程读的时候,会造成写了一半就去读 2.多线程写,会造成脏数据 26.Asynctask和线程池,GC相关(怎么判断哪些内存该GC,GC算法) 1.Asynctask:异步任务类,单线程线程池+Handler 2.线程池: 1.ThreadPoolExecutor:通过Executors可以构造单线程池、固定数目线程池、不固定数目线程池。 2.ScheduledThreadPoolExecutor:可以延时调用线程或者延时重复调度线程。 3.GC相关:重要 1.搜索算法: 1.引用计数 2.图搜索,可达性分析 2.回收算法: 1.标记清除复制:用于青年代 2.标记整理:用于老年代 3.堆分区: 1.青年区eden 80%、survivor1 10%、survivor2 10% 2.老年区 4.虚拟机栈分区: 1.局部变量表 2.操作数栈 3.动态链接 4.方法返回地址 5.GC Roots: 1.虚拟机栈(栈桢中的本地变量表)中的引用的对象 2.方法区中的类静态属性引用的对象 3.方法区中的常量引用的对象 4.本地方法栈中JNI的引用的对象 27.网络 1.ARP协议:在IP以太网中,当一个上层协议要发包时,有了该节点的IP地址,ARP就能提供该节点的MAC地址。 2.HTTP HTTPS的区别: 1.HTTPS使用TLS(SSL)进行加密 2.HTTPS缺省工作在TCP协议443端口 3.它的工作流程一般如以下方式: 1.完成TCP三次同步握手 2.客户端验证服务器数字证书,通过,进入步骤3 3.DH算法协商对称加密算法的密钥、hash算法的密钥 4.SSL安全加密隧道协商完成 5.网页以加密的方式传输,用协商的对称加密算法和密钥加密,保证数据机密性;用协商的hash算法进行数据完整性保护,保证数据不被篡改 3.http请求包结构,http返回码的分类,400和500的区别 1.包结构: 1.请求:请求行、头部、数据 2.返回:状态行、头部、数据 2.http返回码分类:1到5分别是,消息、成功、重定向、客户端错误、服务端错误 4.Tcp 1.可靠连接,三次握手,四次挥手 1.三次握手:防止了服务器端的一直等待而浪费资源,例如只是两次握手,如果s确认之后c就掉线了,那么s就会浪费资源 1.syn-c = x,表示这消息是x序号 2.ack-s = x + 1,表示syn-c这个消息接收成功。syn-s = y,表示这消息是y序号。 3.ack-c = y + 1,表示syn-s这条消息接收成功 2.四次挥手:TCP是全双工模式 1.fin-c = x , 表示现在需要关闭c到s了。ack-c = y,表示上一条s的消息已经接收完毕 2.ack-s = x + 1,表示需要关闭的fin-c消息已经接收到了,同意关闭 3.fin-s = y + 1,表示s已经准备好关闭了,就等c的最后一条命令 4.ack-c = y + 1,表示c已经关闭,让s也关闭 3.滑动窗口,停止等待、后退N、选择重传 4.拥塞控制,慢启动、拥塞避免、加速递减、快重传快恢复 28.数据库性能优化:索引和事务,需要找本专门的书大概了解一下 29.13.APK打包流程和其内容 1.流程 1.aapt生成R文件 2.aidl生成java文件 3.将全部java文件编译成class文件 4.将全部class文件和第三方包合并成dex文件 5.将资源、so文件、dex文件整合成apk 6.apk签名 7.apk字节对齐 2.内容:so、dex、asset、资源文件 30.网络劫持的类型原理:可以百度一下了解一下具体概念 1.DNS劫持、欺骗、污染 2.http劫持:重定向、注入js,http注入、报文扩展 31.java类加载过程: 1.加载时机:创建实例、访问静态变量或方法、反射、加载子类之前 2.验证:验证文件格式、元数据、字节码、符号引用的正确性 3.加载:根据全类名获取文件字节流、将字节流转化为静态储存结构放入方法区、生成class对象 4.准备:在堆上为静态变量划分内存 5.解析:将常量池中的符号引用转换为直接引用 6.初始化:初始化静态变量 7.书籍推荐:深入理解java虚拟机,博客推荐:Java/Android阿里面试JVM部分理解 32.retrofit的了解 1.动态代理创建一个接口的代理类 2.通过反射解析每个接口的注解、入参构造http请求 3.获取到返回的http请求,使用Adapter解析成需要的返回值。 33.bundle的数据结构,如何存储 1.键值对储存 2.传递的数据可以是boolean、byte、int、long、float、double、string等基本类型或它们对应的数组,也可以是对象或对象数组。 3.当Bundle传递的是对象或对象数组时,必须实现Serializable 或Parcelable接口 34.listview内点击buttom并移动的事件流完整拦截过程: 1.点下按钮的时候: 1.产生了一个down事件,activity-->phoneWindow-->ViewGroup-->ListView-->botton,中间如果有重写了拦截方法,则事件被该view拦截可能消耗。 2.没拦截,事件到达了button,这个过程中建立了一条事件传递的view链表 3.到button的dispatch方法-->onTouch-->view是否可用-->Touch代理 2.移动点击按钮的时候: 1.产生move事件,listView中会对move事件做拦截 2.此时listView会将该滑动事件消费掉 3.后续的滑动事件都会被listView消费掉 3.手指抬起来时候:前面建立了一个view链表,listView的父view在获取事件的时候,会直接取链表中的listView让其进行事件消耗。 35.service的意义:不需要界面,在后台执行的程序 36.android的IPC通信方式,线程(进程间)通信机制有哪些 1.ipc通信方式:binder、contentprovider、socket 2.操作系统进程通讯方式:共享内存、socket、管道 37.操作系统进程和线程的区别 1.简而言之,一个程序至少有一个进程,一个进程至少有一个线程. 2.线程的划分尺度小于进程,使得多线程程序的并发性高。 3.另外,进程在执行过程中拥有独立的内存单元,而多个线程共享内存,从而极大地提高了程序的运行效率。 4.多线程的意义在于一个应用程序中,有多个执行部分可以同时执行。有将多个线程看做多个独立的应用,来实现进程的调度和管理以及资源分配 38.HashMap的实现过程:Capacity就是buckets的数目,Load factor就是buckets填满程度的最大比例。如果对迭代性能要求很高的话不要把capacity设置过大,也不要把load factor设置过小。 1.简单来说HashMap就是一个会自动扩容的数组链表 2.put过程 1.对key的hashCode()做hash,然后再计算index; 2.如果没碰撞直接放到bucket里; 3.如果碰撞了,以链表的形式存在buckets后; 4.如果碰撞导致链表过长(大于等于TREEIFY_THRESHOLD),就把链表转换成红黑树; 5.如果节点已经存在就替换old value(保证key的唯一性) 6.如果bucket满了(超过load factor*current capacity),就要resize。 3.resize:当put时,如果发现目前的bucket占用程度已经超过了Load Factor所希望的比例,那么就会发生resize。在resize的过程,简单的说就是把bucket扩充为2倍,之后重新计算index,把节点再放到新的bucket中 4.get过程 1.根据key的hash算出数组下表 2.使用equals遍历链表进行比较 39.mvc、mvp、mvvm: 1.mvc:数据、View、Activity,View将操作反馈给Activity,Activitiy去获取数据,数据通过观察者模式刷新给View。循环依赖 1.Activity重,很难单元测试 2.View和Model耦合严重 2.mvp:数据、View、Presenter,View将操作给Presenter,Presenter去获取数据,数据获取好了返回给Presenter,Presenter去刷新View。PV,PM双向依赖 1.接口爆炸 2.Presenter很重 3.mvvm:数据、View、ViewModel,View将操作给ViewModel,ViewModel去获取数据,数据和界面绑定了,数据更新界面更新。 1.viewModel的业务逻辑可以单独拿来测试 2.一个view 对应一个 viewModel 业务逻辑可以分离,不会出现全能类 3.数据和界面绑定了,不用写垃圾代码,但是复用起来不舒服 40.java的线程如何实现 1.Thread继承 2.Runnale 3.Future 4.线程池 41.ArrayList 如何删除重复的元素或者指定的元素; 1.删除重复:Set 2.删除指定:迭代器 42.如何设计在 UDP 上层保证 UDP 的可靠性传输; 1.简单来讲,要使用UDP来构建可靠的面向连接的数据传输,就要实现类似于TCP协议的超时重传,有序接受,应答确认,滑动窗口流量控制等机制,等于说要在传输层的上一层(或者直接在应用层)实现TCP协议的可靠数据传输机制。 2.比如使用UDP数据包+序列号,UDP数据包+时间戳等方法,在服务器端进行应答确认机制,这样就会保证不可靠的UDP协议进行可靠的数据传输。 3.基于udp的可靠传输协议有:RUDP、RTP、UDT 43.Java 中内部类为什么可以访问外部类 1.因为内部类创建的时候,需要外部类的对象,在内部类对象创建的时候会把外部类的引用传递进去 44.设计移动端的联系人存储与查询的功能,要求快速搜索联系人,可以用到哪些数据结构?数据库索引,平衡二叉树(B树、红黑树) 45.红黑树特点 1.root节点和叶子节点是黑色 2.红色节点后必须为黑色节点 3.从root到叶子每条路径的黑节点数量相同 46.linux异步和同步i/o: 1.同步:对于client,client一直等待,但是client不挂起:主线程调用 2.异步:对于client,client发起请求,service好了再回调client:其他线程调用,调用完成之后进行回调 3.阻塞:对于service,在准备io的时候会将service端挂起,直至准备完成然后唤醒service:bio 3.非阻塞:对于service,在准备io的时候不会将service端挂起,而是service一直去轮询判断io是否准备完成,准备完成了就进行操作:nio、linux的select、poll、epoll 4.多路复用io:非阻塞io的一种优化,java nio,用一个线程去轮询多个 io端口是否可用,如果一个可用就通知对应的io请求,这使用一个线程轮询可以大大增强性能。 1.我可以采用 多线程+ 阻塞IO 达到类似的效果,但是由于在多线程 + 阻塞IO 中,每个socket对应一个线程,这样会造成很大的资源占用。 2.而在多路复用IO中,轮询每个socket状态是内核在进行的,这个效率要比用户线程要高的多。 5.异步io:aio,用户线程完全不感知io的进行,所有操作都交给内核,io完成之后内核通知用户线程。 1.这种io才是异步的,2、3、4都是同步io,因为内核进行数据拷贝的过程都会让用户线程阻塞。 2.异步IO是需要操作系统的底层支持,也就是内核支持,Java 7中,提供了Asynchronous IO 47.ConcurrentHashMap内部实现,HashTable的实现被废弃的原因: 1.HashTable容器在竞争激烈的并发环境下表现出效率低下的原因,是因为所有访问HashTable的线程都必须竞争同一把锁,那假如容器里有多把锁,每一把锁用于锁容器其中一部分数据,那么当多线程访问容器里不同数据段的数据时,线程间就不会存在锁竞争,从而可以有效的提高并发访问效率,这就是ConcurrentHashMap所使用的锁分段技术,首先将数据分成一段一段的存储,然后给每一段数据配一把锁,当一个线程占用锁访问其中一个段数据的时候,其他段的数据也能被其他线程访问。 2.ConcurrentHashMap是由Segment数组结构和HashEntry数组结构组成。Segment是一种可重入锁ReentrantLock,在ConcurrentHashMap里扮演锁的角色,HashEntry则用于存储键值对数据。一个ConcurrentHashMap里包含一个Segment数组,Segment的结构和HashMap类似,是一种数组和链表结构, 一个Segment里包含一个HashEntry数组,每个HashEntry是一个链表结构的元素,每个Segment守护者一个HashEntry数组里的元素,当对HashEntry数组的数据进行修改时,必须首先获得它对应的Segment锁。 48.HandlerThread是什么 1.MessageQueue + Looper + Handler 49.IntentService是什么 1.含有HandlerThread的Service,可以多次startService()来多次在子线程中进行 onHandlerIntent()的调用。 50.class和dex 1.dvm执行的是dex格式文件,jvm执行的是class文件,android程序编译完之后生产class文件。然后dex工具会把class文件处理成dex文件,然后把资源文件和.dex文件等打包成apk文件。 2.dvm是基于寄存器的虚拟机,而jvm执行是基于虚拟栈的虚拟机。寄存器存取速度比栈快的多,dvm可以根据硬件实现最大的优化,比较适合移动设备。 3.class文件存在很多的冗余信息,dex工具会去除冗余信息,并把所有的class文件整合到dex文件中。减少了I/O操作,提高了类的查找速度 51.内存泄漏 1.其他线程持有一个Listener,Listener操作activity。那么在线程么有完毕的时候,activity关闭了,原本是要被回收的但是,不能被回收。 2.例如Handler导致的内存泄漏,Handler就相当于Listener。 3.在activity关闭的时候注意停止线程,或者将Listener的注册取消 3.使用弱引用,这样即使Listener持有了activity,在GC的时候还是会被回收 4.工具:LeakCanary 52.过度绘制、卡顿优化: 1.过度绘制: 1.移除Window默认的Background:getWidow.setBackgroundDrawable(null); 2.移除XML布局文件中非必需的Background 3.减少布局嵌套(扁平化的一个体现,减少View数的深度,也就减少了View树的遍历时间,渲染的时候,前后期的工作,总是按View树结点来) 4.在引入布局文件里面,最外层可以用merge替代LinearLayout,RelativeLayout,这样把子UI元素直接衔接在include位置 5.工具:HierarchyViewer 查看视图层级 2.卡顿优化:16ms数据更新 53.apk瘦身: 1.classes.dex:通过代码混淆,删掉不必要的jar包和代码实现该文件的优化 2.资源文件:通过Lint工具扫描代码中没有使用到的静态资源 3.图片资源:使用tinypng和webP,下面详细介绍图片资源优化的方案,矢量图 4.SO文件将不用的去掉,目前主流app一般只放一个arm的so包 54.ANR的形成,各个组件上出现ARN的时间限制是多少 1.只要是主线程耗时的操作就会ARN 如io 2.broadcast超时时间为10秒 按键无响应的超时时间为5秒 前台service无响应的超时时间为20秒,后台service为200秒 55.Serializable和Parcelable 的区别 1.P 消耗内存小 2.网络传输用S 程序内使用P 3.S将数据持久化方便 4.S使用了反射 容易触发垃圾回收 比较慢 56.Sharedpreferences源码简述 1.储存于硬盘上的xml键值对,数据多了会有性能问题 2.ContextImpl记录着SharedPreferences的重要数据,文件路径和实例的键值对 3.在xml文件全部内加载到内存中之前,读取操作是阻塞的,在xml文件全部内加载到内存中之后,是直接读取内存中的数据 4.apply因为是异步的没有返回值, commit是同步的有返回值能知道修改是否提交成功 5.多并发的提交commit时,需等待正在处理的commit数据更新到磁盘文件后才会继续往下执行,从而降低效率; 而apply只是原子更新到内存,后调用apply函数会直接覆盖前面内存数据,从一定程度上提高很多效率。 3.edit()每次都是创建新的EditorImpl对象. 6.博客推荐:全面剖析SharedPreferences 57.操作系统如何管理内存的: 1.使用寄存器进行将进程地址和物理内存进行映射 2.虚拟内存进行内存映射到硬盘上增大内存 3.虚拟内存是进行内存分页管理 4.页表实现分页,就是 页+地址偏移。 5.如果程序的内存在硬盘上,那么就需要用页置换算法来将其调入内存中:先进先出、最近未使用最少等等 6.博客推荐:现代操作系统部分章节笔记 58.浏览器输入地址到返回结果发生了什么 1.DNS解析 2.TCP连接 3.发送HTTP请求 4.服务器处理请求并返回HTTP报文 5.浏览器解析渲染页面 6.连接结束 59.java泛型类型擦除发生在什么时候,通配符有什么需要注意的。 1.发生在编译的时候 2.PECS,extends善于提供精确的对象 A是B的子集,Super善于插入精确的对象 A是B的超集 3.博客推荐:Effective Java笔记(不含反序列化、并发、注解和枚举)、android阿里面试java基础锦集 60.activity的生命周期 1.a启动b,后退键再到a的生命周期流程:a.create-->a.start-->a.resume-->a.pause-->b.create-->b.start-->b.resume-->b界面绘制-->a.stop-->b.pause-->b.stop-->b.destroy-->a.restart-->a.start-->a.resume 2.意外销毁会调用saveInstance,重新恢复的时候回调用restoreInstance。储存数据的时候使用了委托机制,从activity-->window-->viewGroup-->view 会递归调用save来保持本view的数据,restore则是递归恢复本view数据。我们可以在里面做一些自己需要的数据操作。 61.面试常考的算法 1.快排、堆排序为首的各种排序算法 2.链表的各种操作:判断成环、判断相交、合并链表、倒数K个节点、寻找成环节点 3.二叉树、红黑树、B树定义以及时间复杂度计算方式 4.动态规划、贪心算法、简单的图论 5.推荐书籍:算法导论,将图论之前的例子写一遍 62.Launcher进程启动另外一个进程的过程:启动一个app 63.开源框架源码 1.Fresco 1.mvc框架: 1.Controller控制数据显示在Hierarchy中的Drawable的显隐 2.ImagePipeline在Controller中负责进行数据获取,返回的数据是CloseableImage 3.Drawee把除了初始化之外的操作全部交给Holder去做,Holder持有Controller和Hierarchy 2.Drawable层次以及绘制: 1.如果要绘制一次Drawable就调用invalidateSelf()来触发onDraw() 2.Drawable分为:容器类(保存一些Drawable)、自我绘制类(进度条)、图形变换类(scale、rotate、矩阵变换)、动画类(内部不断刷新,进行webp和gif的帧绘制) 3.ImagePipeline返回的CloseableImage是由一个个DrawableFactory解析成Drawable的 4.webp和gif动画是由jni代码解析的,然后其他静态图片是根据不同的android平台使用BitmapFactory来解析的 3.职责链模式:producer不做操作标n,表示只是提供一个consumer。获取图片--》解码图片缓存Producer--》后台线程Producer--》client图片处理producer(n)--》解码producer(n)--》旋转或剪裁producer(n)--》编码图片内存缓存producer--》读硬盘缓存producer--》写硬盘缓存producer(n)--》网络producer提供CloseableImage《--解码图片缓存consumer《--client图片处理consumer《--解码consumer《--旋转或剪裁consumer《--编码图片内存缓存consumer《--写硬盘缓存consumer《--图片数据 4.内存缓存: 1.一个CountingLruMap保存已经没有被引用的缓存条目,一个CountingLruMap保存所有的条目包括没有引用的条目。每当缓存策略改变和一定时间缓存配置的更新的时候,就会将 待销毁条目Map中的条目一个个移除,直到缓存大小符合配置。 2.这里的引用计数是用Fresco组件实现的引用计数器。 3.缓存有一个代理类,用来追踪缓存的存取。 4.CountingLruMap是使用LinkedHashMap来储存数据的。 5.硬盘缓存: 1.DefaultDiskStorage使用Lru策略。 2.为了不让所有的文件集中在一个文件中,创建很多命名不同的文件夹,然后使用hash算法把缓存文件分散 3.DiskStorageCache封装了DefaultDiskStorage,不仅进行缓存存取追踪,并且其在内存里面维持着一个 <key,value> 的键值对,因为文件修改频繁,所有只是定时刷新,因此如果在内存中找不到,还要去硬盘中找一次。 4.删除硬盘的缓存只出现在硬盘数据大小超限的时候,此时同时也会删除缓存中的key,所以不会出现内存中有key,但是硬盘上没有的情况。 5.在插入硬盘数据的时候,采用的是插入器的形式。返回一个Inserter,在Inserter.writeData()中传入一个CallBack(里面封装了客户端插入数据的逻辑和文件引用),让内部实现调用CallBack的逻辑来插入文件数据,前面写的文件后缀是.temp,只有调用commit()之后才会修改后缀,让文件对客户端可见。 6.使用了java提供的FileTreeVisitor来遍历文件 6.对象池: 1.使用数组来存储一个桶,桶内部是一个Queue。数组下标是数据申请内存的byte大小,桶内部的Queue存的是内存块的。所以数组使用的是稀疏数组 2.申请内存的方式有两种 1.java堆上开辟的内存 2.ashme 的本地内存中开辟的内存 7.设计模式:Builder、职责链、观察者、代理、组合、享元、适配器、装饰者、策略、生产者消费者、提供者 8.自定义计数引用:类似c++智能指针 1.使用一个静态IdentityHashMap <储存需要被计数引用的对象,其被引用的次数> 2.用SharedReference分装需要被计数引用的对象,提供一个销毁资源的销毁器,提供一个静态工厂方法来复制自己,复制一个引用计数加一。提供一个方法销毁自己,表示自己需要变成无人引用的对象了,此时引用计数减一。 3.引用计数归零,销毁器将销毁资源,如bitmap的recycle或者是jni内存调用jni方法归还内存。 9.博客推荐:Android Fresco源码文档翻译、从零开始撸一个Fresco之硬盘缓存、从零开始撸一个Fresco之gif和Webp动画、从零开始撸一个Fresco之内存缓存、从零开始撸一个Fresco之总结 2.oKhttp: 1.同步和异步: 1.异步使用了Dispatcher来将存储在 Deque 中的请求分派给线程池中各个线程执行。 2.当任务执行完成后,无论是否有异常,finally代码段总会被执行,也就是会调用Dispatcher的finished函数,它将正在运行的任务Call从队列runningAsyncCalls中移除后,主动的把缓存队列向前走了一步。 2.连接池: 1.一个Connection封装了一个socket,ConnectionPool中储存s着所有的Connection,StreamAllocation是引用计数的一个单位 2.当一个请求获取一个Connection的时候要传入一个StreamAllocation,Connection中存着一个弱引用的StreamAllocation列表,每当上层应用引用一次Connection,StreamAllocation就会加一个。反之如果上层应用不使用了,就会删除一个。 3.ConnectionPool中会有一个后台任务定时清理StreamAllocation列表为空的Connection。5分钟时间,维持5个socket 3.选择路线与建立连接 1.选择路线有两种方式: 1.无代理,那么在本地使用DNS查找到ip,注意结果是数组,即一个域名有多个IP,这就是自动重连的来源 2.有代理HTTP:设置socket的ip为代理地址的ip,设置socket的端口为代理地址的端口 3.代理好处:HTTP代理会帮你在远程服务器进行DNS查询,可以减少DNS劫持。 2.建立连接 1.连接池中已经存在连接,就从中取出(get)RealConnection,如果没有命中就进入下一步 2.根据选择的路线(Route),调用Platform.get().connectSocket选择当前平台Runtime下最好的socket库进行握手 3.将建立成功的RealConnection放入(put)连接池缓存 4.如果存在TLS,就根据SSL版本与证书进行安全握手 5.构造HttpStream并维护刚刚的socket连接,管道建立完成 4.职责链模式:缓存、重试、建立连接等功能存在于拦截器中网络请求相关,主要是网络请求优化。网络请求的时候遇到的问题 5.博客推荐:Android数据层架构的实现 上篇、Android数据层架构的实现 下篇 3.okio 1.简介; 1.sink:自己--》别人 2.source:别人--》自己 3.BufferSink:有缓存区域的sink 4.BufferSource:有缓存区域的source 5.Buffer:实现了3、4的缓存区域,内部有Segment的双向链表,在在转移数据的时候,只需要将指针转移指向就行 2.比java io的好处: 1.减少内存申请和数据拷贝 2.类少,功能齐全,开发效率高 3.内部实现: 1.Buffer的Segment双向链表,减少数据拷贝 2.Segment的内部byte数组的共享,减少数据拷贝 3.SegmentPool的共享和回收Segment 4.sink和source中被实际操作的其实是Buffer,Buffer可以充当sink和source 5.最终okio只是对java io的封装,所有操作都是基于java io 的

优秀的个人博客,低调大师

[算法总结] 3 道题搞定 BAT 面试——堆栈和队列

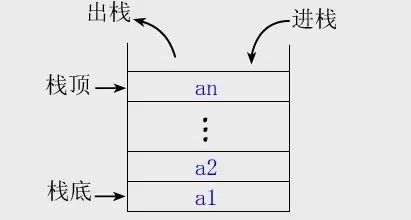
本文首发于我的个人博客:尾尾部落 0. 基础概念 栈:后进先出(LIFO) image 队列:先进先出(FIFO) image 1. 栈的 java 实现 import java.util.Arrays; public class Stack { private int size = 0; //栈顶位置 private int[] array; public Stack(){ this(10); } public Stack(int init) { if(init <= 0){ init = 10; } array = new int[init]; } /** * 入栈操作 * @param item 入栈的元素 */ public void push(int item){ if(size == array.length){ array = Arrays.copyOf(array, size*2); //扩容操作 } array[size++] = item; } /** * 获取栈顶元素,但栈顶元素不出栈 * @return 栈顶元素 */ public int peek(){ if(size == 0){ //空栈 throw new IndexOutOfBoundsException("栈是空的"); } return array[size-1]; } /** * 出栈,同时获取栈顶元素 * @return */ public int pop(){ int item = peek(); //获取栈顶元素 size--; //直接使元素个数减1,不用清除元素,下次入栈会覆盖旧元素的值 return item; } /** * 判断栈是否已满 * @return */ public boolean isFull(){ return size == array.length; } /** * 判断栈是否为空 * @return */ public boolean isEmpty(){ return size == 0; } public int getSize(){ return size; } } 2. 队列的 java 实现 public class ArrayQueue { private final Object[] queue; //声明一个数组 private int head; private int tail; /** * 初始化队列 * @param capacity 队列长度 */ public ArrayQueue(int capacity){ this.queue = new Object[capacity]; } /** * 入队 * @param o 入队元素 * @return 入队成功与否 */ public boolean put(Object o){ if(head == (tail+1)%queue.length){ //说明队满 return false; } queue[tail] = o; tail = (tail+1)%queue.length; //tail标记后移一位 return true; } /** * 返回队首元素,但不出队 * @return */ public Object peak() { if(head==tail){ //队空 return null; } return queue[head]; } /** * 出队 * @return 出队元素 */ public Object pull(){ if(head==tail){ return null; } Object item = queue[head]; queue[head] = null; return item; } /** * 判断是否为空 * @return */ public boolean isEmpty(){ return head == tail; } /** * 判断是否为满 * @return */ public boolean isFull(){ return head == (tail+1)%queue.length; } /** * 获取队列中的元素个数 * @return */ public int getsize(){ if(tail>=head){ return tail-head; }else{ return (tail+queue.length)-head; } } } 3. 用两个栈实现队列 剑指offer:用两个栈实现队列 LeetCode:Implement Queue using Stacks class MyQueue { Stack<Integer> input = new Stack<Integer>(); Stack<Integer> output = new Stack<Integer>(); /** Push element x to the back of queue. */ public void push(int x) { input.push(x); } /** Removes the element from in front of queue and returns that element. */ public int pop() { peek(); return output.pop(); } /** Get the front element. */ public int peek() { if(output.isEmpty()){ while(!input.isEmpty()) output.push(input.pop()); } return output.peek(); } /** Returns whether the queue is empty. */ public boolean empty() { return input.isEmpty() && output.isEmpty(); } } 4. 用队列实现栈 LeetCode:Implement Stack using Queues class MyStack { Queue<Integer> q1 = new LinkedList<Integer>(); Queue<Integer> q2 = new LinkedList<Integer>(); /** Push element x onto stack. */ public void push(int x) { if(q1.isEmpty()){ q1.add(x); for(int i = 0; i < q2.size(); i++){ q1.add(q2.poll()); } }else{ q2.add(x); for(int i = 0; i < q1.size(); i++){ q2.add(q1.poll()); } } } /** Removes the element on top of the stack and returns that element. */ public int pop() { return q1.isEmpty() ? q2.poll() : q1.poll(); } /** Get the top element. */ public int top() { return q1.isEmpty() ? q2.peek() : q1.peek(); } /** Returns whether the stack is empty. */ public boolean empty() { return q1.isEmpty() && q2.isEmpty(); } } 5. 包含min函数的栈 剑指offer:包含min函数的栈 定义栈的数据结构,请在该类型中实现一个能够得到栈最小元素的min函数。 class MinStack { Stack<Integer> stack = new Stack<Integer>(); Stack<Integer> temp = new Stack<Integer>(); public void push(int x) { stack.push(x); if(temp.isEmpty() || temp.peek() >= x) temp.push(x); } public void pop() { int x = stack.pop(); int min = temp.peek(); if(x == min) temp.pop(); } public int top() { return stack.peek(); } public int getMin() { return temp.peek(); } } 6. 栈的压入、弹出序列 剑指offer:栈的压入、弹出序列 输入两个整数序列,第一个序列表示栈的压入顺序,请判断第二个序列是否为该栈的弹出顺序。假设压入栈的所有数字均不相等。例如序列1,2,3,4,5是某栈的压入顺序,序列4,5,3,2,1是该压栈序列对应的一个弹出序列,但4,3,5,1,2就不可能是该压栈序列的弹出序列。(注意:这两个序列的长度是相等的) import java.util.ArrayList; import java.util.Stack; public class Solution { public boolean IsPopOrder(int [] pushA, int [] popA) { if(pushA.length != popA.length || pushA.length == 0 || popA.length == 0) return false; Stack<Integer> stack = new Stack<>(); int index = 0; for(int i = 0; i < pushA.length; i++){ stack.push(pushA[i]); while(!stack.empty() && stack.peek() == popA[index]){ stack.pop(); index++; } } return stack.empty(); } }

优秀的个人博客,低调大师

Android大厂面试题锦集(BAT TMD JD 小米)

上次写这篇文章的时候也差不多是一年前了,这一年我兜兜转转从android到java又回到android,校招面了很多大厂,阿里、京东、小米、头条、知乎、腾讯、有赞,也收获了几个offer。感谢大家的关注,让我在简书上面也混到了一个简书程序员优秀作者的称号,所以为了回馈大家,一篇最完全的android面经诞生了。这是我集合了牛客网、百度、简书等网站的几十篇面经和我自己面试的经历的合集,希望大家喜欢。(ps:里面当然会有纰漏,如果有问题欢迎大家留言或者加我QQ讨论) 1.android事件分发机制,请详细说下整个流程 事件分发(面试).png 2.android view绘制机制和加载过程,请详细说下整个流程 1.ViewRootImpl会调用performTraversals(),其内部会调用performMeasure()、performLayout、performDraw()。 2.performMeasure()会调用最外层的ViewGroup的measure()-->onMeasure(),ViewGroup的onMeasure()是抽象方法,但其提供了measureChildren(),这之中会遍历子View然后循环调用measureChild()这之中会用getChildMeasureSpec()+父View的MeasureSpec+子View的LayoutParam一起获取本View的MeasureSpec,然后调用子View的measure()到View的onMeasure()-->setMeasureDimension(getDefaultSize(),getDefaultSize()),getDefaultSize()默认返回measureSpec的测量数值,所以继承View进行自定义的wrap_content需要重写。 3.performLayout()会调用最外层的ViewGroup的layout(l,t,r,b),本View在其中使用setFrame()设置本View的四个顶点位置。在onLayout(抽象方法)中确定子View的位置,如LinearLayout会遍历子View,循环调用setChildFrame()-->子View.layout()。 4.performDraw()会调用最外层ViewGroup的draw():其中会先后调用background.draw()(绘制背景)、onDraw()(绘制自己)、dispatchDraw()(绘制子View)、onDrawScrollBars()(绘制装饰)。 5.MeasureSpec由2位SpecMode(UNSPECIFIED、EXACTLY(对应精确值和match_parent)、AT_MOST(对应warp_content))和30位SpecSize组成一个int,DecorView的MeasureSpec由窗口大小和其LayoutParams决定,其他View由父View的MeasureSpec和本View的LayoutParams决定。ViewGroup中有getChildMeasureSpec()来获取子View的MeasureSpec。 6.三种方式获取measure()后的宽高: 1.Activity#onWindowFocusChange()中调用获取 2.view.post(Runnable)将获取的代码投递到消息队列的尾部。 3.ViewTreeObservable. 3.android四大组件的加载过程,请详细介绍下 1.android四大组件的加载过程:这是我总结的一篇博客 4.Activity的启动模式 1.standard:默认标准模式,每启动一个都会创建一个实例, 2.singleTop:栈顶复用,如果在栈顶就调用onNewIntent复用,从onResume()开始 3.singleTask:栈内复用,本栈内只要用该类型Activity就会将其顶部的activity出栈 4.singleInstance:单例模式,除了3中特性,系统会单独给该Activity创建一个栈, 5.A、B、C、D分别是四种Activity的启动模式,那么A->B->C->D->A->B->C->D分别启动,最后的activity栈是怎么样的 1.这个题目需要深入了解activity的启动模式 2.最后的答案是:两个栈,前台栈是只有D,后台栈从底至上是A、B、C 6.Activity缓存方法 1.配置改变导致Activity被杀死,横屏变竖屏:在onStop之前会调用onSaveInstanceState()保存数据在重建Activity之后,会在onStart()之后调用onRestoreInstanceState(),并把保存下来的Bundle传给onCreate()和它会默认重建Activity当前的视图,我们可以在onCreate()中,回复自己的数据。 2.内存不足杀掉Activity,优先级分别是:前台可见,可见非前台,后台。 7.Service的生命周期,两种启动方法,有什么区别 1.context.startService() ->onCreate()- >onStart()->Service running-->(如果调用context.stopService() )->onDestroy() ->Service shut down 1.如果Service还没有运行,则调用onCreate()然后调用onStart(); 2.如果Service已经运行,则只调用onStart(),所以一个Service的onStart方法可能会重复调用多次。 3.调用stopService的时候直接onDestroy, 4.如果是调用者自己直接退出而没有调用stopService的话,Service会一直在后台运行。该Service的调用者再启动起来后可以通过stopService关闭Service。 2.context.bindService()->onCreate()->onBind()->Service running-->onUnbind() -> onDestroy() ->Service stop 1.onBind将返回给客户端一个IBind接口实例,IBind允许客户端回调服务的方法,比如得到Service运行的状态或其他操作。 2.这个时候会把调用者和Service绑定在一起,Context退出了,Service就会调用onUnbind->onDestroy相应退出。 3.所以调用bindService的生命周期为:onCreate --> onBind(只一次,不可多次绑定) --> onUnbind --> onDestory。 8.怎么保证service不被杀死 1.提升service优先级 2.提升service进程优先级 3.onDestroy方法里重启service 9.静态的Broadcast 和动态的有什么区别 1.动态的比静态的安全 2.静态在app启动的时候就初始化了 动态使用代码初始化 3.静态需要配置 动态不需要 4.生存期,静态广播的生存期可以比动态广播的长很多 5.优先级动态广播的优先级比静态广播高 10.Intent可以传递哪些数据类型 1.Serializable 2.charsequence: 主要用来传递String,char等 3.parcelable 4.Bundle 11.Json有什么优劣势、解析的原理 1.JSON的速度要远远快于XML 2.JSON相对于XML来讲,数据的体积小 3.JSON对数据的描述性比XML较差 4.解析的基本原理是:词法分析 12.一个语言的编译过程 1.词法分析:将一串文本按规则分割成最小的结构,关键字、标识符、运算符、界符和常量等。一般实现方法是自动机和正则表达式 2.语法分析:将一系列单词组合成语法树。一般实现方法有自顶向下和自底向上 3.语义分析:对结构上正确的源程序进行上下文有关性质的审查 4.目标代码生成 5.代码优化:优化生成的目标代码, 13.动画有哪几类,各有什么特点 1.动画的基本原理:其实就是利用插值器和估值器,来计算出各个时刻View的属性,然后通过改变View的属性来,实现View的动画效果。 2.View动画:只是影像变化,view的实际位置还在原来的地方。 3.帧动画是在xml中定义好一系列图片之后,使用AnimationDrawable来播放的动画。 4.View的属性动画: 1.插值器:作用是根据时间的流逝的百分比来计算属性改变的百分比 2.估值器:在1的基础上由这个东西来计算出属性到底变化了多少数值的类 14.Handler、Looper消息队列模型,各部分的作用 1.MessageQueue:读取会自动删除消息,单链表维护,在插入和删除上有优势。在其next()中会无限循环,不断判断是否有消息,有就返回这条消息并移除。 2.Looper:Looper创建的时候会创建一个MessageQueue,调用loop()方法的时候消息循环开始,loop()也是一个死循环,会不断调用messageQueue的next(),当有消息就处理,否则阻塞在messageQueue的next()中。当Looper的quit()被调用的时候会调用messageQueue的quit(),此时next()会返回null,然后loop()方法也跟着退出。 3.Handler:在主线程构造一个Handler,然后在其他线程调用sendMessage(),此时主线程的MessageQueue中会插入一条message,然后被Looper使用。 4.系统的主线程在ActivityThread的main()为入口开启主线程,其中定义了内部类Activity.H定义了一系列消息类型,包含四大组件的启动停止。 5.MessageQueue和Looper是一对一关系,Handler和Looper是多对一 15.怎样退出终止App 1.自己设置一个Activity的栈,然后一个个finish() 16.Android IPC:Binder原理 1.在Activity和Service进行通讯的时候,用到了Binder。 1.当属于同个进程我们可以继承Binder然后在Activity中对Service进行操作 2.当不属于同个进程,那么要用到AIDL让系统给我们创建一个Binder,然后在Activity中对远端的Service进行操作。 2.系统给我们生成的Binder: 1.Stub类中有:接口方法的id,有该Binder的标识,有asInterface(IBinder)(让我们在Activity中获取实现了Binder的接口,接口的实现在Service里,同进程时候返回Stub否则返回Proxy),有onTransact()这个方法是在不同进程的时候让Proxy在Activity进行远端调用实现Activity操作Service 2.Proxy类是代理,在Activity端,其中有:IBinder mRemote(这就是远端的Binder),两个接口的实现方法不过是代理最终还是要在远端的onTransact()中进行实际操作。 3.哪一端的Binder是副本,该端就可以被另一端进行操作,因为Binder本体在定义的时候可以操作本端的东西。所以可以在Activity端传入本端的Binder,让Service端对其进行操作称为Listener,可以用RemoteCallbackList这个容器来装Listener,防止Listener因为经历过序列化而产生的问题。 4.当Activity端向远端进行调用的时候,当前线程会挂起,当方法处理完毕才会唤醒。 5.如果一个AIDL就用一个Service太奢侈,所以可以使用Binder池的方式,建立一个AIDL其中的方法是返回IBinder,然后根据方法中传入的参数返回具体的AIDL。 6.IPC的方式有:Bundle(在Intent启动的时候传入,不过是一次性的),文件共享(对于SharedPreference是特例,因为其在内存中会有缓存),使用Messenger(其底层用的也是AIDL,同理要操作哪端,就在哪端定义Messenger),AIDL,ContentProvider(在本进程中继承实现一个ContentProvider,在增删改查方法中调用本进程的SQLite,在其他进程中查询),Socket 17.描述一次跨进程通讯 1.client、proxy、serviceManager、BinderDriver、impl、service 2.client发起一个请求service信息的Binder请求到BinderDriver中,serviceManager发现BinderDiriver中有自己的请求 然后将clinet请求的service的数据返回给client这样完成了一次Binder通讯 3.clinet获取的service信息就是该service的proxy,此时调用proxy的方法,proxy将请求发送到BinderDriver中,此时service的 Binder线程池循环发现有自己的请求,然后用impl就处理这个请求最后返回,这样完成了第二次Binder通讯 4.中间client可挂起,也可以不挂起,有一个关键字oneway可以解决这个 18.android重要术语解释 1.ActivityManagerServices,简称AMS,服务端对象,负责系统中所有Activity的生命周期 2.ActivityThread,App的真正入口。当开启App之后,会调用main()开始运行,开启消息循环队列,这就是传说中的UI线程或者叫主线程。与ActivityManagerServices配合,一起完成Activity的管理工作 3.ApplicationThread,用来实现ActivityManagerService与ActivityThread之间的交互。在ActivityManagerService需要管理相关Application中的Activity的生命周期时,通过ApplicationThread的代理对象与ActivityThread通讯。 4.ApplicationThreadProxy,是ApplicationThread在服务器端的代理,负责和客户端的ApplicationThread通讯。AMS就是通过该代理与ActivityThread进行通信的。 5.Instrumentation,每一个应用程序只有一个Instrumentation对象,每个Activity内都有一个对该对象的引用。Instrumentation可以理解为应用进程的管家,ActivityThread要创建或暂停某个Activity时,都需要通过Instrumentation来进行具体的操作。 6.ActivityStack,Activity在AMS的栈管理,用来记录已经启动的Activity的先后关系,状态信息等。通过ActivityStack决定是否需要启动新的进程。 7.ActivityRecord,ActivityStack的管理对象,每个Activity在AMS对应一个ActivityRecord,来记录Activity的状态以及其他的管理信息。其实就是服务器端的Activity对象的映像。 8.TaskRecord,AMS抽象出来的一个“任务”的概念,是记录ActivityRecord的栈,一个“Task”包含若干个ActivityRecord。AMS用TaskRecord确保Activity启动和退出的顺序。如果你清楚Activity的4种launchMode,那么对这个概念应该不陌生。 19.理解Window和WindowManager 1.Window用于显示View和接收各种事件,Window有三种类型:应用Window(每个Activity对应一个Window)、子Window(不能单独存在,附属于特定Window)、系统window(Toast和状态栏) 2.Window分层级,应用Window在1-99、子Window在1000-1999、系统Window在2000-2999.WindowManager提供了增删改View三个功能。 3.Window是个抽象概念:每一个Window对应着一个View和ViewRootImpl,Window通过ViewRootImpl来和View建立联系,View是Window存在的实体,只能通过WindowManager来访问Window。 4.WindowManager的实现是WindowManagerImpl其再委托给WindowManagerGlobal来对Window进行操作,其中有四个List分别储存对应的View、ViewRootImpl、WindowManger.LayoutParams和正在被删除的View 5.Window的实体是存在于远端的WindowMangerService中,所以增删改Window在本端是修改上面的几个List然后通过ViewRootImpl重绘View,通过WindowSession(每个应用一个)在远端修改Window。 6.Activity创建Window:Activity会在attach()中创建Window并设置其回调(onAttachedToWindow()、dispatchTouchEvent()),Activity的Window是由Policy类创建PhoneWindow实现的。然后通过Activity#setContentView()调用PhoneWindow的setContentView。 20.Bitmap的处理 1.当使用ImageView的时候,可能图片的像素大于ImageView,此时就可以通过BitmapFactory.Option来对图片进行压缩,inSampleSize表示缩小2^(inSampleSize-1)倍。 2.BitMap的缓存: 1.使用LruCache进行内存缓存。 2.使用DiskLruCache进行硬盘缓存。 3.实现一个ImageLoader的流程:同步异步加载、图片压缩、内存硬盘缓存、网络拉取 1.同步加载只创建一个线程然后按照顺序进行图片加载 2.异步加载使用线程池,让存在的加载任务都处于不同线程 3.为了不开启过多的异步任务,只在列表静止的时候开启图片加载 21.如何实现一个网络框架(参考Volley) 1.缓存队列,以url为key缓存内容可以参考Bitmap的处理方式,这里单独开启一个线程。 2.网络请求队列,使用线程池进行请求。 3.提供各种不同类型的返回值的解析如String,Json,图片等等。 22.ClassLoader的基础知识 1.双亲委托:一个ClassLoader类负责加载这个类所涉及的所有类,在加载的时候会判断该类是否已经被加载过,然后会递归去他父ClassLoader中找。 2.可以动态加载Jar通过URLClassLoader 3.ClassLoader 隔离问题 JVM识别一个类是由:ClassLoader id+PackageName+ClassName。 4.加载不同Jar包中的公共类: 1.让父ClassLoader加载公共的Jar,子ClassLoader加载包含公共Jar的Jar,此时子ClassLoader在加载公共Jar的时候会先去父ClassLoader中找。(只适用Java) 2.重写加载包含公共Jar的Jar的ClassLoader,在loadClass中找到已经加载过公共Jar的ClassLoader,也就是把父ClassLoader替换掉。(只适用Java) 3.在生成包含公共Jar的Jar时候把公共Jar去掉。 23.插件化框架描述:dynamicLoadApk为例子 1.可以通过DexClassLoader来对apk中的dex包进行加载访问 2.如何加载资源是个很大的问题,因为宿主程序中并没有apk中的资源,所以调用R资源会报错,所以这里使用了Activity中的实现ContextImpl的getAssets()和getResources()再加上反射来实现。 3.由于系统启动Activity有很多初始化动作要做,而我们手动反射很难完成,所以可以采用接口机制,将Activity的大部分生命周期提取成接口,然后通过代理Activity去调用插件Activity的生命周期。同时如果像增加一个新生命周期方法的时候,只需要在接口中和代理中声明一下就行。 4.缺点: 1.慎用this,因为在apk中使用this并不代表宿主中的activity,当然如果this只是表示自己的接口还是可以的。除此之外可以使用that代替this。 2.不支持Service和静态注册的Broadcast 3.不支持LaunchMode和Apk中Activity的隐式调用。 24.热修复:Andfix为例子 1.大致原理:apkpatch将两个apk做一次对比,然后找出不同的部分。可以看到生成的apatch了文件,后缀改成zip再解压开,里面有一个dex文件。通过jadx查看一下源码,里面就是被修复的代码所在的类文件,这些更改过的类都加上了一个_CF的后缀,并且变动的方法都被加上了一个叫@MethodReplace的annotation,通过clazz和method指定了需要替换的方法。然后客户端sdk得到补丁文件后就会根据annotation来寻找需要替换的方法。最后由JNI层完成方法的替换。 2.无法添加新类和新的字段、补丁文件很容易被反编译、加固平台可能会使热补丁功能失效 25.线程同步的问题,常用的线程同步 1.sycn:保证了原子性、可见性、有序性 2.锁:保证了原子性、可见性、有序性 1.自旋锁:可以使线程在没有取得锁的时候,不被挂起,而转去执行一个空循环。 1.优点:线程被挂起的几率减少,线程执行的连贯性加强。用于对于锁竞争不是很激烈,锁占用时间很短的并发线程。 2.缺点:过多浪费CPU时间,有一个线程连续两次试图获得自旋锁引起死锁 2.阻塞锁:没得到锁的线程等待或者挂起,Sycn、Lock 3.可重入锁:一个线程可多次获取该锁,Sycn、Lock 4.悲观锁:每次去拿数据的时候都认为别人会修改,所以会阻塞全部其他线程 Sycn、Lock 5.乐观锁:每次去拿数据的时候都认为别人不会修改,所以不会上锁,但是在更新的时候会判断一下在此期间别人有没有去更新这个数据,可以使用版本号等机制。cas 6.显示锁和内置锁:显示锁用Lock来定义、内置锁用synchronized。 7.读-写锁:为了提高性能,Java提供了读 3.volatile 1.只能保证可见性,不能保证原子性 2.自增操作有三步,此时多线程写会出现问题 4.cas 1.操作:内存值V、旧的预期值A、要修改的值B,当且仅当预期值A和内存值V相同时,将内存值修改为B并返回true,否则什么都不做并返回false。 2.解释:本地副本为A,共享内存为V,线程A要把V修改成B。某个时刻线程A要把V修改成B,如果A和V不同那么就表示有其他线程在修改V,此时就表示修改失败,否则表示没有其他线程修改,那么把V改成B。 3.局限:如果V被修改成V1然后又被改成V,此时cas识别不出变化,还是认为没有其他线程在修改V,此时就会有问题 4.局限解决:将V带上版本。 5.线程不安全到底是怎么回事: 1.一个线程写,多个线程读的时候,会造成写了一半就去读 2.多线程写,会造成脏数据 26.Asynctask和线程池,GC相关(怎么判断哪些内存该GC,GC算法) 1.Asynctask:异步任务类,单线程线程池+Handler 2.线程池: 1.ThreadPoolExecutor:通过Executors可以构造单线程池、固定数目线程池、不固定数目线程池。 2.ScheduledThreadPoolExecutor:可以延时调用线程或者延时重复调度线程。 3.GC相关:重要 1.搜索算法: 1.引用计数 2.图搜索,可达性分析 2.回收算法: 1.标记清除复制:用于青年代 2.标记整理:用于老年代 3.堆分区: 1.青年区eden 80%、survivor1 10%、survivor2 10% 2.老年区 4.虚拟机栈分区: 1.局部变量表 2.操作数栈 3.动态链接 4.方法返回地址 5.GC Roots: 1.虚拟机栈(栈桢中的本地变量表)中的引用的对象 2.方法区中的类静态属性引用的对象 3.方法区中的常量引用的对象 4.本地方法栈中JNI的引用的对象 27.网络 1.ARP协议:在IP以太网中,当一个上层协议要发包时,有了该节点的IP地址,ARP就能提供该节点的MAC地址。 2.HTTP HTTPS的区别: 1.HTTPS使用TLS(SSL)进行加密 2.HTTPS缺省工作在TCP协议443端口 3.它的工作流程一般如以下方式: 1.完成TCP三次同步握手 2.客户端验证服务器数字证书,通过,进入步骤3 3.DH算法协商对称加密算法的密钥、hash算法的密钥 4.SSL安全加密隧道协商完成 5.网页以加密的方式传输,用协商的对称加密算法和密钥加密,保证数据机密性;用协商的hash算法进行数据完整性保护,保证数据不被篡改 3.http请求包结构,http返回码的分类,400和500的区别 1.包结构: 1.请求:请求行、头部、数据 2.返回:状态行、头部、数据 2.http返回码分类:1到5分别是,消息、成功、重定向、客户端错误、服务端错误 4.Tcp 1.可靠连接,三次握手,四次挥手 1.三次握手:防止了服务器端的一直等待而浪费资源,例如只是两次握手,如果s确认之后c就掉线了,那么s就会浪费资源 1.syn-c = x,表示这消息是x序号 2.ack-s = x + 1,表示syn-c这个消息接收成功。syn-s = y,表示这消息是y序号。 3.ack-c = y + 1,表示syn-s这条消息接收成功 2.四次挥手:TCP是全双工模式 1.fin-c = x , 表示现在需要关闭c到s了。ack-c = y,表示上一条s的消息已经接收完毕 2.ack-s = x + 1,表示需要关闭的fin-c消息已经接收到了,同意关闭 3.fin-s = y + 1,表示s已经准备好关闭了,就等c的最后一条命令 4.ack-c = y + 1,表示c已经关闭,让s也关闭 3.滑动窗口,停止等待、后退N、选择重传 4.拥塞控制,慢启动、拥塞避免、加速递减、快重传快恢复 28.数据库性能优化:索引和事务,需要找本专门的书大概了解一下 29.13.APK打包流程和其内容 1.流程 1.aapt生成R文件 2.aidl生成java文件 3.将全部java文件编译成class文件 4.将全部class文件和第三方包合并成dex文件 5.将资源、so文件、dex文件整合成apk 6.apk签名 7.apk字节对齐 2.内容:so、dex、asset、资源文件 30.网络劫持的类型原理:可以百度一下了解一下具体概念 1.DNS劫持、欺骗、污染 2.http劫持:重定向、注入js,http注入、报文扩展 31.java类加载过程: 1.加载时机:创建实例、访问静态变量或方法、反射、加载子类之前 2.验证:验证文件格式、元数据、字节码、符号引用的正确性 3.加载:根据全类名获取文件字节流、将字节流转化为静态储存结构放入方法区、生成class对象 4.准备:在堆上为静态变量划分内存 5.解析:将常量池中的符号引用转换为直接引用 6.初始化:初始化静态变量 7.书籍推荐:深入理解java虚拟机,博客推荐:Java/Android阿里面试JVM部分理解 32.retrofit的了解 1.动态代理创建一个接口的代理类 2.通过反射解析每个接口的注解、入参构造http请求 3.获取到返回的http请求,使用Adapter解析成需要的返回值。 33.bundle的数据结构,如何存储 1.键值对储存 2.传递的数据可以是boolean、byte、int、long、float、double、string等基本类型或它们对应的数组,也可以是对象或对象数组。 3.当Bundle传递的是对象或对象数组时,必须实现Serializable 或Parcelable接口 34.listview内点击buttom并移动的事件流完整拦截过程: 1.点下按钮的时候: 1.产生了一个down事件,activity-->phoneWindow-->ViewGroup-->ListView-->botton,中间如果有重写了拦截方法,则事件被该view拦截可能消耗。 2.没拦截,事件到达了button,这个过程中建立了一条事件传递的view链表 3.到button的dispatch方法-->onTouch-->view是否可用-->Touch代理 2.移动点击按钮的时候: 1.产生move事件,listView中会对move事件做拦截 2.此时listView会将该滑动事件消费掉 3.后续的滑动事件都会被listView消费掉 3.手指抬起来时候:前面建立了一个view链表,listView的父view在获取事件的时候,会直接取链表中的listView让其进行事件消耗。 35.service的意义:不需要界面,在后台执行的程序 36.android的IPC通信方式,线程(进程间)通信机制有哪些 1.ipc通信方式:binder、contentprovider、socket 2.操作系统进程通讯方式:共享内存、socket、管道 37.操作系统进程和线程的区别 1.简而言之,一个程序至少有一个进程,一个进程至少有一个线程. 2.线程的划分尺度小于进程,使得多线程程序的并发性高。 3.另外,进程在执行过程中拥有独立的内存单元,而多个线程共享内存,从而极大地提高了程序的运行效率。 4.多线程的意义在于一个应用程序中,有多个执行部分可以同时执行。有将多个线程看做多个独立的应用,来实现进程的调度和管理以及资源分配 38.HashMap的实现过程:Capacity就是buckets的数目,Load factor就是buckets填满程度的最大比例。如果对迭代性能要求很高的话不要把capacity设置过大,也不要把load factor设置过小。 1.简单来说HashMap就是一个会自动扩容的数组链表 2.put过程 1.对key的hashCode()做hash,然后再计算index; 2.如果没碰撞直接放到bucket里; 3.如果碰撞了,以链表的形式存在buckets后; 4.如果碰撞导致链表过长(大于等于TREEIFY_THRESHOLD),就把链表转换成红黑树; 5.如果节点已经存在就替换old value(保证key的唯一性) 6.如果bucket满了(超过load factor*current capacity),就要resize。 3.resize:当put时,如果发现目前的bucket占用程度已经超过了Load Factor所希望的比例,那么就会发生resize。在resize的过程,简单的说就是把bucket扩充为2倍,之后重新计算index,把节点再放到新的bucket中 4.get过程 1.根据key的hash算出数组下表 2.使用equals遍历链表进行比较 39.mvc、mvp、mvvm: 1.mvc:数据、View、Activity,View将操作反馈给Activity,Activitiy去获取数据,数据通过观察者模式刷新给View。循环依赖 1.Activity重,很难单元测试 2.View和Model耦合严重 2.mvp:数据、View、Presenter,View将操作给Presenter,Presenter去获取数据,数据获取好了返回给Presenter,Presenter去刷新View。PV,PM双向依赖 1.接口爆炸 2.Presenter很重 3.mvvm:数据、View、ViewModel,View将操作给ViewModel,ViewModel去获取数据,数据和界面绑定了,数据更新界面更新。 1.viewModel的业务逻辑可以单独拿来测试 2.一个view 对应一个 viewModel 业务逻辑可以分离,不会出现全能类 3.数据和界面绑定了,不用写垃圾代码,但是复用起来不舒服 40.java的线程如何实现 1.Thread继承 2.Runnale 3.Future 4.线程池 41.ArrayList 如何删除重复的元素或者指定的元素; 1.删除重复:Set 2.删除指定:迭代器 42.如何设计在 UDP 上层保证 UDP 的可靠性传输; 1.简单来讲,要使用UDP来构建可靠的面向连接的数据传输,就要实现类似于TCP协议的超时重传,有序接受,应答确认,滑动窗口流量控制等机制,等于说要在传输层的上一层(或者直接在应用层)实现TCP协议的可靠数据传输机制。 2.比如使用UDP数据包+序列号,UDP数据包+时间戳等方法,在服务器端进行应答确认机制,这样就会保证不可靠的UDP协议进行可靠的数据传输。 3.基于udp的可靠传输协议有:RUDP、RTP、UDT 43.Java 中内部类为什么可以访问外部类 1.因为内部类创建的时候,需要外部类的对象,在内部类对象创建的时候会把外部类的引用传递进去 44.设计移动端的联系人存储与查询的功能,要求快速搜索联系人,可以用到哪些数据结构?数据库索引,平衡二叉树(B树、红黑树) 45.红黑树特点 1.root节点和叶子节点是黑色 2.红色节点后必须为黑色节点 3.从root到叶子每条路径的黑节点数量相同 46.linux异步和同步i/o: 1.同步:对于client,client一直等待,但是client不挂起:主线程调用 2.异步:对于client,client发起请求,service好了再回调client:其他线程调用,调用完成之后进行回调 3.阻塞:对于service,在准备io的时候会将service端挂起,直至准备完成然后唤醒service:bio 3.非阻塞:对于service,在准备io的时候不会将service端挂起,而是service一直去轮询判断io是否准备完成,准备完成了就进行操作:nio、linux的select、poll、epoll 4.多路复用io:非阻塞io的一种优化,java nio,用一个线程去轮询多个 io端口是否可用,如果一个可用就通知对应的io请求,这使用一个线程轮询可以大大增强性能。 1.我可以采用 多线程+ 阻塞IO 达到类似的效果,但是由于在多线程 + 阻塞IO 中,每个socket对应一个线程,这样会造成很大的资源占用。 2.而在多路复用IO中,轮询每个socket状态是内核在进行的,这个效率要比用户线程要高的多。 5.异步io:aio,用户线程完全不感知io的进行,所有操作都交给内核,io完成之后内核通知用户线程。 1.这种io才是异步的,2、3、4都是同步io,因为内核进行数据拷贝的过程都会让用户线程阻塞。 2.异步IO是需要操作系统的底层支持,也就是内核支持,Java 7中,提供了Asynchronous IO 47.ConcurrentHashMap内部实现,HashTable的实现被废弃的原因: 1.HashTable容器在竞争激烈的并发环境下表现出效率低下的原因,是因为所有访问HashTable的线程都必须竞争同一把锁,那假如容器里有多把锁,每一把锁用于锁容器其中一部分数据,那么当多线程访问容器里不同数据段的数据时,线程间就不会存在锁竞争,从而可以有效的提高并发访问效率,这就是ConcurrentHashMap所使用的锁分段技术,首先将数据分成一段一段的存储,然后给每一段数据配一把锁,当一个线程占用锁访问其中一个段数据的时候,其他段的数据也能被其他线程访问。 2.ConcurrentHashMap是由Segment数组结构和HashEntry数组结构组成。Segment是一种可重入锁ReentrantLock,在ConcurrentHashMap里扮演锁的角色,HashEntry则用于存储键值对数据。一个ConcurrentHashMap里包含一个Segment数组,Segment的结构和HashMap类似,是一种数组和链表结构, 一个Segment里包含一个HashEntry数组,每个HashEntry是一个链表结构的元素,每个Segment守护者一个HashEntry数组里的元素,当对HashEntry数组的数据进行修改时,必须首先获得它对应的Segment锁。 48.HandlerThread是什么 1.MessageQueue + Looper + Handler 49.IntentService是什么 1.含有HandlerThread的Service,可以多次startService()来多次在子线程中进行 onHandlerIntent()的调用。 50.class和dex 1.dvm执行的是dex格式文件,jvm执行的是class文件,android程序编译完之后生产class文件。然后dex工具会把class文件处理成dex文件,然后把资源文件和.dex文件等打包成apk文件。 2.dvm是基于寄存器的虚拟机,而jvm执行是基于虚拟栈的虚拟机。寄存器存取速度比栈快的多,dvm可以根据硬件实现最大的优化,比较适合移动设备。 3.class文件存在很多的冗余信息,dex工具会去除冗余信息,并把所有的class文件整合到dex文件中。减少了I/O操作,提高了类的查找速度 51.内存泄漏 1.其他线程持有一个Listener,Listener操作activity。那么在线程么有完毕的时候,activity关闭了,原本是要被回收的但是,不能被回收。 2.例如Handler导致的内存泄漏,Handler就相当于Listener。 3.在activity关闭的时候注意停止线程,或者将Listener的注册取消 3.使用弱引用,这样即使Listener持有了activity,在GC的时候还是会被回收 4.工具:LeakCanary 52.过度绘制、卡顿优化: 1.过度绘制: 1.移除Window默认的Background:getWidow.setBackgroundDrawable(null); 2.移除XML布局文件中非必需的Background 3.减少布局嵌套(扁平化的一个体现,减少View数的深度,也就减少了View树的遍历时间,渲染的时候,前后期的工作,总是按View树结点来) 4.在引入布局文件里面,最外层可以用merge替代LinearLayout,RelativeLayout,这样把子UI元素直接衔接在include位置 5.工具:HierarchyViewer 查看视图层级 2.卡顿优化:16ms数据更新 53.apk瘦身: 1.classes.dex:通过代码混淆,删掉不必要的jar包和代码实现该文件的优化 2.资源文件:通过Lint工具扫描代码中没有使用到的静态资源 3.图片资源:使用tinypng和webP,下面详细介绍图片资源优化的方案,矢量图 4.SO文件将不用的去掉,目前主流app一般只放一个arm的so包 54.ANR的形成,各个组件上出现ARN的时间限制是多少 1.只要是主线程耗时的操作就会ARN 如io 2.broadcast超时时间为10秒 按键无响应的超时时间为5秒 前台service无响应的超时时间为20秒,后台service为200秒 55.Serializable和Parcelable 的区别 1.P 消耗内存小 2.网络传输用S 程序内使用P 3.S将数据持久化方便 4.S使用了反射 容易触发垃圾回收 比较慢 56.Sharedpreferences源码简述 1.储存于硬盘上的xml键值对,数据多了会有性能问题 2.ContextImpl记录着SharedPreferences的重要数据,文件路径和实例的键值对 3.在xml文件全部内加载到内存中之前,读取操作是阻塞的,在xml文件全部内加载到内存中之后,是直接读取内存中的数据 4.apply因为是异步的没有返回值, commit是同步的有返回值能知道修改是否提交成功 5.多并发的提交commit时,需等待正在处理的commit数据更新到磁盘文件后才会继续往下执行,从而降低效率; 而apply只是原子更新到内存,后调用apply函数会直接覆盖前面内存数据,从一定程度上提高很多效率。 3.edit()每次都是创建新的EditorImpl对象. 6.博客推荐:全面剖析SharedPreferences 57.操作系统如何管理内存的: 1.使用寄存器进行将进程地址和物理内存进行映射 2.虚拟内存进行内存映射到硬盘上增大内存 3.虚拟内存是进行内存分页管理 4.页表实现分页,就是 页+地址偏移。 5.如果程序的内存在硬盘上,那么就需要用页置换算法来将其调入内存中:先进先出、最近未使用最少等等 6.博客推荐:现代操作系统部分章节笔记 58.浏览器输入地址到返回结果发生了什么 1.DNS解析 2.TCP连接 3.发送HTTP请求 4.服务器处理请求并返回HTTP报文 5.浏览器解析渲染页面 6.连接结束 59.java泛型类型擦除发生在什么时候,通配符有什么需要注意的。 1.发生在编译的时候 2.PECS,extends善于提供精确的对象 A是B的子集,Super善于插入精确的对象 A是B的超集 3.博客推荐:Effective Java笔记(不含反序列化、并发、注解和枚举)、android阿里面试java基础锦集 60.activity的生命周期 1.a启动b,后退键再到a的生命周期流程:a.create-->a.start-->a.resume-->a.pause-->b.create-->b.start-->b.resume-->b界面绘制-->a.stop-->b.pause-->b.stop-->b.destroy-->a.restart-->a.start-->a.resume 2.意外销毁会调用saveInstance,重新恢复的时候回调用restoreInstance。储存数据的时候使用了委托机制,从activity-->window-->viewGroup-->view 会递归调用save来保持本view的数据,restore则是递归恢复本view数据。我们可以在里面做一些自己需要的数据操作。 61.面试常考的算法 1.快排、堆排序为首的各种排序算法 2.链表的各种操作:判断成环、判断相交、合并链表、倒数K个节点、寻找成环节点 3.二叉树、红黑树、B树定义以及时间复杂度计算方式 4.动态规划、贪心算法、简单的图论 5.推荐书籍:算法导论,将图论之前的例子写一遍 62.Launcher进程启动另外一个进程的过程:启动一个app 63.开源框架源码 1.Fresco 1.mvc框架: 1.Controller控制数据显示在Hierarchy中的Drawable的显隐 2.ImagePipeline在Controller中负责进行数据获取,返回的数据是CloseableImage 3.Drawee把除了初始化之外的操作全部交给Holder去做,Holder持有Controller和Hierarchy 2.Drawable层次以及绘制: 1.如果要绘制一次Drawable就调用invalidateSelf()来触发onDraw() 2.Drawable分为:容器类(保存一些Drawable)、自我绘制类(进度条)、图形变换类(scale、rotate、矩阵变换)、动画类(内部不断刷新,进行webp和gif的帧绘制) 3.ImagePipeline返回的CloseableImage是由一个个DrawableFactory解析成Drawable的 4.webp和gif动画是由jni代码解析的,然后其他静态图片是根据不同的android平台使用BitmapFactory来解析的 3.职责链模式:producer不做操作标n,表示只是提供一个consumer。获取图片--》解码图片缓存Producer--》后台线程Producer--》client图片处理producer(n)--》解码producer(n)--》旋转或剪裁producer(n)--》编码图片内存缓存producer--》读硬盘缓存producer--》写硬盘缓存producer(n)--》网络producer提供CloseableImage《--解码图片缓存consumer《--client图片处理consumer《--解码consumer《--旋转或剪裁consumer《--编码图片内存缓存consumer《--写硬盘缓存consumer《--图片数据 4.内存缓存: 1.一个CountingLruMap保存已经没有被引用的缓存条目,一个CountingLruMap保存所有的条目包括没有引用的条目。每当缓存策略改变和一定时间缓存配置的更新的时候,就会将 待销毁条目Map中的条目一个个移除,直到缓存大小符合配置。 2.这里的引用计数是用Fresco组件实现的引用计数器。 3.缓存有一个代理类,用来追踪缓存的存取。 4.CountingLruMap是使用LinkedHashMap来储存数据的。 5.硬盘缓存: 1.DefaultDiskStorage使用Lru策略。 2.为了不让所有的文件集中在一个文件中,创建很多命名不同的文件夹,然后使用hash算法把缓存文件分散 3.DiskStorageCache封装了DefaultDiskStorage,不仅进行缓存存取追踪,并且其在内存里面维持着一个 <key,value> 的键值对,因为文件修改频繁,所有只是定时刷新,因此如果在内存中找不到,还要去硬盘中找一次。 4.删除硬盘的缓存只出现在硬盘数据大小超限的时候,此时同时也会删除缓存中的key,所以不会出现内存中有key,但是硬盘上没有的情况。 5.在插入硬盘数据的时候,采用的是插入器的形式。返回一个Inserter,在Inserter.writeData()中传入一个CallBack(里面封装了客户端插入数据的逻辑和文件引用),让内部实现调用CallBack的逻辑来插入文件数据,前面写的文件后缀是.temp,只有调用commit()之后才会修改后缀,让文件对客户端可见。 6.使用了java提供的FileTreeVisitor来遍历文件 6.对象池: 1.使用数组来存储一个桶,桶内部是一个Queue。数组下标是数据申请内存的byte大小,桶内部的Queue存的是内存块的。所以数组使用的是稀疏数组 2.申请内存的方式有两种 1.java堆上开辟的内存 2.ashme 的本地内存中开辟的内存 7.设计模式:Builder、职责链、观察者、代理、组合、享元、适配器、装饰者、策略、生产者消费者、提供者 8.自定义计数引用:类似c++智能指针 1.使用一个静态IdentityHashMap <储存需要被计数引用的对象,其被引用的次数> 2.用SharedReference分装需要被计数引用的对象,提供一个销毁资源的销毁器,提供一个静态工厂方法来复制自己,复制一个引用计数加一。提供一个方法销毁自己,表示自己需要变成无人引用的对象了,此时引用计数减一。 3.引用计数归零,销毁器将销毁资源,如bitmap的recycle或者是jni内存调用jni方法归还内存。 9.博客推荐:Android Fresco源码文档翻译、从零开始撸一个Fresco之硬盘缓存、从零开始撸一个Fresco之gif和Webp动画、从零开始撸一个Fresco之内存缓存、从零开始撸一个Fresco之总结 2.oKhttp: 1.同步和异步: 1.异步使用了Dispatcher来将存储在 Deque 中的请求分派给线程池中各个线程执行。 2.当任务执行完成后,无论是否有异常,finally代码段总会被执行,也就是会调用Dispatcher的finished函数,它将正在运行的任务Call从队列runningAsyncCalls中移除后,主动的把缓存队列向前走了一步。 2.连接池: 1.一个Connection封装了一个socket,ConnectionPool中储存s着所有的Connection,StreamAllocation是引用计数的一个单位 2.当一个请求获取一个Connection的时候要传入一个StreamAllocation,Connection中存着一个弱引用的StreamAllocation列表,每当上层应用引用一次Connection,StreamAllocation就会加一个。反之如果上层应用不使用了,就会删除一个。 3.ConnectionPool中会有一个后台任务定时清理StreamAllocation列表为空的Connection。5分钟时间,维持5个socket 3.选择路线与建立连接 1.选择路线有两种方式: 1.无代理,那么在本地使用DNS查找到ip,注意结果是数组,即一个域名有多个IP,这就是自动重连的来源 2.有代理HTTP:设置socket的ip为代理地址的ip,设置socket的端口为代理地址的端口 3.代理好处:HTTP代理会帮你在远程服务器进行DNS查询,可以减少DNS劫持。 2.建立连接 1.连接池中已经存在连接,就从中取出(get)RealConnection,如果没有命中就进入下一步 2.根据选择的路线(Route),调用Platform.get().connectSocket选择当前平台Runtime下最好的socket库进行握手 3.将建立成功的RealConnection放入(put)连接池缓存 4.如果存在TLS,就根据SSL版本与证书进行安全握手 5.构造HttpStream并维护刚刚的socket连接,管道建立完成 4.职责链模式:缓存、重试、建立连接等功能存在于拦截器中网络请求相关,主要是网络请求优化。网络请求的时候遇到的问题 5.博客推荐:Android数据层架构的实现 上篇、Android数据层架构的实现 下篇 3.okio 1.简介; 1.sink:自己--》别人 2.source:别人--》自己 3.BufferSink:有缓存区域的sink 4.BufferSource:有缓存区域的source 5.Buffer:实现了3、4的缓存区域,内部有Segment的双向链表,在在转移数据的时候,只需要将指针转移指向就行 2.比java io的好处: 1.减少内存申请和数据拷贝 2.类少,功能齐全,开发效率高 3.内部实现: 1.Buffer的Segment双向链表,减少数据拷贝 2.Segment的内部byte数组的共享,减少数据拷贝 3.SegmentPool的共享和回收Segment 4.sink和source中被实际操作的其实是Buffer,Buffer可以充当sink和source 5.最终okio只是对java io的封装,所有操作都是基于java io 的 写在最后:能看到这里的人,我挺佩服你的.这篇文章是我在头条面试之前整理的,最后80%的题目都命中了,所以祝你好运.

优秀的个人博客,低调大师

从一道BAT的面试题再看setState源码

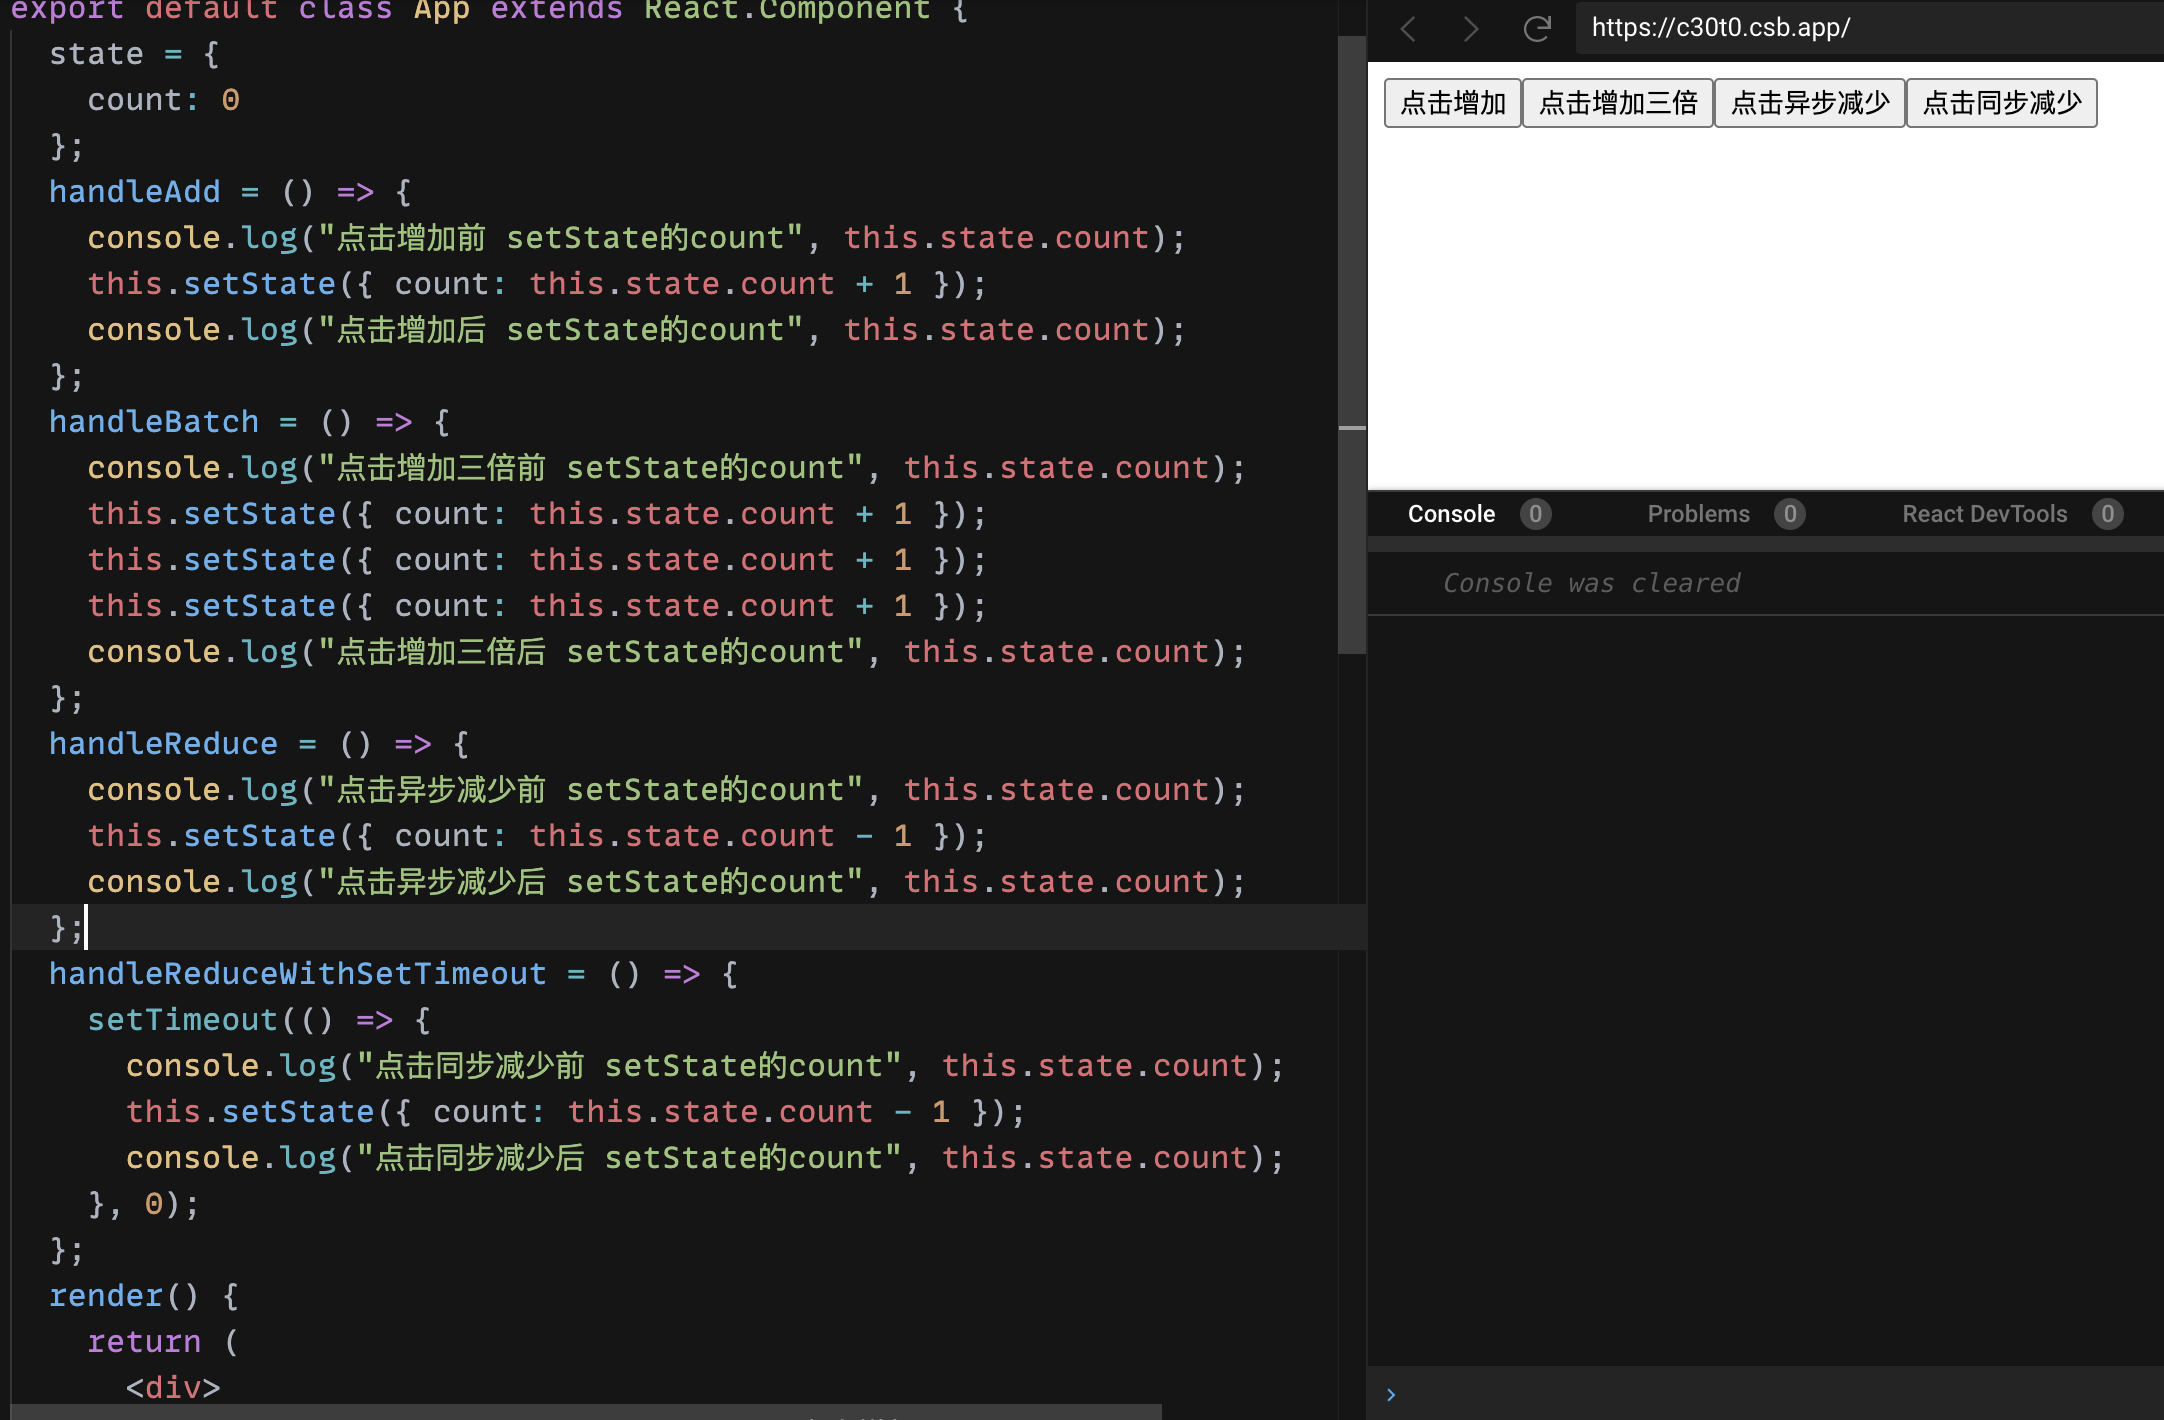
首先,我们先上一道变体繁多的面试题,这里不贴代码,截图效果会好一些,感兴趣的点击这里查看DEMO代码。 一、变体繁多的面试 问题是:从左到右依次点击按钮,控制台会输出什么?建议在脑海里先跑一遍,接着看看和下图的结果是否一致? 嗯哼,结果如何呢?是让你大跌眼镜还是符合预期?若是前者,没关系,跟着我一起探个究竟,若是后者,先恭喜你,也邀请你一起来探讨! 二、在 setState 调用之后,发生了什么? 你可能会想到React 15生命周期中的更新阶段,我们假设 ”一次setState就触发一个完整的更新流程“,那么每执行 this.setState({ count: this.state.count + 1 }); 便会完整的执行下图的更新流程,其中re-render步骤 本身涉及了DOM操作,带来了较大的性能开销,进而导致多刷新几次视图就卡死了 三、异步 - 批量更新的艺术 为了避免频繁的re-render,在React管控下的setState被设计为异步的。它的实现类似于Vue的 $nextTick 和 浏览器的Event-Loop,在实际的React运行中:每来一个setState就把它塞进一个队列里,直到同步的代码执行完毕,便把state结果合并,最后针对最新的state执行一次上图的更新流程,即“批量更新” 到这里,我们回过头来看看上面面试题的前三个按钮点击后的执行流程: 由于异步的原因 state本身不会立即发生改变,因此点击增加前和后的count依然是初始化的0 四、“同步现象”背后的故事 机灵的同学有疑问了,不是说在React管控下的setState一定是异步的吗?那么点击同步减少里的逻辑: setTimeout(() => { console.log("点击同步减少前 setState的count", this.state.count); this.setState({ count: this.state.count - 1 }); console.log("点击同步减少后 setState的count", this.state.count); }, 0); setTimeout 又是如何将setState的执行顺序从异步改变为同步呢?接下来,我们从源码里去求证这个谜底 1、setState工作流 React中对于功能的拆分比较细致,在源码中 setState 涉及比较多的方法,为了更好的解析,这里把主流程提取出来如下: 接下来,我们沿着这个流程,逐个在源码中找出对应的函数 enqueueSetState 主要做了两件事 将新的state塞进组件的状态队列里 调用 enqueueUpdate处理将要更新的实例对象 enqueueSetState: function (publicInstance, partialState) { // 获取对应的组件实例 var internalInstance = getInternalInstanceReadyForUpdate(publicInstance, 'setState'); // 获取一个组件实例的 state 数组 var queue = internalInstance._pendingStateQueue || (internalInstance._pendingStateQueue = []); queue.push(partialState); // 处理当前的组件实例 enqueueUpdate(internalInstance); } enqueueUpdate batchingStrategy 是React内部专门用于管控批量更新的对象,其isBatchingUpdates属性决定了当下是走更新流程还是排队等待,batchedUpdates 方法可以直接发起更新流程 将batchingStrategy 类比“锁管理器”,则isBatchingUpdates是React全局唯一的任务“锁”,它初始值为false 意味着当前并未进行任何批量更新操作 当React调用batchedUpdates 执行更新动作时,会先把“锁”给关上(置为true)表明现在正处于批量更新过程中 关上“锁”后,任何需要更新的组件依次入队等候下一次的批量更新 function enqueueUpdate(component) { ensureInjected(); // isBatchingUpdates标识着当前是否处于批量创建/更新组件的阶段 if (!batchingStrategy.isBatchingUpdates) { // 若当前没有处于批量创建/更新组件的阶段,则立即更新组件 batchingStrategy.batchedUpdates(enqueueUpdate, component); return; } // 否则,先把组件塞入 dirtyComponents 队列里,让它“再等等” dirtyComponents.push(component); if (component._updateBatchNumber == null) { component._updateBatchNumber = updateBatchNumber + 1; } } batchedUpdates 函数里调用了React的事务机制Transaction 2、React 的事务机制 Transaction 官方对于 Transaction 的描述以及React源码中针对 Transaction 的注释如下: Transaction 是创建一个黑盒,该黑盒能够封装任何的方法。因此,那些需要在函数运行前、后运行的方法可以通过此方法封装,实例化Transaction只需提供相关的方法即可 wrappers (injected at creation time) + + | | +-----------------|--------|--------------+ | v | | | +---------------+ | | | +--| wrapper1 |---|----+ | | | +---------------+ v | | | | +-------------+ | | | | +----| wrapper2 |--------+ | | | | +-------------+ | | | | | | | | | | v v v v | wrapper | +---+ +---+ +---------+ +---+ +---+ | invariants perform(anyMethod) | | | | | | | | | | | | maintained +----------------->|-|---|-|---|-->|anyMethod|---|---|-|---|-|--------> | | | | | | | | | | | | | | | | | | | | | | | | | | | | | | | | | | | | | +---+ +---+ +---------+ +---+ +---+ | | initialize close | +-----------------------------------------+ 事务机制 一个 wrapper 包含 一组 initialize 、close 方法 Transaction 类似于一个“壳子”,它将目标函数用 wrapper 封装起来,使用 Transaction类暴露的 perform 方法去执行它 在 anyMethod 执行前,perform会先执行所有 wrapper 的 initialize方法,执行后,再执行所有 wrapper 的 close 方法 更新策略 结合 事务机制 的理解,看下源码里的一个批量更新策略事务ReactDefaultBatchingStrategy,它有两个 wrapper,分别是 RESET_BATCHED_UPDATES 和 FLUSH_BATCHED_UPDATES var RESET_BATCHED_UPDATES = { initialize: emptyFunction, close: function () { ReactDefaultBatchingStrategy.isBatchingUpdates = false; } }; var FLUSH_BATCHED_UPDATES = { initialize: emptyFunction, close: ReactUpdates.flushBatchedUpdates.bind(ReactUpdates) }; var TRANSACTION_WRAPPERS = [FLUSH_BATCHED_UPDATES, RESET_BATCHED_UPDATES]; 当 anyMethod 执行完之后 FLUSH_BATCHED_UPDATES 执行 flushBatchedUpdates消费dirtyComponents,调用updateComponent执行所有生命周期,实现组件的更新 RESET_BATCHED_UPDATES 将 isBatchingUpdates 置为 false,表明批量更新完成 五、“同步现象”的本质 接着,在源码中全局搜索batchedUpdates,调用它的地方很多,但与更新流程相关的,只有下面两处: 1、首次渲染组件会执行的_renderNewRootComponent 函数 开发者很有可能在声明周期函数中调用setState,因此需要通过开启batchedUpdates来确保所有的更新都能进入dirtyComponents,进而确保初始渲染流程中的所有setState生效 // ReactMount.js _renderNewRootComponent: function( nextElement, container, shouldReuseMarkup, context ) { // 实例化组件 var componentInstance = instantiateReactComponent(nextElement); // 初始渲染直接调用 batchedUpdates 进行同步渲染 ReactUpdates.batchedUpdates( batchedMountComponentIntoNode, componentInstance, container, shouldReuseMarkup, context ); ... } 2、React 事件系统的 dispatchEvent 函数 开发者在组件上绑定了事件之后,事件中很有可能会触发setState,为了确保每一次setState生效,同样在此处也手动开启batchedUpdates // ReactEventListener.js dispatchEvent: function (topLevelType, nativeEvent) { ... try { // 处理事件 ReactUpdates.batchedUpdates(handleTopLevelImpl, bookKeeping); } finally { TopLevelCallbackBookKeeping.release(bookKeeping); } } 3、setState 并不具备同步特性,只是在特定的情境下,它会从React的异步管控中“逃脱”掉 通过上面两处batchedUpdates的调用,可以证明:在 React 的生命周期函数 以及 合成事件 执行前,isBatchingUpdates属性已经被悄悄修改为true,此时我们所做的setState操作自然不会立即生效。当函数执行完成后,事务的close函数再将isBatchingUpdates置为 false 我们再次回到我们的面试题最后两个按钮的逻辑上: handleReduce 函数在 isBatchingUpdates 的约束下,setState 只能是异步的 而 isBatchingUpdates 对 setTimeout 里面的执行逻辑却完全没有约束能力 原因是:isBatchingUpdates 是在同步代码执行,而 setTimeout 的逻辑是异步执行的 也就是当 setState 调用真正执行的时候,isBatchingUpdates已经被置为false,使得当前场景下 setState 具备了立刻发起同步更新的能力 六、总结 setState并不是单纯 同步/异步,它的表现会因调用场景不同而不同: 在 React 钩子函数及合成事件中,它表现为异步 而在 setTimeout 、setInterval 等函数中,包括在 DOM 原生事件中,它都表现为同步 造成这种差异的本质是:React 事务机制 和 批量更新机制 的 工作方式

优秀的个人博客,低调大师

3年java开发面试BAT,你必须彻底搞定Maven!

前言 现在的Java项目中,Maven随处可见。Maven的仓库管理、依赖管理、继承和聚合等特性为项目的构建提供了一整套完善的解决方案,如果你搞不懂Maven,那么一个多模块的项目足以让你头疼,依赖冲突就会让你不知所措,甚至搞不清楚项目是如何运行起来的...回想一下,当你新到一家公司,安装完JDK后就会安装配置Maven,很大可能性你需要修改settings.xml文件,比如你会修改本地仓库地址路径,比如你很可能会copy一段配置到你的settings.xml中(很可能就是私服的一些配置)。接下来,你会到IDEA或者Eclipse中进行Maven插件配置,然后你就可以在工程中的pom.xml里面开始添加标签来管理jar包,在Maven规范的目录结构下进行编写代码,最后你会通过插件的方式来进行测试、打包(jar or war)、部署、运行。上面描述了对Maven的一些使用方式,下面我们进行一些思考: 1、本地仓库?Maven到底有哪些仓库?它们什么关系? Maven仓库: 本地仓库路径配置: 你要jar包,不可能每次都要联网去下载吧,多费劲,所以本地仓库就是相当于加了一层jar包缓存,先到这里来查。如果这里查不到,那么就去私服上找,如果私服也找不到,那么去中央仓库去找,找到jar后,会把jar的信息同步到私服和本地仓库中。私服,就是公司内部局域网的一台服务器而已,你想一下,当你的工程Project-A依赖别人的Project-B的接口,怎么做呢?没有Maven的时候,当然是copy Project-B jar到你的本地lib中引入,那么Maven的方式,很显然需要其他人把Project-B deploy到私服仓库中供你使用。因此私服中存储了本公司的内部专用的jar!不仅如此,私服还充当了中央仓库的镜像,说白了就是一个代理!中央仓库:该仓库存储了互联网上的jar,由Maven团队来维护,地址是:http://repo1.maven.org/maven2/。 2、关于的使用 依赖管理: 其实这个标签揭示了jar的查找坐标:groupId、artifactId、version。 一般而言,我们可以到私服上输入artifactId进行搜索,或者到http://search.maven.org/、http://mvnrepository.com/上进行查找确定坐标。 version分为开发版本(Snapshot)和发布版本(Release),那么为什么要分呢?在实际开发中,我们经常遇到这样的场景,比如A服务依赖于B服务,A和B同时开发,B在开发中发现了BUG,修改后,将版本由1.0升级为2.0,那么A必须也跟着在POM.XML中进行版本升级。过了几天后,B又发现了问题,进行修改后升级版本发布,然后通知A进行升级...可以说这是开发过程中的版本不稳定导致了这样的问题。Maven,已经替我们想好了解决方案,就是使用Snapshot版本,在开发过程中B发布的版本标志为Snapshot版本,A进行依赖的时候选择Snapshot版本,那么每次B发布的话,会在私服仓库中,形成带有时间戳的Snapshot版本,而A构建的时候会自动下载B最新时间戳的Snapshot版本! 3、既然Maven进行了依赖管理,为什么还会出现依赖冲突?处理依赖冲突的手段是? 依赖的版本? 首先来说,对于Maven而言,同一个groupId同一个artifactId下,只能使用一个version!根据上图的依赖顺序,将使用1.2版本的jar。现在,我们可以思考下了,比如工程中需要引入A、B,而A依赖1.0版本的C,B依赖2.0版本的C,那么问题来了,C使用的版本将由引入A、B的顺序而定?这显然不靠谱!如果A的依赖写在B的依赖后面,将意味着最后引入的是1.0版本的C,很可能在运行阶段出现类(ClassNotFoundException)、方法(NoSuchMethodError)找不到的错误(因为B使用的是高版本的C)!这里其实涉及到了2个概念:依赖传递(transitive)、Maven的最近依赖策略。依赖传递:如果A依赖B,B依赖C,那么引入A,意味着B和C都会被引入。Maven的最近依赖策略:如果一个项目依赖相同的groupId、artifactId的多个版本,那么在依赖树(mvn dependency:tree)中离项目最近的那个版本将会被使用。(从这里可以看出Maven是不是有点小问题呢?能不能选择高版本的进行依赖么?据了解,Gradle就是version+策略)现在,我们可以想想如何处理依赖冲突呢?想法1:要使用哪个版本,我们是清楚的,那么能不能不管如何依赖传递,都可以进行版本锁定呢?使用 [这种主要用于子模块的版本一致性中]想法2:在依赖传递中,能不能去掉我们不想依赖的?使用 [在实际中我们可以在IDEA中直接利用插件帮助我们生成]想法3:既然是最近依赖策略,那么我们就直接使用显式依赖指定版本,那不就是最靠近项目的么?使用 4、引入依赖的最佳实践,提前发现问题! 在工程中,我们避免不了需要加一些依赖,也许加了依赖后运行时才发现存在依赖冲突在去解决,似乎有点晚!那么能不能提前发现问题呢?如果我们新加入一个依赖的话,那么先通过mvn dependency:tree命令形成依赖树,看看我们新加入的依赖,是否存在传递依赖,传递依赖中是否和依赖树中的版本存在冲突,如果存在多个版本冲突,利用上文的方式进行解决! 5、Maven规范化目录结构 这里需要注意2点:第一:src/main下内容最终会打包到Jar/War中,而src/test下是测试内容,并不会打包进去。第二:src/main/resources中的资源文件会COPY至目标目录,这是Maven的默认生命周期中的一个规定动作。(想一想,hibernate/mybatis的映射XML需要放入resources下,而不能在放在其他地方了) 6、Maven的生命周期 Maven生命周期: 我们只需要注意一点:执行后面的命令时,前面的命令自动得到执行。实际上,我们最常用的就是这么几个:clean:有问题,多清理!package:打成Jar or War包,会自动进行clean+compileinstall:将本地工程Jar上传到本地仓库deploy:上传到私服7、关于scope依赖范围既然,Maven的生命周期存在编译、测试、运行这些过程,那么显然有些依赖只用于测试,比如junit;有些依赖编译用不到,只有运行的时候才能用到,比如mysql的驱动包在编译期就用不到(编译期用的是JDBC接口),而是在运行时用到的;还有些依赖,编译期要用到,而运行期不需要提供,因为有些容器已经提供了,比如servlet-api在tomcat中已经提供了,我们只需要的是编译期提供而已。总结来说:compile:默认的scope,运行期有效,需要打入包中。provided:编译期有效,运行期不需要提供,不会打入包中。runtime:编译不需要,在运行期有效,需要导入包中。(接口与实现分离)test:测试需要,不会打入包中。system:非本地仓库引入、存在系统的某个路径下的jar。(一般不使用) 最后欢迎大家一起交流,喜欢文章记得点个赞哟,感谢支持!

资源下载

更多资源
优质分享App

优质分享App

近一个月的开发和优化,本站点的第一个app全新上线。该app采用极致压缩,本体才4.36MB。系统里面做了大量数据访问、缓存优化。方便用户在手机上查看文章。后续会推出HarmonyOS的适配版本。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册