首页 文章 精选 留言 我的

精选列表

搜索[webpack入门],共10001篇文章
优秀的个人博客,低调大师

Fabric Kafka入门

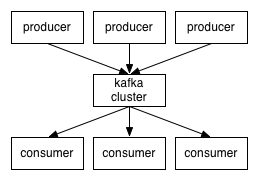
Hyperledger Fabric推荐Kafa用于生产环境。Kafa是一个分布式、具有水平伸缩能力、崩溃容错能力的日志系统。在Hyperledger Fabric区块链中可以有多个Kafka节点,使用zookeeper进行同步管理。本文将介绍Kfaka的基本工作原理,以及在HyperledgerFabric中使用Kafka和zookeeper实现共识的原理,并通过一个实例剖析Hyperledger Farbic中Kafka共识的达成过程。 如果希望快速掌握Fabric区块链的链码及应用开发,建议访问汇智网的在线互动课程: Fabric区块链Java开发详解 Fabric区块链NodeJs开发详解 一、Kafka工作原理 Kafka本质上是一个消息处理系统,它使用的是经典的发布-订阅模型。消息的消费者订阅特定的主题,以便收到新消息的通知,生产者则负责消息的发布。 当主题的数据规模变得越来越大时,可以拆分为多个分区,Kafka保障在一个分区内的消息是按顺序排列的。 Kafka并不跟踪消费者读取了哪些消息,也不会自动删除已经读取的消息。Kafka会保存消息一段时间,例如一天,或者直到数据规模超过一定的阈值。消费者需要轮询新的消息,这是的他们可以根据自己的需求来定位消息,因此可以重放或重新处理事件。消费者处于不同的消费者分组,对应一个或多个消费者进程。每个分区被分贝给单一的消费者进程,因此同样的消息不会被多次读取。 崩溃容错机制是通过在多个Kafka代理之间复制分区来实现的。因此如果一个代理由于软件或硬件故障挂掉,数据也不会丢失。当然接下来还需要一个领导-跟随机制,领导者持有分区,跟随者则进行分区的复制。当领导者挂掉后,会有某个跟随者转变为新的领导者。 如果一个消费者订阅了某个主体,那么它怎么知道从哪个分区领导者来读取订阅的消息? 答案在于zookeeper服务。 zookeeper是一个分布式key-value存储库,通常用于存储元数据及集群机制的实现。zookeeper允许服务(Kafka代理)的客户端订阅变化并获得实时通知。这就是代理如何确定应当使用哪个分区领导者的原因。zookeeper有超强的故障容错能力,因此Kafka的运行严重依赖于它。 在zookeeper中存储的元数据包括: 消费者分组在每个分区的读取偏移量 访问控制清单,用于访问授权与限制 生产者及消费者配额,每秒最多消息数量 分区领导者及健康信息 二、Hyperledger Fabric中的Kafka 要理解在超级账本Hyperledger Fabric中的Kafka是如何工作的,首先需要理解几个重要的术语: Chain - 指的是一组客户端(通道/channel)可以访问的日志 Channel - 一个通道类似于一个主题,授权的对等节点(peer)可以订阅并且成为通道的成员。 只有通道的成员可以在通道上交易,一个通道中的交易在其他通道中看不到。 OSN - 即排序服务节点(Ordering Service Node),在Fabric中被称为排序节点。排序节点负责: 进行客户鉴权 允许客户端通过一个简单的接口写入或读取通道 执行配置交易的过滤与验证,实现通道的重新配置或创建新的通道 RPC - 即远程过程调用(Remote Procedure Call),是一种用于调用其他机器上的服务而无需了解 通信与实现细节的通信协议,目的是像调用本地函数一样调用网络中其他机器上的函数 广播PRC - 交易提交调用,由排序节点执行 分发RPC - 交易分发请求,当交易由kafka代理处理后,分发给请求节点 注意,虽然在Hyperledger Fabric中Kafka被称为共识(Consensus),但是其核心是交易排序服务以及额外的崩溃容错能力。 在Hyperledger Fabric中的Kafka实际运行逻辑如下: 对于每一条链,都有一个对应的分区 每个链对应一个单一的分区主题 排序节点负责将来自特定链的交易(通过广播RPC接收)中继到对应的分区 排序节点可以读取分区并获得在所有排序节点间达成一致的排序交易列表 一个链中的交易是定时分批处理的,也就是说当一个新的批次的第一个交易进来时,开始计时 当交易达到最大数量时或超时后进行批次切分,生成新的区块 定时交易是另一个交易,由上面描述的定时器生成 每个排序节点为每个链维护一个本地日志,生成的区块保存在本地账本中 交易区块通过分发RPC返回客户端 当发生崩溃时,可以利用不同的排序节点分发区块,因为所有的排序节点都维护有本地日志 三、Hyperledger Fabric Kafka实例解析 考虑下图,假设排序节点OSN0和OSN2时连接到广播客户端,OSN1连接到分发客户端。 OSN0已经有了交易foo,中继到kafka集群 此时OSN2将交易baz广播到集群中 最后,交易bar由OSN0发送到集群中 集群现在有三个交易,可以在图中看到三个交易的在日志中的位置偏移量 客户端发送分发请求,在OSN1的本地日志中,上述三个交易在4#区块里。 因此OSN1将4#区块返回客户端,处理结束 Kakfa的高性能对于Hyperledger Fabric有很大的帮助,多个排序节点通过Kafka实现同步,而Kafka本身并不是排序节点,它只是将排序节点通过流连接起来。虽然Kafka支持崩溃容错,它并不能提供对网络中恶意攻击的保护。需要一种拜占庭容错方案(BFT)才可以对抗恶意的攻击,但是目前在Farbic框架中还有待实现这一机制。 总而言之,在Hyperledger Farbic中,Kafka共识模块是可以用于生产环境的,它可以支持崩溃容错,但无法对抗恶意攻击。 原文:The ABCs of Kafka in Hyperledger Fabric

优秀的个人博客,低调大师

yaml 语言入门

编程免不了要写配置文件,YAML 是专门用来写配置文件的语言,非常简洁和强大,远比 JSON 格式方便。本文介绍 YAML 的语法,以JS-YAML的实现为例。你可以去在线 Demo验证下面的例子。 一、简介 YAML 语言(发音 /ˈjæməl/ )的设计目标,就是方便人类读写。它实质上是一种通用的数据串行化格式。 它的基本语法规则如下。 大小写敏感 使用缩进表示层级关系 缩进时不允许使用Tab键,只允许使用空格。 缩进的空格数目不重要,只要相同层级的元素左侧对齐即可 #表示注释,从这个字符一直到行尾,都会被解析器忽略。 YAML 支持的数据结构有三种。 对象:键值对的集合,又称为映射(mapping)/ 哈希(hashes) / 字典(dictionary) 数组:一组按次序排列的值,又称为序列(sequence) / 列表(list) 纯量(scalars):单个的、不可再分的值 以下分别介绍这三种数据结构。 二、对象 对象的一组键值对,使用冒号结构表示。 animal: pets 转为 JavaScript 如下。 { animal: 'pets' } Yaml 也允许另一种写法,将所有键值对写成一个行内对象。 hash: { name: Steve, foo: bar } 转为 JavaScript 如下。 { hash: { name: 'Steve', foo: 'bar' } } 三、数组 一组连词线开头的行,构成一个数组。 - Cat - Dog - Goldfish 转为 JavaScript 如下。 [ 'Cat', 'Dog', 'Goldfish' ] 数据结构的子成员是一个数组,则可以在该项下面缩进一个空格。 - - Cat - Dog - Goldfish 转为 JavaScript 如下。 [ [ 'Cat', 'Dog', 'Goldfish' ] ] 数组也可以采用行内表示法。 animal: [Cat, Dog] 转为 JavaScript 如下。 { animal: [ 'Cat', 'Dog' ] } 四、复合结构 对象和数组可以结合使用,形成复合结构。 languages: - Ruby - Perl - Python websites: YAML: yaml.org Ruby: ruby-lang.org Python: python.org Perl: use.perl.org 转为 JavaScript 如下。 { languages: [ 'Ruby', 'Perl', 'Python' ], websites: { YAML: 'yaml.org', Ruby: 'ruby-lang.org', Python: 'python.org', Perl: 'use.perl.org' } } 五、纯量 纯量是最基本的、不可再分的值。以下数据类型都属于 JavaScript 的纯量。 字符串 布尔值 整数 浮点数 Null 时间 日期数值直接以字面量的形式表示。 number: 12.30 转为 JavaScript 如下。 { number: 12.30 } 布尔值用true和false表示。 isSet: true 转为 JavaScript 如下。 { isSet: true } null用~表示。 parent: ~ 转为 JavaScript 如下。 { parent: null } 时间采用 ISO8601 格式。 iso8601: 2001-12-14t21:59:43.10-05:00 转为 JavaScript 如下。 { iso8601: new Date('2001-12-14t21:59:43.10-05:00') } 日期采用复合 iso8601 格式的年、月、日表示。 date: 1976-07-31 转为 JavaScript 如下。 { date: new Date('1976-07-31') } YAML 允许使用两个感叹号,强制转换数据类型。 e: !!str 123 f: !!str true 转为 JavaScript 如下。 { e: '123', f: 'true' } 六、字符串 字符串是最常见,也是最复杂的一种数据类型。 字符串默认不使用引号表示。 str: 这是一行字符串 转为 JavaScript 如下。 { str: '这是一行字符串' } 如果字符串之中包含空格或特殊字符,需要放在引号之中。 str: '内容: 字符串' 转为 JavaScript 如下。 { str: '内容: 字符串' } 单引号和双引号都可以使用,双引号不会对特殊字符转义。 s1: '内容\n字符串' s2: "内容\n字符串" 转为 JavaScript 如下。 { s1: '内容\\n字符串', s2: '内容\n字符串' } 单引号之中如果还有单引号,必须连续使用两个单引号转义。 str: 'labor''s day' 转为 JavaScript 如下。 { str: 'labor\'s day' } 字符串可以写成多行,从第二行开始,必须有一个单空格缩进。换行符会被转为空格。 str: 这是一段 多行 字符串 转为 JavaScript 如下。 { str: '这是一段 多行 字符串' } 多行字符串可以使用|保留换行符,也可以使用>折叠换行。 this: | Foo Bar that: > Foo Bar 转为 JavaScript 代码如下。 { this: 'Foo\nBar\n', that: 'Foo Bar\n' } +表示保留文字块末尾的换行,-表示删除字符串末尾的换行。 s1: | Foo s2: |+ Foo s3: |- Foo 转为 JavaScript 代码如下。 { s1: 'Foo\n', s2: 'Foo\n\n\n', s3: 'Foo' } 字符串之中可以插入 HTML 标记。 message: | <p style="color: red"> 段落 </p> 转为 JavaScript 如下。 { message: '\n<p style="color: red">\n 段落\n</p>\n' } 七、引用 锚点&和别名*,可以用来引用。 defaults: &defaults adapter: postgres host: localhost development: database: myapp_development <<: *defaults test: database: myapp_test <<: *defaults 等同于下面的代码。 defaults: adapter: postgres host: localhost development: database: myapp_development adapter: postgres host: localhost test: database: myapp_test adapter: postgres host: localhost &用来建立锚点(defaults),<<表示合并到当前数据,*用来引用锚点。 下面是另一个例子。 - &showell Steve - Clark - Brian - Oren - *showell 转为 JavaScript 代码如下。 [ 'Steve', 'Clark', 'Brian', 'Oren', 'Steve' ] 八、函数和正则表达式的转换 这是JS-YAML库特有的功能,可以把函数和正则表达式转为字符串。 # example.yml fn: function () { return 1 } reg: /test/ 解析上面的 yml 文件的代码如下。 var yaml = require('js-yaml'); var fs = require('fs'); try { var doc = yaml.load( fs.readFileSync('./example.yml', 'utf8') ); console.log(doc); } catch (e) { console.log(e); } 从 JavaScript 对象还原到 yaml 文件的代码如下。 var yaml = require('js-yaml'); var fs = require('fs'); var obj = { fn: function () { return 1 }, reg: /test/ }; try { fs.writeFileSync( './example.yml', yaml.dump(obj), 'utf8' ); } catch (e) { console.log(e); }

优秀的个人博客,低调大师

docker 入门应用

1、docker介绍Docker 是一个开源的应用容器引擎,让开发者可以打包他们的应用以及依赖包到一个可移植的容器中,然后发布到任何流行的 Linux 机器上,也可以实现虚拟化。容器是完全使用沙箱机制,相互之间不会有任何接口。 2、docker的使用docker主要是应用在集成环境的开发,例如后端php开发,可以集成php、nginx、mysql、redis等,docker可以选用contos X 、ubutun等操作系统,个人习惯于ubutun 14.0.4 系统较稳定。docker搭建的环境可以实现远程复制,对于开发者来说,是极其方便的,可以保证开发、测试、线上的环境一致。同时docker各环境之间是互不影响的,可以实现独立开发、运行。 3、docker的优劣势简单来说docker就是一个虚拟机,跟VMWare一样搭建虚拟环境 特性 docker 虚拟机启动速度 秒级 分钟级性能 接近原生 较弱内存代价 很小 较多硬盘使用 一般为MB 一般为GB运行密度 单机支持上千个容器 一般几十个隔离性 安全隔离 完全隔离迁移性 优秀 一般4、docker内部构造Docker 镜像 - Docker imagesDocker 仓库 - Docker registeriesDocker 容器 - Docker containers 1.Docker 镜像Docker 镜像是 Docker 容器运行时的只读模板,每一个镜像由一系列的层 (layers) 组成。Docker 使用 UnionFS 来将这些层联合到单独的镜像中。UnionFS 允许独立文件系统中的文件和文件夹(称之为分支)被透明覆盖,形成一个单独连贯的文件系统。正因为有了这些层的存在,Docker 是如此的轻量。当你改变了一个 Docker 镜像,比如升级到某个程序到新的版本,一个新的层会被创建。因此,不用替换整个原先的镜像或者重新建立(在使用虚拟机的时候你可能会这么做),只是一个新 的层被添加或升级了。现在你不用重新发布整个镜像,只需要升级,层使得分发 Docker 镜像变得简单和快速。 2.Docker 仓库Docker 仓库用来保存镜像,可以理解为代码控制中的代码仓库。同样的,Docker 仓库也有公有和私有的概念。公有的 Docker 仓库名字是 Docker Hub。Docker Hub 提供了庞大的镜像集合供使用。这些镜像可以是自己创建,或者在别人的镜像基础上创建。Docker 仓库是 Docker 的分发部分。 3.Docker 容器 Docker 容器和文件夹很类似,一个Docker容器包含了所有的某个应用运行所需要的环境。每一个 Docker 容器都是从 Docker 镜像创建的。Docker 容器可以运行、开始、停止、移动和删除。每一个 Docker 容器都是独立和安全的应用平台,Docker 容器是 Docker 的运行部分。

优秀的个人博客,低调大师

Spring Boot入门

Spring官方网站本身使用Spring框架开发,随着功能以及业务逻辑的日益复杂,应用伴随着大量的XML配置文件以及复杂的Bean依赖关系。随着Spring 3.0的发布,Spring IO团队逐渐开始摆脱XML配置文件,并且在开发过程中大量使用“约定优先配置”(convention over configuration)的思想来摆脱Spring框架中各类繁复纷杂的配置(即时是Java Config)。 Spring Boot正是在这样的一个背景下被抽象出来的开发框架,它本身并不提供Spring框架的核心特性以及扩展功能,只是用于快速、敏捷地开发新一代基于Spring框架的应用程序。也就是说,它并不是用来替代Spring的解决方案,而是和Spring框架紧密结合用于提升Spring开发者体验的工具。同时它集成了大量常用的第三方库配置(例如Jackson, JDBC, Mongo, Redis, Mail等等),Spring Boot应用中这些第三方库几乎可以零配置的开箱即用(out-of-the-box),大部分的Spring Boot应用都只需要非常少量的配置代码,开发者能够更加专注于业务逻辑。 Hello World 传统基于Spring的Java Web应用,需要配置web.xml,applicationContext.xml,将应用打成war包放入应用服务器(Tomcat, Jetty等)中并运行。如果基于Spring Boot,这一切都将变得简单: 以Maven项目为例,首先引入Spring Boot的开发依赖: <parent> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-parent</artifactId> <version>1.2.5.RELEASE</version> </parent> <dependencies> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-web</artifactId> </dependency> </dependencies> 编写一个类包含处理HTTP请求的方法以及一个main()函数: @Controller@EnableAutoConfigurationpublicclassSampleController{@RequestMapping("/")@ResponseBody Stringhome(){ return"HelloWorld!"; } publicstaticvoidmain(String[]args)throwsException{ SpringApplication.run(SampleController.class,args); } } 启动main函数后,在控制台中可以发现启动了一个Tomcat容器,一个基于Spring MVC的应用也同时启动起来,这时访问http://localhost:8080就可以看到Hello World!出现在浏览器中了。 Spring Boot初探 在Maven依赖中引入了spring-boot-starter-web,它包含了Spring Boot预定义的一些Web开发的常用依赖: spring-web,spring-webmvcSpring WebMvc框架 tomcat-embed-*内嵌Tomcat容器 jackson处理json数据 spring-*Spring框架 spring-boot-autoconfigureSpring Boot提供的自动配置功能 Java代码中没有任何配置,和传统的Spring应用相比,多了两个我们不认识的符号: @EnableAutoConfiguration SpringApplication 它们都是由Spring Boot框架提供。在SpringApplication.run()方法执行后,Spring Boot的autoconfigure发现这是一个Web应用(根据类路径上的依赖确定),于是在内嵌的Tomcat容器中启动了一个Spring的应用上下文,并且监听默认的tcp端口8080(默认约定)。同时在Spring Context中根据默认的约定配置了Spring WebMvc: Servlet容器默认的Context路径是/ DispatherServlet匹配的路径(servlet-mapping中的url-patterns)是/* @ComponentScan路径被默认设置为SampleController的同名package,也就是该package下的所有@Controller,@Service,@Component,@Repository都会被实例化后并加入Spring Context中。 没有一行配置代码、也没有web.xml。基于Spring Boot的应用在大多数情况下都不需要我们去显式地声明各类配置,而是将最常用的默认配置作为约定,在不声明的情况下也能适应大多数的开发场景。 实例:数据库访问 除了最基本的Web框架,另一种非常普遍的开发场景是访问数据库。在传统的Spring应用中,访问数据库我们需要配置: 类路径上添加数据库访问驱动 实例化DataSource对象,指定数据库url,username,password等信息 注入JdbcTemplate对象,如果使用Hibernate,Mybatis等框架,还需要进一步配置框架信息 在Spring Boot中,上述过程会被简化。首先在Maven项目依赖中定义: <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-web-jdbc</artifactId> </dependency> <dependency> <groupId>com.h2database</groupId> <artifactId>h2</artifactId> </dependency> spring-boot-starter-web-jdbc引入了spring-jdbc依赖,h2是一个内存关系型数据库。在引入了这些依赖并启动Spring Boot应用程序后,autoconfigure发现spring-jdbc位于类路径中,于是: 根据类路径上的JDBC驱动类型(这里是h2,预定义了derby,sqlite,mysql,oracle,sqlserver等等),创建一个DataSource连接池对象,本例中的h2是内存数据库,无需任何配置,如果是mysql,oracle等类型的数据库需要开发者配置相关信息。 在Spring Context中创建一个JdbcTemplate对象(使用DataSource初始化) 接下来开发者的工作就非常简单了,在业务逻辑中直接引入JdbcTemplate即可: @ServicepublicclassMyService{@Autowired JdbcTemplatejdbcTemplate; } 除了spring-jdbc,Spring Boot还能够支持JPA,以及各种NoSQL数据库——包括MongoDB,Redis,全文索引工具elasticsearch,solr等等。 配置 Spring Boot最大的特色是“约定优先配置”,大量的默认配置对开发者十分的友好。但是在实际的应用开发过程中,默认配置不可能满足所有场景,同时用户也需要配置一些必须的配置项——例如数据库连接信息。Spring Boot的配置系统能够让开发者快速的覆盖默认约定,同时支持Properties配置文件和YAML配置文件两种格式,默认情况下Spring Boot加载类路径上的application.properties或application.yml文件,例如: spring.datasource.url=jdbc:mysql://localhost/testspring.datasource.username=dbuser spring.datasource.password=dbpass spring.datasource.driver-class-name=com.mysql.jdbc.Driver YAML格式更加简洁: spring:datasource: url:jdbc:mysql://localhost/test username:dbuser password:dbpass driver-class:com.mysql.jdbc.Driver 一旦发现这些信息,Spring Boot就会根据它们创建DataSource对象。另一个常见的配置场景是Web应用服务器: #Serversettings(ServerProperties) server: port:8080 address:127.0.0.1 sessionTimeout:30 contextPath:/ #Tomcatspecifics tomcat: accessLogEnabled:false protocolHeader:x-forwarded-proto remoteIpHeader:x-forwarded-for basedir: backgroundProcessorDelay:30#secs 通过port和address可以修改服务器监听的地址和端口,sessionTimeout配置session过期时间(再也不用修改web.xml了,因为它根本不存在)。同时如果在生产环境中使用内嵌Tomcat,当然希望能够配置它的日志、线程池等信息,这些现在都可以通过Spring Boot的属性文件配置,而不再需要再对生产环境中的Tomcat实例进行单独的配置管理了。 @EnableAutoCongiguration 从Spring 3.0开始,为了替代繁琐的XML配置,引入了@Enable...注解对@Configuration类进行修饰以达到和XML配置相同的效果。想必不少开发者已经使用过类似注解: @EnableTransactionManagement开启Spring事务管理,相当于XMl中的<tx:*> @EnableWebMvc使用Spring MVC框架的一些默认配置 @EnableScheduling会初始化一个Scheduler用于执行定时任务和异步任务 Spring Boot提供的@EnableAutoCongiguration似乎功能更加强大,一旦加上,上述所有的配置似乎都被包含进来而无需开发者显式声明。它究竟是如何做到的呢,先看看它的定义: @Target(ElementType.TYPE) @Retention(RetentionPolicy.RUNTIME) @Documented @Import({EnableAutoConfigurationImportSelector.class, AutoConfigurationPackages.Registrar.class}) public@interfaceEnableAutoConfiguration{/** *Excludespecificauto-configurationclassessuchthattheywillneverbeapplied. */ Class<?>[]exclude()default{}; } EnableAutoConfigurationImportSelector使用的是spring-core模块中的SpringFactoriesLoader#loadFactoryNames()方法,它的作用是在类路径上扫描META-INF/spring.factories文件中定义的类: #Initializers org.springframework.context.ApplicationContextInitializer=\ org.springframework.boot.autoconfigure.logging.AutoConfigurationReportLoggingInitializer #AutoConfigure org.springframework.boot.autoconfigure.EnableAutoConfiguration=\ org.springframework.boot.autoconfigure.aop.AopAutoConfiguration,\ org.springframework.boot.autoconfigure.amqp.RabbitAutoConfiguration,\ org.springframework.boot.autoconfigure.MessageSourceAutoConfiguration,\ org.springframework.boot.autoconfigure.PropertyPlaceholderAutoConfiguration,\ org.springframework.boot.autoconfigure.batch.BatchAutoConfiguration,\ org.springframework.boot.autoconfigure.data.JpaRepositoriesAutoConfiguration,\ org.springframework.boot.autoconfigure.data.MongoRepositoriesAutoConfiguration,\ org.springframework.boot.autoconfigure.redis.RedisAutoConfiguration,\ org.springframework.boot.autoconfigure.jdbc.DataSourceAutoConfiguration,\ org.springframework.boot.autoconfigure.jdbc.DataSourceTransactionManagerAutoConfiguration,\ org.springframework.boot.autoconfigure.jms.JmsTemplateAutoConfiguration,\ org.springframework.boot.autoconfigure.jmx.JmxAutoConfiguration,\ org.springframework.boot.autoconfigure.mobile.DeviceResolverAutoConfiguration,\ org.springframework.boot.autoconfigure.mongo.MongoAutoConfiguration,\ org.springframework.boot.autoconfigure.mongo.MongoTemplateAutoConfiguration,\ org.springframework.boot.autoconfigure.orm.jpa.HibernateJpaAutoConfiguration,\ org.springframework.boot.autoconfigure.reactor.ReactorAutoConfiguration,\ org.springframework.boot.autoconfigure.security.SecurityAutoConfiguration,\ org.springframework.boot.autoconfigure.security.FallbackWebSecurityAutoConfiguration,\ org.springframework.boot.autoconfigure.thymeleaf.ThymeleafAutoConfiguration,\ org.springframework.boot.autoconfigure.web.EmbeddedServletContainerAutoConfiguration,\ org.springframework.boot.autoconfigure.web.DispatcherServletAutoConfiguration,\ org.springframework.boot.autoconfigure.web.ServerPropertiesAutoConfiguration,\ org.springframework.boot.autoconfigure.web.MultipartAutoConfiguration,\ org.springframework.boot.autoconfigure.web.HttpMessageConvertersAutoConfiguration,\ org.springframework.boot.autoconfigure.web.WebMvcAutoConfiguration,\ org.springframework.boot.autoconfigure.websocket.WebSocketAutoConfiguration 实际上这就是Spring Boot会自动配置的一些对象,例如前面提到的Web框架由EmbeddedServletContainerAutoConfiguration,DispatcherServletAutoConfiguration,ServerPropertiesAutoConfiguration等配置完成,而DataSource的自动配置则是由DataSourceAutoConfiguration完成。现在我们以Mongo的配置MongoAutoConfiguration为例,来探索Spring Boot是如何完成这些配置的: @Configuration@ConditionalOnClass(Mongo.class)@EnableConfigurationProperties(MongoProperties.class) publicclassMongoAutoConfiguration{ @Autowired privateMongoPropertiesproperties; privateMongomongo; @PreDestroy publicvoidclose()throwsUnknownHostException{ if(this.mongo!=null){ this.mongo.close(); } } @Bean @ConditionalOnMissingBean publicMongomongo()throwsUnknownHostException{ this.mongo=this.properties.createMongoClient(); returnthis.mongo; } } 首先这是一个Spring的配置@Configuration,它定义了我们访问Mongo需要的@Bean,如果这个@Configuration被Spring Context扫描到,那么Context中自然也就有两个一个Mongo对象能够直接为开发者所用。 但是注意到其它几个Spring注解: @ConditionOnClass表明该@Configuration仅仅在一定条件下才会被加载,这里的条件是Mongo.class位于类路径上 @EnableConfigurationProperties将Spring Boot的配置文件(application.properties)中的spring.data.mongodb.*属性映射为MongoProperties并注入到MongoAutoConfiguration中。 @ConditionalOnMissingBean说明Spring Boot仅仅在当前上下文中不存在Mongo对象时,才会实例化一个Bean。这个逻辑也体现了Spring Boot的另外一个特性——自定义的Bean优先于框架的默认配置,我们如果显式的在业务代码中定义了一个Mongo对象,那么Spring Boot就不再创建。 接下来看一看MongoProperties: @ConfigurationProperties(prefix="spring.data.mongodb") publicclassMongoProperties{ privateStringhost; privateintport=DBPort.PORT; privateStringuri="mongodb://localhost/test"; privateStringdatabase; //...getters/settersomitted } 显然,它就是以spring.data.mongodb作为前缀的属性,然后通过名字直接映射为对象的属性,同时还包含了一些默认值。如果不配置,那么mongo.uri就是mongodb://localhost/test。 Production特性 从前面的例子可以看出,Spring Boot能够非常快速的做出一些原型应用,但是它同样可以被用于生产环境。为了添加生产环境特性支持,需要在Maven依赖中引入: <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-actuator</artifactId> </dependency> 加入actuator依赖后,应用启动后会创建一些基于Web的Endpoint: /autoconfig,用来查看Spring Boot的框架自动配置信息,哪些被自动配置,哪些没有,原因是什么。 /beans,显示应用上下文的Bean列表 /dump,显示线程dump信息 /health,应用健康状况检查 /metrics /shutdown, 默认没有打开 /trace 总结 Spring Boot是新一代Spring应用的开发框架,它能够快速的进行应用开发,让人忘记传统的繁琐配置,更加专注于业务逻辑。现在Spring官方文档中所有的Guide中的例子都是使用Spring Boot进行构建,这也是一个学习Spring, Spring Boot非常好的地方。

优秀的个人博客,低调大师

ActiveMQ入门实例

在开始之前需要去到网上去下载一个activeMQ,(官方网站下载:http://activemq.apache.org/),然后直接解压运行bin目录下面的activemq.bat文件,启动后登陆:http://localhost:8161/admin/,创建一个Queue,命名为FirstQueue,到这里准备工作就完成了,然后就可以开始了。 第一步,创建一个普通的java项目,然后导入java包(本人导入的是activemq-all-5.9.0.jar) 第二步、添加消息发送者 publicclassSender{ //连接工厂 privatestaticConnectionFactoryconnectionFactory; static{ connectionFactory=newActiveMQConnectionFactory(ActiveMQConnection.DEFAULT_USER,ActiveMQConnection.DEFAULT_PASSWORD,"tcp://localhost:61616"); } publicstaticvoidmain(String[]args){ //连接 Connectionconnection=null; //会话 Sessionsession=null; //目的地,消息要发往的地方 Destinationdestination; //消息发送者 MessageProducerproducer=null; try{ //获取消息连接 connection=connectionFactory.createConnection(); //开启连接 connection.start(); //通过连接创建会话 session=connection.createSession(Boolean.TRUE,Session.AUTO_ACKNOWLEDGE); //创建消息队列 destination=session.createQueue("FirstQueue"); //创建发送者 producer=session.createProducer(destination); //发送消息 send(session,producer); }catch(JMSExceptione){ e.printStackTrace(); }finally{ try{ session.commit(); connection.close(); }catch(JMSExceptione){ e.printStackTrace(); } } } publicstaticvoidsend(Sessionsession,MessageProducerproducer)throwsJMSException{ for(inti=0;i<10;i++){ //创建消息 TextMessagemsg=session.createTextMessage("消息"+i); //发送消息 producer.send(msg); System.out.println("发送消息:消息"+i); } } } 最后一步,添加消息的接受者 publicclassconsumer{ privatestaticConnectionFactoryconnectionFactory; static{ connectionFactory=newActiveMQConnectionFactory(ActiveMQConnection.DEFAULT_USER,ActiveMQConnection.DEFAULT_PASSWORD,"tcp://localhost:61616"); } publicstaticvoidmain(String[]args){ Connectionconnection=null; Sessionsession=null; Destinationdestination; MessageConsumerconsumer=null; try{ connection=connectionFactory.createConnection(); connection.start(); session=connection.createSession(Boolean.FALSE,Session.AUTO_ACKNOWLEDGE); destination=session.createQueue("FirstQueue"); consumer=session.createConsumer(destination); while(true){ TextMessagemsg=(TextMessage)consumer.receive(30000); if(msg!=null){ System.out.println("接受到的消息:"+msg.getText()); }else{ break; } } }catch(JMSExceptione){ e.printStackTrace(); }finally{ try{ consumer.close(); session.commit(); connection.close(); }catch(JMSExceptione){ e.printStackTrace(); } } } } 注意:接受消息还可以通过MessageListener接收 publicclassconsumerList{ privatestaticConnectionFactoryconnectionFactory; static{ connectionFactory=newActiveMQConnectionFactory(ActiveMQConnection.DEFAULT_USER,ActiveMQConnection.DEFAULT_PASSWORD,"tcp://localhost:61616"); } publicstaticvoidmain(String[]args){ Connectionconnection=null; Sessionsession=null; Destinationdestination; MessageConsumerconsumer=null; try{ connection=connectionFactory.createConnection(); connection.start(); session=connection.createSession(Boolean.TRUE,Session.AUTO_ACKNOWLEDGE); destination=session.createQueue("FirstQueue"); consumer=session.createConsumer(destination); consumer.setMessageListener(newMessageListener(){ @Override publicvoidonMessage(Messagemessage){ TextMessagemsg=(TextMessage)message; try{ System.out.println(msg.getText()); }catch(JMSExceptione){ e.printStackTrace(); } } }); }catch(JMSExceptione){ e.printStackTrace(); }finally{ try{ consumer.close(); session.commit(); connection.close(); }catch(JMSExceptione){ e.printStackTrace(); } } } }

优秀的个人博客,低调大师

Spring MVC入门

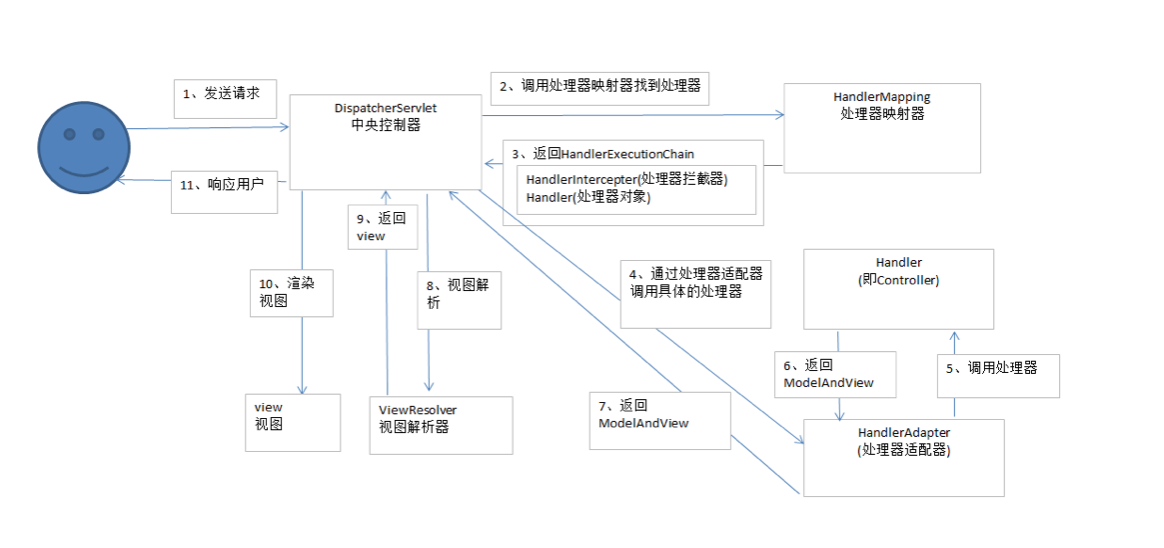
Spring mvc架构 1.1架构图 1.2.架构流程 1.用户发送请求至前端控制器DispatcherServlet 2.DispatcherServlet收到请求调用HandlerMapping处理器映射器。 3.处理器映射器根据请求url找到具体的处理器,生成处理器对象及处理器拦截器(如果有则生成)一并返回给DispatcherServlet。 4.DispatcherServlet通过HandlerAdapter处理器适配器调用处理器 5.执行处理器(Controller,也叫后端控制器)。 6.Controller执行完成返回ModelAndView 7.HandlerAdapter将controller执行结果ModelAndView返回 8.DispatcherServletDispatcherServlet将ModelAndView传给ViewReslover视图解析器 9.ViewReslover解析后返回具体View 10.DispatcherServlet对View进行渲染视图(即将模型数据填充至视图中)。 11.DispatcherServlet响应用户 一.前端控制器(DispatcherServlet) <servlet> <servlet-name>JdbcSqlServlet</servlet-name> <servlet-class>com.imooc.page.servlet.JdbcSqlServlet</servlet-class> </servlet> <servlet-mapping> <servlet-name>JdbcSqlServlet</servlet-name> <url-pattern>/jdbcSql/JdbcSqlServlet</url-pattern> </servlet-mapping> 二.Spring MVC配置文件(同Spring配置文件) <?xmlversion="1.0"encoding="UTF-8"?> <beansxmlns="http://www.springframework.org/schema/beans" xmlns:mvc="http://www.springframework.org/schema/mvc"xmlns:context="http://www.springframework.org/schema/context" xmlns:tx="http://www.springframework.org/schema/tx"xmlns:aop="http://www.springframework.org/schema/aop" xmlns:p="http://www.springframework.org/schema/p"xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance" xsi:schemaLocation=" http://www.springframework.org/schema/beans http://www.springframework.org/schema/beans/spring-beans.xsd http://www.springframework.org/schema/mvc http://www.springframework.org/schema/mvc/spring-mvc.xsd http://www.springframework.org/schema/context http://www.springframework.org/schema/context/spring-context.xsd http://www.springframework.org/schema/tx http://www.springframework.org/schema/tx/spring-tx.xsd http://www.springframework.org/schema/aop http://www.springframework.org/schema/aop/spring-aop.xsd"> 前端控制器(DispatcherServlet)带有默认的,映射器和适配器 三.处理器映射器(HandlerMapping) 用户发起的request请求,前端控制器(DispatcherServlet) 首先会请求 处理器映射器(HandlerMapping)来查找 后端控制器(Handler) 四.处理器适配器(HandlerAdapter) 处理器映射器将查找到的Handler返回给DispatcherServlet后,DispatcherServlet会调用适配器执行Handler,通过适配器去扩展对不同Handler的执行。 五.后端控制器的编写(Handler) Controller.java 六.配置视图解析器(ViewResolver) <bean class="org.springframework.web.servlet.view.InternalResourceViewResolver"> </bean>

优秀的个人博客,低调大师

Java入门—集合

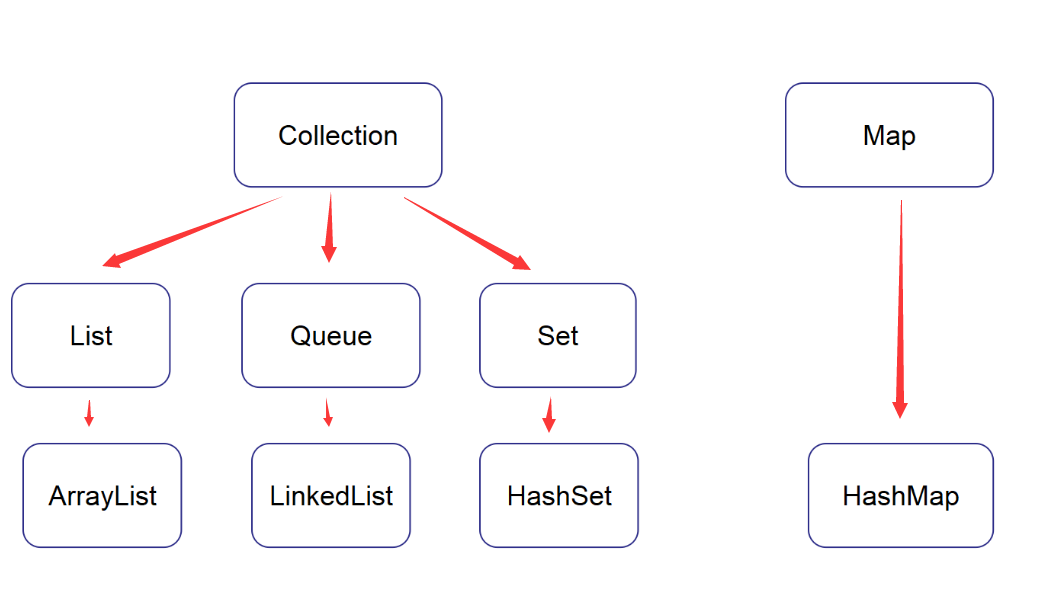
应用场景: 无法预测存储数据的数量 同时存储具有一对一关系的数据 需要进行数据的增删 数据重复问题 集合概览 image.png List(列表) List是元素有序并且可以重复的集合,称为序列。 List可以精确控制每个元素的插入位置,或者删除某个为止的元素。 List两个主要实现类是ArrayList 和 LinkedList。 ArrayList 和 LinkedList 两者的数据存储方式是不同的: ArrayList :和数组相似,但是长度可以动态增长,在内存中的一片连续存储空间进行存储 LinkedList:本身是链表 Set 无序、不重复集合。 HashSet HashSet是Set的一个重要实现类,称为哈希集。 HashSet中元素无需并且不可重复。 HashSet中只允许一个null元素。 具有良好的存取和查找性能。 HashSet底层是hashMap。 遍历HashSet需要使用迭代器方法。 Iterator(迭代器) Iterator接口可以以统一的方式对各种集合元素进行遍历 hasNext()方法检测集合中是否还有下一个元素(返回ture或false) next() 方法返回集合中的下一个元素 import java.util.HashSet; import java.util.Set; import java.util.Iterator; public class TestIterator { public static void main(String[] args){ Set s = new HashSet(); s.add("allen"); s.add("ming"); s.add("hello"); Iterator it = s.iterator(); while (it.hasNext()){ System.out.println(it.next()); } } } Map Map中的数据是以键值对(key-value)形式存储的 key-value以Entry类型的对象实例存在 通过key可以快速查找value值 不能包含重复的建(key值必须唯一) HashMap 基于哈希表的Map接口实现 允许使用null值和null键值 HashMap中Entry对象时无序排列的 总结 ArrayList 底层由数组实现 元素有序且可以重复 可以动态增长,以满足应用程序的需求 元素值可以为null HashSet 元素无序并且不可以重复 只允许一个null元素 HashMap 键不能重复 允许使用null值和null键 HashMap中的Entry对象是无序排列的 Iterator(迭代器) Iterator接口以统一的方式对各种集合元素进行遍历 image.png

优秀的个人博客,低调大师

pipenv快速入门

学过Python的同学应该都了解pip这个工具,我们用pip绝大部分的第三方库都可以用pip来安装,用起来很方便。但是如果我们要把项目部署到服务器上面的话,就稍微有些麻烦了,因为还需要在服务器上用pip安装这些包,假如项目中用到很多包的话,一个个安装会很麻烦,而且没有通用性。Java上的maven、gradle,NodeJS的npm这些工具就不存在这个问题,它们有一个或多个的专门的依赖文件来管理这些包。pipenv就是这样一个类似的工具,可以帮助我们管理Python和第三方库的版本。 安装 安装pipenv很简单,用pip命令就可以安装。 pip install pipenv 将来需要更新pipenv的时候,运行: pip install --user --upgrade pipenv 首次运行 如果是第一次在项目中运行pipenv命令的话,会在项目中创建一个名为Pipfile的文件,文件内容类似下面这样。用过maven、gradle等工具的同学对此应该熟悉,相信不用我解释其中的含义。 [[source]] url = "https://pypi.org/simple" verify_ssl = true name = "pypi" [packages] requests-html = "*" [dev-packages] [requires] python_version = "3.7" 如果运行过install、update等命令的话,还会创建一个Pipfile.lock文件,类似npm中的lock文件。这两个文件就是pipenv用于管理第三方库的配置文件,如果同时使用版本控制软件的话,需要将它们也加入进去。 常用命令 安装 例如,我想在项目中安装requests这个包,运行: pipenv install requests 如果需要指定具体版本号,可以这样: pipenv install requests==2.13.0 如果是第一次运行pipenv的话,会先创建Pipfile文件,否则会修改Pipfile`文件。 该命令还有一个常用参数-d或--dev,用于安装仅供开发使用的包。 卸载 相应的还有命令来卸载第三方包,该命令还有两个参数--all和--all-dev用于卸载所有包和所有开发包。 pipenv uninstall requests 更新 查看所有需要更新的包: pipenv update --outdated 更新所有包: pipenv update 更新指定的包: pipenv update <包名> 从requirements.txt导入 如果项目中有requirements.txt文件,pipenv会在安装的时候自动导入。如果需要导入其他位置的requirements.txt,可以用下面的命令: pipenv install -r path/to/requirements.txt 指定Python版本 pipenv会创建虚拟Python环境,并在其中用pip安装所有包。如果要指定Python版本,可以用下面的命令,三种版本号都支持: pipenv --python 3 pipenv --python 3.6 pipenv --python 2.7.14 如果不指定版本号,pipenv会使用系统默认的Python版本。需要注意,这里指定的Python必须是系统已经安装的、可以在环境变量中搜索到的版本号,如果指定未安装的版本,会提示错误。 运行命令 用下面的命令可以启动一个在虚拟环境中的shell: pipenv shell 如果不想启动shell,而是直接在虚拟环境中执行命令,可以使用run: pipenv run python --version 高级用法 一开始我文档没看全,然后用pipenv的时候发现有一些问题,后来我发现官方文档还有一部分高级内容也很重要,所以再来补充一下。当然如果有需要的话还是得看原文。 导出requirements.txt 用下面的命令就可以将Pipfile和Pipfile.lock文件里面的包导出为requirements.txt文件。 pipenv lock -r 如果只想导出开发用的包,可以添加--dev参数: pipenv lock -r --dev 自动安装Python pipenv只能搜索系统中已经安装的Python版本,对于未安装的版本,会提示错误。但是如果你同时安装了pyenv的话,pipenv会自动发现pyenv,然后直接询问你是否要安装。这样一来,原来的工作流程是:用pyenv安装某个Python->用virtualenv或venv创建虚拟环境->用pip从requirements.txt中安装包->将来可能还要更新包。现在完全可以用pipenv一两条命令解决,真的是非常方便。 自动加载.env文件 .env文件可以设置一些环境变量,在程序开发的时候模拟环境变量。pipenv也可以自动加载.env文件。 $ cat .env HELLO=WORLD⏎ $ pipenv run python Loading .env environment variables… Python 2.7.13 (default, Jul 18 2017, 09:17:00) [GCC 4.2.1 Compatible Apple LLVM 8.1.0 (clang-802.0.42)] on darwin Type "help", "copyright", "credits" or "license" for more information. >>> import os >>> os.environ['HELLO'] 'WORLD' 环境变量支持 在Pipfile中也可以引用环境变量的值,格式为${MY_ENVAR}或$MY_ENVAR,在Windows系统中还支持%MY_ENVAR%。 [[source]] url = "https://${PYPI_USERNAME}:${PYPI_PASSWORD}@my_private_repo.example.com/simple" verify_ssl = true name = "pypi" [dev-packages] [packages] requests = {version="*", index="home"} maya = {version="*", index="pypi"} records = "*" 自定义虚拟环境路径 很多工具遵循Linux开发习惯,将东西全存在用户目录中,在Linux中可能没啥,但是在Windows下可能有人不喜欢把这些东西放在用户目录。当然pipenv也可以自定义,只需要设置或修改WORKON_HOME环境变量的值即可。 如果设置了PIPENV_VENV_IN_PROJECT环境变量,pipenv会把虚拟环境放在项目目录的.venv目录下。 配置pipenv pipenv还有一些配置,都是使用环境变量配置的,由于配置项比较多,这里就不介绍了,直接看官方文档好了。 从setup.py安装 pipenv也可以从setup.py安装: pipenv install -e . 那么为什么不全用pipenv来安装呢?官方文档这里为我们做出了解释:项目可以分为两种,程序和库,对于程序来说应该使用pipenv,而对于库来说则是在setup.py中安装。详细解释说实话我没太看懂,大意就是抽象依赖和具体依赖,还有一个责任分配的问题,原文在这里。

优秀的个人博客,低调大师

pyenv快速入门

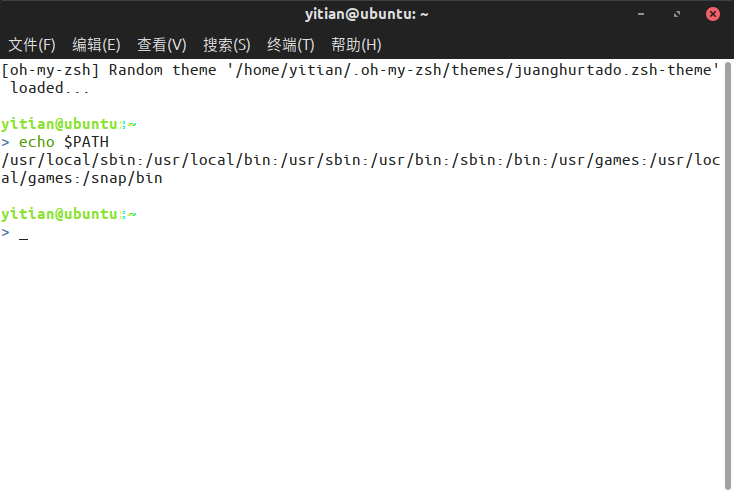
在开发Python程序的时候,有时候可能需要在不同版本的Python上进行测试。pyenv就是这么一个管理多版本Python的工具。由于在Windows中我们可以同时安装多个版本的Python,所以这里是在Linux下介绍该工具。 安装 首先当然是安装pyenv了,最简单的办法就是利用官方Github仓库中的安装脚本了: $ curl -L https://github.com/pyenv/pyenv-installer/raw/master/bin/pyenv-installer | bash 安装脚本有可能会提示你手动把几行命令添加到shell的配置文件中。 如果你用的是zsh的话,别忘了替换命令中的bash。将来如果要删除的话,需要在.zshrc文件中删除。如果你用oh-my-zsh的话,不需要在.zshrc中添加那几行(加了也没用),而是在.zshrc中启用pyenv插件。 将来要进行更新的话: $ pyenv update 要卸载pyenv的话更加简单,直接删除目录即可: $ rm -fr ~/.pyenv 别忘了把.bashrc中的这几行也一并删掉: export PATH="~/.pyenv/bin:$PATH" eval "$(pyenv init -)" eval "$(pyenv virtualenv-init -)" 工作原理 Linux环境变量 当执行命令的时候,系统会在环境变量中从左到右依次寻找匹配的命令并执行。环境变量中是一组以冒号:分隔的路径。 环境变量 垫片(Shims) pyenv的工作原理其实很简单,将它自己管理的Python目录插到环境变量的最前面,这样一来系统在搜索Python的时候第一个找到的就是pyenv管理的Python环境。这个插到最前面的路径就叫做垫片(shims),当然这是在英文语境下,在中文环境下我老觉得怪怪的,反正理解意思就好。 选择Python版本 当执行pyenv命令的时候,它会按照以下顺序来决定要使用的Python版本: 使用PYENV_VERSION环境变量(如果存在). 你可以使用pyenv shell 命令来在当前shell环境中设置该环境变量. 当前目录中应用程序指定的.python-version文件(如果存在). 你可以用pyenv local 命令来修改当前目录的.python-version文件. 自底向上搜索各层上级目录,找到的第一个.python-version, 直到到达文件系统根目录. 全局的$(pyenv root)/version文件. 可以使用 pyenv global 命令来修改. 如果全局版本文件不存在, pyenv假设你使用系统安装的Python. (换句话说就是未安装pyenv时环境变量中找到的Python.) 常用命令 完整命令请参考官方文档。 安装 列出所有可安装的Python版本: pyenv install -l|--list 安装某个Python: pyenv install <version> 卸载 卸载某个Python,-f参数指定是否强制卸载,如果强制卸载的话不会弹出提示,而且如果版本不存在的话也不会显示错误信息: pyenv uninstall [-f|--force] <version> versions 列出所有已安装的Python,当前使用的Python会用星号标出: $ pyenv versions 2.5.6 2.6.8 * 2.7.6 (set by /home/yyuu/.pyenv/version) 3.3.3 jython-2.5.3 pypy-2.2.1 global 通过写~/.pyenv/version文件的方式设置全局Python: $ pyenv global 2.7.6 local 通过在当前目录写.python-version文件的方式设置当前目录下的Python: pyenv local 2.7.6 当不再需要本地Python的时候,用--set来清除: $ pyenv local --unset shell 指定当前shell使用的Python: $ pyenv shell pypy-2.2.1 当不再需要的时候,用--set来清除: $ pyenv shell --unset 最后展示一下pyenv install -l的输出,可以看到,pyenv可以方便的安装大部分版本的Python,省略号表示中间有一大堆: yitian@ubuntu:~ $ pyenv install -l Available versions: 2.1.3 ... 2.7.15 ... 3.6.6 3.7.0 3.7-dev 3.8-dev activepython-2.7.14 activepython-3.5.4 activepython-3.6.0 anaconda-1.4.0 ... anaconda3-5.2.0 ironpython-dev ironpython-2.7.4 ironpython-2.7.5 ironpython-2.7.6.3 ironpython-2.7.7 jython-dev jython-2.5.0 jython-2.5-dev jython-2.5.1 jython-2.5.2 jython-2.5.3 jython-2.5.4-rc1 jython-2.7.0 jython-2.7.1 micropython-dev micropython-1.9.3 micropython-1.9.4 miniconda-latest miniconda-2.2.2 ... miniconda3-4.3.30 pypy-c-jit-latest pypy-c-nojit-latest pypy-dev pypy-stm-2.3 pypy-stm-2.5.1 pypy-1.5-src pypy-1.5 ... pypy3.5-6.0.0 pyston-0.5.1 pyston-0.6.0 pyston-0.6.1 stackless-dev stackless-2.7-dev stackless-2.7.2 ... stackless-3.5.4 常见问题 用pyenv安装Python的时候可能会出现各种各样问题,例如缺少zlib、缺少ctypes模块等等。对此pyenv也有专门一个页面解决。对于我的Ubuntu 18.04虚拟机来说,安装以下一坨软件可以解决问题: sudo apt-get install -y make build-essential libssl-dev zlib1g-dev libbz2-dev \ libreadline-dev libsqlite3-dev wget curl llvm libncurses5-dev libncursesw5-dev \ xz-utils tk-dev libffi-dev liblzma-dev libedit-dev 其他系统请查看pyenv的页面,如果有其它问题请自行搜索Stack Overflow。

优秀的个人博客,低调大师

【原创】nginx入门

一、简介 Nginx (engine x) 是一个高性能的HTTP和反向代理服务,也是一个IMAP/POP3/SMTP服务。Nginx是由伊戈尔·赛索耶夫为俄罗斯访问量第二的Rambler.ru站点(俄文:Рамблер)开发的,第一个公开版本0.1.0发布于2004年10月4日。2018年08月28日发布1.15.3版本。 其将源代码以类BSD许可证的形式发布,因它的稳定性、丰富的功能集、示例配置文件和低系统资源的消耗而闻名。 二、功能概述 1、HTTP基础功能: 处理静态文件,索引文件以及自动索引; 反向代理加速(无缓存),简单的负载均衡和容错; FastCGI,简单的负载均衡和容错; 模块化的结构。过滤器包括gzipping, byte ranges, chunked responses, 以及 SSI-filter 。在SSI过滤器中,到同一个 proxy 或者 FastCGI 的多个子请求并发处理; SSL 和 TLS SNI 支持; 2、IMAP/POP3 代理服务功能: 使用外部 HTTP 认证服务器重定向用户到 IMAP/POP3 后端; 使用外部 HTTP 认证服务器认证用户后连接重定向到内部的 SMTP 后端; 认证方法: POP3: POP3 USER/PASS, APOP, AUTH LOGIN PLAIN CRAM-MD5; IMAP: IMAP LOGIN; SMTP: AUTH LOGIN PLAIN CRAM-MD5; SSL 支持; 在 IMAP 和 POP3 模式下的 STARTTLS 和 STLS 支持; 3、支持的操作系统: FreeBSD 3.x, 4.x, 5.x, 6.x i386; FreeBSD 5.x, 6.x amd64; Linux 2.2, 2.4, 2.6 i386; Linux 2.6 amd64; Solaris 8 i386; Solaris 9 i386 and sun4u; Solaris 10 i386; MacOS X (10.4) PPC; 4、结构与扩展: 一个主进程和多个工作进程。工作进程是单线程的,且不需要特殊授权即可运行; kqueue (FreeBSD 4.1+), epoll (Linux 2.6+), rt signals (Linux 2.2.19+), /dev/poll (Solaris 7 11/99+), select, 以及 poll 支持; kqueue支持的不同功能包括 EV_CLEAR, EV_DISABLE (临时禁止事件), NOTE_LOWAT, EV_EOF, 有效数据的数目,错误代码; sendfile (FreeBSD 3.1+), sendfile (Linux 2.2+), sendfile64 (Linux 2.4.21+), 和 sendfilev (Solaris 8 7/01+) 支持; 输入过滤 (FreeBSD 4.1+) 以及 TCP_DEFER_ACCEPT (Linux 2.4+) 支持; 10,000 非活动的 HTTP keep-alive 连接仅需要 2.5M 内存。 最小化的数据拷贝操作; 5、其他HTTP功能: 基于IP 和名称的虚拟主机服务; Memcached 的 GET 接口; 支持 keep-alive 和管道连接; 灵活简单的配置; 重新配置和在线升级而无须中断客户的工作进程; 可定制的访问日志,日志写入缓存,以及快捷的日志回卷; 4xx-5xx 错误代码重定向; 基于 PCRE 的 rewrite 重写模块; 基于客户端 IP 地址和 HTTP 基本认证的访问控制; PUT, DELETE, 和 MKCOL 方法; 支持 FLV (Flash 视频); 带宽限制; 三、安装与启动 命令: yum install -y gcc gcc-c++ pcre pcre-devel zlib zlib-devel # 安装依赖 cd /usr/local/src wget http://nginx.org/download/nginx-1.15.3.tar.gz # 下载源代码 tar -xvzf nginx-1.15.3.tar.gz cd nginx-1.15.3 ./configure --prefix=/usr/local/nginxmake && make install #编译、安装 启动:/usr/local/nginx/sbin/nginx 测试配置文件:/usr/local/nginx/sbin/nginx –t 重启:/usr/local/nginx/sbin/nginx -s reopen 重新载入配置文件:/usr/local/nginx/sbin/nginx -s reload 快速关闭:/usr/local/nginx/sbin/nginx -s stop 优雅关闭:/usr/local/nginx/sbin/nginx -s quit 访问: http://192.168.141.130/ 四、配置示例 1)、反向代理 正向代理-转发代理(forward proxy): 反向代理(reverse proxy): 配置: server { listen 80; server_name fxdl.test.com; location /fxdl { proxy_redirect off; proxy_set_header Host $host; proxy_set_header X-Real-IP $remote_addr; proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for; proxy_pass http://192.168.141.130:8080/fxdl; } } 2)、动静分离 配置: server { listen 80; server_name djfl.test.com; location ^~ /static/ { alias /usr/local/nginx/djfl/; break; } location /djfl { proxy_redirect off; proxy_set_header Host $host; proxy_set_header X-Real-IP $remote_addr; proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for; proxy_pass http://192.168.141.130:8080/djfl; } } 3)、负载均衡 配置: upstream fzjh { server 192.168.141.130:8080; server 192.168.141.130:9090; } server { listen 80; server_name fzjh.test.com; location ^~ /static/ { alias /usr/local/nginx/fzjh/; break; } location /fzjh { proxy_redirect off; proxy_set_header Host $host; proxy_set_header X-Real-IP $remote_addr; proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for; proxy_pass http://fzjh/fzjh; } } 负载均衡算法: Nginx的upstream目前支持以下几种方式的分配 (1)、轮询(默认) 每个请求按时间顺序逐一分配到不同的后端服务器,如果后端服务器down掉,能自动剔除。 (2)、weight 指定轮询几率,weight和访问比率成正比,用于后端服务器性能不均的情况。 (3)、ip_hash 每个请求按访问ip的hash结果分配,这样每个访客固定访问一个后端服务器,可以解决session的问题。 (4)、fair(第三方) 按后端服务器的响应时间来分配请求,响应时间短的优先分配。 (5)、url_hash(第三方) 按访问url的hash结果来分配请求,使每个url定向到同一个后端服务器,后端服务器为缓存时比较有效。 4)、FastCGI FastCGI是一个可伸缩地、高速地在HTTP服务器和动态脚本语言间通信的接口(FastCGI接口在Linux下是socket(可以是文件socket,也可以是ip socket)),主要优点是把动态语言和HTTP服务器分离开来。多数流行的HTTP服务器都支持FastCGI,包括Apache、Nginx和lightpd。 同时,FastCGI也被许多脚本语言所支持,比较流行的脚本语言之一为PHP。FastCGI接口方式采用C/S架构,可以将HTTP服务器和脚本解析服务器分开,同时在脚本解析服务器上启动一个或多个脚本解析守护进程。当HTTP服务器每次遇到动态程序时,可以将其直接交付给FastCGI进程执行,然后将得到的结构返回给浏览器。这种方式可以让HTTP服务器专一地处理静态请求或者将动态脚本服务器的结果返回给客户端,这在很大程度上提高了整个应用系统的性能。 FastCGI的重要特点: 1、FastCGI是HTTP服务器和动态脚本语言间通信的接口或者工具。 2、FastCGI优点是把动态语言解析和HTTP服务器分离开来。 3、Nginx、Apache、Lighttpd以及多数动态语言都支持FastCGI。 4、FastCGI接口方式采用C/S架构,分为客户端(HTTP服务器)和服务端(动态语言解析服务器)。 5、PHP动态语言服务端可以启动多个FastCGI的守护进程。 6、HTTP服务器通过FastCGI客户端和动态语言FastCGI服务端通信。 Nginx FastCGI的运行原理 Nginx不支持对外部动态程序的直接调用或者解析,所有的外部程序(包括PHP)必须通过FastCGI接口来调用。FastCGI接口在Linux下是socket(可以是文件socket,也可以是ip socket)。为了调用CGI程序,还需要一个FastCGI的wrapper,这个wrapper绑定在某个固定socket上,如端口或者文件socket。当Nginx将CGI请求发送给这个socket的时候,通过FastCGI接口,wrapper接收到请求,然后派生出一个新的线程,这个线程调用解释器或者外部程序处理脚本并读取返回数据;接着,wrapper再将返回的数据通过FastCGI接口,沿着固定的socket传递给Nginx;最后,Nginx将返回的数据发送给客户端,这就是Nginx+FastCGI的整个运作过程。 FastCGI的主要优点是把动态语言和HTTP服务器分离开来,是Nginx专一处理静态请求和向后转发动态请求,而PHP/PHP-FPM服务器专一解析PHP动态请求。 5)、rewrite 看下面两张图: 配置: server { listen 80; server_name old.test.com; rewrite ^(.*)$ http://new.test.com$1 permanent; #return 301 http://new.test.com$request_uri; } server { listen 80; server_name new.test.com; location / { root html; index index.html index.htm; } } 五、nginx和apache httpd服务器的对比 server Apache Nginx Proxy代理 非常好 非常好 Rewriter 好 非常好 Fcgi 不好 好 热部署 不支持 支持 系统压力比较 很大 很小 稳定性 好 非常好 安全性 好 一般 技术支持 非常好 很少 静态文件处理 一般 非常好 Vhosts虚拟主机 支持 不支持 反向代理 一般 非常好 Session sticky 支持 不支持 Apache和Nginx比较 功能对比 Nginx和Apache一样,都是HTTP服务器软件,在功能实现上都采用模块化结构设计,都支持通用的语言接口,如PHP、Perl、Python等,同时还支持正向和反向代理、虚拟主机、URL重写、压缩传输、SSL加密传输等。 在功能实现上,Apache的所有模块都支持动、静态编译,而Nginx模块都是静态编译的, 对FastCGI的支持,Apache对Fcgi的支持不好,而Nginx对Fcgi的支持非常好; 在处理连接方式上,Nginx支持epoll,而Apache却不支持; 在空间使用上,Nginx安装包仅仅只有几百K,和Nginx比起来Apache绝对是庞然大物。 Nginx相对apache的优点 轻量级,同样起web 服务,比apache 占用更少的内存及资源 静态处理,Nginx 静态处理性能比 Apache 高 3倍以上 抗并发,nginx 处理请求是异步非阻塞的,而apache则是阻塞型的,在高并发下nginx 能保持低资源低消耗高性能。在Apache+PHP(prefork)模式下,如果PHP处理慢或者前端压力很大的情况下,很容易出现Apache进程数飙升,从而拒绝服务的现象。 高度模块化的设计,编写模块相对简单 社区活跃,各种高性能模块出品迅速啊 apache相对nginx的优点 rewrite,比nginx 的rewrite 强大 模块超多,基本想到的都可以找到 少bug,nginx的bug相对较多 超稳定 Apache对PHP支持比较简单,Nginx需要配合其他后端用 选择Nginx的优势所在 作为Web服务器: Nginx处理静态文件、索引文件,自动索引的效率非常高。 作为代理服务器,Nginx可以实现无缓存的反向代理加速,提高网站运行速度。 作为负载均衡服务器,Nginx既可以在内部直接支持Rails和PHP,也可以支持HTTP代理服务器对外进行服务,同时还支持简单的容错和利用算法进行负载均衡。 在性能方面,Nginx是专门为性能优化而开发的,在实现上非常注重效率。它采用内核Poll模型(epoll and kqueue ),可以支持更多的并发连接,最大可以支持对50 000个并发连接数的响应,而且只占用很低的内存资源。 在稳定性方面,Nginx采取了分阶段资源分配技术,使得CPU与内存的占用率非常低。Nginx官方表示,Nginx保持10 000个没有活动的连接,而这些连接只占用2.5MB内存,因此,类似DOS这样的攻击对Nginx来说基本上是没有任何作用的。 在高可用性方面,Nginx支持热部署,启动速度特别迅速,因此可以在不间断服务的情况下,对软件版本或者配置进行升级,即使运行数月也无需重新启动,几乎可以做到7×24小时不间断地运行。 同时使用Nginx和Apache 由于Nginx和Apache各自的优势,现在很多人选择了让两者在服务器中共存。在服务器端让Nginx在前,Apache在后。由Nginx做负载均衡和反向代理,并且处理静态文件,讲动态请求(如PHP应用)交给Apache去处理。 作者: Candyメ奶糖 出处: http://www.cnblogs.com/Candies/ 本文版权归作者和博客园共有,欢迎转载,但未经作者同意必须保留此段声明,且在文章页面明显位置给出原文连接,否则保留追究法律责任的权利。 博文来源广泛,如原作者认为我侵犯知识产权,请尽快给我发邮件 359031282@qq.com联系,我将以第一时间删除相关内容。

优秀的个人博客,低调大师

Jackson快速入门

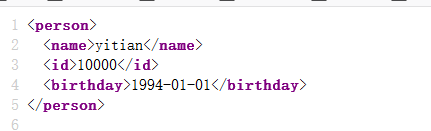
Java生态圈中有很多处理JSON和XML格式化的类库,Jackson是其中比较著名的一个。虽然JDK自带了XML处理类库,但是相对来说比较低级,使用本文介绍的Jackson等高级类库处理起来会方便很多。 引入类库 由于Jackson相关类库按照功能分为几个相对独立的,所以需要同时引入多个类库,为了方便我将版本号单独提取出来设置,相关Gradle配置如下。 ext { jacksonVersion = '2.9.5' } dependencies { compile group: 'com.fasterxml.jackson.core', name: 'jackson-core', version: jacksonVersion compile group: 'com.fasterxml.jackson.core', name: 'jackson-databind', version: jacksonVersion compile group: 'com.fasterxml.jackson.core', name: 'jackson-annotations', version: jacksonVersion // 引入XML功能 compile group: 'com.fasterxml.jackson.dataformat', name: 'jackson-dataformat-xml', version: jacksonVersion // 比JDK自带XML实现更高效的类库 compile group: 'com.fasterxml.woodstox', name: 'woodstox-core', version: '5.1.0' // Java 8 新功能 compile group: 'com.fasterxml.jackson.datatype', name: 'jackson-datatype-jsr310', version: jacksonVersion compile group: 'com.fasterxml.jackson.module', name: 'jackson-module-parameter-names', version: jacksonVersion compile group: 'com.fasterxml.jackson.datatype', name: 'jackson-datatype-jdk8', version: jacksonVersion compileOnly group: 'org.projectlombok', name: 'lombok', version: '1.16.22' } Maven配置请去mvnrepository搜索。 Jackson注解 Jackson类库包含了很多注解,可以让我们快速建立Java类与JSON之间的关系。详细文档可以参考Jackson-Annotations。下面介绍一下常用的。 属性命名 @JsonProperty注解指定一个属性用于JSON映射,默认情况下映射的JSON属性与注解的属性名称相同,不过可以使用该注解的value值修改JSON属性名,该注解还有一个index属性指定生成JSON属性的顺序,如果有必要的话。 属性包含 还有一些注解可以管理在映射JSON的时候包含或排除某些属性,下面介绍一下常用的几个。 @JsonIgnore注解用于排除某个属性,这样该属性就不会被Jackson序列化和反序列化。 @JsonIgnoreProperties注解是类注解。在序列化为JSON的时候,@JsonIgnoreProperties({"prop1", "prop2"})会忽略pro1和pro2两个属性。在从JSON反序列化为Java类的时候,@JsonIgnoreProperties(ignoreUnknown=true)会忽略所有没有Getter和Setter的属性。该注解在Java类和JSON不完全匹配的时候很有用。 @JsonIgnoreType也是类注解,会排除所有指定类型的属性。 序列化相关 @JsonPropertyOrder和@JsonProperty的index属性类似,指定属性序列化时的顺序。 @JsonRootName注解用于指定JSON根属性的名称。 处理JSON 简单映射 我们用Lombok设置一个简单的Java类。 @Data @AllArgsConstructor @NoArgsConstructor public class Friend { private String nickname; private int age; } 然后就可以处理JSON数据了。首先需要一个ObjectMapper对象,序列化和反序列化都需要它。 ObjectMapper mapper = new ObjectMapper(); Friend friend = new Friend("yitian", 25); // 写为字符串 String text = mapper.writeValueAsString(friend); // 写为文件 mapper.writeValue(new File("friend.json"), friend); // 写为字节流 byte[] bytes = mapper.writeValueAsBytes(friend); System.out.println(text); // 从字符串中读取 Friend newFriend = mapper.readValue(text, Friend.class); // 从字节流中读取 newFriend = mapper.readValue(bytes, Friend.class); // 从文件中读取 newFriend = mapper.readValue(new File("friend.json"), Friend.class); System.out.println(newFriend); 程序结果如下。可以看到生成的JSON属性和Java类中定义的一致。 {"nickname":"yitian","age":25} Friend(nickname=yitian, age=25) 集合的映射 除了使用Java类进行映射之外,我们还可以直接使用Map和List等Java集合组织JSON数据,在需要的时候可以使用readTree方法直接读取JSON中的某个属性值。需要注意的是从JSON转换为Map对象的时候,由于Java的类型擦除,所以类型需要我们手动用new TypeReference<T>给出。 ObjectMapper mapper = new ObjectMapper(); Map<String, Object> map = new HashMap<>(); map.put("age", 25); map.put("name", "yitian"); map.put("interests", new String[]{"pc games", "music"}); String text = mapper.writeValueAsString(map); System.out.println(text); Map<String, Object> map2 = mapper.readValue(text, new TypeReference<Map<String, Object>>() { }); System.out.println(map2); JsonNode root = mapper.readTree(text); String name = root.get("name").asText(); int age = root.get("age").asInt(); System.out.println("name:" + name + " age:" + age); 程序结果如下。 {"name":"yitian","interests":["pc games","music"],"age":25} {name=yitian, interests=[pc games, music], age=25} name:yitian age:25 Jackson配置 Jackson预定义了一些配置,我们通过启用和禁用某些属性可以修改Jackson运行的某些行为。详细文档参考JacksonFeatures。下面我简单翻译一下Jackson README上列出的一些属性。 // 美化输出 mapper.enable(SerializationFeature.INDENT_OUTPUT); // 允许序列化空的POJO类 // (否则会抛出异常) mapper.disable(SerializationFeature.FAIL_ON_EMPTY_BEANS); // 把java.util.Date, Calendar输出为数字(时间戳) mapper.disable(SerializationFeature.WRITE_DATES_AS_TIMESTAMPS); // 在遇到未知属性的时候不抛出异常 mapper.disable(DeserializationFeature.FAIL_ON_UNKNOWN_PROPERTIES); // 强制JSON 空字符串("")转换为null对象值: mapper.enable(DeserializationFeature.ACCEPT_EMPTY_STRING_AS_NULL_OBJECT); // 在JSON中允许C/C++ 样式的注释(非标准,默认禁用) mapper.configure(JsonParser.Feature.ALLOW_COMMENTS, true); // 允许没有引号的字段名(非标准) mapper.configure(JsonParser.Feature.ALLOW_UNQUOTED_FIELD_NAMES, true); // 允许单引号(非标准) mapper.configure(JsonParser.Feature.ALLOW_SINGLE_QUOTES, true); // 强制转义非ASCII字符 mapper.configure(JsonGenerator.Feature.ESCAPE_NON_ASCII, true); // 将内容包裹为一个JSON属性,属性名由@JsonRootName注解指定 mapper.configure(SerializationFeature.WRAP_ROOT_VALUE, true); 这里有三个方法,configure方法接受配置名和要设置的值,Jackson 2.5版本新加的enable和disable方法则直接启用和禁用相应属性,我推荐使用后面两个方法。 用注解管理映射 前面介绍了一些Jackson注解,下面来应用一下这些注解。首先来看看使用了注解的Java类。 @Data @NoArgsConstructor @AllArgsConstructor @JsonRootName("FriendDetail") @JsonIgnoreProperties({"uselessProp1", "uselessProp3"}) public class FriendDetail { @JsonProperty("NickName") private String name; @JsonProperty("Age") private int age; private String uselessProp1; @JsonIgnore private int uselessProp2; private String uselessProp3; } 然后看看代码。需要注意的是,由于设置了排除的属性,所以生成的JSON和Java类并不是完全对应关系,所以禁用DeserializationFeature.FAIL_ON_UNKNOWN_PROPERTIES是必要的。 ObjectMapper mapper = new ObjectMapper(); //mapper.enable(SerializationFeature.WRAP_ROOT_VALUE); mapper.disable(DeserializationFeature.FAIL_ON_UNKNOWN_PROPERTIES); FriendDetail fd = new FriendDetail("yitian", 25, "", 0, ""); String text = mapper.writeValueAsString(fd); System.out.println(text); FriendDetail fd2 = mapper.readValue(text, FriendDetail.class); System.out.println(fd2); 运行结果如下。可以看到生成JSON的时候忽略了我们制定的值,而且在转换为Java类的时候对应的属性为空。 {"NickName":"yitian","Age":25} FriendDetail(name=yitian, age=25, uselessProp1=null, uselessProp2=0, uselessProp3=null) 然后取消注释代码中的那行,也就是启用WRAP_ROOT_VALUE功能,再运行一下程序,运行结果如下。可以看到生成的JSON结果发生了变化,而且由于JSON结果变化,所以Java类转换失败(所有字段值全为空)。WRAP_ROOT_VALUE这个功能在有些时候比较有用,因为有些JSON文件需要这种结构。 {"FriendDetail":{"NickName":"yitian","Age":25}} FriendDetail(name=null, age=0, uselessProp1=null, uselessProp2=0, uselessProp3=null) Java8日期时间类支持 Java8增加了一套全新的日期时间类,Jackson对此也有支持。这些支持是以Jackson模块形式提供的,所以首先就是注册这些模块。 ObjectMapper mapper = new ObjectMapper() .registerModule(new JavaTimeModule()) .registerModule(new ParameterNamesModule()) .registerModule(new Jdk8Module()); 导入类库之后,Jackson也可以自动搜索所有模块,不需要我们手动注册。 mapper.findAndRegisterModules(); 我们新建一个带有LocalDate字段的Java类。 @Data @NoArgsConstructor @AllArgsConstructor @JsonRootName("Person") public class Person { @JsonProperty("Name") private String name; @JsonProperty("NickName") private String nickname; @JsonProperty("Age") private int age; @JsonProperty("IdentityCode") private String identityCode; @JsonProperty @JsonFormat(pattern = "yyyy-MM-DD") private LocalDate birthday; } 然后来看看代码。 static void java8DateTime() throws IOException { Person p1 = new Person("yitian", "易天", 25, "10000", LocalDate.of(1994, 1, 1)); ObjectMapper mapper = new ObjectMapper() .registerModule(new JavaTimeModule()); //mapper.disable(SerializationFeature.WRITE_DATES_AS_TIMESTAMPS); String text = mapper.writeValueAsString(p1); System.out.println(text); Person p2 = mapper.readValue(text, Person.class); System.out.println(p2); } 运行结果如下。可以看到,生成的JSON日期变成了[1994,1,1]这样的时间戳形式,一般情况下不符合我们的要求。 {"birthday":[1994,1,1],"Name":"yitian","NickName":"易天","Age":25,"IdentityCode":"10000"} Person(name=yitian, nickname=易天, age=25, identityCode=10000, birthday=1994-01-01) 取消注释那行代码,程序运行结果如下。这样一来就变成了我们一般使用的形式了。如果有格式需要的话,可以使用@JsonFormat(pattern = "yyyy-MM-DD")注解格式化日期显示。 {"birthday":"1994-01-01","Name":"yitian","NickName":"易天","Age":25,"IdentityCode":"10000"} Person(name=yitian, nickname=易天, age=25, identityCode=10000, birthday=1994-01-01) 处理XML Jackson是一个处理JSON的类库,不过它也通过jackson-dataformat-xml包提供了处理XML的功能。Jackson建议我们在处理XML的时候使用woodstox-core包,它是一个XML的实现,比JDK自带XML实现更加高效,也更加安全。 这里有个注意事项,如果你正在使用Java 9以上的JDK,可能会出现java.lang.NoClassDefFoundError: javax/xml/bind/JAXBException异常,这是因为Java 9实现了JDK的模块化,将原本和JDK打包在一起的JAXB实现分隔出来。所以这时候需要我们手动添加JAXB的实现。在Gradle中添加下面的代码即可。 compile group: 'javax.xml.bind', name: 'jaxb-api', version: '2.3.0' 注解 Jackson XML除了使用Jackson JSON和JDK JAXB的一些注解之外,自己也定义了一些注解。下面简单介绍一下几个常用注解。 @JacksonXmlProperty注解有三个属性,namespace和localname属性用于指定XML命名空间的名称,isAttribute指定该属性作为XML的属性(<a b="xxx"></a>)还是作为子标签(<a><b></b></a>). @JacksonXmlRootElement注解有两个属性,namespace和localname属性用于指定XML根元素命名空间的名称。 @JacksonXmlText注解将属性直接作为未被标签包裹的普通文本表现。 @JacksonXmlCData将属性包裹在CDATA标签中。 XML映射 新建如下一个Java类。 @Data @NoArgsConstructor @AllArgsConstructor @JsonRootName("Person") public class Person { @JsonProperty("Name") private String name; @JsonProperty("NickName") //@JacksonXmlText private String nickname; @JsonProperty("Age") private int age; @JsonProperty("IdentityCode") @JacksonXmlCData private String identityCode; @JsonProperty("Birthday") //@JacksonXmlProperty(isAttribute = true) @JsonFormat(pattern = "yyyy/MM/DD") private LocalDate birthday; } 下面是代码示例,基本上和JSON的API非常相似,XmlMapper实际上就是ObjectMapper的子类。 Person p1 = new Person("yitian", "易天", 25, "10000", LocalDate.of(1994, 1, 1)); XmlMapper mapper = new XmlMapper(); mapper.findAndRegisterModules(); mapper.disable(SerializationFeature.WRITE_DATES_AS_TIMESTAMPS); mapper.enable(SerializationFeature.INDENT_OUTPUT); String text = mapper.writeValueAsString(p1); System.out.println(text); Person p2 = mapper.readValue(text, Person.class); System.out.println(p2); 运行结果如下。 <Person> <Name>yitian</Name> <NickName>易天</NickName> <Age>25</Age> <IdentityCode><![CDATA[10000]]></IdentityCode> <Birthday>1994/01/01</Birthday> </Person> Person(name=yitian, nickname=易天, age=25, identityCode=10000, birthday=1994-01-01) 如果取消那两行注释,那么运行结果如下。可以看到Jackson XML注解对生成的XML的控制效果。 <Person birthday="1994/01/01"> <Name>yitian</Name>易天 <Age>25</Age> <IdentityCode><![CDATA[10000]]></IdentityCode> </Person> Person(name=yitian, nickname=null, age=25, identityCode=10000, birthday=1994-01-01) Spring Boot集成 自动配置 Spring Boot对Jackson的支持非常完善,只要我们引入相应类库,Spring Boot就可以自动配置开箱即用的Bean。Spring自动配置的ObjectMapper(或者XmlMapper)作了如下配置,基本上可以适应大部分情况。 禁用了MapperFeature.DEFAULT_VIEW_INCLUSION 禁用了DeserializationFeature.FAIL_ON_UNKNOWN_PROPERTIES 禁用了SerializationFeature.WRITE_DATES_AS_TIMESTAMPS 如果需要修改自动配置的ObjectMapper属性也非常简单,Spring Boot提供了一组环境变量,直接在application.properties文件中修改即可。 Jackson枚举 Spring环境变量 com.fasterxml.jackson.databind.DeserializationFeature spring.jackson.deserialization.<feature_name>=true|false com.fasterxml.jackson.core.JsonGenerator.Feature spring.jackson.generator.<feature_name>=true|false com.fasterxml.jackson.databind.MapperFeature spring.jackson.mapper.<feature_name>=true|false com.fasterxml.jackson.core.JsonParser.Feature spring.jackson.parser.<feature_name>=true|false com.fasterxml.jackson.databind.SerializationFeature spring.jackson.serialization.<feature_name>=true|false com.fasterxml.jackson.annotation.JsonInclude.Include spring.jackson.default-property-inclusion=always|non_null|non_absent|non_default|non_empty 由于Spring会同时配置相应的HttpMessageConverters,所以我们其实要做的很简单,用Jackson注解标注好要映射的Java类,然后直接让控制器返回对象即可!下面是一个Java类。 @JsonRootName("person") public class Person { @JsonProperty private String name; @JsonProperty private int id; @JsonFormat(pattern = "yyyy-MM-DD") private LocalDate birthday; public Person(String name, int id, LocalDate birthday) { this.name = name; this.id = id; this.birthday = birthday; } } 然后是控制器代码。在整个过程中我们只需要引入Jackson类库,然后编写业务代码就好了。关于如何配置Jackson类库,我们完全不需要管,这就是Spring Boot的方便之处。 @Controller public class MainController { private Person person = new Person("yitian", 10000, LocalDate.of(1994, 1, 1)); @RequestMapping("/") public String index() { return "index"; } @RequestMapping(value = "/json", produces = "application/json") @ResponseBody public Person json() { return person; } } 进入localhost:8080/xml就可以看到对应结果了。 结果 手动配置 Spring Boot自动配置非常方便,但不是万能的。在必要的时候,我们需要手动配置Bean来替代自动配置的Bean。 @Configuration public class JacksonConfig { @Bean @Primary @Qualifier("xml") public XmlMapper xmlMapper(Jackson2ObjectMapperBuilder builder) { XmlMapper mapper = builder.createXmlMapper(true) .build(); mapper.enable(SerializationFeature.INDENT_OUTPUT); mapper.disable(SerializationFeature.WRITE_DATES_AS_TIMESTAMPS); return mapper; } @Bean @Qualifier("json") public ObjectMapper jsonMapper(Jackson2ObjectMapperBuilder builder) { ObjectMapper mapper = builder.createXmlMapper(false) .build(); mapper.enable(SerializationFeature.INDENT_OUTPUT); mapper.disable(SerializationFeature.WRITE_DATES_AS_TIMESTAMPS); return mapper; } } 然后在需要的地方进行依赖注入。需要注意为了区分ObjectMapper和XmlMapper,需要使用@Qualifier注解进行标记。 @Controller public class MainController { private ObjectMapper jsonMapper; private XmlMapper xmlMapper; private Person person = new Person("yitian", 10000, LocalDate.of(1994, 1, 1)); public MainController(@Autowired @Qualifier("json") ObjectMapper jsonMapper, @Autowired @Qualifier("xml") XmlMapper xmlMapper) { this.jsonMapper = jsonMapper; this.xmlMapper = xmlMapper; } 以上就是Jackson类库的一些介绍,希望对大家有所帮助。项目代码在我的Github,感兴趣的同学可以看看。


优秀的个人博客,低调大师

Jupyter Notebooks 入门

自从有了纸莎草纸以来,出版人们一直在努力以吸引读者的方式来格式化数据。尤其是在数学、科学、和编程领域,设计良好的图表、插图和方程式可以成为帮助人们理解技术信息的关键。 Jupyter Notebook 通过重新构想我们如何制作教学文本来解决这个问题。Jupyter (我在 2017 年 10 月在 All Things Open 上首次了解到)是一款开源应用程序,它使用户能够创建包含实时代码、方程式、可视化和文本的交互式共享笔记本。 Jupyter 从 IPython 项目发展而来,它是个具有交互式 shell 和基于浏览器的笔记本,支持代码、文本和数学表达式。Jupyter 支持超过 40 种编程语言,包括 Python、R 和 Julia,其代码可以导出为 HTML、LaTeX、PDF、图像和视频,或者作为 IPyhton 笔记本与其他用户共享。 一个有趣的事实是:“Jupyter” 是 “Julia、Python 和 R” 的缩写。 根据 Jupyter 项目网站介绍,它的一些用途包括“数据清理和转换,数值模拟,统计建模,数据可视化,机器学习等等”。科学机构正在使用 Jupyter Notebooks 来解释研究结果。代码可以来自实际数据,可以调整和重新调整以可视化成不同的结果和情景。通过这种方式,Jupyter Notebooks 变成了生动的文本和报告。 安装并开始 Jupyter Jupyter 软件是开源的,其授权于修改过的 BSD 许可证,它可以安装在 Linux、MacOS 或 Windows 上。有很多种方法可以安装 Jupyter;我在 Linux 和 MacOS 上试过 PIP 和 Anaconda 安装方式。PIP 安装要求你的计算机上已经安装了 Python;Jupyter 推荐 Python 3。 由于 Python 3 已经安装在我的电脑上,我通过在终端(在 Linux 或 Mac 上)运行以下命令来安装 Jupyter: $ python3 -m pip install --upgrade pip $ python3 -m pip install jupyter 在终端提示符输入以下命令立即启动应用程序: $ jupyter notebook 很快,我的浏览器打开并显示了我在 http://localhost:8888 的 Jupyter Notebook 服务器。(支持的浏览器有 Google Chrome、Firefox 和 Safari) 在右上角有一个标有 “New” 的下拉菜单,它使我能够根据自己的指示和代码快速创建新的笔记本。请注意,我的新笔记本默认为 Python 3,这是我目前的环境。 一个带有一些默认值的新笔记本,它可以被改变(包括笔记本的名字),已打开。 笔记本有两种不同的模式:“命令模式”和“编辑模式”。命令模式允许你添加或删除单元格。你可以通过按下 Escape 键进入命令模式,按 Enter 键或单击单元格进入编辑模式。 单元格周围的绿色高亮显示你处于编辑模式,蓝色高亮显示你处于命令模式。以下笔记本处于命令模式并准备好执行单元中的 Python 代码。注意,我已将笔记本的名称更改为 “First Notebook”。 使用 Jupyter Jupyter Notebooks 的强大之处在于除了能够输入代码之外,你还可以用 Markdown 添加叙述性和解释性文本。我想添加一个标题,所以我在代码上面添加了一个单元格,并以 Markdown 输入了一个标题。当我按下 Ctrl+Enter 时,我的标题转换为 HTML。(LCTT 译注:或者可以按下 Run 按钮。) 我可以通过在命令前追加 ! 来添加 Bash 命令或脚本的输出。 我也可以利用 IPython 的 line magic 和 cell magic 命令。你可以通过在代码单元内附加 % 或 %% 符号来列出魔术命令。例如,%lsmagic 将输出所有可用于 Jupyter notebooks 的魔法命令。 这些魔术命令的例子包括 %pwd——它输出当前工作目录(例如 /Users/YourName)和 %ls——它列出当前工作目录中的所有文件和子目录。另一个神奇命令显示从笔记本中的 matplotlib 生成的图表。%%html 将该单元格中的任何内容呈现为 HTML,这对嵌入视频和链接很有用,还有 JavaScript 和 Bash 的单元魔术命令。 如果你需要更多关于使用 Jupyter Notebooks 和它的特性的信息,它的帮助部分是非常完整的。 人们用许多有趣的方式使用 Jupyter Notebooks;你可以在这个展示栏目里找到一些很好的例子。你如何使用 Jupyter 笔记本?请在下面的评论中分享你的想法。 原文发布时间为:2018-05-21 本文来自云栖社区合作伙伴“Linux中国开源社区”,了解相关信息可以关注“Linux中国开源社区”。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册