首页 文章 精选 留言 我的

精选列表

搜索[Python],共10000篇文章
优秀的个人博客,低调大师

Python 爬取周杰伦 instagram

整体框架 使用国内能访问的某国外 app angine 爬取Jay的 Instagram 并显示,再使用国内的 sae 访问这个网站,再爬取一次并发送到微博小号。 bs4 使用requests爬取 Instagram 时候,并没有加request header,Instagram 对 robot 还算友好,直接返回不带 js 的网页信息。通过bs4迅速定位到照片、视频信息,再用正则表达式提取到链接并下载、显示。,正则表达式让人头痛,使用str.split(' ')来使字符串变成列表。 from bs4 import BeautifulSoup filepath = 'C:\Users\hndx\Desktop\ins.html' soup = BeautifulSoup(open(filepath),'lxml') script = soup.select('script') print str(script[2]).split('},{"node":')[1] 通过分析ins.html,得到每个node就是一个动态。这样str(script[2]).split('},{"node":')[1]就是带有Jay最新动态信息的 Unicode 字符了。应用json 直接将这个信息转化成字典dict,如下 import json i = json.loads(info) print i["edge_media_to_caption"]['edges'] """ [{u'node': {u'text': u'Just finished now \u8b1d\u8b1d\u91d1\u83ef\u7684\u670b\u53cb\u5011 high\u7684\u4e0d\u8981\u4e0d\u8981\u7684 #\u91d1\u83ef #\u96d9\u7bc0\u68cd#\u96d9\u622a\u68cd'}}] """ 保存图片 参考 :如何用requests优雅的下载图片? ,这个应该是最简洁的答案了。 import requests s = requests.session() ss = s.get('https://www.baidu.com/img/bd_logo1.png') open('logo.png', 'wb').write(ss.content) 数据库 ORM Flask-SQLAlchemy 学习参考 Flask-SQLAlchemy 官方文档有关增删改查的操作 flask SQLAlchemy 数据库操作数据库对象 class photo(db.Model): __tablename__ = "photoid" id = db.Column(db.Integer) #参数 primary_key=True 表示此键值不能重复,必须有一个primary_key=True。 url = db.Column(db.String(4096),primary_key=True ) text = db.Column(db.String(4096)) def __init__(self, id, url,text): self.id = id self.url = url self.text = text #这里有三个行 关于创建、查找 In [1]: import flask_app In [2]: con = ['1','2'] In [3]: flask_app.photo(con[0],con[1]) Out[3]: <flask_app.photo at 0x7fa109b5ccd0> In [4]: flask_app.db.session.add(flask_app.photo(con[0],con[1])) In [5]: flask_app.db.session.commit() In [6]: flask_app.photo.query.filter_by(id='1').first() Out[6]: <flask_app.photo at 0x7fa11179e890> In [7]: p1 =flask_app.photo.query.filter_by(id='1').first() In [8]: p1.id Out[8]: 1 In [9]: p1.url Out[9]: u'2' Mysql 用到的语句 DROP TABLE table_name ; 删除数据表 insta.py # -*- coding: utf-8 -*- """ insta 爬虫 Created on Fri May 04 09:02:26 2018 @author: aubucuo """ import requests from json import loads from bs4 import BeautifulSoup import re s = requests.session() u = 'https://www.instagram.com/jaychou/' def ins(pid): rt = [] c1 = s.get(u) soup = BeautifulSoup(c1.content,'lxml') script = soup.select('script') ls = script[2].contents ls1 = re.findall('window._sharedData = (.+?);', str(ls[0])) js = loads(ls1[0])['entry_data']['ProfilePage'][0]['graphql']['user']['edge_owner_to_timeline_media']['edges'] j_id = js[0]['node']['id'] is_video =js[0]['node']['is_video'] j_url = js[0]['node']['display_url'] j_text = js[0]['node']['edge_media_to_caption']['edges'][0]['node']['text'] if j_id!= pid and not is_video: #如果id 不重复 且不是video rt.append(True) rt.append(j_id) rt.append(j_url) rt.append(j_text) c2 = s.get(j_url) open('mysite/static/jay.jpg', 'wb').write(c2.content) return rt else : rt.append(False) return rt 其中pid是上次执行时候最新一张图片的id,用来判断是否有更新。其实这里bs4对我的帮助并不大。上面程序只做到了保存最新的一张图片(jay.jpg),实测中,总是保存第二张图片,可能是正则表达式的问题。不影响功能,不再深究了。使用 json 精准定位N次,(注意到js变量) 发微博参见 微博API 学习记录

优秀的个人博客,低调大师

Python使用itchat获取微信好友

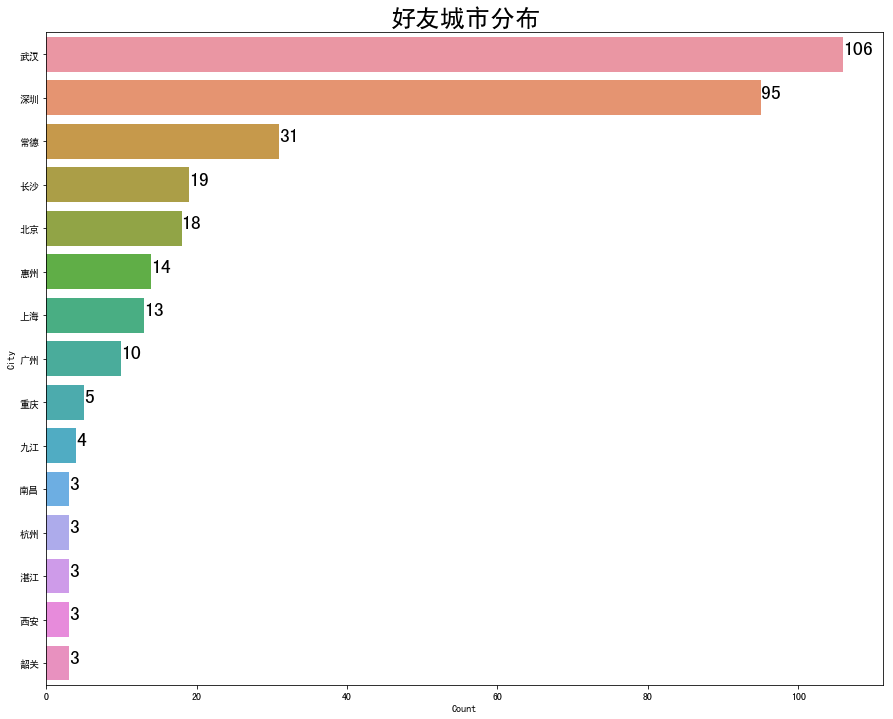
最近发现了一个好玩的包itchat,通过调用微信网页版的接口实现收发消息,获取好友信息等一些功能,各位可以移步itchat项目介绍查看详细信息。 目标: 获取好友列表 统计性别及城市分布 根据好友签名生成词云 获取好友信息 前文说了,itchat其实是调用微信网页版的接口,所以登陆的时候会弹出二维码进行登陆,然后通过itchat.get_friends获取好友信息就好了,相当简单。 # -*- coding: utf-8 -*- import itchat import pandas as pd import seaborn as sns import matplotlib.pyplot as plt import warnings import jieba import re from scipy.misc import imread from wordcloud import WordCloud, STOPWORDS, ImageColorGenerator itchat.login() #登陆网页版微信,需要手机扫码确认 warnings.filterwarnings("ignore") 获取好友信息的时候需要注意一点,因为好友列表中第一位是自己,所以从第二位开始保存。 friends = itchat.get_friends(update=True) for counter,content in enumerate(friends[1:]): if counter == 0: df=pd.DataFrame(content) df.columns=content.keys() else: df.loc[counter]=content.values() print '获取到%d位好友信息'%counter df.columns 字段信息如下: Index([u'UserName', u'City', u'DisplayName', u'UniFriend', u'MemberList', u'PYQuanPin', u'RemarkPYInitial', u'Sex', u'AppAccountFlag', u'VerifyFlag', u'Province', u'KeyWord', u'RemarkName', u'PYInitial', u'IsOwner', u'ChatRoomId', u'HideInputBarFlag', u'EncryChatRoomId', u'AttrStatus', u'SnsFlag', u'MemberCount', u'OwnerUin', u'Alias', u'Signature', u'ContactFlag', u'NickName', u'RemarkPYQuanPin', u'HeadImgUrl', u'Uin', u'StarFriend', u'Statues'], dtype='object') 好友城市分布 因为微信中位置信息是两级,省份和城市,对于北京上海这种直辖市,City字段中保存的是区的信息,这个部分做了下处理改为相应的城市名。 df['City'][df['Province']==u'北京']= u'北京' df['City'][df['Province']==u'上海']= u'上海' df['City'][df['Province']==u'重庆']= u'重庆' #微信对于直辖市将city字段填写为区 plt.figure(figsize = (15,12)) data_temp = df[df['City']!=''] #剔除城市未填写的记录 data_temp = data_temp.groupby(['City'])['UserName'].count().reset_index() data_temp = data_temp.nlargest(15,'UserName') data_temp.columns = ['City','Count'] sns.barplot(data=data_temp ,y='City',x='Count') for y,x in enumerate(data_temp['Count']): plt.text(x,y,x,fontsize = 20) plt.title(u'好友城市分布',fontsize =25) plt.show() 只取了前15位,效果如下: 性别分布 Sex字段中有0,1,2三个值,分别代表性别不明,男,女,相应的replace一下就好。 df['Sex'] = df['Sex'].replace({0:u'性别不明',1:u'男',2:u'女'}) plt.figure(figsize = (15,8)) plt.subplot(1,2,1) data_temp = df.groupby(['Sex'])['UserName'].count().reset_index() data_temp = data_temp.sort_values('UserName') data_temp.columns = ['Sex','Count'] sns.barplot(data=data_temp ,x='Sex',y='Count') for x,y in enumerate(data_temp['Count']): plt.text(x-0.05,y,y,fontsize = 20) plt.subplot(1,2,2) sex_list = [u'男',u'女',u'性别不明'] countlist = [292,227,25] explode = (0.05,0,0) plt.pie(countlist,labels = sex_list,explode =explode,startangle = 90,autopct = '%3.1f%%') plt.axis('equal') plt.show() 效果如下: 根据好友签名绘制词云 Signature中保存的是好友签名,开始试了一次,发现签名中emoji表情占了好大的比例,后面用正则表达式处理了下,只保留了汉字部分。 back_color = imread('tencent.jpg') # 解析该图片 wc = WordCloud(background_color='white', # 背景颜色 max_words=1000, # 最大词数 mask=back_color, # 以该参数值作图绘制词云,这个参数不为空时,width和height会被忽略 max_font_size=100, # 显示字体的最大值 font_path="/Users/tangwenpan/Downloads/simhei.ttf", # 解决显示口字型乱码问题 random_state=42, # 为每个词返回一个PIL颜色 ) text='' xx= u"[\u4e00-\u9fa5]" #保留汉字 for x in df['Signature']: pattern = re.compile(xx) text_temp = pattern.findall(x) for xxx in text_temp: text = text +xxx def word_cloud(texts): words_list = [] word_generator = jieba.cut(texts, cut_all=False) # 返回的是一个迭代器 for word in word_generator: if len(word) > 1: #去掉单字 words_list.append(word) return ' '.join(words_list) text = word_cloud(text) wc.generate(text) # 基于彩色图像生成相应彩色 image_colors = ImageColorGenerator(back_color) plt.figure(figsize = (15,15)) plt.axis('off') # 绘制词云 plt.imshow(wc.recolor(color_func=image_colors)) plt.axis('off') # 保存图片 wc.to_file('comment.png') print 'comment.png has bee saved!' 使用背景图片 效果如下: peace~


资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册