首页 文章 精选 留言 我的

精选列表

搜索[k8s],共4074篇文章
优秀的个人博客,低调大师

k8s部署服务——内部服务关联

背景 相信大家应该都在自己的电脑中部署过tomcat与mysql集群,我们可以通过访问tomcat来访问后台 数据库。kubernetes是一个可自动部署、扩缩、管理容器化应用的工具。本篇博客主要讲解如何在kubernetes中部署tomcat与mysql集群。当然,这涉及到kubernetes的自动化部署功能。至于扩缩、管理功能,我这里就不详述了,以后有机会再讲解。 基础 在kubernetes中部署tomcat与mysql集群之前必须要有以下这些基础: 1. 已安装、配置kubernetes 2. 集群中有tomcat与mysql容器镜像 3. 有docker基础 具体步骤 部署tomcat 创建tomcat RC对象 我们想要在kubernetes集群中配置tomcat服务器,首先要保证集群中的节点上有tomcat镜像,镜像可以从docker Hub中拉取,也可以放在自己的私有仓库中。这在我之前的博客中讲过,这里就不详述了。 要部署tomcat服务,我们需要做两件事,一是创建RC(Replication Controller),二是创建Service。RC是kubernetes中的副本控制器,也就是说,RC负责自动部署容器化应用。Service是我们访问tomcat服务的入口地址,我们是通过Service来对该服务就行访问的。 创建RC与Service对象,我这里用的是创建yaml文件的方式。yaml文件中的内容是声明式的。这些声明让kubernetes做你想要它做的事情。声明与命令有所不同,声明是告诉它你的需要是什么,而不涉及具体的实现的步骤,而命令,如linux中的ls,你是告诉它去做什么。声明与命令是不同的,请自己体会。话不多说了,上代码: apiVersion: v1 kind: ReplicationController metadata: name: myweb spec: replicas: 1 selector: app: myweb template: metadata: labels: app: myweb spec: containers: - image: kubeguide/tomcat-app:v1 name: myweb resources: limits: cpu: "0.5" memory: 200Mi ports: - containerPort: 8080 env: - name: MYSQL_SERVICE_HOST value: 'mysql' - name: MYSQL_SERVICE_PORT 如上所示就是我写的yaml文件,此文件名为myweb-rc1.yaml 这里我简单的说明一下此yaml文件声明了什么: 1 apiVersion: v1 //描述RC对象的版本是v1 2 kind: ReplicationController //我现在在声明RC对象 3 metadata: //metadata中的是对此RC对象描述信息 4 name: myweb //此RC对象在default命名空间中名为myweb,同一个命名空间中的命名一定是不同的 5 spec: //spec中是对RC对象的具体描述 6 replicas: 5 //我要创建5个副本,单位当然是pod 7 selector: //选择器,用来选择对象的 8 app: myweb //我选择了标签为app: myweb的pod 9 template: //模版,以下用来描述创建的pod的模版 10 metadata: //对pod模版描述的元数据 11 labels: //给以下的东西打上标签,以让selector来选择 12 app: myweb //给pod模版打上app: myweb这样的标签 13 spec: //对pod模版的具体描述 14 containers: //以下就是要放入pod模版中的容器了 15 - image: kubeguide/tomcat-app:v1 //选择镜像 16 name: myweb //容器名 17 resources: //给该容器分配的资源大小 18 limits: 19 cpu: "2" 20 memory: 4Gi 21 ports: //容器端口号 22 - containerPort: 8080 23 env: //给该容器设置环境变量,这里就可以将mysql与我们的tomcat连接 24 - name: MYSQL_SERVICE_HOST 25 value: 'mysql' 26 - name: MYSQL_SERVICE_PORT 大家可能看完比较蒙,仔细研究就发现其实yaml文件的规范还是比较严谨的。它是通过缩进与对齐的方式来表达了具体的信息的。比如一个metadata,在我这个yaml文件中就有两个。实际上通过缩进与对齐,我们就可以了解到,第一个metadata是对这个RC对象进行描述的元数据,而第二个metadata因为缩进了,实际上它是对pod模版进行描述的元数据。当然是不一样的。spec也有两个,同样的道理,大家可以自行分析。 创建tomcat RC对象的结果 如下,我截了个屏: 可以看到,我在创建完了tomcat的RC对象之后,它就立马自动部署了5个pod,这5个pod已经健康的跑起来了。为什么是创建5个pod?因为我在yaml文件中声明了我需要5个副本。是不是很方便? 创建tomcat Service对象 单单创建了RC对象还不行,虽然RC对象为我们自动部署了5个pod,但是我们还需要一个Service对象来作为入口地址来对创建好的tomcat进行访问,所以,接下来我们的任务就是创建Service对象。 此文件名为myweb-svc1.yaml。还是直接上代码: apiVersion: v1 kind: Service metadata: name: myweb spec: ports: - name: myweb-svc port: 8080 targetPort: 8080 nodePort: 31111 selector: app: myweb 关于yaml文件声明的含义我已经解释过了。这里不再重复解释。只挑不同的地方强调一下: 1 apiVersion: v1 2 kind: Service //对象是Service了哦 3 metadata: 4 name: myweb 5 spec: 6 ports: 7 - name: myweb-svc //端口名称,Service是必须指定端口名称的 8 port: 8080 //Service的端口号 9 targetPort: 8080 //容器暴露的端口号 10 nodePort: 31111 //node的真实端口号 11 selector: 12 app: myweb //Service选择了标签为app: myweb的pod 重点在于三个端口的区别,容器有端口,Service有端口,node也有真实的端口号,这里我们将这三者关联起来,在一会访问的时候会看出门道。所以,我们就拿结果说话吧。 创建tomcat Service对象的结果 大家可以看到,我已经创建好了名为myweb的Service。而且这个Service也已经通过selector选择了刚才创建好的5个pod。所以我可以通过Service来访问tomcat的服务了。我这里使用命令行来演示。 访问服务的方式 我们可以通过两种方式来访问已经创建好的服务。 1. 集群内部访问服务 我们可以通过Service IP + Service端口号的方式来从集群内部访问已经创建好的服务,所以,我们来看看tomcat Service的IP与端口号。 好了,现在可以进行访问了。 可以看到该服务已经通了,已经可以访问了,具体访问的是哪个pod中的tomcat,这是要根据具体情况进行负载均衡的。 2. 集群外部访问服务 从集群的外部我们可以通过node IP + node端口号的方式来对服务进行访问。pod实际上已经分在了不同的node中了,我们只用找到其中一个pod所在的node就行了。 可以看到我这个pod所在的IP地址。刚才已经看到了,在yaml文件中我将物理端口设为31111。好的,接下来就可以从外部对服务进行访问了。 可以看到,此时也可以访问服务。 部署mysql 如果你能将tomcat部署成功了,那么部署mysql就没有什么好讲的了。照前面做就行了。 创建mysql RC对象 我将此RC对象命名为mysql-rc1.yaml 直接上代码: apiVersion: v1 kind: ReplicationController metadata: name: mysql spec: replicas: 1 selector: app: mysql template: metadata: labels: app: mysql spec: containers: - image: img.reg.3g:15000/mysql:5.7.13 name: mysql resources: limits: cpu: "2" memory: 4Gi ports: - containerPort: 3306 env: - name: MYSQL_ROOT_PASSWORD 不同之处在于创建mysql的RC对象yaml文件时,注入了一个name为MYSQL_ROOT_PASSWORD的环境变量,这个是给mysql数据库设置密码,这个环境变量的注入是必须的,如果没有此环境变量,虽然RC可以被创建成功,但是系统是无法启动mysql容器的。不信可以试试。算了,还是给你演示一下吧。 创建mysql RC对象的结果 我把环境变量删了之后运行的结果如下: 可以看到,删掉环境变量的mysql RC虽然可以创建成功,但是容器启动失败了。 增加环境变量之后的结果 增加环境变量之后就可以启动起来容器了 创建mysql Service对象 同样道理,mysql也需要一个访问入口地址。创建的Service yaml文件名为mysql-svc1.yaml 还是直接上代码 apiVersion: v1 kind: Service metadata: name: mysql spec: ports: - name: mysql-svc port: 3306 targetPort: 3306 nodePort: 31101 selector: app: mysql 没什么好解释的。 创建mysql Service对象的结果 可以看到,mysql Service对象也已经启动成功了。 由于前面已经详细介绍过如何访问服务了,这里我就不再赘述了。大家可以自己访问mysql的服务看看。 需要注意的细节 我认为,在kubernetes中部署应用集群的时候有两点特别需要注意的,当然,是我会犯错的地方,与大家分享: 1. yaml文件的格式问题 我初次编写yaml文件可是花了不少时间,就是因为格式的问题,总是创建不了RC或者Servcice。尤其是需要注意,缩进要用空格缩进而不能用TAB键缩进。否则是成功不了的。 2. 理解pod、Service、node IP以及端口的关系 这里的概念可能会比较难以理解,但一定要搞清楚,这是访问时的重点 总结 在kubernetes中部署容器,不仅可以用yaml,也可以用Json。还有,现在有许多容器化应用都是通过deployment部署的。当然,如果用RC部署也是可以的。我是第一次在kubernetes中部署容器化应用集群,所以就从简单的入手。希望本篇博客能够帮助到有些也刚刚接触kubernetes的同学。 本文转自CSDN-k8s部署服务——内部服务关联
优秀的个人博客,低调大师

k8s基本概念及使用

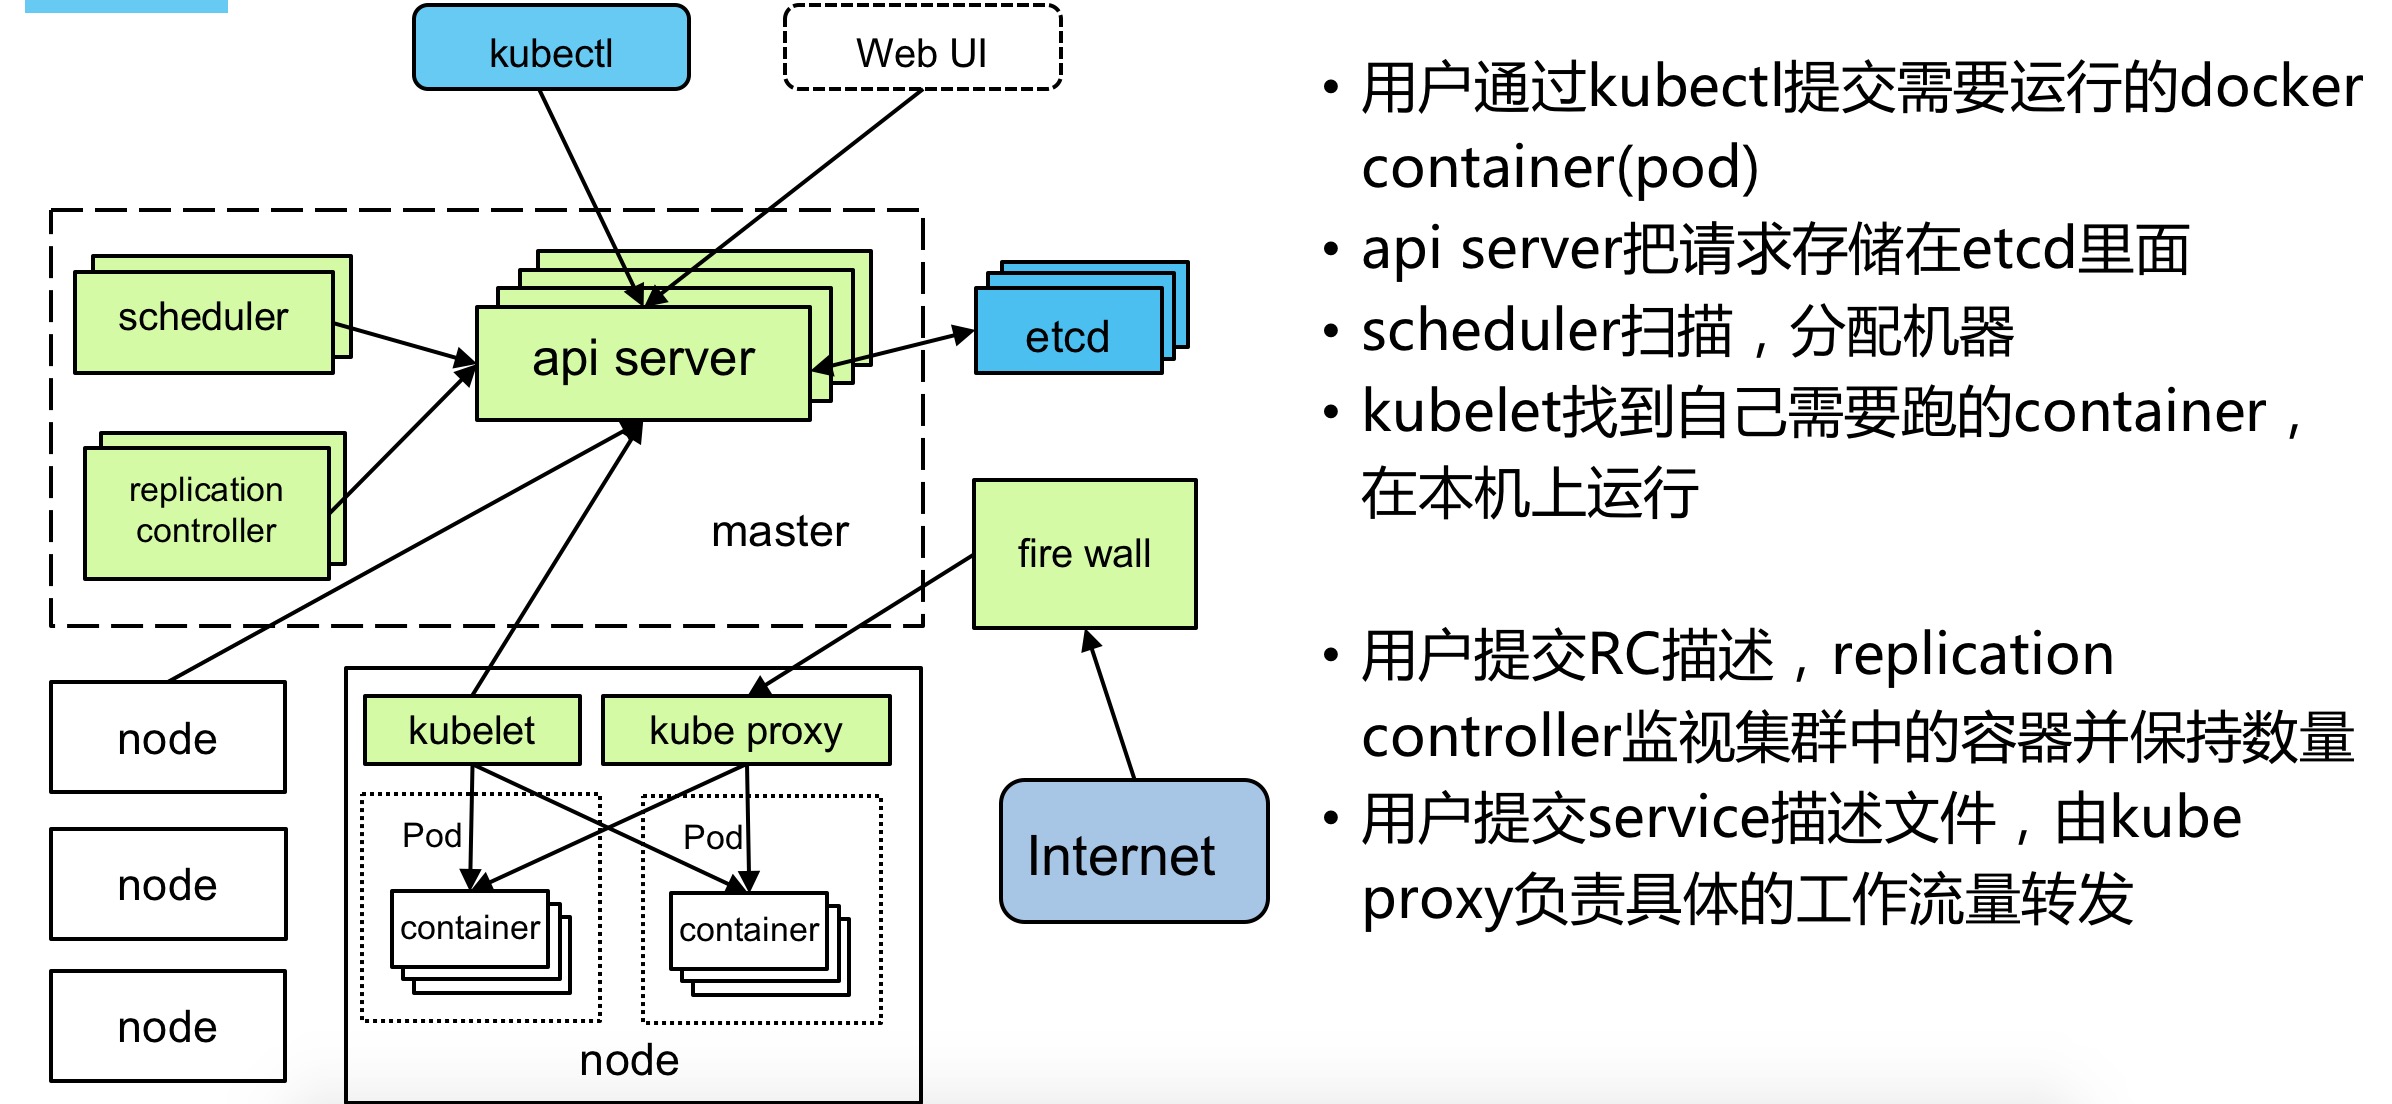
1.1 Kubernetes是什么 首先,它是一个全新的基于容器技术的分布式架构领先方案; 其次,Kubernetes是一个开放的开发平台; 最后,Kubernetes是一个完备的分布式系统支撑平台。 1.2 为什么要用Kubernetes 使用Kubernetes的理由很多,最根本的一个理由就是:IT从来都是一个由新技术驱动的行业。 使用Kubernetes所带来的好处: 首先,最直接的感受就是我们可以“轻装上阵”地开发复杂系统了; 其次,使用Kubernetes就是在全面拥抱微服务架构; 然后,我们的系统可以随时随地整体“搬迁”到公有云上; 最后,Kubernetes系统架构具备了超强的横向扩容能力。 1.3 Kubernetes基本概念和术语 在Kubernetes中,Node、Pod、Replication Controller、Service等概念都可以看作一种资源对象,通过Kubernetes提供的Kubectl工具或者API调用进行操作,并保存在etcd中。 1.3.1 Node(节点) Node(节点)是Kubernetes集群中相对于Master而言的工作主机,在较早的版本中也被称为Minion。Node可以是一台物理主机,也可以是一台虚拟机(VM)。在每个Node上运行用于启动和管理Pid的服务Kubelet,并能够被Master管理。在Node上运行的服务进行包括Kubelet、kube-proxy和docker daemon。 Node信息如下: Node地址:主机的IP地址,或者Node ID。 Node运行状态:包括Pending、Running、Terminated三种状态。 Node Condition(条件):描述Running状态Node的运行条件,目前只有一种条件----Ready。Ready表示Node处于健康状态,可以接收从Master发来的创建Pod的指令。 Node系统容量:描述Node可用的系统资源,包括CPU、内存数量、最大可调度Pod数量等。 其他:Node的其他信息,包括实例的内核版本号、Kubernetes版本号、Docker版本号、操作系统名称等。 1. Node的管理 Node通常是物理机、虚拟机或者云服务商提供的资源,并不是由Kubernetes创建的。我们说Kubernetes创建一个Node,仅仅表示Kubernetes在系统内部创建了一个Node对象,创建后即会对其进行一系列健康检查,包括是否可以连通、服务是否正确启动、是否可以创建Pod等。如果检查未能通过,则该Node将会在集群中被标记为不可用(Not Ready)。 2. 使用Node Controller对Node进行管理 Node Controller是Kubernetes Master中的一个组件,用于管理Node对象。它的两个主要功能包括:集群范围内的Node信息同步,以及单个Node的生命周期管理。 Node信息同步可以通过kube-controller-manager的启动参数--node-sync-period设置同步的时间周期。 3. Node的自注册 当Kubelet的--register-node参数被设置为true(默认值即为true)时,Kubelet会向apiserver注册自己。这也是Kubernetes推荐的Node管理方式。 Kubelet进行自注册的启动参数如下: --apiservers=: apiserver地址; --kubeconfig=: 登录apiserver所需凭据/证书的目录; --cloud_provider=: 云服务商地址,用于获取自身的metadata; --register-node=: 设置为true表示自动注册到apiserver。 4. 手动管理Node Kubernetes集群管理员也可以手工创建和修改Node对象。当需要这样操作时,先要将Kubelet启动参数中的--register-node参数的值设置为false。这样,在Node上的Kubelet就不会把自己注册到apiserver中去了。 另外,Kubernetes提供了一种运行时加入或者隔离某些Node的方法。具体操作请参考第四章。 1.3.2 Pod Pod是Kubernetes的最基本操作单元,包含一个活多个紧密相关的容器,类似于豌豆荚的概念。一个Pod可以被一个容器化的环境看作应用层的“逻辑宿主机”(Logical Host)。一个Pod中的多个容器应用通常是紧耦合的。Pod在Node上被创建、启动或者销毁。 为什么Kubernetes使用Pod在容器之上再封装一层呢?一个很重要的原因是,Docker容器之间的通信受到Docker网络机制的限制。在Docker的世界中,一个容器需要link方式才能访问另一个容器提供的服务(端口)。大量容器之间的link将是一个非常繁重的工作。通过Pod的概念将多个容器组合在一个虚拟的“主机”内,可以实现容器之间仅需要通过Localhost就能相互通信了。 一个Pod中的应用容器共享同一组资源,如下所述: PID命名空间:Pod中的不同应用程序可以看到其他应用程序的进程ID; 网络命名空间:Pod中的多个容器能够访问同一个IP和端口范围; IPC命名空间:Pod中的多个容器能够使用SystemV IPC或者POSIX消息队列进行通信; UTS命名空间:Pod中的多个容器共享一个主机名; Volumes(共享存储卷):Pod中的各个容器可以访问在Pod级别定义的Volumes。 1. 对Pod的定义 对Pod的定义通过Yaml或Json格式的配置文件来完成。下面的配置文件将定义一个名为redis-slave的Pod,其中kind为Pod。在spec中主要包含了Containers(容器)的定义,可以定义多个容器。 apiVersion: v1 kind: Pod metadata: name: redis-slave labels: name: redis-slave spec: containers: - name: slave image: kubeguide/guestbook-redis-slave env: - name: GET_HOSTS_FROM value: env ports: - containerPort: 6379 Pod的生命周期是通过Replication Controller来管理的。Pod的生命周期过程包括:通过模板进行定义,然后分配到一个Node上运行,在Pod所含容器运行结束后Pod也结束。在整个过程中,Pod处于一下4种状态之一: Pending:Pod定义正确,提交到Master,但其所包含的容器镜像还未完成创建。通常Master对Pod进行调度需要一些时间,之后Node对镜像进行下载也需要一些时间; Running:Pod已被分配到某个Node上,且其包含的所有容器镜像都已经创建完成,并成功运行起来; Succeeded:Pod中所有容器都成功结束,并且不会被重启,这是Pod的一种最终状态; Failed:Pod中所有容器都结束了,但至少一个容器是以失败状态结束的,这也是Pod的一种最终状态。 Kubernetes为Pod设计了一套独特的网络配置,包括:为每个Pod分配一个IP地址,使用Pod名作为容器间通信的主机名等。关于Kubernetes网络的设计原理将在第2章进行详细说明。 另外,不建议在Kubernetes的一个Pod内运行相同应用的多个实例。 1.3.3 Label(标签) Label是Kubernetes系统中的一个核心概念。Label以key/value键值对的形式附加到各种对象上,如Pod、Service、RC、Node等。Label定义了这些对象的可识别属性,用来对它们进行管理和选择。Label可以在创建时附加到对象上,也可以在对象创建后通过API进行管理。 在为对象定义好Label后,其他对象就可以使用Label Selector(选择器)来定义其作用的对象了。 Label Selector的定义由多个逗号分隔的条件组成。 "labels": { "key1": "value1", "key2": "value2" } 当前有两种Label Selector:基于等式的(Equality-based)和基于集合的(Set-based),在使用时可以将多个Label进行组合来选择。 基于等式的Label Selector使用等式类的表达式来进行选择: name = redis-slave: 选择所有包含Label中key="name"且value="redis-slave"的对象; env != production: 选择所有包括Label中的key="env"且value不等于"production"的对象。 基于集合的Label Selector使用集合操作的表达式来进行选择: name in (redis-master, redis-slave): 选择所有包含Label中的key="name"且value="redis-master"或"redis-slave"的对象; name not in (php-frontend): 选择所有包含Label中的key="name"且value不等于"php-frontend"的对象。 在某些对象需要对另一些对象进行选择时,可以将多个Label Selector进行组合,使用逗号","进行分隔即可。基于等式的LabelSelector和基于集合的Label Selector可以任意组合。例如: name=redis-slave,env!=production name not in (php-frontend),env!=production 1.3.4 Replication Controller(RC) Replication Controller是Kubernetes系统中的核心概念,用于定义Pod副本的数量。在Master内,Controller Manager进程通过RC的定义来完成Pod的创建、监控、启停等操作。 根据Replication Controller的定义,Kubernetes能够确保在任意时刻都能运行用于指定的Pod“副本”(Replica)数量。如果有过多的Pod副本在运行,系统就会停掉一些Pod;如果运行的Pod副本数量太少,系统就会再启动一些Pod,总之,通过RC的定义,Kubernetes总是保证集群中运行着用户期望的副本数量。 同时,Kubernetes会对全部运行的Pod进行监控和管理,如果有需要(例如某个Pod停止运行),就会将Pod重启命令提交给Node上的某个程序来完成(如Kubelet或Docker)。 可以说,通过对Replication Controller的使用,Kubernetes实现了应用集群的高可用性,并大大减少了系统管理员在传统IT环境中需要完成的许多手工运维工作(如主机监控脚本、应用监控脚本、故障恢复脚本等)。 对Replication Controller的定义使用Yaml或Json格式的配置文件来完成。以redis-slave为例,在配置文件中通过spec.template定义Pod的属性(这部分定义与Pod的定义是一致的),设置spec.replicas=2来定义Pod副本的数量。 apiVersion: v1 kind: ReplicationController metadata: name: redis-slave labels: redis-slave name: redis-slave spec: replicas: 2 selector: name: redis-slave template: metadata: labels: name: redis-slave spec: container: - name: slave image: kubeguide/guestbook-redis-slave env: - name: GET_HOSTS_FROM value: env ports: - containerPort: 6379 通常,Kubernetes集群中不止一个Node,假设一个集群有3个Node,根据RC的定义,系统将可能在其中的两个Node上创建Pod。 1.3.5 Service(服务) 在Kubernetes的世界里,虽然每个Pod都会被分配一个单独的IP地址,这个IP地址会随时Pod的销毁而消失。这就引出一个问题:如果有一组Pod组成一个集群来提供服务,那么如何来访问它们呢? Kubernetes的Service(服务)就是用来解决这个问题的核心概念。 一个Service可以看作一组提供相同服务的Pod的对外访问接口。Service作用于哪些Pod是通过Label Selector来定义的。 1. 对Service的定义 对Service的定义同样使用Yaml或Json格式的配置文件来完成。以redis-slave服务的定义为例: apiVersion: v1 kind: Service metadata: name: redis-slave labels: name: redis-slave spec: ports: - port: 6379 selector: name: redis-slave 通过该定义,Kubernetes将会创建一个名为“redis-slave”的服务,并在6379端口上监听。spec.selector的定义表示该Service将包含所有具有"name=redis-slave"的Label的Pod。 在Pod正常启动后,系统将会根据Service的定义创建出与Pod对应的Endpoint(端点)对象,以建立起Service与后端Pod的对应关系。随着Pod的创建、销毁,Endpoint对象也将被更新。Endpoint对象主要有Pod的IP地址和容器所需监听的端口号组成。 2. Pod的IP地址和Service的Cluster IP地址 Pod的IP地址是Docker Daemon根据docker0网桥的IP地址段进行分配的,但Service的Cluster IP地址是Kubernetes系统中的虚拟IP地址,由系统动态分配。Service的Cluster IP地址相对于Pod的IP地址来说相对稳定,Service被创建时即被分配一个IP地址,在销毁该Service之前,这个IP地址都不会再变化了。而Pod在Kubernetes集群中生命周期较短,可能被ReplicationContrller销毁、再次创建,新创建的Pod将会分配一个新的IP地址。 3. 外部访问Service 由于Service对象在Cluster IP Range池中分配到的IP只能在内部访问,所以其他Pod都可以无障碍地访问到它。到如果这个Service作为前端服务,准备为集群外的客户端提供服务,我们就需要给这个服务提供公共IP了。 Kubernetes支持两种对外提供服务的Service的type定义:NodePort和LoadBalancer。 1. NodePort 在定义Service时指定spec.type=NodePort,并指定spec.ports.nodePort的值,系统就会在Kubernetes集群中的每个Node上打开一个主机上的真实端口号。这样,能够访问Node的客户端都就能通过这个端口号访问到内部的Service了。 以php-frontend service的定义为例,nodePort=80,这样,在每一个启动了该php-frontend Pod的Node节点上,都会打开80端口。 apiVersion: v1 kind: Service metadata: name: frontend labels: name: frontend spec: type: NodePort ports: - port: 80 nodePort: 30001 selector: name: frontend 2. LoadBalancer 如果云服务商支持外接负载均衡器,则可以通过spec.type=LoadBalaner定义Service,同时需要制定负载均衡器的IP地址。使用这种类型需要指定Service的nodePort和clusterIP。例如: apiVersion: v1 kind: Service metadata: { "kind" "Service", "apiVersion": "v1", "metadata": { "name": "my-service" }, "spec": { "type": "LoadBalaner", "clusterIP": "10.0.171.239", "selector": { "app": "MyApp" }, "ports": [ { "protocol": "TCP", "port": 80, "targetPort": 9376, "nodePort": 30061 } ], }, "status": { "loadBalancer": { "ingress": [ { "ip": "146.148.47.155" } ] } } } 在这个例子中,status.loadBalancer.ingress.ip设置的146.146.47.155为云服务商提供的负载均衡器的IP地址。 之后,对该Service的访问请求将会通过LoadBalancer转发到后端Pod上去,负载分发的实现方式则依赖于云服务上提供的LoadBalancer的实现机制。 1.3.6 Volume(存储卷) Volume是Pod中能够被多个容器访问的共享目录。Kubernetes的Volume概念与Docker的Volume比较类似,但不完全相同。Kubernetes中的Volume与Pod生命周期相同,但与容器的生命周期不相关。当容器终止或者重启时,Volume中的数据也不会丢失。另外,Kubernetes支持多种类型的Volume,并且一个Pod可以同时使用任意多个Volume。 Kubernetes提供了非常丰富的Volume类型,下面逐一进行说明。 EmptyDir:一个EmptyDir Volume是在Pod分配到Node时创建的。从它的名称就可以看出,它的初始内容为空。在同一个Pod中所有容器可以读和写EmptyDir中的相同文件。当Pod从Node上移除时,EmptyDir中的数据也会永久删除。 hostPath:在Pod上挂载宿主机上的文件或目录。 gcePersistentDisk:使用这种类型的Volume表示使用谷歌计算引擎(Google Compute Engine,GCE)上永久磁盘(Persistent Disk,PD)上的文件。与EmptyDir不同,PD上的内容会永久保存,当Pod被删除时,PD只是被卸载(Unmount),但不会被删除。需要注意的是,你需要先创建一个永久磁盘(PD)才能使用gcePersistentDisk。 awsElasticBlockStore:与GCE类似,该类型的Volume使用Amazon提供的Amazon Web Service(AWS)的EBS Volume,并可以挂在到Pod中去。需要注意到是,需要首先创建一个EBS Volume才能使用awsElasticBlockStore。 nfs:使用NFS(网络文件系统)提供的共享目录挂载到Pod中。在系统中需要一个运行中的NFS系统。 iscsi:使用iSCSI存储设备上的目录挂载到Pod中。 glusterfs:使用开源GlusterFS网络文件系统的目录挂载到Pod中。 rbd:使用Linux块设备共享存储(Rados Block Device)挂载到Pod中。 gitRepo:通过挂载一个空目录,并从GIT库clone一个git respository以供Pod使用。 secret:一个secret volume用于为Pod提供加密的信息,你可以将定义在Kubernetes中的secret直接挂载为文件让Pod访问。secret volume是通过tmfs(内存文件系统)实现的,所以这种类型的volume总是不会持久化的。 persistentVolumeClaim:从PV(PersistentVolume)中申请所需的空间,PV通常是一种网络存储,例如GCEPersistentDisk、AWSElasticBlockStore、NFS、iSCSI等。 1.3.7 Namespace(命名空间) Namespace(命名空间)是Kubernetes系统中的另一个非常重要的概念,通过将系统内部的对象“分配”到不同的Namespace中,形成逻辑上分组的不同项目、小组或用户组,便于不同的分组在共享使用整个集群的资源的同时还能被分别管理。 Kubernetes集群在启动后,会创建一个名为“default”的Namespace,通过Kubectl可以查看到。 使用Namespace来组织Kubernetes的各种对象,可以实现对用户的分组,即“多租户”管理。对不同的租户还可以进行单独的资源配额设置和管理,使得整个集群的资源配置非常灵活、方便。 1.3.8 Annotation(注解) Annotation与Label类似,也使用key/value键值对的形式进行定义。Label具有严格的命名规则,它定义的是Kubernetes对象的元数据(Metadata),并且用于Label Selector。Annotation则是用户任意定义的“附加”信息,以便于外部工具进行查找。 用Annotation来记录的信息包括: build信息、release信息、Docker镜像信息等,例如时间戳、release id号、PR号、镜像hash值、docker registry地址等; 日志库、监控库、分析库等资源库的地址信息; 程序调试工具信息,例如工具名称、版本号等; 团队的联系信息,例如电话号码、负责人名称、网址等。ß 1.3.9 小结 上述这些组件是Kubernetes系统的核心组件,它们共同构成了Kubernetes系统的框架和计算模型。通过对它们进行灵活组合,用户就可以快速、方便地对容器集群进行配置、创建和管理。 除了以上核心组件,在Kubernetes系统中还有许多可供配置的资源对象,例如LimitRange、ResourceQuota。另外,一些系统内部使用的对象Binding、Event等请参考Kubernetes的API文档。 1.4 Kubernetes总体架构 Kubernetes集群由两类节点组成:Master和Node。在Master上运行etcd、API Server、Controller Manager和Scheduler四个组件,其中后三个组件构成了Kubernetes的总控中心,负责对集群中所有资源进行管理和调度。在每个Node上运行Kubelet、Proxy和Docker Daemon三个组件,负责对本节点上的Pod的生命周期进行管理,以及实现服务代理的功能。另外在所有节点上都可以运行Kubectl命令行工具,它提供了Kubernetes的集群管理工具集。 本文转自CSDN-k8s基本概念及使用

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册