首页 文章 精选 留言 我的

精选列表

搜索[MSA技术],共10000篇文章
优秀的个人博客,低调大师

浅谈SQL优化小技巧 | 京东云技术团队

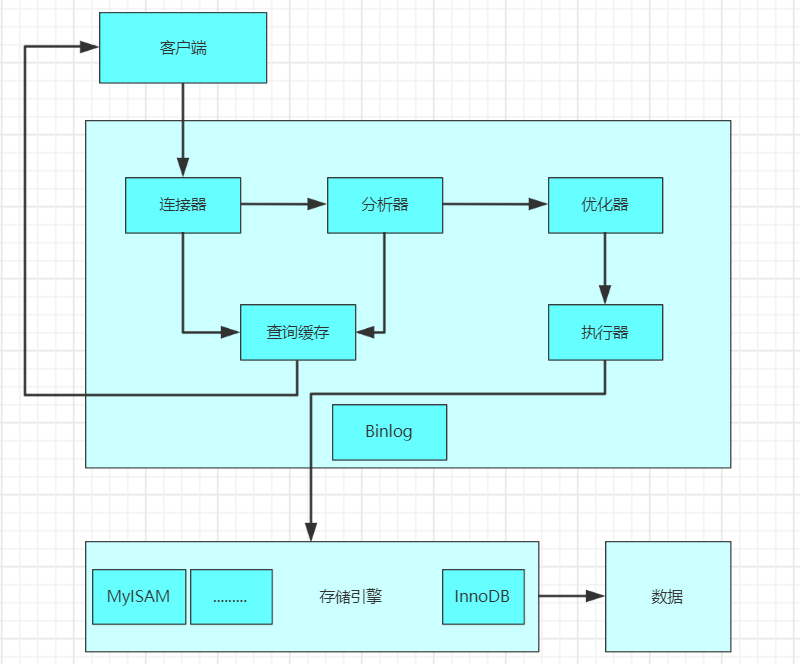
回顾MySQL的执行过程,帮助介绍如何进行sql优化。 (1)客户端发送一条查询语句到服务器; (2)服务器先查询缓存,如果命中缓存,则立即返回存储在缓存中的数据; (3)未命中缓存后,MySQL通过关键字将SQL语句进行解析,并生成一颗对应的解析树,MySQL解析器将使用MySQL语法进行验证和解析。 ​ 例如,验证是否使用了错误的关键字,或者关键字的使用是否正确; (4)预处理是根据一些MySQL规则检查解析树是否合理,比如检查表和列是否存在,还会解析名字和别名,然后预处理器会验证权限; ​ 根据执行计划查询执行引擎,调用API接口调用存储引擎来查询数据; (5)将结果返回客户端,并进行缓存;  SQL语句性能优化常用策略 1、 为 WHERE 及 ORDER BY 涉及的列上建立索引 对查询进行优化,应尽量避免全表扫描,首先应考虑在 WHERE 及 ORDER BY 涉及的列上建立索引。 2、where中使用默认值代替null 应尽量避免在 WHERE 子句中对字段进行 NULL 值判断,创建表时 NULL 是默认值,但大多数时候应该使用 NOT NULL,或者使用一个特殊的值,如 0,-1 作为默认值。 为啥建议where中使用默认值代替null,四个原因: (1)并不是说使用了is null或者 is not null就会不走索引了,这个跟mysql版本以及查询成本都有关; (2)如果mysql优化器发现,走索引比不走索引成本还要高,就会放弃索引,这些条件 !=,<>,is null,is not null经常被认为让索引失效; (3)其实是因为一般情况下,查询的成本高,优化器自动放弃索引的; (4)如果把null值,换成默认值,很多时候让走索引成为可能,同时,表达意思也相对清晰一点; 3、慎用 != 或 <> 操作符。 MySQL 只有对以下操作符才使用索引:<,<=,=,>,>=,BETWEEN,IN,以及某些时候的 LIKE。 所以:应尽量避免在 WHERE 子句中使用 != 或 <> 操作符, 会导致全表扫描。 4、慎用 OR 来连接条件 使用or可能会使索引失效,从而全表扫描; 应尽量避免在 WHERE 子句中使用 OR 来连接条件,否则将导致引擎放弃使用索引而进行全表扫描, 可以使用 UNION 合并查询: select id from t where num=10 union all select id from t where num=20 一个关键的问题是否用到索引。他们的速度只同是否使用索引有关,如果查询需要用到联合索引,用 UNION all 执行的效率更高。多个 OR 的字句没有用到索引,改写成 UNION 的形式再试图与索引匹配。 5、慎用 IN 和 NOT IN IN 和 NOT IN 要慎用,否则会导致全表扫描。对于连续的数值,能用 BETWEEN 就不要用 IN:select id from t where num between 1 and 3。 6、慎用 左模糊like ‘%…’ 模糊查询,程序员最喜欢的就是使用like,like很可能让索引失效。 比如: select id from t where name like‘%abc%’ select id from t where name like‘%abc’ 而select id from t where name like‘abc%’才用到索引。 所以: 首先尽量避免模糊查询,如果必须使用,不采用全模糊查询,也应尽量采用右模糊查询, 即like ‘…%’,是会使用索引的; 左模糊like ‘%…’无法直接使用索引,但可以利用reverse + function index的形式,变化成 like ‘…%’; 全模糊查询是无法优化的,一定要使用的话建议使用搜索引擎,比如 ElasticSearch。 备注:如果一定要用左模糊like ‘%…’检索, 一般建议 ElasticSearch+Hbase架构 7、WHERE条件使用参数会导致全表扫描。 如下面语句将进行全表扫描: select id from t where num=@num 因为SQL只有在运行时才会解析局部变量,但优化程序不能将访问计划的选择推 迟到 运行时; 它必须在编译时进行选择。然而,如果在编译时建立访问计划,变量的值还是未知的,因而无法作为索引选择的输入项。 所以, 可以改为强制查询使用索引: select id from t with(index(索引名)) where num=@num 8、用 EXISTS 代替 IN 是一个好的选择 很多时候用exists 代替in 是一个好的选择: select num from a where num in(select num from b) 用下面的语句替换: select num from a where exists(select 1 from b where num=a.num) 9、索引并不是越多越好 索引固然可以提高相应的 SELECT 的效率,但同时也降低了 INSERT 及 UPDATE 的效。 因为 INSERT 或 UPDATE 时有可能会重建索引,所以怎样建索引需要慎重考虑,视具体情况而定。 一个表的索引数最好不要超过 6 个,若太多则应考虑一些不常使用到的列上建的索引是否有必要。 10、尽量使用数字型字段 (1)因为引擎在处理查询和连接时会逐个比较字符串中每一个字符; (2)而对于数字型而言只需要比较一次就够了; (3)字符会降低查询和连接的性能,并会增加存储开销; 所以:尽量使用数字型字段,若只含数值信息的字段尽量不要设计为字符型,这会降低查询和连接的性能,并会增加存储开销。 11、尽可能的使用 varchar, nvarchar 代替 char, nchar (1)varchar变长字段按数据内容实际长度存储,存储空间小,可以节省存储空间; (2)char按声明大小存储,不足补空格; (3)其次对于查询来说,在一个相对较小的字段内搜索,效率更高; 因为首先变长字段存储空间小,可以节省存储空间,其次对于查询来说,在一个相对较小的字段内搜索效率显然要高些。 14、查询SQL尽量不要使用select *,而是具体字段 最好不要使用返回所有:select * from t ,用具体的字段列表代替 “*”,不要返回用不到的任何字段。 select *的弊端: (1)增加很多不必要的消耗,比如CPU、IO、内存、网络带宽; (2)增加了使用覆盖索引的可能性; (3)增加了回表的可能性; (4)当表结构发生变化时,前端也需要更改; (5)查询效率低; 15、将需要查询的结果预先计算好 将需要查询的结果预先计算好放在表中,查询的时候再Select,而不是查询的时候进行计算。 16、IN后出现最频繁的值放在最前面 如果一定用IN,那么:在IN后面值的列表中,将出现最频繁的值放在最前面,出现得最少的放在最后面,减少判断的次数。 17、尽量使用 EXISTS 代替 select count(1) 来判断是否存在记录。 count 函数只有在统计表中所有行数时使用,而且 count(1) 比 count(*) 更有效率。 18、用批量插入或批量更新 当有一批处理的插入或更新时,用批量插入或批量更新,绝不会一条条记录的去更新。 (1)多条提交 INSERT INTO user (id,username) VALUES(1,'xx'); INSERT INTO user (id,username) VALUES(2,'yy'); (2)批量提交 INSERT INTO user (id,username) VALUES(1,'xx'),(2,'yy'); 默认新增SQL有事务控制,导致每条都需要事务开启和事务提交,而批量处理是一次事务开启和提交,效率提升明显,达到一定量级,效果显著,平时看不出来。 19、将不需要的记录在 GROUP BY 之前过滤掉 提高 GROUP BY 语句的效率,可以通过将不需要的记录在 GROUP BY 之前过滤掉。 下面两个查询返回相同结果,但第二个明显就快了许多。 低效: SELECT JOB, AVG(SAL) FROM EMP GROUP BY JOB HAVING JOB = 'PRESIDENT' OR JOB = 'MANAGER' 高效: SELECT JOB, AVG(SAL) FROM EMP WHERE JOB = 'PRESIDENT' OR JOB = 'MANAGER' GROUP BY JOB 20、避免死锁 在你的存储过程和触发器中访问同一个表时总是以相同的顺序;事务应经可能地缩短,在一个事务中应尽可能减少涉及到的数据量;永远不要在事务中等待用户输入。 21、索引创建规则: 表的主键、外键必须有索引; 数据量超过 300 的表应该有索引; 经常与其他表进行连接的表,在连接字段上应该建立索引; 经常出现在 WHERE 子句中的字段,特别是大表的字段,应该建立索引; 索引应该建在选择性高的字段上; 索引应该建在小字段上,对于大的文本字段甚至超长字段,不要建索引; 复合索引的建立需要进行仔细分析,尽量考虑用单字段索引代替; 正确选择复合索引中的主列字段,一般是选择性较好的字段; 复合索引的几个字段是否经常同时以 AND 方式出现在 WHERE 子句中?单字段查询是否极少甚至没有?如果是,则可以建立复合索引;否则考虑单字段索引; 如果复合索引中包含的字段经常单独出现在 WHERE 子句中,则分解为多个单字段索引; 如果复合索引所包含的字段超过 3 个,那么仔细考虑其必要性,考虑减少复合的字段; 如果既有单字段索引,又有这几个字段上的复合索引,一般可以删除复合索引; 频繁进行数据操作的表,不要建立太多的索引; 删除无用的索引,避免对执行计划造成负面影响; 表上建立的每个索引都会增加存储开销,索引对于插入、删除、更新操作也会增加处理上的开销。 另外,过多的复合索引,在有单字段索引的情况下,一般都是没有存在价值的;相反,还会降低数据增加删除时的性能,特别是对频繁更新的表来说,负面影响更大。 尽量不要对数据库中某个含有大量重复的值的字段建立索引。 22、在写 SQL 语句时,应尽量减少空格的使用 查询缓冲并不自动处理空格,因此,在写 SQL 语句时,应尽量减少空格的使用,尤其是在 SQL 首和尾的空格(因为查询缓冲并不自动截取首尾空格)。 23、每张表都设置一个 ID 做为其主键 我们应该为数据库里的每张表都设置一个 ID 做为其主键,而且最好的是一个 INT 型的(推荐使用 UNSIGNED),并设置上自动增加的 AUTO_INCREMENT 标志。 24、使用explain分析你SQL执行计划 (1)type system:表仅有一行,基本用不到; const:表最多一行数据配合,主键查询时触发较多; eq_ref:对于每个来自于前面的表的行组合,从该表中读取一行。这可能是最好的联接类型,除了const类型; ref:对于每个来自于前面的表的行组合,所有有匹配索引值的行将从这张表中读取; range:只检索给定范围的行,使用一个索引来选择行。当使用=、<>、>、>=、<、<=、IS NULL、<=>、BETWEEN或者IN操作符,用常量比较关键字列时,可以使用range; index:该联接类型与ALL相同,除了只有索引树被扫描。这通常比ALL快,因为索引文件通常比数据文件小; all:全表扫描; 性能排名:system > const > eq_ref > ref > range > index > all。 实际sql优化中,最后达到ref或range级别。 (2)Extra常用关键字 Using index:只从索引树中获取信息,而不需要回表查询; Using where:WHERE子句用于限制哪一个行匹配下一个表或发送到客户。除非你专门从表中索取或检查所有行,如果Extra值不为Using where并且表联接类型为ALL或index,查询可能会有一些错误。需要回表查询。 Using temporary:mysql常建一个临时表来容纳结果,典型情况如查询包含可以按不同情况列出列的GROUP BY和ORDER BY子句时; 25、当只要一行数据时使用 LIMIT 1 当你查询表的有些时候,你已经知道结果只会有一条结果,但因为你可能需要去fetch游标,或是你也许会去检查返回的记录数。 在这种情况下,加上 LIMIT 1 可以增加性能。 这样一来,MySQL 数据库引擎会在找到一条数据后停止搜索,而不是继续往后查少下一条符合记录的数据。 26、将大的DELETE,UPDATE、INSERT 查询变成多个小查询 能写一个几十行、几百行的SQL语句是不是显得逼格很高?然而,为了达到更好的性能以及更好的数据控制,你可以将他们变成多个小查询。 27、合理分表 尽量控制单表数据量的大小,建议控制在500万以内 500万并不是MySQL数据库的限制,过大会造成修改表结构,备份,恢复都会有很大的问题。 可以用历史数据归档(应用于日志数据),分库分表(应用于业务数据)等手段来控制数据量大小。 作者:京东科技 梁发文 来源:京东云开发者社区 转载请注明来源

优秀的个人博客,低调大师

MYSQL EXPLAIN 执行计划 | 京东物流技术团队

EXPLAIN 执行计划 有了慢查询语句后,就要对语句进行分析。一条查询语句在经过 MySQL 查询优化器的各种基于成本和规则的优化会后生成一个所谓的执行计划,这个执行计划展示了接下来具体执行查询的方式,比如多表连接的顺序是什么,对于每个表采用什么访问方法来具体执行查询等等。EXPLAIN 语句来能够查看某个查询语句的具体执行计划,要搞懂 EPLATN 的各个输出项都有什么作用,从而可以有针对性的提升查询语句的性能。 通过使用 EXPLAIN 关键字可以模拟优化器执行 SQL 查询语句,从而知道 MySQL 是如何处理 SQL 语句的。分析查询语句或是表结构的性能瓶颈。 EXPLAIN 可以得到以下结果: 表的读取顺序; 数据读取操作的操作类型; 哪些索引可以使用; 哪些索引被实际使用; 表之间的引用; 每张表有多少行被优化器查询; EXPLAIN 基本语法 执行计划的语法非常简单:在 SQL 查询的前面加上 EXPLAIN 关键字。比如:EXPLAIN select * from tableName; 除了以 SELECT 开头的查询语句,其余的 DELETE、INSERT、UPOATE 语句前边都可以加上 EXPLAIN,用来查看这些语句的执行计划,只不过大多数情况下都会对 SELECT 语句更感兴趣。 EXPLAIN 详解 执行 sql explain SELECT * FROM order_test; 输出结果如图:  每列的含义 id 查询语句一般都以 SELECT 关键字开头,比较简单的查询语句里只有一个 SELECT 关键字,稍微复杂一点的连接查询中也只有一个 SELECT 关键字,比如: explain SELECT * FROM test1 t1 INNER JOIN test2 t2 ON t1.id=t2.id ; 但是下边两种情况下在一条查询语句中会出现多个 SELECT 关键字: 1. 查询中包含子查询的情况:explain SELECT * FROM test1 WHERE id IN(SELECT id FROM test2); 2. 查询中包含 UNION / UNION ALL 语句的情况:EXPLAIN SELECT * FROM test1 UNION ALL SELECT * FROM test2; 查询语句中每出现一个 SELECT 关键字,MySQL 就会为它分配一个唯一的 id 值。这个 id 值就是 EXPLAIN 语句的第一列的值,并且 id 的顺序是按 SELECT 出现的顺序增长的,id 列越大执行优先级越高,id 相同则从上往下执行,id 为 NULL 最后执行。 单 SELECT 关键字 比如下边这个查询中只有一个 SELECT 关键字,所以 EXPLAIN 的结果中也就只有一条 id 列为 1 的记录。  连接查询 对于连接查询来说,一个 SELECT 关键字后边的 FROM 子句中可以跟随多个表,所以在连接查询的执行计划中,每个表都会对应一条记录,但是这些记录的 id 值都是相同的。  可以看到,上述连接查询中参与连接的 test1 和 test2 表分别对应一条记录,但是这两条记录对应的 id 值都是 1,在连接查询的执行计划中,每个表都会对应一条记录,这些记录的 id 列的值是相同的。 包含子查询 对于包含子查询的查询语句来说,就可能涉及多个 SELECT 关键字,所以在包含子查询的查询语句的执行计划中,每个 SELECT 关键字都会对应一个唯一的 id 值。 但是这里需要特别注意,查询优化器可能对涉及子查询的查询语句进行重写,从而转换为连接查询。所以如果我们想知道查询优化器对某个包含子查询的语句是否进行了重写,直接查看执行计划。  可以看到,虽然查询语句是一个子查询,但是执行计划中 test1 和 test2 表对应的记录的 id 值全部是 1,这就表明了查询优化器将子查询转换为了连接查询。 包含 UNION \ UNION ALL 子句 对于包含 UNION 子句的查询语句来说,每个 SELECT 关键字对应一个 id 值也是没错的,不过还是有点儿特别。  这个语句的执行计划的第三条记录是因为 UNION 子句会把多个查询的结果集合并起来并对结果集中的记录进行去重,MySQL 使用的是内部的临时表。UNION 子句是为了把 id 为 1 的查询和 id 为 2 的查询的结果集合并起来并去重,所以在内部创建了一个名为 <union1,2> 的临时表,就是执行计划第三条记录的 table 列的名称,id 为 NULL 表明这个临时表是为了合并两个查询的结果集而创建的。 跟 UNION 对比起来 UNION ALL 就不需要为最终的结果集进行去重,它只是单纯的把多个查询的结果集中的记录合并成一个并返回给用户,所以也就不需要使用临时表。所以在包含 UNION ALL 子句的查询的执行计划中,就没有那个 id 为 NULL 的记录。  select_type 一条大的查询语句里边可以包含若干个 SELECT 关键字,每个 SELECT 关键字代表着一个小的查询语句,而每个 SELECT 关键字的 FROM 子句中都可以包含若干张表,每一张表都对应着执行计划输出中的一条记录,对于在同一个 SELECT 关键字中的表来说,它们的 id 值是相同的。 MySQL 为每一个 SELECT 关键字代表的小查询都定义了一个称之为:select_type 的属性,意思是我们只要知道了某个小查询的 select_type 属性,就知道了这个小查询在整个大查询中扮演了一个什么角色,select_type 取值如下: SIMPLE:简单的 SELECT 查询,不使用 union 及子查询; PRIMARY:最外层的 SELECT 查询; UNION:UNION 中的第二个或随后的 SELECT 查询,不依赖于外部查询的结果集; UNION RESULT:UNION 结果集; SUBQUERY:子查询中的第一个 SELECT 查询,不依赖于外部查询的结果集; DERIVED: 用于 FROM 子句里有子查询的情况,MySQL 会递归执行这些子查询,把结果放在临时表里; SIMPLE 简单的 select 查询,查询中不包含子查询或者 UNION。  连接查询也算是 SIMPLE 类型。  PRIMARY 对于包含 UNION、UNION ALL 或者子查询的大查询来说,它是由几个小查询组成的,其中最左边的那个查询的 select_type 值就是 PRIMARY。 从结果中可以看到,最左边的小查询 SELECT * FROMN test1 对应的是执行计划中的第一条记录,它的 select_type 值就是 PRIMARY。 UNION 对于包含 UNION 或者 UNION ALL 的大查询来说,它是由几个小查询组成的,其中除了最左边的那个小查询以外,其余的查询的 select_type 值就是 UNION。  UNION RESULT MySQL 选择使用临时表来完成 UNION 查询的去重工作,针对该临时表的查询的 select_type 就是 UNION RESULT,如上图。 SUBQUERY 包含在 SELECT 中的子查询,不在 FROM 子句中。  DERIVED 包含在 FROM 子句中的子查询。MySQL 会将结果存放在一个临时表中,也称为派生表。  从执行计划中可以看出, id 为 2 的记录就代表子查询的执行方式,它的 select_type 是 DERIVED ,说明该子查询是以派生表的方式执行的。id 为 1 的记录代表外层查询,注意看它的 table 列显示的是 <derived2>,表示该查询是针对将派生表之后的表进行查询的。 table 不论我们的查询语句有多复杂,里边包含了多少个表,到最后也是需要对每个表进行单表访问的,MySQL 规定 EXPLAIN 语句输出的每条记录都对应着某个单表的访问方法,该条记录的 table 列代表着该表的表名。  只涉及对 test1 表的单表查询,所以 EXPLAIN 输出中只有一条记录,其中的 table 列的值是 test1;  连接查询的执行计划中有两条记录,这两条记录的 table 列分别是 test1和 test2。 partitions 和分区表有关,一般情况下查询语句的执行计划的 partitions 列的值都是NULL。 type 执行计划的一条记录就代表着 MySQL 对某个表的执行查询时的访问方法或访问类型,其中的 type 列就表明了这个访问方法或访问类型是较为重要的一个指标,结果值从最好到最坏依次是:system > const > eq_ref > ref > range > index > ALL。 一般来说,得保证查询至少达到 range 级别,最好能达到 ref。 system 当表中只有一条记录并且该表使用的存储引擎的统计数据是精确的,比如:MyISAM、Memory,那么对该表的访问方法就是 system。  如果改成使用 InnoDB 存储引擎,type 的值就是 all。  const 根据主键或者唯一二级索引列与常数进行等值匹配时,对单表的访问方法就是 const。因为只匹配一行数据,所以很快。  B+ Tree 叶子节点中的记录是按照索引列排序的,对于的聚簇索引来说,它对应的B+树叶子节点中的记录就是按照id列排序的。B+树矮胖,所以这样根据主键值定位一条记录的速度很快。类似的,我们根据唯一二级索引列来定位一条记录的速度也很快的,比如下边这个查询: eq_ref 在连接查询时,如果被驱动表是通过主键或者唯一二级索引列等值匹配的方式进行访问的,如果该主键或者唯一二级索引是联合索引的话,所有的索引列都必须进行等值比较,则对该被驱动表的访问方法就是:eq_ref。  从执行计划的结果中可以看出,MySQL 打算将 test2 作为驱动表,test1 作为被驱动表,重点关注 test1 的访问方法是 eq_ref,表明在访问 test1 表的时候可以通过主键的等值匹配来进行访问。 驱动表与被驱动表:A 表和 B 表 join 连接查询,如果通过 A 表的结果集作为循环基础数据,然后一条一条地通过该结果集中的数据作为过滤条件到 B 表中查询数据,然后合并结果。那么我们称 A 表为驱动表,B 表为被驱动表。 ref 当通过普通的二级索引列与常量进行等值匹配时来查询某个表,那么对该表的访问方法就可能是 ref。 本质上也是一种索引访问,它返回所有匹配某个单独值的行,它可能会找到多个符合条件的行,所以他属于查找和扫描的混合体。 对于这个查询可以选择全表扫描来逐一对比搜索条件是否满足要求,也可以先使用二级索引找到对应记录的 id 值,然后再回表到聚簇索引中查找完整的用户记录。 由于普通二级索引并不限制索引列值的唯一性,所以可能找到多条对应的记录,也就是说使用二级索引来执行查询的代价取决于等值匹配到的二级索引记录条数。 如果匹配的记录较少,则回表的代价还是比较低的,所以 MySQL 可能选择使用索引而不是全表扫描的方式来执行查询。这种搜索条件为二级索引列与常数等值比较,采用二级索引来执行查询的访问方法称为:ref。 对于普通的二级索引来说,通过索引列进行等值比较后可能匹配到多条连续的记录,而不是像主键或者唯一二级索引那样最多只能匹配 1 条记录,所以这种 ref 访问方法比 const 要差些,但是在二级索引等值比较时匹配的记录数较少时的效率还是很高的,如果匹配的二级索引记录太多那么回表的成本就太大了。 对于某个包含多个索引列的二级索引来说,只要是最左边的连续索引列是与常数的等值比较就可能采用 ref 的访问方法。 range 如果使用索引获取某些范围区间的记录,那么就可能使用到 range 访问方法,一般就是在 where 语句中出现了 between、<、>、in 等的查询。 这种范围扫描索引比全表扫描要好,因为它只需要开始于索引的某一点,而结束语另一点,不用扫描全部索引。  这种利用索引(聚簇索引、二级索引)进行范围匹配的访问方法称之为:range。 index 可以使用索引覆盖,但需要扫描全部的索引记录时,该表的访问方法就是:index。  ALL 最熟悉的全表扫描,将遍历全表以找到匹配的行。  possible_keys 和 key 在 EXPLAIN 语句输出的执行计划中,possible_keys 列表示在某个查询语句中,对某个表执行单表查询时可能用到的索引有哪些。key 列表示实际用到的索引有哪些,如果为 NULL,则没有使用索引。  上述执行计划的 possible_keys 列的值表示该查询可能使用到 u_idx_day_status、idx_insert_time 两个索引,然后 key 列的值是 u_idx_day_status,表示经过查询优化器计算使用不同索引的成本后,最后决定使用 u_idx_day_status 来执行查询比较划算。 key_len key_len 列,表示当优化器决定使用某个索引执行查询时,该索引记录的最大长度,计算方式如下: 对于使用固定长度类型的索引列来说,它实际占用的存储空间的最大长度就是该固定值,对于指定字符集的变长类型的索引列来说,如:某个索引列的类型是VARCHAR(100),使用的字符集是 utf8,那么该列实际占用的最大存储空间就是100x3=300个字节; 如果该索引列可以存储 NULL 值,则 key_len 比不可以存储 NULL 值时多 1 个字节; 对于变长字段来说,都会有 2 个字节的空间来存储该变长列的实际长度;  由于 id 列的类型是 bigint,并且不可以存储 NULL 值,所以在使用该列的索引时 key_len 大小就是 8。 对于可变长度的索引列来说。  由于 order_no 列的类型是 VARCHAR(50),所以该列实际最多占用的存储空间就是 50*3 字节,又因为该列是可变长度列,所以 key_len 需要加2,所以最后ken_len 的值就是 152。 执行计划的生成是在 MySQL server 层中的功能,并不是针对具体某个存储引擎的功能,MySQL 在执行计划中输出 key_len 列主要是为了区分某个使用联合索引的查询具体用了几个索引列,而不是为了准确的说明针对某个具体存储引擎存储变长字段的实际长度占用的空间到底是占用几个字节。 key_len 表示索引中使用的字节数,可通过该列计算查询中使用的索引的长度。在不损失精确性的情况下,长度越短越好。 key_len 显示的值为索引字段的最大可能长度,并非实际使用长度,即 key_len 是根据表定义计算而得,不是通过表内检索出的。 注:char 和 varchar 跟字符编码也有密切的联系,比如 latin1 占用 1 个字节,gbk 占用 2 个字节,utf8 占用 3 个字节。 ref 当使用索引列等值查询时,与索引列进行等值匹配的对象信息;  可以看到 ref 列的值是 const,表明在使用 idx_order_no 索引执行查询时,与 order_no 列作等值匹配的对象是一个常数。 复杂的情况。  可以看到对被驱动表 t1 的访问方法是 eg_ref,而对应的 ref 列的值是 test.t2.id,这说明在对被驱动表进行访问时会用到 PRIMARY 索引,也就是聚簇索引与一个列进行等值匹配的条件,与 t2 表的 id 作等值匹配的对象就是 test.t2.id列,格式:数据库名称.表名.字段。 rows 如果查询优化器决定使用全表扫描的方式对某个表执行查询时,执行计划的 rows 列就代表预计需要扫描的行数,如果使用索引来执行查询时,执行计划的 rows 列就代表预计扫描的索引记录行数。  filtered 某个表经过搜索条件过滤后剩余记录条数的百分比;  从执行计划的 key 列中可以看出来,该查询使用 PRIMARY 索引来执行查询,从 rows 列可以看出满足 id>5890 的记录有 5177 条。执行计划的 filtered 列就代表查询优化器预测在这 5177 条记录中,有多少条记录满足其余的搜索条件,也就是 order_note='a' 这个条件的百分比。此处 filtered 列的值是 10.0,说明查询优化器预测在 5177 条记录中有 10.00% 的记录满足 order_note='a' 这个条件。 Extra Extra 列是用来说明一些额外信息的,可以通过这些额外信息来更准确的理解 MySQL 到底将如何执行给定的查询语句。MySQL 提供的额外信息很多,常见的重要值如下: Using index:当我们的查询列表以及搜索条件中只包含属于某个索引的列,也就是在可以使用索引覆盖的情况下,在 Extra 列将会提示该额外信息。  这个查询中只需要用到 u_idx_day_status 而不需要回表操作。 Using where:当我们使用全表扫描来执行对某个表的查询,并且该语句的 WHERE 子句中有针对该表的搜索条件时,在 Extra 列中会提示。  Using where 只是表示 MySQL 使用 where 子句中的条件对记录进行了过滤。 Using index condition:有些搜索条件中虽然出现了索引列,但却不能使用到索引。  其中的 order_no >'z' 可以使用到索引,但是 order_no LIKE '%a' 却无法使用到索引,在以前版本的 MySQL 中,是按照下边步骤来执行这个查询的: 先根据 order_no>'z' 这个条件,从二级索引 idx_order_no 中获取到对应的二级索引记录; 根据上一步骤得到的二级索引记录中的主键值进行回表,找到完整的用户记录再检测该记录是否符合 order_no LIKE '%a' 这个条件,将符合条件的记录加入到最后的结果集; 虽然 order_no LIKE '%a' 不能组成范围区间参与 range 访问方法的执行,但这个条件毕竟只涉及到了 order_no 列,MySQL 把上边的步骤改进了一下。 索引条件下推 先根据 order_no>'z' 这个条件,定位到二级索引 idx_order_no 中对应的二级索引记录; 对于指定的二级索引记录,先不着急回表,而是先检测一下该记录是否满足 order_no LIKE '%a' 这个条件,如果这个条件不满足,则该二级索引记录压根儿就没必要回表; 对于满足 order_no LIKE '%a' 这个条件的二级索引记录执行回表操作,回表操作其实是一个随机 IO 比较耗时; 所以上述修改可以省去很多回表操作的成本,这个改进称之为索引条件下推。 如果在查询语句的执行过程中将要使用索引条件下推这个特性,在 Extra 列中将会显示 Using index condition。 Using temporary:在许多查询的执行过程中,MySQL 可能会借助临时表来完成一些功能,比如去重、排序之类的,比如在执行许多包含 DISTINCT、GROUPBY、UNION 等子句的查询过程中,如果不能有效利用索引来完成查询,MySQL 很有可能寻求通过建立内部的临时表来执行查询。如果查询中使用到了内部的临时表,在执行计划的 Extra 列将会显示 Using temporary。   上边的 GROUP BY 的执行计划的 Extra 列不仅仅包含 Using temporary 提示,还包含 Using filesort 提示,可是查询语句中明明没有写 ORDER BY 子句,这是因为 MySQL 会在包含 GROUP BY 子句的查询中默认添加上 ORDER BY 子句。 如果不想为包含 GROUP BY 子句的查询进行排序,需要显式的写上 ORDER BY NULL。  Using filesort:有一些情况下对结果集中的记录进行排序是可以使用到索引的。  这个查询语句可以利用 idx_order_no 索引直接取出 order_no 列的 10 条记录,然后再进行回表操作。但是很多情况下排序操作无法使用到索引,只能在内存中或者磁盘中进行排序,MySQL 把这种在内存中或者磁盘上进行排序的方式统称为文件排序。如果某个查询需要使用文件排序的方式执行查询,就会在执行计划的Extra 列中显示 Using filesort。  Select tables optimized away:使用某些聚合函数,比如:max、min 来访问存在索引的某个字段是。  作者:京东物流张士欣 来源:京东云开发者社区 自猿其说Tech 转载请注明来源

优秀的个人博客,低调大师

聊一聊大模型 | 京东云技术团队

事情还得从ChatGPT说起。 2022年12月OpenAI发布了自然语言生成模型ChatGPT,一个可以基于用户输入文本自动生成回答的人工智能体。它有着赶超人类的自然对话程度以及逆天的学识。一时间引爆了整个人工智能界,各大巨头也纷纷跟进发布了自家的大模型,如:百度-文心一言、科大讯飞-星火大模型、Meta-LLama等 那么到底多大的模型算大模型呢?截至目前仍没有明确的标准,但从目前各家所发布的模型来看,模型参数至少要在B(十亿)级别才能算作入门级大模型,理论上还可以更大,没有上限。以上只是个人理解,目前还没有人对大模型进行详细的定义。 来一张图我们了解一下大模型的发展历程,从图中可以看到所谓大模型家族都有同一个根(elmo这一支除外)即Transformer,我们知道transformer由encoder-decoder两部分组成,encoder部分负责编码,更侧重于信息理解;而decoder部分负责解码,更侧重于文本生成;这样在模型选型方面就会有3种不同的选型,即:【only-encoder】这部分以大名鼎鼎的Bert为代表、【only-decoder】这部分的代表就是我们的当红炸子鸡GPT系列、【encoder-decoder】这部分相比于其他两个部分就显得略微暗淡一些,但同样也有一些相当不错的成果,其中尤以T5为代表。个人理解T5更像一个过渡产品,通过添加一些prefix或者prompt将几乎所有NLP任务都可以转换为Text-to-Text的任务,这样就使得原本仅适合encoder的任务(classification)也可以使用decoder的模式来处理。 图中时间节点可以看到是从2018年开始,2018年应该算是NLP领域的中兴之年,这一年诞生了大名鼎鼎的Bert(仅使用Transformer的Encoder部分),一举革了以RNN/LSTM/GRU等为代表的老牌编码器的命。Bert确立了一种新的范式,在Bert之前我们的模型是与任务强相关的,一个模型绑定一个任务,迁移性差。而Bert将NLP任务划分为预训练+微调的两阶段模式:预训练阶段使用大量的无标记数据训练一个Mask Language Model,而具体的下游任务只需要少量的数据在预训练的基础上微调即可。这样带来两个好处:(a)不需要针对专门的任务设计模型,只需要在预训练模型上稍作调整即可,迁移性好,真的方便。(b)效果是真的好,毕竟预训练学了那么多的知识。所以在接下来的几年内几乎所有的工作都是在围绕Bert来展看,又好用又有效果,谁能不爱呢?如下图就是Bert家族的明星们。 Transformer解决了哪些问题? 在没出现Transformer之前,NLP领域几乎都是以RNN模型为主导,RNN有两个比较明显的缺陷:(a)RNN模型是一个串行模型,只能一个时序一个时序的依次来处理信息,后一个时序需要依赖前一个时序的输出,这样就导致不能并行,时序越长性能越低同时也会造成一定的信息丢失。(b)RNN模型是一个单向模型,只能从左到右或者从右到左进行处理,无法实现真正的双向编码。 Transformer摒弃了RNN的顺序编码方式,完全使用注意力机制来对信息进行编码,如上图所示,Transformer的计算过程是完全并行的,可以同时计算所有时序的注意力得分。另外Transformer是真正的双向编码,如上图所示,在计算input#2的注意力得分时,input#2是可以同时看见input#1、input#3的且对于input#2而言input#1、input#3、甚至input#n都是同等距离的,没有所谓距离的概念,真正的天涯若比邻的感觉。 Tranformer的庐山真面目。 接下来我们从头更加深入的剖析一下Transformer结构,以及为什么大模型都要基于Transformer架构。以及在大模型时代我们都对Transformer做了哪些调整及修改。 同样来一张图,下面这张图就是我们Transformer的架构图,从图中可以看出,Transformer由左右两部分组成,左边这部分是Encoder,右边这部分就是Decoder了。Encoder负责对信息进行编码而Decoder则负责对信息解码 。下面我们从下往上对下图的每个部分进行解读。 Stage-1部分就做两件事:对输入的文本进行编码、对文本位置进行编码。 Token Embedding 这部分主要是对文本进行编码,其核心部分为如何切分Token。典型的做法有Sentence Piece、Word Picece、BPE、甚至UniGram切词等。切词方式没有定数,个人理解切词的一个原则是:在能够覆盖到你的数据集的同时词汇表尽可能的小。故对切词方式不在赘述。下面啰嗦一下如何得到Token Embedding: Positional Encoding 位置编码,前面我们有提到过在计算注意力的时候是没有所谓位置的概念的(见图-3),而对于任何一门语言,单词在句子中的位置以及排列顺序是非常重要的,它们不仅是一个句子的语法结构的组成部分,更是表达语义的重要概念。一个单词在句子的位置或排列顺序不同,可能整个句子的意思就发生了偏差,比如:”我喜欢你“和”你喜欢我“对于self attention来说可能会被处理为同一个意思,但真实意思却不尽相同。再比如下面这句话“天上飞来一只鸟,它的头上插着一支旗子;地上躺着一只狗,它的颜色是黑色的。”,当我们在计算”鸟“的注意力分值的时候,第一个“它”与第二个“它”理论上对“鸟”的贡献程度是不一样的,同样若没有位置信息则这两个”它“对于”鸟“来说就会有同样的贡献度,这显然是不合理的。为了消除上述这些问题,Transformer里引入了Position Encoding的概念。那么如何对位置进行编码? 用整数值编辑位置。一种很朴素的做法是按照token序列依次进行编码,即:0,1,2,3,……_n_。这种方式会有一些缺陷如:(a)无法处理更长的序列,外推性差。(b)模型的位置表示是无界的,随着序列长度的增加,位置值会越来越大。这种和Bert的可学习的编码方式原理一致,不再赘述。 用[0,1]范围标记位置。为了解决整数值带来的问题,我们可以考虑将范围编码限制在[0,1]之间,0表示第一个token,1表示最后一个token,然后按照token的多少平均划分[0,1]区间,这样一来我们的编码就是有界的。举个例子:当有3个token时位置信息就表示为 4个token时则表示为 等以此类推。但这样同样会遇到一些问题,比如当序列长度不一样时,token之间的相对距离就会不同。比如当token数为3时,token之间的相对值为 若token数为4时则相对值变为 1.它能为每个时间步骤输出一个独一无二的编码,即编码是唯一且确定的; 2.在序列长度不同的情况下,不同序列中token的相对位置/距离也要保持一致; 3.模型应该能毫不费力地泛化到更长的句子,它的值应该是有界的; 大模型时代常用的位置编码方式。 大模型时代如何编码能够获得更好的外推性显得尤为重要,那么为什么要强调外推性?一个很现实的原因是在随着模型不断的变大,动辄几千张卡甚至几万张卡的计算资源就把绝大部分的从业者挡在了门外,而我们面临的问题也越来越复杂,输入越来越长。我们没办法根据不同的问题去调整模型,这样就需要一个全能的基座模型,它能够处理比训练长度更长的输入。以下面两种编码方式为代表。 具体操作流程如下图所示: AliBi。AliBi的做法相较于正弦波或RoPE编码来的简单粗暴,与传统方法不同,ALiBi不会向token embedding中添加position embedding,取而代之的是直接将token的相对距离直接加到了AttentionScore矩阵上,比如_q_和_k_相对位置差 1 就加上一个 -1 的偏置,两个 token 距离越远这个负数就越大,代表他们的相互贡献越低。如下图,左侧的矩阵展示了每一对query-key的注意力得分,右侧的矩阵展示了每一对query-key之间的距离,m是固定的参数,每个注意头对应一个标量。原有注意力矩阵_A_,叠加了位置偏移矩阵_B_之后为 A+B_×_m Attention注意力机制 公式-5就是Self Attention的核心,只要理解了这个公式也就理解了Transformer。 我们仔细看一下图-4中的Stage-2部分会发现Encoder和Decoder这部分是不太一样的,Encoder这部分叫做Multi Head Attention而Decoder部分叫做Masked Multi Head Attention。多了个Masked,先记下来后面我们来对这部分做解释。 在【那么为什么要提出Transformer架构?】部分我们讲到了,Transformer摒弃了RNN的顺序编码方式,采用了一种叫做注意力机制的方法来进行编码,那么什么是注意力机制?如下: 这个公式的输出就是注意力得分,怎么来理解这个式子,我们用一个例子来类比。想象一下我们在百度进行搜索的一个场景,_Q_就相当于我们在输入框输入的关键词,当我们输入关键词之后搜索引擎会根据我们的关键词与文档的相似度输出一个快照列表,_K_就是这个快照列表,每个文档与我们输入的关键词的相似度不同,所以排在第一个的是搜索引擎认为最重要的文档,打分就高,其他依次降序排列;然后你点进去阅读了这篇文章,那么这篇文章的内容我们就可以类比为_V_。这是一个搜索引擎的检索过程,而Attention的计算过程与搜索的过程几乎完全相同,我们结合下面这张图来详细的说明一下注意力的计算过程。 Multi Head Attention(MHA) 先来看一下Multi Head Attention的计算方法,很清晰是吧。前面说到的Attention就是在一个头里的计算,那么多头就是把这个计算多跑几次,分别得到每个头的输出,然后将所有的头输出进行连结,最后再乘一个矩阵_WO_将输出拉回到某个维度空间(Transformer里为512维),如下图有8个注意力头。 为什么要使用多头注意力?多头注意力机制提供了多个表示子空间,每个头独享不同得_Q_,K,_V_权重矩阵,这些权重矩阵每一个都是随机初始化,在训练之后,每个头都将输入投影到不同的表示空间,多个head学习得注意力侧重点可能略微不同,这样给了模型更大的容量。(可以想象一下CNN中不同的滤波器分别关注着不同的特征一样)。 这里说一下Multi Query Attention(MQA),这也是在一些大模型中使用的对MHA进行改造的手段,比如:Falcon、PaLM等。MQA就是在所有的注意力头上共享_K_,V,提升推理性能、减少显存占用。就这么简单。 残差链接、Norm、FFN、激活函数。 在深度神经网络中,当网络的深度增加时,模型过拟合以及梯度消失、爆炸的问题发生的概率也会随之增加,导致浅层网路参数无法更新,残差链接正是为了解决这些问题;Norm可以将每一层的输出通过归一化到符合某个分布,可以使模型更加稳定。常见的Norm的方法有BatchNorm、LayerNorm。NLP任务中由于输入长度不一致的问题一般都是用LayerNorm来做归一化。在大模型时代,很多模型都使用RMSNorm来替代LayerNorm,比如LLaMA、ChatGLM等,只不过大家在使用Norm的时候位置不同罢了。有些模型可能会将Norm放在残差之前(LLaMA)、有些可能会在残差之后(ChatGLM)、甚至Embedding之后甚至放在整个Transformer之后等,至于哪个效果好,仁者见仁。 下面是LayerNorm和RMSNorm的计算公式,RMSNorm想相较于LayerNorm去除了计算均值平移的部分,计算速度更快,且效果与LayerNorm相当。公式如下所示。 激活函数如果非要提的话那就提一下SwiGLU,在很多大模型中都有用到,比如LLaMA2、ChatGLM2等,扔个公式,体会一下。 至此我们几乎已经聊完了Transformer的核心部分。图-4中Stage-2(左)部分与Stage-3(右)完全相同,Stage-3(左)与Stage-4(右)完全相同,Stage-2(右)部分几乎与Stage-2(左)部分完全相同,只不过右侧部分的Attention需要掩码,这是因为右侧是一个Decoder的过程,而Decoder是一个从左到右的自回归的过程,想象一下我们在写下一句话【今天的天很蓝】,你是从左到右依次写出的这几个字,当你在写“今”的时候这时候还没“天”所以“天”这个位置对于“今”这个位置的注意力应该为0,以此类推。这时候就要对t+1时刻做掩码。即计算t时刻的注意力分值的时候将t+1时刻对t时刻的注意力设为0即可。如下图所示,将查询矩阵的上三角设置为一个极小值即可,不再赘述。 接下来说一下在大模型时代我们对Attention部分有哪些改造。常见的改造方法即Flash Attention Flash Attention。 3.依次迭代,直至计算完毕。因整个计算全部在GPU SRAM中进行仅有个别中间值的保存需要与HBM进行交互,减少了与HBM的交互,提升计算性能。 预训练及微调方法 介绍完了Transformer的原理以及大模型时代针对于Transformer的每个组件都做了哪些修改。接下来我们聊一下如何训练以及如何微调大模型。 前面我们说到Bert时代将所有的NLP任务统一划分为了预训练+微调两阶段,预训练负责从大量无标记的数据中学习语言特征,微调使用有标记的数据调整模型适应具体的下游任务。这个模式同样适用于大模型。 预训练。市面上绝大部分的大模型都是only-decoder的自回归模型,即用前n个token预测第n+1个token的值得概率。这是一个语言模型,不再赘述。但也有比较特殊的,比如ChatGLM,如下图,它既有Encoder部分也有Decoder部分。稍微复杂一点,首先它会在输入中随机Mask一些span,然后将Mask后的span随机的拼接在原始输入的后边。训练的时候分两步:(1)对[S]后进行续写,这部分是个Decoder的部分,单向的。(2)对Mask掉的部分进行预测,使用第(1)步的生成结果进行调整。从而使模型达到收敛。 总之预训练的任务就是从大量无标号得数据中学习到某些知识,因为是很自然得语言模型,所以不需要人工打标,只要能收集到大量得文本数据就可以训练,前提是算力够,理论上预训练得数据越多越好。大模型时代几乎都是几十亿token的数据。 微调(Fine Tuning)。微调是为了适应具体得下游任务,使用特定的有标记的数据集对模型进行进一步调整从而往模型中注入某些知识的手段。如果你有足够的资源全参数微调是个不错的选择,它可以更加充分的学习到你的特定数据的特性,理论上效果应该是最好的。但大模型动辄几十个G,训练起来存储至少还要再翻一倍,非常耗费资源。那么有没有别的方法也能往模型中注入特定域的知识呢?还是有一些方法的,既然全参数跑不动那么我们就调整部分参数,这就是参数高效微调(Parameter-Efficient Fine-Tuning)这一类方法的思想。下面我们说一些几种参数高效微调的方法。 P-Tuning。这是一类方法(prompt tuning、prefix tuning、p-tuning、p-tuning v2),虽然实现不同但思路大同小异,至于那个名字对应到那个方法我也记不清,所以这块我们把这些放在一块来说。p-tuning这一类方法的做法是在模型原有结构上增加一部分参数,比如:在原输入上硬编码增加一些提示词、在原始Embedding前面拼接上一些可训练的张量等。当然这些张量的生成上也有不同,有些是跟模型一起训练的、有些是专门针对这部分搞个编码器;其次拼接位置也有所不同,有的是拼接在Embedding上,有的可能每个层都拼接。总之就是搞了一部分可学习的参数然后放在模型里面一起训练,只更新这部分参数的权重,从而达到往模型中注入知识的目的。来张图体验一下。这一类的方法的缺陷是会占用原有模型的一部分空间,这样可能会降低原有模型能够处理的文本长度的上限。 Adapter。Adapter的做法是在预训练模型的某些层中间添加Adapter块(如下图中间部分所示),微调的时候主体模型冻结,只更新Adapter块的权重,由Adapter块学习特定的下游任务。每个Adapter由两个前馈层组成,第一个前馈层将输入从原始维度投影到一个相对较小的维度,然后再经过一层非线性转换,第二个前馈层再还原到原始输入维度,作为Adapter的输出,与预训练其他模型进行连接。与前面提到的P-Tuning系列不同,P-Tuning是在预训练模型的某些层上增加一些可训练的参数,而Adapter是在预训练模型的层之间添加可训练参数。一个更形象的说法P-Tuning使模型变胖了(实际上是压缩了一部分原有空间),Adapter使模型变高了。Adapter的插入可以分为串行和并行两种,如下图左右两图所示,很好理解。 训练方式。 最后我们再聊一下在现有算力下如何训练一个大模型。大模型训练是一个复杂的任务,随着模型和数据规模的增大意味着训练时间的增长。 传统的单卡训练几乎无法来完成这个事情,于是就要借助于分布式训练来大规模的训练模型。分布式的思想其实也很简单,总结一句话就是:化繁为简、化整为零。将整个训练拆解到不同的卡上,各卡之间协作来完成训练。那么如何来拆解整个训练过程?大提升可以分为以下几种: 数据并行:所谓数据并行就是将样本数据切分成不同的更小的输入,每张卡只需要处理更小的一部分数据,最终在合并计算梯度,然后将梯度分别更新到每个节点上。数据并行的前提是单卡能够吃得下整个模型。 模型并行:模型并行可细分为流水线并行和张量并行。流水线并行是将模型的不同层分发到不同的机器上,每个机器负责某些层的计算。比如:0~3层由gpu0来处理、4~8层由gpu1来处理等最终再汇总计算梯度进行更新。张量并行相对于流水线并行切分的更细,流水线并行是对层进行切分,但每个层仍然是完整的分在一张卡上,而张量并行是对层内进行切分,将一个层切分为由多个张量组成的部分,每个张量由不同的机器进行运算。如下图所示,可能绿色部分在一张卡上,蓝色部分在另一张卡上进行计算。 在模型训练这块也有很多现成的框架以供使用,如:DeepSpeed、Megatron-LM等,本次介绍主要已模型框架及原理为主,相关训练框架不在本次介绍范围之内,后续我们再针对训练框架做一些专门的介绍。 总结: 本文对大模型从原理及结构上做了简单的介绍,希望能给各位在了解大模型的路上提供一些帮助。个人经验有限,说的不对的地方还请及时提出宝贵的意见,也可以联系本人线下讨论。下期会结合我们在财富领域训练大模型的经验写一篇偏实践的文章出来。 参考文献: 1.Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer 2.Fast Transformer Decoding: One Write-Head is All You Need 3.GLU Variants Improve Transformer 4.GAUSSIAN ERROR LINEAR UNITS (GELUs) 5.Root Mean Square Layer Normalization 6.BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding 7.Language Models are Few-Shot Learners 8.Attention Is All You Need 9.TRAIN SHORT, TEST LONG: ATTENTION WITH LINEAR BIASES ENABLES INPUT LENGTH EXTRAPOLATION 10.ROFORMER: ENHANCED TRANSFORMER WITH ROTARY POSITION EMBEDDING 11.GLM: General Language Model Pretraining with Autoregressive Blank Infilling 12.FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness 13.Parameter-Efficient Transfer Learning for NLP 14.The Power of Scale for Parameter-Efficient Prompt Tuning 15.Prefix-Tuning: Optimizing Continuous Prompts for Generation 16.P-Tuning v2: Prompt Tuning Can Be Comparable to Fine-tuning Universally Across Scales and Tasks 17.LORA: LOW-RANK ADAPTATION OF LARGE LANGUAGE MODELS 18.Training language models to follow instructions with human feedback 19.https://spaces.ac.cn/archives/8265 作者:京东科技张新朋 来源:京东云开发者社区 转载请注明来源

优秀的个人博客,低调大师

iOS APP包分析工具 | 京东云技术团队

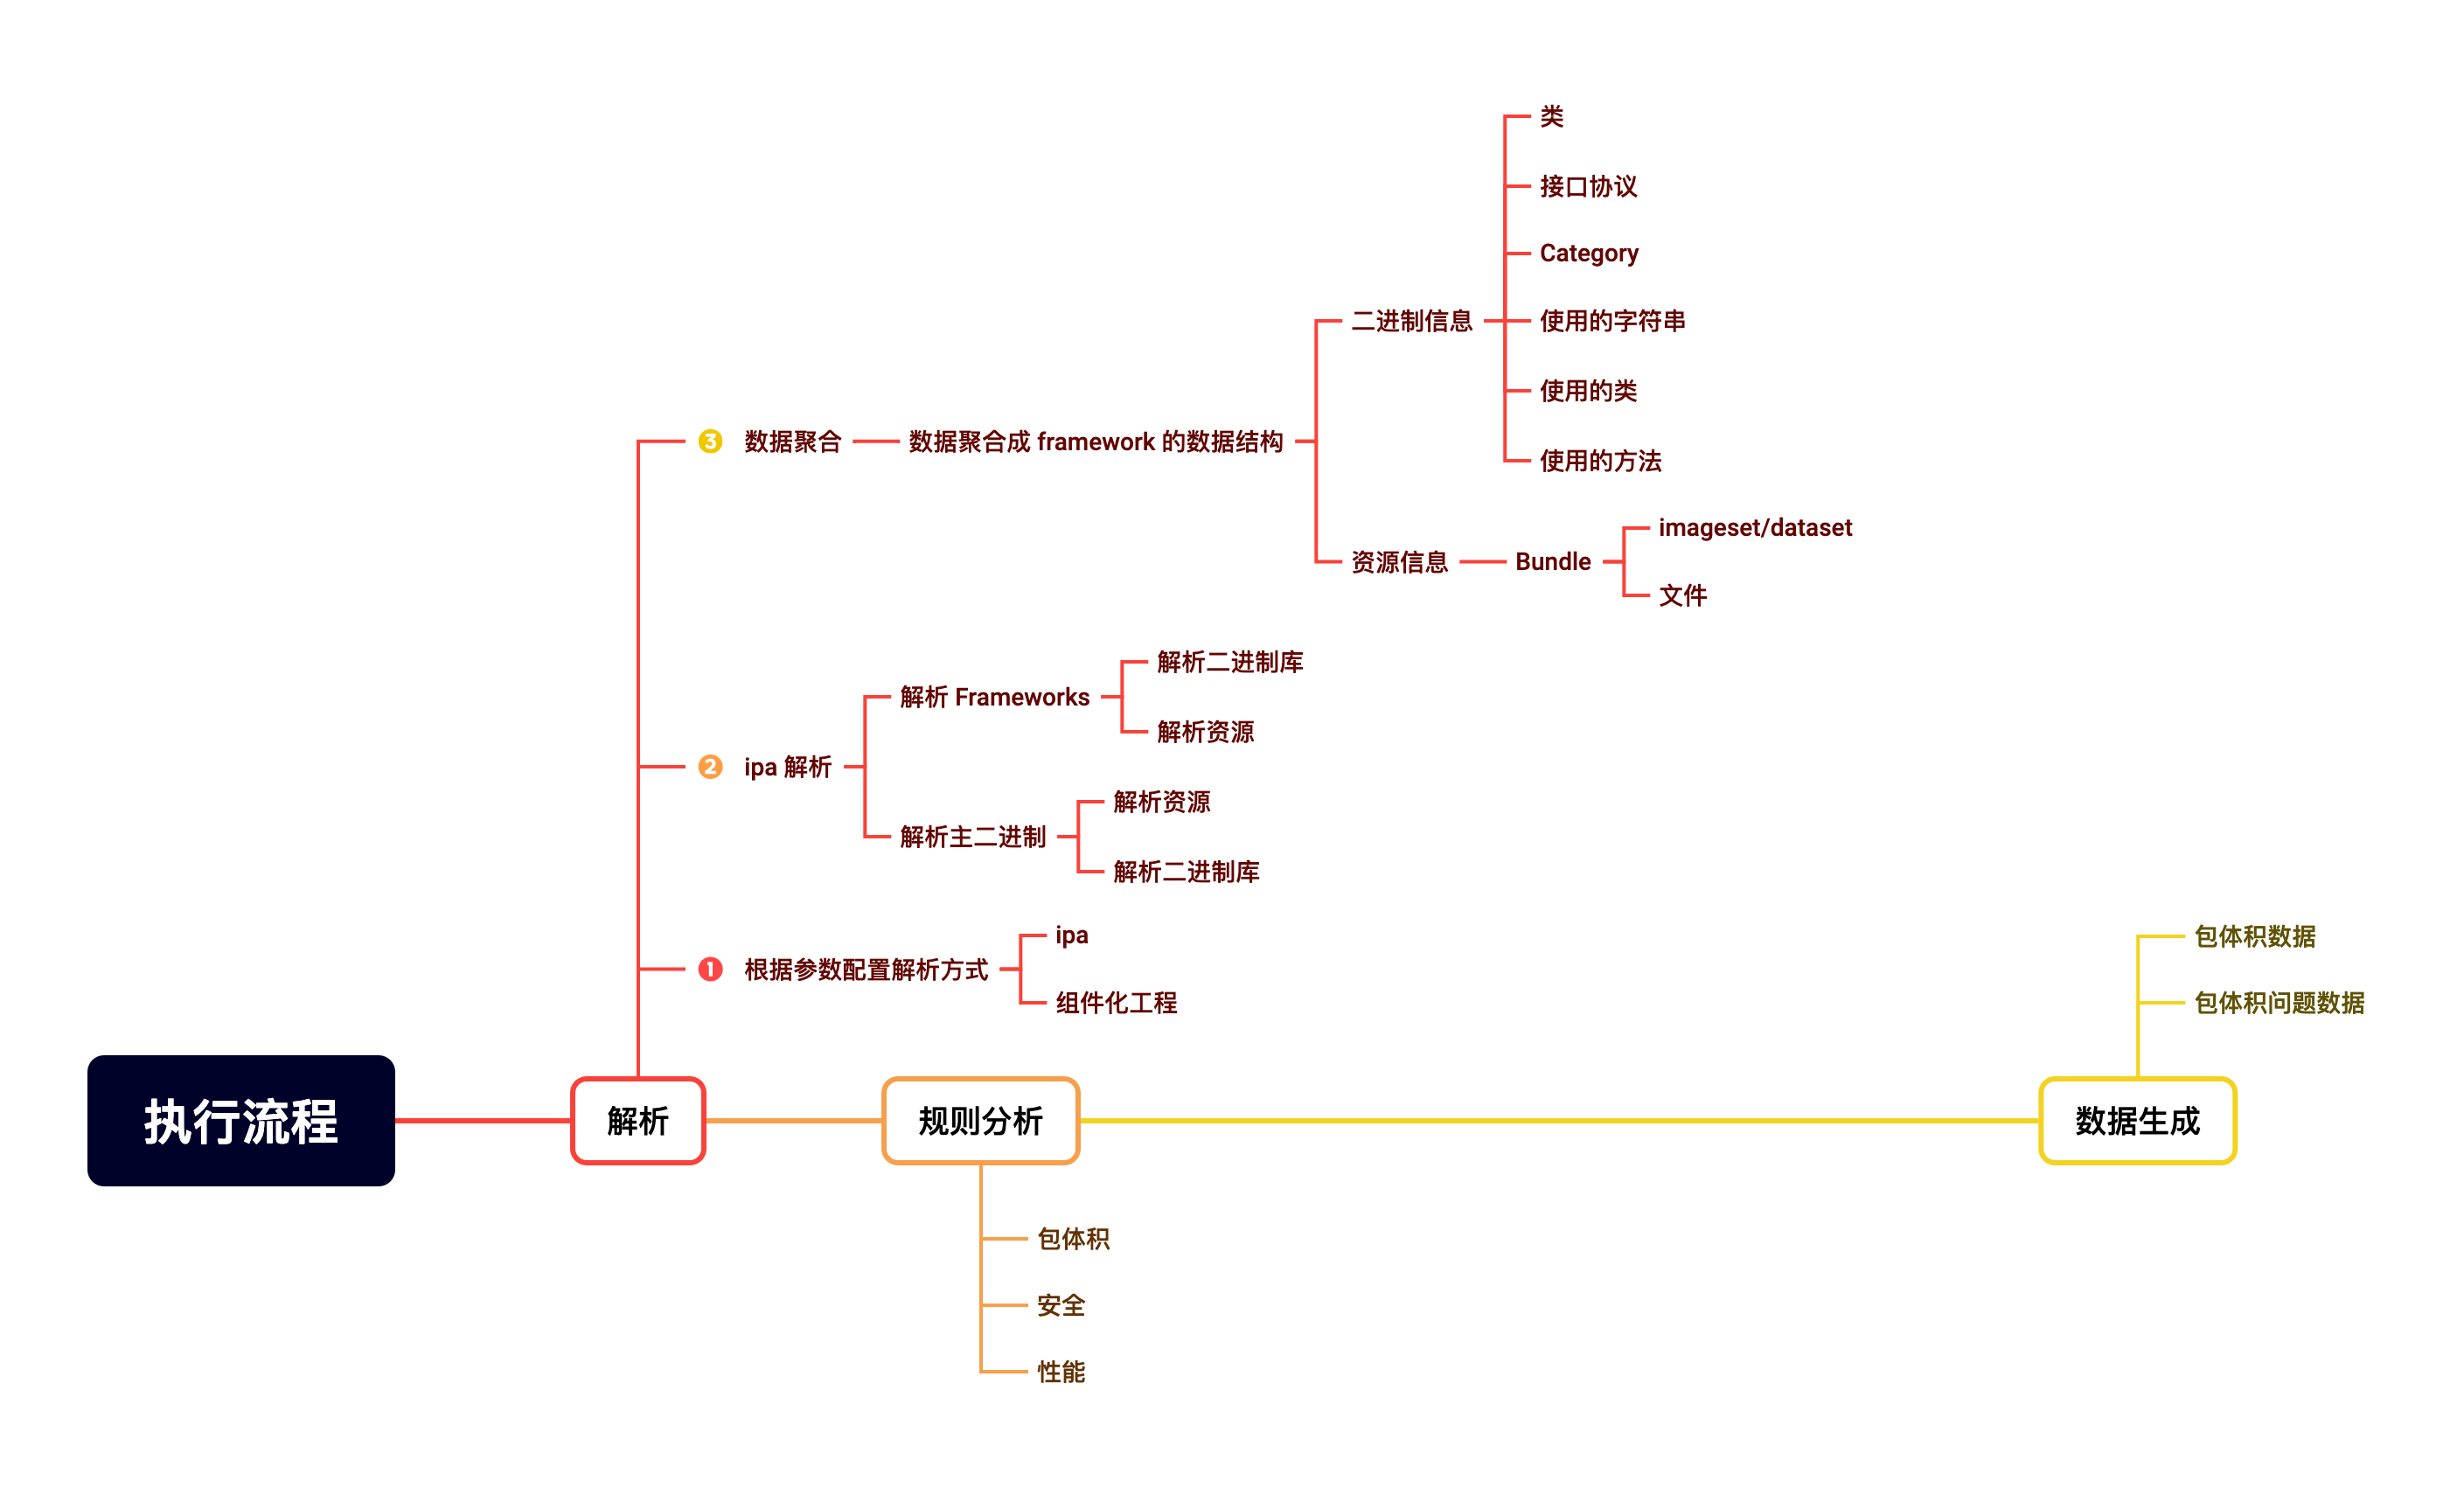
介绍 分享一款用于分析iOSipa包的脚本工具,使用此工具可以自动扫描发现可修复的包体积问题,同时可以生成包体积数据用于查看。这块工具我们团队内部已经使用很长一段时间,希望可以帮助到更多的开发同学更加效率的优化包体积问题。 工具下载地址 背景 APPAnalyze工具最早诞生主要是为了解决以下包体积管理的问题: 对于定位下沉市场的APP来讲,包体积是一个非常重要的性能指标,包体积过大会影响用户下载APP的意愿。但是在早期我们缺少一些手段帮助我们更高效的去进行包体积管理。 自动发现问题 提升效率- 人工排查问题效率低,对于常见的问题尽可能自动扫描出来。并且对于组件化工程来讲,很多外部组件是通过Framework方式提供,没有仓库源码权限用于分析包体积问题。 流程化- 形成自动化的质量流程,添加到CI流水线自动发现包体积问题。 数据指标量化 包体积问题- 提供数据化平台查看每个组件的包体积待修复问题 包体积大小- 提供数据化平台查看每个组件的包体积占比,包括总大小,单个文件二进制大小和每个资源大小。可以针对不同的APP版本进行组件化粒度的包体积数据对比,更方便查看每个版本的组件大小增量。 实现方式 我们选择了不依赖源码而是直接扫描二进制库的方式来实现这个能力,总体的执行流程一下: 提示:基于组件化工程的扫描方式内部支持,只是暂时不对外开放。 使用指南 安装 无需安装。通过下载链接直接下载终端可执行命令文件APPAnalyzeCommand到本地即可使用。 APPAnalyzeCommand 下载地址 使用 $ /Users/Test/APPAnalyzeCommand --help OPTIONS: --version <version> 当前版本 1.0.0 --output <output> 输出文件目录。必传参数 --config <config> 配置JSON文件地址。非必传参数 --ipa <ipa> ipa.app文件地址。必传参数 -h, --help Show help information. 执行 打开终端程序直接执行以下shell指令,即可生成ipa的包体积数据以及包体积待修复问题。 提示:不能直接使用AppStore的包,AppStore的包需要砸壳。建议尽量使用XCodeDebug的包。 /Users/Test/APPAnalyzeCommand --ipa ipas/JDAPP/JDAPP.app --output ipas/JDAPP 提示:如果提示permission denied没有权限,执行sudo chmod -R 777 /Users/a/Desktop/ipas/APPAnalyzeCommand即可。 生成产物 指令执行完成以后,会在ouput参数指定的文件夹生成APPAnalyze文件夹。具体文件介绍如下: 包体积信息 app_size.html- 展示ipa每个framework的包体积数据,可直接用浏览器打开。 提示:按照主程序和动态库进行粒度划分 framework_size.html- 展示单个framework所有的包体积数据,二级页面不要直接打开。 提示:XCode生成Assets.car时会将一些小图片拼接成一张PackedAssetImage的大图片。 package_size.json-ipa包体积 JSON 数据 包体积待修复问题 app_issues.html- 展示ipa每个framework的包体积待修复问题数量,可直接用浏览器打开。 提示:按照主程序和动态库进行粒度划分 framework_issues.html- 展示单个framework所有的待修复问题详细数据,二级页面不要单独打开。 issues.json-ipa待修复包体积问题 JSON 数据 提示:json数据可用于搭建自己的数据平台,扩展更多的能力。例如查看不同APP版本以及支持多个APP版本对比等。 规则介绍 包体积 未使用的类 定义了类没有被使用到,包含ObjC类和Swift类。 扫描规则 没有查到到对应的ObjC类被引用 没有被当做父类使用 没有使用的字符串和类名一致 没有被当做属性类型使用 没有被创建或调用方法 没有实现+load方法 可选的修复方式 移除未使用的类 Swift类如果只是用了static方法考虑修改成Enum类型 如果只是在类型转换时使用了也会检测出是未使用的类,例如(ABCClass *)object;。建议检查是否真的有没有到相关类后删除 对于ObjC,如果只是作为方法参数类型使用也会被检测出是未使用的类。建议删除相关方法即可。 提示:删除类相对是一种安全的行为,因为删除后如果有被使用到会产生编译时错误。虽然有做字符串调用的扫描过滤,不过还是建议检查是否可能被Runtime动态创建调用 未使用的ObjC协议 定义了ObjC协议没有被类使用 扫描规则 对应的协议没有被类引用 可选的修复方式 移除未使用的协议 Bundle内多Scale图片 Bundle内同一张图片包含多个Scale会导致更大的包体积。 扫描规则 同一个Bundle内存在同名但是scale不同的图片。例如a@2x.png/a@3x.png 可选的修复方式 移除Scale更低的图片 大资源 文件大小超过一定大小的即为大资源,默认为20KB。 扫描规则 某个文件超过设置的大资源限额 可选的修复方式 移除资源动态下发 使用更小的数据格式,例如使用更小的图片格式 重复的资源文件 存在多个同样的重复文件。 扫描规则 多个文件MD5一致即判定为重复文件。 可选的修复方式 移除多余的文件 未使用的类Property属性 ObjC类中定义的属性没有被使用到。 扫描规则 对应的属性没有被调用 set/get 方法,同时也没有被_的方式使用 不是来自实现协议的属性 不是来自Category的属性 不存在字符串使用和属性名一致 可选的修复方式 移除对应的属性 如果是接口协议的属性,需要添加类实现此接口 注意事项 可能存在部分动态使用的场景,需要进行一定的检查。例如一些继承NSObject的数据模型类,可能存在属性没有被直接使用到,但是可能会被传唤成JSON作为参数的情况。例如后台下发的数据模型 未使用的ImageSet/DataSet 包含的Imageset/DataSet并没有被使用到。 扫描规则 未检测到和Imageset同样名字的字符串使用 可选的修复方式 移除ImageSet/DataSet 注意事项 某些Swift代码中使用的字符串不能被发现所以会被当做未使用。 使用字符串拼接的名字作为imageset的名字。 被合成到PackedAssetImage里的Imageset不能被扫描出来 未使用的ObjC方法 定义的ObjCCategory 方法并未被使用到。 扫描规则 不存在和此方法一样的方法名使用 不存在使用的字符串和方法名一致 不是来自父类或Category的方法 不是来自实现接口的方法 不是属性 set/get 方法 可选的修复方式 移除对应方法 未使用的分类方法 定义的ObjCCategory 方法并未被使用到。 扫描规则 不存在和此方法一样的方法名使用 不存在和方法名一致的字符串使用 不是来自父类或Category的方法 不是来自实现接口的方法 可选的修复方式 移除未使用的方法 如果是接口协议的方法,需要添加类实现此接口 未使用的资源文件 包含的文件资源并没有被使用到。这里的资源不包含Imageset/DataSet。 扫描规则 未检测到和文件名同样名字的字符串使用 可选的修复方式 移除资源 注意事项 某些Swift代码中使用的字符串不能被发现所以会被当做未使用 使用字符串拼接的名字作为资源的名字 安全 动态反射调用ObjC类 存在类名和字符串一致,可能使用NSClassFromString()方法动态调用类。当字符串或类名变更时无法利用编译时检查发现问题,可能会导致功能异常。 扫描规则 存在使用的字符串和NSObject子类类名相同 可选的修复方式 使用NSStringFromClass()获取类名字符串 使用Framework外部的类应该使用方法封装,除了少部分功能不应该使用反射去调用类 提示:包含继承NSObject的 swift 类。 ObjC属性内存申明错误 一些特殊的NSObject类型的属性内存类型申明错误,可能会导致功能异常或触发Crash。 扫描规则 NSArray/NSSet/NSDictionary类型的属性使用strong申明 NSMutableArray/NSMutableSet/NSMutableDictionary类型的属性使用copy申明 可选的修复方式 修改strong/copy申明 冲突的分类方法 ObjC同一个类的多个Category分类中存在多个相同的方法,由于运行时最终会加载方法可能是不确定的,可能会导致功能异常等未知的行为。 扫描规则 NSObject类的多个Category分类中存在多个相同的方法 修复方式 移除多余的分类方法 重复的分类方法 ObjC原始类和类的Category分类中有相同的方法,分类中的方法会覆盖原始类的方法,可能会导致功能异常等未知的行为。 扫描规则 NSObject原始类和类的Category分类中有相同的方法 修复方式 移除重复的分类方法 未实现的ObjC协议方法 类实现了某个ObjC协议,但是没有实现协议的非可选方法。可能会导致功能异常或触发Crash。 扫描规则 类和分类未实现NSObject协议的非可选方法 可选的修复方式 对应的类实现缺失的非可选协议方法 将对应的协议方法标识为optional可选方法 重复的ObjC类 多个动态库和静态库之间存在同样的类。不会导致编译失败,但是运行时只会使用其中一个类,可能会导致功能异常或触发Crash。同时会增加包体积。 扫描规则 多个动态库和静态库之间存在同样的NSObject类符号 可能的修复方式 移除重复的类 性能 使用动态库 使用动态库会增加启动耗时。 扫描规则 Macho为动态库 可选的修复方式 使用静态库 使用Mergeable Library 实现+load方法的类 APP启动后会执行所有+load方法,减少+load方法可以降低启动耗时。 扫描规则 实现+load方法的NSObject类 可选的修复方式 移除+load方法 使用+initialize替代 自定义配置 重要配置 systemFrameworkPaths 可以基于自身项目进行系统库目录的配置,解析工程时也会对系统库进行解析。配置系统库目录对于未使用方法的查找可以提供更多的信息避免误报。但是配置更多会导致执行的更慢,建议至少配置Foundation/UIKit。 unusedObjCProperty-enable unusedObjCProperty规则默认不开启。 开启未使用属性检查以后,会扫描macho的__TEXT段,会增加分析的耗时。 unusedClass-swiftEnable unusedClass-swiftEnable默认不开启。 开启Swift类检查以后,会扫描macho的__TEXT段,会增加分析的耗时。 未使用Swift类的项目建议不要开启,如果考虑执行性能的话Swift使用相对比较多的再开启。 提示:扫描macho的__TEXT段需要使用XCodeRun编译出的包,不能直接使用用于上架APP Store构建出的包。主要是Debug会包含更多的信息用于扫描。 配置属性 /Users/Test/APPAnalyzeCommand -ipa /Users/Desktop/ipas/APPMobile/APPMobile.app -config /Users/Desktop/ipas/config.json --output /Users/Desktop/ipas/APPMobile 可基于自身项目需要,添加下列规则可配置参数。在使用APPAnalyzeCommand指令时添加--config配置文件地址。 { "systemFrameworkPaths": ["/Applications/Xcode.app/Contents/Developer/Platforms/iPhoneOS.platform/Library/Developer/CoreSimulator/Profiles/Runtimes/iOS.simruntime/Contents/Resources/RuntimeRoot/System/Library/PrivateFrameworks/UIKitCore.framework/UIKitCore", "/Applications/Xcode.app/Contents/Developer/Platforms/iPhoneOS.platform/Library/Developer/CoreSimulator/Profiles/Runtimes/iOS.simruntime/Contents/Resources/RuntimeRoot/System/Library/Frameworks/CoreFoundation.framework/CoreFoundation", "/Applications/Xcode.app/Contents/Developer/Platforms/iPhoneOS.platform/Library/Developer/CoreSimulator/Profiles/Runtimes/iOS.simruntime/Contents/Resources/RuntimeRoot/System/Library/Frameworks/Foundation.framework/Foundation" ], // 配置系统库。会极大增加未使用方法的误报 "rules": { "dynamicCallObjCClass": { // 动态调`ObjC类 "enable": false, // 是否启用 "excludeClasslist": [ // 过滤类名 "NSObject", "param" ] }, "incorrectObjCPropertyDefine": { // 错误的 ObjC 属性定义 "enable": false // 是否启动 }, "largeResource": { // 大资源 "maxSize": 20480 // 配置大资源判定大小。默认 20480Byte=20KB }, "unusedObjCProperty": { // 未使用的 ObjC 属性 "enable": false, // 是否启用。默认不开启 "excludeTypes": ["NSString", "NSArray", "NSDictionary", "NSNumber", "NSMutableArray", "NSMutableDictionary", "NSSet"] // 过滤掉部分类型的属性 }, "unusedClass": { // 未使用的类 "swiftEnable": false, // 是否支持 Swift 类。默认不支持 "excludeSuperClasslist": ["JDProtocolHandler", "JDProtocolScheme"],// 如果类继承了某些类就过滤 "excludeProtocols": ["RCTBridgeModule"], // 如果类实现了某些协议就过滤 "excludeClassRegex": ["^jd.*Module$", "^PodsDummy_", "^pg.*Module$", "^SF.*Module$"] // 过滤掉名字符合正则表达式的类 }, "unusedObjCMethod": { // 未使用的 ObjC 方法 "excludeInstanceMethods": [""], // 过滤掉某些名字的对象方法 "excludeClassMethods": [""], // 过滤掉某些名字的类方法 "excludeInstanceMethodRegex": ["^jumpHandle_"], // 过滤掉名字符合正则表达式的对象方法 "excludeClassMethodRegex": ["^routerHandle_"], // 过滤掉名字符合正则表达式的类方法 "excludeProtocols": ["RCTBridgeModule"] // 如果类集成了某些协议就不再检查,例如 RN 方法 }, "loadObjCClass": { // 调用 ObjC + load 方法 "excludeSuperClasslist": ["ProtocolHandler"], // 如果类继承了某些类就过滤 "excludeProtocols": ["RCTBridgeModule"] // 如果类实现了某些协议就过滤,例如 RN 方法 }, "unusedImageset": { // 未使用 imageset "excludeNameRegex": [""] // 过滤掉名字符合正则表达式的imageset }, "unusedResource": { // 未使用资源 "excludeNameRegex": [""] // 过滤掉名字符合正则表达式的资源 } } } 组件化工程扫描 可以基于APPAnalyzeCore.framework定制实现自己的组件化工程扫描,或者添加基于自身组件化工程的检查规则。详情可以看Demo。 基于组件化扫描方式有以下优势: 细化数据粒度- 可以细化每个模块的包体积和包体积问题,更容易进行包体积优化。 更多的检查- 例如检查不同组件同一个Bundle包含同名的文件,不同组件包含同一个category方法的的实现。 检查结果更准确- 例如ObjC未使用方法的检查,只要存在一个和方法名同样的调用就表示方法有被使用到。但是整个ipa中可能存在很多一样的方法名但是只有一个方法有真正被调用到,如果细分到组件的粒度就可以发现更多问题。 提示:只有APP主工程无代码,全部通过子组件以framework的形式导入二进制库的方式的工程才适合这种模式。 其他 扫描质量如何 这套工具我们团队内部开发加逐步完善有一年的时间了。基于此工具修改了几十个组件的包体积问题,同时不断的修复误报问题。目前现有提供的这些规则检查误报率是很低的,只有极少数几个规则可能存在误报的可能性,总体扫描质量还是很高的。 和社区开源的工具有什么差异 我们在早期调研了社区的几个同类型的开源工具,主要存在以下几个问题: 扩展性不够- 无法支持项目更好的扩展定制能力,例如添加扫描规则、支持不同类型扫描方式、生成更多的报告类型。 功能不全- 只提供部分能力,例如只提供未使用资源或者未使用类。 无法生成包体积数据- 无法生成包体积完整的数据。 检查质量不高- 扫描发现的错误数据多,或者有一些问题不能被发现。 开源计划 后续一定会开源。主要是希望调整一些内部结构再开源,开源后就不方便调整。顺便修复一些常见的问题。 开源带来的好处 开源带来的好处是,部分工程可以基于自身的业务需要,扩展定制自己的扫描工具。同时也可以将一些更好的想法实现添加进来。 扩展解析方式- 目前只支持ipa模式扫描,很快会开放支持project组件化工程的扫描方式。基于组件化工程的扫描可以更加准确,但是不同的公司组件化工程的构建方式可能是不一样的,有需要可以在上层定制自身组件化工程的扫描解析。 扩展扫描规则- 虽然现在已经添加了比较多的通用性的规则,同时提供了一定的灵活性配置能力。但是不同的项目可能需要定制一些其他的规则,这些规则没办法通过在现有规则上添加配置能力实现。 扩展数据生成- 默认包里只包含两种数据生成,包体积数据还有包体积待修复问题数据。可以扩展更多的数据生成格式,例如我们自身的项目就有添加基于组件的依赖树格式。 后续规划 组件化工程支持 添加更多用于组件化工程的扫描 对于 Swift 更好的支持 对于Swift语言只要开启XCode编译优化以后就能在生成产物的时候支持无用代码的移除,包括未使用类型和未使用方法的自动移除,但是依然有部分场景不会进行优化。所以这一块也是后续完善的重点: 未使用属性- 编译器不会对于未使用属性进行移除,包括class和struct的属性。 未使用方法- 对于class的方法,编译器并不会进行移除,即使没有申明[@objc](https://my.oschina.net/TnhqVdFXL8vnu)进行消息派发。 相关链接 Github地址 作者:京东零售 何骁 来源:京东云开发者社区 转载请注明来源


优秀的个人博客,低调大师

| 京东云技术团队

使用场景: 开发中会碰到一些耗时较长或者不需要立即得到执行结果的逻辑,比如消息推送、商品同步等都可以使用异步方法,这时我们可以用到@Async。但是直接使用 @Async 会有风险,当我们没有指定线程池时,他会默认使用其Spring自带的 SimpleAsyncTaskExecutor 线程池,会不断的创建线程,当并发大的时候会严重影响性能。所以可以将异步指定线程池使用 简介: @Async是Spring的注解,可以加在类或方法上。通俗的来讲,如果加上了这个注解,那么该类或者该方法在使用时将会进行异步处理,也就是创建一个线程来实现这个类或者方法,实现多线程。 线程池的执行顺序: 两种使用方式: 第一种: 使用的是Spring默认的线程池SimpleAsyncTaskExecutor。 接入步骤: 1.需要在@SpringBootApplication启动类或者@configure注解类上 添加注解@EnableAsync启动多线程注解。 2.在需要异步执行的方法上添加@Async注解。 默认的线程池配置: 如果需要修改默认的配置可以在yaml或者properties中添加,修改默认配置: 执行后会打印出你的执行线程名称: 第二种:(推荐使用) 自定义线程池,执行异步。 自定义线程池有如下模式,我们只介绍最后一种: 重新实现接口AsyncConfigurer; 继承AsyncConfigurerSupport; 配置由自定义的TaskExecutor替代内置的任务执行器。 然后添加注解到对应的方法上并指定线程池:asyncExecutor 指定线程池的名称为自定义的线程池名称。 查看日志: 注意事项: 查到了@Async失效的几个原因: 注解@Async的方法不是public方法; 注解@Async的返回值只能为void或Future; 注解@Async方法使用static修饰也会失效; 启动类没加@EnableAsync注解; 调用方和@Async不能在一个类中; 在Async方法上标注@Transactional是没用的,但在Async方法调用的方法上标注@Transcational是有效的; 作者:京东零售郭春元 来源:京东云开发者社区 转载请注明来源

优秀的个人博客,低调大师

MYSQL 事务的底层原理 | 京东物流技术团队

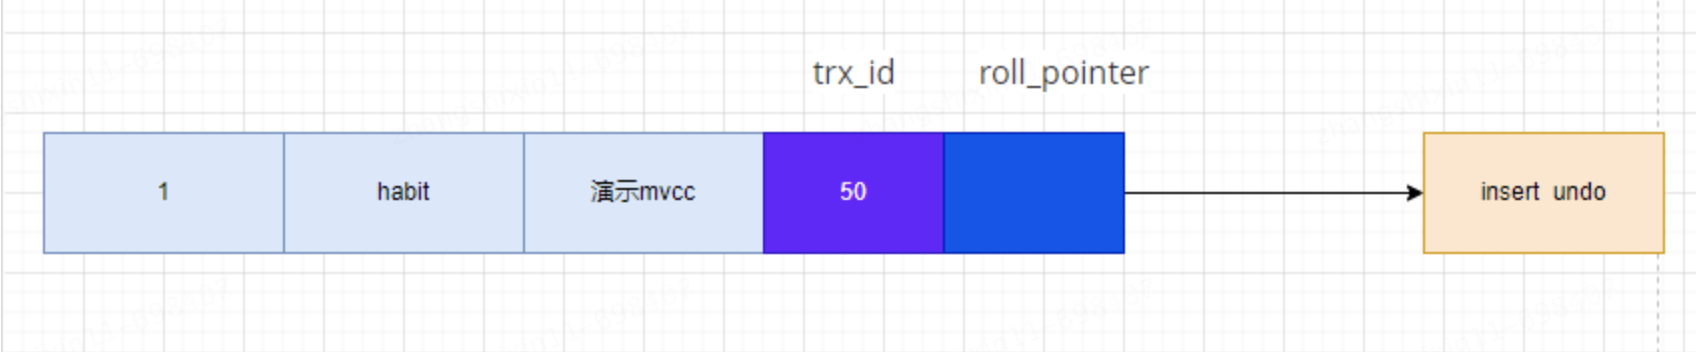
事务的底层原理 在事务的实现机制上,MySQL 采用的是 WAL:Write-ahead logging,预写式日志,机制来实现的。 在使用 WAL 的系统中,所有的修改都先被写入到日志中,然后再被应用到系统中。通常包含 redo 和 undo 两部分信息。 为什么需要使用 WAL,然后包含 redo 和 undo 信息呢?举个例子,如果一个系统直接将变更应用到系统状态中,那么在机器掉电重启之后系统需要知道操作是成功了,还是只有部分成功或者是失败了。如果使用了 WAL,那么在重启之后系统可以通过比较日志和系统状态来决定是继续完成操作还是撤销操作。 redo log 称为重做日志,每当有操作时,在数据变更之前将操作写入 redo log,这样当发生掉电之类的情况时系统可以在重启后继续操作。 undo log 称为撤销日志,当一些变更执行到一半无法完成时,可以根据撤销日志恢复到变更之间的状态。 MySQL 中用 redo log 来在系统 Crash 重启之类的情况时修复数据,而 undo log 来保证事务的原子性。 事务 id 一个事务可以是一个只读事务,或者是一个读写事务:可以通过 START TRANSACTION READ ONLY 语句开启一个只读事务。 在只读事务中不可以对普通的表进行增、删、改操作,但可以对用户临时表做增、删、改操作。 可以通过 START TRANSACTION READ WRITE 语句开启一个读写事务,或者使用 BEGIN、START TRANSACTION 语句开启的事务默认也算是读写事务。 在读写事务中可以对表执行增删改查操作。 如果某个事务执行过程中对某个表执行了增、删、改操作,那么 InnoDB 存储引擎就会给它分配一个独一无二的事务 id,针对 MySQL 5.7 分配方式如下: 对于只读事务来说,只有在它第一次对某个用户创建的临时表执行增、删、改操作时才会为这个事务分配一个事务 id,否则的话是不分配事务 id 的。 对于读写事务来说,只有在它第一次对某个表执行增、删、改操作时才会为这个事务分配一个事务 id,否则的话也是不分配事务 id 的。 有的时候虽然开启了一个读写事务,但是在这个事务中全是查询语句,并没有执行增、删、改的语句,那也就意味着这个事务并不会被分配一个事务 id。 这个事务 id 本质上就是一个数字,它的分配策略和隐藏列 row_id 的分配策略大抵相同,具体策略如下: 服务器会在内存中维护一个全局变量,每当需要为某个事务分配一个事务 id 时,就会把该变量的值当作事务 id 分配给该事务,并且把该变量自增 1。 每当这个变量的值为 256 的倍数时,就会将该变量的值刷新到系统表空间的页号为 5 的页面中一个称之为 Max Trx ID 的属性处,这个属性占用 8 个字节的存 储空间。 当系统下一次重新启动时,会将上边提到的 Max Trx ID 属性加载到内存中,将该值加上 256 之后赋值给全局变量,因为在上次关机时该全局变量的值可能大于Max Trx ID 属性值。 这样就可以保证整个系统中分配的事务 id 值是一个递增的数字。先被分配 id 的事务得到的是较小的事务 id,后被分配 id 的事务得到的是较大的事务 id。 mvcc 全称 Multi-Version Concurrency Control,即多版本并发控制,主要是为了提高数据库的并发性能。 同一行数据平时发生读写请求时,会上锁阻塞住。但 MVCC 用更好的方式去处理读写请求,做到在发生读写请求冲突时不用加锁。 这个读是指的快照读,而不是当前读,当前读是一种加锁操作,是悲观锁。 MVCC 原理 在事务并发执行遇到的问题如下: 脏读:如果一个事务读到了另一个未提交事务修改过的数据,那就意味着发生了脏读; 不可重复读:如果一个事务只能读到另一个已经提交的事务修改过的数据,并且其他事务每对该数据进行一次修改并提交后,该事务都能查询得到最新值,那就意味着发生了不可重复读; 幻读:如果一个事务先根据某些条件查询出一些记录,之后另一个事务又向表中插入了符合这些条件的记录,原先的事务再次按照该条件查询时,能把另一个事务插入的记录也读出来,那就意味着发生了幻读,幻读强调的是一个事务按照某个相同条件多次读取记录时,后读取时读到了之前没有读到的记录,幻读只是重点强调了读取到了之前读取没有获取到的记录。 MySQL 在 REPEATABLE READ 隔离级别下,是可以很大程度避免幻读问题的发生的。 版本链 对于使用 InnoDB 存储引擎的表来说,它的聚簇索引记录中都包含两个必要的隐藏列: trx_id:每次一个事务对某条聚簇索引记录进行改动时,都会把该事务的事务 id 赋值给 trx_id 隐藏列; roll_pointer:每次对某条聚簇索引记录进行改动时,都会把旧的版本写入到 undo 日志中,然后这个隐藏列就相当于一个指针,可以通过它来找到该记录修 改前的信息; 演示 -- 创建表 CREATE TABLE mvcc_test ( id INT, name VARCHAR(100), domain varchar(100), PRIMARY KEY (id) ) Engine=InnoDB CHARSET=utf8; -- 添加数据 INSERT INTO mvcc_test VALUES(1, 'habit', '演示mvcc'); 假设插入该记录的事务 id=50,那么该条记录的展示如图:  假设之后两个事务 id 分别为 70、90 的事务对这条记录进行 UPDATE 操作。 trx_id=70 trx_id=90 begin   begin   update mvcc_test set name='habit_trx_id_70_01' where id=1  update mvcc_test set name='habit_trx_id_70_02' where id=1  commit   update mvcc_test set name='habit_trx_id_90_01' where id=1  update mvcc_test set name='habit_trx_id_90_02' where id=1  commit 每次对记录进行改动,都会记录一条 undo 日志,每条 undo 日志也都有一个 roll_pointer 属性,可以将这些 undo 日志都连起来,串成一个链表。  对该记录每次更新后,都会将旧值放到一条 undo 日志中,就算是该记录的一个旧版本,随着更新次数的增多,所有的版本都会被 roll_pointer 属性连接成一个链表,把这个链表称之为版本链,版本链的头节点就是当前记录最新的值。另外,每个版本中还包含生成该版本时对应的事务 id。于是可以利用这个记录的版本链来控制并发事务访问相同记录的行为,那么这种机制就被称之为:多版本并发控制,即 MVCC。 ReadView 对于使用 READ UNCOMMITTED 隔离级别的事务来说,由于可以读到未提交事务修改过的记录,所以直接读取记录的最新版本就好了。 对于使用 SERIALIZABLE 隔离级别的事务来说,InnoDB 使用加锁的方式来访问记录。 对于使用 READ COMMITTED 和 REPEATABLE READ 隔离级别的事务来说,都必须保证读到已经提交了的事务修改过的记录,也就是说假如另一个事务已经修改了记录但是尚未提交,是不能直接读取最新版本的记录的,核心问题就是:READ COMMITTED 和 REPEATABLE READ 隔离级别在不可重复读和幻读上的区别是从哪里来的,其实结合前面的知识,这两种隔离级别关键是需要判断一下版本链中的哪个版本是当前事务可见的。 为此,InnoDB 提出了一个 ReadView 的概念,这个 ReadView 中主要包含 4 个比较重要的内容: m_ids:表示在生成 ReadView 时当前系统中活跃的读写事务的事务id 列表; min_trx_id:表示在生成 ReadView 时当前系统中活跃的读写事务中最小的事务 id,也就是 m_ids 中的最小值; max_trx_id:表示在生成 ReadView 时系统中应该分配给下一个事务的 id 值,注:max_trx_id 并不是 m_ids 中的最大值,事务 id 是递增分配的。比方说现在有 id 为 1,2,3 这三个事务,之后 id 为 3 的事务提交了。那么一个新的读事务在生成 ReadView 时,m_ids 就包括 1 和 2,min_trx_id 的值就是 1,max_trx_id 的值就是 4; creator_trx_id:表示生成该 ReadView 的事务的事务 id; 有了这个 ReadView,这样在访问某条记录时,只需要按照下边的步骤判断记录的某个版本是否可见: 如果被访问版本的 trx_id 属性值与 ReadView 中的 creator_trx_id 值相同,意味着当前事务在访问它自己修改过的记录,所以该版本可以被当前事务访问; 如果被访问版本的 trx_id 属性值小于 ReadView 中的 min_trx_id 值,表明生成该版本的事务在当前事务生成 ReadView 前已经提交,所以该版本可以被当前事务访问; 如果被访问版本的 trx_id 属性值大于或等于 ReadView 中的 max_trx_id 值,表明生成该版本的事务在当前事务生成 ReadView 后才开启,所以该版本不可以被当前事务访问; 如果被访问版本的 trx_id 属性值在 ReadView 的 min_trx_id 和 max_trx_id之间 min_trx_id < trx_id < max_trx_id,那就需要判断一下 trx_id 属性值是不是在 m_ids 列表中,如果在,说明创建 ReadView 时生成该版本的事务还是活跃的,该版本不可以被访问;如果不在,说明创建 ReadView 时生成该版本的事务已经被提交,该版本可以被访问; 如果某个版本的数据对当前事务不可见的话,那就顺着版本链找到下一个版本的数据,继续按照上边的步骤判断可见性,依此类推,直到版本链中的最后一个版本。如果最后一个版本也不可见的话,那么就意味着该条记录对该事务完全不可见,查询结果就不包含该记录; 在 MySQL 中,READ COMMITTED 和 REPEATABLE READ 隔离级别的一个非常大的区别就是它们生成 ReadView 的时机不同。 还是以表 mvcc_test 为例,假设现在表 mvcc_test 中只有一条由事务 id 为 50 的事务插入的一条记录,接下来看一下 READ COMMITTED 和 REPEATABLE READ 所谓的生成 ReadView 的时机不同到底不同在哪里。 READ COMMITTED: 每次读取数据前都生成一个 ReadView; 比方说现在系统里有两个事务id 分别为 70、90 的事务在执行: -- T 70 UPDATE mvcc_test SET name = 'habit_trx_id_70_01' WHERE id = 1; UPDATE mvcc_test SET name = 'habit_trx_id_70_02' WHERE id = 1; 此时表 mvcc_test 中 id 为 1 的记录得到的版本链表如下所示:  假设现在有一个使用 READ COMMITTED 隔离级别的事务开始执行: -- 使用 READ COMMITTED 隔离级别的事务 BEGIN; -- SELECE1:Transaction 70、90 未提交 SELECT * FROM mvcc_test WHERE id = 1; -- 得到的列 name 的值为'habit' 这个 SELECE1 的执行过程如下: 在执行 SELECT 语句时会先生成一个 ReadView,ReadView 的 m_ids 列表的内容就是[70, 90],min_trx_id 为 70,max_trx_id 为 91,creator_trx_id 为 0。 然后从版本链中挑选可见的记录,从图中可以看出,最新版本的列 name 的内容是 habit_trx_id_70_02,该版本的 trx_id 值为 70,在 m_ids 列表内,所以不符合可见性要求第 4 条:如果被访问版本的 trx_id 属性值在 ReadView 的 min_trx_id 和 max_trx_id之间 min_trx_id < trx_id < max_trx_id,那就需要判断一下trx_id 属性值是不是在 m_ids 列表中,如果在,说明创建 ReadView 时生成该版本的事务还是活跃的,该版本不可以被访问;如果不在,说明创建 ReadView 时生成该版本的事务已经被提交,该版本可以被访问。根据 roll_pointer 跳到下一个版本。 下一个版本的列 name 的内容是 habit_trx_id_70_01,该版本的 trx_id 值也为 70,也在 m_ids 列表内,所以也不符合要求,继续跳到下一个版本。 下一个版本的列 name 的内容是 habit,该版本的 trx_id 值为 50,小于 ReadView 中的 min_trx_id 值,所以这个版本是符合要求的第 2 条:如果被访问版本的 trx_id 属性值小于 ReadView 中的 min_trx_id 值,表明生成该版本的事务在当前事务生成 ReadView 前已经提交,所以该版本可以被当前事务访问。最后返回的版本就是这条列 name 为 habit 的记录。 之后,把事务 id 为 70 的事务提交一下,然后再到事务 id 为 90 的事务中更新一下表 mvcc_test 中 id 为 1 的记录: -- T 90 UPDATE mvcc_test SET name = 'habit_trx_id_90_01' WHERE id = 1; UPDATE mvcc_test SET name = 'habit_trx_id_90_02' WHERE id = 1; 此时表 mvcc 中 id 为 1 的记录的版本链就长这样:  然后再到刚才使用 READ COMMITTED 隔离级别的事务中继续查找这个 id 为 1 的记录,如下: -- 使用 READ COMMITTED 隔离级别的事务 BEGIN; -- SELECE1:Transaction 70、90 均未提交 SELECT * FROM mvcc_test WHERE id = 1; -- 得到的列 name 的值为'habit' -- SELECE2:Transaction 70 提交,Transaction 90 未提交 SELECT * FROM mvcc_test WHERE id = 1; -- 得到的列 name 的值为'habit_trx_id_70_02' 这个SELECE2 的执行过程如下: 在执行 SELECT 语句时又会单独生成一个 ReadView,该 ReadView 的 m_ids 列表的内容就是[90],min_trx_id 为90,max_trx_id 为 91,creator_trx_id 为 0。 然后从版本链中挑选可见的记录,从图中可以看出,最新版本的列 name 的内容是 habit_trx_id_90_02,该版本的 trx_id 值为 90,在 m_ids 列表内,所以不符合可见性要求,根据 roll_pointer 跳到下一个版本。 下一个版本的列 name 的内容是 habit_trx_id_90_01,该版本的 trx_id 值为 90,也在 m_ids 列表内,所以也不符合要求,继续跳到下一个版本。 下一个版本的列 name 的内容是 habit_trx_id_70_02,该版本的 trx_id 值为 70,小于 ReadView 中的 min_trx_id 值 90,所以这个版本是符合要求的,最后返回这个版本中列 name 为 habit_trx_id_70_02 的记录。 以此类推,如果之后事务 id 为 90 的记录也提交了,再次在使用 READ COMMITTED 隔离级别的事务中查询表 mvcc_test 中 id 值为 1 的记录时,得到的结果就是 habit_trx_id_90_02 了。 总结:使用 READ COMMITTED 隔离级别的事务在每次查询开始时都会生成一个独立的 ReadView。 REPEATABLE READ:在第一次读取数据时生成一个 ReadView; 对于使用 REPEATABLE READ 隔离级别的事务来说,只会在第一次执行查询语句时生成一个 ReadView,之后的查询就不会重复生成了。 比方说现在系统里有两个事务id 分别为 70、90 的事务在执行: -- T 70 UPDATE mvcc_test SET name = 'habit_trx_id_70_01' WHERE id = 1; UPDATE mvcc_test SET name = 'habit_trx_id_70_02' WHERE id = 1; 此时表 mvcc_test 中 id 为 1 的记录得到的版本链表如下所示:  假设现在有一个使用 REPEATABLE READ 隔离级别的事务开始执行: -- 使用 REPEATABLE READ 隔离级别的事务 BEGIN; -- SELECE1:Transaction 70、90 未提交 SELECT * FROM mvcc_test WHERE id = 1; -- 得到的列name 的值为'habit' 这个 SELECE1 的执行过程如下: 在执行 SELECT 语句时会先生成一个 ReadView,ReadView 的 m_ids 列表的内容就是[70, 90],min_trx_id 为 70,max_trx_id 为 91,creator_trx_id 为 0。 然后从版本链中挑选可见的记录,从图中可以看出,最新版本的列 name 的内容是 habit_trx_id_70_02,该版本的 trx_id 值为 70,在 m_ids 列表内,所以不符合可见性要求,根据 roll_pointer 跳到下一个版本。 下一个版本的列 name 的内容是 habit_trx_id_70_01,该版本的 trx_id 值也为 70,也在 m_ids 列表内,所以也不符合要求,继续跳到下一个版本。 下一个版本的列 name 的内容是 habit,该版本的 trx_id 值为 50,小于 ReadView 中的 min_trx_id 值,所以这个版本是符合要求的,最后返回的就是这条列name 为 habit 的记录。 之后,把事务 id 为 70 的事务提交一下,然后再到事务 id 为 90 的事务中更新一下表 mvcc_test 中 id 为 1 的记录: -- 使用 REPEATABLE READ 隔离级别的事务 BEGIN; UPDATE mvcc_test SET name = 'habit_trx_id_90_01' WHERE id = 1; UPDATE mvcc_test SET name = 'habit_trx_id_90_02' WHERE id = 1; 此刻,表 mvcc_test 中 id 为 1 的记录的版本链就长这样:  然后再到刚才使用 REPEATABLE READ 隔离级别的事务中继续查找这个 id 为 1 的记录,如下: -- 使用 REPEATABLE READ 隔离级别的事务 BEGIN; -- SELECE1:Transaction 70、90 均未提交 SELECT * FROM mvcc_test WHERE id = 1; -- 得到的列 name 的值为'habit' -- SELECE2:Transaction 70 提交,Transaction 90 未提交 SELECT * FROM mvcc_test WHERE id = 1; -- 得到的列 name 的值为'habit' 这个 SELECE2 的执行过程如下: 因为当前事务的隔离级别为 REPEATABLE READ,而之前在执行 SELECE1 时已经生成过 ReadView 了,所以此时直接复用之前的 ReadView,之前的 ReadView的 m_ids 列表的内容就是[70, 90],min_trx_id 为 70,max_trx_id 为 91, creator_trx_id 为 0。 然后从版本链中挑选可见的记录,从图中可以看出,最新版本的列 name 的内容是 habit_trx_id_90_02,该版本的 trx_id 值为 90,在 m_ids 列表内,所以不符合可见性要求,根据 roll_pointer 跳到下一个版本。 下一个版本的列 name 的内容是 habit_trx_id_90_01,该版本的 trx_id 值为 90,也在 m_ids 列表内,所以也不符合要求,继续跳到下一个版本。 下一个版本的列 name 的内容是 habit_trx_id_70_02,该版本的 trx_id 值为 70,而 m_ids 列表中是包含值为 70 的事务 id 的,所以该版本也不符合要求,同理下一个列 name 的内容是 habit_trx_id_70_01 的版本也不符合要求。继续跳到下一个版本。 下一个版本的列 name 的内容是 habit,该版本的 trx_id 值为 50,小于 ReadView 中的 min_trx_id 值 70,所以这个版本是符合要求的,最后返回给用户的版本就是这条列 name 为 habit 的记录。 也就是说两次 SELECT 查询得到的结果是重复的,记录的列 name 值都是 habit,这就是可重复读的含义。如果之后再把事务 id 为 90 的记录提交了,然后再到刚才使用 REPEATABLE READ 隔离级别的事务中继续查找这个 id 为 1 的记录,得到的结果还是 habit。 MVCC 下的幻读解决和幻读现象 REPEATABLE READ 隔离级别下 MVCC 可以解决不可重复读问题,那么幻读呢?MVCC 是怎么解决的?幻读是一个事务按照某个相同条件多次读取记录时,后读取时读到了之前没有读到的记录,而这个记录来自另一个事务添加的新记录。 可以想想,在 REPEATABLE READ 隔离级别下的事务 T1 先根据某个搜索条件读取到多条记录,然后事务 T2 插入一条符合相应搜索条件的记录并提交,然后事务 T1 再根据相同搜索条件执行查询。结果会是什么?按照 ReadView 中的比较规则中的第 3 条和第 4 条不管事务 T2 比事务 T1 是否先开启,事务 T1 都是看不到 T2 的提交的。 但是,在 REPEATABLE READ 隔离级别下 InnoDB 中的 MVCC 可以很大程度地避免幻读现象,而不是完全禁止幻读。怎么回事呢?来看下面的情况:  首先在事务 T1 中执行:select * from mvcc_test where id = 30; 这个时候是找不到 id = 30 的记录的。 在事务 T2 中,执行插入语句:insert into mvcc_test values(30,'luxi','luxi'); 此时回到事务 T1,执行: update mvcc_test set domain='luxi_t1' where id=30; select * from mvcc_test where id = 30; 事务T1 很明显出现了幻读现象。 在 REPEATABLE READ 隔离级别下,T1 第一次执行普通的 SELECT 语句时生成了一个 ReadView,之后 T2 向 mvcc_test 表中新插入一条记录并提交。 ReadView 并不能阻止 T1 执行 UPDATE 或者 DELETE 语句来改动这个新插入的记录,由于 T2 已经提交,因此改动该记录并不会造成阻塞,但是这样一来,这条新记录的 trx_id 隐藏列的值就变成了 T1 的事务 id。之后 T1 再使用普通的 SELECT 语句去查询这条记录时就可以看到这条记录了,也就可以把这条记录返回给客户端。因为这个特殊现象的存在,可以认为 MVCC 并不能完全禁止幻读。 mvcc 总结 从上边的描述中可以看出来,所谓的 MVCC(Multi-Version Concurrency Control ,多版本并发控制)指的就是在使用 READ COMMITTD、REPEATABLE READ 这两种隔离级别的事务在执行普通的 SELECT 操作时访问记录的版本链的过程,这样子可以使不同事务的读写、写读操作并发执行,从而提升系统性能。 READ COMMITTD、REPEATABLE READ 这两个隔离级别的一个很大不同就是:生成 ReadView 的时机不同,READ COMMITTD 在每一次进行普通 SELECT 操作前都会生成一个 ReadView,而 REPEATABLE READ 只在第一次进行普通 SELECT 操作前生成一个 ReadView,之后的查询操作都重复使用这个 ReadView 就好了,从而基本上可以避免幻读现象。 InnoDB 的 Buffer Pool 对于使用 InnoDB 作为存储引擎的表来说,不管是用于存储用户数据的索引,包括:聚簇索引和二级索引,还是各种系统数据,都是以页的形式存放在表空间中的,而所谓的表空间只不过是 InnoDB 对文件系统上一个或几个实际文件的抽象,也就是说数据还是存储在磁盘上的。 但是磁盘的速度慢,所以 InnoDB 存储引擎在处理客户端的请求时,当需要访问某个页的数据时,就会把完整的页的数据全部加载到内存中,即使只需要访问一个页的一条记录,那也需要先把整个页的数据加载到内存中。将整个页加载到内存中后就可以进行读写访问了,在进行完读写访问之后并不着急把该页对应的内存空间释放掉,而是将其缓存起来,这样将来有请求再次访问该页面时,就可以省去磁盘 IO 的开销了。 Buffer Pool InnoDB 为了缓存磁盘中的页,在 MySQL 服务器启动的时候就向操作系统申请了一片连续的内存,这块连续内存叫做:Buffer Pool,中文名:缓冲池。 默认情况下 Buffer Pool 只有 128M 大小。 查看该值:show variables like 'innodb_buffer_pool_size'; 可以在启动服务器的时候配置 innodb_buffer_pool_size 参数的值,它表示 Buffer Pool 的大小,配置如下: [server] innodb_buffer_pool_size = 268435456 其中,268435456 的单位是字节,也就是指定 Buffer Pool 的大小为 256M,Buffer Pool 也不能太小,最小值为 5M,当小于该值时会自动设置成 5M。 启动 MySQL 服务器的时候,需要完成对 Buffer Pool 的初始化过程,就是先向操作系统申请 Buffer Pool 的内存空间,然后把它划分成若干对控制块和缓 存页。但是此时并没有真实的磁盘页被缓存到 Buffer Pool 中,之后随着程序的运行,会不断的有磁盘上的页被缓存到 Buffer Pool 中。 在 Buffer Pool 中会创建多个缓存页,默认的缓存页大小和在磁盘上默认的页大小是一样的,都是 16KB。 那么怎么知道该页在不在 Buffer Pool 中呢? 在查找数据的时候,先通过哈希表中查找 key 是否在哈希表中,如果在证明 Buffer Pool 中存在该缓存也信息,如果不存在证明不存该缓存也信息,则通过读取磁盘加载该页信息放到 Buffer Pool 中,哈希表中的 key 是通过表空间号+ 页号作组成的,value 是 Buffer Pool 的缓存页。 flush 链表的管理 如果修改了 Buffer Pool 中某个缓存页的数据,那它就和磁盘上的页不一致了,这样的缓存页也被称为:脏页。最简单的做法就是每发生一次修改就立即同步到磁盘上对应的页上,但是频繁的往磁盘中写数据会严重的影响程序的性能。所以每次修改缓存页后,并不着急把修改同步到磁盘上,而是在未来的某个时间进行同步。 但是如果不立即同步到磁盘的话,那之后再同步的时候怎么知道 Buffer Pool 中哪些页是脏页,哪些页从来没被修改过呢?总不能把所有的缓存页都同步到磁盘上吧,如果 Buffer Pool 被设置的很大,那一次性同步会非常慢。 所以,需要再创建一个存储脏页的链表,凡是修改过的缓存页对应的控制块都会作为一个节点加入到一个链表中,因为这个链表节点对应的缓存页都是需要被刷新到磁盘上的,所以也叫 flush 链表。 刷新脏页到磁盘 后台有专门的线程每隔一段时间负责把脏页刷新到磁盘,这样可以不影响用户线程处理正常的请求。 从 flush 链表中刷新一部分页面到磁盘,后台线程也会定时从 flush 链表中刷新一部分页面到磁盘,刷新的速率取决于当时系统是不是很繁忙。这种刷新页面的方式被称之为:BUF_FLUSH_LIST。 redo 日志 redo 日志的作用 InnoDB 存储引擎是以页为单位来管理存储空间的,增删改查操作其实本质上都是在访问页面,包括:读页面、写页面、创建新页面等操作。在真正访问页面之前,需要把在磁盘上的页缓存到内存中的 Buffer Pool 之后才可以访问。但是在事务的时候又强调过一个称之为持久性的特性,就是说对于一个已经提交的事务,在事务提交后即使系统发生了崩溃,这个事务对数据库中所做的更改也不能丢失。 如果只在内存的 Buffer Pool 中修改了页面,假设在事务提交后突然发生了某个故障,导致内存中的数据都失效了,那么这个已经提交了的事务对数据库中所做的更改也就跟着丢失了,这是所不能忍受的。那么如何保证这个持久性呢?一个很简单的做法就是在事务提交完成之前把该事务所修改的所有页面都刷新到磁盘,但是这个简单粗暴的做法有些问题: 刷新一个完整的数据页太浪费了;有时候仅仅修改了某个页面中的一个字节,但是在 InnoDB 中是以页为单位来进行磁盘 IO 的,也就是说在该事务提交时不得不将一个完整的页面从内存中刷新到磁盘,一个页面默认是16KB 大小,只修改一个字节就要刷新 16KB 的数据到磁盘上显然是太浪费了。 随机 IO 刷起来比较慢;一个事务可能包含很多语句,即使是一条语句也可能修改许多页面,该事务修改的这些页面可能并不相邻,这就意味着在将某个事务修改的 Buffer Pool 中的页面刷新到磁盘时,需要进行很多的随机 IO,随机 IO 比顺序 IO 要慢,尤其对于传统的机械硬盘来说。 只是想让已经提交了的事务对数据库中数据所做的修改永久生效,即使后来系统崩溃,在重启后也能把这种修改恢复出来。其实没有必要在每次事务提交时就把该事务在内存中修改过的全部页面刷新到磁盘,只需要把修改了哪些东西记录一下就好,比方说:某个事务将系统表空间中的第 5 号页面中偏移量为 5000 处的那个字节的值 0 改成 5 只需要记录一下:将第 5 号表空间的 5 号页面的偏移量为 5000 处的值更新为:5。 这样在事务提交时,把上述内容刷新到磁盘中,即使之后系统崩溃了,重启之后只要按照上述内容所记录的步骤重新更新一下数据页,那么该事务对数据库中所做的修改又可以被恢复出来,也就意味着满足持久性的要求。因为在系统崩溃重启时需要按照上述内容所记录的步骤重新更新数据页,所以上述内容也被称之为:重做日志,即:redo log。与在事务提交时将所有修改过的内存中的页面刷新到磁盘中相比,只将该事务执行过程中产生的 redo log 刷新到磁盘的好处如下: redo log 占用的空间非常小存储表空间 ID、页号、偏移量以及需要更新的值所需的存储空间是很小的; redo log 是顺序写入磁盘的在执行事务的过程中,每执行一条语句,就可能产生若干条 redo log,这些日志是按照产生的顺序写入磁盘的,也就是使用顺序 IO; redo log 的写入过程 InnoDB 为了更好的进行系统崩溃恢复,把一次原子操作生成的 redo log 都放在了大小为 512 字节的块(block)中。 为了解决磁盘速度过慢的问题而引入了 Buffer Pool。同理,写入 redo log 时也不能直接写到磁盘上,实际上在服务器启动时就向操作系统申请了一大片称之为 redo log buffer 的连续内存空间,即:redo log 缓冲区,也可以简称:log buffer。这片内存空间被划分成若干个连续的 redo log block,可以通过启动参数innodb_log_buffer_size 来指定 log buffer 的大小,该启动参数的默认值为:16MB。 向 log buffer 中写入 redo log 的过程是顺序的,也就是先往前边的 block 中写,当该 block 的空闲空间用完之后再往下一个 block 中写。 redo log 刷盘时机 log buffer 什么时候会写入到磁盘呢? log buffer 空间不足时,如果不停的往这个有限大小的 log buffer 里塞入日志,很快它就会被填满。InnoDB 认为如果当前写入 log buffer 的 redo log 量已 经占满了 log buffer 总容量的大约一半左右,就需要把这些日志刷新到磁盘上。 事务提交时,必须要把修改这些页面对应的 redo log 刷新到磁盘。 后台有一个线程,大约每秒都会刷新一次 log buffer 中的 redo log 到磁盘。 正常关闭服务器时等等。 undo 日志 事务需要保证原子性,也就是事务中的操作要么全部完成,要么什么也不做。但是偏偏有时候事务执行到一半会出现一些情况,比如: 情况一:事务执行过程中可能遇到各种错误,比如服务器本身的错误,操作系统错误,甚至是突然断电导致的错误。 情况二:程序员可以在事务执行过程中手动输入 ROLLBACK 语句结束当前的事务的执行。 这两种情况都会导致事务执行到一半就结束,但是事务执行过程中可能已经修改了很多东西,为了保证事务的原子性,需要把东西改回原先的样子,这个过程就称之为回滚,即:rollback,这样就可以造成这个事务看起来什么都没做,所以符合原子性要求。 每当要对一条记录做改动时,都需要把回滚时所需的东西都给记下来。 比方说: 插入一条记录时,至少要把这条记录的主键值记下来,之后回滚的时候只需要把这个主键值对应的记录删掉。 删除了一条记录,至少要把这条记录中的内容都记下来,这样之后回滚时再把由这些内容组成的记录插入到表中。 修改了一条记录,至少要把修改这条记录前的旧值都记录下来,这样之后回滚时再把这条记录更新为旧值。 这些为了回滚而记录的这些东西称之为撤销日志,即:undo log。这里需要注意的一点是,由于查询操作并不会修改任何用户记录,所以在查询操作执行时,并不需要记录相应的 undo log。 undo 日志的格式 为了实现事务的原子性,InnoDB 存储引擎在实际进行增、删、改一条记录时,都需要先把对应的 undo 日志记下来。一般每对一条记录做一次改动,就对应着一条 undo 日志,但在某些更新记录的操作中,也可能会对应着 2 条 undo 日志。 一个事务在执行过程中可能新增、删除、更新若干条记录,也就是说需要记录很多条对应的 undo 日志,这些 undo 日志会被从 0 开始编号,也就是说根据生成的顺序分别被称为第 0 号 undo 日志、第 1 号 undo 日志、...、第 n 号 undo 日志等,这个编号也被称之为 undo no。 这些 undo 日志是被记录到类型为 FIL_PAGE_UNDO_LOG 的页面中。这些页面可以从系统表空间中分配,也可以从一种专门存放 undo 日志的表空间,也就是所谓的 undo tablespace 中分配。 作者:京东物流 张士欣 来源:京东云开发者社区 自圆其说Tech 转载请注明来源

优秀的个人博客,低调大师

Java类加载机制详解 | 京东云技术团队

一.类加载器及双亲委派机制  类加载器 加载类 备注 启动类加载器(Bootstrap ClassLoader) JAVA_HOME/jre/lib 无上级,无法直接访问 由jvm加载 拓展类加载器(Extension ClassLoader) JAVA_HOME/jre/lib/ext 父加载器为 Bootstrap,显示为 null 。该类由Bootstrap加载 应用类加载器(Application ClassLoader) classpath 父加载器上级为 Extension,该类由Bootstrap加载 自定义类加载器 自定义路径 父加载器为 Application,该类由Application ClassLoader加载 1.类加载器继承结构   2. 类加载器的核心方法 方法名 说明 getParent() 返回该类加载器的父类加载器 findClass(String name) 查找名字为name的类,返回的结果是java.lang.Class类的实例 loadClass(String name) 加载名为name的类,返回java.lang.Class类的实例 defineClass(String name,byte[] b,int off,int len) 根据字节数组b中的数据转化成Java类,返回的结果是java.lang.Class类的实例 3. Launcher类源码解析 public class Launcher { private static URLStreamHandlerFactory factory = new Factory(); private static Launcher launcher = new Launcher(); // 启动类加载器加载路径 private static String bootClassPath = System.getProperty("sun.boot.class.path"); public static Launcher getLauncher() { return launcher; } private ClassLoader loader; public Launcher() { // Create the extension class loader ClassLoader extcl; try { // 获取扩展类加载器 extcl = ExtClassLoader.getExtClassLoader(); } catch (IOException e) { throw new InternalError( "Could not create extension class loader", e); } // Now create the class loader to use to launch the application try { // 获取应用类加载器 loader = AppClassLoader.getAppClassLoader(extcl); } catch (IOException e) { throw new InternalError( "Could not create application class loader", e); } // Also set the context class loader for the primordial thread. // 设置线程上下文类加载器为应用类加载器 Thread.currentThread().setContextClassLoader(loader); } /* * The class loader used for loading installed extensions. */ static class ExtClassLoader extends URLClassLoader { private static volatile ExtClassLoader instance = null; /** * create an ExtClassLoader. The ExtClassLoader is created * within a context that limits which files it can read */ public static ExtClassLoader getExtClassLoader() throws IOException { if (instance == null) { synchronized(ExtClassLoader.class) { if (instance == null) { instance = createExtClassLoader(); } } } return instance; } /** * 获取加载路径 */ private static File[] getExtDirs() { // 扩展类加载器加载路径 String s = System.getProperty("java.ext.dirs"); } } /** * The class loader used for loading from java.class.path. * runs in a restricted security context. */ static class AppClassLoader extends URLClassLoader { public static ClassLoader getAppClassLoader(final ClassLoader extcl) throws IOException { // 应用类加载器加载路径 final String s = System.getProperty("java.class.path"); final File[] path = (s == null) ? new File[0] : getClassPath(s); return AccessController.doPrivileged( new PrivilegedAction<AppClassLoader>() { public AppClassLoader run() { URL[] urls = (s == null) ? new URL[0] : pathToURLs(path); return new AppClassLoader(urls, extcl); } }); } } 4. ClassLoader类源码解析 public abstract class ClassLoader { protected Class<?> loadClass(String name, boolean resolve) throws ClassNotFoundException { synchronized (getClassLoadingLock(name)) { // First, check if the class has already been loaded // 从系统缓存中获取 Class<?> c = findLoadedClass(name); if (c == null) { long t0 = System.nanoTime(); try { // 委托父加载器加载 if (parent != null) { c = parent.loadClass(name, false); } else { c = findBootstrapClassOrNull(name); } } catch (ClassNotFoundException e) { // ClassNotFoundException thrown if class not found // from the non-null parent class loader } if (c == null) { // If still not found, then invoke findClass in order // to find the class. long t1 = System.nanoTime(); // 自己加载,从指定路径 c = findClass(name); // this is the defining class loader; record the stats sun.misc.PerfCounter.getParentDelegationTime().addTime(t1 - t0); sun.misc.PerfCounter.getFindClassTime().addElapsedTimeFrom(t1); sun.misc.PerfCounter.getFindClasses().increment(); } } if (resolve) { resolveClass(c); } return c; } } // 自定义类加载器需要重写该方法 protected Class<?> findClass(String name) throws ClassNotFoundException { throw new ClassNotFoundException(name); } } 5. 双亲委派机制优缺点 优点: 1、保证安全性,层级关系代表优先级,也就是所有类的加载,优先给启动类加载器,这样就保证了核心类库类 2、避免类的重复加载,如果父类加载器加载过了,子类加载器就没有必要再去加载了,确保一个类的全局唯一性 缺点: 检查类是否加载的委派过程是单向的, 这个方式虽然从结构上说比较清晰,使各个 ClassLoader 的职责非常明确, 但是同时会带来一个问题, 即顶层的ClassLoader 无法访问底层的ClassLoader 所加载的类 通常情况下, 启动类加载器中的类为系统核心类, 包括一些重要的系统接口,而在应用类加载器中, 为应用类。 按照这种模式, 应用类访问系统类自然是没有问题, 但是系统类访问应用类就会出现问题。 二.spi接口及线程上下文类加载器 1.spi接口定义及线程上下文加载的作用 Java提供了很多核心接口的定义,这些接口被称为SPI接口。(Service Provider Interface,SPI),允许第三方为这些接口提供实现。常见的 SPI 有 JDBC、JCE、JNDI、JAXP 和 JBI 等。 这些 SPI 的接口由 Java 核心库来提供,而这些 SPI 的实现代码则是作为 Java 应用所依赖的 jar 包被包含进类路径(CLASSPATH)里。SPI接口中的代码经常需要加载具体的实现类。那么问题来了,SPI的接口是Java核心库的一部分,是由启动类加载器(Bootstrap Classloader)来加载的;SPI的实现类是由系统类加载器(System ClassLoader)来加载的。引导类加载器是无法找到 SPI 的实现类的,因为依照双亲委派模型,BootstrapClassloader无法委派AppClassLoader来加载类。而线程上下文类加载器破坏了“双亲委派模型”,可以在执行线程中抛弃双亲委派加载链模式,使程序可以逆向使用类加载器。 类加载传导规则:JVM 会选择当前类的类加载器来加载所有该类的引用的类。例如我们定义了 TestA 和 TestB 两个类,TestA 会引用 TestB,只要我们使用自定义的类加载器加载 TestA,那么在运行时,当 TestA 调用到 TestB 的时候, TestB 也会被 JVM 使用 TestA 的类加载器加载。依此类推,只要是 TestA 及其引用类关联的所有 jar 包的类都会被自定义类加载器加载。通过这种方式,我们只要让模块的 main 方法类使用不同的类加载器加载,那么每个模块的都会使用 main 方法类的类加载器加载的,这样就能让多个模块分别使用不同类加载器。这也是 OSGi 和 SofaArk 能够实现类隔离的核心原理。 2. spi加载原理 当第三方实现者提供了服务接口的一种实现之后,在jar包的 META-INF/services/ 目录里同时创建一个以服务接口命名的文件,该文件就是实现该服务接口的实现类。而当外部程序装配这个模块的时候,就能通过该jar包 META-INF/services/ 里的配置文件找到具体的实现类名,并装载实例化,完成模块的注入。 JDK官方提供了一个查找服务实现者的工具类:java.util.ServiceLoader public final class ServiceLoader<S> implements Iterable<S> { // 加载spi接口实现类配置文件固定路径 private static final String PREFIX = "META-INF/services/"; /** * Creates a new service loader for the given service type, using the * current thread's {@linkplain java.lang.Thread#getContextClassLoader * context class loader}. * * <p> An invocation of this convenience method of the form * * <blockquote><pre> * ServiceLoader.load(<i>service</i>)</pre></blockquote> * * is equivalent to * * <blockquote><pre> * ServiceLoader.load(<i>service</i>, * Thread.currentThread().getContextClassLoader())</pre></blockquote> * * @param <S> the class of the service type * * @param service * The interface or abstract class representing the service * * @return A new service loader */ public static <S> ServiceLoader<S> load(Class<S> service) { // 线程上下文类加载器 ClassLoader cl = Thread.currentThread().getContextClassLoader(); return ServiceLoader.load(service, cl); } } 3.示列代码 代码: public interface IShout { void shout(); } public class Dog implements IShout { @Override public void shout() { System.out.println("wang wang"); } } public class Cat implements IShout { @Override public void shout() { System.out.println("miao miao"); } } public class Main { public static void main(String[] args) { ServiceLoader<IShout> shouts = ServiceLoader.load(IShout.class); for (IShout s : shouts) { s.shout(); } } } 配置: 4.MySQL驱动类加载 // 加载Class到AppClassLoader(系统类加载器),然后注册驱动类 //Class.forName("com.mysql.jdbc.Driver").newInstance(); String url = "jdbc:mysql://localhost:3306/testdb"; // 通过java库获取数据库连接 Connection conn = java.sql.DriverManager.getConnection(url, "name", "password"); public class DriverManager { static { loadInitialDrivers(); println("JDBC DriverManager initialized"); } private static void loadInitialDrivers() { 。。。。。。。 AccessController.doPrivileged(new PrivilegedAction<Void>() { public Void run() { ServiceLoader<Driver> loadedDrivers = ServiceLoader.load(Driver.class); Iterator<Driver> driversIterator = loadedDrivers.iterator(); /* Load these drivers, so that they can be instantiated. * It may be the case that the driver class may not be there * i.e. there may be a packaged driver with the service class * as implementation of java.sql.Driver but the actual class * may be missing. In that case a java.util.ServiceConfigurationError * will be thrown at runtime by the VM trying to locate * and load the service. * * Adding a try catch block to catch those runtime errors * if driver not available in classpath but it's * packaged as service and that service is there in classpath. */ try{ while(driversIterator.hasNext()) { driversIterator.next(); } } catch(Throwable t) { // Do nothing } return null; } }); println("DriverManager.initialize: jdbc.drivers = " + drivers); if (drivers == null || drivers.equals("")) { return; } String[] driversList = drivers.split(":"); println("number of Drivers:" + driversList.length); for (String aDriver : driversList) { try { println("DriverManager.Initialize: loading " + aDriver); Class.forName(aDriver, true, ClassLoader.getSystemClassLoader()); } catch (Exception ex) { println("DriverManager.Initialize: load failed: " + ex); } } } } 三.自定义动态类加载器 1.示例代码 public class DynamicClassLoad extends ClassLoader{ public static void main(String[] args) { Executors.newSingleThreadScheduledExecutor().scheduleAtFixedRate(new Runnable() { @Override public void run() { try { DynamicClassLoad myClassLoad = new DynamicClassLoad(); Class clazz = myClassLoad.findClass("/Users/wangzhaoqing1/Desktop/MyTest.class"); Object obj = clazz.newInstance(); Method sayHello = clazz.getDeclaredMethod("sayHello"); sayHello.invoke(obj, null); } catch (Throwable e) { e.printStackTrace(); } } }, 1, 2, TimeUnit.SECONDS); } @Override protected Class<?> findClass(String name) throws ClassNotFoundException { File file = new File(name); try { byte[] bytes = FileUtils.readFileToByteArray(file); Class<?> c = this.defineClass(null, bytes, 0, bytes.length); return c; } catch (Exception e) { e.printStackTrace(); } return super.findClass(name); } } // DynamicClassLoad启动后,修改本类重新编译 public class MyTest { public void sayHello(){ System.out.println("hello wzq 6666666666"); } } 作者:京东零售 王照清 来源:京东云开发者社区 转载请注明来源

优秀的个人博客,低调大师

Android Kotlin 协程初探 | 京东物流技术团队

1 它是什么(协程 和 Kotlin协程) 1.1 协程是什么 维基百科:协程,英文Coroutine [kəru’tin] (可入厅),是计算机程序的一类组件,推广了协作式多任务的子程序,允许执行被挂起与被恢复。 作为Google钦定的Android开发首选语言Kotlin,协程并不是 Kotlin 提出来的新概念,目前有协程概念的编程语言有Lua语言、Python语言、Go语言、C语言等,它只是一种编程思想,不局限于特定的语言。 而每一种编程语言中的协程的概念及实现又不完全一样,本次分享主要讲Kotlin协程。 1.2 Kotlin协程是什么 Kotlin官网:协程是轻量级线程 可简单理解:一个线程框架,是全新的处理并发的方式,也是Android上方便简化异步执行代码的方式 类似于 Java:线程池 Android:Handler和AsyncTask,RxJava的Schedulers 注:Kotlin不仅仅是面向JVM平台的,还有JS/Native,如果用kotlin来写前端,那Koltin的协程就是JS意义上的协程。如果仅仅JVM 平台,那确实应该是线程框架。 1.3 进程、线程、协程比较 可通过以下两张图理解三者的不同和关系 2 为什么选择它(协程解决什么问题) 异步场景举例: 第一步:接口获取当前用户token及用户信息 第二步:将用户的昵称展示界面上 第三步:然后再通过这个token获取当前用户的消息未读数 第四步:并展示在界面上 2.1 现有方案实现 apiService.getUserInfo().enqueue(object :Callback<User>{ override fun onResponse(call: Call<User>, response: Response<User>) { val user = response.body() tvNickName.text = user?.nickName apiService.getUnReadMsgCount(user?.token).enqueue(object :Callback<Int>{ override fun onResponse(call: Call<Int>, response: Response<Int>) { val tvUnReadMsgCount = response.body() tvMsgCount.text = tvUnReadMsgCount.toString() } }) } }) 现有方案如何拿到异步任务的数据,得不到就毁掉哈哈哈,就是通过回调函数来解决。若嵌套多了,这种画风是不是有点回调地狱的感觉,俗称的「callback hell」 2.2 协程实现 mainScope.launch { val user = apiService.getUserInfoSuspend() //IO线程请求数据 tvNickName.text = user?.nickName //UI线程更新界面 val unReadMsgCount = apiService.getUnReadMsgCountSuspend(user?.token) //IO线程请求数据 tvMsgCount.text = unReadMsgCount.toString() //UI线程更新界面 } suspend fun getUserInfoSuspend() :User? { return withContext(Dispatchers.IO){ //模拟网络请求耗时操作 delay(10) User("asd123", "userName", "nickName") } } suspend fun getUnReadMsgCountSuspend(token:String?) :Int{ return withContext(Dispatchers.IO){ //模拟网络请求耗时操作 delay(10) 10 } } 红色框框内的就是一个协程代码块。 可以看得出在协程实现中告别了callback,所以再也不会出现回调地狱这种情况了,协程解决了回调地狱 协程可以让我们用同步的代码写出异步的效果,这也是协程最大的优势,异步代码同步去写。 小结:协程可以异步代码同步去写,解决回调地狱,让程序员更方便地处理异步业务,更方便地切线程,保证主线程安全。 它是怎么做到的? 3 它是怎么工作的(协程的原理浅析) 3.1 协程的挂起和恢复 挂起(非阻塞式挂起) suspend 关键字,它是协程中核心的关键字,是挂起的标识。 下面看一下上述示例代码切换线程的过程: 每一次从主线程切到IO线程都是一次协程的挂起操作; 每一次从IO线程切换主线程都是一次协程的恢复操作; 挂起和恢复是suspend函数特有的能力,其他函数不具备,挂起的内容是协程,不是挂起线程,也不是挂起函数,当线程执行到suspend函数的地方,不会继续执行当前协程的代码了,所以它不会阻塞线程,是非阻塞式挂起。 有挂起必然有恢复流程, 恢复是指将已经被挂起的目标协程从挂起之处开始恢复执行。在协程中,挂起和恢复都不需要我们手动处理,这些都是kotlin协程帮我们自动完成的。 那Kotlin协程是如何帮我们自动实现挂起和恢复操作的呢? 它是通过Continuation来实现的。 [kənˌtɪnjuˈeɪʃ(ə)n] (继续;延续;连续性;后续部分) 3.2 协程的挂起和恢复的工作原理(Continuation) CPS + 状态机 Java中没有suspend函数,suspend是Kotlin中特有的关键字,当编译时,Kotlin编译器会将含有suspend关键字的函数进行一次转换。 这种被编译器转换在kotlin中叫CPS转换(cotinuation-passing-style)。 转换流程如下所示 程序员写的挂起函数代码: suspend fun getUserInfo() : User { val user = User("asd123", "userName", "nickName") return user } 假想的一种中间态代码(便于理解): fun getUserInfo(callback: Callback<User>): Any? { val user = User("asd123", "userName", "nickName") callback.onSuccess(user) return Unit } 转换后的代码: fun getUserInfo(cont: Continuation<User>): Any? { val user = User("asd123", "userName", "nickName") cont.resume(user) return Unit } 我们通过Kotlin生成字节码工具查看字节码,然后将其反编译成Java代码: @Nullable public final Object getUserInfo(@NotNull Continuation $completion) { User user = new User("asd123", "userName", "nickName"); return user; } 这也验证了确实是会通过引入一个Continuation对象来实现恢复的流程,这里的这个Continuation对象中包含了Callback的形态。 它有两个作用:1. 暂停并记住执行点位;2. 记住函数暂停时刻的局部变量上下文。 所以为什么我们可以用同步的方式写异步代码,是因为Continuation帮我们做了回调的流程。 下面看一下这个Continuation 的源码部分 可以看到这个Continuation中封装了一个resumeWith的方法,这个方法就是恢复用的。 internal abstract class BaseContinuationImpl() : Continuation<Any?> { public final override fun resumeWith(result: Result<Any?>) { //省略好多代码 invokeSuspend() //省略好多代码 } protected abstract fun invokeSuspend(result: Result<Any?>): Any? } internal abstract class ContinuationImpl( completion: Continuation<Any?>?, private val _context: CoroutineContext? ) : BaseContinuationImpl(completion) { protected abstract fun invokeSuspend(result: Result<Any?>): Any? //invokeSuspend() 这个方法是恢复的关键一步 继续看上述例子: 这是一个CPS之前的代码: suspend fun testCoroutine() { val user = apiService.getUserInfoSuspend() //挂起函数 IO线程 tvNickName.text = user?.nickName //UI线程更新界面 val unReadMsgCount = apiService.getUnReadMsgCountSuspend(user?.token) //挂起函数 IO线程 tvMsgCount.text = unReadMsgCount.toString() //UI线程更新界面 } 当前挂起函数里有两个挂起函数 通过kotlin编译器编译后: fun testCoroutine(completion: Continuation<Any?>): Any? { // TestContinuation本质上是匿名内部类 class TestContinuation(completion: Continuation<Any?>?) : ContinuationImpl(completion) { // 表示协程状态机当前的状态 var label: Int = 0 // 两个变量,对应原函数的2个变量 lateinit var user: Any lateinit var unReadMsgCount: Int // result 接收协程的运行结果 var result = continuation.result // suspendReturn 接收挂起函数的返回值 var suspendReturn: Any? = null // CoroutineSingletons 是个枚举类 // COROUTINE_SUSPENDED 代表当前函数被挂起了 val sFlag = CoroutineSingletons.COROUTINE_SUSPENDED // invokeSuspend 是协程的关键 // 它最终会调用 testCoroutine(this) 开启协程状态机 // 状态机相关代码就是后面的 when 语句 // 协程的本质,可以说就是 CPS + 状态机 override fun invokeSuspend(_result: Result<Any?>): Any? { result = _result label = label or Int.Companion.MIN_VALUE return testCoroutine(this) } } // ... val continuation = if (completion is TestContinuation) { completion } else { // 作为参数 // ↓ TestContinuation(completion) loop = true while(loop) { when (continuation.label) { 0 -> { // 检测异常 throwOnFailure(result) // 将 label 置为 1,准备进入下一次状态 continuation.label = 1 // 执行 getUserInfoSuspend(第一个挂起函数) suspendReturn = getUserInfoSuspend(continuation) // 判断是否挂起 if (suspendReturn == sFlag) { return suspendReturn } else { result = suspendReturn //go to next state } } 1 -> { throwOnFailure(result) // 获取 user 值 user = result as Any // 准备进入下一个状态 continuation.label = 2 // 执行 getUnReadMsgCountSuspend suspendReturn = getUnReadMsgCountSuspend(user.token, continuation) // 判断是否挂起 if (suspendReturn == sFlag) { return suspendReturn } else { result = suspendReturn //go to next state } } 2 -> { throwOnFailure(result) user = continuation.mUser as Any unReadMsgCount = continuation.unReadMsgCount as Int loop = false } } 通过一个label标签控制分支代码执行,label为0,首先会进入第一个分支,首先将label设置为下一个分支的数值,然后执行第一个suspend方法并传递当前Continuation,得到返回值,如果是COROUTINE SUSPENDED,协程框架就直接return,协程挂起,当第一个suspend方法执行完成,会回调Continuation的invokeSuspend方法,进入第二个分支执行,以此类推执行完所有suspend方法。 每一个挂起点和初始挂起点对应的 Continuation 都会转化为一种状态,协程恢复只是跳转到下一种状态中。挂起函数将执行过程分为多个 Continuation 片段,并且利用状态机的方式保证各个片段是顺序执行的。 小结:协程的挂起和恢复的本质是CPS + 状态机 4 总结 总结几个不用协程实现起来很麻烦的骚操作: 如果有一个函数,它的返回值需要等到多个耗时的异步任务都执行完毕返回之后,组合所有任务的返回值作为 最终返回值 如果有一个函数,需要顺序执行多个网络请求,并且后一个请求依赖前一个请求的执行结果 当前正在执行一项异步任务,但是你突然不想要它执行了,随时可以取消 如果你想让一个任务最多执行3秒,超过3秒则自动取消 Kotlin协程之所以被认为是假协程,是因为它并不在同一个线程运行,而是真的会创建多个线程。 Kotlin协程在Android上只是一个类似线程池的封装,真就是一个线程框架。但是它却可以让我们用同步的代码风格写出异步的效果,至于怎么做的,这个不需要我们操心,这些都是kotlin帮我们处理好了,我们需要关心的是怎么用好它 它就是一个线程框架。 作者:京东物流 王斌 来源:京东云开发者社区 自猿其说Tech 转载请注明来源

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册