首页 文章 精选 留言 我的

精选列表

搜索[MSA技术],共10000篇文章
优秀的个人博客,低调大师

基于Effect的组件设计 | 京东云技术团队

Effect的概念起源 从输入输出的角度理解Effect https://link.excalidraw.com/p/readonly/KXAy7d2DlnkM8X1yps6L 编程中的Effect起源于函数式编程中纯函数的概念 纯函数是指在相同的输入下,总是产生相同的输出,并且没有任何副作用(side effect)的函数。 副作用是指函数执行过程中对函数外部环境进行的可观察的改变,比如修改全局变量、打印输出、写入文件等。 前端的典型副作用场景是 浏览器环境中在window上注册变量 副作用引入了不确定性,使得程序的行为难以预测和调试。为了处理那些需要进行副作用的操作,函数式编程引入了Effect的抽象概念。 它可以表示诸如读取文件、写入数据库、发送网络请求、DOM渲染等对外部环境产生可观察改变的操作。通过将这些操作包装在Effect中,函数式编程可以更好地控制和管理副作用,使得代码更具可预测性和可维护性。 实际工作中我们也是从React的useEffect开始直接使用Effect的说法 React: useEffect useEffect is a React Hook that lets you synchronize a component with an external system. import { useState, useEffect } from 'react'; // 模拟异步事件 function getMsg() { return new Promise((resolve) => { setTimeout(() => { resolve('React') }, 1000) }) } export default function Hello() { const [msg, setMsg] = useState('World') useEffect(() => { getMsg().then((msg) => { setMsg(msg) }) const timer = setInterval(() => { console.log('test interval') }) return () => { // 清除异步事件 clearTimeout(timer) } }, []) return ( <h1>Hello { msg }</h1> ); } Effect中处理异步事件,并在此处消除异步事件的副作用clearTimeout(timer),避免闭包一直无法被销毁 Vue: watcher 运行期自动依赖收集 示例 <script setup> import { ref } from 'vue' const msg = ref('World!') setTimeout(() => { msg.value = 'Vue' }, 1000) </script> <template> <h1>Hello {{ msg }}</h1> </template> _createElementVNode("h1", null, _toDisplayString(msg.value), 1 /* TEXT */) runtime的render期间通过msg.value对msg产生了引用,此时产生了一个watch effect:msg的watchlist中多了一个render的watcher,在msg变化的时候 render会通过watcher重新执行 Svelte: $ 编译器依赖收集 示例 suffix的值依赖name,在name变化之后,suffix值也更新 <script> let name = 'world'; $: suffix = name + '!' setTimeout(() => { name = 'svelte' }, 1000) </script> <h1>Hello {suffix}</h1> // 编译后部分代码 function instance($$self, $$props, $$invalidate) { let suffix let name = 'world' setTimeout(() => { $$invalidate(1, (name = 'svelte')) }, 1000) // 更新关系 $$self.$$.update = () => { if ($$self.$$.dirty & /*name*/ 2) { $: $$invalidate(0, (suffix = name + '!')) } } return [suffix, name] } Effect分类 React先介绍了两种典型的Effect 渲染逻辑中可以获取 props 和 state,并对它们进行转换,然后返回您希望在屏幕上看到的 JSX。渲染代码必须是纯的,就像数学公式一样,它只应该计算结果,而不做其他任何事情。 事件处理程序是嵌套在组件内部的函数,它们执行操作而不仅仅做计算。事件处理程序可以更新输入字段、提交HTTP POST请求以购买产品或将用户导航到另一个页面。它包含由用户特定操作(例如按钮点击或输入)引起的 “副作用”(它们改变程序的状态)。 Consider a ChatRoom component that must connect to the chat server whenever it’s visible on the screen. Connecting to a server is not a pure calculation (it’s a side effect) so it can’t happen during rendering. However, there is no single particular event like a click that causes ChatRoom to be displayed. 考虑一个ChatRoom组件,每当它在屏幕上可见时都必须连接到聊天服务器。连接到服务器不是一个纯粹的计算(它是一个副作用),因此不能在渲染期间发生(渲染必须是纯函数)。然而,并没有单个特定的事件(如点击)会触发ChatRoom的展示 Effects let you specify side effects that are caused by rendering itself, rather than by a particular event. Sending a message in the chat is an event because it is directly caused by the user clicking a specific button. However, setting up a server connection is an Effect because it should happen no matter which interaction caused the component to appear. Effects run at the end of a commit after the screen updates. This is a good time to synchronize the React components with some external system (like network or a third-party library). Effect 允许指定由渲染本身引起的副作用,而不是由特定事件引起的副作用。在聊天中发送消息是一个事件,因为它直接由用户点击特定按钮引起。然而不管是任何交互触发的组件展示,设置服务器连接都是一个Effect。Effect会在页面更新后的commit结束时运行。这是与某个外部系统(如网络或第三方库)同步React组件的好时机 以下Effect尽量达到不重不漏,不重的意义是他们之间是相互独立的,每个模块可以独立实现,这样可以在系统设计的初期可以将业务Model建设和Effect处理分离,甚至于将Effects提取成独立的utils 渲染 生命周期 组件被初始化、更新、卸载的时候我们需要做一些业务逻辑处理,例如:组件初始化时调用接口更新数据 React react基于自己的fiber结构,通过闭包完成状态的管理,不会建立值和渲染过程的绑定关系,通过在commit之后执行Effect达到值的状态更新等副作用操作,因此声明周期需要自己模拟实现 import { useState, useEffect } from 'react'; export default function Hello() { const [msg, setMsg] = useState('World') // dependency是空 因此只会在第一次执行 声明周期上可以理解为onMounted useEffect(() => { // 异步事件 const timer = setTimeout(() => { // setMsg会触发重渲染 https://react.dev/learn/render-and-commit setMsg('React') }, 1000) return () => { // 卸载时/重新执行Effect前 清除异步事件 clearTimeout(timer) } // 如果dependency有值 则每次更新如果dependency不一样就会执行Effect }, []) return ( <h1>Hello { msg }</h1> ); } <script setup> import { onMounted, onUnmounted, onUpdated, ref } from 'vue' const msg = ref('Hello World!') // 挂载 onMounted(async () => { function getValue() { return Promise.resolve('hello, vue') } const value = await getValue() msg.value = value }) onUpdated(() => {}) // 更新 onUnmounted(() => {}) // 卸载 </script> <template> <h1>{{ msg }}</h1> <input v-model="msg"> </template> <script> import { onMount, onDestroy, beforeUpdate } from 'svelte' let name = 'world' $: suffix = name + '!' onMount(() => { setTimeout(() => { name = 'svelte' }, 1000) }) beforeUpdate(() => {}) // 更新 onDestroy(() => {}) // 卸载/销毁 </script> <h1>Hello {suffix}</h1> Action 用户行为 对应React中提到的两个典型Effect中的 事件处理程序 在不考虑跳出应用(location.href='xxx')的情况下,我们的行为都只能改变当前应用的状态,不管是输入、选择还是触发异步事件的提交,网络相关的副作用在下节讨论 点击/输入 <!-- 原生 要求onClick是全局变量 --> <div onclick="onClick"/> <!-- React --> <div onClick={onClick}/> <!-- Vue --> <div @click="onClick"/> <!-- Svelte --> <div on:click="onClick"/> 滑动输入、键盘输入等 <!-- React view和model的关系需要自己处理 --> <input value={value} onChange={val => setValue(val)} placeholder="enter your name" /> <!-- Vue 通过指令自动建立view和model的绑定关系 --> <input v-model="name" placeholder="enter your name" /> <!-- Svelte --> <input bind:value={name} placeholder="enter your name" /> 所谓的MVVM即是视图和模型的绑定关系通过框架(v-mode,bind:valuel)完成,所以需要自己处理绑定关系的React不是MVVM 滚动 同上 Network 网络请求 基础:XMLHttpRequest,Fetch NPM包:Axios,useSwr Storage 存储 任何存储行为都是副作用:POST请求、变量赋值、local存储、cookie设置、URL参数设置 Remote 缓存/数据库,同上 网络请求 Local 内存 局部变量 闭包 React的函数式组件中的useState的值的变更 全局变量 window 浏览器环境初始化完成之后,我们的context中就会有window全局变量,修改window的属性会使同一个页面环境中的所有内容都被影响(微前端的window隔离方案除外) LocalStorage 兼容localStorage存储和 原生APP存储;返回Promise 其实也可以兼容从接口获取、存储数据 export function getItem(key) { const now = Date.now(); if (window.XWebView) { window.XWebView.callNative( 'JDBStoragePlugin', 'getItem', JSON.stringify({ key, }), `orange_${now}`, '-1', ); } else { setTimeout(() => { window[`orange_${now}`]( JSON.stringify({ status: '0', data: { result: 'success', data: localStorage.getItem(key), }, }), ); }, 0); } return new Promise((resolve, reject) => { window[`orange_${now}`] = (result) => { try { const obj = JSON.parse(result); const { status, data } = obj; if (status === '0' && data && data.result === 'success') { resolve(data.data); } else { reject(result); } } catch (e) { reject(e); } window[`orange_${now}`] = undefined; }; }); } export function setItem(key, value = BABEL_CHANNEL) { const now = Date.now(); if (window.XWebView) { window.XWebView.callNative( 'JDBStoragePlugin', 'setItem', JSON.stringify({ key, value, }), `orange_${now}`, '-1', ); } else { setTimeout(() => { window[`orange_${now}`]( JSON.stringify({ status: '0', data: { result: 'success', data: localStorage.setItem(key, value), }, }), ); }, 0); } return new Promise((resolve, reject) => { window[`orange_${now}`] = (result) => { console.log('MKT ~ file: storage.js:46 ~ returnnewPromise ~ result:', result); try { const obj = JSON.parse(result); const { status, data } = obj; if (status === '0' && data && data.result === 'success') { resolve(data.data); } else { reject(result); } } catch (e) { reject(e); } window[`orange_${now}`] = undefined; }; }); } Cookie https://www.npmjs.com/package/js-cookie  URL 参见地址栏参数 举个栗子🌰 组件诉求 1. 支持分页 2. 支持搜索 3. 已选择的门店需要回显,但是已选择的门店只能分页获取,无法全部获取 4. 需要知道用户移除了哪些选项,增加了哪些选项 5. 支持服务端全选 组件Effect分析 业务组件可以视load-data为纯函数,因为loda-data的调用不会影响外部业务组件,清晰的Effects归属可以降低业务的复杂度,最大程度上降低组件的耦合 用户在组件内的行为(除了确定之外)产生的Effect只对组件自身产生影响,提升了组件的内聚  组件模型设计 组件list兼容搜索和下拉场景 const { result: list, hasNext } = await this.loadData(param).catch(() => ({ hasNext: false, result: [] })) const lastRemove = this.remove // 本次新增之前移除的内容 if (param.pageNo === 1 && !param.search) { this.list = list } else { // 建立新值的索引 接口返回的信息是无状态属性的(选中与否) const map = list.reduce((pre, cur) => { pre[cur.id] = Object.assign(cur, { from: param.search }) return pre }, {}) // 此处应该遍历list 而不是 this.list this.list = this.list.map(item => { const diff = map[item.id] // 找到之前已经有的数据 就从map中移动到之前list的位置做替换 if (diff) delete map[item.id] return diff || item // 剩余的值补充到最后面 }).concat(Object.values(map)) } const value = diffBy(this.last.add.concat(this.remote, this.local, this.checked), lastRemove) this.value = value  接口返回选中的值通过checked-by-remote纯函数的依赖反转实现惰性计算 业务组件默认选中的值通过checked-by-local纯函数的依赖反转实现惰性计算 增加或者移除的值通过相应的diff计算出来 Reactivity极大提升了Model的表达能力 { computed: { /** * 接口返回已选中的数据且不能在已移除的数据中, 否则上次移除的数据会被自动选中 */ remote() { return diffBy(this.list.filter(this.checkedByRemote || emptyFilter).map(it => it.id), this.last.remove) }, /** * 本地默认选中 且不是从remote选中的 且不是上次选中的 */ local() { return diffBy(this.list.filter(this.checkedByLocal || emptyFilter).map(it => it.id), this.remote, this.last.add) }, // 用户选择的 checked() { return diffBy(this.value, this.remote, this.last.add, this.local) }, // 1. 本地有接口没有的 是新增,this.value中已包含了last.add 2. 需要新增的且不在上次本地移除的范围内:上次移除的可能不在this.remote范围内 add() { return diffBy(this.value, this.remote, this.last.remove) }, // 1. 接口有本地没有的 是移除 2. 需要移除的 且 不在上次本地新增的范围内 remove() { return this.last.remove.concat(diffBy(this.remote, this.value, this.last.remove)) } }, } 参考资料 面向 Model 编程的前端架构设计 https://mp.weixin.qq.com/s/g4hnfirDmyeuXAdEt-zk9w Synchronizing with Effects https://react.dev/learn/synchronizing-with-effects 作者:京东零售 刘威 来源:京东云开发者社区 转载请注明来源

优秀的个人博客,低调大师

深入理解线段树 | 京东物流技术团队

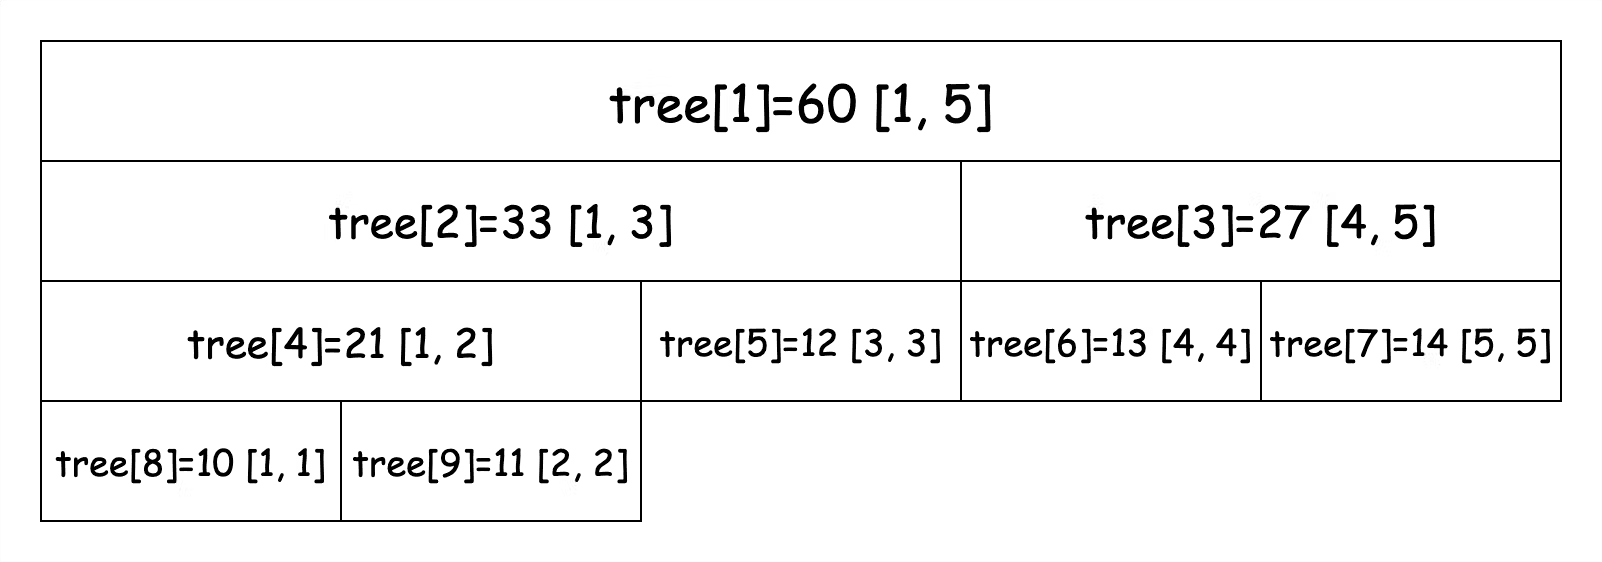
线段树(Segment Tree)是常用的维护区间信息的数据结构,它可以在 O(logn) 的时间复杂度下实现单点修改、区间修改、区间查询(区间求和、区间最大值或区间最小值)等操作,常用来解决 RMQ 问题。 RMQ(Range Minimum/Maximum Query) 问题是指:对于长度为 n 的数列 A,回答若干询问 RMQ(A, i, j) 其中 i, j <= n,返回数列 A 中下标在 i, j 里的最小(大)值。也就是说:RMQ问题是指求区间最值的问题。通常该类型题目的解法有递归分治、动态规划、线段树和单调栈/单调队列。 这篇内容断断续续写了两周,随着练习对线段树的理解不断深入,慢慢地学习下来也不觉得它有多么困难,更多的体会还是熟能生巧,虽然它起初看上去确实代码量大一些,但是我觉得只要大家放平心态,循序渐进的掌握下文中的三部分,也没什么难的。 1. 线段树 线段树会将每个长度不为 1 的区间划分成左右两个区间来递归求解,通过合并左右两区间的信息来求得当前区间的信息。 比如,我们将一个大小为 5 的数组 nums = {10, 11, 12, 13, 14} 转换成线段树,并规定线段树的根节点编号为 1。用数组 tree[] 来保存线段树的节点,tree[i] 表示线段树上编号为 i 的节点,图示如下: 图示中每个节点展示了区间和以及区间范围,tree[i] 左子树节点为 tree[2i],右子树节点为 tree[2i + 1]。如果 tree[i] 记录的区间为 [a, b] 的话,那么左子树节点记录的区间为 [a, mid],右子树节点记录的区间为 [mid + 1, b],其中 mid = (a + b) / 2。 现在我们已经对线段树有了基本的认识,接下来我们看看区间查询和单点修改的代码实现。 区间查询和单点修改线段树 首先,我们定义线段树的节点: /** * 定义线段树节点 */ class Node { /** * 区间和 或 区间最大/最小值 */ int val; int left; int right; public Node(int left, int right) { this.left = left; this.right = right; } } 注意其中的 val 字段保存的是区间的和。定义完树的节点,我们来看一下建树的逻辑,注意代码中的注释,我们为线段树分配的节点数组大小为原数组大小的 4 倍,这是考虑到数组转换成满二叉树的最坏情况。 public SegmentTree(int[] nums) { this.nums = nums; tree = new Node[nums.length * 4]; // 建树,注意表示区间时使用的是从 1 开始的索引值 build(1, 1, nums.length); } /** * 建树 * * @param pos 当前节点编号 * @param left 当前节点区间下界 * @param right 当前节点区间上界 */ private void build(int pos, int left, int right) { // 创建节点 tree[pos] = new Node(left, right); // 递归结束条件 if (left == right) { // 赋值 tree[pos].val = nums[left - 1]; return; } // 如果没有到根节点,则继续递归 int mid = left + right >> 1; build(pos << 1, left, mid); build(pos << 1 | 1, mid + 1, right); // 当前节点的值是左子树和右子树节点的和 pushUp(pos); } /** * 用于向上回溯时修改父节点的值 */ private void pushUp(int pos) { tree[pos].val = tree[pos << 1].val + tree[pos << 1 | 1].val; } 我们在建树时,表示区间并不是从索引 0 开始,而是从索引 1 开始,这样才能保证在计算左子树节点索引时为 2i,右子树节点索引为 2i + 1。 build()方法执行时,我们会先在对应的位置上创建节点而不进行赋值,只有在递归到叶子节点时才赋值,此时区间大小为 1,节点值即为当前区间的值。之后非叶子节点值都是通过pushUp()方法回溯加和当前节点的两个子节点值得出来的。 接下来我们看修改区间中的值,线段树对值的更新方法,关注其中的注释: /** * 修改单节点的值 * * @param pos 当前节点编号 * @param numPos 需要修改的区间中值的位置 * @param val 修改后的值 */ private void update(int pos, int numPos, int val) { // 找到该数值所在线段树中的叶子节点 if (tree[pos].left == numPos && tree[pos].right == numPos) { tree[pos].val = val; return; } // 如果不是当前节点那么需要判断是去左或右去找 int mid = tree[pos].left + tree[pos].right >> 1; if (numPos <= mid) { update(pos << 1, numPos, val); } else { update(pos << 1 | 1, numPos, val); } // 叶子节点的值修改完了,需要回溯更新所有相关父节点的值 pushUp(pos); } 修改方法比较简单,当叶子节点值更新完毕时,我们仍然需要调用pushUp()方法对所有相关父节点值进行更新。 接下来我们看查找对应区间和的方法: /** * 查找对应区间的值 * * @param pos 当前节点 * @param left 要查询的区间的下界 * @param right 要查询的区间的上界 */ private int query(int pos, int left, int right) { // 如果我们要查找的区间把当前节点区间全部包含起来 if (left <= tree[pos].left && tree[pos].right <= right) { return tree[pos].val; } int res = 0; int mid = tree[pos].left + tree[pos].right >> 1; // 根据区间范围去左右节点分别查找求和 if (left <= mid) { res += query(pos << 1, left, right); } if (right > mid) { res += query(pos << 1 | 1, left, right); } return res; } 该方法也比较简单,需要判断区间范围是否需要对向左子节点和右子节点的分别查找计算。 现在表示区间和的线段树已经讲解完毕了,为了方便大家学习和看代码,我把全量的代码在这里贴出来: public class SegmentTree { /** * 定义线段树节点 */ static class Node { /** * 区间和 或 区间最大/最小值 */ int val; int left; int right; public Node(int left, int right) { this.left = left; this.right = right; } } Node[] tree; int[] nums; public SegmentTree(int[] nums) { this.nums = nums; tree = new Node[nums.length * 4]; // 建树,注意表示区间时使用的是从 1 开始的索引值 build(1, 1, nums.length); } /** * 建树 * * @param pos 当前节点编号 * @param left 当前节点区间下界 * @param right 当前节点区间上界 */ private void build(int pos, int left, int right) { // 创建节点 tree[pos] = new Node(left, right); // 递归结束条件 if (left == right) { // 赋值 tree[pos].val = nums[left - 1]; return; } // 如果没有到根节点,则继续递归 int mid = left + right >> 1; build(pos << 1, left, mid); build(pos << 1 | 1, mid + 1, right); // 当前节点的值是左子树和右子树节点的和 pushUp(pos); } /** * 修改单节点的值 * * @param pos 当前节点编号 * @param numPos 需要修改的区间中值的位置 * @param val 修改后的值 */ private void update(int pos, int numPos, int val) { // 找到该数值所在线段树种的叶子节点 if (tree[pos].left == numPos && tree[pos].right == numPos) { tree[pos].val = val; return; } // 如果不是当前节点那么需要判断是去左或右去找 int mid = tree[pos].left + tree[pos].right >> 1; if (numPos <= mid) { update(pos << 1, numPos, val); } else { update(pos << 1 | 1, numPos, val); } // 叶子节点的值修改完了,需要回溯更新所有相关父节点的值 pushUp(pos); } /** * 用于向上回溯时修改父节点的值 */ private void pushUp(int pos) { tree[pos].val = tree[pos << 1].val + tree[pos << 1 | 1].val; } /** * 查找对应区间的值 * * @param pos 当前节点 * @param left 要查询的区间的下界 * @param right 要查询的区间的上界 */ private int query(int pos, int left, int right) { // 如果我们要查找的区间把当前节点区间全部包含起来 if (left <= tree[pos].left && tree[pos].right <= right) { return tree[pos].val; } int res = 0; int mid = tree[pos].left + tree[pos].right >> 1; // 根据区间范围去左右节点分别查找求和 if (left <= mid) { res += query(pos << 1, left, right); } if (right > mid) { res += query(pos << 1 | 1, left, right); } return res; } } 如果要创建表示区间最大值或最小值的线段树,建树的逻辑不变,只需要将**pushUp()方法和query()**方法修改成计算最大值或最小值的逻辑即可。 2. 线段树的区间修改与懒惰标记 如果我们不仅对单点进行修改,也对区间进行修改,那么在区间修改时就需要将当前区间值及包含当前区间的子区间值都修改一遍,这样所产生的开销是没办法接受的,因此在这里我们会使用一种懒惰标记的方法来帮助我们避免这种即时开销。 简单来说,懒惰标记是通过延迟对节点信息的更改,从而减少可能不必要的操作次数。每次执行修改时,我们通过打标记的方法表明该节点对应的区间在某一次操作中被更改,但不更新该节点的子节点的信息。实质性的修改则在下一次**“即将访问(update 或 query)”到带有懒惰标记节点的子节点**时才进行。 我们通过在节点类中添加 add 字段记录懒惰标记,它表示的是该区间的子区间值需要“变化的大小”(一定好好好的理解),并通过 pushDown 方法“累加”到当前区间的两个子节点区间值中。 只要不访问到当前区间的子区间,那么子区间值始终都不会变化,相当于子区间值的变化量被当前节点通过 add 字段“持有” pushDown 方法区别于我们上文中提到的 pushUp 方法,前者是将当前节点值累计的懒惰标记值同步到子节点中,而后者是完成子节点修改后,回溯修改当前子节点的父节点值,我们能够根据 Down 和 Up 来更好的理解这两个方法的作用方向和修改范围。 下面我们一起来看看过程和具体的代码,节点类如下,增加 add 字段: static class Node { int left; int right; int val; int add; public Node(int left, int right) { this.left = left; this.right = right; } } 区间修改 建树的流程与我们上述的一致,就不在这里赘述了,我们主要关注区间修改的过程,还是以如下初始的线段树为例,此时各个节点的 add 均为 0: 接下来我们修改区间 [3, 5] 且区间内每个值变化量为 1,过程如下: 先遍历节点 1,发现 [3, 5] 区间不能将 [1, 5] 区间完全包含,不进行修改,继续遍历节点 2。节点 2 依然没有被区间 [3, 5] 包含,需要继续遍历节点 5,发现该节点被区间完全包含,进行修改并添加懒惰标记值,如下图所示: 完成这一步骤后需要向上回溯修改 tree[2] 节点的值: 现在 [3, 5] 区间中 3 已经完成修改,还有 4, 5 没有被修改,我们需要在右子树中继续递归查找,发现 tree[3] 中区间被我们要修改的区间 [3, 5] 完全包含,那么需要将这个节点进行修改并懒惰标记,如下,注意这里虽然 tree[3] 节点有两个子节点,但是因为我们没有访问到它的子节点所以无需同步 add 值到各个子节点中: 同样,完成这一步骤也需要向上回溯修改父节点的值: 到现在我们的区间修改就已经完成了,根据这个过程代码示例如下: /** * 修改区间的值 * * @param pos 当前节点编号 * @param left 要修改区间的下界 * @param right 要修改区间的上界 * @param val 区间内每个值的变化量 */ public void update(int pos, int left, int right, int val) { // 如果该区间被要修改的区间包围的话,那么需要将该区间所有的值都修改 if (left <= tree[pos].left && tree[pos].right <= right) { tree[pos].val += (tree[pos].right - tree[pos].left + 1) * val; // 懒惰标记 tree[pos].add += val; return; } // 该区间没有被包围的话,需要修改节点的信息 pushDown(pos); int mid = tree[pos].left + tree[pos].right >> 1; // 如果下界在 mid 左边,那么左子树需要修改 if (left <= mid) { update(pos << 1, left, right, val); } // 如果上界在 mid 右边,那么右子树也需要修改 if (right > mid) { update(pos << 1 | 1, left, right, val); } // 修改完成后向上回溯修改父节点的值 pushUp(pos); } private void pushDown(int pos) { // 根节点 和 懒惰标记为 0 的情况不需要再向下遍历 if (tree[pos].left != tree[pos].right && tree[pos].add != 0) { int add = tree[pos].add; // 计算累加变化量 tree[pos << 1].val += add * (tree[pos << 1].right - tree[pos << 1].left + 1); tree[pos << 1 | 1].val += add * (tree[pos << 1 | 1].right - tree[pos << 1 | 1].left + 1); // 子节点懒惰标记累加 tree[pos << 1].add += add; tree[pos << 1 | 1].add += add; // 懒惰标记清 0 tree[pos].add = 0; } } private void pushUp(int pos) { tree[pos].val = tree[pos << 1].val + tree[pos << 1 | 1].val; } 区间查询 tree[3] 节点是有懒惰标记 1 的,如果我们此时查询区间 [5, 5] 的值,就需要在递归经过 tree[3] 节点时,进行 pushDown 懒惰标记计算,将 tree[6] 和 tree[7] 的节点值进行修改,结果如下: 最终我们会获取到结果值为 15,区间查询过程的示例代码如下: public int query(int pos, int left, int right) { if (left <= tree[pos].left && tree[pos].right <= right) { // 当前区间被包围 return tree[pos].val; } // 懒惰标记需要下传修改子节点的值 pushDown(pos); int res = 0; int mid = tree[pos].left + tree[pos].right >> 1; if (left <= mid) { res += query(pos << 1, left, right); } if (right > mid) { res += query(pos << 1 | 1, left, right); } return res; } 同样,为了方便大家学习,我把全量代码也列出来,我认为学习线段树的区间修改比较重要的点是理解 add 字段表示的含义和 pushDown 方法的作用时机,而且需要注意只有线段树中的某个区间被我们要修改的区间全部包含时(update 和 query 方法的条件判断),才进行值修改并懒惰标记,否则该区间值只在 pushUp 方法回溯时被修改。 public class SegmentTree2 { static class Node { int left; int right; int val; int add; public Node(int left, int right) { this.left = left; this.right = right; } } Node[] tree; int[] nums; public SegmentTree2(int[] nums) { this.tree = new Node[nums.length * 4]; this.nums = nums; build(1, 1, nums.length); } private void build(int pos, int left, int right) { tree[pos] = new Node(left, right); // 递归结束条件 if (left == right) { tree[pos].val = nums[left - 1]; return; } int mid = left + right >> 1; build(pos << 1, left, mid); build(pos << 1 | 1, mid + 1, right); // 回溯修改父节点的值 pushUp(pos); } /** * 修改区间的值 * * @param pos 当前节点编号 * @param left 要修改区间的下界 * @param right 要修改区间的上界 * @param val 区间内每个值的变化量 */ public void update(int pos, int left, int right, int val) { // 如果该区间被要修改的区间包围的话,那么需要将该区间所有的值都修改 if (left <= tree[pos].left && tree[pos].right <= right) { tree[pos].val += (tree[pos].right - tree[pos].left + 1) * val; // 懒惰标记 tree[pos].add += val; return; } // 该区间没有被包围的话,需要修改节点的信息 pushDown(pos); int mid = tree[pos].left + tree[pos].right >> 1; // 如果下界在 mid 左边,那么左子树需要修改 if (left <= mid) { update(pos << 1, left, right, val); } // 如果上界在 mid 右边,那么右子树也需要修改 if (right > mid) { update(pos << 1 | 1, left, right, val); } // 修改完成后向上回溯修改父节点的值 pushUp(pos); } public int query(int pos, int left, int right) { if (left <= tree[pos].left && tree[pos].right <= right) { // 当前区间被包围 return tree[pos].val; } // 懒惰标记需要下传修改子节点的值 pushDown(pos); int res = 0; int mid = tree[pos].left + tree[pos].right >> 1; if (left <= mid) { res += query(pos << 1, left, right); } if (right > mid) { res += query(pos << 1 | 1, left, right); } return res; } private void pushDown(int pos) { // 根节点 和 懒惰标记为 0 的情况不需要再向下遍历 if (tree[pos].left != tree[pos].right && tree[pos].add != 0) { int add = tree[pos].add; // 计算累加变化量 tree[pos << 1].val += add * (tree[pos << 1].right - tree[pos << 1].left + 1); tree[pos << 1 | 1].val += add * (tree[pos << 1 | 1].right - tree[pos << 1 | 1].left + 1); // 子节点懒惰标记 tree[pos << 1].add += add; tree[pos << 1 | 1].add += add; // 懒惰标记清 0 tree[pos].add = 0; } } private void pushUp(int pos) { tree[pos].val = tree[pos << 1].val + tree[pos << 1 | 1].val; } } 3. 线段树动态开点 线段树的动态开点其实不难理解,它与我们上述直接创建好线段树所有节点不同,动态开点的线段树在最初只创建一个根节点代表整个区间,其他节点只在需要的时候被创建,节省出了空间。当然,我们因此也不能再使用pos << 1和pos << 1 | 1来寻找当前节点的左右子节点,取而代之的是在节点中使用 left 和 right 记录左右子节点在 tree[] 中的位置,这一点需要注意: static class Node { // left 和 right 不再表示区间范围而是表示左右子节点在 tree 中的索引位置 int left, right; int val; int add; } 我们以区间 [1, 5] 为例,创建区间 [5, 5] 为 14 的过程图示如下: 我们可以发现,会先创建默认的根节点 tree[1],之后创建出上图中 tree[2] 和 tree[3] 节点,而此时并没有找到区间 [5, 5],那么需要继续创建上图中的 tree[4] 和 tree[5] 节点(与直接创建出所有节点不同,如果是直接创建好所有节点的话它们的位置应该在 tree[6] 和 tree[7]),现在 tree[5] 节点表示的区间符合我们要找的条件,可以进行赋值和 pushUp 操作了,与直接创建出所有节点相比,动态开点少创建了 4 个节点,也就是图中标红的四个节点我们是没有创建的。 由于每次操作都可能创建并访问全新的一系列节点,因此 m 次单点操作后节点的空间复杂度是 O(mlogn),如果我们采用线段树动态开点解题的话,空间要开的尽可能大,Java 在 128M 可以开到 5e6 个节点以上。 结合图示大家应该能理解动态开点的过程了~~(不明白就自己画一遍)~~,下面我们看下具体的代码: /** * 修改区间的值 * * @param pos 当前节点的索引值 * @param left 当前线段树节点表示的范围下界 * @param right 当前线段树节点表示的范围上界 * @param l 要修改的区间下界 * @param r 要修改的区间上界 * @param val 区间值变化的大小 */ public void update(int pos, int left, int right, int l, int r, int val) { // 当前区间被要修改的区间全部包含 if (l <= left && right <= r) { tree[pos].val += (right - left + 1) * val; tree[pos].add += val; return; } lazyCreate(pos); pushDown(pos, right - left + 1); int mid = left + right >> 1; if (l <= mid) { update(tree[pos].left, left, mid, l, r, val); } if (r > mid) { update(tree[pos].right, mid + 1, right, l, r, val); } pushUp(pos); } // 为该位置创建节点 private void lazyCreate(int pos) { if (tree[pos] == null) { tree[pos] = new Node(); } // 创建左子树节点 if (tree[pos].left == 0) { tree[pos].left = ++count; tree[tree[pos].left] = new Node(); } // 创建右子树节点 if (tree[pos].right == 0) { tree[pos].right = ++count; tree[tree[pos].right] = new Node(); } } private void pushDown(int pos, int len) { if (tree[pos].left != 0 && tree[pos].right != 0 && tree[pos].add != 0) { // 计算左右子树的值 tree[tree[pos].left].val += (len - len / 2) * tree[pos].add; tree[tree[pos].right].val += len / 2 * tree[pos].add; // 子节点懒惰标记 tree[tree[pos].left].add += tree[pos].add; tree[tree[pos].right].add += tree[pos].add; tree[pos].add = 0; } } private void pushUp(int pos) { tree[pos].val = tree[tree[pos].left].val + tree[tree[pos].right].val; } 整体的逻辑并不难,新增的 lazyCreate 方法是动态开点的逻辑,需要注意的是执行区间更新时我们方法的参数中多了 left 和 right 表示当前节点区间范围的参数,因为我们现在的节点中只保存了左右子节点的位置,而没有区间信息,所以我们需要在参数中携带才行,否则我们没有办法判断当前区间和要找的区间是否匹配。 我还是将全量代码放在下面,方便大家学习: public class SegmentTree3 { static class Node { // left 和 right 不再表示区间范围而是表示左右子节点在 tree 中的索引位置 int left, right; int val; int add; } // 记录当前节点数 int count; Node[] tree; public SegmentTree3() { count = 1; tree = new Node[(int) 5e6]; tree[count] = new Node(); } public int query(int pos, int left, int right, int l, int r) { if (l <= left && right <= r) { return tree[pos].val; } lazyCreate(pos); pushDown(pos, right - left + 1); int res = 0; int mid = left + right >> 1; if (l <= mid) { res += query(tree[pos].left, left, mid, l, r); } if (r > mid) { res += query(tree[pos].right, mid + 1, right, l, r); } return res; } /** * 修改区间的值 * * @param pos 当前节点的索引值 * @param left 当前线段树节点表示的范围下界 * @param right 当前线段树节点表示的范围上界 * @param l 要修改的区间下界 * @param r 要修改的区间上界 * @param val 区间值变化的大小 */ public void update(int pos, int left, int right, int l, int r, int val) { // 当前区间被要修改的区间全部包含 if (l <= left && right <= r) { tree[pos].val += (right - left + 1) * val; tree[pos].add += val; return; } lazyCreate(pos); pushDown(pos, right - left + 1); int mid = left + right >> 1; if (l <= mid) { update(tree[pos].left, left, mid, l, r, val); } if (r > mid) { update(tree[pos].right, mid + 1, right, l, r, val); } pushUp(pos); } // 为该位置创建节点 private void lazyCreate(int pos) { if (tree[pos] == null) { tree[pos] = new Node(); } // 创建左子树节点 if (tree[pos].left == 0) { tree[pos].left = ++count; tree[tree[pos].left] = new Node(); } // 创建右子树节点 if (tree[pos].right == 0) { tree[pos].right = ++count; tree[tree[pos].right] = new Node(); } } private void pushDown(int pos, int len) { if (tree[pos].left != 0 && tree[pos].right != 0 && tree[pos].add != 0) { // 计算左右子树的值 tree[tree[pos].left].val += (len - len / 2) * tree[pos].add; tree[tree[pos].right].val += len / 2 * tree[pos].add; // 子节点懒惰标记 tree[tree[pos].left].add += tree[pos].add; tree[tree[pos].right].add += tree[pos].add; tree[pos].add = 0; } } private void pushUp(int pos) { tree[pos].val = tree[tree[pos].left].val + tree[tree[pos].right].val; } } 巨人的肩膀 【宫水三叶】一题三解 :「递归分治」&「线段树」&「单调栈」 线段树浅谈 线段树什么的不是简简单单嘛,我教你!:基础篇 OI-wiki 线段树 维基百科:线段树 【RMQ 专题】关于 RMQ 的若干解法(内含彩蛋) 【宫水三叶】一题双解 :「差分」&「线段树」(附区间求和目录) 【宫水三叶】一题三解 :「模拟」&「线段树(动态开点)」&「分块 + 位运算(分桶)」 作者:京东物流 王奕龙 来源:京东云开发者社区 自猿其说 Tech 转载请注明来源

优秀的个人博客,低调大师

深入理解树状数组 | 京东物流技术团队

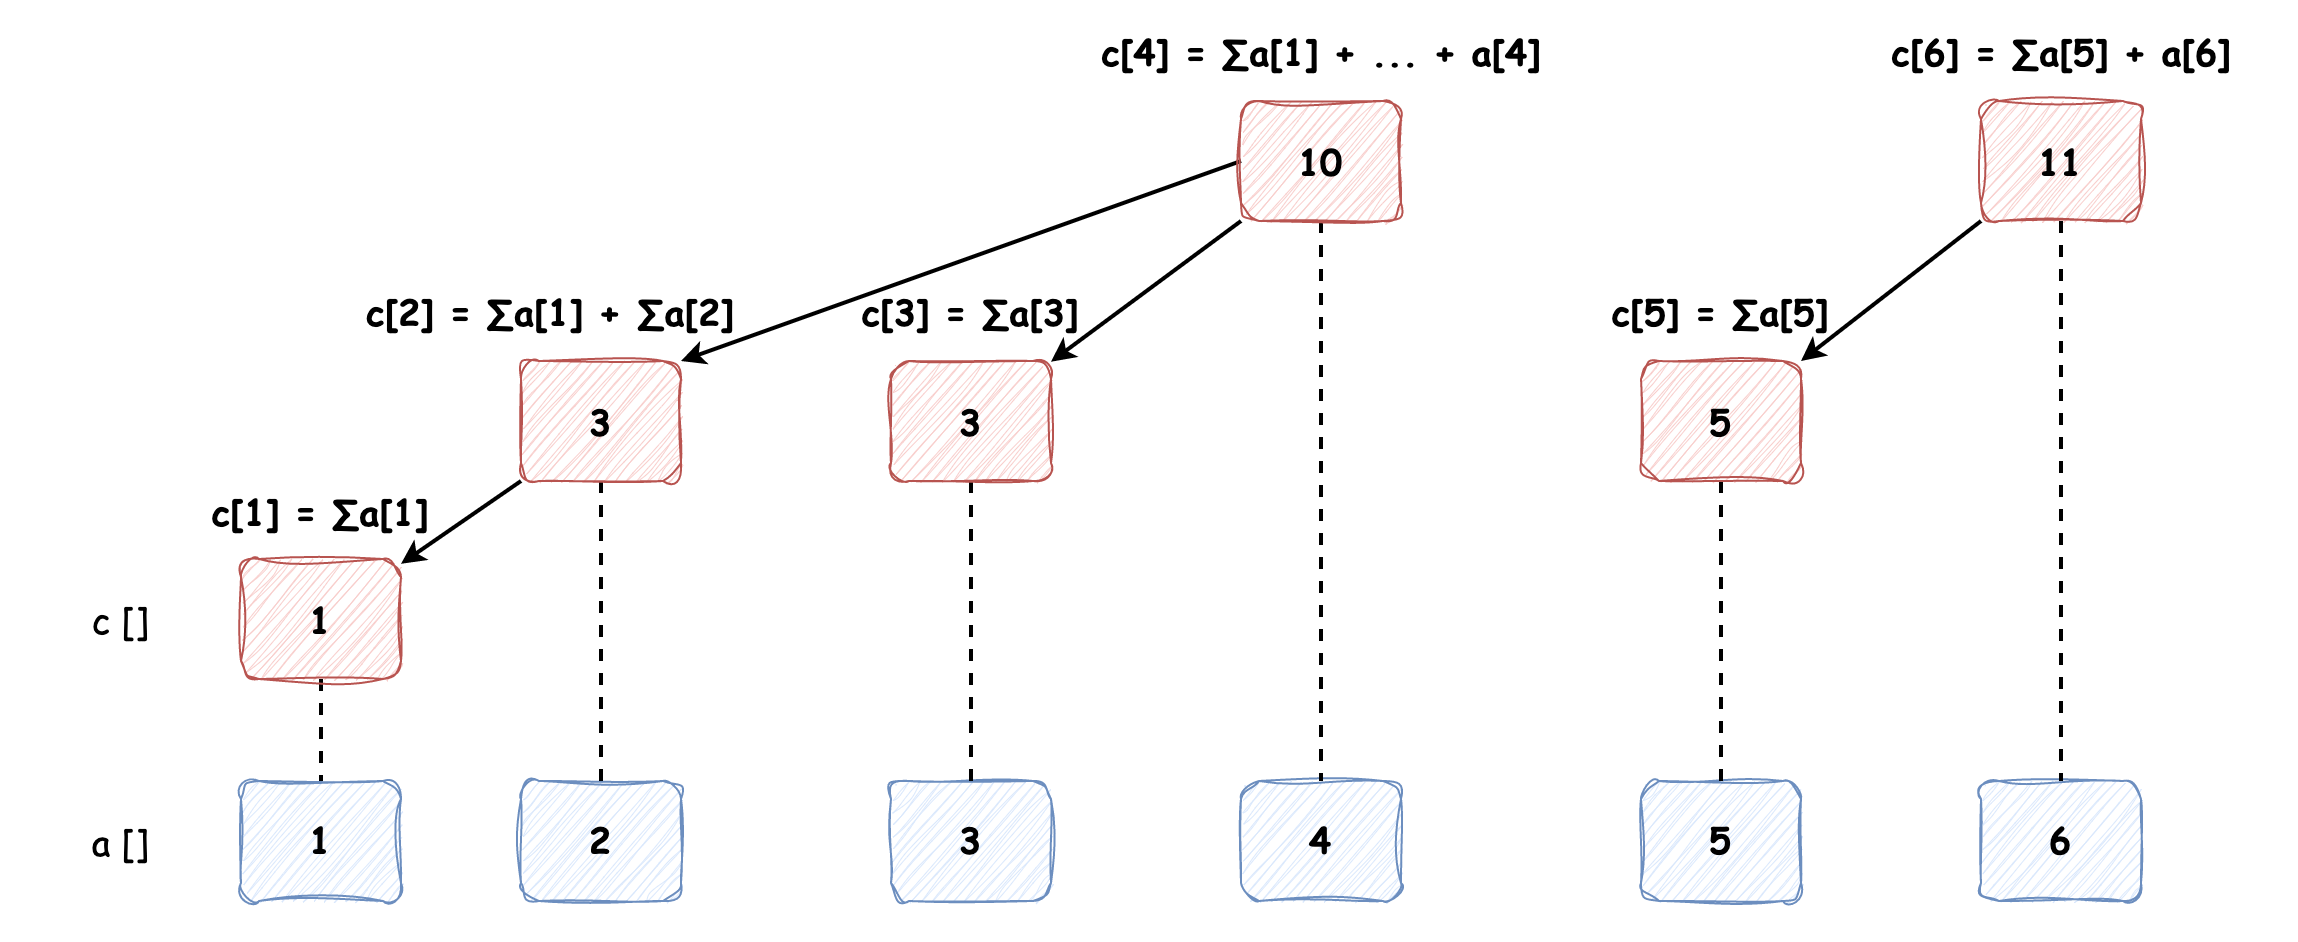
树状数组 树状数组(BIT, Binary Indexed Tree)是简洁优美的数据结构,它能在很少的代码量下支持单点修改和区间查询,我们先以a[] {1, 2, 3, 4, 5, 6}数组为例建立树状数组看一下树状数组的样子: 可以发现:不是所有节点都是连接在一起的,c[1], c[2], c[3], c[4] 和 c[5], c[6] 分别构成了两棵树;奇数索引位置的节点只管辖一个数组元素(我们例子中以 1 为起始索引)。那么这个树状数组是怎么计算和推导出来的呢? 管辖的区间 树状数组的每个元素会管辖多少个数组元素?也就是说每个元素的区间长度是多少?我们从上图中已经知道了奇数的树状数组元素只管辖一个元素,区间为 c[x] = [x, x],那么我们只需再研究下偶数元素管辖的区间长度即可。 c[y] 所管辖的区间长度为 2k,其中 k 为 y 的 2 进制表示中最低位 1 后面所有 0 的数量;c[y] 所管辖的区间为:[y - 2k+ 1, y] 我们以 c[4] 为例,它管辖多少个元素呢?4 的 2 进制表示为 0100,最低位 1 后面 0 的数量为 2,即 k = 2,那么 2k= 22= 4,所以它管辖的区间长度为 4,也就是 4 个数组元素,区间为 [4 - 4 + 1, 4] = [1, 4]。 父节点是谁? 现在我们知道每个元素所管辖的区间范围了,那么我们怎么才能知道它的父节点是谁呢?就比如说我们现在得到了 c[1] 元素,我们想知道它的父节点,要怎么计算呢? c[x] 的父节点为 c[x + lowbit(x)] 怎么回事?其中的**lowbit(x)**是什么东西?其实它的值和 2k一致,其中 k 为 x 的 2 进制表示中最低位 1 后面所有 0 的数量,熟悉不熟悉?这个 lowbit(x) 和我们上文中计算该元素所管辖区间长度的值一致!这不就简单了! lowbit(x) 的计算方法:lowbit(x) = x & -x 我们以计算 c[2] 为例,lowbit(2) = 2 & -2,其中 2 的 2 进制表示为 0010,-2 的 2 进行表示为 1110,它的计算方法为将 2 的所有非符号位二进制全部取反后再加 1,即 1101 + 1 = 1110,执行 & 运算后结果为 0010,十进制表示为 2,与 21值一致。lowbit 的计算用代码表示为: int lowbit(int x) { return x & -x; } 我们以 c[1] 节点为例计算下它的父节点是谁,lowbit(1) = 1 & -1 = 0001 & 1111 = 0001 = 1,那么它的父节点为 c[1 + 1] = c[2],与图上表示的一致。 现在我们已经知道如何通过计算来创建树状数组了, 接下来我们要看下它的应用。 区间查询 区间查询我们先讨论计算前 N 项和的方法,比如我们现在要查询前 6 项和,我们来看下它查询的过程: 从 c[6] 开始找子节点,有 c[6] 管辖的区间为 [5, 6],那么再往下找需要找 c[4],它的区间为 [1, 4],计算这两个节点的和即可。 那么从 c[6] 跳到 c[4] 是如何计算出来的呢?我们可以通过 c[6] 区间的下界减 1 来得到,转换成公式表示即为 x - lowbit(x) = 6 - 2 = 4,当它跳到 c[4] 时发现已经满足求和条件,不再向下跳而结束查找,而且我们可以通过计算 4 - lowbit(4) = 4 - 4 = 0 ,可以发现当 x - lowbit(x) = 0 时为结束查找的条件。我们用代码来表示为: int query(int x) { int res = 0; for (int i = x; i > 0; i -= lowbit(i)) { res += c[i]; } return res; } 那么我们计算区间 [3, 6] 的和该如何计算呢?我们从图中可以发现,先计算出[1, 6] 和 [1, 2] 的和,再使用前者减去后者即为所得,用代码表示为: int query(int left, int right) { return query(right) - query(left - 1); } 单点修改 如果我们要修改 a[x] 的值,我们仅需要修改所有管辖了 a[x] 的 c[y] 即可,而 a[x] 可能会被多个 c[y] 管辖,这些所有的 c[y] 节点该如何确定呢?我们可以回头再去看看前面的树状数组配图,比如我们要修改 a[1] 的值,那么我们需要修改 c[1], c[2] 和 c[4] ,能不能发现它是在不断的跳父节点修改?所以,如果我们要修改数组中某个元素的值,树状数组的更新则是不断地更新父节点值。好,我们直接上代码吧: // 将 index 索引处的值更新为 num void update(int index, int num) { a[index] = num; add(index, num - a[index]); } // 更新 c[index] 的值,变化差值为 val void add(int index, int val) { for (int i = index; i <= c.length; i += lowbit(i)) { c[i] += val; } } 建树 好了,区间查询和单点修改我们都讲完了,但是从头到尾我们还没说过树状数组是怎么建立的呢。我们可以想一下,c 数组初始化时每个索引处的值都为 0,建树仅需要将 a 数组中所有值都在树状数组中执行单点修改即可: public BinaryIndexedTree(int[] a) { this.a = a; this.c = new int[a.length + 1]; for (int i = 0; i < a.length; i++) { add(i + 1, a[i]); } } 到这里我们基本上已经将树状数组讲解完毕了,它的全量代码如下: public class BinaryIndexedTree { int[] a; int[] c; public BinaryIndexedTree(int[] a) { this.a = a; this.c = new int[a.length + 1]; for (int i = 0; i < a.length; i++) { add(i + 1, a[i]); } } // 将 index 索引处的值更新为 num void update(int index, int num) { a[index] = num; add(index, num - a[index]); } // 更新 c[index] 的值,变化差值为 val void add(int index, int val) { for (int i = index; i < c.length; i += lowbit(i)) { c[i] += val; } } int query(int left, int right) { return query(right) - query(left - 1); } // 查询前缀和的方法 int query(int x) { int res = 0; for (int i = x; i > 0; i -= lowbit(i)) { res += c[i]; } return res; } int lowbit(int x) { return x & -x; } } 巨人的肩膀 树状数组(简单介绍) 负数的二进制表示方法(正数:原码、负数:补码) 树状数组 算法学习笔记(2) : 树状数组 维基百科 - 树状数组 关于各类「区间和」问题如何选择解决方案(含模板) 算法学习笔记(19): 离散化 作者:京东物流 王奕龙 来源:京东云开发者社区 自猿其说Tech 转载请注明来源

优秀的个人博客,低调大师

全场景流量验证系统 | 京东物流技术团队

本文介绍了一种基于线上流量实现对重构系统进行功能和性能验证的实践方案。针对线上流量如何拦截、如何录制、如何存储、如何回放以及如何发压均作了详细说明,为具有类似需求的读者提供了一种可供参考的思路。 1 业务背景 随着百川项目的启动,中台需要对订单流量收口,将ECLP、各BP的接单入口全部切换至百川统一接单系统。且各个接单入口调用方式各异,有JOS请求(外部商家)、JSF请求(如TC),也有MQ异步消息(如POP)。为了确保各系统平稳切量,最大程度降低切量风险,需要在切量前做充分的流量验证(包括功能验证和性能验证)。为此,设计了一套全场景流量验证系统,支持基于线上流量的AB验证(功能验证)、压测(性能验证),为各业务线接单切量工作提供了可靠的基础支撑。 2 名词解释 引流:把各个接单入口所在系统的线上流量引入到流量验证系统。 录制:复制线上流量并做持久化存储。 回放:把录制的流量打到待验证系统。 切量:把接单流量从ECLP等老的接单系统切换到新的百川统一接单系统中。 AB验证:线上流量同时打到正式环境和AB环境,对两个环境的结果做对比分析,验证AB环境的正确性。 3 设计思路 如何引流? 可以在业务系统中引入流量代理的方式实现引流。 如何录制? 考虑需要支持大数据量以及复合查询,选择使用ES作为持久化存储方案。 如何回放? 为避免对各业务系统Jar包依赖,选择使用JSF泛化调用实现流量回放。 是否有类似的系统可用? 月光宝盒(jcase):由京东零售开发的一款流量录制回放系统。其支持流量录制、回放功能,但是并不能满足一些个性化的需求,比如按自定义业务规则录制、切量控制等。 4 系统设计 4.1 总体设计 流量代理:通过拦截、过滤、上报将流量引流到验证系统中。 录制服务:接收流量代理引入的线上流量并做持久化存储。 回放引擎:使用录制的线上流量请求待验证目标接口。 压测引擎:使用录制的线上流量向待验证目标接口实现多线程发压。 4.2 详细设计 4.2.1 流量代理 1)通用流量代理 在业务系统中引入流量代理,通过流量代理拦截(JSF Filter或AOP)线上流量,并将流量通过异步MQ方式上报给录制服务做持久化存储。 2)JOS流量代理 外部商家通过HTTP方式调用JOS平台,JOS平台内部转JSF调用接单服务。为使外部商家无感,发布一个和业务系统接口完全相同的JSF服务(虚服务),不同的是提供一个新的别名,通过JOS平台配置切换到新的别名,这样就把JOS流量引入到了录制代理,然后再由录制代理通过异步MQ方式将流量上报给录制服务做持久化存储。 4.2.2 流量存储 录制的流量持久化存储到ES,按照[接口:方法]维度创建录制任务,同一个录制任务下的记录主键均以录制任务编号为前缀,后缀为数字递增,最大后缀(缓存到Redis中)即该录制任务下录制的记录总数。 属性名 示例值 示例值 id RT7625109167934456_1 主键标识 recordData {"args":[{"fakeNo":"fakeNo001"}],"argsType":["cn.jdl.baichuan.router.replay.contract.domain.fake.FlowFakeRequest"],"attachments":{"traceId":"8112206384546625","type":"1"},"clazzName":"cn.jdl.baichuan.router.replay.contract.service.RouterFlowFakeService","methodName":"match","resultObj":true} 录制的body体 recordTaskNo RT7625109167934456 所属录制任务编号 timestamp 1636719778929 时间戳 4.2.3 流量回放 支持单条、批量、按录制任务维度批量回放。回放调用采用JSF泛化调用方式,避免了对业务系统Jar包的依赖。 流量回放的同时,支持配置对比服务,对比服务接收入参以及新老接口的出参结果,可以对新老接口处理结果进行对比分析,以验证新接口功能的正确性。 4.2.4 流量压测 为了实现发压的效果,需要采用多机、多线程并发的方式请求目标接口。但是多机、多线程共用了同一份录制数据作为压力数据源。因此,在真正发压之前,需要为每个执行线程分配好数据,各个线程只取自己的数据,互不干扰。 发压策略(主从架构,Master分配,Slave执行) 压测引擎采用主从架构,压力机分主从节点,主节点负责接收压测请求并分配压测任务;从节点负责执行压测任务。 数据分配策略(按量平均,余数轮询,滑动窗口) 1)计算窗口 按录制任务中录制总量,平均分配到各个线程,余数再按轮询方式分配给每个线程,分完为止,这样可以确定出每个线程分配的记录条数(窗口大小); 2)按窗口滑动 将所有录制任务从左到右水平平铺,每个线程按照自己窗口大小从左到右依次占用录制记录。 5 业务实践 5.1 切量验证 以仓配POP接单接口切换为例,我们需要用新的订单中心替换原来的ECLP-SO系统。在正式切换之前,仍然由ECLP-SO系统提供线上接单服务,但同时会通过流量验证系统录制线上流量并回放到新的订单中心。通过对比新老系统对相同接单请求的处理结果,验证新的订单中心的接单功能。经过充分功能验证后才会将接单流量切换到新的订单中心,从而极大降低了切量的风险。 5.2 需求迭代 产品校验服务是产品中心对外提供的一个核心接口,接口逻辑复杂,每一次需求迭代上线都面临极大挑战。即便是经过了测试环境、预发环境验证,依然不能百分百保证上线后对线上业务没有影响。毕竟测试环境、预发环境的验证请求参数单一且有限,无法反映线上请求的多样性和复杂性。因此,产品中心接入了流量验证系统,每次有新的需求迭代上线前,首先录制线上流量,使用线上真实流量在预发环境进行充分验证后再做上线操作。这样极大降低了由于验证不充分,导致线上业务受损的几率,为线上业务提供了一层安全保障,提高了线上系统稳定性。 作者:京东物流 朱永昌 来源:京东云开发者社区自猿其说Tech 转载请注明来源

优秀的个人博客,低调大师

MySQL事务死锁问题排查 | 京东云技术团队

一、背景 在预发环境中,由消息驱动最终触发执行事务来写库存,但是导致MySQL发生死锁,写库存失败。 com.mysql.jdbc.exceptions.jdbc4.MySQLTransactionRollbackException: rpc error: code = Aborted desc = Deadlock found when trying to get lock; try restarting transaction (errno 1213) (sqlstate 40001) (CallerID: ): Sql: "/* uag::omni_stock_rw;xx.xx.xx.xx:xxxxx;xx.xx.xx.xx:xxxxx;xx.xx.xx.xx:xxxxx;enable */ insert into stock_info(tenant_id, sku_id, store_id, available_num, actual_good_num, order_num, created, modified, SAVE_VERSION, stock_id) values (:vtg1, :vtg2, :_store_id0, :vtg4, :vtg5, :vtg6, now(), now(), :vtg7, :__seq0) /* vtgate:: keyspace_id:e267ed155be60efe */", BindVars: {__seq0: "type:INT64 value:\"29332459\" "_store_id0: "type:INT64 value:\"50650235\" "vtg1: "type:INT64 value:\"71\" "vtg2: "type:INT64 value:\"113817631\" "vtg3: "type:INT64 value:\"50650235\" "vtg4: "type:FLOAT64 value:\"1000.000\" "vtg5: "type:FLOAT64 value:\"1000.000\" "vtg6: "type:INT64 value:\"0\" "vtg7: "type:INT64 value:\"20937611645\" "} 初步排查,在同一时刻有两条请求进行写库存的操作。 时间前后相差1s,但最终执行结果是,这两个事务相互死锁,均失败。 事务定义非常简单,伪代码描述如下: start transaction // 1、查询数据 data = select for update(tenantId, storeId, skuId); if (data == null) { // 插入数据 insert(tenantId, storeId, skuId); } else { // 更新数据 update(tenantId, storeId, skuId); } end transaction 该数据库表的索引结构如下: 索引类型 索引组成列 PRIMARY KEY (`stock_id`) UNIQUE KEY (`sku_id`,`store_id`) 所使用的数据库引擎为Innodb,隔离级别为RR[Repeatable Read]可重复读。 二、分析思路 首先了解下Innodb引擎中有关于锁的内容 2.1 Innodb中的锁 2.1.1 行级锁 在Innodb引擎中,行级锁的实现方式有以下三种: 名称 描述 Record Lock 锁定单行记录,在隔离级别RC和RR下均支持。 Gap Lock 间隙锁,锁定索引记录间隙(不包含查询的记录),锁定区间为左开右开,仅在RR隔离级别下支持。 Next-Key Lock 临键锁,锁定查询记录所在行,同时锁定前面的区间,故区间为左开右闭,仅在RR隔离级别下支持。 同时,在Innodb中实现了标准的行锁,按照锁定类型又可分为两类: 名称 符号 描述 共享锁 S 允许事务读一行数据,阻止其他事务获得相同的数据集的排他锁。 排他锁 X 允许事务删除或更新一行数据,阻止其他事务获得相同数据集的共享锁和排他锁。 简言之,当某个事物获取了共享锁后,其他事物只能获取共享锁,若想获取排他锁,必须要等待共享锁释放;若某个事物获取了排他锁,则其余事物无论获取共享锁还是排他锁,都需要等待排他锁释放。如下表所示: 将获取的锁(下)\已获取的锁(右) 共享锁S 排他锁X 共享锁S 兼容 不兼容 排他锁X 不兼容 不兼容  2.1.2 RR隔离级别下加锁示例 假如现在有这样一张表user,下面将针对不同的查询请求逐一分析加锁情况。user表定义如下: CREATE TABLE `user` ( `id` bigint(20) unsigned NOT NULL AUTO_INCREMENT COMMENT '主键ID', `user_id` bigint(20) DEFAULT NULL COMMENT '用户id', `mobile_num` bigint(20) NOT NULL COMMENT '手机号', PRIMARY KEY (`id`), UNIQUE KEY `IDX_USER_ID` (`user_id`), KEY `IDX_MOBILE_NUM` (`mobile_num`) ) ENGINE=InnoDB DEFAULT CHARSET=utf8 COMMENT='用户信息表' 其中主键id与user_id为唯一索引,user_name为普通索引。 假设该表中现有数据如下所示: id user_id mobile_num 1 1 3 5 5 6 8 8 7 9 9 9  下面将使用select ... for update 语句进行查询,分别针对唯一索引、普通索引来进行举例。 1、唯一索引等值查询 select * from user where id = 5 for update select * from user where user_id = 5 for update 在这两条SQL中,Innodb执行查询过程时,会如何加锁呢? 我们都知道Innodb默认的索引数据结构为B+树,B+树的叶子结点包含指向下一个叶子结点的指针。在查询过程中,会按照B+树的搜索方式来进行查找,其底层原理类似二分查找。故在加锁过程中会按照以下两条原则进行加锁: 1. 只会对满足查询目标附近的区间加锁,并不是对搜索路径中的所有区间都加锁。本例中对搜索id=5或者user_id=5时,最终可以定位到满足该搜索条件的区域(1,5]。 2. 加锁时,会以Next key Lock为加锁单位。那按照1满足的区域进行加Next key Lock锁(左开右闭),同时因为id=5或者user_id=5存在,所以该Next key Lock会退化为Record Lock,故只对id=5或user_id=5这个索引行加锁。  如果查询的id不存在,例如: select * from user where id = 6 for update 按照上面两条原则,首先按照满足查询目标条件附近区域加锁,所以最终会找到的区间为(5,8]。因为id=6这条记录并不存在,所以Next key Lock(5, 8]最终会退化为Gap Lock,即对索引(5,8)加间隙锁。 2、唯一索引范围查询 select * from user where id >= 4 and id <8 for update 同理,在范围查询中,会首先匹配左值id=4,此时会对区间(1,5]加Next key Lock,因为id=4不存在,所以锁退化为 Gap Lock(1,5);接着会往后继续查找id=8的记录,直到找到第一个不满足的区间,即Next key Lock(8, 9],因为8不在范围内,所以锁退化为Gap Lock(8, 9)。故该范围查询最终会锁的区域为(1, 9) 3、非唯一索引等值查询 对非唯一索引查询时,与上述的加锁方式稍有区别。除了要对包含查询值区间内加Next key Lock之外,还要对不满足查询条件的下一个区间加Gap Lock,也就是需要加两把锁。 select * from user where mobile_num = 6 for update 需要对索引(3, 6]加Next key Lock,因为此时是非唯一索引,那么也就有可能有多个6存在,所以此时不会退化为Record Lock;此外还要对不满足该查询条件的下一个区间加Gap Lock,也就是对索引(6,7)加锁。故总体来看,对索引加了(3,6]Next key Lock和(6, 7) Gap Lock。 若非唯一索引不命中时,如下: select * from user where mobile_num = 8 for update 那么需要对索引(7, 9]加Next key Lock,又因为8不存在,所以锁退化为Gap Lock (7, 9) 4、非唯一索引范围查询 select * from user where mobile_num >= 6 and mobile_num < 8 for update 首先先匹配mobile_num=6,此时会对索引(3, 6]加Next Key Lock,虽然此时非唯一索引存在,但是不会退化为Record Lock;其次再看后半部分的查询mobile_num=8,需要对索引(7, 9]加Next key Lock,又因为8不存在,所以退化为Gap Lock (7, 9)。最终,需要对索引行加Next key Lock(3, 6] 和 Gap Lock(7, 9)。 2.1.3 意向锁(Intention Locks) Innodb为了支持多粒度锁定,引入了意向锁。意向锁是一种表级锁,用于表明事务将要对某张表某行数据操作而进行的锁定。同样,意向锁也分为类:共享意向锁(IS)和排他意向锁(IX)。 名称 符号 描述 共享意向锁 IS 表明事务将要对表的个别行设置共享锁 排他意向锁 IX 表明事务将要对表的个别行设置排他锁 例如select ... lock in shared mode会设置共享意向锁IS;select ... for update会设置排他意向锁IX 设置意向锁时需要按照以下两条原则进行设置: 1. 当事务需要申请行的共享锁S时,必须先对表申请共享意向IS锁或更强的锁 2. 当事务需要申请行的排他锁X时,必须先对表申请排他意向IX锁 表级锁兼容性矩阵如下表: 将获取的锁(下)/已获取的锁(右) X IX S IS X 冲突 冲突 冲突 冲突 IX 冲突 兼容 冲突 兼容 S 冲突 冲突 兼容 兼容 IS 冲突 兼容 兼容 兼容 如果请求锁的事务与现有锁兼容,则会将锁授予该事务,但如果与现有锁冲突,则不会授予该事务。事务等待,直到冲突的现有锁被释放。 意向锁的目的就是为了说明事务正在对表的一行进行锁定,或将要对表的一行进行锁定。在意向锁概念中,除了对全表加锁会导致意向锁阻塞外,其余情况意向锁均不会阻塞任何请求! 2.1.4 插入意向锁 插入意向锁是一种特殊的意向锁,同时也是一种特殊的“Gap Lock”,是在Insert操作之前设置的Gap Lock。 如果此时有多个事务执行insert操作,恰好需要插入的位置都在同一个Gap Lock中,但是并不是在Gap Lock的同一个位置时,此时的插入意向锁彼此之间不会阻塞。 2.2 过程分析 回到本文的问题上来,本文中有两个事务执行同样的动作,分别为先执行select ... for update获取排他锁,其次判断若为空,则执行insert动作,否则执行update动作。伪代码描述如下: start transaction // 1、查询数据 data = select for update(tenantId, storeId, skuId); if (data == null) { // 插入数据 insert(tenantId, storeId, skuId); } else { // 更新数据 update(tenantId, storeId, skuId); } end transaction 现在对这两个事务所执行的动作进行逐一分析,如下表所示: 时间点 事务A 事务B 潜在动作 1 开始事务 开始事务  2 执行select ... for update操作  事务A申请到IX 事务A申请到X,Gap Lock 3  执行select ... for update操作 事务B申请到IX,与事务A的IX不冲突。 事务B申请到Gap Lock,Gap Lock可共存。 4 执行insert操作  事务A先申请插入意向锁IX,与事务B的Gap Lock冲突,等待事务B的Gap Lock释放。 5  执行insert操作 事务B先申请插入意向锁IX,与事务A的Gap Lock冲突,等待事务A的Gap Lock释放。 6   死锁检测器检测到死锁 详细分析: 时间点1,事务A与事务B开始执行事务 时间点2,事务A执行select ... for update操作,执行该操作时首先需要申请意向排他锁IX作用于表上,接着申请到了排他锁X作用于区间,因为查询的值不存在,故Next key Lock退化为Gap Lock。 时间点3,事务B执行select ... for update操作,首先申请意向排他锁IX,根据2.1.3节表级锁兼容矩阵可以看到,意向锁之间是相互兼容的,故申请IX成功。由于查询值不存在,故可以申请X的Gap Lock,而Gap Lock之间是可以共存的,不论是共享还是排他。这一点可以参考Innodb关于Gap Lock的描述,关键描述本文粘贴至此: Gap locks can co-exist. A gap lock taken by one transaction does not prevent another transaction from taking a gap lock on the same gap. There is no difference between shared and exclusive gap locks. They do not conflict with each other, and they perform the same function. 时间点4,事务A执行insert操作前,首先会申请插入意向锁,但此时事务B已经拥有了插入区间的排他锁,根据2.1.3节表级锁兼容矩阵可知,在已有X锁情况下,再次申请IX锁是冲突的,需要等待事务B对X Gap Lock释放。 时间点5,事务B执行insert操作前,也会首先申请插入意向锁,此时事务A也对插入区间拥有X Gap Lock,因此需要等待事务A对X锁进行释放。 时间点6,事务A与事务B均在等待对方释放X锁,后被MySQL的死锁检测器检测到后,报Dead Lock错误。 思考:假如select ... for update 查询的数据存在时,会是什么样的过程呢?过程如下表: 时间点 事务A 事务B 潜在动作 1 开始事务 开始事务  2 执行select ... for update操作  事务A申请到IX 事务A申请到X行锁,因数据存在故锁退化为Record Lock。 3  执行select ... for update操作 事务B申请到IX,与事务A的IX不冲突。 事务B想申请目标行的Record Lock,此时需要等待事务A释放该锁资源。 4 执行update操作  事务A先申请插入意向锁IX,此时事务B仅仅拥有IX锁资源,兼容,不冲突。然后事务A拥有X的Record Lock,故执行更新。 5 commit  事务A提交,释放IX与X锁资源。 6  执行select ... for update操作 事务B事务B此时获取到X Record Lock。 7  执行update操作 事务B拥有X Record Lock执行更新 8  commit 事务B释放IX与X锁资源 也就是当查询数据存在时,不会出现死锁问题。 三、解决方法 1、在事务开始之前,采用CAS+分布式锁来控制并发写请求。分布式锁key可以设置为store_skuId_version 2、事务过程可以改写为: start transaction // RR级别下,读视图 data = select from table(tenantId, storeId, skuId) if (data == null) { // 可能出现写并发 insert } else { data = select for update(tenantId, storeId, skuId) update } end transaction 虽然解决了插入数据不存在时会出现的死锁问题,但是可能存在并发写的问题,第一个事务获得锁会首先插入成功,第二个事务等待第一个事务提交后,插入数据,因为数据存在了所以报错回滚。 3、调整事务隔离级别为RC,在RC下没有next key lock(注意,此处并不准确,RC会有少部分情况加Next key lock),故此时仅仅会有record lock,所以事务2进行select for update时需要等待事务1提交。 参考文献 [1] Innodb锁官方文档:https://dev.mysql.com/doc/refman/5.7/en/innodb-locking.html [2] https://blog.csdn.net/qq_43684538/article/details/131450395 [3] https://www.jianshu.com/p/027afd6345d5 [4] https://www.cnblogs.com/micrari/p/8029710.html 若有错误,还望批评指正 作者:京东零售 刘哲 来源:京东云开发者社区 转载请注明来源

优秀的个人博客,低调大师

后端服务之应用预热 | 京东云技术团队

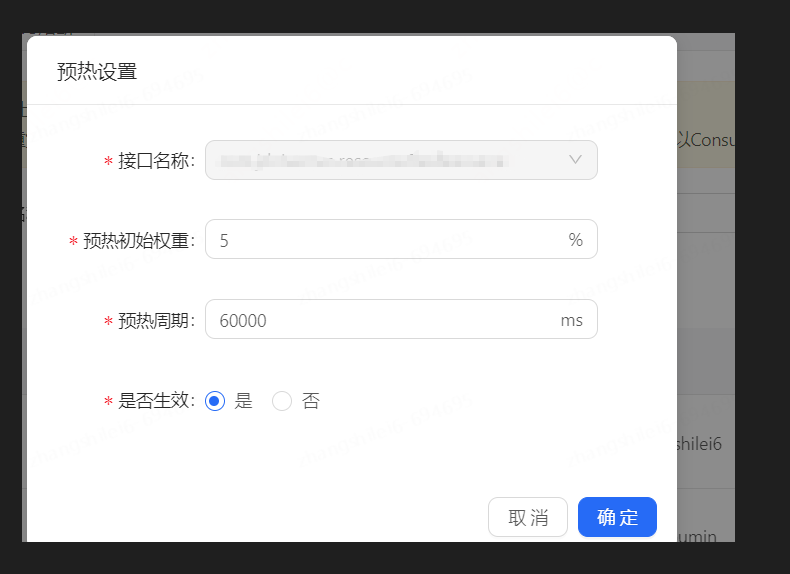
一 背景 C端服务应用升级和重启,导致耗时瞬时抖动,业务超时,应用监控报警,上游感知明显,导致用户体验变差。 二 应用升级重启导致抖动的原因 1 C端服务应用升级和重启的冷启动阶段,它需要重新加载和初始化各种资源,例如数据库连接、缓存数据等,导致耗时瞬时飙升。 2 应用重启后,本地缓存失效,应用需要重新加载数据,导致耗时变长。 3 应用重启后,有大量请求堆积,导致系统负载增加,线程处理不及时,导致系统响应变慢。 三 解决方案 1 停服时,先下线JSF接口,再升级应用,待应用启动成功后,JSF服务接口延迟注册到注册中心。 2 JSF开启预热功能,是服务提供者重启后,JSF上线后,消费者与服务者建立链接后,调用方客户端先放设置比例的小部分流量过来到升级重启的实例,在预热周期内,逐步到100% 3 在应用升级流程编排中,结合流量回放,编排流程,在流量回放后再操作JSF上线,实现略复杂,依赖基础运维 方案1,方案2实现简单,预热效果也比较好,使用的是JSF的预热功能,以下效果对比的实现来自方案2的JSF预热功能。 四 采用JSF开启预热功能效果对比 1 服务提供者配置预热周期 预热初始权重:consumer连接到provider后,provider的初始权重(provider端权重会在预热周期内会逐渐恢复到正常权重,一般是100)  2 未开启预热容器实例整体升级重启监控: 应用部署在3个机房,所以看到3次抖动,可以看到TP999最高的机房达到了近25s。  开启预热后整体实例升级重启效果: 应用部署在3个机房,所以看到3次抖动,可以看到TP999最高的机房降到了2.5s,降幅达10倍。  3 未开启预热,单实例应用重启监控 max达到了20s,TP999到达了18s  开启预热后,单实例应用重启监控 max降到了2s,TP999将到了1.5s左右,降幅达10倍,TPS在配置的预热周期内(60s)呈现线性增长  五 注意事项 依赖服务调用方升级JSF到1.7.6版本及以上,推动所有调用方升级JSF 可根据应用的启动时间和特性,调整应用匹配的预热周期,达到相对预热效果最好的状态。至于是否有必要结合流量回放和流程编排实现预热,需结合自己的业务情况和实现成本考虑。 作者:京东科技 张石磊 来源:京东云开发者社区 转载请注明来源

优秀的个人博客,低调大师

慢SQL的致胜法宝 | 京东物流技术团队

大促备战,最大的隐患项之一就是慢SQL,对于服务平稳运行带来的破坏性最大,也是日常工作中经常带来整个应用抖动的最大隐患,在日常开发中如何避免出现慢SQL,出现了慢SQL应该按照什么思路去解决是我们必须要知道的。本文主要介绍对于慢SQL的排查、解决思路,通过一个个实际的例子深入分析总结,以便更快更准确的定位并解决问题。 解决步骤 step1、观察SQL 出于一些历史原因有的SQL查询可能非常复杂,需要同时关联非常多的表,使用一些复杂的函数、子查询,这样的SQL在项目初期由于数据量比较少,不会对数据库造成较大的压力,但是随着时间的积累以及业务的发展,这些SQL慢慢就会转变为慢SQL,对数据库的性能产生一定的影响。 对于这样的SQL,建议先了解业务场景,梳理关联关系,尝试将SQL拆解为几个简单的小SQL,在内存中关联组合。 step2、分析问题 大家在分析慢SQL时最常用的工具肯定是explain语句,如下是explain语句的执行输出。 一般情况下我们最需要关注的指标有type、possible_keys、key、rows、extra几项。 type为连接类型,有如下几种取值,性能从好到坏排序如下: system:该表只有一行(相当于系统表),system是const类型的特例 const:针对主键或唯一索引的等值查询扫描, 最多只返回一行数据. const 查询速度非常快, 因为它仅仅读取一次即可 eq_ref:当使用了索引的全部组成部分,并且索引是PRIMARY KEY或UNIQUE NOT NULL 才会使用该类型,性能仅次于system及const。 ref:当满足索引的最左前缀规则,或者索引不是主键也不是唯一索引时才会发生。如果使用的索引只会匹配到少量的行,性能也是不错的。 TIPS 最左前缀原则,指的是索引按照最左优先的方式匹配索引。比如创建了一个组合索引(column1, column2, column3),那么,如果查询条件是: WHERE column1 = 1、WHERE column1= 1 AND column2 = 2、WHERE column1= 1 AND column2 = 2 AND column3 = 3 都可以使用该索引; WHERE column1 = 2、WHERE column1 = 1 AND column3 = 3就无法匹配该索引。 fulltext:全文索引 ref_or_null:该类型类似于ref,但是MySQL会额外搜索哪些行包含了NULL。这种类型常见于解析子查询 index_merge:此类型表示使用了索引合并优化,表示一个查询里面用到了多个索引 unique_subquery:该类型和eq_ref类似,但是使用了IN查询,且子查询是主键或者唯一索引。例如: index_subquery:和unique_subquery类似,只是子查询使用的是非唯一索引 range:范围扫描,表示检索了指定范围的行,主要用于有限制的索引扫描。比较常见的范围扫描是带有BETWEEN子句或WHERE子句里有>、>=、<、<=、IS NULL、<=>、BETWEEN、LIKE、IN()等操作符。 index:全索引扫描,和ALL类似,只不过index是全盘扫描了索引的数据。当查询仅使用索引中的一部分列时,可使用此类型。有两种场景会触发: 如果索引是查询的覆盖索引,并且索引查询的数据就可以满足查询中所需的所有数据,则只扫描索引树。此时,explain的Extra 列的结果是Using index。index通常比ALL快,因为索引的大小通常小于表数据。 按索引的顺序来查找数据行,执行了全表扫描。此时,explain的Extra列的结果不会出现Uses index。 ALL:全表扫描,性能最差。 possible_keys 展示当前查询可以使用哪些索引,这一列的数据是在优化过程的早期创建的,因此有些索引可能对于后续优化过程是没用的。 key 表示MySQL实际选择的索引,重点需要注意Using filesort和Using temporary,前者代表无法利用索引完成排序操作,数据较少时从内存排序,否则从磁盘排序,后者MySQL需要创建一个临时表来保存结果。 通过EXPLAIN可以初步定位出SQL是否使用索引,使用的索引是否正确,排序是否合理、索引列区分度等情况,通过这些基本就可以定位出绝大部分问题。 step3、指定方案 若无法从SQL本身解决可以根据业务场景和数据分布情况等因素合理制定修改方案。 案例展示 1、本SQL主要存在两个问题,一个是查询结果数据量较大,大约2W条数据,其次就是根据非索引字段oil_gun_price排序,造成filesort。有两种修改选择,一种是改造为分页查询,根据id升序排序,根据id偏移避免深分页的问题,另外就是直接获取符合条件的全量数据,不指定排序方式,然后在内存中排序即可。像这样的场景尽量不要使用数据库进行排序,除非可以直接利用索引进行排序,不然尽量选择一次性或者分页的方式将所有数据加载到内存后在进行排序。 SELECT gs.id, gs.gas_code, gs.tpl_gas_code, gs.gas_name, gs.province_id, gs.province_name, gs.city_id, gs.city_name, gs.county_id, gs.county_name, gs.town_id, gs.town_name, gs.detail_address, gs.banner_image, gs.logo_image, gs.longitude, gs.latitude, gs.oil_gun_serials, gs.gas_labels, gs.status, gs.source, gp.oil_number, gp.oil_gun_price FROM fi_club_oil_gas gs LEFT JOIN fi_club_oil_gas_price gp ON gs.gas_code = gp.gas_code WHERE oil_number = 95 AND status = 1 AND gs.yn = 1 AND gp.yn=1 ORDER BY gp.oil_gun_price ASC; 2、本SQL主要的问题在于在关联查询中使用了子查询进行拼接,子查询中条件较少,相当于先执行了一次全表扫描,将第一次查询的结果加载到内存中再去执行关联,查询时长2.63秒,是比较常见的导致慢SQL的原因,应该尽量避免使用,这里选择子查询改为关联查询,最后执行时长0.71秒 SELECT count(0) FROM trans_scheduler_base tsb INNER JOIN (SELECT scheduler_code, vehicle_number, vehicle_type_code FROM trans_scheduler_calendar WHERE yn = 1 GROUP BY scheduler_code) tsc ON tsb.scheduler_code = tsc.scheduler_code WHERE tsb.type = 3 AND tsb.yn = 1; ----------修改后-------------- SELECT count(distinct(tsc.scheduler_code)) FROM trans_scheduler_base tsb LEFT JOIN trans_scheduler_calendar tsc ON tsb.scheduler_code = tsc.scheduler_code WHERE tsb.type = 3 AND tsb.yn = 1 AND tsc.yn=1 3、本SQL比较典型,是非常容易被忽视但又经常出现的慢SQL。SQL中carrier_code和trader_code都有索引,但是最后使用了update_time索引,这是由于MYSQL优化器优化后的结果,可能导致实际执行时使用的索引跟预想的不一样,这种SQL常见于在使用共用的查询SQL,实际上很多情况下并不能完全适用,例如排序方式,查询字段,返回条数等等,因此还是建议不同的业务逻辑使用自己单独定义的SQL。解决方式可以使用force_index根据情况指定索引或者修改排序方式 SELECT id, carrier_name, carrier_code, trader_name, trader_code, route_type_name, begin_province_name, begin_city_name, begin_county_name, end_province_name, end_city_name, end_county_name FROM carrier_route_config WHERE yn = 1 AND carrier_code ='C211206007386' AND trader_code ='010K1769496' ORDER BY update_time DESC LIMIT 10; 对于 limit N 带有 group by ,order by 的 SQL 语句 (order by 和 group by 的字段有索引可以使用),MySQL 优化器会尽可能选择利用现有索引的有序性,减少排序--这看起来是 SQL 的执行计划的最优解,但是实际上效果可能会南辕北辙,相信大家都遇到过很多案例中 SQL 执行计划选择 order by id 的索引进而导致全表扫描,而不是利用 where 条件中的索引查找过滤数据,这样就可能导致查询很低效(当然查询也可能很高效,这个跟表中数据的具体分布有关) order by limit 优化能起到正面作用的前提是,首先假设有序索引和无序索引是不相关的,其次假设数据是均匀分布的。 这两个假设是估算通过排序索引来访问cost 的前提(但是现实生产环境中这两个假设在绝大多数场景中都是不成立的,所以就造成多数场景下索引选择错误),有可能会遇到通过条件索引过滤执行时间为几十毫秒,但是通过索引排序扫描耗时1小时的情况,可以认为是MySQL的一个bug。 4、SQL中的limit也是经常导致慢SQL的原因之一,当对SQL使用了limit进行限制时,如果SQL使用的limit限制大于剩余的总条数,并且使用的索引条件不能很好的利用上有序的特性,那么MYSQL很可能会进行全表扫描。例如下面这个SQL,SQL在执行过程中使用了create_time索引,但是条件中没有create_time作为条件,而SQL结果总条数为6,小于此时limit的结果10,因此MYSQL进行了全表扫描,耗时2.19秒,而当将limit改为6时,SQL执行时长为0.01秒,因为当MYSQL在查询到6条满足条件的结果时就直接返回了,不会再进行全表扫描。因此,当分页查询的数据已经不满一页的情况下,最好手动设置limit参数。 SELECT cva.id, cva.carrier_vehicle_approval_code, dsi.driver_erp, d.driver_name, cva.vehicle_number, cva.vehicle_type, cva.vehicle_kind, cva.fuel_type, cva.audit_user_code, dsi.driver_id, cva.operate_type, dsi.org_code, dsi.org_name, dsi.prov_code, dsi.prov_name, dsi.area_code, dsi.area_name, dsi.node_code, dsi.node_name, dsi.position_name, cva.create_user_code, cva.audit_status, cva.create_time, cva.audit_time, cva.audit_reason, d.jd_pin, d.call_source, cv.valid_status FROM driver_staff_info dsi INNER JOIN carrier_vehicle_approval cva ON cva.driver_id = dsi.driver_id INNER JOIN driver d ON dsi.driver_id = d.driver_id INNER JOIN carrier_vehicle_info cv ON cv.vehicle_number = cva.vehicle_number WHERE dsi.yn = 1 AND d.yn = 1 AND cva.yn = 1 AND cv.yn = 1 AND dsi.org_code = '3' AND dsi.prov_code = '021S002' AND cva.carrier_code = 'C230425013337' AND cva.yn = 1 AND cva.audit_status = 0 AND d.call_source IN ('kuaidi', 'kuaiyun') ORDER BY cva.create_time DESC LIMIT 10 5、如下SQL表关联过多,导致数据库加载的数据量比较大,可以根据实际情况选择先查出来一张表的数据作为基础数据,再根据连表条件把剩下的字段填充上。数据量较大的表不建议关联过多表,可以通过适当冗余字段或者加工宽表代替。 SELECT blsw.bid_line_code, blsw.bid_bill_code, blsw.bid_line_name, blsw.step_code, blsw.step_type, blsw.step_type_name, blsw.step_weight, blsw.step_weight_scale, blsw.block_price, blsw.max_weight_flag, blsw.id, blsw.need_quote_price, bbs.step_item_code, bbs.step_item_name, bbs.step_seq, bl.bid_line_seq FROM bid_line_step_weight blsw LEFT JOIN bid_bill_step bbs ON blsw.bid_bill_code = bbs.bid_bill_code AND blsw.step_code = bbs.step_code AND blsw.step_type = bbs.step_type LEFT JOIN bid_line bl ON blsw.bid_line_code = bl.bid_line_code AND blsw.bid_bill_code = bl.bid_bill_code WHERE blsw.yn = 1 AND bbs.yn = 1 AND bl.yn=1 AND blsw.bid_bill_code = 'BL230423051192'; 6、本SQL使用update_time作为时间范围索引,需要注意是否存在热数据过于集中的问题,导致查询数据量非常大,排序条件比较复杂,无法直接通过SQL优化解决。一方面需要先解决热数据过于集中的问题,一方面需要根据业务场景优化,比如增加一些默认条件以缩减数据量。 SELECT r.id, r.carrier_code, r.carrier_name, r.personal_name, r.status, r.register_org_name, r.register_org_code, r.register_city_name, r.verify_status, r.cancel_time, r.reenter_time, r.verify_user_code, r.data_source, r.sign_contract_flag, r.register_time, r.update_time, r.promotion_erp, r.promotion_name, r.promotion_pin, r.board_time, r.sync_basic_status, r.personal_verify_result, r.cert_verify_result, r.qualify_verify_result, r.photo_verify_result, d.jd_pin, d.driver_id, v.vehicle_number, v.vehicle_type, v.vehicle_length, r.cancellation_code , r.cancellation_remarks FROM carrier_resource r LEFT JOIN carrier_driver d ON r.carrier_code = d.carrier_code LEFT JOIN carrier_vehicle v ON r.carrier_code = v.carrier_code WHERE r.update_time >= '2023-03-26 00:00:00' AND r.update_time <= '2023-04-02 00:00:00' AND r.yn = 1 AND v.yn = 1 AND d.yn = 1 AND d.status != -1 AND IFNULL(r.carrier_individual_type,'') != '2' ORDER BY (case r.verify_status WHEN 30 THEN 1 WHEN 20 THEN 2 WHEN 25 THEN 3 WHEN 35 THEN 4 WHEN 1 THEN 5 ELSE 6 end), r.update_time desc, if((v.driving_license_time IS null AND d.driver_license_time IS null), 0, 1) desc, if(((v.driving_license_time IS NOT null AND v.driving_license_time < NOW()) OR (d.driver_license_time IS NOT null AND d.driver_license_time < NOW())), 2, 0) DESC LIMIT 10; 实际开发过程中还有许多从SQL本身不好优化的场景,比如查询数据加载过多、表数据量过大、数据倾斜严重等等,尽量根据业务场景进行一些必要的保护措施限制,在不影响业务的情况下寻找替代方案,例如使用ES进行查询,不过还是需要根据实际的场景选择不同的方式解决。 7、对于一些较大数据量的表,在进行分页查询的时候其实很快就能返回结果,但是在进行分页count总条数时往往很慢,这是因为在分页查询时会有pageSize的限制,当MYSQL查询到满足条数的数据后就会直接返回,而在进行count时则会根据条件全表查询,当条件包含的数据量过大时就会限制SQL的性能。这种情况下建议一方面将分页逻辑重写,分离count和selectList,可以考虑应用ES作为count数据来源,或在某些条件下如果已存在总条数则不再count,减少分页count的次数;另一方面限制分页深度避免出现深分页。 总体优化原则 创建合适的索引 减少不必要访问的列 使用覆盖索引 语句改写 数据结转 选择合适的列进行排序 适当的列冗余 SQL拆分 适当应用ES 作者:京东物流 李文浩 来源:京东云开发者社区 自猿其说Tech 转载请注明来源

优秀的个人博客,低调大师

MySQL MVCC 原理分析 | StoneDB技术分享会 #6

StoneDB开源地址 https://github.com/stoneatom/stonedb 设计:小艾 审核:丁奇、李浩 责编:宇亭 作者:张烜玮 佐治亚理工学院-计算机科学-在读硕士 StoneDB 内核研发实习生 当多个事务操作同一行数据时,会出现各种并发问题。MySQL 通过四个隔离级别来解决这些问题: 读未提交隔离级别最宽松,基本上不进行隔离,因此实现非常简单。读提交隔离级别是每次执行语句(包括查询和更新语句)时,都会生成一个一致的视图,以确保当前事务可以看到其他事务提交的数据。可重复读隔离级别的实现是每个事务在打开时都会生成一个一致的视图。当其他事务提交时,它不会影响当前事务中的数据。为了确保这一点,MySQL 通过多版本控制机制 MVCC 实现。串行化隔离级别的隔离级别相对较高,是通过锁定实现的,因此 MySQL 有一套锁定机制。 提交读取和可重复读取隔离级别都依赖于 MVCC 多版本控制机制的实现。今天我们将讨论 MySQL 中的 MVCC 多版本控制机制。 MVCC 基本原理 MVCC 机制使用read-view机制和undo log版本链比较机制,使得不同的事务根据数据版本链比较规则读取相同数据的不同版本。 undo log 版本链 当一个事务被打开时,它首先会申请一个事务 ID:transaction-id 当一个事务修改一行数据时,MySQL 会保留修改前的 undo 回滚日志,并将事务 ID:transaction id 分配给版本记录中的trx_id字段。 将这些 undo 日志连接起来形成历史版本链,如图所示: 请注意,此处记录的版本并非真实的物理实体。实际上,只有最新的记录存在于真实的物理实体中,其他历史记录都是从 undo 日志中推导出来的。 一致性视图 可重复读隔离级别和读提交隔离级别是通过生成一个一致的视图来实现的,即读视图。什么是一致性视图? 当事务启动时,InnoDB 为事务构造一个数组,以存储事务启动时处于活动状态的所有事务 ID。Active 表示它已启动,但未提交。 数组中 id 的最小值为低位,最大值+1 记录为高位,即一致性视图。 每个事务进行查询时,都会根据一致性视图的可见性规则,推导出撤销日志版本链中对应的数据。 下面我们结合源码分析下一致性视图 ReadView 类的主要构成 classReadView{.../**任何trx_id大于等于该值的记录都不应该被读到*/trx_id_tm_low_limit_id;//highposition/**任何trx_id小于该值的记录都可以读取到*/trx_id_tm_up_limit_id;//lowposition/**生成该ReadView的事务的txn_id.*/trx_id_tm_creator_trx_id;/**生成ReadView时,当前系统中所有活跃事务的txn_id列表*/ids_tm_ids;} 由分析可知 ReadView 类中的 m_low_limit_id 变量对应的是上图中的高位,m_up_limit_id 变量对应的是低位,在下面具体的案例分析中我们还是使用高位和低位来描述一致性视图 ReadView。 可见性规则的应用 如果当前事务 id落在紫色部分,则表示该版本是已提交事务或由当前事务本身生成,并且该数据是可见的。 如果当前事务 id落在蓝色部分,则表示该版本是由未来启动的事务生成的,肯定是不可见的。 如果当前事务 id位于橙色部分,则包括两种情况: A.如果行trx_id在数组中,则表示此版本是由尚未提交且不可见的事务生成的。 B.如果行trx_id不在数组中,则表示此版本由已提交的事务生成,可见。 下面我们以可重复读隔离级别为例,分析一些典型的并发事务可见性判断场景。 Case 1 在图中,事务 A 查询的是什么i?让我们先分析一下。 按照从上到下打开事务的顺序,每个事务对应的一致性视图如下: 一致性视图数组transaction A [11] 一致性视图数组transaction B [11,12] 一致性视图数组transaction C [11,12,13] 当事务 A 查询时,undo 日志版本链为: {trx_id=11,id=1,i=10,roll_pointer=0}<<<{trx_id=13,id=1,i=11,roll_pointer=1}<<<{trx_id=12,id=1,i=12,roll_pointer=2} {}表示版本记录。 <<<表示回滚日志 undo log。 当事务 A 查询时,事务 B 和事务 C 属于未来事务,对事务 A 不可见。 因此,事务 A 查询的数据是通过按照 undo 日志不断向前回滚和回滚到最新数据记录获得的:i=10。 Case 2 事务 A 的两次 SELECT 的查询结果分别是什么? 根据 ReadView 的可见性规则,对于事务 A,事务 B 是一个未来的事务,对事务 A 不可见,所以第一次的查询结果为 i=10。 对于第二次的查询,按照可重复读隔离级别的可见性规则,事务 A 应该无法感知事务 B 中的更新,但是查询结果是 i=12 而不是 i=11,这是为什么呢? 因为当事务 A 要去更新数据的时候,就不能再在历史版本上更新了,否则事务 B 的更新就丢失了。因此,事务 A 此时的 update i=i+1 必须应该在当前最新版本数据 (即 i=11) 的基础上进行的操作。所以,这里就用到了这样一条规则:更新数据都是先读后写的,而这个读,只能读当前的值,称为“「当前读」”(与之对应的是走 MVCC 逻辑的快照读)。 所以只要事务中有 update 语句,则 update 语句以当前读取模式读取版本记录中的最新数据,然后执行更新操作,因此上图中的查询结果为 i=12。 以下两种查询方法也是当前读取: selectkfromtwhereid=1lockinsharemode;selectkfromtwhereid=1forupdate; 以上是 MVCC 机制的可见性判断,其是可重复读和读提交隔离级别的实现原理。(下文以 RR 和 RC 代替) ReadView 相关源码分析 ReadView 创建 当我们在进行查询操作的时候,在我们开启一个事务的时候,系统会依据隔离级别,在相应的位置通过trx_assign_read_view 函数来创建一个属于该事务的 ReadView,在该事务的执行周期内会对于每个要访问的记录与该 ReadView 进行可见性判断。 对于 RC 隔离级别和 RR 隔离级别下,ReadView 的产生时机不同: RR 只在第一次进行快照读 SELECT 时生成一个 ReadView RC 则需要在每一次进行快照读 SELECT 前生成一个 ReadView。 我们依然以 RR 为例分析源码流程: 在事务启动的 trans_begin 函数最终会调用到innobase_start_trx_and_assign_read_view函数 以下代码取自该函数: if(trx->isolation_level==TRX_ISO_REPEATABLE_READ){trx_assign_read_view(trx); trx_assign_read_view调用view_open函数用来创建一个 Read View,具体为其成员变量复制是在prepare 函数中完成的: voidReadView::prepare(trx_id_tid){ut_ad(trx_sys_mutex_own());m_creator_trx_id=id;//与purge策略相关,本文暂不讨论m_low_limit_no=trx_get_serialisation_min_trx_no();m_low_limit_id=trx_sys_get_next_trx_id_or_no();//将当前只读事务的id拷贝到view中的m_ids。if(!trx_sys->rw_trx_ids.empty()){copy_trx_ids(trx_sys->rw_trx_ids);}else{m_ids.clear();}...} 可见性判断 上文讲解了建立 ReadView 的过程,使用聚簇索引判断可见性的函数入口是lock_clust_rec_cons_read_sees,判断逻辑即为前文的 ReadView 可见性规则,篇幅有限此处不展开。 我们主要讨论查询语句的查询字段只有二级索引的情况,那么系统只会读取二级索引的页的记录,不会回表去读取聚簇索引的页记录。但是,版本链的头结点在聚簇索引中,不在二级索引中,通过二级索引的记录无法直接找到版本链。在这种情况下如何使用 MVCC? 二级索引页的头部有一个 page_max_trx_id 表示修改过该页的最大事务 id。 执行 SELECT 时命中该页,如果 ReadView 的 min_trx_id 比该页的 page_max_trx_id 大,说明这个二级索引页修改的事务已经提交,该页的所有记录对本事务的本次查询可见。 否则,就要对“在二级索引页找到的匹配条件的记录”进行回表操作,在聚簇索引对应的记录中按照之前所说的规则找到可见版本: boollock_sec_rec_cons_read_sees(constrec_t*rec,constdict_index_t*index,constReadView*view){...//取索引页上的PAGE_MAX_TRX_ID字段。trx_id_tmax_trx_id=page_get_max_trx_id(page_align(rec));ut_ad(max_trx_id>0);return(view->sees(max_trx_id));} ReadView:sees直接返回PAGE_MAX_TRX_ID是否小于 ReadView 初始化时的最小事务 id,也就是判断修改页上记录的最大事务 id 是否在快照生成的时候已经提交了。 boolsees(trx_id_tid)const{return(id<m_up_limit_id);} 参考文献 MySQL 8.0.33 源码 MySQL 官方文档[1] 数据库内核月报[2] Reference [1] MySQL 官方文档: https://www.notion.so/MySQL-MVCC-b33cae19f3224bf2925143c2b1d85a61?pvs=21 [2] 数据库内核月报: http://mysql.taobao.org/monthly/2015/12/01/ StoneDB 介绍 StoneDB 是石原子科技自主设计研发的国内首款完全兼容于 MySQL 生态的开源 一体化实时 HTAP 数据库产品,具备行列混存、智能索引等核心特性,为 MySQL 数据库提供在线数据实时就近分析服务,能够高效解决 MySQL 数据库在分析型应用场景中面临的能力问题。 同时,StoneDB 使用多存储引擎架构的设计,事务引擎具有数据强一致特性,具备完整的事务并发处理能力,使得 StoneDB 可以替代 MySQL 数据库满足在线事务处理场景的需求,使用 MySQL 的用户,通过 StoneDB 可以实现 TP+AP 混合负载,分析性能提升 10倍以上,不需要进行数据迁移,也无需与其他 AP 集成,弥补 MySQL 分析领域的空白。 加入StoneDB社区 Github:https://github.com/stoneatom/stonedb Gitee:https://gitee.com/StoneDB/stonedb 社区官网:https://stonedb.io/ 哔哩哔哩:https://space.bilibili.com/1154290084 Twitter:https://twitter.com/StoneDataBase Linkedin:https://www.linkedin.com/in/stonedb/ 加入微信群:添加社区助理-小石侠;加入钉钉群:扫描下方钉钉群二维码。 本文分享自微信公众号 - StoneDB(StoneDB2021)。 如有侵权,请联系 support@oschina.cn 删除。 本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

浅谈Redis - 热点key问题 | 京东云技术团队

热key问题描述 热key问题就是突然有几十万的请求去访问redis上的某个特定key,那么这样会造成流量过于集中,达到物理网卡上限,从而导致这台redis服务器直接宕机。 如何发现热点key 凭借业务经验,进行预估哪些是热key。比如某些商品要做秒杀,则商品key就可以判断为热key,但并非所有业务都能预估出热key。 在客户端进行收集。比如在redis客户端执行redis命令之前,加入一行代码进行命令数据收集,然后通过网络将收集的命令发送出去,缺点是对客户端代码有入侵。 在Proxy层做收集,但是并非所有的redis集群都有proxy。 用redis自带命令,monitor命令可以实时抓取出redis服务器接收到的命令,然后写代码统计出热key是啥,不过高并发条件下,有内存暴增的隐患,影响redis的性能。redis4.0.3提供了客户端热点key发现功能,如果key比较多,执行比较慢。 自己抓包评估,redis客户端使用TCP协议与服务端进行交互,通信协议采用RESP,自己写程序监听端口,按照RESP协议规则解析数据进行分析,不过开发成本较高,不易维护。 如何解决热key 增加二级缓存,发现热key以后,可以把热key数据加载到系统JVM并设置合适的缓存过期时间,针对热key的请求就会直接分散到各业务服务器上,防止所有请求同时访问同一台redis。 备份热key。可以把热点key的数据备份到所有redis的集群节点中,可以通过在热点key后面拼接集群节点编号,然后将这些备份key分散到所有集群节点中,客户端访问热点key的时候也在热点key后面随机拼接集群节点编号,将热点key的请求分散到不同集群节点上。 作者:京东零售曹志飞 来源:京东云开发社区 转载请注明来源

优秀的个人博客,低调大师

React请求机制优化思路 | 京东云技术团队

说起数据加载的机制,有一个绕不开的话题就是前端性能,很多电商门户的首页其实都会做一些垂直的定制优化,比如让请求在页面最早加载,或者在前一个页面就进行预加载等等。随着react18的发布,请求机制这一块也是被不断谈起,并且在后续其实也给出了明确的方向。 假如我们页面中有三个组件C1、C2、C3依次嵌套,每个组件中有对应的请求F1、F2、F3,通常大多数人会使用useeffect和state变量来实现数据流的获取,这样就意味着必须在组件加载时才能发起请求,所有数据获取都发生在组件的生命周期中,如下图所示,我们可以将这种获取数据的方式称作瀑布流渲染,但是这种方式有一个问题是,在这种方法中,组件之间的数据获取是按顺序进行的,这实际上意味着它们彼此阻塞,如果组件的层级嵌套很深的话,就会导致页面的加载时间特别长。 为了阻止组件间数据获取的这种顺序阻塞,另一种方法就是在组件加载前可以使用Promise.all获取所有的请求数据,这样在组件加载时就已经获取到所有的数据了。这种方式解决了组件加载顺序阻塞彼此数据流获取的问题,但是也产生了一个新的问题,在请求完成之前页面都会是空白的。 基于第二种先请求后渲染的方式,还可以使用Suspense将请求和渲染并行化,Suspense 可以使得组件可以“等待”某些操作结束后,再进行渲染。而这种方式如果要用到实际项目中,还需要考虑C1、C2、C3对应的请求写在哪里,如果写在组件中,那么加载还是慢的。如果拆分出来,就需要考虑文件拆分、code splitting等工程化问题。 在认真的分析了以上三种方式以后,发现各有优劣,同时基于上述方案,我也提供一个请求优化的思路,首先将请求的JS单独拆分出来打一个文件request.js,在html头部引入request.js并使用async属性让脚本并行执行(如下代码所示),这样既可以保证我们的请求在最开始就能发出,也能不阻塞后续React代码打包的js文件的执行,相当请求和渲染的代码在并行执行。 // html头部引入request.js <script async src="/js/request.js"></script> 在发送完请求之后,需要将返回的数据注入到React组件中,这部分怎么注入呢?简单的代码示例如下: // request.js 中请求部分 evt是发布订阅模式的一个实例 window.InitData = { data: null, on: (msg, fn) => evt.on(msg, e => fn(e)), emit: (msg, data) => evt.emit(msg, data), }; fetch().then(rs => { InitData.data = rs; InitData.emit("init_data", rs); return rs; }); // index.js react代码逻辑 ……. useEffect(() => { if (InitData.data !== null) { // 这里已经获取到了请求的返回值 doSomething(); } else { InitData.on("init_data", (data) => { // 利用发布订阅模式获取到数据 doSomething(); }); } }, []); ……. 总体思路就是在html中最先加载单独打包出来的请求文件并加入async属性使脚本并行执行,将返回的数据挂载到window下或者利用发布订阅模式将数据注入到react组件中。这样其实类似于边请求边渲染的模式,利用提前请求来减少加载的时间。后续也是希望能用工程化的方式去解决数据的请求机制。 未来的话在开发时肯定是更倾向于边请求边渲染的这种模式,在React的官网中也有说到未来计划让Suspense 处理更多的场景,包括获取数据等等,在新发布的React18中Suspense也是支持了服务端渲染,包括近期开源的remix也都在优化请求机制能够让应用更快的加载。也欢迎有兴趣的小伙伴一起来讨论和实践。 作者:京东零售梁峰峰 来源:京东云开发者社区

优秀的个人博客,低调大师

技术干货|如何使用 DolphinDB 解决数据精度问题

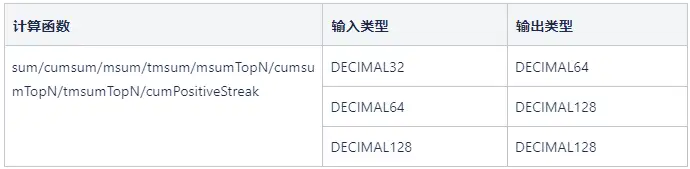
1 DECIMAL 的计算特性 1.1 DECIMAL 的计算方式 DECIMAL 的存储分为两部分,即存储整型数据的 raw data 和存储小数位数的 scale。例如,对于DECIMAL32(2) 类型的 1.23, 它存储了两个数据:(1) raw data:即整型 123,(2) scale:即 2。这样存储的好处是,在计算时可以直接使用整型的 raw data 进行计算,从而避免精度损失。 对于大多数计算函数,如果最后返回的结果是浮点数类型,DECIMAL 在进行计算时, 会使用 raw data 参与计算,尽量延迟转换成浮点数的时机,从而确保得到精确结果。比如计算 avg 时,假设数据为 DECIMAL32(2) 类型:[1.11, 2.22, 3.33],其 raw data 为:[111, 222, 333]。在计算时,先算出 raw data 的 sum:111 + 222 + 333 = 666,然后转换成浮点数:double(666) / 102 / 3 = 2.22。 对于DECIMAL算术运算的规则,可参照:DECIMAL 使用教程 - 知乎 1.2 DECIMAL 的计算输出 本节主要讲述DECIMAL作为计算函数输入的输出结果。 在 DolphinDB 计算函数中,以 DECIMAL 类型作为输入,输出结果仍为 DECIMAL 类型的函数较少,仅有:sum、max、min、first、last、firstNot、lastNot及其 cum、m、tm、TopN 系列函数,如cummax、mmin、tmsum、msumTopN,cumsumTopN,tmsumTopN等;以及cumPositiveStreak。 a = decimal64(rand(10,100),4) typestr(sum(a)) >> DECIMAL128 typestr(cummax(a)) >> FAST DECIMAL64 VECTOR typestr(mmin(a,5)) >> FAST DECIMAL64 VECTOR T = 2023.03.23..2023.06.30 typestr(tmsum(T, a, 3)) >> FAST DECIMAL128 VECTOR typestr(cumPositiveStreak(a)) >> FAST DECIMAL128 VECTOR 需要注意的是,在引入 DECIMAL128 类型后,自 2.00.10 版本起,sum 系列函数和cumPositiveStreak的输入输出类型对应规则如下: 除了上述函数外,cum、m、tm、TopN 系列的函数,包括它们对应的原始的函数,比如avg、std、var、skew等,以 DECIMAL 类型作为输入,都将返回 DOUBLE 类型的输出结果。 a = decimal64(rand(10,100),4) typestr(avg(a)) >> DOUBLE typestr(cumstd(a)) >> FAST DOUBLE VECTOR typestr(mvar(a,5)) >> FAST DOUBLE VECTOR T = 2023.03.23..2023.06.30 typestr(tmskew(T, a, 3)) >> FAST DOUBLE VECTOR 下面将以 DECIMAL64 作为输入为例,列出常见计算函数的输出结果类型。 2 DECIMAL 的优缺点 2.1 DECIMAL 的优点 实数在计算机内部无法被精确地表示为浮点数的原因主要有两个:第一个原因是类似于 0.1 这样的数字,具有有限的十进制表示,但是在二进制中能表示为无穷重复的数据,等于 0.1 的近似值,无法被精确表示;第二个原因是数值超出了数据类型能表示的数值范围,系统将对数据做一定处理。与浮点数相比,DECIMAL 类型最大的优点,就在于它能够精确地表示和计算数据。 例如,在表示123.0001 a =123.0001 print(a) >> 123.000100000000003 b = decimal64(`123.0001,15) print(b) >> 123.000100000000000 可见,浮点数无法精确表示123.0001,而 DECIMAL 可以。 在计算 avg 时: a = array(DOUBLE,0) for (i in 1..100){ a.append!(123.0000+0.0003*i) } avg(a) >> 123.015149999999 avg(a) == 123.01515 >> false eqFloat(avg(a),123.01515) >> true b= array(DECIMAL64(4),0) for (i in 1..100){ b.append!(123.0000+0.0003*i) } avg(b) >> 123.015150000000 typestr(avg(b)) >> DOUBLE avg(b) == 123.01515 >> true 可见,在进行 avg 计算时,浮点数没有返回精确结果,而 DECIMAL 虽然返回结果也是 DOUBLE 类型,但返回了精确结果。 2.2 DECIMAL 的缺点 2.2.1 容易溢出 DECIMAL32/DECIMAL64/DECIMAL128 类型的数值范围如下表所示,其中,DECIMAL32(S)、DECIMAL64(S) 和 DECIMAL128(S) 中的 S 表示保留的小数位数。 底层存储数据类型 字节占用 Scale有效范围 有效数值范围 最大表示位数 DECIMAL32 int32_t 占用4个字节 [0,9] (-1 * 10 ^ (9 - S), 1 * 10 ^ (9 - S)) 9位 DECIMAL64 int64_t 占用8个字节 [0,18] (-1 * 10 ^ (18 - S), 1 * 10 ^ (18 - S)) 18位 DECIMAL128 int128_t 占用16个字节 [0,38] (-1 * 10 ^ (38 - S), 1 * 10 ^ (38 - S)) 38位 在有效数值范围和最大表示位数的限制下,DECIMAL 类型很容易溢出。自 2.00.10 版本起,我们支持算术运算溢出后,若存在更高精度的类型,则将自动拓展结果的数据类型,从而降低溢出风险: version 2.00.9.6: a = decimal32(4.0000,4) b = decimal32(8.0000,4) c = a*b >> Server response: 'c = a * b => Decimal math overflow' version 2.00.10: a = decimal32(4.0000,4) b = decimal32(8.0000,4) c = a*b print(c) >> 32.00000000 typestr(c) >> DECIMAL64 但即使如此,DECIMAL128 仍存在溢出风险: a = decimal128(36.00000000,8) b = a*a*a*a >> Server response: 'b = a * a * a * a => Decimal math overflow' 如上所示,由于 DolphinDB 中 DECIMAL 类型的数据乘法运算结果的 scale 是逐个累加的,b 的预期结果将会是 1679616.00000000000000000000000000000000,将会有39位数字,超出了 DECIMAL128 的最大表示位数38位,导致了溢出。 2.00.10版本新增支持了 DECIMAL 类型的乘法函数decimalMultiply,与multiply函数 (*运算符) 相比,该函数可以指定计算结果的精度。当 DEICMAL 类型的乘法运算导致 scale 累加存在溢出风险时,可以按需使用decimalMultiply函数,指定计算结果精度。 a = decimal64(36.00000000,8) decimalMultiply(a, a, 8) >> 1296.00000000 2.2.2 转换误差 当我们直接使用常量生成 DECIMAL 类型时,可能会因为浮点数的转换产生误差: a = 0.5599 decimal64(a,4) >> 0.5598 为了避免这种误差,可以使用字符串来生成 DECIMAL: a = "0.5599" decimal64(a,4) >> 0.5599 2.2.3 内存占用 DECIMAL32、DECIMAL64 和 DECIMAL128 类型在内存中分别占用4个字节、8个字节和16个字节,而 FLOAT 和 DOUBLE 类型在内存中占用4个字节和8个字节。因此,在数据量相同的情况下,DECIMAL128 占用的内存是 DOUBLE 的两倍。 且由于算术运算溢出后,将自动拓展结果的数据类型,每次拓展后等量数据占用的内存将翻倍,存在一定的内存风险。 2.2.4 性能差异 与 FLOAT 和 DOUBLE 类型相比,DECIMAL 类型的计算速度更慢,我们将在第三节中进行详细比较。 2.2.5 局限性 在 DolphinDB 中,DECIMAL 类型与 FLOAT/DOUBLE 类型相比,目前所支持的功能和结构较少。 在函数支持方面,尚有少部分计算函数不支持 DECIMAL 类型。 计算结果方面,cum, tm, m, TopN 系列的函数,包括它们对应的原始的函数(sum、max、min、firstNot、lastNot、cumPositiveStreak除外),即使原始数据是 DECIMAL 类型,返回结果还是浮点数类型。 数据结构方面,DolphinDB 系统目前暂未支持 DECIMAL 类型在 matrix 和 set 中使用。 数据类型转换方面,DolphinDB 系统暂不支持 BOOL/CHAR/SYMBOL/UUID/IPADDR/INT128 等类型和 temporal 集合下的时间相关类型与 DECIMAL 类型相互转换,其中 STRING/BLOB 类型的数据如需转换成 DECIMAL 类型,必须满足 STRING/BLOB 类型的数据可以转换成数值类型的前提。 3 浮点数与 DECIMAL 计算性能差异比较 为了比较浮点数类型与 DECIMAL 类型的计算性能差异,我们选取了一些常用的计算函数,比较相同数据情况下,各个数据类型的计算耗时。 首先,模拟数据脚本如下: n = 1000000 data1 = rand(float(100.0),n) data2 = double(data1) data3 = decimal32(data1,4) data4 = decimal64(data1,4) data5 = decimal128(data1,4) 随后,使用timer语句统计常用计算函数对于各个类型数据的计算耗时: timer(100){sum(data1)} //执行100次,避免单次计算误差,并放大不同类型间的耗时差异 timer(100){sum(data2)} timer(100){sum(data3)} timer(100){sum(data4)} timer(100){sum(data5)} ... ... 得到的计算耗时统计结果如下(单位:ms): FLOAT DOUBLE DECIMAL32 DECIMAL64 DECIMAL128 sum 52.985 64.331 28.721 57.234 107.126 sum2 173.278 211.772 176.261 180.051 603.422 prod 63.650 55.641 171.718 174.389 18850.009 avg 178.086 210.495 26.094 106.869 258.508 std 362.388 345.758 278.933 319.177 968.276 kurtosis 547.751 407.561 585.859 769.879 1013.591 skew 546.705 439.348 622.758 842.994 1074.128 根据上述统计结果,可以得知: (1)对于大部分计算函数,DECIMAL 的性能都比 FLOAT/DOUBLE 差; (2)DECIMAL128 在计算时,会转换成 LONG DOUBLE(DECIMAL32/DECIMAL64 会转换成 DOUBLE),而 LONG DOUBLE 的实现取决于编译器和 CPU,可能是 12 字节或者 16 字节,LONG DOUBLE 的乘法在数据很大时非常耗时。在本节的测试样例中,vector 里的元素的取值范围较大,所以其乘积非常大,计算非常耗时。而如果把取值范围取小一些,比如 [0.5, 1.0],则 DECIMAL128 的计算和 DECIMAL32/DECIMAL64 相差不大; (3)对于sum、avg、std这样的函数,DECIMAL 类型在计算时都没有做循环展开,而浮点数类型对sum做了循环展开,avg则没有。此外,由于 DECIMAL 计算时会使用 raw data 先参与计算,再直接返回 DECIMAL 类型或转化为浮点数,本质是整型计算,实际过程比浮点数运算更高效。因此,它们的性能相差不大,甚至 DECIMAL32/DECIMAL64 的性能比 FLOAT/DOUBLE 更好。 4 DECIMAL 最佳实践:避免 mavg 计算精度损失 本节将以具体场景,比较 DECIMAL 类型和浮点数类型在实际计算中的精度差异。 mavg和moving(avg,…)虽然在含义上完全相同,但两者的实现方式并不一致。mavg的算法是:随着窗口的移动,总和加上进入窗口的数,减去离开窗口的数,再计算 avg,所以在这个加减的过程中,会产生浮点数精度问题。 首先,我们导入样例数据tick.csv,原始数据类型均为 DOUBLE 类型,并计算mavg、moving(avg,…): data = loadText("<yourDirectory>/tick.csv") t = select MDTime, ((LastPx - prev(LastPx)) / (prev(LastPx) + 1E-10) * 1000) as val, mavg(((LastPx - prev(LastPx)) / (prev(LastPx) + 1E-10) * 1000), 20, 1), moving(avg, ((LastPx - prev(LastPx)) / (prev(LastPx) + 1E-10) * 1000), 20, 1) from data 得到的结果如下图所示: 可以看到,计算结果从09:31:53.000开始产生误差。 为了避免这种计算误差,我们先将中间计算结果转换为 DECIMAL128 类型,再计算mavg和moving(avg,…): t = select MDTime, ((LastPx - prev(LastPx)) / (prev(LastPx) + 1E-10) * 1000) as val, mavg(decimal128(((LastPx - prev(LastPx)) / (prev(LastPx) + 1E-10) * 1000),12), 20, 1), moving(avg, decimal128(((LastPx - prev(LastPx)) / (prev(LastPx) + 1E-10) * 1000),12), 20, 1) from data 得到的结果如下图所示: 可以看到,mavg和moving(avg,…)的计算结果完全一致。 由于浮点数的精度问题,cum, tm, m, TopN 系列的函数,包括它们对应的原始的函数,比如avg、std等,都有可能导致计算的精度误差。在对精度极为关注的场景下,我们推荐使用 DECIMAL 进行计算。需要注意的是,除了sum、max、min、firstNot、lastNot、cumPositiveStreak及其对应的系列函数,在入参是 DECIMAL 类型时能够返回 DECIMAL 类型的计算结果,其他函数都将返回浮点数类型。虽然存在一定的 DECIMAL 类型转换为浮点数类型的精度误差风险,但避免了计算过程中的精度损失,也可以对计算结果使用round函数或再次转换为 DECIMAL 类型,得到相对精确的结果。 5 总结 浮点数由于其实现方式,在计算机内部无法精确地表示某些数值,因而容易出现精度误差,导致存储或计算结果与预期不符。DECIMAL 可以精确表示数值,但存在容易溢出、内存占用大、性能较劣、有一定局限性等缺点。尽管如此,在某些场景中,选用 DECIMAL 类型依旧能够很好地避免存储或计算结果与预期不符的情况出现。 综上所述,在实际应用时,需要考虑具体需要,选用合适的数据类型,对数据进行相应的精度管理。

优秀的个人博客,低调大师

MySQL 执行计划详解 | 京东物流技术团队

1. EXPLAIN详解 本文基于MySQL 8.0编写,理论支持MySQL 5.0及更高版本。 2. EXPLAIN使用 2.1 explain分析SQL的执行计划 {EXPLAIN | DESCRIBE | DESC} tbl_name [col_name | wild] {EXPLAIN | DESCRIBE | DESC} [explain_type] {explainable_stmt | FOR CONNECTION connection_id} {EXPLAIN | DESCRIBE | DESC} ANALYZE select_statement explain_type: { FORMAT = format_name } format_name: { TRADITIONAL | JSON | TREE } explainable_stmt: { SELECT statement | TABLE statement | DELETE statement | INSERT statement | REPLACE statement | UPDATE statement } 2.2 示例 EXPLAIN format = TRADITIONAL json SELECT tt.TicketNumber, tt.TimeIn, tt.ProjectReference, tt.EstimatedShipDate, tt.ActualShipDate, tt.ClientID, tt.ServiceCodes, tt.RepetitiveID, tt.CurrentProcess, tt.CurrentDPPerson, tt.RecordVolume, tt.DPPrinted, et.COUNTRY, et_1.COUNTRY, do.CUSTNAME FROM tt, et, et AS et_1, do WHERE tt.SubmitTime IS NULL AND tt.ActualPC = et.EMPLOYID AND tt.AssignedPC = et_1.EMPLOYID AND tt.ClientID = do.CUSTNMBR; 2.3 结果输出展示 3. 结果解读 id:该语句的唯一标识。如果explain的结果包括多个id值,则数字越大越先执行;而对于相同id的行,则表示从上往下依次执行。 select_type:查询类型,有如下几种取值: table:表示当前这一行正在访问哪张表,如果SQL定义了别名,则展示表的别名 **partitions:**当前查询匹配记录的分区。对于未分区的表,返回null type:连接类型,有如下几种取值,性能从好到坏排序如下: ◦system:该表只有一行(相当于系统表),system是const类型的特例 ◦const:针对主键或唯一索引的等值查询扫描, 最多只返回一行数据. const 查询速度非常快, 因为它仅仅读取一次即可 ◦eq_ref:当使用了索引的全部组成部分,并且索引是PRIMARY KEY或UNIQUE NOT NULL 才会使用该类型,性能仅次于system及const。 -- 多表关联查询,单行匹配 SELECT * FROM ref_table,other_table WHERE ref_table.key_column=other_table.column; -- 多表关联查询,联合索引,多行匹配 SELECT * FROM ref_table,other_table WHERE ref_table.key_column_part1=other_table.column AND ref_table.key_column_part2=1; ◦ref:当满足索引的最左前缀规则,或者索引不是主键也不是唯一索引时才会发生。如果使用的索引只会匹配到少量的行,性能也是不错的。 -- 根据索引(非主键,非唯一索引),匹配到多行 SELECT * FROM ref_table WHERE key_column=expr; -- 多表关联查询,单个索引,多行匹配 SELECT * FROM ref_table,other_table WHERE ref_table.key_column=other_table.column; -- 多表关联查询,联合索引,多行匹配 SELECT * FROM ref_table,other_table WHERE ref_table.key_column_part1=other_table.column AND ref_table.key_column_part2=1; TIPS最左前缀原则 指的是索引按照最左优先的方式匹配索引。比如创建了一个组合索引(column1, column2, column3),那么,如果查询条件是: WHERE column1 = 1、WHERE column1= 1 AND column2 = 2、WHERE column1= 1 AND column2 = 2 AND column3 = 3 都可以使用该索引; WHERE column1 = 2、WHERE column1 = 1 AND column3 = 3就无法匹配该索引。 ◦fulltext:全文索引ref_or_null:该类型类似于ref,但是MySQL会额外搜索哪些行包含了NULL。这种类型常见于解析子查询 SELECT * FROM ref_table WHERE key_column=expr OR key_column IS NULL; ◦index_merge:此类型表示使用了索引合并优化,表示一个查询里面用到了多个索引 ◦unique_subquery:该类型和eq_ref类似,但是使用了IN查询,且子查询是主键或者唯一索引。例如:value IN (SELECT primary_key FROM single_table WHERE some_expr) ◦index_subquery:和unique_subquery类似,只是子查询使用的是非唯一索引。value IN (SELECT key_column FROM single_table WHERE some_expr) ◦range:范围扫描,表示检索了指定范围的行,主要用于有限制的索引扫描。比较常见的范围扫描是带有BETWEEN子句或WHERE子句里有>、>=、<、<=、IS NULL、<=>、BETWEEN、LIKE、IN()等操作符。 SELECT * FROM tbl_name WHERE key_column BETWEEN 10 and 20; SELECT * FROM tbl_name WHERE key_column IN (10,20,30); ◦index:全索引扫描,和ALL类似,只不过index是全盘扫描了索引的数据。当查询仅使用索引中的一部分列时,可使用此类型。有两种场景会触发: ▪如果索引是查询的覆盖索引,并且索引查询的数据就可以满足查询中所需的所有数据,则只扫描索引树。此时,explain的Extra 列的结果是Using index。index通常比ALL快,因为索引的大小通常小于表数据。 ▪按索引的顺序来查找数据行,执行了全表扫描。此时,explain的Extra列的结果不会出现Uses index。 ◦ALL:全表扫描,性能最差。 possible_keys:展示当前查询可以使用哪些索引,这一列的数据是在优化过程的早期创建的,因此有些索引可能对于后续优化过程是没用的。 key:表示MySQL实际选择的索引key_len:索引使用的字节数。由于存储格式,当字段允许为NULL时,key_len比不允许为空时大1字节。 ◦key_len计算公式:https://www.cnblogs.com/gomysql/p/4004244.html ref:表示将哪个字段或常量和key列所使用的字段进行比较。如果ref是一个函数,则使用的值是函数的结果。要想查看是哪个函数,可在EXPLAIN语句之后紧跟一个SHOW WARNING语句。 rows:MySQL估算会扫描的行数,数值越小越好。 filtered:表示符合查询条件的数据百分比,最大100。用rows × filtered可获得和下一张表连接的行数。例如rows = 1000,filtered = 50%,则和下一张表连接的行数是500。 TIPS 在MySQL 5.7之前,想要显示此字段需使用explain extended命令; MySQL.5.7及更高版本,explain默认就会展示filtered Extra:展示有关本次查询的附加信息,取值如下: ◦Child of ‘table’ pushed join@1:此值只会在NDB Cluster下出现。 ◦const row not found:例如查询语句SELECT … FROM tbl_name,而表是空的 ◦Deleting all rows:对于DELETE语句,某些引擎(例如MyISAM)支持以一种简单而快速的方式删除所有的数据,如果使用了这种优化,则显示此值 ◦Distinct:查找distinct值,当找到第一个匹配的行后,将停止为当前行组合搜索更多行 ◦FirstMatch(tbl_name):当前使用了半连接FirstMatch策略,详见 https://mariadb.com/kb/en/firstmatch-strategy/ ,翻译 https://www.cnblogs.com/abclife/p/10895624.html ◦Full scan on NULL key:子查询中的一种优化方式,在无法通过索引访问null值的时候使用 ◦Impossible HAVING:HAVING子句始终为false,不会命中任何行 ◦Impossible WHERE:WHERE子句始终为false,不会命中任何行 ◦Impossible WHERE noticed after reading const tables:MySQL已经读取了所有const(或system)表,并发现WHERE子句始终为false ◦LooseScan(m…n):当前使用了半连接LooseScan策略,详见 https://mariadb.com/kb/en/loosescan-strategy/ ,翻译 http://www.javacoder.cn/?p=39 ◦No matching min/max row:没有任何能满足例如 SELECT MIN(…) FROM … WHERE condition 中的condition的行 ◦no matching row in const table:对于关联查询,存在一个空表,或者没有行能够满足唯一索引条件 ◦No matching rows after partition pruning:对于DELETE或UPDATE语句,优化器在partition pruning(分区修剪)之后,找不到要delete或update的内容 ◦No tables used:当此查询没有FROM子句或拥有FROM DUAL子句时出现。例如:explain select 1 ◦Not exists:MySQL能对LEFT JOIN优化,在找到符合LEFT JOIN的行后,不会为上一行组合中检查此表中的更多行。例如: SELECT * FROM t1 LEFT JOIN t2 ON t1.id=t2.id WHERE t2.id IS NULL; ◦假设t2.id定义成了NOT NULL ,此时,MySQL会扫描t1,并使用t1.id的值查找t2中的行。 如果MySQL在t2中找到一个匹配的行,它会知道t2.id永远不会为NULL,并且不会扫描t2中具有相同id值的其余行。也就是说,对于t1中的每一行,MySQL只需要在t2中只执行一次查找,而不考虑在t2中实际匹配的行数。 ◦在MySQL 8.0.17及更高版本中,如果出现此提示,还可表示形如 NOT IN (subquery) 或 NOT EXISTS (subquery) 的WHERE条件已经在内部转换为反连接。这将删除子查询并将其表放入最顶层的查询计划中,从而改进查询的开销。通过合并半连接和反联接,优化器可以更加自由地对执行计划中的表重新排序,在某些情况下,可让查询提速。你可以通过在EXPLAIN语句后紧跟一个SHOW WARNING语句,并分析结果中的Message列,从而查看何时对该查询执行了反联接转换。 ◦Note:两表关联只返回主表的数据,并且只返回主表与子表没关联上的数据,这种连接就叫反连接Plan isn’t ready yet:使用了EXPLAIN FOR CONNECTION,当优化器尚未完成为在指定连接中为执行的语句创建执行计划时, 就会出现此值。MySQL没有找到合适的索引去使用,但是去检查是否可以使用range或index_merge来检索行时,会出现此提示。index map N索引的编号从1开始,按照与表的SHOW INDEX所示相同的顺序。 索引映射值N是指示哪些索引是候选的位掩码值。 例如0x19(二进制11001)的值意味着将考虑索引1、4和5。 Plan isn’t ready yet:使用了EXPLAIN FOR CONNECTION,当优化器尚未完成为在指定连接中为执行的语句创建执行计划时, 就会出现此值。 ◦MySQL没有找到合适的索引去使用,但是去检查是否可以使用range或index_merge来检索行时,会出现此提示。index map N索引的编号从1开始,按照与表的SHOW INDEX所示相同的顺序。 索引映射值N是指示哪些索引是候选的位掩码值。 例如0x19(二进制11001)的值意味着将考虑索引1、4和5。 ◦示例:下面例子中,name是varchar类型,但是条件给出整数型,涉及到隐式转换。图中t2也没有用到索引,是因为查询之前我将t2中name字段排序规则改为utf8_bin导致的链接字段排序规则不匹配。 explain select a.* from t1 a left join t2 b on t1.name = t2.name where t2.name = 2; 结果: Recursive:出现了递归查询。详见“WITH (Common Table Expressions)” Rematerialize:用得很少,使用类似如下SQL时,会展示Rematerialize SELECT ... FROM t, LATERAL (derived table that refers to t) AS dt ... Scanned N databases:表示在处理INFORMATION_SCHEMA表的查询时,扫描了几个目录,N的取值可以是0,1或者all。详见 “Optimizing INFORMATION_SCHEMA Queries” Select tables optimized away:优化器确定:①最多返回1行;②要产生该行的数据,要读取一组确定的行,时会出现此提示。一般在用某些聚合函数访问存在索引的某个字段时,优化器会通过索引直接一次定位到所需要的数据行完成整个查询时展示,例如下面这条SQL。 explain select min(id) from t1; Skip_open_table, Open_frm_only, Open_full_table:这些值表示适用于INFORMATION_SCHEMA表查询的文件打开优化; ◦Skip_open_table:无需打开表文件,信息已经通过扫描数据字典获得 ◦Open_frm_only:仅需要读取数据字典以获取表信息 ◦Open_full_table:未优化的信息查找。表信息必须从数据字典以及表文件中读取Start temporary, End temporary:表示临时表使用Duplicate Weedout策略,详见 https://mariadb.com/kb/en/duplicateweedout-strategy/ ,翻译 https://www.cnblogs.com/abclife/p/10895531.html unique row not found:对于形如 SELECT … FROM tbl_name 的查询,但没有行能够满足唯一索引或主键查询的条件 Using filesort:当Query 中包含 ORDER BY 操作,而且无法利用索引完成排序操作的时候,MySQL Query Optimizer 不得不选择相应的排序算法来实现。数据较少时从内存排序,否则从磁盘排序。Explain不会显示的告诉客户端用哪种排序。官方解释:“MySQL需要额外的一次传递,以找出如何按排序顺序检索行。通过根据联接类型浏览所有行并为所有匹配WHERE子句的行保存排序关键字和行的指针来完成排序。然后关键字被排序,并按排序顺序检索行”Using index:仅使用索引树中的信息从表中检索列信息,而不必进行其他查找以读取实际行。当查询仅使用属于单个索引的列时,可以使用此策略。例如:explain SELECT id FROM t Using index condition:表示先按条件过滤索引,过滤完索引后找到所有符合索引条件的数据行,随后用 WHERE 子句中的其他条件去过滤这些数据行。通过这种方式,除非有必要,否则索引信息将可以延迟“下推”读取整个行的数据。详见 “Index Condition Pushdown Optimization” 。例如: MySQL分成了Server层和引擎层,下推指的是将请求交给引擎层处理。理解这个功能,可创建所以INDEX (zipcode, lastname, firstname),并分别用如下指令, SET optimizer_switch = 'index_condition_pushdown=off'; SET optimizer_switch = 'index_condition_pushdown=on'; 开或者关闭索引条件下推,并对比: explain SELECT * FROM people WHERE zipcode='95054' AND lastname LIKE '%etrunia%' AND address LIKE '%Main Street%'; 的执行结果。index condition pushdown从MySQL 5.6开始支持,是MySQL针对特定场景的优化机制,感兴趣的可以看下 https://blog.51cto.com/lee90/2060449 Using index for group-by:数据访问和 Using index 一样,所需数据只须要读取索引,当Query 中使用GROUP BY或DISTINCT 子句时,如果分组字段也在索引中,Extra中的信息就会是 Using index for group-by。详见 “GROUP BY Optimization” -- name字段有索引 explain SELECT name FROM t1 group by name Using index for skip scan:表示使用了Skip Scan。详见 Skip Scan Range Access Method Using join buffer (Block Nested Loop), Using join buffer (Batched Key Access):使用Block Nested Loop或Batched Key Access算法提高join的性能。详见 https://www.cnblogs.com/chenpingzhao/p/6720531.html Using MRR:使用了Multi-Range Read优化策略。详见 “Multi-Range Read Optimization”Using sort_union(…), Using union(…), Using intersect(…):这些指示索引扫描如何合并为index_merge连接类型。详见 “Index Merge Optimization” Using temporary:为了解决该查询,MySQL需要创建一个临时表来保存结果。如果查询包含不同列的GROUP BY和 ORDER BY子句,通常会发生这种情况。 -- name无索引 explain SELECT name FROM t1 group by name Using where:如果我们不是读取表的所有数据,或者不是仅仅通过索引就可以获取所有需要的数据,则会出现using where信息 explain SELECT * FROM t1 where id > 5 Using where with pushed condition:仅用于NDB Zero limit:该查询有一个limit 0子句,不能选择任何行explain SELECT name FROM resource_template limit 0 4. 扩展的EXPLAIN EXPLAIN可产生额外的扩展信息,可通过在EXPLAIN语句后紧跟一条SHOW WARNING语句查看扩展信息。 TIPS 在MySQL 8.0.12及更高版本,扩展信息可用于SELECT、DELETE、INSERT、REPLACE、UPDATE语句;在MySQL 8.0.12之前,扩展信息仅适用于SELECT语句; 在MySQL 5.6及更低版本,需使用EXPLAIN EXTENDED xxx语句;而从MySQL 5.7开始,无需添加EXTENDED关键词。 使用示例: mysql> EXPLAIN SELECT t1.a, t1.a IN (SELECT t2.a FROM t2) FROM t1\G *************************** 1. row *************************** id: 1 select_type: PRIMARY table: t1 type: index possible_keys: NULL key: PRIMARY key_len: 4 ref: NULL rows: 4 filtered: 100.00 Extra: Using index *************************** 2. row *************************** id: 2 select_type: SUBQUERY table: t2 type: index possible_keys: a key: a key_len: 5 ref: NULL rows: 3 filtered: 100.00 Extra: Using index 2 rows in set, 1 warning (0.00 sec) mysql> SHOW WARNINGS\G *************************** 1. row *************************** Level: Note Code: 1003 Message: /* select#1 */ select `test`.`t1`.`a` AS `a`, <in_optimizer>(`test`.`t1`.`a`,`test`.`t1`.`a` in ( <materialize> (/* select#2 */ select `test`.`t2`.`a` from `test`.`t2` where 1 having 1 ), <primary_index_lookup>(`test`.`t1`.`a` in <temporary table> on <auto_key> where ((`test`.`t1`.`a` = `materialized-subquery`.`a`))))) AS `t1.a IN (SELECT t2.a FROM t2)` from `test`.`t1` 1 row in set (0.00 sec) 由于SHOW WARNING的结果并不一定是一个有效SQL,也不一定能够执行(因为里面包含了很多特殊标记)。特殊标记取值如下: ◦<auto_key>:自动生成的临时表key ◦<cache>(expr):表达式(例如标量子查询)执行了一次,并且将值保存在了内存中以备以后使用。对于包括多个值的结果,可能会创建临时表,你将会看到 <temporary table> 的字样 ◦<exists>(query fragment):子查询被转换为 EXISTS ◦<in_optimizer>(query fragment):这是一个内部优化器对象,对用户没有任何意义 ◦<index_lookup>(query fragment):使用索引查找来处理查询片段,从而找到合格的行 ◦<if>(condition, expr1, expr2):如果条件是true,则取expr1,否则取expr2 ◦<is_not_null_test>(expr):验证表达式不为NULL的测试 ◦<materialize>(query fragment):使用子查询实现 ◦materialized-subquery.col_name:在内部物化临时表中对col_name的引用,以保存子查询的结果 ◦<primary_index_lookup>(query fragment):使用主键来处理查询片段,从而找到合格的行 ◦<ref_null_helper>(expr):这是一个内部优化器对象,对用户没有任何意义 ◦/* select#N */ select_stmt:SELECT与非扩展的EXPLAIN输出中id=N的那行关联 ◦outer_tables semi join (inner_tables):半连接操作。inner_tables展示未拉出的表。详见 “Optimizing Subqueries, Derived Tables, and View References with Semijoin Transformations” ◦<temporary table>:表示创建了内部临时表而缓存中间结果 当某些表是const或system类型时,这些表中的列所涉及的表达式将由优化器尽早评估,并且不属于所显示语句的一部分。但是,当使用FORMAT=JSON时,某些const表的访问将显示为ref。 5. 估计查询性能 多数情况下,你可以通过计算磁盘的搜索次数来估算查询性能。对于比较小的表,通常可以在一次磁盘搜索中找到行(因为索引可能已经被缓存了),而对于更大的表,你可以使用B-tree索引进行估算:你需要进行多少次查找才能找到行:log(row_count) / log(index_block_length / 3 * 2 / (index_length + data_pointer_length)) + 1 在MySQL中,index_block_length通常是1024字节,数据指针一般是4字节。比方说,有一个500,000的表,key是3字节,那么根据计算公式 log(500,000)/log(1024/3*2/(3+4)) + 1 = 4 次搜索。 该索引将需要500,000 * 7 * 3/2 = 5.2MB的存储空间(假设典型的索引缓存的填充率是2/3),因此你可以在内存中存放更多索引,可能只要一到两个调用就可以找到想要的行了。 但是,对于写操作,你需要四个搜索请求来查找在何处放置新的索引值,然后通常需要2次搜索来更新索引并写入行。 前面的讨论并不意味着你的应用性能会因为log N而缓慢下降。只要内容被OS或MySQL服务器缓存,随着表的变大,只会稍微变慢。在数据量变得太大而无法缓存后,将会变慢很多,直到你的应用程序受到磁盘搜索约束(按照log N增长)。为了避免这种情况,可以根据数据的增长而增加key的。对于MyISAM表,key的缓存大小由名为key_buffer_size的系统变量控制,详见Section 5.1.1, “Configuring the Server” 6. 参考文档 EXPLAIN Output Format EXPLAIN Statement Extended EXPLAIN Output Format Estimating Query Performance MySQL中explain执行计划中额外信息字段(Extra)详解 explain参数详解 最官方的 mysql explain type 字段解读 What does eq_ref and ref types mean in MySQL explain 面试官:不会看 Explain执行计划,简历敢写 SQL 优化? 作者:京东物流 柳宏 来源:京东云开发者社区 自猿其说Tech 转载请注明来源

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册