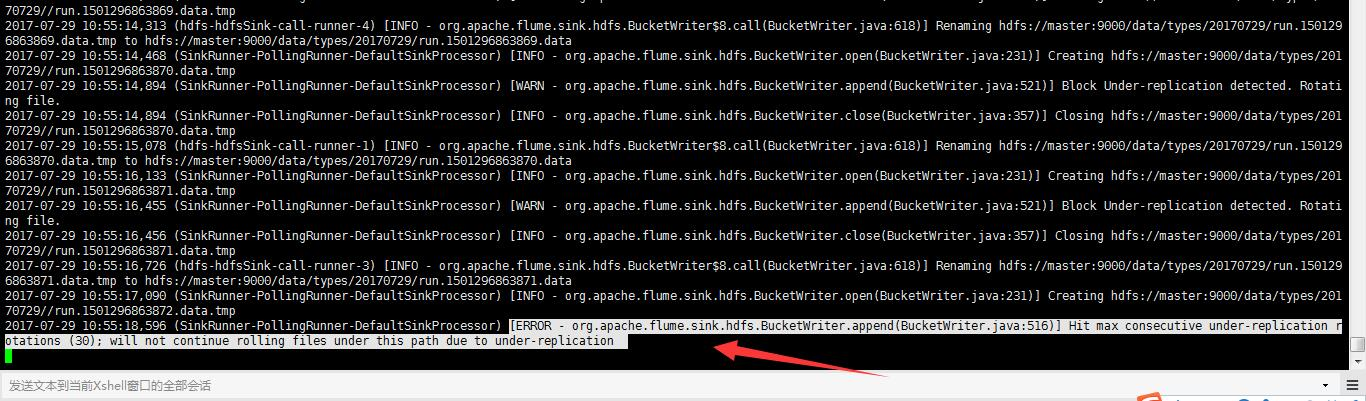
Flume启动报错[ERROR - org.apache.flume.sink.hdfs. Hit max consecutive unde...
问题详情 2017-07-29 11:22:16,303 (SinkRunner-PollingRunner-DefaultSinkProcessor) [WARN - org.apache.flume.sink.hdfs.BucketWriter.append(BucketWriter.java:521)] Block Under-replication detected. Rotating file. 2017-07-29 11:22:16,303 (SinkRunner-PollingRunner-DefaultSinkProcessor) [INFO - org.apache.flume.sink.hdfs.BucketWriter.close(BucketWriter.java:357)] Closing hdfs://master:9000/data/types/20170729//run.1501298449107.data.tmp 2017-07-29 11:22:16,538 (hdfs-hdfsSink-call-runner-0) [INFO - org.apache.flume.sink.hdfs.BucketWriter$8.call(BucketWriter.java:618)] Renaming hdfs://master:9000/data/types/20170729/run.1501298449107.data.tmp to hdfs://master:9000/data/types/20170729/run.1501298449107.data 2017-07-29 11:22:16,907 (SinkRunner-PollingRunner-DefaultSinkProcessor) [INFO - org.apache.flume.sink.hdfs.BucketWriter.open(BucketWriter.java:231)] Creating hdfs://master:9000/data/types/20170729//run.1501298449108.data.tmp 2017-07-29 11:22:17,866 (SinkRunner-PollingRunner-DefaultSinkProcessor) [WARN - org.apache.flume.sink.hdfs.BucketWriter.append(BucketWriter.java:521)] Block Under-replication detected. Rotating file. 2017-07-29 11:22:17,867 (SinkRunner-PollingRunner-DefaultSinkProcessor) [INFO - org.apache.flume.sink.hdfs.BucketWriter.close(BucketWriter.java:357)] Closing hdfs://master:9000/data/types/20170729//run.1501298449108.data.tmp 2017-07-29 11:22:18,055 (hdfs-hdfsSink-call-runner-1) [INFO - org.apache.flume.sink.hdfs.BucketWriter$8.call(BucketWriter.java:618)] Renaming hdfs://master:9000/data/types/20170729/run.1501298449108.data.tmp to hdfs://master:9000/data/types/20170729/run.1501298449108.data 2017-07-29 11:22:19,567 (SinkRunner-PollingRunner-DefaultSinkProcessor) [INFO - org.apache.flume.sink.hdfs.BucketWriter.open(BucketWriter.java:231)] Creating hdfs://master:9000/data/types/20170729//run.1501298449109.data.tmp 2017-07-29 11:22:21,869 (SinkRunner-PollingRunner-DefaultSinkProcessor) [ERROR - org.apache.flume.sink.hdfs.BucketWriter.append(BucketWriter.java:516)] Hit max consecutive under-replication rotations (30); will not continue rolling files under this path due to under-replication 解决办法 [hadoop@master flume-1.7.0]$ su root Password: [root@master flume-1.7.0]# ntpdate pool.ntp.org 29 Jul 13:31:36 ntpdate[7954]: step time server 85.199.214.101 offset 19.074422 sec [root@master flume-1.7.0]# [hadoop@slave1 ~]$ su root Password: [root@slave1 hadoop]# ntpdate pool.ntp.org 29 Jul 13:31:33 ntpdate[3851]: step time server 85.199.214.101 offset 326.201928 sec [root@slave1 hadoop]# [hadoop@slave2 ~]$ su root Password: [root@slave2 hadoop]# ntpdate pool.ntp.org 29 Jul 13:31:32 ntpdate[3850]: step time server 85.199.214.101 offset 36.857045 sec [root@slave2 hadoop]# [hadoop@master flume-1.7.0]$ date Sat Jul 29 13:33:01 CST 2017 [hadoop@master flume-1.7.0]$ [hadoop@slave1 ~]$ date Sat Jul 29 13:33:01 CST 2017 [hadoop@slave1 ~]$ [hadoop@slave2 ~]$ date Sat Jul 29 13:33:02 CST 2017 [hadoop@slave2 ~]$ 或者 #source的名字 agent1.sources = fileSource # channels的名字,建议按照type来命名 agent1.channels = memoryChannel # sink的名字,建议按照目标来命名 agent1.sinks = hdfsSink # 指定source使用的channel名字 agent1.sources.fileSource.channels = memoryChannel # 指定sink需要使用的channel的名字,注意这里是channel agent1.sinks.hdfsSink.channel = memoryChannel agent1.sources.fileSource.type = exec agent1.sources.fileSource.command = tail -F /usr/local/log/server.log #------- fileChannel-1相关配置------------------------- # channel类型 agent1.channels.memoryChannel.type = memory agent1.channels.memoryChannel.capacity = 1000 agent1.channels.memoryChannel.transactionCapacity = 1000 agent1.channels.memoryChannel.byteCapacityBufferPercentage = 20 agent1.channels.memoryChannel.byteCapacity = 800000 agent1.channels.memoryChannel.keep-alive = 60 agent1.channels.memoryChannel.capacity = 1000000 #---------拦截器相关配置------------------ #定义拦截器 agent1.sources.r1.interceptors = i1 i2 # 设置拦截器类型 agent1.sources.r1.interceptors.i1.type = zhouls.bigdata.MySearchAndReplaceInterceptor$Builder agent1.sources.r1.interceptors.i1.searchReplace = gift_record:giftRecord,video_info:videoInfo,user_info:userInfo # 设置拦截器类型 agent1.sources.r1.interceptors.i2.type = regex_extractor # 设置正则表达式,匹配指定的数据,这样设置会在数据的header中增加log_type="某个值" agent1.sources.r1.interceptors.i2.regex = "type":"(\\w+)" agent1.sources.r1.interceptors.i2.serializers = s1 agent1.sources.r1.interceptors.i2.serializers.s1.name = log_type #---------hdfsSink 相关配置------------------ agent1.sinks.hdfsSink.type = hdfs # 注意, 我们输出到下面一个子文件夹datax中 agent1.sinks.hdfsSink.hdfs.path = hdfs://master:9000/data/types/%Y%m%d/%{log_type} agent1.sinks.hdfsSink.hdfs.writeFormat = Text agent1.sinks.hdfsSink.hdfs.fileType = DataStream agent1.sinks.hdfsSink.hdfs.callTimeout = 3600000 agent1.sinks.hdfsSink.hdfs.useLocalTimeStamp = true #当文件大小为52428800字节时,将临时文件滚动成一个目标文件 agent1.sinks.hdfsSink.hdfs.rollSize = 52428800 #events数据达到该数量的时候,将临时文件滚动成目标文件 agent1.sinks.hdfsSink.hdfs.rollCount = 0 #每隔N s将临时文件滚动成一个目标文件 agent1.sinks.hdfsSink.hdfs.rollInterval = 1200 #配置前缀和后缀 agent1.sinks.hdfsSink.hdfs.filePrefix=run agent1.sinks.hdfsSink.hdfs.fileSuffix=.data 或者, 将机器重启,也许是网络的问题 或者, 进一步解决问题 https://stackoverflow.com/questions/22145899/flume-hdfs-sink-keeps-rolling-small-files 本文转自大数据躺过的坑博客园博客,原文链接:http://www.cnblogs.com/zlslch/p/7255373.html,如需转载请自行联系原作者