首页 文章 精选 留言 我的

精选列表

搜索[AI生态系],共10000篇文章
优秀的个人博客,低调大师

构建基因数据应用生态系统:Docker在基因数据的应用实践

以下内容根据演讲PPT以及现场分享整理而成。 容器技术在各个行业有很广泛的应用,今天分享是docker技术在基因数据方面的应用以及如何建设基因数据应用的“APP Store”。 一、基因组学数据与分析应用 我们都知道人有23对染色体,上面包含了人的基因组信息,这些信息决定了一个人的身高体重、头发的颜色以及一些可能会患有的疾病的风险信息。一个有意思的小常识是人类的基因和老鼠的基因有85%的相似度,与猫的基因相似度达到了90%,和人类的近亲大猩猩的基因相似度则高达96%,而人与人之间在基因组信息上的差别只有0.1个百分点,但是这0.1%却决定了不同的个体。 为什么靠这0.1%的不同基因信息就能够决定人与人之间的差别呢?其实在基因学上有这样的一个中心法则:DNA转录成为RNA,RNA翻译成蛋白质,蛋白质就决定了性状。这就是基因学上最核心的中心法则,在这个过程中产生的数据有哪些呢?依靠目前先进的测序技术基因组信息可以被序列化成为数据信息,其次还有基因在不同时空中表达的RNA信息,其编码的蛋白还有结构信息,并且蛋白质之间的相互作用决定了性状信息,这些就构成了基因组学的数据。 当然,人的性状不单单由基因组信息决定,环境以及生活方式也会产生很大影响。目前华大基因正在利用基因测序技术解决人类生老病死的问题,我们希望能从基因组学的层面上结合外部环境和人体内环境进行精准医学的生活指导,在生活的各方面给出相应的医学指导。 基因组学其实是数据密集型的科学,需要大数据计算的支持。在基因测序方面,大家都知道当年人类基因组计划花费了十几亿才能够将测序工作完成,但是今天在美国,每个人只需要一千美元就可以获得自己的基因组信息,基因测序的价格将会越来越便宜,其价格的下降速度会超过摩尔定律。从整个基因产业的价值链来讲,未来的技术瓶颈和价值所在都是基因的数据分析。学计算机的都知道,对于计算而言,需要有一些input和相应的output,这其中的计算需要是软件或者算法。但即便是能获取到再好的数据,使用一个糟糕的软件或者算法流程的话,也只能获得一些垃圾数据,并不能解决实际的问题。 真正的基因组学应用如果以能够解决之前提到的问题,其实是非常复杂的,因为需要很多的数据输入和操作步骤才能达到最终想要的结果,而这就是一个比较重要的问题,未来生物信息学工具和方法的创新必将带来产业革命。 一般认为基因测序信息的有效期是5到10年,而从现在往后的5年,基因序列并不会发生什么重大的变化,变化的只可能是基因测序技术的成本。对于这些测出的基因组信息,有什么利用价值呢?其实取决于对于基因组信息进行的创新,如果说现在的软件开发者能够通过基因测序信息判断一个人有没有携带癌症的潜在基因的话,就可以做到早期的癌症筛查。 二、存在的问题与挑战 下图是基因信息分析工具,可以看出目前基因信息分析工具有很多。 下图是基因测序圈比较有名的论坛的统计,可以看出在基因分析中使用的语言很多,涉及的操作系统也是种类繁多。目前来讲,基因测序的工作流可以运行在个人电脑中也可以运行在计算性能高的工作站中,或者更大的计算集群,乃至于像阿里云这样的云端。 为了使基因测序以及基因分析的工作流能运行在各种架构上,需要让基因组学应用满足可移植性、可扩展性和可重复性的要求。为了满足这些的需求,华大基因也正在探索如何利用docker技术去将基因组学应用标准化。 三、docker与应用标准化 下图是docker的应用案例,其依赖于两个特性就是应用的隔离和对于配置的简化。 具体而言如何去使用docker技术对于基因组学应用进行标准化呢? 1.使用预配置docker镜像提供运行时环境 docker相比VM更加轻量化,更简单易用,而且性能稳定,不涉及到编译程序和配置环境,而且它不区分开发语言和操作系统,便于使用胶水语言将各部分程序粘合到一起,对于生物专业的同学更容易使用,还可以进行版本化控制。 2.统一的CLI(执行)描述语言 对于很多生物专业的同学而言,不见得具有很强的IT技术方面的知识,并且对于应用而言,也不应使用差异化的命令行去进行操作,需要提供对于命令行的统一封装,所以需要docker提供命令的包装工具,这样也便于文件的标准化,同时对执行引擎也更加友好。 生物信息领域的同学更加熟悉Linux,但是也要让应用尽量兼容POSIX标准。而且在基因组应用构建过程中会需要对数据进行比对,来寻找变异,需要连接到引用数据进行分析,而生物学中有一些数据量很大的参考数据库,不能包含在docker中,所以需要link-data的形式。 3.统一流程(DAG)描述语言 DAG其实就是有向无环图,在生物信息领域上的应用就是进行生物信息分析。所以要想支持生物基因组应用,就需要支持DAG。对于DAG而言,需要使用工具或者子流程构建并定义任务依赖关系,而且需要根据动态数据生成作业。 4.提供完整的工具链(support tooling) 基因组应用需要提供完整的工具链,也就是需要不花费太大的学习成本来使用工具开发以及在本地进行调试,并且支持快速地在HPC或者云端进行部署。 5.统一的分发方式 应用需要dockerfile透明化地完成版本控制和自动构建,并且需要dockerRegistry进行版本仓库和软件分发。对于用户来说,只需要将软件下载到本地就可以直接应用了。 所以大家目前在努力的方向就是标准化。Global Alliance提出对于一个基因组应用而言,需要一个镜像,这也是目前docker所做的,还有对于如何使用这个镜像的描述,以及如何编译并且获得这个镜像的描述文档。 四、如何构构建基因“APP Store” 华大基因与阿里巴巴同一年成立,目前在生物信息方面有了大量的积累,我们希望能够将信息提供给客户,应该如何实现呢?其实对于基因组学而言,创建一个“APP Store”,让用户可以直接使用类似于SaaS这样的服务,这是非常有价值的。做到这样的,其实也能帮助基因组学测序技术的发展。 对于生物信息软件而言,可以说是来源众多,形式多样。我们希望能构建这样原型:开发者通过撰写dockerfile并且提交到构建系统中去,系统自动构建docker镜像,最终提交到APP Store里面去,用户可以自由浏览APP Store中的软件并且下载和应用,并且这样的软件都能够提供JSON格式的接口文件,用户直接将数据输入到文件中就可以获取经过工作流处理的数据,这样用户就可以只关注数据本身,而不必关心软件系统的搭建和计算过程。 如果将APP Store的模型实现的话,对开发者而言,生物信息领域应用的构建和分享将会容易很多。 对于生物信息领域的人,容易写出标准dockerfile文档。那么如何降低他们的学习成本呢?其实有很多在线开发工具可以使用,预先配置好工具模板以及文件结构,开发者只需要在一些地方实现自己的算法,最终整个应用就可以自动打包成为标准的形式。 另外就是可视化流程编辑器,用户可以通过简单的拖拽形式构建工作流程。

优秀的个人博客,低调大师

基于Sublime—APICloud 发布“多开发工具支持策略”打造闭环生态系

【大咖・来了 第7期】10月24日晚8点观看《智能导购对话机器人实践》 2015年9月15日下午APICloud在中关村创业大街Binggo咖啡举办了开源分享会。在移动互联网时代用户体验这个词已经被反复蹂躏。作为一名开发者,最直观的开发体验就是开发工具好不好用,顺手与否。 APICloud成立一年以来,有二十万开发者围绕着APICloud做开发。虽然APICloud在上线之初就提供了自己的开发工具,经过一年对开发者深入的了解及反馈,APICloud 除了早前提供的 Eclipse 插件扩展的支持,还提供了基于 Sublime 的开源 APICloud Plugins,并且已经被 Package Control 成功收录,Sublime 用户可不更换开发工具,即可在 APICloud 开发跨平台应用。 当然在提供工具之外APICloud遵循 Aptana3.0GPL 开源协议,将 IDE 全部源代码以无条件继承 GPL 开源协议的方式开放出来,并让开发者同时享有全部的复制权、修改权、自定义权、OEM 权……以此满足开发者对开发工具的个性化需求。 早在成立之初,APICloud 就提出了生态圈的概念,一年以来除了不断加强技术 创新之外,也在为生态平台而努力。APICloudCTO邹达说:“既然决定做生态,我们就要提供技术规范而非开发所有的产品。在当前的形势下,如果一些SI或者传统软件厂商,不把产品开源很难将自己的业务框架增加到开发者的产品中去。 除了工具之外,APICloud在外包服务上也有着一定的优势,在除了传统的外包模式以外,基于APICloud的自身特性,通过其本身的系统,让需求双方非常清楚的看到应用状态。 “APICloud一定会围绕着生态生态区发展,因为我们做生态不仅仅是一句口号”。APICloudCTO 邹达在采访***说到。 【责任编辑: chenqingxiang TEL:(010)68476606】

优秀的个人博客,低调大师

基于Hadoop生态系统的一种高性能数据存储格式CarbonData(性能篇)

一、评测环境 1)网络拓扑图 2)配置参数 Ø 服务器配置 二、性能对比目前主流hadoop的文件存储格式有行存储的CSV格式,列式存储的ORC和Parquet等。本章给出的是Parquet+Spark和CarbonData+Spark在过滤查询场景和聚合计算场景的性能测试结果。 1)测试数据 创建沈阳社保的数据仓库,导入、集成1年的测试数据,如下表: 生成CarbonData格式文件,如下表: 2)过滤查询场景测试 Parquet和CarbonData在过滤查询场景下的性能对比 3)聚合计算场景测试 Parquet和CarbonData在聚合计算场景下的性能对比 4)总结分析 在过滤查询中,CarbonData的查询效率比parquet效率好,主要体现在列数据的索引查询,极大地提高了精确查询的性能。在聚合查询中,CarbonData通过使用全局字典编码来加快计算速度,这使得处理、查询引擎可以直接在编码好的数据上进行处理而不需要转换数据,数据只有在返回结果给用户的时候才转换成用户可读的形式,通过索引有效过滤文件数据块减少磁盘的IO,提高查询性能。 三、小结CarbonData在数据查询的性能表现比Parquet好很多,在写一次读多次的场景下非常适合使用;社区比较活跃,响应也很及时。目前官网发布版本1.3.0与最新的spark稳定版Spark2.2.1集成,增加了支持标准的Hive分区,支持流数据准实时入库等新特性,相信会有越来越多的项目会使用到。 原文发布时间为:2018-07-06本文作者:东软本文来自云栖社区合作伙伴“ Linux宝库”,了解相关信息可以关注“ Linux宝库”。

优秀的个人博客,低调大师

Spark入门到精通视频学习资料--第二章:Spark生态系统介绍,Spark整体概述与Spark编程模型(2讲)

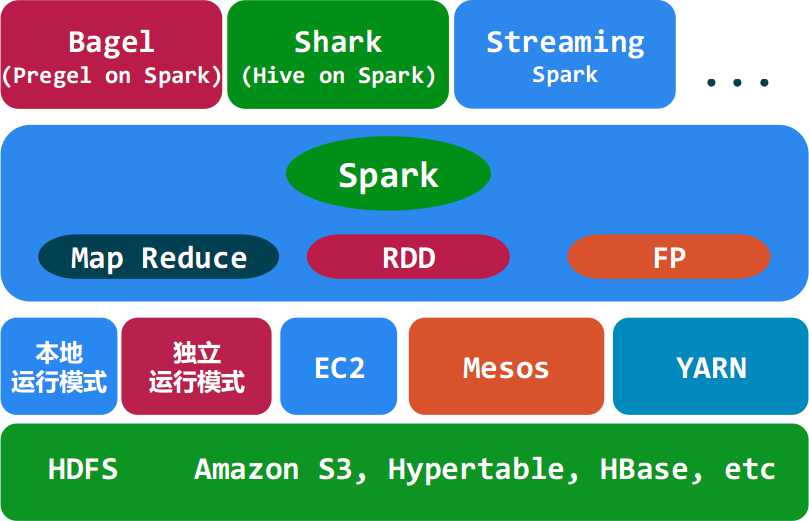
概述 什么是Spark ◆ Spark是UC Berkeley AMP lab所开源的类Hadoop MapReduce的通用的并行计算框架,Spark基于map reduce算法实现的分布式计算,拥有Hadoop MapReduce所具有的优点;但不同于MapReduce的是Job中间输出和结果可以保存在内存中,从而不再需要读写HDFS,因此Spark能更好地适用于数据挖掘与机器学习等需要迭代的map reduce的算法。其架构如下图所示: Spark的适用场景 ◆ Spark是基于内存的迭代计算框架,适用于需要多次操作特定数据集的应用场合。需要反复操作的次数越多,所需读取的数据量越大,受益越大,数据量小但是计算密集度较大的场合,受益就相对较小 ◆ 由于RDD的特性,Spark不适用那种异步细粒度更新状态的应用,例如web服务的存储或者是增量的web爬虫和索引。就是对于那种增量修改的应用模型不适合。 ◆ 总的来说Spark的适用面比较广泛且比较通用。 详细内容请参考视频: Spark概述与编程模型(上) http://pan.baidu.com/s/1kT9okBl Spark概述与编程模型(下) http://pan.baidu.com/s/16OEjc 另外给个相关的PDF文件供参考: Spark概述与编程模型.pdf http://pan.baidu.com/s/1mg64rMw ========================================================== 申明:视频资料已过期,建议不要再下载了。 ==========================================================

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册