首页 文章 精选 留言 我的

精选列表

搜索[AI生态系],共10000篇文章
优秀的个人博客,低调大师

【干货索引】阿里云大数据计算服务MaxCompute与生态系统的融合

MaxCompute大家都不陌生,之前产品名称叫ODPS,之后随国际化而更名。从支持阿里集团内部99%数据业务到计算能力对外输出,帮助政府、互联网公司、金融等进行大数据项目服务,使得数据变现。很多开发者都会把MaxCompute和开源社区Hadoop、hive进行比较,此处不做过多评论,各有优势。但是不得不说MaxCompute这几年在生态上向前走了一大步。 关于 MaxCompute2.0 对开源系统的支持与融合 的整体介绍及团队规划,详见文档。 最近,我也针对MaxCompute在生态融合上也进行了一些研究和拜读,因为现在资料还比较零散,就把自己在过程中遇到的好材料统一为大家梳理如下,包括SDK、JDBC等。 MaxCompute SDK 首先我们先来看SDK,想必很多有能力的互联网公司都有大量的个性化需求,都会对SDK/API有一些

优秀的个人博客,低调大师

Forrester:全面掌握关于容器技术的云原生解决方案生态系

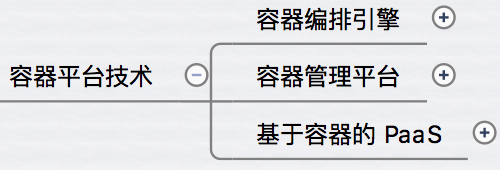
容器技术让企业能更快速地开发出高度差异化的应用和服务,并且带来应用质量和地域覆盖范围的提升,以此创造出富有吸引力的用户体验。容器技术已成为数字化转型中至关重要的元素,它为企业架构师带来了更快速的软件交付,更大的应用规模,更好的弹性和灵活性以及更丰富的实施方案选择。企业应用的基础设施、开发方式以及架构都在发生改变,而容器技术在每个方面都扮演着重要角色。 然而正如Forrester的《科技雷达图:商业科技基础设施》报告中提到的,容器和容器管理技术依旧处在创建阶段,这意味着容器的一些组件和管理工具依旧不够成熟并且正在迅速发展变化。企业需要规划出各技术组件的发展版图,才能很好的搭建、组合以及部署容器。为帮助技术管理专家加速云技术的演化,Forrester近期发表了一篇关于典型的容器管理软件架构当中各层的软件技术发展版图。 报告中的一些要点见下: 容器技术战略对于企业的数字商业至关重要。云原生应用和平台都是围绕着最中心的容器技术而产生,因此容器技术能够带来业务和架构上的优势,例如通过改善DevOps方式的软件交付能力来加速技术创新,或是在基础设施自动化和提效方面存在性能优势。容器技术在云平台中几乎无处不在 – 不论是本地还是公有云,在Linux和Windows环境下也均可。企业架构师必须明确定义容器战略,才能加速企业数字化转型。 基于容器的应用平台是容器战略的关键。我们介绍了两类平台架构:原生容器和集成平台。每种都具有独特优势- 原生容器架构的量级较轻,但需要额外进行一些集成。集成平台架构则更加成熟并且功能更全。开源组件在其中也扮演着重要角色,基于容器的应用平台参考架构涵盖从容器基础架构到运营管理的各个领域。 容器技术提供商差异化明显并且数量迅速增长。基于容器的应用平台的每一层都有各类容器软件,它们可以是开源软件或是商业软件。在规划容器技术解决方案的发展版图时,企业架构师将起到重要作用,比如协助挑选基础设施软件提供商、开源社群、原生容器解决方案提供商、PaaS提供商以及公有云平台提供商等。同时也要注意各类技术提供商的数量正在迅速增多。 原文发布时间为:2017年6月17日 本文来自云栖社区合作伙伴至顶网,了解相关信息可以关注至顶网。

优秀的个人博客,低调大师

一步一步学习大数据:Hadoop生态系统与场景

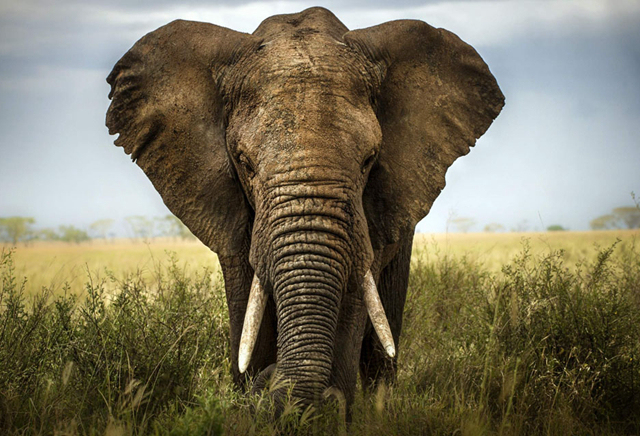
Hadoop概要 到底是业务推动了技术的发展,还是技术推动了业务的发展,这个话题放在什么时候都会惹来一些争议。 随着互联网以及物联网的蓬勃发展,我们进入了大数据时代。IDC预测,到2020年,全球会有44ZB的数据量。传统存储和技术架构无法满足需求。在2013年出版的《大数据时代》一书中,定义了大数据的5V特点:Volume(大量)、Velocity(高速)、Variety(多样)、Value(低价值密度)、Veracity(真实性)。 当我们把时间往回看10年,来到了2003年,这一年Google发表《Google File System》,其中提出一个GFS集群中由多个节点组成,其中主要分为两类:一个Master node,很多Chunkservers。之后于2004年Google发表论文并引入MapReduce。2006年2月,Doug Cutting等人在Nutch项目上应用GFS和 MapReduce思想,并演化为Hadoop项目。 Doug Cutting曾经说过他非常喜欢自己的程序被千万人使用的感觉,很明显,他做到了;下图就是本尊照片,帅气的一塌糊涂 2008年1月, Hadoop成为Apache的开源项目。 Hadoop的出现解决了互联网时代的海量数据存储和处理,其是一种支持分布式计算和存储的框架体系。假如把Hadoop集群抽象成一台机器的话,理论上我们的硬件资源(CPU、Memoery等)是可以无限扩展的。 Hadoop通过其各个组件来扩展其应用场景,例如离线分析、实时处理等。 Hadoop相关组件介绍 本文主要是依据Hadoop2.7版本,后面没有特殊说明也是按照此版本 HDFS HDFS,Hadoop Distributed File System (Hadoop分布式文件系统)被设计成适合运行在通用硬件(commodity hardware)上的分布式文件系统。它和现有的分布式文件系统有很多共同点,例如典型的Master/Slave架构(这里不准备展开介绍);然而HDFS是一个高度容错性的系统,适合部署在廉价的机器上。 关于HDFS主要想说两点。 HDFS中的默认副本数是3,这里涉及到一个问题为什么是3而不是2或者4。 机架感知(Rack Awareness)。 只有深刻理解了这两点才能理解为什么Hadoop有着高度的容错性,高度容错性是Hadoop可以在通用硬件上运行的基础。 Yarn Yarn,Yet Another Resource Negotiator(又一个资源协调者),是继Common、HDFS、MapReduce之后Hadoop 的又一个子项目。Yarn的出现是因为在Hadoop1.x中存在如下几个问题: 扩展性差。JobTracker兼备资源管理和作业控制两个功能。 可靠性差。在Master/Slave架构中,存在Master单点故障。 资源利用率低。Map Slot(1.x中资源分配的单位)和Reduce Slot分开,两者之间无法共享。 无法支持多种计算框架。MapReduce计算框架是基于磁盘的离线计算 模型,新应用要求支持内存计算、流式计算、迭代式计算等多种计算框架。 Yarn通过拆分原有的JobTracker为: 全局的 ResourceManager(RM)。 每个Application有一个ApplicationMaster(AM)。 由Yarn专门负责资源管理,JobTracker可以专门负责作业控制,Yarn接替 TaskScheduler的资源管理功能,这种松耦合的架构方式 实现了Hadoop整体框架的灵活性。 Hive Hive的是基于Hadoop上的数据仓库基础构架,利用简单的SQL语句(简称HQL)来查询、分析存储在HDFS的数据。并且把SQL语句转换成MapReduce程序来数据的处理。 Hive与传统的关系数据库主要区别在以下几点: 存储的位置 Hive的数据存储在HDFS或者Hbase中,而后者一般存储在裸设备或者本地的文件系统中。 数据库更新 Hive是不支持更新的,一般是一次写入多次读写。 执行SQL的延迟 Hive的延迟相对较高,因为每次执行HQL需要解析成MapReduce。 数据的规模上 Hive一般是TB级别,而后者相对较小。 可扩展性上 Hive支持UDF/UDAF/UDTF,后者相对来说较差。 HBase HBase,是Hadoop Database,是一个高可靠性、高性能、面向列、可伸缩的分布式存储系统。它底层的文件系统使用HDFS,使用Zookeeper来管理集群的HMaster和各Region server之间的通信,监控各Region server的状态,存储各Region的入口地址等。 HBase是Key-Value形式的数据库(类比Java中的Map)。那么既然是数据库那肯定就有表,HBase中的表大概有以下几个特点: 大:一个表可以有上亿行,上百万列(列多时,插入变慢)。面向列:面向列(族)的存储和权限控制,列(族)独立检索。 稀疏:对于为空(null)的列,并不占用存储空间,因此,表可以设计的非常稀疏。 每个cell中的数据可以有多个版本,默认情况下版本号自动分配,是单元格插入时的时间戳。 HBase中的数据都是字节,没有类型(因为系统需要适应不同种类的数据格式和数据源,不能预先严格定义模式)。 Spark Spark是由伯克利大学开发的分布式计算引擎,解决了海量数据流式分析的问题。Spark首先将数据导入Spark集群,然后再通过基于内存的管理方式对数据进行快速扫描 ,通过迭代算法实现全局I/O操作的最小化,达到提升整体处理性能的目的,这与Hadoop从“计算”找“数据”的实现思路是类似的。 Other Tools Phoneix 基于Hbase的SQL接口,安装完Phoneix之后可以适用SQL语句来操作Hbase数据库。 Sqoop Sqoop的主要作用是方便不同的关系数据库将数据迁移到Hadoop,支持多种数据库例如Postgres,Mysql等。 Hadoop集群硬件和拓扑规划 规划这件事情并没有最优解,只是在预算、数据规模、应用场景下之间的平衡。 硬件配置 Raid 首先Raid是否需要,在回答这个问题之前,我们首先了解什么是Raid0以及Raid1。 Raid0是提高存储性能的原理是把连续的数据分散到多个磁盘上存取,这样,系统有数据请求就可以被多个磁盘并行的执行,每个磁盘执行属于它自己的那部分数据请求。这种数据上的并行操作可以充分利用总线的带宽,显著提高磁盘整体存取性能。(来源百度百科) 当Raid0与Hadoop结合在一起会产生什么影响呢? 优势: 提高IO。 加快读写。 消除单块磁盘的读写过热的情况。 然而在Hadoop系统中,当Raid0中的一块磁盘数据出现问题(或者读写变得很慢的时候)时,你需要重新格式化整个Raid,并且数据需要重新恢复到DataNode中。整个周期会随着数据的增加而逐步增加。 其次Raid0的瓶颈是Raid中最慢的那一块盘,当你需要替换其中最慢的那一块盘的时候就会重新格式化整个Raid然后恢复数据。 RAID 1通过磁盘数据镜像实现数据冗余,在成对的独立磁盘上产生互 为备份的数据。当原始数据繁忙时,可直接从镜像拷贝中读取数据,因此RAID 1可以提高读取性能。RAID 1是磁盘阵列中单位成本最高的,但提供了很高的数据安全性和可用性。当一个磁盘失效时,系统可以自动切换到镜像磁盘上读写,而不需要重组失效的数据。(来源百度百科) 所以Raid1的本质是提高数据的冗余,而Hadoop本身默认就是3个副本,所以当存在Raid1时候,副本数将会变成6,将会提高系统对于硬件资源的需求。 所以在Hadoop系统中不建议适用Raid的,其实更加推荐JBOD,当一块磁盘出现问题时,直接unmount然后替换磁盘(很多时候直接换机器的)。 集群规模及资源 这里主要依据数据总量来推算集群规模,不考虑CPU以以及内存配置。 一般情况来说,我们是根据磁盘的的需求来计算需要机器的个数。 首先我们需要调研整个系统的当量以及增量数据。 举个例子来说,假如现在系统中存在8T的数据,默认副本数为3,那么所需要的存储=8T*3/80% = 30T左右。 每台机器存储为6T,则数据节点个数为5。 加上Master节点,不考虑HA的情况下,大概是6台左右机器。 软件配置 根据业务需求是否需要配置HA方案进行划分,由于实际场景复杂多变,下面方案仅供参考。 1.非HA方案 一般考虑将所有的管理节点放在一台机器上,同时在数据节点上启动若干个Zookeeper服务(奇数)。 管理节点:NameNode+ResourceManager+HMaster 数据节点:SecondaryNameNode 数据节点:DataNode +RegionServer+Zookeeper 2.HA方案 在HA方案中,需要将Primary Node 与Standby Node 放在不同的机器上,一般在实际场景中,考虑到节省机器,可能会将不同的组件的Master节点进行交叉互备,如A机器上有Primary NameNonde 以及 Standby HMaster ,B机器上有Standby NameNode 以及 Primary Master。 管理节 点:NameNode(Primary)+HMaster(Standby) 管理节点:NameNode(Standby)+HMaster(Primary) 管理节点:ResourceManager 数据节点:DataNode +RegionServer+Zookeeper Hadoop的设计目标和适用场景 其实在上面的Hadoop概要上我们就可以看到Hadoop当初的设计目标是什么。Hadoop在很多场合下都是大数据的代名词。其主要是用来处理半结构以及非结构数据(例如MapReduce)。 其本质也是通过Mapreduce程序来将半结构化或者非结构化的数据结构化继而来进行后续的处理。 其次由于Hadoop是分布式的架构,其针对的是大规模的数据处理,所以相对较少的数据量并不能体现Hadoop的优势。例如处理GB级别的数据量,利用传统的关系型数据库的速度可能相对较快。 基于上述来看Hadoop的适用场景如下: 离线日志的处理(包括ETL过程,其实本质就是基于Hadoop的数据仓库)。 大规模并行计算。 Hadoop的架构解析 Hadoop由主要由两部分组成: 分布式文件系统(HDFS),主要用于大规模的数据存储。 分布式计算框架MapReduce,其主要用来对HDFS上的数据进行运算处理。 HDFS主要由NameNode(Master)以及DataNode(Slave)组成。前者主要是对命名空间管理:如对HDFS中的目录、文件和块做类似 文件系统的创建、修改、删除、列表文件和目录等基本操作。后者存储实际的数据块,并与NameNode保持一定的心跳。 MapReduce2.0的计算框架本质是有Yarn来完成的,Yarn是关注点分离的思路,由Yarn专门负责资源管理 ,JobTracker可以专门负责作业控制,Yarn接替 TaskScheduler的资源管理功能,这种松耦合的架构方式 实现了Hadoop整体框架的灵活性。 MapReduce工作原理和案例说明 MapReduce可谓Hadoop的精华所在,是用于数据处理的编程模型。MapReduce从名称上面可以看到Map以及Reduce两个部分。其思想类似于先分后合,Map对与数据进行抽取转换,Reduce对数据进行汇总。其中需要注意的是Map任务将输出结果存储在本地磁盘,而不是HDFS。 在我们执行MapReduce的过程中,根据Map与数据库的关系大体上可以分为三类: 数据本地 机架本地 跨机架 从上述几种可以看出来,假设一个MapReduce过程中存在大量的数据移动对于执行效率来说是灾难性。 MapReduce数据流 从数据流来看MapReduce的关系大体可以分为以下几类: 单Reduce 多Reduce 无Reduce 然而无论什么MapReduce关系如何,MapReduce的执行流程都如下图所示: 其中在执行每个Map Task时,无论Map方法中执行什么逻辑,最终都是要把输出写到磁盘上。如果没有Reduce阶段,则直接输出到HDFS上。如果有Reduce作业,则每个Map方法的输出在写磁盘前线在内存中缓存。每个Map Task都有一个环状的内存缓冲区,存储着Map的输出结果,默认100m,在每次当缓冲区快满的时候由一个独立的线程将缓冲区的数据以一个溢出文件的方式存放到磁盘,当整个Map Task结束后再对磁盘中这个Map Task产生的所有溢出文件做合并,被合并成已分区且已排序的输出文件。然后等待Reduce Task来拉数据。 上述这个过程其实也MapReduce中赫赫有名的Shuffle过程。 MapReduce实际案例 Raw Data原始的数据文件是普通的文本文件,每一行记录中存在一个年份以及改年份中每一天的温度。 MapMap过程中,将每一行记录都生成一个key,key一般是改行在文件中的行数(Offset),例如下图中的0,106代表第一行、第107行。其中粗体的地方代表年份以及温度。 Shuffle该过程中获取所要的记录组成键值对{年份,温度}。 Sort将上一步过程中的相同key的value组成一个list,即{年份,List<温度>},传到Reduce端。 ReduceReduce端对list进行处理,获取最大值,然后输出到HDFS中。 上述过程进行总结下来流程如下: 本文作者:Lee 来源:51CTO

优秀的个人博客,低调大师

Nacos Go 微服务生态系列(一)| Dubbo-go 云原生核心引擎探索

作者 |李志鹏 近几年,随着 Go 语言社区逐渐发展和壮大,越来越多的公司开始尝试采用 Go 搭建微服务体系,也涌现了一批 Go 的微服务框架,如 go-micro、go-kit、Dubbo-go 等,跟微服务治理相关的组件也逐渐开始在 Go 生态发力,如 Sentinel、Hystrix 等都推出了 Go 语言版本,而作为微服务框架的核心引擎--注册中心,也是必不可缺少的组件,市面已经有多款注册中心支持 Go 语言,应该如何选择呢?我们可以对目前主流的支持 Go 语言的注册中心做个对比。 图 1 根据上表的对比我们可以从以下几个维度得出结论: 生态:各注册中心对 Go 语言都有支持,但是 Nacos、 Consul、Etcd 社区活跃,zookeeper 和 Eureka 社区活跃度较低; 易用性:Nacos、Eureka、Consul 都有现成的管控平台,Etcd、zookeeper 本身作为 kv 存储,没有相应的管控平台,Nacos 支持中文界面,比较符合国人使用习惯; 场景支持:CP 模型主要针对强一致场景,如金融类,AP 模型适用于高可用场景,Nacos 可以同时满足两种场景,Eureka 主要满足高可用场景,Consul、Zookeepr、Etcd 主要满足强一致场景,此外 Nacos 支持从其它注册中心同步数据,方便用户注册中心迁移; 功能完整性:所有注册中心都支持健康检查,Nacos、Consul 支持的检查方式较多,满足不同应用场景,Zookeeper 通过 keep alive 方式,能实时感知实例变化;Nacos、Consul 和 Eureka 都支持负载均衡策略,Nacos 通过 Metadata selector 支持更灵活的策略;此外,Nacos、Eureka 都支持雪崩保护,避免因为过多的实例不健康对健康的实例造成雪崩效应。 综合上面各维度的对比,可以了解到 Nacos 作为注册中心有一定的优势,那么它对 Go 微服务生态的集成做得如何?为此,我们策划了本系列文章,该系列将为大家介绍 Nacos 在 Go 微服务生态集成中做的一些工作和实践经验,系列内容将主要包含以下三个篇章: Dubbo-go 云原生核心引擎探索; Sentinel-go 外部动态数据源初探; go-micro 集成 Nacos 实践; 接下来我们首先探索下 Nacos 是如何与 Dubbo-go 集成。 引言 Dubbo-go 目前是 Dubbo 多语言生态中最火热的一个项目,从 2016 年发布至今,已经走过 5 个年头。最近,Dubbo-go 发布了 v1.5 版本,全面兼容 Dubbo 2.7.x 版本,支持了应用维度的服务注册与发现,和主流的注册模型保持一致,标志着 Dubbo-go 向云原生迈出了关键的一步。 作为驱动服务运转的核心引擎--注册中心,在切换到应用维度的注册模型后,也需要做相应的适配,本文将解析如何以 Nacos 为核心引擎实现应用维度的服务注册与发现,并且给出相应的实践案例。此外,本文代码基于 Dubbo-go v1.5.1,Nacos-SDK-go v1.0.0 和 Nacos v1.3.2。 服务注册与发现架构 从架构中,我们可以看到,与接口级别的服务注册发现不同的是,Dubbo-go 的 provider 启动后会调用 Nacos-go-sdk 的 RegisterInstance 接口向 Nacos 注册服务实例,注册的服务名即为应用名称,而不是接口名称。Conusmer 启动后则会调用 Subscribe 接口订阅该应用的服务实例变化,并对的实例发起服务调用。 图 2 服务模型 图 3 是我们 Dubbo-go 的应用维度服务发现模型,主要有服务和实例两个层级关系,服务实例的属性主要包含实例Id、主机地址、服务端口、激活状态和元数据。图 4 为 Nacos 的服务分级存储模型,包含服务、集群和实例三个层次。两者对比,多了一个集群维度的层级,而且实例属性信息能够完全匹配。 所以在 Dubbo-go 将应用服务实例注册到 Nacos 时,我们只需要将集群设置为默认集群,再填充服务和实例的相关属性,即可完成服务模型上的匹配。此外 Nacos 可以将服务注册到不同的 Namespace 下,实现多租户的隔离。 图 3 图 4 服务实例心跳维持 Dubbo-go 的 Provider 在向 Nacos 注册应用服务实例信息后,需要主动上报心跳,让 Nacos 服务端感知实例的存活与否,以判断是否将该节点从实例列表中移除。维护心跳的工作是在 Nacos-SDK-go 完成的,从图 5 代码中可以看到,当 Dubbo-go 调用 RegisterInstance 注册一个服务实例时,SDK 除了调用 Nacos 的 Register API 之外,还会调用 AddBeatInfo,将服务实例信息添加到本地缓存,通过后台协程定期向 Nacos 发送服务实例信息,保持心跳。 当服务下线时,可以通过调用 DeRegisterInstance 执行反注册,并移除本地的心跳保持任务,Nacos 实例列表中也会将该实例移除。 图 5 订阅服务实例变化 Dubbo-go 的 Consumer 在启动的时候会调用 Nacos-SDK-go 的 Subscribe 接口,该接口入参如图 6,订阅的时候只需要传递 ServiceName 即应用名和回调函数 SubscribeCallback,Nacos 在服务实例发生变化的时候即可通过回调函数通知 Dubbo-go。Nacos-SDK-go 是如何感知 Nacos 的服务实例变化的呢?主要有两种方式: Nacos 服务端主动推送,Nacos-SDK-go 在启动的时候会监听一个 UDP 端口,该端口在调用 Nacos Register API 的时候作为参数传递,Nacos 会记录 Ip 和端口,当服务实例发生变化时,Nacos 会对所有监听该服务的 Ip 和端口发送 UDP 请求,推送变化后的服务实例信息; Nacos-SDK-go 定期查询,SDK 会对订阅的服务实例定时调用查询接口,如果查询有变化则通过回调接口通知 Dubbo-go。作为兜底策略保证 Nacos 服务端推送失败后,仍能感知到变化。 图 6 此外 Nacos-SDK-go 还支持推空保护,当 Nacos 推送的实例列表为空时,不更新本地缓存,也不通知 Dubbo-go 变更,避免 Consumer 无可用实例调用,造成故障。同时,SDK 还支持服务实例信息本地持久化存储,可以保证在 Nacos 服务故障过程中,Consumer 重启也能获取到可用实例,具备容灾效果。 范例实践 1. 环境准备 dubbo-go samples 代码下载:https://github.com/apache/dubbo-samples/tree/master/golang,基于 Nacos 注册中心的应用级服务发现的 hello world 代码目录在 registry/servicediscovery/nacos; 图 7 Nacos 服务端搭建,参考官方文档:https://nacos.io/zh-cn/docs/quick-start.html,或者使用官方提供的公共 Nacos 服务:http://console.nacos.io/nacos(账号密码:nacos,仅供测试),或者购买阿里云服务:https://help.aliyun.com/document_detail/139460.html。 2. Server 端搭建 进入 registry/servicediscovery/nacos/go-server/profiles 文件,可以看到有 dev、release 和 test 三个文件夹,分别对应开发、测试和生产配置。我们使用 dev 配置来搭建开发环境,dev 文件下有 log.yml 和 server.yml 文件,下面对 server.yml 配置进行修改。 remote 配置,这里使用公共的 Nacos 服务,address 支持配置多个地址,用逗号分割。params 参数配置 nacos-sdk 的日志目录。 remote: nacos: address: "console.nacos.io:80" timeout: "5s" params: logDir: "/data/nacos-sdk/log" configCenter 配置: config_center: protocol: "nacos" address: "console.nacos.io:80" 配置 server 端环境变量: export CONF_PROVIDER_FILE_PATH=server端的server.yml文件路径 export APP_LOG_CONF_FILE=server端的log.yml文件路径 进入 registry/servicediscovery/nacos/go-server/app,运行 server.go 的 main 方法,可以从 Nacos 的控制台看到,应用 user-info-server 已经注册成功。 Nacos 的控制台地址:http://console.nacos.io/nacos/#/serviceManagement?dataId=&group=&appName=&namespace= 图 8 图 9 3. Client 端搭建 client 的配置文件在 registry/servicediscovery/nacos/go-server/profiles 目录下,需要修改的地方跟 server 端一样,这里不赘述。 配置 client 端环境变量: export CONF_CONSUMER_FILE_PATH=client端的server.yml文件路径 export APP_LOG_CONF_FILE=client端的log.yml文件路径 进入 registry/servicediscovery/nacos/go-client/app,运行 client.go 的 main 方法,看到如下日志输出,表示调用 server 端成功。 图 10 相关链接 Dubbo-go 项目地址:https://github.com/apache/dubbo-go Dubbo-go 社区交流钉钉群:23331795 Nacos 项目地址:https://nacos.io/ Nacos 社区交流钉钉群:30438813 Nacos golang 生态交流钉钉群:23191211 Nacos-SDK-go 项目地址:https://github.com/nacos-group/nacos-sdk-go 招聘信息 如果你对我们在做的事情感兴趣,欢迎你加入我们团队。内推邮箱:water.lyl@alibaba-inc.com 作者简介 李志鹏,Github 账号:Lzp0412,开源社区爱好者,Nacos Committer,Nacos-SDK-go 作者,现就职于阿里云云原生应用平台,主要参与服务发现、CoreDNS、ServiceMesh 相关工作,负责推动 Nacos Go 微服务生态建设。 Spring Cloud Alibaba 七天训练营 服务注册与发现是微服务架构体系中最关键的组件之一,为了带领大家系统入门微服务架构,9 月 24 日,由 Spring Cloud Alibaba 创始团队主笔的 Spring Cloud Alibaba 实战训练营将正式开营。七天时间了解微服务各模块的实现原理,手把手教学如何独立开发一个微服务应用,助力小白开发者从 0 到 1 建立系统化的知识体系。点击链接即可参与:https://developer.aliyun.com/learning/trainingcamp/spring/1 “阿里巴巴云原生关注微服务、Serverless、容器、Service Mesh 等技术领域、聚焦云原生流行技术趋势、云原生大规模的落地实践,做最懂云原生开发者的公众号。”

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册