首页 文章 精选 留言 我的

精选列表

搜索[智能推荐],共10009篇文章
优秀的个人博客,低调大师

Mysql Explain 详解[强烈推荐]

1. EXPLAIN简介 使用EXPLAIN关键字可以模拟优化器执行SQL查询语句,从而知道MySQL是如何处理你的SQL语句的。分析你的查询语句或是表结构的性能瓶颈。 ➤通过EXPLAIN,我们可以分析出以下结果: 表的读取顺序 数据读取操作的操作类型 哪些索引可以使用 哪些索引被实际使用 表之间的引用 每张表有多少行被优化器查询 ➤使用方式如下: EXPLAIN +SQL语句 EXPLAIN SELECT * FROM t1 1 执行计划包含的信息 2. 执行计划各字段含义 2.1 id select查询的序列号,包含一组数字,表示查询中执行select子句或操作表的顺序 id的结果共有3中情况 id相同,执行顺序由上至下 [总结]加载表的顺序如上图table列所示:t1 t3 t2 id不同,如果是子查询,id的序号会递增,id值越大优先级越高,越先被执行 id相同不同,同时存在 如上图所示,在id为1时,table显示的是<derived2>,这里指的是指向id为2的表,即t3表的衍生表。 2.2 select_type 常见和常用的值有如下几种: 分别用来表示查询的类型,主要是用于区别普通查询、联合查询、子查询等的复杂查询。 SIMPLE简单的select查询,查询中不包含子查询或者UNION PRIMARY 查询中若包含任何复杂的子部分,最外层查询则被标记为PRIMARY SUBQUERY在SELECT或WHERE列表中包含了子查询 DERIVED 在FROM列表中包含的子查询被标记为DERIVED(衍生),MySQL会递归执行这些子查询,把结果放在临时表中 UNION 若第二个SELECT出现在UNION之后,则被标记为UNION:若UNION包含在FROM子句的子查询中,外层SELECT将被标记为:DERIVED UNION RESULT 从UNION表获取结果的SELECT 2.3 table 指的就是当前执行的表 2.4 type type所显示的是查询使用了哪种类型,type包含的类型包括如下图所示的几种: 从最好到最差依次是: system > const > eq_ref > ref > range > index > all 1 一般来说,得保证查询至少达到range级别,最好能达到ref。 system表只有一行记录(等于系统表),这是const类型的特列,平时不会出现,这个也可以忽略不计 const表示通过索引一次就找到了,const用于比较primary key 或者unique索引。因为只匹配一行数据,所以很快。如将主键置于where列表中,MySQL就能将该查询转换为一个常量。 首先进行子查询得到一个结果的d1临时表,子查询条件为id = 1 是常量,所以type是const,id为1的相当于只查询一条记录,所以type为system。 eq_ref唯一性索引扫描,对于每个索引键,表中只有一条记录与之匹配。常见于主键或唯一索引扫描 ref非唯一性索引扫描,返回匹配某个单独值的所有行,本质上也是一种索引访问,它返回所有匹配某个单独值的行,然而,它可能会找到多个符合条件的行,所以他应该属于查找和扫描的混合体。 range只检索给定范围的行,使用一个索引来选择行,key列显示使用了哪个索引,一般就是在你的where语句中出现between、< 、>、in等的查询,这种范围扫描索引比全表扫描要好,因为它只需要开始于索引的某一点,而结束于另一点,不用扫描全部索引。 indexFull Index Scan,Index与All区别为index类型只遍历索引树。这通常比ALL快,因为索引文件通常比数据文件小。(也就是说虽然all和Index都是读全表,但index是从索引中读取的,而all是从硬盘读取的) id是主键,所以存在主键索引 allFull Table Scan 将遍历全表以找到匹配的行 2.5 possible_keys 和 key possible_keys显示可能应用在这张表中的索引,一个或多个。查询涉及到的字段上若存在索引,则该索引将被列出,但不一定被查询实际使用。 key 实际使用的索引,如果为NULL,则没有使用索引。(可能原因包括没有建立索引或索引失效) 查询中若使用了覆盖索引(select 后要查询的字段刚好和创建的索引字段完全相同),则该索引仅出现在key列表中 2.6 key_len 表示索引中使用的字节数,可通过该列计算查询中使用的索引的长度,在不损失精确性的情况下,长度越短越好。key_len显示的值为索引字段的最大可能长度,并非实际使用长度,即key_len是根据表定义计算而得,不是通过表内检索出的。 2.7 ref 显示索引的那一列被使用了,如果可能的话,最好是一个常数。哪些列或常量被用于查找索引列上的值。 2.8 rows 根据表统计信息及索引选用情况,大致估算出找到所需的记录所需要读取的行数,也就是说,用的越少越好 2.9 Extra 包含不适合在其他列中显式但十分重要的额外信息 2.9.1 Using filesort(九死一生) 说明mysql会对数据使用一个外部的索引排序,而不是按照表内的索引顺序进行读取。MySQL中无法利用索引完成的排序操作称为“文件排序”。 2.9.2 Using temporary(十死无生) 使用了用临时表保存中间结果,MySQL在对查询结果排序时使用临时表。常见于排序order by和分组查询group by。 2.9.3 Using index(发财了) 表示相应的select操作中使用了覆盖索引(Covering Index),避免访问了表的数据行,效率不错。如果同时出现using where,表明索引被用来执行索引键值的查找;如果没有同时出现using where,表明索引用来读取数据而非执行查找动作。 2.9.4 Using where 表明使用了where过滤 2.9.5 Using join buffer 表明使用了连接缓存,比如说在查询的时候,多表join的次数非常多,那么将配置文件中的缓冲区的join buffer调大一些。 2.9.6 impossible where where子句的值总是false,不能用来获取任何元组 SELECT * FROM t_user WHERE id = '1' and id = '2' 1 2.9.7 select tables optimized away 在没有GROUPBY子句的情况下,基于索引优化MIN/MAX操作或者对于MyISAM存储引擎优化COUNT(*)操作,不必等到执行阶段再进行计算,查询执行计划生成的阶段即完成优化。 2.9.8 distinct 优化distinct操作,在找到第一匹配的元组后即停止找同样值的动作 3. 实例分析 执行顺序1:select_type为UNION,说明第四个select是UNION里的第二个select,最先执行【select name,id from t2】 执行顺序2:id为3,是整个查询中第三个select的一部分。因查询包含在from中,所以为DERIVED【select id,name from t1 where other_column=’’】 执行顺序3:select列表中的子查询select_type为subquery,为整个查询中的第二个select【select id from t3】 执行顺序4:id列为1,表示是UNION里的第一个select,select_type列的primary表示该查询为外层查询,table列被标记为<derived3>,表示查询结果来自一个衍生表,其中derived3中的3代表该查询衍生自第三个select查询,即id为3的select。【select d1.name …】 执行顺序5:代表从UNION的临时表中读取行的阶段,table列的< union1,4 >表示用第一个和第四个select的结果进行UNION操作。【两个结果union操作】

优秀的个人博客,低调大师

常用的内网穿透软件推荐

这里列举了一些比较好用的开源的内网穿透工具,详细介绍一下各个软件工具的特点: 1. holer 轻量级的内网穿透工具,holer服务端采用Java语言实现,服务端界面漂亮简洁。Holer客户端采用了Java语言和GO语言实现了两种版本,支持几乎所有的OS平台。用到流行的微服务框架springboot和Java网络框架netty。配置很简单,针对所有TCP协议只需在客户端设置一个holer access key即可。采用MySQL数据库统一管理数据。 2. frp FRP功能完整,主要采用GO语言实现,重量级的工具,服务端界面样式风格一般。配置繁琐,不同的协议需要配置不同的参数,采用文件存放数据,不支持数据库管理数据。 3. nps 轻量级的内网穿透工具,完全采用GO语言实现,服务端界面漂亮简洁。支持的协议最广泛,配置稍简单,采用文件存放数据,不支持数据库管理数据。 4. lanproxy 轻量级的内网穿透工具,客户端采用GO语言和Java语言实现两种版本,采用了Java网络框架netty,服务端界面体验较差。配置稍繁琐,采用文件存放数据,不支持数据库管理数据。

优秀的个人博客,低调大师

Android学习网站推荐(转)

收集了一些比较好的Android学习网站,希望对大家有所帮助: 1、http://developer.android.com/ Android官方网站,可惜被屏蔽了,需要使用FQ软件 2、http://www.eoeandroid.com/index.php 最大的Android开发社区 3、http://dev.10086.cn/android 中国移动通信开发者社区,丝毫不比eoeandroid差,里面很多源代码 4、http://www.anddev.org/ 刚刚发现的一个外国Android开发者社区 另外,比较有名的社区还有机锋网、安卓网等,但是这几网站商业气息太浓,学习有关的东西占得比例比较小。 转自:链接 本文转自SharkBin博客园博客,原文链接:http://www.cnblogs.com/SharkBin/p/4940300.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

Spark编程模型(博主推荐

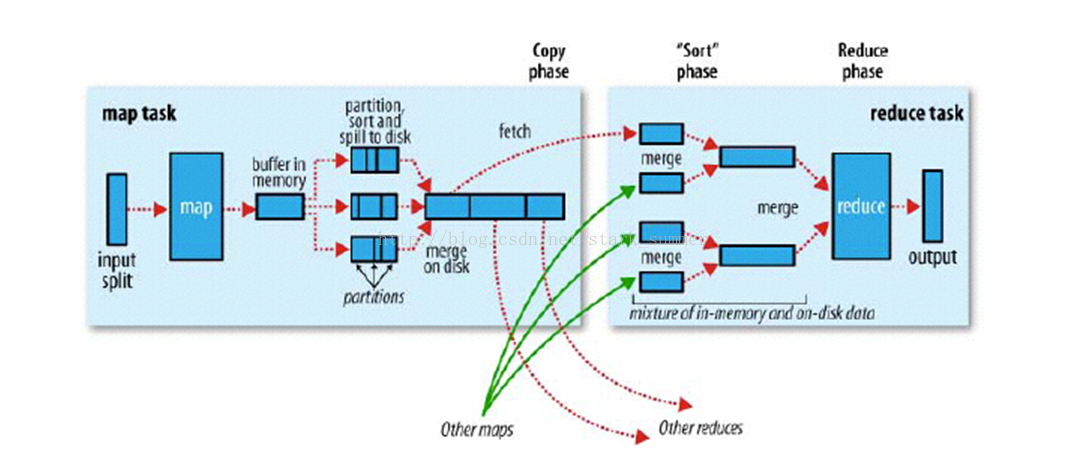
一、Spark编程模型(上) 从Hadoop MR到Spark 回顾hadoop—mapreduce计算过程 MRVS Spark Spark编程模型 核心概念 注意:对比mr里的概念来学习。 这些概念,大家一定要好好理解!!! Spark Application的组成 其中,Driver Program是运行main函数并且新建SparkContext的程序 Cluster Manager是在集群上获取资源的外部服务(例如: standalonde、Mesos、Yarn) Worker Node是集群中任何运行应用代码的节点 Executor是在一个worker node上为某应用启动的一个进程,该进程负责运行任务,并且负责将数据存在内存或磁盘上。每个应用都有各自独立的executors。 Task是被送到某个executor上的工作单元 Spark应用程序的组成 (1)Driver (2)Executor 注意:对照helloworld来思考 Spark Application基本概念 Spark Application编程模型 Spark 应用程序编程模型 – Driver Program ( SparkContext ) – Executor ( RDD 操作) (1)输入Base-> RDD (2)Transformation RDD->RDD (3)Action RDD->driver or Base (4)缓存 Persist or cache() – 共享变量 (1)broadcast variables(广播变量) (2)accumulators(累加器) 回顾Spark Hello World 初识RDD 什么是RDD 定义:Resilient distributed datasets (RDD), an efficient, general-purpose and fault-tolerant abstraction for sharing data in cluster applications. RDD 是只读的。 RDD 是分区记录的集合。 RDD 是容错的。--- lineage RDD 是高效的。 RDD 不需要物化。---物化:进行实际的变换并最终写入稳定的存储器上 RDD 可以缓存的。---课指定缓存级别 RDD是spark的核心,也是整个spark的架构基础,RDD是弹性分布式集合(Resilient Distributed Datasets)的简称,是分布式只读且已分区集合对象。这些集合是弹性的,如果数据集一部分丢失,则可以对它们进行重建。 RDD接口 RDD的本质特征 RDD--partitions Spark中将1~100的数组转换为rdd 通过第15行的size获得rdd的partition的个数,此处创建rdd显式指定定分区个数2,默认数值是这个程序所分配到的资源的cpu核的个数 RDD-preferredLocations 返回此RDD的一个partition的数据块信息,如果一个数据块(block)有多个备份在返回所有备份的location地址信息 主机ip或域名 作用:spark在进行任务调度室尽可能根据block的地址做到本地计算 RDD-dependencies RDD之间的依赖关系分为两类: (1)窄依赖 每个父RDD的分区都至多被一个子RDD的分区使用,即为OneToOneDependecies; (2)宽依赖 多个子RDD的分区依赖一个父RDD的分区,即为ShuffleDependency 。例如,map操作是一种窄依赖,而join操作是一种宽依赖(除非父RDD已经基于Hash策略被划分过了,co-partitioned) (1)窄依赖相比宽依赖更高效资源消耗更少 (2)允许在单个集群节点上流水线式执行,这个节点可以计算所有父级分区。例如,可以逐个元素地依次执行filter操作和map操作。 (3)相反,宽依赖需要所有的父RDD数据可用并且数据已经通过类MapReduce的操作shuffle完成。 (4)在窄依赖中,节点失败后的恢复更加高效。因为只有丢失的父级分区需要重新计算,并且这些丢失的父级分区可以并行地在不同节点上重新计算。 (5)与此相反,在宽依赖的继承关系中,单个失败的节点可能导致一个RDD的所有先祖RDD中的一些分区丢失,导致计算的重新执行。 RDD-compute 分区计算 Spark对RDD的计算是以partition为最小单位的,并且都是对迭代器进行复合,不需要保存每次的计算结果 RDD- partitioner 分区函数:目前spark中提供两种分区函数: (1)HashPatitioner(哈希分区) (2)RangePatitioner(区域分区) 且partitioner只存在于(K,V)类型的RDD中,rdd本身决定了分区的数量。 RDD- lineage val lines = sc.textFile("hdfs://...") // transformed RDDs val errors = lines.filter(_.startsWith("ERROR")) val messages = errors.map(_.split("\t")).map(r => r(1)) messages.cache() // action 1 messages.filter(_.contains("mysql")).count() // action 2 messages.filter(_.contains("php")).count() RDD经过trans或action后产生一个新的RDD,RDD之间的通过lineage来表达依赖关系,lineage是rdd容错的重要机制,rdd转换后的分区可能在转换前分区的节点内存中 典型RDD的特征 不同角度看RDD Scheduler Optimizations Spark编程模型(中) 创建RDD 方式一:从集合创建RDD (1)makeRDD (2)Parallelize 注意:makeRDD可以指定每个分区perferredLocations参数,而parallelize则没有。 方式二:读取外部存储创建RDD Spark与Hadoop完全兼容,所以对Hadoop所支持的文件类型或者数据库类型,Spark同样支持。 (1)多文件格式支持: (2)多文件系统支持: 1)本地文件系统 2)S3 3)HDFS (3)数据库 1)JdbcRDD 2)spark-cassandra-connector(datastax/spark-cassandra-connector) 3)org.apache.hadoop.hbase.mapreduce.TableInputFormat(SparkContext.newAPIHadoopRDD) 4)Elasticsearch-Hadoop transformation操作 惰性求值 (1)RDD 的转化操作都是惰性求值的。这意味着在被调用行动操作之前Spark 不会开始计算 (2)读取数据到RDD的操作也是惰性的 (3)惰性求值的好处: a.Spark 使用惰性求值可以把一些操作合并到一起来减少计算数据的步骤。在类似 Hadoop MapReduce 的系统中,开发者常常花费大量时间考虑如何把操作组合到一起,以减少MapReduce 的周期数。 b.而在Spark 中,写出一个非常复杂的映射并不见得能比使用很多简单的连续操作获得好很多的性能。因此,用户可以用更小的操作来组织他们的程序,这样也使这些操作更容易管理。 转换操作 RDD 的转化操作是返回新RDD 的操作 我们不应该把RDD 看作存放着特定数据的数据集,而最好把每个RDD 当作我们通过转化操作构建出来的、记录如何计算数据的指令列表。 基本转换操作1 基本转换操作2 控制操作 (1)persist操作,可以将RDD持久化到不同层次的存储介质,以便后续操作重复使用。 1)cache:RDD[T] 2)persist:RDD[T] 3)Persist(level:StorageLevel):RDD[T] (2)checkpoint 将RDD持久化到HDFS中,与persist操作不同的是checkpoint会切断此RDD之前的依赖关系,而persist依然保留RDD的依赖关系。 注意:控制操作的细节会在后续博客专门讲解 action操作 Spark编程模型(下) 什么是Pair RDD (1)包含键值对类型的RDD被称作Pair RDD (2)Pair RDD通常用来进行聚合计算 (3)Pair RDD通常由普通RDD做ETL转换而来 创建Pair RDD Python语言 pairs = lines.map(lambda x: (x.split(" ")[0], x)) scala语言 val pairs = lines.map(x => (x.split(" ")(0), x)) Java语言 PairFunction keyData = new PairFunction() { public Tuple2 call(String x) { return new Tuple2(x.split(" ")[0], x); } }; JavaPairRDD pairs = lines.mapToPair(keyData); Pair RDD的transformation操作 Pair RDD转换操作1 Pair RDD 可以使用所有标准RDD 上转化操作,还提供了特有的转换操作。 Pair RDD转换操作2 Pair RDD的action操作 Pair RDD转换操作1 所有基础RDD 支持的行动操作也都在pair RDD 上可用 Pair RDD的分区控制 Pair RDD的分区控制 (1) Spark 中所有的键值对RDD 都可以进行分区控制---自定义分区 (2)自定义分区的好处: 1)避免数据倾斜 2)控制task并行度 自定义分区方式 class DomainNamePartitioner(numParts: Int) extends Partitioner { override def numPartitions: Int = numParts override def getPartition(key: Any): Int = { val domain = new Java.net.URL(key.toString).getHost() val code = (domain.hashCode % numPartitions) if(code < 0) { code + numPartitions // 使其非负 }else{ code } } // 用来让Spark区分分区函数对象的Java equals方法 override def equals(other: Any): Boolean = other match { case dnp: DomainNamePartitioner => dnp.numPartitions == numPartitions case _ => false }

优秀的个人博客,低调大师

推荐5个机器学习API

机器学习作为大数据的前沿无疑是让人生畏的,因为只有技术极客和数据科学领域的专家才能驾驭机器学习算法和技术,对于大部分企业和组织而言,过去这一直都是一个遥不可及的事情。但是现在这种情况正在发生改变,正如标准的API简化了应用程序的开发一样,机器学习API也降低了这一领域的门槛,让越来越多的人和企业能够借助技术底蕴深厚的公司所提供的API试水机器学习。 机器学习API隐藏了创建和部署机器学习模型的复杂性,让开发者能够专注于数据挖掘和用户体验。同时,将机器学习商业化成云服务也是当今的趋势,IBM、Microsoft、Google、Amazon以及BigML等公司都为业务分析师和开发人员提供了自己的机器学习即服务(MLaaS),最近Khushbu Shah在KDnuggets上发表了一篇文章,介绍了这5个公司的机器学习API。 IBM Wat

优秀的个人博客,低调大师

使用fuel快速安装openstack 推荐

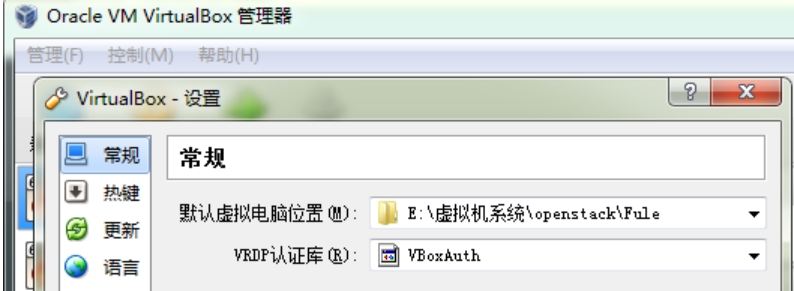
openstack,安装的门槛比较高,而且相当麻烦,很多的安装文档作者省了不少安装步骤。这对初学的人带来了很大的麻烦,也许作者轻易节省一步,就会创成后面的安装失败。而且初学者由于对openstack不是很了解,错误无法排查,因此很多人都在中途放弃对openstack的学习。其实有一个安装工具可以快速的安装openstack,不需要了解openstack各个组件的之间的关系,只需鼠标轻轻一点,就可以完成对openstack的安装;而且还有诸多功能,如对openstack健康检查,查看节点日志等。 首先我们来了解一下fuel,fuel是Mirantis服务集成商开发一套openstack安装工具。Mirantis是一家很NB的openstack服务集成商,在openstack社区贡献排名前5名。下面来说说fuel 是一个为openstack端至端的一健部署工具,其自身包含自动的PXE方式安装操作系统,DHCP服务、业务健康检查以及log查看。底层也是使用puppet对各节点的安装。下面开始干活。 环境: 1、 笔记本:i5cpu,8G内存,空闲100G硬盘。(大家的硬件最好高一点,如果没有8g以上的内存,跑起四个虚拟主机会非常卡) 2、 Oracle VM VirtualBox 3、 MirantisOpenStack-5.1 注意: CPU一定要支持虚拟化、BIOS要开启虚拟化的功能。 软件下载 fuel: http://pan.baidu.com/s/1c0erOjA (大家也可以去官网下载,只需注册一下就可以下载。) VM VirtualBox 大家自行下载吧! 安装Fuel Master: 把默认主机的位置,放在别的盘里,默认是C盘。 管理---全局设置 创建四块网卡 点击加号创建 选择Fuel Master的ISO镜像文件。然后开始安装就可以了。 左边Ctrl+鼠标的右键 移出virtualBOX。这一点做的没有VMware好呀,搞了半天才出来! 同时我们也看到了fuel的访问端口。 因为我的杀毒软件的有隔离,需要建立一个隧道。你们也可以直接使用:http:10.20.0.2:8000进行访问 用户名和密码默认是:admin #选择你要安装的系统环境 部署的模式,刚开始学习建议先部署多节点的环境 虚拟化类型的选择 不需要选择 到这里我们的配置环境已经都配置好了,目前还没有节点加入进来,我们需要有节点服务器。 节点服务: 在虚拟机上创建节点服务,但网卡需要如下设置: 如果电脑配置的好把计算节点把CPU和内存调大一点: 因为我们这里使用网卡启动,所以不需要光盘启动。点取消。在安装的过程中我们不用对安装介质进行选择默认会安装一个非常小的linux系统,等一下会让fuel帮我安装Centos. 等服务都启完之后。fuel这边会有一边提示 在日志那边 第二台机器 NOde节点的分配就完成,下面开始配置网络。 网络验证正确之后在保存设置,其它的配置默认就可以了。下面我们开始部署。 部署变更------部署。 这时我们就可以看到部署的进度条 这个时候我们可以看到正在安装Centos,我在实验环境做的时候,还需要切到openstack的控制节点和计算节点,点一下OK。 安装后Centos 控制节点,开始安装openstack. 安装完成之后,我们应该会在界面上有显示的openstack的登录地址,因为我这里是把机器重启了,这里没有显示,但我们可以去日志里看到。 哈哈 这就看到的了高大山的openstack 用户名密码:admin 创建一个虚拟主机: 将网络拖进去。然后 运行 云主机创建成功。 设置一个浮动的IP地址:从下面下拉的窗口中随意选取一个 由于openstack自身有防火墙的功能我们需要设置一下icmp 和22号端口 虚拟主机的用户名和密码在vm1 日志 里可以看到。 用户:cirros 密码:cubswin:) ssh 连接上去 可以ping通172.16.0.0段的网关 openstack添加云硬盘的功能: 把虚拟机的网卡按照上面的调试方法调试一下,并让他从网络启动: 验证网络之后,我们就开始部署。 创建一块云硬盘: 更多 将云硬盘挂载到那个主机 这个小小kernel 必须使用sudo 命令才能执行操作: OK 看到云硬盘了!测试fuel安装openstack完成,fuel还有很多其他的功能,各位可以去测试。 最后让我们来看一下fuel安装openstack的架构: 感谢各位的观看请不要吝惜你手中的 赞 哦!

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册