首页 文章 精选 留言 我的

精选列表

搜索[开启],共10012篇文章
优秀的个人博客,低调大师

环保先行 新IT开启 “治霾”新模式

179天雾霾日,46天重度污染,PM2.5年平均浓度80.6微克/立方米,超过国家标准1.3倍,多次黄色预警,1次重污染红色预警,过年一年,北京历经“十面霾伏”。 受雾霾影响,北京周边有超40个城市遭受持续性大范围雾霾天气过程。统计数据显示,河北省去年平均雾霾日45.9天,较常年同期偏多15.9天,为历年同期最多。平均重度雾霾日11天,较常年偏多3.8天。对于河南省而言,雾霾则更为严重,仅2015年12月1日至24日,河南省平均雾霾日数高达12.9天,较常年同期偏多8.3天,分布范围也十分广泛。 2016年,雾霾持续“突袭”,在全国政协十二届四次会议期间,天空呈中度污染,未现“两会蓝”,雾霾成为两会绕不开的话题。本次大会上,国务院总理李克强在政府工作报告中提出,重拳治理大气雾霾和水污染,要求今年二氧化硫、氮氧化物排放量分别下降3%,重点地区细颗粒物(PM2.5)浓度继续下降……加大工业污染源治理力度,对排污企业全面实行在线监测。 解决雾霾,要靠政策引导,更需要环保先行。河北环保部门以清醒的认识和科学的方法,开出了治理雾霾的良方——建设智慧环保,通过云计算、物联网和移动互联网技术,对信息化系统进行整合,开展信息资源规划、污染源和环境质量数据整合,实现全方位监管,从源头进行治理。 在智慧环保建设过程中,河北省采用了华三通信云计算解决方案,通过H3C CAS软件将底层计算虚拟化,形成弹性的数据中心资源池,为上层应用提供支撑。同时,河北省还利用H3C CIC云业务管理中心构建了灵活的IaaS服务资源平台,实现资源的统一申请,集中管理,节约了网络与软硬件资源,降低了运维成本,为智慧环保提供了有力后盾。 与河北智慧环保建设并行,河南省环保厅也启动了智慧环保云数据中心项目建设,利用华三通信提供的CAS虚拟化软件、H3Cloud OS云管理平台、SDN网络安全控制平台、iMC综合运维管理平台、M9000安全网关等以及配套的云服务,打造了“自动化、虚拟化、拓展化、服务化”的智慧环保云平台,满足了河南省环保业务系统及应用不断扩展极延伸需求。 治霾之路任重而道远,不过借助华三通信新IT技术,各地环保管理部门可以一年365天,每天24小时全天候监测、管理、预测任何环境变化并做出进一步的分析,科学管理分析,为今后实现天蓝水清,建设美丽城市提供强有力的技术和服务保障,真正实现智慧环保落地应用。 原文发布时间为: 2016年04月13日 本文来自云栖社区合作伙伴至顶网,了解相关信息可以关注至顶网。

优秀的个人博客,低调大师

OpenStack 官方云管理员认证开启

云计算是当今IT世界最紧俏的技术,而这个领域的人才同样稀缺。随着技术的不断成熟,企业对于云计算的采纳程度越来越高,企业亟需云就绪人才,与云技能相关的工作,在全球IT就业范围中,几乎都是呈上长趋势的。目前云计算岗位人才缺失的原因主要在于缺乏适当的培训、缺乏实践经验以及缺乏相关认证。 要在围绕云计算的所有喧闹中找到有效的培训和认证可能是很难的。因为有很多潜在的训练机构,使我们难以选择最合适的课程。OpenStack是当前最流行的开源云堆栈技术,得到了大量开发者以及IT厂商的极力支持。在推出短短几年时间里,在技术发展象限中逐渐走向成熟。 OpenStack官方云管理员认证 在日本东京举办的OpenStack Summit上,为了促进OpenStack人才网络与全球社区的战略性发展,OpenStack基金会宣布启动全新的职业认证项目。该项目将为世界范围内的OpenStack专业使用者提供衡量知识和技术的基准。 OpenStack管理员认证 OpenStack基金会执行总监Jonathan Bryce在致辞时表示,首批OpenStack管理员认证(COA)将于2016年进行。OpenStack由非常庞大的子项目组成,非常复杂,对于想要采纳这项技术作为云解决方案的企业而言,需要找到合格的管理员。几年前,基金会发布了一个培训的Marketplace,列出了一些来自主要的 OpenStack厂商的课程。Jonathan Bryce表示这个项目非常成功,但是他也意识到建立OpenStack人才库是一项持续的挑战。 这项新的认证流程来源于主要的OpenStack厂商的帮助,也意味着创立了OpenStack管理员的一个基准。想要拥有这个认证的管理员,至少具备六个月的OpenStack使用经验,并拥有OpenStack云管理和日常操作能力,同时要参加一个虚拟认证考试。认证测试将由Linux基金会协助运作,在虚拟测试平台上,便于测试者在全球范围内以较低费用进行COA测试。预计COA测试将于2016年第二季度启动。 实际上,全球目前已有几十家公司提供OpenStack培训,来自十个不同国家的OpenStack生态系统合作伙伴也已加入了这一协作,以对 OpenStack认证管理员进行技术认证,比如Asean Labs、Canonical、Cisco、Cloud Enabled、EMC、Rackspace等。 摆脱选择困难 OpenStack Project Navigator 在主题演讲后的新闻发布会中,OpenStack COO Mark Collier表示基金会未来计划向OpenStack开发者以及其他的角色提供类似的认证。除了培训项目,OpenStack基金会还发布了一项新的工具Project Navigator,旨在让用户更好地理解相关信息,以帮助他们在如何使用软件方面作出明智的决策。该基金会还进行了更新并继续为OpenStack Marketplace增加产品,后者同样致力于帮助用户更加轻松地部署软件。 这项服务主要也是为了减少采纳OpenStack技术的企业复杂度,降低进入门槛而设置的。目前,OpenStack已有超过25种云相关服务或项目,OpenStack用户面临的一项挑战就是了解每项服务的功能应用广度和成熟度。Project Navigator通过整合每个项目的重要信息——如成熟度、发布日期、封装和文档支持——形成易于浏览的界面,从而帮助解决这一问题。 Project Navigator为用户提供了各种OpenStack项目的信息分类,包括其成熟度和封装的数据以及文档支持。另一方面,Project Navigator也向OpenStack的组织架构施压,现在已经将项目分成了核心项目,比如计算、网络和存储这样的最长部署的项目,和可选服务,用户可以根据应用案例选择部署或者不部署这种类型的服务。 之所以将项目进行这样的划分,OpenStack基金会首席运营官Mark Collier表示:“社区将这些项目重新组织成核心和可选服务的一个主要原因在于,简化构建和部署OpenStack驱动的云平台的流程。 Project Navigator则更进一步通过以简单的图解形式向我们社区的新用户展示核心和可选项目信息,帮助他们迅速地就所需部署组件做出明智决策。” 除了提供有关每个项目的数据外,Project Navigator还能显示基于真实用户应用案例和白皮书的范例配置,包括大数据、网络托管、电子商务、高吞吐计算、公共云以及视频处理和内容交付。 OpenStack项目技术委员会主席Thierry Carrez表示:“技术委员会将今年的大部分时间用于从整合版过渡到‘大帐篷’治理模式,利用各种标签来描述项目属性。Project Navigator是一种非常有用的工具,可以整合技术委员会的大部分工作,并进行直观而简洁地展示。该工具有望成为OpenStack新用户获取有用信息的重要来源。” Project Navigator现已上线,可通过以下网址访问: http://www.openstack.org/software/project-navigator 原文链接:http://www.searchcloudcomputing.com.cn/showcontent_91069.htm 关于OpenStack OpenStack是一个由NASA(美国国家航空航天局)和Rackspace合作研发并发起的,是一个开源的云计算管理平台项目,由几个主要的组件组合起来完成具体工作。OpenStack支持几乎所有类型的云环境,项目目标是提供实施简单、可大规模扩展、丰富、标准统一的云计算管理平台。 OpenStack除了有Rackspace和NASA的大力支持外,还有包括戴尔、Citrix、Cisco、Canonical等重量级公司的贡献和支持,致力于简化云的部署过程并为其带来良好的可扩展性。 本文作者:张培颖 来源:51CTO

优秀的个人博客,低调大师

“大数据时代”开启产业转型新模式

有人把数据比喻为蕴藏能量的煤矿,不同煤矿的挖掘成本又不一样。与此类似,大数据并不在“大”,而在于“有用”,价值含量、挖掘成本比数量更为重要。现在的社会是一个高速发展的社会,科技发达,信息流通,人们之间的交流越来越密切,生活也越来越方便,大数据就是这个高科技时代的产物。 大数据带来新产业 说起“大数据”这三个字,很多人都听过,但要说真正了解“大数据”是什么意思,相信绝大多数人都并不清楚。近日,记者来到位于南河道高新大厦的汉唐大数据研究院,这里是由兰州睿创波迪信息科技有限公司发起,在省、市相关政府部门支持下,联合国内知名高校、科研院所,聘请了十多名包括院士、长江学者、千人计划学者在内的国内顶级专家,集产、学、研一体的大数据研究机构,同时,作为兰州市高新区创业中心重点扶持项目之一,也得到了一整层楼共1066㎡的创业场所作为扶持。 “近两年,大家对大数据的概念听得很多,但大都是一些概念上的炒作,人们都不知道大数据到底是做什么的。很多人都问过我一个问题,你的数据从哪来?其实大数据而言,它不仅是一个数据的加工分析利用,其实是一整个技术产业链的发展,需要各方面的配套,并不是单纯某个方面的问题。”兰州睿创波迪信息科技有限公司总经理张亚东说。他认为,大数据的概念比较多,可能现在大众比较认同的一种解释是:数据量大、或者复杂到一定程度,已经用传统的方式无法进行处理的数据,称之为大数据。与传统数据相比较,大数据呈现出诸多新的特性,如数据容量大、数据类型繁多、价值密度低及处理速度快等,其最核心的价值就是在于对海量数据进行存储、分析与挖掘,需要研究与之相应地一系列新方法、新技术或新标准。 从技术上看,大数据与云计算的关系就像一枚硬币的正反面一样密不可分。大数据必然无法用单台的计算机进行处理,必须采用分布式计算架构。它的特色在于对海量数据的挖掘,但它必须依托云计算的分布式处理、分布式数据库、云存储和虚拟化技术。简而言之,从各种各样类型的数据中,快速获得有价值信息的能力,就是大数据技术。 研究差异决定细化走向 “其实一开始建数据院是为了服务我们自己的项目,睿创波迪信息科技有限公司是以做软件为主,包括移动互联网这块,需要一些大数据的分析,我们聘请的博士就是大数据研究领域的专业人士。在项目开展过程中发现以传统的项目角度来做大数据存在诸多问题,主要是由于当前项目与人的生活、商业、医疗、教育、物业等方面都有关系,是一个产业性的问题,单独靠一两个人或一两个企业是很难解决的。所以去年我们就跑去北京,到中科院、清华这些专业人士聚集的地方‘取经’,最终邀请到数位活跃在物联网、云计算、数据库的国内知名专家加入我们,可以说他们的一些技术、成果,通过我们可以很好的应用到现实中,所以大家一拍即合,为了搭建一个良好的协作平台,最终由睿创波迪作为发起方,共同筹建成立了我们这个汉唐大数据研究院。” 张亚东告诉记者,初期以面向消费服务的商业大数据研究为目标,研究基于时空数据的数据采集、存储、检索体系架构,建设CTM公共商业数据平台,在此基础上围绕安全、交通、健康、金融、商业、生活等,凝练出几个准国家级重点实验室或工程中心的研究方向,形成几个具有自有特色的研究实体。目前,研究院下设有:大数据基础理论与关键技术研究中心、智慧生活大数据研究中心、隐私安全大数据研究中心、 健康与教育大数据研究中心。 记者了解到,根据不同的研究方向,每个实验室所侧重的数据研究方向也各有不同。比如在智慧生活大数据研究中心,围绕智慧生活,包括家居、商业、交通、旅游等,相关的系统架构、关键技术为主要研究目标,以产业化应用为目的,研究方向主要包括智慧社区、智慧商业、智慧交通、智慧旅游等方面。“我们正在榆中建立西北首个真正意义上的‘智慧社区’,它不等同于拥有很多智能化设备的智能社区,而是像‘智慧城市’这种概念,为每个人提供的服务都是不一样的,可以说是个性化服务,数据能自动识别、自动判别为不同的人提供不同的服务。但‘智慧城市’是一个很宽泛、涉及的行业非常广的一个项目,它的建设周期或者建设成本是非常耗时耗力的,所以我们以点入手,先从社区开始。”张亚东表示,在我们生活中,每个人每天面临到的信息量都非常的大,像视频、图像、语音等等这些“非结构化”的数据信息的采集、存储、加工、利用就是未来大数据要做的事情。 力争建设大数据“贝尔实验室” 在谈到如何将大数据技术应用到实际生活中时,张亚东表示,接下来汉唐大数据研究院将和地产公司亨威集团合作,在榆中建立一座“主题购物公园”。“传统的城市综合体都是提着大包小包的在购物,如何将拎包购物变成一个休闲娱乐购物呢?”他解释,逛商场时看中某件商品,扫描刷卡以后可以继续去逛街去吃饭去休闲娱乐,而不用自己拎着大包小包,整个逛完以后买好的商品全部都打包好直接送到家里,或者直接送到地下停车场顾客的车位旁,是不是很方便呢?“这都是我们下一步计划要做的事情,都是应用大数据的技术,更有可能的是,比如你在商场里走路,通过你走路的快慢,你眼光的方向,通过大数据的集中处理,就可以判断出你感兴趣的东西是什么,你走的慢,要么是有事情在这里等人,要么就是你有个感兴趣的东西在这里,这就是大数据的视频技术。很多个体无意识的行为,在一个群体里面,他就是有规律可寻的,这就是大数据体现在生活中的一个方面。” 技术服务商是研究院今后扮演的重要角色。把政府、企业、高校、研究院所、资本和创业型企业连接起来,实现产学研对接、推动行业发展是中心建设的重要目标。力争建设成为大数据行业的“贝尔实验室”,并将研究院建设成为学科、学术、技术、产业、机制等均在国内具有引领地位的大型创新平台。 “兰州有个三维标准大数据研究院,也是在做数据的研究分析数据标准化的工作。我们更注重从实际市场需求出发来做,这就是我们之间的差别。我们拥有的专家队伍,包括长江学者、千人计划学者等,可能与目前一些已经成立的大数据研究院相比,相对具有一定的优势,另一方面,我们提出的概念就是CTM,C是con-sumers消费者,M是make制造,我们围绕人们的生活,拥有具体的、能落地的应用目标。”张亚东认为,因为传统方式对数据的分析利用受到一定的局限性,所以大数据将会是未来的一个方向。“从物联网、云计算、移动互联网、车联网、手机、平板电脑、PC以及遍布地球各个角落的各种各样的传感器出现以后,无一不是数据来源或者承载的方式,这也为大数据今后的发展提供了无限的可能性。” 加快数据兰州建设意义重大 目前,汉唐大数据研究院学术委员会由十余位国内知名专家组成,中国工程院院士、中国技术经济学家及数量经济学家李京文院士担任,常务副主任由中国计算机学会(CCF)大数据专委会委员丁治明教授担任,其余专家均为相关领域教授或研究员,研究方向涵盖大数据、云计算、公共安全、人工智能、物联网等领域。 该委员会认为,当今世界变化很快,我们已经进入了大数据时代,做为新的热点技术,大数据已形成产业化发展潮流,呈现出井喷式爆发性增长。大数据已经渗透到各个行业和领域,成为重要的生产因素,是带动产业升级转型和催生新业态的利器,对人们的生产生活必将产生重大而深远的影响。从经济和产业发展维度看大数据及相关产业发展潜力,我国独特的位势和经济社会高速稳定发展,给大数据及其应用带来了巨大的发展空间,国家大数据战略也已发布。但是如何获取、存储、分析、处理大数据,需要我们不断去创新,去研究解决这些问题。 甘肃于丝绸之路腹地,是华夏文明的重要源头,兰州做为丝路重镇,位于丝绸之路经济带黄金地段,汉唐大数据研究院落地兰州高新技术产业开发区,是对国家大数据战略的响应,对“云上兰州、数据兰州”的建设,对甘肃在丝绸之路经济带的作用和地位都有着长远的意义。抢占先机,赢得未来,汉唐大数据研究院将把握科技革命历史机遇,推动甘肃大数据产业发展,并带动相关产业的创业创新。本文转自d1net(转载)

优秀的个人博客,低调大师

MiniMax M2.7: 开启模型的自我进化

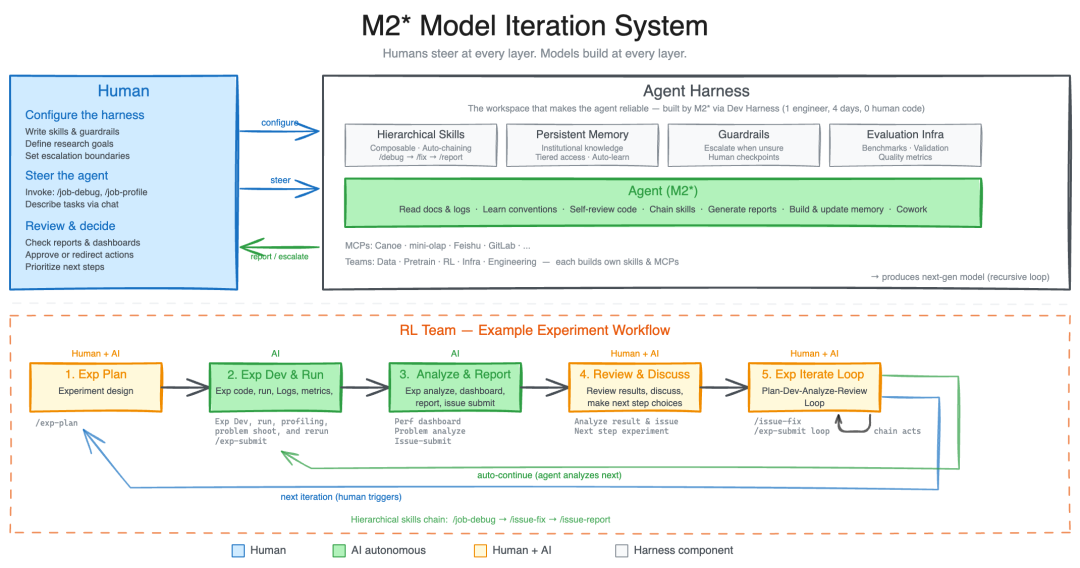
MiniMax 公司宣布推出 MiniMax M2.7大模型。据称与以往依靠人类工程师迭代模型不同,M2.7 能够深度参与自身的迭代过程,驱动模型的自我进化。 具体实践是构建了一个“研究型 Agent 框架”,让模型(作为 Agent)能够与研究员协作,承担从文献调研、实验配置、代码修复到监控分析等大量研发工作,可以胜任 30-50% 的工作流,显著加速实验迭代。 更进一步,模型能够自主优化其自身的运行系统(如 Agent Harness),例如通过执行“分析-规划-修改-评测”的循环超过100轮,最终在内部评测集上实现了30%的性能提升。 核心能力表现 软件工程:在真实世界的软件工程项目中表现优异。 故障调试:具备综合推理能力,可关联监控、分析日志、定位数据库问题,甚至在紧急情况下做出SRE级别的决策(如建议“非阻塞建索引”先止血),可将线上故障恢复时间缩短到3分钟内。 编程基准:在 SWE-Pro 中得分为 56.22%,接近当时顶级模型 Opus 的最佳水平。在 VIBE-Pro(端到端项目交付)和 Terminal Bench 2(复杂系统理解)中也取得了接近 Opus 4.6 水平的成绩。 多智能体协作:具备原生的 Agent Teams​ 能力,能稳定扮演不同角色、进行对抗性推理和遵循复杂协议,可用于产品原型开发等需要团队协作的场景 专业办公:提升了在办公领域的专业知识与任务交付能力。 知识水平:在 GDPval-AA 评测中获得 1495 ELO 分,处于开源模型最高水平。 文件处理:对 Word、Excel、PPT 的复杂编辑和多轮高保真修改能力显著提升。 复杂环境交互:在 Toolathon 评测中正确率达到 46.3%(全球第一梯队)。在拥有40个复杂技能的案例中,技能遵循率仍保持97%。 专业领域应用:以金融领域为例,M2.7 可以自主阅读公司年报、研报,设计假设并构建营收预测模型,最终输出包含 PPT、研究报告和 Excel 图表的完整分析,其产出物可作为初稿进入工作流程。文章用了大量篇幅展示其为台积电(TSMC)制作的财务分析与预测报告案例。 互动娱乐:极大地加强了模型的身份保持能力和情商,旨在使 AI 从纯粹的生产力工具拓展到互动娱乐场景。为此,MiniMax 开源了一个名为 OpenRoom​ 的 Agent 交互系统原型,将 AI 互动置于一个可视化的 GUI 空间中,实现“对话即驱动”,探索全新的人机交互方式。 M2.7 模型已在 MiniMax Agent 平台和开放 API 平台上全面上线。 MiniMax Agent:agent.minimaxi.com API 服务:platform.minimaxi.com Coding Plan 订阅:platform.minimaxi.com/subscribe/coding-plan

优秀的个人博客,低调大师

阿里云 E-MapReduce 全面开启 Serverless 时代

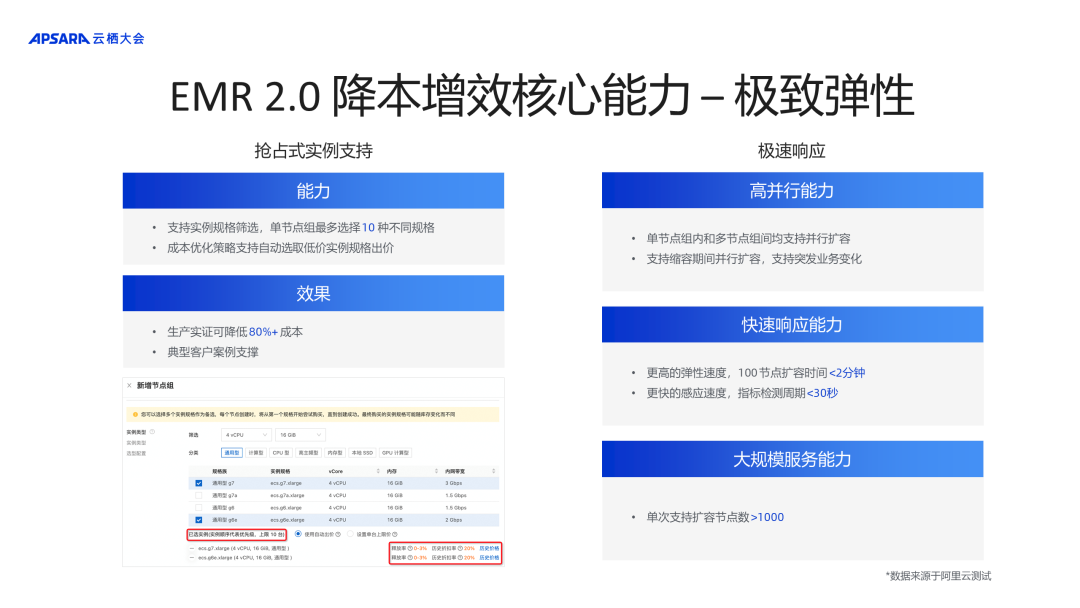
作者:李钰 - 阿里云资深技术专家、EMR 负责人 EMR 2.0 平台 阿里云正式发布云原生开源大数据平台EMR 2.0已历经一年时间,如今EMR 2.0全新平台在生产上已经全面落地,资源占比超过60%。EMR 2.0平台之所以在生产上这么快落地,源于其体验全面提升,更重要的一点是为客户实现了全面降本增效。 EMR 2.0 平台实现降本增效主要源于四个核心能力 极致弹性 EMR 2.0平台提供极致弹性的能力,主要表现在两个方面。第一是支持抢占式实例,客户可以指定使用抢占式实例的优先级,单节点组最多选择10种不同规格,成本优化策略支持自动选取低价实例规格出价,当抢占式实例不足的时候,会给客户补充按量付费的实例,兼顾成本和业务效果。第二就是极速响应能力,单节点组内和多节点组间均支持并行扩容,支持缩容期间并行扩容,支持突发业务变化;并且在响应能力上也有大幅提升,扩容速度不随着节点的增加而增加,100节点扩容时间小于2分钟 ,弹性指标检测周期低于30秒,能够更好地响应负载变化;而且单次扩容规模能够达到1000个节点。 智能诊断 EMR 2.0平台具备智能诊断能力,通过EMR Doctor的集群日报和实时检测功能,可以实现避免资源浪费、风险提前预警和实时分析建议的核心效果:通过健康检查服务的集群日报功能查看集群是否存在资源浪费;通过任务评分倒排 Top N,找到资源浪费最多的作业进行优化;通过持续优化,最大化利用资源,避免浪费。 新硬件支持 EMR 2.0平台全面支持倚天 ECS 实例,相较X86实例成本降低20%以上。另外在软件层面、计算引擎层面,针对ARM的指令集也做了一系列优化,性能更高,CPU 占用率更低,在典型TPC-DS大数据 Benchmark 下能够进一步将性能提升1/4,意味着使用EMR2.0新平台加上倚天实例构建大数据集群,可以实现40%成本下降。 资源配比优化 EMR 2.0平台提供资源配比优化能力。虽然大数据负载具备动态性,但是在一定时间内也具备一定的周期性。EMR 2.0平台提供HBO能力,基于历史用量分析用量高峰低谷,推荐更低成本的预付费(包年包月固定资源)和后付费(按量弹性资源)配比。固定和弹性资源用量和账单可视化,历史用量曲线跟踪,更直观地度量资源配比调整前后成本绩效。 基于以上四个方面的优化,使用EMR 2.0平台的客户在生产上确确实实地实现了降本增效。EMR 团队也开始进一步思考以ECS集群方式构建大数据的解决方案是否存在难以解决的问题。 EMR 集群形态难以解决的问题? 有物理机运维经验的同学应该知道,当CPU和内存的使用率都超过70%时,整个集群的负载水位就很高了。所以在生产当中如果资源的综合使用率能够达到70%,就可以认为整个集群的资源使用率是比较高的。如果以70%的资源使用率为标准评判集群的资源是否利用得比较充分,则会观察到一个现象。10%的线上集群资源使用较为充分,有90%的集群资源利用率不到70%。另外观察到超过 3 成集群资源综合使用率不足 50%,而且没有明显的资源峰谷,只是日常综合的使用率。另外考虑到业务负载动态变化,以及集群形态对资源规划者能力要求极高,如果想在资源利用率上更进一步,全面 Serverless 化势在必行。基于以上背景,近一年阿里云EMR团队在Serverless化产品上取得了较大进展。 EMR Serverless 化产品 (阿里云EMR数据湖仓架构) EMR Serverless Notebook 上图是阿里云EMR数据湖仓架构。首先看一下数据开发层,数据开发层分为开发和调度两方面。在数据开发方面EMR推出了Serverless Notebook,是一款即开即用免运维的产品,提供完善的用户权限和企业级的安全能力。用户可以开发SQL、Python等非常通用的Notebook作业。另外EMR Serverless Notebook 几乎全面兼容了HUE的能力,历史存量业务可以无缝迁移,还支持无缝对接各种形态的EMR集群。目前还在测试中,感兴趣的用户可以到EMR官网申请试用。 EMR Serverless Workflow 在数据工作流调度方面,EMR推出了Serverless Workflow。这款产品也是即开即用免运维的全托管产品,完全兼容Apache DolphinScheduler,也提供用户权限和企业级的安全能力。另外还可以随着调度负载的增加和减少提供弹性伸缩的能力,可以无缝对接各种形态的EMR集群,支持包括Spark、Flink在内的各种大数据作业开发,感兴趣的用户可以在EMR工作台直接开通测试。 接下来看一下计算层,我们通常将大数据的计算分为三类,批处理、流处理和Olap交互式分析。流处理主流产品是Flink,阿里云对应推出了实时计算Flink版产品。EMR则在批处理和Olap两个方向分别推出了对应的产品。 EMR Serverless Spark 一站式数据开发平台 EMR Serverless Spark 提供了一站式数据开发平台,在这个一站式数据开发平台上面,用户可以便捷地开发SQL作业,也可以很方便地进行试运行和调试,调试完成后支持一键上线及发布,同时还提供内置工作流编排能力,用户可以基于已经开发好的SQL作业来编排工作流,并且在工作流上做定时调度,当工作流编排调度好了之后还提供工作流和任务两个维度且比较完善的监控和运维能力。用户可以在工作流维度上看到工作流每次运行的状态,例如运行到哪个节点失败,点击失败的节点可以看到失败的原因。此外还支持智能诊断,比如Spark作业有数据倾斜或者某个并发数据GC的问题,智能诊断能力可以帮助用户更快地解决问题。 企业级Native引擎 除了一站式数据开发平台,EMR Serverless Spark 在内核上也做了优化。首先是企业级Native引擎优化,基于Native算子及SIMDJson优化的向量化执行引擎;支持高性能列式的Shuffle,可以将Shuffle的数据量最多减少40%;面向不同指令集做的指令集粒度优化,包括zstd等比较先进的压缩、解压缩算法的优化;最后还提供原生的C++接口来对接湖格式、OSS—HDFS存储,从而提供端到端完整的高性能。下图左侧是EMR Native Engine 和 Apache Spark3.3在TPC-DS 10TB这个benchmark上的对比,可以看到企业级Native引擎可以达到开源引擎3倍以上的性能。 企业级RSS支持 EMR Serverless Spark 提供企业级 RSS 支持。众所周知,批处理云原生和Serverless化需要将本地的状态和存储依赖去掉,就要把ESS转换成使用Remote shuffle service。EMR Serverless Spark 提供的企业级 RSS 支持是基于Apache Celeborn 的,也是阿里云EMR团队捐赠给 Apache 孵化器的一款 RSS 软件,目前在整个生态上面有非常多国内外公司在使用,包括国外的 Linkedin、Shopee,国内的网易、哔哩哔哩。EMR Serverless Spark 在完全兼容Celeborn的基础上,还提供了企业级多租户能力,支持企业级的安全隔离。另外依托于阿里内部的生产实践,在大规模、高性能和全面功能性上都做了完整的提升。下图左侧就是Remote Shulffe Service相比于ESS的性能对比情况,可以看到有非常明显的提升。 按量付费&极致弹性 此外,EMR Serverless Spark 支持按量付费和极致弹性。全新的按量计费方式,打破了传统的按规格计费方式,根据计算资源和存储空间的实际使用量计费,计算资源以CU为单位,1个CU性能等于 1 Core CPU 4 GB Mem。在同样规则的情况下,Serverless 可以更好地响应负载变化,成本节省高达50%! EMR Serverlesss StarRocks EMR Serverlesss StarRocks 已经正式商业化,除了有一站式应用的开发平台之外,还能够全面覆盖数据湖分析的各种场景,另外还具备企业级内核能力和云原生能力。 企业级StarRoksManager管控 EMR Serverless StarRocks 提供企业级 StarRocks manager 管控,不仅支持实例级别管理和监控,还可以做一站式SQL开发查询,支持慢 SQL Profile 查询分析,另外还提供智能诊断分析能力,帮助用户更方便地使用 StarRocks。 企业级数据湖分析场景支持 EMR Serverless StarRocks 在数据湖分析场景的支持也非常完善。一方面支持数据湖查询加速,另一方面在传统数仓分层ETL的场景下,作为ADS层的Olap引擎,同时也支持DWD和DWS层的查询加速。EMR Serverless StarRocks 在企业级数据湖分析场景做到按需秒级弹性,0负载0成本,提供全面的负载分析和诊断分析;通过内核优化实现了相比于开源Trino3—5倍的提升,支持 Trino 兼容以及一键迁移,另外在 Benchmark测试下性能显著优于开源的ClickHouse和Apache Doris;另外在查询加速方面,针对缓存管理也做了增强,企业级外表物化视图,可有效实现湖仓分层,企业级缓存管理模块,支持配置热表,热分区等淘汰策略,可根据业务场景平衡性能与成本。 企业级物化视图ELT场景支持 EMR Serverless StarRocks 提供企业级物化视图ELT场景支持。当数据量没有那么大的时候,可以用 StarRocks 处理所有 Pipeline,极大地加速整个业务流程。EMR Serverless StarRocks 通过大量算子 Spill 特性优化,提供企业级 MPP ETL 模式,确保了高稳定性,同时利用 VVP CTAS / CDAS 能力打造了全链路实时数仓;完善的 Data Sink Connector,支持多种湖格式,基于 DataLake 的 ELT 全链路,一站式读写和加工湖数据;此外,后续还会推出视图血缘功能,提供企业级物化视图血缘关系,可以更方便地构建实时数仓,还可以基于历史信息优化,推荐更完善、性能更好、更稳定的物化视图,帮助用户在ELT场景下更好地支撑业务。 存算分离&极致弹性 除了能够全面地支撑数据湖分析场景之外,EMR Serverless StarRocks 还支持企业级的存算分离和极致弹性能力。在存算分离架构下,基于底层的OSS数据湖存储在极大地降低存储成本的同时,还能够保证很高的数据可靠性;另外多 Data WareHouse 场景可以基于同一份物理数据创建两个 Virtual Data Warehouse,一个用于扫表,一个用于高维查询,两个Warehouse 有各自的缓存策略,对于业务隔离和SLA保障有非常好的提升;另外在性能上,依托于EMR Serverless StarRocks 企业级缓存能力,在缓存打开的时候性能和存算一体基本持平,当缓存不命中的情况下,查询性能也较为可控。 数据湖管理 DLF 重磅升级 统一元数据管理 首先在元数据管理方面,DLF 有2.5倍性能提升,单表支持500万分区;推出了全面兼容HMS功能,也就是Hive MetaStore的能力。 统一权限管理 中心化权限管理方面,全面兼容 Ranger 鉴权,全面支持访问审计,还支持对接 LDAP;全场景权限检查方面,支持 Hive/Spark 表鉴权, 支持文件目录鉴权,另外还可以对接 EMR 全系列产品组件。 统一数据治理 在数据治理方面也做了很多工作。在生命周期管理方面,支持全面分析访问日志、访问时间,智能识别数据冷热,允许指定规则,智能执行冷热分层和归档,较好地节约成本;湖表格式加速方面也全面支持湖表格式加速,全面覆盖 Paimon、Delta、Hudi、 Iceberg 等常用湖格式。 在线平滑迁移 DLF 支持HMS 迁移、支持 HDFS、S3 迁移 、支持双跑校验比对;支持 HDFS 透明协议代理。实现在线平滑迁移,不影响在线应用,无需修改业务,在数据迁移过程中和迁移之后可以做双跑数据对比校验,没有数据损害。 数据湖存储 OSS-HDFS 全面升级 数据湖存储 OSS-HDFS 也做了全面升级,目前在线上已经有超过1000个客户,服务存储量超过100PB。 大幅提升性能 元数据访问性能提升了2倍以上,对于某些特定的操作,性能提升能够达到10倍。IO 访问支持智能预读,请求数减少 20%+,支持高效并发,CPU 使用降低 30%+。 多举措降低成本 全面支持 OSS 归档能力,新增支持冷归档和深冷归档,支持归档直读,无须回转;对于分层存储和归档数据也有完善管理,支持无限制目录级/分区级归档,支持目录 Access Time,高效识别数据冷热。 全方位数据保护 对 Kerberos 认证、Ranger鉴权、审计日志、数据清单功能进行全面安全支持,另外还提供目录保护的能力,支持指定目录保护,避免误删,对于回收站的清理策略也支持更细粒度的管理。 全面开源生态兼容 全面兼容HDFS,兼容 HDFS 接口、支持 HDFS 二进制协议兼容、支持 HDFS 命令;另外还支持 fsimage 导出 。 最后,阿里云 EMR 团队也在规划全托管数据湖缓存加速,预计明年4月份会和大家见面,欢迎关注。

优秀的个人博客,低调大师

Jakarta EE 10 发布,开启云原生 Java 时代

Eclipse 基金会已发布Jakarta EE 10 平台、Web Profile 和新的 Core Profile 规范。Jakarta EE 10 引入了用于构建现代化、简化和轻量级云原生 Java 应用程序的功能。据Eclipse 基金会执行董事 Mike Milinkovich 称 这个版本是在现代微服务和容器时代牢牢植入 Jakarta EE 的“大版本“,Jakarta EE 10 的发布反映了全球贡献者社区的工作,随着这个版本的发布,它现在已经为云原生时代带来了关键的创新,这对我们行业的未来至关重要。 Jakarta EE 10 通过指定 API 中的版本更新,在 20 多个组件规范中提供了新功能。例如: Jakarta Contexts and Dependency Injection (CDI) 4.0,包括支持构建时间扩展的 CDI-Lite Jakarta RESTful Web Services 3.1 标准化了 Java SE Bootstrap API ,并支持多部分/表单数据 Jakarta Security 3.0 支持 OpenID Connect 和 Jakarta Persistence 查询中的新功能,并使用纯 Java 创建 Jakarta Faces 视图 Jakarta EE 10 版本使用 Jakarta EE Core Profile 10 定义了一个新的配置文件规范,该规范定义了一个用于现代化和轻量级 Java 应用程序和微服务的多供应商平台。 新的核心配置文件提供了 Jakarta EE 规范的子集,这些规范针对适合具有轻量级运行时的微服务开发的较小运行时,包括用于构建轻量级 Jakarta EE 应用程序的新 CDI-Lite 规范。 Jakarta Servlet 6.0 用于简化编程并提高安全性 带有使用 CDI 的现代化 API 的 Jakarta Faces (JSF) 4.0 Jakarta JSON Binding (JSON-B) 3.0 新增对多态类型的支持 Jakarta Persistence 将 UUID 标准化为基本类型并扩展查询语言和查询 API Jakarta Concurrency 3.0 移至 Web Profile ,增强了应用程序可用的并行和反应式编程模型 Jakarta EE 10 版本使构建现代化云原生 Java 应用程序的企业能够: 在 Java SE 11 和 Java SE 17(Java SE 的最新 LTS 版本)上开发和部署 Jakarta EE 10 应用程序 利用 Java SE 9 中引入并在 Java SE 11 中支持的模块系统等新功能 此版本通过支持更广泛地使用附加注释来简化应用程序开发,使构建模块化应用程序变得更加容易,并提供了跨组件 API 的改进集成。 此版本可帮助开发人员更轻松地实现具有现代安全要求的应用程序,并删除已弃用的 API,同时还保持与先前 Jakarta EE 版本的高度兼容性。 除了这些增强功能之外,还有越来越多的兼容产品来支持已经丰富的生态系统。例如,Eclipse GlassFish 7、Open Liberty、22.0.0.10-beta 和 Wild Fly 27.0.0 目前正在提供兼容版本。 更多内容可查看 Jakarta EE 10 的发布公告 | 下载页。

优秀的个人博客,低调大师

腾讯云消息队列 TDMQ RabbitMQ 版开启公测

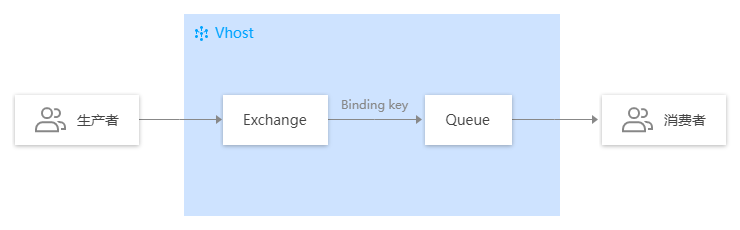
导语 1月6日,TDMQ RabbitMQ 版正式公测!TDMQ RabbitMQ 版是TDMQ系列产品中的一款子产品,是一款分布式高可用的消息队列服务,支持AMQP 0-9-1 协议,完全兼容开源 RabbitMQ 的各个组件与概念。欢迎大家扫描文末二维码使用体验! TDMQ RabbitMQ 版的背景 众所周知,RabbitMQ是一个历史比较悠久的消息队列中间件,它是使用Erlang语言开发的实现AMQP(Advanced Message Queue Protocol 高级消息队列协议)的消息中间件。RabbitMQ最初起源于金融系统,它在可靠性、可用性、扩展性、消息持久化、高并发等方面的有着卓越的表现。TDMQ RabbitMQ 版是依托于TDMQ而生的一款子产品,支持AMQP 0-9-1 协议,完全兼容开源 RabbitMQ 的各个组件与概念,稳定可靠,易用免运维,相比开源RabbitMQ,性能更佳且易拓展。 产品介绍 TDMQ RabbitMQ 版(TDMQ for RabbitMQ)具备计算存储分离,灵活扩缩容的底层优势,拥有极为灵活的路由来适应各类业务的消息投递规则,能有缓冲上游的流量压力,保证消息系统的稳定运行。常用于系统间的异步通信和服务解耦,减轻不同服务之间的依赖,广泛应用于金融等行业的分布式系统中。 TDMQ RabbitMQ 版的基本概念如下: 生产者:向 Exchange 发送消息。 Vhost:用作逻辑隔离,不同Vhost 之间的 Exchange 和 Queue 相互隔离,互不干扰。 Exchange:接收来自生产者的消息并将消息路由到 Queue 的组件。 Queue:存储消息的缓冲区,供消费者消费消息。 消费者:从 Queue 拉取消息进行消费。 产品优势 兼容开源 支持 AMQP 0-9-1 版本标准协议,完全支持开源 RabbitMQ 社区和 Queue、Exchange、Vhost 组件,并支持原生RabbitMQ周边组件的无缝接入。还将支持一键迁移开源 RabbitMQ 元数据,实现迁移上云零成本(即将上线)。 功能完备 TDMQ RabbitMQ 版支持原生 RabbitMQ 的各类消息模型。支持死信交换机与备用交换机,用户无需担心由于消息过期、路由失败等因素造成的消息丢失。默认支持开源延时消息插件,无需额外安装也可方便使用延时消息。 稳定可靠 持久化机制确保了 TDMQ RabbitMQ 版的高可靠性。设置 Exchange、Queue、消息的持久化,保证服务重启后元数据与消息内容不丢失。消息采用三副本存储策略,某台物理机故障时,能够实现数据的快速迁移,保证用户数据3个备份可用,服务可用性达99.95%。 高扩展性 TDMQ RabbitMQ 版相比于开源 RabbitMQ 支持更高的队列数量,可扩展能力强,底层系统可根据业务规模自动弹性伸缩、扩容/缩容集群规模,对用户透明。 易用免运维 提供 API 访问接口,支持开源所有语言和版本的 SDK。提供腾讯云平台整套运维服务,实时监控,帮助用户快速发现并解决问题,保证服务的可用性。另外还支持对某个时间段的消息进行快速查询,精准定位您的业务问题。 应用场景 秒杀系统流量削峰 秒杀系统可能因瞬时流量过大导致系统“宕机”,TDMQ RabbitMQ 版缓冲上游的流量压力,保证消息系统的稳定运行。 业务系统异步解耦 交易系统的订单数据涉及下游上百个业务系统,如发货、物流、订单等。TDMQ RabbitMQ 版可以实现系统间的异步通信和服务解耦,减轻不同服务之间的依赖,提升处理效率,保证系统稳定性。 产品体验入口 腾讯云消息队列TDMQ RabbitMQ 版已经开放公测,欢迎大家使用体验: 扫描二维码,立即体验 在1月6日~1月20日期间特别推出有奖产品体验活动,您可以将产品使用后的建议填写到下方问卷中,我们将挑选10个优质的产品体验建议,为您送去腾讯公仔盲盒的礼品; 扫描二维码,填写产品体验调查问卷

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册