首页 文章 精选 留言 我的

精选列表

搜索[智能解析],共10000篇文章
优秀的个人博客,低调大师

每日一博 | Redis GeoHash 核心原理解析

1. 引言 小麦同学是个吃货+技术宅,平日里就喜欢拿着手机地图点点按按来查询一些好玩的东西。某一天到北海公园游玩,肚肚饿了,于是乎打开手机地图,搜索北海公园附近的餐馆,并选了其中一家用餐。饱暖思yin欲的麦叔饭后思考地图后台如何根据自己所在位置查询来查询附近餐馆的呢?苦思冥想了半天,小麦想出了个方法:计算所在位置P与北京所有餐馆的距离,然后返回距离<=1000米的餐馆。小得意了一会儿,小麦发现北京的餐馆何其多啊,这样计算不得了,于是想了,既然知道经纬度了,那它应该知道自己在西城区,那应该计算所在位置P与西城区所有餐馆的距离啊,机机运用了递归的思想,想到了西城区也很多餐馆啊,应该计算所在位置P与所在街道所有餐馆的距离,这样计算量又小了,效率也提升了。 小麦的计算思想很朴素,就是通过过滤的方法来减小参与计算的餐馆数目,从某种角度上讲,机机在使用索引技术。 一提到索引,大家脑子里马上浮现出B树索引,因为大量的数据库(如MySQL、oracle、PostgreSQL等)都在使用B树。B树索引本质上是对索引字段进行排序,然后通过类似二分查找的方法进行快速查找,即它要求索引的字段是可排序的,一般而言,可排序的是一维字段,比如时间、年龄、薪水等等。但是对于空间上的一个点(二维,包括经度和纬度),如何排序呢?又如何索引呢?解决的方法很多,下文介绍一种方法来解决这一问题。 思想:如果能通过某种方法将二维的点数据转换成一维的数据,那样不就可以继续使用B树索引了嘛。那这种方法真的存在嘛,答案是肯定的。目前很火的GeoHash算法就是运用了上述思想,下面我们就开始GeoHash之旅吧。 2. 感性认识 先来两个干货,在线查看GPS某个区域的GeoHash值。 1. http://geohash.gofreerange.com/ 在这里插入图片描述 2. http://www.geohash.cn/ 跟更好用些 3. 通俗说 GeoHash将二维的经纬度转换成字符串,比如下图展示了北京9个区域的GeoHash字符串,分别是WX4ER,WX4G2、WX4G3等等,每一个字符串代表了某一矩形区域。也就是说,这个矩形区域内所有的点(经纬度坐标)都共享相同的GeoHash字符串,这样既可以保护隐私(只表示大概区域位置而不是具体的点),又比较容易做缓存,比如左上角这个区域内的用户不断发送位置信息请求餐馆数据,由于这些用户的GeoHash字符串都是WX4ER,所以可以把WX4ER当作key,把该区域的餐馆信息当作value来进行缓存,而如果不使用GeoHash的话,由于区域内的用户传来的经纬度是各不相同的,很难做缓存。字符串越长,表示的范围越精确。如图所示,5位的编码能表示10平方千米范围的矩形区域,而6位编码能表示更精细的区域(约0.34平方千米)字符串相似的表示距离相近(特殊情况后文阐述),这样可以利用字符串的前缀匹配来查询附近的POI信息。如下两个图所示,第一个在城区,第二个在郊区,城区的GeoHash字符串之间比较相似,郊区的字符串之间也比较相似,而城区和郊区的GeoHash字符串相似程度要低些。通过上面的介绍我们知道了GeoHash就是一种将经纬度转换成字符串的方法,并且使得在大部分情况下,字符串前缀匹配越多的距离越近,回到我们的案例,根据所在位置查询来查询附近餐馆时,只需要将所在位置经纬度转换成GeoHash字符串,并与各个餐馆的GeoHash字符串进行前缀匹配,匹配越多的距离越近。 4. GeoHash算法的步骤 下面以北海公园附近随便一个位置为例介绍GeoHash算法的计算步骤,先用百度 GPS反定位系统查找看下经纬度。纬度=116.395371,经度=39.931957。 根据经纬度计算GeoHash二进制编码 地球纬度区间是[-90,90], 北海公园的纬度是39.928167,可以通过下面算法对纬度39.928167进行逼近编码: 区间[-90,90]进行二分为[-90,0),[0,90],称为左右区间,可以确定39.928167属于右区间[0,90],给标记为1; 接着将区间[0,90]进行二分为 [0,45),[45,90],可以确定39.928167属于左区间 [0,45),给标记为0; 递归上述过程39.928167总是属于某个区间[a,b]。随着每次迭代区间[a,b]总在缩小,并越来越逼近39.928167; 如果给定的纬度x(39.928167)属于左区间,则记录0,如果属于右区间则记录1,这样随着算法的进行会产生一个序列1011100,序列的长度跟给定的区间划分次数有关。 39.928167 根据纬度算编码 bit min mid max 1 -90.000 0.000 90.000 0 0.000 45.000 90.000 1 0.000 22.500 45.000 1 22.500 33.750 45.000 1 33.750 39.375 45.000 0 39.375 42.188 45.000 0 39.375 40.7815 42.188 0 39.375 40.07825 40.7815 1 39.375 39.726625 40.07825 1 39.726625 39.9024375 40.07825 同理,地球经度区间是[-180,180],可以对经度116.389550进行编码。根据经度算编码 bit min mid max 1 -180 0.000 180 1 0.000 90 180 0 90 135 180 1 90 112.5 135 0 112.5 123.75 135 0 112.5 118.125 123.75 1 112.5 115.3125 118.125 0 115.3125 116.71875 118.125 1 115.3125 116.015625 116.71875 1 116.015625 116.3671875 116.71875 组码 通过上述计算,纬度产生的编码为10111 00011,经度产生的编码为11010 01011。偶数位放经度,奇数位放纬度,把2串编码组合生成新串:11100 11101 00100 01111。最后使用用0-9、b-z(去掉a, i, l, o)这32个字母进行base32编码,首先将11100 11101 00100 01111转成十进制,对应着28、29、4、15,十进制对应的编码就是wx4g。同理,将编码转换成经纬度的解码算法与之相反,具体不再赘述。 5. GeoHash Base32编码长度与精度 可以看出,当geohash base32编码长度为8时,精度在19米左右,而当编码长度为9时,精度在2米左右,编码长度需要根据数据情况进行选择。 一、经纬度距离换算 在纬度相等的情况下: 经度每隔0.00001度,距离相差约1米; 每隔0.0001度,距离相差约10米; 每隔0.001度,距离相差约100米; 每隔0.01度,距离相差约1000米; 每隔0.1度,距离相差约10000米。 在经度相等的情况下: 纬度每隔0.00001度,距离相差约1.1米; 每隔0.0001度,距离相差约11米; 每隔0.001度,距离相差约111米; 每隔0.01度,距离相差约1113米; 每隔0.1度,距离相差约11132米。 6. GeoHash算法 上文讲了GeoHash的计算步骤,仅仅说明是什么而没有说明为什么?为什么分别给经度和维度编码?为什么需要将经纬度两串编码交叉组合成一串编码?本节试图回答这一问题。 如下图所示,我们将二进制编码的结果填写到空间中,当将空间划分为四块时候,编码的顺序分别是左下角00,左上角01,右下脚10,右上角11,也就是类似于Z的曲线,当我们递归的将各个块分解成更小的子块时,编码的顺序是自相似的(分形),每一个子快也形成Z曲线,这种类型的曲线被称为Peano空间填充曲线。 这种类型的空间填充曲线的优点是将二维空间转换成一维曲线(事实上是分形维),对大部分而言,编码相似的距离也相近, 但Peano空间填充曲线最大的缺点就是突变性,有些编码相邻但距离却相差很远,比如0111与1000,编码是相邻的,但距离相差很大。 除Peano空间填充曲线外,还有很多空间填充曲线,如图所示,其中效果公认较好是Hilbert空间填充曲线,相较于Peano曲线而言,Hilbert曲线没有较大的突变。为什么GeoHash不选择Hilbert空间填充曲线呢?可能是Peano曲线思路以及计算上比较简单吧,事实上,Peano曲线就是一种四叉树线性编码方式。 7. 使用注意点 1. 临界问题 由于GeoHash是将区域划分为一个个规则矩形,并对每个矩形进行编码,这样在查询附近POI信息时会导致以下问题,比如红色的点是我们的位置,绿色的两个点分别是附近的两个餐馆,但是在查询的时候会发现距离较远餐馆的GeoHash编码与我们一样(因为在同一个GeoHash区域块上),而较近餐馆的GeoHash编码与我们不一致。这个问题往往产生在边界处。 解决的思路很简单,我们查询时,除了使用定位点的GeoHash编码进行匹配外,还使用周围8个区域的GeoHash编码,这样可以避免这个问题。 2. 注意点 我们已经知道现有的GeoHash算法使用的是Peano空间填充曲线,这种曲线会产生突变,造成了编码虽然相似但距离可能相差很大的问题,因此在查询附近餐馆时候,首先筛选GeoHash编码相似的POI(point of interest)点,然后进行实际距离计算。 3. 使用心得 GeoHash只是空间索引的一种方式,特别适合点数据,而对线、面数据采用R树索引更有优势(可为什么需要空间索引)。 GeoHash值可以区分精度,位数越多,精度越高,表达的地理位置越精细;如一位的GeoHash值把地球划分为32个矩形,8位的geohash值把地球划分为32^8个小矩形 适合根据某个经纬度坐标position计算出GeoHash值,然后和数据库中精度更高的GeoHash值做前缀比较 8.空间索引 常见问题:如何根据自己所在位置查询来查询附近50米的POI(point of interest,比如商家、景点等)呢(图1a)?每个POI都有经纬度信息,用图1b的SQL语句在mySQL中建立了POI_spatial的表,其中lat和lng两个字段来代表纬度和经度。为后续分析方便起见,我人造了40万个POI数据。 方法一:暴力方法 该方法的思路很直接:计算位置与所有POI的距离,并保留距离小于50米的POI。 插句题外话,计算经纬度之间的距离不能像求欧式距离那样平方开根号,因为地球是个不规整的球体(图2a),普通计算适合都是默认按最简单的完美球体假设,两点之间的距离函数应该如图2b所示。 该方法的复杂度为:40万*距离函数。我们将球体距离函数写为mysql存储过程distance,之后我们执行查询操作(图3),发现花费了4.66秒。 方法二:矩形过滤方法 该方法采用逐步细化的方式,一般分为两部: 先用矩形框过滤(图4a),判断一个点在矩形框内很简单,只要进行两次判断(LtMin<lat<LtMax; LnMin<lng<LnMax),落在矩形框内的POI个数为n(n<<40万); 用球面距离公式计算位置与矩形框内n个POI的距离(图4b),并保留距离小于50米的POI 矩形过滤方法的复杂度:40万矩形过滤函数 + n距离函数(n<<40万)。 根据这个思路我们执行SQl查询(图5)(注:经度或纬度每隔0.001度,距离相差约100米,由此推算出矩形左下角和右上角坐标),发现过滤后正好剩下两个POI。 此查询花费了0.36秒,相比于方法一查询时间大大降低,但是对于一次查询来说还是很长。时间长的原因在于遍历了40万次。 方法三:B树对经度或纬度建立索引 方法二耗时的原因在于执行了遍历操作,为了不进行遍历,我们自然想到了索引。我们对纬度进行了B树索引。 altertablepoi_spatialaddindexlatindex(lat);altertablepoi_spatialaddindexlngindex(lng); 此方法包括三个步骤: 通过B树快速找到某纬度范围的POI(图6a),个数为m(m<40万),复杂度为Log(40万)*过滤函数; 在步骤a过滤得到的m个POI中查找某经度范围的POI(图6b),个数为n(n<m),复杂度为m*过滤函数; 用球面距离公式计算位置与步骤b得到的n个POI的距离(图6c),并保留距离小于50米的POI 执行SQL查询(图7),发现时间已经大大降低,从方法2的0.36秒下降到0.01秒 三、B树能索引空间数据吗? 这时候有人会说了:方法三效果如此好,能够满足我们附近POI查询问题啊,看来B树用来索引空间数据也是可以的嘛!那么B树真的能够索引空间数据吗? 只能对经度或纬度索引(一维索引),与期望的不符 我们期待的是快速找出落在某一空间范围的POI(如矩形)(图8a),而不是快速找出落在某纬度或经度范围的POI(图8b),想象一下,我要查询北京某区的POI,但是B树索引不仅给我找出了北京的,还有与北京同一维度的天津、大同、甚至国外城市的POI,当数据量很大时,效率很低。 当数据是多维,比如三维(x,y,z),B树怎么索引?比如z可能是高程值,也可能是时间。有人会说B树其实可以对多个字段进行索引,但这时需要指定优先级,形成一个组合字段,而空间数据在各个维度方向上不存在优先级,我们不能说纬度比经度更重要,也不能说纬度比高程更重要。 当空间数据不是点,而是线(道路、地铁、河流等),面(行政区边界、建筑物等),B树怎么索引?对于面来说,它由一系列首尾相连的经纬度坐标点组成,一个面可能有成百上千个坐标,这时数据库怎么存储,B树怎么索引,这些都是问题。 既然传统的索引不能很好的索引空间数据,我们自然需要一种方法能对空间数据进行索引,即空间索引。 参考 Java实现GPS范围查找 浙大大佬通俗说GPS 本文分享自微信公众号 - sowhat1412(sowhat9094)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

几道高级前端面试题解析

为什么 0.1 + 0.2 != 0.3,请详述理由 因为 JS 采用 IEEE 754 双精度版本(64位),并且只要采用 IEEE 754 的语言都有该问题。 我们都知道计算机表示十进制是采用二进制表示的,所以 0.1 在二进制表示为 // (0011) 表示循环 0.1 = 2^-4 * 1.10011(0011) 复制代码 那么如何得到这个二进制的呢,我们可以来演算下 小数算二进制和整数不同。乘法计算时,只计算小数位,整数位用作每一位的二进制,并且得到的第一位为最高位。所以我们得出 0.1 = 2^-4 * 1.10011(0011),那么 0.2 的演算也基本如上所示,只需要去掉第一步乘法,所以得出 0.2 = 2^-3 * 1.10011(0011)。 回来继续说 IEEE 754 双精度。六十四位中符号位占一位,整数位占十一位,其余五十二位都为小数位。因为 0.1 和 0.2 都是无限循环的二进制了,所以在小数位末尾处需要判断是否进位(就和十进制的四舍五入一样)。 所以 2^-4 * 1.10011...001 进位后就变成了 2^-4 * 1.10011(0011 * 12次)010 。那么把这两个二进制加起来会得出 2^-2 * 1.0011(0011 * 11次)0100 , 这个值算成十进制就是 0.30000000000000004 下面说一下原生解决办法,如下代码所示 parseFloat((0.1 + 0.2).toFixed(10)) 复制代码 10 个 Ajax 同时发起请求,全部返回展示结果,并且至多允许三次失败,说出设计思路 这个问题相信很多人会第一时间想到 Promise.all ,但是这个函数有一个局限在于如果失败一次就返回了,直接这样实现会有点问题,需要变通下。以下是两种实现思路 // 以下是不完整代码,着重于思路 非 Promise 写法 let successCount = 0 let errorCount = 0 let datas = [] ajax(url, (res) => { if (success) { success++ if (success + errorCount === 10) { console.log(datas) } else { datas.push(res.data) } } else { errorCount++ if (errorCount > 3) { // 失败次数大于3次就应该报错了 throw Error('失败三次') } } }) // Promise 写法 let errorCount = 0 let p = new Promise((resolve, reject) => { if (success) { resolve(res.data) } else { errorCount++ if (errorCount > 3) { // 失败次数大于3次就应该报错了 reject(error) } else { resolve(error) } } }) Promise.all([p]).then(v => { console.log(v); }); 复制代码 基于 Localstorage 设计一个 1M 的缓存系统,需要实现缓存淘汰机制 设计思路如下: 存储的每个对象需要添加两个属性:分别是过期时间和存储时间。 利用一个属性保存系统中目前所占空间大小,每次存储都增加该属性。当该属性值大于 1M 时,需要按照时间排序系统中的数据,删除一定量的数据保证能够存储下目前需要存储的数据。 每次取数据时,需要判断该缓存数据是否过期,如果过期就删除。 以下是代码实现,实现了思路,但是可能会存在 Bug,但是这种设计题一般是给出设计思路和部分代码,不会需要写出一个无问题的代码 class Store { constructor() { let store = localStorage.getItem('cache') if (!store) { store = { maxSize: 1024 * 1024, size: 0 } this.store = store } else { this.store = JSON.parse(store) } } set(key, value, expire) { this.store[key] = { date: Date.now(), expire, value } let size = this.sizeOf(JSON.stringify(this.store[key])) if (this.store.maxSize < size + this.store.size) { console.log('超了-----------'); var keys = Object.keys(this.store); // 时间排序 keys = keys.sort((a, b) => { let item1 = this.store[a], item2 = this.store[b]; return item2.date - item1.date; }); while (size + this.store.size > this.store.maxSize) { let index = keys[keys.length - 1] this.store.size -= this.sizeOf(JSON.stringify(this.store[index])) delete this.store[index] } } this.store.size += size localStorage.setItem('cache', JSON.stringify(this.store)) } get(key) { let d = this.store[key] if (!d) { console.log('找不到该属性'); return } if (d.expire > Date.now) { console.log('过期删除'); delete this.store[key] localStorage.setItem('cache', JSON.stringify(this.store)) } else { return d.value } } sizeOf(str, charset) { var total = 0, charCode, i, len; charset = charset ? charset.toLowerCase() : ''; if (charset === 'utf-16' || charset === 'utf16') { for (i = 0, len = str.length; i < len; i++) { charCode = str.charCodeAt(i); if (charCode <= 0xffff) { total += 2; } else { total += 4; } } } else { for (i = 0, len = str.length; i < len; i++) { charCode = str.charCodeAt(i); if (charCode <= 0x007f) { total += 1; } else if (charCode <= 0x07ff) { total += 2; } else if (charCode <= 0xffff) { total += 3; } else { total += 4; } } } return total; } } 复制代码 详细说明 Event loop 众所周知 JS 是门非阻塞单线程语言,因为在最初 JS 就是为了和浏览器交互而诞生的。如果 JS 是门多线程的语言话,我们在多个线程中处理 DOM 就可能会发生问题(一个线程中新加节点,另一个线程中删除节点),当然可以引入读写锁解决这个问题。 JS 在执行的过程中会产生执行环境,这些执行环境会被顺序的加入到执行栈中。如果遇到异步的代码,会被挂起并加入到 Task(有多种 task) 队列中。一旦执行栈为空,Event Loop 就会从 Task 队列中拿出需要执行的代码并放入执行栈中执行,所以本质上来说 JS 中的异步还是同步行为。 console.log('script start'); setTimeout(function() { console.log('setTimeout'); }, 0); console.log('script end'); 复制代码 以上代码虽然 setTimeout 延时为 0,其实还是异步。这是因为 HTML5 标准规定这个函数第二个参数不得小于 4 毫秒,不足会自动增加。所以 setTimeout 还是会在 script end 之后打印。 不同的任务源会被分配到不同的 Task 队列中,任务源可以分为 微任务(microtask) 和 宏任务(macrotask)。在 ES6 规范中,microtask 称为 jobs,macrotask 称为 task。 console.log('script start'); setTimeout(function() { console.log('setTimeout'); }, 0); new Promise((resolve) => { console.log('Promise') resolve() }).then(function() { console.log('promise1'); }).then(function() { console.log('promise2'); }); console.log('script end'); // script start => Promise => script end => promise1 => promise2 => setTimeout 复制代码 以上代码虽然 setTimeout 写在 Promise 之前,但是因为 Promise 属于微任务而 setTimeout 属于宏任务,所以会有以上的打印。 微任务包括 process.nextTick ,promise ,Object.observe ,MutationObserver 宏任务包括 script , setTimeout ,setInterval ,setImmediate ,I/O ,UI rendering 很多人有个误区,认为微任务快于宏任务,其实是错误的。因为宏任务中包括了 script ,浏览器会先执行一个宏任务,接下来有异步代码的话就先执行微任务。 所以正确的一次 Event loop 顺序是这样的 执行同步代码,这属于宏任务 执行栈为空,查询是否有微任务需要执行 执行所有微任务 必要的话渲染 UI 然后开始下一轮 Event loop,执行宏任务中的异步代码 通过上述的 Event loop 顺序可知,如果宏任务中的异步代码有大量的计算并且需要操作 DOM 的话,为了更快的 界面响应,我们可以把操作 DOM 放入微任务中。 Node 中的 Event loop Node 中的 Event loop 和浏览器中的不相同。 Node 的 Event loop 分为6个阶段,它们会按照顺序反复运行 ┌───────────────────────┐ ┌─>│ timers │ │ └──────────┬────────────┘ │ ┌──────────┴────────────┐ │ │ I/O callbacks │ │ └──────────┬────────────┘ │ ┌──────────┴────────────┐ │ │ idle, prepare │ │ └──────────┬────────────┘ ┌───────────────┐ │ ┌──────────┴────────────┐ │ incoming: │ │ │ poll │<──connections─── │ │ └──────────┬────────────┘ │ data, etc. │ │ ┌──────────┴────────────┐ └───────────────┘ │ │ check │ │ └──────────┬────────────┘ │ ┌──────────┴────────────┐ └──┤ close callbacks │ └───────────────────────┘ 复制代码 timer timers 阶段会执行 setTimeout 和 setInterval 一个 timer 指定的时间并不是准确时间,而是在达到这个时间后尽快执行回调,可能会因为系统正在执行别的事务而延迟。 下限的时间有一个范围:[1, 2147483647] ,如果设定的时间不在这个范围,将被设置为1。 I/O I/O 阶段会执行除了 close 事件,定时器和 setImmediate 的回调 idle, prepare idle, prepare 阶段内部实现 poll poll 阶段很重要,这一阶段中,系统会做两件事情 执行到点的定时器 执行 poll 队列中的事件 并且当 poll 中没有定时器的情况下,会发现以下两件事情 如果 poll 队列不为空,会遍历回调队列并同步执行,直到队列为空或者系统限制 如果 poll 队列为空,会有两件事发生 如果有 setImmediate 需要执行,poll 阶段会停止并且进入到 check 阶段执行 setImmediate 如果没有 setImmediate 需要执行,会等待回调被加入到队列中并立即执行回调 如果有别的定时器需要被执行,会回到 timer 阶段执行回调。 check check 阶段执行 setImmediate close callbacks close callbacks 阶段执行 close 事件 并且在 Node 中,有些情况下的定时器执行顺序是随机的 setTimeout(() => { console.log('setTimeout'); }, 0); setImmediate(() => { console.log('setImmediate'); }) // 这里可能会输出 setTimeout,setImmediate // 可能也会相反的输出,这取决于性能 // 因为可能进入 event loop 用了不到 1 毫秒,这时候会执行 setImmediate // 否则会执行 setTimeout 复制代码 当然在这种情况下,执行顺序是相同的 var fs = require('fs') fs.readFile(__filename, () => { setTimeout(() => { console.log('timeout'); }, 0); setImmediate(() => { console.log('immediate'); }); }); // 因为 readFile 的回调在 poll 中执行 // 发现有 setImmediate ,所以会立即跳到 check 阶段执行回调 // 再去 timer 阶段执行 setTimeout // 所以以上输出一定是 setImmediate,setTimeout 复制代码 上面介绍的都是 macrotask 的执行情况,microtask 会在以上每个阶段完成后立即执行。 setTimeout(()=>{ console.log('timer1') Promise.resolve().then(function() { console.log('promise1') }) }, 0) setTimeout(()=>{ console.log('timer2') Promise.resolve().then(function() { console.log('promise2') }) }, 0) // 以上代码在浏览器和 node 中打印情况是不同的 // 浏览器中打印 timer1, promise1, timer2, promise2 // node 中打印 timer1, timer2, promise1, promise2 复制代码 Node 中的 process.nextTick 会先于其他 microtask 执行。 setTimeout(() => { console.log("timer1"); Promise.resolve().then(function() { console.log("promise1"); }); }, 0); process.nextTick(() => { console.log("nextTick"); }); // nextTick, timer1, promise1 1.如果觉得这篇文章还不错,来个分享、点赞吧,让更多的人也看到 如果你觉得这篇文章对你有点用的话,麻烦请给我们的开源项目点点star: http://github.crmeb.net/u/defu 不胜感激 ! 来自 “开源世界 ” ,链接: https://ym.baisou.ltd/post/754.html ,如需转载,请注明出处,否则将追究法律责任。

优秀的个人博客,低调大师

深入解析,快速教会你 SQL 子查询优化!

子查询(Subquery)的优化一直以来都是 SQL 查询优化中的难点之一。关联子查询的基本执行方式类似于 Nested-Loop,但是这种执行方式的效率常常低到难以忍受。当数据量稍大时,必须在优化器中对其进行去关联化(Decoorelation 或 Unnesting),将其改写为类似于 Semi-Join 这样的更高效的算子。 前人已经总结出一套完整的方法论,理论上能对任意一个查询进行去关联化。本文结合 SQL Server 以及 HyPer 的几篇经典论文,由浅入深地讲解一下这套去关联化的理论体系。它们二者所用的方法大同小异,基本思想是想通的。 子查询简介 子查询是定义在 SQL 标准中一种语法,它可以出现在 SQL 的几乎任何地方,包括 SELECT, FROM, WHERE 等子句中。 总的来说,子查询可以分为关联子查询(Correlated Subquery)和非关联子查询(Non-correlated Subquery)。后者非关联子查询是个很简单的问题,最简单地,只要先执行它、得到结果集并物化,再执行外层查询即可。下面是一个例子: SELECT c_count, count(*) AS custdist FROM ( SELECT c_custkey, count(o_orderkey) AS c_count FROM CUSTOMER LEFT OUTER JOIN ORDERS ON c_custkey = o_custkey AND o_comment NOT LIKE '%pending%deposits%' GROUP BY c_custkey ) c_orders GROUP BY c_count ORDER BY custdist DESC, c_count DESC; 非关联子查询不在本文讨论范围之列,除非特别声明,以下我们说的子查询都是指关联子查询。 关联子查询的特别之处在于,其本身是不完整的:它的闭包中包含一些外层查询提供的参数。显然,只有知道这些参数才能运行该查询,所以我们不能像对待非关联子查询那样。 根据产生的数据来分类,子查询可以分成以下几种: 标量(Scalar-valued)子查询:输出一个只有一行一列的结果表,这个标量值就是它的结果。如果结果为空(0 行),则输出一个 NULL。但是注意,超过 1 行结果是不被允许的,会产生一个运行时异常。 标量子查询可以出现在任意包含标量的地方,例如 SELECT、WHERE 等子句里。下面是一个例子: SELECT c_custkey FROM CUSTOMER WHERE 1000000 < ( SELECT SUM(o_totalprice) FROM ORDERS WHERE o_custkey = c_custkey ) Query 1: 一个出现在 WHERE 子句中的标量子查询,关联参数用红色字体标明了 SELECT o_orderkey, ( SELECT c_name FROM CUSTOMER WHERE c_custkey = o_custkey ) AS c_name FROM ORDERS Query 2: 一个出现在 SELECT 子句中的标量子查询 存在性检测(Existential Test)子查询:特指 EXISTS 的子查询,返回一个布尔值。如果出现在 WHERE 中,这就是我们熟悉的 Semi-Join。当然,它可能出现在任何可以放布尔值的地方。 SELECT c_custkey FROM CUSTOMER WHERE c_nationkey = 86 AND EXISTS( SELECT * FROM ORDERS WHERE o_custkey = c_custkey ) Query 3: 一个 Semi-Join 的例子 集合比较(Quantified Comparision)子查询:特指 IN、SOME、ANY 的查询,返回一个布尔值,常用的形式有:x = SOME(Q)(等价于x IN Q)或X &lt;&gt; ALL(Q)(等价于x NOT IN Q)。同上,它可能出现在任何可以放布尔值的地方。 SELECT c_name FROM CUSTOMER WHERE c_nationkey <> ALL (SELECT s_nationkey FROM SUPPLIER) Query 4: 一个集合比较的非关联子查询 原始执行计划 我们以 Query 1 为例,直观地感受一下,为什么说关联子查询的去关联化是十分必要的。 下面是 Query 1 的未经去关联化的原始查询计划(Relation Tree)。与其他查询计划不一样的是,我们特地画出了表达式树(Expression Tree),可以清晰地看到:子查询是实际上是挂在 Filter 的条件表达式下面的。 实际执行时,查询计划执行器(Executor)在执行到 Filter 时,调用表达式执行器(Evaluator);由于这个条件表达式中包含一个标量子查询,所以 Evaluator 又会调用 Executor 计算标量子查询的结果。 这种 Executor - Evaluator - Executor 的交替调用十分低效!考虑到 Filter 上可能会有上百万行数据经过,如果为每行数据都执行一次子查询,那查询执行的总时长显然是不可接受的。 Apply 算子 上文说到的 Relation - Expression - Relation 这种交替引用不仅执行性能堪忧,而且,对于优化器也是个麻烦的存在——我们的优化规则都是在匹配并且对 Relation 进行变换,而这里的子查询却藏在 Expression 里,令人无从下手。 为此,在开始去关联化之前,我们引入 Apply 算子: Apply 算子(也称作 Correlated Join)接收两个关系树的输入,与一般 Join 不同的是,Apply 的 Inner 输入(图中是右子树)是一个带有参数的关系树。 Apply 的含义用下图右半部分的集合表达式定义:对于 Outer Relation RR 中的每一条数据 rr,计算 Inner Relation E(r)E(r),输出它们连接(Join)起来的结果 r⊗E(r)r⊗E(r)。Apply 的结果是所有这些结果的并集(本文中说的并集指的是 Bag 语义下的并集,也就是 UNION ALL)。 Apply 是 SQL Server 的命名,它在 HyPer 的文章中叫做 Correlated Join。它们是完全等价的。考虑到 SQL Server 的文章发表更早、影响更广,本文中都沿用它的命名。 根据连接方式(⊗⊗)的不同,Apply 又有 4 种形式: Cross ApplyA×A×:这是最基本的形式,行为刚刚我们已经描述过了; Left Outer ApplyALOJALOJ:即使 E(r)E(r) 为空,也生成一个 r∘{NULLs}r∘{NULLs}。 Semi ApplyA∃A∃:如果 E(r)E(r) 不为空则返回 rr,否则丢弃; Anti-Semi ApplyA∄A∄:如果 E(r)E(r) 为空则返回 rr,否则丢弃; 我们用刚刚定义的 Apply 算子来改写之前的例子:把子查询从 Expression 内部提取出来。结果如下: 上面的例子中,我们可以肯定 Scalar Agg 子查询有且只有一行结果,所以可以直接转成 Apply。但某些情况下,可能无法肯定子查询一定能返回 0 或 1 行结果(例如,想象一下 Query 2 如果 c_custkey 不是唯一的),为了确保 SQL 语义,还要在 Apply 右边加一个 Max1RowMax1Row 算子: Max1Row(E)=⎧⎩⎨⎪⎪Null,E,error,if |E|=0if |E|=1otherwiseMax1Row(E)={Null,if |E|=0E,if |E|=1error,otherwise 理论上,我们可以将所有的子查询转换成 Apply 算子,一个通用的方法如下: 1.如果某个算子的表达式中出现了子查询,我们就把这个子查询提取到该算子下面(留下一个子查询的结果变量),构成一个 ALOJALOJ 算子。如果不止一个子查询,则会产生多个 ALOJALOJ。必要的时候加上 Max1RowMax1Row 算子。 2.然后应用其他一些规则,将 ALOJALOJ 转换成 A×A×、A∃A∃、A∄A∄。例如上面例子中的子查询结果 XX 被用作 Filter 的过滤条件,NULL 值会被过滤掉,因此可以安全地转换成 A×A×。 下面这个例子中,Filter 条件表达式中包含 Q1Q1、Q2Q2 两个子查询。转换之后分别生成了对应的 Apply 算子。其中 Q2Q2 无法确定只会生成恰好一条记录,所以还加上了 Max1RowMax1Row 算子。 基本消除规则 第一组规则是最基本的规则,等式中的 ⊗⊗ 说明它不限制连接类型,可以是 {×,LOJ,∃,∄}{×,LOJ,∃,∄} 中的任意一个。 这两条规则是非常显而易见的,翻译成大白话就是:如果 Apply 的右边不包含来自左边的参数,那它就和直接 Join 是等价的。 下面是对 Query 3 应用规则 (2) 的例子: Project 和 Filter 的去关联化 第二组规则描述了如何处理子查询中的 Project 和 Filter,其思想可以用一句话来描述:尽可能把 Apply 往下推、把 Apply 下面的算子向上提。 注意这些规则仅处理 Cross Apply 这一种情况。其他 3 种 Apply 的变体,理论上都可以转换成 Cross Apply,暂时我们只要知道这个事实就可以了。 你可能会问:通常我们都是尽可能把 Filter、Project 往下推,为什么这里会反其道而行呢?关键在于:Filter、Project 里面原本包含了带有关联变量的表达式,但是把它提到 Apply 上方之后,关联变量就变成普通变量了!这正是我们想要的。 我们稍后就会看到这样做的巨大收益:当 Apply 被推最下面时,就可以应用第一组规则,直接把 Apply 变成 Join,也就完成了子查询去关联化的优化过程。 下面是对 Query 2 应用规则 (3) 的例子。之后再应用规则 (1),就完成了去关联化过程。 Aggregate 的去关联化 第三组规则描述如何处理子查询中的 Aggregate(即 Group By)。和上一组一样,我们的指导思想仍然是:尽可能把 Apply 往下推、把 Apply 下面的算子向上提。 下面等式中,GA,FGA,F 表示带有 Group By 分组的聚合(Group Agg),其中 AA 表示分组的列,FF 表示聚合函数的列;G1FGF1 表示不带有分组的聚合(Scalar Agg)。 这一组规则不像之前那么简单直白,我们先看一个例子找找感觉。下面是对 Query 1 运用规则 (9) 的结果: 规则 (9) 在下推 Apply 的同时,还将 ScalarAgg 变成了 GroupAgg,其中,分组列就是 R 的 key,在这里也就是 CUSTOMER 的主键 c_custkey。 如果 R 没有主键或唯一键,理论上,我们可以在 Scan 时生成一个。 为什么变换前后是等价的呢?变换前,我们是给每个 R 的行做了一次 ScalarAgg 聚合计算,然后再把聚合的结果合并起来;变换后,我们先是将所有要聚合的数据准备好(这被称为 augment),然后使用 GroupAgg 一次性地做完所有聚合。 这也解释了为什么我们要用 ALOJALOJ 而不是原本的 A×A× :原来的 ScalarAgg 上,即使输入是空集,也会输出一个 NULL。如果我们这里用 ALOJALOJ,恰好也会得到一样的行为(*);反之,如果用 A×A× 就有问题了——没有对应 ORDERS 的客户在结果中消失了! 规则 (8) 处理的是 GroupAgg,道理也是一样的,只不过原来的分组列也要留着。 ScalarAgg 转换中的细节* 细心的读者可能注意到,规则 (9) 右边产生的聚合函数是 F′F′,多了一个单引号,这暗示它和原来的聚合函数 FF 可能是有些不同的。那什么情况下会不同呢?这个话题比较深入了,不感兴趣的同学可以跳过。 首先我们思考下,GroupAgg 以及 ALOJALOJ 的行为真的和变换前一模一样吗?其实不然。举个反例: SELECT c_custkey, ( SELECT COUNT(*) FROM ORDERS WHERE o_custkey = c_custkey ) AS count_orders FROM CUSTOMER 设想一下:客户 Eric 没有任何订单,那么这个查询应当返回一个['Eric', 0]的行。但是,当我们应用了规则 (9) 做变换之后,却得到了一个['Eric', 1]的值,结果出错了! 为何会这样呢?变换之后,我们是先用 LeftOuterJoin 准备好中间数据(augment),然后用 GroupAgg 做聚合。LeftOuterJoin 为客户 Eric 生成了一个['Eric', NULL, NULL, ...]的行;之后的 GroupAgg 中,聚合函数COUNT(*)认为 Eric 这个分组有 1 行数据,所以输出了['Eric', 1]。 下面是个更复杂的例子,也有类似的问题: SELECT c_custkey FROM CUSTOMER WHERE 200000 < ( SELECT MAX(IF_NULL(o_totalprice, 42)) -- o_totalprice may be NULL FROM ORDERS WHERE o_custkey = c_custkey ) 作为总结,问题的根源在于:F(∅)≠F({NULL})F(∅)≠F({NULL}),这样的聚合函数 FF 都有这个问题。 变换后的 GroupAgg 无法区分它看到的 NULL 数据到底是 OuterJoin 产生的,还是原本就存在的,有时候,这两种情形在变换前的 ScalarAgg 中会产生不同的结果。 幸运的是,SQL 标准中定义的聚合函数 F(col)F(col) 都是 OK 的——它们都满足 F(∅)=F({NULL})F(∅)=F({NULL}),我们只要对 FF 稍加变换就能解决这个问题。 对于例子一,将COUNT(*)替换成一个对非空列(例如主键)的 Count 即可,例如:COUNT(o_orderkey); 对于例子二,需要把MIN(IF_NULL(o_totalprice, 42))分成两步来做:定义中间变量X,先用 Project 计算X = IF_NULL(o_totalprice, 42),再对聚合函数MIN(X)进行去关联化即可。 集合运算的去关联化 最后一组优化规则用来处理带有 Union(对应UNION ALL)、Subtract(对应EXCEPT ALL) 和 Inner Join 算子的子查询。再强调一遍,我们的指导思想是:尽可能把 Apply 往下推、把 Apply 下面的算子向上提。 下面的等式中,×× 表示 Cross Join,⋈R.key⋈R.key 表示按照 RR 的 Key 做自然连接:r∘e1∘e2r∘e1∘e2 。和之前一样,我们假设 RR 存在主键或唯一键,如果没有也可以在 Scan 的时候加上一个。 注意到,这些规则与之前我们见过的规则有个显著的不同:等式右边 RR 出现了两次。这样一来,要么我们把这颗子树拷贝一份,要么做成一个 DAG 的执行计划,总之会麻烦许多。 事实上,这一组规则很少能派上用场。在 [2] 中提到,在 TPC-H 的 Schema 下甚至很难写出一个带有 Union All 的、有意义的子查询。 其他 有几个我认为比较重要的点,用 FAQ 的形式列在下面。 ► 是否任意的关联子查询都可以被去关联化? 可以说是这样的,在加上少量限定之后,理论上可以证明:任意的关联子查询都可以被去关联化。 证明方法在 [1]、[3] 中都有提及。以 [1] 中为例,思路大致是: 对于任意的查询关系树,首先将关联子查询从表达式中提取出来,用 Apply 算子表示; 一步步去掉其中非基本关系算子,首先,通过等价变换去掉 Union 和 Subtract; 进一步缩小算子集合,去掉 OuterJoin、ALOJALOJ、A∃A∃、A∄A∄; 最后,去掉所有的 A×A×,剩下的关系树仅包含基本的一些关系算子,即完成了去关联化。 另一方面,现实世界中用户使用的子查询大多是比较简单的,本文中描述的这些规则可能已经覆盖到 99% 的场景。虽然理论上任意子查询都可以处理,但是实际上,没有任何一个已知的 DBMS 实现了所有这些变换规则。 ► HyPer 和 SQL Server 的做法有什么异同? HyPer 的理论覆盖了更多的去关联化场景。例如各种 Join 等算子,[3] 中都给出了相应的等价变换规则(作为例子,下图是对 Outer Join 的变换)。而在 [1] 中仅仅是证明了这些情况都可以被规约到可处理的情形(实际上嘛,可想而知,一定是没有处理的)。 另一个细节是,HyPer 中还存在这样一条规则: 其中,D=ΠF(T2)∩A(T1)(T1)D=ΠF(T2)∩A(T1)(T1),表示对 T1T1 的 Distinct Project 结果(所谓的Magic Set)。直接看等式比较晦涩,看下面的例子就容易理解了: 图中,在做 Apply 之前,先拿到需要 Apply 的列的 Distinct 值集合,拿这些值做 Apply,之后再用普通的 Join 把 Apply 的结果连接上去。 这样做的好处是:如果被 Apply 的数据存在大量重复,则 Distinct Project 之后需要 Apply 的行数大大减少。这样一来,即使之后 Apply 没有被优化掉,迭代执行的代价也会减小不少。 ► 本文说的这些变换规则,应该用在 RBO 还是 CBO 中呢?换句话说,去关联化后之后的执行计划一定比去关联化之前更好吗? 答案是,不一定。 直观的看,如果 Apply 的左边数据量比较少(例如,仅有 1 条数据),那直接带入 Apply 的右边计算反而是更好的方式。另一种情况是,右边有合适的索引,这种情况下,多次 Apply 的代价也并非不可接受。 所以把这些规则放进一个 CBO 的优化器是更合适的,优化器根据代价估计选出最优的计划来。甚至,在某些情况下,我们还会自右向左地运用这些等式,做“加关联化”。 这和用 HashJoin 还是 NestedLoopJoin 是同样的道理。事实上,NestedLoopJoin 就是 Apply 的一个特例。如果存在合适的索引,NestedLoopJoin 效率高于 HashJoin 是很常见的事情。

优秀的个人博客,低调大师

每日一博 | RocketMQ 基础概念剖析&源码解析

Topic Topic是一类消息的集合,是一种逻辑上的分区。为什么说是逻辑分区呢?因为最终数据是存储到Broker上的,而且为了满足高可用,采用了分布式的存储。 这和Kafka中的实现如出一辙,Kafka的Topic也是一种逻辑概念,每个Topic的数据会分成很多份,然后存储在不同的Broker上,这个「份」叫Partition。而在RocketMQ中,Topic的数据也会分布式的存储,这个「份」叫MessageQueue。 其分布可以用下图来表示。 这样一来,如果某个Broker所在的机器意外宕机,而且刚好MessageQueue中的数据还没有持久化到磁盘,那么该Topic下的这部分消息就会完全丢失。此时如果有备份的话,MQ就可以继续对外提供服务。 为什么还会出现没有持久化到磁盘的情况呢?现在的OS当中,程序写入数据到文件之后,并不会立马写入到磁盘,因为磁盘I/O是非常耗时的操作,在计算机来看是非常慢的一种操作。所以写入文件的数据会先写入到OS自己的缓存中去,然后择机异步的将Buffer中的数据刷入磁盘。 通过多副本冗余的机制,使得RocketMQ具有了高可用的特性。除此之外,分布式存储能够应对后期业务大量的数据存储。如果不使用分布式进行存储,那么随着后期业务发展,消息量越来越大,单机是无论如何也满足不了RocketMQ消息的存储需求的。如果不做处理,那么一台机器的磁盘总有被塞满的时候,此时的系统就不具备可伸缩的特性,也无法满足业务的使用要求了。 但是这里的可伸缩,和微服务中的服务可伸缩还不太一样。因为在微服务中,各个服务是无状态的。而Broker是有状态的,每个Broker上存储的数据都不太一样,因为Producer在发送消息的时候会通过指定的算法,从Message Queue列表中选出一个MessageQueue发送消息。 如果不是很理解这个横向扩展,那么可以把它当成Redis的Cluster,通过一致性哈希,选择到Redis Cluster中的具体某个节点,然后将数据写入Redis Master中去。如果此时想要扩容很方便,只需要往Redis Cluster中新增Master节点就好了。 所以,数据分布式的存储本质上是一种数据分片的机制。在此基础上,通过冗余多副本,达成了高可用。 Broker Broker可以理解为我们微服务中的一个服务的某个实例,因为微服务中我们的服务一般来说都会多实例部署,而RocketMQ也同理,多实例部署可以帮助系统扛住更多的流量,也从某种方面提高了系统的健壮性。 在RocketMQ4.5之前,它使用主从架构,每一个Master Broker都有一个自己的Slave Broker。 那RocketMQ的主从Broker是如何进行数据同步的呢? Broker启动的时候,会启动一个定时任务,定期的从Master Broker同步全量的数据。 这块可以先不用纠结,后面我们会通过源码来验证这个主从同步逻辑。 上面提到了Broker会部署很多个实例,那么既然多实例部署,那必然会存在一个问题,客户端是如何得知自己是连接的哪个服务器?如何得知对应的Broker的IP地址和端口?如果某个Broker突然挂了怎么办? NameServer 这就需要NameServer了,NameServer是什么? 这里先拿Spring Cloud举例子——Spring Cloud中服务启动的时候会将自己注册到Eureka注册中心上。当服务实例启动的时候,会从Eureka拉取全量的注册表,并且之后定期的从Eureka增量同步,并且每隔30秒发送心跳到Eureka去续约。如果Eureka检测到某个服务超过了90秒没有发送心跳,那么就会该服务宕机,就会将其从注册表中移除。 RocketMQ中,NameServer充当的也是类似的角色。两者从功能上也有一定的区别。 Broker在启动的时候会向NameServer注册自己,并且每隔30秒向NameServerv发送心跳。如果某个Broker超过了120秒没有发送心跳,那么就会认为该Broker宕机,就会将其从维护的信息中移除。这块后面也会从源码层面验证。 当然NameServer不仅仅是存储了各个Broker的IP地址和端口,还存储了对应的Topic的路由数据。什么是路由数据呢?那就是某个Topic下的哪个Message Queue在哪台Broker上。 Producer 总体流程 接下来,我们来看看Producer发送一条消息到Broker的时候会做什么事情,整体的流程如下。 检查消息合法性 整体来看,其实是个很简单的操作,跟我们平时写代码是一样的,来请求了先校验请求是否合法。Producer启动这里会去校验当前Topic数据的合法性。 Topic名称中是否包含了非法字符 Topic名称长度是否超过了最大的长度限制,由常量TOPIC_MAX_LENGTH来决定,其默认值为127 当前消息体是否是NULL或者是空消息 当前消息体是否超过了最大限制,由常量maxMessageSize决定,值为1024 * 1024 * 4,也就是4M。 都是些很常规的操作,和我们平时写的checker都差不多。 获取Topic的详情 当通过了消息的合法性校验之后,就需要继续往下走。此时的关注点就应该从消息是否合法转移到我要发消息给谁。 此时就需要通过当前消息所属的Topic拿到Topic的详细数据。 获取Topic的方法源码在上面已经给出来了,首先会从内存中维护的一份Map中获取数据。顺带一提,这里的Map是ConcurrentHashMap,是线程安全的,和Golang中的Sync.Map类似。 当然,首次发送的话,这个Map肯定是空的,此时会调用NameServer的接口,通过Topic去获取详情的Topic数据,此时会在上面的方法中将其加入到Map中去,这样一来下次再往该Topic发送消息就能够直接从内存中获取。这里就是简单的实现的缓存机制 。 从方法名称来看,是通过Topic获取路由数据。实际上该方法,通过调用NameServer提供的API,更新了两部分数据,分别是: Topic路由信息 Topic下的Broker相关信息 而这两部分数据都来源于同一个结构体TopicRouteData。其结构如下。 通过源码可以看到,就包含了该Topic下所有Broker下的Message Queue相关的数据、所有Broker的地址信息。 发送的具体Queue 此时我们获取到了需要发送到的Broker详情,包括地址和MessageQueue,那么此时问题的关注点又该从「消息发送给谁」转移到「消息具体发送到哪儿」。 什么叫发送到哪儿? 开篇提到过一个Topic下会被分为很多个MessageQueue,「发送到哪儿」指的就是具体发送到哪一个Message Queue中去。 Message Queue选择机制 核心的选择逻辑 还是先给出流程图 核心逻辑,用大白话讲就是将一个随机数和Message Queue的容量取模。这个随机数存储在Thread Local中,首次计算的时候,会直接随机一个数。 此后,都直接从ThreadLocal中取出该值,并且+1返回,拿到了MessageQueue的数量和随机数两个关键的参数之后,就会执行最终的计算逻辑。 接下来,我们来看看选择Message Queue的方法SelectOneMessageQueue都做了什么操作吧。 可以看到,主逻辑被变量sendLatencyFaultEnable分为了两部分。 容错机制下的选择逻辑 该变量表意为发送延迟故障。本质上是一种容错的策略,在原有的MessageQueue选择基础上,再过滤掉不可用的Broker,对之前失败的Broker,按一定的时间做退避。 可以看到,如果调用Broker信息发生了异常,那么就会调用updateFault这个方法,来更新Broker的Aviable情况。注意这个参数isolation的值为true。接下来我们从源码级别来验证上面说的退避3000ms的事实。 可以看到,isolation值是true,则duration通过三元运算符计算出来结果为30000,也就是30秒。所以我们可以得出结论,如果发送消息抛出了异常,那么直接会将该Broker设置为30秒内不可用。 而如果只是发送延迟较高,则会根据如下的map,根据延迟的具体时间,来判断该设置多少时间的不可用。 例如,如果上次请求的latency超过550ms,就退避3000ms;超过1000,就退避60000; 正常情况下的选择逻辑 而正常情况下,如果当前发送故障延迟没有启用,则会走常规逻辑,同样的会去for循环计算,循环中取到了MessageQueue之后会去判断是否和上次选择的MessageQueue属于同一个Broker,如果是同一个Broker,则会重新选择,直到选择到不属于同一个Broker的MessageQueue,或者直到循环结束。这也是为了将消息均匀的分发存储,防止数据倾斜。 发送消息 选到了具体的Message Queue之后就会开始执行发送消息的逻辑,就会调用底层Netty的接口给发送出去,这块暂时没啥可看的。 Broker的启动流程 主从同步 在上面提到过,RocketMQ有自己的主从同步,但是有两个不同的版本,版本的分水岭是在4.5版本。这两个版本区别是什么呢? 4.5之前:有点类似于Redis中,我们手动的将某台机器通过命令slave of 变成另一台Redis的Slave节点,这样一来就变成了一个较为原始的一主一从的架构。为什么说原始呢?因为如果此时Master节点宕机,我们需要人肉的去做故障转移。RocketMQ的主从架构也是这种情况。 4.5之后:引入了Dleger,可以实现一主多从,并且实现自动的故障转移。这就跟Redis后续推出了Sentinel是一样的。Dleger也是类似的作用。 下图是Broker启动代码中的源码。 可以看到判断了是否开启了Dleger,默认是不开启的。所以就会执行其中的逻辑。 刚好我们就看到了,里面有Rocket主从同步数据的相关代码。 如果当前Broker节点的角色是Slave,则会启动一个周期性的定时任务,定期(也就是10秒)去Master Broker同步全量的数据。同步的数据包括: Topic的相关配置 Cosumer的消费偏移量 延迟消息的Offset 订阅组的相关数据和配置 注册Broker 完成了主动同步定时任务的启动之后,就会去调用registerBrokerAll去注册Broker。可能这里会有点疑问,我这里是Broker启动,只有当前一个Broker实例,那这个All是什么意思呢? All是指所有的NameServer,Broker启动的时候会将自己注册到每一个NameServer上去。为什么不只注册到一个NameServer就完事了呢?这样一来还可以提高效率。归根结底还是高可用的问题。 如果Broker只注册到了一台NameServer上,万一这台NameServer挂了呢?这个Broker对所有客户端就都不可见了。实际上Broker还在正常的运行。 进到registerBrokerAll中去。 可以看到,这里会判断是否需要进行注册。通过上面的截图可以看到,此时forceRegister的值为true,而是否要注册,决定权就交给了needRegister 为什么需要判断是否需要注册呢?因为Broker一旦注册到了NameServer之后,由于Producer不停的在写入数据,Consumer也在不停的消费数据,Broker也可能因为故障导致某些Topic下的Message Queue等关键的路由信息发生变动。 这样一来,NameServer中的数据和Broker中的数据就会不一致。 如何判断是否需要注册 大致的思路是,Broker会从每一个NameServer中获取到当前Broker的数据,并和当前Broker节点中的数据做对比。但凡有一台NameServer数据和当前Broker不一致,都会进行注册操作。 接下来,我们从源码层面验证这个逻辑。关键的逻辑我在图中也标注了出来。 可以看到, 就是通过对比Broker中的数据版本和NameServer中的数据版本来实现的。这个版本,注册的时候会写到注册的数据中存入NameServer中。 这里由于是有多个,所以RocketMQ用线程池来实现了多线程操作,并且用CountDownLatch来等待所有的返回结果。经典的用空间换时间,Golang里面也有类似的操作,那就是sync.waitGroup。 关于任何一个数据不匹配,都会进行重新注册的事实,我们也从源码层面来验证一下。 可以看到,如果任何一台NameServer的数据发生了Change,都会break,返回true。 这里的结果列表使用的是CopyOnWriteList来实现的。 因为这里是多线程去执行的判断逻辑,而正常的列表不是线程安全的。CopyOnWriteArrayList之所以是线程安全的,这归功于COW(Copy On Write),读请求时共用同一个List,涉及到写请求时,会复制出一个List,并在写入数据的时候加入独占锁。比起直接对所有操作加锁,读写锁的形式分离了读、写请求,使其互不影响,只对写请求加锁,降低了加锁的次数、减少了加锁的消耗,提升了整体操作的并发。 执行注册逻辑 这块就是构建数据,然后多线程并发的去发送请求,用CopyOnWriteArrayList来保存结果。不过,上面我们提到过,Broker注册的时候,会把数据版本发送到NameServer并且存储起来,这块我们可以看看发送到NameServer的数据结构。 可以看到,Topic的数据分为了两部分,一部分是核心的逻辑,另一部分是DataVersion,也就是我们刚刚一直提到的数据版本。 Broker如何存储数据 刚刚在聊Producer最后提到的是,发送消息到Broker就完了。不知道大家有没有想过Broker是如何存储消息的? Commit log 先给出流程图 然后给出结论,Producer发送的消息是存储在一种叫commit log的文件中的,Producer端每次写入的消息是不等长的,当该CommitLog文件写入满1G,就会新建另一个新的CommitLog,继续写入。此次采取的是顺序写入。 那么问题来了,Consumer来消费的时候,Broker是如何快速找到对应的消息的呢?我们首先排除遍历文件查找的方法, 因为RocketMQ是以高吞吐、高性能著称的,肯定不可能采取这种对于很慢的操作。那RocketMQ是如何做的呢? 答案是ConsumerQueue ConsumerQueue ConsumerQueue是什么?是文件。引入的目的是什么呢?提高消费的性能。 Broker在收到一条消息的时候,写入Commit Log的同时,还会将当前这条消息在commit log中的offset、消息的size和对应的Tag的Hash写入到consumer queue文件中去。 每个MessageQueue都会有对应的ConsumerQueue文件存储在磁盘上,每个ConsumerQueue文件包含了30W条消息,每条消息的size大小为20字节,包含了8字节CommitLog的Offset、4字节的消息长度、8字节的Tag的哈希值。这样一来,每个ConsumerQueue的文件大小就约为5.72M。 当该ConsumerQueue文件写满了之后,就会再新建一个ConsumerQueue文件,继续写入。 所以,ConsumerQueue文件可以看成是CommitLog文件的索引。 负载均衡 什么意思呢?假设我们总共有6个MessageQueue,然后此时分布在了3台Broker上,每个Broker上包含了两个queue。此时Consumer有3台,我们可以大致的认为每个Consumer负责2个MessageQueue的消费。但是这里有一个原则,那就是一个MessageQueue只能被一台Consumer消费,而一台Consumer可以消费多个MessageQueue。 为什么?道理很简单,RocketMQ支持的顺序消费,是指的分区顺序性,也就是在单个MessageQueue中,消息是具有顺序性的,而如果多台Consumer去消费同一个MessageQueue,就很难去保证顺序消费了。 由于有很多个Consumer在消费多个MessageQueue,所以为了不出现数据倾斜,也为了资源的合理分配利用,在Producer发送消息的时候,需要尽可能的将消息均匀的分发给多个MessageQueue。 同时,上面那种一个Consumer消费了2个MessageQueue的情况,万一这台Consumer挂了呢?这两个MessageQueue不就没人消费了? 以上两种情况分别是Producer端的负载均衡、Consumer端的负载均衡。 Producer端负载均衡 关于Producer端上面的负载均衡,上面的流程图已经给了出来,并且给出了源码的验证。首先是容错策略,会去避开一段时间有问题的Broker,并且加上如果选择了上次的Broker,就会重新进行选择。 Consumer端负载均衡 首先Consumer端的负责均衡可以由两个对象触发: Broker Consumer自身 Consumer也会向所有的Broker发送心跳,将消息的消费组名称、订阅关系集合、消息的通信模式和客户端的ID等等。Broker收到了Consumer的心跳之后,会将其存在Broker维护的一个Manager中,名字叫ConsumerManager。当Broker监听到了Consumer数量发生了变动,就会通知Consumer进行Rebalance。 但是如果Broker通知Consumer进行Rebalance的消息丢了呢?这也就是为什么需要第Consumer自身进行触发的原因。Consumer会在启动的时候启动定时任务,周期性的执行rebalance操作。 默认是20秒执行一次。具体的代码如下。 具体流程 首先,Consumer的Rebalance会获取到本地缓存的Topic的全部数据,然后向Broker发起请求,拉取该Topic和ConsumerGroup下的所有的消费者信息。此处的Broker数据来源就是Consumer之前的心跳发送过去的数据。然后会对Topic中MessageQueue和消费者ID进行排序,然后用消息队列默认分配算法来进行分配,这里的默认分配策略是平均分配。 首先会均匀的按照类似分页的思想,将MessageQueue分配给Consumer,如果分配的不均匀,则会依次的将剩下的MessageQueue按照排序的顺序,从上往下的分配。所以在这里Consumer 1被分配到了4个MessageQueue,而Consumer 2被分配到了3个MessageQueue。 Rebalance完了之后,会将结果和Consumer缓存的数据做对比,移除不在ReBalance结果中的MessageQueue,将原本没有的MessageQueue给新增到缓存中。 触发时机 Consumer启动时 启动之后会立马进行Rebalance Consumer运行中 运行中会监听Broker发送过来的Rebalance消息,以及Consumer自身的定时任务触发的Rebalance Consumer停止运行 停止时没有直接的调用Rebalance,而是会通知Broker自己下线了,然后Broker会通知其余的Consumer进行Rebalance。 换一个角度来分析,其实就是两个方面,一个是队列信息发生了变化,另一种是消费者发生了变化。 源码验证 然后给出核心的代码验证,获取数据的逻辑如下 验证了我们刚刚说的获取了本地的Topic数据缓存,和从Broker端拉取所有的ConsumerID。 接下来是验证刚说的排序逻辑。 接下来是看判断结果是否发生了变化的源码。 可以看到,Consumer通知Broker策略,其本质上就是发送心跳,将更新后的数据通过心跳发送给所有的Broker。 Consumer更多的细节 可能关于Consumer,我们使用的更多一点。例如我们知道我们可以设置集群消费和广播消息,分别对应RocketMQ中的CLUSTERING和BROADCASTING**。 再比如我们知道,我们可以设置顺序消费和并发消费等等,接下来就让我们用源码来看看这些功能在RocketMQ中是怎么实现的。 消费模型 在Consumer中,默认都是采用集群消费,这块在Consumer的代码中也有体现。 而消费模式的不同,会影响到管理offset的具体实现。 可以看到,当消费模型是广播模式时,Offset的持久化管理会使用实现LocalFileOffsetStorage 当消费模式是集群消费时,则会使用RemoteBrokerOffsetStore。 具体原因是什么呢?首先我们得知道广播模式和集群模式的区别在哪儿: 广播模式下,一条消息会被ConsumerGroup中的每一台机器所消费 集群模式下,一条消息只会被ConsumerGroup中的一台机器消费 所以在广播模式下,每个ConsumerGroup的消费进度都不一样,所以需要由Consumer自身来管理Offset。而集群模式下,同个ConsumerGroup下的消费进度其实是一样的,所以可以交由Broker统一管理。 消费模式 消费模式则分为顺序消费和并发消费,分别对应实现MessageListenerOrderly和MessageListenerConcurrently两种方式。 不同的消费方式会采取不同的底层实现,配置完成之后就会调用start。 拉取消息 接下来我们来看一个跟我们最最相关的问题,那就是我们平时消费的消息到底是怎么样从Broker发到的Consumer。在靠近启动Rebalance的地方,Consumer也开启了一个定时拉取消息的线程。 这个线程做了什么事呢?它会不停的从一个维护在内存中的Queue中获取一个在写入的时候就构建好的PullRequest对象,调用具体实现去不停的拉取消息了。 处理消费结果 在这里是否开启AutoCommit,所做的处理差不了很多,大家也都知道,唯一区别就在于是否自动的提交Offset。对于处理成功的逻辑也差不多,我们平时业务逻辑中可能也并不关心消费成功的消息。我们更多关注的是如果消费失败了,RocketMQ是怎么处理的? 这是在AutoCommit下,如果消费失败了的处理逻辑。会记录一个失败的TPS,然后这里有一个非常关键的逻辑,那就是checkReconsumeTimes。 如果当前消息的重试次数,如果大于了最大的重试消费次数,就会把消费发回给Broker。那最大重试次数是如何定义的。 如果值为-1,那么最大次数就是MAX_VALUE,也就是2147483647。这里有点奇怪啊,按照我们平常的认知,难道不是重试16次吗?然后就看到了很骚的一句注释。 -1 means 16 times,这代码确实有点,一言难尽。 然后,如果超过了最大的次数限制,就会将该消息调用Prodcuer的默认实现,将其发送到死信队列中。当然,死信队列也不是什么特殊的存在,就是一个单独的Topic而已。 通过getRetryTopic来获取的,默认是给当前的ConsumerGroup名称加上一个前缀。 好了以上就是本篇博客的全部内容了,如果你觉得这篇文章对你有帮助,还麻烦点个赞,关个注,分个享,留个言。 欢迎微信搜索关注【SH的全栈笔记】,查看更多相关文章

优秀的个人博客,低调大师

Curve 技术解析之 MDS 元数据管理

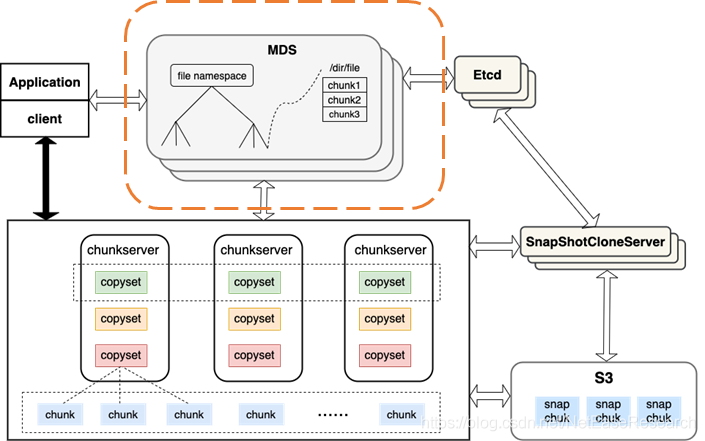
Curve简介 Curve是网易数帆于今年7月份开源的一个高性能、高可用、高可靠的分布式存储系统,主打高性能、低延迟。 Curve设计可以作为多种存储场景的底层存储:例如块存储,对象存储,云原生数据库,EC等。 当前Curve已实现高性能块存储,并且基于这⼀场景对接了OpenStack 和 Kubernetes。OpenStack上主要是用做云主机的系统盘和云盘,目前已经在线上稳定一年多了。Kubernetes上主要是想作为计算节点的数据目录,这个场景目前在灰度环境中测试验证中。 github主页:https://opencurve.github.io/ github代码仓库:https://github.com/opencurve/curve 如上图所示,Curve存储系统的基础设计框架与经典的GFS基本类似,采用有中心节点的架构,核心服务由三个部分组成: 元数据节点MDS,主要有两个职责,一方面管理和存储元数据信息,另一方面感知集群状态并进行调度。元数据存储在etcd中。 数据节点ChunkServer, 一方面负责数据的存储,另一方面负责数据一致性(如果底层是多副本,需要负责副本间的数据一致性)。 客户端Client, 向上层应用提供对文件的操作接口(open、read、write等), 会和MDS以及ChunkServer交互,与MDS交互实现对元数据的增删改查;与ChunkServer交互实现对数据的增删改查。 还有一个快照克隆服务器: 快照克隆服务器独立于核心服务,对外提供了http接口,用于处理和管理快照克隆任务。 这篇文章会介绍Curve的元数据的管理,主要是MDS的元数据的管理。 MDS是Curve的元数据管理服务,负责整个集群的元数据管理。MDS的所有元数据信息都会持久化到kv存储中,Curve选择了etcd作为元数据的存储。 为了加快元数据的访问,mds还在内存维护了一个元数据的cache。cache采用LRU(Least Recently Used)淘汰策略,cache最多缓存的记录条目数量,通过mds的配置文件进行配置。 mds存储的元数据包含拓扑信息的元数据,namespace的元数据。所有的信息都是经过一定的编码,以kv的方式保存在元数据中。不同类型的元数据的编码方式不同,所有保存在mds的元数据的key都是以 “prefix + 其他字段”的方式进行编码。value则是对应的元数据序列化为字符串。 不同类型的元数据的前缀不同,这些前缀比如: const char FILEINFOKEYPREFIX[] = "01";const char SEGMENTINFOKEYPREFIX[] = "02";const char SNAPSHOTFILEINFOKEYPREFIX[] = "03";const char CHUNKSTOREKEY[] = "05";const char TOPOLOGYITEMPRIFIX[] = "10"; 拓扑元数据信息 curve的拓扑信息由mds的topology模块管理,topology管理集群的 topo元数据信息。用于管理和组织机器,利用底层机器的放置、网络的规划以面向业务提供如下功能和非功能需求。 故障域的隔离:比如副本的放置分布在不同机器,不同机架,或是不同的交换机下面。 隔离和共享:不同用户的数据可以实现固定物理资源的隔离和共享。 下图是一个topology的层级关系图。一个集群可以支持1到多个Pool,每个Pool下有多个zone,每个zone由多个server组成,每个server上有多个chunkserver。 介绍一下各个组件的概念。 pool:用于实现对机器资源进行物理隔离,server不能跨Pool交互。运维上,建议以pool为单元进行物理资源的扩容。 zone:故障隔离的基本单元,一般来说属于不同zone的机器至少是部署在不同的机架,一个server必须归属于一个zone。 server:用于抽象描述一台物理服务器,chunkserver必须归属一个于server。 Chunkserver:用于抽象描述物理服务器上的一块物理磁盘(SSD),chunkserver以一块磁盘作为最小的服务单元。 curve在上物理pool之上又引入了逻辑pool的概念,以实现统一存储系统的需求,即在单个存储系统中可以同时支持块存储、对象存储、进行对象存储。 Curve底层通过不同的文件类型支撑不同上层应用, curve的数据组织形式是文件。Curve提供三种文件类型,PageFile、AppendFile、AppendECFile PageFile支持块设备。 AppendFile支持在线对象存储(规划中)。 AppendECFile支持近线对象存储可以共存(规划中)。 目前我们只实现了对块存储的支持。 如下图所示LogicalPool与物理pool为多对一的关系,一个物理pool可以存放各种类型的file。当然由于curve支持多个pool,可以选择一个logicalPool独享一个pool。 topo的元数据信息的来源有两种:一部分是curve集群上线时确定的;还有一部分是集群在运行的过程中,通过心跳上报的信息。 集群上线的topo信息,这个是集群上线时,在配置文件中指定。比如下面是一个新集群上线的例子,一个简单的配置文件如下。在这个集群中,有一个物理pool pool1,这个物理pool由3个zone组成,分别为zone1, zone2, zone3。每个zone有一台server。在物理pool上,还创建了一个逻辑pool,逻辑pool使用3个zone,采用3副本。 cluster_map: servers: - name: server1 internalip: 192.168.0.1 internalport: 8200 externalip: 192.168.0.1 externalport: 8200 zone: zone1 physicalpool: pool1 - name: server2 internalip: 192.168.0.2 internalport: 8200 externalip: 192.168.0.2 externalport: 8200 zone: zone2 physicalpool: pool1 - name: server3 internalip: 192.168.0.3 internalport: 8200 externalip: 192.168.0.3 externalport: 8200 zone: zone3 physicalpool: pool1 logicalpools: - name: logicalPool1 physicalpool: pool1 type: 0 replicasnum: 3 copysetnum: 100 zonenum: 3 scatterwidth: 0 心跳上报的topo信息,主要是chunkserver和mds之间的心跳信息。chunkserver会定期向mds发行心跳信息,在心跳信息中其实带有chunkserver的状态信息,比如chunkserver上的负载、容量、副本状态、是否可用等信息。mds根据收到上报的信息,更新拓扑元数据。如果mds一段时间没有收到chunkserver心跳,还会修改chunkserver的状态。 Online: chunk server在线,正常服务。 Unstable: chunk server一段时间没收到心跳(默认30s),但是还没有到达offline的时间(默认30min),chunkserver状态改为unstable状态,打印一条warning日志。 Offline:chunk server超过offline的时间没有收到心跳(默认30min), chunkserver状态改为offline,打印一条error日志。调度模块感知到offline状态,触发chunk server的recover修复。 namespace元数据信息 curve目前仅支持块存储,每个块设备在mds都有一个对应的文件。为了方便管理,curve还引入类似于文件系统那种层次结构。一个curve集群在curvefs中有且仅有一个根目录“/”,根目录在系统初始化的时候自动创建。目录可以嵌套,目录下可以存放子目录或者文件。 curve的namespace信息一方面保存着文件和目录的元数据信息,一方面还保存着文件和目录的层次关系。 无论是目录,还是文件,统一都用FileInfo表示,区别在于他们的类型不一样。 FileInfo的编码方式: key:prefix(2Byte)+parentId(8Byte)+fileName; Value:FileInfo序列化后的字符串。 FileInfo的各个字段含义如下: 如下图所示的一个curvefs的目录层次结构,根目录下有目录home和文件tmp,home下有目录dir1,目录dir2,文件filez,dir1下有文件filex,dir2下有文件filey。 如上图所示。这些文件和目录经过编码,以kv的方式保存在etcd中。文件和目录的key的前缀都相同,这里省略了prefix,在KV中,Key是ParentID + "/"+ BaseName,Value是自身的文件ID;这种方式可以很好地平衡几个需求: 文件列目录:列出目录下的所有文件和目录 文件查找:查找一个具体的文件 目录重命名:对一个目录/文件进行重命名 地址空间映射元数据信息: curve的空间采用瘦分配(thin provisioning)的方式进行空间分配,也就是说卷在开始创建的时候,是没有实际分配空间的,仅仅是在元数据中记录了文件的长度和空间分配的粒度,真正的空间分配只有在地址第一次真正访问到的时候才会触发。 curve的底层按照chunk进行空间管理,但是chunk的切分粒度比较小,如果按照chunk进行分配,大量chunk分配会对元数据造成一定的压力,而且对性能也有影响。所有chunk的分配按照批量分配的原则,也就是一次性分配一批chunk。在chunk之上引入了一个segment的概念。Segment是⼀个逻辑概念,也是空间分配的基本单元。在curve中,一个curve文件会按照segment为粒度去进行空间分配。chunk外⾯包⼀层segment的好处是减少元数据量。 如下图所示,一个curve的文件由若干个segment组成,segment的大小由配置文件指定,目前curve默认segment的粒度为1GB,所以curve的文件大小必须是1GB的整数倍。一个segment由若干个chunk组成。 client在对空间进行读写请求之前,会先去mds查询指定offset和length的空间所在的segment的元数据信息。并把这个元数据信息缓存在client本地,以后client就可以使用缓存在本地的元数据信息对数据进行访问。segment元数据信息包含了以下的字段。 所有的文件在curve中都是由多个Segment组成的。每个segment的元数据记录着该segment是从哪个logicalpool分配出来,这个segment的size,组成这个segment的chunk的size,这个segment在文件中的偏移,以及这个组成这个segment的每一个chunk的信息。 Segment的持久化,Segment的编码方式: key:prefix(2Byte)+文件的inodeid(8Byte)+offset(8Byte); Value:PageFileSegment序列化后的字符串。 Segment是由多个chunk组成的,这里的chunk是实际的物理存储单元,对应着chunk server上的⼀个物理⽂件。chunk的元数据,包含了chunk所属的copyset id和chunkid。 每个chunk实际上由多个副本的组成的,chunk的实际的存储位置,由copyset确定。copy保存着chunk的复制组的成员关系,在copyset中,记录着chunk的3个副本实际上分布在哪些chunkserver节点上。copyeset类似于ceph中的pg。为什么不直接记录chunk的3个副本,而是通过chunk→copyset,copyset→三个副本的方式存储元数据呢? 这里简要介绍下引入copyset的好处,后期curve团队还会对copyset进行更加详细的介绍。 减少元数据量:一般来说实际物理文件chunk不会设置的太大,都是M级别的。如果直接去记录这些chunk的信息,元数据量会很大。引入copyset可以认为就是分组,对于chunk的信息记录就是组信息+组内信息,数据量会少很多。如果为每个Chunk去保存复制组成员关系,需要至少 ChunkID+3×NodeID=20 个byte,而如果在Chunk到复制组之间引入一个CopySet,每个Chunk可以用ChunkID+CopySetID=12个byte。 减少复制组数量:如果一个数据节点存在 256K个复制组,复制组的内存资源占用将会非常恐怖;复制组之间的通信将会非常复杂,例如复制组内Primary给Secondary定期发送心跳进行探活,在256K个复制组的情况下,心跳的流量将会非常大;而引入CopySet的概念之后,可以以CopySet的粒度进行探活、配置变更,降低开销。 提高数据可靠性:在数据复制组过度打散的情况下,在发生多个节点同时故障的情况下,数据的可靠性会受到影响。引入CopySet,可提高分布式存储系统中的数据持久性,降低数据丢失的概率。 小结 至此,这篇文章分别从拓扑信息的元数据、namespace元数据、地址空间映射元数据三个方面,介绍了Curve的MDS的元数据的管理,介绍了拓扑信息的组成,元数据的持久化,空间的分配等。 更多CurveMDS技术解读,参考以下视频: 【视频】Curve核心组件之MDS元数据节点 更多Curve信息介绍请参考: 网易数帆存储负责人亲述:我眼中的Curve与Ceph 分布式存储开发:Curve中的内存管理 后续Curve团队还会陆续对Curve其他部分进行介绍,欢迎大家持续关注。 作者简介 陈威,网易数帆存储团队资深开发工程师,有多年存储阵列、分布式存储研发运维经验。 Curve项目已经完全开源到github:https://github.com/opencurve/curve,欢迎感兴趣的小伙伴去star&&fork。如对curve有疑问或者想参加curve的开发,欢迎给我们提issue或者pr。 Curve微信交流群,7*24h为大家答疑解惑,欢迎搜索微信号opencurve加好友后拉进群。 Curve系列技术课程,每周五晚19:00 B站直播,本周五主题为 Curve 快照克隆,敬请收看!

优秀的个人博客,低调大师

微服务开源框架TARS 之 框架服务解析

作者 herman 简介 本文源自herman的系列文章之一《鹅厂开源框架TARS之运营服务监控》。相关代码已按TARS开源社区最新版本更新。 TARS框架为用户提供了涉及到开发、运维、以及测试的一整套解决方案,帮助一个产品或者服务快速开发、部署、测试、上线。 它集可扩展协议编解码、高性能RPC通信框架、名字路由与发现、发布监控、日志统计、配置管理等于一体。其中发布监控,日志统计等运维功能依靠着TARS框架中的运维服务和工具,本文将对各运维服务的功能和作用进行分析,并通过部分源码帮助读者进一步理解TARS的工作原理。 目录 运维工具概览 TarsWeb Registry服务 Patch服务 Config服务 Log服务 Stat服务 Property服务 Notify服务 Node服务 运维工具概览 如上图,可以清楚看到TARS框架的运维服务和工具:包括主控 Registry 、发布平台 Patch 、配置文件中心Config 、远程 Log 、指标统计 Stat 、业务信息 Property 、异常信息 Notify 等主要服务,再结合 TarsWeb 平台对这些服务进行可视化操作和运用,对开发和运维人员算是非常方便和人性化了。 TarsWeb —— 管理平台 TarsWeb 服务管理平台用于服务的管理与运维,功能包括: 提供服务状态信息查询和起停服务、设置服务日志级别、发送自定义命令等操作页面 提供部署服务、自动编译发布、配置管理等运维操作页面 提供自动测试操作界面 展示服务性能指标数据 展示业务特性指标数据 TarsWeb 可视化管理平台对服务的管理和运维功能都是基于TARS框架运维服务的接口来提供服务的。 Registry服务 —— 主控服务 Registry 服务提供对象名称寻址服务,返回 IP:Port 列表,为客户端提供可用服务列表信息。 同时,它提供TARS框架核心管理功能 :服务部署、服务起停、服务状态信息查询、发布、配置管理、命令通知。 Registry 提供的接口有 registerNode(node节点注册) keepAlive(node上报心跳负载) getServers(获取在该node部署的server列表) updateServer(更新server状态) 同时主控提供了 AdminRegImp (关联控制接口类),提供如下接口: getAllApplicationNames(获取application列表) getAllNodeNames(获取node列表) shutdownNode(停止 node) getServerState(获取特定server状态) startServer(启动特定server) restartServer( 重启特定server) notifyServer(通知服务) patchServer(发布特定server) 下面来看看 startServer 接口如何实现。 startServer 接口的实现中,先调用 updateServerState 更新服务的状态 //更新数据库server的设置状态 DBPROXY->updateServerState(application, serverName, nodeName, "setting_state", tars::Active); 然后判断 server 是否为 DNS:DNS直接通过db修改状态,非DNS则通过Node节点启动服务(下节介绍Node节点) if(server.size() != 0 && server[0].serverType == "tars_dns") { TLOGINFO(" '" + application + "." + serverName + "_" + nodeName + "' is tars_dns server" << endl); iRet = DBPROXY->updateServerState(application, serverName, nodeName, "present_state", tars::Active); } else { // 获取Node节点proxy NodePrx nodePrx = DBPROXY->getNodePrx(nodeName); TLOGINFO("call node into " << __FUNCTION__ << "|" << application << "." << serverName << "_" << nodeName << "|" << current->getHostName() << ":" << current->getPort() <<endl); current->setResponse(false); NodePrxCallbackPtr callback = new StartServerCallbackImp(application, serverName, nodeName, current); // 异步启动服务 nodePrx->async_startServer(callback, application, serverName); } Patch服务 —— 统一发布 Patch服务提供服务的发布功能,用于实现服务发布包的上传、管理与发布,配合TarsWeb平台,能够管理所有需要发布的服务和文件的目录,如下 Patch 服务中定义了以下四个接口 /** * 获取路径下所有文件列表信息 * @param path, 目录路径, 相对_directory的路径, 不能有.. * @param vector<FileInfo>, 文件列表信息 * @return int */ int listFileInfo(const string &path, vector<FileInfo> &vf, TarsCurrentPtr current); /** * 下载文件 * @param file, 文件完全路径 * @param pos, 从什么位置开始下载 * @return vector<byte>, 文件内容 */ int download(const string &file, int pos, vector<char> &vb, TarsCurrentPtr current); /** * 准备好需要patch的文件,将发布的文件从上传目录复制到发布目录 * @param app, 应用名 * @param serverName, 服务名 * @param patchFile, 需要发布的文件名 * @return int, 0: 成功, <0: 失败 */ int preparePatchFile(const string &app, const string &serverName, const string &patchFile, TarsCurrentPtr current); /** * 删除patch文件 * @param app * @param serverName * @param patchFile * @param current * @return */ int deletePatchFile(const string & app, const string & serverName, const string & patchFile, TarsCurrentPtr current); Config 服务 —— 配置中心 Config 服务用于提供整套框架的配置文件保存和读取等操作,后台使用mysql存储。配置拉取服务化,服务只需调用配置服务的接口即可获取到配置文件。 为了能灵活管理配置文件,配置文件分为几个级别:应用配置、Set配置、服务配置和节点配置。 应用配置为最高一级的配置文件,它是多个服务配置提炼出来的公共配置,服务配置通过引用它来使用其配置内容。 Set配置是具体一个Set分组下所有服务的公共配置,在应用配置的基础上进行补充追加。 服务配置是具体一个服务下所有节点的公共配置,可以引用应用配置。 节点配置是一个应用节点的个性化配置,它和服务配置合并成为具体一个服务节点的配置。 下图是服务配置管理页面 添加配置的实现 在服务业务代码中,可以通过调用 addAppConfig 和 addConfig 来分别添加应用级配置文件和服务配置文件。接下来我们来对 addAppConfig 和 addConfig 的添加配置的过程进行分析。 addAppConfig addAppConfig("DBConnection.conf"); //添加应用级别的配置文件 addAppConfig 中会调用 RemoteConfig::getInstance()->addConfig(filename, result, true) 函数; 然后该函数会调用 getRemoteFile 函数从 Config 服务远程获取配置文件信息。 getRemoteFile 函数中,通过 _configPrx 向 Config 服务发起 rpc 调用实现,如下 _configPrx->loadConfig(_sApp, (bAppConfigOnly ? "" : _sServerName), sFileName, stream); ConfigImp::loadConfig 函数是 Config 的接口函数 ,如果是应用级别的配置文件,则执行 select id,config from t_config_files... 并且把结果使用string 的方式回传给调用者。 调用者获取到文件内容,根据文件的名字生成在本地以供后续程序使用文件: std::ofstream out(newFile.c_str()); addConfig addConfig(ServerConfig::ServerName + ".conf"); 和 addAppConfig 相似, addConfig 也会调用 RemoteConfig::getInstance()->addConfig(filename, result, false) 。最后一个参数 bAppConfigOnly 设置为 false ,表示获取服务配置,而不是应用配置。 接着进行 rpc 调用 int ret = _configPrx->loadConfig(_sApp, (bAppConfigOnly ? "" : _sServerName), sFileName, stream); 和加载应用级别的配置文件有所不同,这里调用 _configPrx 服务器的参数,增加了 _sServerName,即 rpc 调用 loadConfig 接口的时候 server 参数不为空字符串,会改调用 loadConfigByHost 函数 ... if(!server.empty()) { return loadConfigByHost(app + "." + server, fileName, current->getHostName() , config, current); } else { return loadAppConfig(app, fileName, config, current); } loadConfigByHost 函数同样是通过mysql查询 t_config_files 表格,但修改了 where 查询条件,appName 替换为 appServerName,即查询服务配置,如下 ... "where server_name = '" + _mysqlConfig.escapeString(appServerName) + "' " ... 至此,实现了从指定服务器拉取配置文件的功能 (这里还关系到引用配置等功能,多个同名文件还涉及到文件合并等,这里先不做详细说明)。 Log服务 —— 日志中心 TARS框架的日志服务,用于接收远程日志。 提供两个接口,如下 /** * 输出日志信息到指定文件 * @param app 业务名称 * @param server 服务名称 * @param file 日志文件名称 * @param format 日志输出格式 * @param buffer 日志内容 */ void logger(const string &app, const string &server, const string &file, const string &format, const vector<string> &buffer, tars::TarsCurrentPtr current); /** * 获取数据 * @param info * @param buffer */ void loggerbyInfo(const LogInfo & info,const vector<std::string> & buffer,tars::TarsCurrentPtr current); 业务服务以框架层的 API 异步发送日志到日志服务器,例如 Stat 服务的 ReapSSDThread::run 中通过 FDLOG 发送日志 FDLOG("CountStat") << "stat ip:" << ServerConfig::LocalIp << "|Buffer Index:" << iBufferIndex << "|ReapSSDThread::run insert record num:" << iTotalNum << "|tast patch finished." << endl; 在TarsWeb上可以查询到相应的日志 FDLOG 的定义在库文件的 RemoteLogger.h ,定义如下: #define FDLOG(x) (RemoteTimeLogger::getInstance()->logger(x)->any()) RemoteTimeLogger::getInstance()->logger(x) 函数生成并返回:TimeLogger*,TimeLogger 的定义如下: typedef TC_Logger<TimeWriteT, TC_RollByTime> TimeLogger; 其中 TC_Logger 为日志基类模板:模板第一个参数 TimeWriteT 负责写Logger。在 applicantion 服务启动的时候会调用设置远程日志服务器对象的服务,例如 log=tars.tarslog.LogObj,然后调用 setLogInfo 设置本地信息 RemoteTimeLogger::getInstance()->setLogInfo(_communicator, ServerConfig::Log, ServerConfig::Application, ServerConfig::ServerName, ServerConfig::LogPath,setDivision()); 这里底层实现函数如下,会获取远程日志服务器的地址 void RemoteTimeLogger::setLogInfo(const CommunicatorPtr &comm, const string &obj, const string &sApp, const string &sServer, const string &sLogpath, const string& setdivision, const bool &bLogStatReport) { _app = sApp; _server = sServer; _logpath = sLogpath; _comm = comm; _setDivision = setdivision; _logStatReport = bLogStatReport; if(!obj.empty()) { _logPrx = _comm->stringToProxy<LogPrx>(obj); //单独设置超时时间 _logPrx->tars_timeout(3000); if(_defaultLogger) { _defaultLogger->getWriteT().setLogPrx(_logPrx); } } //创建本地目录 TC_File::makeDirRecursive(_logpath + "/" + _app + "/" + _server); } 具体写日志的时候,TimeWriteT 类重载了 operator() ,会调用远程日志服务的logger 接口写远程日志,从而实现了日志从本地到远程日志服务器的功能 void TimeWriteT::operator()(ostream &of, const deque<pair<size_t, string> > &buffer) { ... _logPrx->logger(DYEING_DIR, DYEING_FILE, "day", "%Y%m%d", vDyeingLog, ServerConfig::Context); ... } Stat服务 —— 性能指标统计 Stat 服务用于监控服务进程的运行质量,提供服务模块间调用信息统计上报的功能。Stat采集的数据包含 服务的性能数据,包括:调用时间、成功次数、超时次数、异常次数、耗时分布等信息。 服务间的调用关系链采样,包括:主调、被调、接口名等信息,以便定位问题服务。 以下为 Stat 服务定义的接口: /** * 上报模块间调用信息 * @param statmsg, 上报信息 * @return int, 返回0表示成功 */ virtual int reportMicMsg( const map<tars::StatMicMsgHead, tars::StatMicMsgBody>& statmsg, bool bFromClient, tars::TarsCurrentPtr current ); /** * 上报模块间调用采样信息 * @param sample, 上报信息 * @return int, 返回0表示成功 */ virtual int reportSampleMsg(const vector<StatSampleMsg> &msg,tars::TarsCurrentPtr current ); Property服务 —— 业务指标统计 Property服务提供用户自定义属性上报功能,用于监控业务的运行质量情况和相关指标的统计。采集的数据包含 服务业务特性数据,包括内存大小、队列大小、cache命中率等;支持平均、计数、求和、分布等统计方式。 Property服务提供接口 reportPropMsg 进行服务特性上报,接口声明如下 /** * 上报属性信息 * @param statmsg, 上报信息 * @return int, 返回0表示成功 */ virtual int reportPropMsg(const map<StatPropMsgHead,StatPropMsgBody>& propMsg, tars::TarsCurrentPtr current ); Notify服务 —— 异常信息 官方文档定义为异常信息,用于获取服务的业务异常上报的report,输出的信息可以在TarsWeb平台里面看到。 具体服务业务代码中,通过获取 RemoteNotify 实例调用 report 上报异常信息,例如: RemoteNotify::getInstance()->report("This is a report test"); 服务管理界面回显示服务上报的异常信息,如下 源码实现主要部分如下: if(_notifyPrx) { ReportInfo info; info.eType = REPORT; info.sApp = _app; info.sServer = _serverName; info.sSet = _setName; info.sThreadId = TC_Common::tostr(std::this_thread::get_id()); info.sMessage = sResult; info.sNodeName = _nodeName; if(!bSync) { _notifyPrx->async_reportNotifyInfo(NULL, info); } else { _notifyPrx->reportNotifyInfo(info); } } Notify 服务的实现,主要就是把数据插入 t_server_notifys_ 数据库。这里默认都是使用异步的接口,否则效率可能会有问题,毕竟是直接操作db,相关操作源码如下 ... string sql; TC_Mysql::RECORD_DATA rd; rd["application"] = make_pair(TC_Mysql::DB_STR, info.sApp); rd["server_name"] = make_pair(TC_Mysql::DB_STR, info.sServer); rd["container_name"] = make_pair(TC_Mysql::DB_STR, info.sContainer); rd["server_id"] = make_pair(TC_Mysql::DB_STR, info.sApp + "." + info.sServer + "_" + nodeId); rd["node_name"] = make_pair(TC_Mysql::DB_STR, nodeId); rd["thread_id"] = make_pair(TC_Mysql::DB_STR, info.sThreadId); if (!info.sSet.empty()) { vector<string> v = TC_Common::sepstr<string>(info.sSet, "."); if (v.size() != 3 || (v.size() == 3 && (v[0] == "*" || v[1] == "*"))) { TLOGERROR("NotifyImp::reportNotifyInfo bad set name:" << info.sSet << endl); } else { rd["set_name"] = make_pair(TC_Mysql::DB_STR, v[0]); rd["set_area"] = make_pair(TC_Mysql::DB_STR, v[1]); rd["set_group"] = make_pair(TC_Mysql::DB_STR, v[2]); } } else { rd["set_name"] = make_pair(TC_Mysql::DB_STR, ""); rd["set_area"] = make_pair(TC_Mysql::DB_STR, ""); rd["set_group"] = make_pair(TC_Mysql::DB_STR, ""); } rd["result"] = make_pair(TC_Mysql::DB_STR, info.sMessage); rd["notifytime"] = make_pair(TC_Mysql::DB_INT, "now()"); string sTable = "t_server_notifys"; try { _mysqlConfig.insertRecord(sTable, rd); } ... Node服务 —— 节点管理 服务节点可以认为是服务所实际运行的一个具体的操作系统实例,可以是物理主机或者虚拟主机、云主机。每台服务节点上均有一个Node服务和多个业务服务,Node服务会对业务服务进行统一管理,包括: 同一节点(容器、服务器、虚拟机等)上的服务起停、服务状态信息采集、发布、配置管理、自定义消息通知。 同一节点上的服务监控,异常退出、僵死等监控重启。 Node 服务提供的主要接口: patch(patch指定服务) destroyServer (销毁指定服务) shutdown (关闭Node) stopAllServers (停止所有服务) loadServer (加载指定服务) startServer (启动指定服务) stopServer (停止指定服务) notifyServer (通知服务) Registry 服务的 startServer 会调用本节中 Node 服务的 startServer 接口,startServer 再通过调用 CommandStart 类的 startByScript 函数实现服务的启动,该派生自 ServerCommand ,同理也有 CommandStop, CommandPatch 等,具体详见源码。 startByScript 通过拉取服务的启动脚本启动服务,启动脚本一般随服务conf存储在DB中,然后调用以下函数执行脚本启动服务 _serverObjectPtr->getActivator()->activate(sStartScript, sMonitorScript, sResult); 最终通过C语言exec系列函数执行启动脚本启动服务。 除了以上主要的管理服务的接口外,还有用于获取Node服务信息的接口,如 getState 用于获取指定服务状态,实现如下: ServerState NodeImp::getState( const string& application, const string& serverName, string &result, TarsCurrentPtr current ) { string serverId = application + "." + serverName; result = string(__FUNCTION__)+" ["+serverId+"] "; ServerObjectPtr pServerObjectPtr = ServerFactory::getInstance()->getServer( application, serverName ); if ( pServerObjectPtr ) { result += "succ"; return pServerObjectPtr->getState(); } result += "server not exist"; NODE_LOG(serverId)->error() << "NodeImp::getState " << result << endl; return tars::Inactive; } 总结 本文介绍分析了TARS框架中如何通过不同运维服务工具实现对服务的运营和监控,为开发和运维人员提供方便、人性化的服务管理和维护功能。 TARS可以在考虑到易用性和高性能的同时快速构建系统并自动生成代码,帮助开发人员和企业以微服务的方式快速构建自己稳定可靠的分布式应用,从而令开发人员只关注业务逻辑,提高运营效率。多语言、敏捷研发、高可用和高效运营的特性使 TARS 成为企业级产品。 TARS微服务助您数字化转型,欢迎访问: TARS官网:https://TarsCloud.org TARS源码:https://github.com/TarsCloud 获取《TARS官方培训电子书》:https://wj.qq.com/s2/6570357/3adb/ 或扫码获取:

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册