首页 文章 精选 留言 我的

精选列表

搜索[赛博朋克],共10000篇文章
优秀的个人博客,低调大师

每日一博 | 彩票调度算法,让进程们拼手气

这篇文章主要想介绍下彩票调度(个人觉得这个算法非常有意思~ ),还有随机算法相对传统算法的一点优势,毕竟现在绝大多数算法都是追求确定性,尤其在操作系统,大家都希望一切可控,所以随机算法的出现听起来有些“不合时宜”,但它确实能够解决某些传统算法难以解决的边角问题(算是给自己挖个坑,以后可能会写),也为我们提供了一种新的思路。 以下是正文: 进程调度器今天突然召集大伙,说是要讨论一件重要的事情,问他他还卖关子:“你去了就知道,我现在不告诉你们。” 还没到约定时间,大伙儿就已经来到了内存家,只见进程调度器气定神闲的坐在椅子上,翘着个二郎腿,好不自在。 “调度器老哥,现在人也都来的差不多了,咱们现在就开始吧,早点结束大家伙儿好接着回去干活啊。” 调度器“嗯”了一声,起身走向白板,说:“我向大家先说明一下背景吧,咱们原来的调度算法,比如先来先服务,短进程优先,优先级调度等等,大都是为了优化周转时间和响应时间,效果也还不错。不过这些算法,有些可能会导致饥饿的问题,我想不少进程深有体会。” 饥饿问题确实困扰操作系统很长时间了,虽然饥饿不如死锁那么有破坏力,但还是影响到了进程家庭内部的和谐。听调度器的意思,他是能解决这个问题? 几个低优先级进程开始小声议论起来,像他们这种优先级别低的,总会因为高优先级进程“插队”而得不到 CPU 资源,心里早就憋着一口气呢。忍不住问调度器:“现在是有什么好办法了吗?我们可受够饥饿的生活了!” 调度器得意的说:“那当然,不然我今天把你们大伙叫过来干什么?我最近想到一个好点子,咱们可以调整一下调度目标,改成确保每个任务获得一定比例的 CPU 时间,这样只要我们提前约定好份额,每个人最后都可以享受到应有的待遇,不可能出现某一进程独占的现象!听起来是不是很公平?我打算把这类算法叫「比例份额调度」或者「公平份额调度」。” 系统进程提出了质疑:“公平?你别说大话了,这个目标咱们又不是没有追求过,也就时间片轮转算法勉强达到了我们的要求,可一旦再划分出优先级(指的是多级优先队列调度),就可能会造成进程饥饿,追求公平可不是那么简单的!” “你先听我说嘛,绝对的公平确实很难达到,我们现在退而求其次,追求一个相对公平——就是说短时间里可能会有些许不公平,但从长期来看,大家在 CPU 上运行的时间所占比例就是一开始约定好的。” “听起来很有道理,但是你打算怎么实现?” “嘿嘿,我给这个方法取名叫「彩票调度」,咱们一开始的时候给每个进程发彩票——优先级越高,发的彩票越多,然后每隔一段时间(一个时间片),举行一次彩票抽奖,抽出来的号是谁的,谁就能运行~” “哈哈哈哈,我还以为是什么厉害的算法呢”,一时间,大家都笑了出来,整个内存里充满了快活的气息。调度器的脸唰的一下就红了。 操作系统吐槽道:“调度器,你是不是跟那帮人类学坏了?在我们这儿还搞什么彩票,下一步是不是打算骗大家的时间片?再这么搞下去,小心我把你职位撤了啊!” 调度器赶紧为自己解释:”诶,我可是经过深思熟虑才想出来的,你们别误会啊!打个比方吧,假如有两个进程 A 和 B,我想让 A 占用 80% 的 CPU 时间,B 占用 20% 的 CPU 时间,我就给 A 发80 张彩票,给 B 发 20 张彩票。**这样,每次抽奖的时候,A 就有 80% 的概率占用 CPU,从数学期望上讲,1 秒钟之内,A 能运行 800ms。**我是打算利用随机性来达到按比例分配的目标的,可从没打算骗大家。“ 操作系统看起来有点认可这个算法了,他点点头:“有点意思,你接着说下去。” 调度器松了一口气,继续说:“我觉得这种算法有个很好的地方——即使某进程只有一张彩票,经过多轮迭代,他总会获得 CPU 的使用权。所以饥饿的问题就能解决了~” PS:可别跟现实的彩票等价啊,现实彩票中奖率低的吓人。。。没法比的(不信你自己算一算)。 那几个经常饥饿的进程听了,两眼放光,仿佛抓到了希望。 "别急,还没完呢!你们想想,咱们用过的**「最短响应比优先」算法,还得记录每个进程在就绪队列等待了多长时间**,多麻烦!我这个「彩票调度」,不需要记录任何状态,拿来就用,特别的轻量,而且这种随机方法很快,只要生成一个随机数,就能快速做出决策。为了向你们展示,我还特意写了段伪代码。" //当进入时钟中断时运行 //counter 用来数哪个进程拿到了 winner 彩票 int counter = 0; //选出胜者,其中 totalticks 是彩票总数 int winner = randint(0, totaltickets); //指针,指向队列里的进程 job_t *current_job = head; while(current_job != null) { counter = counter + current_job->ticket; if (counter > winner)//说明当前进程拿到了 winner 彩票 break; current_job = current_job->next; } //切换至 current 指向的进程 操作系统看完了代码,赞叹道:“好家伙,确实是个简洁的调度算法,简洁的都有点儿不可思议了。不过你这个代码只解决了调度问题,最开始的彩票分配问题你打算怎么解决?” 调度器面露难色:“我这几天也在想这个问题,不过暂时没有想到好的解决方案,所以说要靠试运行来摸索嘛,如果找到好的分配方法,就可以长期运行下去了。” “确实,我也觉得这个方法有的一试,咱们明天就按这个调度算法来,看看效果能不能比上现有的算法!” 调度器高兴地叫出来:“好,太好了,我马上就去准备!” 实际上彩票调度并没有在 CPU 调度程序里广泛使用,一个原因是不能很好的适合 I/O(有论文研究过这个问题),另一个原因就是文中所提到的,票数分配问题没有确定的解决方式,比如你新打开了一个浏览器进程,那该给他分配多少票?票数少了,响应跟不上,票数多了,又会浪费 CPU 时间。 与此相比,常见的通用调度程序,比如多级优先队列,就做的很好,因此现在得到了广泛的应用。 但不代表这种思想就没有用了,在某些容易确定份额比例的领域里,比例份额调度程序就更有用——比如在虚拟数据中心,你可能希望 1/4 的 CPU 时间给 Windows 虚拟机,剩下的时间给 Linux 虚拟机,这时候靠彩票调度就很方便了。 所以彩票调度机制还是有一定应用价值的,说不定你以后在哪里就用上了呢? 希望你在看完我的文章之后有所收获,期待你的赞和转发! 如果本文对你有帮助,欢迎关注我的公众号 tobe的呓语 ,带你深入计算机的世界~ 公众号后台回复关键词【计算机】有惊喜哦~
优秀的个人博客,低调大师

每日一博 | 开源,基础软件最好的商业模式

Milvus 向量搜索引擎已开源。欢迎大家在 Github 上关注我们。 虽然已经 2019 年,但还是有不少人(甚至是大部分人),一提到“开源”,想到的就是“免费”与“个人开发的业余(低水平)软件”。然而事实恰恰相反,今天“开源”正是基础软件最好的生长模式。“开源”能对基础软件公司提供三方面的助力:技术/品牌推广,用户/开发者拓展,人才吸引。 是不是言过其实?让我们一起细细探究什么是“开源”。 “开源”简史 “开源”( Open Source )这个口号源于 1998 年的一次软件黑客峰会。当时,自由软件运动已经进行了 15 个年头。 软件自由 1969 年, Unix 操作系统诞生于贝尔实验室(隶属于 AT&T )。当时的 AT&T 因为反垄断原因,被限制不得进入计算机行业。因此 AT&T 最初对 Unix 的源码进行免费分发。然而,1982 年针对 AT&T 不得进入计算机行业的禁令失效了。 1983 年, AT&T 发布了大名鼎鼎的 Unix System V 。同时 AT&T 改变了 Unix 的授权模式,将其变成了收费的闭源商业软件。AT&T 的行为只是当时软件行业的一个缩影,很多企业或个人都一改过去的源码免费分发模式,而转向闭源的商业软件模式。由此催生了自由软件运动(始于 1983 年)。发起人 Richard Matthew Stallman ,业界尊之为 RMS 。(能被人用 3 个字母的缩写指代的美国人,都不是一般人,比如 JFK 。) RMS 是学院派黑客的典型代表,他发起的自由软件运动不仅针对商业软件,更关乎用户自由使用软件的权益。自由软件运动虽然有过于理想化的问题,但它所代表的社区力量的觉醒早已深深影响了今天的软件行业。 经过不懈的努力与坚持,1990 年代自由软件阵营终于迎来了重量级的成员(使用 GPL 许可证)—— Linux ( 1991 )和 MySQL ( 1995 )。既然自由软件逐步走入正轨,为什么还要打出“开源”这样一面新的旗帜呢? 黑客与商业 1994 年,Netscape 公司成立。通过独创的 Javascript 编程语言和浏览器渲染引擎, Netscape 最风光的时候独占了浏览器市场 90% 以上的份额。Netscape 浏览器本身是收费的商业软件,但用户也可以选择下载免费的评估版。 然而,微软也瞄准了网络浏览器这个赛道。通过在 Windows 上内置 Internet Explorer 的方式,微软快速蚕食着 Netscape 的市场份额。尤其 1998 年,微软发布的 Windows 98 中内置的 Internet Explorer 4.0 从功能上也压倒了 Netscape 的产品。岌岌可危的 Netscape 在卖身于 AOL 之前做了一个大胆的决定:公开 Netscape 网络浏览器的源码。(日后它将重生为 Firefox ,与 IE 展开新的争夺。)不过自由软件过于理想化的理念,显然与 Netscape 这样的商业公司存在一定的差异。 正是在这样的背景下,O'Reilly 召集了黑客社区中的重要成员: Linus ,三大脚本语言( Perl/Tcl/Python )的发明人, Netscape 公司代表, Apache 维护者等重量级人物一起召开了一次讨论会。讨论的重要成果之一是明确了不论是自由软件,还是开源软件,最重要的共性便是公开源码。这也是“开源”这个口号的由来。另一个开放式的话题则是,如何将开源背后的黑客文化与商业市场相结合。谁曾想 20 多年后的今天,我们依旧在寻找这个问题的答案。 因此,开源项目不应该避讳谈商业模式。因为从“开源”诞生的第一天,商业模式的探索就是其中重要的一环。可以说开源理念是对自由软件思想的延申,开源理念强调——共享与合作开发软件源码是有商业潜力的。 LAMP “开源”,生逢其时。 1997/1998 亚洲金融危机之后,一方面资金回流美国,另一方面美国的利率也处于较低水平。第一轮互联网热潮( dot-com bubble )越发汹涌。 当时商业软件与服务器过于昂贵。开发人员开始采用 PC 硬件和日后大名鼎鼎的 LAMP 开源技术栈来构建自己的网站。 LAMP ,即 Linux 操作系统, Apache 网络服务器, MySQL 数据库和 PHP 开发语言。不夸张的说,这些开源软件就是互联网早期的明灯( lamp )。 时至今日,Linux 和 MySQL 已经是地球上任何数据中心里的标配。而 Apache ,更是成为了巨无霸式的开源基金会,拥有 1.9 亿行代码。根据 COCOMO II 模型估算,这些代码的开发成本超过 200 亿美元( 2019 年报)。可见本文一开始提到的两个关于“开源”的偏见是多么可笑。 创新先锋 开源软件的基因中深深印刻着黑客社区的精英文化与创新精神。即便从自由软件运动开始算起,“开源”的诞生也不过 30 多年。但“开源”已经对今天的软件产业,甚至整个 IT 产业带来了深刻的启发与影响。 如果回溯近 20 年的 IT 产业发展脉络,以下几个标志应该是公认的: 互联网、移动互联网,云计算 整个互联网行业引领了近 20 年的 IT 技术发展。始于 1990 年代的互联网虽然是非常年轻的行业,但也是对 IT 技术最敏感的行业。开源 LAMP 技术栈为互联网行业的发展奠定了基础,而互联网行业的急速发展也帮助孕育了大量开源软件。 最初当 SuSE 和 Red Hat 将 Linux 引入企业服务器市场时,开源软件只是商业软件的低成本替代品。 在相当长的一段时间里,开源软件都忙着去补齐相比商业软件所缺失的能力。但即便是在那个阶段,开源软件也贡献了不少创新的工具,组件和理念。其中最典型的一个例子, MySQL 数据库将计算引擎与存储引擎两部分进行了独立的模块化设计(和今天说的云环境下的计算与存储分离不是一个概念)。 MySQL 允许用户选择自己需要的存储引擎,甚至这个存储引擎可以是由另一个公司开发的。(虽然现在 MySQL 和 InnoDB 都在 Oracle 手里,但早先他们其实是两家公司。)Db2 和 Oracle 可没这样的操作。 及至最近十年,移动互联网与云计算大放异彩。 Redis , MongoDB , Spark , Docker ……这些带来创新理念的基础软件,无一是按照传统商业软件的模式进行运作的。 大数据 大数据这个概念, 1990 年代就开始出现。早期对大数据价值的挖掘利用,主要是通过 EDW/BI (企业数据仓库,商业智能)这样的解决方案来实现。当时, Teradata 是数据仓库中绝对的霸主。而 IBM 通过收购 Cognos 和 SPSS 在 BI 领域占有重要的位置。这些商业解决方案当年主要服务于金融,电信,大型制造等行业。 大数据的特点之一是价值密度比较低( 2 倍的数据无法带来 2 倍的价值)。因此传统的分析处理方式虽然在性能上也许依然可以满足要求,但在成本上却很难被用户所接受。一直到 2005 年 Hadoop HDFS 的出现,数据处理的成本大幅下降。终于在开源软件的推动下,企业级的大数据分析处理能力变得唾手可得。 机器学习与深度学习 2016年 DeepMind 研发的 AlphaGo 4:1 战胜李世乭。由此将人工智能的这一波浪潮推向了新的高度。这一轮人工智能还能走多远?这个问题的答案见仁见智。但值得注意的是,各种主流的人工智能平台框架( Tensor Flow , Caffe , Keras , PyTorch , Paddle Paddle 等等)都是开源的。甚至英伟达这样的硬件厂商都推出了 RAPIDS 这样的开源 AI 框架。 开源软件的创新之处,不单单体现在技术上。更重要的是开源软件背后的开放协作理念,以及对软件价值的重新定义,彻底改变了今天的软件世界。 重塑软件价值 时间回到 2009 年,那正是商业软件公司欣欣向荣的时代。那时笔者是 IBM 的一名软件售前工程师。同事们热烈讨论着日暮西山的 SUN 究竟还有什么出路。 有传闻 IBM 会收购 SUN,不过这样的收购恐怕过不了反垄断调查。 谁曾想 Oracle 最终出手。这笔交易完成后, Oracle 成为了与 IBM 一样的集软硬件,服务于一体的全栈型企业 IT 公司。 Oracle 与 IBM 之间的双雄争霸似乎将会从数据库领域拓展到企业 IT 的各个领域。 然而,我们知道这样的事情最终并没有发生。 Oracle 与 IBM 双双迷失在这开源软件大爆发的时代…… 传统商业软件的玩法 我们都知道传统商业软件通常采用许可证( license )销售模式。一般的流程是,软件厂商会将用户的硬件配置(比如 CPU 核数,存储容量等等),代入他们的神奇公式(公式里的各种常量大概都是上帝确定的),最终计算出软件许可证的金额。 那么用户支付许可证费用以后,就能愉快的使用软件了吗?对于软件厂商来说,还有两个问题: 许可证费用一般都给了很大的折扣(为抢标,报价 1 块钱的也不是没有)。 许可证往往是一次性收费,今年收了,明年怎么办呢? 因此除了一次性收取的许可证费用,软件厂商又设计出了按年收取的软件升级保护费用(通常是按比例从许可证费用折算而来)。 只要购买了升级保护,用户以后就可以一直使用最新的“版本”,而无需重新支付许可证费用。 Oracle 称其为许可证支持( license support ), IBM 称其为订阅与支持( subscription & support )。 按照一般的直觉,人们会认为商业软件的核心是许可证费用,软件升级保护只是许可证的附加产品(毕竟连计算方法都是跟着许可证走的)。但事实往往是反直觉的,请看 Oracle 2017 年财报: 2017 收入 Total revenues 37,728 New software licenses 6,418 Software license updates and product support 19,229 成本 Total operating expenses 25,018 Research and development 6,159 单位:百万美元 原来,软件升级保护收入超过整体收入的 50 % ,是新售软件许可证收入的 3 倍,也是整个公司研发支出的 3 倍。真是了不起的成就!也正是依靠这个基本盘, Oracle 的转型之路还算是比较从容。足见可持续性收入对于软件公司有多么的重要。 为了保住 license support 的收入,2018 年开始 Oracle 甚至修改了自家数据库的发布周期与命名规范。既然 license support 是按年收取的,那么每年至少要发个“版本”,不然用户这一年的升级保护不是白交了么?但其实例如 Oracle 18c ,它并不是新的数据库“版本”。严格意义上讲,它是 Oracle 12.2.0.2 ( Version.Release.Modification.Fixpack ),更像是一个 fixpack (或者按 IBM 的叫法是 function level )。 按照惯例, fixpack 升级本来也不需要购买升级保护…… Oracle 未来的“版本”发布节奏 顺便说一下,这里为什么只给出 2017 年的数据呢?因为自 2018 财年第 4 季度开始, Oracle 不再单独列出软件升级保护的收入金额,转而将软件升级保护收入与(总是达不到市场预期的)云收入合并后一起汇报。(这波操作厉害。反正都是按年收取的可持续性收入,合并也没毛病。所以说 Oracle 是最牛的商业软件公司。) 其实何止 Oracle , IBM 和微软也开始采用淡化版本的方式进行软件发布了。这些商业软件巨头一个个学起了开源软件的迭代模式,可见“开源”对软件行业的影响多么巨大。 “开源”带来的改变 目前比较常见的开源基础软件商业模式是这样的: 针对一般用户,提供基础开源版本,满足用户的基本需求 针对核心用户,提供收费的高级版,满足用户的进阶需求(如分布式,高可用,以及工具链软件等) 收费模式通常是以软件订阅的名义,按年进行支付 坦白地说,目前开源软件的商业设计比起传统商业软件还是稚嫩了不少。甚至,开源软件的订阅模式与传统的软件升级保护,形式上看似乎也没有那么大的区别。但为什么开源软件能造成这么大的影响呢?原因在于,开源软件的模式触及了用户心中长久以来的一个疑问:软件究竟是什么? 传统商业软件公司将软件以产品的形式卖给用户。因此,用户花钱买来的软件许可证以及软件升级保护是一种资产。什么样的资产呢?既不生息,也不能转售,只会慢慢折旧的资产。这样的资产放着有什么用?谁又会喜欢这样的资产呢? 而在开源模式下,软件开发者向用户提供的是一种服务。这种服务不单纯只是软件本身,还包括了软件的前期开发过程,以及使用/试用反馈。可是,难道传统商业软件公司不从用户那里收集需求?不听取用户的意见来改进自己的产品?没错,这些他们都做了。但有多少用户感受到了呢(除了少数几个特殊照顾的大客户)? 其中的区别可以用 SuSE 公司的口号来说明:“ We're the open open source company ”。“开源”背后的关键之一就是开放协作( open collaboration )。以开放的流程与心态,方便用户参与到软件的设计,研发,及反馈中。哪怕用户不写一行代码,他也可以参与其中。通过查阅公开的文档与问题记录,用户能清楚的了解项目的进展,设计的思路,存在的问题及解决方法。这不仅仅是“参与感”,用户也能建立起对项目的控制感与信任。一个可参照的例子,华为为了赢得英国电信市场的信任,主动将通信产品相关的源码与开发流程交由英国监管机构审查。 更改版本命名规则,让用户觉得每年的升级保护没有白买,是一条容易的路。构建一个开放协作的环境,为用户提供软件服务,是一条困难的路。 我们,选择那条能通往未来的路。

优秀的个人博客,低调大师

每日一博 | 重新认识 D 编程语言 —— 基础篇

编程语言的兴盛往往随着全球信息技术产业方向而变化,同样也会因为跟不上节奏而没落。 D 语言曾经兴盛过,也随着信息技术发展而颓废过,但最终我们很高兴的看到它又带着强烈的自信开始复苏,希望通过本文让现代计算机科学工作者进一步了解这门具有独特魅力的编程语言。 作者:邹佳庆、张雪平 引言 D 语言是一门语法相当优雅的编译型语言,自 1999 年发布至今已发展了 20 年,它既拥有 Java 那样强大的表现力,又具有 C++ 相当的性能,本来是一门未来相当明朗的语言,但是当年因为 2.x 版本破坏性升级导致社区大量核心开发者将其放弃。 2010 年,伴随着 Andrei Alexandrescu 新书《The D Programming Language》的出版,D 语言又变得活跃起来,D 语言 2.0 的特性变得稳定,运行库与标准库的分离,解决了 D 语言 1.0 时期标准库之争的问题。 2011 年,D 语言的开发迁移到了 Github,在有了更好的代码管理和 bug 跟踪方式之后,参与到 D 语言编译器、运行库和标准库开发的人员也有了明显的增加。次年,D 语言 1.0 版本停止更新,开发者全力投入到 2.0 的开发。 2014 年,D 语言编译器前端代码的许可协议变更为更加宽松的 Boost 许可。在 2017 年,编译器所有代码最终都使用了 Boost 许可。在解决编译器源码许可问题之后,D 语言在开源社区中变得更加开放,并顺利合并进入了 GCC 9.x。 直到 2015 年,D 语言社区进一步恢复活力,基于包管理的构建方式开始成熟,大量的开发库开始涌现并应用到实际项目中。目前,已注册项目库达 1 千 6 百多个。 重新燃起希望的 D 语言在版本发布的规划上非常稳健,直至今日来说每两个月都可以保证一个大版本的发布。平均每个版本的开发者数量都有超过 50 个核心贡献者,最近的 2.087.0 更是达到了 62 位核心开发者的贡献。 编程语言的战争异常惨烈,本文希望通过介绍,让开发者重新来了解一下 D 语言,认识到 D 语言其实是一门能力强大的语言,并且它可以用于不同的场景,生态也在不断发展完善中。 第一部分:D 语言主要特点 D 语言是在吸取 C++ 遇到的各种教训基础上设计出来的,拥有与之类似的编程风格,许多概念与 C 或 C++ 都是相通的。不过,D 语言也有自己的一些特点,如支持闭包、匿名函数、编译时函数执行、支持垃圾回收等。具体来讲,D 语言拥有以下几个主要特点: 面向对象编程 D 语言允许定义类和接口。像 Java 一样,D 语言的继承模型是单类继承和多接口继承。所有的类都有一个根类 Object。D 语言的类和接口都是引用类型,而结构是值类型,且不允许继承。 函数式编程 D 语言像 C++ 一样,允许在类或结构外单独定义函数。它还提供了各种不可变数据类型、匿名函数和闭包、UFCS(统一函数调用语法)等特性来更好地支持函数式编程。 泛型编程 D 语言允许定义模型类型,也支持直接定义模板类和模板函数。模板允许嵌套定义,模板方法甚至允许递归调用。通过模板约束可以实现模板类型重载。模板参数支持不定个数类型。除此以外,模板参数类型还支持自动推导。 元编程 D 语言里的纯函数不会对全局变量产生任何影响,因此可以在编译时直接调用。借助 static if、static foreach、mixin 等语句,可以编写在编译时执行的代码,动态生成代码,满足快速定制应用功能的需求。 安全内存 默认支持基于垃圾回收的内存管理方式,从而让编程变得更简单,内存变得安全,程序变得更稳定。除此之外,也可以根据需要对关键的内存资源选择手动管理方式。借助 scope 语句,可以很好地控制内存资源申请和释放点。D 语言内部有一套核心的类型定义和实现,它是 D 语言的一个子集,也被称作 SafeD,用于保护内存的安全。 模块化编程 D 语言的每一个源文件都被定义为一个模块(module),源文件之间的依赖即体现了模块之间的依赖。同一目录下的多个模块可以组成一个包(package)。基于模块的代码让项目的逻辑变得更加清晰,也为项目的快速构建和编译提供了支持。 其他语言交互 D语言的ABI与C语言完全兼容,因此它也具有很好的与其他语言交互的能力,如与 C、C++ 和 Objective-C 等语言进行交互编程。D 语言甚至支持直接嵌入汇编语言,部分性能关键的代码可以直接使用汇编语言来实现。D 语言的 BetterC 特性是 D 语言的一个子集,能完全去除 GC 依赖,并以更好 C 语言的方式来代替 C 语言编程,它能胜任 C 语言做的绝大部分工作。在 Windows 平台下,可以使用 COM 接口实现与其他语言的交互。 基于包的应用构建 这个不属于 D 语言本身特性,但是在 D 语言的开发生态里,这是一种很非常重要和便捷的 D 语言应用构建方式。dub 是 D 语言的应用构建工具,它可以很好地管理应用包之间的依赖关系,快速地构建出 D 语言应用。 除了上述特点,D 语言还提供了许多其他特性,如内建关联数组、单元测试、内联汇编、内嵌文档等,这些特性让 D 语言成为了一门功能强大的语言。 第二部分:与其它语言的简要对比 D 语言与 Java 相比 众所周知 Java 对工业化架构的设计非常棒,远超越 C++、Golang 等语言,能与 Java 相提并论的只有 C#,在研究中我们发现 D 同样具备工业化的特性,而且不需要那么庞杂的虚拟机开发环境,D 的性能比起 Java 来说好的非常明显,而且整合 C、C++ 库的时候也非常方便,而 Java 想整合 C、C++ 就需要非常麻烦的 jni 对去接。毕竟 D 语言是名副其实的系统级开发语言,D 语言在面向对象方面并不像 Java 那样强制每个文件都是对象,而更像 C++ 那样拥有一个 main() 函数作为程序入口。 示例代码 import std.stdio; void main() { writeln("Hello world!"); } D 语言与 C++ 相比 说到性能,C++ 一直占据服务端高性能的首选,但是 D 的性能与 C++ 相比几乎打成平手,但效率可以 3~5 倍于 C++。当然 D 与 C 语言各种库整合同样方便,因为 D 语言是二进制与 C、C++ 兼容的,语法更像是 C++ 的超级升级版,D 在对 hashMap 操作时性能比 C++ 还要高,而且只要是掌握 C++ 的人可以没有任何门槛地使用 D 语言。 示例代码 import std.stdio; void main() { foreach(i; 1..10) { writeln(i); } } D 语言与 PHP 相比 PHP 是服务端脚本语言占有率最高的语言,PHP 的优势就是简单,无需引入什么包就可以使用语言本身的所有函数,但是也就是这样 PHP 的性能一直没有明显改进,虽然说 PHP 7.x 的出现让 PHP 的性能提升了 2.x 倍,但是那只是和非常慢的 PHP 5.x 相比而已,与编译型语言相比还是相差太多。PHP 有非常明显的短板,比如不支持多线程、长连接不友好、弱类型、跨语言 RPC 协议支持不稳定、部署需要 PHP 运行环境等,而 D 语言具备 C++ 可实现的所有功能,包括内嵌汇编,开发效率上来讲与 PHP 相比只是多了个强类型的概念,而 D 语言标准库也提供 to 方法让你非常方便地进行各种类型的转换。 示例代码 import std.stdio : writeln; import std.conv : to;  void main() { int i = 10000; string s = "Is string "; s ~= i.to!string; // PHP 使用点连接两个字符串,而 D 语言使用波浪线连接两个字符串 writeln(s); // 输出结果 Is string 10000 } D 语言可替代 C 语言 前阵子有一篇文章比较火,有一位 i3 核心开发者在文章中说到,D 才是真正替代 C 的首选语言,他认为 D 二进制与 C、C++ 完全兼容所以可直接使用这两个语言的二进制库,D 甚至可以用 dpp 项目直接 #include 语法引入 *.h 文件,作者同时也说到为什么 C 的替代者不是 Rust 和 Golang,有兴趣的同学可以自行了解原文《D as a C Replacement》。 gcc 整合 D 语言编译支持 这是一个非常大的进步,在近期发布的 gcc 9.1 大版本中整合了 DLang 全新的编译器前端也就是 gdc,现在整个社区有更多开发者对 D 项目进行推进,也有更多人在使用 D 完成之前 C/C++ 的工作。 第三部分:D 语言主要应用 作为一门支持 GC 的系统语言,D 语言已被许多公司采纳和应用,其中不乏像 Facebook、eBay 这样的大公司。D 的应用涉及了游戏、Web 应用、GUI 应用、操作系统、编译器、嵌入式、科学计算与教育等多个领域。 游戏开发 Remedy 公司已成功地用 D 语言将一款 3A 游戏 Quantum Break 移植到了 XBox One 和 Windows 10 平台。另外,有纯 D 语言实现的 3D 游戏引擎 Dash 和 D 语言游戏开发工具库 gfm。 Web 框架 编程语言在 Web 服务端框架非常重要,有好用的框架可以让整个语言充满活力,就像 Java 有一个 Spring Framework 框架,PHP 有一个 laravel 框架,Python 拥有一个 Django,而 Ruby 拥有 Rails,所以既然是构建服务端应用 DLang 也同样拥有一个代表性的框架 Hunt Framework。 数据库操作 数据库操作是大部分应用项目都不可或缺的一个基本操作,操作方式主要有两种:编写 SQL 脚本和 ORM。 直接操作数据库的 D 语言开库有 ddbc / (http://code.dlang.org/packages/ddbc)hunt-database 等,支持的数据库包括 MySQL、PostgreSQL 和 SQLite 等。其中,新版本的 hunt-database 的底层驱动库已从绑定 C 语言的方式升级为了直接使用 D 语言实现,减少了对第三方库的依赖。 采用 ORM 方式的 D 语言开库有 hibernated / hunt-entity 等。其中,hunt-entity 借鉴了 Java JPA 和 spring-data-jpa 的概念,工业化程度高,操作合理并且易于维护。 微服务相关 hunt-service 是基于 gRPC 协议的分布式 RPC 服务器与客户端库,很容易使用,也非常方便与 hunt-framework 整合构建微服务架构。 neton 是基于 raft 算法的分布式服务发现注册应用服务。 GUI 应用 其实 D 语言的推出比较早,所以 GTK 的整合非常完整,众所周知 gtk 官方的 vala 语言也大量借鉴了 D 的语言设计,所以 gtkd 能够非常方便的构建客户端应用,官方也有开发者推出了新的教程站点非常棒:gtkDcoding | Simple examples of how to use GtkD to build GUI applications(https://gtkdcoding.com/) 此外,纯 D 语言实现的跨平台 GUI 库 dlangui 也有不俗的表现,有一个 DLangIDE 就是基于它实现的。更多 GUI 库可以参考这里。 系统应用 在编译器方面,DMD 前端已实现自举。在操作系统方面,有 PowerNex(https://github.com/xomboverlord/xomb/tree/unborn) 与 Trinix 等系统尝试。编译器 LDC 甚至允许在更多的系统平台下进行应用开发,如支持基于 ARM 和 MIPS 架构的嵌入式系统、Android 系统等。 科学计算 现在使用 D 语言可以方便的进行科学计算,mir 是其中的佼佼者,它对多维数组计算提供了优秀的支持,性能超越了许多数值计算库,达到商业水平。 结语 简单来说,D 语言是一门在各个领域具有优势的编程语言,同时它当前的生态也在不断发展,本文希望通过简单的介绍,让开发者重新认识 D 语言。如果你还不了解 D 语言,读完本文,希望你对它产生兴趣;如果你此前有听说过 D 语言,读完本文,希望你能重新认识它;如果你对 Web 开感兴趣,请持续关注本系列接下来的 Web 应用篇。 参考资料 https://en.wikipedia.org/wiki/D_(programming_language) https://dlang.org/overview.html https://en.wikipedia.org/wiki/Uniform_Function_Call_Syntax https://dlang.org/articles/safed.html https://dlang.org/orgs-using-d.html https://dlang.org/areas-of-d-usage.html http://dconf.org/2016/talks/watson.html

优秀的个人博客,低调大师

每日一博 | 跟我一起认识 Little's Law

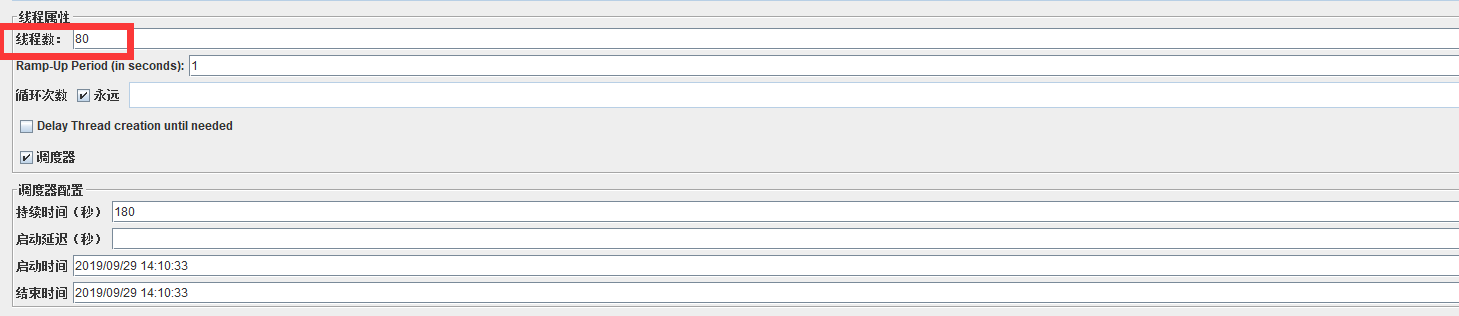
1.前言 开发的同学或多或少都会跟“性能”这个玩意打交道,本文将要介绍的Little's Law跟衡量性能的常见指标关系密切,所以在引出今天的主角Little's Law之前,有必要先统一一下我们描述“性能”的“基本语言”,毕竟语言不通是没法交流的不是。另外,以下叙述都是我的个人理解,不当之处请指正。 2.“性能”的“基本语言” 不同的服务设备对性能的定义也不同,例如CPU主要看主频,磁盘主要看IOPS。本文主要针对后端的软件服务性能(比如api服务,数据库服务等)展开讨论。限定好范围后就应该给出一个性能的定义了:性能就是服务的处理请求的能力。衡量性能的指标常见的有三个:并发用户数、吞吐量、响应时间。 2.1并发用户数 指真正对服务发送请求的用户数量,需要注意和在线用户数的区别; 比如,某一时刻,在线用户数为1000,其中只有100个用户的操作触发了与远端服务的交互, 那么这时对远端服务来说,并发用户数是100,而不是1000。 2.2吞吐量 单位时间内处理的请求数。 2.3响应时间 对应的英文是response time,也有的地方用 latency表示,即延迟。 需要统计一个时间段内的响应时间,求出特征值来表示响应时间。 常见的特征值包括平均值、最大值、最小值、分位值。 3.主角Little's Law登场 3.1 Little's Law的定义 稳定的系统中同时被服务的用户数量等于用户到达系统的速度乘以每个用户在系统中驻留的时间,适用于所有需要排队的场景。 对应公式表示为: N = X * R,其中 N 表示系统中同时活动的用户, X 表示用户相继到达系统的速率,在稳定(这个词非常重要!!!)状态(用户到达系统的速度等于用户离开系统的速度)时即为系统吞吐量, R 表示每个用户在系统中平均的驻留时间。 比如说,你正在排队进入一个体检中心,你可以通过估计人们进入的速率来知道自己还要等待多长时间。 体检中心能容纳约600人,每个人完成体检的时间是2个小时, 即R=2小时,N=600人,根据公式计算: X=N/R=600人/2小时=300人/小时 所以以每小时300人的速度进入。 如果现在你的前面还有300个人,那么大约还要等上一个小时才会进入体检中心。 3.2 Little's Law与性能指标的关系 前一部分说的三个指标的关系可以用Little's Law来表示,因为对用户请求不断发送到服务端进行处理的情况来说,就是一种排队的场景,把Little's Law具体到这种场景那么对应的公式为: 并发数=吞吐量*响应时间 3.3 通过实例感受Little's Law的存在 下面主要从接口服务和mysql服务两个实例来观察Little's Law的存在。 3.3.1 接口服务的实例 3.3.1.1 准备过程介绍 基于springboot暴露一个接口 接口本身会根据参数值休眠一段时间,这样客户端的压测工具就可以控制接口的响应时间了。 @RestController public class ApiLatency { @RequestMapping("/test/latency/{ms}") public String latency(@PathVariable long ms) { try { Thread.sleep(ms); } catch (InterruptedException e) { e.printStackTrace(); } return "Hello World!"; } } 通过jmeter设置不同的并发数对上面的接口进行压测 3.3.1.2 结果展示与分析 初始阶段响应时间基本稳定,吞吐量随着并发数的增加而增加; 随着并发数增加,系统到达“拐点”,吞吐量开始出现下降的趋势,同时响应时间也开始增大;继续增加并发数,系统负载超负荷,从而进入过饱和区,此时响应时间急剧增大,吞吐量急剧下降。在“拐点”之前和刚进入拐点这段区域,此时可以认为系统为“稳定”的,此时并发数、吞吐量、平均响应时间是符合Little's Law公式的。 3.3.2 mysql服务的实例 3.3.2.1 准备过程介绍 准备一个腾讯云mysql服务(5.6版本,配置为2核4G)和一台云服务器(腾讯云内网测试) 用sysbench(0.5版本)对mysql服务进行测试 ## 数据预置 sysbench --mysql-host=192.168.0.10 --mysql-port=3306 --mysql-user=root --mysql-password=test --mysql-db=loadtest --mysql-table-engine=innodb --test=/usr/local/share/sysbench/tests/include/oltp_legacy/oltp.lua --oltp_tables_count=8 --oltp-table-size=4000000 --rand-init=on prepare ## 执行shell脚本进行测试 for i in 5 7 8 10 12 25 50 128 200 400 700 1000 do sysbench --mysql-host=192.168.0.10 --mysql-port=3306 --mysql-user=root --mysql-password=test --mysql-db=loadtest --test=/usr/local/share/sysbench/tests/include/oltp_legacy/oltp.lua --oltp_tables_count=8 --oltp-table-size=4000000 --num-threads=${i} --oltp-read-only=off --rand-type=special --max-time=180 --max-requests=0 --percentile=99 --oltp-point-selects=4 --report-interval=3 --forced-shutdown=1 run | tee -a sysbench.${i}.oltp.txt done ## 清理数据 sysbench --mysql-host=192.168.0.10 --mysql-port=3306 --mysql-user=root --mysql-password=test --mysql-db=loadtest --mysql-table-engine=innodb --test=/usr/local/share/sysbench/tests/include/oltp_legacy/oltp.lua --oltp_tables_count=8 --oltp-table-size=4000000 --rand-init=on cleanup ## 脚本中参数的含义 --oltp_tables_count=8,表示本次用于测试的表数量为8张。 --oltp-table-size=4000000,表示本次测试使用的表行数均为400万行。 --num-threads=n,表示本次测试的客户端连接并发数为n。 --oltp-read-only=off ,off 表示测试关闭只读测试模型,采用读写混合模型。 --rand-type=special,表示随机模型为特定的。 --max-time=180,表示本次测试的执行时间180秒。 --max-requests=0,0 表示不限制总请求数,而是按 max-time 来测试。 --percentile=99,表示设定采样比例,默认是95%,即丢弃1%的长请求,在剩余的99%里取最大值。 --oltp-point-selects=4,表示 oltp 脚本中 sql 测试命令,select 操作次数为4,默认值为1。 3.3.2.2 结果展示与分析 初始阶段响应时间基本稳定,吞吐量随着并发数的增加而增加; 随着并发数增加,系统到达“拐点”,吞吐量开始出现下降的趋势,同时响应时间也开始增大;继续增加并发数,系统负载超负荷,从而进入过饱和区,此时响应时间急剧增大,吞吐量急剧下降。在“拐点”之前和刚进入拐点这段区域,此时可以认为系统为“稳定”的,此时并发数、吞吐量、平均响应时间是符合Little's Law公式的。 4.总结 4.1 Little's Law公式系统“稳定”时成立 基于前述的两个实测的例子,对于并发数、吞吐量、响应时间三者的关系,我们可以用上图表示。 刚开始为“线性增长区”,此时响应时间基本稳定,吞吐量随着并发用户数的增加而增加; 当系统的资源利用率饱和时,系统到达“拐点”,随着并发用户数增加,吞吐量开始出现下降的趋势,同时响应时间也开始增大; 继续增加并发用户数,系统负载超负荷,从而进入过饱和区,此时响应时间急剧增大,吞吐量急剧下降。 在“拐点”之前和刚进入拐点这段区域,此时可以认为系统为“稳定”的,此时并发数、吞吐量、平均响应时间是符合Little's Law公式的。 4.2 并发数并不是实际用户数 比如你这样设置jmeter的线程数为80,测出的结果并不是说你的服务在80个用户使用情况下的性能表现,实际场景中可能1000个真实用户产生的压力也没有这里的80个线程(或者叫虚拟用户数)产生的压力大。我倾向于把并发数理解为一种压力的度量,80的并发对服务的压力肯定是大于60的并发对服务的压力的。 4.3 低延迟(响应时间)不一定高吞吐,高延迟(响应时间)也不一定低吞吐 假如一个程序只有1个线程,这个线程每秒可以处理10次事件,那么我们说这个程序处理单次事件的延迟为100ms,吞吐为10次/秒。 假如一个程序有4个线程,每个线程每秒可以处理5次事件,那么我们说这个程序处理单次事件的延迟为200ms,吞吐为20次/秒。 假如一个程序有1个线程,每个线程每秒可以处理20次事件,那么我们说这个程序处理单次事件的延迟为50ms,吞吐为20次/秒。 由Little's Law我们知道,并发数=吞吐量*响应时间,所以延迟和吞吐的关系是受并发数影响的,抛开并发数去找另外两者的关系是没有规律的。 4.4 响应时间要和吞吐量挂钩 性能如果只看吞吐量,不看响应时间是没有意义的。从前面的分析我们知道,随着并发数的逐渐增加,吞吐量有一个先上升再下降的过程,也就是存在同一个吞吐量的值,在不同并发下,会对应不同的响应时间。比如某接口吞吐量为10000TPS,响应时间达到5秒,那这个10000TPS也没什么意义了。 4.5 响应时间、吞吐量和成功率要挂钩 比如在接口测试中,当并发数达到4000时,错误率达到了40%,那么此时的1270.8TPS就没什么意义了。 4.6 又多又快又好 我理解的服务的性能就是又多又快又好的处理请求,“多”就是吞吐量大,“快”就是响应时间短,“好”就是错误率尽量低。 4.7 last but not least 在Little's Law中我们一直用的响应时间是“平均响应时间”,而实际工作中我们通常用响应时间的“分位值”来作为响应时间的统计值来衡量性能的,平均值只是作为一个辅助参考。原因你应该懂得,比如“平均工资”通常没多大参考价值,有可能很多人是被平均的。 5.扩展 Eric Man Wong 于2004年发表的《Method for Estimating the Number of Concurrent Users》论文中介绍了一种对系统并发用户数估算的公式: 这个公式和Little's Law是等价的,具体论述过程参考Eric's并发用户数估算与Little定律的等价性 6.参考 性能调优攻略 性能测试应该怎么做? 知己知彼–对Aurora进行压力测试 Amazon Aurora Sysbench benchmark 腾讯云_高可用版性能测试报告 如何监控Tomcat的性能? Eric's并发用户数估算与Little定律的等价性

优秀的个人博客,低调大师

每日一博 | Scala implicit 隐式转换安全驾驶指南

这篇短文将结合实例对隐式转换的各种场景进行解释和总结,希望看完的人能够安全驶过隐式转换这个大坑。 隐式转换函数 隐式转换函数有两种作用场景。 1 转换为期望类型:就是指一旦编译器看到X,但需要Y,就会检查从X到Y的隐式转换函数。 2 转换方法的调用者:简单来说,如obj.f(),如果obj对象没有f方法,则尝试将obj转换为拥有f方法的类型。 object ImpFunction extends App { class Dog(val name: String) { def bark(): Unit = println(s"$name say: Wang !") } implicit def double2int(d: Double): Int = d.toInt implicit def string2Dog(s: String): Dog = new Dog(s) val f: Int = 1.1 //转换为期望类型,1.1通过double2int转成了Int类型 println(f) "Teddy".bark() // 转换方法的调用者,字符串通过string2Dog转成了Dog, 于是有了bark方法 } // output // 1 // Teddy say: Wang ! val f: Int = 1.1 因为类型不匹配,这段本来是无法通过编译的,但是编译器发现存在一个Double至Int的隐式转换函数,所以进行了隐式转换。 "Teddy".bark() String类型本来是没有bark方法的,但是编译器发现了隐式转换string2Dog可以使得String转成一种拥有bark方法的类型,相当于进行了这样的转换:string2Dog("Teddy").bark()。 注意事项 需要注意的是,编译器只关心隐式转换函数的输入输出类型,不关心函数名,为避免歧义,同一个作用域中不能有输入输出类型相同的两个隐式转换函数,不然编译器会报错。 隐式类 Scala 2.10引入了一种叫做隐式类的新特性。隐式类指的是用implicit关键字修饰的类。使用情况与隐式转换函数类似,可以看做将类的构造函数定义为隐式转换函数,返回类型就是这个类。 package io.github.liam8.impl object ImpClass extends App { implicit class Dog(val name: String) { def bark(): Unit = println(s"$name say: Wang !") } "Teddy".bark() } 注意事项 这段来自官网IMPLICIT CLASSES 隐式类有以下限制条件: 1 只能在别的trait/类/对象内部定义。 object Helpers { implicit class RichInt(x: Int) // 正确! } implicit class RichDouble(x: Double) // 错误! 2 构造函数只能携带一个非隐式参数。 implicit class RichDate(date: java.util.Date) // 正确! implicit class Indexer[T](collecton: Seq[T], index: Int) // 错误! implicit class Indexer[T](collecton: Seq[T])(implicit index: Index) // 正确! 虽然我们可以创建带有多个非隐式参数的隐式类,但这些类无法用于隐式转换。 3 在同一作用域内,不能有任何方法、成员或对象与隐式类同名。 注意:这意味着隐式类不能是case class。 object Bar implicit class Bar(x: Int) // 错误! val x = 5 implicit class x(y: Int) // 错误! implicit case class Baz(x: Int) // 错误! 隐式参数 & 隐式值 package io.github.liam8.impl object ImpParam extends App { def bark(implicit name: String): Unit = println(s"$name say: Wang !") implicit val t: String = "Hot Dog" bark } 参数加上implicit就成了隐式参数,需要与隐式值(变量定义加上implicit)搭配使用,最后一行的bark缺少了一个String类型的参数,编译器找到了String类型的隐式值,便将其传入,相当于执行了bark(t)。 implicit关键字会作用于函数列表中的的所有参数,如def test(implicitx:Int, y: Double)这样定义函数,x和y就都成了隐式函数。但是通常我们只希望部分参数为隐式参数,就好比通常会给部分参数提供默认值而不是全部都指定默认值,于是隐式参数常常与柯里化函数一起使用,这样可以使得只有最后一个参数为隐式参数,例如def test(x: Int)(implicit y: Double)。 👇是完整的例子。 object ImpParamWithCurry extends App { def bark(name: String)(implicit word: String): Unit = println(s"$name say: $word !") implicit val w: String = "Wang" bark("Hot Dog") } 注意事项 下面这段来自scala的隐式转换学习总结(详细) 1)当函数没有柯里化时,implicit关键字会作用于函数列表中的的所有参数。 2)隐式参数使用时要么全部不指定,要么全不指定,不能只指定部分。 3)同类型的隐式值只能在作用域内出现一次,即不能在同一个作用域中定义多个相同类型的隐式值。 4)在指定隐式参数时,implicit 关键字只能出现在参数开头。 5)如果想要实现参数的部分隐式参数,只能使用函数的柯里化, 如要实现这种形式的函数,def test(x:Int, implicit y: Double)的形式,必须使用柯里化实现:def test(x: Int)(implicit y: Double). 6)柯里化的函数, implicit 关键字只能作用于最后一个参数。否则,不合法。 7)implicit 关键字在隐式参数中只能出现一次,柯里化的函数也不例外! 隐式对象 类似于隐式值, 要结合隐式参数使用。先看一个栗子(下面的代码需要认真体会)。 package io.github.liam8.impl object ImpObject extends App { //定义一个`排序器`接口,能够比较两个相同类型的值的大小 trait Ordering[T] { //如果x<y返回-1,x>y返回1,x==y则返回0. def compare(x: T, y: T): Int } //实现一个Int类型的排序器 implicit object IntOrdering extends Ordering[Int] { override def compare(x: Int, y: Int): Int = { if (x < y) -1 else if (x == y) 0 else 1 } } //实现一个String类型的排序器 implicit object StringOrdering extends Ordering[String] { override def compare(x: String, y: String): Int = x.compareTo(y) } //一个通用的max函数 def max[T](x: T, y: T)(implicit ord: Ordering[T]): T = { if (ord.compare(x, y) >= 0) x else y } println(max(1, 2)) println(max("a", "b")) } //output: // 2 // b max函数的作用显然是返回x和y中的最大值,但是x和y的值类型不是固定的,max不知道如何比较x和y的大型,于是定义了一个隐式参数implicit ord: Ordering[T],希望能传入一个Ordering[T]类型的排序器帮助进行x和y的比较。 在调用max(1, 2)的时候,编译器发现需要一个Ordering[Int]类型的参数,刚好implicit object IntOrdering定义了一个隐式对象符合要求,于是被用来传入max函数。 隐式对象跟上面的隐式值非常相似,只是类型特殊而已。 在Scala中scala.math.Ordering很常用的内置特质,如果你理解了这段代码,也就大致理解了Ordering的原理。 上下文界定(context bounds) 这是一种隐式参数的语法糖。 再看上面隐式对象的例子,如果要添加一个min函数,大致就是这样 def min[T](x: T, y: T)(implicit ord: Ordering[T]): T = { if (ord.compare(x, y) >= 0) y else x } 但是max和min函数的参数都比较长,于是出现了一种简化的写法 def min[T: Ordering](x: T, y: T): T = { val ord = implicitly[Ordering[T]] if (ord.compare(x, y) >= 0) y else x } [T: Ordering]这种语法就叫上下文界定,含义是上下文中必须有一个Ordering[T]类型的隐式值,这个值会被传入min函数。但是由于这个隐式值并没有明确赋值给某个变量,没法直接使用它,所以需要一个implicitly函数把隐式值取出来。 implicitly函数的定义非常简单,作用就是将T类型的隐含值返回: @inline def implicitly[T](implicit e: T) = e 视界 这个语法已经被废弃了,但是你还是可能会看到,简单解释下。 def min[T <% Ordered[T]](x: T, y: T): T = { if (x > y) y else x } 视界的定义T <% Ordered[T]的含义是T可以被隐式转换成Ordered[T],这也是为什么x > y可以编译通过。 上面的写法其实等同于下面这样,所以视界的语法不能用了也不要紧。 def min[T](x: T, y: T)(implicit c: T => Ordered[T]): T = { if (x > y) y else x } 隐式转换机制 隐式转换通用规则 标记规则:只有标记为implicit的定义才是可用的。 作用域规则:插入的隐式转换必须以单一标识符的形式处于作用域中,或与转换的源或目标类型关联在一起。 单一标识符意思是不能插入形式为someVariable.convert(x)的转换,只能是convert(x)。 单一标识符规则有个例外,编译器还将在源类型或转换的期望目标类型的伴生对象中寻找隐式定义。 有点难理解?看个例子! package io.github.liam8.impl object ImpCompObject extends App { object Dog { implicit def dogToCat(d: Dog) = new Cat(d.name) } class Cat(val name: String) { def miao(): Unit = println(s"$name say: Miao !") } class Dog(val name: String) { def bark(): Unit = println(s"$name say: Wang !") } new Dog("Teddy").miao() } //Teddy say: Miao ! 当前作用域中没有定义和引入隐式函数,但是在Dog的伴生对象中找到了,所以Dog可以被转成Cat,这个跟上下文没有关系,而是Dog自带技能。 无歧义规则:隐式转换唯有不存在其他转换的前提下有效。 单一调用规则:只会尝试一个隐式操作。 显示操作先行规则:若编写的代码类型检查无误,则不会尝试隐式操作。 转换时机 当类型与目标类型不一致时 当对象调用类中不存在的方法或成员时 缺少隐式参数时 也即是能用到隐式操作的有三个地方:转换为期望类型、指定(方法)调用者的转换、隐式参数。 转换机制 这段来自深入理解Scala的隐式转换 即编译器是如何查找到缺失信息的,解析具有以下两种规则: 1.首先会在当前代码作用域下查找隐式实体(隐式方法 隐式类 隐式对象) 2.如果第一条规则查找隐式实体失败,会继续在隐式参数的类型的作用域里查找 类型的作用域是指与该类型相关联的全部伴生模块,一个隐式实体的类型T它的查找范围如下: 1 如果T被定义为T with A with B with C,那么A,B,C都是T的部分,在T的隐式解析过程中,它们的伴生对象都会被搜索 2 如果T是参数化类型,那么类型参数和与类型参数相关联的部分都算作T的部分,比如List[String]的隐式搜索会搜索List的伴生对象和String的伴生对象 3 如果T是一个单例类型p.T,即T是属于某个p对象内,那么这个p对象也会被搜索 4 如果T是个类型注入S#T,那么S和T都会被搜索 上路前的话 这段话来自《Scala编程》 隐式操作若过于频繁使用,会让代码变得晦涩难懂。因此,在考虑添加新的隐式转换之前,请首先自问是否能够通过其他手段,诸如继承、混入组合或方法重载,达到同样的目的。如果所有这些都不能成功,并且你感觉代码仍有一些繁复和冗余,那么隐式操作或许正好能帮到你。 所以。。。谨慎使用,小心翻车,good luck! 参考文献 IMPLICIT CLASSES scala的隐式转换学习总结(详细) 《Scala编程》 深入理解Scala的隐式转换 本文代码 Github仓库 转载请注明原文地址:https://liam-blog.ml/2019/09/28/scala-implicit/

优秀的个人博客,低调大师

每日一博 | ES2019 中的 JavaScript 新特性

JavaScript 从成立之初就已经走了很长一段路,提供了许多新的功能,这些功能是专门设计来使该语言更加人性化和提升效率。以下是我最近发现的一些有趣的JavaScript 新增内容。其中一些功能已在 Node,Chrome,Firefox 和 Safari 中可用,而其他功能仍处于建议阶段。 Optional chaining (可选链) Optional chaining 可选链使用?.操作符来表示,Optional Chaining 使我们能检查一个对象上面是否存在某属性。其它一些语言有类似的特性。例如 C# 有 Null Conditional 操作符。而 JavaScript 的 Optional chaining 在需要深度访问嵌套对象属性时就特别有用。 当我们在访问对象的属性前,我们需要用?.操作符来确定该属性是否存在。 首先看看下面代码: const users = [ { name: "Olagunju Gbolahan", occupation: "Software Developer", sayName(){ console.log(`my name is ${this.name}`); }, address: { office: "New York" } }, { name: "Olawaseyi Moses" }, { name: "Tunde Ednut" } ]; 在该数组对象中,第二个对象是 secondUser: const secondUser = users[1]; 我们需要知道该用户的办公室地址,在没有 Optional chaining 之前,我们需要使用一种很低效的方式来验证该属性是否已存在: const theAddress = secondUser.address && secondUser.address.office; console.log(theAddress); // undefined 如果我们是一个深度嵌套的对象,那就必须通过 && 操作符来判断每一层的对象是否有效: 但是有了 optional chaining ,代码便可简化如下: const theAddress = secondUser?.address?.office; console.log(theAddress); // undefined 我们还可以使用 optional chaining 来确认对象的某个方法是否存在: const firstUser = users[0]; console.log(firstUser.sayName?.()); // 我的名字是 Olagunju Gbolahan 如果方法名不存在的话,它会简单的返回undefined: console.log(firstUser.sayOccupation?.()); // undefined 目前该特性尚未添加到 JavaScript 规范中,目前还处于草案建议阶段。 你可以通过babel-plugin-proposal-optional-chaining这个插件来实现相同功能。 你也可以阅读 《Optional Chaining 特性进入 Stage 3,TypeScript 跟进》 这篇文章来了解更多关于该特性的进展。 Optional catch binding (可选的错误捕获绑定) 当我们事先知道错误将是什么,并且我们不希望冗余未使用的变量时,此功能将派上用场。 首先看看常规的 try 和 catch 的代码块: try { const parsedJsonData = JSON.parse(obj); } catch (error) { //obj 变量在使用时没有进行定义 console.log(obj); } 而通过错误捕获绑定,我们无需提供未使用的变量,特别是当我们已经为 try 块提供默认处理的情况下: function getName () { let name = "Gbolahan Olagunju"; try { name = obj.details.name } catch {} console.log(name); } 管道操作符 这是对 JavaScript 的拟议补充之一,目前处于第1阶段。本质上,它有助于使对同一参数的多个函数调用可读。 它通过将表达式的值作为参数传递给函数来实现。 在没有管道运算符的情况下调用以下函数|>。 const capitalize = (input) => input[0].toUpperCase() + input.substring(1); const removeSpaces = (input) => input.trim(); const repeat = (input) => `${input}, ${input}`; const withoutpipe = repeat(capitalize(removeSpaces(' i am gbols '))); console.log(withoutpipe); // I am gbols, I am gbols 而通过管道操作符,可读性大幅提升: const withpipe = ' i am gbols ' |> removeSpaces |> capitalize |> repeat; console.log(withpipe); // // I am gbols, I am gbols String.trimStart 和 String.trimEnd 这两个方法在之前被命名为trimRight 和 trimLeft,但在 ES2019 中将名字修改为trimStart 和 trimEnd ,表述更加直观: 示例代码: let message = " Welcome to LogRocket "; message.trimStart(); // "Welcome to LogRocket " message.trimEnd(); // "Welcome to LogRocket"; Object.fromEntries 在聊 Object.fromEntries 之前,有必要先看看 Object.entries. Object.entries 是在 ES2017 规范中引入的,用于将对象转成数组,并可通过数组相关的函数进行访问。 示例代码: const devs = { gbols: 5, andrew: 3, kelani: 10, dafe: 8, }; const arrOfDevs = Object.entries(devs); console.log(arrOfDevs); //[ // ["gbols", 5] // ["andrew", 3] // ["kelani", 10] // ["dafe", 8] //] 然后我们可以使用filter方法来获取数组中超过 5 年经验的对象: const expDevs = arrOfDevs.filter(([name, yrsOfExp]) => yrsOfExp > 5); console.log(expDevs); //[ // ["kelani", 10] // ["dafe", 8] //] 那么就会有一个新的问题:没有一个简单的方法将最新的数组重新变成对象。通常我们需要自己编写代码将数组变成对象: const expDevsObj = {}; for (let [name, yrsOfExp] of expDevs) { expDevsObj[name] = yrsOfExp; } console.log(expDevsObj); //{ //dafe: 8 //kelani: 10 //} 但是现在通过 Object.fromEntries 就可以把这个过程极大简化: console.log(Object.fromEntries(expDevs)); //{ //dafe: 8 //kelani: 10 //} Flat 很多使用我们需要处理深度嵌套的数组,这个时候将数组展平就特别重要。 先看看如下代码: const developers = [ { name: 'Gbolahan Olagunju', yrsOfExp: 6, stacks: ['Javascript', 'NodeJs', ['ReactJs', ['ExpressJs', 'PostgresSql']]] }, { name: 'Daniel Show', yrsOfExp: 2, stacks: ['Ruby', 'Jest', ['Rails', ['JQuery', 'MySql']]] }, { name: 'Edafe Emunotor', yrsOfExp: 9, stacks: ['PHP', 'Lumen', ['Angular', 'NgRx']] } ]; const allStacks = developers.map(({stacks}) => stacks); console.log(allStacks); // [ // ['Javascript', 'NodeJs', ['ReactJs', ['ExpressJs', 'PostgresSql']]] // ['Ruby', 'Jest', ['Rails', ['JQuery', 'MySql']]] // ['PHP', 'Lumen', ['Angular', 'NgRx']] // ] allstacks变量包含深度嵌套的数组,为了将该数组展平,我们可以使用 Array.prototype.flat 方法。 示例代码: const flatSingle = allStacks.flat(); console.log(flatSingle); //[ // "JavaScript", // "NodeJs", // ['ReactJs', ['ExpressJs', 'PostgresSql']]] // "Ruby", // "Jest", // ['Rails', ['JQuery', 'MySql']]] // "PHP", // "Lumen" // ["Angular", "NgRx"] //] 从上面代码可以推断出数组被展平了一层深,这是 array.prototype.flat 的默认参数。 我们可以向flat方法传递一个参数,以确定要展平的程度。 defaults 参数的值为1。为了完全展平数组,我们可以传递一个无穷大的参数。参数 infinity 使数组完全变平,与数组的深度无关。 示例代码: const completelyFlat = allStacks.flat(Infinity); console.log(completelyFlat); //[ // "JavaScript", // "NodeJs", // "ReactJs", // "ExpressJs", // "PostgresSql", // "Ruby", // "Jest", // "Rails", // "JQuery", // "MySql", // "PHP", // "Lumen", // "Angular", // "NgRx" //] FlatMap FlatMap 相当于将 map 方法和 flat 方法合并起来,并默认使用深度为 1 的新方法。相当于是以更简洁的代码实现两种逻辑的组合。 下面是一个简单使用 map 和 flatMap 的代码: let arr = ['my name is Gbols', ' ', 'and i am great developer']; console.log(arr.map(word => word.split(' '))); //[ // ["my", "name", "is", "Gbols"], // ["", ""], // ["and", "i", "am", "great", "developer"] //] console.log(arr.flatMap(word => word.split(' '))); //[ "my" // "name" // "is" // "Gbols" // "" // "" // "and" // "i" // "am" // "great" // "developer" //] 总结 在这篇文字中,我们详细介绍了一些 JavaScript 最新添加的新特性,这些新的特性通过减少冗长的代码以及提升代码的可读性来增强了开发者的体验。不过还有很多新的特性在本文中没有涉及,欢迎大家补充和分享。 本文翻译自https://blog.logrocket.com/new-es2019-javascript-features-every-developer-should-be-excited-about/ 欢迎关注我的个人公众号 —— 红薯胡说

优秀的个人博客,低调大师

每日一博 | 全方位详解 Service Mesh(服务网格)

Service mesh是近几年才出现的一个新兴概念。它可以解决微服务之间通信愈发复杂的问题。那么什么是Service mesh?它有什么具体的功能?它的架构又是如何的呢?它与Kubernetes的关系是怎样的?所有答案戳文了解! 在数字化转型的旗帜下,IT界的一大变化是大型单体应用程序被分解为微服务架构,即小型、离散的功能单元,并且这些应用程序在容器中运行。包含所有服务代码以及依赖项的软件包被隔离起来,并且能轻松从一个服务器迁移到另一个。 像这样的容器化架构很容易在云中扩展和运行,并且能够快速迭代和推出每个微服务。然而,当应用程序越来越大并且在同一个服务上同时运行多个实例时,微服务之间通信将会变得愈发复杂。Service mesh的出现将解决这一问题,它是一个新兴的架构形式,旨在以减少管理和编程开销的形式来连接这些微服务。 什么是Service mesh? 关于Service mesh的定义,最为广泛接受的观点是:它是一种控制应用程序不同部分彼此共享数据的方式。这一描述包含了service mesh的方方面面。事实上,它听起来更像是大多数开发人员从客户端-服务器应用程序中熟悉的中间件。 Service mesh也有其独特之处:它能够适应分布式微服务环境的独特性质。在搭建在微服务中的大规模应用程序中,有许多既定的服务实例,它们跨本地和云服务器运行。所有这些移动部件显然使得各个微服务难以找到他们需要与之通信的其他服务。Service mesh可以在短时间内自动处理发现和连接服务,而无需开发人员以及各个微服务自行匹配。 我们可以将service mesh等同为软件定义网络(SDN)的OSI网络模型第7层。正如SDN创建一个抽象层后网络管理员不必处理物理网络连接,service mesh将解耦在抽象架构中的与你交互的应用程序的底层基础架构。 随着开发人员开始努力解决真正庞大的分布式架构的问题,service mesh的概念适时地出现了。这一领域的第一个项目是Linkerd,它一开始是Twitter内部项目的一个分支。Istio是另一个十分流行的service mesh项目,它起源于Lyft,现在这一项目获得了许多企业的支持。 Service mesh负载均衡 Service mesh其中一个关键功能是负载均衡。我们常常将负载均衡视为网络功能——你想要防止服务器或网络链接被流量淹没,因此相应地你会路由你的数据包,而Service mesh在应用程序层面也在执行类似的事情。 本质上,Service mesh的工作之一是跟踪分布在基础设施上的各种微服务的哪些实例是“最健康的”。它可能对他们进行调查来查看它们如何工作的或跟踪哪些实例对服务请求响应缓慢并将后续请求发送到其他实例。此外,service mesh也会为网络路由做类似的工作,如果发现当消息需要很长时间才能送达,那么service mesh将会采用其他路由进行补偿。这些减速可能是由于底层硬件出现问题,或者仅仅是由于服务因请求过载或处理能力不足导致的。但没有关系,service mesh会找到另一个相同服务的实例,然后将其路由以替代响应缓慢的实例,高效利用了整个应用程序的资源。 Service mesh vs Kubernetes 如果你稍微熟悉基于容器的架构,你可能会想Kubernetes这个流行的开源容器编排平台能否适合这种情况。毕竟,Kubernetes不就是管理着你的容器之间如何互相通信的吗?你可将Kubernetes“服务”资源视为非常基础的service mesh,因为它提供服务发现和请求的轮询调度均衡。但是完整的service mesh则提供更丰富的功能,如管理安全策略和加密、“断路”以暂停对缓慢响应的实例的请求以及如上所述的负载均衡等。 请记住,大多数service mesh确实需要像Kubernetes这样的编排系统。Service mesh只是提供扩展功能,而非替代编排平台。 Service mesh vs API 网关 每个微服务都会提供一个API,它会作为其他服务与其通信的手段。这引发了service mesh与其他更传统的API管理形式(如API网关)之间的差异问题。API网关位于一组微服务和“外部”世界之间,它根据需要路由服务请求,以便请求者不需要知道它正在处理基于微服务的应用程序即可完成请求。而service mesh调解微服务应用程序内部的请求,各种组件完全了解其环境。 另一方面,service mesh用于优化集群内东西流量(server-server流量),API网关用于进出集群的南北流量(server-client流量)。但service mesh目前依旧处于早期阶段还在不断发展变化中。许多service mesh(包括Linkerd和Istio)现在已经可以提供南北功能。 Service mesh 架构 Service mesh这一概念其实出现的时间并不长,并且已经有相当数量的不同的方法来解决“service mesh”的问题,如管理微服务通信。目前,确定了三种service mesh创建的通信层可能存在的位置: 每个微服务导入的library 在特定节点提供服务给所有容器的节点agent 与应用程序容器一起运行的sidecar容器 基于sidecar的模式目前是service mesh最受欢迎的模式之一,以至于它在某种程度上已经成为了service mesh的代名词。尽管这种说法并不严谨,但是sidecar已经引起了很大的关注,我们将在下文更详细地研究这一架构。 Sidecar Sidecar容器与你的应用程序容器一起运行意味着什么呢?在这类service mesh中每个微服务容器都有另一个proxy容器与之相对应。所有的服务间通信的需求都会被抽象出微服务之外并且放入sidecar。 这似乎很复杂,毕竟你有效地将应用程序中的容器数量增加了1倍。但你使用的这一种设计模式对于简化分布式应用程序至关重要。通过将所有的网络和通信代码放到单独的容器中,将其作为基础架构的一部分,并使开发人员无需将其作为应用程序的一部分实现。 本质上,你所留下的是一个聚焦于业务逻辑的微服务。这个微服务不需要知道如何在其运行的环境中与所有其他服务进行通信。它只需要知道如何与sidecar进行通信即可,剩下的将由sidecar完成。 Service mesh明星项目:Linkerd、Envio、Istio、Consul 那么说了这么多,什么是可用的service mesh呢?目前,这一领域还没有出现完全现成的商业产品。大部分的service mesh只是开源项目,需要通过一定的操作步骤才能实现,现在比较知名的项目有: Linkerd:2016年发布,是这些项目中最老的。Linkerd是从Twitter开发的library中分离出来的。在这一领域另一位重量型选手,Conduit,已经进入了Linkerd项目并构成了Linkerd 2.0的基础。 Envoy:由Lyft创建,为了能够提供完整的service mesh功能,Envoy占据“数据平面”的部分,与其进行匹配。 Istio:由Lyft、IBM与google联合开发,Istio可以在不修改微服务源代码的情况下,轻松为其加上如负载均衡、身份验证等功能,它可以通过控制Envoy等代理服务来控制所有的流量。此外,Istio提供容错、金丝雀部署、A/B测试、监控等功能,并且支持自定义的组件和集成。 Rancher 2.3 Preview2版本上开始支持Istio,用户可以直接在UI界面中启动Istio并且可以为每个命名空间注入自动sidecar。Rancher内置了一个支持Kiali的仪表盘,简化Istio的安装和配置。这一切让部署和管理Istio变得简单而快速。 HashiCorp Consul:与Consul 1.2一起推出了一项名为Connect的功能,为HashiCorp的分布式系统添加了服务加密和基于身份的授权,可用于服务发现和配置。 哪个service mesh适合你?如果要进行一个全面的比较的话,超出了本文所涉及的范围。但上述的所有产品都已经在大型且严苛的环境中得到验证。目前,Linkerd和Istio包含最丰富的功能集,但一切都还在迅速发展中,现在下定论还为时过早。

优秀的个人博客,低调大师

每日一博 | Python 内存分配时的小秘密

Python 中的sys 模块极为基础而重要,它主要提供了一些给解释器使用(或由它维护)的变量,以及一些与解释器强交互的函数。 本文将会频繁地使用该模块的getsizeof() 方法,因此,我先简要介绍一下: 该方法用于获取一个对象的字节大小(bytes) 它只计算直接占用的内存,而不计算对象内所引用对象的内存 这里有个直观的例子: importsys a=[1,2] b=[a,a]#即[[1,2],[1,2]] #a、b都只有两个元素,所以直接占用的大小相等 sys.getsizeof(a)#结果:80 sys.getsizeof(b)#结果:80 上例说明了一件事:一个静态创建的列表,如果只包含两个元素,那它自身占用的内存就是 80 字节,不管其元素所指向的对象是什么。 好了,拥有这把测量工具,我们就来探究一下 Python 的内置对象都藏了哪些小秘密吧。 1、空对象不是“空”的! 对于我们熟知的一些空对象,例如空字符串、空列表、空字典等等,不知道大家是否曾好奇过,是否曾思考过这些问题:空的对象是不是不占用内存呢?如果占内存,那占用多少呢?为什么是这样分配的呢? 直接上代码吧,一起来看看几类基本数据结构的空对象的大小: importsys sys.getsizeof("")#49 sys.getsizeof([])#64 sys.getsizeof(())#48 sys.getsizeof(set())#224 sys.getsizeof(dict())#240 #作为参照: sys.getsizeof(1)#28 sys.getsizeof(True)#28 可见,虽然都是空对象,但是这些对象在内存分配上并不为“空”,而且分配得还挺大(记住这几个数字哦,后面会考)。 排一下序:基础数字<空元组 < 空字符串 < 空列表 < 空集合 < 空字典。 这个小秘密该怎么解释呢? 因为这些空对象都是容器,我们可以抽象地理解:它们的一部分内存用于创建容器的骨架、记录容器的信息(如引用计数、使用量信息等等)、还有一部分内存则是预分配的。 2、内存扩充不是均匀的! 空对象并不为空,一部分原因是 Python 解释器为它们预分配了一些初始空间。在不超出初始内存的情况下,每次新增元素,就使用已有内存,因而避免了再去申请新的内存。 那么,如果初始内存被分配完之后,新的内存是怎么分配的呢? importsys letters="abcdefghijklmnopqrstuvwxyz" a=[] foriinletters: a.append(i) print(f'{len(a)},sys.getsizeof(a)={sys.getsizeof(a)}') b=set() forjinletters: b.add(j) print(f'{len(b)},sys.getsizeof(b)={sys.getsizeof(b)}') c=dict() forkinletters: c[k]=k print(f'{len(c)},sys.getsizeof(c)={sys.getsizeof(c)}') 分别给三类可变对象添加 26 个元素,看看结果如何: 由此能看出可变对象在扩充时的秘密: 超额分配机制: 申请新内存时并不是按需分配的,而是多分配一些,因此当再添加少量元素时,不需要马上去申请新内存 非均匀分配机制: 三类对象申请新内存的频率是不同的,而同一类对象每次超额分配的内存并不是均匀的,而是逐渐扩大的 3、列表不等于列表! 以上的可变对象在扩充时,有相似的分配机制,在动态扩容时可明显看出效果。 那么,静态创建的对象是否也有这样的分配机制呢?它跟动态扩容比,是否有所区别呢? 先看看集合与字典: #静态创建对象 set_1={1,2,3,4} set_2={1,2,3,4,5} dict_1={'a':1,'b':2,'c':3,'d':4,'e':5} dict_2={'a':1,'b':2,'c':3,'d':4,'e':5,'f':6} sys.getsizeof(set_1)#224 sys.getsizeof(set_2)#736 sys.getsizeof(dict_1)#240 sys.getsizeof(dict_2)#368 看到这个结果,再对比上一节的截图,可以看出:在元素个数相等时,静态创建的集合/字典所占的内存跟动态扩容时完全一样。 这个结论是否适用于列表对象呢?一起看看: list_1=['a','b'] list_2=['a','b','c'] list_3=['a','b','c','d'] list_4=['a','b','c','d','e'] sys.getsizeof(list_1)#80 sys.getsizeof(list_2)#88 sys.getsizeof(list_3)#96 sys.getsizeof(list_4)#104 上一节的截图显示,列表在前 4 个元素时都占 96 字节,在 5 个元素时占 128 字节,与这里明显矛盾。 所以,这个秘密昭然若揭:在元素个数相等时,静态创建的列表所占的内存有可能小于动态扩容时的内存! 也就是说,这两种列表看似相同,实际却不同!列表不等于列表! 4、消减元素并不会释放内存! 前面提到了,扩充可变对象时,可能会申请新的内存。 那么,如果反过来缩减可变对象,减掉一些元素后,新申请的内存是否会自动回收掉呢? importsys a=[1,2,3,4] sys.getsizeof(a)#初始值:96 a.append(5)#扩充后:[1,2,3,4,5] sys.getsizeof(a)#扩充后:128 a.pop()#缩减后:[1,2,3,4] sys.getsizeof(a)#缩减后:128 如代码所示,列表在一扩一缩后,虽然回到了原样,但是所占用的内存空间可没有自动释放啊。其它的可变对象同理。 这就是 Python 的小秘密了,“胖子无法减重原理” :瘦子变胖容易,缩减身型也容易,但是体重减不掉,哈哈~~~ 5、空字典不等于空字典! 使用 pop() 方法,只会缩减可变对象中的元素,但并不会释放已申请的内存空间。 还有个 clear() 方法,它会清空可变对象的所有元素,让我们试试看吧: importsys a=[1,2,3] b={1,2,3} c={'a':1,'b':2,'c':3} sys.getsizeof(a)#88 sys.getsizeof(b)#224 sys.getsizeof(c)#240 a.clear()#清空后:[] b.clear()#清空后:set() c.clear()#清空后:{},也即dict() 调用 clear() 方法,我们就获得了几个空对象。 在第一小节里,它们的内存大小已经被查验过了。(前面说过会考的,请默写 回看下) 但是,如果这时再去查验的话,你会惊讶地发现,这些空对象的大小跟前面查的并不完全一样! #承接前面的清空操作: sys.getsizeof(a)#64 sys.getsizeof(b)#224 sys.getsizeof(c)#72 空列表与空元组的大小不变,然而空字典(72)竟然比前面的空字典(240)要小很多! 也就是说,列表与元组在清空元素后,回到起点不变初心,然而,字典这家伙却是“赔了夫人又折兵”,不仅把“吃”进去的全吐出来了,还把自己的老本给亏掉了! 字典的这个秘密藏得挺深的,说实话我也是刚刚获知,百思不得其解…… 以上就是 Python 在分配内存时的几个小秘密啦,看完之后,你是否觉得涨见识了呢? 你想明白了几个呢,又产生了多少新的谜团呢?欢迎留言一起交流哦~ 对于那些没有充分解释的小秘密,今后我们再慢慢揭秘…… 作者简介: 豌豆花下猫,生于广东毕业于武大,现为苏漂程序员,有一些极客思维,也有一些人文情怀,有一些温度,还有一些态度。公众号:「Python猫」(python_cat)

优秀的个人博客,低调大师

每日一博 | 测试人员如何深入到项目实现中去?

(“马蜂窝技术”公众号原创内容,ID: mfwtech) 一个项目从需求确定到最后上线,通常来说流程是这样的: 「测试」作为一个项目质量保证角色,在上面的整个流程中均有参与。而用例设计、项目测试环节更像测试的主场,PRD 的评审测试人员也会发表很多自己的观点,对项目的技术评审虽然测试人员也有参与,但也不如前两个环节的参与程度深。 其实,一个优秀的测试人员应该深入到项目的每一个环节中去发现问题,提出自己的观点,保证项目质量。那么要真正深入到项目实现中,测试应该怎么做呢? 一、Review 接口定义结构 接口定义文档在测试过程是测试人员接触比较多的设计文档,尤其是与最外层面向用户的接口设计相关的部分。在参加接口文档评审、编写接口用例这些场景下,测试人员都会仔细阅读接口设计文档。 通过接口文档,可以帮助测试人员清晰了解到前端与后断是怎么交互的,每个页面哪些操作与后端存在交互,不同的接口之间是否存在关联,清楚这些可以帮助测试人员在测试过程中对出现的问题进行精准判断,确定导致问题出现的范围。 在阅读接口文档可以关注以下几个方面: 接口中定义字段是否考虑了扩展性; 字段是否必须有明确的说明;如果是代码实现需要清晰定义 NotNull/NotBlank; 字段含义是否存在歧义,字段的含义要有明确的解释; 接口是否覆盖到了所有业务场景; 返回值结构、内容是否正确;通常返回值都有固定格式规范,返回值结构要规范统一,并且接口请求失败有明确的失败原因; 字段类型是否正确; 入参风格统一;比如日期格式如果是 yyyy-mm-dd 格式,每个接口最好都统一。 除了上面提到这些,在接口文档还要关注数据库表结构,确保表结构能满足接口需求;接口返回数据量要控制在一个合理的范围,返回数据量太大会有传输压力从而产生性能问题;接口之间要注意低耦 二、关注架构设计方案 对于测试工程师来说学习项目架构或者说系统架构是一个不小挑战,因为基本上所有的架构知识、开发框架都是基于开发人员进行设计的,而这些内容对于开发人员也是一个不小的挑战。 那测试人员为什么还要去了解学习?有测试同行曾经开玩笑说「了解项目的架构设计是为了在开会的时候听懂开发在说什么」。虽然是一句玩笑话,但也说明测试人员需要了解这方面的内容重要性。了解项目的架构设计可以在以下几方帮助到测试人员: 1.培养测试人员的架构思维 因为测试环节不应该仅仅发生在提测后,在前期项目设计阶段也同样需要进行测试,只有通过对业务代码、架构设计、用到的技术有了解,才能够在设计阶段发现缺陷。 2. 帮助测试更全面、更有针对性地进行 比如性能测试,如果不清楚整个系统的架构,没办法对压测结果进行分析,甚至设计的压测方案可能都是存在问题的。还有就是在压测时候尤其互联网的系统架构压测时经常需要「预热」,需要预热的原因我们清楚吗?因为服务端会对数据进行缓冲。 比如在项目架构迁移时如何做到不漏测,拿火车票电子票从 PHP 迁移到 Java 的乘车人模块为例,迁移前和迁移后访问乘车人模块流程如下图所示。 1)迁移前电子票和抢票访问乘车人模块方式: 2)迁移后如下(黄色部分是这次迁移改动部分) 从流程图中可以看出,乘车人模块是抢票和电子票两个业务的公共模块,而此次迁移只有电子票的 App 调用 Java 接口访问乘车人,其他还是调用旧接口,所以乘车人模块重构后要保证电子票和抢票的两个端(App 和小程序)不管从旧接口还是从新接口访问功能都正常,就要弄清楚电子票和抢票这个两个业务哪部分做了迁移,哪部分没有迁移,技术方案设计是怎么样的,这样才能保证不漏测。 那测试人员应该怎么了解一个项目的架构呢?测试人员学习架构或者说了解架构设计应该有测试的独特视角,通常能做到清楚基本原理、了解被测系统部署架构、用到了哪些技术,从测试的角度调用到哪些接口就够了,当然如果能学习的深入更好。 首先,不管是已经上线的项目还是在正在进行中的项目,都有系统架构图,先从系统架构图入手,了解服务都有哪些,这些服务分布在哪一层,比如有面向用户接入层,中间处理不同业务的业务层服务,还有从外部服务获取数据外部接入层服务,还有数据存储、缓冲,不同层之间进行交互的协议、中间件都可以从架构图中看到,能帮助我们快速的对整个项目建立一个框架。 其次,查看服务之间的业务交互关系,明确业务数据流转。通过阅读流程图、泳道图、时序图都能帮助测试人员理清楚各个微服务之间的交互关系。下图是根据我自己对马蜂窝大交通抢票业务的理解,梳理的业务架构图: 另外,清楚业务状态机也很重要。熟悉状态机能帮助测试人员更加清晰的理解业务,需求文档是对业务功能的概括,状态机是对业务功能不同情况的分解。 最后,了解一些架构设计知识,比如为什么要用消息队列,好处是什么,在项目中不断积累架构相关的知识,架构相关的知识不断的丰满在进行项目设计方案评审时就可从测试角度提出问题,发现问题,对项目质量起到帮助,因为越早发现问题,损失越小。 三、关注数据库设计 数据库的重要性不言而喻,任何一条业务线都离不开。数据库表设计是否合理、是否考虑了业务扩展、是否考虑了读写分离等,都是需要测试人员在参加数据库设计评审,甚至在数据库设计时考虑的。下面分享一些在 Review 数据库设计表时的参考检查项: 1)不同表,相同含义的字段命名是否统一; 2)字段类型是否符合要求,比如数据量大的字段类型设计成 int,应该用 bigint 更合理; 3)字段长度设计是否合理;举例,曾经测试过一个功能,每 10 分钟查询 Redis 中 key 的值存到 MySQL 中,统计值和查询 key 分两列存储,字段长度设计是 60,实际情况是 key 的长度远远大于 60,对 key 进行截断存储,导致查询不到不结果。 4)字段是否为空;接口设计字段可以空,但是表结构设计字段 NOT NULL,与接口数据结构设计不一致,提交的时候显然回报错; 5)是否存在冗余字段;当然有些情况为了效率会允许冗余字段的存在; 6)是否需要分库分表。 除了以上提到的点,在数据库设计方面需要 Review 的内容还有很多,比如是否需要考虑读写分离、表之间的关联是否合理等等。建议大家去了解一些与数据库设计规则相关的知识,来帮助我们在 Review 或者参与数据库设计时发现更多问题。 四、阅读开发的代码 说到 Code Review 大家并不陌生,上线前分支合并 Master 要进行 Code Review,开发人员相互交叉进行 Review,研发同学常会听到这样的对话「飞哥帮我 review 下代码」。 Code Review 对于开发人员是很重要的 Check 步骤,对于测试人员也是一样,一个发现缺陷、理解项目的重要手段。阅读代码可以从以下几个方面帮助到我们: 1. 检查测试用例的遗漏点 我们都知道测试做不到穷尽测试,不管是做单元测试还是功能用例都不容易做到全部覆盖,尤其是有多个条件的情况下越不容易做到,Code Review 可以帮助我们再次检查是否测试中遗漏功能点。 2. 帮助测试人员更加熟悉系统,深入理解业务 黑盒测试的被测对象是已经成型的系统,不能清楚看到业务功能是在系统架构哪部分上实现的。比如现在流行的微服务架构,一个业务功能可能是多个微服务相互协作完成,通过阅读代码,能够清晰的知道业务实现的入口在哪里,调用了哪些服务,一个业务场景从开始到结束经过哪些环节都可以清楚地看到。 3. 发现增量功能 Bug 和设计缺陷 业务线的功能是不断迭代的,因提升体验而进行的功能优化和增加新功能都在迭代的范围内。测试人员面对是整个业务线,每次的迭代需要准确判断本次迭代影响的范围来确定测试范围。通过业务代码清楚具体的实现细节、实现方式,在业务功能迭代时,测试人员能准确的判断出代码增量是哪部分,关联受影响的代码是哪部分,确定测试范围,做到精准的测试,在设计评审时反馈可会产生影响的功能给开发人员,与开发形成良好的互动。 说了阅读代码的好处,测试人员如何去 Review 开发人员代码?从哪几个方面入手? 1. 带着任务看代码 带着任务去看代码就是清楚本次迭代有哪些功能,最好在 Review 之前在熟悉一下测试用例,带着功能实现是否存在问题心态去看,关注业务逻辑实现、接口参数定义部分,一些配置的 config 实现可以不用关注,避免陷入到与功能无关的细节中。 2. 关注代码条件判断 实现业务逻辑各类条件的判断是必不可少的,也是容易出问题的地方,条件判断错误功能表现可能就是「失之毫厘,差之千里」。条件的判断需要结合业务实际情况,如: (1)检查 if 语句中每个条件表达式是否正确。比如:变量取值 isNotBlank 和 isNotEmpty 就会导致不同结果,涉及与、或、非的表达式尤其要注意; (2)检查条件表达式是否涵盖所有关联的变量。举个例子:一个订单状态流转和 a、b 两个变量的取值有关系,其中 b 变量在某些特情况下影响订单状态。如果在条件中只考虑对 a 的判断而忽略 b,就导致功能不完整。 在进行火车票的改签测试有这样一个 bug,同一个乘客成功购票后——>将票改签到其他日期——>再退票,然后这个乘客在买同样日期相同车次的票提示行程冲突,预期结果是:用户已经改签到其他日期并且退票,可以再次购买。下图是一个简化的流程图,判断是否行程冲突(黄色部分是导致bug的原因): 从流程图可以看出如果乘客有已出票的订单需要先判断是否出行或退票,如果否的话说明还是在出票状态,那需要继续判断是否进行了改签,如果已经改签允许用户继续创单,导致 Bug 的原因就是少判断了是否改签这个条件。 (3)检查对条件不同值给出的处理结果是否正确。举一个简单的例子:学生成绩不同区间对应 a、b、c 三个不同档有如下伪码: If (s>=90): Print「a」 Elseif (s>=80 && s<90): Print「b」 Else: Print「c」 上面的这段代码没有考虑s取异常值的情况,学生成绩取值是大于等于0的,还有就是成绩大于100时,在c档是否合理,也需要考虑实际需求。 3. 关注循环语句 所有的循环是否都有结束条件即所有的循环都能正常的结束;进入循环的入口条件是否正确即能进入到循环中;循环的条件是否存在越界的错误等。 4. 检查代码中接口定义与接口文档的定义是否一致 5. 针对增量代码进行 Review 通常由于时间有限,没有足够的时间阅读所有的代码,可以选择仅对对增量代码进行 Review,检查是否存在功能遗漏、改动代码对是否原有功能产生影响。 6. Review 后知识沉底 前面的几点都是再说如何去做,在阅读代码的过程中进行知识沉淀也很重要。在 Review 完成后,可以对发现的问题进行整理归类,在后面的测试过程中可以做为测试用例进行补充。Review 完成可以尝试画服务的流程图,项目架构图,帮助的自己对项目理解更深入。 7. 测试人员进行代码的反讲 阅读完代码后,测试人员反讲对代码的理解,可以邀请开发人员一起参加。 当然,我们在看到代码会碰到很多问题,可以向开发同学请教,了解代码结构,比如哪部分是业务实现代码,哪些是和数据库交互设计、哪些配置文件、哪些是接口定义文件,这些都可以帮助我们快速了解项目代码结构。 五、熟悉项目配置文件 为了灵活应对一些由于突发状况或频繁上线对业务带来的影响,在项目的实现过程中研发人员会把一些功能通过配置文件的方式去实现,比如流控配置、对不同业务场景的需求配置、为进行灰度测试的配置等,除此之外还有静态的环境配置。在配置文件内容的 Review 中应该关注的重点包括: 不同环境的配置文件不同,以防止将测试环境的配置同步到生产环境产生损失 功能配置开关,比如限流、降级服务开关、外部依赖如供应商的上下线 业务参数配置,业务功能的一些参数需要随时灵活配置,比如一些活动规则、临时性的通知信息 除了业务相关配置还有中间件的配置也需要关注,比如 tomcat、dubbo、mq 的参数设置很重要,对服务性能的影响非常明显。 测试人员深入到一个项目中,需要了解熟悉的远远不止我在上面提到这几个方面,还有很多,比如缓冲设计、缓冲失效时间设置,存储方式等,服务日志记录,随着对业务、系统架构的熟悉,这些都需要去了解,从而在测试中帮助到我们。 总结 上面是我对测试人员为什么要深入到一个项目实现中的,以及如何去深入的一些看法。测试作为项目最后一个环节,新的测试技术、手段、理念不断出现,但是保证项目质量的目标没有变。而深入到项目中,了解项目代码、了解项目设计对于一个优秀测试人员是必须具备的技能。当然,文中的内容也存在一些局限,欢迎其他测试小伙伴一起交流。 最后,马蜂窝大交通团队也在持续招聘中,测试、前端、Java 开发多个坑位,欢迎有意向的小伙伴来勾搭,简历请发送至邮箱:dongmin@mafengwo.com 本文作者:董敏,大交通研发团队测试工程师。

优秀的个人博客,低调大师

每日一博 | 如何编写高质量的 JS 函数

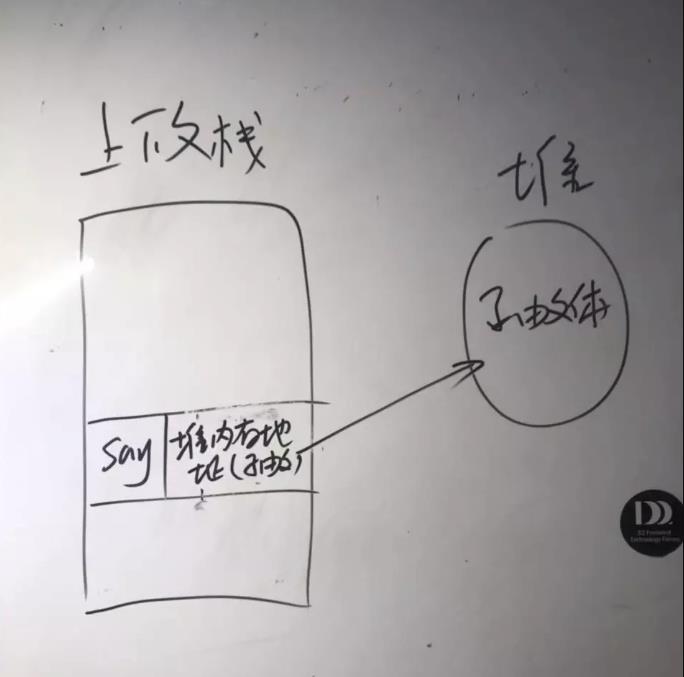
本文首发于 vivo互联网技术 微信公众号 链接:https://mp.weixin.qq.com/s/7lCK9cHmunvYlbm7Xi7JxQ 作者:杨昆 一千个读者,有一千个哈姆雷特。 此系列文章将会从函数的执行机制、鲁棒性、函数式编程、设计模式等方面,全面阐述如何通过 JavaScript 编写高质量的函数。 一、引言 如何通过 JavaScript 编写高质量的函数,这是一个很难回答的问题,不同人心中对高质量有自己的看法,这里我将全面的阐述我个人对如何编写高质量函数的一些看法。看法可能不够全面,也可能会有一些错误的见解,欢迎一起讨论,就像过日子的人,小吵小闹总会不经意的出现,一颗包容的心莫过于是最好的 best practice 。 我打算用几篇文章来完成《如何编写高质量的 JS 函数》这个系列。 主要从以下几个方面进行阐述: 函数(一切皆有可能) 函数的命名 函数的注释 函数的复杂度 函数的鲁棒性(防御性编程) 函数的入参和出参(返回) 如何用函数式编程打通函数的任督二脉 如何用设计模式让函数如虎添翼 编写对V8友好的函数是一种什么style 前端工程师的函数狂想录 本篇只说第一节函数,擒贼先擒王,下面我们来盘一盘函数的七七八八。 二、函数(一切皆有可能) 函数二字,代表着一切皆有可能。 我们想一下:我们用的函数究竟离我们有多远。就像打麻将一样,你觉得你能像雀神那样,想摸啥就来啥么(夸张修辞手法)。 天天和函数打交道,函数出现的目的是什么?再深入想,函数的执行机制是什么?下面我们就来简单的分析一下。 1、函数出现的目的 函数是迄今为止发明出来的用于节约空间和提高性能的最重要的手段。 PS: 注意,没有之一。 2、函数的执行机制 有句话说的好,知己知彼,百战不殆。想要胜利,一定要非常的了解敌人。JS 肯定不是敌人啦,但是要想掌握 JS 的函数,要更轻松的编写高质量的函数,那就要掌握在 JS 中函数的执行机制。 怎么去解释函数的执行机制呢? 先来模仿一道前端面试题:输入一个 url 后,会发生什么? 执行一个函数,会发生什么? 参考下面代码: function say() { let str = 'hello world' console.log(str) } 这道面试题要是交给你,你能答出多少呢? 如果让我来答,我大致会这样说: 首先我会创建一个函数。如果你学过 C++,可能会说我要先开辟一个堆内存。 所以,我会从创建函数到执行函数以及其底层实现,这三个层次进行分析。 (1)创建函数 函数不是平白无故产生的,需要创建。创建函数时会发生什么呢? 第一步:开辟一个新的堆内存 每个字母都是要存储空间的,只要有数据,就一定得有存储数据的地方。而计算机组成原理中,堆允许程序在运行时动态地申请某个大小的内存空间,所以你可以在程序运行的时候,为函数申请内存。 第二步:创建一个函数 say ,把这个函数体中的代码放在这个堆内存中。 函数体是以字符串的形式放在堆内存中的。 为什么呢?我们来看一下 say 函数体的代码: let str = 'hello world' console.log(str) 这些语句以字符串的形式放在堆内存中比较好,因为没有规律。如果是对象,由于有规律,可以按照键值对的形式存储在堆内存中。而没规律的通常都是变成字符串的形式。 第三步:在当前上下文中声明 say 函数(变量),函数声明和定义会提升到最前面 注意,当前上下文,我们可以理解为上下文堆栈(栈),say 是放在堆栈(栈)中的,同时它的右边还有一个堆内存地址,用来指向堆中的函数体的。 PS: 建议去学习一下数据结构,栈中的一块一块的,我们称为帧。你可以把栈理解中 DOM 树,帧理解为节点,每一帧( 节点 )都有自己的名字和内容。 第四步:把开辟的堆内存地址赋值给函数名 say 这里关键是把堆内存地址赋值给函数名 say 。 下面我画了一个简单的示意图: 结合上图 say 右边的存储,再去理解上面的四个步骤,是不是有点感悟了呢。 (2)你真的懂赋值这个操作吗? 这里提到赋值操作。我把堆内存地址赋值给函数名 say 意味着什么呢? 赋值操作是从计算机组成原理角度看,内存分为好几个区域,比如代码区域,栈区域,堆区域等。 这几个区域每一个存储空间的内存地址都是不一样。也就是说,赋值(引用类型)的操作就是将堆区域的某一个地址,通过总线管道流入(复制)到对应栈区域的某一个地址中,从而使栈区域的某一个地址内的存储空间中有了引用堆区域数据的地址。业界叫句柄,也就是指针。只不过在高级语言中,把指针隐藏了,直接用变量代替指针。 所以一个简单的赋值,其在计算机底层实现上,都是很复杂的。这里,也许通过汇编语言,可以更好的去理解赋值的真正含义,比如 1 + 1 用汇编语言编写,就是下面代码: start: mov ax, 1 mov bx, 1 add ax, bx end start; 从上面代码中,我们可以看到,把 1 赋值给 ax ,使用到了 mov 指令。而 mov 是 move 移动的缩写,这也证明了,在赋值这个操作上,本质上是数据或者数据的句柄在一张地址表中的流动。 PS: 所以如果是值类型,那就是直接把数据,流(移动)到指定内存地址的存储空间中。 以上是我从计算机底层去解释一些创建函数方面最基础的现象,先阐述到这里。 (3)执行函数 执行函数过程也非常重要,我用个人的总结去解释执行这个过程。 思考一个点。 我们知道,函数体的代码是以字符串形式的保存在堆内存中的。如果我们要执行堆内存中的代码,首先要将字符串变成真正的 JS 代码,就像数据传输中的序列化和反序列化。 思考题一:为什么会存在序列化和反序列化?大家可以自行思考一下,有些越简单的道理,背后越是有着非凡的思想。 (4)将字符串变成真正的 JS 代码 每一个函数调用,都会在函数上下文堆栈中创建帧。栈是一个基本的数据结构。 为什么函数执行要在栈中执行呢? 栈是先进后出的数据结构,也就意味着可以很好的保存和恢复调用现场。 来看一段代码: function f1() { let b = 1; function f2() { cnsole.log(b) } return f2 } let fun = f1() fun() 函数上下文堆栈是什么? 函数上下文堆栈是一个数据结构,如果学过 C++ 或者 C 的,可以理解成是一个 struct (结构体)。这个结构体负责管理函数执行已经关闭变量作用域。函数上下文堆栈在程序运行时产生,并且一开始加入到栈里面的是全局上下文帧,位于栈底。 (5)开始执行函数 首先要明白一点:执行函数(函数调用)是在栈上完成的 。 这也就是为什么 JS 函数可以递归。因为栈先进后出的数据结构,赋予了其递归能力。 继续往下看,函数执行大致有以下四个步骤: 第一步:形成一个供代码执行的环境,也是一个栈内存。 这里,我们先思考几个问题: 这个供代码执行的环境是什么? 这个栈内存是怎么分配出来的? 这个栈内存的内部是一种什么样的样子? 第二步:将存储的字符串复制一份到新开辟的栈内存中,使其变为真正的 JS 代码。 第三步:先对形参进行赋值,再进行变量提升,比如将 var function 变量提升。 第四步:在这个新开辟的作用域中自上而下执行。 思考题:为什么是自上而下执行呢? 将执行结果返回给当前调用的函数 思考题:将执行结果返回给当前调用的函数,其背后是如何实现的呢? 三、谈谈底层实现 1、计算机中最本质的闭包解释 函数在执行的时候,都会形成一个全新的私有作用域,也叫私有栈内存。 目的有如下两点: 第一点:把原有堆内存中存储的字符串变成真正的 JS 代码。 第二点:保护该栈内存的私有变量不受外界的干扰。 函数执行的这种保护机制,在计算机中称之为 闭包。 可能有人不明白,咋就私有了呢? 没问题,我们可以反推。假设不是私有栈内存的,那么在执行一个递归时,基本就结束了,因为一个函数上下文堆栈中,有很多相同的 JS 代码,比如局部变量等,如果不私有化,那岂不乱套了?所以假设矛盾,私有栈内存成立。 2、栈内存是怎么分配出来? JS 的栈内存是系统自动分配的,大小固定。如果自动适应的话,那就基本不存在除死循环这种情况之外的栈溢出了。 3、这个栈内存的内部是一种什么样的样子? 举个例子,每天写 return 语句,那你知道 return 的底层是如何实现的吗?每天写子程序,那你知道子程序底层的一些真相吗? 我们来看一张图: 上图显示了一次函数调用的栈结构,从结构中可以看到,内部的组成部分,比如实参,局部变量,返回地址。 看下面代码: function f1() { return 'hello godkun' } let result = f1() f2(result) 上面这行代码的底层含义就是,f()函数在私有栈内存中执行完后,使用 return 后,将执行结果传递给 EAX (累加寄存器),常用于函数返回值。 这里说一下 Return Addr ,Addr 主要目的是让子程序能够多次被调用。 看下面代码: function main() { say() // TODO: say() } 如上,在 main 函数中进行多次调用子程序 say ,在底层实现上面,是通过在栈结构中保存一个 Addr 用来保存函数的起始运行地址,当第一个 say 函数运行完以后,Addr 就会指向起始运行地址,以备后面多次调用子程序。 四、JS 引擎是如何执行函数 上面从很多方面分析了函数执行的机制。现在来简要分析一下,JS 引擎是如何执行函数的。 推荐一篇博客《探索JS引擎工作原理》,我将在此篇博客的基础上分析一些很重要的细节。 代码如下: //定义一个全局变量 x var x = 1 function A(y) { //定义一个局部变量 x var x = 2 function B(z) { //定义一个内部函数 B console.log(x + y + z) } //返回函数B的引用 return B } //执行A,返回B var C = A(1) //执行函数B C(1) 执行A函数时 JS 引擎构造的 ESCstack 结构如下: 简称 A 图: 执行B函数时 JS 引擎构造的 ESCstack 结构如下: 简称 B 图: 1、局部变量是如何被保存起来的 核心代码: EC(B) = { [scope]:AO(A), var AO(B) = { z:1, arguments:[], this:window }, scopeChain:<AO(B),B[[scope]]> } 这是在执行 B 函数 时,创建的 B 函数的执行环境(一个对象结构)。里面有一个 AO(B),这是 B 函数的活动对象。 那 AO(B)的目的是什么?其实 AO(B)就是每个链表的节点其指向的内容。 同时,这里还定义了[scope]属性,我们可以理解为指针,[scope]指向了 AO(A),而 AO(A)就是函数 A 的活动对象。 函数活动对象保存着 局部变量、参数数组、this 属性。这也是为什么可以在函数内部使用 this 和 arguments 的原因。 scopeChain 是作用域链,熟悉数据结构的同学肯定知道我函数作用域链本质就是链表,执行哪个函数,那链表就初始化为哪个函数的作用域,然后把当前指向的函数活动对象放到 scopeChain 链表的表头中。 比如执行B函数,那B的链表看起来就是AO(B) --> AO(A) 同时,A 函数也是有自己的链表的,为 AO(A) --> VO(G)。所以整个链表就串起来来,B 的链表(作用域)就是:AO(B) --> AO(A) --> VO(G) 链表是一个闭环,因为查了一圈,回到自己的时候,如果还没找到,那就返回 undefined 。 思考题:[scope]和[[scope]] 为什么以这种形式命名? 2、通过 A 函数的 ECS 我们能看到什么 我们能看到,JS 语言是静态作用域语言,在执行函数之前,整个程序的作用域链就确定了,从 A 图中的函数 B 的 B[[scope]]就可以看到作用域链已经确定。不像 lisp 那种在运行时才能确定作用域。 3、执行环境,上下文环境是一种什么样的存在 执行环境的数据结构是栈结构,其实本质上是给一个数组增加一些属性和方法。 执行环境可以用 ECStack 表示,可以理解成 ECSack = []这种形式。 栈(执行环境)专门用来存放各种数据,比如最经典的就是保存函数执行时的各种子数据结构。比如 A 函数的执行环境是 EC(A)。当执行函数 A 的时候,相当于 ECStack.push[A],当属于 A 的东西被放入到栈中,都会被包裹成一个私有栈内存。 私有栈是怎么形成的?从汇编语言角度去看,一个栈的内存分配,栈结构的各种变换,都是有底层标准去控制的。 4、开启上帝模式看穿 this this为什么在运行时才能确定 上面两张图中的红色箭头,箭头处的信息非常非常重要。 看 A 图,执行 A 函数时,只有 A 函数有 this 属性,执行 B 函数时,只有 B 函数有 this 属性,这也就证实了 this 只有在运行时才会存在。 this的指向真相 看一下 this 的指向,A 函数调用的时候,属性 this 的属性是 window ,而 通过 var C = A(1)调用 A 函数后,A 函数的执行环境已经 pop 出栈了。此时执行 C()就是在执行 B 函数,EC(B)已经在栈顶了,this 属性值是 window 全局变量。 通过 A 图 和 B 图的比较,直接展示 this 的本质。 5、作用域的本质是链表中的一个节点 通过A图 和B图的比较,直接秒杀 作用域 的所有用法 看 A 图,执行 A 函数时,B 函数的作用域是创建 A 函数的活动对象 AO(A)。作用域就是一个属性,一个属于 A 函数的执行环境中的属性,它的名字叫做[scope]。 [scope] 指向的是一个函数活动对象,核心点是把这个函数对象当成一个作用域,最好理解成一个链表节点。 PS: B 执行 B 函数时,只有 B 函数有 this 属性,这也就交叉证实了 this 只有在运行时才会存在。 6、作用域链的本质就是链表 通过比较 A 图和 B 图的 scopeChain ,可以确定的是: 作用域链本质就是链表,执行哪个函数,链表就初始化为哪个函数的作用域,然后将该函数的[scope]放在表头,形成闭环链表。作用域链是通过链表查找的,如果走了一圈还没找到,那就返回 undefined 。 五、用一道面试题让你更上一层楼(走火入魔) 再举一个例子,这是一道经常被问的面试题,看下面代码: 第一个程序如下: function kun() { var result = [] for (var i = 0; i < 10; i++) { result[i] = function() { return i } } return result } let r = kun() r.forEach(fn => { console.log('fn',fn()) }) 第二个程序如下: function kun() { var result = [] for (var i = 0; i < 10; i++) { result[i] = (function(n) { return function() { return n } })(i) } return result } let r = kun() r.forEach(fn => { console.log('fn', fn()) }) 输出结果大家应该都知道了,结果分别是如下截图: 第一个程序,输出 10个 10: 第二个程序,输出 0 到 9 : 那么问题来了,其内部的原理机制是什么呢? 一部分 coder 只能答到立即调用,闭包。 大多数 coder 可以答到作用域相关知识。 极少部分 coder (大佬级别) 可以从核心底层原因来分析。 下面从核心底层原因来分析 。 1、分析输出10个10 代码如下: function kun() { var result = [] for (var i = 0; i < 10; i++) { result[i] = function() { return i } } return result } let r = kun() r.forEach(fn => { console.log('fn',fn()) }) 只有函数在执行的时候,函数的执行环境才会生成。依据这个规则,在完成 r = kun() 的时候,kun 函数只执行了一次,生成了对应的 AO(kun) 。如下: AO(kun):{ i = 10; kun = function(){...}; kun[[scope]] = this; } 这时,在执行 kun()之后,i 的值已经是 10了。请注意,kun 函数只执行了一次,也就意味着: 在 kun 函数的 AO(kun) 中的 i 属性是 10 。 继续分享, kun 函数的作用域链如下: AO(kun) --> VO(G) 而且 kun 函数已经从栈顶被删除了,只留下 AO(kun) 。 注意:这里的 AO(kun) 表示一个节点。这个节点有指针和数据,其中指针指向了 VO(G) ,数据就是 kun 函数的活动对象。 那么,当一次执行 result 中的数组的时候,会发生什么现象? 注意:result 数组中的每一个函数其作用域都已经确定了,而 JS 是静态作用域语言,其在程序声明阶段,所有的作用域都将确定。 那么 ,result 数组中每一个函数其作用域链如下: AO(result[i]) --> AO(kun) --> VO(G) 因此 result 中的每一个函数执行时,其 i 的值都是沿着这条作用域链去查找的,而且由于 kun 函数只执行了一次,导致了 i 值是最后的结果,也就是 10。所以输出结果就是 10个 10。 总结一下,就是result数组中的10个函数在声明后,总共拥有了10个链表(作用域链),都是AO(result[i]) --> AO(kun) --> VO(G)这种形式,但是 10个作用域链中的 AO(kun)都是一样的。所以导致了,输出结果是 10个 10。 下面我们来分析输出0到 9 的结果。 2、分析输出0到9 代码如下: function kun() { var result = [] for (var i = 0; i < 10; i++) { result[i] = (function(n) { return function() { return n } })(i) } return result } let r = kun() r.forEach(fn => { console.log('fn', fn()) }) 首先,在声明函数 kun 的时候,就已经执行了 10次匿名函数。函数在执行时将生成执行环境,也就意味着,在 ECS 栈中,有 10个 EC(kun)执行环境,分别对应result 数组中的 10个函数。 下面通过伪代码来展示: ECSack = [ EC(kun) = { [scope]: VO(G) AO(kun) = { i: 0, result[0] = function() {...// return i}, arguments:[], this: window }, scopeChain:<AO(kun), kun[[scope]]> }, // ..... EC(kun) = [ [scope]: VO(G) AO(kun) = { i: 9, result[9] = function() {...// return i}, arguments:[], this: window }, scopeChain:<AO(kun), kun[[scope]]> ] ] 上面简单的用结构化的语言表示了 kun 函数在声明时的内部情况,需要注意一下两点: 第一点:每一个 EC(kun)中的 AO(kun)中的 i 属性值都是不一样的,比如通过上面结构化表示,可以看到: result[0]函数的父执行环境是 EC(kun),这个 VO(kun)里面的 i 值 是0。 result[9] 函数的父执行环境是 EC(kun),这个 VO(kun)里面的 i 值 是 9 。 记住 AO(kun)是一段存储空间。 第二点:关于作用域链,也就是 scopeChain ,result 中的函数的 链表形式仍然是下面这种形式: AO(result[i]) --> AO(kun) --> VO(G) 但不一样的是,对应节点的存储地址不一样,相当于是 10个新的 AO(kun)。而每一个 AO(kun)的节点内容中的 i 值是不一样的。 所以总结就是:执行 result 数组中的 10个函数时,运行10个不同的链表,同时每个链表的 AO(kun)节点是不一样的。每个 AO(kun)节点中的 i 值也是不一样的。 所以输出的结果最后显示为0到 9 。 六、总结 通过对底层实现原理的分析,我们可以更加深刻的去理解函数的执行机制,从而写出高质量的函数。 如何减少作用域链(链表)的查找 比如很多库,像JQ 等,都会在立即执行函数的最外面传一个 window 参数。这样做的目的是因为,window 是全局对象,通过传参,避免了查找整个作用域链,提高了函数的执行效率。 如何防止栈溢出?每一次执行函数,都会创建函数的执行环境,也就意味着占用一些栈内存,而栈内存大小是固定的,如果写了很大的递归函数,就会造成栈内存溢出,引发错误。 我觉得,我们要去努力的达成这样一个成就: 做到当我在手写一个函数时,我心中非常清楚的知道我正在写的每一行代码,其在内存中是怎么表现的,或者说其在底层是如何执行的,从而达到**眼中有码,心中无码**的境界。 如果能做到这样的话,那还怕写不出高质量的函数吗? 七、参考文档 JS 函数的创建和执行机制 探索JS引擎工作原理 程序内存空间(代码段、数据段、堆栈段) 函数调用–函数栈 堆栈向上增长和向下增长的深入理解 更多内容敬请关注vivo 互联网技术微信公众号 注:转载文章请先与微信号:labs2020联系。

优秀的个人博客,低调大师

每日一博 | Spring 如何解决循环依赖的问题

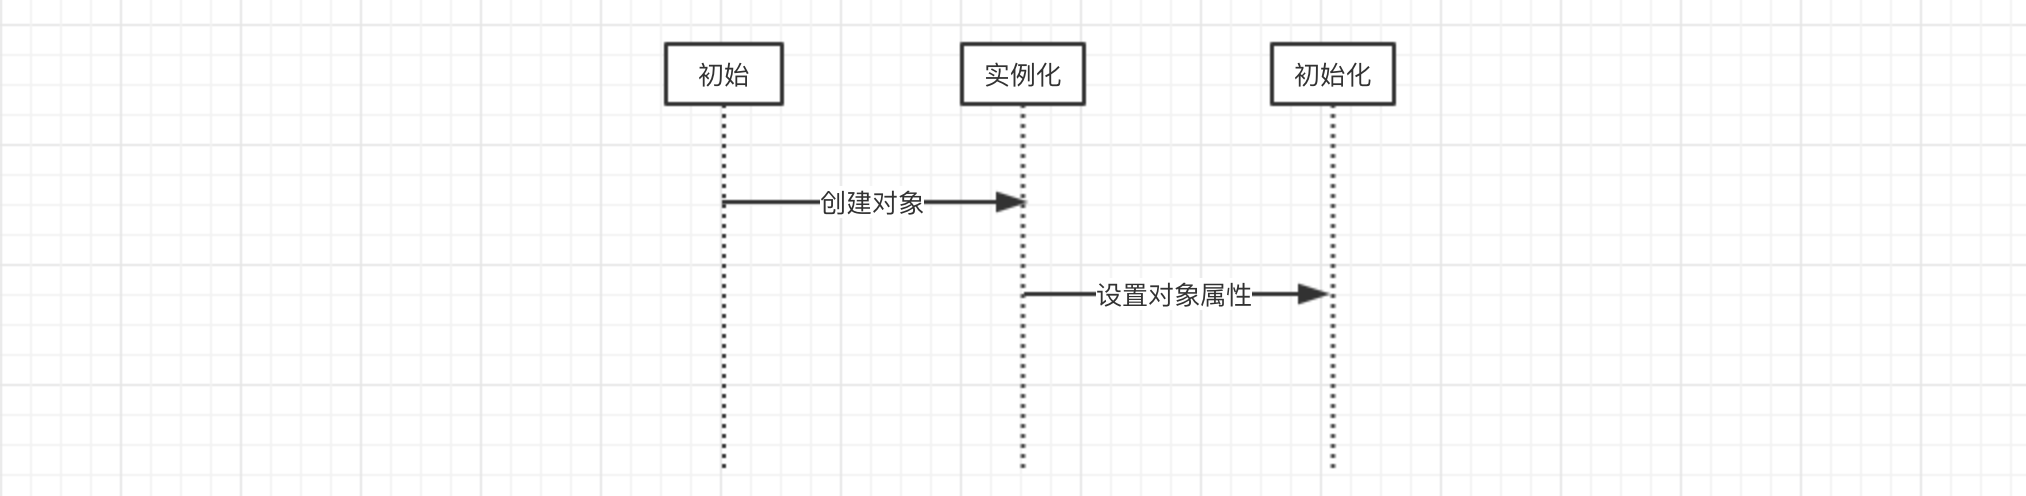
在关于Spring的面试中,我们经常会被问到一个问题,就是Spring是如何解决循环依赖的问题的。这个问题算是关于Spring的一个高频面试题,因为如果不刻意研读,相信即使读过源码,面试者也不一定能够一下子思考出个中奥秘。本文主要针对这个问题,从源码的角度对其实现原理进行讲解。 1. 过程演示 关于Spring bean的创建,其本质上还是一个对象的创建,既然是对象,读者朋友一定要明白一点就是,一个完整的对象包含两部分:当前对象实例化和对象属性的实例化。在Spring中,对象的实例化是通过反射实现的,而对象的属性则是在对象实例化之后通过一定的方式设置的。这个过程可以按照如下方式进行理解: 理解这一个点之后,对于循环依赖的理解就已经帮助一大步了,我们这里以两个类A和B为例进行讲解,如下是A和B的声明: @Component public class A { private B b; public void setB(B b) { this.b = b; } } @Component public class B { private A a; public void setA(A a) { this.a = a; } } 可以看到,这里A和B中各自都以对方为自己的全局属性。这里首先需要说明的一点是,Spring实例化bean是通过ApplicationContext.getBean()方法来进行的。如果要获取的对象依赖了另一个对象,那么其首先会创建当前对象,然后通过递归的调用ApplicationContext.getBean()方法来获取所依赖的对象,最后将获取到的对象注入到当前对象中。这里我们以上面的首先初始化A对象实例为例进行讲解。首先Spring尝试通过ApplicationContext.getBean()方法获取A对象的实例,由于Spring容器中还没有A对象实例,因而其会创建一个A对象,然后发现其依赖了B对象,因而会尝试递归的通过ApplicationContext.getBean()方法获取B对象的实例,但是Spring容器中此时也没有B对象的实例,因而其还是会先创建一个B对象的实例。读者需要注意这个时间点,此时A对象和B对象都已经创建了,并且保存在Spring容器中了,只不过A对象的属性b和B对象的属性a都还没有设置进去。在前面Spring创建B对象之后,Spring发现B对象依赖了属性A,因而此时还是会尝试递归的调用ApplicationContext.getBean()方法获取A对象的实例,因为Spring中已经有一个A对象的实例,虽然只是半成品(其属性b还未初始化),但其也还是目标bean,因而会将该A对象的实例返回。此时,B对象的属性a就设置进去了,然后还是ApplicationContext.getBean()方法递归的返回,也就是将B对象的实例返回,此时就会将该实例设置到A对象的属性b中。这个时候,注意A对象的属性b和B对象的属性a都已经设置了目标对象的实例了。读者朋友可能会比较疑惑的是,前面在为对象B设置属性a的时候,这个A类型属性还是个半成品。但是需要注意的是,这个A是一个引用,其本质上还是最开始就实例化的A对象。而在上面这个递归过程的最后,Spring将获取到的B对象实例设置到了A对象的属性b中了,这里的A对象其实和前面设置到实例B中的半成品A对象是同一个对象,其引用地址是同一个,这里为A对象的b属性设置了值,其实也就是为那个半成品的a属性设置了值。下面我们通过一个流程图来对这个过程进行讲解: 图中getBean()表示调用Spring的ApplicationContext.getBean()方法,而该方法中的参数,则表示我们要尝试获取的目标对象。图中的黑色箭头表示一开始的方法调用走向,走到最后,返回了Spring中缓存的A对象之后,表示递归调用返回了,此时使用绿色的箭头表示。从图中我们可以很清楚的看到,B对象的a属性是在第三步中注入的半成品A对象,而A对象的b属性是在第二步中注入的成品B对象,此时半成品的A对象也就变成了成品的A对象,因为其属性已经设置完成了。 2. 源码讲解 对于Spring处理循环依赖问题的方式,我们这里通过上面的流程图其实很容易就可以理解,需要注意的一个点就是,Spring是如何标记开始生成的A对象是一个半成品,并且是如何保存A对象的。这里的标记工作Spring是使用ApplicationContext的属性Set<String> singletonsCurrentlyInCreation来保存的,而半成品的A对象则是通过Map<String, ObjectFactory<?>> singletonFactories来保存的,这里的ObjectFactory是一个工厂对象,可通过调用其getObject()方法来获取目标对象。在AbstractBeanFactory.doGetBean()方法中获取对象的方法如下: protected <T> T doGetBean(final String name, @Nullable final Class<T> requiredType, @Nullable final Object[] args, boolean typeCheckOnly) throws BeansException { // 尝试通过bean名称获取目标bean对象,比如这里的A对象 Object sharedInstance = getSingleton(beanName); // 我们这里的目标对象都是单例的 if (mbd.isSingleton()) { // 这里就尝试创建目标对象,第二个参数传的就是一个ObjectFactory类型的对象,这里是使用Java8的lamada // 表达式书写的,只要上面的getSingleton()方法返回值为空,则会调用这里的getSingleton()方法来创建 // 目标对象 sharedInstance = getSingleton(beanName, () -> { try { // 尝试创建目标对象 return createBean(beanName, mbd, args); } catch (BeansException ex) { throw ex; } }); } return (T) bean; } 这里的doGetBean()方法是非常关键的一个方法(中间省略了其他代码),上面也主要有两个步骤,第一个步骤的getSingleton()方法的作用是尝试从缓存中获取目标对象,如果没有获取到,则尝试获取半成品的目标对象;如果第一个步骤没有获取到目标对象的实例,那么就进入第二个步骤,第二个步骤的getSingleton()方法的作用是尝试创建目标对象,并且为该对象注入其所依赖的属性。 这里其实就是主干逻辑,我们前面图中已经标明,在整个过程中会调用三次doGetBean()方法,第一次调用的时候会尝试获取A对象实例,此时走的是第一个getSingleton()方法,由于没有已经创建的A对象的成品或半成品,因而这里得到的是null,然后就会调用第二个getSingleton()方法,创建A对象的实例,然后递归的调用doGetBean()方法,尝试获取B对象的实例以注入到A对象中,此时由于Spring容器中也没有B对象的成品或半成品,因而还是会走到第二个getSingleton()方法,在该方法中创建B对象的实例,创建完成之后,尝试获取其所依赖的A的实例作为其属性,因而还是会递归的调用doGetBean()方法,此时需要注意的是,在前面由于已经有了一个半成品的A对象的实例,因而这个时候,再尝试获取A对象的实例的时候,会走第一个getSingleton()方法,在该方法中会得到一个半成品的A对象的实例。然后将该实例返回,并且将其注入到B对象的属性a中,此时B对象实例化完成。然后将实例化完成的B对象递归的返回,此时就会将该实例注入到A对象中,这样就得到了一个成品的A对象。我们这里可以阅读上面的第一个getSingleton()方法: @Nullable protected Object getSingleton(String beanName, boolean allowEarlyReference) { // 尝试从缓存中获取成品的目标对象,如果存在,则直接返回 Object singletonObject = this.singletonObjects.get(beanName); // 如果缓存中不存在目标对象,则判断当前对象是否已经处于创建过程中,在前面的讲解中,第一次尝试获取A对象 // 的实例之后,就会将A对象标记为正在创建中,因而最后再尝试获取A对象的时候,这里的if判断就会为true if (singletonObject == null && isSingletonCurrentlyInCreation(beanName)) { synchronized (this.singletonObjects) { singletonObject = this.earlySingletonObjects.get(beanName); if (singletonObject == null && allowEarlyReference) { // 这里的singletonFactories是一个Map,其key是bean的名称,而值是一个ObjectFactory类型的 // 对象,这里对于A和B而言,调用图其getObject()方法返回的就是A和B对象的实例,无论是否是半成品 ObjectFactory<?> singletonFactory = this.singletonFactories.get(beanName); if (singletonFactory != null) { // 获取目标对象的实例 singletonObject = singletonFactory.getObject(); this.earlySingletonObjects.put(beanName, singletonObject); this.singletonFactories.remove(beanName); } } } } return singletonObject; } 这里我们会存在一个问题就是A的半成品实例是如何实例化的,然后是如何将其封装为一个ObjectFactory类型的对象,并且将其放到上面的singletonFactories属性中的。这主要是在前面的第二个getSingleton()方法中,其最终会通过其传入的第二个参数,从而调用createBean()方法,该方法的最终调用是委托给了另一个doCreateBean()方法进行的,这里面有如下一段代码: protected Object doCreateBean(final String beanName, final RootBeanDefinition mbd, final @Nullable Object[] args) throws BeanCreationException { // 实例化当前尝试获取的bean对象,比如A对象和B对象都是在这里实例化的 BeanWrapper instanceWrapper = null; if (mbd.isSingleton()) { instanceWrapper = this.factoryBeanInstanceCache.remove(beanName); } if (instanceWrapper == null) { instanceWrapper = createBeanInstance(beanName, mbd, args); } // 判断Spring是否配置了支持提前暴露目标bean,也就是是否支持提前暴露半成品的bean boolean earlySingletonExposure = (mbd.isSingleton() && this.allowCircularReferences && isSingletonCurrentlyInCreation(beanName)); if (earlySingletonExposure) { // 如果支持,这里就会将当前生成的半成品的bean放到singletonFactories中,这个singletonFactories // 就是前面第一个getSingleton()方法中所使用到的singletonFactories属性,也就是说,这里就是 // 封装半成品的bean的地方。而这里的getEarlyBeanReference()本质上是直接将放入的第三个参数,也就是 // 目标bean直接返回 addSingletonFactory(beanName, () -> getEarlyBeanReference(beanName, mbd, bean)); } try { // 在初始化实例之后,这里就是判断当前bean是否依赖了其他的bean,如果依赖了, // 就会递归的调用getBean()方法尝试获取目标bean populateBean(beanName, mbd, instanceWrapper); } catch (Throwable ex) { // 省略... } return exposedObject; } 到这里,Spring整个解决循环依赖问题的实现思路已经比较清楚了。对于整体过程,读者朋友只要理解两点: Spring是通过递归的方式获取目标bean及其所依赖的bean的; Spring实例化一个bean的时候,是分两步进行的,首先实例化目标bean,然后为其注入属性。 结合这两点,也就是说,Spring在实例化一个bean的时候,是首先递归的实例化其所依赖的所有bean,直到某个bean没有依赖其他bean,此时就会将该实例返回,然后反递归的将获取到的bean设置为各个上层bean的属性的。 3. 小结 本文首先通过图文的方式对Spring是如何解决循环依赖的问题进行了讲解,然后从源码的角度详细讲解了Spring是如何实现各个bean的装配工作的。

优秀的个人博客,低调大师

每日一博 | 如何参与一个顶级开源项目

前言 最近个人事情比较多(搬家、换工作、短暂休息)所以一直也没有顾得上博客更新,恰好最近收到一封邮件提醒了我。 也是时候写一篇文章来聊聊参与开源项目的事(最近也确实进入了笔荒期)。 ps:第一次收到这样的中秋节礼物,加上 Dubbo 社区的活跃及阿里的重视度,还在做 RPC 或微服务技术选型的朋友可以考虑 Dubbo。 参与开源 现在具体来聊聊参与开源的事; 日常几乎所有的开发者都会享受到开源项目所带来的便利甚至是收益,受限于环境早在十几年前甚至几年前开源活动一直都是有国外开发者主导。 但这几年国内互联网公司逐渐国际化扩大影响力也很大程度的提高了我们的开发水平,以 BAT 为首出现了许多优秀的开源项目。 现在甚至参与开源项目还能另辟蹊径的拿到大厂 offer,所以其实不少朋友都想参与其中,可能这事给人的第一感觉就不太容易,所以现在还卡在第一步。 具体步骤 以下是以我个人经验总结的几大步骤: 发现问题或自荐 feature 。 fork 源码。 本地开发、自测。 发起 pull request 。 等待社区 Code Review 。 跟进社区意见调整代码。 审核通过,合并进 master 分支,完成本次贡献。 下面我会结合最近一次参与 Dubbo 的流程来具体聊聊。 发现问题或自荐 feature 首先第一步自然要搞清楚自己本次贡献的内容是什么?通常都是解决某个问题或者是提交一个新的 feature ;前者相对起来更加容易一些。 当然这个问题可以是自己使用过程中发现的,也可以是 Issues 列表中待解决的问题。 以本次为例,就是我在使用过程中所发现的问题,也提交了相关 Issue 并写了一篇文章记录并解决了该问题:What?一个 Dubbo 服务启动要两个小时! 值得注意的是在提交 Issue 之前最好是先在 Issue 列表中通过关键字检索下是否已经有相关问题,避免重复。 同时提交之后也许社区会进行跟进,被打上 invalid 标签认为不是问题,或者是使用姿势不对也是有可能的。 fork 源码,本地开发 当确定这是一个待修复的问题时就可以着手开发了。 首先第一步自然是将源码拷贝一份到自己仓库中。 接着只需要 clone 自己仓库中的源码到本地进行开发。 先回顾下我遇到的这个问题。 简单来说就是启动 Dubbo 服务非常缓慢,经过定位是 main 线程阻塞在了获取本机 ip 处。 所以当时我提出的方案是:在获取本机 ip 时加上超时时间,一旦超时便抛出异常或者是再次重试,但起码得有日志方便用户定位问题。 问题是主线程会一直阻塞在此处 InetAddress.getLocalHost().getHostAddress(),但又需要知道它阻塞了多久才好判断是否超时。 所以只能再额外开启一个线程,定时去检测 main 线程是否已经完成任务了,以下便是我第一次 pr 的内容。 这次的重点不是讨论这里具体的技术细节,所以简单说下步骤: 额为声明了大小为 1 的线程池。 再声明了一个 volatile 标志用于判断主线程是否有完成任务。 声明了一个 condition 用于新线程做等待。 最后只需要运行这个线程用于判断这个标志即可。 如何自测 开发完成后下一步就是自测,由于这类项目是作为一个基础包依赖于其他的项目才能运行的,所以通常我们还得新建一个项目来配合做全流程测试(单测除外)。 这里我觉得还是有几个小技巧值得注意。 第一个是版本号;因为在本地测试,所以需要使用 mvn clean install 将包安装到本地才能在其他项目中依赖进去进行测试。 但由于我们从官方拉出来的代码版本都已经发布到了 maven 中央仓库中(不管是 release 还是 snapshot),所以我们本地仓库中肯定已经存在这几个版本的 jar 包。 一旦我们执行 mvn clean install 将自己修改的代码安装到本地时,大概率是会出问题的(也可能是我姿势不对),这样就会导致新建的项目中依赖不了自己新增的代码。 所以我通常的做法是修改版本号,这个版本号是从来没有被官方发布到中央仓库中的,可以确保自己新增的代码会以一个全新版本安装到本地,这样我们再依赖这个版本进行测试即可。 不过再提交时得注意不要把这个版本号提交上去了。 发起 pull request 自测完成后便可发起 pull request 了,不要大意,这里还得有一个地方需要注意,那就是代码换行符的问题。 一旦换行符与源仓库的不一致时,git 会认为这次修改是删除后重来的,这样会给 code review 带来巨大的麻烦。 就像这样,明明我改动的行数并不多,但 git 确认为你是推翻了重来,导致审核起来根本不知道你改了哪些地方。 最简单的方法就是设置自己 git 的全局配置,可以参考这里。 # 提交时转换为LF,检出时转换为CRLF git config --global core.autocrlf true # 提交时转换为LF,检出时不转换 git config --global core.autocrlf input # 提交检出均不转换 git config --global core.autocrlf false 确认没问题后便可点击这里发起 pull request,后面按照引导执行即可。 当然各个项目之间还会有自己定制的贡献流程,最好就是查看官方的贡献指南。 http://dubbo.apache.org/en-us/docs/developers/contributor-guide/new-contributor-guide_dev.html Code Review pr 发起后便可等待社区审核了。 在这过程中要充分和社区进行交流,有可能你的方案和社区的想法并不一致。 比如像我这次: 最终通过沟通加上自己后面的思考觉得还是社区的方案更加轻便合理一些,达成一致之后社区便将这次 pr 合并进 master 中。 其实整个过程我觉得最有意义的便是 code review 的过程,所有人都可以参与其中头脑风暴,其中也不乏技术大牛,不知不觉便能学到不少东西。 类似案例 虽然我之前的方案没有被采纳,但类似的用法(一个线程监控其他线程)还是不少,正好在 Dubbo 中也有用到。 便是其中核心的服务调用,默认情况下对使用者来说这看起来是一个同步调用,也就是说消费方会等待 RPC 执行完毕后才会执行后续逻辑。 但其实在底层这就是一个 TCP 网络包的发送过程,本身就是异步的。 只是 Dubbo 在你不知道的情况下做了异步转同步,这样看起来就像是一个同步方法。 如图中的红框部分,Dubbo 自身调用了 get() 方法用于同步获取服务提供者的返回结果。 逻辑其实也挺简单,和我上文的方案类似,只是这里的 isDone() 函数返回的是是否已经拿到了服务提供者的返回值而已。 总结 本次总结了参与开源的具体步骤,其实也挺简单;就如官方所说哪怕是提个 Issue,修改一个错别字都算是参与,所以不要想的太难。 最后还简单分析了 Dubbo 调用过程中的异步转同步的过程,掌握这些操作对自己平时开发也是很有帮助的。 你的点赞与分享是对我最大的支持

优秀的个人博客,低调大师

每日一博 | WebFlux 定点推送,全推送灵活 Websocket 运用

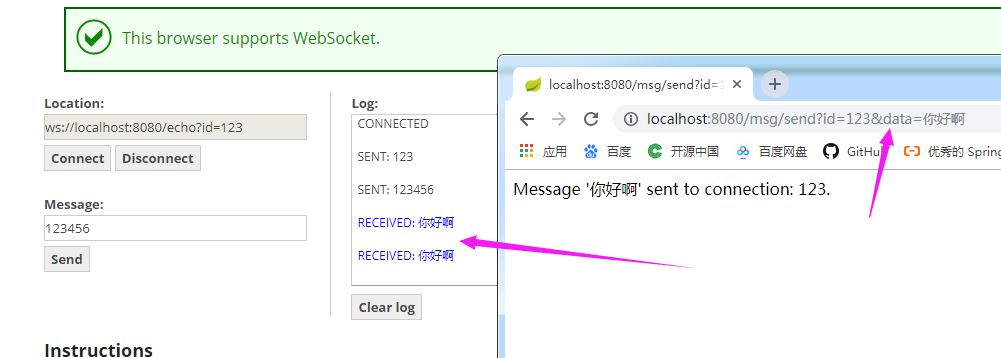
前言 WebFlux 本身提供了对 WebSocket 协议的支持,处理 WebSocket 请求需要对应的 handler 实现 WebSocketHandler 接口,每一个 WebSocket 都有一个关联的 WebSocketSession,包含了建立请求时的握手信息HandshakeInfo,以及其它相关的信息。可以通过 session 的receive()方法来接收客户端的数据,通过 session 的send()方法向客户端发送数据。 示例 下面是一个简单的 WebSocketHandler 示例: @Component public class EchoHandler implements WebSocketHandler { public Mono<Void> handle(WebSocketSession session) { return session.send( session.receive().map( msg -> session.textMessage("ECHO -> " + msg.getPayloadAsText()))); } } 有了 handler 之后,还需要让 WebFlux 知道哪些请求需要交给这个 handler 进行处理,因此要创建相应的 HandlerMapping。 在处理 HTTP 请求时,我们经常使用 WebFlux 中最简单的 handler 定义方式,即通过注解@RequestMapping将某个方法定义为处理特定路径请求的 handler。 但是这个注解是用于处理 HTTP 请求的,对于 WebSocket 请求而言,收到请求后还需要协议升级的过程,之后才是 handler 的执行,所以我们不能直接通过该注解定义请求映射,不过可以使用 SimpleUrlHandlerMapping 来添加映射。 @Configuration public class WebSocketConfiguration { @Bean public HandlerMapping webSocketMapping(EchoHandler echoHandler) { final Map<String, WebSocketHandler> map = new HashMap<>(1); map.put("/echo", echoHandler); final SimpleUrlHandlerMapping mapping = new SimpleUrlHandlerMapping(); mapping.setOrder(Ordered.HIGHEST_PRECEDENCE); mapping.setUrlMap(map); return mapping; } @Bean public WebSocketHandlerAdapter handlerAdapter() { return new WebSocketHandlerAdapter(); } } 这样就能够将发往/echo的 WebSocket 请求交给 EchoHandler 处理。 我们还要为 WebSocket 类型的 handler 创建对应的 WebSocketHandlerAdapter,以便让 DispatcherHandler 能够调用我们的 WebSocketHandler。 完成这三个步骤后,当一个 WebSocket 请求到达 WebFlux 时,首先由 DispatcherHandler 进行处理,它会根据已有的 HandlerMapping 找到这个 WebSocket 请求对应的 handler,接着发现该 handler 实现了 WebSocketHandler 接口,于是会通过 WebSocketHandlerAdapter 来完成该 handler 的调用。 疑惑 从上面的例子不难看出,没接收一个请求后,就得在里面里面返回消息,后面就不能再给他发消息了。其次是我每次新添加或者删除一个消息的处理类Handler,就得每次去修改配置文件中的SimpleUrlHandlerMapping的UrlMap的内容,感觉不是很友好。于是针对这2点进行修改和调整如下: 1. 用自定义注解注册 Handler 我们能否像注册 HTTP 请求的 Handler 那样,也通过类似 RequestMapping 的注解来注册 Handler 呢? 虽然官方没有相关实现,但我们可以自己实现一个类似的注解,不妨叫作WebSocketMapping: @Retention(RetentionPolicy.RUNTIME) @Target(ElementType.TYPE) public @interface WebSocketMapping { String value() default ""; } @Retention(RetentionPolicy.RUNTIME)表明该注解工作在运行期间,@Target(ElementType.TYPE)表明该注解作用在类上。 我们先看下该注解最终的使用方式。下面是一个 TimeHandler 的示例,它会每秒钟会向客户端发送一次时间。我们通过注解@WebSocketMapping("/time")完成了 TimeHandler 的注册,告诉 WebFlux 当有 WebSocket 请求发往/echo路径时,就交给 EchoHandler 处理: @Component @WebSocketMapping("/echo") public class EchoHandler implements WebSocketHandler { @Override public Mono<Void> handle(final WebSocketSession session) { return session.send( session.receive() .map(msg -> session.textMessage( "服务端返回:小明, -> " + msg.getPayloadAsText()))); } } 是不是和 RequestMapping 一样方便? 到目前为止,这个注解还没有实际的功能,还不能自动注册 handler。回顾我们上面注册路由的方式,我们创建了一个 SimpleUrlHandlerMapping,并手动添加了 EchoHandler 的映射规则,然后将其作为 HandlerMapping 的 Bean 返回。 现在我们要创建一个专门的 HandlerMapping 类来处理 WebSocketMapping 注解,自动完成 handler 的注册: public class WebSocketMappingHandlerMapping extends SimpleUrlHandlerMapping{ private Map<String, WebSocketHandler> handlerMap = new LinkedHashMap<>(); /** * Register WebSocket handlers annotated by @WebSocketMapping * @throws BeansException */ @Override public void initApplicationContext() throws BeansException { Map<String, Object> beanMap = obtainApplicationContext() .getBeansWithAnnotation(WebSocketMapping.class); beanMap.values().forEach(bean -> { if (!(bean instanceof WebSocketHandler)) { throw new RuntimeException( String.format("Controller [%s] doesn't implement WebSocketHandler interface.", bean.getClass().getName())); } WebSocketMapping annotation = AnnotationUtils.getAnnotation( bean.getClass(), WebSocketMapping.class); //webSocketMapping 映射到管理中 handlerMap.put(Objects.requireNonNull(annotation).value(),(WebSocketHandler) bean); }); super.setOrder(Ordered.HIGHEST_PRECEDENCE); super.setUrlMap(handlerMap); super.initApplicationContext(); } } 我们的 WebSocketMappingHandlerMapping 类,实际上就是 SimpleUrlHandlerMapping,只不过增加了一些初始化的操作。 initApplicationContext()方法是 Spring 中 ApplicationObjectSupport 类的方法,用于自定义类的初始化行为,在我们的 WebSocketMappingHandlerMapping 中,初始化工作主要是收集使用了@WebSocketMapping注解并且实现来WebSocketHandler接口的 Component,然后将它们注册到内部的 SimpleUrlHandlerMapping 中。之后的路由工作都是由父类 SimpleUrlHandlerMapping 已实现的功能来完成。 现在,我们只需要返回 WebSocketMappingHandlerMapping 的 Bean,就能自动处理@WebSocketMapping注解了: @Configuration public class WebSocketConfiguration { @Bean public HandlerMapping webSocketMapping() { return new WebSocketMappingHandlerMapping(); } @Bean public WebSocketHandlerAdapter handlerAdapter() { return new WebSocketHandlerAdapter(); } } 2. WebSocket 请求处理过程剖析 我们来看下基于 Reactor Netty 的 WebFlux 具体是如何处理 WebSocket 请求的。 前面说过,WebSocket 请求进入 WebFlux 后,首先会从 HandlerMapping 中找到对应的 WebSocketHandler,再由 WebSocketHandlerAdapter 进行实际的调用。这就不再多做阐述,有兴趣的朋友可以去看看WebSocketHandler,WebSocketHandlerAdapter。 3. 分离数据的接收与发送操作 我们知道 HTTP 协议是半双工通信,虽然客户端和服务器都能给对方发数据,但是同一时间内只会由一方向另一方发送数据,并且在顺序上是客户端先发送请求,然后才由服务器返回响应数据。所以服务器处理 HTTP 的逻辑很简单,就是每接收到一个客户端请求,就返回一个响应。 而 WebSocket 是全双工通信,客户端和服务器可以随时向另一方发送数据,所以不再是"发送请求、返回响应"的通信方式了。我们上面的 EchoHandler 示例用的仍旧是这一方式,即收到数据后再针对性地返回一条数据,我们下面就来看看如何充分利用 WebSocket 的双向通信。 WebSocket 的处理,主要是通过 session 完成对两个数据流的操作,一个是客户端发给服务器的数据流,一个是服务器发给客户端的数据流: WebSocketSession方法 描述 Flux<WebSocketMessage> receive() 接收来自客户端的数据流,当连接关闭时数据流结束。 Mono<Void> send(Publisher<WebSocketMessage>) 向客户端发送数据流,当数据流结束时,往客户端的写操作也会随之结束,此时返回的Mono<Void>会发出一个完成信号。 在 WebSocketHandler 中,最后应该将两个数据流的处理结果整合成一个信号流,并返回一个Mono<Void>用于表明处理是否结束。 我们分别为两个流定义处理的逻辑: 对于输出流:服务器每秒向客户端发送一个数字; 对于输入流:每当收到客户端消息时,就打印到标准输出 Mono<Void> input = session.receive() .map(WebSocketMessage::getPayloadAsText) .map(msg -> id + ": " + msg) .doOnNext(System.out::println).then(); Mono<Void> output = session.send(Flux.create(sink -> senderMap.put(id, new WebSocketSender(session, sink)))); 这两个处理逻辑互相独立,它们之间没有先后关系,操作执行完之后都是返回一个Mono<Void>,但是如何将这两个操作的结果整合成一个信号流返回给 WebFlux 呢?我们可以使用 WebFlux 中的Mono.zip()方法: @Component @WebSocketMapping("/echo") public class EchoHandler implements WebSocketHandler { @Autowired private ConcurrentHashMap<String, WebSocketSender> senderMap; @Override public Mono<Void> handle(WebSocketSession session) { Mono<Void> input = session.receive() .map(WebSocketMessage::getPayloadAsText).map(msg -> id + ": " + msg) .doOnNext(System.out::println).then(); Mono<Void> output = session.send(Flux.create(sink -> senderMap.put(id, new WebSocketSender(session, sink)))); /** * Mono.zip() 会将多个 Mono 合并为一个新的 Mono, * 任何一个 Mono 产生 error 或 complete 都会导致合并后的 Mono * 也随之产生 error 或 complete,此时其它的 Mono 则会被执行取消操作。 */ return Mono.zip(input, output).then(); } } 4. 从 Handler 外部发送数据 这里所说的从外部发送数据,指的是需要在 WebSocketHandler 的代码范围之外,在其它地方通过代码调用的方式向 WebSocket 连接发送数据。 思路:在定义 session 的send()操作时,通过编程的方式创建 Flux,即使用Flux.create()方法创建,将发布 Flux 数据的FluxSink暴露出来,并进行保存,然后在需要发送数据的地方,调用FluxSink<T>的next(T data)方法,向 Flux 的订阅者发布数据。 create 方法是以编程方式创建 Flux 的高级形式,它允许每次产生多个数据,并且可以由多个线程产生。 create 方法将内部的 FluxSink 暴露出来,FluxSink 提供了 next、error、complete 方法。通过 create 方法,可以将响应式堆栈中的 API 与其它 API 进行连接。 考虑这么一个场景:服务器与客户端 A 建立 WebSocket 连接后,允许客户端 B 通过 HTTP 向客户端 A 发送数据。 不考虑安全性、鲁棒性等问题,我们给出一个简单的示例。 首先是 WebSocketHandler 的实现,客户端发送 WebSocket 建立请求时,需要在 query 参数中为当前连接指定一个 id,服务器会以该 id 为键,以对应的 WebSocketSender 为值存放到 senderMap 中: @Component @WebSocketMapping("/echo") public class EchoHandler implements WebSocketHandler { @Autowired private ConcurrentHashMap<String, WebSocketSender> senderMap; @Override public Mono<Void> handle(WebSocketSession session) { // TODO Auto-generated method stub HandshakeInfo handshakeInfo = session.getHandshakeInfo(); Map<String, String> queryMap = getQueryMap(handshakeInfo.getUri().getQuery()); String id = queryMap.getOrDefault("id", "defaultId"); Mono<Void> input = session.receive().map(WebSocketMessage::getPayloadAsText).map(msg -> id + ": " + msg) .doOnNext(System.out::println).then(); Mono<Void> output = session.send(Flux.create(sink -> senderMap.put(id, new WebSocketSender(session, sink)))); /** * Mono.zip() 会将多个 Mono 合并为一个新的 Mono,任何一个 Mono 产生 error 或 complete 都会导致合并后的 Mono * 也随之产生 error 或 complete,此时其它的 Mono 则会被执行取消操作。 */ return Mono.zip(input, output).then(); } //用于获取url参数 private Map<String, String> getQueryMap(String queryStr) { Map<String, String> queryMap = new HashMap<>(); if (!StringUtils.isEmpty(queryStr)) { String[] queryParam = queryStr.split("&"); Arrays.stream(queryParam).forEach(s -> { String[] kv = s.split("=", 2); String value = kv.length == 2 ? kv[1] : ""; queryMap.put(kv[0], value); }); } return queryMap; } } 其中,senderMap是我们自己定义的 Bean,在配置文件中定义: @Configuration public class WebSocketConfiguration { @Bean public HandlerMapping webSocketMapping() { return new WebSocketMappingHandlerMapping(); } @Bean public ConcurrentHashMap<String, WebSocketSender> senderMap() { return new ConcurrentHashMap<String, WebSocketSender>(); } @Bean public WebSocketHandlerAdapter handlerAdapter() { return new WebSocketHandlerAdapter(); } } WebSocketSender是我们自己创建的类,目的是保存 WebSocket 连接的 session 以及对应的 FluxSink,以便在 WebSocketHandler 代码范围外发送数据: public class WebSocketSender { private WebSocketSession session; private FluxSink<WebSocketMessage> sink; public WebSocketSender(WebSocketSession session, FluxSink<WebSocketMessage> sink) { this.session = session; this.sink = sink; } public void sendData(String data) { sink.next(session.textMessage(data)); } } 接着我们来实现 HTTP Controller,用户在发起 HTTP 请求时,通过 query 参数指定要通信的 WebSocket 连接 id,以及要发送的数据,然后从 senderMap 中取出对应的 WebSocketSender,调用其send()方法向客户端发送数据: @RestController @RequestMapping("/msg") public class MsgController { @Autowired private ConcurrentHashMap<String, WebSocketSender> senderMap; @RequestMapping("/send") public String sendMessage(@RequestParam String id, @RequestParam String data) { WebSocketSender sender = senderMap.get(id); if (sender != null) { sender.sendData(data); return String.format("Message '%s' sent to connection: %s.", data, id); } else { return String.format("Connection of id '%s' doesn't exist", id); } } } 5. 测试 我这就不再写页面了,直接就用https://www.websocket.org/echo.html进行测试了,结果如下: 这样就算完成了定点推送了,全推送,和部分推送就不再写了,只要从ConcurrentHashMap中取出来去发送就是了。

优秀的个人博客,低调大师

每日一博 | 构建 SaaS 平台项目失败后的反思

记一次构建SaaS平台项目失败后的反思 前言: 笔者从2017年起开始着手将公司现有的软件系统改造成多租户模式,以降低整个系统的运营成本。但最后这个项目以失败告终。今天,我将对这个SaaS项目是如何走向失败,做一个分析和反思。 此前,我们花费了两年的时间研发了一套教学系统,考虑到用户的数量与营运成本,后期决定将这套单体的应用程序改造为基于SaaS架构的多租户应用程序。经过短暂的需求分析后,便开始了重构工作。经过一年的艰苦奋斗,SaaS化的产品不仅用户不能接受,就连我们自己也无法成功运营。其功能的完成度差强人意,运营的成本也没有比单体应用少,反而运营难度上升了。通过一段时间的整理与思考,总结了这一次SaaS化平台失败的原因。 一、不务实的需求 一个成功的SaaS产品,需要有足够多的用户需求样本数据以及对这些样本数据深入的挖掘、分析和抽象,以得到一份通用的,覆盖率大的应用场景数据。只有如此,才能够开发出一款具有普世价值的应用软件,才能贴合SaaS用户的实际需求。而在此次的SaaS化产品的过程中,我们犯了“闭门造车”的严重错误,导致这一错误产生的原因是我们拿到的原始需求不够,仅仅凭借一两个客户的需求数据,并以此为蓝本展开系统的设计,实现了很多用户根本不需要的功能,比如用户只想要一个文档存储的功能,我们实现了一个网盘的功能;又比如说我们没有考虑到中学禁止学生使用手机,而我们的系统功能很多是基于移动端进行设计的,最后导致系统的功能和用户的需求对不上号。当我们花了很长时间去实现一个自己认为很棒的功能时,客户不认可这样的设计给了我们狠狠的一剂耳光,痛并郁闷着。 客户需求数据过少,加之主观上的臆想,导致了系统中充斥着大量华而不实的功能。表面上看,系统的各个功能都比较高大上,但就是这样高大上的功能,却和客户的想法背道而驰。客户的想法是最实际的,华丽的功能在一定程度上太过于注重“表演”,而无法真正帮助客户解决实际的问题。 面对这样一个问题,就需要在提出一个好的创意时,需要再三的与实际的需求做比对,只有创意与需求能够契合在一起时,创意才能转化为有效的功能,才能起到锦上添花的效果。而解决这一个问题,需要将如下的几个工作落实到实处: 1、获取尽可能多的需求样本数据 2、对需求数据进行划分、得出需求场景 3、以场景建立用户故事,梳理业务逻辑 4、以业务逻辑为单元,评估系统规模,展开系统设计 5、建立有效的沟通机制,及时将设计原型与用户进行沟通,确定有效需求 下面,通过一张图来说明如何排除不务实的系统需求: 说明: 在第一步中,我们需要收集不同用户数量,不同知识结构、不同硬件环境以及不同资金支配能力的客户需求,这样才能从不同的维度去了解客户的想法和业务痛点。如用户量大的客户,更则种系统的整体协能力,以及业务的流程的连贯性和时效性。而用户量较小的客户可能则重于系统的高效和便捷程度。对于可支配资金,直接影响着系统在设计时的布局,如性能的分配和交互的体验度,以及后期定制收费标准。 第二步、建立场景是为了把庞杂的需求进行切割,建立科学的需求分类,减轻需求分析的难度和时长。将杂乱的需求按照类别进行深入分析,挖掘客户的业务痛点,为构建起用户故事提供素材和依据。 第三步中,分析的视角将从局部变为全局,通过第二步得到数据,建立起用户故事,以分析各需求之间的联系和各自的主线。 第四部是对需求进行统筹规划,将需求变成可用的业务逻辑,并对此业务逻辑进行技术可行性和风险评估,最后将此评估结果与客户需求进行比对和调整,确定最终的有效需求。 二、技术债务过大 任何应用程序的开发,都需要考虑技术债务问题,即木桶定理。从项目开始提案开始,就犯了技术冒进的错误。选择了技术一系列比较新的技术框架和设计思想,如前后端分离设计,微服务化和容器化等较新的技术栈,以及项目开始实施前没有做好相关技术的培训工作,导致项目组成员的技术能力良莠不齐,项目推进缓慢,接连踩坑,很多关键技术没有吃透,很多技术问题没有解决,导致应用系统性能脆弱,部署周期长,运维难度大,直至后面项目搁浅。 出现这样巨大的技术债务,是过于盲目的跟随市场技术浪潮,没有对自身团队技术能力做一个有效的评估所造成的。新技术固然有它超越现有技术的威力所在,但弊病也不少。首先是学习成本,需要花费大量的时间对整个团队进行培训,而培训并不是所有的人都能一个水平,从这开始,木桶的短板就开始产生了。由于技术掌握不牢固,开发工程中踩坑是避免不了的,这就导致项目进度急剧拉长,技术债务开始累积,最后的结果就是,产品千疮百孔,无法使用。 由于花费的巨大的时间去解决技术问题,从而忽略了一开始的运维问题(更多的是无暇顾及,先把产品搞出来再说)。很多时候,在开发调试阶段应用程序没有出现问题,一旦放到生产环境就开始问题百出。这是因为我们想当然的认为,新技术已经把所有的问题都解决了,抱着一种侥幸的心理,在匆忙之间将项目上线,从而忽视那些极为致命的问题,线上安全问题、性能问题、网络问题、环境问题、终端适配问题等等。 这些问题归集到一起,主要问题出在架构师身上,导致可以终结出这种架构师的几点特质: 1、出方案靠拍脑袋,一锤子买卖。一拍脑袋,就这么定了,根本没有考虑后续的问题 2、实现过程排胸脯,保证没有问题。过于自信,导致太过自负。对于架构师而言,没有问题就是最大的问题 3、出问题排大腿,这么回这样。等到问题出现了,才恍然大悟,当初为什么没有想到会这样 4、程序崩溃排桌子,坑爹的框架。没有认真的选择合适的技术栈来完成项目,从一开始的设计从确定了系统的先天性顽疾,并不是框架本身的错。 那么,该如何避免技术债务过大的问题能?我的建议是杜绝设计上的冒进,不是新技术就一定好。可以采取小步快走,缩小升级范围,先将非核心功能进行改造,实现系统平滑过渡到新的技术框架,也让团队的成员有一个适应期,避免一次性集中踩雷的风险。与此同时,还需注意另外一个问题,系统重构不等于推翻重来。很多人会觉得推翻重来一定会比之前的设计好,在一定程度上可以将之前系统暴露的问题进行规避,但新的设计又会带来新的,更多的问题。所以,在进行升级过渡到SaaS产品时,一定要学会利用以后的成熟技术,减少升级的难度和成本,快速多批次的进行升级,这样,即便出现问题,也可以将问题控制在一个可以接受的范围,不至于蔓延至整个系统,甚至造成应用程序的不可用。 最后就是关于运维的问题,在设计一套系统架构时,一定要提前预估它的运维工作量,如果解决系统的“后顾之忧”,运维所带来的技术债务不比开发过程的少,以这次项目为例,应用程序按照业务分成了若干个服务,每个服务对应着10到20个不等的运行实例,由于项目组无法拿出有效的容器化方案,以及部署环境不支持Docker容器技术,也没有持续发布应用实例的环境,最后只能人工手动维护200多个JAR包的运行实例,当出现应用程序不可用,或者宕机问题时,需要人工重启对应的应用程序,这是一个糟糕的设计,或者说是失败的设计,对于运维来说,这是一场灾难。由于先天性的不足,加速了产品走向奔溃的边缘。 三、一口吃成大胖子 导致项目最终走向失败还有另外一个重要的原因,一口吃太多,嚼不烂。在确定需求的过程中,对于每一个租户提出的需求,我们采取了尽可能满足的方法,导致整个系统过于臃肿,杂乱,就好比一个万花筒。 按照这样一种方式,平台需要具备多端接入的能力,如PC、平板、智能手机等,以满足不同租户的要求,但最终我们连PC端都没有实现好。好高骛远,往往就是走向失败的开始;量体裁衣,才是做系统设计的硬道理。体系太过于庞大,团队的技术能力无法覆盖一下子覆盖到这么大的面,而且核心的功能还未接受市场的检验,就同时要满足适配多端的能力,这无疑是在开玩笑,最终将会得到一个烂尾工程。即便项目完成,充其量也就是一个软件中的“玩具”。 因此,在软件开发之初,切忌好大喜功,一下子将全部的功能都纳入到实现的范围,需要识别出哪些是必须功能,哪些是核心功能,哪些是扩展功能。需要分清楚产品的愿景与产品实现的本质区别。愿景是对产品生态链的展望,而技术实现需要实事求是,根据现有的技术水平和用户需求,做出一个折中的方案,任何设计都有妥协,没有一步到位的软件产品,也没有最好的软件产品,只有通过一步步的优化设计,一步步的升级技术,才能做出更好的软件产品。这一点在研发SaaS平台时尤为重要,你不可能同时满足多个租户的需求,你需要甄别出最具代表性和最有价值的那一部分租户,你的研发方向也需要向这一部分租户靠拢,下面通过一张图来说明构建一个SaaS平台时,需求占比应该如何分配: 为什么会有这样的一个配比?首先,能够创造价值的租户,是能够向你进行付费使用软件的租户,对于这一部分租户提出的需求,你可以以定制软件的态度去对待,对于他们提出的要求,你需要想办法去实现。而具有发展潜力的租户,是那些有可能成为你付费用户的群体,你需要研究产品的核心功能是什么?,以及什么样的核心功能才能打动他们。而具有代表性的租户是指那些能够提出比较创新的,具有一市场价值的需求的群体,他们是产品发展的创新所在,可以考虑为这一部分群体单独扩展出他们想要的功能,以观察市场的对平台的反应。最后是基础租户,他们的需求都具有普世性,需要考虑一定量的通用功能为其服务。 四、业务于产品先行 最后,谈谈技术之外的一些看法。大部分的团队都会犯这样一个错误:当产品开发完成之后,再去寻找市场。我们在这个项目中,也犯了同样的错误。可以思考这样一个问题,用户的需求随着时间的推移在发生改变,如果你不紧跟市场的动向,及时调整自己的产品功能,而是拿到一份需求后就开始闭门造车,当你的产品开发完时,就已经被淘汰了。为了避免产品没有市场,业务就必须限于产品动起来。通过不断的获取用户的需求,提取有价值的需求数据,及时调整产品的方向,才能缩短产品功能与用户需求之间的差距。业务先行,在间接的帮助平台设计者完善和充实现有的功能,及时的发现平台隐藏的问题,并对此做出调整,在交付产品前尽可能的规避可能出现的故障,提高平台的服务能力。 总结 对于今天的软件设计者来说,让软件使用者来适应你所设计的产品的时代已经不复存在。你需要主动的调整自己,从内到外多角度的看待问题,才能帮助你出色的完成软件的设计。在技术上,需要沉着冷静,实事求是的分析所面对的问题,需要懂得如何把控技术风险;科学有序的开展软件设计工作,断不可不顾现实情况,盲目跟风,技术冒进以及唯技术论的路子对待软件设计。在业务上,需要实时跟进需求的变化,具备敏锐的眼光去发现用户的痛点和难点,能够快速的对用户需求的变更做出合理、科学的反应。 文章转自:https://www.toutiao.com/i6699138217674801667/ 作者:ramostear

优秀的个人博客,低调大师

每日一博 | Linux中如何保证数据安全落盘

背景 在很多IO场景中,我们经常需要确保数据已经安全的写到磁盘上,以便在系统宕机重启之后还能读到这些数据。但是我们都知道,linux系统的IO路径还是很复杂的,分为很多层,每一层都可能会有buffer来加速IO读写。同时,用户态的应用程序和库函数也可能拥有自己的buffer,这又给IO路径增加了一些复杂性。可见,要想保证数据安全的写到磁盘上,并不是简单调一个write/fwrite就可以搞定的。 那么要怎么做呢?很多人会想到很多办法,比如:fflush()、fsync()、fdatasync()、sync()、open()使用O_DIRECT或O_SYNC标志等。嗯,这些手段(或者某些组合)的确可以保证数据安全的持久化,那么它们之间有什么区别呢?fflush()和fsync()有啥区别?O_DIRECT是啥意思,它可以保证数据安全的持久化吗?O_DIRECT和O_SYNC区别什么?O_SYNC和fsync()呢?fsync能完成msync的功能吗?本文将试图理解、解释这些概念的作用和区别。 Linux IO 所谓一图胜千言,为了解析清楚这些概念的区别,我特意画了一张图,仔细看,应该可以清晰的看出它们的作用和区别。 这里重点说一下O_DIRECT和O_SYNC,首先要明确的是,O_DIRECT只是说数据不会经过page cache(一般用在用户态自己管理buffer)而是直接提交给块设备层,但是不会同步等待数据安全写入磁盘之后才返回(比如数据可能还在块层排队或者在磁盘自己的cache中)。而O_SYNC标志,虽然数据还是会写page cache,但是此时会采用write through的策略,并同步等待数据安全写入磁盘后才会返回。因此如果同时使用O_DIRECT和O_SYNC,则表示数据不会经过page cache并同步等待数据安全写入磁盘才返回,当然这样IO的性能会非常低下。 由于O_DIRECT会bypass page cache,因此如果有另一个进程使用普通的方式读文件,有可能会出现数据不一致的现象,这个也需要注意。 为了做一下辅助说明,此处我贴一下我探讨过程中看过的一些资料。首先是引用open系统调用:http://man7.org/linux/man-pages/man2/open.2.html相关参数的说明: 以及innodb相关的文档:https://lwn.net/Articles/457667/ fsync和fdatasync的区别:http://man7.org/linux/man-pages/man2/fsync.2.html msync:http://man7.org/linux/man-pages/man2/msync.2.html DAX 其实还有一种IO模式,就是DAX(Direct Access),是不是看上去和O_DIRECT很像。这种模式需要filesystem和block driver都支持才可以,一般主要用在non volatile memory上,本质上也是绕过page cache直接操作设备。DAX本文先不做深入探讨,后面我会自己写一个支持DAX模式的ramdisk块设备驱动,然后格式化为ext4文件系统并-o dax模式挂载,再来详细研究DAX的IO路径。https://www.kernel.org/doc/Documentation/filesystems/dax.txt 最后附上Linux在常见场景下的io路径跟踪:https://my.oschina.net/fileoptions/blog/3061822 参考 参照:https://blog.pythian.com/innodb-flushing-linux-io/

优秀的个人博客,低调大师

每日一博 | 从MySQL源码看其网络IO模型

从MySQL源码看其网络IO模型 前言 MySQL是当今最流行的开源数据库,阅读其源码是一件大有裨益的事情(虽然其代码感觉比较凌乱)。而笔者阅读一个Server源码的习惯就是先从其网络IO模型看起。于是,便有了本篇博客。 MySQL启动Socket监听 看源码,首先就需要找到其入口点,mysqld的入口点为mysqld_main,跳过了各种配置文件的加载 之后,我们来到了network_init初始化网络环节,如下图所示: 下面是其调用栈: mysqld_main (MySQL Server Entry Point) |-network_init (初始化网络) /* 建立tcp套接字 */ |-create_socket (AF_INET) |-mysql_socket_bind (AF_INET) |-mysql_socket_listen (AF_INET) /* 建立UNIX套接字*/ |-mysql_socket_socket (AF_UNIX) |-mysql_socket_bind (AF_UNIX) |-mysql_socket_listen (AF_UNIX) 值得注意的是,在tcp socket的初始化过程中,考虑到了ipv4/v6的两种情况: // 首先创建ipv4连接 ip_sock= create_socket(ai, AF_INET, &a); // 如果无法创建ipv4连接,则尝试创建ipv6连接 if(mysql_socket_getfd(ip_sock) == INVALID_SOCKET) ip_sock= create_socket(ai, AF_INET6, &a); 如果我们以很快的速度stop/start mysql,会出现上一个mysql的listen port没有被release导致无法当前mysql的socket无法bind的情况,在此种情况下mysql会循环等待,其每次等待时间为当前重试次数retry * retry/3 +1秒,一直到设置的--port-open-timeout(默认为0)为止,如下图所示: MySQL新建连接处理循环 通过handle_connections_sockets处理MySQL的新建连接循环,根据操作系统的配置通过poll/select处理循环(非epoll,这样可移植性较高,且mysql瓶颈不在网络上)。 MySQL通过线程池的模式处理连接(一个连接对应一个线程,连接关闭后将线程归还到池中),如下图所示: 对应的调用栈如下所示: handle_connections_sockets |->poll/select |->new_sock=mysql_socket_accept(...sock...) /*从listen socket中获取新连接*/ |->new THD 连接线程上下文 /* 如果获取不到足够内存,则shutdown new_sock*/ |->mysql_socket_getfd(sock) 从socket中获取 /** 设置为NONBLOCK和环境有关 **/ |->fcntl(mysql_socket_getfd(sock), F_SETFL, flags | O_NONBLOCK); |->mysql_socket_vio_new |->vio_init (VIO_TYPE_TCPIP) |->(vio->write = vio_write) /* 默认用的是vio_read */ |->(vio->read=(flags & VIO_BUFFERED_READ) ?vio_read_buff :vio_read;) |->(vio->viokeepalive = vio_keepalive) /*tcp层面的keepalive*/ |->..... |->mysql_net_init |->设置超时时间,最大packet等参数 |->create_new_thread(thd) /* 实际是从线程池拿,不够再新建pthread线程 */ |->最大连接数限制 |->create_thread_to_handle_connection |->首先看下线程池是否有空闲线程 |->mysql_cond_signal(&COND_thread_cache) /* 有则发送信号 */ /** 这边的hanlde_one_connection是mysql连接的主要处理函数 */ |->mysql_thread_create(...handle_one_connection...) MySQL的VIO 如上图代码中,每新建一个连接,都随之新建一个vio(mysql_socket_vio_new->vio_init),在vio_init的过程中,初始化了一堆回掉函数,如下图所示: 我们关注点在vio_read和vio_write上,如上面代码所示,在笔者所处机器的环境下将MySQL连接的socket设置成了非阻塞模式(O_NONBLOCK)模式。所以在vio的代码里面采用了nonblock代码的编写模式,如下面源码所示: vio_read size_t vio_read(Vio *vio, uchar *buf, size_t size) { while ((ret= mysql_socket_recv(vio->mysql_socket, (SOCKBUF_T *)buf, size, flags)) == -1) { ...... // 如果上面获取的数据为空,则通过select的方式去获取读取事件,并设置超时timeout时间 if ((ret= vio_socket_io_wait(vio, VIO_IO_EVENT_READ))) break; } } 即通过while循环去读取socket中的数据,如果读取为空,则通过vio_socket_io_wait去等待(借助于select的超时机制),其源码如下所示: vio_socket_io_wait |->vio_io_wait |-> (ret= select(fd + 1, &readfds, &writefds, &exceptfds, (timeout >= 0) ? &tm : NULL)) 笔者在jdk源码中看到java的connection time out也是通过这,select(...wait_time)的方式去实现连接超时的。 由上述源码可以看出,这个mysql的read_timeout是针对每次socket recv(而不是整个packet的),所以可能出现超过read_timeout MySQL仍旧不会报错的情况,如下图所示: vio_write vio_write实现模式和vio_read一致,也是通过select来实现超时时间的判定,如下面源码所示: size_t vio_write(Vio *vio, const uchar* buf, size_t size) { while ((ret= mysql_socket_send(vio->mysql_socket, (SOCKBUF_T *)buf, size, flags)) == -1) { int error= socket_errno; /* The operation would block? */ // 处理EAGAIN和EWOULDBLOCK返回,NON_BLOCK模式都必须处理 if (error != SOCKET_EAGAIN && error != SOCKET_EWOULDBLOCK) break; /* Wait for the output buffer to become writable.*/ if ((ret= vio_socket_io_wait(vio, VIO_IO_EVENT_WRITE))) break; } } MySQL的连接处理线程 从上面的代码: mysql_thread_create(...handle_one_connection...) 可以发现,MySQL每个线程的处理函数为handle_one_connection,其过程如下图所示: 代码如下所示: for(;;){ // 这边做了连接的handshake和auth的工作 rc= thd_prepare_connection(thd); // 和通常的线程处理一样,一个无限循环获取连接请求 while(thd_is_connection_alive(thd)) { if(do_command(thd)) break; } // 出循环之后,连接已经被clientdu端关闭或者出现异常 // 这边做了连接的销毁动作 end_connection(thd); end_thread: ... // 这边调用end_thread做清理动作,并将当前线程返还给线程池重用 // end_thread对应为one_thread_per_connection_end if (MYSQL_CALLBACK_ELSE(thread_scheduler, end_thread, (thd, 1), 0)) return; ... // 这边current_thd是个宏定义,其实是current_thd(); // 主要是从线程上下文中获取新塞进去的thd // my_pthread_getspecific_ptr(THD*,THR_THD); thd= current_thd; ... } mysql的每个woker线程通过无限循环去处理请求。 线程的归还过程 MySQL通过调用one_thread_per_connection_end(即上面的end_thread)去归还连接。 MYSQL_CALLBACK_ELSE(...end_thread) one_thread_per_connection_end |->thd->release_resources() |->...... |->block_until_new_connection 线程在新连接尚未到来之前,等待在信号量上(下面代码是C/C++ mutex condition的标准使用模式): static bool block_until_new_connection() { mysql_mutex_lock(&LOCK_thread_count); ...... while (!abort_loop && !wake_pthread && !kill_blocked_pthreads_flag) mysql_cond_wait(&x1, &LOCK_thread_count); ...... // 从等待列表中获取需要处理的THD thd= waiting_thd_list->front(); waiting_thd_list->pop_front(); ...... // 将thd放入到当前线程上下文中 // my_pthread_setspecific_ptr(THR_THD, this) thd->store_globals(); ...... mysql_mutex_unlock(&LOCK_thread_count); ..... } 整个过程如下图所示: 由于MySQL的调用栈比较深,所以将thd放入线程上下文中能够有效的在调用栈中减少传递参数的数量。 总结 MySQL的网络IO模型采用了经典的线程池技术,虽然性能上不及reactor模型,但好在其瓶颈并不在网络IO上,采用这种方法无疑可以节省大量的精力去专注于处理sql等其它方面的优化。 原文链接 https://my.oschina.net/alchemystar/blog/3048760

优秀的个人博客,低调大师

每日一博 | 消息队列的消费语义和投递语义

引言 所谓的消费语义,指的就是如下三种情况 如何保证消息最多消费一次 如何保证消息至少消费一次 如何保证消息恰好消费一次 其实类似还有一个投递语义 如何保证消息最多投递一次 如何保证消息至少投递一次 如何保证消息恰好投递一次 说句实在话,其实还是老问题,只是换了一种问法! OK,开始我们的正文 正文 我们先做如下约定 Producer代表生产者 Consumer代表消费者 Message Queue代表消息队列 投递语义 我们先从投递语义开始讲起,因为要先把这个概念讲明白了,才能讲消费语义。恰巧,kafka实现了这三种语义,我们以kafka来说明。 如何保证消息最多投递一次? 简单,就是我已经投出去了,收没收到不管了,会存在消息丢失。 我们在初始化Producer时可以通过配置request.required.acks不同的值,来实现不同的发送模式。 这里将request.required.acks设为0,意思就是Producer不等待Leader确认,只管发出即可;最可能丢失消息。如果丢了消息,就是投递0次。如果没丢,就是投递1次。符合最多投递一次的含义。 如何保证消息至少投递一次? 这里将request.required.acks设为-1。Producer往kafka的Leader(主)节点发送消息后,会等follower(从)节点同步完数据以后,再给Producer返回ACK确认消息。 但是这里是有几率出现重复消费的问题的。 例如,kafka保存消息后,发送ACK前宕机,Producer认为消息未发送成功并重试,造成数据重复! 那么,在这种情况下,就会出现大于1次的投递情况,符合至少投递一次的含义。 如何保证消息恰好投递一次? kafka在0.11.0.0版本之后支持恰好投递一次的语义。 我们将enable.idempotence设置为ture,此时就会默认把request.required.acks设为-1,可以达到恰好投递一次的语义。 如何做到的? 为了实现Producer的幂等语义,Kafka引入了Producer ID(即PID)和Sequence Number。 kafka为每个Producer分配一个pid,作为该Producer的唯一标识。 Producer会为每一个<topic,partition>维护一个单调递增的seq。 类似的,Message Queue也会为每个<pid,topic,partition>记录下最新的seq。 当req_seq == message_seq+1时,Message Queue才会接受该消息。因为: (1)消息的seq比Message Queue的seq大一以上,说明中间有数据还没写入,即乱序了。 (2)消息的seq比Message Queue的seq小,那么说明该消息已被保存。 消费语义 这里我们还是做一个定义如下所示 consumer.poll()表示消费者获取消息内容 processMsg(message)表示下游系统进行消费消息 consumer.commit()表示消费者往消息队列提交确认信息,消息队列接到确认消息,删除该消息。 注意了,我是以processMsg函数,即处理消息的过程,定义为消费消息。 如何保证消息最多消费一次? Producer:满足最多投递一次的语义即可,即只管发消息,不需要等待消息队列返回确认消息。 Message Queue:接到消息后往内存中一放就行,不用持久化存储。 Consumer:拉取到消息以后,直接给消息队列返回确认消息即可。至于后续消费消息成功与否,无所谓的。即按照以下顺序执行 consumer.poll(); consumer.commit(); processMsg(message); 如何保证消息至少消费一次? Producer:满足至少投递一次语义即可,即发送消息后,需要等待消息队列返回确认消息。如果超时没收到确认消息,则重发。 Message Queue:接到消息后,进行持久化存储,而后返回生产者确认消息。 Consumer:拉取到消息后,进行消费,消费成功后,再返回确认消息。即按照如下顺序执行 consumer.poll(); processMsg(message); consumer.commit(); 由于这里Producer满足的是至少投递一次语义,因此消息队列中是有重复消息的。所以我们的Consumer会出现重复消费的情形! 如何保证消息恰好消费一次? 在保证至少消费一次的基础上,processMsg满足幂等性操作即可。 如何保证幂等性操作? 老问题了,比如有状态的消息啊。比如唯一表啊。大家搜一搜,一大堆答案,不想重复说了。 总结 本文讲的是消息队列的消费语义和投递语义的含义,希望大家有所收获。 出处:https://www.cnblogs.com/rjzheng/p/11050673.html

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册