首页 文章 精选 留言 我的

精选列表

搜索[赛博朋克],共10000篇文章
优秀的个人博客,低调大师

每日一博 | MyBatis 源码解析:SQL 语句的执行机制

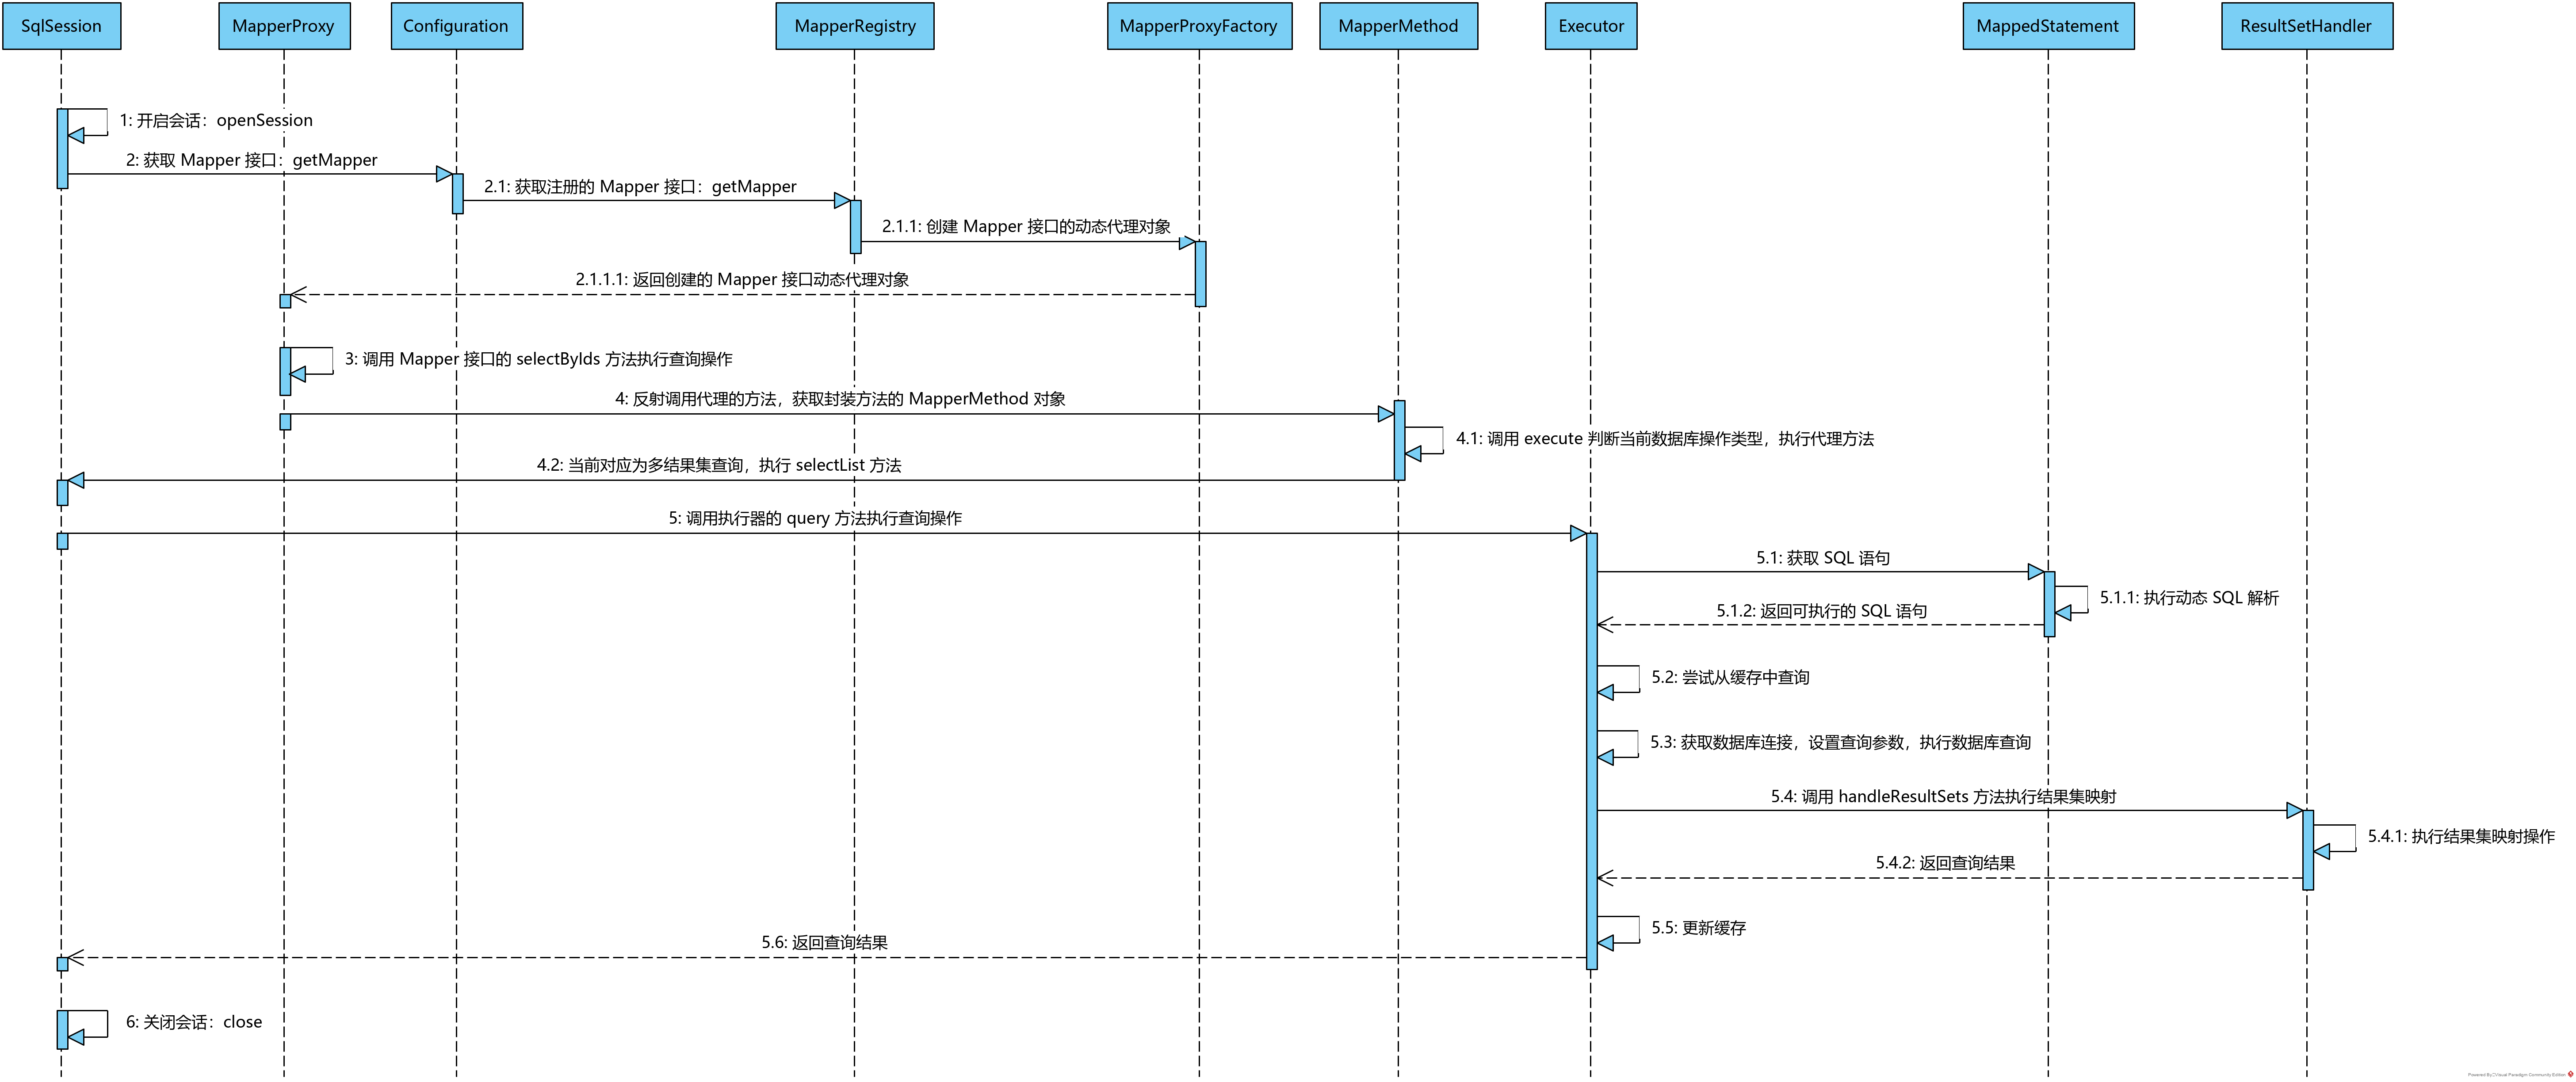
通过前面两篇文章,我们完成了对 MyBatis 所有配置文件(包括配置文件和映射文件)解析过程的分析。回忆一下我们最开始给出的小示例(如下),经过前面的跋山涉水,我们终于完成了第一行代码的 99% (手动滑稽),这最后的 1% 就是创建 SqlSessionFactory 对象。所有的配置解析最后都会封装到 Configuration 对象中,接下去就是调用 SqlSessionFactoryBuilder#build 方法创建 SqlSessionFactory 对象,实际使用的是 DefaultSqlSessionFactory 实现类进行实例化。 SqlSessionFactory sessionFactory = new SqlSessionFactoryBuilder() .build(Resources.getResourceAsStream("mybatis-config.xml")); try (SqlSession sqlSession = sessionFactory.openSession()) { UserMapper mapper = sqlSession.getMapper(UserMapper.class); User user = mapper.selectByName("zhenchao"); // ... use user object } SqlSessionFactory 是一个工厂类,用于创建 SqlSession 对象。按照官方文档的说明,SqlSessionFactory 对象一旦被创建就应该在应用的运行期间一直存在,不应该在运行期间对其进行清除或重建。调用该工厂的 SqlSessionFactory#openSession 方法可以开启一次会话,即创建一个 SqlSession 对象。SqlSession 封装了面向数据库执行 SQL 的所有 API,它不是线程安全的,因此不能被共享,所以该对象的最佳作用域是请求或方法作用域。在上面的示例中,我们用 SqlSession 拿到相应的 Mapper 接口对象(更准确的说是一个动态代理对象),然后执行指定的数据库操作,最后关闭此次会话。 上面这张时序图我们在本系列开篇的文章中已经引用过,描绘了 MyBatis 在一次会话生命周期内执行数据库操作的交互时序。下面对这幅图中所描绘的执行过程中类之间的交互时序关系作进一步说明,稍后我们会对图中涉及到的类和接口从源码层面进行分析,执行时序如下: 调用 SqlSessionFactory#openSession 方法创建 SqlSession 对象,开启一次会话; 调用 SqlSession#getMapper 方法获取指定的 Mapper 接口对象,这里实际上将请求委托给 Configuration#getMapper 方法执行,由前面分析映射文件解析过程时我们知道所有的 Mapper 接口都会注册到全局唯一的配置对象 Configuration 的 MapperRegistry 类型属性中; MapperRegistry 在执行 MapperRegistry#getMapper 操作时会反射创建 Mapper 接口的动态代理对象并返回; 执行对应的数据库操作方法(例如 UserMapper#selectByName),即调用 Mapper 接口动态代理对象的 MapperProxy#invoke 方法,在该方法中会获取封装执行方法的 MapperMethod 对象; 执行 MapperMethod#execute 方法,该方法会判定当前数据库操作类型(例如 SELECT),依据类型选择执行 SqlSession 对应的数据库操作方法; SqlSession 会将数据库操作委托给具体的 Executor 执行。对于动态 SQL 语句而言,在这里会依据参数执行解析;对于查询语句而言,Executor 在条件允许的情况下会尝试先从缓存中进行查询,缓存不命中才会操作具体的数据库并更新缓存。MyBatis 强大的结果集映射操作也在这里完成; 返回查询结果; 调用当前会话的 SqlSession#close 方法关闭本次会话。 整个过程围绕一次查询操作展开,虽然不能覆盖 MyBatis 执行 SQL 语句的各个方面,但主线上还是能够说明白 MyBatis 针对一次 SQL 执行的大概过程。在下面的篇幅中,我们将一起分析这一整套时序背后的实现机制。 SQL 会话管理 SqlSession 接口是 MyBatis 对外提供的数据库操作 API,是 MyBatis 的核心接口之一,用于管理一次数据库会话。围绕 SqlSession 接口的类继承关系如下图所示,其中 DefaultSqlSession 是默认的 SqlSession 实现。SqlSessionFactory 是一个工厂接口,其功能是用来创建 SqlSession 对象,该接口中声明了多个重载版本的 SqlSessionFactory#openSession 方法,DefaultSqlSessionFactory 是该接口的默认实现。上述示例程序中 SqlSessionFactoryBuilder#build 方法就是基于该实现类创建的 SqlSessionFactory 对象。SqlSessionManager 类实现了这两个接口,所以具备创建、使用,以及管理 SqlSession 对象的能力,后面会详细说明。 SqlSession 接口中声明的方法都比较直观,感兴趣的读者可以自行阅读源码。我们来看一下针对该接口的默认实现类 DefaultSqlSession,该类的属性定义如下: /** 全局唯一的配置对象 */ private final Configuration configuration; /** SQL 语句执行器 */ private final Executor executor; /** 是否自动提交事务 */ private final boolean autoCommit; /** 标记当前缓存中是否存在脏数据 */ private boolean dirty; /** 记录已经打开的游标 */ private List<Cursor<?>> cursorList; DefaultSqlSession 中的方法实现基本上都是对 Executor 接口方法的封装,实现上都比较简单。这里解释一下 DefaultSqlSession#cursorList 这个属性,在 DefaultSqlSession#selectCursor 方法中会记录查询返回的游标(Cursor)对象,并在关闭 SqlSession 会话时遍历集合逐一关闭,从而防止打开的游标没有被关闭的现象。 DefaultSqlSessionFactory 是 SqlSessionFactory 接口的默认实现,用于创建 SqlSession 对象。该实现类提供了两种创建 SqlSession 对象的方式,分别是基于当前数据源创建会话和基于当前数据库连接创建会话,对应的实现如下。 基于数据源创建会话 private SqlSession openSessionFromDataSource( ExecutorType execType, TransactionIsolationLevel level, boolean autoCommit) { Transaction tx = null; try { // 获取当前激活的数据库环境配置 final Environment environment = configuration.getEnvironment(); // 获取当前数据库环境对应的 TransactionFactory 对象,不存在的话就创建一个 final TransactionFactory transactionFactory = this.getTransactionFactoryFromEnvironment(environment); tx = transactionFactory.newTransaction(environment.getDataSource(), level, autoCommit); // 依据指定的 Executor 类型创建对应的 Executor 对象 final Executor executor = configuration.newExecutor(tx, execType); // 创建 SqlSession 对象 return new DefaultSqlSession(configuration, executor, autoCommit); } catch (Exception e) { this.closeTransaction(tx); // may have fetched a connection so lets call close() throw ExceptionFactory.wrapException("Error opening session. Cause: " + e, e); } finally { ErrorContext.instance().reset(); } } 基于数据库连接创建会话 private SqlSession openSessionFromConnection(ExecutorType execType, Connection connection) { try { boolean autoCommit; try { autoCommit = connection.getAutoCommit(); } catch (SQLException e) { // 考虑到很多驱动或者数据库不支持事务,设置自动提交事务 autoCommit = true; } // 获取当前激活的数据库环境配置 final Environment environment = configuration.getEnvironment(); // 获取当前数据库环境对应的 TransactionFactory 对象,不存在的话就创建一个 final TransactionFactory transactionFactory = this.getTransactionFactoryFromEnvironment(environment); final Transaction tx = transactionFactory.newTransaction(connection); // 依据指定的 Executor 类型创建对应的 Executor 对象 final Executor executor = configuration.newExecutor(tx, execType); // 创建 SqlSession 对象 return new DefaultSqlSession(configuration, executor, autoCommit); } catch (Exception e) { throw ExceptionFactory.wrapException("Error opening session. Cause: " + e, e); } finally { ErrorContext.instance().reset(); } } 两种创建会话的方式在执行流程上基本一致,具体细节如上述代码注释。 SqlSessionManager 同时实现了 SqlSessionFactory 和 SqlSession 两个接口,所以具备这两个接口全部的功能。该实现类的属性定义如下: /** 封装的 {@link SqlSessionFactory} 对象 */ private final SqlSessionFactory sqlSessionFactory; /** 线程私有的 SqlSession 对象的动态代理对象 */ private final SqlSession sqlSessionProxy; /** 线程私有的 SqlSession 对象 */ private final ThreadLocal<SqlSession> localSqlSession = new ThreadLocal<SqlSession>(); 针对 SqlSessionFactory 接口中声明的方法,SqlSessionManager 均委托给持有的 SqlSessionFactory 对象完成。对于 SqlSession 接口中声明的方法,SqlSessionManager 提供了两种实现方式:如果当前线程已经绑定了一个 SqlSession 对象,那么只要未主动调用 SqlSessionManager#close 方法,就会一直复用该线程私有的 SqlSession 对象;否则会在每次执行数据库操作时创建一个新的 SqlSession 对象,并在使用完毕之后关闭会话。相关逻辑位于 SqlSessionInterceptor 类中,这是一个定义在 SqlSessionManager 中的内部类,属性 SqlSessionManager#sqlSessionProxy 是基于该类实现的动态代理对象: this.sqlSessionProxy = (SqlSession) Proxy.newProxyInstance( SqlSessionFactory.class.getClassLoader(), new Class[]{SqlSession.class}, new SqlSessionInterceptor()); SqlSessionInterceptor 类实现自 InvocationHandler 接口,对应的 SqlSessionInterceptor#invoke 方法实现如下: public Object invoke(Object proxy, Method method, Object[] args) throws Throwable { // 获取当前线程私有的 SqlSession 对象 final SqlSession sqlSession = localSqlSession.get(); // 会话未被关闭 if (sqlSession != null) { try { // 直接反射调用相应的方法 return method.invoke(sqlSession, args); } catch (Throwable t) { throw ExceptionUtil.unwrapThrowable(t); } } // 没有 SqlSession,或已关闭,创建一个,使用完毕之后即关闭会话 else { try (SqlSession autoSqlSession = SqlSessionManager.this.openSession()) { try { // 反射调用相应的方法 final Object result = method.invoke(autoSqlSession, args); // 提交事务 autoSqlSession.commit(); return result; } catch (Throwable t) { // 回滚事务 autoSqlSession.rollback(); throw ExceptionUtil.unwrapThrowable(t); } } } } SqlSessionInterceptor 首先会尝试获取线程私有的 SqlSession 对象,对于未绑定的线程来说会创建一个新的 SqlSession 对象,并在使用完毕之后立刻关闭。 动态代理 Mapper 接口 MyBatis 要求所有的 Mapper 都定义成接口的形式,这主要是为了配合 JDK 内置的动态代理机制,JDK 内置的动态代理要求被代理的类必须抽象出一个接口。常用的动态代理除了 JDK 内置的方式,还有基于 CGlib 等第三方组件的方式,MyBatis 采用了 JDK 内置的方式创建 Mapper 接口的动态代理对象。 我们先来复习一下 JDK 内置的动态代理机制,假设现在有一个接口 Mapper 及其实现类如下: public interface Mapper { int select(); } public class MapperImpl implements Mapper { @Override public int select() { System.out.println("do select."); return 0; } } 现在我们希望在方法执行之前打印一行调用日志,基于动态代理的实现方式如下。我们需要定义一个实现了 InvocationHandler 接口的代理类,然后在其 InvocationHandler#invoke 方法中实现增强逻辑: public class MapperProxy implements InvocationHandler { private Mapper mapper; public MapperProxy(Mapper mapper) { this.mapper = mapper; } @Override public Object invoke(Object proxy, Method method, Object[] args) throws Throwable { System.out.println("before invoke."); return method.invoke(this.mapper, args); } } 客户端调用代码: Mapper mapper = new MapperImpl(); Mapper mapperProxy = (Mapper) Proxy.newProxyInstance( mapper.getClass().getClassLoader(), mapper.getClass().getInterfaces(), new MapperProxy(mapper)); mapperProxy.select(); 回到 MyBatis 框架本身,我们在执行目标数据库操作时,一般会直接调用目标 Mapper 接口的相应方法,这里框架返回给我们的实际上是 Mapper 接口的动态代理类对象。MyBatis 基于 JDK 的动态代理机制实现了 Mapper 接口中声明的方法,这其中包含了 获取 SQL 语句、参数绑定、缓存操作、数据库操作,以及结果集映射处理 等步骤,下面就 Mapper 接口动态代理机制涉及到的相关类和方法进行分析。 上一篇在分析映射文件时我们介绍了在 MapperRegistry#knownMappers 属性中记录了 Mapper 接口与 MapperProxyFactory 的映射关系,MapperProxyFactory 顾名思义是 MapperProxy 的工厂类,其中定义了创建 Mapper 接口代理对象的方法,如下: public T newInstance(SqlSession sqlSession) { final MapperProxy<T> mapperProxy = new MapperProxy<>(sqlSession, mapperInterface, methodCache); return this.newInstance(mapperProxy); } protected T newInstance(MapperProxy<T> mapperProxy) { // 创建 Mapper 接口对应的动态代理对象(基于 JDK 内置的动态代理机制) return (T) Proxy.newProxyInstance( mapperInterface.getClassLoader(), new Class[] {mapperInterface}, mapperProxy); } 来看一下 MapperProxy 实现,该类实现了 InvocationHandler 接口,对应的 InvocationHandler#invoke 实现如下: public Object invoke(Object proxy, Method method, Object[] args) throws Throwable { try { // 对于 Object 类中声明的方法,直接调用 if (Object.class.equals(method.getDeclaringClass())) { return method.invoke(this, args); } // 对于非 Object 类中声明的方法 else { // 获取方法关联的 MapperMethodInvoker 对象,并执行数据库操作 return this.cachedInvoker(method).invoke(proxy, method, args, sqlSession); } } catch (Throwable t) { throw ExceptionUtil.unwrapThrowable(t); } } 上述方法的核心逻辑在于获取当前执行方法 Method 对象对应的 MapperMethodInvoker 方法调用器,并执行 MapperMethodInvoker#invoke 方法触发对应的数据库操作。 围绕 MapperMethodInvoker 接口,MyBatis 提供了两种实现,即 DefaultMethodInvoker 和 PlainMethodInvoker,其中前者用于支持 JDK 7 引入的动态类型语言特性,后者则是对 MapperMethod 的封装。MapperMethod 中主要定义两个内部类: SqlCommand:用于封装方法关联的 SQL 语句名称和类型。 MethodSignature:用来封装方法相关的签名信息。 先来看一下 SqlCommand 的具体实现,该类定义了 SqlCommand#name 和 SqlCommand#type 两个属性,分别用于记录对应 SQL 语句的名称和类型,并在构造方法中实现了相应的解析逻辑和初始化操作,如下: public SqlCommand(Configuration configuration, Class<?> mapperInterface, Method method) { // 获取方法名称 final String methodName = method.getName(); // 获取方法隶属的类或接口的 Class 对象 final Class<?> declaringClass = method.getDeclaringClass(); // 解析方法关联的 SQL 语句对应的 MappedStatement 对象(用于封装 SQL 语句) MappedStatement ms = this.resolveMappedStatement(mapperInterface, methodName, declaringClass, configuration); // 未找当前方法对应的 MappedStatement 对象 if (ms == null) { // 如果对应方法注解了 @Flush,表示执行缓存的批量更新语句,则进行标记 if (method.getAnnotation(Flush.class) != null) { name = null; type = SqlCommandType.FLUSH; } else { throw new BindingException( "Invalid bound statement (not found): " + mapperInterface.getName() + "." + methodName); } } // 找当前方法对应的 MappedStatement 对象,初始化 SQL 语句名称和类型 else { name = ms.getId(); type = ms.getSqlCommandType(); if (type == SqlCommandType.UNKNOWN) { throw new BindingException("Unknown execution method for: " + name); } } } private MappedStatement resolveMappedStatement( Class<?> mapperInterface, String methodName, Class<?> declaringClass, Configuration configuration) { // 接口名称.方法名 String statementId = mapperInterface.getName() + "." + methodName; // 方法存在关联的 SQL 语句,则获取封装该 SQL 语句的 MappedStatement 对象 if (configuration.hasStatement(statementId)) { return configuration.getMappedStatement(statementId); } // 已经递归到该方法隶属的最上层类,但是仍然没有找到关联的 MappedStatement 对象 else if (mapperInterface.equals(declaringClass)) { return null; } // 沿着继承关系向上递归检索 for (Class<?> superInterface : mapperInterface.getInterfaces()) { if (declaringClass.isAssignableFrom(superInterface)) { // 递归检索 MappedStatement ms = this.resolveMappedStatement( superInterface, methodName, declaringClass, configuration); if (ms != null) { return ms; } } } return null; } SqlCommand 在实例化时所做的主要工作就是解析当前 Mapper 方法关联的 SQL 对应的 MappedStatement 对象,并初始化记录的 SQL 语句名称和类型,整个解析过程如上述代码注释。 再来看一下 MethodSignature 类,该类用于封装一个具体 Mapper 方法的相关签名信息,其中定义的方法实现都比较简单,这里列举一下其属性定义: /** 标记返回值是否是 {@link java.util.Collection} 或数组类型 */ private final boolean returnsMany; /** 标记返回值是否是 {@link Map} 类型 */ private final boolean returnsMap; /** 标记返回值是否是 {@link Void} 类型 */ private final boolean returnsVoid; /** 标记返回值是否是 {@link Cursor} 类型 */ private final boolean returnsCursor; /** 标记返回值是否是 {@link Optional} 类型 */ private final boolean returnsOptional; /** 返回值类型 */ private final Class<?> returnType; /** 对于 Map 类型的返回值,用于记录 key 的别名 */ private final String mapKey; /** 标记参数列表中 {@link ResultHandler} 的下标 */ private final Integer resultHandlerIndex; /** 标记参数列表中 {@link RowBounds} 的下标 */ private final Integer rowBoundsIndex; /** 参数名称解析器 */ private final ParamNameResolver paramNameResolver; 上面属性中重点介绍一下 ParamNameResolver 这个类,它的作用在于解析 Mapper 方法的参数列表,以便于在方法实参和方法关联的 SQL 语句的参数之间建立映射关系。其中一个比较重要的属性是 ParamNameResolver#names,定义如下: /** * 记录参数在参数列表中的下标和参数名称之间的对应关系。 * 参数名称通过 {@link Param} 注解指定,如果没有指定则使用参数下标作为参数名称, * 需要注意的是,如果参数列表中包含 {@link RowBounds} 或 {@link ResultHandler} 类型的参数, * 这两种功能型参数不会记录到集合中,此时如果用下标表示参数名称,索引值 key 与对应的参数名称(实际索引)可能会不一致。 * * <p> * The key is the index and the value is the name of the parameter.<br /> * The name is obtained from {@link Param} if specified. When {@link Param} is not specified, * the parameter index is used. Note that this index could be different from the actual index * when the method has special parameters (i.e. {@link RowBounds} or {@link ResultHandler}). * </p> * <ul> * <li>aMethod(@Param("M") int a, @Param("N") int b) -&gt; {{0, "M"}, {1, "N"}}</li> * <li>aMethod(int a, int b) -&gt; {{0, "0"}, {1, "1"}}</li> * <li>aMethod(int a, RowBounds rb, int b) -&gt; {{0, "0"}, {2, "1"}}</li> * </ul> */ private final SortedMap<Integer, String> names; 我把它的英文注释和我的理解都写在代码注释中,应该可以清楚理解该属性的作用。至于为什么需要跳过 RowBounds 和 ResultHandler 这两个类型的参数,是因为前者用于设置 LIMIT 参数,后者用于设置结果集处理器,所以都不是真正意义上的参数,按照我的话说这两种类型的参数都是功能型的参数。 ParamNameResolver 在构造方法中实现了对参数列表的解析,如下: public ParamNameResolver(Configuration config, Method method) { // 获取参数类型列表 final Class<?>[] paramTypes = method.getParameterTypes(); // 获取参数列表上的注解列表 final Annotation[][] paramAnnotations = method.getParameterAnnotations(); final SortedMap<Integer, String> map = new TreeMap<>(); int paramCount = paramAnnotations.length; // 遍历处理方法所有的参数 for (int paramIndex = 0; paramIndex < paramCount; paramIndex++) { // 跳过 RowBounds 和 ResultHandler 类型参数 if (isSpecialParameter(paramTypes[paramIndex])) { continue; } // 查找当前参数是否有 @Param 注解 String name = null; for (Annotation annotation : paramAnnotations[paramIndex]) { // 获取注解指定的参数名称 if (annotation instanceof Param) { hasParamAnnotation = true; name = ((Param) annotation).value(); break; } } // 没有 @Param 注解 if (name == null) { // 基于配置开关决定是否获取参数的真实名称 if (config.isUseActualParamName()) { name = this.getActualParamName(method, paramIndex); } // 使用下标作为参数名称 if (name == null) { // use the parameter index as the name ("0", "1", ...) // gcode issue #71 name = String.valueOf(map.size()); } } map.put(paramIndex, name); } names = Collections.unmodifiableSortedMap(map); } 整个过程概括来说就是遍历处理指定方法的参数列表,忽略 RowBounds 和 ResultHandler 类型的参数,并判断参数前面是否有 @Param 注解,如果有则尝试以注解指定的字符串作为参数名称,否则基于配置决定是否采用参数的真实名称作为这里的参数名,再不济就采用下标值作为参数名称。 考虑到会忽略 RowBounds 和 ResultHandler 两种类型的参数,但是属性 ParamNameResolver#names 对应的 key 又是递增的,所以就可能出现在以下标值作为参数名称时,参数名称与对应下标值不一致的情况。例如,假设有一个方法的参数列表为 (int a, RowBounds rb, int b),因为有 RowBounds 类型夹在中间,如果以下标值作为参数名称的最终解析结果就是 {0, "0"}, {2, "1"},下标与具体的参数名称不一致。 ParamNameResolver 中还有一个比较重要的方法 ParamNameResolver#getNamedParams,用于关联实参和形参列表,其中 args 参数是用户传递的实参数组,方法基于前面的参数列表解析结果将传递的实现与对应的方法参数进行关联,最终记录到 Object 对象中进行返回,实现如下: public Object getNamedParams(Object[] args) { // names 属性记录参数在参数列表中的下标和参数名称之间的对应关系 final int paramCount = names.size(); // 无参方法,直接返回 if (args == null || paramCount == 0) { return null; } // 没有 @Param 注解,且只有一个参数 else if (!hasParamAnnotation && paramCount == 1) { return args[names.firstKey()]; } // 有 @Param 注解,或存在多个参数 else { final Map<String, Object> param = new ParamMap<>(); int i = 0; // 遍历处理参数列表中的非功能性参数 for (Map.Entry<Integer, String> entry : names.entrySet()) { // 记录参数名称与参数值之间的映射关系 param.put(entry.getValue(), args[entry.getKey()]); // 构造一般参数名称,即 (param1, param2, ...) 形式参数 final String genericParamName = GENERIC_NAME_PREFIX + (i + 1); // 以“param + 索引”的形式再记录一次,如果 @Param 指定的参数名称已经是这种形式则不覆盖 if (!names.containsValue(genericParamName)) { param.put(genericParamName, args[entry.getKey()]); } i++; } return param; } } 做了这么多的铺垫,是时候回来继续分析 MapperMethod 的核心方法 MapperMethod#execute 了。该方法的作用在于委托 SqlSession 对象执行方法对应的 SQL 语句,实现如下: public Object execute(SqlSession sqlSession, Object[] args) { Object result; switch (command.getType()) { case INSERT: { // 关联实参与方法参数列表 Object param = method.convertArgsToSqlCommandParam(args); // 调用 SqlSession#insert 方法执行插入操作,并对执行结果进行转换 result = this.rowCountResult(sqlSession.insert(command.getName(), param)); break; } case UPDATE: { // 关联实参与方法参数列表 Object param = method.convertArgsToSqlCommandParam(args); // 调用 SqlSession#update 方法执行更新操作,并对执行结果进行转换 result = this.rowCountResult(sqlSession.update(command.getName(), param)); break; } case DELETE: { // 关联实参与方法参数列表 Object param = method.convertArgsToSqlCommandParam(args); // 调用 SqlSession#delete 方法执行删除操作,并对执行结果进行转换 result = this.rowCountResult(sqlSession.delete(command.getName(), param)); break; } case SELECT: // 返回值是 void 类型,且指定了 ResultHandler 处理结果集 if (method.returnsVoid() && method.hasResultHandler()) { this.executeWithResultHandler(sqlSession, args); result = null; } // 返回值为 Collection 或数组 else if (method.returnsMany()) { result = this.executeForMany(sqlSession, args); } // 返回值为 Map 类型 else if (method.returnsMap()) { result = this.executeForMap(sqlSession, args); } // 返回值为 Cursor 类型 else if (method.returnsCursor()) { result = this.executeForCursor(sqlSession, args); } // 处理其它返回类型 else { Object param = method.convertArgsToSqlCommandParam(args); result = sqlSession.selectOne(command.getName(), param); if (method.returnsOptional() // Optional 类型 && (result == null || !method.getReturnType().equals(result.getClass()))) { result = Optional.ofNullable(result); } } break; case FLUSH: // 如果方法注解了 @Flush,则执行 SqlSession#flushStatements 方法提交缓存的批量更新操作 result = sqlSession.flushStatements(); break; default: throw new BindingException("Unknown execution method for: " + command.getName()); } if (result == null && method.getReturnType().isPrimitive() && !method.returnsVoid()) { throw new BindingException("Mapper method '" + command.getName() + " attempted to return null from a method with a primitive return type (" + method.getReturnType() + ")."); } return result; } 上述方法会依据具体的 SQL 语句类型分而治之。对于 INSERT、UPDATE,以及 DELETE 类型而言,会先调用 MethodSignature#convertArgsToSqlCommandParam 方法关联实参与方法形参,本质上是调用前面介绍的 ParamNameResolver#getNamedParams 方法。然后就是调用 SqlSession 对应的方法执行数据库操作,并通过方法 MapperMethod#rowCountResult 对结果进行类型转换。关于 SqlSession 相关方法的具体实现留到下一节针对性介绍。对于 SELECT 类型而言,则需要考虑不同的返回类型,分为 void、Collection、数组、Map、Cursor,以及对象几类情况,这里所做的都是对于参数或返回结果的处理,核心逻辑也都位于 SqlSession 中,在这一层面的实现都比较简单,就不再一一展开。对于 FLUSH 类型来说,官方文档的说明如下: 如果使用了这个注解,它将调用定义在 Mapper 接口中的 SqlSession#flushStatements 方法。 具体的实现也就位于这里。 SQL 语句执行器 Executor 接口声明了基本的数据库操作,前面在介绍 SqlSession 时曾描述 SqlSession 是 MyBatis 框架对外提供的 API 接口,其中声明了对数据库的基本操作方法,而这些操作方法基本上都是对 Executor 方法的封装。Executor 接口定义如下: public interface Executor { ResultHandler NO_RESULT_HANDLER = null; /** 执行数据库更新操作:update、insert、delete */ int update(MappedStatement ms, Object parameter) throws SQLException; /** 执行数据库查询操作 */ <E> List<E> query(MappedStatement ms, Object parameter, RowBounds rowBounds, ResultHandler resultHandler, CacheKey cacheKey, BoundSql boundSql) throws SQLException; <E> List<E> query(MappedStatement ms, Object parameter, RowBounds rowBounds, ResultHandler resultHandler) throws SQLException; /** 执行数据库查询操作,返回游标对象 */ <E> Cursor<E> queryCursor(MappedStatement ms, Object parameter, RowBounds rowBounds) throws SQLException; /** 批量提交 SQL 语句 */ List<BatchResult> flushStatements() throws SQLException; /** 提交事务 */ void commit(boolean required) throws SQLException; /** 回滚事务 */ void rollback(boolean required) throws SQLException; /** 创建缓存 key 对象 */ CacheKey createCacheKey(MappedStatement ms, Object parameterObject, RowBounds rowBounds, BoundSql boundSql); /** 判断是否缓存 */ boolean isCached(MappedStatement ms, CacheKey key); /** 清空一级缓存 */ void clearLocalCache(); /** 延迟加载一级缓存中的数据 */ void deferLoad(MappedStatement ms, MetaObject resultObject, String property, CacheKey key, Class<?> targetType); /** 获取事务对象 */ Transaction getTransaction(); /** 关闭当前 Executor */ void close(boolean forceRollback); /** 是否已经关闭 */ boolean isClosed(); /** 设置装饰的 Executor 对象 */ void setExecutorWrapper(Executor executor); } 围绕 Executor 接口的类继承关系如下图,其中 CachingExecutor 实现类用于为 Executor 提供二级缓存支持。 BaseExecutor 抽象类实现了 Executor 接口中声明的所有方法,并抽象了 4 个模板方法交由子类实现,这 4 个方法分别是:doUpdate、doFlushStatements、doQuery,以及 doQueryCursor。SimpleExecutor 派生自 BaseExecutor 抽象类,并为这 4 个模板方法提供了最简单的实现。ReuseExecutor 如其名,提供了重用的特性,提供对 Statement 对象的重用,以减少 SQL 预编译,以及创建和销毁 Statement 对象的开销。BatchExecutor 实现类则提供了对 SQL 语句批量执行的特性,也是针对提升性能的一种优化实现。 缓存结构设计 考虑到 Executor 在执行数据库操作时与缓存操作存在密切联系,所以在具体介绍 Executor 的实现之前我们先来了解一下 MyBatis 的缓存机制。 在谈论数据库架构设计时往往需要引入缓存的概念,数据库是相对脆弱且耗时的,所以需要尽量避免请求落库。在实际项目架构设计中,我们一般会引入 Redis、Memcached 这一类的组件对数据进行缓存,MyBatis 作为一个强大的 ORM 框架,也为缓存提供了内建的实现。前面我们在分析配置文件加载与解析时曾介绍过 MyBatis 缓存组件的具体实现,MyBatis 在数据存储上采用 HashMap 作为基本存储结构,并提供了多种装饰器从多个方面为缓存增加相应的特性。 本小节我们关注的是 MyBatis 在缓存结构方面的设计,MyBatis 缓存从结构上可以分为 一级缓存 和 二级缓存,一级缓存相对于二级缓存在粒度上更细,生命周期也更短。 上图描绘了 MyBatis 缓存的结构设计,当我们发起一次数据库查询时,如果启用了二级缓存的话,MyBatis 首先会从二级缓存中检索查询结果,如果缓存不命中则会继续检索一级缓存,只有在这两层缓存都不命中的情况下才会查询数据库,最后会以数据库返回的结果更新一级缓存和二级缓存。 MyBatis 的 一级缓存是会话级别的缓存(生命周期与本次会话相同),当我们开启一次数据库会话时,框架默认会为本次会话绑定一个一级缓存对象。此类缓存主要应对在一个会话范围内的冗余查询操作,比如使用同一个 SqlSession 对象同时连续执行多次相同的查询语句。这种情况下每次查询都落库是没有必要的,因为短时间内数据库变化的可能性会很小,但是每次都落库却是一笔不必要的开销。一级缓存默认是开启的,且无需进行配置,即一级缓存对开发者是透明的,如果确实希望干预一级缓存的内在运行,可以借助于插件来实现。 对于二级缓存而言,默认也是开启的,MyBatis 提供了相应的治理选项,具体可以参考官方文档。二级缓存是应用级别的缓存,随着服务的启动而存在,并随着服务的关闭消亡。前面我们在分析 <cache/> 和 <cache-ref/> 标签时介绍了一个二级缓存会与一个具体的 namespace 绑定,并且支持引用一个已定义 namespace 缓存,即多个 namespace 可以共享同一个缓存。 本小节从整体结构上对 MyBatis 的缓存实现机制进行说明,目的在于对 MyBatis 的缓存有一个整体感知,关于一级缓存和二级缓存的具体实现,留到下面介绍分析 Executor 接口具体实现时穿插说明。 Statement 处理器 StatementHandler 接口及其实现类是 Executor 实现的基础,可以将其看作是 MyBatis 与数据库操作之间的纽带,实现了对 java.sql.Statement 对象的获取,以及 SQL 语句参数绑定与执行的逻辑。StatementHandler 接口及其实现类的类继承关系如下图所示: 其中 BaseStatementHandler 中实现了一些公共的逻辑;SimpleStatementHandler、PreparedStatementHandler,以及 CallableStatementHandler 实现类分别对应 Statement、PreparedStatement 和 CallableStatement 的相关实现;RoutingStatementHandler 并没有添加新的实现,而是对前面三种 StatementHandler 实现类的封装,它会在构造方法中依据当前传递的 Statement 类型创建对应的 StatementHandler 实现类对象。 StatementHandler 接口定义如下: public interface StatementHandler { /** 获取对应的 {@link Statement } 对象 */ Statement prepare(Connection connection, Integer transactionTimeout) throws SQLException; /** 绑定 Statement 执行 SQL 时需要的实参 */ void parameterize(Statement statement) throws SQLException; /** 批量执行 SQL 语句 */ void batch(Statement statement) throws SQLException; /** 执行数据库更新操作:insert、update、delete */ int update(Statement statement) throws SQLException; /** 执行 select 操作 */ <E> List<E> query(Statement statement, ResultHandler resultHandler) throws SQLException; /** 执行 select 操作,返回游标对象 */ <E> Cursor<E> queryCursor(Statement statement) throws SQLException; /** 获取对应的 SQL 对象 */ BoundSql getBoundSql(); /** 获取对应的 {@link ParameterHandler} 对象,用于参数绑定 */ ParameterHandler getParameterHandler(); } 首先来看一下 BaseStatementHandler 实现,该类中主要实现了获取 Statement 对象的逻辑,该类的属性定义如下: protected final Configuration configuration; protected final ObjectFactory objectFactory; protected final TypeHandlerRegistry typeHandlerRegistry; /** 处理结果集映射 */ protected final ResultSetHandler resultSetHandler; /** 用于为 SQL 语句绑定实参 */ protected final ParameterHandler parameterHandler; /** SQL 语句执行器 */ protected final Executor executor; /** 对应 SQL 语句标签对象 */ protected final MappedStatement mappedStatement; /** 封装 LIMIT 参数 */ protected final RowBounds rowBounds; /** 可执行的 SQL 语句 */ protected BoundSql boundSql; BaseStatementHandler 之于 StatementHandler#prepare 方法的实现如下: public Statement prepare(Connection connection, Integer transactionTimeout) throws SQLException { ErrorContext.instance().sql(boundSql.getSql()); Statement statement = null; try { // 从数据库连接中获取 Statement 对象,由子类实现 statement = this.instantiateStatement(connection); // 设置超时时间 this.setStatementTimeout(statement, transactionTimeout); // 设置返回的行数 this.setFetchSize(statement); return statement; } catch (SQLException e) { this.closeStatement(statement); throw e; } catch (Exception e) { this.closeStatement(statement); throw new ExecutorException("Error preparing statement. Cause: " + e, e); } } 上述方法首先会调用 BaseStatementHandler#instantiateStatement 方法获取一个 Statement 对象,这是一个模板方法交由子类实现;然后对拿到的 Statement 对象设置超时时间和返回的行数属性。 BaseStatementHandler 中定义了 ParameterHandler 类型的属性,主要用于为包含 ? 占位符的 SQL 语句绑定实参。ParameterHandler 接口定义如下: public interface ParameterHandler { /** 获取输出类型参数 */ Object getParameterObject(); /** 为 SQL 语句绑定实参 */ void setParameters(PreparedStatement ps) throws SQLException; } 其中,方法 ParameterHandler#getParameterObject 与存储过程相关,下面主要分析一下 ParameterHandler#setParameters 方法的实现。该方法用来为 SQL 语句绑定实参,具体操作等同于我们在直接使用 PreparedStatement 对象时注入相应类型的参数填充 SQL 语句。DefaultParameterHandler 是目前该接口的唯一实现,其 DefaultParameterHandler#setParameters 方法实现如下: public void setParameters(PreparedStatement ps) { ErrorContext.instance().activity("setting parameters").object(mappedStatement.getParameterMap().getId()); // 获取 BoundSql 中记录的参数映射关系列表 List<ParameterMapping> parameterMappings = boundSql.getParameterMappings(); if (parameterMappings != null) { // 遍历为 SQL 语句绑定对应的参数值 for (int i = 0; i < parameterMappings.size(); i++) { ParameterMapping parameterMapping = parameterMappings.get(i); // 忽略存储过程中的输出参数 if (parameterMapping.getMode() != ParameterMode.OUT) { Object value; // 用于记录对应的参数值 // 获取参数名称 String propertyName = parameterMapping.getProperty(); // 获取对应的参数值 if (boundSql.hasAdditionalParameter(propertyName)) { // issue #448 ask first for additional params value = boundSql.getAdditionalParameter(propertyName); } // 用户未传递实参 else if (parameterObject == null) { value = null; } // 实参类型存在对应的类型处理器,即已经是最终的参数值 else if (typeHandlerRegistry.hasTypeHandler(parameterObject.getClass())) { value = parameterObject; } // 获取实参对象中对应的参数值 else { MetaObject metaObject = configuration.newMetaObject(parameterObject); value = metaObject.getValue(propertyName); } TypeHandler typeHandler = parameterMapping.getTypeHandler(); JdbcType jdbcType = parameterMapping.getJdbcType(); if (value == null && jdbcType == null) { jdbcType = configuration.getJdbcTypeForNull(); } try { // 为 SQL 语句绑定对应的实参到 PreparedStatement 对象中 typeHandler.setParameter(ps, i + 1, value, jdbcType); } catch (TypeException | SQLException e) { throw new TypeException("Could not set parameters for mapping: " + parameterMapping + ". Cause: " + e, e); } } } } } 上述实现整体上就是获取 BoundSql 对象记录的参数名称与 SQL 语句中参数的映射关系,然后获取参数名称对应的用户传递的实参设置到 PreparedStatement 对象中。如果使用过原生 JDBC 操作过数据库,对往 PreparedStatement 中填充实参的过程应该不难理解。 关于其余几个 StatementHandler 实现类的都比较简单,就不再展开。 结果集映射 结果集映射是 MyBatis 提供的一个强大且易用的特性,标签 <resultMap/> 用于配置数据库返回的结果集 ResultSet 与实体类属性之间的映射关系。前面我们分析了该标签的解析过程,本小节一起来探究一下 MyBatis 是如何基于这些配置执行结果集映射操作。 SQL 语句执行器 Executor 在调用具体的 StatementHandler 执行数据库查询操作时会针对数据库返回的结果集调用 ResultSetHandler 中相应方法执行结果集到实体类对象的映射处理。例如下面的代码块是 PreparedStatementHandler 在执行 PreparedStatementHandler#query 时的具体逻辑: public <E> List<E> query(Statement statement, ResultHandler resultHandler) throws SQLException { PreparedStatement ps = (PreparedStatement) statement; // 执行数据库操作 ps.execute(); // 调用 ResultSetHandler#handleResultSets 执行结果集映射 return resultSetHandler.handleResultSets(ps); } ResultSetHandler 接口定义了结果集映射所需要的方法,具体如下: public interface ResultSetHandler { /** 处理结果集,返回对应的结果对象集合 */ <E> List<E> handleResultSets(Statement stmt) throws SQLException; /** 处理结果集,返回对应的游标对象 */ <E> Cursor<E> handleCursorResultSets(Statement stmt) throws SQLException; /** 处理存储过程中的输出类型参数 */ void handleOutputParameters(CallableStatement cs) throws SQLException; } DefaultResultSetHandler 是目前 ResultSetHandler 接口的唯一实现。MyBatis 为结果集映射提供了灵活的配置,灵活的背后是强(复)大(杂)的映射解析过程,尤其是对于嵌套映射配置的情况。本小节力图对整个映射过程做一个比较详细的介绍,不过还是建议读者自己亲自 debug 跟踪一下整个执行过程。接下来我们围绕 ResultSetHandler#handleResultSets 方法对结果集映射处理过程进行分析,该方法实现如下: public List<Object> handleResultSets(Statement stmt) throws SQLException { ErrorContext.instance().activity("handling results").object(mappedStatement.getId()); /* 1. 处理普通映射情况 */ // 用于记录结果集映射的结果对象集合 final List<Object> multipleResults = new ArrayList<>(); int resultSetCount = 0; // 获取第一个结果集 ResultSetWrapper rsw = this.getFirstResultSet(stmt); // 获取之前解析得到的封装结果集映射配置的 ResultMap 对象集合 List<ResultMap> resultMaps = mappedStatement.getResultMaps(); int resultMapCount = resultMaps.size(); // 验证,如果结果集不为 null,则 resultMaps 也不能为空 this.validateResultMapsCount(rsw, resultMapCount); // 遍历处理所有的结果集,基于结果集映射规则进行映射,并将结果记录到 multipleResults 集合中 while (rsw != null && resultMapCount > resultSetCount) { // 获取一个配置的结果集映射标签 <resultMap/> 配置 ResultMap resultMap = resultMaps.get(resultSetCount); // 依据结果集映射配置对结果集对象进行解析,并记录到 multipleResults 集合中 this.handleResultSet(rsw, resultMap, multipleResults, null); // 获取下一个待处理的结果集 rsw = this.getNextResultSet(stmt); // 清空 nestedResultObjects this.cleanUpAfterHandlingResultSet(); resultSetCount++; } /* * 2. 处理多结果集的情况 * * 常见于存储过程,存在 <select resultSets="aaa,bbb"/> 类似的配置, * 针对过程 1 未执行映射的结果集进行映射 */ String[] resultSets = mappedStatement.getResultSets(); if (resultSets != null) { while (rsw != null && resultSetCount < resultSets.length) { // 获取 resultSet 配置名称对应的 ResultMapping 配置 ResultMapping parentMapping = nextResultMaps.get(resultSets[resultSetCount]); if (parentMapping != null) { // 获取对应的 <resultMap/> 标签配置 String nestedResultMapId = parentMapping.getNestedResultMapId(); ResultMap resultMap = configuration.getResultMap(nestedResultMapId); // 执行结果集映射 this.handleResultSet(rsw, resultMap, null, parentMapping); } // 获取下一个待处理的结果集 rsw = this.getNextResultSet(stmt); // 清空 nestedResultObjects this.cleanUpAfterHandlingResultSet(); resultSetCount++; } } // multipleResults.size() == 1 ? (List<Object>) multipleResults.get(0) : multipleResults return this.collapseSingleResultList(multipleResults); } 上述方法的执行过程可以分为两部分:普通结果集映射和多结果集映射。其中,多结果集映射一般用于存储过程,这是一个小众化的需求,所以大部分时候上述方法仅执行第一部分的逻辑。这一部分的执行过程如代码注释,其核心在于 DefaultResultSetHandler#handleResultSet 方法,该方法在第二部分中也会被调用,后面会针对该方法进行专门说明。 下面就第二部分的触发机制举例说明,能够执行到这里一般都伴随着存储过程,这里以 MySQL 数据库为例创建一个可以返回多结果集的存储过程,其中 t_blog 表和 t_post 表的定义参考官方文档示例: CREATE PROCEDURE usp_demo(IN ID INT) BEGIN SELECT * FROM t_blog WHERE id = ID; SELECT * FROM t_post WHERE id = ID; END; 对应的映射配置如下: <resultMap id="usp_demo_result_map" type="org.zhenchao.mybatis.entity.Blog"> <constructor> <idArg column="id" javaType="int"/> </constructor> <result property="title" column="title"/> <collection property="posts" ofType="org.zhenchao.mybatis.entity.Post" resultSet="posts"> <id property="id" column="id"/> <result property="subject" column="subject"/> </collection> </resultMap> <select id="uspDemo" resultSets="blogs,posts" resultMap="usp_demo_result_map" statementType="CALLABLE"> {CALL usp_demo(#{id, jdbcType=INTEGER, mode=IN})} </select> 上述配置中,我们基于 resultSets 属性分别为对应的结果集命名,在执行该存储过程时会先映射 t_blog 数据表对应的结果集,映射的过程中遇到名为 posts 的结果集时,MyBatis 不会转去解析该结果集,而是会将该结果集记录到 DefaultResultSetHandler#nextResultMaps 属性中,等运行到第二部分时再对这些未解析的结果集统一进行映射处理。 上述过程中处理结果集映射的核心逻辑均位于 DefaultResultSetHandler#handleResultSet 方法中。该方法执行的主要逻辑在于判断当前是否指定了结果集处理器(即前面介绍过的 ResultHandler),如果没有指定则会创建一个默认的结果集处理器(默认采用 DefaultResultHandler 实现),然后调用 DefaultResultSetHandler#handleRowValues 方法执行映射逻辑。方法 DefaultResultSetHandler#handleResultSet 的实现如下: private void handleResultSet(ResultSetWrapper rsw, ResultMap resultMap, List<Object> multipleResults, ResultMapping parentMapping) throws SQLException { try { if (parentMapping != null) { // 处理多结果集嵌套映射的情况 this.handleRowValues(rsw, resultMap, null, RowBounds.DEFAULT, parentMapping); } else { // 未指定 ResultHandler,构造默认的处理器 if (resultHandler == null) { DefaultResultHandler defaultResultHandler = new DefaultResultHandler(objectFactory); // 对结果集进行映射,并将映射结果记录到 DefaultResultHandler 对象中 this.handleRowValues(rsw, resultMap, defaultResultHandler, rowBounds, null); // 获取保存在 DefaultResultHandler 对象中映射结果,记录到 multipleResults 中 multipleResults.add(defaultResultHandler.getResultList()); } // 用户指定了 ResultHandler,使用该处理器进行处理 else { this.handleRowValues(rsw, resultMap, resultHandler, rowBounds, null); } } } finally { // issue #228 (close resultsets) this.closeResultSet(rsw.getResultSet()); } } 方法 DefaultResultSetHandler#handleRowValues 会判断当前映射配置中是否存在嵌套映射的情况,如果存在嵌套映射则执行方法 DefaultResultSetHandler#handleRowValuesForNestedResultMap 方法处理嵌套结果集映射,否则执行 DefaultResultSetHandler#handleRowValuesForSimpleResultMap 方法处理简单的结果集映射。下面以简单结果集映射的过程进行分析,对于嵌套结果集映射的过程还是强烈建议大家去 debug 跟踪理解,单凭静态文字很难说清楚。 方法 DefaultResultSetHandler#handleRowValuesForSimpleResultMap 实现了对简单(相对于嵌套而言)结果集映射的处理逻辑。首先会基于 RowBounds 设置定位具体的处理行,MyBatis 对于 LIMIT 分页的处理是逻辑分页,而不是物理分页,即将符合条件的记录全部载入内存,然后在内存中进行截取,如果希望执行物理分页,可以自己编码插件,或者使用第三方插件,然后会遍历结果集中目标记录行对其逐一映射。 方法 DefaultResultSetHandler#handleRowValuesForSimpleResultMap 实现如下: private void handleRowValuesForSimpleResultMap(ResultSetWrapper rsw, ResultMap resultMap, ResultHandler<?> resultHandler, RowBounds rowBounds, ResultMapping parentMapping) throws SQLException { DefaultResultContext<Object> resultContext = new DefaultResultContext<>(); ResultSet resultSet = rsw.getResultSet(); // 针对设置了 RowBounds 定位指定的记录行 this.skipRows(resultSet, rowBounds); // 检测是否可以继续对后续的记录行进行映射操作,可以的话就一直循环 while (this.shouldProcessMoreRows(resultContext, rowBounds) && !resultSet.isClosed() && resultSet.next()) { // 确定具体使用的映射配置,如果配置了 <discriminator/> 标签则获取最终引用的 ResultMap,否则使用当前的 ResultMap 对象 ResultMap discriminatedResultMap = this.resolveDiscriminatedResultMap(resultSet, resultMap, null); // 基于映射配置对当前记录行进行解析 Object rowValue = this.getRowValue(rsw, discriminatedResultMap, null); // 保存映射得到的结果对象 this.storeObject(resultHandler, resultContext, rowValue, parentMapping, resultSet); } } 针对记录行的映射处理,方法首先会获取记录行对应的真正 ResultMap 映射配置对象,因为可能存在配置了 <discriminator/> 标签执行条件映射的情况,如果没有配置该标签则会使用当前实参对应的 ResultMap 对象。标签 <discriminator/> 的处理过程位于 DefaultResultSetHandler#resolveDiscriminatedResultMap 方法中,对照配置应该比较容易理解。获取到 ResultMap 映射配置对象之后,下一步就可以调用 DefaultResultSetHandler#getRowValue 方法对当前记录行执行映射处理,该方法实现如下: private Object getRowValue(ResultSetWrapper rsw, ResultMap resultMap, String columnPrefix) throws SQLException { final ResultLoaderMap lazyLoader = new ResultLoaderMap(); // 创建记录行映射结果对象 Object rowValue = this.createResultObject(rsw, resultMap, lazyLoader, columnPrefix); // 如果结果对象不为 null,且没有对应的类型处理器 if (rowValue != null && !this.hasTypeHandlerForResultObject(rsw, resultMap.getType())) { // 创建结果对象的 MetaObject 对象 final MetaObject metaObject = configuration.newMetaObject(rowValue); // 标记是否成功映射任何一个属性 boolean foundValues = this.useConstructorMappings; // 是否需要自动映射 if (this.shouldApplyAutomaticMappings(resultMap, false)) { // 自动映射未在 <resultMap/> 标签中指定的列 foundValues = this.applyAutomaticMappings(rsw, resultMap, metaObject, columnPrefix) || foundValues; } // 映射在 <resultMap/> 标签中指定的列 foundValues = this.applyPropertyMappings(rsw, resultMap, metaObject, lazyLoader, columnPrefix) || foundValues; foundValues = lazyLoader.size() > 0 || foundValues; rowValue = foundValues || configuration.isReturnInstanceForEmptyRow() ? rowValue : null; } return rowValue; } 方法首先会调用 DefaultResultSetHandler#createResultObject 方法创建实体结果对象,然后为该对象执行属性映射注入。对于未配置映射关系的属性会基于配置决定是否执行自动映射,对于明确指定映射关系的属性,则调用 DefaultResultSetHandler#applyPropertyMappings 方法执行映射处理,该方法的具体实现如下: private boolean applyPropertyMappings(ResultSetWrapper rsw, ResultMap resultMap, MetaObject metaObject, ResultLoaderMap lazyLoader, String columnPrefix) throws SQLException { // 获取所有指明了映射关系的列名集合 final List<String> mappedColumnNames = rsw.getMappedColumnNames(resultMap, columnPrefix); boolean foundValues = false; // 获取当前 ResultMap 包含的所有映射关系配置对象 ResultMapping 列表 final List<ResultMapping> propertyMappings = resultMap.getPropertyResultMappings(); // 遍历处理映射关系 ResultMapping 列表,执行映射过程 for (ResultMapping propertyMapping : propertyMappings) { // 处理列前缀 String column = this.prependPrefix(propertyMapping.getColumn(), columnPrefix); // 忽略嵌套的 ResultMap 映射 if (propertyMapping.getNestedResultMapId() != null) { // the user added a column attribute to a nested result map, ignore it column = null; } // 嵌套查询 | 配置了映射关系 | 多结果集 if (propertyMapping.isCompositeResult() || (column != null && mappedColumnNames.contains(column.toUpperCase(Locale.ENGLISH))) || propertyMapping.getResultSet() != null) { // 存在多结果集 // 执行映射,返回属性值 Object value = this.getPropertyMappingValue( rsw.getResultSet(), metaObject, propertyMapping, lazyLoader, columnPrefix); // issue #541 make property optional final String property = propertyMapping.getProperty(); if (property == null) { continue; } // 延迟加载的情况 else if (value == DEFERRED) { foundValues = true; continue; } if (value != null) { foundValues = true; } // 设置属性值 if (value != null || (configuration.isCallSettersOnNulls() && !metaObject.getSetterType(property).isPrimitive())) { // gcode issue #377, call setter on nulls (value is not 'found') metaObject.setValue(property, value); } } } return foundValues; } 方法首先会获取当前结果集对应的映射关系配置和列名集合,然后遍历处理映射配置。针对嵌套查询、多结果集映射,以及普通映射的情况分而治之,这一过程位于 DefaultResultSetHandler#getPropertyMappingValue 方法中(实现如下)。针对嵌套查询的情况我们后面专门进行分析;对于多结果集的情况会将对应的结果集配置对象记录到 DefaultResultSetHandler#nextResultMaps 属性中,稍后会专门处理(即前面的第二部分代码);针对普通的映射则会基于 TypeHandler 获取属性对应的 java 类型值,也就是我们期望的值。 private Object getPropertyMappingValue(ResultSet rs, MetaObject metaResultObject, ResultMapping propertyMapping, ResultLoaderMap lazyLoader, String columnPrefix) throws SQLException { // 嵌套查询 if (propertyMapping.getNestedQueryId() != null) { return this.getNestedQueryMappingValue(rs, metaResultObject, propertyMapping, lazyLoader, columnPrefix); } // 多结果集情况,记录对应的 resultSet,后续处理 else if (propertyMapping.getResultSet() != null) { this.addPendingChildRelation(rs, metaResultObject, propertyMapping); return DEFERRED; } // 基于 TypeHandler 获取属性值 else { final TypeHandler<?> typeHandler = propertyMapping.getTypeHandler(); final String column = this.prependPrefix(propertyMapping.getColumn(), columnPrefix); return typeHandler.getResult(rs, column); } } 最后会调用 DefaultResultSetHandler#storeObject 方法将实体结果对象记录到 DefaultResultHandler#list 属性中,并在 DefaultResultSetHandler#handleResultSet 方法中调用 DefaultResultHandler#getResultList 方法拿到这些结果对象。 执行器实现 前面已经介绍了 Executor 接口以及相关的实现类继承关系,本小节将对这些执行器实现类逐一展开分析。 BaseExecutor BaseExecutor 是一个抽象类,实现了 Executor 接口中声明的所有方法,并采用模板方法模式抽象出 4 个模板方法交由子类实现。需要强调的一点是,BaseExecutor 抽象类引入了一级缓存支持,在相应方法实现中增加了对一级缓存的操作,因此该抽象类的所有实现类都具备一级缓存的特性。BaseExecutor 抽象类的属性定义如下: /** 事务对象 */ protected Transaction transaction; /** 封装的 SQL 语句执行器 */ protected Executor wrapper; /** 延迟加载队列 */ protected ConcurrentLinkedQueue<DeferredLoad> deferredLoads; /** 缓存结果对象(一级缓存) */ protected PerpetualCache localCache; /** 缓存存储过程输出类型参数(一级缓存) */ protected PerpetualCache localOutputParameterCache; /** 全局唯一的配置对象 */ protected Configuration configuration; /** 记录嵌套查询的层数 */ protected int queryStack; /** 标记当前 Executor 是否已经关闭 */ private boolean closed; 下面针对一些比较复杂的方法实现展开说明,首先来看一下 BaseExecutor#update 方法实现(如下)。需要注意的是这里的 update 并不等同于 SQL 语句中的 UPDATE 操作,对于 Executor 而言数据库操作只包含 query 和 update 两大类,这里的 query 可以理解为 SQL 语句的 SELECT 操作,而 update 则对应着 SQL 语句中的 INSERT、UPDATE、DELECT 三类操作。 public int update(MappedStatement ms, Object parameter) throws SQLException { ErrorContext.instance().resource(ms.getResource()).activity("executing an update").object(ms.getId()); if (closed) { throw new ExecutorException("Executor was closed."); } // 先清空一级缓存 this.clearLocalCache(); // 执行更新操作,交由子类实现 return this.doUpdate(ms, parameter); } 上述方法首先会判定当前 Executor 是否已被关闭,对于没有关闭的 Executor 会首先清空一级缓存,然后调用 BaseExecutor#doUpdate 模板方法,该方法由子类实现。 再来看一下 BaseExecutor#query 方法,该方法用于执行数据库查询操作。因为引入了一级缓存,所以这里的查询不是简单的直接查询数据库,而是会先查询一级缓存,只有在缓存不命中的情况下才会查询数据库,并利用数据库返回的结果对象更新一级缓存。该方法的实现如下: public <E> List<E> query(MappedStatement ms, Object parameter, RowBounds rowBounds, ResultHandler resultHandler) throws SQLException { // 获取执行的 SQL 语句 BoundSql boundSql = ms.getBoundSql(parameter); // 创建缓存 key CacheKey key = this.createCacheKey(ms, parameter, rowBounds, boundSql); // 调用重载的 query 方法执行查询操作 return this.query(ms, parameter, rowBounds, resultHandler, key, boundSql); } public <E> List<E> query(MappedStatement ms, Object parameter, RowBounds rowBounds, ResultHandler resultHandler, CacheKey key, BoundSql boundSql) throws SQLException { ErrorContext.instance().resource(ms.getResource()).activity("executing a query").object(ms.getId()); if (closed) { throw new ExecutorException("Executor was closed."); } // 如果是非嵌套查询,且配置 <select flushCache="true"/> 要求执行该语句时清空一级缓存和二级缓存 if (queryStack == 0 && ms.isFlushCacheRequired()) { // 清空一级缓存 this.clearLocalCache(); } List<E> list; try { queryStack++; // 尝试从一级缓存中获取结果 list = resultHandler == null ? (List<E>) localCache.getObject(key) : null; // 缓存名命中,针对存储过程特殊处理,获取缓存中保存的输出类型参数记录到实参对象中 if (list != null) { this.handleLocallyCachedOutputParameters(ms, key, parameter, boundSql); } // 缓存不命中,查数据库并更新缓存,本质上调用的是 doQuery 方法 else { list = this.queryFromDatabase(ms, parameter, rowBounds, resultHandler, key, boundSql); } } finally { queryStack--; } // 加载缓存中记录的嵌套查询的结果对象 if (queryStack == 0) { for (DeferredLoad deferredLoad : deferredLoads) { deferredLoad.load(); } // issue #601 deferredLoads.clear(); if (configuration.getLocalCacheScope() == LocalCacheScope.STATEMENT) { // issue #482 this.clearLocalCache(); } } return list; } 整个 BaseExecutor#query 方法的执行过程如上述代码注释。 方法 BaseExecutor#queryCursor 与 BaseExecutor#query 都是提供数据库查询操作,区别在于前者返回的是一个游标(Cursor)对象,而后者返回的是已经完成结果集映射的结果对象,游标需要等待用户真正操作时才会执行结果集映射的过程。 SimpleExecutor SimpleExecutor 提供了对 Executor 的简单实现,针对每一次数据库操作都会创建一个新的 Statement 对象,并在操作完毕之后进行关闭。SimpleExecutor 针对抽象类 BaseExecutor 中声明的方法实现流程都相同,下面以 SimpleExecutor#doQuery 方法为例进行分析,该方法的实现如下: public <E> List<E> doQuery(MappedStatement ms, Object parameter, RowBounds rowBounds, ResultHandler resultHandler, BoundSql boundSql) throws SQLException { Statement stmt = null; try { Configuration configuration = ms.getConfiguration(); // 创建 StatementHandler 对象 StatementHandler handler = configuration.newStatementHandler( wrapper, ms, parameter, rowBounds, resultHandler, boundSql); // 创建 Statement 对象并为 SQL 语句绑定实参 stmt = this.prepareStatement(handler, ms.getStatementLog()); // 执行数据库查询操作,以及结果集映射 return handler.query(stmt, resultHandler); } finally { // 关闭 Statement this.closeStatement(stmt); } } 方法首先会基于 Configuration#newStatementHandler 创建对应的 StatementHandler 对象,这里实际上是采用了前面介绍的 RoutingStatementHandler 实现类依据入参进行创建。然后会调用 SimpleExecutor#prepareStatement 方法创建 Statement 对象,并为 SQL 语句绑定实参。接着执行具体的数据库查询操作,对于查询操作此时会执行结果集映射处理。最后关闭 Statement 对象。 方法 SimpleExecutor#prepareStatement 实现如下: private Statement prepareStatement(StatementHandler handler, Log statementLog) throws SQLException { Statement stmt; // 获取数据库连接 Connection connection = this.getConnection(statementLog); // 获取 Statement 对象 stmt = handler.prepare(connection, transaction.getTimeout()); // 执行参数绑定 handler.parameterize(stmt); return stmt; } 其中 StatementHandler#prepare 方法的运行逻辑前面已经分析过。方法 StatementHandler#parameterize 执行了参数绑定的操作,该方法在 SimpleStatementHandler 中为空实现,毕竟对于 Statement 来说不支持设置参数;而对于 PreparedStatementHandler 和 CallableStatementHandler 而言都是调用了 ParameterHandler#setParameters 方法,该方法在前面已经专门分析过,不再重复介绍。 ReuseExecutor ReuseExecutor 提供了对 Statement 对象重用的机制,以减少该对象创建和销毁,以及 SQL 预编译所带来的开销。ReuseExecutor 类中定义了一个 ReuseExecutor#statementMap 属性(如下),其中 key 为 SQL 语句,value 为对应的 Statement 对象,以此实现对 Statement 对象的复用。 /** 缓存 Statement 对象,key 为对应的 SQL 语句(带有 ? 占位符) */ private final Map<String, Statement> statementMap = new HashMap<String, Statement>(); ReuseExecutor 中的方法实现也基本上沿用了同一套思路,仍然以 ReuseExecutor#doQuery 为例进行说明,该方法实现如下: public <E> List<E> doQuery(MappedStatement ms, Object parameter, RowBounds rowBounds, ResultHandler resultHandler, BoundSql boundSql) throws SQLException { Configuration configuration = ms.getConfiguration(); // 创建对应的 StatementHandler 对象 StatementHandler handler = configuration.newStatementHandler(wrapper, ms, parameter, rowBounds, resultHandler, boundSql); // 先尝试从缓存中获取当前 SQL 对应的 Statement 对象,缓存不命中则创建一个新的并缓存 Statement stmt = this.prepareStatement(handler, ms.getStatementLog()); // 执行数据库查询操作,以及结果集映射 return handler.query(stmt, resultHandler); } 上述方法与 SimpleExecutor#doQuery 的区别在于在获取 Statement 对象时会先尝试从本地缓存中获取,如果缓存不命中则会创建一个新的 Statement 对象,并更新缓存,实现位于 ReuseExecutor#prepareStatement 方法中: private Statement prepareStatement(StatementHandler handler, Log statementLog) throws SQLException { Statement stmt; BoundSql boundSql = handler.getBoundSql(); String sql = boundSql.getSql(); // 获取缓存的 Statement 对象 if (this.hasStatementFor(sql)) { stmt = this.getStatement(sql); this.applyTransactionTimeout(stmt); } // 缓存不命中,新建一个 Statement 对象并缓存 else { Connection connection = this.getConnection(statementLog); stmt = handler.prepare(connection, transaction.getTimeout()); this.putStatement(sql, stmt); } // 绑定实参 handler.parameterize(stmt); return stmt; } BatchExecutor BatchExecutor 用于批量执行 SQL 语句。通常应用程序都是单行的执行 SQL 语句,但是某些场景下单行执行数据库操作是比较耗时的,比如需要远程执行数据库操作。因此,JDBC 针对 INSERT、UPDATE,以及 DELETE 操作提供了批量执行的支持。 BatchExecutor 是批量 SQL 语句执行器,其属性定义如下: /** 缓存多个 {@link Statement} 对象,每个对象都对应多条 SQL 语句 */ private final List<Statement> statementList = new ArrayList<>(); /** 记录批处理的结果,每个 {@link BatchResult} 对应一个 {@link Statement} 对象 */ private final List<BatchResult> batchResultList = new ArrayList<>(); /** 当前执行的 SQL 语句 */ private String currentSql; /** 当前操作的 {@link MappedStatement} 对象 */ private MappedStatement currentStatement; 下面探究一下 BatchExecutor 的批处理执行过程。首先来看一下 BatchExecutor#doUpdate 方法实现,该方法用于添加批处理 SQL 语句: public int doUpdate(MappedStatement ms, Object parameterObject) throws SQLException { final Configuration configuration = ms.getConfiguration(); // 基于参数创建对应的 StatementHandler 对象 final StatementHandler handler = configuration.newStatementHandler( this, ms, parameterObject, RowBounds.DEFAULT, null, null); final BoundSql boundSql = handler.getBoundSql(); final String sql = boundSql.getSql(); final Statement stmt; // 当前执行的 SQL 语句与前一次执行的 SQL 语句(不包含实参)相同,且对应的 MappedStatement 对象也相同 if (sql.equals(currentSql) && ms.equals(currentStatement)) { // 获取缓存的最后一个 Statement 对象,即前一次使用的 Statement 对象 int last = statementList.size() - 1; stmt = statementList.get(last); this.applyTransactionTimeout(stmt); // 绑定实参 handler.parameterize(stmt);//fix Issues 322 BatchResult batchResult = batchResultList.get(last); batchResult.addParameterObject(parameterObject); } // 当前执行的 SQL 语句与前一次执行的 SQL 语句不同 else { Connection connection = this.getConnection(ms.getStatementLog()); // 获取一个新的 Statement 对象 stmt = handler.prepare(connection, transaction.getTimeout()); // 绑定实参 handler.parameterize(stmt); //fix Issues 322 // 记录本次执行的 SQL 语句和 MappedStatement 对象 currentSql = sql; currentStatement = ms; // 缓存新建的 Statement 对象 statementList.add(stmt); batchResultList.add(new BatchResult(ms, sql, parameterObject)); } // 基于 Statement#addBatch 方法添加批量 SQL 语句 handler.batch(stmt); return BATCH_UPDATE_RETURN_VALUE; } 上述方法中会判断当前执行的 SQL 模式(包含 ? 占位符的 SQL 语句)是否与前一次执行的相同,如果相同就会获取上次执行的 Statement 对象,并为之绑定实参;否则就会创建一个新的 Statement 对象,并记录本次执行的 SQL 模式,最后基于底层的数据库批处理方法 Statement#addBatch 添加批量 SQL 语句。由上述方法我们可以知道,对于连续同模式的批处理 SQL 操作会共享同一个 Statement 对象。 那么这些添加的批量 SQL 又是如何被执行的呢?这个过程位于 BatchExecutor#doFlushStatements 方法中,方法如下: public List<BatchResult> doFlushStatements(boolean isRollback) throws SQLException { try { // 用于存储批量处理结果 List<BatchResult> results = new ArrayList<>(); if (isRollback) { return Collections.emptyList(); } // 遍历处理缓存的 Statement 集合 for (int i = 0, n = statementList.size(); i < n; i++) { Statement stmt = statementList.get(i); this.applyTransactionTimeout(stmt); BatchResult batchResult = batchResultList.get(i); try { // 批量执行当前 Statement 蕴含的多条 SQL 语句,并记录每条 SQL 语句影响的行数 batchResult.setUpdateCounts(stmt.executeBatch()); MappedStatement ms = batchResult.getMappedStatement(); List<Object> parameterObjects = batchResult.getParameterObjects(); KeyGenerator keyGenerator = ms.getKeyGenerator(); if (Jdbc3KeyGenerator.class.equals(keyGenerator.getClass())) { // 获取数据库生成的主键,并记录到 parameterObjects 中 Jdbc3KeyGenerator jdbc3KeyGenerator = (Jdbc3KeyGenerator) keyGenerator; jdbc3KeyGenerator.processBatch(ms, stmt, parameterObjects); } else if (!NoKeyGenerator.class.equals(keyGenerator.getClass())) { //issue #141 for (Object parameter : parameterObjects) { keyGenerator.processAfter(this, ms, stmt, parameter); } } // Close statement to close cursor #1109 this.closeStatement(stmt); } catch (BatchUpdateException e) { // ... 省略异常处理 } // 记录封装当前 Statement 对象执行结果的 batchResult 到集合中 results.add(batchResult); } return results; } finally { // 关闭所有的 Statement 对象 for (Statement stmt : statementList) { this.closeStatement(stmt); } currentSql = null; statementList.clear(); batchResultList.clear(); } } 方法会遍历我们在 BatchExecutor#doUpdate 中构造的 Statement 集合,分别执行集合中蕴含的 Statement 对象,并将执行的结果记录到 BatchResult 对象中(说明:在 BatchExecutor#doUpdate 方法中已经为每个 Statement 对象构造好了一个空的 BatchResult 对象,记录在 BatchExecutor#batchResultList 集合中),最后将 BatchResult 对象封装到集合中返回。因为都是数据库更新一类的操作,所以这里没有复杂的结果集映射,只需要记录每一条 SQL 语句执行所影响的行数即可。 CachingExecutor 由前面 Executor 的继承关系我们可以看到,CachingExecutor 相对于其它 Executor 实现来说似乎有其特别之处。CachingExecutor 直接实现了 Executor 接口,实际上它是一个 Executor 装饰器,用于为 Executor 提供二级缓存支持。该接口的属性定义如下: /** 装饰的 {@link Executor} 对象 */ private final Executor delegate; /** 用于管理当前使用的二级缓存对象 */ private final TransactionalCacheManager tcm = new TransactionalCacheManager(); 其中第一个属性就是 CachingExecutor 具体修饰的 Executor 对象。我们来看一下第二个属性,TransactionalCacheManager 用来管理当前 CachingExecutor 对应的二级缓存对象,它的方法实现都比较简单,其中相对让人疑惑的是它的唯一一个属性: /** key 为对应的 {@link CachingExecutor} 使用的二级缓存对象,value 为采用 {@link TransactionalCache} 装饰的二级缓存对象 */ private final Map<Cache, TransactionalCache> transactionalCaches = new HashMap<>(); 该属性的 key 就是当前对应的二级缓存,而 value 则是对于该二级缓存对象采用 TransactionalCache 装饰后的对象。所以 key 和 value 本质上都映射到同一个缓存对象,只是 value 采用了 TransactionalCache 进行增强。TransactionalCache 也是一个缓存装饰器,在前面介绍缓存装饰器实现时特意留着没有说明,这里一起来分析一下。该装饰器的属性定义如下: /** 被装饰的 {@link Cache} 对象(二级缓存) */ private final Cache delegate; /** 是否在提交事务时清空缓存 */ private boolean clearOnCommit; /** 用于缓存数据,当提交事务时会将其中的数据写入二级缓存 */ private final Map<Object, Object> entriesToAddOnCommit; /** 缓存未命中的 key */ private final Set<Object> entriesMissedInCache; 对应的读缓存和写缓存操作,以及事务提交方法实现比较简单,读者可以自行阅读源码。 继续回来看 CachingExecutor 的实现,所有实现方法中只有 CachingExecutor#query 方法稍微复杂一些,该方法的实现如下: public <E> List<E> query(MappedStatement ms, Object parameterObject, RowBounds rowBounds, ResultHandler resultHandler) throws SQLException { // 获取对应的 BoundSql 对象,并创建对应的 CacheKey BoundSql boundSql = ms.getBoundSql(parameterObject); CacheKey key = this.createCacheKey(ms, parameterObject, rowBounds, boundSql); // 调用重载的 query 方法 return this.query(ms, parameterObject, rowBounds, resultHandler, key, boundSql); } public <E> List<E> query(MappedStatement ms, Object parameterObject, RowBounds rowBounds, ResultHandler resultHandler, CacheKey key, BoundSql boundSql) throws SQLException { // 获取当前命名空间对应的二级缓存对象 Cache cache = ms.getCache(); // 判断是否启用了二级缓存 if (cache != null) { // 依据配置决定是否清空二级缓存 this.flushCacheIfRequired(ms); if (ms.isUseCache() && resultHandler == null) { // 确保不是存储过程输出类型的参数 this.ensureNoOutParams(ms, boundSql); // 查询二级缓存 @SuppressWarnings("unchecked") List<E> list = (List<E>) tcm.getObject(cache, key); if (list == null) { // 二级缓存不命中,执行一级缓存查询,再不命中就查询数据库 list = delegate.query(ms, parameterObject, rowBounds, resultHandler, key, boundSql); // 缓存到 TransactionalCache#entriesToAddOnCommit 中 tcm.putObject(cache, key, list); // issue #578 and #116 } return list; } } // 未启用二级缓存,则查询一级缓存,再不命中就查询数据库 return delegate.query(ms, parameterObject, rowBounds, resultHandler, key, boundSql); } 正如我们一开始对于 MyBatis 缓存结构设计描绘的那样,上述方法首先在二级缓存中进行检索,如果二级缓存不命中则会执行被装饰的 Executor 对象的 Executor#query 方法。由前面的分析我们知道,Executor 的实现都自带一级缓存特性,所以接下去会查询一级缓存。只有在一级缓存也不命中的情况下,请求才会落库,并由数据库返回的结果对象更新一级缓存和二级缓存。 那么这里使用的二级缓存对象是在哪里创建的呢?实际上前面我们就定义说二级缓存是应用级别的,所以当应用启动时二级缓存就已经被创建了,这个过程发生在对映射文件进行解析时。在映射文件中我们会按照需要配置一定的 <cache/> 和 <cache-ref> 标签,而在解析 <cache/> 标签时会调用 MapperBuilderAssistant#useNewCache 方法创建对应的二级缓存对象。 总结 本文对 MyBatis 执行 SQL 语句所涉及到的各个方面做了一个比较详细的分析。当我们基于 MyBatis 触发一次数据库操作时,首先需要开启一次数据库会话,然后获取目标 Mapper 接口,并调用相应的 Mapper 方法执行数据库操作,最后拿到操作结果。MyBatis 在这中间基于动态代理机制实现了 SQL 语句的检索、参数绑定、数据库操作,以及结果集映射等一系列操作,并引入了缓存机制优化数据库查询性能。 回过头来看,MyBatis 的整体设计还是非常巧妙的,却也很是直观且简单,是对动态代理机制的典型应用,其设计思想和对于设计模式的应用值得我们在实际开发中借鉴。 本文是 MyBatis 源码解析系列的最后一篇文章,由于时间仓促,再加上作者水平有限,整个系列的文章中不免有错误之处,还望批评指正! 参考 MyBatis 官方文档 MyBatis 技术内幕

优秀的个人博客,低调大师

每日一博 | ABA问题的本质及其解决办法

简介 CAS的全称是compare and swap,它是java同步类的基础,java.util.concurrent中的同步类基本上都是使用CAS来实现其原子性的。 CAS的原理其实很简单,为了保证在多线程环境下我们的更新是符合预期的,或者说一个线程在更新某个对象的时候,没有其他的线程对该对象进行修改。在线程更新某个对象(或值)之前,先保存更新前的值,然后在实际更新的时候传入之前保存的值,进行比较,如果一致的话就进行更新,否则失败。 注意,CAS在java中是用native方法来实现的,利用了系统本身提供的原子性操作。 那么CAS在使用中会有什么问题呢?一般来说CAS如果设计的不够完美的话,可能会产生ABA问题,而ABA问题又可以分为两类,我们先看来看一类问题。 更多内容请访问www.flydean.com 第一类问题 我们考虑下面一种ABA的情况: 在多线程的环境中,线程a从共享的地址X中读取到了对象A。 在线程a准备对地址X进行更新之前,线程b将地址X中的值修改为了B。 接着线程b将地址X中的值又修改回了A。 最新线程a对地址X执行CAS,发现X中存储的还是对象A,对象匹配,CAS成功。 上面的例子中CAS成功了,但是实际上这个CAS并不是原子操作,如果我们想要依赖CAS来实现原子操作的话可能就会出现隐藏的bug。 第一类问题的关键就在2和3两步。这两步我们可以看到线程b直接替换了内存地址X中的内容。 在拥有自动GC环境的编程语言,比如说java中,2,3的情况是不可能出现的,因为在java中,只要两个对象的地址一致,就表示这两个对象是相等的。 2,3两步可能出现的情况就在像C++这种,不存在自动GC环境的编程语言中。因为可以自己控制对象的生命周期,如果我们从一个list中删除掉了一个对象,然后又重新分配了一个对象,并将其add back到list中去,那么根据 MRU memory allocation算法,这个新的对象很有可能和之前删除对象的内存地址是一样的。这样就会导致ABA的问题。 第二类问题 如果我们在拥有自动GC的编程语言中,那么是否仍然存在CAS问题呢? 考虑下面的情况,有一个链表里面的数据是A->B->C,我们希望执行一个CAS操作,将A替换成D,生成链表D->B->C。考虑下面的步骤: 线程a读取链表头部节点A。 线程b将链表中的B节点删掉,链表变成了A->C 线程a执行CAS操作,将A替换从D。 最后我们的到的链表是D->C,而不是D->B->C。 问题出在哪呢?CAS比较的节点A和最新的头部节点是不是同一个节点,它并没有关心节点A在步骤1和3之间是否内容发生变化。 我们举个例子: public void useABAReference(){ CustUser a= new CustUser(); CustUser b= new CustUser(); CustUser c= new CustUser(); AtomicReference<CustUser> atomicReference= new AtomicReference<>(a); log.info("{}",atomicReference.compareAndSet(a,b)); log.info("{}",atomicReference.compareAndSet(b,a)); a.setName("change for new name"); log.info("{}",atomicReference.compareAndSet(a,c)); } 上面的例子中,我们使用了AtomicReference的CAS方法来判断对象是否发生变化。在CAS b和a之后,我们将a的name进行了修改,我们看下最后的输出结果: [main] INFO com.flydean.aba.ABAUsage - true [main] INFO com.flydean.aba.ABAUsage - true [main] INFO com.flydean.aba.ABAUsage - true 三个CAS的结果都是true。说明CAS确实比较的两者是否为统一对象,对其中内容的变化并不关心。 第二类问题可能会导致某些集合类的操作并不是原子性的,因为你并不能保证在CAS的过程中,有没有其他的节点发送变化。 第一类问题的解决 第一类问题在存在自动GC的编程语言中是不存在的,我们主要看下怎么在C++之类的语言中解决这个问题。 根据官方的说法,第一类问题大概有四种解法: 使用中间节点 - 使用一些不代表任何数据的中间节点来表示某些节点是标记被删除的。 使用自动GC。 使用hazard pointers - hazard pointers 保存了当前线程正在访问的节点的地址,在这些hazard pointers中的节点不能够被修改和删除。 使用read-copy update (RCU) - 在每次更新的之前,都做一份拷贝,每次更新的是拷贝出来的新结构。 第二类问题的解决 第二类问题其实算是整体集合对象的CAS问题了。一个简单的解决办法就是每次做CAS更新的时候再添加一个版本号。如果版本号不是预期的版本,就说明有其他的线程更新了集合中的某些节点,这次CAS是失败的。 我们举个AtomicStampedReference的例子: public void useABAStampReference(){ Object a= new Object(); Object b= new Object(); Object c= new Object(); AtomicStampedReference<Object> atomicStampedReference= new AtomicStampedReference(a,0); log.info("{}",atomicStampedReference.compareAndSet(a,b,0,1)); log.info("{}",atomicStampedReference.compareAndSet(b,a,1,2)); log.info("{}",atomicStampedReference.compareAndSet(a,c,0,1)); } AtomicStampedReference的compareAndSet方法,多出了两个参数,分别是expectedStamp和newStamp,两个参数都是int型的,需要我们手动传入。 总结 ABA问题其实是由两类问题组成的,需要我们分开来对待和解决。 本文的例子https://github.com/ddean2009/ learn-java-base-9-to-20 本文作者:flydean程序那些事 本文链接:http://www.flydean.com/aba-cas-stamp/ 本文来源:flydean的博客 欢迎关注我的公众号:程序那些事,更多精彩等着您!

优秀的个人博客,低调大师

每日一博 | 机器阅读理解是什么?有哪些应用?

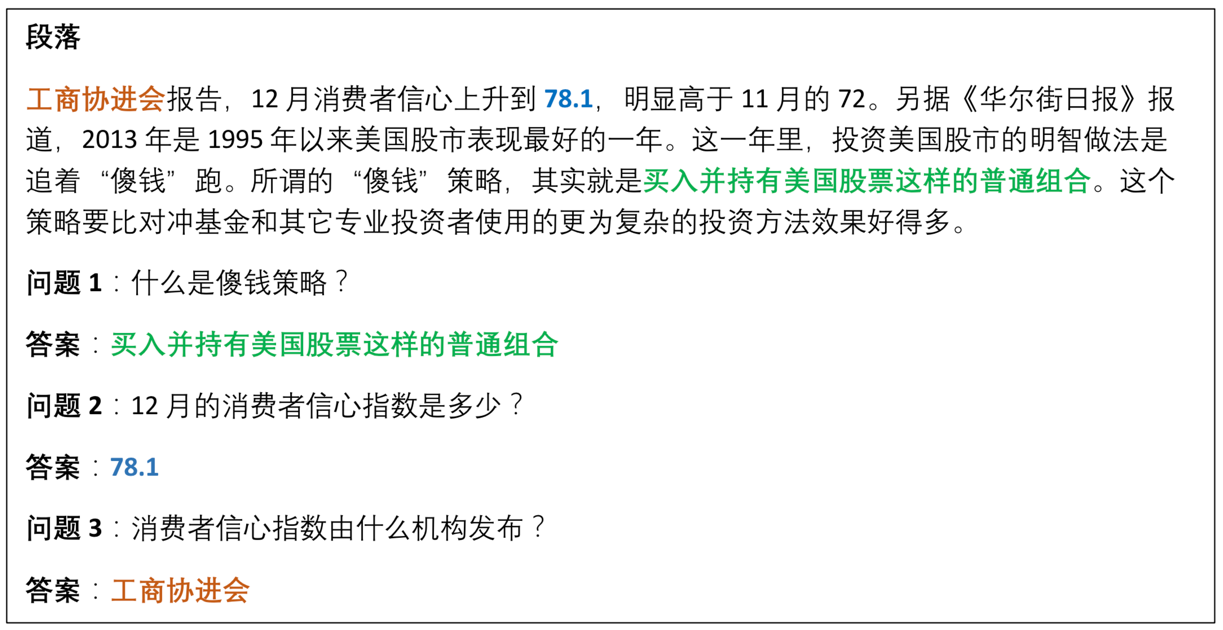
作者:朱晨光 1. 机器阅读理解是什么 机器阅读理解(Machine Reading Comprehension,MRC)是一种利用算法使计算机理解文章语义并回答相关问题的技术。由于文章和问题均采用人类语言的形式,因此机器阅读理解属于自然语言处理(NLP)的范畴,也是其中最新最热门的课题之一。近些年来,随着机器学习,特别是深度学习的发展,机器阅读理解研究有了长足的进步,并在实际应用中崭露头角。 学者 C. Snow 在 2002 年的一篇论文中定义阅读理解是“通过交互从书面文字中提取与构造文章语义的过程”。而机器阅读理解的目标是利用人工智能技术,使计算机具有和人类一样理解文章的能力。图1给出了一个机器阅读理解的样例。其中,模型需要用文章中的一段原文回答问题。 图1 机器阅读理解任务样例 大部分机器阅读理解任务采用问答式测评:设计与文章内容相关的自然语言式问题,让模型理解问题并根据文章作答。为了评判答案的正确性,一般有如下几种形式的参考答案: 多项选择式,即模型需要从给定的若干选项中选出正确答案; 区间答案式,即答案限定是文章的一个子句,需要模型在文章中标明正确的答案起始位置和终止位置; 自由回答式,即不限定模型生成答案的形式,允许模型自由生成语句; 完形填空式,即在原文中除去若干关键词,需要模型填入正确单词或短语。 此外,一些数据集设计了“无答案”问题,即一个问题可能在文章中没有合适答案,需要模型输出“无法回答”(unanswerable)。 在以上的答案形式中,多项选择和完形填空属于客观类答案,测评时可以将模型答案直接与正确答案比较,并以准确率作为评测标准,易于计算。 2. 机器阅读理解主流框架 早期的阅读理解模型大多基于检索技术,即根据问题在文章中进行搜索,找到相关的语句作为答案。但是,信息检索主要依赖关键词匹配,而在很多情况下,单纯依靠问题和文章片段的文字匹配找到的答案与问题并不相关。随着深度学习的发展,机器阅读理解进入了神经网络时代。相关技术的进步给模型的效率和质量都带来了很大的提升。机器阅读理解模型的准确率不断提高,在一些数据集上已经达到或超过了人类的平均水平。 基于深度学习的机器阅读理解模型虽然构造各异,但是经过多年的实践和探索,逐渐形成了稳定的框架结构。机器阅读理解模型的输入为文章和问题。因此,首先要对这两部分进行数字化编码,变成可以被计算机处理的信息单元。在编码的过程中,模型需要保留原有语句在文章中的语义。因此,每个单词、短语和句子的编码必须建立在理解上下文的基础上。我们把模型中进行编码的模块称为编码层。 接下来,由于文章和问题之间存在相关性,模型需要建立文章和问题之间的联系。例如,如果问题中出现关键词“河流”,而文章中出现关键词“长江”,虽然两个词不完全一样,但是其语义编码接近。因此,文章中“长江”一词以及邻近的语句将成为模型回答问题时的重点关注对象。这可以通过自然语言处理中的注意力机制加以解决。在这个过程中,阅读理解模型将文章和问题的语义结合在一起进行考量,进一步加深模型对于两者各自的理解。我们将这个模块称为交互层。 经过交互层,模型建立起文章和问题之间的语义联系,就可以预测问题的答案。完成预测功能的模块称为输出层。由于机器阅读理解任务的答案有多种类型,因此输出层的具体形式需要和任务的答案类型相关联。此外,输出层需要确定模型优化时的评估函数和损失函数。 图2是机器阅读理解模型的一般架构。可以看出,编码层用于对文章和问题分别进行底层处理,将文本转化成为数字编码。交互层可以让模型聚焦文章和问题的语义联系,借助于文章的语义分析加深对问题的理解,同时也借助于问题的语义分析加深对文章的理解。输出层根据语义分析结果和答案的类型生成模型的答案输出。 图2 机器阅读理解模型的总体架构,输出层以区间式答案为例 3. 机器阅读理解的相关模型 在基本框架的指引下,众多优秀的机器阅读理解模型脱颖而出。这些模型在网络架构、模块设计、训练方法等方面实现了各种创新,大大提高了算法理解文本和问题的能力和预测答案的准确性,在诸多机器阅读理解数据集和竞赛中取得了非常优秀的成绩。其中具有代表性的模型有:双向注意力流(BiDAF),使用门机制的 R-net、融合网络(FusionNet)等。 而近期非常流行的预训练模型给机器阅读理解领域带来了革命性的改变。预训练方法源于机器学习中迁移学习的概念:为了完成一个学习任务,首先在其他相关任务上预训练模型,然后将模型在目标任务上进一步优化,实现模型所学知识的迁移。预训练模型最大的好处是,可以克服目标任务(如机器阅读理解)数据不足的问题,利用大量其他任务的数据,建立有效的模型再迁移到目标任务,大大提高了模型的准确度。这其中最具有代表性的便是 Google 于 2018 年提出的双向编码器模型 BERT。BERT 采用无监督学习在大规模语料上进行预训练,并创新性地利用掩码设计与判断下一段文本两个子任务增强了模型的语言能力。在论文作者开源了代码和预训练模型后,BERT 立即被研究者运用在各种 NLP 任务中,并频繁大幅刷新之前的最好结果。例如,在 SQuAD 2.0 竞赛中,排名前 20 名的模型全部基于 BERT;CoQA 竞赛中,前 10 名模型全部基于 BERT。并且这两个竞赛中模型的最好表现已经超越人类水平。 4. 机器阅读理解在工业界的应用 机器阅读理解利用人工智能技术为计算机赋予了阅读、分析和归纳文本的能力。随着信息时代的到来,文本的规模呈爆炸式发展。因此,机器阅读理解带来的自动化和智能化恰逢其时,在众多工业界领域和人们生活中的方方面面都有着广阔的应用空间。 客服机器人是一种基于自然语言处理的拟人式服务,通过文字或语音与用户进行多轮交流,获取相关信息并提供解答。机器阅读理解可以帮助客服系统根据用户提供的信息在产品文档中快速找到解决方案,如图 3 所示。 图3 客服机器人与用户与产品文档的关系 智能法律用于自动处理和应用各种错综复杂的法律法规实现对案例的自动审判,这正可以利用机器阅读理解在处理和分析大规模文档方面的速度优势。 智能教育利用计算机辅助人类的学习过程。机器阅读理解在这个领域的典型应用是作文自动批阅。自动作文批阅模型可以作为学生写作时的助手,理解作文语义,自动修改语法错误,个性化总结易错知识点。这些技术与当前流行的在线教育结合,很有可能在不久的将来对教育行业产生颠覆性的影响。 展望未来,机器阅读理解研究仍面临如知识与推理能力、可解释性、缺乏训练数据等挑战,但也有很大的应用空间。基于机器阅读理解高速处理大量文本的特点,这项技术最容易在劳动密集型文本处理行业落地。而在其产业化的进程中,可以有部分替代人类和完全替代人类两种模式。部分替代人类模式是指模型的质量没有完全达到可接受的水平,但是可以很好地处理简单高频的场景,然后由人类接力处理。而在作文自动批阅等需要模型独立完成任务的场景中,可以使用强化学习等手段根据用户的反馈不断改进模型的架构和参数,得到更好的表现。 在今后的发展中,一方面,机器阅读理解可以在自然语言理解已获得成功的深耕领域进一步细分与提升质量,如搜索引擎、广告、推荐等;另一方面,我们相信,随着机器阅读理解技术的不断进步,机器与人类的差距会不断缩小,我们必将迎来技术的奇点,使得这项技术对更多的行业产生革命性的影响。 5. 机器阅读理解常见问题集 最近,笔者参加了开源中国社区的“高手问答”活动,对读者们的提出的问题进行了总结,大致可以分为以下几个方面: 人工智能的语言 不少读者提到实现机器阅读理解和深度学习最好使用什么语言。首先,需要指出的是,任何编程语言都只是实现工具,而背后的算法和模型才是精髓。当前人工智能最热门的语言是 Python,主要原因是 Python 上手比较简单,语法规则没有 Java、C++ 那样复杂。而且 Python 属于解释性语言,即不需要编译就可以运行,可以一边写一边运行,利于调试。正因为如此,当前最流行的深度学习 TensorFlow 和 PyTorch 都基于 Python。使用的人多了,相关社区建立起来以后各种功能包、论文代码实现等都很齐全,就使得 Python 更加流行。 当然,我们还是需要先关注模型和算法,然后再用具体语言实现以加深理解。本书中介绍了机器阅读理解的各种模型,使用 PyTorch 展示,但也很容易转用其他框架或语言实现。 多模态阅读理解 市面上比较流行和成功的人工智能产品大多与多模态人工智能相关,特别是语音和语言的理解。例如 Amazon Echo、Google Home、天猫精灵等产品都嵌入了语言识别,意图理解,语音合成等人工智能技术。一般来说,这些产品首先将语音转化为文本,然后对文本进行类似于机器阅读理解的处理和分析,得到用户的意图。这个过程还包括理解对话的上下文(如指代词)、搜寻数据库(如找到用户想播放的歌的音频文件)、进一步提问以确定意图等技术。这些技术提升了用户与产品的交流体验,大大提高了用户对产品的满意度。因此,本书在最后一章提出,多模态是未来阅读理解的重要发展方向之一。 而对于其他多模态形式,例如文本图片混合,可以关注视觉问答(Visual Question Answering)等研究方向。 机器阅读理解的应用 不少读者提到了机器阅读理解的具体应用场景。下面列举一些。 人工智能自动写文章和作诗属于自然语言生成的范畴。书中在 3.3 节详细介绍了如何让自然语言模型生成文字。一般来说,利用大规模语料训练可以达到很好的效果,例如 GPT-2。 一位读者问对方言的阅读理解应该如何进行。由于方言中含有大量与标准汉语不同的单词、短语和语言用法,因此直接使用一般的中文模型效果较差,必须在专门的方言语料库上进一步训练。然而,缺少方言数据是一个很大的挑战。因此,可以考虑在深度学习中加入人工编辑的规则,将从方言中采集到的一些常见用法作为规则输入,是一种可行的解决办法。 此外,一些读者关心中文阅读理解的进展。近年来,随着各种论文、开源代码的普及,基本上所有英文方面的最新自然语言处理成果都有中文的实现和应用,而且方法基本类似。而中文和英文的不同点如分词、标点等都有专门的处理工具,如 Python 包 jieba 在中文分词方面有很好的效果(书中 2.1.1 节有代码实现)。 如何阅读本书 有读者问到阅读这本书需要有哪些基础。《机器阅读理解》这本书从深度学习和自然语言处理的基础讲起,例如分词、词向量、语言模型、语言理解、语言生成等。书中既有理论介绍,也有代码实践。因此,第 1-3 章可以作为自然语言处理和深度学习的入门书。 本书从第 4 章开始全面讲解机器阅读理解的任务、模型理论分析和实战代码,并介绍了各种落地应用,有很强的实用价值。 如果读者朋友有更多问题,欢迎阅读《机器阅读理解:算法与实践》一书,本书的源代码已开源在https://github.com/zcgzcgzcg1/MRC_book。欢迎读者朋友们通过邮箱 zcg.stanford@gmail.com 与我联系。 作者介绍 朱晨光,微软公司自然语言处理高级研究员、斯坦福大学计算机系博士。负责自然语言处理研究与开发、对话机器人的语义理解、机器阅读理解研究等,精通人工智能、深度学习与自然语言处理,尤其擅长机器阅读理解、文本总结、对话处理等方向。带领团队负责客服对话机器人的语义理解与分析,进行机器阅读理解研究,在斯坦福大学举办的 SQuAD 1.0 机器阅读理解竞赛中获得全球第一名,在 CoQA 对话阅读理解竞赛中成绩超过人类水平并获得第一名。在人工智能和自然语言处理顶级会议 ICLR、ACL、EMNLP、NAACL 中发表多篇文章。 《机器阅读理解:算法与实践》 微软人工智能首席技术官黄学东、中国计算机学会秘书长杜子德联袂推荐!微软高级研究员、斯坦福大学计算机系博士、2届全球阅读理解竞赛冠军朱晨光撰写。让你深刻认识机器阅读理解并直接进行相关模型开发、实验和部署。

优秀的个人博客,低调大师

每日一博 | MySQL 的 crash-safe 原理解析

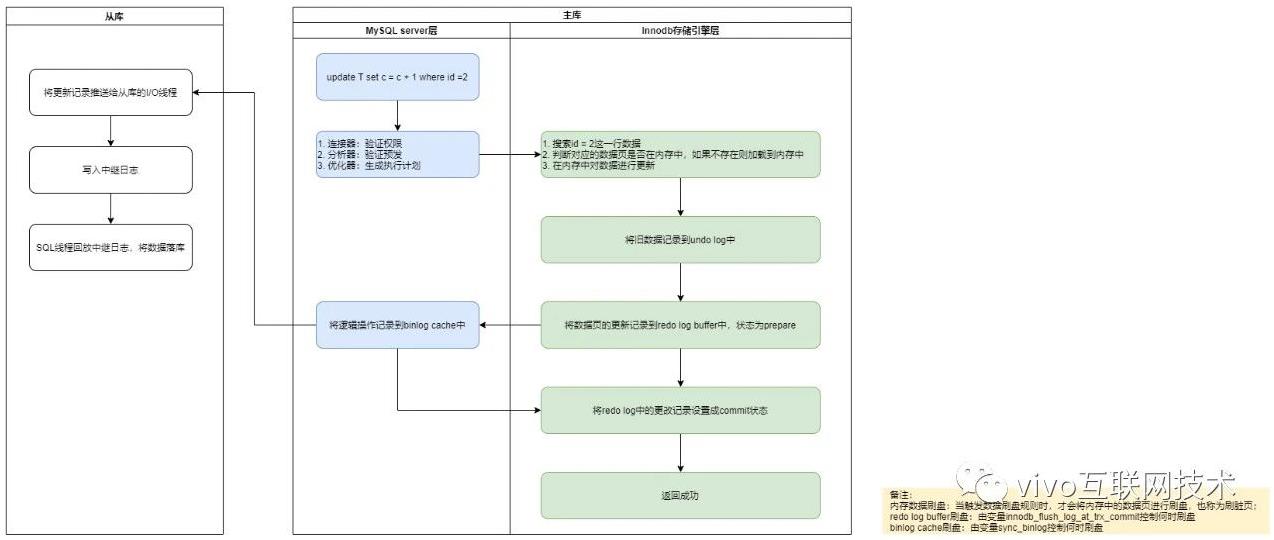
本文首发于 vivo互联网技术 微信公众号 链接:https://mp.weixin.qq.com/s/5i9wmJs4_Er7RaYfNnETyA 作者:xieweipeng MySQL作为当下最流行的开源关系型数据库,有一个很关键和基本的能力,就是必须能够保证数据不会丢。那么在这个能力背后,MySQL是如何设计才能保证不管在什么时间崩溃,恢复后都能保证数据不会丢呢?有哪些关键技术支撑了这个能力?本文将为我们一一揭晓。 一、前言 MySQL保证数据不会丢的能力主要体现在两方面: 能够恢复到任何时间点的状态; 能够保证MySQL在任何时间段突然奔溃,重启后之前提交的记录都不会丢失; 对于第一点将MySQL恢复到任何时间点的状态,相信很多人都知道,只要保留有足够的binlog,就能通过重跑binlog来实现。 对于第二点的能力,也就是本文标题所讲的crash-safe。即在 InnoDB 存储引擎中,事务提交过程中任何阶段,MySQL突然奔溃,重启后都能保证事务的完整性,已提交的数据不会丢失,未提交完整的数据会自动进行回滚。这个能力依赖的就是redo log和unod log两个日志。 因为crash-safe主要体现在事务执行过程中突然奔溃,重启后能保证事务完整性,所以在讲解具体原理之前,先了解下MySQL事务执行有哪些关键阶段,后面才能依据这几个阶段来进行解析。下面以一条更新语句的执行流程为例,话不多说,直接上图: 从上图可以清晰地看出一条更新语句在MySQL中是怎么执行的,简单进行总结一下: 从内存中找出这条数据记录,对其进行更新; 将对数据页的更改记录到redo log中; 将逻辑操作记录到binlog中; 对于内存中的数据和日志,都是由后台线程,当触发到落盘规则后再异步进行刷盘; 上面演示了一条更新语句的详细执行过程,接下来咱们通过解答问题,带着问题来剖析这个crash-safe的设计原理。 二、WAL机制 问题:为什么不直接更改磁盘中的数据,而要在内存中更改,然后还需要写日志,最后再落盘这么复杂? 这个问题相信很多同学都能猜出来,MySQL更改数据的时候,之所以不直接写磁盘文件中的数据,最主要就是性能问题。因为直接写磁盘文件是随机写,开销大性能低,没办法满足MySQL的性能要求。所以才会设计成先在内存中对数据进行更改,再异步落盘。但是内存总是不可靠,万一断电重启,还没来得及落盘的内存数据就会丢失,所以还需要加上写日志这个步骤,万一断电重启,还能通过日志中的记录进行恢复。 写日志虽然也是写磁盘,但是它是顺序写,相比随机写开销更小,能提升语句执行的性能(针对顺序写为什么比随机写更快,可以比喻为你有一个本子,按照顺序一页一页写肯定比写一个字都要找到对应页写快得多)。 这个技术就是大多数存储系统基本都会用的WAL(Write Ahead Log)技术,也称为日志先行的技术,指的是对数据文件进行修改前,必须将修改先记录日志。保证了数据一致性和持久性,并且提升语句执行性能。 三、核心日志模块 问题:更新SQL语句执行流程中,总共需要写3个日志,这3个是不是都需要,能不能进行简化? 更新SQL执行过程中,总共涉及MySQL日志模块其中的三个核心日志,分别是redo log(重做日志)、undo log(回滚日志)、binlog(归档日志)。这里提前预告,crash-safe的能力主要依赖的就是这三大日志。 接下来,针对每个日志将单独介绍各自的作用,然后再来评估是否能简化掉。 1、重做日志 redo log redo log也称为事务日志,由InnoDB存储引擎层产生。记录的是数据库中每个页的修改,而不是某一行或某几行修改成怎样,可以用来恢复提交后的物理数据页(恢复数据页,且只能恢复到最后一次提交的位置,因为修改会覆盖之前的)。 前面提到的WAL技术,redo log就是WAL的典型应用,MySQL在有事务提交对数据进行更改时,只会在内存中修改对应的数据页和记录redo log日志,完成后即表示事务提交成功,至于磁盘数据文件的更新则由后台线程异步处理。由于redo log的加入,保证了MySQL数据一致性和持久性(即使数据刷盘之前MySQL奔溃了,重启后仍然能通过redo log里的更改记录进行重放,重新刷盘),此外还能提升语句的执行性能(写redo log是顺序写,相比于更新数据文件的随机写,日志的写入开销更小,能显著提升语句的执行性能,提高并发量),由此可见redo log是必不可少的。 redo log是固定大小的,所以只能循环写,从头开始写,写到末尾就又回到开头,相当于一个环形。当日志写满了,就需要对旧的记录进行擦除,但在擦除之前,需要确保这些要被擦除记录对应在内存中的数据页都已经刷到磁盘中了。在redo log满了到擦除旧记录腾出新空间这段期间,是不能再接收新的更新请求,所以有可能会导致MySQL卡顿。(所以针对并发量大的系统,适当设置redo log的文件大小非常重要!!!) 2、回滚日志 undo log undo log顾名思义,主要就是提供了回滚的作用,但其还有另一个主要作用,就是多个行版本控制(MVCC),保证事务的原子性。在数据修改的流程中,会记录一条与当前操作相反的逻辑日志到undo log中(可以认为当delete一条记录时,undo log中会记录一条对应的insert记录,反之亦然,当update一条记录时,它记录一条对应相反的update记录),如果因为某些原因导致事务异常失败了,可以借助该undo log进行回滚,保证事务的完整性,所以undo log也必不可少。 3、归档日志 binlog binlog在MySQL的server层产生,不属于任何引擎,主要记录用户对数据库操作的SQL语句(除了查询语句)。之所以将binlog称为归档日志,是因为binlog不会像redo log一样擦掉之前的记录循环写,而是一直记录(超过有效期才会被清理),如果超过单日志的最大值(默认1G,可以通过变量 max_binlog_size 设置),则会新起一个文件继续记录。但由于日志可能是基于事务来记录的(如InnoDB表类型),而事务是绝对不可能也不应该跨文件记录的,如果正好binlog日志文件达到了最大值但事务还没有提交则不会切换新的文件记录,而是继续增大日志,所以 max_binlog_size 指定的值和实际的binlog日志大小不一定相等。 正是由于binlog有归档的作用,所以binlog主要用作主从同步和数据库基于时间点的还原。 那么回到刚才的问题,binlog可以简化掉吗?这里需要分场景来看: 如果是主从模式下,binlog是必须的,因为从库的数据同步依赖的就是binlog; 如果是单机模式,并且不考虑数据库基于时间点的还原,binlog就不是必须,因为有redo log就可以保证crash-safe能力了;但如果万一需要回滚到某个时间点的状态,这时候就无能为力,所以建议binlog还是一直开启; 根据上面对三个日志的详解,我们可以对这个问题进行解答:在主从模式下,三个日志都是必须的;在单机模式下,binlog可以视情况而定,保险起见最好开启。 四、两阶段提交 问题:为什么redo log要分两步写,中间再穿插写binlog呢? 从上面可以看出,因为redo log影响主库的数据,binlog影响从库的数据,所以redo log和binlog必须保持一致才能保证主从数据一致,这是前提。 相信很多有过开发经验的同学都知道分布式事务,这里的redo log和binlog其实就是很典型的分布式事务场景,因为两者本身就是两个独立的个体,要想保持一致,就必须使用分布式事务的解决方案来处理。而将redo log分成了两步,其实就是使用了两阶段提交协议(Two-phase Commit,2PC)。 下面对更新语句的执行流程进行简化,看一下MySQL的两阶段提交是如何实现的: 从图中可看出,事务的提交过程有两个阶段,就是将redo log的写入拆成了两个步骤:prepare和commit,中间再穿插写入binlog。 如果这时候你很疑惑,为什么一定要用两阶段提交呢,如果不用两阶段提交会出现什么情况,比如先写redo log,再写binlog或者先写binlog,再写redo log不行吗?下面我们用反证法来进行论证。 我们继续用update T set c=c+1 where id=2这个例子,假设id=2这一条数据的c初始值为0。那么在redo log写完,binlog还没有写完的时候,MySQL进程异常重启。由于redo log已经写完了,系统重启后会通过redo log将数据恢复回来,所以恢复后这一行c的值是1。但是由于binlog没写完就crash了,这时候binlog里面就没有记录这个语句。因此,不管是现在的从库还是之后通过这份binlog还原临时库都没有这一次更新,c的值还是0,与原库的值不同。 同理,如果先写binlog,再写redo log,中途系统crash了,也会导致主从不一致,这里就不再详述。 所以将redo log分成两步写,即两阶段提交,才能保证redo log和binlog内容一致,从而保证主从数据一致。 两阶段提交虽然能够保证单事务两个日志的内容一致,但在多事务的情况下,却不能保证两者的提交顺序一致,比如下面这个例子,假设现在有3个事务同时提交: T1 (--prepare--binlog---------------------commit) T2 (-----prepare-----binlog----commit) T3 (--------prepare-------binlog------commit) 解析: redo log prepare的顺序:T1 --》T2 --》T3 binlog的写入顺序:T1 --》 T2 --》T3 redo log commit的顺序:T2 --》 T3 --》T1 结论:由于binlog写入的顺序和redo log提交结束的顺序不一致,导致binlog和redo log所记录的事务提交结束的顺序不一样,最终导致的结果就是主从数据不一致。 因此,在两阶段提交的流程基础上,还需要加一个锁来保证提交的原子性,从而保证多事务的情况下,两个日志的提交顺序一致。所以在早期的MySQL版本中,通过使用prepare_commit_mutex锁来保证事务提交的顺序,在一个事务获取到锁时才能进入prepare,一直到commit结束才能释放锁,下个事务才可以继续进行prepare操作。通过加锁虽然完美地解决了顺序一致性的问题,但在并发量较大的时候,就会导致对锁的争用,性能不佳。除了锁的争用会影响到性能之外,还有一个对性能影响更大的点,就是每个事务提交都会进行两次fsync(写磁盘),一次是redo log落盘,另一次是binlog落盘。大家都知道,写磁盘是昂贵的操作,对于普通磁盘,每秒的QPS大概也就是几百。 五、组提交 问题:针对通过在两阶段提交中加锁控制事务提交顺序这种实现方式遇到的性能瓶颈问题,有没有更好的解决方案呢? 答案自然是有的,在MySQL 5.6 就引入了binlog组提交,即BLGC(Binary Log Group Commit)。binlog组提交的基本思想是,引入队列机制保证InnoDB commit顺序与binlog落盘顺序一致,并将事务分组,组内的binlog刷盘动作交给一个事务进行,实现组提交目的。具体如图: 第一阶段(prepare阶段): 持有prepare_commit_mutex,并且write/fsync redo log到磁盘,设置为prepared状态,完成后就释放prepare_commit_mutex,binlog不作任何操作。 第二个阶段(commit阶段):这里拆分成了三步,每一步的任务分配给一个专门的线程处理: Flush Stage(写入binlog缓存) ① 持有Lock_log mutex [leader持有,follower等待] ② 获取队列中的一组binlog(队列中的所有事务) ③ 写入binlog缓存 Sync Stage(将binlog落盘) ①释放Lock_log mutex,持有Lock_sync mutex[leader持有,follower等待] ②将一组binlog落盘(fsync动作,最耗时,假设sync_binlog为1)。 CommitStage(InnoDB commit,清楚undo信息) ①释放Lock_sync mutex,持有Lock_commit mutex[leader持有,follower等待] ② 遍历队列中的事务,逐一进行InnoDB commit ③ 释放Lock_commit mutex 每个Stage都有自己的队列,队列中的第一个事务称为leader,其他事务称为follower,leader控制着follower的行为。每个队列各自有mutex保护,队列之间是顺序的。只有flush完成后,才能进入到sync阶段的队列中;sync完成后,才能进入到commit阶段的队列中。但是这三个阶段的作业是可以同时并发执行的,即当一组事务在进行commit阶段时,其他新事务可以进行flush阶段,实现了真正意义上的组提交,大幅度降低磁盘的IOPS消耗。 针对组提交为什么比两阶段提交加锁性能更好,简单做个总结:组提交虽然在每个队列中仍然保留了prepare_commit_mutex锁,但是锁的粒度变小了,变成了原来两阶段提交的1/4,所以锁的争用性也会大大降低;另外,组提交是批量刷盘,相比之前的单条记录都要刷盘,能大幅度降低磁盘的IO消耗。 六、数据恢复流程 问题:假设事务提交过程中,MySQL进程突然奔溃,重启后是怎么保证数据不丢失的? 下图就是MySQL重启后,提供服务前会先做的事 -- 恢复数据的流程: 对上图进行简单描述就是:奔溃重启后会检查redo log中是完整并且处于prepare状态的事务,然后根据XID(事务ID),从binlog中找到对应的事务,如果找不到,则回滚;找到并且事务完整则重新commit redo log,完成事务的提交。 下面我们根据事务提交流程,在不同的阶段时刻,看看MySQL突然奔溃后,按照上述流程是如何恢复数据的。 时刻A(刚在内存中更改完数据页,还没有开始写redo log的时候奔溃): 因为内存中的脏页还没刷盘,也没有写redo log和binlog,即这个事务还没有开始提交,所以奔溃恢复跟该事务没有关系; 时刻B(正在写redo log或者已经写完redo log并且落盘后,处于prepare状态,还没有开始写binlog的时候奔溃): 恢复后会判断redo log的事务是不是完整的,如果不是则根据undo log回滚;如果是完整的并且是prepare状态,则进一步判断对应的事务binlog是不是完整的,如果不完整则一样根据undo log进行回滚; 时刻C(正在写binlog或者已经写完binlog并且落盘了,还没有开始commit redo log的时候奔溃): 恢复后会跟时刻B一样,先检查redo log中是完整并且处于prepare状态的事务,然后判断对应的事务binlog是不是完整的,如果不完整则一样根据undo log回滚,完整则重新commit redo log; 时刻D(正在commit redo log或者事务已经提交完的时候,还没有反馈成功给客户端的时候奔溃): 恢复后跟时刻C基本一样,都会对照redo log和binlog的事务完整性,来确认是回滚还是重新提交。 七、总结 至此对MySQL 的crash-safe原理细节就基本讲完了,简单回顾一下: 首先简单介绍了WAL日志先行技术,包括它的定义、流程和作用。WAL是大部分数据库系统实现一致性和持久性的通用设计模式。; 接着对MySQL的日志模块,redo log、undo log、binlog、两阶段提交和组提交都进行了详细介绍; 最后讲解了数据恢复流程,并从不同时刻加以验证。 更多内容敬请关注vivo 互联网技术微信公众号 注:转载文章请先与微信号:Labs2020联系。

优秀的个人博客,低调大师

每日一博|京喜前端自动化测试之路

作者: 阿翔 前言 京喜(原京东拼购)项目,作为京东战略级业务,拥有千万级别的流量入口。为了保障线上业务的稳定运行,每月例行开展前端容灾演习,主要包含小程序及 H5 版本,要求各页面各模块在异常情况下进行适当的降级处理,不能出现空窗、样式错乱、不合理的错误提示等体验问题。 原来的容灾演习过程:小程序(通信方式改成 Https )和 H5 通过 Whistle 对接口返回进行修改来模拟异常情况,验证各页面各模块的降级处理符合预期。容灾演习是一项长期持续的工作,且涉及页面功能及场景多,人工的切换场景模拟异常导致演习效率很低,因此想通过开发自动化测试工具来提升研发效率,让容灾演习工作随时可以轻松开展。京喜 H5 和小程序场景差异比较大,因此自动化测试之路分 H5 和小程序两部分进行,以 H5 作为一个开篇。 综上所述,我们希望京喜 H5 自动化测试工具可以提供以下功能: 访问目标页面,对页面进行截图; 设置 UA(模拟不同渠道:微信、手Q、其它浏览器等); 模拟用户点击、滑动页面操作; 网络拦截、模拟异常情况(接口响应码 500、接口返回数据异常); 操作缓存数据(模拟有无缓存的场景等)。 技术选型 提到 Web 的自动化测试,很多人熟悉的是 Selenium 2.0(Selenium WebDriver), 支持多平台、多语言、多款浏览器(通过各种浏览器的驱动来驱动浏览器),提供了功能丰富的API接口。而随着前端技术的发展,Selenium 2.0 逐渐呈现出环境安装复杂、API 调用不友好、性能不高等缺点。新一代的自动化测试工具 —— Puppeteer ,相较于 Selenium WebDriver 环境安装更简单、性能更好、效率更高、在浏览器执行 Javascript 的 API 更简单,它还提供了网络拦截等功能。 Puppeteer 是一个 Node 库,它提供了一套高阶 API ,通过 Devtools 协议控制 Chromium 或 Chrome 浏览器。Puppeteer 默认以 Headless 模式运行,但是可以通过修改配置文件运行“有头”模式。 官方描述的功能: 生成页面 PDF; 抓取 SPA(单页应用)并生成预渲染内容(即“ SSR ”,服务器端渲染); 自动提交表单,进行 UI 测试,键盘输入等; 创建一个时时更新的自动化测试环境,使用 JavaScript 和最新的浏览器功能直接在最新版本的 Chrome 中执行测试; 捕获网站的 Timeline Trace,用来帮助分析性能问题; 测试浏览器扩展。 Puppeteer 提供了一种启动 Chromium 实例的方法。 当 Puppeteer 连接到一个 Chromium 实例的时候会通过 puppeteer.launch 或 puppeteer.connect 创建一个 Browser 对象,在通过 Browser 创建一个 Page 实例,导航到一个 Url ,然后保存截图。一个 Browser 实例可以有多个 Page 实例。 下面就是使用 Puppeteer 进行自动化的一个典型示例: const puppeteer = require('puppeteer'); puppeteer.launch().then(async browser => { const page = await browser.newPage(); await page.goto('https://example.com'); await page.screenshot({path: 'screenshot.png'}); await browser.close(); }); 综上所述,我们选择基于 Puppeteer 来开发京喜首页容灾演习的自动化测试工具,通过 Puppeteer 提供的一系列 API ,实现访问目标页面、模拟异常场景、生成截图的过程自动化。最后再通过人工比对截图,判断页面降级处理是否符合预期、用户体验是否友好。 实现方案 我们将容灾演习过程分为自动化流程和人工操作两部分。 自动化流程: 模拟用户访问页面操作; 拦截网络请求,修改接口返回数据,模拟异常场景(接口返回 500、异常数据等); 生成截图。 人工操作: 自动化脚本执行完毕后,人工比对各个场景的截图,判断是否符合预期。 方案流程图: 开发实录 安装 Puppeteer ,你可能会遇到的那些事 通过 npm init 初始化项目后, 就可以安装 Puppeteer 依赖了: npm i puppeteer :在安装时自动下载最新版本 Chromium。 或者 npm i puppeteer-core :在安装时不会自动下载 Chromium。(不能生成截图) 另外,在安装过程中可能会因为下载 Chromium 导致报错,官网建议是先通过 npm i --save puppeteer --ignore-scripts 阻止下载 Chromium, 然后再手动下载 Chromium 。 手动下载后,需要配置指定路径,修改 index.js 文件 const puppeteer = require('puppeteer'); (async () => { const browser = await puppeteer.launch({ // 运行 Chromium 或 Chrome 可执行文件的路径(相对路径) executablePath: './chrome-mac/Chromium.app/Contents/MacOS/Chromium', headless: false }); const page = await browser.newPage(); await page.goto('https://example.com'); await page.screenshot({path: 'screenshot.png'}); browser.close(); })(); 快速创建测试用例 为了提高测试脚本的可维护性、扩展性,我们将测试用例的信息都配置到 JSON 文件中,这样编写测试脚本的时候,我们只需关注测试流程的实现。 测试用例 JSON 数据配置包括公用数据(global)和私有数据: 公用数据(global):各测试用例都需要用到的数据,如:模拟访问的目标页面地址、名字、描述、设备类型等。 私有数据: 各测试用例特定的数据,如测试模块信息、API 地址、测试场景、预期结果、截图名字等数据。 { "global": { "url": "https://wqs.jd.com/xxx/index.shtml", "pageName": "index", "pageDesc": "首页", "device": "iPhone 7" }, "homePageApi": { "id": 1, "module": "home_page_api", "moduleDesc": "首页主接口", "api": "https://wqcoss.jd.com/xxx", "operation": "模拟响应码 500", "expectRules": [ "1. 显示异常信息、刷新按钮", "2. 点击刷新按钮,显示异常信息", "3. 恢复网络,点击刷新按钮,显示正常数据" ], "screenshot": [ { "name": "normal", "desc": "正常场景" }, { "name": "500_cache", "desc": "有缓存-返回500" }, { "name": "500_no_cache", "desc": "无缓存-返回500" }, { "name": "500_no_cache_reload", "desc": "无缓存-返回500-点击刷新按钮" }, { "name": "500_no_cache_recover", "desc": "无缓存-返回500-恢复网络" } ] }, … } 编写测试脚本 我们以京喜首页主接口的测试用例为例子,通过模接口返回 500 响应码的异常场景,验证主接口的异常处理机制是否完善、用户体验是否友好。 预期效果: 有缓存情况下,显示缓存数据 无缓存情况下显示异常信息、刷新按钮 点击刷新按钮,显示异常信息 恢复网络,点击刷新按钮,显示正常数据 测试流程: 场景实现: 根据测试流程以及配置的测试用例信息,编写测试脚本,实现测试用例场景: 访问页面 await page.goto(url) 生成截图 await page.screenshot({ path: './screenshot/index_home_page_500.png' }) 拦截接口请求 async test () => { ... // 创建 Page 实例,访问首页 await page.setRequestInterception(true) // 设置拦截请求 page.on("request", interceptionEvent) // 监听请求事件,当请求发起后页面会触发这个事件 ... // 刷新页面,触发请求拦截,生成测试场景截图 } 若测试用例需要拦截不同的请求,或是模拟多种场景,则需要设置多个请求监听事件。且一个事件执行结束后,必须要移除事件监听,才能继续下一个事件监听。 添加事件监听:page.on("request", eventFunction) 移除事件监听:page.off("request", eventFunction) // 设置拦截请求 await page.setRequestInterception(true) const iconInterception1 = requestInterception(api, "body") // 添加事件 1 监听 page.on("request", iconInterception1) await page.goto(url) await page.screenshot({ path: './screenshot/1.png' }) // 移除事件 1 监听 page.off("request", iconInterception1) const iconInterception2 = requestInterception(api, "body", ) // 添加事件 2 监听 page.on("request", iconInterception2) await page.goto(url) await page.screenshot({ path: './screenshot/2.png' }) // 移除事件 2 监听 page.off("request", iconInterception2) 模拟异常数据场景,生成 mock 数据。 function requestInterception (api, setProps, setValue) { let mockData switch (setProps) { case "status": // 修改返回状态码 mockData = { status: setValue } break case "contentType": // 修改返回内容类型 mockData = { contentType: setValue } break case "body": // 修改返回数据 mockData = { contentType: getMockResponse(setValue) } break default: break } return async req => { // 如果是需要拦截的 API,则通过 req.respond(mockData) 修改返回数据,否则 continue 继续请求别的 if (req.url().includes(api)) { // 拦截 API req.respond(mockData) // 修改返回数据 return false // 处理完了某个请求必须退出,不再执行 continue } req.continue() } 模拟接口返回 500: const interception500 = requestInterception(api, 'status', 500) page.on("request", interception500) // 当请求发起后页面会触发这个事件 模拟异常数据: const iconInterception = requestInterception(api, "body", { "data": { "modules": [{ "tpl": "3000", "content": [] }] } }) page.on("request", iconInterception) 生成 mock 数据有两种实现方案,可依据实际情况而定: [ ] 直接通过修改接口真实返回的数据生成 mock 数据,需要先获取接口实时返回数据 [x] 本地存储一份完整的接口数据,通过修改本地存储数据的方式生成 mock 数据(本文所述案例均基于此方案实现) 若选择第一种方案,则需先拦截接口请求,通过 req.response() 获取接口实时返回数据,根据测试场景修改实时返回数据作为 mock 数据。 由于京喜 H5 页面接口返回是 JSONP 格式的数据,所以在模拟返回数据的时候,必须先截取 JSONP 的 callback 信息,与模拟数据拼接后再返回; function requestInterception (api, setProps, setValue) { let mockData switch (setProps) { case "status": mockData = { status: setValue } break case "contentType": mockData = { contentType: setValue } break default: break } return async req => { if (req.url().includes(api)) { if (setProps === "body") { const callback = getUrlParam("callback", req.url()) // 获取 callback 信息 const localData = getLocalMockResponse(api) // 匹配 API ,获取本地存储数据 mockData = { body: getResponseMockLocalData(localData, setValue, callback, api) // 生成 mock 数据 } } req.respond(mockData) // 设置返回数据 return false } req.continue() } } 清除缓存 page.evaluate(() => { try { localStorage.clear() sessionStorage.clear() } catch (e) { console.log(e) } }) 点击刷新按钮 await page.waitFor(".page-error__refresh-btn") // 可以传 CSS 选择器,也可以传时间(单位毫秒) await page.click(".page-error__refresh-btn") 在模拟点击刷新按钮之前,需等待按钮渲染完成,再触发按钮点击。(防止刷新页面后,DOM 还未渲染完成的情况下,因找不到 DOM 导致报错) 取消拦截,恢复网络 await page.setRequestInterception(false) 运行脚本及调试 由于第一阶段的测试工具尚未平台化,自动化测试流程先通过在终端输入命令行,运行脚本的方式启动。 在项目的 package.json 文件中,使用 scripts 字段定义脚本命令: "scripts": { "test:real": "node ./pages/index/index.js", "test:mock": "node ./pages/index-mock/index.js" }, 运行: 在终端切入到项目根目录路径,输入以下命令行,就可以启动测试工具,运行测试脚本。 - npm run test:real // 接口真实返回的数据测试 - npm run test:mock // 使用本地 mock 数据测试 调试: 开启调试模式之前,需要先了解 Headless Chrome。 Headless Chrome ,无头模式,浏览器的无界面形态,可以在不打开浏览器的前提下,在命令行中运行测试脚本,能够完全像真实浏览器一样完成用户所有操作,不用担心运行测试脚本时浏览器受到外界的干扰,也不需要借助任何显示设备,使自动化测试更稳定。 Puppeteer 默认以无头模式运行。 那么要开启调试模式,就必须取消无头模式,在打开浏览器的场景下,进行自动化测试。因此,在命令行脚本中增加了“取消无头模式”和“打开开发者工具”的参数,测试脚本通过获取到的参数,决定是否开启调试模式。 const headless = process.argv[2] !== 'head' // 获取是否开启无头模式参数 const devtools = process.argv[3] === 'dev' // 获取是否打开开发者工具参数 const browser = await puppeteer.launch({ executablePath: browserPath, headless, devtools }) 在终端切入到项目根目录路径,输入以下命令行,就可以开启调试模式,运行测试脚本。 - npm run test:mock head // 打开 Chromium 窗口 - npm run test:mock head dev // 打开 Chromium 窗口 和 开发者工具窗口 head 参数:取消无头模式,打开 Chromium 窗口运行脚本; head dev 参数:在打开 Chromium 窗口运行脚本,并打开 Devtools 窗口,开启调试模式。 测试结果 人工比对截图结果: 运行脚本示例: 更多测试场景实现 1. 截取从页面顶部到指定 DOM 之间的区域(内容可能超出一屏的长图) Puppeteer 提供了四种截图方式: (1)截取一屏内容(默认普通截屏); (2)截取指定 DOM; (3)截取全屏; (4)指定裁剪区域,可设置 x、y、width、height。 x, y 是相对页面左上角。但只能截取一屏的内容,超出一屏不展示。 基于第四种方法进行改造: 通过原生 JavaScript 的 getBoundingClientRect() 方法获取到指定 DOM 的 x,y 坐标值; 通过 page.setViewport() 重置视口的高度; 调用截图 API 生成截图。 async function screenshotToElement (page, selector, path) { try { await page.waitForSelector(selector) let clip = await page.evaluate(selector => { const element = document.querySelector(selector) let { x, y, width, height } = element.getBoundingClientRect() return { x: 0, y: 0, width, height: M(y), } }, selector) await page.setViewport(clip) await page.screenshot({ path: path, clip: clip }) } catch (e) { console.log(e) } } height: y :截到指定 DOM 的顶部,不包含该 DOM; height: y + height : 截到指定 DOM 的底部,包含该 DOM; 原生 Javascript 的 getBoundingClientRect() 方法获取 DOM 元素定位和宽高值可能是小数,而 Puppeteer 的 setViewport() 设置视口方法不支持小数,所以需要对获取到的 DOM 元素定位信息取整。 2. 模拟不同渠道,如:手Q场景: // 设置 UA await page.setUserAgent("Mozilla/5.0 (iPhone; CPU iPhone OS 10_2_1 like Mac OS X) AppleWebKit/602.4.6 (KHTML, like Gecko) Mobile/14D27 QQ/6.7.1.416 V1_IPH_SQ_6.7.1_1_APP_A Pixel/750 Core/UIWebView NetType/4G QBWebViewType/1") 3. 滚动页面 await page.evaluate((top) => { window.scrollTo(0, top) }, top) page.evaluate(pageFunction, …args):在当前页面实例上下文中执行 JavaScript 代码 4. 监听页面崩溃事件 // 当页面崩溃时触发 page.on('error', (e) => { console.log(e) }) 结语 第一阶段的 H5 自动化之路告一段落,容灾演习已实现了半自动化,可通过在终端运行测试脚本,模拟异常场景自动生成截图,再配合人工比对截图操作,判断演习结果是否符合预期。目前已投入到每个月的容灾演习中使用。 随着京喜业务的迭代,页面也将更新改版,因此测用例也需要持续维护和更新。后续将持续优化自动化工具,共享测试脚本、在生成截图的基础上自动比对测试结果是否符合预期、数据入库、将测试结果转化成文档,自动发送邮件等等。基于容灾演习的自动化测试,还可扩展广告位的监测,数据上报监自动化测试…… 对于京喜首页自动化测试之路,远没有结束,还有很多可以优化和扩展的地方,接下来分阶段持续优化自动化测试工具,敬请期待! 相关链接 Puppeteer 欢迎关注凹凸实验室博客:aotu.io 或者关注凹凸实验室公众号(AOTULabs),不定时推送文章:

优秀的个人博客,低调大师

每日一博 | DDD 实践之路(二):事件驱动与 CQRS

本文首发于 vivo互联网技术 微信公众号 链接: https://mp.weixin.qq.com/s/Z3uJhxJGDif3qN5OlE_woA 作者:wenbo zhang 【领域驱动设计实践之路】系列往期精彩文章: 《领域驱动设计(DDD)实践之路(一)》 主要讲述了战略层面的DDD原则。 这是“领域驱动设计实践之路”系列的第二篇文章,分析了如何应用事件来分离软件核心复杂度。探究CQRS为什么广泛应用于DDD项目中,以及如何落地实现CQRS框架。当然我们也要警惕一些失败的教训,利弊分析以后再去抉择正确的应对之道。 一、前言:从物流详情开始 大家对物流跟踪都不陌生,它详细记录了在什么时间发生了什么,并且数据作为重要凭证是不可变的。我理解其背后的价值有这么几个方面:业务方可以管控每个子过程、知道目前所处的环节;另一方面,当需要追溯时候仅仅通过每一步的记录就可以回放整个历史过程。 我在之前的文章中提出过“软件项目也是人类社会生产关系的范畴,只不过我们所创造的劳动成果看不见摸不着而已”。所以我们可以借鉴物流跟踪的思路来开发软件项目,把复杂过程拆解为一个个步骤、子过程、状态,这和我们事件划分是一致的,这就是事件驱动的典型案例。 二、领域事件 领域事件(Domain Events)是领域驱动设计(Domain Driven Design,DDD)中的一个概念,用于捕获我们所建模的领域中所发生过的事情。 领域事件本身也作为通用语言(Ubiquitous Language)的一部分成为包括领域专家在内的所有项目成员的交流用语。 比如在前述的跨境物流例子中,货品达到保税仓以后需要分派工作人员进行分拣分包,那么“货品已到达保税仓”便是一个领域事件。 首先,从业务逻辑来说该事件关系到整个流程的成功或者失败;同时又将触发后续子流程;而对于业务方来说,该事件也是一个标志性的里程碑,代表自己的货品就快配送到自己手中。 所以通常来说,一个领域事件具有以下几个特征:较高的业务价值,有助于形成完整的业务闭环,将导致进一步的业务操作。这里还要强调一点,领域事件具有明确的边界。 比如:如果你建模的是餐厅的结账系统,那么此时的“客户已到达”便不是你关心的重点,因为你不可能在客户到达时就立即向对方要钱,而“客户已下单”才是对结账系统有用的事件。 1、建模领域事件 在建模领域事件时,我们应该根据限界上下文中的通用语言来命名事件及属性。如果事件由聚合上的命令操作产生,那么我们通常根据该操作方法的名字来命名领域事件。 对于上面的例子“货品已到达保税仓”,我们将发布与之对应的领域事件 GoodsArrivedBondedWarehouseEvent(当然在明确的界限上下文中也可以去掉聚合的名字,直接建模为ArrivedBondedWarehouseEvent,这都是命名方面的习惯)。 事件的名字表明了聚合上的命令方法在执行成功之后所发生的事情,换句话说待定项以及不确定的状态是不能作为领域事件的。 一个行之有效的方法是画出当前业务的状态流转图,包含前置操作以及引起的状态变更,这里表达的是已经变更完成的状态所以我们不用过去时态表示,比如删除或者取消,即代表已经删除或者已经取消。 然后对于其中的节点进行事件建模。如下图是文件云端存储的业务,我们分别对预上传、上传完成确认、删除等环节建模“过去时”事件,PreUploadedEvent、ConfirmUploadedEvent、RemovedEvent。 2、领域事件代码解读 package domain.event; import java.util.Date; import java.util.UUID; /** * @Description: * @Author: zhangwenbo * @Since: 2019/3/6 */ public class DomainEvent { /** * 领域事件还包含了唯一ID, * 但是该ID并不是实体(Entity)层面的ID概念, * 而是主要用于事件追溯和日志。 * 如果是数据库存储,该字段通常为唯一索引。 */ private final String id; /** * 创建时间用于追溯,另一方面不管使用了 * 哪种事件存储都有可能遇到事件延迟, * 我们通过创建时间能够确保其发生顺序。 */ private final Date occurredOn; public DomainEvent() { this.id = String.valueOf(UUID.randomUUID()); this.occurredOn = new Date(); } } 在创建领域事件时,需要注意2点: 领域事件本身应该是不变的(Immutable); 领域事件应该携带与事件发生时相关的上下文数据信息,但是并不是整个聚合根的状态数据。例如,在创建订单时可以携带订单的基本信息,而对于用户更新订单收货地址事件AddressUpdatedEvent事件,只需要包含订单、用户以及新的地址等信息即可。 publicclassAddressUpdatedEventextendsDomainEvent{ //通过userId+orderId来校验订单的合法性; private String userId; private String orderId; //新的地址 private Address address; //略去具体业务逻辑 } 3、领域事件的存储 事件的不可变性与可追溯性都决定了其必须要持久化的原则,我们来看看常见的几种方案。 3.1单独的EventStore 有的业务场景中会创建一个单独的事件存储中心,可能是Mysql、Redis、Mongo、甚至文件存储等。这里以Mysql举例,business_code、event_code用来区分不同业务的不同事件,具体的命名规则可以根据实际需要。 这里需要注意该数据源与业务数据源不一致的场景,我们要确保当业务数据更新以后事件能够准确无误的记录下来,实践中尽量避免使用分布式事务,或者尽量避免其跨库的场景,否则你就得想想如何补偿了。千万要避免,用户更新了收货地址,但是AddressUpdatedEvent事件保存失败。 总的原则就是对分布式事务Say No,无论如何,我相信方法总比问题多,在实践中我们总可以想到解决方案,区别在于该方案是否简洁、是否做到了解耦。 # 考虑是否需要分表,事件存储建议逻辑简单 CREATE TABLE `event_store` ( `event_id` int(11) NOT NULL auto increment, `event_code` varchar(32) NOT NULL, `event_name` varchar(64) NOT NULL, `event_body` varchar(4096) NOT NULL, `occurred_on` datetime NOT NULL, `business_code` varchar(128) NOT NULL, UNIQUE KEY (`event id`) ) ENGINE=InnoDB COMMENT '事件存储表'; 3.2 与业务数据一起存储 在分布式架构中,每个模块都做的相对比较小,准确的说是“自治”。如果当前业务数据量较小,可以将事件与业务数据一起存储,用相关标识区分是真实的业务数据还是事件记录;或者在当前业务数据库中建立该业务自己的事件存储,但是要考虑到事件存储的量级必然大于真实的业务数据,考虑是否需要分表。 这种方案的优势:数据自治;避免分布式事务;不需要额外的事件存储中心。当然其劣势就是不能复用。 4、领域事件如何发布 4.1 由领域聚合发送领域事件 /* * 一个关于比赛的充血模型例子 * 贫血模型会构造一个MatchService,我们这里通过模型来触发相应的事件 * 本例中略去了具体的业务细节 */ public class Match { public void start() { //构造Event.... MatchEvent matchStartedEvent = new MatchStartedEvent(); //略去具体业务逻辑 DefaultDomainEventBus.publish(matchStartedEvent); } public void finish() { //构造Event.... MatchEvent matchFinishedEvent = new MatchFinishedEvent(); //略去具体业务逻辑 DefaultDomainEventBus.publish(matchFinishedEvent); } //略去Match对象基本属性 } 4.2 事件总线VS消息中间件 微服务内的领域事件可以通过事件总线或利用应用服务实现不同聚合之间的业务协同。即微服务内发生领域事件时,由于大部分事件的集成发生在同一个线程内,不一定需要引入消息中间件。但一个事件如果同时更新多个聚合数据,按照 DDD“一个事务只更新一个聚合根”的原则,可以考虑引入消息中间件,通过异步化的方式,对微服务内不同的聚合根采用不同的事务 三、Saga分布式事务 1、Saga概要 我们看看如何使用 Saga 模式维护数据一致性? Saga 是一种在微服务架构中维护数据一致性的机制,它可以避免分布式事务所带来的问题。 一个 Saga 表示需要更新的多个服务中的一个,即Saga由一连串的本地事务组成。每一个本地事务负责更新它所在服务的私有数据库,这些操作仍旧依赖于我们所熟悉的ACID事务框架和函数库。 模式:Saga 通过使用异步消息来协调一系列本地事务,从而维护多个服务之间的数据一致性。 请参阅(强烈建议):https://microservices.io/patterns/data/saga.html Saga与TCC相比少了一步Try的操作,TCC无论最终事务成功失败都需要与事务参与方交互两次。而Saga在事务成功的情况下只需要与事务参与方交互一次, 如果事务失败,需要额外进行补偿回滚。 每个Saga由一系列sub-transaction Ti 组成; 每个Ti 都有对应的补偿动作Ci,补偿动作用于撤销Ti造成的结果; 可以看到,和TCC相比,Saga没有“预留”动作,它的Ti就是直接提交到库。 Saga的执行顺序有两种: success:T1, T2, T3, ..., Tn ; failure:T1, T2, ..., Tj, Cj,..., C2, C1,其中0 < j < n; 所以我们可以看到Saga的撤销十分关键,可以说使用Saga的难点就在于如何设计你的回滚策略。 2、Saga实现 通过上面的例子我们对Saga有了初步的体感,现在来深入探讨下如何实现。当通过系统命令启动Saga时,协调逻辑必须选择并通知第一个Saga参与方执行本地事务。一旦该事务完成,Saga协调选择并调用下一个Saga参与方。 这个过程一直持续到Saga执行完所有步骤。如果任何本地事务失败,则 Saga必须以相反的顺序执行补偿事务。以下几种不同的方法可用来构建Saga的协调逻辑。 2.1 协同式(choreography) 把 Saga 的决策和执行顺序逻辑分布在 Saga的每一个参与方中,它们通过交换事件的方式来进行沟通。 (引用于《微服务架构设计模式》相关章节) Order服务创建一个Order并发布OrderCreated事件。 Consumer服务消费OrderCreated事件,验证消费者是否可以下订单,并发布ConsumerVerified事件。 Kitchen服务消费OrderCreated事件,验证订单,在CREATE_PENDING状态下创建故障单,并发布TicketCreated事件。 Accounting服务消费OrderCreated事件并创建一个处于PENDING状态的Credit CardAuthorization。 Accounting服务消费TicketCreated和ConsumerVerified事件,向消费者的信用卡收费,并发布信用卡授权失败事件。 Kitchen服务使用信用卡授权失败事件并将故障单的状态更改为REJECTED。 订单服务消费信用卡授权失败事件,并将订单状态更改为已拒绝。 2.2 编排式(orchestration) 把Saga的决策和执行顺序逻辑集中在一个Saga编排器类中。Saga 编排器发出命令式消息给各个 Saga 参与方,指示这些参与方服务完成具体操作(本地事务)。类似于一个状态机,当参与方服务完成操作以后会给编排器发送一个状态指令,以决定下一步做什么。 (引用于《微服务架构设计模式》相关章节) 我们来分析一下执行流程 Order Service首先创建一个Order和一个创建订单控制器。之后,路径的流程如下: Saga orchestrator向Consumer Service发送Verify Consumer命令。 Consumer Service回复Consumer Verified消息。 Saga orchestrator向Kitchen Service发送Create Ticket命令。 Kitchen Service回复Ticket Created消息。 Saga协调器向Accounting Service发送授权卡消息。 Accounting服务部门使用卡片授权消息回复。 Saga orchestrator向Kitchen Service发送Approve Ticket命令。 Saga orchestrator向订单服务发送批准订单命令。 2.3补偿策略 之前的描述中我们说过Saga最重要的是如何处理异常,状态机还定义了许多异常状态。如上面的6就会发生失败,触发AuthorizeCardFailure,此时我们就要结束订单并把之前提交的事务进行回滚。这里面要区分哪些是校验性事务、哪些是需要补偿的事务。 一个Saga由三种不同类型的事务组成:可补偿性事务(可以回滚,因此有一个补偿事务);关键性事务(这是 Saga的成败关键点,比如4账户代扣);以及可重复性事务,它不需要回滚并保证能够完成(比如6更新状态)。 在Create Order Saga 中,createOrder()、createTicket()步骤是可补偿性事务且具有撤销其更新的补偿事务。 verifyConsumerDetails()事务是只读的,因此不需要补偿事务。authorizeCreditCard()事务是这个 Saga的关键性事务。如果消费者的信用卡可以授权,那么这个Saga保证完成。approveTicket()和approveRestaurantOrder()步骤是在关键性事务之后的可重复性事务。 认真拆解每个步骤、然后评估其补偿策略尤为重要,正如你看到的,每种类型的事务在对策中扮演着不同的角色。 四、CQRS 前面讲述了事件的概念,又分析了Saga如何解决复杂事务,现在我们来看看CQRS为什么在DDD中广泛被采用。除了读写分离的特征以外,我们用事件驱动的方式来实践Command逻辑能有效降低业务的复杂度。 当你明白如何建模事件、如何规避复杂事务,明白什么时候用消息中间件、什么时候采用事件总线,才能理解为什么是CQRS、怎么正确应用。 (图片来源于网络) 下面是我们项目中的设计,这里为什么会出现Read/Write Service,是为了封装调用,service内部是基于聚合发送事件。因为我发现在实际项目中,很多人都会第一时间问我要XXXService而不是XXX模型,所以在DDD没有完全普及的项目中建议大家采取这种居中策略。这也符合咱们的解耦,对方依赖我的抽象能力,然而我内部是基于DDD还是传统的流程代码对其是无关透明的。 我们先来看看事件以及处理器的时序关系。 这里还是以文件云端存储业务为例,下面是一些处理器的核心代码。注释行是对代码功能、用法以及扩展方面的解读,请认真阅读。 package domain; import domain.event.DomainEvent; import domain.handler.event.DomainEventHandler; import java.util.ArrayList; import java.util.HashMap; import java.util.List; import java.util.Map; /** * @Description: 事件注册逻辑 * @Author: zhangwenbo * @Since: 2019/3/6 */ public class DomainRegistry { private Map<String, List<DomainEventHandler>> handlerMap = new HashMap<String, List<DomainEventHandler>>(); private static DomainRegistry instance; private DomainRegistry() { } public static DomainRegistry getInstance() { if (instance == null) { instance = new DomainRegistry(); } return instance; } public Map<String, List<DomainEventHandler>> getHandlerMap() { return handlerMap; } public List<DomainEventHandler> find(String name) { if (name == null) { return null; } return handlerMap.get(name); } //事件注册与维护,register分多少个场景根据业务拆分, //这里是业务流的核心。如果多个事件需要维护前后依赖关系, //可以维护一个priority逻辑 public void register(Class<? extends DomainEvent> domainEvent, DomainEventHandler handler) { if (domainEvent == null) { return; } if (handlerMap.get(domainEvent.getName()) == null) { handlerMap.put(domainEvent.getName(), new ArrayList<DomainEventHandler>()); } handlerMap.get(domainEvent.getName()).add(handler); //按照优先级进行事件处理器排序 。。。 } } 文件上传完毕事件的例子。 package domain.handler.event; import domain.DomainRegistry; import domain.StateDispatcher; import domain.entity.meta.MetaActionEnums; import domain.event.DomainEvent; import domain.event.MetaEvent; import domain.repository.meta.MetaRepository; import org.springframework.stereotype.Component; import javax.annotation.PostConstruct; import javax.annotation.Resource; /** * @Description:一个事件操作的处理器 * 我们混合使用了Saga的两种模式,外层事件交互; * 对于单个复杂的事件内部采取状态流转实现。 * @Author: zhangwenbo * @Since: 2019/3/6 */ @Component public class MetaConfirmUploadedHandler implements DomainEventHandler { @Resource private MetaRepository metaRepository; public void handle(DomainEvent event) { //1.我们在当前的上下文中定义个ThreadLocal变量 //用于存放事件影响的聚合根信息(线程共享) //2.当然如果有需要额外的信息,可以基于event所 //携带的信息构造Specification从repository获取 // 代码示例 // metaRepository.queryBySpecification(SpecificationFactory.build(event)); DomainEvent domainEvent = metaRepository.load(); //此处是我们的逻辑 。。。。 //对于单个操作比较复杂的,可以使用状态流转进一步拆分 domainEvent.setStatus(nextState); //在事件触发之后,仍需要一个状态跟踪器来解决大事务问题 //Saga编排式 StateDispatcher.dispatch(); } @PostConstruct public void autoRegister() { //此处可以更加细分,注册在哪一类场景中,这也是事件驱动的强大、灵活之处。 //避免了if...else判断。我们可以有这样的意识,一旦你的逻辑里面充斥了大量 //switch、if的时候来看看自己注册的场景是否可以继续细分 DomainRegistry.getInstance().register(MetaEvent.class, this); } public String getAction() { return MetaActionEnums.CONFIRM_UPLOADED.name(); } //适用于前后依赖的事件,通过优先级指定执行顺序 public Integer getPriority() { return PriorityEnums.FIRST.getValue(); } } 事件总线逻辑 package domain; import domain.event.DomainEvent; import domain.handler.event.DomainEventHandler; import java.util.List; /** * @Description: * @Author: zhangwenbo * @Since: 2019/3/6 */ public class DefaultDomainEventBus { public static void publish(DomainEvent event, String action, EventCallback callback) { List<DomainEventHandler> handlers = DomainRegistry.getInstance(). find(event.getClass().getName()); handlers.stream().forEach(handler -> { if (action != null && action.equals(handler.getAction())) { Exception e = null; boolean result = true; try { handler.handle(event); } catch (Exception ex) { e = ex; result = false; //自定义异常处理 。。。 } finally { //write into event store saveEvent(event); } //根据实际业务处理回调场景,DefaultEventCallback可以返回 if (callback != null) { callback.callback(event, action, result, e); } } }); } } 五、自治服务和系统 DDD中强调限界上下文的自治特性,事实上,从更小的粒度来看,对象仍然需要具备自治的这四个特性,即:最小完备、自我履行、稳定空间、独立进化。其中自我履行是重点,因为不强依赖外部所以稳定、因为稳定才可能独立进化。这就是六边形架构在DDD中较为普遍的原因。 (图片来源于网络) 六、结语 本文所讲述的事件、Saga、CQRS的方案均可以单独使用,可以应用到你的某个method、或者你的整个package。项目中我们并不一定要实践一整套CQRS,只要其中的某些思想解决了我们项目中的某个问题就足够了。 也许你现在已经磨刀霍霍,准备在项目中实践一下这些技巧。不过我们要明白“每一个硬币都有两面性”,我们不仅看到高扩展、解耦的、易编排的优点以外,仍然要明白其所带来的问题。利弊分析以后再去决定如何实现才是正确的应对之道。 这类编程模式有一定的学习曲线; 基于消息传递的应用程序的复杂性; 处理事件的演化有一定难度; 删除数据存在一定难度; 查询事件存储库非常有挑战性。 不过我们还是要认识到在其适合的场景中,六边形架构以及DDD战术将加速我们的领域建模过程,也迫使我们从严格的通用语言角度来解释一个领域,而不是一个个需求。任何更强调核心域而不是技术实现的方式都可以增加业务价值,并使我们获得更大的竞争优势。 附:参考文献 Pattern: Saga 分布式事务:Saga模式 书籍:《微服务架构设计模式》 更多内容敬请关注vivo 互联网技术微信公众号 注:转载文章请先与微信号:Labs2020联系。

优秀的个人博客,低调大师

每日一博 | 探秘 ThreadLocal 的实现机制与小地雷

Java 多线程类库对于共享数据的读写访问主要采用同步机制来保证线程安全,而本文所要探究的 ThreadLocal 则采用了一种完全不同的策略,它不是用来解决共享数据的并发访问问题的,ThreadLocal 让每个线程都将目标数据复制一份作为线程私有,后续对于该数据的操作都是在各自私有的副本上进行,线程之间彼此相互隔离,也就不存在竞争问题。 下面的例子演示了 ThreadLocal 的典型应用场景。在 jdk 1.8 之前,如果我们希望对日期和时间进行格式化操作,则需要使用 SimpleDateFormat 类,而我们知道它是是线程不安全的,在多线程并发执行时会出现一些奇怪的问题。对于该类使用的最佳实践则是采用 ThreadLocal 进行包装,以保证每个线程都有一份属于自己的 SimpleDateFormat 对象,如下所示: ThreadLocal<SimpleDateFormat> sdf = new ThreadLocal<SimpleDateFormat>() { @Override protected SimpleDateFormat initialValue() { return new SimpleDateFormat("yyyy-MM-dd HH:mm:ss"); } }; 实现机制 那么 ThreadLocal 是怎么做到让修饰的对象能够在每个线程中各自持有一份呢?我们先来从整体的角度简单概括一下。 在 ThreadLocal 中定义了一个静态内部类 ThreadLocalMap,可以将其理解为一个特有的 Map 类型,而在 Thread 类中声明了一个 ThreadLocalMap 类型的 threadLocals 属性。针对每个 Thread 对象,也就是每个线程来说都包含了一个 ThreadLocalMap 对象,即每个线程都有一个属于自己的内存数据库,而数据库中存储的就是我们用 ThreadLocal 修饰的对象。整个过程还是有点绕的,可以借助下面这幅图进行理解: 这里的 key 就是对应的 ThreadLocal 对象自身,而 value 就是 ThreadLocal 修饰的属性值。当希望获取该对象时,我们首先需要拿到当前线程对应的 Thread 对象,然后获取到该对象对应的 threadLocals 属性,也就拿到了线程私有的内存数据库,最后以 ThreadLocal 对象为 key 获取到其修饰的目标值。 线程内存数据库 接下来看一下相应的源码实现,首先来看一下内部定义的 ThreadLocalMap 静态内部类: static class ThreadLocalMap { // 弱引用的key,继承自 WeakReference static class Entry extends WeakReference<ThreadLocal<?>> { /** ThreadLocal 修饰的对象 */ Object value; Entry(ThreadLocal<?> k, Object v) { super(k); value = v; } } /** 初始化大小,必须是二次幂 */ private static final int INITIAL_CAPACITY = 16; /** 承载键值对的表,长度必须是二次幂 */ private Entry[] table; /** 记录键值对表的大小 */ private int size = 0; /** 再散列阈值 */ private int threshold; // Default to 0 // 构造方法 ThreadLocalMap(ThreadLocal<?> firstKey, Object firstValue) { table = new Entry[INITIAL_CAPACITY]; int i = firstKey.threadLocalHashCode & (INITIAL_CAPACITY - 1); table[i] = new Entry(firstKey, firstValue); size = 1; setThreshold(INITIAL_CAPACITY); } // 构造方法 private ThreadLocalMap(ThreadLocalMap parentMap) { Entry[] parentTable = parentMap.table; int len = parentTable.length; setThreshold(len); table = new Entry[len]; for (int j = 0; j < len; j++) { Entry e = parentTable[j]; if (e != null) { @SuppressWarnings("unchecked") ThreadLocal<Object> key = (ThreadLocal<Object>) e.get(); if (key != null) { Object value = key.childValue(e.value); Entry c = new Entry(key, value); int h = key.threadLocalHashCode & (len - 1); while (table[h] != null) h = nextIndex(h, len); table[h] = c; size++; } } } } // 省略相应的方法实现 } ThreadLocalMap 是一个定制化的 Map 实现,可以简单将其理解为一般的 Map,用作键值存储的内存数据库,至于为什么要专门实现而不是复用已有的 HashMap,我们在后面进行说明。 API 实现分析 了解了 ThreadLocalMap 的定义,我们再来看一下 ThreadLocal 的实现。对于 ThreadLocal 来说,对外暴露的方法主要有 get、set,以及 remove 三个,下面逐一展开分析。 获取线程私有值 与一般的 Map 取值操作不同,这里的 ThreadLocal#get 方法并没有要求提供查询的 key,也正如前面所说的,这里的 key 就是调用 ThreadLocal#get 方法的 ThreadLocal 对象自身: public T get() { // 获取当前线程对象 Thread t = Thread.currentThread(); // 获取当前线程对象的 threadLocals 属性 ThreadLocalMap map = getMap(t); if (map != null) { // 以 ThreadLocal 对象为 key 获取目标线程私有值 ThreadLocalMap.Entry e = map.getEntry(this); if (e != null) { @SuppressWarnings("unchecked") T result = (T)e.value; return result; } } return setInitialValue(); } 如果当前线程对应的内存数据库 map 对象还未创建,则会调用 ThreadLocal#setInitialValue 方法执行创建,如果在构造 ThreadLocal 对象时覆盖实现了 ThreadLocal#initialValue 方法,则会调用该方法获取构造的初始化值并记录到创建的 map 对象中: private T setInitialValue() { // 调用模板方法 initialValue 获取指定的初始值 T value = initialValue(); Thread t = Thread.currentThread(); ThreadLocalMap map = getMap(t); if (map != null) // 以当前 ThreadLocal 对象为 key 记录初始值 map.set(this, value); else // 创建 map 并记录初始值 createMap(t, value); return value; } 设置线程私有值 再来看一下 ThreadLocal#set 方法,因为 key 就是当前 ThreadLocal 对象,所以 ThreadLocal#set 方法也不需要指定 key: public void set(T value) { // 获取当前线程对象 Thread t = Thread.currentThread(); // 获取当前线程对象的 threadLocals 属性 ThreadLocalMap map = getMap(t); if (map != null) // 以当前 ThreadLocal 对象为 key 记录线程私有值 map.set(this, value); else createMap(t, value); } 和 ThreadLocal#get 方法的流程大致一样,都是操作当前线程私有的内存数据库 ThreadLocalMap,并记录目标值。 删除线程私有值 方法 ThreadLocal#remove 以当前 ThreadLocal 对象为 key,从当前线程内存数据库 ThreadLocalMap 中删除目标值,具体逻辑比较简单: public void remove() { ThreadLocalMap m = getMap(Thread.currentThread()); if (m != null) // 以当前 ThreadLocal 对象为 key m.remove(this); } ThreadLocal 对外暴露的功能虽然有点小神奇,但是具体对应到内部实现并没有什么复杂的逻辑。如果我们把每个线程持有的专属 ThreadLocalMap 对象理解为当前线程的私有数据库,那么也就不难理解 ThreadLocal 的运行机制。每个线程自己维护自己的数据,彼此相互隔离,不存在竞争,也就没有线程安全问题可言。 真的就高枕无忧了吗 虽然对于每个线程来说数据是隔离的,但这也不表示任何对象丢到 ThreadLocal 中就万事大吉了,思考一下下面几种情况: 如果记录在 ThreadLocal 中的是一个线程共享的外部对象呢? 引入线程池,情况又会有什么变化? 如果 ThreadLocal 被 static 关键字修饰呢? 先来看 第 1 个问题,如果我们记录的是一个外部线程共享的对象,虽然我们以当前线程私有的 ThreadLocal 对象作为 key 对其进行了存储,但是恶魔终究是恶魔,共享的本质并不会因此而改变,这种情况下的访问还是需要进行同步控制,最好的方法就是从源头屏蔽掉这类问题。我们来举个例子: public class ThreadLocalWithSharedInstance implements Runnable { // list 是一个事实共享的实例,即使被 ThreadLocal 修饰 private static List<String> list = new ArrayList<>(); private ThreadLocal<List<String>> threadLocal = ThreadLocal.withInitial(() -> list); @Override public void run() { for (int i = 0; i < 5; i++) { List<String> li = threadLocal.get(); li.add(Thread.currentThread().getName() + "_" + RandomUtils.nextInt(0, 10)); threadLocal.set(li); } System.out.println("[Thread-" + Thread.currentThread().getName() + "], list=" + threadLocal.get()); } public static void main(String[] args) throws Exception { Thread ta = new Thread(new ThreadLocalWithSharedInstance(), "a"); Thread tb = new Thread(new ThreadLocalWithSharedInstance(), "b"); Thread tc = new Thread(new ThreadLocalWithSharedInstance(), "c"); ta.start(); ta.join(); tb.start(); tb.join(); tc.start(); tc.join(); } } 以上程序最终的输出如下: [Thread-a], list=[a_2, a_7, a_4, a_5, a_7] [Thread-b], list=[a_2, a_7, a_4, a_5, a_7, b_3, b_3, b_4, b_7, b_7] [Thread-c], list=[a_2, a_7, a_4, a_5, a_7, b_3, b_3, b_4, b_7, b_7, c_8, c_3, c_4, c_7, c_5] 可以看到虽然使用了 ThreadLocal 修饰,但是 list 还是以共享的方式在多个线程之间被访问,如果不加控制则会存在线程安全问题。 再来看 第 2 个问题,相对问题 1 来说引入线程池就更加可怕,因为大部分时候我们都不会意识到问题的存在,直到代码暴露出奇怪的现象。这一场景并没有违背线程私有的本质,只是一个线程被复用来处理多个业务,而这个被线程私有的对象也会在多个业务之间被共享。例如: public class ThreadLocalWithThreadPool implements Callable<Boolean> { private static final int NCPU = Runtime.getRuntime().availableProcessors(); private ThreadLocal<List<String>> threadLocal = ThreadLocal.withInitial(() -> { System.out.println("thread-" + Thread.currentThread().getId() + " init thread local"); return new ArrayList<>(); }); @Override public Boolean call() throws Exception { for (int i = 0; i < 5; i++) { List<String> li = threadLocal.get(); li.add(Thread.currentThread().getId() + "_" + RandomUtils.nextInt(0, 10)); threadLocal.set(li); } System.out.println("[Thread-" + Thread.currentThread().getId() + "], list=" + threadLocal.get()); return true; } public static void main(String[] args) throws Exception { System.out.println("cpu core size : " + NCPU); List<Callable<Boolean>> tasks = new ArrayList<>(NCPU * 2); ThreadLocalWithThreadPool tl = new ThreadLocalWithThreadPool(); for (int i = 0; i < NCPU * 2; i++) { tasks.add(tl); } ExecutorService es = Executors.newFixedThreadPool(2); List<Future<Boolean>> futures = es.invokeAll(tasks); for (final Future<Boolean> future : futures) { future.get(); } es.shutdown(); } } 以上程序的最终输出如下: cpu core size : 8 thread-12 init thread local thread-11 init thread local [Thread-12], list=[12_8, 12_8, 12_4, 12_0, 12_1] [Thread-11], list=[11_3, 11_3, 11_4, 11_8, 11_4] [Thread-12], list=[12_8, 12_8, 12_4, 12_0, 12_1, 12_6, 12_7, 12_8, 12_8, 12_8] [Thread-11], list=[11_3, 11_3, 11_4, 11_8, 11_4, 11_0, 11_2, 11_1, 11_7, 11_9] [Thread-12], list=[12_8, 12_8, 12_4, 12_0, 12_1, 12_6, 12_7, 12_8, 12_8, 12_8, 12_8, 12_2, 12_8, 12_0, 12_6] [Thread-11], list=[11_3, 11_3, 11_4, 11_8, 11_4, 11_0, 11_2, 11_1, 11_7, 11_9, 11_0, 11_6, 11_1, 11_2, 11_9] [Thread-12], list=[12_8, 12_8, 12_4, 12_0, 12_1, 12_6, 12_7, 12_8, 12_8, 12_8, 12_8, 12_2, 12_8, 12_0, 12_6, 12_6, 12_3, 12_3, 12_1, 12_1] [Thread-11], list=[11_3, 11_3, 11_4, 11_8, 11_4, 11_0, 11_2, 11_1, 11_7, 11_9, 11_0, 11_6, 11_1, 11_2, 11_9, 11_7, 11_5, 11_0, 11_6, 11_9] [Thread-12], list=[12_8, 12_8, 12_4, 12_0, 12_1, 12_6, 12_7, 12_8, 12_8, 12_8, 12_8, 12_2, 12_8, 12_0, 12_6, 12_6, 12_3, 12_3, 12_1, 12_1, 12_0, 12_0, 12_1, 12_9, 12_5] [Thread-11], list=[11_3, 11_3, 11_4, 11_8, 11_4, 11_0, 11_2, 11_1, 11_7, 11_9, 11_0, 11_6, 11_1, 11_2, 11_9, 11_7, 11_5, 11_0, 11_6, 11_9, 11_2, 11_7, 11_0, 11_8, 11_0] [Thread-12], list=[12_8, 12_8, 12_4, 12_0, 12_1, 12_6, 12_7, 12_8, 12_8, 12_8, 12_8, 12_2, 12_8, 12_0, 12_6, 12_6, 12_3, 12_3, 12_1, 12_1, 12_0, 12_0, 12_1, 12_9, 12_5, 12_3, 12_6, 12_6, 12_0, 12_9] [Thread-11], list=[11_3, 11_3, 11_4, 11_8, 11_4, 11_0, 11_2, 11_1, 11_7, 11_9, 11_0, 11_6, 11_1, 11_2, 11_9, 11_7, 11_5, 11_0, 11_6, 11_9, 11_2, 11_7, 11_0, 11_8, 11_0, 11_0, 11_9, 11_2, 11_7, 11_2] [Thread-12], list=[12_8, 12_8, 12_4, 12_0, 12_1, 12_6, 12_7, 12_8, 12_8, 12_8, 12_8, 12_2, 12_8, 12_0, 12_6, 12_6, 12_3, 12_3, 12_1, 12_1, 12_0, 12_0, 12_1, 12_9, 12_5, 12_3, 12_6, 12_6, 12_0, 12_9, 12_5, 12_7, 12_7, 12_9, 12_7] [Thread-11], list=[11_3, 11_3, 11_4, 11_8, 11_4, 11_0, 11_2, 11_1, 11_7, 11_9, 11_0, 11_6, 11_1, 11_2, 11_9, 11_7, 11_5, 11_0, 11_6, 11_9, 11_2, 11_7, 11_0, 11_8, 11_0, 11_0, 11_9, 11_2, 11_7, 11_2, 11_4, 11_9, 11_7, 11_5, 11_5] [Thread-12], list=[12_8, 12_8, 12_4, 12_0, 12_1, 12_6, 12_7, 12_8, 12_8, 12_8, 12_8, 12_2, 12_8, 12_0, 12_6, 12_6, 12_3, 12_3, 12_1, 12_1, 12_0, 12_0, 12_1, 12_9, 12_5, 12_3, 12_6, 12_6, 12_0, 12_9, 12_5, 12_7, 12_7, 12_9, 12_7, 12_6, 12_1, 12_7, 12_8, 12_7] [Thread-11], list=[11_3, 11_3, 11_4, 11_8, 11_4, 11_0, 11_2, 11_1, 11_7, 11_9, 11_0, 11_6, 11_1, 11_2, 11_9, 11_7, 11_5, 11_0, 11_6, 11_9, 11_2, 11_7, 11_0, 11_8, 11_0, 11_0, 11_9, 11_2, 11_7, 11_2, 11_4, 11_9, 11_7, 11_5, 11_5, 11_8, 11_5, 11_0, 11_2, 11_2] 示例中,我用一个大小为 2 的线程池进行了模拟,可以看到初始化方法被调用了两次,所有线程的操作都是复用这两个线程。 回忆一下前文所说的,ThreadLocal 的本质就是为每个线程维护一个线程私有的内存数据库来记录线程私有的对象,但是在线程池情况下线程是会被复用的,也就是说线程私有的内存数据库也会被复用,如果在一个线程被使用完准备回放到线程池中之前,我们没有对记录在数据库中的数据执行清理,那么这部分数据就会被下一个复用该线程的业务看到,从而间接的共享了该部分数据。 最后我们再来看一下 第 3 个问题,我们尝试将 ThreadLocal 对象用 static 关键字进行修饰: public class ThreadLocalWithStaticEmbellish implements Runnable { private static final int NCPU = Runtime.getRuntime().availableProcessors(); private static ThreadLocal<List<String>> threadLocal = ThreadLocal.withInitial(() -> { System.out.println("thread-" + Thread.currentThread().getName() + " init thread local"); return new ArrayList<>(); }); @Override public void run() { for (int i = 0; i < 5; i++) { List<String> li = threadLocal.get(); li.add(Thread.currentThread().getId() + "_" + RandomUtils.nextInt(0, 10)); threadLocal.set(li); } System.out.println("[Thread-" + Thread.currentThread().getName() + "], list=" + threadLocal.get()); } public static void main(String[] args) throws Exception { ThreadLocalWithStaticEmbellish tl = new ThreadLocalWithStaticEmbellish(); for (int i = 0; i < NCPU + 1; i++) { Thread thread = new Thread(tl, String.valueOf((char) (i + 97))); thread.start(); thread.join(); } } } 以上程序的最终输出如下: thread-a init thread local [Thread-a], list=[11_4, 11_4, 11_4, 11_8, 11_0] thread-b init thread local [Thread-b], list=[12_0, 12_9, 12_0, 12_3, 12_3] thread-c init thread local [Thread-c], list=[13_6, 13_7, 13_5, 13_2, 13_0] thread-d init thread local [Thread-d], list=[14_1, 14_5, 14_5, 14_9, 14_2] thread-e init thread local [Thread-e], list=[15_4, 15_2, 15_6, 15_0, 15_8] thread-f init thread local [Thread-f], list=[16_7, 16_3, 16_8, 16_0, 16_0] thread-g init thread local [Thread-g], list=[17_6, 17_3, 17_8, 17_7, 17_1] thread-h init thread local [Thread-h], list=[18_0, 18_4, 18_5, 18_9, 18_3] thread-i init thread local [Thread-i], list=[19_7, 19_3, 19_7, 19_2, 19_0] 由程序运行结果可以看到 static 修饰并没有引出什么问题,实际上这也是很容易理解的,ThreadLocal 采用 static 修饰仅仅是让数据库中记录的 key 是一样的,但是每个线程的内存数据库还是私有的,并没有被共享,就像不同的公司都有自己的用户信息表,即使一些公司之间的用户 ID 是一样的,但是对应的用户数据却是完全隔离的。 以上例子演示了一开始抛出的 3 个问题,其中问题 1 和问题 2 都是 ThreadLocal 使用过程中的小地雷。例子举的不一定恰当,实际中可能也不一定会如示例中这样去使用 ThreadLocal,主要还是为了传达一些意识。如果明白了 ThreadLocal 的内部实现细节,就能够很自然的绕过这些小地雷。 真的会内存泄露吗 关于 ThreadLocal 导致内存泄露的问题,曾经有一段时间在网上争得沸沸扬扬,那么到底会不会导致内存泄露呢?这里先给出答案: 如果使用不恰当,存在内存泄露的可能性。 我们来分析一下内存泄露的条件和原因,在最开始看 ThreadLocal 源码的时候,我就有一个疑问,ThreadLocal 为什么要专门实现 ThreadLocalMap,而不是采用已有的 HashMap 代替? 后来分析具体实现时看到执行存储时的 key 为当前 ThreadLocal 对象,不需要专门指定 key 能够在一定程度上简化使用,但这并不足以为此专门去实现 ThreadLocalMap。继续阅读我发现 ThreadLocalMap 在实现 Entry 的时候有些奇怪,居然继承了 WeakReference: static class Entry extends WeakReference<ThreadLocal<?>> { /** The value associated with this ThreadLocal. */ Object value; Entry(ThreadLocal<?> k, Object v) { super(k); value = v; } } 从而让 key 成为一个弱引用,我们知道弱引用对象拥有非常短暂的生命周期,在垃圾收集器线程扫描其所管辖的内存区域过程中,一旦发现了弱引用对象,不管当前内存空间是否足够都会回收它的内存。也就是说这样的设计会很容易导致 ThreadLocal 对象被回收,线程所执行任务的时间长度是不固定的,这样的设计能够方便垃圾收集器回收线程私有的变量。 由此可以看出作者这样设计的目的是为了防止内存泄露,那怎么就变成了被很多文章所分析的是内存泄漏的导火索呢?这些文章的共同观点就是 key 被回收了,但是 value 是一个强引用没有被回收,这些 value 就变成了一个个的僵尸。这样的分析没有错,value 确实存在,且和线程是同生命周期的,但是如下策略可以保证尽量避免内存泄露: ThreadLocal 在每次执行 get 和 set 操作的时候都会去清理 key 为 null 的 value 值。 value 与线程同生命周期,线程死亡之时,也是 value 被 GC 之日。 策略 1 没啥好说的,看看源码就知道,我们来举例验证一下策略 2: public class ThreadLocalWithMemoryLeak implements Callable<Boolean> { private class My50MB { private byte[] buffer = new byte[50 * 1024 * 1024]; @Override protected void finalize() throws Throwable { super.finalize(); System.out.println("gc my 50 mb"); } } private class MyThreadLocal<T> extends ThreadLocal<T> { @Override protected void finalize() throws Throwable { super.finalize(); System.out.println("gc my thread local"); } } private MyThreadLocal<My50MB> threadLocal = new MyThreadLocal<>(); @Override public Boolean call() throws Exception { System.out.println("Thread-" + Thread.currentThread().getId() + " is running"); threadLocal.set(new My50MB()); threadLocal = null; return true; } public static void main(String[] args) throws Exception { ExecutorService es = Executors.newCachedThreadPool(); Future<Boolean> future = es.submit(new ThreadLocalWithMemoryLeak()); future.get(); // gc my thread local System.out.println("do gc"); System.gc(); TimeUnit.SECONDS.sleep(1); // sleep 60s System.out.println("sleep 60s"); TimeUnit.SECONDS.sleep(60); // gc my 50 mb System.out.println("do gc"); System.gc(); es.shutdown(); } } 以上程序的最终输出如下: Thread-11 is running do gc gc my thread local sleep 60s do gc gc my 50 mb 可以看到 value 最终还是被 GC 了,虽然第 1 次 GC 的时候没有被回收,这也验证 value 和线程是同生命周期的,之所以示例中等待 60 秒是因为 Executors#newCachedThreadPool 中的线程默认生命周期是 60 秒,如果生命周期内该线程没有被再次复用则会死亡,我们这里就是要等待线程死亡,一但线程死亡,value 也就被 GC 了。 所以 出现内存泄露的前提必须是持有 value 的线程一直存活,这在使用线程池时是很正常的,在这种情况下 value 一直不会被 GC,因为线程对象与 value 之间维护的是强引用。此外就是 后续线程执行的业务一直没有调用 ThreadLocal 的 get 或 set 方法,导致不会主动去删除 key 为 null 的 value 对象,在满足这两个条件下 value 对象一直常驻内存,所以存在内存泄露的可能性。 那么我们应该怎么避免呢?前面我们分析过线程池情况下使用 ThreadLocal 存在小地雷,这里的内存泄露一般也都是发生在线程池的情况下,所以在使用 ThreadLocal 时,对于不再有效的 value 主动调用一下 remove 方法来进行清除,从而消除隐患,这也算是最佳实践吧。 InheritableThreadLocal 又是什么鬼 InheritableThreadLocal 继承自 ThreadLocal,实现上也比较简单(如下),那么 InheritableThreadLocal 与 ThreadLocal 到底有什么区别呢? public class InheritableThreadLocal<T> extends ThreadLocal<T> { @Override protected T childValue(T parentValue) { return parentValue; } @Override ThreadLocalMap getMap(Thread t) { return t.inheritableThreadLocals; } @Override void createMap(Thread t, T firstValue) { t.inheritableThreadLocals = new ThreadLocalMap(this, firstValue); } } 在开始分析之前,我们先演示一个 ThreadLocal 的案例,如下: private static ThreadLocal<String> tl = new ThreadLocal<>(); public static void main(String[] args) { tl.set("zhenchao"); System.out.println("Main thread: " + tl.get()); Thread thread = new Thread(() -> System.out.println("Sub thread: " + tl.get())); thread.start(); } 运行上述示例,输出如下: Main thread: zhenchao Sub thread: null 可以看出,子线程拿不到主线程设置的 ThreadLocal 变量,当然这也是可以理解的,毕竟主线程和子线程之间仍然是两个线程,但是在一些场景下我们希望对于主线程和子线程这种关系而言,ThreadLocal 变量能够被继承。这个时候就可以使用 InheritableThreadLocal 来实现,对于上述示例而言,只需要将 ThreadLocal 改为 InheritableThreadLocal 即可,具体实现比较简单,读者可以自己尝试一下。 下面我们来分析一下 InheritableThreadLocal 是如何做到让 ThreadLocal 变量在主线程和子线程之间进行继承的。由 InheritableThreadLocal 的实现来看,InheritableThreadLocal 使用了 inheritableThreadLocals 变量替换了 ThreadLocal 的 threadLocals 变量,而这两个变量都是 ThreadLocalMap 类型。子线程在初始化时会判断父线程的 inheritableThreadLocals 是否为 null,如果不为 null,则使用父类的 inheritableThreadLocals 变量初始化自己的 inheritableThreadLocals,实现如下(位于 Thread#init 方法中): // 如果父线程的 inheritableThreadLocals 变量不为空,则复制给子线程 if (inheritThreadLocals && parent.inheritableThreadLocals != null) { this.inheritableThreadLocals = ThreadLocal.createInheritedMap(parent.inheritableThreadLocals); } 而 ThreadLocal#createInheritedMap 的实现如下: static ThreadLocalMap createInheritedMap(ThreadLocalMap parentMap) { return new ThreadLocalMap(parentMap); } private ThreadLocalMap(ThreadLocalMap parentMap) { Entry[] parentTable = parentMap.table; int len = parentTable.length; setThreshold(len); table = new Entry[len]; for (int j = 0; j < len; j++) { Entry e = parentTable[j]; if (e != null) { @SuppressWarnings("unchecked") ThreadLocal<Object> key = (ThreadLocal<Object>) e.get(); if (key != null) { // 调用 InheritableThreadLocal 的 childValue 方法 Object value = key.childValue(e.value); Entry c = new Entry(key, value); int h = key.threadLocalHashCode & (len - 1); while (table[h] != null) { h = nextIndex(h, len); } table[h] = c; size++; } } } } 方法 InheritableThreadLocal#childValue 的实现只是简单返回了父线程中的值,所以上述过程本质上就是一个拷贝父线程中 ThreadLocal 变量值的过程。 由上述实现我们可以看到,父线程和子线程在 ThreadLocal 变量的存储上仍然是隔离的,只是在初始化子线程时会拷贝父线程的 ThreadLocal 变量,之后在运行期间彼此互不干涉,也就是说在子线程启动起来之后,父线程和子线程各自对同一个 InheritableThreadLocal 实例的改动并不会被对方所看见。 总结 本文我们分析了 ThreadLocal 的实现,以及存在的一些小地雷,并讨论了在什么情况下会造成内存泄漏,最后还分析了与 ThreadLocal 师出同宗的 InheritableThreadLocal 类。ThreadLocal 和 InheritableThreadLocal 在保证线程安全性方面算是另辟蹊径,能够在一些场景下简化多线程编程,是 java 程序员必须掌握的一部分。当然,理解其实现原理能够帮助我们更好的使用其特性,避免不经意踩到小地雷。

优秀的个人博客,低调大师

每日一博 | 跨域问题是怎样造成的

跨域问题的由来 相信很多人都或多或少了解过跨域问题,尤其在现如今前后端分离大行其道的时候。 你在本地开发一个前端项目,这个项目是通过 node 运行的,端口是9528,而服务端是通过 spring boot 提供的,端口号是7001。 当你调用一个服务端接口时,很可能得到类似下面这样的一个错误: 然后你在发送请求的地方debug,在出现异常的地方你将得到这样的结果: 异常对象很诡异,返回的 response 是 undefined 的,并且 message 消息中只有一个"Network Error"。 看到这里你应该要知道,你遇到跨域问题了。 但是你需要明确的一点是,这个请求已经发出去了,服务端也接收到并处理了,但是返回的响应结果不是浏览器想要的结果,所以浏览器将这个响应的结果给拦截了,这就是为什么你看到的response是undefined。 浏览器的同源策略 那浏览器为什么会将服务端返回的结果拦截掉呢? 这就需要我们了解浏览器基于安全方面的考虑,而引入的 同源策略(same-origin policy) 了。 早在1995年,Netscape 公司就在浏览器中引入了“同源策略”。 最初的 “同源策略”,主要是限制Cookie的访问,A网页设置的 Cookie,B网页无法访问,除非B网页和A网页是“同源”的。 那么怎么确定两个网页是不是“同源”呢,所谓“同源”就是指"协议+域名+端口"三者相同,即便两个不同的域名指向同一个ip地址,也非同源。 没有同源策略的保护 那么为什么要做这个同源的限制呢?因为如果没有同源策略的保护,浏览器将没有任何安全可言。 老李是一个钓鱼爱好者,经常在 我要买(51mai.com) 的网站上买各种钓鱼的工具,并且通过 银行(yinhang.com) 以账号密码的方式直接支付。 这天老李又在 51mai.com 上买了一根鱼竿,输入银行账号密码支付成功后,在支付成功页看到一个叫 钓鱼(diaoyu.com) 的网站投放的一个"免费领取鱼饵"的广告。 老李什么都没想就点击了这个广告,跳转到了钓鱼的网站,殊不知这真是一个 “钓鱼” 网站,老李银行账户里面钱全部被转走了。 以上就是老李的钱被盗走的过程: 1.老李购买鱼竿,并登录了银行的网站输入账号密码进行了支付,浏览器在本地缓存了银行的Cookie 2.老李点击钓鱼网站,钓鱼网站使用老李登录银行之后的Cookie,伪造成自己是老李进行了转账操作。 这个过程就是著名的CSRF(Cross Site Request Forgery),跨站请求伪造,正是由于可能存在的伪造请求,导致了浏览器的不安全。 那么如何防止CSRF攻击呢,可以参考这篇文章:如何防止CSRF攻击? 同源策略限制哪些行为 上面说了 **同源策略 **是一个安全机制,他本质是限制了从一个源加载的文档或脚本如何与来自另一个源的资源进行交互,这是一个用于隔离潜在恶意文件的重要安全机制。 随着互联网的发展,"同源策略"越来越严格,不仅限于Cookie的读取。目前,如果非同源,共有三种行为受到限制。 (1) Cookie、LocalStorage 和 IndexDB 无法读取。 (2) DOM 无法获得。 (3) 请求的响应被拦截。 虽然这些限制是必要的,但是有时很不方便,合理的用途也会受到影响,所以为了能够获取非“同源”的资源,就有了跨域资源共享。 跨域资源共享 看到这里你应该明白,为什么文章开头的请求会被拦截了,原因就是请求的源和服务端的源不是“同源”,而服务端又没有设置允许的跨域资源共享,所以请求的响应被浏览器给拦截掉了。 CORS 是一个 W3C 标准,全称是"跨域资源共享"(Cross Origin Resource Sharing),它允许浏览器向跨源服务器,发出 XMLHttpRequest 请求,从而克服了只能发送同源请求的限制。 CORS实现机制 那跨域资源共享机制是怎样实现的呢? 当一个资源(origin)通过脚本向另一个资源(host)发起请求,而被请求的资源(host)和请求源(origin)是不同的源时(协议、域名、端口不全部相同),浏览器就会发起一个 跨域 HTTP 请求 ,并且浏览器会自动将当前资源的域添加在请求头中一个叫 Origin 的 Header 中。 当然了,有三个标签本身就是允许跨域加载资源的: <img src=XXX> <link href=XXX> <script src=XXX> 比如某个网站的首页 http://domain-a.com/index.html 通过 <img src="http://domain-b.com/image.jpg" /> 来加载其他域上的图片,除此之外还有诸如通过 CDN 节点引入css和js文件的方式。 出于安全原因,浏览器限制从脚本内发起的跨域 HTTP 请求。 例如,XMLHttpRequest 和 Fetch API 遵循同源策略。 也就是说使用这些 API 的 Web 应用程序只能从加载应用程序的同一个域请求 HTTP 资源,除非响应报文中包含了正确 CORS 响应头。 通过在响应报文中设置额外的 HTTP 响应头来告诉浏览器,运行在某个 origin 上的 Web 应用被准许访问来自不同源服务器上的资源,此时浏览器就不会将该响应拦截掉了。 那这些额外的 HTTP 响应头是什么呢? 响应头 是否必须 含义 Access-Control-Allow-Origin 是 该字段表示,服务端接收哪些来源的域的请求 Access-Control-Allow-Credentials 否 是否可以向服务端发送Cookie,默认是 false Access-Control-Expose-Headers 否 可以向请求额外暴露的响应头 其中只有 Access-Control-Allow-Origin 是必须的,该响应头的值可以是请求的 Origin 的值,也可以是 * ,表示服务端接收所有来源的请求。 当浏览器发起 CORS 请求时,默认只能获得6个响应头的值: Cache-Control、Content-Language、Content-Type、Expires、Last-Modified、Pragma 如果还需要返回其他的响应头给前端,则可以通过在 Access-Control-Expose-Headers 中指定。 CORS的两种请求类型 CORS有两种类型的请求,分别是:简单请求(simple request)和非简单请求(not-so-simple request) 只要同时满足以下两大条件,就属于简单请求。 (1) 请求方法是以下三种方法之一: HEAD GET POST (2) HTTP的头信息不超出以下几种字段: Accept Accept-Language Content-Language Last-Event-ID Content-Type:只限于三个值 application/x-www-form-urlencoded 、multipart/form-data、text/plain 凡是不同时满足上面两个条件,就属于非简单请求,浏览器对这两种请求的处理,是不一样的。 为什么会有两种不同类型的请求呢? CORS 规范要求,对那些可能对服务器数据产生副作用的 HTTP 请求方法(特别是 GET 以外的 HTTP 请求,或者搭配某些 MIME 类型的 POST 请求),浏览器必须首先使用 OPTIONS 方法发起一个预检请求(preflight request),从而获知服务端是否允许该跨域请求。 服务器确认允许之后,浏览器才能发起实际的 HTTP 请求。在预检请求的返回中,服务器端也可以通知客户端,是否需要携带身份凭证(包括 Cookies 和 HTTP 认证相关的数据)。 非简单请求就要求浏览器先发送一个预检请求,预检通过后再发送实际的请求。 怎样实现CORS 知道了CORS的实现机制之后,我们就可以解决遇到的CORS的问题了。 1.通过JSONP 利用 <script> 标签没有跨域限制的漏洞,网页可以得到从其他来源动态产生的 JSON 数据。JSONP请求一定需要对方的服务器做支持才可以。 JSONP 和 AJAX 相同,都是客户端向服务器端发送请求,从服务器端获取数据的方式。但 AJAX 属于同源策略,JSONP 属于非同源策略(支持跨域请求)。JSONP优点是简单兼容性好,可用于解决主流浏览器的跨域数据访问的问题。缺点是仅支持 GET 方法具有局限性,不安全可能会遭受XSS攻击。 2.利用反向代理服务器 同源策略是浏览器需要遵循的标准,而如果是服务器向服务器请求就无需遵循同源策略 所以通过反向代理服务器可以有效的解决跨域问题,代理服务器需要做以下几个步骤: 1.接受客户端的请求 2.将请求转发给实际的服务器 3.将服务器的响应结果返回给客户端 Nginx就是类似的反向代理服务器,可以通过配置Nginx代理来解决跨域问题。 3.服务端支持CORS 最安全的还是服务端来设置允许哪些来源的请求,即服务端在接收到请求之后,对允许的请求源设置 Access-Control-Allow-Origin 的响应头。 通过@CrossOrigin注解 这里以 Spring Boot 为例,可以通过 @CrossOrigin 注解来指定哪些类或者方法支持跨越,如下列代码所示: /** * 在类上加注解 */ @CrossOrigin({"http://127.0.0.1:9528", "http://localhost:9528"}) @RestController public class UserController { } @RestController public class UserController { @Resource private UserFacade userFacade; /** * 在方法上加注解 */ @GetMapping(ApiConstant.Urls.GET_USER_INFO) @CrossOrigin({"http://127.0.0.1:9528", "http://localhost:9528"}) public PojoResult<UserDTO> getUserInfo() { return userFacade.getUserInfo(); } } 通过CorsRegistry设置全局跨域配置 @Configuration @EnableWebMvc public class WebConfig extends WebMvcConfigurerAdapter { @Override public void addCorsMappings(CorsRegistry registry) { registry.addMapping("/**") .allowedOrigins("http://127.0.0.1:9528", "http://localhost:9528"); } } 如果你使用的是 Spring Boot,推荐的做法是只定义一个 WebMvcConfigurer 的Bean: @Configuration public class MyConfiguration { @Bean public WebMvcConfigurer corsConfigurer() { return new WebMvcConfigurerAdapter() { @Override public void addCorsMappings(CorsRegistry registry) { registry.addMapping("/**") .allowedOrigins("http://127.0.0.1:9528", "http://localhost:9528"); } }; } } 以上两种方式在没有定义拦截器(Interceptor)的时候,使用一切正常,但是如果你有一个全局的拦截器用来检测用户的登录态,例如下面的简易代码: public class AuthenticationInterceptor implements HandlerInterceptor { @Override public boolean preHandle(HttpServletRequest httpServletRequest, HttpServletResponse httpServletResponse, Object object) throws Exception { // 从 http 请求头中取出 token String token = httpServletRequest.getHeader("token"); // 检查是否登录 if (token == null) { throw new InvalidTokenException(ResultCode.INVALID_TOKEN.getCode(), "登录态失效,请重新登录"); } return true; } } 当自定义拦截器返回true时,一切正常,但是当拦截器抛出异常(或者返回false)时,后续的CORS设置将不会生效。 为什么拦截器抛出异常时,CORS不生效呢?可以看下这个issue: when interceptor preHandler throw exception, the cors is broken 有个人提交了一个issue,说明如果在自定义拦截器的preHandler方法中抛出异常的话,通过 CorsRegistry 设置的全局 CORS 配置就失效了,但是Spring Boot 的成员不认为这是一个Bug。 然后提交者举了个具体的例子: 他先定义了CorsRegistry,并添加了一个自定义的拦截器,拦截器中抛出了异常 然后他发现AbstractHandlerMapping在添加CorsInterceptor的时候,是将 Cors 的拦截器加在拦截器链的最后: 那就会造成上面说的问题,在自定义拦截器中抛出异常之后,CorsInterceptor 拦截器就没有机会执行向 response 中设置 CORS 相关响应头了。 issue的提交者也给出了解决的方案,就是将用来处理 Cors 的拦截器 CorsInterceptor 加在拦截器链的第一个位置: 这样的话请求来了之后,第一个就会为 response 设置相应的 CORS 响应头,后续如果其他自定义拦截器抛出异常,也不会有影响了。 感觉是一个可行的解决方案,但是 Spring Boot 的成员认为这不是 Spring Boot 的Bug,而是 Spring Framework 的 Bug,所以将这个issue关闭了。 通过CorsFilter设置全局跨域配置 既然通过拦截器设置全局跨域配置会有问题,那我们还有另外一种方案,通过过滤器 CorsFilter 的方式来设置,代码如下: @Configuration public class MyConfiguration { @Bean public FilterRegistrationBean corsFilter() { UrlBasedCorsConfigurationSource source = new UrlBasedCorsConfigurationSource(); CorsConfiguration config = new CorsConfiguration(); config.setAllowCredentials(true); config.addAllowedOrigin("http://127.0.0.1:9528"); config.addAllowedOrigin("http://localhost:9528"); config.addAllowedHeader("*"); config.addAllowedMethod("*"); source.registerCorsConfiguration("/**", config); FilterRegistrationBean bean = new FilterRegistrationBean(new CorsFilter(source)); bean.setOrder(0); return bean; } } 为什么过滤器可以而拦截器不行呢? 因为过滤器依赖于 Servlet 容器,基于函数回调,它可以对几乎所有请求进行过滤。而拦截器是依赖于 Web 框架(如Spring MVC框架),基于反射通过AOP的方式实现的。 在触发顺序上如下图所示: 因为过滤器在触发上是先于拦截器的,但是如果有多个过滤器的话,也需要将 CorsFilter 设置为第一个过滤器才行。 参考文献 浏览器的同源策略 浏览器同源政策及其规避方法 HTTP访问控制(CORS) 跨域资源共享 CORS 详解 如何防止CSRF攻击? 逐码,专注于原创分享,用通俗易懂的图文描述源码及原理

优秀的个人博客,低调大师

每日一博 | Java 泛型可行与不可行

泛型基础 理解 ​ 一般情况,一个类的属性,或者一个方法的参数/返回值都需要在编写代码时声明基本类型或者自定义类型,但有时候无法在编写代码时使用现有的类来表达参数类型或者返回值类型,这时候就需有一种方式可以表达下面的意思:这里需要一个类,它满足这些要求就可以了,具体是什么类可以在使用这个类或方法时指定。Java中这种方式就是泛型。但是java泛型在使用上有很多限制,使用时要注意,同时注意泛型主义上的理解,Java中泛型的声明使用更多 作用 ​ 一定程序上继承与接口就可以完成上面的功能,但泛型有很多额外的作用 泛型可以更安全 使用泛型就是告诉编译器想使用什么类型,在使用泛型时编译器会对代码进行类型检查,让错误暴露在编译期,而不是运行期,更安全 可以快速创建复杂的类型 因为在编写时没有指定具体类型,所以在使用时就可以更随意的指定类型,这个功能可以完成类似js中对象的功能,对象的属性规定好,具体是什么类型你随便,但是没能像js那样随意添加属性 public class TupleTest<T, R> { public final T t; public final R r; public TupleTest(T t, R r) { this.t = t; this.r = r; } public static <A, B> TupleTest<A, B> make(A a, B b) { return new TupleTest<>(a, b); } /** * 如果返回值声明里声明了泛型,那么在方法返回值 new 时就要有尖括号,不然会警告 * jdk1.5中返回值声明时的泛型去掉,也会有编译警告 * * @return tupleTest */ public TupleTest<String, String> make() { return new TupleTest<>("a", "b"); } public R getR() { return r; } } 可以自动完成类型的转换 在泛型出现之前,如果一个方法不能确定方法的返回值类型,或者根据入参可以确定多种类型返回值类型,那么这个方法就只能返回Object ,有了泛型之后,在方法返回正确的值后,会自动转为具体的类型,而这在代码上没有额外的代码,而且这种转换很安全 上面例子编译之后再反编译回来 make 方法是这样的 public com.zoro.thinkinginjava.four.TupleTest<String, String> make() { return new com.zoro.thinkinginjava.four.TupleTest((T)"a", (R)"b"); } 再看一个调用时的代码 public class TupleMain { public static void main(String[] args) { TupleTest<Apple, Orange> tuple = new TupleTest<>(new Apple(), new Orange()); Orange orange = tuple.getR(); } } 反编译之后 public class TupleMain { public static void main(String[] args) { TupleTest<Apple, Orange> tuple = new TupleTest(new Apple(), new Orange()); Orange orange = (Orange)tuple.getR(); } } 可以看到自动对参数进行了转型,所以编译器不会产生转型警告 还有一些更高级的用法,比如 泛型自限定 困难之处 书写泛型代码的主要困难是因为泛型在运行时被擦除,所以在运行期没有泛型类的具体信息,这意味着泛型参数看上去就借一个Object类,什么都干不了,需要注意以下方法 同样的类型,不同的泛型参数在编译期代表着不同类型,在运行期就没有差别了 public class EraseMain { public static void main(String[] args) { List<String> list1 = new ArrayList<>(); List<Integer> list2 = new ArrayList<>(); // list1 = list2; // 编译期是不同的 System.out.println(list1.getClass().getName()); System.out.println(list2.getClass().getName()); // 运行期类型是相同的 System.out.println(list1.getClass() == list2.getClass()); } } 不能使用 new 来创建泛型类型的具体对象,最好的方案是使用 Class.newInstance()或者使用工场模式 public T getNewInstance() { // return new T(); // Error:(12, 20) java: 意外的类型 // 需要: 类 // 找到: 类型参数T try { return t.newInstance(); } catch (Exception e) { throw new RuntimeException(e); } } 不能使用 instanceof 操作符了,但可以用 Class.isInstance(Object)方法 public class EraseEntity<T> { Class<T> tClass; public EraseEntity(Class<T> tClass) { this.tClass = tClass; } public boolean instanceOf(Object t) { // return t instanceof T; // 这样就不可以了 return tClass.isInstance(t); // 这样是可以的 } } 不能new 一个泛型数组,而且要产生泛型数组非常麻烦,可以使用Array.newInstance(Class<?>,int) public T[] createArray(){ return (T[]) Array.newInstance(t,5); } 但是这样也会有警告,需要压制 除非设定边界,否则不能调用任何自定义的方法 基本类型不能作为泛型参数,但是其包装类型可以,并可以自动包装 // List<int> list2 = new ArrayList<>(); List<Integer> list2 = new ArrayList<>(); 一个类不能实现同一个泛型接口的两种变体,但去掉泛型实现可以; public class ImplTest extends AbstractA implements InterfaceA<Integer> { //public class ImplTest extends AbstractA implements InterfaceA<String> { // ImplTest类实现InterfaceA接口时声明的泛型参数是String,AbstractA实现InterfaceA时声明的泛型参数是 Integer,这时就不可以了, // 如果可以会导致类型冲突,比如 get方法,在AbstractA中返回值是Integer,但是在ImplTest中就变成了String,无论重载或重写都不能解决这个问题 } interface InterfaceA<T> { T get(T t); } abstract class AbstractA implements InterfaceA<Integer> { public Integer get(Integer integer) { return 0; } } 不能通过不同的泛型参数进行方法重载,但是可以使用 <R extends List<?>> 给泛型参数添加边界重载方法 public class OverLoadTest { public <T> void test(T t) { } // 因为T与R没有设置边界在运行时 T与R 都是类似Object,所以不能通过方法签名区分这两个方法 // public <R> void test(R r) { } // 这样是可以的 因为R一定会是一个List的子类,List与Object(T)是有区别的,就可以通过方法签名区分了 public <R extends List<?>> void test(R r) { } } 泛型边界 可以使用 extends 限定泛型类型的边界,可以是多个(&连接),类写在前面,限定边界之后在泛型方法或者类的内部就可以使用边界类上的方法了 public class WildCardTest<T extends List<String> & Iterable<String> & InterfaceA<?>> { public void test(T t) { t.add(""); // List接口的方法 t.iterator(); // Iterable接口的方法 t.testMethod(); // InterfaceA方法 } } interface InterfaceA<T>{ // void add(T t); // List接口也有同样方法签名的方法,所以在 同时将 List与InterfaceA设置为上边界时List与InterfaceA的泛型参数要兼容,否则也会出错 void testMethod(); } 通配符 通配符在泛型中的应用是为了解决下面的问题:有一个容器的泛型是基类的变量,想要将一个泛型是子类的容器赋值给这个变量,编译器是不允许的;因为运行时会将泛型擦除,一旦将一个泛型是子类的容器赋值给泛型是基类的容器变量,在运行时就可以将一个这个基类的其他子类对象放入这个窗口,造成在取出对象时的类型不安全,所以编译期不允许这样赋值; public class WildCardTest<T extends List<String> & Iterable<String> & InterfaceA<?>> { public static void main(String[] args) { List<InterfaceA<String>> list ; List<Impl> impls = new ArrayList<>(); // list = impls; // 将 impls赋值给 list是不可以的,原因: // 1. 编译期 List<InterfaceA<String>> 与 List<Impl>是不同的且不能向上转型 // 2. 一旦允许这样赋值,那么之后 的操作会出现类型问题,比如此例,将一个ArrayList<Impl> 赋值给 List<InterfaceA>变量list, // 那么之后可以向list 中add 一个 Impl2对象,Impl2与Impl不兼容 } } interface InterfaceA<T>{} class Impl implements InterfaceA<String> {} class Impl2 implements InterfaceA<String> {} 容器的这一特点与数组不同,子类数组对象可以赋值给基类数组变量(类似向上转型),但是在运行期jvm 可以知道数组元素中的对象类型是哪个具体子类,所以如果将数组中元素赋值时,如果不是原数组中的类型,会报错(ArrayStoreException) public class WildCardTest2 { public static void main(String[] args) { InterfaceA<?>[] arr1 = new Impl[3]; arr1[0] = new Impl(); //会报错 //arr1[2] = new Impl2(); // 兼容的类型可以 InterfaceA<?>[] arr2 = new InterfaceA[4]; arr2[0] = new Impl(); arr2[0] = new Impl2(); } } 为了保证类型安全,又可以将子类泛型容器赋值给基类泛型变量,可以使用通配符(单一边界,extends 后面只能有一个类型) 通配符的困难之处 当一个类在声明时使用了<? extends Fruit> 这种泛型,而这个类的写法如同下面这样 class TestClass<T>{ public void test(T t){ // somecode } public void test2(Object o){ // somecode } } 在使用时 TestClass<? extends Fruit> f = new TestClass<Apple>; 这样写会出现的问题是不能调用test(T)方法了,因为test 需要的是一个具体的Fruit 的子类,例子中应该是Applie,但 ? extends Fruit 代表的不仅仅是 Apple 这一种子类,也可能是 orange 。如果调用时真的用orange 类型实例做为能数,类型就不安全,所以 test(T) 方法不能用了;但是 test2(Object) 还可以用 逆变 逆变指的是 < ? super Apple> 这种写法,这种写法的特性与 <? extends Apple> 的写法的特性是相反的。上面的例子,泛型入参方法不能用了,而逆变的特性是入参可以是任何Apple 的子类,注意是子类,不是基类,因为Apple 的基类有多种,如果编译器允许传入基类,就会存在风险,但是传入子类就不会有风险,因为子类可以转型为Apple 类,Apple 类可以算是Apple的基类; public class WildcardTest4 { public static void main(String[] args) { List<? super Apple> appleList = new ArrayList<Fruit>(); List<? super Apple> appleList2 = new ArrayList<Apple>(); List<? super Apple> appleList3 = new ArrayList<>(); // 前三种情况都可以,但是这种不可以 // List<? super Apple> appleList4 = new ArrayList<BigApple>(); // 不可以 //appleList3.add(new Orange()); appleList3.add(new Apple()); appleList3.add(new BigApple()); // 虽然字面上是 任何 Apple 的父类,但是Apple父类很多,不能确定类型,所以实际上任何Apple 的父类都不行 //appleList3.add(new Fruit()); // 只能Object 接 Object a = appleList3.get(1); } } class Fruit {} class Orange extends Fruit {} class Apple extends Fruit {} class BigApple extends Apple implements Runnable { @Override public void run() { } } class SmallApple extends Apple {} 逆变的困难之处在于方法的返回值,它的返回值只能用Object 类型的变量接受 无界通配符 两个功能 这里想用泛型代码来编写,这里并不是要用原生的类型,但是当前情况下,泛型参数可以持有任何类型 当有个地方需要多个泛型参数,但你只能确定一部分时可以使用无界通配符? 例:Map<String, ?> 当一个地方要求泛型,如果你没有给出泛型,会有警告,但使用无界通配符会消除警告 无界通配符与原生类型是不一样的,以List 和List<?> 为例,List 代表持有任何Object类型的List,List<?>代表具有某种特定类型的的非原生List,但目前不确定是什么类型; 下面例子显示这种区别 public class WildcardTest5 { public static void main(String[] args) { List list = new ArrayList(); list.add(new Apple());// 有警告,但是不会编译报错 Object o = list.get(0); List<?> list1 = new ArrayList<>(); // list1.add(new Apple());// 不可这样写,编译报错 } } 总结 在使用泛型时,时刻都要想着,我这样定义泛型,编译器为了保证泛型安全,这里我只能接受什么样的类型; 方法的返回值会是什么样的;同时要想着这里是否会发生转型

优秀的个人博客,低调大师

每日一博 | 数据安全(反爬虫)之「防重放」策略

在大前端时代的安全性一文中讲了 Web 前端和 Native 客户端如何从数据安全层面做反爬虫策略,本文接着之前的背景,将从 API 数据接口的层面讲一种技术方案,实现数据安全。 一、 API 接口请求安全性问题 API 接口存在很多常见的安全性问题,常见的有下面几种情况 即使采用 HTTPS,诸如 Charles、Wireshark 之类的专业抓包工具可以扮演证书颁发、校验的角色,因此可以查看到数据 拿到请求信息后原封不动的发起第二个请求,在服务器上生产了部分脏数据(接口是背后的逻辑是对 DB 的数据插入、删除等) 所以针对上述的问题也有一些解决方案: HTTPS 证书的双向认证解决抓包工具问题 假如通过网络层高手截获了 HTTPS 加证书认证后的数据,所以需要对请求参数做签名 「防重放策略」解决请求的多次发起问题 请求参数和返回内容做额外 RSA 加密处理,即使截获,也无法查看到明文。 关于 HTTPS 证书双向认证和 Web 端反爬虫技术方案均在大前端时代的安全性一文中有具体讲解。接下来引出本文主角:防重放 二、 请求参数防篡改 在之前的文章也讲过,HTTPS 依旧可以被抓包,造成安全问题。抓包工具下数据依旧是裸奔的,可以查看Charles 从入门到精通文中讲的如何获取 HTTPS 数据。 假如通过网络层高手截获了 HTTPS 加证书认证后的数据,所以需要对请求参数做签名。步骤如下 客户端使用约定好的密钥对请求参数进行加密,得到签名 signature。并将签名加入到请求参数中,发送给服务端 服务端接收到客户端请求,使用约定好的密钥对请求参数(不包括 signature)进行再次签名,得到值 autograph 服务器对比 signature 和 autograph,相等则认为是一次合法请求,否则则认为参数被篡改,判定为一次非法请求 因为中间人不知道签名密钥,所以即使拦截到请求,修改了某项参数,但是无法得到正确的签名 signature,这样构造的一个请求,会被服务器判定为一次非法请求。 三、 防重放策略 在工程师文化中,我们要做一个事情,就首先要对这个事情下个定义。我们才能知道做什么、怎么做。 理论上,一个 API 接口请求被收到,服务会做校验,但是当一个合法请求被中间人拦截后,中间人原封不动得重复发送该请求一次或多次,这种重复利用合法请求进行得攻击被成为重放。 重放会造成服务器问题,所以我们需要针对重放做防重放。本质上就是如何区别去一次正常、合法的请求。 3.1 基于 timestamp 的方案 理论上,客户端发起一次请求,到服务端接收到这个请求的时间,业界判定为不超过60秒。利用这个特征,客户端每次请求都加上 timestamp1,客户端将 timestamp1 和其他请求参数一起签名得到 signature,之后发送请求到服务器。 服务器拿到当前时间戳 timestamp2,timestap2 - timestamp1 > 60s,则认为非法 服务端接收到客户端请求,使用约定好的密钥对请求参数(不包括 signature、timestamp1)进行再次签名,得到值 autograph。比对 signature 和 autograph,若不相等则认为是一次非法请求 假如中间人拦截到请求,修改了 timestamp 或者其他的任何参数,但是不知道密钥,所以服务器依旧判定为非法请求。 中间人从抓包、篡改参数、发起请求的过程一般来说大于60秒,所以服务器依旧会判定为非法请求。 基于 timestamp 的设计缺陷也很明显,种种原因下,60秒内的请求,会钻规则漏洞,服务器判定为一次合法请求。 3.2 基于 nonce 的方案 既然时间戳会有漏洞,那么新方案是基于随机字符串 nonce。也就是说每次请求都加入一个随机字符串,然后将其他参数一起利用密钥加密得到签名 signature。服务端收到请求后 先判断 nonce 参数是否能存在于某个集合中,如果存在则认为是非法请求;如果不存在,则将 nonce 添加到当前的集合中 服务端将客户端请求参数(除 nonce)结合密钥加密得到 autograph,将 signature 和 autograph 比对,不相等则认为非法请求 但是该方案也有缺点,因为当次的请求都需要和集合中去搜索匹配,所以该集合不能太大,不然匹配算法特别耗时,接口性能降低。所以不得不定期删除部分 nonce 值。但是这样的情况下,被删除的 nonce 被利用为重放攻击,服务器判定为合法请求。 假设服务器只保存24小时内请求的 nonce,该存储仍旧是一笔不小的开销。 3.3 基于 timestamp + nonce 的方案 根据 timestamp 和 nonce 各自的特点:timestamp 无法解决60秒内的重放请求;nonce 存储和查找消耗较大。所以结合2者的特点,便有了 「timestamp + nonce 的防重放方案」。 利用 timestamp 解决超过60秒被认为非法请求的问题 利用 nonce 解决 timestamp 60秒内的漏网之鱼 步骤: 客户端将当前 timestamp1、随机字符串和其他请求参数,按照密钥,生成签名 signature 服务端收到请求,利用服务端密钥,将除 timestamp1、随机字符串之外的请求参数,加密生成签名 autograph 服务端对比 signature 和 autograph,不相等则认为非法请求 拿到服务端时间戳, timestamp2 - timestamp1 < 60,则判定为一次合法请求,然后保存 nonce 服务端只保存60秒内的 nonce,定时将集合内过期的 nonce 删除 该集合不应该直接操作文件或者数据库,否则服务端 IO 太多,造成性能瓶颈。可以是 mmap 或者其他内存到文件的读写机制。根据场景可以选择乐观锁、悲观锁。 其中有一个 timestamp 的问题,服务器会将请求参数中的 timestamp 判断差值,其中一个致命的缺点是服务器的时间和客户端的时间是存在时间差的,当然你也可以通过校验时间戳解决此问题。时间同步请继续看下面部分。 四、 计算机网络时间同步技术原理 客户端和服务端的时间同步在很多场景下非常重要,举几个例子,这些场景都是经常发生的。 一个商品秒杀系统。用户打开页面,浏览各个类目的商品,商品列表界面右侧和详情页都有倒计时秒杀功能。用户在详情页加购、下单、结算。发现弹出提示“商品库存不足,请购买同类其他品牌商品” 一个答题系统,题目是该公司核心竞争力。所以有心的程序员为接口设计了「防重放」功能。但是前端小哥不给力,接口带过去的 timestamp 与服务器不在一个时区,差好几秒。别有用心的竞品公司的爬虫工程师发现了该漏洞,爬取了题目数据。 所以该现象在计算机领域有非常普遍,有解决方案。 如果精度要求不高的情况下:先请求服务器上的时间 ServerTime,然后记录下来,同时记录当前的时间 LocalTime1;需要获取当前的时间时,用最新的当前时间 (LocalTime2 - LocalTime1 + ServerTime) 拿 iOS 端举例: App 启动后通过接口获取服务器时间 ServerTime,保存本地。并同时记录当前时间 LocalTime1 需要使用服务器时间时,先拿到当前时间 LocalTime2 - LocalTime1 + ServerTime 若获取服务器时间接口失败,则从缓存中拿到之前同步的结果(初始的时间在 App 打包阶段内置了) 使用 NSSystemClockDidChangeNotification 监测系统时间发生改变,若变化则重新获取接口,进行时同步 如果需要精度更高,比如 100纳秒的情况,则需要使用 NTP(Network Time Protocol)网络时间协议、PTP (Precision Time Protocol)精确时间同步协议了。 NTP、PTP 不在本文的范畴,感兴趣的可以查看这篇文章

优秀的个人博客,低调大师

每日一博 | Spring Cloud 的限流、降级和熔断 —— Hystrix

一、前言 分布式系统环境中,服务间类似依赖非常常见,一个业余调用通常依赖多个基础服务。如下图,对于同步调用,当库存服务不可用时,商品服务请求线程被阻塞,当有大批量请求调用库存服务时,最终可能导致整个商品服务资源耗尽,无法继续对外提供服务。并且这种不可用可能沿请求调用链向上传递,这种现象称为雪崩效应。 二、雪崩效应 1、常见场景 (1)硬件故障:如服务器宕机,机房断电,光纤被挖断等。 (2)流量激增:如异常流量,重试加大流量等。 (3)缓存穿透:一般发生在应用重启,所有缓存失效时,以及短时间内大量缓存失效时。大量的缓存不命中,使请求直击后端服务,造成服务提供者超负荷运行,引起服务不可用。 (4)程序bug:如程序逻辑导致内存泄漏,JVM长时间FullGC等。 (5)同步等待:服务间采用同步调用模式,同步等待造成的资源耗尽。 2、应对策略 针对造成雪崩效应的不同场景,可以使用不同的应对策略,没有一种通用所有场景的策略。 (1)硬件故障:多机房容灾、异地多活等。 (2)流量激增:服务自动扩容、流量控制(限流、关闭重试)等。 (3)缓存穿透:缓存预加载、缓存异步加载等。 (4)程序bug:修改程序bug、及时释放资源等。 (5)同步等待:资源隔离、MQ解耦。、不可用服务调用快速失败等。资源隔离通常指不同服务调用采取不同的线程池;不可用服务调用快速失败一般通过熔断模式结合超时机制实现。 综上所述,如果一个应用不能对来自依赖的故障进行隔离,那该应用本身就处在被拖垮的风险中。因此,为了构建稳定、可靠的分布式系统,我们的服务应当具有自我保护能力,当依赖服务不可用时,当前服务启动自我保护功能,从而避免发生雪崩效应。本文将重点介绍使用Hystrix解决同步等待的雪崩问题。 三、初探Hystrix Hystrix,中文含义是豪猪,因其背上长满荆棘,从而拥有了自我保护的能力。本文所说的Hystrix是Netflix公司开源的一款容错框架,同样具有自我保护能力。为了实现容错和自我保护,下面我们看看Hystrix如何设计和实现的。 Hystrix设计目标: 对来自依赖的延迟和故障进行防护和控制,这些依赖通常都是通过网络访问的。 阻止失败并迅速恢复 回退并优雅降级 提供近实时的监控与告警 Hystrix遵循的设计原则: 防止任何单独的依赖耗尽资源(线程) 过载立即切断并快速失败,防止排队 尽可能提供回退以保护用户免受故障 使用隔离技术(例如隔板、泳道和断路器模式)来限制任何一个依赖的影响 通过近实时的指标,监控和告警,确保故障被及时发现 通过动态修改配置属性,确保故障及时恢复 防止整个依赖客户端执行失败,而不仅仅是网络通信 Hystrix如何实现这些设计目标? 使用命令模式将所有对外部服务(或依赖关系)的调用包装在HystrixCommand或 HystrixObservableCommand对象中,并将该对象放在单独的线程中执行。 每个依赖都维护着一个线程池(或信号量),线程池被耗尽则拒绝请求(而不是让请求排队)。 记录请求成功,失败,超时和线程拒绝。 服务错误百分比超过了阈值,熔断器开关自动打开,一段时间内停止对该服务的所有请求。 请求失败,被拒绝,超时或熔断时执行降级逻辑。 近实时地监控指标和配置的修改。 四、Hystrix处理流程 (一)Hystrix 整个工作流程如下: 1、构造一个 HystrixCommand或HystrixObservableCommand对象, 用于封装请求,并在构造方法配置请求被执行需要的参数; 2、执行命令, Hystrix 提供了4种执行命令的方法,后面详述; 3、判断是否使用缓存响应请求,若启用了缓存,且缓存可用,直接使用缓存响应请求。 Hystrix 支持请求缓存,但需要用户自定义启动; 4、判断熔断器是否打开,如果打开,调到第8步; 5、判断线程池、队列、信号量是否已满,已满则调到第8步; 6、执行 HystrixObservableCommand.construct()或HystrixCommand.run(), 如果执行失败或者超时,跳到第8步;否者,跳到第9步; 7、统计熔断器监控指标; 8、走Fallback降级方法; 9、返回请求响应。 从流程图上可知道,第5步线程池、队列、信号量已满时,还会执行第7步逻辑,更新熔断器统计信息,而第6步无论成功与否,都会更新熔断器统计信息。 (二)执行命令的几种方法: Hystrix提供了4种执行命令的方法,execute()和queue()适用于 HystrixCommand 对象,而observer()和toObservable()适用于 HystrixObservableCommand对象。 1、execute() 以同步阻塞方法执行run(),只支持接收一个值对象。 Hystrix会从线程池中取一个线程来执行run(),并等待返回值。 2、queue() 以异步非阻塞方法执行run(),只支持接收一个值对象。调用queue()就直接返回一个Future对象。可通过Future.get()拿到run()的返回结果,但 Future.get() 是阻塞执行的。若执行成功, Future.get() 返回单个返回值。当执行失败时,如果没有重写fallback, Future.get() 抛出异常。 3、observe() 事件注册前执行run()/construct(),支持接收多个值对象,取决于发射源。调用observe()会返回一个hot Observable,也就是说,调用 observe()自动触发执行run()/construct(),无论是否存在订阅者。 如果继承的是HystrixCommand,hystrix会从线程池中取一个线程以非阻塞方式执行run();如果继承的是HystrixObservableCommand,将以调用线程阻塞执行construct()。 observe()使用方法: (1)调用 observe()会返回一个Observable对象 (2)调用这个 Observable对象的subscribe()方法完成事件注册,从而获取结果 4、toObservable() 事件注册后执行run()/construct(),支持接收多个值对象,取决于发射源。调用 toObservable() 会返回一个cold Observable,也就是说,调用 toObservable() 不会立即触发执行run()/construct(),必须有订阅者订阅 Observable时才会执行。 如果继承的是 HystrixComman,hystrix会从线程池中取一个线程以非阻塞方式执行run(),调用线程不必等待run();如果继承的是 HystrixObservableCommand ,将以调用线程堵塞执行construct(),调用线程需等待construct()执行完才能继续往下走。 toObservable()使用方法: (1)调用observe()会返回一个Observable对象 (2)调用这个 Observable对象的subscribe()方法完成事件注册,从而获取结果 需注意的是, HystrixCommand也支持 toObservable()和observe(),但是即使将 HystrixCommand转换成Observable,它也只能发射一个值对象。只有 HystrixObservableCommand才支持发射多个值对象。 (三)几种方法的关系 execute()实际是调用了queue().get() queue()实际调用了toObservable().toBlocking().toFuture() observe()实际调用toObservable()获得一个coldObservable,再创建一个ReplaySubject对象订阅Observable,将源Observable转化为hot Observable。因此调用observe()会自动触发执行run()/construct()。 Hystrix 总是以Observable的形式作为相应返回,不同执行命令的方法只是进行了相应的转换。 五、 Hystrix 容错 Hystrix 的容错主要是通过添加容许延迟和容错方法,帮助控制这些分布式服务之间的交互。还通过隔离服务之间的访问点,阻止它们之间的级联故障以及提供退回选项来实现这一点,从而提高系统的整体弹性。 Hystrix主要提供了一下几种容错方法: 资源隔离 熔断 降级 (一)资源熔断 资源隔离主要指对线程的隔离。 Hystrix提供了两种线程隔离的方式:线程池和信号量。 1、线程隔离-线程池 Hystrix还通过命令模式对发送请求的对象和执行请求的对象进行解耦,将不同类型的业务请求封装为对应的命令请求。如订单服务查询商品,查询商品请求->商品command;商品服务查询库存,查询库存请求->库存command。并且为每个类型的command配置一个线程池,当第一次创建command时,根据配置创建一个线程池,并放入ConcurrentHashMap,如商品command: final static ConcurrentHashMap<String, HystrixThreadPool> threadPools = new ConcurrentHashMap<String, HystrixThreadPool>(); ... if (!threadPools.containsKey(key)) { threadPools.put(key, new HystrixThreadPoolDefault(threadPoolKey, propertiesBuilder)); } 后续查询商品的请求创建command时,将会重用已创建的线程池。线程池隔离之后的服务依赖关系: 通过发送请求线程与执行请求的线程分离,可有效防止发生级联故障。当线程池或请求队列饱和时,Hystrix将拒绝服务,使得请求线程可以快速失败,从而避免依赖问题扩散。 线程池隔离优点: 保护应用程序以免受来自依赖故障的影响,指定依赖线程池饱和不会影响应用程序的其余部分。 当引入新客户端lib时,即使发生问题,也是在lib中,并不会影响其他内容。 当依赖从故障恢复正常时,应用程序会立即恢复正常的性能。 当应用程序一些配置参数错误时,线程池的运行状况会很快检测到这一点(通过增加错误、延迟、超时、拒绝等),同时可以通过动态属性进行实时纠正错误的参数配置。 如果服务的性能有变化,需要实时调整,比如增加或减少超时时间,更改重试次数,可以通过线程池指标状态属性修改,而且不会影响到其它调用请求。 除了隔离优势外, Hystrix 拥有专门的线程可提供内置的并发功能,使得可以在同步调用之上构建异步门面(外观模式),为异步编程提供了支持( Hystrix 引入了R小Java异步框架)。 注意:尽管线程池提供了线程隔离,我们的客户端底层代码也必须要有超时设置或响应线程中断,不能无限制的阻塞以致线程池一直饱和。 缺点: 线程池的主要缺点是增加了计算开销。每个命令的执行都在单独的线程完成,增加了排队、调度和上下文切换的开销。因此,要使用 Hystrix ,就必须接受它带来的开销,以换取它所提供的的好处。 通常情况下,线程池引入的开销足够小,不会有重大的成本和性能影响。但对于一些访问延迟极低的服务,如只依赖内存缓存,线程池引入的开销就比较明显了,这时候使用线程池隔离技术就不合适了,我们需要考虑更轻量级的方式,如信号量隔离。 2、线程隔离-信号量 上面提到了线程池隔离的缺点,当依赖延迟极低的服务时,线程池隔离技术引入的开销超过了它所带来的好处。这时候可以使用信号量隔离技术来代替,通过设置信号量来限制对任何给定依赖的并发调用量。下图说明了线程池隔离和信号量隔离的主要区别: 使用线程池时,发送请求的线程和执行依赖服务的线程不是同一个,而使用信号量时,发送请求的线程和执行依赖服务的线程时同一个, 都是发起请求的线程。 3、线程隔离总结 线程池和信号量都可以做线程隔离,但各有各的优缺点和支持的场景,对比如下: 线程切换 支持异步 支持超时 支持熔断 限流 开销 信号量 否 否 否 是 是 小 线程池 是 是 是 是 是 大 线程池和信号量都支持熔断和限流。相比线程池,信号量不需要线程切换,因此避免了不必要的开销。但是信号量不支持异步,也不支持超时,也就是说当所请求的服务不可用时,信号量会控制超过限制的请求立即返回,但是已经持有信号量的线程只能等待服务响应或从超时中返回,即可能出现长时间等待。线程池模式下,当超过指定时间未响应的服务, Hystrix会通过响应中断的方式通知线程立即结束并返回。 (二)熔断器 现实生活中,可能大家都有注意到家庭电路中通常会安装一个保险盒,当负载过载时,保险盒中的保险丝会自动熔断,以保护电路及家里的各种电器,这就是熔断器的一个常见例子。Hystrix中的熔断器(Circuit Breaker)也是起类似作用,Hystrix在运行过程中会向每个commandKey对应的熔断器报告成功、失败、超时和拒绝的状态,熔断器维护并统计这些数据,并根据这些统计信息来决策熔断开关是否打开。如果打开,熔断后续请求,快速返回。隔一段时间(默认是5s)之后熔断器尝试半开,放入一部分流量请求进来,相当于对依赖服务进行一次健康检查,如果请求成功,熔断器关闭。 熔断器配置,Circuit Breaker主要包括如下6个参数: 1、circuitBreaker.enabled 是否启用熔断器,默认是TRUE。 2 、circuitBreaker.forceOpen 熔断器强制打开,始终保持打开状态,不关注熔断开关的实际状态。默认值FLASE。 3、circuitBreaker.forceClosed 熔断器强制关闭,始终保持关闭状态,不关注熔断开关的实际状态。默认值FLASE。 4、circuitBreaker.errorThresholdPercentage 错误率,默认值50%,例如一段时间(10s)内有100个请求,其中有54个超时或者异常,那么这段时间内的错误率是54%,大于了默认值50%,这种情况下会触发熔断器打开。 5、circuitBreaker.requestVolumeThreshold 默认值20。含义是一段时间内至少有20个请求才进行errorThresholdPercentage计算。比如一段时间了有19个请求,且这些请求全部失败了,错误率是100%,但熔断器不会打开,总请求数不满足20。 6、circuitBreaker.sleepWindowInMilliseconds 半开状态试探睡眠时间,默认值5000ms。如:当熔断器开启5000ms之后,会尝试放过去一部分流量进行试探,确定依赖服务是否恢复。 (三)熔断器工作原理 下图展示了HystrixCircuitBreaker的工作原理: 熔断器工作的详细过程如下: 第一步,调用 allowRequest() 判断是否允许将请求提交到线程池 1、允许熔断器强制打开, circuitBreaker.forceOpen为true,不允许放行,返回。 2、如果熔断器强制关闭, circuitBreaker.forceOpen为true,允许放行。 此外不必关注熔断器实际状态,也就是说熔断器仍然会维护统计数据和开关状态,只是不生效而已。 第二步,调用isOpen()判断熔断器开关是否打开 1、 如果熔断器开关打开,进入第三步,否则继续; 2、 如果一个周期内总的请求数小于circuitBreaker.requestVolumeThreshold的值,允许请求放行,否则继续; 3、 如果一个周期内错误率小于circuitBreaker.errorThresholdPercentage的值,允许请求放行。否则,打开熔断器开关,进入第三步。 第三步, 调用allowSingleTest()判断是否允许单个请求通行,检查依赖服务是否恢复 如果熔断器打开,且距离熔断器打开的时间或上一次试探请求放行的时间超过circuitBreaker.sleepWindowInMilliseconds的值时,熔断器器进入半开状态,允许放行一个试探请求;否则,不允许放行。 此外,为了提供决策依据,每个熔断默认维护了10个bucket,每秒一个bucket,当心的bucket被创建时,最旧的bucket会被抛弃。其中每个bucket维护了请求、失败、超时、拒绝的计数器,Hystrix负责收集并统计这些计数器。 (四)回退降级 降级,通常指事务高峰期,为了保证核心服务正常运行,需要停掉一些不太重要的业务,或者某些服务不可用时,执行备用逻辑从故障服务中快速失败或快速返回,以保障主体业务不受影响。 Hystrix提供的降级主要是为了容错,保证当前服务不受依赖服务故障的影响,从而提高服务的健壮性。要支持回退或降级处理,可以重写 HystrixCommand的getFallBack方法或HystrixObservableCommand的resumeWithFallback方法。 1、Hystrix在以下几种情况下会走降级逻辑: 执行construct()或run()抛出异常 熔断器打开导致命令短路 命令的线程池和队列或信号量的容量超额,命令被拒绝 命令执行超时 2、降级回退方式 (1)Fail Fast快速失败 快速失败是最普通的命令执行方法,命令没有重写降级逻辑。如果命令执行发生任何类型的故障,它将直接抛出异常。 (2)Fail Fast无声失败 指在降级方法中通过返回null,空Map,空List或其他类似的响应来完成。 (3)FallBack:Static 指在降级方法中返回静态默认值。 这不会导致服务以“无声失败”的方式被删除,而是导致默认行为发生。如:应用根据命令执行返回true / false执行相应逻辑,但命令执行失败,则默认为true。 (4)FallBack:Stubbed 当命令返回一个包含多个字段的复合对象时,适合以Stubbed 的方式回退。 (5)FallBack:Cache via Network 有时,如果调用依赖服务失败,可以从缓存服务(如redis)中查询旧数据版本。由于又会发起远程调用,所以建议重新封装一个Command,使用不同的ThreadPoolKey,与主线程池进行隔离。 (6)Primary+Secondary with FallBack 有时系统具有两种行为- 主要和次要,或主要和故障转移。主要和次要逻辑涉及到不同的网络调用和业务逻辑,所以需要将主次逻辑封装在不同的Command中,使用线程池进行隔离。为了实现主从逻辑切换,可以将主次command封装在外观HystrixCommand的run方法中,并结合配置中心设置的开关切换主从逻辑。由于主次逻辑都是经过线程池隔离的HystrixCommand,因此外观HystrixCommand可以使用信号量隔离,而没有必要使用线程池隔离引入不必要的开销。原理图如下: 主次模型的使用场景还是很多的。如当系统升级新功能时,如果新版本的功能出现问题,通过开关控制降级调用旧版本的功能。 通常情况下,建议重写getFallBack或resumeWithFallback提供自己的备用逻辑,但不建议在回退逻辑中执行任何可能失败的操作。 六、总结 本文介绍了Hystrix及其工作原理,还介绍了Hystrix线程池隔离、信号量隔离和熔断器的工作原理,以及如何使用Hystrix的资源隔离,熔断和降级等技术实现服务容错,从而提高系统的整体健壮性。 虽然Hystrix已经停更很久了,Spring Cloud体系的使用者和拥护者一片哀嚎,实际上,spring作为java最大的家族,根本不需要担心其中一两个组件的废弃, Hystrix的停更,只会催生更多更好的组件替代它,但是 Hystrix既然存在过,就一定就它存在的价值,既然存在,我就必须搞懂它。 每一篇博客都是一种经历,程序猿生涯的痕迹,知识改变命运,命运要由自己掌控,愿你游历半生,归来仍是少年。 欲速则不达,欲达则欲速! 更多精彩内容,首发公众号【素小暖】,欢迎关注。

优秀的个人博客,低调大师

每日一博 | Go testing.common 公共类源码剖析

简介 我们知道单元测试函数需要传递一个testing.T类型的参数,而性能测试函数需要传递一个testing.B类型的参数,该参数可用于控制测试的流程,比如标记测试失败等。 testing.T和testing.B属于testing包中的两个数据类型,该类型提供一系列的方法用于控制函数执行流程,考虑到二者有一定的相似性,所以Go实现时抽象出一个testing.common作为一个基础类型,而testing.T和testing.B则属于testing.common的扩展。 本节,我们重点看testing.common,通过其成员及方法,来了解其实现原理。 数据结构 // common holds the elements common between T and B and // captures common methods such as Errorf. type common struct { mu sync.RWMutex // guards this group of fields output []byte // Output generated by test or benchmark. w io.Writer // For flushToParent. ran bool // Test or benchmark (or one of its subtests) was executed. failed bool // Test or benchmark has failed. skipped bool // Test of benchmark has been skipped. done bool // Test is finished and all subtests have completed. helpers map[string]struct{} // functions to be skipped when writing file/line info chatty bool // A copy of the chatty flag. finished bool // Test function has completed. hasSub int32 // written atomically raceErrors int // number of races detected during test runner string // function name of tRunner running the test parent *common level int // Nesting depth of test or benchmark. creator []uintptr // If level > 0, the stack trace at the point where the parent called t.Run. name string // Name of test or benchmark. start time.Time // Time test or benchmark started duration time.Duration barrier chan bool // To signal parallel subtests they may start. signal chan bool // To signal a test is done. sub []*T // Queue of subtests to be run in parallel. } common.mu 读写锁,仅用于控制本数据内的成员访问。 common.output 存储当前测试产生的日志,每产生一条日志则追加到该切片中,待测试结束后再一并输出。 common.w 子测试执行结束需要把产生的日志输送到父测试中的output切片中,传递时需要考虑缩进等格式调整,通过w把日志传递到父测试。 common.ran 仅表示是否已执行过。比如,跟据某个规范筛选测试,如果没有测试被匹配到的话,则common.ran为false,表示没有测试运行过。 common.failed 如果当前测试执行失败,则置为true。 common.skipped 标记当前测试是否已跳过。 common.done 表示当前测试及其子测试已结束,此状态下再执行Fail()之类的方法标记测试状态会产生panic。 common.helpers 标记当前为函数为help函数,其中打印的日志,在记录日志时不会显示其文件名及行号。 common.chatty 对应命令行中的-v参数,默认为false,true则打印更多详细日志。 common.finished 如果当前测试结束,则置为true。 common.hasSub 标记当前测试是否包含子测试,当测试使用t.Run()方法启动子测试时,t.hasSub则置为1。 common.raceErrors 竞态检测错误数。 common.runner 执行当前测试的函数名。 common.parent 如果当前测试为子测试,则置为父测试的指针。 common.level 测试嵌套层数,比如创建子测试时,子测试嵌套层数就会加1。 common.creator 测试函数调用栈。 common.name 记录每个测试函数名,比如测试函数TestAdd(t *testing.T), 其中t.name即“TestAdd”。 测试结束,打印测试结果会用到该成员。 common.start 记录测试开始的时间。 common.duration 记录测试所花费的时间。 common.barrier 用于控制父测试和子测试执行的channel,如果测试为Parallel,则会阻塞等待父测试结束后再继续。 common.signal 通知当前测试结束。 common.sub 子测试列表。 成员方法 common.Name() // Name returns the name of the running test or benchmark. func (c *common) Name() string { return c.name } 该方法直接返回common结构体中存储的名称。 common.Fail() // Fail marks the function as having failed but continues execution. func (c *common) Fail() { if c.parent != nil { c.parent.Fail() } c.mu.Lock() defer c.mu.Unlock() // c.done needs to be locked to synchronize checks to c.done in parent tests. if c.done { panic("Fail in goroutine after " + c.name + " has completed") } c.failed = true } Fail()方法会标记当前测试为失败,然后继续运行,并不会立即退出当前测试。如果是子测试,则除了标记当前测试结果外还通过c.parent.Fail()来标记父测试失败。 common.FailNow() func (c *common) FailNow() { c.Fail() c.finished = true runtime.Goexit() } FailNow()内部会调用Fail()标记测试失败,还会标记测试结束并退出当前测试协程。 可以简单的把一个测试理解为一个协程,FailNow()只会退出当前协程,并不会影响其他测试协程,但要保证在当前测试协程中调用FailNow()才有效,不可以在当前测试创建的协程中调用该方法。 common.log() func (c *common) log(s string) { c.mu.Lock() defer c.mu.Unlock() c.output = append(c.output, c.decorate(s)...) } common.log()为内部记录日志入口,日志会统一记录到common.output切片中,测试结束时再统一打印出来。 日志记录时会调用common.decorate()进行装饰,即加上文件名和行号,还会做一些其他格式化处理。 调用common.log()的方法,有Log()、Logf()、Error()、Errorf()、Fatal()、Fatalf()、Skip()、Skipf()等。 注意:单元测试中记录的日志只有在执行失败或指定了-v参数才会打印,否则不会打印。而在性能测试中则总是被打印出来,因为是否打印日志有可能影响性能测试结果。 common.Log(args ...interface{}) func (c *common) Log(args ...interface{}) { c.log(fmt.Sprintln(args...)) } common.Log()方法用于记录简单日志,通过fmt.Sprintln()方法生成日志字符串后记录。 common.Logf(format string, args ...interface{}) func (c *common) Logf(format string, args ...interface{}) { c.log(fmt.Sprintf(format, args...)) } common.Logf()方法用于格式化记录日志,通过fmt.Sprintf()生成字符串后记录。 common.Error(args ...interface{}) // Error is equivalent to Log followed by Fail. func (c *common) Error(args ...interface{}) { c.log(fmt.Sprintln(args...)) c.Fail() } common.Error()方法等同于common.Log()+common.Fail(),即记录日志并标记失败,但测试继续进行。 common.Errorf(format string, args ...interface{}) // Errorf is equivalent to Logf followed by Fail. func (c *common) Errorf(format string, args ...interface{}) { c.log(fmt.Sprintf(format, args...)) c.Fail() } common.Errorf()方法等同于common.Logf()+common.Fail(),即记录日志并标记失败,但测试继续进行。 common.Fatal(args ...interface{}) // Fatal is equivalent to Log followed by FailNow. func (c *common) Fatal(args ...interface{}) { c.log(fmt.Sprintln(args...)) c.FailNow() } common.Fatal()方法等同于common.Log()+common.FailNow(),即记录日志、标记失败并退出当前测试。 common.Fatalf(format string, args ...interface{}) // Fatalf is equivalent to Logf followed by FailNow. func (c *common) Fatalf(format string, args ...interface{}) { c.log(fmt.Sprintf(format, args...)) c.FailNow() } common.Fatalf()方法等同于common.Logf()+common.FailNow(),即记录日志、标记失败并退出当前测试。 common.skip() func (c *common) skip() { c.mu.Lock() defer c.mu.Unlock() c.skipped = true } common.skip()方法标记当前测试为已跳过状态,比如测试中检测到某种条件,不再继续测试。该函数仅标记测试跳过,与测试结果无关。测试结果仍然取决于common.failed。 common.SkipNow() func (c *common) SkipNow() { c.skip() c.finished = true runtime.Goexit() } common.SkipNow()方法标记测试跳过,并标记测试结束,最后退出当前测试。 common.Skip(args ...interface{}) // Skip is equivalent to Log followed by SkipNow. func (c *common) Skip(args ...interface{}) { c.log(fmt.Sprintln(args...)) c.SkipNow() } common.Skip()方法等同于common.Log()+common.SkipNow()。 common.Skipf(format string, args ...interface{}) // Skipf is equivalent to Logf followed by SkipNow. func (c *common) Skipf(format string, args ...interface{}) { c.log(fmt.Sprintf(format, args...)) c.SkipNow() } common.Skipf()方法等同于common.Logf() + common.SkipNow()。 common.Helper() // Helper marks the calling function as a test helper function. // When printing file and line information, that function will be skipped. // Helper may be called simultaneously from multiple goroutines. func (c *common) Helper() { c.mu.Lock() defer c.mu.Unlock() if c.helpers == nil { c.helpers = make(map[string]struct{}) } c.helpers[callerName(1)] = struct{}{} } common.Helper()方法标记当前函数为help函数,所谓help函数,即其中打印的日志,不记录help函数的函数名及行号,而是记录上一层函数的函数名和行号。 赠人玫瑰手留余香,如果觉得不错请给个赞~ 本篇文章已归档到GitHub项目,求星~ 点我即达

优秀的个人博客,低调大师

每日一博 | nginx 基于 epoll 模型事件驱动流程详解

epoll是一种基于事件驱动的模型,其是nginx能够高效处理客户端请求的重要原因之一。从流程上来讲,epoll模型的使用主要分为三步:epoll句柄的创建,监听文件描述符的添加和等待事件的触发,本文将介绍nginx是如何基于这三个步骤实现客户端请求的高效处理的。 1. epoll模型介绍 在介绍nginx的实现原理之前,我们首先需要介绍一下epoll模型的基本使用方式。epoll在使用的时候主要有三个方法: // 创建epoll句柄 int epoll_create(int size); // 往epoll句柄中添加需要进行监听的文件描述符 int epoll_ctl(int epfd,int op,int fd,struct epoll_event* event); // 等待需要监听的文件描述符上对应的事件的发生 int epoll_wait(int epfd,struct epoll_event* events,int maxevents,int timeout); 首先,我们会调用epoll_create()方法创建一个epoll实例的句柄,可以将这里的句柄理解为一个eventpoll结构体实例,而这个结构体中有一个红黑树和一个队列,红黑树中主要存储需要监听的文件描述符,而队列则是在所监听的文件描述符中有指定的事件发生时就会将这些事件添加到队列中,如下图所示为eventpoll的示意图: 一般来说,这个epoll句柄在程序的整个运行周期中只会有一个,比如nginx每个worker进程就都只维护了一个epoll句柄。在创建完句柄之后,对于我们的程序监听的每一个端口,其实本质上也都是一个文件描述符,这个文件描述符上是可以发生Accept事件,也即接收到客户端请求的。因而,初始时,我们会将需要监听的端口对应的文件描述符通过epoll_ctl()方法添加到epoll句柄中。添加成功之后,这每一个监听的文件描述符就对应了eventpoll的红黑树中的一个节点。另外,在调用epoll_ctl()方法添加了文件描述符之后,会将其与相应的设备(网卡)进行关联,当设备驱动发生某个事件时,就会回调当前文件描述符的回调方法ep_poll_callback(),从而生成一个事件,并且将该事件添加到eventpoll的事件队列中。最后,当我们调用epoll_wait()方法时,就会从epoll句柄中获取对应的事件,本质上就是检查eventpoll的事件队列是否为空,如果有事件则将其返回,否则就会等待事件的发生。另外,对于epoll的使用,这里获取的事件一般都是Accept事件,而在处理这个事件的时候,会获取客户端的连接的句柄,这个句柄本质上也是一个文件描述符,此时我们则会将其继续通过epoll_ctl()方法添加到当前的epoll句柄中,以继续通过epoll_wait()方法等待其数据的读取和写入事件。 通过这里我们可以看出,在epoll使用的过程中,会有两类文件描述符,一类是我们所监听的端口所对应的文件描述符,这类描述符我们一般监听其Accept事件,以等待客户端连接,另一类则是每个客户端连接所对应的一个文件描述符,而这里描述符我们一般监听其读写事件以接收和发送数据给客户端。 2. nginx中epoll实现方式 在前面的文章中,我们讲解了nginx是如何初始化事件驱动框架的,其中讲到事件框架的一个核心模块的定义如下: ngx_module_t ngx_event_core_module = { NGX_MODULE_V1, &ngx_event_core_module_ctx, /* module context */ ngx_event_core_commands, /* module directives */ NGX_EVENT_MODULE, /* module type */ NULL, /* init master */ // 该方法主要是在master进程启动的过程中调用的,用于初始化时间模块 ngx_event_module_init, /* init module */ // 该方法是在各个worker进程启动之后调用的 ngx_event_process_init, /* init process */ NULL, /* init thread */ NULL, /* exit thread */ NULL, /* exit process */ NULL, /* exit master */ NGX_MODULE_V1_PADDING }; 这里我们需要特别注意一下ngx_event_process_init()方法,我们讲到,这个方法是在每个worker创建的时候进行初始化调用的,这里面就涉及到两个非常重要的调用:a. 进行对应的事件模型的初始化;b. 监听配置文件中指定的各个端口。如下是这两个步骤的主要代码: static ngx_int_t ngx_event_process_init(ngx_cycle_t *cycle) { // 省略部分代码.... // 在nginx.conf配置文件的events{}配置块中需要使用use指令指定当前使用的事件模型, // 此时就会将所使用的事件模型的索引号存储在ecf->use中,下面的代码就是通过这种方式获取当前 // 所指定的事件模型所对应的模块的,然后调用该模块的actions.init()方法初始化该事件模型 for (m = 0; cycle->modules[m]; m++) { if (cycle->modules[m]->type != NGX_EVENT_MODULE) { continue; } // ecf->use存储了所选用的事件模型的模块序号,这里是找到该模块 if (cycle->modules[m]->ctx_index != ecf->use) { continue; } // module即为所选用的事件模型对应的模块 module = cycle->modules[m]->ctx; // 调用指定事件模型的初始化方法 if (module->actions.init(cycle, ngx_timer_resolution) != NGX_OK) { exit(2); } break; } // 省略部分代码... ls = cycle->listening.elts; for (i = 0; i < cycle->listening.nelts; i++) { #if (NGX_HAVE_REUSEPORT) if (ls[i].reuseport && ls[i].worker != ngx_worker) { continue; } #endif // 这里是为当前所监听的每一个端口都绑定一个ngx_connection_t结构体 c = ngx_get_connection(ls[i].fd, cycle->log); if (c == NULL) { return NGX_ERROR; } rev = c->read; // SOCK_STREAM表示TCP,一般都是TCP,也就是说在接收到客户端的accept事件之后, // 就会调用ngx_event_accept()方法处理该事件 rev->handler = (c->type == SOCK_STREAM) ? ngx_event_accept : ngx_event_recvmsg; if ((ngx_event_flags & NGX_USE_EPOLL_EVENT) && ccf->worker_processes > 1) { if (ngx_add_event(rev, NGX_READ_EVENT, NGX_EXCLUSIVE_EVENT) == NGX_ERROR) { return NGX_ERROR; } continue; } } return NGX_OK; } 对这里的代码主要完成了如下几部分的工作: 首先找到所使用的事件模型模块,然后调用其init()方法初始化该模型,这个方法里主要做了两件事,一个是通过epoll_create()方法创建一个epoll句柄,该句柄是当前worker进程运行的一个基础;另一个是为全局变量ngx_event_actions进行了赋值,即: // 这里将epoll相关的事件操作方法赋值给ngx_event_actions, // 也就是说后续有相关的事件发生则都会使用epoll相关的方法 ngx_event_actions = ngx_epoll_module_ctx.actions; 这个赋值的调用是非常重要的,在赋值之后,nginx所定义的几个方法宏就都是使用的epoll模块中所指定的方法,这里的几个宏定义如下: #define ngx_process_events ngx_event_actions.process_events #define ngx_done_events ngx_event_actions.done #define ngx_add_event ngx_event_actions.add #define ngx_del_event ngx_event_actions.del #define ngx_add_conn ngx_event_actions.add_conn #define ngx_del_conn ngx_event_actions.del_conn 而这里的ngx_epoll_module_ctx.actions结构体的定义如下: { // 对应于ngx_event_actions_t中的add方法 ngx_epoll_add_event, /* add an event */ // 对应于ngx_event_actions_t中的del方法 ngx_epoll_del_event, /* delete an event */ // 对应于ngx_event_actions_t中的enable方法,与add方法一致 ngx_epoll_add_event, /* enable an event */ // 对应于ngx_event_actions_t中的disable方法,与del方法一致 ngx_epoll_del_event, /* disable an event */ // 对应于ngx_event_actions_t中的add_conn方法 ngx_epoll_add_connection, /* add an connection */ // 对应于ngx_event_actions_t中的del_conn方法 ngx_epoll_del_connection, /* delete an connection */ #if (NGX_HAVE_EVENTFD) ngx_epoll_notify, /* trigger a notify */ #else NULL, /* trigger a notify */ #endif // 对应于ngx_event_actions_t中的process_events方法 ngx_epoll_process_events, /* process the events */ // 对应于ngx_event_actions_t中的init方法 ngx_epoll_init, /* init the events */ // 对应于ngx_event_actions_t中的done方法 ngx_epoll_done, /* done the events */ } 由此,就可以看出nginx出色的设计方式了,通过我们所选用的事件模型,就可以动态的为ngx_add_event()等宏指定所实现的子模块了。 上面的方法完成的第二个主要的工作就是遍历所有监听的端口,获取其描述符,然后通过ngx_add_event()方法将其添加到epoll句柄中以监听其客户端连接事件。从这里就可以感觉到比较巧妙了,因为上面一步中正好对epoll模块进行了初始化,并且设置了ngx_add_event()宏的实现方法,而这里就使用到了这里设置的方法,该方法本质上就是通过epoll_ctl()方法将当前监听的socket描述符添加到epoll句柄中; 最后就是上面的方法在遍历所有监听的端口的时候,为每个连接的accept事件添加的回调方法是ngx_event_accept(),通过前面我们对epoll模型的使用方式的介绍,我们大概可以理解,这里的ngx_event_accept()方法的主要作用是将当前accept到的客户端连接的句柄通过epoll_ctl()方法添加到当前epoll句柄中,以继续监听其读写事件; 这里我们首先看一下上面第一点中介绍的module->actions.init(cycle, ngx_timer_resolution)方法调用时是如何初始化epoll模块的。由于是epoll模块,这里的init()方法指向的就是ngx_epoll_init()方法,如下是该方法的源码: static ngx_int_t ngx_epoll_init(ngx_cycle_t *cycle, ngx_msec_t timer) { ngx_epoll_conf_t *epcf; // 获取解析得到的ngx_epoll_conf_t结构体 epcf = ngx_event_get_conf(cycle->conf_ctx, ngx_epoll_module); if (ep == -1) { // 创建eventpoll结构体,将创建得到的文件描述符返回 ep = epoll_create(cycle->connection_n / 2); // ep==-1表示创建失败 if (ep == -1) { ngx_log_error(NGX_LOG_EMERG, cycle->log, ngx_errno, "epoll_create() failed"); return NGX_ERROR; } } // 如果nevents小于epcf->events,说明event_list数组的长度不够,因而需要重新申请内存空间 if (nevents < epcf->events) { if (event_list) { ngx_free(event_list); } // 为event_list重新申请内存空间 event_list = ngx_alloc(sizeof(struct epoll_event) * epcf->events, cycle->log); if (event_list == NULL) { return NGX_ERROR; } } // 将nevents更新为配置文件中指定的大小 nevents = epcf->events; ngx_io = ngx_os_io; // 这里将epoll相关的事件操作方法赋值给ngx_event_actions,也就是说后续有相关的事件发生则 // 都会使用epoll相关的方法 ngx_event_actions = ngx_epoll_module_ctx.actions; // 这里NGX_USE_CLEAR_EVENT指的是使用ET模式来使用epoll,默认使用ET模式, // 而NGX_USE_LEVEL_EVENT表示使用LE模式来使用epoll #if (NGX_HAVE_CLEAR_EVENT) ngx_event_flags = NGX_USE_CLEAR_EVENT #else ngx_event_flags = NGX_USE_LEVEL_EVENT #endif // NGX_USE_GREEDY_EVENT表示每次拉取事件是都尝试拉取最多的事件 | NGX_USE_GREEDY_EVENT | NGX_USE_EPOLL_EVENT; return NGX_OK; } 可以看到,这里的ngx_epoll_init()方法主要的作用有两个:a. 通过epoll_create()方法创建一个epoll句柄;b. 设置ngx_event_actions属性所指向的方法的实现,从而确定ngx_add_event()等宏的实现方法。下面我们来看一下ngx_add_event()是如何将需要监听的文件描述符添加到epoll句柄中的: static ngx_int_t ngx_epoll_add_event(ngx_event_t *ev, ngx_int_t event, ngx_uint_t flags) { int op; uint32_t events, prev; ngx_event_t *e; ngx_connection_t *c; struct epoll_event ee; // ev->data在使用的过程中存储的是当前对应的ngx_connection_t,如果是free_connection, // 则存储的是下一个节点的指针 c = ev->data; // 事件类型 events = (uint32_t) event; // 如果是读事件 if (event == NGX_READ_EVENT) { e = c->write; prev = EPOLLOUT; #if (NGX_READ_EVENT != EPOLLIN | EPOLLRDHUP) events = EPOLLIN | EPOLLRDHUP; // 设置读事件类型 #endif } else { e = c->read; prev = EPOLLIN | EPOLLRDHUP; #if (NGX_WRITE_EVENT != EPOLLOUT) events = EPOLLOUT; // 设置写事件类型 #endif } // 根据active标志位确定是否为活跃事件,以决定到底是修改还是添加事件 if (e->active) { op = EPOLL_CTL_MOD; // 类型为修改事件 events |= prev; } else { op = EPOLL_CTL_ADD; // 类型为添加事件 } #if (NGX_HAVE_EPOLLEXCLUSIVE && NGX_HAVE_EPOLLRDHUP) if (flags & NGX_EXCLUSIVE_EVENT) { events &= ~EPOLLRDHUP; } #endif // 将flags参数指定的事件添加到监听列表中 ee.events = events | (uint32_t) flags; // 这里是将connection指针的最后一位赋值为ev->instance,然后将其赋值给事件的ptr属性,通过这种方式检测事件是否过期 ee.data.ptr = (void *) ((uintptr_t) c | ev->instance); ngx_log_debug3(NGX_LOG_DEBUG_EVENT, ev->log, 0, "epoll add event: fd:%d op:%d ev:%08XD", c->fd, op, ee.events); // 将事件添加到epoll句柄中 if (epoll_ctl(ep, op, c->fd, &ee) == -1) { ngx_log_error(NGX_LOG_ALERT, ev->log, ngx_errno, "epoll_ctl(%d, %d) failed", op, c->fd); return NGX_ERROR; } // 将事件标记为活跃状态 ev->active = 1; #if 0 ev->oneshot = (flags & NGX_ONESHOT_EVENT) ? 1 : 0; #endif return NGX_OK; } 这里的ngx_add_event()方法本质上是比较简单的,就是将当前的ngx_event_t转换为一个epoll_event结构体,并且会设置该结构体中需要监听的事件类型,然后通过epoll_ctl()方法将当前epoll_event添加到epoll句柄中。 在前面的ngx_event_process_init()方法中,nginx通过ngx_add_event()方法将各个监听的端口的描述符添加到epoll句柄中之后,就会开始监听这些描述符上的accept连接事件,如果有客户端连接请求,此时就会回调ngx_event_accept()方法处理该请求,我们来看一下该方法是如何处理客户端建立连接的请求的: /** * 当客户端有accept事件到达时,将调用此方法处理该事件 */ void ngx_event_accept(ngx_event_t *ev) { socklen_t socklen; ngx_err_t err; ngx_log_t *log; ngx_uint_t level; ngx_socket_t s; ngx_event_t *rev, *wev; ngx_sockaddr_t sa; ngx_listening_t *ls; ngx_connection_t *c, *lc; ngx_event_conf_t *ecf; #if (NGX_HAVE_ACCEPT4) static ngx_uint_t use_accept4 = 1; #endif if (ev->timedout) { // 如果当前事件超时了,则继续将其添加到epoll句柄中以监听accept事件 if (ngx_enable_accept_events((ngx_cycle_t *) ngx_cycle) != NGX_OK) { return; } ev->timedout = 0; } // 获取解析event核心配置结构体 ecf = ngx_event_get_conf(ngx_cycle->conf_ctx, ngx_event_core_module); if (!(ngx_event_flags & NGX_USE_KQUEUE_EVENT)) { ev->available = ecf->multi_accept; } lc = ev->data; ls = lc->listening; ev->ready = 0; do { socklen = sizeof(ngx_sockaddr_t); #if (NGX_HAVE_ACCEPT4) if (use_accept4) { s = accept4(lc->fd, &sa.sockaddr, &socklen, SOCK_NONBLOCK); } else { s = accept(lc->fd, &sa.sockaddr, &socklen); } #else // 这里lc->fd指向的是监听的文件句柄,调用accept()获取客户端的连接,并且将其存储到sa.sockaddr中 s = accept(lc->fd, &sa.sockaddr, &socklen); #endif // 检查当前进程获取的连接个数是否超过了最大可用连接数的7/8,是则不再继续接收连接 ngx_accept_disabled = ngx_cycle->connection_n / 8 - ngx_cycle->free_connection_n; // 获取新的连接 c = ngx_get_connection(s, ev->log); // 获取连接失败则直接返回 if (c == NULL) { if (ngx_close_socket(s) == -1) { ngx_log_error(NGX_LOG_ALERT, ev->log, ngx_socket_errno, ngx_close_socket_n " failed"); } return; } // 标记当前为TCP连接 c->type = SOCK_STREAM; // 为当前连接创建连接池 c->pool = ngx_create_pool(ls->pool_size, ev->log); if (c->pool == NULL) { ngx_close_accepted_connection(c); return; } // 更新socklen的长度 if (socklen > (socklen_t) sizeof(ngx_sockaddr_t)) { socklen = sizeof(ngx_sockaddr_t); } // 为sockaddr申请内存空间,并且将客户端连接地址复制到c->sockaddr中 c->sockaddr = ngx_palloc(c->pool, socklen); if (c->sockaddr == NULL) { ngx_close_accepted_connection(c); return; } ngx_memcpy(c->sockaddr, &sa, socklen); // 申请ngx_log_t结构体的内存空间 log = ngx_palloc(c->pool, sizeof(ngx_log_t)); if (log == NULL) { ngx_close_accepted_connection(c); return; } /* set a blocking mode for iocp and non-blocking mode for others */ if (ngx_inherited_nonblocking) { if (ngx_event_flags & NGX_USE_IOCP_EVENT) { // 将连接设置为阻塞模式 if (ngx_blocking(s) == -1) { ngx_log_error(NGX_LOG_ALERT, ev->log, ngx_socket_errno, ngx_blocking_n " failed"); ngx_close_accepted_connection(c); return; } } } else { if (!(ngx_event_flags & NGX_USE_IOCP_EVENT)) { // 将连接设置为非阻塞模式 if (ngx_nonblocking(s) == -1) { ngx_log_error(NGX_LOG_ALERT, ev->log, ngx_socket_errno, ngx_nonblocking_n " failed"); ngx_close_accepted_connection(c); return; } } } *log = ls->log; // 设置连接的基本属性 c->recv = ngx_recv; c->send = ngx_send; c->recv_chain = ngx_recv_chain; c->send_chain = ngx_send_chain; c->log = log; c->pool->log = log; c->socklen = socklen; c->listening = ls; c->local_sockaddr = ls->sockaddr; c->local_socklen = ls->socklen; #if (NGX_HAVE_UNIX_DOMAIN) if (c->sockaddr->sa_family == AF_UNIX) { c->tcp_nopush = NGX_TCP_NOPUSH_DISABLED; c->tcp_nodelay = NGX_TCP_NODELAY_DISABLED; #if (NGX_SOLARIS) /* Solaris's sendfilev() supports AF_NCA, AF_INET, and AF_INET6 */ c->sendfile = 0; #endif } #endif rev = c->read; wev = c->write; wev->ready = 1; if (ngx_event_flags & NGX_USE_IOCP_EVENT) { rev->ready = 1; } if (ev->deferred_accept) { rev->ready = 1; #if (NGX_HAVE_KQUEUE || NGX_HAVE_EPOLLRDHUP) rev->available = 1; #endif } rev->log = log; wev->log = log; // 更新连接使用次数 c->number = ngx_atomic_fetch_add(ngx_connection_counter, 1); // 将网络地址更新为字符串形式的地址 if (ls->addr_ntop) { c->addr_text.data = ngx_pnalloc(c->pool, ls->addr_text_max_len); if (c->addr_text.data == NULL) { ngx_close_accepted_connection(c); return; } c->addr_text.len = ngx_sock_ntop(c->sockaddr, c->socklen, c->addr_text.data, ls->addr_text_max_len, 0); if (c->addr_text.len == 0) { ngx_close_accepted_connection(c); return; } } #if (NGX_DEBUG) { ngx_str_t addr; u_char text[NGX_SOCKADDR_STRLEN]; ngx_debug_accepted_connection(ecf, c); if (log->log_level & NGX_LOG_DEBUG_EVENT) { addr.data = text; addr.len = ngx_sock_ntop(c->sockaddr, c->socklen, text, NGX_SOCKADDR_STRLEN, 1); ngx_log_debug3(NGX_LOG_DEBUG_EVENT, log, 0, "*%uA accept: %V fd:%d", c->number, &addr, s); } } #endif // 将当前连接添加到epoll句柄中进行监控 if (ngx_add_conn && (ngx_event_flags & NGX_USE_EPOLL_EVENT) == 0) { if (ngx_add_conn(c) == NGX_ERROR) { ngx_close_accepted_connection(c); return; } } log->data = NULL; log->handler = NULL; // 建立新连接之后的回调方法 ls->handler(c); if (ngx_event_flags & NGX_USE_KQUEUE_EVENT) { ev->available--; } } while (ev->available); } 这里客户端连接的建立过程主要可以分为如下几个步骤: 首先调用accept()方法获取当前客户端建立的连接,并且将其地址信息保存到结构体sa中; 接着通过调用ngx_get_connection()方法获取一个ngx_connection_t结构体以对应当前获取到的客户端连接,并且会初始化该结构体的各个属性; 调用ngx_add_conn()方法将当前方法添加到epoll句柄中,这里的添加过程本质上就是通过epoll_ctl()方法将当前客户端的连接的文件描述符添加到epoll句柄中,以监听其读写事件; 如此我们就讲解了从epoll句柄的创建,到指定的端口的监听,接着处理客户端连接,并且将客户端连接对应的文件描述符继续添加到epoll句柄中以监听读写事件的流程。下面我们继续来看一下nginx是如何等待所监听的这些句柄上的事件的发生的,也即整个事件框架的驱动程序。worker进程对于事件的处理,主要在ngx_process_events_and_timers()方法中,如下是该方法的源码: void ngx_process_events_and_timers(ngx_cycle_t *cycle) { // 尝试获取共享锁 if (ngx_trylock_accept_mutex(cycle) == NGX_ERROR) { return; } // 这里开始处理事件,对于kqueue模型,其指向的是ngx_kqueue_process_events()方法, // 而对于epoll模型,其指向的是ngx_epoll_process_events()方法 // 这个方法的主要作用是,在对应的事件模型中获取事件列表,然后将事件添加到ngx_posted_accept_events // 队列或者ngx_posted_events队列中 (void) ngx_process_events(cycle, timer, flags); // 这里开始处理accept事件,将其交由ngx_event_accept.c的ngx_event_accept()方法处理; ngx_event_process_posted(cycle, &ngx_posted_accept_events); // 开始释放锁 if (ngx_accept_mutex_held) { ngx_shmtx_unlock(&ngx_accept_mutex); } // 如果不需要在事件队列中进行处理,则直接处理该事件 // 对于事件的处理,如果是accept事件,则将其交由ngx_event_accept.c的ngx_event_accept()方法处理; // 如果是读事件,则将其交由ngx_http_request.c的ngx_http_wait_request_handler()方法处理; // 对于处理完成的事件,最后会交由ngx_http_request.c的ngx_http_keepalive_handler()方法处理。 // 这里开始处理除accept事件外的其他事件 ngx_event_process_posted(cycle, &ngx_posted_events); } 这里的ngx_process_events_and_timers()方法我们省略了大部分代码,只留下了主要的流程。简而言之,其主要实现了如下几个步骤的工作: 获取共享锁,以得到获取客户端连接的权限; 调用ngx_process_events()方法监听epoll句柄中各个文件描述符的事件,并且处理这些事件。在前面我们讲到,nginx在调用epoll模块的init()方法时,初始化了ngx_event_actions属性的值,将其指向了epoll模块所实现的方法,这里就包括ngx_process_events方法宏所对应的方法,也即ngx_epoll_process_events()方法,因而这里其实就可以理解,ngx_epoll_process_events()方法本质上就是调用epoll_wait()方法等待epoll句柄上所监听的事件的发生; 处理ngx_posted_accept_events队列中的事件,这些事件其实就是前面讲到的客户端建立连接的事件,在ngx_epoll_process_events()方法中获取到事件之后,会判断其是accept事件还是读写事件,如果是accept事件,就会将其添加到ngx_posted_accept_events队列中,如果是读写事件,就会将其添加到ngx_posted_events队列中; 释放共享锁,以让其他的worker进程可以获取锁,从而接收客户端连接; 处理ngx_posted_events队列中的事件,也即客户端连接的读写事件。从这里就可以看出nginx高性能的一个原因,其将accept事件和读写事件放到了两个不同的队列中,accept事件是必须在锁内部处理的,而读写事件则可以异步于accept事件,这提高了nginx处理客户端请求的能力。 下面我们来看一下ngx_epoll_process_events()方法是如何处理epoll句柄中的事件的: static ngx_int_t ngx_epoll_process_events(ngx_cycle_t *cycle, ngx_msec_t timer, ngx_uint_t flags) { int events; uint32_t revents; ngx_int_t instance, i; ngx_uint_t level; ngx_err_t err; ngx_event_t *rev, *wev; ngx_queue_t *queue; ngx_connection_t *c; /* NGX_TIMER_INFINITE == INFTIM */ ngx_log_debug1(NGX_LOG_DEBUG_EVENT, cycle->log, 0, "epoll timer: %M", timer); // 通过epoll_wait()方法进行事件的获取,获取到的事件将存放在event_list中,并且会将获取的事件个数返回 events = epoll_wait(ep, event_list, (int) nevents, timer); err = (events == -1) ? ngx_errno : 0; // 这里的ngx_event_timer_alarm是通过一个定时器任务来触发的,在定时器中会将其置为1, // 从而实现定期更新nginx缓存的时间的目的 if (flags & NGX_UPDATE_TIME || ngx_event_timer_alarm) { ngx_time_update(); } if (err) { if (err == NGX_EINTR) { if (ngx_event_timer_alarm) { ngx_event_timer_alarm = 0; return NGX_OK; } level = NGX_LOG_INFO; } else { level = NGX_LOG_ALERT; } ngx_log_error(level, cycle->log, err, "epoll_wait() failed"); return NGX_ERROR; } // 获取的事件个数为0 if (events == 0) { // 如果当前时间类型不为NGX_TIMER_INFINITE,说明获取事件超时了,则直接返回 if (timer != NGX_TIMER_INFINITE) { return NGX_OK; } // 这里说明时间类型为NGX_TIMER_INFINITE,但是却返回了0个事件,说明epoll_wait()调用出现了问题 ngx_log_error(NGX_LOG_ALERT, cycle->log, 0, "epoll_wait() returned no events without timeout"); return NGX_ERROR; } // 遍历各个事件 for (i = 0; i < events; i++) { // 每个事件的data.ptr中存储了当前事件对应的connection对象 c = event_list[i].data.ptr; // 获取事件中存储的instance的值 instance = (uintptr_t) c & 1; // 获取connection指针地址值 c = (ngx_connection_t *) ((uintptr_t) c & (uintptr_t) ~1); // 获取读事件结构体 rev = c->read; // 如果当前连接的文件描述符为-1,获取其instance不等于当前事件的instance, // 说明该连接已经过期了,则不对该事件进行处理 if (c->fd == -1 || rev->instance != instance) { /* * the stale event from a file descriptor * that was just closed in this iteration */ ngx_log_debug1(NGX_LOG_DEBUG_EVENT, cycle->log, 0, "epoll: stale event %p", c); continue; } // 获取当前事件监听的类型 revents = event_list[i].events; ngx_log_debug3(NGX_LOG_DEBUG_EVENT, cycle->log, 0, "epoll: fd:%d ev:%04XD d:%p", c->fd, revents, event_list[i].data.ptr); // 如果事件发生错误,则打印相应的日志 if (revents & (EPOLLERR | EPOLLHUP)) { ngx_log_debug2(NGX_LOG_DEBUG_EVENT, cycle->log, 0, "epoll_wait() error on fd:%d ev:%04XD", c->fd, revents); /* * if the error events were returned, add EPOLLIN and EPOLLOUT * to handle the events at least in one active handler */ revents |= EPOLLIN | EPOLLOUT; } #if 0 if (revents & ~(EPOLLIN|EPOLLOUT|EPOLLERR|EPOLLHUP)) { ngx_log_error(NGX_LOG_ALERT, cycle->log, 0, "strange epoll_wait() events fd:%d ev:%04XD", c->fd, revents); } #endif // 如果当前是读事件,并且事件是活跃的 if ((revents & EPOLLIN) && rev->active) { #if (NGX_HAVE_EPOLLRDHUP) if (revents & EPOLLRDHUP) { rev->pending_eof = 1; } rev->available = 1; #endif // 将事件标记为就绪状态 rev->ready = 1; // 默认是开启了NGX_POST_EVENTS开关的 if (flags & NGX_POST_EVENTS) { // 如果当前是accept事件,则将其添加到ngx_posted_accept_events队列中, // 如果是读写事件,则将其添加到ngx_posted_events队列中 queue = rev->accept ? &ngx_posted_accept_events : &ngx_posted_events; ngx_post_event(rev, queue); } else { // 如果不需要分离accept和读写事件,则直接处理该事件 rev->handler(rev); } } // 获取写事件结构体 wev = c->write; if ((revents & EPOLLOUT) && wev->active) { // 如果当前连接的文件描述符为-1,获取其instance不等于当前事件的instance, // 说明该连接已经过期了,则不对该事件进行处理 if (c->fd == -1 || wev->instance != instance) { /* * the stale event from a file descriptor * that was just closed in this iteration */ ngx_log_debug1(NGX_LOG_DEBUG_EVENT, cycle->log, 0, "epoll: stale event %p", c); continue; } // 将当前事件标记为就绪状态 wev->ready = 1; #if (NGX_THREADS) wev->complete = 1; #endif // 由于是写事件,并且需要标记为了NGX_POST_EVENTS状态, // 因而将其直接添加到ngx_posted_events队列中,否则直接处理该事件 if (flags & NGX_POST_EVENTS) { ngx_post_event(wev, &ngx_posted_events); } else { wev->handler(wev); } } } return NGX_OK; } 这里ngx_epoll_process_events()方法首先就是调用epoll_wait()方法获取所监听的句柄的事件,然后遍历获取的事件,根据事件的类型,如果是accept事件,则添加到ngx_posted_accept_events队列中,如果是读写事件,则添加到ngx_posted_events队列中,而队列中事件的处理,则在上面介绍的ngx_process_events_and_timers()方法中进行。 4. 小结 本文首先对epoll模型的实现原理进行了讲解,然后从源码的层面对nginx是如何基于epoll模型实现事件驱动模式的原理进行了讲解。 5. 广告 读者朋友如果觉得本文还不错,可以点击下面的广告链接,这可以为作者带来一定的收入,从而激励作者创作更好的文章,非常感谢! 在项目开发过程中,企业会有很多的任务、需求、缺陷等需要进行管理,CORNERSTONE 提供敏捷、任务、需求、缺陷、测试管理、WIKI、共享文件和日历等功能模块,帮助企业完成团队协作和敏捷开发中的项目管理需求;更有甘特图、看板、思维导图、燃尽图等多维度视图,帮助企业全面把控项目情况。

优秀的个人博客,低调大师

每日一博 | Java 8 Stream 的终极技巧——Collectors 操作

1. 前言 昨天在 Collection移除元素操作 相关的文章中提到了 Collectors 。相信很多同学对这个比较感兴趣,那我们今天就来研究一下 Collectors 。 2. Collectors 的作用 Collectors 是 Java 8 加入的操作类,位于 java.util.stream 包下。它会根据不同的策略将元素收集归纳起来,比如最简单常用的是将元素装入Map、Set、List 等可变容器中。特别对于 Java 8 Stream Api 来说非常有用。它提供了collect() 方法来对 Stream 流进行终结操作派生出基于各种策略的结果集。我们就借助于 Stream 来熟悉一下 Collectors 吧。我们依然用昨天的例子: List<String> servers = new ArrayList<>(); servers.add("Felordcn"); servers.add("Tomcat"); servers.add("Jetty"); servers.add("Undertow"); servers.add("Resin"); 3. Java 8 中 Collectors 的方法 Collectors 提供了一系列的静态方法供我们使用,通常情况我们静态导入即可使用。接下来我们来看看都提供了哪些方法吧。 3.1 类型归纳 这是一个系列,作用是将元素分别归纳进可变容器 List、Map、Set、Collection 或者ConcurrentMap 。 Collectors.toList(); Collectors.toMap(); Collectors.toSet(); Collectors.toCollection(); Collectors.toConcurrentMap(); 我们可以根据以上提供的 API 使用 Stream 的 collect 方法中的转换为熟悉的集合容器。非常简单这里不再演示。 3.2 joining 将元素以某种规则连接起来。该方法有三种重载 joining(CharSequence delimiter) 和 joining(CharSequence delimiter,CharSequence prefix,CharSequence suffix) // 输出 FelordcnTomcatJettyUndertowResin servers.stream().collect(Collectors.joining()); // 输出 Felordcn,Tomcat,Jetty,Undertow,Resin servers.stream().collect(Collectors.joining("," )); // 输出 [Felordcn,Tomcat,Jetty,Undertow,Resin] servers.stream().collect(Collectors.joining(",", "[", "]")); 用的比较多的是读取 HttpServletRequest 中的 body : HttpServletRequest.getReader().lines().collect(Collectors.joining()); 3.3 collectingAndThen 该方法先执行了一个归纳操作,然后再对归纳的结果进行 Function 函数处理输出一个新的结果。 // 比如我们将servers joining 然后转成大写,结果为: FELORDCN,TOMCAT,JETTY,UNDERTOW,RESIN servers.stream.collect(Collectors.collectingAndThen(Collectors.joining(","), String::toUpperCase)); 3.4 groupingBy 按照条件对元素进行分组,和 SQL 中的 group by 用法有异曲同工之妙,通常也建议使用 Java 进行分组处理以减轻数据库压力。groupingBy 也有三个重载方法 我们将 servers 按照长度进行分组: // 按照字符串长度进行分组 符合条件的元素将组成一个 List 映射到以条件长度为key 的 Map<Integer, List<String>> 中 servers.stream.collect(Collectors.groupingBy(String::length)) 如果我不想 Map 的 value 为 List 怎么办? 上面的实现实际上调用了下面的方式: //Map<Integer, Set<String>> servers.stream.collect(Collectors.groupingBy(String::length, Collectors.toSet())) 我要考虑同步安全问题怎么办? 当然使用线程安全的同步容器啊,那前两种都用不成了吧! 别急! 我们来推断一下,其实第二种等同于下面的写法: Supplier<Map<Integer,Set<String>>> mapSupplier = HashMap::new; Map<Integer,Set<String>> collect = servers.stream.collect(Collectors.groupingBy(String::length, mapSupplier, Collectors.toSet())); 这就非常好办了,我们提供一个同步 Map 不就行了,于是问题解决了: Supplier<Map<Integer, Set<String>>> mapSupplier = () -> Collections.synchronizedMap(new HashMap<>()); Map<Integer, Set<String>> collect = servers.stream.collect(Collectors.groupingBy(String::length, mapSupplier, Collectors.toSet())); 其实同步安全问题 Collectors 的另一个方法 groupingByConcurrent 给我们提供了解决方案。用法和 groupingBy 差不多。 3.5 partitioningBy partitioningBy 我们在本文开头的提到的文章中已经见识过了,可以看作 groupingBy 的一个特例,基于断言(Predicate)策略分组。这里不再举例说明。 3.6 counting 该方法归纳元素的的数量,非常简单,不再举例说明。 3.7 maxBy/minBy 这两个方法分别提供了查找大小元素的操作,它们基于比较器接口 Comparator 来比较 ,返回的是一个 Optional 对象。 我们来获取 servers 中最小长度的元素: // Jetty Optional<String> min = servers.stream.collect(Collectors.minBy(Comparator.comparingInt(String::length))); 这里其实 Resin 长度也是最小,这里遵循了 "先入为主" 的原则 。当然 Stream.min() 可以很方便的获取最小长度的元素。maxBy 同样的道理。 3.8 summingInt/Double/Long 用来做累加计算。计算元素某个属性的总和,类似 Mysql 的 sum 函数,比如计算各个项目的盈利总和、计算本月的全部工资总和等等。我们这里就计算一下 servers 中字符串的长度之和 (为了举例不考虑其它写法)。 // 总长度 32 servers.stream.collect(Collectors.summingInt(s -> s.length())); 3.9 summarizingInt/Double/Long 如果我们对 3.6章节-3.8章节 的操作结果都要怎么办?难不成我们搞5个 Stream 流吗? 所以就有了 summarizingInt、summarizingDouble、summarizingLong 三个方法。 这三个方法通过对元素某个属性的提取,会返回对元素该属性的统计数据对象,分别对应 IntSummaryStatistics、DoubleSummaryStatistics、LongSummaryStatistics。我们对 servers 中元素的长度进行统计: DoubleSummaryStatistics doubleSummaryStatistics = servers.stream.collect(Collectors.summarizingDouble(String::length)); // {count=5, sum=32.000000, min=5.000000, average=6.400000, max=8.000000} System.out.println("doubleSummaryStatistics.toString() = " + doubleSummaryStatistics.toString()); 结果 DoubleSummaryStatistics 中包含了 总数,总和,最小值,最大值,平均值 五个指标。 3.10 mapping 该方法是先对元素使用 Function 进行再加工操作,然后用另一个Collector 归纳。比如我们先去掉 servers 中元素的首字母,然后将它们装入 List 。 // [elordcn, omcat, etty, ndertow, esin] servers.stream.collect(Collectors.mapping(s -> s.substring(1), Collectors.toList())); 有点类似 Stream 先进行了 map 操作再进行 collect : servers.stream.map(s -> s.substring(1)).collect(Collectors.toList()); 3.11 reducing 这个方法非常有用!但是如果要了解这个就必须了解其参数 BinaryOperator<T> 。 这是一个函数式接口,是给两个相同类型的量,返回一个跟这两个量相同类型的一个结果,伪表达式为 (T,T) -> T。默认给了两个实现 maxBy 和 minBy ,根据比较器来比较大小并分别返回最大值或者最小值。当然你可以灵活定制。然后 reducing 就很好理解了,元素两两之间进行比较根据策略淘汰一个,随着轮次的进行元素个数就是 reduce 的。那这个有什么用处呢? Java 官方给了一个例子:统计每个城市个子最高的人。 Comparator<Person> byHeight = Comparator.comparing(Person::getHeight); Map<String, Optional<Person>> tallestByCity = people.stream() .collect(Collectors.groupingBy(Person::getCity, Collectors.reducing(BinaryOperator.maxBy(byHeight)))); 结合最开始给的例子你可以使用 reducing 找出最长的字符串试试。 上面这一层是根据 Height 属性找最高的 Person ,而且如果这个属性没有初始化值或者没有数据,很有可能拿不到结果所以给出的是 Optional<Person>。 如果我们给出了 identity 作一个基准值,那么我们首先会跟这个基准值进行 BinaryOperator 操作。 比如我们给出高于 2 米 的人作为 identity。 我们就可以统计每个城市不低于 2 米 而且最高的那个人,当然如果该城市没有人高于 2 米则返回基准值identity : Comparator<Person> byHeight = Comparator.comparing(Person::getHeight); Person identity= new Person(); identity.setHeight(2.); identity.setName("identity"); Map<String, Person> collect = persons.stream() .collect(Collectors.groupingBy(Person::getCity, Collectors.reducing(identity, BinaryOperator.maxBy(byHeight)))); 这时候就确定一定会返回一个 Person 了,最起码会是基准值identity 不再是 Optional 。 还有些情况,我们想在 reducing 的时候把 Person 的身高先四舍五入一下。这就需要我们做一个映射处理。定义一个 Function<? super T, ? extends U> mapper 来干这个活。那么上面的逻辑就可以变更为: Comparator<Person> byHeight = Comparator.comparing(Person::getHeight); Person identity = new Person(); identity.setHeight(2.); identity.setName("identity"); // 定义映射 处理 四舍五入 Function<Person, Person> mapper = ps -> { Double height = ps.getHeight(); BigDecimal decimal = new BigDecimal(height); Double d = decimal.setScale(1, BigDecimal.ROUND_HALF_UP).doubleValue(); ps.setHeight(d); return ps; }; Map<String, Person> collect = persons.stream() .collect(Collectors.groupingBy(Person::getCity, Collectors.reducing(identity, mapper, BinaryOperator.maxBy(byHeight)))); 4. 总结 今天我们对 Java 8 中的 Collectors 进行了详细的讲解。如果你熟悉了 Collectors 操作 Stream 会更加得心应手。当然在 Java 8 之后的 Java 9 和 Java 12 中 Collectors 都有新增的功能, 后面有时间我们会继续进行讲解。敬请关注! 关注公众号:Felordcn获取更多资讯 个人博客:https://felord.cn

优秀的个人博客,低调大师

每日一博 | 记一次 Kafka 集群线上扩容

前段时间收到某个 Kafka 集群的生产客户端反馈发送消息耗时很高,于是花了一段时间去排查这个问题,最后该集群进行扩容,由于某些主题的当前数据量实在太大,在对这些主题迁移过程中话费了很长一段时间,不过这个过程还算顺利,因为在迁移过程中也做足了各方面的调研,包括分区重平衡过程中对客户端的影响,以及对整个集群的性能影响等,特此将这个过程总结一下,也为双十一打了一剂强心剂。 排查问题与分析 接到用户的反馈后,我用脚本测试了一遍,并对比了另外一个正常的 Kafka 集群,发现耗时确实很高,接下来 经过排查,发现有客户端在频繁断开与集群节点的连接,发现日志频繁打印如下内容: Attempting to send response via channel for which there is no open connection, connection id xxx(kafka.network.Processor) 定位到源码位置: kafka.network.Processor#sendResponse: 看源码注释,是远程连接关闭了或者空闲时间太长了的意思,找到具体客户端负责人,经询问后,这是大数据 Spark 集群的节点。 从以上日志看出,Spark 集群的某个消费组 OrderDeliveryTypeCnt,竟然发生了近 4 万次重平衡操作,这显然就是一个不正常的事件,Kafka 消费组发生重平衡的条件有以下几个: 消费组成员发生变更,有新消费者加入或者离开,或者有消费者崩溃; 消费组订阅的主题数量发生变更; 消费组订阅的分区数发生变更。 很显然第 2、3 点都没有发生,那么可以断定,这是 Spark集群节点频繁断开与kafka的连接导致消费组成员发生变更,导致消费组发生重平滑。 那为什么 Spark 集群会产生频繁断开重连呢? 查看 Spark 集群用的 Kafka 版本还是 0.10.1.1 版本,而 Kafka 集群的版本为 2.2.1,一开始以为是版本兼容问题,接着数据智能部的小伙伴将 Spark 集群连接到某个版本为 0.11.1.1 的 Kafka 集群,使用 8 个 Spark 任务消费进行消费,同样发现了连接断开的问题。说明此问题是由于 Spark 内部消费 Kafka 机制导致的,和 kafka 版本关系不大。 经过几番跟大数据的人员讨论,这个频繁重平衡貌似是 Spark 2.3 版本内部机制导致的,Spark 2.4 版本没有这个问题存在。 由于这个频繁断开重连,并不是开发人员开发过程中导致的,考虑到双十一临近,不能贸然升级改动项目,那么现在最好的方案就是对集群进行水平扩展,增加集群的负载能力,并对专门的主题进行分区重分配。 分区重分配方案的分析 目前集群一共有 6 个节点,扩容以 50% 为基准,那么需要在准备 3 个节点,在运维准备好机器并且将其加入到集群中后,接下来就要准备对主题进行分区重分配的策略文件了。 在执行分区重分配的过程中,对集群的影响主要有两点: 分区重分配主要是对主题数据进行 Broker 间的迁移,因此会占用集群的带宽资源; 分区重分配会改变分区 Leader 所在的 Broker,因此会影响客户端。 针对以上两点,第 1 点可以在晚间进行(太苦逼了,记得有个主题数据迁移进行了将近5小时),针对第二点,我想到了两个方案: 整个分配方案分成两个步骤:1)手动生成分配方案,对原有的分区 Leader 位置不改变,只对副本进行分区重分配;2)等待数据迁移完成后,再手动更改分区分配方案,目的是均衡 Leader。 直接用 Kafka 提供的 API 生成 分区重分配方案,直接执行分区重分配。 第一个方案理论上是对客户端影响最小的,把整个分配方案分成了两个步骤,也就是将对集群的带宽资源与客户端的影响分开了,对过程可控性更高了,但问题来了,集群中的某些主题,有 64 个分区,副本因子为 3,副本一共有 192 个,你需要保持原有分区 Leader 位置不变的情况下,去手动均衡其余副本,这个考验难度真的太大了,稍微有一点偏差,就会造成副本不均衡。 因此我特意去看了分区重分配的源码,并对其过程进行了进一步分析,发现分配重分配的步骤是将分区原有的副本与新分配的副本的集合,组成一个分区副本集合,新分配的副本努力追上 Leader 的位移,最终加入 ISR,待全部副本都加入 ISR 之后,就会进行分区 Leader 选举,选举完后就会将原有的副本删除,具体细节我会单独写一篇文章。 根据以上重分配的步骤,意味着在数据进行过程中不会发生客户端阻塞,因为期间 Leader 并没有发生变更,在数据迁移完成进行 Leader 选举时才会,但影响不大,针对这点影响我特意用脚本测试了一下: 可以发现,在发送过程中,如果 Leader 发生了变更,生产者会及时拉取最新的元数据,并重新进行消息发送。 针对以上的分析与测试,我们决定采取第二种方案,具体步骤如下: 对每个主题生成分配分区分配策略:执行时间段(10:00-17:00),并对分配策略进行检查,并保存执行的 topic1_partition_reassignment.json 文件,并把原来的方案保存到topic1_partition_reassignment_rollback.json 文件中,以备后续的 rollback 操作; 执行分配策略:执行时间段(00:30-02:30),准备好的 topic1_partition_reassignment.json 文件,执行完再验证并查看副本分配情况,每执行一个分配策略都要查看 ISR 收缩扩张状况、消息流转状况,确定没问题后再执行下一个分配策略; 由于集群 broker 端的参数 auto.leader.rebalance.enable=true,因此会自动执行 Preferred Leader 选举,默认时间间隔为 300 秒,期间需要观察 Preferred Leader 选举状况。 分区重分配 对于新增的 Broker,Kafka 是不会自动地分配已有主题的负载,即不会将主题的分区分配到新增的 Broker,但我们可以通过 Kafka 提供的 API 对主题分区进行重分配操作,具体操作如下: 生成需要执行分区重分配的主题列表 json 文件: echo '{"version":1,"topics":[{"topic":"sjzn_spark_binlog_order_topic"}]}' > sjzn_spark_binlog_order_topic.json 生成主题的分配方案: bin/kafka-reassign-partitions.sh --zookeeper --zookeeper xxx.xxx.xx.xxx:2181,xxx.xxx.xx.xxx:2181,xxx.xxx.xx.xxx:2181 --topics-to-move-json-file sjzn_spark_binlog_order_topic.json --broker-list "0,1,2,3,4,5,6,7,8" --generate 由于主题的有64个分区,每个分区3个副本,生成的分配数据还是挺大的,这里就不一一贴出来了 将分配方案保存到一个 json 文件中: echo '{"version":1,"partitions":[{"topic":"sjzn_spark_binlog_order_topic","partition":59,"replicas":[4,8,0],"log_dirs":["any","any","any"]} ......' > sjzn_spark_binlog_order_topic_reassignment.json 执行分区重分配: bin/kafka-reassign-partitions.sh --zookeeper xxx.xxx.xx.xxx:2181,xxx.xxx.xx.xxx:2181,xxx.xxx.xx.xxx:2181 --reassignment-json-file sjzn_spark_binlog_order_topic_reassignment.json --execute 验证分区重分配是否执行成功: bin/kafka-reassign-partitions.sh --zookeeper xxx.xxx.xx.xxx:2181,xxx.xxx.xx.xxx:2181,xxx.xxx.xx.xxx:2181 --reassignment-json-file sjzn_spark_order_unique_topic_resign.json --verify 由于该主题存在的数据量特别大,整个重分配过程需要维持了好几个小时: 在它进行数据迁移过程中,我特意去 kafka-manage 控制台观察了各分区数据的变动情况: 从控制台可看出,各分区的副本数目基本都增加了,这也印证了分区当前的副本数等于原有的副本加上新分配的副本的集合,新分配的副本集合目前还没追上 Leader 的位移,因此没有加入 ISR 列表。 有没有注意到一点,此时各分区的 Leader 都不在 Preferred Leader 中,因此后续等待新分配的副本追上 ISR 后,会进行新一轮的 Preferred Leader 选举,选举的细节实现我会单独写一篇文章去分析,敬请期待。 过一段时间后,发现位移已经改变了: 从这点也印证了在分区重分配过程中,只要 Leader 没有发生变更,客户端是可以持续发送消息给分区 Leader 的。 从上图可看出,新分配的副本追上 Leader 的位移后,就会加入 ISR 列表中。 现在去看看集群带宽负载情况: 从上图中可看出,在迁移过程中,新分配的副本不断地从 Leader 拉取数据,占用了集群带宽。 主题各分区重分配完成后的副本情况: 从以上图中可看出,各分区的新分配的副本都已经全部在 ISR 列表中了,并且将旧分配的副本删除,经过 Preferred Leader 选举之后,各分区新分配副本的 Preferred Leader 大多数成为了该分区 leader。 更多精彩文章请关注作者维护的公众号「后端进阶」,这是一个专注后端相关技术的公众号。 关注公众号并回复「后端」免费领取后端相关电子书籍。 欢迎分享,转载请保留出处。

优秀的个人博客,低调大师

每日一博 | 产品经理如何驱动产品安全建设

一、序言 本文从产品经理的角度出发,对产品经理的安全职责、产品驱动安全的内涵、工作内容、工作方法、所需安全资源、以及产品经理的安全工作量进行了分析。希望所有产品经理在没有心理负担的情况下,有目标、有方法、有资源推进产品安全建设。 二、背景 安全是软件产品天然属性的一部分,“无安全不金融”,对于金融软件产品而言,安全尤为重要,因为客户总是能够从各种安全漏洞联想到他的金融资产安全和个人信息安全。以前偶尔会在一些安全沙龙或峰会听见同行吐槽,“信息安全说起来重要、做起来次要、忙起来不要”。吐槽背后的原因很复杂,其中很重要的一点是跟产品经理安全意识淡薄、不清楚如何推进产品安全建设有关,比如不重视产品安全属性、产品安全需求不明确、产品安全资源不充分、产品安全建设无从下手等。本文主要站在产品经理的角度,从产品经理能力维度出发,探讨产品经理如何推动产品的安全性建设。 众所周知,安全性作为软件产品的天然属性,从产品定义与规划角度来看,产品经理对产品安全负有不可推卸的责任,但产品经理如何履行自己的安全职责,业界还没有给出一个清晰可行的行动方案。 目前,软件产品安全需求通常是基于开发人员和安全人员的职业常识提出相应的解决方案,比如目前业内比较通用的敏感信息五要素分析方法: 1 2 3 4 5 姓名 身份证号 电话号码 银行卡信息 联系地址 这种方法简单易行,但往往不能涵盖所有的敏感信息,比如 用户的多系统用户数据关联ID(超级ID)。 交易过程中的音视频等多媒体数据。 各种非结构化的文档数据,如合同扫描件。 用户的行为画像数据等内容。 这些信息均为有价值的敏感数据,显然不属于前述的敏感数据范围,但往往没有明确的防护要求。从特定业务场景出发,产品经理对敏感数据范围及其业务价值最有发言权。 三、安全部门的尴尬 前述的敏感信息五要素分析方法是典型的安全驱动产品的方法,即安全部门推动产品相关各团队的安全工作开展。这种模式存在很多弊端,比如: 安全需求可能不完整,职业常识代替不了特定业务场景的深度分析; 产品各团队的安全工作资源无法保证,研发团队有理由认为安全团队干扰研发计划,研发进度与资源不变的情况下,额外增加了工作量; 安全部门通常没机会参与制订研发计划,产品研发计划与安全脱节; 安全团队高度依赖话语权,强制性驱动往往陷入窘境。 (图1 安全驱动产品) 众多的安全实践表明,安全驱动产品的思路与方法存在众多弊端,如果反过来,产品驱动安全,让产品经理明晰自己的安全职责、主动推动产品的安全建设,就会产生对比鲜明的效果。 四、产品驱动安全的合理性 产品驱动安全并非意味着产品经理单一角色推动产品的安全建设,而是说产品经理主动承担相应的产品安全责任,主动与安全部门一起推动产品的安全建设,由安全驱动产品的单轮驱动转变为产品驱动安全的双轮驱动。如下图所示: (图2 产品驱动安全) 安全是软件产品的天然属性,是产品经理职责的一部分。同时产品经理作为产品规划演进与研发资源投入的指挥棒,可以保证研发团队在安全上的适度投入。通过简单分析,产品经理承担产品安全责任,主动推动产品安全建设应该是十分合理的逻辑。 五、产品如何驱动安全 产品经理有意愿做好产品安全,可能会问如下几个问题: 内容方面,产品经理需要做哪些安全工作; 能力方面,为了完成这些工作,产品经理需要具备什么样的安全能力; 方法方面,这些安全工作如何做,才能既兼顾产品业务功能研发与安全,又能保持研发敏捷性和项目管理流程不变形; 安全资源,从安全部门和其他部门可以获取哪些安全支持,来提升自己和研发团队安全工作的效率和效果,降低安全工作的能力门槛; 工作负担,安全工作会不会让产品经理很辛苦,影响其工作品质和生活品质。 为产品经理解决了以上问题,消除其后顾之忧,产品经理才有可能大概率地拥抱安全,从根本上解决研发与安全间的矛盾。 六、产品经理的安全工作内容 产品经理的安全工作内容大致如下: 明确产品安全需求; 保障安全研发资源,将安全工作设定到研发计划中,并分拨足够的安全研发资源; 推动研发团队安全能力建设,确保研发计划中的安全工作执行到位; 整合周边安全资源,确保研发计划中的安全工作执行到位。 (图3 产品经理的安全工作内容) 6.1 明确产品安全需求 产品安全需求是指站在业务角度,软件产品需要满足的数据安全需求、业务合规需求和业务连续性要求,它是业务安全需求的一部分。本文描述的产品安全需求通常包括: 产品承载的业务数据安全防护需求,主要关注点是业务数据的机密性和完整性。 产品相关信息的安全监管要求,如等级保护、行业信息安全监管等要求。 产品承载的业务连续性要求。由于通常由数据中心或运维部门统一牵头实施该项任务,本文将不会展开描述该项内容。 (图4 产品安全需求) 6.2 产品数据安全需求 产品数据安全需求是指系统安全体系应确保恰当的用户在恰当的时间与地点以恰当的途径用恰当的动作访问恰当的数据,确保其承载数据的机密性、完整性和可用性。即系统安全体系应确保类似于白名单的合法访问行为清单,只要属于清单范围内的行为均为合法行为,白名单行为之外的行为都是默认不恰当的数据访问行为,需要安全措施进行预防,本文称之为黑名单行为。 由于黑名单行为通常为黑客攻击行为,其典型行为的分析与罗列需要较强的攻防技术背景,不在业务人员和产品经理能力范围之内,需要安全专家根据产品运行环境进行分析,所以本文要求产品经理明确的产品安全需求通常为其白名单部分,黑名单部分需要产品经理组织安全专家和研发专家配合明确。产品设计所包含的各种安全措施主要目标就是确保白名单行为一定成功,黑名单行为一定被预防、监控和审计。 从业务安全角度出发,定义合法数据访问行为之后,还需要有数据访问行为审计手段,帮助业务确保访问行为的正确性,以及对违规的数据访问行为进行审计。 (图5 产品数据安全需求) 基于上文分析,白名单行为清单的明确只需要了解业务模型相关信息就可以做到,对于产品经理而言,不存在能力上的门槛。过程中产品经理需要明确的数据包括: ID 内容 说明 1 合法用户清单 系统用户类别、办公地点与访问方式,用户类别应包括有接口调用关系的对端系统 2 敏感数据清单 敏感数据范围与清单,及其分类、分级说明 3 业务访问行为清单 系统用户与敏感数据之间的访问映射关系与操作方式清单 4 敏感行为清单 需要记录业务操作日志的最小集合,为业务审计提供依据,该清单与上面的业务访问行为清单基本重合 在明确上述信息的过程中,产品经理应遵循如下两个原则: ID 原则 解释 1 最小权限 将用户对数据的访问操作的方式和动作最小化,如对于某个用户类别,OA网访问可满足业务需求的就不应开放到外网访问,数据脱敏可读可满足业务需求的情况应不开放明文可读或可写权限 2 知所必需 将用户的数据访问范围最小化,如对于某个用户类别,单个文件访问可以满足业务需求,决不开放2个或多个文件访问 设计人员可以根据该白名单进行权限管理与访问控制模型设计,测试人员可以将白名单作为数据安全测试基线,任何违背白名单的测试发现均为系统的安全bug,比如: 敏感数据未脱敏。 多余的数据操作权限。 横向或纵向数据访问越权。 关键行为的日志痕迹缺失。 6.3 合规性需求 合规性需求是指由于系统运行地点、服务网络以及客户所在地区或国家相关部门,对服务提供模式、数据安全以及业务连续性提出了限制性要求。目前公司系统所面对的主要监管要求包括: ID 监管要求 监管层级 1 网络安全法及其两高释法(国家) 国家 2 信息系统等级保护(公安部) 公安部 3 个人信息保护规范(工信部) 工信部 4 GDPR(涉及到服务欧盟公民的相关IT服务) 欧盟 2019年国家相关部门提出了一系列App收集个人信息相关监管要求: ID 名称 时间 发文部门 1 关于开展App违法违规收集使用个人信息专项治理的公告 2019/1/25 中央网信办、工业和信息化部、公安部、市场监管总局 2 移动互联网应用基本业务功能必要信息规范 2019/6/1 全国信息安全标准化技术委员会 3 App违法违规收集使用个人信息自评估指南 2019/3/1 APP专项治理工作组 4 App违法违规收集使用个人信息行为认定方法(征求意见稿) 2019/5/5 APP专项治理工作组 5 信息安全技术 移动互联网应用程序(App)收集个人信息基本规范(草案) 2019/10/25 全国信息安全标准化技术委员会 6 关于开展APP侵害用户权益专项整治工作的通知 2019/11/6 工业和信息化部 在产品经理罗列出合规要求、安全部得到相关部门的权威解释后,与产品线沟通建议各种安全措施设计,将会在很大程度上满足IT安全合规要求。等级保护相关要求为所有系统需要面对的共通要求,无需产品经理罗列,安全部可以直接解释。 关于具体安全需求的定义与维护方法,笔者将通过其他文章进行说明。 七、产品经理安全能力分析与建设 分析产品经理的安全工作内容,最主要的考验来自于明确业务安全需求的四个清单。相关安全能力分析如下表: ID 产品经理安全需求工作内容 能力分析 1 明确合法用户清单 无需额外能力,需要描述模板支持 2 明确敏感数据清单 需要理解安全基础概念,在指定敏感数据安全等级时,需要敏感数据分类分级标准支持,需要模板支持 3 明确业务访问行为清单 无需额外能力,需要描述模板支持 4 明确敏感行为清单 无需额外能力,需要描述模板支持 产品经理其他安全开发工作所需能力分析如下: ID 工作内容 能力分析 1 保障安全研发资源 在产品迭代研发计划中增加安全相关活动与环节,并指定责任人。计划制订本身无需额外能力,但在安排相关安全活动时,为保持开发的敏捷性和现有的项目管理机制不变形,需要安全、质量管理和项目管理等部门提供方法论支持。需要产品经理有一定的安全意识。 2 推动研发团队安全能力建设 为了保证迭代研发计划中的活动执行成功,研发团队(设计、开发和测试)需要较高的安全意识和一些基础的安全能力,如安全设计、安全编码和安全测试。安全部应统筹各团队的安全能力建设需求,提供相关安全能力建设支持。需要产品经理有一定的安全意识。 3 整合周边安全资源 为了保证迭代研发计划中的活动执行成功,需要整合周边部门的专业性安全服务,比如安全部的各类安全评审服务、威胁建模、代码审计、渗透测试、流量实时监控等服务,基础研发部的SSO平台,运维的统一身份管理服务等等。甚至需要法务与合规等部门的安全支持。安全部门有责任提供和维护一份持续可用的安全服务清单,让产品经理和研发团队知晓服务清单,并知晓何处获取相关安全服务。需要产品经理有一定的安全意识。 综上所述,产品经理要履行相关安全职责,必要的能力和素质是具有较高安全意识,能够理解相关安全基础概念,没有过高的能力门槛,通过一定的安全培训,产品经理完全可以达到相应的能力要求。 八、产品安全研发方法 针对目前敏捷开发与DevOps开发普遍落地的情况,安全开发不应固守与瀑布开发相结合的陈旧经验。因为瀑布开发周期长、资源充分,在繁杂的计划活动中安排一些零星的安全活动不会产生明显的延期压力和资源压力。而敏捷开发和DevOps开发要求快速响应用户需求的同时,兼顾开发质量与效率,如果在迭代计划中设置过重的安全开发活动,迭代开发容易失去敏捷特性。 为了将安全开发理念在敏捷与DevOps开发中得到贯彻,建议采用如下原则: 安全开发活动轻量化。轻量化可以通过工具化、自动化来实现,尽量减少人工耗费大和耗时长的安全开发活动; 安全开发活动分散化。将那些短期无法轻量化处理的安全开发活动分解并分散到多个迭代周期中执行; 安全开发活动并行化。将安全开发相关活动与其他活动并行,如渗透测试通常安排在测试的最后一个环节,避免单轮次渗透测试无法覆盖那些并行的修复点,当然渗透测试也可以由多个轮次来弥补这种情况,但通常资源不允许。实际上这种同步修复导致渗透测试覆盖率下降的问题,完全可以通过良好的沟通和团队文化建设进行弥补。 优化现有敏捷开发与DevOps相关的流程与工具平台,使得安全专家能够充分参与项目,提升安全开发沟通效率,快速获取安全反馈; 将安全专家纳入到敏捷开发和DevOps文化建设中来,信息安全人人有责,安全专家可以充分发挥教练员角色和守门员角色,使得团队人人有能力履行自己的安全职责,安全专家在恰当的时机对安全交付物进行质量把控; 提前进行安全基础设施规划与布局,如身份与权限管理系统、SSO系统、加解密平台与SDK、日志分析与监控平台、全流量检测平台等等,使得安全措施标准化、服务化和平台化,降低安全设计与编码的能力门槛,对安全基础设施的测试与验证取代设施所承载应用的大部分安全测试,可以有效消减安全测试工作量。 对于一些安全开发活动的计划安排示例如下: ID 安全活动名称 迭代执行要求 触发场景与基线示例 1 创建产品安全需求名单 一次性执行 产品原型发布之前 2 维护产品安全需求白名单 每迭代执行 3 评审产品安全需求白名单 多迭代执行 重大需求变更或累积变更开发量达到n人天 4 创建产品数据流图 一次性执行 产品原型发布之前 5 建立威胁初始模型 一次性执行 产品原型发布之前 6 维护威胁模型 每迭代执行 重大需求变更或累积变更开发量达到n人天 7 评审威胁模型 多迭代执行 重大需求变更或累积变更开发量达到n人天 8 安全设计评审 多迭代执行 重大需求变更或累积变更开发量达到n人天 9 代码扫描及其报告分析(开发) 每天/迭代执行 10 代码扫描及其报告分析(安全部) 多迭代执行 重大需求变更或累积变更开发量达到n人天 11 深度黑盒安全扫描 每天/迭代执行 ... ... ... 上表中“多迭代执行”指的是按照一定要求,间隔多个迭代后执行一次。关于多迭代执行的安全活动需要制订一个执行基线,该基线无标准可参考,需要根据各产品线实际情况逐渐摸索调整。 安全活动的触发场景与基线不是固定的,随着团队安全能力与自动化、工具化程度的提高,多迭代执行的安全活动可能转变为每迭代执行;不是所有识别出来的安全活动都必须执行,一切以控制主要安全风险、不拖迭代项目后腿为基准。通常安全团队会与所有产品经理和项目管理进行多次沟通,提出一个多方基本认可的安全活动触发场景与基线表,供产品经理参考。 九、产品经理获取安全资源支持 产品经理在履行各项安全职责时,需要周边部门提供的安全服务与支持包括但不限于: ID 产品经理工作内容 所需资源或服务 提供者 1 明确产品安全需求白名单 敏感数据分类分级标准及其相关模板和Demo;产品安全需求变更发生判断标准 安全部 2 保障安全研发资源 安全活动清单及其迭代基线 安全部&QA 3 推动研发团队安全能力建设 安全培训与实操 安全部 4 整合周边安全资源 安全资源清单,包括安全咨询、评审、培训、开发包、平台或服务 安全部&法务&合规 十、产品经理安全工作压力分析 产品经理安全工作压力分析如下表: ID 产品经理工作内容 产品经理工作压力分析 1 明确产品安全需求白名单 初次创建产品安全需求白名单的4张表格有一定的工作量,但属于一次性工作。产品经理也可以分批次完成,先完善主要信息,其它信息后续择机补充。后续产品安全需求白名单维护工作压力比较小,新增需求或变更只要不触动白名单4张表格的内容,就无需维护。实践表明,产品的用户、数据、访问白名单在经过少数几轮迭代后趋于稳定,很少有机会对表格进行变更。 2 保障安全研发资源 是迭代研发计划制订与推进工作的一部分,无需额外花费时间;每年可能需要花费一天左右的时间参加安全培训,了解安全活动迭代安排基线,了解安全基础概念,了解产品安全需求制订与维护方法。 3 推动研发团队安全能力建设 在研发团队能力建设计划与方案中添加安全相关内容,可能会涉及到一部分预算和人天。能力建设推进过程中可能涉及到一部分参加培训和演练的人天投入,但这部分资源占比应该会较小,构不成明显资源压力。可能存在一些安全部能力暂时无法覆盖的培训,需要外购,比如云安全、移动安全等,产品经理可以独立申请预算,或安全部跟产品线统筹统一申请预算。 4 整合周边安全资源 为解决已知安全问题,很多产品经理日常也在推进该项工作,成为日常沟通协调工作的一部分。主要是将这种被动的、个案化的行动转换为主动的、常态化的工作行为。目前公司有较为清晰的安全责任划分和流程,构不成明显工作压力。 上表描述了产品经理可能会遇到的主要工作内容,但并不是全部内容。整体而言,会增加产品经理一定的工作量,但不会构成明显的工作压力。 十一、小结 产品经理对产品安全负有责任,通过明确产品安全需求中的白名单指明产品安全目标,通过制订安全研发计划、推动团队安全能力建设和协调周边安全资源,实现产品安全落地。 经过简短安全培训后,相关工作均在产品经理能力范畴,工作量不会对产品经理形成心理压力,灵活的安全活动触发标准也不会影响研发的敏捷性。笔者在这里衷心期望各位产品经理放心大胆、勇往直前地拥抱安全,和安全部一起不断地将产品安全推向新高潮。 十二、感悟 在笔者的工作经历中,安全部门为了推动安全工作,总是想着法地“抱大腿”,期望借助外力以推动安全工作,却没有注意到产品经理这个“大腿”,只需觉醒其安全意识,这一“大腿”不仅粗壮有力,而且有着主动拥抱安全的强烈动因。 安全部与产品经理合作,很容易建立基于迭代开发的常态化安全落地机制,而与其他部门合作,例如合规或法务,常常只在特定阶段推动特定安全工作的落地。建议各位应用安全同行和产品经理多多交流,因为:产品经理才是我们安全部最需要拥抱的“大腿”! 作者:危国洪 郭建伟 来源:宜信技术学院

优秀的个人博客,低调大师

每日一博 | 分布式事务——两阶段提交

在分布式系统中,为了保证数据的高可用,通常会将数据保留多个副本(replica), 这些副本会放置在不同的节点上。这些数据节点可能是物理机器,也可能是虚拟机。为了对用户提供正确的CURD等语意,我们需要保证这些放置在不同节点上的副本是一致的,这就涉及分布式事务的问题。 本文介绍分布式事务处理方案之一的两阶段提交协议。 分布式事务 分布式事务是指发生在多个数据节点之间的事务,分布式事务比单机事务要复杂的多。在分布式系统中,各个节点之间在是相互独立的,需要通过网络进行沟通和协调。由于存在事务机制,可以保证每个独立节点上的数据操作可以满足ACID。但是,相互独立的节点之间无法准确地知道其他节点的事务执行情况。所以从理论上来讲,两个节点的数据是无法达到一致的状态。如果想让分布式部署的多个节点中的数据保持一致性,那么就要保证在所有节点数据的写操作,要么全部都执行,要么全部都不执行。但是,一台机器在执行本地事务的时候无法知道其他机器中的本地事务的执行结果,所以它也就不知道本次事务到底应该commit还是rollback。所以,常规的解决办法就是引入一个"协调者"的组件来统一调度所有分布式节点的执行。 为了解决这种分布式一致性问题,前人在性能和数据一致性的反反复复权衡过程中总结了许多典型的协议和算法。其中比较著名的有二阶提交协议(Two Phase Commitment Protocol)、三阶提交协议(Three Phase Commitment Protocol)和Paxos算法。针对分布式事务,是X/Open 这个组织定义的一套分布式事务的标准X/Open DTP(X/Open Distributed Transaction Processing ReferenceModel),定义了规范和API接口,可以由各个厂商进行具体的实现。 大部分的关系型数据库通过两阶段提交(Two Phase Commit,2PC)算法来完成分布式事务,比如Oracle中通过dblink方式进行事务处理。下面重点介绍下2PC算法。 两阶段提交概述 两阶段提交协议最早是分布式事务的专家Jim Gray在1978年的一篇文章Notes on Database Operating Systems中提及。两阶段提交协议可以保证数据的强一致性,即保证了分布式事务的原子性:所有结点要么全做要么全不做。许多分布式关系型数据管理系统采用此协议来完成分布式事务。它是协调所有分布式原子事务参与者,并决定提交或取消(回滚)的分布式算法。同时也是解决一致性问题的算法。该算法能够解决很多的临时性系统故障(包括进程、网络节点、通信等故障),被广泛地使用。但是,它并不能够通过配置来解决所有的故障,在某些情况下它还需要人为的参与才能解决问题。 顾名思义,两阶段提交分为以下两个阶段: 准备阶段(Prepare Phase) 提交阶段(Commit Phase) 在两阶段提交协议中,系统一般包含两类角色: 协调者(Coordinator),通常一个系统中只有一个; 参与者(Participant),一般包含多个,在数据存储系统中可以理解为数据副本的个数。 准备阶段 在准备阶段,协调者将通知事务参与者准备提交或取消事务,写本地的redo和undo日志,但不提交,然后进入表决过程。在表决过程中,参与者将告知协调者自己的决策:同意(事务参与者本地作业执行成功)或取消(本地作业执行故障)。 协调者协议流程如下: 写本地日志“BEGIN_COMMIT”,并进入WAIT状态; 向所有参与者发送“VOTE_REQUEST”消息; 等待并接收参与者发送的对“VOTE_REQUEST”的响应。参与者响应“VOTE_ABORT”或“VOTE_COMMIT”消息给协调者。 提交阶段 在该阶段,协调者将基于第一个阶段的投票结果进行决策:提交或取消。当且仅当所有的参与者同意提交事务协调者才通知所有的参与者提交事务,否则协调者将通知所有的参与者取消事务。参与者在接收到协调者发来的消息后将执行响应的操作。 协调者协议流程如下: 若收到任何一个参与者发送的“VOTE_ABORT”消息; 写本地“GLOBAL_ABORT”日志,进入ABORT状态; 向所有的参与者发送“GLOBAL_ABORT”消息; 若收到所有参与者发送的“VOTE_COMMIT”消息; 写本地“GLOBAL_COMMIT”日志,进入COMMIT状态; 向所有的参与者发送“GLOBAL_COMMIT”消息; 等待并接收参与者发送的对“GLOBAL_ABORT”消息或“GLOBAL_COMMIT”消息的确认响应消息,一旦收到所有参与者的确认消息,写本地“END_TRANSACTION”日志流程结束。 两阶段提交状态机 下图为两阶段提交协议中的协调者及参与者的状态机。左侧a为协调者状态机;右侧b为参与者状态机。 实际案例 MySQL从5.5版本开始支持,SQL Server 2005开始支持,Oracle 7开始支持。 两阶段提交的缺陷 一般情况下,两阶段提交机制都能较好的运行,当在事务进行过程中,有参与者宕机时,重启以后,可以通过询问其他参与者或者协调者,从而知道这个事务到底提交了没有。当然,这一切的前提都是各个参与者在进行每一步操作时,都会事先写入日志。 两阶段提交不能解决的困境如下: 同步阻塞问题。执行过程中,所有参与节点都是事务阻塞型的。当参与者占有公共资源时,其他第三方节点访问公共资源不得不处于阻塞状态。 单点故障。由于协调者的重要性,一旦协调者发生故障,参与者会一直阻塞下去。尤其在第二阶段,协调者发生故障,那么所有的参与者还都处于锁定事务资源的状态中,而无法继续完成事务操作。(如果是协调者挂掉,可以重新选举一个协调者,但是无法解决因为协调者宕机导致的参与者处于阻塞状态的问题) 数据不一致。在二阶段提交的阶段二中,当协调者向参与者发送commit请求之后,发生了局部网络异常或者在发送commit请求过程中协调者发生了故障,这回导致只有一部分参与者接受到了commit请求。而在这部分参与者接到commit请求之后就会执行commit操作。但是其他部分未接到commit请求的机器则无法执行事务提交。于是整个分布式系统便出现了数据不一致性的现象。 参考引用 本文同步至: https://waylau.com/two-phase-commitment-protocol/ Distributed systems: principles and paradigms Notes on Database Operating Systems 分布式系统常用技术及案例分析:https://github.com/waylau/distributed-systems-technologies-and-cases-analysis

优秀的个人博客,低调大师

每日一博 | 谈谈 Act 的依赖注入和模板输出

1. 背景 依赖注入工具 jBeanBox 的作者 drinkjava 同学最近在 gitee 上对 Actframework 项目 提出了如下评论: 首先感谢 drinkjava 同学的意见, 看得出来是问题是认真思考之后提出来的. 本文将就评论中的两段意见分别作答. 在此之前先解释一下上面那段评论中的术语: DI - Dependency Injection - 依赖注入, 反向控制的一个特例, 指在构造对象时对象的(某些)状态不由对象类自身逻辑初始化,由 DI 框架依照环境配置以及状态上的申明注入. AOP - Aspect Oriented Programming - 面向切面编程, 允许使用特定技术将逻辑编织进程序结构中, 逻辑对应程序结构中特定的切点. 2. [意见一] 一个 MVC 工具为什么要引入 DI 依赖注入 你这个DI工具的出发点可能有问题,一个MVC工具为什么要引入DI依赖注入? 这个问题有两个地方值得商榷: 上面这个问题隐含的一个前提假设是 Act 是一个 MVC 工具. 实际上这个前提有一点问题, 我启动 Act 项目的动机是希望弄一个符合自己想法的 PlayFramework V1.x 的后继者. Play 本身除了是一个开发框架,也是一个运行时平台, Act 也是. 单单用 "MVC 工具" 来描述 Act 并不符合我自己的想法. 用 "MVC 工具" 来描述 Act 的依赖 osgl-mvc 更能够贴切一点. MVC 工具为什么不能引入 DI 依赖注入. 后面 drinkjava 同学也提到 "直接引入 Spring 或 Guice 的不好吗?", 说明 drinkjava 并不是认为 MVC 工具不能引入 DI 依赖注入, 而是认为 Act 引入的 DI 依赖注入 Genie 没有提供 AOP 功能, 而 AOP 功能在他看来是实现声明式事务必须的,所以才认为不适合. 2.1 Act 的依赖注入机制与应用 下面我们就 javadrink 同学上面的关切来谈谈 Act 的依赖注入机制与应用. 这里是来自 Wikipedia 对依赖注入的定义 "In software engineering, dependency injection is a technique whereby one object supplies the dependencies of another object". 简单地说就是对象的状态不由自己来创建, 而是交给另外的对象来注入. 举个例子: public class UserService { @Inject private Dao<User> userDao; @GetAction("/users/{userId}") public User get(String userId) { return userDao.findById(userId); } } 上面是一个简单的 UserService 端口. 其中需要使用对应与 User 实体类的 Dao. 在上面的代码中我们没有看到 userDao 是如何初始化的, 因为 userDao 是 Act 框架在实例化 UserService 的时候注入的. 这就是一个典型的 Act 应用依赖注入的方式. 当然 Act 对于依赖注入的使用还有其他的扩展. 我们稍后会提到. 2.1.1 为什么不用 Guice 或者 Spring 这个和Spring或Guice的功能重叠了。直接引入Spring或Guice的不好吗? 现在我来回答 drinkjava 的这个问题: "直接引入 Spring 或 Guice 的不好吗?". 实际上在开发 Genie 之前 Act 尝试过另外两种依赖注入: act-guice act-feather 在 Act 正式发布之前, 这上面两种注入都曾经在 act 0.x 版本中进入过实际项目 (当然是老码农所在公司的 - 开坑自己先踩是老码农做开源的基本原则).最终我选择了自己开发 Genie 来提供 Act 的依赖注入, 主要原因有一下几点: Feather 的实现足够简单轻量; 但并不是 JSR 330 的完整实现, 比如不支持方法注入, 对 Scope 的支持不完善, 扩展性不够好 Guice 提供了完整的 JSR 330 实现; 但同时也引入了一些额外的特性, 比如 Servlet 集成等. Guice 的代码实现也相对比较晦涩. Spring 的依赖注入至始至终都不是我的一个选项, 首先 Spring 的依赖注入不是 JSR 330 标准的实现, 另外 Spring 的依赖注入运行时效率太低 (参见依赖注入性能测试项目). 最终 Feather 简洁的代码实现激励了我启动 Genie 项目, 这个依赖注入库完整实现了 JSR 330, 同时提供了一些有趣且实用的扩展, 比如注入集合类型数据以及注入值数据 等, 这些扩展对实现 Act 里面的 @LoadResource, @LoadConfig 还有 @Configuration 等机制至关重要. 另外因为代码实现比较紧凑, 运行时效率也很不错, 在多项测试中都领先 Guice; 具体数据可以参考这个项目 2.1.2 依赖注入扩展 I - 请求处理方法参数的注入 接下来说说 Act 对传统依赖注入的第一个扩展扩展: 注入请求处理方法参数. 上面那个 UserService 的例子是经典的依赖注入使用方式, 除了将依赖注入字段, Act 还允许直接将服务注入请求处理方法, 例如: @GetAction("/users/userId") public User get(String userId, Dao<User> userDao) { return userDao.findById(userId); } 上面代码中, get 方法有两个参数, userId 和 userDao, 其中 userId 绑定到 URL 路径参数, 假如请求是 /users/abc123, 那 userId 的值就是 abc123; 而第二个参数 userDao 就是依赖注入了, 这个和前面注入到 userDao 字段是一样的. 但 又例如: @PostAction("login") public void login(String email, char[] password, ActionContext context) { User user = userDao.findByEmail(email); badRequestIf(null == user, MSG_BAD_EMAIL_PASSWORD); badRequestIfNot(user.verifyPassword(password), MSG_BAD_EMAIL_PASSWORD); context.login(user); } 上面代码中的 ActionContext 也是依赖注入的对象, 而 email, password 则绑定自请求参数. 2.1.3 依赖注入的扩展 II - 资源和配置参数注入 得益于 Genie 的扩展机制, Act 中可以很轻易地注入加载资源和配置参数. public static class Dao extends MorphiaDao<Contact> { @LoadResource("industry_type.mapping") private Map<String, String> industryTypeMapping; @Configuration("sql.url") private String jdbcUrl; ... } 上面的代码来自实际项目, 其中使用了两种扩展注入: @LoadResource("industry_type.mapping) 将资源文件 industry_type.mapping 的内容加载进 Map<String, String> industryTypeMapping 字段 @Configuration("sql.url") 将配置项 sql.url 的值加载进 String jdbcUrl 字段 资源文件 industry_type.mapping 的内容为: AG1 - Agriculture=Agriculture AG2 - Agribusiness=Agribusiness AG3 - Hospitality=Tourism and Hospitality AG4 - Food Manufacturing/Processing=Food Manufacturing/ Processing ... 可以看出依赖注入在这种场景的使用减少了 boilerplate 代码的使用, 让应用代码变得更加简洁易懂. 值得一提的是 @LoadResource 除了可以注入上面显示的 Map<String, String> 类型, 还能注入很多其他类型, 包括: List<T> File InputStream ... 更多关于 @LoadResource 的示例参见 resource loading 示例项目. 2.1.4 依赖注入机制总结 通过上面关于依赖注入机制的介绍, 可以看出依赖注入在 Act 应用中是基本的机制, 其适用范围远远超出了 drinkjava 同学在问题中表达的观点 "DI唯一比较经典的用法只是用来进行声明式事务才需要". 2.2 关于声明式事务和 AOP 按我的观点,DI唯一比较经典的用法只是用来进行声明式事务才需要,从这个角度出发,就必须要DI支持AOP切面功能,而你却没有加入这个功能,这就很尴尬了,当需要声明式事务的时候,不得不引入一个支持AOP的DI工具,例如Spring/Guice/jFinal,这就造成了使用ACT的项目随时都具备了2套DI工具,也就是说你自带的DI工具实际上是多余的,尤其在流行的Boot环境下,各种配置都是建立在Spring-Core这个IOC/AOP工具基础上,别人不大可能移到Genie内核上。 如果说依赖注入并不只是用来进行声明式事务, 将 drinkjava 同学上面的声明换个说法 "声明式事务是 AOP 少数几个经典用法之一" 我觉得倒是可以接受. drinkjava 同学后面讲到 "从这个角度出发,就必须要DI支持AOP切面功能,而你却没有加入这个功能", 这一点我不同意. DI 和 AOP 是完全不同的概念, 我从来不知道 DI 必须支持 AOP, DI 的 Java 标准 JSR 330 也完全没有提到这个特性. 而 Wikipedia 上 AOP 的页面 也根本没有谈到 Dependency Injection 的概念. 把 DI 和 AOP 放在一起 Google 了一下, 发现这篇 .net 的文章详细分解了这两个概念, 比较其异同以及相关性, 有兴趣的同学可以点击进去看看. Act 目前不支持通用的 AOP, 但 Act 提供的 SQL DB 插件, 包括 act-ebean, act-hibernate 以及 act-eclipselink 都支持声明式事务. 具体应用代码可以参考下面几个示例项目: transaction-hibernate transaction-eclipselink transaction-ebean act-ebean 和 act-hibernate, act-eclipselink 对声明式事务的实现机制是不同的. act-ebean 将声明式事务的实现交给 ebean 引擎. 而 Ebean 是采用了 java agent 对代码做增强来实现声明式事务 act-hibernate 和 act-eclipselink 对声明式事务的实现机制都在 act-jpa-common 插件中, 是通过 ASM 对代码做增强来实现的. 我并不认为通用的 AOP 对于应用开发来说是一个非常重要的特性, 也一直没有动手做 AOP 的支持. 我的理由如下: 我认为 AOP 的应用场合并不是非常普遍的, 可能的场景有: 声明式事务 - ACT 有相应的实现机制 (act-db) Auditing (审计) - ACT 有相应的实现机制 (act-aaa) 性能监控 - ACT 有相应的实现机制 (act-core, ASM based MetricEnhancer) 异常处理 - 我不赞同复杂而精巧的异常处理 - 更新的语言包括 .net C# 还有 groovy, kotlin 等都去掉了 CheckedException 这个概念. Web 应用程序的异常处理应该尽量轻量化. 从框架角度出发以上 AOP 应用场景都不应该交给应用来完全负责, 通过框架或者插件提供专门的支持才是更加合理的处理方式. 通用的 AOP 的对于应用开发来说太过晦涩, 且容易导致难以调试的功能性以及性能方面的问题. 基于上面的阐述, 我可以断言 drinkjava 同学评论中的说法是不成立的: "当需要声明式事务的时候,不得不引入一个支持AOP的DI工具,例如Spring/Guice/jFinal,这就造成了使用ACT的项目随时都具备了2套DI工具,也就是说你自带的DI工具实际上是多余的". 一句话, 在 Act 中使用声明式事务以及我上面提到的另外两种 AOP 应用场景都不需要 AOP. 另一方面, 即便需要支持通用 AOP 的支持也不一定使用 DI 工具, 即 Proxy-Based AOP. 如果我一定要在 Act 中加入通用 AOP 的支持, 我倾向于 LTW (Load Time Weaving), 即在进行类加载的时候使用 ASM 工具对类进行增强, 这样做起码在运行时效率上要高很多. 3. [意见二] 考虑一下支持多种模板输出,如包括PDF输出 ... 必要时抄源码 另外考虑一下支持多种模板输出,如包括PDF输出,这才是MVC的V层要做的事,可以参见SpringMVC和Jfinal,必要时可抄它们的源码 看到这个建议我感觉 drinkjava 同学可能还不太熟悉 Act 的模板输出机制. views 示例项目展示了 Act 中同时使用多种不同的模板引擎的特性, 包括: beetl freemarker mustache rythm thymeleaf velocity 而 response-type 示例项目中展示了 Excel 模板的输出 (采用 JXLS 引擎). 可以说 Act 的模板输出框架是足够满足 (同时) 使用多种模板的. 当然到目前我还没有开发 PDF 的模板插件, 这个可以作为今后的一个工作. 至于评论原文中谈到的必要时抄源码, 我这里可以小自豪一下, 老码农做开源没有抄袭源码的习惯, 从 greenscript 到 play-morphia, 再到 rythm 系列, osgl 系列 以及 act 系列, 你要是找到了老码农抄袭别人的代码可以大声叫出来, 算我输. 我做开源的理念很简单: 做别人家没有的, 或者比别人好的; 没有理由去抄袭. 另外我也可以不客气地说 Act 的对输出的支持包括后台模板渲染应该很少有框架能匹敌. 不同意的话我们可以专门讨论一下这个话题. 4. [意见三] 集中精力在 MVC 这里回答 drinkjava 同学评论的最后一部分: jFinal的问题是DAO、IOC、MVC混成一团,是优点,更是一个大缺点,希望你将主要精力集中在MVC,将它做成一个精致、干净的后台表现层,不要介入任何DI、AOP、DAO、事务的工作,这方面优秀的、流行的工具太多,没必要重造轮子。你现在这个HTTP内核也是自已做的,为了一点点效率或钻牛角尖的小特性,放弃通用性,也是冒风险的,在项目MVC架构选型的第一步就可能被Pass,如果能将HTTP内核和MVC分开,比如说ACT的MVC即可以和自已的内核合用,也可以和Jetty或内嵌Tomcat内核合用,这才是一个比较优秀的架构。 "希望你将主要精力集中在MVC,将它做成一个精致、干净的后台表现层" - 在博客开头我也有讲, Act 并不是一个 MVC 工具, 而是 Web 应用框架以及运行时平台. 另外 "后台表现层" 是个什么鬼? 原谅我读书少, 理解不了这个术语 ^_^. "这方面优秀的、流行的工具太多,没必要重造轮子" - 这句话我不太赞同, MVC 本身优秀的,流行的工具也很多,SpringMVC 就是一张大伞, 按照这个说法, Act 干脆就不要做了. 我的策略是, 首先看市面上有没有满足自己要求的, 有就用 (比如以前的 Play 1.x, FastJSON, JXLS 等等), 没有就自己做 (比如 Rythm, Act, Genie 等等). 另外 drinkjava 同学自己也造了很多轮子, 包括 DI/AOP 工具 JBeanBox 和 数据库访问工具 JSqlBox 等等. 这意思是说你的工具很优秀, 老码农的水准不够, 就不要玩了吗 ;-) "你现在这个HTTP内核也是自已做的,为了一点点效率或钻牛角尖的小特性,放弃通用性,也是冒风险的". - 这里 drinkjava 同学高看我了, Act 的 HTTP 核心实现是 JBoss 的 Undertow. 我有打算在未来的版本中迁移到 Netty 上去. 不过我想问问 drinkjava 同学, 你说的 "钻牛角尖的小特性"是指什么? "通用性" 又是指什么? "如果能将HTTP内核和MVC分开,比如说ACT的MVC即可以和自已的内核合用,也可以和Jetty或内嵌Tomcat内核合用,这才是一个比较优秀的架构。" - Jetty 和 Tomcat 是基于 Servlet 架构的 (不是 HTTP 网络层核心, 而是 API 层的架构), 我认为 Servlet 架构背负太多的历史包袱, 对于现代 Web 框架来说并不是一个很好的选择. 至于 Act 是否是一个比较优秀的架构, 我并不是特别在意. 能在开发时提供友好的支持, 运行时提供足够的性能就好. 最后再次感谢 drinkjava 的评论, 很认真, 信息量很多, 所以我也很认真地使用一篇来回答你的评论.

优秀的个人博客,低调大师

每日一博 | 一文搞懂 Cookie、Session 与 Token

> 笔者文笔功力尚浅,如有不妥,请慷慨指出,必定感激不尽 Cookie 洛:大爷,楼上322住的是马冬梅家吧? 大爷:马都什么? 夏洛:马冬梅。 大爷:什么都没啊? 夏洛:马冬梅啊。 大爷:马什么没? 夏洛:行,大爷你先凉快着吧。 在了解这三个概念之前我们先要了解HTTP是无状态的Web服务器,什么是无状态呢?就像上面夏洛特烦恼中经典的一幕对话一样,一次对话完成后下一次对话完全不知道上一次对话发生了什么。如果在Web服务器中只是用来管理静态文件还好说,对方是谁并不重要,把文件从磁盘中读取出来发出去即可。但是随着网络的不断发展,比如电商中的购物车只有记住了用户的身份才能够执行接下来的一系列动作。所以此时就需要我们无状态的服务器记住一些事情。 那么Web服务器是如何记住一些事情呢?既然Web服务器记不住东西,那么我们就在外部想办法记住,相当于服务器给每个客户端都贴上了一个小纸条。上面记录了服务器给我们返回的一些信息。然后服务器看到这张小纸条就知道我们是谁了。那么Cookie是谁产生的呢?Cookies是由服务器产生的。接下来我们描述一下Cookie产生的过程 浏览器第一次访问服务端时,服务器此时肯定不知道他的身份,所以创建一个独特的身份标识数据,格式为key=value,放入到Set-Cookie字段里,随着响应报文发给浏览器。 浏览器看到有Set-Cookie字段以后就知道这是服务器给的身份标识,于是就保存起来,下次请求时会自动将此key=value值放入到Cookie字段中发给服务端。 服务端收到请求报文后,发现Cookie字段中有值,就能根据此值识别用户的身份然后提供个性化的服务。 接下来我们用代码演示一下服务器是如何生成,我们自己搭建一个后台服务器,这里我用的是SpringBoot搭建的,并且写入SpringMVC的代码如下。 @RequestMapping("/testCookies") public String cookies(HttpServletResponse response){ response.addCookie(new Cookie("testUser","xxxx")); return "cookies"; } 项目启动以后我们输入路径http://localhost:8005/testCookies,然后查看发的请求。可以看到下面那张图使我们首次访问服务器时发送的请求,可以看到服务器返回的响应中有Set-Cookie字段。而里面的key=value值正是我们服务器中设置的值。 接下来我们再次刷新这个页面可以看到在请求体中已经设置了Cookie字段,并且将我们的值也带过去了。这样服务器就能够根据Cookie中的值记住我们的信息了。 接下来我们换一个请求呢?是不是Cookie也会带过去呢?接下来我们输入路径http://localhost:8005请求。我们可以看到Cookie字段还是被带过去了。 那么浏览器的Cookie是存放在哪呢?如果是使用的是Chrome浏览器的话,那么可以按照下面步骤。 在计算机打开Chrome 在右上角,一次点击更多图标->设置 在底部,点击高级 在隐私设置和安全性下方,点击网站设置 依次点击Cookie->查看所有Cookie和网站数据 然后可以根据域名进行搜索所管理的Cookie数据。所以是浏览器替你管理了Cookie的数据,如果此时你换成了Firefox等其他的浏览器,因为Cookie刚才是存储在Chrome里面的,所以服务器又蒙圈了,不知道你是谁,就会给Firefox再次贴上小纸条。 Cookie中的参数设置 说到这里,应该知道了Cookie就是服务器委托浏览器存储在客户端里的一些数据,而这些数据通常都会记录用户的关键识别信息。所以Cookie需要用一些其他的手段用来保护,防止外泄或者窃取,这些手段就是Cookie的属性。 参数名 作用 后端设置方法 Max-Age 设置cookie的过期时间,单位为秒 cookie.setMaxAge(10) Domain 指定了Cookie所属的域名 cookie.setDomain("") Path 指定了Cookie所属的路径 cookie.setPath(""); HttpOnly 告诉浏览器此Cookie只能靠浏览器Http协议传输,禁止其他方式访问 cookie.setHttpOnly(true) Secure 告诉浏览器此Cookie只能在Https安全协议中传输,如果是Http则禁止传输 cookie.setSecure(true) 下面我就简单演示一下这几个参数的用法及现象。 Path 设置为cookie.setPath("/testCookies"),接下来我们访问http://localhost:8005/testCookies,我们可以看到在左边和我们指定的路径是一样的,所以Cookie才在请求头中出现,接下来我们访问http://localhost:8005,我们发现没有Cookie字段了,这就是Path控制的路径。 Domain 设置为cookie.setDomain("localhost"),接下来我们访问http://localhost:8005/testCookies我们发现下图中左边的是有Cookie的字段的,但是我们访问http://172.16.42.81:8005/testCookies,看下图的右边可以看到没有Cookie的字段了。这就是Domain控制的域名发送Cookie。 接下来的几个参数就不一一演示了,相信到这里大家应该对Cookie有一些了解了。 Session > Cookie是存储在客户端方,Session是存储在服务端方,客户端只存储SessionId 在上面我们了解了什么是Cookie,既然浏览器已经通过Cookie实现了有状态这一需求,那么为什么又来了一个Session呢?这里我们想象一下,如果将账户的一些信息都存入Cookie中的话,一旦信息被拦截,那么我们所有的账户信息都会丢失掉。所以就出现了Session,在一次会话中将重要信息保存在Session中,浏览器只记录SessionId一个SessionId对应一次会话请求。 @RequestMapping("/testSession") @ResponseBody public String testSession(HttpSession session){ session.setAttribute("testSession","this is my session"); return "testSession"; } @RequestMapping("/testGetSession") @ResponseBody public String testGetSession(HttpSession session){ Object testSession = session.getAttribute("testSession"); return String.valueOf(testSession); } 这里我们写一个新的方法来测试Session是如何产生的,我们在请求参数中加上HttpSession session,然后再浏览器中输入http://localhost:8005/testSession进行访问可以看到在服务器的返回头中在Cookie中生成了一个SessionId。然后浏览器记住此SessionId下次访问时可以带着此Id,然后就能根据此Id找到存储在服务端的信息了。 此时我们访问路径http://localhost:8005/testGetSession,发现得到了我们上面存储在Session中的信息。那么Session什么时候过期呢? 客户端:和Cookie过期一致,如果没设置,默认是关了浏览器就没了,即再打开浏览器的时候初次请求头中是没有SessionId了。 服务端:服务端的过期是真的过期,即服务器端的Session存储的数据结构多久不可用了,默认是30分钟。 既然我们知道了Session是在服务端进行管理的,那么或许你们看到这有几个疑问,Session是在在哪创建的?Session是存储在什么数据结构中?接下来带领大家一起看一下Session是如何被管理的。 Session的管理是在容器中被管理的,什么是容器呢?Tomcat、Jetty等都是容器。接下来我们拿最常用的Tomcat为例来看下Tomcat是如何管理Session的。在ManageBase的createSession是用来创建Session的。 @Override public Session createSession(String sessionId) { //首先判断Session数量是不是到了最大值,最大Session数可以通过参数设置 if ((maxActiveSessions &gt;= 0) &amp;&amp; (getActiveSessions() &gt;= maxActiveSessions)) { rejectedSessions++; throw new TooManyActiveSessionsException( sm.getString("managerBase.createSession.ise"), maxActiveSessions); } // 重用或者创建一个新的Session对象,请注意在Tomcat中就是StandardSession // 它是HttpSession的具体实现类,而HttpSession是Servlet规范中定义的接口 Session session = createEmptySession(); // 初始化新Session的值 session.setNew(true); session.setValid(true); session.setCreationTime(System.currentTimeMillis()); // 设置Session过期时间是30分钟 session.setMaxInactiveInterval(getContext().getSessionTimeout() * 60); String id = sessionId; if (id == null) { id = generateSessionId(); } session.setId(id);// 这里会将Session添加到ConcurrentHashMap中 sessionCounter++; //将创建时间添加到LinkedList中,并且把最先添加的时间移除 //主要还是方便清理过期Session SessionTiming timing = new SessionTiming(session.getCreationTime(), 0); synchronized (sessionCreationTiming) { sessionCreationTiming.add(timing); sessionCreationTiming.poll(); } return session } 到此我们明白了Session是如何创建出来的,创建出来后Session会被保存到一个ConcurrentHashMap中。可以看StandardSession类。 protected Map<string, session> sessions = new ConcurrentHashMap&lt;&gt;(); 到这里大家应该对Session有简单的了解了。 > Session是存储在Tomcat的容器中,所以如果后端机器是多台的话,因此多个机器间是无法共享Session的,此时可以使用Spring提供的分布式Session的解决方案,是将Session放在了Redis中。 Token Session是将要验证的信息存储在服务端,并以SessionId和数据进行对应,SessionId由客户端存储,在请求时将SessionId也带过去,因此实现了状态的对应。而Token是在服务端将用户信息经过Base64Url编码过后传给在客户端,每次用户请求的时候都会带上这一段信息,因此服务端拿到此信息进行解密后就知道此用户是谁了,这个方法叫做JWT(Json Web Token)。 > Token相比较于Session的优点在于,当后端系统有多台时,由于是客户端访问时直接带着数据,因此无需做共享数据的操作。 Token的优点 简洁:可以通过URL,POST参数或者是在HTTP头参数发送,因为数据量小,传输速度也很快 自包含:由于串包含了用户所需要的信息,避免了多次查询数据库 因为Token是以Json的形式保存在客户端的,所以JWT是跨语言的 不需要在服务端保存会话信息,特别适用于分布式微服务 JWT的结构 实际的JWT大概长下面的这样,它是一个很长的字符串,中间用.分割成三部分 JWT是有三部分组成的 Header 是一个Json对象,描述JWT的元数据,通常是下面这样子的 { "alg": "HS256", "typ": "JWT" } 上面代码中,alg属性表示签名的算法(algorithm),默认是 HMAC SHA256(写成 HS256);typ属性表示这个令牌(token)的类型(type),JWT 令牌统一写为JWT。 最后,将上面的 JSON 对象使用 Base64URL 算法转成字符串。 > JWT 作为一个令牌(token),有些场合可能会放到 URL(比如 api.example.com/?token=xxx)。Base64 有三个字符+、/和=,在 URL 里面有特殊含义,所以要被替换掉:=被省略、+替换成-,/替换成_ 。这就是 Base64URL 算法。 Payload Payload部分也是一个Json对象,用来存放实际需要传输的数据,JWT官方规定了下面几个官方的字段供选用。 iss (issuer):签发人 exp (expiration time):过期时间 sub (subject):主题 aud (audience):受众 nbf (Not Before):生效时间 iat (Issued At):签发时间 jti (JWT ID):编号 当然除了官方提供的这几个字段我们也能够自己定义私有字段,下面就是一个例子 { "name": "xiaoMing", "age": 14 } 默认情况下JWT是不加密的,任何人只要在网上进行Base64解码就可以读到信息,所以一般不要将秘密信息放在这个部分。这个Json对象也要用Base64URL 算法转成字符串 Signature Signature部分是对前面的两部分的数据进行签名,防止数据篡改。 首先需要定义一个秘钥,这个秘钥只有服务器才知道,不能泄露给用户,然后使用Header中指定的签名算法(默认情况是HMAC SHA256),算出签名以后将Header、Payload、Signature三部分拼成一个字符串,每个部分用.分割开来,就可以返给用户了。 > HS256可以使用单个密钥为给定的数据样本创建签名。当消息与签名一起传输时,接收方可以使用相同的密钥来验证签名是否与消息匹配。 Java中如何使用Token 上面我们介绍了关于JWT的一些概念,接下来如何使用呢?首先在项目中引入Jar包 compile('io.jsonwebtoken:jjwt:0.9.0') 然后编码如下 // 签名算法 ,将对token进行签名 SignatureAlgorithm signatureAlgorithm = SignatureAlgorithm.HS256; // 通过秘钥签名JWT byte[] apiKeySecretBytes = DatatypeConverter.parseBase64Binary("SECRET"); Key signingKey = new SecretKeySpec(apiKeySecretBytes, signatureAlgorithm.getJcaName()); Map<string,object> claimsMap = new HashMap&lt;&gt;(); claimsMap.put("name","xiaoMing"); claimsMap.put("age",14); JwtBuilder builderWithSercet = Jwts.builder() .setSubject("subject") .setIssuer("issuer") .addClaims(claimsMap) .signWith(signatureAlgorithm, signingKey); System.out.printf(builderWithSercet.compact()); 发现输出的Token如下 eyJhbGciOiJIUzI1NiJ9.eyJzdWIiOiJzdWJqZWN0IiwiaXNzIjoiaXNzdWVyIiwibmFtZSI6InhpYW9NaW5nIiwiYWdlIjoxNH0.3KOWQ-oYvBSzslW5vgB1D-JpCwS-HkWGyWdXCP5l3Ko 此时在网上随便找个Base64解码的网站就能将信息解码出来 总结 相信大家看到这应该对Cookie、Session、Token有一定的了解了,接下来再回顾一下重要的知识点 Cookie是存储在客户端的 Session是存储在服务端的,可以理解为一个状态列表。拥有一个唯一会话标识SessionId。可以根据SessionId在服务端查询到存储的信息。 Session会引发一个问题,即后端多台机器时Session共享的问题,解决方案可以使用Spring提供的框架。 Token类似一个令牌,无状态的,服务端所需的信息被Base64编码后放到Token中,服务器可以直接解码出其中的数据。 GitHub代码地址 参考文章 Cookies vs. Tokens: The Definitive Guide 彻底弄懂session,cookie,token 透视HTTP协议 Manager组件:Tomcat的Session管理机制解析 JSON Web Token 入门教程 SpringBoot集成JWT实现token验证 JSON Web Token - 在Web应用间安全地传递信息</string,object></string,>

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册