首页 文章 精选 留言 我的

精选列表

搜索[赛博朋克],共10000篇文章
优秀的个人博客,低调大师

每日一博 | 火焰图:全局视野的 Linux 性能剖析

文章背景 日常的工作中,会收到一堆CPU使用率过高的告警邮件,遇到某台服务的CPU被占满了,这时候我们就要去查看是什么进程将服务器的CPU资源占用满了。通常我们会通过top或者htop来快速的查看占据CPU最高的那个进程,如下图: 这里是通过一个普通的服务器做演示使用,如图所示当前服务器占用CPU最高的是一个叫做kube-apiserver命令运行的一个进程,该进程的PID为25633,当然你可能遇到一个服务器上运行有多个服务,想快速知道占用率最高的那几个进程的话,你可以使用以下命令: psaux|head-1;ps-aux|sort-k3nr|head-n10//查看前10个最占用CPU的进程psaux|head-1;ps-aux|sort-k4nr|head-n10//查看前10个最占用内存的进程 但是通过以上的方法获取到服务器占用资源的进程之后,还是不知道CPU使用究竟耗时在哪里,不清楚瓶颈在哪里,此时就可以通过Linux系统的性能分析工具perf分析,分析其返回的正在消耗CPU的函数以及调用栈。然后可以通过解析perf采集的数据,渲染到火焰图🔥,就清楚的知道究竟占用系统CPU资源的罪魁祸首了。 在制作火焰图之前,需要先来说说这个Linux性能分析工具perf,该工具是一个相对简单易上手的性能分析工具,是Performance单词的缩写,通过其perf的命令选项完成系统事件的采集到解析,我们来简单的认识一下: linux上的性能分析工具Perf 安装perf 我目前的服务器发行版是Ubuntu 16.04.6 LTS因此需要先安装perf才能使用,该工具由linux-tools-common提供,但是它需要安装后面的依赖。 #安装root@master:~#aptinstalllinux-tools-commonlinux-tools-4.4.0-142-genericlinux-cloud-tools-4.4.0-142-generic-yroot@master:~#perf-v#显示perf的版本perfversion4.4.167 在安装完成时候,我们就可以对上图CPU使用率最高的进程ID为25633的进程进行采样分析。 首选我们采集一下该进程的调用栈信息: root@master:~#sudoperfrecord-F99-p25633-g--sleep30[perfrecord:Wokenup1timestowritedata][perfrecord:Capturedandwrote0.039MBperf.data(120samples)] 这个命令会产生一个大的数据文件,取决与你采集的进程与CPU的配置,如果一台服务器有16个 CPU,每秒抽样99次,持续30秒,就得到 47,520 个调用栈,长达几十万甚至上百万行。上面的命令中,perf record表示记录,-F 99表示每秒99次,-p 25633是进程号,即对哪个进程进行分析,-g表示记录调用栈,sleep 30则是持续30秒,参数信息可以视情况调整。生成的数据采集文件在当前目录下,名称为perf.data。 perf record命令可以从高到低排列统计每个调用栈出现的百分比,显示结果如下图所示: root@master:~#sudoperfreport-n--stdio 这样的效果对使用者来说还是不那么直观易读,这时候,火焰🔥图也就真正的派上用途了。 制作火焰🔥图 火焰🔥图并非一定就是火焰系列的颜色主题,只是通过🔥色系更能表达出含义。火焰图常见的类型有 On-CPU[1], Off-CPU[2], 还有 Memory[3], Hot/Cold[4], Differential[5] 等等. on-CPU/off-cpu的区别就是一个是用于CPU是性能瓶颈,一个是IO是性能瓶颈,当你不知道当前的服务器的性能瓶颈究竟是什么的时候,你可以使用这两种类型进行对比,通过两种火焰图的差别是比较大的,如果两张火焰图长得差不多, 那么通常认为CPU被其它进程抢占了. 另外一种情况就是如果无法确定当前的系统瓶颈, 可以通过压测工具来确认 : 通过压测工具看看能否让CPU使用率趋于饱和, 如果能那么使用 On-CPU 火焰图, 如果不管怎么压, CPU 使用率始终上不来, 那么多半说明程序被 IO 或锁卡住了, 此时适合使用 Off-CPU 火焰图. 你可以通过压测工具进行测试,目前比较常用的就是ab和wrk,我建议尝试使用诸如 wrk[6] 之类更现代的压测工具. 如果选择 ab 的话, 那么务必记得开启 -k 选项, 以避免耗尽系统的可用端口 Github上有Brendan D. Gregg 的 Flame Graph 工程实现了一套生成火焰图的脚本.我们可以直接克隆下来直接用。 cd&&gitclonehttps://github.com/brendangregg/FlameGraph.git 生成火焰🔥图,我们一般都遵循以下流程 捕获堆栈: 使用 perf捕捉进程运行堆栈信息 折叠堆栈: 对抓取的系统和程序运行每一时刻的堆栈信息进行分析组合, 将重复的堆栈累计在一起, 从而体现出负载和关键路径,通过 stackcollapse脚本完成 生成火焰图:分析 stackcollapse 输出的堆栈信息渲染成火焰图 Flame Graph中提供了抓取不同信息的脚本,可以按需使用。下面我们需要对捕获到的进程堆栈信息perf.data进行折叠,生成折叠的堆栈信息: root@master:~#perfscript-i/root/perf.data&>/root/perf.unfold 用 stackcollapse-perf.pl 将 perf 解析出的内容 perf.unfold 中的符号进行折叠 root@master:~/FlameGraph#lsaix-perf.pldocsexample-perf.svgpkgsplit-perf.plstackcollapse-aix.plstackcollapse-go.plstackcollapse-ljp.awkstackcollapse-pmc.plstackcollapse-vsprof.pltest.shdemosexample-dtrace-stacks.txtfiles.plrange-perf.plstackcollapse-bpftrace.plstackcollapse-instruments.plstackcollapse-perf.plstackcollapse-recursive.plstackcollapse-vtune.pldevexample-dtrace.svgflamegraph.plREADME.mdstackcollapse-elfutils.plstackcollapse-java-exceptions.plstackcollapse-perf-sched.awkstackcollapse-sample.awkstackcollapse-xdebug.phpdifffolded.plexample-perf-stacks.txt.gzjmapsrecord-test.shstackcollapse-gdb.plstackcollapse-jstack.plstackcollapse.plstackcollapse-stap.pltestroot@master:~/FlameGraph#./stackcollapse-perf.pl/root/perf.unfold&>/root/perf.foldedroot@master:~/FlameGraph# 最后就是生成火焰🔥图了 root@master:~/FlameGraph#./flamegraph.pl/root/perf.folded>/root/perf.svg 当然也可以通过管道符|将整个过程简化: cd&&perfscript|FlameGraph/stackcollapse-perf.pl|FlameGraph/flamegraph.pl>process.svg 最后在谷歌浏览器上打开该火焰图: 火焰图是基于stack信息生成的SVG 图片, 用来展示 CPU 的调用栈。 y 轴表示调用栈, 每一层都是一个函数. 调用栈越深, 火焰就越高, 顶部就是正在执行的函数, 下方都是它的父函数. x 轴表示抽样数, 如果一个函数在 x 轴占据的宽度越宽, 就表示它被抽到的次数多, 即执行的时间长. 注意, x 轴不代表时间, 而是所有的调用栈合并后, 按字母顺序排列的. 火焰图就是看顶层的哪个函数占据的宽度最大. 只要有"平顶"(plateaus), 就表示该函数可能存在性能问题。颜色没有特殊含义, 因为火焰图表示的是 CPU 的繁忙程度, 所以一般选择暖色调. 当调用栈不完整调用栈过深时,某些系统只返回前面的一部分(比如前10层);当函数名缺失,函数没有名字,编译器只用内存地址来表示(比如匿名函数),所以使用火焰图也是存在分析不到的地方。你也可以通过以下脚本进行采集分析火焰图: if[$#-ne1];thenecho"Usage:$0seconds"exit1fiperfrecord-a-g-operf.data&PID=`psaux|grep"perfrecord"|grep-vgrep|awk'{print$2}'`if[-n"$PID"];thensleep$1kill-sINT$PIDfi#waituntilperfexitesleep1perfscript-iperf.data&>perf.unfoldperlstackcollapse-perf.plperf.unfold&>perf.foldedperlflamegraph.plperf.folded>perf.svg 更多精彩干货文章 👉最流行的五款Kubernetes交互式可视化工具 👉日志分析平台ELK 7.0时代来了 👉轻松爬取拉勾网招聘岗位信息 👉Yearning - 最Popular的MYSQL审计平台 👉YAPI-高效、易用、功能强大的 api 管理平台 👉OpenVPN高级进阶: 5个使用场景和问题集 参考资料 [1]On-CPU: http://www.brendangregg.com/FlameGraphs/cpuflamegraphs.html [2]Off-CPU: http://www.brendangregg.com/FlameGraphs/offcpuflamegraphs.html [3]Memory: http://www.brendangregg.com/FlameGraphs/memoryflamegraphs.html [4]Hot/Cold: http://www.brendangregg.com/FlameGraphs/hotcoldflamegraphs.html [5]Differential: http://www.brendangregg.com/blog/2014-11-09/differential-flame-graphs.html [6]wrk: https://github.com/wg/wrk 本文分享自微信公众号 - 云原生生态圈(CloudNativeEcoSystem)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | 导致 MySQL 索引失效的几种常见写法

最近一直忙着处理原来老项目遗留的一些SQL优化问题,由于当初表的设计以及字段设计的问题,随着业务的增长,出现了大量的慢SQL,导致MySQL的CPU资源飙升,基于此,给大家简单分享下这些比较使用的易于学习和使用的经验。 这次的话简单说下如何防止你的索引失效。 再说之前我先根据我最近的经验说下我对索引的看法,我觉得并不是所以的表都需要去建立索引,对于一些业务数据,可能量比较大了,查询数据已经有了一点压力,那么最简单、快速的办法就是建立合适的索引,但是有些业务可能表里就没多少数据,或者表的使用频率非常不高的情况下是没必要必须要去做索引的。就像我们有些表,2年了可能就10来条数据,有索引和没索引性能方面差不多多少。 索引只是我们优化业务的一种方式,千万为了为了建索引而去建索引。 下面是我此次测试使用的一张表结构以及一些测试数据 CREATETABLE`user`(`id`int(5)unsignedNOTNULLAUTO_INCREMENT,`create_time`datetimeNOTNULL,`name`varchar(5)NOTNULL,`age`tinyint(2)unsignedzerofillNOTNULL,`sex`char(1)NOTNULL,`mobile`char(12)NOTNULLDEFAULT'',`address`char(120)DEFAULTNULL,`height`varchar(10)DEFAULTNULL,PRIMARYKEY(`id`),KEY`idx_createtime`(`create_time`)USINGBTREE,KEY`idx_name_age_sex`(`name`,`sex`,`age`)USINGBTREE,KEY`idx_height`(`height`)USINGBTREE,KEY`idx_address`(`address`)USINGBTREE,KEY`idx_age`(`age`)USINGBTREE)ENGINE=InnoDBAUTO_INCREMENT=261DEFAULTCHARSET=utf8; INSERTINTO`bingfeng`.`user`(`id`,`create_time`,`name`,`age`,`sex`,`mobile`,`address`,`height`)VALUES(1,'2019-09-0210:17:47','冰峰',22,'男','1','陕西省咸阳市彬县','175');INSERTINTO`bingfeng`.`user`(`id`,`create_time`,`name`,`age`,`sex`,`mobile`,`address`,`height`)VALUES(2,'2020-09-0210:17:47','松子',13,'女','1',NULL,'180');INSERTINTO`bingfeng`.`user`(`id`,`create_time`,`name`,`age`,`sex`,`mobile`,`address`,`height`)VALUES(3,'2020-09-0210:17:48','蚕豆',20,'女','1',NULL,'180');INSERTINTO`bingfeng`.`user`(`id`,`create_time`,`name`,`age`,`sex`,`mobile`,`address`,`height`)VALUES(4,'2020-09-0210:17:47','冰峰',20,'男','17765010977','陕西省西安市','155');INSERTINTO`bingfeng`.`user`(`id`,`create_time`,`name`,`age`,`sex`,`mobile`,`address`,`height`)VALUES(255,'2020-09-0210:17:47','竹笋',22,'男','我测试下可以储存几个中文',NULL,'180');INSERTINTO`bingfeng`.`user`(`id`,`create_time`,`name`,`age`,`sex`,`mobile`,`address`,`height`)VALUES(256,'2020-09-0310:17:47','冰峰',21,'女','',NULL,'167');INSERTINTO`bingfeng`.`user`(`id`,`create_time`,`name`,`age`,`sex`,`mobile`,`address`,`height`)VALUES(257,'2020-09-0210:17:47','小红',20,'','',NULL,'180');INSERTINTO`bingfeng`.`user`(`id`,`create_time`,`name`,`age`,`sex`,`mobile`,`address`,`height`)VALUES(258,'2020-09-0210:17:47','小鹏',20,'','',NULL,'188');INSERTINTO`bingfeng`.`user`(`id`,`create_time`,`name`,`age`,`sex`,`mobile`,`address`,`height`)VALUES(259,'2020-09-0210:17:47','张三',20,'','',NULL,'180');INSERTINTO`bingfeng`.`user`(`id`,`create_time`,`name`,`age`,`sex`,`mobile`,`address`,`height`)VALUES(260,'2020-09-0210:17:47','李四',22,'','',NULL,'165'); 单个索引 1、使用!= 或者 <> 导致索引失效 SELECT*FROM`user`WHERE`name`!='冰峰'; 我们给name字段建立了索引,但是如果!= 或者 <> 这种都会导致索引失效,进行全表扫描,所以如果数据量大的话,谨慎使用 可以通过分析SQL看到,type类型是ALL,扫描了10行数据,进行了全表扫描。<>也是同样的结果。 2、类型不一致导致的索引失效 在说这个之前,一定要说一下设计表字段的时候,千万、一定、必须要保持字段类型的一致性,啥意思?比如user表的id是int自增,到了用户的账户表user_id这个字段,一定、必须也是int类型,千万不要写成varchar、char什么的骚操作。 SELECT*FROM`user`WHEREheight=175; 这个SQL诸位一定要看清楚,height表字段类型是varchar,但是我查询的时候使用了数字类型,因为这个中间存在一个隐式的类型转换,所以就会导致索引失效,进行全表扫描。 现在明白我为啥说设计字段的时候一定要保持类型的一致性了不,如果你不保证一致性,一个int一个varchar,在进行多表联合查询(eg: 1 = '1')必然走不了索引。 遇到这样的表,里面有几千万数据,改又不能改,那种痛可能你们暂时还体会。 少年们,切记,切记。 3、函数导致的索引失效 SELECT*FROM`user`WHEREDATE(create_time)='2020-09-03'; 如果你的索引字段使用了索引,对不起,他是真的不走索引的。 4、运算符导致的索引失效 SELECT*FROM`user`WHEREage-1=20; 如果你对列进行了(+,-,*,/,!), 那么都将不会走索引。 5、OR引起的索引失效 SELECT*FROM`user`WHERE`name`='张三'ORheight='175'; OR导致索引是在特定情况下的,并不是所有的OR都是使索引失效,如果OR连接的是同一个字段,那么索引不会失效,反之索引失效。 6、模糊搜索导致的索引失效 SELECT*FROM`user`WHERE`name`LIKE'%冰'; 这个我相信大家都明白,模糊搜索如果你前缀也进行模糊搜索,那么不会走索引。 7、NOT IN、NOT EXISTS导致索引失效 SELECTs.*FROM`user`sWHERENOTEXISTS(SELECT*FROM`user`uWHEREu.name=s.`name`ANDu.`name`='冰峰') SELECT*FROM`user`WHERE`name`NOTIN('冰峰'); 这两种用法,也将使索引失效。但是NOT IN 还是走索引的,千万不要误解为 IN 全部是不走索引的。我之前就有误解(丢人了...)。 8、IS NULL不走索引,IS NOT NULL走索引 SELECT*FROM`user`WHEREaddressISNULL 不走索引。 SELECT*FROM`user`WHEREaddressISNOTNULL; 走索引。 根据这个情况,建议大家这设计字段的时候,如果没有必要的要求必须为NULL,那么最好给个默认值空字符串,这可以解决很多后续的麻烦(有深刻的体验<体验=教训>)。 符合索引 1、最左匹配原则 EXPLAINSELECT*FROM`user`WHEREsex='男'; EXPLAINSELECT*FROM`user`WHEREname='冰峰'ANDsex='男'; 测试之前,删除其他的单列索引。 啥叫最左匹配原则,就是对于符合索引来说,它的一个索引的顺序是从左往右依次进行比较的,像第二个查询语句,name走索引,接下来回去找age,结果条件中没有age那么后面的sex也将不走索引。 注意: SELECT*FROM`user`WHEREsex='男'ANDage=22AND`name`='冰峰'; 可能有些搬砖工可能跟我最开始有个误解,我们的索引顺序明明是name、sex、age,你现在的查询顺序是sex、age、name,这肯定不走索引啊,你要是自己没测试过,也有这种不成熟的想法,那跟我一样还是太年轻了,它其实跟顺序是没有任何关系的,因为mysql的底层会帮我们做一个优化,它会把你的SQL优化为它认为一个效率最高的样子进行执行。所以千万不要有这种误解。 2、如果使用了!=会导致后面的索引全部失效 SELECT*FROM`user`WHEREsex='男'AND`name`!='冰峰'ANDage=22; 我们在name字段使用了 != ,由于name字段是最左边的一个字段,根据最左匹配原则,如果name不走索引,后面的字段也将不走索引。 关于符合索引导致索引失效的情况能说的目前就这两种,其实我觉得对于符合索引来说,重要的是如何建立高效的索引,千万不能说我用到那个字段我就去建立一个单独的索引,不是就可以全局用了嘛。这样是可以,但是这样并没有符合索引高效,所以为了成为高级的搬砖工,我们还是要继续学习,如何创建高效的索引。 日拱一卒,功不唐捐 今日推荐 为什么建议你使用枚举? 用户输入的虎狼之词,怎么校验之后不见了? 本文分享自微信公众号 - 一个程序员的成长(xiaozaibuluo)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | 常见机器学习算法背后的数学

不同的机器学习算法是如何从数据中学习并预测未见数据的呢? 机器学习算法是这样设计的,它们从经验中学习,当它们获取越来越多的数据时,性能就会提高。每种算法都有自己学习和预测数据的方法。在本文中,我们将介绍一些机器学习算法的功能,以及在这些算法中实现的有助于学习过程的一些数学方程。 机器学习算法的类型 机器学习算法大致可以分为以下四类: 监督学习:预测的目标或输出变量是已知的。这些算法生成一个函数,该函数将输入映射到输出变量。回归和分类算法属于这一类。在回归中,输出变量是连续的,而在分类中,输出变量包含两个或更多的离散值。一些监督学习算法包括线性回归,逻辑回归,随机森林,支持向量机,决策树,朴素贝叶斯,神经网络。 无监督学习:目标或输出变量是未知的。这些算法通常对数据进行分析并生成数据簇。关联、聚类和维数约简算法属于这一类。K-means聚类、PCA(主成分分析)、Apriori算法等是非监督学习算法。 半监督学习:它是监督和非监督学习方法的结合。它使用已知数据来训练自己,然后标记未知数据。 强化学习:机器或代理被训练从“试错”过程中学习。机器从过去的决策经验中学习,并利用它的学习来预测未来决策的结果。强化学习算法的例子有Q-Learning, Temporal Difference等。 线性回归 线性回归是通过拟合数据点上的最佳直线来预测连续变量的结果。最佳拟合线定义了因变量和自变量之间的关系。该算法试图找到最适合预测目标变量值的直线。通过使数据点与回归线之间的差的平方和最小达到最佳拟合线。 公式:Y = c + m₁X₁ + m₂X₂ + ….. +mₙXₙ 逻辑回归 逻辑回归是一种基于自变量估计分类变量结果的分类算法。它通过将数据拟合到logistic函数来预测某一事件发生的概率。通过最大化似然函数,对logistic函数中自变量的系数进行优化。优化决策边界,使成本函数最小。利用梯度下降法可以使代价函数最小化。 逻辑回归的s型曲线 Logistic回归的代价函数 逻辑回归方程 朴素贝叶斯 朴素贝叶斯是一种基于贝叶斯定理的分类算法。该算法假设自变量之间不存在相关性。在一个类中出现的某个特性与在同一类中出现的另一个特性没有关系。我们针对类为所有预测器创建一个频率表(目标变量的不同值),并计算所有预测器的可能性。利用朴素贝叶斯方程,计算所有类别的后验概率。朴素贝叶斯分类器的结果将是所有类概率中概率最高的类。 c→类,X→预测 决策树 决策树主要用于分类问题,但它们也可以用于回归。在该算法中,我们根据最有效地划分数据集的属性,将数据集划分为两个或多个同构集。选择将分割数据集的属性的方法之一是计算熵和信息增益。熵反映了变量中杂质的数量。信息增益是父节点的熵减去子节点的熵之和。选择提供最大信息增益的属性进行分割。我们也可以使用基尼指数作为杂质标准来分割数据集。为了防止过度分裂,我们优化了max_features、min_samples_split、max_depth等决策树的超参数。 熵:c→类的数量 基尼指数 随机森林 随机森林由多个决策树组成,决策树作为一个集合来运行。一个整体由一组用来预测结果的模型组成,而不是一个单独的模型。在随机森林中,每棵决策树预测一个类结果,投票最多的类结果成为随机森林的预测。为了做出准确的预测,决策树之间的相关性应该最小。有两种方法可以确保这一点,即使用Bagging和特性选择。Bagging是一种从数据集中选择随机观察样本的技术。特征选择允许决策树仅在特征的随机子集上建模。这就防止单个树使用相同的特性进行预测。 k -近邻 该算法也可用于回归和分类。该算法通过计算数据点与所有数据点的距离来找到k个数据点的最近邻。数据点被分配给k个邻居中点数最多的类(投票过程)。在回归的情况下,它计算k个最近邻居的平均值。不同的距离度量可以使用欧几里得距离,曼哈顿距离,闵可夫斯基距离等。为了消除平局的概率,k的值必须是一个奇数。由于每个数据点与其他数据点的距离都需要计算,因此该算法的计算开销较大。 k - means K-Means是一种无监督学习算法,用于形成数据簇。形成的集群应该使集群内的数据点尽可能相似,集群之间的差异尽可能明显。它随机选择K个位置,每个位置作为一个簇的质心。数据点被分配到最近的簇。在分配数据点之后,计算每个聚类的质心,再次将数据点分配到最近的聚类中。此过程将重复进行,直到在每次连续迭代中数据点保持在同一簇中,或簇的中心不改变为止。我们还可以指示算法在进行一定次数的迭代后停止计算。 Apriori算法 Apriori算法是一种基于关联规则的数据库频繁项集识别算法。频繁项集是支持度大于阈值(支持度)的项集。关联规则可以被认为是一种IF-THEN关系。它通常用于市场篮子(market basket)分析中,发现不同商品之间的关联。支持、信心和提升是帮助确定关联的三个措施。 支持指示某些项目集一起出现的频率。 置信度计算项目集在其中一个项目出现时发生的概率。 Lift表示关联规则的强度。支持是用户定义的阈值。 XGBoost XGBoost是一种基于决策树的梯度增强算法(集成的另一种类型)。XGBoost涉及一组较弱的学习者,它们结合在一起可以做出值得注意的准确预测。Boosting是一个序列集成,每个模型都是在修正之前模型错误分类的基础上构建的。换句话说,它接收到前一个模型的错误,并试图通过学习这些错误来改进模型。 支持向量机(SVM) SVM也是一种监督学习算法,可用于分类和回归问题。支持向量机试图在N维空间(N指特征的数量)中找到一个最优超平面来帮助分类不同的类。它利用Hinge损失函数,通过最大化类观测值之间的裕度距离来寻找最优超平面。超平面的维数取决于输入特征的数量。如果特征个数为N,则超平面的维数为N-1。 Hinge损失函数:t→目标变量,w→模型参数,x→输入变量 DeepHub 微信号 : deephub-imba 每日大数据和人工智能的重磅干货 大厂职位内推信息 长按识别二维码关注-> 喜欢就请三连暴击! 作者:Prathamesh Thakar deephub翻译组 https://towardsdatascience.com/the-math-behind-machine-learning-algorithms-9c5e4c87fff 本文分享自微信公众号 - DeepHub IMBA(deephub-imba)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | Vue.js 组件复用和扩展之道

软件编程有一个重要的原则是 D.R.Y(Don't Repeat Yourself),讲的是尽量复用代码和逻辑,减少重复。组件扩展可以避免重复代码,更易于快速开发和维护。那么,扩展 Vue 组件的最佳方法是什么? Vue 提供了不少 API 和模式来支持组件复用和扩展,你可以根据自己的目的和偏好来选择。 本文介绍几种比较常见的方法和模式,希望对你有所帮助。 扩展组件是否必要 扩展往往通过继承基础组件来达到功能复用的目的。要知道,所有的组件扩展方法都会增加复杂性和额外代码,有时候还会增加性能消耗。经验告诉我们,组合模式优于继承。 因此,在决定扩展组件之前,最好先看看有没有其他更简单的设计模式能完成目标。 下面几种模式通常足够替代扩展组件了: props配合模板逻辑 slot 插槽 JavaScript 工具函数 props配合模板逻辑 最简单的方法是通过props结合模板条件渲染,来实现组件的多功能。 比如通过type属性: MyVersatileComponent.vue <template> <divclass="wrapper"> <divv-if="type==='a'">...</div> <divv-else-if="type==='b'">...</div> <!--etcetc--> </div> </template> <script> exportdefault{ props:{type:String}, ... } </script> 使用组件的时候传不同的type值就能实现不同的结果。 //*ParentComponent.vue* <template> <MyVersatileComponenttype="a"/> <MyVersatileComponenttype="b"/> </template> 如果出现下面两种情况,就说明这种模式不适用了,或者用法不对: 组件组合模式把状态和逻辑分解成原子部分,从而让应用具备可扩展性。如果组件内存在大量条件判断,可读性和可维护性就会变差。 props 和模板逻辑的本意是让组件动态化,但是也存在运行时资源消耗。如果你利用这种机制在运行时解决代码组合问题,那是一种反模式。 slot(插槽) 另一种可避免组件扩展的方式是利用slots(插槽),就是让父组件在子组件内设置自定义内容。 //*MyVersatileComponent.vue* <template> <divclass="wrapper"> <h3>Commonmarkup</div> <slot/> </div> </template> //*ParentComponent.vue* <template> <MyVersatileComponent> <h4>Insertingintotheslot</h4> </MyVersatileComponent> </template> 渲染结果: <divclass="wrapper"> <h3>Commonmarkup</div> <h4>Insertingintotheslot</h4> </div> 这种模式有一个潜在约束, slot 内的元素从属于父组件的上下文,在拆分逻辑和状态时可能不太自然。scoped slot会更灵活,后面会在无渲染组件一节里提到。 JavaScript 工具函数 如果只需要在各组件之间复用独立的函数,那么只需要抽取这些 JavaScript 模块就行了,根本不需要用到组件扩展模式。 JavaScript 的模块系统是一种非常灵活和健壮的代码共享方式,所以你应该尽可能地依靠它。 MyUtilityFunction.js exportdefaultfunction(){ ... } MyComponent.vue importMyUtilityFunctionfrom"./MyUtilityFunction"; exportdefault{ methods:{ MyUtilityFunction } } 扩展组件的几种模式 如果你已经考虑过以上几种简单的模式,但这些模式还不够灵活,无法满足需求。那么就可以考虑扩展组件了。 扩展 Vue 组件最流行的方法有以下四种: Composition API mixin 高阶组件(HOC) 无渲染组件 每一种方法都有其优缺点,根据使用场景,或多或少都有适用的部分。 Composition API 组件之间共享状态和逻辑的最新方案是 Composition API。这是 Vue 3 推出的 API,也可以在 Vue 2 里当插件使用。 跟之前在组件定义配置对象里声明data,computed,methods等属性的方式不同,Composition API 通过一个setup函数声明和返回这些配置。 比如,用 Vue 2 配置属性的方式声明Counter组件是这样的: Counter.vue <template> <button@click="increment"> Countis:{{count}},doubleis:{{double}} </button> <template> <script> exportdefault{ data:()=>({ count:0 }), methods:{ increment(){ this.count++; } }, computed:{ double(){ returnthis.count*2; } } } </script> 用 Composition API 重构这个组件,功能完全一样: Counter.vue <template><!--asabove--><template> <script> import{reactive,computed}from"vue"; exportdefault{ setup(){ conststate=reactive({ count:0, double:computed(()=>state.count*2) }); functionincrement(){ state.count++ } return{ count, double, increment } } } </script> 用 Composition API 声明组件的主要好处之一是,逻辑复用和抽取变得非常轻松。 进一步重构,把计数器的功能移到 JavaScript 模块useCounter.js中: useCounter.js import{reactive,computed}from"vue"; exportdefaultfunction{ conststate=reactive({ count:0, double:computed(()=>state.count*2) }); functionincrement(){ state.count++ } return{ count, double, increment } } 现在,计数器功能可以通过setup函数无缝引入到任意 Vue 组件中: MyComponent.vue <template><!--asabove--></template> <script> importuseCounterfrom"./useCounter"; exportdefault{ setup(){ const{count,double,increment}=useCounter(); return{ count, double, increment } } } </script> Composition 函数让功能模块化、可重用,是扩展组件最直接和低成本的方式。 Composition API 的缺点 Composition API 的缺点其实不算什么——可能就是看起来有点啰嗦,并且新的用法对一些 Vue 开发者来说有点陌生。新技术总有个适应的过程,迟早会大面积应用。 mixin 如果你还在用 Vue 2,或者只是喜欢用配置对象的方式定义组件功能,可以用 mixin 模式。mixin 把公共逻辑和状态抽取到单独的对象,跟使用 mixin 的组件内部定义对象合并。 我们继续用之前的Counter组件例子,把公共逻辑和状态放到CounterMixin.js模块中。 CounterMixin.js exportdefault{ data:()=>({ count:0 }), methods:{ increment(){ this.count++; } }, computed:{ double(){ returnthis.count*2; } } } 使用 mixin 也很简单,只要导入对应模块并在mixins数组里加上变量就行。组件初始化时会把 mixin 对象与组件内部定义对象合并。 MyComponent.vue importCounterMixinfrom"./CounterMixin"; exportdefault{ mixins:[CounterMixin], methods:{ decrement(){ this.count--; } } } 选项合并 如果组件内的选项跟 mixin 冲突怎么办? 比如,给组件定义一个自带的increment方法,哪个优先级更高呢? MyComponent.vue importCounterMixinfrom"./CounterMixin"; exportdefault{ mixins:[CounterMixin], methods:{ //自带的`increment``方法会覆盖 mixin 的`increment`吗? increment(){...} } } 这个时候就要说到 Vue 的合并策略了。Vue 有一系列的规则,决定了如何处理同名选项。 通常,组件自带的选项会覆盖来自 mixin 的选项。但也有例外,比如同类型的生命周期钩子,不是直接覆盖,而是都放进数组,按顺序执行。 你也可以通过自定义合并策略改变默认行为。 mixin 的缺点 作为扩展组件的一种模式,mixin 对于简单的场景还算好用,一旦规模扩大,问题就来了。不仅需要注意命名冲突问题(尤其是第三方 mixin),使用了多个 mixin 的组件,很难搞清楚某个功能到底来自于哪里,定位问题也比较困难。 高阶组件 高阶组件(HOC)是从 React 借用的概念,Vue 也能使用。 为了理解这个概念,我们先抛开组件,看看两个简单的 JavaScript 函数,increment和double。 functionincrement(x){ returnx++; } functiondouble(x){ returnx*2; } 假设我们想给这两个函数都加一个功能:在控制台输出结果。 为此,我们可以用高阶函数模式,新建一个addLogging函数,接受函数作为参数,并返回一个带有新增功能的函数。 functionaddLogging(fn){ returnfunction(x){ constresult=fn(x); console.log("Theresultis:",result); returnresult; }; } constincrementWithLogging=addLogging(increment); constdoubleWithLogging=addLogging(double); 组件如何利用这种模式呢?类似地,我们创建一个高阶组件来渲染Counter组件,同时添加一个decrement方法作为实例属性。 实际代码比较复杂,这里只给出伪代码作为示意: importCounterfrom"./Counter"; //伪代码 constCounterWithDecrement=>({ render(createElement){ constoptions={ decrement(){ this.count--; } } returncreateElement(Counter,options); } }); HOC 模式比 mixin 更简洁,扩展性更好,但是代价是增加了一个包裹组件,实现起来也需要技巧。 无渲染组件 如果需要在多个组件上使用相同的逻辑和状态,只是展示方式不同,那么就可以考虑无渲染组件模式。 该模式需要用到两类组件:逻辑组件用于声明逻辑和状态,展示组件用于展示数据。 逻辑组件 还是回到Counter的例子,假设我们需要在多个地方重用这个组件,但是展示方式不同。 创建一个CounterRenderless.js用于定义逻辑组件,包含逻辑和状态,但是不包含模板,而是通过render函数声明scoped slot。 scoped slot暴露三个属性给父组件使用:状态count,方法increment和计算属性double。 CounterRenderless.js exportdefault{ data:()=>({ count:0 }), methods:{ increment(){ this.count++; } }, computed:{ double(){ returnthis.count*2; } }, render(){ returnthis.$scopedSlots.default({ count:this.count, double:this.double, increment:this.toggleState, }) } } 这里的scoped slot是这种模式里逻辑组件的关键所在。 展示组件 接下来是展示组件,作为无渲染组件的使用方,提供具体的展示方式。 所有的元素标签都包含在scoped slot里。可以看到,这些属性在使用上跟模板直接放在逻辑组件里没什么两样。 CounterWithButton.vue <template> <counter-renderlessslot-scope="{count,double,increment}"> <div>Countis:{{count}}</div> <div>Doubleis:{{double}}</div> <button@click="increment">Increment</button> </counter-renderless> </template> <script> importCounterRenderlessfrom"./CountRenderless"; exportdefault{ components:{ CounterRenderless } } </script> 无渲染组件模式非常灵活,也容易理解。但是,它没有前面那几种方法那么通用,可能只有一种应用场景,那就是用于开发组件库。 模板扩展 上面的 API 也好,设计模式也罢,都有一种局限性,就是无法扩展组件的模板。Vue 在逻辑和状态方面有办法重用,但是对于模板标签就无能为力了。 有一种比较 hack 的方式,就是利用 HTML 预处理器,比如 Pug,来处理模板扩展。 第一步是创建一个基础模板.pug文件,包含公共的页面元素。还要包含一个block input,作为模板扩展的占位符。 BaseTemplate.pug div.wrapper h3{{myCommonProp}}<!--commonmarkup--> blockinput<!--extendedmarkupoutlet--> 为了能扩展这个模板,需要安装 Vue Loader 的 Pug 插件。然后就可以引入基础模板并利用block input语法替换占位部分了: MyComponent.vue <templatelang="pug"> extendsBaseTemplate.pug blockinput h4{{myLocalProp}}<!--getsincludedinthebasetemplate--> </template> 一开始你可能会认为它跟 slot 的概念是一样的,但是有个区别,这里的基础模板不属于任何单独的组件。它在编译时跟当前组件合并,而不是像 slot 那样是在运行时替换。 参考资料: https://reactjs.org/blog/2016/07/13/mixins-considered-harmful.html https://adamwathan.me/renderless-components-in-vuejs/ 顺手点“在看”,每天早下班;转发加关注,共奔小康路~ 本文分享自微信公众号 - 1024译站(trans1024)。 如有侵权,请联系 support@oschina.cn 删除。 本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | 最全分布式锁设计方案

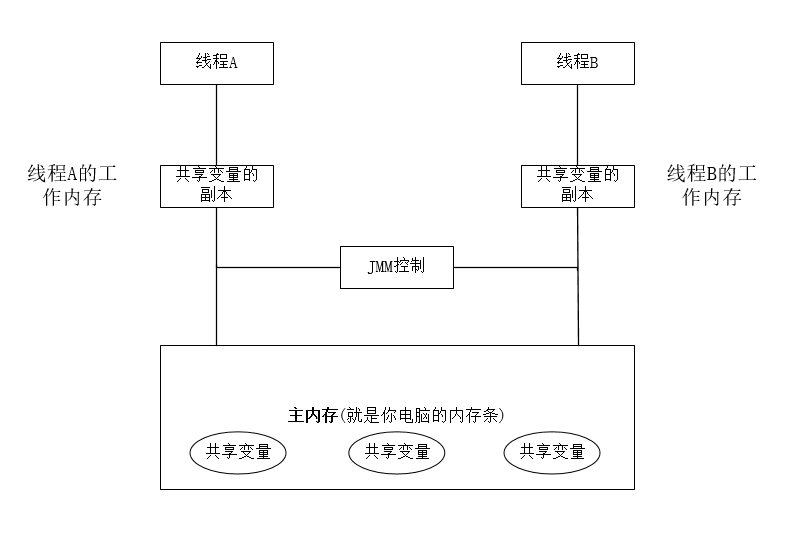
本文涉及内容: 分布式锁介绍; 用数据表做分布式锁原理介绍 & 数据表设计; 用redis做分布式锁原理介绍 & 代码实操; 用redisson做分布式锁原理介绍 & 代码实操; 用zookeeper做分布式锁原理介绍; 用curator做分布式锁代码实操; 实现分布式锁的各方案比较; 完整项目的GitHub地址 一、是什么? 1、锁的应用场景: 在单体应用中,我们会使用ReentrantLock或Synchronized来应对并发场景。比如最常见的卖票场景,假如总共有100张票,线程A和线程B同时操作,如下图: JMM内存模型 这时有一个共享变量100,线程A和B将100拷贝到自己的工作内存中,当线程A抢到执行权的时候,此时A工作内存中的值是100,然后售票,进行自减操作,将自己工作内存中的值变成了99。当A还没来得及将99刷回到主内存的时候,线程B进来了,此时B拿到的主内存的值还是100,然后售票,进行自减,也是99。这就出现了同一张票出售了两次的情况。所以我们会加锁加volatile保证原子性保证可见性。 2、分布式锁是什么? 上面的场景中,我们可以通过ReentrantLock或者Synchronized搞定,因为你的项目只运行在一台服务器上,只有一个JVM,所有的共享变量都加载到同一个主内存中。而分布式应用中,一个项目部署在多台服务器上,最基本的架构如下图: 最简单的分布式架构 比如现在server1、server2和server3读取到数据库的票数都是100,在每一个server中,我们可以用JDK的锁来保证多个用户同时访问我这台server时不会出问题。但问题是,如果client1访问到的是server1,票数是100,然后购票,还没来得及将数据库票数改为99,client2也开始访问系统购票了,client2如果访问的是server1,自然不会出问题,如果访问的是server2,这时server2读取到数据库的票数还是100,那么就出问题了,又出现了同一张票卖了两次的情况。在分布式应用中,JDK的锁机制就无法满足需求了,所以就出现了分布式锁。 3、分布式锁应该满足的条件: 四个一:同一个方法在同一时刻只能被一台机器的一个线程执行 三个具备:具备可重入特性;具备锁失效机制,防止死锁;具备非阻塞锁特性,即没获取到锁返回获取锁失败,而不是一直等待 两个高:高性能地获取与释放锁;高可用的获取与释放锁 4、分布式锁的实现方式: 基于数据库:用数据库的排他锁实现 基于redis:利用redis的 set key value NX EX 30000;也可以用redis的第三方库比如Redisson 基于zookeeper:利用zookeeper的临时顺序节点实现;也可以用zookeeper的第三方库比如Curator 二、基于数据库实现 1、建表: CREATETABLE`tb_distributed_lock`(`dl_id`INTNOTNULLauto_incrementCOMMENT'主键,自增',`dl_method_name`VARCHAR(64)NOTNULLDEFAULT''COMMENT'方法名',`dl_device_info`VARCHAR(100)NOTNULLDEFAULT''COMMENT'ip+线程id',`dl_operate_time`TIMESTAMPNOTNULLDEFAULTCURRENT_TIMESTAMPONUPDATECURRENT_TIMESTAMPCOMMENT'数据被操作的时间',PRIMARYKEY(`dl_id`),UNIQUEKEY`uq_method_name`(`dl_method_name`)USINGBTREE)ENGINE=INNODBDEFAULTcharset=utf8COMMENT='分布式锁表'; 2、思路: 当执行一个方法的时候,我们首先尝试往表中插入一条数据。如果插入成功,则占锁成功,继续往下执行,执行完删除该记录。如果插入失败,我们再以当前方法名、当前机器ip+线程id、数据被操作时间为5分钟内(5分钟表示锁失效的时间)为条件去查询,如果有记录,表示该机器的该线程在5分钟内占有过锁了,直接往下执行最后删除记录;如果没有记录,占有锁失败。一个用户就是一个线程,所以我们可以把机器ip和用户id组合一起当成dl_device_info。 3、占有锁和释放锁: 占有锁: INSERTINTOtb_distributed_lock(dl_method_name,dl_device_info)VALUES('方法名','ip&用户id'); 如果insert失败,则: SELECTcount(*)FROMtb_distributed_lockWHEREdl_method_name='方法名'ANDdl_device_info='ip&用户id'ANDdl_operate_time<SYSDATE()-5; 释放锁: DELETEFROMtb_distributed_lockWHEREdl_method_name='方法名'ANDdl_device_info='ip&用户id'; 4、小总结: 以上表结构可能并不是很好,只是提供了这么一个思路。下面说它的优缺点: 优点:成本低,不需要引入其他的技术 缺点:对数据库依赖性强,如果数据库挂了,那就凉凉了,所以数据库最好也是高可用的 三、基于redis实现 1、原理: 基于redis的set key value nx ex 30,这条语句的意思就是如果key不存在就设置,并且过期时间为30s,如果key已经存在就会返回false。如果要以毫秒为单位,把ex换成px就好了。我们执行方法前,先将方法名当成key,执行这条语句,如果执行成功就是获取锁成功,执行失败就是获取锁失败。 2、代码实现: RedisUtil的部分代码: /***key不存在时就设置,返回true,key已存在就返回false*@paramkey*@paramvalue*@paramtimeout*@return*/publicstaticbooleansetIfAbsent(Stringkey,Stringvalue,Longtimeout){returnredisTemplate.opsForValue().setIfAbsent(key,value,timeout,TimeUnit.SECONDS);}/***获取key-value*@paramkey*@return*/publicstaticStringgetString(Stringkey){return(String)redisTemplate.opsForValue().get(key);}/***删除key*@paramkey*@return*/publicstaticbooleandelKey(Stringkey){returnredisTemplate.delete(key);} 业务方法中使用: publicStringhello(){//方法名当作keyStringkey="hello";Stringvalue="hellolock";if(RedisUtil.setIfAbsent(key,value,60*2L)){System.out.println("成功获取到锁,开始执行业务逻辑……");//假如执行业务逻辑需要1分钟try{TimeUnit.MINUTES.sleep(1L);}catch(Exceptione){e.printStackTrace();};//释放锁先校验value,避免释放错if(value.equals(RedisUtil.getString(key))){RedisUtil.delKey(key);System.out.println("执行完业务逻辑,释放锁成功");}return"success";}else{System.out.println("锁被别的线程占有,获取锁失败");return"acquirelockfailed";}} 3、小总结: 优点:简单易用,一条redis命令就搞定。可以设置过期时间,避免释放锁失败造成其他线程长时间无法获取锁的问题。 缺点:这种做法只适合redis是单机的时候,如果redis有集群,这样做就会出问题。假如一个线程在master上获取锁成功了,在master还没来得及将数据同步到slave上的时候,master挂了,slave升级为master。第二个线程进来尝试获取锁,因为新的master上并没有这个key,所以,也能成功获取到锁。 解决办法:针对上面的缺点,我们可以采用redis的RedLock算法。假如集群中有n个redis,我们先从这n个redis中尝试获取锁(锁的过期时间为x),并记录获取锁的消耗的总时间t,获取锁成功数量为s,当且仅当t < x 并且 s >= (n/2 + 1)时,认为获取锁成功。 四、基于Redisson实现 1、是什么? 官网地址:https://github.com/redisson/redisson/wiki/Table-of-Content Redisson是一个功能十分强大的redis客户端,封装了很多分布式操作,比如分布式对象、分布式集合、分布式锁等。它的分布式锁也很多,什么公平锁、可重入锁、redlock等一应俱全,下面来看看如何在springboot项目中使用它。 2、使用redisson做分布式锁: 添加依赖: <!--redisson-springboot-starter--><dependency><groupId>org.redisson</groupId><artifactId>redisson-spring-boot-starter</artifactId><version>3.12.3</version></dependency><!--io.netty/netty-all--><dependency><groupId>io.netty</groupId><artifactId>netty-all</artifactId></dependency> application.yml: spring:application:name:distributed-lockredis:#redis单机版的写法host:192.168.2.43port:6379#集群的写法#cluster:#nodes:#-192.168.0.106,192.168.0.107#哨兵的写法#sentinel:#master:192.168.0.106#nodes:#-192.168.0.107,192.168.0.108 用法:直接注入RedissonClient,然后用它获取锁,得到锁之后就可以进行占锁和释放锁了。有阻塞式锁,也有非阻塞式锁,具体用法如下: @AutowiredprivateRedissonClientredisson;/***未设置过期时间,没获取到就会一直阻塞着*@return*/@GetMapping("/testLock")publicStringtestLock(){log.info("进入testLock方法,开始获取锁");Stringkey="testLock";RLocklock=redisson.getLock(key);lock.lock();log.info("获取锁成功,开始执行业务逻辑……");try{TimeUnit.SECONDS.sleep(10L);}catch(Exceptione){e.printStackTrace();};log.info("执行完业务逻辑,释放锁");lock.unlock();return"success";}/***尝试获取锁,没获取到就直接失败,不会阻塞*@return*/@GetMapping("/testTryLock")publicStringtestTryLock(){log.info("进入testTryLock方法,开始获取锁");Stringkey="testTryLock";RLocklock=redisson.getLock(key);booleanres=lock.tryLock();if(!res){log.error("尝试获取锁失败");return"fail";}else{log.info("获取锁成功,开始执行业务逻辑……");try{TimeUnit.SECONDS.sleep(30L);}catch(Exceptione){e.printStackTrace();};log.info("执行完业务逻辑,释放锁");lock.unlock();return"success";}}/***锁设置了过期时间,即使最后面的unlock失败,20秒后也会自动释放锁*@return*/@GetMapping("/testLockTimeout")publicStringtestLockTimeout(){log.info("进入testLockTimeout方法,开始获取锁");Stringkey="testLockTimeout";RLocklock=redisson.getLock(key);//20秒后自动释放锁lock.lock(20,TimeUnit.SECONDS);log.info("获取锁成功,开始执行业务逻辑……");try{TimeUnit.SECONDS.sleep(10L);}catch(Exceptione){e.printStackTrace();};lock.unlock();return"success";}/***尝试获取锁,15秒还没获取到就获取锁失败;获取到了会持有20秒,20秒后自动释放锁*@return*/@GetMapping("/testTryLockTimeout")publicStringtestTryLockTimeout(){log.info("进入testTryLockTimeout方法,开始获取锁");Stringkey="testTryLockTimeout";RLocklock=redisson.getLock(key);booleanres=false;try{res=lock.tryLock(15,20,TimeUnit.SECONDS);}catch(InterruptedExceptione1){e1.printStackTrace();}if(!res){log.error("尝试获取锁失败");return"fail";}else{log.info("获取锁成功,开始执行业务逻辑……");try{TimeUnit.SECONDS.sleep(10L);}catch(Exceptione){e.printStackTrace();};log.info("执行完业务逻辑,释放锁");lock.unlock();return"success";}} 3、小总结: 以上就是使用redisson做分布式锁的简单demo,用起来十分的方便。上面是与springboot项目集成,直接用它提供的springboot的starter就好了。用它来做分布式锁的更多用法请移步至官网:redisson分布式锁。 五、基于zookeeper实现 1、zookeeper知识点回顾: zookeeper有四种类型的节点: 持久节点:默认的节点类型,客户端与zookeeper断开连接后,节点依然存在 持久顺序节点:首先是持久节点,顺序的意思是,zookeeper会根据节点创建的顺序编号 临时节点:客户端与zookeeper断开连接后节点不复存在 临时顺序节点:客户端与zookeeper断开连接后节点不复存在,zookeeper会根据节点创建的顺序编号 2、基于zookeeper实现分布式锁的原理: 我们正是利用了zookeeper的临时顺序节点来实现分布式锁。首先我们创建一个名为lock(节点名称随意)的持久节点。线程1获取锁时,就在lock下面创建一个名为lock1的临时顺序节点,然后查找lock下所有的节点,判断自己的lock1是不是第一个,如果是,获取锁成功,继续执行业务逻辑,执行完后删除lock1节点;如果不是第一个,获取锁失败,就watch排在自己前面一位的节点,当排在自己前一位的节点被干掉时,再检查自己是不是排第一了,如果是,获取锁成功。图解过程如下: zookeeper分布式锁原理 线程1创建了一个lock1,发现lock1的第一个节点,占锁成功;在线程1还没释放锁的时候,线程2来了,创建了一个lock2,发现lock2不是第一个,便监控lock1,线程3此时进行就监控lock2。直到自己是第一个节点时才占锁成功。假如某个线程释放锁的时候zookeeper崩了也没关系,因为是临时节点,断开连接节点就没了,其他线程还是可以正常获取锁,这就是要用临时节点的原因。 说清楚了原理,用代码实现也就不难了,可以引入zookeeper的客户端zkClient,自己写代码实现(偷个懒,自己就不写了,有兴趣的可以参考我zookeeper的文章,肯定可以自己写出来的)。不过有非常优秀的开源解决方案比如curator,下面就看看curator怎么用。 六、基于curator实现 1、springboot整合curator: pom.xml: <!--curatorstart--><dependency><groupId>org.apache.zookeeper</groupId><artifactId>zookeeper</artifactId><version>3.4.14</version></dependency><dependency><groupId>org.apache.curator</groupId><artifactId>curator-framework</artifactId><version>4.2.0</version></dependency><dependency><groupId>org.apache.curator</groupId><artifactId>curator-recipes</artifactId><version>4.2.0</version></dependency><dependency><groupId>org.seleniumhq.selenium</groupId><artifactId>selenium-java</artifactId></dependency><!--curatorend--> application.yml:注意,curator下面这些属性spring是没有集成的,也就是说写的时候不会有提示 curator:retryCount:5#连接失败的重试次数retryTimeInterval:5000#每隔5秒重试一次url:192.168.2.43:2181#zookeeper连接地址sessionTimeout:60000#session超时时间1分钟connectionTimeout:5000#连接超时时间5秒钟 配置类:读取application.yml中的属性,创建CuratorFramework实例 @ConfigurationpublicclassCutatorConfig{@Value("${curator.retryCount}")privateIntegerretryCount;@Value("${curator.retryTimeInterval}")privateIntegerretryTimeInterval;@Value("${curator.url}")privateStringurl;@Value("${curator.sessionTimeout}")privateIntegersessionTimeout;@Value("${curator.connectionTimeout}")privateIntegerconnectionTimeout;@BeanpublicCuratorFrameworkcuratorFramework(){returnCuratorFrameworkFactory.newClient(url,sessionTimeout,connectionTimeout,newRetryNTimes(retryCount,retryTimeInterval));}} 测试类:测试整合curator框架是否成功 @SpringBootTest(classes={DistributedLockApplication.class})@RunWith(SpringRunner.class)publicclassDistributedLockApplicationTests{@AutowiredprivateCuratorFrameworkcuratorFramework;@TestpublicvoidcontextLoads(){curatorFramework.start();try{curatorFramework.create().creatingParentContainersIfNeeded().withMode(CreateMode.PERSISTENT).forPath("/zhusl","test".getBytes());}catch(Exceptione){e.printStackTrace();}}} 在确保zookeeper成功启动了的情况下,执行这个单元测试,最后回到linux中,用zkCli.sh连接,查看是否成功创建节点。 2、使用Curator做分布式锁: Curator封装了很多锁,比如可重入共享锁、不可重入共享锁、可重入读写锁、联锁等。具体可以参考官网:curator分布式锁的用法。 ZookeeperUtil.java:工具类,封装获取锁,释放锁等方法。这里主要简单地封装了上面说的四种锁,仅供参考。 @Component@Slf4jpublicclassZookeeperUtil{privatestaticCuratorFrameworkcuratorFramework;privatestaticInterProcessLocklock;/**持久节点*/privatefinalstaticStringROOT_PATH="/lock/";/**可重入共享锁*/privatestaticInterProcessMutexinterProcessMutex;/**不可重入共享锁*/privatestaticInterProcessSemaphoreMutexinterProcessSemaphoreMutex;/**可重入读写锁*/privatestaticInterProcessReadWriteLockinterProcessReadWriteLock;/**多共享锁(将多把锁当成一把来用)*/privatestaticInterProcessMultiLockinterProcessMultiLock;@AutowiredprivatevoidsetCuratorFramework(CuratorFrameworkcuratorFramework){ZookeeperUtil.curatorFramework=curatorFramework;ZookeeperUtil.curatorFramework.start();}/***获取可重入排他锁**@paramlockName*@return*/publicstaticbooleaninterProcessMutex(StringlockName){interProcessMutex=newInterProcessMutex(curatorFramework,ROOT_PATH+lockName);lock=interProcessMutex;returnacquireLock(lockName,lock);}/***获取不可重入排他锁**@paramlockName*@return*/publicstaticbooleaninterProcessSemaphoreMutex(StringlockName){interProcessSemaphoreMutex=newInterProcessSemaphoreMutex(curatorFramework,ROOT_PATH+lockName);lock=interProcessSemaphoreMutex;returnacquireLock(lockName,lock);}/***获取可重入读锁**@paramlockName*@return*/publicstaticbooleaninterProcessReadLock(StringlockName){interProcessReadWriteLock=newInterProcessReadWriteLock(curatorFramework,ROOT_PATH+lockName);lock=interProcessReadWriteLock.readLock();returnacquireLock(lockName,lock);}/***获取可重入写锁**@paramlockName*@return*/publicstaticbooleaninterProcessWriteLock(StringlockName){interProcessReadWriteLock=newInterProcessReadWriteLock(curatorFramework,ROOT_PATH+lockName);lock=interProcessReadWriteLock.writeLock();returnacquireLock(lockName,lock);}/***获取联锁(多把锁当成一把来用)*@paramlockNames*@return*/publicstaticbooleaninterProcessMultiLock(List<String>lockNames){if(lockNames==null||lockNames.isEmpty()){log.error("nolockNamesfound");returnfalse;}interProcessMultiLock=newInterProcessMultiLock(curatorFramework,lockNames);try{if(!interProcessMultiLock.acquire(10,TimeUnit.SECONDS)){log.info("Thread:"+Thread.currentThread().getId()+"acquiredistributedlockfail");returnfalse;}else{log.info("Thread:"+Thread.currentThread().getId()+"acquiredistributedlocksuccess");returntrue;}}catch(Exceptione){log.info("Thread:"+Thread.currentThread().getId()+"releaselockoccuredanexception="+e);returnfalse;}}/***释放锁**@paramlockName*/publicstaticvoidreleaseLock(StringlockName){try{if(lock!=null&&lock.isAcquiredInThisProcess()){lock.release();curatorFramework.delete().inBackground().forPath(ROOT_PATH+lockName);log.info("Thread:"+Thread.currentThread().getId()+"releaselocksuccess");}}catch(Exceptione){log.info("Thread:"+Thread.currentThread().getId()+"releaselockoccuredanexception="+e);}}/***释放联锁*/publicstaticvoidreleaseMultiLock(List<String>lockNames){try{if(lockNames==null||lockNames.isEmpty()){log.error("nonolockNamesfoundtorelease");return;}if(interProcessMultiLock!=null&&interProcessMultiLock.isAcquiredInThisProcess()){interProcessMultiLock.release();for(StringlockName:lockNames){curatorFramework.delete().inBackground().forPath(ROOT_PATH+lockName);}log.info("Thread:"+Thread.currentThread().getId()+"releaselocksuccess");}}catch(Exceptione){log.info("Thread:"+Thread.currentThread().getId()+"releaselockoccuredanexception="+e);}}/***获取锁**@paramlockName*@paraminterProcessLock*@return*/privatestaticbooleanacquireLock(StringlockName,InterProcessLockinterProcessLock){intflag=0;try{while(!interProcessLock.acquire(2,TimeUnit.SECONDS)){flag++;if(flag>1){break;}}}catch(Exceptione){log.error("acquirelockoccuredanexception="+e);returnfalse;}if(flag>1){log.info("Thread:"+Thread.currentThread().getId()+"acquiredistributedlockfail");returnfalse;}else{log.info("Thread:"+Thread.currentThread().getId()+"acquiredistributedlocksuccess");returntrue;}}} ZookeeperLockController.java:写一个接口,用Curator加锁,然后用浏览器进行访问 @RestController@RequestMapping("/zookeeper-lock")publicclassZookeeperLockController{@GetMapping("/testLock")publicStringtestLock(){//获取锁booleanlockResult=ZookeeperUtil.interProcessMutex("testLock");if(lockResult){try{//模拟执行业务逻辑TimeUnit.MINUTES.sleep(1L);}catch(InterruptedExceptione){e.printStackTrace();}//释放锁ZookeeperUtil.releaseLock("testLock");return"success";}else{return"fail";}}} 打开一个浏览器窗口访问,后台打印出获取锁成功的日志,在1分钟之内,开启另一个窗口再次访问,打印出获取锁失败的日志,说明分布式锁生效了。 七、实现分布式锁的各方案比较 基于数据库实现最简单,不需要引入第三方应用。但是因为每次加锁和解锁都要进行IO操作,性能不是很好。 基于redis实现比较均衡,性能很好,也不是很难,比较可靠。 基于zookeeper实现难度较大,因为需要维护一个zookeeper集群,如果项目原本没有用到zookeeper,还是用redis比较好。 本文项目地址:分布式锁 -java开发那些事- 长按扫描二维码 关注我获取更多内容 本文分享自微信公众号 - java开发那些事(javawebkf)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | 操作系统和并发的爱恨纠葛

点击蓝色“Java建设者”关注我哟 加个“星标”,及时阅读最新技术文章 这是Java建设者的第 110 篇原创文章 我一直没有急于写并发的原因是我参不透操作系统,如今,我已经把操作系统刷了一遍,这次试着写一些并发,看看能不能写清楚,卑微小编在线求鼓励...... 我打算采取操作系统和并发同时结合讲起来的方式。 并发历史 在计算机最早期的时候,没有操作系统,执行程序只需要一个过程,那就是从头到尾依次执行。任何资源都会为这个程序服务,这必然就会存在 浪费资源 的情况。 ❝ 这里说的浪费资源指的是资源空闲,没有充分使用的情况。 ❞ 操作系统为我们的程序带来了 并发性,操作系统使我们的程序同时运行多个程序,一个程序就是一个进程,也就相当于同时运行了多个进程。 操作系统是一个并发系统,并发性是操作系统非常重要的特征,操作系统具有同时处理和调度多个程序的能力,比如多个 I/O 设备同时在输入输出;设备 I/O 和 CPU 计算同时进行;内存中同时有多个系统和用户程序被启动交替、穿插地执行。操作系统在协调和分配进程的同时,操作系统也会为不同进程分配不同的资源。 操作系统实现多个程序同时运行解决了单个程序无法做到的问题,主要有下面三点 资源利用率,我们上面说到,单个进程存在资源浪费的情况,举个例子,当你在为某个文件夹赋予权限的时候,输入程序无法接受外部的输入字符,只能等到权限赋予完毕后才能接受外部输入。综合来讲,就是在等待程序时无法执行其他工作。如果在等待程序的同时可以运行另一个程序,那么将会大大提高资源的利用率。(资源并不会觉得累)因为它不会划水~ 公平性,不同的用户和程序对于计算机上的资源有着同样的使用权。一种高效的运行方式是为不同的程序划分时间片使用资源,但是有一点需要注意,操作系统可以决定不同进程的优先级,虽然每个进程都有能够公平享有资源的权利,但是每次前一个进程释放资源后的同时有一个优先级更高的进程抢夺资源,就会造成优先级低的进程无法获得资源,久而久之会导致进程饥饿。 便利性,单个进程是无法通信的,通信这一点我认为其实是一种 避雷针策略,通信的本质就是 信息交换,及时进行信息交换能够避免 信息孤岛,做重复性的工作;任何并发能做的事情,顺序编程也能够实现,只不过这种方式效率很低,它是一种 阻塞式 的。 但是,顺序编程(也称为串行编程)也不是一无是处的,串行编程的优势在于其「直观性和简单性」,客观来讲,串行编程更适合我们人脑的思考方式,但是我们并不会满足于顺序编程,「we want it more!!!」 。资源利用率、公平性和便利性促使着进程出现的同时也促使着线程的出现。 如果你还不是很理解进程和线程的区别的话,那么我就以我多年操作系统的经验(吹牛逼,实则半年)来为你解释一下:「进程是一个应用程序,而线程是应用程序中的一条顺序流」。 或者阮一峰老师也给出了你通俗易懂的解释 摘自 https://www.ruanyifeng.com/blog/2013/04/processes_and_threads.html 线程会共享进程范围内的资源,例如内存和文件句柄,但是每个线程也有自己私有的内容,比如程序计数器、栈以及局部变量。下面汇总了进程和线程共享资源的区别 线程被描述为一种轻量级的进程,轻量级体现在线程的创建和销毁要比进程的开销小很多。 ❝ 注意:任何比较都是相对的。 ❞ 在大多数现代操作系统中,都以线程为基本的调度单位,所以我们的视角着重放在对线程的探究。 线程 优势和劣势 合理使用线程是一门艺术,合理编写一道准确无误的多线程程序更是一门艺术,如果线程使用得当,能够有效的降低程序的开发和维护成本。 在 GUI 中,线程可以提高用户界面的响应灵敏度,在服务器应用程序中,并发可以提高资源利用率以及系统吞吐率。 Java 很好的在用户空间实现了开发工具包,并在内核空间提供系统调用来支持多线程编程,Java 支持了丰富的类库 java.util.concurrent 和跨平台的内存模型,同时也提高了开发人员的门槛,并发一直以来是一个高阶的主题,但是现在,并发也成为了主流开发人员的必备素质。 虽然线程带来的好处很多,但是编写正确的多线程(并发)程序是一件极困难的事情,并发程序的 Bug 往往会诡异地出现又诡异的消失,在当你认为没有问题的时候它就出现了,难以定位 是并发程序的一个特征,所以在此基础上你需要有扎实的并发基本功。那么,并发为什么会出现呢? 为什么是并发 计算机世界的快速发展离不开 CPU、内存和 I/O 设备的高速发展,但是这三者一直存在速度差异性问题,我们可以从存储器的层次结构可以看出 CPU 内部是寄存器的构造,寄存器的访问速度要高于高速缓存,高速缓存的访问速度要高于内存,最慢的是磁盘访问。 程序是在内存中执行的,程序里大部分语句都要访问内存,有些还需要访问 I/O 设备,根据漏桶理论来说,程序整体的性能取决于最慢的操作也就是磁盘访问速度。 因为 CPU 速度太快了,所以为了发挥 CPU 的速度优势,平衡这三者的速度差异,计算机体系机构、操作系统、编译程序都做出了贡献,主要体现为: CPU 使用缓存来中和和内存的访问速度差异 操作系统提供进程和线程调度,让 CPU 在执行指令的同时分时复用线程,让内存和磁盘不断交互,不同的 CPU 时间片 能够执行不同的任务,从而均衡这三者的差异 编译程序提供优化指令的执行顺序,让缓存能够合理的使用 我们在享受这些便利的同时,多线程也为我们带来了挑战,下面我们就来探讨一下并发问题为什么会出现以及多线程的源头是什么 线程带来的安全性问题 线程安全性是非常复杂的,在没有采用同步机制的情况下,多个线程中的执行操作往往是不可预测的,这也是多线程带来的挑战之一,下面我们给出一段代码,来看看安全性问题体现在哪 publicclassTSynchronizedimplementsRunnable{ staticinti=0; publicvoidincrease(){ i++; } @Override publicvoidrun(){ for(inti=0;i<1000;i++){ increase(); } } publicstaticvoidmain(String[]args)throwsInterruptedException{ TSynchronizedtSynchronized=newTSynchronized(); ThreadaThread=newThread(tSynchronized); ThreadbThread=newThread(tSynchronized); aThread.start(); bThread.start(); System.out.println("i="+i); } } 这段程序输出后会发现,i 的值每次都不一样,这不符合我们的预测,那么为什么会出现这种情况呢?我们先来分析一下程序的运行过程。 TSynchronized 实现了 Runnable 接口,并定义了一个静态变量 i,然后在 increase 方法中每次都增加 i 的值,在其实现的 run 方法中进行循环调用,共执行 1000 次。 可见性问题 在单核 CPU 时代,所有的线程共用一个 CPU,CPU 缓存和内存的一致性问题容易解决,CPU 和 内存之间 如果用图来表示的话我想会是下面这样 在多核时代,因为有多核的存在,每个核都能够独立的运行一个线程,每颗 CPU 都有自己的缓存,这时 CPU 缓存与内存的数据一致性就没那么容易解决了,当多个线程在不同的 CPU 上执行时,这些线程操作的是不同的 CPU 缓存 因为 i 是静态变量,没有经过任何线程安全措施的保护,多个线程会并发修改 i 的值,所以我们认为 i 不是线程安全的,导致这种结果的出现是由于 aThread 和 bThread 中读取的 i 值彼此不可见,所以这是由于 可见性 导致的线程安全问题。 原子性问题 看起来很普通的一段程序却因为两个线程 aThread 和 bThread 交替执行产生了不同的结果。但是根源不是因为创建了两个线程导致的,多线程只是产生线程安全性的必要条件,最终的根源出现在 i++ 这个操作上。 这个操作怎么了?这不就是一个给 i 递增的操作吗?也就是 「i++ => i = i + 1」,这怎么就会产生问题了? 因为 i++ 不是一个 原子性 操作,仔细想一下,i++ 其实有三个步骤,读取 i 的值,执行 i + 1 操作,然后把 i + 1 得出的值重新赋给 i(将结果写入内存)。 当两个线程开始运行后,每个线程都会把 i 的值读入到 CPU 缓存中,然后执行 + 1 操作,再把 + 1 之后的值写入内存。因为线程间都有各自的虚拟机栈和程序计数器,他们彼此之间没有数据交换,所以当 aThread 执行 + 1 操作后,会把数据写入到内存,同时 bThread 执行 + 1 操作后,也会把数据写入到内存,因为 CPU 时间片的执行周期是不确定的,所以会出现当 aThread 还没有把数据写入内存时,bThread 就会读取内存中的数据,然后执行 + 1操作,再写回内存,从而覆盖 i 的值,导致 aThread 所做的努力白费。 为什么上面的线程切换会出现问题呢? 我们先来考虑一下正常情况下(即不会出现线程安全性问题的情况下)两条线程的执行顺序 可以看到,当 aThread 在执行完整个 i++ 的操作后,操作系统对线程进行切换,由 aThread -> bThread,这是最理想的操作,一旦操作系统在任意 读取/增加/写入 阶段产生线程切换,都会产生线程安全问题。例如如下图所示 最开始的时候,内存中 i = 0,aThread 读取内存中的值并把它读取到自己的寄存器中,执行 +1 操作,此时发生线程切换,bThread 开始执行,读取内存中的值并把它读取到自己的寄存器中,此时发生线程切换,线程切换至 aThread 开始运行,aThread 把自己寄存器的值写回到内存中,此时又发生线程切换,由 aThread -> bThread,线程 bThread 把自己寄存器的值 +1 然后写回内存,写完后内存中的值不是 2 ,而是 1, 内存中的 i 值被覆盖了。 我们上面提到 原子性 这个概念,那么什么是原子性呢? ❝ 并发编程的原子性操作是完全独立于任何其他进程运行的操作,原子操作多用于现代操作系统和并行处理系统中。 原子操作通常在内核中使用,因为内核是操作系统的主要组件。但是,大多数计算机硬件,编译器和库也提供原子性操作。 在加载和存储中,计算机硬件对存储器字进行读取和写入。为了对值进行匹配、增加或者减小操作,一般通过原子操作进行。在原子操作期间,处理器可以在同一数据传输期间完成读取和写入。这样,其他输入/输出机制或处理器无法执行存储器读取或写入任务,直到原子操作完成为止。 ❞ 简单来讲,就是「原子操作要么全部执行,要么全部不执行」。数据库事务的原子性也是基于这个概念演进的。 有序性问题 在并发编程中还有带来让人非常头疼的 有序性 问题,有序性顾名思义就是顺序性,在计算机中指的就是指令的先后执行顺序。一个非常显而易见的例子就是 JVM 中的类加载 这是一个 JVM 加载类的过程图,也称为类的生命周期,类从加载到 JVM 到卸载一共会经历五个阶段 「加载、连接、初始化、使用、卸载」。这五个过程的执行顺序是一定的,但是在连接阶段,也会分为三个过程,即 「验证、准备、解析」 阶段,这三个阶段的执行顺序不是确定的,通常交叉进行,在一个阶段的执行过程中会激活另一个阶段。 有序性问题一般是编译器带来的,编译器有的时候确实是 「好心办坏事」,它为了优化系统性能,往往更换指令的执行顺序。 活跃性问题 多线程还会带来活跃性问题,如何定义活跃性问题呢?活跃性问题关注的是 「某件事情是否会发生」。 「如果一组线程中的每个线程都在等待一个事件,而这个事件只能由该组中的另一个线程触发,这种情况会导致死锁」。 简单一点来表述一下,就是每个线程都在等待其他线程释放资源,而其他资源也在等待每个线程释放资源,这样没有线程抢先释放自己的资源,这种情况会产生死锁,所有线程都会无限的等待下去。 换句话说,死锁线程集合中的每个线程都在等待另一个死锁线程占有的资源。但是由于所有线程都不能运行,它们之中任何一个资源都无法释放资源,所以没有一个线程可以被唤醒。 如果说死锁很痴情的话,那么活锁用一则成语来表示就是 弄巧成拙。 某些情况下,当线程意识到它不能获取所需要的下一个锁时,就会尝试礼貌的释放已经获得的锁,然后等待非常短的时间再次尝试获取。可以想像一下这个场景:当两个人在狭路相逢的时候,都想给对方让路,相同的步调会导致双方都无法前进。 现在假想有一对并行的线程用到了两个资源。它们分别尝试获取另一个锁失败后,两个线程都会释放自己持有的锁,再次进行尝试,这个过程会一直进行重复。很明显,这个过程中没有线程阻塞,但是线程仍然不会向下执行,这种状况我们称之为 活锁(livelock)。 如果我们期望的事情一直不会发生,就会产生活跃性问题,比如单线程中的无限循环 while(true){...} for(;;){} 在多线程中,比如 aThread 和 bThread 都需要某种资源,aThread 一直占用资源不释放,bThread 一直得不到执行,就会造成活跃性问题,bThread 线程会产生饥饿,我们后面会说。 性能问题 与活跃性问题密切相关的是 性能 问题,如果说活跃性问题关注的是最终的结果,那么性能问题关注的就是造成结果的过程,性能问题有很多方面:比如服务时间过长,吞吐率过低,资源消耗过高,在多线程中这样的问题同样存在。 在多线程中,有一个非常重要的性能因素那就是我们上面提到的 线程切换,也称为 上下文切换(Context Switch),这种操作开销很大。 ❝ 在计算机世界中,老外都喜欢用 context 上下文这个词,这个词涵盖的内容很多,包括上下文切换的资源,寄存器的状态、程序计数器等。context switch 一般指的就是这些上下文切换的资源、寄存器状态、程序计数器的变化等。 ❞ 在上下文切换中,会保存和恢复上下文,丢失局部性,把大量的时间消耗在线程切换上而不是线程运行上。 为什么线程切换会开销如此之大呢?线程间的切换会涉及到以下几个步骤 将 CPU 从一个线程切换到另一线程涉及挂起当前线程,保存其状态,例如寄存器,然后恢复到要切换的线程的状态,加载新的程序计数器,此时线程切换实际上就已经完成了;此时,CPU 不在执行线程切换代码,进而执行新的和线程关联的代码。 引起线程切换的几种方式 线程间的切换一般是操作系统层面需要考虑的问题,那么引起线程上下文切换有哪几种方式呢?或者说线程切换有哪几种诱因呢?主要有下面几种引起上下文切换的方式 当前正在执行的任务完成,系统的 CPU 正常调度下一个需要运行的线程 当前正在执行的任务遇到 I/O 等阻塞操作,线程调度器挂起此任务,继续调度下一个任务。 多个任务并发抢占锁资源,当前任务没有获得锁资源,被线程调度器挂起,继续调度下一个任务。 用户的代码挂起当前任务,比如线程执行 sleep 方法,让出CPU。 使用硬件中断的方式引起上下文切换 线程安全性 在 Java 中,要实现线程安全性,必须要正确的使用线程和锁,但是这些只是满足线程安全的一种方式,要编写正确无误的线程安全的代码,其核心就是对状态访问操作进行管理。最重要的就是最 共享(Shared)的 和 可变(Mutable)的状态。只有共享和可变的变量才会出现问题,私有变量不会出现问题,参考程序计数器。 对象的状态可以理解为存储在实例变量或者静态变量中的数据,共享意味着某个变量可以被多个线程同时访问、可变意味着变量在生命周期内会发生变化。一个变量是否是线程安全的,取决于它是否被多个线程访问。要使变量能够被安全访问,必须通过同步机制来对变量进行修饰。 如果不采用同步机制的话,那么就要避免多线程对共享变量的访问,主要有下面两种方式 不要在多线程之间共享变量 将共享变量置为不可变的 我们说了这么多次线程安全性,那么什么是线程安全性呢? 什么是线程安全性 根据上面的探讨,我们可以得出一个简单的定义:「当多个线程访问某个类时,这个类始终都能表现出正确的行为,那么就称这个类是线程安全的」。 单线程就是一个线程数量为 1 的多线程,单线程一定是线程安全的。读取某个变量的值不会产生安全性问题,因为不管读取多少次,这个变量的值都不会被修改。 原子性 我们上面提到了原子性的概念,你可以把原子性操作想象成为一个不可分割 的整体,它的结果只有两种,要么全部执行,要么全部回滚。你可以把原子性认为是 婚姻关系 的一种,男人和女人只会产生两种结果,好好的 和 说散就散,一般男人的一生都可以把他看成是原子性的一种,当然我们不排除时间管理(线程切换)的个例,我们知道线程切换必然会伴随着安全性问题,男人要出去浪也会造成两种结果,这两种结果分别对应安全性的两个结果:线程安全(好好的)和线程不安全(说散就散)。 竞态条件 有了上面的线程切换的功底,那么竞态条件也就好定义了,它指的就是「两个或多个线程同时对一共享数据进行修改,从而影响程序运行的正确性时,这种就被称为竞态条件(race condition)」 ,线程切换是导致竞态条件出现的诱导因素,我们通过一个示例来说明,来看一段代码 publicclassRaceCondition{ privateSignletonsingle=null; publicSignletonnewSingleton(){ if(single==null){ single=newSignleton(); } returnsingle; } } 在上面的代码中,涉及到一个竞态条件,那就是判断 single 的时候,如果 single 判断为空,此时发生了线程切换,另外一个线程执行,判断 single 的时候,也是空,执行 new 操作,然后线程切换回之前的线程,再执行 new 操作,那么内存中就会有两个 Singleton 对象。 加锁机制 在 Java 中,有很多种方式来对共享和可变的资源进行加锁和保护。Java 提供一种内置的机制对资源进行保护:synchronized 关键字,它有三种保护机制 对方法进行加锁,确保多个线程中只有一个线程执行方法; 对某个对象实例(在我们上面的探讨中,变量可以使用对象来替换)进行加锁,确保多个线程中只有一个线程对对象实例进行访问; 对类对象进行加锁,确保多个线程只有一个线程能够访问类中的资源。 synchronized 关键字对资源进行保护的代码块俗称 同步代码块(Synchronized Block),例如 synchronized(lock){ //线程安全的代码 } 每个 Java 对象都可以用做一个实现同步的锁,这些锁被称为 内置锁(Instrinsic Lock)或者 监视器锁(Monitor Lock)。线程在进入同步代码之前会自动获得锁,并且在退出同步代码时自动释放锁,而无论是通过正常执行路径退出还是通过异常路径退出,获得内置锁的唯一途径就是进入这个由锁保护的同步代码块或方法。 synchronized 的另一种隐含的语义就是 互斥,互斥意味着独占,最多只有一个线程持有锁,当线程 A 尝试获得一个由线程 B 持有的锁时,线程 A 必须等待或者阻塞,直到线程 B 释放这个锁,如果线程 B 不释放锁的话,那么线程 A 将会一直等待下去。 线程 A 获得线程 B 持有的锁时,线程 A 必须等待或者阻塞,但是获取锁的线程 B 可以重入,重入的意思可以用一段代码表示 publicclassRetreent{ publicsynchronizedvoiddoSomething(){ doSomethingElse(); System.out.println("doSomething......"); } publicsynchronizedvoiddoSomethingElse(){ System.out.println("doSomethingElse......"); } 获取 doSomething() 方法锁的线程可以执行 doSomethingElse() 方法,执行完毕后可以重新执行 doSomething() 方法中的内容。锁重入也支持子类和父类之间的重入,具体的我们后面会进行介绍。 volatile 是一种轻量级的 synchronized,也就是一种轻量级的加锁方式,volatile 通过保证共享变量的可见性来从侧面对对象进行加锁。可见性的意思就是当一个线程修改一个共享变量时,另外一个线程能够 看见 这个修改的值。volatile 的执行成本要比 synchronized 低很多,因为 volatile 不会引起线程的上下文切换。 关于 volatile 的具体实现,我们后面会说。 我们还可以使用原子类 来保证线程安全,原子类其实就是 rt.jar 下面以 atomic 开头的类 除此之外,我们还可以使用 java.util.concurrent 工具包下的线程安全的集合类来确保线程安全,具体的实现类和其原理我们后面会说。 本文分享自微信公众号 - Java建设者(javajianshe)。 如有侵权,请联系 support@oschina.cn 删除。 本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | QUIC 协议详解之 Initial 包的处理

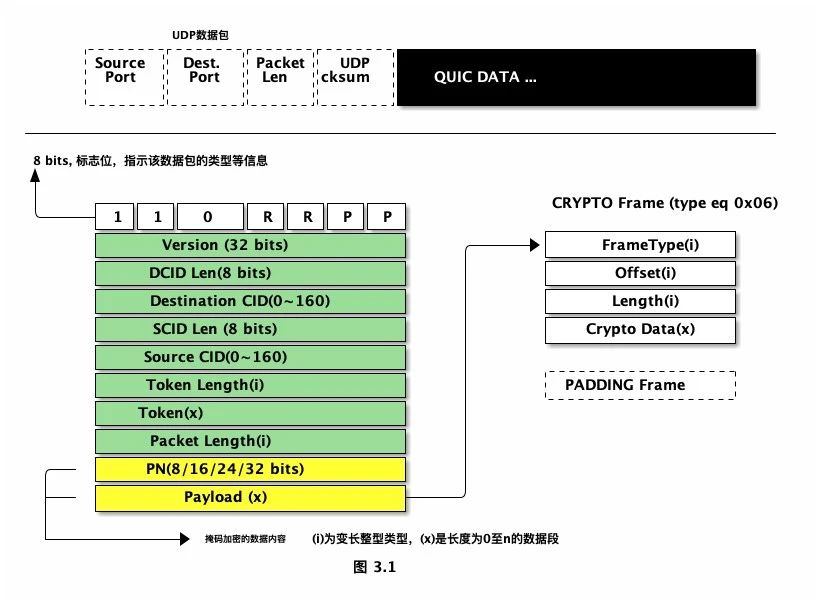
从服务器发起请求开始追踪,细说数据包在 QUIC 协议中经历的每一步。大量实例代码展示,简明易懂了解 QUIC。 前言 本文介绍了在 QUIC 服务器在收到 QUIC 客户端发起的第一个 UDP 请求— Initial 数据包的分析、处理和解密过程,涉及Initial数据包的格式,数据包头部保护的去除, Packet Number 的计算,负载数据的解密,client hello 的解析,等等。本文的 C 实现采用 OpenSSL,并基于 IETFQUIC Draft-27。 术语 **PacketNumber :**数据包序号 **Initial Packet:**初始数据包 **Variable-length Integer Encode:**可变长度整型编码 **HMAC:**Hash-based messageauthencation code,基于 Hash 的验证信息码 **HKDF: **HMAC-based Extract-and-Expand KeyDerivation Function,基于 HMAC 的提取扩展密钥衍生函数 AEAD: authenticated encryption withassociated data, 带有关联数据的认证加密 ECB: Electronic codebook,电子密码本 GCM: Galois/Counter Mode,伽罗瓦/计数器模式 IV: InitialVector, 初始化向量 基本概念介绍 Initial 数据包的结构 Initial 包是长头部结构的数据包,结构如图 3.1 所示,在 CRYPTO 帧后面需要跟上 PADDING 帧,这是 QUIC 协议预防 UDP 攻击的手段之一。一般情况下,CRYPTO 帧太短了(确实也有比较长“一锅炖不下”的情况,可参阅 QTS-TLS 4.3节),服务端为了响应 CRYPTO, 必须发送数据长度大得多的握手包(Handshake Packet),这样就会造成所谓的反射攻击。 QUIC 使用三种方法来抑制此类攻击: 含有 ClientHello 的数据包必须使用 PADDING 帧,达到协议要求的最小数据长度 1200 字节; 当服务端响应未经验证原地址的请求,第一次(firstflight)发送数据时,不允许发送超过三个 UDP 数据报的数据; 确认握手包是带验证的,盲攻击者无法伪造。 typedef struct { uint8_t flag; uint32_t version; uint8_t dcid_length; uint8_t *dcid; uint8_t scid_length; uint8_t *scid; uint64_t token_length; uint8_t *token; uint64_t packet_length; uint8_t *payload;} quic_long_header_packet_t; Packet Number 三种上下文空间 Packet Number 为整型变量,其值在 0 到 2^62-1 之间,它也用于生成数据包加密所需的 nonce。通讯双方维护各自的 Packet Number 体系, 并且分为三个独立的上下文空间: Initial 空间:所有的 Initial 数据包的 Packet Number 均在这个上下文空间里; Handshake 空间:所有的握手数据包; 应用数据空间:所有的 0-RTT 和 1-RTT 包。 所谓的 Packet Number 空间,指得是一种上下文关系,在这个上下文关系里,数据包被处理,被确认。换言之,初始数据包只能使用初始数据包专用的密钥,也只能确认初始数据包。类似的, 握手包只能使用握手包专用的密钥,也只能确认握手数据包。从 Initial 阶段进入 Handshake 阶段后, Initial 阶段使用的密钥就可以被丢弃了,Packet Number 也重新从 0 开始编号。 0-RTT 和 1-RTT 共享同一个 Packet Number 空间,这样做是为了更容易实现这两类数据包的丢包处理算法。 在同一连接同一个 Packet Number 空间里,你不能复用包号,包号必须是单调递增的,当然,具体实现的时候草案并不强制要求每次都递增1, 你可以递增 20,30。当 Packet Number 达到 2^62 -1 时,发送方必须关闭该连接。 通讯过程 Packet Number 的处理还有许多细节,比如重复抑制问题,这部分可以参考 QUIC-TLS 部分以及 RFC4303 的 3.4.3 节,这里就不深入展开讨论。 HKDF:基于 HMAC 的密钥衍生函数 密钥衍生函数(KDF)是加密系统最为基本核心的组件,它将初始密钥作为输入,生成一个或多个足够健壮的加密密钥。 HKDF 的提出一方面是为了给其他协议和应用程序提供基本的功能块,同时也为了解决各种不同机制的密钥衍生函数实现的激增问题。它采用“先提取再扩展(extract-and-expand)”的设计方式,逻辑上,一般采用两个步骤来完成密钥衍生。第一步,将输入的字符转换成固定长度的伪随机密钥。第二步,将其扩展成若干个伪随机密钥。一般人们把通过 Diffie-Hellman 交换的共享密文转换为指定长度的密钥,用于加密,完整性检查以及验证。具体原理可参考 RFC5869。 可变长度整型编码 QUIC 协议中大量使用可变长度整型编码,用首字节的高 2 位来表示数据的长度,编码规则如下: 举个例子: 0b00000011 01011110,0x035e => 2Bit=00,代表长度为 1,可用位数 6, 所以,Value = 3 0b01011001 01011110,0x595e => 2Bit=01,代表长度为 2,可用位数 14,所以,Value = 6494 代码如下: uint64_t Buffer_pull_uint_var(upai_buffer_t buf, ssize_t size) { CK_RD_BOUNDS(buf, 1) uint64_t value; switch ((buf->pos) >> 6) { case 0: value = (buf->pos++) & 0x3F; if (size != NULL) size = 1; break; case 1: CK_RD_BOUNDS(buf, 2) value = (uint16_t)((buf->pos) & 0x3F) << 8 | (uint16_t)((buf->pos + 1)); buf->pos += 2; if (size != NULL) size = 2; break; case 2: CK_RD_BOUNDS(buf, 4) value = (uint32_t)((buf->pos) & 0x3F) << 24 | (uint32_t)((buf->pos + 1)) << 16 | (uint32_t)((buf->pos + 2)) << 8 | (uint32_t)((buf->pos + 3)); buf->pos += 4; if (size != NULL) *size = 4; break; default: CK_RD_BOUNDS(buf, 8) value = (uint64_t)(*(buf->pos) & 0x3F) << 56 | (uint64_t)(*(buf->pos + 1)) << 48 | (uint64_t)(*(buf->pos + 2)) << 40 | (uint64_t)(*(buf->pos + 3)) << 32 | (uint64_t)(*(buf->pos + 4)) << 24 | (uint64_t)(*(buf->pos + 5)) << 16 | (uint64_t)(*(buf->pos + 6)) << 8 | (uint64_t)(*(buf->pos + 7)); buf->pos += 8; if (size != NULL) *size = 8; break; } return value;} Initial 包的处理过程 头部明文信息解析 这部分比较简单,直接上代码: uapi_err_t pull_quic_header(upai_buffer_t *buf, quic_header_packet_t *header){ int32_t retcode = 0; CK_RET(Buffer_pull_uint8(buf, &(header->flag)), UPAI_ERR_HEADER|1)) header->is_long_header = (header->flag & PACKET_LONG_HEADER) == 0 ? -1 : 1; if (header->is_long_header > 0) { CK_RET(Buffer_pull_uint32(buf, &(header->version)), UPAI_ERR_HEADER|2) CK_RET(Buffer_pull_uint8(buf, &(header->dcid_length)), UPAI_ERR_HEADER|3) CK_RET(Buffer_pull_bytes(buf, header->dcid_length, &(header->dcid)), UPAI_ERR_HEADER|4) CK_RET(Buffer_pull_uint8(buf, &(header->scid_length)), UPAI_ERR_HEADER|5) CK_RET(Buffer_pull_bytes(buf, header->scid_length , &(header->scid)), UPAI_ERR_HEADER|6) if (header->version == PROTO_NEGOTIATION) { header->packet_type = 0; } else { header->packet_type = header->flag & PACKET_TYPE_MASK; } if (header->packet_type == PACKET_TYPE_INITIAL) { CK_RET(Buffer_pull_uint_var(buf, NULL, &(header->token_length)), UPAI_ERR_HEADER|7) CK_RET(Buffer_pull_bytes(buf, header->token_length, &(header->token)), UPAI_ERR_HEADER|8) CK_RET(Buffer_pull_uint_var(buf, NULL, &(header->packet_length)), UPAI_ERR_HEADER|9) header->packet_number_offset = buffer_tell(buf); CK_RET(Buffer_pull_bytes(buf, header->packet_length, &(header->payload)), UPAI_ERR_HEADER|10) } else if (header->packet_type == PACKET_TYPE_RETRY) { //TODO: deal with retry packet parsing } else { CK_RET(Buffer_pull_uint_var(buf, NULL, &(header->packet_length)), UPAI_ERR_HEADER|11) CK_RET(Buffer_pull_bytes(buf, header->packet_length, &(header->payload)), UPAI_ERR_HEADER|12) } } else { //TODO: short header parse } return UPAI_RES_OK;} 生成 KEY, IV, HP QUIC 协议定义了 4 组加密密钥集,对应四个不同的加密层级,这与 Packet Number 空间有类似的意思,他们是: Initial 密钥集 Early Data(0-RTT)密钥集 Handshake,握手密钥集 Application Data(1-RTT),应用数据密钥集 QUIC 的 CRYPTO 帧和 TCP 上的 TLS 最大不不同点在于,一个 QUIC 数据包里可能含有多个数据帧,协议规范本身也要求,只要在同一加密密钥层里,一个数据包就应该尽可能的多放入数据帧。 解密 Initial 数据包,使用的便是 Initial 密钥集。进入某个加密层级,需要三样东西: 初始密钥 AEAD 函数 HKDF 函数 QUIC 的 Initial 包的初始机密(Initial secrets)同版本号,目标 Connection ID 相关,加密算法固定为 AES-128-GCM,Initial secrets 的提取方式如下: uint32_t algorithm_digest_size = _get_algorithm_digest_size(ctx->cipher_name);//SHA256的长度是32 const uint8_t initial_salt_d27 []= {0xc3,0xee,0xf7,0x12, 0xc7,0x2e,0xbb,0x5a, 0x11,0xa7,0xd2,0x43, 0x2b,0xb4,0x63,0x65, 0xbe,0xf9,0xf5,0x02};//Draft-27的salt uint8_t *initial_secrets = (uint8_t *)upai_mem_pool_alloc(algorithm_digest_size); ret = upai_HKDF_Extract(_get_hash_method(ctx->cipher_name), //SHA256 initial_salt_d27, sizeof(initial_salt_d27), initial_packet.dcid, initial_packet.dcid_length, initial_secrets); CK_KG_RET(ret, UPAI_KG_ERR | 1) 提取出 Initial Secrets 之后,便是扩展出 Key,IV 和 HP 了,在这之前,于服务端,需要先扩展出接收机密(receive secrets),需要用“client in”作为标签。标签函数大致长这样: static uapi_err_tupai_hkdf_label( upai_memory_pool_t *m, const uint8_t * label, uint32_t sz_label, const uint8_t * hash_value, uint32_t sz_hash_value, uint32_t sz, uint8_t **out, uint32_t *sz_out){ uint32_t full_size = 10 + sz_label + sz_hash_value; if (sz_out != NULL) *sz_out = full_size; *out = (uint8_t *)upai_mem_pool_alloc(m, full_size); (*out)[0] = (uint8_t)((uint16_t)(sz >> 8)); (*out)[1] = (uint8_t) sz; (*out)[2] = 6 + sz_label; memcpy(*out+3, "tls13 ", 6); memcpy(*out + 9, label, sz_label); (*out)[sz_label + 9] = sz_hash_value; memcpy(*out + 9 + sz_label + 1, hash_value, sz_hash_value); return UPAI_RES_OK;} 有了 receive secrets,接下来就是由它再扩展出以“quic key”为标签的 Key,以“quiciv”为标签的 IV 和以“quic hp”为标签的 HP。前两个用于解密负载,后一个用于去除数据包头部掩码。代码如下所示: uint8_t *recv_label; uint32_t sz_recv_label; uint32_t sz_defined_key = = _get_algorithm_key_size(ctx->cipher_name); upai_hkdf_label(m, "client in", 9, "", 0, algorithm_digest_size, &recv_label, &sz_recv_label); uint8_t *recv_secrets = (uint8_t *)upai_mem_pool_alloc(ctx->mem, algorithm_digest_size); ret = upai_HKDF_Expand(_get_hash_method(ctx->cipher_name), initial_secrets, sz_initial_secrets, recv_label, sz_recv_label, recv_secrets, algorithm_digest_size); CK_KG_RET(ret, UPAI_KG_ERR | 2) uint8_t *key, *iv, *hp;uint32_t sz_key, sz_iv, sz_hp; upai_hkdf_label(m, "quic key", 8, "", 0, sz_defined_key, &key, &sz_key); upai_hkdf_label(m, "quic iv", 7, "", 0, AEAD_NONCE_LENGTH, &iv, &sz_iv); upai_hkdf_label(m, "quic hp", 7, "", 0, sz_defined_key, &hp, &sz_hp); uint8_t *key_for_client = upai_mem_pool_alloc(ctx->mem, sz_defined_key); uint8_t *iv_for_client = upai_mem_pool_alloc(ctx->mem, AEAD_NONCE_LENGTH); uint8_t *hp_for_client= upai_mem_pool_alloc(ctx->mem, sz_defined_key); ret = upai_HKDF_Expand(_get_hash_method(ctx->cipher_name), //Initial包的Hash函数是SHA256 recv_secrets, algorithm_digest_size, key, sz_key, key_for_client, sz_defined_key); CK_KG_RET(ret, UPAI_KG_ERR | 3) ret = upai_HKDF_Expand(_get_hash_method(ctx->cipher_name), recv_secrets, algorithm_digest_size, iv, sz_iv, iv_for_client, AEAD_NONCE_LENGTH); CK_KG_RET(ret, UPAI_KG_ERR | 4) ret = upai_HKDF_Expand(_get_hash_method(ctx->cipher_name), recv_secrets, algorithm_digest_size, hp, sz_hp, hp_for_client, sz_defined_key); CK_KG_RET(ret, UPAI_KG_ERR | 5) 去除头部保护 QUIC 协议的 Initial 数据包头部第一个字节的后 4~5 比特,以及头部的 PacketNumber 域是经过 AES-128-ECB 混淆的, 其中第一字节的最后两位指示了 Packet Number 的存储长度,使得数据包的 Pakcet Number 长度不可见。不确定 Packet Number 的长度,负载的解密也无从谈起。加密这两部分的密钥由初始化向量IV以及保护密钥衍生而来。该密钥使用“quic hp”作为标签(生成方式可参考上一节),作用于头部第一字节的最低有效位和 Packet Number 域,如果是长头部,则加密 4 位;若是短头部则加密最低 5 位。不过版本协商包和重试包不需要做头部加密。 以下代码初始化 crypto_context,并执行 remove header protection 操作: upai_memory_pool_t *m = upai_create_memory_pool(MEM_POOL_SIZE);//创建内存池 //..... //此处省略若干无关代码 //..... uint8_t *plain_header; uint32_t plain_header_len, truncated_pn, pn_length; upai_crypto_ctx_t * crypt_ctx = upai_create_quic_crypto(m); crypt_ctx->initialize(crypt_ctx, "AES-128-ECB", //去除头部混淆用的算法 "AES-128-GCM", //负载部分的加解密算法 key_for_client, sz_key, //Key iv_for_client, sz_iv, //IV hp_for_client, sz_hp); //HP crypt_ctx->remove_hp(crypt_ctx, Buffer_get_base(quic_buffer), //QUIC数据包存储首地址 Buffer_get_size(quic_buffer), //长度 initial_packet.packet_number_offset, //Packet Number域的偏移位置 &plain_header, //输出的纯文本头部 &plain_header_len, //长度 &truncated_pn, //编码后的Packet Number &pn_length);//PN存储长度 以下为 crypt_ctx->initialize 函数的头部保护去除初始化部分代码 //header protection init int res = EVP_CipherInit(ctx->hp_ctx, EVP_get_cipherbyname(hp_cipher_name), NULL, NULL, 1); CRYPTO_CK_RET(res, UPAI_ERR_CRYPTO | 1) res = EVP_CIPHER_CTX_set_key_length(ctx->hp_ctx, hp_len); CRYPTO_CK_RET(res, UPAI_ERR_CRYPTO | 2) res = EVP_CipherInit_ex(ctx->hp_ctx, NULL, NULL, hp, NULL, 1); CRYPTO_CK_RET(res, UPAI_ERR_CRYPTO | 3) 解密头部保护的代码如下 //remove_hp主要代码u int8_t mask[32] = {0}, buffer[PACKET_LENGTH_MAX] = {0}; int32_t outlen; uint8_t *sample = packet_buffer + packet_number_offset + PACKET_NUMBER_LENGTH_MAX; int32_t res = EVP_CipherUpdate(ctx->hp_ctx, mask, &outlen, sample, SAMPLE_LENGTH); CRYPTO_CK_RET(res, UPAI_ERR_CRYPTO | 4) memcpy(buffer, packet_buffer, packet_number_offset + PACKET_NUMBER_LENGTH_MAX); if (buffer[0] & 0x80) //长头部数据包,后4位去混淆 { buffer[0] ^= mask[0] & 0x0f; } else //短头部数据包,后5位去混淆 { buffer[0] ^= mask[0] & 0x1f; } int pn_length = (buffer[0] & 0x03) + 1;//第一字节的最低2位指示Packet Number的长度 *truncated_pn = 0; for (int i = 0; i < pn_length; ++ i) { buffer[packet_number_offset + i] ^= mask[i + 1]; *truncated_pn = buffer[packet_number_offset + i] | (*truncated_pn) << 8); } *plain_header =(uint8_t *) upai_mem_pool_alloc(ctx->mem, packet_number_offset + pn_length); memcpy(*plain_header, buffer, packet_number_offset + pn_length); *plain_header_len = packet_number_offset + pn_length; *packet_number_len = pn_length; 计算 Packet Number Packet numbers 是大小为 0-2^62-1 之间的整型数值,单调递增,表示数据包的先后顺序, 但是放入 QUIC 数据包头部时却编码成 1-4 字节的数据。通过丢弃 packet number 的高位数据 接收方通过上下文恢复 packet number,这样一来就达到缩减数据长度的目的。 发送端的 packet number 数据存储容量,一般要求是其最近确认收到的数据包的 packet number 与正要发送的数据包的 packet number 之差的两倍以上,如此接收端方能正确解码。 举个例子,如果通讯的某一方收到对方的确认帧,确认己方发出的 packetnumber 为 0xabe8bc 的数据包已收到, 那么如果要发送 packetnumber 为 0xac5c02 的数据包,则至少需要(0xac5c02- 0xabe8bc)* 2 = 0xe68c, 16 位的编码空间,如果发送packet number是0xace8fe,则至少需要(0xace8fe - 0xabe8bc)*2= 0x20084, 24 位的编码空间。 接收端必须得去掉包头保护,再才能进行 packet number 的解码工作。头部保护去掉后就可以拿到编码过的 packet number 亦即 truncatedpacket number,需根据一定算法还原真实数字。其中 expected 为解码端预期的包号,即已接收的最大包号值加 1。举个例子,当前最大的包号是 0xa82f30ea,那么如果接收到的编码包号是 16 位数据 0x9b32, 那么最终解码出来的 packet number 是 0xa82f9b32。 实现代码如下所示。 uint64_t decode_packet_number(uint32_t truncated, uint8_t num_bits, uint64_t expected){ uint64_t window = 1L << num_bits; uint64_t half_window = (uint64_t )(window/2); uint64_t candidate = (expected & ~(window - 1)) | truncated; const uint64_t pn_max = 1L << 62; if (((int64_t)candidate <= (int64_t)(expected - half_window)) && (candidate < (pn_max - window))) { return candidate + window; } else if ((candidate > expected + half_window)&&(candidate >= window)) { return candidate - window; } else { return candidate; }} 解密负载内容 Initial 数据包的负载采用的是 AES-128-GCM 加密算法。首先初始化 OpenSSL EVP: res = EVP_CipherInit_ex(ctx->decrypt_ctx, EVP_get_cipherbyname(aead_cipher_name), //Cipher name=AES-128-GCM NULL, NULL, NULL, 0); CRYPTO_CK_RET(res, UPAI_ERR_CRYPTO|6) res = EVP_CIPHER_CTX_set_key_length(ctx->decrypt_ctx, key_len); CRYPTO_CK_RET(res, UPAI_ERR_CRYPTO|7) res = EVP_CIPHER_CTX_ctrl(ctx->decrypt_ctx, EVP_CTRL_GCM_SET_IVLEN, iv_len, NULL); CRYPTO_CK_RET(res, UPAI_ERR_CRYPTO|8) 解密负载时,IV 部分还需要 PacketNumber 参与计算最终生成 nonce, uint8_t nonce[AEAD_NONCE_LENGTH] = {0}; memcpy(nonce, ctx->iv, AEAD_NONCE_LENGTH); *plain_payload_len = 0; *plain_payload = NULL; uint8_t *data = packet_buffer + plain_header_len; uint32_t data_len = packet_buffer_len - plain_header_len; uint8_t buffer_payload[PACKET_LENGTH_MAX] = {0}; for (int i = 0; i < 8; i++) { nonce[AEAD_NONCE_LENGTH - 1 - i] ^= (uint8_t )(packet_number >> 8 * i); } int32_t res = EVP_CipherInit_ex(ctx->decrypt_ctx, NULL, NULL, ctx->key, nonce, 0); res = EVP_CIPHER_CTX_ctrl(ctx->decrypt_ctx, EVP_CTRL_GCM_SET_TAG, AEAD_TAG_LENGTH, (void *)(data + (data_len-AEAD_TAG_LENGTH))); CRYPTO_CK_RET(res, UPAI_ERR_CRYPTO|10) int32_t outlen, outlen2; res = EVP_CipherUpdate(ctx->decrypt_ctx, NULL, &outlen, plain_header, plain_header_len); CRYPTO_CK_RET(res, UPAI_ERR_CRYPTO|11) res = EVP_CipherUpdate(ctx->decrypt_ctx, buffer_payload, &outlen, data, data_len - AEAD_TAG_LENGTH); CRYPTO_CK_RET(res, UPAI_ERR_CRYPTO|12) res = EVP_CipherFinal_ex(ctx->decrypt_ctx, NULL, &outlen2); if (res == 0) { return UPAI_ERR_CRYPTO|14; } else { *plain_payload = (uint8_t *) upai_mem_pool_alloc(ctx->mem, outlen); memcpy(*plain_payload, buffer_payload, outlen); *plain_payload_len = outlen; return UPAI_RES_OK; } 解析 ClientHello 上一节我们拿到了负载的明文, 这个区域存储的是至少一个或者一个以上的数据帧。Initial 数据包负载区第一帧一般是 CRYPTO 数据帧,FrameType 值为 0x06。以下代码获取了 CRYPTO 帧的四个数据段:FrameType,Offset, Length,CryptoData。其中,Offset,为变长整型数值,指示数据在该帧中的字节偏移位置, Length 段,为变长整型数值,指示 Crypto Data 的长度。 uint64_t frame_type, frame_length, frame_offset; uint8_t *crypto_data; Ref_buffer(m, payload_buffer, 0, plain_payload, plain_payload_len); Buffer_pull_uint_var(payload_buffer, NULL, &frame_type); if (frame_type == FRAME_TYPE_CRYPTO) { Buffer_pull_uint_var(plain_payload_buffer, NULL, &frame_offset); Buffer_pull_uint_var(plain_payload_buffer, NULL, &frame_length); Buffer_pull_bytes(plain_payload_buffer, frame_length, &crypto_data); } 取得 Crypto Data 后,接着是对该段数据的解析。第一个字节是 HandshakeType,定义如下: typedef enum { client_hello = 1, server_hello = 2, new_session_ticket = 4, end_of_early_data = 5, encrypted_extensions = 8, certificate = 11, certificate_request = 13, certificate_verify = 15, finished = 20, key_update = 24, message_hash = 254} handshake_type_t; 显而易见,Initial 包里该段的类型值为 0x01,表明是 ClientHello 数据。接下来便是解析 TLS1.3 的 ClientHello 数据结构。 以下为 RFC8446 的 ClientHello 结构体: uint16_t ProtocolVersion;opaque Random[32]; uint8 CipherSuite[2]; struct { ProtocolVersion legacy_version = 0x0303; /* TLS v1.2 */ Random random; opaque legacy_session_id<0..32>; CipherSuite cipher_suites<2..2^16-2>; opaque legacy_compression_methods<1..2^8-1>; Extension extensions<8..2^16-1>; } ClientHello; 解释一下为什么 legacy_version 是 0x0303: 在 TLS 的前一个版本中,该字段用于版本协商,也表示客户端能支持到的最高版本号。实践证明许多服务器并没有很好地实现版本协商功能,导致了所谓的“版本不宽容”的问题,只要此版号高于服务器能支持的,它就会连带着拒绝其他它它能接受的 ClientHello,在 TLS1.3 中, 客户端可以在 ClientHello 扩展信息的“supported_versions”字段中声明它版本支持的优先级, 因此,为兼容性考虑,legacy_version 就必须设为 0x0303,表示版本 TLS1.2。如此一来, 通过将 legacy_version 等于 0x0303,并在 supported_versions 字段中设 0x0304 为最高优先版本, 就可以表明,此 ClientHello 为 TLS1.3 了。 简单的实现代码如下: uint8_t handshake_type; uint8_t h_length; uint16_t l_length; uint16_t tls_version; uint8_t *random_value; uint8_t session_id_length; uint8_t *session_id; uint16_t cipher_suites_length; uint16_t ciphers[256]; uint8_t compression_length; uint8_t *compression_methods; Buffer_pull_uint8(plain_payload_buffer, &handshake_type); Buffer_pull_uint8(plain_payload_buffer, &h_length); Buffer_pull_uint16(plain_payload_buffer, &l_length); Buffer_pull_uint16(plain_payload_buffer, &tls_version); Buffer_pull_bytes(plain_payload_buffer, 32, &random_value); Buffer_pull_uint8(plain_payload_buffer, &session_id_length); Buffer_pull_bytes(plain_payload_buffer, session_id_length, &session_id); Buffer_pull_uint16(plain_payload_buffer, &cipher_suites_length); for (int i = 0; i < cipher_suites_length/2;i++){ Buffer_pull_uint16(plain_payload_buffer, ciphers + i); } Buffer_pull_uint8(plain_payload_buffer, &compression_length); Buffer_pull_bytes(plain_payload_buffer, compression_length, &compression_methods); 最后,我们来看看 Extension 的结构,引用自 RFC8446。 struct { ExtensionType extension_type; opaque extension_data<0..2^16-1>;} Extension; enum { server_name(0), /* RFC 6066 / max_fragment_length(1), / RFC 6066 / status_request(5), / RFC 6066 / supported_groups(10), / RFC 8422, 7919 / signature_algorithms(13), / RFC 8446 / use_srtp(14), / RFC 5764 / heartbeat(15), / RFC 6520 / application_layer_protocol_negotiation(16), / RFC 7301 / signed_certificate_timestamp(18), / RFC 6962 / client_certificate_type(19), / RFC 7250 / server_certificate_type(20), / RFC 7250 / padding(21), / RFC 7685 / pre_shared_key(41), / RFC 8446 / early_data(42), / RFC 8446 / supported_versions(43), / RFC 8446 / cookie(44), / RFC 8446 / psk_key_exchange_modes(45), / RFC 8446 / certificate_authorities(47), / RFC 8446 / oid_filters(48), / RFC 8446 / post_handshake_auth(49), / RFC 8446 / signature_algorithms_cert(50), / RFC 8446 / key_share(51), / RFC 8446 */ (65535)} ExtensionType; 总结 到这里,QUIC 协议的解析总算是走出了万里长征的第一步,作为服务端,得回复 ACK 帧,告知客户端“你方请求已经收到”,然后回复 ServerHello,放入 CRYPTO 帧,把该交代的事情交代清楚,该协商的事情协商明白,这两个帧塞在同一个数据包发给客户端,然后,双方就可以愉快的步入 Handshake 的殿堂了。是的,1-RTT 握手过程就是这样。 ##参考资料 https://tools.ietf.org/html/draft-ietf-quic-transport-27/ https://datatracker.ietf.org/doc/draft-ietf-quic-tls/27/ https://github.com/aiortc/aioquic https://github.com/carlescufi/wireshark/blob/bb7014731cfa39f7742f552f2817461b75ed084f/epan/dissectors/packet-quic.c https://tools.ietf.org/html/rfc5246 TLS1.2 https://tools.ietf.org/html/rfc8446 TLS1.3 https://tools.ietf.org/html/rfc5869 HKDF https://tools.ietf.org/html/rfc4303 IPEncapsulating Security Payload 推荐阅读 从新冠疫情出发,漫谈 Gossip 协议 QUIC/HTTP3 协议简析

优秀的个人博客,低调大师

每日一博 | 给 Twitter 设计个安全修复方案

不要神化国外的安全建设 Twitter的苦衷 要解决的问题 设计安全方案的原则 访问控制架构 注意事项 不要神化国外的安全建设 安全做的不差的NetFlix(参考Netflix的DevSecOps最佳实践),因为财报不理想最近股价大跌,Twitter有高危漏洞但是股价并未受影响,更加说明了笔者的论断:企业业务发展远比安全风险给股价带来的长期影响重要..... 此类漏洞举一反三TSRC(参考企业安全建设 丨 当我们在谈论推特安全事件时,我们在谈论什么?)给出的解决办法是一、内部系统需要零信任;二、权限类收敛采用框架集成全链路票据,数据操作层集中验票的,想来在腾讯完全落地有难度,也不能让Twitter快速解决问题。笔者看到Twitter内部这么久还没闭环,作为美国股市精神股东真替他们捉急。:) 根据最新的媒体报告,Twitter认为此次漏洞原因是”公司检测到了一次协同式社交工程攻击,发动者成功锁定了一些具有访问内部系统和工具权限的Twitter员工。黑客利用这些访问权限控制了许多知名账号和密码,之后便使用其账号发布关于比特币的动态。“,属于内部的人为失误\蓄意破坏\信息窃取这一类风险。上一次出类似的事情是前亚马逊工程师Paige Thompson 被指控利用工作方便来访问Amazon云服务上的Capital One服务器。 Twitter的市值只是1/48个谷歌,1/2个百度,市值决定安全的投入,不能盲目崇拜国外科技公司的安全建设。从历史反复漏洞披露的信息看到,Twitter内部存在不少历史安全问题。黑客简单社工后即可完全控制内部系管理统,利用内部权限可以控制用户Twitter账户,无审核机制,直接修改邮件重置密码,用户信息无隐私保护和数据脱敏。 疑似被攻击的后台面板 Twitter的苦衷 Twitter案例中关键突破点是内部系统的高权限被社工或收买了。内部应用通常会涉及敏感数据或功能,例如用于生产系统的调试面板、账户管理系统或具有敏感公司数据的数据流和机器学习模型。Twitter安全性做的不好,是因为: 一、现有的商用防护方案又难以覆盖,传统的基于网络、员工身份的隔离方案完全不适用。不能仅仅将这些内部应用程序通过防火墙隔离,网络隔离仍然有可能会被意外配置暴露在公网,而且外部攻击者仍可通过XSS+CSRF或SSRF组合拳攻击,或者通过内网环境中已经隐藏攻击者(黑客或内部人员)。 二、这类问题一般并视为运维安全和办公网安全和开发安全的三者责任间。与生产环境相比,内部应用程序通常会被安全团队有意无意的忽略,安全团队反馈的吐槽是两个大问题:这类系统太多了,属于历史遗留问题;开发语言多样,没有统一的解决方案。 三、安全人员不足:Twitter的安全招聘信息已经挂了两个月了,看来还是缺人惹的祸。 推特招安全人员的JD是两个月前的 要解决的问题 所以说现在的攻防趋势是技术上直接攻击越来越难,黑客转而关注间接从内部获取权限,并不仅仅遵循从internert-dmz-db存储的方式,走向了internert-内部用户或内部系统-信任关系-db存储。线上的生产环境经过了白帽子反复蹂躏,基本做到了符合安全基线,背后的开发语言、应用框架、资产管理是相对完善的。但是内部的私搭乱建,各种员工机器的的CI|CD系统,重要的内部服务系统,就有五花八门的开发语言,技术和风险了。 间接攻击示意图 设计安全方案的原则 风险是普遍了,问题是需要复盘的。假设我们要防御类似于Twitter这样的攻击,需要安全建设的理念是: 不是ServiceMesh架构不能照搬lstio方案 防御方案应该是可扩展的,并且兼容后端的技术栈。 结合软件开发和发布流程 设计出色的技术解决方案还不够,落地才是 应用防御措施时,安全团队和开发项目组都需要参与进来 访问控制架构 以上是成形的架构。具体的解决办法是分为五步走: 设置中间层代理,以往员工直接单独访问内部系统进行操作,危害性参考有:无网络隔离直接访问内部系统 里面可能包含未脱敏信息 缺少鉴权机制 这时候加个访问层的代理是解决问题的第一步。加入代理的好处多多,可以收敛入口,设置网络隔离,访问系统管理。一切的机制是在隔层的代理上做,代理的形式可以是api网关、统一portal。 传输层加密。在准备推进代理的时候,不用等系统开发完成,可以调研引入全链路的tls进行传输层的加密。这里的理由有两个:Twitter这样和客户隐私强相关的企业,必须要防止内部网络层的窃听,每一层的安全措施都要做到底。借鉴google自研的ALTS,参考https://cloud.google.com/security/encryption-in-transit/application-layer-transport-security?hl=zh-cn 或者FaceBook的方案 https://engineering.fb.com/security/service-encryption/ ,保证应用传输的安全,借用pki证书或者Kerberos机制可以用来表示服务的身份模型,而且具备极强的架构伸缩性。 做到访问的统一收口,基于代理开发sso+u2f的机制做到访问的统一收口,逐步梳理系统让加入此机制。u2f机制一定层面上杜绝密码猜解、调用、离职员工访问的途径,后续添加FIDO等零信任访问控制措施。 收敛员工的使用新版浏览器,前后端加入监控,日志,埋点,行为检测等功能,由运营风险分析(ORA)团队处置审计。 代理添加通用CSRF保护(添加SameSitecookie标志)和XSS保护(Content-Security-Policy标头+随机数),设置内网waf。比如攻击者有个xss,可以使用csrf获取内部系统信息,这个时候在代理层设置csrf策略,对防护者成本极低,内部应用也无感知,但是收敛面向内部高权限人员xss的危害收益极高。内网的waf听起来会受到的接入阻力较多,但是内网场景固定,干扰项少,实际上内网waf的误报会很少,没有很多的噪音。 注意事项 拍脑袋出具安全方案不是问题,落地有防护效果才是,以下是几个要注意的点: 安全需联合技术团队合作开发维护代理层,并在出现问题随时响应。有数字取证,安全工程或隐私工程方面的技术经验很重要,有维护高可用、系统稳定性运营经验的团队更重要! 基于存量系统增加安全防护系统首先要考虑可维护性,可用性高于安全性,一定要避免出case。 在不影响业务运营的时候同步进行开发和部署。理想情况下,如果代理服务器出现故障,背后存在关键系统,会阻止正常工作,假设如果代理后面有堡垒机,则如果代理发生故障,将再也无法再登录堡垒机故障排除...... 推进的节奏不用全面收敛,优先关注高危的风险。如何确定要收敛的风险范围做到不遗漏呢?内部多打就好了。 向上管理。这个框架可以帮助确定Twitter距离谷歌的差距在哪里,未来的安全投资方向是什么。有基于事件驱动的安全不可怕,没有将策略传达给高级管理层才可怕。笔者这里提供个简单的示例,点击可右移滑动: 定义 防御 检测 响应 恢复 需要让哪些团队参与 账户、运维 社会工程学 异地登录、xss、异常感知 应急流程、公关 恢复异常账户 必须构建什么技术 开发流程、数据安全技术 培训、邮件网关、零信任 身份认证、行为检测 工单、操作审计 私信、公告板 创建什么流程 背景调查,安全顾问理事会 培训机制 应急响应流程,知识库 应急响应流程 媒体应急发布流程 推荐阅读: 安全漏洞?是时候抄底Twitter股票了 浅谈漏洞修复的方法论 周年赠书福利 参与方式一:点击下方抽奖小程序,关注公众号 安全乐观主义,将本文转发到朋友圈和微信看一看即可参与!公众号后台将随机抽选取幸运用户,每人赠书一本! 参与方式二:为本公众号投稿一篇安全相关的文章,内容形式不限,即可获得赠书一本!赶快参与起来吧~ 本文分享自微信公众号 - 安全乐观主义(gh_d6239d0bb816)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | JavaScript 基础心法——深拷贝和浅拷贝

浅拷贝和深拷贝都是对于 JS 中的引用类型而言的,浅拷贝就只是复制对象的引用,如果拷贝后的对象发生变化,原对象也会发生变化。只有深拷贝才是真正地对对象的拷贝。 前言 说到深浅拷贝,必须先提到的是JavaScript的数据类型,之前的一篇文章JavaScript基础心法——数据类型说的很清楚了,这里就不多说了。 需要知道的就是一点:JavaScript的数据类型分为基本数据类型和引用数据类型。 对于基本数据类型的拷贝,并没有深浅拷贝的区别,我们所说的深浅拷贝都是对于引用数据类型而言的。 浅拷贝 浅拷贝的意思就是只复制引用,而未复制真正的值。 const originArray = [1,2,3,4,5];const originObj = {a:'a',b:'b',c:[1,2,3],d:{dd:'dd'}};const cloneArray = originArray;const cloneObj = originObj;console.log(cloneArray); // [1,2,3,4,5]console.log(originObj); // {a:'a',b:'b',c:Array[3],d:{dd:'dd'}}cloneArray.push(6);cloneObj.a = {aa:'aa'};console.log(cloneArray); // [1,2,3,4,5,6]console.log(originArray); // [1,2,3,4,5,6]console.log(cloneObj); // {a:{aa:'aa'},b:'b',c:Array[3],d:{dd:'dd'}}console.log(originArray); // {a:{aa:'aa'},b:'b',c:Array[3],d:{dd:'dd'}} 上面的代码是最简单的利用 = 赋值操作符实现了一个浅拷贝,可以很清楚的看到,随着 cloneArray 和 cloneObj 改变,originArray 和 originObj 也随着发生了变化。 深拷贝 深拷贝就是对目标的完全拷贝,不像浅拷贝那样只是复制了一层引用,就连值也都复制了。 只要进行了深拷贝,它们老死不相往来,谁也不会影响谁。 目前实现深拷贝的方法不多,主要是两种: 利用 JSON 对象中的 parse 和 stringify 利用递归来实现每一层都重新创建对象并赋值 JSON.stringify/parse的方法 先看看这两个方法吧: The JSON.stringify() method converts a JavaScript value to a JSON string. JSON.stringify 是将一个 JavaScript 值转成一个 JSON 字符串。 The JSON.parse() method parses a JSON string, constructing the JavaScript value or object described by the string. JSON.parse 是将一个 JSON 字符串转成一个 JavaScript 值或对象。 很好理解吧,就是 JavaScript 值和 JSON 字符串的相互转换。 它能实现深拷贝呢?我们来试试。 const originArray = [1,2,3,4,5];const cloneArray = JSON.parse(JSON.stringify(originArray));console.log(cloneArray === originArray); // falseconst originObj = {a:'a',b:'b',c:[1,2,3],d:{dd:'dd'}};const cloneObj = JSON.parse(JSON.stringify(originObj));console.log(cloneObj === originObj); // falsecloneObj.a = 'aa';cloneObj.c = [1,1,1];cloneObj.d.dd = 'doubled';console.log(cloneObj); // {a:'aa',b:'b',c:[1,1,1],d:{dd:'doubled'}};console.log(originObj); // {a:'a',b:'b',c:[1,2,3],d:{dd:'dd'}}; 确实是深拷贝,也很方便。但是,这个方法只能适用于一些简单的情况。比如下面这样的一个对象就不适用: const originObj = { name:'axuebin', sayHello:function(){ console.log('Hello World'); }}console.log(originObj); // {name: "axuebin", sayHello: ƒ}const cloneObj = JSON.parse(JSON.stringify(originObj));console.log(cloneObj); // {name: "axuebin"} 发现在 cloneObj 中,有属性丢失了。。。那是为什么呢? 在 MDN 上找到了原因: If undefined, a function, or a symbol is encountered during conversion it is either omitted (when it is found in an object) or censored to null (when it is found in an array). JSON.stringify can also just return undefined when passing in "pure" values like JSON.stringify(function(){}) or JSON.stringify(undefined). undefined、function、symbol 会在转换过程中被忽略。。。 明白了吧,就是说如果对象中含有一个函数时(很常见),就不能用这个方法进行深拷贝。 递归的方法 递归的思想就很简单了,就是对每一层的数据都实现一次 创建对象->对象赋值 的操作,简单粗暴上代码: function deepClone(source){ const targetObj = source.constructor === Array ? [] : {}; // 判断复制的目标是数组还是对象 for(let keys in source){ // 遍历目标 if(source.hasOwnProperty(keys)){ if(source[keys] && typeof source[keys] === 'object'){ // 如果值是对象,就递归一下 targetObj[keys] = source[keys].constructor === Array ? [] : {}; targetObj[keys] = deepClone(source[keys]); }else{ // 如果不是,就直接赋值 targetObj[keys] = source[keys]; } } } return targetObj;} 我们来试试: const originObj = {a:'a',b:'b',c:[1,2,3],d:{dd:'dd'}};const cloneObj = deepClone(originObj);console.log(cloneObj === originObj); // falsecloneObj.a = 'aa';cloneObj.c = [1,1,1];cloneObj.d.dd = 'doubled';console.log(cloneObj); // {a:'aa',b:'b',c:[1,1,1],d:{dd:'doubled'}};console.log(originObj); // {a:'a',b:'b',c:[1,2,3],d:{dd:'dd'}}; 可以。那再试试带有函数的: const originObj = { name:'axuebin', sayHello:function(){ console.log('Hello World'); }}console.log(originObj); // {name: "axuebin", sayHello: ƒ}const cloneObj = deepClone(originObj);console.log(cloneObj); // {name: "axuebin", sayHello: ƒ} 也可以。搞定。 是不是以为这样就完了??当然不是。 JavaScript中的拷贝方法 我们知道在 JavaScript 中,数组有两个方法 concat 和 slice 是可以实现对原数组的拷贝的,这两个方法都不会修改原数组,而是返回一个修改后的新数组。 同时,ES6 中 引入了 Object.assgn 方法和 ... 展开运算符也能实现对对象的拷贝。 那它们是浅拷贝还是深拷贝呢? concat The concat() method is used to merge two or more arrays. This method does not change the existing arrays, but instead returns a new array. 该方法可以连接两个或者更多的数组,但是它不会修改已存在的数组,而是返回一个新数组。 看着这意思,很像是深拷贝啊,我们来试试: const originArray = [1,2,3,4,5];const cloneArray = originArray.concat();console.log(cloneArray === originArray); // falsecloneArray.push(6); // [1,2,3,4,5,6]console.log(originArray); [1,2,3,4,5]; 看上去是深拷贝的。 我们来考虑一个问题,如果这个对象是多层的,会怎样。 const originArray = [1,[1,2,3],{a:1}];const cloneArray = originArray.concat();console.log(cloneArray === originArray); // falsecloneArray[1].push(4);cloneArray[2].a = 2; console.log(originArray); // [1,[1,2,3,4],{a:2}] originArray 中含有数组 [1,2,3] 和对象 {a:1},如果我们直接修改数组和对象,不会影响 originArray,但是我们修改数组 [1,2,3] 或对象 {a:1} 时,发现 originArray 也发生了变化。 结论:concat 只是对数组的第一层进行深拷贝。 slice The slice() method returns a shallow copy of a portion of an array into a new array object selected from begin to end (end not included). The original array will not be modified. 解释中都直接写道是 a shallow copy 了 ~ 但是,并不是! const originArray = [1,2,3,4,5];const cloneArray = originArray.slice();console.log(cloneArray === originArray); // falsecloneArray.push(6); // [1,2,3,4,5,6]console.log(originArray); [1,2,3,4,5]; 同样地,我们试试多层的数组。 const originArray = [1,[1,2,3],{a:1}];const cloneArray = originArray.slice();console.log(cloneArray === originArray); // falsecloneArray[1].push(4);cloneArray[2].a = 2; console.log(originArray); // [1,[1,2,3,4],{a:2}] 果然,结果和 concat 是一样的。 结论:slice 只是对数组的第一层进行深拷贝。 Object.assign() The Object.assign() method is used to copy the values of all enumerable own properties from one or more source objects to a target object. It will return the target object. 复制复制复制。 那到底是浅拷贝还是深拷贝呢? 自己试试吧。。 结论:Object.assign() 拷贝的是属性值。假如源对象的属性值是一个指向对象的引用,它也只拷贝那个引用值。 ... 展开运算符 const originArray = [1,2,3,4,5,[6,7,8]];const originObj = {a:1,b:{bb:1}};const cloneArray = [...originArray];cloneArray[0] = 0;cloneArray[5].push(9);console.log(originArray); // [1,2,3,4,5,[6,7,8,9]]const cloneObj = {...originObj};cloneObj.a = 2;cloneObj.b.bb = 2;console.log(originObj); // {a:1,b:{bb:2}} 结论:... 实现的是对象第一层的深拷贝。后面的只是拷贝的引用值。 首层浅拷贝 我们知道了,会有一种情况,就是对目标对象的第一层进行深拷贝,然后后面的是浅拷贝,可以称作“首层浅拷贝”。 我们可以自己实现一个这样的函数: function shallowClone(source) { const targetObj = source.constructor === Array ? [] : {}; // 判断复制的目标是数组还是对象 for (let keys in source) { // 遍历目标 if (source.hasOwnProperty(keys)) { targetObj[keys] = source[keys]; } } return targetObj;} 我们来测试一下: const originObj = {a:'a',b:'b',c:[1,2,3],d:{dd:'dd'}};const cloneObj = shallowClone(originObj);console.log(cloneObj === originObj); // falsecloneObj.a='aa';cloneObj.c=[1,1,1];cloneObj.d.dd='surprise'; 经过上面的修改,cloneObj 不用说,肯定是 {a:'aa',b:'b',c:[1,1,1],d:{dd:'surprise'}} 了,那 originObj 呢?刚刚我们验证了 cloneObj === originObj 是 false,说明这两个对象引用地址不同啊,那应该就是修改了 cloneObj 并不影响 originObj。 console.log(cloneObj); // {a:'aa',b:'b',c:[1,1,1],d:{dd:'surprise'}}console.log(originObj); // {a:'a',b:'b',c:[1,2,3],d:{dd:'surprise'}} What happend? originObj 中关于 a、c都没被影响,但是 d 中的一个对象被修改了。。。说好的深拷贝呢?不是引用地址都不一样了吗? 原来是这样: 从 shallowClone 的代码中我们可以看出,我们只对第一层的目标进行了 深拷贝 ,而第二层开始的目标我们是直接利用 = 赋值操作符进行拷贝的。 so,第二层后的目标都只是复制了一个引用,也就是浅拷贝。 总结 赋值运算符 = 实现的是浅拷贝,只拷贝对象的引用值; JavaScript 数组和对象自带的拷贝方法都是“首层浅拷贝”; JSON.stringify 实现的是深拷贝,但是对目标对象有要求; 若想真正意义上的深拷贝,请递归。 本文分享自微信公众号 - 前端试炼(code-photo)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | 自然语言处理十大应用

作者|ABHISHEK SHARMA 编译|VK 来源|Analytics Vidhya 介绍 自然语言处理是数据科学领域最热门的课题之一。公司在这一领域投入大量资金进行研究。每个人都在努力了解自然语言处理及其应用,并以此为生。 你知道为什么吗? 因为仅仅在短短几年的时间里,自然语言处理已经发展成为一种无人能想象的强大而有影响力的东西。 为了了解自然语言处理的力量及其对我们生活的影响,我们需要看看它的应用。因此,我列出了自然语言处理的十大应用。 那么,让我们从自然语言处理的第一个应用开始。 搜索自动更正和自动完成 每当你在谷歌上搜索某个东西,在输入2-3个字母后,它会显示可能的搜索词。或者,如果你搜索一些有错别字的东西,它会更正它们,仍然会找到适合你的相关结果。是不是很神奇? 它是每个人每天都在使用的东西,但从来没有太多的关注它。这是自然语言处理的一个很好的应用,也是一个很好的例子。它影响世界上数百万人,包括你和我。 搜索自动完成和自动更正都有助于我们更有效地找到准确的结果。现在,其他许多公司也开始在他们的网站上使用这个功能,比如Facebook和Quora。 搜索自动完成和自动更正背后的驱动引擎是语言模型。 语言翻译 你有没有用谷歌翻译来找出不同语言中的某个词或短语?它将一段文字用一种语言翻译成另一种语言的容易程度是相当惊人的,对吧?它背后的技术是机器翻译。 机器翻译是将一种语言中的文本自动转换成另一种语言,同时保持原意不变的过程。 在早期,机器翻译系统是基于词典和基于规则的系统,它们的成功率非常有限。 然而,由于神经网络领域的发展、海量数据的可用性和强大的机器,机器翻译在将文本从一种语言转换成另一种语言时变得相当精确。 如今,像Google翻译这样的工具可以很容易地将文本从一种语言转换成另一种语言。这些工具正在帮助许多人和企业打破语言障碍并取得成功。 社交媒体监控 如今,越来越多的人开始使用社交媒体发布他们对某一特定产品、政策或事项的看法。这些信息可能包含一些关于个人好恶的有用信息。 因此,分析这些非结构化数据有助于生成有价值的信息。自然语言处理在这里也起到了作用。 如今,公司使用各种NLP技术分析社交媒体帖子,了解客户对其产品的看法。公司还利用社交媒体监控来了解客户在使用产品时所面临的问题。 不仅仅是公司,甚至政府也用它来识别与国家安全相关的潜在威胁。 聊天机器人 对任何公司来说,客户服务和体验是最重要的。它可以帮助企业改进产品,也可以使顾客满意。但与每个客户进行手动交互,并解决问题可能是一项乏味的任务。 聊天机器人可以帮助解决这一情况,聊天机器人帮助公司实现流畅的客户体验的目标。 如今,许多公司在他们的应用程序和网站上使用聊天机器人,这可以解决客户的基本查询。它不仅使公司的流程更容易,而且还使客户从等待与客服呼求帮助时的沮丧情绪中解脱出来。 此外,它还可以降低为公司聘请客服的成本。起初,聊天机器人只是用来解决客户的查询的工具,但今天它们已经演变成了个人伙伴。从推荐产品到获得客户反馈,聊天机器人可以做任何事情。 调查分析 调查是评估公司业绩的重要方法。公司进行了许多调查以获得客户对各种产品的反馈。这对于理解缺陷和帮助公司改进产品非常有用。 但是,当很多客户接受调查导致数据量增加时,问题就出现了。一个人不可能把它们全部读出来并得出结论。这就是公司使用自然语言处理来分析调查并从中挖掘信息的地方。 比如从反馈中了解用户对事件的看法,分析产品评论以了解利弊。今天,大多数公司使用这些方法是因为它们提供了更准确和有用的信息。 定向广告 一天,我在亚马逊上搜索手机,几分钟后,谷歌开始在各种网页上给我展示类似手机的广告。我相信你已经经历过了。 你知道这里发生了什么吗?定向广告! 是啊!你读对了有针对性的广告。定向广告是一种在线广告,根据用户的在线活动向他们展示广告。 现在大多数的在线公司都使用这种方法,因为第一,它为公司节省了很多钱;第二,相关的广告只向潜在的客户展示。 针对性广告的工作主要是关键字匹配。广告与关键字或短语相关联,并且只向那些搜索与广告关联的关键字相似的关键字的用户显示。 显然,这还不够,还有其他因素,比如他们最近访问过的网站,以及他们感兴趣的网页,都被考虑到为用户提供他们可能感兴趣的产品的相关广告。 招聘与求职 人力资源部是每个公司不可分割的一部分。他们最重要的工作是为公司挑选合适的员工。 但是,今天,在这个竞争激烈的世界里,招聘人员需要为一个职位审查成百上千份简历。筛选简历和筛选候选人可能需要几个小时。这个任务可以自动化吗? 对!在自然语言处理的帮助下,招聘人员可以轻松地找到合适的候选人。这就意味着招聘人员不必检查每一份简历,并手动筛选出合适的候选人。 该技术与命名实体识别的信息抽取一样,可以用于提取技能、姓名、位置和教育等信息。然后,利用这些特征在特征空间中表示候选对象,并将其分为适合或不适合特定角色的类别。或者,他们也可以根据简历推荐一个不同的角色。 这样就可以对简历进行无偏见的筛选,并为空缺职位挑选出最合适的人选,而不需要太多人力。大多数公司使用申请跟踪系统来有效筛选简历。 语音助理 我敢肯定你已经见过他们了,谷歌助手,苹果Siri,亚马逊Alexa。是的,这些都是语音助理。 语音助手是一种软件,它使用语音识别、自然语言理解和自然语言处理来理解用户的口头命令并执行相应的操作。 你可能会说它类似于聊天机器人,但我把语音助理单独包括在内,因为它们应该在这个列表中占据更好的位置。他们不仅仅是聊天机器人,而且可以做比聊天机器人更多的事情。 今天,我们大多数人无法想象没有语音助手的生活。这些年来,他们已经变成了一个非常可靠和强大的朋友。从设置我们的闹钟到为我们找一家餐厅,语音助理可以做任何事情。它们为用户和公司打开了一扇新的机会之门。 语法检查程序 这是自然语言处理中应用最广泛的应用之一。像Grammarly这样的语法检查工具提供了大量的功能,可以帮助人们写出更好的内容。他们可以把任何普通的文本变成美丽的文学作品。 如果你想给你的老板写封电子邮件,或者你要写一篇报告或者更好的一篇文章,无可否认的是你需要这些有用的朋友。 这些工具可以纠正语法、拼写、建议更好的同义词,并帮助以更好的清晰度和参与度交付内容。 它们也有助于提高内容的可读性,从而允许你以尽可能好的方式传达你的信息。如果你看看五年前语法检查的工具,你会发现他们的能力远不如今天。 你知道为什么吗? 因为自然语言处理的transformers是在2017年问世。 电子邮件过滤 你用过Gmail吗? 我肯定你已经注意到了,不管你什么时候收到的都是社交邮件。最好的是垃圾邮件也被过滤到一个单独的部分。是不是既神奇又有益?是的,这就是邮件过滤的全部内容。我不必告诉你我们的日常工作有多依赖于这个功能。 使用文本分类过滤电子邮件,这是一种自然语言处理技术。你可能已经猜到了。 文本分类是将一段文本分类为预定义的类别的过程。文本分类的另一个很好的例子是将新闻文章分成不同的类别。 结尾 既然你熟悉自然语言处理应用程序,现在就可以深入自然语言处理领域了。 原文链接:https://www.analyticsvidhya.com/blog/2020/07/top-10-applications-of-natural-language-processing-nlp/ 欢迎关注磐创AI博客站: http://panchuang.net/ sklearn机器学习中文官方文档: http://sklearn123.com/ 欢迎关注磐创博客资源汇总站: http://docs.panchuang.net/

优秀的个人博客,低调大师

每日一博 | Go+ 可有效补全 Python 的不足

王益,蚂蚁集团研究员,开源项目SQLFlow 和 ElasticDL 的负责人。他从10岁开始写代码。曾经用自己焊接的电路板扩展“中华学习机”来把自家的老式“威力牌”双筒洗衣机改造成了自动洗衣机;用Apple BASIC语言和6502汇编混合编程写了人生中第一个游戏;高中自学了大学所有计算机课程,参加计算机水平测试,先后获得了“程序员”、“高级程序员”、“系统分析员”认证。王益从事 AI 基础架构工作十三年,先后在全球多家顶级互联网公司任职,亦曾在硅谷和北京两地创业。 不久前许式伟(江湖人称老许)的 Go+ 项目在 Hacker News 上掀起了一阵风潮[1]。我一见倾心,参与贡献。最近老许和社区组织了一个视频交流,拉我跟大家说说为啥关注 Go+ 以及图个啥。在直播交流后,根据弹幕反馈,以及两位好友——洪明胜(TensorFlow Runtime 负责人)以及王玉(沈雕墨)的建议,做了修改。 我做分布式深度学习系统十三年了,尤其是 2016 年徐伟老师让我接替他作为他原创的 PaddlePaddle 项目的负责人之后,在工业系统中对 Python 的亲身体会让我对其局限了解愈深。而 Go+ 是我见过的弥补方案里最靠谱的。 我期待 Go+ 对标 Python,补全 Python 的不足,并且在此基础上有一个类似 numpy 的项目(姑且称之为 numgo+ 吧)用来支持张量(tensor)运算,满足数据科学的需求;在 numgo+ 之上再构建一个类似 PyTorch 的深度学习基础库(姑且称之为 GoTorch 吧)。如果可以,进一步成为深度学习编译器生态的一种前端语言。 我现在在蚂蚁集团工作,负责一个开源 SQL 编译器 SQLFlow —— 把扩展语法以支持 AI 的 SQL 程序翻译成 Python 程序。同事们说,如果 Go+ 这套生态能成熟起来,很乐意让 SQLFlow 输出 Go+ 程序。 很多读者估计觉得我瞎说八道—— Python 如此如日中天一般火热的语言,何须“补足”? Python 的优势 Python 的语法很灵活,融合了其他很多语言令人觉得方便的特点。比如,和 C++ 一样, Python 允许重载操作符,numpy 的作者于是重载了算数操作符来做张量运算。和 Lisp 一样,Python 的 eval 函数递归地实现了 Python 解释器,可以解释执行 Python 表达式,所以 Python 程序可以生成自己。 这样的灵活性允许程序员随心所欲,因此特别适合探索性工作。比如研究生们用 Python 做科研;数据科学家们用来替代之前各种昂贵的商业化系统;在随后诞生的深度学习领域,Python 也迅速蓬勃。 Python的劣势 Python 的优势同时也隐含了其劣势。我亲身感受的痛点有二。 难以保证代码质量 语法灵活的另一种说法是:一个程序有多重写法。现代软件工程里没有孤胆英雄,全靠大家合作。多种可能的写法往往意味着团队容易在 code review 时吵架——而且难以平息,因为不一定有客观选择标准。很多其他语言也有类似问题,比如 Java。解法是,社区里定一些设计模式(design patterns),程序员写程序前先看看有没有可以套用的设计模式,如果有,则遵循之。所以 Java 程序员除了学习 Java 语法,还要学习设计模式。C++ 也有类似的问题。解法之一是 Google 定了一套 code style——哪些语法可以用,哪些不许用——按照 Rob Pike 的解释,允许用的部分语法挑出来,就是 Go 的设计初衷。Python 太灵活,以至于 code style 都没法定义得和 C++ 的一样细致—— PEP8 几乎只是说说排版要求,对语法的选用几乎没有限制。Python 也没法定义模式——太多了,写不完。 Python 为了灵活采用动态类型,所以我们看一个 Python 函数,必须得细读其代码,否则都不知道它有没有返回值,以及返回值是啥。Python 也有语法扩展,要求编程者指明输入输出的数据类型,不过用的人不多——毕竟大家都是冲着“灵活”来的;要是限制灵活性,那就真不如用静态类型语言了。这个结果是,每个 Python 函数都不能太长,否则看不明白了。可是 Python 程序员就是冲着灵活性来的,要的就是信马由缰的感觉,管你懂不懂呢,我自己明白就行,反正发完论文就毕业了。拆分函数细化粒度?不可能的,这辈子都不可能的。 有没有写的很好的 Python 代码呢?有的。比如 Google Tangent。这是一个很小众的项目。作者也只有两个。其代码结构清晰——每个函数基本都在十行代码之内,代码和注释一样长,所以很好懂。不过这也和 Python 用户众多的印象相悖了。我在负责 PaddlePaddle 项目的时候,除了自己努力学习和总结 Python 的模式,也配置 CI 调用各种工具做源码检查,然并卵,这些工具没有智能化到可以自动注释代码,也不会自动拆分太长的函数定义。 难以优化计算效率 Python 的语法丰富、灵活性强,所以解释器写起来很复杂,要优化性能也很难。相比之下,Go 语言语法简洁,表达能力远胜于 C 但是 keyword 总数少于 C,这种简洁使得 Go 程序的性能优化比较容易。在 Go 诞生后几年,Go 编译器对代码的性能优化水平就快速接近 GCC 对 C++ 程序的优化水平了,而 C++ 和 Python 一样,语法丰富,所以编译器里的代码性能优化功能很不容易开发。 有人尝试写 Python 的编译器来代替解释器,从而在程序执行之前先做性能优化。但是 Python 语法比 C++ 更灵活,以至于几乎没法写一个完全支持 Python 标准语法的编译器出来。几个尝试因此作罢。目前的普遍的做法是解释器来做执行时优化(JIT compilation),因为有 runtime 信息,所以相对编译器更容易一些。 在 AI 领域,深度学习训练非常消耗计算资源。TensorFlow 的图模式的解法是:用户写的 Python 程序在执行时并不真的做训练,而是把训练过程输出成一个被称为”计算图“的数据结构,交给 TenosrFlow runtime 这个“解释器”来执行。只要保证 TensorFlow runtime 的执行效率,即可不受 Python 解释器效率的限制。 TensorFlow 图模式用心良苦,也画蛇添足——源程序、各层 IR、以及 binary code 是一直以来人们用来描述计算过程的表达方式,TensorFlow 项目早年间发明的计算图重复造了个轮子,而且造得不专业——图难以表达 if-else、循环、函数定义和调用,更别提 closure、coroutine 和 threading 这样的高级控制流结构了。人工智能工程师的非专业编译器设计让 LLVM 的作者 Chris Lattener 掩面而笑,于是他尝试用 Swift for TensorFlow 替换 Python 作为前端语言,用 MLIR 代替 TensorFlow 中的“计算图” [2] 。 补全局限的尝试 我在负责 PaddlePaddle 期间为了验证 Paddle Fluid 的能力,和我的同事陈曦一起做了一个无人驾驶船,尝试用 Fluid 写 immitation learning 方法,让船能学习人类驾驶员的驾驶技术,详情请见系列博客 [3] 。可是如果我们把跑 Python 程序的 MacBook Pro 带上船则太费电,而嵌入式的设备上又不适合跑 Python 写的训练程序。如果每次停船后上传数据到服务器训练,那么船向人学习迭代的进度就太慢了。 为此,当时另一位同事杨杨写了 Paddle Tape,用 C++ 实现了 PyTorch 的自动求导能力,结合 Paddle Fluid 积累的众多用 C++ 写的基本计算单元(operators),Tape 完全是一个 C++ 实现的深度学习系统系统,和 Python 没啥关系了。 2019 年初,我的朋友洪明胜在 Google 负责 Swift for TensorFlow 项目,这也是一个 AI 基础架构去 Python 化的尝试。他当时拉我给 Chris Lattener 的团队分享了 Paddle Tape 和无人船的故事,并修改了我的幻灯片 [4] ,记录了讲稿 [5] 。 我在蚂蚁集团负责的一个开源分布式深度学习训练系统 ElasticDL,尝试过调用 TensorFlow graph mode、eager execution mode、PyTorch、和 Swift for TensorFlow,很受 Swift for TensorFlow 的设计理念以及和 Python 生态共荣的策略的启发。 Go+ 和数据科学 以上尝试提醒我,语言的选择标准必须包括:语法清晰简练和语法稳定容易学习。也希望语言的使用者是比较有探索精神的一个群体。Go+ 及其基于 Go 社区的用户群体刚好符合这些条件。 在 Go+ 出现之前,也有把 Go 用于数据科学的尝试,也有用 Go 实现的张量运算库(比如 gonum),但是用起来都不如用 numpy 的 Python 程序简练,很直接的一个原因是 Go 的常量需要指定数据类型,而 Python 的则不用。我写了几个对比 [6] 。 用 Go 定义一个 ndarray 类型的常量,用户需要写: x :=numgo.NdArray( [][]float64{ {1.0, 2.0, 3.0}, {1.0, 2.0, 3.0}}) 而用 Python 是: x = numpy.ndarray( [[1.0,2.0, 3.0], [1.0,2.0, 3.0]]) 有了 Go+ 来自动推导数据类型,写法就和 Python 几乎一样了: x :=numgo.NdArray( [[1.0, 2.0, 3.0], [1.0,2.0, 3.0]]) 更进一步,老许加的一个 comment 解释 Go+ 准备支持 MATLAB 的张量定义语法。这样一来,这个程序就更简单了: x :=numgo.NdArray( [1.0, 2.0, 3.0; 1.0, 2.0, 3.0]) 类似的便捷的语法改进在 Go+ 已经积累了不少,我记录了一些例子 [7] 。这些语法扩展足以极大简化数据科学编程。 而 Go+ compiler 负责把利用这些语法糖写作的 Go+ 程序翻译成 Go 程序。这样可以和其他 Go 语言写的库一起编译,从而复用 Go 生态里的代码。 复用 Go 生态是 Go+ 语言的一个长项。在 Go 的发展过程中,已经积累了不少科学计算的基础技术,比如实现张量的 Go 数据类型的封装。这些数据类型的计算也有高效的 Go 实现,部分缘于 Go 程序可以方便地调用 C/C++ 程序,包括科学计算领域里久经考验的基础库如 LAPACK,甚至 NVIDIA GPU 的接口库 CUDA。值得注意的是,这些基于 C/C++ 的基础库也是 Python 的数据科学生态的基础,所以本文的标题是 Go+ 补全 Python 生态。 Go+ 和深度学习编译器 上文提到了深度学习技术。这是 Python 被广泛使用的另一个领域,和数据科学有自然的联系,比如 PyTorch 和 TensorFlow 的 tensor 数据结构和 numpy 的 ndarray 一样。而在深度学习领域,编译器是最新的主流研究方向。 Go 社区里目前后台系统开发者居多;视频直播时,有听众在弹幕里说自己不是 AI 工程师,不关注 AI。如果真的这么想,恐怕不只是技术理想问题,而且是对饭碗不负责任了。 后台系统和 AI 系统之间的界限越来越模糊,因为后台系统指的是互联网服务的后台系统;而整个互联网经济建立在用不眠不休的服务器取代人来服务大众,而 AI 是这个逻辑成立的基础,详见我的一篇老文 [8] ,例数了最近二十年被 AI 技术淘汰的人类职业。 而且这个界限在不久的将来会彻底消失,因为随着 online learning、reinforcement learning、 imitation learning、federated learning 技术取代 sueprvised learning 成为互联网智能(包括传统的搜索、广告、推荐,也包括新兴的无人驾驶和金融智能)的主流技术,AI 系统将不再能被分为训练和预测两部分,也不再由 AI 工程师负责前者,而后台工程师负责后者了。 在 AI 领域里,深度学习超越传统机器学习的一个重要原因是:传统机器的每一个模型(可以理解为对知识结构的描述)往往对应一种甚至多种训练算法;而深度学习里,几乎所有模型都用一种算法 stochastic gradient descend(SGD)或者其大同小异的变种来训练。这样,基础架构工程师负责训练系统的开发;模型研究人员复用之,大大减小了科研的工程负担,提升了模型研发的效率。 深度学习系统的核心问题在于 autodiff,这是 SGD 算法的数学特点决定的。SGD 算法通过交替执行前向计算过程(forward pass)和反向计算过程(backward pass),即可从训练数据归纳出模型的参数。模型加参数就是知识。这里的工程挑战在于模型研究者在定义模型的时候,就附带描述了前向计算过程,但是反向计算过程很难由人来描述,最好有一个程序自动从前向计算过程推导出反向计算过程。这个自动推导被称为 autodiff。 目前有两种 autodiff 的策略。第一种在运行时推导,也被称为 dynamic net 和 tape-based approach。基本思路是不管前向计算过程有多复杂,哪怕包括 if-else、循环、函数定义和调用、甚至 coroutine 和 multithreading,只要把依次执行的基本操作(operator)记录下来,到一个 tape 里,那么反向计算过程就是回溯这个 tape 里的记录,并且依次调用每个 operator 对应的求导数 operator(gradient operator)。这是 PyTorch、TensorFlow eager execution、以及 Paddle Tape 采用的策略。这种策略和编译器关系不大,和 JIT compilation 有点关系。 另一种策略是运行之前推导反向计算过程,为此需要引入一个专门做 autodiff 的编译器。TensorFlow graph mode、Caffe/Caffe2、Paddle Fluid、Google Tangent、Julia、Swift for TensorFlow 用的是这个策略。编译器一般来说是把源语言描述的源程序翻译成目标语言描述的目标程序。但是前三种技术偷懒了,没有引入源语言,而是让用户通过调用 Python library 来描述前向计算过程。Google Tangent、Julia、Swift for TensorFlow 分别让用户用 Python 语言、Julia 语言、Swift 语言来定义函数,从而描述前向计算过程,并且能把前向计算函数翻译成反向计算函数。 严格地说,Julia 的作者实现了多种 autodiff 方案:有运行时的、也有编译时的、也有二者混合的。明胜在帮我修改此文时提醒: For a different vision, where the same language is used to both implement kernels and construct + executeprograms/graphs based on the kernels, see [9] . 这里的 kernel 指的是深度学习基本操作单元 operator 的实现。 编译时和运行时 autodiff 这两种策略,也都适用于 Go+,而且并不妨碍 Go+ 复用现有技术。就像数据科学领域应该复用 LAPACK 这些基础库,深度学习领域也应该复用基础的 operators 和 gradient operators。 运行时用 tape 实现 autodiff 的策略的实现更简单。我记得杨扬用一个星期时间就开发了 Paddle Tape。而编译的策略复杂很多。Paddle Fluid 二十多人在 TensorFlow 团队 Yuan Yu 老师的工作 [10] 的基础上,用了好几个月的时间,才搞定 if-else、循环、函数定义和调用的 autodiff。 这些尝试提醒我们复用社区核心技术的重要性。比如,用 MLIR 代替计算图从而能描述更复杂的控制流——计算图肯定没法描述 goroutine 和 select。用 TVM 作为编译器后段(backend),用深度学习技术学习如何优化深度学习程序。所有这些技术的输出,都是对基本 operaotor 的调用。从这个角度看,之前深度学习技术生态积累的 operators 类似 built-in functions。这也是洪明胜在修改此文时反复提醒的。 希望不久的将来,Go+ 可以作为一种新的深度学习前端语言,与 Python、Julia、Swift 并列,共同复用更底层的 IR、编译器后段、以及基本 operators。 小结 我理解未来 Go+ 项目的核心战术工作是:在维持 Go 的语法简洁性的本色之上,合理准入简化语法——不要像 Python 和 C++ 那样融入太多灵活性,同时在 Go 的极简语法规范之上,适当地更加灵活度。 此外,通过社区合作开发 numgo+ 和 GoTorch 这样的探索性项目,丰富技术生态是社区的战略方向。甚至更进一步,成为一种深度学习编译器的前端语言,以复用多年来社区沉淀的深度学习底层计算技术。 最后,感谢老许和 Go+ 的核心贡献者柴树杉和陈东坡、Go 社区的杰出贡献者 Asta Xie、以及我的同事 ONNX 社区核心贡献者张科校阅。 点击下方“阅读原文”,进入蚂蚁机器学习工具 SQLFlow 专栏。 相关链接: [1] https://news.ycombinator.com/item?id=23550042 [2] https://www.tensorflow.org/mlir/dialects [3]https://zhuanlan.zhihu.com/p/38395601 [4] https://github.com/wangkuiyi/notes/tree/master/s4tf [5]https://docs.google.com/document/d/1WLD4OcntBKQoNIH9VVYF0NPRe6V5exN3mu5uFlE0P0w/edit?usp=sharing [6] https://github.com/qiniu/goplus/issues/307 [7] https://github.com/qiniu/goplus/tree/master/tutorial [8] https://zhuanlan.zhihu.com/p/19901967 [9] https://julialang.org/blog/2018/12/ml-language-compiler/ [10] https://arxiv.org/pdf/1805.01772.pdf -END- 本文分享自微信公众号 - 支付宝技术(Ant-Techfin)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | 走进 Golang 之 Channel 的数据结构

上篇文章讲了 channel 的基本使用,讲了一些使用时需要注意的事项,本文将重点介绍 channel 中的两个数据结构:循环队列 与 双端链表 。 channel 的需求描述 为了理解这些数据结构解决了什么问题,我们先来做个简单的回顾,看看为什么需要这两个数据结构,他们解决了什么问题。我们知道 goroutine 是用户态的线程,不同的 goroutine 之间是有消息传递这个需求的。在原始的进程与线程(系统线程)编程中我们会采用管道的方式,而 channel 就是用户态线程传递消息的管道实现,并且是类型安全的。 既然 channel 是一个管道,用来满足不同 goroutine 间交换消息的。那么实现这样一个管道要怎么做呢? 来看看我们日常传递消息的需求: 能够有多个 goroutine 向 channel 进行读写,并且保证没有竞争问题,需要用 队列 来管理阻塞的 goroutine,解决竞争问题; 需要管理发送到 channel 的消息(有缓冲、无缓冲),对于有缓存的 channel 可以采用 循环队列 来管理多个消息。 当然上面的需求是经过简化的,比如 channel 还需要具备阻塞、唤醒 goroutine 的能力,不过为了本文我们更加专注焦点问题,先只关注上面两个问题。 channel 的数据结构 接下来我们分析一下 channel 在实际运行中,它的结构体是怎么样的。当然这又分为两种类型,有缓冲与无缓冲的。我们先来看一个无缓冲的情况。 无缓冲 先把示例代码贴出来。就是两个读的 goroutine 被阻塞在一个无缓冲的 channel 上。 funcmain(){ch:=make(chanint)//无缓冲gogoRoutineA(ch)gogoRoutineB(ch)ch<-1time.Sleep(time.Second*1)}funcgoRoutineA(chchanint){v:=<-chfmt.Printf("Areceiveddata:%d\n",v)}funcgoRoutineB(chchanint){v:=<-chfmt.Printf("Breceiveddata:%d\n",v)} 来看看当代码执行到 ch <- 1 这一行之后 channel 的结构体被填充成什么样子了! 无缓冲 channel 注意其中 buf 字段可存储的长度是0,这是因为 无缓冲 channel 不会用到循环队列来存储数据。它一定是等读、写 goroutine 都准备好了,然后直接把数据交给对方。我们用一副图来看一下无缓冲的数据交换过程。 交换数据 上图描述的是数据交换过程,再看一下读 goroutine 被阻塞的结构示意图。被阻塞的 goroutine 会挂载到对应的队列上,该队列是一个双端队列。 上面的例子,由于两个读 goroutine 在启动的时候,写还没有准备好,因此读全部被挂起在队列中;当有写goroutine准备好的时候,由于此时读已经就绪,因此写不会阻塞,挂起放到 sendq 中。大家可以修改上面的代码,自己看一下写阻塞,读立马执行的情况。 结构示例 有缓冲 我们将上面的代码改成有缓冲的通道,然后再来看看有缓冲的情况。 funcmain(){ch:=make(chanint,3)//有缓冲//都不会阻塞ch<-1ch<-2ch<-3//会阻塞,被挂起到sendq中gofunc(){ch<-4}()//只是为了debugvaraintfmt.Println(a)gogoRoutineA(ch)gogoRoutineA(ch)gogoRoutineB(ch)gogoRoutineB(ch)//猜猜这里会被挂起吗?time.Sleep(time.Second*2)}funcgoRoutineA(chchanint){v:=<-chfmt.Printf("Areceiveddata:%d\n",v)}funcgoRoutineB(chchanint){v:=<-chfmt.Printf("Breceiveddata:%d\n",v)} 贴出执行到第一行的 go goRoutineA(ch) 时, hchan 的结构填充情况。 有缓冲 channel 在这里可以看到缓冲的大小是3,由于增加了缓冲,只要写 goroutine 没有把缓冲写满,则不会导致协程阻塞。但是一旦缓冲没有多余的空间,则会把写 goroutine 挂起到 sendq 中,直到有空间时将他唤醒(还有其它唤醒的场景,这一略过)。 其实有缓冲的 channel,就是把同步的通信变为了异步的通信。写的 channel 不需要关注读 channel,只要有空间它就写;而读也一样,只要有数据就正常读就可以,如果没有就挂起到队列中,等待被唤醒。下图形象的展示了有缓冲 channel 是如何交换数据的。 交换数据 我们再来用图的形式看一下此时结构体的样子,这里图有些偷懒,只是在上面图的基础上增加了循环队列部分的描述,实际到该例子中,读 goroutine时不会被阻塞的,看的时候需要注意这一点。 结构示例 循环队列 今天最重要的是理解 channel 中两个关键的数据结构。为了下一讲阅读源码做准备,我把 channel 中的循环队列部分的代码抽象出来了。 //队列满了varErrQFull=errors.New("circularisfull")//没有值varErrQEmpty=errors.New("circularisempty")//定义循环队列//如何确定队空,还是队满?q.sendx =(q.sendx+1)% q.dataqsiztypequeuestruct{buf[]int//队列元素存储dataqsizuint//circular队列长度qcountuint//有多少元素在buf中qcount=len(buf)sendxuint//可以理解为队尾指针,向队列写入数据recvxuint//可以理解为队头指针,从队列读取数据}funcmakeQ(sizeint)*queue{q:=&queue{dataqsiz:uint(size),buf:nil,}q.buf=make([]int,q.dataqsiz)returnq}//向buf中写入数据//请看chansend函数func(c*queue)insert(eleint)error{//检查队列是否有空间ifc.dataqsiz>0&&c.qcount==c.dataqsiz{returnErrQFull}//存入数据c.buf[c.sendx]=elec.sendx++//尾指针后移ifc.sendx==c.dataqsiz{//如果相等,说明队列写满了,sendx放到开始位置c.sendx=0}c.qcount++returnnil}//从buf中读取数据func(c*queue)read()(int,error){//队列中没有数据了ifc.dataqsiz>0&&c.qcount==0{return0,ErrQEmpty}ret:=c.buf[c.recvx]//取出元素c.buf[c.recvx]=0c.recvx++ifc.recvx==c.dataqsiz{//如果相等,说明写到末尾了,recvx放到开始位置c.recvx=0}c.qcount--returnret,nil} 上面的代码基本上就是 channel 的循环队列部分的实现。这个队列的实现与我们平常实现的循环队列稍微有些不一样。一般我们为了方便判空,会浪费一个buf的空间来方便判空,公式是:(tail+1)%n=head ;但是在 channel 这里的循环队列,由于有了一个循环队列元素的计数,确保了这个空间不会被浪费,并且同时也能够满足 O(1) 时间复杂度计算有缓冲 channel 元素个数。 总结 总结一下今天的主要信息。 channel 中用到了两个数据结构: 循环队列 和 双端链表; 循环队列 只有在有缓冲 channel 中才会使用,它主要是做为消息的缓冲、保证消息的有序性; 双端链表 是用来挂起阻塞的读、写 goroutine 的,在被唤醒时会按照入队顺序公平的进行通知; 无缓冲的 channel 不会用到 循环队列 相关的结构,它必须读写 goroutine 都准备好后才能进行消息交换; 做为缓冲消息的 循环队列 通过一个当前元素个数字段的标记,避免了浪费一个数据空间。 下一章我们就尝试阅读一下 channel 的源码,想要尝试录制一个视频来讲这部分源码! 参考资料 [1] [Diving Deep Into The Golang Channels.](https://codeburst.io/diving-deep-into-the-golang-channels-549fd4ed21a8) [2] [Understanding Channels](https://speakerdeck.com/kavya719/understanding-channels) [3] [The Nature Of Channels In Go](https://www.ardanlabs.com/blog/2014/02/the-nature-of-channels-in-go.html) 推荐阅读 [3] 走进Golang之Channel的使用 [2] 走进Golang之运行与Plan9汇编 [1] 走进Golang之编译器原理 程序改变的不止是世界 也改变了你我的头发 公众号ID dayuTalk 本文分享自微信公众号 - 大愚Talk(dayuTalk)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | 如何将 Web 框架迁移到 Serverless

Serverless 通常翻译为「无服务架构」,是一种软件系统设计架构思想和方法,并不是一个开发框架或者工具。他的出现是为了让开发者更加关注业务的开发,而将繁杂的运维和部署交给云厂商。Serverless 由 Faas 和 Baas 组成,Faas 为开发者提供业务运算环境,然后与 Baas 提供的数据和存储服务,进行交互,从而提供与传统服务一致的体验。但是由于 Faas 是无状态的,并且其运行环境是有读写限制的,最重要的是它是基于事件触发的。因此如果传统 Web 服务想迁移到 Serverless 上,是需要进行相关改造和特殊处理的,为此迁移成本是必不可少的。本文将具体帮助大家剖析下,如何 Serverless 化传统的 Web 服务。 读完本文将了解到: 传统 Web 服务特点 Serverless 适用场景 Web 框架如何迁移到 Serverless 使用 Serverless Components 快速部署 Web 框架 传统 Web 服务特点 Web 服务定义: Web 服务是一种 面向服务的架构 (SOA) 的技术,通过标准的 Web 协议提供服务,目的是保证不同平台的应用服务可以互操作。 日常生活中,接触最多的就是基于 HTTP 协议的服务,客户端发起请求,服务端接受请求,进行计算处理,然后返回响应,简单示意图如下: 传统 Web 服务部署流程:通常需要将项目代码部署到服务器上,启动服务进程,监听服务器的相关端口,然后等待客户端请求,从而响应返回处理结果。而这个服务进程是常驻的,就算没有客户端请求,也会占用相应服务器资源。 一般我们的服务是由高流量和低流量场景交替组成的,但是为了考虑高流量场景,我们需要提供较高的服务器配置和多台服务进行负载均衡。这就导致服务处在低流量场景时,会多出很多额外的闲置资源,但是购买的资源却需要按照高流量场景进行付费,这是非常不划算的。 如果我们的服务能在高流量场景自动扩容,低流量场景自动缩容,并且只在进行计算处理响应时,才进行收费,而空闲时间不占用任何资源,就不需要收费呢? 答案就是 Serverless。 Serverless 适用场景 上面已经提到了 Serverless 的两个核心特点:按需使用和收费 和 自动扩缩容。而且近几年 Serverless 的应用也越来越广泛,但是它并不是银弹,任何技术都是有它的适合场景和不适合场景。我们不能因为一项技术的火热,而盲目的追捧。Serverless 是有它的局限性的,一般 Serverless 适合如下几种场景: 异步的并发,组件可独立部署和扩展 应对突发或服务使用量不可预测 无状态,计算耗时较短服务 请求延时不敏感服务 需要快速开发迭代的业务 如果你的服务不满足以上条件,笔者是不推荐迁移到 Serverless。 Web 框架如何迁移到 Serverless 如果你的服务是以上提到的任何话一个场景,那么就可以尝试迁移到 Serverless 上。 常见的 Serverless HTTP 服务结构图如下: 那么我们如何将 Web 服务进行迁移呢? 我们知道 Faas (云函数)是基于事件触发的,也就是云函数被触发运行时,接收到的是一个 JSON 结构体,它跟传统 Web 请求时有区别的,这就是为什么需要额外的改造工作。而改造的工作就是围绕如何将事件 JSON 结构体转化成标准的 Web 请求。 所以 Serverless 化 Web 服务的核心就是需要开发一个 适配层,来帮我们将触发事件转化为标准的 Web 请求。 整个处理流程图如下: 接下来将介绍如何为 Express 框架开发一个适配层。 Serverless Express 适配层开发 实现原理 首先我们先来看看一个标准的云函数结构: module.exports.handler = (event, context) => { // do some culculation return res; }; 在介绍如何开发一个 Express 的适配层前,我们先来熟悉下 Express 框架。 一个简单的 Node.js Web 服务如下: const http = require("http"); const server = http.createServer(function (req, res) { res.end("helloword"); }); server.listen(3000); Express 就是基于 Node.js 的 Web 框架,而 Express 核心就是 通过中间件的方式,生成一个回调函数,然后提供给 http.createServer() 方法使用。 Express 核心架构图如下: 由此可知,我们可以将 Express 框架生成的回调函数,作为 http.createServer() 的参数,来创建可控的 HTTP Server,然后将云函数的 event 对象转化成一个 request 对象,通过 http.request() 方法发起 HTTP 请求,获取请求响应,返回给用户,就可以实现我们想要的结果。 Node.js Server 的监听方式选择 对于 Node.js 的 HTTP Server,可以通过调用 server.listen() 方法来启动服务,listen() 方法支持多种参数类型,主要有两种监听方式 从一个TCP端口启动监听 和 从一个UNIX Socket套接字启动监听。 server.listen(port[, hostname][, backlog][, callback]):从一个TCP端口启动监听 server.listen(path, [callback]):从一个UNIX Domain Socket启动监听 服务器创建后,我们可以像下面这样启动服务器: // 从'127.0.0.1'和3000端口开始接收连接 server.listen(3000, '127.0.0.1', () => {}); // 从 UNIX 套接字所在路径 path 上监听连接 server.listen('path/to/socket', () => {}) 无论是 TCP Socket 还是 Unix Domain Socket,每个 Socket 都是唯一的。TCP Socket 通过 IP和端口 描述,而 Unix Domain Socket 通过 文件路径 描述。 TCP 属于传输层的协议,使用 TCP Socket 进行通讯时,需要经过传输层 TCP/IP 协议的解析。 而 Unix Domain Socket 可用于不同进程间的通讯和传递,使用 Unix Domain Socket 进行通讯时不需要经过传输层,也不需要使用 TCP/IP 协议。所以,理论上讲 Unix Domain Socket 具有更好的传输效率。 因此这里在设计启动服务时,采用了 Unix Domain Socket 方式,以便减少函数执行时间,节约成本。 关于 Node.js 如何实现 IPC 通信,这里就不详细介绍的,感兴趣的小伙伴可以深入研究下,这里有个简单的示例,nodejs-ipc 代码实现 原理大概介绍清楚了,我们的核心实现代码需要以下三步: 通过 Node.js HTTP Server 监听 Unix Domain Socket,启动服务 function createServer(requestListener, serverListenCallback) { const server = http.createServer(requestListener); server._socketPathSuffix = getRandomString(); server.on("listening", () => { server._isListening = true; if (serverListenCallback) serverListenCallback(); }); server .on("close", () => { server._isListening = false; }) .on("error", (error) => { // ... }); server.listen(`/tmp/server-${server._socketPathSuffix}.sock`) return server; } 将 Serverless Event 对象转化为 Http 请求 function forwardRequestToNodeServer(server, event, context, resolver) { try { const requestOptions = mapApiGatewayEventToHttpRequest( event, context, getSocketPath(server._socketPathSuffix), ); // make http request to node server const req = http.request(requestOptions, (response) => forwardResponseToApiGateway(server, response, resolver), ); if (event.body) { const body = getEventBody(event); req.write(body); } req .on('error', (error) => // ... ) .end(); } catch (error) { // ... return server; } } 将 HTTP 响应转化为 API 网关标准数据结构 function forwardResponseToApiGateway(server, response, resolver) { response .on("data", (chunk) => buf.push(chunk)) .on("end", () => { // ... resolver.succeed({ statusCode, body, headers, isBase64Encoded, }); }); } 最后函数的 handler 将异步请求返回就可以了。 借助 tencent-serverless-http 库实现 如果不想手写这些适配层代码,可以直接使用 tencent-serverless-http 模块。 它使用起来很简单,创建我们的 Express 应用入口文件 sls.js: const express = require("express"); const app = express(); // Routes app.get(`/`, (req, res) => { res.send({ msg: `Hello Express`, }); }); module.exports = app; 然后创建云函数 sl_handler.js 文件: const { createServer, proxy } = require("tencent-serverless-http"); const app = require("./app"); exports.handler = async (event, context) => { const server = createServer(app); const result = await proxy(server, event, context, "PROMISE").promise; }; 接下来,将业务代码和依赖模块一起打包部署到云函数就可以了(记得指定 执行方法 为 sl_handler.handler )。 其他 Node.js 框架 除了 Express 框架,其他的 Node.js 框架也基本类似,只需要按照要求,exports 一个 HTTP Server 的回调函数就可以。 比如 Koa,我们拿到初始化的 Koa 应用后,只需要将 app.callback() 作为 createServer() 方法的参数就可以了,如下: const { createServer, proxy } = require("tencent-serverless-http"); const app = require("./app"); exports.handler = async (event, context) => { // 这里和 Express 略有区别 const server = createServer(app.callback()); const result = await proxy(server, event, context, "PROMISE").promise; }; 其他语言框架 对于非 Node.js 框架,比如 Python 的 Flask 框架,原理都是一样的,核心只需要做到 将 Serverless Event 对象转化为 Http 请求,就可以了。由于笔者对其他语言不太熟悉,这里就不做深入介绍了,感兴趣的小伙伴,可以到 Github 社区搜索下,已经有很多对应的解决方案了,或者自己尝试手撸也是可以的。 使用 Serverless Components 快速部署 Web 框架 读到这里,相信你已经清楚,如何将自己的 Node.js 框架迁移到 Serverless 了。但是在这之前,我们都是手动处理的,而且每次都需要自己创建 handler.js 文件,还是不够方便。 为此开源社区提供了一套优秀的解决方案 Serverless Component,通过组件,我们进行简单的 yaml 文件配置后,就可以方便的将我们的框架代码部署到云端。 比如上面提到的 Express 框架,就有对应的组件,我们只需要在项目根目录下创建 serverless.yml 配置文件: component: express name: expressDemo inputs: src: ./ region: ap-guangzhou runtime: Nodejs10.15 apigatewayConf: protocols: - https environment: release 然后全局安装 serverless 命令 npm install serverless -g 之后,执行部署命令即可: $ serverless deploy 耐心等待几秒,我们的 Express 应用就成功部署到云端了。更多详细信息,请参考 Express 官方文档 注意:本文 Serverless 服务均基于 腾讯云 部署。 Serverless Express 组件不仅能帮我们快速部署 Express 应用,而且它还提供了 实时日志 和 云端调试 的能力。 只需要在项目目录下执行 serverless dev 命令,serverless 命令行工具就会自动监听项目业务代码的更改,并且实时部署,同时我们可以通过打开 Chrome Devtools 来调试 Express 应用。 关于云端调试,腾讯云 Serverless Framework 正式发布公告 中有详细的介绍,并且有视频演示。 而且除了 Express 组件,还支持: Koa.js,Egg.js,Next.js,Nuxt.js..... 发现更多组件 最后 当然 Serverless 化 Web 服务并没有本文介绍的那么简单,比如文件读写,服务日志存储,Cookie/Session 存储等......实际开发中,我们还会面临各种未知的坑,但是比起困难,Serverless 带给我们的收益是值得去尝试的。当然传统 Web 服务真的适合迁移到 Serverless 架构上,也是值得我们去思考的问题,毕竟现有的 Web 框架都是面向传统 Web 服务开发实现的 (推荐阅读 利与弊-传统框架要不要部署在 Serverless 架构上)。但是笔者相信,很快就会出现一个专门为 Serverless 而生的 Web 框架,可以帮助我们更好地基于 Serverless 开发应用 ~ One More Thing 3 秒你能做什么?喝一口水,看一封邮件,还是 —— 部署一个完整的 Serverless 应用? 复制链接至 PC 浏览器访问:https://serverless.cloud.tencent.com/deploy/express 3 秒极速部署,立即体验史上最快的 Serverless HTTP 实战开发! 传送门: GitHub: github.com/serverless 官网:serverless.com 欢迎访问:Serverless 中文网,您可以在 最佳实践 里体验更多关于 Serverless 应用的开发! 推荐阅读:《Serverless 架构:从原理、设计到项目实战》

优秀的个人博客,低调大师

每日一博 | 当我谈 HTTP 时,我谈些什么?

当我们打开网站时也许不会去留意网站前面的HTTP是怎么来的。但是它毫无疑问在网络中有着举足轻重的地位。本文从起源到发展,详说HTTP从1到3的演变。 说在前面 本文不致力于讲完 HTTP 的全部内容,事实上短短的篇幅也不可能讲完。本文也无意于深挖 HTTP 中的某一点,这是像 《HTTP 权威指南》或者是 RFC 协议做的事。 本文目标是帮助读者理清 HTTP 的演化过程,说说 HTTP 变化的那些事。 HTTP 的起源 HTTP 最初是 Tim BernersLee 1989 年在欧洲核子研究组织(CERN)所发起的。Tim BernersLee 提出了一种能让远隔两地的研究者们共享知识的设想。这个设想的基本理念是:借助多文档之间相互关联形成的超文本(HyperText),连成可相互参阅的 WWW(World Wide Web,万维网)。用于传输的超文本传输协议(HyperText Transfer Protocol),即 HTTP 由此诞生。 WWW 这一名称,是 Web 浏览器当年用来浏览超文本的客户端应用程序时的名称。现在则用来表示这一系列的集合,也可简称为 Web。 HTTP 本身是一个简单的请求-响应协议,它通常运行在 TCP 之上。从整个网络模型来看,HTTP 是应用层的一个协议。在 OSI 七层模型中,HTTP 位于最上层。它并不涉及数据包的传输,只是规定了客户端和服务器之间的通信格式。定了客户端可能发送给服务器什么样的消息以及得到什么样的响应。请求和响应消息的头以 ASCII 码形式给出。 HTTP 采用 BS 架构,也就是浏览器到服务器的架构,客户端通过浏览器发送 HTTP 请求给服务器,服务器经过解析响应客户端的请求。就是这个简单实用的模型,使得 HTTP 这个基于 TCP/IP 的协议迅速推广。 HTTP/0.9 到 HTTP/1.1 HTTP 的演化并不是一蹴而就的。当年 HTTP 的出现主要是为了解决文本传输的难题。由于协议本身非常简单,于是在此基础上设想了很多应用方法并投入了实际使用。现在 HTTP 已经超出了 Web 这个框架的局限,被运用到了各种场景里。 HTTP/0.9 HTTP 协议最早的一个版本是 1990 年发布的 HTTP/0.9。 前面说到,HTTP 于 1989 年问世。那时的 HTTP 并没有作为正式的标准被建立。这时的 HTTP 其实含有 HTTP/1.0 之前版本的意思,因此被称为 HTTP/0.9。这个版本只有一个命令:GET。通过 GET 可以获取服务器的资源,比如请求服务器根目录下的 index.html 文件。这个版本的协议规定,服务器只能回应 HTML 格式的字符串,不能回应其它格式,也就是说图像、视频等多媒体资源,在 HTTP/0.9 这个版本上是无法进行传输的。 HTTP/1.0 HTTP 正式作为标准被公布是在 1996 年的 5 月,版本被命名为 HTTP/1.0,并记载于 RFC1945 [https://www.ietf.org/rfc/rfc1945.txt]。虽说是初期标准,但该协议标准至今仍被广泛使用在服务器端。 HTTP/1.0 版本发布,增加了 POST 命令和 HEAD 命令,丰富了浏览器与服务器的互动手段。这个版本的 HTTP 协议可以发送任何格式的内容,包括传输文字、图像、视频、文件等,这为互联网的大发展奠定了基础。 HTTP/1.0 除了增加了请求方法以及对发送文件的支持之外,还增加了格式的改变。除了数据部分,每次通信都必须包括头信息(HTTP header),用来描述一些元数据。另外还增加了状态码、多字符集支持、多部分发送(multi-part type)、权限(authorization)、缓存(cache)、内容编码(content encoding)等等。 HTTP/1.1 HTTP/1.0 版也并不是完美的,它的主要缺点是,每一次建立 TCP 连接只能发送一个请求。发送数据完毕,连接就关闭,如果还要请求其他资源,就必须再新建一个连接。如果多次请求,势必就会对服务器产生较大的资源性能损耗。 1997 年 1 月公布的 HTTP/1.1 是目前主流的 HTTP 协议版本。当初的标准是 RFC2068,之后发布的修订版 RFC2616 就是当前的最新版本。 其中最著名的是 1999 年 6 月公布的 RFC 2616 [https://tools.ietf.org/html/rfc2616],定义了 HTTP 协议中现今广泛使用的一个版本——HTTP/1.1。 这个版本最大的变化就是将持久化连接加入了 HTTP 标准,即 TCP 连接默认不关闭,可以被多个请求复用。此外,HTTP/1.1 版还新增了许多方法,例如:PUT、PATCH、HEAD、OPTIONS、DELETE。得到进一步完善的HTTP/1.1 版本,一直沿用至今。 HTTP 协议简单介绍 请求 客户端发送一个 HTTP 请求到服务器,请求消息包括以下格式: 请求行(request line)、请求头部(header)、空行和请求数据四个部分组成。 Get 请求例子 1 > GET / HTTP/1.1 2 > Host: www.baidu.com 3 > User-Agent: curl/7.52.1 4 > Accept: / 第一部分:请求行,用来说明请求类型,要访问的资源以及所使用的 HTTP 版本。 第二部分:请求头部,紧接着请求行(即第一行)之后的部分,用来说明服务器要使用的附加信息 从第二行起为请求头部,HOST 将指出请求的目的地。User-Agent,服务器端和客户端脚本都能访问它,它是浏览器类型检测逻辑的重要基础。该信息由你的浏览器来定义,并且在每个请求中自动发送等等。 第三部分:空行,请求头部后面的空行是必须的 即使第四部分的请求数据为空,也必须有空行。 第四部分:请求数据也叫主体,可以添加任意的其他数据。 这个例子的请求数据为空。 响应消息 一般情况下,服务器接收并处理客户端发过来的请求后,会返回一个 HTTP 的响应消息。 HTTP 响应也由四个部分组成,分别是:状态行、消息报头、空行和响应正文。 例子 1 < HTTP/1.1 200 OK 2 < Accept-Ranges: bytes 3 < Cache-Control: private, no-cache, no-store, proxy-revalidate, no-transform 4 < Connection: keep-alive 5 < Content-Length: 2381 6 < Content-Type: text/html 7 < Date: Thu, 11 Jun 2020 16:04:33 GMT 8 < Etag: "588604c8-94d" 9 < Last-Modified: Mon, 23 Jan 2017 13:27:36 GMT 10 < Pragma: no-cache 11 < Server: bfe/1.0.8.18 12 < Set-Cookie: BDORZ=27315; max-age=86400; domain=.baidu.com; path=/ 13 < 14 < !DOCTYPE html> 15 < !--STATUS OK--><html> <head><meta HTTP-equiv=content-type content=text/html;charset=utf-8><meta HTTP-equiv=X-UA-Compatible content=IE=Edge><meta content=always name=referrer>... </html> 16 第一部分:状态行,由 HTTP 协议版本号、状态码、状态消息三部分组成。 第一行为状态行,(HTTP/1.1)表明 HTTP 版本为 1.1 版本,状态码为 200,状态消息为(ok) 第二部分:消息报头,用来说明客户端要使用的一些附加信息 第二行和第三行为消息报头。 Date:生成响应的日期和时间;Content-Type:指定了 MIME 类型的 HTML(text/html),编码类型是 UTF-8 第三部分:空行,消息报头后面的空行是必须的 第四部分:响应正文,服务器返回给客户端的文本信息。 空行后面的 HTML 部分为响应正文。 状态码 状态代码有三位数字组成,第一个数字定义了响应的类别,共分五种类别: 1xx:指示信息–表示请求已接收,继续处理 2xx:成功–表示请求已被成功接收、理解、接受 3xx:重定向–要完成请求必须进行更进一步的操作 4xx:客户端错误–请求有语法错误或请求无法实现 5xx:服务器端错误–服务器未能实现合法的请求 安全性与 HTTPS HTTP 的诞生是为了解决信息传递和共享的问题,并没有考虑到互联网高速发展后面临的安全问题。 一般来说 HTTP 从 TCP 三次握手后,便开始了数据传输。由于 HTTP 本身以明文形式来传输数据,并不具备任何数据加密、身份校验的机制。同时下层协议并不对数据安全性、保密性提供保证。所以在网络传输的过程中,任意节点的第三方都可以随意劫持流量、篡改数据或窃取信息。 HTTP 无法确保数据的保密性、完整性和真实性,已经不能适应现代互联网应用的安全需求。 随着 Web 的日益壮大,HTTP 的使用呈巨额增长趋势,对信息安全的需求也愈来愈迫切,SSL(Secure SocketsLayer ,安全套接层)应运而生。 当对于安全需求,首先想到的就是对信息进行加密。SSL ,安全套接层,顾名思义是在 TCP 上提供的安全套接字层。其位于应用层和传输层之间,应用层数据不再直接传递给传输层而是传递给 SSL 层,SSL 层对从应用层收到的数据进行加密,利用数据加密、身份验证和消息完整性验证机制,为网络上数据的传输提供安全性保证。HTTPS 便是指 Hyper Text Transfer Protocol over SecureSocket Layer。 谈到具体实施上,业内通常采用的一般有对称加密和非对称加密。采用何种方式进行加密?如何判断服务器未被篡改?如何传递加密密钥?带着这样的问题,我们来看看 HTTPS 的工作流程。 1、客户端发起 HTTPS 请求 这个没什么好说的,就是用户在浏览器里输入一个 HTTPS 网址,然后连接到 server 的 443 端口。 2、服务端的配置 采用 HTTPS 协议的服务器必须要有一套数字证书,可以自己制作,也可以向组织申请,区别就是自己颁发的证书需要客户端验证通过,才可以继续访问,而使用受信任的公司申请的证书则不会弹出提示页面(Let‘s Encrypt 就是个不错的选择,免费的 SSL 证书)。 这套证书其实就是一对公钥和私钥,如果对公钥和私钥不太理解,可以想象成一把钥匙和一个锁头,只是全世界只有你一个人有这把钥匙,你可以把锁头给别人,别人可以用这个锁把重要的东西锁起来,然后发给你,因为只有你一个人有这把钥匙,所以只有你才能看到被这把锁锁起来的东西。 3、传送证书 这个证书其实就是公钥,只是包含了很多信息,如证书的颁发机构,过期时间等等。 4、客户端解析证书 这部分工作是有客户端的 TLS 来完成的,首先会验证公钥是否有效,比如颁发机构,过期时间等等,如果发现异常,则会弹出一个警告框,提示证书存在问题。 如果证书没有问题,那么就生成一个随机值,然后用证书对该随机值进行加密,就好像上面说的,把随机值用锁头锁起来,这样除非有钥匙,不然看不到被锁住的内容。 5、传送加密信息 这部分传送的是用证书加密后的随机值,目的就是让服务端得到这个随机值,以后客户端和服务端的通信就可以通过这个随机值来进行加密解密了。 6、服务段解密信息 服务端用私钥解密后,得到了客户端传过来的随机值(私钥),然后把内容通过该值进行对称加密,所谓对称加密就是,将信息和私钥通过某种算法混合在一起,这样除非知道私钥,不然无法获取内容,而正好客户端和服务端都知道这个私钥,所以只要加密算法够彪悍,私钥够复杂,数据就够安全。 7、传输加密后的信息 这部分信息是服务段用私钥加密后的信息,可以在客户端被还原。 8、客户端解密信息 客户端用之前生成的私钥解密服务段传过来的信息,于是获取了解密后的内容,整个过程第三方即使监听到了数据,也束手无策。 简单说完了 HTTPS 的工作流程。让我们再将注意力放在 SSL 的演化上。 1994年,Netscape 创建了 SSL 协议的原始规范并逐步发布协议改进版本。1995 年发布 SSL 2.0。1996年,Netscape 和 Paul Kocher 共同设计发布 SSL 3.0 协议,获得互联网广泛认可和支持。因特网工程任务组(IETF)接手负责该协议,并将其重命名为 TLS(传输层安全)协议。 我们看到,SSL 2.0 规范是在 1995 年左右发布的,而 SSL 3.0 是在 1996 年 11 月发布的。有趣的是,SSL 3.0 是在 RFC 6101 [https://tools.ietf.org/html/rfc6101] 中描述的,该 RFC 于 2011 年 8 月发布。它位于历史类别中,该类别通常是被考虑和被丢弃的文档想法,或者是在决定记录它们时已经具有历史意义的协议(根据 IETF [https://www.ietf.org/about/groups/iesg/statements/] 说明)。在这种情况下,有一个描述 SSL 3.0 的 IETF 文档是很有必要的,因为在其可以被用作规范参考。 再来看看,SSL 是如何激发 TLS 的发展的。后者在 1996 年 11 月以 draft-ietf-tls-protocol-00 [https://tools.ietf.org/html/draft-ietf-tls-protocol-00] 宣告开始。它经历了六个草案版本,并于 1999 年初作为 RFC 2246 [https://tools.ietf.org/html/rfc2246] - TLS 1.0 正式发布。 在 1995 和 1999 年间,SSL 和 TLS 协议用于保护互联网上的 HTTP 通信。这作为事实上的标准运行良好。直到 1998 年 1 月,随着 I-D draft-ietf-tls-HTTPs-00 [https://tools.ietf.org/html/draft-ietf-tls-HTTPs-00] 的发布,HTTPS 的正式标准化过程才开始。该工作于 2000 年 5 月以 RFC 2616 - HTTP 上的 TLS 的发布结束。 TLS 在 2000 到 2007 年间继续发展,标准化为 TLS 1.1 和 1.2。直至七年后,TLS 的下一个版本开始进行,该版本在 2014 年四月被采纳为 draft-ietf-tls-tls13-00 [https://tools.ietf.org/html/draft-ietf-tls-tls13-00],并在 28 份草稿后,于 2018 年八月出了完成版本 RFC 8446 [https://tools.ietf.org/html/rfc8446] - TLS 1.3。 改进与 HTTP2 回到 HTTP 本身。在很长一段时间里,HTTP/1.1 已经足够好了(确实是,现在仍应用最为广泛),但是,Web 不断变化的需求使得我们需要一个更好更合适的协议。 HTTP/1.1 自从 1997 年发布以来,我们已经使用 HTTP/1.x 相当长一段时间了。但随着互联网近十年爆炸式的发展,从当初网页内容以文本为主,到现在以富媒体(如图片、声音、视频)为主,而且对页面内容实时性高要求的应用越来越多(比如聊天、视频直播),所以当时协议规定的某些特性,已经逐渐无法满足现代网络的需求了。 如果你有仔细观察,那些最流行的网站首页所需要下载资源的话,会发现一个非常明显的趋势。近年来加载网站首页需要下载的数据量在逐渐增加,并已经超过了 2100K。但在这里我们更关心的是:平均每个页面为了完成显示与渲染所需要下载的资源数也已经超过了 100 个。 基于此,在 2010 年到 2015 年,谷歌通过实践一个实验性的 SPDY 协议,证明了一个在客户端和服务器端交换数据的另类方式。其收集了浏览器和服务器端的开发者的焦点问题,明确了响应数量的增加和解决复杂的数据传输。在启动 SPDY 这个项目时预设的目标是: 页面加载时间 (PLT) 减少 50%。 无需网站作者修改任何内容。 将部署复杂性降至最低,无需变更网络基础设施。 与开源社区合作开发这个新协议。 收集真实性能数据,验证这个实验性协议是否有效。为了达到降低目标,减少页面加载时间的目标,SPDY 引入了一个新的二进制分帧数据层,以实现多向请求和响应、优先次序、最小化及消除不必要的网络延迟,目的是更有效地利用底层 TCP 连接。 **HTTP/1.1 有两个主要的缺点:安全不足和性能不高,**由于背负着 HTTP/1.x 庞大的历史包袱,所以协议的修改,兼容性是首要考虑的目标,否则就会破坏互联网上无数现有的资产。 而如上图所示,SPDY 位于 HTTP 之下,TCP 和 SSL 之上,这样可以轻松兼容老版本的 HTTP 协议同时可以使用已有的 SSL 功能。 SPDY 协议在 Chrome 浏览器上证明可行以后,就被当作 HTTP/2 的基础,主要特性都在 HTTP/2 之中得到继承。 于是时间来到 2015 年,HTTP/2.0 问世。 HTTP/2 相比 HTTP/1.1 的修改并不会破坏现有程序的工作,但是新的程序可以借由新特性得到更好的速度。 HTTP/2 保留了 HTTP/1.1 的大部分语义,例如请求方法、状态码、乃至 URI 和绝大多数 HTTP 头部字段一致。而 HTTP/2 采用了新的方法来编码、传输客户端和服务器间的数据。 来看看 HTTP/2 的具体特点: 二进制分帧层:在应用层与传输层之间增加一个二进制分帧层,以此达到在不改动 HTTP 的语义,HTTP 方法、状态码、URI 及首部字段的情况下,突破 HTTP/1.1 的性能限制,改进传输性能,实现低延迟和高吞吐量。在二进制分帧层上,HTTP/2.0 会将所有传输的信息分割为更小的消息和帧,并对它们采用二进制格式的编码,其中 HTTP1.x 的首部信息会被封装到 Headers 帧,而我们的 request body 则封装到 Data 帧里面。 多路复用:对于 HTTP/1.x,即使开启了长连接,请求的发送也是串行发送的,在带宽足够的情况下,对带宽的利用率不够,HTTP/2.0 采用了多路复用的方式,可以并行发送多个请求,提高对带宽的利用率。 数据流优先级:由于请求可以并发发送了,那么如果出现了浏览器在等待关键的 CSS 或者 JS 文件完成对页面的渲染时,服务器却在专注的发送图片资源的情况怎么办呢?HTTP/2.0 对数据流可以设置优先值,这个优先值决定了客户端和服务端处理不同的流采用不同的优先级策略。 服务端推送:在 HTTP/2.0 中,服务器可以向客户发送请求之外的内容,比如正在请求一个页面时,服务器会把页面相关的 logo,CSS 等文件直接推送到客户端,而不会等到请求来的时候再发送,因为服务器认为客户端会用到这些东西。这相当于在一个 HTML 文档内集合了所有的资源。 头部压缩:使用首部表来跟踪和存储之前发送的键值对,对于相同的内容,不会再每次请求和响应时发送。 HTTP/2.0 支持明文 HTTP 传输,而 SPDY 强制使用 HTTPS。 HTTP/2.0 消息头的压缩算法采用 HPACK,而非 SPDY 采用的 DEFLATE。 QUIC 和 HTTP3 虽然 HTTP/2 提高了网页的性能,但是并不代表它已经是完美的了,HTTP/3 就是为了解决 HTTP/2 所存在的一些问题而被推出来的。随着时间的演进,越来越多的流量都往手机端移动,手机的网络环境会遇到的问题像是封包丢失机率较高、较长的 Round Trip Time (RTT)和连接迁移等问题,都让主要是为了有线网路设计的HTTP/TCP协议遇到贫颈。 我们可以看两个典型的问题。 第一握手带来的消耗。HTTP/2 使用 TCP 协议来传输的,而如果使用 HTTPS 的话,还需要使用 TLS 协议进行安全传输,而使用 TLS 也需要一个握手过程,这样就需要有两个握手延迟过程: 在建立 TCP 连接的时候,需要和服务器进行三次握手来确认连接成功,也就是说需要在消耗完 1.5 个 RTT 之后才能进行数据传输。 进行 TLS 连接,TLS 有两个版本——TLS 1.2 和 TLS 1.3,每个版本建立连接所花的时间不同,大致是需要1~2个 RTT。 总之,在传输数据之前,我们需要花掉 3~4 个 RTT。 第二,TCP 的队头阻塞并没有得到彻底解决。我们知道,为了实现多路复用,在 HTTP/2 中多个请求是跑在一个 TCP 管道中的。但当出现了丢包时,HTTP/2 的表现反倒不如 HTTP/1.X 了。因为 TCP 为了保证可靠传输,有个特别的丢包重传机制,丢失的包必须要等待重新传输确认,HTTP/2 出现丢包时,整个 TCP 都要开始等待重传,那么就会阻塞该 TCP 连接中的所有请求。而对于 HTTP/1.1 来说,可以开启多个 TCP 连接,出现这种情况反到只会影响其中一个连接,剩余的 TCP 连接还可以正常传输数据。 至此,我们很容易就会想到,为什么不直接去修改 TCP 协议?其实这已经是一件不可能完成的任务了。因为 TCP 存在的时间实在太长,已经充斥在各种设备中,并且这个协议是由操作系统实现的,更新起来非常麻烦,不具备显示操作性。 HTTP/3 乘着 QUIC 来了。 HTTP3 是基于 QUIC 的协议,如上图。先说 QUIC,QUIC 协议是 Google 提出的一套开源协议,它基于 UDP 来实现,直接竞争对手是 TCP 协议。QUIC 协议的性能非常好,甚至在某些场景下可以实现 0-RTT 的加密通信。 在 Google 关于 QUIC [https://docs.google.com/document/d/1gY9-YNDNAB1eip-RTPbqphgySwSNSDHLq9D5Bty4FSU/edit] 的文件中提到,与 HTTP/2 相比,QUIC 主要具有下列优势: Reduce connection establishment latency (减少连接建立时间) Improved congestion control (改进拥塞控制) Multiplexing without head-of-line blocking (没有队头阻塞的多路复用) Forward error correction (修复之前的错误) Connection migration(支持网络迁移) 多路复用,避免队头阻塞 这句话说起来很容易,但理解起来并不那么显然,要想理解 QUIC 协议到底做了什么以及这么做的必要性,我想还是从最基础的 HTTP/1.0 聊起比较合适。 Pipiline 根据谷歌的调查, 现在请求一个网页,平均涉及到 80 个资源,30 多个域名。考虑最原始的情况,每请求一个资源都需要建立一次 TCP 请求,显然不可接受。HTTP 协议规定了一个字段 Connection,不过默认的值是 close,也就是不开启。 早在 1999 年提出的 HTTP 1.1 [https://www.ietf.org/rfc/rfc2616.txt] 协议 中就把 Connection 的默认值改成了Keep-Alive,这样同一个域名下的多个 HTTP 请求就可以复用同一个 TCP 连接。这种做法被称为 HTTP Pipeline,优点是显著的减少了建立连接的次数,也就是大幅度减少了 RTT。 以上面的数据为例,如果 80 个资源都要走一次 HTTP 1.0,那么需要建立 80 个 TCP 连接,握手 80 次,也就是 80 个 RTT。如果采用了 HTTP 1.1 的 Pipeline,只需要建立 30 个 TCP 连接,也就是 30 个 RTT,提高了 62.5% 的效率。 Pipeline 解决了 TCP 连接浪费的问题,但它自己还存在一些不足之处,也就是所有管道模型都难以避免的队头阻塞问题。 队头阻塞 我们再举个简单而且直观的例子,假设加载一个 HTML 一共要请求 10 个资源,那么请求的总时间是每一个资源请求时间的总和。最直观的体验就是,网速越快请求时间越短。然而如果某一个资源的请求被阻塞了(比如 SQL 语句执行非常慢)。但对于客户端来说所有后续的请求都会因此而被阻塞。 队头阻塞(Head of line blocking,下文简称 HOC)说的是当有多个串行请求执行时,如果第一个请求不执行完,后续的请求也无法执行。比如上图中,如果第四个资源的传输花了很久,后面的资源都得等着,平白浪费了很多时间,带宽资源没有得到充分利用。 因此,HTTP 协议允许客户端发起多个并行请求,比如在笔者的机器上最多支持六个并发请求。并发请求主要是用于解决 HOC 问题,当有三个并发请求时,情况会变成这样: 可见虽然第四个资源的请求被阻塞了,但是其他的资源请求并不一定会被阻塞,这样总的来说网络的平均利用率得到了提升。 支持并发请求是解决 HOC 问题的一种方案,这句话没有错。但是我们要理解到:“并发请求并非是直接解决了 HOC 的问题,而是尽可能减少 HOC 造成的影响“,以上图为例,HOC 的问题依然存在,只是不会太浪费带宽而已。 有读者可能会好奇,为什么不多搞几个并发的 HTTP 请求呢?刚刚说过笔者的电脑最多支持 6 个并发请求,谷歌曾经做过实验,把 6 改成 10,然后尝试访问了三千多个网页,发现平均访问时间竟然还增加了 5% 左右。这是因为一次请求涉及的域名有限,再多的并发 HTTP 请求并不能显著提高带宽利用率,反而会消耗性能。 SPDY 的做法 有没有办法解决队头阻塞呢? 答案是肯定的。SPDY 协议的做法很值得借鉴,它采用了多路复用(Multiplexing)技术,允许多个 HTTP 请求共享同一个 TCP 连接。我们假设每个资源被分为多个包传递,在 HTTP 1.1 中只有前面一个资源的所有数据包传输完毕后,后面资源的包才能开始传递(HOC 问题),而 SPDY 并不这么要求,大家可以一起传输。 这么做的代价是数据会略微有一些冗余,每一个资源的数据包都要带上标记,用来指明自己属于哪个资源,这样客户端最后才能把他们正确的拼接起来。不同的标记可以理解为图中不同的颜色,每一个小方格可以理解为资源的某一个包。 TCP 窗口 是不是觉得 SPDY 的多路复用已经够厉害了,解决了队头阻塞问题?很遗憾的是,并没有,而且我可以很肯定的说,只要你还在用 TCP 链接,HOC 就是逃不掉的噩梦,不信我们来看看 TCP 的实现细节。 我们知道 TCP 协议会保证数据的可达性,如果发生了丢包或者错包,数据就会被重传。于是问题来了,如果一个包丢了,那么后面的包就得停下来等这个包重新传输,也就是发生了队头阻塞。当然 TCP 协议的设计者们也不傻,他们发明了滑动窗口的概念: 这样的好处是在第一个数据包(1-1000) 发出后,不必等到 ACK 返回就可以立刻发送第二个数据包。可以看出图中的 TCP 窗口大小是 4,所以第四个包发送后就会开始等待,直到第一个包的 ACK 返回。这样窗口可以向后滑动一位,第五个包被发送。 如果第一、二、三个的包都丢失了也没有关系,当发送方收到第四个包时,它可以确信一定是前三个 ACK 丢了而不是数据包丢了,否则不会收到 4001 的 ACK,所以发送方可以大胆的把窗口向后滑动四位。 滑动窗口的概念大幅度提高了 TCP 传输数据时抗干扰的能力,一般丢失一两个 ACK 根本没关系。但如果是发送的包丢失,或者出错,窗口就无法向前滑动,出现了队头阻塞的现象。 QUIC 是如何做的 QUIC 协议基于 UDP 实现,我们知道 UDP 协议只负责发送数据,并不保证数据可达性。这一方面为 QUIC 的多路复用提供了基础,另一方面也要求 QUIC 协议自己保证数据可达性。 SPDY 为各个数据包做好标记,指明他们属于哪个 HTTP 请求,至于这些包能不能到达客户端,SPDY 并不关心,因为数据可达性由 TCP 协议保证。既然客户端一定能收到包,那就只要排序、拼接就行了。QUIC 协议采用了多路复用的思想,但同时还得自己保证数据的可达性。 TCP 协议的丢包重传并不是一个好想法,因为一旦有了前后顺序,队头阻塞问题将不可避免。而无序的数据发送给接受者以后,如何保证不丢包,不错包呢?这看起来是个不可能完成的任务,不过如果把要求降低成:最多丢一个包,或者错一个包。事情就简单多了,操作系统中有一种存储方式叫 RAID 5,采用的是异或运算加上数据冗余的方式来保证前向纠错(FEC: Forward Error Correcting)。QUIC 协议也是采用这样的思想,这里不再赘述。 利用冗余数据的思想,QUIC 协议基本上避免了重发数据的情况。当然 QUIC 协议还是支持重传的,比如某些非常重要的数据或者丢失两个包的情况。 少 RTT,请求更快速 前面说到,一次 HTTPS 请求,它的基本流程是三次 TCP 握手外加四次 SSL/TLS 握手。也就是需要三个 RTT。但是 QUIC 在某些场景下,甚至能够做到 0RTT。 首先介绍下什么是 0RTT。所谓的 0RTT 就是通信双方发起通信连接时,第一个数据包便可以携带有效的业务数据。而我们知道,这个使用传统的TCP是完全不可能的,除非你使能了 TCP 快速打开特性,而这个很难,因为几乎没人愿意为了这个收益去对操作系统的网络协议栈大动手脚。未使能 TCP 快速打开特性的TCP传输第一笔数据前,至少要等1个RTT。 我们这里再说说 HTTP2。对于 HTTP2 来说,本来需要一个额外的 RTT 来进行协商,判断客户端与服务器是不是都支持 HTTP2,不过好在它可以和 SSL 握手的请求合并。这也导致了一个现象,就是大多数主流浏览器仅支持 HTTPS2 而不单独支持 HTTP2。因为 HTTP2 需要一个额外的 RTT,HTTPS2 需要两个额外的 RTT,仅仅是增加一个 RTT 就能获得数据安全性,还是很划算的。 TCP 快速打开 何谓 TCP 快速打开,即客户端可以在发送第一个 SYN 握手包时携带数据,但是 TCP 协议的实现者不允许将把这个数据包上传给应用层。这主要是为了防止 TCP 泛洪攻击 [https://tools.ietf.org/html/rfc4987]。 因为如果 SYN 握手的包能被传输到应用层,那么现有的防护措施都无法防御泛洪攻击,而且服务端也会因为这些攻击而耗尽内存和 CPU。 当然 TCP 快速打开并不是完全不可行的。人们设计了 TFO (TCP Fast Open),这是对 TCP 的拓展,不仅可以在发送 SYN 时携带数据,还可以保证安全性。 TFO 设计了一个 Cookie,它在第一次握手时由 server 生成,Cookie 主要是用来标识客户端的身份,以及保存上次会话的配置信息。因此在后续重新建立 TCP 连接时,客户端会携带 SYN + Cookie + 请求数据,然后不等 ACK 返回就直接开始发送数据。 服务端收到 SYN 后会验证 Cookie 是否有效,如果无效则会退回到三次握手的步骤,如下图所示: 同时,为了安全起见,服务端为每个端口记录了一个值 PendingFastOpenRequests,用来表示有多少请求利用了 TFO,如果超过预设上限就不再接受。 关于 TFO 的优化,可以总结出三点内容: TFO 设计的 Cookie 思想和 SSL 恢复握手时的 Session Ticket 很像,都是由服务端生成一段 Cookie 交给客户端保存,从而避免后续的握手,有利于快速恢复。 第一次请求绝对不会触发 TFO,因为服务器会在接收到 SYN 请求后把 Cookie 和 ACK 一起返回。后续客户端如果要重新连接,才有可能使用这个 Cookie 进行 TFO TFO 并不考虑在 TCP 层过滤重复请求,以前也有类似的提案想要做过滤,但因为无法保证安全性而被拒绝。所以 TFO 仅仅是避免了泛洪攻击(类似于 backlog),但客户端接收到的,和 SYN 包一起发来的数据,依然有可能重复。不过也只有可能是 SYN 数据重复,所以 TFO 并不处理这种情况,要求服务端程序自行解决。这也就是说,不仅仅要操作系统的支持,更要求应用程序(比如 MySQL)也支持 TFO。 TFO 使得 TCP 协议有可能变成 0-RTT,核心思想和 Session Ticket 的概念类似: 将当前会话的上下文缓存在客户端。如果以后需要恢复对话,只需要将缓存发给服务器校验,而不必花费一个 RTT 去等待。 结合 TFO 和 Session Ticket 技术,一个本来需要花费 3 个 RTT 才能完成的请求可以被优化到一个 RTT。如果使用 QUIC 协议,我们甚至可以更进一步,将 Session Ticket 也放到 TFO 中一起发送,这样就实现了 0-RTT 的对话恢复。 QUIC 是怎么做的 让我们看看 QUIC 是怎么做的。 首先声明一点,如果一对使用 QUIC 进行加密通信的双方此前从来没有通信过,那么 0-RTT 是不可能的,即便是 QUIC 也是不可能的。 QUIC 握手的过程需要一次数据交互,0-RTT 时延即可完成握手过程中的密钥协商,比 TLS 相比效率提高了 5 倍,且具有更高的安全性。在握手过程中使用 Diffie-Hellman 算法协商初始密钥,初始密钥依赖于服务器存储的一组配置参数,该参数会周期性的更新。初始密钥协商成功后,服务器会提供一个临时随机数,双方根据这个数再生成会话密钥。 具体握手过程如下: (1) 客户端判断本地是否已有服务器的全部配置参数,如果有则直接跳转到(5),否则继续 (2) 客户端向服务器发送 inchoate client hello(CHLO) 消息,请求服务器传输配置参数 (3) 服务器收到 CHLO,回复 rejection(REJ) 消息,其中包含服务器的部分配置参数 (4) 客户端收到 REJ,提取并存储服务器配置参数,跳回到(1) (5) 客户端向服务器发送 full client hello 消息,开始正式握手,消息中包括客户端选择的公开数。此时客户端根据获取的服务器配置参数和自己选择的公开数,可以计算出初始密钥。 (6) 服务器收到 full client hello,如果不同意连接就回复 REJ,同(3);如果同意连接,根据客户端的公开数计算出初始密钥,回复 server hello(SHLO)消息,SHLO 用初始密钥加密,并且其中包含服务器选择的一个临时公开数。 (7) 客户端收到服务器的回复,如果是 REJ 则情况同(4);如果是 SHLO,则尝试用初始密钥解密,提取出临时公开数 (8) 客户端和服务器根据临时公开数和初始密钥,各自基于 SHA-256 算法推导出会话密钥 (9) 双方更换为使用会话密钥通信,初始密钥此时已无用,QUIC 握手过程完毕。之后会话密钥更新的流程与以上过程类似,只是数据包中的某些字段略有不同。 写在最后 想起有一个名言:计算机领域没有什么问题是加一层解决不了的,如果有,就再加一层。网络模型本来就是层层累加,到了 Web 得以快速生动的展现给人们以丰富的内容。从 HTTP 的演变过程中,我们可以看到中间又累加了若干层。不知道以后,又会是怎么样呢? 大家会发现,笔者在文中不止一次提到了演变这个词。是的,这是来自达尔文进化论中的理论。在笔者看来,“物竞天择,适者生存”的演变理论和计算机领域的技术变化是很类似的,只不过在这里,不是天择,而是人择。由市场,由用户来选择。不知道接下来,作为选择者的我们,又将怎样主导技术的走向? 推荐阅读 QUIC/HTTP3 协议简析 聊聊 WebSocket,还有 HTTP

优秀的个人博客,低调大师

每日一博 | 深入了解 kafka 系列-消费者

前言 与生产者对应的是消费者,应用程序可以通过KafkaConsumer来订阅主题,并从订阅的主题中拉取消息。不过在使用KafkaConsumer消费消息之前需要先了解消费者和消费组的概念,否则无法理解如何使用KafkaConsumer。 <!--more--> Consumer 消费者(Consumer)负责订阅Kafka中的主题(Topic),并且从订阅的主题上拉取消息。与其他一些消息中间件不同的是:在Kafka的消费理念中还有一层消费组(Consumer Group)的概念,每个消费者都有一个对应的消费组。 当消息发布到主题后,只会被投递给订阅它的每个消费组中的一个消费者。如图所示,某个主题中共有4个分区(Partition):P0、P1、P2、P3。有两个消费组A和B都订阅了这个主题,消费组A中有4个消费者(C0、C1、C2和C3),消费组B中有2个消费者(C4和C5)。按照Kafka默认的规则,最后的分配结果是消费组A中的每一个消费者分配到1个分区,消费组B中的每一个消费者分配到2个分区,两个消费组之间互不影响。每个消费者只能消费所分配到的分区中的消息。换言之,每一个分区只能被一个消费组中的一个消费者所消费。 分区分配的演变(Rebalance) 我们再来看一下消费组内的消费者个数变化时所对应的分区分配的演变。假设目前某消费组内只有一个消费者C0,订阅了一个主题,这个主题包含 7 个分区:P0、P1、P2、P3、P4、P5、P6。也就是说,这个消费者C0订阅了7个分区,具体分配情形如图。 消费者与消费组此时消费组内又加入了一个新的消费者C1,按照既定的逻辑,需要将原来消费者C0的部分分区分配给消费者C1消费,如下图所示。消费者C0和C1各自负责消费所分配到的分区,彼此之间并无逻辑上的干扰。 紧接着消费组内又加入了一个新的消费者C2,消费者C0、C1和C2按照下图方式各自负责消费所分配到的分区。 消费者与消费组这种模型可以让整体的消费能力具备横向伸缩性,我们可以增加(或减少)消费者的个数来提高(或降低)整体的消费能力。对于分区数固定的情况,一味地增加消费者并不会让消费能力一直得到提升,如果消费者过多,出现了消费者的个数大于分区个数的情况,就会有消费者分配不到任何分区。参考图如下,一共有8个消费者,7个分区,那么最后的消费者C7由于分配不到任何分区而无法消费任何消息。 投递模式 以上分配逻辑都是基于默认的分区分配策略进行分析的,可以通过消费者客户端参数partition.assignment.strategy 来设置消费者与订阅主题之间的分区分配策略,有关分区分配的更多细节可以再接下来的系列继续聊。 对于消息中间件而言,一般有两种消息投递模式: 点对点(P2P,Point-to-Point)模式: 点对点模式是基于队列的,消息生产者发送消息到队列,消息消费者从队列中接收消息。 发布/订阅(Pub/Sub)模式: 发布订阅模式定义了如何向一个内容节点发布和订阅消息,这个内容节点称为主题(Topic),主题可以认为是消息传递的中介,消息发布者将消息发布到某个主题,而消息订阅者从主题中订阅消息。主题使得消息的订阅者和发布者互相保持独立,不需要进行接触即可保证消息的传递,发布/订阅模式在消息的一对多广播时采用。 Kafka 同时支持两种消息投递模式,而这正是得益于消费者与消费组模型的契合: 如果所有的消费者都隶属于同一个消费组,那么所有的消息都会被均衡地投递给每一个消费者,即每条消息只会被一个消费者处理,这就相当于点对点模式的应用。 如果所有的消费者都隶属于不同的消费组,那么所有的消息都会被广播给所有的消费者,即每条消息会被所有的消费者处理,这就相当于发布/订阅模式的应用 消费组是一个逻辑上的概念,它将旗下的消费者归为一类,每一个消费者只隶属于一个消费组。每一个消费组都会有一个固定的名称,消费者在进行消费前需要指定其所属消费组的名称,这个可以通过消费者客户端参数group.id来配置,默认值为空字符串。消费者并非逻辑上的概念,它是实际的应用实例,它可以是一个线程,也可以是一个进程。同一个消费组内的消费者既可以部署在同一台机器上,也可以部署在不同的机器上。 创建一个Kafka消费者 以下代码段显示了如何创建KafkaConsumer: Properties props = new Properties(); props.put("bootstrap.servers", "broker1:9092,broker2:9092"); props.put("group.id", "CountryCounter"); props.put("key.deserializer", "org.apache.kafka.common.serialization.StringDeserializer"); props.put("value.deserializer", "org.apache.kafka.common.serialization.StringDeserializer"); KafkaConsumer<String, String> consumer = new KafkaConsumer<String, String>(props); 订阅主题 consumer.subscribe(Collections.singletonList("customerCountries")); 要订阅所有test主题,我们可以: consumer.subscribe(Pattern.compile("test.*")); 轮询循环 消费者API的核心是一个简单的循环,用于轮询服务器以获取更多数据。 一旦用户订阅了主题,轮询循环便会处理协调,分区重新平衡,心跳和数据获取的所有详细信息,从而为开发人员提供了一个干净的API,该API仅从分配的分区中返回可用数据。 消费者的主体如下所示 try { while (true) { 1 ConsumerRecords<String, String> records = consumer.poll(100); 2 for (ConsumerRecord<String, String> record : records) 3 { log.debug("topic = %s, partition = %d, offset = %d," customer = %s, country = %s\n", record.topic(), record.partition(), record.offset(), record.key(), record.value()); int updatedCount = 1; if (custCountryMap.countainsKey(record.value())) { updatedCount = custCountryMap.get(record.value()) + 1; } custCountryMap.put(record.value(), updatedCount) JSONObject json = new JSONObject(custCountryMap); System.out.println(json.toString(4)) 4 } } } finally { consumer.close(); 5 } 反序列化 public class StringDeserializer implements Deserializer<String> { private String encoding = "UTF8"; @Override public void configure(Map<String, ?> configs, boolean isKey) { String propertyName = isKey ? "key.deserializer.encoding" : "value.deserializer.encoding"; Object encodingValue = configs.get(propertyName); if (encodingValue == null) encodingValue = configs.get("deserializer.encoding"); if (encodingValue instanceof String) encoding = (String) encodingValue; } @Override public String deserialize(String topic, byte[] data) { try { if (data == null) return null; else return new String(data, encoding); } catch (UnsupportedEncodingException e) { throw new SerializationException("Error when deserializing byte[] to string due to unsupported encoding " + encoding); } } } 消息消费 Kafka中的消费是基于拉模式的。消息的消费一般有两种模式:推模式和拉模式。推模式是服务端主动将消息推送给消费者,而拉模式是消费者主动向服务端发起请求来拉取消息。从轮询循环代码清单中可以看出,Kafka中的消息消费是一个不断轮询的过程,消费者所要做的就是重复地调用poll()方法,而poll()方法返回的是所订阅的主题(分区)上的一组消息。对于poll()方法而言,如果某些分区中没有可供消费的消息,那么此分区对应的消息拉取的结果就为空;如果订阅的所有分区中都没有可供消费的消息,那么poll()方法返回为空的消息集合。 poll(long)方法中timeout的时间单位固定为毫秒,而poll(Duration)方法可以根据Duration中的ofMillis()、ofSeconds()、ofMinutes()、ofHours()等多种不同的方法指定不同的时间单位,灵活性更强。并且 poll(long)方法也已经被标注为@Deprecated,虽然目前还可以使用,如果条件允许的话,还是推荐使用poll(Duration)的方式。 我们在消费消息的时候可以直接对 ConsumerRecord 中感兴趣的字段进行具体的业务逻辑处理。 poll()方法的返回值类型是 ConsumerRecords,它用来表示一次拉取操作所获得的消息集,内部包含了若干ConsumerRecord,它提供了一个iterator()方法来循环遍历消息集内部的消息,iterator()方法的定义如下: @Override public Iterator<ConsumerRecord<K, V>> iterator() { return new ConcatenatedIterable<>(records.values()).iterator(); } 在 ConsumerRecords 类中还提供了几个方法来方便开发人员对消息集进行处理:count()方法用来计算出消息集中的消息个数,返回类型是int;isEmpty()方法用来判断消息集是否为空,返回类型是boolean;empty()方法用来获取一个空的消息集,返回类型是ConsumerRecord<K,V>。 到目前为止,可以简单地认为poll()方法只是拉取一下消息而已,但就其内部逻辑而言并不简单,它涉及消费位移、消费者协调器、组协调器、消费者的选举、分区分配的分发、再均衡的逻辑、心跳等内容 位移提交 对于Kafka中的分区而言,它的每条消息都有唯一的offset,用来表示消息在分区中对应的位置。对于消费者而言,它也有一个offset的概念,消费者使用offset来表示消费到分区中某个消息所在的位置。单词“offset”可以翻译为“偏移量”,也可以翻译为“位移”,很多同学可能并没有过多地在意这一点:在很多中文资料中都会交叉使用“偏移量”和“位移”这两个词,并没有很严谨地进行区分。 我对offset做了一些区分:对于消息在分区中的位置,我们将offset称为“偏移量”;对于消费者消费到的位置,将 offset 称为“位移”,有时候也会更明确地称之为“消费位移”。做这一区分的目的是让读者在遇到 offset 的时候可以很容易甄别出是在讲分区存储层面的内容,还是在讲消费层面的内容 在每次调用poll()方法时,它返回的是还没有被消费过的消息集(当然这个前提是消息已经存储在Kafka 中了,并且暂不考虑异常情况的发生),在旧消费者客户端中,消费位移是存储在ZooKeeper中的。而在新消费者客户端中,消费位移存储在Kafka内部的主题__consumer_offsets中。这里把将消费位移存储起来(持久化)的动作称为“提交”,消费者在消费完消息之后需要执行消费位移的提交。 指定位移消费 正是有了消费位移的持久化,才使消费者在关闭、崩溃或者在遇到再均衡的时候,可以让接替的消费者能够根据存储的消费位移继续进行消费 ,可是有一个问题则是 _consumer_offsets 位移信息过期而被删除后,它也没有可以查找的消费位移 ,这个时候就会根据消费者客户端参数auto.offset.reset的配置来决定从何处开始进行消费 除了查找不到消费位移,位移越界也会触发 auto.offset.reset 参数的执行 ,然而有些时候,我们需要一种更细粒度的掌控,可以让我们从特定的位移处开始拉取消息,哎 !这个时候 KafkaConsumer 中的 seek()方法正好提供了这个功能,让我们得以追前消费或回溯消费。seek()方法的具体定义如下: public void seek(TopicPartition partition, long offset) {} seek()方法为我们提供了从特定位置读取消息的能力,我们可以通过这个方法来向前跳过若干消息,也可以通过这个方法来向后回溯若干消息,这样为消息的消费提供了很大的灵活性 原创不易,如果觉得有点用的话,请毫不留情点个赞,转发一下,这将是我持续输出优质文章的最强动力。

优秀的个人博客,低调大师

每日一博 | 为你的应用选择合适的 API

架构师的主要活动是做出正确的技术决策。选择何使得API是一项重要的技术决策。那么今天就看看API的选择问题。 应用程序编程接口(API)是一种计算接口,它定义了多个软件中介之间的交互。它定义了可以进行的调用或请求的类型,如何进行调用,应使用的数据格式,遵循的约定等。它还可以提供扩展机制,以便用户可以以各种方式扩展现有功能。在不同程度上。API可以是完全定制的,特定于组件,也可以基于行业标准进行设计以确保互操作性。有些API必须记录在案,而其他API则经过设计,以便可以“查询”它们以确定支持的功能。由于其他组件/系统仅依赖于API,因此提供API的系统可以(理想地)在API的“后面”更改其内部详细信息,而不会影响其用户。 正如上述的定义所述,API提供了多个软件之间的交互。所以我们这里强调的是交互性。我们在使用任何的语言开发一个应用的时候,都会提供内部的基于该语言的API,这种内部的API不是我们今天要讨论的内容,因为这种内部的交互不涉及到软件之间。我们今天要讨论的API主要要涉及到系统之间的交互。对于具体应用而言,更多是进程之间(本机),主机之间(本网络),服务之间(可能跨域广域网)的交互。 最早在Unix/Linux的编程领域,提供了进程间通信的手段,例如:管道,信号量,消息队列,套接字(Socket)等。如果你的应用是由不同语言编写的,那么这里只能选择Socket通信作为应用之间的API手段。但是Socket通信是一种非常低Level的通信手段,它以底层的数据包作为抽象和通信内容,很难维护和使用。当然还有一些其它的系统间通信的手段例如通过共享文件或者FTP的方式,同样面临着各种不便。我们希望提供一种更高级的交互手段,直接和我的应用的抽象交互,这些抽象可能是方法,函数和对象。于是就有了各种支撑这些需求的API技术。 早期的进程间通信技术包括: DCOM ( Distributed Component Object Model )分布式组件对象模型,这个是微软的技术,只能用于Windows平台, 通过网络实现远程对象间的通信 RMI ( Remote Method Call) Java的远程方法调用,这个是Java自己的RPC,只能用于Java应用之间的远程调用。 JNI Java的本地接口, 支持Java应用调用本地方法,这个是跨越语言障碍的,但是仅仅局限于Java应用调用其它的本地应用,不具备互操作性,是个单项通道。 CORBA 在1991年一种名叫CORBA ( Common Object Request Broker Architecture ) 的技术出现了,我记得我的第一份工作是一个电信网管系统的开发,我们就是利用CORBA来实现不同的系统之间的通信。主要涉及C++和Java。 CORBA和之前提到的DCOM和RMI类似,都提供了远程的对象/方法调用,但是CORBA是一种与语言和实现无关的技术,我记得我们当时的测试脚本使用了TCL,也有CORBA的实现,也就是说CORBA定了与语言解耦的系统间通信的标准。这个是它的最大的优势。那个年代的应用,采用CORBA作为系统间的通信手段非常普遍。 开发CORAB的过程从IDL的定义开始,用户通过IDL定义了对象,然后在Server端实现该对象的应用逻辑,在Client端调用该对象。 但是CORBA并非没有缺点,否则我们也不会很少再看见今天的应用用CORAB作为API的了。他的主要问题是: 对象的生命周期管理比较复杂。远程对象的发现,创建和销毁都会带来问题 整个CORAB的架构比较复杂,看看它的架构图就知道了 总之,今天你要开发一个引用,除非要个已有系统交互,你应该不会选择CORBA。 XML-RPC / SOAP XML-RPC发表于1998年,由UserLand Software(UserLand Software)的Dave Winer及Microsoft共同发表。后来在新的功能不断被引入下,这个标准慢慢演变成为今日的SOAP协议 下面是一个 XML-RPC的请求/响应的例子 <?xml version="1.0"?> <methodCall> <methodName>examples.getStateName</methodName> <params> <param> <value><i4>40</i4></value> </param> </params> </methodCall> <?xml version="1.0"?> <methodResponse> <params> <param> <value><string>South Dakota</string></value> </param> </params> </methodResponse> SOAP是 Simple Object Access Protocol的缩写。SOAP为Web服务提供了Web服务协议栈的Messaging Protocol层。它是一个基于XML的协议,由三部分组成: 一个信封,它定义了消息结构以及如何处理它 一组用于表达应用程序定义的数据类型实例的编码规则 表示过程调用和响应的约定 SOAP具有三个主要特征: 可扩展性(安全性和WS-Addressing在开发中) 中立性(SOAP可以通过HTTP,SMTP,TCP,UDP等任何协议进行操作) 独立性(SOAP允许任何编程语言) 作为SOAP过程可以执行的操作的示例,应用程序可以将SOAP请求发送到启用了带有搜索参数的Web服务的服务器(例如,房地产价格数据库)。然后,服务器返回SOAP响应(包含结果数据的XML格式的文档),例如价格,位置,功能。由于生成的数据采用标准化的机器可解析格式,因此发出请求的应用程序可以直接将其集成。 SOAP体系结构由以下几层规范组成: 讯息格式 邮件交换模式(MEP) 底层传输协议绑定 消息处理模型 协议可扩展性 这里是一个SOAP消息的例子: POST /InStock HTTP/1.1 Host: www.example.org Content-Type: application/soap+xml; charset=utf-8 Content-Length: 299 SOAPAction: "http://www.w3.org/2003/05/soap-envelope" <?xml version="1.0"?> <soap:Envelope xmlns:soap="http://www.w3.org/2003/05/soap-envelope" xmlns:m="http://www.example.org"> <soap:Header> </soap:Header> <soap:Body> <m:GetStockPrice> <m:StockName>T</m:StockName> </m:GetStockPrice> </soap:Body> </soap:Envelope> 相比较XML-RPC,他的功能更多,当然消息结构也更复杂。 SOAP是W3C推荐的Webservice标准,一度也是非常的流行,但是我们看到基于XML的消息比较复杂,消息本身因为XML的原因,有相当多的开销。于是后面又有了基于JSON的RPC格式。但总的来说,SOAP也已经是昨日黄花,当今的应用构建,你选它的概率应该也不大了。 REST REST是当今最为流行的API。因为大量的Web应用采用REST作为其API的选择。REST是 Representational State Transfer 的缩写。是Roy Thomas Fielding博士于2000年在他的博士论文中提出来的一种万维网软件架构风格,目的是便于不同软件/程序在网络(例如互联网)中互相传递信息。表现层状态转换是根基于超文本传输协议(HTTP)之上而确定的一组约束和属性,是一种设计提供万维网络服务的软件构建风格。符合或兼容于这种架构风格(简称为 REST 或 RESTful)的网络服务,允许客户端发出以统一资源标识符访问和操作网络资源的请求,而与预先定义好的无状态操作集一致化。因此表现层状态转换提供了在互联网络的计算系统之间,彼此资源可交互使用的协作性质(interoperability)。相对于其它种类的网络服务,例如SOAP服务,则是以本身所定义的操作集,来访问网络上的资源。目前在三种主流的Web服务实现方案中,因为REST模式与复杂的SOAP和XML-RPC相比更加简洁,越来越多的Web服务开始采用REST风格设计和实现。所以我么可以看到软件的发展,大体是从复杂变得简单,只有简单的东西才会变的更有生命力。 为了使任何应用程序真正实现RESTful,必须遵循六个体系结构约束: 统一接口:意味着必须向Web应用程序中的API使用者提供API接口。 客户端服务器:客户端和服务器必须彼此独立,并且客户端应仅知道资源的URI。 无状态:服务器不得存储与客户端请求相关的任何内容。 客户端负责维护应用程序的状态。 可缓存的:资源必须可缓存。 分层系统:体系结构必须是分层的,这意味着体系结构的组件可以位于多个服务器中。 按需代码:客户端必须能够获取可执行代码作为响应。 这是一个可选约束。 基于REST的Web服务被称为RESTful Web服务。 在这些应用程序中,每个组件都是一种资源,可以使用HTTP标准方法通过公共接口访问这些资源。 以下四种HTTP方法通常用于基于REST的体系结构中: GET-对资源的只读访问。 POST —创建一个新资源。 DELETE—删除资源。 PUT-更新现有资源/创建新资源。 RESTFul风格API所有的操作都是一个动词,对应HTTP请求的一种类型。每一个操作都定义了对操作的资源的某种行为。这种抽象,特别适合相当多的Web应为,后台是一个数据库,每一个REST的端点对应了一张数据库的表,很自然的利用REST操作来实现表的增删查改。 当然RESTFul的风格也有它的不足: 不是所有的应用操作都可以用资源的增删查改来对应,在实际的开发中经常会需要把一个操作映射为一个资源这种不伦不类的行为。 REST是同步服务,如果需要可能要引入回调机制。例如Webhook。 REST只提供客户端调用服务器的选项,不支持服务器端发起请求。 于是新的API类型会出现来解决这些问题。 GraphQL GraphQL是一个开源的API数据查询和操作语言及实现为了实现上述操作的相应运行环境。 2012年,GraphQL由Facebook内部开发,2015年公开公布。 2018年11月7日,Facebook将GraphQL项目转移到新成立的GraphQL基金会。 GraphQL规范概述了5条设计原则,这使其成为现代前端开发的精心设计的解决方案。 让我们研究一下GraphQL的设计原则。 查询是分层结构的,具有分层和嵌套字段,查询与响应数据一对一匹配。 查询和响应的形状像树,可以查询每个项目的其他嵌套字段。 该结构以产品为中心,着重于前端希望如何接收数据,并构建交付所需的运行时。 这样一来,就可以向后端请求一个所需的所有数据,然后让服务器根据GraphQL的规范从不同的端点获取数据。 它使用特定于应用程序的类型系统,使开发人员能够确保查询使用有效类型,并且在执行之前在语法上正确。 GraphQL查询是在客户端指定的,因此客户端确切知道它将以什么格式接收数据。 带有GraphQL的服务器结构必须是自省的,或者可由GraphQL本身查询。 这将启用功能强大的开发人员工具,例如GraphiQL或GraphQL Playground,这两种工具都将使开发人员能够准确查看哪些查询和字段可供他们在服务器中使用. 像RESTful API一样,GraphQL API旨在处理HTTP请求并提供对这些请求的响应。 但是,相似之处到此结束。 在REST API建立在请求方法和端点之间的连接上的情况下,GraphQL API设计为仅使用一个始终通过POST请求查询的端点,通常使用URL yourdomain.com/graphql。 达到GraphQL端点后,客户端请求的负担将完全在请求主体内处理。 该请求主体必须遵守GraphQL规范,并且API必须具有适当的服务器端逻辑来处理这些请求并提供适当的响应。 与RESTful API相比,这提供了更流畅的客户端体验,后者可能要求客户端对多个数据进行多次请求,并在数据返回后进行操作。 如上图的例子,用户通过RESTFul的API来请求数据,需要两个GET请求,先获取Assets,再通过AssetID获取comments。而通过GraphQL,用户只需要描述需要请求的数据的结构和条件,就可以通过一个请求获取全部所需要的数据,简化了客户端与服务器的交互。 GraphQL提供的性能优于REST API,可以为前端开发人员带来回报。 使用GraphQL规范创建服务器可能需要更多设置和编写预测性服务器端逻辑来解析和处理请求。 尽管GraphQL的安装成本可能会高于传统的REST架构,但更具可维护性的代码,强大的开发工具以及简化的客户端查询,这些都是不错的收益。 除了灵活性这个最大的优点外,GraphQL还有以下的优点: 声明性的数据获取,避免了客户端和服务器端的额外交互 优秀的开发体验,不需要版本控制,因为引入新的字段不会影响到API查询。同时客户端和服务器端的团队可以并行的独立工作。 强类型的GraphQL模式使得代码可预测,并及早发现错误。 当然,GraphQL也不是没有缺点: 使用GraphQL,如果您需要查找有关列表或记录集合的信息,则处理起来会很棘手。 例如,如果您想获取包含其地址的用户列表的详细信息,则它将执行n + 1个查询。 一个用于用户列表,然后n查询每个用户的地址。现在它会严重影响性能,因此必须非常小心地处理它。 很难缓存,缓存API响应的目的主要是为了更快地从将来的请求中获取响应。 与GraphQL不同,RESTful API可以利用HTTP规范中内置的缓存。 正如前面提到的,GraphQL查询可以请求资源的任何字段,因此缓存本质上是困难的。 gRPC gRPC是一个开源的远程过程调用框架,用于在服务之间进行高性能的通信。 这是将以不同语言编写的服务与可插拔支持(用于负载平衡,跟踪,运行状况检查和身份验证)相连接的有效方法。 默认情况下,gRPC使用Protobuf(协议缓冲区)序列化结构化数据。 通常,对于微服务体系结构,gRPC被认为是REST协议的更好替代方案。 gRPC中的" g"可以归因于最初开发该技术的Google。 gRPC是对传统RPC框架的改编。 那么,它与现有的RPC框架有何不同? 最重要的区别是gRPC使用protobuf 协议缓冲区作为接口定义语言进行序列化和通信,而不是JSON / XML。 协议缓冲区可以描述数据的结构,并且可以从该描述中生成代码,以生成或解析表示结构化数据的字节流。 这就是为什么gRPC首选多语言(使用不同技术实现)的Web应用程序的原因。 二进制数据格式使通信更轻松。 gRPC也可以与其他数据格式一起使用,但是首选的是protobuf。 同样,gRPC建立在HTTP / 2之上,它支持双向通信以及传统的请求/响应。 gRPC允许服务器和客户端之间的松散耦合。 在实践中,客户端打开与gRPC服务器的长期连接,并且将为每个RPC调用打开一个新的HTTP / 2流。 与使用JSON(主要是JSON)的REST不同,gRPC使用Protobuf,这是编码数据的更好方法。 由于JSON是基于文本的格式,因此它比protobuf格式的压缩数据要重得多。与REST相比,gRPC的另一个显着改进是它使用HTTP 2作为其传输协议。 REST使用的HTTP 1.1基本上是一个请求-响应模型。 gRPC利用HTTP 2的双向通信功能以及传统的响应请求结构。 在HTTP 1.1中,当多个请求来自多个客户端时,它们将被一一处理。 这会降低系统速度。 HTTP 2允许多路复用,因此可以同时处理多个请求和响应。 gRPC的开发模式和之前提到的CORBA有些类似。Protobuf充当了IDL的角色,然后利用工具生成各种语言的代码,最后在生成的代码上实现服务器端和客户端的逻辑。 gRPC的优点是: 出色的性能,因为采用protobuf编码和http/2 支持服务器端和客户端的双向通信 易用,相比REST开发,需要更少的代码 缺点: 更陡峭的学习曲线 支持的语言的种类没有REST多,当然它还在发展中 因为需要Protobuf的编译,这带来了服务器和客户端一定的耦合,因为接口变动的时候需要重新编译生成代码。REST的化,基于不同的工具链可能由不同的解决方案 因为其高性能,gRPC更适合被用于系统内部组件的通信选择。在下图的微服务架构中,对外的服务采用了REST或者GraphQL的API,而内部微服务之间使用的是gRPC。

优秀的个人博客,低调大师

每日一博 | 使用 Kubeflow 构建机器学习流水线

在此前的文章中,我已经向你介绍了Kubeflow,这是一个为团队设置的机器学习平台,需要构建机器学习流水线。 在本文中,我们将了解如何采用现有的机器学习详细并将其变成Kubeflow的机器学习流水线,进而可以部署在Kubernetes上。在进行本次练习的时候,请考虑你该如何将现有的机器学习项目转换到Kubeflow上。 我将使用Fashion MNIST作为例子,因为在本次练习中模型的复杂性并不是我们需要解决的主要目标。对于这一简单的例子,我将流水线分为3个阶段: Git clone代码库 下载并重新处理训练和测试数据 训练评估 当然,你可以根据自己的用例将流水线以任意形式拆分,并且可以随意扩展流水线。 获取代码 你可以从Github上获取代码: % git clone https://github.com/benjamintanweihao/kubeflow-mnist.git 以下是我们用来创建流水线的完整清单。实际上,你的代码很可能跨多个库和文件。在我们的例子中,我们将代码分为两个脚本,preprocessing.py和train.py。 from tensorflow import keras import argparse import os import pickle def preprocess(data_dir: str): fashion_mnist = keras.datasets.fashion_mnist (train_images, train_labels), (test_images, test_labels) = fashion_mnist.load_data() train_images = train_images / 255.0 test_images = test_images / 255.0 os.makedirs(data_dir, exist_ok=True) with open(os.path.join(data_dir, 'train_images.pickle'), 'wb') as f: pickle.dump(train_images, f) with open(os.path.join(data_dir, 'train_labels.pickle'), 'wb') as f: pickle.dump(train_labels, f) with open(os.path.join(data_dir, 'test_images.pickle'), 'wb') as f: pickle.dump(test_images, f) with open(os.path.join(data_dir, 'test_labels.pickle'), 'wb') as f: pickle.dump(test_labels, f) if __name__ == '__main__': parser = argparse.ArgumentParser(description='Kubeflow MNIST training script') parser.add_argument('--data_dir', help='path to images and labels.') args = parser.parse_args() preprocess(data_dir=args.data_dir) 处理脚本采用单个参数data_dir。它下载并预处理数据,并将pickled版本保存在data_dir中。在生产代码中,这可能是TFRecords的存储目录。 train.py import calendar import os import time import tensorflow as tf import pickle import argparse from tensorflow import keras from constants import PROJECT_ROOT def train(data_dir: str): # Training model = keras.Sequential([ keras.layers.Flatten(input_shape=(28, 28)), keras.layers.Dense(128, activation='relu'), keras.layers.Dense(10)]) model.compile(optimizer='adam', loss=tf.keras.losses.SparseCategoricalCrossentropy(from_logits=True), metrics=['accuracy']) with open(os.path.join(data_dir, 'train_images.pickle'), 'rb') as f: train_images = pickle.load(f) with open(os.path.join(data_dir, 'train_labels.pickle'), 'rb') as f: train_labels = pickle.load(f) model.fit(train_images, train_labels, epochs=10) with open(os.path.join(data_dir, 'test_images.pickle'), 'rb') as f: test_images = pickle.load(f) with open(os.path.join(data_dir, 'test_labels.pickle'), 'rb') as f: test_labels = pickle.load(f) # Evaluation test_loss, test_acc = model.evaluate(test_images, test_labels, verbose=2) print(f'Test Loss: {test_loss}') print(f'Test Acc: {test_acc}') # Save model ts = calendar.timegm(time.gmtime()) model_path = os.path.join(PROJECT_ROOT, f'mnist-{ts}.h5') tf.saved_model.save(model, model_path) with open(os.path.join(PROJECT_ROOT, 'output.txt'), 'w') as f: f.write(model_path) print(f'Model written to: {model_path}') if __name__ == '__main__': parser = argparse.ArgumentParser(description='Kubeflow FMNIST training script') parser.add_argument('--data_dir', help='path to images and labels.') args = parser.parse_args() train(data_dir=args.data_dir) 在train.py中,将建立模型,并使用data_dir指定训练和测试数据的位置。模型训练完毕并且开始执行评估后,将模型写入带有时间戳的路径。请注意,该路径也已写入output.txt。稍后将对此进行引用。 开发Kubeflow流水线 为了开始创建Kubeflow流水线,我们需要拉取一些依赖项。我准备了一个environment.yml,其中包括了kfp 0.5.0、tensorflow以及其他所需的依赖项。 你需要安装Conda,然后执行以下步骤: % conda env create -f environment.yml % source activate kubeflow-mnist % python preprocessing.py --data_dir=/path/to/data % python train.py --data_dir=/path/to/data 现在我们来回顾一下我们流水线中的几个步骤: Git clone代码库 下载并预处理训练和测试数据 训练并进行评估 在我们开始写代码之前,需要从宏观上了解Kubeflow流水线。 流水线由连接组件构成。一个组件的输出成为另一个组件的输入,每个组件实际上都在容器中执行(在本例中为Docker)。将发生的情况是,我们会执行一个我们稍后将要指定的Docker镜像,它包含了我们运行preprocessing.py和train.py所需的一切。当然,这两个阶段会有它们的组件。 我们还需要额外的一个镜像以git clone项目。我们需要将项目bake到Docker镜像,但在实际项目中,这可能会导致Docker镜像的大小膨胀。 说到Docker镜像,我们应该先创建一个。 Step0:创建一个Docker镜像 如果你只是想进行测试,那么这个步骤不是必须的,因为我已经在Docker Hub上准备了一个镜像。这是Dockerfile的全貌: FROM tensorflow/tensorflow:1.14.0-gpu-py3 LABEL MAINTAINER "Benjamin Tan <benjamintanweihao@gmail.com>" SHELL ["/bin/bash", "-c"] # Set the locale RUN echo 'Acquire {http::Pipeline-Depth "0";};' >> /etc/apt/apt.conf RUN DEBIAN_FRONTEND="noninteractive" RUN apt-get update && apt-get -y install --no-install-recommends locales && locale-gen en_US.UTF-8 ENV LANG en_US.UTF-8 ENV LANGUAGE en_US:en ENV LC_ALL en_US.UTF-8 RUN apt-get install -y --no-install-recommends \ wget \ git \ python3-pip \ openssh-client \ python3-setuptools \ google-perftools && \ rm -rf /var/lib/apt/lists/* # install conda WORKDIR /tmp RUN wget --quiet https://repo.anaconda.com/miniconda/Miniconda3-4.7.12-Linux-x86_64.sh -O ~/miniconda.sh && \ /bin/bash ~/miniconda.sh -b -p /opt/conda && \ rm ~/miniconda.sh && \ ln -s /opt/conda/etc/profile.d/conda.sh /etc/profile.d/conda.sh && \ echo ". /opt/conda/etc/profile.d/conda.sh" >> ~/.bashrc # build conda environments COPY environment.yml /tmp/kubeflow-mnist/conda/ RUN /opt/conda/bin/conda update -n base -c defaults conda RUN /opt/conda/bin/conda env create -f /tmp/kubeflow-mnist/conda/environment.yml RUN /opt/conda/bin/conda clean -afy # Cleanup RUN rm -rf /workspace/{nvidia,docker}-examples && rm -rf /usr/local/nvidia-examples && \ rm /tmp/kubeflow-mnist/conda/environment.yml # switch to the conda environment RUN echo "conda activate kubeflow-mnist" >> ~/.bashrc ENV PATH /opt/conda/envs/kubeflow-mnist/bin:$PATH RUN /opt/conda/bin/activate kubeflow-mnist # make /bin/sh symlink to bash instead of dash: RUN echo "dash dash/sh boolean false" | debconf-set-selections && \ DEBIAN_FRONTEND=noninteractive dpkg-reconfigure dash # Set the new Allocator ENV LD_PRELOAD /usr/lib/x86_64-linux-gnu/libtcmalloc.so. 关于Dockerfile值得关注的重要一点是Conda环境是否设置完成并准备就绪。要构建镜像: % docker build -t your-user-name/kubeflow-mnist . -f Dockerfile % docker push your-user-name/kubeflow-mnist 那么,现在让我们来创建第一个组件! 在pipeline.py中可以找到以下代码片段。 Step1:Git Clone 在这一步中,我们将从远程的Git代码库中执行一个git clone。特别是,我想要向你展示如何从私有仓库中进行git clone,因为这是大多数企业的项目所在的位置。当然,这也是一个很好的机会来演示Rancher中一个很棒的功能,它能简单地添加诸如SSH密钥之类的密钥。 使用Rancher添加密钥 访问Rancher界面。在左上角,选择local,然后选择二级菜单的Default: 然后,选择Resources下的Secrets 你应该看到一个密钥的列表,它们正在被你刚刚选择的集群所使用。点击Add Secret: 使用你在下图中所看到的值来填写该页面。如果kubeflow没有在命名空间栏下展示出来,你可以通过选择Add to a new namespace并且输入kubeflow简单地创建一个。 确保Scope仅是个命名空间。如果将Scope设置为所有命名空间,那么将使得在Default项目中的任意工作负载都能够使用你的ssh密钥。 在Secret Values中,key是id_rsa,值是id_rsa的内容。完成之后,点击Save。 如果一些进展顺利,你将会看到下图的内容。现在你已经成功地在kubeflow命名空间中添加了你的SSH密钥,并且无需使用kubectl! 既然我们已经添加了我们的SSH key,那么是时候回到代码。我们如何利用新添加的SSH密钥来访问私有git仓库? def git_clone_darkrai_op(repo_url: str): volume_op = dsl.VolumeOp( name="create pipeline volume", resource_name="pipeline-pvc", modes=["ReadWriteOnce"], size="3Gi" ) image = 'alpine/git:latest' commands = [ "mkdir ~/.ssh", "cp /etc/ssh-key/id_rsa ~/.ssh/id_rsa", "chmod 600 ~/.ssh/id_rsa", "ssh-keyscan bitbucket.org >> ~/.ssh/known_hosts", f"git clone {repo_url} {PROJECT_ROOT}", f"cd {PROJECT_ROOT}"] op = dsl.ContainerOp( name='git clone', image=image, command=['sh'], arguments=['-c', ' && '.join(commands)], container_kwargs={'image_pull_policy': 'IfNotPresent'}, pvolumes={"/workspace": volume_op.volume} ) # Mount Git Secrets op.add_volume(V1Volume(name='ssh-key-volume', secret=V1SecretVolumeSource(secret_name='ssh-key-secret'))) op.add_volume_mount(V1VolumeMount(mount_path='/etc/ssh-key', name='ssh-key-volume', read_only=True)) return op 首先,创建一个Kubernetes volume,预定义大小为3Gi。其次,将image变量指定为我们将要使用的alpine/git Docker镜像。之后是在Docker容器中执行的命令列表。这些命令实质上是设置SSH密钥的,以便于流水线可以从私有仓库git clone,或者使用git://URL来代替 https://。 该函数的核心是下面一行,返回一个dsl.ContainerOp。 command和arguments指定了执行镜像之后需要执行的命令。 最后一个变量十分有趣,是pvolumes,它是Pipeline Volumes简称。它创建一个Kubernetes volume并允许流水线组件来共享单个存储。该volume被挂载在/workspace上。那么这个组件要做的就是把仓库git clone到/workspace中。 使用Secrets 再次查看命令和复制SSH密钥的位置。 流水线volume在哪里创建呢?当我们将所有组件都整合到一个流水线中时,就会看到创建好的volume。我们在/etc/ssh-key/上安装secrets: op.add_volume_mount(V1VolumeMount(mount_path='/etc/ssh-key', name='ssh-key-volume', read_only=True)) 请记得我们将secret命名为ssh-key-secret: op.add_volume(V1Volume(name='ssh-key-volume', secret=V1SecretVolumeSource(secret_name='ssh-key-secret'))) 通过使用相同的volume名称ssh-key-volume,我们可以把一切绑定在一起。 Step2:预处理 def preprocess_op(image: str, pvolume: PipelineVolume, data_dir: str): return dsl.ContainerOp( name='preprocessing', image=image, command=[CONDA_PYTHON_CMD, f"{PROJECT_ROOT}/preprocessing.py"], arguments=["--data_dir", data_dir], container_kwargs={'image_pull_policy': 'IfNotPresent'}, pvolumes={"/workspace": pvolume} ) 正如你所看到的, 预处理步骤看起来十分相似。 image指向我们在Step0中创建的Docker镜像。 这里的command使用指定的conda python简单地执行了preprocessing.py脚本。变量data_dir被用于执行preprocessing.py脚本。 在这一步骤中pvolume将在/workspace里有仓库,这意味着我们所有的脚本在这一阶段都是可用的。并且在这一步中预处理数据会存储在/workspace下的data_dir中。 Step3:训练和评估 def train_and_eval_op(image: str, pvolume: PipelineVolume, data_dir: str, ): return dsl.ContainerOp( name='training and evaluation', image=image, command=[CONDA_PYTHON_CMD, f"{PROJECT_ROOT}/train.py"], arguments=["--data_dir", data_dir], file_outputs={'output': f'{PROJECT_ROOT}/output.txt'}, container_kwargs={'image_pull_policy': 'IfNotPresent'}, pvolumes={"/workspace": pvolume} ) 最后,是时候进行训练和评估这一步骤。这一步唯一的区别在于file_outputs变量。如果我们再次查看train.py,则有以下代码段: with open(os.path.join(PROJECT_ROOT, 'output.txt'), 'w') as f: f.write(model_path) print(f'Model written to: {model_path}') 我们正在将模型路径写入名为output.txt的文本文件中。通常,可以将其发送到下一个流水线组件,在这种情况下,该参数将包含模型的路径。 将一切放在一起 要指定流水线,你需要使用dsl.pipeline来注释流水线功能: @dsl.pipeline( name='Fashion MNIST Training Pipeline', description='Fashion MNIST Training Pipeline to be executed on KubeFlow.' ) def training_pipeline(image: str = 'benjamintanweihao/kubeflow-mnist', repo_url: str = 'https://github.com/benjamintanweihao/kubeflow-mnist.git', data_dir: str = '/workspace'): git_clone = git_clone_darkrai_op(repo_url=repo_url) preprocess_data = preprocess_op(image=image, pvolume=git_clone.pvolume, data_dir=data_dir) _training_and_eval = train_and_eval_op(image=image, pvolume=preprocess_data.pvolume, data_dir=data_dir) if __name__ == '__main__': import kfp.compiler as compiler compiler.Compiler().compile(training_pipeline, __file__ + '.tar.gz') 还记得流水线组件的输出是另一个组件的输入吗?在这里,git clone、container_op的pvolume将传递到preprocess_cp。 最后一部分将pipeline.py转换为可执行脚本。最后一步是编译流水线: % dsl-compile --py pipeline.py --output pipeline.tar.gz 上传并执行流水线 现在要进行最有趣的部分啦!第一步,上传流水线。点击Upload a pipeline: 接下来,填写Pipeline Name和Pipeline Description,然后选择Choose file并且指向pipeline.tar.gz以上传流水线。 下一页将会展示完整的流水线。我们所看到的是一个流水线的有向无环图,在本例中这意味着依赖项会通往一个方向并且它不包含循环。点击蓝色按钮Create run 以开始训练。 大部分字段已经已经填写完毕。请注意,Run parameters与使用@ dsl.pipeline注释的training_pipeline函数中指定的参数相同: 最后,当你点击蓝色的Start按钮时,整个流水线就开始运转了!你点击每个组件并查看日志就能够知道发生了什么。当整个流水线执行完毕时,在所有组件的右方会有一个绿色的确认标志,如下所示: 结论 如果你从上一篇文章开始就一直在关注,那么你应该已经安装了Kubeflow,并且应该能体会到大规模管理机器学习项目的复杂性。 在这篇文章中,我们先介绍了为Kubeflow准备一个机器学习项目的过程,然后是构建一个Kubeflow流水线,最后是使用Kubeflow接口上传并执行流水线。这种方法的奇妙之处在于,你的机器学习项目可以是简单的,也可以是复杂的,只要你愿意,你就可以使用相同的技术。 因为Kubeflow使用Docker容器作为组件,你可以自由地加入任何你喜欢的工具。而且由于Kubeflow运行在Kubernetes上,你可以让Kubernetes处理机器学习工作负载的调度。 我们还了解了一个我喜欢的Rancher功能,它十分方便,可以轻松添加secrets。立刻,你就可以轻松地组织secrets(如SSH密钥),并选择将其分配到哪个命名空间,而无需为Base64编码而烦恼。就像Rancher的应用商店一样,这些便利性使Kubernetes的工作更加愉快,更不容易出错。 当然,Rancher提供的服务远不止这些,我鼓励你自己去做一些探索。我相信你会偶然发现一些让你大吃一惊的功能。Rancher作为一个开源的企业级Kubernetes管理平台,Run Kubernetes Everywhere一直是我们的愿景和宗旨。开源和无厂商锁定的特性,可以让用户轻松地在不同的基础设施部署和使用Rancher。此外,Rancher极简的操作体验也可以让用户在不同的场景中利用Rancher提升效率,帮助开发人员专注于创新,而无需在繁琐的小事中浪费精力。

优秀的个人博客,低调大师

每日一博 | MyBatis 源码解析:SQL 语句的执行机制

通过前面两篇文章,我们完成了对 MyBatis 所有配置文件(包括配置文件和映射文件)解析过程的分析。回忆一下我们最开始给出的小示例(如下),经过前面的跋山涉水,我们终于完成了第一行代码的 99% (手动滑稽),这最后的 1% 就是创建 SqlSessionFactory 对象。所有的配置解析最后都会封装到 Configuration 对象中,接下去就是调用 SqlSessionFactoryBuilder#build 方法创建 SqlSessionFactory 对象,实际使用的是 DefaultSqlSessionFactory 实现类进行实例化。 SqlSessionFactory sessionFactory = new SqlSessionFactoryBuilder() .build(Resources.getResourceAsStream("mybatis-config.xml")); try (SqlSession sqlSession = sessionFactory.openSession()) { UserMapper mapper = sqlSession.getMapper(UserMapper.class); User user = mapper.selectByName("zhenchao"); // ... use user object } SqlSessionFactory 是一个工厂类,用于创建 SqlSession 对象。按照官方文档的说明,SqlSessionFactory 对象一旦被创建就应该在应用的运行期间一直存在,不应该在运行期间对其进行清除或重建。调用该工厂的 SqlSessionFactory#openSession 方法可以开启一次会话,即创建一个 SqlSession 对象。SqlSession 封装了面向数据库执行 SQL 的所有 API,它不是线程安全的,因此不能被共享,所以该对象的最佳作用域是请求或方法作用域。在上面的示例中,我们用 SqlSession 拿到相应的 Mapper 接口对象(更准确的说是一个动态代理对象),然后执行指定的数据库操作,最后关闭此次会话。 上面这张时序图我们在本系列开篇的文章中已经引用过,描绘了 MyBatis 在一次会话生命周期内执行数据库操作的交互时序。下面对这幅图中所描绘的执行过程中类之间的交互时序关系作进一步说明,稍后我们会对图中涉及到的类和接口从源码层面进行分析,执行时序如下: 调用 SqlSessionFactory#openSession 方法创建 SqlSession 对象,开启一次会话; 调用 SqlSession#getMapper 方法获取指定的 Mapper 接口对象,这里实际上将请求委托给 Configuration#getMapper 方法执行,由前面分析映射文件解析过程时我们知道所有的 Mapper 接口都会注册到全局唯一的配置对象 Configuration 的 MapperRegistry 类型属性中; MapperRegistry 在执行 MapperRegistry#getMapper 操作时会反射创建 Mapper 接口的动态代理对象并返回; 执行对应的数据库操作方法(例如 UserMapper#selectByName),即调用 Mapper 接口动态代理对象的 MapperProxy#invoke 方法,在该方法中会获取封装执行方法的 MapperMethod 对象; 执行 MapperMethod#execute 方法,该方法会判定当前数据库操作类型(例如 SELECT),依据类型选择执行 SqlSession 对应的数据库操作方法; SqlSession 会将数据库操作委托给具体的 Executor 执行。对于动态 SQL 语句而言,在这里会依据参数执行解析;对于查询语句而言,Executor 在条件允许的情况下会尝试先从缓存中进行查询,缓存不命中才会操作具体的数据库并更新缓存。MyBatis 强大的结果集映射操作也在这里完成; 返回查询结果; 调用当前会话的 SqlSession#close 方法关闭本次会话。 整个过程围绕一次查询操作展开,虽然不能覆盖 MyBatis 执行 SQL 语句的各个方面,但主线上还是能够说明白 MyBatis 针对一次 SQL 执行的大概过程。在下面的篇幅中,我们将一起分析这一整套时序背后的实现机制。 SQL 会话管理 SqlSession 接口是 MyBatis 对外提供的数据库操作 API,是 MyBatis 的核心接口之一,用于管理一次数据库会话。围绕 SqlSession 接口的类继承关系如下图所示,其中 DefaultSqlSession 是默认的 SqlSession 实现。SqlSessionFactory 是一个工厂接口,其功能是用来创建 SqlSession 对象,该接口中声明了多个重载版本的 SqlSessionFactory#openSession 方法,DefaultSqlSessionFactory 是该接口的默认实现。上述示例程序中 SqlSessionFactoryBuilder#build 方法就是基于该实现类创建的 SqlSessionFactory 对象。SqlSessionManager 类实现了这两个接口,所以具备创建、使用,以及管理 SqlSession 对象的能力,后面会详细说明。 SqlSession 接口中声明的方法都比较直观,感兴趣的读者可以自行阅读源码。我们来看一下针对该接口的默认实现类 DefaultSqlSession,该类的属性定义如下: /** 全局唯一的配置对象 */ private final Configuration configuration; /** SQL 语句执行器 */ private final Executor executor; /** 是否自动提交事务 */ private final boolean autoCommit; /** 标记当前缓存中是否存在脏数据 */ private boolean dirty; /** 记录已经打开的游标 */ private List<Cursor<?>> cursorList; DefaultSqlSession 中的方法实现基本上都是对 Executor 接口方法的封装,实现上都比较简单。这里解释一下 DefaultSqlSession#cursorList 这个属性,在 DefaultSqlSession#selectCursor 方法中会记录查询返回的游标(Cursor)对象,并在关闭 SqlSession 会话时遍历集合逐一关闭,从而防止打开的游标没有被关闭的现象。 DefaultSqlSessionFactory 是 SqlSessionFactory 接口的默认实现,用于创建 SqlSession 对象。该实现类提供了两种创建 SqlSession 对象的方式,分别是基于当前数据源创建会话和基于当前数据库连接创建会话,对应的实现如下。 基于数据源创建会话 private SqlSession openSessionFromDataSource( ExecutorType execType, TransactionIsolationLevel level, boolean autoCommit) { Transaction tx = null; try { // 获取当前激活的数据库环境配置 final Environment environment = configuration.getEnvironment(); // 获取当前数据库环境对应的 TransactionFactory 对象,不存在的话就创建一个 final TransactionFactory transactionFactory = this.getTransactionFactoryFromEnvironment(environment); tx = transactionFactory.newTransaction(environment.getDataSource(), level, autoCommit); // 依据指定的 Executor 类型创建对应的 Executor 对象 final Executor executor = configuration.newExecutor(tx, execType); // 创建 SqlSession 对象 return new DefaultSqlSession(configuration, executor, autoCommit); } catch (Exception e) { this.closeTransaction(tx); // may have fetched a connection so lets call close() throw ExceptionFactory.wrapException("Error opening session. Cause: " + e, e); } finally { ErrorContext.instance().reset(); } } 基于数据库连接创建会话 private SqlSession openSessionFromConnection(ExecutorType execType, Connection connection) { try { boolean autoCommit; try { autoCommit = connection.getAutoCommit(); } catch (SQLException e) { // 考虑到很多驱动或者数据库不支持事务,设置自动提交事务 autoCommit = true; } // 获取当前激活的数据库环境配置 final Environment environment = configuration.getEnvironment(); // 获取当前数据库环境对应的 TransactionFactory 对象,不存在的话就创建一个 final TransactionFactory transactionFactory = this.getTransactionFactoryFromEnvironment(environment); final Transaction tx = transactionFactory.newTransaction(connection); // 依据指定的 Executor 类型创建对应的 Executor 对象 final Executor executor = configuration.newExecutor(tx, execType); // 创建 SqlSession 对象 return new DefaultSqlSession(configuration, executor, autoCommit); } catch (Exception e) { throw ExceptionFactory.wrapException("Error opening session. Cause: " + e, e); } finally { ErrorContext.instance().reset(); } } 两种创建会话的方式在执行流程上基本一致,具体细节如上述代码注释。 SqlSessionManager 同时实现了 SqlSessionFactory 和 SqlSession 两个接口,所以具备这两个接口全部的功能。该实现类的属性定义如下: /** 封装的 {@link SqlSessionFactory} 对象 */ private final SqlSessionFactory sqlSessionFactory; /** 线程私有的 SqlSession 对象的动态代理对象 */ private final SqlSession sqlSessionProxy; /** 线程私有的 SqlSession 对象 */ private final ThreadLocal<SqlSession> localSqlSession = new ThreadLocal<SqlSession>(); 针对 SqlSessionFactory 接口中声明的方法,SqlSessionManager 均委托给持有的 SqlSessionFactory 对象完成。对于 SqlSession 接口中声明的方法,SqlSessionManager 提供了两种实现方式:如果当前线程已经绑定了一个 SqlSession 对象,那么只要未主动调用 SqlSessionManager#close 方法,就会一直复用该线程私有的 SqlSession 对象;否则会在每次执行数据库操作时创建一个新的 SqlSession 对象,并在使用完毕之后关闭会话。相关逻辑位于 SqlSessionInterceptor 类中,这是一个定义在 SqlSessionManager 中的内部类,属性 SqlSessionManager#sqlSessionProxy 是基于该类实现的动态代理对象: this.sqlSessionProxy = (SqlSession) Proxy.newProxyInstance( SqlSessionFactory.class.getClassLoader(), new Class[]{SqlSession.class}, new SqlSessionInterceptor()); SqlSessionInterceptor 类实现自 InvocationHandler 接口,对应的 SqlSessionInterceptor#invoke 方法实现如下: public Object invoke(Object proxy, Method method, Object[] args) throws Throwable { // 获取当前线程私有的 SqlSession 对象 final SqlSession sqlSession = localSqlSession.get(); // 会话未被关闭 if (sqlSession != null) { try { // 直接反射调用相应的方法 return method.invoke(sqlSession, args); } catch (Throwable t) { throw ExceptionUtil.unwrapThrowable(t); } } // 没有 SqlSession,或已关闭,创建一个,使用完毕之后即关闭会话 else { try (SqlSession autoSqlSession = SqlSessionManager.this.openSession()) { try { // 反射调用相应的方法 final Object result = method.invoke(autoSqlSession, args); // 提交事务 autoSqlSession.commit(); return result; } catch (Throwable t) { // 回滚事务 autoSqlSession.rollback(); throw ExceptionUtil.unwrapThrowable(t); } } } } SqlSessionInterceptor 首先会尝试获取线程私有的 SqlSession 对象,对于未绑定的线程来说会创建一个新的 SqlSession 对象,并在使用完毕之后立刻关闭。 动态代理 Mapper 接口 MyBatis 要求所有的 Mapper 都定义成接口的形式,这主要是为了配合 JDK 内置的动态代理机制,JDK 内置的动态代理要求被代理的类必须抽象出一个接口。常用的动态代理除了 JDK 内置的方式,还有基于 CGlib 等第三方组件的方式,MyBatis 采用了 JDK 内置的方式创建 Mapper 接口的动态代理对象。 我们先来复习一下 JDK 内置的动态代理机制,假设现在有一个接口 Mapper 及其实现类如下: public interface Mapper { int select(); } public class MapperImpl implements Mapper { @Override public int select() { System.out.println("do select."); return 0; } } 现在我们希望在方法执行之前打印一行调用日志,基于动态代理的实现方式如下。我们需要定义一个实现了 InvocationHandler 接口的代理类,然后在其 InvocationHandler#invoke 方法中实现增强逻辑: public class MapperProxy implements InvocationHandler { private Mapper mapper; public MapperProxy(Mapper mapper) { this.mapper = mapper; } @Override public Object invoke(Object proxy, Method method, Object[] args) throws Throwable { System.out.println("before invoke."); return method.invoke(this.mapper, args); } } 客户端调用代码: Mapper mapper = new MapperImpl(); Mapper mapperProxy = (Mapper) Proxy.newProxyInstance( mapper.getClass().getClassLoader(), mapper.getClass().getInterfaces(), new MapperProxy(mapper)); mapperProxy.select(); 回到 MyBatis 框架本身,我们在执行目标数据库操作时,一般会直接调用目标 Mapper 接口的相应方法,这里框架返回给我们的实际上是 Mapper 接口的动态代理类对象。MyBatis 基于 JDK 的动态代理机制实现了 Mapper 接口中声明的方法,这其中包含了 获取 SQL 语句、参数绑定、缓存操作、数据库操作,以及结果集映射处理 等步骤,下面就 Mapper 接口动态代理机制涉及到的相关类和方法进行分析。 上一篇在分析映射文件时我们介绍了在 MapperRegistry#knownMappers 属性中记录了 Mapper 接口与 MapperProxyFactory 的映射关系,MapperProxyFactory 顾名思义是 MapperProxy 的工厂类,其中定义了创建 Mapper 接口代理对象的方法,如下: public T newInstance(SqlSession sqlSession) { final MapperProxy<T> mapperProxy = new MapperProxy<>(sqlSession, mapperInterface, methodCache); return this.newInstance(mapperProxy); } protected T newInstance(MapperProxy<T> mapperProxy) { // 创建 Mapper 接口对应的动态代理对象(基于 JDK 内置的动态代理机制) return (T) Proxy.newProxyInstance( mapperInterface.getClassLoader(), new Class[] {mapperInterface}, mapperProxy); } 来看一下 MapperProxy 实现,该类实现了 InvocationHandler 接口,对应的 InvocationHandler#invoke 实现如下: public Object invoke(Object proxy, Method method, Object[] args) throws Throwable { try { // 对于 Object 类中声明的方法,直接调用 if (Object.class.equals(method.getDeclaringClass())) { return method.invoke(this, args); } // 对于非 Object 类中声明的方法 else { // 获取方法关联的 MapperMethodInvoker 对象,并执行数据库操作 return this.cachedInvoker(method).invoke(proxy, method, args, sqlSession); } } catch (Throwable t) { throw ExceptionUtil.unwrapThrowable(t); } } 上述方法的核心逻辑在于获取当前执行方法 Method 对象对应的 MapperMethodInvoker 方法调用器,并执行 MapperMethodInvoker#invoke 方法触发对应的数据库操作。 围绕 MapperMethodInvoker 接口,MyBatis 提供了两种实现,即 DefaultMethodInvoker 和 PlainMethodInvoker,其中前者用于支持 JDK 7 引入的动态类型语言特性,后者则是对 MapperMethod 的封装。MapperMethod 中主要定义两个内部类: SqlCommand:用于封装方法关联的 SQL 语句名称和类型。 MethodSignature:用来封装方法相关的签名信息。 先来看一下 SqlCommand 的具体实现,该类定义了 SqlCommand#name 和 SqlCommand#type 两个属性,分别用于记录对应 SQL 语句的名称和类型,并在构造方法中实现了相应的解析逻辑和初始化操作,如下: public SqlCommand(Configuration configuration, Class<?> mapperInterface, Method method) { // 获取方法名称 final String methodName = method.getName(); // 获取方法隶属的类或接口的 Class 对象 final Class<?> declaringClass = method.getDeclaringClass(); // 解析方法关联的 SQL 语句对应的 MappedStatement 对象(用于封装 SQL 语句) MappedStatement ms = this.resolveMappedStatement(mapperInterface, methodName, declaringClass, configuration); // 未找当前方法对应的 MappedStatement 对象 if (ms == null) { // 如果对应方法注解了 @Flush,表示执行缓存的批量更新语句,则进行标记 if (method.getAnnotation(Flush.class) != null) { name = null; type = SqlCommandType.FLUSH; } else { throw new BindingException( "Invalid bound statement (not found): " + mapperInterface.getName() + "." + methodName); } } // 找当前方法对应的 MappedStatement 对象,初始化 SQL 语句名称和类型 else { name = ms.getId(); type = ms.getSqlCommandType(); if (type == SqlCommandType.UNKNOWN) { throw new BindingException("Unknown execution method for: " + name); } } } private MappedStatement resolveMappedStatement( Class<?> mapperInterface, String methodName, Class<?> declaringClass, Configuration configuration) { // 接口名称.方法名 String statementId = mapperInterface.getName() + "." + methodName; // 方法存在关联的 SQL 语句,则获取封装该 SQL 语句的 MappedStatement 对象 if (configuration.hasStatement(statementId)) { return configuration.getMappedStatement(statementId); } // 已经递归到该方法隶属的最上层类,但是仍然没有找到关联的 MappedStatement 对象 else if (mapperInterface.equals(declaringClass)) { return null; } // 沿着继承关系向上递归检索 for (Class<?> superInterface : mapperInterface.getInterfaces()) { if (declaringClass.isAssignableFrom(superInterface)) { // 递归检索 MappedStatement ms = this.resolveMappedStatement( superInterface, methodName, declaringClass, configuration); if (ms != null) { return ms; } } } return null; } SqlCommand 在实例化时所做的主要工作就是解析当前 Mapper 方法关联的 SQL 对应的 MappedStatement 对象,并初始化记录的 SQL 语句名称和类型,整个解析过程如上述代码注释。 再来看一下 MethodSignature 类,该类用于封装一个具体 Mapper 方法的相关签名信息,其中定义的方法实现都比较简单,这里列举一下其属性定义: /** 标记返回值是否是 {@link java.util.Collection} 或数组类型 */ private final boolean returnsMany; /** 标记返回值是否是 {@link Map} 类型 */ private final boolean returnsMap; /** 标记返回值是否是 {@link Void} 类型 */ private final boolean returnsVoid; /** 标记返回值是否是 {@link Cursor} 类型 */ private final boolean returnsCursor; /** 标记返回值是否是 {@link Optional} 类型 */ private final boolean returnsOptional; /** 返回值类型 */ private final Class<?> returnType; /** 对于 Map 类型的返回值,用于记录 key 的别名 */ private final String mapKey; /** 标记参数列表中 {@link ResultHandler} 的下标 */ private final Integer resultHandlerIndex; /** 标记参数列表中 {@link RowBounds} 的下标 */ private final Integer rowBoundsIndex; /** 参数名称解析器 */ private final ParamNameResolver paramNameResolver; 上面属性中重点介绍一下 ParamNameResolver 这个类,它的作用在于解析 Mapper 方法的参数列表,以便于在方法实参和方法关联的 SQL 语句的参数之间建立映射关系。其中一个比较重要的属性是 ParamNameResolver#names,定义如下: /** * 记录参数在参数列表中的下标和参数名称之间的对应关系。 * 参数名称通过 {@link Param} 注解指定,如果没有指定则使用参数下标作为参数名称, * 需要注意的是,如果参数列表中包含 {@link RowBounds} 或 {@link ResultHandler} 类型的参数, * 这两种功能型参数不会记录到集合中,此时如果用下标表示参数名称,索引值 key 与对应的参数名称(实际索引)可能会不一致。 * * <p> * The key is the index and the value is the name of the parameter.<br /> * The name is obtained from {@link Param} if specified. When {@link Param} is not specified, * the parameter index is used. Note that this index could be different from the actual index * when the method has special parameters (i.e. {@link RowBounds} or {@link ResultHandler}). * </p> * <ul> * <li>aMethod(@Param("M") int a, @Param("N") int b) -&gt; {{0, "M"}, {1, "N"}}</li> * <li>aMethod(int a, int b) -&gt; {{0, "0"}, {1, "1"}}</li> * <li>aMethod(int a, RowBounds rb, int b) -&gt; {{0, "0"}, {2, "1"}}</li> * </ul> */ private final SortedMap<Integer, String> names; 我把它的英文注释和我的理解都写在代码注释中,应该可以清楚理解该属性的作用。至于为什么需要跳过 RowBounds 和 ResultHandler 这两个类型的参数,是因为前者用于设置 LIMIT 参数,后者用于设置结果集处理器,所以都不是真正意义上的参数,按照我的话说这两种类型的参数都是功能型的参数。 ParamNameResolver 在构造方法中实现了对参数列表的解析,如下: public ParamNameResolver(Configuration config, Method method) { // 获取参数类型列表 final Class<?>[] paramTypes = method.getParameterTypes(); // 获取参数列表上的注解列表 final Annotation[][] paramAnnotations = method.getParameterAnnotations(); final SortedMap<Integer, String> map = new TreeMap<>(); int paramCount = paramAnnotations.length; // 遍历处理方法所有的参数 for (int paramIndex = 0; paramIndex < paramCount; paramIndex++) { // 跳过 RowBounds 和 ResultHandler 类型参数 if (isSpecialParameter(paramTypes[paramIndex])) { continue; } // 查找当前参数是否有 @Param 注解 String name = null; for (Annotation annotation : paramAnnotations[paramIndex]) { // 获取注解指定的参数名称 if (annotation instanceof Param) { hasParamAnnotation = true; name = ((Param) annotation).value(); break; } } // 没有 @Param 注解 if (name == null) { // 基于配置开关决定是否获取参数的真实名称 if (config.isUseActualParamName()) { name = this.getActualParamName(method, paramIndex); } // 使用下标作为参数名称 if (name == null) { // use the parameter index as the name ("0", "1", ...) // gcode issue #71 name = String.valueOf(map.size()); } } map.put(paramIndex, name); } names = Collections.unmodifiableSortedMap(map); } 整个过程概括来说就是遍历处理指定方法的参数列表,忽略 RowBounds 和 ResultHandler 类型的参数,并判断参数前面是否有 @Param 注解,如果有则尝试以注解指定的字符串作为参数名称,否则基于配置决定是否采用参数的真实名称作为这里的参数名,再不济就采用下标值作为参数名称。 考虑到会忽略 RowBounds 和 ResultHandler 两种类型的参数,但是属性 ParamNameResolver#names 对应的 key 又是递增的,所以就可能出现在以下标值作为参数名称时,参数名称与对应下标值不一致的情况。例如,假设有一个方法的参数列表为 (int a, RowBounds rb, int b),因为有 RowBounds 类型夹在中间,如果以下标值作为参数名称的最终解析结果就是 {0, "0"}, {2, "1"},下标与具体的参数名称不一致。 ParamNameResolver 中还有一个比较重要的方法 ParamNameResolver#getNamedParams,用于关联实参和形参列表,其中 args 参数是用户传递的实参数组,方法基于前面的参数列表解析结果将传递的实现与对应的方法参数进行关联,最终记录到 Object 对象中进行返回,实现如下: public Object getNamedParams(Object[] args) { // names 属性记录参数在参数列表中的下标和参数名称之间的对应关系 final int paramCount = names.size(); // 无参方法,直接返回 if (args == null || paramCount == 0) { return null; } // 没有 @Param 注解,且只有一个参数 else if (!hasParamAnnotation && paramCount == 1) { return args[names.firstKey()]; } // 有 @Param 注解,或存在多个参数 else { final Map<String, Object> param = new ParamMap<>(); int i = 0; // 遍历处理参数列表中的非功能性参数 for (Map.Entry<Integer, String> entry : names.entrySet()) { // 记录参数名称与参数值之间的映射关系 param.put(entry.getValue(), args[entry.getKey()]); // 构造一般参数名称,即 (param1, param2, ...) 形式参数 final String genericParamName = GENERIC_NAME_PREFIX + (i + 1); // 以“param + 索引”的形式再记录一次,如果 @Param 指定的参数名称已经是这种形式则不覆盖 if (!names.containsValue(genericParamName)) { param.put(genericParamName, args[entry.getKey()]); } i++; } return param; } } 做了这么多的铺垫,是时候回来继续分析 MapperMethod 的核心方法 MapperMethod#execute 了。该方法的作用在于委托 SqlSession 对象执行方法对应的 SQL 语句,实现如下: public Object execute(SqlSession sqlSession, Object[] args) { Object result; switch (command.getType()) { case INSERT: { // 关联实参与方法参数列表 Object param = method.convertArgsToSqlCommandParam(args); // 调用 SqlSession#insert 方法执行插入操作,并对执行结果进行转换 result = this.rowCountResult(sqlSession.insert(command.getName(), param)); break; } case UPDATE: { // 关联实参与方法参数列表 Object param = method.convertArgsToSqlCommandParam(args); // 调用 SqlSession#update 方法执行更新操作,并对执行结果进行转换 result = this.rowCountResult(sqlSession.update(command.getName(), param)); break; } case DELETE: { // 关联实参与方法参数列表 Object param = method.convertArgsToSqlCommandParam(args); // 调用 SqlSession#delete 方法执行删除操作,并对执行结果进行转换 result = this.rowCountResult(sqlSession.delete(command.getName(), param)); break; } case SELECT: // 返回值是 void 类型,且指定了 ResultHandler 处理结果集 if (method.returnsVoid() && method.hasResultHandler()) { this.executeWithResultHandler(sqlSession, args); result = null; } // 返回值为 Collection 或数组 else if (method.returnsMany()) { result = this.executeForMany(sqlSession, args); } // 返回值为 Map 类型 else if (method.returnsMap()) { result = this.executeForMap(sqlSession, args); } // 返回值为 Cursor 类型 else if (method.returnsCursor()) { result = this.executeForCursor(sqlSession, args); } // 处理其它返回类型 else { Object param = method.convertArgsToSqlCommandParam(args); result = sqlSession.selectOne(command.getName(), param); if (method.returnsOptional() // Optional 类型 && (result == null || !method.getReturnType().equals(result.getClass()))) { result = Optional.ofNullable(result); } } break; case FLUSH: // 如果方法注解了 @Flush,则执行 SqlSession#flushStatements 方法提交缓存的批量更新操作 result = sqlSession.flushStatements(); break; default: throw new BindingException("Unknown execution method for: " + command.getName()); } if (result == null && method.getReturnType().isPrimitive() && !method.returnsVoid()) { throw new BindingException("Mapper method '" + command.getName() + " attempted to return null from a method with a primitive return type (" + method.getReturnType() + ")."); } return result; } 上述方法会依据具体的 SQL 语句类型分而治之。对于 INSERT、UPDATE,以及 DELETE 类型而言,会先调用 MethodSignature#convertArgsToSqlCommandParam 方法关联实参与方法形参,本质上是调用前面介绍的 ParamNameResolver#getNamedParams 方法。然后就是调用 SqlSession 对应的方法执行数据库操作,并通过方法 MapperMethod#rowCountResult 对结果进行类型转换。关于 SqlSession 相关方法的具体实现留到下一节针对性介绍。对于 SELECT 类型而言,则需要考虑不同的返回类型,分为 void、Collection、数组、Map、Cursor,以及对象几类情况,这里所做的都是对于参数或返回结果的处理,核心逻辑也都位于 SqlSession 中,在这一层面的实现都比较简单,就不再一一展开。对于 FLUSH 类型来说,官方文档的说明如下: 如果使用了这个注解,它将调用定义在 Mapper 接口中的 SqlSession#flushStatements 方法。 具体的实现也就位于这里。 SQL 语句执行器 Executor 接口声明了基本的数据库操作,前面在介绍 SqlSession 时曾描述 SqlSession 是 MyBatis 框架对外提供的 API 接口,其中声明了对数据库的基本操作方法,而这些操作方法基本上都是对 Executor 方法的封装。Executor 接口定义如下: public interface Executor { ResultHandler NO_RESULT_HANDLER = null; /** 执行数据库更新操作:update、insert、delete */ int update(MappedStatement ms, Object parameter) throws SQLException; /** 执行数据库查询操作 */ <E> List<E> query(MappedStatement ms, Object parameter, RowBounds rowBounds, ResultHandler resultHandler, CacheKey cacheKey, BoundSql boundSql) throws SQLException; <E> List<E> query(MappedStatement ms, Object parameter, RowBounds rowBounds, ResultHandler resultHandler) throws SQLException; /** 执行数据库查询操作,返回游标对象 */ <E> Cursor<E> queryCursor(MappedStatement ms, Object parameter, RowBounds rowBounds) throws SQLException; /** 批量提交 SQL 语句 */ List<BatchResult> flushStatements() throws SQLException; /** 提交事务 */ void commit(boolean required) throws SQLException; /** 回滚事务 */ void rollback(boolean required) throws SQLException; /** 创建缓存 key 对象 */ CacheKey createCacheKey(MappedStatement ms, Object parameterObject, RowBounds rowBounds, BoundSql boundSql); /** 判断是否缓存 */ boolean isCached(MappedStatement ms, CacheKey key); /** 清空一级缓存 */ void clearLocalCache(); /** 延迟加载一级缓存中的数据 */ void deferLoad(MappedStatement ms, MetaObject resultObject, String property, CacheKey key, Class<?> targetType); /** 获取事务对象 */ Transaction getTransaction(); /** 关闭当前 Executor */ void close(boolean forceRollback); /** 是否已经关闭 */ boolean isClosed(); /** 设置装饰的 Executor 对象 */ void setExecutorWrapper(Executor executor); } 围绕 Executor 接口的类继承关系如下图,其中 CachingExecutor 实现类用于为 Executor 提供二级缓存支持。 BaseExecutor 抽象类实现了 Executor 接口中声明的所有方法,并抽象了 4 个模板方法交由子类实现,这 4 个方法分别是:doUpdate、doFlushStatements、doQuery,以及 doQueryCursor。SimpleExecutor 派生自 BaseExecutor 抽象类,并为这 4 个模板方法提供了最简单的实现。ReuseExecutor 如其名,提供了重用的特性,提供对 Statement 对象的重用,以减少 SQL 预编译,以及创建和销毁 Statement 对象的开销。BatchExecutor 实现类则提供了对 SQL 语句批量执行的特性,也是针对提升性能的一种优化实现。 缓存结构设计 考虑到 Executor 在执行数据库操作时与缓存操作存在密切联系,所以在具体介绍 Executor 的实现之前我们先来了解一下 MyBatis 的缓存机制。 在谈论数据库架构设计时往往需要引入缓存的概念,数据库是相对脆弱且耗时的,所以需要尽量避免请求落库。在实际项目架构设计中,我们一般会引入 Redis、Memcached 这一类的组件对数据进行缓存,MyBatis 作为一个强大的 ORM 框架,也为缓存提供了内建的实现。前面我们在分析配置文件加载与解析时曾介绍过 MyBatis 缓存组件的具体实现,MyBatis 在数据存储上采用 HashMap 作为基本存储结构,并提供了多种装饰器从多个方面为缓存增加相应的特性。 本小节我们关注的是 MyBatis 在缓存结构方面的设计,MyBatis 缓存从结构上可以分为 一级缓存 和 二级缓存,一级缓存相对于二级缓存在粒度上更细,生命周期也更短。 上图描绘了 MyBatis 缓存的结构设计,当我们发起一次数据库查询时,如果启用了二级缓存的话,MyBatis 首先会从二级缓存中检索查询结果,如果缓存不命中则会继续检索一级缓存,只有在这两层缓存都不命中的情况下才会查询数据库,最后会以数据库返回的结果更新一级缓存和二级缓存。 MyBatis 的 一级缓存是会话级别的缓存(生命周期与本次会话相同),当我们开启一次数据库会话时,框架默认会为本次会话绑定一个一级缓存对象。此类缓存主要应对在一个会话范围内的冗余查询操作,比如使用同一个 SqlSession 对象同时连续执行多次相同的查询语句。这种情况下每次查询都落库是没有必要的,因为短时间内数据库变化的可能性会很小,但是每次都落库却是一笔不必要的开销。一级缓存默认是开启的,且无需进行配置,即一级缓存对开发者是透明的,如果确实希望干预一级缓存的内在运行,可以借助于插件来实现。 对于二级缓存而言,默认也是开启的,MyBatis 提供了相应的治理选项,具体可以参考官方文档。二级缓存是应用级别的缓存,随着服务的启动而存在,并随着服务的关闭消亡。前面我们在分析 <cache/> 和 <cache-ref/> 标签时介绍了一个二级缓存会与一个具体的 namespace 绑定,并且支持引用一个已定义 namespace 缓存,即多个 namespace 可以共享同一个缓存。 本小节从整体结构上对 MyBatis 的缓存实现机制进行说明,目的在于对 MyBatis 的缓存有一个整体感知,关于一级缓存和二级缓存的具体实现,留到下面介绍分析 Executor 接口具体实现时穿插说明。 Statement 处理器 StatementHandler 接口及其实现类是 Executor 实现的基础,可以将其看作是 MyBatis 与数据库操作之间的纽带,实现了对 java.sql.Statement 对象的获取,以及 SQL 语句参数绑定与执行的逻辑。StatementHandler 接口及其实现类的类继承关系如下图所示: 其中 BaseStatementHandler 中实现了一些公共的逻辑;SimpleStatementHandler、PreparedStatementHandler,以及 CallableStatementHandler 实现类分别对应 Statement、PreparedStatement 和 CallableStatement 的相关实现;RoutingStatementHandler 并没有添加新的实现,而是对前面三种 StatementHandler 实现类的封装,它会在构造方法中依据当前传递的 Statement 类型创建对应的 StatementHandler 实现类对象。 StatementHandler 接口定义如下: public interface StatementHandler { /** 获取对应的 {@link Statement } 对象 */ Statement prepare(Connection connection, Integer transactionTimeout) throws SQLException; /** 绑定 Statement 执行 SQL 时需要的实参 */ void parameterize(Statement statement) throws SQLException; /** 批量执行 SQL 语句 */ void batch(Statement statement) throws SQLException; /** 执行数据库更新操作:insert、update、delete */ int update(Statement statement) throws SQLException; /** 执行 select 操作 */ <E> List<E> query(Statement statement, ResultHandler resultHandler) throws SQLException; /** 执行 select 操作,返回游标对象 */ <E> Cursor<E> queryCursor(Statement statement) throws SQLException; /** 获取对应的 SQL 对象 */ BoundSql getBoundSql(); /** 获取对应的 {@link ParameterHandler} 对象,用于参数绑定 */ ParameterHandler getParameterHandler(); } 首先来看一下 BaseStatementHandler 实现,该类中主要实现了获取 Statement 对象的逻辑,该类的属性定义如下: protected final Configuration configuration; protected final ObjectFactory objectFactory; protected final TypeHandlerRegistry typeHandlerRegistry; /** 处理结果集映射 */ protected final ResultSetHandler resultSetHandler; /** 用于为 SQL 语句绑定实参 */ protected final ParameterHandler parameterHandler; /** SQL 语句执行器 */ protected final Executor executor; /** 对应 SQL 语句标签对象 */ protected final MappedStatement mappedStatement; /** 封装 LIMIT 参数 */ protected final RowBounds rowBounds; /** 可执行的 SQL 语句 */ protected BoundSql boundSql; BaseStatementHandler 之于 StatementHandler#prepare 方法的实现如下: public Statement prepare(Connection connection, Integer transactionTimeout) throws SQLException { ErrorContext.instance().sql(boundSql.getSql()); Statement statement = null; try { // 从数据库连接中获取 Statement 对象,由子类实现 statement = this.instantiateStatement(connection); // 设置超时时间 this.setStatementTimeout(statement, transactionTimeout); // 设置返回的行数 this.setFetchSize(statement); return statement; } catch (SQLException e) { this.closeStatement(statement); throw e; } catch (Exception e) { this.closeStatement(statement); throw new ExecutorException("Error preparing statement. Cause: " + e, e); } } 上述方法首先会调用 BaseStatementHandler#instantiateStatement 方法获取一个 Statement 对象,这是一个模板方法交由子类实现;然后对拿到的 Statement 对象设置超时时间和返回的行数属性。 BaseStatementHandler 中定义了 ParameterHandler 类型的属性,主要用于为包含 ? 占位符的 SQL 语句绑定实参。ParameterHandler 接口定义如下: public interface ParameterHandler { /** 获取输出类型参数 */ Object getParameterObject(); /** 为 SQL 语句绑定实参 */ void setParameters(PreparedStatement ps) throws SQLException; } 其中,方法 ParameterHandler#getParameterObject 与存储过程相关,下面主要分析一下 ParameterHandler#setParameters 方法的实现。该方法用来为 SQL 语句绑定实参,具体操作等同于我们在直接使用 PreparedStatement 对象时注入相应类型的参数填充 SQL 语句。DefaultParameterHandler 是目前该接口的唯一实现,其 DefaultParameterHandler#setParameters 方法实现如下: public void setParameters(PreparedStatement ps) { ErrorContext.instance().activity("setting parameters").object(mappedStatement.getParameterMap().getId()); // 获取 BoundSql 中记录的参数映射关系列表 List<ParameterMapping> parameterMappings = boundSql.getParameterMappings(); if (parameterMappings != null) { // 遍历为 SQL 语句绑定对应的参数值 for (int i = 0; i < parameterMappings.size(); i++) { ParameterMapping parameterMapping = parameterMappings.get(i); // 忽略存储过程中的输出参数 if (parameterMapping.getMode() != ParameterMode.OUT) { Object value; // 用于记录对应的参数值 // 获取参数名称 String propertyName = parameterMapping.getProperty(); // 获取对应的参数值 if (boundSql.hasAdditionalParameter(propertyName)) { // issue #448 ask first for additional params value = boundSql.getAdditionalParameter(propertyName); } // 用户未传递实参 else if (parameterObject == null) { value = null; } // 实参类型存在对应的类型处理器,即已经是最终的参数值 else if (typeHandlerRegistry.hasTypeHandler(parameterObject.getClass())) { value = parameterObject; } // 获取实参对象中对应的参数值 else { MetaObject metaObject = configuration.newMetaObject(parameterObject); value = metaObject.getValue(propertyName); } TypeHandler typeHandler = parameterMapping.getTypeHandler(); JdbcType jdbcType = parameterMapping.getJdbcType(); if (value == null && jdbcType == null) { jdbcType = configuration.getJdbcTypeForNull(); } try { // 为 SQL 语句绑定对应的实参到 PreparedStatement 对象中 typeHandler.setParameter(ps, i + 1, value, jdbcType); } catch (TypeException | SQLException e) { throw new TypeException("Could not set parameters for mapping: " + parameterMapping + ". Cause: " + e, e); } } } } } 上述实现整体上就是获取 BoundSql 对象记录的参数名称与 SQL 语句中参数的映射关系,然后获取参数名称对应的用户传递的实参设置到 PreparedStatement 对象中。如果使用过原生 JDBC 操作过数据库,对往 PreparedStatement 中填充实参的过程应该不难理解。 关于其余几个 StatementHandler 实现类的都比较简单,就不再展开。 结果集映射 结果集映射是 MyBatis 提供的一个强大且易用的特性,标签 <resultMap/> 用于配置数据库返回的结果集 ResultSet 与实体类属性之间的映射关系。前面我们分析了该标签的解析过程,本小节一起来探究一下 MyBatis 是如何基于这些配置执行结果集映射操作。 SQL 语句执行器 Executor 在调用具体的 StatementHandler 执行数据库查询操作时会针对数据库返回的结果集调用 ResultSetHandler 中相应方法执行结果集到实体类对象的映射处理。例如下面的代码块是 PreparedStatementHandler 在执行 PreparedStatementHandler#query 时的具体逻辑: public <E> List<E> query(Statement statement, ResultHandler resultHandler) throws SQLException { PreparedStatement ps = (PreparedStatement) statement; // 执行数据库操作 ps.execute(); // 调用 ResultSetHandler#handleResultSets 执行结果集映射 return resultSetHandler.handleResultSets(ps); } ResultSetHandler 接口定义了结果集映射所需要的方法,具体如下: public interface ResultSetHandler { /** 处理结果集,返回对应的结果对象集合 */ <E> List<E> handleResultSets(Statement stmt) throws SQLException; /** 处理结果集,返回对应的游标对象 */ <E> Cursor<E> handleCursorResultSets(Statement stmt) throws SQLException; /** 处理存储过程中的输出类型参数 */ void handleOutputParameters(CallableStatement cs) throws SQLException; } DefaultResultSetHandler 是目前 ResultSetHandler 接口的唯一实现。MyBatis 为结果集映射提供了灵活的配置,灵活的背后是强(复)大(杂)的映射解析过程,尤其是对于嵌套映射配置的情况。本小节力图对整个映射过程做一个比较详细的介绍,不过还是建议读者自己亲自 debug 跟踪一下整个执行过程。接下来我们围绕 ResultSetHandler#handleResultSets 方法对结果集映射处理过程进行分析,该方法实现如下: public List<Object> handleResultSets(Statement stmt) throws SQLException { ErrorContext.instance().activity("handling results").object(mappedStatement.getId()); /* 1. 处理普通映射情况 */ // 用于记录结果集映射的结果对象集合 final List<Object> multipleResults = new ArrayList<>(); int resultSetCount = 0; // 获取第一个结果集 ResultSetWrapper rsw = this.getFirstResultSet(stmt); // 获取之前解析得到的封装结果集映射配置的 ResultMap 对象集合 List<ResultMap> resultMaps = mappedStatement.getResultMaps(); int resultMapCount = resultMaps.size(); // 验证,如果结果集不为 null,则 resultMaps 也不能为空 this.validateResultMapsCount(rsw, resultMapCount); // 遍历处理所有的结果集,基于结果集映射规则进行映射,并将结果记录到 multipleResults 集合中 while (rsw != null && resultMapCount > resultSetCount) { // 获取一个配置的结果集映射标签 <resultMap/> 配置 ResultMap resultMap = resultMaps.get(resultSetCount); // 依据结果集映射配置对结果集对象进行解析,并记录到 multipleResults 集合中 this.handleResultSet(rsw, resultMap, multipleResults, null); // 获取下一个待处理的结果集 rsw = this.getNextResultSet(stmt); // 清空 nestedResultObjects this.cleanUpAfterHandlingResultSet(); resultSetCount++; } /* * 2. 处理多结果集的情况 * * 常见于存储过程,存在 <select resultSets="aaa,bbb"/> 类似的配置, * 针对过程 1 未执行映射的结果集进行映射 */ String[] resultSets = mappedStatement.getResultSets(); if (resultSets != null) { while (rsw != null && resultSetCount < resultSets.length) { // 获取 resultSet 配置名称对应的 ResultMapping 配置 ResultMapping parentMapping = nextResultMaps.get(resultSets[resultSetCount]); if (parentMapping != null) { // 获取对应的 <resultMap/> 标签配置 String nestedResultMapId = parentMapping.getNestedResultMapId(); ResultMap resultMap = configuration.getResultMap(nestedResultMapId); // 执行结果集映射 this.handleResultSet(rsw, resultMap, null, parentMapping); } // 获取下一个待处理的结果集 rsw = this.getNextResultSet(stmt); // 清空 nestedResultObjects this.cleanUpAfterHandlingResultSet(); resultSetCount++; } } // multipleResults.size() == 1 ? (List<Object>) multipleResults.get(0) : multipleResults return this.collapseSingleResultList(multipleResults); } 上述方法的执行过程可以分为两部分:普通结果集映射和多结果集映射。其中,多结果集映射一般用于存储过程,这是一个小众化的需求,所以大部分时候上述方法仅执行第一部分的逻辑。这一部分的执行过程如代码注释,其核心在于 DefaultResultSetHandler#handleResultSet 方法,该方法在第二部分中也会被调用,后面会针对该方法进行专门说明。 下面就第二部分的触发机制举例说明,能够执行到这里一般都伴随着存储过程,这里以 MySQL 数据库为例创建一个可以返回多结果集的存储过程,其中 t_blog 表和 t_post 表的定义参考官方文档示例: CREATE PROCEDURE usp_demo(IN ID INT) BEGIN SELECT * FROM t_blog WHERE id = ID; SELECT * FROM t_post WHERE id = ID; END; 对应的映射配置如下: <resultMap id="usp_demo_result_map" type="org.zhenchao.mybatis.entity.Blog"> <constructor> <idArg column="id" javaType="int"/> </constructor> <result property="title" column="title"/> <collection property="posts" ofType="org.zhenchao.mybatis.entity.Post" resultSet="posts"> <id property="id" column="id"/> <result property="subject" column="subject"/> </collection> </resultMap> <select id="uspDemo" resultSets="blogs,posts" resultMap="usp_demo_result_map" statementType="CALLABLE"> {CALL usp_demo(#{id, jdbcType=INTEGER, mode=IN})} </select> 上述配置中,我们基于 resultSets 属性分别为对应的结果集命名,在执行该存储过程时会先映射 t_blog 数据表对应的结果集,映射的过程中遇到名为 posts 的结果集时,MyBatis 不会转去解析该结果集,而是会将该结果集记录到 DefaultResultSetHandler#nextResultMaps 属性中,等运行到第二部分时再对这些未解析的结果集统一进行映射处理。 上述过程中处理结果集映射的核心逻辑均位于 DefaultResultSetHandler#handleResultSet 方法中。该方法执行的主要逻辑在于判断当前是否指定了结果集处理器(即前面介绍过的 ResultHandler),如果没有指定则会创建一个默认的结果集处理器(默认采用 DefaultResultHandler 实现),然后调用 DefaultResultSetHandler#handleRowValues 方法执行映射逻辑。方法 DefaultResultSetHandler#handleResultSet 的实现如下: private void handleResultSet(ResultSetWrapper rsw, ResultMap resultMap, List<Object> multipleResults, ResultMapping parentMapping) throws SQLException { try { if (parentMapping != null) { // 处理多结果集嵌套映射的情况 this.handleRowValues(rsw, resultMap, null, RowBounds.DEFAULT, parentMapping); } else { // 未指定 ResultHandler,构造默认的处理器 if (resultHandler == null) { DefaultResultHandler defaultResultHandler = new DefaultResultHandler(objectFactory); // 对结果集进行映射,并将映射结果记录到 DefaultResultHandler 对象中 this.handleRowValues(rsw, resultMap, defaultResultHandler, rowBounds, null); // 获取保存在 DefaultResultHandler 对象中映射结果,记录到 multipleResults 中 multipleResults.add(defaultResultHandler.getResultList()); } // 用户指定了 ResultHandler,使用该处理器进行处理 else { this.handleRowValues(rsw, resultMap, resultHandler, rowBounds, null); } } } finally { // issue #228 (close resultsets) this.closeResultSet(rsw.getResultSet()); } } 方法 DefaultResultSetHandler#handleRowValues 会判断当前映射配置中是否存在嵌套映射的情况,如果存在嵌套映射则执行方法 DefaultResultSetHandler#handleRowValuesForNestedResultMap 方法处理嵌套结果集映射,否则执行 DefaultResultSetHandler#handleRowValuesForSimpleResultMap 方法处理简单的结果集映射。下面以简单结果集映射的过程进行分析,对于嵌套结果集映射的过程还是强烈建议大家去 debug 跟踪理解,单凭静态文字很难说清楚。 方法 DefaultResultSetHandler#handleRowValuesForSimpleResultMap 实现了对简单(相对于嵌套而言)结果集映射的处理逻辑。首先会基于 RowBounds 设置定位具体的处理行,MyBatis 对于 LIMIT 分页的处理是逻辑分页,而不是物理分页,即将符合条件的记录全部载入内存,然后在内存中进行截取,如果希望执行物理分页,可以自己编码插件,或者使用第三方插件,然后会遍历结果集中目标记录行对其逐一映射。 方法 DefaultResultSetHandler#handleRowValuesForSimpleResultMap 实现如下: private void handleRowValuesForSimpleResultMap(ResultSetWrapper rsw, ResultMap resultMap, ResultHandler<?> resultHandler, RowBounds rowBounds, ResultMapping parentMapping) throws SQLException { DefaultResultContext<Object> resultContext = new DefaultResultContext<>(); ResultSet resultSet = rsw.getResultSet(); // 针对设置了 RowBounds 定位指定的记录行 this.skipRows(resultSet, rowBounds); // 检测是否可以继续对后续的记录行进行映射操作,可以的话就一直循环 while (this.shouldProcessMoreRows(resultContext, rowBounds) && !resultSet.isClosed() && resultSet.next()) { // 确定具体使用的映射配置,如果配置了 <discriminator/> 标签则获取最终引用的 ResultMap,否则使用当前的 ResultMap 对象 ResultMap discriminatedResultMap = this.resolveDiscriminatedResultMap(resultSet, resultMap, null); // 基于映射配置对当前记录行进行解析 Object rowValue = this.getRowValue(rsw, discriminatedResultMap, null); // 保存映射得到的结果对象 this.storeObject(resultHandler, resultContext, rowValue, parentMapping, resultSet); } } 针对记录行的映射处理,方法首先会获取记录行对应的真正 ResultMap 映射配置对象,因为可能存在配置了 <discriminator/> 标签执行条件映射的情况,如果没有配置该标签则会使用当前实参对应的 ResultMap 对象。标签 <discriminator/> 的处理过程位于 DefaultResultSetHandler#resolveDiscriminatedResultMap 方法中,对照配置应该比较容易理解。获取到 ResultMap 映射配置对象之后,下一步就可以调用 DefaultResultSetHandler#getRowValue 方法对当前记录行执行映射处理,该方法实现如下: private Object getRowValue(ResultSetWrapper rsw, ResultMap resultMap, String columnPrefix) throws SQLException { final ResultLoaderMap lazyLoader = new ResultLoaderMap(); // 创建记录行映射结果对象 Object rowValue = this.createResultObject(rsw, resultMap, lazyLoader, columnPrefix); // 如果结果对象不为 null,且没有对应的类型处理器 if (rowValue != null && !this.hasTypeHandlerForResultObject(rsw, resultMap.getType())) { // 创建结果对象的 MetaObject 对象 final MetaObject metaObject = configuration.newMetaObject(rowValue); // 标记是否成功映射任何一个属性 boolean foundValues = this.useConstructorMappings; // 是否需要自动映射 if (this.shouldApplyAutomaticMappings(resultMap, false)) { // 自动映射未在 <resultMap/> 标签中指定的列 foundValues = this.applyAutomaticMappings(rsw, resultMap, metaObject, columnPrefix) || foundValues; } // 映射在 <resultMap/> 标签中指定的列 foundValues = this.applyPropertyMappings(rsw, resultMap, metaObject, lazyLoader, columnPrefix) || foundValues; foundValues = lazyLoader.size() > 0 || foundValues; rowValue = foundValues || configuration.isReturnInstanceForEmptyRow() ? rowValue : null; } return rowValue; } 方法首先会调用 DefaultResultSetHandler#createResultObject 方法创建实体结果对象,然后为该对象执行属性映射注入。对于未配置映射关系的属性会基于配置决定是否执行自动映射,对于明确指定映射关系的属性,则调用 DefaultResultSetHandler#applyPropertyMappings 方法执行映射处理,该方法的具体实现如下: private boolean applyPropertyMappings(ResultSetWrapper rsw, ResultMap resultMap, MetaObject metaObject, ResultLoaderMap lazyLoader, String columnPrefix) throws SQLException { // 获取所有指明了映射关系的列名集合 final List<String> mappedColumnNames = rsw.getMappedColumnNames(resultMap, columnPrefix); boolean foundValues = false; // 获取当前 ResultMap 包含的所有映射关系配置对象 ResultMapping 列表 final List<ResultMapping> propertyMappings = resultMap.getPropertyResultMappings(); // 遍历处理映射关系 ResultMapping 列表,执行映射过程 for (ResultMapping propertyMapping : propertyMappings) { // 处理列前缀 String column = this.prependPrefix(propertyMapping.getColumn(), columnPrefix); // 忽略嵌套的 ResultMap 映射 if (propertyMapping.getNestedResultMapId() != null) { // the user added a column attribute to a nested result map, ignore it column = null; } // 嵌套查询 | 配置了映射关系 | 多结果集 if (propertyMapping.isCompositeResult() || (column != null && mappedColumnNames.contains(column.toUpperCase(Locale.ENGLISH))) || propertyMapping.getResultSet() != null) { // 存在多结果集 // 执行映射,返回属性值 Object value = this.getPropertyMappingValue( rsw.getResultSet(), metaObject, propertyMapping, lazyLoader, columnPrefix); // issue #541 make property optional final String property = propertyMapping.getProperty(); if (property == null) { continue; } // 延迟加载的情况 else if (value == DEFERRED) { foundValues = true; continue; } if (value != null) { foundValues = true; } // 设置属性值 if (value != null || (configuration.isCallSettersOnNulls() && !metaObject.getSetterType(property).isPrimitive())) { // gcode issue #377, call setter on nulls (value is not 'found') metaObject.setValue(property, value); } } } return foundValues; } 方法首先会获取当前结果集对应的映射关系配置和列名集合,然后遍历处理映射配置。针对嵌套查询、多结果集映射,以及普通映射的情况分而治之,这一过程位于 DefaultResultSetHandler#getPropertyMappingValue 方法中(实现如下)。针对嵌套查询的情况我们后面专门进行分析;对于多结果集的情况会将对应的结果集配置对象记录到 DefaultResultSetHandler#nextResultMaps 属性中,稍后会专门处理(即前面的第二部分代码);针对普通的映射则会基于 TypeHandler 获取属性对应的 java 类型值,也就是我们期望的值。 private Object getPropertyMappingValue(ResultSet rs, MetaObject metaResultObject, ResultMapping propertyMapping, ResultLoaderMap lazyLoader, String columnPrefix) throws SQLException { // 嵌套查询 if (propertyMapping.getNestedQueryId() != null) { return this.getNestedQueryMappingValue(rs, metaResultObject, propertyMapping, lazyLoader, columnPrefix); } // 多结果集情况,记录对应的 resultSet,后续处理 else if (propertyMapping.getResultSet() != null) { this.addPendingChildRelation(rs, metaResultObject, propertyMapping); return DEFERRED; } // 基于 TypeHandler 获取属性值 else { final TypeHandler<?> typeHandler = propertyMapping.getTypeHandler(); final String column = this.prependPrefix(propertyMapping.getColumn(), columnPrefix); return typeHandler.getResult(rs, column); } } 最后会调用 DefaultResultSetHandler#storeObject 方法将实体结果对象记录到 DefaultResultHandler#list 属性中,并在 DefaultResultSetHandler#handleResultSet 方法中调用 DefaultResultHandler#getResultList 方法拿到这些结果对象。 执行器实现 前面已经介绍了 Executor 接口以及相关的实现类继承关系,本小节将对这些执行器实现类逐一展开分析。 BaseExecutor BaseExecutor 是一个抽象类,实现了 Executor 接口中声明的所有方法,并采用模板方法模式抽象出 4 个模板方法交由子类实现。需要强调的一点是,BaseExecutor 抽象类引入了一级缓存支持,在相应方法实现中增加了对一级缓存的操作,因此该抽象类的所有实现类都具备一级缓存的特性。BaseExecutor 抽象类的属性定义如下: /** 事务对象 */ protected Transaction transaction; /** 封装的 SQL 语句执行器 */ protected Executor wrapper; /** 延迟加载队列 */ protected ConcurrentLinkedQueue<DeferredLoad> deferredLoads; /** 缓存结果对象(一级缓存) */ protected PerpetualCache localCache; /** 缓存存储过程输出类型参数(一级缓存) */ protected PerpetualCache localOutputParameterCache; /** 全局唯一的配置对象 */ protected Configuration configuration; /** 记录嵌套查询的层数 */ protected int queryStack; /** 标记当前 Executor 是否已经关闭 */ private boolean closed; 下面针对一些比较复杂的方法实现展开说明,首先来看一下 BaseExecutor#update 方法实现(如下)。需要注意的是这里的 update 并不等同于 SQL 语句中的 UPDATE 操作,对于 Executor 而言数据库操作只包含 query 和 update 两大类,这里的 query 可以理解为 SQL 语句的 SELECT 操作,而 update 则对应着 SQL 语句中的 INSERT、UPDATE、DELECT 三类操作。 public int update(MappedStatement ms, Object parameter) throws SQLException { ErrorContext.instance().resource(ms.getResource()).activity("executing an update").object(ms.getId()); if (closed) { throw new ExecutorException("Executor was closed."); } // 先清空一级缓存 this.clearLocalCache(); // 执行更新操作,交由子类实现 return this.doUpdate(ms, parameter); } 上述方法首先会判定当前 Executor 是否已被关闭,对于没有关闭的 Executor 会首先清空一级缓存,然后调用 BaseExecutor#doUpdate 模板方法,该方法由子类实现。 再来看一下 BaseExecutor#query 方法,该方法用于执行数据库查询操作。因为引入了一级缓存,所以这里的查询不是简单的直接查询数据库,而是会先查询一级缓存,只有在缓存不命中的情况下才会查询数据库,并利用数据库返回的结果对象更新一级缓存。该方法的实现如下: public <E> List<E> query(MappedStatement ms, Object parameter, RowBounds rowBounds, ResultHandler resultHandler) throws SQLException { // 获取执行的 SQL 语句 BoundSql boundSql = ms.getBoundSql(parameter); // 创建缓存 key CacheKey key = this.createCacheKey(ms, parameter, rowBounds, boundSql); // 调用重载的 query 方法执行查询操作 return this.query(ms, parameter, rowBounds, resultHandler, key, boundSql); } public <E> List<E> query(MappedStatement ms, Object parameter, RowBounds rowBounds, ResultHandler resultHandler, CacheKey key, BoundSql boundSql) throws SQLException { ErrorContext.instance().resource(ms.getResource()).activity("executing a query").object(ms.getId()); if (closed) { throw new ExecutorException("Executor was closed."); } // 如果是非嵌套查询,且配置 <select flushCache="true"/> 要求执行该语句时清空一级缓存和二级缓存 if (queryStack == 0 && ms.isFlushCacheRequired()) { // 清空一级缓存 this.clearLocalCache(); } List<E> list; try { queryStack++; // 尝试从一级缓存中获取结果 list = resultHandler == null ? (List<E>) localCache.getObject(key) : null; // 缓存名命中,针对存储过程特殊处理,获取缓存中保存的输出类型参数记录到实参对象中 if (list != null) { this.handleLocallyCachedOutputParameters(ms, key, parameter, boundSql); } // 缓存不命中,查数据库并更新缓存,本质上调用的是 doQuery 方法 else { list = this.queryFromDatabase(ms, parameter, rowBounds, resultHandler, key, boundSql); } } finally { queryStack--; } // 加载缓存中记录的嵌套查询的结果对象 if (queryStack == 0) { for (DeferredLoad deferredLoad : deferredLoads) { deferredLoad.load(); } // issue #601 deferredLoads.clear(); if (configuration.getLocalCacheScope() == LocalCacheScope.STATEMENT) { // issue #482 this.clearLocalCache(); } } return list; } 整个 BaseExecutor#query 方法的执行过程如上述代码注释。 方法 BaseExecutor#queryCursor 与 BaseExecutor#query 都是提供数据库查询操作,区别在于前者返回的是一个游标(Cursor)对象,而后者返回的是已经完成结果集映射的结果对象,游标需要等待用户真正操作时才会执行结果集映射的过程。 SimpleExecutor SimpleExecutor 提供了对 Executor 的简单实现,针对每一次数据库操作都会创建一个新的 Statement 对象,并在操作完毕之后进行关闭。SimpleExecutor 针对抽象类 BaseExecutor 中声明的方法实现流程都相同,下面以 SimpleExecutor#doQuery 方法为例进行分析,该方法的实现如下: public <E> List<E> doQuery(MappedStatement ms, Object parameter, RowBounds rowBounds, ResultHandler resultHandler, BoundSql boundSql) throws SQLException { Statement stmt = null; try { Configuration configuration = ms.getConfiguration(); // 创建 StatementHandler 对象 StatementHandler handler = configuration.newStatementHandler( wrapper, ms, parameter, rowBounds, resultHandler, boundSql); // 创建 Statement 对象并为 SQL 语句绑定实参 stmt = this.prepareStatement(handler, ms.getStatementLog()); // 执行数据库查询操作,以及结果集映射 return handler.query(stmt, resultHandler); } finally { // 关闭 Statement this.closeStatement(stmt); } } 方法首先会基于 Configuration#newStatementHandler 创建对应的 StatementHandler 对象,这里实际上是采用了前面介绍的 RoutingStatementHandler 实现类依据入参进行创建。然后会调用 SimpleExecutor#prepareStatement 方法创建 Statement 对象,并为 SQL 语句绑定实参。接着执行具体的数据库查询操作,对于查询操作此时会执行结果集映射处理。最后关闭 Statement 对象。 方法 SimpleExecutor#prepareStatement 实现如下: private Statement prepareStatement(StatementHandler handler, Log statementLog) throws SQLException { Statement stmt; // 获取数据库连接 Connection connection = this.getConnection(statementLog); // 获取 Statement 对象 stmt = handler.prepare(connection, transaction.getTimeout()); // 执行参数绑定 handler.parameterize(stmt); return stmt; } 其中 StatementHandler#prepare 方法的运行逻辑前面已经分析过。方法 StatementHandler#parameterize 执行了参数绑定的操作,该方法在 SimpleStatementHandler 中为空实现,毕竟对于 Statement 来说不支持设置参数;而对于 PreparedStatementHandler 和 CallableStatementHandler 而言都是调用了 ParameterHandler#setParameters 方法,该方法在前面已经专门分析过,不再重复介绍。 ReuseExecutor ReuseExecutor 提供了对 Statement 对象重用的机制,以减少该对象创建和销毁,以及 SQL 预编译所带来的开销。ReuseExecutor 类中定义了一个 ReuseExecutor#statementMap 属性(如下),其中 key 为 SQL 语句,value 为对应的 Statement 对象,以此实现对 Statement 对象的复用。 /** 缓存 Statement 对象,key 为对应的 SQL 语句(带有 ? 占位符) */ private final Map<String, Statement> statementMap = new HashMap<String, Statement>(); ReuseExecutor 中的方法实现也基本上沿用了同一套思路,仍然以 ReuseExecutor#doQuery 为例进行说明,该方法实现如下: public <E> List<E> doQuery(MappedStatement ms, Object parameter, RowBounds rowBounds, ResultHandler resultHandler, BoundSql boundSql) throws SQLException { Configuration configuration = ms.getConfiguration(); // 创建对应的 StatementHandler 对象 StatementHandler handler = configuration.newStatementHandler(wrapper, ms, parameter, rowBounds, resultHandler, boundSql); // 先尝试从缓存中获取当前 SQL 对应的 Statement 对象,缓存不命中则创建一个新的并缓存 Statement stmt = this.prepareStatement(handler, ms.getStatementLog()); // 执行数据库查询操作,以及结果集映射 return handler.query(stmt, resultHandler); } 上述方法与 SimpleExecutor#doQuery 的区别在于在获取 Statement 对象时会先尝试从本地缓存中获取,如果缓存不命中则会创建一个新的 Statement 对象,并更新缓存,实现位于 ReuseExecutor#prepareStatement 方法中: private Statement prepareStatement(StatementHandler handler, Log statementLog) throws SQLException { Statement stmt; BoundSql boundSql = handler.getBoundSql(); String sql = boundSql.getSql(); // 获取缓存的 Statement 对象 if (this.hasStatementFor(sql)) { stmt = this.getStatement(sql); this.applyTransactionTimeout(stmt); } // 缓存不命中,新建一个 Statement 对象并缓存 else { Connection connection = this.getConnection(statementLog); stmt = handler.prepare(connection, transaction.getTimeout()); this.putStatement(sql, stmt); } // 绑定实参 handler.parameterize(stmt); return stmt; } BatchExecutor BatchExecutor 用于批量执行 SQL 语句。通常应用程序都是单行的执行 SQL 语句,但是某些场景下单行执行数据库操作是比较耗时的,比如需要远程执行数据库操作。因此,JDBC 针对 INSERT、UPDATE,以及 DELETE 操作提供了批量执行的支持。 BatchExecutor 是批量 SQL 语句执行器,其属性定义如下: /** 缓存多个 {@link Statement} 对象,每个对象都对应多条 SQL 语句 */ private final List<Statement> statementList = new ArrayList<>(); /** 记录批处理的结果,每个 {@link BatchResult} 对应一个 {@link Statement} 对象 */ private final List<BatchResult> batchResultList = new ArrayList<>(); /** 当前执行的 SQL 语句 */ private String currentSql; /** 当前操作的 {@link MappedStatement} 对象 */ private MappedStatement currentStatement; 下面探究一下 BatchExecutor 的批处理执行过程。首先来看一下 BatchExecutor#doUpdate 方法实现,该方法用于添加批处理 SQL 语句: public int doUpdate(MappedStatement ms, Object parameterObject) throws SQLException { final Configuration configuration = ms.getConfiguration(); // 基于参数创建对应的 StatementHandler 对象 final StatementHandler handler = configuration.newStatementHandler( this, ms, parameterObject, RowBounds.DEFAULT, null, null); final BoundSql boundSql = handler.getBoundSql(); final String sql = boundSql.getSql(); final Statement stmt; // 当前执行的 SQL 语句与前一次执行的 SQL 语句(不包含实参)相同,且对应的 MappedStatement 对象也相同 if (sql.equals(currentSql) && ms.equals(currentStatement)) { // 获取缓存的最后一个 Statement 对象,即前一次使用的 Statement 对象 int last = statementList.size() - 1; stmt = statementList.get(last); this.applyTransactionTimeout(stmt); // 绑定实参 handler.parameterize(stmt);//fix Issues 322 BatchResult batchResult = batchResultList.get(last); batchResult.addParameterObject(parameterObject); } // 当前执行的 SQL 语句与前一次执行的 SQL 语句不同 else { Connection connection = this.getConnection(ms.getStatementLog()); // 获取一个新的 Statement 对象 stmt = handler.prepare(connection, transaction.getTimeout()); // 绑定实参 handler.parameterize(stmt); //fix Issues 322 // 记录本次执行的 SQL 语句和 MappedStatement 对象 currentSql = sql; currentStatement = ms; // 缓存新建的 Statement 对象 statementList.add(stmt); batchResultList.add(new BatchResult(ms, sql, parameterObject)); } // 基于 Statement#addBatch 方法添加批量 SQL 语句 handler.batch(stmt); return BATCH_UPDATE_RETURN_VALUE; } 上述方法中会判断当前执行的 SQL 模式(包含 ? 占位符的 SQL 语句)是否与前一次执行的相同,如果相同就会获取上次执行的 Statement 对象,并为之绑定实参;否则就会创建一个新的 Statement 对象,并记录本次执行的 SQL 模式,最后基于底层的数据库批处理方法 Statement#addBatch 添加批量 SQL 语句。由上述方法我们可以知道,对于连续同模式的批处理 SQL 操作会共享同一个 Statement 对象。 那么这些添加的批量 SQL 又是如何被执行的呢?这个过程位于 BatchExecutor#doFlushStatements 方法中,方法如下: public List<BatchResult> doFlushStatements(boolean isRollback) throws SQLException { try { // 用于存储批量处理结果 List<BatchResult> results = new ArrayList<>(); if (isRollback) { return Collections.emptyList(); } // 遍历处理缓存的 Statement 集合 for (int i = 0, n = statementList.size(); i < n; i++) { Statement stmt = statementList.get(i); this.applyTransactionTimeout(stmt); BatchResult batchResult = batchResultList.get(i); try { // 批量执行当前 Statement 蕴含的多条 SQL 语句,并记录每条 SQL 语句影响的行数 batchResult.setUpdateCounts(stmt.executeBatch()); MappedStatement ms = batchResult.getMappedStatement(); List<Object> parameterObjects = batchResult.getParameterObjects(); KeyGenerator keyGenerator = ms.getKeyGenerator(); if (Jdbc3KeyGenerator.class.equals(keyGenerator.getClass())) { // 获取数据库生成的主键,并记录到 parameterObjects 中 Jdbc3KeyGenerator jdbc3KeyGenerator = (Jdbc3KeyGenerator) keyGenerator; jdbc3KeyGenerator.processBatch(ms, stmt, parameterObjects); } else if (!NoKeyGenerator.class.equals(keyGenerator.getClass())) { //issue #141 for (Object parameter : parameterObjects) { keyGenerator.processAfter(this, ms, stmt, parameter); } } // Close statement to close cursor #1109 this.closeStatement(stmt); } catch (BatchUpdateException e) { // ... 省略异常处理 } // 记录封装当前 Statement 对象执行结果的 batchResult 到集合中 results.add(batchResult); } return results; } finally { // 关闭所有的 Statement 对象 for (Statement stmt : statementList) { this.closeStatement(stmt); } currentSql = null; statementList.clear(); batchResultList.clear(); } } 方法会遍历我们在 BatchExecutor#doUpdate 中构造的 Statement 集合,分别执行集合中蕴含的 Statement 对象,并将执行的结果记录到 BatchResult 对象中(说明:在 BatchExecutor#doUpdate 方法中已经为每个 Statement 对象构造好了一个空的 BatchResult 对象,记录在 BatchExecutor#batchResultList 集合中),最后将 BatchResult 对象封装到集合中返回。因为都是数据库更新一类的操作,所以这里没有复杂的结果集映射,只需要记录每一条 SQL 语句执行所影响的行数即可。 CachingExecutor 由前面 Executor 的继承关系我们可以看到,CachingExecutor 相对于其它 Executor 实现来说似乎有其特别之处。CachingExecutor 直接实现了 Executor 接口,实际上它是一个 Executor 装饰器,用于为 Executor 提供二级缓存支持。该接口的属性定义如下: /** 装饰的 {@link Executor} 对象 */ private final Executor delegate; /** 用于管理当前使用的二级缓存对象 */ private final TransactionalCacheManager tcm = new TransactionalCacheManager(); 其中第一个属性就是 CachingExecutor 具体修饰的 Executor 对象。我们来看一下第二个属性,TransactionalCacheManager 用来管理当前 CachingExecutor 对应的二级缓存对象,它的方法实现都比较简单,其中相对让人疑惑的是它的唯一一个属性: /** key 为对应的 {@link CachingExecutor} 使用的二级缓存对象,value 为采用 {@link TransactionalCache} 装饰的二级缓存对象 */ private final Map<Cache, TransactionalCache> transactionalCaches = new HashMap<>(); 该属性的 key 就是当前对应的二级缓存,而 value 则是对于该二级缓存对象采用 TransactionalCache 装饰后的对象。所以 key 和 value 本质上都映射到同一个缓存对象,只是 value 采用了 TransactionalCache 进行增强。TransactionalCache 也是一个缓存装饰器,在前面介绍缓存装饰器实现时特意留着没有说明,这里一起来分析一下。该装饰器的属性定义如下: /** 被装饰的 {@link Cache} 对象(二级缓存) */ private final Cache delegate; /** 是否在提交事务时清空缓存 */ private boolean clearOnCommit; /** 用于缓存数据,当提交事务时会将其中的数据写入二级缓存 */ private final Map<Object, Object> entriesToAddOnCommit; /** 缓存未命中的 key */ private final Set<Object> entriesMissedInCache; 对应的读缓存和写缓存操作,以及事务提交方法实现比较简单,读者可以自行阅读源码。 继续回来看 CachingExecutor 的实现,所有实现方法中只有 CachingExecutor#query 方法稍微复杂一些,该方法的实现如下: public <E> List<E> query(MappedStatement ms, Object parameterObject, RowBounds rowBounds, ResultHandler resultHandler) throws SQLException { // 获取对应的 BoundSql 对象,并创建对应的 CacheKey BoundSql boundSql = ms.getBoundSql(parameterObject); CacheKey key = this.createCacheKey(ms, parameterObject, rowBounds, boundSql); // 调用重载的 query 方法 return this.query(ms, parameterObject, rowBounds, resultHandler, key, boundSql); } public <E> List<E> query(MappedStatement ms, Object parameterObject, RowBounds rowBounds, ResultHandler resultHandler, CacheKey key, BoundSql boundSql) throws SQLException { // 获取当前命名空间对应的二级缓存对象 Cache cache = ms.getCache(); // 判断是否启用了二级缓存 if (cache != null) { // 依据配置决定是否清空二级缓存 this.flushCacheIfRequired(ms); if (ms.isUseCache() && resultHandler == null) { // 确保不是存储过程输出类型的参数 this.ensureNoOutParams(ms, boundSql); // 查询二级缓存 @SuppressWarnings("unchecked") List<E> list = (List<E>) tcm.getObject(cache, key); if (list == null) { // 二级缓存不命中,执行一级缓存查询,再不命中就查询数据库 list = delegate.query(ms, parameterObject, rowBounds, resultHandler, key, boundSql); // 缓存到 TransactionalCache#entriesToAddOnCommit 中 tcm.putObject(cache, key, list); // issue #578 and #116 } return list; } } // 未启用二级缓存,则查询一级缓存,再不命中就查询数据库 return delegate.query(ms, parameterObject, rowBounds, resultHandler, key, boundSql); } 正如我们一开始对于 MyBatis 缓存结构设计描绘的那样,上述方法首先在二级缓存中进行检索,如果二级缓存不命中则会执行被装饰的 Executor 对象的 Executor#query 方法。由前面的分析我们知道,Executor 的实现都自带一级缓存特性,所以接下去会查询一级缓存。只有在一级缓存也不命中的情况下,请求才会落库,并由数据库返回的结果对象更新一级缓存和二级缓存。 那么这里使用的二级缓存对象是在哪里创建的呢?实际上前面我们就定义说二级缓存是应用级别的,所以当应用启动时二级缓存就已经被创建了,这个过程发生在对映射文件进行解析时。在映射文件中我们会按照需要配置一定的 <cache/> 和 <cache-ref> 标签,而在解析 <cache/> 标签时会调用 MapperBuilderAssistant#useNewCache 方法创建对应的二级缓存对象。 总结 本文对 MyBatis 执行 SQL 语句所涉及到的各个方面做了一个比较详细的分析。当我们基于 MyBatis 触发一次数据库操作时,首先需要开启一次数据库会话,然后获取目标 Mapper 接口,并调用相应的 Mapper 方法执行数据库操作,最后拿到操作结果。MyBatis 在这中间基于动态代理机制实现了 SQL 语句的检索、参数绑定、数据库操作,以及结果集映射等一系列操作,并引入了缓存机制优化数据库查询性能。 回过头来看,MyBatis 的整体设计还是非常巧妙的,却也很是直观且简单,是对动态代理机制的典型应用,其设计思想和对于设计模式的应用值得我们在实际开发中借鉴。 本文是 MyBatis 源码解析系列的最后一篇文章,由于时间仓促,再加上作者水平有限,整个系列的文章中不免有错误之处,还望批评指正! 参考 MyBatis 官方文档 MyBatis 技术内幕
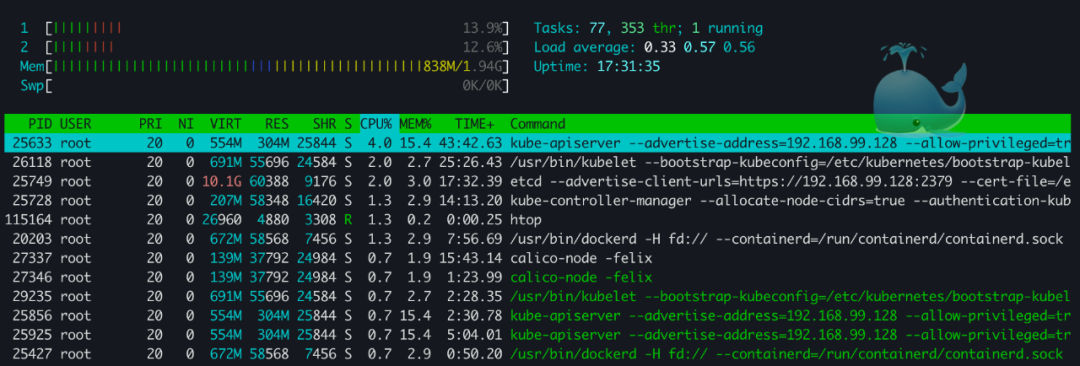
资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册