首页 文章 精选 留言 我的

精选列表

搜索[赛博朋克],共10000篇文章
优秀的个人博客,低调大师

每日一博 | Node.js 的 EventEmitter 事件处理详解

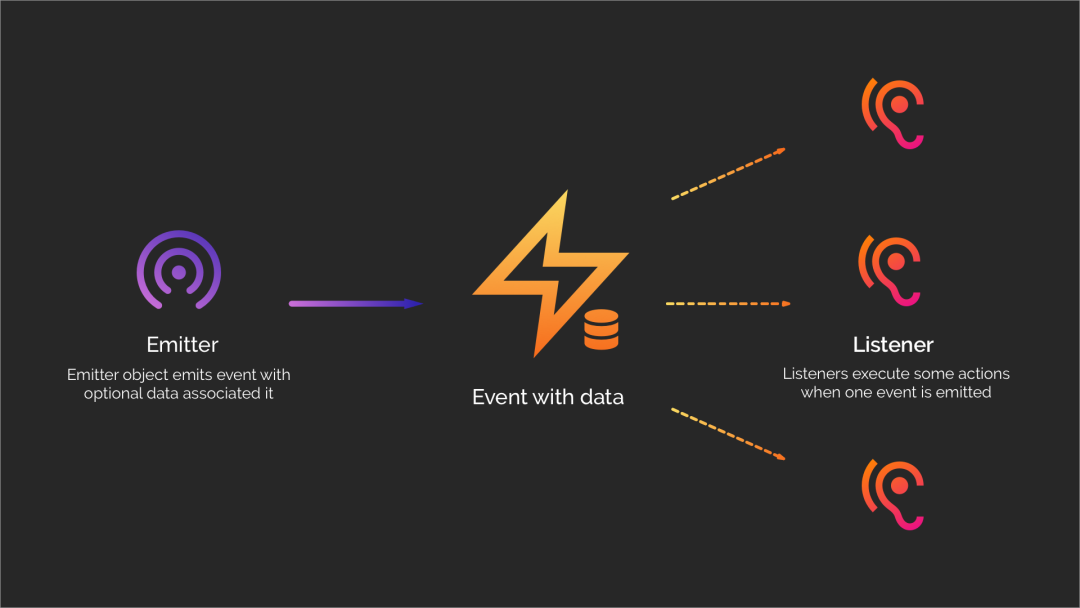
//每日前端夜话第417篇//正文共:3700字//预计阅读时间:10分钟 在本教程中我们学习 Node.js 的原生 EvenEmitter 类。学完后你将了解事件、怎样使用 EvenEmitter 以及如何在程序中利用事件。另外还会学习 EventEmitter 类从其他本地模块扩展的内容,并通过一些例子了解背后的原理。 本文涵盖了关于 EventEmitter 类的所有内容。 什么是事件? 当今事件驱动的体系结构非常普遍,事件驱动的程序可以产生、检测和响应各种事件。 Node.js 的核心部分是事件驱动的,有许多诸如文件系统(fs)和 stream 这样的模块本身都是用 EventEmitter 编写的。 在事件驱动的编程中,事件(event) 是一个或多个动作的结果,这可能是用户的操作或者传感器的定时输出等。 我们可以把事件驱动程序看作是发布-订阅模型,其中发布者触发事件,订阅者侦听事件并采取相应的措施。 例如,假设有一个服务器,用户可以向其上传图片。在事件驱动的编程中,诸如上传图片之类的动作将会发出一个事件,为了利用它,该事件还会有 1 到 n 个订阅者。 在触发上传事件后,订阅者可以通过向网站的管理员发电子邮件,让他们知道用户已上传照片并对此做出反应;另一个订阅者可能会收集有关操作的信息,并将其保存在数据库中。 这些事件通常是彼此独立的,尽管它们也可能是相互依赖的。 什么是EventEmitter? EventEmitter 类是 Node.js 的内置类,位于 events 模块。根据文档中的描述: ❝ 大部分的 Node.js 核心 API 都是基于惯用的异步事件驱动的体系结构所实现的,在该体系结构中,某些类型的对象(称为“发射器”)发出已命名事件,这些事件会导致调用 Function 对象(“监听器”)” ❞ 这个类在某种程度上可以描述为发布-订阅模型的辅助工具的实现,因为它可以用简单的方法帮助事件发送器(发布者)发布事件(消息)给监听器(订阅者)。 创建 EventEmitters 话虽如此,但还是先创建一个 EventEmitter 更加实在。可以通过创建类本身的实例或通过自定义类实现,然后再创建该类的实例来完成。 创建 EventEmitter 对象 先从一个简单的例子开始:创建一个 EventEmitter,它每秒发出一个含有程序运行时间信息的事件。 首先从 events 模块中导入 EventEmitter 类: const{EventEmitter}=require('events'); 然后创建一个 EventEmitter: consttimerEventEmitter=newEventEmitter(); 用这个对象发布事件非常容易: timerEventEmitter.emit("update"); 前面已经指定了事件名,并把它发布为事件。但是程序没有任何反应,因为还没有侦听器对这个事件做出反应。 先让这个事件每秒重复一次。用 setInterval() 方法创建一个计时器,每秒发布一次 update 事件: letcurrentTime=0;//每秒触发一次update事件setInterval(()=>{currentTime++;timerEventEmitter.emit('update',currentTime);},1000); EventEmitter 实例用来接受事件名称和参数。把 update 作为事件名, currentTime 作为自程序启动以来的时间进行传递。 通过 emit() 方法触发发射器,该方法用我们提供的信息推送事件。准备好事件发射器之后,为其订阅事件监听器: timerEventEmitter.on('update',(time)=>{console.log('从发布者收到的消息:');console.log(`程序已经运行了${time}秒`);}); 通过 on() 方法创建侦听器,并传递事件名称来指定希望将侦听器附加到哪个事件上。在 update 事件上,运行一个记录时间的方法。 on() 函数的第二个参数是一个回调,可以接受事件发出的附加数据。 运行代码将会输出: 从发布者收到的消息:程序已经运行了 1 秒从发布者收到的消息:程序已经运行了 2 秒从发布者收到的消息:程序已经运行了 3 秒... 如果只在事件首次触发时才需要执行某些操作,也可以用 once() 方法进行订阅: timerEventEmitter.once('update',(time)=>{console.log('从发布者收到的消息:');console.log(`程序已经运行了${time}秒`);}); 运行这段代码会输出: 从发布者收到的消息:程序已经运行了 1 秒 EventEmitter 与多个监听器 下面创建另一种事件发送器。这是一个计时程序,有三个侦听器。第一个监听器每秒更新一次时间,第二个监听器在计时即将结束时触发,最后一个在计时结束时触发: update:每秒触发一次 end:在倒数计时结束时触发 end-soon:在计时结束前 2 秒触发 先写一个创建这个事件发射器的函数: constcountDown=(countdownTime)=>{consteventEmitter=newEventEmitter();letcurrentTime=0;//每秒触发一次update事件consttimer=setInterval(()=>{currentTime++;eventEmitter.emit('update',currentTime);//检查计时是否已经结束if(currentTime===countdownTime){clearInterval(timer);eventEmitter.emit('end');}//检查计时是否会在2秒后结束if(currentTime===countdownTime-2){eventEmitter.emit('end-soon');}},1000);returneventEmitter;}; 这个函数启动了一个每秒钟发出一次 update 事件的事件。 第一个 if 用来检查计时是否已经结束并停止基于间隔的事件。如果已结束将会发布 end 事件。 如果计时没有结束,那么就检查计时是不是离结束还有 2 秒,如果是则发布 end-soon 事件。 向该事件发射器添加一些订阅者: constmyCountDown=countDown(5);myCountDown.on('update',(t)=>{console.log(`程序已经运行了${t}秒`);});myCountDown.on('end',()=>{console.log('计时结束');});myCountDown.on('end-soon',()=>{console.log('计时将在2秒后结束');}); 这段代码将会输出: 程序已经运行了 1 秒程序已经运行了 2 秒程序已经运行了 3 秒计时将在2秒后结束程序已经运行了 4 秒程序已经运行了 5 秒计时结束 扩展 EventEmitter 接下来通过扩展 EventEmitter 类来实现相同的功能。首先创建一个处理事件的 CountDown 类: const{EventEmitter}=require('events');classCountDownextendsEventEmitter{constructor(countdownTime){super();this.countdownTime=countdownTime;this.currentTime=0;}startTimer(){consttimer=setInterval(()=>{this.currentTime++;this.emit('update',this.currentTime);//检查计时是否已经结束if(this.currentTime===this.countdownTime){clearInterval(timer);this.emit('end');}//检查计时是否会在2秒后结束if(this.currentTime===this.countdownTime-2){this.emit('end-soon');}},1000);}} 可以在类的内部直接使用 this.emit()。另外 startTimer() 函数用于控制计时开始的时间。否则它将在创建对象后立即开始计时。 创建一个 CountDown 的新对象并订阅它: constmyCountDown=newCountDown(5);myCountDown.on('update',(t)=>{console.log(`计时开始了${t}秒`);});myCountDown.on('end',()=>{console.log('计时结束');});myCountDown.on('end-soon',()=>{console.log('计时将在2秒后结束');});myCountDown.startTimer(); 运行程序会输出: 程序已经运行了 1 秒程序已经运行了 2 秒程序已经运行了 3 秒计时将在2秒后结束程序已经运行了 4 秒程序已经运行了 5 秒计时结束 on() 函数的别名是 addListener()。看一下 end-soon 事件监听器: myCountDown.on('end-soon',()=>{console.log('计时将在2秒后结束');}); 也可以用 addListener() 来完成相同的操作,例如: myCountDown.addListener('end-soon',()=>{console.log('计时将在2秒后结束');}); EventEmitter 的主要函数 eventNames() 此函数将以数组形式返回所有活动的侦听器名称: constmyCountDown=newCountDown(5);myCountDown.on('update',(t)=>{console.log(`程序已经运行了${t}秒`);});myCountDown.on('end',()=>{console.log('计时结束');});myCountDown.on('end-soon',()=>{console.log('计时将在2秒后结束');});console.log(myCountDown.eventNames()); 运行这段代码会输出: ['update','end','end-soon'] 如果要订阅另一个事件,例如 myCount.on('some-event', ...),则新事件也会添加到数组中。 这个方法不会返回已发布的事件,而是返回订阅的事件的列表。 removeListener() 这个函数可以从 EventEmitter 中删除已订阅的监听器: const{EventEmitter}=require('events');constemitter=newEventEmitter();constf1=()=>{console.log('f1被触发');}constf2=()=>{console.log('f2被触发');}emitter.on('some-event',f1);emitter.on('some-event',f2);emitter.emit('some-event');emitter.removeListener('some-event',f1);emitter.emit('some-event'); 在第一个事件触发后,由于 f1 和 f2 都处于活动状态,这两个函数都将被执行。之后从 EventEmitter 中删除了 f1。当再次发出事件时,将会只执行 f2: f1 被触发f2 被触发f2 被触发 An alias for removeListener() is off(). For example, we could have written: removeListener() 的别名是 off()。例如可以这样写: emitter.off('some-event',f1); removeAllListeners() 该函数用于从 EventEmitter 的所有事件中删除所有侦听器: const{EventEmitter}=require('events');constemitter=newEventEmitter();constf1=()=>{console.log('f1被触发');}constf2=()=>{console.log('f2被触发');}emitter.on('some-event',f1);emitter.on('some-event',f2);emitter.emit('some-event');emitter.removeAllListeners();emitter.emit('some-event'); 第一个 emit() 会同时触发 f1 和 f2,因为它们当时正处于活动状态。删除它们后,emit() 函数将发出事件,但没有侦听器对此作出响应: f1被触发f2被触发 错误处理 如果要在 EventEmitter 发出错误,必须用 error 事件名来完成。这是 Node.js 中所有 EventEmitter 对象的标准配置。这个事件必须还要有一个 Error 对象。例如可以像这样发出错误事件: myEventEmitter.emit('error',newError('出现了一些错误')); error 事件的侦听器都应该有一个带有一个参数的回调,用来捕获 Error 对象并处理。如果 EventEmitter 发出了 error 事件,但是没有订阅者订阅 error 事件,那么 Node.js 程序将会抛出这个 Error。这会导致 Node.js 进程停止运行并退出程序,同时在控制台中显示这个错误的跟踪栈。 例如在 CountDown 类中,countdownTime参数的值不能小于 2,否则会无法触发 end-soon 事件。在这种情况下应该发出一个 error 事件: classCountDownextendsEventEmitter{constructor(countdownTime){super();if(countdownTimer<2){this.emit('error',newError('countdownTimer的值不能小于2'));}this.countdownTime=countdownTime;this.currentTime=0;}//...........} 处理这个错误的方式与其他事件相同: myCountDown.on('error',(err)=>{console.error('发生错误:',err);}); 始终对 error 事件进行监听是一种很专业的做法。 使用 EventEmitter 的原生模块 Node.js 中许多原生模块扩展了EventEmitter 类,因此它们本身就是事件发射器。 一个典型的例子是 Stream 类。官方文档指出: ❝ 流可以是可读的、可写的,或两者均可。所有流都是 EventEmitter 的实例。 ❞ 先看一下经典的 Stream 用法: constfs=require('fs');constwriter=fs.createWriteStream('example.txt');for(leti=0;i<100;i++){writer.write(`hello,#${i}!\n`);}writer.on('finish',()=>{console.log('Allwritesarenowcomplete.');});writer.end('Thisistheend\n'); 但是,在写操作和 writer.end() 调用之间,我们添加了一个侦听器。Stream 在完成后会发出一个 finished 事件。在发生错误时会发出 error 事件,把读取流通过管道传输到写入流时会发出 pipe 事件,从写入流中取消管道传输时,会发出 unpipe 事件。 另一个类是 child_process 类及其 spawn() 方法: const{spawn}=require('child_process');constls=spawn('ls',['-lh','/usr']);ls.stdout.on('data',(data)=>{console.log(`stdout:${data}`);});ls.stderr.on('data',(data)=>{console.error(`stderr:${data}`);});ls.on('close',(code)=>{console.log(`childprocessexitedwithcode${code}`);}); 当 child_process 写入标准输出管道时,将会触发 stdout 的 data 事件。当输出流遇到错误时,将从 stderr 管道发送 data 事件。 最后,在进程退出后,将会触发 close 事件。 总结 事件驱动的体系结构使我们能够创建高内聚低耦合的系统。事件表示某个动作的结果,可以定义 1个或多个侦听器并对其做出反应。 本文深入探讨了 EventEmitter 类及其功能。对其进行实例化后直接使用,并将其行为扩展到了一个自定义对象中。最后介绍了该类的一些重要函数。 精彩文章回顾,点击直达 转了吗 赞了吗 在看吗 本文分享自微信公众号 - 前端先锋(jingchengyideng)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | 社群编码识别黑灰产攻击实践

导读:所谓黑灰产,包含网络黑产、灰产两条产业链,随着互联网的飞速发展,网络黑灰产也在不断演变,当前网络黑灰产已经趋于平台化、专业化、精细化运作。基于黑灰产攻击特点,我们提出了一种基于社群编码的黑灰产攻击识别方法,社群发现部分基于图关系,编码部分引入大规模的图嵌入表示学习。相比于传统的图谱关系挖掘,可以更好的识别和度量未知攻击。而且我们还提出了基于异步准实时的工程化实现,对频繁变化的黑灰产攻击有更强的应变灵活性。 全文4424字,预计阅读时间12分钟。 一、背景 所谓黑灰产,包含网络黑产、灰色两条产业链,随着互联网的飞速发展,网络黑灰产也在不断发展,当前网络黑灰产已经形成了一个平台化、专业化、精细化,相互独立又紧密协作的产业链。从近几年多起重大网络安全事故看,黑灰产已经不再局限在半公开化的纯攻击模式,而是转化成为敛财工具和商业竞争的不良手段,据不完全统计,当前网络黑灰产的市场规模已经超过千亿元人民币,在这千亿级的市场规模下,发展出了非常多的细分领域,如木马病毒,养号刷单,薅羊毛,电信诈骗,知识盗版,流量劫持等。 各互联网平台为了防止被网络黑灰产攻击,开发了很多防御及识别技术,最常被广大用户感知到的验证码技术就是其中之一,在验证码技术背后,还有非常多的识别方法,例如通过规则引擎依据防攻击规则进行分析拦截,通过行为序列建模对单次请求进行黑灰产行为判定,通过图谱关系挖掘用户之间的相关性以识别黑灰产团伙,基于层次聚类、均值聚类、高斯混合等聚类模型对黑灰产攻击进行无监督识别,这些方法均能在不同程度上对黑灰产起到识别和防御作用。 基于以上黑灰产攻击特点,我们提出了一种基于社群编码的黑灰产攻击识别方法,社群发现部分基于图关系,编码部分引入了大规模的图嵌入表示学习方法,相比于已有的图谱关系挖掘,可以更好的识别和度量未知攻击,而且我们也提出了基于异步准实时的工程化算法实现,对频繁变化的黑灰产攻击有更强的应变灵活性。 二、社群结构 基于社群编码的黑灰产攻击识别方法,在原有图谱挖掘的基础上,引入了大规模的图嵌入表示学习技术,除了能挖掘出黑灰产本身的关联关系,还能识别出潜在的黑灰产网络结构,让识别过程更加准确稳定。 该方法基于的关联图有两种,分别是同构图和异构图,这也是黑灰产挖掘过程中经常会遇到的关联图结构。同构图表示网络图中所有节点的类型都相同,如对于一个账号关联而言,网络图中的节点有都是用户的账号ID。异构图则表示网络图中所有节点的类型可能是不同的,如在账号关联网络中,网络图中的节点除了账号ID外,可能还有IP地址,设备号,手机号等其他类型的节点。 下图表示了同构和异构的两种示意图,同构图表示所有账号ID组成的网络结构,异构图表示由账号ID、设备ID、手机号和IP地址组成的网络结构。 对于图结构网络,除了边关系,节点自身也会很多固有属性,如对于一个账号ID的UGC场景,会有不同的活跃时间,不同的业务场景(如浏览图文,浏览视频,发表图文等),不同的操作类型(如发文、评论,点赞,转发等)。这类节点自身属性如下图中表格所示。 为了便于说明一般情况,后文说明中默认全是异构图结构,因为同构图作为异构图的一种特殊情况,即使是实际推广中是同构图,也不影响使用异构图的方法进行分析。实际场景中图网络关系如下图例所示。 为了识别出关联结构图中的社群,目前已经有比较多的识别方法,常用的有基于节点的统计特征,基于节点出入度的分布变化,基于关联边的自定义权重,人工标注等方法,此类方法能识别很多关联社群,但是由于图谱关联中难以定义边的权重,会存在较多误召,所以我们在实践中基于已有社群挖掘结果进行编码以提升黑灰产识别效果,同时嵌入式图编码还可以基于节点的邻居关系进行相似性的无监督学习。 三、图嵌入式编码 图嵌入式编码是一种将节点编码成向量的node2vec方法,我们采用的图嵌入式编码方法为斯坦福大学William L. Hamilton、Rex Ying和Jure Leskovec等人在2016年提出的GraphSAGE,与node2vec相比较而言,node2vec是在图的节点级别上进行嵌入,GraphSAGE则是在整个图的级别上进行嵌入。GraphSAGE同时利用节点特征信息和结构信息得到Graph Embedding的映射,相比之前保存映射结果的方法,GraphSAGE保存了生成embedding的映射,可扩展性更强,对于节点分类和链接预测问题的表现也更加突出。 GraphSAGE算法流程包含三个步骤: (1)对图中每个节点邻居节点进行采样,因为每个节点的度是不一致的,所以为了计算高效,为每个节点采样固定数量的邻居。 (2)根据聚合函数聚合邻居顶点蕴含的信息。 (3)得到图中各顶点的向量表示供下游任务使用。 下图为该算法作者在论文中提供的采样和聚合示意图。 使用下图所示的方法进行节点采样。每一层的node由上一层生成,与本层无关,如此,1层的账号ID 1已经聚合了0层设备ID 1和手机号2的信息,在二层,手机号2再聚合IP地址1的信息,经过两层采样,就可以扩展到账号ID 1的2阶邻居包含设备ID 1、手机号1、设备ID 2、手机号2、账号ID 2和IP地址1的所有信息。 采样过程中固定采样层数(本实践使用2层)和每层采样点的节点数(如邻居节点数上限为200个),可以控制每次采样过程对内存的消耗和运算耗时,该方法适用于大规模数据集,对大数据集下的黑灰产社群挖掘非常有效。 我们采用的聚合函数为均值聚合,直接对目标节点和所有邻居emebdding中每个维度取平均,后再非线性转换,原论文中相应函数表达式如下: 其主要思想是将目标顶点和邻居顶点的第k−1层向量进行拼接,然后对向量的每个维度进行求均值的操作,将得到的结果做一次非线性变换产生目标顶点的第k层表示向量。不同的聚合函数计算方法不同,除均值聚合函数外,还有池化聚合器、LSTM聚合器等可选,经过测试,对于黑灰产社群挖掘而言,不同的聚合函数差异并不明显。 如此,经过以上对黑灰产社群的采样与邻居聚合,可以得到每一个节点在网络图上的向量表示。如上面采用图示中账号ID 1的向量就包含了设备ID 1、手机号1、设备ID 2、手机号2、账号ID 2和IP地址1的网络结构信息,同时包含了这些ID在不同时间点、不同业务场景、不同操作类型上的行为特征。 四、模型训练 基于上面的采样和聚合函数,开始进行参数学习,GraphSAGE不同的损失函数代表了不同的参数学习方法,如下所示损失函数就是一种无监督的损失,倾向于使得相邻的顶点有相似的表示,相互远离的顶点的表示差异变大。 上式表示节点 u 和随机游走到的邻居节点 v 有相似的embedding表示,而与经过负采样得到的不相邻节点 vn 有不相似的embedding表示。 对于无监督损失学习到的节点embedding,可继续供下游任务使用,本实践就是采用的该方法。当然,对于特定分类任务,也可以使用特定的损失函数,如使用交叉熵进行分类预测。 我们通过节点的统计特征,人工标注确定了正负样本,使用节点的编码向量作为特征进行分类模型训练,下图所示即为部分数据的挖掘结果可视化。 直观而言,对于社群团伙的挖掘还是比较合理的,总体分为三类,红色为一社群,黄色为一社群,其余(绿色)自动归为一类。 五、工程化实现 为了在实际应用中发挥编码的价值,我们提出了一种异步准实时的黑灰产识别方案。下图表示了这种识别方案的流程结构。 一个用户开始请求客户端,可以采集到用户的关键因子信息,如账号ID、IP地址、设备号、手机号等,将这部分日志信息写入暂存区,暂存区存储着所有在过去10分钟(也可以是其他某个时间段,一般而言,日志量越大,暂存区时间越短,反之越长)内请求过该客户端的用户的关键因子信息。 超过10分钟的关键信息则存入离线的分区日志库,基于分区日志库进行图谱构建,黑灰产社群挖掘,社群编码,以及使用向量表示训练分类模型,分类模型可以不用实时训练,定期使用过去一段时间的分区日志训练即可。 对于还在暂存区的关键因子,会对请求的用户进行实时图谱构建,以该用户为中心进行节点采样并做向量表示,使用已经训练好的分类模型对该用户的表示向量进行黑灰产预测,如果预测为正常用户,则允许用户在客户端上的操作,如果预测该用户为黑灰产用户,则拒绝该用户进行客户端操作。 下图是训练部分较详细的过程: 下图是预测部分的较详细过程: 六、创新点 本实践提出的一种基于社群编码的黑灰产攻击识别方法,主要创新技术点包括: 基于社群编码对黑灰产进行有监督识别的方法,相比于既有图谱挖掘算法,该方法不直接依赖于单个节点属性,而是将整个社群的关联结构编码到一个表示向量中,对黑灰产的表示更加准确,而且对于历史上未出现的黑灰产账号,也能通过网络结构之间的相似性,通过向量表示进行识别。同时可以有效避免因为噪声关系(如黑灰产账号连接了商场wifi)导致的错误识别。 由于图编码结果本身就具备邻居之间的强相似性,非邻居之间的弱相似性。故使用编码后的向量进行无监督学习(如密度聚类和层次聚类),也可以识别出部分黑灰产在IP、账号ID、手机号及设备号之间的内在关系,挖掘出相似黑灰产组成的聚类簇。 使用暂存区将大规模的图嵌入表示学习方法与小数据集的异步预测结合在一起,并使用编码后的有监督模型进行快速预测,为实际工程化应用提供了参考方法。 七、部分实践效果 搭建的因子编码模型包含有ip(IP地址)、cookie_id(cookie信息)、device_id(设备ID)、userid(用户ID)、mobile(手机号)等共计5个关键因子,编码的特征包含 scence(业务场景), page(页面), risk(风险程度)等信息(编码特征需依据具体场景而定)。 按10分钟为一个暂存区窗口,获取因子数量百万量级,编码的关系数量近千万,编码的向量长度300左右。经过人工校验,对embding结果使用有监督方式例行化产出ip维度的风险,使用其他策略交叉校验,该策略准确率能达到95%左右。无监督模型实践中效果较差,没有实际使用。 八、发展与思考 基于以上实践发现,社群编码方法在黑灰产识别中具有较好的正向效果,但在实际生产过程中,仍然面临一些问题,以下作简要探讨。 计算问题:图计算非常消耗计算资源,而且完整过程中需要短时间进行大量预测,当前结合mini batch训练预测,在独立的GPU环境中,完整计算一个日志分区约需要半小时。 关键因子和编码特征的选择问题:图算法的结果非常依赖于图结构和特征属性,这为前期的因子选择和特征工程带来巨大挑战。 识别过程的自动化问题:GraphSAGE算法本身具备无监督识别的能力,但黑灰产识别过程中发现这非常容易受到中心节点的影响(这可以通过权重优化得到一定程度解决),故当前仍然需要提前做部分社群定义,而该过程需要人工或其他建模方法介入,难以实现完全自动化。 招聘信息: 百度移动生态事业部MEG,用户中心招聘研发岗位(PHP/GO/C++)。我们主要负责公司Passport、用户资产、属性、百度APP会员等核心业务方向,致力于打造高效、便捷、安全的用户体系。如果你对Passport、百万级QPS服务、分布式设计&治理感兴趣欢迎加入我们。 关注同名公众号百度Geek说,输入内推即可,我们期待你的加入! 推荐阅读: |百度C++工程师的那些极限优化(并发篇) |百度C++工程师的那些极限优化(内存篇) |百度大规模Service Mesh落地实践 |一种基于实时分位数计算的系统及方法 ---------- END ---------- 百度Geek说 百度官方技术公众号上线啦! 技术干货 · 行业资讯 · 线上沙龙 · 行业大会 招聘信息 · 内推信息 · 技术书籍 · 百度周边 欢迎各位同学关注

优秀的个人博客,低调大师

每日一博 | 深入浅出聊聊 Rust WebAssembly(一)

什么是 webassembly 在 2019 年 12 月之前,如果你要编写一个web页面,那一定离不开 html、css、js 这三个好兄弟。在 2019 年 12 月之后 W3C 宣布 webassembly 加入了他们。为什么要在三兄弟后加入 webassembly ?它和之前的有什么区别么?以 js 为对比,我们具体看一下它们的区别。 wasm 与 js 的区别 js 是一种解释型语言,它代码运行之前不会进行编译工作,而是在执行的过程中实时编译。为了让边编译边执行能够顺利进行,我们拥有了 js 引擎。 wasm 则与之不同,它本身不是一种编程语言,而是一种字节码的标准,可以通过不同种类的高级编程语言,比如 Rust、Go、Python 等等,通过各自编译器将代码转换成 .wasm 文件,放入到浏览器预先做好的 wasm 虚拟机当中运行。 同时这种与 js 不同,可以预先运行的特色,也给 wasm 带来了一些优势: 拥有一套完成的语义: wasm 这套体积小且加载快的二进制格式的完整语义,可以让硬件充分发挥能力以达到原生的执行效率。 编译和优化时间所需时间较少: 相比 js 作为一个动态类型需要多次编译代码,wasm 让文件在推送到服务器前就进行了众多优化,能够有效减少编译和优化时间。 执行速度更快: wasm 是二进制文件,它的指令更接近机器码,执行起来的速度相比 js 更快。 垃圾回收效率更高: wasm 目前并不支持自动垃圾回收,垃圾回收都是手动控制的,比自动垃圾回收效率更高。 当然如果只是这么说,我们并不能很直观的感受出这些优势究竟有多大,刚好目前浏览器已经支持了以 wasm 规范的虚拟机。 接下来,我们通过一个 Chrome 与 Safari 的实例测试,来感受一下。 wasm与js执行速度比较 首先我们用原生的 js 写一段 fib 代码测试时间,代码内容如下: <!DOCTYPE html> <html lang="en"> <head> <meta charset="UTF-8"> <meta name="viewport" content="width=device-width, initial-scale=1.0"> <title>Document</title> </head> <body> <script> function fibonacci(n) { if (n == 0 || n == 1) return n; return fibonacci(n - 1) + fibonacci(n - 2); } function fibonacciTime() { console.time("js") fibonacci(40) console.timeEnd("js") } fibonacciTime() </script> </body> </html> 用 live-server 测试时间,用时 1275 毫秒到 1329 毫秒。 然后我们用 Rust 转义成 wasm 再次测试。特别需要注意的是,测试用到的算法都是最普通的递归迭代,在实际使用中我们还可以使用动态规划来再次优化。 言归正传,然后我们用 rust-wasm 编译器将用 rust 写好的 fib 代码转换成 wasm 文件。 下载 wasm 编译器: curl https://rustwasm.github.io/wasm-pack/installer/init.sh -sSf | sh 配置 Cargo.toml: [package] name = "wasm" version = "0.2.0" authors = ["hzjsea"] edition = "2018" # See more keys and their definitions at https://doc.rust-lang.org/cargo/reference/manifest.html [lib] crate-type = ["cdylib"] path = "src/main.rs" [dependencies] wasm-bindgen = "0.2.48" chrono = "0.4.19" main.rs: use chrono::Utc; use wasm_bindgen::prelude::*; use std::time::Instant; #[wasm_bindgen] pub fn fib(n: i32) -> i32 { match n { 0 => 1, 1 => 1, _ => fib(n - 1) + fib(n - 2), } } pub fn main(){ let result = fib(40); println!("{:?}", result); } 挂载wasm文件,即类似 vue,使用 index.html 把 wasm.js 文件挂载起来: <script type="module"> main() async function main() { const wasm = await import('/pkg/wasm.js') await wasm.default('/pkg/wasm_bg.wasm') console.time("rust") console.log(wasm.fib(40)) console.timeEnd("rust") } function fibonacci(n) { if(n==0 || n == 1) return n; return fibonacci(n-1) + fibonacci(n-2); } function fibonacciTime(){ console.time("js") fibonacci(40) console.timeEnd("js") } fibonacciTime() </script> 之后用编译器编译 Rust 代码生成 .wasm 文件: wasm-pack build --target web --no-typescript --mode normal 然后我们可以明显看到,在相同的 live-server 测试下时间相差一倍左右。 因为此次编译指定不生成 wasm 的 ts 版本。所有只有上面的几个文件,其中: package.json { "name": "wasm", "collaborators": [ "hzjsea" ], "version": "0.2.0", "files": [ "wasm_bg.wasm", "wasm.js" ], "module": "wasm.js", "sideEffects": false } 指定打包的各类属性 wasm_bg.wasm wasm.js转义后的二进制文件 wasm.js 由rust代码转移过来的wasm.js文件。 wasm 的组件库 看完了实例测试,我们不能略过测试中提到的 Rust。Rust 中有个类似于 react 的框架,叫做Yew。关于 Yew 官方[https://github.com/yewstack/yew]描述如下: Yew is a modern Rust framework for creating multi-threaded front-end web apps with WebAssembly. Features a macro for declaring interactive HTML with Rust expressions. Developers who have experience using JSX in React should feel quite at home when using Yew. Achieves high performance by minimizing DOM API calls for each page render and by making it easy to offload processing to background web workers. Supports JavaScript interoperability, allowing developers to leverage NPM packages and integrate with existing JavaScript applications. 计时器 大致看完了 Rust,如果你还想看更多的 WebAssembly 流程,官方提供的一个计时器的练手项目可以满足你的需求 项目地址 https://yew.rs/docs/zh-CN/getting-started/build-a-sample-app 主要可以看下 lib.rs 这个文件 总结与思考 虽然 webassembly 作为一种新的 web 技术常常被提起,但是因为其工具链的调试困难,包体积过大等等问题还在解决的过程中,同时也表明了 wasm 并不可能在短时间内直接代替 js,他们之间更多的是一种互补合作的关系。但不可否认的是,适合 webassembly 场景的项目会在未来的一段时间内不断的出现,大家可以多多了解一下。 推荐阅读 Flink 在又拍云日志批处理中的实践 用户 IP,里面藏了多少秘密?

优秀的个人博客,低调大师

每日一博 | 应该在 JavaScript 中使用 Class 吗?

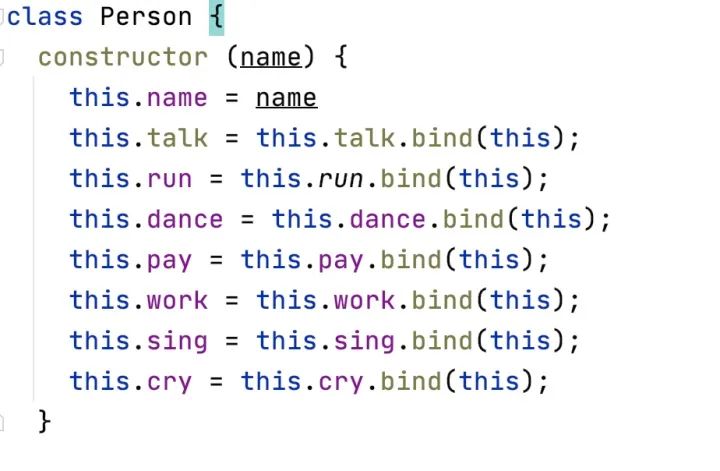
来源:FreewheelLee https://zhuanlan.zhihu.com/p/158956514 看似无处不在的OOP OOP 即 面向对象编程 (Object Oriented Programming)毫无疑问是软件设计和发展中的一大进步。事实上,一些编程语言如 Java 、C++ 就是基于 OOP 的核心概念 class 开发出来。 在高校的 CS 相关专业中,无论教授什么编程语言,OOP的学习是绝对不会被落下的。 同时,OOP在业界中也的确被大量使用,尤其是的后端服务领域、桌面软件、移动APP开发等。 因此,OOP看起来在软件行业无处不在,在这种有点教条主义的氛围下,很多程序员甚至以为 class 是编程固有的概念 —— 然而并不是。 OOP 只是一套帮助开发者设计和编写软件的方法论,但并不代表它能解决所有领域的问题,也不是能在所有编程语言的任何场景下都适用。我们应避免陷入这种教条主义。 JavaScript中使用Class的坑 ES6 之后,JavaScript 也引入了 class 关键字用于声明一个类。但需要注意的是,这样声明出来的类其实在底层还是使用了 JavaScript 的函数 和 原型链 (来模拟类的行为) 看个例子: class Person { constructor (name) { this.name = name } talk () { console.log(`${this.name} says hello`) }} 上面的代码在底层实现时,非常接近于 function Person (name) { this.name = name}Person.prototype.talk = function () { console.log(`${this.name} says hello`)} 这边可以注意到 talk 其实并不是一个Person类内部封装的方法,而只是一个常规的JavaScript函数,赋值到了Person的原型上而已。因此,talk 函数里的 this 对应的是调用时的上下文而不是定义时的上下文,这点跟 Java 和 C++ 的差别很大。 这种差异最明显的影响是在别的对象试图调用这个对象的talk时 const Grey = new Person('Grey')const mockDomButton = {} // 模拟一个DOM上的按钮对象mockDomButton.onClick = Grey.talk; // 绑定点击事件mockDomButton.onClick() // 输出的结果是 undefined says hello 上面这段模拟代码输出的结果并不是我们想要的。原因是 onClick 被调用时,其实是 talk 函数在执行,且talk 函数的this 指向的是 mockDomButton 而不是 Grey ,mockDomButton 并没有 name 属性于是 输出了 undefined says hello 这种“特殊”的表现让很多 JavaScript 新手感到头疼,尤其是那些从 Java 或者 C++ 背景过来的新手前端程序员。 解决这个问题的办法当然是有的,先介绍两个仍然使用 class 的方案 方案一: 使用函数的 bind 方法 **bind()**方法创建一个新的函数,在bind()被调用时,这个新函数的this被指定为bind()的第一个参数 修改 Person.js 文件如下 class Person { constructor (name) { this.name = name this.talk = this.talk.bind(this); // 在构造器里显式调用 bind 函数绑定 this } talk () { console.log(`${this.name} says hello`) }} 再次运行上面的测试代码,这次的输出就是正确的了 —— Grey says hello 这种方案的缺点就是需要繁琐地写这种 bind 方法调用语句,当这个类的方法很多时,会显得构造器非常臃肿,降低可读性和编码效率如 方案二: 使用类属性+箭头函数的方式来定义方法 即 class Person { constructor(name) { this.name = name } talk = () => { console.log(`${this.name} says hello`) }} 这种语法是 ES2017 才引入的,它等效于 class Person { constructor(name) { this.name = name this.talk = () => { console.log(`${this.name} says hello`) } }} 运行测试代码,依然能成功输出 Grey says hello 但是,这种方案也有缺点 —— 由于它等效于函数定义放在了构造器内,所以 一、这个方法不在原型链上,即 Person.prototype.talk 的值是undefined ,所以这个类的子类并不能使用 super.talk() 调用到父类这个方法,所以下面这段代码会报错 class Student extends Person { talk = () => { super.talk(); // 报错 console.log("student talk hi"); }}const student = new Student('Tom');student.talk(); 二、每次创建一个 Person 实例都会创建一个 talk 函数,造成性能浪费 (仅仅是用来与方案一对比) const Grey = new Person('Grey')const Tom = new Person('Tom')console.log(Grey.talk === Tom.talk); // 输出 false 在 JavaScript 中使用类居然有上面这么多坑,那何不试试其他方案? 首先,我们回到源头想想什么是类,我们想利用类达到什么目的: 大多数时候,我们定义的类 其实是 创建对象的蓝图(模板) —— 我们先规划好一个类的模样,之后通过 new 的方式创建出许许多多的对象,每个对象都符合我们想要的格式(即属性,方法) 在 JavaScript 中,我们还有其他方案可以达到这个目的 工厂函数(factory functions) const PersonFactory = (name) => { return { talk: () => { console.log(`${name} says Hello`) } }} PersonFactory 是个简单的工厂函数,它返回一个对象,这个对象拥有一个 talk 方法 (p.s. 我更新了一下代码,看起来可读性更高一点,想看原版代码的可以查看历史记录) const Grey = PersonFactory('Grey'); // 使用工厂函数生成对象const mockDomButton = {} // 模拟一个DOM上的按钮对象mockDomButton.onClick = Grey.talk; // 绑定点击事件mockDomButton.onClick() // 输出的结果是 Grey says Hello 由于JavaScript的闭包特性,name已经被封装在了函数里,所以上面的测试代码可以正常运作。而且更赞的是,这个方案中,name甚至自动成为了私有的变量,不怕被更改(上面的那些 class 方案里 name 都可以被公共访问的) 而且相比之下,工厂函数的代码更简洁易读,也不需要考虑 this 的繁琐问题。 因此,如果只是为了给对象创建绘制蓝图(模板),工厂函数是比类更合适的方案。 继承 类的另一个特征是继承机制,子类可以继承(分享)来自父类的属性和方法。 如果仅仅是共享属性和方法,使用组合(composition)也可以很容易实现 const Workable = { inOffice: true}const WorkablePersonFactory = (name) => ( Object.assign( {}, Workable, PersonFactory(name) ))// 或者const WorkablePersonFactory = (name) => ( { ... Workable, ...PersonFactory(name), }) 上面的代码意图十分明显,可读性很高,这也是组合模式的一个优点。 当然,对于某些更复杂的类使用场景,工厂函数并不能替代类。 关注代码表达性而不是死守教条主义 在 JavaScript 的现实场景中,尤其是前端代码,我们很少真正用到类继承,大多数时候,工厂函数就能完成我们的目标。 以React为例,官方这几年推崇 Hooks 的意图也很明显 —— 摆脱JavaScript class 带来的复杂性,拥抱函数式风格。 由于 JavaScript 实现的特殊性,在 JavaScript 应用中使用 class 对于一些程序员来说有许多坑,于此同时,大多数场景下其他替代方案如 工厂函数 可能更契合JavaScript的特性,反而带来更好的效果。 当然,并不是一杆子打死 JavaScript 的 class,在一些特别适合 OOP 的场景中,依然鼓励使用 class 。 总之,不要被教条主义所束缚,牢记编写程序最重要的两点是: 真正将需求转化成了代码 写出可读的,容易维护的,方便理解的代码 个人体验 在我的工作负责的几个项目中,其中一个Nodejs项目,我发现了大量的不必要的 class ,在constructor中充斥着大量的 bind 语句,而且这些 class 的方法之间并没有太多关系,很多class也没有内部状态;更像是为了声明这些函数是属于同一个模块而已 —— 也就是说根本不必要以 class 的形式组织代码。 于是,在日常任务完成之余,我就花了点时间,把这些class方法全部重构成普通的 function,再利用 ES6 module 的形式重新组织这些代码。现在这些代码干净、清晰了很多。 (关于 Nodejs 的 module 以及如何在 Nodejs 中使用 ES6 module,欢迎阅读我的另一篇文章 ) FreewheelLee:[搬运] JavaScript 模块化:CommonJS vs AMD vs ES6: <https://zhuanlan.zhihu.com/p/158683510> 补充: 本文的讨论的场景主要是基于业务开发的上下文,不包括底层库、工具库开发等场景。 1. bind 以外的其他方案 感谢 @贺师俊 大佬的提醒 class fields或者autobind decorator都有很多问题,而且这两者还不是最终标准,建议不要用 读者们可以参考 2. 关于 工厂函数 的举例 首先这个例子主要是针对这种场景 ——在 JavaScript 给创建某类对象定制一个标准,以便可以用这个 模板 创建许多对象 这个例子的确还不够亮眼,那我再举个更实际的例子吧 function httpClientFactory(baseUrl) { return { baseUrl: baseUrl, listUsers: () => { return axios.get(`${baseUrl}/users`) }, getUser: (id) => { return axios.get(`${baseUrl}/users/${id}`) }, createUser: (user) => { return axios.post(`${baseUrl}/users`, user); }, listBooks: () => { return axios.get(`${baseUrl}/books`) }, getBook: (bookName) => { return axios.get(`${baseUrl}/books/${bookName}`) }, createBook: (book) => { return axios.post(`${baseUrl}/books`, book) } }}const httpClient = httpClientFactory("https://your-endpoints/api");httpClient.getUser("123");httpClient.getBook("JavaScript Is Interesting");console.log("The httpClient's baseUrl is " + httpClient.baseUrl); 对比 class HttpClient { constructor(baseUrl) { this.baseUrl = baseUrl; this.listUsers = this.listUsers.bind(this); this.getUser = this.getUser.bind(this); this.createUser = this.createUser.bind(this); this.listBooks = this.listBooks.bind(this); this.getBook = this.listUsers.bind(this); this.createBook = this.createBook.bind(this); } listUsers() { return axios.get(`${this.baseUrl}/users`) } getUser(id) { return axios.get(`${this.baseUrl}/users/${id}`) } createUser(user) { return axios.post(`${this.baseUrl}/users`, user); } listBooks() { return axios.get(`${this.baseUrl}/books`) } getBook(bookName) { return axios.get(`${this.baseUrl}/books/${bookName}`) } createBook(book) { return axios.post(`${this.baseUrl}/books`, book) }}const httpClient = new HttpClient("https://your-endpoints/api");httpClient.getUser("123");httpClient.getBook("JavaScript Is Interesting");console.log("The httpClient's baseUrl is " + httpClient.baseUrl); 感受一下代码的整洁程度 (彩蛋:bind 语句复制粘贴导致的bug你们发现了吗?) 3. 注意使用 class 的初衷 太多开发者一上来就写个class的原因通常是因为 他/她 是从OOP背景过来的 —— 在Java,你不能光秃秃地定义一个常量,一个函数或者一个表达式,你得先有个类,然后在类里定义一个静态不可变的属性 (public static final 三连) 才能产生一个常量,类似的,也只能在类里定义一个(静态或者非静态)的方法才能让函数有容身之地 (为了防杠,我谨慎加一条 —— Java 8 的 functional interface 开始可以让函数单独出来走两步了,但前提还是要有interface) 如果你想好好写 native JavaScript,那么你通常不需要一个类 // xxx.jsimport _ from 'lodash';export const BOOK_NAME_PREFIX = "JS_"; // 定义常量export const DEFAULT_USER_AGE = 18;export const convertVarToObject = function (v) { // 定义一个工具方法,将传入的值包装返回一个对象 // ...}const privateSecret = "zhimakaimen"; // 不export的常量自然变成模块私有的function privateFunc(){ // 同样可以定义模块私有的函数 // ...}export default { // 可以export出自定义的对象(包含自定义的属性) render: xxx, property: yyy,} 直接在 js module 里定义常量、函数,然后 export 出来给其他模块用,这么简单直接不香吗?(js module 里也可以定义私有的变量、常量、函数等) 再次推荐阅读 这篇文章,好好理解 js 模块,别再像 Java 那样只用 class 来组织所有代码了。 FreewheelLee:[搬运] JavaScript 模块化:CommonJS vs AMD vs ES6:<https://zhuanlan.zhihu.com/p/158683510> 4. 使用 class 的心智负担 业务代码中,现在大家写 JavaScript class 相信已经不会再直接访问 prototype 了,而是使用 class 关键字 —— 而 class 关键字的底层实现仍然是 prototype,仍然要考虑 this 的复杂性,在复杂的继承场景中甚至仍然得理解 prototype chaining 也就是说,一个新手接触/维护一个由大量类构成的项目时,他要么赶紧精通理解JavaScript class,要么就很可能掉进坑里。 我在个人体验里谈到的那个Nodejs项目,实习生新增一个方法后忘记加bind语句,然后程序一直报错 ReferenceError: XXX is not defined, 他一头雾水 —— ”明明方法定义就在那儿啊!“ 当然这是因为实习生的基础问题,他需要更多学习历练,但话说回来**这样的心智负担真的有必要吗?为什么不让程序更简单明了一点?**仅仅是为了让代码看起来更 OOP 吗? 这个油管视频 https://www.youtube.com/watch?v=Tllw4EPhLiQ (有条件的读者可以看看) 里说 在 JavaScript添加 class 关键字 就好像 giving clean needles to meth addicts 简单来说,JavaScript 并不擅长玩 OOP class 这一套,它有自己非常擅长且自然而然的风格(函数式),如果你想好好学 JavaScript 且正宗地用好 JavaScript ,我个人十分建议,把你花在 JavaScript OOP上的时间用来先搞清楚 JavaScript function 和 闭包 (React 开发者学好 Hooks)—— 然后再去学 class、prototype 等知识 牢记JavaScript的一个特性 —— Functions are first-class in JavaScript 函数是一等公民 5. 工厂函数会每次都重复生成函数(影响性能)吗? 可以参考这个回答 brambles:现代浏览器生成一个 JS 函数的开销多大?React hooks 的设计频繁生成新函数对性能有影响吗?www.zhihu.com 另外,可以简单回想一下,在我们日常业务开发中,真的有需要创建那么多类对象吗? 你写的类里被 new 过几次?真的每次 new 都有必要吗?如果没有,往上看第 3 点。 6. @贺师俊 贺大提到另一个点 class具有更高的声明性和静态可分析性,也跟platform api更为一致,同时在现代引擎里也有更好的优化 感谢贺大的指出,底层库的开发我本人经历不多,目前接触更多是还是业务代码为主。 至于引擎的代码优化,我持保留意见,之前在研究React Hooks的时候,不记得在哪看到过React的官方开发者认为在未来 Functional Component 的优化有比 Class Component 更好的趋势(原句和原文我暂时找不到了,找到了再补充回来,有读者看到过也可以评论给我,谢谢) —— 更新:找到了 https://zh-hans.reactjs.org/docs/hooks-intro.html#classes-confuse-both-people-and-machines 最后 欢迎加我微信(winty230),拉你进技术群,长期交流学习... 欢迎关注「前端Q」,认真学前端,做个专业的技术人... 点个 在看支持我吧 本文分享自微信公众号 - 前端Q(luckyWinty)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | 从源码出发看 ZGC 的技术内幕

笔者经过上次对zgc在不同环境下进行的测试后,发现zgc所带来的提升非常之大。一时间对zgc在生产中使用充满信心,但是在全面使用之前,难免对其几大新特性有一些好奇,比如:染色指针,读屏障,动态region,支持NUMA等等。其中有一些是比较好理解的,但是有一些例如染色指针,读屏障刚接触的时候会不明其意。在网上搜索一番后发现很多文档都只是简单一笔盖过,或者只介绍个概念,甚至还有错误或者模糊的介绍,具体的实现和意义最让笔者好奇,但又找不到答案。所以笔者在经过一段时间的ZGC源码学习后,在此做一番总结。 特性一:染色指针 我们都知道jvm的垃圾回收器回收过程中都涉及到对对象进行标记,只有标记过的对象才是存活的对象,未被标记的对象将在GC中被回收掉。zgc的对象标记实现用的则是染色指针技术。(传统的GC都是将标记记录在对象头中,G1则是将标记记录在与对象独立的数据结构上-----Rset) 话不多说先看一张图: 从图中我们可以得知zgc在64位操作系统的虚拟地址中取了4个bit进行标记,分别是 43---Marked0,44---Marked1,45---Remapped,46---Finalizeble(这里可以先简单了解,后面会具体讲不同标志位的意义) 前42位(jdk15中jvm会根据堆设置大小控制长度42-44位)则是具体的对象地址,后18位无意义。 在GC过程中会对对象的指针进行标记,这样就可以在GC标记追踪对象的时候只与指针打交道,而不用管对象本身。 以上就是在网上或者其他文档中可以搜索到的关于染色指针的解读,笔者了解下来仍旧对其很模糊,所以下面我们看下源码更深刻的理解染色指针技术的意义。 1.1 染色指针源码解读(基于openjdk15): 我们先看下创建对象返回指针的方法: 这里的ZAddress可以理解为用来处理染色指针的工具类,good()方法是返回对象在当前视图的好指针的方法。看到这里会出现两个问题: 1.视图:即marked0, marked1,remapped视图,他们对应用一个物理空间,在ZGC中这三个视图在同一时间点有且仅有一个生效。每个视图是一个对物理地址的映射。 2.好指针:简单理解就是当前视图下的指针在当前视图下是好指针,在其他视图下即为坏指针(先简单理解) //例:创建大对象 uintptr_t ZObjectAllocator::alloc_large_object(size_t size, ZAllocationFlags flags) { uintptr_t addr = 0; const size_t page_size = align_up(size, ZGranuleSize); //申请一个大页 ZPage* const page = alloc_page(ZPageTypeLarge, page_size, flags); if (page != NULL) { //从页中申请大小 addr = page->alloc_object(size); } return addr; } //返回当前页top inline uintptr_t ZPage::alloc_object(size_t size) { const size_t aligned_size = align_up(size, object_alignment()); //top其实是页中虚拟内存段上的地址 即0-4T const uintptr_t addr = top(); const uintptr_t new_top = addr + aligned_size; if (new_top > end()) { return 0; } //修改新top _top = new_top; //返回地址----转化位当前视图的good指针 return ZAddress::good(addr); } 看下good()方法: 这里可以看出好指针的意义,好指针会和当前的GoodMask进行或运算,GoodMask会根据当前视图切换而改变 //每次创建对象后都会用这个方法处理返回地址 ZAddress::good(addr); //取前后42位(42位 4T)(44位 16T)地址位 //ZAddressOffsetMask 的前4位染色位是0 //后面全是1,与符号计算后可以过滤掉前4位 inline uintptr_t ZAddress::offset(uintptr_t value) { return value & ZAddressOffsetMask; } //用对染色位进行赋值 //ZAddressGoodMasked实际上是当前视图下的标记 //可以是ZAddressMetadataMarked0 //或ZAddressMetadataMarked1 //或ZAddressMetadataRemapped //这三个标记只有染色位有1,所以可以进行指针染色 //这个就是当前视图下的指针染色方法 inline uintptr_t ZAddress::good(uintptr_t value) { return offset(value) | ZAddressGoodMask; } 视图切换方法: //切换视图方法,本质是修改good指针判断标记 //切换到marked视图,这个方法会从marked0切换到marked1,从marked1切换到marked0 void ZAddress::flip_to_marked() { ZAddressMetadataMarked ^= (ZAddressMetadataMarked0 | ZAddressMetadataMarked1); set_good_mask(ZAddressMetadataMarked); } //切换到remapped视图 void ZAddress::flip_to_remapped() { set_good_mask(ZAddressMetadataRemapped); } 返回一个地址对应视图下地址的方法: 默认情况下ZAddressMetadataMarked0 = 1<<42 ZAddressMetadataMarked1 = 1<<43 ZAddressMetadataRemapped = 1<<44 这里返回的就是传入地址的视图下映射的地址 inline uintptr_t ZAddress::marked0(uintptr_t value) { return offset(value) | ZAddressMetadataMarked0; } inline uintptr_t ZAddress::marked1(uintptr_t value) { return offset(value) | ZAddressMetadataMarked1; } inline uintptr_t ZAddress::remapped(uintptr_t value) { return offset(value) | ZAddressMetadataRemapped; } 到这里代码是比较好看懂的,但是笔者不由得又产生一个疑问,我们现在知道了如何判断当前视图,但是视图是怎么产生的? 视图是由多重内存映射产生的,多重内存映射是使用染色指针技术的产物(但是笔者理解zgc中的染色指针实现方法是多重内存映射) 在看内存映射代码之前我们要先了解下jvm关于内存的代码结构: zColloectHeap----zgc堆的集合 zHeap---zgc堆 zPageCache---包含一个zPage集合 zPage---zgc页(zgc的page概念相当于g1的region),每个页内部包含一段物理内存和一段虚拟内存 zVirtualMemory---虚拟内存,由ZVirtualMemoryManager创建并管理 zPhysicalMemory---物理内存(这里实际上还是用户空间的虚拟内存,只不过zgc将其管理的虚拟内存分为物理内存和虚拟内存便于管理,后面的物理内存都是指的是这个)由ZPhysicalMemoryManager创建并管理 zPhysicalMemorySegment---zgc的物理内存会分为一个个segment方便管理 由此我们可以找到指针映射的入口: //入口 jint Universe::initialize_heap() { assert(_collectedHeap == NULL, "Heap already created"); _collectedHeap = GCConfig::arguments()->create_heap(); return _collectedHeap->initialize(); } //一切的开始 ZArguments是 GCArguments的子类 CollectedHeap* ZArguments::create_heap() { //new 一个zgcCollectedHeap return new ZCollectedHeap(); } //ZCollectedHeap的析构函数(类似构造函数)中会创建一个zHeap //在初始化zheap的时候调用ZPageAllocator析构函数会先初始化虚拟内存,之后初始化物理内存 //这里就不贴出具体调用过程 //虚拟内存析构函数 ZVirtualMemoryManager::ZVirtualMemoryManager(size_t max_capacity) : _manager(), _initialized(false) { ... //申请地址空间 if (!reserve(max_capacity)) { log_error_pd(gc)("Failed to reserve enough address space for Java heap"); return; } ... } //最终会调用这个方法,把虚拟地址映射成3个虚拟地址视图 bool ZVirtualMemoryManager::reserve_contiguous(size_t size) { // Allow at most 8192 attempts spread evenly across [0, ZAddressOffsetMax) const size_t end = ZAddressOffsetMax - size; const size_t increment = align_up(end / 8192, ZGranuleSize); for (size_t start = 0; start <= end; start += increment) { //这里把最大地址切分成2m的段,会选择从可以映射的段开始映射,大小为堆大小 if (reserve_contiguous_platform(start, size)) { // 映射完的内存会加入zMemory的FreeList集合中 // 虚拟内存映射完的内存会加入zMemory的FreeList集合中 _manager.free(start, size); return true; } } return false; } bool ZVirtualMemoryManager::reserve_contiguous_platform(uintptr_t start, size_t size) { //获取地址的三个视图,这三个方法便是上面提到的 const uintptr_t marked0 = ZAddress::marked0(start); const uintptr_t marked1 = ZAddress::marked1(start); const uintptr_t remapped = ZAddress::remapped(start); //同一个地址映射三次 if (!map(marked0, size)) { return false; } if (!map(marked1, size)) { unmap(marked0, size); return false; } if (!map(remapped, size)) { unmap(marked0, size); unmap(marked1, size); return false; } ... return true; } //映射地址的方法 //虚拟内存这里是匿名映射,这里本质是分配内存,作用类似malloc,简单说就是分配一段内存,返回该内存的 //真实地址(这里是虚拟内存) static bool map(uintptr_t start, size_t size) { const void* const res = mmap((void*)start, size, PROT_NONE, MAP_ANONYMOUS|MAP_PRIVATE|MAP_NORESERVE, -1, 0); if (res == MAP_FAILED) { return false; } if ((uintptr_t)res != start) { unmap((uintptr_t)res, size); return false; } // Success return true; } 下面来看zgc管理的物理内存源码: //在ZPageAllocator的析构函数中会申请物理内存 //这里的物理内存并不是真正意义上的物理内存。仍然是用户空间的虚拟内存。 //最终在ZPageAllocator的析构函数中会调用去申请page bool ZPageAllocator::prime_cache(ZWorkers* workers, size_t size) { ZAllocationFlags flags; flags.set_non_blocking(); flags.set_low_address(); ZPage* const page = alloc_page(ZPageTypeLarge, size, flags); if (page == NULL) { return false; } free_page(page, false /* reclaimed */); return true; } //如果没有页会去创建 Page* ZPageAllocator::alloc_page_create(ZPageAllocation* allocation) { const size_t size = allocation->size(); //申请一段虚拟内存加入到页中,其实是从上面提到的zMemory的FreeList集合中申请 const ZVirtualMemory vmem = _virtual.alloc(size, allocation->flags().low_address()); .... // Create new page return new ZPage(allocation->type(), vmem, pmem); } //最终会调用这个方法,创建的page会进行映射,page->start()返回的是页中虚拟内存段的start void ZPageAllocator::map_page(const ZPage* page) const { // Map physical memory _physical.map(page->start(), page->physical_memory()); } //这里会将三个视图进行映射到同一个物理内存上(可以是文件,可以是内存)和文件描述符有关 void ZPhysicalMemoryManager::map(uintptr_t offset, const ZPhysicalMemory& pmem) const { const size_t size = pmem.size(); if (ZVerifyViews) { // Map good view map_view(ZAddress::good(offset), pmem); } else { //映射所有视图 map_view(ZAddress::marked0(offset), pmem); map_view(ZAddress::marked1(offset), pmem); map_view(ZAddress::remapped(offset), pmem); } nmt_commit(offset, size); } void ZPhysicalMemoryManager::map_view(uintptr_t addr, const ZPhysicalMemory& pmem) const { size_t size = 0; // Map segments for (uint32_t i = 0; i < pmem.nsegments(); i++) { //zgc内部把物理内存分成一个个segment const ZPhysicalMemorySegment& segment = pmem.segment(i); //每个segment从开始到结束进行映射 _backing.map(addr + size, segment.size(), segment.start()); size += segment.size(); } ..... } void ZPhysicalMemoryBacking::map(uintptr_t addr, size_t size, uintptr_t offset) const { //最终调用mmap函数映射内存 const void* const res = mmap((void*)addr, size, PROT_READ|PROT_WRITE, MAP_FIXED|MAP_SHARED, _fd, offset); if (res == MAP_FAILED) { ZErrno err; fatal("Failed to map memory (%s)", err.to_string()); } } 只看源码有些枯燥,我们画个图来整理下逻辑关系: 由此我们可以画出对应的关系: 到这里,我们可以总结下,染色指针不光是把标记信息存储在指针上,还对物理内存进行了多重映射,同一时间只存在一个视图,当我们访问对象时,只需要判断其指针的标志位是否是当前视图下的好指针,就可以判断其标记情况,性能提升是巨大的,这里说到底还是空间换时间的思路。 特性二:读屏障 读屏障相比较来说比较好理解,传统gc使用的都是写屏障,去解决标记对象时漏标的问题,这部分会涉及三色标记和漏标的知识点,网上文章比较多,笔者就不过多阐述。ZGC则是使用的读屏障,在访问对象之前我们只要判断对象的引用标志位,对象是否是处于移动后,不需要整个gc过程结束,这样可以大大减少停顿时间。每次访问对象,因为由染色指针的技术,也可以在非常段的时间内判断对象的标志,所以使用读屏障并不会影响性能。 我们来看下其主要方法: 可以看到其主要逻辑是访问对象时,只需要判断其指针在当前视图下是不是好指针,如果是则证明其可以正常访问,直接返回,如果不是则判断是不是正在移动中,如果是则等待其移动,如果不是,对其进行指针修复,修复到正确的地址上(修复的方法我们下一章再讲,这里先简略)。 //读屏障 address ZBarrierSetRuntime::load_barrier_on_oop_field_preloaded_addr(DecoratorSet decorators) { //判断是什么引用 if (decorators & ON_PHANTOM_OOP_REF) { return load_barrier_on_phantom_oop_field_preloaded_addr(); } else if (decorators & ON_WEAK_OOP_REF) { return load_barrier_on_weak_oop_field_preloaded_addr(); } else { //先看这里 return load_barrier_on_oop_field_preloaded_addr(); } } //这里传入两个闭包函数 inline oop ZBarrier::load_barrier_on_oop_field_preloaded(volatile oop* p, oop o) { return barrier<is_good_or_null_fast_path, load_barrier_on_oop_slow_path>(p, o); } template <ZBarrierFastPath fast_path, ZBarrierSlowPath slow_path> inline oop ZBarrier::barrier(volatile oop* p, oop o) { const uintptr_t addr = ZOop::to_address(o); //这里调第一个闭包,第一个会判断是否是当前视图下的好指针 if (fast_path(addr)) { return ZOop::from_address(addr); } //这里调第二个闭包 const uintptr_t good_addr = slow_path(addr); if (p != NULL) { self_heal<fast_path>(p, addr, good_addr); } return ZOop::from_address(good_addr); } //第二个闭包,这里会判断对象是否在移动中,如果是则进行移动,如果不是则标记并修改指针到新对象 uintptr_t ZBarrier::relocate_or_mark(uintptr_t addr) { return during_relocate() ? relocate(addr) : mark<Follow, Strong, Publish>(addr); } 到这里,我们现在知道了zgc的染色指针和读屏障具体是怎么回事,但是笔者不禁又对视图产生了好奇,gc的过程中是如何切换视图?gc过程对象是如何搬运的? zgc过程解读 先上代码(jdk15中gc是9步,其他版本可能有10步): 这里是gc方法的源码,我们可以看到有清晰的9步 //zgc过程 9步 void ZDriver::gc(GCCause::Cause cause) { ZDriverGCScope scope(cause); // Phase 1: Pause Mark Start 初始标记 //调用pause<VM_ZMarkStart>();全局停顿 //最终调用void ZHeap::mark_start() 执行初次标记 pause_mark_start(); // Phase 2: Concurrent Mark 并发标记 concurrent_mark(); // Phase 3: Pause Mark End //全局停顿 while (!pause_mark_end()) { // Phase 3.5: Concurrent Mark Continue concurrent_mark_continue(); } // Phase 4: Concurrent Process Non-Strong References concurrent_process_non_strong_references(); // Phase 5: Concurrent Reset Relocation Set concurrent_reset_relocation_set(); // Phase 6: Pause Verify 验证GC状态 pause_verify(); // Phase 7: Concurrent Select Relocation Set concurrent_select_relocation_set(); // Phase 8: Pause Relocate Start // 全局停顿 pause_relocate_start(); // Phase 9: Concurrent Relocate 并发回收 concurrent_relocate(); } 具体的代码比较繁多,直接看的话可能会有些概念不太清楚,笔者先画图来辅助大家理解,并在其中解释一些概念,之后笔者会贴上对应的代码进行讲解学习: 1.初始标记 初始标记会从GcRoot出发快速修改相关引用的指针,这一步代表GcRoot直接引用的对象已经被标记,其指针已经被染色为当前视图下的指针。 jvm初始化时创建的指针都是remapped视图下的,而marked标记(用来表示当前marked轮次的,后面源码中会看到)则是marked0,在第一次进行marked视图切换时,由于marked标记是marked0,所以会从marked0切换到marked1,所以这里视图切换是从remapped切换成marked1。1 2 4对象已经是marked1,其他对对象还是remapped。这里会有第一次全局停顿。 2.并发标记 这里会继续遍历整个堆中的存活对象,并将其指针进行染色。5 8 的指针也会被染色为当前视图下指针,3 6 7 则不变,进行标记的时候还会在每个页中记录下存活对象的字节数大小,方便后面选择迁移页。还有一点,这个阶段还会修复坏指针,由于演示的是第一次GC情况,所以图中不会展示出来,后面第二次GC就可以看到指针修复的情况。 3.重新标记 这个阶段会做一些收尾工作,会把并发标记阶段未处理完的任务继续处理完,若没有处理完则继续进行并发标记,如果处理完了则继续进行下一步,这个阶段会控制在1ms内,超过1ms会继续并发标记。这个阶段是第二次全局停顿 4.并发迁移准备 这个阶段在源码中是这4步: // Phase 4: Concurrent Process Non-Strong References concurrent_process_non_strong_references(); // Phase 5: Concurrent Reset Relocation Set // 重置迁移集合 concurrent_reset_relocation_set(); // Phase 6: Pause Verify 验证GC状态 pause_verify(); // Phase 7: Concurrent Select Relocation Set // 选择需要迁移的集合 concurrent_select_relocation_set(); 这一步会先清空Forwarding Table(用来记录迁移对象后的映射关系),之后再清空RelocationSet。 然后再根据一定规则去选择需要迁移的页,如果页中有存活的对象(可以理解为在进行标记的时候还会对页进行标记标记其为存活页,后面源码分析中会提到),则注册成存活页,如果没有存活对象则直接回收页。最后再从存活页中按一定策略选择需要迁移的页并按一定顺序填充进迁移集合。(ZGC中的页分为,大页,中页,小页,这里规则是中页在前,小页在后,每个页组将按存活对象字节数升序进行排序)填充的操作其实是将页的信息封装成一个个Forwarding存到RlocationSet中并排序。 填充后会将这些Forwarding加入到Forwarding Table中,此时这里面还只有需要迁移对象的信息。 5.初始迁移 这个阶段会先切换视图,将视图切换到remapped视图,之后会扫描与根节点相关的对象,判断其指针是好是坏,如果是好指针则直接返回。如果是坏指针,则会先判断是否在Forwarding Tables中有其信息,如果没有就代表不需要迁移,则直接标记成当前视图下好指针并返回,如果有则代表需要进行迁移。上图中1 ,2 均不在Forwarding Tables中,则直接指针被染色,而4则进行迁移。 先申请块内存,然后将对象copy过去,之后把映射关系记录在Forwarding Table中,最后修改gcRoot指针到新对象上。这个过程只扫描少数对象,过程非常快,是全局停顿的。 6.并发迁移 在这个阶段会先遍历RelocationSet中所有的forwarding,从中获取需要回收的页信息,从页信息中遍历存活的对象,并对其进行迁移 之后会根据存活对象大小申请新的内存并将对象copy过去,然后在forwarding中记录映射关系,forwarding同时会反应在Forwarding Tables中,图中 5 8 都进行了copy但其颜色还未改变,这时候会体现ZGC的优势,如果应用访问这两个对象,则会触发读屏障,快速的判断其指针颜色发现是坏指针然后修复指针。(只有第一次访问的时候会修复,后面都会变成好指针) 最后则会把之前relocationSet中记录的页进行回收,这时候红色箭头的都是失效的指针都是坏指针,如果用户访问这些指针会触发读屏障进行指针修复。 7.第一次GC结束,第二次GC前 以上第一次GC过程结束,之后一些坏指针会在用户访问之后进行修复,但是有些指针可能没有被访问到,则会在第二次GC的时候进行修复。上图对象4到5的指针会因为读屏障修复,所以指针被染色成remapped。 8.初次标记(第二次GC) 第二次GC的初次标记阶段,由于之前的marked标记是1,现在会切换到0,所以视图是从remapped切换到marked0,所以1 2 4 的指针都被染色成marked0 9.并发标记(第二次GC) 第二此并发标记会将没有被读屏障修复的指针进行修复并染色,现在1 2 4 5 8 都被染成marked0视图的指针 10.并发迁移准备(第二次GC) 在第二次GC的并发迁移准备阶段,会将之前保存的relocationSet和Forwarding Table都清空。之后的阶段就和第一次GC一样,在这里就不进行画图描述了。 GC阶段源码 上图是笔者根据源码学习后画出的,但是只看图和过程讲解还是不够深刻,源码中还有很多细节是图不能表现的,图只能帮助我们理解轮廓,下面我们一起看下源码是如何进行GC的,这里再把GC9步的源码方法先贴出来 //zgc过程 9步 void ZDriver::gc(GCCause::Cause cause) { ZDriverGCScope scope(cause); // Phase 1: Pause Mark Start 初始标记 //调用pause<VM_ZMarkStart>();全局停顿 //最终调用void ZHeap::mark_start() 执行初次标记 pause_mark_start(); // Phase 2: Concurrent Mark 并发标记 concurrent_mark(); // Phase 3: Pause Mark End //全局停顿 while (!pause_mark_end()) { // Phase 3.5: Concurrent Mark Continue concurrent_mark_continue(); } // Phase 4: Concurrent Process Non-Strong References concurrent_process_non_strong_references(); // Phase 5: Concurrent Reset Relocation Set concurrent_reset_relocation_set(); // Phase 6: Pause Verify 验证GC状态 pause_verify(); // Phase 7: Concurrent Select Relocation Set concurrent_select_relocation_set(); // Phase 8: Pause Relocate Start // 全局停顿 pause_relocate_start(); // Phase 9: Concurrent Relocate 并发回收 concurrent_relocate(); } 1.初次标记源码: 初次标记方法经过一连串调用,最后会进入这个方法 //初次标记最后会调这个方法 void ZHeap::mark_start() { assert(SafepointSynchronize::is_at_safepoint(), "Should be at safepoint"); //更新统计数据(提供给GC日志的统计数据,后文都不在做解释) ZStatSample(ZSamplerHeapUsedBeforeMark, used()); // 切换内存映射视图 // remapp视图切换到marked0,marked1视图 // 第一次的话是切到M1视图 flip_to_marked(); //重置对象页数据 _object_allocator.retire_pages(); //重置页数据 _page_allocator.reset_statistics(); //重置引用数据 _reference_processor.reset_statistics(); //修改标记位 ZGlobalPhase = ZPhaseMark; //初始标记,标记根节点 _mark.start(); //更新统计数据 ZStatHeap::set_at_mark_start(soft_max_capacity(), capacity(), used()); } 先来看看filp_toMarked()切换视图的方法: //切换marked视图 void ZAddress::flip_to_marked() { //这个就是上文提到marked标记 ZAddressMetadataMarked ^= (ZAddressMetadataMarked0 | ZAddressMetadataMarked1); //将marked标记设置成好指针标记 set_good_mask(ZAddressMetadataMarked); } 可以看出marked标记会再marked0和marked1之间互相转换,当marked标记为marked0时,调用这个方法后会变成marked1,反之则会变成marked0。 跳过几个重置页和数据的方法,我们直接看标记根节点的方法_mark.start(),方法主要是遍历根节点,中间调用了几个迭代器类,这里就不列出,我们直接看遍历对象的方法: //遍历的方法是ZMarkRootsIteratorClosure这个类中的 //传入的是gc中的根节点直接引用的对象,包括栈里的引用和一些VM静态数据指向堆中的引用,这里就不详细列举 virtual void do_oop(oop* p) { ZBarrier::mark_barrier_on_root_oop_field(p); } inline void ZBarrier::mark_barrier_on_root_oop_field(oop* p) { const oop o = *p; //这个方法会传入两个闭包方法 root_barrier<is_good_or_null_fast_path, mark_barrier_on_root_oop_slow_path>(p, o); } template <ZBarrierFastPath fast_path, ZBarrierSlowPath slow_path> inline void ZBarrier::root_barrier(oop* p, oop o) { //获取地址 const uintptr_t addr = ZOop::to_address(o); //第一个闭包方法,这个闭包方法就是判断指针是否是好指针,这里就不再论述 if (fast_path(addr)) { return; } //第二个闭包方法,返回当前视图下的好指针,实际上是指针染色 const uintptr_t good_addr = slow_path(addr); //将染色后的指针转化为地址并修改之前的指针 *p = ZOop::from_address(good_addr); } //第二个闭包方法 uintptr_t ZBarrier::mark_barrier_on_root_oop_slow_path(uintptr_t addr) { //标记并返回染色指针 return mark<Follow, Strong, Publish>(addr); } //这个方法是指针染色的核心方法 template <bool follow, bool finalizable, bool publish> uintptr_t ZBarrier::mark(uintptr_t addr) { uintptr_t good_addr; if (ZAddress::is_marked(addr)) { // 判断是否是当前marked视图下的指针,是则直接返回好指针(染色) good_addr = ZAddress::good(addr); } else if (ZAddress::is_remapped(addr)) { // 这个阶段主要会进入这个分支 // 判断是否是remapped视图下的指针,直接返回当前视图的好指针(染色) good_addr = ZAddress::good(addr); } else { // 这个阶段不会进入这个分支,这里说明是坏指针,会进行指针修复和染色 good_addr = remap(addr); } // 这里的标记方法会将标记任务先放到一个stack中,等到并发标记时再处理 if (should_mark_through<finalizable>(addr)) { ZHeap::heap()->mark_object<follow, finalizable, publish>(good_addr); } ... return good_addr; } 不难看出,这个阶段虽然是会全局停顿,但是实际上只是对根节点直接引用的对象指针进行染色处理,大部分指针是由remapped视图被染色成maked视图(0或者1) 2.并发标记源码: 并发标记最终会进入这个方法: void ZMark::mark(bool initial) { //这个标识符是判断是不是第一次进入并发标记 //上文说到初始标记结束会判断并发标记是否成功,如果没成功获取超过1ms则会再次进入并发标记阶段,再次进入的并发标 //标记阶段此标识符就是false if (initial) { //并发标记任务 ZMarkConcurrentRootsTask task(this); _workers->run_concurrent(&task); } //标记任务 //这里会处理上文提到的stack中的任务进行标记,实际上是在对象所处的页中的存活map中标记出来 ZMarkTask task(this); _workers->run_concurrent(&task); } 先来看看并发标记任务,其中也会经过一些迭代器工具,和初次标记一样,我们主要看看遍历对象的方法: //最终调用ZMarkConcurrentRootsIteratorClosure迭代器的方法 virtual void do_oop(oop* p) { ZBarrier::mark_barrier_on_oop_field(p, false /* finalizable */); } //标记方法 inline void ZBarrier::mark_barrier_on_oop_field(volatile oop* p, bool finalizable) { //原子类加载对象 const oop o = Atomic::load(p); //这里false if (finalizable) { barrier<is_marked_or_null_fast_path, mark_barrier_on_finalizable_oop_slow_path>(p, o); } else { const uintptr_t addr = ZOop::to_address(o); //判断指针好坏 if (ZAddress::is_good(addr)) { //好指针直接进行标记 mark_barrier_on_oop_slow_path(addr); } else { //坏指针则需要修复并染色之后再标记 //再看到这个方法已经很熟悉了,我们直接来看第二个闭包方法 barrier<is_good_or_null_fast_path, mark_barrier_on_oop_slow_path>(p, o); } } } template <bool follow, bool finalizable, bool publish> uintptr_t ZBarrier::mark(uintptr_t addr) { uintptr_t good_addr; if (ZAddress::is_marked(addr)) { good_addr = ZAddress::good(addr); } else if (ZAddress::is_remapped(addr)) { //如果是remapped视图则会在此进行染色变成marked视图 good_addr = ZAddress::good(addr); } else { //这个阶段可能会有指针走这个分支进行指针修复,主要是上个阶段GC留下的没有被读屏障修复过的坏指针 good_addr = remap(addr); } // 和初次标记一样,先把对象信息封装到一个stack里 if (should_mark_through<finalizable>(addr)) { ZHeap::heap()->mark_object<follow, finalizable, publish>(good_addr); } ... return good_addr; 我们来看看一直提到的修复指针方法: //最终会调用这个方法去修复指针 inline uintptr_t ZHeap::remap_object(uintptr_t addr) { //从forwarding_table中获取映射关系 ZForwarding* const forwarding = _forwarding_table.get(addr); if (forwarding == NULL) { // Not forwarding return ZAddress::good(addr); } return _relocate.forward_object(forwarding, addr); } uintptr_t ZRelocate::forward_object(ZForwarding* forwarding, uintptr_t from_addr) const { const uintptr_t from_offset = ZAddress::offset(from_addr); const uintptr_t from_index = (from_offset - forwarding->start()) >> forwarding->object_alignment_shift(); //从forwarding中找到对应对象信息 const ZForwardingEntry entry = forwarding->find(from_index); //返回新的指针并染色 return ZAddress::good(entry.to_offset()); } 在之前画图阶段我们已经提到过forwarding_table和forwarding,其最终记录了迁移指针的映射关系,entry.to_offset()返回的就是到迁移后对象的指针,这里直接进行染色并返回,之后会替换调原坏指针,所以是修复并染色的过程。 以上根节点和所有存活对象的指针染色过程就完成了,我们来看看刚才提到过的标记过程,刚才说到标记方法其实是将对象信息封装到一个stack里面,然后再并发标记阶段的标记任务,下面我们看下标记任务: //标记任务最后调用这个方法 void ZMark::work(uint64_t timeout_in_millis) { ZMarkCache cache(_stripes.nstripes()); ZMarkStripe* const stripe = _stripes.stripe_for_worker(_nworkers, ZThread::worker_id()); ZMarkThreadLocalStacks* const stacks = ZThreadLocalData::stacks(Thread::current()); if (timeout_in_millis == 0) { //直接标记 work_without_timeout(&cache, stripe, stacks); } else { //有超时时间的标记 work_with_timeout(&cache, stripe, stacks, timeout_in_millis); } // 清空Stack stacks->free(&_allocator); } //直接标记和超时时间标记顾名思义区别再有超时时间,我们看下直接标记的方法 //最后会跳到这 template <typename T> bool ZMark::drain(ZMarkStripe* stripe, ZMarkThreadLocalStacks* stacks, ZMarkCache* cache, T* timeout) { ZMarkStackEntry entry; //从stack中出栈 while (stacks->pop(&_allocator, &_stripes, stripe, entry)) { //标记方法 mark_and_follow(cache, entry); 处理超时时间 if (timeout->has_expired()) { return false; } } return true; } //再经过几个方法调用会到这里标记对象的方法 inline bool ZPage::mark_object(uintptr_t addr, bool finalizable, bool& inc_live) { const size_t index = ((ZAddress::offset(addr) - start()) >> object_alignment_shift()) * 2; //我们看到其实是再zPage中的liveMap进行标记 return _livemap.set(index, finalizable, inc_live); } 现在我们知道了标记会再页中的存活对象map中进行记录,后面在选择迁移页时会使用到,之后我们还会看到处理的代码。至此并发标记阶段结束 3.初始标记结束源码 //这个阶段会试着结束标记阶段,如果没有成功则继续进行并发标记 bool ZHeap::mark_end() { //结束标记工作 //这里会flush,本地线程栈 if (!_mark.end()) { return false; } //更改标识符,进入标记完成阶段 ZGlobalPhase = ZPhaseMarkCompleted; ZVerify::after_mark(); //更新统计数据 ZStatSample(ZSamplerHeapUsedAfterMark, used()); ZStatHeap::set_at_mark_end(capacity(), allocated(), used()); ZResurrection::block(); //处理弱引用 _weak_roots_processor.process_weak_roots(); // 准备卸载过期的元数据和nmethods _unload.prepare(); return true; } 这个阶段比较简单,是全局停顿的,在_mark.end()方法中会处理前面提到的stack中的任务,如果超时则会返回false重新回到并发标记阶段。 4.准备迁移阶段源码 前面提到这个阶段的方法涉及4个: // Phase 4:处理一些非强引用,非本文重点,这里就不论述了 concurrent_process_non_strong_references(); // Phase 5: 重置迁移集合 concurrent_reset_relocation_set(); // Phase 6: 验证GC状态,非本文重点,这里就不论述了 pause_verify(); // Phase 7: 选择迁移集合 concurrent_select_relocation_set(); 我们先看看重置迁移集合: //重置迁移集合 void ZHeap::reset_relocation_set() { //初始化一个空的forwarding table用来保存迁移前后的关系 ZRelocationSetIterator iter(&_relocation_set); for (ZForwarding* forwarding; iter.next(&forwarding);) { _forwarding_table.remove(forwarding); } //重置回收集合 _relocation_set.reset(); } 逻辑比较简单,就是先删除_forwarding_table中的forwarding,之后再清空relocationSet 再来看看选择迁移集合方法: //选择迁移集合 void ZHeap::select_relocation_set() { //不允许页被删除,底层为加个锁(非本文重点) _page_allocator.enable_deferred_delete(); // 注册一个迁移页选择器 ZRelocationSetSelector selector; ZPageTableIterator pt_iter(&_page_table); //循环所有页 for (ZPage* page; pt_iter.next(&page);) { //如果已经被标记要迁移 if (!page->is_relocatable()) { //不用回收 continue; } //判断page是否被标记过,这里就是看页中liveMap是否有数据 if (page->is_marked()) { //注册为存活页 selector.register_live_page(page); } else { //注册为垃圾页 selector.register_garbage_page(page); //立刻回收没有存活对象的垃圾页 free_page(page, true /* reclaimed */); } } //释放删除页的锁(非本文重点) _page_allocator.disable_deferred_delete(); // 选择页去回收,使用策略计算需要回收的页放入回收集合 selector.select(&_relocation_set); // 向forwarding table加入fowarding记录 ZRelocationSetIterator rs_iter(&_relocation_set); for (ZForwarding* forwarding; rs_iter.next(&forwarding);) { _forwarding_table.insert(forwarding); } // 更新统计数据 ZStatRelocation::set_at_select_relocation_set(selector.stats()); ZStatHeap::set_at_select_relocation_set(selector.stats(), reclaimed()); } 逻辑也比较简单,遍历所有页,判断页是否需要回收,依据就是前文提到的liveMap中是否有数据,如果liveMap中没有数据则可以直接回收,有则注册到选择器中。然后会对回收页进行选择排序,我们看下源码 void ZRelocationSetSelector::select(ZRelocationSet* relocation_set) { EventZRelocationSet event; // 选则器中会将大,中,小页分为三个组这里先再组内按存活对象大小字节数排序 _large.select(); _medium.select(); _small.select(); // 然后进行填充,这里先填充中页,后小页(大页并没有回收,这里先不论述) relocation_set->populate(_medium.selected(), _medium.nselected(), _small.selected(), _small.nselected()); //zgc的异步支持,事件处理器,这里非本文重点就不论述了 event.commit(total(), empty(), compacting_from(), compacting_to()); } //填充方法 void ZRelocationSet::populate(ZPage* const* group0, size_t ngroup0, ZPage* const* group1, size_t ngroup1) { _nforwardings = ngroup0 + ngroup1; _forwardings = REALLOC_C_HEAP_ARRAY(ZForwarding*, _forwardings, _nforwardings, mtGC); size_t j = 0; // 填充方法就是将页信息封装成forwarding加入relocationSet的forwarding数组中 for (size_t i = 0; i < ngroup0; i++) { _forwardings[j++] = ZForwarding::create(group0[i]); } for (size_t i = 0; i < ngroup1; i++) { _forwardings[j++] = ZForwarding::create(group1[i]); } } 看到这里应该可以应证我们之前画的图,relocationSet中的forwarding信息又被遍历然后加入到forwarding Table中,至此迁移准备阶段结束。 5.初始迁移源码 //初始迁移的方法 void ZHeap::relocate_start() { assert(SafepointSynchronize::is_at_safepoint(), "Should be at safepoint"); _unload.finish(); // 切换视图到remapped flip_to_remapped(); // 修改gc标识符 ZGlobalPhase = ZPhaseRelocate; // 更新gc统计数据 ZStatSample(ZSamplerHeapUsedBeforeRelocation, used()); ZStatHeap::set_at_relocate_start(capacity(), allocated(), used()); // 迁移gcRoot直接引用的对象 _relocate.start(); } 迁移gcRoot引用的对象和标记时一样会调用许多层迭代器,我们直接来看迁移的方法: //ZRelocateRootsIteratorClosure迭代器的方法 virtual void do_oop(oop* p) { ZBarrier::relocate_barrier_on_root_oop_field(p); } //又是似曾相识的方法,但其实不一样这此有迁移的逻辑 //这里只有第二个闭包方法不一样,我们直接来看看 inline void ZBarrier::relocate_barrier_on_root_oop_field(oop* p) { const oop o = *p; root_barrier<is_good_or_null_fast_path, relocate_barrier_on_root_oop_slow_path>(p, o); } //第二个闭包方法,不是好指针的情况下会到这里,如果是好指针则直接返回染色的指针 uintptr_t ZBarrier::relocate_barrier_on_root_oop_slow_path(uintptr_t addr) { // 简单干脆直接迁移 return relocate(addr); } //最后会调这个方法 inline uintptr_t ZHeap::relocate_object(uintptr_t addr) { //先判断时候在forwarding_table中 ZForwarding* const forwarding = _forwarding_table.get(addr); if (forwarding == NULL) { // Not forwarding return ZAddress::good(addr); } const bool retained = forwarding->retain_page(); //进行迁移 const uintptr_t new_addr = _relocate.relocate_object(forwarding, addr); if (retained) { forwarding->release_page(); } return new_addr; } //真正的迁移方法 uintptr_t ZRelocate::relocate_object_inner(ZForwarding* forwarding, uintptr_t from_index, uintptr_t from_offset) const { ZForwardingCursor cursor; ... // 申请新的内存 const uintptr_t from_good = ZAddress::good(from_offset); const size_t size = ZUtils::object_size(from_good); // 这里会从空闲的页中申请新的内存,具体就不再论述 const uintptr_t to_good = ZHeap::heap()->alloc_object_for_relocation(size); if (to_good == 0) { return forwarding->insert(from_index, from_offset, &cursor); } // 拷贝对象 ZUtils::object_copy(from_good, to_good, size); // 保存forwarding记录映射关系 // 对象地址被标记位remap的视图 const uintptr_t to_offset = ZAddress::offset(to_good); const uintptr_t to_offset_final = forwarding->insert(from_index, to_offset, &cursor); if (to_offset_final == to_offset) { return to_offset; } ... return to_offset_final; } 这个阶段会遍历gcRoot直接引用的对象指针,判断指针是好是坏,如果是好指针则染色并返回,这部分的方法和之前一样,笔者就没贴出来。如果是坏指针则会将其进行迁移,在空闲的页中申请一块内存将对象copy过去,然后在forwarding中插入映射关系。 5.并发迁移源码 并发迁移和并发标记一样,也会经过几个迭代器的调用,我们直接贴出核心代码: //最后调用这个方法 bool ZRelocate::work(ZRelocationSetParallelIterator* iter) { bool success = true; // 遍历relocationSet中的forwarding数组 for (ZForwarding* forwarding; iter->next(&forwarding);) { // 从forwarding中获取页信息并把迭代器传进入遍历页中liveMap中的对象 ZRelocateObjectClosure cl(this, forwarding); forwarding->page()->object_iterate(&cl); if (ZVerifyForwarding) { forwarding->verify(); } //判断页是否是固定的 if (forwarding->is_pinned()) { success = false; } else { // 不是的话则进行回收 forwarding->release_page(); } } return success; } //object_iterate方法其实是遍历页中的liveMap中的对象 inline void ZPage::object_iterate(ObjectClosure* cl) { _livemap.iterate(cl, ZAddress::good(start()), object_alignment_shift()); } 到这里我们知道这个阶段会逐个遍历需要回收的页中的livemap中的对象,我们看看ZRelocateObjectClosure 迁移迭代器的迭代方法: virtual void do_object(oop o) { _relocate->relocate_object(_forwarding, ZOop::to_address(o)); } //熟悉的配方,熟悉的味道 uintptr_t ZRelocate::relocate_object(ZForwarding* forwarding, uintptr_t from_addr) const { const uintptr_t from_offset = ZAddress::offset(from_addr); const uintptr_t from_index = (from_offset - forwarding->start()) >> forwarding->object_alignment_shift(); const uintptr_t to_offset = relocate_object_inner(forwarding, from_index, from_offset); if (from_offset == to_offset) { forwarding->set_pinned(); } return ZAddress::good(to_offset); } 又回到了gcRoot迁移的方法,这里就不再次论述了,至此整个GC过程的源码就结束了。相信大家看到此处应该知道为何笔者要先画图在理解,如果直接看源码确实会陷入一个一个问题陷阱,所以笔者在画图时已经把需要关注的点和一些问题标注出来,等到我们学习源码的时候可以结合之前的图进行学习,这样可以更加清晰的理解和学习。 总结: 经过此次对ZGC源码的学习,我们对染色指针染的是什么,读屏障为什么效率这么高,ZGC停顿在哪里,为什么停顿时间这么短,应该有了更深刻的理解,对生产环境使用ZGC也有了更多的信心,只有清楚其原理和构成,我们才可以放心的使用。 笔者也不由得发出感概,与其看千百遍文章不如自己去读读源码,源码中蕴含这许多精妙的设计和细节。当然笔者限于水平,可能有些地方理解还不够完全,欢迎大家指出。
优秀的个人博客,低调大师

每日一博 | 使用 ML 和 DNN 建模的技巧总结

每个人都可以轻松地将数据放入任何模型机器学习或深度学习框架中。但是遵循最佳实践技巧可能有助于提升工作效率。以下是常见的一些方法。 本文内容 数据预处理 处理原始数据 使用张量 数据扩充 数据采样 模型训练 存储中间状态 虚拟周期 简化原则 定位问题 调试 定位问题 使用评价模型 数据转换 欠拟合 过拟合 生产 元数据关联 切换到推理模型 缩放成本 无状态模式 批处理 使用C++ 数据预处理(Data Preparation) 处理原始数据(Process Your Own Data) 因为消费者可能不知道开展数据处理和特征工程,所以数据分析师需要在模型内进行数据预处理。 以文本分类问题为例,使用BERT进行分类。数据分析师不能要求客户进行标记处理和特征整理。 以回归问题为例,时间是特征之一。在初始模型中,数据分析师只能使用星期几(如星期四)作为特征。经过几次迭代之后,星期几不再是一个好的特征因素,数据分析师只想使用日期(如31号)作为特征。而客户可能只提供了星期几的信息,而没有具体日期的信息,因此需要进行数据预处理。 以语音识别为例,消费者只能向数据分析师发送音频,而不能发送诸如Mel Cepstral Coefficient(MFCC)等经典特征数据。 因此,建议在代码中嵌入数据预处理,而不是要求客户机进行预处理。 使用张量(Use Tensor) 张量是一个N维数组,用于多维计算。它比使用Python字典或数组要快,深度学习框架(例如PyTorch或TensorFlow)的对象数据格式是tensor。 数据扩充(Data Augmentation) 缺少标记数据是从业者通常面临的挑战之一。迁移学习是克服这一问题的途径之一,计算机视觉从业者可以考虑使用ResNet,自然语言处理从业者可以考虑BERT。另一方面,可以生成合成数据以增加标记数据。albumentations和imgaug可以生成图像数据,而nlpaug可以生成文本数据。 如果你了解你的数据,你应该量身设计数据扩充方法。请记住,数据科学的黄金法则是garbage in garbage out。 数据采样(Sampling Same Data) 大多数情况下,我们希望随机抽取数据,以保持样本数据在训练集、测试集和验证集之间的概率分布是一致的。同时,也希望保持这种“随机”行为,使得我们可以在不同的时刻获得相同的训练集、测试集和验证集。 如果数据带有日期属性,则可以按日期拆分数据。 否则,可以更改随机种子,使其具有一致的随机行为。 import torchimport numpy as npimport randomseed = 1234random.seed(seed)np.random.seed(seed)torch.manual_seed(seed)torch.cuda.manual_seed(seed) 模型训练(Model Training) 存储中间状态(Saving Intermediate Checkpoint) 只是在训练完成后保存模型,通常具有以下几个缺点: 由于模型的复杂性、计算资源和训练数据的大小,整个模型训练过程可能需要几天或几周的时间。如果没有中间状态被存储,这将是非常危险的,因为机器可能会被意外关闭。 一般来说,较长训练能够获得更好的结果(例如,损失更少)。然而,可能会发生过度拟合。在大多数情况下,最后一个模型状态并不能提供最佳结果。我们大部分时间都需要使用中间状态的模型来进行生产。 使用检查-停止机制能够节省资金。注意到一个模型在几个周期内并没有改进,我们可以早点停止它以节省时间和资源。 理想情况下,我们可以连续性存储模型(例如,在每个epoch之后保存模型),但它需要大量的存储。事实上,我们建议只保留最好的模型(或最好的三个模型)和最后一个模型。 虚拟周期(Virtual Epoch) Epoch是模型训练中一个非常常见的参数。如果初始化不正确,可能会影响模型性能。 例如,如果我们有100万条记录,我们设置了5个epoch,那么总共有500万条的训练数据。三周后,我们又得到了50万条记录。如果我们使用相同的epoch进行模型训练,总训练数据将达到750万。问题是: 难以确定模型性能的改进是由于特定数据的数量增加还是总体数据的数量增加。 新的50万条数据使训练时间延长1小时甚至几天。它增加了机器故障的风险。 建议用虚拟epoch代替原始静态epoch。虚拟epoch可以根据训练数据的大小、期望epoch、批大小来计算得到。 通常的静态epoch如下: #originalnum_data = 1000 * 1000batch_size = 100num_step = 14 * 1000 * 1000num_checkpoint = 20steps_per_epoch = num_step//num_checkpoint#TensorFlow/ Kerasmodel.fit(x, epoch=num_checkpoint, steps_per_epoch=steps_per_epoch, batch_size=batch_size) 而虚拟epoch如下: num_data = 1000 * 1000num_total_data = 14 * 1000 * 1000batch_size = 100num_checkpoint = 20steps_per_epoch = num_total_data // (batch_size*num_checkpoint)#TensorFlow/ Kerasmodel.fit(x, epoch=num_checkpoint, steps_per_epoch=steps_per_epoch, batch_size=batch_size) 简化原则(Simple is Beauty) 从业者通常打算使用最先进的模型来构建初始模型。事实上,我们建议建立一个足够简单的模型作为基线模型。原因是: 我们总是需要一个基线模型来证明所提出的模型是正确的。 基线模型不需要在性能方面非常好,但它必须是可解释的。业务用户总是想知道预测结果的原因。 易于实施是非常重要的。客户不能等一年才能得到一个足够好的模型。我们需要建立一套模型,以便从投资者那里获得动力,在初始模型的基础上建立你的精彩模型。 以下是一些建议的不同领域的基线模型: 语音识别:可以使用经典特征,如mel frequency cepstral coefficient(MFCC)或 mel spectrogram features,而不是训练模型来获得向量表征(如增加嵌入层)。将这些特征传递给一个长短期记忆网络(LSTM)或卷积神经网络(CNN)和一个完全连接的层进行分类或预测。 计算机视觉:TODO。 自然语言处理:使用bag-of-words 或 classic word embeddings嵌入LSTM是一个很好的出发点,然后再转向其它模型,如BERT或XLNet。 调试(Debugging) 简化问题(Simplifying Problem) 有时,分类问题包括100万个数据和1000个类别。当模型性能低于理想值时,很难调试模型。糟糕的性能可能是由模型复杂性、数据质量或bug造成的。因此,建议简化问题,这样我们就可以保证它是无缺陷的。我们可以利用过度拟合问题来实现这一目标。 一开始,不需要对1000个类别进行分类,可以先对10个类别进行抽样,每个类别有100个数据,并训练模型。通过使用相同的训练数据集(或子集)作为评估数据集,能够过度拟合模型并获得良好的结果(例如,80甚至90+的精确度)。在这一基础上进行模型开发能够减少bug的出现。 使用评估模式(Using Eval Mode for Training) 如果评估模式的精度在前几个epoch中没有变化,通常可能是忘记在评估后重置为“训练”模式。 在Pytorch中,需要在训练和评估阶段转换训练模式以及评估模式。如果启用训练模式,批标准化、dropout或其他参数将受到影响。有时,数据分析师可能会在评估模式后忘记启用训练模式。 model = MyModel() # Default mode is training modefor e in range(epoch): # mode.train() # forget to enable train mode logits = model(x_train) loss = loss_func(logits, y_train) model.zero_grad() loss.backward() optimizer.step()mode.eval() # enable eval mode with torch.no_grad(): eval_preds = model(x_val) 数据转换(Data Shifting) 当训练数据集与评估/测试数据集存在显著差异时,需要进行数据转换。在计算机视觉任务中,可能大部分训练数据是白天的图片,而测试数据是夜间的图片。 如果发现训练损失/准确度和测试损失/准确度之间存在很大差异,可以从两个数据集中随机抽取一些样本进行检查。为了解决这个问题,可以考虑如下方法: 确保在训练、测试和预测数据集之间保持相似的数据分布。 如果可能,添加更多的训练数据。 通过利用相关库添加合成数据。考虑使用nlpaug(用于自然语言处理和声学任务)和imgaug(用于计算机视觉任务)。 欠拟合问题(Addressing Underfitting) 欠拟合是指训练误差大于期望误差。换言之,模型无法达到预期的性能。造成大误差的因素很多。要解决这个问题,可以从一个更简单的模型或者方法开始,看看它是否可以解决。 执行错误分析。通过LIME、SHAP或Anchor来解释你的模型,这样你就可以感觉到问题所在。 初始模型可能过于简单。增加模型的复杂性,例如增加长短期记忆(LSTM)层、卷积神经网络(CNN)层或完全连接(FC)层。 通过减少正则化层,稍微过拟合模型。Dropout和降低权重则可以防止过拟合。然后可以尝试移除这些正则化层,看看是否可以解决问题。 采用最先进的模型架构。考虑在自然语言处理(NLP)中使用转换器(如BERT或XLNet)。 引入合成数据。生成更多数据有助于提高模型性能,而无需任何人工操作。理论上,生成的数据应该共享同一个标签。它允许模型“看到”更多不同的数据,并最终提高鲁棒性。可以利用nlpaug和imgaug来执行数据扩充。 分配更好的超参数和优化器。可以考虑执行超参数调整,而不是使用默认/常规学习速率、epoch、batch size。考虑使用波束搜索、网格搜索或随机搜索来识别更好的超参数和优化器。这种方法相对简单,只需改变超参数,但可能需要较长的时间。 重新查看数据并引入额外的特征。 过拟合问题(Addressing Overfitting) 除了欠拟合,你还可能面临着过拟合的问题。过度拟合意味着你的模型太适合你的训练集,而对其他数据没有足够的适用性。换句话说,训练集准确性比验证集准确性要好。考虑以下解决方法: 执行错误分析。通过LIME、SHAP或Anchor来解释你的模型,这样你就可能发现问题所在。 增加更多的训练数据。 引入正则化层。Dropout(正则化层)和批处理标准化(normalization layer)通过删除一些输入和平滑输入来帮助减少过度拟合。 引入合成数据。生成更多数据有助于提高模型性能,而无需任何人工操作。 分配更好的超参数和优化器。 移除部分特征。 模型可能太过于复杂。可以减少模型复杂度。 生产(Production) 元数据联系(Meta Data Association) 在模型推出后,需要检查一些例外数据。一种方法是生成ID并将添加到数据库中。然而,它伴随着几个问题,也增加了故障排除的难度。以下是一些缺点: 影响系统的灵活性。从体系结构设计的角度来看,解耦是构建高柔性系统的途径之一。如果我们生成ID并将带有此ID的预测结果传递给客户,那么客户需要在其数据库中持久使用它。如果我们更改了格式或数据类型,需要通知所有使用者更新他们的数据库。 我们可能需要根据使用者的关键数据收集更多的元数据。额外的关键数据增加了连接的复杂性和存储消耗。 为了克服这个问题,预测结果应该直接与使用者的关键数据相关联。 转换为推理模型(Switch to Inference Mode) 使用Pytorch时,在将模型部署到生产环境中时,需要注意几个设置。前面提到了Pytorch中的eval,它使这些层(如Dropout、BatchNorm)在推理模式下工作,例如在推理阶段内不应用任何Dropout操作。它不仅能加快你的进程,而且能把所有的信息输入神经网络。 mode.eval() # enable eval modewith torch.no_grad(): eval_preds = model(x_val) 计算成本(Scalling Cost) 当尝试扩展API以处理更大的数据量时,有时可能会考虑使用GPU。的确,GPU虚拟机比CPU贵得多。然而,GPU带来了一些优势,例如计算时间更少,并且需要较少的VM来维持相同的服务级别。数据分析师应该试着评估一下GPU是否能节省一些钱。 无状态化(Stateless) 试着使你的API无状态化,这样你的API服务可以很容易地调整。无状态意味着不在API服务器(内存或本地存储)中保存任何中间结果。只需保持API服务器的简单性,并将结果返回给客户端,而无需在内存或本地存储中存储任何内容。 批处理(Batch Process) 预测一组数据通常比逐个预测更快。大多数现代机器学习或深度学习框架优化了预测性能(在速度方面)。你可能会注意到,切换到批处理模式预测对于效率有很大的改进。 使用C++ 虽然Python是机器学习领域中的主流语言,但与其他编程语言(如C++)相比,Python可能太慢了。如果希望低延迟的计算推理时间,可以考虑使用TorchScript。一般的方案是,你仍然可以在Python中训练你的模型,但是通过使用它生成C++兼容的模型。 作者:Edward Ma deephub翻译组:Oliver Lee 本文分享自微信公众号 - DeepHub IMBA(deephub-imba)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | 问题这样查,拒做背锅侠

技术的锅太多,到底该不该你背? 话说这天一大早,那个悲催的中年架构师大刘又被手机微信群给炸醒。部门的运维兄弟在公司微信群里说: 短信的生产环境服务器 CPU 占用率过高,疯狂报警。是不是你们昨天上线看门狗导致的? 大刘迷了巴登的想了想,没错,昨天确实给短信服务装上了看门狗。但是看门狗服务肯定不会有问题(架构师必备的蜜汁自信),而且上线之前各轮测试也都测过了,没见过这个想象啊。 难道是测试妹子没测试到位?难道线上短信应用自身出现了问题? 生产无小事,小事更不能忽视,主要是怕扣绩效奖金。大刘迅速打开电脑,打开 VPN ,远程登上短信生产服务器,开始大刘最拿手的 2W1H 三板斧诊断之旅。 接下来的诊断内容有点烧脑,节奏有点快,请大家坐稳扶好。 1. 病号是谁(WHO)? 大刘拿出控制台诊断仪器,输入 top 命令一探究竟。我勒个去,不看不知道一看吓一跳,PID 为 1878 的病号,CPU 占用居然 200% 多。 问题算是定位到了,但是 PID 为 1878 的病号到底是谁,难道真是昨天上线的看门狗 ? 虽然大刘久经职场,但是排查生产问题时,内心还是比较忐忑,毕竟这是生产环境。 说时迟那时快,只见大刘一个命令输入: ps -ef | grep 1878 定睛一看,原来是放屁瞅别人,短信服务自己在作祟,和看门狗没关系,大刘心里一下子平缓了不少。 锅找到了主儿,其实这个时候大刘完全可以把这个问题甩给短信开发团队,但是大刘最喜欢做的不是甩锅,而是打破砂锅刨到底。 2. 病号哪里出了问题(WHERE)? 为什么 1878 号病人占用 CPU 会这么高呢? 只见黑乎乎的控制台诊断仪器上,大刘熟练的输入: jstack -l 1878 >> 1878号病历.log 这样便得到一份 1878 号病人的病历详情单,一会儿用得上。 到底 1878 号病人的哪个部位出了问题呢? 话没说完,只见大刘又在控制台诊断仪器上,输入一个: top -Hp 1878 白板黑字,把 1878 号病人的器官信息全部列了出来。 看到结果,甚是一惊,PID 代号为 8721 的器官占用 CPU 100% 多。 疑惑油然而生,这个 PID 代号 为 8721 的器官是啥,是头、是眼睛、还是胳膊腿呢?这些器官展示的 PID 列都是昵称,都这么善于伪装,如何揭露它的真面目呢? 还好大刘有高招,借助照妖镜算法,熟练的输入: printf "%x\n" 8721 果真使得代号为 8721 的器官,现了真身,真实身份居然是 2211 的呼吸道,怪不得病号一直气喘吁吁,上气不接下气。 到这一步还无法对症下药啊,还需要进一步确诊 2211 的呼吸道到底出了什么幺蛾子,导致 1878 号病人一直气喘吁吁,上气不接下气? 只见黑乎乎的控制台诊断仪器上,大刘再次飞一般的在输入: grep 2211 -A20 1878号病历.log 诊断结果随之显示在诊断仪器上。 曾经背了很多锅的大刘,看到诊断结果心里乐了一下,一眼就看出是高并发情况下用了 HashMap 的问题(请大家们自行寻找谷歌、百度,就不在此深入展开啦),终于拨开云雾见青天。 3. 如何对症下药( HOW )? 在大刘行云流水没有一丝一毫的拖泥带水般的神操作下,1878 号病人的诊断也就结束了,这个锅就彻底被打破了。 术业有专攻,大刘就可以郑重的告诉短信开发同事具体原因了,捉得病根,开发同事也就可以对症下药啦。 大刘这套行走江湖的诊断问题方式你 get 到了没?大刘自己简单概括为 2W1H 三板斧:病号是谁、病号哪里出了问题、对症下药。 1、病号是谁?(WHO) 第一步:采用 top 命令,找出 CPU 占用最高的病号 PID ; 第二步:通过 ps -ef | grep PID 查看病号对应的真实身份。 2、病号哪里出了问题?(WHERE) 第一步:采用 jstack -l PID >> PID.log 获取病号的各器官信息的病历单; 第二步:采用 top -Hp PID 拿到占用 CPU 最高的器官昵称 PID ; 第三步:采用 printf "%x\n" PID 根据器官昵称 PID 的拿到器官真实身份 TID ; 第四步:采用 grep TID -A20 pid.log 根据 TID 去病历单中匹配,确定是哪出了问题。 3、捉得病根、便可拿出医药箱,对症下药啦。(HOW) 作为程序猿,工作中难免会遇到不少类似这样的问题。面对问题,你如果像无头苍蝇一样乱撞,撞得头破血流依然不知道缘由,在背锅即将成为现实时,那就不妨试试大刘的 2W1H 三板斧的诊断方式,说不定会帮你快速定位、解决线上问题,毕竟快速的解决生产问题会把损失降到最低。 最后,想对大家说一句: 作为程序猿,一定要有程序猿的态度。避免背锅,拒绝甩锅,打破砂锅,从你我做起。 你好,我是四猿外,一家上市公司的技术总监,管理的技术团队一百余人。 我从一名非计算机专业的毕业生,转行到程序员,一路打拼,一路成长。 我会把自己的成长故事写成文章,把枯燥的技术文章写成故事。 欢迎关注我的公众号:四猿外

优秀的个人博客,低调大师

每日一博 | Flutter Web 插件实现:打通 JavaScript 和 Dart

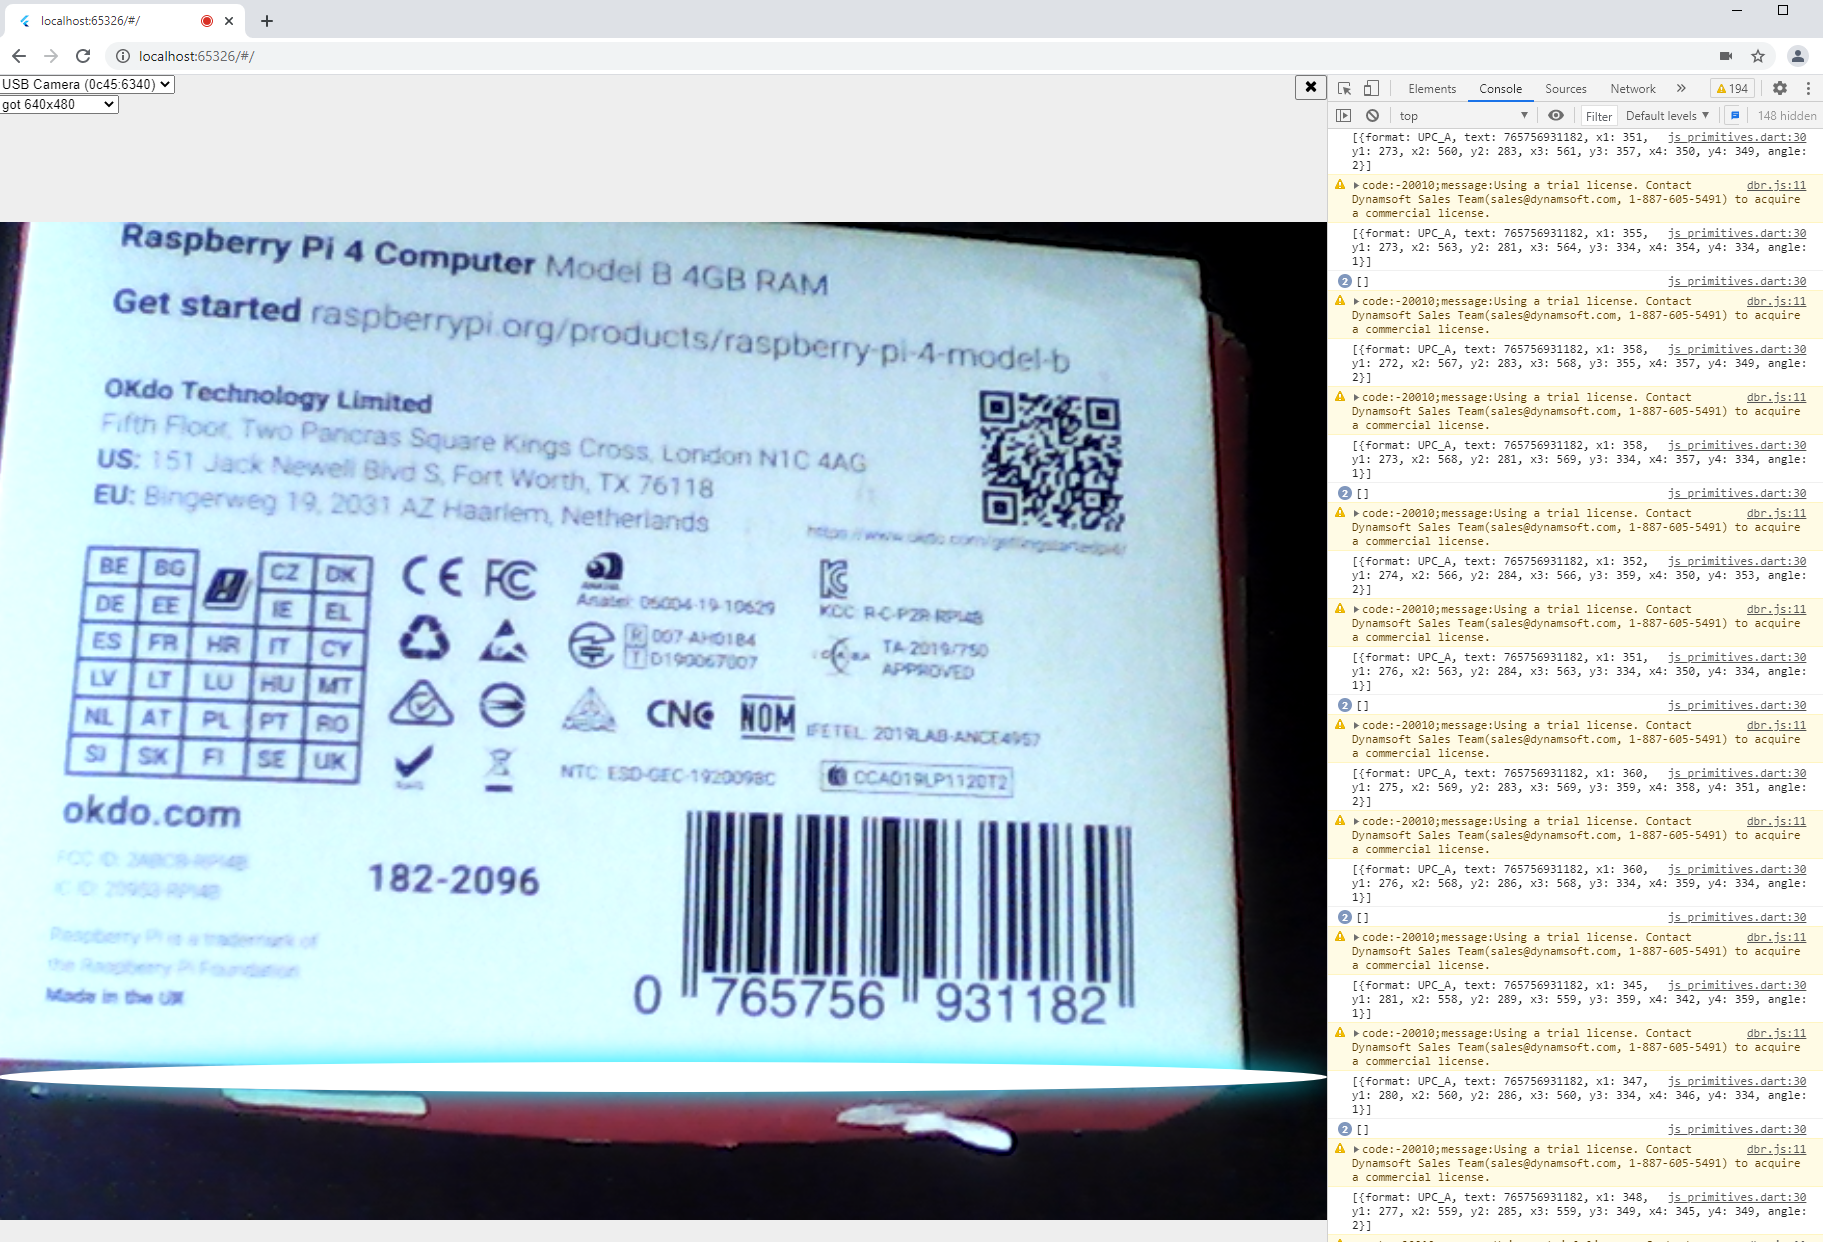
之前分享了如何在Flutter插件中支持Android和Windows,这篇文章将增加Web插件的实现方法,以及创建一个简单的web一维码,二维码识别应用。 参考资源 https://dart.dev/web/js-interop https://github.com/grandnexus/firebase-dart https://pub.dev/packages/js 开发Flutter Web插件 Web插件开发,主要问题是如何实现Dart和JavaScript的相互调用。官网提供的firebase_web示例值得学习和参考。 初始化web插件 在当前的插件工程中增加Web模板: flutter create --template=plugin --platforms=web . 和Windows, Android不同,web模板没有生成一个叫web的目录,也没有生成任何的JavaScritp代码文件。我们只看到一个新的flutter_barcode_sdk_web.dart文件。 接下来把插件声明添加到pubspec.yaml中: flutter: plugin: platforms: android: package: com.dynamsoft.flutter_barcode_sdk pluginClass: FlutterBarcodeSdkPlugin windows: pluginClass: FlutterBarcodeSdkPlugin web: pluginClass: FlutterBarcodeSdkWeb fileName: flutter_barcode_sdk_web.dart 如何实现JavaScript和Dart交互 和其它平台一样,handleMethodCall()是入口: Future<dynamic> handleMethodCall(MethodCall call) async { switch (call.method) { case 'getPlatformVersion': return getPlatformVersion(); default: throw PlatformException( code: 'Unimplemented', details: 'flutter_barcode_sdk for web doesn\'t implement \'${call.method}\'', ); } } 但不同的是,web并不需要在插件中引入依赖库编译,我们要做的只是定义接口。 我定义了两个接口:decodeFile()和decodeVideo(),分别用于通过图像和通过视频来识别一维码和二维码。 BarcodeManager _barcodeManager = BarcodeManager(); /// Decode barcodes from an image file. Future<List<Map<dynamic, dynamic>>> decodeFile(String file) async { return _barcodeManager.decodeFile(file); } /// Decode barcodes from real-time video stream. Future<void> decodeVideo() async { _barcodeManager.decodeVideo(); } 在视频模式下,结果是通过回调返回的。然而,在上层的flutter_barcode_sdk.dart中,回调函数引用没有办法通过invokeMethod传递下来。我的解决方法是使用全局变量保存回调函数: Future<void> decodeVideo(Function callback) async { globalCallback = callback; await _channel.invokeMethod('decodeVideo'); } 为了避免和其它平台冲突,这个变量单独定义在一个global.dart 文件中: Function globalCallback = () => {}; 现在打开barcode_manager.dart,根据dynamsoft-javascript-barcode定义JavaScript的调用接口: @JS('Dynamsoft') library dynamsoft; import 'dart:convert'; import 'dart:js'; import 'package:flutter_barcode_sdk/barcode_result.dart'; import 'package:flutter_barcode_sdk/global.dart'; import 'package:js/js.dart'; import 'utils.dart'; /// BarcodeScanner class @JS('DBR.BarcodeScanner') class BarcodeScanner { external static PromiseJsImpl<BarcodeScanner> createInstance(); external void show(); external set onFrameRead(Function func); } /// BarcodeReader class @JS('DBR.BarcodeReader') class BarcodeReader { external static PromiseJsImpl<BarcodeReader> createInstance(); external PromiseJsImpl<List<dynamic>> decode(dynamic file); } 为了实现JavaScript的Promise,我们需要在另外一个utils.dart文件中定义: import 'dart:async'; import 'dart:js_util'; import 'package:js/js.dart'; typedef Func1<A, R> = R Function(A a); @JS('JSON.stringify') external String stringify(Object obj); @JS('console.log') external void log(Object obj); @JS('Promise') class PromiseJsImpl<T> extends ThenableJsImpl<T> { external PromiseJsImpl(Function resolver); external static PromiseJsImpl<List> all(List<PromiseJsImpl> values); external static PromiseJsImpl reject(error); external static PromiseJsImpl resolve(value); } @anonymous @JS() abstract class ThenableJsImpl<T> { external ThenableJsImpl then([Func1 onResolve, Func1 onReject]); } Future<T> handleThenable<T>(ThenableJsImpl<T> thenable) => promiseToFuture(thenable); 接下来实现对象初始化: /// Initialize Barcode Scanner. void initBarcodeScanner(BarcodeScanner scanner) { _barcodeScanner = scanner; _barcodeScanner.onFrameRead = allowInterop((results) => {globalCallback(callbackResults(_resultWrapper(results)))}); } /// Initialize Barcode Reader. void initBarcodeReader(BarcodeReader reader) { _barcodeReader = reader; } BarcodeManager() { handleThenable(BarcodeScanner.createInstance()) .then((scanner) => {initBarcodeScanner(scanner)}); Dart的函数需要通过allowInterop()封装才能够被JavaScript调用。 实现decodeFile(): Future<List<Map<dynamic, dynamic>>> decodeFile(String filename) async { List<dynamic> barcodeResults = await handleThenable(_barcodeReader.decode(filename)); return _resultWrapper(barcodeResults); } 实现decodeVideo()回调: _barcodeScanner.onFrameRead = allowInterop((results) => {globalCallback(callbackResults(_resultWrapper(results)))}); 创建Web一维码,二维码识别程序 创建一个新的Flutter工程,并在web/index.html中添加<script src="https://cdn.jsdelivr.net/npm/dynamsoft-javascript-barcode@8.2.3/dist/dbr.js" data-productKeys="PRODUCT-KEYS"></script>。 在pubspec.yaml中添加image_picker和flutter_barcode_sdk: dependencies: flutter_barcode_sdk: image_picker: 在UI中添加两个按钮,一个用于加载图片,一个用于开启摄像头视频流: final picker = ImagePicker(); @override Widget build(BuildContext context) { return MaterialApp( home: Scaffold( appBar: AppBar( title: const Text('Dynamsoft Barcode Reader'), ), body: Column(children: [ Container( height: 100, child: Row(children: <Widget>[ Text( _platformVersion, style: TextStyle(fontSize: 14, color: Colors.black), ) ]), ), Expanded( child: SingleChildScrollView( child: Column( children: [ _file == null ? Image.asset('images/default.png') : Image.network(_file), Text( _barcodeResults, style: TextStyle(fontSize: 14, color: Colors.black), ), ], ), ), ), Container( height: 100, child: Row( mainAxisAlignment: MainAxisAlignment.spaceEvenly, children: <Widget>[ MaterialButton( child: Text('Barcode Reader'), textColor: Colors.white, color: Colors.blue, onPressed: () async { final pickedFile = await picker.getImage(source: ImageSource.camera); setState(() { if (pickedFile != null) { _file = pickedFile.path; } else { print('No image selected.'); } _barcodeResults = ''; }); if (_file != null) { List<BarcodeResult> results = await _barcodeReader.decodeFile(_file); updateResults(results); } }), MaterialButton( child: Text('Barcode Scanner'), textColor: Colors.white, color: Colors.blue, onPressed: () async { _barcodeReader.decodeVideo( (results) => {updateResults(results)}); }), ]), ), ])), ); 最后运行程序: flutter run -d chrome Flutter插件下载 https://pub.dev/packages/flutter_barcode_sdk 源码 https://github.com/yushulx/flutter_barcode_sdk

优秀的个人博客,低调大师

每日一博 | 如何把 Caffeine Cache 用得如丝般顺滑?

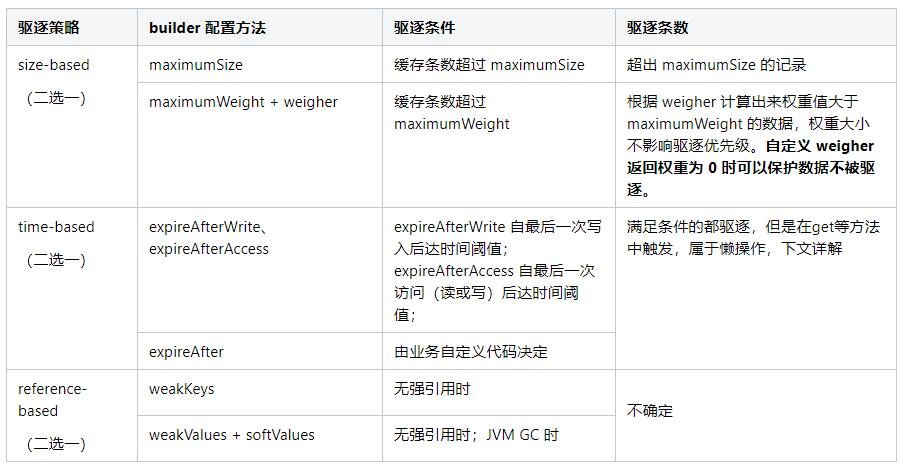
一、关于 Caffeine Cache 在推荐服务中,虽然允许少量请求因计算超时等原因返回默认列表。但从运营指标来说,越高的“完算率”意味着越完整的算法效果呈现,也意味着越高的商业收益。(完算率类比视频的完播率,成功完成整个推荐线上流程计算的请求次数/总请求次数) 为了能够尽可能快地完成计算,多级缓存方案已经成为推荐线上服务的标配。其中本地缓存显得尤为重要,而 Caffeine Cache 就是近几年脱颖而出的高性能本地缓存库。Caffeine Cache 已经在 Spring Boot 2.0 中取代了 Google Guava 成为默认缓存框架,足见其成熟和可靠。 关于 Caffeine 的介绍文章有很多,不再累述,可阅读文末的参考资料了解 Caffeine 的简述、性能基准测试结果、基本 API 用法和 Window-TinyLFU 缓存算法原理等。虽然接触 Caffeine 的时间不长,但其简洁的 API 和如丝般顺滑的异步加载能力简直不要太好用。而本菜鸟在使用的过程中也踩了一些坑,使用不当甚至缓存也能卡得和磁盘 IO 一样慢。 经过一番学习尝试,总算了解到 Caffeine Cache 如丝般顺滑的奥秘,总结下来分享一下。 二、Caffeine Cache 配置套路 使用 Caffeine Cache,除了 Spring 中常见的 @EnableCache、@Cacheable 等注解外,直接使用 Caffeine.newBuilder().build() 方法创建 LoadingCache 也是推荐服务常用的方式。 我们先来看看 Caffeine#builder 都有哪些配置套路: 2.1 追问三连 2.1.1 ObjectPool 当然可以,光脚的不怕穿鞋的,上线后别走…… 2.1.2 expireAfterWrite、expireAfterAccess 都配置? 虽然 expireAfterWrite 和 expireAfterAccess 同时配置不报错,但 access 包含了 write,所以选一个就好了亲。 2.1.3 reference-based 驱逐有啥特点? 只要配置上都会使用 == 来比较对象相等,而不是 equals;还有一个非常重要的配置,也是决定缓存如丝般顺滑的秘诀:刷新策略 refreshAfterWrite。该配置使得 Caffeine 可以在数据加载后超过给定时间时刷新数据。下文详解。 机智如我在 Builder 上也能踩坑 和 lombok 的 builder 不同,Caffeine#builder 的策略调用两次将会导致运行时异常!这是因为 Caffeine 构建时每个策略都保存了已设置的标记位,所以重复设置并不是覆盖而是直接抛异常: public Caffeine<K, V> maximumWeight(@NonNegative long maximumWeight) { requireState(this.maximumWeight == UNSET_INT, "maximum weight was already set to %s", this.maximumWeight); requireState(this.maximumSize == UNSET_INT, "maximum size was already set to %s", this.maximumSize); this.maximumWeight = maximumWeight; requireArgument(maximumWeight >= 0, "maximum weight must not be negative"); return this; } 比如上述代码,maximumWeight() 调用两次的话就会抛出异常并提示 maximum weight was already set to xxx。 三、Caffeine Cache 精华 3.1 get 方法都做了什么? 首先在实现类 LocalLoadingCache<K, V> 中可以看到; default @Nullable V get(K key) { return cache().computeIfAbsent(key, mappingFunction()); } 但突然发现这个 get 方法没有实现类!Why?我们跟踪 cache() 方法就可以发现端倪: public BoundedLocalCache<K, V> cache() { return cache; } public UnboundedLocalCache<K, V> cache() { return cache; } 根据调用 Caffeine.newBuilder().build() 的过程,决定了具体生成的是 BoundedLocalCache 还是 UnboundedLocalCache; 判定 BoundedLocalCache 的条件如下: public <K1 extends K, V1 extends V> LoadingCache<K1, V1> build( @NonNull CacheLoader<? super K1, V1> loader) { requireWeightWithWeigher(); @SuppressWarnings("unchecked") Caffeine<K1, V1> self = (Caffeine<K1, V1>) this; return isBounded() || refreshes() ? new BoundedLocalCache.BoundedLocalLoadingCache<>(self, loader) : new UnboundedLocalCache.UnboundedLocalLoadingCache<>(self, loader); } 其中的 isBounded()、refreshes() 方法分别如下: boolean isBounded() { return (maximumSize != UNSET_INT) || (maximumWeight != UNSET_INT) || (expireAfterAccessNanos != UNSET_INT) || (expireAfterWriteNanos != UNSET_INT) || (expiry != null) || (keyStrength != null) || (valueStrength != null); } boolean refreshes() { // 调用了 refreshAfter 就会返回 false return refreshNanos != UNSET_INT; } 可以看到一般情况下常规的配置都是 BoundedLocalCache。所以我们以它为例继续看 BoundedLocalCache#computeIfAbsent 方法吧: public @Nullable V computeIfAbsent(K key, Function<? super K, ? extends V> mappingFunction, boolean recordStats, boolean recordLoad) { // 常用的 LoadingCache#get 方法 recordStats、recordLoad 都为 true // mappingFunction 即 builder 中传入的 CacheLoader 实例包装 requireNonNull(key); requireNonNull(mappingFunction); // 默认的 ticker read 返回的是 System.nanoTime(); // 关于其他的 ticker 见文末参考文献,可以让使用者自定义超时的计时方式 long now = expirationTicker().read(); // data 是 ConcurrentHashMap<Object, Node<K, V>> // key 根据代码目前都是 LookupKeyReference 对象 // 可以发现 LookupKeyReference 保存的是 System.identityHashCode(key) 结果 // 关于 identityHashCode 和 hashCode 的区别可阅读文末参考资料 Node<K, V> node = data.get(nodeFactory.newLookupKey(key)); if (node != null) { V value = node.getValue(); if ((value != null) && !hasExpired(node, now)) { // isComputingAsync 中将会判断当前是否为异步类的缓存实例 // 是的话再判断 node.getValue 是否完成。BoundedLocaCache 总是返回 false if (!isComputingAsync(node)) { // 此处在 BoundedLocaCache 中也是直接 return 不会执行 tryExpireAfterRead(node, key, value, expiry(), now); setAccessTime(node, now); } // 异步驱逐任务提交、异步刷新操作 // CacheLoader#asyncReload 就在其中的 refreshIfNeeded 方法被调用 afterRead(node, now, recordStats); return value; } } if (recordStats) { // 记录缓存的加载成功、失败等统计信息 mappingFunction = statsAware(mappingFunction, recordLoad); } // 这里2.8.0版本不同实现类生成的都是 WeakKeyReference Object keyRef = nodeFactory.newReferenceKey(key, keyReferenceQueue()); // 本地缓存没有,使用加载函数读取到缓存 return doComputeIfAbsent(key, keyRef, mappingFunction, new long[] { now }, recordStats); } 上文中 hasExpired 判断数据是否过期,看代码就很明白了:是通过 builder 的配置 + 时间计算来判断的。 boolean hasExpired(Node<K, V> node, long now) { return (expiresAfterAccess() && (now - node.getAccessTime() >= expiresAfterAccessNanos())) | (expiresAfterWrite() && (now - node.getWriteTime() >= expiresAfterWriteNanos())) | (expiresVariable() && (now - node.getVariableTime() >= 0)); } 继续看代码,doComputeIfAbsent 方法主要内容如下: @Nullable V doComputeIfAbsent(K key, Object keyRef, Function<? super K, ? extends V> mappingFunction, long[] now, boolean recordStats) { @SuppressWarnings("unchecked") V[] oldValue = (V[]) new Object[1]; @SuppressWarnings("unchecked") V[] newValue = (V[]) new Object[1]; @SuppressWarnings("unchecked") K[] nodeKey = (K[]) new Object[1]; @SuppressWarnings({"unchecked", "rawtypes"}) Node<K, V>[] removed = new Node[1]; int[] weight = new int[2]; // old, new RemovalCause[] cause = new RemovalCause[1]; // 对 data 这个 ConcurrentHashMap 调用 compute 方法,计算 key 对应的值 // compute 方法的执行是原子的,并且会对 key 加锁 // JDK 注释说明 compute 应该短而快并且不要在其中更新其他的 key-value Node<K, V> node = data.compute(keyRef, (k, n) -> { if (n == null) { // 没有值的时候调用 builder 传入的 CacheLoader#load 方法 // mappingFunction 是在 LocalLoadingCache#newMappingFunction 中创建的 newValue[0] = mappingFunction.apply(key); if (newValue[0] == null) { return null; } now[0] = expirationTicker().read(); // builder 没有指定 weigher 时,这里默认为 SingletonWeigher,总是返回 1 weight[1] = weigher.weigh(key, newValue[0]); n = nodeFactory.newNode(key, keyReferenceQueue(), newValue[0], valueReferenceQueue(), weight[1], now[0]); setVariableTime(n, expireAfterCreate(key, newValue[0], expiry(), now[0])); return n; } // 有值的时候对 node 实例加同步块 synchronized (n) { nodeKey[0] = n.getKey(); weight[0] = n.getWeight(); oldValue[0] = n.getValue(); // 设置驱逐原因,如果数据有效直接返回 if ((nodeKey[0] == null) || (oldValue[0] == null)) { cause[0] = RemovalCause.COLLECTED; } else if (hasExpired(n, now[0])) { cause[0] = RemovalCause.EXPIRED; } else { return n; } // 默认的配置 writer 是 CacheWriter.disabledWriter(),无操作; // 自己定义的 CacheWriter 一般用于驱逐数据时得到回调进行外部数据源操作 // 详情可以参考文末的资料 writer.delete(nodeKey[0], oldValue[0], cause[0]); newValue[0] = mappingFunction.apply(key); if (newValue[0] == null) { removed[0] = n; n.retire(); return null; } weight[1] = weigher.weigh(key, newValue[0]); n.setValue(newValue[0], valueReferenceQueue()); n.setWeight(weight[1]); now[0] = expirationTicker().read(); setVariableTime(n, expireAfterCreate(key, newValue[0], expiry(), now[0])); setAccessTime(n, now[0]); setWriteTime(n, now[0]); return n; } }); // 剩下的代码主要是调用 afterWrite、notifyRemoval 等方法 // 进行后置操作,后置操作中将会再次尝试缓存驱逐 // ... return newValue[0]; } 看完上面的代码,遇到这些问题也就心里有数了。 3.2 缓存的数据什么时候淘汰? 显式调用 invalid 方法时;弱引用、软引用可回收时;get 方法老值存在且已完成异步加载后调用 afterRead。 get 方法老值不存在,调用 doComputeIfAbsent 加载完数据后调用 afterWrite。 3.3 CacheLoader#load和 CacheLoader#asyncReload 有什么区别? 首先 CacheLoader#load 方法是必须提供的,缓存调用时将是同步操作(回顾上文 data.compute 方法),会阻塞当前线程。 而 CacheLoader#asyncReload 需要配合builder#refreshAfterWrite 使用这样将在computeIfAbsent->afterRead->refreshIfNeeded 中调用,并异步更新到 data 对象上;并且,load 方法没有传入oldValue,而 asyncReload 方法提供了oldValue,这意味着如果触发 load 操作时,缓存是不能保证 oldValue 是否存在的(可能是首次,也可能是已失效)。 3.4 加载数据耗时较长,对性能的影响是什么? CacheLoader#load 耗时长,将会导致缓存运行过程中查询数据时阻塞等待加载,当多个线程同时查询同一个 key 时,业务请求可能阻塞,甚至超时失败; CacheLoader#asyncReload 耗时长,在时间周期满足的情况下,即使耗时长,对业务的影响也较小 3.5 说好的如丝般顺滑呢? 首要前提是外部数据查询能保证单次查询的性能(一次查询天长地久那加本地缓存也于事无补);然后,我们在构建 LoadingCache 时,配置 refreshAfterWrite 并在 CacheLoader 实例上定义 asyncReload 方法; 灵魂追问:只有以上两步就够了吗? 机智的我突然觉得事情并不简单。还有一个时间设置的问题,我们来看看: 如果 expireAfterWrite 周期 < refreshAfterWrite 周期会如何?此时查询失效数据时总是会调用 load 方法,refreshAfterWrite 根本没用! 如果 CacheLoader#asyncReload 有额外操作,导致它自身实际执行查询耗时超过 expireAfterWrite 又会如何?还是 CacheLoader#load 生效,refreshAfterWrite 还是没用! 所以丝滑的正确打开方式,是 refreshAfterWrite 周期明显小于 expireAfterWrite 周期,并且 CacheLoader#asyncReload 本身也有较好的性能,才能如丝般顺滑地加载数据。此时就会发现业务不断进行 get 操作,根本感知不到数据加载时的卡顿! 3.6 用本地缓存会不会出现缓存穿透?怎么防止? computeIfAbsent 和 doComputeIfAbsent 方法可以看出如果加载结果是 null,那么每次从缓存查询,都会触发 mappingFunction.apply,进一步调用 CacheLoader#load。从而流量会直接打到后端数据库,造成缓存穿透。 防止的方法也比较简单,在业务可接受的情况下,如果未能查询到结果,则返回一个非 null 的“假对象”到本地缓存中。 灵魂追问:如果查不到,new 一个对象返回行不行? key 范围不大时可以,builder 设置了 size-based 驱逐策略时可以,但都存在消耗较多内存的风险,可以定义一个默认的 PLACE_HOLDER 静态对象作为引用。 灵魂追问:都用同一个假对象引用真的大丈夫(没问题)? 这么大的坑本菜鸟怎么能错过!缓存中存的是对象引用,如果业务 get 后修改了对象的内容,那么其他线程再次获取到这个对象时,将会得到修改后的值!鬼知道那个深夜定位出这个问题的我有多兴奋(苍蝇搓手)。 当时缓存中保存的是 List<Item>,而不同线程中对这些 item 的 score 进行了不同的 set 操作,导致同一个 item 排序后的分数和顺序变幻莫测。本菜鸟一度以为是推荐之神降临,冥冥中加持 CTR 所以把 score 变来变去。 灵魂追问:那怎么解决缓存被意外修改的问题呢?怎么 copy 一个对象呢? So easy,就在 get 的时候 copy 一下对象就好了。 灵魂追问4:怎么 copy 一个对象?……停!咱们以后有机会再来说说这个浅拷贝和深拷贝,以及常见的拷贝工具吧,聚焦聚焦…… 3.7 某次加载数据失败怎么办,还能用之前的缓存值吗? 根据 CacheLoader#load和 CacheLoader#asyncReload 的参数区别,我们可以发现: 应该在 asyncReload 中来处理,如果查询数据库异常,则可以返回 oldValue 来继续使用之前的缓存;否则只能通过 load 方法中返回预留空对象来解决。使用哪一种方法需要根据具体的业务场景来决定。 【踩坑】返回 null 将导致 Caffeine 认为该值不需要缓存,下次查询还会继续调用 load 方法,缓存并没生效。 3.8 多个线程同时 get 一个本地缓存不存在的值,会如何? 根据代码可以知道,已经进入 doComputeIfAbsent 的线程将阻塞在 data.compute 方法上; 比如短时间内有 N 个线程同时 get 相同的 key 并且 key 不存在,则这 N 个线程最终都会反复执行 compute 方法。但只要 data 中该 key 的值更新成功,其他进入 computeIfAbsent 的线程都可直接获得结果返回,不会出现阻塞等待加载; 所以,如果一开始就有大量请求进入 doComputeIfAbsent 阻塞等待数据,就会造成短时间请求挂起、超时的问题。由此在大流量场景下升级服务时,需要考虑在接入流量前对缓存进行预热(我查我自己,嗯),防止瞬时请求太多导致大量请求挂起或超时。 灵魂追问:如果一次 load 耗时 100ms,一开始有 10 个线程冷启动,最终等待时间会是 1s 左右吗? 其实……要看情况,回顾一下 data.compute 里面的代码: if (n == null) { // 这部分代码其他后续线程进入后已经有值,不再执行 } synchronized (n) { // ... if ((nodeKey[0] == null) || (oldValue[0] == null)) { cause[0] = RemovalCause.COLLECTED; } else if (hasExpired(n, now[0])) { cause[0] = RemovalCause.EXPIRED; } else { // 未失效时在这里返回,不会触发 load 函数 return n; } // ... } 所以,如果 load 结果不是 null,那么只第一个线程花了 100ms,后续线程会尽快返回,最终时长应该只比 100ms 多一点。但如果 load 结果返回 null(缓存穿透),相当于没有查到数据,于是后续线程还会再次执行 load,最终时间就是 1s 左右。 以上就是本菜鸟目前总结的内容,如有疏漏欢迎指出。在学习源码的过程中,Caffeine Cache 还使用了其他编码小技巧,咱们下次有空接着聊。 三、参考资料 1.Caffeine使用及原理 2.Caffeine Cache-高性能Java本地缓存组件 3.Eviction和Ticker相关介绍 4.Efficiency 5.CacheWriter 6.System.identityHashCode(obj)与obj.hashcode 作者:vivo 互联网服务器团队-Li Haoxuan

优秀的个人博客,低调大师

每日一博 | 谈谈对不同 I/O 模型的理解

点击上方蓝色字体,选择“标星公众号” 优质文章,第一时间送达 作者|小熊餐馆 来源 | urlify.cn/aAJZfm 66套java从入门到精通实战课程分享 一、关于I/O模型的问题 最近通过对ucore操作系统的学习,让我打开了操作系统内核这一黑盒子,与之前所学知识结合起来,解答了长久以来困扰我的关于I/O的一些问题。 1. 为什么redis能以单工作线程处理高达几万的并发请求? 2. 什么是I/O多路复用?为什么redis、nginx、nodeJS以及netty等以高性能著称的服务器其底层都利用了I/O多路复用技术? 3. 非阻塞I/O为什么会流行起来,在许多场景下取代了传统的阻塞I/O? 4. 非阻塞I/O真的是银弹吗?为什么即使在为海量用户提供服务的,追求高性能的互联网公司中依然有那么多的服务器在传统的阻塞IO模型下工作? 5. 什么是协程?为什么Go语言这么受欢迎? 在这篇博客中,将介绍不同层面、不同I/O模型的原理,并尝试着给出我对上述问题的回答。如果你也或多或少的对上述问题感到疑惑,希望这篇博客能为你提供帮助。 I/O模型和硬件、操作系统内核息息相关,博客中会涉及到诸如保护模式、中断、特权级、进程/线程、上下文切换、系统调用等关于操作系统、硬件相关的概念。由于计算机中的知识是按照层次组织起来的,如果对这些相对底层的概念不是很了解的话可能会影响对整体内容的理解。可以参考一下我关于操作系统、硬件学习相关的博客:x86汇编学习、操作系统学习(持续更新中)。 二、硬件I/O模型 软件的功能总是构建在硬件上的,计算机中的I/O本质上是CPU/内存与外设(网卡、磁盘等)进行数据的单向或双向传输。 从外设读入数据到CPU/内存称作Input输入,从CPU/内存中写出数据到外设称作Output输出。 要想理解软件层次上的不同I/O模型,必须先对其基于的硬件I/O模型有一个基本的认识。硬件I/O模型大致可以分为三种:程序控制I/O、中断驱动I/O、使用DMA的I/O。 程序控制I/O: 程序控制I/O模型中,通过指令控制CPU不断的轮询外设是否就绪,当硬件就绪时一点一点的反复读/写数据。 从CPU的角度来说,程序控制I/O模型是同步、阻塞的(同步指的是I/O操作依然是处于程序指令控制,由CPU主导的;阻塞指的是在发起I/O后CPU必须持续轮询完成状态,无法执行别的指令)。 程序控制I/O的优点: 硬件结构简单,编写对应程序也简单。 程序控制I/O的缺点: 十分消耗CPU,持续的轮训令宝贵的CPU资源无谓的浪费在了等待I/O完成的过程中,导致CPU利用率不高。 中断驱动I/O: 为了解决上述程序控制I/O模型对CPU资源利用率不高的问题,计算机硬件的设计者令CPU拥有了处理中断的功能。 在中断驱动I/O模型中,CPU发起对外设的I/O请求后,就直接去执行别的指令了。当硬件处理完I/O请求后,通过中断异步的通知CPU。接到读取完成中断通知后,CPU负责将数据从外设缓冲区中写入内存;接到写出完成中断通知后,CPU需要将内存中后续的数据接着写出交给外设处理。 从CPU的角度来说,中断驱动I/O模型是同步、非阻塞的(同步指的是I/O操作依然是处于程序指令控制,由CPU主导的;非阻塞指的是在发起I/O后CPU不会停下等待,而是可以执行别的指令)。 中断驱动I/O的优点: 由于I/O总是相对耗时的,比起通过程序控制I/O模型下CPU不停的轮训。在等待硬件I/O完成的过程中CPU可以解放出来执行另外的命令,大大提高了I/O密集程序的CPU利用率。 中断驱动I/O的缺点: 受制于硬件缓冲区的大小,一次硬件I/O可以处理的数据是相对有限的。在处理一次大数据的I/O请求中,CPU需要被反复的中断,而处理读写中断事件本身也是有一定开销的。 使用DMA的I/O: 为了解决中断驱动I/O模型中,大数据量的I/O传输使得CPU需要反复处理中断的缺陷,计算机硬件的设计者提出了基于DMA模式的I/O(DMA Direct Memory Access 直接存储器访问)。DMA也是一种处理器芯片,和CPU一样也可以访问内存和外设,但DMA芯片是被设计来专门处理I/O数据传输的,因此其成本相对CPU较低。 在使用DMA的I/O模型中,CPU与DMA芯片交互,指定需要读/写的数据块大小和需要进行I/O数据的目的内存地址后,便异步的处理别的指令了。由DMA与外设硬件进行交互,一次大数据量的I/O需要DMA反复的与外设进行交互,当DMA完成了整体数据块的I/O后(完整的将数据读入到内存或是完整的将某一内存块的数据写出到外设),再发起DMA中断通知CPU。 从CPU的角度来说,使用DMA的I/O模型是异步、非阻塞的(异步指的是整个I/O操作并不是由CPU主导,而是由DMA芯片与外设交互完成的;非阻塞指的是在发起I/O后CPU不会停下等待,而是可以执行别的指令)。 使用DMA的I/O优点: 比起外设硬件中断通知,对于一次完整的大数据内存与外设间的I/O,CPU只需要处理一次中断。CPU的利用效率相对来说是最高的。 使用DMA的I/O缺点: 1. 引入DMA芯片令硬件结构变复杂,成本较高。 2. 由于DMA芯片的引入,使得DMA和CPU并发的对内存进行操作,在拥有高速缓存的CPU中,引入了高速缓存与内存不一致的问题。 总的来说,自DMA技术被发明以来,由于其极大减少了CPU在I/O时的性能损耗,已经成为了绝大多数通用计算机的硬件标配。随着技术的发展又出现了更先进的通道I/O方式,相当于并发的DMA,允许并发的处理涉及多个不同内存区域、外设硬件的I/O操作。 三、操作系统I/O模型 介绍完硬件的I/O模型后,下面介绍这篇博客的重点:操作系统I/O模型。 操作系统帮我们屏蔽了诸多硬件外设的差异,为应用程序的开发者提供了友好、统一的服务。为了避免应用程序破坏操作系统内核,CPU提供了保护模式机制,使得应用程序无法直接访问被操作系统管理起来的外设,而必须通过内核提供的系统调用间接的访问外设。关于操作系统I/O模型的讨论针对的就是应用程序与内核之间进行I/O交互的系统调用模型。 ' 操作系统内核提供的I/O模型大致可以分为几种:同步阻塞I/O、同步非阻塞I/O、同步I/O多路复用、异步非阻塞I/O(信号驱动I/O用的比较少,就不在这里展开了)。 同步阻塞I/O(Blocking I/O BIO) 我们已经知道,高效的硬件层面I/O模型对于CPU来说是异步的,但应用程序开发者总是希望在执行完I/O系统调用后能同步的返回,线性的执行后续逻辑(例如当磁盘读取的系统调用返回后,下一行代码中就能直接访问到所读出的数据)。但这与硬件层面耗时、异步的I/O模型相违背(程序控制I/O过于浪费CPU),因此操作系统内核提供了基于同步、阻塞I/O的系统调用(BIO)来解决这一问题。 举个例子:当线程通过基于BIO的系统调用进行磁盘读取时,内核会令当前线程进入阻塞态,让出CPU资源给其它并发的就绪态线程,以便更有效率的利用CPU。当DMA完成读取,异步的I/O中断到来时,内核会找到先前被阻塞的对应线程,将其唤醒进入就绪态。当这个就绪态的线程被内核CPU调度器选中再度获得CPU时,便能从对应的缓冲区结构中得到读取到的磁盘数据,程序同步的执行流便能顺利的向下执行了。(感觉好像线程卡在了那里不动,过了一会才执行下一行,且指定的缓冲区中已经有了所需的数据) 下面的伪代码示例中参考linux的设计,将不同的外设统一抽象为文件,通过文件描述符(file descriptor)来统一的访问。 BIO伪代码实例 : //创建TCP套接字并绑定端口8888,进行服务监听listenfd=serverSocket(8888,"tcp");while(true){//accept同步阻塞调用newfd=accept(listenfd);//read会阻塞,因此使用线程异步处理,避免阻塞accpet(一般使用线程池)newthread(()->{//同步阻塞读取数据xxx=read(newfd);...dosomething//关闭连接close(newfd);});} BIO模型的优点: BIO的I/O模型由于同步、阻塞的特性,屏蔽了底层实质上异步的硬件交互方式,令程序员可以编写出简单易懂的线性程序逻辑。 BIO模型的缺点: 1. BIO的同步、阻塞特性在简单易用的同时,也存在一些性能上的缺陷。由于BIO在等待I/O完成的时间中,线程虽然被阻塞不消耗CPU,但内核维护一个系统级线程本身也是有一定的开销(维护线程控制块、内核线程栈空间等等)。 2. 不同线程在调度时的上下文切换CPU开销较大,在如今大量用户、高并发的互联网时代越来越成为web服务器性能的瓶颈。线程上下文切换本身需要需要保存、恢复现场,同时还会清空CPU指令流水线,以及令高速缓存大量失效。对于一个web服务器,如果使用BIO模型,服务器将至少需要1:1的维护同等数量的系统级线程(内核线程),由于持续并发的网络数据交互,导致不同线程由于网络I/O的完成事件被内核反复的调度。 在著名的C10K问题的语境下,一台服务器需要同时维护1W个并发的tcp连接和对等的1W个系统级线程。量变引起质变,1W个系统级线程调度引起的上下文切换和100个系统级线程的调度开销完全不同,其将耗尽CPU资源,令整个系统卡死,崩溃。 BIO交互流程示意图: 同步非阻塞I/O(NonBlocking I/O NIO) BIO模型简单易用,但其阻塞内核线程的特性使得其已经不适用于需要处理大量(1K以上)并发网络连接场景的web服务器了。为此,操作系统内核提供了非阻塞特性的I/O系统调用,即NIO(NonBlocking-IO)。 针对BIO模型的缺陷,NIO模型的系统调用不会阻塞当前调用线程。但由于I/O本质上的耗时特性,无法立即得到I/O处理的结果,NIO的系统调用在I/O未完成时会返回特定标识,代表对应的I/O事件还未完成。因此需要应用程序按照一定的频率反复调用,以获取最新的IO状态。 NIO伪代码实例 : //创建TCP套接字并绑定端口8888,进行服务监听listenfd=serverSocket(8888,"tcp");clientFdSet=empty_set();while(true){//开启事件监听循环//accept同步非阻塞调用,判断是否接收了新的连接newfd=acceptNonBlock(listenfd);if(newfd!=EMPTY){//如果存在新连接将其加入监听连接集合clientFdSet.add(newfd);}//申请一个1024字节的缓冲区buffer=newbuffer(1024);for(clientfdinclientFdSet){//非阻塞read读num=readNonBlock(clientfd,buffer);if(num>0){//读缓冲区存在数据data=buffer;...dosomethingif(needClose(data)){//关闭连接时,移除当前监听的连接clientFdSet.remove(clientfd);}}...dosomething//清空bufferbuffer.clear();}} NIO模型的优点: NIO因为其非阻塞的特性,使得一个线程可以处理多个并发的网络I/O连接。在C10K问题的语境下,理论上可以通过一个线程处理这1W个并发连接(对于多核CPU,可以创建多个线程在每个CPU核心中分摊负载,提高性能)。 NIO模型的缺点: NIO克服了BIO在高并发条件下的缺陷,但原始的NIO系统调用依然有着一定的性能问题。在上述伪代码示例中,每个文件描述符对应的I/O状态查询,都必须通过一次NIO系统调用才能完成。 由于操作系统内核利用CPU提供的保护模式机制,使内核运行在高特权级,而令用户程序运行在执行、访问受限的低特权级。这样设计的一个好处就是使得应用程序无法直接的访问硬件,而必须由操作系统提供的系统调用间接的访问硬件(网卡、磁盘甚至电源等)。执行系统调用时,需要令应用线程通过系统调用陷入内核(即提高应用程序的当前特权级CPL,使其能够访问受保护的硬件),并在系统调用返回时恢复为低特权级,这样一个过程在硬件上是通过中断实现的。 通过中断实现系统调用的效率远低于应用程序本地的函数调用,因此原始的NIO模式下通过系统调用循环访问每个文件描述符I/O就绪状态的方式是低效的。 NIO交互流程示意图: 同步I/O多路复用(I/O Multiplexing) 为了解决上述NIO模型的系统调用中,一次事件循环遍历进行N次系统调用的缺陷。操作系统内核在NIO系统调用的基础上提供了I/O多路复用模型的系统调用。 I/O多路复用相对于NIO模型的一个优化便是允许在一次I/O状态查询的系统调用中,一次传递复数个文件描述符进行批量的I/O状态查询。在一次事件循环中只需要进行一次I/O多路复用的系统调用就能得到所传递文件描述符集合的I/O状态,减少了原始NIO模型中不必要的系统调用开销。 多路复用I/O模型大致可以分为三种实现(虽然不同操作系统在最终实现上略有不同,但原理是类似的,示例代码以linux内核举例):select、poll、epoll。 select多路复用器介绍 select I/O多路复用器允许应用程序传递需要监听事件变化的文件描述符集合,监听其读/写,接受连接等I/O事件的状态。 select系统调用本身是同步、阻塞的,当所传递的文件描述符集合中都没有就绪的I/O事件时,执行select系统调用的线程将会进入阻塞态,直到至少一个文件描述符对应的I/O事件就绪,则唤醒被select阻塞的线程(可以指定超时时间来强制唤醒并返回)。唤醒后获得CPU的线程在select系统调用返回后可以遍历所传入的文件描述符集合,处理完成了I/O事件的文件描述符。 select伪代码示例: //创建TCP套接字并绑定端口8888,进行服务监听listenfd=serverSocket(8888,"tcp");fdNum=1;clientFdSet=empty_set();clientFdSet.add(listenfd);while(true){//开启事件监听循环//man2select(查看linux系统文档)//intselect(intnfds,fd_set*readfds,fd_set*writefds,fd_set*exceptfds,structtimeval*timeout);//参数nfds:一共需要监听的readfds、writefds、exceptfds中文件描述符个数+1//参数readfds/writefds/exceptfds:需要监听读、写、异常事件的文件描述符集合//参数timeout:select是同步阻塞的,当timeout时间内都没有任何I/O事件就绪,则调用线程被唤醒并返回(ret=0)//timeout为null代表永久阻塞//返回值ret://1.返回大于0的整数,代表传入的readfds/writefds/exceptfds中共有ret个被激活(需要应用程序自己遍历),//2.返回0,在阻塞超时前没有任何I/O事件就绪//3.返回-1,出现错误listenReadFd=clientFdSet;//select多路复用,一次传入需要监听事件的全量连接集合(超时时间1s)result=select(fdNum+1,listenReadFd,null,null,timeval("1s"));if(result>0){//如果服务器监听连接存在读事件if(IN_SET(listenfd,listenReadFd)){//接收并建立连接newClientFd=accept(listenfd);//加入客户端连接集合clientFdSet.add(newClientFd);fdNum++;}//遍历整个需要监听的客户端连接集合for(clientFd:clientFdSet){//如果当前客户端连接存在读事件if(IN_SET(clientFd,listenReadFd)){//阻塞读取数据data=read(clientfd);...dosomethingif(needClose(data)){//关闭连接时,移除当前监听的连接clientFdSet.remove(clientfd);fdNum--;}}}}} select的优点: 1. select多路复用避免了上述原始NIO模型中无谓的多次查询I/O状态的系统调用,将其聚合成集合,批量的进行监听并返回结果集。 2. select实现相对简单,windows、linux等主流的操作系统都实现了select系统调用,跨平台的兼容性好。 select的缺点: 1. 在事件循环中,每次select系统调用都需要从用户态全量的传递所需要监听的文件描述符集合,并且select返回后还需要全量遍历之前传入的文件描述符集合的状态。 2. 出于性能的考量,内核设置了select所监听文件描述符集合元素的最大数量(一般为1024,可在内核启动时指定),使得单次select所能监听的连接数受到了限制。 3. 抛开性能的考虑,从接口设计的角度来看,select将系统调用的参数与返回值混合到了一起(返回值覆盖了参数),增加了使用者理解的困难度。 I/O多路复用交互示意图: poll多路复用器介绍 poll I/O多路复用器在使用上和select大同小异,也是通过传入指定的文件描述符集合以及指定内核监听对应文件描述符上的I/O事件集合,但在实现的细节上基于select做了一定的优化。 和select一样,poll系统调用在没有任何就绪事件发生时也是同步、阻塞的(可以指定超时时间强制唤醒并返回),当返回后要判断是否有就绪事件时,也一样需要全量的遍历整个返回的文件描述符集合。 poll伪代码示例: /*//man2poll(查看linux系统文档)//和select不同将参数events和返回值revents分开了structpollfd{intfd;//filedescriptor对应的文件描述符shortevents;//requestedevents需要监听的事件shortrevents;//returnedevents返回时,就绪的事件};//参数fds,要监听的poolfd数组集合//参数nfds,传入fds数组中需要监听的元素个数//参数timeout,阻塞的超时时间(传入-1代表永久阻塞)intpoll(structpollfd*fds,nfds_tnfds,inttimeout);//events/revents是位图表示的//revents&POLLIN==1存在就绪的读事件//revents&POLLOUT==1存在就绪的写事件//revents&POLLHUP==1存在对端断开连接或是通信完成事件*///创建TCP套接字并绑定端口8888,进行服务监听listenfd=serverSocket(8888,"tcp");MAX_LISTEN_SIZE=100;structpollfdfds[MAX_LISTEN_SIZE];//设置服务器监听套接字(监听读事件)fds[0].fd=listenfd;fds[0].events=POLLIN;fds[0].revents=0;//客户端连接数一开始为0intclientCount=0;while(true){//poll同步阻塞调用(超时时间-1表示永久阻塞直到存在监听的就绪事件)intret=poll(fds,clientCount+1,-1);for(inti=0;i<clientCount+1;i++){if(fds[i].fd==listenfd&&fds[i].revents&POLLIN){//服务器监听套接字读事件就绪,建立新连接clientCount++;fds[clientCount].fd=conn;fds[clientCount].events=POLLIN|POLLRDHUP;fds[clientCount].revents=0;}elseif(fds[i].revents&POLLIN){//其他链接可读,进行读取read(fds[i].fd);...doSomething}elseif(fds[i].revents&POLLRDHUP){//监听到客户端连接断开,移除该连接fds[i]=fds[clientCount];i--;clientCount--;//关闭该连接close(fd);}}} poll的优点: 1. poll解决了select系统调用受限于内核配置参数的限制问题,可以同时监听更多文件描述符的I/O状态(但不能超过内核限制当前进程所能拥有的最大文件描述符数目限制)。 2. 优化了接口设计,将参数与返回值的进行了分离。 poll的缺点: 1. poll优化了select,但在处理大量闲置连接时,即使真正产生I/O就绪事件的活跃文件描述符数量很少,依然免不了线性的遍历整个监听的文件描述符集合。每次调用时,需要全量的将整个感兴趣的文件描述符集合从用户态复制到内核态。 2. 由于select/poll都需要全量的传递参数以及遍历返回值,因此其时间复杂度为O(n),即处理的开销随着并发连接数n的增加而增加,而无论并发连接本身活跃与否。但一般情况下即使并发连接数很多,大量连接都产生I/O就绪事件的情况并不多,更多的情况是1W的并发连接,可能只有几百个是处于活跃状态的,这种情况下select/poll的性能并不理想,还存在优化的空间。 epoll多路复用器: epoll是linux系统中独有的,针对select/poll上述缺点进行改进的高性能I/O多路复用器。 针对poll系统调用介绍中的第一个缺点:在每次事件循环时都需要从用户态全量传递整个需要监听的文件描述符集合。 epoll在内核中分配内存空间用于缓存被监听的文件描述符集合。通过创建epoll的系统调用(epoll_create),在内核中维护了一个epoll结构,而在应用程序中只需要保留epoll结构的句柄就可对其进行访问(也是一个文件描述符)。可以动态的在epoll结构的内核空间中增加/删除/更新所要监听的文件描述符以及不同的监听事件(epoll_ctl),而不必每次都全量的传递需要监听的文件描述符集合。 针对select/poll的第二个缺点:在系统调用返回后通过修改所监听文件描述符结构的状态,来标识文件描述符对应的I/O事件是否就绪。每次系统调用返回时,都需要全量的遍历整个监听文件描述符集合,而无论是否真的完成了I/O。 epoll监听事件的系统调用完成后,只会将真正活跃的、完成了I/O事件的文件描述符返回,避免了全量的遍历。在并发的连接数很大,但闲置连接占比很高时,epoll的性能大大优于select/poll这两种I/O多路复用器。epoll的时间复杂度为O(m),即处理的开销不随着并发连接n的增加而增加,而是仅仅和监控的活跃连接m相关;在某些情况下n远大于m,epoll的时间复杂度甚至可以认为近似的达到了O(1)。 通过epoll_wait系统调用,监听参数中传入对应epoll结构中关联的所有文件描述符的对应I/O状态。epoll_wait本身是同步、阻塞的(可以指定超时时间强制唤醒并返回),当epoll_wait同步返回时,会返回处于活跃状态的完成I/O事件的文件描述符集合,避免了select/poll中的无效遍历。同时epoll使用了mmap机制,将内核中的维护的就绪文件描述符集合所在空间映射到了用户态,令应用程序与epoll的内核共享这一区域的内存,避免了epoll返回就绪文件描述符集合时的一次内存复制。 epoll伪代码示例: /**epoll比较复杂,使用时大致依赖三个系统调用(man7epoll)1.epoll_create创建一个epoll结构,返回对应epoll的文件描述符(man2epoll_create)intepoll_create();2.epoll_ctl控制某一epoll结构(epfd),向其增加/删除/更新(op)某一其它连接(fd),监控其I/O事件(event)(man2epoll_ctl)op有三种合法值:EPOLL_CTL_ADD代表新增、EPOLL_CTL_MOD代表更新、EPOLL_CTL_DEL代表删除intepoll_ctl(intepfd,intop,intfd,structepoll_event*event);3.epoll_wait令某一epoll同步阻塞的开始监听(epfd),感兴趣的I/O事件(events),所监听fd的最大个数(maxevents),指定阻塞超时时间(timeout)(man2epoll_wait)intepoll_wait(intepfd,structepoll_event*events,intmaxevents,inttimeout);*///创建TCP套接字并绑定端口8888,进行服务监听listenfd=serverSocket(8888,"tcp");//创建一个epoll结构epollfd=epoll_create();ev=newepoll_event();ev.events=EPOLLIN;//读事件ev.data.fd=listenfd;//通过epoll监听服务器端口读事件(新连接建立请求)epoll_ctl(epollfd,EPOLL_CTL_ADD,listenfd,ev);//最大监听1000个连接MAX_EVENTS=1000;listenEvents=newevent[MAX_EVENTS];while(true){//同步阻塞监听事件//最多返回MAX_EVENTS个事件响应结果//(超时时间1000ms,标识在超时时间内没有任何事件就绪则当前线程被唤醒,返回值nfd将为0)nfds=epoll_wait(epollfd,listenEvents,MAX_EVENTS,1*1000);for(n=0;n<nfds;++n){if(events[n].data.fd==listenfd){//当发现服务器监听套接字存在可读事件,建立新的套接字连接clientfd=accept(listenfd);ev.events=EPOLLIN|EPOLLET;ev.data.fd=clientfd;//新建立的套接字连接也加入当前epoll的监听(监听读(EPOLLIN)/写(EPOLLET)事件)epoll_ctl(epollfd,EPOLL_CTL_ADD,clientfd,ev);}else{//否则是其它连接的I/O事件就绪,进行对应的操作...do_something}}} epoll的优点: epoll是目前性能最好的I/O多路复用器之一,具有I/O多路复用优点的情况下很好的解决了select/poll的缺陷。目前linux平台中,像nginx、redis、netty等高性能服务器都是首选epoll作为基础来实现网络I/O功能的。 epoll的缺点: 1. 常规情况下闲置连接占比很大,epoll的性能表现的很好。但是也有少部分场景中,绝大多数连接都是活跃的,那么其性能与select/poll这种基于位图、数组等简单结构的I/O多路复用器相比,就不那么有优势了。因为select/poll被诟病的一点就是通常情况下进行了无谓的全量检查,而当活跃连接数占比一直超过90%甚至更高时,就不再是浪费了;相反的,由于epoll内部结构比较复杂,在这种情况下其性能比select/poll还要低一点。 2. epoll是linux操作系统下独有的,使得基于epoll实现的应用程序的跨平台兼容性受到了一定影响。 异步非阻塞I/O(Asynchronous I/O AIO) windows和linux都支持了select系统调用,但linux内核在之后又实现了epoll这一更高性能的I/O多路复用器来改进select。 windows没有模仿linux,而是提供了被称为IOCP(Input/Output Completion Port 输入输出完成端口)的功能解决select性能的问题。IOCP采用异步非阻塞IO(AIO)的模型,其与epoll同步非阻塞IO的最大区别在于,epoll调用完成后,仅仅返回了就绪的文件描述符集合;而IOCP则在内核中自动的完成了epoll中原本应该由应用程序主动发起的I/O操作。 举个例子,当监听到就绪事件开始读取某一网络连接的请求报文时,epoll依然需要通过程序主动的发起读取请求,将数据从内核中读入用户空间。而windows下的IOCP则是通过注册回调事件的方式工作,由内核自动的将数据放入指定的用户空间,当处理完毕后会调度激活注册的回调事件,被唤醒的线程能直接访问到所需要的数据。 这也是为什么BIO/NIO/IO多路复用被称为同步I/O,而IOCP被称为异步I/O的原因。 同步I/O与异步I/O的主要区别就在于站在应用程序的视角看,真正读取/写入数据时是否是由应用程序主导的。如果需要用户程序主动发起最终的I/O请求就被称为同步I/O;而如果是内核自动完成I/O后通知用户程序,则被称为异步I/O。(可以类比在前面硬件I/O模型中,站在CPU视角的同步、异步I/O模型,只不过这里CPU变成了应用程序,而外设/DMA变成了操作系统内核) AIO的优点: AIO作为异步I/O,由内核自动的完成了底层一整套的I/O操作,应用程序在事件回调通知中能直接获取到所需数据。内核中可以实现非常高效的调度、通知框架。拥有前面NIO高性能的优点,又简化了应用程序的开发。 AIO的缺点: 由内核全盘控制的全自动I/O虽然能够做到足够高效,但是在一些特定场景下性能并不一定能超过由应用程序主导的,经过深度优化的代码。像epoll在支持了和select/poll一样的水平触发I/O的同时,还支持了更加细致的边缘触发I/O,允许用户自主的决定当I/O就绪时,是否需要立即处理或是缓存起来等待稍后再处理。(就像java等支持自动内存垃圾回收的语言,即使其垃圾收集器经过持续的优化,在大多数情况下性能都很不错,但却依然无法达到和经过开发人员反复调优,手动回收内存的C、C++等语言实现的程序一样的性能) (截图自《Unix网络编程 卷1》) 操作系统I/O模型小结 1. 同步I/O包括了同步阻塞I/O和同步非阻塞I/O,而异步I/O中由于异步阻塞I/O模型没有太大价值,因此提到异步I/O(AIO)时,默认指的就是异步非阻塞I/O。 2. 在I/O多路复用器的工作中,当监听到对应文件描述符I/O事件就绪时,后续进行的读/写操作既可以是阻塞的,也可以是非阻塞的。如果是都以阻塞的方式进行读/写,虽然实现简单,但如果某一文件描述符需要读写的数据量很大时将耗时较多,可能会导致事件循环中的其它事件得不到及时处理。因此截图中的阻塞读写数据部分并不准确,需要辩证的看待。 四、非阻塞I/O是银弹吗? 计算机技术的发展看似日新月异,但本质上有两类目标指引着其前进。一是尽可能的增强、压榨硬件的性能,提高机器效率;二是尽可能的通过持续的抽象、封装简化软件复杂度,提高程序员的开发效率。计算机软件的发展方向必须至少需要满足其中一种目标。 从上面关于操作系统内核I/O模型的发展中可以看到,最初被广泛使用的是易理解、开发简单的BIO模型;但由于互联网时代的到来,web服务器系统面临着C10K问题,需要能支持海量的并发客户端连接,因此出现了包括NIO、I/O多路复用、AIO等技术,利用一个内核线程管理成百上千的并发连接,来解决BIO模型中一个内核线程对应一个网络连接的工作模式中,由于处理大量连接导致内核线程上下文频繁切换,造成CPU资源耗尽的问题。上述的第一条原则指引着内核I/O模型的发展,使得web服务器能够获得更大的连接服务吞吐量,提高了机器效率。 但非阻塞I/O真的是完美无缺的吗? 有着非阻塞I/O模型开发经验的程序员都知道,正是由于一个内核线程管理着成百上千个客户端连接,因此在整个线程的执行流中不能出现耗时、阻塞的操作(比如同步阻塞的数据库查询、rpc接口调用等)。如果这种操作不可避免,则需要单独使用另外的线程异步的处理,而不能阻塞当前的整个事件循环,否则将会导致其它连接的请求得不到及时的处理,造成饥饿。 对于多数互联网分布式架构下处理业务逻辑的应用程序服务器来说,在一个网络请求服务中,可能需要频繁的访问数据库或者通过网络远程调用其它服务的接口。如果使用的是基于NIO模型进行工作的话,则要求rpc库以及数据库、中间件等连接的库是支持异步非阻塞的。如果由于同步阻塞库的存在,在每次接受连接进行服务时依然被迫通过另外的线程处理以避免阻塞,则NIO服务器的性能将退化到和使用传统的BIO模型一样的地步。 所幸的是随着非阻塞I/O的逐渐流行,上述问题得到了很大的改善,越来越的框架/库都提供了异步非阻塞的api接口。 非阻塞I/O带来的新问题 异步非阻塞库改变了同步阻塞库下程序员习以为常的,线性的思维方式,在编码时被迫的以事件驱动的方式思考。逻辑上连贯的业务代码为了适应异步非阻塞的库程序,被迫分隔成多个独立片段嵌套在各个不同层次的回调函数中。对于复杂的业务而言,很容易出现嵌套为一层层的回调函数调用链,形成臭名昭著的callback hell(回调地狱)。 最早被callback hell折磨的可能是客户端程序的开发人员,因为客户端程序需要时刻监听着用户操作事件的产生,通常以基于事件驱动的方式组织异步处理代码。 callback hell伪代码示例: //由于互相之间有前后的数据依赖,按照顺序异步的调用A、B、C、DA.dosomething((res)->{data=res.xxx;B.dosomething(data,(res)->{data=res.xxx;C.dosomething(data,(res)->{data=res.xxxD.dosomething(data,(res)->{//。。。有依赖的同步业务越复杂,层次越深,就像一个无底洞})})})}) 异步非阻塞库的使用割裂了代码的连贯结构,使得程序变得难以理解、调试,这一缺陷在堆积着复杂晦涩业务逻辑的web应用程序服务器程序中显得难以忍受。这也是为什么如今web服务器仍然有很大一部分依然使用传统的同步阻塞的BIO模型进行开发的主要原因。通过分布式、集群的方式分摊大量并发的连接,而只在业务相对简单的API网关、消息队列等I/O密集型的中间件程序中NIO才被广泛使用(实在不行,业务服务器集群可以加机器,保证开发效率也同样重要)。 那么就没有什么办法既能够拥有非阻塞I/O支撑海量并发、高吞吐量的性能优势;又能够令程序员以同步方式思考、编写程序,以提高开发效率吗? 解决办法当然是存在的,且相关技术依然在不断发展。上述计算机技术发展的第二个原则指导着这些技术发展,目的是为了简化代码复杂性,提高程序员的效率。 1. 优化语法、语言库以简化异步编程的难度 在函数式编程的领域,就一直有着诸多晦涩的“黑科技”(CPS变换、monad等),能够简化callback hell,使得可以以几乎是同步的方式编写实质上是异步执行的代码。例如EcmaScript便在EcmaScript6、EcmaScript7中分别引入了promise和async/await来解决这一问题。 2. 在语言级别支持用户级线程(协程) 前面提到,传统的基于BIO模型的工作模式最大的优点在于可以同步的编写代码,遇到需要等待的耗时操作时能够被阻塞,使用起来简单易懂。但由于1:1的维护内核线程在处理海量连接时由于频繁的内核线程上下文切换而力不从心,催生了非阻塞I/O。 而由于上述非阻塞I/O引起的代码复杂度增加的问题,计算机科学家们想到了很早之前就在操作系统概念中提出,但一直没有被广泛使用的另一种线程实现方式:用户级线程。 用户级线程顾名思义,就是在用户级实现的线程,操作系统内核对其是无感知的。用户级线程在许多方面与大家所熟知的内核级线程相似,都有着自己独立的执行流,和进程中的其它线程共享内存空间。 用户级线程与内核级线程最大的一个区别就在于由于操作系统对其无感知,因此无法对用户级线程进行基于中断的抢占式调度。要使得同一进程下的不同用户级线程能够协调工作,必须小心的编写执行逻辑,以互相之间主动让渡CPU的形式工作,否则将会导致一个用户级线程持续不断的占用CPU,而令其它用户级线程处于饥饿状态,因此用户级线程也被称为协程,即互相协作的线程。 用户级线程无论如何是基于至少一个内核线程/进程的,多个用户级线程可以挂载在一个内核线程/进程中被内核统一的调度管理。 (截图自《现代操作系统》) 协程可以在遇到I/O等耗时操作时选择主动的让出CPU,以实现同步阻塞的效果,令程序执行流转移到另一个协程中。由于多个协程可以复用一个内核线程,每个协程所占用的开销相对内核级线程来说非常小;且协程上下文切换时由于不需要陷入内核,其切换效率也远比内核线程的上下文切换高(开销近似于一个函数调用)。 最近很流行的Go语言就是由于其支持语言层面的协程而备受推崇。程序员可以利用一些语言层面提供的协程机制编写高效的web服务器程序(例如在语句中添加控制协程同步的关键字)。通过在编译后的最终代码中加入对应的协程调度指令,由协程调度器接手,控制协程同步时在耗时I/O操作发生时主动的让出CPU,并在处理完毕后能被调度回来接着执行。Go语言通过语言层面上对协程的支持,降低了编写正确、协调工作的协程代码的难度。 Go编写的高性能web服务器如果运行在多核CPU的linux操作系统中,一般会创建m个内核线程和n个协程(m正比与CPU核心数,n远大于m且正比于并发连接数),底层每个内核线程依然可以利用epoll IO多路复用器处理并发的网络连接,并将业务逻辑处理的任务转交给用户态的协程(gorountine)。每个协程可以在不同的内核线程(CPU核心)中被来回调度,以获得最大的CPU吞吐量。 使用协程,程序员在开发时能够编写同步阻塞的耗时I/O代码,又不用担心高并发情况下BIO模型中的性能问题。可以说协程兼顾了程序开发效率与机器执行效率,因此越来越多的语言也在语言层面或是在函数库中提供协程机制。 3. 实现用户透明的协程 在通过虚拟机作为中间媒介,操作系统平台无关的语言中(比如java),虚拟机作为应用程序与操作系统内核的中间层,可以对应用程序进行各方面的优化,令程序员可以轻松编写出高效的代码。 有大牛在知乎的一篇回答中提到过,其曾经领导团队在阿里巴巴工作时在java中实现了透明的协程。但似乎没有和官方标准达成统一因此并没有对外开放。 如果能够在虚拟机中提供高效、用户透明的协程机制,使得原本基于BIO多线程的服务器程序无需改造便自动的获得了支持海量并发的能力,那真是太强了Orz。 五、总结 通过对ucore操作系统源码级的研究学习,加深了我对操作系统原理书中各种抽象概念的理解,也渐渐理解了一些关于各种I/O模型的问题。 一方面,通过对操作系统I/O模型的总结,使得我对于上层应用程序如java中的nio和netty中的非阻塞的编程风格有了更深的理解,不再像之前只习惯于BIO编程那样感到奇怪,而是觉得非常自然。另一方面,又意识到了自己还有太多的不足。 站在操作系统I/O模型这一层面,向上看,依然对基于nio的各种中间件不太熟悉,不了解在具体实践中如何利用好NIO这一利器,写出鲁棒、高效的代码;向下看,由于ucore为了尽可能的简化实验课的难度,省略了很多的功能没有实现,导致我对于操作系统底层是如何实现网络协议栈、如何实现nio和io多路复用器的原理知之甚少,暂时只能将其当作黑盒子看待,很多地方可能理解的有偏差。令我在拓宽知识面的同时,感叹知道的越多就越感觉自己无知,但人总是要向前走的,在学习中希望尽量能做到知其然而知其所以然。通过对ucore操作系统的学习,使得我对于操作系统内核的学习不再感到恐惧,在认知学习概念中就是从恐惧区转为了学习区。以后有机会的话,可以通过研究早期的linux内核源码来解答我关于I/O模型底层实现的一系列问题。 这篇博客是这一段时间来对操作系统学习的一个阶段性总结,直接或间接的回答了博客开头的几个问题,希望能帮到对操作系统、I/O模型感兴趣的人。这篇文章中还存在许多理解不到位的地方,请多多指教。 粉丝福利:实战springboot+CAS单点登录系统视频教程免费领取 👇👇👇 👆长按上方微信二维码2 秒 即可获取资料 感谢点赞支持下哈 本文分享自微信公众号 - java1234(gh_27ed55ecb177)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | 图解神秘的 NC4HW4

【GiantPandaCV导语】以卷积和im2col+gemm实现卷积操作举例,来图解深度学习中Tensor的NC4HW4(其实应该是N{C/4+C%4>0?1:0}HW4),写成NC4HW4方便阅读. 什么是NC4HW4? 对于卷积操作, 根据计算机内存排布特点, 按行进行处理.处理完一个通道的数据, 转入下一个通道继续按行处理. 卷积操作示意图 对于一个nchw格式的Tensor来说, 其在计算机中的内存排布是这样的: NCHW的Tensor内存排布示意图 使用cpp一次指令处理一个数据, 用来处理卷积操作, 即循环实现乘法相加即可. 卷积实现示意图 现在有一条指令处理4组数据的能力, 比如x86结构的sse指令,arm的neon指令.以及GPGPU的OpenGL和OpenCL,单次处理RGBA四组数据. 如果继续使用nchw内存排布的话, 是这样的. 想使用指令集加速卷积,不能直接计算 根据按行处理特点, 对于Feature和kernel的宽不是4倍数进行处理, 会出现错误. 图中的kernel很明显以已经到了第二行的值。那么有没有方法在按行处理的思想上, 一次处理4个数,而不受影响.答案是有的, 即NC4HW4.即把前4个通道合并在一个通道上, 依次类推, 在通道数不够4的情况下进行补0. 经过NC4HW4重排后的Tensor在内存中的排布情况如下: 经过NC4HW4重排后的Tensor在内存中的排布示意图 那么, 此时在进行单次指令处理4组数据的处理,就没有问题了.只不过处理结果也是NC4HW4结构的,需要在结果输出加上NC4HW4转nchw. 使用指令集加速卷积,可以直接计算 NC4HW4中使用im2col+gemm实现卷积: im2col+gemm在深度学习中是最常用的对卷积进行加速计算的方案。最早在caffe框架中支持。思路如下: 卷积示意图 使用im2col+gemm进行计算: Im2Col图解 对于NC4HW4内存排布的Tensor来说,同样可以采用im2col+gemm来处理. 有如下卷积,可以使用NC4HW4内存排布方式,使用指令集优化对卷积进行加速. 卷积示意图 NCHW转NC4HW4. NCHW转NC4HW4 NC4HW4对feature进行im2col NC4HW4对feature进行im2col示意图 NC4HW4对kernel进行im2col NC4HW4对kernel进行im2col 使用SSE,Neon,OpenCL或OpenGL实现Gemm. 使用SSE,Neon,OpenCL或OpenGL实现Gemm 最后 欢迎关注我和BBuf及公众号的小伙伴们一块维护的一个深度学习框架Msnhnet: https://github.com/msnh2012/Msnhnet 推荐阅读 多平台轻量级PyTorch模型推理框架MsnhNet Pytorch转Msnhnet模型思路分享 视觉算法工业部署及优化学习路线分享 基于how-to-optimize-gemm初探矩阵乘法优化 详解Im2Col+Pack+Sgemm策略更好的优化卷积运算 Im2Col+GEMM的改进方法MEC,一种更加高效的卷积计算策略 欢迎关注GiantPandaCV, 在这里你将看到独家的深度学习分享,坚持原创,每天分享我们学习到的新鲜知识。( • ̀ω•́ )✧ 有对文章相关的问题,或者想要加入交流群,欢迎添加BBuf微信: 二维码 为了方便读者获取资料以及我们公众号的作者发布一些Github工程的更新,我们成立了一个QQ群,二维码如下,感兴趣可以加入。 公众号QQ交流群 本文分享自微信公众号 - GiantPandaCV(BBuf233)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | Tomcat 的原理之架构设计模式

Tomcat的设计模式分析 Tomcat 中运用的许多经典设计模式,如模版模式、工厂模式和单例模式等。通过学习它们的实践运用能给我们以后的软件设计起到一定的借鉴作用。 门面设计模式 门面设计模式在 Tomcat中有多处使用,在 Request 和 Response 对象封装中Standard Wrapper 到 ServletConfig 封装中、ApplicationContext 到 ServletContext 封装中等都用到了这种设计模式 门面设计模式的原理 顾名思义,就是将一个东西封装成一个门面好与人家更容易进行交流,就像一个国家的外交部一样。 这种设计模式主要用在一个大的系统中有多个子系统组成时,多个子系统肯定要涉及到相互通信,但是每个子系统又不能将自己的内部数据过多的暴露给其它系统,不然就没有必要划分子系统了。 每个子系统都会设计一个门面,把别的系统感兴趣的数据封装起来,通过这个门面来进行访问。这就是门面设计模式存在的意义。 门面设计模式示意图如下: Client 只能访问到 Façade 中提供的数据是门面设计模式的关键,至于Client 如何访问 Façade 和 Subsystem 如何提供 Façade 门面设计模式并没有规定死。 Tomcat 的门面设计模式示例 Tomcat 中门面设计模式使用的很多,因为 Tomcat 中有很多不同组件,每个组件要相互交互数据,用门面模式隔离数据是个很好的方法。 下面是 Request 上使用的门面设计模式 从图中可以看出 HttpRequestFacade 类封装了 HttpRequest 接口能够提供数据,通过 HttpRequestFacade 访问到的数据都被代理到HttpRequest 中,通常被封装的对象都被设为 Private 或者Protected 访问修饰,以防止在 Façade 中被直接访问。 观察者设计模式 设计模式也是常用的设计方法通常也叫发布 - 订阅模式,也就是事件监听机制,通常在某个事件发生的前后会触发一些操作。 观察者模式的原理 观察者模式原理也很简单,就是你在做事的时候旁边总有一个人在盯着你,当你做的事情是它感兴趣的时候,它就会跟着做另外一些事情。但是盯着你的人必须要到你那去登记,否则你不会允许它盯着你或者监视着你的。 观察者模式通常包含下面这几个角色: Subject 就是抽象主题:它负责管理所有观察者的引用,同时定义主要的事件操作。 ConcreteSubject 具体主题:它实现了抽象主题的所有定义的接口,当自己发生变 化时,会通知所有观察者。 Observer 观察者:监听主题发生变化相应的操作接口。 Tomcat 的观察者模式示例 Tomcat 中观察者模式也有多处使用,前面讲的控制组件生命周期的 Lifecycle 就是这种模式的体现,还有对 Servlet 实例的创建、Session 的管理、Container 等都是同样的原理。下面主要看一下Lifecycle 的具体实现。 Lifecycle 的观察者模式结构图: 上面的结构图中,LifecycleListener 代表的是抽象观察者,它定义一个 lifecycleEvent 方法,这个方法就是当主题变化时要执行的方法。 ServerLifecycleListener 代表的是具体的观察者,它实现了LifecycleListener 接口的方法,就是这个具体的观察者具体的实现方式。 Lifecycle 接口代表的是抽象主题,它定义了管理观察者的方法和它要所做的其它方法。而 StandardServer 代表的是具体主题,它实现了抽象主题的所有方法。这里 Tomcat 对观察者做了扩展,增加了另外两个类:LifecycleSupport、LifecycleEvent,它们作为辅助类扩展了观察者的功能。 LifecycleEvent使得可以定义事件类别,不同的事件可区别处理,更加灵活。 LifecycleSupport 类代理了主题对多观察者的管理,将这个管理抽出来统一实现,以后如果修改只要修改 LifecycleSupport 类就可以了,不需要去修改所有具体主题, 因为所有具体主题的对观察者的操作都被代理给 LifecycleSupport类了。这可以认为是观察者模式的改进版。实际执行者就是LifecyleSupport去执行 LifecycleSupport 调用观察者的方法代码如下: 清单 1. LifecycleSupport 中的 fireLifecycleEvent 方 public void fireLifecycleEvent(String type, Object data) { LifecycleEvent event = new LifecycleEvent(lifecycle, type, data); LifecycleListener interested[] = null; synchronized (listeners) { interested = (LifecycleListener[]) listeners.clone(); } for (int i = 0; i < interested.length; i++) interested[i].lifecycleEvent(event); } } 主题是怎么通知观察者呢?看下面代码: 清单 2. 容器中的 start 方法 public void start() throws LifecycleException { lifecycle.fireLifecycleEvent(BEFORE_START_EVENT, null); lifecycle.fireLifecycleEvent(START_EVENT, null); started = true; synchronized (services) { for (int i = 0; i < services.length; i++) { if (services[i] instanceof Lifecycle) ((Lifecycle) services[i]).start(); } } lifecycle.fireLifecycleEvent(AFTER_START_EVENT, null); } 命令设计模式 Tomcat 中两个核心组件 Connector 和 Container,比作一对夫妻。男的将接受过来的请求以命令的方式交给女主人。对应到 Connector 和 Container,Connector 也是通过命令模式调用Container 的。 命令模式的原理 下面是命令模式通常包含下面几个角色: Client:创建一个命令,并决定接受者 Command 命令:命令接口定义一个抽象方法 ConcreteCommand:具体命令,负责调用接受者的相应操作 Invoker 请求者:负责调用命令对象执行请求 Receiver 接受者:负责具体实施和执行一次请求 Tomcat 中的命令模式的示例 Tomcat 中命令模式在 Connector 和 Container 组件之间有体现,Tomcat 作为应用服务器,无疑会接受到很多请求,如何分配和执行这些请求是必须的功能。 下面看一下 Tomcat 是如何实现命令模式的结构图 Connector 作为抽象请求者,HttpConnector 作为具体请求者。 HttpProcessor 作为命令。 Container 作为命令的抽象接受者,ContainerBase 作为具体的接受者。 客户端就是应用服务器 Server组件了。 Server 首先创建命令请求者 HttpConnector 对象,创建命令 HttpProcessor 命令对象,把请求者封装到命令对象里面。 再把命令对象交给命令接受者ContainerBase 容器来处理命令。命令的最终是被 Tomcat 的Container 执行的。 命令可以以队列的方式进来,Container可以以不同的方式来处理请求,如HTTP1.0 协议和 HTTP1.1 的处理方式就会不同。 责任链模式 Tomcat 中一个最容易发现的设计模式就是责任链模式,这个设计模式也是 Tomcat 中 Container 设计的基础,整个容器的就是通过一个链连接在一起,这个链一直将请求正确的传递给最终处理请求的那个 Servlet。 责任链模式的原理 责任链模式,就是很多对象有每个对象对其下家的引用而连接起来形成一条链,请求在这条链上传递,直到链上的某个对象处理此请求,或者每个对象都可以处理请求,并传给下一家,直到最终链上每个对象都处理完。这样可以不影响客户端而能够在链上增加任意的处理节点。 通常责任链模式包含下面几个角色: Handler(抽象处理者):定义一个处理请求的接口 ConcreteHandler(具体处理者):处理请求的具体类,或者传给下家 Tomcat中责任链模式示例 在 tomcat 中这种设计模式几乎被完整的使用,tomcat 的容器设置就是责任链模式,从 Engine 到 Host 再到 Context 一直到Wrapper 都是通过一个链传递请求。 Tomcat 中责任链模式的类结构图如下: 上图基本描述了四个子容器使用责任链模式的类结构图,对应的责任链模式的角色,Container 扮演抽象处理者角色,具体处理者由StandardEngine 等子容器扮演。与标准的责任链不同的是,这里引入了 Pipeline 和 Valve 接口。他们有什么作用呢? 实际上 Pipeline 和 Valve 是扩展了这个链的功能,使得在链往下传递过程中,能够接受外界的干预。Pipeline 就是连接每个子容器的管子,里面传递的 Request 和 Response 对象好比管子里流的水,而 Valve 就是这个管子上开的一个个小口子,让你有机会能够接触到里面的水,做一些额外的事情。 为了防止水被引出来而不能流到下一个容器中,每一段管子最后总有一个节点保证它一定能流到下一个子容器,所以每个容器都有一个 StandardXXXValve。只要涉及到这种有链式是处理流程这是一个非常值得借鉴的模式。

优秀的个人博客,低调大师

每日一博 | Elasticsearch/DB 到 SFTP/FTP 的数据同步

Elasticsearch/DB到SFTP/FTP数据同步 通过bboss数据同步工具,可以非常高效快速方便地将Elasticsearch和Database中的数据实时导出(增量/全量)到文件并上传到SFTP/FTP服务器,本文通过案例来详细介绍。 1.案例源码工程 https://gitee.com/bboss/elasticsearch-file2ftp https://github.com/bbossgroups/elasticsearch-file2ftp 2.案例功能说明 串行将数据导出到文件并上传ftp和sftp 串行批量将数据导出到文件并上传ftp和sftp 并行将数据批量导出到文件并上传ftp和sftp 通过设置disableftp为true,控制只生成数据文件,禁用文件上传sftp/ftp功能(生成的文件保留在fileDir对应的目录下) 特别关注点 除了bboss同步工具通用特性(增量/全量同步、异步/同步、增删改查同步),需额外说明一下本案例中特定的特色: 支持上传失败文件重传功能 支持上传成功文件备份功能,并可指定备份多长时间 支持备份文件自动清理功能 支持按记录条数切割文件 优雅解决elasticsearch异步延迟写入特性可能导致增量同步遗漏步数据问题 本文只介绍elasticsearch数据同步上传到sftp案例 https://github.com/bbossgroups/elasticsearch-file2ftp/blob/main/src/main/java/org/frameworkset/elasticsearch/imp/ES2FileFtpBatchSplitFileDemo.java 其他案例直接查看源码: elasticsearch数据同步上传到ftp案例代码地址 https://github.com/bbossgroups/elasticsearch-file2ftp/blob/main/src/main/java/org/frameworkset/elasticsearch/imp/ftp/ES2FileFtpBatchDemo.java 数据库同步上传到sftp案例代码地址 https://github.com/bbossgroups/elasticsearch-file2ftp/blob/main/src/main/java/org/frameworkset/elasticsearch/imp/db/DB2FileFtpDemo.java 3.案例讲解 接下来以elasticsearch数据导出并上传sftp服务器为例进行介绍, 3.1建立同步作业处理类 先看完整的同步作业处理类-ES2FileFtpBatchSplitFileDemo,然后再详细讲解。 package org.frameworkset.elasticsearch.imp; import com.frameworkset.util.SimpleStringUtil; import org.frameworkset.elasticsearch.serial.SerialUtil; import org.frameworkset.runtime.CommonLauncher; import org.frameworkset.tran.CommonRecord; import org.frameworkset.tran.DataRefactor; import org.frameworkset.tran.DataStream; import org.frameworkset.tran.context.Context; import org.frameworkset.tran.input.fileftp.es.ES2FileFtpExportBuilder; import org.frameworkset.tran.output.fileftp.FileFtpOupputConfig; import org.frameworkset.tran.output.fileftp.FilenameGenerator; import org.frameworkset.tran.output.fileftp.ReocordGenerator; import org.frameworkset.tran.schedule.CallInterceptor; import org.frameworkset.tran.schedule.ImportIncreamentConfig; import org.frameworkset.tran.schedule.TaskContext; import java.io.Writer; import java.text.DateFormat; import java.text.SimpleDateFormat; import java.util.Date; import java.util.Map; public class ES2FileFtpBatchSplitFileDemo { public static void main(String[] args){ ES2FileFtpExportBuilder importBuilder = new ES2FileFtpExportBuilder(); importBuilder.setBatchSize(500).setFetchSize(1000); String ftpIp = CommonLauncher.getProperty("ftpIP","10.13.6.127");//同时指定了默认值 FileFtpOupputConfig fileFtpOupputConfig = new FileFtpOupputConfig(); fileFtpOupputConfig.setFtpIP(ftpIp); fileFtpOupputConfig.setFileDir("D:\\workdir"); fileFtpOupputConfig.setFtpPort(5322); fileFtpOupputConfig.addHostKeyVerifier("2a:da:5a:6a:cf:7d:65:e5:ac:ff:d3:73:7f:2c:55:c9"); fileFtpOupputConfig.setFtpUser("ecs"); fileFtpOupputConfig.setFtpPassword("ecs@123"); fileFtpOupputConfig.setRemoteFileDir("/home/ecs/failLog"); fileFtpOupputConfig.setKeepAliveTimeout(100000); fileFtpOupputConfig.setTransferEmptyFiles(true); //true 上传空文件,false 不上传 fileFtpOupputConfig.setFailedFileResendInterval(5000); //上传失败文件重传时间间隔,单位:毫秒,<=0时不重传 fileFtpOupputConfig.setBackupSuccessFiles(true);//true 备份上传成功文件,false不备份 fileFtpOupputConfig.setSuccessFilesCleanInterval(5000);//定期扫描清理过期备份文件时间间隔,单位:毫秒 fileFtpOupputConfig.setFileLiveTime(86400);//设置上传成功文件备份保留时间,默认2天 fileFtpOupputConfig.setMaxFileRecordSize(1000);//每千条记录生成一个文件 fileFtpOupputConfig.setDisableftp(false);//false 启用sftp/ftp上传功能,true 禁止(只生成数据文件,保留在FileDir对应的目录下面) //自定义文件名称 fileFtpOupputConfig.setFilenameGenerator(new FilenameGenerator() { @Override public String genName( TaskContext taskContext,int fileSeq) { //fileSeq为切割文件时的文件递增序号 String time = (String)taskContext.getTaskData("time");//从任务上下文中获取本次任务执行前设置时间戳 String _fileSeq = fileSeq+""; int t = 6 - _fileSeq.length(); if(t > 0){ String tmp = ""; for(int i = 0; i < t; i ++){ tmp += "0"; } _fileSeq = tmp+_fileSeq; } return "HN_BOSS_TRADE"+_fileSeq + "_"+time +"_" + _fileSeq+".txt"; } }); //指定文件中每条记录格式,不指定默认为json格式输出 fileFtpOupputConfig.setReocordGenerator(new ReocordGenerator() { @Override public void buildRecord(Context taskContext, CommonRecord record, Writer builder) { //直接将记录按照json格式输出到文本文件中 SerialUtil.normalObject2json(record.getDatas(),//获取记录中的字段数据 builder); String data = (String)taskContext.getTaskContext().getTaskData("data");//从任务上下文中获取本次任务执行前设置时间戳 // System.out.println(data); } }); importBuilder.setFileFtpOupputConfig(fileFtpOupputConfig); importBuilder.setIncreamentEndOffset(300);//单位秒 //vops-chbizcollect-2020.11.26,vops-chbizcollect-2020.11.27 importBuilder .setDsl2ndSqlFile("dsl2ndSqlFile.xml") .setDslName("scrollQuery") .setScrollLiveTime("10m") // .setSliceQuery(true) // .setSliceSize(5) // .setQueryUrl("dbdemo/_search") //通过简单的示例,演示根据实间范围计算queryUrl,lastStartTime 记录查询开始时间,lastEndtime 查询为截止时间(在设置了IncreamentEndOffset情况下有值) .setQueryUrlFunction((TaskContext taskContext,Date lastStartTime,Date lastEndTime)->{ String formate = "yyyy.MM.dd"; SimpleDateFormat dateFormat = new SimpleDateFormat(formate); String startTime = dateFormat.format(lastEndTime); // Date lastEndTime = new Date(); String endTimeStr = dateFormat.format(lastEndTime); return "dbdemo-"+startTime+ ",dbdemo-"+endTimeStr+"/_search"; // return "vops-chbizcollect-2020.11.26,vops-chbizcollect-2020.11.27/_search"; // return "dbdemo/_search"; }) .addParam("fullImport",false) // //添加dsl中需要用到的参数及参数值 .addParam("var1","v1") .addParam("var2","v2") .addParam("var3","v3"); //定时任务配置, importBuilder.setFixedRate(false)//参考jdk timer task文档对fixedRate的说明 // .setScheduleDate(date) //指定任务开始执行时间:日期 .setDeyLay(1000L) // 任务延迟执行deylay毫秒后执行 .setPeriod(30000L); //每隔period毫秒执行,如果不设置,只执行一次 //定时任务配置结束 //设置任务执行拦截器,可以添加多个 importBuilder.addCallInterceptor(new CallInterceptor() { @Override public void preCall(TaskContext taskContext) { String formate = "yyyyMMddHHmmss"; //HN_BOSS_TRADE00001_YYYYMMDDHHMM_000001.txt SimpleDateFormat dateFormat = new SimpleDateFormat(formate); String time = dateFormat.format(new Date()); taskContext.addTaskData("time",time); } @Override public void afterCall(TaskContext taskContext) { System.out.println("afterCall 1"); } @Override public void throwException(TaskContext taskContext, Exception e) { System.out.println("throwException 1"); } }); // //设置任务执行拦截器结束,可以添加多个 //增量配置开始 importBuilder.setLastValueColumn("collecttime");//手动指定日期增量查询字段变量名称 importBuilder.setFromFirst(true);//setFromfirst(false),如果作业停了,作业重启后从上次截止位置开始采集数据, //setFromfirst(true) 如果作业停了,作业重启后,重新开始采集数据 importBuilder.setLastValueStorePath("es2fileftp_batchsplitimport");//记录上次采集的增量字段值的文件路径,作为下次增量(或者重启后)采集数据的起点,不同的任务这个路径要不一样 // importBuilder.setLastValueStoreTableName("logs");//记录上次采集的增量字段值的表,可以不指定,采用默认表名increament_tab importBuilder.setLastValueType(ImportIncreamentConfig.TIMESTAMP_TYPE);//如果没有指定增量查询字段名称,则需要指定字段类型:ImportIncreamentConfig.NUMBER_TYPE 数字类型 // 或者ImportIncreamentConfig.TIMESTAMP_TYPE 日期类型 // importBuilder.setLastValue(new Date()); //增量配置结束 //映射和转换配置开始 // /** // * db-es mapping 表字段名称到es 文档字段的映射:比如document_id -> docId // * 可以配置mapping,也可以不配置,默认基于java 驼峰规则进行db field-es field的映射和转换 // */ // importBuilder.addFieldMapping("document_id","docId") // .addFieldMapping("docwtime","docwTime") // .addIgnoreFieldMapping("channel_id");//添加忽略字段 // // // /** // * 为每条记录添加额外的字段和值 // * 可以为基本数据类型,也可以是复杂的对象 // */ // importBuilder.addFieldValue("testF1","f1value"); // importBuilder.addFieldValue("testInt",0); // importBuilder.addFieldValue("testDate",new Date()); // importBuilder.addFieldValue("testFormateDate","yyyy-MM-dd HH",new Date()); // TestObject testObject = new TestObject(); // testObject.setId("testid"); // testObject.setName("jackson"); // importBuilder.addFieldValue("testObject",testObject); importBuilder.addFieldValue("author","张无忌"); // importBuilder.addFieldMapping("operModule","OPER_MODULE"); // importBuilder.addFieldMapping("logContent","LOG_CONTENT"); // importBuilder.addFieldMapping("logOperuser","LOG_OPERUSER"); //设置ip地址信息库地址 importBuilder.setGeoipDatabase("E:/workspace/hnai/terminal/geolite2/GeoLite2-City.mmdb"); importBuilder.setGeoipAsnDatabase("E:/workspace/hnai/terminal/geolite2/GeoLite2-ASN.mmdb"); importBuilder.setGeoip2regionDatabase("E:/workspace/hnai/terminal/geolite2/ip2region.db"); /** * 重新设置es数据结构 */ importBuilder.setDataRefactor(new DataRefactor() { public void refactor(Context context) throws Exception { //可以根据条件定义是否丢弃当前记录 //context.setDrop(true);return; // if(s.incrementAndGet() % 2 == 0) { // context.setDrop(true); // return; // } String data = (String)context.getTaskContext().getTaskData("data"); // System.out.println(data); // context.addFieldValue("author","duoduo");//将会覆盖全局设置的author变量 context.addFieldValue("title","解放"); context.addFieldValue("subtitle","小康"); // context.addIgnoreFieldMapping("title"); //上述三个属性已经放置到docInfo中,如果无需再放置到索引文档中,可以忽略掉这些属性 // context.addIgnoreFieldMapping("author"); // //修改字段名称title为新名称newTitle,并且修改字段的值 // context.newName2ndData("title","newTitle",(String)context.getValue("title")+" append new Value"); /** * 获取ip对应的运营商和区域信息 */ IpInfo ipInfo = (IpInfo) context.getIpInfo("logVisitorial"); if(ipInfo != null) context.addFieldValue("ipinfo", ipInfo); else{ context.addFieldValue("ipinfo", ""); } DateFormat dateFormat = SerialUtil.getDateFormateMeta().toDateFormat(); // Date optime = context.getDateValue("LOG_OPERTIME",dateFormat); // context.addFieldValue("logOpertime",optime); context.addFieldValue("newcollecttime",new Date()); /** //关联查询数据,单值查询 Map headdata = SQLExecutor.queryObjectWithDBName(Map.class,context.getEsjdbc().getDbConfig().getDbName(), "select * from head where billid = ? and othercondition= ?", context.getIntegerValue("billid"),"otherconditionvalue");//多个条件用逗号分隔追加 //将headdata中的数据,调用addFieldValue方法将数据加入当前es文档,具体如何构建文档数据结构根据需求定 context.addFieldValue("headdata",headdata); //关联查询数据,多值查询 List<Map> facedatas = SQLExecutor.queryListWithDBName(Map.class,context.getEsjdbc().getDbConfig().getDbName(), "select * from facedata where billid = ?", context.getIntegerValue("billid")); //将facedatas中的数据,调用addFieldValue方法将数据加入当前es文档,具体如何构建文档数据结构根据需求定 context.addFieldValue("facedatas",facedatas); */ } }); //映射和转换配置结束 /** * 一次、作业创建一个内置的线程池,实现多线程并行数据导入elasticsearch功能,作业完毕后关闭线程池 */ importBuilder.setParallel(false);//设置为多线程并行批量导入,false串行 importBuilder.setQueue(10);//设置批量导入线程池等待队列长度 importBuilder.setThreadCount(50);//设置批量导入线程池工作线程数量 importBuilder.setContinueOnError(true);//任务出现异常,是否继续执行作业:true(默认值)继续执行 false 中断作业执行 importBuilder.setAsyn(false);//true 异步方式执行,不等待所有导入作业任务结束,方法快速返回;false(默认值) 同步方式执行,等待所有导入作业任务结束,所有作业结束后方法才返回 importBuilder.setPrintTaskLog(true); /** * 执行es数据导出和sftp上传作业 */ DataStream dataStream = importBuilder.builder(); dataStream.execute();//执行导入操作 } } 3.2 作业配置-ES2FileFtpExportBuilder 通过org.frameworkset.tran.input.fileftp.es.ES2FileFtpExportBuilder类来构建导出elasticsearch数据到sftp/ftp文件上传同步作业。bboss还提供了org.frameworkset.tran.input.fileftp.db.DB2FileFtpImportBuilder类来构建导出各种关系数据库(oracle、mysql等)到文件并上传到sftp/ftp服务器同步作业。 3.3 设置批量写文件的记录条数-BatchSize和批量从elasticsearch获取记录条数fetchSize importBuilder.setBatchSize(500).setFetchSize(1000); 3.4 SFTP/FTP配置 通过FileFtpOupputConfig类来设置sftp和ftp上传的的相关配置: 参数名称 描述 默认值 对应协议 ftpIP 必填,String类型,ftp/sftp服务器ip地址 空 ftp/sftp ftpPort 必填,int类型,ftp/sftp服务器端口 空 ftp/sftp ftpUser 必填,String类型,ftp/sftp服务器用户账号 空 ftp/sftp ftpPassword 必填,String类型,ftp/sftp服务器用户口令 空 ftp/sftp remoteFileDir 必填,String类型,指定ftp/sftp服务器目录地址,用户存放上传的文件 空 ftp/sftp fileDir 必填,String类型,指定导出数据生成的文件存放的本地目录、上传成功文件备份目录、上传失败文件存放目录(便于定时重传) 空 ftp/sftp keepAliveTimeout 必填,long类型,单位毫秒,ftp/sftp通讯协议连接存活超时时间 0 ftp/sftp transferEmptyFiles 必填,boolean类型,是否上传空文件,true上传,false不上传 true ftp/sftp backupSuccessFiles 必填,boolean类型,是备份上传成功文件,true备份,false不备份 false ftp/sftp failedFileResendInterval 必填,long类型,失败文件重传时间间隔,-1或者0不重传,单位:毫秒 5000 ftp/sftp successFilesCleanInterval 必填,long类型,扫描需要清理上传成功文件时间间隔,单位:毫秒 5000 ftp/sftp fileLiveTime 必填,int类型,上传成功文件保留时间,单位:秒 2天 ftp/sftp maxFileRecordSize 必填,int类型,切割文件时,指定每个文件保存的记录条数,>0时启用文件切割机制;按记录条数切割文件机制对并行导出数据不起作用 -1 ftp/sftp filenameGenerator 必填,FilenameGenerator接口类型,用于自定义生成文件的名称 无 ftp/sftp hostKeyVerifier 必填,适用于sftp协议,如果sftp协议需要指定,可以先不设置,然后将运行报错日志中打印出来字符串设置即可 无 sftp reocordGenerator 可选,ReocordGenerator接口类型,用来定义生成的记录格式,如果不设置默认为json格式 JsonReocordGenerator ftp/sftp disableftp 可选,boolean类型。false 启用sftp/ftp上传功能,true 禁止(只生成数据文件,保留在FileDir对应的目录下面) false ftp/sftp 示例代码如下: String ftpIp = CommonLauncher.getProperty("ftpIP","10.13.6.127");//同时指定了默认值 FileFtpOupputConfig fileFtpOupputConfig = new FileFtpOupputConfig(); fileFtpOupputConfig.setFtpIP(ftpIp); fileFtpOupputConfig.setFileDir("D:\\workdir"); fileFtpOupputConfig.setFtpPort(5322); fileFtpOupputConfig.addHostKeyVerifier("2a:da:5a:6a:cf:7d:65:e5:ac:ff:d3:73:7f:2c:55:c9"); fileFtpOupputConfig.setFtpUser("ecs"); fileFtpOupputConfig.setFtpPassword("ecs@123"); fileFtpOupputConfig.setRemoteFileDir("/home/ecs/failLog"); fileFtpOupputConfig.setKeepAliveTimeout(100000); fileFtpOupputConfig.setTransferEmptyFiles(true); //true 上传空文件,false 不上传 fileFtpOupputConfig.setFailedFileResendInterval(5000); //上传失败文件重传时间间隔,单位:毫秒,<=0时不重传 fileFtpOupputConfig.setBackupSuccessFiles(true);//true 备份上传成功文件,false不备份 fileFtpOupputConfig.setSuccessFilesCleanInterval(5000);//定期扫描清理过期备份文件时间间隔,单位:毫秒 fileFtpOupputConfig.setFileLiveTime(86400);//设置上传成功文件备份保留时间,默认2天 fileFtpOupputConfig.setMaxFileRecordSize(1000);//每千条记录生成一个文件 fileFtpOupputConfig.setDisableftp(false);//false 启用sftp/ftp上传功能,true 禁止(只生成数据文件,保留在FileDir对应的目录下面) //自定义文件名称 fileFtpOupputConfig.setFilenameGenerator(new FilenameGenerator() { @Override public String genName( TaskContext taskContext,int fileSeq) { //fileSeq为切割文件时的文件递增序号 String time = (String)taskContext.getTaskData("time");//从任务上下文中获取本次任务执行前设置时间戳 String _fileSeq = fileSeq+""; int t = 6 - _fileSeq.length(); if(t > 0){ String tmp = ""; for(int i = 0; i < t; i ++){ tmp += "0"; } _fileSeq = tmp+_fileSeq; } return "HN_BOSS_TRADE"+_fileSeq + "_"+time +"_" + _fileSeq+".txt"; } }); //指定文件中每条记录格式,不指定默认为json格式输出 fileFtpOupputConfig.setReocordGenerator(new ReocordGenerator() { @Override public void buildRecord(Context taskContext, CommonRecord record, Writer builder) { //直接将记录按照json格式输出到文本文件中 SerialUtil.normalObject2json(record.getDatas(),//获取记录中的字段数据 builder); String data = (String)taskContext.getTaskContext().getTaskData("data");//从任务上下文中获取本次任务执行前设置时间戳 // System.out.println(data); } }); importBuilder.setFileFtpOupputConfig(fileFtpOupputConfig); 3.5 文件名称生成机制配置 必须通过FileFtpOupputConfig对象的setFilenameGenerator方法设置文件名称生成接口FilenameGenerator,示例代码如下: //自定义文件名称 fileFtpOupputConfig.setFilenameGenerator(new FilenameGenerator() { @Override public String genName( TaskContext taskContext,int fileSeq) { //fileSeq为切割文件时的文件递增序号 String time = (String)taskContext.getTaskData("time");//从任务上下文中获取本次任务执行前设置时间戳 String _fileSeq = fileSeq+""; int t = 6 - _fileSeq.length(); if(t > 0){ String tmp = ""; for(int i = 0; i < t; i ++){ tmp += "0"; } _fileSeq = tmp+_fileSeq; } return "HN_BOSS_TRADE"+_fileSeq + "_"+time +"_" + _fileSeq+".txt"; } }); 接口方法genName带有两个参数: TaskContext taskContext, 任务上下文对象,包含任务执行过程中需要的上下文数据,比如任务执行时间戳、其他任务执行过程中需要用到的数据 int fileSeq 文件序号,从1开始,自动递增,如果指定了每个文件保存的最大记录数,fileSeq就会被用到文件名称中,用来区分各种文件 3.6 自定义记录输出格式 默认采用json格式输出每条记录到文件中,我们可以FileFtpOupputConfig对象的setReocordGenerator方法设置自定义记录生成接口ReocordGenerator。 接口方法buildRecord参数说明: Context recordContext, 记录处理上下文对象,可以通过recordContext.getTaskContext()获取任务执行上下文对象,并获取任务上下文数据 CommonRecord record, 处理当前记录对象,包含记录数据Map<key,value> Writer builder 记录数据写入器 直接将record中的数据转换为json文本并输出到Writer builder中: //指定文件中每条记录格式,不指定默认为json格式输出 fileFtpOupputConfig.setReocordGenerator(new ReocordGenerator() { @Override public void buildRecord(Context recordContext, CommonRecord record, Writer builder) { //直接将记录按照json格式输出到文本文件中 SerialUtil.normalObject2json(record.getDatas(),//获取记录中的字段数据 builder); //String data = (String)recordContext.getTaskContext().getTaskData("data");//从任务上下文中获取本次任务执行前设置时间戳 // System.out.println(data); } }); 竖线|分隔字段值: public class DataSendReocordGenerator implements ReocordGenerator { @Override public void buildRecord(Context taskContext, CommonRecord record, Writer builder) { Map<String, Object> datas = record.getDatas(); try { Map<String,String> chanMap = (Map<String,String>)taskContext.getTaskContext().getTaskData("chanMap");//从任务上下文中获取渠道字典数据 String phoneNumber = (String) datas.get("phoneNumber");//手机号码 if(phoneNumber==null){ phoneNumber=""; } builder.write(phoneNumber);//将字段内容输出到文件 builder.write("|");//输出字段分隔符 String chanId = (String) datas.get("chanId");//办理渠道名称 通过Id获取名称 String chanName = null; if(chanId==null){ chanName=""; }else{ chanName=chanMap.get(chanId); if(chanName == null){ chanName = chanId; } } builder.write(chanName); builder.write("|"); builder.write(goodsName); builder.write("|"); String goodsCode = (String) datas.get("goodsCode");//资费档次编码 if(goodsCode==null){ goodsCode=""; } builder.write(goodsCode); builder.write("|"); String bossErrorCode = (String) datas.get("bossErrorCode");//错误码 if(bossErrorCode==null){ bossErrorCode=""; } builder.write(bossErrorCode); builder.write("|"); String bossErrorDesc = (String) datas.get("bossErrorDesc");//错误码描述 if(bossErrorDesc==null){ bossErrorDesc=""; }else{ bossErrorDesc = bossErrorDesc.replace("|","\\|").replace("\r\n","\\\\r\\\\n"); //处理字段内容中包含的|字符和回车换行符 } builder.write(bossErrorDesc); } catch (IOException e) { e.printStackTrace(); } } } 3.7 elasticsearch增量导出截止时间偏移量设置 elasticsearch增量导出截止时间偏移量设置-IncreamentEndOffset,由于elasticsearch异步写入数据的特性,如果采用原有的增量时间戳机制(起始时间>lastImporttime,没有截止时间),会导致遗漏部分未落盘数据,因此需要指定基于当前时间往前偏移IncreamentEndOffset对应的时间作为数据导出截止时间,单位:秒 示例如下: importBuilder.setIncreamentEndOffset(300);//单位秒,同步从上次同步截止时间当前时间前5分钟的数据,下次继续从上次截止时间开始同步数据 3.8 从elasticsearch检索数据配置 下面介绍从Elasticsearch检索数据的相关配置参数 参数名称 描述 默认值 dsl2ndSqlFile String类型,必填,检索dsl的xml配置文件路径,相对应于classpath路径,配置案例:dsl2ndSqlFile.xml 无 dslName String类型,必填,在xml配置文件中dsl的配置名称,dsl语句中的关键配置增量字段xxx和增加截止字段xxx__endTime命名约定:截止字段为增量字段名称xxx自动加上__endTime后缀,示例: { ## 增量检索范围,可以是时间范围,也可以是数字范围,这里采用的是数字增量字段 "range": { #if($collecttime) "collecttime": { ## 时间增量检索字段 "gt": #[collecttime], "lte": #[collecttime__endTime] } #end } } 无 scrollLiveTime String类型,必填,scroll上下文件有效期,根据实际情况设置,例如:10m 无 queryUrl String类型,可选,直接指定elasticsearch查询rest服务地址,格式:索引名称/_search,例如:dbdemo/_search queryUrlFunction QueryUrlFunction接口类型,可选,public String queryUrl(Date lastTime),根据接口方法同步数据参数lastTime来动态设置同步的索引名称和检索服务地址,适用于于按时间分索引的场景。 sourceElasticsearch String类型,可选,设置elasticsearch数据源(bboss支持配置多个数据源),具体的配置在application.properties中配置 addParam 方法类型,可选,通过name/value方式,添加dsl中的检索条件,例如:importBuilder.addParam("var1","v1");对应dsl中的写法:{ "term": { "var1.keyword": #[var1] } } sliceQuery 可选,boolean 类型,标记查询是否是slicescroll 查询 false sliceSize 可选,int类型,设置slice scroll并行查询的slicesize 配置代码示例: importBuilder .setDsl2ndSqlFile("dsl2ndSqlFile.xml") .setDslName("scrollQuery") .setScrollLiveTime("10m") // .setSliceQuery(true) // .setSliceSize(5) // .setQueryUrl("dbdemo/_search") //通过简单的示例,演示根据实间范围计算queryUrl,lastStartTime 记录查询开始时间,lastEndtime 查询为截止时间(在设置了IncreamentEndOffset情况下有值) .setQueryUrlFunction((TaskContext taskContext,Date lastStartTime,Date lastEndTime)->{ String formate = "yyyy.MM.dd"; SimpleDateFormat dateFormat = new SimpleDateFormat(formate); String startTime = dateFormat.format(lastEndTime); // Date lastEndTime = new Date(); String endTimeStr = dateFormat.format(lastEndTime); return "dbdemo-"+startTime+ ",dbdemo-"+endTimeStr+"/_search"; // return "vops-chbizcollect-2020.11.26,vops-chbizcollect-2020.11.27/_search"; // return "dbdemo/_search"; }) .addParam("fullImport",false) // //添加dsl中需要用到的参数及参数值 .addParam("var1","v1") .addParam("var2","v2") .addParam("var3","v3"); //指定elasticsearch数据源名称 importBuilder.setSourceElasticsearch("default"); dsl配置文件dsl2ndSqlFile.xml和对应的dsl语句名称案例: <?xml version="1.0" encoding='UTF-8'?> <properties> <description> <![CDATA[ 配置数据导入的dsl ]]> </description> <!-- 条件片段 --> <property name="queryCondition"> <![CDATA[ "query": { "bool": { "filter": [ ## 可以设置同步数据的过滤参数条件,通过addParam方法添加var1变量值,下面的条件已经被注释掉 #* { "term": { "var1.keyword": #[var1] } }, { "term": { "var2.keyword": #[var2] } }, { "term": { "var3.keyword": #[var3] } }, *# ## 根据fullImport参数控制是否设置增量检索条件,true 全量检索 false增量检索,通过addParam方法添加fullImport变量值 #if(!$fullImport) { ## 增量检索范围,可以是时间范围,也可以是数字范围,这里采用的是数字增量字段 "range": { #if($collecttime) "collecttime": { ## 时间增量检索字段 "gt": #[collecttime], "lte": #[collecttime__endTime] } #end } } #end ] } } ]]> </property> <!-- 简单的scroll query案例,复杂的条件修改query dsl即可 --> <property name="scrollQuery"> <![CDATA[ { "size":#[size], ## size变量对应于作业定义时设置的fetchSize参数 @{queryCondition} } ]]> </property> <!-- 简单的slice scroll query案例,复杂的条件修改query dsl即可 --> <property name="scrollSliceQuery"> <![CDATA[ { "slice": { "id": #[sliceId], ## 必须使用sliceId作为变量名称,框架自动填充变量值 "max": #[sliceMax] ## 必须使用sliceMax作为变量名称,对应于作业定义时设置的sliceSize参数值 }, "size":#[size], ## size变量对应于作业定义时设置的fetchSize参数 @{queryCondition} } ]]> </property> </properties> scrollQuery为本案例对应的dsl,scrollSliceQuery为slice导出需要用到的dsl,他们共用了条件片段queryCondition,内部基于bboss开源的另外一个elasticsearch rest java client项目从elasticsearch检索数据,该客户端使用参考文档: https://esdoc.bbossgroups.com/#/development 3.9 定时任务配置 //定时任务配置, importBuilder.setFixedRate(false)//参考jdk timer task文档对fixedRate的说明 // .setScheduleDate(date) //指定任务开始执行时间:日期 .setDeyLay(1000L) // 任务延迟执行deylay毫秒后执行 .setPeriod(30000L); //每隔period毫秒执行,如果不设置,只执行一次 上面的配置表示:同步作业任务延迟1秒执行,每隔30秒执行一次。 3.10 任务上下文数据定义和获取 在一些特定场景下,避免任务执行过程中重复加载数据,需要在任务每次调度执行前加载一些任务执行过程中不会变化的数据,放入任务上下文TaskContext;任务执行过程中,直接从任务上下文中获取数据即可。例如:将每次任务执行的时间戳放入任务执行上下文。 通过TaskContext对象的addTaskData方法来添加上下文数据,通过TaskContext对象的getTaskData方法来获取任务上下文数据. 3.10.1 定义任务上下文数据 任务上下文数据定义-通过CallInterceptor接口的preCall的来往TaskContext对象来添加 任务上下文数据 @Override public void preCall(TaskContext taskContext) { String formate = "yyyyMMddHHmmss"; //HN_BOSS_TRADE00001_YYYYMMDDHHMM_000001.txt SimpleDateFormat dateFormat = new SimpleDateFormat(formate); String time = dateFormat.format(new Date()); taskContext.addTaskData("time",time);//定义任务执行时时间戳参数time } 完整代码- 任务上下文数据定义 //设置任务执行拦截器,可以添加多个 importBuilder.addCallInterceptor(new CallInterceptor() { @Override public void preCall(TaskContext taskContext) { String formate = "yyyyMMddHHmmss"; //HN_BOSS_TRADE00001_YYYYMMDDHHMM_000001.txt SimpleDateFormat dateFormat = new SimpleDateFormat(formate); String time = dateFormat.format(new Date()); taskContext.addTaskData("time",time);//定义任务执行时时间戳参数time } @Override public void afterCall(TaskContext taskContext) { System.out.println("afterCall 1"); } @Override public void throwException(TaskContext taskContext, Exception e) { System.out.println("throwException 1"); } }); //设置任务执行拦截器结束,可以添加多个 3.10.2 获取任务上下文数据 在生成文件名称的接口方法中获取任务上下文数据 fileFtpOupputConfig.setFilenameGenerator(new FilenameGenerator() { @Override public String genName( TaskContext taskContext,int fileSeq) { String time = (String)taskContext.getTaskData("time");//获取任务执行时间戳参数time String _fileSeq = fileSeq+""; int t = 6 - _fileSeq.length(); if(t > 0){ String tmp = ""; for(int i = 0; i < t; i ++){ tmp += "0"; } _fileSeq = tmp+_fileSeq; } return "HN_BOSS_TRADE"+_fileSeq + "_"+time +"_" + _fileSeq+".txt"; } }); 在生成文件中的记录内容时获取任务上下文数据 fileFtpOupputConfig.setReocordGenerator(new ReocordGenerator() { @Override public void buildRecord(Context context, CommonRecord record, Writer builder) { //SerialUtil.normalObject2json(record.getDatas(),builder); String data = (String)context.getTaskContext().getTaskData("data");//获取全局参数 // System.out.println(data); } }); 在datarefactor方法中获取任务上下文数据 /** * 重新设置es数据结构 */ importBuilder.setDataRefactor(new DataRefactor() { public void refactor(Context context) throws Exception { String data = (String)context.getTaskContext().getTaskData("data"); } }); 3.11 设置IP地址信息库地址 我们通过以下代码设置IP地址信息库地址: //设置ip地址信息库地址,配置参考文档 importBuilder.setGeoipDatabase("E:/workspace/hnai/terminal/geolite2/GeoLite2-City.mmdb"); importBuilder.setGeoipAsnDatabase("E:/workspace/hnai/terminal/geolite2/GeoLite2-ASN.mmdb"); importBuilder.setGeoip2regionDatabase("E:/workspace/hnai/terminal/geolite2/ip2region.db"); IP地址库配置详细参考文档:设置IP地址信息库地址 3.12 调整记录数据内容 可以通过datarefactor接口调整记录数据内容,示例代码如下: /** * 重新设置es数据结构 */ importBuilder.setDataRefactor(new DataRefactor() { public void refactor(Context context) throws Exception { //可以根据条件定义是否丢弃当前记录 //context.setDrop(true);return; // if(s.incrementAndGet() % 2 == 0) { // context.setDrop(true); // return; // } String data = (String)context.getTaskContext().getTaskData("data"); // System.out.println(data); // context.addFieldValue("author","duoduo");//将会覆盖全局设置的author变量 context.addFieldValue("title","解放"); context.addFieldValue("subtitle","小康"); // context.addIgnoreFieldMapping("title"); //上述三个属性已经放置到docInfo中,如果无需再放置到索引文档中,可以忽略掉这些属性 // context.addIgnoreFieldMapping("author"); // //修改字段名称title为新名称newTitle,并且修改字段的值 // context.newName2ndData("title","newTitle",(String)context.getValue("title")+" append new Value"); /** * 获取ip对应的运营商和区域信息,字段logVisitorial值对应了一个ip地址 */ IpInfo ipInfo = (IpInfo) context.getIpInfo("logVisitorial"); if(ipInfo != null) context.addFieldValue("ipinfo", ipInfo); else{ context.addFieldValue("ipinfo", ""); } DateFormat dateFormat = SerialUtil.getDateFormateMeta().toDateFormat(); // Date optime = context.getDateValue("LOG_OPERTIME",dateFormat); // context.addFieldValue("logOpertime",optime); context.addFieldValue("newcollecttime",new Date()); /** //关联查询数据,单值查询 Map headdata = SQLExecutor.queryObjectWithDBName(Map.class,context.getEsjdbc().getDbConfig().getDbName(), "select * from head where billid = ? and othercondition= ?", context.getIntegerValue("billid"),"otherconditionvalue");//多个条件用逗号分隔追加 //将headdata中的数据,调用addFieldValue方法将数据加入当前es文档,具体如何构建文档数据结构根据需求定 context.addFieldValue("headdata",headdata); //关联查询数据,多值查询 List<Map> facedatas = SQLExecutor.queryListWithDBName(Map.class,context.getEsjdbc().getDbConfig().getDbName(), "select * from facedata where billid = ?", context.getIntegerValue("billid")); //将facedatas中的数据,调用addFieldValue方法将数据加入当前es文档,具体如何构建文档数据结构根据需求定 context.addFieldValue("facedatas",facedatas); */ } }); 3.13 增量同步配置 //增量配置开始 importBuilder.setLastValueColumn("collecttime");//手动指定日期增量查询字段变量名称 importBuilder.setFromFirst(true);//setFromfirst(false),如果作业停了,作业重启后从上次截止位置开始采集数据, //setFromfirst(true) 如果作业停了,作业重启后,重新开始采集数据 importBuilder.setLastValueStorePath("es2fileftp_batchsplitimport");//记录上次采集的增量字段值的文件路径,作为下次增量(或者重启后)采集数据的起点,不同的任务这个路径要不一样 // importBuilder.setLastValueStoreTableName("logs");//记录上次采集的增量字段值的表,可以不指定,采用默认表名increament_tab importBuilder.setLastValueType(ImportIncreamentConfig.TIMESTAMP_TYPE);//如果没有指定增量查询字段名称,则需要指定字段类型:ImportIncreamentConfig.NUMBER_TYPE 数字类型 // 或者ImportIncreamentConfig.TIMESTAMP_TYPE 日期类型 //指定增量同步的起始时间,默认中1970-01-01 00:00:00开始 // importBuilder.setLastValue(new Date()); //增量配置结束 3.14 并行同步配置 importBuilder.setParallel(false);//设置为多线程并行批量导入,true并行,false串行 importBuilder.setQueue(10);//设置批量导入线程池等待队列长度 importBuilder.setThreadCount(50);//设置批量导入线程池工作线程数量 importBuilder.setContinueOnError(true);//任务出现异常,是否继续执行作业:true(默认值)继续执行 false 中断作业执行 importBuilder.setAsyn(false);//true 异步方式执行,不等待所有导入作业任务结束,方法快速返回;false(默认值) 同步方式执行,等待所有导入作业任务结束,所有作业结束后方法才返回 3.15 同步任务日志打印开关 importBuilder.setPrintTaskLog(true);// true打印,false不打印 3.16 同步作业执行 /** * 启动es数据导入文件并上传sftp/ftp作业 */ DataStream dataStream = importBuilder.builder(); dataStream.execute();//启动同步作业 3.17 同步作业调试、发布和部署运行 下载elasticsearcch/database-sftp/ftp同步作业样板工程,定义好自己的作业后,可以按照以下文档调试、发布和部署运行同步作业 作业调试:参考文档 查看任务执行详细日志: 参考文档 作业运行jvm内存配置:参考文档 作业发布和部署:参考文档 3.18开发交流 bboss elasticsearch交流QQ群:21220580,166471282

优秀的个人博客,低调大师

每日一博 | 盘点 Excel 中的那些有趣的“bug”

本文由葡萄城技术团队原创并首发 转载请注明出处:葡萄城官网,葡萄城为开发者提供专业的开发工具、解决方案和服务,赋能开发者。 Excel 1.0早在1985年正式进入市场,距今已经有36年了,虽然在推出时市面上已经有了类似软件Lotus 1-2-3,但Excel仍然凭借着其对竞品在功能上的全面超越,再加之和Windows环境的直接捆绑,直接将Excel推向了电子表格办公软件的王者的地位。 但在今天这篇文章里,我们不是为了讲Excel中那些大家已经耳熟能详的功能,让我们一起来看看,即便强大如Excel也会有的一些令人费解的计算结果吧! 1900年2月29日 小学生都知道在我们现在使用的公历(格里高利历)中规定:年份是4的倍数,且不是100的倍数的,为闰年;年份为100的倍数,必须是400的倍数才是闰年。 那么1900年并不满足上述条件不是闰年,但是在Excel中却存在1900年2月29日这天,通过拖拽填充的方式,可以看到2月28日之后是29日。是因为Excel还在使用4年一润的儒略历吗?经过测试在Excel中并不存在2100年2月29日,那为什么只有1900年这一天错了? Excel官方给出过回复,这是Excel前身Lotus 1-2-3的一个bug,但是修复问题会导致历史文件出现一天的误差,出于对老文件的兼容,同时这个Bug影响很小,Excel并未修复这个bug,1900年2月29日保留至今。 38/12/31是1938还是2038 进入21世纪一个百年轮回开始,日常中我们习惯只说年份的两位例如1987年简称87年,2002年简称02年。在Excel中也支持2位年份的输入,例如输入87/12/31,自动识别为1987/1231;输入20/12/31自动识别为,2020/12/31。可是在输入30/12/31却又变会1930年了,Excel按照什么规则判断年份呢? 在这里Excel有一个2029规则,记输入00-29中的数字会自动识别为21世纪,其余则是20世纪,如果想输入29年之后的年份,就需要输入四位数字了。当然也可以通过修改操作系统设置来改变2029这个节点,具体可参考Excel的官方说明:https://docs.microsoft.com/zh-cn/office/troubleshoot/excel/two-digit-year-numbers。 两数不相等 在Excel中输入=1.2-1.1=0.1,回车后计算结果为FALSE,这说明1.2减1.1的结果不是0.1,是Excel算错了吗?可是输入=1.2-1.1确实显示0.1啊。 这的确是Excel算错了,但是这个并不是Excel特有的错误,而是计算机2进制特性导致的浮点数计算精读误差问题。简而言之,计算机计算过程使用二进制,对于1.2-1.1的结果为2进制循环小数,在存储时会进行小数截断,导致出现误差。 如果在Excel中设置显示位数20位就会发现实际计算值为0.09999999999999990000。 通常对于误差较小的结果,Excel可以自行修正,但是向1.2-1.1的结果Excel却没有处理。 因此,在进行数值比较的时候使用ROUND是一个好习惯,可以根据业务场景涉及到的小数范围设置参数。例如:=ROUND(1.2-1.1, 10)=0.1。 四舍五没入 在上述例子中使用的ROUND函数规则是四舍五入,但是同样因为精度问题造成了一些计算问题。例如=ROUND((8.92-8.71)/6,2),结果是0.03。期待值是0.4,由于误差计算结果并未达到0.35,并没有五入。 由于计算误差想要得到一个四舍五入的2为小数,需要进行2次ROUND,首先修正误差,然后再四舍五入保留2位小数。对于所有操作计算都做两次ROUND过于繁琐,这里可以使用Excel提供的另一个设置,使用“显示精度”,这样Excel在存储计算时,会按照单元格设置的显示小数位数来保留精度。 在 "文件" 菜单上,单击 "选项",然后单击 "高级" 类别。 在 "计算此工作簿时" 部分,选择所需的工作簿,然后选中 " 将精度设定为显示" 复选框。 但是要注意,后续计算需要真实的计算结果还是格式化后的结果,不正确的使用这个功能可能会导致误差越来越大。 数字不计算 如截图,单元格中对SUM结果为0,同时单元格左上角有绿色三角提示“以文本形式存储的数字“。这个提示就是SUM结果为0的原因,这些数字实际存储格式为文本,而文本并不参加数字的运算。 这里有个概念是存储格式,当在Excel单元格中输入数字0,Excel默认会以数字格式作为存储,也就是前面说的2进制,但是如果先设置这个单元格类型为文本,则0当作文本。在Excel中数字和日期默认靠右显示,文本靠左。 这也是我们经常在输入电话号码和身份证号是存在的问题,输入身份证号后,显示成了科学计数法,这里就需要先设置单元格为文本再输入。 总结 Excel中有很多这样并不是很符合日常行为的操作,以上只是葡萄城在研究Excel电子表格时遇到的其中一部分有趣的内容,相信大家也遇到过什么比较奇妙的计算错误,欢迎留言吐槽。

优秀的个人博客,低调大师

每日一博 | 用 Rust 实现一个猜谜游戏

在深入探索Rust语法的细枝末节之前,先通过一个麻雀虽小但五脏俱全的小项目来整体把握Rust,这样可以避免迷失在细节的海洋中。我们可能会通过这个小项目一下子接触到很多新概念,但不必惊慌,我们只需浅尝辄止对这些概念有个印象即可。 《TRPL》(Rustaceans对《The Rust Programming Language》的爱称)中就给出了一个经典的猜谜游戏的例子,我们一起来学习它。 猜谜游戏:程序将会随机生成一个 1 到 100 之间的随机整数。接着它会请玩家猜一个数并输入,然后提示猜测是大了还是小了。如果猜对了,它会打印祝贺信息并退出。 Rust如何管理项目 并不是所有的代码都像hello_world.rs一样,一个文件就可以搞定。一个项目往往具有复杂的代码,我们需要一种机制来管理这种复杂性,将一个项目切分成若干小部分,每个部分再进行切分,层层抽象,直到达到人脑可以处理的规模。每种编程语言都有这样的机制,例如Java的package机制,Rust也不例外。 Rust用了两个概念来管理项目:一个是crate(项目),一个是mod(模块)。模块是用于在crate内部进行分层和封装的机制,模块内部可以包含模块。 crate:可以简单理解为一个项目,crate是Rust中的独立编译单元(compile unit),每个crate对应生成一个库或者可执行文件。作为对比,我们比较熟悉的C语言中,一个单独的.c文件和其所有的include文件组成一个编译单元,每个.c生成一个.o,然后将这些.o链接起来生成可执行文件。 mod:可以简单理解为命名空间。mod可以嵌套(注意crate之间不能出现循环引用),还可以控制内部元素的可见性。 说到可见性问题,在Rust中,元素默认都是私有的,用pub关键字修饰的才是公开的。公开和私有的访问权限规定如下: 如果一个元素是私有的,那么只有本模块内的元素以及它的子模块可以访问 如果一个元素是公开的,那么可以在本模块外的作用域访问它。 模块是一种抽象的概念,文件是承载这个概念的实体,但是模块和文件并不是简单的一一对应关系。在一个crate内部创建mod的方式有下面三种: 在一个rs文件中创建内嵌模块,直接使用mod关键字即可。 独立的一个rs文件就是一个模块,文件名即是模块名。 一个文件夹也可以创建一个模块,文件夹内部要有一个xxx.rs文件,这个文件是这个模块的入口。必须要在这个xxx.rs中声明其子模块,否则子模块无法被当成这个项目的源码进行编译。 新建项目 cargo不仅是Rust的包管理器,还可以用于创建项目。使用下列命令可以创建一个名为guessing_game的项目: cargo new guessing_game --bin 注意,后面的--bin意味着我们希望项目生成的是可执行程序,如果希望是library,则可以使用--lib选项。 以上为在命令行中手工创建项目,在Clion中可以点击File->New Project后如下图填写,然后点击Create按钮: 项目结构 我们可以使用tree .命令或者直接在Clion中查看当前的文件夹结构,如下图所示: src/main.rs:这是cargo自动生成的rs文件。还记得前面讲的crate和mod的概念吗?在这个项目中,guessing_game是crate,src文件夹是mod,main.rs是srcmod的入口。我们可以在srcmod中创建子模块,但注意,这些子模块都要在main.rs中声明,否则无法参与编译。 .gitignore:这是git忽略文件,不懂其作用的同学可以自行搜索。这里重点要说的是通过cargo new创建的项目天然就是一个git项目,这也印证了Rust对开源的拥护。 Cargo.toml:这是项目管理配置文件。TOML是一种非常简洁好用的配置文件格式,TOML是Tom's Obvious, Minimal Language的首字母缩写,这里的Tom是Github的联合创始人之一,感兴趣的同学可以进一步自行了解TOML配置文件的写法。 Cargo.lock:该文件包含项目依赖项的确切信息,由Cargo维护,我们无须关心它。 编译执行 在src/main.rs里cargo已经自动生成了输出Hello, world!的代码,我们来运行一下它看能否正常输出。 插一句题外话,在你日后漫长的Rust编码生涯中,你会发现,你将在处理编译错误上耗费大量的时间。还记得吗,Rust 的一大特色是保证内存安全,这保证了Rust代码只要运行起来就几乎不会发生内存错误,这么诱人的效果的背后的代价就是,我们要在编码时付出额外的努力。Rust为了保证内存安全设计了一套复杂的规则,这导致我们的代码一不留神就会编译不过。所以,在你日后经常用的一个操作就是检查能否编译通过,而不是直接编译,因为直接编译还要做代码优化等会相对费时。可以使用下列命令检查编译错误: cargo check 在Clion中需要新加一个Configuration来执行cargo check命令,如下图所示: 确保cargo check通过后,可以执行cargo build来执行编译。编译后会产生一个target文件夹,在target/debug下会有一个和crate同名的可执行文件。但一般为了方便,可以直接执行cargo run,这条命令等价于先编译后执行。下图是执行cargo run后Clion的控制台输出: 猜谜游戏 在完成了项目搭建后,接下来就要开始猜谜游戏的代码编写了,我将它们分成六部分:创建变量、输入、输出、错误处理、随机数生成、完整代码。 创建变量 使用let语句创建变量,需要注意的是,在Rust中,变量默认是不可变的,可以在变量名前使用mut来使得变量可变: let a = 5; // 不可变 let mut b = 10; // 可变 在上面的let语句中,我们并没有显示声明变量的类型,但这并不代表Rust是动态类型的,Rust仍然是静态类型的,只不过Rust有一个可以通过上下文推断类型的强大编译器。 输出 我们早已在hello_world.rs中见识过了最基本的输出方式: println!("Hello, world!"); 需要注意的是,这里的println!是一个宏,而非一个函数,println后面的感叹号就是宏的标志。Rust中的宏与C/C++中的宏是完全不一样的东西,简单说,可以把它理解为一种安全版的编译期语法扩展。这里之所以使用输出宏而非函数,是因为标准输出宏可以完成编译期格式检查,更加安全。 如果需要输出某个变量的值,可以使用占位符{},例如: let x = 0; let y = 10; println!("x = {} and y = {}", x, y); 其输出结果为: x = 0 and y = 10 输入 为了从控制台中获取用户的输入,需要使用标准库std::io。使用use语句将该库引入当前作用域: use std::io; 我们可以使用io库中的函数stdin: let mut guess = String::new(); // 创建一个字符串类型的可变变量 io::stdin().read_line(&mut guess).expect("Failed to read line"); stdin函数返回一个std::io::Stdin的实例,这代表终端标准输入句柄的类型。然后调用read_line方法,可以从标准输入中读取一行并存入到guess变量中去。&表示这是一个引用,这是一个复杂的特性,我们现在无须了解它。 读取用户输入后,我们需要判断用户是否正确输入了数字。String类型带有处理字符串处理的一些方法: let guess: u32 = guess.trim().parse().expect("Please type a number!"); 字符串的 parse 方法将字符串解析成数字。因为这个方法可以解析多种数字类型,因此需要告诉 Rust 具体的数字类型,这里通过 let guess: u32 指定。guess 后的冒号:告诉 Rust 我们指定了变量的类型。Rust 有一些内建的数字类型,u32 是一个无符号的 32 位整型。trim方法用于消除回车空格等符号。 错误处理 上一小节代码中还有一个expect没有分析,而这就涉及到Rust中的错误处理机制了。read_line的返回值类型是io::Result,它是Result类型在io模块的特化版本。Result是枚举类型,其成员为Ok和Err,Ok 成员表示操作成功,内部包含成功时产生的值。Err 成员则意味着操作失败,并且包含失败的前因后果。 Result类型的作用是编码错误处理信息。Result 类型像其他类型一样,拥有定义于其上的方法。io::Result的实例拥有expect方法。如果 io::Result 实例的值是 Err,expect 会导致程序崩溃,并打印参数传递给 expect 的信息。如果io::Result实例的值是 Ok,expect 会获取 Ok 中的值并返回。在本例中,这个值是用户输入到标准输入中的字节数。 随机数生成 猜谜游戏需要能够自动生成随机数。Rust标准库中尚未包含随机数功能,但我们可以通过引入外部crate来获得随机数功能。还记得Rust的官方开源仓库吗,那里可是有很多宝贝的。打开https://crates.io/,在搜索框中键入rand来搜索具有随机数功能的crate,出来的第一个结果就是我们需要的crate。 现在我们将这个库引入到我们的项目中。打开Cargo.toml,在[dependencies]下添加: [dependencies] rand = "0.8.3" [dependencies] 告诉 Cargo 本项目依赖了哪些外部 crate 及其版本。 下面使用rand库来产生随机数。首先,使用use语句引入rand,use rand::Rng;。然后调用下列函数产生一个1和100之间的数: let number = rand::thread_rng().gen_range(1..=100); 完整代码 猜谜游戏的完整代码如下。 use std::io; use std::cmp::Ordering; use rand::Rng; fn main() { println!("Guess the number!"); let secret_number = rand::thread_rng().gen_range(1..=100); loop { println!("Please input your guess."); let mut guess = String::new(); io::stdin().read_line(&mut guess) .expect("Failed to read line"); let guess: u32 = match guess.trim().parse() { Ok(num) => num, Err(_) => continue, }; println!("You guessed: {}", guess); match guess.cmp(&secret_number) { Ordering::Less => println!("Too small!"), Ordering::Greater => println!("Too big!"), Ordering::Equal => { println!("You win!"); break; } } } } 其中,涉及控制流操作的loop、match、continue、break等语法,大家应当能够望文生义。对于这个完整代码,大家能够阅读并知道每一行干了啥即可,不必纠结于语法细节。 猜谜游戏运行结果如下: 参考文献 《The Rust Programming Language》 《Rust编程之道》张汉东 《深入浅出Rust》范长春

优秀的个人博客,低调大师

每日一博 | 个推异常值检测和实战应用

日前,由又拍云举办的大数据与 AI 技术实践|Open Talk 杭州站沙龙在杭州西溪科创园顺利举办。本次活动邀请了有赞、个推、方得智能、又拍云等公司核心技术开发者,现场分享各自领域的大数据技术经验和心得。以下内容整理自个推资深算法工程师令狐冲现场分享: 令狐冲(花名),个推资深算法工程师,目前负责个推深度学习相关研发工作,对 AI 算法有深入的了解及丰富的实践经验,擅长将大数据分析与深度学习神经网络相结合,为业务落地输出算法产品化能力。 大家好,我是来自个推的令狐冲,今天主要分享大数据中的异常值检测和实战应用,围绕研究背景、异常值检测方法、异常检测实战应用等话题,结合相关实战数据介绍异常值检测算法的最新进展情况。 研究背景 异常值检测是大数据分析中一个重要的研究方向,实时异常值自动检测有助于运营人员快速发现系统异常问题。我们常说的异常值通常是相对于正常值来表述的,要结合实际业务来讲一个值是否正常,也就说这是一个业务描述。如果我们要解决一个业务问题,首先要做的就是将这个问题数学化,将业务描述转化为数学描述,这样你才可以使用适合的算法或使用其他分析方法来解决。 对于异常值而言,从数学上看可以看做一个离群点。当然在实际业务中,考虑到业务的结合情况不同,有些异常值看似是离群点,但是从全局业务上看也可能是一个正常值。具体情况需要结合结果来分析,不过我们大致可以使用离群点来代表异常值。 上图为异常值描述图,从图中我们可以看到在回归时有一些值不在回归线上,这些就是离群点。当我们在做聚类或分类的时候,这些孤立的值可能就是我们的异常值。 异常值检测相比其他人热门项目而言是一个比较小众的方向,但是它在流量监控、金融欺诈、系统故障检测等场景下也是有较多应用的: 流量监控:运维同学平常都比较关心流量检测,比如当服务访问出现异常的时候,需要第一时间找出问题 金融场景:金融场景涉及到的东西很多,因此异常检测我们以其中的金融欺诈举例:正常情况下的金融转账或消费是一个低频事件,但是当一个账号在短时间内多次转账或消费时就可能存在金融诈骗的风险 系统故障检测:这个在工业界用的较多,因为一个工业系统内会安装各种各样的传感器,这些传感器会实时传送系统内部件状态的数据,当这些系统内部件发生故障时往往会产生异常信号,如果能及时检测出异常信号找出异常原因就可以挽回大量的损失 异常值检测方法 接下来和大家谈一下异常值检测的方法。业内对于异常值检测方法都有不同的观点,总结下来就会有很多的分类,因此今天我们只谈我的观点。在我看来异常值检测方法可以分为两种,一种是“基于统计的方法”,稍微了解一点统计的话应该知道,统计是有分布的,比如典型的 3σ 原则和箱体图;另一种则是“基于模型的方法”,也就是通过构建模型来区分正常值和异常值。 基于统计的异常值检测 如上图所示,左图是我们经常听到的 3σ 法则,3σ 法则比较简单但很实用,它是一个经验法则,具体是什么意思呢?其实 σ 是标准差,当我们检测数据服从正常的统计分布时,我们可以将超过 3σ 的数据认为是异常数据。它的标准均值为 0,从标准分布图来看,大约有 0.3% 的数据为异常值。当然如果你的均值是非 0 分布,你可以把均值加上去。不过由于 3σ 法则是一个经验法则,还是比较粗糙的,因此在实际工作中,建议大家只在某些特定的场景下使用它。 右图是箱体图,在数据的统计分析中特别常用,比如我们用 pandas 做处理时就经常使用这个方式处理异常值。如图所示构成箱体的一般是分界位的四分之一到四分之三,而分界则是左边箱体的边界减去箱体长度的某一倍数,通常我们这个倍数为 1.5 倍,异常值则是超过最左边和最右边边界的值。 上图是两种统计方式的对应关系。假设数据分布是一个纯粹的正态分布,我们可以看到箱体图对应的 σ 值只有 2.7σ 左右,不到 3σ 。当然很多时候我们并不知道它的具体分布是什么,需要根据样本的方差、标准差来求 σ,如果你实在不知道是什么分布,可以将它假设为是一个正态分布。因为正态分布是自然界一个比较“和谐“的分布,一般场景中就算有偏差也不会过于离谱。 基于统计的异常值检测有两个明显的优点:一个是是简单方便,因为我们既不需要考虑它的鲜艳,也不需要考虑它的特殊分布;第二个则是因为这是基于统计学来的,有较好的数学基础。当然它的缺点也很明显:首先是需要较多的样本数据,其次是高维数据比较难处理。上图展示的是一维分布,处理起来还比较简单,高维数据中联合分布会涉及到一些相关性,处理起来就会比较困难。 基于模型的异常值检测 接下来我们来谈一谈基于模型的异常值检测。在我们谈具体模型之前,我们需要先知道如果从分类的角度来看正常值和异常值,那它就是一个二分类问题,尽管它因为正常值多而异常值少的原因比常规的二分类问题特殊一些。因此我们可以把它看做一个样本不均衡、分类不均匀的数学分类问题。 有监督模型 确认了问题类型后,我先具体介绍一下有监督模型,通过这个常见的分类算法,比如 k- 最近邻,可以知道到底是正常还是异常的标签。除此外还有典型的二分类模型支持向量机 SVM。同时因为样本不均衡的原因,也衍生出了 oneclassSVM。 那分类模型具体是如何进行异常值检测的呢?简单举个例子,大家可以看一下上图。我们常规的 SVM 是使用一个超平面将正负样本分开。但是如果只有一个类,或者说负样本极少的时候要怎么办呢?我可以使用超球面将正样本包含,然后将超球面以外的当做异常样本,通过这种方式去进行异常值检测。 接着说一下现在比较多的神经网络深度学习的方法是如何用在异常值检测上的。一般来说神经网络方法比较多的用在分类问题上,如果你需要将它使用在异常值检测上,你可以输入一个样本值,令其经过一个隐藏层,经过 decoder 层进行编码得到输出向量。如果是正常的样本我们就让 input 和 output 尽可能的接近,将它压缩到隐藏层也就是压缩到一个 code 内,然后用它来进行表征。后续需要通过各种方式,比如均方误差损失等,训练网络减少输入和输出的误差,当这个网络能够达到正常值输入计算结果落实较小、异常值输入计算结果落实较大时,就可以用来进行异常值检测了。 上图我们可以看到右边对左边的模型进行了改进,不止是一层编码层,而是构造了中间的 code 分布,通过这个分布右边的稳定性会比左边好。 无监督模型 刚刚介绍的是有监督模型,但是实际上我们做异常值检测时更多的还是使用无监督模型。因为异常值是很少的,而且还会出现没有遇到的情况,这就导致你标注的异常点会非常的少。所以我们更多的是通过无监督的学习方法,让异常值能够比较完整的表征出来。 无监督模型比较典型的是下列三类: 密度聚类:DBSCAN 孤立森林:IsolationForest(IF) 随机剪切森林:RadomCutForest(RCF) 密度聚类这里就不用细讲了,参考上图左侧,大家可以看一下。 孤立森林最早是由周志华教授团队提出的,听名字大家可能觉得和随机森林或者 adboosting 这些方法相似,其实不止名字相似本质上也和这些方法相似。孤立森林是通过将一些样本或者一些点构造为多棵树,让这些值快速的到达叶子节点,之后根据每个点对应的树的深度来计算该点的平均深度。由于异常值和其他值不一样,会出现一些异常的现象,我们就可以通过设置阈值来快速的检测异常值。 随机剪切森林是由英文 RadomCutForest 直译过来的,简写为 RCF。它其实和孤立森林的整体思路是相同的,都是经过构造树来处理。但是因为我们构造树的时候需要选取样本,而随机剪切森林在采样方法上更好一些,能够更有效的处理多维度的相关性。同时因为随机剪切森林有更好的集成模块,所以在实战程度上比较推荐使用这个方法。 **刚才也讲过随机剪切森林和孤立森林的整体思路是相同的,那它们之间有什么区别?**大家可以参考下图了解一下。左边的公式是一些数学映射,里面 c(n) 代表样本的平均深度。右图中的红线代表 s,也就是最后的异常值得分。蓝色曲线是构造的预设正弦曲线,异常值则是在某一时段让曲线的一段成为直线的部分。 上图右侧上方的图表展示的是孤立森林算法的结果图。我们可以看到图中有两个异常值,孤立森林算法在计算异常值得分 s 时,对于后面的突变点会有突然增高,这里我们可以设置一个合适的阈值来找出对应的点。 上图右侧下方的图表展示的是随机剪切森林算法的结果图。我们可以明显看到虽然在整体上比较相似,但是该算法即便是前面较小的跳变点也可以精准找出,这就是随机剪切森林比孤立森林算法有优势的地方。 ##异常值检测实战应用 说完了检测方法,我们接下来看一下异常值检测在实战中的应用。下面是某应用(app)的日活进行监测, 其日活并不是稳定不变的,比如促销活动时日活会变高,但当日活突然变低时则需要我们去排查是否统计日志或数据流本身出了问题。 上图是某应用 2016 年 8 月到 2019 年 9 月的日活统计。这么直接一看就可以看到它有很多的突变点,这些点可能就是它的异常行为。而异常值检测要做的就是使用统计或者机器学习的方法将这些异常点找出来。 当成静止数据时的异常值检测 上图是将之前的日活统计当成整体数据后检测的结果,这是一个静止的数据。我们可以看到左图 3σ 法则的检测效果并不好,只检测出了少数的几个点;而右图使用孤立森林算法则的优势则可以很明显的看到,它基本能够将人眼看到的异常全部检测出来,而且还有一些人眼没看到需要局部放大才能发现的数据,它也能够检测出来。 当成流式数据时的异常值检测 在实际操作中我们会遇到很多流失数据的情况,不能够单纯的将数据当做静止的均值数据看,所以我们现在来看一下流式数据的异常值检测。 在检测实时数据时,基于统计的方法可以使用滑动窗方式来检测,让窗去滑动更新,而我们只需要统计窗的情况就好。使用这种方式后 3σ 法则就可以将绝大部分的突变点都检测出来了,当然很明显的可以看到右图中使用 RCF(随机剪切森林算法能够检测到的突变点更多,不过现在这张图我没有放大,但是 RCF 其实将局部的小异常也检测出来了。 **无论是静止数据还是流式数据,我们都可以明显看到基于 RCF 的方法检测的更准确一些,但是这并不代表我们可以完全放弃基于统计的方法。**当我们在检测那些数据量很大而且异常点的损失较少的数据时,我们仍然可以使用基于统计的方法。虽然它的精准度不如 RCF,但是它操作简单。目前大多数没有接触异常值检测的公司使用的都是基于统计的方法,通过设置一个 3σ 阈值或使用箱体图来进行异常值判断。而在对异常值检测有较深接触后,RCF 就成为了异常检测的主流。 下图是基于不同异变点所作的算法总结: 时序变点异常:对于这种时间点的突变,使用统计算法就可以比较好的检测出来; 时序折点异常:对于这种不是一个点的跳动而是台阶式跳动的异常,可以使用 RCF(随机剪切森林) 算法来检测; 时序周期异常:对于这种周期异常的检测,推荐的检测方法是流式图算法。这里说的图算法其实是指图神经网络。这点我之前并没有提到,是因为目前图算法还处于一个初步阶段,它的研究并不成熟,把图神经网络和异常值检测结合起来的运用还特别的少。但是因为图神经网络现在的发展很快,所以在未来它一定会在异常值检测方面有很好的效果。 讲到现在其实我们已经看了很多具体的算法例子,但是如果一定要说哪种算法最好,没有办法给出一个唯一答案,毕竟具体的选择需要和你的实际业务结合起来,合适才是最好的。 推荐阅读 微服务架构下 CI/CD 如何落地 有赞统一接入层架构演进

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册