首页 文章 精选 留言 我的

精选列表

搜索[赛博朋克],共10000篇文章
优秀的个人博客,低调大师

每日一博 | Svelte 组件之间通讯的 6 种方法

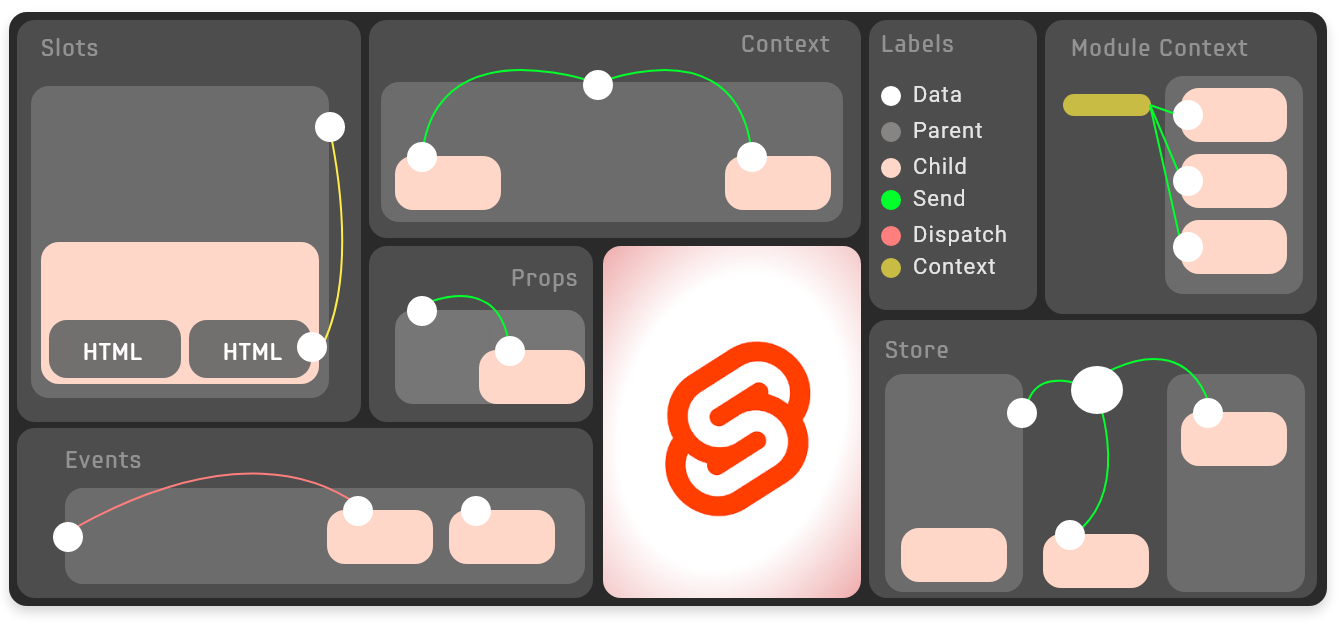
使用组件设计用户界面的主要挑战是管理不同组件上的应用状态。而 Svelte 提供了强大的能力实现在组件中进行数据传递。 “Great communication begins with connection.“ — Oprah Winfrey 译注:奥普拉·盖尔·温弗里(英语:Oprah Gail Winfrey,1954年1月29日-),生于美国密西西比州,美国电视脱口秀主持人、制作人、投资家、慈善家及演员,美国最具影响力的非洲裔名人之一,时代百大人物。 她是入选时代百大人物次数最多者,总共9次。2005年美国在线举办票选活动—《最伟大的美国人》,她被选为美国最伟大的人物中的第九位。 接下来开始来了解 6 种实现 Svelte 组件间通讯的方法,他们分别是: 将数据发送到子组件:Props 在组件内渲染 HTML:Slots 子组件将数据通过事件方式通知父组件:Events 通过上下文 API 传递数据:Context API 在所有组件的实例之间共享数据:Module Context 在任意组件之间共享数据:Store 在本文中,我们写了一些简单的示例,应用了不同的 Svelte 组件通讯技术。这些代码不会包含所有零碎的东西,只是为了让你了解这些技术的本质。 1. Props 在真实应用中,经常需要将数据从一个组件传递到其他的子组件。最基本的方法就是使用组件属性,在 Svelte 中可以使用 export 关键字来定义组件属性。 请注意下图代码中高亮部分的 export 关键字: Card.svelte with props 简单的引入 Card 组件,并通过属性将数据传递给 Card 。 <script> import Card from './Card.svelte'; </script> ​​​​​​​<Card userid="#2312312" name="Jhon Doe"/> 提示: 在 Svelte 中使用 Typescript 可以解决组件内的属性类型检查问题。 2. Slots Slots (槽) —— 子组件可以通过使用槽来传递要渲染的内容,这是基于 Web 组件槽的建议。 <div class="card"> <slot/> </div> 槽的默认定义方法是在子组件中使用<slot>这个 HTML 标签。 槽有助于将组件设计为一个模板,同时也可以基于命名的方式来注入 HTML 内容。下面栗子展示命名槽的做法: Card component with slots 3. Events 在设计组件时,捕获来自子组件的事件是一件很有意思的事情。继续更新上述的代码,当我们点击心图标的时候就会在喜欢与不喜欢之间做切换。如图所示: 为了分发事件,需要引入Svelte 的 {createEventDispatcher} 函数。然后在子组件中通过这个函数来触发事件。来看看代码: <script> import { createEventDispatcher } from 'svelte'; //Declare the dispatch const dispatch = createEventDispatcher(); export let id = 'ID'; export let name = 'unknown' export let favor = false; let hearts = ['♡','♥']; let heartIcon = hearts[0]; //if you wonder $: its svelte way make reactive statement $: heartIcon = favor ? hearts[1] : hearts[0]; const favorite = (id) => { favor = !favor; //Dispatch the favorite event with object data dispatch('favorite', {id, favor}); } </script> <div class="card"> <i>{id}</i> <h2>{name}</h2> <span class="btnHeart" on:click={() => favorite(id)}>{heartIcon}</span> </div> <style> .card{position:relative;margin:50px auto;width:300px;padding:20px;border-radius:9px;background-color:#F5F7F0; } i{ color:#999;} h2{margin:0; color:#491D3C;} .btnHeart{position:absolute;right:20px; top:10px;font-size:32px;cursor:pointer; } </style> CardEvent.svelte 文件根据点击来分发事件。 这里我们获取到三个值,分别是 id, name, favor ,然后通过 dispatch 分发给父组件: <script> import Card from './CardEvent.svelte' let user ={ id : '#1212', name: 'Jhon Doe', favor : false } const whenFavored = (event) => user.favor = event.detail.favor; </script> <Card {...user} on:favorite={whenFavored}/> App.svelte using CardEvent.svelte 这里使用了{...}操作符来设置user对象作为子组件的属性,并侦听favorite点击事件,当有点击的时候触发whenFavored()函数执行并设置值到父对象中。 黑科技 在多级嵌套的组件中,可以使用 <card on:favorite />来转发事件,它将事件传递给父组件,这个机制同样也适用于 DOM 的事件。 可以将子组件作为一个引用传递给父组件,并在父组件中调用所有子组件输出的方法。例如可以使用 <Card bind:this={userCard} />来引用Card组件为一个userCard对象。 4. Context API 上下文 API。 现在我们进入 Svelte 通讯技术里高级部分,这部分非常有用。上下文 API 提供了一个强大的机制实现组件间的对话。 “Communication is only effective when we communicate in a way that is meaningful to the recipient, not ourselves.“ "只有当我们以对接收者而不是我们自己有意义的方式进行沟通时,沟通才有效。“ — Rich Simmonds (LinkedIn 联合创始人兼 CEO) 首先顶层的组件需要使用setContext()来设置数据,然后其他组件通过getContext()来获取数据。是不是相当简单? //App.svelte <script> import Card from './CardContext.svelte' import {setContext} from 'svelte'; let user ={ id:123456, name:'Jhon Doe', favor : true } setContext('user', user); </script> <Card/> 我们通过上下文 API 将对象 user 传递给所有子组件: <script> import {getContext} from 'svelte'; //Get the Ancestor user object const user = getContext('user'); let hearts = ['♡','♥']; let heartIcon = hearts[0]; //Apply the favor value to reactive heartIcon $: heartIcon = user.favor ? hearts[1] : hearts[0]; </script> <div class="card"> <i>{user.id}</i> <h2>{user.name}</h2> <span class="btnHeart">{heartIcon}</span> </div> <style> .card{ position:relative; margin:50px auto; width:300px; padding:20px; border-radius:9px;background-color:#F5F7F0;} i{ color:#999;} h2{margin:0; color:#491D3C;} .btnHeart{ position:absolute; right:20px; top:10px; font-size:32px; cursor:pointer; } </style> CardContext.svelte 注意,上下文中的状态仅对子组件有效,如果要使用组件的多个实例,而不使一个组件的状态干扰其他组件的状态,这将非常有用。 5.Module Context (模块上下文) 在 Svelte 中,同一个组件的多个实例想要共享相同数据是非常简单的,只需要将这些变量定义在<script context='module'></script>之间即可。 来看这么一个例子,当点击标签名词的时候,其他组件实例也会相应的展示相同效果。 点击 Clear All 可以清除所有按钮状态。 首先在 App.svelte 中使用 users 对象创建 Card 实例并使用属性来传递 user 对象。 <script> import Card,{ clearAll } from './CardWithModuleContext.svelte' let users=[ {id:101, name:'Jhon Doe', tags:['Javascript','HTML','PHP']}, {id:102, name:'Mark Dane', tags:['C++','HTML','CSS']}, {id:103, name:'Clark Jose', tags:['Javascript','HTML','CSS']}, ]; </script> <button on:click={clearAll} style="border-radius:9px;" >Clear All </button> {#each users as user} <Card {user}/> {/each} App.svelte 同时添加一个模块方法{clearAll}来清除所有高亮的标签: <script context="module"> //data shared accross each instance of this componenet let tagSelected; export function clearAll() { tagSelected = "" } </script> <script> import { onMount, onDestroy } from "svelte"; export let user; let choosed; let interval; const selectIt = (tag) => { tagSelected = tag; choosed = tagSelected } //read the data on interval onMount(() => { interval = setInterval(()=> choosed = tagSelected, 100); }); //destroy the timer onDestroy(() => clearInterval(interval)); </script> <div class="card"> <i>#{user.id}</i> <h2>{user.name}</h2> <dl> {#each user.tags as tag} <dd on:click={()=>selectIt(tag)} class:apply={choosed == tag}>{tag}</dd> {/each} </dl> </div> <style> .card{width:300px;padding:20px;border-radius:9px;background-color:#F5F7F0;margin-bottom:10px;} i{ color:#999;} h2{margin:0; color:#491D3C;} dl{margin:0; padding:0; margin-top:10px;} dd{display:inline-block;margin:0; margin-right:10px; color:#999; padding:1px 10px; border:1px solid #ccc; border-radius:15px; font-size:14px;cursor:pointer; } .apply{color:#900; background:#ccc;} </style> CardWithModuleContext.svelte 变量tagSelected将在组件的不同实例间共享,理解起来非常有趣,这里添加一个 100 毫秒的定时器来更新标签的高亮。如你所见,子组件中的所有逻辑就是用来和其他实例通讯的。 6. Store 随着应用越来越复杂,增加越来越多的特性,越来越多的组件,复杂度日益增加。这个时候我们需要在组件的层次结构之外保存一些应用的状态。而 Svelte 内建的 store 就可以实现这个。 在 Svelte 存储中,可以存单个对象、数组等。Svelte 提供了多种存储,包括writable, readable, derived, 或者 custom. 接下来做一个简单例子实现图书列表: BookStore.js import { writable } from 'svelte/store' export let bookStore = writable([ {name:"Hamlet",author:"William Shakespeare"}, {name:"The Great Gatsby",author:"F. Scott Fitzgerald"} ]); BookList.svelte <script> import { bookStore } from './BookStore.js' </script> <ul> {#each $bookStore as book} <li>{book.name} - {book.author}</li> {/each} </ul> BookForm.svelte <script> import { bookStore } from './BookStore.js' let bookName; let author; const addNew = ()=>{ $bookStore = [{name:bookName, author:author},...$bookStore,]; } </script> <input type="text" bind:value={bookName} placeholder="Book Name"/> <input type="text" bind:value={author} placeholder="Author Name"/> <button on:click={addNew}>+ Add Book</button> App.svelte <script> import BookList from './BookList.svelte' import BookForm from './BookForm.svelte' </script> <BookForm/> <BookList/> 这里创建了一个bookStore作为 writable 数组,通过 $ 这个语法糖在表单和列表组件中引用来访问数据。 Context vs Store Context 和 Store 二者比较类似,区别在于 Store 可在应用的任一组件中访问,而 Context 只能用于子组件。 示例代码 了解本文中介绍的所有示例,这些示例在 Svelte REPL 中可用。要进行测试,请通过导入不同的卡组件来更新 App.svelte 文件,以检查结果。 (demo) 结论 构建组件之间的通信是应用程序设计中最重要的部分。在Svelte中,我们有用于状态管理的内置功能,可以给我们很好的灵活性来设计更好的应用程序。 本文翻译自https://betterprogramming.pub/6-ways-to-do-component-communications-in-svelte-b3f2a483913c
优秀的个人博客,低调大师

每日一博 | Blazor 是春天还是寒风里的挣扎

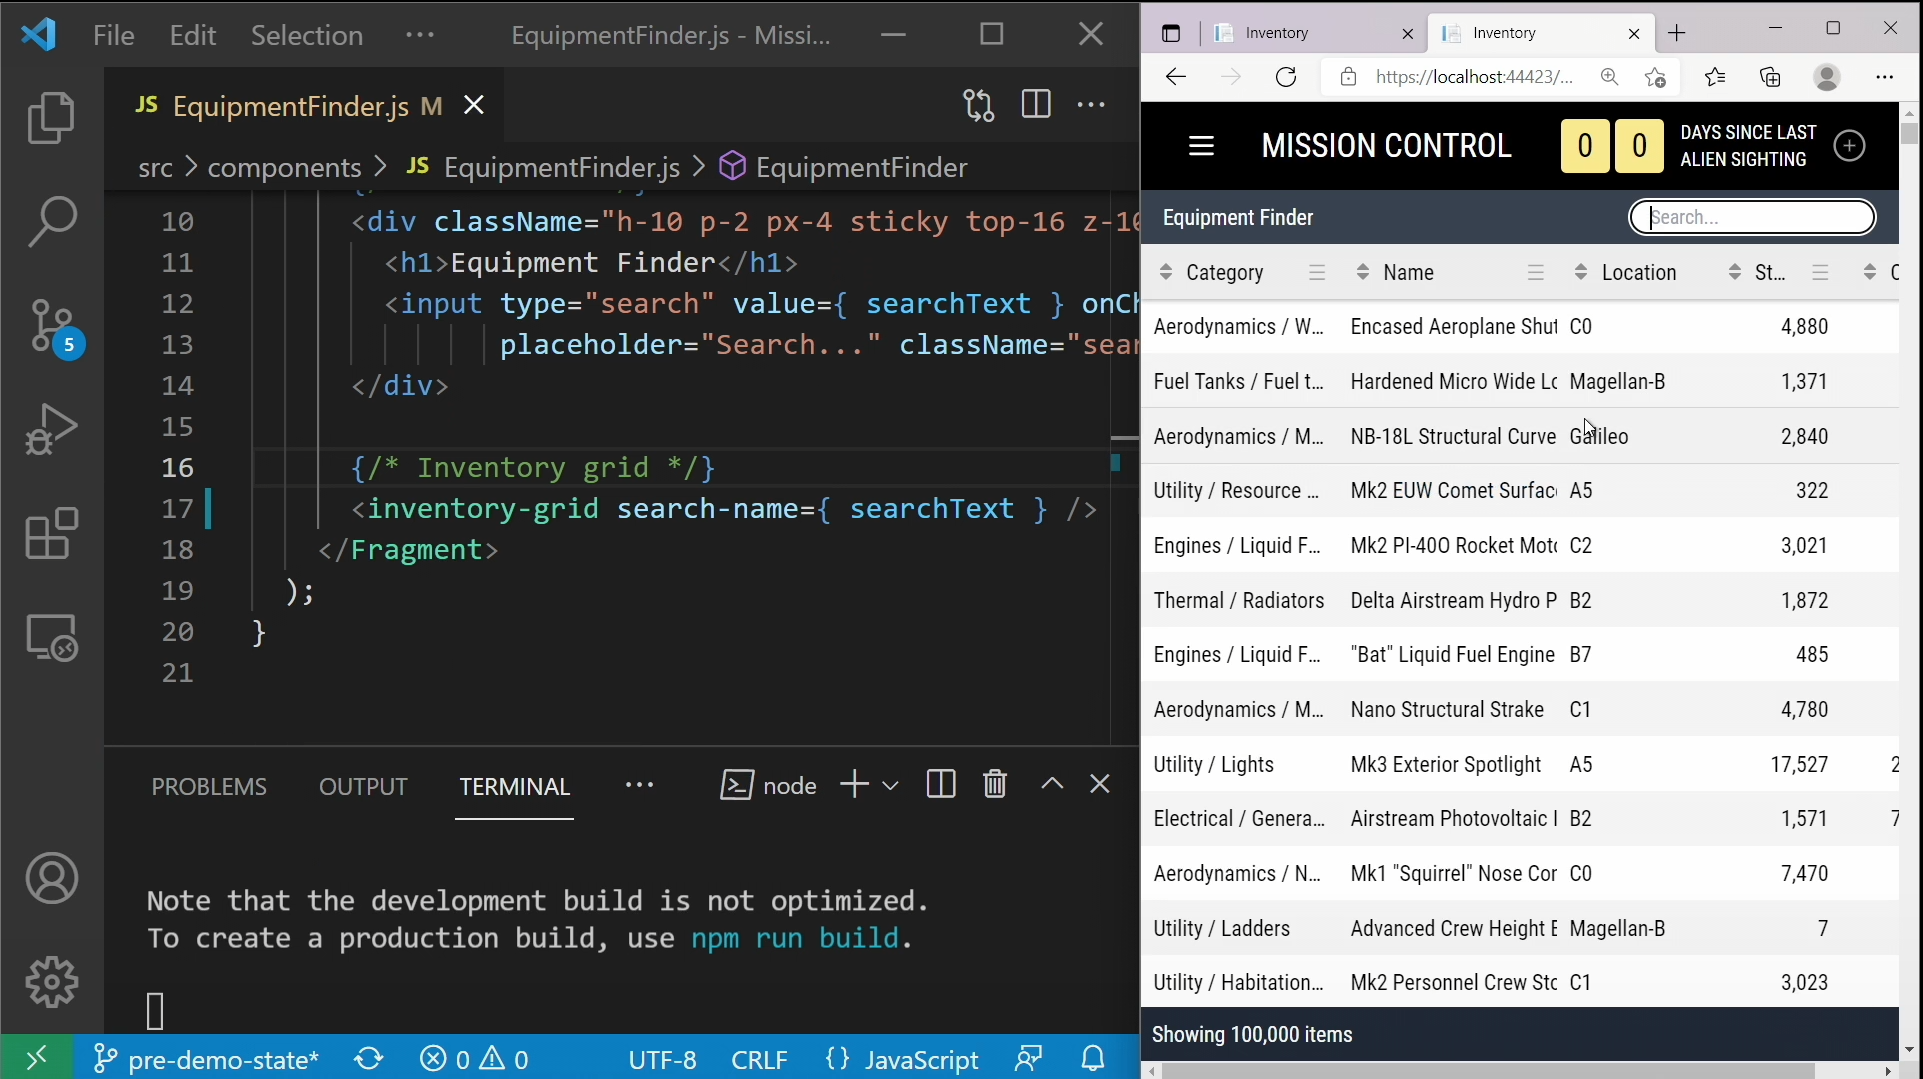
官方解释Blazor Blazor允许您使用c#而不是JavaScript构建交互式web UI。 Blazor应用由可重用的web UI组件组成,这些组件使用c#、HTML和CSS实现。客户端和服务器代码都是用c#编写的,允许您共享代码和库。 Blazor 是一个使用 .NET 生成交互式客户端 Web UI 的框架: 使用 C# 代替 JavaScript 来创建信息丰富的交互式 UI。 共享使用 .NET 编写的服务器端和客户端应用逻辑。 将 UI 呈现为 HTML 和 CSS,以支持众多浏览器,其中包括移动浏览器。 与新式托管平台(如 Docker)集成。 使用 .NET 进行客户端 Web 开发可提供以下优势: 使用 C# 代替 JavaScript 来编写代码。 利用现有的 .NET 库生态系统。 在服务器和客户端之间共享应用逻辑。 受益于 .NET 的性能、可靠性和安全性。 在 Windows、Linux 和 macOS 上使用 Visual Studio 保持高效工作。 以一组稳定、功能丰富且易用的通用语言、框架和工具为基础来进行生成。 看到这里有些小伙伴手中的瓜已经要丢出来了,的确有部分是夸大了的,起码VS在三个平台高效工作这事儿,嗯。。。其他的继续吃瓜吧 <!-- more --> Blazor Vs MVC 什么是MVC 官方解释:ASP.NET Core MVC 是使用“模型-视图-控制器”设计模式构建 Web 应用和 API 的丰富框架。 圈重点,Blazor是交互式Web UI,而MVC是Web应用和API 什么是交互式Web UI 谷歌、百度转了一圈,没有这个解释,连Wiki也是一脸懵逼。 尝试理解一下吧,交互式Web UI重点在于交互,而Blazor的官方解释是用C#代替JavaScript,那我们看看JavaScript有什么功能,我百度找一段过来: 嵌入动态文本于HTML页面 对浏览器事件做出响应 读写HTML元素 在数据被提交到服务器之前验证数据 检测访客的浏览器信息。控制cookies,包括创建和修改等 有这些基础功能,用户不需要在静态页面里跳来跳去了,的确体验会好很多 Blazor有什么优势 提供了一些交互能力,不再是纯粹的静态页,虽然mvc可以使用JavaScript达到同样的效果,但你需要掌握JavaScript,甚至还要再学习jQuery、Angular、Vue等。而Blazor提供的交互能力则是使用C#。 吹是吹完了,但你真的可以100% C#吗?这很难,你会遇到各种问题,比如兼容性、性能等。好了,那我可以不用了吗?等等,下面还有瓜 Blazor Vs 现代前端(Angular、Vue等) 我们从几个方面来对比一下吧 调试 Blazor:Vistual Stuidio + F5,VS Code/命令行工具 + dotnet watch 比WebPack要快很多,跟Vite差不多 在非复杂场景下Hot Reload是可以的,但奇奇怪怪的问题太多了,前景很好,目前来看还是用Ctrl + F5启动或者用命令行吧 VS 2022的Ctrl + F5已经支持Hot Reload了 现代前端:Webpack/Vite 全家桶 以Vue为例,Vue全家桶包括Vue Cli、Vue Router、Vuex Blazor: Cli:dotnet cli Router:Microsoft.AspNetCore.Components.Routing.Router Vuex:Blazor状态管理,区别在于WASM状态保存在浏览器内存中,而Server保存在服务器内存中。而且Blazor状态管理更强大的是借助.Net的能力,原生支持持久化存储、跨线路保存(Server下共享服务器内存)、ASP.NET Core 受保护的浏览器存储(Server独享功能) 组件库 主流的Bootstrap, Ant Design, Material Design等双方都有。但由于现代前端多年的积累,质量上的确有一定差距。 除了丰富程度上,Blazor允许被JavaScript调用加载,并生成Angualr、React等组件。 虽然这看起来跟用C#解决代替JavaScript有点冲突,但融入大环境也是不错的 下图演示的是Blazor提供的inventory-grid Component被React引用的例子(当然也可以给Angular): 更神奇的是,在React复用的Blazor Component居然也支持Hot Reload。先不说Hot Reload到底如何,单是这个方向其实还是值得期待一下Hot Reload的未来吧。 不止可以给React提供复用的组件,还可以给WPF 第三方库 举几个前端常用库来比较。 网络:现代前端有axios,Blazor有HttpClient 数据操作:现代前端有Lodash,Blazor有Linq 时间:现代前端有moment.js、Day.js,Blazor有DateTime全家桶 响应式编程:现代前端有rx.js,Blazor有Rx.Net(没有用过,理论上.Net基本都能用,欢迎纠错) Mock:现代前端有Mock.Js,Blazor有Moq,当然除了mock以外还有端到端的,双方也都有。 对比下来其实.Net反而还有点优势,那就完美吗?当然不是,再说点劣势的部分吧。 Charts:现代前端有ECharts等,Blazor不想说话 虽然目前Blazor的确没有成熟、免费的Charts组件库,但因为Blazor可以与JS交互的能力,调用ECharts也很简单,稍微考验一点点小伙伴的动手能力 富文本编辑器、拖拽。。。 Blazor骂骂咧咧的退出了群聊。。。 包管理 Blazor:NuGet 现代前端:NPM、Yarn 性能 数据不直观,先从.Net Conf 2021上的演示截图看一下: 有量化数据吗?有: 视频地址:https://sec.ch9.ms/ch9/daba/468d5211-982b-4c86-8b51-e1c8824edaba/dotNETConfNewBlazorWebAssembly_high.mp4 那AOT可以解千愁吗?也不是。起码应用大小上来说的确也大了不少,但这并不妨碍AOT可以解决特定场景的问题。技术总要选择在适合的场景使用它,而不是盲目的。 完了吗 当然没有,其实这样比较对于Blazor是不公平的,因为Blazor站在.Net的肩膀上有更多的亮点,比如原生支持的泛型、DI、面向对象设计(虽然TS也是)、数不过来的.Net类库、跨平台应用(MAUI)等。 其实没有必要只看到Blazor的劣势,也可以看看站在.Net上的前端能走多远,这不也是我们期待的吗? 看到这里,有些.Net古董级大佬要出来发话了,Silverlight!是的,但这次WASM没有再要求下载插件了。 Web Assembly Vs Server(服务器端渲染) Web Assembly:WebAssembly是一种新的编码方式,可以在现代的网络浏览器中运行 - 它是一种低级的类汇编语言,具有紧凑的二进制格式,可以接近原生的性能运行,并为诸如C / C ++等语言提供一个编译目标,以便它们可以在Web上运行。它也被设计为可以与JavaScript共存,允许两者一起工作。 Server(Server Side Render - SSR):将组件渲染为服务器端的 HTML 字符串,将它们直接发送到浏览器,最后将这些静态标记"激活"为客户端上完全可交互的应用程序。 为什么用SSR 服务器端渲染 (SSR) 的优势主要在于: 更好的 SEO,由于搜索引擎爬虫抓取工具可以直接查看完全渲染的页面。 更快的内容到达时间 (time-to-content) 什么时候用SSR 使用服务器端渲染 (SSR) 时还需要有一些权衡之处: 开发条件所限。浏览器特定的代码,只能在某些生命周期钩子函数 (lifecycle hook) 中使用;一些外部扩展库 (external library) 可能需要特殊处理,才能在服务器渲染应用程序中运行。 涉及构建设置和部署的更多要求。与可以部署在任何静态文件服务器上的完全静态单页面应用程序 (SPA) 不同,服务器渲染应用程序,需要处于服务端运行环境。 更多的服务器端负载。 服务器端渲染 vs 预渲染 (SSR vs Prerendering) 如果你调研服务器端渲染 (SSR) 只是用来改善少数营销页面(例如 /, /about, /contact 等)的 SEO,那么你可能需要预渲染。无需使用 web 服务器实时动态编译 HTML,而是使用预渲染方式,在构建时 (build time) 简单地生成针对特定路由的静态 HTML 文件。优点是设置预渲染更简单,并可以将你的前端作为一个完全静态的站点。 Blazor Server支持Prerendering Blazor该选Web Assembly还是Server 看一下.Net Conf 2021大会上的一张图: 总结一下: Server要持久化长连接,有更高的UI延迟 Web Assembly则是更大的下载大小,和更慢的运行时性能 我们在做什么 又是一个老生常谈的问题,.Net的覆盖面太广了也导致很难解决所有问题。我们在权衡利弊之后是不是可以为.Net生态共建出自己小小的一份力呢? 开源的组件库 再回到组件库上,目前市面上的组件库其实不少了,何必要继续在这个泥潭里插一脚呢? 开发过组件库的同学,或者贡献过源码的同学应该都体会到了,写一个组件是多么的复杂。而大家对于一个设计的审美角度也是不同的。当你喜欢的设计没有提供实现怎么办?从头写吗,那太累了,所以我们尝试了一件事情。 先看一下大概思路: 简单的剖析一下: 在Blazor的基础上,构建一个新的组件库叫 Blazor Component 那他有哪些特性呢? 只提供交互,不提供样式 标准化Dom结构 开放几乎所有可以自定义的Slots(插槽,概念引自Vue),允许你替换Slots的Dom 插槽与交互的统一单元测试(目前正在38%,短期目标是80%,长期目标是90%+) 基于Material Design(样式引自Vuetify)的示例项目,可以达到生产可用(我们自己的公司在用,也是世界五百强企业在用) 快速实现新的组件库,只需要基于某个Design + 样式控制属性 + 特殊交互即可 未来是值得憧憬的,我们希望未来是这样的: 惭愧,蹭了一波字节的热度 MASA Blazor 基于Blazor Component和Material Design的Blazor组件库 截止目前共68个基础组件,后续会继续增加 预置组件,提供与.Net功能深度集成且常用组合类组件,如Url、面包屑、菜单三联动,高级搜索,i18n等 MASA Blazor Pro提供多种常见场景的预设布局 全职团队维护,Issue快速响应 知名企业在用,未来MASA Stack产品线也将一直使用,持续增加新功能 免费、开源 我们还计划未来支持一键切换主题(代码切换已经提供)、预置布局、数据展示类组件、WorkFlow类组件等。 MASA Blazor Pro 基于MASA Blazor提供的Admin模板,先放几张设计稿吧,源码会跟MASA Blazor一起放出。 MASA EShop 基于MASA Framework搭建的 EShopOnDapr,将会使用MASA Blazor Pro提供完整的前后端示例 开源地址:https://github.com/masalabs/MASA.EShop 总结 说到底没有完美的技术,在你权衡利弊之后在正确的场景使用它就是最合适的。 是春天还是寒冬也不重要,重要的是当下这一刻,它是否解决了你的痛点。 最后,一个小小的广告 MASA Blazor 即将发布,敬请期待,如果你对我们的组件库感兴趣,无论是代码贡献、使用、提Issue,欢迎联系我们 参考 https://dotnet.microsoft.com/apps/aspnet/web-apps/blazor https://docs.microsoft.com/zh-cn/aspnet/core/blazor/state-management?view=aspnetcore-6.0&pivots=server#persist-state-across-circuits https://sec.ch9.ms/ch9/daba/468d5211-982b-4c86-8b51-e1c8824edaba/dotNETConfNewBlazorWebAssembly_high.mp4 https://developer.mozilla.org/zh-CN/docs/WebAssembly https://ssr.vuejs.org/zh/

优秀的个人博客,低调大师

博文推荐|基于 Apache Pulsar 的分布式锁

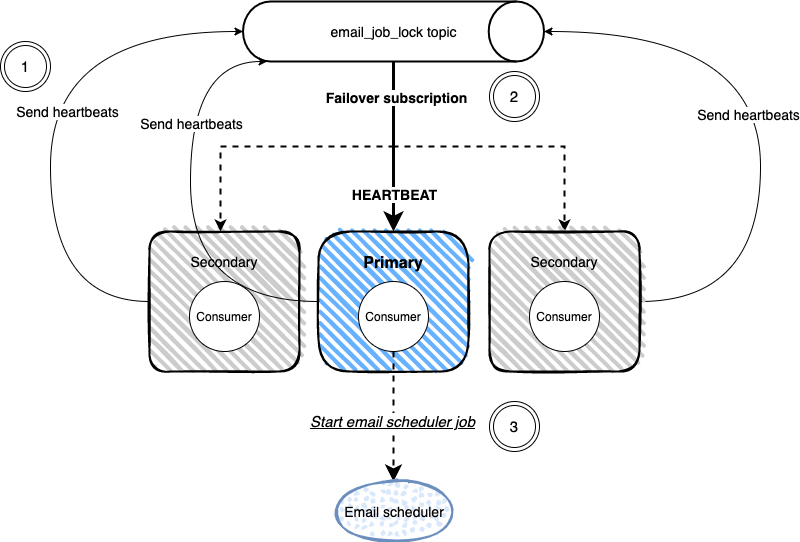
本文翻译自《Distributed Locks with Apache Pulsar》。原文链接:https://theboreddev.com/distributed-locks-with-apache-pulsar/ 译者简介 魏伟 kivenwei,7 年研发工作经历, 主要经历了 SOA、微服务架构。熟悉云计算领域的开源软件发展和 CNCF、云原生生态,目前就职于中广核智能科技有限责任公司。 有时,软件工程师经常面临最具挑战性的工作就是如何确保我们的分布式应用程序中每次只有一个组件在执行相应的计算。 例如,应用程序中三个运行节点,并且我们需要每天运行一个计划任务,如何保证仅其中一个节点可以触发运行任务呢?如果我们在此任务中向客户发送电子邮件并在三个节点上运行任务,则我们的客户可能会收到 3 次此电子邮件。事与愿违, 那么如何解决此问题呢? 有人可能会说:“简单,只运行一个节点!”。 其实,没那么容易。在大多数情况下,我们必须确保服务具有足够的可用性级别,而仅运行一个节点意味着如果出现问题,服务将不可用。 我们真正需要的方案是选择某个“主节点”来负责此任务。另一个需要考虑的因素是如果我们的主节点出现故障,则必须立即将此任务委托给其中一个备用节点执行任务以避免中断。 让我们来看看,我们想要实现的效果。如下图: 在操作上,需要找出一种简单的方法来“选举”负责执行任务的主节点,其它节点将耐心等待轮到它执行的情况。因此这些备用节点将处于所谓的“休眠”状态;只有在主节点故障或无响应时,备用节点才会被唤醒。 如何解决这个问题 在一些场景中,会倾向于用一些相当复杂的实现去确保只有其中一个节点执行任务。 现在一些数据库引擎支持的“CAS”原子操作,可能是快速解决这个问题的合理方法。我们利用数据库中一项特性即可解决问题,而无需自己重新实现。但是如果数据库不支持这样的原子操作呢? 问题会变得更复杂,因为每个节点都会尝试竞争以获得锁,但是两个节点可以同时获得锁的值为“free”且都成功设置了值,而不会注意到另一个节点也“获得锁”。这意味着不仅有一个节点,而是两个节点都将执行此任务,例如向客户发送电子邮件, 然而,即使在数据库中支持 CAS 操作,也需要提供一些机制来确保如果我们的主节点故障后备用节点来接管:一个类似于心跳的进程,不断检查状态并在节点出现故障时采取相应措施。然而,这种方案较为耗时耗精力,理想情况下,我们希望利用完善的并经过全面测试的产品。 如果你已经部署了 Pulsar,那么这正是我们使用 Apache Pulsar 这类产品来解决这一问题的原因。Kafka 也可以实现类似的解决方案,但这篇文章主要聚焦于 Apache Pulsar。 使用 Apache Pulsar 实现分布式锁 那么如何去利用 Apache Pulsar 的优势呢?Pulsar 提供了一种叫做 failover(灾备)的订阅机制,它主要实现了一个 leader 选举机制。 如何充分利用这种选举机制来保证计划任务只执行一次呢? 无需深入了解实现的具体细节,因为这在很大程度上取决于使用场景,可以想出一个简单的方法来实现这一点。具体如下: 基于心跳事件的自动启动调度器 一个实现方法是启动一个消费者并开始监听心跳事件,然后立即开始发送心跳事件。消费者将使用 failover(灾备)订阅来订阅主题。因此,只有一个节点能够启动调度程序。如果主节点故障,那么其他备用节点将接管并立即启动任务。下图是实现的思路: 在这个例子中,我们有一个主题来管理分布式锁,每个消费者定期向这个主题发送心跳,同时使用 failover(灾备)订阅主题。只有其中一个节点会成为主节点并处理心跳事件。如果主节点还没有启动邮件调度器,它会在收到第一个心跳后立即启动;对于其余的心跳,只要调度程序在运行,它们就会被忽略。 如果主节点故障后将会发生什么?具体看下图: 在主节点故障的情况下,Pulsar 的灾备(failover)订阅会检测到该节点已经故障,备用节点将接管。在图中,左侧的备用节点将收到心跳,触发任务执行的开始。一旦以前的主节点恢复,它将作为备用节点再次“休眠”。 结论 我们一般不建议只为了实现分布式锁就采用任何新技术,通常寻找并利用当前产品的优势可以节省时间、降低操作的复杂性。 当然,用户也可以在其他系统上构建自己的分布式锁,但这需要时间,而且也容易出错。但是在 Pulsar 的实现过程中,该特性经过其他工程师的彻底测试后可用且可靠,可为用户节省宝贵的时间,减少操作上的问题。 ▼关注「Apache Pulsar」,获取干货与动态▼ 👇🏻 加入 Apache Pulsar 中文交流群 👇🏻 戳👇下方阅读原文进行PulsarSummitAsia2021报名! 本文分享自微信公众号 - ApachePulsar(ApachePulsar)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | 带你了解 Typescript 的14个基础语法

摘要:Typescript可以说是JavaScript的超集,在JS的基础上新增了许多语法特性,使得类型不再可以随意转换,能大大减少开发阶段的错误。 本文分享自华为云社区《Typescript基础语法全解析》,作者:北极光之夜。 。 一.Ts是什么: 首先,强类型不允许随意的隐式类型转换,而弱类型是允许的。JavaScript就是经典的弱类型语言。而Typescript可以说是JavaScript的超集,在JS的基础上新增了许多语法特性,使得类型不再可以随意转换,能大大减少开发阶段的错误。 二. 基本语法: 1.声明原始数据类型: 在变量后面指定一个关键字表示其只能为什么类型。 string类型: const a: string = 'auroras' number类型: const b: number = 666 // 包括 NAN Infinity boolean类型: const c: boolean = true null类型: const d: null = null undefined类型: const e: undefined = undefined symbol类型: const h: symbol = Symbol() 2.声明Object类型: 首先,object类型不单单可以指定对象,还可以指定数组或函数: const foo1: object = {}; const foo2: object = []; const foo3: object = function(){}; 如果只想指定为对象,如下,对象属性都要提前声明好类型: const obj: {name: string,age: number} = { name: '北极光', age:18 } 3.1声明数组类型: 可以指定声明Array且通过<>指定元素类型,比如指定声明元素都为数字的数组: const arr: Array<number> = [1,2,3] 第二种方式如下,也指定声明元素都为数字的数组: const arr: number[] = [1,2,3] 3.2声明元组类型: 就是要提前指定数组里每个元素的类型,严格一一对应: const tuple: [number,string,boolean] = [666,'auraros',true] 4.声明枚举类型: 通过关键字enum声明一个枚举类型,如: enum Status { pedding = 1, resolve = 2, reject = '3' } //访问 console.log(Status.pedding); 如果全不写值,默认值为从0开始递增。如果第一个元素为字符类型,就必须全部定义值。如果第一个元素指定为一个数字,后面元素不写值,那值为第一个元素值按位置大小递增的结果。 5.函数参数与返回类型: 函数声明式: 指定函数传入参数类型,指定返回值类型,调用时传入参数个数与类型都必须相同: 括号里指定每个参数类型,括号右边指定返回值的类型。 function fun (name:string,age:number):string{ return 'sss' } fun('auroras',18); 如果传入参数不确定传不传,那么可以给参数加个‘?’表明它是可选的: function fun (name:string,age?:number):string{ return 'sss' } fun('auroras'); 或者给参数添加默认值,那也会成为可选参数: function fun (name:string,age:number=666):string{ return 'sss' } fun('auroras'); 如果参数个数不确定,可以用扩展运算符加解构赋值表示,当然要传入与指定类型一致的: function fun (name:string,age:number=666,...res:number[]):string{ return 'sss' } fun('auroras',1,2,3); 函数表达式: const fun2:(name:string,age:number)=>string = function(name:string,age:number){ return 'sss' } 定义接口时再详细说。 6.任意类型: 通过指定any关键字表示任意类型,跟原来 js 一样,可以任意赋不同类型的值: let num:any = 1; num = 'a'; num = true; 7.类型断言: 类型断言就是明确的告诉typescript这个变量就是某种类型的,百分之百确定。不用typescript在一些情况下要自己推断某些没有明确定义或者多变的场景是什么类型。 可以通过 as+类型 断言它就是某种类型的: const res = 1; const num = res as number; 也可以通过 <类型> 形式断言(不推荐): const res = 1; const num = <number>res 8.接口基本使用: 接口可以理解为一种规范,一种契约。可以约束一个对象里应该有哪些成员,这些成员都是怎么样的。 通过interface定义一个Post接口,这个接口是一个对象,规则为有一个name属性类型为string,age属性类型为number。 interface Post { name:string; age:number } 然后比如有一个函数 printPost ,它的参数 post 使用我们定义的 Post 接口的规则,那么调用此函数传参时要传入符合 Post 接口规则的数据。 interface Post { name:string; age:number } function printPost(post: Post){ console.log(post.name); console.log(post.age); } printPost({name:'asd',age:666}) 当然,函数传参时可能有些参数是可选的,那么我们可以给接口也定义可选的成员,通过属性后加一个‘?’指定可选成员: interface Post { name:string; age:number; sex?:string; } const auroras: Post = { name:'asd', age: 18 } 如果用readonly修饰成员,那么这个成员属性在初始化后便不可修改: interface Post { name:string; age:number; sex?:string; readonly like:string } const auroras: Post = { name:'asd', age: 18, like: 'natrue' } auroras.name = 'aaaa'; //保错 auroras.like = 'wind'; 如果连成员属性名称都不确定,那么可以声明动态成员,要指定成员名字类型与成员值的类型,如: interface Post { [prop:string]:string } const auroras: Post = { name:'asd', like: 'natrue' } 9.类基本使用: 描述一类具体事物的抽象特征。ts增强了es6中class类的相关语法。 首先,类的属性使用前必须提前声明好: class Person { name: string; age: number; constructor(name:string,age:number){ this.name = name; this.age = age; } sayHi(msg:string):void { console.log(`hi,${msg},i am ${this.name}`); } } 10.类的访问修饰符: private修饰私有属性,只能在类内部访问。public修饰公用属性(默认),外部也可访问: class Person { public name: string; private age: number; constructor(name:string,age:number){ this.name = name; this.age = age; } sayHi(msg:string):void { console.log(`hi,${msg},i am ${this.name}`); console.log(this.age); } } const jack = new Person('jack',20); //Person类公有属性可以访问 console.log(jack.name); //Person类私有属性不可以访问 console.log(jack.age); protected修饰为受保护的,外部也不可访问。但与private的区别是若是继承的子类是可以访问的。 class Person { public name: string; private age: number; // protected protected gender: boolean; constructor(name:string,age:number){ this.name = name; this.age = age; this.gender = true; } sayHi(msg:string):void { console.log(`hi,${msg},i am ${this.name}`); console.log(this.age); } } class children extends Person{ constructor(name:string,age:number){ super(name,age,); //可以访问 console.log(this.gender); } } 11.类只读属性: 给属性设置readonly则为只读属性,该属性初始化后便不可再修改。 class Person { public name: string; private age: number; // readonly protected readonly gender: boolean; constructor(name:string,age:number){ this.name = name; this.age = age; this.gender = true; } sayHi(msg:string):void { console.log(`hi,${msg},i am ${this.name}`); console.log(this.age); } } 12.类与接口: 一些类与类之间有些许共同的特征,这些共同的特征可以抽象成为接口。 比如 Person 类和 Animal 类,虽然是不同类,但是人和动物都会吃东西和走路等,这些共同的特征可以由接口定义。最后一个特征就定义一个接口。 //吃接口 interface Eat { eat(food:string):void } //行进接口 interface Run { run(behavior:string):void } //人 class People implements Eat,Run { eat(food:string){ console.log(`在餐桌上吃${food}`); } run(behavior:string){ console.log(`站着${behavior}`); } } //动物 class Animal implements Eat,Run { eat(food:string){ console.log(`在地上上吃${food}`); } run(behavior:string){ console.log(`爬着${behavior}`); } } 13.抽象类: 约束子类必须有某些成员,有点类似接口,不同的是抽象类可以包含一些具体的实现。比如动物类应该为一个抽象类,它的子类有猫,狗,熊猫等。它们都是动物,也有一些共同的特征。定义一个类为抽象类后,就不能再new实例了,只能被其子类继承。 其中abstract定义抽象类,类里用abstract定义一个抽象方法,子类必须实现抽象方法。 abstract class Animal { eat(food:string){ console.log(`在地上吃${food}`); } abstract run (behavior:string):void } //猫 class Dog extends Animal{ run(behavior:string):void{ console.log(behavior); } } const d1 = new Dog(); d1.eat('骨头') d1.run('四脚爬行') //兔子 class rabbit extends Animal{ run(behavior:string):void{ console.log(behavior); } } const r1 = new rabbit(); d1.eat('萝卜') d1.run('蹦蹦跳跳') 14.泛型: 泛型就是在定义函数,接口或者类的时候没有指定具体类型,等到使用时才指定具体类型。极大程度的复用代码。 比如有一个 identity 函数,这个函数会返回任何传入它的值,且传入的类型与返回的类型应该是相同的。如果传入数字,不用泛型的话,这个函数可能是下面这样: function identity(arg:number):number{ return arg } 如果传入字符串,这个函数可能是下面这样: function identity(arg:string):string{ return arg } 这样的话太麻烦,所以可以使用泛型,一般用大写 T 表示泛型,它可以适用于多个类型,且传入类型与返回类型是相同的。 function identity<T>(arg:T):T{ return arg } 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

每日一博 | 我的截图插件被 Gitee 使用了

前言 上周六有个群友@我说Gitee的反馈模块新增了截图功能,我就去体验了下,发现他们用的就是我的插件😁,本文就跟大家分享下这个插件,欢迎各位感兴趣的开发者阅读本文。 插件地址与实现原理 本插件采用原生js实现,可以集成在任意一个web项目中,插件npm地址与GitHub地址请移步: js-screen-shot(npm) js-screen-shot(GitHub) 插件的实现原理请移步: 实现Web端自定义截屏 实现Web端自定义截屏(JS版) 在线体验本插件,可移步我的开源项目chat-system进行体验,插件的运行效果视频请移步实现web端自定义截屏功能-效果视频。 Gitee产品经理的青睐 月初的时候,Gitee的产品经理在掘金看到我的截图插件js-screen-shot觉得还不错,他们最近在做这方面的功能,就打算将我的插件直接集成进去,跟我沟通了下版权相关的事情。 沟通完成后,他问我要不要把插件在Gitee也放一份,可以帮我推荐下,我毫不犹豫的抱住了大腿,就把插件搬过去了,得到一波首页推荐😂 Gitee的反馈模块需要登录后,点页面右侧的发送反馈图标。 影响体验的一些小问题 上周二,从GitHub来了个网友,加了我微信,给我的插件提了两个issues,因为周内没时间处理这些问题,就计划周末统一处理下插件的issues。 整理有效的issues 时间回到上周六早上,我打开GitHub瞅了一眼issues,许久不看居然已经有19条了。 经过一番整理,去掉一些无用的和已经修改好了的,最终确定了4条: 调用者可以在框选区域外绘制问题 截图区域工具栏首次点击时删除裁剪框的8个可操作点 修复框选完成后,鼠标点击其他位置截图工具栏跟着移动问题 添加可选参数支持单击截全屏功能 解决issues 问题整理完成,接下来就是解决问题环节了。 选区外绘制问题 正常情况下,截图区域确立后,用户都会在裁剪框区域内进行绘制,所以我就没考虑这个边界情况🤥,插件用的人多了后,自然就有人发现了这个问题,我们拿gitee的反馈模块举例(gitee目前用的还是我的旧版插件,肯定存在这个问题),如下所示,我们绘制的4个红色方框都超出裁剪框了: 实现思路 这个问题解决起来比较简单,裁剪框已经绘制好了,知道它的坐标信息,我们在进行绘制时,只需要判断当前鼠标位置是否超出裁剪框的坐标点区域即可。部分实现代码如下所示: // 获取裁剪框位置信息 const cutBoxPosition = this.data.getCutOutBoxPosition(); // 绘制中工具的起始x、y坐标不能小于裁剪框的起始坐标 // 绘制中工具的起始x、y坐标不能大于裁剪框的结束坐标 // 当前鼠标的x坐标不能小于裁剪框起始x坐标,不能大于裁剪框的结束坐标 // 当前鼠标的y坐标不能小于裁剪框起始y坐标,不能大于裁剪框的结束坐标 if ( !getDrawBoundaryStatus(startX, startY, cutBoxPosition) || !getDrawBoundaryStatus(currentX, currentY, cutBoxPosition) ) return; getDrawBoundaryStatus函数实现如下所示: /** * 获取工具栏工具边界绘制状态 * @param startX x轴绘制起点 * @param startY y轴绘制起点 * @param cutBoxPosition 裁剪框位置信息 */ export function getDrawBoundaryStatus( startX: number, startY: number, cutBoxPosition: positionInfoType ): boolean { if ( startX < cutBoxPosition.startX || startY < cutBoxPosition.startY || startX > cutBoxPosition.startX + cutBoxPosition.width || startY > cutBoxPosition.startY + cutBoxPosition.height ) { // 无法绘制 return false; } // 可以绘制 return true; } 具体代码请移步提交记录: fix: 修复插件调用者可以在框选区域外绘制问题 实现效果 实现后的效果如下所示: 工具栏跟随鼠标移动问题 这个问题可以描述为:裁剪框确定后,工具栏尚未点击,此时鼠标点其他位置,截图工具栏就跟着鼠标重新计算了位置,我们继续用Gitee来举例,如下所示: 实现思路 当鼠标左键抬起时,如果工具栏尚未被点击,则会根据当前鼠标的位置结合裁剪框的大小确立截图工具栏的位置。用户只是单纯的点击了裁剪框区域的任意位置,工具栏就跟着移动了。 解决这个问题也很简单,我们只需要在鼠标移动时添加一个标识,鼠标抬起时判断这个标识是否为true即可。部分代码如下所示: // 鼠标拖动状态 private dragFlag = false; // 鼠标移动事件 private mouseMoveEvent = (event: MouseEvent) => { // 工具栏未选择且鼠标处于按下状态时 if (!this.data.getToolClickStatus() && this.data.getDragging()) { // 修改拖动状态为true; this.dragFlag = true; } } // 鼠标抬起事件 private mouseUpEvent = () => { // 鼠标尚未拖动且工具栏未选择则不修改工具栏位置 if (!this.dragFlag && !this.data.getToolClickStatus()) { // 复原裁剪框的坐标 this.drawGraphPosition.startX = this.drawGraphPrevX; this.drawGraphPosition.startY = this.drawGraphPrevY; // 显示截图工具栏 this.data.setToolStatus(true); return; } } 具体代码请移步提交记录:fix: 修复框选完成后,鼠标点击其他位置截图工具栏跟着移动问题 实现结果 修复后的效果如下所示: 删除8个可操作点 去年截图插件刚写好时,我就发现这个问题了,当截图工具栏点击后裁剪框就不允许更改了,如果8个可操作点依然存在的话,看起来很奇怪,当时想到的思路是直接删除边框的8点,但是这8个点都是绘制上去的,折腾了挺久没找到方案就搁置了,这个问题如下图所示: 实现思路 一年后的今天,我知道删除那8个点的思路肯定行不通,我就一遍又一遍的体验QQ的截图,观察他是怎么做的,突然,我灵感惊现😼,我既然有裁剪框的坐标和大小信息,我重新绘制一下这个裁剪框不就好了🤒,裁剪框四周的8个可操作点删除后,我就可以删掉生成图片时优化那8个点的计算逻辑,导致范围不精确问题,从而实现完美截图。部分实现代码如下所示: // 工具栏尚未点击,当前属于首次点击,重新绘制一个无像素点的裁剪框 if (!data.getToolClickStatus()) { // 获取裁剪框位置信息 const cutBoxPosition = data.getCutOutBoxPosition(); // 开始绘制无像素点裁剪框 drawCutOutBox( cutBoxPosition.startX, cutBoxPosition.startY, cutBoxPosition.width, cutBoxPosition.height, screenShortCanvas, data.getBorderSize(), screenShortController as HTMLCanvasElement, ScreenShortImageController, false ); } 具体代码请移步提交记录:fix: 截图区域工具栏首次点击时删除裁剪框的8个可操作点 实现效果 实现单击截全屏功能 给我提issues的那个网友希望截图插件加载完毕后,用户不拖拽生成选框,直接鼠标左键单击就能截取整个屏幕,我觉得这个需求需要的人不多,就将其做成了可选参数。 实现思路 这个也很简单,鼠标抬起时,如果开启了单击截全屏,则从坐标(0,0)位置绘制一个与画布同等大小的裁剪框即可,部分代码如下所示: // 鼠标抬起事件 private mouseUpEvent = () => { if ( cutBoxPosition.width === 0 && cutBoxPosition.height === 0 && cutBoxPosition.startX === 0 && cutBoxPosition.startY === 0 && !this.dragFlag && this.clickCutFullScreen ) { // 设置裁剪框位置为全屏 this.tempGraphPosition = drawCutOutBox( 0, 0, this.screenShortImageController.width, this.screenShortImageController.height, this.screenShortCanvas, this.data.getBorderSize(), this.screenShortController, this.screenShortImageController ) as drawCutOutBoxReturnType; } } 具体代码请移步提交记录:feat: 添加可选参数支持单击截全屏功能 写在最后 至此,文章就分享完毕了。 我是神奇的程序员,一位前端开发工程师。 如果你对我感兴趣,请移步我的个人网站,进一步了解。 文中如有错误,欢迎在评论区指正,如果这篇文章帮到了你,欢迎点赞和关注😊 本文首发于神奇的程序员公众号,未经许可禁止转载💌

优秀的个人博客,低调大师

每日一博 | StratoVirt vCPU 管理 Rust 线程同步的实现

StratoVirt是开源在openEuler社区的轻量级虚拟化平台,具备轻量低噪、强安全性的行业竞争力。 StratoVirt进程运行在用户态,在虚拟机启动之前,StratoVirt会完成启动之前的准备工作,包括虚拟机内存的初始化、CPU寄存器初始化、设备初始化等,启动,CPU寄存器初始化和虚拟机在运行过程中vCPU陷出事件的处理,都是由StratoVirt的vCPU管理模块CPU完成。如下是StratoVirt中vCPU管理模块的组成,以及其在StratoVirt中的位置。 stratovirt├──acpi├──address_space├──boot_loader├──Cargo.lock├──Cargo.toml├──cpu│├──Cargo.toml│└──src│├──aarch64││├──caps.rs││├──core_regs.rs││└──mod.rs│├──lib.rs│└──x86_64│├──caps.rs│├──cpuid.rs│└──mod.rs├──devices├──hypervisor├──machine├──machine_manager├──migration├──migration_derive├──ozone├──pci├──src│└──main.rs├──sysbus├──util├──vfio└──virtio StratoVirt vCPU模块的整体设计 StratoVirt的虚拟化解决方案也是一套软硬结合的硬件辅助虚拟化解决方案,它的运作依赖于硬件辅助虚拟化的能力(如VT-X或Kunpeng-V)。vCPU模块的实现也是紧密依赖于这一套硬件辅助虚拟化的解决方案的。 对于物理机的CPU而言,硬件辅助虚拟化为CPU增加了一种新的模式:Non-Root模式,在该模式下,CPU执行的并不是物理机的指令,而是虚拟机的指令。这种指令执行方式消除了大部分性能开销,非常高效。但是特权指令(如I/O指令)不能通过这种方式执行,还是会强制将CPU退出到普通模式(即ROOT模式)下交给内核KVM模块和用户态StratoVirt去处理,处理完再重新回到Non-Root模式下执行下一条指令。 而StratoVirt中的vCPU模块主要围绕着KVM模块中对vCPU的模拟来实现,为了支持KVM模块中对CPU的模拟,CPU子系统主要负责处理退出到普通模式的事件,以及根据在GuestOS内核开始运行前对vCPU寄存器等虚拟硬件状态的初始化。整个vCPU模块的设计模型如下图所示: StratoVirt通过第三方库 kvm_ioctls来完成和KVM模块的交互,通过匹配 vcpu_fd.run()函数的返回值来处理退出到ROOT模式的事件,该函数的返回值是一个名为 VcpuExit的枚举,定义了退出到ROOT模式的事件类型,包括I/O的下发、系统关机事件、系统异常事件等,根据事件的类型vCPU将对不同的事件作出各自的处理。以上的整个过程都被包含在一个独立的vCPU线程中,用户可以自己通过对vCPU线程进行绑核等方式让虚拟机的vCPU获取物理机CPU近似百分之百的性能。 同时,对vCPU寄存器虚拟硬件状态信息的初始化则是和StratoVirt的另一个模块BootLoader相互结合,在BootLoader中实现了一种根据Linux启动协议快速引导启动Linux内核镜像的方法,在这套启动流程中,BootLoader将主动完成传统BIOS对一些硬件信息的获取,将对应的硬件表保存在虚拟机内存中,同时将提供一定的寄存器设置信息,这些寄存器设置信息将传输给vCPU模块,通过设置vCPU结构中的寄存器值,让虚拟机CPU跳过实模式直接进入保护模式运行,这样Linux内核就能直接从保护模式的入口开始运行,这种方式让StratoVirt的启动流程变得轻量快速。 在整个vCPU模块中,因为涉及到内核的KVM模块,少不了与C语言代码做交互。作为系统编程语言,Rust对FFI有非常完善的支持,让vCPU中和KVM模块交互的部分高效且安全。 vCPU线程模型同步 vCPU模块还有一大职责就是管理vCPU的生命周期,包括new(创建),realize(使能),run(运行),pause(暂停),resume(恢复),destroy(销毁)。New和realize的过程就是结构体创建和寄存器初始化的流程,run的过程即是实现KVM中vCPU运作和 VCPU_EXIT退出事件处理的流程。 另外的三种生命周期的实现则涉及到对线程同步的精密控制,例如在虚拟机destroy的过程中,一般只有某一个vCPU接收到 VCPU_EXIT中的 SHUTDOWN事件,该vCPU线程需要把该事件传递到所有的vCPU线程,同步所有vCPU线程的状态,完成虚拟机的优雅关机。在这种场景下,我们就需要考虑在Rust中如何实现在多线程中进行状态同步。 Rust中通过条件变量来实现同步 Rust多线程编程中,有一类用于同步的机制叫做屏障(Barrier),用于让多线程来同步一些流程开始的位置,它相当于一个闸口,使用wait方法,将该线程放进临界区并阻塞住,只有每个Barrier都到达wait方法调用的点,闸口才会打开,所有的线程同步往下运行。 而在比较复杂的同步场景中,Rust还提供了另一个同步机制条件变量(Condition Variable)来支持更复杂的同步场景,它和屏障的功能类似,但是它并不阻塞全部进程,而是在满足指定的条件之前阻塞某个得到互斥锁的进程。也就是说,通过条件变量,我们可以在达到某种条件之前阻塞某个线程,这个特性可以让我们很好得对线程进行同步。 为了支持各种场景的同步控制,条件变量还提供了三个方法: notify_one(): 用来通知一次阻塞线程,如果有复数个线程被阻塞住, notify_one会被一个阻塞的线程所消耗,不会传递到别的阻塞线程去。 notify_all(): 用来通知所有的阻塞线程。 wait_timeout(): 将当前线程置入临界区阻塞住并等待通知,可以设定一个 timeout来设置阻塞的最大时间,以免造成永久的阻塞导致程序卡死。 需要注意的一点是条件变量需要和锁一起使用,而在程序运行中,每个条件变量每次只能和一个互斥体(被Mutex等锁包裹都可称为互斥体)进行使用。 vCPU生命周期控制和线程同步 在CPU数据结构初始化时,创建一个互斥的生命周期枚举(CpuLifecycleState)和一个条件变量。 pubfnnew(vcpu_fd:Arc<VcpuFd>,id:u8,arch_cpu:Arc<Mutex<ArchCPU>>,vm:Arc<Mutex<dynMachineInterface+Send+Sync>>,)->Self{CPU{id,fd:vcpu_fd,arch_cpu,state:Arc::new((Mutex::new(CpuLifecycleState::Created),Condvar::new())),work_queue:Arc::new((Mutex::new(0),Condvar::new())),task:Arc::new(Mutex::new(None)),tid:Arc::new(Mutex::new(None)),vm:Arc::downgrade(&vm),}} 以destory生命周期为例,在x86_64架构下,当某个vCPU线程接收到VcpuExit::Shutdown事件后,会将该线程的CpuLifecycleState修改为Stopped,并调用保存在CPU数据结构中一个指向上层结构的虚拟机destroy方法,该方法能遍历一个保存着所有CPU数据结构的数组,执行数组中每一个CPU的destory()方法,该函数的实现如下: fndestory(&self)->Result<()>{let(cpu_state,cvar)=&*self.state;if*cpu_state.lock().unwrap()==CpuLifecycleState::Running{*cpu_state.lock().unwrap()=CpuLifecycleState::Stopping;}else{*cpu_state.lock().unwrap()=CpuLifecycleState::Stopped;}/*省略具体的关机逻辑*/letmutcpu_state=cpu_state.lock().unwrap();cpu_state=cvar.wait_timeout(cpu_state,Duration::from_millis(32)).unwrap().0;if*cpu_state==CpuLifecycleState::Stopped{*cpu_state=CpuLifecycleState::Nothing;Ok(())}else{Err(ErrorKind::DestroyVcpu(format!("VCPUstillin{:?}state",*cpu_state)).into())}} 作为CPU的成员方法,destory函数能获取到每个CPU数据结构的互斥状态和条件变量,此时将除触发vCPU外所有的CPU数据的互斥状态解锁,并将状态从运行时的Running修改为vCPU关机时的Stopping。这里要注意一点,此时所有CPU的destroy函数都是在触发关机事件的vCPU进程中进行的,而不是在每个vCPU各自的进程中进行。 紧接着进入Stopping状态后,destroy函数会执行每个vCPU各自的关机逻辑,包括触发vCPU,这部分主要还是与KVM模块进行交互,进行一些退出状态的变更等。在执行完vCPU的关机逻辑后,条件变量会进入到wait_timeout的等待状态,它的参数为每个vCPU的CpuLifecycleState生命周期状态枚举和等待超时时间,也就是说在该生命周期枚举状态变化前,该线程都会进入阻塞状态。 此时除触发vCPU外的vCPU线程中,CpuLifecycleState都已经进入了Stopping状态,在所有vCPU线程中,vCPU的指令模拟函数kvm_vcpu_exec()都运行在一个循环中,对于每次循环的入口,都会执行ready_for_running()函数进入是否继续模拟的判断,在该函数中会对每个vCPU对应的CpuLifecycleState进行监控,当发现CpuLifecycleState已经变成Stopping时,vCPU将会退出循环,不继续进行vCPU的模拟,退出模拟的循环后,将会修改CpuLifecycleState为Stopped: //Thevcputhreadisabouttoexit,markingthestateoftheCPUstateasStopped.let(cpu_state,_)=&*self.thread_cpu.state;*cpu_state.lock().unwrap()=CpuLifecycleState::Stopped; 修改vCPU线程中互斥的生命周期状态枚举后,将会触发阻塞线程中对应的wait_timeout()函数,同时,该vCPU线程的生命周期结束。而对于阻塞线程,当其余vCPU线程的状态都已经变成Stopped后,阻塞解除,此时,所有的vCPU线程都已经状态都已经同步到了Stopped,线程状态同步成功。 用类似思路也可以实现pause(暂停)和resume(恢复)的生命周期控制。 关注我们 StratoVirt 当前已经在 openEuler 社区开源。后续我们将开展一系列主题分享,如果您对 StratoVirt 的使用和实现感兴趣,欢迎您围观和加入。 项目地址:https://gitee.com/openeuler/stratovirt 项目wiki:https://gitee.com/openeuler/stratovirt/wikis 您也可以订阅邮件列表:https://mailweb.openeuler.org/postorius/lists/virt.openeuler.org/ 如有疑问,也欢迎提交 issue:https://gitee.com/openeuler/stratovirt/issues 入群 如果您对虚拟化技术感兴趣,可以进入 openEuler StratoVirt 主页查看相关资源点击阅读原文进入项目主页,包括安装指导、虚拟机配置、代码仓库、学习资料等。也欢迎加入 Virt SIG 技术交流群,讨论 StratoVirt、KVM、QEMU 和 Libvirt 等相关虚拟化技术。感兴趣的同学可以添加如下微信小助手,回复 StratoVirt 入群。 本文分享自微信公众号 - openEuler(openEulercommunity)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | 淘特 Flutter 流式场景的深度优化

作者:江泽军(眞意) 淘特在很多业务场景都使用了 Flutter,加上业务场景本身具有一定的复杂性,使得 Flutter 在低端机流式场景的滑动浏览过程中卡顿、跳帧对比使用原生(Android/iOS)开发明显。通过分析业务层在 Flutter 渲染流程中的每个阶段存在的性能问题进行了一系列的深度优化后,平均帧率已经达到50帧之上超越了原生的表现, 但卡顿率依然达不到最佳的体验效果,遇到了难以突破的瓶颈和技术挑战,需要进行技术尝试和突破。 本文会从底层原理、优化思路、实际场景的优化策略、核心技术实现、优化成果等方面进行讲述,期望可以为大家带来一定的启发和帮助,也欢迎多多交流与指正,共建美好的 Flutter 技术社区。 渲染机制 原生 vs Flutter Flutter 本身是基于原生系统之上的,所以渲染机制和 Native 是非常接近的,引用 Google Flutter 团队 Xiao Yu分享[1],如下图所示: 渲染流程 如图左中,Flutter 从接收到 VSync 信号之后整体经历 8 个阶段,其中 Compositing 阶段后会将数据提交给GPU。 Semantics 阶段会将 RenderObject marked 需要做语义化更新的信息传递给系统,实现辅助功能,通过语义化接口可以帮助有视力障碍的用户来理解UI内容,和整体绘制流程关联不大。 Finalize Tree 阶段会将所有添加到 _inactiveElements 的不活跃 Element 全部 unmount 掉,和整体绘制流程关联不大。 所以,Flutter 整体渲染流程主要关注 上图图右 中的阶段: GPU Vsync Flutter Engine 在收到垂直同步信号后,会通知 Flutter Framework 进行 beginFrame,进入 Animation 阶段。 Animation 主要执行了 transientCallbacks 回调。Flutter Engine 会通知 Flutter Framework 进行 drawFrame,进入 Build 阶段。 Build 构建要呈现的UI组件树的数据结构,即创建对应的 Widget 以及对应的 Element。 Layout 目的是要计算出每个节点所占空间的真实大小进行布局,然后更新所有 dirty render objects 的布局信息。 Compositing Bits 对需要更新的 RenderObject 进行 update 操作。 Paint 生成 Layer Tree,生成 Layer Tree 并不能直接使用,还需要 Compositing 合成为一个 Scene 并进行 Rasterize 光栅化处理。层级合并的原因是因为一般 Flutter 的层级很多,直接把每一层传递给 GPU 效率很低,所以会先做Composite 提高效率。光栅化之后才会交给 Flutter Engine 处理。 Compositing 将 Layout Tree 合成为 Scene,并创建场景当前状态的栅格图像,即进行 Rasterize 光栅化处理,然后提交给Flutter Engine,最后 Skia 通过 Open GL or Vulkan 接口提交数据给 GPU, GPU经过处理后进行显示。 核心渲染阶段 Widget 我们平时在写的大都是 Widget,Widget 其实可以理解为是一个组件树的数据结构,是 Build 阶段的主要部分。其中 Widget Tree 的深度、 StatefulWidget 的 setState 合理性、build 函数中是否有不合理逻辑以及使用了调用saveLayer 的相关Widget往往会成为性能问题。 Element 关联 Widget 和 RenderObject ,生成 Widget 对应的 Element 存放上下文信息,Flutter 通过遍历 Element 来生成RenderObject 视图树支撑UI结构。 RenderObject RenderObject 在 Layout 阶段确定布局信息,Paint 阶段生成为对应的 Layer,可见其重要程度。所以 Flutter 中大部分的绘图性能优化发生在这里。RenderObject 树构建的数据会被加入到 Engine 所需的 LayerTree 中。 性能优化思路 了解底层渲染机制和核心渲染阶段,可以将优化分为三层: 这里不具体展开讲每一层的优化细节,本文主要从实际的场景来讲述。 流式场景 流式组件原理 在原生开发下,通常使用 RecyclerView/UICollectionView 进行列表场景的开发;在Flutter开发下,Flutter Framework 也提供了ListView的组件,它的实质其实是 SliverList。 核心源码 我们从 SliverList 的核心源码来进行分析: class SliverList extends SliverMultiBoxAdaptorWidget { @override RenderSliverList createRenderObject(BuildContext context) { final SliverMultiBoxAdaptorElement element = context as SliverMultiBoxAdaptorElement; return RenderSliverList(childManager: element); } } abstract class SliverMultiBoxAdaptorWidget extends SliverWithKeepAliveWidget { final SliverChildDelegate delegate; @override SliverMultiBoxAdaptorElement createElement() => SliverMultiBoxAdaptorElement(this); @override RenderSliverMultiBoxAdaptor createRenderObject(BuildContext context); } 通过查看 SliverList 的源代码可知,SliverList 是一个 RenderObjectWidget ,结构如下: 我们首先看它的 RenderObject 的核心源码: class RenderSliverList extends RenderSliverMultiBoxAdaptor { RenderSliverList({ @required RenderSliverBoxChildManager childManager, }) : super(childManager: childManager); @override void performLayout(){ ... //父节点对子节点的布局限制 final SliverConstraints constraints = this.constraints; final double scrollOffset = constraints.scrollOffset + constraints.cacheOrigin; final double remainingExtent = constraints.remainingCacheExtent; final double targetEndScrollOffset = scrollOffset + remainingExtent; final BoxConstraints childConstraints = constraints.asBoxConstraints(); ... insertAndLayoutLeadingChild(childConstraints, parentUsesSize: true); ... insertAndLayoutChild(childConstraints,after: trailingChildWithLayout,parentUsesSize: true); ... collectGarbage(leadingGarbage, trailingGarbage); ... } } abstract class RenderSliverMultiBoxAdaptor extends RenderSliver ...{ @protected RenderBox insertAndLayoutChild(BoxConstraints childConstraints, {@required RenderBox after,...}) { _createOrObtainChild(index, after: after); ... } RenderBox insertAndLayoutLeadingChild(BoxConstraints childConstraints, {@required RenderBox after,...}) { _createOrObtainChild(index, after: after); ... } @protected void collectGarbage(int leadingGarbage, int trailingGarbage) { _destroyOrCacheChild(firstChild); ... } void _createOrObtainChild(int index, { RenderBox after }) { _childManager.createChild(index, after: after); ... } void _destroyOrCacheChild(RenderBox child) { if (childParentData.keepAlive) { //为了更好的性能表现不会进行keepAlive,走else逻辑. ... } else { _childManager.removeChild(child); ... } } } 查看 RenderSliverList 的源码发现,对于 child 的创建和移除都是通过其父类 RenderSliverMultiBoxAdaptor 进行。而 RenderSliverMultiBoxAdaptor 是通过 _childManager 即 SliverMultiBoxAdaptorElement 进行的,整个 SliverList绘制过程中布局大小由父节点给出了限制。 在流式场景下: 在滑动过程中是通过 SliverMultiBoxAdaptorElement.createChild 进行对进入可视区新的 child 的创建;(即业务场景的每一个item卡片) 在滑动过程中是通过 SliverMultiBoxAdaptorElement.removeChild 进行对不在可视区旧的 child 的移除。 我们来看下 SliverMultiBoxAdaptorElement 的核心源码: class SliverMultiBoxAdaptorElement extends RenderObjectElement implements RenderSliverBoxChildManager { final SplayTreeMap<int, Element> _childElements = SplayTreeMap<int, Element>(); @override void createChild(int index, { @required RenderBox after }) { ... Element newChild = updateChild(_childElements[index], _build(index), index); if (newChild != null) { _childElements[index] = newChild; } else { _childElements.remove(index); } ... } @override void removeChild(RenderBox child) { ... final Element result = updateChild(_childElements[index], null, index); _childElements.remove(index); ... } @override Element updateChild(Element child, Widget newWidget, dynamic newSlot) { ... final Element newChild = super.updateChild(child, newWidget, newSlot); ... } } 通过查看 SliverMultiBoxAdaptorElement 的源码可以发现,对于 child 的操作其实都是通过父类 Element 的updateChild 进行的。 接下来,我们来看下 Element 的核心代码: abstract class Element extends DiagnosticableTree implements BuildContext { @protected Element updateChild(Element child, Widget newWidget, dynamic newSlot) { if (newWidget == null) { if (child != null) deactivateChild(child); return null; } Element newChild; if (child != null) { ... bool hasSameSuperclass = oldElementClass == newWidgetClass;; if (hasSameSuperclass && child.widget == newWidget) { if (child.slot != newSlot) updateSlotForChild(child, newSlot); newChild = child; } else if (hasSameSuperclass && Widget.canUpdate(child.widget, newWidget)) { if (child.slot != newSlot) updateSlotForChild(child, newSlot); child.update(newWidget); newChild = child; } else { deactivateChild(child); newChild = inflateWidget(newWidget, newSlot); } } else { newChild = inflateWidget(newWidget, newSlot); } ... return newChild; } @protected Element inflateWidget(Widget newWidget, dynamic newSlot) { ... final Element newChild = newWidget.createElement(); newChild.mount(this, newSlot); ... return newChild; } @protected void deactivateChild(Element child) { child._parent = null; child.detachRenderObject(); owner._inactiveElements.add(child); // this eventually calls child.deactivate() & child.unmount() ... } } 可以看到主要调用 Element 的 mount 和 detachRenderObject,这里我们来看下 RenderObjectElement 的 这两个方法的源码: abstract class RenderObjectElement extends Element { @override void mount(Element parent, dynamic newSlot) { super.mount(parent, newSlot); ... _renderObject = widget.createRenderObject(this); attachRenderObject(newSlot); ... } @override void attachRenderObject(dynamic newSlot) { ... _ancestorRenderObjectElement = _findAncestorRenderObjectElement(); _ancestorRenderObjectElement?.insertChildRenderObject(renderObject, newSlot); ... } @override void detachRenderObject() { if (_ancestorRenderObjectElement != null) { _ancestorRenderObjectElement.removeChildRenderObject(renderObject); _ancestorRenderObjectElement = null; } ... } } 通过查看上面源码的追溯,可知: 在流式场景下: 在滑动过程中进入可视区新的 child 的创建,是通过创建全新的 Element 并 mount 挂载到 Element Tree;然后创建对应的 RenderObject,调用了 _ancestorRenderObjectElement?.insertChildRenderObject; 在滑动过程中不在可视区旧的 child 的移除,将对应的 Element 从 Element Tree unmount 移除挂载;然后调用了_ancestorRenderObjectElement.removeChildRenderObject。 其实这个 _ancestorRenderObjectElement 就是 SliverMultiBoxAdaptorElement,我们再来看下SliverMultiBoxAdaptorElement: class SliverMultiBoxAdaptorElement extends RenderObjectElement implements RenderSliverBoxChildManager { @override void insertChildRenderObject(covariant RenderObject child, int slot) { ... renderObject.insert(child as RenderBox, after: _currentBeforeChild); ... } @override void removeChildRenderObject(covariant RenderObject child) { ... renderObject.remove(child as RenderBox); } } 其实调用的都是 ContainerRenderObjectMixin 的方法,我们再来看下 ContainerRenderObjectMixin: mixin ContainerRenderObjectMixin<ChildType extends RenderObject, ... { void insert(ChildType child, { ChildType after }) { ... adoptChild(child);// attach render object _insertIntoChildList(child, after: after); } void remove(ChildType child) { _removeFromChildList(child); dropChild(child);// detach render object } } ContainerRenderObjectMixin 维护了一个双向链表来持有当前 children RenderObject,所以在滑动过程中创建和移除都会同步在 ContainerRenderObjectMixin 的双向链表中进行添加和移除。 最后总结下来: 在滑动过程中进入可视区新的 child 的创建,是通过创建全新的 Element 并 mount 挂载到 Element Tree;然后创建对应的 RenderObject, 通过调用 SliverMultiBoxAdaptorElement.insertChildRenderObject attach 到 Render Tree,并同步将 RenderObject 添加到 SliverMultiBoxAdaptorElement 所 mixin 的双链表中; 在滑动过程中不在可视区旧的 child 的移除,将对应的 Element 从 Element Tree unmount 移除挂载;然后通过用SliverMultiBoxAdaptorElement.removeChildRenderObject 将对应的 RenderObject 从所 mixin 的双链表中移除并同步将 RenderObject 从 Render Tree detach 掉。 渲染原理 通过核心源码的分析,我们可以对流式场景的 Element 做如下分类: 下面我们来看用户向上滑动查看更多商品卡片并触发加载下一页数据进行展示时,整体的渲染流程和机制: 向上滑动时,顶部 0 和 1 的卡片移出 Viewport 区域(Visible Area + Cache Area),我们定义它为进入 Detach Area,进入 Detach Area 后将对应的 RenderObject 从 Render Tree detach 掉,并且将对应的 Element 从 Element Tree unmount 移除挂载,并同步从双向链表中移除; 通过监听 ScrollController 的滑动计算位置来判断是否需要开始加载下一页数据,然后底部 Loading Footer 组件会进入可视区 or 缓存区,需要对 SliverChildBuilderDelegate 的 childCount +1,最后一个 child 返回 Loading Footer组件,同时调用 setState 对整个 SliverList 刷新。update 会调用 performRebuild 进行重构建,中间部分在用户可视区会全部进行 update 操作;然后创建 Loading Footer 组件对应新的 Element 和 RenderObject,并同步添加到双向链表中; 当 loading 结束数据返回后,会再次调用 setState 对整个 SliverList 刷新,update 会调用 performRebuild 进行重构建,中间部分在用户可视区会全部进行 update 操作;然后将 Loading Footer 组件将对应的 RenderObject 从Render Tree detach 掉,并且将对应的 Element 从 Element Tree unmount 移除挂载,并同步从双向链表中移除; 底部新的 item 会进入可视区 or 缓存区,需要创建对应新的 Element 和 RenderObject,并同步添加到双向链表中。 优化策略 上面用户向上滑动查看更多商品卡片并触发加载下一页数据进行展示的场景,可以从五个方向进行优化: Load More 通过监听 ScrollController 的滑动不断进行计算,最好无需判断,自动识别到需要加载下一页数据然后发起loadMore() 回调。新建 ReuseSliverChildBuilderDelegate 增加 loadMore 以及和 item Builder 同级的footerBuilder,并默认包含 Loading Footer 组件,在 SliverMultiBoxAdaptorElement.createChild(int index,...) 判断是否需要动态回调 loadMore() 并自动构建 footer 组件。 局部刷新 参考了闲鱼之前在长列表的流畅度优化[2],在下一页数据回来之后调用 setState 对整个 SliverList 刷新,导致中间部分在用户可视区会全部进行 update 操作,实际只需刷新新创建的部分,优化SliverMultiBoxAdaptorElement.update(SliverMultiBoxAdaptorWidget newWidget) 的部分实现局部刷新,如下图: Element & RenderObject 复用 参考了闲鱼之前在长列表的流畅度优化[2] 和 Google Android RecyclerView ViewHolder 复用设计[3],在有新的item 创建时,可以做类似 Android RecyclerView 的 ViewHolder 对组件进行持有并复用。基于对渲染机制原理分析,在 Flutter 中 Widget 其实可以理解为是一个组件树的数据结构,即更多是组件结构的数据表达。我们需要对移除的 item 的 Element 和 RenderObject 分组件类型进行缓存持有,在创建新的 item 的时候优先从缓存持有中取出进行复用。同时不破坏 Flutter 本身对 Key 的设计,当如果 item 有使用 Key 的时候,只复用和它 Key 相同的Element 和 RenderObject。但在流式场景列表数据都是不同的数据,所以在流式场景中使用了 Key,也就无法进行任何的复用。如果对 Element 和 RenderObject 进行复用,item 组件不建议使用 Key。 我们在对原有流式场景下 Element 的分类增加一个缓存态: 如下图: GC 抑制 Dart 自身有 GC 的机制,类似 Java 的分代回收,可以在滑动的过程中对 GC 进行抑制,定制 GC 回收的算法。针对这项和 Google 的 Flutter 专家讨论,其实 Dart 不像 Java 会存在多线程切换进行垃圾回收的情况,单线程(主isolate)垃圾回收更快更轻量级,同时需要对 Flutter Engine 做深度的改造,考虑收益不大暂不进行。 异步化 Flutter Engine 限制非 Main Isolate 调用 Platform 相关 Api,将非跟 Platform Thread 交互的逻辑全部放至新的isolate中,频繁 Isolate 的创建和回收也会对性能有一定的影响,Flutter compute<Q, R>(isolates.ComputeCallback<Q, R> callback, Q message, { String debugLabel }) 每次调用会创建新的 Isolate,执行完任务后会进行回收,实现一个类似线程池的 Isolate 来进行处理非视图任务。经过实际测试提升不明显,不展开讲述。 核心技术实现 我们可以将调用链路的代码做如下分类: 所有渲染核心在继承自 RenderObjectElement 的 SliverMultiBoxAdaptorElement 中,不破坏原有功能设计以及Flutter Framework 的结构,新增了 ReuseSliverMultiBoxAdaptorElement 的 Element 来进行优化策略的实现,并且可以直接搭配原有 SliverList 的 RenderSliverList 使用或者自定义的流式组件(例如:瀑布流组件)的RenderObject 使用。 局部刷新 调用链路优化 在 ReuseSliverMultiBoxAdaptorElement 的 update 方法做是否为局部刷新的判断,如果不是局部刷新依然走performRebuild;如果是局部刷新,只创建新产生的 item。 核心代码 @override void update(covariant ReuseSliverMultiBoxAdaptorWidget newWidget) { ... //是否进行局部刷新 if(_isPartialRefresh(oldDelegate, newDelegate)) { ... int index = _childElements.lastKey() + 1; Widget newWidget = _buildItem(index); // do not create child when new widget is null if (newWidget == null) { return; } _currentBeforeChild = _childElements[index - 1].renderObject as RenderBox; _createChild(index, newWidget); } else { // need to rebuild performRebuild(); } } Element & RenderObject 复用 调用链路优化 创建:在 ReuseSliverMultiBoxAdaptorElement 的 createChild 方法读取 _cacheElements 对应组件类型缓存的 Element 进行复用;如果没有同类型可复用的 Element 则创建对应新的 Element 和 RenderObject。 移除:在 ReuseSliverMultiBoxAdaptorElement 的 removeChild 方法将移除的 RenderObject 从双链表中移除,不进行Element 的 deactive 和 RenderObject 的 detach,并将对应的 Element 的 _slot 更新为null,使下次可以正常复用,然后将对应的 Element 缓存到 _cacheElements 对应组件类型的链表中。 注:不 deactive Element 其实不进行调用即可实现,但不 detach RenderObject 无法直接做到,需要在 Flutter Framework 层的 object.dart 文件中,新增一个方法 removeOnly 就是只将 RenderObject 从双链表中移除不进行detach。 核心代码 创建 //新增的方法,createChild会调用到这个方法 _createChild(int index, Widget newWidget){ ... Type delegateChildRuntimeType = _getWidgetRuntimeType(newWidget); if(_cacheElements[delegateChildRuntimeType] != null && _cacheElements[delegateChildRuntimeType].isNotEmpty){ child = _cacheElements[delegateChildRuntimeType].removeAt(0); }else { child = _childElements[index]; } ... newChild = updateChild(child, newWidget, index); ... } 移除 @override void removeChild(RenderBox child) { ... removeChildRenderObject(child); // call removeOnly ... removeElement = _childElements.remove(index); _performCacheElement(removeElement); } Load More 调用链路优化 在 createChild 时候判断是否是构建 footer 来进行处理。 核心代码 @override void createChild(int index, { @required RenderBox after }) { ... Widget newWidget; if(_isBuildFooter(index)){ // call footerBuilder & call onLoadMore newWidget = _buildFooter(); }else{ newWidget = _buildItem(index); } ... _createChild(index, newWidget); ... } 整体结构设计 将核心的优化能力内聚在 Element 层,提供底层能力; 将 ReuseSliverMultiBoxAdaptorWidget 做为基类默认返回优化后的 Element; 将 loadMore 和 FooterBuilder 的能力统一由继承自 SliverChildBuilderDelegate 的 ReuseSliverChildBuilderDelegate对上层暴露; 如有自己单独定制的流式组件 Widget ,直接把继承关系从 RenderObjectWidget 换为ReuseSliverMultiBoxAdaptorWidget 即可,例如自定义的单列表组件(ReuseSliverList)、瀑布流组件(ReuseWaterFall)等。 优化成果 基于在之前的一系列深度优化以及切换 Flutter Engine 为UC Hummer 之上,单独控制流式场景的优化变量,使用PerfDog 获取流畅度数据,进行了流畅度测试对比: 可以看到整体性能数据都有优化提升,结合替换 Engine 之前的测试数据平均来看,对帧率有 2-3 帧的提升,卡顿率下降 1.5 个百分点。 总结 使用方式 和原生 SliverList 的使用方式一样,Widget 换成对应可以进行复用的组件 (ReuseSliverList/ReuseWaterFall/ CustomSliverList),delegate 如果需要 footer 和 loadMore 使用 ReuseSliverChildBuilderDelegate;如果不需要直接使用原生的 SliverChildBuilderDelegate 即可。 需要分页场景 return ReuseSliverList( // ReuseWaterFall or CustomSliverList delegate: ReuseSliverChildBuilderDelegate( (BuildContext context, int index) { return getItemWidget(index); }, //构建footer footerBuilder: (BuildContext context) { return DetailMiniFootWidget(); }, //添加loadMore监听 addUnderFlowListener: loadMore, childCount: dataOfWidgetList.length ) ); 无需分页场景 return ReuseSliverList( // ReuseWaterFall or CustomSliverList delegate: SliverChildBuilderDelegate( (BuildContext context, int index) { return getItemWidget(index); }, childCount: dataOfWidgetList.length ) ); 注意点 使用的时候 item/footer 组件不要加 Key,否则认为只对同 Key 进行复用。因为复用了 Element,虽然表达组件树数据结果的 Widget 会每次进行更新,但 StatefulElement 的 State 是在 Element 创建的时候生成的,同时也会被复用下来,和 Flutter 本身设计保持一致,所以需要在 didUpdateWidget(covariant T oldWidget) 将 State 缓存的数据重新从 Widget 获取即可。 Reuse Element Lifecycle 将每个 item 的状态进行回调,上层可以做逻辑处理和资源释放等,例如之前在 didUpdateWidget(covariant T oldWidget) 将 State 缓存的数据重新从 Widget 获取可以放置在 onDisappear里或者自动播放的视频流等; /// 复用的生命周期 mixin ReuseSliverLifeCycle{ // 前台可见的 void onAppear() {} // 后台不可见的 void onDisappear() {} } 参考资料 [1]:Google Flutter团队 Xiao Yu:Flutter Performance Profiling and Theory:https://files.flutter-io.cn/events/gdd2018/Profiling_your_Flutter_Apps.pdf [2]:闲鱼云从:他把闲鱼APP长列表流畅度翻了倍 [3]:Google Android RecyclerView.ViewHolder:RecyclerView.Adapter#onCreateViewHolder:https://developer.android.com/reference/androidx/recyclerview/widget/RecyclerView.Adapter#onCreateViewHolder(android.view.ViewGroup,%20int) 关注【阿里巴巴移动技术】官方公众号,每周 3 篇移动技术实践&干货给你思考!

优秀的个人博客,低调大师

每日一博 | 使用 Vue 搞定无法解决的“动态挂载”

在一些特殊场景下,使用组件的时机无法确定,或者无法在Vue的template中确定要我们要使用的组件,这时就需要动态的挂载组件,或者使用运行时编译动态创建组件并挂载。 今天我们将带大家从实际项目出发,看看在实际解决客户问题时,如何将组件进行动态挂载,并为大家展示一个完整的解决动态挂载问题的完整过程。 无法解决的“动态挂载” 我们的电子表格控件SpreadJS在运行时,存在这样一个功能:当用户双击单元格会显示一个输入框用于编辑单元格的内容,用户可以根据需求按照自定义单元格类型的规范自定义输入框的形式,集成任何Form表单输入类型。 这个输入框的创建销毁都是通过继承单元格类型对应方法实现的,因此这里就存在一个问题——这个动态的创建方式并不能简单在VUE template中配置,然后直接使用。 而就在前不久,客户问然询问我:你家控件的自定义单元格是否支持Vue组件比如ElementUI的AutoComplete? 由于前面提到的这个问题: 沉思许久,我认真给客户回复:“组件运行生命周期不一致,用不了”,但又话锋一转,表示可以使用通用组件解决这个问题。 问题呢,是顺利解决了。 但是这个无奈的"用不了",却也成为我这几天午夜梦回跨不去的坎。 后来,某天看Vue文档时,我想到App是运行时挂载到#app上的。,从理论上来说,其他组件也应该能动态挂载到需要的Dom上,这样创建时机的问题不就解决了嘛! 正式开启动态挂载 让我们继续查看文档,全局APIVue.extend( options )是通过extend创建的。Vue实例可以使用$mount方法直接挂载到DOM元素上——这正是我们需要的。 <div id="mount-point"></div> // 创建构造器 var Profile = Vue.extend({ template: '<p>{{firstName}} {{lastName}} aka {{alias}}</p>', data: function () { return { firstName: 'Walter', lastName: 'White', alias: 'Heisenberg' } } }) // 创建 Profile 实例,并挂载到一个元素上。 new Profile().$mount('#mount-point') 按照SpreadJS自定义单元格示例创建AutoCompleteCellType,并设置到单元格中: function AutoComplateCellType() { } AutoComplateCellType.prototype = new GC.Spread.Sheets.CellTypes.Base(); AutoComplateCellType.prototype.createEditorElement = function (context, cellWrapperElement) { // cellWrapperElement.setAttribute("gcUIElement", "gcEditingInput"); cellWrapperElement.style.overflow = 'visible' let editorContext = document.createElement("div") editorContext.setAttribute("gcUIElement", "gcEditingInput"); let editor = document.createElement("div"); // 自定义单元格中editorContext作为容器,需要在创建一个child用于挂载,不能直接挂载到editorContext上 editorContext.appendChild(editor); return editorContext; } AutoComplateCellType.prototype.activateEditor = function (editorContext, cellStyle, cellRect, context) { let width = cellRect.width > 180 ? cellRect.width : 180; if (editorContext) { // 创建构造器 var Profile = Vue.extend({ template: '<p>{{firstName}} {{lastName}} aka {{alias}}</p>', data: function () { return { firstName: 'Walter', lastName: 'White', alias: 'Heisenberg' } } }) // 创建 Profile 实例,并挂载到一个元素上。 new Profile().$mount(editorContext.firstChild); } }; 运行,双击进入编辑状态,结果却发现报错了 [Vue warn]: You are using the runtime-only build of Vue where the template compiler is not available. Either pre-compile the templates into render functions, or use the compiler-included build. 根据报错提示,此时候我们有两种解决办法: 开启runtimeCompiler,在vue.config.js中加入runtimeCompiler: true的配置,允许运行时编译,这样可以动态生成template,满足动态组件的需求 提前编译模板仅动态挂载,autocomplete的组件是确定的,我们可以使用这种方法 新建AutoComplete.vue组件用于动态挂载,这样可以挂载编译好的组件。 <template> <div> <p>{{ firstName }} {{ lastName }} aka {{ alias }}</p> </div> </template> <script> export default { data: function () { return { firstName: "Walter", lastName: "White", alias: "Heisenberg", }; }, }; </script> import AutoComplate from './AutoComplate.vue' AutoComplateCellType.prototype.activateEditor = function (editorContext, cellStyle, cellRect, context) { let width = cellRect.width > 180 ? cellRect.width : 180; if (editorContext) { // 创建构造器 var Profile = Vue.extend(AutoComplate); // 创建 Profile 实例,并挂载到一个元素上。 new Profile().$mount(editorContext.firstChild); } }; 双击进入编辑状态,看到组件中的内容 下一步,对于自定义单元格还需要设置和获取组件中的编辑内容,这时通过给组件添加props,同时在挂载时创建的VueComponent实例上直接获取到所有props内容,对应操作即可实现数据获取设置。 更新AutoComplate.vue,添加props,增加input用于编辑 <template> <div> <p>{{ firstName }} {{ lastName }} aka {{ alias }}</p> <input type="text" v-model="value"> </div> </template> <script> export default { props:["value"], data: function () { return { firstName: "Walter", lastName: "White", alias: "Heisenberg", }; }, }; </script> 通过this.vm存储VueComponent实例,在getEditorValue 和setEditorValue 方法中获取和给VUE组件设置Value。编辑结束,通过调用$destroy()方法销毁动态创建的组件。 AutoComplateCellType.prototype.activateEditor = function (editorContext, cellStyle, cellRect, context) { let width = cellRect.width > 180 ? cellRect.width : 180; if (editorContext) { // 创建构造器 var Profile = Vue.extend(MyInput); // 创建 Profile 实例,并挂载到一个元素上。 this.vm = new Profile().$mount(editorContext.firstChild); } }; AutoComplateCellType.prototype.getEditorValue = function (editorContext) { // 设置组件默认值 if (this.vm) { return this.vm.value; } }; AutoComplateCellType.prototype.setEditorValue = function (editorContext, value) { // 获取组件编辑后的值 if (editorContext) { this.vm.value = value; } }; AutoComplateCellType.prototype.deactivateEditor = function (editorContext, context) { // 销毁组件 this.vm.$destroy(); this.vm = undefined; }; 整个流程跑通了,下来只需要在AutoComplate.vue中,将input替换成ElementUI 的el- autocomplete并实现对应方法就好了。 结果 让我们看看效果吧。 其实动态挂载并不是什么复杂操作,理解了Vue示例,通过vm来操作实例,灵活的运用动态挂载或者运行时编译的组件就不是什么难事了。 其实一切的解决方案就在Vue教程入门教程中,但是脚手架的使用和各种工具的使用让我们忘记了Vue的初心,反而把简单问题复杂化了。 今天的分享到这里就结束啦,后续还会为大家带来更多严肃和有趣的内容~ 你有什么在开发中"忘记初心"的事情吗?

优秀的个人博客,低调大师

每日一博 | 详解浏览器渲染引擎工作原理

今天我们来学习一下浏览器渲染引擎的工作原理,文章内容较多,建议先收藏再学习! 先来看看Chrome浏览器的架构图: 通常,我们编写的HTML、CSS、JavaScript等文件,经过浏览器运行之后就会显示出页面,那他们是如何转化为页面的?这背后的原理是什么?这个过程就是浏览器的渲染进程来操作实现的。浏览器的渲染进程的主要任务就是将静态资源转化为可视化界面: 对于中间的浏览器,它就是一个黑盒,下面就来看看这个黑盒是如何将静态资源转化为前端界面的。由于渲染机制比较复杂,所以渲染模块在执行过程中会被划分为很多子阶段,输入的静态资源经过这些子阶段,最后输出页面。我们将一个处理流程称为渲染流水线,其大致流程如下图所示: 这里主要包含五个过程: DOM树构建:渲染引擎使用HTML解析器(调用XML解析器)解析HTML文档,将各个HTML元素逐个转化成DOM节点,从而生成DOM树; CSSOM树构建:CSS解析器解析CSS,并将其转化为CSS对象,将这些CSS对象组装起来,构建CSSOM树; 渲染树构建:DOM 树和 CSSOM 树都构建完成以后,浏览器会根据这两棵树构建出一棵渲染树; 页面布局:渲染树构建完毕之后,元素的位置关系以及需要应用的样式就确定了,这时浏览器会计算出所有元素的大小和绝对位置; 页面绘制:页面布局完成之后,浏览器会将根据处理出来的结果,把每一个页面图层转换为像素,并对所有的媒体文件进行解码。 对于这五个流程,每一阶段都有对应的产物,分别是:DOM树、CSSOM树、渲染树、盒模型、界面。 下图为渲染引擎工作流程中各个步骤所对应的模块: 从图中可以看出,渲染引擎主要包含的模块有: HTML解析器:解析HTML文档,主要作用是将HTML文档转换成DOM树; CSS解析器:将DOM中的各个元素对象进行计算,获取样式信息,用于渲染树的构建; JavaScript解释器:使用JavaScript可以修改网页的内容、CSS规则等。JavaScript解释器能够解释JavaScript代码,并通过DOM接口和CSSOM接口来修改网页内容、样式规则,从而改变渲染结果; 页面布局:DOM创建之后,渲染引擎将其中的元素对象与样式规则进行结合,可以得到渲染树。布局则是针对渲染树,计算其各个元素的大小、位置等布局信息。 页面绘制:使用图形库将布局计算后的渲染树绘制成可视化的图像结果。 下面就分别来看看这些过程都做了哪些操作。 一、DOM树构建 在说构建DOM树之前,我们首先需要知道,为什么要构建DOM树呢? 这是因为,浏览器是无法直接理解和使用HTML的,所以需要将HTML转化为浏览器能够理解的结构——DOM树。 了解过数据结构的小伙伴对于树结构应该不陌生,树是由结点或顶点和边组成的且不存在着任何环的一种数据结构。一棵非空的树包括一个根结点,还有多个附加结点,所有结点构成一个多级分层结构。下面通过一张图来看看什么是树结构: 对于上面的三个结构,前两个都是树,他们都只有唯一的根节点,而且不存在环结构。而第三个存在环,所以就不是一个树结构。 说完树结构,就回归正题,来看看什么是DOM树。在页面中,每个HTML标签都会被浏览器解析成文档对象。HTML本质上就是一个嵌套结构,在解析时会把每个文档对象用一个树形结构组织起来,所有的文档对象都会挂在document上,这种组织方式就是HTML最基础的结构——文档对象模型(DOM),这棵树的每个文档对象就叫做DOM节点。 ​ 在渲染引擎中,DOM 有三个层面的作用: 从页面的视角来看,DOM 是生成页面的基础数据结构; 从 JavaScript 脚本视角来看,DOM 提供给 JavaScript 脚本操作的接口,通过这套接口,JavaScript 可以对 DOM 结构进行访问,从而改变文档的结构、样式和内容; 从安全视角来看,DOM 是一道安全防护线,一些不安全的内容在 DOM 解析阶段会被拒之门外。 在渲染引擎内部,HTML 解析器负责将 HTML 字节流转换为 DOM 结构,其转化过程如下: 1. 字符流→词(token) HTML结构会首先通过分词器将字节流拆分为词(token)。Token分为Tag Token 和文本 Token。下面来看一个HTML代码是如何被拆分的: <body> <div> <p>hello world</p> </div> </body> 复制代码 对于这句代码,可以拆成词: 可以看到,Tag Token 又分 StartTag 和 EndTag,<body>、<div>、<p>就是 StartTag ,</body>、</div>、</p>就是 EndTag,分别对应图中的蓝色和红色块,文本 Token 对应绿色块。 ​ 这里会通过状态机将字符拆分成token,所谓的状态机就是将每个词的特征逐个拆分成独立的状态,然后再将所有词的特征字符合并起来,形成一个连通的图结构。那为什么要使用状态机呢?因为每读取一个字符,都要做一次决策,这些决策都和当前的状态有关。 ​ 实际上,状态机的作用就是用来做词法分析的,将字符流分解为词(token)。 2. 词(token)→DOM树 接下来就需要将 Token 解析为 DOM 节点,并将 DOM 节点添加到 DOM 树中。这个过程是通过栈结构来实现的,这个栈主要用来计算节点之间的父子关系,上面步骤中生成的token会按顺序压入栈中,该过程的规则如下: 如果分词器解析出来是StartTag Token,HTML 解析器会为该 Token 创建一个 DOM 节点,然后将该节点加入到 DOM 树中,它的父节点就是栈中相邻的那个元素生成的节点; 如果分词器解析出来是 文本 Token,那么会生成一个文本节点,然后将该节点加入到 DOM 树中,文本 Token 是不需要压入到栈中,它的父节点就是当前栈顶 Token 所对应的 DOM 节点; 如果分词器解析出来的是EndTag Token,比如是 EndTag div,HTML 解析器会查看 Token 栈顶的元素是否是 StarTag div,如果是,就将 StartTag div从栈中弹出,表示该 div 元素解析完成。 通过分词器产生的新 Token 就这样不停地入栈和出栈,整个解析过程就这样一直持续下去,直到分词器将所有字节流分词完成。 下面来看看这的Token栈是如何工作的,有如下HTML结构: <html> <body> <div>hello juejin</div> <p>hello world</p> </body> </html> 复制代码 开始时,HTML解析器会创建一个根为 document 的空的 DOM 结构,同时将 StartTag document 的Token压入栈中,然后再将解析出来的第一个 StartTag html 压入栈中,并创建一个 html 的DOM节点,添加到document上,这时Token栈和DOM树如下: 接下来body和div标签也会和上面的过程一样,进行入栈操作: 随后就会解析到 div标签中的文本Token,渲染引擎会为该 Token 创建一个文本节点,并将该 Token 添加到 DOM 中,它的父节点就是当前 Token 栈顶元素对应的节点: 接下来就是第一个EndTag div,这时 HTML 解析器会判断当前栈顶元素是否是 StartTag div,如果是,则从栈顶弹出 StartTag div,如下图所示: 再之后的过程就和上面类似了,最终的结果如下: 二、CSSOM树构建 上面已经基本了解了DOM的构建过程,但是这个DOM结构只包含节点,并不包含任何的样式信息。下面就来看看,浏览器是如何把CSS样式应用到DOM节点上的。 同样,浏览器也是无法直接理解CSS代码的,需要将其浏览器可以理解的CSSOM树。实际上。浏览器在构建 DOM 树的同时,如果样式也加载完成了,那么 CSSOM 树也会同步构建。CSSOM 树和 DOM 树类似,它主要有两个作用: 提供给 JavaScript 操作样式的能力; 为渲染树的合成提供基础的样式信息。 不过,CSSOM 树和 DOM 树是独立的两个数据结构,它们并没有一一对应关系。DOM 树描述的是 HTML 标签的层级关系,CSSOM 树描述的是选择器之间的层级关系。可以在浏览器的控制台,通过document.styleSheets命令来查看CSSOM树: 那CSS样式的来源有哪些呢? 可以看到,CSS样式的来源主要有三种: 通过 link 引用的外部 CSS 样式文件; <style>标签内的CSS样式; 元素的style属性内嵌的CSS。 在将CSS转化为树形对象之前,还需要将样式表中的属性值进行标准化处理,比如,当遇到以下CSS样式: body { font-size: 2em } p {color:blue;} div {font-weight: bold} div p {color:green;} div {color:red; } 复制代码 可以看到上面CSS中有很多属性值,比如2em、blue、red、bold等,这些数值并不能被浏览器直接理解。所以,需要将所有值转化为浏览器渲染引擎容易理解的、标准化的计算值,这个过程就是属性值标准化。经过标准化的过程,上面的代码会变成这样: body { font-size: 32px } p {color: rgb(0, 0, 255);} div {font-weight: 700} div p {color: (0, 128, 0);} div {color: (255, 0, 0); } 复制代码 可以看到,2em被解析成了32px,blue被解析成了rgb(255, 0, 0),bold被解析成700。现在样式的属性已被标准化了,接下来就需要计算 DOM 树中每个节点的样式属性了,这就涉及到 CSS 的继承规则和层叠规则。 (1)样式继承 在 CSS 中存在样式的继承机制,CSS 继承就是每个 DOM 节点都包含有父节点的样式。比如在 HTML 上设置“font-size:20px;”,那么页面里基本所有的标签都可以继承到这个属性了。 在CSS中,有继承性的属性主要有以下几种: 字体系列属性 font-family:字体系列 font-weight:字体的粗细 font-size:字体的大小 font-style:字体的风格 文本系列属性 text-indent:文本缩进 text-align:文本水平对齐 line-height:行高 word-spacing:单词之间的间距 letter-spacing:中文或者字母之间的间距 text-transform:控制文本大小写(就是uppercase、lowercase、capitalize这三个) color:文本颜色 元素可见性 visibility:控制元素显示隐藏 列表布局属性 list-style:列表风格,包括list-style-type、list-style-image等 光标属性 cursor:光标显示为何种形态 (2)样式层叠 样式计算过程中的第二个规则是样式层叠。层叠是 CSS 的一个基本特征,它是一个定义了 如何合并来自多个源的属性值的算法。它在 CSS 处于核心地位,CSS 的全称“层叠样式表”正是强调了这一点。这里不再多说。 总之,样式计算阶段的目的是为了计算出 DOM 节点中每个元素的具体样式,在计算过程 中需要遵守 CSS 的继承和层叠两个规则。这个阶段最终输出的内容是每个 DOM 节点的样 式,并被保存在 ComputedStyle 的结构内。 对于以下代码: <html> <head> <link href="./style.css"> <style> .juejin { width: 100px; height: 50px; background: red; } .content { font-size: 25px; line-height: 25px; margin: 10px; } </style> </head> <body> <div class="juejin"> <div>CUGGZ</div> </div> <p style="color: blue" class="content"> <span>hello world</span> <p style="display: none;">浏览器</p> </p> </body> </html> 复制代码 最终生成的CSSOM树大致如下: 三、渲染树构建 在 DOM 树和 CSSOM 树都渲染完成之后,就会进入渲染树的构建阶段。渲染树就是 DOM 树和 CSSOM 树的结合,会得到一个可以知道每个节点会应用什么样式的数据结构。这个结合的过程就是遍历整个 DOM 树,然后在 CSSOM 树里查询到匹配的样式。 在不同浏览器里,构建渲染树的过程不太一样: 在 Chrome 里会在每个节点上使用 attach() 方法,把 CSSOM 树的节点挂在 DOM 树上作为渲染树。 在 Firefox 里会单独构造一个新的结构, 用来连接 DOM 树和 CSSOM 树的映射关系。 那为什么要构建渲染树呢?在上面的示例中可以看到,DOM树可能包含一些不可见的元素,比如head标签,使用display:none;属性的元素等。所以在显示页面之前,还要额外地构建一棵只包含可见元素的渲染树。 下面来看看构建渲染树的过程: 可以看到,DOM树中不可见的节点都没有包含到渲染树中。为了构建渲染树,浏览器上大致做了如下工作:遍历DOM树中所有可见节点,并把这些节点加到布局中,而不可见的节点会被布局树忽略掉,如 head 标签下面的全部内容,再比如 p.p 这个元素,因为它的属性包含 dispaly:none,所以这个元素也没有被包含进渲染树中。如果给元素设置了visibility: hidden;属性,那这个元素会出现在渲染树中,因为具有这个样式的元素是需要占位的,只不过不需要显示出来。 ​ 这里在查找的过程中,出于效率的考虑,会从 CSSOM 树的叶子节点开始查找,对应在 CSS 选择器上也就是从选择器的最右侧向左查找。所以,不建议使用标签选择器和通配符选择器来定义元素样式。 ​ 除此之外,同一个 DOM 节点可能会匹配到多个 CSSOM 节点,而最终的效果由哪个 CSS 规则来确定,就是样式优先级的问题了。当一个 DOM 元素受到多条样式控制时,样式的优先级顺序如下:内联样式 > ID选择器 > 类选择器 > 标签选择器 > 通用选择器 > 继承样式 > 浏览器默认样式 ​ CSS常见选择器的优先级如下: 选择器 格式 优先级权重 id选择器 #id 100 类选择器 .classname 10 属性选择器 a[ref=“eee”] 10 伪类选择器 li:last-child 10 标签选择器 div 1 伪元素选择器 li:after 1 相邻兄弟选择器 h1+p 0 子选择器 ul>li 0 后代选择器 li a 0 通配符选择器 * 0 对于选择器的优先级: 标签选择器、伪元素选择器:1; 类选择器、伪类选择器、属性选择器:10; id 选择器:100; 内联样式:1000; 注意: !important声明的样式的优先级最高; 如果优先级相同,则最后出现的样式生效; 继承得到的样式的优先级最低; 四、页面布局 经过上面的步骤,就生成了一棵渲染树,这棵树就是展示页面的关键。到现在为止,已经有了需要渲染的所有节点之间的结构关系及其样式信息。下面就需要进行页面的布局。 通过计算渲染树上每个节点的样式,就能得出来每个元素所占空间的大小和位置。当有了所有元素的大小和位置后,就可以在浏览器的页面区域里去绘制元素的边框了。这个过程就是布局。这个过程中,浏览器对渲染树进行遍历,将元素间嵌套关系以盒模型的形式写入文档流: 盒模型在布局过程中会计算出元素确切的大小和定位。计算完毕后,相应的信息被写回渲染树上,就形成了布局渲染树。同时,每一个元素盒子也都携带着自身的样式信息,作为后续绘制的依据。 五、页面绘制 1. 构建图层 经过布局,每个元素的位置和大小就有了,那下面是不是就该开始绘制页面了?答案是否定的,因为页面上可能有很多复杂的场景,比如3D变化、页面滚动、使用z-index进行z轴的排序等。所以,为了实现这些效果,渲染引擎还需要为特定的节点生成专用的图层,并生成一棵对应的图层树。 那什么是图层呢?相信用过Photoshop的小伙伴对图层并不陌生。我们也可以在Chrome浏览器的开发者工具中,选择Layers标签(如果没有,可以在更多工具中查找),就可以看到页面的分层情况,以掘金首页为例,其分层情况如下: 可以看到,渲染引擎给页面分了很多图层,这些图层会按照一定顺序叠加在一起,就形成了最终的页面。这里,将页面分解成多个图层的操作就成为分层, 最后将这些图层合并到一层的操作就成为合成, 分层和合成通常是一起使用的。Chrome 引入了分层和合成的机制就是为了提升每帧的渲染效率。 通常情况下,并不是渲染树上的每个节点都包含一个图层,如果一个节点没有对应的图层,那这个节点就会属于其父节点的图层。那什么样的节点才能让浏览器引擎为其创建一个新的图层呢?需要满足以下其中一个条件: (1)拥有层叠上下文属性的元素 我们看到的页面通常是二维的平面,而层叠上下文能够让页面具有三维的概念。这些 HTML 元素按照自身属性的优先级分布在垂直于这个二维平面的 z 轴上。下面是盒模型的层叠规则: 对于上图,由上到下分别是: 背景和边框:建立当前层叠上下文元素的背景和边框。 负的z-index:当前层叠上下文中,z-index属性值为负的元素。 块级盒:文档流内非行内级非定位后代元素。 浮动盒:非定位浮动元素。 行内盒:文档流内行内级非定位后代元素。 z-index:0:层叠级数为0的定位元素。 正z-index:z-index属性值为正的定位元素。 注意: 当定位元素z-index:auto,生成盒在当前层叠上下文中的层级为 0,不会建立新的层叠上下文,除非是根元素。 (2)需要裁剪的元素 什么是裁剪呢?假如有一个固定宽高的div盒子,而里面的文字较多超过了盒子的高度,这时就会产生裁剪,浏览器渲染引擎会把裁剪文字内容的一部分用于显示在 div 区域。当出现裁剪时,浏览器的渲染引擎就会为文字部分单独创建一个图层,如果出现滚动条,那么滚动条也会被提升为单独的图层。 2. 绘制图层 在完成图层树的构建之后,渲染引擎会对图层树中的每个图层进行绘制,下面就来看看渲染引擎是怎么实现图层绘制的。 渲染引擎在绘制图层时,会把一个图层的绘制分成很多绘制指令,然后把这些指令按照顺序组成一个待绘制的列表: 可以看到,绘制列表中的指令就是一系列的绘制操作。通常情况下,绘制一个元素需要执行多条绘制指令,因为每个元素的背景、边框等属性都需要单独的指令进行绘制。所以在图层绘制阶段,输出的内容就是绘制列表。 在Chrome浏览器的开发者工具中,通过Layer标签可以看到图层的绘制列表和绘制过程: 绘制列表只是用来记录绘制顺序和绘制指令的列表,而绘制操作是由渲染引擎中的合成线程来完成的。当图层绘制列表准备好之后,主线程会把该绘制列表提交给合成线程。 注意:合成操作是在合成线程上完成的,所以,在执行合成操作时并不会影响到主线程的执行。 ​ 很多情况下,图层可能很大,比如掘金的一篇长文,需要滚动很久才能到底,但是用户只能看到视口的内容,所以没必要把整个图层都绘制出来。因此,合成线程会将图层划分为图块,这些图块的大小通常是 256x256 或者 512x512。合成线程会优先将视口附近的图块生成位图。实际生成位图的操作是在光栅化阶段来执行的,所谓的光栅化就是按照绘制列表中的指令生成图片。 当所有的图块都被光栅化之后,合成线程就会生成一个绘制图块的命令,浏览器相关进程收到这个指令之后,就会将其页面内容绘制在内存中,最后将内存显示在屏幕上,这样就完成了页面的绘制。 至此,整个渲染流程就完成了,其过程总结如下: 将HTML内容构建成DOM树; 将CSS内容构建成CSSOM树; 将DOM 树和 CSSOM 树合成渲染树; 根据渲染树进行页面元素的布局; 对渲染树进行分层操作,并生成分层树; 为每个图层生成绘制列表,并提交到合成线程; 合成线程将图层分成不同的图块,并通过栅格化将图块转化为位图; 合成线程给浏览器进程发送绘制图块指令; 浏览器进程会生成页面,并显示在屏幕上。 六、其他 1. 重排和重绘 说完浏览器引擎的渲染流程,再来看两个重要的概念:重排(Reflow)和重绘(Repaint)。 ​ 我们知道,渲染树是动态构建的,所以,DOM节点和CSS节点的改动都可能会造成渲染树的重新构建。渲染树的改动就会造成页面的重排或者重绘。下面就来看看这两个概念,以及它们触发的条件和减少触发的操作。 (1)重排 当我们的操作引发了 DOM 树中几何尺寸的变化(改变元素的大小、位置、布局方式等),这时渲染树里有改动的节点和它影响的节点都要重新计算。这个过程就叫做重排,也称为回流。在改动发生时,要重新经历页面渲染的整个流程,所以开销是很大的。 ​ 以下操作都会导致页面重排: 页面首次渲染; 浏览器窗口大小发生变化; 元素的内容发生变化; 元素的尺寸或者位置发生变化; 元素的字体大小发生变化; 激活CSS伪类; 查询某些属性或者调用某些方法; 添加或者删除可见的DOM元素。 在触发重排时,由于浏览器渲染页面是基于流式布局的,所以当触发回流时,会导致周围的DOM元素重新排列,它的影响范围有两种: 全局范围:从根节点开始,对整个渲染树进行重新布局; 局部范围:对渲染树的某部分或者一个渲染对象进行重新布局。 (2)重绘 当对 DOM 的修改导致了样式的变化、但未影响其几何属性(比如修改颜色、背景色)时,浏览器不需重新计算元素的几何属性、直接为该元素绘制新的样式(会跳过重排环节),这个过程叫做重绘。简单来说,重绘是由对元素绘制属性的修改引发的。 ​ 当我们修改元素绘制属性时,页面布局阶段不会执行,因为并没有引起几何位置的变换,所以就直接进入了绘制阶段,然后执行之后的一系列子阶段。相较于重排操作,重绘省去了布局和分层阶段,所以执行效率会比重排操作要高一些。 下面这些属性会导致回流: color、background 相关属性:background-color、background-image 等; outline 相关属性:outline-color、outline-width 、text-decoration; border-radius、visibility、box-shadow。 注意: 当触发重排时,一定会触发重绘,但是重绘不一定会引发重排。 相对来说,重排操作的消耗会比较大,所以在操作中尽量少的造成页面的重排。为了减少重排,可以通过以下方式进行优化: 在条件允许的情况下尽量使用 CSS3 动画,它可以调用 GPU 执行渲染。 操作DOM时,尽量在低层级的DOM节点进行操作 不要使用table布局, 一个小的改动可能会使整个table进行重新布局 使用CSS的表达式 不要频繁操作元素的样式,对于静态页面,可以修改类名,而不是样式。 使用absolute或者fixed,使元素脱离文档流,这样他们发生变化就不会影响其他元素 避免频繁操作DOM,可以创建一个文档片段documentFragment,在它上面应用所有DOM操作,最后再把它添加到文档中 将元素先设置display: none,操作结束后再把它显示出来。因为在display属性为none的元素上进行的DOM操作不会引发回流和重绘。 将DOM的多个读操作(或者写操作)放在一起,而不是读写操作穿插着写。这得益于浏览器的渲染队列机制。 浏览器针对页面的回流与重绘,进行了自身的优化——渲染队列, 浏览器会将所有的回流、重绘的操作放在一个队列中,当队列中的操作到了一定的数量或者到了一定的时间间隔,浏览器就会对队列进行批处理。这样就会让多次的回流、重绘变成一次回流重绘。 2. JavaScript对DOM的影响 最后我们再看看看JavaScript脚本对DOM的影响。当解析器解析HTML时,如果遇到了 来看一段代码: <html> <body> <div>hello juejin</div> <script> document.getElementsByTagName('div')[0].innerText = 'juejin yyds' </script> <p>hello world</p> </body> </html> 复制代码 这里,当解析完div标签后,就会解析script标签,这时的DOM结构如下: 这时,HTML解析器就会暂停工作,JavaScript引擎就会开始工作,并执行script标签中的脚本内容。由于这段脚本修改了第一个div的内容,所以执行完这个脚本之后,div中的文本就变成了“juejin yyds”,当脚本执行完成之后,HTML解析器就会恢复解析过程,继续解析后面的内容,直至生成最终的DOM。 上面我们说的JavaScript脚本是通过script标签直接嵌入到HTML中的。当在页面中引入JavaScript脚本时,情况就会变得复杂。比如: <html> <body> <div>hello juejin</div> <script type="text/javascript" src='./index.js'></script> <p>hello world</p> </body> </html> 复制代码 其实这里的执行流程和上面时一样的,当遇到script标签时,HTML解析器都会暂停解析并去执行脚本文件。不过这里执行 JavaScript 脚本时,需要先下载脚本。脚本的下载过程会阻塞 DOM 的解析,而通常下载又是非常耗时的,会受到网络环境、JavaScript 脚本文件大小等因素的影响。 ​ 经过上面的分析可知,JavaScript 线程会阻塞 DOM 的解析,我们可以通过CDN、压缩脚本等方式来加速 JavaScript 脚本的加载。如果脚本文件中没有操作DOM的相关代码,就可以将JavaScript脚本设置为异步加载,可以给script标签添加 async 或 defer 属性来实现脚本的异步加载。两者的使用方式如下: <script async type="text/javascript" src='./index.js'></script> <script defer type="text/javascript" src='./index.js'></script> 复制代码 下图可以直观的看出异步加载和直接加载的区别: 其中蓝色代表JavaScript脚本加载时间,红色代表JavaScript脚本执行时间,绿色代表HTML解析。 defer 和 async属性都是去异步加载外部的JS脚本文件,它们都不会阻塞页面的解析,其区别如下: 执行顺序: 多个带async属性的标签,不能保证加载的顺序;多个带defer属性的标签,按照加载顺序执行; 脚本是否并行执行: async属性,表示后续文档的加载和执行与js脚本的加载和执行是并行进行的,即异步执行;defer属性,加载后续文档的过程和js脚本的加载(此时仅加载不执行)是并行进行的(异步),JavaScript 脚本需要等到文档所有元素解析完成之后才执行,DOMContentLoaded事件触发执行之前。 再来看另外一种情况,示例代码如下: <html> <head> <style src='./style.css'></style> </head> <body> <div>hello juejin</div> <script> const ele = document.getElementsByTagName('div')[0]; ele.innerText = 'juejin yyds'; // 操作DOM ele.style.color = 'skyblue'; // 操作CSSOM </script> <p>hello world</p> </body> </html> 复制代码 上面的代码中,第9行是操作DOM的,而第10行是操作CSSOM的,所以在执行 JavaScript 脚本之前,还需要先解析 JavaScript 语句之上所有的 CSS 样式。所以如果代码里引用了外部的 CSS 文件,那么在执行 JavaScript 之前,还需要 等待外部的 CSS 文件下载完成,并解析生成 CSSOM 对象之后,才能执行 JavaScript 脚本。而 JavaScript 引擎在解析 JavaScript 之前,是不知道 JavaScript 是否操纵了 CSSOM 的,所以渲染引擎在遇到 JavaScript 脚本时,不管该脚本是否操纵了 CSSOM,都会执行 CSS 文件下载,解析操作,再执行 JavaScript 脚本。 所以,JavaScript 会阻塞 DOM 生成,而样式文件又会阻塞 JavaScript 的执行,我们在开发时需要格外注意这一点。 最后再来看一种情况,示例代码如下: <html> <head> <style src='./style.css'></style> </head> <body> <div>hello juejin</div> <script type="text/javascript" src='./index.js'></script> <p>hello world</p> </body> </html> 复制代码 这段HTML代码中包含了CSS外部引用和JavaScript外部文件,在接收到 HTML 数据之后的预解析过程中,HTML 预解析器识别出来了有 CSS 文件和 JavaScript 文件需要下载,就会同时发起两个文件的下载请求。 总结 如果你觉得此文对你有一丁点帮助,点个赞。或者可以加入我的开发交流群:1025263163相互学习,我们会有专业的技术答疑解惑 如果你觉得这篇文章对你有点用的话,麻烦请给我们的开源项目点点star:http://github.crmeb.net/u/defu不胜感激!

优秀的个人博客,低调大师

每日一博 | 说一说 Web 端侧 AI

前言 AI 正在不断拓展前端的技术边界, 算法的加持也为前端研发注入了全新的力量。本文为大家介绍什么是端智能,端智能的应用场景以及 Web 端侧实现 AI 的基本原理概念。 什么是端智能 首先,回顾一个AI应用的开发流程,具体步骤包括了 数据的采集与预处理 模型的选取与训练 模型的评估 模型服务部署 模型训练的中间产物为一个模型文件,通过加载模型文件,部署为可调用的服务,然后就可以调用进行推理预测了。 在传统流程中,模型服务会部署在高性能的服务器上,由客户端发起请求,由服务器端进行推理,将预测结果返回给客户端,而端智能则是在客户端上完成推理的过程。 端智能的应用场景 端智能现在已经有非常多的应用场景,涵盖视觉类的 AR 、互动游戏,推荐类的信息流推荐,触达类的智能Push等,语音类的直播、智能降噪等多个领域。算法逐渐从服务端覆盖到用户实时感知更强的移动终端。 典型应用包括了 AR 应用、游戏。由 AI 提供理解视觉信息的能力,由 AR 根据视觉信息来实现虚实结合的交互,带来更沉浸式的购物、互动体验。比如美颜相机、虚拟试妆,即是通过检测人脸面部的关键点,在特定区域使用 AR 增强、渲染妆容。 互动游戏。飞猪双十一的互动游戏"找一找", 即是一个跑在 h5 页面的图片分类应用,通过摄像头实时捕捉图片,调用分类模型进行分类,当出现游戏设定目标时得分。 端侧重排。通过实时的用户意识识别,对服务器推荐算法下发的feeds流进行重新排列,做出更精准的内容推荐。 智能Push。通过端侧感知用户状态,决策是否需要向用户实施干预,推送Push,选取合适的时机主动触达用户,而非服务器端定时的批量推送,带来更精准的营销,更好的用户体验。 端智能的优势 从普遍的应用场景,可以看到端智能的明显优势,包括了 低延时 实时的计算节省了网络请求的时间。对于高帧率要求的应用,比如美颜相机每秒都要请求服务器,高延迟绝对是用户所不能接受的。而对于高频交互场景,比如游戏,低延时变得更为重要。 低服务成本 本地的计算节省了服务器资源,现在的新手机发布都会强调手机芯片的 AI 计算能力,越来越强的终端性能让更多的端上 AI 应用成为了可能。 保护隐私 数据隐私的话题在今天变得越来越重要。通过在端侧进行模型的推理,用户数据不需要上传到服务器,保证了用户隐私的安全。 端智能的局限 同时,端智能也有一个最明显的局限,就是低算力,虽然端侧的性能越来越强,但是和服务器相比还是相差甚远。为了在有限的资源里做复杂的算法,就需要对硬件平台进行适配,做指令级的优化,让模型能够在终端设备中跑起来,同时,需要对模型进行压缩,在时间和空间上减少消耗。 现在已经有一些比较成熟的端侧推理引擎了,这些框架、引擎都对终端设备做了优化来充分发挥设备的算力。比如Tensorflow Lite、Pytorch mobile、阿里的 MNN、百度飞桨 PaddlePaddle。 Web端呢 Web 端同样拥有端侧 AI 的优势与局限,作为在 PC 上用户访问互联网内容和服务的主要手段,在移动端很多APP也会嵌入 Web 页面,但是浏览器内存和存储配额的有限,让 Web 上运行 AI 应用看上去更不可能。 然而在 2015 年的时候就已经出现了一个 ConvNetJS的库,可以在浏览器里用卷积神经网络做分类、回归任务,虽然现在已经不维护了,2018 年的时候涌现了非常多的JS的机器学习、深度学习框架。如 Tensorflow.js 、 Synaptic 、 Brain.js 、 Mind 、 Keras.js 、 WebDNN 等。 受限于浏览器算力,部分框架如 keras.js 、 WebDNN框架只支持加载模型进行推理,而不能在浏览器中训练。 此外,一些框架不适用于通用的深度学习任务,它们支持的网络类型有所不同。比如 TensorFlow.js 、 Keras.js 和 WebDNN 支持了 DNN 、 CNN 和 RNN。而 ConvNetJS 主要支持 CNN 任务,不支持 RNN。Brain.js 和 synaptic 主要支持 RNN 任务,不支持 CNN 网络中使用的卷积和池化操作。Mind 仅支持基本的 DNN。 在选择框架时需要看下是否支持具体需求。 Web端架构 Web端是如何利用有限的算力的呢? 一个典型的 JavaScript 机器学习框架如图所示,从底向上分别是驱动硬件,使用硬件的浏览器接口,各种机器学习框架、图形处理库,最后是我们的应用。 CPU vs GPU 在 Web 浏览器中运行机器学习模型的一个先决条件是通过 GPU 加速获得足够的计算能力。 在机器学习中,尤其是深度网络模型,广泛使用的操作是将大矩阵与向量相乘,再与另一个向量做加法。这种类型的典型操作涉及数千或数百万个浮点操作,而是它们通常是可并行化的。 以一个简单的向量相加为例,将两个向量相加可分为许多较小的运算,即每个索引位置相加。这些较小的操作并不相互依赖。尽管 CPU 对每个单独的加法所需的时间通常更少,随着计算量规模的变大,并发会逐渐显示出优势。 WebGPU/WebGL vs WebAssembly 有了硬件之后,需要对硬件进行充分的利用。 WebGL WebGL 是目前性能最高的 GPU 利用方案,WebGL 为在浏览器中加速 2D 和 3D图形渲染而设计,但可以用于神经网络的并行计算来加速推理过程,实现速度数量级的提升。 WebGPU 随着 Web 应用对可编程 3D 图形、图像处理和 GPU 访问需求的持续增强,为了在 WEB 中引入GPU 加速科学计算性能,W3C 在 2017 年提出了 WebGPU ,作为下一代 WEB 图形的的 API 标准,具有更低的驱动开销,更好的支持多线程、使用 GPU 进行计算。 WebAssembly 当终端设备没有 WebGL 支持或者性能较弱的时候,使用 CPU 的通用计算方案为 WebAssembly 。WebAssembly是一种新的编码方式,可以在现代的网络浏览器中运行,它是一种低级的类汇编语言,具有紧凑的二进制格式,可以接近原生的性能运行,并为诸如C / C ++ 等语言提供一个编译目标,以便它们可以在 Web 上运行。 Tensorflow.js 以 Tensorflow.js 为例,为了在不同的环境下实现运行,tensorflow 支持了不同的后端,根据设备条件自动选择相应的后端 ,当然也支持手动更改。 tf.setBackend('cpu'); console.log(tf.getBackend()); 对一些通用模型进行测试,WebGL速度大于普通 CPU 后端计算的 100 倍,WebAssembly 则比普通的 JS CPU 后端快 10-30 倍。 同时, tensorflow 也提供了 tfjs-node 版本,通过 C++ 和 CUDA 代码编译的本机编译库驱动 CPU 、 GPU 进行计算,训练速度与 Python 版本的 Keras 相当。不需要切换常用语言,可以直接在 nodejs 服务上添加 AI 模块,而不是再启动一个 python 的服务。 模型压缩 有了框架对于硬件设备的适配,还需要对模型进行压缩,复杂的模型固然有更好的预测精度,但是高额的存储空间、计算资源的消耗,过长的推理速度在大部分移动端场景中还是难以接受的。 模型的复杂度在于模型结构的复杂以及海量的参数。模型文件中通常存储了两部分信息:结构与参数,如下图中简化的神经网络所示,每个方块对应一个神经元,每个神经元以及神经元中的连线上都是参数。 模型的推理即从左侧输入,通过与神经元进行计算,再通过连线加上权重传到下一层计算,到最终层得到预测输出。节点越多、连接越多,则计算量越大。 模型剪枝 对训练好的模型进行裁剪,是模型压缩的一个常见方式,网络模型中存在着大量冗余的参数,大量神经元激活值趋近于 0,通过对无效节点或者是不那么重要的节点进行裁剪,可以减少模型的冗余。 最简单粗暴的剪枝即 DropOut ,在训练过程中随机对神经元进行丢弃。 大部分的剪枝方法会计算重要性因子,计算神经元节点对于最终的结果的重要性,剪去不那么重要的节点。 模型剪枝的过程是迭代反复进行的,并非剪枝后直接用来推理,通过剪枝后的训练恢复模型的精度,模型的压缩过程是在精度和压缩比例之间的不断权衡,在可接受的精度损失范围内选择最好的压缩效果。 模型量化 为了保证较高的精度,大部分的科学运算都是采用浮点型进行计算,常见的是 32 位浮点型和 64 位浮点型,即 float32 和 double64。量化即是把高精度的数值转化为低精度。 如二值量化(1bit量化)会直接将 Float32/float64 的值映射到 1bit ,存储空间直接压缩 32 倍/ 64 倍,计算时加载所需内存同样也会变小,更小的模型尺寸,带来更低的功耗以及更快的计算速度。除此还有8bit量化、任意bit量化。 知识蒸馏 知识蒸馏则是将深度网络中所学到的知识转移到另一个相对简单的网络中,先训练一个 teacher 网络,然后使用这个 teacher 网络的输出和数据的真实标签去训练 student 网络。 工具 模型压缩的实现较为复杂,如果只是面向应用,大概了解其作用原理即可,可以直接用封装好的工具。 比如 Tensorflow Model Optimization Toolkit 提供了量化功能,其官方对于一些通用模型进行了压缩测试,如下表可以看到,对于 mobilenet 模型,模型大小由 10M+ 压缩到了 3、4M,而模型的精度损失很小。 百度的飞桨提供的 PaddleSlim 则提供了上述三种压缩方法。 总结 综上,开发一个 Web 端上的 AI 应用,流程即变成了 针对特定场景设计算法、训练模型 对模型进行压缩 转换为推理引擎所需要的格式 加载模型进行推理预测 对于算法而言,通用的深度学习框架已然提供了若干的通用预训练模型,可以直接用来做推理,也可以在其基础上训练自己的数据集。模型的压缩与推理也可以使用现有的工具。 参考文献 [1] https://tech.taobao.org/news/2021-1-7-32.html [2] https://juejin.cn/post/6844904152095539214 [3] Ma Y, Xiang D, Zheng S, et al. Moving deep learning into web browser: How far can we go?[C]//The World Wide Web Conference. 2019: 1234-1244. [4] WebGPU: https://www.w3.org/TR/webgpu/ [5] Tensorflow.js: https://www.tensorflow.org/js?hl=zh-cn [6] WebAssembly: https://developer.mozilla.org/zh-CN/docs/WebAssembly [7] Deep Learning with JavaScript https://www.manning.com/books/deep-learning-with-javascript 欢迎关注凹凸实验室博客:aotu.io 或者关注凹凸实验室公众号(AOTULabs),不定时推送文章。

优秀的个人博客,低调大师

每日一博 | 前端插件化架构的探索和实践

babel插件、webpack插件、vue-cli插件,为啥这么多的优秀框架都是使用插件系统?插件化架构是什么?带来了什么好处?可以应用到什么场景呢? 1. 插件化架构定义 插件化架构又称微核架构,指的是软件的内核相对较小,主要功能和业务逻辑都通过插件实现。插件化架构一般有两个核心的概念:内核和插件。 内核(pluginCore)通常只包含系统运行的最小功能; 插件(plugin)则是互相独立的模块,一般会提供单一的功能。 内核一般会将要完成的所有业务进行抽象,抽象出最小粒度的基础接口,供插件方来调用。这样,插件开发的效率将会极大的提高。比方说,浏览器就是一个典型的插件化架构,浏览器是内核,页面是插件,这样通过不同的URL地址加载不同的页面,来提供非常丰富的功能。而且,我们开发网页时候,浏览器会提供很多API和能力,这些接口通过 window来挂载, 比如,DOM、BOM、Event、Location等等。 设计一个完善的插件化架构的系统,包含三要素: plugCore:插件内核,提供插件运行时,管理插件的加载、运行、卸载等生命周期(类比浏览器); pluginAPI:插件运行时需要的基础接口(类比浏览器例子,相当于window); plugin:一系列特定功能的独立模块(类比浏览器例子,相当于不同的网页)。 2. 插件化架构的实践 我们将从plugCore、 pluginAPI和plugin三要素,来解析jQuery、Babel和Vue CLI这三大优秀的开源库其插件化架构的实践。 2.1 jQuery的插件化架构 jQuery 是一个 JavaScript 库,极大地简化了JavaScript 编程,用更少的代码完成更多工作。早期浏览器的标准不统一,开发网页需要兼容不同浏览器的用户使用是一件十分痛苦的事情。jQuery在适配了不同浏览器的差异的基础上提供了更加完善易用API,供前端开发人员完成网页编程,使用jQuery编写的网页,在一套代码下也可以在不同厂商的浏览器上正常运行。在 MV* 框架流行之前,jQuery是绝对的扛霸子。jQuery是可扩展的,其拥有完善的插件体系,网页开发所需要的各种插件在其生态都可以找到。我们解析一下jQuery插件体系。 插件定义: 特别说明:$.fn = jQuery.protype(插件精髓)。jQuery的插件机制通过原型链来挂载。 插件机制执行过程 demo 示例 $app便可以在原型链上查找到myPlugin: 从三要素来总结: pluginCore:通过原型链赋值来扩展不同的插件,再获得jQuery实例后可以被调用。 pluginAPI:jQuery包的核心接口,(jQuery依靠其优异的Api取胜) plugin:无限制,可以是JavaScript的类型,一般是实现具体功能的模块,比如,日期选择器等。 2.2 Babel的插件化架构 Babel 是一个工具链,主要用于将 ECMAScript 2015+ 版本的代码转换为向后兼容的 JavaScript 语法,以便能够运行在当前和旧版本的浏览器或其他环境中。在代码转换的过程中会涉及许多特性和语法的转换,而且ECMAScript的提案总是不断地更新。如何组织大量(不断增加)的转换规则呢?我们来看看 Babel的工作原理。 Babel转换源码,分为三个步骤: 解析(parse):进行词法分析(Lexical Analysis)和语法分析(Syntactic Analysis)以生成抽象语法树(AST); 转换 (transform):遍历AST中每个节点并进行相应的转换操作,该过程通过使用不同的插件来实现各种特性和语法的转换; 生成 (generate):根据AST生成目标代码。 Babel在AST转换的过程(即上图的第2步),便使用插件化架构,下面将会详细讲解这个转换过程的插件化架构的使用。 插件定义: 插件是一个函数,返回值是一个包含visitor的对象。插件定义的部分概念说明: name:插件名 pluginAPI: 插件运行时传入的API visitor: 是一个对象,对象的key是AST的每节点的类型,对象的值是一个函数,AST转换的过程便在这里发生的。 nodePath:是一个AST的节点的实例对象,详细可以参考:@babel/parser/src/parser/node.js [1],其中, type字段 : 该节点的类型,常见类型:VariableDeclaration(变量声明)、VariableDeclarator(变量声明表达式)、ArrowFunctionExpression(箭头函数表达式)等等,详细可以参考@babel/types [2]。 (笔者认为pluginAPI还应包括nodePath,因为,每个节点实例除了语法和词法描述,还包含需求语法间的转换方法) 插件示例 箭头函数转换成普通函数的插件:@babel/plugin-transform-arrow-functions [3]源码: 插件的执行思路: 第一步,执行该插件,获取到包含visitor对象; 第二步,ATS遍历节点,检测nodePath的type === 'ArrowFunctionExpression',寻找到vistor对象的中key为 ArrowFunctionExpression的函数; 第三步,将nodePath传入该函数进行调用(AST在这步被修改); 单个插件的执行思路很明确了,那么在ATS遍历过程,怎么做到多个插件一起工作呢? Babel在转换源码过程中,插件化架构的工作流程是这样的: 第一步:通过解析babel的配置文件(或者命令行--plugins参数),获取Babel配置的所有插件的描述; 第二步,将插件的require进内存,获得插件函数,并执行插件函数,获取到多个包含vistor字段对象;(详细逻辑:@babel/core/src/config/full.js [4]) 第三步,将多个包含vistor字段对象整合成一个大的visitor源码展示(详细逻辑:@babel/core/src/transformation/index.js [5]): 合并后的visitor对象: visitor的对象中的值变成了 Array<function(nodePath)> 第四步,AST遍历时,每个节点根据 NodeType,来获取 visitor[NodeType],并依次执行。 从三要素来总结: pluginCore:插件加载并整合(即vistor合并),AST遍历期间是调用查找vistor[NodeType]并依次调用; pluginAPI:nodePath,提供不同类型节点的接口来转换AST节点; plugin:visitor[NodeType]=function(nodepath)。 2.3 vue-cli的插件化架构 Vue CLI 是一个基于 Vue.js 进行快速开发的完整系统。CLI插件是向你的 Vue 项目提供可选功能的 npm 包,例如 Babel/TypeScript 转译、ESLint 集成、单元测试和 end-to-end 测试等。Vue CLI 插件的名字以 @vue/cli-plugin- (内建插件) 或 vue-cli-plugin- (社区插件) 开头,非常容易使用。下面,我们将会解析cli插件的定义、执行、安装等过程。 插件定义 插件必须是vue-cli-plugin-命名的npm包,并且目录结构也是要严格遵循文件命名来定义。 注意:@vue/cli-service [6],会通过 项目根目录下package.json中dependencies和devDependencies中定义的 npm包中符合插件命名规范的 npm包作为项目的插件。 文件命名和内容说明: generator.js:会在插件被添加时执行,可以安装npm包、修改项目源码等功能; prompts.js:所有的对话逻辑都存储在 prompts.js 文件中。对话内部是通过 inquirer [7] 实现,在调用其获得安装选项结果,并在 generator.js调用时作为参数存入; index.js:Service插件的入口,@vue/cli-service [8]启动时被执行 详情可以去看Vue Cli 插件开发指南 [9] 我们把Vue CLI的插件执行分成两种情况: 第一种:插件未安装,插件被添加的时候调用(prompts.js + generator.js) 第二种:插件已安装,插件系统启动时被执行(index.js) 第一种 安装流程 相比Babel的手动安装添加插件方式,Vue CLI的插件系统提供命令行的安装方式就显得很方便了。我们看看Vue Cli插件系统时怎么实现一行命令添加插件的功能。 安装流程的执行思路如下: 第一步:从命令行参数解析出插件名,使用npm(yarn)install vue-cli-plugin-xxx 安装插件,源码位置:@vue/cli/lib/add.js [10] 第二步:require('vue-cli-plugin-xxx/prompts'),并获取用户安装是选项结果pluginOptions,源码位置:@vue/cli/lib/invoke.js [11] 第三步:使用pluginName和pluginOptions作为参数构成出Generator [12]对象的实例 第四步:执行generator.generate方法。这步包括了三个关键步骤:1)require(vue-cli-plugin-xxx/generator),获得插件的执行函数;2)构建GeneratorAPI(即pluginAPI);3)调用generator.js导出函数。 详细代码:@vue/cli/lib/Generator.js [113] 第五步:将插件的参数添加到vue.config.js文件中。 第二种 运行流程 插件运行流程是由@vue/cli-service [14]这个插件系统定义的,这里的调用插件有两种: 第一种 内置插件@vue/cli-service的命令和配置相关,将系插件统功能拆分出多个内置插件,在插件系统中默认调用); 第二种 项目插件,package.json 中定义的npm包名符合插件命名规范)。 插件运行逻辑很简单: 这两个流程的 pluginAPI是不一样的。 安装流程:@vue/cli/lib/GeneratorAPI [15] 运行流程:@vue/cli-service/lib/PluginAPI [16] 从三要素来总结: 1)安装流程 pluginCore:@vue/cli [17]通过命令行参数获得插件包名,然后安装插件的npm包,并执行prompts.js 获得用户安装选项结果,然后,使用选项结果和generator.js作为参数构造出generator,并在调用generator.generate中执行generator.js函数; pluginAPI:GeneratorAPI [18],提供了源码修改、npm包管理、模版文件生成等功能; plugin:由prompts.js和generator.js组成,解决某种能力植入项目时,要处理的依赖。 2)运行流程 pluginCore:@vue/cli-service [19],通过package.json中获得项目插件后,与系统内置插件合并,最后依次执行; pluginApI:PluginAPI [20],提供webpack配置修改和命令管理的能力; plugin:index.js文件,在不同命令下进行工作。 一个插件系统是可以不多个插件类型,并且插件系统通过命令安装插件的实现,用户在使用插件系统时添加插件也是十分方便的。 3. 插件化架构的应用 3.1 应用场景 通过上述的实例,总结处理插件架构的应用场景。 第一种:富pluginAPI场景:代码在多种场景中运行,需要抹平场景中差异。(jQuery); 第二种:富plugin场景,插件系统,可预期需求会越来越多,适合通过更多的插件来简化系统的代码量(Babel) 第三种:富pluginCore和pluginAPI场景,插件系统本身非常复杂,需要对开发人员要求极高,这时候,将复杂的工作放到内核和中pluginApi实现,剩下大部分的简单的编码工作留给插件方实现,插件方借助pluginApi也可以快速完成业务开发(Vue CLI) 3.2 发展方向 通过建立一个插件标准,将研发流程沉淀的能力进行插件化编程,整个公司通过使用一套的插件系统(中台),这样意味着,我们不用重复造业务轮子,团队和企业可以持续积累自己的插件生态,让软件开可以像汽车等工业制造一样,打造一条标准化装配的流水线。 参考链接: 1. https://github.com/babel/babel/blob/31b361b736ee519180f9ea341e2a3e4e710d2ef4/packages/babel-parser/src/parser/node.js 2. https://babeljs.io/docs/en/babel-types 3. https://babeljs.io/docs/en/next/babel-plugin-transform-arrow-functions 4. https://github.com/babel/babel/blob/fa975bf7cd2b9054faaff107a79e41dcaad305b1/packages/babel-core/src/config/full.js 5. https://github.com/babel/babel/blob/fa975bf7cd2b9054faaff107a79e41dcaad305b1/packages/babel-core/src/transformation/index.js#L107 6. https://github.com/vuejs/vue-cli/tree/dev/packages/%40vue/cli-service 7. https://github.com/SBoudrias/Inquirer.js 8. https://github.com/vuejs/vue-cli/tree/dev/packages/%40vue/cli-service 9. https://cli.vuejs.org/zh/dev-guide/plugin-dev.html 10. https://github.com/vuejs/vue-cli/blob/aee9e178e7c9598f317ceeed2940c94ac82e8340/packages/%40vue/cli/lib/add.js#L52 11. https://github.com/vuejs/vue-cli/blob/aee9e178e7c9598f317ceeed2940c94ac82e8340/packages/%40vue/cli/lib/invoke.js#L69 12. https://github.com/vuejs/vue-cli/blob/aee9e178e7c9598f317ceeed2940c94ac82e8340/packages/%40vue/cli/lib/Generator.js#L77 13. https://github.com/vuejs/vue-cli/blob/aee9e178e7c9598f317ceeed2940c94ac82e8340/packages/%40vue/cli/lib/Generator.js#L149 14. https://github.com/vuejs/vue-cli/tree/dev/packages/%40vue/cli-service 15. https://github.com/vuejs/vue-cli/blob/aee9e178e7c9598f317ceeed2940c94ac82e8340/packages/%40vue/cli/lib/GeneratorAPI.js 16. https://github.com/vuejs/vue-cli/blob/aee9e178e7c9598f317ceeed2940c94ac82e8340/packages/%40vue/cli-service/lib/PluginAPI.js 17. https://github.com/vuejs/vue-cli/tree/aee9e178e7c9598f317ceeed2940c94ac82e8340/packages/%40vue/cli 18. https://github.com/vuejs/vue-cli/blob/aee9e178e7c9598f317ceeed2940c94ac82e8340/packages/%40vue/cli/lib/GeneratorAPI.js 19. https://github.com/vuejs/vue-cli/tree/aee9e178e7c9598f317ceeed2940c94ac82e8340/packages/%40vue/cli-service 20. https://github.com/vuejs/vue-cli/blob/aee9e178e7c9598f317ceeed2940c94ac82e8340/packages/%40vue/cli-service/lib/PluginAPI.js ☆END☆ 招聘信息 OPPO互联网基础技术团队招聘一大波岗位,涵盖C++、Go、OpenJDK、Java、DevOps、Android、ElasticSearch等多个方向,请点击这里查看详细信息及JD。 你可能还喜欢 OPPO自研ESA DataFlow架构与实践 数据同步一致性保障:OPPO自研JinS数据同步框架实践 微服务全链路异步化实践 Dubbo协议解析与ESA RPC实践 自研代码审查系统火眼Code Review实践 更多技术干货 扫码关注 OPPO互联网技术 我就知道你“在看” 本文分享自微信公众号 - OPPO互联网技术(OPPO_tech)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | 微服务全链路异步化实践

1. 背景 随着公司业务的发展,核心服务流量越来越大,使用到的资源也越来越多。在微服务架构体系中,大部分的业务是基于Java 语言实现的,受限于Java 的线程实现,一个Java 线程映射到一个kernel 线程,造成了高并发场景下线程资源的极大浪费,线程成为提高系统并发和吞吐量的瓶颈。 在微服务架构下,使用同步编程模式时不仅造成了资源的极大浪费,并且在流量发生激增波动的时候,受制于系统资源而无法快速的扩容。本文将探索服务异步化在并发、吞吐量方面对系统带来的提升。 2. 如何快速提高服务吞吐量 首先,以微服务架构中的RPC 服务调用举例,测试和探索在微服务架构中,异步架构如何提高服务的吞吐量和并发。ESA Stack 是OPPO 自研的基础框架技术栈,ESA RPC 是自研的RPC 框架。本节测试服务我们使用ESA RPC 搭建。 关于ESA RPC的详情,可以参考我们之前发布的文章《Dubbo协议解析及ESA RPC实践》。 2.1 服务架构 下图所示为测试环境架构。其中Service A 既是服务端也是客户端,它模拟了生产环境中大部分服务的角色。我们对Service A 分别采用同步模型和纯异步模型进行压测,其中纯异步模型包含了客户端、服务端逻辑的异步处理。Service B 模拟一个耗时为N ms 的下游服务,为Service A 的调用提供固定的延时响应。 测试服务器的配置为8 核16G,千兆网卡。 2.2 同步异步模型对比 测试场景1: 并发压测客户端200~8000,服务耗时50ms,分别对同步和异步架构进行压测,对比TPS、服务耗时、CPU 上下文切换;同步模式下,线程数和并发客户端相同;异步模式下,使用框架默认的200 线程。测试数据如下。 测试场景2: 并发压测客户端8000,服务耗时50~500ms,分别对同步和异步模式进行压测,对比TPS、服务耗时、CPU 上下文切换;同步模式下服务端8000 线程;异步模式下,使用框架默认的200 线程。 2.3 服务扩展性对比 并发指服务瞬时同时处理的任务数(包含处于IO 等待状态的任务)。服务端设置业务处理线程200,那么同步模式下能提供的并发为200;纯异步模式下服务并发不受线程限制,IO密集型服务尤其收益。在系统流量突增的情景下,异步模式具有更强的可扩展性(Scalability)。 2.4 结论 根据上面的测试数据可以做出以下对比: 同步模式,线程数与并发成正比,并发越高对线程的消耗越多 异步模式,提高并发不需要线程增加 同步模式,系统Context Switch 次数随并发提高而快速增加 异步模式,系统Context Switch 次数明显小于同步模式 同步模式,并发超过某个临界点后,服务耗时快速上升,系统吞吐量急剧下降 异步模式,吞吐量随着并发增加,服务耗时上升速度明显低于同步模式 从而得出以下结论: 可以通过异步化微服务架构,提高相同资源配置下的服务吞吐量 随着下游平均耗时的增加,异步化带来的吞吐和耗时的提升作用减小 线程资源有限(内核、内存),不能无限增加来提高并发能力,异步化能极大提高系统瞬时并发能力(Scalability) 结论分析: 高并发下同步模型大量线程在内核态度/用户态、不同CPU 核之间进行切换,Context Switch 增加,系统性能下降 下游平均耗时增加时,系统CPU 繁忙程度降低,Context Switch 对性能系统影响下降 3. 异步模型探索 3.1 阻塞与非阻塞 在操作系统中,线程是CPU 调度的基本单位;阻塞调用是指发起调用后,线程进入阻塞状态(让出CPU),直到获得结果或异常返回;非阻塞调用是指不等待结果,调用不阻塞线程直接返回。 3.2 同步与异步 同步和异步关注的是消息通信机制;同步就是在发起调用后就得到返回结果(未必是完整结果),也就是由调用者主动等待结果;异步则是调用在发出之后直接返回,通过信号通知、回调函数处理来通知结果。 3.3 四种IO 模型 非IO 系统调用层面, 阻塞/非阻塞和同步/异步基本是同义词;在IO 系统调用层面,同步/异步和阻塞/非阻塞有以下组合: 同步阻塞调用,线程同步等待阻塞调用结果 同步非阻塞调用,线程通过轮训获取非阻塞调用结果 异步阻塞调用,IO 事件阻塞,IO 操作不阻塞 异步非阻塞调用,调用立即返回,信号/回调处理结果 我们通过一个简单的客户端来介绍四种IO 模型的代码写法: 同步阻塞IO 非同步阻塞IO 多路复用IO Asynchnorous IO 对四中IO 模型,有以下的对比: 同步阻塞式IO 模型,编程简单但线程阻塞,资源利用率低; 同步非阻塞式IO 模型,需要轮训CPU,浪费资源; 异步非阻塞AIO 模型,不阻塞线程,使用回调方式处理数据,但是编程难度高; 多路复用IO 模型,能够实现异步非阻塞IO,且编程简单,方便实现同步和异步调用,因此成为RPC 框架的首选。 4. 全链路异步编程指南 4.1 全链路组成及现状 微服务架构下的全链路包含了网关层、WEB 服务、RPC 服务、数据层等。目前公司的网关层已经实现了纯异步架构,Web 框架和RPC 框架支持纯异步编程,数据存储层目前异步方案还不成熟。 4.2 网关异步化 网关层由于其特殊性,不需要访问业务数据库只做协议转换和流量转发,目前已经使用了纯异步的架构;其IO 密集型的特点,特别适合纯异步的架构,可以极大的节省资源。 4.3 Web 服务异步化 Web 服务作为微服务体系内的重要组成,服务节点众多,传统的Web 服务框架SpringMVC 不支持纯异步化编程,OPPO 自研Web 框架Restlight 支持纯异步编程,且性能远超SpringMVC。下面是性能对比及Restlight 异步实践。 Restlight 框架异步编程实践:通过Controller 方法返回值区分同步和异步调用,且支持三种异步调用方式,CompletableFuture、ListenableFuture(Guava)、Future(Netty)。 4.4 RPC 调用异步化 RPC 调用等待下游response 返回时,线程不应处于block 状态;作为微服务架构中数据流量最大的一部分,RPC 调用异步化的收益巨大;目前ESA RPC 已经具备了纯异步化的能力,提供RPC 调用的服务一般既是客户端也是服务端,因此包含了客户端异步调用能力和服务端异步处理能力;为了兼容存量接口,ESA RPC 既支持CompletableFuture 也支持普通返回值的接口。 客户端异步化实践:底层使用异步非阻塞IO 收发网路数据包,使用CompletableFUture传递IO 事件以实现响应式编程,客户端不被RPC 调用阻塞,可继续调用其他服务。 接口返回CompletableFuture 来实现异步调用: 普通接口使用ESARpcContext::asyncCall 实现异步调用: 服务端异步化实践:通过服务端异步功能返回CompletableFuture 给框架以释放Biz 线程,自定义线程池或者IO 线程池收到下游response 后,完成返回给框架的Future。 接口定义返回CompletableFuture 来实现异步调用: 普通接口通过ESARpcContext::startAsync 开启服务端异步: 4.5 存储层异步化 数据操作是每个请求调用链的终点,纯异步的架构必须使用异步存储层客户端,目前OPPO 没有自研的存储层异步客户端,但业界开源方案欣欣向荣: 数据库:Vert.x JDBC 客户端 Redis:Redisson、Lettuce Queue:基本都支持异步调用 4.6 纯异步与伪异步 异步调用目的在于防止当前业务线程被阻塞。伪异步将任务包装为Runnable 放入另一个线程执行并等待,当前Biz 线程不阻塞;纯异步为响应式编程模型,通过IO 实践驱动任务完成。他们的区别不在于是否将请求放入另一个线程池执行,而在于是否有线程阻塞等待Response。 5. 异步化未来发展 5.1 异步化带来的问题 相比于同步模型,异步模型存在以下问题: 代码可读性和可维护性较差,可能出现Callback Hell 框架SDK 变得复杂,使用门槛增加 业务可能不清楚代码逻辑执行线程 大量的ThreadLocal 需要手动export/import 简单来说,异步编程就是以编程的简单性(simplity)来交换性能(performance)。 5.2 使用协程实现异步非阻塞 目前在其他语言中,Erlang、Go、Kotlin 等都支持了协程,使用协程的好处是在语言层面支持了异步调用,业务代码可以使用同步的写法达到异步的效果,线程不被阻塞,避免大量的CPU 上下文切换,提升系统的性能。 目前Java 对协程的支持也在进行中, Project Loom 就是Java 的协程项目:http://openjdk.java.net/projects/loom/。 主要有以下几个概念: Fiber,轻量级线程(用户态线程),基于Continuation 实现 Continuation,指令执行单元, 阻塞时调用Continuation::yield , 恢复时调用Continuation::run Scheduler,用户态Fiber 调度器(ForkJoinPool),使用有限Workers 线程执行任意数量Fibers 开发者可以使用 Fiber 来执行业务代码块,当遇到LockSupport::park、socket io 等阻塞调用时,Fiber 中的代码单元执行会被阻塞,但是底层的线程并不会被阻塞。由此达到了开发同步模式代码,运行时达到异步执行的目的。 未来,ESAStack服务框架会支持协程。目前 Restlight框架已经支持协程并在内部开始试用,ESARPC也有支持协程的计划。框架提供的服务线程使用 Fiber 执行业务逻辑,业务实现中数据库请求、下游服务调用均在 Fiber 之中执行, 其包含的 IO 等阻塞调用只挂起 Fiber 而不阻塞所在线程,从而避免了过多的上下文切换提升 了吞吐量,达到了和异步模式一样的效果。 ☆END☆ 招聘信息 OPPO互联网基础技术团队招聘一大波岗位,涵盖C++、Go、OpenJDK、Java、DevOps、Android、ElasticSearch等多个方向,请点击这里查看详细信息及JD。 你可能还喜欢 OPPO自研ESA DataFlow架构与实践 Dubbo协议解析与ESA RPC实践 自研代码审查系统火眼Code Review实践 OPPO异地多活实践——缓存篇 更多技术干货 扫码关注 OPPO互联网技术 我就知道你“在看” 本文分享自微信公众号 - OPPO互联网技术(OPPO_tech)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | 如何设计一个幂等接口

什么叫幂等接口 幂等性,就是只多次操作的结果是一致的。这里可能有人会有疑问。 问:为什么要多次操作结果都一致呢?比如我查询数据,每次查出来的都一样,即使我修改了每次查出来的也都要一样吗? 答:我们说的多次,是指同一次请求中的多次操作。这个多次操作可能会在如下情况发生: 前端重复提交。比如这个业务处理需要2秒钟,我在2秒之内,提交按钮连续点了3次,如果非幂等性接口,那么后端就会处理3次。如果是查询,自然是没有影响的,因为查询本身就是幂等操作,但如果是新增,本来只是新增1条记录的,连点3次,就增加了3条,这显然不行。 响应超时而导致请求重试:在微服务相互调用的过程中,假如订单服务调用支付服务,支付服务支付成功了,但是订单服务接收支付服务返回的信息时超时了,于是订单服务进行重试,又去请求支付服务,结果支付服务又扣了一遍用户的钱。如果真这样的话,用户估计早就提着砍刀来了。 如何设计幂等接口 经过上面的描述,相信大家已经清楚了什么叫接口幂等性及其重要性。那么如何设计呢?大致有以下几种方案: 数据库记录状态机制:即每次操作前先查询状态,根据数据库记录的状态来判断是否要继续执行操作。比如订单服务调用支付服务,每次调用之前,先查询该笔订单的支付状态,从而避免重复操作。 token机制:请求业务接口之前,先请求token接口(会将生成的token放入redis中)获取一个token,然后请求业务接口时,带上token。在进行业务操作之前,我们先获取请求中携带的token,看看在redis中是否有该token,有的话,就删除,删除成功说明token校验通过,并且继续执行业务操作;如果redis中没有该token,说明已经被删除了,也就是已经执行过业务操作了,就不让其再进行业务操作。大致流程如下: 其他方案:接口幂等性设计还有很多其他方案,比如全局唯一id、乐观锁等。本文主要讲token机制的使用,若感兴趣可以自行研究。 用token机制实现接口自动幂等 1、pom.xml:主要是引入了redis相关依赖 <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-web</artifactId></dependency><!-- spring-boot-starter-data-redis --><dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-data-redis</artifactId></dependency><dependency> <groupId>org.apache.commons</groupId> <artifactId>commons-pool2</artifactId></dependency><!-- jedis --><dependency> <groupId>redis.clients</groupId> <artifactId>jedis</artifactId></dependency><dependency> <groupId>org.projectlombok</groupId> <artifactId>lombok</artifactId> <optional>true</optional></dependency><dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-test</artifactId> <scope>test</scope></dependency><!-- commons-lang3 --><dependency> <groupId>org.apache.commons</groupId> <artifactId>commons-lang3</artifactId></dependency><!-- org.json/json --><dependency> <groupId>org.json</groupId> <artifactId>json</artifactId> <version>20190722</version></dependency> 2、application.yml:主要是配置redis server: port: 6666spring: application: name: idempotent-api redis: host: 192.168.2.43 port: 6379 3、业务代码: •新建一个枚举,列出常用返回信息,如下: @Getter@AllArgsConstructorpublic enum ResultEnum { REPEATREQUEST(405, "重复请求"), OPERATEEXCEPTION(406, "操作异常"), HEADERNOTOKEN(407, "请求头未携带token"), ERRORTOKEN(408, "token正确") ; private Integer code; private String msg;} •新建一个JsonUtil,当请求异常时往页面中输出json: public class JsonUtil { private JsonUtil() {} public static void writeJsonToPage(HttpServletResponse response, String msg) { PrintWriter writer = null; response.setCharacterEncoding("UTF-8"); response.setContentType("text/html; charset=utf-8"); try { writer = response.getWriter(); writer.print(msg); } catch (IOException e) { } finally { if (writer != null) writer.close(); } }} •新建一个RedisUtil,用来操作redis: @Componentpublic class RedisUtil { private RedisUtil() {} private static RedisTemplate redisTemplate; @Autowired public void setRedisTemplate(@SuppressWarnings("rawtypes") RedisTemplate redisTemplate) { redisTemplate.setKeySerializer(new StringRedisSerializer()); //设置序列化Value的实例化对象 redisTemplate.setValueSerializer(new GenericJackson2JsonRedisSerializer()); RedisUtil.redisTemplate = redisTemplate; } /** * 设置key-value,过期时间为timeout秒 * @param key * @param value * @param timeout */ public static void setString(String key, String value, Long timeout) { redisTemplate.opsForValue().set(key, value, timeout, TimeUnit.SECONDS); } /** * 设置key-value * @param key * @param value */ public static void setString(String key, String value) { redisTemplate.opsForValue().set(key, value); } /** * 获取key-value * @param key * @return */ public static String getString(String key) { return (String) redisTemplate.opsForValue().get(key); } /** * 判断key是否存在 * @param key * @return */ public static boolean isExist(String key) { return redisTemplate.hasKey(key); } /** * 删除key * @param key * @return */ public static boolean delKey(String key) { return redisTemplate.delete(key); }} •新建一个TokenUtil,用来生成和校验token:生成token没什么好说的,这里为了简单直接用uuid生成,然后放入redis中。校验token,如果用户没有携带token,直接返回false;如果携带了token,但是redis中没有这个token,说明已经被删除了,即已经访问了,返回false;如果redis中有,但是redis中的token和用户携带的token不一致,也返回false;有且一致,说明是第一次访问,就将redis中的token删除,然后返回true。 public class TokenUtil { private TokenUtil() {} private static final String KEY = "token"; private static final String CODE = "code"; private static final String MSG = "msg"; private static final String JSON = "json"; private static final String RESULT = "result"; /** * 生成token并放入redis中 * @return */ public static String createToken() { String token = UUID.randomUUID().toString(); RedisUtil.setString(KEY, token, 60L); return RedisUtil.getString(KEY); } /** * 校验token * @param request * @return * @throws JSONException */ public static Map<String, Object> checkToken(HttpServletRequest request) throws JSONException { String headerToken = request.getHeader(KEY); JSONObject json = new JSONObject(); Map<String, Object> resultMap = new HashMap<>(); // 请求头中没有携带token,直接返回false if (StringUtils.isEmpty(headerToken)) { json.put(CODE, ResultEnum.HEADERNOTOKEN.getCode()); json.put(MSG, ResultEnum.HEADERNOTOKEN.getMsg()); resultMap.put(RESULT, false); resultMap.put(JSON, json.toString()); return resultMap; } if (StringUtils.isEmpty(RedisUtil.getString(KEY))) { // 如果redis中没有token,说明已经访问成功过了,直接返回false json.put(CODE, ResultEnum.REPEATREQUEST.getCode()); json.put(MSG, ResultEnum.REPEATREQUEST.getMsg()); resultMap.put(RESULT, false); resultMap.put(JSON, json.toString()); return resultMap; } else { // 如果redis中有token,就删除掉,删除成功返回true,删除失败返回false String redisToken = RedisUtil.getString(KEY); boolean result = false; if (!redisToken.equals(headerToken)) { json.put(CODE, ResultEnum.ERRORTOKEN.getCode()); json.put(MSG, ResultEnum.ERRORTOKEN.getMsg()); } else { result = RedisUtil.delKey(KEY); String msg = result ? null : ResultEnum.OPERATEEXCEPTION.getMsg(); json.put(CODE, 400); json.put(MSG, msg); } resultMap.put(RESULT, result); resultMap.put(JSON, json.toString()); return resultMap; } }} 新建一个注解,用来标注需要进行幂等的接口: @Target(ElementType.METHOD)@Retention(RetentionPolicy.RUNTIME)public @interface NeedIdempotent {} 接着要新建一个拦截器,对有@NeedIdempotent注解的方法进行拦截,进行自动幂等。 public class IdempotentInterceptor implements HandlerInterceptor{ @Override public boolean preHandle(HttpServletRequest httpServletRequest, HttpServletResponse httpServletResponse,Object object) throws JSONException { // 拦截的不是方法,直接放行 if (!(object instanceof HandlerMethod)) { return true; } HandlerMethod handlerMethod = (HandlerMethod) object; Method method = handlerMethod.getMethod(); // 如果是方法,并且有@NeedIdempotent注解,就自动幂等 if (method.isAnnotationPresent(NeedIdempotent.class)) { Map<String, Object> resultMap = TokenUtil.checkToken(httpServletRequest); boolean result = (boolean) resultMap.get("result"); String json = (String) resultMap.get("json"); if (!result) { JsonUtil.writeJsonToPage(httpServletResponse, json); } return result; } else { return true; } } @Override public void postHandle(HttpServletRequest httpServletRequest,HttpServletResponse httpServletResponse, Object o,ModelAndView modelAndView) { } @Override public void afterCompletion(HttpServletRequest httpServletRequest,HttpServletResponse httpServletResponse,Object o, Exception e) { }} 然后将这个拦截器配置到spring中去: @Configurationpublic class InterceptorConfig implements WebMvcConfigurer { @Override public void addInterceptors(InterceptorRegistry registry) { registry.addInterceptor(idempotentInterceptor()) .addPathPatterns("/**"); } @Bean public IdempotentInterceptor idempotentInterceptor() { return new IdempotentInterceptor(); }} •最后新建一个controller,就可以愉快地进行测试了: @RestController@RequestMapping("/idempotent")public class IdempotentApiController { @NeedIdempotent @GetMapping("/hello") public String hello() { return "are you ok?"; } @GetMapping("/token") public String token() { return TokenUtil.createToken(); }} 访问/token,不需要什么校验,访问/hello,就会自动幂等,每一次访问都要先获取token,一个token不能用两次。 -java开发那些事- 长按扫描二维码 关注我获取更多内容 本文分享自微信公众号 - java开发那些事(javawebkf)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | 服务注册与发现的原理和实现

什么是服务注册发现? 对于搞微服务的同学来说,服务注册、服务发现的概念应该不会太陌生。 简单来说,当服务A需要依赖服务B时,我们就需要告诉服务A,哪里可以调用到服务B,这就是服务注册发现要解决的问题。 Service B 把自己注册到 Service Registry 叫做 服务注册 Service A 从 Service Registry 发现 Service B 的节点信息叫做 服务发现 服务注册 服务注册是针对服务端的,服务启动后需要注册,分为几个部分: 启动注册 定时续期 退出撤销 启动注册 当一个服务节点起来之后,需要把自己注册到 Service Registry 上,便于其它节点来发现自己。注册需要在服务启动完成并可以接受请求时才会去注册自己,并且会设置有效期,防止进程异常退出后依然被访问。 定时续期 定时续期相当于 keep alive,定期告诉 Service Registry 自己还在,能够继续服务。 退出撤销 当进程退出时,我们应该主动去撤销注册信息,便于调用方及时将请求分发到别的节点。同时,go-zero 通过自适应的负载均衡来保证即使节点退出没有主动注销,也能及时摘除该节点。 服务发现 服务发现是针对调用端的,一般分为两类问题: 存量获取 增量侦听 还有一个常见的工程问题是 应对服务发现故障 当服务发现服务(比如 etcd, consul, nacos等)出现问题的时候,我们不要去修改已经获取到的 endpoints 列表,从而可以更好的确保 etcd 等宕机后所依赖的服务依然可以正常交互。 存量获取 当 Service A 启动时,需要从 Service Registry 获取 Service B 的已有节点列表:Service B1, Service B2, Service B3,然后根据自己的负载均衡算法来选择合适的节点发送请求。 增量侦听 上图已经有了 Service B1, Service B2, Service B3,如果此时又启动了 Service B4,那么我们就需要通知 Service A 有个新增的节点。如图: 应对服务发现故障 对于服务调用方来说,我们都会在内存里缓存一个可用节点列表。不管是使用 etcd,consul 或者 nacos 等,我们都可能面临服务发现集群故障,以 etcd 为例,当遇到 etcd 故障时,我们就需要冻结 Service B 的节点信息而不去变更,此时一定不能去清空节点信息,一旦清空就无法获取了,而此时 Service B 的节点很可能都是正常的,并且 go-zero 会自动隔离和恢复故障节点。 服务注册、服务发现的基本原理大致如此,当然实现起来还是比较复杂的,接下来我们一起看看 go-zero 里支持哪些服务发现的方式。 go-zero 之内置服务发现 go-zero 默认支持三种服务发现方式: 直连 基于 etcd 的服务发现 基于 kubernetes endpoints 的服务发现 直连 直连是最简单的方式,当我们的服务足够简单时,比如单机即可承载我们的业务,我们可以直接只用这种方式。 在 rpc 的配置文件里直接指定 endpoints 即可,比如: Rpc: Endpoints: - 192.168.0.111:3456 - 192.168.0.112:3456 zrpc 调用端就会分配负载到这两个节点上,其中一个节点有问题时 zrpc 会自动摘除,等节点恢复时会再次分配负载。 这个方法的缺点是不能动态增加节点,每次新增节点都需要修改调用方配置并重启。 基于 etcd 的服务发现 当我们的服务有一定规模之后,因为一个服务可能会被很多个服务依赖,我们就需要能够动态增减节点,而无需修改很多的调用方配置并重启。 常见的服务发现方案有 etcd, consul, nacos 等。 go-zero内置集成了基于 etcd 的服务发现方案,具体使用方法如下: Rpc: Etcd: Hosts: - 192.168.0.111:2379 - 192.168.0.112:2379 - 192.168.0.113:2379 Key: user.rpc Hosts 是 etcd 集群地址 Key 是服务注册上去的 key 基于 Kubernetes Endpoints 的服务发现 如果我们的服务都是部署在 Kubernetes 集群上的话,Kubernetes 本身是通过自带的 etcd 管理集群状态的,所有的服务都会把自己的节点信息注册到 Endpoints 对象,我们可以直接给 deployment 权限去读取集群的 Endpoints 对象即可获得节点信息。 Service B 的每个 Pod 启动时,会将自己注册到集群的 Endpoints 里 Service A 的每个 Pod 启动时,可以从集群的 Endpoints 里获取 Service B 的节点信息 当 Service B 的节点发生改变时,Service A 可以通过 watch 集群的 Endpoints 感知到 在这个机制工作之前,我们需要配置好当前 namespace 内 pod 对集群 Endpoints 访问权限,这里有三个概念: ClusterRole 定义集群范围的权限角色,不受 namespace 控制 ServiceAccount 定义 namespace 范围内的 service account ClusterRoleBinding 将定义好的 ClusterRole 和不同 namespace 的 ServiceAccount 进行绑定 具体的 Kubernetes 配置文件可以参考 这里,其中 namespace 按需修改。 注意:当启动时报没有权限获取 Endpoints 时记得检查这些配置有没落实 :) zrpc 的基于 Kubernetes Endpoints 的服务发现使用方法如下: Rpc: Target: k8s://mynamespace/myservice:3456 其中: mynamespace:被调用的 rpc 服务所在的 namespace myservice:被调用的 rpc 服务的名字 3456:被调用的 rpc 服务的端口 在创建 deployment 配置文件时一定要加上 serviceAccountName 来指定使用哪个 ServiceAccount,示例如下: apiVersion: apps/v1 kind: Deployment metadata: name: alpine-deployment labels: app: alpine spec: replicas: 1 selector: matchLabels: app: alpine template: metadata: labels: app: alpine spec: serviceAccountName: endpoints-reader containers: - name: alpine image: alpine command: - sleep - infinity 注意其中 serviceAccountName 指定该 deployment 创建出来的 pod 用哪个 ServiceAccount。 server 和 client 都部署到 Kubernetes 集群里之后可以通过以下命令滚动重启所有 server 节点 kubectl rollout restart deploy -n adhoc server-deployment 利用如下命令查看 client 节点日志: kubectl -n adhoc logs -f deploy/client-deployment --all-containers=true 可以看到我们的服务发现机制完美跟进了 server 节点的变化,并且在服务更新期间没有出现异常请求。 完整代码示例见 https://github.com/zeromicro/zero-examples/tree/main/discovery/k8s 下一篇文章我将讲解在 go-zero 里如何实现基于 consul, nacos 等的服务注册发现,敬请期待! 项目地址 https://github.com/tal-tech/go-zero https://gitee.com/kevwan/go-zero 欢迎使用 go-zero 并 star 支持我们! 微信交流群 关注『微服务实践』公众号并点击 交流群 获取社区群二维码。

优秀的个人博客,低调大师

每日一博 | 深度学习中的优化算法与实现

GiantPandaCV导语:这篇文章的内容主要是参考 沐神的mxnet/gluon视频中,Aston Zhang讲解的优化部分 对深度学习调参背后的数学原理进行讲解。文章有些长,小伙伴们可以耐心读完,相信收获一定会很大。本文同步在我的知乎,地址为:https://zhuanlan.zhihu.com/p/35229268 1. 前言 通过这么长时间的学习,我们应该对于通过深度学习解决问题的大体流程有个宏观的概念了吧? 设计模型 构造loss function 通过优化算法,找到一个某种意义上的optim值 其实在找optim的值过程,就是我们通常所说的调参的过程。 同一个model,一样的loss function,为什么不同的人对于同一个数据集会得到不同的结果?这其实就是调参的魅力了。。。 当然,调参并不是盲目的瞎调,也不是靠着运气乱调参,其背后也是遵循着一定的数学原理的。(本人是调参新手,如果说的不对,请各位评论区拍砖指教) 2. 调参背后的数学原理 通过前面关于深度学习的介绍和沐神的视频教程,我们已经接触到了很多优化算法。比如说,在训练模型的时候,不断迭代参数以最小化损失函数。 在大多数的ML问题中,我们往往都是这样做的: 定义一个损失函数 loss function 通过优化算法来最小化这个loss function 找到使得loss function最大或者最小的optim解作为model的parameter值 其实,这个优化过程中更多是针对训练集上进行的,而实际的ML问题求解过程中,我们更需要的是对于测试集上的表现来衡量,比如前面讲过的各种正则化,weight decay等手段来应对过拟合现象。 在这里,主要关注loss function在训练集上的得到的结果。又把loss function称作目标函数。 现在,再来看看求解优化问题的challenge,我们知道,绝大数深度学习中的目标函数都很复杂。因此,很多优化问题并不存在解析解,所以,我们就需要通过基于数值方法的优化算法来找到目标函数的近似解。而寻找近似解的过程,我们就需要不断迭代更新解的数值,从而找到那个在某种意义上最optim的解。 3. 从梯度下降说起 有关梯度下降的具体概念这里就不详细展开了。 如果不知道的小伙伴,可以去我的模式识别和机器学习笔记专栏中学习。 首先假设我们要学习的参数是 那么, 这里的 和 都是一维实数集上的一个映射 那么,我们需要回忆下,大学学过的泰勒展开。 因自百度百科中的概念: 数学中,泰勒公式是一个用函数在某点的信息描述其附近取值的公式。如果函数足够平滑的话,在已知函数在某一点的各阶导数值的情况之下,泰勒公式可以用这些导数值做系数构建一个多项式来近似函数在这一点的邻域中的值。泰勒公式还给出了这个多项式和实际的函数值之间的偏差。 通过数学公式表达出来就是: 上述公式中的 往往被替换成为 那么,此时上述的公式就可以被写成 因为,在定义中, 往往就是一个非常小的值,那么,其2次方,3次方,一直到n次方,那就几乎等于0了。所以,我们把从第二次方项开始的所有结果的和定义为 ,这一项被称作无穷小项。 那么此时的式子就被简化成为了: 注意到 是一个大于等于0的数 也是一个大于0的数,那么 也是一个大于等于0的数 可以类比到开始我们讲过的公式 那么,此时式子又可以被简化为: 其实,上面这个被简化的式子就是在做一件事情:不断的修改函数自变量的取值,使得其能够满足左边的数值尽可能都小于右边的值,也就是朝着 减少的方向一步一步的走。 我们还记着 的定义吗?它是一个非常小的数值且接近0,可以通过 来替换。 当 固定的时候,如果 是一个非常大的数值的时候,那么此时的 就不能满足非常小的定义。那么,这个时候 这一项就不能被drop掉,如果不能被drop掉,就不能满足泰勒展开的基本定义。这也就对应了我们在训练的过程中,如果把learning_rate(此处的 对应到learning_rate)调的太大,就出现了NaN的情况。 当 是一个固定的很小值的时候,如果 的初始值选择了一个很大的数值,比如说,这里 ,那么此时的 , ,这一项的数值也会变得非常大。导致其不能满足 不是一个非常小的数值的条件。此时训练肯定也会出问题。 总结:这里就发现了导致model难以训练的两个问题: 学习率的大小选择 初始化参数值的选择 其实, 这仅仅是从一维空间稍微为小伙伴们介绍了下 “调参和其背后数学原理” 的联系。。。 4. 学习率 上述梯度下降算法中的 (取正数)叫做学习率或步长。 我们现在就来讨论下,学习率过大和过小会带来什么问题。 4.1 当我们 学习率太小的时候: 如上图所示,当我们的初始值是从最左边的这个值开始的时候,随着 不断迭代,使得 不断的增加,我们发现,其一步一步的走向了最低点,如果learning_rate设置的太小,那么走的步数就会相当多,以至于很长时间,loss都没办法收敛。这就是所说的undershoot问题。 试想:如果以相同的学习率走了很多步后,终于走到了上图中的最低点附近,那么是不是很容易就能走到最低点了呢? 答案 :不行的。因为如果我们不对learning_rate进行一个自适应的decay,比如说,随着epoch的增多,learning_rate不断的减小。是很难保证其最终能走到这个真正意义上的最低点的。 4.2 当我们的学习率设置的过大 此时,就会产生一个走“之”字型的现象。 假设此时的初始值点是图中左下角的点,那么根据 ,第一步就走到图中右下角的这个点,然后不断这样迭代,有可能最后整个结果都没办法收敛下来。。。 这也就是在我们调参的过程中,设定太大的learning_rate会导致NaN的情况。 5. 随机梯度下降 然而, 当训练数据集很大的时候,梯度下降法可能会难以使用。 接下来,我们从数学原理方面来解释下为什么数据量变大的时候,往往不去采用梯度下降法 先来看看我们优化问题的目标函数 其中 表示的是第 个样本所带来的损失 可以观察到,梯度下降每次进行迭代的开销随着n的增长呈线性增长。 因此,如果我们的训练样本个数非常多,那么一次迭代的开销也将非常大 针对这个问题,我们就引入了随机梯度下降(sgd)方法,该方法从所有训练样本中随机均匀采样i,然后计算 。 实际上,随机梯度 是对梯度 的一个无偏估计,也就是说 6. Mini-Batch的随机梯度下降 虽然已经有了梯度下降和随机梯度下降,在实际的训练过程中,我们还是更倾向于使用带有mini-batch的sgd。 它就是说,随机均匀采样一个由训练数据构成的小的batch。然后,通过这个batch上的所有样本点的损失得到最终的损失,更新x的公式都和前面一样,这里就不写了。。。 同样,也可以通过数学来证明mini-batch的sgd对于原始梯度来说,也是无偏估计,证明方法同上。 6.1 算法实现 其实,我们只要实现一个mini-batch的sgd就行了。 当batch_size == 1的时候,就是sgd 当batch_size == 整个训练集大小的时候,就是梯度下降 defsgd(params,lr,batch_size):forparaminparams:param[:]=param-lr*param.grad/batch_size 实验中,我们以最简单的线性回归为例,完整代码如下: frommxnetimportgluonfrommxnet.gluonimportnnfrommxnetimportndarrayasndfrommxnetimportautogradimportmxnetasmxfromtimeimporttimefrommxnetimportsymimportmatplotlib.pyplotaspltimportnumpyasnpimportrandommx.random.seed(1)random.seed(1)defsgd(params,lr,batch_size):forparaminparams:param[:]=param-lr*param.grad/batch_size#生成数据集num_inputs=2num_examples=1000true_w=[2,-3.4]true_b=4.2X=nd.random_normal(scale=1,shape=(num_examples,num_inputs))y=true_w[0]*X[:,0]+true_w[1]*X[:,1]+true_by+=0.01*nd.random_normal(scale=1,shape=y.shape)dataset=gluon.data.ArrayDataset(X,y)defdata_iter(batch_size):idx=list(range(num_examples))random.shuffle(idx)forbatch_i,iinenumerate(range(0,num_examples,batch_size)):j=nd.array(idx[i:min(i+batch_size,num_examples)])yieldbatch_i,X.take(j),y.take(j)definit_params():w=nd.random_normal(scale=1,shape=(num_inputs,1))b=nd.zeros(shape=(1,))params=[w,b]forparaminparams:param.attach_grad()returnparamsdefnet(X,w,b):returnnd.dot(X,w)+bdefsquare_loss(yhat,y):return(yhat-y.reshape(yhat.shape))**2/2deftrain(batch_size,lr,epochs,period):assertperiod>=batch_sizeandperiod%batch_size==0w,b=init_params()total_loss=[np.mean(square_loss(net(X,w,b),y).asnumpy())]#注意epoch从1开始计数。forepochinrange(1,epochs+1):#学习率自我衰减。ifepoch>2:lr*=0.1forbatch_i,data,labelindata_iter(batch_size):withautograd.record():output=net(data,w,b)loss=square_loss(output,label)loss.backward()sgd([w,b],lr,batch_size)ifbatch_i*batch_size%period==0:total_loss.append(np.mean(square_loss(net(X,w,b),y).asnumpy()))print("Batchsize%d,Learningrate%f,Epoch%d,loss%.4e"%(batch_size,lr,epoch,total_loss[-1]))print('w:',np.reshape(w.asnumpy(),(1,-1)),'b:',b.asnumpy()[0],'\n')x_axis=np.linspace(0,epochs,len(total_loss),endpoint=True)plt.semilogy(x_axis,total_loss)plt.xlabel('epoch')plt.ylabel('loss')plt.show() 关于上述代码中参数的说明,当epoch大于2的时候,学习率会有一个自我衰减的过程,也就是lr = lr *0.1。 period参数:每次采用到与period相同数目的数据点后,记录当前目标函数值用于作图。 比如,当batch_size = 10, period = 10,那么,每次迭代一个batch后,都会记录loss的值用于作图。 6.2 调参 现在,我们来分析下不同参数对于loss变化的影响。 当batch_size = 1时,该训练方式就是sgd,当前lr的情况下,loss function在前期快速减少,当epoch > 2的时候,lr会出现自我衰减,loss function下降后基本收敛,最终学习到的parameter和真实parameter相当。 train(batch_size=1,lr=0.1,epochs=5,period=10) 当batch_size = 1000时,由于训练数据集包含1000个样本,此时训练使用的是标注的梯度下降算法。loss function还是在前两个epoch的时候下降较快。当epoch > 2的时候,lr自我衰减。loss function下降缓慢。最终学习到的parameter和真实parameter相当 当batch_size = 10时,由于训练样本中含有1000个样本,此时训练使用mini-batch的sgd来进行。最终学到的parameter与真实parameter相当 还是针对mini-batch的sgd,当我们把lr调大,那么loss就会出现了nan的情况,也就是前面所分析的由于lr太大,导致loss不断上升。 train(batch_size=10,lr=3,epochs=5,period=10) 还是针对mini-batch的sgd,当我们把lr调的非常小,那么此时,已经经过了两个epoch,loss下降还是非常缓慢的,这就是前面分析的lr太小,导致收敛过慢 7. 动量法 momentum 动量法在前面的学习中应该有所接触,但是理解的不深。通过Aston Zhang的讲解,我对于为什么要发明这个方法, 以及这个方法所能带来的好处有了更进一步的认识。 先来看下面的图: 如果我们是从最左边的眼睛看,那么会看到一个变化非常“陡峭”的部分 如果我们是从最下面的眼睛看,那么会看到一个相对“平缓”的部分 那么,结合前面讲过的sgd中lr的选择问题 如果lr选择的过大,就会出现overshot问题,模型loss出现nan,黑色线条部分 如果lr选择的过小,就会出现undershot问题,迭代多步仍不收敛,红色线条部分 那么,我们就需要找到一个处于红色部分和黑色部分的折中方式,使得其前进的方向朝着我们的optim值(红色的点)能够更快,更准的移动。 基于这个问题,就出现了 动量法 知道了问题产生的背景,那么我们接下里定义一些符号化的表示。 注意到,当 的时候,那么就退化成为了前面讲过的梯度下降方法 现在,我们在对上面有关 的公式进行改写: 我们在引入一个叫做EMA(Estimation Moving Average)的东西,可以把上面这个有关 的式子以另外一种更加优美的方式来表示 其实这两种表示在某种意义上是等价的。。。 关于EMA,Aston Zhang通过虚拟货币交易市场中的例子来解释的 就是说,在一个时时刻刻都在发生频繁交易的市场中,我们想尽可能的通过一条光滑的曲线来模拟这种频繁的抖动和变化。。。类似于moving average的思想。 此时,我们通过对式子中的参数赋予具体的值来达到更加具体化的学习。 , 通过这样一步一步的迭代下去。我们可以发现: 随着迭代的进行, 的指数越大,那么前面的系数就越小 的指数越接近20的项,其前面的系数就越大 那么,再来把上面涉及到的数学公式放在一起看: 就相当于对 变成了原来的 的倍数。 通过图来形象的解释就是: 其实,就是说,对于: 出现overshot的问题的时候,momentum方法可以对其进行一个裁剪。使得其在方差过大的走偏情况下,能够尽量削弱这种情况,得到尽可能小的方差 出现undershot的问题的时候,momentum方法可以对其进行一个加速,使得这种趋势能够加强。 总结一下:加入momentum能够加速达到optim的值。 现在用代码实现下: importmxnetasmxfrommxnetimportautogradfrommxnetimportgluonfrommxnetimportndarrayasndimportnumpyasnpimportrandommx.random.seed(1)random.seed(1)#生成数据集。num_inputs=2num_examples=1000true_w=[2,-3.4]true_b=4.2X=nd.random_normal(scale=1,shape=(num_examples,num_inputs))y=true_w[0]*X[:,0]+true_w[1]*X[:,1]+true_by+=.01*nd.random_normal(scale=1,shape=y.shape)dataset=gluon.data.ArrayDataset(X,y)net=gluon.nn.Sequential()net.add(gluon.nn.Dense(1))square_loss=gluon.loss.L2Loss()%matplotlibinlineimportmatplotlibasmplmpl.rcParams['figure.dpi']=120importmatplotlib.pyplotaspltdeftrain(batch_size,lr,mom,epochs,period):assertperiod>=batch_sizeandperiod%batch_size==0net.collect_params().initialize(mx.init.Normal(sigma=1),force_reinit=True)#动量法。trainer=gluon.Trainer(net.collect_params(),'sgd',{'learning_rate':lr,'momentum':mom})data_iter=gluon.data.DataLoader(dataset,batch_size,shuffle=True)total_loss=[np.mean(square_loss(net(X),y).asnumpy())]forepochinrange(1,epochs+1):#重设学习率。ifepoch>2:trainer.set_learning_rate(trainer.learning_rate*0.1)forbatch_i,(data,label)inenumerate(data_iter):withautograd.record():output=net(data)loss=square_loss(output,label)loss.backward()trainer.step(batch_size)ifbatch_i*batch_size%period==0:total_loss.append(np.mean(square_loss(net(X),y).asnumpy()))print("Batchsize%d,Learningrate%f,Epoch%d,loss%.4e"%(batch_size,trainer.learning_rate,epoch,total_loss[-1]))print('w:',np.reshape(net[0].weight.data().asnumpy(),(1,-1)),'b:',net[0].bias.data().asnumpy()[0],'\n')x_axis=np.linspace(0,epochs,len(total_loss),endpoint=True)plt.semilogy(x_axis,total_loss)plt.xlabel('epoch')plt.ylabel('loss')plt.show() 通过momentum的方法,我们先将momentum/ 设置为0.9,此时正常,并且epoch>2后快速收敛了 train(batch_size=10,lr=0.2,mom=0.9,epochs=5,period=10) 再把 设置的更大,0.99,此时梯度应该变为100倍,已经训练飞了 8. Adagrad 在前面讲过的这些优化算法中,基本都是使用同一个learning_rate来更新所有的参数。 举个二元函数的例子 ,假设学习率为 ,那么参数的更新过程就是: 那么,Adagrad要做的,就是对于不同的parameter,使用不同的learning_rate进行更新,并且其在迭代的过程中,能够不断自我调整learning_rate。 Adagrad算法具体是这样操作的: 使用一个梯度按元素平方的累加变量 其中 就是通过mini-batch的计算得到的梯度 然后通过下面的式子对模型中每个参数的学习率通过按照元素重新调整 其中 是初始学习率, 是为了维持数值稳定性而添加的元素,防止分母除以0 然后再通过 对相应的parameter进行了更新 Adagrad算法的核心思想:我们注意到 其实是一个累加项的过程, 如果loss function相对于某一个parameter的偏导数一直都很大,那么就让他下降的快一点。 如果loss function相对于某一个parameter的偏导数一直都比较小,那么就让他下降的慢一点。 关于Adagrad的实现,我们只要将上述数学公式翻译成python代码即可: defadagrad(params,sqrs,lr,batch_size):eps_stable=1e-7forparam,sqrinzip(params,sqrs):g=param.grad/batch_sizesqr[:]+=nd.square(g)div=lr*g/nd.sqrt(sqr+eps_stable)param[:]-=div 整个程序的实现代码和上述相似,这里就不写了,具体可以看看沐神的gluon教程。 9. RMSProp 在前面刚刚讲过的Adagrad中,每个参数都有一个适应自己的learning_rate去更新,但是,当学习率在迭代早起降得比较快且这个时候的解依然比较不理想的时候,那么有可能在就找不到一个更加理想的解了,也就是early stopping到了一个并不是我们认为最optim的点。 所以,RMSProp是对adagrad的一个改进。。。 其实,看到RMSProp的第一个式子,我就相当了Aston将的EMA的例子。看下面的公式 相比adagrad算法,RMSProp增加了一个衰减系数来控制对历史信息的获取多少。 剩下的公式和adagrad是一样的。。。 写成代码: defrmsprop(params,sqrs,lr,gamma,batch_size):eps_stable=1e-8forparam,sqrinzip(params,sqrs):g=param.grad/batch_sizesqr[:]=gamma*sqr+(1.-gamma)*nd.square(g)div=lr*g/nd.sqrt(sqr+eps_stable)param[:]-=div 当我们把这个系数 设置为0.9,得到下面的曲线 再将 设置的大一些,比如0.999,发现后期的曲线就比较平滑了 10. Adam Adam算法其实是前面讲过的momentum方法和RMSProp方法的组合。 它使用了一个动量变量 和一个RMSProp中梯度安装元素平方的指数加权移动平均变量 每次的迭代 在Adam算法里,为了减轻 和 被初始化为0,在迭代初期对于计算指数加权移动平均的影响,进行了如下的修正: 在教程中讲到, ,并且他们都在 之间。当我们随着迭代的进行, 比较大的时候,其对于 和 将不会有太大的影响。 接下来通过: Adam的实现: defadam(params,vs,sqrs,lr,batch_size,t):beta1=0.9beta2=0.999eps_stable=1e-8forparam,v,sqrinzip(params,vs,sqrs):g=param.grad/batch_sizev[:]=beta1*v+(1.-beta1)*gsqr[:]=beta2*sqr+(1.-beta2)*nd.square(g)v_bias_corr=v/(1.-beta1**t)sqr_bias_corr=sqr/(1.-beta2**t)div=lr*v_bias_corr/(nd.sqrt(sqr_bias_corr)+eps_stable)param[:]=param-div 当学习率为0.1的时候,曲线图如下 11. Adadelta 前面,我们已经介绍了有关momentum,RMSProp,Adagrad,Adam算法,这些算法有一个共性就是都带有学习率,这一部分介绍的Adadelta算法是没有learning_rate这个参数的。 其计算过程和RMSProp一样: 首先 然后计算需要更新的parameter的变化量: 这里相比前面的算法出现了 ,初始化为零张量。 且其计算表达式为 的取值一般在0.9~0.999范围内,当然也可以根据情况来调 代码实现: defadadelta(params,sqrs,deltas,rho,batch_size):eps_stable=1e-5forparam,sqr,deltainzip(params,sqrs,deltas):g=param.grad/batch_sizesqr[:]=rho*sqr+(1.-rho)*nd.square(g)cur_delta=nd.sqrt(delta+eps_stable)/nd.sqrt(sqr+eps_stable)*gdelta[:]=rho*delta+(1.-rho)*cur_delta*cur_deltaparam[:]-=cur_delta 当 ,batch_size = 10时候的loss曲线图 可以发现,整个过程中,没有出现有关learning_rate的任何信息,同样做到了很好地优化。。 12. 总结 有关优化的算法,大体上就按照Aston zhang的讲解介绍这么多,希望大家在理解了基本的概念以及每一个优化算法背后的原理后,在使用gluon的时候,就能“自信”的在trainer中设置自己想要的优化算法了。 - END - 欢迎关注GiantPandaCV, 在这里你将看到独家的深度学习分享,坚持原创,每天分享我们学习到的新鲜知识。( • ̀ω•́ )✧ 有对文章相关的问题,或者想要加入交流群,欢迎添加BBuf微信: 二维码 为了方便读者获取资料以及我们公众号的作者发布一些Github工程的更新,我们成立了一个QQ群,二维码如下,感兴趣可以加入。 公众号QQ交流群 - END - 本文分享自微信公众号 - GiantPandaCV(BBuf233)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | 中间件运维之故障自愈

1.背景 1.目前中间件容器节点故障、机器资源不足(磁盘大小、内存大小、cpu)等问题时有发生,接入自动化运维后可快速的处理集群异常问题。 2.以前处理问题需要人工介入,人力成本较大,运维流程缺乏规范。 2.目标 1. 标准化,规范运维流程,制定标准的运维流程。 2. 可视化,运维流程可视化、平台化,做到可追踪,可回溯。 3. 自动化,容器重建,进程启停,部分指标通过根因分析实现故障自愈。 3.故障自愈架构图 故障自愈的监控数据采集模块,周期性将采集到的各实例指标数据上报给处理器,处理器通过调用元数据模块获取匹配规则、故障自愈处理流。匹配异常数据成功并生成运维事件,再经过事件收敛过滤以确保没有大批量相同属性(如同业务、机房等),最后执行对应编排的自愈处理流,运维事件恢复,发送通知,业务恢复正常。 产品架构图: 整体流程图: 4. 方案设计 4.1 故障识别 通过拉取实例监控数据、多指标聚合检测识别出异常,并触发故障自动化流程。 方案一:过滤型检测监控数据 过滤型检测匹配,只跟数据本身有关,时间窗口设定没有要求,数据来一条处理一条。达到设定的异常阈值时触发运维事件。此检测方案过于粗暴,对于一些监控数据存在瞬时突刺现象也会触发误运维,若频繁自愈会影响中间件稳定性。此方案一般用于告警触发,用作运维触发存在一定风险。 方案二:基于窗口时间检测 窗口选择分类: 固定窗口(fixed windows):设置一个固定的时间长度,实时统计窗口时间内的数据。通常情况会根据key做一些Partition划分,这样可以做一些并发处理,加速计算。 滑动窗口(sliding windows):设置一个窗口长度和滑动长度,如果滑动长度小于窗口的长度,那么就出现一部分窗口会互相覆盖,部分数据存在重复计算;如果窗口长度等于执行周期,那么就是固定窗口的模式;如果窗口长度小于执行周期,就是抽样的计算了。 会话窗口(session windows): 针对的是具体的某个事件,比如特定的人看的视频集合等。会话要等待的数据是不确定什么时候到来的,窗口永远是不规整的。 结论:周期性监控数据可以看作相对规律且无穷的数据,故而前两种窗口模式做流式计算比较适合。 窗口时间选择: 基于计算时间的窗口处理问题是非常简单的,只要关注窗口内的数据就可以了,数据完整性也不用操心。但是实际的数据里肯定带有事件时间,这个时间的数据通常在分布式系统中也是无序的,要是系统出现某些点的延迟,那么得到的结果其准确性就大大降低了。基于事件时间对于业务准确性有很明显的好处,但是也有很明显的缺点,因为数据延迟,在分布式系统很难说这段时间内,数据已经完整了。 数据完整性保障: 显然无论窗口给的多大,永远无法保证,符合窗口内事件时间的数据一定能够准时到达,利用watermarks (水位线)可以解决什么时候认为数据结束关闭窗口进行计算的问题。如下图: 设定固定窗口2分钟聚合计算,得到的4个窗口聚合结果分别是6、6、7、12,但在第一个窗口12:02聚合结束后,其实该窗口数据在12:03才算完整完整,故而得到的结果不准确,引入watermark可得到正确的聚合结果11。这里的watermark表示多长时间以前的数据将不再更新,也就是说每次窗口聚合之前会进行watermark的计算,首先判断这次聚合窗口最大事件时间,然后加上所能忍受的延迟时间就是watermark,当一组数据或新接收的数据事件时间大于watermark时,则该数据不会更新,可弹出窗口内的数据进行计算且在内存中不再维护该组数据的状态。 流式计算之固定窗口: 中间件监控数据周期性上报数据量不是很大,分布式系统中对于轻量级流可以考虑利用redis做实时聚合,并实现滚动窗口触发。 如上图所示,设定匹配的窗口大小为2分钟,允许数据最大延迟时间为2分钟,则watermark = 窗口时间的最大值+2,通过往redis缓存实时聚合两个窗口结果即可完成窗口持续滚动,当事件时间大于window1窗口的watermark threshold 时间时,立即弹出window1窗口给process处理器判断是否超过异常阈值,若超过则产生运维事件等待自愈,同时将第二个窗口window2的数据移动至第一个窗口window1中,从而实现持续滚动效果。 总结:滚动窗口占用缓存空间较少,聚合速度快,不足地方可能存在匹配不精准,如果设置窗口时间较大,聚合结果到达配置阈值的数据刚好位于两个窗口相连的数据集中,此时是不会触发运维事件的,其次多指标(一个监控指标对应一个固定窗口)匹配运维事件时,会存在多窗口到达水位线后的弹出时间对不齐的情况,可能存在永远匹配不上的情况。这个时候还需增加窗口之间匹配等待来解决该问题。基于滑动窗口方式可解决以上两个问题。 流式计算之滑动窗口: 多指标滑动窗口; DataEvent为某个实例监控数据,每分钟上报一次或多次,数据包含3个指标项metrics1、metrics2、metrics3,若配置三个指标项周期聚合结果超过设定阀值则触发运维事件,其周期窗口大小分别为6分钟、5分钟、3分钟,滑动窗口时间1分钟,允许最大延迟时间为1分钟,则在12:08分后同时弹出三个窗口数据进行聚合匹配运维事件规则。同时窗口向前移动,不再参与统计的数据则可不在缓存中维护,如上图带虚线的指标项数据。 4.2 事件收敛及自愈控制 事件收敛: 相同事件在短时间内多次发生,自愈事件可能会发生并行执行或在短时间内多次触发。自愈往往会涉及到容器或者服务重启,频繁自愈影响集群稳定性,对此可设置一个静默时间对事件做收敛,静默时间未过不再往自愈服务发送事件。 自愈控制: 1.同一集群下,集群事件与实例事件互斥,即保证在同一时刻只允许集群中的一个节点进行自愈行为。若集群中的实例都在自愈(如垂直扩容),则会导致集群不可用。同集群实例实现串行化自愈可通过MQ发送端利用集群ID做路由到指定队列上,消费端拉取队列按顺序消费完成。如下图所示: 2.当有新节点添加/下线时,会给节点2分钟的容忍时间,防止由于节点刚刚添加到集群/或下线的不稳定性导致错误自愈。 3.针对自愈解决不了的场景设置自愈次数上限,防止循环自愈,并发通知。 4.历史过期事件过滤,每个事件有过期时间,表示这个事件在发生多久后,会认为过期,事件在决策流程时会先判断是否有效,过期的事件不用再处理。 4.3故障原因分析 运维事件触发回调进行故障分析,分析根本原因,识别误运维。拉取运维事件对应的根因分析策略,主要利用动态指标+决策树实现自愈,整个分析自愈模块可视化。指标:主要是监控项的指标,如系统负载、cpu使用率、内存使用率、网络I/O、磁盘使用率、系统日志、gc日志等 e.g决策树模型 e.g节点离线总结结论 4.4 故障自愈 利用根因分析及异常结论总结,在元数据模块进行可视化的事件处理流程编排以及决策动作、执行动作的配置,当检测到运维事件发生后,结合事先编排的事件处理流,并执行相关的流程动作,实现服务自愈效果。 节点异常处理流编排如下: 5. 总结 通过拉取监控数据,检测匹配异常数据触发运维事件,再结合编排的事件处理流自动完成一些比较繁琐的自愈行为,整个执行流程可视化、串行化。以上仅例举节点异常事件编排,还可编排磁盘清理、扩容等运维场景,同时沉淀故障处理经验形成知识库,回溯过往发生的异常监控数据来提前发现问题,并处理潜在故障。 作者简介 Carry OPPO高级后端工程师 目前在OPPO中间件团体负责中间件自动化运维的研发,关注分布式调度、消息队列、Redis等中间件技术。 更多精彩内容,请关注[OPPO数智技术]公众号

优秀的个人博客,低调大师

每日一博 | DeepWalk:图网络与 NLP 的巧妙融合

作者 | kaiyuan 整理 | NewBeeNLP公众号 最近这段时间一直在做图网络相关,也差不多收尾了,有空整体复盘了下,大致以下几个主题,不过没整理完全哈哈(下次一定) 顺手再安利几份资料吧 斯坦福的CS224W课程 清华大学唐杰老师的很多分享 清华大学 thunlp/GNNPapers 一些大佬们的新书:《Graph Representation Learning》、《Deep Learning on Graphs》 等等 ok,回到正题,今天要介绍的这篇是『Graph Embedding』系列第一篇,十分经典 论文:DeepWalk: Online Learning of Social Representations [1] 代码:https://github.com/phanein/deepwalk enjoy~ TL;DR DeepWalk是首次将深度学习技术(无监督学习)引入到网络分析(network analysis)中的工作,它的输入是一个图,最终目标就是获得网络图中每个结点的向量表示 。毕竟万物皆可向量,得到向量之后能做的事情就非常多了。如下所示是论文中给出的Karate network例子。 先验知识 说到生成向量表示,最有名的莫过于Word2Vec了,那么是不是可以将network embedding的问题转化为熟悉的word embedding形式呢?这样我们就可以借用word2vec的思想来解决了。 转化的方式就是Random Walk ,通过这种方式将图结构表示为一个个序列,然后我们就可以把这些序列当成一个个句子,每个序列中的结点就是句子中的单词。 简单的说,DeepWalk = RandomWalk + SikpGram, 下面我们来具体介绍下两种技术。 Random Walk 随机游走,顾名思义,就是从输入图中的任意一个结点 开始,随机选取与其邻接的下一个结点,直至达到给定长度 , 生成的序列 。在论文中,对于每一个顶点 , 都会随机游走出 条序列。 采用随机游走有两个好处: 「利于并行化」:随机游走可以同时从不同的顶点开始采样,加快整个大图的处理速度; 「较强适应性」:可以适应网络局部的变化; Skip Gram word2vec的skip-gram相信大家都非常熟悉了,这里就不再赘述,放一张图。 DeepWalk 结合上面两点, deepwalk其实就是首先利用random walk来表示图结构,然后利用skip-gram模型来更新学习节点表示。算法流程如下所示: 算法有两层循环,第一层循环采样 条路径,第二层循环遍历图中的所有结点随机采样一条路径并利用skip-gram模型进行参数更新。 其中第2步构建二叉树的目的是为了方便后续 SkipGram模型的层次softmax算法。 参数更新的流程如下: 一个小结 deepwalk可以说给网络学习方向打开了一个新思路,有很多优点: 支持数据稀疏场景 支持大规模场景(并行化) 但是仍然存在许多不足: 游走是完全随机的,但其实是不符合真实的社交网络的; 未考虑有向图、带权图 本文参考资料 [1]DeepWalk: Online Learning of Social Representations: https://arxiv.org/abs/1403.6652 -END- Graph-Bert:没有我Attention解决不了的 2020-08-17 ACL2020 | 什么时候值得用BERT上下文嵌入 2020-08-07 ICML2020研究趋势 2020-07-27 记得把NewBeeNLP设为星标哦 等你在看 本文分享自微信公众号 - NewBeeNLP(NewBeeNLP)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | 目前大火的 Jamstack 到底是什么?

目前大火的 Jamstack 到底是什么? 作者:Timothy McCallum、Miley Fu 与 Vivian Hu Jamstack 是一套用于构建现代互联网应用的技术栈。它在边缘云、serverless 计算、以及大前端有广泛的应用,也在今年受到资本市场的追捧。它到底有什么魔力呢?这篇文章将带你了解 Jamstack 的概念以及开发范式。我们也将讨论 Rust 与 WebAssembly 这样的新兴技术如何让 Jamstack 更快,更安全,更易用。 什么是Jamstack? Jamstack 是一种构建网站和 web 应用程序的新方法。Jamstack 的 Stack 指的是许多独立,但是可以组合,的技术层。当它们结合在一起时能够提供一个完整的 web 应用。 Jamstack 架构中的 JAM 是指客户端 JavaScript、可重用的后端 API,和用户界面的 Markup,比如 HTML 与 CSS。 Jamstack 的关键特征是前端 Web UI 与基于 API 的后端服务之间的清晰区分。与垂直集成的传统 Web 应用程序不同的是, Jamstack 应用程序是模块化和分散式的:UI 可以通过静态网页服务器、CDN、甚至基于区块链的存储进行分发;后端 API 服务可以部署在云上,也可以由边缘节点就近提供服务。 为什么 Jamstack 超级赞? 从技术栈比较的角度来看,用于开发 Web 应用程序的另一个常见技术栈是 LAMP (Linux, Apache, MySQL, PHP) 以后其后的 MEAN (MongoDB, Express.JS, Angular, Node.JS)。 LAMP 概览 K7.india at English Wikipedia, CC BY 3.0 https://creativecommons.org/licenses/by/3.0, via Wikimedia Commons 从上面的图表可以看出,从应用开发者的角度,当使用 LAMP 技术栈时,有很多的组件可以安装,并且可以同时配置和维护。LAMP 应用的用户界面是由后端服务器动态生成的。绝大部分逻辑与计算都在服务器上。前端的浏览器只负责渲染。 JAM 概览 与 LAMP 技术栈相比,Jamstack 在许多不同之处 ,这对开发者构建网站或 web 应用的方式有着深远的影响。从部署架构上讲,Jamstack 应用的用户界面是通过“编译”生成的静态网页,从而大大提高了性能,安全性,以及降低了服务端的复杂度与计算负载。 从开发者的角度来看,一些主要的区别包括: Jamstack 开发者不需要安装或管理操作系统(如 Linux) Jamstack 开发者不需要管理安全策略(服务器防火墙) Jamstack 开发者不需要安装或管理应用程序数据库(如 MySQL) Jamstack 开发者可以在不使用 HTTP (Web)服务器(如 Apache)的情况下部署 Web 站点或 Web 应用 总体而言,选择使用 Jamstack 创建网站和 web 应用有4个主要好处: 成本效益、性能改进、更好的安全性和更好的用户/开发者体验。 JAM 组件 让我们先快速看一下构成 JAM 的 3个组件; Javascript、APIs 和 Markup。然后,我们会重点关注动态可编程的 API 组件。 Javascript 毋庸置疑,JavaScript 是网络上最流行的编程语言之一。Javascript 允许 Web 应用开发者在 HTML 页面中轻松地进行请求后端服务产生的动态内容。这些安全的 HTTP 请求(由客户端发出)可用于调用远程 API 端点并将结果返回给客户端(应用)。 API API 是以微服务的形式访问动态数据的一种很好的方式。互联网上有许多公开可用的 API 端点,它们可以返回大量很有用的数据。其中一个例子是太阳系开放数据 API,它可以返回所有行星、卫星、矮星、彗星和小行星等各种数据。 这里有一个例子,说明了我们如何通过 API 获得水星的轴向倾斜。 [https://api.le-systeme-solaire.net/rest/bodies/mercury](https://api.le-systeme-solaire.net/rest/bodies/mercury) 这个 API 服务节点返回相当多的数据,如下所示。 { "id": "mercure", "name": "Mercure", "englishName": "Mercury", "isPlanet": true, "moons": null, "semimajorAxis": 57909227, "perihelion": 46001200, "aphelion": 69816900, "eccentricity": 0.20560, "inclination": 7.00000, "mass": { "massValue": 3.30114, "massExponent": 23 }, "vol": { "volValue": 6.08300, "volExponent": 10 }, "density": 5.42910, "gravity": 3.70000, "escape": 4250.00000, "meanRadius": 2439.40000, "equaRadius": 2440.53000, "polarRadius": 2439.70000, "flattening": 0, "dimension": "", "sideralOrbit": 87.96900, "sideralRotation": 1407.60000, "aroundPlanet": null, "discoveredBy": "", "discoveryDate": "", "alternativeName": "", "axialTilt": 0.0352 } 正如这里能看到的,到目前为我们无需设置任何服务器基础设施就可以访问动态内容。让我们快速查看如何使用 JAM 管理该项任务,即几行 Javascript 来得到数据,以及一些 markup 来将数据作为有效信息展示。 Markup Markup 使我们可以非常容易地创建视觉上令人满意的网页。为了演示这一点,我创建了一个简单的 HTML 页面(源代码在这里),你可以试一下,如下图所示。 NASA/Johns Hopkins University Applied Physics Laboratory/Carnegie Institution of Washington. Edited version of Image:Mercury in color — Prockter07.jpg by Papa Lima Whiskey., Public domain, via Wikimedia Commons 你会注意到,这个 demo 仅使用 GitHub pages托管。当然,你也可以将 HTML 源代码复制到本地的文件夹,并在 PC 本地将它打开。根本不需要运行服务器。使用内容分发网路(CDN)还可以帮助你将客户端的响应时间减到最少。 如果你想生成一个更为花哨的静态站点,有很多软件产品可以帮助你,比如Gatsby 、Hugo、Netlify 、Vercel 等等。 无需服务器,创建和发布你自己的 API 端点 SpaceX, CC0, via Wikimedia Commons 刚刚演示了我们不费吹灰之力地从公开可用的公共端点获取数据。但是…… 如果你可以创建和部署自己的 API 端点,但不想要任何额外的服务器,有没有什么办法 🤔 ? 我们不仅可以访问开放数据(如上所示) ,编写自己定制的逻辑来处理数据、图像和视频。我们还可以与其他人共享我们开发的 API 端点(自定义函数) 。 Serverless 服务 顾名思义,serverless 服务让开发者在不运行自己的服务器的情况下提供 API 服务。开发者只需要上传一段代码就可以提供服务。公有云一般来说提供两种 serverless 服务。 Database-as-a-service (DaaS) 数据库服务为 Jamstack 应用提供基于云数据库的存储与查询服务。它用来管理应用的状态,比如用户数据的存储。 Function-as-a-service (FaaS) 函数服务提供无状态的计算。它通常支持多种编程语言与框架,与数据库或者云存储服务一起为 Jamstack 应用提供逻辑后端。 细心的读者可能已经发现,在公有云上部署 serverless API 服务并不完全适合 Jamstack 的理念。J 与 M 都已经通过边缘云部署了,为什么 A 不行呢?在边缘云上部署 serverless 函数的需要新一代的轻量级软件容器。这是 CNCF 旗下的 WasmEdge 这种 WebAssembly 沙箱的重要应用场景。 Rust 函数计算服务 WasmEdge 可以部署在边缘云与边缘设备上。它符合 OCI 标准,能被 CRI-O 与 Kubernetes 这样的工具调度与管理。WasmEdge 可以让开发者用 Rust 语言写安全高性能的函数服务,也可以支持为场景定制的 DSL 低代码解决方案。 在这篇文章,我们用 Second State 公司基于 WasmEdge 发布的一个免费 FaaS 服务作为示例,来演示怎么用 Rust 语言开发部署 Jamstack 应用的 serverless API 服务。 Second State 提供了跨云的 FaaS 基础设施,可以使用它来创建、部署和调用自己的定制函数。无论你想创建一个全新的 web 应用,迁移你现有的 web 应用,还是仅仅[增强你 web 应用的客户端] (https://medium.com/wasm/an-easy-way-to-boost-your-client-side-javascript-using-webassembly-wasm-de35c53cc2a2),基于 WasmEdge 的 FaaS 都是很好的选择。甚至不需要用户名和密码。所有的调用都是通过开放的 Web 、通过安全的 HTTP 请求执行的。几分钟内就可以部署一个自己的应用。 这里有许多精彩的预建 demo 和教程,使你能够学习如何创建自己的 FaaS 端点。这些预构建函数(demos)包括: 图像分类 (教程、demo) 面部识别 (教程、 demo) 发送邮件 (教程、demo) 给图片打水印 (教程、demo) 在视频中识别食物 (教程、 demo) 解迷字母异位词 你也来试试吧! 这里的要点是,你可以创建自己的代码执行服务,即在不提供任何基础设施的情况下运行自己的自定义代码。Second State 的 FaaS“允许开发者在不管理服务器的情况下在云中上传和执行代码”。 下一步 这篇文章,我们介绍了 Jamstack 的基本概念,以及如何基于 WasmEdge 根据自己的需求快速开发出一个动态的 API。下一篇,我们将介绍如何在目前大火的 Vercel 中使用 WebAssembly Runtime/WasmEdge 在 Jamstack 应用中使用 Rust 函数来编写 API。

优秀的个人博客,低调大师

每日一博 | 统一预估引擎的设计与实现

1. 背景 随着互联网的快速发展,互联网上出现了各种海量的信息。怎么样为用户推荐感兴趣的信息是个很大的挑战?各种各样的推荐算法、系统都涌现出来。而预估引擎可以说是推荐系统中比较重要的一环,预估引擎效果的好坏严重影响了算法效果。结合oppo的业务场景,我们的预估引擎需要解决几个问题: (1)通用性:oppo的推荐业务场景非常多,包括信息流、商店、短视频、联盟、锁屏杂志、音乐等业务,预估引擎要支持这么多的场景,框架一定要通用。 (2)多模型预估:在广告场景中,需要支持ocpx,需要一次请求同时预估ctr和cvr,可能是多个不同的转化模型(例如下载、付费等)。 (3)模型的动态更新:有些模型是小时更新、有些模型是天级更新,需要做到能够无感的动态更新。 (4)扩展性:各个业务用到的特征、字典、模型类型都可能不一样,要做到比较容易扩展。 2. 定位与技术选型 考虑到各个业务的业务特征差异比较大,统一预估引擎如果要支持各个业务的策略实验和分流实验,会让预估引擎模块非常臃肿,没法维护。所以最终决定预估引擎只做预估相关的事情。 从原始数据到得到预估ctr结果,需要经过特征提取,提取特征之后的结果再进行模型预估。考虑到特征提取结果比较大,一次预估需要用的特征结果大约有2M,这么大的数据如果通过网络来传输,耗时太长。所以预估引擎总体的流程包括了两部分:特征提取和模型预估。 3. Predictor的设计与实现 3.1 Predictor模块在整个推荐系统中的位置 以oppo手机应用市场为类来说明predictor模块在整个系统中的位置, ranker模块负责排序,包括各种分流实验和各种运营策略等。它通过grpc框架与predictor模块进行通信。 3.2 Predictor模块的主体流程 图中示意了两个请求的处理流程,图中提特征包括多个特征conf,每个样本、每个特征配置提取一次。预估也会是多个模型,每个样本、每个conf、每个模型会预估多次。特征提取依赖外部字典,预估依赖外部的模型文件,外部字典的更新、双buf切换都是通过字典管理模块来完成的。下面分别就字典管理模块、分task, 提特征,预估,merge进行详细说明。 3.3 字典管理模块 如下图所示:conf1, conf2, lr_model_x0等表示磁盘上的文件,每个文件名都是通过不同的字典解析类来解析,这个字典解析类负责管理这个文件的加载,双buf切换。例如:FeatureConfDict负责解析conf1,它内部保存两个FeatureConfList类型的buf,当conf1文件发生更新时,就用备的FeatureConfList* 进行加载,加载完成后,在加载过程中,服务使用主的FeatureConfList*指针。加载完成后,进行主从切换,待没有请求使用老的buf,就释放到老的buf内存。 3.4 分task逻辑 接收到一个请求,这个请求指定了多conf多模型来预估。如下图所示: 上图表示一共有8条样本,分别用两个conf:conf0, conf1来提取特征,其中conf0的结果由model0,model1来预估,conf1由model2,model3来预估。按照2个样本一个task,拆分完task之后会得到4个task,如下图所示: 按照样本维度进行拆分成4个task,丢到线程池去执行。 3.5 Merge流程 在预估完成之后,需要按照conf/model这个维度进行组织预估结果给ranker, 最终的response如下图右子图所示。 3.6 特征提取框架的设计 特征提取框架线上、线下都会用到,这样比较好保证线上线下的一致性。所以设计的时候要同时考虑到线上线下的业务场景。 线上是将请求带来的数据与字典数据拼成一条条样本,进行特征提取的。而线下是编译so,通过mapreduce来调用,样本是通过反序列化hdfs的一条条文本得到的。 3.6.1 特征配置文件格式 特征配置文件包括两部分: schema部分,特征算子部分。 3.6.2 schema部分 上图中有5个 schema配置 user_schema:表示当前的用户相关信息,只在在线方式使用,由上游请求带过来。 item_schema:表示推荐的item相关信息,只在在线方式使用,一部分由请求带过来,一部分由字典文件中获取。 context_schema:表示推荐的上下文相关信息,只在在线方式使用,由上游戏请求带过来。例如:当前网络状态是wifi还是4G。 all_schema: 表示最终的样本的schema信息。在线模式是将user_schema, item_schema,context_schema的各个字段放在all_schema的对应位置,离线模块是将hdfs的一行行文本,按照all_schema_type指定的类型进行反序列化生成的。不管是在线还是离线,特征框架的样本最终的字段顺序都是按照all_schema顺序存放的 all_schema_type: 离线模式才会用到,指定了各个schema的类型,这些类型名都是事先定义好的,在离线模式下,根据schema类型来反序列化各个字段。 3.6.3 特征算子配置部分 每个特征包括下面这些字段: Name: 特征名字 Class:表示这个特征用的哪个特征算子类,对应代码里类名 Slot: 唯一标识一个特征 Depend: 表示该特征依赖哪些字段, 这个字段在上述all_schema中必须存在 Args: 表示传给特征算子的参数, 框架会转成float传给算子 Str_args: 传给特征算子的参数,以字符串的形式传递。 3.6.4 特征分group(common和uncommon) 一次预估请求里面,所有样本的用户和context信息是一样的, 考虑到有些特征只依赖用户和context信息,这部分特征只需要提取一次,所有样本共用。 特征配置里面一部分特征会依赖其他的特征(例如组合特征、 cvm特征),所以需要对特征的依赖进行分析,用来判断一个特征最终依赖的字段信息。 i_id特征依赖item字段的item_id,所以它是uncommon特征 u_a/net特征只依赖user_schema或者context字段, 不依赖item字段,所以它是common特征 u_a-i_id组合特征依赖i_id特征,间隔依赖item_id,所以它是uncommon特征, u_a-net组合特征只依赖u_a和network字段,所以它是common特征,在特征提取的时候,一次请求只算一次。 注意:这里特征分group是异步字典更新线程来负责计算好的,不是请求来了现算的。 3.7 预估部分 前面提到了,一个请求里面指定了用哪个特征配置文件来提取特征,用哪个模型来预估。所有的模型都是有异步字典更新线程来负责更新。目前支持了LR, FM, DSSM, Deep&Wide等模型的预估,并且比较容易扩展。下面大概介绍下两个根据业务场景做了深度优化的模型: 3.7.1 FM模型预估(LR类似) 其中 考虑到业务场景,多个样本的user/context信息是一样的,那么线上FM的 预估可以写成这个形式: 标红部分所有样本都是一样的,一个请求只用计算一次。 3.7.2 DSSM(双塔)模型 双塔模型的网络结构如下图所示: 实际上一共有三个塔,C(context信息),U(user信息), I(item信息), user与item子塔得到的向量经过点积,再与C进行求和。 3.7.3 在线serving部分 考虑一些场景的item的信息变化比较慢,一般离线将item的子塔先计算好,得到向量,通过字典的方式动态加载。 在线的时候只用计算c塔,u塔, 一个请求只有一条样本需要计算;I塔部分由查字典得到向量。计算量相比全连接,大幅度减少。性能有大幅度的提升,但是由于user信息与item只有一层点积相乘,相比全连接,离线auc会下降1%,所以比较适合召回或者粗排等对准确度要求不高的场景。在信息流广告、联盟广告业务替换原来的统计 ctr粗排,综合指标提升5、6个百分点。 3.8 性能优化 预估引擎模块对时延要求很高,但是为了达到比较好的算法效果,特征规模又在不断的增加,所以在设计预估引擎的时候,做了很多性能优化的考量。主要包括以下几个方面: (1)通过对象池来减少内存分配,提高性能。 (2) 特征字段的依赖都事先转化成下标,在提取特征的时候,就直接使用下标来取对应的字段,减少计算量。 (3)有些特征依赖其他特征结果,会频繁按照slot去查询对应结果,考虑到slot数据有限,采用数组来代替。 4. 总结 目前predictor模块支持了大多数推荐场景,包括信息流内容、信息流广告、应用市场、联盟、搜索、短视频、oppo锁屏杂志、音乐等场景,部署在近2000台机器上,说明这套设计还比较稳定、扩展性比较好。目前支持业务平滑的切换到dnn模型,各个业务场景都取得一定的收益。 作者简介 肖超 高级数据挖掘工程师 10+年的广告系统工程落地经验,在oppo主要负责模型的特征提取、推理的工程落地工作。 更多精彩内容,请扫码关注【OPPO互联网技术】公众号

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册