首页 文章 精选 留言 我的

精选列表

搜索[赛博朋克],共10000篇文章
优秀的个人博客,低调大师

每日一博 | Golang 常见设计模式之单例模式

之前我们已经看过了 Golang 常见设计模式中的装饰和选项模式,今天要看的是 Golang 设计模式里最简单的单例模式。单例模式的作用是确保无论对象被实例化多少次,全局都只有一个实例存在。根据这一特性,我们可以将其应用到全局唯一性配置、数据库连接对象、文件访问对象等。Go 语言实现单例模式的方法有很多种,下面我们就一起来看一下。 饿汉式 饿汉式实现单例模式非常简单,直接看代码: package singleton type singleton struct{} var instance = &singleton{} func GetSingleton() *singleton { return instance } singleton 包在被导入时会自动初始化 instance 实例,使用时通过调用 singleton.GetSingleton() 函数即可获得 singleton 这个结构体的单例对象。 这种方式的单例对象是在包加载时立即被创建,所以这个方式叫作饿汉式。与之对应的另一种实现方式叫作懒汉式,懒汉式模式下实例会在第一次被使用时被创建。 需要注意的是,尽管饿汉式实现单例模式的方式简单,但大多数情况下并不推荐。因为如果单例实例化时初始化内容过多,会造成程序加载用时较长。 懒汉式 接下来我们再来看下如何通过懒汉式实现单例模式: package singleton type singleton struct{} var instance *singleton func GetSingleton() *singleton { if instance == nil { instance = &singleton{} } return instance } 相较于饿汉式的实现,懒汉式将实例化 singleton 结构体部分的代码移到了 GetSingleton() 函数内部。这样能够将对象实例化的步骤延迟到 GetSingleton() 第一次被调用时。 不过通过 instance == nil 的判断来实现单例并不十分可靠,如果有多个 goroutine 同时调用 GetSingleton() 就无法保证并发安全。 支持并发的单例 如果你使用 Go 语言写过并发编程,应该很快能想到该如何解决懒汉式单例模式并发安全问题,比如像下面这样: package singleton import "sync" type singleton struct{} var instance *singleton var mu sync.Mutex func GetSingleton() *singleton { mu.Lock() defer mu.Unlock() if instance == nil { instance = &singleton{} } return instance } 上面代码的修改是通过加锁机制,即在 GetSingleton() 函数最开始加了如下两行代码: mu.Lock() defer mu.Unlock() 加锁的机制可以有效保证这个实现单例模式的函数是并发安全的。 不过使用了锁机制也带来了一些问题,这让每次调用 GetSingleton() 时程序都会进行加锁、解锁的步骤,从而导致程序性能的下降。 双重锁定 加锁会导致程序性能下降,但又不用锁又无法保证程序的并发安全。为了解决这个问题有人提出了双重锁定(Double-Check Locking)的方案: package singleton import "sync" type singleton struct{} var instance *singleton var mu sync.Mutex func GetSingleton() *singleton { if instance == nil { mu.Lock() defer mu.Unlock() if instance == nil { instance = &singleton{} } } return instance } 通过上面的可以看到,所谓双重锁定实际上就是在程序加锁前又加了一层 instance == nil 判断,通过这种方式来兼顾性能和安全两个方面。不过这让代码看起来有些奇怪,外层已经判断了 instance == nil,但是加锁后又进行了第二次 instance == nil 判断。 其实外层的 instance == nil 判断是为了提高程序的执行效率,免去原来每次调用 GetSingleton() 都上锁的操作,将加锁的粒度更加精细化。简单说就是如果 instance 已经存在,则无需进入 if 逻辑,程序直接返回 instance 即可。而内层的 instance == nil 判断则考虑了并发安全,考虑到万一在极端情况下,多个 goroutine 同时走到了加锁这一步,内层判断会在这里起到作用。 Gopher 惯用方案 虽然双重锁定机制兼顾和性能和并发安全,但显然代码有些丑陋,不符合广大 Gopher 的期待。好在 Go 语言在 sync 包中提供了 Once 机制能够帮助我们写出更加优雅的代码: package singleton import "sync" type singleton struct{} var instance *singleton var once sync.Once func GetSingleton() *singleton { once.Do(func() { instance = &singleton{} }) return instance } Once 是一个结构体,在执行 Do 方法的内部通过 atomic 操作和加锁机制来保证并发安全,且 once.Do 能够保证多个 goroutine 同时执行时 &singleton{} 只被创建一次。 其实 Once 并不神秘,其内部实现跟上面使用的双重锁定机制非常类似,只不过把 instance == nil 换成了 atomic 操作,感兴趣的同学可以查看下其对应源码。 总结 以上就是 Go 语言中实现单例模式的几种常用套路,经过对比可以得出结论,最推荐的方式是使用 once.Do 来实现,sync.Once 包帮我们隐藏了部分细节,却可以让代码可读性得到很大提升。 推荐阅读 Golang 常见设计模式之装饰模式 Golang 常见设计模式之选项模式

优秀的个人博客,低调大师

每日一博 | 如何实现一个任务调度系统

阅读一篇「定时任务框架选型」的文章时,一位网友的留言电到了我: 我看过那么多所谓的教程,大部分都是教“如何使用工具”的,没有多少是教“如何制作工具”的,能教“如何仿制工具”的都已经是凤毛麟角,中国 软件行业,缺的是真正可以“制作工具”的程序员,而绝对不缺那些“使用工具”的程序员! ...... ”这个业界最不需要的就是“会使用XX工具的工程师”,而是“有创造力的软件工程师”!业界所有的饭碗,本质就是“有创造力的软件工程师”提供出来的啊! 写这篇文章,想和大家从头到脚说说任务调度,希望大家读完之后,能够理解实现一个任务调度系统的核心逻辑。 1 Quartz Quartz是一款Java开源任务调度框架,也是很多Java工程师接触任务调度的起点。 下图显示了任务调度的整体流程: Quartz的核心是三个组件。 任务:Job 用于表示被调度的任务; 触发器:Trigger 定义调度时间的元素,即按照什么时间规则去执行任务。一个Job可以被多个Trigger关联,但是一个Trigger 只能关联一个Job; 调度器 :工厂类创建Scheduler,根据触发器定义的时间规则调度任务。 上图代码中Quartz 的JobStore是 RAMJobStore,Trigger 和 Job 存储在内存中。 执行任务调度的核心类是 QuartzSchedulerThread 。 调度线程从JobStore中获取需要执行的的触发器列表,并修改触发器的状态; <font color="red">Fire</font>触发器,修改触发器信息(下次执行触发器的时间,以及触发器状态),并存储起来。 最后创建具体的执行任务对象,通过worker线程池执行任务。 接下来再聊聊 Quartz 的集群部署方案。 Quartz的集群部署方案,需要针对不同的数据库类型(MySQL , ORACLE) 在数据库实例上创建Quartz表,JobStore是: JobStoreSupport 。 这种方案是分布式的,没有负责集中管理的节点,而是利用数据库行级锁的方式来实现集群环境下的并发控制。 scheduler实例在集群模式下首先获取{0}LOCKS表中的行锁,Mysql 获取行锁的语句: {0}会替换为配置文件默认配置的QRTZ_。sched_name为应用集群的实例名,lock_name就是行级锁名。Quartz主要有两个行级锁触发器访问锁 (TRIGGER_ACCESS) 和 状态访问锁(STATE_ACCESS)。 这个架构解决了任务的分布式调度问题,同一个任务只能有一个节点运行,其他节点将不执行任务,当碰到大量短任务时,各个节点频繁的竞争数据库锁,节点越多性能就会越差。 2 分布式锁模式 Quartz的集群模式可以水平扩展,也可以分布式调度,但需要业务方在数据库中添加对应的表,有一定的强侵入性。 有不少研发同学为了避免这种侵入性,也探索出分布式锁模式。 业务场景:电商项目,用户下单后一段时间没有付款,系统就会在超时后关闭该订单。 通常我们会做一个定时任务每两分钟来检查前半小时的订单,将没有付款的订单列表查询出来,然后对订单中的商品进行库存的恢复,然后将该订单设置为无效。 我们使用Spring Schedule的方式做一个定时任务。 @Scheduled(cron = "0 */2 * * * ? ") public void doTask() { log.info("定时任务启动"); //执行关闭订单的操作 orderService.closeExpireUnpayOrders(); log.info("定时任务结束"); } 在单服务器运行正常,考虑到高可用,业务量激增,架构会演进成集群模式,在同一时刻有多个服务执行一个定时任务,有可能会导致业务紊乱。 解决方案是在任务执行的时候,使用Redis 分布式锁来解决这类问题。 @Scheduled(cron = "0 */2 * * * ? ") public void doTask() { log.info("定时任务启动"); String lockName = "closeExpireUnpayOrdersLock"; RedisLock redisLock = redisClient.getLock(lockName); //尝试加锁,最多等待3秒,上锁以后5分钟自动解锁 boolean locked = redisLock.tryLock(3, 300, TimeUnit.SECONDS); if(!locked){ log.info("没有获得分布式锁:{}" , lockName); return; } try{ //执行关闭订单的操作 orderService.closeExpireUnpayOrders(); } finally { redisLock.unlock(); } log.info("定时任务结束"); } Redis的读写性能极好,分布式锁也比Quartz数据库行级锁更轻量级。当然Redis锁也可以替换成Zookeeper锁,也是同样的机制。 在小型项目中,使用:定时任务框架(Quartz/Spring Schedule)和 分布式锁(redis/zookeeper)有不错的效果。 但是呢?我们可以发现这种组合有两个问题: 定时任务在分布式场景下有空跑的情况,而且任务也无法做到分片; 要想手工触发任务,必须添加额外的代码才能完成。 3 ElasticJob-Lite 框架 ElasticJob-Lite 定位为轻量级无中心化解决方案,使用 jar 的形式提供分布式任务的协调服务。 应用内部定义任务类,实现SimpleJob接口,编写自己任务的实际业务流程即可。 public class MyElasticJob implements SimpleJob { @Override public void execute(ShardingContext context) { switch (context.getShardingItem()) { case 0: // do something by sharding item 0 break; case 1: // do something by sharding item 1 break; case 2: // do something by sharding item 2 break; // case n: ... } } } 举例:应用A有五个任务需要执行,分别是A,B,C,D,E。任务E需要分成四个子任务,应用部署在两台机器上。 应用A在启动后, 5个任务通过 Zookeeper 协调后被分配到两台机器上,通过Quartz Scheduler 分开执行不同的任务。 ElasticJob 从本质上来讲 ,底层任务调度还是通过 Quartz ,相比Redis分布式锁 或者 Quartz 分布式部署 ,它的优势在于可以依赖 Zookeeper 这个大杀器 ,将任务通过负载均衡算法分配给应用内的 Quartz Scheduler容器。 从使用者的角度来讲,是非常简单易用的。但从架构来看,调度器和执行器依然在同一个应用方JVM内,而且容器在启动后,依然需要做负载均衡。应用假如频繁的重启,不断的去选主,对分片做负载均衡,这些都是相对比较重的操作。 另外,ElasticJob 的控制台是比较粗糙的,通过读取注册中心数据展现作业状态,更新注册中心数据修改全局任务配置。 4 中心化流派 中心化的原理是:把调度和任务执行,隔离成两个部分:调度中心和执行器。调度中心模块只需要负责任务调度属性,触发调度命令。执行器接收调度命令,去执行具体的业务逻辑,而且两者都可以进行分布式扩容。 4.1 MQ模式 先谈谈我在艺龙促销团队接触的第一种中心化架构。 调度中心依赖Quartz集群模式,当任务调度时候,发送消息到RabbitMQ 。业务应用收到任务消息后,消费任务信息。 这种模型充分利用了MQ解耦的特性,调度中心发送任务,应用方作为执行器的角色,接收任务并执行。 但这种设计强依赖消息队列,可扩展性和功能,系统负载都和消息队列有极大的关联。这种架构设计需要架构师对消息队列非常熟悉。 4.2 XXL-JOB XXL-JOB 是一个分布式任务调度平台,其核心设计目标是开发迅速、学习简单、轻量级、易扩展。现已开放源代码并接入多家公司线上产品线,开箱即用。 我们重点剖析下架构图 : ▍ 网络通讯 server-worker 模型 调度中心和执行器 两个模块之间通讯是 server-worker 模式。调度中心本身就是一个SpringBoot 工程,启动会监听8080端口。 执行器启动后,会启动内置服务( EmbedServer )监听9994端口。这样双方都可以给对方发送命令。 那调度中心如何知道执行器的地址信息呢 ?上图中,执行器会定时发送注册命令 ,这样调度中心就可以获取在线的执行器列表。 通过执行器列表,就可以根据任务配置的路由策略选择节点执行任务。常见的路由策略有如下三种: 随机节点执行:选择集群中一个可用的执行节点执行调度任务。适用场景:离线订单结算。 广播执行:在集群中所有的执行节点分发调度任务并执行。适用场景:批量更新应用本地缓存。 分片执行:按照用户自定义分片逻辑进行拆分,分发到集群中不同节点并行执行,提升资源利用效率。适用场景:海量日志统计。 ▍ 调度器 调度器是任务调度系统里面非常核心的组件。XXL-JOB 的早期版本是依赖Quartz。 但在v2.1.0版本中完全去掉了Quartz的依赖,原来需要创建的 Quartz表也替换成了自研的表。 核心的调度类是:JobTriggerPoolHelper 。调用start方法后,会启动两个线程:scheduleThread 和 ringThread 。 首先 scheduleThread 会定时从数据库加载需要调度的任务,这里从本质上还是基于数据库行锁保证同时只有一个调度中心节点触发任务调度。 Connection conn = XxlJobAdminConfig.getAdminConfig() .getDataSource().getConnection(); connAutoCommit = conn.getAutoCommit(); conn.setAutoCommit(false); preparedStatement = conn.prepareStatement( "select * from xxl_job_lock where lock_name = 'schedule_lock' for update"); preparedStatement.execute(); # 触发任务调度 (伪代码) for (XxlJobInfo jobInfo: scheduleList) { // 省略代码 } # 事务提交 conn.commit(); 调度线程会根据任务的「下次触发时间」,采取不同的动作: 已过期的任务需要立刻执行的,直接放入线程池中触发执行 ,五秒内需要执行的任务放到 ringData 对象里。 ringThread 启动后,定时从 ringData 对象里获取需要执行的任务列表 ,放入到线程池中触发执行。 5 自研在巨人的肩膀上 2018年,我有一段自研任务调度系统的经历。 背景是:兼容技术团队自研的RPC框架,技术团队不需要修改代码,RPC注解方法可以托管在任务调度系统中,直接当做一个任务来执行。 自研过程中,研读了XXL-JOB 源码,同时从阿里云分布式任务调度 SchedulerX 吸取了很多营养。 Scheduler-console 是任务调度的控制台,用于创建、管理定时任务。负责数据的创建、修改和查询。在产品内部与 scheduler server 交互。 Scheduler-server 是任务调度的服务端,是 Scheduler的核心组件。负责客户端任务的调度触发以及任务执行状态的监测。 Scheduler-client 是任务调度的客户端。每个接入客户端的应用进程就是一个的 Worker。 Worker 负责与 scheduler-server 建立通信,让 scheduler-server发现客户端的机器。 并向scheduler-server注册当前应用所在的分组,这样 scheduler-server 才能向客户端定时触发任务。 我们模仿了SchedulerX的模块,架构设计如下图: 我选择了 RocketMQ 源码的通讯模块 remoting 作为自研调度系统的通讯框架。基于如下两点: 我对业界大名鼎鼎的 Dubbo不熟悉,而remoting我已经做了多个轮子,我相信自己可以搞定; 在阅读 SchedulerX 1.0 client 源码中,发现 SchedulerX 的通讯框架和RocketMQ Remoting很多地方都很类似。它的源码里有现成的工程实现,完全就是一个宝藏。 我将 RocketMQ remoting 模块去掉名字服务代码,做了一定程度的定制。 在RocketMQ的remoting里,服务端采用 Processor 模式。 调度中心需要注册两个处理器:回调结果处理器CallBackProcessor和心跳处理器HeartBeatProcessor 。执行器需要注册触发任务处理器TriggerTaskProcessor 。 public void registerProcessor( int requestCode, NettyRequestProcessor processor, ExecutorService executor); 处理器的接口: public interface NettyRequestProcessor { RemotingCommand processRequest( ChannelHandlerContext ctx, RemotingCommand request) throws Exception; boolean rejectRequest(); } 对于通讯框架来讲,我并不需要关注通讯细节,只需要实现处理器接口即可。 以触发任务处理器TriggerTaskProcessor举例: 搞定网络通讯后,调度器如何设计 ?最终我还是选择了Quartz 集群模式。主要是基于以下几点原因: 调度量不大的情况下 ,Quartz 集群模式足够稳定,而且可以兼容原来的XXL-JOB任务; 使用时间轮的话,本身没有足够的实践经验,担心出问题。 另外,如何让任务通过不同的调度服务(schedule-server)触发, 需要有一个协调器。于是想到Zookeeper。但这样的话,又引入了新的组件。 研发周期不能太长,想快点出成果。 自研版的调度服务花费一个半月上线了。系统运行非常稳定,研发团队接入也很顺畅。 调度量也不大 ,四个月总共接近4000万到5000万之间的调度量。 坦率的讲,自研版的瓶颈,我的脑海里经常能看到。 数据量大,我可以搞定分库分表,但 Quartz 集群基于行级锁的模式 ,注定上限不会太高。 为了解除心中的困惑,我写一个轮子DEMO看看可否work: 去掉外置的注册中心,调度服务(schedule-server)管理会话; 引入zookeeper,通过zk协调调度服务。但是HA机制很粗糙,相当于一个任务调度服务运行,另一个服务standby; Quartz 替换成时间轮 (参考Dubbo里的时间轮源码)。 这个Demo版本在开发环境可以运行,但有很多细节需要优化,仅仅是个玩具,并没有机会运行到生产环境。 最近读阿里云的一篇文章《如何通过任务调度实现百万规则报警》,SchedulerX2.0 高可用架构见下图: 文章提到: 每个应用都会做三备份,通过 zk 抢锁,一主两备,如果某台 Server 挂了,会进行 failover,由其他 Server 接管调度任务。 这次自研任务调度系统从架构来讲,并不复杂,实现了XXL-JOB的核心功能,也兼容了技术团队的RPC框架,但并没有实现工作流以及mapreduce分片。 SchedulerX 在升级到2.0之后基于全新的Akka 架构,这种架构号称实现高性能工作流引擎,实现进程间通信,减少网络通讯代码。 在我调研的开源任务调度系统中,PowerJob也是基于Akka 架构,同时也实现了工作流和MapReduce执行模式。 我对PowerJob非常感兴趣,也会在学习实践后输出相关文章,敬请期待。 6 技术选型 首先我们将任务调度开源产品和商业产品 SchedulerX 放在一起,生成一张对照表: Quartz 和 ElasticJob从本质上还是属于框架的层面。 中心化产品从架构上来讲更加清晰,调度层面更灵活,可以支持更复杂的调度(mapreduce动态分片,工作流)。 XXL-JOB 从产品层面已经做到极简,开箱即用,调度模式可以满足大部分研发团队的需求。简单易用 + 能打,所以非常受大家欢迎。 其实每个技术团队的技术储备不尽相同,面对的场景也不一样,所以技术选型并不能一概而论。 不管是使用哪种技术,在编写任务业务代码时,还是需要注意两点: 幂等。当任务被重复执行的时候,或者分布式锁失效的时候,程序依然可以输出正确的结果; 任务不跑了,千万别惊慌。查看调度日志,JVM层面使用Jstack命令查看堆栈,网络通讯要添加超时时间 ,一般能解决大部分问题。 7 写到最后 2015年其实是非常有趣的一年。ElasticJob 和 XXL-JOB 这两种不同流派的任务调度项目都开源了。 在 XXL-JOB 源码里,至今还保留着许雪里老师在开源中国的一条动态截图: 刚写的任务调度框架 ,Web动态管理任务,实时生效,热乎的。没有意外的话,明天中午推送到git.osc上去。哈哈,下楼炒个面加个荷包蛋庆祝下。 看到这个截图,内心深处竟然会有一种共情,嘴角不自禁的上扬。 我又想起:2016年,ElasticJob的作者张亮老师开源了sharding-jdbc 。我在github上创建了一个私有项目,参考sharding-jdbc的源码,自己实现分库分表的功能。第一个类名叫:ShardingDataSource,时间定格在 2016/3/29。 我不知道如何定义“有创造力的软件工程师”,但我相信:一个有好奇心,努力学习,乐于分享,愿意去帮助别人的工程师,运气肯定不会太差。 觉得对您有帮助的话,请给作者一个「点赞」和「收藏」,我们下期见。

优秀的个人博客,低调大师

每日一博 | 数据库异常智能分析与诊断

DAS(Database Autonomy Service, 数据库自治服务)面向研发和DBA,是一款为用户提供数据库性能分析、故障诊断、安全管理等功能的数据库自治服务。DAS利用大数据手段、机器学习、专家经验,帮助用户消除数据库管理的复杂性及人工操作引发的服务故障,有效保障数据库服务的稳定和高效运行。本文主要讲述DAS的历史背景、演进策略、重要功能及实现思路,希望能对从事相关开发的同学有所帮助或者启发。 1 现状与问题 1.1 规模增长与运维能力发展之间的不平衡问题凸显 伴随着最近几年美团业务的快速发展,数据库的规模也保持着高速增长。而作为整个业务系统的“神经末梢”,数据库一旦出现问题,对业务造成的损失就会非常大。同时,因数据库规模的快速增长,出现问题的数量也大大增加,完全依靠人力的被动分析与定位已经不堪重负。下图是当时数据库实例近年来的增长趋势: 1.2 理想很丰满,现实很骨感 美团数据库团队当前面临的主要矛盾是:实例规模增长与运维能力发展之间的不平衡,而主要矛盾体现在数据库稳定性要求较高与关键数据缺失。由于产品能力不足,只能依赖专业DBA手动排查问题,异常处理时间较长。因此,我们决定补齐关键信息,提供自助或自动定位问题的能力,缩短处理时长。 我们复盘了过去一段时间内的故障和告警,深入分析了这些问题的根因,发现任何一个异常其实都可以按时间拆分为异常预防、异常处理和异常复盘三阶段。针对这三阶段,结合MTTR的定义,然后调研了美团内部及业界的解决方案,我们做了一张涵盖数据库异常处理方案的全景图。如下图所示: 通过对比,我们发现: 每个环节我们都有相关的工具支撑,但能力又不够强,相比头部云厂商大概20%~30%左右的能力,短板比较明显。 自助化和自动化能力也不足,工具虽多,但整个链条没有打通,未形成合力。 那如何解决这一问题呢?团队成员经过深入分析和讨论后,我们提出了一种比较符合当前发展阶段的解决思路。 2 解决的思路 2.1 既解决短期矛盾,也立足长远发展 从对历史故障的复盘来看,80%故障中80%的时间都花在分析和定位上。解决异常分析和定位效率短期的ROI(投资回报率)最高。长期来看,只有完善能力版图,才能持续不断地提升整个数据库的稳定性及保障能力。因此,我们当时的一个想法就是既要解决短期矛盾,又要立足长远发展(Think Big Picture, Think Long Term)。新的方案要为未来留足足够的发展空间,不能只是“头痛医头、脚痛医脚”。 在宏观层面,我们希望能将更多的功能做到自动定位,基于自动定位来自助或自动地处理变更,从而提高异常恢复的效率,最终提升用户体验。将异常处理效率提高和用户体验提升后,运维人员(主要是DBA)的沟通成本将会极大被降低,这样运维人员就有更多时间进行技术投入,能将更多“人肉处理”的异常变成自助或自动处理,从而形成“飞轮效应”。最终达成高效的稳定性保障的目标。 在微观层面,我们基于已有的数据,通过结构化的信息输出,提升可观测性,补齐关键数据缺失的短板。同时,我们基于完善的信息输出,通过规则(专家经验)和AI的配合,提供自助或自动定位的能力,缩短处理时长。 2.2 夯实基础能力,赋能上层业务,实现数据库自治 有了明确的指导思想,我们该采取怎样的发展策略和路径呢?就当时团队的人力情况来看,没有同学有过类似异常自治的开发经验,甚至对数据库的异常分析的能力都还不具备,人才结构不能满足产品的终极目标。所谓“天下大事必作于细,天下难事必作于易”。我们思路是从小功能和容易的地方入手,先完指标监控、慢查询、活跃会话这些简单的功能,再逐步深入到全量SQL、异常根因分析和慢查询优化建议等这些复杂的功能,通过这些基础工作来“借假修真”,不断提升团队攻坚克难的能力,同时也可以为智能化打下一个良好的基础。 以下便是我们根据当时人才结构以及未来目标设定的2年路径规划(实现数据自治目标规划在2022以后的启动,下图会省略掉这部分): 2.3 建立科学的评估体系,持续的跟踪产品质量 美国著名管理学者卡普兰说过:“没有度量就没有管理”。只有建立科学的评估体系,才能推进产品不断迈向更高峰,怎样评估产品的质量并持续改善呢?之前我们也做过很多指标,但都不可控,没有办法指导我们的工作。比如,我们最开始考虑根因定位使用的是结果指标准确率和召回率,但结果指标不可控难以指导我们的日常工作。这就需要找其中的可控因素,并不断改善。 我们在学习亚马逊的时候,刚好发现他们有一个可控输入和输出指标的方法论,就很好地指导了我们的工作。只要在正确的可控输入指标上不断优化和提升,最终我们的输出指标也能够得到提升(这也印证了曾国藩曾说过的一句话:“在因上致力,但在果上随缘”)。 以下是我们关于根因定位的指标设计和技术实现思路(在模拟环境不断提升可控的部分,最终线上的实际效果也会得到提升。主要包括“根因定位可控输入和输出指标设计思路”和“根因定位可控输入指标获取的技术实现思路”)。 根因定位可控输入和输出指标设计思路 根因定位可控输入指标获取的技术实现思路 在图5中,我们通过场景复现方式,用技术手段来模拟一些用低成本就能实现的异常(绝大部份异常)。在对于复现成本比较高的异常(极少部分),比如机器异常、硬件故障等,我们目前的思路是通过“人肉运营”的方式,发现和优化问题,等到下次线上异常重复发生后,根据优化后诊断的结果,通过和预期比较来确定验收是否通过。 未来我们会建立回溯系统,将发生问题时刻的异常指标保存,通过异常指标输入給回溯系统后的输出结果,判断系统改进的有效性,从而构建更加轻量和更广覆盖的复现方式。图6是复现系统的具体技术实现思路。 有了指导思想,符合当前发展阶段的路径规划以及科学的评估体系后,接下来聊聊技术方案的构思。 3 技术方案 3.1 技术架构的顶层设计 在技术架构顶层设计上,我们秉承平台化、自助化、智能化和自动化四步走的演进策略。 首先,我们要完善可观测的能力,通过关键信息的展示,构建一个易用的数据库监控平台。然后我们根据这些关键信息为变更(比如数据变更和索引变更等)提供赋能,将一部分高频运维工作通过这些结构化的关键信息(比如索引变更,可以监测近期是否有访问流量,来确保变更安全性)让用户自主决策,也就是自助化。接下来,我们加入一些智能的元素(专家经验+AI),进一步覆盖自助化的场景,并逐步将部分低风险的功能自动化,最终通过系统的不断完善,走到高级或完全自动化的阶段。 为什么我们将自动化放在智能化之后?因为我们认为智能化的目标也是为了自动化,智能化是自动化的前提,自动化是智能化的结果。只有不断提升智能化,才能达到高级或者完全自动化。下图便是我们的顶层架构设计(左侧是演进策略,右侧是技术架构的顶层设计以及2021年底的现状): 顶层设计只是“万里长征第一步”,接下来我们将自底向上逐步介绍我们基于顶层设计开展的具体工作,将从数据采集层的设计、计算存储层的设计和分析决策层的设计逐步展开。 3.2 数据采集层的设计 这上面的架构图里,数据采集层是所有链路的最底层和最重要的环节,采集数据的质量直接决定了整个系统的能力。同时,它和数据库实例直接打交道,任何设计上的缺陷都将可能导致大规模的故障。所以,技术方案上必须兼顾数据采集质量和实例稳定性,在二者无法平衡的情况下,宁可牺牲掉采集质量也要保证数据库的稳定性。 在数据采集上,业界都采取基于内核的方式,但美团自研内核较晚,而且部署周期长,所以我们短期的方式是采用抓包的方式做一个过渡,等基于内核的采集部署到一定规模后再逐步切换过来。以下是我们基于抓包思路的技术方案调研: 方案 性能 通用性 备注 pcap 低 高 美团酒旅团队已线上实践 pf_ring 中 中 需要改造MySQL dpdk 高 低 需要重新编译网卡驱动 从调研上我们可以看到,基于pf_ring和dpdk的方案都有较大的依赖性,短期难以实现,之前也没有经验。但是,基于pcap的方式没有依赖,我们也有过一定的经验,之前美团酒旅团队基于抓包的方式做过全量SQL数据采集的工具,并经过了1年时间的验证。因此,我们最终采取了基于pcap抓包方式的技术方案。以下是采集层方案的架构图和采集质量以及对数据库性能带来的影响情况。 Agent的技术设计 对数据库的影响 3.3 计算存储层的设计 由于美团整个数据库实例数量和流量巨大,而且随着业务的快速发展,还呈现出快速增长的态势。所以,我们的设计不仅要满足当前,还要考虑未来5年及更长的时间也能够满足要求。同时,对数据库故障分析来说,数据的实时性和完备性是快速和高效定位问题的关键,而保证数据实时性和完备性需要的容量成本也不容忽视。因此,结合上述要求和其他方面的一些考虑,我们对该部分设计提出了一些原则,主要包括: 全内存计算:确保所有的计算都在单线程内或单进程内做纯内存的操作,追求性能跟吞吐量的极致。 上报原始数据:MySQL实例上报的数据尽量维持原始数据状态,不做或者尽量少做数据加工。 数据压缩:由于上报量巨大,需要保障上报的数据进行极致的压缩。 内存消耗可控:通过理论和实际压测保障几乎不可能会发生内存溢出。 最小化对MySQL实例的影响:计算尽量后置,不在Agent上做复杂计算,确保不对RDS实例生产较大影响。以下是具体的架构图: 全量SQL(所有访问数据库的SQL)是整个系统最具挑战的功能,也是数据库异常分析最重要的信息之一,因此会就全量SQL的聚合方式、聚合和压缩的效果和补偿设计做一些重点的介绍。 3.3.1 全量SQL的聚合方式 由于明细数据巨大,我们采取了聚合的方式。消费线程会对相同模板SQL的消息按分钟粒度进行聚合计算,以“RDSIP+DBName+SQL模版ID+SQL查询结束时间所在分钟数”为聚合键。聚合健的计算公式为:Aggkey=RDS_IP_DBName_SQL_Template_ID_Time_Minute (Time_Minute的值取自SQL查询结束时间所在的“年、月、日、时、分钟”) 3.3.2 全量SQL数据聚合和压缩的效果 在数据压缩方面,遵循层层减流原则,使用消息压缩、预聚合、字典化、分钟级聚合的手段,保证流量在经过每个组件时进行递减,最终达到节省带宽减少存储量的目的。以下是相关的压缩环节和测试数据表现情况(敏感数据做了脱敏,不代表美团实际的情况): 3.3.3 全量SQL数据补偿机制 如上所述,在数据聚合端是按一分钟进行聚合,并允许额外一分钟的消息延迟,如果消息延迟超过1分钟会被直接丢弃掉,这样在业务高峰期延迟比较严重的场景下,会丢失比较大量的数据,从而对后续数据库异常分析的准确性造成较大的影响。 因此,我们增加了延迟消息补偿机制,对过期的数据发入补偿队列(采用的是美团消息队列服务Mafka),通过过期数据补偿的方式,保证延迟久的消息也能正常存储,通过最终一致性保证了后续的数据库异常分析的准确性。以下是数据补偿机制的设计方案: 3.4 分析决策层的设计 在有了比较全的数据之后,接下来就是基于数据进行决策,推断出可能的根因。这部分我们使用了基于专家经验结合AI的方式。我们把演进路径化分为了四个阶段: 第一阶段:完全以规则为主,积累领域经验,探索可行的路径。 第二阶段:探索AI场景,但以专家经验为主,在少量低频场景上使用AI算法,验证AI能力。 第三阶段:在专家经验和AI上齐头并进,专家经验继续在已有的场景上迭代和延伸,AI在新的场景上进行落地,通过双轨制保证原有能力不退化。 第四阶段:完成AI对大部分专家经验的替换,以AI为主专家经验为辅,极致发挥AI能力。 以下是分析决策部分整体的技术设计(我们参考了华为一篇文章:《网络云根因智荐的探索与实践》): 在决策分析层,我们主要采取了专家经验和AI两者方式,接下来会介绍专家经验(基于规则的方式)和AI方式(基于AI算法的方式)的相关实现。 3.4.1 基于规则的方式 专家经验部分,我们采取了GRAI(Goal、Result、Analysis和Insight的简称)的复盘方法论来指导工作,通过持续、大量、高频的复盘,我们提炼了一些靠谱的规则,并通过持续的迭代,不断提升准确率和召回率。下面例举的是主从延迟的规则提炼过程: 3.4.2 基于AI算法的方式 异常数据库指标检测 数据库核心指标的异常检测依赖于对指标历史数据的合理建模,通过将离线过程的定期建模与实时过程的流检测相结合,将有助于在数据库实例存在故障或风险的情况下,有效地定位根本问题所在,从而实现及时有效地解决问题。 建模过程主要分为3个流程。首先,我们通过一些前置的模块对指标的历史数据进行预处理,包含缺失数值填充,数据的平滑与聚合等过程。随后,我们通过分类模块创建了后续的不同分支,针对不同类型的指标运用不同的手段来建模。最终,将模型进行序列化存储后提供Flink任务读取实现流检测。 以下是检测的设计图 根因诊断(构建中) 订阅告警消息(基于规则或者异常检测触发),触发诊断流程,采集、分析数据,推断出根因并筛选出有效信息辅助用户解决。诊断结果通过大象通知用户,并提供诊断诊断详情页面,用户可通过标注来优化诊断准确性。 数据采集:采集数据库性能指标、数据库状态抓取、系统指标、硬件问题、日志、记录等数据。 特征提取:从各类数据中提取特征,包括算法提取的时序特征、文本特征以及利用数据库知识提取的领域特征等。 根因分类:包括特征预处理、特征筛选、算法分类、根因排序等部分。 根因扩展:基于根因类别进行相关信息的深入挖掘,提高用户处理问题的效率。具体包括SQL行为分析、专家规则、指标关联、维度下钻、日志分析等功能模块。 4 建设成果 4.1 指标表现 我们目前主要是通过“梳理触发告警场景->模拟复现场景->根因分析和诊断->改进计划->验收改进质量->梳理触发告警场景”的闭环方法(详情请参考前文建立科学的评估体系,持续的跟踪产品质量部分),持续不断的进行优化和迭代。通过可控输入指标的提升,来优化改善线上的输出指标,从而保证系统不断的朝着正确的方向发展。以下是近期根因召回率和准确率指标表现情况。 用户告警根因反馈准确率 告警诊断分析总体召回率 4.2 用户案例 在根因结果推送上,我们和美团内部的IM系统(大象)进行了打通,出现问题后通过告警发现异常->大象推送诊断根因->点击诊断链接详情查看详细信息->一键预案处理->跟踪反馈处理的效果->执行成功或者回滚,来完成异常的发现、定位、确认和处理的闭环。以下是活跃会话规则触发告警后根因分析的一个案例。 自动拉群,并给出根因 点击诊断报告,查看详情 以下是出现Load告警后,我们的一个慢查询优化建议推送案例(脱敏原因,采用了测试环境模拟的案例)。 5 总结与未来展望 数据库自治服务经过2年左右的发展,已基本夯实了基础能力,在部分业务场景上完成了初步赋能(比如针对问题SQL,业务服务上线发布前自动识别,提示潜在风险;针对索引误变更,工单执行前自动检测索引近期访问流量,阻断误变更等)。接下来,我们的目标除了在已完成工作上继续深耕,提升能力外,重点会瞄准数据库自治能力。主要的工作规划将围绕以下3个方向: (1)计算存储能力增强:随着数据库实例和业务流量的持续高速增长,以及采集的信息的不断丰富,亟需对现有数据通道能力进行增强,确保能支撑未来3-5年的处理能力。 (2)自治能力在少部分场景上落地:数据库自治能力上,会采取三步走的策略: 第一步:建立根因诊断和SOP文档的关联,将诊断和处理透明化; 第二步:SOP文档平台化,将诊断和处理流程化; 第三步:部分低风险无人干预,将诊断和处理自动化,逐步实现数据库自治。 (3)更灵活的异常回溯系统:某个场景根因定位算法在上线前或者改进后的验证非常关键,我们会完善验证体系,建立灵活的异常回溯系统,通过基于现场信息的回放来不断优化和提升系统定位准确率。 6 作者及团队 金龙,来自美团基础技术部/数据库研发中心/数据库平台研发组。 美团基础技术部-数据库技术中心诚招高级、资深技术专家,Base上海、北京。美团关系数据库规模大,每年快速的增长,每天承载数千亿的访问流量。在这里可以体验高并发,高可用,高可扩展性的业务挑战,可以紧跟并开拓业界前沿技术,体会到技术进步带来的生产力提升。欢迎有兴趣的同学投送简历至:edp.itu.zhaopin@meituan.com。 阅读美团技术团队更多技术文章合集 前端 | 算法 | 后端 | 数据 | 安全 | 运维 | iOS | Android | 测试 | 在公众号菜单栏对话框回复【2021年货】、【2020年货】、【2019年货】、【2018年货】、【2017年货】等关键词,可查看美团技术团队历年技术文章合集。 | 本文系美团技术团队出品,著作权归属美团。欢迎出于分享和交流等非商业目的转载或使用本文内容,敬请注明“内容转载自美团技术团队”。本文未经许可,不得进行商业性转载或者使用。任何商用行为,请发送邮件至tech@meituan.com申请授权。

优秀的个人博客,低调大师

每日一博 | 一文详解 Java 日志框架 JUL

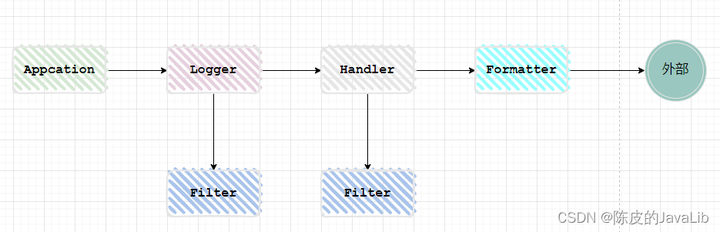
摘要:JUL(Java util logging),Java原生日志框架,不需要引入第三方依赖包,使用简单方便。 本文分享自华为云社区《Java 日志框架 JUL 详解大全》,作者: 陈皮的JavaLib 。 JUL 简介 JUL(Java util logging),Java 原生日志框架,不需要引入第三方依赖包,使用简单方便,一般在小型应用中使用,主流项目中现在很少使用了。 JUL 架构 Application:Java 应用程序。 Logger:记录器,Java 应用程序通过调用记录器的方法来发布日志记录。 Handler:处理器,每一个 Logger 都可以关联一个或多个 Handler,Handler 从 Logger 获取日志并将日志输出到某个目的地,目的地可以是控制台,本地文件,或网络日志服务,或将它们转发到操作系统日志等等。通过Handler.setLevel(level.off)方法可以禁用一个 Handler,也可以设置其他级别来开启此 Handler。 Filter:过滤器,根据条件过滤哪些日志记录。每一个 Logger 和 Handler 都可以关联一个 Filter。 Formatter :格式化器,负责对日志事件中的日志记录进行转换和格式化。 Level:每一条日志记录都有一个关联的日志级别,表示此条日志的重要性和紧急程度。也可以对 Logger 和 Handler 设置关联的日志级别。 入门示例 package com.chenpi; import java.util.logging.Level; import java.util.logging.Logger; import org.junit.Test; /** * @author 陈皮 * @version 1.0 * @description * @date 2022/3/2 */ public class ChenPiJULMain { // JUL 日志框架演示 @Test public void testLog() { // 获取日志记录器对象 Logger logger = Logger.getLogger("com.chenpi.ChenPiJULMain"); // 日志记录输出 logger.severe(">>>>> Hello ChenPi!!"); logger.warning(">>>>> Hello ChenPi!!"); logger.info(">>>>> Hello ChenPi!!"); // 默认日志级别 logger.config(">>>>> Hello ChenPi!!"); logger.fine(">>>>> Hello ChenPi!!"); logger.finer(">>>>> Hello ChenPi!!"); logger.finest(">>>>> Hello ChenPi!!"); // 输出指定日志级别的日志记录 logger.log(Level.WARNING, ">>>>> Hello Warning ChenPi!!"); // 占位符形式 String name = "ChenPi"; int age = 18; logger.log(Level.INFO, ">>>>> Hello {0},{1} years old!", new Object[]{name, age}); // 异常堆栈信息 logger.log(Level.SEVERE, ">>>>> Hello NPE!", new NullPointerException()); } } JUL 默认将日志信息输出到控制台,默认日志级别是 info。控制台输出结果如下: Logger 父子继承关系 在 JUL 中,Logger 有父子继承关系概念,会根据 Logger 对象的名称的包含关系,划分父子继承关系。对于某个 Logger 对象,如果找不到显性创建的父 Logger 对象,那么它的父 Logger 是根 Logger,即 RootLogger。 子代 Logger 对象会继承父 Logger 的配置,例如日志级别,关联的 Handler,日志格式等等。对于任何 Logger 对象,如果没对其做特殊配置,那么它最终都会继承 RootLogger 的配置。 package com.chenpi; import java.util.logging.Logger; import org.junit.Test; /** * @author 陈皮 * @version 1.0 * @description * @date 2022/3/2 */ public class ChenPiJULMain { @Test public void testLog() { // logger1的父Logger是RootLogger Logger logger1 = Logger.getLogger("com.chenpi.a"); // logger2的父Logger是logger1 Logger logger2 = Logger.getLogger("com.chenpi.a.b.c"); Logger logger1Parent = logger1.getParent(); System.out.println("logger1Parent:" + logger1Parent + ",name:" + logger1Parent.getName()); Logger logger2Parent = logger2.getParent(); System.out.println("logger1:" + logger1 + ",name:" + logger1.getName()); System.out.println("logger2Parent:" + logger2Parent + ",name:" + logger2Parent.getName()); } } // 输出结果如下 logger1Parent:java.util.logging.LogManager$RootLogger@61e717c2,name: logger1:java.util.logging.Logger@66cd51c3,name:com.chenpi.a logger2Parent:java.util.logging.Logger@66cd51c3,name:com.chenpi.a 日志配置 我们可以通过2种方式调整 JUL 默认的日志行为(设置日志级别,日志输出目的地,日志格式等等),一种是通过在程序中硬编码形式(不推荐),另一种是通过单独的配置文件形式。 硬编码日志配置 在 JUL 中,Logger 是有父子继承关系的,所以当我们需要对某一个 Logger 对象进行单独的配置时,需要将它设置为不继承使用父 Logger 的配置。 以下演示名称为com.chenpi.ChenPiJULMain的 Logger 对象单独进行配置,并且关联两个 Handler。 package com.chenpi; import java.io.IOException; import java.util.logging.*; import org.junit.Test; /** * @author 陈皮 * @version 1.0 * @description * @date 2022/3/2 */ public class ChenPiJULMain { @Test public void testLog() throws IOException { // 获取日志记录器对象 Logger logger = Logger.getLogger("com.chenpi.ChenPiJULMain"); // 关闭默认配置,即不使用父Logger的Handlers logger.setUseParentHandlers(false); // 设置记录器的日志级别为ALL logger.setLevel(Level.ALL); // 日志记录格式,使用简单格式转换对象 SimpleFormatter simpleFormatter = new SimpleFormatter(); // 控制台输出Handler,并且设置日志级别为INFO,日志记录格式 ConsoleHandler consoleHandler = new ConsoleHandler(); consoleHandler.setLevel(Level.INFO); consoleHandler.setFormatter(simpleFormatter); // 文件输出Handler,并且设置日志级别为FINE,日志记录格式 FileHandler fileHandler = new FileHandler("./jul.log"); fileHandler.setLevel(Level.FINE); fileHandler.setFormatter(simpleFormatter); // 记录器关联处理器,即此logger对象的日志信息输出到这两个Handler进行处理 logger.addHandler(consoleHandler); logger.addHandler(fileHandler); // 日志记录输出 logger.severe(">>>>> Hello ChenPi!!"); logger.warning(">>>>> Hello ChenPi!!"); logger.info(">>>>> Hello ChenPi!!"); logger.config(">>>>> Hello ChenPi!!"); logger.fine(">>>>> Hello ChenPi!!"); logger.finer(">>>>> Hello ChenPi!!"); logger.finest(">>>>> Hello ChenPi!!"); } } 因为 Logger 设置的日志级别是 ALL,即所有级别的日志记录都可以通过。但是 ConsoleHandler 设置的日志级别是 INFO,所以控制台只输出 INFO 级别以上的日志记录。而 FileHandler 设置的日志级别是 FINE,所以日志文件中输出的是 FINE 级别以上的日志记录。 以下是控制台输出的日志结果: 以下是日志文件jul.log中输出的日志结果: 日志配置文件 通过 debug 调试,按以下方法顺序,可以发现,如果我们没有配置 JUL 的配置文件,系统默认从 JDK 的安装目录下的 lib 目录下读取默认的配置文件logging.properties。 getLogger() -> demandLogger() -> LogManager.getLogManager() -> ensureLogManagerInitialized() -> owner.readPrimordialConfiguration() -> readConfiguration() 以下是 JDK 自带的 JUL 默认日志配置文件内容: 对于配置选项有哪些,其实可以通过相应类的源码找出,例如 Logger 类的源码如下: FileHandler 类的源码如下: 所以我们可以拷贝默认的配置文件到我们工程的 resources 目录下,自定义修改配置信息。 ############################################################ # 全局属性 ############################################################ # 顶级RootLogger关联的Handler,多个Handler使用逗号隔开 # 对于其他Logger,如果没有指定自己的Handler,则默认继承此 handlers= java.util.logging.FileHandler, java.util.logging.ConsoleHandler # 默认全局日志级别,Logger和Handler都可以设置自己的日志级别来覆盖此级别 .level= ALL ############################################################ # Handler 配置 ############################################################ # FileHandler定义 # 日志文件存储位置 java.util.logging.FileHandler.pattern = ./jul%u.log # 单个文件的最大字节数,0代表不限制 java.util.logging.FileHandler.limit = 50000 # 文件数量上限,多个文件为jul0.log.0,jul0.log.1 ... java.util.logging.FileHandler.count = 5 # 日志级别 java.util.logging.FileHandler.level = SEVERE # 日志追加方式 java.util.logging.FileHandler.append = true # Handler对象采用的字符集 java.util.logging.FileHandler.encoding = UTF-8 # 日志格式,使用系统默认的简单格式 java.util.logging.FileHandler.formatter = java.util.logging.SimpleFormatter # ConsoleHandler定义 # 日志级别 java.util.logging.ConsoleHandler.level = INFO # Handler对象采用的字符集 java.util.logging.ConsoleHandler.encoding = UTF-8 # 日志格式,使用系统默认的简单格式 java.util.logging.ConsoleHandler.formatter = java.util.logging.SimpleFormatter ############################################################ # Logger 配置 ############################################################ # 设置名称为com.chenpi.person的Logger对象的日志级别为WARNING com.chenpi.person.level = WARNING 然后我们应用中加载我们类路径中自定义的配置文件。 package com.chenpi; import java.io.IOException; import java.io.InputStream; import java.util.logging.LogManager; import java.util.logging.Logger; import org.junit.Test; /** * @author 陈皮 * @version 1.0 * @description * @date 2022/3/2 */ public class ChenPiJULMain { // JUL 日志框架演示 @Test public void testLog() throws IOException { // 读取配置文件 // 也可以通过使用java.util.logging.config.file系统属性指定文件名 // 例如 java -Djava.util.logging.config.file=myfile InputStream resourceAsStream = ChenPiJULMain.class.getClassLoader() .getResourceAsStream("logging.properties"); // 获取LogManager LogManager logManager = LogManager.getLogManager(); // 记载配置文件 logManager.readConfiguration(resourceAsStream); // 获取日志记录器对象 Logger logger = Logger.getLogger("com.chenpi.ChenPiJULMain"); // 日志记录输出 logger.severe(">>>>> Hello ChenPi!!"); logger.warning(">>>>> Hello ChenPi!!"); logger.info(">>>>> Hello ChenPi!!"); logger.config(">>>>> Hello ChenPi!!"); logger.fine(">>>>> Hello ChenPi!!"); logger.finer(">>>>> Hello ChenPi!!"); logger.finest(">>>>> Hello ChenPi!!"); // 获取日志记录器对象 Logger personLogger = Logger.getLogger("com.chenpi.person"); // 日志记录输出 personLogger.severe(">>>>> Hello Person!!"); personLogger.warning(">>>>> Hello Person!!"); personLogger.info(">>>>> Hello Person!!"); personLogger.config(">>>>> Hello Person!!"); personLogger.fine(">>>>> Hello Person!!"); personLogger.finer(">>>>> Hello Person!!"); personLogger.finest(">>>>> Hello Person!!"); } } 控制台和文件中输出内容如下: 自定义 Logger 我们可以针对某一个 Logger 进行单独的配置,例如日志级别,关联的 Handler 等,而不默认继承父级的。 当然我们也可以为以包名为名称的 Logger 进行配置,这样这个包名下的所有子代 Logger 都能继承此配置。 ############################################################ # 全局属性 ############################################################ # 顶级RootLogger关联的Handler,多个Handler使用逗号隔开 # 对于其他Logger,如果没有指定自己的Handler,则默认继承此 handlers= java.util.logging.FileHandler, java.util.logging.ConsoleHandler # 默认全局日志级别,Logger和Handler都可以设置自己的日志级别来覆盖此级别 .level= ALL ############################################################ # Handler 配置 ############################################################ # FileHandler定义 # 日志文件存储位置 java.util.logging.FileHandler.pattern = ./jul%u.log # 单个文件的最大字节数,0代表不限制 java.util.logging.FileHandler.limit = 50000 # 文件数量上限 java.util.logging.FileHandler.count = 5 # 日志级别 java.util.logging.FileHandler.level = SEVERE # 日志追加方式 java.util.logging.FileHandler.append = true # Handler对象采用的字符集 java.util.logging.FileHandler.encoding = UTF-8 # 日志格式,使用系统默认的简单格式 java.util.logging.FileHandler.formatter = java.util.logging.SimpleFormatter # ConsoleHandler定义 # 日志级别 java.util.logging.ConsoleHandler.level = INFO # Handler对象采用的字符集 java.util.logging.ConsoleHandler.encoding = UTF-8 # 日志格式,使用系统默认的简单格式 java.util.logging.ConsoleHandler.formatter = java.util.logging.SimpleFormatter ############################################################ # Logger 配置 ############################################################ # 设置名称为com.chenpi.person的Logger对象的日志级别为WARNING com.chenpi.person.level = WARNING # 只关联FileHandler com.chenpi.person.handlers = java.util.logging.FileHandler # 关闭默认配置 com.chenpi.person.useParentHandlers = false package com.chenpi; import java.io.IOException; import java.io.InputStream; import java.util.logging.LogManager; import java.util.logging.Logger; import org.junit.Test; /** * @author 陈皮 * @version 1.0 * @description * @date 2022/3/2 */ public class ChenPiJULMain { // JUL 日志框架演示 @Test public void testLog() throws IOException { // 读取配置文件 InputStream resourceAsStream = ChenPiJULMain.class.getClassLoader() .getResourceAsStream("logging.properties"); // 获取LogManager LogManager logManager = LogManager.getLogManager(); // 记载配置文件 logManager.readConfiguration(resourceAsStream); // 获取日志记录器对象 Logger logger = Logger.getLogger("com.chenpi.ChenPiJULMain"); // 日志记录输出 logger.severe(">>>>> Hello ChenPi!!"); logger.warning(">>>>> Hello ChenPi!!"); logger.info(">>>>> Hello ChenPi!!"); logger.config(">>>>> Hello ChenPi!!"); logger.fine(">>>>> Hello ChenPi!!"); logger.finer(">>>>> Hello ChenPi!!"); logger.finest(">>>>> Hello ChenPi!!"); // 获取日志记录器对象 Logger personLogger = Logger.getLogger("com.chenpi.person"); // 日志记录输出 personLogger.severe(">>>>> Hello Person!!"); personLogger.warning(">>>>> Hello Person!!"); personLogger.info(">>>>> Hello Person!!"); personLogger.config(">>>>> Hello Person!!"); personLogger.fine(">>>>> Hello Person!!"); personLogger.finer(">>>>> Hello Person!!"); personLogger.finest(">>>>> Hello Person!!"); } } 上述例子中,对于名称为com.chenpi.person的 Logger,只将日志输出到文件中,其他 Logger 则会同时输出到控制台和文件中。 自定义日志格式 以SimpleFormatter类源码为例,再到LoggingSupport类源码,发现首先判断我们是否通过java.util.logging.SimpleFormatter.format属性配置了格式,如果没有则使用默认的日志格式。 所以我们可以在配置文件中自定义日志记录的格式。 ############################################################ # 全局属性 ############################################################ # 顶级RootLogger关联的Handler,多个Handler使用逗号隔开 # 对于其他Logger,如果没有指定自己的Handler,则默认继承此 handlers= java.util.logging.FileHandler, java.util.logging.ConsoleHandler # 默认全局日志级别,Logger和Handler都可以设置自己的日志级别来覆盖此级别 .level= ALL ############################################################ # Handler 配置 ############################################################ # FileHandler定义 # 日志文件存储位置 java.util.logging.FileHandler.pattern = ./jul%u.log # 单个文件的最大字节数,0代表不限制 java.util.logging.FileHandler.limit = 1024 # 文件数量上限 java.util.logging.FileHandler.count = 5 # 日志级别 java.util.logging.FileHandler.level = FINE # 日志追加方式 java.util.logging.FileHandler.append = true # Handler对象采用的字符集 java.util.logging.FileHandler.encoding = UTF-8 # 日志格式,使用系统默认的简单格式 java.util.logging.FileHandler.formatter = java.util.logging.SimpleFormatter # 自定义SimpleFormatter的日志格式 java.util.logging.SimpleFormatter.format = %4$s: %5$s [%1$tc]%n # ConsoleHandler定义 # 日志级别 java.util.logging.ConsoleHandler.level = INFO # Handler对象采用的字符集 java.util.logging.ConsoleHandler.encoding = UTF-8 # 日志格式,使用系统默认的简单格式 java.util.logging.ConsoleHandler.formatter = java.util.logging.SimpleFormatter ############################################################ # Logger 配置 ############################################################ # 设置名称为com.chenpi.person的Logger对象的日志级别为WARNING com.chenpi.person.level = WARNING 这样,所有绑定了 SimpleFormatter 的 Handler 的所有日志记录就使用了自定义的格式。 当然通过源码发现,日志格式类还有其他几个实现,如下所示: 日志过滤器 Filter,日志过滤器,用来对输出的日志记录进行过滤。我们可以根据多个维度进行过滤,例如只输出 message 包含某段文本信息的日志,只输出某个方法中记录的日志,某个级别的日志等等。 Logger 对象将日志信息包装成一个 LogRecord 对象,然后将该对象传给 Handler 进行处理。每一个 Logger 和 Handler 都可以关联一个 Filter。LogRecord 中包含了日志的文本信息、日志生成的时间戳、日志来自于哪个类、日志来自于哪个方法、日志来自于哪个线程等等信息。 Filter 源码如下所示,我们只需要创建一个 Filter 的实现类,重写方法即可。 package java.util.logging; /** * A Filter can be used to provide fine grain control over * what is logged, beyond the control provided by log levels. * <p> * Each Logger and each Handler can have a filter associated with it. * The Logger or Handler will call the isLoggable method to check * if a given LogRecord should be published. If isLoggable returns * false, the LogRecord will be discarded. * * @since 1.4 */ @FunctionalInterface public interface Filter { /** * Check if a given log record should be published. * @param record a LogRecord * @return true if the log record should be published. */ public boolean isLoggable(LogRecord record); } 我们实现一个 Filter ,如果日志消息包含暴力两个字,则不予放行,即不记录此条日志。 package com.chenpi; import java.util.logging.Filter; import java.util.logging.LogRecord; /** * @author 陈皮 * @version 1.0 * @description * @date 2022/3/2 */ public class MyLoggerFilter implements Filter { private static final String SENSITIVE_MESSAGE = "暴力"; @Override public boolean isLoggable(LogRecord record) { String message = record.getMessage(); return null == message || !message.contains(SENSITIVE_MESSAGE); } } 然后我们将此过滤器对象设置绑定到 Logger 中即可。 package com.chenpi; import java.io.IOException; import java.io.InputStream; import java.util.logging.LogManager; import java.util.logging.Logger; import org.junit.Test; /** * @author 陈皮 * @version 1.0 * @description * @date 2022/3/2 */ public class ChenPiJULMain { // JUL 日志框架演示 @Test public void testLog() throws IOException { // 读取配置文件 InputStream resourceAsStream = ChenPiJULMain.class.getClassLoader() .getResourceAsStream("logging.properties"); // 获取LogManager LogManager logManager = LogManager.getLogManager(); // 记载配置文件 logManager.readConfiguration(resourceAsStream); // 获取日志记录器对象 Logger logger = Logger.getLogger("com.chenpi.ChenPiJULMain"); // Logger关联过滤器 logger.setFilter(new MyLoggerFilter()); // 日志记录输出 logger.info(">>>>> Hello ChenPi!!"); logger.info(">>>>> 暴力小孩!!"); } } // 输出结果如下 信息: >>>>> Hello ChenPi!! [星期三 三月 02 15:31:06 CST 2022] 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

每日一博 | Linux下跨语言调用 C++ 实践

不同的开发语言适合不同的领域,例如Python适合做数据分析,C++适合做系统的底层开发,假如它们需要用到相同功能的基础组件,组件使用多种语言分别开发的话,不仅增加了开发和维护成本,而且不能确保多种语言间在处理效果上是一致的。本文讲述在Linux系统下跨语言调用的实践总结,即开发一次C++语言的组件,其他语言通过跨语言调用技术调用C++组件。 1 背景介绍 查询理解(QU, Query Understanding)是美团搜索的核心模块,主要职责是理解用户查询,生成查询意图、成分、改写等基础信号,应用于搜索的召回、排序、展示等多个环节,对搜索基础体验至关重要。该服务的线上主体程序基于C++语言开发,服务中会加载大量的词表数据、预估模型等,这些数据与模型的离线生产过程有很多文本解析能力需要与线上服务保持一致,从而保证效果层面的一致性,如文本归一化、分词等。 而这些离线生产过程通常用Python与Java实现。如果在线、离线用不同语言各自开发一份,则很难维持策略与效果上的统一。同时这些能力会有不断的迭代,在这种动态场景下,不断维护多语言版本的效果打平,给我们的日常迭代带来了极大的成本。因此,我们尝试通过跨语言调用动态链接库的技术解决这个问题,即开发一次基于C++的so,通过不同语言的链接层封装成不同语言的组件库,并投入到对应的生成过程。这种方案的优势非常明显,主体的业务逻辑只需要开发一次,封装层只需要极少量的代码,主体业务迭代升级,其它语言几乎不需要改动,只需要包含最新的动态链接库,发布最新版本即可。同时C++作为更底层的语言,在很多场景下,它的计算效率更高,硬件资源利用率更高,也为我们带来了一些性能上的优势。 本文对我们在实际生产中尝试这一技术方案时,遇到的问题与一些实践经验做了完整的梳理,希望能为大家提供一些参考或帮助。 2 方案概述 为了达到业务方开箱即用的目的,综合考虑C++、Python、Java用户的使用习惯,我们设计了如下的协作结构: 3 实现详情 Python、Java支持调用C接口,但不支持调用C++接口,因此对于C++语言实现的接口,必须转换为C语言实现。为了不修改原始C++代码,在C++接口上层用C语言进行一次封装,这部分代码通常被称为“胶水代码”(Glue Code)。具体方案如下图所示: 本章节各部分内容如下: 【功能代码】部分,通过打印字符串的例子来讲述各语言部分的编码工作。 【打包发布】部分,介绍如何将生成的动态库作为资源文件与Python、Java代码打包在一起发布到仓库,以降低使用方的接入成本。 【业务使用】部分,介绍开箱即用的使用示例。 【易用性优化】部分,结合实际使用中遇到的问题,讲述了对于Python版本兼容,以及动态库依赖问题的处理方式。 3.1 功能代码 3.1.1 C++代码 作为示例,实现一个打印字符串的功能。为了模拟实际的工业场景,对以下代码进行编译,分别生成动态库 libstr_print_cpp.so、静态库libstr_print_cpp.a。 str_print.h #pragma once #include <string> class StrPrint { public: void print(const std::string& text); }; str_print.cpp #include <iostream> #include "str_print.h" void StrPrint::print(const std::string& text) { std::cout << text << std::endl; } 3.1.2 c_wrapper代码 如上文所述,需要对C++库进行封装,改造成对外提供C语言格式的接口。 c_wrapper.cpp #include "str_print.h" extern "C" { void str_print(const char* text) { StrPrint cpp_ins; std::string str = text; cpp_ins.print(str); } } 3.1.3 生成动态库 为了支持Python与Java的跨语言调用,我们需要对封装好的接口生成动态库,生成动态库的方式有以下三种 方式一:源码依赖方式,将c_wrapper和C++代码一起编译生成libstr_print.so。这种方式业务方只需要依赖一个so,使用成本较小,但是需要获取到源码。对于一些现成的动态库,可能不适用。 g++ -o libstr_print.so str_print.cpp c_wrapper.cpp -fPIC -shared 方式二:动态链接方式,这种方式生成的libstr_print.so,发布时需要携带上其依赖库libstr_print_cpp.so。 这种方式,业务方需要同时依赖两个so,使用的成本相对要高,但是不必提供原动态库的源码。 g++ -o libstr_print.so c_wrapper.cpp -fPIC -shared -L. -lstr_print_cpp 方式三:静态链接方式,这种方式生成的libstr_print.so,发布时无需携带上libstr_print_cpp.so。 这种方式,业务方只需依赖一个so,不必依赖源码,但是需要提供静态库。 g++ c_wrapper.cpp libstr_print_cpp.a -fPIC -shared -o libstr_print.so 上述三种方式,各自有适用场景和优缺点。在我们本次的业务场景下,因为工具库与封装库均由我们自己开发,能够获取到源码,因此选择第一种方式,业务方依赖更加简单。 3.1.4 Python接入代码 Python标准库自带的ctypes可以实现加载C的动态库的功能,使用方法如下: str_print.py # -*- coding: utf-8 -*- import ctypes # 加载 C lib lib = ctypes.cdll.LoadLibrary("./libstr_print.so") # 接口参数类型映射 lib.str_print.argtypes = [ctypes.c_char_p] lib.str_print.restype = None # 调用接口 lib.str_print('Hello World') LoadLibrary会返回一个指向动态库的实例,通过它可以在Python里直接调用该库中的函数。argtypes与restype是动态库中函数的参数属性,前者是一个ctypes类型的列表或元组,用于指定动态库中函数接口的参数类型,后者是函数的返回类型(默认是c_int,可以不指定,对于非c_int型需要显示指定)。该部分涉及到的参数类型映射,以及如何向函数中传递struct、指针等高级类型,可以参考附录中的文档。 3.1.5 Java接入代码 Java调用C lib有JNI与JNA两种方式,从使用便捷性来看,更推荐JNA方式。 3.1.5.1 JNI接入 Java从1.1版本开始支持JNI接口协议,用于实现Java语言调用C/C++动态库。JNI方式下,前文提到的c_wrapper模块不再适用,JNI协议本身提供了适配层的接口定义,需要按照这个定义进行实现。JNI方式的具体接入步骤为: Java代码里,在需要跨语言调用的方法上,增加native关键字,用以声明这是一个本地方法。 import java.lang.String; public class JniDemo { public native void print(String text); } 通过javah命令,将代码中的native方法生成对应的C语言的头文件。这个头文件类似于前文提到的c_wrapper作用。 javah JniDemo 得到的头文件如下(为节省篇幅,这里简化了一些注释和宏): #include <jni.h> #ifdef __cplusplus extern "C" { #endif JNIEXPORT void JNICALL Java_JniDemo_print (JNIEnv *, jobject, jstring); #ifdef __cplusplus } #endif jni.h在JDK中提供,其中定义了Java与C语言调用所必需的相关实现。 JNIEXPORT和JNICALL是JNI中定义的两个宏,JNIEXPORT标识了支持在外部程序代码中调用该动态库中的方法,JNICALL定义了函数调用时参数的入栈出栈约定。 Java_JniDemo_print是一个自动生成的函数名,它的格式是固定的由Java_{className}_{methodName}构成,JNI会按照这个约定去注册Java方法与C函数的映射。 三个参数里,前两个是固定的。JNIEnv中封装了jni.h 里的一些工具方法,jobject指向Java中的调用类,即JniDemo,通过它可以找到Java里class中的成员变量在C的堆栈中的拷贝。 jstring 指向传入参数 text,这是对于Java 中String类型的一个映射。有关类型映射的具体内容,会在后文详细展开。 编写实现Java_JniDemo_print方法。 JniDemo.cpp #include <string> #include "JniDemo.h" #include "str_print.h" JNIEXPORT void JNICALL Java_JniDemo_print (JNIEnv *env, jobject obj, jstring text) { char* str=(char*)env->GetStringUTFChars(text,JNI_FALSE); std::string tmp = str; StrPrint ins; ins.print(tmp); } 编译生成动态库。 g++ -o libJniDemo.so JniDemo.cpp str_print.cpp -fPIC -shared -I<$JAVA_HOME>/include/ -I<$JAVA_HOME>/include/linux 编译运行。 java -Djava.library.path=<path_to_libJniDemo.so> JniDemo JNI机制通过一层C/C++ 的桥接,实现了跨语言调用协议。这一功能在Android系统中一些图形计算相关的Java程序下有着大量应用。一方面能够通过Java调用大量操作系统底层库,极大的减少了JDK上的驱动开发的工作量,另一方面能够更充分的利用硬件性能。但是通过3.1.5.1中的描述也可以看到,JNI的实现方式本身的实现成本还是比较高的。尤其桥接层的C/C++代码的编写,在处理复杂类型的参数传递时,开发成本较大。为了优化这个过程,Sun公司主导了JNA(Java Native Access)开源工程的工作。 3.1.5.2 JNA接入 JNA是在JNI基础上实现的编程框架,它提供了C语言动态转发器,实现了Java类型到C类型的自动转换。因此,Java开发人员只要在一个Java接口中描述目标native library的函数与结构,不再需要编写任何Native/JNI代码,极大的降低了Java调用本地共享库的开发难度。 JNA的使用方法如下: 在Java项目中引入JNA库。 <dependency> <groupId>com.sun.jna</groupId> <artifactId>jna</artifactId> <version>5.4.0</version> </dependency> 声明与动态库对应的Java接口类。 public interface CLibrary extends Library { void str_print(String text); // 方法名和动态库接口一致,参数类型需要用Java里的类型表示,执行时会做类型映射,原理介绍章节会有详细解释 } 加载动态链接库,并实现接口方法。 JnaDemo.java package com.jna.demo; import com.sun.jna.Library; import com.sun.jna.Native; public class JnaDemo { private CLibrary cLibrary; public interface CLibrary extends Library { void str_print(String text); } public JnaDemo() { cLibrary = Native.load("str_print", CLibrary.class); } public void str_print(String text) { cLibrary.str_print(text); } } 对比可以发现,相比于JNI,JNA不再需要指定native关键字,不再需要生成JNI部分C代码,也不再需要显示的做参数类型转化,极大地提高了调用动态库的效率。 3.2 打包发布 为了做到开箱即用,我们将动态库与对应语言代码打包在一起,并自动准备好对应依赖环境。这样使用方只需要安装对应的库,并引入到工程中,就可以直接开始调用。这里需要解释的是,我们没有将so发布到运行机器上,而是将其和接口代码一并发布至代码仓库,原因是我们所开发的工具代码可能被不同业务、不同背景(非C++)团队使用,不能保证各个业务方团队都使用统一的、标准化的运行环境,无法做到so的统一发布、更新。 3.2.1 Python 包发布 Python可以通过setuptools将工具库打包,发布至pypi公共仓库中。具体操作方法如下: 创建目录。 . ├── MANIFEST.in #指定静态依赖 ├── setup.py # 发布配置的代码 └── strprint # 工具库的源码目录 ├── __init__.py # 工具包的入口 └── libstr_print.so # 依赖的c_wrapper 动态库 编写__init__.py, 将上文代码封装成方法。 # -*- coding: utf-8 -*- import ctypes import os import sys dirname, _ = os.path.split(os.path.abspath(__file__)) lib = ctypes.cdll.LoadLibrary(dirname + "/libstr_print.so") lib.str_print.argtypes = [ctypes.c_char_p] lib.str_print.restype = None def str_print(text): lib.str_print(text) 编写setup.py。 from setuptools import setup, find_packages setup( name="strprint", version="1.0.0", packages=find_packages(), include_package_data=True, description='str print', author='xxx', package_data={ 'strprint': ['*.so'] }, ) 编写MANIFEST.in。 include strprint/libstr_print.so 打包发布。 python setup.py sdist upload 3.2.2 Java接口 对于Java接口,将其打包成JAR包,并发布至Maven仓库中。 编写封装接口代码JnaDemo.java。 package com.jna.demo; import com.sun.jna.Library; import com.sun.jna.Native; import com.sun.jna.Pointer; public class JnaDemo { private CLibrary cLibrary; public interface CLibrary extends Library { Pointer create(); void str_print(String text); } public static JnaDemo create() { JnaDemo jnademo = new JnaDemo(); jnademo.cLibrary = Native.load("str_print", CLibrary.class); //System.out.println("test"); return jnademo; } public void print(String text) { cLibrary.str_print(text); } } 创建resources目录,并将依赖的动态库放到该目录。 通过打包插件,将依赖的库一并打包到JAR包中。 <plugin> <artifactId>maven-assembly-plugin</artifactId> <configuration> <appendAssemblyId>false</appendAssemblyId> <descriptorRefs> <descriptorRef>jar-with-dependencies</descriptorRef> </descriptorRefs> </configuration> <executions> <execution> <id>make-assembly</id> <phase>package</phase> <goals> <goal>assembly</goal> </goals> </execution> </executions> </plugin> 3.3 业务使用 3.3.1 Python使用 安装strprint包。 pip install strprint==1.0.0 使用示例: # -*- coding: utf-8 -*- import sys from strprint import * str_print('Hello py') 3.3.2 Java使用 pom引入JAR包。 <dependency> <groupId>com.jna.demo</groupId> <artifactId>jnademo</artifactId> <version>1.0</version> </dependency> 使用示例: JnaDemo jnademo = new JnaDemo(); jnademo.str_print("hello jna"); 3.4 易用性优化 3.4.1 Python版本兼容 Python2与Python3版本的问题,是Python开发用户一直诟病的槽点。因为工具面向不同的业务团队,我们没有办法强制要求使用统一的Python版本,但是我们可以通过对工具库做一下简单处理,实现两个版本的兼容。Python版本兼容里,需要注意两方面的问题: 语法兼容 数据编码 Python代码的封装里,基本不牵扯语法兼容问题,我们的工作主要集中在数据编码问题上。由于Python 3的str类型使用的是unicode编码,而在C中,我们需要的char* 是utf8编码,因此需要对于传入的字符串做utf8编码处理,对于C语言返回的字符串,做utf8转换成unicode的解码处理。于是对于上例子,我们做了如下改造: # -*- coding: utf-8 -*- import ctypes import os import sys dirname, _ = os.path.split(os.path.abspath(__file__)) lib = ctypes.cdll.LoadLibrary(dirname + "/libstr_print.so") lib.str_print.argtypes = [ctypes.c_char_p] lib.str_print.restype = None def is_python3(): return sys.version_info[0] == 3 def encode_str(input): if is_python3() and type(input) is str: return bytes(input, encoding='utf8') return input def decode_str(input): if is_python3() and type(input) is bytes: return input.decode('utf8') return input def str_print(text): lib.str_print(encode_str(text)) 3.4.2 依赖管理 在很多情况下,我们调用的动态库,会依赖其它动态库,比如当我们依赖的gcc/g++版本与运行环境上的不一致时,时常会遇到glibc_X.XX not found的问题,这时需要我们提供指定版本的libstdc.so与libstdc++.so.6。 为了实现开箱即用的目标,在依赖并不复杂的情况下,我们会将这些依赖也一并打包到发布包里,随工具包一起提供。对于这些间接依赖,在封装的代码里,并不需要显式的load,因为Python与Java的实现里,加载动态库,最终调用的都是系统函数dlopen。这个函数在加载目标动态库时,会自动的加载它的间接依赖。所以我们所需要做的,就只是将这些依赖放置到dlopen能够查找到路径下。 dlopen查找依赖的顺序如下: 从dlopen调用方ELF(Executable and Linkable Format)的DT_RPATH所指定的目录下寻找,ELF是so的文件格式,这里的DT_RPATH是写在动态库文件的,常规手段下,我们无法修改这个部分。 从环境变量LD_LIBRARY_PATH所指定的目录下寻找,这是最常用的指定动态库路径的方式。 从dlopen调用方ELF的DT_RUNPATH所指定的目录下寻找,同样是在so文件中指定的路径。 从/etc/ld.so.cache寻找,需要修改/etc/ld.so.conf文件构建的目标缓存,因为需要root权限,所以在实际生产中,一般很少修改。 从/lib寻找, 系统目录,一般存放系统依赖的动态库。 从/usr/lib寻找,通过root安装的动态库,同样因为需要root权限,生产中,很少使用。 从上述查找顺序中可以看出,对于依赖管理的最好方式,是通过指定LD_LIBRARY_PATH变量的方式,使其包含我们的工具包中的动态库资源所在的路径。另外,对于Java程序而言,我们也可以通过指定java.library.path运行参数的方式来指定动态库的位置。Java程序会将java.library.path与动态库文件名拼接到一起作为绝对路径传递给dlopen,其加载顺序排在上述顺序之前。 最后,在Java中还有一个细节需要注意,我们发布的工具包是以JAR包形式提供,JAR包本质上是一个压缩包,在Java程序中,我们能够直接通过Native.load()方法,直接加载位于项目resources目录里的so,这些资源文件打包后,会被放到JAR包中的根目录。 但是dlopen无法加载这个目录。对于这一问题,最好的方案可以参考【2.1.3 生成动态库】一节中的打包方法,将依赖的动态库合成一个so,这样无须做任何环境配置,开箱即用。但是对于诸如libstdc++.so.6等无法打包在一个so的中系统库,更为通用的做法是,在服务初始化时将so文件从JAR包中拷贝至本地某个目录,并指定LD_LIBRARY_PATH包含该目录。 4. 原理介绍 4.1 为什么需要一个c_wrapper 实现方案一节中提到Python/Java不能直接调用C++接口,要先对C++中对外提供的接口用C语言的形式进行封装。这里根本原因在于使用动态库中的接口前,需要根据函数名查找接口在内存中的地址,动态库中函数的寻址通过系统函数dlsym实现,dlsym是严格按照传入的函数名寻址。 在C语言中,函数签名即为代码函数的名称,而在C++语言中,因为需要支持函数重载,可能会有多个同名函数。为了保证签名唯一,C++通过name mangling机制为相同名字不同实现的函数生成不同的签名,生成的签名会是一个像__Z4funcPN4printE这样的字符串,无法被dlsym识别(注:Linux系统下可执行程序或者动态库多是以ELF格式组织二进制数据,其中所有的非静态函数(non-static)以“符号(symbol)”作为唯一标识,用于在链接过程和执行过程中区分不同的函数,并在执行时映射到具体的指令地址,这个“符号”我们通常称之为函数签名)。 为了解决这个问题,我们需要通过extern "C" 指定函数使用C的签名方式进行编译。因此当依赖的动态库是C++库时,需要通过一个c_wrapper模块作为桥接。而对于依赖库是C语言编译的动态库时,则不需要这个模块,可以直接调用。 4.2 跨语言调用如何实现参数传递 C/C++函数调用的标准过程如下: 在内存的栈空间中为被调函数分配一个栈帧,用来存放被调函数的形参、局部变量和返回地址。 将实参的值复制给相应的形参变量(可以是指针、引用、值拷贝)。 控制流转移到被调函数的起始位置,并执行。 控制流返回到函数调用点,并将返回值给到调用方,同时栈帧释放。 由以上过程可知,函数调用涉及内存的申请释放、实参到形参的拷贝等,Python/Java这种基于虚拟机运行的程序,在其虚拟机内部也同样遵守上述过程,但涉及到调用非原生语言实现的动态库程序时,调用过程是怎样的呢? 由于Python/Java的调用过程基本一致,我们以Java的调用过程为例来进行解释,对于Python的调用过程不再赘述。 4.2.1 内存管理 在Java的世界里,内存由JVM统一进行管理,JVM的内存由栈区、堆区、方法区构成,在较为详细的资料中,还会提到native heap与native stack,其实这个问题,我们不从JVM的角度去看,而是从操作系统层面出发来理解会更为简单直观。以Linux系统下为例,首先JVM名义上是一个虚拟机,但是其本质就是跑在操作系统上的一个进程,因此这个进程的内存会存在如下左图所示划分。而JVM的内存管理实质上是在进程的堆上进行重新划分,自己又“虚拟”出Java世界里的堆栈。如右图所示,native的栈区就是JVM进程的栈区,进程的堆区一部分用于JVM进行管理,剩余的则可以给native方法进行分配使用。 4.2.2 调用过程 前文提到,native方法调用前,需要将其所在的动态库加载到内存中,这个过程是利用Linux的dlopen实现的,JVM会把动态库中的代码片段放到Native Code区域,同时会在JVM Bytecode区域保存一份native方法名与其所在Native Code里的内存地址映射。 一次native方法的调用步骤,大致分为四步: 从JVM Bytecode获取native方法的地址。 准备方法所需的参数。 切换到native栈中,执行native方法。 native方法出栈后,切换回JVM方法,JVM将结果拷贝至JVM的栈或堆中。 由上述步骤可以看出,native方法的调用同样涉及参数的拷贝,并且其拷贝是建立在JVM堆栈和原生堆栈之间。 对于原生数据类型,参数是通过值拷贝方式与native方法地址一起入栈。而对于复杂数据类型,则需要一套协议,将Java中的object映射到C/C++中能识别的数据字节。原因是JVM与C语言中的内存排布差异较大,不能直接内存拷贝,这些差异主要包括: 类型长度不同,比如char在Java里为16字节,在C里面却是8个字节。 JVM与操作系统的字节顺序(Big Endian还是Little Endian)可能不一致。 JVM的对象中,会包含一些meta信息,而C里的struct则只是基础类型的并列排布,同样Java中没有指针,也需要进行封装和映射。 上图展示了native方法调用过程中参数传递的过程,其中映射拷贝在JNI中是由C/C++链接部分的胶水代码实现,类型的映射定义在jni.h中。 Java基本类型与C基本类型的映射(通过值传递。将Java对象在JVM内存里的值拷贝至栈帧的形参位置): typedef unsigned char jboolean; typedef unsigned short jchar; typedef short jshort; typedef float jfloat; typedef double jdouble; typedef jint jsize; Java复杂类型与C复杂类型的映射(通过指针传递。首先根据基本类型一一映射,将组装好的新对象的地址拷贝至栈帧的形参位置): typedef _jobject *jobject; typedef _jclass *jclass; typedef _jthrowable *jthrowable; typedef _jstring *jstring; typedef _jarray *jarray; 注:在Java中,非原生类型均是Object的派生类,多个object的数组本身也是一个object,每个object的类型是一个class,同时class本身也是一个object。 class _jobject {}; class _jclass : public _jobject {}; class _jthrowable : public _jobject {}; class _jarray : public _jobject {}; class _jcharArray : public _jarray {}; class _jobjectArray : public _jarray {}; jni.h 中配套提供了内存拷贝和读取的工具类,比如前面例子中的GetStringUTFChars能够将JVM中的字符串中的文本内容,按照utf8编码的格式,拷贝到native heap中,并将char*指针传递给native方法使用。 整个调用过程,产生的内存拷贝,Java中的对象由JVM的GC进行清理,Native Heap中的对象如果是由 JNI框架分配生成的,如上文JNI示例中的参数,均由框架进行统一释放。而在C/C++中新分配的对象,则需要用户代码在C/C++中手动释放。简而言之,Native Heap中与普通的C/C++进程一致,没有GC机制的存在,并且遵循着谁分配谁释放的内存治理原则。 4.3 扩展阅读(JNA直接映射) 相比于JNI,JNA使用了其函数调用的基础框架,其中的内存映射部分,由JNA工具库中的工具类自动化的完成类型映射和内存拷贝的大部分工作,从而避免大量胶水代码的编写,使用上更为友好,但相应的这部分工作则产生了一些性能上的损耗。 JNA还额外提供了一种“直接映射”(DirectMapping)的调用方式来弥补这一不足。但是直接映射对于参数有着较为严格的限制,只能传递原生类型、对应数组以及Native引用类型,并且不支持不定参数,方法返回类型只能是原生类型。 直接映射的Java代码中需要增加native关键字,这与JNI的写法一致。 DirectMapping示例 import com.sun.jna.*; public class JnaDemo { public static native double cos(DoubleByReference x); static { Native.register(Platform.C_LIBRARY_NAME); } public static void main(String[] args) { System.out.println(cos(new DoubleByReference(1.0))); } } DoubleByReference即是双精度浮点数的Native引用类型的实现,它的JNA源码定义如下(仅截取相关代码): //DoubleByReference public class DoubleByReference extends ByReference { public DoubleByReference(double value) { super(8); setValue(value); } } // ByReference public abstract class ByReference extends PointerType { protected ByReference(int dataSize) { setPointer(new Memory(dataSize)); } } Memory类型是Java版的shared_ptr实现,它通过引用引数的方式,封装了内存分配、引用、释放的相关细节。这种类型的数据内存实际上是分配在native的堆中,Java代码中,只能拿到指向该内存的引用。JNA在构造Memory对象的时候通过调用malloc在堆中分配新内存,并记录指向该内存的指针。 在ByReference的对象释放时,调用free,释放该内存。JNA的源码中ByReference基类的finalize 方法会在GC时调用,此时会去释放对应申请的内存。因此在JNA的实现中,动态库中的分配的内存由动态库的代码管理,JNA框架分配的内存由JNA中的代码显示释放,但是其触发时机,则是靠JVM中的GC机制释放JNA对象时来触发运行。这与前文提到的Native Heap中不存在GC机制,遵循谁分配谁释放的原则是一致的。 @Override protected void finalize() { dispose(); } /** Free the native memory and set peer to zero */ protected synchronized void dispose() { if (peer == 0) { // someone called dispose before, the finalizer will call dispose again return; } try { free(peer); } finally { peer = 0; // no null check here, tracking is only null for SharedMemory // SharedMemory is overriding the dispose method reference.unlink(); } } 4.4 性能分析 提高运算效率是Native调用中的一个重要目的,但是经过上述分析也不难发现,在一次跨语言本地化的调用过程中,仍然有大量的跨语言工作需要完成,这些过程也需要支出对应的算力。因此并不是所有Native调用,都能提高运算效率。为此我们需要理解语言间的性能差异在哪儿,以及跨语言调用需要耗费多大的算力支出。 语言间的性能差异主要体现在三个方面: Python与Java语言都是解释执行类语言,在运行时期,需要先把脚本或字节码翻译成二进制机器指令,再交给CPU进行执行。而C/C++编译执行类语言,则是直接编译为机器指令执行。尽管有JIT等运行时优化机制,但也只能一定程度上缩小这一差距。 上层语言有较多操作,本身就是通过跨语言调用的方式由操作系统底层实现,这一部分显然不如直接调用的效率高。 Python与Java语言的内存管理机制引入了垃圾回收机制,用于简化内存管理,GC工作在运行时,会占用一定的系统开销。这一部分效率差异,通常以运行时毛刺的形态出现,即对平均运行时长影响不明显,但是对个别时刻的运行效率造成较大影响。 而跨语言调用的开销,主要包括三部分: 对于JNA这种由动态代理实现的跨语言调用,在调用过程中存在堆栈切换、代理路由等工作。 寻址与构造本地方法栈,即将Java中native方法对应到动态库中的函数地址,并构造调用现场的工作。 内存映射,尤其存在大量数据从JVM Heap向Native Heap 进行拷贝时,这部分的开销是跨语言调用的主要耗时所在。 我们通过如下实验简单做了一下性能对比,我们分别用C语言、Java、JNI、JNA以及JNA直接映射五种方式,分别进行100万次到1000万次的余弦计算,得到耗时对比。在6核16G机器,我们得到如下结果: 由实验数据可知,运行效率依次是 C > Java > JNI > JNA DirectMapping > JNA。 C语言高于Java的效率,但两者非常接近。JNI与JNA DirectMapping的方式性能基本一致,但是会比原生语言的实现要慢很多。普通模式下的JNA的速度最慢,会比JNI慢5到6倍。 综上所述,跨语言本地化调用,并不总是能够提升计算性能,需要综合计算任务的复杂度和跨语言调用的耗时进行综合权衡。我们目前总结到的适合跨语言调用的场景有: 离线数据分析:离线任务可能会涉及到多种语言开发,且对耗时不敏感,核心点在于多语言下的效果打平,跨语言调用可以节省多语言版本的开发成本。 跨语言RPC调用转换为跨语言本地化调用:对于计算耗时是微秒级以及更小的量级的计算请求,如果通过RPC调用来获得结果,用于网络传输的时间至少是毫秒级,远大于计算开销。在依赖简单的情况下,转化为本地化调用,将大幅缩减单请求的处理时间。 对于一些复杂的模型计算,Python/Java跨语言调用C++可以提升计算效率。 5 应用案例 如上文所述,通过本地化调用的方案能够在性能和开发成本上带来一些收益。我们将这些技术在离线任务计算与实时服务调用做了一些尝试,并取得了比较理想的结果。 5.1 离线任务中的应用 搜索业务中会有大量的词表挖掘、数据处理、索引构建等离线计算任务。这个过程会用到较多查询理解里的文本处理和识别能力,如分词、名命体识别等。因为开发语言的差异,将这些能力在本地重新开发一遍,成本上无法接受。因此之前的任务中,在离线计算过程中会通过RPC方式调用线上服务。这个方案带来如下问题: 离线计算任务的量级通常较大,执行过程中请求比较密集,会占用占用线上资源,影响线上用户请求,安全性较低。 单次RPC的耗时至少是毫秒级,而实际的计算时间往往非常短,因此大部分时间实际上浪费在了网络通信上,严重影响任务的执行效率。 RPC服务因为网络抖动等因为,调用成功率不能达到100%,影响任务执行效果。 离线任务需引入RPC调用相关代码,在Python脚本等轻量级计算任务里,这部分的代码往往因为一些基础组件的不完善,导致接入成本较高。 将RPC调用改造为跨语言本地化调用后,上述问题得以解决,收益明显。 不再调用线上服务,流量隔离,对线上安全不产生影响。 对于1000万条以上的离线任务,累计节省至少10小时以上的网络开销时间。 消除网络抖动导致的请求失败问题。 通过上述章节的工作,提供了开箱即用的本地化工具,极大的简化了使用成本。 5.2 在线服务中的应用 查询理解作为美团内部的基础服务平台,提供分词词性、查询纠错、查询改写、地标识别、异地识别、意图识别、实体识别、实体链接等文本分析,是一个较大的CPU密集型服务,承接了公司内非常多的本文分析业务场景,其中有部分场景只是需要个别信号,甚至只需要查询理解服务中的基础函数组件,对于大部分是通过Java开发的业务服务,无法直接引用查询理解的C++动态库,此前一般是通过RPC调用获取结果。通过上述工作,在非C++语言的调用方服务中,可以将RPC调用转化为跨语言本地化调用,能够明显的提升调用端的性能以及成功率,同时也能有效减少服务端的资源开销。 6 总结 微服务等技术的发展使得服务创建、发布和接入变得越来越简单,但是在实际工业生产中,并非所有场景都适合通过RPC服务完成计算。尤其在计算密集型和耗时敏感型的业务场景下,当性能成为瓶颈时,远程调用带来的网络开销就成了业务不可承受之痛。本文对语言本地化调用的技术进行了总结,并给出一些实践经验,希望能为大家解决类似的问题提供一些帮助。 当然,本次工作中还有许多不足,例如因为实际生产环境的要求,我们的工作基本都集中在Linux系统下,如果是以开放库形式,让使用方可以自由使用的话,可能还需要考虑兼容Windows下的DLL,Mac OS下的dylib等等。本文可能还存在其他不足之处,欢迎大家指留言指正、探讨。 本文例子的源代码请访问:GitHub。 7 参考文献 JNI内存相关文档 JNI类型映射 JNA开源地址 Linux dlopen Linux dlclose Linux dlsym CPython源码 CPython中ctypes的介绍 CTypes Struct实现 Python项目分发打包 C与C++函数签名 JNI,JNA与JNR性能对比 8 本文作者 林阳、朱超、识瀚,均来自美团平台/搜索与NLP部/搜索技术部。 阅读美团技术团队更多技术文章合集 前端 | 算法 | 后端 | 数据 | 安全 | 运维 | iOS | Android | 测试 | 在公众号菜单栏对话框回复【2021年货】、【2020年货】、【2019年货】、【2018年货】、【2017年货】等关键词,可查看美团技术团队历年技术文章合集。 | 本文系美团技术团队出品,著作权归属美团。欢迎出于分享和交流等非商业目的转载或使用本文内容,敬请注明“内容转载自美团技术团队”。本文未经许可,不得进行商业性转载或者使用。任何商用行为,请发送邮件至tech@meituan.com申请授权。

优秀的个人博客,低调大师

每日一博 | FastDFS 海量小文件存储解决之道

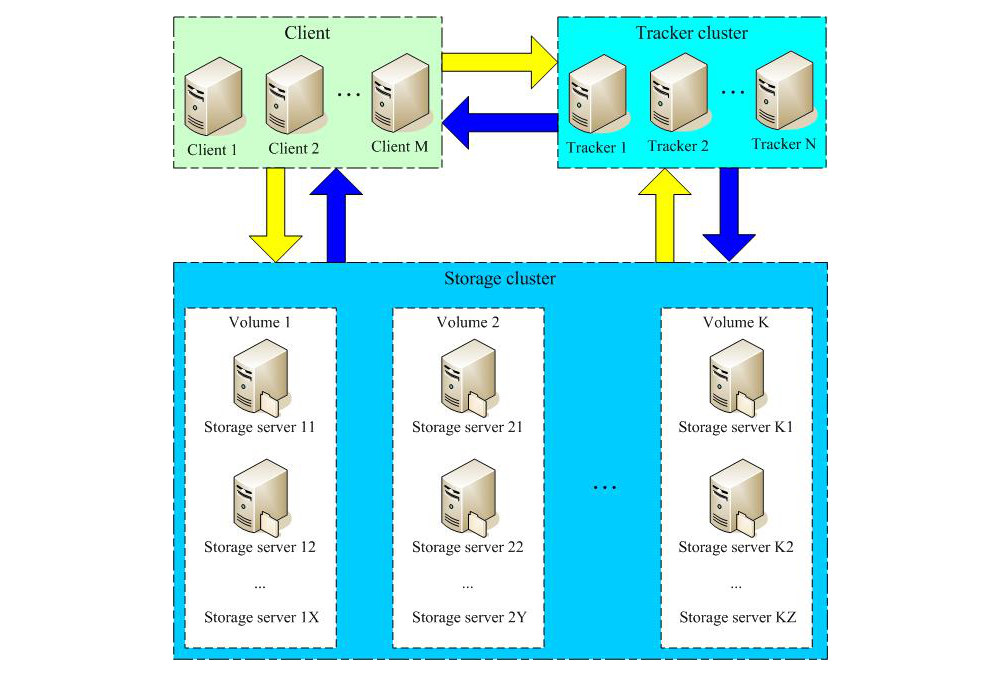
作者:vivo互联网服务器团队-Zhou Changqing 一、FastDFS原理介绍 FastDFS是一个C语言实现的开源轻量级分布式文件系统。 支持 Linux、FreeBSD、AID 等Unix系统,解决了大容量的文件存储和高并发访问问题,文件存取实现了负载均衡,适合存储 4KB~500MB 之间的小文件,特别适合以文件为载体的在线服务,如图片、视频、文档等等。 二、FastDFS 架构 FastDFS 由三个部分构成: 客户端(Client) 跟踪服务器(TrackerServer) 存储服务器(StorageServer) 2.1 Tracker Server (跟踪服务器) Tracker Server (跟踪服务器) 主要是做调度工作,起到负载均衡的作用。 **(1)【服务注册】**管理StorageServer存储集群,StorageServer启动时,会把自己注册到TrackerServer上,并且定期报告自身状态信息,包括磁盘剩余空间、文件同步状况、文件上传下载次数等统计信息。 **(2)【服务发现】**Client访问StorageServer之前,必须先访问TrackerServer,动态获取到StorageServer的连接信息,最终数据是和一个可用的StorageServer进行传输。 (3)【负载均衡】 store group分配策略: 0:轮询方式 1:指定组 2:平衡负载(选择最大剩余空间的组(卷)上传) store server分配策略: 0:轮询方式 1:根据 IP 地址进行排序选择第一个服务器( IP 地址最小者) 2:根据优先级进行排序(上传优先级由storage server来设置,参数名为upload_priority) stroe path分配: 0:轮流方式,多个目录依次存放文件 2:选择剩余空间最大的目录存放文件(注意:剩余磁盘空间是动态的,因此存储到的目录或磁盘可能也是变化的) 2.2 Tracker Server (跟踪服务器) Tracker Server (跟踪服务器) 主要提供容量和备份服务。 **【分组管理】**以Group为单位,每个Group包含多台Storage Server,数据互为备份,存储容量以Group内容量最小的 storage 为准,已 Group 为单位组织存储方便应用隔离、负载均衡和副本数据定制。 **缺点:**Group容量受单机存储容量的限制,数据恢复只能依赖Group其他机器重新同步。 **【数据同步】**文件同步只能在 Group 内的Storage Server之间进行,采用push方式,即源服务器同步给目标服务器。源服务器读取 binlog 文件,将文件内容解析后,按操作命令发送给目标服务器,有目标服务按命令进行操作。 三、上传下载流程 3.1 上传流程解析 3.1.1选择Tracker Server 集群中的 tracker 之间都是对等的,客户端在上传文件时可任意选择一个 tracker 即可。 3.1.2 分配Group、Stroage Server 和storage path(磁盘或者挂载点) tracker 接收到上传请求时会先给该文件分配一个可以存储的 Group ,然后在Group中分配一个Storage Server给客户端,最后在接收到客户端写文件请求时,Storage Server 会分配一个数据存储目录并写入。 (该过程中的分配策略详见:【负载均衡】) 3.1.3 生成file_id写入并返回 Storage 会生成一个 file_id 来作为当前文件名,file_id 采用 base64 编码,包含:源 storage server ip、文件创建时间、文件大小、文件CRC32校验码和随机数。每个存储目录下 有两个256*256个子目录。 Storage 会根据 file_id 进行两次 hash 路由到其中一个子目录中。 最后以file_id为文件名存储文件到该子目录下并返回文件路径给客户端。 最终文件存储路径: **分组 |磁盘|子目录| 文件名 ** group1/M00/00/89/eQ6h3FKJf_PRl8p4AUz4wO8tqaA688.apk 【分组】:文件上传时分配 Group。 【磁盘路径】:存储服务器配置的虚拟路径,对应配置参数 store_path 例如:M00对应store_path0,M01对应store_path1。 【两级目录】:存储服务器在每个虚拟磁盘路径下创建的两级目录,用于存储文件。 3.2 下载流程解析 3.2.1解析路径并路由 tracker 接收 client 发送的下载请求时,tracker 从文件名中解析出 Group、大小、创建时间等信息,然后根据Group 选择一个 storage server 返回。 3.2.2 校验读取并返回 客户端和 Storage Server 建立链接,校验文件是否存在,最终返回文件数据。 **缺点:**Group之间文件同步是异步进行的,可能上传的文件还未同步到当前访问的 Storage Server 这台机器上或者延迟原因,将导致下载文件出现404。所以引入nginx_fastdfs_module 可以很好的解决同步和延迟问题。 3.3 引入fastdfs_nginx_module组件后的下载架构 FastDFS Nginx Module功能介绍 (1)【防盗链检查】 利用 FastDFS nginx 扩展功能动态生成token,设置http.conf 配置。 开启防盗链功能 http.default_content_type = application/octet-stream http.mime_types_filename=mime.types 开启token防盗链功能 http.anti_steal.check_token=true token过期时间 http.anti_steal.token_ttl=900 密钥 http.anti_steal.secret_key=xxx token 过期后返回的内容 http.anti_steal.token_check_fail=/etc/fdfs/anti-steal.jpg 【token 生成算法】:md5(fileid_without_group + privKey + ts) 同时ts没有超过 ttl 范围。 服务器会自动根据token,st 以及设置的秘钥来验证合法性。访问链接形式如: http://localhost/G1/M00/00/01/wKgBD01c15nvKU1cAABAOeCdFS466570.jpg?token=b32cd06a53dea4376e43d71cc882f9cb&ts=1297930137 (2)【文件元数据解析】 根据 file_id 获取元数据信息, 包括:源storage ip,文件路径,名称,大小等。 (3)【文件访问路由】 因文件的file_Id 包含了上传文件时的源 Storage Server IP ,所以在获取不到本机下的文件时(未同步或者延迟情况下)FastDFS 扩展组件,会根据源服务器IP 来重定向或者代理方式获取文件。 重定向模式 配置项response_mode = redirect,服务器返回302,重定向url http://源storage ip:port/文件路径?redirect=1 代理模式 配置项response_mode = proxy,使用源storage 地址作为代理proxy的host,其他部分不变 四、同步机制 4.1 同步规则 同步只发生在本组的 Storage Server 之间。 源头数据才需要同步,备份数据不需要再次同步。 新增 Storage Server 时,会由已有一台 Storage Server 将已有的所有数据(源头数据和备份数据)同步给新增服务器。 4.2 Binlog 复制 FastDFS 文件同步采用binlog异步复制方式,Storage Server 使用binlog文件记录文件上传、删除等操作,根据Binlog进行文件同步。Binlog中只记录文件ID和操作,不记录文件内容 .binlog 格式如下: 时间戳 | 操作类型 | 文件名 1490251373 C M02/52/CB/CtAqWVjTbm2AIqTkAAACd_nIZ7M797.jpg 操作类型(部分): C表示源创建、c表示副本创建 A表示源追加、a表示副本追加 D表示源删除、d表示副本删除 . . . . . . . 4.3 同步流程 新增 Storage Server 后,组内其他 Storage Server 服务器会启动同步线程,在 tracker的协调下向新增服务器发起全量和增量同步操作。 (1)Storage C启动后向tracker 上报所属group、ip、port、版本号、存储目录数、子目录数、启动时间、老数据是否同步完成,当前状态等信息。 (2)tracker 收到Storage C 加入申请请求后,更新本地storage list,返回给C,并适时同步给A、B。 (3)storage C向tracker 申请同步请求,响应后变更自身状态为WAIT_SYNC。 (4)storage A 和B 在心跳周期内从同步到的新storage list 发现没有C,则启动同步线程,先向tracker发起同步申请(TRACKER_PROTO_CMD_STORAGE_SYNC_SRC_REQ),tracker会把同步源IP级同步时间戳返回给A和B,如果源IP和自己本地IP一致,则标记自己作为同步源用来做老数据同步(全量同步源),如果不一致,则标记自己作为增量同步源(只有在C节点状态为Active时才同步)。该决策是由tracker 选择产生的,不可A、B同时作为同步源,同时同步给C。 (5)同步源(假设是storage A)以 .mark为后缀的文件记录目标机器同步信息,并上报变更storage C状态为SYNCING。 (6)从/data.sync目录下读取binlog.index 中的,binlog文件Id,binlog.000读取逐行读取,进行解析.(详见上面binlog 内格式) 发送数据给storage C ,C接收并保存。 (7)数据同步过程中 storage C 的状态变更过程OFFLINE->ONLINE->ACTIVE。ACTIVE 是最终状态,表示storage C 已对外提供服务。 五、文件存储 5.1 LOSF问题 小文件存储(LOSF)面临的问题: 本地文件系统innode梳理优先,存储小文件数量受限。 目录层级和目录中文件数量会导致访问文件开销很大(IO次数多)。 小文件存储,备份和恢复效率低。 针对小文件存储问题,FastDFS 提供了文件合并解决方案。FastDFS 默认创建大文件为 64M,大文件可以存储很多小文件,容纳一个小文件的空间叫slot,solt 最小256字节,最大16M。小于256字节当256字节存储,超过16M文件单独存储。 5.2 存储方式 **(1)【默认存储方式】**未开启合并 ,FastDFS生成的file_id 和磁盘上实际存储的文件一一对应。 **(2)【合并存储方式】**多个file_id对应文件被存储成了一个大文件 。trunk文件名格式:/fastdfs/data/00/000001 文件名从1开始递增。而生成的file_id 更长,会新增16个字节额外内容用来保存偏移量等信息。 如下: 【file_size】:占用大文件的空间(注意按照最小slot-256字节进行对齐) 【mtime】:文件修改时间 【crc32】:文件内容的crc32码 【formatted_ext_name】:文件扩展名 【alloc_size】:文件大小与size相等 【id】:大文件ID如000001 【offset】:文件内容在trunk文件中的偏移量 【size】:文件大小。 5.3 存储空间管理 **(1)【Trunk Server】**由tracker leader 在一组Storage Server 选择出来的,并通知给该组内所有Storage Server,负责为该组内所有upload操作分配空间。 **(2)【空闲平衡树】**trunk server 会为每个store_path构造一个空闲平衡树,相同大小的空闲块保存在链表中,每次上传请求时会到根据上传的文件大小到平衡树中查找获取大于或者接近的空闲块,然后从空闲块中分割出多余的作为新的空闲块,重新加入平衡树。如果找不到则会重建一个新的trunk文件,并加入到平衡树中。该分配过程即是一个维护空闲平衡树的过程。 **(3)【Trunk Binlog】**开启了合并存储后,Trunk Server 会多出一个TrunkBinlog同步。TrunkBinlog记录了TrunkServer 所有分配与回收的空闲块操作,并由Trunk Server同步给同组中其他storage server。 TrunkBinlog格式如下: 时间戳 | 操作类型 | store_path_index |sub_path_high| sub_path_low |file.id| offset |size 1410750754 A 0 0 0 1 0 67108864 各字段含义如下: 【file.id】:TrunkFile文件名,比如 000001 【offset】:在TrunkFile文件中的偏移量 【size】:占用的大小,按照slot对齐 六、文件去重 FastDFS不具备文件去重能力,必须引入FastDHT 来配合完成。FastDHT 是一个键值对的高效分布式hash系统,底层采用Berkeley DB 来做数据库持久化,同步方式使用binlog复制方式。在FastDFS去重场景中,对文件内容做hash,然后判断文件是否一致。 在文件上传成功后,查看 Storage存储对应存储路径,会发现返回的是一个软链接,之后每次重复上传都是返回一个指向第一次上传的文件的软链接。也就保证了文件只保存了一份。 (注意:FastDFS不会返回原始文件的索引,返回的全部都是软链接,当所有的软链接都被删除的时候,原始文件也会从FastDFS中被删除)。 七、总结 FastDFS 真正意义上只是一个管理文件的系统(应用级文件系统),比如管理上传文件、图片等。并不像系统磁盘文件系统NTFS或者FAT 等这种系统级文件系统。

优秀的个人博客,低调大师

每日一博 | 详细解读13种日志模式解析算法

云智慧 AIOps 社区是由云智慧发起,针对运维业务场景,提供算法、算力、数据集整体的服务体系及智能运维业务场景的解决方案交流社区。该社区致力于传播 AIOps 技术,旨在与各行业客户、用户、研究者和开发者们共同解决智能运维行业技术难题,推动 AIOps 技术在企业中落地,建设健康共赢的AIOps 开发者生态。 日志模式解析是将日志从半结构化数据解析为结构化数据的一种算法,可以帮助我们快速了解大量日志的概貌,在日志的自动化分析过程中,常作为中间步骤,服务于日志后续的异常检测等任务。本技术黑板报中,我们将围绕三个问题来详细讲解日志模式解析:日志模式解析是什么,为什么要做日志模式解析,如何实现日志模式解析。 一、日志模式解析是什么: 我们可以用下面这张图来理解日志模式解析所做的工作: 首先需要明确的是,日志是一种半结构化数据,他是由特定的代码生成的。如上图中,日志消息:2015-10-18 18:05:29,570 INFO dfs.DataNode$PacketResponder: Received block blk_-562725280853087685 of size 67108864 from /10.251.91.84。就是由代码LOG.info("Received block " + block + " of size " + block.getNumBytes() + " from " + inAddr);生成。日志模式解析的目的就是将日志解析成如上图所示的结构化数据的形式,即从日志中提取出时间戳、等级、组件、日志模板和参数信息。日志的时间戳、等级、组件这三个信息通过简单的正则就可以非常容易获得,所以日志模式解析算法真正关注的是日志模板及参数的提取。 什么是日志模板和参数呢?稍微有一点代码知识,我们都能知道代码LOG.info("Received block " + block + " of size " + block.getNumBytes() + " from " + inAddr)打印出的日志中,都会出现文本:Received block 、of size 、from,这些文本我们称为常量,而由于每次打印日志时系统状态的不同,每条日志打印出的block、block.getNumBytes()、inAddr可能不同,这些文本我们称为参数。我们将日志中的常量保留,参数用特定符号<*>代替,这样所生成的文本就是日志的模板。 日志模式解析过程可以理解为是一个倒推日志打印代码的过程,也是一个对日志聚类的过程(相同模板的日志认为是同一类日志)。不同文章对日志模式解析有不同的称呼,日志模板挖掘、日志模式发现、日志模式识别、日志聚类等,其实指的都是日志模式解析。 二、为什么要做日志模式解析: 日志模式解析是现在很多日志产品中都有的一个功能,为什么大家都要做日志模式解析这件事呢?首先,日志模式解析可以帮助我们快速了解日志概貌,在如今的计算机系统中,日志数量往往非常庞大,一个系统一天内可能就会产生上百万条日志,人眼直接观测显然不现实,但通过日志模式解析,我们可以将上百万条日志压缩成几百个模板,这样就可以达到人眼可看的目的(如下图)。 其次,模式解析常常是自动化分析过程的中间步骤,服务与后续异常检测等任务,因为模式解析后的结果是更易于分析的。比如,我们可以通过对某种模式的日志的打印时间进行分析,获得模式的周期性,将不符合周期的点认为是异常;又比如,我们可以通过分析得到模式之间的出现顺序关系,如若当我们发现模式2总是会跟在模式1后面出现,如果突然发现在某个时间,模式2单独出现了,这大概率也是一个异常;此外,对某种模式参数的占比进行分析,也能判断异常。 三、如何实现日志模式解析: 本技术黑板报一共调研了13种经典日志解析算法,其中大部分出自于综述《Tools and Benchmarks for Automated Log Parsing》中。本技术黑板报中,根据算法的原理,将这些算法分为三类:基于聚类的日志模式解析算法、基于频繁项挖掘的日志模式解析算法、基于启发的日志模式解析算法。下图为本技术黑板报中设计到的算法及其分类: 被同一条代码打印出来的日志肯定是相似的,所以我们可以得到第一种模式解析的思路,给出文本相似度公式或距离公式,通过聚类算法,将相同模式的日志聚到一起,然后再获取日志模板,即基于聚类的日志模式解析算法,如Drain、Spell(LCS也可以认为是一种文本相似度)、Lenma、Logmine、SHISO等。 而因为代码在打印日志的时候,常量在所有打印出来的日志中都会出现,参数则在日志中可能大不相同,所以我们认为,常量在日志中出现的频率较高,参数在日志中出现的频率较低,换言之,出现频率较高的为常量,出现频率较低的为参数,通过这个性质,我们可以得到第二种模式解析的思路,即基于频繁项挖掘的日志模式解析算法,如SLCT、Logram、FT-Tree。 此外,某些算法中包含对日志的一些启发性假设,比如相同长度的日志才有可能是同一类日志、前几个单词相同的日志才有可能是同一类日志,这些假设也能用于模式解析中。某些聚类算法也有可能含有一些启发性假设,但可以通过算法是否使用了相似度来分辨基于聚类的日志模式解析算法与基于启发的日志模式解析算法。 整体来说,这三类方法,都可以抽象为以下流程,其中,少部分方法中会涉及到模式融合流程,大部分方法只有预处理、聚类、模板获得过程,而模板获得常常与聚类过程融合,部分算法甚至先获得模板,然后将相同模板的日志聚在一起,所以本技术黑板报将这两个流程合在聚类流程中介绍。 1、预处理: 不管是基于聚类的日志模式解析算法、基于频繁项挖掘的日志模式解析算法还是基于启发的日志模式解析算法,在对日志进行解析前,都会先进行分词,因为词是表达完整含义的最小单位。除了分词之外,Drain、DAGDrain、POP、LogMine、LkE均提到要进行类型识别,即通过正则匹配,将一些特殊词,如IP地址、时间等给识别出来,然后替换为特殊字符或去掉,这是由于这些特殊词明显是参数,如此处理可以有效提高相同模式日志的相似度。AEL则提出要识别key-value对,并将value替换成特殊字段,也是类似的考量。此外,Logram提出,在进行解析之前,需要将日志的header给去除(即日志的时间戳、等级、组件信息)。而Lenma、SHISO算法,是基于日志提取的特征向量计算相似度的,而不是基于分词后的日志单词列表,所以这俩算法预处理时会多特征提取这一步骤。 2、聚类: 本节将根据解析算法的类别来对聚类方法进行说明。 (1). 基于聚类的日志模式解析: a. 相似度 基于聚类的日志模式解析,都会通过文本相似度或距离公式,判断日志是否属于某一模式。有些算法在计算文本相似度时,直接通过单词列表计算相似度,如Drain、DAGDrain等;而有些算法,则是先通过单词列表提取特征,然后计算特征的相似度,如Lenma、SHISO。有些算法使用的文本相似度公式要求输入等长,而有些算法则不需要。 从上表中可以看到,大部分算法使用的文本相似度公式中,都是要求输入要等长的,这是由于这些算法都有假定,同一模式的日志长度相同,这一假定可以有效减少相似度计算的次数,降低相似度计算的难度,但也存在一定的局限性。 Drain和DAGDrain使用的相似度公式相同,都为: 公式翻译下来,就是两条日志从左往右,一个一个单词看,相不相同,统计相同单词的数量,除以日志长度就得到相似度了,如日志[Node,001,is,unconnected]与日志[Node,002,is,unconnected],Node、is、unconneted三个单词相同,且位置一致,所以两条日志的相似度为3/4。 LogMine使用的距离公式为: 这个距离公式与Drain使用的相似度公式非常相似,不过他允许两条日志不等长,也允许手动设置单词相同时的分数。公式翻译下来,也是两条日志从左往右,一个一个单词看相不相同,直到更短的日志看到了结尾就不看了,统计相同单词的数量,除以更大的日志长度得到相似度。如,若k1=1,日志[Node,001,is,unconnected]与日志[Node,002,is, unconnected,too],Node、is、unconneted三个单词相同,且位置一致,所以两条日志的相似度为3/5。但是这个距离公式同样有局限性,若日志位置出现了一点偏移,那么相同模式的日志计算出的相似度也会非常低,如日志[Node,001,is,unconnected]与日志[Node,002,003,is,unconnected]。虽然日志都包含单词Node、is、unconneted,属于同一模式,但is、unconneted在两条日志中的位置不同,所以两条日志的相似度算下来只有1/5。 Spell中,则通过LCS(最大公共子序列)来判断相似度: LCS是计算机科学中的一个经典问题,不了解的同学可以自行百度一下,Spell通过LCS判断相似度的方式突破了长度的局限性,但是也带来了效率的问题,因为精确解决LCS问题的算法需要O(mn) (m,n为seq1、seq2长度) 的时间复杂度。 LKE使用的距离为文本的编辑距离,及计算将seq1转化为seq2,所需要操作(增、删、改)的最小单词数量。此外,LKE提出,在计算距离时,要考虑到操作的单词的位置,操作的单词越靠前,两条文本的距离越大。因此,文章提出了加权的编辑距离: 编辑距离同样突破了长度的局限性,但时间复杂度仍然是一个痛点。 Lenma计算相似度时,需要先根据日志消息,提取特征向量。Lenma使用的特征向量叫做词长度向量,提取的方式很简单,即记下日志每个单词的长度,然后将长度拼接在一块就可以了。如日志[Node,001,is,unconneted],其词长度向量为[4,3,2,10]。其相似度计算公式为词长度向量的余弦相似度: 先提取特征向量再计算相似度的优点在于,向量可以并行进行矩阵计算,在相似度计算这一模块计算效率会更高,但是提取特征,也意味着丢失信息。 SHISO的所使用的相似度公式为: 其中,C(W1[i])、C(W2[i])为根据单词W1[i]、W2[i]生成的特征向量。SHISO中考虑的特征向量有大写字母、小写字母、数字、及其他,则生成的向量为4维,每一维度分别是大写字母、小写字母、数字、及其他的个数。如单词Node,生成的特征向量为[1,3,0,0]。 b. 聚类逻辑: 有了相似度计算公式之后,就可以进行聚类了。一种最简单的聚类逻辑就是,将所有聚类簇存储下来,当有一条日志需要解析时,将该日志与所有聚类簇的聚类中心(聚类中心可能是单词列表,也可能是特征向量,由第一个进入该聚类簇的日志决定,并随着进入的日志而更新)一一计算相似度,找到相似度最大的聚类簇。若相似度满足阈值要求,则将待解析日志并入该聚类簇中,并更新聚类中心,若没有满足阈值要求的聚类簇,则将待解析日志作为聚类中心,创建新的聚类簇。Spell和Lenma用的都是这样的聚类逻辑。 这种聚类逻辑非常简单,但有一个问题,就是计算相似度的次数太多,有多少个聚类簇就要计算多少次相似度,计算效率低下。所以,更多的算法,在计算相似度之前,会先给日志进行分组,然后每个组内采用这样的聚类逻辑进行聚类。 如Drain算法,就采用了树结构的方式对日志进行分组。Drain的分组策略有两块:根据日志的长度分组以及根据日志的前几个单词分组。Drain的树深度可设,树深度决定了用前多少个单词进行分组。其分组策略如图所示,当有一条日志需要解析时,会根据该日志的长度及前几个单词依次向下搜索,直到叶子节点。叶子节点下存储着该组别中的聚类簇,搜索到叶子节点后再计算相似度,根据相似度计算结果更新聚类中心或者创建新的聚类簇。 DAGDrain算法与Drain算法类似,也采用了树结构进行分组,分组策略有两块:根据日志的长度分组及根据日志的首单词或尾单词分组。日志的长度容易理解,根据日志的首单词或尾单词分组的方式是:根据日志的首单词或者尾单词是否含有数字及特殊字符,提取出日志的首单词或者尾单词,并给其加上首单词或者尾单词的标志作为split_token,split_token一致的日志才会被分到同一组别当中。 AEL算法则会根据日志长度及key-value对的对数给日志进行分组,然后在组别下计算相似度进行聚类。 总结下来,提前分组的方式一共有四种:根据日志长度分组,根据日志前几个单词分组,根据日志的首单词或者尾单词分组,根据key-value对的对数分组,这四种方式其实都有其不足之处。根据日志长度分组受分词影响太大,不当的分词可能会使相同模式的日志有不同的长度,而且,对于某些参数占多个位置的日志,长度也会将其错误的分到不同组别中。如日志[Node,000,is,unconnected]与日志[Node,001,002,is,unconnected]。根据日志前几个单词分组在大部分时候是有用的,但有时参数也有可能在日志前列。根据日志的首单词或者尾单词分组的策略,若日志的header未去除,则大概率无法发挥其效果。根据key-value对的对数分组,则有可能受到正则匹配不当的影响。 除了提前分组之外,层次聚类也是提高解析效率的一个方法,如SHISO,SHISO也是一个树结构的解析算法,树的每个节点都对应一个聚类簇,算法要求每个节点的子节点个数都要小于阈值t。其算法流程为:遍历子节点,看是否存在相似度满足要求的聚类簇。若存在,则更新聚类中心;若不存在,且子节点个数小于阈值,则在该节点下插入新聚类簇;若不存在,且子节点个数等于阈值,则找到相似度最大的节点,在该节点下继续遍历子节点,一直迭代直到找到相似度满足要求的聚类簇。 Logmine中也提到可以用层次聚类算法,不过他的层次聚类目的却并不是提高效率,相反,可能还会降低一定的解析效率,但却给人工灵活处理解析等级提供了可能。Logmine也是采用的树结构进行聚类,其提出,在树的第一层,用非常小的距离阈值对日志进行聚类,形成聚类簇,这样,可以将日志分的足够细,避免不同模式的日志聚在一起,聚类簇的聚类中心为第一个进入该聚类簇的日志,且不更新。第二层开始,用更大的距离阈值,对上一层的聚类中心进行聚类,形成聚类中心的聚类簇,聚类中心为第一个进入聚类簇的数据,且随着新的数据进入而更新。 c. 自动阈值: 大部分基于聚类的解析算法,相似度阈值都是需要人工设置的,LKE和DAGDrain给出了两种自动阈值的思路。LKE提出可以通过k-means聚类获得相似度阈值,而DAGDrain则提出如下的自动阈值公式: 然而自动阈值的有效性还有待验证,在此就不再展开说明。 (2). 基于频繁项挖掘的日志模式解析: 基于频繁项挖掘的日志模式解析算法,在聚类前,要对频率进行统计(大部分是单词频率,Logram统计的是n-gram频率)。 SLCT是最早的日志模式解析算法,其原理较为简单,算法流程如下:如果某条日志中日志单词W(i)的出现频率大于阈值s,那么认为W(i)是一个频繁词,将该条日志的所有频繁词及其位置提取出来,作为聚类候选。如日志[Interface,eth0,down]中,若Interface,down的出现频率大于阈值,则该日志生成的聚类候选为{(Interface, 1) (down, 3)},聚类簇候选出现次数大于阈值则正式称为聚类簇。 Logram创新性的将n-gram引入到频繁项挖掘算法中。其在解析前,需要统计日志中所有的n-gram频率(n=1,2,……k, k为设置参数)。解析时,先获得日志的k-gram频率,将频率小于k-gram阈值的k-gram挑出来作为参数候选,然后,将挑选出来的k-gram分解为k-1-gram,再从其跳出k-1-gram的参数候选,直到2-gram。对于日志的任一单词,若其所有2-gram都在2-gram参数候选中,则该单词为参数,反之为常量。如日志[Node,000,is,unconnected]中,000的2-gram有Node->000,000->is,若Node->000,000->is都在2-gram参数候选中,则000为参数。将常量固定,参数转化为特殊符号<*>即可获得日志模式。 SLCT与Logram都是效率非常快的算法,但是他们均有一个问题:判断频繁词(或频繁n-gram)的阈值不好确定。而且,在现实中,存在这样一种情况:某些代码打印的次数非常少,但有些代码打印的次数非常多,这就意味着,那些打印次数少的代码生成的日志中,常量的频率也会很低,非常容易被认为是参数。所以,这两种算法不太推荐使用。 FT-tree也是一种基于频繁项挖掘的日志模式解析算法,采用了独创的FT-tree的数据结构进行解析。在解析前,该算法会遍历所有日志,然后获得日志中单词的出现频率,将单词根据其出现频率从大到小排序,形成列表L。解析日志时,对于待解析日志,会根据列表L对日志的单词进行排序,然后插入到FT-tree中(这样可以让频率高的单词更靠近根节点,频率低的单词更远离根节点),如图所示,直到所有日志都插入完成。那接下来FT-tree又是如何判断常量与参数的呢? 我们考虑对于同一代码打印出来的日志,如[Node,000,is,unconnected],[Node,001,is,unconnected],[Node,002,is,unconnected],将这些日志插入到FT-tree中后,越靠近根节点的单词肯定越有可能是常量,因为出现频率越高。而且,我们会发现,在靠近根节点时,树几乎没有分岔,但到某个节点后,子节点的个数将指数型上升,该节点正是常量与参数的分界线。通过这个思想实验,我们可以很自然的得到FT-tree接下来的操作——剪枝。这样一来,留在FT-tree中的节点代表的就都是常量了。含有相同常量的日志,FT-tree认为属于同一模式。 FT-tree结构巧妙,但也有可能存在一些问题,如有些参数可能是有限的,在FT-tree上不会造成那么大的分岔,可能也会留在FT-tree上,此外,不同模式之间,若含有共同的常量,在该常量下也有可能会造成分岔而导致子节点被剪枝,将多种模式分到一起。 (3). 基于启发的日志模式解析 本文调研的基于启发的日志模式解析算法只有两种,POP和IPLOM,但是其实,在基于聚类的日志模式解析算法中,也用到了很多启发式规则,如Drain、DAGDrain的分组策略。 POP中所用的启发式策略有两个:1、根据日志长度分组。2、根据单词位置分组。根据单词位置分组的思路与FT-tree的思路有些类似,都是基于认为参数会导致分岔过多而设计的。其步骤是:在组别内,统计每个位置上,该组别中一共有几种单词,找到单词种类最少但不为1的位置进行分组。如下图四条日志中,就可以选择位置1或位置2进行分组,因为位置1和位置2都只有2种单词,而位置3有4种。一直如此分,直到非1的最小单词种类数及单词种类数除以组内日志数的值都大于阈值。 IPLOM中用的启发式策略有三个:1、根据日志长度分组。2、根据单词位置分组。3、根据双射关系分组。其中,启发式策略3的原理同样是认为参数会导致分岔过多,在此不继续介绍。 3、模式融合: DAGDrain算法及POP算法中,都提到在得到日志模式之后,可以将通过计算日志模式之间的相似度,将日志模式再次聚类进行融合。日志模式融合是一个高杠杆的操作,因为模式的融合需要聚类的数据量为模式数量,远小于日志数量,所以相对于日志聚类,模式融合花费的时间非常少,而其又可以起到改善聚类结果的作用。 DAGDrain中,采用的模式融合相似度为: 其中,lenNew为融合后的新模式的长度,lenExist为原有模式的长度,lenLCS为新模式与原有模式的最大公共子序列长度。 POP中,采用的模式融合距离公式为曼哈顿距离: 其中,N为两个文本所含有的公共单词,ai、bi分别值文本a、b中,第i个单词的数量。 四、小tip: 日志解析算法很多,而且通过刚才的介绍我们可以发现,上述算法中,很多步骤,都可以理解为是一个分组的过程,分组是互相不影响的过程,我们根据这个策略分组之后,在分完的组内,继续通过其他策略分组也是可以的。所以我们不妨大胆一些,有很多算法中的方法都是可以相互融合组成新算法的。比如说,在Drain算法的树结构中,是否可以加入按照key-value对个数分组的层呢?又比如说,是否可以将FT-tree的树结构,看做是一个分组的过程,分组之后,再根据相似度计算进行聚类呢?又比如说,Drain算法分完组后,是否可以再使用SHISO的层次聚类策略,避免Drain算法某个叶子节点下的模式过多影响效率呢?但是,在融合的过程,永远要注意效果,与效率。 写在最后 近年来,在AIOps领域快速发展的背景下,IT工具、平台能力、解决方案、AI场景及可用数据集的迫切需求在各行业迸发。基于此,云智慧在2021年8月发布了AIOps社区, 旨在树起一面开源旗帜,为各行业客户、用户、研究者和开发者们构建活跃的用户及开发者社区,共同贡献及解决行业难题、促进该领域技术发展。 社区先后 开源 了数据可视化编排平台-FlyFish、运维管理平台 OMP 、云服务管理平台-摩尔平台、 Hours 算法等产品。 可视化编排平台-FlyFish: 项目介绍:https://www.cloudwise.ai/flyFish.html Github地址: https://github.com/CloudWise-OpenSource/FlyFish Gitee地址: https://gitee.com/CloudWise/fly-fish 行业案例:https://www.bilibili.com/video/BV1z44y1n77Y/ 部分大屏案例: 请您通过上方链接了解我们,添加小助手(xiaoyuerwie)备注:飞鱼。加入开发者交流群,可与业内大咖进行1V1交流! 也可通过小助手获取云智慧AIOps资讯,了解云智慧FlyFish最新进展!

优秀的个人博客,低调大师

每日一博 | 日志中台不重不丢实现浅谈

导读:日志数据的生命周期包含日志采集、接入、传输、应用等各个环节。数据的稳定性对于公司报表建设、决策分析、转化策略效果都有至关重要的影响。全文旨在介绍百度日志中台当前的现状,公司内部应用推广情况。尤其在数据准确性的建设上,进行深入的探讨。数据产生到最终业务应用中各个环节的稳定性建设,包括:数据上报时效性优化、接入持久化的思考、数据流式计算过程中的不重不丢建设等。 全文4047字,预计阅读时间12分钟 一 简述 1.1 中台定位 日志中台是针对打点数据的一站式服务,实现打点数据的全生命周期管理,只需简单开发就能快捷完成日志数据采集、传输、管理以及查询分析等功能,适用于产品运营分析、研发性能分析、运维管理等业务场景,帮助APP端、服务端等客户探索数据、挖掘价值、预见未来。 1.2 接入情况 日志中台已覆盖了厂内大多数重点产品,其中包括:百度APP全打点、小程序、矩阵APP等,接入方面收益如下: 接入情况:几乎覆盖了厂内已有APP,小程序,创新孵化APP,以及厂外收购APP 服务规模:日志条数 几千亿 条/天,高峰QPS 几百万/秒,服务稳定性 99.9995 % 1.3 名词解释 客户端:指用户可以直接使用的软件系统,通常部署在用户手机或PC等终端设备上。例如百度APP、小程序等。 服务端:用于响应客户端发起的网络请求的服务,通常部署在云服务器上。 日志中台:此处特指端日志中台,包括端日志全生命周期的能力建设。包括打点SDK / 打点server/ 日志管理平台等核心组件。 打点SDK:负责打点日志的采集、封装、上报等功能。根据不同的日志生产端,分为APP端SDK、H5端SDK,根据场景区分为通用点位SDK、性能SDK、小程序SDK等,用户根据需求可以集成不同的SDK。 打点server:日志接收服务端,是日志中台服务端最核心的模块。 特征/模型服务:日志中台将需要进行策略模型计算的点位信息实时转发给下游<策略推荐中台>。特征/模型服务是<策略推荐中台>的入口模块。 1.4 服务全景图 日志服务主要包括基础层、管理平台、业务数据应用、产品支撑几个层面。围绕着各个层级,在2021.6月,制定&发布了百度客户端日志上报规范。 基础层:支持了APP-SDK、JS-SDK,性能SDK、通用SDK,满足各类打点需求的快速接入场景。依托大数据基础服务,将打点数据分发至各个应用方。 平台层:管理平台支持数据元信息管理、维护,并控制打点生命全周期环节。在线层面支持数据的实时、离线转发、并依托合理的流量控制、监控保证服务稳定性在99.995%。 业务能力:日志打点数据输出至数据中心、性能平台、策略中台、增长中台等,有效助力产品决策分析、端质量监控、策略增长等领域。 业务支持:覆盖重点APP、新孵化矩阵APP,横向通用组件方面。 二、日志中台核心目标 如前文介绍,日志中台承载着百度内所有APP日志打点、站在数据生产的最前沿,在保证功能覆盖全、接入快速&灵活的基础上,面临的最重要核心挑战是数据的准确性。整个数据从产出、日志中台接入处理、下游应用,一切数据质量问题需要日志中台承载。而数据的准确性可以拆解为2部分: 不重:保证数据严格意义的不重复。需要防止系统层面的各种重试、架构异常恢复导致的数据重复问题; 不丢:保证数据严格意义的不丢失。需要防止系统层面的故障、代码层面bug等导致的数据丢失问题。 而做到系统层面的近乎100%的不重不丢,需要面临较多的难题。 2.1 日志中台架构 接入日志中台打点数据从端上生产至在线服务到最终(实时/离线)转发至下游,需要经过如下几个环节: 数据应用方式不同,有以下集中类型: 实时 准实时流(消息队列):供下游数据分析使用,特点:较高(min)时效性,需要严格意义的数据准确。典型应用:研发平台、trace平台; 纯实时流(RPC代理):供下游策略应用,特点:秒级时效性,允许一定程度的数据丢失。典型应用:推荐架构。 离线:离线大表,所有日志全集,特点:天级/小时级时效性,需要严格意义的数据准确。 其他:需要一定时效性和准确率 2.2 面临的问题 从上面日志中台架构来看,存在如下问题: 巨型模块:打点server承载了所有的数据处理逻辑,功能耦合严重: 功能多:接入&持久化、业务逻辑处理、各种类型转发(rpc、消息队列、pb落盘); 扇出多:有10+个业务扇出流,通过打点server转发。 直接对接消息队列:从业务视角看,存在发送消息队列消息丢失风险,且无法满足业务不重不丢要求。 业务无等级划分: 核心业务与非核心业务架构部署耦合 相互迭代、相互影响 三、不重不丢实现 3.1 数据不丢的理论基础 3.1.1 唯2丢失数据理论 端:由于移动端的客观环境影响,如白屏、闪退、无法常驻进程、启动周期不确定等因素,导致客户端消息会存在一定概率丢失 接入层:由于服务器不可避免的存在故障(服务重启、服务器故障)的可能性,也存在一定的数据丢失概率 计算层:接入点之后,基于流式框架,建设需要严格意义的保证数据不重不丢。 3.1.2 日志中台架构优化方向 数据接入层面: 先持久化数据,后业务处理的原则 降低逻辑复杂度 下游转发层面: 实时流类:严格意义不丢失 高时效类:保证数据时效,允许可能存在的部分丢失 资源隔离:将不同业务的部署进行物理隔离,避免不同业务相互影响 区分优先级:按照业务对不同数据诉求,区分不同类型 3.2 架构拆解 基于日志中台现状分析,结合日志打点服务的唯2理论,我们针对日志中台对现有架构进行问题拆解和架构重构。 3.2.1 打点server服务拆解(优化接入层数据丢失) 基于以上不重不丢的理论,日志接入层进行了如下几个方面的建设,尽可能做到数据不重不丢。 日志优先持久化:尽可能降低接入点因服务器故障等原因导致的数据丢失问题; 巨型服务拆解:接入点应该秉承简单、轻量的思路建设,避免过多业务属性导致的服务稳定性问题; 灵活&易用:在不重不丢的同时,基于业务需求特点,设计合理的流式计算架构。 3.2.1.1 日志优先持久化 日志中台现有的扇出数据,需要优先进行持久化,这是日志接入层基本要求。而实时流方面,在保证业务数据转发分钟级延迟的情况下,要做到数据“尽可能不丢”。 持久化:接入层在真正业务处理之前,优先将数据持久化处理,“尽可能”先保证数据不丢失。 实时流:避免直接对接消息队列,优先采用落盘+minos转发消息队列方式,保证数据至多分钟级延迟的情况下,尽量不丢。 3.2.1.2 巨型服务拆解&功能下沉 为降低日志服务过多的功能迭代带来的稳定性风险,同时需要满足下游业务灵活订阅的需求,需要保证日志中台扇出的合理性。我们将在线服务进一步拆解: 实时流类业务:打点消息流转经过接入层→扇出层→业务层→ 业务。 接入层:功能单一,设计目标为数据尽可能不丢,保证数据第一时间持久化; 扇出层:保证下游灵活的订阅方式,进行数据拆分&重组(目前基于打点id维度扇出); 业务层:组合订阅扇出层数据,完成业务自有的需求实现,负责将打点数据生产并转发至下游; 高时效类业务: 策略实时推荐类的业务,单独抽离服务,支撑rpc类的数据转发,保证超高时效并保证数据转发SLA达到99.95%以上; 其他类业务: 数据监控、vip、灰度等业务,对时效、丢失率要求进一步降低,可将这部分业务抽离至单独服务; 技术选型:针对数据流式计算特点,我们选用了streamcompute架构,保证数据在经过接入层之后,全流程的“不重不丢”。 因此,将日志服务进一步拆解,如下图所示: 3.2.1.3 流式计算思考 为了保证严格数据流稳定性,需要依赖流式计算架构,在解决数据在业务计算过程中完全的不重不丢同时,满足业务不同场景获取数据的诉求。针对日志中台特点,我们对流式计算处理架构进入如下设计: 打点server:将实时流通过消息队列,单独扇出至流式框架(分流flow入口) 分流flow:将不同点位信息,基于流量大小,进行拆分输出至不同消息队列。这样做的好处是兼顾了数据灵活扇出要求,下游可以灵活订阅; QPS小于某些阈值 or 横向点位等:单独消息队列输出,达到灵活扇出; QPS较小点位,进行聚合输出至聚合队列,以便节省资源; 业务flow:如果业务有自己的数据流式处理需求,可以单独部署作业,以便各个作业资源隔离。 输入:组合订阅分流flow的不同扇出数据,进行数据计算; 输出:数据混合计算后,输出至业务消息队列,业务方自行订阅处理; 业务filter:作为发送至业务层的终极算子,负责各个数据流在端到端层面。(打点server、端的系统重试数据)的不重。打点server将每一条打点数据生成唯一标识(类似一条数据md5),业务flow filter算子进行全局的去重。 3.2.2 打点SDK数据上报优化(解决端上报数据丢失) 客户端打点,因端所处的环境问题,会存在一定的数据丢失风险。尤其当打点调用并发较高时候,数据不可能第一时间全部发送到服务端。因此,客户端需要将业务打点数据暂存本地的数据库,然后异步进行消息发送至服务端,以达到异步发送、优先本地持久化不丢的保证。但是,APP可以在任何情况下退出、卸载,那数据在本地停留越久,对业务数据价值越小,更容易丢失,所以我们需要针对数据上报进行如下方向的优化: 增加上报时机:单独定时任务轮询、业务打点时触发携带缓存数据、缓存消息达到阈值触发(实验获得)等手段,提高缓存数据的上报的时机,尽量降低消息在本地缓存时间。 增加上报消息个数:在保证数据上报大小、条数(实验对比得到阈值),将上报消息的条数进行调整,取得合理上报个数,达到消息第一时间到达服务端的最大收益。 通过客户端发送逻辑不断优化,在时效性上也取得了巨大收益。收敛率双端提升2%+。 四、展望 前文介绍了日志中台服务在打点数据准确性保障方面,做的一些努力。当然,后面我们还会继续深挖系统的风险点,如: 磁盘故障导致数据丢失:接入层后续针对磁盘故障,基于公司的数据持久化能力,建设数据的严格不丢失基础 希望,日志中台持续不断优化,为业务准确使用打点数据做出贡献。 推荐阅读: 视觉Transformer中的输入可视化方法 深入理解 WKWebView (渲染篇) —— DOM 树的构建 深入理解 WKWebView(入门篇)—— WebKit 源码调试与分析 GDP Streaming RPC 设计 百度APP视频播放中的解码优

优秀的个人博客,低调大师

每日一博 | 解析分布式系统的缓存设计

一、缓存简介 1.1 什么是缓存 缓存就是数据交换的缓冲区。缓存的本质是一个内存 Hash。缓存是一种利用空间换时间的设计,其目标就是更快、更近:极大的提高。 将数据写入/读取速度更快的存储(设备); 将数据缓存到离应用最近的位置; 将数据缓存到离用户最近的位置。 缓存是用于存储数据的硬件或软件的组成部分,以使得后续更快访问相应的数据。缓存中的数据可能是提前计算好的结果、数据的副本等。典型的应用场景:有 cpu cache, 磁盘 cache 等。本文中提及到缓存主要是指互联网应用中所使用的缓存组件。 缓存命中率是缓存的重要度量指标,命中率越高越好。 缓存命中率 = 从缓存中读取次数 / 总读取次数 1.2 何时需要缓存 引入缓存,会增加系统的复杂度。所以,引入缓存前,需要先权衡是否值得,考量点如下: CPU 开销- 如果应用某个计算需要消耗大量 CPU,可以考虑缓存其计算结果。典型场景:复杂的、频繁调用的正则计算;分布式计算中间状态等。 IO 开销- 如果数据库连接池比较繁忙,可以考虑缓存其查询结果。 在数据层引入缓存,有以下几个好处: 提升数据读取速度。 提升系统扩展能力,通过扩展缓存,提升系统承载能力。 降低存储成本,Cache+DB 的方式可以承担原有需要多台 DB 才能承担的请求量,节省机器成本。 1.3 缓存的基本原理 根据业务场景,通常缓存有以下几种使用方式: 懒汉式(读时触发):先查询 DB 里的数据, 然后把相关的数据写入 Cache。 饥饿式(写时触发):写入 DB 后, 然后把相关的数据也写入 Cache。 定期刷新:适合周期性的跑数据的任务,或者列表型的数据,而且不要求绝对实时性。 1.4 缓存淘汰策略 缓存淘汰的类型: 1)基于空间:设置缓存空间大小。 2)基于容量:设置缓存存储记录数。 3)基于时间 TTL(Time To Live,即存活期)缓存数据从创建到过期的时间。 TTI(Time To Idle,即空闲期)缓存数据多久没被访问的时间。 缓存淘汰算法: 1)FIFO:先进先出。在这种淘汰算法中,先进入缓存的会先被淘汰。这种可谓是最简单的了,但是会导致我们命中率很低。试想一下我们如果有个访问频率很高的数据是所有数据第一个访问的,而那些不是很高的是后面再访问的,那这样就会把我们的首个数据但是他的访问频率很高给挤出。 2)LRU:最近最少使用算法。在这种算法中避免了上面的问题,每次访问数据都会将其放在我们的队尾,如果需要淘汰数据,就只需要淘汰队首即可。但是这个依然有个问题,如果有个数据在 1 个小时的前 59 分钟访问了 1 万次(可见这是个热点数据),再后一分钟没有访问这个数据,但是有其他的数据访问,就导致了我们这个热点数据被淘汰。 3)LFU:最近最少频率使用。在这种算法中又对上面进行了优化,利用额外的空间记录每个数据的使用频率,然后选出频率最低进行淘汰。这样就避免了 LRU 不能处理时间段的问题。 这三种缓存淘汰算法,实现复杂度一个比一个高,同样的命中率也是一个比一个好。而我们一般来说选择的方案居中即可,即实现成本不是太高,而命中率也还行的 LRU。 二、缓存的分类 缓存从部署角度,可以分为客户端缓存和服务端缓存。 客户端缓存 HTTP 缓存 浏览器缓存 APP 缓存(1、Android 2、IOS) 服务端缓存 CDN 缓存:存放 HTML、CSS、JS 等静态资源。 反向代理缓存:动静分离,只缓存用户请求的静态资源。 数据库缓存:数据库(如 MySQL)自身一般也有缓存,但因为命中率和更新频率问题,不推荐使用。 进程内缓存:缓存应用字典等常用数据。 分布式缓存:缓存数据库中的热点数据。 其中,CDN 缓存、反向代理缓存、数据库缓存一般由专职人员维护(运维、DBA)。后端开发一般聚焦于进程内缓存、分布式缓存。 2.1 HTTP 缓存 2.2 CDN 缓存 CDN 将数据缓存到离用户物理距离最近的服务器,使得用户可以就近获取请求内容。CDN 一般缓存静态资源文件(页面,脚本,图片,视频,文件等)。 国内网络异常复杂,跨运营商的网络访问会很慢。为了解决跨运营商或各地用户访问问题,可以在重要的城市,部署 CDN 应用。使用户就近获取所需内容,降低网络拥塞,提高用户访问响应速度和命中率。 图片引用自:Why use a CDN 2.1.1 CDN 原理 CDN 的基本原理是广泛采用各种缓存服务器,将这些缓存服务器分布到用户访问相对集中的地区或网络中,在用户访问网站时,利用全局负载技术将用户的访问指向距离最近的工作正常的缓存服务器上,由缓存服务器直接响应用户请求。 1)未部署 CDN 应用前的网络路径: 请求:本机网络(局域网)=> 运营商网络 => 应用服务器机房 响应:应用服务器机房 => 运营商网络 => 本机网络(局域网) 在不考虑复杂网络的情况下,从请求到响应需要经过 3 个节点,6 个步骤完成一次用户访问操作。 2)部署 CDN 应用后网络路径: 请求:本机网络(局域网) => 运营商网络 响应:运营商网络 => 本机网络(局域网) 在不考虑复杂网络的情况下,从请求到响应需要经过 2 个节点,2 个步骤完成一次用户访问操作。与不部署 CDN 服务相比,减少了 1 个节点,4 个步骤的访问。极大的提高了系统的响应速度。 2.1.2 CDN 特点 优点 本地 Cache 加速:提升访问速度,尤其含有大量图片和静态页面站点; 实现跨运营商的网络加速:消除了不同运营商之间互联的瓶颈造成的影响,实现了跨运营商的网络加速,保证不同网络中的用户都能得到良好的访问质量; 远程加速:远程访问用户根据 DNS 负载均衡技术智能自动选择 Cache 服务器,选择最快的 Cache 服务器,加快远程访问的速度; 带宽优化:自动生成服务器的远程 Mirror(镜像)cache 服务器,远程用户访问时从 cache 服务器上读取数据,减少远程访问的带宽、分担网络流量、减轻原站点 WEB 服务器负载等功能。 集群抗攻击:广泛分布的 CDN 节点加上节点之间的智能冗余机制,可以有效地预防黑客入侵以及降低各种 D.D.o.S 攻击对网站的影响,同时保证较好的服务质量。 缺点 不适宜缓存动态资源 解决方案:主要缓存静态资源,动态资源建立多级缓存或准实时同步; 存在数据的一致性问题 1.解决方案(主要是在性能和数据一致性二者间寻找一个平衡)。 2.设置缓存失效时间(1 个小时,过期后同步数据)。 3.针对资源设置版本号。 2.2 反向代理缓存 反向代理(Reverse Proxy)方式是指以代理服务器来接受 internet 上的连接请求,然后将请求转发给内部网络上的服务器,并将从服务器上得到的结果返回给 internet 上请求连接的客户端,此时代理服务器对外就表现为一个反向代理服务器。 2.2.1 反向代理缓存原理 反向代理位于应用服务器同一网络,处理所有对 WEB 服务器的请求。反向代理缓存的原理: 如果用户请求的页面在代理服务器上有缓存的话,代理服务器直接将缓存内容发送给用户。 如果没有缓存则先向 WEB 服务器发出请求,取回数据,本地缓存后再发送给用户。 这种方式通过降低向 WEB 服务器的请求数,从而降低了 WEB 服务器的负载。 反向代理缓存一般针对的是静态资源,而将动态资源请求转发到应用服务器处理。常用的缓存应用服务器有 Varnish,Ngnix,Squid。 2.2.2 反向代理缓存比较 常用的代理缓存有 Varnish,Squid,Ngnix,简单比较如下: Varnish 和 Squid 是专业的 cache 服务,Ngnix 需要第三方模块支持; Varnish 采用内存型缓存,避免了频繁在内存、磁盘中交换文件,性能比 Squid 高; Varnish 由于是内存 cache,所以对小文件如 css、js、小图片的支持很棒,后端的持久化缓存可以采用的是 Squid 或 ATS; Squid 功能全而大,适合于各种静态的文件缓存,一般会在前端挂一个 HAProxy 或 Ngnix 做负载均衡跑多个实例; Nginx 采用第三方模块 ncache 做的缓冲,性能基本达到 Varnish,一般作为反向代理使用,可以实现简单的缓存。 三、进程内缓存 进程内缓存是指应用内部的缓存,标准的分布式系统,一般有多级缓存构成。本地缓存是离应用最近的缓存,一般可以将数据缓存到硬盘或内存。 硬盘缓存:将数据缓存到硬盘中,读取时从硬盘读取。原理是直接读取本机文件,减少了网络传输消耗,比通过网络读取数据库速度更快。可以应用在对速度要求不是很高,但需要大量缓存存储的场景。 内存缓存:直接将数据存储到本机内存中,通过程序直接维护缓存对象,是访问速度最快的方式。 常见的本地缓存实现方案:HashMap、Guava Cache、Caffeine、Ehcache。 3.1 ConcurrentHashMap 最简单的进程内缓存可以通过 JDK 自带的 HashMap 或 ConcurrentHashMap 实现。 适用场景:不需要淘汰的缓存数据。 缺点:无法进行缓存淘汰,内存会无限制的增长。 3.2LRUHashMap 可以通过继承 LinkedHashMap 来实现一个简单的 LRUHashMap。重写 removeEldestEntry 方法,即可完成一个简单的最近最少使用算法。 缺点: 锁竞争严重,性能比较低。 不支持过期时间。 不支持自动刷新。 3.3 Guava Cache 解决了LRUHashMap 中的几个缺点。Guava Cache 采用了类似 ConcurrentHashMap 的思想,分段加锁,减少锁竞争。 Guava Cache 对于过期的 Entry 并没有马上过期(也就是并没有后台线程一直在扫),而是通过进行读写操作的时候进行过期处理,这样做的好处是避免后台线程扫描的时候进行全局加锁。直接通过查询,判断其是否满足刷新条件,进行刷新。 3.4 Caffeine Caffeine 实现了 W-TinyLFU(LFU + LRU 算法的变种),其命中率和读写吞吐量大大优于 Guava Cache。其实现原理较复杂,可以参考你应该知道的缓存进化史。 3.5 Ehcache EhCache 是一个纯 Java 的进程内缓存框架,具有快速、精干等特点,是 Hibernate 中默认的 CacheProvider。 优点 快速、简单; 支持多种缓存策略:LRU、LFU、FIFO 淘汰算法; 缓存数据有两级:内存和磁盘,因此无需担心容量问题; 缓存数据会在虚拟机重启的过程中写入磁盘; 可以通过 RMI、可插入 API 等方式进行分布式缓存; 具有缓存和缓存管理器的侦听接口; 支持多缓存管理器实例,以及一个实例的多个缓存区域; 提供 Hibernate 的缓存实现。 缺点 使用磁盘 Cache 的时候非常占用磁盘空间; 不保证数据的安全; 虽然支持分布式缓存,但效率不高(通过组播方式,在不同节点之间同步数据)。 3.6 进程内缓存对比 常用进程内缓存技术对比: ConcurrentHashMap:比较适合缓存比较固定不变的元素,且缓存的数量较小的。虽然从上面表格中比起来有点逊色,但是其由于是 JDK 自带的类,在各种框架中依然有大量的使用,比如我们可以用来缓存我们反射的 Method,Field 等等;也可以缓存一些链接,防止其重复建立。在 Caffeine 中也是使用的 ConcurrentHashMap 来存储元素。 LRUMap:如果不想引入第三方包,又想使用淘汰算法淘汰数据,可以使用这个。 Ehcache:由于其 jar 包很大,较重量级。对于需要持久化和集群的一些功能的,可以选择 Ehcache。需要注意的是,虽然 Ehcache 也支持分布式缓存,但是由于其节点间通信方式为 rmi,表现不如 Redis,所以一般不建议用它来作为分布式缓存。 Guava Cache:Guava 这个 jar 包在很多 Java 应用程序中都有大量的引入,所以很多时候其实是直接用就好了,并且其本身是轻量级的而且功能较为丰富,在不了解 Caffeine 的情况下可以选择 Guava Cache。 Caffeine:其在命中率,读写性能上都比 Guava Cache 好很多,并且其 API 和 Guava cache 基本一致,甚至会多一点。在真实环境中使用 Caffeine,取得过不错的效果。 总结一下:如果不需要淘汰算法则选择 ConcurrentHashMap,如果需要淘汰算法和一些丰富的 API,推荐选择。 四、分布式缓存 分布式缓存解决了进程内缓存最大的问题:如果应用是分布式系统,节点之间无法共享彼此的进程内缓存。分布式缓存的应用场景: 缓存经过复杂计算得到的数据。 缓存系统中频繁访问的热点数据,减轻数据库压力。 不同分布式缓存的实现原理往往有比较大的差异。本文主要针对 Memcached 和 Redis 进行说明。 4.1 Memcached Memcached 是一个高性能,分布式内存对象缓存系统,通过在内存里维护一个统一的巨大的Hash表,它能够用来存储各种格式的数据,包括图像、视频、文件以及数据库检索的结果等。 简单的说就是:将数据缓存到内存中,然后从内存中读取,从而大大提高读取速度。 4.1.1 Memcached 特性 使用物理内存作为缓存区,可独立运行在服务器上。每个进程最大 2G,如果想缓存更多的数据,可以开辟更多的 Memcached 进程(不同端口)或者使用分布式 Memcached 进行缓存,将数据缓存到不同的物理机或者虚拟机上。 使用 key-value 的方式来存储数据。这是一种单索引的结构化数据组织形式,可使数据项查询时间复杂度为 O(1)。 协议简单,基于文本行的协议。直接通过 telnet 在 Memcached 服务器上可进行存取数据操作,简单,方便多种缓存参考此协议; 基于 libevent 高性能通信。Libevent 是一套利用 C 开发的程序库,它将 BSD 系统的 kqueue,Linux 系统的 epoll 等事件处理功能封装成一个接口,与传统的 select 相比,提高了性能。 分布式能力取决于 Memcached 客户端,服务器之间互不通信。各个 Memcached 服务器之间互不通信,各自独立存取数据,不共享任何信息。服务器并不具有分布式功能,分布式部署取决于 Memcached 客户端。 采用 LRU 缓存淘汰策略。在 Memcached 内存储数据项时,可以指定它在缓存的失效时间,默认为永久。当 Memcached 服务器用完分配的内时,失效的数据被首先替换,然后也是最近未使用的数据。在 LRU 中,Memcached 使用的是一种 Lazy Expiration 策略,自己不会监控存入的 key/vlue 对是否过期,而是在获取 key 值时查看记录的时间戳,检查 key/value 对空间是否过期,这样可减轻服务器的负载。 内置了一套高效的内存管理算法。这套内存管理效率很高,而且不会造成内存碎片,但是它最大的缺点就是会导致空间浪费。当内存满后,通过 LRU 算法自动删除不使用的缓存。 不支持持久化。Memcached 没有考虑数据的容灾问题,重启服务,所有数据会丢失。 4.1.2 Memcached 工作原理 1)内存管理 Memcached 利用 slab allocation 机制来分配和管理内存,它按照预先规定的大小,将分配的内存分割成特定长度的内存块,再把尺寸相同的内存块分成组,数据在存放时,根据键值 大小去匹配 slab 大小,找就近的 slab 存放,所以存在空间浪费现象。 这套内存管理效率很高,而且不会造成内存碎片,但是它最大的缺点就是会导致空间浪费。 2)缓存淘汰策略 Memcached 的缓存淘汰策略是 LRU + 到期失效策略。 当你在 Memcached 内存储数据项时,你有可能会指定它在缓存的失效时间,默认为永久。当 Memcached 服务器用完分配的内时,失效的数据被首先替换,然后是最近未使用的数据。 在 LRU 中,Memcached 使用的是一种 Lazy Expiration 策略:Memcached 不会监控存入的 key/vlue 对是否过期,而是在获取 key 值时查看记录的时间戳,检查 key/value 对空间是否过期,这样可减轻服务器的负载。 3)分区 Memcached 服务器之间彼此不通信,它的分布式能力是依赖客户端来实现。具体来说,就是在客户端实现一种算法,根据 key 来计算出数据应该向哪个服务器节点读/写。 而这种选取集群节点的算法常见的有三种: 哈希取余算法:使用公式:Hash(key)% N 计算出 哈希值 来决定数据映射到哪一个节点。 一致性哈希算法:可以很好的解决 稳定性问题,可以将所有的 存储节点 排列在 首尾相接 的 Hash 环上,每个 key 在计算 Hash 后会 顺时针 找到 临接 的 存储节点 存放。而当有节点 加入 或 退出 时,仅影响该节点在 Hash 环上 顺时针相邻 的 后续节点。 虚拟 Hash 槽算法:使用 分散度良好 的 哈希函数 把所有数据 映射 到一个 固定范围 的 整数集合 中,整数定义为 槽(slot),这个范围一般 远远大于 节点数。槽 是集群内 数据管理 和 迁移 的 基本单位。采用 大范围槽 的主要目的是为了方便 数据拆分 和 集群扩展。每个节点会负责 一定数量的槽。 4.2Redis Redis 是一个开源(BSD 许可)的,基于内存的,多数据结构存储系统。可以用作数据库、缓存和消息中间件。 Redis 还可以使用客户端分片来扩展写性能。内置了 复制(replication),LUA 脚本(Lua scripting),LRU 驱动事件(LRU eviction),事务(transactions) 和不同级别的 磁盘持久化(persistence), 并通过 Redis 哨兵(Sentinel)和自动分区(Cluster)提供高可用性(high availability)。 4.2.1 Redis 特性 支持多种数据类型 - string、Hash、list、set、sorted set。 支持多种数据淘汰策略; volatile-lru:从已设置过期时间的数据集中挑选最近最少使用的数据淘汰; **volatile-ttl**:从已设置过期时间的数据集中挑选将要过期的数据淘汰; volatile-random:从已设置过期时间的数据集中任意选择数据淘汰; allkeys-lru:从所有数据集中挑选最近最少使用的数据淘汰; allkeys-random:从所有数据集中任意选择数据进行淘汰; noeviction:禁止驱逐数据。 提供两种持久化方式 - RDB 和 AOF。 通过 Redis cluster 提供集群模式。 4.2.2 Redis 原理 1)缓存淘汰 Redis 有两种数据淘汰实现; 消极方式:访问 Redis key 时,如果发现它已经失效,则删除它 积极方式:周期性从设置了失效时间的 key 中,根据淘汰策略,选择一部分失效的 key 进行删除。 2)分区 Redis Cluster 集群包含 16384 个虚拟 Hash 槽,它通过一个高效的算法来计算 key 属于哪个 Hash 槽。 Redis Cluster 支持请求分发 - 节点在接到一个命令请求时,会先检测这个命令请求要处理的键所在的槽是否由自己负责,如果不是的话,节点将向客户端返回一个 MOVED 错误,MOVED 错误携带的信息可以指引客户端将请求重定向至正在负责相关槽的节点。 3)主从复制 Redis 2.8 后支持异步复制。它有两种模式: 完整重同步(full resychronization) - 用于初次复制。执行步骤与 SYNC 命令基本一致。 部分重同步(partial resychronization) - 用于断线后重复制。如果条件允许,主服务器可以将主从服务器连接断开期间执行的写命令发送给从服务器,从服务器只需接收并执行这些写命令,即可将主从服务器的数据库状态保持一致。 集群中每个节点都会定期向集群中的其他节点发送 PING 消息,以此来检测对方是否在线。 如果一个主节点被认为下线,则在其从节点中,根据 Raft 算法,选举出一个节点,升级为主节点。 4)数据一致性 Redis 不保证强一致性,因为这会使得集群性能大大降低。 Redis 是通过异步复制来实现最终一致性。 4.3 分布式缓存对比 不同的分布式缓存功能特性和实现原理方面有很大的差异,因此他们所适应的场景也有所不同。 这里选取三个比较出名的分布式缓存(MemCache,Redis,Tair)来作为比较: MemCache:只适合基于内存的缓存框架;且不支持数据持久化和容灾。 Redis:支持丰富的数据结构,读写性能很高,但是数据全内存,必须要考虑资源成本,支持持久化。 Tair:支持丰富的数据结构,读写性能较高,部分类型比较慢,理论上容量可以无限扩充。 总结:如果服务对延迟比较敏感,Map/Set 数据也比较多的话,比较适合 Redis。如果服务需要放入缓存量的数据很大,对延迟又不是特别敏感的话,那就可以选择 Memcached。 五、多级缓存 5.1 整体缓存框架 通常,一个大型软件系统的缓存采用多级缓存方案: 请求过程: 浏览器向客户端发起请求,如果 CDN 有缓存则直接返回; 如果 CDN 无缓存,则访问反向代理服务器; 如果反向代理服务器有缓存则直接返回; 如果反向代理服务器无缓存或动态请求,则访问应用服务器; 应用服务器访问进程内缓存;如果有缓存,则返回代理服务器,并缓存数据(动态请求不缓存); 如果进程内缓存无数据,则读取分布式缓存;并返回应用服务器;应用服务器将数据缓存到本地缓存(部分); 如果分布式缓存无数据,则应用程序读取数据库数据,并放入分布式缓存; 5.2 使用进程内缓存 如果应用服务是单点应用,那么进程内缓存当然是缓存的首选方案。对于进程内缓存,其本来受限于内存的大小的限制,以及进程缓存更新后其他缓存无法得知,所以一般来说进程缓存适用于: 数据量不是很大且更新频率较低的数据。 如果更新频繁的数据,也想使用进程内缓存,那么可以将其过期时间设置为较短的时间,或者设置较短的自动刷新时间。 这种方案存在以下问题: 如果应用服务是分布式系统,应用节点之间无法共享缓存,存在数据不一致问题。 由于进程内缓存受限于内存大小的限制,所以缓存不能无限扩展。 5.3 使用分布式缓存 如果应用服务是分布式系统,那么最简单的缓存方案就是直接使用分布式缓存。其应用场景如图所示: Redis 用来存储热点数据,如果缓存不命中,则去查询数据库,并更新缓存。这种方案存在以下问题: 缓存服务如果挂了,这时应用只能访问数据库,容易造成缓存雪崩。 访问分布式缓存服务会有一定的 I/O 以及序列化反序列化的开销,虽然性能很高,但是其终究没有在内存中查询快。 5.4使用多级缓存 单纯使用进程内缓存和分布式缓存都存在各自的不足。如果需要更高的性能以及更好的可用性,我们可以将缓存设计为多级结构。将最热的数据使用进程内缓存存储在内存中,进一步提升访问速度。 这个设计思路在计算机系统中也存在,比如 CPU 使用 L1、L2、L3 多级缓存,用来减少对内存的直接访问,从而加快访问速度。一般来说,多级缓存架构使用二级缓存已可以满足大部分业务需求,过多的分级会增加系统的复杂度以及维护的成本。因此,多级缓存不是分级越多越好,需要根据实际情况进行权衡。 一个典型的二级缓存架构,可以使用进程内缓存(如:Caffeine/Google Guava/Ehcache/HashMap)作为一级缓存;使用分布式缓存(如:Redis/Memcached)作为二级缓存。 5.4.1 多级缓存查询 多级缓存查询流程如下: 首先,查询 L1 缓存,如果缓存命中,直接返回结果;如果没有命中,执行下一步。 接下来,查询 L2 缓存,如果缓存命中,直接返回结果并回填 L1 缓存;如果没有命中,执行下一步。 最后,查询数据库,返回结果并依次回填 L2 缓存、L1 缓存。 5.4.2 多级缓存更新 对于 L1 缓存,如果有数据更新,只能删除并更新所在机器上的缓存,其他机器只能通过超时机制来刷新缓存。超时设定可以有两种策略: 设置成写入后多少时间后过期; 设置成写入后多少时间刷新。 对于 L2 缓存,如果有数据更新,其他机器立马可见。但是,也必须要设置超时时间,其时间应该比 L1 缓存的有效时间长。为了解决进程内缓存不一致的问题,设计可以进一步优化; 通过消息队列的发布、订阅机制,可以通知其他应用节点对进程内缓存进行更新。使用这种方案,即使消息队列服务挂了或不可靠,由于先执行了数据库更新,但进程内缓存过期,刷新缓存时,也能保证数据的最终一致性。 六、缓存问题 6.1 缓存雪崩 缓存雪崩是指缓存不可用或者大量缓存由于超时时间相同在同一时间段失效,大量请求直接访问数据库,数据库压力过大导致系统雪崩。 举例来说,对于系统 A,假设每天高峰期每秒 5000 个请求,本来缓存在高峰期可以扛住每秒 4000 个请求,但是缓存机器意外发生了全盘宕机。缓存挂了,此时 1 秒 5000 个请求全部落数据库,数据库必然扛不住,它会报一下警,然后就挂了。此时,如果没有采用什么特别的方案来处理这个故障,DBA 很着急,重启数据库,但是数据库立马又被新的流量给打死了。 解决缓存雪崩的主要手段如下: 增加缓存系统可用性(事前)。例如:部署 Redis Cluster(主从+哨兵),以实现 Redis 的高可用,避免全盘崩溃。 采用多级缓存方案(事中)。例如:本地缓存(Ehcache/Caffine/Guava Cache) + 分布式缓存(Redis/ Memcached)。 限流、降级、熔断方案(事中),避免被流量打死。如:使用 Hystrix 进行熔断、降级。 缓存如果支持持久化,可以在恢复工作后恢复数据(事后)。如:Redis 支持持久化,一旦重启,自动从磁盘上加载数据,快速恢复缓存数据。 上面的解决方案简单来说,就是多级缓存方案。系统收到一个查询请求,先查本地缓存,再查分布式缓存,最后查数据库,只要命中,立即返回。 解决缓存雪崩的辅助手段如下: 监控缓存,弹性扩容。 缓存的过期时间可以取个随机值。这么做是为避免缓存同时失效,使得数据库 IO 骤升。比如:以前是设置 10 分钟的超时时间,那每个 Key 都可以随机 8-13 分钟过期,尽量让不同 Key 的过期时间不同。 6.2 缓存穿透 缓存穿透是指:查询的数据在数据库中不存在,那么缓存中自然也不存在。所以,应用在缓存中查不到,则会去查询数据库。当这样的请求多了后,数据库的压力就会增大。 解决缓存穿透,一般有两种方法: 1)缓存空值 对于返回为 NULL 的依然缓存,对于抛出异常的返回不进行缓存。 采用这种手段的会增加我们缓存的维护成本,需要在插入缓存的时候删除这个空缓存,当然我们可以通过设置较短的超时时间来解决这个问题。 2)过滤不可能存在的数据 制定一些规则过滤一些不可能存在的数据。可以使用布隆过滤器(针对二进制操作的数据结构,所以性能高),比如你的订单 ID 明显是在一个范围 1-1000,如果不是 1-1000 之内的数据那其实可以直接给过滤掉。 针对于一些恶意攻击,攻击带过来的大量 key 是不存在的,那么我们采用第一种方案就会缓存大量不存在 key 的数据。此时我们采用第一种方案就不合适了,我们完全可以先对使用第二种方案进行过滤掉这些 key。针对这种 key 异常多、请求重复率比较低的数据,我们就没有必要进行缓存,使用第二种方案直接过滤掉。而对于空数据的 key 有限的,重复率比较高的,我们则可以采用第一种方式进行缓存。 6.3缓存击穿 缓存击穿是指,热点数据失效瞬间,大量请求直接访问数据库。例如,某些 key 是热点数据,访问非常频繁。如果某个 key 失效的瞬间,大量的请求过来,缓存未命中,然后去数据库访问,此时数据库访问量会急剧增加。 为了避免这个问题,我们可以采取下面的两个手段: 分布式锁:锁住热点数据的 key,避免大量线程同时访问同一个 key。 定时异步刷新:可以对部分数据采取失效前自动刷新的策略,而不是到期自动淘汰。淘汰其实也是为了数据的时效性,所以采用自动刷新也可以。 6.4 小结 上面逐一介绍了缓存使用中常见的问题。这里,从发生时间段的角度整体归纳一下缓存问题解决方案。 事前:Redis 高可用方案(Redis Cluster + 主从 + 哨兵),避免缓存全面崩溃。 事中:(一)采用多级缓存方案,本地缓存(Ehcache/Caffine/Guava Cache) + 分布式缓存(Redis/ Memcached)。(二)限流 + 熔断 + 降级(Hystrix),避免极端情况下,数据库被打死。 事后:Redis 持久化(RDB+AOF),一旦重启,自动从磁盘上加载数据,快速恢复缓存数据。 分布式缓存 Memcached ,由于数据类型不如 Redis 丰富,并且不支持持久化、容灾。所以,一般会选择 Redis 做分布式缓存。 七、缓存策略 7.1 缓存预热 缓存预热是指系统启动后,直接查询热点数据并缓存。这样就可以避免用户请求的时候,先查询数据库,然后再更新缓存的问题。 解决方案: 手动刷新缓存:直接写个缓存刷新页面,上线时手工操作下。 应用启动时刷新缓存:数据量不大,可以在项目启动的时候自动进行加载。 定时异步刷新缓存。 7.2如何缓存 7.2.1 不过期缓存 缓存更新模式: 开启事务; 写 SQL; 提交事务; 写缓存; 不要把写缓存操作放在事务中,尤其是写分布式缓存。因为网络抖动可能导致写缓存响应时间很慢,引起数据库事务阻塞。如果对缓存数据一致性要求不是那么高,数据量也不是很大,可以考虑定期全量同步缓存。 这种模式存在这样的情况:存在事务成功,但缓存写失败的可能。但这种情况相对于上面的问题,影响较小。 7.2.2 过期缓存 采用懒加载。对于热点数据,可以设置较短的缓存时间,并定期异步加载。 7.3缓存更新 一般来说,系统如果不是严格要求缓存和数据库保持一致性的话,尽量不要将读请求和写请求串行化。串行化可以保证一定不会出现数据不一致的情况,但是它会导致系统的吞吐量大幅度下降。 一般来说缓存的更新有两种情况: 先删除缓存,再更新数据库; 先更新数据库,再删除缓存; 为什么是删除缓存,而不是更新缓存呢? 你可以想想当有多个并发的请求更新数据,你并不能保证更新数据库的顺序和更新缓存的顺序一致,那就会出现数据库中和缓存中数据不一致的情况。所以一般来说考虑删除缓存。 先删除缓存,再更新数据库; 对于一个更新操作简单来说,就是先去各级缓存进行删除,然后更新数据库。这个操作有一个比较大的问题,在对缓存删除完之后,有一个读请求,这个时候由于缓存被删除所以直接会读库,读操作的数据是老的并且会被加载进入缓存当中,后续读请求全部访问的老数据。 对缓存的操作不论成功失败都不能阻塞我们对数据库的操作,那么很多时候删除缓存可以用异步的操作,但是先删除缓存不能很好的适用于这个场景。先删除缓存也有一个好处是,如果对数据库操作失败了,那么由于先删除的缓存,最多只是造成 Cache Miss。 1)先更新数据库,再删除缓存(注:更推荐使用这种策略)。 如果我们使用更新数据库,再删除缓存就能避免上面的问题。 但是同样的引入了新的问题:假设执行更新操作时,又接收到查询请求,此时就会返回缓存中的老数据。更麻烦的是,如果数据库更新操作执行失败,则缓存中可能永远是脏数据。 2)应该选择哪种更新策略 通过上面的内容,我们知道,两种更新策略都存在并发问题。 但是建议选择先更新数据库,再删除缓存,因为其并发问题出现的概率可能非常低,因为这个条件需要发生在读缓存时缓存失效,而且同时有一个并发写操作。而实际上数据库的写操作会比读操作慢得多,而且还要锁表,而读操作必需在写操作前进入数据库操作,而又要晚于写操作更新缓存,所有的这些条件都具备的概率基本并不大。 如果需要数据库和缓存保证强一致性,则可以通过 2PC 或 Paxos 协议来实现。但是 2PC 太慢,而 Paxos 太复杂,所以如果不是非常重要的数据,不建议使用强一致性方案。更详细的分析可以参考:分布式之数据库和缓存双写一致性方案解析。 八、总结 最后,通过一张思维导图来总结一下本文所述的知识点,帮助大家对缓存有一个系统性的认识。 九、参考资料 1、《大型网站技术架构:核心原理与案例分析》 2、你应该知道的缓存进化史 3、如何优雅的设计和使用缓存? 4、理解分布式系统中的缓存架构(上) 5、缓存那些事 6、分布式之数据库和缓存双写一致性方案解析 作者:vivo互联网服务器团队-Zhang Peng

优秀的个人博客,低调大师

每日一博 | 一文了解 MySQL 的 Buffer Pool

摘要:Innodb 存储引擎设计了一个缓冲池(Buffer Pool),来提高数据库的读写性能。 本文分享自华为云社区《MySQL 的 Buffer Pool,终于被我搞懂了》,作者:小林coding 。 今天就聊 MySQL 的 Buffer Pool,发车! 为什么要有 Buffer Pool? 虽然说 MySQL 的数据是存储在磁盘里的,但是也不能每次都从磁盘里面读取数据,这样性能是极差的。 要想提升查询性能,加个缓存就行了嘛。所以,当数据从磁盘中取出后,缓存内存中,下次查询同样的数据的时候,直接从内存中读取。 为此,Innodb 存储引擎设计了一个缓冲池(Buffer Pool),来提高数据库的读写性能。 有了缓冲池后: 当读取数据时,如果数据存在于 Buffer Pool 中,客户端就会直接读取 Buffer Pool 中的数据,否则再去磁盘中读取。 当修改数据时,首先是修改 Buffer Pool 中数据所在的页,然后将其页设置为脏页,最后由后台线程将脏页写入到磁盘。 Buffer Pool 有多大? Buffer Pool 是在 MySQL 启动的时候,向操作系统申请的一片连续的内存空间,默认配置下 Buffer Pool 只有 128MB 。 可以通过调整 innodb_buffer_pool_size 参数来设置 Buffer Pool 的大小,一般建议设置成可用物理内存的 60%~80%。 Buffer Pool 缓存什么? InnoDB 会把存储的数据划分为若干个「页」,以页作为磁盘和内存交互的基本单位,一个页的默认大小为 16KB。因此,Buffer Pool 同样需要按「页」来划分。 在 MySQL 启动的时候,InnoDB 会为 Buffer Pool 申请一片连续的内存空间,然后按照默认的16KB的大小划分出一个个的页, Buffer Pool 中的页就叫做缓存页。此时这些缓存页都是空闲的,之后随着程序的运行,才会有磁盘上的页被缓存到 Buffer Pool 中。 所以,MySQL 刚启动的时候,你会观察到使用的虚拟内存空间很大,而使用到的物理内存空间却很小,这是因为只有这些虚拟内存被访问后,操作系统才会触发缺页中断,接着将虚拟地址和物理地址建立映射关系。 Buffer Pool 除了缓存「索引页」和「数据页」,还包括了 undo 页,插入缓存、自适应哈希索引、锁信息等等。 为了更好的管理这些在 Buffer Pool 中的缓存页,InnoDB 为每一个缓存页都创建了一个控制块,控制块信息包括「缓存页的表空间、页号、缓存页地址、链表节点」等等。 控制块也是占有内存空间的,它是放在 Buffer Pool 的最前面,接着才是缓存页,如下图: 上图中控制块和缓存页之间灰色部分称为碎片空间。 为什么会有碎片空间呢? 你想想啊,每一个控制块都对应一个缓存页,那在分配足够多的控制块和缓存页后,可能剩余的那点儿空间不够一对控制块和缓存页的大小,自然就用不到喽,这个用不到的那点儿内存空间就被称为碎片了。 当然,如果你把 Buffer Pool 的大小设置的刚刚好的话,也可能不会产生碎片。 查询一条记录,就只需要缓冲一条记录吗? 不是的。 当我们查询一条记录时,InnoDB 是会把整个页的数据加载到 Buffer Pool 中,因为,通过索引只能定位到磁盘中的页,而不能定位到页中的一条记录。将页加载到 Buffer Pool 后,再通过页里的页目录去定位到某条具体的记录。 关于页结构长什么样和索引怎么查询数据的问题可以在这篇找到答案:换一个角度看 B+ 树 如何管理 Buffer Pool? 如何管理空闲页? Buffer Pool 是一片连续的内存空间,当 MySQL 运行一段时间后,这片连续的内存空间中的缓存页既有空闲的,也有被使用的。 那当我们从磁盘读取数据的时候,总不能通过遍历这一片连续的内存空间来找到空闲的缓存页吧,这样效率太低了。 所以,为了能够快速找到空闲的缓存页,可以使用链表结构,将空闲缓存页的「控制块」作为链表的节点,这个链表称为Free 链表(空闲链表)。 Free 链表上除了有控制块,还有一个头节点,该头节点包含链表的头节点地址,尾节点地址,以及当前链表中节点的数量等信息。 Free 链表节点是一个一个的控制块,而每个控制块包含着对应缓存页的地址,所以相当于 Free 链表节点都对应一个空闲的缓存页。 有了 Free 链表后,每当需要从磁盘中加载一个页到 Buffer Pool 中时,就从 Free链表中取一个空闲的缓存页,并且把该缓存页对应的控制块的信息填上,然后把该缓存页对应的控制块从 Free 链表中移除。 如何管理脏页? 设计 Buffer Pool 除了能提高读性能,还能提高写性能,也就是更新数据的时候,不需要每次都要写入磁盘,而是将 Buffer Pool 对应的缓存页标记为脏页,然后再由后台线程将脏页写入到磁盘。 那为了能快速知道哪些缓存页是脏的,于是就设计出Flush 链表,它跟 Free 链表类似的,链表的节点也是控制块,区别在于 Flush 链表的元素都是脏页。 有了 Flush 链表后,后台线程就可以遍历 Flush 链表,将脏页写入到磁盘。 如何提高缓存命中率? Buffer Pool 的大小是有限的,对于一些频繁访问的数据我们希望可以一直留在 Buffer Pool 中,而一些很少访问的数据希望可以在某些时机可以淘汰掉,从而保证 Buffer Pool 不会因为满了而导致无法再缓存新的数据,同时还能保证常用数据留在 Buffer Pool 中。 要实现这个,最容易想到的就是 LRU(Least recently used)算法。 该算法的思路是,链表头部的节点是最近使用的,而链表末尾的节点是最久没被使用的。那么,当空间不够了,就淘汰最久没被使用的节点,从而腾出空间。 简单的 LRU 算法的实现思路是这样的: 当访问的页在 Buffer Pool 里,就直接把该页对应的 LRU 链表节点移动到链表的头部。 当访问的页不在 Buffer Pool 里,除了要把页放入到 LRU 链表的头部,还要淘汰 LRU 链表末尾的节点。 比如下图,假设 LRU 链表长度为 5,LRU 链表从左到右有 1,2,3,4,5 的页。 如果访问了 3 号的页,因为 3 号页在 Buffer Pool 里,所以把 3 号页移动到头部即可。 而如果接下来,访问了 8 号页,因为 8 号页不在 Buffer Pool 里,所以需要先淘汰末尾的 5 号页,然后再将 8 号页加入到头部。 到这里我们可以知道,Buffer Pool 里有三种页和链表来管理数据。 图中: Free Page(空闲页),表示此页未被使用,位于 Free 链表; Clean Page(干净页),表示此页已被使用,但是页面未发生修改,位于LRU 链表。 Dirty Page(脏页),表示此页「已被使用」且「已经被修改」,其数据和磁盘上的数据已经不一致。当脏页上的数据写入磁盘后,内存数据和磁盘数据一致,那么该页就变成了干净页。脏页同时存在于 LRU 链表和 Flush 链表。 简单的 LRU 算法并没有被 MySQL 使用,因为简单的 LRU 算法无法避免下面这两个问题: 预读失效; Buffer Pool 污染; 什么是预读失效? 先来说说 MySQL 的预读机制。程序是有空间局部性的,靠近当前被访问数据的数据,在未来很大概率会被访问到。 所以,MySQL 在加载数据页时,会提前把它相邻的数据页一并加载进来,目的是为了减少磁盘 IO。 但是可能这些被提前加载进来的数据页,并没有被访问,相当于这个预读是白做了,这个就是预读失效。 如果使用简单的 LRU 算法,就会把预读页放到 LRU 链表头部,而当 Buffer Pool空间不够的时候,还需要把末尾的页淘汰掉。 如果这些预读页如果一直不会被访问到,就会出现一个很奇怪的问题,不会被访问的预读页却占用了 LRU 链表前排的位置,而末尾淘汰的页,可能是频繁访问的页,这样就大大降低了缓存命中率。 怎么解决预读失效而导致缓存命中率降低的问题? 我们不能因为害怕预读失效,而将预读机制去掉,大部分情况下,局部性原理还是成立的。 要避免预读失效带来影响,最好就是让预读的页停留在 Buffer Pool 里的时间要尽可能的短,让真正被访问的页才移动到 LRU 链表的头部,从而保证真正被读取的热数据留在 Buffer Pool 里的时间尽可能长。 那到底怎么才能避免呢? MySQL 是这样做的,它改进了 LRU 算法,将 LRU 划分了 2 个区域:old 区域 和 young 区域。 young 区域在 LRU 链表的前半部分,old 区域则是在后半部分,如下图: old 区域占整个 LRU 链表长度的比例可以通过 innodb_old_blocks_pc 参数来设置,默认是 37,代表整个 LRU 链表中 young 区域与 old 区域比例是 63:37。 划分这两个区域后,预读的页就只需要加入到 old 区域的头部,当页被真正访问的时候,才将页插入 young 区域的头部。如果预读的页一直没有被访问,就会从 old 区域移除,这样就不会影响 young 区域中的热点数据。 接下来,给大家举个例子。 假设有一个长度为 10 的 LRU 链表,其中 young 区域占比 70 %,old 区域占比 20 %。 现在有个编号为 20 的页被预读了,这个页只会被插入到 old 区域头部,而 old 区域末尾的页(10号)会被淘汰掉。 如果 20 号页一直不会被访问,它也没有占用到 young 区域的位置,而且还会比 young 区域的数据更早被淘汰出去。 如果 20 号页被预读后,立刻被访问了,那么就会将它插入到 young 区域的头部,young 区域末尾的页(7号),会被挤到 old 区域,作为 old 区域的头部,这个过程并不会有页被淘汰。 虽然通过划分 old 区域 和 young 区域避免了预读失效带来的影响,但是还有个问题无法解决,那就是 Buffer Pool 污染的问题。 什么是 Buffer Pool 污染? 当某一个 SQL 语句扫描了大量的数据时,在 Buffer Pool 空间比较有限的情况下,可能会将Buffer Pool 里的所有页都替换出去,导致大量热数据被淘汰了,等这些热数据又被再次访问的时候,由于缓存未命中,就会产生大量的磁盘 IO,MySQL 性能就会急剧下降,这个过程被称为Buffer Pool 污染。 注意, Buffer Pool 污染并不只是查询语句查询出了大量的数据才出现的问题,即使查询出来的结果集很小,也会造成 Buffer Pool 污染。 比如,在一个数据量非常大的表,执行了这条语句: select * from t_user where name like "%xiaolin%"; 可能这个查询出来的结果就几条记录,但是由于这条语句会发生索引失效,所以这个查询过程是全表扫描的,接着会发生如下的过程: 从磁盘读到的页加入到 LRU 链表的 old 区域头部; 当从页里读取行记录时,也就是页被访问的时候,就要将该页放到 young 区域头部; 接下来拿行记录的 name 字段和字符串 xiaolin 进行模糊匹配,如果符合条件,就加入到结果集里; 如此往复,直到扫描完表中的所有记录。 经过这一番折腾,原本 young 区域的热点数据都会被替换掉。 举个例子,假设需要批量扫描:21,22,23,24,25 这五个页,这些页都会被逐一访问(读取页里的记录)。 在批量访问这些数据的时候,会被逐一插入到 young 区域头部。 可以看到,原本在 young 区域的热点数据 6 和 7 号页都被淘汰了,这就是 Buffer Pool 污染的问题。 怎么解决出现 Buffer Pool 污染而导致缓存命中率下降的问题? 像前面这种全表扫描的查询,很多缓冲页其实只会被访问一次,但是它却只因为被访问了一次而进入到 young 区域,从而导致热点数据被替换了。 LRU 链表中 young 区域就是热点数据,只要我们提高进入到 young 区域的门槛,就能有效地保证 young 区域里的热点数据不会被替换掉。 MySQL 是这样做的,进入到 young 区域条件增加了一个停留在 old 区域的时间判断。 具体是这样做的,在对某个处在 old 区域的缓存页进行第一次访问时,就在它对应的控制块中记录下来这个访问时间: 如果后续的访问时间与第一次访问的时间在某个时间间隔内,那么该缓存页就不会被从 old 区域移动到 young 区域的头部; 如果后续的访问时间与第一次访问的时间不在某个时间间隔内,那么该缓存页移动到 young 区域的头部; 这个间隔时间是由 innodb_old_blocks_time 控制的,默认是 1000 ms。 也就说,只有同时满足「被访问」与「在 old 区域停留时间超过 1 秒」两个条件,才会被插入到 young 区域头部,这样就解决了 Buffer Pool 污染的问题 。 另外,MySQL 针对 young 区域其实做了一个优化,为了防止 young 区域节点频繁移动到头部。young 区域前面 1/4 被访问不会移动到链表头部,只有后面的 3/4被访问了才会。 脏页什么时候会被刷入磁盘? 引入了 Buffer Pool 后,当修改数据时,首先是修改 Buffer Pool 中数据所在的页,然后将其页设置为脏页,但是磁盘中还是原数据。 因此,脏页需要被刷入磁盘,保证缓存和磁盘数据一致,但是若每次修改数据都刷入磁盘,则性能会很差,因此一般都会在一定时机进行批量刷盘。 可能大家担心,如果在脏页还没有来得及刷入到磁盘时,MySQL 宕机了,不就丢失数据了吗? 这个不用担心,InnoDB 的更新操作采用的是 Write Ahead Log 策略,即先写日志,再写入磁盘,通过 redo log 日志让 MySQL 拥有了崩溃恢复能力。 下面几种情况会触发脏页的刷新: 当 redo log 日志满了的情况下,会主动触发脏页刷新到磁盘; Buffer Pool 空间不足时,需要将一部分数据页淘汰掉,如果淘汰的是脏页,需要先将脏页同步到磁盘; MySQL 认为空闲时,后台线程回定期将适量的脏页刷入到磁盘; MySQL 正常关闭之前,会把所有的脏页刷入到磁盘; 在我们开启了慢 SQL 监控后,如果你发现**「偶尔」会出现一些用时稍长的 SQL**,这可能是因为脏页在刷新到磁盘时可能会给数据库带来性能开销,导致数据库操作抖动。 如果间断出现这种现象,就需要调大 Buffer Pool 空间或 redo log 日志的大小。 总结 Innodb 存储引擎设计了一个缓冲池(Buffer Pool),来提高数据库的读写性能。 Buffer Pool 以页为单位缓冲数据,可以通过 innodb_buffer_pool_size 参数调整缓冲池的大小,默认是 128 M。 Innodb 通过三种链表来管理缓页: Free List (空闲页链表),管理空闲页; Flush List (脏页链表),管理脏页; LRU List,管理脏页+干净页,将最近且经常查询的数据缓存在其中,而不常查询的数据就淘汰出去。; InnoDB 对 LRU 做了一些优化,我们熟悉的 LRU 算法通常是将最近查询的数据放到 LRU 链表的头部,而 InnoDB 做 2 点优化: 将 LRU 链表 分为young 和 old 两个区域,加入缓冲池的页,优先插入 old 区域;页被访问时,才进入 young 区域,目的是为了解决预读失效的问题。 当「页被访问」且「 old 区域停留时间超过 innodb_old_blocks_time 阈值(默认为1秒)」时,才会将页插入到 young 区域,否则还是插入到 old 区域,目的是为了解决批量数据访问,大量热数据淘汰的问题。 可以通过调整 innodb_old_blocks_pc 参数,设置 young 区域和 old 区域比例。 在开启了慢 SQL 监控后,如果你发现「偶尔」会出现一些用时稍长的 SQL,这可因为脏页在刷新到磁盘时导致数据库性能抖动。如果在很短的时间出现这种现象,就需要调大 Buffer Pool 空间或 redo log 日志的大小。 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

每日一博 | 系统性能分析从入门到进阶

作者 | 勿非 本文以系统为中心, 结合日常工作和用例, 由浅入深地介绍了性能分析的一些方法和体会, 希望对想了解系统性能分析的同学有所帮助。 入门篇 资源角度 USE 产品跑在系统的各种资源上面, 从系统资源的角度入门性能分析是个不错的选择, 我们以业界知名大牛 Brendan Gregg 的 USE 方法开始, USE 特点就是简单有效适合入门, 用 Brendan 的话描述 USE 的效果: I find it solves about 80% of server issues with 5% of the effort. USE 从系统资源的角度, 包括但不限于 CPU, 内存, 磁盘, 网络等, 关注以下3个方面: • Utilization (U): as a percent over a time interval. eg, "one disk is running at 90% utilization". 大多数情况可以合理推测利用率高可能会影响性能 • Saturation (S): as a queue length. eg, "the CPUs have an average run queue length of four". 资源竞争的激烈程度 • Errors (E). scalar counts. eg, "this network interface has had fifty late collisions". Errors 相对直观 CPU 对于 CPU, 主要关注以下指标: • Utilization. CPU 的利用率 • Saturation. 可以是 load average, runqueue length, sched latency 等 CPU 利用率用 top 看下: top - 17:13:49 up 83 days, 23:10, 1 user, load average: 433.52, 422.54, 438.70 Tasks: 2765 total, 23 running, 1621 sleeping, 0 stopped, 34 zombie %Cpu(s): 23.4 us, 9.5 sy, 0.0 ni, 65.5 id, 0.7 wa, 0.0 hi, 1.0 si, 0.0 st CPU 利用率拆分成了更细粒度的几部分: • us, sys, ni - 对应 un-niced user, kernel, niced user 的 CPU 利用率 • id, wa - 对应到 idle, io wait 的比例, io wait 本质上也是一种 idle, 区别在于对应 cpu 上有等待 io 的任务 • hi, si - 对应 hardirq, softirq 的比例 • st - 因为超卖等原因, hypervisor 从该 vm 偷走的时间 (todo: docker) 继续看 load average, 3 个数值分别对应到系统 1/5/15 分钟内的系统平均 load, load 是个比较模糊的概念, 可以简单认为是对资源有需求的任务数, 包括 on cpu, runnable 的任务, 也包括等待 IO 及任意 D 状态的任务. load 使用采样的方式, 每隔 5 秒采样一样, 越近的采样权重越大, 这样从 1/5/15 的趋势可以看出系统压力的变化。 load average: 433.52, 422.54, 438.70 在这台 128 个 CPU 的机器上, loadavg 看起来有些偏高, 但是具体影响目前不得而知, 性能低是相对具体目标而言的, load 高只是现象, 它可能相关也可能无关, 但至少是值得注意的。 再看下 dstat 关于任务状态的统计: • run - 对应到/proc/stat 里面的 procs_running, 也就是 runnable 任务数 • blk - 对应到/proc/stat 里面的 procs_blocked, 阻塞在 I/O 的任务数 实际上和 loadavg 没有本质区别, 只是 load 模糊了 runnable 和 D 状态, 同时 load 使用 1/5/15 分钟的力度, 而 dstat 可以使用更细粒度, 如果只看某一时间点用 load, 如果要观察长时间的变化使用 dstat (/proc/stat)。 #dstat -tp ----system---- ---procs--- time |run blk new 07-03 17:56:50|204 1.0 202 07-03 17:56:51|212 0 238 07-03 17:56:52|346 1.0 266 07-03 17:56:53|279 5.0 262 07-03 17:56:54|435 7.0 177 07-03 17:56:55|442 3.0 251 07-03 17:56:56|792 8.0 419 07-03 17:56:57|504 16 152 07-03 17:56:58|547 3.0 156 07-03 17:56:59|606 2.0 212 07-03 17:57:00|770 0 186 内存 这里主要关注内存容量方面, 不关注访存的性能。 • Utilization. 内存利用率 • Saturation. 这里主要考察内存回收算法的效率 简单的内存利用率用 free 命令: • total - MemTotal + SwapTotal, 一般来说 MemTotal 会略小于真实的物理内存 • free - 未使用的内存. Linux 倾向于缓存更多页面以提高性能, 所以不能简单通过 free 来判断内存是否不足 • buff/cache - 系统缓存, 一般不需要严格区分 buffer 和 cache • available - 估计的可用物理内存大小 • used - 等于 total - free - buffers - cache • Swap - 该机器上未配置 #free -g total used free shared buff/cache available Mem: 503 193 7 2 301 301 Swap: 0 0 0 更详细的信息可以直接去读/proc/meminfo: #cat /proc/meminfo MemTotal: 527624224 kB MemFree: 8177852 kB MemAvailable: 316023388 kB Buffers: 23920716 kB Cached: 275403332 kB SwapCached: 0 kB Active: 59079772 kB Inactive: 431064908 kB Active(anon): 1593580 kB Inactive(anon): 191649352 kB Active(file): 57486192 kB Inactive(file): 239415556 kB Unevictable: 249700 kB Mlocked: 249700 kB SwapTotal: 0 kB SwapFree: 0 kB [...] 再来看下内存回收相关的信息, sar 的数据主要从/proc/vmstat 采集, 主要关注: • pgscank/pgscand - 分别对应 kswapd/direct 内存回收时扫描的 page 数 • pgsteal - 回收的 page 数 • %vmeff - pgsteal/(pgscank+pgscand) 要理解这些数据的具体含义, 需要对内存管理算法有一定了解, 比如这里的 pgscan/pgsteal 只是针对inactive list而言的, 在内存回收的时候可能还需要先把页面从 active list 搬到 inactive list 等. 如果这里有异常, 我们可以先把这当成入口, 再慢慢深入, 具体到这里的%vmeff, 最好情况就是每个扫描的 page 都能回收, 也就是 vmeff 越高越好。 #sar -B 1 11:00:16 AM pgscank/s pgscand/s pgsteal/s %vmeff 11:00:17 AM 0.00 0.00 3591.00 0.00 11:00:18 AM 0.00 0.00 10313.00 0.00 11:00:19 AM 0.00 0.00 8452.00 0.00 I/O 存储 I/O 的 USE 模型: • Utilization. 存储设备的利用率, 单位时间内设备在处理 I/O 请求的时间 • Saturation. 队列长度 我们一般关注这些部分: • %util - 利用率. 注意即使达到 100%的 util, 也不代表设备没有性能余量了, 特别地现在的 SSD 盘内部都支持并发. 打个比方, 一家旅馆有 10 间房, 每天只要有 1 个房间入住, util 就是 100%。 • svctm - 新版 iostat 已经删掉 • await/r_await/w_await - I/O 延迟, 包括排队时间 • avgrq-sz - 平均 request size, 请求处理时间和大小有一定关系, 不一定线性 • argqu-sz - 评估 queue size, 可以用来判断是否有积压 • rMB/s, wMB/s, r/s, w/s - 基本语义 资源粒度 当我们判断资源是否是瓶颈的时候, 只看系统级别的资源是不够的, 比如可以用 htop 看下每个 CPU 的利用率, 目标任务运行在不同 CPU 上的性能可能相差很大。 内存也有类似情况, 运行 numastat -m Node 0 Node 1 Node 2 Node 3 --------------- --------------- --------------- --------------- MemTotal 31511.92 32255.18 32255.18 32255.18 MemFree 2738.79 131.89 806.50 10352.02 MemUsed 28773.12 32123.29 31448.69 21903.16 Active 7580.58 419.80 9597.45 5780.64 Inactive 17081.27 26844.28 19806.99 13504.79 Active(anon) 6.63 0.93 2.08 5.64 Inactive(anon) 12635.75 25560.53 12754.29 9053.80 Active(file) 7573.95 418.87 9595.37 5775.00 Inactive(file) 4445.52 1283.75 7052.70 4450.98 系统不一定就是物理机, 如果产品跑在 cgroup, 那么这个 cgroup 是更需要关注的系统, 比如在空闲系统上执行如下命令: #mkdir /sys/fs/cgroup/cpuset/overloaded #echo 0-1 > /sys/fs/cgroup/cpuset/cpuset.cpus #echo 0 > /sys/fs/cgroup/cpuset/cpuset.mems #echo $$ #for i in {0..1023}; do /tmp/busy & done 此时从物理机级别看, 系统的 load 很高, 但是因为 cpuset 的限制, 竞争约束在 cpu 0 和 1 上, 对运行在其他 cpu 上的产品影响并不大。 #uptime 14:10:54 up 6 days, 18:52, 10 users, load average: 920.92, 411.61, 166.95 应用角度 系统资源和应用的性能可能会有某种关联, 但是也可以更直接地从应用的角度出发定位问题: • 应用能使用多少资源, 而不是系统提供了多少资源, 这里面可能会有gap, 系统是个模糊的概念, 而应用本身却相对具体. 以上面cpuset为例, 物理机是个系统, cpuset管理的资源也可以成为系统, 但是应用在cpuset里面还是外面是确定的。 • 应用对资源的需求, 即使系统资源再多, 应用用不上性能也上不去, 也就是系统可能没问题, 而是应用本身的原因。 以下面的myserv为例, 它的4个线程%cpu都达到了100, 这个时候再去分析整个系统的load什么用处不大, 系统有再多的空闲cpu对myserv来说已经没有意义。 #pidstat -p `pgrep myserv` -t 1 15:47:05 UID TGID TID %usr %system %guest %CPU CPU Command 15:47:06 0 71942 - 415.00 0.00 0.00 415.00 22 myserv 15:47:06 0 - 71942 0.00 0.00 0.00 0.00 22 |__myserv ... 15:47:06 0 - 72079 7.00 94.00 0.00 101.00 21 |__myserv 15:47:06 0 - 72080 10.00 90.00 0.00 100.00 19 |__myserv 15:47:06 0 - 72081 9.00 91.00 0.00 100.00 35 |__myserv 15:47:06 0 - 72082 5.00 95.00 0.00 100.00 29 |__myserv 常用命令 基本命令 基本命令一般用来读取内核中记录的各种统计信息, 特别是/proc下面的各种文件, 这里简单列举部分: • top - 提供了交互模式和batch模式, 不带参数进入交互模式, 按下h键可以看到各种功能 • ps - 提供了各种参数查看系统中任务的状态, 比如ps aux或者ps -eLf, 很多参数可以在需要的时候查看手册 • free - 内存信息 • iostat - I/O性能 • pidstat - 查看进程相关的信息, 上面已经介绍过 • mpstat - 可以查看单独cpu的利用率, softirq, hardirq个数等 • vmstat - 可以查看虚拟内存及各种系统信息 • netstat - 网络相关 • dstat - 可以查看cpu/disk/mem/net等各种信息, 这些stat命令哪个方便用哪个 • htop - 上面介绍过 • irqstat - 方便观察中断信息 • sar/tsar/ssar - 收集和查看系统运行的各种历史信息, 也提供实时模式 这里举个ps的例子, 我们监控mysqld服务, 当该进程使用的内存超过系统内存70%的时候, 通过gdb调用jemalloc的malloc_stats_print函数来分析可能的内存泄漏。 largest=70 while :; do mem=$(ps -p `pidof mysqld` -o %mem | tail -1) imem=$(printf %.0f $mem) if [ $imem -gt $largest ]; then echo 'p malloc_stats_print(0,0,0)' | gdb --quiet -nx -p `pidof mysqld` fi sleep 10 done perf perf是性能分析的必备工具, 它最核心的能力是能访问硬件上的Performance Monitor Unit (PMU), 对分析CPU bound的问题很有帮助, 当然perf也支持各种软件event. perf的主要能力包括: • 通过采样发现程序热点 • 通过硬件PMU深入分析问题的根源, 特别是配合硬件上的优化 perf list可以列出支持的event, 我们可以通过perf来获取cache misses, cycles等等。 #perf list | grep Hardware branch-misses [Hardware event] bus-cycles [Hardware event] cache-misses [Hardware event] cache-references [Hardware event] cpu-cycles OR cycles [Hardware event] instructions [Hardware event] L1-dcache-load-misses [Hardware cache event] L1-dcache-loads [Hardware cache event] L1-dcache-store-misses [Hardware cache event] L1-dcache-stores [Hardware cache event] L1-icache-load-misses [Hardware cache event] L1-icache-loads [Hardware cache event] branch-load-misses [Hardware cache event] branch-loads [Hardware cache event] dTLB-load-misses [Hardware cache event] iTLB-load-misses [Hardware cache event] mem:<addr>[/len][:access] [Hardware breakpoint] perf使用的时候一般会传入以下参数: • 通过-e指定感兴趣的一个或多个event • 指定采样的范围, 比如进程级别 (-p), 线程级别 (-t), cpu级别 (-C), 系统级别 (-a) 这里使用默认的event看下进程31925的执行情况. 一个比较重要的信息是insns per cycle (IPC), 也就是每个cycle能执行多少指令, 其他pmu event像cache misses, branch misses如果有问题最终都会反映到IPC上. 虽然没有一个明确的标准, 但是下面0.09的IPC是比较低的, 有必要继续深入。 #perf stat -p 31925 sleep 1 Performance counter stats for process id '31925': 2184.986720 task-clock (msec) # 2.180 CPUs utilized 3,210 context-switches # 0.001 M/sec 345 cpu-migrations # 0.158 K/sec 0 page-faults # 0.000 K/sec 4,311,798,055 cycles # 1.973 GHz <not supported> stalled-cycles-frontend <not supported> stalled-cycles-backend 409,465,681 instructions # 0.09 insns per cycle <not supported> branches 8,680,257 branch-misses # 0.00% of all branches 1.002506001 seconds time elapsed 除了stat外, perf另一个可能更常用的方式是采样来确定程序的热点, 现在有如下程序: void busy(long us) { struct timeval tv1, tv2; long delta = 0; gettimeofday(&tv1, NULL); do { gettimeofday(&tv2, NULL); delta = (tv2.tv_sec - tv1.tv_sec) * 1000000 + tv2.tv_usec - tv1.tv_usec; } while (delta < us); } void A() { busy(2000); } void B() { busy(8000); } int main() { while (1) { A(); B(); } return 0; } 函数A和B执行时间的比例, perf的采样结果和我们期望的2:8基本一致。 #perf record -g -e cycles ./a.out #perf report Samples: 27K of event 'cycles', Event count (approx.): 14381317911 Children Self Command Shared Object Symbol + 99.99% 0.00% a.out [unknown] [.] 0x0000fffffb925137 + 99.99% 0.00% a.out a.out [.] _start + 99.99% 0.00% a.out libc-2.17.so [.] __libc_start_main + 99.99% 0.00% a.out a.out [.] main + 99.06% 25.95% a.out a.out [.] busy + 79.98% 0.00% a.out a.out [.] B - 71.31% 71.31% a.out [vdso] [.] __kernel_gettimeofday __kernel_gettimeofday - busy + 79.84% B + 20.16% A + 20.01% 0.00% a.out a.out [.] A strace trace相对于采样最大的优势在于精度, trace能抓住每次操作, 这给调试和理解带来很大方便. strace专门用来trace系统调用。 strace通过捕获所有的系统调用能快速帮助理解应用的某些行为, 这里使用strace来看下上面提到的perf-record的实现, 很容易发现系统调用perf_event_open以及它的参数, 因为有128个cpu, 针对每个cpu都会调用一次该系统调用。 #strace -v perf record -g -e cycles ./a.out perf_event_open({type=PERF_TYPE_HARDWARE, size=PERF_ATTR_SIZE_VER5, config=PERF_COUNT_HW_CPU_CYCLES, sample_freq=4000, sample_type=PERF_SAMPLE_IP|PERF_SAMPLE_TID|PERF_SAMPLE_TIME|PERF_SAMPLE_CALLCHAIN|PERF_SAMPLE_PERIOD, read_format=0, disabled=1, inherit=1, pinned=0, exclusive=0, exclusive_user=0, exclude_kernel=0, exclude_hv=0, exclude_idle=0, mmap=1, comm=1, freq=1, inherit_stat=0, enable_on_exec=1, task=1, watermark=0, precise_ip=0 /* arbitrary skid */, mmap_data=0, sample_id_all=1, exclude_host=0, exclude_guest=1, exclude_callchain_kernel=0, exclude_callchain_user=0, mmap2=1, comm_exec=1, use_clockid=0, context_switch=0, write_backward=0, namespaces=0, wakeup_events=0, config1=0, config2=0, sample_regs_user=0, sample_regs_intr=0, aux_watermark=0, sample_max_stack=0}, 51876, 25, -1, PERF_FLAG_FD_CLOEXEC) = 30 blktrace iostat因为粒度太粗有的时候并不能很好地定位问题, blktrace通过跟踪每个I/O, 并在I/O的关键路径打桩, 可以获得更精确的信息, 从而帮忙分析问题. blktrace封装了几个命令: • blktrace: 收集 • blkparse: 处理 • btt: 强大的分析工具 • btrace: blktrace/blkparse的一个简单封装, 相当于blktrace -d /dev/sda -o - | blkparse -i - 简单看下blktrace的输出, 里面记录了I/O路径上的关键信息, 特别地: • 时间戳, 性能分析的关键信息之一 • event, 第6列, 对应到I/O路径上的关键点, 具体对应关系可以查找相应手册或源码, 理解这些关键点是调试I/O性能的必要技能 • I/O sector. I/O请求对应的扇区和大小 $ sudo btrace /dev/sda 8,0 0 1 0.000000000 1024 A WS 302266328 + 8 <- (8,5) 79435736 8,0 0 2 0.000001654 1024 Q WS 302266328 + 8 [jbd2/sda5-8] 8,0 0 3 0.000010042 1024 G WS 302266328 + 8 [jbd2/sda5-8] 8,0 0 4 0.000011605 1024 P N [jbd2/sda5-8] 8,0 0 5 0.000014993 1024 I WS 302266328 + 8 [jbd2/sda5-8] 8,0 0 0 0.000018026 0 m N cfq1024SN / insert_request 8,0 0 0 0.000019598 0 m N cfq1024SN / add_to_rr 8,0 0 6 0.000022546 1024 U N [jbd2/sda5-8] 1 这是btt的一个输出, 可以看到S2G的个数和延迟, 正常情况不应该出现这个问题, 这样就找到了一条可以深入的线索。 $ sudo blktrace -d /dev/sdb -w 5 $ blkparse sdb -d sdb.bin $ btt -i sdb.bin ==================== All Devices ==================== ALL MIN AVG MAX N --------------- ------------- ------------- ------------- ----------- Q2Q 0.000000001 0.000014397 0.008275391 347303 Q2G 0.000000499 0.000071615 0.010518692 347298 S2G 0.000128160 0.002107990 0.010517875 11512 G2I 0.000000600 0.000001570 0.000040010 347298 I2D 0.000000395 0.000000929 0.000003743 347298 D2C 0.000116199 0.000144157 0.008443855 347288 Q2C 0.000118211 0.000218273 0.010678657 347288 ==================== Device Overhead ==================== DEV | Q2G G2I Q2M I2D D2C ---------- | --------- --------- --------- --------- --------- ( 8, 16) | 32.8106% 0.7191% 0.0000% 0.4256% 66.0447% ---------- | --------- --------- --------- --------- --------- Overall | 32.8106% 0.7191% 0.0000% 0.4256% 66.0447% 进阶篇 大学教材 通过教程能够系统地了解一门课的全貌, 网上搜到的大部分性能分析的教程都是基于Raj Jain的The Art of Computer Systems Performance Analysis, 这本书里面主要包括几个部分: • Part I: AN OVERVIEW OF PERFORMANCE EVALUATION • Part II: MEASUREMENT TECHNIQUES AND TOOLS • Part III: PROBABILITY THEORY AND STATISTICS • Part IV: EXPERIMENTAL DESIGN AND ANALYSIS • Part V: SIMULATION • Part VI: QUEUEING MODELS 书的重心放在performance analysis上面, 涉及较多概率和统计的计算, 另外rice大学的这个教程写得挺不错[1]。 技术博客 • 参考文末[2]有时间可以都过一遍, 总的来说主要包括3个部分: • 性能分析的方法集. 代表作 USE方法 • 性能数据的搜集. 代表作 "工具大图" • 性能数据的可视化. 代表作 火焰图 • 文末链接[3] • 文末链接[4] • 文末链接[5] 知识结构 系统性能分析在深度和广度上都有要求, 对底层包括OS和硬件, 以及一些通用能力要做到足够深, 对上层产品的理解又需要有足够的广度, 近一年在混合云亲手摸过的产品估计不下二十款, 当然重点分析过的只有几个。 操作系统 操作系统是系统分析的基础, 不管是I/O, 内存, 网络, 调度, docker等等都离不开操作系统, 操作系统知识可以从Understanding the Linux Kernel开始, 这本书虽然老了但不妨碍理解OS的基本概念, 慢慢做到能阅读内核文档和源码。 在适配某款arm平台的时候发现, 在numa off的情况下: • ecs绑在socket 0上性能好 • mysql绑在socket 1上性能好 能确定的是, 该平台跨socket性能访问不管是latency还是throughput和本地访问都有较大差距, 所以一个合理的方向是跨socket的内存访问, 如果有类似x86 pcm的话会比较直接, 但是该平台上缺少该类pmu来查看跨socket的信息, 我们尝试从OS的角度来回答这个问题。 首先通过将内存压测工具跑在不同的socket/node上, 发现numa off表现出了和numa on相同的性能特征, 和硬件产生确认该平台numa off和on的实现在硬件上并没有区别, 只是bios不传递numa信息给操作系统, 这样是可以知道物理地址在哪个socket/node上的。 接下来只要确定ecs/mysql的物理内存位置, 就可以用于判断性能和跨socket的相关性. Linux在用户态可以通过pagemap将虚拟地址对应到物理地址, 只需要稍加修改tools/vm/page-types.c就能拿到进程对应的所有物理地址. 经确认, 确实ecs/mysql的性能和它们使用的物理内存的位置强相关。最后要回答的是为什么ecs和mysql表现恰好相反, 注意到ecs使用hugepage而mysql使用normal page, 有如下假设, 具体代码这里不再列出。 • 系统启动的时候, 物理内存加到伙伴系统是先socket 0后socket 1 • socket 1上的内存会被先分出来, 所以mysql分配的内存在socket 1. 特定集群的机器不会随意跑其他进程 • 在ecs的host上, 因为要分配的hugepage已经超过了socket 1上的所有内存, 所以后面分配的hugepage已经落在了socket 0 • hugepage的分配是后进先出, 意味着ecs一开始分配到的hugepage在socket 0, 而该机器资源并没全部用完, 测试用的几个ecs内存全落在了socket 0上, 所以将ecs进程绑到socket 0的性能更好 硬件知识 如果一直是x86架构, 事情会简单很多, 一是x86的知识大家耳濡目染很久了, 多多少少都了解一些, 二是架构变化相对较小, 各种应用都适配较好, 需要调优的用例较少. 随着各种新平台的崛起, 它们性能各异, 对整个系统性能带来的冲击是巨大的, 这不是影响某个产品, 这影响的几乎是所有产品. 最基本地, 我们要处理以下问题: • 新的平台上, 应用原有的很多假设被打破, 需要重新适配, 否则性能可能不及预期. 比如在Intel上面, 开关numa的性能差距不大, 在其他平台上可能就不一样 • 新的平台要取代老的平台, 就存在性能的比较. 由于平台性能差异大并且差异点多, 虽然speccpu之类的benchmark能一定程度反应平台整体的计算性能, 但很多时候还需要结合不同场景分别进行性能调优 • 不排除新平台存在某种bug或者未知的feature, 都需要我们去摸索解决的办法 数据分析 在收集了大量数据后, 经过数据分析可以放大数据的价值 • 数据提取. 利用各种工具比如awk/sed/perl等脚本语言提取所需的数据 • 数据抽象. 从不同角度加工数据, 识别异常, 比如单机/集群分别是什么表现, 统计哪些值 • 可视化. 可视化是数据处理非常重要的能力, 一图胜千言, 火焰图就是最好的例子. 常用画图工具有gnuplot, excel等 比如分析MapReduce任务在10台机器的集群上的性能, 即使每台机器都体现出一定的共性, 但是如果从集群角度看的话则更加明显, 也很容易验证这种共性。 换种显示方式则更加明显, 很容易知道在不同阶段的表现, 比如正常Map和Reduce阶段cpu利用率也只有80%, 这个是否符合预期, 另外在Map和Reduce切换的时候, 系统idle很明显, 会不会是潜在优化点。 如果有对照的话, 可以直观地看不到不同表现, 特别是巨大的长尾时间有进一步优化的空间。 Benchmarking Benchmarking是获取性能指标最基本的手段, 也是测试常用的方法, 每个领域几乎都有自己的一套测试用例. 对于benchmarking, 首先需要知道它测的是什么. 以spec cpu2017为例, 它主要测试的是处理器, 内存子系统以及编译器的性能, 那么在测试的时候我们除了关注CPU型号, 还要考虑内存大小插法型号, 以及编译器及其参数等等, 在做性能比对时也能清楚它的使用范围。 Benchmark的一个特点是可重复性, spec.org做得很好的一点是上面有大量公布的测试结果, 可以参考这些测试结果来验证我们自己的测试方法参数是否合理. 如果想测试cpu2017, 第一件事就是先重做别人的测试, 直到能复现别人的数据, 这个过程可能会有很多收获, 对benchmark也会有更多了解. 以intel 8160为例, 在硬件基本一致的情况下, 不经额外的配置自己环境cpu2017 integer rate只能跑到140, 而spec.org上面的测试用例能达到240, 性能逐步逼近240的过程, 也是深入理解cpu2017的过程。 关于性能数据, 首先想要强调的是有数据并不一定比没数据强, 只有解释过的数据才是有效数据, 没解释过的数据反而会引起不必要的误判, 比如上面cpu2017的例子, 在做不同平台性能对比的时候, 8160到底用140还是240呢, 得出的结论会十万八千里. 再比如使用下面的命令测试某新平台的内存延迟: lat_mem_rd -P 1 -N 1 10240 512 测试出的延迟是7.4ns, 不加分析采用该结果就可能得出新平台延迟太好的错误结论. 所以对待数据要足够谨慎, 一般会有几个阶段: 在信任关系建立前, 对别人的数据保持谨慎. 一是有可能自己对这块还没有足够理解, 二是需要测试报告提供足够的信息供他人做判断。 相信自己的数据. 必须相信自己, 但是选择相信自己的数据, 是因为有过详细合理的分析。 相信别人的数据. 信任链建立之后, 以及自己有了足够理解后, 选择相信. 更多工具 ftrace 想要快速理解代码实现, 没有什么比打印调用路径更直接了. ftrace可以用来解决2个问题: • 谁调用了我. 这个只要在执行对应函数的时候拿到对应的栈就可以, 多种工具可以实现 • 我调用了谁. 这个是ftrace比较unique的功能 为了方便我们使用ftrace的wrapper trace-cmd, 假设我们已经知道I/O路径会经过generic_make_request, 为了查看完整的路径我们可以这样: #trace-cmd record -p function --func-stack -l generic_make_request dd if=/dev/zero of=file bs=4k count=1 oflag=direct 通过report来查看就一目了然了: #trace-cmd report cpus=128 dd-11344 [104] 4148325.319997: function: generic_make_request dd-11344 [104] 4148325.320002: kernel_stack: <stack trace> => ftrace_graph_call (ffff00000809849c) => generic_make_request (ffff000008445b80) => submit_bio (ffff000008445f00) => __blockdev_direct_IO (ffff00000835a0a8) => ext4_direct_IO_write (ffff000001615ff8) => ext4_direct_IO (ffff0000016164c4) => generic_file_direct_write (ffff00000825c4e0) => __generic_file_write_iter (ffff00000825c684) => ext4_file_write_iter (ffff0000016013b8) => __vfs_write (ffff00000830c308) => vfs_write (ffff00000830c564) => ksys_write (ffff00000830c884) => __arm64_sys_write (ffff00000830c918) => el0_svc_common (ffff000008095f38) => el0_svc_handler (ffff0000080960b0) => el0_svc (ffff000008084088) 现在如果我们想继续深入generic_make_request, 使用function_graph plugin: $ sudo trace-cmd record -p function_graph -g generic_make_request dd if=/dev/zero of=file bs=4k count=1 oflag=direct 这样就可以拿到整个调用过程 (report结果稍微整理过): $ trace-cmd report dd-22961 | generic_make_request() { dd-22961 | generic_make_request_checks() { dd-22961 0.080 us | _cond_resched(); dd-22961 | create_task_io_context() { dd-22961 0.485 us | kmem_cache_alloc_node(); dd-22961 0.042 us | _raw_spin_lock(); dd-22961 0.039 us | _raw_spin_unlock(); dd-22961 1.820 us | } dd-22961 | blk_throtl_bio() { dd-22961 0.302 us | throtl_update_dispatch_stats(); dd-22961 1.748 us | } dd-22961 6.110 us | } dd-22961 | blk_queue_bio() { dd-22961 0.491 us | blk_queue_split(); dd-22961 0.299 us | blk_queue_bounce(); dd-22961 0.200 us | bio_integrity_enabled(); dd-22961 0.183 us | blk_attempt_plug_merge(); dd-22961 0.042 us | _raw_spin_lock_irq(); dd-22961 | elv_merge() { dd-22961 0.176 us | elv_rqhash_find.isra.9(); dd-22961 | deadline_merge() { dd-22961 0.108 us | elv_rb_find(); dd-22961 0.852 us | } dd-22961 2.229 us | } dd-22961 | get_request() { dd-22961 0.130 us | elv_may_queue(); dd-22961 | mempool_alloc() { dd-22961 0.040 us | _cond_resched(); dd-22961 | mempool_alloc_slab() { dd-22961 0.395 us | kmem_cache_alloc(); dd-22961 0.744 us | } dd-22961 1.650 us | } dd-22961 0.334 us | blk_rq_init(); dd-22961 0.055 us | elv_set_request(); dd-22961 4.565 us | } dd-22961 | init_request_from_bio() { dd-22961 | blk_rq_bio_prep() { dd-22961 | blk_recount_segments() { dd-22961 0.222 us | __blk_recalc_rq_segments(); dd-22961 0.653 us | } dd-22961 1.141 us | } dd-22961 1.620 us | } dd-22961 | blk_account_io_start() { dd-22961 0.137 us | disk_map_sector_rcu(); dd-22961 | part_round_stats() { dd-22961 0.195 us | part_round_stats_single(); dd-22961 0.054 us | part_round_stats_single(); dd-22961 0.955 us | } dd-22961 2.148 us | } dd-22961 + 15.847 us | } dd-22961 + 23.642 us | } uftrace uftrace在用户态实现了一个类似ftrace的功能, 对需要快速理解用户态的逻辑会有帮助, 但是需要加上-pg重新编译源码, 详情见[6]。 #gcc -pg a.c #uftrace ./a.out # DURATION TID FUNCTION [ 69439] | main() { [ 69439] | A() { 0.160 us [ 69439] | busy(); 1.080 us [ 69439] | } /* A */ [ 69439] | B() { 0.050 us [ 69439] | busy(); 0.240 us [ 69439] | } /* B */ 1.720 us [ 69439] | } /* main */ BPF BPF (eBPF) 是这几年的热点, 通过BPF几乎可以看清系统的各个角落, 给诊断带来了极大的方便. BPF不是一个工具, BPF是生产工具的工具, BPF工具编写是性能分析必须掌握的技能之一。 这里举个使用BPF来分析QEMU I/O延迟的例子. 为了简化问题, 先确保vm里面的块设备只有fio在使用, fio控制设备只有一个并发I/O, 这样我们在host上选择2个观察点: • tracepoint:kvm:kvm_mmio. host捕获guest mmio操作, guest里面最终通过写该mmio发送请求给host • kprobe:kvm_set_msi. 因为guest里面vdb使用msi中断, 中断最终通过该函数注入 因为host上有多个vm和虚拟盘需要区分, 使用以下信息捕获并且只捕获我们关注的这个设备: • 只关注该qemu-kvm pid • vbd mmio对应的gpa, 这个可以在guest里面通过lspci获得 对于kvm_set_msi, 使用如下信息: • struct kvm的userspace_pid, struct kvm对应的qemu-kvm进程 • struct kvm_kernel_irq_routing_entry的msi.devid, 对应到pci设备id #include <linux/kvm_host.h> BEGIN { @qemu_pid = $1; @mmio_start = 0xa000a00000; @mmio_end = 0xa000a00000 + 16384; @devid = 1536; } tracepoint:kvm:kvm_mmio /pid == @qemu_pid/ { if (args->gpa >= @mmio_start && args->gpa < @mmio_end) { @start = nsecs; } } kprobe:kvm_set_msi { $e = (struct kvm_kernel_irq_routing_entry *)arg0; $kvm = (struct kvm *)arg1; if (@start > 0 && $kvm->userspace_pid == @qemu_pid && $e->msi.devid == @devid) { @dur = stats(nsecs - @start); @start = 0; } } interval:s:1 { print(@dur); clear(@dur); } 执行结果如下: @dur: count 598, average 1606320, total 960579533 @dur: count 543, average 1785906, total 969747196 @dur: count 644, average 1495419, total 963049914 @dur: count 624, average 1546575, total 965062935 @dur: count 645, average 1495250, total 964436299 更深理解 很多技术需要反复去理解验证, 每一次可能都有不同的收获, 这里举个loadavg的例子. 引用kernel/sched/loadavg.c最开始的一段注释: 5 * This file contains the magic bits required to compute the global loadavg 6 * figure. Its a silly number but people think its important. We go through 7 * great pains to make it work on big machines and tickless kernels. 这里的silly我想说的是loadavg有一定的局限性, 总的来说loadavg是有一定语义和价值的, 毕竟它只用了3个数字描述了过去一段时间的"load", 反过来说如果loadavg is silly, 那么有没有更好的选择? • 如果是实时观察的话, vmstat/dstat输出的runnable和I/O blocked的信息是种更好的选择, 因为相对于loadavg每5秒的采样, vmstat可以做到粒度更细, 而且loadavg的算法某种程度可以理解为有损的。 • 如果是sar/tsar的话, 假设收集间隔是10min的话, loadavg因为能覆盖更大的范围, 确实比10min一个的数字包含更多的信息, 但我们需要思考它对调试的真正价值. 另外, 5秒钟的采样间隔是比较大的, 我们可以构造个测试用例执行了大量时间但跳过采样 • 获取load采样点的时间 • 测试用例刚好跳过该采样点 查看calc_load_fold_active在cpu 0上的调用时间: kprobe:calc_load_fold_active /cpu == 0/ { printf("%ld\n", nsecs / 1000000000); } 运行没有输出, 监控上一层函数: #include "kernel/sched/sched.h" kprobe:calc_global_load_tick /cpu == 0/ { $rq = (struct rq *)arg0; @[$rq->calc_load_update] = count(); } interval:s:5 { print(@); clear(@); } 执行结果符合预期: #./calc_load.bt -I /kernel-source @[4465886482]: 61 @[4465887733]: 1189 @[4465887733]: 62 @[4465888984]: 1188 查看汇编发现这里代码被优化, 但是刚好id_nr_invalid调用没优化, 当然最方便的是能够直接在函数偏移处直接打点: kprobe:id_nr_invalid /cpu == 0/ { printf("%ld\n", nsecs / 1000000000); } 根据这个时间戳, 可以很容易跳过load的统计: while :; do sec=$(awk -F. '{print $1}' /proc/uptime) rem=$((sec % 5)) if [ $rem -eq 2 ]; then # 1s after updating load break; fi sleep 0.1 done for i in {0..63}; do ./busy 3 & # run 3s done 大量busy进程成功跳过load的统计, 可以设想像cron执行的任务也是有这个可能的. 虽然不能否认loadavg的价值, 但总的来说load有以下缺陷: • 系统级别的统计, 和具体应用产生的联系不够直接 • 使用采样的方式并且采样间隔 (5s) 较大, 有的场景不能真实反映系统 • 统计的间隔较大(1/5/15分钟), 不利于及时反映当时的情况 • 语义稍微不够清晰, 不只包括cpu的load, 还包括D状态的任务, 这个本身不是大问题, 更多可以认为是feature Linux增加了Pressure Stall Information (PSI), PSI从任务的角度分别统计了10/60/300s内因为cpu/io/memory等资源不足而不能运行的时长, 并按照影响范围分成2类: • some - 因为缺少资源导致部分任务不能执行 • full - 因为缺少资源导致所有任务不能执行, cpu不存在这种情况 我们在一台96c的arm机器上扫描所有cgroup的cpu.pressure: 这里会引出几个问题, 篇幅原因这里不再展开。 • 父cgroup的avg为什么比子cgroup还小? 是实现问题还是有额外的配置参数? • avg10等于33, 也就是1/3的时间有task因为没有cpu而得不到执行, 考虑到系统cpu利用率在40%左右并不算高, 我们怎么合理看待和使用这个值 top - 09:55:41 up 127 days, 1:44, 1 user, load average: 111.70, 87.08, 79.41 Tasks: 3685 total, 21 running, 2977 sleeping, 1 stopped, 8 zombie %Cpu(s): 27.3 us, 8.9 sy, 0.0 ni, 59.8 id, 0.1 wa, 0.0 hi, 4.0 si, 0.0 st RTFSC 有的时候RTFM已经不够了, 手册包括工具本身的更新没对上内核的节奏, 我们回到上面页面回收的例子, 估计有的同学之前就有疑问, 没有scan哪里来的steal。 #sar -B 1 11:00:16 AM pgscank/s pgscand/s pgsteal/s %vmeff 11:00:17 AM 0.00 0.00 3591.00 0.00 11:00:18 AM 0.00 0.00 10313.00 0.00 11:00:19 AM 0.00 0.00 8452.00 0.00 先看sysstat (sar) 里面的实现, 主要是读取分析/proc/vmstat: • pgscand: 对应到pgscan_direct域 • pgscank: 对应到pgscan_kswapd域 • pgsteal: 对应到pgsteal_开头的域 #gdb --args ./sar -B 1 (gdb) b read_vmstat_paging (gdb) set follow-fork-mode child (gdb) r Breakpoint 1, read_vmstat_paging (st_paging=0x424f40) at rd_stats.c:751 751 if ((fp = fopen(VMSTAT, "r")) == NULL) (gdb) n 754 st_paging->pgsteal = 0; (gdb) 757 while (fgets(line, sizeof(line), fp) != NULL) { (gdb) 759 if (!strncmp(line, "pgpgin ", 7)) { (gdb) 763 else if (!strncmp(line, "pgpgout ", 8)) { (gdb) 767 else if (!strncmp(line, "pgfault ", 8)) { (gdb) 771 else if (!strncmp(line, "pgmajfault ", 11)) { (gdb) 775 else if (!strncmp(line, "pgfree ", 7)) { (gdb) 779 else if (!strncmp(line, "pgsteal_", 8)) { (gdb) 784 else if (!strncmp(line, "pgscan_kswapd", 13)) { (gdb) 789 else if (!strncmp(line, "pgscan_direct", 13)) { (gdb) 757 while (fgets(line, sizeof(line), fp) != NULL) { (gdb) 看下/proc/vmstat都有什么: #grep pgsteal_ /proc/vmstat pgsteal_kswapd 168563 pgsteal_direct 0 pgsteal_anon 0 pgsteal_file 978205 #grep pgscan_ /proc/vmstat pgscan_kswapd 204242 pgscan_direct 0 pgscan_direct_throttle 0 pgscan_anon 0 pgscan_file 50583828 最后看看内核的实现, pgsteal和pgscan的逻辑是一样, 除了nr_scanned换成了nr_reclaimed: 现在问题很清晰了: • 这里sar取得是系统的/proc/vmstat, 而cgroup里面pgscan_kswapd和pgscan_direct只会加到cgroup的统计, 不会加到系统级的统计 • cgroup里面pgsteal_kswapd和pgsteal_direct同样只会加到cgroup自己的统计 • 但是主要pgscan_anon, pgscan_file和pgsteal_anon, pgsteal_file都只加到系统级的统计 • sar读取了pgscan_kswapd, pgscan_direct, 以及pgsteal_, 这里还包括了pgsteal_anon和pgsteal_file 这整个逻辑都乱了, 我们有必要解决这个bug让sar的输出变得更加有意义. 那么在cgroup内是不是没问题? #df -h . Filesystem Size Used Avail Use% Mounted on cgroup 0 0 0 - /sys/fs/cgroup/memory #grep -c 'pgscan\|pgsteal' memory.stat 0 这些统计信息在cgroup v1上完全没有输出, 而只在v2版本有输出. 在以前内核没有专门LRU_UNEVICTABLE的时候, 如果有很多比如mlock page的时候, 碰到过不停扫描却不能回收内存的情况, 这个统计会非常有用, 即使是现在我相信这个统计还是有用的, 只是大部分时候还不用看到这么细。 多上手 纸上得来终觉浅, 自己动手去做带来很多好处: • 回答预设问题. 调试分析就是不断提出问题和验证的过程, 没有上手的话就会一直停留在第一个问题上. 比如我想了解某平台上物理内存是怎么编址的, 没有文档的话只能自己去实验 • 提出新的问题. 调试分析中不怕有问题, 怕的是提不出问题 • 会有意外收获. 很多时候并不是有意为之, 比如准备的是分析cpu调频能否降功耗, 上去却发现系统一直运行在最低频率 • 熟练. 熟练就是效率 • 改进产品. 可以试想下在整个云环境所有机器上扫描 (类似全面体检) 会发现多少潜在问题 参考资料 [1]https://www.cs.rice.edu/~johnmc/comp528/lecture-notes/ [2]https://brendangregg.com/ [3]http://dtrace.org/blogs/bmc/ [4]https://blog.stgolabs.net/ [5]https://lwn.net/ [6]https://github.com/namhyung/uftrace [7]https://www.brendangregg.com/[8]The Art of Computer Systems Performance Analysis

优秀的个人博客,低调大师

每日一博 | 自上而下地理解网络 —— ARP 与 Ethernet Ⅱ

自上而下的理解网络(6)——终篇!ARP与Ethernet Ⅱ 本篇是本系列博客的最后一篇,回顾此系列文章的介绍过程,我们介绍了: 1.网上冲浪的第一步:DNS域名解析协议 https://my.oschina.net/u/2340880/blog/5272671 2.离我们最近的应用层协议:HTTP https://my.oschina.net/u/2340880/blog/5308979 3.高安全性,高可靠性的应用层协议:HTTPS https://my.oschina.net/u/2340880/blog/5373824 4.可靠的传输层协议:TCP https://my.oschina.net/u/2340880/blog/5420433 5.涉及路由与寻址的网络层协议:IP https://my.oschina.net/u/2340880/blog/5465312 我们一步步的接近了网络传输的底层真相,大千世界,天涯咫尺。看似神奇的网络通信其实就是在这中分层的思想下变得纯粹和简单。本篇之所以是此系列文章的终篇,原因之一是到IP协议这一层后,我们基本已经从逻辑上可以清楚的理解了网络传输的过程,物理层的具体数据传输方式并不会影响我们逻辑上的理解。除此之外,更重要的原因是笔者学识薄浅,对链路层及以下的知识确实不甚了解,因此我们就到此为止。 一. 为什么我们需要MAC地址 本篇文章要从MAC地址说起,如果你认为当要传输的数据被完整的封装成IP报文,明确了源IP地址和目的IP地址后就万事大吉了,那只能说你还太年轻了。我们使用Wireshark来抓一个简单的TCP协议报文来看。如下图: 可以看到,在IP协议这一层,是只关注IP地址的,但是再向下,到封装成数据链路层的数据帧时,已经被转换成了源MAC地址和目的MAC地址。你可能会有疑惑,按照我们前面的理解,通过IP地址已经可以唯一的定位到要进行网络通信的两端,为何要多此一举的又使用MAC地址呢?这样做究竟是什么目的又有什么必要性呢?本篇文章就来帮你解惑。 1. 什么是MAC地址 首先我们需要先了解下什么是MAC地址,MAC地址全称为Media Access Control Address,通常也将其叫做以太网地址或物理地址,是一个用来确定设备网络位置的地址。我们平时使用的可连接互联网的设备中,都会有一个网卡元件,每个网卡都会有一个全球唯一的MAC地址,是由网络设备制造商生产时烧录在元件内部的。 MAC地址的长度为48位,即6个字节。一般在表示时,我们会以字节为组表示,中间使用冒号进行分割。你也可以查看下当前设备的MAC地址,如下图: 当数据报在网络中输出时,可能需要经过多个中间节点的转发才能最终到达目标节点,在初始节点,我们需要将目标节点的IP映射到中间节点的MAC地址,之后第二个节点根据IP来映射到下一个节点的MAC地址,依次进行映射,直到最终达到目标。因此,数据传输的关键是IP地址到MAC地址的映射,ARP协议就是来做这件事情的。 2. 有了IP地址,为什么还需要MAC地址? 我想,这个问题是初次了解到MAC地址的同学都会有的一个问题,要解答这个问题,我们首先要清楚IP地址和MAC地址间的异同之处。 IP地址和MAC地址最大的相同点是他们都是唯一的,我们主要看它们的不同之处: · IP地址是网络层使用的,MAC地址是链路层使用的 这一点很容易理解,IP协议本身就是网络层的协议,虽然IP地址是唯一的,但其实基于网络拓扑而设计的,同一台设备修改IP地址很容易。MAC地址则是链路层的概念,其在硬件生产是就烧录好了,同一台设备一般无法变动。 · 长度不同 IPv4版本的IP地址长度为32位,IPv6版本的IP地址长度为128位,而MAC地址的长度固定为48位。 IP地址是逻辑上的地址,我们可以理解其作用是将数据从一个逻辑上的网络传递到另一个逻辑上的网络,而MAC地址是链路上的地址,其作用是将数据从一个设备节点传递到另一个设备节点。那么是否可以去掉MAC地址,只使用IP地址呢?理论上好像可行,但实际上却不行。核心的原因也在于IP是逻辑上的,当网卡接收到一块数据时,由于链路层属于下层无法获取上层的逻辑数据,网卡无法自主来过滤这块数据是否是发给我的,需要讲给CPU去运算,上层通过IP逻辑比较来确定的数据报的归属,这会大大的影响网络传输效率,当然如果干掉了分层的概念,可能只需要一个唯一地址就可以解决问题,但是至少对于目前的互联网架构这样是不可行的,这就比如有了域名,我们为什么还需要IP地址是一样的,本质是它们工作在不同的网络分层上。 二. 如何获取目标的MAC地址 现在我们知道了MAC地址是通信过程中所必须的,那么是如何获取到MAC地址呢。 1. 缓存表 和IP路由类似,我们的网络设备中还会存储两个与MAC地址相关的表。一个是ARP缓存表,一个是MAC地址表。当网络层的数据将要被封装成数据链路层的数据帧时,会通过ARP缓存表来查询IP地址与MAC地址的映射关系,当然如果没有缓存的话,会通过网络层的ARP协议来解析。MAC地址表则是存储着各端口的主机源MAC地址和端口号的映射,以便交换机将数据发送到指定的端口去。 2. ARP协议 上面所说的ARP缓存表,其中的数据实际上是通过ARP协议解析到的。ARP协议的核心作用是将IP地址解析成对应的MAC地址,回忆一下,这是否很像我们之前所介绍的DNS协议的作用。首先,ARP协议是IP协议簇中的成员之一,核心的工作原理是源主机在需要获取目的IP的MAC地址时,将目的IP组装成ARP数据报广播到局域网上的所有主机,并接收返回的数据,从而确定目标的MAC地址,接收到数据后,会将数据存储ARP缓存表中,下次查询时直接使用缓存,节省网络资源。这个过程就好比: 1.A想要知道B的MAC地址,其首先会向周围所有网络设备广播如下内容: IP是A的设备要想知道IP是B的设备的MAC地址,你们谁知道,请发给我? 2.M,N,P,Q可能都收到了此询问请求,M发现自己知道B设备的MAC地址,因此会回给A: IP是A的设备,我要将IP是B的设备的MAC地址发给你,请接收。 3.A设备收到M设备的返回后,拿到自己想要的MAC地址,之后组装链路层数据帧进行发送。 通过上面的过程你也可以发现,其实ARP本身并不是一个安全的协议,任何设备在接收到广播后都可以编造一个MAC地址进行返回,从而产生ARP欺诈风险,但这也并非完全无法防范,比如使用指定的安全的ARP服务器,建立静态的IP-MAC映射表等,我们这里不再讨论。 3. 分析下ARP协议 在访问网页时,你的设备可能随时会发起ARP请求和接收ARP响应,我们可以先抓一个ARP协议的请求和返回数据来简单看下ARP协议的结构,如下图: 如图中所示,抓到了两条ARP协议数据,其中第一条为ARP请求报文,第二条为ARP响应报文。可以看到请求报文的目标地址是广播地址,报文内包含硬件类型,协议类型,ARP类型,源MAC地址,源IP地址和目的IP地址。如果是响应报文,则其中还会包含目的MAC地址。相比较我们前面介绍的应用层的协议,ARP协议非常简单(越底层通常越简单与专注),协议格式如下: 其中,ARP首部占了8个字节: 前2个字节指定了硬件的类型,即链路层的协议,一般为1,表示以太网。 第3和第4个字节指定了所使用的协议类型,其中0x0800表示IPv4协议。 第5个字节表示链路层协议的地址长度,比如MAC地址长度为6个字节,这里的值是6。 第6个字节表示所使用的协议地址长度,比如IPv4的长度为4个字节,,则这里的值是4。 第7和第8个字节是Opcode码,是一个ARP操纵码,1表示ARP请求,2表示ARP响应。 ARP协议的首部是固定的,数据部分是可边长的,依次排布着源链路层地址,源逻辑层地址,目标链路层地址和目标逻辑层地址。 ARP协议本身简单,这里就不再过多阐述,还有一个与之对应的RARP协议,此协议是将MAC地址解析为IP地址,作用与ARP刚好相反,有兴趣的话,你也可以研究下。 三. 以太网链路层EthernetⅡ帧 最后,我们再简单了解下EthernetⅡ帧的相关内容,其实拿到MAC地址后,网络传输整体架构中有关逻辑的部分就完全结束后,后面就是向数据包前拼装上链路层协议的相关数据,组装成EthernetⅡ帧进行发送。从抓包工具可以看到,这一层只是向头部拼接了目标MAC地址,源MAC地址和所使用的网络层协议。有时候,在数据的最后也会加上数据帧校验序列,如下图: 在底层的原理,我们这里就不再深究了。本系列博客也将暂时告一段落,希望能对你有所帮助。 专注技术,热爱生活,交流技术,也做朋友。 ——珲少 QQ:316045346 同时,如果本篇文章让你觉得有用,欢迎分享给更多朋友,请标明出处。

优秀的个人博客,低调大师

每日一博 | 测试在项目流程中的那些事儿

前言 测试作为整个项目中的一环,在项目流程中起着不可或缺的作用。部分团队是缺少项目管理角色的,这个时候,测试对项目流程的推进、项目质量的保证显得尤为重要。好的测试,能在整个项目流程中以QA角度做好项目管理和及时的风险预警,让项目如期上线且保障质量。业界一直强调测试前置,那么测试在项目中,如何根据项目情况做前置工作推进项目流程,让大家都开心工作呢?本文以自己所在的项目组为例讲述项目流程中的一些事,希望可以与大家一同探讨~ 一、QA在项目中扮演的角色 【why】明确目标是什么:明确做这个项目的目标是什么,可适当根据目标对需求实现、项目质量、研发提测时间点等做一些调节。 【when】项目的deadline:考虑项目组的特殊性,我们需要知道项目需要什么时候上线,明确项目deadline,根据时间节点制定合适的测试计划 【what】各阶段我们需要做什么:可以重点关注项目流程中,QA参与与输出的环节。有输入才会有输出,所以输出的环节往往是需要QA花费时间去思考的地方。 【how】遇到风险点时怎么做:测试阶段,除了QA环节的风险点需要及时暴露和push外,这个阶段研发和产品也在做一些工作。在项目流程管理中,作为最下游的参与者,需要关注这些风险点,及时暴露和push解决。 【who】QA、RD、PM 二、我们面临的挑战 2.1挑战点 1.发版频率在排名第二,2021全年发版71次,相当于每周都有一个版本在进行迭代,快速迭代的节奏, 对人效和团队协同效率要求高。 2.整个2021年,研发人均bug数为123个,bug较多, 提测质量不高。为了不拉长项目周期, 保障较短的bugfix时间非常关键,同时要考虑如何提高提测质量。 3.整个2021年,测试人均提bug量最多,在项目节奏紧张的情况下,发现和提bug的效率必须提升。 2.2关于提测质量 针对上述挑战的内容,我们可以看到提测质量上,我们存在不足之处。我们之前做过提高冒烟用例比例、冒烟交叉执行、时间预估增加冒烟时间等尝试,最后发现收获的效果有限。主要原因如下: 多方合作、项目有固定deadline:由于项目特殊性,部分需求是多方合作的模式且有固定的deadline,就需要项目尽快上线,在对项目效率有极高要求的情况下,我们允许带一些层级深的bug上线,针对上线情况做hot fix。 项目节奏紧张,需快速迭代更新:现有研发团队是串行的节奏,能持续高效迭代,为保证项目节奏的稳定性,避免出现因一个项目周期拉的过长导致节奏紊乱,我们接受分步提测的形式,就有可能出现冒烟功能不完整的情况,导致提测质量不如预期。 基于以上原因,我们可以看到在质量与效率之间需要做一定的选择时,需要向项目效率倾斜,所以我们既然无法更好地改变提测质量,那就去改变我们能改变的。 三、面对这些挑战,QA可以做什么 QA可以做什么让整个迭代周期变短,在bug很多的情况下还能快速迭代且线上问题较少呢?先来看下我们的项目流程: 从整个项目流程上看,可能与很多团队如出一辙。在流程上,QA作为下游的一个部分,可以看到QA参与输出的内容其实有很多,这些部分就是我们可以尝试去改变提升的点。 那么我们从这些输出内容看下,面对上述挑战,QA都做了哪些改变以及还有哪些困境。 3.1项目排期计划 项目排期计划模板: 【when】项目排期一般是需求评审完后,根据需求拆分需求模块和开发模块。 排期计划中,QA的工作:熟悉需求,拆分需求模块,制定测试计划 QA同学加入进模块拆解,能更好的了解需求,拆分的开发模块也能更快的知道当有bug时,bug是属于哪个端的,提给哪位对应的开发。 根据各模块的提测时间和大致开发周期,QA同学也能制定对应的测试计划。 【what】-- QA具体需要做什么 协助开发拆分功能模块,确保模块都有对应的开发负责人 确认项目deadline、开发总预计时间和提测时间 3.2测试计划制定 项目测试计划模板: 【when】测试计划一般在项目排期给出后1天内提供,后续根据排期动态调整 测试计划中,QA的工作:根据需求预估时间和人力,明确测试环境与策略,制定合理的测试计划,预估风险 【what】-- QA具体需要做什么 1.拆分功能模块,模块明确好对应的测试。(包含用例编写安排、一、二轮测试安排和兼容测试安排) 2.预估好项目的总体测试时间和各轮次的测试时间 3.一轮接近尾声时,与开发明确好上预发时间;二轮接近尾声时,与开发明确好上online环境的时间 4.如有数据配置项,二轮测试开始前与产品明确好配置所需内容和完成时间节点 以上1、2两点尽早提供,其余可在对应时间点给出。当然,如遇到需求变更、人力变更等需要及时提出和调整。 【how】-- 具体怎么做 根据开发排期,动态制定和调整合理测试的计划。 根据提测时间,决定用例执行顺序与分配: 如下图拆分的测试计划,后台配置(星火)与用户端提测时间不一致,结合两个提测时间点,我们利用用户端提测前的时间,先执行后台配置的用例,这样即使是分步提测,我们也能确保每次提测时测试资源能跟上。 根据功能制定测试轮次 对于主干功能:需要多次执行测试用例,一般制定三轮的测试,一轮在测试环境,二轮预发环境,三轮线上环境 对于对内的、不影响用户使用的功能:制定一轮测试,在测试环境测一轮。比如星火等配置后台是给运营使用的,做一轮测试,上预发后产品走查验证+配置内容即可 活动类的功能:依据活动的复杂程度和使用频次,制定测试轮次。比如新年活动,是一次性的活动且活动时间紧,评估后我们在预发做了一轮测试就上线了,上线质量也一样较好。具体测试流程:活动类测试流程尝试 按照模块、用例量与难度划分,制定每人每天用例执行目标 一轮测试模块划分根据用例编写与熟悉度划分 实行交叉测试,避免因不熟悉导致遗漏或效率降低 二轮进测试进行交叉,利用TC平台的任务指派,也可以清楚看到组员的任务数量与完成情况。 如下图,测试计划的拆解与人员分配,细致划分到每人每日的工作目标,且各模块的分配会进行交叉,一轮测试人员发现用例不完善或测试不方便的地方也即使提供了文档以便二轮人员尽快上手测试。 【小结】:我们可以看到,调整测试计划的4种方式,主要目的都是通过这些办法去更高效地去完成测试任务,保障项目如期上线;更完善、全面地去发现bug,提升项目质量。测试计划的合理调整分配,是面对项目过程中各种挑战的有效方式之一。 3.3jira定制化流程 定制化的jira项目流程: 版本发布管理三部曲: jira版本发布管理:从产品建立版本开始,到最终复盘,整个流程和数据统计都体现在jira看板中,方便统一管理 项目进度自动同步:如下,项目组成员能很清晰的知道当前项目进度,且版本进度每天都会自动在大群同步;完结的项目,也会根据项目情况自动同步复盘信息 【小结】: 1.定制化的流程,让流程更加统一规范和智能化。 2.关键信息的及时同步,能减少每日站会、信息同步会等重复会议,节约了时间。 各团队之前的协作更加顺畅,那团队协同效率和人效也就自然而然能进一步提高。 QA高效提bug、研发快速修bug秘诀: 2021Q1 效率工具的需求收集提效讨论中,提bug流程的优化建议一一实现了,每个人提bug 的速度大幅提升,主要汇总如下: bug区分问题类型 —— 使bug分类更精准,能更好地分析数据,push对应人员 bug状态展示优化 —— 各状态一目了然,更快找到需要处理的bug bug描述预置版本、步骤、设备等信息 —— 减少重复内容输入,提bug效率更高 jira移动版接入使用 —— 附件内容更方便上传,bug描述更准确,减少因无法复现、描述不清等原因带来的重复沟通成本 bug流程新增:一轮漏测、fix bug引入选项、bug描述不清的状态 —— 当然这些指标目的不是为了追究是开发或是测试的责任,是为了分析bug,总结原因,从中找出不足的地方(比如用例设计不完善、开发修复bug未自测等问题),大家共同进步,提升项目质量,从而让项目进行更流畅与高效。 自动提醒开发QAfix和验收bug:—— 精准找到需要处理bug,处理效率大大提升 项目流程复盘中,我们约定p1bug当天需要fix,p2bug原则上fix周期不超过T+1天,验收不超过T+2天。如下图,就是根据形成的规范自动提醒研发、测试的内容: 【小结】: 1.即使是预置的一些提bug信息和界面优化,也让测试更“优雅”地工作,提bug和验bug也更有劲儿了。 2.T+1修复周期的约定与消息推送,给了研发一个心里预期,正如我们根据项目情况调整测试策略一般,研发也根据我们给的预期调整了工作模式,从而使研发fix bug周期保障到最短,高效且有质量地修复了bug。 工作流程的调整与满满预期的加持,让整个团队的工作效率极大提高。 3.4测试报告 测试日报 【when】一般项目提测后,需要每日下班前发送日报 【what】-- QA具体需要做什么 汇总其他QA的进度,根据项目情况发送日报or周报。 日报中风险项一环节可根据项目情况修改,同步计划、提醒事项等都可以写入。 push开发fix bug:p1 修复周期不超过T+1天,bug数量较多时,可根据测试情况适当催开发修改(比如一轮测试接近尾声,还有很多服务端前端bug,就需要催一下了) 【how】-- 具体怎么做 在galaxy平台工具上,实现了日报自动生成工具,每日可自动生成日报内容,方便大家看进度,且日报中还有当前bug状态和链接,研发也能更快找到自己的bug。 日报一键生成效果如下: 【小结】: 日报的自动生成,节省了测试每日汇总进度的时间,更是直接大幅减少了关键信息的沟通同步成本,是人效和团队协同效率提升的又一次加成buff。 质量报告(测试报告) 【when】项目上线后,对项目进行总结梳理 【how】-- 具体怎么做 结合jira的使用流程,可一键生成测试报告并同步质量平台。 生成的测试报告示例: 3.5项目复盘 【when】项目上线后的一周内,小型项目如有必要可合并组织 【why】复盘的目的:针对项目中不足之处,共同讨论对策,争取下次做的更好 【what】-- QA具体需要做什么 1.数据文档准备:形式其实不做限制,需要的数据、文档等准备好即可,也可以与开发轮流组织。 2.会议上形成的todo list需要进行跟进处理 【how】-- 具体怎么做 复盘例子: 复盘提效jira看板:如下图 — ps:催bug或者发日报的时候也可以使用,比较清晰 【小结】:定期做项目复盘,让团队意识到我们当前存在的问题,推进项目流程一次比一次做的更好。 【不足】: 当然,在复盘过程中,各团队虽然达成一些共识共同改进,也遇到了一些列问题。 问题一:项目节奏已经很紧张的情况下,大家可能都在赶项目进度,没有余力去做复盘总结工作,追求效率从而忽视了质量。 问题二:复盘形成的todolist也没时间去跟进,导致复盘的总结内容最后不了了之,复盘失去意义。 问题三:一些复盘改进点,往往由于各种特殊原因而不能按规定执行 。 基于以上原因,复盘收获的效果是比较有限的,也是我们今后需要探讨与改进的一个命题。 四、项目风险 4.1风险评估 项目流程中,我们关注各个阶段需要做什么事的同时也会做项目管理与把控,关注项目风险,守住deadline。 风险可以分为两类:质量风险和进度风险 举个例子: 用例编写的时间不够,影响测试时间和上线时间,我们称之为进度风险;而用例编写时,编写用例人员不熟该功能,用例覆盖不足,我们可以称之为质量风险。 这里我们主要关注的是项目进度,所以着重关注进度风险一项。进度风险,就是在项目进度中出现的风险从而影响了整个项目的时间点。 在测试计中,我们设计了风险一栏放于第一位,目的就是让QA在项目流程中,及时从测试角度去观测和记录风险。 比如: 4.2风险对策 面对风险出现时,需要case by case讨论。在进度风险出现时,首要原则就是及时暴露风险、寻找方法去尽可能降低风险。 项目组很多项目因与其他部门配合,有固定deadline并且允许有部分已知问题带上线,那么我们一般从测试开发角度去商议的解决办法如下: 以上方案如果还不能守住deadline,就要考虑项目延期。 结语 上述内容是作者所在项目组结合已有的测试流程,针对项目遇到的挑战进行流程推进以及推进后的总结介绍。 鉴于不同项目组的特殊和差异性,文中提到的方法和手段可能只是冰山一角,不一定完全适用各类项目。根据项目情况做前置工作推进项目流程,其实是一个很大的命题,不同项目组有时存在的问题也不尽相同,测试在项目流程中还能做哪些更 nice 的事,还是需要靠大家在现有情况下去进行探索和总结。也欢迎大家留言与我们交流讨论~

优秀的个人博客,低调大师

每日一博 | 公网传输技术之 SRT 协议解析(上)

作者:张博力 编辑:Alex ▼扫描图中二维码了解音视频技术大会更多信息▼ 摘 要: SRT协议(即安全可靠传输协议)是一个新兴的网络传输协议,适用于实时音视频传输。本文将从SRT协议的原理分析入手,尝试定义出一个衡量SRT链路可靠性高低的指标:链路安全冗余量(Secure-Margin),并详细介绍如何依照这个指标来部署一个可靠的SRT传输链路,并分析在不同的直播场景中的参数调整策略。 引 言 音视频的信号传输技术作为广电领域的重点技术之一,保障了传输的安全和质量。传统的信号传输手段也许可以用三句话来概括:天上一颗星,地下一根缆,中间面对面的微波。 “天上一颗星” 指的是卫星传输,优点是灵活安全可靠并且对于直播现场的条件没有特殊要求,但其设备投资和费用非常昂贵。“地下一根缆” 指的是光纤传输,优点是安全可靠并且延时极低,但它很依赖光缆链路的基础建设,灵活性较差。“中间面对面的微波” 最初指的是通视条件下的定向微波,后来又发展出长距离的U波段“大微波”和短距离的2G波段“小微波”。随着5G和互联网技术的飞速发展,通过公共互联网安全可靠的传输音视频信号已经成为一种可能,实际上我们的传输手段又多了一种:无需面对面的公网传输。 然而公共互联网中普遍存在着不同程度的丢包、抖动、延时和带宽波动,这就需要一种可靠的传输协议来保证传输链路的可靠性。SRT(Secure Reliable Transport)协议,即安全可靠传输协议,是一种新兴的音视频传输协议,在音视频的点对点实时传输方面有着非常好的应用效果。 广电的技术人员习惯通过链路的冗余量来估算链路的可靠程度,卫星链路中的类似指标是载噪比冗余量(C/N Margin),光纤链路可以通过光功率衰减和接收端灵敏度来估算光功率冗余量。类比这些概念,本文将从SRT协议的理论基础谈起,尝试定义一个衡量SRT链路可靠性的指标——安全冗余量(Secure-Margin)。接着根据这个指标,讨论SRT协议中相关参数的设置步骤和策略。 1、SRT协议原理分析 SRT协议能够在不可预测的互联网环境下提供安全、可靠的数据传输,目前广泛应用在流媒体传输领域。理论上SRT可以传输任意类型的数据,但由于其特别针对实时音视频传输做了优化,目前的主要应用场景是跨越公共互联网点对点传输实时音视频数据。 SRT协议最初是一个私有协议,在2017年4月由SRT联盟将其开源,由于该协议良好的性能以及开源、应用灵活等特性,越来越多的厂商和设备开始支持SRT协议。在实际工作中,搭配使用不同厂商的SRT设备也能够实现高可靠、低延时的音视频传输,这对于用户来说非常方便和灵活。 1.1 SRT协议和UDP协议 追述SRT的开发历程我们会发现,它是由**UDT(UDP-based Data Transfer)**协议改进而来,SRT协议保留了UDT协议大多数的核心概念和机制,同时引进了一些改进和增强功能,其中主要包括针对实时音视频的流量控制、增强的拥塞控制、控制数据的修改、加密机制的改进。UDT协议由Grossman提出,该协议在UDP协议的基础上添加了可靠性控制和拥塞控制机制来保证可靠性,可以有效地利用高速广域网络的高带宽,实现文件的高效、可靠传输。由于UDT协议主要适用于高吞吐的文件传输,SRT主要适用于流媒体传输,所以从应用层面来说,SRT协议和UDT协议之间的差别其实是不可跨越的。 抛开SRT协议的历史,我们可以把它理解成一个基于UDP协议的流媒体传输协议。众所周知,UDP协议是一种基于数据报的不可靠传输协议,它以提高数据的传输速率作为主要设计原则,只能提供不可靠的数据传输服务,尽最大努力交付。 图1展示了裸露的UDP协议在有损网络上的传输效果,测试中利用软件Netem模拟了具有丢包、抖动、延迟的有损网络,在源端将音视频信号进行信源编码,编码后输出的TS流具有可变比特率(VBR)和固定的帧间隔,但是在跨越网络后输出的码流特性已经完全改变,固定的帧间隔也因为网络的抖动发生了改变,实际上解码器很难从这样的码流中恢复出正常的音视频信号。 图1 UDP协议在有损网络下的传输性能 由图2可以看到,SRT协议很好地克服了有损网络环境中的丢包和抖动,在输出端很好地还原了输入的码流,它通过有效的差错控制、精确的时间戳、反馈信号、根据延时量定义缓冲区等一系列机制,实现了在有损网络下的流媒体传输,其中差错控制使用了自动重传请求机制(ARQ)。 图2 SRT协议在有损网络下的传输性能 1.2 自动重传请求:ARQ 数字通信中的差错控制方法大致可分为两类:前向纠错(FEC,Forward Error Correction)和自动重传请求(ARQ,Automatic Repeat reQuest)。从七十年代开始,ARQ思想就被广泛应用在各类通信技术和传输协议中,发展至今经历了多次进化,SRT协议发明者声称其对ARQ技术的改进可以称得上ARQ技术的第三次飞跃。 图3表示了ARQ技术的基本思想,接收端成功收到数据包后通过反馈信道向发送端传送一个指示接收成功的信号(ACK),若超时未收到, 则通过反馈信道向发送端传送一个要求重传的信号(NAK),发送端收到此NAK信号后就重新传送相应的未被接收的数据包。因此这种机制除了要求发送端需要一个重传缓冲区之外,接收端也需要一个能依次存放数据包的缓冲区。 图3 自动重传请求技术(ARQ)基本思想 图4表示了ARQ和FEC之间的区别,一般情况下,我****们要根据实用场景的特点和需求来选择ARQ或FEC。以卫星通信为例,通信链路的单次往返时延即RTT约为540ms,并且噪声都为高斯白噪声,这种情况下使用ARQ效率就很低,也会造成非常大的延时,FEC就成为了最合适的选择。互联网环境中的丢包和抖动有很多都是突发的,这种环境就比较适合ARQ技术来工作,因此SRT最初选择了ARQ作为纠错方式。随着SRT应用领域的发展和扩大,最新版的SRT也加入了对FEC的支持,从而更好地适应各类场景下的应用。 图4 FEC和ARQ链路对比图 2、定义链路的安全冗余量 (Secure-Margin) 在广电领域的直播工作中,工作人员都会习惯通过链路的冗余量来估算链路的可靠程度,卫星链路中的类似指标是载噪比冗余量(C/N Margin),光纤链路可以通过光功率衰减和接收端灵敏度来估算光功率冗余量。类比这些概念,本文从应用层面出发,尝试定义出SRT链路的安全冗余量(Secure-Margin),并给出定性和定量的分析。 在讨论安全冗余量之前,我们首先来了解**单次往返时延(RTT,Round-Trip Time)**的概念:它表示了数据在发送端和接收端之间进行一次往返所需要花费的时间,也可以理解为两点之间一来一回所需要的时间。RTT的值与两点之间物理距离有关,同时也受到网络接入方式和路由选择的影响。 也许可以用一句话表示如何配置一个可靠的SRT传输链路:我们要保证发送缓冲区的使用量(使用单位毫秒来衡量)低于延时量,并且保证接收缓冲区的使用量永远不会接近零。这句话的原理将在下文详述,它实际上指出了SRT链路中的两个临界崩溃点,而SRT链路安全冗余量表示了链路离临界崩溃点还有多少余量。 2.1 发送端缓冲区冗余量 参考图3,ARQ的工作机制决定了发送端需要一个重传缓冲区,接收端也需要一个能依次存放数据包的缓冲区。另一方面,SRT协议通过设定延时量(Latency)统一规定了发送缓冲区和接收缓冲区的最大可使用量。 发送缓冲区的作用是来保存有可能需要重传的数据包,即那些还没有收到肯定应答(ACK)的数据包,如果发送端收到了关于某个数据包的肯定应答,该数据包将被从发送端缓冲区踢出。如果一直没接收到回复的ACK信号,该数据也不能永远保存在发送端缓冲区中,SRT协议规定了保存的最长时间为延时量。 参考图5,并结合SRT的工作原理,我们把延时量的长度想象成一个同时在发送端和接收端从左向右滑动的窗口,图中的1号至6号数据包都已收到肯定应答(ACK),已从发送端缓冲区踢出,7号数据包还保存在缓冲区等待接收方的回复。这是一种较好的传输状态,发送端缓冲区的使用比例很小,大部分数据都已经被及时接收并且收到肯定应答。 参考图6,接收方没有收到3号数据包,并向发送端回复了否定应答(NAK),由于种种原因这一过程被延误,导致3号数据包已经处在窗口最左侧,随着窗口的滑动下一步它将被从发送端缓冲区踢出。这种情况下如果3号数据包的重新传输再出现丢失或者延误,该数据包就会丢包,解码端的图像可能也会出现问题。同时我们也注意到图中发送端缓冲区已经被填满,这也表示了一种处于丢包临界点的传输状态。 图5 发送端和接收端缓冲区(较好状态) 图6 发送端和接收端缓冲区(较差状态) 根据分析可以得出结论:发送端缓冲区被占用的比例越少,链路越安全,若发送端缓冲区被占满,链路则很有可能发生丢包。 根据SRT的工作机制可知:数据保存在发送端缓冲区的最长时间为延时量(Latency),相反保存在发送端缓冲区的最短时间为链路的单次往返时延(RTT)。如果把发送端缓冲区被填满定为临界崩溃点,则发送端缓冲区冗余量SendBuffer-Margin的定义为:一段时间内缓冲区的最大空余量除以发送端缓冲区的最大值,则公式如下: 需要注意的是,我们通过状态图观察发送端缓冲区最大占用量的使用可以忽略那些偶尔出现的短时间峰值。 图7是某次直播当天的发送端缓冲区监测图,图中延时量为125ms,RTT为10ms,这段时间内的发送端缓冲区冗余量约为40%。由于通过测试选择了合适的参数,即使图中后半段网络出现了波动,我们仍然保证了较为充足的发送端缓冲区冗余量。 图7 发送端缓冲区监测图 2.2 接收缓冲区冗余量 接收缓冲区的作用是将收到的数据包排序(SRT协议在SRT包头记录了精确的时间戳),排序一方面是解码的需要,另一方面是为了找出未及时到达的数据包,向发送端返回否定应答(NAK),并等待重传。 参考图5,接收端的1号数据包已经被送至解码器,2号数据包随着延时量窗口的滑动也即将送至解码器,同时2号至6号数据包都已保存在接收缓存区中,接收缓冲区几乎被数据包填满,这是一种较好的链路状态。 参考图6,这是一种较差的链路状态,接收端未收到3号数据包,并且3号数据包在接收端窗口最左侧,意味着3号数据包很可能被跳过,解码出的图像会出现问题。在这种情况下接收缓冲区数据包较少,原因有可能是丢包或者网络带宽和视频码率不匹配。 由此可以得出结论:接收缓冲区的理想状态应该是其使用量应该略低于延时量,若接收缓冲区占用量变为零,解码图像很可能会出现问题。 根据SRT的工作机制可知:数据存放在接收端缓冲区的最长时间应略低于延时量的数值(Latency)。如果把接收端缓冲区使用量变为零看作临界崩溃点,则接收端缓冲区冗余量ReceiveBuffer-Margin的定义为:一段时间之内接收端缓冲区的最小占用量除以接收端缓冲区的最大值,公式如下: 图8是某次直播当天的接收端缓冲区监测图,图中延时量为125ms,RTT为10ms,在图中这一段时间内的接收缓冲区冗余量约为40%。 图8 接收端缓冲区监测图 2.3 链路的安全冗余量 根据SRT的工作机制,发送端和接收端的缓冲区状态是相互影响的,并且状态较差一端的缓冲区冗余量实际上决定了链路的安全冗余量,那么定义链路的安全冗余量(Secure-Margin)等于发送端缓冲区冗余量(SendBuffer-Margin)和接收端缓冲区冗余量(ReceiveBuffer-Margin)两者的最小值。 根据SRT的机制和延时量的含义,实际上延时量和RTT一起定义了数据包能够被重传的次数,这个次数等于延时量除以RTT,我们可以依此进一步定义重传次数冗余量的概念: 至此我们分别用百分比和重传次数两种形式定义了链路的安全冗余量(Secure-Margin),该指标表示了SRT链路差错控制能力的冗余量,同时也是从应用的层面出发,给SRT协议的链路测试以及参数调整设立了一个目标。理解安全冗余量的含义能够帮助工作人员更好地读懂缓冲区状态图,并且以此为参考更有针对性地调整参数,我们也强烈推荐结合该指标和缓冲区状态图来一起评估链路的安全状态。 参照图7和图8,可以观察到RTT一直比较平稳,有时候我们的直播任务往往没有这么好的网络条件,如果遇到RTT突增的情况,链路安全冗余量在下降,而重传次数冗余量在成倍的下降,这时以百分比计算的安全冗余量就不能真实反映链路安全的变化情况,需要同时计算链路的重传次数冗余量。 3、配置SRT流的策略 3.1 测量网络链路的基础参数 在配置SRT流之前我们必须测量自身链路的可用带宽、丢包率、单次往返时延RTT,并注意观察这些指标是否在变动以及变动的范围。 可用带宽:可以使用Iperf软件测量SRT流的链路可用带宽。 丢包率:丢包率是衡量网络堵塞程度的一种方法,使用丢失数据包与发送数据包的百分比表示。信道的丢包率会驱动SRT延迟和带宽开销计算,并可从Iperf统计信息中提取。 RTT:要确定两台设备之间的RTT,可以使用ping命令,如果RTT<=20ms,则使用20ms作为RTT值。这是因为SRT无法对时间尺度小于20ms的事件进行响应。 3.2 设定延时量 延时量(Latency)可以说是SRT协议中最重要的参数,它是一个固定值,可设置范围是80ms-8000ms。延时量越大,SRT链路的差错控制能力就越高,但链路总延时会增加。通过前期测试选择合适的延时量,能够帮助我们在链路的可靠性和低延时之间取得平衡。表1给出了不同丢包率和RTT下延时量的建议值。 最大丢包率(%) RTT乘数 带宽开销(%) 最小延时量(当RTT<=20ms) <=1 3 33 60ms <=3 4 25 80ms <=7 5 20 100ms <=10 6 17 120ms 表1 SRT参数设置表 参考表1,延时量的计算公式如下,其中如果RTT小于20ms,按20ms来计算: 延时量Latency=RTT*RTT乘数 上式中RTT乘数的实际含义是SRT链路能够完成的重传次数,也代表了链路的差错控制能力,这也是为什么丢包率越高,所需要的RTT乘数越高,所需要的延时量也越高,而之前定义的链路重传次数冗余量可以理解成目前还未使用的重传次数。 最初我们完全按照这张表来配置SRT链路,但经过多次直播工作之后我们发现按照推荐值配置的链路安全冗余量并不一定充足,一个好的习惯是提前进行链路测试,并结合安全冗余量和缓冲区状态图来选择合适的延时量。 关于延时量还有其他几个需要注意的点: 在链路其他参数固定的情况下,提高延时量,安全冗余量(Secure-Margin)会随之增大。 延时量(Latency)可以在编码器和解码器上分别设置,若数值不一样,以较高的数值为准,这也就意味着我们仅在某一端把延时量参数降低是无法生效的。 延时量参数并不能代表传输链路的端到端延时,计算链路总延时还需要考虑编码器延时、解码器延时以及RTT。 体育比赛这类直播的传输链路需要很低的延时,因为观众肯定不希望从邻居的欢呼声或者朋友圈得知进球,我们需要非常谨慎地权衡延时量和安全冗余量,从而找到一个折衷的参数。以上图的直播为例,在保证充足安全冗余量的情况下,端到端延时只有0.8秒左右,远小于卫星链路的延时。 3.3 设定带宽开销比例 带宽开销(Bandwidth Overhead)是一个百分比参数,其计算基数为音视频码流比特率,默认值为25%,最高不建议超过50%。这部分由用户分配的额外带宽是用来重传丢失的数据包、传输反向控制数据以及处理拥塞,也就是说带宽开销比例与链路的差错控制能力也是息息相关的,实际上SRT协议中每丢失一个数据包就需要在接收端消耗大约400bps的可用带宽。 图9是一种SRT链路发生崩溃的极端情况,可以用该图来理解带宽开销的功用。在链路崩溃发生后,首先缓冲区数据会暂时填补解码器对数据的持续需求,紧接着链路恢复后,额外划定的带宽开销会弥补之前对缓冲区数据的消耗,在处理完这次突发事件后,整个SRT链路会恢复正常。 图9 带宽开销示意图 关于带宽开销有几点需要注意: 参考表1,可以找到在不同丢包率下的带宽开销比例的最小值,根据链路状态可稍作上浮。 带宽开销的计算基数是视频+音频+元数据+其他辅助数据的总比特率,在估算时要加以注意。 在确定了编码的流带宽之后,可以通过_流带宽*(1+带宽开销)_来计算所需要的链路可用带宽,实际应用中建议在此基础上再增加一些链路可用带宽来对抗波动,建议值为**流带宽*(1+带宽开销)*1.33**。以HEVC方式编码4K信号为例,如果编码后的TS流为40Mbits,带宽开销为25%,建议的链路可用带宽应该在67Mbits以上。 参考图9,区域A和区域B必须相等,实际上SRT链路能够容忍的网络中断时间为_延时量*带宽开销_。综艺晚会或者政府会议这样的直播工作,其对延时并不敏感,可以考虑充分利用延时量和带宽开销这两个参数来极大增强链路的可靠性。假设我们在这种情况下设置延时为8000ms,带宽开销为50%,那么网络即使中断4秒钟也不会影响SRT链路的正常工作,SRT链路这一特性甚至是卫星和光纤链路都不具备的。 结 束 语 近年来,SRT协议在广电领域的发展呈现多点开花的趋势,在现场直播、远程制作、上行推流、国际间远距离传输多方面都有着广泛的应用。在实际部署SRT链路的过程中,前期大量的测试工作是必不可少的,在测试时可以通过观察安全冗余量和缓冲区状态图来判断链路的安全性。 《公网传输技术之SRT协议解析》的下篇将从SRT数据包的角度来分析SRT协议的运行机制和原理,并演示如何通过Wireshark来进行抓包和故障诊断,敬请期待。 参考文献: 1. Haivision.SRT Protocol Technical Overview[M/OL].(2018-10) [2022-02].www3.haivision.com/srt-protocol-technical-overview. 2. Yunhong Gu,Robert L.Grossman.UDT:UDP-based data transfer for high-sspeed wide area networks[J].Computer Networks,2006,51(7):1777-1799. 3. Haivision.SRT Open Source White Paper[M/OL].(2019-1) [2022-02].www3.haivision.com/srt-open-source-wp. 4. SRT Alliance. SRT Deployment Guide,v1.1,Issue 01[M/OL].(2018-10) [2022-02].www3.haivision.com/srt-alliance-guide. 作者简介: 张博力,安徽广播电视台工程师。

优秀的个人博客,低调大师

每日一博 | 云原生时代的 Java 应用优化实践

Java从诞生至今已经走过了26年,在这26年的时间里,Java应用从未停下脚步,从最开始的单机版到web应用再到现在的微服务应用,依靠其强大的生态,它仍然占据着当今语言之争的“天下第一”的宝座。但在如今的云原生serverless时代,Java应用却遭遇到了前所未有的挑战。 在云原生时代,云原生技术利用各种公有云、私有云和混合云等新型动态环境,构建和运行可弹性扩展的应用。而我们应用也越来越呈现出以下特点: 基于容器镜像构建 Java诞生之初,靠着“一次编译,到处运行”的口号,以语言层虚拟化的方式,在那个操作系统平台尚不统一的年代,建立起了优势。但如今步入云原生时代,以Docker为首的容器技术同样提出了“一次构建,到处运行”的口号,通过操作系统虚拟化的方式,为应用程序提供了环境兼容性和平台无关性。因此,在云原生时代的今天,Java“一次编译,到处运行”的优势,已经被容器技术大幅度地削弱,不再是大多数服务端开发者技术选型的主要考虑因素了。此外,因为是基于镜像,云原生时代对镜像大小可以说是十分敏感,而包含了JDK的Java应用动辄几百兆的镜像大小,无疑是越来越不符合时代的要求。 生命周期缩短,并经常需要弹性扩缩容 灵活和弹性可以说是云原生应用的一个显著特性,而这也意味着应用需要具备更短的冷启动时间,以应对灵活弹性的要求。Java应用往往面向长时间大规模程序而设计,JVM的JIT和分层编译优化技术,会使得Java应用在不断的运行中进行自我优化,并在一段时间后达到性能顶峰。但与运行性能相反,Java应用往往有着缓慢的启动时间。流行的框架(例如Spring)中大量的类加载、字节码增强和初始化逻辑,更是加重了这一问题。这无疑是与云原生时代的理念是相悖的。 对计算资源用量敏感 进入公有云时代,应用往往是按用量付费,这意味着应用所需要的计算资源就变的十分重要。Java应用固有的内存占用多的劣势,在云原生时代被放大,相对于其他语言,使用起来变得更加“昂贵”。 由此可见,在云原生时代,Java应用的优势正在不断被蚕食,而劣势却在不断的被放大。因此,如何让我们的应用更加顺应时代的发展,使Java语言能在云原生时代发挥更大的价值,就成了一个值得探讨的话题。为此,笔者将尝试跳出语言对比的固有思路,为大家从一个更全局的角度,来看看在云原生应用发布的全流程中,我们都能够做哪些优化。 镜像构建优化 Dockerfile 从Dockerfile说起是因为它是最基础的,也是最简单的优化,它可以简单的加快我们的应用构建镜像和拉取镜像的时间。 以一个Springboot应用为例,我们通常会看到这种样子的Dockerfile: FROM openjdk:8-jdk-alpine COPY app.jar / ENTRYPOINT ["java","-jar","/app.jar"] 足够简单清晰,但很显然,这并不是一个很好的Dockerfile,因为它没有利用到Image layer去进行效率更高的缓存。 我们都知道,Docker拥有足够高效的缓存机制,但如果不好好的应用这一特性,而是简单的将Jar包打成单一layer镜像,就会导致,即使应用只改动一行代码,我们也需要重新构建整个Springboot Jar包,而这其中Spring的庞大依赖类库其实都没有发生过更改,这无疑是一种得不偿失的做法。因此,将应用的所有依赖库作为一个单独的layer显然是一个更好的方案。 因此,一个更合理的Dockerfile应该长这个样子: FROM openjdk:8-jdk-alpine ARG DEPENDENCY=target/dependency COPY ${DEPENDENCY}/BOOT-INF/lib /app/lib COPY ${DEPENDENCY}/META-INF /app/META-INF COPY ${DEPENDENCY}/BOOT-INF/classes /app ENTRYPOINT ["java","-cp","app:app/lib/*","HelloApplication"] 这样,我们就可以充分利用Image layer cache来加快构建镜像和拉取镜像的时间。 构建组件 在Docker占有镜像构建的绝对话语权的今天,我们在实际开发过程中,往往会忽视构建组件的选择,但事实上,选择一个高效的构建组件,往往能使我们的构建效率事半功倍。 传统的docker build存在哪些问题? 在Docker v18.06之前的docker build会存在一些问题: 改变Dockerfile中的任意一行,就会使之后的所有行的缓存失效 # 假设只改变此Dockerfile中的EXPOSE端口号 # 那么接下来的RUN命令的缓存就会失效 FROM debian EXPOSE 80 RUN apt update && apt install –y HEAVY-PACKAGES 多阶段并行构建效率不佳 # 即使stage0和stage1之间并没有依赖 # docker也无法并行构建,而是选择串行 FROM openjdk:8-jdk AS stage0 RUN ./gradlew clean build FROM openjdk:8-jdk AS stage1 RUN ./gradlew clean build FROM openjdk:8-jdk-alpine COPY --from=stage0 /app-0.jar / COPY --from=stage1 /app-1.jar / 无法提供编译历史缓存 # 单纯的RUN命令无法提供编译历史缓存 # 而RUN --mount的新语法在旧版本docker下无法支持 RUN ./gradlew build # since Docker v18.06 # syntax = docker/dockerfile:1.1-experimental RUN --mount=type=cache,target=/.cache ./gradlew build 镜像push和pull的过程中存在压缩和解压的固有耗时 如上图所示,在传统的docker pull push阶段,存在着pack和unpack的耗时,而这一部分并非必须的 针对这些固有的弊病,业界也一直在积极的探讨,并诞生了一些可以顺应新时代的构建工具。 新一代构建组件: 在最佳的新一代构建工具选择上,是一个没有银弹的话题,但通过一些简单的对比,我们仍能选出一个最适合的构建工具,我们认为,一个适合云原生平台的构建工具应该至少具备以下几个特点: 能够支持完整的Dockerfile语法,以便应用平顺迁移 能够弥补上述传统Docker构建的缺点 能够在非root privilege模式下执行(在基于Kubernetes的CICD环境中显得尤为重要) 因此,Buildkit就脱颖而出,这个由Docker公司开发,目前由社区和Docker公司合理维护的“含着金钥匙出生”的新一代构建工具,拥有良好的扩展性、极大地提高了构建速度,并提供了更好的安全性。Buildkit支持全部的Dockerfile语法,能更高效的命中构建缓存,增量的转发build context,多并发直接推送镜像层至镜像仓库。 (Buildkit与其他构建组件的对比) (Buildkit的构建效率) 镜像大小 为了在拉取和推送镜像过程中更高的控制耗时,我们通常会尽可能的减少镜像的大小。 Alpine Linux是许多Docker容器首选的基础镜像,因为它只有5 MB大小,比起其他Cent OS、Debain 等动辄一百多MB的发行版来说,更适合用于容器环境。不过Alpine Linux为了尽量瘦身,默认是用musl作为C标准库的,而非传统的glibc(GNU C library),因此要以Alpine Linux为基础制作OpenJDK镜像,必须先安装glibc,此时基础镜像大约有12 MB。 在JEP 386中,OpenJDK将上游代码移植到musl,并通过兼容性测试。这一特性已经在Java 16中发布。这样制作出来的镜像仅有41MB,不仅远低于Cent OS的OpenJDK(大约 396 MB),也要比官方的slim版(约200MB)要小得多。 应用启动加速 让我们首先来看一下,一个Java应用在启动过程中,会有哪些阶段 这个图代表了Java运行时各个阶段的生命周期,可以看到它要经过五个阶段,首先是VM init虚拟机的初始化阶段,然后是App init应用的初始化阶段,再经过App active(warmup)的应用预热时期,在预热一段时间后进入App active(steady)达到性能巅峰期,最后应用结束完成整个生命周期。 使用AppCDS 从上面的图中,我们不难发现,蓝色的CL(ClassLoad)部分,实际长占用了Java应用启动的阶段的一大部分时间。而Java也一直在致力于减少应用启动的ClassLoad时间。 从JDK 1.5开始,HotSpot就提供了CDS(Class Data Sharing)功能,很长一段时间以来,它的功能都非常有限,并且只有部分商业化。早期的CDS致力于,在同一主机上的JVM实例之间“共享”同样需要加载一次的类,但是遗憾的是早期的CDS不能处理由AppClassloader加载的类,这使得它在实际开发实践中,显得比较“鸡肋”。 但在从OpenJDK 10 (2018) 开始,AppCDS【JEP 310】在CDS的基础上,加入了对AppClassloader的适配,它的出现,使得CDS技术变得广泛可用并且更加适用。尤其是对于动辄需要加载数千个类的Spring Boot程序,因为JVM不需要在每个实例的每次启动时加载(解析和验证)这些类,因此,启动应该变得更快并且内存占用应该更小。看起来,AppCDS的一切都很美好,但实际使用也确实如此吗? 当我们试图使用AppCDS时,它应该包含以下几个步骤: 使用-XX:DumpLoadedClassList参数来获取我们希望在应用程序实例之间共享的类 使用-Xshare:dump参数将类存储到适合内存映射的存档(.jsa文件)中 使用-Xshare:on参数在启动时将存档附加到每个应用程序实例 乍一看,使用AppCDS似乎很容易,只需3个简单的步骤。但是,在实际使用过程中,你会发现每一步都可能变成一次带有特定JVM Options的应用启动,我们无法简单的通过一次启动来获得可重复使用的类加载存档文件。尽管在JDK 13中,提供了新的动态CDS【JEP 350】,来将上述步骤1和步骤2合并为一步。但在目前流行的JDK 11中,我们仍然逃不开上述三个步骤(三次启动)。因此,使用AppCDS往往意味着对应用的启动过程进行复杂的改造,并伴随着更为漫长的首次编译和启动时间。 同时需要注意的是,在使用AppCDS时,许多应用的类路径将会变得更加混乱:它们既位于原来的位置(JAR包)中,同时又位于新的共享存档(.jsa文件)中。在我们应用开发的过程中,我们会不断更改、删除原来的类,而JVM会从新的类中进行解析。这种情况所带来的危险是显而易见的:如果类归档文件保持不变,那么类不匹配是迟早的事,我们会遇到典型的“Classpath Hell”问题。 JVM无法阻止类的变化,但它至少应该能够在适当的时候检测到类不匹配。然而,在JVM的实现中,并没有检测每一个单独的类,而是选择去比较整个类路径,因此,在AppCDS的官方描述中,我们可以找到这样一句话: The classpath used with -Xshare:dump must be the same as, or be a prefix of, the classpath used with -Xshare:on. Otherwise, the JVM will print an error message 即第二部步归档文件创建时使用的类路径必须与运行时使用的类路径相同(或前者是后者的前缀)。 但这是一个相当含糊的陈述,因为类路径可能以几种不同的方式形成,例如: 从带有Jar包的目录中直接加载.class文件,例如java com.example.Main 使用通配符,扫描带有Jar包的目录,例如java -cp mydir/* com.example.Main 使用明确的Jar包路径,例如java -cp lib1.jar:lib2.jar com.example.Main 在这些方式中,AppCDS唯一支持的方式只有第三种,即是显式列出Jar包路径。这使得那些使用了大规模Jar包依赖的应用的启动语句变得十分繁琐。 同时,我们也要必须注意到,这种显式列出Jar包路径的方式并不会进行递归查找,即它只会在包含所有class文件的FatJar中生效。这意味着使用SpringBoot框架的嵌套Jar包结构,将很难利用AppCDS技术所带来的便利。 因此,SpringBoot如果想在云原生环境中使用AppCDS,就必须进行应用侵入性的改造,不去使用SpringBoot默认的嵌套Jar启动结构,而是用类似maven shade plugin重新打FatJar,并在程序中显示的声明能让程序自然关闭的接口或参数,通过Volume挂载或者Dockerfile改造的方式,来存储和加载类的归档文件。这里给出一个改造过的Dockerfile的示例: # 这里假设我们已经做过FatJar改造,并且Jar包中包含应用运行所需的全部class文件 FROM eclipse-temurin:11-jre as APPCDS COPY target/helloworld.jar /helloworld.jar # 运行应用,同时设置一个'--appcds'参数使程序在运行后能够停止 RUN java -XX:DumpLoadedClassList=classes.lst -jar helloworld.jar --appcds=true # 使用上一步得到的class列表来生成类归档文件 RUN java -Xshare:dump -XX:SharedClassListFile=classes.lst -XX:SharedArchiveFile=appcds.jsa --class-path helloworld.jar FROM eclipse-temurin:11-jre # 同时复制Jar包和类归档文件 COPY --from=APPCDS /helloworld.jar /helloworld.jar COPY --from=APPCDS /appcds.jsa /appcds.jsa # 使用-Xshare:on参数来启动应用 ENTRYPOINT java -Xshare:on -XX:SharedArchiveFile=appcds.jsa -jar helloworld.jar 由此可见,使用AppCDS还是要付出相当多的学习和改造成本的,并且许多改造都会对我们的应用产生入侵。 JVM优化 除了构建阶段和启动阶段,我们还可以从JVM本身入手,根据云原生环境的特点,进行针对性的优化。 使用可以感知容器内存资源的JDK 在虚拟机和物理机中,对于 CPU 和内存分配,JVM会从常见位置(例如,Linux 中的/proc/cpuinfo和/proc/meminfo)查找其可以使用的CPU和内存。但是,在容器中运行时,CPU和内存限制条件存储在/proc/cgroups/...中。较旧版本的JDK会继续在/proc(而不是/proc/cgroups)中查找,这可能会导致CPU和内存用量超出分配的上限,并因此引发多种严重的问题: 线程过多,因为线程池大小由Runtime.availableProcessors()配置 JVM的对内存使用超出容器内存上限。并导致容器被OOMKilled。 JDK 8u131首先实现了UseCGroupMemoryLimitForHeap的参数。但这个参数存在缺陷,为应用添加UnlockExperimentalVMOptions和UseCGroupMemoryLimitForHeap参数后,JVM确实可以感知到容器内存,并控制应用的实际堆大小。但是这并没有充分利用我们为容器分配的内存。 因此JVM提供-XX:MaxRAMFraction标志来帮助更好的计算堆大小,MaxRAMFraction默认值是4(即除以4),但它是一个分数,而不是一个百分比,因此很难设置一个能有效利用可用内存的值。 JDK 10附带了对容器环境的更好支持。如果在Linux容器中运行Java应用程序,JVM将使用UseContainerSupport选项自动检测内存限制。然后,通过InitialRAMPercentage、MaxRAMPercentage和MinRAMPercentage来进行对内存控制。这时,我们使用的是百分比而不是分数,这将更加准确。 默认情况下,UseContainerSupport参数是激活的,MaxRAMPercentage是25%,MinRAMPercentage是50%。 需要注意的是,这里MinRAMPercentage并不是用来设置堆大小的最小值,而是仅当物理服务器(或容器)中的总可用内存小于250MB时,JVM将用此参数来限制堆的大小。 同理,MaxRAMPercentage是当物理服务器(或容器)中的总可用内存大小超过250MB时,JVM将用此参数来限制堆的大小。 这几个参数已经向下移植到JDK 8u191。UseContainerSupport默认情况下是激活的。我们可以设置-XX:InitialRAMPercentage=50.0 -XX:MaxRAMPercentage=80.0来JVM感知并充分利用容器的可用内存。需要注意的是,在指定-Xms -Xmx时,InitialRAMPercentage和MaxRAMPercentage将会失效。 关闭优化编译器 默认情况下,JVM有多个阶段的JIT编译。虽然这些阶段可以逐渐提高应用的效率,但它们也会增加内存使用的开销,并增加启动时间。 对于短期运行的云原生应用,可以考虑使用以下参数来关闭优化阶段,以牺牲长期运行效率来换取更短的启动时间。 JAVA_TOOL_OPTIONS="-XX:+TieredCompilation -XX:TieredStopAtLevel=1" 关闭类验证 当JVM将类加载到内存中以供执行时,它会验证该类未被篡改并且没有恶意修改或损坏。但在云原生环境,CI/CD流水线通常也由云原生平台提供,这表示我们的应用的编译和部署是可信的,因此我们应该考虑使用以下参数关闭验证。如果在启动时加载大量类,则关闭验证可能会提高启动速度。 JAVA_TOOL_OPTIONS="-noverify" 减小线程栈大小 大多数Java Web应用都是基于每个连接一个线程的模式。每个Java线程都会消耗本机内存(而不是堆内存)。这称为线程栈,并且每个线程默认为1 MB。如果您的应用处理100个并发请求,则它可能至少有100个线程,这相当于使用了100MB的线程栈空间。该内存不计入堆大小。我们可以使用以下参数来减小线程栈大小。 JAVA_TOOL_OPTIONS="-Xss256k" 需要注意如果减小得太多,则将出现java.lang.StackOverflowError。您可以对应用进行分析,并找到要配置的最佳线程栈大小。 使用TEM进行零改造的Java应用云原生优化 通过上面的分析,我们可以看出,如果想要让我们的Java应用能在云原生时代发挥出最大实力,是需要付出许多侵入性的改造和优化操作的。那么有没有一种方式能够帮助我们零改造的开展Java应用云原生优化? 腾讯云的TEM弹性微服务就为广大Java开发者提供了一种应用零改造的最佳实践,帮助您的Java应用以最优姿态快速上云。使用TEM您可以享受的以下优势: 零构建部署。直接选择使用Jar包/War包交付,无需自行构建镜像。TEM默认提供能充分利用构建缓存的构建流程,使用新一代构建利器Buildkit进行高速构建,构建速度优化50%以上,并且整个构建流程可追溯,构建日志可查,简单高效。 (直接使用Jar包部署) (构建日志可查) (构建速度对比) 零改造加速。直接使用KONA Jdk 11/Open Jdk 11进行应用加速,并且默认支持SpringBoot应用零改造加速。您无需改造原有的SpringBoot嵌套Jar包结构,TEM将直接提供Java应用加速的最佳实践,实例扩容时的启动时间将缩短至10%~40%。 (不使用应用加速,规格1c2g) (使用应用加速,规格1c2g) (应用启动速度对比,以spring petclinic为例,规格1c2g) 零运维监控。使用SkyWalking为您的Java应用进行应用级别的监控,您可以直观的查看JVM堆内存,GC次数/耗时,接口RT/QPS等关键参数,帮助您即使找到应用性能瓶颈。 (应用JVM监控) 极致弹性。TEM默认提供使用率较高的定时弹性策略和基于资源的弹性策略,为您的应用提供秒级的弹性性能,帮助您应对流量洪峰,并能在实例闲置时及时节省资源。 (指标弹性策略) (定时弹性策略) 总结 工欲善其事,必先利其器。在步入云原生时代的今天,如何让您的Java应用的部署效率和运行性能最大化,这对所有开发者都是一个挑战。而TEM作为一款面向微服务应用的Serverless PaaS平台,将成为您手中的“云端利器”,TEM将致力于为企业和开发者服务,帮助您的业务以最快速、便捷、省心的姿态,无忧上云,享受云原生时代的便利。 腾讯云弹性微服务(Tencent Cloud Elastic Microservice,TEM)是面向微服务应用的 Serverless 平台,实现 Serverless 与微服务的完美结合,提供开箱即用的微服务解决方案。目前腾讯云最新一代Serverless微服务应用管理平台TEM正在限时免费,速来官网体验使用! 参考文档 http://seanthefish.com/2020/11/11/jvm-in-container/ https://www.infoq.cn/article/rqfww2r2zpyqiolc1wbe https://medium.com/@toparvion/appcds-for-spring-boot-applications-first-contact-6216db6a4194 https://events19.linuxfoundation.org/wp-content/uploads/2017/11/Comparing-Next-Generation-Container-Image-Building-Tools-OSS-Akihiro-Suda.pdf https://static.sched.com/hosted_files/kccnceu19/12/Building%20images%20%20efficiently%20and%20securely%20on%20Kubernetes%20with%20BuildKit.pdf

优秀的个人博客,低调大师

每日一博 | 从 generator 的角度看 Rust 异步代码

文|Ruihang Xia 目前参与边缘时序数据存储引擎项目 本文 6992 字 阅读 18 分钟 前 言 作为 2018 edition 一个比较重要的特性 Rust 的异步编程现在已经得到了广泛的使用。使用的时候难免会好奇它是如何运作的,这篇文章尝试从 generator 以及变量捕获的方面进行探索,而后介绍了在嵌入式时序存储引擎 ceresdb-helix 的研发过程中遇到的一个场景。 囿于作者水平内容难免存在一些错漏之处,还烦请留言告知。 PART. 1 async/.await, coroutine and generator async/.await 语法在 1.39 版本[1]进入 stable channel,它能够很方便地编写异步代码: 、、、java async fn asynchronous() { // snipped } async fn foo() { let x: usize = 233; asynchronous().await; println!("{}", x); 、、、 在上面的示例中,局部变量 x 能够直接在一次异步过程(fn asynchoronous)之后使用,和写同步代码一样。而在这之前,异步代码一般是通过类似 futures 0.1[2] 形式的组合子来使用,想要给接下来 (如 and_then()) 的异步过程的使用的局部变量需要被显式手动地以闭包出入参的方式链式处理,体验不是特别好。 async/.await 所做的实际上就是将代码变换一下,变成 generator/coroutine[3] 的形式去执行。一个 coroutine 过程可以被挂起,去做一些别的事情然后再继续恢复执行,目前用起来就是 .await 的样子。以上面的代码为例,在异步过程 foo()中调用了另一个异步过程 asynchronous() ,在第七行的 .await 时当前过程的执行被挂起,等到可以继续执行的时候再被恢复。 而恢复执行可能需要之前的一些信息,如在 foo()中我们在第八行用到了之前的信息 x。也就是说 async 过程要有能力保存一些内部局部状态,使得它们能够在 .await 之后被继续使用。换句话说要在 generator state 里面保存可能在 yield 之后被使用的局部变量。这里需要引入 pin[4] 机制解决可能出现的自引用问题,这部分不再赘述。 PART. 2 visualize generator via MIR 我们可以透过 MIR[5]来看一下前面提到的 generator 是什么样子的。MIR 是 Rust 的一个中间表示,基于控制流图 CFG[6]表示。CFG 能够比较直观地展示程序执行起来大概是什么样子,MIR 在有时不清楚你的 Rust 代码到底变成了什么样子的时候能够起到一些帮助。 想要得到代码的 MIR 表示有几种方法,假如现在手边有一个可用的 Rust toolchain,可以像这样传递一个环境变量给 rustc ,再使用 cargo 进行构建来产生 MIR: RUSTFLAGS="--emit mir" cargo build 构建成功的话会在 target/debug/deps/ 目录下生成一个 .mir 的文件。或者也能通过 https://play.rust-lang.org/ 来获取 MIR,在 Run 旁边的溢出菜单上选择 MIR 就可以。 由 2021-08 nightly 的 toolchain 所产生的 MIR 大概是这个样子的,有许多不认识的东西可以不用管,大概知道一下。 _0, _1 这些是变量 有许多语法和 Rust 差不多,如类型注解,函数定义及调用和注释等就行了。 fn future_1() -> impl Future { let mut _0: impl std::future::Future; // return place in scope 0 at src/anchored.rs:27:21: 27:21 let mut _1: [static generator@src/anchored.rs:27:21: 27:23]; // in scope 0 at src/anchored.rs:27:21: 27:23 bb0: { discriminant(_1) = 0; // scope 0 at src/anchored.rs:27:21: 27:23 _0 = from_generator::<[static generator@src/anchored.rs:27:21: 27:23]>(move _1) -> bb1; // scope 0 at src/anchored.rs:27:21: 27:23 // mir::Constant // + span: src/anchored.rs:27:21: 27:23 // + literal: Const { ty: fn([static generator@src/anchored.rs:27:21: 27:23]) -> impl std::future::Future {std::future::from_generator::<[static generator@src/anchored.rs:27:21: 27:23]>}, val: Value(Scalar(<ZST>)) } } bb1: { return; // scope 0 at src/anchored.rs:27:23: 27:23 } } fn future_1::{closure#0}(_1: Pin<&mut [static generator@src/anchored.rs:27:21: 27:23]>, _2: ResumeTy) -> GeneratorState<(), ()> { debug _task_context => _4; // in scope 0 at src/anchored.rs:27:21: 27:23 let mut _0: std::ops::GeneratorState<(), ()>; // return place in scope 0 at src/anchored.rs:27:21: 27:23 let mut _3: (); // in scope 0 at src/anchored.rs:27:21: 27:23 let mut _4: std::future::ResumeTy; // in scope 0 at src/anchored.rs:27:21: 27:23 let mut _5: u32; // in scope 0 at src/anchored.rs:27:21: 27:23 bb0: { _5 = discriminant((*(_1.0: &mut [static generator@src/anchored.rs:27:21: 27:23]))); // scope 0 at src/anchored.rs:27:21: 27:23 switchInt(move _5) -> [0_u32: bb1, 1_u32: bb2, otherwise: bb3]; // scope 0 at src/anchored.rs:27:21: 27:23 } bb1: { _4 = move _2; // scope 0 at src/anchored.rs:27:21: 27:23 _3 = const (); // scope 0 at src/anchored.rs:27:21: 27:23 ((_0 as Complete).0: ()) = move _3; // scope 0 at src/anchored.rs:27:23: 27:23 discriminant(_0) = 1; // scope 0 at src/anchored.rs:27:23: 27:23 discriminant((*(_1.0: &mut [static generator@src/anchored.rs:27:21: 27:23]))) = 1; // scope 0 at src/anchored.rs:27:23: 27:23 return; // scope 0 at src/anchored.rs:27:23: 27:23 } bb2: { assert(const false, "`async fn` resumed after completion") -> bb2; // scope 0 at src/anchored.rs:27:21: 27:23 } bb3: { unreachable; // scope 0 at src/anchored.rs:27:21: 27:23 } } 这个 demo crate 中还有一些别的代码,不过对应上面的 MIR 的源码比较简单: async fn future_1() {} 只是一个简单的空的异步函数,可以看到生成的 MIR 会膨胀很多,如果内容稍微多一点的话通过文本形式不太好看。我们可以指定一下生成的 MIR 的格式,然后将它可视化。 步骤大概如下: RUSTFLAGS="--emit mir -Z dump-mir=F -Z dump-mir-dataflow -Z unpretty=mir-cfg" cargo build > mir.dot dot -T svg -o mir.svg mir.dot 能够在当前目录下找到 mir.svg,打开之后可以看到一个像流程图的东西(另一幅差不多的图省略掉了,有兴趣的可以尝试通过上面的方法自己生成一份)。 这里将 MIR 按照基本单位 basic block (bb) 组织,原本的信息都在,并且将各个 basic block 之间的跳转关系画了出来。从上面的图中我们可以看到四个 basic blocks,其中一个是起点,另外三个是终点。首先起点的 bb0 switch(match in rust)了一个变量 _5,按照不同的值分支到不同的 blocks。能大概想象一下这样的代码: match _5 { 0: jump(bb1), 1: jump(bb2), _ => unreachable() } 而 generator 的 state 可以当成就是那个 _5,不同的值就是这个 generator 的各个状态。future_1 的状态写出来大概是这样 enum Future1State { Start, Finished, } 如果是 §1 中的 async fn foo(),可能还会多一个枚举值来表示那一次 yield。此时再想之前的问题,就能够很自然地想到要跨越 generator 不同阶段的变量需要如何保存了。 enum FooState { Start, Yield(usize), Finished, } PART. 3 generator captured 让我们把保存在 generator state 中,能够跨越 .await/yield 被后续阶段使用的变量称为被捕获的变量。那么能不能知道到底哪些变量实际上被捕获了呢?让我们试一试,首先写一个稍微复杂一点的异步函数: async fn complex() { let x = 0; future_1().await; let y = 1; future_1().await; println!("{}, {}", x, y); } 生成的 MIR 及 svg 比较复杂,截取了一段放在了附录中,可以尝试自己生成一份完整的内容。 稍微浏览一下生成的内容,我们可以看到一个很长的类型总是出现,像是这样子的东西: [static generator@src/anchored.rs:27:20: 33:2] // or (((*(_1.0: &mut [static generator@src/anchored.rs:27:20: 33:2])) as variant#3).0: i32) 对照我们代码的位置可以发现这个类型中所带的两个文件位置就是我们异步函数 complex()的首尾两个大括号,这个类型是一个跟我们这整个异步函数相关的类型。 通过更进一步的探索我们大概能猜一下,上面代码片段中第一行的是一个实现了 Generator trait[7] 的匿名类型(struct),而 "as variant#3" 是 MIR 中的一个操作,Projection 的 Projection::Downcast,大概在这里[8]生成。在这个 downcast 之后所做的 projection 的到的类型是我们认识的 i32。综合其他类似的片段我们能够推测这个匿名类型和前面描述的 generator state 是差不多的东西,而各个 variant 是不同的状态元组,投影这个 N 元组能够拿到被捕获的局部变量。 PART. 4 anchored 知道哪些变量会被捕获能够帮助我们理解自己的代码,也能够基于这些信息进行一些应用。 先提一下 Rust 类型系统中特殊的一种东西 auto trait[9] 。最常见的就是 Send 和 Sync,这种 auto trait 会自动为所有的类型实现,除非显式地用 negative impl opt-out,并且 negative impl 会传递,如包含了 !Send 的 Rc 结构也是 !Send 的。通过 auto trait 和 negative impl 我们控制一些结构的类型,并让编译器帮忙检查。 比如 anchored[10] crate 就是提供了通过 auto trait 和 generator 捕获机制所实现的一个小工具,它能够阻止异步函数中指定的变量穿过 .await 点。比较有用的一个场景就是异步过程中关于变量内部可变性的获取。 通常来说,我们会通过异步锁如 tokio::sync::Mutex 来提供变量的内部可变性;如果这个变量不会穿过 .await point 即被 generator state 捕获,那么 std::sync::Mutex 这种同步锁或者 RefCell 也能使用;如果想要更高的性能,避免这两者运行时的开销,那也能够考虑 UnsafeCell 或其他 unsafe 手段,但是就有一点危险了。而通过 anchored 我们可以在这种场景下控制不安全因素,实现一个安全的方法来提供内部可变性,只要将变量通过 anchored::Anchored 这个 ZST 进行标记,再给整个 async fn 带上一个 attribute 就能够让编译器帮我们确认没有东西错误地被捕获并穿越了 .await、然后导致灾难性的数据竞争。 就像这样: #[unanchored] async fn foo(){ { let bar = Anchored::new(Bar {}); } async_fn().await; } 而这种就会导致编译错误: #[unanchored] async fn foo(){ let bar = Anchored::new(Bar {}); async_fn().await; drop(bar); } 对于 std 的 Mutex, Ref 和 RefMut 等常见类型,clippy 提供了两个 lints[11] ,它们也是通过分析 generator 的类型来实现的。并且与 anchored 一样都有一个缺点,在除了像上面那样明确使用单独的 block 放置变量外,都会出现 false positive 的情况[12]。因为局部变量在其他的形式下都会被记录下来[13],导致信息被污染。 anchored 目前还缺少一些 ergonomic 的接口,attribute macro 和 ecosystem 的其他工具交互的时候也存在一点问题,欢迎感兴趣的小伙伴来了解一下 https://github.com/waynexia/anchored 文档:https://docs.rs/anchored/0.1.0/anchored/ 「参 考」 [1]https://blog.rust-lang.org/2019/11/07/Async-await-stable.html [2]https://docs.rs/futures/0.1.21/futures/ [3]https://github.com/rust-lang/rfcs/blob/master/text/2033-experimental-coroutines.md [4]https://doc.rust-lang.org/std/pin/index.html [5]https://blog.rust-lang.org/2016/04/19/MIR.html [6]https://en.wikipedia.org/wiki/Control-flow_graph [7]https://doc.rust-lang.org/std/ops/trait.Generator.html [8]https://github.com/rust-lang/rust/blob/b834c4c1bad7521af47f38f44a4048be0a1fe2ee/compiler/rustc_middle/src/mir/mod.rs#L1915 [9]https://doc.rust-lang.org/beta/unstable-book/language-features/auto-traits.html [10]https://crates.io/crates/anchored [11]https://rust-lang.github.io/rust-clippy/master/#await_holding [12]https://github.com/rust-lang/rust-clippy/issues/6353 [13]https://doc.rust-lang.org/stable/nightly-rustc/src/rustc_typeck/check/generator_interior.rs.html#325-334 本周推荐阅读 Prometheus on CeresDB 演进之路 深入 HTTP/3(一)|从 QUIC 链接的建立与关闭看协议的演进 降本提效!注册中心在蚂蚁集团的蜕变之路 蚂蚁大规模 Sigma 集群 Etcd 拆分实践

优秀的个人博客,低调大师

每日一博 | 关于 Lisp 的一己之见

Lisp是一种计算机编程语言,由约翰·麦卡锡(John McCarthy)于1958年发明。“Lisp”这个名称是“List Processing”的缩写,具有表处理的意思...以上大概是公认的比较权威的介绍,网络上很多资料大概都是这么讲的。从这些信息中可以看出,Lisp应该是一种和C、Java类似的计算机编程语言,是一种和中文、英文等所谓自然语言不同的、用来给计算机编程的语言,这或许是大部分人对它的印象。然而,在学习Lisp的过程中,感受到了很多与编程语言常识相背的地方,产生了一些感想,本文就表达一些自己对Lisp的一己之见。 1. Lisp语言和方言 如果特指一种语言的话,“Lisp语言”指的应该1958那时John McCarthy发明的那个版本。但是,那个版本的Lisp应该已经停留在书本里了,接下来的几十年里,Lisp快速发展、演变,现代的各种Lisp跟最初的那个版本已经不能称为同一种语言了,只是看上去有点像,都是用包含括号的S-表达式来表示的,但是语言特性和实现已经是天差地别了。那么,现在所说的“Lisp语言”用来指代包含最初的Lisp及其衍生出来的各种方言(例如:Common Lisp,Scheme,Emacs Lisp)在内的一类语言比较合适。 你可能从未听过计算机方言,毕竟没有“C++方言”或者“Java方言”这样的说法,那是因为Java的某一版本明确定义了这个语言这个版本的所有语法,开发者并不能直接修改语法或添加语法。但是,Lisp语言由于提供了扩展词法、语法的功能(例如 Common Lisp 的宏和读取宏),使得Lisp语言的使用者可以给自己手头的Lisp实现添加很多自己想要的语言特性,这样就形成了大量方言,有一些可能连名字都没有。 Common Lisp 和 Scheme 是现在相对主流的两大Lisp方言,各自有着诸多的实现和衍生出来的方言。其余还有 Emacs Lisp、AutoLisp 也仍保持活跃,不过只适合特定环境特定场景,Emacs Lisp 仅用于Emacs编辑器中,而AutoLisp则内嵌于AutoCAD中。还有一些方言用于特定科研领域,在此不多介绍了。 虽说 Common Lisp 和 Scheme 是两大主流Lisp方言,但是并非具体的Lisp实现,仅仅是一种规范,而对应的具体实现也并非只有规范中规定的语言特性和API,通常都包含各自的扩展。下面列出一些常见实现和对应的官方主页(或项目地址)。个人比较推荐 SBCL 和 ChezScheme。 Common Lisp实现: 名称 官方主页 Steel Bank Common Lisp (SBCL) http://www.sbcl.org/ GNU CLISP https://clisp.sourceforge.io/ Embeddable Common-Lisp (ECL) https://ecl.common-lisp.dev/ Armed Bear Common Lisp (ABCL) https://www.abcl.org/ Scheme实现: 名称 官方主页 Chez Scheme https://scheme.com/ 或 https://cisco.github.io/ChezScheme/ Racket https://www.racket-lang.org/ GNU Guile http://www.gnu.org/software/guile/ 2. Lisp的程序 谈论一门编程语言,没有程序示例,讲得再多也会显得空洞抽象。这一节就展示一下Lisp的程序大概是什么样子的。 首先,我们来看几个 hello world 例子: 示例 1. 打印5行helloworld 英语:print 5 lines of "hello world" Lisp:(print 5 line "hello world") 或 (打印 5 行 "hello world") 示例 2. 字符串"hello world" 英语:the string "hello world" Lisp:(the string "hello world") 或 #T(字符串 "hello world") 示例 3. John 说:"hello world" 英语:"hello world," John said Lisp:(say by John "hello world") 或 #P(John say "hello world") 或 (John 说 "hello world") 看到这里,或许有人已经把上面的例子在Lisp实现中试了下,然后遇到了一堆错误。并不是我捉弄大家,上面那些确实可以作为Lisp语言的程序,不过缺少对应宏或操作符的实现。好了,言归正传,下面附上能运行几个简单示例(Common Lisp 实现): (print "hello world") ;打印"hello world" (list 1 2 3 4) ;创建一个列表,包含元素1、2、3、4 (defun test-fun (a b) ;定义函数test-fun执行加法 (+ a b)) (test-fun 1 2) ;用1和2来调用函数test-fun (dolist (i (list 1 2 3 4)) ;对列表进行遍历并打印 (print i)) 我们可以看到上述的Lisp程序都有个普遍的特征:都是 (xxx ......) 这样的括号包含符号的形式。这里重申下,Lisp是表处理(List Processing)的缩写,而这里括号包起来的就是表,例如,程序(list 1 2 3 4)返回的结果(1 2 3 4) 就是一个表,包含元素1、2、3、4,而空表就是()。(可能有人注意到#P(...)还有#Y[...]这类表达方式,这是 Common Lisp 提供的读取器宏的机制,由读取器将其转换为由表组成的Lisp程序,可以用来实现一些便利的语法糖,甚至内嵌类似JSON的语法:#J{ "id" : "XX123" , "type" : 2 }。) Lisp的程序本身就是由这样的表组成,用这样的表组织起来的内容基本可以成为Lisp程序。如果懂一些解析器和解释器相关的知识,借助Lisp实现提供的扩展机制,还可以为Lisp加入其他代码组织形式。所以,综上所述,Lisp的代码形式是多变的,限制程序形式的有时候是开发者的想象力和习惯。 接下来附上两段贴近应用的Lisp程序。 首先是一段 Common Lisp 程序,这是借助 SxQL 实现数据库查询的示例,也是基于宏的DSL实现(懂SQL的应该都理解这段程序做了什么事吧): (select (:title :author :year) (from :books) (where (:and (:>= :year 1995) (:< :year 2010))) (order-by (:desc :year))) 下面这段是《Essentials of Programming Languages》书中作者给出的习题参考答案(中文是我额外添加的注释),用Scheme实现,用来构建一个LET语言的解析器: (define the-lexical-spec ;定义词法规范 '((whitespace (whitespace) skip) ;空白字符的词法(引用Scheme的空白字符)和对应操作,skip表示跳过,什么都不做 (comment ("%" (arbno (not #\newline))) skip) ;注释的词法(%开头直到行末)和对应操作,arbno类似正则里的“*”,表示“任意个” (identifier ;标识符的词法(字母开头加上任意个字母数字符号组合)和对应操作,symbol表示保留为符号 (letter (arbno (or letter digit "_" "-" "?"))) symbol) (number (digit (arbno digit)) number) ;数字的词法(1个以上的数字)和对应操作,number表示保留为数字 (number ("-" digit (arbno digit)) number))) ;数字的词法(-开头加1个以上的数字)和对应操作,number表示保留为数字 (define the-grammar ;定义语法规范 '((program (expression) a-program) ;程序由表达式组成 (expression (number) const-exp) (expression ;表达式可以是“-(1,2)”这样的表达式 ("-" "(" expression "," expression ")") diff-exp) (expression ;表达式可以是“zero?(a)”这样的表达式 ("zero?" "(" expression ")") zero?-exp) (expression ;表达式可以是“if ... then ... else”这样的表达式 ("if" expression "then" expression "else" expression) if-exp) (expression (identifier) var-exp) ;表达式可以是一个标识符 (expression ;表达式可以是“let a = 1 in ...”这样的表达式 ("let" identifier "=" expression "in" expression) let-exp))) ;;;;;;;;;;;;;;;; sllgen boilerplate ;;;;;;;;;;;;;;;; (sllgen:make-define-datatypes the-lexical-spec the-grammar) ;根据词法和语法规范生成对应数据结构 (define scan&parse (sllgen:make-string-parser the-lexical-spec the-grammar)) ;根据词法和语法规范生成对应解析器 Lisp的语法是可扩展的,有着动态性极强的宏机制,因此Lisp语言可以自我扩展,甚至在运行时扩展语法,诞生新的语言。另外,Lisp语言编写的代码由表(list)组成(例如,(+ 1 2 3 4),表示对1、2、3、4求和),而表又是Lisp语言中的基本结构之一(例如,'(+ 1 2 3 4)或(list '+ '1 '2 '3 '4),表示包含+、1、2、3、4五个元素的表),因此使用Lisp语言操纵修改Lisp语言编写的代码十分地便捷,生成Lisp代码也很简单(例如,(setf (first '(+ 1 2 3 4)) '-),把表中的第一个元素'+'换成'-',程序就从累加变成了累减)。正因为Lisp语言中数据和代码的高度一致性,写Lisp的人很多都能自己实现Lisp的解释器和编译器。 3. Lisp的特点 分析一门语言,不可避免地需要去分析这个语言与其他语言相比的优点和缺点,但是优缺点是容易受到应用场景和开发者能力的影响,可能是“甲之蜜糖,乙之砒霜”的情况。因此,这里还是列举一些Lisp语言的特点,结合开发场景对其使用中可能造成的利弊来展开讨论。 说到特点,可能理解为“特有的点”,Lisp是一门古老的语言,存在已经超过了半个世纪,这段时间里,很多原来Lisp特有的语言特性都被其他语言所接受并吸收,甚至成为业界标配(比如函数递归调用),又从别的语言吸收到很多现代的语言特性(比如面向对象编程)。如果只谈论特有的点,那么就略显片面,所以还是将Lisp作为一门语言的各个方面的特点都说明下。(由于Lisp的各个方言之间有着很大区别,这里暂且谈论所有方言中都有的特点。Common Lisp 和 Scheme 中都有很多值得一提的点,但是还是另写长文来介绍比较好) 3.1 语法简单 很少有语言具有比Lisp更简单的语法,正如SICP书中开头提到的“所有的形式化性质可以在一小时内讲完,然后就不用去关注语法细节了(因为根本就没有)”,尤其是Scheme(Common Lisp又稍微复杂点)。做SICP的习题时,大概用了300行不到的代码就实现了Scheme基本语法的解释。现在有很多《xx入门》、《xx天学习xxx》这样的书,基本都两三百页以上,如果哪天有《Scheme入门》之类的,估计100页都撑不满。SICP有400页,已经把简单的Scheme编译器解释器都讲完了。 对于开发者学习而言,这样的简单性极大地缩短了学习时间,把更多的精力放到高级特性和程序设计上。对于语言处理程序(编译器、解释器)而言,简化了解析过程,使得编写语言处理程序也变得简单。 但是这样的简单性带来的也不全然是好处,主要问题还是代码的肉眼解析难度。举个例子说, fun1(1,2); //1 if (type == 0){ //2 Console.log("...");//... 3 return 0; //... 3 } 在上述JavaScript代码中不需要仔细看每个字符就可以知道1处是函数调用,2处是if分支,3处是代码块,只要眼睛一瞥。把上面代码换成Common Lisp代码如下: (fun1 1 2) (if (= type 0) (progn (print "...") (return 0))) 不知道fun1是一个函数,还是一个宏或者特殊操作符;看不出if是一个特殊操作符,看不出条件和分支;也看不出(progn ...)引入了一个类似代码块的形式。更不可能通过简单一瞥看出程序的大体结构,必须观察到字符级别。因为Lisp的代码都是S-表达式,有时候无法在词法和语法层面判断出一个符号到底是函数还是宏,因此编辑器也无法做到像Java那样完美的语法高亮,给工程管理带来了一些难度。 3.2 实现和运行原理多样化 介绍一门编程语言必然涉及语言的底层实现/运行原理,例如,C语言可以使用GCC编译器编译为对应平台机器码执行,python语言可以由python解释器来解释执行,而Java语言可以通过Java编译器编译为Java字节码然后由Java虚拟机解释执行。每个语言也都有自己的官方实现和较为具体的规范。 Lisp并没有所谓的官方实现,Common Lisp 和 Scheme 都是如此,而语言规范也仅仅是语言的规范,没有指定具体的解释行为和编译行为(但还是指定了一些相关的API)。事实上,Lisp语言的运行好像包含了编程语言的所有方式:clisp、guile等大部分实现可以在命令行以repl交互式的形式使用;而SBCL和ChezScheme可以将Lisp编译成本地机器码来执行;ECL可以嵌入到C/C++程序中,clisp可以把代码编译成对应字节码并解释执行字节码;ABCL内嵌到Java程序中运行于Java虚拟机之上,等等。和大部分使用软件实现的语言不同,在20世纪80年代还有用来直接执行Lisp的硬件设备--Lisp机器。那是一种在硬件上实现Lisp程序的解释器的机器,在那个年代曾风靡一时,现在可能只能在博物馆里看到了。 而且,Lisp对编译期和运行期也没有严格的限制,不一定非得编译成独立文件执行,也不一定非得解释执行。在一段 Common Lisp 程序中,甚至可以做下面这些事: (setf a 1 fun-name 'add1) ;设置符号a为1,函数名fun-name为add1 (setf exp1 (list '+ 'a 1)) ;生成表达式(+ a 1),并设置给符号exp1 (eval exp1) ;对符号exp1的值进行解释求值 (setf fun-def-exp `(defun ,fun-name (a) ,exp1));生成函数定义表达式(defun add1 (a) (+ a 1)) (eval fun-def-exp) ;解释并求值上面函数的定义 (compile fun-name) ;编译该函数 (funcall fun-name 2) ;调用该函数 这样多样的实现使得使用者可以根据场景找到并选择适合自己的实现:编程成本地机器码的SBCL和ChezScheme适合关注性能的场合;具有良好交互式体验的clisp可以作为命令行的REPL;精简的ABCL和ECL可以分别内嵌到Java和C/C++的程序中作为内置脚本引擎来用,等等。丰富的运行方式也使得在程序运行时生成、编译并加载代码成为可能,让开发者不再受制于程序的执行方式。 但是,“多样化”常常和“分裂”挂钩,各种实现都包含自己的扩展功能,甚至扩展语法(例如,Racket都快扩展成另一种语言了)。按照语言规范写的程序在各个实现上移植性和向后兼容性都不错,但是如果使用了一些实现扩展的功能,那么这个程序的移植性就受影响。例如,日本的 Common Lisp 开发者深町英太郎开发的名为woo的http服务器有着极为优异的性能,但是用到了SBCL特有的功能而无法在其他 Common Lisp 实现上使用。 3.3 自动内存管理(GC) 即便在这个GC满大街的时代,这也是一个不想多说但又不得不说的特点... Lisp是历史上第一个采用垃圾回收的语言,这在那个年代是突破性的(“Lisp之父”同时也是“GC之父”)。这种内存管理方式增强了内存安全性,减少了开发者管理内存带来的心智压力,也使得语言变得更加简单,特定算法还可以提高内存的连续性。相比于C语言开发者排查内存泄漏的问题,C++开发者折腾各种引用、指针,还有Rust开发者跟编译器斗智斗勇,使用带垃圾回收的语言进行开发省心很多。Lisp强大的表达能力、自由的风格加上自动内存管理使得开发者可以把精力完全投入到程序设计中而不必过多关注内存问题。夸张的说,这是一个可以直接提升开发者幸福感的特性。 不过垃圾回收机制的弊端同样成为Lisp的弊端,最大暂停时间的问题使得无法应用于实时性要求较高的场景,而堆使用效率降低也导致无法运行于资源紧张的低端嵌入式设备上。另外,距离第一个垃圾回收算法的提出已经超过半个世纪了,但为应用场景选择合适的垃圾回收算法,调整GC参数,并编写和垃圾回收算法相契合的程序,仍然是一门高超且稀有的手艺。 3.4 First-class Function和函数式编程 Lisp是一个提供 First-class Function(这里暂且翻译为“第一类函数”)的语言,因此也是一个支持函数式编程的语言。这里的第一类函数具有如下性质: 可以用变量命名 可以提供给过程作为参数 可以由过程作为结果返回 可以包含在数据结构中 用JavaScript程序表示就是: var f = (a) => a + 1 //1 (function (a) { a() })(() => console.log("hello")) //2 function test (x){ return (a) => a + x //3 } [1, 2, () => console.log("hello")] //4 近似的 Scheme 程序是: (define f (lambda (a) (+ a 1))) ;1 ((lambda (a) (a)) (lambda () (printf "hello"))) ;2 (define test (lambda (x) (lambda (a) (+ a x)))) ;3 (list 1 (lambda () (printf "hello")));4 如上所述,在Lisp里函数使用起来就跟数字、字符串一样,这为函数式编程提供了基础。与Java、Python这些“加入”了函数式特性的语言相比,具有更好的体验。 不过Lisp是建议/支持使用函数式编程,而非强制使用,也没有过多强调纯函数。它并非所谓的“函数式语言”,确切说应该是“多范式语言”,除了函数式编程外,不管是面向对象编程、面向语言编程、逻辑式编程等都是可以实现的(如果做不到,那就扩展语法来做)。因此,语言提供的基础特性里缺少一些先进的/激进的函数式特性和功能模块(例如,不可变数据结构和惰性求值),只能自己去扩展实现或找一些开源实现。 3.5 代码就是数据 在大部分流行的编程语言中,编写的程序可以构建出各种各样复杂的数据结构和计算过程,但是构建出这些东西的代码本身处于特殊的地位,甚至是只读的、受保护的,例如Java和C中访问受限的方法区和代码区。而且大部分语言因为复杂的语法使得经过解析后的代码结构也非常复杂。这些原因也增加了这些语言的代码生成程序和代码处理工具的开发难度。但是在Lisp中,这个问题得到了很好的解决。Lisp程序本身就是由Lisp基础列表结构组织起来,非常贴近抽象语法树本身;另外,Lisp对符号数据的支持也使得代码中的标识符、关键字可以简单的表示。这两点极大地简化的Lisp代码的操作过程。 举例来说: (list 1 2 3 4) ;1. 得到列表(1 2 3 4) (quote (list 1 2 3 4));2. 得到列表(LIST 1 2 3 4) '(list 1 2 3 4) ;3. 得到列表(LIST 1 2 3 4) 上面这段 Lisp 代码中,1处代码是一个函数调用,构建出对应数据的列表;2处的通过quote操作得到上面代码的表结构数据(列表中“LIST”就是一个符号);3处的代码是2处的简写。这样我们就可以轻而易举的做到下面这些事: (let ((exp '(list 1 2 3 4))) ;将一个表达式作为列表数据绑定给符号exp (print (length (cdr exp))) ;获取表达式的参数数量 (setf exp (cons '+ (cdr exp)));将表达式的操作替换为“+” (eval exp)) ;对新的表达式进行求值 就像 John McCarthy 所说的:“LISP程序作为LISP数据的表示,可以被对象程序操作。这就防止了系统程序员和应用程序程序员之间的分离。”在其他编程语言中,开发语言的人和使用语言之间所面对的数据、所拥有的权限有着天壤之别;在Lisp中,这两种人并没有那么大的差别,所面对的都是Lisp的表结构。 3.6 自由扩展 要给程序添加新功能时,C语言添加新的结构体和函数,Java添加新的类,各个语言都都有自己的一套方案,甚至一些多范式语言提供了多套方案(例如,C++和Scala)。但是,在追求简洁、高度抽象的表达时,语言的语法都会成为一道屏障,将开发者限制在一个圈子里,或者迫使开发者拐弯抹角地来实现想要的功能,面对复杂的现实,只好“适当的领域使用适当的语言”。 相比之下,Lisp也有自己的方案,但是Lisp并不将开发者限定在“自己的方案”里,它给开发者提供了各种扩展自身的机制(如:Common Lisp里的宏和元对象协议)。例如,下面这段代码利用Common Lisp 的读取器宏来给Common Lisp加入了类似切片的语法: (set-macro-character #\] (get-macro-character #\))) (set-dispatch-macro-character #\# #\[ #'(lambda (stream char1 char2) (declare (ignore char1 char2)) (let ((accum nil) (pair (read-delimited-list #\] stream t))) (do ((i (ceiling (car pair)) (1+ i))) ((> i (floor (cadr pair))) (list 'quote (nreverse accum))) (push i accum))))) #[2 7] ;产生 (2 3 4 5 6 7) 其他语言的表达遇到不适用的场景,那么你就“另请高明”吧;在Lisp的表达遇到不适用的场景,那你就让Lisp来适合这个场景。这也使得Lisp受很多崇尚自由的黑客的欢迎。就如 John McCarthy 所说的的那样:“每个人都可以“改进”自己的LISP,而这些“改进”中有许多已经发展成为对语言的改进。”一个“精通”Java的人不一定能实现Java,但是一个“熟悉”Lisp的人一般都能实现一个可运行的Lisp。 自由促进了多样化,也促进了分裂。各种方言、各种程序设计方法的实现方式层出不穷,想要给Lisp加入面向对象编程、逻辑式编程就和上学时的课后练习一样,一天开发几百行代码就解决了。虽然这让开发者变得更加“独立”,但也使得社区不像其他语言的社区那么热闹,联系那么紧密。 另外,这样的自由也为项目失控埋下隐患。有一句玩笑话说“Lisp语言跑着跑着跑成了另一门语言,Lisp程序跑着跑着跑成了另一个程序”,这样的动态性如果在可控制范围内那么会是一个巨大的优点,但是一旦失控很可能是致命的。Lisp开发者如果不自律,完全放飞自我,容易写出高度抽象又毫无章法的程序,这样排查问题时远比其他语言的情况更痛苦。 4. Lisp相关的一些建议 最后,如果有对Lisp产生兴趣的朋友,给一些建议(真正的一己之见)。 Lisp适合具有以下特征的人群学习(适合人群): 希望开阔自己的眼界(建议把SICP或PAIP读了,可能会有从井底之蛙进入外太空的感觉)。 对计算机科学(尤其是PL领域)感兴趣(可以找到很多教材和论文,Lisp在工程领域的书比较少)。 不想写代码,想生成代码(学习Lisp可以加深用程序处理代码和生成代码的理解)。 想要实现编程语言(Lisp是捷径,虽然现在大量语言解释器都用C语言实现,但借助C语言来学习解释器是一条漫长且坎坷的路)。 但是如果包含以下特征,还是不建议花费时间学习Lisp(不适合人群): 期望直接得到项目解决方案或直接应用到工作中去(Lisp的三方库缺乏,中文资料少); 对编程语言有宗教式的崇拜(因崇拜而导致不重视Lisp语言设计上的缺点是很危险的); 时间、精力过于宝贵的人(Lisp的很多好书都是需要花大量时间钻研、做习题甚至啃生肉的,修行道路更长,天花板更高)。 推荐几本相关读物: 《ANSI Common Lisp》Paul Graham 著,适合 Common Lisp 入门。电子版链接:https://acl.readthedocs.io/en/latest/zhCN/ 《实用Common Lisp》(英文名《Practical Common Lisp》),适合 Common Lisp 入门。 《程序设计方法》(英文名《How to Design Programs》,简称HTDP),适合Scheme(确切说是Racket)入门、程序设计入门,也是很多世界一流名校的教材。 《On Lisp》Paul Graham 著,适合 CommonLisp 宏进阶学习,里面包含很多宏的实践。 Daniel P. Friedman的《The Little 。。。》系列,有好几本,包含Scheme的入门和一些实践,范围包括函数式编程、逻辑式编程、类型系统、程序验证等等,风格深入浅出。 《计算机程序的构造和解释》(英文名《Structure and Interpretation of Computer Programs》,简称SICP),是一本魔法书,适合进阶。 《Essentials of Programming Languages》(中文意思是编程语言概要,简称EOPL),也是Daniel P. Friedman所著,适合PL(Programming Language)入门,可以加深对Lisp或者说对编程语言的理解。 《Common Lisp the Language, 2nd Edition》Common Lisp的权威之作,适合完整学习以掌握 Common Lisp 的全貌,也适合查阅。 《Paradigms of Artificial Intelligence Programming: Case Studies in Common Lisp》(中文意思是人工智能编程范例(Common Lisp案例研究),简称PAIP),Peter Norvig著,适合Common Lisp进阶,包含面比较广,涉及编程语言、自然语言处理、逻辑编程、搜索等等等等。

优秀的个人博客,低调大师

每日一博 | vivo 直播应用技术实践与探索

一、概述 2019年vivo直播平台立项,初期与优秀的顶部直播平台进行联运直播开发,进行市场,产品和技术的初步探索;再到后来为了丰富直播的内容和形式,开始自己独立探索;之后,我们结合vivo现阶段的直播业务,陆续完成了泛娱乐,互动,公司事件直播等多种直播形式的落地,相信后续根据业务的规划,我们会给用户带来更好的直播体验。 今天和大家分享一下,vivo直播平台这两年相关的技术发展历程,希望大家对直播有一个基础的了解,如果有相关的同学刚刚开始从事直播相关业务的开发,能够给大家带来一些启发。 二、业务背景介绍 截止到目前为止,vivo直播平台支持三个大类的直播,第一个就是经典的泛娱乐秀场直播,平台提供秀场直播一些标准的功能,例如互动聊天,PK,送礼等基础功能。泛娱乐直播市场起步比较早,相关的功能玩法也比较丰富和多样,例如主播连麦PK,主播与用户连麦互动,礼物连击,事件榜单,你画我猜等等相关的娱乐功能,目前平台正在持续迭代相关经典的功能,持续给用户带来更好的用户体验。 第二种类型的直播就是目前基于实时音视频技术的低时延互动直播,低时延直播的特点就是互动性强,用户的参与感强,与之而来的就是较强的技术挑战和较高的维护成本。 第三种,就是目前在疫情的大背景下,诞生了公司信息分发的事件直播,例如公司年会,校招宣讲会直播,品牌文化直播,疫情防护知识直播。这类直播的最大特点就是灵活、多变、且内容形式多样。对于直播平台来说,我们需要为其提供一站式的直播解决方案,方便公司利用直播这种形式进行更好更稳定的品牌,文化的宣发。 首先,我们再来看下vivo直播平台的一个业务架构模型,底层是我们的公司全链路监控平台,会对直播流量、网络、相关直播业务的数据指标进行监控,并提供相关告警服务,便于我们能够第一时间响应、定位并解决直播在各个模块在分发过程中遇到的一些实际问题。 在此监控之上,我们进行上层业务的逻辑迭代。在直播内容的分发上,主要的方式还是依赖于云厂商的CDN和我们内部的直播服务器集群。一种是C端的直接流量分发,另一种是通过内部转拉进行相关的业务处理。在业务能力方面,目前我们已经初步具备了如下一些基础能力,例如海量的信息存储、视频处理、内容识别、直播视频内容的安全合规实时审核及直播间事件同步异步处理等能力。同时基于这些能力进行SDK的封装,例如推流、播放、IM 等场景化SDK,通过提供标准的SDK进行直播能力的分发和复用,同时也能够方便业务方进行功能的集成。 在内容产出和对外服务上,我们对自己的手机APP,例如i视频、vivo短视频、i音乐、浏览器等APP进行直播能力的赋能,丰富消费者的手机体验。此外,除了对vivo相关手机APP进行直播能力的支持外,我们也会和第三方直播平台进行合作,做一些内容的分发和转播。 三、技术实践 3.1 泛娱乐秀场直播 首先,我们先介绍一下最经典的泛娱乐秀场直播,如下图所示,这是一套基于RTMP协议的标准直播流程。 一般过程如下,首先进行输入源的采集,一般由屏幕、摄像头、麦克风等进行相关采集;接下来对其进行图像加工,例如美颜,滤镜,水印等;之后进行标准的h264编码,利用RTMP协议传输,传输到中心机房对相关事件做好相应的处理后,最后分发到边缘节点,用户终端逆向去边缘节点拉取直播流,最后在终端设备解码播放。在此标准观看流程之上,泛娱乐秀场直播也会提供一些常见的功能,例如互动聊天,直播间小游戏,PK ,送礼等等。 这一套标准直播流程涉及到的直播技术点也特别多,接下来和大家具体聊一聊我们团队在落地相关直播业务过程中遇到的一些实际问题。 我们遇到如下四个问题,开播工具的推流美颜就是我们遇到的第一个技术难点,主播众多,对“美”的定义不一,主观性强,个性化需求多,在贴纸,色温,画面的饱和感等方面要求较高,同时在开播过程中,要求面部的不抖动不失真,同时对直播画面的清晰度,颗粒感也有相关的要求。 第二个问题就是消息的分发,也就是我们传统说的IM即时通讯技术,与传统的即时通讯技术不一样的是,除了群聊,私聊,广播这些经典的IM消息分发场景外,“群”成员不稳定也是我们需要考虑的,用户频繁进出直播间,切换直播间,晚高峰的消息风暴和流量突刺,也是我们需要应对和解决的问题。 第三个问题就是直播时延的问题,这也是直播经典的问题之一,引起时延的因素很多,例如终端设备,传输协议,网络带宽,编解码等等。 最后一个问题,就是直播成本的问题,想必做过直播的相关友商,都会清楚地知道,RTMP和CDN不分家,作为基础的云服务产品,CDN对于这种流媒体的分发,计费也是相对比较贵的,所以我们也要在确保产品功能和用户体验的基础上,兼顾控制我们的直播成本。 针对第一个技术难点,我们做了如下处理,我们在端上进行了一些技术优化。在美颜方面,充分利用了公司影像团队相关的技术积累,对美颜,滤镜,贴纸,美妆,风格妆都进行了标准化,通用化,定制化的处理。 同时我们在推流模块也做了一系列的实验,进行云端转码,超分,锐化等处理,确保每一个主播的画风具备一定的观众吸引力。礼物动画播放部分,经过多次实验采用MP4进行特效礼物动画播放,测试数据表明,MP4相对于svga占用的内存和文件大小显著降低。最后在直播间秒开这个重要指标上,播放器内核团队对播放器进行了定制化处理,通过共享播放器、滑动、点击预创建等方式,使得直播间秒开这个指标能够达到行业内一流标准。 第二部分,我们再介绍一下直播的另一个问题,就是即时消息的处理,潜在的问题可以从以下两个维度进行分析。首先是用户维度,用户的主动行为包括送礼,礼物连击、点赞,互动聊天,以及在开播时瞬间涌入的大量的用户,这些场景都会引起IM的消息洪峰,使得服务器的负载压力一下子会提高很多,纵使我们把IM模块组件化,进行模块间的隔离,但是突发的IM流量也会影响其他高优先级或者系统消息的分发。 第二个方面就是系统维度,在群发消息的场景下,也会有一个读扩散的问题,并且针对直播间这个场景,导致我们IM分发的也都是结构化的数据,有些特别复杂的业务场景,结构化的数据包体积也比较大,在这种情况下如果瞬时分发的消息比较多,会导致机房的出口带宽存在一定的压力;第二个影响因素就是手机终端消息处理能力也有一定的限制,如果分发过多的消息,而部分消息的特效又比较复杂的话,部分低端手机机型会存在无法即时处理的问题。 在这些场景限制下,我们做了如下的三个方案,第一就是消息推拉结合,业务流量高峰IM长链接和http短轮询共同作业;第二个就是消息使用protobuf压缩和分级限频,对直播间的消息进行业务和主播两个维度分级,限制不同类型不同直播间分发的频率;最后一个方案就是监控降级,我们可以对指定直播间进行监控,在监控出现问题的时候,能够自动切换消息分发的方式,确保消息的到达率。 第三个就是直播时延问题,其实在直播时延的问题的处理上,我们希望能够做到在特定的直播场景下规避不必要的时延,从而能够达到标准的直播时延,而不是一味的追求极致的低时延。要解决直播时延的问题,首先我们要分析出产生时延的几个环节,并且梳理这些环节上我们能够做的优化。采集端主要受缓存策略和数据编码所影响,同时网络环境、传输协议和物理距离也都会对时延产生一定的影响,针对这些问题,我们收集了主播的手机型号和实际网络环境,根据实际情况进行相应清晰度的编码,弱化机型和网络对直播的影响。 其次我们都知道另外80%的时延是在下游CDN播放环节产生的,在播放端,为了抗卡顿,需要做缓冲自适应,码率自适应,前向纠错,丢包重传等工作,因为协议本身的限制,我们只能根据不同的用户终端分发不同协议和不同清晰度的观看链接,同时我们针对特殊的场景引入新的直播协议,例如WebRTC,QUIC,SRT等。 最后一个方面,就是泛娱乐直播成本问题,作为业务部门,成本也是我们一直关注的,直播的费用主要有存储和带宽两个主要组成部分,我们做了如下三个方面的优化,存储上,我们首先将主播的录像进行转码,降低存储文件的大小,其次对主播进行热度分级,进行不同时间的存储处理,最后也会剪辑相关的精彩瞬间,在符合国家相关法规的基础上,删除原文件,从而降低存储的费用。 第二个就是基础服务CDN费用,云厂商的收费方式有按照带宽峰值和流量这两种,所以我们也会从业务的角度上,进行一定程度的策略优化,针对推送场景,我们会分批次分时间段进行推送,防止大量直播观看用户同时瞬时涌入直播间,打高直播的带宽峰值。同时观看端支持多清晰度,根据业务出现的不同流量时间段,分发不同清晰度的观看链接,最后从策略上进行限制,在进行主播运营的时候,进行科学的开播时间规划,防止高流量主播扎堆开播,造成不必要的峰值带宽而带来的额外流量费用,最后一个就是监控,对每一个周期的费用进行判断和计算,通过实际的使用情况,对下一个周期进行阶段性调整,确保能够得到阶段收费较优解。 3.2 互动直播 分析完了泛娱乐秀场直播的几个经典问题的解决方案后,我们也来也介绍一下目前如火如荼的低时延的互动直播,互动直播核心特点就是超低时延,互动性强,在一定的业务场景下,对各类消息分发的顺序性和实时性的要求也特别高,目前常见的互动直播,目前业界内落地比较好的场景就是电商,教育,连麦互动娱乐,政企直播等。 与互动直播相关的功能和技术主要如上所示,例如多端的信息同步,媒体处理,与泛娱乐直播相比,在流媒体安全审核,多用户终端一致性上,也有更加严格的要求,相关的技术栈,很大一部分都是基于实时音视频技术,并且也会结合一下SEI技术,进行信息顺序同步,一般来说,是可以满足业务的需求。 我们在落地互动直播的时候主要遇到两个业务痛点,第一个痛点就是,基于RTMP协议的一个冗长的直播链路的秒级时延是很难胜任的,并且基于RTMP协议的多终端媒体流画面处理,例如连麦,混流。静音等场景,RTMP处理相对复杂,且不利于多终端同步。第二个方面就是信息管控方面,信息管控也是我们在实际开发过程中遇到的问题,例如终端一致性管控,流媒体安全管控,异常管控等。在实际生产环境下,因为存在大量的多终端的互动,互动过程中产生大量的消息,部分业务场景会存在消息分发的时候出现延迟、顺序错乱、甚至丢失,最终导致各个业务终端出现状态不一致的问题,这也是目前,互动直播除了时延外,另一个比较明显的问题。 针对互动直播的低时延多互动的业务特点,目前业内的标准解决方案是RTC相关的技术, RTC与RTMP+CDN这两个解决方案从技术特点上来说,是完全不一样的,RTMP的技术特点就是与CDN绑定耦合,RTMP需要借助CDN边缘网络的能力,使得多地区的用户能够就近获取直播内容,并且能够提高用户获取直播视频流的成功率和秒开率,但是也是因为受限于网络协议等因素,带来了对应的延迟是RTMP技术协议栈所无法避免的。而RTC的也有两个比较明显的技术特点,基于UDP协议的RTC理论时延在百毫秒内,第二个特点就是借助SFU和MCU通信方式适合做多端交互,当然,在多端互动的场景下RTC对机器和网络的要求也比较高,所以我们也会针对指定场景,运用不同的相关技术去解决实际问题。 在互动直播的开发过程中,我们遇到了信息管控的一系列问题,首当其冲的就是一致性管控,互动直播业务内容信息和流媒体信息强相关,需要实时进行无差别的信息顺序传递,我们做了如下的一些补偿控制,进行客户端单个和批量信息上报,由服务端纠正个别终端的异常状态;第二就是合理使用SEI,在视频流信息携带少量的业务信息,例如K歌房、带货、直播答题等,这样能够保证信息的一致性和同步性。 第二个就是安全性管控,按照国家相关规定,音视频直播内容是否违规是相关部门重点审核的对象,在秀场直播这边,我们目前做了视频流定时截帧审核,使用机审和人审双重审核机制,互动直播方面,则会对每一个终端进行独立审核,精确识别出违规的互动终端,最终打造绿色健康的直播环境。最后一个场景也是业务复杂性决定的,正因为互动终端设备多。人为、网络、设备等因素导致异常概率也大大增加,所以我们要准备快速识别断流,有效地利用回调或者客户端能力范围内的上报,在做好业务校验后,进行相关的异常恢复流程的处理。第二就是利用心跳检测机制,客户端定时上报心跳,如果服务端超过指定次数没有收到相关的心跳,就能识别出该设备出现异常,同样进行相关的异常逻辑处理。 3.3 事件直播 最后一个模块,我们再重点介绍一下直播平台给公司内部相关业务进行直播赋能的案例。vivo公司日常也会有很多官方的事件直播,例如技术分享、校招宣讲会、疫情知识宣讲、品牌形象直播,以及更具有官方性的手机发布会直播。 为什么在这里会重点提及公司直播呢? 首先就是官方组织,影响面比较巨大,受众群体也比其他类型的直播更大,我们投入开发运维和保障直播的精力也会相比其他直播更多。在公司直播这块也进行了一些技术的归纳和总结。首先需要保证整场直播的稳定性和流畅性,我们对网络进行相关的监控和优化,同时搭建多地域的内部直播服务器做好多地域的流量隔离和负载均衡。另一个方面就是针对灵活性的技术支持,为了节省我们的开发时间,在助力几场大型公司直播之后,我们也系统地进行整理,归纳出一些通用的功能SDK,通过使用这些多次实践证明没有问题的SDK能够降低直播出错的概率,也能够提高整场直播的成功率。 接下来讲两个比较有意思的案例,也是我们在探索实践公司内部直播几个比较有趣且实用的案例,第一个案例就是我们去年公司因为疫情的原因,只能举办线上直播年会,vivo的员工办公地点很多,坐落在全国各个地方,所以如何高效地保障国内外多个办公地点的万名员工同时高清观看就是我们当时需要解决的问题。 这个问题的根本原因就是每个办公地区的出口带宽是有限的,如果公司员工都使用公司无线网络观看的时候,会导致个办公地区的出口带宽被打满,从而会影响部分员工观看的体验,甚至会影响大家的日常办公。 针对带宽限制的问题,一般而言,业界有两个比较通用的解决方案; 临时提高各个办公地点网络运营商的出口带宽; 通过降低直播的码率以来降低带宽的压力和成本。 其实这两种方案都不能完全保障直播没有问题,并且前提还是需要牺牲部分用户的观看体验的基础上,这种方案也是很难接受的。最后落地并成功实践的方案就是通过内网转推,内网服务器再做负载均衡,并且不同办公地点的观看请求通过DNS解析到本地办公地点的直播服务器,这样就可以成功解决带宽的问题,并且还可以支持高清4k的清晰度。目前这个能力已经被多次验证可行,相关的实践细节也在多家权威技术网站发表,得到社区的一致好评,如果大家有兴趣可以进行相关的查阅。 第二个有趣的案例,就是公司日常的发布会、宣讲会,需要同时推流到多个第三方直播平台,例如B站,腾讯直播等等。因为推流设备推流有个数限制,无法支持多个推流地址,之前的方案都是协调各个直播转播合作伙伴,拉群同步一个拉流地址,每次都会有大量的协调沟通确认工作,很大程度上影响大家的效率,并且很容易出现部分合作商因为配置错误,导致无法正常直播。 在这个大的背景下,我们做出了一些调整,通过整合内部直播服务器和云直播服务器,做好对应的网络容灾,在主线网络出现问题的时候,能够系统自动识别并更换到另一个推流集群,最终保证直播全程的流畅性和稳定性,此外我们还搭建了人工运营平台,提前系统的配置好相关的地址,并且通过开放平台,合作方可以临时去修改相关的配置,这样可以大大降低人工配置错误的可能性,可以更高效率的对公司相关的直播进行支持。 四、总结 目前vivo直播平台还处于初步搭建和不断摸索的过程中,不过我们的方向和规划是清晰的,就是通过不断地丰富C端直播形式,引入更多形式的直播,给vivo手机用户带来更好的用户体验,同时进行相关技术的沉淀和积累,最后把这些技术形成一些标准的解决方案,向公司的横向部门进行内容和技术的产出,例如技术SDK服务,内部直播服务,直播短视频服务等等,形成内外平台相互反哺的良性循环。 作者:vivo互联网服务器团队-Li Guolin

优秀的个人博客,低调大师

每日一博 | 使用 APICloud AVM 框架开发预约应用

前段时间跟朋友一起搞了一个预约的项目,前端用的APICloud的AVM框架做的,后端用的php开发的,用的tp5框架,没几天就搞出来了。简单跟大家分享一下开发中的一些功能点的实现吧。也欢迎大家一起探讨。 一、整理项目脑图 二、项目原型图 原型是用的码前做的,大家可以通过​​www.devbefore.com/protomobile/47942983009476608​​查看 三、项目前端 本项目中前端采用APICloud AVM多端开发技术进行开发,要点包括 swiper 轮播图、网络请求封装等。使用 APICloud 多端技术进行开发,实现一套代码多端运行,支持编译成 Android & iOS App 以及微信小程序。 1、APICloud使用步骤: (1)下载APICloud Studio 3 作为开发工具。下载地址:​​​www.apicloud.com/studio3​​​ (2)注册账号后在控制台创建app,控制台地址:​​www.apicloud.com/console​​ (3)设置证书,一键创建安卓证书 (4)APICloud Studio3 拉取代码,点击项目,导出云端检出 检出 检出后工作目录 (5)修改或者提交项目源码,并为当前项目云编译自定义 Loader 进行真机同步调试预览。 使用 AppLoader 进行真机同步调试预览,后台自动以loader下载到手机端,安装后,点击小圆圈,输入ip地址:192.168.2.152 端口:10916,连接后真机同步,可以看到刚创建后的结果。 2、AVM框架的使用 为什么选择AVM? 易用:有 Vue、React 基础,可快速上手,配套专用的开发工具APICloud Studio3。 多端:一次开发,多端渲染,一个技术栈搞定移动端开发。 功能 API 丰富:提供 1千+ 模块和 2万+ API 可直接调用,面向行业和场景无限制) (1)UI 官方文档:​​https://docs.apicloud.com/apicloud3/#/component/view?index=4&subIndex=0​​ 原来有一个叫流浪男的做的AUI框架,还不错,后来就是用一些简单的大公司的框架,这个看自己了。好多UI都是自己设计,自己写一些UI。字体图标用的阿里字体图标。CSS框架,要是没啥选择推荐可以用AUI,这个框架有CSS基础的一看就知道写的啥,而且特别好修改。实在不行了直接改源码。 APICloud官网组装了一套vant的,​​https://docs.apicloud.com/Client-API/AVM-Components/readme.md​​ (2)ajax网络交互 // 表单方式提交数据或文件 // 表单方式提交数据或文件 api.ajax({ url: 'http://192.168.1.101:3101/upLoad', method: 'post', data: { values: { name: 'haha' }, files: { file: 'fs://a.gif' } } }, function(ret, err) { if (ret) { api.alert({ msg: JSON.stringify(ret) }); } else { api.alert({ msg: JSON.stringify(err) }); } }); // 提交JSON数据 api.ajax({ url: 'http://192.168.1.101:3101/upLoad', method: 'post', headers: { 'Content-Type': 'application/json;charset=utf-8' }, data: { body: { name: 'haha' } } }, function(ret, err) { if (ret) { api.alert({ msg: JSON.stringify(ret) }); } else { api.alert({ msg: JSON.stringify(err) }); } }); (3)vue指令使用(v-for v-show v-if v-else v-for v-on v-bind v-model等) 1>数据绑定 使用 Mustache 语法: <text text={{msg}}></text> 使用v-bind指令: <text v-bind:text="msg"></text> 2>事件绑定 <template> <text onclick="doThis('avm');">Click me!</text> </template> <script> export default { name: 'test', methods: { doThis(msg){ api.alert({ msg: msg }); } } } </script> (4)注册、登录 1>注册接口链接:​​http://showdoc.deui.cn/web/#/27?page_id=365​​ 注册代码 <template name='tpl'> <view class="page"> <div class="page1"> <safe-area class="header"> <!-- <text class="header__title">APICloud</text> --> </safe-area> <scroll-view class="main"> <view> <image src="https://baodinglingqian.oss-cn-beijing.aliyuncs.com/1.png" class="touxiang " /> </view> <div class="zhanghao"> <input placeholder="请输入账号" v-model="zhanghao" maxlength="10" autofocus /> </div> <div class="mima"> <input type="password" placeholder="请输入密码" v-model="password" /> </div> <text class="zhuce" @click="reg()">注册</text> <text class="denglu" @click="handleClick()">登录</text> </scroll-view> </div> <image class="originImage" mode="scaleToFill" src={src}></image> </view> </template> <script> export default { name: "tpl", apiready() { api.setStatusBarStyle({ style: "light", color: "-" }); }, data() { return { zhanghao: '', password: '', src: "https://baodinglingqian.oss-cn-beijing.aliyuncs.com/bg.png" }; }, computed: { }, methods: { handleClick(e) { api.openWin({ name: 'main', url: './main.stml', pageParam: { name: 'test' } }); }, reg() { var _this = this; // 提交JSON数据 api.ajax({ url: 'http://yy.deui.cn/api.php/index/re', method: 'get', // headers: { // 'Content-Type': 'application/json;charset=utf-8' // }, data: { body: { username: _this.zhanghao, password: _this.password } } }, function (ret, err) { console.log(JSON.stringify(ret)) if (ret.msg == '返回成功') { api.toast({ msg: '注册成功', location: "middle" }); } else { api.alert({ msg: JSON.stringify(err) }); } }); } } }; </script> <style> .denglu { margin-top: 10px; font-size: 14px; } .touxiang { margin-top: 10%; width: 150px; height: 150px; border-radius: 100px; margin: 0 auto; } html { width: 100%; height: 100%; } body { width: 100%; height: 100%; } .originImage { position: absolute; top: 0px; left: 0px; right: 0px; bottom: 0px; z-index: 1; } .page { /* position:fixed; */ position: relative; z-index: 9; width: 100%; height: 100%; } .page1 { position: absolute; top: 0px; left: 0px; right: 0px; bottom: 0px; z-index: 2; } input { padding-left: 10px; line-height: 35px; height: 35px; border-radius: 5px; } .zhanghao { display: block; margin: 0 auto; margin-top: 15%; margin-bottom: 15px; height: 60px; } .mima { display: block; margin: 0 auto; margin-top: 25px; } .zhuce { width: 100%; height: 35px; line-height: 35px; background-color: coral; text-align: center; color: #fff; margin-top: 25px; } .page { height: 100%; background-color: white; } .header { background: #81a9c3; justify-content: center; align-items: center; } .header__title { color: #fff; font-size: 18px; font-weight: bold; height: 50px; line-height: 50px; } .main { flex: 1; padding: 15px; } .h1 { font-size: 24px; } .item { flex-direction: row; padding: 10px 0; } .item__text { color: #333; white-space: nowrap; } .item__value { margin-left: 5px; } .footer { background: #81a9c3; flex-direction: row; justify-content: center; align-items: center; } .footer__text { color: #fff; font-size: 14px; height: 30px; line-height: 30px; } </style> 2>登录接口链接:​​http://showdoc.deui.cn/web/#/27?page_id=364​​ 登录代码 <template name='tpl'> <view class="page"> <div class="page1"> <safe-area class="header"> <!-- <text class="header__title">APICloud</text> --> </safe-area> <scroll-view class="main"> <view> <image src="https://baodinglingqian.oss-cn-beijing.aliyuncs.com/1.png" class="touxiang " /> </view> <div class="zhanghao"> <input placeholder="请输入账号" v-model="zhanghao" maxlength="10" autofocus /> </div> <div class="mima"> <input type="password" placeholder="请输入mima" v-model="password" /> </div> <text class="zhuce" @click="login()">登录</text> <text class="denglu" @click="handleClick()">注册</text> </scroll-view> </div> <image class="originImage" mode="scaleToFill" src={src}></image> </view> </template> <script> export default { name: "tpl", apiready() { api.setStatusBarStyle({ style: "light", color: "-" }); var value = localStorage.getItem('uid'); api.openWin({ name: 'home', url: './home.stml' }); }, data() { return { zhanghao: '', password: '', src: "https://baodinglingqian.oss-cn-beijing.aliyuncs.com/bg.png" }; }, computed: { }, methods: { handleClick(e) { api.openWin({ name: 'region', url: './region.stml', pageParam: { name: 'test' } }); // api.toast({ // msg: this.data.text, // location: "middle" // }); }, login() { var _this = this; api.ajax({ url: 'http://yy.deui.cn/api.php/index/login', method: 'get', // headers: { // 'Content-Type': 'application/json;charset=utf-8' // }, data: { body: { username: _this.zhanghao, password: _this.password } } }, function (ret, err) { console.log(JSON.stringify(ret)) localStorage.setItem('uid', ret.data.data[0]['id']); if (ret.msg == '返回成功') { api.toast({ msg: '登录成功', location: "middle" }); api.openWin({ name: 'home', url: './home.stml' }); } else { api.alert({ msg: JSON.stringify(err) }); } }); } } }; </script> <style> .denglu { margin-top: 10px; font-size: 14px; } .touxiang { margin-top: 10%; width: 150px; height: 150px; border-radius: 100px; margin: 0 auto; } html { width: 100%; height: 100%; } body { width: 100%; height: 100%; } .originImage { position: absolute; top: 0px; left: 0px; right: 0px; bottom: 0px; z-index: 1; } .page { /* position:fixed; */ position: relative; z-index: 9; width: 100%; height: 100%; } .page1 { position: absolute; top: 0px; left: 0px; right: 0px; bottom: 0px; z-index: 2; } input { padding-left: 10px; line-height: 35px; height: 35px; border-radius: 5px; } .zhanghao { display: block; margin: 0 auto; margin-top: 15%; margin-bottom: 15px; height: 60px; } .mima { display: block; margin: 0 auto; margin-top: 25px; } .zhuce { width: 100%; height: 35px; line-height: 35px; background-color: coral; text-align: center; color: #fff; margin-top: 25px; } .page { height: 100%; background-color: white; } .header { background: #81a9c3; justify-content: center; align-items: center; } .header__title { color: #fff; font-size: 18px; font-weight: bold; height: 50px; line-height: 50px; } .main { flex: 1; padding: 15px; } .h1 { font-size: 24px; } .item { flex-direction: row; padding: 10px 0; } .item__text { color: #333; white-space: nowrap; } .item__value { margin-left: 5px; } .footer { background: #81a9c3; flex-direction: row; justify-content: center; align-items: center; } .footer__text { color: #fff; font-size: 14px; height: 30px; line-height: 30px; } </style> (5)首页轮播图 轮播图链接:​​http://showdoc.deui.cn/web/#/27?page_id=366​​ <template name='tpl'> <view class="page"> <div class="page1"> <safe-area class="header"> <text class="header__title">首页</text> </safe-area> <scroll-view class="main" scroll-y> <swiper class="swiper" id="customSwiper" autoplay circular indicator-dots indicator-color="#ddd" indicator-active-color="#f0f"> <swiper-item class="swiper-item" v-for="(_item,_index) in bannerlist"> <!-- <text class="desc">{_item.image}</text> --> <image mode="scaleToFill" src={_item.image}></image> </swiper-item> </swiper> <div> <a-cell-group> <a-cell v-bind:title="_item.name" v-bind:value="_item.content" v-bind:label="_item.address" arrow-direction="right" @click="godetial(_item)" v-for="(_item,_index) in shangjialist" /> <!-- <a-cell title="单元格" value="内容" label="描述信息" /> --> </a-cell-group> </div> </scroll-view> </div> <image class="originImage" mode="scaleToFill" src={src}></image> </view> </template> <script> import ACellGroup from "../../components/act/a-cell-group"; import ACell from "../../components/act/a-cell"; export default { name: 'test', data() { return { shangjialist: [], bannerlist: [], current: 0, src: "https://baodinglingqian.oss-cn-beijing.aliyuncs.com/bg.png" } }, methods: { apiready() { this.banner() this.allstores() // var customSwiper = document.getElementById('customSwiper'); // customSwiper.load({ // data: this.data.dataList // }); }, onchange(e) { this.data.current = e.detail.current; }, godetial(item) { console.log(JSON.stringify(item)) api.openWin({ name: 'detial', url: './detial.stml', pageParam: { id: item.id } }); }, banner() { var _this = this; api.ajax({ url: 'http://yy.deui.cn/api.php/index/banner', method: 'get', }, function (ret, err) { if (ret.msg == '返回成功') { _this.data.bannerlist = ret.data.data // var customSwiper = document.getElementById('customSwiper'); // customSwiper.load({ // data: _this.data.bannerlist // }); // console.log(JSON.stringify(_this.bannerlist)) } else { api.alert({ msg: JSON.stringify(err) }); } }); }, allstores() { var _this = this; api.ajax({ url: 'http://yy.deui.cn/api.php/index/stores', method: 'get', }, function (ret, err) { if (ret.msg == '返回成功') { console.log(1) console.log(JSON.stringify(ret.data.data)) console.log(1) var obj = ret.data.data for (let index = 0; index < obj.length; index++) { const element = obj[index]; element['content'] = element['content'].substring(0, 9) + '...' } console.log(JSON.stringify(obj)) _this.data.shangjialist = obj } else { api.alert({ msg: JSON.stringify(err) }); } }); } } } </script> <style> .denglu { margin-top: 10px; font-size: 14px; } .touxiang { margin-top: 10%; width: 150px; height: 150px; border-radius: 100px; margin: 0 auto; } html { width: 100%; height: 100%; } body { width: 100%; height: 100%; } .originImage { position: absolute; top: 0px; left: 0px; right: 0px; bottom: 0px; z-index: 1; } .page { /* position:fixed; */ position: relative; z-index: 9; width: 100%; height: 100%; } .page1 { position: absolute; top: 0px; left: 0px; right: 0px; bottom: 0px; z-index: 2; } input { padding-left: 10px; line-height: 35px; height: 35px; border-radius: 5px; } .zhanghao { display: block; margin: 0 auto; margin-top: 15%; margin-bottom: 15px; height: 60px; } .mima { display: block; margin: 0 auto; margin-top: 25px; } .zhuce { width: 100%; height: 35px; line-height: 35px; background-color: coral; text-align: center; color: #fff; margin-top: 25px; } .page { height: 100%; background-color: white; } .header { background: #81a9c3; justify-content: center; align-items: center; } .header__title { color: #fff; font-size: 18px; font-weight: bold; height: 50px; line-height: 50px; } .main { flex: 1; padding: 0px; } .h1 { font-size: 24px; } .item { flex-direction: row; padding: 10px 0; } .item__text { color: #333; white-space: nowrap; } .item__value { margin-left: 5px; } .footer { background: #81a9c3; flex-direction: row; justify-content: center; align-items: center; } .footer__text { color: #fff; font-size: 14px; height: 30px; line-height: 30px; } .main { width: 100%; height: 100%; } .swiper { width: 100%; height: 190px; /* background-color: blue; */ } .swiper-item { justify-content: center; } .title { padding: 10px 0; font-size: 20px; } .desc { width: 100%; text-align: center; } .container { width: 100%; height: 200px; } .indicator { flex-direction: row; justify-content: center; position: absolute; width: 100%; height: 20px; bottom: 8px; } .indicator-item { width: 15px; height: 8px; margin: 3px; } .indicator-item-normal { background-color: #ddd; } .indicator-item-active { background-color: red; } </style> (6)首页列表 所有店铺链接:​​http://showdoc.deui.cn/web/#/27?page_id=369​​ 上面的5的代码里面含有了。 <a-cell-group> <a-cell v-bind:title="_item.name" v-bind:value="_item.content" v-bind:label="_item.address" arrow-direction="right" @click="godetial(_item)" v-for="(_item,_index) in shangjialist" /> </a-cell-group> shangjialist: [], allstores() { var _this = this; api.ajax({ url: 'http://yy.deui.cn/api.php/index/stores', method: 'get', }, function (ret, err) { if (ret.msg == '返回成功') { console.log(1) console.log(JSON.stringify(ret.data.data)) console.log(1) var obj = ret.data.data for (let index = 0; index < obj.length; index++) { const element = obj[index]; element['content'] = element['content'].substring(0, 9) + '...' } console.log(JSON.stringify(obj)) _this.data.shangjialist = obj } else { api.alert({ msg: JSON.stringify(err) }); } }); } (7)页面传参获取详情 api.openWin({ name: 'detial', url: './detial.stml', pageParam: { id: 123 } }); apiready() {//like created if (api.pageParam.id) { this.data.id = api.pageParam.id } console.log(this.data.id) } 店铺详情:​​http://showdoc.deui.cn/web/#/27?page_id=370​​ <template> <view class="page"> <view> <a-nav-bar v-bind:title="title" left-text="返回" left-arrow @click-left="onClickLeft" @click-right="onClickRight" /> </view> <view> <a-cell-group> <a-cell title="名称" v-bind:value="store.name" /> <a-cell title="电话" v-bind:value="store.phone" /> <a-cell title="城市" v-bind:value="store.city" /> <a-cell title="地址" v-bind:value="store.address" /> <a-cell title="内容" v-bind:value="store.content" /> </a-cell-group> <!-- <text text={{store.name}}></text> <text text={{store.city}}></text> <text text={{store.content}}></text> <text text={{store.address}}></text> <text text={{store.phone}}></text> --> </view> <view> <a-button type="success">产品</a-button> </view> <view> <a-cell-group> <a-cell v-bind:title="_item.name" v-bind:value="_item.content" label="点击可预约" v-for="(_item,_index) in product" @click="yuyuproduct(_item)" /> </a-cell-group> </view> </view> </template> <script> import ACellGroup from "../../components/act/a-cell-group"; import ACell from "../../components/act/a-cell"; import ANavBar from "../../components/act/a-nav-bar"; import AButton from "../../components/act/a-button"; export default { name: 'detial', apiready() {//like created if (api.pageParam.id) { this.data.id = api.pageParam.id } console.log(this.data.id) this.init() }, data() { return { title: "详情", id: 1, store: {}, product:[] } }, methods: { init() { var _this = this; api.ajax({ url: 'http://yy.deui.cn/api.php/index/searchstore', method: 'get', data: { body: { id: _this.data.id } } }, function (ret, err) { if (ret.msg == '返回成功') { console.log(1) console.log(JSON.stringify(ret.data.product)) console.log(1) _this.data.store = ret.data.data[0] _this.data.product = ret.data.product } else { api.alert({ msg: JSON.stringify(err) }); } }); }, yuyuproduct(_item){ console.log(JSON.stringify(_item)) }, onClickLeft() { api.closeWin(); }, onClickRight() { } } } </script> <style> .page { height: 100%; } </style> (8)导航栏组件 import ANavBar from "../../components/act/a-nav-bar"; <view> <a-nav-bar v-bind:title="title" left-text="返回" left-arrow @click-left="onClickLeft" @click-right="onClickRight" /> </view> 注意:导航栏组件的使用,文档中的引用 import ACell from"../../components/act/a-nav-bar.stml"; 使用中建议去掉stml后缀,import ACell from"../../components/act/a-nav-bar"; (9)localStorage 对象使用 main.stml里面的这个,就是用的这个对象 localStorage.setItem('uid', ret.data.data[0]['id']); 下面是localStorage的用法 // 设置存储. sessionStorage.setItem('key', 'value'); // 获取存储. var value = sessionStorage.getItem('key'); // 移除存储 sessionStorage.removeItem('key'); // 清除所有存储项 sessionStorage.clear(); // 获取已有存储项数 var length = sessionStorage.length; // 根据存储项索引获取存储键名 var keyName = sessionStorage.key(index); (10)APICloud组件、模块的使用 模块中添加模块,如果是H5的需要下载后,放到自己的代码中;如果是原生的模块,需要添加到自己应用中,去require去使用。网上有专门介绍这块的教程,不清楚的可以去搜搜。 四、项目后台 这块是自己写的php后台,用的tp5框架。 tp5下的fastadmin框架,可以根据fastadmin一键生成简单后台,数据库文件为: 后台接口代码 <?php namespace app\api\controller; use app\common\controller\Api; use think\Db; /** * 首页接口 */ class Index extends Api { protected $noNeedLogin = ['*']; protected $noNeedRight = ['*']; /** * 首页 * */ public function index() { $this->success('请求成功'); } //注册 public function re(){ $username = $this->request->request("username"); $password = md5($this->request->request("password")); $sql = " INSERT INTO `yuyuuser` (`id`, `group_id`, `username`, `nickname`, `password`, `salt`, `email`, `mobile`, `avatar`, `level`, `gender`, `birthday`, `bio`, `money`, `score`, `successions`, `maxsuccessions`, `prevtime`, `logintime`, `loginip`, `loginfailure`, `joinip`, `jointime`, `createtime`, `updatetime`, `token`, `status`, `verification`) VALUES (NULL, '0', '', '".$username ."', '".$password."', '', '', '', '', '0', '0', NULL, '', '0.00', '0', '1', '1', NULL, NULL, '', '0', '', NULL, NULL, NULL, '', '', '')"; $rst = Db::query($sql); $data =1; $this->success('返回成功', ['data' => $data]); } //登录 public function login(){ $username = $this->request->request("username"); $password = md5($this->request->request("password")); $sql = "SELECT nickname,id FROM yuyuuser where nickname='".$username."' and password='".$password."' order by id DESC LIMIT 1"; $rst = Db::query($sql); $this->success('返回成功', ['data' => $rst]); } //获取轮播图 public function banner() { $sql = "SELECT * FROM `yuyubanner`"; $rst = Db::query($sql); $this->success('返回成功', ['data' => $rst]); } //获取网络协议 public function xieyi() { $sql = "SELECT * FROM `yuyuxieyi`"; $rst = Db::query($sql); $this->success('返回成功', ['data' => $rst]); } //所有类型 public function leixing() { $sql = " SELECT * FROM `yuyutype`"; $rst = Db::query($sql); $this->success('返回成功', ['data' => $rst]); } //所有店面 public function stores() { $sql = " SELECT * FROM `yuyustore`"; $rst = Db::query($sql); $this->success('返回成功', ['data' => $rst]); } //店铺信息 public function searchstore() { $id = $this->request->request("id"); $sql = " SELECT * FROM `yuyustore` where id = ".$id; $sql1 = "SELECT * FROM `yuyuproduct` where store_id = ".$id; $rst = Db::query($sql); $rst1 = Db::query($sql1); $this->success('返回成功', ['data' => $rst,'product'=>$rst1]); } }

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册