首页 文章 精选 留言 我的

精选列表

搜索[赛博朋克],共10000篇文章
优秀的个人博客,低调大师

每日一博 | 为什么 NGINX 的 reload 不是热加载?

作者:刘维 这段时间在 Reddit 看到一个讨论,为什么 NGINX 不支持热加载?乍看之下很反常识,作为世界第一大 Web 服务器,不支持热加载?难道大家都在使用的 nginx -s reload 命令都用错了? 带着这个疑问,让我们开始这次探索之旅,一起聊聊热加载和 NGINX 的故事。 NGINX 相关介绍 NGINX 是一个跨平台的开源 Web 服务器,使用 C 语言开发。据统计,全世界流量最高的前 1000 名网站中,有超过 40% 的网站都在使用 NGINX 处理海量请求。 NGINX 有什么优势,导致它从众多的 Web 服务器中脱颖而出,并一直保持高使用量呢? 我觉得核心原因在于,NGINX 天生善于处理高并发,能在高并发请求的同时保持高效的服务。相比于同时代的其他竞争对手例如 Apache、Tomcat 等,其领先的事件驱动型设计和全异步的网络 I/O 处理机制,以及极致的内存分配管理等众多优秀设计,将服务器硬件资源压缩到了极致。使得 NGINX 成为高性能 Web 服务器的代名词。 当然,除此之外还有一些其他原因,比如: 高度模块化的设计,使得 NGINX 拥有无数个功能丰富的官方模块和第三方拓展模块。 最自由的 BSD 许可协议,使得无数开发者愿意为 NGINX 贡献自己的想法。 支持热加载,能保证 NGINX 提供 7x24h 不间断的服务。 关于热加载 大家期望的热加载功能是什么样的?我个人认为,首先应该是用户端无感知的,在保证用户请求正常和连接不断的情况下,实现服务端或上游的动态更新。 那什么情况下需要热加载?在如今云原生时代下,微服务架构盛行,越来越多的应用场景有了更加频繁的服务变更需求。包括反向代理域名上下线、上游地址变更、IP 黑白名单更新等,这些都和热加载息息相关。 那么 NGINX 是如何实现热加载的? NGINX 热加载的原理 执行 nginx -s reload 热加载命令,就等同于向 NGINX 的 master 进程发送 HUP 信号。在 master 进程收到 HUP 信号后,会依次打开新的监听端口,然后启动新的 worker 进程。 此时会存在新旧两套 worker 进程,在新的 worker 进程起来后,master 会向老的 worker 进程发送 QUIT 信号进行优雅关闭。老的 worker 进程收到 QUIT 信号后,会首先关闭监听句柄,此时新的连接就只会流进到新的 worker 进程中,老的 worker 进程处理完当前连接后就会结束进程。 从原理上看,NGINX 的热加载能很好地满足我们的需求吗?答案很可能是否定的,让我们来看下 NGINX 的热加载存在哪些问题。 NGINX 热加载的缺陷 首先,NGINX 频繁热加载会造成连接不稳定,增加丢失业务的可能性。 NGINX 在执行 reload 指令时,会在旧的 worker 进程上处理已经存在的连接,处理完连接上的当前请求后,会主动断开连接。此时如果客户端没处理好,就可能会丢失业务,这对于客户端来说明显就不是无感知的了。 其次,在某些场景下,旧进程回收时间长,进而影响正常业务。 比如代理 WebSocket 协议时,由于 NGINX 不解析通讯帧,所以无法知道该请求是否为已处理完毕状态。即使 worker 进程收到来自 master 的退出指令,它也无法立刻退出,而是需要等到这些连接出现异常、超时或者某一端主动断开后,才能正常退出。 再比如 NGINX 做 TCP 层和 UDP 层的反向代理时,它也没法知道一个请求究竟要经过多少次请求才算真正地结束。 这就导致旧 worker 进程的回收时间特别长,尤其是在直播、新闻媒体活语音识别等行业。旧 worker 进程的回收时间通常能达到半小时甚至更长,这时如果再频繁 reload,将会导致 shutting down 进程持续增加,最终甚至会导致 NGINX OOM,严重影响业务。 # 一直存在旧 worker 进程: nobody 6246 6241 0 10:51 ? 00:00:00 nginx: worker process nobody 6247 6241 0 10:51 ? 00:00:00 nginx: worker process nobody 6247 6241 0 10:51 ? 00:00:00 nginx: worker process nobody 6248 6241 0 10:51 ? 00:00:00 nginx: worker process nobody 6249 6241 0 10:51 ? 00:00:00 nginx: worker process nobody 7995 10419 0 10:30 ? 00:20:37 nginx: worker process is shutting down <= here nobody 7995 10419 0 10:30 ? 00:20:37 nginx: worker process is shutting down nobody 7996 10419 0 10:30 ? 00:20:37 nginx: worker process is shutting down 从上述内容可以看到,通过nginx -s reload方式支持的“热加载”,虽然在以往的技术场景中够用,但是在微服务和云原生迅速发展的今天,它已经捉襟见肘且不合时宜。 如果你的业务变更频率是每周或者每天,那么 NGINX 这种 reload 还是满足你的需求的。但如果变更频率是每小时、每分钟呢?假设你有 100 个 NGINX 服务,每小时 reload 一次的话,就要 reload 2400 次;如果每分钟 reload 一次,就是 864 万次。这显然是无法接受的。 因此,我们需要一个不需要进程替换的 reload 方案,在现有 NGINX 进程内可以直接完成内容的更新和实时生效。 在内存中直接生效的热加载方案 在 Apache APISIX 诞生之初,就是希望来解决 NGINX 热加载这个问题的。 Apache APISIX 是基于 NGINX + Lua 的技术栈,以 ETCD 作为配置中心实现的云原生、高性能、全动态的微服务 API 网关,提供负载均衡、动态上游、灰度发布、精细化路由、限流限速、服务降级、服务熔断、身份认证、可观测性等数百项功能。 使用 APISIX 你不需要重启服务就可以更新配置,这意味着修改上游、路由、插件时都不用重启。既然是基于 NGINX,APISIX 又是如何摆脱 NGINX 的限制实现完美热更新?我们先看下 APISIX 的架构。 通过上述架构图可以看到,之所以 APISIX 能摆脱 NGINX 的限制是因为它把上游等配置全部放到 APISIX Core 和 Plugin Runtime 中动态指定。 以路由为例,NGINX 需要在配置文件内进行配置,每次更改都需要 reload 之后才能生效。而为了实现路由动态配置,Apache APISIX 在 NGINX 配置文件内配置了单个 server,这个 server 中只有一个 location。我们把这个 location 作为主入口,所有的请求都会经过这个 location,再由 APISIX Core 动态指定具体上游。因此 Apache APISIX 的路由模块支持在运行时增减、修改和删除路由,实现了动态加载。所有的这些变化,对客户端都零感知,没有任何影响。 再来几个典型场景的描述。 比如增加某个新域名的反向代理,在 APISIX 中只需创建上游,并添加新的路由即可,整个过程中不需要 NGINX 进程有任何重启。再比如插件系统,APISIX 可以通过 ip-restriction 插件实现 IP 黑白名单功能,这些能力的更新也是动态方式,同样不需要重启服务。借助架构内的 ETCD,配置策略以增量方式实时推送,最终让所有规则实时、动态的生效,为用户带来极致体验。 总结 NGINX 的热加载在某些场景下会长时间存在新旧两套进程,导致额外消耗资源,同时频繁热加载也会导致小概率业务丢失。 面对当下云原生和微服务的技术趋势下, 服务变化更加的频繁,控制 API 的策略也发生了变化,导致我们对热加载的需求提出了新需求,NGINX 的热加载已经不能满足实际业务需求。 现在是时候切换到更贴合云原生时代并且更完善的热加载策略、性能表现卓越的 API 网关——Apache APISIX,从而享受动态、统一管理等特性带来的管理效率上的极大提升。

优秀的个人博客,低调大师

每日一博 | RocketMQ 重试机制详解及最佳实践

作者:斜阳 引言 本文主要介绍在使用 RocketMQ 时为什么需要重试与兜底机制,生产者与消费者触发重试的条件和具体行为,如何在 RocketMQ 中合理使用重试机制,帮助构建弹性,高可用系统的最佳实践。 RocketMQ 的重试机制包括三部分,分别是生产者重试,服务端内部数据复制遇到非预期问题时重试,消费者消费重试。本文中仅讨论生产者重试和消费者消费重试两种面向用户侧的实现。 生产者发送重试 RocketMQ 的生产者在发送消息到服务端时,可能会因为网络问题,服务异常等原因导致调用失败,这时候应该怎么办?如何尽可能的保证消息不丢失呢? 1. 生产者重试次数 RocketMQ 在客户端中内置了请求重试逻辑,支持在初始化时配置消息发送最大重试次数(默认为 2 次),失败时会按照设置的重试次数重新发送。直到消息发送成功,或者达到最大重试次数时结束,并在最后一次失败后返回调用错误的响应。对于同步发送和异步发送,均支持消息发送重试。 同步发送:调用线程会一直阻塞,直到某次重试成功或最终重试失败(返回错误码或抛出异常)。 异步发送:调用线程不会阻塞,但调用结果会通过回调的形式,以异常事件或者成功事件返回。 2. 生产者重试间隔 在介绍生产者重试前,我们先来了解下流控的概念,流控一般是指服务端压力过大,容量不足时服务端会限制客户端收发消息的行为,是服务端自我保护的一种设计。RocketMQ 会根据当前是否触发了流控而采用不同的重试策略: 非流控错误场景:其他触发条件触发重试后,均会立即进行重试,无等待间隔。 流控错误场景:系统会按照预设的指数退避策略进行延迟重试。 为什么要引入退避和随机抖动? 如果故障是由过载流控引起的,重试会增加服务端负载,导致情况进一步恶化,因此客户端在遇到流控时会在两次尝试之间等待一段时间。每次尝试后的等待时间都呈指数级延长。指数回退可能导致很长的回退时间,因为指数函数增长很快。指数退避算法通过以下参数控制重试行为,更多信息,请参见connection-backoff.md。 INITIAL_BACKOFF:第一次失败重试前后需等待多久,默认值:1 秒; MULTIPLIER :指数退避因子,即退避倍率,默认值:1.6; JITTER :随机抖动因子,默认值:0.2; MAX_BACKOFF :等待间隔时间上限,默认值:120 秒; MIN_CONNECT_TIMEOUT :最短重试间隔,默认值:20 秒。 ConnectWithBackoff() current_backoff = INITIAL_BACKOFF current_deadline = now() + INITIAL_BACKOFF while (TryConnect(Max(current_deadline, now() + MIN_CONNECT_TIMEOUT))!= SUCCESS) SleepUntil(current_deadline) current_backoff = Min(current_backoff * MULTIPLIER, MAX_BACKOFF) current_deadline = now() + current_backoff + UniformRandom(-JITTER * current_backoff, JITTER * current_backoff) 特别说明:对于事务消息,只会进行透明重试(transparent retries),网络超时或异常等场景不会进行重试。 3. 重试带来的副作用 不停的重试看起来很美好,但也是有副作用的,主要包括两方面:消息重复,服务端压力增大 远程调用的不确定性,因请求超时触发消息发送重试流程,此时客户端无法感知服务端的处理结果;客户端进行的消息发送重试可能会导致消费方重复消费,应该按照用户ID、业务主键等信息幂等处理消息。 较多的重试次数也会增大服务端的处理压力。 4. 用户的最佳实践是什么 1)合理设置发送超时时间,发送的最大次数 发送的最大次数在初始化客户端时配置在 ClientConfiguration;对于某些实时调用类场景,可能会导致消息发送请求链路被阻塞导致业务请求整体耗时高或耗时;需要合理评估每次调用请求的超时时间以及最大重试次数,避免影响全链路的耗时。 2)如何保证发送消息不丢失 由于分布式环境的复杂性,例如网络不可达时 RocketMQ 客户端发送请求重试机制并不能保证消息发送一定成功。业务方需要捕获异常,并做好冗余保护处理,常见的解决方案有两种: 向调用方返回业务处理失败; 尝试将失败的消息存储到数据库,然后由后台线程定时重试,保证业务逻辑的最终一致性。 3)关注流控异常导致无法重试 触发流控的根本原因是系统容量不足,如果因为突发原因触发消息流控,且客户端内置的重试流程执行失败,则建议执行服务端扩容,将请求调用临时替换到其他系统进行应急处理。 4)早期版本客户端如何使用故障延迟机制进行发送重试? 对于 RocketMQ 4.x 和 3.x以下客户端开启故障延迟机制可以用: producer.setSendLatencyFaultEnable(true) 配置重试次数使用: producer.setRetryTimesWhenSendFailed() producer.setRetryTimesWhenSendAsyncFailed() 消费者消费重试 消息中间件做异步解耦时的一个典型问题是如果下游服务处理消息事件失败,那应该怎么做呢? RocketMQ 的消息确认机制以及消费重试策略可以帮助分析如下问题: 如何保证业务完整处理消息? 消费重试策略可以在设计实现消费者逻辑时保证每条消息处理的完整性,避免部分消息消费异常导致业务状态不一致。 业务应用异常时处理中的消息状态如何恢复? 当系统出现异常(宕机故障)等场景时,处理中的消息状态如何恢复,消费重试具体行为是什么。 1. 什么是消费重试? 什么时候认为消费失败? 消费者在接收到消息后将调用用户的消费函数执行业务逻辑。如果客户端返回消费失败 ReconsumeLater,抛出非预期异常,或消息处理超时(包括在 PushConsumer 中排队超时),只要服务端服务端一定时间内没收到响应,将认为消费失败。 消费重试是什么? 消费者在消费某条消息失败后,服务端会根据重试策略重新向客户端投递该消息。超过一次定数后若还未消费成功,则该消息将不再继续重试,直接被发送到死信队列中; 重试过程状态机:消息在重试流程中的状态和变化逻辑; 重试间隔:上一次消费失败或超时后,下次重新尝试消费的间隔时间; 最大重试次数:消息可被重试消费的最大次数。 2. 消息重试的场景 需要注意重试是应对异常情况,给予程序再次消费失败消息的机会,不应该被用作常态化的链路。 推荐使用场景: 业务处理失败,失败原因跟当前的消息内容相关,预期一段时间后可执行成功; 是一个小概率事件,对于大批的消息只有很少量的失败,后面的消息大概率会消费成功,是非常态化的。 正例:消费逻辑是扣减库存,极少量商品因为乐观锁版本冲突导致扣减失败,重试一般立刻成功。 错误使用场景: 消费处理逻辑中使用消费失败来做条件判断的结果分流,是不合理的。 反例:订单在数据库中状态已经是已取消,此时如果收到发货的消息,处理时不应返回消费失败,而应该返回成功并标记不用发货。 消费处理中使用消费失败来做处理速率限流,是不合理的。 限流的目的是将超出流量的消息暂时堆积在队列中达到削峰的作用,而不是让消息进入重试链路。 这种做法会让消息反复在服务端和客户端之间传递,增大了系统的开销,主要包括以下方面: <!----> RocketMQ 内部重试涉及写放大,每一次重试将生成新的重试消息,大量重试将带来严重的 IO 压力; 重试有复杂的退避逻辑,内部实现为梯度定时器,该定时器本身不具备高吞吐的特性,大量重试将导致重试消息无法及时出队。重试的间隔将不稳定,将导致大量重试消息延后消费,即削峰的周期被大幅度延长。 3. 不要以重试替代限流 上述误用的场景实际上是组合了限流和重试能力来进行削峰,RocketMQ 推荐的削峰最佳手段为组合限流和堆积,业务以保护自身为前提,需要对消费流量进行限流,并利用 RocketMQ 提供的堆积能力将超出业务当前处理的消息滞后消费,以达到削峰的目的。下图中超过处理能力的消息都应该被堆积在服务端,而不是通过消费失败进行重试。 如果不想依赖额外的产品/组件来完成该功能,也可以利用一些本地工具类,比如 Guava 的 RateLimiter 来完成单机限流。如下所示,声明一个 50 QPS 的 RateLimiter,在消费前以阻塞的方式 acquire 一个令牌,获取到即处理消息,未获取到阻塞。 RateLimiter rateLimiter = RateLimiter.create(50); PushConsumer pushConsumer = provider.newPushConsumerBuilder() .setClientConfiguration(clientConfiguration) // 设置订阅组名称 .setConsumerGroup(consumerGroup) // 设置订阅的过滤器 .setSubscriptionExpressions(Collections.singletonMap(topic, filterExpression)) .setMessageListener(messageView -> { // 阻塞直到获得一个令牌,也可以配置一个超时时间 rateLimiter.acquire(); LOGGER.info("Consume message={}", messageView); return ConsumeResult.SUCCESS; }) .build(); 4. PushConsumer 消费重试策略 PushConsumer 消费消息时,消息的几个主要状态如下: Ready:已就绪状态。消息在消息队列RocketMQ版服务端已就绪,可以被消费者消费; Inflight:处理中状态。消息被消费者客户端获取,处于消费中还未返回消费结果的状态; Commit:提交状态。消费成功的状态,消费者返回成功响应即可结束消息的状态机; DLQ:死信状态 消费逻辑的最终兜底机制,若消息一直处理失败并不断进行重试,直到超过最大重试次数还未成功,此时消息不会再重试。 该消息会被投递至死信队列。您可以通过消费死信队列的消息进行业务恢复。 最大重试次数 PushConsumer 的最大重试次数由创建时决定。 例如,最大重试次数为 3 次,则该消息最多可被投递 4 次,1 次为原始消息,3 次为重试投递次数。 重试间隔时间 <!----> 无序消息(非顺序消息):重试间隔为阶梯时间,具体时间如下: 说明:若重试次数超过 16 次,后面每次重试间隔都为 2 小时。 顺序消息:重试间隔为固定时间,默认为 3 秒。 5. SimpleConsumer 消费重试策略 和 PushConsumer 消费重试策略不同,SimpleConsumer 消费者的重试间隔是预分配的,每次获取消息消费者会在调用 API 时设置一个不可见时间参数 InvisibleDuration,即消息的最大处理时长。若消息消费失败触发重试,不需要设置下一次重试的时间间隔,直接复用不可见时间参数的取值。 由于不可见时间为预分配的,可能和实际业务中的消息处理时间差别较大,可以通过 API 接口修改不可见时间。 例如,预设消息处理耗时最多 20 ms,但实际业务中 20 ms内消息处理不完,可以修改消息不可见时间,延长消息处理时间,避免消息触发重试机制。 修改消息不可见时间需要满足以下条件: 消息处理未超时 消息处理未提交消费状态 如下图所示,消息不可见时间修改后立即生效,即从调用 API 时刻开始,重新计算消息不可见时间。 最大重试次数 与 PushConsumer 相同。 消息重试间隔 消息重试间隔 = 不可见时间 - 消息实际处理时长 例如:消息不可见时间为 30 ms,实际消息处理用了 10 ms 就返回失败响应,则距下次消息重试还需要 20 ms,此时的消息重试间隔即为 20 ms;若直到 30 ms 消息还未处理完成且未返回结果,则消息超时,立即重试,此时重试间隔即为 0 ms。 SimpleConsumer 的消费重试间隔通过消息的不可见时间控制。 //消费示例:使用SimpleConsumer消费普通消息,主动获取消息处理并提交。 ClientServiceProvider provider1 = ClientServiceProvider.loadService(); String topic1 = "Your Topic"; FilterExpression filterExpression1 = new FilterExpression("Your Filter Tag", FilterExpressionType.TAG); SimpleConsumer simpleConsumer = provider1.newSimpleConsumerBuilder() //设置消费者分组。 .setConsumerGroup("Your ConsumerGroup") //设置接入点。 .setClientConfiguration(ClientConfiguration.newBuilder().setEndpoints("Your Endpoint").build()) //设置预绑定的订阅关系。 .setSubscriptionExpressions(Collections.singletonMap(topic, filterExpression)) .build(); List<MessageView> messageViewList = null; try { //SimpleConsumer需要主动获取消息,并处理。 messageViewList = simpleConsumer.receive(10, Duration.ofSeconds(30)); messageViewList.forEach(messageView -> { System.out.println(messageView); //消费处理完成后,需要主动调用ACK提交消费结果。 //没有ack会被认为消费失败 try { simpleConsumer.ack(messageView); } catch (ClientException e) { e.printStackTrace(); } }); } catch (ClientException e) { //如果遇到系统流控等原因造成拉取失败,需要重新发起获取消息请求。 e.printStackTrace(); } 修改消息的不可见时间 案例:某产品使用消息队列来发送解耦“视频渲染”的业务逻辑,发送方发送任务编号,消费方收到编号后处理任务。由于消费方的业务逻辑耗时较长,消费者重新消费到同一个任务时,该任务未完成,只能返回消费失败。在这种全新的 API 下,用户可以调用可以通过修改不可见时间给消息续期,实现对单条消息状态的精确控制。 simpleConsumer.changeInvisibleDuration(); simpleConsumer.changeInvisibleDurationAsync(); 6. 功能约束与最佳实践 设置消费的最大超时时间和次数 尽快明确的向服务端返回成功或失败,不要以超时(有时是异常抛出)代替消费失败。 不要用重试机制来进行业务限流 错误示例:如果当前消费速度过高触发限流,则返回消费失败,等待下次重新消费。 正确示例:如果当前消费速度过高触发限流,则延迟获取消息,稍后再消费。 发送重试和消费重试会导致相同的消息重复消费,消费方应该有一个良好的幂等设计 正确示例:某系统中消费的逻辑是为某个用户发送短信,该短信已经发送成功了,当消费者应用重复收到该消息,此时应该返回消费成功。 总结 本文主要介绍重试的基本概念,生产者消费者收发消息时触发重试的条件和具体行为,以及 RocketMQ 收发容错的最佳实践。 重试策略帮助我们从随机的、短暂的瞬态故障中恢复,是在容忍错误时,提高可用性的一种强大机制。但请谨记 “重试是对于分布式系统来说自私的”,因为客户端认为其请求很重要,并要求服务端花费更多资源来处理,盲目的重试设计不可取,合理的使用重试可以帮助我们构建更加弹性且可靠的系统。 欢迎扫描下方二维码加入钉钉群一起沟通交流~ 点击此处,进入官网了解更多详情~

优秀的个人博客,低调大师

每日一博 | 得物极光蓝纸箱尺寸设计实践

一、背景 极光蓝包装盒成潮流标识,得物App成年轻潮人精神归属,特殊的包装材料已经在消费者之间形成了强大的心智,极光蓝等于得物。 但是由于早期箱型尺寸数据由人工经验设计,出现包装箱尺寸和商品尺寸匹配度不高的问题,一般会造成以下影响: 不合理的纸箱尺寸导致部分商品使用了较大的纸箱,造成了纸箱采购成本的浪费。 较大纸箱会造成运输成本的增加。 商品和纸箱之间的空隙过大,可能在运输过程中造成商品的损坏。 二、确定方案 考虑到纸箱招标节奏以及还需要留给仓内打样试装,试发货的时间,所以需要用比较快的速度完成建模和计算。 在这件事上,业务方也无法给出一些特别明确的准则,例如具体要算的综合目标中是包含运输成本的,这之中包含承运商的分配算法规则和他们的运费模板,将这些因素直接纳入到箱型建模之中基本是不可能的,再如箱子的数量是影响采购招标谈判的成本以及仓内的人效的,这里很难量化,也无法直接定义箱型数量值的评判标准。因此首先要和业务方产品分析现状定义目标,将问题全部量化,同时去简化问题。 2.1 问题分析 sku数据:过去一年的发货sku主数据及其对应的销量,再排除规则之外(只考虑用纸箱包装发货的商品、排除异性箱包装商品)和异常值(如sku尺寸异常)。 纸箱尺寸参数约束:考虑面单尺寸(纸箱尺寸下限定义)和便于仓内人员打包等合理性(纸箱尺寸上限定义),我们确定了纸箱上下限,形成数百万组合的空间。 箱型数约束:排除异型箱,需综合考虑装箱率、采购成本和仓内效率,一般来说单仓的箱型数量不宜超过15个。 覆盖率约束:在已经筛选出纸盒外包装打包的sku的前提下,接受部分异形、大件物品不可被箱型组覆盖,要求覆盖发货订单率>=99%。 基于以上对问题的分析可以看出,如果有了一组解K个箱型,去计算装箱率,这个问题的复杂度还好。但是如果正面去计算,则需对符合条件的sku去遍历箱型组合,这个基本上是无法在有效时间内算出结果的。 2.2 问题简化 2.2.1 箱型数约束 排除异型箱,基于得物当前的仓内实际情况,本次预计新设计的箱子数在8~15个,需综合考虑装箱率、采购成本和仓内效率,当箱型数量增加时,装箱率会提高,采购成本也会提高,仓内效率会降低。由于这里并不能量化它,例如给出具体综合指数,因此此处决定给出多个版本,供业务方抉择,而不作为建模的约束或目标,这里相当于直接简化为把M组箱型的M * 固定一种箱型的复杂度,在实际中开发中,只需要用M个容器同时执行一次计算即可。 2.2.2 覆盖率约束 覆盖率约束是个不等式约束,且当前问题,不可覆盖的sku部分的分布是非常显而易见的,集中在长宽高中一个或多个值超过仓内操控方便程度上限值,因此,这里将箱型上限值和接受不覆盖的部分,再建模之前先确定下来。 2.2.3 目标函数定义 对于采购成本来说,这不必说,一定和纸箱的用纸情况有关,纸箱用纸越小(纸箱展开面积越小)则成本越低; 对于运输成本来说,基本上3pl都是用MAX(抛重,实重)的方法来计算,那么这和纸箱展开面积的优化方向也是正的; 如果把各3pl运费模板加入到建模中,同时也需要考虑承运商分配的算法设计,那么问题会过于复杂,计算量也是很大。现在很显然,我们只要优化单均用纸面积,如果某单优化后的纸箱包装未触及运费模板的变动范围,则运费不变,若触及则运费成本必然会降低。 综上,最终考虑用装箱率这个间接指标作为目标,装箱率指的是测试的(数据集sku总体积 / 数据集发货箱子总体积),这个也是产品和业务方很熟悉且一直在关注的指标。 2.2.4 问题建模 经过上述简化,这里将目标函数定义成了装箱率,并且发货订单覆盖率、箱型数约束值放在了建模问题之外。 其中,S_i表示Sku_i的销量,R_i表示Sku_i的推荐箱型结果装箱率 推荐箱型应满足内部间隙大于最低要求,在箱型组中选择最小箱型,即 箱子的大小,应满足至少可以贴运单,也不能过大影响仓内人员打包效率 同时我们对sku进行长>宽>高的排序清洗,同时定义纸箱长>宽>高 最后,我们要求箱子的长宽高数据均为整数,即 三、优化算法 3.1 一般求解方法概述 对于这个优化问题,通常主要包括精确解算法和启发式算法: 精确方法主要是用单纯形法(线性规划)或者一些迭代的方法(非线性规划)再结合分枝定界法找到我们要的整数解。精确方法如果是线性规划问题能通过单纯形法在可行域的顶点中找到全局最优解,非线性规划也是通过微分学方法或者有限次的迭代找到接近于最优解的,由于不是多项式时间的求解方法,故而往往在大规模实例上不可行。 启发算法如遗传算法、蚁群算法、进化算法、智能算法针对普遍的问题。可以将它当作一个黑箱子对几乎任何问题适用。启发式算法,说白了就是有方向的穷举法,在计算资源有限的情况下,需要根据问题场景和模型特点,选择合理的邻域结构或操作机制,在全局搜索能力和局部搜索能力之间做权衡。启发算法通常需要给定初始解;另外,算法不能保证在多项式时间收敛,但常常可以控制算法迭代次数。 3.2 精确解求法 线性规划 对于线性规划问题,它的可行解构成的集合为凸集或者无界域,基可行解对应凸集的顶点,通过凸集的性质得出最优解会在凸集的顶点上,然后通过遍历再排序的方法可以得出最优解,但是当顶点过多的时候,则需要用单纯形法找到线性规划的最优解。 非线性规划 如果目标函数或者约束条件中含有非线性函数,例如当前的问题中目标函数装箱率中具有非线性因素,这种规划问题为非线性规划问题。一般来说,解非线性规划问题要比解规划问题困难的多,它不像求解线性规划有单纯形法这一种通用方法,非线性规划目前还没有适用于各种问题的一般算法,各个方法都有自己特定的适用范围。 整数规划 因为要求输出的结果是整数,所以需要用分支定界法来求解。 分支定界法的核心思想就是分枝和剪枝。当不考虑所求解必须是整数这个条件时,用单纯形法可求出最优解,但是这个解往往不全是整数,因此采用剪枝的方式一点一点缩小范围,直到所求解为整数解。 从图中可以看到,初始化阶段,需要给定输出的全局的上界和下界,如果能有一些启发式的方法获得稍微好点的上下界作为初始解导入那是最好的不过的了。如果没有的话可以先设置为正负无穷大。 接着进入到主循环中,通过求解整数规划的连续松弛问题(线性规划)来得到该子问题的上界;分解问题可以帮助对整数规划问题进行拆分,同时也可以帮助我们得到下界。 3.3 元启发式方法 以遗传算法为代表的这类算法,适合以下场景: 神经网络超参数优化 一部分结构和特性固定的组合优化问题 一部分机理模型难以建立的黑箱优化问题 多目标优化问题 3.3.1 遗传算法 基本概念 基因:可行解的元素 染色体:一条染色体为一个可行解 交叉:多条染色体切断拼接成新的染色体 变异:将染色体的部分基因进行修改 复制:完全遗传复制上一条染色体 执行流程 在算法初始阶段,它会随机生成一组可行解,也就是第一代染色体。 然后采用适应度函数分别计算每一条染色体的适应程度,并根据适应程度计算每一条染色体在下一次进化中被选中的概率。 通过“交叉”,生成N-M条染色体。 再对交叉后生成的N-M条染色体进行“变异”操作。 然后使用“复制”的方式生成M条染色体; 重复2~5。 四、具体建模 4.1 数据分析 首先粗略看下近一年得物发货的sku的长、宽、高主数据及其销量分布,这是我们设计箱型的依据数据。同时综合考虑仓内实际作业时候的效率以及采购的成本,因此箱子的种类数量也不可太多,否则会增加仓内打包人员取箱子的难度,采购成本也会相应提高。 在这一步,考虑到首先要准确和当前箱型 A/B ,同时8~15种这个数量加入到建模参数中也增加了计算复杂度,所以决定固定这个箱型数量的值,首先假设固定N种箱型,每个箱型长宽高三个数,即输出3 * N个参数。 接下来我们定义一下商品sku和箱型的 长>宽>高,首先对近一年的数据进行长宽高排序、异常值等清洗,例如固定了12种箱型,我们就将sku和箱型在长宽高维度用k-means聚类成12组。 做这个聚类分析,一方面,根据实际情况,例如结合面单尺寸定义箱型下限,再结合箱型覆盖率下限值,定义箱型上限尺寸; 另一方面,每个聚类的最大值可以作为箱型的初始化值(实际需要加上5mm作为缝隙)。 4.2 约束和目标 业务上约束来说,只需要将商品装入箱子,留下缝隙即可,且由于确定箱子的种类数量,这里还需要确定的是每组箱子的长>宽>高,即 constraint_ueq = ( # 单个箱子长>宽>高 lambda x: x[1] - x[0], lambda x: x[2] - x[1], lambda x: x[4] - x[3], lambda x: x[5] - x[4], ... ) 目标则是max 装箱率,即 def cal_avg_r_cached(p): '''The objective function. input routine, return total distance. cal_total_distance(np.arange(num_points)) ''' total_r = 0 for row in npd: r = [-1] * box_num for i in range(box_num): if (row[0] <= p[3 * i]) and (row[1] <= p[3 * i + 1]) and (row[2] <= p[3 * i + 2]): r[i] = row[4] / (p[3 * i] * p[3 * i + 1] * p[3 * i + 2]) total_r += max(r) * row[3] print(total_r) return -total_r / sum_cnt 4.3 结论 最终并行跑了几个版本,装箱率均有不等的提升,单均用纸面积有显著下降; 最终选择的1203方案作为工程侧的输出,装箱率提升5.49%,单均用纸面积节约7.6%,单均运费降低0.06元。 五、彩蛋 -- 使用遗传算法绘制NONO 在写这篇文章查相关资料发现的挺有脑洞的内容,用数个带有颜色的三角形,组装成图像。 这里试着用60个三角形绘制了下NONO。 效果大致如下: 在优化算法中,介绍了遗传算法的大致流程,那么绘制这个NONO和箱型设计有啥区别呢? 在箱型设计中,需要基于装箱率指标去计算箱子尺寸,因此,在定义适应度函数的时候,只要取Maximize装箱率这个指标即可,那么到了此处,只要将目标函数定义为不同颜色尺寸的透明三角形组装结果与目标图片的相似度即可。 5.1 适应度函数 首先需要找到能够量化透明三角形组成的图和目标NONO图的差异或者相似度的方法,那么如何定义相似度呢?图像的相似度即在某个颜色空间(例如RGB、HSV)下的值向量的相似度,每个点的差异值总和最小则越接近想要的目标图案,常用的评估函数例如MSE、RMSE、PSNR、ERGAS、SAM等。 下图是对于一些图像噪声方法,各种相似度评估方法对应的相似度结果。其中“Original”一栏显示的是原始图像与自身比较后的分数。 这里选择ERGAS来作为我们的适应度函数的依据。 5.2 选择 这里用不一定完全用轮盘赌方法来做选择,95%概率选择适应度函数靠前的解,5%的概率从其他解里面随机选择。 if random.random() < 0.95: '''选择基因的来源父母,95%几率从最优的祖先中随机''' poly_a = random.choice(polygons[:1]) poly_b = random.choice(polygons[1:5]) else: '''选择基因的来源父母,5%从所有的祖先中随机''' poly_a = random.choice(polygons) poly_b = random.choice(polygons) 5.3 交叉和变异 这里也一样用随机数,大概率随机从父类中继承赋值基因,小概率修改基因值,坐标交叉变异大致如下,颜色交叉变异同理。 temp = random.random() if temp < 1 / polygon_num: '''设定一定几率坐标变异''' rnd_temp_coord = poly_a.coord_list[i][:] rnd_temp_coord[random.randint(0, vertices - 1)] = random.randint(0, img_width), random.randint(0, img_height) temp_coords.append(rnd_temp_coord) elif temp < 0.5: '''随机继承父母中的一个基因''' temp_coords.append(poly_b.coord_list[i]) else: temp_coords.append(poly_a.coord_list[i]) temp = random.random() *文 /酱油 关注得物技术,每周一三五晚18:30更新技术干货 要是觉得文章对你有帮助的话,欢迎评论转发点赞~

优秀的个人博客,低调大师

每日一博 | 解密负载均衡技术和负载均衡算法

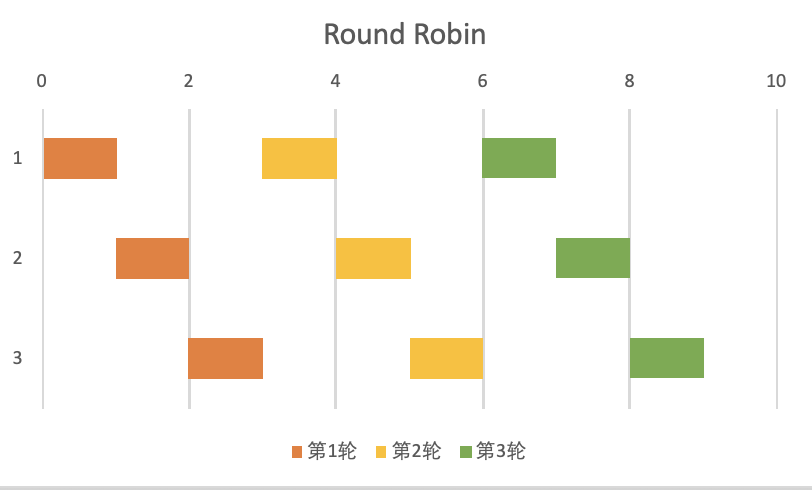
什么是负载均衡技术 负载均衡器是一种软件或硬件设备,它起到了将网络流量分散到一组服务器的作用,可以防止任何一台服务器过载。负载均衡算法就是负载均衡器用来在服务器之间分配网络流量的逻辑(算法是一组预定义的规则),有时候也叫做负载均衡的类型。负载均衡算法的种类非常多,包括从简单的轮询负载均衡算法到基于响应状态信息的自适应负载均衡算法。 负载均衡算法的选择会影响负载分配机制的有效性,从而影响性能和业务连续性(也就是对外承诺的SLA),选择正确的负载均衡算法会对应用程序性能产生重大影响。 本文将会介绍常见的负载均衡算法,并结合主流负载均衡软件或硬件设备介绍各种负载均衡算法的实现方式 常见负载均衡算法介绍 Round Robin(轮询负载均衡算法) 在所有负载均衡算法中,轮询负载均衡算法是最简单的、最常用的负载均衡算法。客户端请求以简单的轮换方式分发到应用程序服务器上。例如,假设有三台应用程序服务器:第一个客户端请求发送到第一台应用程序服务器,第二个客户端请求发送到第二台应用程序服务器,第三个客户端请求发送到第三台应用程序服务器,第四个客户端请求重新从第一台应用程序服务器开始,依次往复。 轮询负载均衡适合所有客户端请求都需要相同的服务器负载,并且所有的服务器实例都具有相同的服务器容量和资源(比如网络带宽和存储) Weighted Round Robin(加权轮询负载均衡算法) 加权负载均衡算法与轮询算法相似,增加了根据每个服务器的相对容量来将请求分散到不同服务器的能力。它适合将传入的客户端请求分散到一组具有不同功能或具有不同负载容量的服务器上。服务器集群管理员根据一个标准为每个应用程序服务器分配一个权重,这个标准表示每个服务器对请求的相对处理能力。 例如,如果在其他资源都是无穷多的情况下,假如服务器#1的CPU核心数是服务器#2和服务器#3的CPU核心数的二倍,那么服务器#1的权重更高,而服务器#2和#3的权重相同(都比#1低)。如果我们有4个连续的客户端请求,那么有2次请求发送到#1,另外2次请求分别发送到#2和#3。 加权轮询负载均衡算法描述的是在一段时间内负载的分布情况,不同的加权轮询负载均衡算法可能会产生不同的选择序列,不应该对处理下一次负载的服务器进行假设。 Least Connections(最少连接负载均衡算法) 最少连接负载均衡算法又叫做最少等待请求算法(Least Outstanding Request, LOR)。最少连接负载均衡是一种动态负载均衡算法,客户端请求被分发到在接收到请求时活动连接数最少的应用服务器。在应用服务器具有类似规格的情况下,一台服务器可能会因为连接数过多而过载(无法接收请求也属于过载),这个算法考虑了活动连接负载。这种技术适合具有不同连接时间的传入请求(多机房)以及一组在处理能力和可用资源方面相对相似的服务器。 Weighted Least Connections(加权最少连接负载均衡算法) 加权最少连接建立在最少连接负载均衡算法上,考虑不同的应用程序服务器特性。与加权轮询负载均衡算法相同,服务器集群管理员根据一个标准为每个应用程序服务器分配一个权重,这个标准表示每个服务器对请求的相对处理能力。负载均衡器根据活动链接和分配的服务器权重做出负载平衡决策(例如,使用连接数乘以权重的倒数,选择值最高的服务器)。 Resource Based(基于资源的负载均衡算法) 基于资源的负载均衡算法又叫做自适应负载均衡算法。基于资源的负载均衡算法根据后端服务器提供的状态指标来做出决策。这个状态指标可以由一个运行在服务器上的自定义应用程序(比如agent),或从基础设施提供方的开放接口获取。负载均衡器定期查询每台服务器的状态指标,然后适当地调整服务器的动态权重。 在这种方式下,负载均衡算法实际上是在每台真实服务器上执行健康检查。这个算法适用于任何需要来自每台服务器的详细健康检查信息来做出负载均衡决策的情况。 例如:此算法适用于工作负载多变且需要详细的应用程序性能和状态来评估服务器运行状态的任何应用程序(例如CPU密集型的最短路径计算,或其他高性能计算场景)。 Fixed Weighting(固定权重负载均衡算法) 固定权重负载均衡算法允许服务器集群管理员根据他们的标准为每个应用程序服务器分配一个权重,以表示每个服务器的相对流量处理能力。权重最高的应用服务器将接收所有流量。如果权重最高的应用服务器出现故障,所有流量将会被引导到下一个权重最高的应用服务器。此方法适用于单个服务器能够处理所有预期传入请求的工作负载,如果当前活动的服务器发生故障,一个或多个“热备用”服务器可以直接用于承担负载。 Weighted Response Time(加权响应时间负载均衡算法) 加权响应时间负载均衡算法使用应用程序的响应时间来计算服务器权重。响应速度最快的应用程序服务器接收下一个请求。此方法适用于应用程序响应时间是最重要的问题的场景。 当应用程序提供的是对外开放服务时尤为重要,因为对外开放服务都会为合作伙伴提供服务级别协议(Service Level Argument,SLA),而SLA中承诺的主要就是服务的可用性与服务的响应时间(TP99、TP999等)。 Source IP Hash(源地址哈希负载均衡算法) 源地址哈希负载均衡算法使用客户端请求的源IP与目标IP地址生成唯一的哈希密钥,用于将客户端请求分配给特定的服务器。如果传输层会话中断,可以重新密钥,因此客户端请求将会被定向到它之前使用的统一服务器。当客户端对于每个连续连接始终返回到同一服务器至关重要时,此方法最适用。 服务端研发经常接触的数据库事务就适用于此场景 Consistent Hash(一致性哈希负载均衡算法) 一致性哈希负载均衡算法类似于源地址哈希,不同在于一致性哈希负载均衡算法可以使用任意应用参数组成唯一的哈希密钥,并且当服务器集群发生变化时可以尽可能少地进行数据迁移。 常见负载均衡算法实现 本节将会介绍各种常见负载均衡算法的实现方式,某些负载均衡算法具有多种不同的实现方式,并且每种实现方式都有各自适用的场景,这些不同的实现方式也会在本节进行介绍。同时本节中会假设所有的请求都是线性的,不会处理并发安全相关的细节。 Round Robin(轮询负载均衡算法) 在所有负载均衡算法中,轮询负载均衡算法实现起来最简单,只需要一个变量表示当前位置并不断增加即可。 public class RoundRobinLoadBalancer { private final List instances; private int position; public RoundRobinLoadBalancer(List instances) { this.instances = instances; this.position = ThreadLocalRandom.current().nextInt(instances.size()); } public ServiceInstance peek(HttpServletRequest request) { int peeked = (position++) & Integer.MAX_VALUE; return instances.get(peeked % instances.size()); } } 这里有两个需要注意的点 当我们初始化位置时,需要将其设置为一个随机值,避免多个负载均衡器同时请求同一个服务器,造成服务器的瞬时压力 在位置自增时,需要忽略符号位,因为Java没有无符号整数,所以当位置的值超出整型最大值时会变成负值导致抛出异常。至于为什么不能使用绝对值,是因为整型的最小值没有对应的绝对值,得到的依旧是负值(Spring Cloud #1074) Weighted Round Robin(加权轮询负载均衡算法) 加权轮询负载均衡算法有很多主流的实现,并且各自都有各自的优点。虽然加权负载均衡产生任意符合全总分配比例分布的选择序列都是合适的,但在短时间窗口内是否能够选择尽可能多的节点提供服务仍是评价加权负载均衡实现的质量的关键指标。 数组展开方式 数组展开实现方式是一种适用空间换时间的策略,适用于较小的服务器集群或专用型负载均衡设备。它的优点是速度非常快,与Round Robin实现完全一致。它的缺点也很明显,当权重的总和很大时会带来很大的内存开销 public class WeightedLoadBalancer { private final List instances; private int position; public WeightedLoadBalancer(List instances) { this.instances = expandByWeight(instances); } public ServiceInstance peek(HttpServletRequest request) { int peeked = (position++) & Integer.MAX_VALUE; return instances.get(peeked % instances.size()); } private List expandByWeight(List instances) { List newInstances = new ArrayList<>(); for (ServiceInstance instance : instances) { int bound = instance.getWeight(); for (int w = 0; weight < bound; weight++) { newInstances.add(instance); } } Collections.shuffle(newInstances); return newInstances; } } 这里有三个需要注意的点: 当实例按权重展开成数组的时候,可能会出现实例权重都很大,但是它们的最大公约数不为1,这个时候可以使用最大公约数来减少展开后的数组大小。因为最大公约数的诸多限制,例如任意自然数N与N+1互质,任意自然数N与1互质,所以很容易出现优化失败的情况,因此本示例并未给出,感兴趣的可以去看Spring Cloud相关PR(Spring Cloud #1140) 在实例按权重展开成数组后,需要对得到的数组进行洗牌,以保证流量尽可能均匀,避免连续请求相同实例(Java中实现的洗牌算法是Fisher-Yates算法,其他语言可以自行实现) 因为是在构建负载均衡器的时候按权重展开成数组的,所以在负载均衡器构建完成后无法再改变实例的权值,对于频繁动态变更权重的场景不适用 上界收敛选择方式 上界收敛选择方式提前计算出所有权重的最大值,并将初始上界设置为所有权重的最大值,接下来我们一轮一轮地去遍历所有实例,并找到权重大于等于上界的实例。当前轮遍历结束后,所有大于等于上界的元素都被选取到了,接下来开始尝试权重更低的节点,直到最后上界为0时,将其重新置为最大值。目前openresty (有人在issue #44上分析了这种算法) public class WeightedLoadBalancer { private final List instances; private final int max; private final int gcd; private int bound; private int position; public WeightedLoadBalancer(List instances) { this.instances = instances; this.max = calculateMaxByWeight(instances); this.gcd = calculateGcdByWeight(instances); this.position = ThreadLocalRandom.current().nextInt(instances.size()); } public ServiceInstance peek(HttpServletRequest request) { if (bound == 0) { bound = max; } while (instances.size() > 0) { for (int peeked = position; peeked < instances.size(); peeked++) { ServiceInstance instance = instances.get(peeked); if (instance.getWeight() >= bound) { position = peeked + 1; return instance; } } position = 0; bound = bound - gcd; } return null; } private static int calculateMaxByWeight(List instances) { int max = 0; for (ServiceInstance instance : instances) { if (instance.getWeight() > max) { max = instance.getWeight(); } } return max; } private static int calculateGcdByWeight(List instances) { int gcd = 0; for (ServiceInstance instance : instances) { gcd = gcd(gcd, instance.getWeight()); } return gcd; } private static int gcd(int a, int b) { if (b == 0) { return a; } return gcd(b, a % b); } } 这里面有四个需要注意的点: 如果是短频率请求,将会一直访问高权重实例,导致在短时间窗口内负载看起来并不均匀。这个可以通过改变方向,从下界向上界逼近来解决。 每一轮后降低上界的值可以取所有权重的最大公约数,因为如果每次下降1的话,中间这些轮会反复请求权重最高的那些实例,导致负载不均衡。 虽然最大公约数可以减少下降次数,但是如果权重相差非常多,并且所有元素都是互质的(n与n+1互质,任意自然数n与1互质,在实践中非常容易出现),那么在上界下降的过程中将会带来很多空转。这个可以参考广度优先遍历的思想,使用先入先出的队列来减少空转。 与数组展开方式遇到的问题相同,因为是在构建负载均衡器的时候计算最大公约数的值,所以对于频繁动态变更权重的场景依旧会有很大的性能开销,但是相较于数组展开方式可以避免频繁动态分配数组导致的性能与内存碎片问题 权重轮转实现 权重轮转算法中将会存储两个权重的值,一个是不会变化的原始权重,一个是会随着每次选择变化的当前权重。权重轮转实现中维护了一个循环不变量——所有节点的当前权重的和为0。每轮遍历过程中所有实例的有效权重都会增加它的原始权重,并选择出当前权重最高的节点。选择出权重最高的节点后将它的当前权重减去所有实例权重的总和,以避免它再次被选择。NGINX中加权轮询负载均衡算法使用此实现(NGINX)。这种算法的优势是它很平滑,低权重节点的等待时间较短,并且每轮权重轮转的最小正周期很小,是所有服务器实例权重的和。。 在NGINX中又叫做平滑加权负载均衡(Smooth Weighted Load Balancing,SWRR)。 public class WeightedLoadBalancer { private final List instances; public WeightedLoadBalancer(List instances) { this.instances = instances; } public ServiceInstance peek(HttpServletRequest request) { ServiceInstance best = null; int total = 0; for (ServiceInstance instance : instances) { total += instance.getWeight(); instance.setCurrentWeight(instance.getCurrentWeight() + instance.getWeight()); if (best == null || instance.getCurrentWeight() > best.getCurrentWeight()) { best = instance; } } if (best != null) { best.setCurrentWeight(best.getCurrentWeight() - total); } return best; } } 这里面有三个需要注意的点: 权重轮转非常适合实例变化频率非常高的集合,因为它不需要提前构建数据结构 权重轮转实现的效率与实例数量相关,时间复杂度是O(n),当集群服务器数量非常大时需要限制每次参与选择的服务器数量(Spring Cloud #1111) 权重轮转实现需要修改服务器实例的数据结构,当服务实例是由其他机构提供时无法使用此实现 EDF(Earliest Deadline First)实现 EDF算法最早被用在CPU调度上,EDF是抢占式单处理器调度的最佳调度算法。EDF实现与权重轮转实现相似,引入了名为deadline的额外变量,可以认为权重越高的服务器实例完成任务的时间越快,那么在假设所有请求的成本相同时,所需要花费的时间是权重的倒数,所以可以很自然地选择可以最早空闲出来提供服务的服务器实例,并将任务分配给它。 实现EDF算法只需要将每个下游服务器实例与deadline绑定,然后以deadline为优先级维护到优先队列中,并不断取出队首元素,调整它的deadline,并将它重新提交到优先队列中。知名Service Mesh代理envoy使用了此方法实现加权负载均衡(envoy),以及蚂蚁开源网络代理mosn中也实现了此方法(mosn #1920) public class WeightedLoadBalancer { private final PriorityQueue entries; public WeightedLoadBalancer(List instances) { this.entries = instances.stream().map(EdfEntry::new).collect(Collectors.toCollection(PriorityQueue::new)); } public ServiceInstance peek(HttpServletRequest request) { EdfEntry entry = entries.poll(); if (entry == null) { return null; } ServiceInstance instance = entry.instance; entry.deadline = entry.deadline + 1.0 / instance.getWeight(); entries.add(entry); return instance; } private static class EdfEntry implements Comparable { final ServiceInstance instance; double deadline; EdfEntry(ServiceInstance instance) { this.instance = instance; this.deadline = 1.0 / instance.getWeight(); } @Override public int compareTo(EdfEntry o) { return Double.compare(deadline, o.deadline); } } } EDF每次选择的算法复杂度为O(log(n)),相较于数组展开要慢,但相较于上界收敛选择在最坏情况下以及权重轮转都需要O(n)的时间复杂度来说,其性能表现的非常好,并且对于超大集群,其性能下降不明显。其空间复杂度为O(n),不会造成很大的内存开销。 Least Connections(最少连接负载均衡算法) 遍历比较方式 最简单的实现方式,遍历所有实例,并找出当前连接数最少的实例 public class LeastConnectionLoadBalancer { private final List instances; public LeastConnectionLoadBalancer(List instances) { this.instances = instances; } public ServiceInstance peek(HttpServletRequest request) { ServiceInstance best = null; for (ServiceInstance instance : instances) { if (best == null || instance.getConnections() < best.getConnections()) { best = instance; } } if (best != null) { best.setConnections(best.getConnections() + 1); } return best; } } 堆维护方式 所有动态有序集合都可以通过优先队列来实现,与EDF算法相同,取出队首的元素,修改它的优先级,并放回队列中 public class LeastConnectionLoadBalancer { private final PriorityQueue instances; public LeastConnectionLoadBalancer(List instances) { this.instances = instances.stream().collect(toCollection( () -> new PriorityQueue<>(comparingInt(ServiceInstance::getConnections)))); } public ServiceInstance peek(HttpServletRequest request) { ServiceInstance best = instances.poll(); if (best == null) { return null; } best.setConnections(best.getConnections() + 1); return best; } } Weighted Least Connections(加权最少连接负载均衡算法) 加权最少连接负载均衡算法的实现方式与最少连接负载均衡算法相同,只是在计算时增加了权重相关的参数 遍历比较方式 public class LeastConnectionLoadBalancer { private final List instances; public LeastConnectionLoadBalancer(List instances) { this.instances = instances; } public ServiceInstance peek(HttpServletRequest request) { ServiceInstance best = null; for (ServiceInstance instance : instances) { if (best == null || instance.getConnections() * best.getWeight() < best.getConnections() * instance.getWeight()) { best = instance; } } if (best != null) { best.setConnections(best.getConnections() + 1); } return best; } } Tips,在不等式中 a/b < c/d 与 ad < bc等价,并且可以避免除法带来的性能与精度问题 堆维护方式 public class LeastConnectionLoadBalancer { private final PriorityQueue instances; public LeastConnectionLoadBalancer(List instances) { this.instances = instances.stream().collect(toCollection( () -> new PriorityQueue<>(comparingDouble(ServiceInstance::getWeightedConnections)))); } public ServiceInstance peek(HttpServletRequest request) { ServiceInstance best = instances.poll(); if (best == null) { return null; } best.setConnections(best.getConnections() + 1); best.setWeightedConnections(1.0 * best.getConnections() / best.getWeight()); return best; } } Weighted Response Time(加权响应时间负载均衡算法) 加权响应时间负载均衡算法使用统计学的方法,通过历史的响应时间来得到预测值,使用这个预测值来选择相对更优的服务器实例。得到预测值的方法有很多,包括时间窗口内的平均值、时间窗口内的TP99、历史所有响应时间的指数移动加权平均数(EWMA)等等。其中Linkerd与APISIX使用了EWMA算法(Linkerd和APISIX)。 通过历史的响应时间来得到预测值这个操作通常是CPU开销很大的,实际使用时可以不用遍历所有元素,而是使用K-临近元素或直接随机选择两个元素进行比较即可,这种启发式方法办法无法保证全局最优但是可以保证不至于全局最差。 Source IP Hash(源地址哈希负载均衡算法) 源地址哈希负载均衡以任意算法将请求地址映射成整型数,并将这个整型数映射到实例列表的下标 public class IpHashLoadBalancer { private final List instances; public IpHashLoadBalancer(List instances) { this.instances = instances; } public ServiceInstance peek(HttpServletRequest request) { int h = hashCode(request); return instances.get(h % instances.size()); } private int hashCode(HttpServletRequest request) { String xForwardedFor = request.getHeader("X-Forwarded-For"); if (xForwardedFor != null) { return xForwardedFor.hashCode(); } else { return request.getRemoteAddr().hashCode(); } } } 这里有一个需要注意的点: 面向公网提供服务的负载均衡器前面可能会经过任意多层反向代理服务器,为了获取到真实的源地址,需要先获取X-Forwarded-For头部,如果该头部不存在再去获取TCP连接的源地址 负载均衡技术扩展 服务注册表与发现(Service Registry and Service Discovery) 在维护大型服务器集群时,服务器实例随时都有可能被创建或移除,当服务器被创建或移除时,集群管理员需要到各个负载均衡设备上去更新服务器实例列表。 服务注册表会在内部维护服务对应的服务器实例列表。在服务器实例被创建并成功运行服务后,服务器实例会去服务注册表中注册自身,包括网络地址(IPv4/IPv6)、服务端口号、服务协议(TCP/TLS/HTTP/HTTPS)以及自身提供的服务名称等等,有的服务注册表本身也会提供主动健康检查的能力(如Eureka与Consul)。在服务器实例正常退出时会在服务注册表执行反注册逻辑,这个时候服务注册表就会将这个服务器实例从服务器实例列表中移除。即使服务器实例异常退出导致无法执行反注册逻辑,服务注册表也会通过主动健康检查机制将这个异常的服务器实例从服务器实例列表中移除。 在拥有服务注册表后,负载均衡设备不需要再手动维护服务器实例列表,而是当请求到来时从服务注册表中拉取对应的服务器实例列表,并在这个服务器实例列表中进行负载均衡。为了提高服务的可用性,负载均衡设备会在本地(内存或本地文件注册表)缓存这些服务器实例列表,以避免由于负载均衡设备与服务注册表无法连接而导致服务不可用。 缓存及重新获取服务器列表的策略根据不同业务场景有不同的实现,在Spring Cloud Loadbalancer中是通过缓存过期而触发重新获取的逻辑(Spring Cloud),当服务注册表不可用时,因为负载均衡设备中无可用的服务器备份而导致服务完全不可用;在大部分的负载均衡设备中将缓存获取与更新逻辑改为定时器主动刷新的机制,这样当服务注册表不可用时可以主动决定是否将旧数据标记为过期。尽管本地缓存可以提高服务的可用性,但是要注意负载均衡设备在使用的仍旧是旧的服务提供方列表,当长时间无法获取到新的服务提供方列表时,负载均衡设备应当舍弃旧的服务提供方列表,并将服务不可用的问题暴露出来,通过基础设施提供的监控与告警能力通知集群管理员来进行处理。 健康检查(Health Check) 健康检查本质是一个预定规则,它向负载均衡器背后的服务器集群中的所有成员发送相同的请求,以确定每个成员服务器是否可以接受客户端请求。 对于某些类型的健康检查,通过评估来自服务器的响应以及收到服务器响应所需的时间以确定每个成员服务器的运行状态。通常情况下,当成员服务器的状态变为不健康时,负载均衡器应该快速地将其从服务器实例列表中移除,并在成员服务器状态恢复正常时将其重新添加回服务器实例列表中。 对于网络层负载均衡器(也叫做NLB或L4LB),通过建立TCP连接,根据是否能够成功建立连接以及建立连接所需要的时间来确定成员服务器的状态。 对于应用层负载均衡器(也叫做ALB或L7LB),通过发送应用层协议(不只是HTTP协议)定义的用于健康检查的请求报文,并根据响应报文内容以及整个请求从建立连接到完整收到所有响应所花费的时间来确定成员服务器的状态。 应用负载均衡器没有固定的模式。例如,对于提供HTTP协议服务的应用,可以提供用于健康检查的URL,设置通过健康检查的HTTP状态码(或状态码集),并验证响应报文中用于表示服务器状态的字段(通过JSONPath或XMLPath等提取)是否是预期值等方式来确认成员服务器状态;对于RPC协议,可以提供专门的ping-pong服务,负载均衡器根据RPC协议组装请求报文,并发送ping请求到成员服务器上,并根据成员服务器返回的内容是否为pong响应来确认成员服务器的状态,具体设计可以参考websocket的ping-pong机制(RFC 6455)。 慢启动(Slow Start) 负载均衡器中的慢启动思想来自于TCP的拥塞控制理论,其核心也是为了避免大量请求涌入刚刚启动完成的应用程序,导致大量请求阻塞、超时或异常的情况。 众所周知,Java是半编译半解释型语言,包括Java语言在内,现代解释型语言的解释器都带有即时编译器(Just In Time,JIT),JIT编译器会跟踪每个方法的执行点,对那些热点路径(Hotspot)进行更高效的优化,这也是Hotspot JVM名字的由来。而JIT对热点路径的优化全都来自于自应用程序启动以来的所有方法调用,也就是说应用程序的系统承载能力是随着程序的运行而不断得到强化的,经过JIT优化的Java代码甚至可以得到近似GCC中O3(最高级别)优化的性能。跟多关于JIT编译器的细节可以看Oracle的Java开发者指南(Java Developer Guide)。 同时,现代应用程序都不可避免的会使用本地缓存,当应用程序刚刚启动时内存中的缓存是空的,随着应用程序的运行,不断地访问外部系统获取数据并将数据写入到内存缓存中,应用程序与外部系统的交互会不断减少,应用程序的系统承载能力也会逐渐达到峰值。 上面是应用程序在启动后性能不断提升的因素中最常见的,初次之外还有很多的因素。所以为了避免大量请求涌入刚刚启动完成的应用程序的现象发生,负载均衡器会通过慢启动的方式,随着服务器运行不断增加这些服务器实例的权重,最终达到服务器的实际权重,从而达到动态调整分配给这些服务器实例的流量的效果。 服务器权重变化算法有很多,包括随时间线性增长、随时间对数增长、随时间指数增长、随时间变幂增长、与随时间按Logistic增长等。目前京东服务框架(JSF)实现的是随时间线性增长;envoy实现了随时间变幂增长,并引入了渐进因子来调整变化速率(envoy slow start)。 总结 负载均衡技术是网络代理与网关组件最核心的组成部分,本文简单介绍了什么是负载均衡技术、常见的负载均衡算法以及常见负载均衡算法的实现,并给出了负载均衡技术的扩展,为将来更深入学习网络代理相关技术打下基础。 因本人才学疏浅经验能力有限,文中难免会有疏忽和遗漏,以及不连贯的地方,欢迎大家与我沟通交流给出建议。 作者:纪卓志

优秀的个人博客,低调大师

每日一博 | 特征平台在数禾的建设与应用

本篇文章为数禾科技数据开发专家杨涵冰的演讲内容整理。主要内容包括: 特征平台概览 特征存储服务 流批一体方案 模型策略调用方案 点击查看更多技术内容 一、特征平台概览 首先是特征平台的概览,整个特征平台分成四层,分别是数据服务、存储服务、计算引擎、原始存储。数据服务层提供向外的服务,主要包括四种: 一是传统的 API 点查; 二是圈选查询; 三是事件消息; 四是同步调用计算。 其中同步调用计算服务是即时计算的,相当于现场进行策略运算,而 API 点查服务是预先计算并存储的。为了提供数据服务,提供特征行存和特征列存两种服务方式,分别支撑 API 点查和圈选查询。计算引擎有两个,分别是离线运算引擎和流批一体运算引擎。特征平台的最底层是原始存储,原始存储是为了支持离线运算功能,而事件存储是为了支持流批一体运算。 下面以 MySQL 为例介绍简化的特征平台数据流转过程。 首先是离线部分,通过 Sqoop 或者其他的抽取工具将 MySQL 数库的数据抽取到 EMR,然后经过 Hive 运算,把最终的运算结果存到 HBase 和 ClickHouse 中,分别对应特征行存和特征列存,以提供 API 点查和圈选查询服务。同时 MySQL 的 Binlog 会实时写入 Kafka,然后 Kafka 的数据会被消费进入 Flink 流批一体运算引擎,同时Kafka的数据也会被消费进入到事件存储 HBase,事件存储 HBase 的数据也会提供给Flink流批一体运算引擎。经过引擎计算以后,数据被写入 HBase 和 ClickHouse 中,此外还会发事件消息。中转到事件存储 HBase 的数据可以提供实时调用服务。 二、特征存储服务 接下来介绍特征存储服务。 我们将特征分为四类,分别是: 同步特征:实时写入、离线修正、流批一体。 即时计算特征:API 调用时运算、线下批量计算,逻辑一致。 实时特征:传统实时链路,实现复杂实时逻辑,一般可使用流批一体代替。 离线特征:传统离线链路,实现复杂离线逻辑。 为什么一定要有离线的链路,原因有以下几点: 一是实时链路是一个纯增量的链路,它的链路会很长,并且在任意的环节都有可能发生问题,一旦出错,数据将会在很长的一段时间都无法被自动修正。 二是实时链路对时效性有要求,特别是涉及到多流 join 的时候,一旦有延迟,需要尽快返回一个降级结果。为了控制实时特征的最终错误率,并且将错误限制在一个较小的时间段内,需要进行离线链路修正。特征存储服务会用两种方式来进行修正,一种就是同步特征,其本身自带修正,是流批一体的链路;其他特征一般是通过实时+离线+即时计算的组合方式。 下面以 MySQL 为例,介绍下存储服务的整体数据流。离线部分,通过 Sqoop 抽取工具将 MySQL 数库的数据抽取到 EMR,然后经过 Hive 运算,把最终的运算结果存到 HBase 和 ClickHouse 中。同时 Binlog 会实时写入 Kafka,然后 Kafka 的数据会被消费进入 Flink 流批一体运算引擎,经过引擎计算以后,数据被写入 HBase 和 ClickHouse 中。HBase 和 ClickHouse 提供 API 点查和圈选查询服务。 2.1 实时特征数据流 在实时特征的数据流中,MySQL 通过 Binlog 写入 Kafka,以及其他埋点类的 Kafka 数据,经过运算以后将结果写入另外一个 Kafka,最后消费数据写入 HBase 和 ClickHouse。 2.2 离线特征数据流 在离线特征数据流中,MySQL 通过 Sqoop,OSS 通过 Spark 或者其他方式抽取,Kafka 通过 Flume 抽取进入 EMR,然后用 Hive 或者 Spark 运算,同时写进 HBase 和 ClickHouse。 2.3 同步特征数据流 在同步特征数据流中,MySQL 的 Binlog 会写进实时的 Kafka,然后 Kafka 的数据会被实时写入事件存储,同时 MySQL 也会离线修正和初始化。Flink 同时做流处理和批处理,写进 HBase 和 ClickHouse。 2.4 即时计算特征数据流 在即时计算特征数据流中,依托于 HBase 和 ClickHouse 的数据,提供 API 点查和圈选查询服务。 以上就是整个存储服务的介绍,该部分内容涉及到特征存储服务的大部分,如图中橙色部分所示。 三、流批一体方案 在只提供了特征存储服务的时间里,我们发现了很多问题以及一些业务诉求。首先是一些问题: 在对现有模型策略精耕细作之前,还有没有什么数据没有被使用?比如说 MySQL 里面状态变化的时间点数据。 输入项离线逻辑是否已经足够完整,为什么实时输入项需要重新梳理与补充逻辑?离线输入项想要编程实时的,需要重新梳理逻辑,有些甚至过于复杂,以至于用传统的方式无法完成实时转换。 不确定使用场景,无法区分点查和跑批,能不能同时覆盖?对于很多业务人员来说,并不知道想要的模型和策略最终需要用跑批还是点查,有没有什么办法能同时满足这两种需求。 流式处理逻辑难以理解,为什么要流 Join,不能直接“取数”吗?对于模型开发人员,他们不了解流处理过程,因此实时特征的制作难以下沉到模型开发人员。 实时模型策略空跑测试需要很长时间,能不能缩短? 模型策略开发训练很快,上线开发实时输入项却需要很久,能不能加速? 对于这些问题,我们提出了一些方案: 【数据】 存储状态变化数据,支持还原任意时刻的数据切片状态。这样做还有一个额外的好处,通过流批一体方案进行模型训练的时候不会有特征穿越的问题,因为没有办法拿到未来的数。 【逻辑】 流批一体,以流为主,逻辑一致,无需验证口径。训练的时候用这份数据作为训练,上线及回测时也是用相同的数据,可以保证最终的结果一致。 【执行】 流、批、调用一体化,自适应不同场景。 【开发】 使用“取数”而不是流合并,封装实时流特有概念,降低实时开发门槛。 【测试】 支持任意时间段回溯测试,增加实时开发测试速度。 【上线】 自助式的流批一体模型开发上线,减少沟通环节,增加上线效率。 传统的实时流方案有 Lambda 和 Kappa 两种。 Lambda 提供了实时和离线的两套逻辑,最终在数据库中将两者合并起来。Lambda 的优点是架构简单,很好地结合了离线批处理和实时流处理的优点,稳定且实时计算成本可控,并且离线数据易于订正;缺点是实时、离线数据很难保持⼀致结果,并且需要维护两套系统。 3.1 流批一体方案 Kappa 则是全部都用实时的逻辑,将历史的数据存下来,每次得到一个切片数据,最后合并起来。Kappa 的优点是只需要维护实时处理模块,可以通过消息重放,无需离线实时数据合并;缺点是强依赖消息中间件缓存能力,实时数据处理时存在丢失数据,这个缺点在金融领域是不能容忍的。 由于 Kappa 在抛弃了离线处理模块的同时也抛弃了离线计算更加可靠稳定的特点,而 Lambda 虽然保证了离线计算的稳定,但是双系统的维护成本非常高,并且两套代码的运维非常复杂。 因此,我们提出了 Lambda+Kappa 的流批一体方案。如图所示,数据流转的前半部分是 Lambda 架构,其中心是一个 HBase 的事件存储;后半部分是 Kappa 架构,供用户完成流处理和批处理。 上图以 MySQL 为例展示了整体流批一体方案。 首先是 MySQL 的 Binlog 进入 Kafka,同时通过离线修正以及切片把数据送到事件中心,同时用相同的 Kafka 完成实时流的触发,然后事件中心会提供数据获取及离线跑批服务。最后由元数据中心统一管理数据,统一维护数据,以避免同步的问题。Flink 提供整个逻辑服务。 3.2 事件中心 图中的事件中心使用 Lambda 架构存储所有变化数据,每日修正,通过冷热混存与重加热机制追求最佳性价比。此外,我们参考 Flink 增加水印机制,确保当前值同步完成。最后,事件中心提供消息的转发机制以及异步转同步的的机制,以“取数”代替流 Join,消息转发机制,异步转同步。支持触发——消息接收及触发——轮询式调用,并同时赋予该接口回溯的能力。 下面介绍事件中心的村塾数据流,如图所示,MySQL、Kafka 等多个数据源通过不同的路径转发到 Kafka,然后 Flink 直接消费 Kafka,并会实时的写入 HBase 热存。此外,离线修正的数据通过 EMR 也写入 HBase 热存。另有一套 Replica 机制完成 HBase 热存和 HBase 冷存之间的复制。HBase 冷存的数据也会通过重新加热进入到 HBase 热存中。 整个事件中心的存储结构如图所示,冷存里面只放主体数据,热存里面除了主题数据以外,还有三个表用来做不同的 index 工作热存一般 TTL 为 32 天,有特殊的情况也可以调整。 事件中心的读取数据流中,实时触发是走是 Kafka,回溯和取数都是走 HBase 热存,内部的重加热机制完成 HBase 冷存到 HBase 热存数据的更新,这部分逻辑对于开发人员是透明的,开发人员不需要关注数据来自于哪里。 下面介绍事件中心的水印机制与流 Join。 假设我们要对两个流进行 Join,也可以简单理解为有两张表,通过某外键进行关联。当任何一张表发生变更时我们都需要至少触发一次最终的完整的 Join 后的记录。我们将两个流分别记录为 A 和 B,并且假设 A 流先到。那么在打开事件中心水印机制的情况下,A 流触发时,A 流的当前事件已经被记录在事件中心中。此时分为两种情况: 在事件中心中可以取到 B 流的相关数据,那么说明在A流当前事件记录进事件中心到运行至读取 B 流相关数据的时间段内,B 流已经完成了事件中心的记录,此时的数据已经完整。 在事件中心中无法取到 B 流的相关数据,那么由于事件中心水印机制,说明此时 B 流相关事件尚未触发。而由于A流当前事件已经被写入事件中心,那么当 B 流相关事件被触发时,一定能获得 A 流的当前事件数据,此时数据也是完整的。由此,通过事件中心水印机制,即可确保用“取数”取代流 Join 后至少会有一次拥有完整数据的计算。 触发消息接收通过消息转发完成。当外部系统发起请求后,会去转发 Kafka,然后 Kafka 的数据同时会进入事件中心,接下来触发相应的计算,最后去用消息队列发送计算结果,外部系统接收这个消息的结果。 同时也提供轮询式的服务,同样也是消息转发,前面与消息接收机制都一样,只是多了一个事件中心,重新存储计算结果,然后提供服务。 3.3 取数一致 在取数的时候还有另外一个问题,那就是不一定能拿到最新的数据,除非直接从元数据库获取数据,但这种操作一般是被禁止的,因为会给主库带来压力。为了保证数据的一致性,我们采取了一些措施。首先我们将取数一致性分为四个级别,分别是: 最终一致:经过一段时间后能访问到更新的数据,整个流批一体方案默认保证最终一致。 触发流强一致(可延迟) :保障触发流中的当前数据及早于当前数据的数据在对触发流的取数过程中能获取到。使用水印方案,水印不满足时进行延迟。 取数强一致(可延迟) :保障取数时早于用户提出的时间要求的数据均能获取到。使用水印方案,水印不满足时进行延迟。 取数强一致(无延迟) :保障取数时早于用户提出的时间要求的数据均能获取到。当水印不满足时直接从数据源增量补足,增量取数会对数据源带来压力。 3.4 流批一体作业 我们使用 PyFlink 实现流批一体作业,使用 python 是因为模型和策略开发人员更加熟悉 Python 语言,而Flink保证了逻辑一致性。基于 PyFlink,我们封装了复杂的触发逻辑、复杂的取数逻辑,并能够复用代码片段。 PyFlink 的代码组织结构如图所示,包含出发、主逻辑、输出三部分。这三部分可以不用自己实现,只需要选择已经封装好的输出。 Flink 整体数据流也简单,最上面是触发逻辑,然后触发主逻辑,主逻辑里面会有取数逻辑去完成取数,最后是输出的逻辑。在这里,触发逻辑、取数逻辑和输出逻辑的底层封装是随流批变化自适应的,所以可以同时确保输入和输出不变,逻辑本身在绝大多数情况下是不需要考虑流批环境变化。 下面介绍一个 PyFlink 典型的使用流程,首先选择触发流,编写取数及预处理逻辑,可引入已发布的取数或处理逻辑代码,设置取样逻辑并试运行,获取试运行结果,在分析平台中进一步分析与训练。训练结束想要发布模型时,可在作业中选择训练完成的模型,如有需要可以设置初始化相关参数。最后是模型发布上线。 四、模型策略调用方案 我们提供了四种调用方案: 特征存储服务方案。Flink 作业进行预运算,将运算结果写入特征存储服务平台,通过该数据服务平台对外服务。 接口触发——轮询方案。调用并轮询事件中心消息转发接口,直到 Flink 作业返回运算结果。 接口触发——消息接收方案。调用事件中心消息转发接口触发 Flink 作业运算,接收 Flink 作业返回的运算结果消息。 直接消息接收方案。直接接收 Flink 作业返回的运算结果消息。 4.1 特征存储服务方案 特征存储服务分为三种情况,分别是实时、离线修正和离线初始化。当有新的变量上线或者老的变量发生逻辑变化,需要对全量的数据进行一次刷新,这时候需要离线初始化。实时流是实时触发的,离线修正和离线初始化都是批量触发。如果有取数逻辑则从 HBase 里面取数,当然取数的过程中实时和离线的作业肯定不一样,但是开发人员不用关注,因为已经封装好了。实时的 Flink 作业结果会发到 Kafka,离线修正和离线初始化的结果都会进 EMR,最后写进特征存储,也就是 HBase 和 Clickhouse。 上图展示了特征存储服务方案的时序,Kafka 触发了 Flink,然后Flink运算完写如特征存储。那么在刚触发的时候,如果有外部调用,是无法获取到最新的数据的,必须要等到运算完成写入存储以后才能获取到更新的数据。 4.2 接口触发——轮询方案 在接口触发——轮询方案中,触发调用会触发到消息转发,转发给 Kafka,然后 Flink 将运算的结果吐入 Kafka。如果这个时候没有超过单次请求的时间,就会直接返回,这个时候触发轮询就退化成单词调用了。反之,则会继续进入事件存储 HBase,通过轮询调用获取结果。 接口触发——轮询方案的时序图如上图所示,当有一个外部调用触发以后,会有一个消息转发触发了 Flink 运算。在 Flink 运算及写入数据库的过程中,会有多次轮询,如果在固定的时间还没有办法获取到,则会提示超时;如果下一次轮询的时候,数据已经写入了,则获取成功。 4.3 接口触发——消息接收方案 接口触发——消息接收方案是对轮训的简化。如果业务系统支持支持消息接收,那么整个链路变得比较简单,只需要通过消息转发服务触发计算,然后监听结果消息就可以了。 接口触发——消息接收方案的时序是串行的。触发了以后,进行 Flink 运算,运算完成以后把结果数据通过消息接收机制传输给调用方。 4.4 直接消息接收方案 直接消息接收方案就是纯流式的,通过 Kafka 触发 Flink 计算,计算完数据传入消息队列,然后等对方订阅接收就可以了。整个时序也是非常的简单,如下图所示。 我们把数据的使用情况分成三种,分别是即时调用、实时流、离线批数据,他们的时效性是依次递减的。我们通过事件中心把这三种情况注册到一起,最后只要通过事件中心作为中转给 Flink 提供相关的数据,对于 Flink 来说,不用关心到底是通过哪种方式来调用。 最后,总结下流、批、调用一体化的四种方案: 特征存储服务方案:通过特征存储服务,提供持久化的特征存储。提供 API 点查与特征圈选服务。 接口触发——轮询方案:通过事件中心的消息转发与消息查询服务,提供同步调用计算服务。 接口触发——消息接收方案:通过事件中心的消息转发服务,提供事件消息服务。 直接消息接收方案: 支持复杂事件触发,提供事件消息服务。 点击查看更多技术内容

优秀的个人博客,低调大师

每日一博 | 超详细的 Angular 国际化方案

第一次在 Angular 框架上落地国际化方案,将 Eoapi 的经验分享给大家~ 1. 项目背景 需要支持 Web 和 Electron 桌面端 技术栈 Angular 14 Electron 19 NG-ZORR 13.0.6 2. 可能遇到的困难 各语言下样式不统一,例如阿拉伯文字展示从右到左,英文比中文长等等 变量本地化,例如初始化 API 数据、日志、时间戳、金额等单位 翻译成本高 协作流程复杂 技术标准的制定、落地 3. 调研 3.1 结论 先上表格看结论,满分三颗星,最终选定 I18n 方案。 一直在运行时语言包和编译手段两种方案徘徊,最后还是选定了使用 I18n 方案,有以下几点考虑: 对代码侵入性低,不影响现有开发模式 方案成熟,经过 angular 团队/社区验证,提前考虑到了各种条件 生成的文件 xlf 遵循国际规范 XLIFF,较通用,即使技术变迁,语言包仍通用 虽然无法支持同一个 URL 动态切换语言包,多套代码方案在桌面端实现不常规(可能需要把各种语言的安装包打进去),但考虑需求上切换语言包是一个超低频的操作以及使用编译手段可以提高良好的开发体验,还是为 i18n 方案所折服。 其实无论是运行时方案和编译手段,只要官方支持,完全可以实现相互转换,期待后续 Angular 支持将语言包反向编译成代码后支持动态切换语言包,那就是我理想中的完美方案了。 3.2 分析 3.2.1 在线翻译 API切换语言包的时候再调用 OpenAPI 翻译当前页面,类似于 google 翻译。 实现难度一般,只要实现了此工具,可以兼容各种语言。 翻译 API 不一定稳定,同时免费的有次数限制,适合表达精确度要求不高,需要支持多语言的静态页。 3.2.2 自研语言编译器 使用编译手段提取,例如识别到代码中的中文,提取出来成为语言包,打包的时候 感兴趣可以看这篇,原理类似:https://juejin.cn/post/6844904042489970695#heading-3 不改变原有开发的模式,没有学习成本。 对代码有一定的侵入性,同时针对不同母语的代码有不同的语言匹配规则。 自研的实现成本较高,可能无法配合市面上热门翻译平台打通流程,工具生态成熟需要时间沉淀。 3.2.3 Angular I18n 方案https://angular.cn/guide/i18n-overview 和自研编译提取语言文本类似,使用一些标识符标记哪些字段需要翻译,同时提供一些额外的附加规则,例如同词不同含义的标记。 较为成熟,代码侵入性低,有一定的开发学习成本。 官方文档推荐的实践都是不同的语言包打包成不同的代码,然后通过 nginx 映射到不同的代码,这适合 web,但在桌面端实现比较麻烦,无法动态加载文件。 理想情况是 angular 方案下支持一套代码加载语言包的国际化方案(one bundle for all languages),官方关于动态切换语言包的讨论: https://github.com/angular/angular/issues/24549#issuecomment-398371120 https://github.com/angular/angular/issues/38953#issuecomment-862492065 截至本方案完成,Angular 只支持打包成多种语言包文件,动态切换语言包目前处于提案通过阶段,未来可期。 3.2.4 运行时语言包 支持 Angular 的方案有: http://www.ngx-translate.com/ https://ngneat.github.io/transloco/docs/translation-in-the-template https://github.com/lokalise/i18n-ally 我认为这种方案最大的问题是开发体验较差,虽然很多工具可以使用 VSCode 插件显示【默认语言文本】抹平差异,但源码仍然是各种变量。 其次是切换语言包是一个低频操作,一般用户长期只会选择一种语言包,运行时方案也会增加不必要的内存占用(当然你要说可以忽略不计那我也不和你辩,算你赢)。 3.2.5 多套代码 没什么技术难点,同步成本高,灵活性高。 4. 技术实现 以下代码配置的源码都在这个仓库,有需要可以拉下来部署看看具体效果。 https://github.com/eolinker/eoapi 国际化主要分为几个流程: 4.1 语言包 4.1.1 语言包配置 4.1.1.1 命令行配置 使用 angular 提供的指令 ng extract-i18n ,同时制定语言包生成的目录 src/locale ng extract-i18n --output-path src/locale 运行后就会生成一个默认语言包 message.xlf 建议使用如下 npm 命令封装,运行 npm run lang:gen 即可生成语言包文件 "scripts": { "lang:gen": "ng extract-i18n --output-path src/locale", .... **4.1.1.2 angular.json ** 配置想要加其他语言包,从默认语言包 message.xlf 复制一个文件,然后配置一下就可以支持多语言。 文件名语言 ID 命名请参考(en-US、zh-Hans) 在 angular.json 中告诉构建工具你语言包叫啥,位置在哪 { ... "projects": { "eoapi": { ... "i18n": { "sourceLocale": "zh-Hans",//中文语言包 "locales": { "en-US": "src/locale/messages.en-US.xlf"//英文语言包 } }, 4.1.1.3 Ant-Design 配置 https://ng.ant.design/docs/i18n/zh /** 导入需要使用的语言包 **/ import { LOCALE_ID } from '@angular/core'; import { registerLocaleData } from '@angular/common'; import en from '@angular/common/locales/en'; import zh from '@angular/common/locales/zh'; registerLocaleData(en); registerLocaleData(zh); /** 配置 ng-zorro-antd 国际化 **/ import { en_US, NZ_I18N, zh_CN } from 'ng-zorro-antd/i18n'; ... { provide: NZ_I18N, useFactory: (localId: string) => { switch (localId) { case 'zh': return zh_CN; default: return en_US; } }, deps: [LOCALE_ID], } 4.1.2 调试 官方原话:由于 i18n 的部署复杂性和最小化重建时间的需要,开发服务器一次仅支持本地化单个语言环境 我来翻译一下:你这需求也不常见,实现太麻烦了,你调试麻烦点就麻烦点吧,构建时间多快呀,我是为你好。 总而言之就是 Angular 调试时只会支持一种语言包,同时意味着你没法直接运行时测试切换语言包的效果(当然可以通过运行两个服务间接实现),关系不大。 你可以使用下面两种配置进行调试: 调试时可以通过设置 "localize":false 在调试时禁用本地化 "architect": { "build": { "builder": "@angular-builders/custom-webpack:browser", "options": { "localize":false, "aot":true,//本地化一定要开启 AOT ... angular.json指定使用某种语言包 { ... "projects": { "eoapi": { ... "architect": { "build": { "options": { "localize":true,//开启本地化 "aot": true, ... }, "configurations": { "web": { //指定某个运行环境下的语言包,传入上面 i18n 定义的语言包名称 "localize": ["zh-Hans"], ... } } }, "serve": { ... "configurations": { "web": { "browserTarget": "eoapi:build:web" } ... 运行时使用命令制定使用 --configuration web 即可 ng serve -c web -o 4.1.3 构建 Angular i18n 方案会打包成两个文件夹,所以需要注意资源在代码里面的相对地址。 4.1.3.1 web 和之前区别不大,主要是通过 index.html 里面的 <base> 标签来指定基础路径,打包后的代码结果如图: 英语语言包的 href="en-US" !DOCTYPE html><html lang="en-US" dir="ltr"><head> <meta charset="utf-8"> <title>Eoapi</title> <base href="/en-US/"> <meta name="viewport" content="width=device-width, initial-scale=1"> <script src="https://lf1-cdn-tos.bytegoofy.com/obj/iconpark/icons_12799_18.e98aaa4d03d4378a3a2c18bfd1670872.js"></script> ... 4.1.3.2 桌面端 Electron 启动需要指定语言 https://github.com/electron/electron/issues/5649 桌面端使用 file 协议,需要将 base href 改成相对路径 ./。 即使使用 ng build --base-href ./,打包后还是会自动在 href 前加语言标识 <base href="./en-US/"> 所以需要在 angular.json 18n 指定 baseHref 为空字符串 "projects": { "eoapi": { "root": "", "i18n": { "sourceLocale": { "code": "zh-Hans", "baseHref": ""//. }, "locales": { "en-US": { "baseHref": "", "translation": "src/locale/messages.en-US.xlf" } } }, 4.1.3.3 Build.js 命令 一般情况下 Angular 框架会帮我们处理好,但是我们产品涉及到 Web 和桌面端,有两套打包逻辑,所以使用了 Node 脚本去执行 Build 命令,在执行 ng build 命令前修改 angular.json 文件。 //change angular.json const fs = require('fs'); const { execSync } = require('child_process'); class webPlatformBuilder { resetBuildConfig(json) { delete json.projects.eoapi.i18n.sourceLocale.baseHref; Object.keys(json.projects.eoapi.i18n.locales).forEach((val) => { delete json.projects.eoapi.i18n.locales[val].baseHref; }); return json; } executeBuild() { execSync('ng build -c production', { stdio: 'inherit' }); } } class appPlatformBuilder { resetBuildConfig(json) { ... } executeBuild() { ... } } class PlatformBuilder { constructor(platForm) { switch (platForm) { case 'web': { this.instance = new webPlatformBuilder(); break; } case 'app': { this.instance = new appPlatformBuilder(); break; } } } build() { const filePath = '../angular.json'; let buildConfigJson = require(filePath); buildConfigJson = this.instance.resetBuildConfig(buildConfigJson); let that=this; fs.writeFile(filePath, JSON.stringify(buildConfigJson), function (err) { if (err) { console.error('build/beforeBuild.js:', err); } that.instance.executeBuild(); }); } } 4.1.4 部署 4.1.4.1 Vercel vercel 不支持多项目配置,所以只能重定向到固定 Language 而不是用户配置的 Language。 { "rewrites": [ { "source": "/:path((?!en/).*)", "destination": "/en/:path*" }, { "source": "/:path((?!zh/).*)", "destination": "/zh/:path*" } ] } 这个方案表现还是不好,拿不到一些初始化的路由信息,所以我手动写了个脚本生产空白 HTML,再手动重定向到相应位置。 fs.writeFile( './dist/index.html', `<!DOCTYPE html> <html> <head> <meta charset="utf-8" /> <title>Eoapi - Easy &amp; Open Source API Ecosystem</title> <script> let lang=window.location.href.includes("/en")?'en':'zh'; try{ lang=JSON.parse(window.localStorage.getItem("LOCAL_SETTINGS_KEY"))["eoapi-language"]=='en-US'?'en':'zh'; }catch(e){ } let baseDir="/"+lang+'/' let search={}; if(window.location.search){ window.location.href=baseDir+window.location.search; }else{ window.location.href=baseDir; } </script> </head> <body></body> </html> `, () => {} ); 4.1.4.2 Nginx 如果使用 Nginx 部署,可以按照官方提供的文件配置。 https://angular.cn/guide/i18n-common-deploy#configure-a-server 4.2 翻译流程工具调研 https://github.com/alibaba/kiwi https://github.com/mozilla/pontoon/(开源) https://www.volcengine.com/product/i18ntranslate 4.2.1 Poeditor https://poeditor.com 免费,体验一般,数据没有丢失,协作流程不够清晰,自动翻译用不了 4.2.2 Crowdin(electron 官方使用) https://zh.crowdin.com/ 体验好,协作清晰,但未来可能付费 5. 结语 整个 Angular 落地国际化的方案讲完了,国际化不止涉及到技术实现,还包括翻译协作流程,如图是一个常见的翻译流程: 以及整个技术团队的国际化技术规范,毕竟翻译不止涉及到 UI,还有各种时间数据储存的格式等等数据规范。 感谢你的阅读,上面实践都落地到开源项目 Eoapi,欢迎关注~[在线体验功能] (https://www.eoapi.io/?utm_source=OS0903) Github:https://github.com/eolinker/eoapi Gitee: https://gitee.com/eolink_admin/eoapi 6. 资料 Angular 项目 国际化方案设计以人为本的国际化(i18n) 工程方案 国际化与本地化 前端国际化 Angular internationalization (i18n) tutorial - Localizely https://cloud.tencent.com/developer/section/1489559 Taobao FED | 淘系前端团队

优秀的个人博客,低调大师

每日一博 | Lepton 无损压缩原理及性能分析

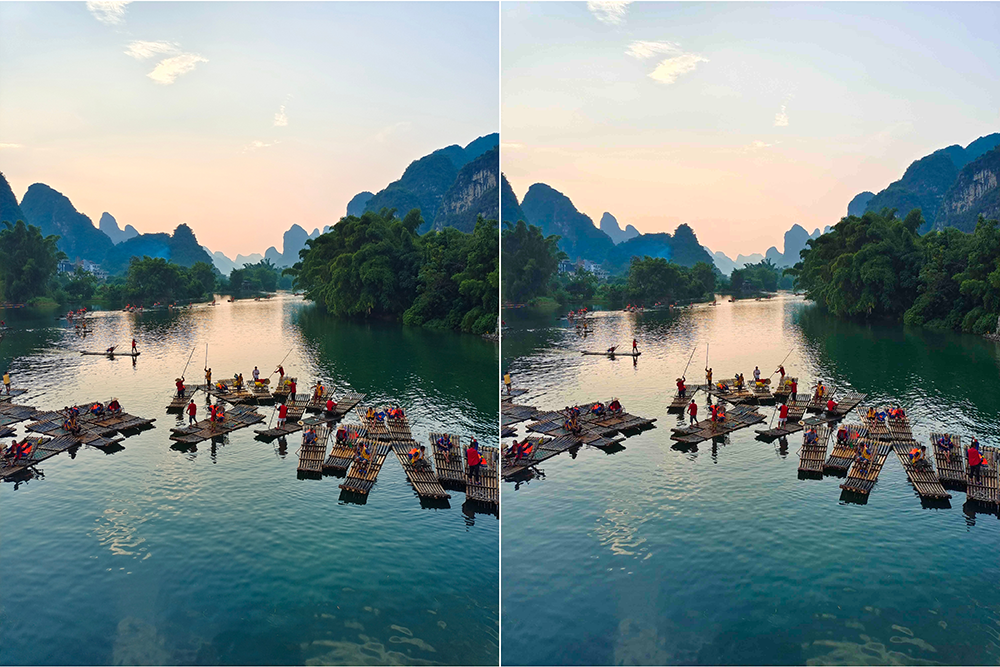
作者:vivo 互联网数据库团队- Li Shihai 本文主要介绍无损压缩图片的概要流程和原理,以及Lepton无损压缩在前期调研中发现的问题和解决方案。 一、从一个游戏开始 1.1 游戏找茬 请拿出你的秒表计时,在15秒时间内找出下面图片的差异。 时间到了,你发现两张图片的差异了吗? 二、智者的成长 在上面的游戏中,你可能你并没有发现两张图片间有任何差异,而实际上它们一张是3.7MB的jpg格式的原图,另外一张是大小为485KB的jpg格式压缩图片,只是大小不同。你可能会有些生气,愤愤不平到这是欺骗,然而聪明的你很快在大脑中产生了一连串的疑问,这些问号让你层层揭开游戏的面纱,不在为愚弄而悔恨,反而从新知中获得快乐。 2.1 苏格拉底助产术 上面图片为何变小了呢? 丢失了的信息去哪了呢? 为什么图片质量下降了,我却看不出来呢? 我还能将它变的更小吗? 我能将它还原成原来的大小吗? 为什么要压缩我的图片? 上面图片为何变小了?图片从3.7MB变成485KB是因为我使用了图片查看工具将原图另存成一张新的图片,在另存的过程中,有一个图片质量选择的参数,我选择了质量最低,保存后便生成了一张更小的图片。可是图片质量下降了,为什么看不出来呢?这就需要了解图片压缩的原理。 2.2 探求表象背后的故事 利用人眼的弱点。 人的视网膜上有两种细胞,视锥细胞和视杆细胞。视锥细胞用来感知颜色,视杆细胞用来感知亮度。而相对于颜色,我们对明暗的感知更明显。 因此可以采取对颜色信息进行压缩来减小图片的大小。 所以我们在图片压缩前会进行颜色空间的变换,JPEG图片通常会变换成YCbCr颜色空间,Y代表亮度,Cb蓝色色彩度,Cr红色色彩度,变换后我们更容易处理色彩部分。然后我们将一张图片切成一块块8*8的像素块,然后使用离散余弦转换算法(DCT)计算出高频区和低频区。 由于人眼对高频区的复杂信息不敏感,因此可以对这一部分进行压缩,这个过程叫量化。最后再将新的文件进行打包。这个流程下来就完成了图片的压缩。 基本流程如下图: JPEG压缩有损。 在上面的流程中,在预测模块的颜色空间转换后,通过舍弃部分颜色浓度信息,提高压缩率。常见选项为4:2:0,经过这一步后原来需要8个数字表示的信息,现在只需要2个,直接抛弃了75%的Cb Cr信息,然而这一步骤是不可逆的,也就造成了图片压缩的有损。此外在熵编码模块,会进一步使用行程长度编码或Huffman编码进一步对图片信息进行压缩,而这一部分的压缩是无损的,是可逆的。 (YCbCr空间转换) 霍夫曼编码原理如下: 假如待编码的字符总共38个符号数据,对其进行统计,得到的符号和对应频度如下表: 首先,对所有符号按照频数大小排序,排序后如下图: 然后,选择两个频数最小的作为叶子节点,频数最小的作为左子节点,另外一个作为右子节点,根节点为两个叶子节点的频数之和。 (Huffman 树) 经过上面的步骤,就形成了一颗Huffman树,Huffman编码经常用在无损压缩中,其基本思想是用短的编码表示出现频率高的字符,用长的编码来表示出现频率低的字符,这使得编码之后的字符串的平均长度、长度的期望值降低,从而实现压缩的目的。 三、故事的主角 Lepton 不完美。 上面的JPEG压缩虽然降低了图片的大小且质量良好以至于人眼很难分辨其差异,但是由于是有损的压缩,图片质量不能恢复到原来的品质,而且实际上此时的jpg图片仍有压缩空间。 Lepton便可以在JPEG基础上进一步对图片进行无损压缩。 3.1 为什么选择 Lepton 与lepton类似的压缩工具还有jpegcan,MozJPEG,PackJPG,PAQ8PX。但这些工具都或多或少有一些缺陷,使得不如lepton更加适合工业生产。 比如PackJPG需要按照全局排序的顺序重新排列文件中的所有压缩像素值。这意味着解压缩是单线程的,同时需要整个图像放入内存中导致处理图片的时延较高吞吐较低。 下图是lepton论文中对几款工具的比较: 3.2 Lepton进行了哪些优化。 首先在算法上Lepton将图像分为两部分header和图片数据本身,header使用DEFLATE进行无损压缩,图片本身使用算数编码替换霍尔曼编码进行无损压缩。由于JPEG使用Huffman编码,这使得利用多线程比较困难,Lepton使用"Huffman切换词"进行了改进。 其次Lepton使用了一个复杂的自适应概率模型,这个模型是通过在大量的野外图像上进行测试而开发的。该模型的目标是对每个系数的值产生最准确的预测,从而产生更小的文件;在工程上允许多线程并发处理,允许分块跨多个服务器分布式处理,流的方式逐行处理有效的控制了内存,同时还保证了数据读取和输出的安全。 正是Lepton在上述关键问题的优化,使得它目前可以很好的在生产环境中使用。 3.3 Lepton在vivo存储中的探索 预期收益: 目前对象存储其中的一个集群大约有100PB数据,其中图片数据大概占70%, 而图片中有90%的图片都是jpeg类型图片,如果按照平均23%的压缩率,那么 100PB * 70% * 90% * 23% = 14.5PB,将实现大约14.5PB的成本节约。 同时由于是无损压缩,很好的保证了用户的使用体验。当前lepton压缩功能的设计如下图: 当前遇到的挑战: lepton压缩与解压缩对服务器的计算性能要求较高、消耗较大。 期望充分利用空闲服务器CPU资源,达到降本增效的目的。 面对潮汐现象具备动态扩缩容的能力。 当前面临的主要问题: 当前大部分图片的大小在4M-5M, 经过测试对于4M-5M大小的文件压缩时延在1s左右的情况下,需要服务器至少16核心、承载5QPS。此时每个核心的利用率都在95%以上。可见 Lepton的压缩对计算性能要求很高。当前常见的解决方案是使用FPGA卡进行硬件加速、以及横向扩容大量的计算节点。FPGA的使用会增加硬件成本,降低压缩带来的成本收益。 解决方案: 为了解决上述问题及挑战,我们尝试采用物理服务器和Kubernetes混合部署的方式解决计算资源的使用和动态扩所容的问题,架构示意图如下: 对于物理服务器的管理以及扩所容通过服务的注册于发现进行弹性扩所容、通过此cgroup/Taskset等方式对进程的cpu使用进行管理。同时对接使用Kubernetes以容器的方式进行管理、容器的灵活性更加适合这种计算型的服务。 3.4 性能评测 无论是同步压缩,还是异步压缩,通常更加关注图片读取的延时。大量的图片读取会给服务器带来较大的压力,压力主要来自于图片的解压计算。为了提高解压缩效率,以及充分利用公司的资源,我们未来将lepton压缩服务以独立的服务模式分布于cpu空闲的服务器,可以按照资源空闲程度,空闲时间,充分利用资源的峰谷来提高计算性能。 压测数据: 我们选取了不同大小的图片文件,在单机环境下进行了压缩与解压缩测试,测试结果如下图: 压缩比平均保持在22%左右。 上图是不同大小的文件压缩与解压缩时间比例图,橙色是解压时间,蓝色是压缩时间。 上图是不同大小的图片,在32线程并发,每个线程处理100个文件的测试数据。 四、图片压缩的常见问题 4.1 通过文件格式区分有损和无损压缩 4.2 常见的无损压缩算法 五、 总结 Lepton的无损压缩能够提供比较高的压缩比,同时不影响用户的图片质量和使用体验、在大数据量的场景下会获得比较明显的收益。 不足之处是对计算性能要求较高、只支持jpeg类型的图片。对于性能的要求行业内也都有比较成熟的解决方案,例如上文提到的FPGA和弹性计算方案。关键在于根据企业需求选择合理的方案。 引用: 《The Design, Implementation, and Deployment of a System to Transparently Compress Hundreds of Petabytes of Image Files For a File-Storage Service》 《基于深度学习的JPEG图像云存储研究》 《JPEG-Lepton压缩技术关键模块VLSI结构设计研究》

优秀的个人博客,低调大师

每日一博 | 源码学习之 MyBatis 的底层查询原理

导读 本文通过MyBatis一个低版本的bug(3.4.5之前的版本)入手,分析MyBatis的一次完整的查询流程,从配置文件的解析到一个查询的完整执行过程详细解读MyBatis的一次查询流程,通过本文可以详细了解MyBatis的一次查询过程。在平时的代码编写中,发现了MyBatis一个低版本的bug(3.4.5之前的版本),由于现在很多工程中的版本都是低于3.4.5的,因此在这里用一个简单的例子复现问题,并且从源码角度分析MyBatis一次查询的流程,让大家了解MyBatis的查询原理。 1 问题现象 1.1 场景问题复现 如下图所示,在示例Mapper中,下面提供了一个方法queryStudents,从student表中查询出符合查询条件的数据,入参可以为student_name或者student_name的集合,示例中参数只传入的是studentName的List集合 List<String> studentNames = new LinkedList<>(); studentNames.add("lct"); studentNames.add("lct2"); condition.setStudentNames(studentNames); <select id="queryStudents" parameterType="mybatis.StudentCondition" resultMap="resultMap"> select * from student <where> <if test="studentNames != null and studentNames.size > 0 "> AND student_name IN <foreach collection="studentNames" item="studentName" open="(" separator="," close=")"> #{studentName, jdbcType=VARCHAR} </foreach> </if> <if test="studentName != null and studentName != '' "> AND student_name = #{studentName, jdbcType=VARCHAR} </if> </where> </select> 期望运行的结果是 select * from student WHERE student_name IN ( 'lct' , 'lct2' ) 但是实际上运行的结果是 ==> Preparing: select * from student WHERE student_name IN ( ? , ? ) AND student_name = ? ==> Parameters: lct(String), lct2(String), lct2(String) <== Columns: id, student_name, age <== Row: 2, lct2, 2 <== Total: 1 通过运行结果可以看到,没有给student_name单独赋值,但是经过MyBatis解析以后,单独给student_name赋值了一个值,可以推断出MyBatis在解析SQL并对变量赋值的时候是有问题的,初步猜测是foreach循环中的变量的值带到了foreach外边,导致SQL解析出现异常,下面通过源码进行分析验证 2 MyBatis查询原理 2.1 MyBatis架构 2.1.1 架构图 先简单来看看MyBatis整体上的架构模型,从整体上看MyBatis主要分为四大模块: 接口层:主要作用就是和数据库打交道 数据处理层:数据处理层可以说是MyBatis的核心,它要完成两个功能: 通过传入参数构建动态SQL语句; SQL语句的执行以及封装查询结果集成List<E> 框架支撑层:主要有事务管理、连接池管理、缓存机制和SQL语句的配置方式 引导层:引导层是配置和启动MyBatis 配置信息的方式。MyBatis 提供两种方式来引导MyBatis :基于XML配置文件的方式和基于Java API 的方式 2.1.2 MyBatis四大对象 贯穿MyBatis整个框架的有四大核心对象,ParameterHandler、ResultSetHandler、StatementHandler和Executor,四大对象贯穿了整个框架的执行过程,四大对象的主要作用为: ParameterHandler:设置预编译参数 ResultSetHandler:处理SQL的返回结果集 StatementHandler:处理sql语句预编译,设置参数等相关工作 Executor:MyBatis的执行器,用于执行增删改查操作 2.2 从源码解读MyBatis的一次查询过程 首先给出复现问题的代码以及相应的准备过程 2.2.1 数据准备 CREATE TABLE `student` ( `id` bigint(20) NOT NULL AUTO_INCREMENT, `student_name` varchar(255) NULL DEFAULT NULL, `age` int(11) NULL DEFAULT NULL, PRIMARY KEY (`id`) USING BTREE ) ENGINE = InnoDB AUTO_INCREMENT = 1; -- ---------------------------- -- Records of student -- ---------------------------- INSERT INTO `student` VALUES (1, 'lct', 1); INSERT INTO `student` VALUES (2, 'lct2', 2); 2.2.2 代码准备 1.mapper配置文件 <?xml version="1.0" encoding="UTF-8"?> <!DOCTYPE mapper PUBLIC "-//mybatis.org//DTD Mapper 3.0//EN" "http://mybatis.org/dtd/mybatis-3-mapper.dtd" > <mapper namespace="mybatis.StudentDao"> <!-- 映射关系 --> <resultMap id="resultMap" type="mybatis.Student"> <id column="id" property="id" jdbcType="BIGINT" /> <result column="student_name" property="studentName" jdbcType="VARCHAR" /> <result column="age" property="age" jdbcType="INTEGER" /> </resultMap> <select id="queryStudents" parameterType="mybatis.StudentCondition" resultMap="resultMap"> select * from student <where> <if test="studentNames != null and studentNames.size > 0 "> AND student_name IN <foreach collection="studentNames" item="studentName" open="(" separator="," close=")"> #{studentName, jdbcType=VARCHAR} </foreach> </if> <if test="studentName != null and studentName != '' "> AND student_name = #{studentName, jdbcType=VARCHAR} </if> </where> </select> </mapper> 2.示例代码 public static void main(String[] args) throws IOException { String resource = "mybatis-config.xml"; InputStream inputStream = Resources.getResourceAsStream(resource); //1.获取SqlSessionFactory对象 SqlSessionFactory sqlSessionFactory = new SqlSessionFactoryBuilder().build(inputStream); //2.获取对象 SqlSession sqlSession = sqlSessionFactory.openSession(); //3.获取接口的代理类对象 StudentDao mapper = sqlSession.getMapper(StudentDao.class); StudentCondition condition = new StudentCondition(); List<String> studentNames = new LinkedList<>(); studentNames.add("lct"); studentNames.add("lct2"); condition.setStudentNames(studentNames); //执行方法 List<Student> students = mapper.queryStudents(condition); } 2.2.3 查询过程分析 1.SqlSessionFactory的构建 先看SqlSessionFactory的对象的创建过程 //1.获取SqlSessionFactory对象 SqlSessionFactory sqlSessionFactory = new SqlSessionFactoryBuilder().build(inputStream); 代码中首先通过调用SqlSessionFactoryBuilder中的build方法来获取对象,进入build方法 public SqlSessionFactory build(InputStream inputStream) { return build(inputStream, null, null); } 调用自身的build方法 图1 build方法自身调用调试图例 在这个方法里会创建一个XMLConfigBuilder的对象,用来解析传入的MyBatis的配置文件,然后调用parse方法进行解析 图2 parse解析入参调试图例 在这个方法中,会从MyBatis的配置文件的根目录中获取xml的内容,其中parser这个对象是一个XPathParser的对象,这个是专门用来解析xml文件的,具体怎么从xml文件中获取到各个节点这里不再进行讲解。这里可以看到解析配置文件是从configuration这个节点开始的,在MyBatis的配置文件中这个节点也是根节点 <?xml version="1.0" encoding="UTF-8" ?> <!DOCTYPE configuration PUBLIC "-//mybatis.org//DTD Config 3.0//EN" "http://mybatis.org/dtd/mybatis-3-config.dtd"> <configuration> <properties> <property name="dialect" value="MYSQL" /> <!-- SQL方言 --> </properties> 然后将解析好的xml文件传入parseConfiguration方法中,在这个方法中会获取在配置文件中的各个节点的配置 图3 解析配置调试图例 以获取mappers节点的配置来看具体的解析过程 <mappers> <mapper resource="mappers/StudentMapper.xml"/> </mappers> 进入mapperElement方法 mapperElement(root.evalNode("mappers")); 图4 mapperElement方法调试图例 看到MyBatis还是通过创建一个XMLMapperBuilder对象来对mappers节点进行解析,在parse方法中 public void parse() { if (!configuration.isResourceLoaded(resource)) { configurationElement(parser.evalNode("/mapper")); configuration.addLoadedResource(resource); bindMapperForNamespace(); } parsePendingResultMaps(); parsePendingCacheRefs(); parsePendingStatements(); } 通过调用configurationElement方法来解析配置的每一个mapper文件 private void configurationElement(XNode context) { try { String namespace = context.getStringAttribute("namespace"); if (namespace == null || namespace.equals("")) { throw new BuilderException("Mapper's namespace cannot be empty"); } builderAssistant.setCurrentNamespace(namespace); cacheRefElement(context.evalNode("cache-ref")); cacheElement(context.evalNode("cache")); parameterMapElement(context.evalNodes("/mapper/parameterMap")); resultMapElements(context.evalNodes("/mapper/resultMap")); sqlElement(context.evalNodes("/mapper/sql")); buildStatementFromContext(context.evalNodes("select|insert|update|delete")); } catch (Exception e) { throw new BuilderException("Error parsing Mapper XML. Cause: " + e, e); } } 以解析mapper中的增删改查的标签来看看是如何解析一个mapper文件的 进入buildStatementFromContext方法 private void buildStatementFromContext(List<XNode> list, String requiredDatabaseId) { for (XNode context : list) { final XMLStatementBuilder statementParser = new XMLStatementBuilder(configuration, builderAssistant, context, requiredDatabaseId); try { statementParser.parseStatementNode(); } catch (IncompleteElementException e) { configuration.addIncompleteStatement(statementParser); } } } 可以看到MyBatis还是通过创建一个XMLStatementBuilder对象来对增删改查节点进行解析,通过调用这个对象的parseStatementNode方法,在这个方法里会获取到配置在这个标签下的所有配置信息,然后进行设置 图5 parseStatementNode方法调试图例 解析完成以后,通过方法addMappedStatement将所有的配置都添加到一个MappedStatement中去,然后再将mappedstatement添加到configuration中去 builderAssistant.addMappedStatement(id, sqlSource, statementType, sqlCommandType, fetchSize, timeout, parameterMap, parameterTypeClass, resultMap, resultTypeClass, resultSetTypeEnum, flushCache, useCache, resultOrdered, keyGenerator, keyProperty, keyColumn, databaseId, langDriver, resultSets); 可以看到一个mappedstatement中包含了一个增删改查标签的详细信息 图7 mappedstatement对象方法调试图例 而一个configuration就包含了所有的配置信息,其中mapperRegistertry和mappedStatements 图8 config对象方法调试图例 具体的流程 图9 SqlSessionFactory对象的构建过程 图9 SqlSessionFactory对象的构建过程 2.SqlSession的创建过程 SqlSessionFactory创建完成以后,接下来看看SqlSession的创建过程 SqlSession sqlSession = sqlSessionFactory.openSession(); 首先会调用DefaultSqlSessionFactory的openSessionFromDataSource方法 @Override public SqlSession openSession() { return openSessionFromDataSource(configuration.getDefaultExecutorType(), null, false); } 在这个方法中,首先会从configuration中获取DataSource等属性组成对象Environment,利用Environment内的属性构建一个事务对象TransactionFactory private SqlSession openSessionFromDataSource(ExecutorType execType, TransactionIsolationLevel level, boolean autoCommit) { Transaction tx = null; try { final Environment environment = configuration.getEnvironment(); final TransactionFactory transactionFactory = getTransactionFactoryFromEnvironment(environment); tx = transactionFactory.newTransaction(environment.getDataSource(), level, autoCommit); final Executor executor = configuration.newExecutor(tx, execType); return new DefaultSqlSession(configuration, executor, autoCommit); } catch (Exception e) { closeTransaction(tx); // may have fetched a connection so lets call close() throw ExceptionFactory.wrapException("Error opening session. Cause: " + e, e); } finally { ErrorContext.instance().reset(); } } 事务创建完成以后开始创建Executor对象,Executor对象的创建是根据 executorType创建的,默认是SIMPLE类型的,没有配置的情况下创建了SimpleExecutor,如果开启二级缓存的话,则会创建CachingExecutor public Executor newExecutor(Transaction transaction, ExecutorType executorType) { executorType = executorType == null ? defaultExecutorType : executorType; executorType = executorType == null ? ExecutorType.SIMPLE : executorType; Executor executor; if (ExecutorType.BATCH == executorType) { executor = new BatchExecutor(this, transaction); } else if (ExecutorType.REUSE == executorType) { executor = new ReuseExecutor(this, transaction); } else { executor = new SimpleExecutor(this, transaction); } if (cacheEnabled) { executor = new CachingExecutor(executor); } executor = (Executor) interceptorChain.pluginAll(executor); return executor; } 创建executor以后,会执行executor = (Executor) interceptorChain.pluginAll(executor)方法,这个方法对应的含义是使用每一个拦截器包装并返回executor,最后调用DefaultSqlSession方法创建SqlSession 图10 SqlSession对象的创建过程 3.Mapper的获取过程 有了SqlSessionFactory和SqlSession以后,就需要获取对应的Mapper,并执行mapper中的方法 StudentDao mapper = sqlSession.getMapper(StudentDao.class); 在第一步中知道所有的mapper都放在MapperRegistry这个对象中,因此通过调用 org.apache.ibatis.binding.MapperRegistry#getMapper方法来获取对应的mapper public <T> T getMapper(Class<T> type, SqlSession sqlSession) { final MapperProxyFactory<T> mapperProxyFactory = (MapperProxyFactory<T>) knownMappers.get(type); if (mapperProxyFactory == null) { throw new BindingException("Type " + type + " is not known to the MapperRegistry."); } try { return mapperProxyFactory.newInstance(sqlSession); } catch (Exception e) { throw new BindingException("Error getting mapper instance. Cause: " + e, e); } } 在MyBatis中,所有的mapper对应的都是一个代理类,获取到mapper对应的代理类以后执行newInstance方法,获取到对应的实例,这样就可以通过这个实例进行方法的调用 public class MapperProxyFactory<T> { private final Class<T> mapperInterface; private final Map<Method, MapperMethod> methodCache = new ConcurrentHashMap<Method, MapperMethod>(); public MapperProxyFactory(Class<T> mapperInterface) { this.mapperInterface = mapperInterface; } public Class<T> getMapperInterface() { return mapperInterface; } public Map<Method, MapperMethod> getMethodCache() { return methodCache; } @SuppressWarnings("unchecked") protected T newInstance(MapperProxy<T> mapperProxy) { return (T) Proxy.newProxyInstance(mapperInterface.getClassLoader(), new Class[] { mapperInterface }, mapperProxy); } public T newInstance(SqlSession sqlSession) { final MapperProxy<T> mapperProxy = new MapperProxy<T>(sqlSession, mapperInterface, methodCache); return newInstance(mapperProxy); } } 获取mapper的流程为 图11 Mapper的获取过程 4.查询过程 获取到mapper以后,就可以调用具体的方法 //执行方法 List<Student> students = mapper.queryStudents(condition); 首先会调用 org.apache.ibatis.binding.MapperProxy#invoke的方法,在这个方法中,会调用org.apache.ibatis.binding.MapperMethod#execute public Object execute(SqlSession sqlSession, Object[] args) { Object result; switch (command.getType()) { case INSERT: { Object param = method.convertArgsToSqlCommandParam(args); result = rowCountResult(sqlSession.insert(command.getName(), param)); break; } case UPDATE: { Object param = method.convertArgsToSqlCommandParam(args); result = rowCountResult(sqlSession.update(command.getName(), param)); break; } case DELETE: { Object param = method.convertArgsToSqlCommandParam(args); result = rowCountResult(sqlSession.delete(command.getName(), param)); break; } case SELECT: if (method.returnsVoid() && method.hasResultHandler()) { executeWithResultHandler(sqlSession, args); result = null; } else if (method.returnsMany()) { result = executeForMany(sqlSession, args); } else if (method.returnsMap()) { result = executeForMap(sqlSession, args); } else if (method.returnsCursor()) { result = executeForCursor(sqlSession, args); } else { Object param = method.convertArgsToSqlCommandParam(args); result = sqlSession.selectOne(command.getName(), param); } break; case FLUSH: result = sqlSession.flushStatements(); break; default: throw new BindingException("Unknown execution method for: " + command.getName()); } if (result == null && method.getReturnType().isPrimitive() && !method.returnsVoid()) { throw new BindingException("Mapper method '" + command.getName() + " attempted to return null from a method with a primitive return type (" + method.getReturnType() + ")."); } return result; } 首先根据SQL的类型增删改查决定执行哪个方法,在此执行的是SELECT方法,在SELECT中根据方法的返回值类型决定执行哪个方法,可以看到在select中没有selectone单独方法,都是通过selectList方法,通过调用 org.apache.ibatis.session.defaults.DefaultSqlSession#selectList(java.lang.String, java.lang.Object)方法来获取到数据 @Override public <E> List<E> selectList(String statement, Object parameter, RowBounds rowBounds) { try { MappedStatement ms = configuration.getMappedStatement(statement); return executor.query(ms, wrapCollection(parameter), rowBounds, Executor.NO_RESULT_HANDLER); } catch (Exception e) { throw ExceptionFactory.wrapException("Error querying database. Cause: " + e, e); } finally { ErrorContext.instance().reset(); } } 在selectList中,首先从configuration对象中获取MappedStatement,在statement中包含了Mapper的相关信息,然后调用 org.apache.ibatis.executor.CachingExecutor#query()方法 图12 query()方法调试图示 在这个方法中,首先对SQL进行解析根据入参和原始SQL,对SQL进行拼接 图13 SQL拼接过程代码图示 调用MapperedStatement里的getBoundSql最终解析出来的SQL为 图14 SQL拼接过程结果图示 接下来调用 org.apache.ibatis.parsing.GenericTokenParser#parse对解析出来的SQL进行解析 图15 SQL解析过程图示 最终解析的结果为 图16 SQL解析结果图示 最后会调用SimpleExecutor中的doQuery方法,在这个方法中,会获取StatementHandler,然后调用 org.apache.ibatis.executor.statement.PreparedStatementHandler#parameterize这个方法进行参数和SQL的处理,最后调用statement的execute方法获取到结果集,然后 利用resultHandler对结进行处理 图17 SQL处理结果图示 查询的主要流程为 图18 查询流程处理图示 5.查询流程总结 总结整个查询流程如下 图19 查询流程抽象 2.3 场景问题原因及解决方案 2.3.1 个人排查 这个问bug出现的地方在于绑定SQL参数的时候再源码中位置为 @Override public <E> List<E> query(MappedStatement ms, Object parameter, RowBounds rowBounds, ResultHandler resultHandler) throws SQLException { BoundSql boundSql = ms.getBoundSql(parameter); CacheKey key = createCacheKey(ms, parameter, rowBounds, boundSql); return query(ms, parameter, rowBounds, resultHandler, key, boundSql); } 由于所写的SQL是一个动态绑定参数的SQL,因此最终会走到 org.apache.ibatis.scripting.xmltags.DynamicSqlSource#getBoundSql这个方法中去 public BoundSql getBoundSql(Object parameterObject) { BoundSql boundSql = sqlSource.getBoundSql(parameterObject); List<ParameterMapping> parameterMappings = boundSql.getParameterMappings(); if (parameterMappings == null || parameterMappings.isEmpty()) { boundSql = new BoundSql(configuration, boundSql.getSql(), parameterMap.getParameterMappings(), parameterObject); } // check for nested result maps in parameter mappings (issue #30) for (ParameterMapping pm : boundSql.getParameterMappings()) { String rmId = pm.getResultMapId(); if (rmId != null) { ResultMap rm = configuration.getResultMap(rmId); if (rm != null) { hasNestedResultMaps |= rm.hasNestedResultMaps(); } } } return boundSql; } 在这个方法中,会调用 rootSqlNode.apply(context)方法,由于这个标签是一个foreach标签,因此这个apply方法会调用到 org.apache.ibatis.scripting.xmltags.ForEachSqlNode#apply这个方法中去 @Override public boolean apply(DynamicContext context) { Map<String, Object> bindings = context.getBindings(); final Iterable<?> iterable = evaluator.evaluateIterable(collectionExpression, bindings); if (!iterable.iterator().hasNext()) { return true; } boolean first = true; applyOpen(context); int i = 0; for (Object o : iterable) { DynamicContext oldContext = context; if (first) { context = new PrefixedContext(context, ""); } else if (separator != null) { context = new PrefixedContext(context, separator); } else { context = new PrefixedContext(context, ""); } int uniqueNumber = context.getUniqueNumber(); // Issue #709 if (o instanceof Map.Entry) { @SuppressWarnings("unchecked") Map.Entry<Object, Object> mapEntry = (Map.Entry<Object, Object>) o; applyIndex(context, mapEntry.getKey(), uniqueNumber); applyItem(context, mapEntry.getValue(), uniqueNumber); } else { applyIndex(context, i, uniqueNumber); applyItem(context, o, uniqueNumber); } contents.apply(new FilteredDynamicContext(configuration, context, index, item, uniqueNumber)); if (first) { first = !((PrefixedContext) context).isPrefixApplied(); } context = oldContext; i++; } applyClose(context); return true; } 当调用appItm方法的时候将参数进行绑定,参数的变量问题都会存在bindings这个参数中区 private void applyItem(DynamicContext context, Object o, int i) { if (item != null) { context.bind(item, o); context.bind(itemizeItem(item, i), o); } } 进行绑定参数的时候,绑定完成foreach的方法的时候,可以看到bindings中不止绑定了foreach中的两个参数还额外有一个参数名字studentName->lct2,也就是说最后一个参数也是会出现在bindings这个参数中的, private void applyItem(DynamicContext context, Object o, int i) { if (item != null) { context.bind(item, o); context.bind(itemizeItem(item, i), o); } } 图20 参数绑定过程 最后判定 org.apache.ibatis.scripting.xmltags.IfSqlNode#apply @Override public boolean apply(DynamicContext context) { if (evaluator.evaluateBoolean(test, context.getBindings())) { contents.apply(context); return true; } return false; } 可以看到在调用evaluateBoolean方法的时候会把context.getBindings()就是前边提到的bindings参数传入进去,因为现在这个参数中有一个studentName,因此在使用Ognl表达式的时候,判定为这个if标签是有值的因此将这个标签进行了解析 图21 单个参数绑定过程 最终绑定的结果为 图22 全部参数绑定过程 因此这个地方绑定参数的地方是有问题的,至此找出了问题的所在。 2.3.2 官方解释 翻阅MyBatis官方文档进行求证,发现在3.4.5版本发行中bug fixes中有这样一句 图23 此问题官方修复github记录 图23 此问题官方修复github记录 修复了foreach版本中对于全局变量context的修改的bug issue地址为https://github.com/mybatis/mybatis-3/pull/966 修复方案为https://github.com/mybatis/mybatis-3/pull/966/commits/84513f915a9dcb97fc1d602e0c06e11a1eef4d6a 可以看到官方给出的修改方案,重新定义了一个对象,分别存储全局变量和局部变量,这样就会解决foreach会改变全局变量的问题。 图24 此问题官方修复代码示例 2.3.3 修复方案 升级MyBatis版本至3.4.5以上 如果保持版本不变的话,在foreach中定义的变量名不要和外部的一致 3 源码阅读过程总结 MyBatis源代码的目录是比较清晰的,基本上每个相同功能的模块都在一起,但是如果直接去阅读源码的话,可能还是有一定的难度,没法理解它的运行过程,本次通过一个简单的查询流程从头到尾跟下来,可以看到MyBatis的设计以及处理流程,例如其中用到的设计模式: 图25 MyBatis代码结构图 组合模式:如ChooseSqlNode,IfSqlNode等 模板方法模式:例如BaseExecutor和SimpleExecutor,还有BaseTypeHandler和所有的子类例如IntegerTypeHandler Builder模式:例如 SqlSessionFactoryBuilder、XMLConfigBuilder、XMLMapperBuilder、XMLStatementBuilder、CacheBuilder 工厂模式:例如SqlSessionFactory、ObjectFactory、MapperProxyFactory 代理模式:MyBatis实现的核心,比如MapperProxy、ConnectionLogger 4 文档参考 https://mybatis.org/mybatis-3/zh/index.htm

优秀的个人博客,低调大师

每日一博 | 社区点赞业务缓存设计优化探索

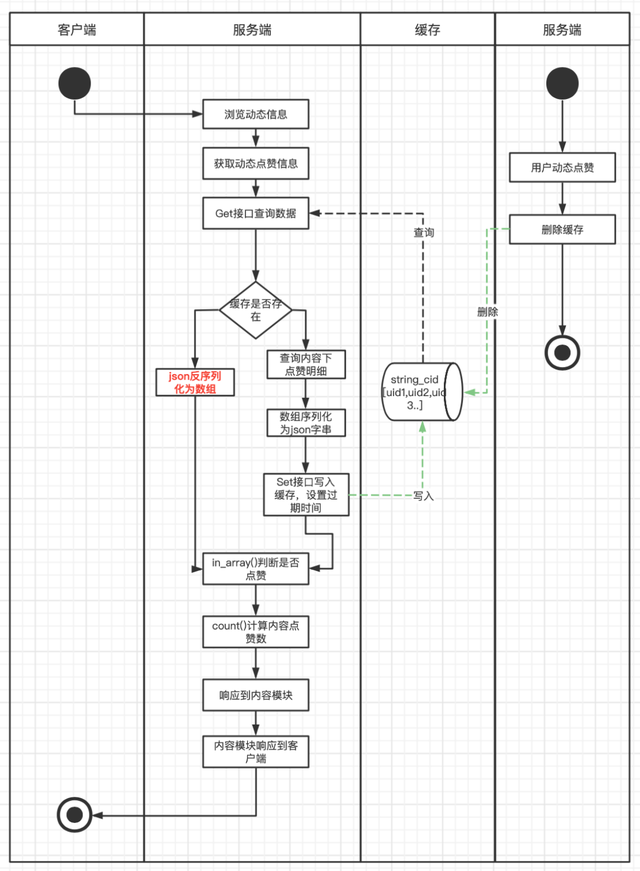
原创 慎之 得物技术 背景 内容点赞业务在得物社区中是一个非常高频的业务场景,功能本身复杂度不高,但是业务场景多、QPS高、而且由于社区的用户体量,整体点赞的数据量非常大。其中最核心、对响应性能要求最高的主要是“用户是否点赞内容”和“内容点赞数”场景。 在得物社区中凡是有内容消费的场景,都会有上面两个点赞场景的处理,所以整体点赞业务的QPS在社区都是非常高的。当我们在刷各种Feed流时,每一次下滑,都需要对数十篇内容进行登录用户是否点赞状态的判断。作为基础业务,内容点赞业务的高性能响应,对上游内容场景的消费体验有极大的影响。 本文对得物社区的点赞业务如何做到高性能响应以及历史上在缓存使用上关于高性能、稳定性、低成本上的优化探索过程进行讲述,希望能给读者带来一些收获。 演进探索 v1.0版本 功能需求 社区各种Feed流及内容详情页“登录用户是否已点赞内容” “内容被赞总数” “内容最新点赞用户列表”几个场景消费展示。 实现方案 点赞业务整体的高性能是基于Redis+MySQL架构。MySQL做数据存储和查询支持,Redis撑起业务的高性能响应。在1.0版本中,服务架构还是单体PHP服务,技术方案上将动态下所有的点赞用户查询出来放到PHP数组里,然后序列化为Json字符串以Key/Value的方式存储到Redis中,当用户浏览内容时,取出缓存数据,反序列化Json为PHP数组,然后通过in_array和count方法判断是否已点赞及内容点赞数。在缓存的维护上,则是每一次有新用户点赞或取消赞则直接清除Redis。 缓存结构图下: cId => '[uid1,uid2,uid3...]' 流程图如下: 主要问题 这个版本的方案存在比较多待优化点。 第一、缓存构造时要查询动态下所有点赞用户数据,数据量大,容易产生慢SQL,对DB和带宽都可能有比较大的压力。 第二、缓存存储数据结构上为Key/Value结构,每次使用时需先从Redis查询,再反序列化成PHP数组,in_array()和count()方法都有比较大的开销,尤其是查询热门动态时,对服务器的CPU和MEM资源都有一定浪费,对Redis也产生了比较大的网络带宽开销。 第三、缓存维护上,每次新增点赞都直接清除缓存,热门动态大量点赞操作下会出现缓存击穿,会造成大量DB回查操作。 v2.0版本 大家都知道一些热点事件很容易在社区中发酵,得物社区自然也存在这种情况。在某一场热点事件中,得物社区瞬间出现多篇热点内容,大量用户进入得物社区浏览相关动态并点赞,从v1.0版本的点赞维护流程上可以看出执行缺陷,即每次有新点赞都会清除缓存!当有大量用户浏览热点动态,同时又有大量用户在点赞而导致缓存清除的场景下,缓存被击穿的风险非常高,这样会导致大量查询请求打到DB层,研发侧在评估风险之后,连夜进行了缓存改造。 功能需求 1、解决热点内容缓存击穿的风险。 2、优化代码层面对缓存数据序列化和反序列化导致的服务器资源消耗。 实现方案 这次改造,除了优化解决缓存击穿的风险外,也针对之前缓存本身的一些不足之处,思考了一些更高效的实现。在缓存数据结构上摒弃了之前的Key/Value结构,采用了集合结构。集合的特性保证集合中的用户ID不会出现重复,可以准确维护了动态下的点赞总数,通过查看用户是否在集合中,可以高效判断用户是否点赞内容。这样解决每次查询时需要从Redis中获取全部数据和每次需要代码解析Json的过程,Redis集合支持直接通过SISMEMBER和SCARD接口判断是否赞和计算点赞数,从而提升了整个模块的响应速度和服务负载。在缓存维护上,每次有新增点赞时,主动向集合中添加用户ID,并更新缓存过期时间。每次查询时,也同样会查询缓存的剩余过期时间,如果低于三分之一,就会重新更新过期时间,这样避免了热门动态有大量新增点赞动作时,出现缓存击穿的情况。 缓存结构如下: cid => [uid1,uid2,uid3...] 流程图如下: 主要问题 在技术方案中,会将动态下全部的点赞记录全部查出,放入一个集合中,当动态是一个热门动态时,点赞用户量会非常大,此时集合变成了一个大Key,而大Key的清理对Redis的稳定性有比较大的影响,随时可能会因为缓存过期,而引起Redis的抖动,进而引起服务的抖动。并且每次查询出全部的点赞用户,容易产生慢SQL,对网络带宽也比较有压力。 v3.0版本 功能需求 1、解决V2.0版本中缓存大Key风险。 2、优化缓存重建时查询内容全部点赞用户产生的慢SQL场景。 实现方案 在3.0版本中,对大Key进行了打散处理,对同一个动态下的点赞用户,进行打散分片再维护到缓存,每次操作缓存时先根据用户ID计算分片值,这样每个分片都具有更小的体积和更快的维护和响应速度。而点赞总数的获取,此时社区服务已经迁移到Go服务架构,我们也搭建了单独的计数服务,单独维护内容的被赞总数,节省了scard接口的消耗。 缓存结构如下: cid_slice1 => [uid1,uid11,uid111...] cid_slice2 => [uid2,uid22,uid222...] cid_slice3 => [uid3,uid33,uid333...] ... 流程图如下: 主要问题 如果仅仅从技术实现上看v3.0版本,似乎已经暂时达到了一个水平,在一定时间内也能正常支撑社区点赞业务的高性能响应。但是如果从业务角度和全局观念上去考虑,这个设计方案仍旧存在比较多的优化点。例如: 缓存分片中仍旧维护了被浏览动态下全部的点赞用户数据,消耗了非常大的Redis资源,也增加了缓存维护难度。缓存数据的有效使用率很低,推荐流场景下,用户浏览过的动态,几乎不会再次浏览到。 当前技术方案针对单篇内容进行设计,在各种Feed流场景中,查询任务在点赞服务里其实放大了十数倍。这种放大对服务器、Redis以及DB,都产生一定的资源消耗浪费。 一些点赞量特别多的历史动态,有人访问时均会重建缓存,重建成本高,但使用率不高。 缓存集合分片的设计维护了较多无用数数据,也产生了大量的Key,Key在Redis中同样是占用内存空间的。 ... ... 总结一下,较高的服务器负载、Redis请求量、DB请求量。非常大的Redis资源使用(几十GB)。 所以我们需要一个更优的方案,解决优化以下现象: 1、Feed流场景下批量查询内容任务放大导致的服务器负载,Redis请求,DB请求放大现象。 2、缓存更高效的存储和使用,降低缓存整体的使用量。 3、缓存更高的命中率。 4、区分冷热数据。 实际Feed场景下的实现逻辑: 批量查询动态点赞数据 V4.0版本 功能需求 结合实际业务场景,大部分场景上游服务都是批量判断是否点赞,社区的动态本身也存在一定的新鲜度(冷热)。对新缓存的要求是: 1、能解决Feed流场景下批量查询流量放大现象。 2、缓存数据区分冷热,减少无效存储(能在内容和点赞用户角度都区分冷热数据)。 3、缓存结构要简单易维护,使业务实现要清晰明了。 实现方案 设计思路: 1、批量查询任务之所以放大是因为之前的缓存是以内容为维度进行设计,新方案要以用户为维度进行设计。 2、旧方案中访问内容点赞数据会重建缓存,有些老旧内容重建缓存性价比低,而且内容下的点赞用户并不是一直活跃和会重新访问内容,新方案要等区分冷热数据,冷数据直接访问DB,不再进行缓存的重建/更新维护。 3、旧方案在维护缓存过期时间和延长过期时间的设计中,每次操作缓存都会进行ttl接口操作,QPS直接x2。新方案要避免ttl操作,但同时又可以维护缓存过期时间。 4、缓存操作和维护要简单,期望一个Redis接口操作能达到目的。 所以新方案Redis数据结构的选择中,能判断是否点赞、是否是冷热数据、是否需要延长过期时间,之前的集合是不能满足了,我们选择Hash表结构。用户ID做Key,contentId做field,考虑到社区内容ID是趋势递增的,一定程度上coententID能代表数据的冷热,在缓存中只维护一定时间和一定数量的contentID,并且增加minCotentnID用于区分冷热数据,为了减少ttl接口的调用,还增加ttl字段用户判断缓存有效期和延长缓存过期时间。一举三得! 缓存结构如下: { "userId":{ "ttl":1653532653, //缓存新建或更新时时间戳 "cid1":1, //用户近一段时间点赞过的动态id "cid2":1, //用户近一段时间点赞过的动态id "cidn":1, //用户近一段时间点赞过的动态id "minCid":3540575, //缓存中最小的动态id,用以区分冷热, } } 在实际业务场景流程如下: 通过流程图,我们可以清晰看到, 上游Feed流,一次批量查询请求,没有了循环逻辑,最优情况下,只有一次Redis操作,业务实现也非常简单明了。 优化结果 优化前后Redis查询量QPS日常峰值下降了20倍。 优化前后接口平均RT下降了10倍。 优化前后DB查询量QPS日常峰值下降了6倍。 优化前后缓存节省了16G左右存储空间。 后续 优化不会结束,技术不会停止,技术方案会随着业务的演进而演进。 总结 本篇文章中对得物社区点赞业务缓存优化的探索演进做了相关历史背景和技术方案的解析,当前其中还有更多的细节。而这么多次版本的优化,都是根据实际的业务场景中出现的风险点以及需求不断摸索出来的,每个版本的方案也都不是完美方案,v4.0也不是最终方案,还需要开发人员也需要进一步思索,探索更优的技术方案。 并且随着业务的不断发展迭代,会涌现出更多的场景和困难,我们一直在优化探索的路上。 *文/慎之 关注得物技术,每周一三五晚 18:30 更新技术干货 要是觉得文章对你有帮助的话,欢迎评论转发点赞~

优秀的个人博客,低调大师

每日一博 | 一文搞懂 SAE 日志采集架构

作者:牛通(奇卫) 日志,对于一个程序的重要程度不言而喻。无论是作为排查问题的手段,记录关键节点信息,或者是预警,配置监控大盘等等,都扮演着至关重要的角色。是每一类,甚至每一个应用程序都需要记录和查看的重要内容。而在云原生时代,日志采集无论是在采集方案,还是在采集架构上,都会和传统的日志采集有一些差异。我们汇总了一下在日志的采集过程中,经常会遇到一些实际的通用问题,例如: 部署在 K8s 的应用,磁盘大小会远远低于物理机,无法把所有日志长期存储,又有查询历史数据的诉求 日志数据非常关键,不允许丢失,即使是在应用重启实例重建后 希望对日志做一些关键字等信息的报警,以及监控大盘 权限管控非常严格,不能使用或者查询例如 SLS 等日志系统,需要导入到自己的日志采集系统 JAVA,PHP 等应用的异常堆栈会产生换行,把堆栈异常打印成多行,如何汇总查看呢? 那么在实际生产环境中,用户是如何使用日志功能采集的呢?而面对不同的业务场景,不同的业务诉求时,采用哪种采集方案更佳呢?Serverless 应用引擎 SAE(Serverless App Engine)作为一个全托管、免运维、高弹性的通用 PaaS 平台,提供了 SLS 采集、挂载 NAS 采集、Kafka 采集等多种采集方式,供用户在不同的场景下使用。本文将着重介绍各种日志采集方式的特点,最佳使用场景,帮助大家来设计合适的采集架构,并规避一些常见的问题。 SAE 的日志采集方式 SLS 采集架构 SLS 采集日志是 SAE 推荐的日志采集方案。一站式提供数据采集、加工、查询与分析、可视化、告警、消费与投递等能力。 SAE 内置集成了 SLS 的采集,可以很方便的将业务日志,容器标准输出采集到 SLS 。SAE 集成 SLS 的架构图如下图所示: SAE 会在 pod 中,挂载一个 logtail (SLS 的采集器)的 Sidecar。 然后将客户配置的,需要采集的文件或者路径,用 volume 的形式,给业务 Container 和 logtail Sidecar 共享。这也是 SAE 日志采集不能配置/home/admin 的原因。因为服务的启动容器是放在/home/admin 中,挂载 volume 会覆盖掉启动容器。 同时 logtail 的数据上报,是通过 SLS 内网地址去上报,因此无需开通外网。 SLS 的 Sidecar 采集,为了不影响业务 Container 的运行,会设置资源的限制,例如 CPU 限制在 0.25C ,内存限制在 100M。 SLS 适合大部分的业务场景,并且支持配置告警和监控图。绝大多数适合直接选择 SLS 就可以了。 NAS 采集架构 NAS 是一种可共享访问、弹性扩展、高可靠以及高性能的分布式文件系统。本身提供高吞吐和高 IOPS 的同时支持文件的随机读写和在线修改。比较适合日志场景。如果想把比较多或比较大的日志在本地留存,可以通过挂载 NAS,然后将日志文件的保存路径指向 NAS 的挂载目录即可。NAS 挂载到 SAE 不牵扯到太多技术点和架构,这里就略过不做过多的介绍了。 NAS 作为日志采集时,可以看作是一块本地盘,即使实例崩溃重建等等各种以外情况,也都不会出现日志丢失的情况,对于非常重要,不允许丢失数据的场景,可以考虑此方案。 Kafka 采集架构 用户本身也可以将日志文件的内容采集到 Kafka,然后通过消费 Kafka 的数据,来实现日志的采集。后续用户可以结合自身的需求,将 Kafka 中的日志导入到 ElasticSearch ,或者程序去消费 Kafka 数据做处理等。 日志采集到 Kafka本身有多种方式,例如最常见的 logstach,比较轻量级的采集组建 filebeat,vector 等等。SAE 使用的采集组件是 vector,SAE 集成 vector 的架构图如下图所示: SAE 会在 pod 中,挂载一个 logtail(vector 采集器)的 Sidecar。 然后将客户配置的,需要采集的文件或者路径,用 volume 的形式,给业务 Container 和 vector Sidecar 共享 vector 会将采集到的日志数据定时发送到 Kafka。vector 本身有比较丰富的参数设置,可以设置采集数据压缩,数据发送间隔,采集指标等等。 Kafka 采集算是对 SLS 采集的一种补充完善。实际生产环境下,有些客户对权限的控制非常严格,可能只有 SAE 的权限,却没有 SLS 的权限,因此需要把日志采集到 Kafka 做后续的查看,或者本身有需求对日志做二次处理加工等场景,也可以选择 Kafka 日志采集方案。 下面是一份基础的 vector.toml 配置: data_dir = "/etc/vector" [sinks.sae_logs_to_kafka] type = "kafka" bootstrap_servers = "kafka_endpoint" encoding.codec = "json" encoding.except_fields = ["source_type","timestamp"] inputs = ["add_tags_0"] topic = "{{ topic }}" [sources.sae_logs_0] type = "file" read_from = "end" max_line_bytes = 1048576 max_read_bytes = 1048576 multiline.start_pattern = '^[^\s]' multiline.mode = "continue_through" multiline.condition_pattern = '(?m)^[\s|\W].*$|(?m)^(Caused|java|org|com|net).+$|(?m)^}.*$' multiline.timeout_ms = 1000 include = ["/sae-stdlog/kafka-select/0.log"] [transforms.add_tags_0] type = "remap" inputs = ["sae_logs_0"] source = '.topic = "test1"' [sources.internal_metrics] scrape_interval_secs = 15 type = "internal_metrics_ext" [sources.internal_metrics.tags] host_key = "host" pid_key = "pid" [transforms.internal_metrics_filter] type = "filter" inputs = [ "internal_metrics"] condition = '.tags.component_type == "file" || .tags.component_type == "kafka" || starts_with!(.name, "vector")' [sinks.internal_metrics_to_prom] type = "prometheus_remote_write" inputs = [ "internal_metrics_filter"] endpoint = "prometheus_endpoint" 重要的参数解析: multiline.start_pattern 是当检测到符合这个正则的行时,会当作一条新的数据处 multiline.condition_pattern 是检测到符合这个正则的行时,会和上一行做行合并,当作一条处理 sinks.internal_metrics_to_prom 配置了之后,会将配置一些 vector 的采集元数据上报到 prometheus 下面是配置了 vector 采集的元数据到 Prometheus,在 Grafana 的监控大盘处配置了 vector 的元数据的一些采集监控图: 最佳实践 在实际使用中,可以根据自身的业务诉求选择不同的日志采集方式。本身 logback 的日志采集策略,需要对文件大小和文件数量做一下限制,不然比较容易把 pod 的磁盘打满。以 JAVA 为例,下面这段配置,会保留最大 7 个文件,每个文件大小最大 100M。 <appender name="TEST" class="ch.qos.logback.core.rolling.RollingFileAppender"> <file>${user.home}/logs/test/test.log</file> <rollingPolicy class="ch.qos.logback.core.rolling.FixedWindowRollingPolicy"> <fileNamePattern>${user.home}/logs/test/test.%i.log</fileNamePattern> <minIndex>1</minIndex> <maxIndex>7</maxIndex> </rollingPolicy> <triggeringPolicy class="ch.qos.logback.core.rolling.SizeBasedTriggeringPolicy"> <maxFileSize>100MB</maxFileSize> </triggeringPolicy> <encoder class="ch.qos.logback.classic.encoder.PatternLayoutEncoder"> <charset>UTF-8</charset> <pattern>%d{yyyy-MM-dd HH:mm:ss}|%msg%n</pattern> </encoder> </appender> 这段 log4j 的配置,是一种比较常见的日志轮转配置。 常见的日志轮转方式有两种,一种是 create 模式,一种是 copytruncate 模式。而不同的日志采集组件,对两者的支持程度会存在一些区别。 create 模式是重命名原日志文件,创建新的日志文件替换。log4j 使用的就是这种模式,详细步骤如下图所示: 当日志的 event log 写入前会判断是否达到文件设置最大容量,如果没达到,则完成写入,如果达到了,则会进入阶段二 首先关闭当前 currentlyActiveFile 指向的文件,之后对原文件进行重命名,并新建一个文件,这个文件的名字和之前 currentlyActiveFile 指向的名字一致 把 currentlyActiveFile 指向的文件变为阶段二新创建的文件 copytruncate 模式的思路是把正在输出的日志拷(copy)一份出来,再清空(trucate)原来的日志。 目前主流组件的支持程度如下: 实际案例演示 下面介绍一下客户实际生产环境中的一些真实场景。 某客户 A 通过日志轮转设置程序的日志,并将日志采集到 SLS。并通过关键字配置相关报警,监控大盘等。 首先通过 log4j 的配置,使日志文件最多保持 10 个,每个大小 200M,保持磁盘的监控,日志文件保存在/home/admin/logs 路径下。这里不进行过多介绍了,可以最佳实践场景介绍的配置。 随后通过 SAE 的 SLS 日志采集功能,把日志采集到 SLS 中。 最后,通过程序中日志的一些关键字,或者一些其他规则,例如 200 状态码比例等进行了报警配置。 通过 Nginx 的日志完成监控大盘的配置。 常见问题 日志合并介绍 很多时候,我们需要采集日志,并不是单纯的一行一行采集,而是需要把多行日志合并成一行进行采集,例如 JAVA 的异常日志等。这个时候就需要用到日志合并功能了。 在 SLS 中,有多行模式的采集模式,这个模式需要用户设置一个正则表达式,用来做多行合并。 vector 采集也有类似的参数,multiline.start_pattern 用于设置新行的正则,符合此正则会被认为是一个新行。可以结合 multiline.mode 参数一起使用。更多参数请参看vector官网。 日志采集丢失分析 无论是 SLS 采集和 vector 采集到 Kafka 为了保证采集日志不丢失。都会将采集的点位(CheckPoint)信息保存到本地,如果遇到服务器意外关闭、进程崩溃等异常情况时,会从上一次记录的位置开始采集数据,尽量保证数据不会丢失。 但是这并不能保证日志一定不会丢失。在一些极端场景下,是有可能造成日志采集丢失的,例如: K8s pod 进程崩溃,liveness 连续失败等异常导致 pod 重建 日志轮转速度极快,例如1秒轮转1次。 日志采集速度长期无法达到日志产生速度。 针对场景 2,3,需要去检查自身的应用程序,是否打印了过多不必要的日志,或者日志轮转设置是否异常。因为正常情况下,这些情况不应该出现。针对场景 1,如果对日志要求非常严格,在 pod 重建后也不能丢失的话,可以将挂载的 NAS 作为日志保存路径,这样即使在 pod 重建后,日志也不会丢失。 总结 本文着重介绍了 SAE 提供了多种日志采集方案,以及相关的架构,场景使用特点。总结起来三点: SLS 采集适配性强,实用大多数场景 NAS 采集任何场景下都不会丢失,适合对日志要求非常严格的场景 Kafka 采集是对 SLS 采集的一种补充,有对日志需要二次加工处理,或者因为权限等原因无法使用 SLS 的场景,可以选择将日志采集到 Kafka 自己做搜集处理。 阿里云重磅推出 SAE Job,支持 XXL-JOB、ElasticJob 任务的全托管,零改造迁移。 目前火热公测中,2022 年 9 月 1 日正式商业化收费,欢迎大家使用! SAE Job 作为面向任务的 Serverless PaaS 平台,重点解决用户的效率和成本问题。根据业务数据处理需求,能在短时间内快速创建大量计算任务,并且在任务完成后快速释放计算资源。支持单机、广播、并行计算、分片任务模型,定时、超时重试、阻塞策略等任务核心特性,比开源任务框架使用更方便(对代码无侵入)、更节省(任务运行完立即释放资源)、更稳定(失败自动重试)、更透明(可视化监控报警)、更省心(免运维)。 更多产品内容,点击此处查看~

优秀的个人博客,低调大师

每日一博 | 极简 Java 工作流概念入门

关于 Flowable 松哥已经更新了好几篇文章了,不过考虑到有的小伙伴可能还从来没接触过流程引擎,因此有一些基础的内容我再来和小伙伴们梳理一下。 1. 为什么需要工作流 松哥将之前的文章转发到朋友圈后,有小伙伴评论说一直不理解为什么需要工作流,今天我们就先来说说这个话题。 假设我有一个请假需求,流程如下: 请假可以提交给我的上司,上司可以选择批准或者拒绝,无论批准还是拒绝,都会给我一个通知。 这个流程比较简单,我们很容易想到解决方案,不用工作流也能解决,有一个专门的请假表,当 A 要请假的时候,就往请假表中添加一条记录,这条记录的内容包含了请假的天数、原因、请假的审批人 B 以及一个名为 status 的字段,这个 status 字段表示这个请假申请目前的状态(待审批、已批准还是已拒绝),然后 B 登录系统之后,在请假表中查询到了 A 的请假信息,然后选择批准,此时将 status 字段的值改一下就行了。 这个流程很简单,相信小伙伴们都能想到。 然而,这是一个非常简单的流程,对于这样的流程,一般来说也确实没有必要使用工作流,但是现实中,我们涉及到的工作流往往都是非常复杂的,我举个例子,就说报销审批吧,这个可能很多小伙伴都经历过。 小伙伴们看到,这个流程相对来说还是比较复杂的,此时你再用一个 status 字段去描述,就很难说的请到底是怎么回事了。每一步审批,都有可能批准也有可能拒绝,拒绝并不意味着流程结束,员工修改报销资料之后,还可以继续提交。此时如果还用 status 去描述,那么 status 将有 N 多个值去表示不同的情况,这个维护起来非常不便。 这就复杂了吗?非也非也,我们再来看一个生产笔记本电脑的例子,假设公司研发了一款新型笔记本电脑,整个研发到生产的流程可能是这样: 相比上面两个,这个就更复杂一些了,不仅有串行任务还有并行任务,如何去设计这样一个系统?单纯的通过状态字段去描述显然已经不够用了,此时我们就得考虑一种通用的、更易维护的方案来实现这样的系统了,这种通用的、易维护的方案,也就是工作流。 2. 三大工作流 一个比较早的工作流是 jBPM,这是一个由 Java 实现的企业级流程引擎,是 JBoss 公司开发的产品之一。 jBPM 的创建者是 Tom Baeyens,这个大佬后来离开了 JBoss,并加入到 Alfresco,并推出了基于 jBPM4 的开源工作流系统 Activiti,而 jBPM 则在后续的代码中完全放弃了 jBPM4 的代码。从这个过程中也能看出来,jBPM 在发展过程中,由于意见相左,后来变成了两个 jBPM 和 Activiti。 然而戏剧的是,Activiti5 没搞多久,从 Activiti 中又分出来一个 Camunda,Activiti 继续发展,又从中分出来一个 Flowable。。。 由于开发 jBPM、Activiti、Camunda 以及 Flowable 的人多多少少有一些关联性,让人不得不猜测意见相左拉一票人出来单干是他们的企业文化。 所以现在市面上主流的流程引擎就一共有三个: Activiti Flowable Camunda 这三个各有特点: Activiti 目前是侧重云,他目前的设计会向 Spring Cloud、Docker 这些去靠拢。 Flowable 核心思想还是在做一个功能丰富的流程引擎工具,除了最最基础的工作流,他还提供了很多其他的扩展点,我们可以基于 Flowable 实现出许多我们想要的功能(当然这也是小伙伴们觉得 Flowable 使用复杂的原因之一)。 Camunda 相对于前两个而言比较轻量级,Camunda 有一个比较有特色的功能就是他提供了一个小巧的编辑器,基于 bpmn.io 来实现的(松哥之前已经发文讲过了)。如果你的项目需求是做一个轻巧的、灵活的、定制性强的编辑器,工作流是嵌入式的,那么可以选择 Camunda。 如果仔细比较起这三个的差异,能列一个长长的表格,这个网上也有不少人都总结过了,松哥这里也就不啰嗦了。 3. 流程图 既然有三个不同的工作流,那么三个不同的工作流画出来的流程图是否都各不相同呢? 不是的。 工作流程图这块其实有一个统一的标准,那就是 BPMN。BPMN 全称是 Business Process Model and Notation,中文译作业务流程模型和标记法,这个中文太绕口了,还是简称 BPMN 吧。 这是一套图形化表示法,用图形来表示业务流程模型。BPMN 最初由业务流程管理倡议组织(BPMI, Business Process Management Initiative)开发,BPMI 于 2005 年与对象管理组织(OMG, Object Management Group)合并,并于 2011 年 1 月 OMG 发布 2.0 版本,同时改为现在的名称。 一句话,就是流程图这块有一个特别古老的规范,那就是 BPMN,而我们前面所说的无论是 Activiti、Flowable 还是 Camunda,都是支持这个规范的,所以呢,无论你使用哪一个流程引擎,都可以使用同一套流程图。 那么这个规范究竟都说了些什么事情呢? 我们以上面生产笔记本的流程图为例,来和小伙伴们做一个简单介绍: 从上图中可以看到,一个流程图中主要包含四方面的内容: 事件 连线 任务 网关 我们一个一个来说。 事件 首先在一个流程图中应该有开始事件和结束事件,也就是上图大家看到的两个圆圈。另外还有一些中间事件、边界事件等。举个中间定时事件的例子,比如用户下单之后,可以有一个中间定时事件,延迟 5 分钟发货。 连线 连线就是将事件、任务、网关等连在一起的线条,一般情况下就是普通连线,有的时候连线会有一些条件,例如松哥之前文章和大家分享的请假,如果经理同意请假申请,就走哪一个线条,如果经理不同意请假申请,就走哪一个线条。对应上图的笔记本生产,如果经理审批通过,就载入图纸准备生产,如果经理审批不通过,就重新设计。 任务 任务这块其实有很多分类。 如果细分大致上可以分为如下几种: 接收任务 在上面的流程图中,等待准备工作完成这一项就是一个接收任务。这个任务里并不需要额外做什么事情,流程到这一步就自动停下来了,需要人工去点一下,推动流程继续向下执行。 发送任务 这个一般用来把消息发送给外部参与者。 服务任务 这个一般由系统自动完成,其实说白了就是我们的一个自定义类,可以在一个自定义类里边完成想要做的事情。 脚本任务 一个自动化活动。当流程执行到脚本任务时,自动执行相应的脚本。 业务规则任务 BPMN2.0 新引入用来对接业务规则引擎,业务规则任务用于同步执行一个或多个规则。 用户任务 用于为那些需要由人工参与者完成的工作建模。 虽然细分类别很多,但是仔细看,其实这几种又可以归为两大类: 用户任务:表示人工要介入做的事情。比如同意与否,或者输入一些参数,要让人工完成任务,就需要一个表单系统,让人工输入数据,或者显示数据给人看,这也是为什么用户任务和表单系统结合在一起的原因,用户任务需要用户向引擎提交一个完成任务的动作,否则流程会暂停在这里等待。 服务任务:表示机器自动做的事情。调用服务的任务,这个服务可以是一个 Spring JavaBean,也可以是一个远程 REST 服务,流程会自动执行服务任务。 活动 活动可以算是一种特殊的任务。活动可以调用另外一个流程使之作为当前流程的子流程去运行。活动也可以分为用户活动、脚本活动等等。从显示上来说,活动比任务边框深一些。仅此而已。 网关 网关要是细分起来,也有很多不同类型的网关。 互斥网关 这种网关也叫排他性网关,我们之前请假流程中的那个网关,就是互斥网关。这种网关有且仅有一个有效出口。 相容网关 这种网关会有多个出口,只要条件满足,都会执行。 事件网关 事件网关是通过中间事件驱动,它在等待的事件发生后才会触发决策。基于事件的网关允许基于事件作出决策。 并行网关 并行网关一般是成对出现的,上面生产笔记本的那个流程中,生产屏幕、键盘等并行操作,就是通过并行网关来实现的。 好啦,这就是关于流程引擎的一些基本概念,捋顺了这些基本概念,在回过头看我们前面几篇关于流程引擎的文章,应该会有一些不一样的理解: Spring Boot 整合流程引擎 Flowable,so easy! SpringBoot+Vue+Flowable,模拟一个请假审批流程! 49张图带领小伙伴们体验一把 Flowable-UI Spring Security + Vue + Flowable 怎么玩?

优秀的个人博客,低调大师

每日一博 | Redis 定长队列的探索和实践

vivo 互联网服务器团队 - Wang Zhi 一、业务背景 从技术的角度来说,技术方案的选型都是受限于实际的业务场景,都以解决实际业务场景为目标。 在我们的实际业务场景中,需要以游戏的维度收集和上报行为数据,考虑数据的量级,执行尽最大努力交付且允许数据的部分丢弃。 数据上报支持游戏的维度的批量上报,支持同一款游戏128个行为进行批量上报。 数据上报需要时效控制,上报的数据必须是上报时刻的前3分钟的数据。 整体数据的业务形态如下图所示: 二、技术选型 从业务的角度来说包含数据的收集和数据的上报,我们把数据的收集比作生产者,数据的上报比作消费者,是一个典型的生产消费模型。 生产消费模型在JVM进程内部通过队列+锁或者无锁的Disruptor来实现,在跨进程场景下通过MQ(RocketMQ/kafka)进行处理解耦。 但是细化到具体业务场景来看,消息的消费有诸多限制,包括:游戏维度的批量行为上报,行为上报的时效限制,细化到各个技术方案选型进行对比。 方案一 使用RocketMQ 或者Kafaka等消息队列来存储上报的消息,但是消费侧需要考虑在业务进程中按照游戏维度进行聚合,其中技术细节涉及按照游戏维度进行拆分,在满足消息时效性和批量性的前提下触发上报。在这种方案下消息中间件扮演的角色本质上消息的中转站,没有解决任何业务场景中提及的游戏维度拆分、批量性和时效性。 方案二 在方案一的基础上,寻求一种技术方案来解决游戏维度的消息分组、批量消费 、时效性。通过Redis的list结构来实现队列(进一步要求实现定长队列)来解决游戏维度的消息分组;通过Redis的list支持的Lrange来实现批量消费;通过业务侧的多线程来解决时效问题,针对高频的游戏使用单独的线程池进行处理,上述两个手段能够保证消费速度大于生产速度。 方案对比 对比两种方案后决定使用Redis的实现了一个伪消息中间件: 通过List对象实现定长队列来保存游戏维度的行为消息(以游戏作为key的List对象来保存用户行为); 通过List来保存所有的存在行为数据的游戏列表; 通过Set来进行去重判断来保证2中的List对象的唯一性。 整体的技术方案如下图所示: 生产过程 步骤一:游戏维度的某行为数据PUSH到游戏维度的队列当中。 步骤二:判断游戏是否在游戏的集合Set中,如果在就直接返回,如果不在进行步骤三。 步骤三:往游戏列表中PUSH游戏。 消费过程 步骤一:从游戏对象的列表中循环取出一款游戏。 步骤二:通过步骤一获取的游戏对象去该游戏对象的行为数据队列中批量获取数据处理。 三、技术原理 在Redis的支持命令中,在List和Set的基础命令,结合Lua脚本来实现整个技术方案。 消息数据层面,通过单独的List循环维护待消费的游戏维度的数据,每个游戏维度使用定长的List来保存消息。 消息生产过程中,通过结合List的llen+lpop+rpush来实现游戏维度的定长队列,保证队列的长度可控。 消息消费过程中,通过结合List的lrange+ltrim来实现游戏维度的消息的批量消费。 在整个执行的复杂度层面,需要保证时间复杂度在0(N)常量维度,保证时间可控。 3.1 Lua 脚本 EVAL script numkeys key [key ...] arg [arg ...] 时间复杂度:取决于脚本本身的执行的时间复杂度。 > eval "return {KEYS[1],KEYS[2],ARGV[1],ARGV[2]}" 2 key1 key2 first second1) "key1"2) "key2"3) "first"4) "second" Redis uses the same Lua interpreter to run all the commands.Also Redis guarantees that a script is executed in an atomic way:no other script or Redis command will be executed while a script is being executed.This semantic is similar to the one of MULTI / EXEC.Fromthepointofviewofalltheotherclientstheeffectsofascriptareeitherstillnotvisibleoralreadycompleted. Redis采用相同的Lua解释器去运行所有命令,我们可以保证,脚本的执行是原子性的。作用就类似于加了MULTI/EXEC。 Lua 脚本内多个命令以原子性的方式执行,保证了命令执行的线程安全。 Lua 脚本结合List命令实现定长队列,实现批量消费。 Lua 脚本仅支持单个key的操作,不支持多key的操作。 3.2 List 对象 LLEN key 计算List的长度 时间复杂度:O(1)。 LPOP key [count] 从List的左侧移除元素 时间复杂度:O(N),N为移除元素的个数。 RPUSH key element [element ...] 从List的右侧保存元素 时间复杂度:O(N),N为保存元素的个数。 List的基础命令包括计算List的长度,移除数据,添加数据,整体命令的复杂度都在O(N)的常量时间。 整合上述三个命令,我们能保证实现固定长度的队列,通过判断队列长度是否达到定长结合新增队列元素和移除队列元素来完成。 LRANGE key start end 时间复杂度:O(S+N), S为偏移量start, N为指定区间内元素的数量。 下标(index)参数 start 和 stop 都以 0 为底,也就是说,以 0 表示列表的第一个元素,以 1 表示列表的第二个元素,以此类推。 你也可以使用负数下标,以 -1 表示列表的最后一个元素, -2 表示列表的倒数第二个元素,以此类推。 LTRIM key start stop 时间复杂度:O(N) where N is the number of elements to be removed by the operation. 修剪(trim)一个已存在的 list,这样 list 就会只包含指定范围的指定元素。 List的基础命令包括批量返回数据和裁剪数据,整体命令的复杂度都在O(N)的常量时间。 整合上述两个命令,我们能够批量消费数据并移除队列数据,通过LRANGE批量返回数据并通过LTRIM保留剩余数据。 3.3 Set 对象 SADD key member [member ...] 往Set集合添加数据。 时间复杂度:O(1)。 SISMEMBER key member 判断Set集合是否存在元素。 时间复杂度:O(1)。 通过Set集合来保证数据的唯一性,且时间复杂度可控。 四、技术应用 4.1 生产消息 定义LUA脚本 CACHE_NPPA_EVENT_LUA = "local retVal = 0 " + "local key = KEYS[1] " + "local num = tonumber(ARGV[1]) " + "local val = ARGV[2] " + "local expire = tonumber(ARGV[3]) " + "if (redis.call('llen', key) < num) then redis.call('rpush', key, val) " + "else redis.call('lpop', key) redis.call('rpush', key, val) retVal = 1 end " + "redis.call('expire', key, expire) return retVal"; 执行LUA脚本 String data = JSON.toJSONString(nppaBehavior); Long retVal = (Long)jedisClusterTemplate.eval(CACHE_NPPA_EVENT_LUA, 1, NPPA_PREFIX + nppaBehavior.getGamePackage(), String.valueOf(MAX_GAME_EVENT_PER_GAME), data, String.valueOf(NPPA_TTL_MINUTE * 60)); 执行效果 实现固长队列的数据存储并设置过期时间 通过整合llen+rpush+lpop三个命令实现定长队列。 通过lua脚本保证上述命令的原子性执行。 整体的执行流程如上图所示,核心理念通过lua脚本的原子性保证了队列长度计算(llen)、队列数据移除(lpop)、队列数据保存(rpush)的原子性执行。 4.2 消费消息 定义LUA脚本 QUERY_NPPA_EVENT_LUA = "local data = {} " + "local key = KEYS[1] " + "local num = tonumber(ARGV[1]) " + "data = redis.call('lrange', key, 0, num) redis.call('ltrim', key, num+1, -1) return data"; 执行LUA脚本 Integer batchSize = NppaConfigUtils.getInteger("nppa.report.batch.size", 1); Object result = jedisClusterTemplate.eval(QUERY_NPPA_EVENT_LUA, 1,NPPA_PREFIX + gamePackage, String.valueOf(batchSize)); 执行效果 取固定数量的对象,然后保留队列的剩余的消息对象。 通过整合lrange+ltrim两个命令实现消息的批量消费。 通过lua脚本保证上述命令的原子性执行。 整体的执行流程如上图所示,核心理念通过lua脚本的原子性保证了数据获取(Lrange)和数据裁剪(Ltrim)的原子性执行。 整体的消费流程选择pull模式,通过多线程循环轮询可消费的队列进行消费。与借助于redis的pub/sub的通知机制实现消费流程的push模式相比,pull模式成本更低效果更佳。 4.3 注意事项 Redis集群模式下,执行Lua脚本建议传单key,多key会报重定向错误。 在不同的Redis版本下,Lua脚本针对null的返回值处理不同,参考官方文档。 消费者的消费过程中通过循环遍历游戏列表,然后根据游戏去获取对应的消息对象,但是不同的游戏对应的热度不同,所以在消费端我们通过配置的方式为热门游戏单独开启消费线程进行消费,相当于针对不同游戏配置不同优先级的消费者。 五、线上效果 生产和消费的QPS约为1w qps左右,整体上报QPS通过批量上报后会远低于生产的消息生产和消费的QPS。 整体数据的使用游戏包名作为key进行存储,性能上不存在热点的问题。 六、适用场景 在描述完方案的原理和实现细节之后,进一步对适用的业务场景进行下总结。整体方案是基于redis的基本数据结构构建一个伪消息队列,用以解决消息的单个生产批量消费的场景,通过多key形式实现消息队列的多Topic模式,重要的是能够借助于redis的原生能力在O(N)的时间复杂度完成批量消费。另外该方案也可以降级作为实现先进先出定长的日志队列。 七、总结 本文主要探索在特定业务场景下通过Redis的原生命令实现类MQ的功能,创新式的通过Lua脚本组合Redis的List的基础命令,实现了消息的分组,消息的定长队列,消息的批量消费功能;整体解决方案在线上环境落地并平稳运行,为特定场景提供了一种通用的解决方案。 END 猜你喜欢 Redis 内存优化在 vivo 的探索与实践 Redis 在 vivo 推送平台的应用与优化实践 本文分享自微信公众号 - vivo互联网技术(vivoVMIC)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | “整洁架构” 和商家前端的重构之路

原创 得物技术 - 陈子煜 1. 背景 团队归属于后方业务支撑部门,组内的项目都以pc中后台应用为主。对比移动端应用,代码库比较庞大,业务逻辑也相对复杂。在持续的迭代过程中,我们发现当前的代码仓库仍然有不少可以优化的点: 可以减弱对ui框架的依赖 21年前端平台决定技术栈统一迁移到React生态,后续平台的基础建设也都围绕React展开,这就使得商家使用Vue生态做开发的系统面临技术栈迁移的难题,将业务逻辑和UI框架节藕变得异常重要。 代码风格可以更加统一 随着代码量和团队成员的增加,应用里风格迥异的代码也越来越多。为了能够持续迅速的进行迭代,团队急需一套统一的顶层代码架构设计方案。 可以集成自动化测试用例 随着业务变得越来越复杂,在迅速的迭代过程中团队需要频繁地对功能进行回归,因此我们对于自动化单测用例的诉求也变的越来越强烈。 为了完成以上的优化,四组对现有的应用架构做了一次重构,而重构的核心就是整洁架构。 2. 整洁架构(The Clean Architecture) 整洁架构(The clean architecture)是由 Robert C. Martin (Uncle Bob)在2012年提出的一套代码组织的理念,其核心主要是依据各部分代码作用的不同将其拆分成不同的层次,在各层次间制定了明确的依赖原则,以达到以下目的: 与框架无关:无论是前端代码还是服务端代码,其逻辑本身都应该是独立的,不应该依赖于某一个第三方框架或工具库。一套独立的代码可以把第三方框架等作为工具使用。 可测试:代码中的业务逻辑可以在不依赖ui、数据库、服务器的情况下进行测试 和ui无关:代码中的业务逻辑不应该和ui做强绑定。比如把一个web应用切换成桌面应用,业务逻辑不应该受到影响。 和数据库无关:无论数据库用的是mysql还是mongodb,无论其怎么变,都不该影响到业务逻辑。 和外部服务无关:无论外部服务怎么变,都不影响到使用该服务的业务逻辑。 为了实现以上目的,整洁架构把应用划分成了entities、use cases、interface adapters(MVC、MVP等)、Web/DB等至少四层。这套架构除了分层之外,在层与层之间还有一个非常明确的依赖关系,外层的逻辑依赖内层的逻辑。 Entity entities封装了企业级的业务逻辑和规则。entities没有什么固定的形式,无论是一个对象也好,是一堆函数的集合也好,唯一的标准就是能够被企业的各个应用所复用。 Use Case entities封装了企业里最通用的一部分逻辑,而应用各自的业务逻辑就都封装在use case里面。日常开发中最常见的对于某个模型的crud操作就属于usecase这一层。 Interface Adapter 这一层类似于胶水层,需要负责内圈的entity和use case同外圈的external interfaces之间的数据转化。需要把外层服务的数据转化成内层entity和usecase可以消费的数据,反之亦然。如上面图上画的,这一层有时候可能很简单(一个转化函数), 有时候可能复杂到包含一整个MVC/MVP的架构。 External Interfaces 我们需要依赖的外部服务,第三方框架,以及需要糊的页面UI都归属在这一层。这一层完全不感知内圈的任何逻辑,所以无论这一层怎么变(ui变化),都不应该影响到内圈的应用层逻辑(usecase)和企业级逻辑(entity)。 依赖原则 在整洁架构的原始设计中,并不是强制一定只能写这么四层,根据业务的需要还可以拆分的更细。不过无论怎么拆,都需要遵守前面提到的从外至内的依赖原则。即entity作为企业级的通用逻辑,不能依赖任何模块。而外层的ui等则可以使用usecase、entity。 3. 重构 前面介绍了当前代码库目前的一些具体问题,而整洁架构的理念正好可以帮助我们优化代码可维护性。 作为前端,我们的业务逻辑不应该依赖视图层(ui框架及其生态),同时应当保证业务逻辑的独立性和可复用性(usecase & entity)。最后,作为数据驱动的端应用,要保证应用视图渲染和业务逻辑等不受数据变动的影响(adapter & entity)。 根据以上的思考,我们对“整洁架构”做了如下落地。 Entities 对于前端应用来说,在entity层我们只需要将服务端的生数据做一层简单的抽象,生成一个贫血对象给后续的渲染和交互逻辑使用。 interface IRawOrder { amount: number barCode: string orderNo: string orderType: string skuId: number deliveryTime: number orderTime: number productImg: string status: number } export default function buildMakeOrder({ formatTimestamp, formatImageUrl, }: { formatTimestamp: (timestamp: number, format?: string) => string formatImageUrl: ( image: string, config?: { width: number; height: number }, ) => string }) { return function makeOrder(raw?: IRawOrder) { if (!raw || !raw.orderNo) { Monitor.warn('脏数据') return null; } return { amount: raw.amount, barCode: raw.barCode, orderNo: raw.orderNo, orderType: raw.orderType, skuId: raw.skuId, status: raw.status, statusDescription: selectStatusDescription(raw.status), deliveryTime: formatTimestamp(raw.deliveryTime), orderTime: formatTimestamp(raw.orderTime), productImg: formatImageUrl(raw.productImg), } } } function selectStatusDescription(status: number): string { switch (status) { case 0: return '待支付' case 1: return '待发货' case 2: return '待收货' case 3: return '已完成' default: return '' } } 以上是商家后台订单模型的entity工厂函数,工厂主要负责对服务端返回的生数据进行加工处理,让其满足渲染层和逻辑层的要求。除了抽象数据之外,可以看到在entity工厂还对数据进行了校验,将脏数据、不符合预期的数据全部处理掉或者进行兜底(具体操作要看业务场景)。 有一点需要注意的是,在设计entity的时候(尤其是基础entity)需要考虑复用性。举个例子,在上面orderEntity的基础上,我们通过简单的组合就可以生成一个虚拟商品订单entity: import { makeOrder } from '@/entities' export default function buildMakeVirtualOrder() { return function makeVirtualOrder(raw?: IRawPresaleOrder) { const order = makeOrder(raw) if(! order || !raw.virtualOrderType) { Monitor.warn('脏数据') return null } return { ...order, virtualOrderType: raw.virtualOrderType, virtualOrderDesc: selectVirtualOrderDesc(raw.virtualOrderType) } } } 如此一来,我们就通过entity层达到了2个目的: 把前端的逻辑和服务端接口数据隔离开,无论服务端怎么变,前端后续的渲染、业务代码不需要变,我们只需要变更entitiy工厂函数;并且经过entity层处理过后,所有流入后续渲染&交互逻辑的数据都是可靠的;对于部分异常数据,前端应用可以第一时间发现并报警。 通过对业务模型进行抽象,实现了模块间的组合、复用。另外,抽象出的entity对代码的维护性也有非常大的帮助,开发者可以非常直观的知道所使用的entity所包含的所有字段。 Usecase usecase这一层即是围绕entity展开的一系列crud操作,以及为了页面渲染做的一些联动(通过ui store实现)。由于当前架构的原因(没有bff层),usecase还可能承担部分微服务串联的工作。 举个例子,商家后台订单页面在渲染前有一堆准备逻辑: 根据route的query参数以及一些商家类型参数来决定默认选中哪个tab 根据是国内商家还是境外商家,调用对应的供应商接口来更新供应商下拉框 现在大致的实现是: { mounted() { const { subType } = this.$route.query /* 7-15行处理了几种分支链路场景下对subType的赋值问题 */ if (Number(subType) === 0 || subType) { this.subType = subType.toString() } else { if (this.user.merchant.typeId === 4) { this.subType = this.tabType.cross } else { this.subType = this.tabType.ordinarySpot } } /* getAllLogisticsCarrier有没有对subType赋值呢?光看这段代码完全不确定 */ this.getAllLogisticsCarrier() /* 21-22行又多出来一个分支需要对subType进行再次赋值 */ if (this.isPersonPermission && !this.crossUser) { this.subType = this.tabType.warehouse } }, getAllLogisticsCarrier() { let getCarrier = API.getAllLogisticsCarrier if (this.crossUser) { getCarrier = API.getOrderShipAllLogistics } getCarrier({}).then(res => { if (res.code === 200) { const options = [] .......... // 给options赋值 this.options2 = options } }) }, } 我们能看到7-15、24-125行对this.subType进行了赋值。但由于我们无法确定20行的函数是否也对this.subType进行了赋值,所以光凭mounted函数的代码我们并不能完全确定subType的值究竟是什么,需要跳转到getAllLogisticsCarrier函数确认。这段代码在这里已经做了简化,实际的代码像getAllLogisticsCarrier这样的调用还有好几个,要想搞清楚逻辑就得把所有函数全看一遍,代码的可读性一般。同时,由于函数都封装在ui组件里,因此要想给函数覆盖单测的话也需要一些改造。 为了解决问题,我们将这部分逻辑都拆分到usecase层: // prepare-order-page.ts import { tabType } from '@/constants' interface IParams { subType?: number merchantType: number isCrossUser: boolean isPersonPermission: boolean } /* 做依赖倒置主要是为了方便后续的单测和复用 */ export default function buildPrepareOrderPage({ queryLogisticsCarriers, }: { queryLogisticsCarriers: () => Promise<{ carriers: ICarrires }> }) { return async function prepareOrderPage(params: IParams) { const activeTab = selectActiveTab(params) const { carriers } = queryLogisticsCarriers(params.isCrossUser) return { activeTab, carriers, } } } function selectActiveTab({ subType, isCrossUser, isPersonPermission, merchantType, }: IParams) { if (isPersonPermission && !isCrossUser) { return tabType.warehouse } if (Number(subType) === 0 || subType) { return subType.toString() } if (merchantType === 4) { return tabType.cross } return tabType.ordinarySpot } // query-logistics-carriers export default function buildQueryLogisticsCarriers({ fetchAllLogisticsCarrier, fetchOrderShipAllLogistics, }: { fetchAllLogisticsCarrier: () => Promise<{ data: {carriers: ICarrires }}> fetchOrderShipAllLogistics: () => Promise<{ data: {carriers: ICarrires }}> }) { return async function queryLogisticsCarriers(isCrossUser: boolean) { if (isCrossUser) { return fetchAllLogisticsCarrier() } return fetchOrderShipAllLogistics() } } // index.vue { mounted() { const {activeTab, carriers} = prepareOrderPage(params) this.subType = activeTab; this.options = buildCarrierOptions(carriers) // 将carries转换成下拉框option } } 首先,可以看到所有usecase一定是一个纯函数,不会存在副作用的问题。 其次,prepareOrderPage usecase专门为订单页定制,拆分后一眼就能看出来订单页的准备工作需要干决定选中的tab和拉取供应商列表两件事情。而另一个拆分出来的queryLogisticsCarriers则是封装了商家后台跨境、国内两种逻辑,后续无论跨境还是国内的逻辑如何变更,其影响范围被限制在了queryLogisticsCarriers函数,我们需要对其进行功能回归;而对于prepareOrderPage来说,queryLogisticsCarriers只是() => Promise<{ carriers: ICarrires }>的一个实现而已,其内部调用queryLogisticsCarriers的逻辑完全不受影响,不需要进行回归。 最后,而由于我们做了依赖倒置,我们可以非常容易的给usecase覆盖单测: import buildPrepareOrderPage from '@/utils/create-goods'; function init() { const queryLogisticsCarriers = jest.fn(); const prepareOrderPage = buildPrepareOrderPage({ queryLogisticsCarriers }); return { prepareOrderPage, queryLogisticsCarriers, }; } describe('订单页准备逻辑', () => { it('当用户是国内商家且在入仓白名单上,在打开订单页时,默认打开入仓tab', async () => { const { prepareOrderPage } = init(); const params = { merchantType: 2 isCrossUser: false isPersonPermission: true } const { activeTab } = await prepareOrderPage(params) expect(activeTab).toEqual({tabType.warehouse}); }); it('当用户是跨境商家,在打开订单页时,默认打开跨境tab', async () => { const { prepareOrderPage } = init(); const params = { merchantType: 4 isCrossUser: true isPersonPermission: true } const { activeTab } = await prepareOrderPage(params) expect(activeTab).toEqual({tabType.cross}); }); ...... }); 单测除了进行功能回归之外,它的描述(demo里使用了Given-When-Then的格式,由于篇幅的原因,关于单测的细节在后续的文章再进行介绍)对于了解代码的逻辑非常非常非常有帮助。由于单测和代码逻辑强行绑定的缘故,我们甚至可以将单测描述当成一份实时更新的业务文档。 除了方便写单测之外,在通过usecase拆分完成之后,ui组件真正成为了只负责“ui”和监听用户交互行为的组件,这为我们后续的React技术栈迁移奠定了基础;通过usecase我们也实现了很不错的模块化,对于使用比较多的一些entity,他的crud操作可以通过独立的usecase具备了在多个页面甚至应用间复用的能力。 Adapter 上面usecase例子中的fetchAllLogisticsCarrier就是一个adapter,这一层起到的作用是将外部系统返回的数据转化成entity,并以一种统一的数据格式返回回来。 这一层很核心的一点即是可以依赖entity的工厂函数,将接口返回的数据转化成前端自己设计的模型数据,保证流入usecase和ui层的数据都是经过处理的“干净数据”。除此之外,通常在这一层我们会用一种固定的数据格式返回数据,比如例子中的 {success: boolean, data?: any}。这样做主要是为了抹平对接多个系统带来的差异性,同时减少多人协作时的沟通成本。 type Request = (url: string, params: Record<string, any>) => Promise<any>; import makeCarrier from '@/entities/makeCarrier' export default function buildFetchAllLogisticsCarrier({request}: {request: Request}) { return async function fetchAllLogisticsCarrier() { // TODO: 异常处理 const response = await request('/fakeapi', info) if (!response || !resposne.code === 200) { return { success: false } } return { success: true, data: { carriers: response.list?.map(makeCarrier) } } } } 通过Adapter + entity的组合,我们基本形成了前端应用和后端服务之间的防腐层,使得前端可以在完全不清楚接口定义的情况下完成ui渲染、usecase等逻辑的开发。在服务端产出定义后,前端只需要将实际接口返回适配到自己定义的模型(通过entity)即可。这一点对前端的测试周提效非常非常非常重要,因为防腐层的存在,我们可以在测试周完成需求评审之后根据prd的内容设计出业务模型,并以此完成需求开发,在真正进入研发周后只需要和服务端对接完成adapter这一层的适配即可。 在实践过程中,我们发现在对接同一个系统的时候(对商家来说就是stark服务)各个adapter对于异常的处理几乎一模一样(上述的11-15行),我们可以通过Proxy对其进行抽离实现复用。当然,后续我们也完全有机会根据接口定义来自动生成adapter。 UI 在经过前面的拆分之后,无论咱们的UI层用React还是Vue来写,要做的工作都很简单了: 监听交互事件并调用对应的usecase来进行响应 通过usecase来获取entity数据进行渲染 由于entity已经做了过滤和适配处理,所以在ui层我们可以放心大胆的用,不需要再写一堆莫名其妙的判断逻辑。另外由于entity是由前端自己定义的模型,无论开发过程中服务端接口怎么变,受影响的都只有entity工厂函数,ui层不会受到影响。 最后,在ui层我们还剩下令人头痛的技术栈迁移问题。整个团队目前使用vue的项目有10个,按迭代频率和项目规模迁移的方案可以分为两类: 迭代频繁的大应用:主要包括代码行数较多、逻辑较为复杂的几个中大型应用。这些应用想要一把梭直接完成迁移成本极高,但同时每个迭代又有相当的需求。基于这种情况,对于这三个应用我们采取了微前端的方式进行迁移。每个应用分别起一个对应的React应用,对于新页面以及部分逻辑已经完全和ui解藕迁移成本不高的业务,都由React应用来承接,最后通过module federation的方式实现融合。 迭代不频繁的小应用:剩下的应用均是复杂度不高的小应用,这部分应用迭代的需求不多,以维护为主。因此我们的方案是对现有逻辑进行整洁架构重构,在ui和逻辑分层之后直接对ui层进行替换完成迁移。 4. 后续 通过整洁架构我们形成了统一的编码规范,在前端应用标准化的道路上迈下了坚实的一步。可以预见的是整个标准化的过程会非常漫长,我们会陆续往标准中增加新的规范使其更加完善,短期内在规划中的有: 单测即文档:上面提到了usecase通过依赖倒置来配合单测落地,后续团队期望将一些业务逻辑的实现细则通过单测的描述来进行沉淀,解决业务文档实时性的问题。 完善监控体系:前端常遇到的3种异常包括 代码逻辑异常、性能瓶颈(渲染卡顿、内存不足等)、数据导致异常。对于数据异常,我们可以在entity层映射的过程中加入对异常数据的埋点上报来填补目前监控的空白。(代码逻辑异常通过sentry已经监控,性能监控对于中后台应用不需要) 后续在标准逐渐稳定之后,我们也期望基于稳定的规范进行一些工程化的实践(比如根据mooncake文档自动生成adapter层、基于usecase实现功能开关等),敬请期待。 参考链接: The Clean Architecture:https://blog.cleancoder.com/uncle-bob/2012/08/13/the-clean-architecture.html Module Federation:https://webpack.js.org/concepts/module-federation/ Anti-corruption Layer pattern:https://docs.microsoft.com/en-us/azure/architecture/patterns/anti-corruption-layer *文/陈子煜 关注得物技术,每周一三五晚 18:30 更新技术干货 要是觉得文章对你有帮助的话,欢迎评论转发点赞~

优秀的个人博客,低调大师

每日一博 | 得物客服热线的演进之路

原创 Lily 得物技术 一、业务背景 得物为什么需要单独的热线? 随着得物业务的快速发展,强有力的客户服务越来越成为得物必不可少的一环,在原有IM聊天基础上,得物催生出属于自己的热线系统。主要意义有: 在通话中解决用户问题,帮助用户查询订单,为用户咨询创建工单进行跟踪; 为在线客服分流一部分咨询压力,满足一部分偏爱电话用户解决紧急复杂问题的场景,提升用户体验。 二、热线功能点 如今的得物客服热线到底可以做些什么? 内呼:用户通过400电话呼入咨询客服,增加用户咨询渠道,减轻IM客服接待压力,提升服务质量; 用户点击专属热线,打开手机拨号,如下图所示: 客服侧在接到来电之后又可以用得物热线工作台做些什么呢?如下图所示: 状态:客服可以在热线工作台进行状态切换,例如:空闲、忙碌、小休、会议等;默认状态为空闲,空闲接入电话,其他状态不会接入电话; 操作台:展示当前坐席接待的最近历史10通通话,如果有通话记录被删除则递补; 接电话:前端获取到响铃事件与数据,带入来电信息到客服操作台,在这里获取用户基本信息,核实用户身份,查询相关订单,工单打点,跳转到工单详情。通话记录的内容包括:手机号、来电时间(接通电话时间)、归属地(省市)、添加备注、技能组、按键轨迹、删除通话记录; 电话条动作:电话条主要是让客服可以在通话过程中主动发起一些动作。 a.点击保持:保留通话,用户侧听到为音乐; b.点击恢复:恢复通话; c.点击转接:转接至空闲客服,可取消转接,被转接客服接听后转接客服挂断 ,转接至客服组,通话挂断,被转接客服组内轮询至空闲客服; d.点击咨询:咨询空闲客服和客服组; e.点击转调查:挂断电话; f.点击邀评:用户评价; g.点击挂断:挂断电话。 坐席外呼:使用客户端电话软件向外拨打电话,主要场景是二线客服,在处理工单的时候,为了及时有效的和客户沟通,坐席通过外呼和客户联系。 三、得物热线发展史 先来看看现在的得物热线有哪些功能,如下图所示: 如上图所示,现在的得物热线功能主要包括工单管理、用户管理、订单管理、查询历史信息和电话管理五大功能模块,功能相对比较完善,基本满足了所有用户进线咨询的需求,然而其实热线的发展也不是一开始就这么完备的。经历了以下几个阶段: 下面来看一下得物热线是如何技术实现这每一个大步的~ 1.从工单衍生的需求 1.1 背景 其实热线通话一开始是从工单侧发起,工单作为客服域最为重要的跟进用户问题的凭证,客服每天都在和各种各样的工单打交道,与用户的实时沟通需求显得尤为迫切,这就是热线业务的初诞生,这个时期的热线只是依附于工单的一个功能。 1.2 技术实现 这个阶段主要是实现的与第三方电话软件的接通,如何让用户和客服能通上话才是重点,用户拨打电话到客服接收到电话,过程如下图: 首先热线的代码里面会注入电话相关SDK,这里使用的是第三方合力SDK,它主要负责三件事情: 负责监听服务器下发的响铃事件; 监听客服主动发起的电话条动作,如来电弹窗转接等; 以轮询的方式向服务器发送请求,及时更新客服状态,例如是否离线,是否有当前坐席的数据变更,获取转接组数据等,如截图所示,前端会保存这些数据。 合力:热线主要用的是合力三方热线服务,通过合力提供的电话服务做二次热线服务能力的开发。 SDK如何监听响铃时间和监听电话条动作,以响铃事件为例: 来电首先会通过合力服务器下发,调用SDK中的_softphonebar_evtRing方法; 通过全局注册的hollyglobal.ringEvent,下发ringEvent事件以及数据; 代码里的事件监听所捕获,在handleRingEvent方法里执行业务逻辑,加工数据; 其他电话条操作同理。 这样基本的通话功能就完成了,接下来只需要操作工单就可以了。 工单时期的热线一览: 2.辅助模块的诞生 2.1 背景 随着客服域章鱼工作台的独立孵化,热线作为重要的一部分,从工单迁移至章鱼工作台,这个时候的章鱼只能接打电话,查询基本信息,因为从工单迁移出来失去了和工单的绑定,因此与工单的重新结合,成为热线的一个里程碑式升级。 2.2 技术实现 在这个地方,热线从之前的iframe内嵌工单页面,转变成接入工单的远程组件。 iframe缺点:热线有不止一处用到工单,每一次打开就是加载另一个完整项目,客服要不断地切换不同通话,整个体验非常卡顿,性能非常不好; 模块联邦优点:从项目降维到组件,不用加载别人整个项目,只需要像使用自己项目里的平常组件一样去使用别人项目里的组件,只需关注这一个组件,开箱即用。 除此之外,服务轨迹模块也绑定了与来电用户手机的绑定,热线从只支持转接到一个客服组,变成还可支持单独的一个坐席,完善了整个转接模块与辅助模块功能。 3.与App金融侧完成对接 3.1 背景 仅仅只有工单打点,查询用户基本信息,热线功能依然是不完善的,用户来电势必会有各种各样的疑问,不仅是名下订单咨询,随着App金融侧计划上线面向用户使用后,询问寄售单以及金融情况的用户大量增多。 增加寄售单查询的功能,满足寄售单查询场景,不再需要单开寄售单查询系统; 增加佳物借贷:客服帮助来电用户查询或询问在分期内提供提现能力,回答备贷贷开通等相关事宜 。 3.2 技术实现 这里因为只有在特定情况下才会进行金融,寄售查询,并且页面只是一个简单的查询结果页面,这里采用iframe嵌入寄售与金融查询两个tab,src查询参数为用户ID,与查询的当前用户实现联动,自动带出页面信息,大幅节省客服时间。 4.语音链路大升级-ivr核身 IVR核身这一升级标志着得物的客服热线系统整条链路已经基本完备。 4.1 背景 为什么需要核身? 得物热线拉取2021年10月份至今的数据,非进线手机咨询量占比为40%,需核身的场景占总进线的20%左右;占比非常之高,且每通电话核身耗时为30S左右,一定程度上拉长平均处理时长,影响用户体验; 人工核身本身存在出错率。 4.2 业务流程 客服会通过进线用户是否本人,或者非本人是否核身情况,条件获取到用户信息,订单详情,服务轨迹以及为用户创建工单; 全程需要记录当前用户是否核身,核身结果会影响web做出不一样的响应,不同身份展示不同数据,业务场景如下图: 核身功能加入后: 4.3 技术挑战 除了合力侧需要在进入人工前的电话环节配置相应的语音提示节点,记录用户输入的手机号或者身份信息,后端返回相应的用户查询结果之外,在进入人工后热线前端主要解决的技术挑战有两个: 缓存:老热线只需要缓存查询出来的结果,客服并没有太多操作需要记录,并且以前默认用户进线号码就是咨询号码,只有这一种情况,缓存相对简单,但随着核身功能的加入,用户的信息变得多了起来,用户本机进线还是非本机进线,客服是否对用户核身,怎么核身的,核身是否通过,这些都是需要记录的数据,怎样维护缓存当前的数据,让客服切换左侧电话列表的同时不丢失上一次的操作,成了一个技术核心; 数据联动的弊端:由于代码里面势必会用到大量watch监听,一个最麻烦的现象就是一个数据的变动被好几个不相关的watch给监听到,于是执行了很多重复的逻辑,非常影响性能这个部分主要是依靠前端对于代码结构的优化。 4.4 解决办法 缓存的解决办法: 把之前一些组件state的数据信息,迁移至store存储,以左边的进线列表,每一通电话都会被记录成以通话ID为key的Object,value为搜索出的结果信息以及客服操作信息; 在切换列表的时候,用watch实现监听,将当前即将离开的页面(old)的state信息commit进store里面实现保存; 对于切入的目标会话(new),就拿取store里面存的值,这里的值也是来源于上一次切出时候保存的最新的值,所以一定是最新的。这里就实现了只需要保存最近结果而不需要保存客服每一次操作。 监听过多的解决办法: 确定watch的范围,什么时候该放大,什么时候该放小,比如一些watch其实是可以合并的,把相同的逻辑合在一起处理; 在一些处理发送接口的逻辑上,尽量缩小watch范围,否则接口就会频繁的触发; 将store结构进行改写,比如热线这里就把基本信息的数据信息单独提取了出来,作为一个常用的watch监听,这样不会干扰其他数据的监听。 到这里,如今的得物热线就这么诞生了~ 四、项目成效 取数范围:4.17-4.26 结论:核身功能上线后,实际核身的电话量占总接话量的6.2%,与人工核身相比,每通平均通话时长下降12.5s。 五、未来规划 当然,现在的得物热线与行业内其他时间更长,更成熟的产品相比还有一定的进步空间,未来主要会做这几步: 合力SDK升级:现阶段电话相关功能都依赖于第三方合力接口,这也使得热线线上稳定性不太容易得到保障,很多时候避免不了和合力的沟通,这一点前期会主要推进合力SDK的升级与规范,梳理核心链路,补充兜底逻辑,总结常见问题,做到快速定位并解决问题,后期还会逐步开始自研一套电话核心SDK供使用; IVR核身升级:增加自助功能,把一些人工查询就能解决的前置到IVR,因为可以看到IVR核身的出现,已经达到了让人工通话时长降低的成效,这在一定程度上说明将大量冗余的人工操作放在电话语音部分是非常有必要的,因此这一部分还会继续保持,前置更多必要的自助功能; 工作台:短中期是会再增加一些坐席在作业中要用的查询信息(比如用户个人信息,订单信息和寄售信息的透出),这一部分主要是前端页面的改动; 规则类的配置:现在的热线还是基于只要是空闲状态就会被分配电话,这一部分准备与在线保持一致,会做一些排队规则,分配规则的配置页面,让热线客服也能被合理安排资源,提升效率,减少成本。 总体来说,得物热线的出现,让得物客服域生态更加完备,也让用户多了一个沟通的渠道,以后的热线也将致力于优化业务逻辑,以提高客服解决问题效率为目标,增强用户与得物客服之间的双向体验~ *文/Lily 关注得物技术,每周一三五晚18:30更新技术干货 要是觉得文章对你有帮助的话,欢迎评论转发点赞~

优秀的个人博客,低调大师

每日一博 | 移动端人脸风格化技术的应用

本文介绍了人脸风格化技术的整个流程,以及该技术在直播、短视频等场景下的应用。该技术可作为氛围营造、提高观感的有效手段,也可在买家秀等图文场景下起到人脸隐私保护、增添乐趣等作用。 前言 随着元宇宙、数字人、虚拟形象等概念的爆发,各种数字化协同互动的泛娱乐应用也在不断的落地。例如,在一些游戏中,玩家成为虚拟艺人参与到高还原度的现实艺人日常工作中,并会在特定情况下,与虚拟艺人在人脸表情等层面上形成强映射提升参与感。而由阿里巴巴天猫推出的超写实数字人AYAYI和井柏然联合“带逛”的杂志《MO Magazine》,则打破传统的平面阅读体验,以虚实结合的形式让读者获得沉浸式体验。 而在这些泛娱乐应用场景中,“人”必然是首要考虑的一步。而人工设计的数字、动画形象,存在过于“抽象”、代价高昂、缺乏个性化等问题。因此在人脸数字化上,我们通过研发具有良好控制感、ID感、风格化程度的人脸风格化技术,实现风格定制化的人脸形象切换。该项技术不仅可以在直播、短视频等娱乐消费场景下作为氛围营造、提高观感的有效手段,也可在买家秀等图文场景下起到人脸隐私保护、增添乐趣等作用。更进一步的想象,若不同的用户聚集在某个数字社区内,用该社区风格的数字形象聊天社交(例如“双城之战吧”的用户在元宇宙内用双城之战风格化形象友好交流),那是多具有代入感的事情。 双城之战动画 左图为原始AYAYI的形象,右图为风格化后的形象。 而为了将人脸风格化这项技术落地到我们的直播、买家秀、卖家秀等不同的泛娱乐业务场景,我们做到了: 低成本生产不同人脸风格化编辑的模型(本文所展示的所有效果均在没有任何设计资源的投入下实现的); 适当进行风格编辑以配合设计、产品、运营进行风格选型; 能够在人脸ID感和风格化程度之间做倾斜与平衡; 保证模型的泛化性,以适用于不同的人脸、角度、场景环境; 在保证清晰度等效果的前提下,降低模型对算力的要求。 接下来,我们先看一下demo,然后再介绍我们整个技术流程:感谢我们的产品mm——多菲~ 整体方案 我们的整体算法方案采用三个阶段: 阶段一:基于StyleGAN的风格化数据生成; 阶段二:非监督图像翻译生成配对图像; 阶段三:使用配对图像进行移动端有监督图像翻译模型的训练。 人脸风格化编辑整体算法方案 当然,也可以用二阶段方案:StyleGAN制作pair图像对,然后直接训练有监督小模型。但增加非监督图像翻译阶段,可以 将风格化数据生产和配对图像数据制作两个任务解耦 开来,通过对阶段内算法、阶段间数据的优化改进,结合移动端有监督小模型训练,最终解决低成本的风格化模型生产、风格的编辑及选型、ID感及风格化的倾斜、部署模型的轻量化等问题。 基于StyleGAN的数据生成 使用StyleGAN算法进行数据生成的工作上,主要针对3个问题的解决: 提升模型的生成数据丰富度和风格化程度:例如生成CG脸更像CG,且各个角度、表情、发型等形象更丰富; 提升数据生成效率:生成的数据良率高、分布更加可控; 风格编辑及选型:例如修改CG脸的眼睛大小。 下面我们针对这三方面展开。 ▐丰富度和风格化 基于StyleGAN2-ADA的迁移学习遇到的第一个重要问题就是:模型的丰富度和模型的风格化程度之间的trade-off。使用训练集进行迁移学习时,受训练集数据的丰富度影响,迁移后的模型在人脸表情、人脸角度、人脸元素等方面的丰富度也会受损;同时,随着迁移训练的迭代代数增加、模型风格化程度/FID的提升,模型丰富度也会越低。这会使得后续应用模型生成的风格化数据集分布过于单调,不利于U-GAT-IT的训练。 为了提升模型的丰富度,我们进行了如下改进: 调整、优化训练数据集的数据分布; 模型融合:因为源模型在大量数据上进行训练,所以源模型的生成空间具有非常高的丰富度;如果将迁移模型低分辨率层的权重替换为源模型对应层权重得到融合模型,则可使得新模型的生成图像在大的元素/特征上的分布与源模型一致,从而在低分辨率特征上获得与源模型一致的丰富度;融合方式:Swap layer直接交换不同层的参数,容易造成生成图像的不协调、细节bad cases;而通过平滑的模型插值,可以获得更好的生成效果(下面的图示皆由插值融合方式的融合模型生成的) 对不同层的学习率以及特征进行约束、优化调整; 迭代优化:人工筛选新生产的数据,添加到原风格化数据集中以提升丰富度,然后在迭代训练优化直到得到一个能生成较高丰富度、满意风格化程度的模型。 原图,迁移模型,融合模型 ▐数据生成效率 如果我们拥有一个丰富度高的StyleGAN2模型,那如何生成一个具有丰富分布的风格数据集呢?有两个做法: 随机采样隐变量,生成随机风格数据集; 使用StyleGAN inversion,输入符合一定分布的人脸数据,制作对应的风格数据集。 做法1可以提供更丰富的风格化数据(特别是背景的丰富度),而做法2可以提高生成数据的有效性和提供一定程度的分布控制,提升风格化数据生产效率。 原始图像,StyleGAN Inversion得到的隐向量送入“高级脸风格/动画风格” StyleGAN2生成器得到的图像 ▐风格编辑及选型 原始风格不太好看是就没法用了 迁移训练后的模型风格就没法改了 No No No,每一个模型不止可以用来生成数据,也可沉淀为一个基础组件、基础能力。不止是想在原始风格上做微调、优化,甚至是想创造新的风格,都是可以的: 模型融合:通过融合多个模型、设置不同的融合参数/层数、使用不同的融合方式等,可以实现对劣势风格模型做优化,也可实现风格的调整; 模型套娃:将不同风格的模型串联,使得最终输出的风格携带了中间模型的一些五官、色调等风格特征。 融合过程中实现对漫画风格的微调(瞳孔颜色、嘴唇、肤色色调等) 通过风格创造及微调,可以实现不同风格的模型,从而实现不同风格人脸数据的生产。 通过基于StyleGAN的迁移学习、风格编辑优化、数据生成,我们便可以获得我们的第一桶金💰:具有较高丰富度的、1024×1024分辨率的、风格选型后的风格化数据集。 基于非监督图像翻译的配对数据制作 非监督图像翻译技术通过学习两个域之间的映射关系,可以将一个域的图像转换到另一个域上,从而提供制作图像对的可能。例如该领域出名的CycleGAN具有如下的结构: CycleGAN主要框架 我在上文讨论“模型丰富度”的时候说过: 这(低丰富度)会使得后续应用模型生成的风格化数据集分布过于单调,不利于U-GAT-IT的训练。 这是为什么么?因为CycleGAN的框架要求两个域的数据要基本符合双射关系,否则域翻译到域后,就很容易发生语义丢失。而StyleGAN2 inversion生成的图像存在一个问题,就是大部分的背景信息会丢失,变成简单的、模糊的背景(当然,有一些最新的论文极大缓解了这个问题,例如腾讯AI Lab的High-Fidelity GAN Inversion)。如果使用数据集和真实人脸数据集直接训练U-GAT-IT,就很容易发生数据集生成的对应图像的背景丢失大量语义信息,导致很难形成有效的图像对。 于是针对此提出了改进U-GAT-IT以实现固定背景的两种方式:基于增加背景约束的Region-based U-GAT-IT算法改进,基于增加掩膜分支的Mask U-GAT-IT算法改进。这两种方式存在ID感和风格化程度强弱和均衡的差异,结合超参的调整,为我们的ID感和风格化提供了一个控制余地。同时,我们也进行网络结构改进、模型EMA、边缘提升等手段进一步提升生成效果。 左为原图,中间和右边是非监督图像翻译的生成效果,差异在于对算法进行了ID感和风格化程度的控制 最终,使用训练好的生成模型对真人图像数据集进行推理翻译得到对应的配对风格化数据集。 有监督图像翻译 基于MNN不同算子及模块在移动端上的计算效率的研究,进行 移动端模型结构设计 及 模型计算量分档,并结合对CartoonGAN、AnimeGAN、pix2pix等研究的改进,最终得到了 轻量、高清晰度、高风格化程度的移动端模型: 模型 清晰度↑ FID↓ Pixel-wise Loss 3.44 32.53 +Perceptual loss + GAN Loss 6.03 8.36 +Edge-promoting 6.24 8.09 +Data Augmentation 6.57 8.26 *清晰度使用 拉普拉斯梯度值求和 作为统计指标 有监督图像翻译模型整体训练框架 在移动端上实现实时的变脸效果: 展望 优化数据集:不同角度图像数据、质量优化; 整体链路的优化、改进、重设计; 更好的数据生成:StyleGAN3、Inversion算法、模型融合、风格编辑/创造、few-shot; 非监督两域翻译:利用较高匹配度的生成数据对做半监督,生成模型结构优化(例如引入傅里叶卷积); 有监督两域翻译:vid2vid 、帧间稳定性提升、极限场景的优化、细节的稳定性; 全图风格化/数字创作:disco diffusion、dalle2,style transfer。 参考文献 Karras, Tero, Miika Aittala, Janne Hellsten, Samuli Laine, Jaakko Lehtinen, and Timo Aila. "Training generative adversarial networks with limited data." arXiv preprint arXiv:2006.06676 (2020). Kim, Junho, Minjae Kim, Hyeonwoo Kang, and Kwanghee Lee. "U-gat-it: Unsupervised generative attentional networks with adaptive layer-instance normalization for image-to-image translation." arXiv preprint arXiv:1907.10830 (2019). Pinkney, Justin NM, and Doron Adler. "Resolution Dependent GAN Interpolation for Controllable Image Synthesis Between Domains." arXiv preprint arXiv:2010.05334 (2020). Tov, Omer, Yuval Alaluf, Yotam Nitzan, Or Patashnik, and Daniel Cohen-Or. "Designing an encoder for stylegan image manipulation." ACM Transactions on Graphics (TOG) 40, no. 4 (2021): 1-14. Song, Guoxian, Linjie Luo, Jing Liu, Wan-Chun Ma, Chunpong Lai, Chuanxia Zheng, and Tat-Jen Cham. "AgileGAN: stylizing portraits by inversion-consistent transfer learning." ACM Transactions on Graphics (TOG) 40, no. 4 (2021): 1-13. zllrunning. face-parsing.PyTorch. https://github.com/zllrunning/face-parsing.PyTorch, 2019. 5 Roy, Abhijit Guha, Nassir Navab, and Christian Wachinger. "Recalibrating fully convolutional networks with spatial and channel “squeeze and excitation” blocks." IEEE transactions on medical imaging 38, no. 2 (2018): 540-549. Chen, Yang, Yu-Kun Lai, and Yong-Jin Liu. "Cartoongan: Generative adversarial networks for photo cartoonization." In Proceedings of the IEEE conference on computer vision and pattern recognition, pp. 9465-9474. 2018. Zhang, Lingzhi, Tarmily Wen, and Jianbo Shi. "Deep image blending." In Proceedings of the IEEE/CVF Winter Conference on Applications of Computer Vision, pp. 231-240. 2020. Wang, Xintao, Ke Yu, Shixiang Wu, Jinjin Gu, Yihao Liu, Chao Dong, Yu Qiao, and Chen Change Loy. "Esrgan: Enhanced super-resolution generative adversarial networks." In Proceedings of the European conference on computer vision (ECCV) workshops, pp. 0-0. 2018. Wang, Xintao, Liangbin Xie, Chao Dong, and Ying Shan. "Real-esrgan: Training real-world blind super-resolution with pure synthetic data." In Proceedings of the IEEE/CVF International Conference on Computer Vision, pp. 1905-1914. 2021. Siddique, Nahian, Sidike Paheding, Colin P. Elkin, and Vijay Devabhaktuni. "U-net and its variants for medical image segmentation: A review of theory and applications." IEEE Access (2021). Wang, Tengfei, et al. "High-fidelity gan inversion for image attribute editing." arXiv preprint arXiv:2109.06590 (2021). 团队介绍 我们是大淘宝技术多媒体生产&视频内容理解算法团队,依托于淘宝天猫数十亿级的视频/图像数据,致力于提供从看点商品多媒体生产到前台视频理解推荐的全链路视觉算法方案。在端云一体的图像/视频处理、跨模态视频内容理解、AR直播、3D数字场、内容智能生产、审核、检索和高层语义理解等技术领域上,持续探索及发力以驱动产品和商品创新;在支持淘宝直播、逛逛、点淘等天猫淘宝内容业务的同时,也通过自研的内容中台为阿里集团内的钉钉、闲鱼、优酷等内容业务提供视觉算法能力支持。我们不断吸引及欢迎机器学习、视觉算法、NLP算法、端侧智能等领域⼈才的加⼊,欢迎联系 judyzha.zjl@alibaba-inc.com。 ✿拓展阅读 作者| 郑煜伟(关良) 编辑| 橙子君 本文分享自微信公众号 - 大淘宝技术(AlibabaMTT)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | 可视化全链路日志追踪

可观测性作为系统高可用的重要保障,已经成为系统建设中不可或缺的一环。然而随着业务逻辑的日益复杂,传统的ELK方案在日志搜集、筛选和分析等方面愈加耗时耗力,而分布式会话跟踪方案虽然基于追踪能力完善了日志的串联,但更聚焦于调用链路,也难以直接应用于高效的业务追踪。本文介绍了可视化全链路日志追踪的新方案,它以业务链路为载体,通过有效组织业务每次执行的日志,实现了执行现场的可视化还原,支持问题的高效定位。 1. 背景 1.1 业务系统日益复杂 随着互联网产品的快速发展,不断变化的商业环境和用户诉求带来了纷繁复杂的业务需求。业务系统需要支撑的业务场景越来越广、涵盖的业务逻辑越来越多,系统的复杂度也跟着快速提升。与此同时,由于微服务架构的演进,业务逻辑的实现往往需要依赖多个服务间的共同协作。总而言之,业务系统的日益复杂已经成为一种常态。 1.2 业务追踪面临挑战 业务系统往往面临着多样的日常客诉和突发问题,“业务追踪”就成为了关键的应对手段。业务追踪可以看做一次业务执行的现场还原过程,通过执行中的各种记录还原出原始现场,可用于业务逻辑执行情况的分析和问题的定位,是整个系统建设中重要的一环。 目前在分布式场景下,业务追踪的主流实现方式包括两类,一类是基于日志的ELK方案,一类是基于单次请求调用的会话跟踪方案。然而随着业务逻辑的日益复杂,上述方案越来越不适用于当下的业务系统。 1.2.1 传统的ELK方案 日志作为业务系统的必备能力,职责就是记录程序运行期间发生的离散事件,并且在事后阶段用于程序的行为分析,比如曾经调用过什么方法、操作过哪些数据等等。在分布式系统中,ELK技术栈已经成为日志收集和分析的通用解决方案。如下图1所示,伴随着业务逻辑的执行,业务日志会被打印,统一收集并存储至Elasticsearch(下称ES) [2] 。 传统的ELK方案需要开发者在编写代码时尽可能全地打印日志,再通过关键字段从ES中搜集筛选出与业务逻辑相关的日志数据,进而拼凑出业务执行的现场信息。然而该方案存在如下的痛点: 日志搜集繁琐:虽然ES提供了日志检索的能力,但是日志数据往往是缺乏结构性的文本段,很难快速完整地搜集到全部相关的日志。 日志筛选困难:不同业务场景、业务逻辑之间存在重叠,重叠逻辑打印的业务日志可能相互干扰,难以从中筛选出正确的关联日志。 日志分析耗时:搜集到的日志只是一条条离散的数据,只能阅读代码,再结合逻辑,由人工对日志进行串联分析,尽可能地还原出现场。 综上所述,随着业务逻辑和系统复杂度的攀升,传统的ELK方案在日志搜集、日志筛选和日志分析方面愈加的耗时耗力,很难快速实现对业务的追踪。 1.2.2 分布式会话跟踪方案 在分布式系统,尤其是微服务系统中,业务场景的某次请求往往需要经过多个服务、多个中间件、多台机器的复杂链路处理才能完成。为了解决复杂链路排查困难的问题,“分布式会话跟踪方案”诞生。该方案的理论知识由Google在2010年《Dapper》论文 [3] 中发表,随后Twitter开发出了一个开源版本Zipkin [4] 。 市面上的同类型框架几乎都是以Google Dapper论文为基础进行实现,整体大同小异,都是通过一个分布式全局唯一的id(即traceId),将分布在各个服务节点上的同一次请求串联起来,还原调用关系、追踪系统问题、分析调用数据、统计系统指标。分布式会话跟踪,是一种会话级别的追踪能力,如下图2所示,单个分布式请求被还原成一条调用链路,从客户端发起请求抵达系统的边界开始,记录请求流经的每一个服务,直到向客户端返回响应为止。 分布式会话跟踪的主要作用是分析分布式系统的调用行为,并不能很好地应用于业务逻辑的追踪。下图3是一个审核业务场景的追踪案例,业务系统对外提供审核能力,待审对象的审核需要经过“初审”和“复审”两个环节(两个环节关联相同的taskId),因此整个审核环节的执行调用了两次审核接口。如图左侧所示,完整的审核场景涉及众多“业务逻辑”的执行,而分布式会话跟踪只是根据两次RPC调用生成了右侧的两条调用链路,并没有办法准确地描述审核场景业务逻辑的执行,问题主要体现在以下几个方面: (1) 无法同时追踪多条调用链路 分布式会话跟踪仅支持单个请求的调用追踪,当业务场景包含了多个调用时,将生成多条调用链路;由于调用链路通过traceId串联,不同链路之间相互独立,因此给完整的业务追踪增加了难度。例如当排查审核场景的业务问题时,由于初审和复审是不同的RPC请求,所以无法直接同时获取到2条调用链路,通常需要额外存储2个traceId的映射关系。 (2) 无法准确描述业务逻辑的全景 分布式会话跟踪生成的调用链路,只包含单次请求的实际调用情况,部分未执行的调用以及本地逻辑无法体现在链路中,导致无法准确描述业务逻辑的全景。例如同样是审核接口,初审链路1包含了服务b的调用,而复审链路2却并没有包含,这是因为审核场景中存在“判断逻辑”,而该逻辑无法体现在调用链路中,还是需要人工结合代码进行分析。 (3) 无法聚焦于当前业务系统的逻辑执行 分布式会话跟踪覆盖了单个请求流经的所有服务、组件、机器等等,不仅包含当前业务系统,还涉及了众多的下游服务,当接口内部逻辑复杂时,调用链路的深度和复杂度都会明显增加,而业务追踪其实仅需要聚焦于当前业务系统的逻辑执行情况。例如审核场景生成的调用链路,就涉及了众多下游服务的内部调用情况,反而给当前业务系统的问题排查增加了复杂度。 1.2.3 总结 传统的ELK方案是一种滞后的业务追踪,需要事后从大量离散的日志中搜集和筛选出需要的日志,并人工进行日志的串联分析,其过程必然耗时耗力。而分布式会话跟踪方案则是在调用执行的同时,实时地完成了链路的动态串联,但由于是会话级别且仅关注于调用关系等问题,导致其无法很好地应用于业务追踪。 因此,无论是传统的ELK方案还是分布式会话跟踪方案,都难以满足日益复杂的业务追踪需求。本文希望能够实现聚焦于业务逻辑追踪的高效解决方案,将业务执行的日志以业务链路为载体进行高效组织和串联,并支持业务执行现场的还原和可视化查看,从而提升定位问题的效率,即可视化全链路日志追踪。 下文将介绍可视化全链路日志追踪的设计思路和通用方案,同时介绍新方案在大众点评内容平台的落地情况,旨在帮助有类似需求的业务系统开发需求的同学提供一些思路。 2. 可视化全链路日志追踪 2.1 设计思路 可视化全链路日志追踪考虑在前置阶段,即业务执行的同时实现业务日志的高效组织和动态串联,如下图4所示,此时离散的日志数据将会根据业务逻辑进行组织,绘制出执行现场,从而可以实现高效的业务追踪。 新方案需要回答两个关键问题:如何高效组织业务日志,以及如何动态串联业务日志。下文将逐一进行回答。 问题1:如何高效组织业务日志? 为了实现高效的业务追踪,首先需要准确完整地描述出业务逻辑,形成业务逻辑的全景图,而业务追踪其实就是通过执行时的日志数据,在全景图中还原出业务执行的现场。 新方案对业务逻辑进行了抽象,定义出业务逻辑链路,下面还是以“审核业务场景”为例,来说明业务逻辑链路的抽象过程: 逻辑节点:业务系统的众多逻辑可以按照业务功能进行拆分,形成一个个相互独立的业务逻辑单元,即逻辑节点,可以是本地方法(如下图5的“判断逻辑”节点)也可以是RPC等远程调用方法(如下图5的“逻辑A”节点)。 逻辑链路:业务系统对外支撑着众多的业务场景,每个业务场景对应一个完整的业务流程,可以抽象为由逻辑节点组合而成的逻辑链路,如下图5中的逻辑链路就准确完整地描述了“审核业务场景”。 一次业务追踪就是逻辑链路的某一次执行情况的还原,逻辑链路完整准确地描述了业务逻辑全景,同时作为载体可以实现业务日志的高效组织。 问题2:如何动态串联业务日志? 业务逻辑执行时的日志数据原本是离散存储的,而此时需要实现的是,随着业务逻辑的执行动态串联各个逻辑节点的日志,进而还原出完整的业务逻辑执行现场。 由于逻辑节点之间、逻辑节点内部往往通过MQ或者RPC等进行交互,新方案可以采用分布式会话跟踪提供的分布式参数透传能力 [5] 实现业务日志的动态串联: 通过在执行线程和网络通信中持续地透传参数,实现在业务逻辑执行的同时,不中断地传递链路和节点的标识,实现离散日志的染色。 基于标识,染色的离散日志会被动态串联至正在执行的节点,逐渐汇聚出完整的逻辑链路,最终实现业务执行现场的高效组织和可视化展示。 与分布式会话跟踪方案不同的是,当同时串联多次分布式调用时,新方案需要结合业务逻辑选取一个公共id作为标识,例如图5的审核场景涉及2次RPC调用,为了保证2次执行被串联至同一条逻辑链路,此时结合审核业务场景,选择初审和复审相同的“任务id”作为标识,完整地实现审核场景的逻辑链路串联和执行现场还原。 2.2 通用方案 明确日志的高效组织和动态串联这两个基本问题后,本文选取图4业务系统中的“逻辑链路1”进行通用方案的详细说明,方案可以拆解为以下步骤: 2.2.1 链路定义 “链路定义”的含义为:使用特定语言,静态描述完整的逻辑链路,链路通常由多个逻辑节点,按照一定的业务规则组合而成,业务规则即各个逻辑节点之间存在的执行关系,包括串行、并行、条件分支。 DSL(Domain Specific Language)是为了解决某一类任务而专门设计的计算机语言,可以通过JSON或XML定义出一系列节点(逻辑节点)的组合关系(业务规则)。因此,本方案选择使用DSL描述逻辑链路,实现逻辑链路从抽象定义到具体实现。 逻辑链路1-DSL [ { "nodeName": "A", "nodeType": "rpc" }, { "nodeName": "Fork", "nodeType": "fork", "forkNodes": [ [ { "nodeName": "B", "nodeType": "rpc" } ], [ { "nodeName": "C", "nodeType": "local" } ] ] }, { "nodeName": "Join", "nodeType": "join", "joinOnList": [ "B", "C" ] }, { "nodeName": "D", "nodeType": "decision", "decisionCases": { "true": [ { "nodeName": "E", "nodeType": "rpc" } ] }, "defaultCase": [ { "nodeName": "F", "nodeType": "rpc" } ] } ] 2.2.2 链路染色 “链路染色”的含义为:在链路执行过程中,通过透传串联标识,明确具体是哪条链路在执行,执行到了哪个节点。 链路染色包括两个步骤: 步骤一:确定串联标识,当逻辑链路开启时,确定唯一标识,能够明确后续待执行的链路和节点。 链路唯一标识 = 业务标识 + 场景标识 + 执行标识 (三个标识共同决定“某个业务场景下的某次执行”) 业务标识:赋予链路业务含义,例如“用户id”、“活动id”等等。 场景标识:赋予链路场景含义,例如当前场景是“逻辑链路1”。 执行标识:赋予链路执行含义,例如只涉及单次调用时,可以直接选择“traceId”;涉及多次调用时则,根据业务逻辑选取多次调用相同的“公共id”。 节点唯一标识 = 链路唯一标识 + 节点名称 (两个标识共同决定“某个业务场景下的某次执行中的某个逻辑节点”) 节点名称:DSL中预设的节点唯一名称,如“A”。 步骤二:传递串联标识,当逻辑链路执行时,在分布式的完整链路中透传串联标识,动态串联链路中已执行的节点,实现链路的染色。例如在“逻辑链路1”中: 当“A”节点触发执行,则开始在后续链路和节点中传递串联标识,随着业务流程的执行,逐步完成整个链路的染色。 当标识传递至“E”节点时,则表示“D”条件分支的判断结果是“true”,同时动态地将“E”节点串联至已执行的链路中。 2.2.3 链路上报 “链路上报”的含义为:在链路执行过程中,将日志以链路的组织形式进行上报,实现业务现场的准确保存。 如上图8所示,上报的日志数据包括:节点日志和业务日志。其中节点日志的作用是绘制链路中的已执行节点,记录了节点的开始、结束、输入、输出;业务日志的作用是展示链路节点具体业务逻辑的执行情况,记录了任何对业务逻辑起到解释作用的数据,包括与上下游交互的入参出参、复杂逻辑的中间变量、逻辑执行抛出的异常。 2.2.4 链路存储 “链路存储”的含义为:将链路执行中上报的日志落地存储,并用于后续的“现场还原”。上报日志可以拆分为链路日志、节点日志和业务日志三类: 链路日志:链路单次执行中,从开始节点和结束节点的日志中提取的链路基本信息,包含链路类型、链路元信息、链路开始/结束时间等。 节点日志:链路单次执行中,已执行节点的基本信息,包含节点名称、节点状态、节点开始/结束时间等。 业务日志:链路单次执行中,已执行节点中的业务日志信息,包含日志级别、日志时间、日志数据等。 下图就是链路存储的存储模型,包含了链路日志,节点日志,业务日志、链路元数据(配置数据),并且是如下图9所示的树状结构,其中业务标识作为根节点,用于后续的链路查询。 3. 大众点评内容平台实践 3.1 业务特点与挑战 互联网时代,内容为王。内容型平台的核心打法就是搭建内容流水线,保障内容可持续、健康且有价值地流转到内容消费者,并最终形成内容“生产→治理→消费→生产”的良性循环。 大众点评和美团App拥有丰富多样的内容,站内外业务方、合作方有着众多的消费场景。对于内容流水线中的三方,分别有如下需求: 内容的生产方:希望生产的内容能在更多的渠道分发,收获更多的流量,被消费者所喜爱。 内容的治理方:希望作为“防火墙”过滤出合法合规的内容,同时整合机器和人工能力,丰富内容属性。 内容的消费方:希望获得满足其个性化需求的内容,能够吸引其种草,或辅助其做出消费决策。 生产方的内容模型各异、所需处理手段各不相同,消费方对于内容也有着个性化的要求。如果由各个生产方和消费方单独对接,内容模型异构、处理流程和输出门槛各异的问题将带来对接的高成本和低效率。在此背景下,点评内容平台应运而生,作为内容流水线的“治理方”,承上启下实现了内容的统一接入、统一处理和统一输出: 统一接入:统一内容数据模型,对接不同的内容生产方,将异构的内容转化为内容平台通用的数据模型。 统一处理:统一处理能力建设,积累并完善通用的机器处理和人工运营能力,保证内容合法合规,属性丰富。 统一输出:统一输出门槛建设,对接不同的内容消费方,为下游提供规范且满足其个性化需求的内容数据。 如下图11所示,是点评内容平台的核心业务流程,每一条内容都会经过这个流程,最终决定在各个渠道下是否分发。 内容是否及时、准确经过内容平台的处理,是内容生产方和消费方的核心关注,也是日常值班的主要客诉类型。而内容平台的业务追踪建设,主要面临以下的困难与复杂性: 业务场景多:业务流程涉及多个不同的业务场景,且逻辑各异,例如实时接入、人工运营、分发重算等图中列出的部分场景。 逻辑节点多:业务场景涉及众多的逻辑节点,且不同内容类型节点各异,例如同样是实时接入场景,笔记内容和直播内容在执行的逻辑节点上存在较大差异。 触发执行多:业务场景会被多次触发执行,且由于来源不同,逻辑也会存在差异,例如笔记内容被作者编辑、被系统审核等等后,都会触发实时接入场景的重新执行。 点评内容平台日均处理百万条内容,涉及百万次业务场景的执行、高达亿级的逻辑节点的执行,而业务日志分散在不同的应用中,并且不同内容,不同场景,不同节点以及多次执行的日志混杂在一起,无论是日志的搜集还是现场的还原都相当繁琐耗时,传统的业务追踪方案越来越不适用于内容平台。 点评内容平台亟需新的解决方案,实现高效的业务追踪,因此我们进行了可视化全链路日志追踪的建设,下面本文将介绍一下相关的实践和成果。 3.2 实践与成果 3.2.1 实践 点评内容平台是一个复杂的业务系统,对外支撑着众多的业务场景,通过对于业务场景的梳理和抽象,可以定义出实时接入、人工运营、任务导入、分发重算等多个业务逻辑链路。由于点评内容平台涉及众多的内部服务和下游依赖服务,每天支撑着大量的内容处理业务,伴随着业务的执行将生成大量的日志数据,与此同时链路上报还需要对众多的服务进行改造。因此在通用的全链路日志追踪方案的基础上,点评内容平台进行了如下的具体实践。 (1) 支持大数据量日志的上报和存储 点评内容平台实现了图12所示的日志上报架构,支持众多服务统一的日志收集、处理和存储,能够很好地支撑大数据量下的日志追踪建设。 日志收集:各应用服务通过机器上部署的log_agent收集异步上报的日志数据,并统一传输至Kafka通道中,此外针对少量不支持log_agent的服务,搭建了如图所示的中转应用。 日志解析:收集的日志通过Kafka接入到Flink中,统一进行解析和处理,根据日志类型对日志进行分类和聚合,解析为链路日志、节点日志和业务日志。 日志存储:完成日志解析后,日志会按照树状的存储模型进行落地存储,结合存储的需求分析以及各个存储选项的特点,点评内容平台最终选择HBase作为存储选型。 需求分析 选型优点 OLTP业务:逻辑链路的实时读写<br>数据量很大:海量的记录数,且未来会持续增长<br>写密集、读较少:日志上报峰值QPS较高<br>业务场景简单:简单读写即可满足需求 存储特性:支持横向扩展、快速扩充字段<br>查询特性:支持精确和前缀匹配查询,且支持快速随机的访问<br>经济成本:存储介质成本低廉 整体而言,log_agent + Kafka + Flink + HBase的日志上报和存储架构能够很好地支持复杂的业务系统,天然支持分布式场景下众多应用的日志上报,同时适用于高流量的数据写入。 (2) 实现众多后端服务的低成本改造 点评内容平台实现了“自定义日志工具包”(即下图13的TraceLogger工具包),屏蔽链路追踪中的上报细节,实现众多服务改造的成本最小化。TraceLogger工具包的功能包括: 模仿slf4j-api:工具包的实现在slf4j框架之上,并模仿slf4j-api对外提供相同的API,因此使用方无学习成本。 屏蔽内部细节,内部封装一系列的链路日志上报逻辑,屏蔽染色等细节,降低使用方的开发成本。 上报判断: 判断链路标识:无标识时,进行兜底的日志上报,防止日志丢失。 判断上报方式:有标识时,支持日志和RPC中转两种上报方式。 日志组装:实现参数占位、异常堆栈输出等功能,并将相关数据组装为Trace对象,便于进行统一的收集和处理。 异常上报:通过ErrorAPI主动上报异常,兼容原日志上报中ErrorAppender。 日志上报:适配Log4j2日志框架实现最终的日志上报。 下面是TraceLogger工具包分别进行业务日志和节点日志上报的使用案例,整体的改造成本较低。 业务日志上报:无学习成本,基本无改造成本。 // 替换前:原日志上报 LOGGER.error("update struct failed, param:{}", GsonUtils.toJson(structRequest), e); // 替换后:全链路日志上报 TraceLogger.error("update struct failed, param:{}", GsonUtils.toJson(structRequest), e); 节点日志上报:支持API、AOP两种上报方式,灵活且成本低。 public Response realTimeInputLink(long contentId) { // 链路开始:传递串联标识(业务标识 + 场景标识 + 执行标识) TraceUtils.passLinkMark("contentId_type_uuid"); // ... // 本地调用(API上报节点日志) TraceUtils.reportNode("contentStore", contentId, StatusEnums.RUNNING) contentStore(contentId); TraceUtils.reportNode("contentStore", structResp, StatusEnums.COMPLETED) // ... // 远程调用 Response processResp = picProcess(contentId); // ... } // AOP上报节点日志 @TraceNode(nodeName="picProcess") public Response picProcess(long contentId) { // 图片处理业务逻辑 // 业务日志数据上报 TraceLogger.warn("picProcess failed, contentId:{}", contentId); } 3.2.2 成果 基于上述实践,点评内容平台实现了可视化全链路日志追踪,能够一键追踪任意一条内容所有业务场景的执行,并通过可视化的链路进行执行现场的还原,追踪效果如下图所示: 【链路查询功能】:根据内容id实时查询该内容所有的逻辑链路执行,覆盖所有的业务场景。 【链路展示功能】:通过链路图可视化展示业务逻辑的全景,同时展示各个节点的执行情况。 【节点详情查询功能】:支持展示任意已执行节点的详情,包括节点输入、输出,以及节点执行过程中的关键业务日志。 目前,可视化全链路日志追踪系统已经成为点评内容平台的“问题排查工具”,我们可以将问题排查耗时从小时级降低到5分钟内;同时也是“测试辅助工具”,利用可视化的日志串联和展示,明显提升了RD自测、QA测试的效率。最后总结一下可视化全链路日志追踪的优点: 接入成本低:DSL配置配合简单的日志上报改造,即可快速接入。 追踪范围广:任意一条内容的所有逻辑链路,均可被追踪。 使用效率高:管理后台支持链路和日志的可视化查询展示,简单快捷。 4. 总结与展望 随着分布式业务系统的日益复杂,可观测性对于业务系统的稳定运行也愈发重要 [6] 。作为大众点评内容流水线中的复杂业务系统,为了保障内容流转的稳定可靠,点评内容平台落地了全链路的可观测建设,在日志(Logging)、指标(Metrics)和追踪(Tracing)的三个具体方向上都进行了一定的探索和建设。 其中之一就是本文的“可视化全链路日志追踪”,结合日志(Logging)与追踪(Tracing),我们提出了一套新的业务追踪通用方案,通过在业务执行阶段,结合完整的业务逻辑动态完成日志的组织串联,替代了传统方案低效且滞后的人工日志串联,最终可以实现业务全流程的高效追踪以及业务问题的高效定位。此外,在指标(Metrics)方向上,点评内容平台实践落地了“可视化全链路指标监控”,支持实时、多维度地展示业务系统的关键业务和技术指标,同时支持相应的告警和异常归因能力,实现了对业务系统整体运行状况的有效把控。 未来,点评内容平台会持续深耕,实现覆盖告警、概况、排错和剖析等功能的可观测体系 [7] ,持续沉淀和输出相关的通用方案,希望可以为业务系统(特别是复杂的业务系统),提供一些可观测性建设的借鉴和启发。 5. 参考文献 [1] Metrics, tracing, and logging [2] ELK Stack: Elasticsearch, Logstash, Kibana | Elastic [3] Dapper, a Large-Scale Distributed Systems Tracing Infrastructure [4] OpenZipkin · A distributed tracing system [5] 分布式会话跟踪系统架构设计与实践 [6] 凤凰架构-可观测性 [7] 万字破解云原生可观测性 6. 作者简介 海友、怀宇、亚平、立森等,均来自点评事业部/内容平台技术团队,负责点评内容平台的建设工作。 7. 团队简介 点评内容平台技术团队,支持点评内容生态的建设,致力于打造支持亿级内容的高吞吐、低延时、高可用、灵活可扩展的内容流式处理系统,为点评信息流和搜索等核心内容分发场景提供丰富且优质的内容供给,更好地满足用户内容消费诉求。 阅读美团技术团队更多技术文章合集 前端 | 算法 | 后端 | 数据 | 安全 | 运维 | iOS | Android | 测试 | 在公众号菜单栏对话框回复【2021年货】、【2020年货】、【2019年货】、【2018年货】、【2017年货】等关键词,可查看美团技术团队历年技术文章合集。 | 本文系美团技术团队出品,著作权归属美团。欢迎出于分享和交流等非商业目的转载或使用本文内容,敬请注明“内容转载自美团技术团队”。本文未经许可,不得进行商业性转载或者使用。任何商用行为,请发送邮件至tech@meituan.com申请授权。

优秀的个人博客,低调大师

每日一博 | 从 RabbitMQ 平滑迁移到 RocketMQ 技术实战

作者:vivo 互联网中间件团队- Liu Runyun 大量业务使用消息中间件进行系统间的解耦、异步化、削峰填谷设计实现。公司内部前期基于RabbitMQ实现了一套高可用的消息中间件平台。随着业务的持续增长,消息体量随之增大,对消息中间件平台提出了更高的要求,此外在运维过程中也遇到了高可用难以保障,功能特性不足等诸多问题。基于遇到的这些问题,决定引入RocketMQ进行替换。本文将介绍基于RocketMQ建设消息中间件平台并实现在线业务无感知的平滑迁移。 一、背景说明 vivo互联网中间件团队于2016年开始基于开源RabbitMQ向业务提供高可用消息中间件平台服务。 为解决好业务流量快速增长的问题,我们通过合理的业务集群拆分和动态调整,较好的交付了业务对消息中间件平台的平台能力需求。 但是随着业务长周期的迅猛发展,消息体量也越来越大,在高并发、大流量场景下RabbitMQ的系统架构设计存在着一定的限制,主要有以下问题: 1.1 高可用能力不足 架构设计存在脑裂风险,并且默认脑裂后无法自动恢复,人工介入恢复存在数据丢失的风险。 为解决脑裂问题,可以选择将网络异常后的处理调整为pause_minority模式,但是也带来了可能微小的网络抖动也会导致集群故障无法恢复的问题。 1.2. 性能不足 业务消息发送后通过exchange路由到对应的queue中,每一个queue由集群中的某个节点实际承载流量,高流量下集群中的某个节点可能会成为瓶颈。 queue由某个节点承载流量后无法快速迁移,强制迁移到其它低负载节点可能会导致queue不可用,这也导致了向集群中添加节点并无法快速提升集群的流量承载能力。 集群性能较低,经测试使用三台机器组成集群,可承载大概数万tps左右,并且由于queue是由集群中某个节点实际承载的,也无法继续提升某个queue的性能,这样就无法支撑大流量业务。 消息堆积到千万或更多后会导致集群性能下降,甚至海量堆积后如果消费请求tps特别高,可能会因为磁盘的性能损耗导致发送性能下降,并且在消息堆积太多时恢复时间长甚至无法恢复。 1.3 功能特性不足 RabbitMQ 默认情况下消费异常会执行立即重新投递,少量的异常消息也可能导致业务无法消费后续消息。 功能特性上未支持事务消息、顺序消息功能。 虽可自行实现消息轨迹逻辑,但是会对集群产生非常大的性能损耗,在正式环境中实际无法基于RabbitMQ原生的能力实现消息轨迹功能。 二、消息中间件平台的项目目标 基于以上问题,中间件团队于2020年Q4开始进行了下一代消息中间件平台方案的调研,为保证下一代消息中间件平台符合业务新的需求,我们首先明确了消息中间件平台的建设目标,主要包含两部分: 业务需求 平台需求 2.1 业务需求分析 高性能:可支撑极高的tps,并且支持水平扩展,可快速满足业务的流量增长需求,消息中间件不应成为业务请求链路性能提升的瓶颈点。 高可用:极高的平台可用性(>99.99%),极高的数据可靠性(>99.99999999%)。 丰富的功能特性:支持集群、广播消费;支持事务消息、顺序消息、延时消息、死信消息;支持消息轨迹。 2.2 平台运维需求分析 可运维:业务使用权限校验;业务生产消费流量限制;业务流量隔离与快速迁移能力。 可观测:丰富的性能指标观察集群的运行情况。 可掌握:可基于开源组件快速进行二次开发,丰富平台功能特性和进行相关问题修复。 云原生:后续可基于容器化提供云原生消息中间件,提供更高的弹性和可伸缩能力。 总结:需要建设高性能、高可靠的下一代消息中间件,具备极高的数据可靠性,丰富的功能特性,并且需要完美兼容当前的RabbitMQ平台,帮助业务快速迁移到新消息中间件平台,减少业务迁移成本。 三、开源组件选型调研 基于当前RabbitMQ平台的问题和对下一代消息中间件平台的项目需求,我们开展了针对当前较流行的两款消息中间件:RocketMQ、Pulsar的调研。 调研过程中主要针对以下两方面进行对比: 3.1 高可用能力分析对比 3.1.1 高可用架构与负载均衡能力对比 Pulsar部署架构(来源:Pulsar社区) RocketMQ部署架构(来源:RocketMQ社区) Pulsar: 采用计算与存储分离架构设计,可以实现海量数据存储,并且支持冷热数据分离存储。 基于ZK和Manager节点控制Broker的故障切换以实现高可用。 BooKeeper采用分层分片存储设计,天然支持负载均衡。 RocketMQ: 采用存算一体架构设计,主从模式部署,master节点异常不影响消息读取,Topic采用分片设计。 需要二次开发支持主从切换实现高可用。 未实现Broker的自动负载均衡,可以将top n流量Topic分布到不同的Broker中实现简单的负载均衡。 3.1.2 扩缩容与故障恢复对比 Pulsar Broker与BooKeeper独立扩缩容,并且扩缩容后会完成自动负载均衡。 Broker节点无状态,故障后承载Topic会自动转移到其它Broker节点,完成故障秒级恢复。 BooKeeper由自动恢复服务进行ledger数据对齐,并恢复到设置的QW份。 故障期间已ack消息不会丢失,未ack消息需要客户端重发。 RocketMQ Broker扩缩容后需要人工介入完成Topic流量均衡,可开发自动负载均衡组件结合Topic的读写权限控制自动化完成扩缩容后的负载均衡。 基于主从切换实现高可用,由于客户端定期30秒从NameSrv更新路由,因此故障恢复时间在30~60秒,可以结合客户端降级策略让客户端主动剔除异常Broker节点,实现更快故障恢复。 采用同步复制异步刷盘部署架构,在极端情况下会造成少量消息丢失,采用同步复制同步刷盘,已写入消息不会丢失。 3.1.3 性能对比 Pulsar 可支撑百万Topic数量,实际受到ZK存储元数据限制。 根据内部压测1KB消息可支撑TPS达数十万。 RocketMQ 逻辑上可支撑百万Topic,实际在达到数万时Broker与NameSrv传输心跳包可能超时,建议单集群不超过5万。 根据压测可支撑1KB消息体TPS达10万+。 3.2 功能特性对比 3.3 总结 从高可用架构分析,Pulsar基于Bookeeper组件实现了架构的计算与存储分离,可以实现故障的快速恢复;RocketMQ采用了主从复制的架构,故障恢复依赖主从切换。 从功能特性分析,Pulsar支持了丰富的过期策略,支持了消息去重,可以支持实时计算中消息只消费一次的语义;RocketMQ在事务消息、消息轨迹、消费模式等特性对在线业务有更好的支持。 从这两方面对比,最终选择了RocketMQ构建我们下一代的消息中间件平台。 四、平滑迁移建设 通过技术调研,确定了基于RocketMQ建设下一代消息中间件平台。 为了实现业务从RabbitMQ平滑迁移到RocketMQ,就需要建设消息网关实现消息从AMQP协议转换到RocketMQ;RabbitMQ与RocketMQ的元数据语义与存储存在差异,需要实现元数据语义的映射与元数据的独立存储。 主要有以下四个事项需要完成: 4.1 消息网关独立部署与嵌入式部署差异对比 4.2 元数据定义映射与维护 4.3 互不干扰的高性能消息推送 RabbitMQ采用推模式进行消息消费,虽然RocketMQ也支持消息推送消费,但是因为AMQP协议中通过prefetch参数限制了客户端缓存消息数量以保证不会因缓存太多消息导致客户端内存异常,因此在消息网关实现消息推送时也需要满足AMQP协议的语义。 同时每个消息网关都需要数千甚至数万的queue的消息推送,每个queue消息消费速率存在差异,并且每个队列可能随时有消息需要推送到客户端进行消费,要保证不同queue之间的推送互不干扰且及时。 为了实现高效的、互不干扰的消息推送,有以下策略: 每个queue采用独立的线程,保证互不干扰和时效性,缺点是无法支撑海量queue的消息推送。 基于信号量、阻塞队列等,在感知到有可推送消息和可消费服务端时按需进行消息的推送,这样可使用少量的线程即可完成高效的消息推送。 最终选择了第2种方案,数据流转图如下图所示: 一个消息消费过程:客户端在启动连接到消息网关后,在消息网关中会构建RocketMQ推送消费客户端实例,并且注入自定义的ConsumeMessageService实例,同时使用一个信号量保存客户端允许推送的消息数量。 当消息从集群侧推送到消息网关时,将消息按照推送的批次封装为一个任务保存在ConsumeMessageService实例的BlockingQueue中,同时推送线程会轮询所有的ConsumeMessageService实例,如果发现本地缓存有待消费的消息并且有可消费消息的业务客户端,将任务提交到线程池中完成消息的推送。 为了保证不会因为少量消费速率特别高的queue导致其它queue的消息推送时效性降低,会限制每一个ConsumeMessageService只允许推送一定数量的消息即转到推送其它queue的消息,以此即可保证所有queue的消息推送的互不干扰和时效性。 在客户端消费ack/uack后再次通过信号量通知下一次推送,这样也保证了使用少量的线程资源即可完成海量消息的推送需求。 4.4消费启停与消费限流能力实现 基于消息网关,可以在消息推送逻辑中增加消费启停和消费限流逻辑。 消费启停可以帮助业务快速实现消费的暂停或是部分异常节点停止消息消费。 消费限流可以帮助业务控制消息消费速率,避免对底层依赖产生太大压力。 4.5 平台架构 最终形成了以上的平台架构。新建设了一个AMQP-proxy消息网关服务实现AMQP消息转换到RocketMQ,支持业务的消息生产消费。 建设了mq-meta服务维护集群的元数据信息。 通过mq-controller控制集群的主从切换,实现集群的高可用,同时增加了集群监控,负载均衡模块保障集群的高可用。 五、平台建设进展与迁移收益 5.1业务使用收益 5.1.1 更高、更稳定的消息发送性能 原生RabbitMQ集群业务压测性能 使用消息网关后业务压测性能 5.1.2 更丰富的功能特性 统一的消息过期时间 消费异常消息将按照梯度延时重投递 直接支持广播消费模式 全环境按需提供消息轨迹功能 支持消费重置到以前的某个位点 5.1.3 业务使用特性变化 消息将不再无限期保留,默认保留3~7天(实际保留时间根据集群配置决定) 消费异常将不再立即重投递,将按照一定的梯度延时重投递,多次异常后将变为死信消息 直接支持广播消费,注意广播消费模式消费无异常重投递,每个消息每个节点只消费一次 业务生产消费性能可支持水平扩展 不支持消费优先级功能 默认消费超时时间15分钟,消费超时后消息重新投递,消费超时时间可按需调整 支持消费启停(全局或限制部分节点消费) 支持全局消费限流 限制消息体大小,当前限制为256KB,超过将直接返回失败,后续将进行流量治理,限制发送大消息体业务流量 5.2平台运维收益 业务从RabbitMQ迁移到RocketMQ后,可支撑业务流量从万TPS级别提升到十万TPS级别,可支撑业务容量从数亿提升至百亿级别。耗用机器资源下降50%以上,运维难度和成本均大大降低,同时可以基于消息网关实现更加丰富的功能特性。 六、未来展望 未来,中间件团队计划在三个方面对消息中间件进行迭代演进: 基于消息网关能力丰富现有平台功能特性,进行业务消息治理。 过去五年中间件团队基于开源RabbitMQ进行了RabbitMQ的高可用建设,发现直接让业务方使用基于开源组件的SDK接入会带来SDK升级困难,与后端消息中间件类型绑定的问题,未来我们计划基于GPRC和消息网关,实现消息队列引擎服务化,业务无需关心底层具体使用的开源消息中间件选型。 调研RocketMQ5.0计算与存储分离构架,进行消息中间件架构的再升级。 END 猜你喜欢 RocketMQ之消费者启动与消费流程 vivo鲁班RocketMQ平台的消息灰度方案 Kafka 负载均衡在 vivo 的落地实践 本文分享自微信公众号 - vivo互联网技术(vivoVMIC)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | 一张图进阶 RocketMQ - 消息存储

前言 三此君看了好几本书,看了很多遍源码整理的 一张图进阶 RocketMQ 图片,关于 RocketMQ 你只需要记住这张图!觉得不错的话,记得点赞关注哦。 【重要】视频在 B 站同步更新,欢迎围观,轻轻松松涨姿势。一张图进阶 RocketMQ-消息存储(视频版) 点击查看【bilibili】 本文是“一张图进阶 RocketMQ”第 5 篇,对 RocketMQ 不了解的同学可以先看看前面 4 期: 一张图进阶 RocketMQ-整体架构 一张图进阶 RocketMQ - NameServer 一张图进阶 RocketMQ - 消息发送 一张图进阶 RocketMQ - 通信机制 前面两期我们主要分享了 RocketMQ 是如何将消息发送出去的,现在消息已经被 Netty 送上路了,接力棒已经交给了 Broker。如果我们自己来实现 Broker 会怎么实现呢?首先肯定得把消息存起来吧,不然宕机了,消息丢失了,那就离大谱了。 可是消息要以什么结构存储呢?二进制、JSON、PB?从功能上来看肯定都是可以的,那 RocketMQ 到底是怎么搞的? 解决了存储结构问题,那消息存到哪里呢?数据库,本地文件,还是对象存储服务器?从功能的角度肯定也都是可以的。可是,哪家数据库可以支持单机十万级吞吐量?那我直接统统存到数据库得了,瞎折腾些啥。难道存在本地文件就可以了?我们自己实现不可以,但是 RocketMQ 可以,那 RocketMQ 有什么黑科技呢? 所以我们今天就来聊一聊 Broker 如何存储消息,【首先明确我们的目标】我们需要先了解 RocketMQ 的存储结构,也就是消息是如何组织的。了解了存储结构,我们才能更好的理解存储流程,不然我们不知道为什么流程是这样的。最后我们需要了解有哪些机制支撑 RocketMQ 单机十万级吞吐量。 存储架构 消息在 Broker 上的存储结构如上图,所有相关文件放在 ROCKETMQ_HOME 下,有哪些文件呢?存放消息本身的 CommitLog,以及消息的索引文件 ConsumeQueue 和 IndexFile: CommitLog 从物理结构上来看,所有的消息都存储在 CommitLog 里面,其实就是所有的消息按照“消息在 CommitLog 各字段示意图”所示,挨个按顺序存储到文件中。 单个 CommitLog 文件大小默认 1G ,文件名长度为 20 位,左边补零,剩余为起始偏移量。比如 00000000000000000000 代表了第一个文件,起始偏移量为 0,文件大小为 1G=1073741824;当第一个文件写满了,第二个文件为 00000000001073741824,起始偏移量为 1073741824,以此类推。消息主要是顺序写入日志文件,当文件满了,写入下一个文件。CommitLog 顺序写,可以大大提高写入效率。 但是问题来了,消息发送的时候我们指定了 Topic,现在所有 Topic 都顺序个写入到 CommitLog,存入的时候是安逸了(顺序写),但是获取消息可就麻烦了。如果我要获取某个 Topic 的消息,需要遍历 commitlog 文件,根据 topic 过滤消息。CommitLog 这个渣男,只管自己爽。有什么办法可以提高消息查询效率呢? ConsumeQueue 我们再回忆一下,消息存入的时候是指定了 Topic,同时我们也说了每个 Topic 会对应多个 ConsumeQueue( queueId 标识)。关键就在 ConsumeQueue 上,ConsumeQueue 是指定 Topic 消息的索引文件,怎么理解呢?从“消息在 ConsumeQueue 各字段示意图”可知,每个条目共 20 个字节,分别为 8 字节的 commitlog 物理偏移量、4 字节的消息长度、8 字节 tag hashcode,单个文件由 30W 个条目组成,可以像数组一样随机访问每一个条目,每个 ConsumeQueue 文件大小约 5.72M。ConsumeQueue 文件可以看成是基于 topic 的 commitlog 索引文件。Consumer 即可根据 ConsumeQueue 来查找待消费的消息。 因为 ConsumeQueue 里只存偏移量信息,所以尺寸是有限的,在实际情况中,大部分的 ConsumeQueue 能够被全部读入内存,所以这个中间结构的操作速度很快,可以认为是内存读取的速度。此外为了保证 CommitLog 和 ConsumeQueue 的一致性,CommitLog 里存储了 ConsumeQueues、Message Key、Tag 等所有信息,即使 ConsumeQueue 丢失,也可以通过 CommitLog 完全恢复出来。 ConsumeQueue 文件夹的组织方式如下:topic/queue/file 三层组织结构,具体存储路径为:$HOME/store/consumequeue/{topic}/{queueId}/{fileName}。 IndexFile IndexFile 是另一种可选索引文件,提供了一种可以通过 key 或时间区间来查询消息的方法。 IndexFile 索引文件其底层实现为 hash 索引,类似于 Java 1.7 HashMap,计算 Key 的 hashcode,hashcode 取余得到 hash 槽,拉链法解决哈希冲突。Index 文件的存储位置是:$HOME \store\index${fileName},文件名 fileName 是以创建时的时间戳命名的,固定的单个 IndexFile 文件大小约为 400M,一个 IndexFile 可以保存 2000W 个索引。 所以,RocketMQ 消息存储架构主要有 CommitLog,ConsumeQueue,IndexFile 构成。我们发送一条消息,会先格式化成“消息在 CommitLog 各字段示意图”中的样子,顺序写入 CommitLog 中,然后 Broker 会按照 ”消息在 ConsumeQueue 各字段示意图“所示构建一条索引记录,存入该消息所属 Topic 的 ConsumeQueue 索引文件中。如果有 IndexFile,还会构建 IndexFile。 现在我们已经知道了 RocketMQ 消息的存储结构,接下来我们的就要了解 RocketMQ 是如何构建 CommitLog、ConsumeQueue 和 IndexFile,以及 RocketMQ 如何保证性能,支撑单机十万级吞吐量的?这是本文的主要目标,一定要抓住主要目标,不要走丢咯。 启动流程 了解了 RocketMQ 消息在磁盘中是怎么存储的,我们就可以来看看具体的存储流程了。首先,还是先来看看 Broker 的启动流程。初始化过程都是这个鸟样,只看初始化过程完全不知所云,但是不看初始化过程,直接看具体执行流程也是摸不着头脑,一堆组件不知道从哪里来的,所以我们还是先耐着性子大致看看。但这并不是我们关注的重点,注意几个关键点即可。 初始化启动环境。部署好 RocketMQ 后,执行/bin/mqbroker 脚本,主要用于设置 RocketMQ 目录环境变量,例如 ROCKETMQ_HOME 。然后调用 ./bin/runbroker.sh 进入 RocketMQ 的启动入口,主要设置了 JVM 启动参数,比如 JAVA_HOME、Xms、Xmx。执行 main 函数。 初始化 BrokerController。该初始化主要包含 RocketMQ 启动命令行参数解析、NettyRemotingServer 初始化、Broker 各个模块配置参数解析、Broker 各个模块初始化、进程关机 Hook 初始化等过程。 启动 RocketMQ 的各个组件。但是这些组件并不是每一个都是核心组件,部分组件会在后面的流程中使用,这里混个眼熟,如果后面流程没有提及的大家可以暂且跳过,我们的目标是把握 RocketMQ 的核心内容,而不是每个细节。 MessageStore:存储层服务,比如 CommitLog、ConsumeQueue 存储管理,消息刷盘,索引构建等。 RemotingServer:普通通道请求处理服务。一般的请求都是在这里被处理的。 FastRemotingServer:VIP 通道请求处理服务。如果普通通道比较忙,那么可以使用 VIP 通道,一般作为客户端降级使用。 BrokerOuterAPI:Broker 访问对外接口的封装对象。 PullRequestHoldService:Pull 长轮询服务。 ClientHousekeepingService:清理心跳超时的生产者、消费者、过滤服务器。 FilterServerManager:过滤服务器管理。 存储流程 在前面 RocketMQ 存储结构中我们了解了 RocketMQ 将所有消息顺序写入 CommitLog,然后构建 ConsumeQueue/IndexFile 索引文件,所以这个小结我们主要的目标就是看看这些文件是如何构建的。 Broker 启动流程中很关键的一点是启动了 NettyRemotingServer,在 RocketMQ 通信机制(视频) 中我们介绍过 Broker(NettyRemotingServer) 初始化会监听端口等待客户端连接,当客户端发送请求的时,NettyRemotingServer WorkerGroup 处理可读事件,调用 NettyServerHandler.channelRead0() 处理数据。 接着调用链到 processRequestCommand 方法,这个方法主要是根据请求中的 RequestCode,从本地缓存 processorTable 中获取相应的 Processor 来执行后续逻辑。处理器是什么?处理器的缓存从哪里来? Processor 就是用来处理特定请求的执行者,例如,生产者存入消息使用 SendMessageProcessor,查询消息使用 QueryMessageProcessor,拉取消息使用 PullMessageProcessor。在 Broker 启动流程中有一步是注册 Processor,以 RequestCode 为 Key ,Processor 为值,添加到 processorTable 缓存中。接着 RocketMQ 消息发送(视频) 流程来看,当生产者的请求达到 Broker,Broker 获取的 Processor 应为 SendMessageProcessor。封装一个 Runable 对象,run 方法内调用 SendMessageProcessor.processRequest ,提交到线程池,继续后面的处理。 SendMessageProcessor.processRequest 调用 sendMessage 方法,主要包含消息的校验及重试逻辑处理,然后调用存储模块 DefaultMessageStore 存储消息。 消息校验:校验 Broker 是否配置可写,校验 Topic 名字是否为默认值,获取或创建 topicConfig,判断 queueId 是否超过限制。 重试消息处理:消费者消费失败后会将消息发回给 Broker,这里我们暂且认为就是生产者发送的请求,先看下面的流程。 DefaultMessageStore.putMessage 只是做了很多的校验,简单看看即可。包括:如果当前 Broker 停止工作则拒绝消息写入、Broker 为 SLAVE 角色则拒绝消息写入、当前 RocketMQ 不支持写入则拒绝消息写入、主题长度超过 256 个字符则拒绝消息写入、消息属性长度超过 65536 个字符则拒绝消息写入、PageCache 忙则报错。然后调用 CommitLog.putMessage 存入消息。 看到这里应该稍微熟悉一些了,终于到我们期待已久的 CommitLog 出场了。主要是延迟消息处理,然后获取可以写入的 CommitLog 进行写入。 延迟消息处理:如果消息的延迟级别大于 0,将消息的原主题名称与原消息队列 ID 存入消息属性中,用延迟消息主题 SCHEDULE_TOPIC、消息队列 ID 更新原先消息的主题与队列,这是并发消息消费重试关键的一步。但不是这个本节的主要目标,后文会进一步分析。 关键点在如何获取可以写入的 CommitLog。存储结构小节里面有提到每个 CommitLog 默认大小 1G,写完一个文件,以偏移量命名创建下一个文件。每个 1G 大小 CommitLog 的在代码层面对应的是 MappedFile,而多个 MappedFiled 组成 MappedFileQueue。逻辑上的 CommitLog 通过持有 MappedFileQueue 管理多个 MappedFile。所以,获取可以写入的 CommitLog 也就是获取 MappedFileQueue 最后一个 MappedFile,为什么是最后一个,因为前面的已经写完了呀。来看看 RocketMQ 逻辑与物理存储的对应关系应该能够更直观的理解。 获取到最后一个 MappedFile 后,调用 MappedFile.appendMessage 将消息追加到该文件中。可是尽管是顺序写入,但是连小学生都知道写磁盘还是很慢,难道想这样支撑 RocketMQ 单机十万吞吐量?too young too simple!从逻辑存储结构和物理存储结构的映射关系来看,MappedFile 持有物理 CommitLog 的 fileChannel (Java NIO 文件读写的通道),通过 fileChannel 可以访问物理 CommitLog 文件,但是 RocketMQ 并没有直接使用 fileChannel,而是映射到一个 MappedByteBuffer,我们的目的就是把消息写入这个 ByteBuffer 中,进而写入 MappedFile 对应的 CommitLog 文件。为什么需要这样做,还有哪些细节,会在”文件内存映射“小结中为大家解答。 继续看流程,得到 MappedFile 对应的 ByteBuffer,我们需要将消息序列化,写入 ByteBuffer 中。 构建消息 id, createMessageId 获取该消息在消息队列的偏移量,CommitLog 中保存了当前所有消息队列的当前待写入偏移量。 判断是否是事务消息:这里主要处理 Prepared 类型和 Rollback 类型的消息,设置消息 queueOffset 为 0 计算消息总大小,calMsgLength。 判断文件的剩余空间,是否足够写入当条消息,如果不可以,则将文件末尾写入剩余空间大小+固定魔数;然后返回一个 END_OF_FILE 的结果 如果空间足够,这将这条消息写入之前得到的 MappedFile 的 ByteBuffer 中。 将各字段按照”消息在 CommitLog 各字段示意图“存入 Bytebuffer,然后返回 PUT_OK 结果 总结 以上就是今天 RocketMQ 消息存储的主要内容,消息只是写入到 CommitLog 对应的 ByteBuffer中,下一期就是我们重要的零拷贝即将登场。我们简单总结一下今天的内容: 要理解消息的存储流程需要先知道消息的存储结构:在物理上消息挨个顺序写入 CommitLog,为了提升消息查询效率需要构建消息的索引文件 ConsumeQueue/IndexFile; Broker 启动时进行参数解析,并初始化了 NettyRemotingServer,启动存储服务用于消息存储及索引构建等; Broker 收到消息存储请求,经过层层校验,获取 CommitLog 对应的 MappedFile,将消息写入MappedFile 对应的内存映射ByteBuffer; 以上就是今天全部的内容,如果觉得本期的内容对你有用的话记得点赞、关注、转发、收藏,这将是对我最大的支持。 如果你需要 RocketMQ 相关的所有资料,可以评论区留言,或者关注公众号:三此君。回复:mq,即可。 消息已经写入 ByteBuffer,写入 ByteBuffer 就可以了吗?那收到消息直接丢弃岂不是更好。消息要落在磁盘上才不会丢失,所以下一期我们要分享的就是消息的刷盘及索引构建,PageCache 及零拷贝也将闪亮登场。感谢观看,下期不见不散。 参考文献 RocketMQ 官方文档 RocketMQ 源码 丁威, 周继锋. RocketMQ技术内幕:RocketMQ架构设计与实现原理. 机械工业出版社, 2019-01. 李伟. RocketMQ分布式消息中间件:核心原理与最佳实践. 电子工业出版社, 2020-08. 杨开元. RocketMQ实战与原理解析. 机械工业出版社, 2018-06.

优秀的个人博客,低调大师

每日一博 | 阅读 Skeleton.css 源码,改善睡眠质量

本文介绍 点赞就等于学会了! 如果本文对您有帮助,建议点赞收藏(点赞就等于学会了) <br> Skeleton 源码一共只有 419 行(加上注释和换行),非常适合用来学习。 本文是根据我的学习过程来编写的,几乎每个章节都包含 使用方法 和 源码分析。 虽然现在大部分业务都不需要重复造轮子了,但对于小白来说,学习完 Skeleton 源码 是能走出新手村的。 <br> 本文不是推荐大家使用 Skeleton.css ,因为现代工程其实已经用不上这个库了。本文的重点在 响应式布局源码的解读。 <br> 本文适合人群: 有 css 基础的(了解浮动、颜色、背景色等); 有一定工作经验,但又没了解过 css 库是如何生成的; <br> Skeleton 介绍 如果您正在着手一个较小的项目,或者觉得不太需要用到大型框架,那么可以尝试使用 Skeleton。 Skeleton仅对少数标准 HTML 元素设置了样式,并提供了一个网格系统。 <br> 『Skeleton.css 官网』 『github 地址』 也可以直接滑到文末获取 Skeleton 源码。 <br> 读css方面的源码,为什么要选 Skeleton ? Bootstrap:太长,不看! Layui:太长,不看! Element ui:和框架绑定的,不适合小白看~ Animate.css:动画库,下次再看。 …… Skeleton:短! <br> 功能目录 网格 - Grid 基础样式 Base Styles 排版 Typography 链接 Links 按钮 Buttons 表单 Forms 链接 Lists 代码 Code 表格 Tables 间隔 Spacing 工具集 Utilities 清除浮动 Clearing 媒体查询 Media Queries <br> <br> 出发!!! 本文所有例子都使用 CDN 的方式引入 skeleton.css ,默认已经引入了,所以在案例中不会再出现引入的代码。 <link href="https://cdn.bootcdn.net/ajax/libs/skeleton/2.0.4/skeleton.css" rel="stylesheet"> <br> 网格系统 Grid<a name="Grid"></a> Skeleton 提供了 12列 的网格布局模式,和现代UI库的24列相比,12列的确有点少了。但这并不影响我们学习。 <br> Skeleton 支持 指定值布局 和 比例布局,这两个名字是我自己起的,官方没这样说。 其实这两种布局方式都是大同小异的,只不过语义上有点不同而已。 <br> 使用方法 <br> 指定值布局 通过使用 1~12 的单词配合 .columns 类名 进行布局。 .one、.two、.three、.four、.five、.six、.seven、.eight、.nine、.ten、.eleven、.twelve <br> Skeleton.css 提供了12列的响应式网格布局,随着浏览器/设备尺寸的减小而缩小。 当浏览器窗口小于 550px 时,所有列都会占满整行。 <div class="container"> <div class="row"> <div class="one column">One</div> <div class="eleven columns">Eleven</div> </div> <div class="row"> <div class="two columns">Two</div> <div class="ten columns">Ten</div> </div> <div class="row"> <div class="three columns">Three</div> <div class="nine columns">Nine</div> </div> <div class="row"> <div class="four columns">Fout</div> <div class="eight columns">Eight</div> </div> <div class="row"> <div class="five columns">Five</div> <div class="seven columns">Seven</div> </div> <div class="row"> <div class="six columns">Six</div> <div class="six columns">Six</div> </div> <div class="row"> <div class="twelve columns">Twelve</div> </div> </div> <style> .row .column, .row .columns { margin-bottom: 10px; background: #eee; } </style> 本例使用了 .container 作为容器,限制了最大宽度是 980px ,并且水平居中。 因为布局容器是不提供背景和外边距等样式,所以本例写了一个背景色给 .columns 以便观察。 .row 这个其实不需要加的,本例添加这个类只是希望代码看起来能更加易读。 <br> 比例布局 提供了3个类名,需要配合 .column 使用。 .one-third:三分之一 .two-thirds:三分之二 .one-half:一半 <div class="container"> <div class="row"> <div class="one-third column">1/3</div> <div class="two-thirds column">2/3</div> </div> <div class="row"> <div class="one-half column">1/2</div> <div class="one-half column">1/2</div> </div> </div> <style> .row .column, .row .columns { margin-bottom: 10px; background: #eee; } </style> <br> 列偏移 <div class="container"> <div class="row"> <div class="offset-by-eleven one columns">One</div> </div> <div class="row"> <div class="offset-by-ten two columns">Two</div> </div> <div class="row"> <div class="offset-by-nine three columns">Three</div> </div> <div class="row"> <div class="offset-by-eight four columns">Fout</div> </div> <div class="row"> <div class="offset-by-seven five columns">Five</div> </div> <div class="row"> <div class="offset-by-six six columns">Six</div> </div> <div class="row"> <div class="offset-by-five seven columns">Seven</div> </div> <div class="row"> <div class="offset-by-four eight columns">Eight</div> </div> <div class="row"> <div class="offset-by-three nine columns">Nine</div> </div> <div class="row"> <div class="offset-by-two ten columns">Ten</div> </div> <div class="row"> <div class="offset-by-one eleven columns">Eleven</div> </div> <div class="row"> <div class="offset-by-two-thirds one-third column">1/3</div> </div> <div class="row"> <div class="offset-by-one-third two-thirds column">2/3</div> </div> <div class="row"> <div class="offset-by-one-half one-half column">1/2</div> </div> </div> <style> .container { border: 1px solid #ccc; } .row .column, .row .columns { margin-bottom: 10px; background: #eee; } </style> <br> 源码分析 布局其实分了几个部分: 容器部分 列(确定值) 列(百分比) 列间距 列偏移 <br> 容器部分 .container { position: relative; /* 相对定位 */ width: 100%; /* 容器宽度100% */ max-width: 960px; /* 但最大宽度不超过980px */ margin: 0 auto; /* 水平居中 */ padding: 0 20px; /* 容器左右内边距20px */ box-sizing: border-box; /* 设置容器盒模型,设置了容器的边框、内边距都不会超过容器宽度 */ } /* 当容器不小于400px时 */ @media (min-width: 400px) { .container { width: 85%; /* 宽度为85% */ padding: 0; /* 内边距为0 */ } } /* 当容器不小于550px时 */ @media (min-width: 550px) { .container { width: 80%; /* 宽度80,同时padding受到 @media (min-width: 400px) 里设置的影响 */ } } .container:after { content: ""; display: table; clear: both; /* 清除浮动 */ } <br> 容器使用了 container 这个类名,可以看出 skeleton 是先写了小屏的解决方案,然后再写大屏的。 默认情况下(文档宽度小于 400px),container 容器的宽度是 100%,最大宽度是 980px ,通过 margin: 0 auto; 实现了水平居中效果。 当文档宽度大于等于 400px 时,容器宽度变成 85%,但也会被最大宽度(980px)限制,同时内边距设为 0。 当文档宽度大于等于 550px 时,容器宽度变成 80%,会覆盖 @media (min-width: 400px) 里设置的宽度,但会受到 @media (min-width: 400px) 里设置的 padding 影响。 最后设置了一个伪元素 :after 清除浮动(clear: both;)。 <br> 列布局(响应式的开始) Skeleton.css 使用 浮动 + 百分比 的方式实现响应式。 <br> 列(确定值 )、**列(百分比)**和 列间距 这三个要放在一起讲。 skeleton 一共有12列布局,所以配置了基本的:one、two、three、four、five、six、seven、eight、nine、ten、eleven、twelve。 <br> 都是基础的数字英文,我就不翻译了。 这里要分2种情况来讨论, 能整除12的(one、two、three、four、six、twelve) 不能整除12的(five、seven、eight、nine、then、eleven) <br> 接下来会分开讨论这两种情况。 .column, .columns { width: 100%; /* 所有列的宽度都是100%。 */ float: left; /* 左浮动 */ box-sizing: border-box; /* 设置容器盒模型,设置了容器的边框、内边距都不会超过容器宽度 */ } @media (min-width: 550px) { .column, .columns { margin-left: 4%; /* 左边距4% */ } .column:first-child, .columns:first-child { margin-left: 0; /* 第一个元素不需要左边距,所以设为0 */ } .one.column, .one.columns { width: 4.66666666667%; } .two.columns { width: 13.3333333333%; } .three.columns { width: 22%; } .four.columns { width: 30.6666666667%; } .five.columns { width: 39.3333333333%; } .six.columns { width: 48%; } .seven.columns { width: 56.6666666667%; } .eight.columns { width: 65.3333333333%; } .nine.columns { width: 74.0%; } .ten.columns { width: 82.6666666667%; } .eleven.columns { width: 91.3333333333%; } .twelve.columns { width: 100%; margin-left: 0; } /* 只有一列,不需要左边距了 */ /* 1/3,对应 .four */ .one-third.column { width: 30.6666666667%; } /* 2/3,对应 .eight */ .two-thirds.column { width: 65.3333333333%; } /* 1/2,对应 .six */ .one-half.column { width: 48%; } } 默认情况下(文档宽度小于 550px)所有列的宽度都是 100%。 除了第一列,后面跟着的列都有一个 4%的左边距 。 <br> 能整除12的 .one、.two、.three、.four、.six、.twelve 布局方式如下图所示(本文只详细讲 .one 和 .two 两种列,其他的原理都是一样的,自己推算就行了) <br> 从上图可以看出,都使用 .one 的话,一共有 12列 、11个间隔 ,一行的宽度是 100% ,每个间隔的占比是 4% ,11个间隔一共就花掉了 44% ,剩下 56% 给12列平均分。 所以 .one 的宽度就是 56 ÷ 12 ≈ 4.66666666667 ,单位是 % <br> 都用.two 的话,从上图可以看出一共有 6列 、5个间隔 ,每个间隔的宽度是 4%,5个间隔合计占用 20% 的宽度,剩下 80% 的宽度给6列平均分。 **所以 .two 的宽度就是 80 ÷ 6 ≈ 13.3333333333 ,单位是 % ** <br> 剩下的我就直接写公式了,不懂的可以在评论区讨论~ 公式:(100% - 间隔数量 × 4%) ÷ 列的数量 .one:(100% - 4% × 11) ÷ 12 ≈ 4.66666666667% .two:(100% - 4% × 5) ÷ 6 ≈ 13.3333333333% .three:(100% - 4% × 3) ÷ 4 = 22% .four:(100% - 4% × 2 ) ÷ 3 ≈ 30.6666666667% .six:(100% - 4% × 1) ÷ 2 = 48% .twelve:就是100%咯,而且不需要左边距 <br> 不能整除12的 .five、.seven、.eight、.nine、.then、.eleven <br> 首先看 .five ,代表 5,12 - 5 = 7,但现在 .five 和 .seven 的值是多少我们都不知道,虽然可以按 5:7 再加一个 间隔(4%) 来计算,但我更愿意使用已知的值来推算。 .two + .five + .five 三列加起来刚好是 12 ,而 .two 的值我们是知道的,由此可以得到一个代数式: 13.3333333333% + 间隔 + .five + 间隔 + .five = 100% <br> 间隔 的占比是 4% 所以得到下面的代数式 13.3333333333% + 4% + .five + 4% + .five = 100% 21.3333333333% + 2(.five) = 100% 2(.five) = 78.6666666667% .five ≈ 39.3333333333% 根据上面的小学生推导法,得知一个 .five 是 39.3333333333% <br> .seven 刚刚有讲到,5 + 7 = 12,那现在 5 出来了,7 也就通过加减法能算出来 .five + 间隔 + .seven = 100% 39.3333333333% + 4% + .seven = 100% .seven = 100% - 39.3333333333% - 4% .seven = 56.6666666667% 综上所述,.seven 的宽度是 56.6666666667% <br> 这是我的推导方式,最后的值也和 skeleton 的值一样。.eight、.nine、.then、.eleven 的推导方式其实也和上面一样,这里我就不再啰嗦了。有疑问的可以在评论区交流。 <br> 最后得出 .five:39.3333333333% .seven:56.6666666667% .eight:65.3333333333% .nine:74.0% .ten:82.6666666667% .eleven:91.3333333333% <br> 比例 .one-third:三分之一。对应 .four .two-thirds:三分之二。对应 .eight .one-half:一半。对应.six <br> 列偏移 列偏移的类名都是 .offset-by- 开头的,后面再加上对应的数字或者比例的单词。 @media (min-width: 550px) { .offset-by-one.column, .offset-by-one.columns { margin-left: 8.66666666667%; } .offset-by-two.column, .offset-by-two.columns { margin-left: 17.3333333333%; } .offset-by-three.column, .offset-by-three.columns { margin-left: 26%; } .offset-by-four.column, .offset-by-four.columns { margin-left: 34.6666666667%; } .offset-by-five.column, .offset-by-five.columns { margin-left: 43.3333333333%; } .offset-by-six.column, .offset-by-six.columns { margin-left: 52%; } .offset-by-seven.column, .offset-by-seven.columns { margin-left: 60.6666666667%; } .offset-by-eight.column, .offset-by-eight.columns { margin-left: 69.3333333333%; } .offset-by-nine.column, .offset-by-nine.columns { margin-left: 78.0%; } .offset-by-ten.column, .offset-by-ten.columns { margin-left: 86.6666666667%; } .offset-by-eleven.column, .offset-by-eleven.columns { margin-left: 95.3333333333%; } .offset-by-one-third.column, .offset-by-one-third.columns { margin-left: 34.6666666667%; } .offset-by-two-thirds.column, .offset-by-two-thirds.columns { margin-left: 69.3333333333%; } .offset-by-one-half.column, .offset-by-one-half.columns { margin-left: 52%; } } <br> 如果用 .offset-by-one ,那我们就需要假设后面的内容补充完是 12。 1 + 11 = 12,我们通过上面的计算得知 .eleven 的宽度是 91.3333333333%,所以 .offset-by-one 的占比是: .offset-by-one = 100% - .eleven .offset-by-one = 8.66666666667% <br> 其他的 .offset-by-two 、.offset-by-three 那些也可以用同样的方法去计算。最后再和 skeleton 的值对比一下就行了。 <br> 基础样式 Base Styles<a name="BaseStyles"></a> 这部分主要定义了全局字体和行距的样式,作用在 html 和 body 标签上。 <br> <br> 使用方法 <div>雷猴</div> <br> <br> 源码分析 看看这部分的源码: html { font-size: 62.5%; /* 16px × 62.5% = 10px */ } body { font-size: 1.5em; /* 10px × 1.5 = 15px */ line-height: 1.6; /* 15px * 1.6 = 24px */ font-weight: 400; /* 字体粗细 */ font-family: "Raleway", "HelveticaNeue", "Helvetica Neue", Helvetica, Arial, sans-serif; /* 字体 */ color: #222; /* 文本颜色 */ } <br> 浏览器的默认字号是 16px ,在 html 设置字号是 62.5%,那就是变成 10px 了。 在 body 设置 font-size: 1.5em; ,那么之后的内容默认都会继承 body 的,也就是普通的文本是 15px。 最后再设置 行高 、字体粗细 、字体 、文本颜色 。 <br> <br> 排版 Typography<a name="Typography"></a> 不需要使用特别的类名,这部分作用在 h1 ~ h6 标签中。使用了 rem 的方式设置字体大小,会受到 <html> 标签字体大小影响。 <br> 使用方法 <h1>Heading</h1> <h2>Heading</h2> <h3>Heading</h3> <h4>Heading</h4> <h5>Heading</h5> <h6>Heading</h6> <p>The base type is 15px over 1.6 line height (24px)</p> <br> <br> 源码分析 h1, h2, h3, h4, h5, h6 { margin-top: 0; margin-bottom: 2rem; font-weight: 300; } h1 { font-size: 4.0rem; line-height: 1.2; letter-spacing: -.1rem;} h2 { font-size: 3.6rem; line-height: 1.25; letter-spacing: -.1rem; } h3 { font-size: 3.0rem; line-height: 1.3; letter-spacing: -.1rem; } h4 { font-size: 2.4rem; line-height: 1.35; letter-spacing: -.08rem; } h5 { font-size: 1.8rem; line-height: 1.5; letter-spacing: -.05rem; } h6 { font-size: 1.5rem; line-height: 1.6; letter-spacing: 0; } /* Larger than phablet */ @media (min-width: 550px) { h1 { font-size: 5.0rem; } h2 { font-size: 4.2rem; } h3 { font-size: 3.6rem; } h4 { font-size: 3.0rem; } h5 { font-size: 2.4rem; } h6 { font-size: 1.5rem; } } p { margin-top: 0; } <br> 这段源码其实没什么好解释的了,主要设置了 h1 ~ h6 的 外边距、字号、文字粗细、行高、字距,并且用 媒体查询 来重新定义不同尺寸的浏览器宽度显示出来的标题 字号 不同。 最后定义了段落 p 的上边距,这里的 p 的字号默认继承 body 里的设置,也就是 15px。 <br> 链接 Links<a name="Links"></a> <br> 使用方法 <a>Colored</a> <br> 源码分析 a { color: #1EAEDB; } a:hover { color: #0FA0CE; } 这里只定义了 a 的字体颜色,还有鼠标经过时的颜色。字号默认继承 body ,也就是 15px。 <br> 按钮 Buttons<a name="Buttons"></a> <br> 使用方法 <!-- 默认 --> <a class="button" href="#">Anchor button</a> <button>Button element</button> <input type="submit" value="submit input"> <input type="button" value="button input"> <!-- primary类型 --> <a class="button button-primary" href="#">Anchor button</a> <button class="button-primary">Button element</button> <input class="button-primary" type="submit" value="submit input"> <input class="button-primary" type="button" value="button input"> <br> 源码分析 /* 默认样式 */ .button, button, input[type="submit"], input[type="reset"], input[type="button"] { display: inline-block; /* 行内块 */ height: 38px; /* 高度 */ padding: 0 30px; /* 内边距:上下0,左右30px */ color: #555; /* 字体颜色:灰色(有点深) */ text-align: center; /* 本文居中 */ font-size: 11px; /* 字号 */ font-weight: 600; /* 字体稍微加粗 */ line-height: 38px; /* 行高(和height一样,所以是垂直居中了) */ letter-spacing: .1rem; /* 字距 */ text-transform: uppercase; /* 字母变成全大写 */ text-decoration: none; /* 不需要文本修饰 */ white-space: nowrap; /* 不换行 */ background-color: transparent; /* 背景色:透明 */ border-radius: 4px; /* 圆角:4px */ border: 1px solid #bbb; /* 边框:1px,实线,浅灰 */ cursor: pointer; /* 鼠标指针样式 */ box-sizing: border-box; /* 盒模型规则 */ } /* 鼠标经过、获得焦点 */ .button:hover, button:hover, input[type="submit"]:hover, input[type="reset"]:hover, input[type="button"]:hover, .button:focus, button:focus, input[type="submit"]:focus, input[type="reset"]:focus, input[type="button"]:focus { color: #333; /* 文字颜色比默认深一点点 */ border-color: #888; /* 边框颜色比默认深一点点 */ outline: 0; /* 轮廓:0 */ } /* primary类型 */ .button.button-primary, button.button-primary, input[type="submit"].button-primary, input[type="reset"].button-primary, input[type="button"].button-primary { color: #FFF; /* 字变白 */ background-color: #33C3F0; /* 背景色变蓝 */ border-color: #33C3F0; /* 边框颜色变蓝 */ } /* 使用primary类型时:鼠标经过、获得焦点 */ .button.button-primary:hover, button.button-primary:hover, input[type="submit"].button-primary:hover, input[type="reset"].button-primary:hover, input[type="button"].button-primary:hover, .button.button-primary:focus, button.button-primary:focus, input[type="submit"].button-primary:focus, input[type="reset"].button-primary:focus, input[type="button"].button-primary:focus { color: #FFF; /* 文本白色 */ background-color: #1EAEDB; /* 背景色变深一点点 */ border-color: #1EAEDB; /* 边框颜色变深一点点 */ } 按钮的实现方式有很多种,比如 <button> 、<input type="submit" /> 等等,这里就不一一列举额了,skeleton 把这类情况都写好了,可以直接在源码中看到。 skeleton 提供了2中样式的按钮,一个是默认的(白底黑字),一个是 primary 的(蓝底白字)。 还有一些选中状态。 skeleton 的做法是先写好默认的,其他状态都在默认状态的基础上覆盖新的样式。 <br> <br> 表单 Forms<a name="Forms"></a> <br> 使用方法 <form> <div class="row"> <div class="six columns"> <label for="exampleEmailInput">Your email</label> <input class="u-full-width" type="email" placeholder="test@mailbox.com" id="exampleEmailInput"> </div> <div class="six columns"> <label for="exampleRecipientInput">Reason for contacting</label> <select class="u-full-width" id="exampleRecipientInput"> <option value="Option 1">Questions</option> <option value="Option 2">Admiration</option> <option value="Option 3">Can I get your number?</option> </select> </div> </div> <label for="exampleMessage">Message</label> <textarea class="u-full-width" placeholder="Hi Dave …" id="exampleMessage"></textarea> <label class="example-send-yourself-copy"> <input type="checkbox"> <span class="label-body">Send a copy to yourself</span> </label> <input class="button-primary" type="submit" value="Submit"> </form> <br> 源码分析 /* 单行文本框、多行文本框、下来选择器 */ input[type="email"], input[type="number"], input[type="search"], input[type="text"], input[type="tel"], input[type="url"], input[type="password"], textarea, select { height: 38px; /* 高度 */ padding: 6px 10px; /* 内边距:上下6px,左右10px */ background-color: #fff; /* 背景色:白色 */ border: 1px solid #D1D1D1; /* 边框:1px,实线,灰色 */ border-radius: 4px; /* 圆角:4px */ box-shadow: none; /* 投影:无 */ box-sizing: border-box; /* 盒模型 */ } /* 针对单行和多行文本框的样式设置 */ input[type="email"], input[type="number"], input[type="search"], input[type="text"], input[type="tel"], input[type="url"], input[type="password"], textarea { -webkit-appearance: none; -moz-appearance: none; appearance: none; /* 外表 */ } /* 多行文本框 */ textarea { min-height: 65px; /* 最小高度是65px,会覆盖上面设置的height */ padding-top: 6px; /* 上内边距 */ padding-bottom: 6px; /* 下内边距 */ } /* 单行文本框、多行文本框、下来选择器 获取焦点时 */ input[type="email"]:focus, input[type="number"]:focus, input[type="search"]:focus, input[type="text"]:focus, input[type="tel"]:focus, input[type="url"]:focus, input[type="password"]:focus, textarea:focus, select:focus { border: 1px solid #33C3F0; /* 边框:1px,实线,蓝色 */ outline: 0; /* 轮廓:0 */ } /* label(标签) legend(组合表单中的相关元素,legend 元素为 fieldset 元素定义标题) */ label, legend { display: block; /* 块状 */ margin-bottom: .5rem; /* 下外边距 */ font-weight: 600; /* 字体有点粗 */ } /* fieldset(可将表单内的相关元素分组) */ fieldset { padding: 0; /* 内边距 */ border-width: 0; /* 边框宽度 */ } /* 多选和单选 */ input[type="checkbox"], input[type="radio"] { display: inline; /* 行内 */ } /* label标签下的 .label-body,可看使用例子 */ label > .label-body { display: inline-block; /* 行内 */ margin-left: .5rem; /* 左外边距:5px */ font-weight: normal; /* 字体粗细 */ } <br> <br> 列表 Lists<a name="Lists"></a> <br> 使用方法 <ul> <li>Item 1</li> <li> Item 2 <ul> <li>Item 2.1</li> <li>Item 2.2</li> </ul> </li> <li>Item 3</li> </ul> <ol> <li>Item 1</li> <li> Item 2 <ol> <li>Item 2.1</li> <li>Item 2.2</li> </ol> </li> <li>Item 3</li> </ol> <br> 源码分析 /* 无序列表 */ ul { list-style: circle inside; /* 标记样式:圆,内侧 */ } /* 有序列表 */ ol { list-style: decimal inside; /* 标记样式:十进制,内侧 */ } ol, ul { padding-left: 0; /* 左侧内边距:0 */ margin-top: 0; /* 左侧外边距:0 */ } /* 嵌套列表 */ ul ul, ul ol, ol ol, ol ul { margin: 1.5rem 0 1.5rem 3rem; /* 外边距 */ font-size: 90%; /* 字号 */ } /* 列表项 */ li { margin-bottom: 1rem; /* 下外边距 */ } <br> <br> 代码 Code<a name="Code"></a> <br> 使用方法 <pre> <code>.some-class { background-color: red; }</code> </pre> <br> 源码分析 code { padding: .2rem .5rem; /* 内边距 */ margin: 0 .2rem; /* 外边距 */ font-size: 90%; /* 字号 */ white-space: nowrap; /* 不换行 */ background: #F1F1F1; /* 背景色:超级浅的灰色 */ border: 1px solid #E1E1E1; /* 边框:1px,实线,灰色 */ border-radius: 4px; /* 圆角:4px */ } pre > code { display: block; /* 块状 */ padding: 1rem 1.5rem; /* 内边距 */ white-space: pre; /* 空白会被浏览器保留。 */ } code 和 pre 是 HTML 原生标签。 <br> <br> 表格 Tables<a name="Tables"></a> <br> 使用方法 <table> <thead> <tr> <th>Name</th> <th>Age</th> <th>Sex</th> <th>Location</th> </tr> </thead> <tbody> <tr> <td>Dave Gamache</td> <td>26</td> <td>Male</td> <td>San Francisco</td> </tr> <tr> <td>Dwayne Johnson</td> <td>42</td> <td>Male</td> <td>Hayward</td> </tr> </tbody> </table> <br> 源码分析 /* 表头的列 和 普通列 */ th, td { padding: 12px 15px; /* 内边距 */ text-align: left; /* 文本左对齐 */ border-bottom: 1px solid #E1E1E1; /* 底边框 */ } /* 第一个表头的列 和 每行第一个普通列 */ th:first-child, td:first-child { padding-left: 0; /* 左内边距 */ } /* 最后一个表头的列 和 每行最后一个普通列 */ th:last-child, td:last-child { padding-right: 0; /* 右内边距 */ } 没想到表格的 css 样式这么简单吧哈哈哈哈~ <br> <br> 间隔 Spacing<a name="Spacing"></a> <br> 源码分析 button, .button { margin-bottom: 1rem; } input, textarea, select, fieldset { margin-bottom: 1.5rem; } pre, blockquote, dl, figure, table, p, ul, ol, form { margin-bottom: 2.5rem; } 这部分主要定义常用的标签和类的底部外边距,太简单,不一一细讲了。 <br> <br> 工具集 Utilities<a name="Utilities"></a> <br> 源码分析 .u-full-width { width: 100%; box-sizing: border-box; } .u-max-full-width { max-width: 100%; box-sizing: border-box; } .u-pull-right { float: right; } .u-pull-left { float: left; } 这部分源码太简单了,不讲了~ .u-full-width :宽度满屏 .u-max-full-width :最大宽度是满屏 .u-pull-right :右浮动 .u-pull-left :左浮动 <br> <br> 分割线 Hr<a name="Hr"></a> <br> 使用方法 <hr /> <br> 源码分析 hr { margin-top: 3rem; margin-bottom: 3.5rem; border-width: 0; border-top: 1px solid #E1E1E1; } 上下设置了外边距 清除掉所有border 最后再设置回顶部边框为1px,实线,灰色 <br> <br> 清除浮动 Clearing<a name="Clearing"></a> <br> 源码分析 .container:after, .row:after, .u-cf { content: ""; display: table; clear: both; } 容器 和 行 都设置了清楚浮动。 .u-cf 是专门清楚浮动的。 清楚浮动的做法在很多基础的 css 教程有讲,这里不再啰嗦了。 <br> <br> 媒体查询 Media Queries<a name="MediaQueries"></a> <br> 源码分析 @media (min-width: 400px) {} @media (min-width: 550px) {} @media (min-width: 750px) {} @media (min-width: 1000px) {} @media (min-width: 1200px) {} 这部分的源码,是预留给开发者自己写的。 如果开发者需要自己重新定义某些元素的样式,根据不同的窗口宽度来定义,可以在此编写。 <br> <br> Skeleton.css源码 /* * Skeleton V2.0.4 * Copyright 2014, Dave Gamache * www.getskeleton.com * Free to use under the MIT license. * http://www.opensource.org/licenses/mit-license.php * 12/29/2014 */ /* Table of contents –––––––––––––––––––––––––––––––––––––––––––––––––– - Grid - Base Styles - Typography - Links - Buttons - Forms - Lists - Code - Tables - Spacing - Utilities - Clearing - Media Queries */ /* Grid –––––––––––––––––––––––––––––––––––––––––––––––––– */ .container { position: relative; width: 100%; max-width: 960px; margin: 0 auto; padding: 0 20px; box-sizing: border-box; } .column, .columns { width: 100%; float: left; box-sizing: border-box; } /* For devices larger than 400px */ @media (min-width: 400px) { .container { width: 85%; padding: 0; } } /* For devices larger than 550px */ @media (min-width: 550px) { .container { width: 80%; } .column, .columns { margin-left: 4%; } .column:first-child, .columns:first-child { margin-left: 0; } .one.column, .one.columns { width: 4.66666666667%; } .two.columns { width: 13.3333333333%; } .three.columns { width: 22%; } .four.columns { width: 30.6666666667%; } .five.columns { width: 39.3333333333%; } .six.columns { width: 48%; } .seven.columns { width: 56.6666666667%; } .eight.columns { width: 65.3333333333%; } .nine.columns { width: 74.0%; } .ten.columns { width: 82.6666666667%; } .eleven.columns { width: 91.3333333333%; } .twelve.columns { width: 100%; margin-left: 0; } .one-third.column { width: 30.6666666667%; } .two-thirds.column { width: 65.3333333333%; } .one-half.column { width: 48%; } /* Offsets */ .offset-by-one.column, .offset-by-one.columns { margin-left: 8.66666666667%; } .offset-by-two.column, .offset-by-two.columns { margin-left: 17.3333333333%; } .offset-by-three.column, .offset-by-three.columns { margin-left: 26%; } .offset-by-four.column, .offset-by-four.columns { margin-left: 34.6666666667%; } .offset-by-five.column, .offset-by-five.columns { margin-left: 43.3333333333%; } .offset-by-six.column, .offset-by-six.columns { margin-left: 52%; } .offset-by-seven.column, .offset-by-seven.columns { margin-left: 60.6666666667%; } .offset-by-eight.column, .offset-by-eight.columns { margin-left: 69.3333333333%; } .offset-by-nine.column, .offset-by-nine.columns { margin-left: 78.0%; } .offset-by-ten.column, .offset-by-ten.columns { margin-left: 86.6666666667%; } .offset-by-eleven.column, .offset-by-eleven.columns { margin-left: 95.3333333333%; } .offset-by-one-third.column, .offset-by-one-third.columns { margin-left: 34.6666666667%; } .offset-by-two-thirds.column, .offset-by-two-thirds.columns { margin-left: 69.3333333333%; } .offset-by-one-half.column, .offset-by-one-half.columns { margin-left: 52%; } } /* Base Styles –––––––––––––––––––––––––––––––––––––––––––––––––– */ /* NOTE html is set to 62.5% so that all the REM measurements throughout Skeleton are based on 10px sizing. So basically 1.5rem = 15px :) */ html { font-size: 62.5%; } body { font-size: 1.5em; /* currently ems cause chrome bug misinterpreting rems on body element */ line-height: 1.6; font-weight: 400; font-family: "Raleway", "HelveticaNeue", "Helvetica Neue", Helvetica, Arial, sans-serif; color: #222; } /* Typography –––––––––––––––––––––––––––––––––––––––––––––––––– */ h1, h2, h3, h4, h5, h6 { margin-top: 0; margin-bottom: 2rem; font-weight: 300; } h1 { font-size: 4.0rem; line-height: 1.2; letter-spacing: -.1rem;} h2 { font-size: 3.6rem; line-height: 1.25; letter-spacing: -.1rem; } h3 { font-size: 3.0rem; line-height: 1.3; letter-spacing: -.1rem; } h4 { font-size: 2.4rem; line-height: 1.35; letter-spacing: -.08rem; } h5 { font-size: 1.8rem; line-height: 1.5; letter-spacing: -.05rem; } h6 { font-size: 1.5rem; line-height: 1.6; letter-spacing: 0; } /* Larger than phablet */ @media (min-width: 550px) { h1 { font-size: 5.0rem; } h2 { font-size: 4.2rem; } h3 { font-size: 3.6rem; } h4 { font-size: 3.0rem; } h5 { font-size: 2.4rem; } h6 { font-size: 1.5rem; } } p { margin-top: 0; } /* Links –––––––––––––––––––––––––––––––––––––––––––––––––– */ a { color: #1EAEDB; } a:hover { color: #0FA0CE; } /* Buttons –––––––––––––––––––––––––––––––––––––––––––––––––– */ .button, button, input[type="submit"], input[type="reset"], input[type="button"] { display: inline-block; height: 38px; padding: 0 30px; color: #555; text-align: center; font-size: 11px; font-weight: 600; line-height: 38px; letter-spacing: .1rem; text-transform: uppercase; text-decoration: none; white-space: nowrap; background-color: transparent; border-radius: 4px; border: 1px solid #bbb; cursor: pointer; box-sizing: border-box; } .button:hover, button:hover, input[type="submit"]:hover, input[type="reset"]:hover, input[type="button"]:hover, .button:focus, button:focus, input[type="submit"]:focus, input[type="reset"]:focus, input[type="button"]:focus { color: #333; border-color: #888; outline: 0; } .button.button-primary, button.button-primary, input[type="submit"].button-primary, input[type="reset"].button-primary, input[type="button"].button-primary { color: #FFF; background-color: #33C3F0; border-color: #33C3F0; } .button.button-primary:hover, button.button-primary:hover, input[type="submit"].button-primary:hover, input[type="reset"].button-primary:hover, input[type="button"].button-primary:hover, .button.button-primary:focus, button.button-primary:focus, input[type="submit"].button-primary:focus, input[type="reset"].button-primary:focus, input[type="button"].button-primary:focus { color: #FFF; background-color: #1EAEDB; border-color: #1EAEDB; } /* Forms –––––––––––––––––––––––––––––––––––––––––––––––––– */ input[type="email"], input[type="number"], input[type="search"], input[type="text"], input[type="tel"], input[type="url"], input[type="password"], textarea, select { height: 38px; padding: 6px 10px; /* The 6px vertically centers text on FF, ignored by Webkit */ background-color: #fff; border: 1px solid #D1D1D1; border-radius: 4px; box-shadow: none; box-sizing: border-box; } /* Removes awkward default styles on some inputs for iOS */ input[type="email"], input[type="number"], input[type="search"], input[type="text"], input[type="tel"], input[type="url"], input[type="password"], textarea { -webkit-appearance: none; -moz-appearance: none; appearance: none; } textarea { min-height: 65px; padding-top: 6px; padding-bottom: 6px; } input[type="email"]:focus, input[type="number"]:focus, input[type="search"]:focus, input[type="text"]:focus, input[type="tel"]:focus, input[type="url"]:focus, input[type="password"]:focus, textarea:focus, select:focus { border: 1px solid #33C3F0; outline: 0; } label, legend { display: block; margin-bottom: .5rem; font-weight: 600; } fieldset { padding: 0; border-width: 0; } input[type="checkbox"], input[type="radio"] { display: inline; } label > .label-body { display: inline-block; margin-left: .5rem; font-weight: normal; } /* Lists –––––––––––––––––––––––––––––––––––––––––––––––––– */ ul { list-style: circle inside; } ol { list-style: decimal inside; } ol, ul { padding-left: 0; margin-top: 0; } ul ul, ul ol, ol ol, ol ul { margin: 1.5rem 0 1.5rem 3rem; font-size: 90%; } li { margin-bottom: 1rem; } /* Code –––––––––––––––––––––––––––––––––––––––––––––––––– */ code { padding: .2rem .5rem; margin: 0 .2rem; font-size: 90%; white-space: nowrap; background: #F1F1F1; border: 1px solid #E1E1E1; border-radius: 4px; } pre > code { display: block; padding: 1rem 1.5rem; white-space: pre; } /* Tables –––––––––––––––––––––––––––––––––––––––––––––––––– */ th, td { padding: 12px 15px; text-align: left; border-bottom: 1px solid #E1E1E1; } th:first-child, td:first-child { padding-left: 0; } th:last-child, td:last-child { padding-right: 0; } /* Spacing –––––––––––––––––––––––––––––––––––––––––––––––––– */ button, .button { margin-bottom: 1rem; } input, textarea, select, fieldset { margin-bottom: 1.5rem; } pre, blockquote, dl, figure, table, p, ul, ol, form { margin-bottom: 2.5rem; } /* Utilities –––––––––––––––––––––––––––––––––––––––––––––––––– */ .u-full-width { width: 100%; box-sizing: border-box; } .u-max-full-width { max-width: 100%; box-sizing: border-box; } .u-pull-right { float: right; } .u-pull-left { float: left; } /* Misc –––––––––––––––––––––––––––––––––––––––––––––––––– */ hr { margin-top: 3rem; margin-bottom: 3.5rem; border-width: 0; border-top: 1px solid #E1E1E1; } /* Clearing –––––––––––––––––––––––––––––––––––––––––––––––––– */ /* Self Clearing Goodness */ .container:after, .row:after, .u-cf { content: ""; display: table; clear: both; } /* Media Queries –––––––––––––––––––––––––––––––––––––––––––––––––– */ /* Note: The best way to structure the use of media queries is to create the queries near the relevant code. For example, if you wanted to change the styles for buttons on small devices, paste the mobile query code up in the buttons section and style it there. */ /* Larger than mobile */ @media (min-width: 400px) {} /* Larger than phablet (also point when grid becomes active) */ @media (min-width: 550px) {} /* Larger than tablet */ @media (min-width: 750px) {} /* Larger than desktop */ @media (min-width: 1000px) {} /* Larger than Desktop HD */ @media (min-width: 1200px) {} <br> <br> 更多推荐 🤖console.log也能插图!!! 👺Vite 搭建 Vue2 项目(Vue2 + vue-router + vuex) 🐱‍💻Fabric.js 从入门到膨胀 点赞 + 关注 + 收藏 = 学会了

优秀的个人博客,低调大师

每日一博 | kLoop:直通 Linux 内核的高性能 asyncio

本文适合有一定编程基础的同学阅读,但不要求有任何专业方向的经验。写作目的,一是撺掇各路英豪一起做开源,二是记录一下新项目的选型设计和概念验证过程。全文小一万字(知乎那个字数统计……),阅读时间大概一下午(连同摆弄代码的时间)。 之前介绍 EdgeDB 历史的那篇文章里有提到,EdgeDB 的 I/O 目前十分依赖 Python asyncio。为了提升 EdgeDB 的速度,Yury 基于 libuv(就是 Node.js 底层的 I/O 库)搞出了人气颇高的 uvloop,最近能预见的几个 EdgeDB 版本都还是会用 uvloop。 与此同时,我们一直在探索进一步提升 I/O 性能的方法,比如用 Linux 内核的 TLS 支持(kTLS)来承接 SSL 连接、用多进程加共享内存来优化多核 I/O,甚至于是用 Rust 重写 EdgeDB 的 I/O 部分等等。我在研究的过程中发现了新的宝藏 io_uring,并用几个周末的时间简单写了点概念验证,于是就有了今天的新坑:kLoop。 https://gitee.com/fantix/kloop kLoop 与 uvloop 对仗,k 表示 Linux 内核(Kernel),主要想法是用内核的 io_uring 和 kTLS 功能来直接实现一个高效率的 asyncio 事件循环,因为我琢磨着这两个人应该是一对儿非常完美的搭档,理论上应该可以把 asyncio 的效率再提升一个档次。接下来我就稍微展开说说,欢迎有兴趣的同学一起跳坑。 技术选型 io_uring:免系统调用的 I/O 熟悉 io_uring 的同学可以放心跳过这一节。 我们的应用程序通常会对磁盘和网络进行操作,而这些 I/O 操作都需要操作系统的配合才能完成,这就需要应用程序去调用操作系统的相应接口,而这类调用就叫做系统调用(syscall),比如用 read() 来读取文件,或者用 send() 来发送网络数据。不管你用的什么编程语言,这些操作在底层基本上都是要做系统调用的。以 Linux 为例,如果仔细观察进程 CPU 的占用率,就能看到每个进程都有 user 占比和 system 占比,这个 system 占比就是该进程花在系统调用上的时间。 fantix@fantix-jammy:~$ time curl https://gitee.com > /dev/null % Total % Received % Xferd Average Speed Time Time Time Current Dload Upload Total Spent Left Speed 100 35991 0 35991 0 0 23711 0 --:--:-- 0:00:01 --:--:-- 23709 real 0m1.527s user 0m0.070s sys 0m0.005s Munin 记录下的 CPU 使用率 虽然系统调用可能会非常频繁,但这种调用并不是没有性能开销的——除了操作系统花在实际执行一次系统调用所需的时间外,在 user 和 system 模式之间切换也是需要时间的。这个开销虽然单次仅有约几百到上千纳秒,但架不住多啊——比如 asyncio 的事件循环每一次至少要 epoll() 一次吧,有进展的 socket 各自又有一次读或写,万一没成功下回还得重试。高并发下,一秒几百次的事件循环,每次循环几十上百次 I/O,光系统调用的额外开销就要占到毫秒级别了。 epoll() 是 Linux 上的高性能事件通知设施,可以同时监视多个文件描述符(比如 socket)的事件状态,如某个 TCP 连接成功了,或者某个 socket 收到消息了等等。 如果能把这些系统调用都放在操作系统里一并完成,不仅能够省去 user 和 system 来回切换的时间,更是抛开了接口封装的枷锁,在内核中直接完成许多之前不好搞的骚操作(比如异步磁盘 I/O),岂不美哉?这就是 io_uring 诞生的原因。 io_uring 是脸书的一个同学开发的,从 5.1 就进 Linux 内核主线了,但陆续改进到 5.11 才有了 kLoop 需要的全部功能,并且仍在持续改进中。笼统来讲,应用程序用内存映射(mmap)的方式拿到两条与内核共享的环状队列,通过其中一条队列(SQ)给内核源源不断的布置任务,然后从另外一条队列(CQ)获取结果;内核则按需进行 epoll(),并在一个线程池中执行就绪的任务。 io_uring 大致架构 一些常见的系统调用,如打开文件、读写文件、socket 操作等等,都可以通过 io_uring 来完成。而应用程序所需要做的,只是一些内存操作,告诉内核要做什么,读写缓冲区在哪里。这里仍然有少量的一些系统调用来控制 io_uring 本身,但都是实现细节了。一些初步的测评显示,io_uring 能比普通 epoll 快出 5% 至 40%。 kTLS:内核和网卡参与计算 我们再来看一个现代网络编程里的大头开销——TLS(也叫 SSL)。 包括 EdgeDB 在内的许多数据库都会建议或要求启用 TLS;HTTP 就更不用说了,你要是后面不带个 S 都不好意思跟别人打招呼;就连 DNS 也有加密版的了,所以 TLS 已经成为了一种公共网络基础设施。而信息的可逆熵增是需要花费能量的,加密解密的运算仍是一笔不小的开销。以 EdgeDB 为例,在 uvloop 已经大幅优化了其 TLS 实现的前提下,TLS 仍然带来了比明文流量高 15%~20% 的额外开销。 TLS 的加密算法分为两部分:集中在连接建立的握手阶段的非对称加密,和集中在数据传输阶段的对称加密。自然地,非对称加密主要影响 TLS 连接的建立速度,对称加密则对实际数据的传输速度有影响。 自 Linux 4.13 起,部分对称加密运算可以在内核中直接完成。这又是脸书小伙伴们的作品,并且在硬件支持的情况下,可以直接把运算工作扔给网卡来做,彻底解放 CPU。这个功能官方叫做 Kernel TLS,我们随大众的叫法,简称为 kTLS。常见 Linux 发行版似乎都构建了这一模块,就叫 tls,只需 modprobe 加载后即可使用。 kTLS 可以在 io_uring 的线程池中运行,也可以代工给网卡 从这张图就能看出来,为什么 io_uring 和 kTLS 是天生一对了——如果网卡不支持加密运算,那么 io_uring 的线程池正好可以给 kTLS 用来做运算池!这就意味着,你的应用程序哪怕只有一个线程,理论上也可以舔着脸去抢多核 CPU 的资源。GIL 手动打出了一个狗头…… CPython 的全局解释器锁(GIL)是一种用来保证 Python 代码在多线程环境中正确执行的同步机制,任何线程只要运行 Python 代码就得先获取这把锁,除非只有一个线程,或者某些函数的底层实现会主动释放 GIL 一段时间。GIL 带来的副作用就是,多线程的 Python 程序往往很难有效地利用多核 CPU 资源。 集成 OpenSSL 对称加密基本上解决了,接下来还需要看看非对称加密怎么办。因为与 TLS certificate 交互包含了许多用户应用逻辑,并不像对称加密那么直截了当,因此内核并不支持 TLS 非对称加密部分,需要由用户自己完成 TLS 握手, 然后把协商出来的对称密钥交给内核,内核才能接管连接加解密。 因为 kLoop 终究是 Python 库,所以 TLS 握手自然要用到 CPython 最常搭配的 OpenSSL。 OpenSSL 自 3.0 起开始支持 kTLS 发包代工,收包代工则需要最新的 3.1 开发版本。按照 NGINX 的说法,单是发包代工就已经能提供约 30% 的性能提升了(配合了原生 sendfile(),io_uring 也可以通过 splice() 实现)。其实,我们完全可以用 OpenSSL 1.1 进行 TLS 握手, 只不过 OpenSSL 封装的比较死,取对称密钥和序列号的手法比较脏(靠 key log 和内存指针偏移量)。再加上无法向 OpenSSL 1.1 直接提供明文数据,所以一旦内核接管了对称加密,所有的 TLS 控制消息就都废了,要么就得你自己编码解析;rekeying/renegotiation 就更别想了,更别说 TLS 1.3 还有 early data 什么的,握手都不一定能握完整,对安全性还是有挺大不确定性的。 TLS 的消息(Record)有多种类型,kTLS 将其分为应用数据消息(application data)和控制消息(control data,包括 TLS 的 alert、handshake 等非 application_data 的 Record)。 索性我们就选择 OpenSSL 3.0 吧,毕竟刚刚发布的 Ubuntu 22.04 就是 OpenSSL 3.0,加上 Linux 5.15 和 Python 3.10,够了。实现细节上,我们需要实现一个定制的 BIO,把里面的 I/O 部分拿出来自己搞,让 OpenSSL 3.0 去协调什么时候是明文、什么时候需要自己加解密就好了。 BIO 全称为基本输入输出,是 OpenSSL 对各种输入输出流封装出来的一个接口,比如 socket 有 socket BIO,文件有文件 BIO,OpenSSL 也允许我们提供自定义的 BIO 实现。 直接接驳 OpenSSL 并不意味着我们要抛弃 Python 的 SSL 实现。我们可以通过一个简单的头文件,把 Python SSLSocket 对象中的 OpenSSL SSL* 指针暴露出来(这里用的是 Cython 语法): cdef extern from "openssl/ssl.h" nogil: ctypedef struct SSL: pass cdef extern from *: """ typedef struct { PyObject_HEAD PyObject *Socket; /* weakref to socket on which we're layered */ SSL *ssl; } PySSLSocket; """ ctypedef struct PySSLSocket: SSL* ssl 有了 SSL* 指针,就可以调用 OpenSSL 的 SSL_set_options() 函数来启用 kTLS 了。 Cython:胶水语言的胶水 如果说 Python 是用来粘合多元宇宙的胶水语言,那么 Cython 就是胶水中的胶水——它与 C 语言的互操作性无可比拟。uvloop、asyncpg 和 EdgeDB 都大量用到了 Cython 编码,kLoop 也做出了同样的选择。 Cython 代码有着类似 Python 的语法,但是却会被编译成 C 代码,最终编译出可供 Python 导入的原生扩展模块。这些模块就可以动态(或者静态!)链接一些需要用到的 C 语言的库,比如链接 OpenSSL 来完成 kTLS 的握手,再比如链接 libc 来实现通往 Linux 内核的系统调用。 以自定义 OpenSSL BIO 为例,我们首先把 OpenSSL 的头文件中需要用到的部分用 Cython 重新定义出来: cdef extern from "openssl/bio.h" nogil: ctypedef struct Method "BIO_METHOD": pass ctypedef struct BIO: pass int get_new_index "BIO_get_new_index" () Method* meth_new "BIO_meth_new" (int type, const char* name) int meth_set_write_ex "BIO_meth_set_write_ex" ( Method* biom, int (*bwrite)(BIO*, const char*, size_t, size_t*), ) BIO* new "BIO_new" (const Method* type) void set_retry_write "BIO_set_retry_write" (BIO *b) 这里我们引入了两个结构体和 5 个函数。C 语言没有命名空间的概念,所以 OpenSSL 为了避免重复,为 BIO 相关的名称添加了 BIO_ 的前缀;但我们用的是 Cython,可以把这个文件保存为 openssl/bio.pxd,这样就可以通过 from openssl cimport bio 的方式,自然地拿到一个 bio. 的命名空间,因此在定义中我们进行了重命名,使其更符合 Python 的行为方式。 随后我们就可以开始自定义 BIO 了。首先需要一个新的 BIO_METHOD* 空间: from openssl cimport bio cdef bio.Method* KTLS_BIO_METHOD = bio.meth_new( bio.get_new_index(), "kTLS BIO" ) 然后实现 BIO 的各个函数,并且设置到这个 BIO_METHOD* 上。以 write_ex() 为例: cdef int bio_write_ex( bio.BIO* b, const char* data, size_t datal, size_t* written ) nogil: with gil: print('bio_write', data[:datal], <int>data) bio.set_retry_write(b) written[0] = 0 return 1 bio.meth_set_write_ex(KTLS_BIO_METHOD, bio_write_ex) 因为我们还没有开始真正实现 kLoop 的功能,所以这里暂时只是虚晃一Q(???),告诉 OpenSSL 这次啥也没写进去,还得重试。然而真正值得注意的是这里 nogil 和 with gil 的用法:nogil 用在方法签名上,标志着这个函数可以安全地用在 C 语言环境中,比如被设置成为 BIO_METHOD* 的一个回调函数。nogil 的函数也同时意味着,这个函数执行时不保证拿到了 Python 的 GIL,因此内部不能有任何的 Python 结构,除非在一个 with gil 上下文中。 这也是为什么我们在用 Python 的 print() 的时候,需要先用 with gil 来获取 Python GIL 的原因。你问我为什么要用 Python 的 print(),而不是用 C 语言的 printf()?因为 Python 好用啊!data[:datal] 就直接把数据显示出来了, <int>data 还能看地址,用来调试代码再方便不过了。 最后就可以用 bio.new(KTLS_BIO_METHOD) 来创建自定义的 BIO* 对象,做任何喜欢做的事情了。 开始制作 kLoop 有了前面的概念验证,我们选出了四种技术:Linux 5.11 的 io_uring、kTLS、OpenSSL 3.0 和 Cython。接下来就是把他们真正放到一起,制作出 kLoop 来了。 首先是作为事件循环基础的 io_uring(文档:《I/O 指环王》)。 io_uring 的接口其实十分简单,只有三个系统调用:setup、enter 和 register。 io_uring_setup:顾名思义,用来设置一个新的 io_uring。 每个应用程序都可以申请(多个)自己的 io_uring 实例,只需给定环形队列长度,setup 就会返回一个文件描述符,用以后续操作这个 io_uring 实例。setup 同时会给出几个指针,用来将环形队列 mmap 到用户空间。 io_uring_enter:这个系统调用会让 io_uring 实例开始工作,并一直阻塞到指定数量的任务完成后,或累计到指定的时间为止。 io_uring 还有另外一种运行模式叫 SQPOLL,可以在 setup 的时候进行设置;在这种模式下,内核会单开一个线程来主动执行任务,而不需要 enter 来触发;只不过为了节省资源,这个线程会在空闲指定的时间后挂起,需要 enter 才能唤醒。这种模式尽管多开了一个线程,但性能更好,因此 kLoop 会启用 SQPOLL。 io_uring_register:register 是用来向内核注册常用文件或缓冲区的,据说能够提高效率,但是我目前还没有研究到。 除了这三个系统调用之外,就是如何 mmap 出两个环形队列,以及如何使用 Linux 的头文件所定义的结构体,在内存中填充和使用这两个队列了。为了简化使用,io_uring 的作者还特意开发了一个 C 语言的封装库 liburing。但 kLoop 用到的部分其实非常简单直接,如果使用 liburing 反而会不方便,依赖链接也会是一个麻烦事。因此,kLoop 就选择了用 Cython 直接与内核通讯(用 libc 做系统调用,然后就是基于 linux/io_uring.h 操作共享内存),一些关键逻辑和结构体就仿照 liburing 来做就好了。 io_uring 用到了一个很有趣的 C11 的无锁多线程同步支持,也就是 stdatomic.h 里的功能(需要 GCC 4.9)。 对于 io_uring 来说,就是用户应用程序的线程和内核线程有可能同时操作环形队列,当竞争发生时,我们必须保证结果是完整的,不能出现数据丢失或重复的情况。多线程同步通常要上锁,但会牺牲部分性能,而 C11 正式引入的原子性操作不需要上锁,可以更高效地完成这一工作。具体来说,编译器会在处理原子性操作时,在 CPU 指令级别保证,不同的原子性操作不会同时发生——哪怕是发生在不同 CPU 上面——除非操作的内存对象不同,因此这种多线程同步的效率是非常高的。 更重要的是,原子性操作可以按需阻止编译器的优化对多线程的影响。我们通常认为,按顺序写的代码也会按顺序执行;但其实,编译器和 CPU 有很大概率会把没有依赖关系的指令“打乱”,在保证结果与顺序执行一样的前提下,优化指令顺序以达到更高的效率。这对于单线程应用来说是好事,但却是多线程的噩梦——尤其多个线程还要访问共享的内存。原子指令则会告诉编译器,在该指令以前的代码必须不能被优化到该指令之后再执行,在该指令之后的代码同样需要等到该指令完成之后才能执行,这就是原子性操作内存顺序中最严格的“顺序一致”(seq_cst)模式。除此之外,还有 acquire(后面的代码不能提前做)、release(前面的代码必须先完成)和 relaxed(编译器可随意优化,但原子性操作本身要保证不同时发生)。具体的例子就不展开讲了,在 kLoop 中的用法也都是参考 liburing 的,有兴趣看的同学可以开启英文模式阅读 GCC 的这一篇文档。 asyncio 的基础循环 kLoop 的事件循环仿照了 asyncio 的默认实现,除了 I/O 部分用 io_uring 替代了之外,“就绪队列”和“计时队列”的用法都是一样的。“就绪队列”是一个普通的链表,表示下一次循环马上可以执行的任务;“计时队列”是一个用最小二叉堆实现的优先队列,表示最近要执行的计时任务。每次循环的逻辑如下: 先计算这次循环能等待的最长时间——如果就绪队列里有东西,那么我们就是“一刻也不想多等”;否则的话,就是最多可以等到最近的计时任务必须开始执行时为止; 然后进 I/O——调用 io_uring_enter(),一直等到有就绪的任务,或者超时为止。就绪任务进就绪队列; 接着检查计时队列——到时的任务就出计时队列,进就绪队列; 最后就绪队列全部出列,然后一次性全部执行。 asyncio 默认实现中,就绪队列用的是 collections.deque,计时序列则是用 heapq 来操作一个普通的 list。这些数据结构的执行效率都是非常高的,但是我们既然已经用 Cython 了,不如就把效率推到极致,用 Cython 来写不包含 Python 结构(nogil)的纯 C 代码,实现与 deque 和 heapq 类似的功能。对于链表,我用数组做了一个环状队列,二叉堆则是直接仿照 CPython 的 heapq,用 Cython 实现了一个 C 的版本。 另外,循环第二步的“调用 io_uring_enter()”并不是每次都执行,因为 kLoop 默认启用了 SQPOLL,只要持续不断的提交 I/O 任务,内核线程就会一直工作,自动执行流水线上的任务;而 kLoop 只需从 CQ 上不断获取结果即可。那什么时候调用 io_uring_enter() 呢?一,内核线程暂停了,而我们又提交了新的 I/O 任务;二,CQ 和就绪队列都空了,而我们又有时间可以等待 I/O。当满负荷工作时,这两个条件都不满足的概率还是相当大的,因此 kLoop 可以(偶尔)做到“零系统调用”运转。 最后值得说明的是,在每次循环的这四个步骤中,前三个都是完全不需要 Python 参与的,所以不需要获取 GIL,完全在 C 的模式下跑,只有第四步才会获取一次 GIL,并一次性把就绪的任务都执行完。这么做可以最大程度地保证,关键路径上的代码都是 C 级别的速度(虽然单线程 GIL 都是 no-op),而且理论上可以让 Python 多线程稍微开心一点。 把所有东西放在一起就是这样的: kLoop 架构图,Aaron 说像 Lucky Charms 卡通麦片的工厂 异步 DNS 解析 细心的同学可能发现了,上面的架构图里藏了一个到目前为止都没有提到过的东西——trust-dns。是的,为了实现异步 DNS 解析,kLoop 封装了一个 Rust 写的 trust-dns 解析器。 选择 trust-dns 的原因主要是,别的高性能异步解析器对于异步运行时的支持都比较固定,只有 trust-dns 可以完全用 io_uring 来提供运行时,而且不仅是 TCP 和 UDP 连接可以自定义,连 /etc/resolv.conf 和 /etc/hosts 文件内容都可以自行提供。别的解析库像 c-ares 就只能给你一个文件描述符去 poll,而 libc 里的 getaddrinfo_a() 则似乎是用多线程来实现的。 因为 DNS 解析属于实现细节,所以我没有用 Rust 和 Python 相互调用,而是直接使用了(我认为更简单的)Rust 和 C/Cython 的接口。毕竟,kLoop 的核心循环并不需要 GIL,把不需要 Python 参与的 DNS 解析放在此处也最为合适。解析请求就是一个域名的字符串,而解析结果则是一个 C 的 SockAddr 结构体数组,这样一来 io_uring 就可以直接拿过来用在 socket 上了。恰巧,Rust 中的解析结果就是 C 结构体的封装,所以并不需要太麻烦的转换,就可以生成我们需要的结果。C 与 Rust 之间的互相调用就更简单了,就是互相调用对方定义的外部函数,只要注意参数类型转换就好了。 最有趣的地方还是在于用基于 C 的 io_uring 来为 Rust 中的异步 trust-dns-resolver 提供一个定制化的运行时环境,换句话说,trust-dns-resolver 定义了一套异步 I/O 接口,解耦了像如何创建一个 TCP 连接、如何发送一个 UDP 数据包等操作,它自己则使用这套接口实现了 DNS 解析的功能,而任何人都可以提供一个不同的接口实现,以不同的方式完成底层的 I/O 操作。 Rust 的异步编程是另外一个话题了,虽然也是很有趣,但是这里就不展开说了,总之就是与 asyncio 大差不差,原理都是一样的。对于 kLoop,io_uring 的主循环自然不由 Rust 这边来控制,所以我们需要一个简单的 Executor 来跑 trust-dns-resolver 创建的 Task,这些 Task 会调用我们提供的运行时来创建 io_uring 的任务,这些任务完成之后又会“唤醒” Rust 中的 Task,并在后续循环中继续执行,直到拿到我们需要的结果为止。 Cython 混编 Rust 进行异步 DNS 解析 TCP 客户端和服务器 回到 kLoop 本身,我们下一步要具体来实现 asyncio 的各种功能了,下面主要以 TCP 客户端为例来说明大体实现思路。 asyncio 对 I/O 操作解耦提供了一对儿基本的概念:transport 由 asyncio 的实现来提供,代表了对 I/O 底层的最终封装;protocol 的实例由用户提供,指定了 I/O 事件发生时应该执行的用户代码。用户可以在 protocol 里写回调代码,然后调用 transport 的方法来操作 I/O。比如说用 asyncio 创建一个 TCP 客户端,用户需要提供目标地址和端口,以及一个用来创建 protocol 实例的工厂函数;asyncio 的实现则会实际创建一个 TCP 连接,返回一个封装了该 TCP 连接的 TCPTransport 实例,以及一个通过给定工厂产生的、与该 transport 绑定的 protocol 实例。 我们在制作 kLoop 时要实现的,就是这个 TCPTransport,以及适时地调用 protocol 中的方法。 对于 io_uring 来说,一条 TCP 连接就是一个 int 类型的文件描述符,所以我们的 TCPTransport 定义就特别简单了: cdef class TCPTransport: cdef: int fd object protocol 连接的过程就不详细展开了,无非就是调用前面的 DNS 解析,拿到一堆 IP 地址,然后挨个儿试。 关键在于发送和接收数据。 io_uring 会在一个线程池中执行提交上来的任务,所以任务执行的顺序未必会同提交的顺序一致,甚至于先后提交的两个任务有可能会被同时执行。Linux 中,虽然 socket 数据的发送和接收操作本身是原子性的——也就是说在一个 socket 上,多个线程同时发送或者多个线程同时接收并不会报错——但这不代表数据不会乱。对于 TCP 来说,数据是有严格顺序的,因此底层代码在将多个并发 send() 的数据合并成一股时,大家通常认为数据有可能会乱掉,对于 recv() 也是一样,并且更没有道理并行接收。(UDP 是一个例外,发送的数据报文都是有固定大小限制的,再加上本身就没有顺序要求,因此多线程发送完全没有问题,接收也行但意义不大。) 因此对于 kLoop 的 TCPTransport,我们需要一个自己搞一个发送队列,当目前已经提交了一个发送任务时,把数据临时放在这个发送队列里,上一个发送任务结束后再提交一个新的去发送剩下的。为了避免内存复制,我们自然是要把用户给我们的数据对象原封不动地放在队列里,但在创建发送任务时,我们可以用 sendmsg() 的数据阵列(Vectored I/O)来一次性将全部积压的数据都发送出去,以节省任务数量。 相比较而言,接收数据就容易的多了。在连接创建之后,首先提交一个接收数据的任务。任务完成,拿到数据,紧接着再提交一个新的接收任务就好了,一直反复直到连接断开为止。因为用户代码处理数据 data_received() 是在 Python 中进行的,所以我们可以用 call_soon() 将其放在下一次循环里,而抓紧时间先创建下一个接收任务,以求吞吐量的最大化。 kLoop 的 TCPTransport 最后聊一下流量控制。比如说,TCPTransport 的 send() 函数是非阻塞的,也就是说,用户可以卯足了劲儿一顿发,发到网卡都反应不过来,结果我们的发送队列就会占用大量内存。 此时,我们的 TCPTransport 应该及时看到缓冲区已经漾了,并且尽快通过 Protocol 的 pause_writing() 函数来通知用户:“别再发啦,歇会儿吧。”。虽然此时用户可以蛮不讲理地继续填鸭,但我们假设用户还是友善地给了我们喘息的机会。等到 io_uring 把该发的发得差不多了的时候,我们在通知用户 resume_writing() 可以继续发了。这里缓冲区有一个警戒线(漾了)和一个安全线(缓过来了),用户可以通过 TCPTransport 的 set_write_buffer_limits() 函数进行设置,我们在实现的时候则会记录下来,作为盯梢的目标。 反过来对于接收端,流量控制也是必要的,只不过不由我们的 TCPTransport 来控制。因为接收下来的数据是给用户处理的,所以用户有可能会遇到处理不过来的情况,或者压根儿这会儿就不想处理任何数据。此时,用户可以主动调用我们的 TCPTransport.pause_reading() 函数来告知这一诉求,而我们只需要把当前的接收任务取消就可以打破这个接收循环了,等到用户调用 resume_reading() 时, 再重新创建接收任务,重启循环。简单直接。 实现 TLS 有了前面的基础,我们就可以开始上 TLS 了。 首先,我们需要支持 Python 的 SSLContext,因为这是 asyncio 使用 TLS 的唯一方式。从 SSLContext 创建 TLS 连接有两种方式,一种是通过 wrap_socket() 将一个普通的 Python socket 升级为 SSLSocket,另一种则是用 wrap_bio() 来封装两个 OpenSSL 的 BIO(上层理论上须为 Python 自己封装的 MemoryBIO 对象,但封装很简单,可以替换成任意 BIO)。前面选型的时候已经说过了,我们需要自定义一个用 io_uring 实现的 BIO,所以这里我们就用 wrap_bio() 的方式来实现: from .includes.openssl cimport ssl as ssl_h from .includes.openssl.bio cimport BIO cdef extern from *: """ typedef struct { PyObject_HEAD BIO *bio; int eof_written; } PySSLMemoryBIO; """ ctypedef struct PySSLMemoryBIO: BIO* bio cdef object wrap_bio(ssl_context, bio.BIO* b, ...): cdef pyssl.PySSLMemoryBIO* c_bio py_bio = ssl.MemoryBIO() c_bio = <pyssl.PySSLMemoryBIO*>py_bio c_bio.bio, b = b, c_bio.bio try: rv = ssl_context.wrap_bio(py_bio, py_bio, ...) ssl_h.set_options( (<pyssl.PySSLSocket*>rv._sslobj).ssl, ssl_h.OP_ENABLE_KTLS ) return rv finally: c_bio.bio, b = b, c_bio.bio 这里我们还是用类似的办法,把 Python MemoryBIO 对象中的 BIO 指针,换成我们自己的实现,然后通知 OpenSSL 启用 kTLS。在 kLoop 的 TLSTransport 里,我们就会先用这个 wrap_bio() 函数创建一个含有我们自己 BIO 实现的 SSLObject 对象,然后后续的 TLS 握手、数据收发和断开连接等操作就都通过这个 SSLObject 来完成了。 TLSTransport 大致架构 比如说握手,我们就调用 do_handshake(),底层从 Python 到 OpenSSL 会最终调用到我们的 BIO 来发送或接收数据,我们的 BIO 则会创建相应的 io_uring 任务并告诉 OpenSSL:“你得等等”,并且一路返回到我们的 TLSTransport,抛出一个 SSLWantReadError 或者 SSLWantWriteError。我们抓到这个异常,忽略掉,正常返回主循环即可。因为 io_uring 的任务完成时,会重新回到这个 TLSTransport 的握手流程,然后重试 do_handshake()。那个时候,该发的已经发出去了,该收的也应该已经收到了,所以握手得以继续,直到完成为止。 同样的操作对于接收和发送数据也是一样的,只不过需要确保重试发送和接收时,缓冲区还得是同一个,因为 io_uring 的任务已经创建了,你不能过河拆桥,偷摸儿把缓冲区换掉就不地道了,人家那边还用着呢。所以 TLSTransport 的发送队列大体上与 TCP 类似,但发送时只能一个一个的发,并且只有在成功之后才能出列,不能批量处理了。 剩下的重点就在于 BIO 如何实现了。 首先,每个 BIO 也得存一个文件描述符,代表了底层的 TCP 连接,收发数据全靠它。 其次,我们需要实现 BIO 的控制回调,尤其是 BIO_CTRL_SET_KTLS——这就是前面 OP_ENABLE_KTLS 的 I/O 实现。此时握手已经结束了或者即将结束,OpenSSL 会把启用 kTLS 所需的密钥啦、初始向量啦、读写序列号什么的都帮我们准备好,我们只需要调用 Linux 的接口启用 kTLS 即可。 最后实现数据收发。最简单的自然是第一次收发,创建一个对应的 io_uring 任务然后返回“得重试”即可。但是这个任务不能就这么忘却了,它的回调需要至少做两件事:一,更新 BIO 的状态,记得说该任务已完成,下次重试记得返回成功;二,安排重试。所以呢,BIO 创建的 io_uring 任务得记得这个 BIO,还得记得上层的 TLSTransport。BIO 也得保存两个状态,一个是当前是不是发送中,另一个是当前是不是接收中。重试时,给进来的缓冲区得与保存的状态一致,然后根据状态对应返回“还得重试” 或者“已经完成”。 kLoop 的 TLS 握手流程 “启用 kTLS 之后,接收到的数据不用再解密了,发送的数据也不用先加密了,这事儿谁管?”反正不是 BIO 管。这就是 BIO 抽象的好处——我只管 I/O,至于数据该怎么处理,那是 TLS 实现的事儿。因为 OpenSSL 3.0 已经搞定了这一块儿了,所以我们最初选 OpenSSL 3.0 也是为了偷这一个懒儿。另外,因为 OpenSSL 自己不会复制内存,所以只要我们老老实实地用 recv_into() 和 memoryview, 那么不管是 kTLS 启用之前还是之后,都不会出现内存复制的额外开销。 剩下还有一些边边角角的,比如 TLS 1.3 early data、rekeying 什么的 Python 暂不支持,再比如优雅断开连接或者降级为明文 TCP 倒是都能实现,篇幅所限就不深究了。 任务拆分及下一步 这篇文章零零散散写了得两个多月了吧——代码倒是没写几行——到这里算是有了一个大概的蓝图了。先总结一下接下来要做的,都是可以直接认领的独立任务: 把 TCP 连接的部分从 transport 里抽离出来,在 nogil 的 Cython 里实现 happy eyeballs 什么的; 完成 TCP 的客户端实现; 完成 TCP 的服务器实现; 完成 TLS 的实现; 性能评测!看看到底能快多少; DNS 部分还有很多 todo!(),不实现的话会崩溃; 加测试,把 uvloop 的测试套件搬过来; 以上基本的功能有了就可以发个 0.1 版了,然后就可以胡搞乱搞了(有些也可以提前认领来做): TLS sendfile() 王炸!写完了可以去跟 NGINX 比速度; UNIX domain socket? UDP? 支持管道和子进程? 系统信号、进程 fork 和多线程什么的; 用 Rust 的各种 HTTP/1/2/3 库搞一个高性能 ASGI 服务器?……以及捎带手搞一个 WSGI 服务器? 支持 Trio 的运行时? 想到再加! 关于 Gitee 的私货 最后随便聊两句关于 Gitee 的事情。 之前做 GINO 的时候,我曾经在 OSChina 发过博客,所以也了解国内有个 @Gitee,但是没太当回事,做了个镜像而已,因为 GINO 在 GitHub 扎根已深。最近这不是挖了个新坑吗,我就想两边儿都看看,结果没想到就碰上了 Gitee 批量重审的事情。 这个事件说实话对我没有什么影响(因为我不用 Gitee 当图床?还有……图床到底是个什么鬼?),因为最早创建 Gitee 项目的时候,就已经让勾选那三个“同意”才能开源了。事发之后,无非也就是周五晚上重新打勾,周六就给审核通过了,之后也没有发现任何异常或延误。 倒是后来网上事件开始发酵,逐渐感觉味道不是太对了。公共内容接受监督本来就是默认的事实,这次 Gitee 突然批量操作也可能确实不专业(也许是因为之前节省了自审成本,出现了猝不及防的漏网之鱼?),但是怎么就突然上升到“违背了开源的自由精神”了?满网乌央乌央地强行蹭流量(好像流量最大的那个问题已经让知乎给夹了),这就是自由的开源精神了?不讨论监督的对错,但不知道大家有没有在 sourceforge.net 上创建过项目,反正我大概 15 年前创建的时候,是要等管理员审批的,性质可能不一样,但对于“普通的”开源项目,操作流程确实是一样的。 听了 Gitee 九周年的直播,才了解到 Gitee 根本不需要人帮忙洗白,人家的业务重心在政企组织。真正需要保护的,是国内开源社区的精气神儿,是能踏实做技术的信心,看起来这也是 Gitee 的团队着急的地方。直播中我还发现,十几年前我与当时还没加入 OSChina 的马老师曾有过一面之缘,当时我就一热血愤青小毛孩,马老师问我,“你觉得开源是什么?”我好像叽里呱啦地说了一堆没用的技术细节。这次直播中,马老师说,“现在开发者要空前的团结,拧成一股绳”。现在对于同一个问题,我可能会说,“开源是踏踏实实做技术,然后你做的东西刚好别的开发者也能用的上,相互激励。” 老子曾经曰过:利而不害,为而不争。kLoop 将使用 Gitee 开发,在 GitHub 设置镜像,欢迎全球开发者一起参与。就酱。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册