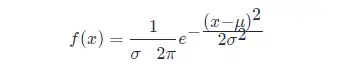首页 文章 精选 留言 我的

精选列表

搜索[赛博朋克],共10000篇文章
优秀的个人博客,低调大师

每日一博 | 电商通用型商品中心设计

作者:京东物流 高峰 1 需求 构建一个电商通用型商品中心,可支持商品的种类和属性繁多,可以售卖实物、虚拟、会员、服务类商品。每一种商品具有不同的规格,不同的规格的商品有多种价格,商品可支持多种货币的支付。 1)目的是什么? 带大家一起实现一个通用型商品中心,从中学到一些扩展性设计思想。 2)你能学到什么? 理解行业术语和概念 动态sku表单设计 属性和sku扩展性设计 价格扩展性设计 商品规格设计 3)不能学到什么? 商品图片存储设计 商品上下架设计 商品标签设计 库存设计 搜索筛选设计 2 商品的基本概念 商品中心是电商各个系统的最基础单元,为商城、订单,优惠促销、库存、仓储物流等系统提供基础数据。 电商的基本术语。 SKU:(Stock Keeping Uint,即库存量单位),库存控制的最小可用单位。例如“iPhone 7 Plus 128G银色”就是一个SKU,仓库管理、采购进货、库存管理都是以SKU为记录单元。 SPU:(Standard Product Unit,即标准化产品单元),是一组标准化信息的集合,例如“iPhone 7 Plus”就是一个SPU。 类目:即分类树。电商常用的有两层类目:前台展示类目和后端商品类目。 前台类目指的是展示给消费者看的类目,会根据季节、销售策略、活动进行变动; 后台类目属于基础数据,不可随意变动,添加SKU时都需要选择后台类目,进行绑定。 属性:分为关键属性、销售属性、非关键属性、特殊属性。 关键属性 是指能够唯一确定产品的属性,是必填项,例如手机的屏幕尺寸、型号属于关键属性。 销售属性 是组成SKU的特殊属性,或称为“规格属性”,例如手机的“颜色”、“内存”。 非关键属性 指的是除关键属性、销售属性外的其他属性,如前置摄象头像素、后置摄像头像素、产地、分辨率。 特殊属性 指需要通过调用其他服务才能获取到的属性。 3 商品架构图 参考下面的商品组成模块图,商品模块的组成较为复杂,在定义SKU与SPU时,涉及类目、属性、品牌、生产信息等数据的组合,在定义出SKU后再创建SPU,在SPU上添加商品描述和规格最后就成了商品。根据商品又衍生出了价格管理、评论管理、搜索筛选等模块。 3.1 商品组成模块图 3.2 商品中心核心ER图 3.3 商品中心整体架构图 4 商品类目 4.1 类目管理 商品类目分为两层:基础数据类目层(后台类目)、前台展示类目层(前台类目)。那为什么要将前、后台类目分开管理,而不是前、后台共用一套类目呢? 后台类目面向商家或供应链人员,商品属性、销售属性及品牌等很多数据都是在基础类目上进行管理; 前台类目面向用户,方便用户查找商品,还可以随着运营需要去调整。比如而且随着节日、时令季节变化,运营会经常变更前台类目。 4.2 后台类目 后台类目主要面向平台运营人员或商家,用于管理商品、属性和品牌等数据。 后台类目相对固定,确定了之后不会轻易变更或删除,如果类目下挂载有商品,就不能删除或作废。 类目树的层次不能太深,一般三层或四层。如果太深,对于商品的管理不太方便。类目树中最后一层类目称为叶子类目,商品必须挂载于叶子类目下。 4.3 前台类目 前台类目主要面向用户,方便用户筛选查找商品,如图图所示。 前台类目可以根据运营需要,灵活多变。所以处理商品的前端类目时,就应该提供多样化的前端类目来支持。 前台类目可支持不同客户端的设置。PC端、H5端、APP端等 前台类目不同于固定的后台类目,编辑很灵活、可重叠、可删除、可随时变动,定时生效。 4.4 类目表结构设计 4.1.1 后端类目表设计 CREATE TABLE `category` ( `id` bigint(11) unsigned NOT NULL AUTO_INCREMENT COMMENT 'id', `name` varchar(32) NOT NULL COMMENT '类目名称', `parent_id` bigint(11) NOT NULL COMMENT '父id', `leaf` tinyint(4) NOT NULL COMMENT '是否叶子节点 1是 0不是', `level` tinyint(4) NOT NULL COMMENT '类目层级', `path` varchar(128) DEFAULT NULL COMMENT '完整父级路径:父父id_父id', `sort` int(11) unsigned NOT NULL COMMENT '排序字段', `status` tinyint(4) NOT NULL COMMENT '分类状态:1上架 2下架', `del` tinyint(4) unsigned NOT NULL COMMENT '是否删除', `create_time` datetime NOT NULL DEFAULT CURRENT_TIMESTAMP COMMENT '创建时间', `update_time` datetime NOT NULL DEFAULT CURRENT_TIMESTAMP COMMENT '更新时间', PRIMARY KEY (`id`) USING BTREE ) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COMMENT='类目表'; 4.4.2 后端类目数据展示 5 SKU SKU算是电商中最基础的概念,SKU是最小库存单元。 以iPhone 8 Plus(SPU)为例,这个SPU的规格有多种(颜色包含金 色、白色、黑色、玫瑰金、银色、亮黑、红色等6种;内存包含32G、 128G、256G等3种),对应18(即3×6)种SKU。比如“iPhone 7 Plus白 色32G”、“iPhone 7 Plus黑色32G”这两个SKU都能具化到实物。仓库系统、采购系统、库存系统等系统都是主要管理SKU。 5.1 sku表设计 CREATE TABLE `sku` ( `id` int(11) NOT NULL AUTO_INCREMENT, `sku_no` varchar(32) DEFAULT '' COMMENT '商品序列号', `sku_name` varchar(50) DEFAULT NULL COMMENT '商品名称', `sku_description` varchar(256) DEFAULT NULL COMMENT '商品描述', `sku_type` tinyint(4) DEFAULT NULL COMMENT '商品类型:1实物商品、2会员商品、3增值商品,4虚拟物品', `status` tinyint(4) NOT NULL COMMENT '状态 1未上架2.已上架 3.已下架', `sort` int(10) DEFAULT '0' COMMENT '排序', `boundle` tinyint(4) unsigned DEFAULT '0' COMMENT '是否组合商品 1是 0否', `create_by` int(11) unsigned NOT NULL COMMENT '创建人ID', `update_by` int(11) unsigned DEFAULT NULL COMMENT '修改人ID', `create_time` timestamp NOT NULL DEFAULT CURRENT_TIMESTAMP COMMENT '创建时间', `update_time` timestamp NULL DEFAULT NULL ON UPDATE CURRENT_TIMESTAMP COMMENT '更新时间', PRIMARY KEY(`id`) USING BTREE, UNIQUE KEY `uk_sku_no` (`sku_no`) USING BTREE ) ENGINE = InnoDB AUTO_INCREMENT = 1 DEFAULT CHARSET = utf8mb4 COMMENT = '商品表' 5.2 sku表数据 5.3 sku属性表 扩展性1:动态无限制创建属性数量。 CREATE TABLE `sku_attr` ( `id` int(11) NOT NULL AUTO_INCREMENT, `sku_no` varchar(32) DEFAULT '' COMMENT '商品序列号', `sku_attrs` json DEFAULT NULL COMMENT 'sku属性(商品属性)', `create_time` timestamp NOT NULL DEFAULT CURRENT_TIMESTAMP COMMENT '创建时间', `update_time` timestamp NULL DEFAULT NULL ON UPDATE CURRENT_TIMESTAMP COMMENT '更新时间', PRIMARY KEY(`id`) USING BTREE, UNIQUE KEY `uk_sku_no` (`sku_no`) USING BTREE ) ENGINE = InnoDB AUTO_INCREMENT = 1 DEFAULT CHARSET = utf8mb4 COMMENT = '商品属性表' 5.4 sku属性数据 不创建新字段,还可以用sql查询,你得到了什么启发? 5.5 sku动态表单 扩展性2:根据不同类目加载不同属性渲染动态表单。 将一组属性挂载到类目来实现动态表单,你得到了什么启发? 5.6 商品类目关联 CREATE TABLE `category_to_goods` ( `id` bigint(11) unsigned NOT NULL AUTO_INCREMENT COMMENT 'id', `category_id` bigint(20) DEFAULT NULL COMMENT '类目id', `goods_no` varchar(32) DEFAULT NULL COMMENT '商品编号', `goods_type` tinyint(4) DEFAULT NULL COMMENT '商品类型:1sku、2spu', `create_time` datetime DEFAULT CURRENT_TIMESTAMP COMMENT '创建时间', `update_time` datetime DEFAULT CURRENT_TIMESTAMP COMMENT '更新时间', `is_deleted` tinyint(4) unsigned NOT NULL DEFAULT '0' COMMENT '是否删除:0-否,1-是', PRIMARY KEY (`id`) USING BTREE ) ENGINE=InnoDB AUTO_INCREMENT=8 DEFAULT CHARSET=utf8mb4 COMMENT='类目商品关联表'; 5.7 组合sku关系表 CREATE TABLE `bundle_to_sku` ( `id` bigint(11) unsigned NOT NULL AUTO_INCREMENT COMMENT 'id', `goods_id` bigint(20) DEFAULT NULL COMMENT '商品id, 组合商品id', `bundle_id` bigint(20) DEFAULT NULL COMMENT '组合商品id', `quantity` int(11) DEFAULT NULL COMMENT '商品数量', `entity_type` tinyint(4) DEFAULT '1' COMMENT '商品的类型:1sku,2组合商品', `create_time` datetime DEFAULT CURRENT_TIMESTAMP COMMENT '创建时间', `update_time` datetime DEFAULT CURRENT_TIMESTAMP COMMENT '更新时间', `is_deleted` tinyint(1) unsigned NOT NULL DEFAULT '0' COMMENT '是否删除:0-否,1-是', PRIMARY KEY (`id`) USING BTREE, KEY `idx_bundle_to_goods_bundle_id_index` (`bundle_id`) USING BTREE, KEY `idx_bundle_to_goods_object_id_entity_type_index` (`object_id`,`entity_type`) USING BTREE ) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COMMENT='套装和sku关联表||套装和spu关联表'; 5.8 组合sku关系数据 sku数据 5.9 创建组合商品表单 6 属性 6.1 属性管理 为了方便商品管理,我们需要在系统中建立一套属性库。在定义一个属性时,需要挂载在类目下,区分属性分类(关键属性、销售属性、非关键属性、特殊属性),并确定属性值、显示类型(单选、多选、可自定义)、是否必填。 6.2 属性的应用场景 添加商品时候的商品表单渲染。在添加商品时,可通过选择叶子类目,将挂载到叶子类目的属性渲染到表单上。 在客户端对可根据不同的属性进行搜索、筛选商品。 在spu页面用户可利用商品规格(销售属性)来定位出不同的sku。 商品详情页面可展示出后台配置的属性参数数据。 6.3 属性表设计 CREATE TABLE `attribute` ( `id` bigint(11) unsigned NOT NULL AUTO_INCREMENT COMMENT 'id', `name` varchar(32) NOT NULL DEFAULT '' COMMENT '属性名称', `code` varchar(32) DEFAULT NULL COMMENT '属性代码(非必填)', `attr_type` tinyint(4) NOT NULL COMMENT '属性应用:1商品属性,2销售属性,3特殊属性', `value_type` tinyint(4) DEFAULT NULL COMMENT '属性值类型:1:字符串,2:数字', `fill_type` tinyint(4) NOT NULL COMMENT '填写类型:1填写型(字符),2填写型(仅整数数字),3选择型(单选值,非id)4选择型(多选值,非id),5多输入框展示型', `is_filter` tinyint(4) unsigned NOT NULL COMMENT '是否支持前台筛选:0否 1是', `status` tinyint(11) NOT NULL COMMENT '状态:1 未上架 2已上架 3已下架', `is_deleted` tinyint(4) unsigned NOT NULL COMMENT '是否删除', `create_time` datetime NOT NULL DEFAULT CURRENT_TIMESTAMP COMMENT '创建时间', `update_time` datetime NOT NULL DEFAULT CURRENT_TIMESTAMP COMMENT '修改时间', PRIMARY KEY (`id`) ) ENGINE=InnoDB AUTO_INCREMENT=7 DEFAULT CHARSET=utf8mb4 COMMENT='属性表'; 6.4 属性表数据 6.5 属性枚举表设计 CREATE TABLE `attribute_enum` ( `id` bigint(11) unsigned NOT NULL AUTO_INCREMENT COMMENT 'id', `attr_id` bigint(20) NOT NULL COMMENT '属性id', `attr_code` varchar(32) DEFAULT NULL, `enum_code` bigint(11) DEFAULT NULL COMMENT 'enumcode', `enum_value` varchar(32) NOT NULL COMMENT '属性枚举值名称', `sort` int(11) NOT NULL COMMENT '排序', `create_time` datetime NOT NULL DEFAULT CURRENT_TIMESTAMP COMMENT '创建时间', `update_time` datetime NOT NULL DEFAULT CURRENT_TIMESTAMP COMMENT '更新时间', PRIMARY KEY (`id`) USING BTREE ) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COMMENT='属性枚举表'; 6.6 属性枚举表数据 6.7 属性和类目关联表设计 CREATE TABLE `category_to_attr` ( `id` bigint(11) unsigned NOT NULL AUTO_INCREMENT COMMENT 'id', `category_id` bigint(11) NOT NULL COMMENT '分类id', `attr_id` bigint(20) NOT NULL COMMENT '属性id', `is_required` tinyint(4) unsigned NOT NULL COMMENT '是否必填', `create_time` datetime NOT NULL DEFAULT CURRENT_TIMESTAMP COMMENT '创建时间', `update_time` datetime NOT NULL DEFAULT CURRENT_TIMESTAMP COMMENT '更新时间', PRIMARY KEY (`id`) USING BTREE ) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COMMENT='分类属性关联表'; 6.8 动态生成属性表单 当属性库搭建完成后,就会被各个叶子类目调用,添加商品时就需要填写这些属性,商品就有了载体,如图所示。 根据这些属性便能确定商品的唯一性(SKU)。 淘宝的商品属性(类目“男装”→“风衣”) 特别需要注意的是一些规格属性(如颜色、尺码等)。很多产品有 多规格,例如衣服、鞋子等。以一双男鞋为例,有颜色(假设白、红、 黑3种颜色),有尺码(从39~44共6种尺码),那么这个SPU(男鞋) 下面就有18个SKU。这些SKU的属性除了规格属性外,其他属性都是一 致的,所以在新建商品时,可聚合到一起,共用其他属性。 7 SPU 7.1 SPU概念 SPU 是标准化产品单元。SPU与SKU的关系有许多种,可以一对多、一对一, 绝大部分SPU与SKU都是一对一,多规格的SPU和SKU之间是通过规格属性来连接的。SPU的库存是由其对应的SKU库存共同决定的。 以iPhone 11(SPU)为例,这个SPU的规格有多种(颜色包含白色、黑色、黄金、紫色、绿色、红色等6种;内存包含32G、 128G、256G等3种),对应18(即3×6)种SKU。比如“iPhone 11 白色 64G”、“iPhone 11 黑色 64G”这两个SKU都能具化到实物。仓库系统、采购系统、库存系统等系统都是主要管理SKU。 在日常运营中也很常见一个SKU对应多个SPU。 7.2 SPU和规格设计 CREATE TABLE `spu` ( `id` bigint(20) unsigned NOT NULL AUTO_INCREMENT COMMENT 'id', `name` varchar(64) DEFAULT NULL COMMENT 'spu名称', `detail` varchar(256) DEFAULT NULL COMMENT '商品介绍', `status` tinyint(4) DEFAULT NULL COMMENT '状态 1未上架2.已上架 2.已下架', `spu_specs` json DEFAULT NULL COMMENT '商品规格', `creator_id` bigint(20) DEFAULT NULL COMMENT '创建者', `is_deleted` tinyint(1) unsigned DEFAULT '0' COMMENT '是否删除,0:未删除 1:已删除', `sort` int(10) DEFAULT '0' COMMENT '排序', `create_time` datetime DEFAULT CURRENT_TIMESTAMP COMMENT '创建时间', `update_time` datetime DEFAULT CURRENT_TIMESTAMP COMMENT '更新时间', PRIMARY KEY (`id`) USING BTREE ) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COMMENT='spu'; 7.3 SPU和规格数据 sku属性数据 spu表单图片 7.4 spu和sku关联表 CREATE TABLE `spu_to_sku` ( `id` bigint(11) unsigned NOT NULL AUTO_INCREMENT COMMENT 'id', `sku_no` varchar(32) NOT NULL DEFAULT '' COMMENT 'sku id', `spu_no` varchar(32) NOT NULL DEFAULT '' COMMENT 'spu id', `is_deleted` tinyint(1) DEFAULT '0' COMMENT '是否删除,0:未删除 1:已删除', `create_time` datetime DEFAULT CURRENT_TIMESTAMP COMMENT '创建时间', `update_time` datetime DEFAULT CURRENT_TIMESTAMP COMMENT '更新时间', PRIMARY KEY (`id`) USING BTREE, KEY `idx_spu_to_sku` (`spu_no`,`sku_no`) USING BTREE ) ENGINE=InnoDB AUTO_INCREMENT=5 DEFAULT CHARSET=utf8mb4 COMMENT='spu商品关联表'; 8 价格设计 价格包括:成本价、原价、售卖价、定金、膨胀金等会随着需求的不断增加,尤其是一些在线教育等垂直行业电商对金额会有各种玩法。 CREATE TABLE `sku_price` ( `id` bigint(11) NOT NULL AUTO_INCREMENT, `sku_id` bigint(11) unsigned NOT NULL COMMENT '商品id', `sku_no` varchar(20) NOT NULL DEFAULT '' COMMENT '商品编号', `sku_type` tinyint(4) NOT NULL COMMENT '商品类型: 1单sku 2组合sku', `sub_goods` tinyint(4) NOT NULL COMMENT '是否子商品:0否1是', `bundle_id` bigint(20) DEFAULT NULL COMMENT '组合商品id 默认 空', `price` decimal(10, 2) NOT NULL COMMENT '价格', `price_type` varchar(32) NOT NULL COMMENT '价格类型枚举(1.商品原价REAL_PRICE 2.售卖价SELL_PRICE 3.售卖底价... )', `currency_type` tinyint(4) NOT NULL DEFAULT '1' COMMENT '货币类型:1人民币 2虚拟币', `enable` tinyint(4) unsigned DEFAULT '1' COMMENT '是否启用 0 不启用 1 启用', `create_by` int(11) unsigned NOT NULL COMMENT '创建人ID', `update_by` int(11) unsigned DEFAULT NULL COMMENT '修改人ID', `create_time` timestamp NOT NULL DEFAULT CURRENT_TIMESTAMP COMMENT '创建时间', `update_time` timestamp NULL DEFAULT NULL ON UPDATE CURRENT_TIMESTAMP COMMENT '更新时间', PRIMARY KEY (`id`) USING BTREE, KEY `idx_sku_id` (`sku_id`) USING BTREE, KEY `idx_sku_no` (`sku_no`) USING BTREE ) ENGINE = InnoDB AUTO_INCREMENT = 1 DEFAULT CHARSET = utf8mb4 COMMENT = '商品价格表' " 扩展性3:不创建新字段,同一个商品可支持多种价格和货币种类 9 总结 本文详细介绍了商品中心设计扩展性设计思想,并在设计方面做了各维度分析。 扩展性总结如下: 动态无限制创建属性数量。 根据不同类目加载不同属性渲染动态表单。 不创建新字段,同一个商品可支持多种价格和货币种类。 希望自己总结的扩展性思想可以让大家在开发过程中有所启发。

优秀的个人博客,低调大师

每日一博 | 微服务进入深水区后该何去何从

作者 | 罗广明 2022 年,关于微服务发生了几件有趣的事情。其一,正式掌管 Twitter 不久的 Elon Musk 对 Twitter 的开发团队 “批判” 了一番。他表示自己为 Twitter 在许多国家的极慢运行速度感到抱歉。之所以如此慢是因为 App 需要执行 1000 多个 “糟糕” 的批处理 RPC,而这只是为了渲染主页的时间线。Musk 表示 “今天的部分工作将是关闭臃肿的"微服务" 。实际上,只有不到 20% 的微服务是 Twitter 需要的。” 其二,GitHub 前 CTO Jason Warner 在社交媒体上表示:“我确信过去十年中,最大的架构错误之一就是全面使用微服务。” “任何构建过大型分布式系统的人都知道他们并不真的那样工作,但还必须适应它。”那么,微服务架构是否是一个错误,或者微服务是否已经过时了呢? 业务是否需要微服务 微服务的起源,最早可以追溯到 2005 年 Peter Rodgers 博士提出的 Micro-Web-Service,即将应用程序设计成细粒度的 Web 服务。2014 年,Martin Fowler 与 James Lewis 首次正式提出了微服务的概念,定义了微服务架构是以开发一组小型服务的方式来开发一个独立的应用系统,每个服务都以一个独立进程的方式运行,每个服务与其他服务使用轻量级通信机制(RPC、HTTP)通信。这些微服务是围绕业务功能构建的,可以采用不同的编程语言。 微服务的诞生绝非偶然,CICD & Infrastructure As Code 的出现与发展,使得基础设施管理逐步简化、功能迭代也更快速和高效,推动与促进了微服务的进一步发展和落地。 然而,微服务架构并非银弹,微服务架构给业务带来收益的同时,也会带来相应的副作用。在合适的阶段采用微服务架构、合理决定微服务架构的拆分粒度以及恰当的微服务技术选型是决定微服务成败的核心。摒弃上述三点不谈,大肆抨击微服务存在的必要性,摇旗呐喊重回单体时代的言论都是站不住脚的。仔细分析 GitHub 前 CTO Jason Warner 的观点,你会发现,其倡导的是从单体到微服务的有序拆分和推进,并且微服务的拆分数量需要适合组织规模,Warner 鼓励企业根据自己的情况来选择,而不是盲从。这和上述倡导的观点本质上是一致的。 合适的阶段采用微服务架构 据观察,几乎所有成功的微服务架构都是从一个巨大的单体架构开始的。面对一个新的产品以及一个新的领域,很难在一开始就把业务理解清晰,往往是经过一段时间后,业务逐渐弄清楚之后,才会逐渐转型成微服务架构。此外,在物理资源和人力资源受限的情况下,采用微服务架构的风险较大,很多优势无法体现,尤其在技术选型不当时,微服务性能上的劣势反而会更加突出。 在微服务划分之前,也应该保证公司内部的基础设施及公共基础服务已经准备完备。可以通过监控组件和产品快速定位服务故障,可以通过工具自动化部署与管理服务,可以通过一站式开发框架降低服务开发的成本,可以通过灰度发布和泳道验证和提升服务的可用性,可以通过资源调度平台快速申请与释放资源,可以通过弹性伸缩服务快速扩展应用。 合理决定微服务架构的拆分粒度 微服务架构的拆分粒度应当合理,微服务架构中的微字,并不代表粒度越小越好,也不代表越多越好,应当追求一个合理的中间值。粒度过微,微服务的缺点将被放大,此时的微服务相对于原先的单体确实弊大于利;粒度不够,单体的缺点并未消除,微服务的优点并未凸显,也是不合理的。微服务架构的粒度拆分是一件相当复杂的事情,对于业务和团队组织架构理解不深的新人或者外部人员,根本无法判断合理的微服务拆分粒度。 随着业务的发展,组织架构的变化,团队开发人员水平的提升,粒度随时可能发生变化,这是一个不断演进的过程,没有绝对的对错。微服务架构的设计与微服务的拆分应当符合康威定律,即微服务架构需要与产生这些设计的组织架构保持一致,甚至是动态一致。 当然,仅仅熟悉业务和团队组织架构是不够的,也需要合理的微服务拆分策略。例如,比较独立的新业务优先采用微服务架构、优先抽象通用服务、优先抽象边界比较清晰的服务、优先抽象具有独立属性的服务。最后,建议优先抽象核心服务,因为微服务的运维成本较高,不是所有的地方都需要拆分,此外随着时间的推移,业务可能发生变化,而核心服务比较稳定从而不需要做较大调整。 恰当的微服务技术选型 决定使用微服务后,微服务相关技术选型至关重要。微服务框架可以封装、抽象分布式场景下的通用能力,例如负载均衡、服务注册发现、容错以及基本的远程通信的能力,可以让开发人员快速开发出高质量的服务。因此,在采用微服务之前,应当进行开发语言的选择以及对应的微服务框架的选型与试用。 那么该如何选择微服务框架呢?建议从扩展性、易用性、功能丰富度以及性能四个角度进行衡量。 首先是 扩展性,一个开源框架如果与内部能力强耦合、支持场景单一且无法进行扩展,那这个框架则很难在企业内部定制化的场景下进行落地。 其次是 易用性,业务开发者不希望关注很多框架底层细节,使用起来需要足够简单;而面向框架的二次开发者,他们需要对框架做一些定制支持,如果框架提供的扩展能力过于宽泛让扩展成本很高,或者可扩展的能力不够多,那这个框架也是存在局限性的。 再次是 功能丰富度,虽然基于扩展性可以对框架进行定制,但不是所有开发者都有足够的精力做定制开发,如果框架本身对各种扩展能力提供了不同选择的支持,对于开发者来说只需要根据自己的基础设施进行组合就能在自己的环境中运行。 前面三点是微服务转型初期选择微服务框架需要重点关注的指标,但随着服务规模和资源消耗变大,性能 就成了不容忽视的问题,从长期来看,选择框架的时候一定要关注性能,否则后续只能面临框架替换的巨大成本问题或者被迫对这个框架做定制优化与维护。 总的来说,微服务并非银弹,但是单体同样有很多缺陷,微服务是在单体架构之上自然衍生发展出来的一个面向现代化与云原生的架构,是大势所趋。只是业务需要在合适的阶段采用微服务架构、合理决定微服务架构的拆分粒度以及进行恰当的微服务技术选型。如果步子迈得太快,服务拆分不合理,技术选型犯了一些错误,架构需要回退到单体,这也是个别案例,但也是大家需要警惕和引以为戒的。 微服务进入深水区后该何去何从 微服务火了近十年,围绕微服务诞生了很多技术创新和开源项目,也有相当多的企业在内部完成了微服务的落地与推广。以字节跳动为例,近年来其微服务数量和规模迎来快速发展,2018 年,在线微服务数大约是 7000-8000,到 2021 年底,微服务数量已经突破了 10 万。企业内部的微服务数量能达到如此规模是相当少见的,但这也意味着微服务在字节得到了深度的发展,那么下一步路在何方呢? 结合字节跳动服务框架团队实践以及业界趋势,我们认为后续的微服务发展方向主要会围绕安全、稳定性、成本优化以及微服务治理标准化展开。 微服务安全 在微服务架构中,微服务的数量随着业务的分解和增长呈指数增加。由于微服务分布在不同的服务器上,因此与同一平台的单一实现相比,微服务通常会暴露出更大、更多样化的攻击面,这使得尽快发现和修复漏洞以避免问题变得更加困难。因此,每个微服务都需要对用户的行为进行认证和许可,明确当前访问用户的身份与权限级别。与此同时,整个系统可能还需要对外提供一定的服务,比如第三方登录授权等。在这种情况下,如果要求每个微服务都实现各自的用户信息管理系统,既增加了开发的工作量,出错的概率也会增加,因此,统一的认证和授权以及支持按需开启 mTLS 就显得尤其重要。 服务鉴定是一种基于身份标识校验请求身份合法性的微服务访问控制能力。服务通过为具体方法或通配方法配置全局开关为开启状态,达到严格的身份鉴定的效果。为了配合合规要求,字节跳动开展了跨业务线数据访问专项治理,治理的一个先决条件就是全面落地零信任(ZTI)的服务身份,从而识别数据请求方的可信身份进一步实现细粒度访问控制来满足用户隐私合规要求,保障微服务接口安全和防止类似删库这样的误操作。 严格授权是一种基于允许访问列表 + 不允许访问列表的微服务访问控制能力。服务通过为具体方法或通配方法配置对上游服务的具体集群或通配集群授权,结合全局开关为开启状态,达到严格的访问控制效果。 部分 RPC 框架本身也具备严格授权能力,但不同框架对于该能力的实现是不对齐的,而且越来越难以满足业务的配置需求。字节跳动基于服务网格 ByteMesh 来实现统一的严格授权能力,这也得益于服务网格技术已经在字节跳动内部实现了全面的落地。 微服务稳定性 线上服务稳定性对互联网应用至关重要,稳定性差的服务将带给用户不好的使用体验,甚至给企业造成直接的经济损失。衡量服务常态稳定性一个重要指标是 SLO(Service-Level Objectives),代表服务可用水平目标。例如将服务接口的成功率 SLO 定为 99.99%,一周内低于 SLO 基线的不可用时长少于 X 小时,超过 X 小时就表示该服务稳定性不达标。通常,微服务的治理能力,如超时、重试、容错、限流等能力可以满足大多数场景,提高微服务的稳定性。字节跳动内部微服务化水平高、规模大,为了做好精细化的服务治理,诞生了单实例治理与动态过载保护等一系列服务治理方案,进一步提升微服务的稳定性。 微服务化、大规模分布式部署带来了一定的运维负担,甚至有些时候,业务很难分辨问题的范畴是基础设施还是业务自身。其中,最为常见也往往不需要业务感知的问题是:极少部分(一个或几个)实例的服务能力异常导致服务 SLA 抖动。我们将这类问题统称为单实例问题。单实例问题的成因复杂,混杂了物理层面、业务层面等多种因素,而且几乎无法彻底根除。 为了降低单实例问题的业务感知、提升业务核心服务的 SLA,字节跳动服务框架团队基于服务网格 ByteMesh 的动态负载均衡能力构建了单实例问题抖动治理的解决方案。该方案通过收集 ByteMesh 数据面上报的 RPC 相关指标(延时、错误率等)、服务端实例的负载指标(排队时间、 CPU/MEM/IO 使用率等),动态更新服务端实例的权重,来达到服务负载更平均的效果。该中心化控制方案在抖音电商等业务经过大规模验证,有效提高了故障识别的效率。以某一个具体服务为例,当发生单实例故障,默认配置在 1min 以内会执行服务发现降权或摘除,因此服务 SLO 不可用时长控制在 1min 以内,并且提供了单实例治理摘除大盘,可以方便排查单实例问题。 微服务成本优化 在云原生时代,随着微服务的不断拆分和大规模增长,出现微服务过微是必然会面临的问题,由此带来的额外延迟和资源消耗等缺点越发凸显。业界也出现了很多反微服务的声音,呼吁回归单体。然而单体更加不是银弹,回归单体无异于饮鸩止渴,更不符合业务发展趋势。为此,针对微服务的成本优化,字节跳动探索出了很多路径,包括但不限于合并部署、JSON 序列化优化、开发框架开销优化等。此外,在公司推进成本优化的背景下,服务框架团队与业务、其他基础团队促成更多的合作,力求挖掘出更多性能优化点。 合并部署 字节在微服务架构之上对性能优化方案做了深入探索,探索了多种合并部署方案。虽然业界其他公司对合并部署也有过一些探索,但相关方案在编译、部署、监控、服务治理、服务隔离多个方面对现有体系的冲击较大,无法很好地支持现有体系,同时部署存在相互影响导致协作效率降低的问题。针对这一问题,基础架构团队提出了一种新的合并部署方案,结合容器亲和性调度、流量调度计算、更高效的本地通信,让原本需要跨机的网络通信变成同机进程间调用,既能与现有体系融合又能减少微服务链路带来的性能损耗。在 QCon 2021 上,基础架构服务框架团队对外分享了《字节跳动微服务合并部署实践》,得到业界其他公司的广泛关注。合并部署方案主要思路是结合容器亲和性调度、流量调度计算、更高效的本地通信,让原本需要跨机的网络通信变成同机进程间调用,既能与现有体系融合又能减少微服务链路带来的性能损耗。 以 IO 密集型测试服务为例,落地合并部署方案后,CPU 降低了 30% - 40%,延迟更加稳定,波动问题也没有了。目前合并部署已经在字节多个业务方落地,在完成性能及策略的进一步优化后,通过全局决策控制,合并部署有望在全公司范围内大规模落地。 JSON 序列化优化 JSON 以其简洁的语法和灵活的自描述能力,被广泛应用于各互联网业务。但是由于 JSON 本质上是一种文本协议,且没有类似 Protobuf 的强制模型约束,编解码效率往往十分低下。再加上有些业务开发者对 JSON 库的不恰当选型与使用,最终导致服务性能急剧劣化。字节跳动也遇到了上述问题。根据此前统计的公司 CPU 占比 TOP 50 服务的性能分析数据,JSON 编解码开销总体接近 10%,单个业务占比甚至超过 40%,提升 JSON 库的性能至关重要。因此字节跳动自研了一套 JSON 高性能编解码库 sonic-go 以及适用于 C/C++ 服务的 sonic-cpp,目前均已开源在 Bytedance GitHub 组织下。 在设计 sonic-go 的过程中,团队借鉴了其他领域 / 语言的优化思想(不仅限于 JSON),将其融合到各个处理环节中。其中较为核心的技术有三块:JIT、lazy-load 与 SIMD 。除了上述提到的技术外,sonic 内部还有很多的细节优化,比如使用 RCU 替换 sync.Map 提升 codec cache 的加载速度,使用内存池减少 encode buffer 的内存分配等等。自 2021 年 7 月份发布以来, sonic-go 已被抖音、今日头条等诸多业务采用,累计为字节跳动节省了数十万 CPU 核。目前 sonic-go v2 正在设计研发中,预计将取得更大性能提升。 而 sonic-cpp 则在设计上整合了 rapidjson ,yyjson 和 simdjson 三者的优点,并在此基础上做进一步的优化。在实现的过程中,主要通过充分利用向量化(SIMD)指令、优化内存布局和按需解析等关键技术,使得序列化、反序列化和增删改查能达到极致的性能。sonic-cpp 在字节内部上线以来, 已为抖音、今日头条等核心业务累计节省了数十万 CPU 核心。 sonic-go 与 sonic-cpp 均兼容常见 json 库的所有接口,改造成本极低,方便存量服务的快速迁移。业务规模越大,迁移到 sonic-go 与 sonic-cpp 的业务所获得收益则更多。 开发框架开销优化 对于业务来说,选择高性能的编程语言很重要,但是往往受限于研发团队的技术栈和历史背景。且语言的迁移往往成本较大,也需要很大的动力来推动。对于一些创业公司,或者对于具有一定规模的公司的新增业务线来说,Golang 在云原生时代是最好的选择之一,掌握这门语言难度不高,对于云原生生态友好,且具有较高的性能表现。 2014 年,Golang 被引入字节跳动,以快速解决长连接推送业务所面临的高并发问题。随后,技术团队推出了 Kite 和 Ginex (基于 Gin 的扩展)框架,这两个原始框架的推出,极大推动了 Golang 在公司内部的应用。在 Kite 和 Ginex 发布之初,由于很多功能版本过低,包括 Thrift 当时只有 v0.9.2,它们其实存在很多问题,再加上 Golang 迎来数轮大版本迭代,Kite 和 Ginex 在性能与可维护性上存在较大问题 。综上种种原因,服务框架团队正式启动了 Kite 这个字节自有 RPC 框架的重构,新的框架命名为 Kitex。这是一个自下而上的整体升级重构,围绕性能和可扩展性的诉求展开设计。类似的设计思路和底层模块也被应用在字节跳动自研 Golang HTTP 框架 Hertz 上,该项目同样具备高性能与高可扩展性。此后,Kitex 与 Hertz 进入了大规模落地的阶段,并且仍旧在围绕性能和扩展性方面持续迭代与优化。2022 年,Kitex 启动了序列化与 Thrift 专项优化,进一步提升与优化内容拷贝以及 IO 操作相关的开销。 在选择了 Golang 的前提之下,选择合适的 Golang 微服务框架同样是至关重要的。如前面所言,最合适的微服务框架应当同时具备高可扩展性、高易用性、高性能以及内置功能足够丰富。CloudWeGo 正是这样的开源的微服务框架与中间件集合,包含了上述字节开源的 Kitex 与 Hertz,是 Golang 领域推荐的微服务框架,也是 CNCF Landscape 推荐的微服务框架。CloudWeGo 除了在字节内部业务大规模落地外,自 2021 年开源以来,已经在森马、华兴证券、贪玩游戏、禾多科技、沐瞳科技等数十家企业落地,基于 CloudWeGo 构建的微服务落地规模从数十个到上千个不等,上线后均获得了性能和稳定性上的收益。 微服务治理标准化 微服务离不开配套的治理能力,如服务可观测、全链路压测与灰度、注册发现、配置中心等,这些治理能力的实现依托于服务框架、SDK、Java Agent 以及服务网格。在这些技术的发展过程中,业界逐渐形成百花齐放的局面,产生了不同的开发语言、框架和架构,这给企业带来了繁重的维护负担以及技术选型上的困扰。而且,不同框架之间的互通也存在各类损耗和高复杂度等问题,不同的微服务开发框架及工具链,对于服务治理体系的理解和实现存在差异性,不利于微服务技术的沉淀及长期发展。终端用户必须在不同的基础设施和适当的工具之间做出艰难的抉择,才可能解决微服务架构落地过程中的各种问题,加大了企业在微服务架构落地过程中的成本。 为了解决这一难题,2022 年诞生了两套微服务治理标准化方案,面向多语言、多框架和异构基础设施,涵盖流量治理、服务容错、服务元信息治理、安全治理等关键治理领域,提供一系列的治理能力与标准、生态适配与最佳实践。 2022 年 3 月,NextArch 基金会正式宣布成立微服务 SIG,来自腾讯、字节跳动、七牛云、快手、BIGO、好未来和蓝色光标等多家企业的技术专家成为首批成员。该小组致力于推动微服务技术及其开源生态的持续发展,将面向企业在微服务生产实践中遇到的问题,针对不同行业和应用场景输出标准化解决方案,并且联合 PolarisMesh、TARS、go-zero、GoFrame、CloudWeGo 和 Spring Cloud Tencent 等开源社区提供开箱即用的实现,从而降低微服务用户的落地门槛。根据各自企业在分布式或者微服务生产实践中的经验和痛点,面向多语言、多框架和异构基础设施,针对不同行业和应用场景输出微服务落地的标准化方案,并且依托相关开源社区提供推荐实现,方便终端用户落地。 2022 年 4 月,微服务治理规范 OpenSergo 项目正式开源。OpenSergo 是开放通用的,覆盖微服务及上下游关联组件的微服务治理项目,从微服务的角度出发,涵盖流量治理、服务容错、服务元信息治理、安全治理等关键治理领域,提供一系列的治理能力与标准、生态适配与最佳实践,支持 Java, Go, Rust 等多语言生态。OpenSergo 项目由阿里巴巴、bilibili、中国移动、SphereEx 等企业,以及 Kratos、CloudWeGo、ShardingSphere、Database Mesh、Spring Cloud Alibaba、Apache Dubbo 等社区联合发起,共同主导微服务治理标准建设与能力演进。OpenSergo 的最大特点就是以统一的一套配置 /DSL/ 协议定义服务治理规则,面向多语言异构化架构,覆盖微服务框架及上下游关联组件。 整体来看,微服务治理标准尚处于早期建设阶段,从微服务治理标准定义,到控制面的实现,以及 Java/Go/C++/Rust 等多语言 SDK 与治理功能的实现,再到各个微服务生态的整合与落地,都还有大量的演进工作,尚需进一步迭代和完善。 总结与展望 微服务并非银弹,但也并非过时。微服务不是香饽饽,落地微服务有一定的挑战;微服务也不是豺狼虎豹,无需避而远之。微服务的持续高速发展,使得它已经和计算、存储、网络、数据库、安全一样成为云计算的基础设施。只不过在每个不同的发展阶段,微服务面临的挑战并不相同。云原生普及之前,微服务开发者专注的是微服务的架构、迭代、交付和运维。随着云原生技术的成熟,微服务也在被云原生化,这时候,开发者和架构师更关心的是如何借助云的优势,简化微服务的治理与运维,并更专注在业务的交付效率上。高性能的服务框架选型与迁移以及微服务治理的标准化同样是微服务进入深水区需要持续探索的方向。 随着云原生和微服务的发展,服务网格应运而生,我们通常将以服务网格为核心的架构称为云原生微服务架构。云原生微服务架构具有以下四个特性:具备弹性计算资源;具备原生微服务基础能力;服务网格统一流量调度;解决多语言 RPC 治理和升级问题。此外,服务网格的落地能够更好地实现微服务的安全管控和稳定性治理。然而,服务网格同样不是银弹,并不能解决所有问题。云原生微服务架构下,Sidecar 增加了系统与运维的复杂性,部分社区实现性能表现不佳还会带来显著的微服务通信时延,组件多语言 SDK 的问题仍然存在且十分严重,通用服务依赖如网关仍需显式接入等。 为了让通用能力持续下沉以及实现服务网格基础能力复用,促使云原生微服务架构逐步演进到多运行时微服务架构(Multiple-Runtime Microservices)。多运行时微服务架构实现多语言 SDK 的进一步下沉,且提供了安全、灵活、可控的变更。当然,多运行时架构也存在一定的局限性,业务仍需进行改造才能接入,且运行时资源与业务资源存在竞争会引发一些较为复杂的问题。为了解决这些问题,我们希望实现更加标准化与平台化的服务网格开发与运维能力,规范化 Sidecar 与运行时的定义,同时将运维平台变得更加标准易用。 路漫漫其修远兮,吾将上下而求索。 作者介绍: 罗广明,字节跳动服务框架团队架构师,先后在爱立信、百度从事云原生、微服务以及开源相关工作,后加入字节跳动,负责 CloudWeGo 等微服务项目开源相关工作。长期关注云原生 & 微服务领域前沿技术、架构演进以及标准化工作。

优秀的个人博客,低调大师

每日一博 | vivo 短视频用户访问体验优化实践

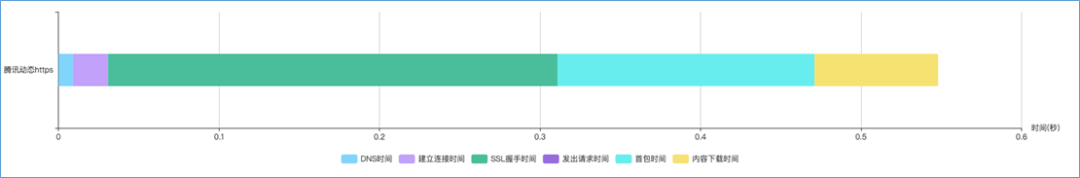
作者:vivo 互联网运维团队- Hu Tao 本文介绍了vivo短视频用户访问体验优化的实践思路,并简单讲解了实践背后的几点原理。 一、背景 我们平时在看抖音快手视频的时候,如果滑动到某个视频画面一直几s不动的时候,大概率就会划走了,所以在短视频项目中,画面卡顿是非常影响用户体验的,启播速度越快,就越能留住用户。 启播速度简单来说就是从调用开始播放到首帧上屏的时间,大致可分为两部分: 视频文件下载耗时 视频解码耗时 本文主要从运维排查问题的角度,从网络这部分的各个环节入手,结合vivo短视频的具体案例,给大家分享下优化过程。 二、用户访问链路 我们先梳理下一次完整的网络请求过程,以客户端视角为例,如下图所示: 在接入CDN的情况下,可分为几个阶段: DNS域名解析:获取服务器的IP地址。 TCP连接建立:与服务器IP建立连接即tcp三次握手。 TLS握手:客户端向服务器索要并验证服务器的公钥,双方协商生产「会话秘钥」并进行加密通信。 CDN响应:将内容资源分发到位于多个地理位置机房中的服务器上并返回给客户端。 针对以上阶段,分别讲下vivo短视频是如何进行优化的。 三、DNS域名解析 我们在上网的时候,通常使用的方式域名,而不是 IP 地址,因为域名方便人类记忆。那么实现这一技术的就是 DNS 域名解析,DNS 可以将域名网址自动转换为具体的 IP 地址。 3.1 域名的层级关系 DNS 中的域名都是用句点来分隔的,比如www.server.com,这里的句点代表了不同层次之间的界限。在域名中,越靠右的位置表示其层级越高。根域是在最顶层,它的下一层就是 com 顶级域,再下面是server.com。 所以域名的层级关系类似一个树状结构: 根DNS服务器 顶级域 DNS 服务器(com) 权威 DNS 服务器(server.com) 根域的 DNS 服务器信息保存在互联网中所有的 DNS 服务器中。这样一来,任何 DNS 服务器就都可以找到并访问根域 DNS 服务器了。 因此,客户端只要能够找到任意一台 DNS 服务器,就可以通过它找到根域 DNS 服务器,然后再一路顺藤摸瓜找到位于下层的某台目标 DNS 服务器。 3.2 域名解析的工作流程 浏览器首先看一下自己的缓存里有没有,如果没有就向操作系统的缓存要,还没有就检查本机域名解析文件 hosts,如果还是没有,就会 DNS 服务器进行查询,查询的过程如下: 客户端首先会发出一个 DNS 请求,问www.server.com的 IP 是啥,并发给本地 DNS 服务器(也就是客户端的 TCP/IP 设置中填写的 DNS 服务器地址)。 本地域名服务器收到客户端的请求后,如果缓存里的表格能找到www.server.com,则它直接返回 IP 地址。如果没有,本地 DNS 会去问它的根域名服务器:“老大, 能告诉我www.server.com的 IP 地址吗?” 根域名服务器是最高层次的,它不直接用于域名解析,但能指明一条道路。 根 DNS 收到来自本地 DNS 的请求后,发现后置是 .com,说:“www.server.com这个域名归 .com 区域管理”,我给你 .com 顶级域名服务器地址给你,你去问问它吧。” 本地 DNS 收到顶级域名服务器的地址后,发起请求问“老二, 你能告诉我www.server.com的 IP 地址吗?” 顶级域名服务器说:“我给你负责www.server.com区域的权威 DNS 服务器的地址,你去问它应该能问到”。 本地 DNS 于是转向问权威 DNS 服务器:“老三,www.server.com对应的IP是啥呀?”server.com的权威 DNS 服务器,它是域名解析结果的原出处。为啥叫权威呢?就是我的域名我做主。 权威 DNS 服务器查询后将对应的 IP 地址 X.X.X.X 告诉本地 DNS。 本地 DNS 再将 IP 地址返回客户端,客户端和目标建立连接,同时本地 DNS 缓存该 IP 地址,这样下一次的解析同一个域名就不需要做 DNS 的迭代查询了。 至此,我们完成了 DNS 的解析过程。现在总结一下,整个过程画成了一个图。 DNS 域名解析的过程蛮有意思的,整个过程就和我们日常生活中找人问路的过程类似,只指路不带路。 3.3 vivo短视频所做的优化 弄清了域名解析的工作流程,将vivo域名和头部厂商域名进行对比分析,发现vivo短视频域名解析耗时不稳定,波动范围很大,怀疑是某些地区用户访问量少,本地DNS服务器缓存命中率低导致的,因此我们的优化思路就是提高本地DNS缓存命中率。 如上图所示,提高DNS缓存命中率一个简单的办法就是添加全国范围内的拨测任务,来进行DNS加热。 通过对调整前后的DNS解析时间进行比较,可以看到耗时降低了30ms左右。 四、HTTP性能 这里简单对比下 HTTP/1、HTTP/2、HTTP/3 的性能。 HTTP协议是基于TCP/IP,并且使用了「请求 - 应答」的通信模式,所以性能的关键就在这两点里。 1. 长连接 早期 HTTP/1.0 性能上的一个很大的问题,那就是每发起一个请求,都要新建一次 TCP 连接(三次握手),而且是串行请求,做了无谓的 TCP 连接建立和断开,增加了通信开销。 为了解决上述 TCP 连接问题,HTTP/1.1 提出了长连接的通信方式,也叫持久连接。这种方式的好处在于减少了 TCP 连接的重复建立和断开所造成的额外开销,减轻了服务器端的负载。 持久连接的特点是,只要任意一端没有明确提出断开连接,则保持 TCP 连接状态。 2. 管道网络传输 HTTP/1.1 采用了长连接的方式,这使得管道(pipeline)网络传输成为了可能。 即可在同一个 TCP 连接里面,客户端可以发起多个请求,只要第一个请求发出去了,不必等其回来,就可以发第二个请求出去,可以减少整体的响应时间。 举例来说,客户端需要请求两个资源。以前的做法是,在同一个TCP连接里面,先发送 A 请求,然后等待服务器做出回应,收到后再发出 B 请求。管道机制则是允许浏览器同时发出 A 请求和 B 请求。 但是服务器还是按照顺序,先回应 A 请求,完成后再回应 B 请求。要是 前面的回应特别慢,后面就会有许多请求排队等着。这称为「队头堵塞」。 3. 队头阻塞 「请求 - 应答」的模式加剧了 HTTP 的性能问题。 因为当顺序发送的请求序列中的一个请求因为某种原因被阻塞时,在后面排队的所有请求也一同被阻塞了,会招致客户端一直请求不到数据,这也就是「队头阻塞」。好比上班的路上塞车。 4.1 HTTP/1.1 相比 HTTP/1.0 性能上的改进: 使用 TCP 长连接的方式改善了 HTTP/1.0 短连接造成的性能开销。 支持 管道(pipeline)网络传输,只要第一个请求发出去了,不必等其回来,就可以发第二个请求出去,可以减少整体的响应时间。 但 HTTP/1.1 还是有性能瓶颈: 请求 / 响应头部(Header)未经压缩就发送,首部信息越多延迟越大。只能压缩 Body 的部分; 发送冗长的首部。每次互相发送相同的首部造成的浪费较多; 服务器是按请求的顺序响应的,如果服务器响应慢,会招致客户端一直请求不到数据,也就是队头阻塞; 没有请求优先级控制; 请求只能从客户端开始,服务器只能被动响应。 针对上面的 HTTP/1.1 的性能瓶颈,HTTP/2 做了一些优化。而且因为 HTTP/2 协议是基于 HTTPS 的,所以 HTTP/2 的安全性也是有保障的。 4.2 HTTP/2 相比 HTTP/1.1 性能上的改进: 1. 头部压缩 HTTP/2 会压缩头(Header)如果你同时发出多个请求,他们的头是一样的或是相似的,那么,协议会帮你消除重复的部分。 这就是所谓的 HPACK 算法:在客户端和服务器同时维护一张头信息表,所有字段都会存入这个表,生成一个索引号,以后就不发送同样字段了,只发送索引号,这样就提高速度了。 2. 二进制格式 HTTP/2 不再像 HTTP/1.1 里的纯文本形式的报文,而是全面采用了二进制格式。 头信息和数据体都是二进制,并且统称为帧(frame):头信息帧和数据帧。 这样虽然对人不友好,但是对计算机非常友好,因为计算机只懂二进制,那么收到报文后,无需再将明文的报文转成二进制,而是直接解析二进制报文,这增加了数据传输的效率。 3. 数据流 HTTP/2 的数据包不是按顺序发送的,同一个连接里面连续的数据包,可能属于不同的回应。因此,必须要对数据包做标记,指出它属于哪个回应。 每个请求或回应的所有数据包,称为一个数据流(Stream)。 每个数据流都标记着一个独一无二的编号,其中规定客户端发出的数据流编号为奇数, 服务器发出的数据流编号为偶数。 客户端还可以指定数据流的优先级。优先级高的请求,服务器就先响应该请求。 4. 多路复用 HTTP/2 是可以在一个连接中并发多个请求或回应,而不用按照顺序一一对应。 移除了 HTTP/1.1 中的串行请求,不需要排队等待,也就不会再出现「队头阻塞」问题,降低了延迟,大幅度提高了连接的利用率。 举例来说,在一个 TCP 连接里,服务器收到了客户端 A 和 B 的两个请求,如果发现 A 处理过程非常耗时,于是就回应 A 请求已经处理好的部分,接着回应 B 请求,完成后,再回应 A 请求剩下的部分。 5. 服务器推送 HTTP/2 还在一定程度上改善了传统的「请求 - 应答」工作模式,服务不再是被动地响应,也可以主动向客户端发送消息。 举例来说,在浏览器刚请求 HTML 的时候,就提前把可能会用到的 JS、CSS 文件等静态资源主动发给客户端,减少延时的等待,也就是服务器推送(Server Push,也叫 Cache Push)。 4.3 那么HTTP/2 有哪些缺陷?HTTP/3 做了哪些优化? HTTP/2 通过头部压缩、二进制编码、多路复用、服务器推送等新特性大幅度提升了 HTTP/1.1 的性能,而美中不足的是 HTTP/2 协议是基于 TCP 实现的,于是存在的缺陷有三个。 TCP 与 TLS 的握手时延迟; 队头阻塞; 网络迁移需要重新连接。 1. TCP 与 TLS 的握手时延迟 对于 HTTP/1 和 HTTP/2 协议,TCP 和 TLS 是分层的,分别属于内核实现的传输层、openssl 库实现的表示层,因此它们难以合并在一起,需要分批次来握手,先 TCP 握手,再 TLS 握手。 发起 HTTP 请求时,需要经过 TCP 三次握手和 TLS 四次握手(TLS 1.2)的过程,因此共需要 3 个 RTT 的时延才能发出请求数据。 另外, TCP 由于具有「拥塞控制」的特性,所以刚建立连接的 TCP 会有个「慢启动」的过程,它会对 TCP 连接产生"减速"效果。 2.队头阻塞 HTTP/2 实现了 Stream 并发,多个 Stream 只需复用 1 个 TCP 连接,节约了 TCP 和 TLS 握手时间,以及减少了 TCP 慢启动阶段对流量的影响。不同的 Stream ID 才可以并发,即使乱序发送帧也没问题,但是同一个 Stream 里的帧必须严格有序。另外,可以根据资源的渲染顺序来设置 Stream 的优先级,从而提高用户体验。 HTTP/2 通过 Stream 的并发能力,解决了 HTTP/1 队头阻塞的问题,看似很完美了,但是 HTTP/2 还是存在“队头阻塞”的问题,只不过问题不是在 HTTP 这一层面,而是在 TCP 这一层。 HTTP/2 多个请求是跑在一个 TCP 连接中的,那么当 TCP 丢包时,整个 TCP 都要等待重传,那么就会阻塞该 TCP 连接中的所有请求。 因为 TCP 是字节流协议,TCP 层必须保证收到的字节数据是完整且有序的,如果序列号较低的 TCP 段在网络传输中丢失了,即使序列号较高的 TCP 段已经被接收了,应用层也无法从内核中读取到这部分数据,从 HTTP 视角看,就是请求被阻塞了。 举个例子,如下图: 图中发送方发送了很多个 packet,每个 packet 都有自己的序号,可以认为是 TCP 的序列号,其中 packet 3 在网络中丢失了,即使 packet 4-6 被接收方收到后,由于内核中的 TCP 数据不是连续的,于是接收方的应用层就无法从内核中读取到,只有等到 packet 3 重传后,接收方的应用层才可以从内核中读取到数据,这就是 HTTP/2 的队头阻塞问题,是在 TCP 层面发生的。 3.网络迁移需要重新连接 一个 TCP 连接是由四元组(源 IP 地址,源端口,目标 IP 地址,目标端口)确定的,这意味着如果 IP 地址或者端口变动了,就会导致需要 TCP 与 TLS 重新握手,这不利于移动设备切换网络的场景,比如 4G 网络环境切换成 WIFI。 这些问题都是 TCP 协议固有的问题,无论应用层的 HTTP/2 在怎么设计都无法逃脱。 要解决这个问题,HTTP/3 就将传输层协议从 TCP 替换成了 UDP,并在 UDP 协议上开发了 QUIC 协议,来保证数据的可靠传输。 4.4 QUIC 协议的特点 无队头阻塞,QUIC 连接上的多个 Stream 之间并没有依赖,都是独立的,也不会有底层协议限制,某个流发生丢包了,只会影响该流,其他流不受影响; 建立连接速度快,因为 QUIC 内部包含 TLS1.3,因此仅需 1 个 RTT 就可以「同时」完成建立连接与 TLS 密钥协商,甚至在第二次连接的时候,应用数据包可以和 QUIC 握手信息(连接信息 + TLS 信息)一起发送,达到 0-RTT 的效果。 连接迁移,QUIC 协议没有用四元组的方式来“绑定”连接,而是通过连接 ID 来标记通信的两个端点,客户端和服务器可以各自选择一组 ID 来标记自己,因此即使移动设备的网络变化后,导致 IP 地址变化了,只要仍保有上下文信息(比如连接 ID、TLS 密钥等),就可以“无缝”地复用原连接,消除重连的成本。 另外 HTTP/3 的 QPACK 通过两个特殊的单向流来同步双方的动态表,解决了 HTTP/2 的 HPACK 队头阻塞问题。 不过,由于 QUIC 使用的是 UDP 传输协议,UDP 属于“二等公民”,大部分路由器在网络繁忙的时候,会丢掉 UDP包,把“空间”让给 TCP 包,所以 QUIC 的推广之路应该没那么简单。期待,HTTP/3 正式推出的那一天! 4.5 vivo短视频所做的优化 随着vivo短视频发展的不同时期,我们做了不同的优化: 1. 使用HTTP/1.1:客户端将首帧图片域名和评论头像域名进行合并,TCP链接复用率提高4%,平均图片加载耗时下降40ms左右; 2.使用HTTP/2:客户端在部分域名上灰度使用H2,卡顿率下降0.5% 3. 使用QUIC:客户端针对弱网场景,优先使用QUIC协议;同时针对短视频业务特点,专项优化QUIC性能。 五、CDN 加速 CDN 的全称叫 Content Delivery Network,中文名叫「内容分发网络」,它是解决由于长距离而网络访问速度慢的问题。 简单来说,CDN 将内容资源分发到位于多个地理位置机房中的服务器上,这样我们在访问内容资源的时候,不用访问源服务器。而是直接访问离我们最近的 CDN 节点 ,这样一来就省去了长途跋涉的时间成本,从而实现了网络加速。 CDN 加速的是内容资源是静态资源。 所谓的「静态资源」是指数据内容静态不变,任何时候来访问都是一样的,比如图片、音频。与之相反的「动态资源」,是指数据内容是动态变化的,每次访问都不一样,比如用户信息等。不过,动态资源如果也想被缓存加速,就要使用动态 CDN,其中一种方式就是将数据的逻辑计算放在 CDN 节点来做,这种方式就被称为边缘计算。 CDN 加速策略有两种方式,分别是「推模式」和「拉模式」。 大部分 CDN 加速策略采用的是「拉模式」,当用户就近访问的 CDN 节点没有缓存请求的数据时,CDN 会主动从源服务器下载数据,并更新到这个 CDN 节点的缓存中。可以看出,拉模式属于被动缓存的方式,与之相反的 「推模式」就属于主动缓存的方式。如果想要把资源在还没有用户访问前缓存到 CDN 节点,则可以采用「推模式」,这种方式也叫 CDN 预热。通过 CDN 服务提供的 API 接口,把需要预热的资源地址和需要预热的区域等信息提交上去,CDN 收到后,就会触发这些区域的 CDN 节点进行回源来实现资源预热。 5.1 如何找到离用户最近的 CDN 节点 ? 找到离用户最近的 CDN 节点是由 CDN 的全局负载均衡器(Global Sever Load Balance,GSLB)负责的。那 GSLB 是在什么时候起作用的呢?在回答这个问题前,我们先来看看在没有 CDN 的情况下,访问域名时发生的事情。在没有 CDN 的情况下,当我们访问域名时,DNS 服务器最终会返回源服务器的地址。比如,当我们在浏览器输入 www.server.com 域名后,在本地 host 文件找不到域名时,客户端就会访问本地 DNS 服务器。 这时候: 如果本地 DNS 服务器有缓存该网站的地址,则直接返回网站的地址; 如果没有就通过递归查询的方式,先请求根 DNS,根 DNS 返回顶级 DNS(.com)的地址;再请求 .com 顶级 DNS 得到server.com的域名服务器地址,再从server.com的域名服务器中查询到www.server.com对应的 IP 地址,然后返回这个 IP 地址,同时本地 DNS 缓存该 IP 地址,这样下一次的解析同一个域名就不需要做 DNS 的迭代查询了。 但加入 CDN 后就不一样了。 会在server.com这个 DNS 服务器上,设置一个 CNAME 别名,指向另外一个域名www.server.cdn.com,返回给本地 DNS 服务器。接着继续解析该域名,这个时候访问的就是server.cdn.com这台 CDN 专用的 DNS 服务器,在这个服务器上,又会设置一个 CNAME,指向另外一个域名,这次指向的就是 CDN 的 GSLB。接着,本地 DNS 服务器去请求 CDN 的 GSLB 的域名,GSLB 就会为用户选择一台合适的 CDN 节点提供服务,选择的依据主要有以下几点: 看用户的 IP 地址,查表得知地理位置,找相对最近的 CDN 节点; 看用户所在的运营商网络,找相同网络的 CDN 节点; 看用户请求 URL,判断哪一台服务器上有用户所请求的资源; 查询 CDN 节点的负载情况,找负载较轻的节点。 GSLB 会基于以上的条件进行综合分析后,找出一台最合适的 CDN 节点,并返回该 CDN 节点的 IP 地址给本地 DNS 服务器,然后本地 DNS 服务器缓存该 IP 地址,并将 IP 返回给客户端,客户端去访问这个 CDN 节点,下载资源。 5.2 vivo短视频所做的优化 通过我们分析后发现,部分接入CDN的域名在全国一些省份没有就近访问, CDN边缘节点跨地区覆盖问题比较严重。于是我们找CDN厂商针对性的做了调整,调整后平均请求耗时降到300ms左右,首包耗时也降到100多。 六、总结与展望 随着业务的发展,提升用户体验也会变得越来越重要,用户访问体验优化将是一个永无止境的过程,除了上面说的这些方法之外,还有一些优化也是我们尝试过的,比如: 连接优化:视频播放上下滑动会频繁的断开连接,无法复用连接。 预缓存文件:减少启动耗时。 内容优化:减少文件传输大小。 希望本文能为大家在日常工作中优化用户访问体验问题带来帮助。

优秀的个人博客,低调大师

每日一博 | TypeScript 与 JavaScript:你应该知道的区别

作者:京东零售 杨冰 译自Radix网站的文章,原文链接:https://radixweb.com/blog/typescript-vs-javascript,原文作者:Nihar Raval 正在寻找经验丰富的 JavaScript 开发团队来将您的应用创意变为现实?作为一名开发人员,如果您有机会参与 Web 开发项目,您一定了解 JavaScript 的工作原理。JavaScript 上市多年,已成为开发者社区中流行的脚本语言。 但正如我们所知,如果一种技术或语言正在崛起,总会有另一种选择进入市场并与领先者展开激烈竞争。这里有一个新的竞争对手 ——TypeScript。随着 TypeScript 的日益普及,我们可以将其视为具有额外功能的 JavaScript 增强版。 谈到 TypeScript,它是一种用于开发大型复杂应用程序的开源编程语言。TypeScript 由科技巨头之一——微软——于 2012 年开发,其创建背后的真正原因是处理大型应用程序。 此外,Angular 还使用 TypeScript 进行 Web 开发服务。根据这项研究,TypeScript 和 JavaScript 分别是开发人员希望使用的第二和第三大流行语言。你知道为什么吗? 实际上,JavaScript 被认为是应用程序和网页的主要脚本语言。因此,现在,我们可以将 JavaScript 用于TezJS 、React等前端框架,以及 Node.Js 和 Deno 框架的后端。 但现在真正的问题是,JavaScript 是为创建大型复杂的 Web 应用程序而开发的吗?我想答案是否定的! 在本文中,我们将比较这两种编程语言——TypeScript 与 JavaScript,它们之间的关系,它们的区别,并概述每种语言的优点。 但在此之前,在此视频中快速了解 TypeScript 和 JavaScript 之间的差异。 TypeScript 与 JavaScript:真正的区别 如果我们同时考虑两者——TypeScript 与 JavaScript,那么每个 JavaScript 代码在 TypeScript 中都是有效的。这意味着 TypeScript 是 JavaScript 的超集。 换句话说,我们可以说, JavaScript + 更多功能 = TypeScript 因此,如果您将 JavaScript 编程文件 (.js) 保存为 TypeScript (.ts) 扩展名,它将执行得非常好。但这并不意味着这两种语言——TypeScript 和 JavaScript 是一样的。 因此,在进一步深入之前,让我们先了解一下每种语言的基本定义。以下是来自 Google Trends 的数据,显示了这两种前端语言过去一年的搜索趋势。 为什么在有 JavaScript 的情况下开发 TypeScript? JavaScript 语言是作为客户端编程语言引入的。但是随着 JavaScript 在 Web 开发中的使用,开发人员了解到它也可以被视为一种服务器端编程语言。 然而,JavaScript 代码也变得相当复杂和沉重。因此,JavaScript 无法满足面向对象编程语言的期望。因此,JavaScript 永远不会作为服务器端技术在业界蓬勃发展。这就是为什么 TypeScript 语言诞生来弥合这一差距的原因。 什么是TypeScript? 如果被问到“什么比 JavaScript 更好?”,您一定会得到答案——TypeScript。 TypeScript 由 Microsoft 开发和维护,是一种面向对象的开源编程语言。它是 JavaScript 的超集,包含可选类型。此外,它还可以编译为纯 JavaScript。 简而言之,TypeScript 是一种静态编译的编程语言,用于编写清晰简洁的 JavaScript 代码。它实现与 JavaScript 相同的目的,可用于客户端和服务器端应用程序。此外,JavaScript 的库也兼容 TypeScript。 TypeScript 是一种同时支持动态类型和静态类型的编程语言。它提供类、可见性范围、命名空间、继承、联合、接口和许多其他特性。此外,它还提供注释、变量、语句、表达式、模块和函数。 您可以在 Node.Js 或任何其他支持 ECMAScript 3 或其最新版本的浏览器上执行它。 由于 TypeScript 是 JavaScript 的增强版本,因此 JavaScript 的所有代码在语法上都是有效的 TypeScript。但是,这并不意味着 TypeScript 编译器可以处理所有 JavaScript: let a = 'a'; a = 1; // throws: error TS2322: Type '1' is not assignable to type 'string'. TypeScript 提供的文件可以包含来自当前目标文件的类型数据,类似于 C++ 头文件如何定义当前目标文件的创建。因此,其他应用程序可以使用文件中定义的值,就像使用静态类型值的 TypeScript 实体一样。 您还会找到流行库(如 jQuery、D3.js 和 MongoDB)的第三方头文件。还有用于 NodeJs 基本模块的 TypeScript 标头,允许在 TypeScript 中进行 Node.Js 开发。 TypeScript 的编译器是在 JavaScript 中组装并用 TypeScript 编写的。它在 Apache License 2.0 下注册。 看完 TypeScript 介绍后,您一定想知道将静态类型添加到 JavaScript 的目的是什么? 好吧,我们可以用给定的陈述来澄清你的疑虑: 您可以避免隐藏忍者错误,例如经典的“未定义”不是函数。 易于重构代码而不会显着破坏它。 在大规模、复杂的系统中定位自己不再是一场噩梦。 根据这项研究,TypeScript 识别出大约 15% 的 JavaScript 错误。 动态类型的自由性经常导致错误,这不仅降低了开发人员的效率,而且由于添加新代码行的开销增加而使开发变得很费劲。 因此,由于缺乏类型和编译时错误检查,JavaScript 对于组织和大型代码库中的服务器端代码来说是一个糟糕的选择。 正如他们的标语所暗示的那样,TypeScript 是可扩展的 JavaScript。 为什么我们需要使用 TypeScript? 正如我们之前所说,TypeScript 是 JavaScript 的增强版。因此,在将它与 CoffeeScript(添加了语法糖)或 PureScript(与 JavaScript 完全不相似)等其他语言进行比较时,编写 TypeScript 代码需要学习很多东西。 在 TypeScript 中,类型是可选的,任何 JavaScript 文件都是有效的 TypeScript 文件。虽然如果您的任何初始文件存在类型问题,编译器会通知您,但它仍会提供一个有效的 JavaScript 文件。TypeScript 将不负众望,随着时间的推移提高您的技能也很简单。 TypeScript 适合前端还是后端? 由于 TypeScript 被编译为 JavaScript,因此它适用于应用程序开发的前端和后端。 此外,JavaScript 是网页和应用程序前端的首选编程语言。因此,出于同样的原因,可能会使用 TypeScript,但它在服务器端也适用于复杂的大型企业项目。 但是,您也可以使用其他顶级前端框架(如 React、Angular、Vue)来构建下一代应用程序。 TypeScript 的类型 TypeScript 包含各种基本类型,例如 Number、Array、Tuple、Boolean、String 等等。好吧,其中一些类型在 JavaScript 中不可用。但是,您可以在TypeScript 文档中了解有关它们的更多信息。 此外,下面是一些其他类型,它们是 TypeScript 的表现力: Any & Unknown 一个名为 Any(任何你想要的)的类型可以覆盖 unknown 是它的类型安全系统。在这里,any 允许您在想要转义类型系统时分配和 JavaScript 变量。它广泛用于描述尚未验证且类型未知的传入变量(例如,来自第三方 API)。 Unknown 类似于 Any,但它不允许您对它执行任何操作,除非它已明确进行类型检查。 Void 当没有返回值时,使用 Void。一般用于不返回任何函数的返回类型。 Never Never 是不应该发生的事情的返回类型,例如异常抛出函数。 Intersection & Union Types(交集和并集类型) 这些类型允许您根据逻辑创建自定义类型。 交集类型让您可以将几种基本类型组合成一种类型。例如,如果我们创建一个自定义类型 Person,它包含first_name:string一个last_name:string. 好吧,你可以这样说:我希望我的类型是这样且那样的。 联合类型允许您输入各种基本类型之一。例如,如果有一个返回result:stringorundefined,您可以这样说:我希望我的类型是这个或那个。 当您将它们视为空间时,所有这些类型都有意义。 TypeScript 同时支持隐式和显式类型。如果您不显式编写类型,编译器将启用类型推断来识别您正在使用的类型。 另一方面,明确编写它们会带来好处,例如协助其他团队成员阅读您的代码并验证您所看到的是编译器所看到的。 TypeScript 的特点 借助 TypeScript 的高级特性,它支持 JavaScript 的附加特性,例如面向对象的编程概念、JS 库、平台无关性等。 Compatibility(兼容性) TypeScript 也支持旧的和新的附加功能。但是,它兼容所有版本的 JavaScript,例如 ES7 和 ES12。它可以将 ES7 中的完整代码编译回 ES5,反之亦然。这确保了平稳过渡和语言可移植性。 Static Typing(静态类型) 静态类型意味着开发人员必须声明变量类型。 假设我们取变量名 str。代码将不会运行,直到您给它一个类型,例如 Integer、Float、List 或任何其他类型。而 TypeScript 是静态类型的。 静态类型可以帮助您及早检测错误、更快地完成代码等等。 现在,让我们在这里为您提供其他突出的特点: 它易于维护并可提高项目生产力。 可以使用静态类型和注释 支持面向对象的特性,例如接口、继承和类 调试简单,问题及早发现。 支持 ES6 (ECMAScript),它为处理对象和继承提供了更简单的语法。 全功能 IDE 支持 TypeScript 的优点 TypeScript 提供了多种优势,可以帮助您为 Web 开发编写更好的编程语言。 Language Features(语言特性) 以下是 TypeScript 支持的其他功能。 命名空间 接口 空检查 泛型 访问修饰符 Optional Parameters(可选参数) // -- TypeScript -- // function log(message: string = null) { } // -- TypeScript compiled output -- // function log(message) { if (message === void 0) { message = null; } } // -- JavaScript with Babel -- // function Log(message = null) { } // -- Babel compiled output -- // "use strict"; function Log() { var message = arguments.length > 0 && arguments[0] !== undefined ? arguments[0] : null; } Classes Class方式 // -- TypeScript -- // class Article { name: string; constructor(name: string) { this.name = name; } } // -- TypeScript compiled output -- // var Article = /** @class */ (function () { function Article(name) { this.name = name; } return Article; }()); // -- JavaScript with Babel -- // class Article { constructor(name) { this.name = name; } } // -- Babel compiled output -- // "use strict"; function _classCallCheck(instance, Constructor) { if (!(instance instanceof Constructor)) { throw new TypeError("Cannot call a class as a function"); } } var Article = function Article(name) { _classCallCheck(this, Article); this.name = name; }; 什么是 JavaScript? JavaScript – 一种脚本语言,用于开发交互式网页。它遵守客户端编程规则;因此,它可以在用户的​​网络浏览器中无缝执行。但是,您可以将 JavaScript 与其他技术(如 XML 和 REST API)结合使用。 JS 的主要目的是使其成为一种互补的脚本语言,类似于 Visual Basic 之于 C++。但是,JavaScript 不适合大型复杂应用程序。它旨在为一个应用程序只编写几百行代码。 以下是 JavaScript 提供的一些独特功能: 灵活、动态和跨平台 它可以用于客户端和服务器端 轻量化解读 所有浏览器都支持 弱类型 即时编译 TypeScript 和 JavaScript 之间的区别 TypeScript 和 JavaScript 之间的区别 在比较两种编程语言——TypeScript 和 JavaScript 时,我们必须考虑许多因素,如下所示: 1) 学习曲线 TypeScript 是 JavaScript 的超集。要编写 TypeScript 代码,您应该对 JavaScript 有基本的了解和知识。此外,您还应该清楚 OOPS 的概念。 另一方面,JavaScript 是一种流行且易于学习的脚本语言。许多开发人员将 JavaScript 与 CSS 和 HTML 结合使用来创建 Web 应用程序。然而,HTML 很难,因为它包含事件处理、Web 行为、动画和脚本。 2)开发者社区 TypeScript 在短时间内流行起来,并被许多企业实施。您会在 Internet 上找到许多学习 TypeScript 的教程和指南。但是,它有一个非常活跃和支持的社区。 另一方面,与 TypeScript 相比,JavaScript 没有庞大的社区。JavaScript 提供了许多库、框架和代码实践。因此,建议您了解最适合您的业务需求的Web 开发团队结构,以获得整体团队绩效。 3)性能 众所周知,创建 TypeScript 是为了克服 JavaScript 对大型复杂应用程序的挑战。因此,TypeScript 节省了开发时间并让开发人员变得更有效率。 TypeScript 和 JavaScript 之间的唯一区别是 TypeScript 代码在执行之前被编译成 JavaScript。 4) 语法 TypeScript 提供了 JavaScript 不提供的变量声明、函数范式和类型系统。它在语法方面类似于 JScript 和 .Net,支持 ECMAScript 2015 标准功能,包括模块、箭头函数语法和类。 JavaScript 也遵循 ECMAScript 定义。但是,它不是像 TypeScript 这样的类型化语言。它使用许多来自 C 语言的结构化编程术语,例如 if 语句、switch 语句、do-while 循环等等。它提供事件驱动风格、函数式和命令式编程。 5)工具和框架 由于微软支持 TypeScript,它拥有许多领先的框架和编辑器。通过与编辑器的紧密集成,它提供了编译期间的错误处理,以避免在运行时出错。 另一方面,市场上有许多JavaScript 框架可用于 Web 开发项目需求。这是一个非常受程序员欢迎的巨大生态系统。您可以快速找到精通 ReactJS、VueJS、Angular 和其他框架的开发人员。 6)代码 对于TypeScript: class Person { private name: string; constructor (private name: string) { this.name = name; } name() { return “name is “ + this.name; } } 对于 JavaScript: var Person = (function() { function Person(personName) { this.name = personName; } Person.prototype.name= function() { return "My name is " + this.name; } return Person; })(); TypeScript 与 JavaScript 有何不同? 我们知道 TypeScript 提供的功能比 JavaScript 多。简而言之,TypeScript 是一种面向对象的编程语言,而 JavaScript 是一种脚本语言。因此,TypeScript 通过 ES6 特性提供接口和模块;另一方面,JavaScript 不提供此类功能。 实际上,一些开发人员可能会混淆面向对象和函数式编程语言。但是,您可以在这里区分函数式编程与面向对象的编程语言,并了解它们之间的区别。 为什么要将您的项目迁移到 TypeScript? 如果您有一个庞大而复杂的代码库,则发生错误的可能性更高。但是,如果能在编译期间解决了一些错误,那就太好了。这时你可以使用 TypeScript 来减少编译时的错误。最好的部分是完整的 Java (此处应该是作者笔误,应该是JavaScript)代码库可以按原样重用。 何时选择:JavaScript 和 TypeScript 的区别 TypeScript 编译时类型检查 使用 Vanilla JavaScript,类型验证在运行时执行。然而,这会增加运行时开销,这可以通过进行编译时验证来避免。 大型项目或多个开发人员 TypeScript 可以在大型项目或许多开发人员一起工作时无缝运行。 易于使用新库或框架 假设,如果你正在使用 React 进行开发并且不熟悉它的 API,你可以获得 语法提示来帮助你识别和导航新界面。但是,它们都提供类型定义 JavaScript 小项目 对于代码较少的小型项目,TypeScript 可能有点矫枉过正。 框架支持 如果 TypeScript 不支持您选择的框架 – 例如EmberJS,那么您可能无法利用它的功能。 构建工具 要生成能运行的最终 JavaScript,TypeScript 需要有一个构建的步骤。不过,在不使用任何构建工具的情况下开发 JavaScript 应用正变得越来越少。 测试工作流程 如果您优秀的 JavaScript 开发人员已经在使用测试驱动开发,那么切换到 TypeScript 的好处可能不足以证明迁移成本是合理的。 我应该学习 JavaScript 还是 TypeScript? 如果你了解 JavaScript,那么你就很容易理解 TypeScript。它们两种语言共享相同的语法和运行时行为。 作为最流行的语言,JavaScript 提供了许多资源和庞大的开发人员社区。由于两种语言在很多情况下都以相同的方式执行,因此TypeScript 开发人员也可以从这些资源中受益。 TypeScript 相对于 JavaScript 的优势 TypeScript 支持静态类型。这意味着静态类型允许在构建时检查类型的准确性。 在开发时,TypeScript 会识别编译错误。因此,运行时评估错误的范围非常小。另一方面,JavaScript 是一种解释型语言。 TypeScript 只是具有一些额外功能的 JS,即 ES6 功能。TS 编译器可以将 .ts 文件编译成 ECMAScript,尽管它可能不会保存在您选择的 Web 浏览器中。 TypeScript 会取代 JavaScript 吗? 那么,上述问题的最短答案是否定的! 在谈论 TypeScript 时,它是一种完全不同的语言,只是它继承了 JavaScript 的基本性质。因此,JavaScript 永远也不会被取代。 JavaScript 是软件开发行业中流行的基础技术之一,被大量开发人员用于客户端和服务器端。 另一方面,TypeScript 不直接在 Web 浏览器中执行。它转译为 JavaScript。JavaScript 更容易调试和编译,因为它直接在 Web 浏览器中执行。然而,TypeScript 并不是为所有类型的项目开发的。因此,两种编程语言都有其优点和缺点以及一组特征。为了顺应企业 Web 发展趋势,您必须采用新技术或框架来获得更好的业务流程和客户体验。 正面比较:TypeScript 与 JavaScript TypeScript 和 JavaScript 在开发交互式网页方面有许多相似之处。在提供 TypeScript 与 JavaScript 的直接比较时,我们可以说 JavaScript 是一种轻量级的解释型动态语言,用于增强 HTML 网页。另一方面,TypeScript 是 JavaScript 的增强版。这意味着 TypeScript 是 JavaScript 和其他一些特性的组合。 TypeScript是由 Microsoft Corporation 开发的一种面向对象的编程语言,而JavaScript是用于 Web 的编程语言。 TypeScript是一种用于构建大型 Web 应用程序的开源语言,而JavaScript是一种有助于开发交互式网页的服务器端编程语言。 另一方面,TypeScript 是 JavaScript 的增强版。这意味着 TypeScript 是 JavaScript 和其他一些特性的组合。让我们了解下表中 TypeScript 与 JavaScript 的重要区别。 范围 Typescript JavaScript 开发者 Microsoft in 2012 Brendan Eich (Netscape),1995 年 定义 TypeScript 是一种强大的面向对象语言,作为 JavaScript 的超集,具有泛型和 JS 特性来解决 JS 的复杂问题。 JavaScript 是一种脚本语言,具有创建动态网页的一流功能。 类型 强类型。TypeScript 支持静态类型和动态类型。 弱类型 。JavaScript 仅支持动态类型。 生态 TypeScript 更像是一种支持静态类型的强大而直观的语言。 JavaScript 是一种简单的语言,它优化了代码的兼容性,易于阅读和编写。 编译 TypeScript 需要编译。 JavaScript 不需要编译。 数据绑定 TypeScript 利用接口和类型等概念来定义所使用的数据。 JavaScript 中没有这样的概念。 学习曲线 TypeScript 有一条不友好的学习曲线。此外,它需要JavaScript知识。 它易于学习并且是一种用于编写 Web 脚本的灵活语言。 Npm 包 使用Typescript,许多npm包要么有静态类型定义,要么有一个更容易安装的外部类型定义。 JavaScript提供了不需要任何构建步骤就可以搜索和生成代码的替代方案。 客户端或服务器端 TypeScript 专门用于客户端。 JavaScript 用于服务器端和客户端。 文件扩展名 .tsx 和 .ts .js 社区 TypeScript 有一个较小的软件开发者社区。 JavaScript 拥有庞大的软件开发人员社区。 原型设计 原型设计特性在 TypeScript 中可用。 JS 不支持原型设计。 公司和网站 Asana, Clever, Screen award Airbnb、Codecademy、Instagram 代码示例 function multiply (a, b){ return a*b;}var result = multiply(a, b);console.log('答案是 - ' + result); <script>function multiply (a, b){ return a\*b;}var result = multiply(a, b);document.write (‘The answer is – ’ + result);</script> 结论 最后,在阅读了我们在本文中整理的所有见解之后,我们可以说这两种语言各有利弊。 TypeScript 适合想要创建整洁干净的可读代码的开发人员。好吧,我们没有提到 TypeScript 提供了什么,包括各种实时错误检查和静态类型。 虽然 JavaScript 不是一种综合性的编程语言,但它可以与 HTML 一起使用来提高网页的质量。甚至,您会发现许多精通 JavaScript 编码的经验丰富的开发人员。 但是,与 JavaScript 一样,并非所有 Web 浏览器都支持 TypeScript。所以,如果你在 TypeScript 和 JavaScript 之间纠结,可以参考上面的文章。 初次翻译,个人水平有限,有翻译不恰当的地方欢迎大佬们指正。

优秀的个人博客,低调大师

每日一博 | 接口优化的常见方案实战总结

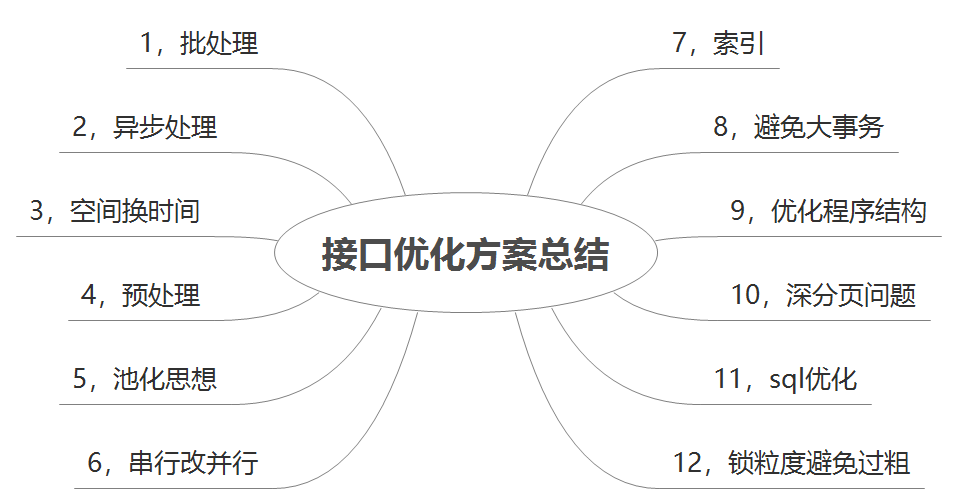
一、背景 针对老项目,去年做了许多降本增效的事情,其中发现最多的就是接口耗时过长的问题,就集中搞了一次接口性能优化。本文将给小伙伴们分享一下接口优化的通用方案。    二、接口优化方案总结 1.批处理 批量思想:批量操作数据库,这个很好理解,我们在循环插入场景的接口中,可以在批处理执行完成后一次性插入或更新数据库,避免多次IO。 //for循环单笔入库 list.stream().forEatch(msg->{ insert(); }); //批量入库 batchInsert(); 2.异步处理 异步思想:针对耗时比较长且不是结果必须的逻辑,我们可以考虑放到异步执行,这样能降低接口耗时。 例如一个理财的申购接口,入账和写入申购文件是同步执行的,因为是T+1交易,后面这两个逻辑其实不是结果必须的,我们并不需要关注它的实时结果,所以我们考虑把入账和写入申购文件改为异步处理。如图所示:  至于异步的实现方式,可以用线程池,也可以用消息队列,还可以用一些调度任务框架。 3.空间换时间 一个很好理解的空间换时间的例子是合理使用缓存,针对一些频繁使用且不频繁变更的数据,可以提前缓存起来,需要时直接查缓存,避免频繁地查询数据库或者重复计算。 需要注意的事,这里用了合理二字,因为空间换时间也是一把双刃剑,需要综合考虑你的使用场景,毕竟缓存带来的数据一致性问题也挺令人头疼。 这里的缓存可以是R2M,也可以是本地缓存、memcached,或者Map。 举一个股票工具的查询例子: 因为策略轮动的调仓信息,每周只更新一次,所以原来的调接口就去查库的逻辑并不合理,而且拿到调仓信息后,需要经过复杂计算,最终得出回测收益和跑赢沪深指数这些我们想要的结果。如果我们把查库操作和计算结果放入缓存,可以节省很多的执行时间。如图:  4.预处理 也就是预取思想,就是提前要把查询的数据,提前计算好,放入缓存或者表中的某个字段,用的时候会大幅提高接口性能。跟上面那个例子很像,但是关注点不同。 举个简单的例子:理财产品,会有根据净值计算年化收益率的数据展示需求,利用净值去套用年化收益率计算公式计算的逻辑我们可以采用预处理,这样每一次接口调用直接取对应字段就可以了。 5.池化思想 我们都用过数据库连接池,线程池等,这就是池思想的体现,它们解决的问题就是避免重复创建对象或创建连接,可以重复利用,避免不必要的损耗,毕竟创建销毁也会占用时间。 池化思想包含但并不局限于以上两种,总的来说池化思想的本质是预分配与循环使用,明白这个原理后,我们即使是在做一些业务场景的需求时,也可以利用起来。 比如:对象池 6.串行改并行 串行就是,当前执行逻辑必须等上一个执行逻辑结束之后才执行,并行就是两个执行逻辑互不干扰,所以并行相对来说就比较节省时间,当然是建立在没有结果参数依赖的前提下。 比如,理财的持仓信息展示接口,我们既需要查询用户的账户信息,也需要查询商品信息和banner位信息等等来渲染持仓页,如果是串行,基本上接口耗时就是累加的。如果是并行,接口耗时将大大降低。 如图:   7.索引 加索引能大大提高数据查询效率,这个在接口设计之出也会考虑到,这里不再多赘述,随着需求的迭代,我们重点整理一下索引不生效的一些场景,希望对小伙伴们有所帮助。 具体不生效场景不再一一举例,后面有时间的话,单独整理一下。  8.避免大事务 所谓大事务问题,就是运行时间较长的事务,由于事务一致不提交,会导致数据库连接被占用,影响到别的请求访问数据库,影响别的接口性能。 举个例子: @Transactional(value = "taskTransactionManager", propagation = Propagation.REQUIRED, isolation = Isolation.READ_COMMITTED, rollbackFor = {RuntimeException.class, Exception.class}) public BasicResult purchaseRequest(PurchaseRecord record) { BasicResult result = new BasicResult(); //插入账户任务 taskMapper.insert(ManagerParamUtil.buildTask(record, TaskEnum.Task_type.pension_account.type(), TaskEnum.Account_bizType.purchase_request.type())); //插入同步任务 taskMapper.insert(ManagerParamUtil.buildTask(record, TaskEnum.Task_type.pension_sync.type(), TaskEnum.Sync_bizType.purchase.type())); //插入影像件上传任务 taskMapper.insert(ManagerParamUtil.buildTask(record, TaskEnum.Task_type.pension_sync.type(), TaskEnum.Sync_bizType.cert.type())); result.setInfo(ResultInfoEnum.SUCCESS); return result; } 上面这块代码主要是申购申请完成后,执行一系列的后续操作,如果现在新增申购完成后,发送push通知用户的需求。很有可能我们会在后面直接追加,如下图所示:事务中嵌套RPC调用,即非DB操作,这些非DB操作如果耗时较大的话,可能会出现大事务问题。大数据引发的问题主要有:死锁、接口超时、主从延迟等。 @Transactional(value = "taskTransactionManager", propagation = Propagation.REQUIRED, isolation = Isolation.READ_COMMITTED, rollbackFor = {RuntimeException.class, Exception.class}) public BasicResult purchaseRequest(PurchaseRecord record) { BasicResult result = new BasicResult(); ... pushRpc.doPush(record); result.setInfo(ResultInfoEnum.SUCCESS); return result; } 所以为避免大事务问题,我们可以通过以下方案规避: 1,RPC调用不放到事务里面 2,查询操作尽量放到事务之外 3,事务中避免处理太多数据 9.优化程序结构 程序结构问题一般出现在多次需求迭代后,代码叠加形成。会造成一些重复查询、多次创建对象等耗时问题。在多人维护一个项目时比较多见。解决起来也比较简单,我们需要针对接口整体做重构,评估每个代码块的作用和用途,调整执行顺序。 10.深分页问题 深分页问题比较常见,分页我们一般最先想到的就是 limit ,为什么会慢,我们可以看下这个SQL: select * from purchase_record where productCode = 'PA9044' and status=4 order by orderTime desc limit 100000,200 limit 100000,200 意味着会扫描100200行,然后返回200行,丢弃掉前100000行。所以执行速度很慢。一般可以采用标签记录法来优化,比如: select * from purchase_record where productCode = 'PA9044' and status=4 and id > 100000 limit 200 这样优化的好处是命中了主键索引,无论多少页,性能都还不错,但是局限性是需要一个连续自增的字段 11.SQL优化 sql优化能大幅提高接口的查询性能,由于本文重点讲述接口优化的方案,具体sql优化不再一一列举,小伙伴们可以结合索引、分页、等关注点考虑优化方案。 12.锁粒度避免过粗 锁一般是为了在高并发场景下保护共享资源采用的一种手段,但是如果锁的粒度太粗,会很影响接口性能。 关于锁粒度:就是你要锁的范围有多大,不管是synchronized还是redis分布式锁,只需要在临界资源处加锁即可,不涉及共享资源的,不必要加锁,就好比你要上卫生间,只需要把卫生间的门锁上就可以,不需要把客厅的门也锁上。 错误的加锁方式: //非共享资源 private void notShare(){ } //共享资源 private void share(){ } private int wrong(){ synchronized (this) { share(); notShare(); } } 正确的加锁方式: //非共享资源 private void notShare(){ } //共享资源 private void share(){ } private int right(){ notShare(); synchronized (this) { share(); } } 三、最后 接口性能问题形成的原因思考 我相信很多接口的效率问题不是一朝一夕形成的,在需求迭代的过程中,为了需求快速上线,采取直接累加代码的方式去实现功能,这样会造成以上这些接口性能问题。 变换思路,更高一级思考问题,站在接口设计者的角度去开发需求,会避免很多这样的问题,也是降本增效的一种行之有效的方式。 以上,共勉!

优秀的个人博客,低调大师

每日一博 | 详解神经网络基础部件 BN 层

摘要:在深度神经网络训练的过程中,由于网络中参数变化而引起网络中间层数据分布发生变化的这一过程被称为内部协变量偏移(Internal Covariate Shift),而 BN 可以解决这个问题。 本文分享自华为云社区《神经网络基础部件-BN层详解》,作者:嵌入式视觉 。 一,数学基础 1.1,概率密度函数 随机变量(random variable)是可以随机地取不同值的变量。随机变量可以是离散的或者连续的。简单起见,本文用大写字母 XX表示随机变量,小写字母 xx表示随机变量能够取到的值。例如,x1x1​ 和 x2x2​ 都是随机变量 XX可能的取值。随机变量必须伴随着一个概率分布来指定每个状态的可能性。 概率分布(probability distribution)用来描述随机变量或一簇随机变量在每一个可能取到的状态的可能性大小。我们描述概率分布的方式取决于随机变量是离散的还是连续的。 当我们研究的对象是连续型随机变量时,我们用概率密度函数(probability density function, PDF)而不是概率质量函数来描述它的概率分布。 更多内容请阅读《花书》第三章-概率与信息论,或者我的文章-深度学习数学基础-概率与信息论。 1.2,正态分布 当我们不知道数据真实分布时使用正态分布的原因之一是,正态分布拥有最大的熵,我们通过这个假设来施加尽可能少的结构。 实数上最常用的分布就是正态分布(normal distribution),也称为高斯分布 (Gaussian distribution)。 如果随机变量 XX,服从位置参数为 μμ、尺度参数为 σσ的概率分布,且其概率密度函数为: 则这个随机变量就称为正态随机变量,正态随机变量服从的概率分布就称为正态分布,记作: 如果位置参数 μ=0μ=0,尺度参数 σ=1σ=1 时,则称为标准正态分布,记作: 此时,概率密度函数公式简化为: 正太分布的数学期望值或期望值 μμ等于位置参数,决定了分布的位置;其方差 σ2σ2 的开平方或标准差 σσ等于尺度参数,决定了分布的幅度。正太分布的概率密度函数曲线呈钟形,常称之为钟形曲线,如下图所示: 可视化正态分布,可直接通过 np.random.normal 函数生成指定均值和标准差的正态分布随机数,然后基于 matplotlib + seaborn 库 kdeplot函数绘制概率密度曲线。示例代码如下所示: import seaborn as sns x1 = np.random.normal(0, 1, 100) x2 = np.random.normal(0, 1.5, 100) x3 = np.random.normal(2, 1.5, 100) plt.figure(dpi = 200) sns.kdeplot(x1, label="μ=0, σ=1") sns.kdeplot(x2, label="μ=0, σ=1.5") sns.kdeplot(x3, label="μ=2, σ=2.5") #显示图例 plt.legend() #添加标题 plt.title("Normal distribution") plt.show() 以上代码直接运行后,输出结果如下图: 当然也可以自己实现正太分布的概率密度函数,代码和程序输出结果如下: import numpy as np import matplotlib.pyplot as plt plt.figure(dpi = 200) plt.style.use('seaborn-darkgrid') # 主题设置 def nd_func(x, sigma, mu): """自定义实现正太分布的概率密度函数 """ a = - (x-mu)**2 / (2*sigma*sigma) f = np.exp(a) / (sigma * np.sqrt(2*np.pi)) return f if __name__ == '__main__': x = np.linspace(-5, 5) f = nd_fun(x, 1, 0) p1, = plt.plot(x, f) f = nd_fun(x, 1.5, 0) p2, = plt.plot(x, f) f = nd_fun(x, 1.5, 2) p3, = plt.plot(x, f) plt.legend([p1 ,p2, p3], ["μ=0,σ=1", "μ=0,σ=1.5", "μ=2,σ=1.5"]) plt.show() 二,背景 训练深度神经网络的复杂性在于,因为前面的层的参数会发生变化导致每层输入的分布在训练过程中会发生变化。这又导致模型需要需要较低的学习率和非常谨慎的参数初始化策略,从而减慢了训练速度,并且具有饱和非线性的模型训练起来也非常困难。 网络层输入数据分布发生变化的这种现象称为内部协变量转移,BN 就是来解决这个问题。 2.1,如何理解 Internal Covariate Shift 在深度神经网络训练的过程中,由于网络中参数变化而引起网络中间层数据分布发生变化的这一过程被称在论文中称之为内部协变量偏移(Internal Covariate Shift)。 那么,为什么网络中间层数据分布会发生变化呢? 在深度神经网络中,我们可以将每一层视为对输入的信号做了一次变换(暂时不考虑激活,因为激活函数不会改变输入数据的分布): 其中 WW和 BB是模型学习的参数,这个公式涵盖了全连接层和卷积层。 随着 SGD 算法更新参数,和网络的每一层的输入数据经过公式5的运算后,其 ZZ的分布一直在变化,因此网络的每一层都需要不断适应新的分布,这一过程就被叫做 Internal Covariate Shift。 而深度神经网络训练的复杂性在于每层的输入受到前面所有层的参数的影响—因此当网络变得更深时,网络参数的微小变化就会被放大。 2.2,Internal Covariate Shift 带来的问题 网络层需要不断适应新的分布,导致网络学习速度的降低。 网络层输入数据容易陷入到非线性的饱和状态并减慢网络收敛,这个影响随着网络深度的增加而放大。 随着网络层的加深,后面网络输入 xx越来越大,而如果我们又采用 Sigmoid 型激活函数,那么每层的输入很容易移动到非线性饱和区域,此时梯度会变得很小甚至接近于 00,导致参数的更新速度就会减慢,进而又会放慢网络的收敛速度。 饱和问题和由此产生的梯度消失通常通过使用修正线性单元激活(ReLU(x)=max(x,0)ReLU(x)=max(x,0)),更好的参数初始化方法和小的学习率来解决。然而,如果我们能保证非线性输入的分布在网络训练时保持更稳定,那么优化器将不太可能陷入饱和状态,进而训练也将加速。 2.3,减少 Internal Covariate Shift 的一些尝试 白化(Whitening): 即输入线性变换为具有零均值和单位方差,并去相关。白化过程由于改变了网络每一层的分布,因而改变了网络层中本身数据的表达能力。底层网络学习到的参数信息会被白化操作丢失掉,而且白化计算成本也高。 标准化(normalization) Normalization 操作虽然缓解了 ICS 问题,让每一层网络的输入数据分布都变得稳定,但却导致了数据表达能力的缺失。 三,批量归一化(BN) 3.1,BN 的前向计算 论文中给出的 Batch Normalizing Transform 算法计算过程如下图所示。其中输入是一个考虑一个大小为 mm的小批量数据 BB。 论文中的公式不太清晰,下面我给出更为清晰的 Batch Normalizing Transform 算法计算过程。 设 mm表示 batch_size 的大小,nn表示 features 数量,即样本特征值数量。在训练过程中,针对每一个 batch 数据,BN 过程进行的操作是,将这组数据 normalization,之后对其进行线性变换,具体算法步骤如下: 以上公式乘法都为元素乘,即 element wise 的乘法。其中,参数 γ,βγ,β是训练出来的, ϵϵ是为零防止 σB2σB2​ 为 00 ,加的一个很小的数值,通常为1e-5。公式各个符号解释如下: 其中: 可以看出 BN 本质上是做线性变换。 3.2,BN 层如何工作 在论文中,训练一个带 BN 层的网络, BN 算法步骤如下图所示: 在训练期间,我们一次向网络提供一小批数据。在前向传播过程中,网络的每一层都处理该小批量数据。 BN 网络层按如下方式执行前向传播计算: 图片来源这里。 注意,图中计算均值与方差的无偏估计方法是吴恩达在 Coursera 上的 Deep Learning 课程上提出的方法:对 train 阶段每个 batch 计算的 mean/variance 采用指数加权平均来得到 test 阶段 mean/variance 的估计。 在训练期间,它只是计算此 EMA,但不对其执行任何操作。在训练结束时,它只是将该值保存为层状态的一部分,以供在推理阶段使用。 如下图可以展示BN 层的前向传播计算过程数据的 shape ,红色框出来的单个样本都指代单个矩阵,即运算都是在单个矩阵运算中计算的。 图片来源 这里。 BN 的反向传播过程中,会更新 BN 层中的所有 ββ和 γγ参数。 3.3,训练和推理式的 BN 层 批量归一化(batch normalization)的“批量”两个字,表示在模型的迭代训练过程中,BN 首先计算小批量( mini-batch,如 32)的均值和方差。但是,在推理过程中,我们只有一个样本,而不是一个小批量。在这种情况下,我们该如何获得均值和方差呢? 第一种方法是,使用的均值和方差数据是在训练过程中样本值的平均,即: 这种做法会把所有训练批次的 μμ和 σσ都保存下来,然后在最后训练完成时(或做测试时)做下平均。 第二种方法是使用类似动量的方法,训练时,加权平均每个批次的值,权值 αα可以为0.9: 推理或测试时,直接使用模型文件中保存的 μmoviμmovi​​ 和 σmoviσmovi​​ 的值即可。 3.4,实验 BN 在 ImageNet 分类数据集上实验结果是 SOTA 的,如下表所示: 3.5,BN 层的优点 BN 使得网络中每层输入数据的分布相对稳定,加速模型训练和收敛速度。 批标准化可以提高学习率。在传统的深度网络中,学习率过高可能会导致梯度爆炸或梯度消失,以及陷入差的局部最小值。批标准化有助于解决这些问题。通过标准化整个网络的激活值,它可以防止层参数的微小变化随着数据在深度网络中的传播而放大。例如,这使 sigmoid 非线性更容易保持在它们的非饱和状态,这对训练深度 sigmoid 网络至关重要,但在传统上很难实现。 BN 允许网络使用饱和非线性激活函数(如 sigmoid,tanh 等)进行训练,其能缓解梯度消失问题。 不需要 dropout 和 LRN(Local Response Normalization)层来实现正则化。批标准化提供了类似丢弃的正则化收益,因为通过实验可以观察到训练样本的激活受到同一小批量样例随机选择的影响。 减少对参数初始化方法的依赖。 参考资料 维基百科-正态分布 Batch Norm Explained Visually — How it works, and why neural networks need it 15.5 批量归一化的原理 Batch Normalization原理与实战 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

每日一博 | 大语言模型:新的摩尔定律?

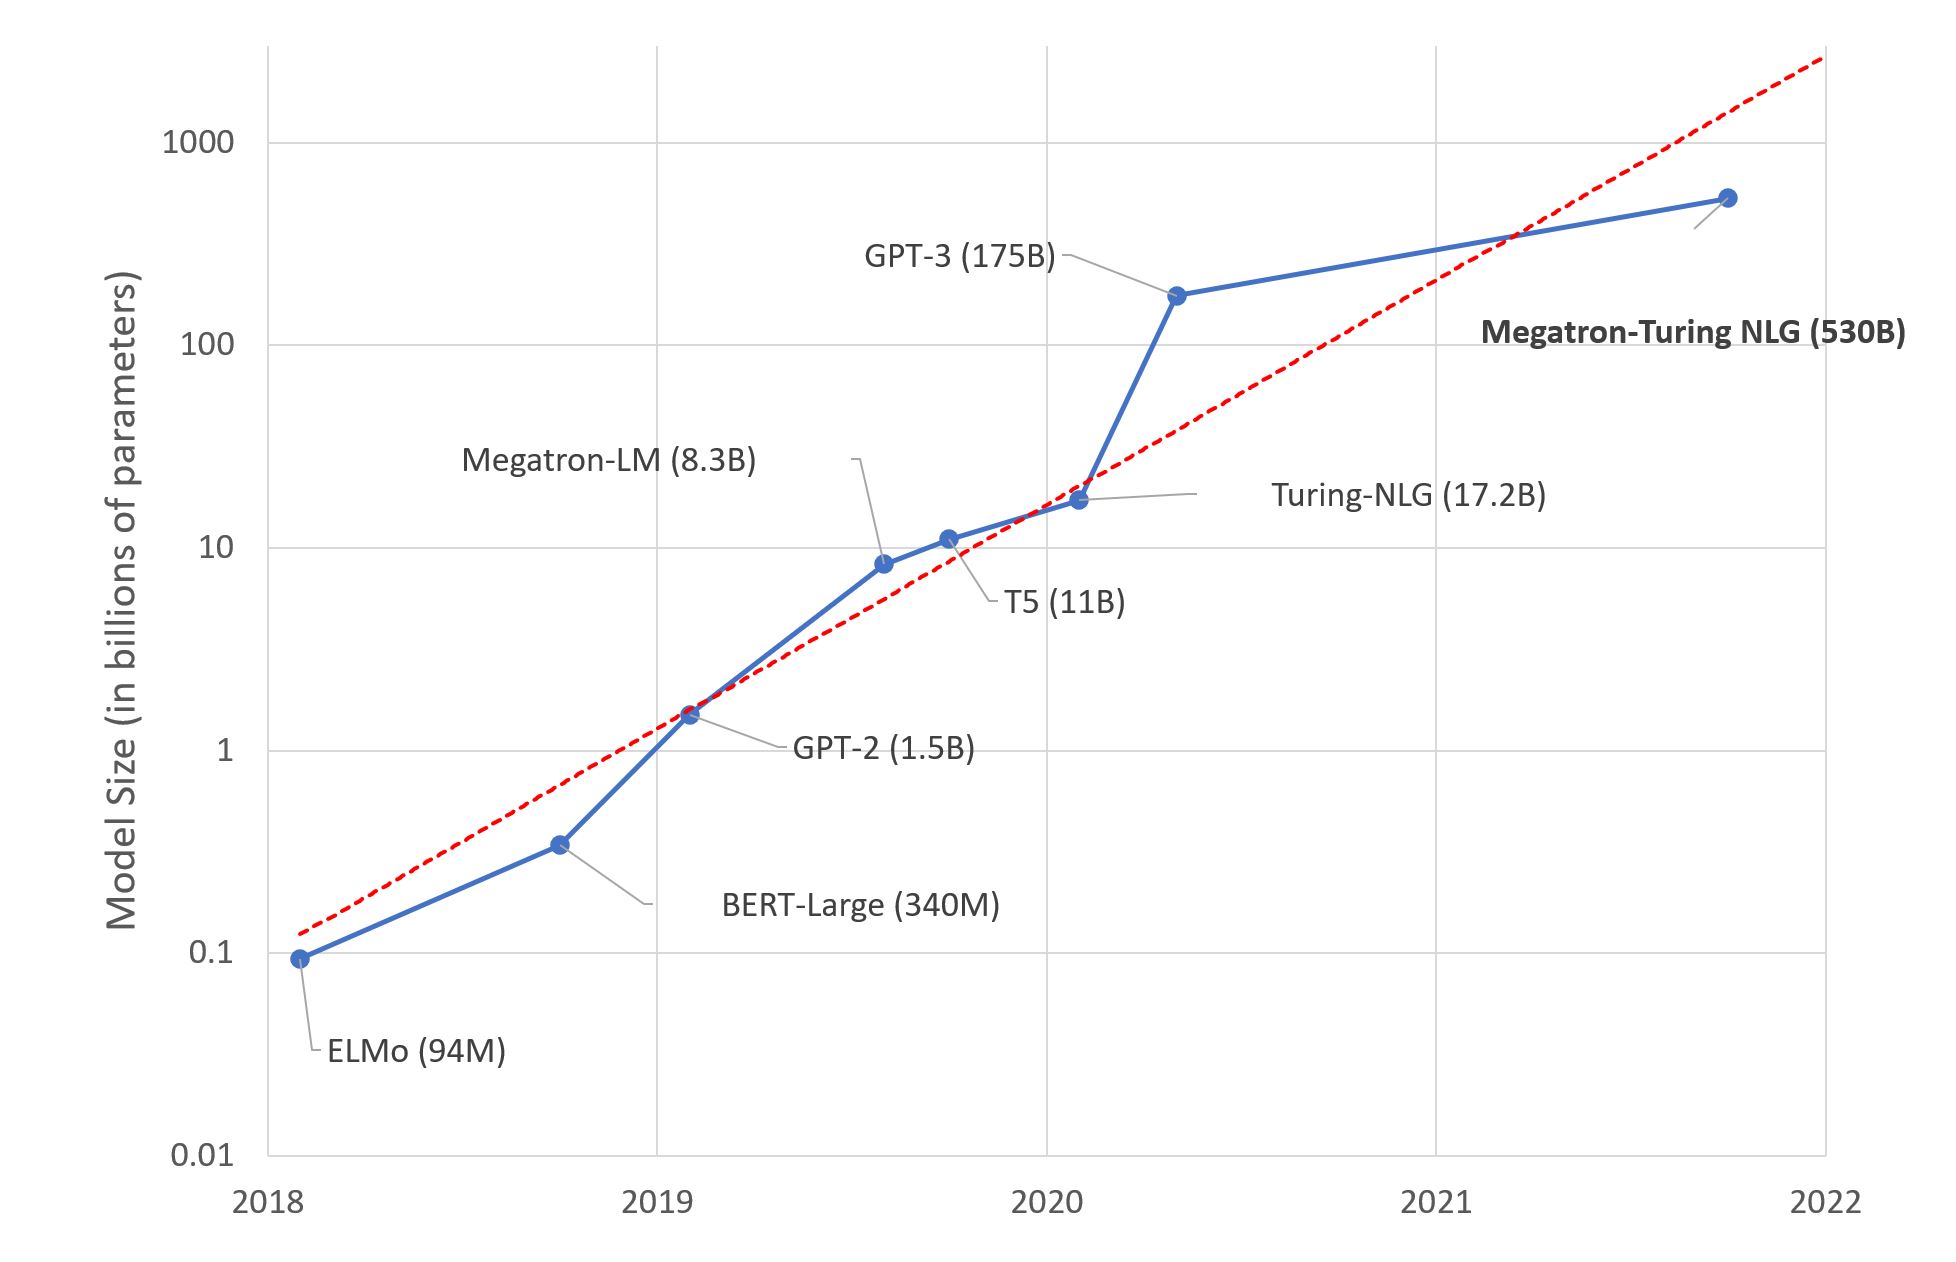
译者按: 最近一段时间,ChatGPT 作为一个现象级应用迅速蹿红,也带动了对其背后的大语言模型 (LLM) 的讨论,这些讨论甚至出了 AI 技术圈,颇有些到了街谈巷议的程度。在 AI 技术圈,关于 LLM 和小模型的讨论在此之前已经持续了不短的时间,处于不同生态位置和产业环节的人都有表达自己的观点,其中不少是有冲突的。 大模型的研究者和大公司出于不同的动机站位 LLM,研究者出于对 LLM 的突现能力 (emergent ability) 的好奇和对 LLM 对 NLP 领域能力边界的拓展、而大公司可能更多出自于商业利益考量;而社区和中小公司犹犹豫豫在小模型的站位上徘徊,一方面是由于对 LLM 最终训练、推理和数据成本的望而却步,一方面也是对大模型可能加强大公司数据霸权的隐隐担忧。但讨论,尤其是公开透明的讨论,总是好事,让大家能够听到不同的声音,才有可能最终收敛至更合理的方案。 我们选译的这篇文章来自于 2021 年 10 月的 Hugging Face 博客,作者在那个时间点站位的是小模型,一年多以后的 2023 年作者的观点有没有改变我们不得而知,但开卷有益,了解作者当时考虑的那些点,把那些合理的点纳入自己的思考体系,并结合新的进展最终作出自己的判断可能才是最终目的。 不久前,微软和 Nvidia 推出 了 Megatron-Turing NLG 530B,一种基于 Transformer 的模型,被誉为是 “世界上最大且最强的生成语言模型”。 毫无疑问,此项成果对于机器学习工程来讲是一场令人印象深刻的能力展示,表明我们的工程能力已经能够训练如此巨大的模型。然而,我们应该为这种超级模型的趋势感到兴奋吗?我个人倾向于否定的回答。我将在通过本文阐述我的理由。 这是你的深度学习大脑 研究人员估计,人脑平均包含 860 亿个神经元和 100 万亿个突触。可以肯定的是,这里面并非所有的神经元和突触都用于语言。有趣的是,GPT-4 预计 有大约 100 万亿个参数...... 虽然这个类比很粗略,但难道我们不应该怀疑一下构建与人脑大小相当的语言模型长期来讲是否是最佳方案? 当然,我们的大脑是一个了不起的器官,它经过数百万年的进化而产生,而深度学习模型仅有几十年的历史。不过,我们的直觉告诉我们: 有些东西无法计算 (这是个双关语,:)) 。 深度学习,深度销金窟? 如你所料,在庞大的文本数据集上训练一个 5300 亿参数的模型需要相当多的基础设施。事实上,Microsoft 和 Nvidia 使用了数百台 DGX A100 GPU 服务器,每台 19 万 9 千美元。如果再把网络设备、托管成本等因素考虑进去的话,任何想要重现该实验的组织或个人都必须花费近 1 亿美元。来根薯条压压惊? 说真的,有哪些组织有那种值得花费 1 亿美元来构建深度学习基础设施的业务?再少点,又有哪些组织有那种可以值得花费 1000 万美元基础设施的业务?很少。既然很少,那么请问,这些模型为谁而生呢? GPU 集群的热 尽管训练大模型需要杰出的工程能力,但在 GPU 上训练深度学习模型本身却是一种蛮力技术。根据规格表,每台 DGX 服务器可消耗高达 6.5 千瓦的功率。同时,数据中心 (或服务器机柜) 至少需要同样多的冷却能力。除非你是史塔克家族的人 (Starks) ,需要在冬天让临冬城 (Winterfell) 保持温暖,否则你必须处理散热问题。 此外,随着公众对气候和社会责任问题意识的增强,还需要考虑碳足迹问题。根据马萨诸塞大学 2019 年的一项 研究,“在 GPU 上训练一次 BERT 产生的碳足迹大致与一次跨美飞行相当”。 BERT-Large 有 3.4 亿个参数。我们可以通过此推断 Megatron-Turing 的碳足迹大致如何……认识我的人都知道,我并不是一个热血环保主义者。尽管如此,这些数字也不容忽视。 所以呢? 我对 Megatron-Turing NLG 530B 和接下来可能会出现的模型巨兽感到兴奋吗?不。我认为值得增加成本、复杂性以及碳足迹去换取 (相对较小的) 测试基准上的改进吗?不。我认为构建和推广这些庞大的模型能帮助组织理解和应用机器学习吗?不。 我想知道这一切有什么意义。为了科学而科学?好的老营销策略?技术至上?可能每个都有一点。如果是这些意义的话,我就不奉陪了。 相反,我更专注于实用且可操作的技术,大家都可以使用这些技术来构建高质量的机器学习解决方案。 使用预训练模型 在绝大多数情况下,你不需要自定义模型架构。也许你会 想要 自己定制一个模型架构 (这是另一回事),但请注意此处猛兽出没,仅限资深玩家! 一个好的起点是寻找已经针对你要解决的任务预训练过的 模型 (例如,英文文本摘要) 。 然后,你应该快速尝试一些模型,用它们来预测你自己的数据。如果指标效果不错,那么打完收工!如果还需要更高一点的准确率,你应该考虑对模型进行微调 (稍后会详细介绍) 。 使用较小的模型 在评估模型时,你应该从那些精度满足要求的模型中选择尺寸最小的那个。它预测得更快,并且需要更少的硬件资源来进行训练和推理。节俭需要从一开始就做起。 这其实也不算什么新招。计算机视觉从业者会记得 SqueezeNet 2017 年问世时,与 AlexNet 相比,模型尺寸减少了 50 倍,而准确率却与 AlexNet 相当甚至更高。多聪明! 自然语言处理社区也在致力于使用迁移学习技术缩减模型尺寸,如使用知识蒸馏技术。 DistilBERT 也许是其中最广为人知的工作。与原始 BERT 模型相比,它保留了 97% 的语言理解能力,同时尺寸缩小了 40%,速度提高了 60%。你可以 Hugging Face 尝试一下 DistilBERT。同样的方法也已经应用于其他模型,例如 Facebook 的 BART,你可以在 Hugging Face 尝试 DistilBART。 Big Science 项目的最新模型也令人印象深刻。下面这张来自于 论文 的图表明,他们的 T0 模型在许多任务上都优于 GPT-3,同时尺寸小 16 倍。你可以 Hugging Face 尝试 T0。 我们需要更多的此类研究! 微调模型 如果你需要特化一个模型,你不应该从头开始训练它。相反,你应该对其进行微调,也就是说,仅针对你自己的数据训练几个回合。如果你缺少数据,也许这些 数据集 中的某个可以帮助你入门。 猜对了,这是进行迁移学习的另一种方式,它会帮助你节省一切! 收集、存储、清理和标注的数据更少, 更快的实验和迭代, 生产过程所需的资源更少。 换句话说: 节省时间,节省金钱,节省硬件资源,拯救世界! 如果你需要教程,Hugging Face 课程 可以帮助你立即入门。 使用云基础设施 不管你是否喜欢它们,事实是云公司懂得如何构建高效的基础设施。可持续性研究表明,基于云的基础设施比其他替代方案更节能减排: 请参阅 AWS、Azure 和 Google。 Earth.org 宣称 虽然云基础设施并不完美,“[它] 比替代方案更节能,并促进了环境友好的服务及经济增长。" 在易用性、灵活性和随用随付方面,云肯定有很多优势。它也比你想象的更环保。如果你的 GPU 不够用,为什么不尝试在 AWS 的机器学习托管服务 Amazon SageMaker 上微调你的 Hugging Face 模型?我们为你准备了 大量示例。 优化你的模型 从编译器到虚拟机,软件工程师长期以来一直在使用能够针对任何运行硬件自动优化代码的工具。 然而,机器学习社区仍在这个课题上苦苦挣扎,这是有充分理由的。优化模型的尺寸和速度是一项极其复杂的任务,其中涉及以下技术: 专用硬件加速: 如训练加速硬件 (Graphcore、Habana) 、推理加速硬件 (Google TPU,AWS Inferentia)。 剪枝: 删除对预测结果影响很小或没有影响的模型参数。 融合: 合并模型层 (例如,卷积和激活) 。 量化: 以较小的位深存储模型参数 (例如,使用 8 位而不是 32 位) 幸运的是,自动化工具开始出现,例如 Optimum 开源库和 Infinity,Infinity 是一个最低能以 1 毫秒的延迟提供 Transformers 推理能力的容器化解决方案。 结论 在过去的几年里,大语言模型的尺寸平均每年增长 10 倍。这开始看起来像另一个摩尔定律。 这条路似曾相识,我们应该知道这条路迟早会遇到收益递减、成本增加、复杂性等问题以及新的风险。指数的结局往往不是会很好。还记得 Meltdown and Spectre 吗?我们想知道人工智能的 Meltdown and Spectre 会是什么吗? 英文原文: https://hf.co/blog/large-language-models 原作者: Julien Simon 译者: Matrix Yao (姚伟峰),英特尔深度学习工程师,工作方向为 transformer-family 模型在各模态数据上的应用及大规模模型的训练推理。 审校、排版: zhongdongy (阿东)

优秀的个人博客,低调大师

每日一博 | 拜占庭将军问题和 Raft 共识算法讲解

作者: 京东物流 郭益如 导读 在分布式系统中, 什么是拜占庭将军问题?产生的场景和解决方案是什么?什么是 Raft 共识算法?Raft 算法是如何解决拜占庭将军问题的?其核心原理和算法逻辑是什么?除了 Raft,还有哪些共识算法?共识问题作为分布式系统的一大难点和痛点,本文主要介绍了其产生的背景、原因,以及通用的 Raft 算法解决方案。 01 拜占庭将军问题 【分布式对等网络中的通信容错问题。 在分布式计算中,不同的计算机通过通讯交换信息达成共识按照一套协作策略行动。有时候,系统中的成员计算机可能出错而发送错误的信息,用于传递信息的通讯网络也可能导致信息损坏,使得网络中不同的成员关于全体协作的策略得出不同结论,从而破坏系统一致性,这就是拜占庭将军问题。 拜占庭将军问题被认为是容错性问题中最难的问题类型之一。】 9 位将军兵分 9 路去打仗,他们各自有权力观测敌情并做出行动判断 —— 进攻或撤退,他们必须行动一致,即所有军队一起进攻或者一起撤退,否则部分进攻部分撤退会造成灾难性后果。 前提: 将军之间只能通过信使互相联系,每位将军将自己的判断发送给其他将军,并接收其他将军发送的判断; 收到信息的将军综合所有的判断,当超过半数都选择进攻时,就决定进攻,当超过半数都选择撤退时就决定撤退; 问题是,将军中间可能出现叛徒,他可能会选择相反的结果进行通信(投票),也可能选择性的发送信息,叛徒要达成的目标是: 选择性的发送信息,欺骗某些将军采取进攻的行动; 促成一个错误的决定,比如将军们不希望进攻时进攻; 迷惑某些将军,使得他们无法做出决定; 如果叛徒达成了其中之一,任何的攻击结果都是注定要失败的,只有完全达成一致的努力才能获得胜利。 比如,可能 9 位将军中有 8 位忠诚的将军和一名叛徒,8 位将军中 4 位选择进攻,4 位选择撤退,叛徒分别给选择进攻的将军发送进攻的信息,给选择撤退的将军发送撤退信息。这样一来,在4 位选择进攻的将军看,共 5 位将军选择进攻,从而发起进攻;而在 4 位选择撤退的将军看,共 5 位将军选择撤退,从而发起撤退,这样各个将军的一致性就遭到了破坏。 并且,叛徒将军可能会伪造其他将军的身份发送信件; 拜占庭将军问题描述的是,在存在信息丢失的不可靠信道上试图通过消息传递的方式达到一致性是不可能的,在系统中除了存在的消息延迟或不可送达故障外,还可能包括消息篡改、节点处理异常等潜在性异常。 1.1 拜占庭容错 在早期的解决方案中,一种是 “拜占庭容错” ,它遵循“少数服从多数”的共识机制,即使出现了错误或伪造的信息,只要有问题的将军数量不到 1/3,仍可以达到“拜占庭容错”,使整个系统便可以正常运作。 为什么是 1/3呢? 其原理是这样的,假设将军总数是 N,其中正直的将军数量是 S,反叛的将军数量是 T, 那么 N=S+T; 为了保证即使反叛的将军都不去投票也能产生最终的结果,那么 S 必须要超过半数,这种情况下,S 都做出相同的选择,依然可以达成共识,即 S>T; 如果叛徒给一半支持进攻的将军发送进攻信息,给一半支持撤退的将军发送撤退信息,这种情况要保证也能产生最终的投票结果,则 X > S/2 + E; 综合以上关系,可以得到: N = S + T X < S X > S/2 + T 求解以上不等式,可以得到: (N-T)/2 > T,即 N > 3T 所以要保证正直的将军至少占所有将军总数的 2/3,才有可能达成共识。 1.2 拜占庭算法 拜占庭算法是一种共识算法,确定共识的原则,各个节点通过这个共识原则既可以保证一致性,又能保证基本的分区容错性。 共识是可容错系统中的一个基本问题: 即使面对故障,服务器如何在共享状态上达成一致? 02 Raft算法 理解,首先 MCube 会依据模板缓存状态判断是否需要网络获取最新模板,当获取到模板后进行模板加载,加载阶段会将产物转换为视图树的结构,转换完成后将通过表达式引擎解析表达式并取得正确的值,通过事件解析引擎解析用户自定义事件并完成事件的绑定,完成解析赋值以及事件绑定后进行视图的渲染,最终将目标页面展示到屏幕。 【Raft 算法解决的是简化版的拜占庭将军问题,即在不考虑数据丢失、篡改的情况下的拜占庭将军问题。】 假设现在有 3 位将军 A、B、C,将军中没有叛徒,信使的信息可靠,但有可能被暗杀,此时将军们如何达成进攻的一致性决定? 方案: Raft的方案是,在所有的将军中选出一个大将军,用来做出所有的决定。大将军派信使给其他将军,如果过一段时间没有回复(可能被暗杀)就再派一个信使,直到收到回复。 如果大将军的信使,派出去一个被干掉一个,其他将军们总也收不到大将军的信息,他们如何达成一致性决定? 方案: 每位将军都有一个随机时间的计时器,时间一到,他就把自己当成大将军的候选人,派信使将选举结果给将军 B、C。 如果将军 B、C 还没有把选举大将军结果投给其他人(包括自己)时,他们就会把选举票投给 A。A 将军的信使返回 A 时,A 将军就知道自己收到了足够的票数,成为了新的大将军。 Raft 算法是一种简单易懂的共识算法,它通过首先选举一个 Leader 主节点,然后让Leader 完全负责数据同步,依靠状态机和主从同步的方式,在各个节点之间实现数据的一致性。 通过这种主节点进行数据同步的方式,Raft 将一致性问题拆分成了三个相对独立的子问题: 1. 主节点选取 Leader Election: 启动集群时,或者现有主节点失败时,会启动新的投票,获得大多数选票(N/2+1)的节点会成为新的主节点; 2. 复制日志 Log Replication: 主节点从客户端接收日志信息,再把信息复制到其他从节点上,使得日志信息都能保持数据一致; 3. 安全性: Raft 定义了一系列规范来保证数据安全性。 2.1 Raft节点 Raft 算法为节点定义了三种角色: Leader(主节点) 、Follower(从节点) 、Candidate(参与投票竞争的节点) ,节点的角色是可以转换的,在任意的时间,每个服务器一定处于三种状态中的一个。 每个节点上都有一个倒计时器(Election Timeout),随机值在 150ms ~ 300ms 之间,当节点收到选举请求,或收到 Leader 的 Heartbeat 时,就会重置倒计时。 2.1.1 主节点 Leader 通常情况下,系统中只有一个主节点,用来发起心跳,处理所有的客户端请求,创建日志和同步日志。 2.1.2 从节点 Follower 除主节点外,其他的节点都是从节点,用于接收主节点的心跳和日志数据,保证其数据状态与主节点一致,以及在 Leader 选举时,投票给 Candidate。 如果有客户端跟Follower 联系,那么 Follower 会把请求重定向给 Leader。 2.1.3 候选人 Candidate 候选人 Candidate是在 Leader 选举过程中的临时角色,由 Follower 转换而来,用于发起投票参与竞选。 Raft 节点状态图: 图1 Raft 节点状态图 启动时,或 Follower 接收不到 Leader 信息时,它就会变成 Candidate 并发起一次选举。获得集群中大多数选票的Candidate 就成为新的 Leader。 2.1.4 任期 Term Raft 把时间分割成任意长度的任期 Term,用连续的整数标记。 图2 各任期 Term 下的状态演变 每一个任期都会开始一次新的选举,一个或多个 Candidate 会尝试成为 Leader。如果一个 Candidate 赢得了选举,它就会在该任期内担任 Leader,直到任期结束或者服务器宕机。在某些情况下,没有选出 Leader(如选票瓜分等),则会开启下一个任期并立刻开始新的选举。 任期在 Raft 算法中充当逻辑时钟的作用,每一个节点都会存储当前的 Term 号,这一编号在整个集群时期内单调增长,服务器之间通信的时候也会交换当前的 Term 号: 如果一个节点发现其 Term 号比其他服务器小,那么它会更新自己的 Term 号到较大的值; 如果一个 Candidate 或者 Leader 发现其 Term 号过期了,那么它会立即恢复成 Follower 状态; 如果一个节点接收到的请求中 Term 号过期了,那么它会直接拒绝此次请求。 Raft 算法中服务器节点之间通信使用远程过程调用(RPCs),并且基本的一致性算法只需要两种类型的 RPCs。请求投票(RequestVote) RPCs 由候选人在选举期间发起,然后附加条目(AppendEntries)RPCs 由领导者发起,用来复制日志和提供一种心跳机制。如果未及时收到响应,则请求者有责任重试 RPC。 2.1.5 事件 Entry 每一个事件是一个 Entry,只有 Leader 可以创建 Entry,结构为 <term, index, cmd>其中 cmd 是可以应用到状态机的操作。 2.1.6 日志 Log 日志是 Raft 的核心概念,是一个由 Entry 构成的数组。只有 Leader 才可以改变其他节点的 Log。Leader 先把 Entry 添加到自己的 Log 数组中,发起共识请求,获得同意后,才会将 Entry 提交给状态机。Follower 只能从 Leader 中获取新日志和当前的 CommitIndex,然后把对应的 Entry 应用到自己的状态机中。 2.2 选取主节点 Leader Election 2.2.1 选举机制 raft 通过心跳机制来触发 Leader 的选举; <!----> Leader 会向所有的 Follower 周期性发送心跳来保证自己的 Leader 地位。 <!----> 如果服务器能够收到来自 Leader 或者 Candidate 的有效信息,那么它会一直保持为 Follower 状态,并且刷新自己的 electionElapsed,重新计时。 <!----> 如果一个 Follower 在一个周期内没有收到任何信息,也就是选举超时,它就会认为此时没有可用的 Leader,开始进行一次选举以选出一个新的 Leader。 当服务器启动时,所有的节点都是 Follower。 2.2.2 选举过程 Follower 自增的 term 号并且转换状态为 Candidate。然后他会向所有节点发起 RequestVoteRPC 请求, Candidate 的状态会持续到以下情况发生: 获得大多数选票(N/2 +1),赢得选举,成为 Leader 其他节点赢得选举 一轮选举结束,无人胜出 在 Candidate 等待选票的时候,它可能收到其他节点声明其是 Leader 的心跳: 该 Leader 的 term 号大于等于自己的 term 号,说明对方已经成为 Leader,则自己回退为 Follower。 该 Leader 的 term 号小于自己的 term 号,那么会拒绝该请求并让该节点更新 term。 为了避免出现“脑裂”,即同一时刻出现多个 Candidate,导致没有 Candidate 获得大多数选票的状况,Raft 增加了随机选举超时时间的方法。每一个Candidate 在发起选举后,都会随机化一个超时时间( 150-300 毫秒),使得各个服务器分散开来,在大多数情况下只有一个服务器会率先超时,赢得选举。 相关代码实现: 【plain】 func (rf *Raft) RequestVote(request *RequestVoteRequest, response *RequestVoteResponse) { rf.mu.Lock() defer rf.mu.Unlock() defer rf.persist() defer DPrintf("{Node %v}'s state is {state %v,term %v,commitIndex %v,lastApplied %v,firstLog %v,lastLog %v} before processing requestVoteRequest %v and reply requestVoteResponse %v", rf.me, rf.state, rf.currentTerm, rf.commitIndex, rf.lastApplied, rf.getFirstLog(), rf.getLastLog(), request, response) if request.Term < rf.currentTerm || (request.Term == rf.currentTerm && rf.votedFor != -1 && rf.votedFor != request.CandidateId) { response.Term, response.VoteGranted = rf.currentTerm, false return } if request.Term > rf.currentTerm { rf.ChangeState(StateFollower) rf.currentTerm, rf.votedFor = request.Term, -1 } if !rf.isLogUpToDate(request.LastLogTerm, request.LastLogIndex) { response.Term, response.VoteGranted = rf.currentTerm, false return } rf.votedFor = request.CandidateId rf.electionTimer.Reset(RandomizedElectionTimeout()) response.Term, response.VoteGranted = rf.currentTerm, true } func (rf *Raft) StartElection() { request := rf.genRequestVoteRequest() DPrintf("{Node %v} starts election with RequestVoteRequest %v", rf.me, request) // use Closure grantedVotes := 1 rf.votedFor = rf.me rf.persist() for peer := range rf.peers { if peer == rf.me { continue } go func(peer int) { response := new(RequestVoteResponse) if rf.sendRequestVote(peer, request, response) { rf.mu.Lock() defer rf.mu.Unlock() DPrintf("{Node %v} receives RequestVoteResponse %v from {Node %v} after sending RequestVoteRequest %v in term %v", rf.me, response, peer, request, rf.currentTerm) if rf.currentTerm == request.Term && rf.state == StateCandidate { if response.VoteGranted { grantedVotes += 1 if grantedVotes > len(rf.peers)/2 { DPrintf("{Node %v} receives majority votes in term %v", rf.me, rf.currentTerm) rf.ChangeState(StateLeader) rf.BroadcastHeartbeat(true) } } else if response.Term > rf.currentTerm { DPrintf("{Node %v} finds a new leader {Node %v} with term %v and steps down in term %v", rf.me, peer, response.Term, rf.currentTerm) rf.ChangeState(StateFollower) rf.currentTerm, rf.votedFor = response.Term, -1 rf.persist() } } } }(peer) } } 2.3 日志同步 Log Replication Raft 通过Leader 向集群中所有 Follower 进行日志同步来保证整个集群数据的最终一致性。 只有 Leader 有权限接受客户端的请求并且同步数据给集群中其他节点。每一个客户端的请求都包含一条需要被复制状态机 RSM(Replicated State Mechine)执行的命令,Leader 收到客户端请求后,会生成一个 Entry,包含,再将这个 entry 添加到自己的日志末尾后,向所有的节点广播该 Entry,要求其他服务器复制这条 Entry。 图3 主从节点进行 Entry 复制 如图所示,Logs 日志是一个顺序存储的 Entry 数组,方框内是任期 Term 号。 2.3.1 日志同步流程 例如,在 Term3 中,Leader 最后一个 Entry 的Index 为 7,x 值为 5,收到请求 set x=4时: 图4 日志同步流程 Leader 收到客户端请求 x←4 时,Leader 会生成一条新的 Entry<8, 3, set x=4>,并将该 Entry 添加到自己的 Log 数组最后 Leader 通过 AppendEntries RPC 广播该 Entry; 如果 Follower 接受该 Entry,则会将 Entry 添加到其日志后面,同时返回给 Leader 同意。 如果 Leader 收到了多数的成功响应,Leader 认为这个 Entry 是 committed,应用到自己的状态机 RSM 中,并且向客户端返回执行结果。之后,该 commited 信息会随着之后的 AppendEntryRPC 传达到其他节点。 committed 表示被 Leader 创建的 Entry 已经复制到了大多数的服务器上,Leader 会跟踪它记录的最大索引值 Index,并在之后的 AppendEntries RPC(包括心跳)中,包含该索引值,以此确保其他服务器同步这个 Entry 已经提交,Follower 接收到该信息后,也会按顺序同步更新到本地的状态机中。 Raft 通过这种日志机制来保证不同服务器上日志的一致性和安全性: 在两个日志里,有两个 entry 拥有相同的 index 和 term,那么它们一定有相同的 cmd; 在两个日志里,有两个 entry 拥有相同的 index 和 term,那么它们前面的 entry 也一定相同。 2.3.2 Leader Crash 一般情况下,Leader 和 Follower 的日志保持一致,AppendEntries 的一致性检查通常不会失败。然后,Leader Crash 可能会导致数据丢失: 图5 Leader Crash时的数据状况 当最上面的 Leader 掌权后,Follower 日志可能有 a~f 几种情况: 1. 日志丢失(a,b); 2. Follower 含有未提交数据(c、d); 3. 日志丢失 + Follower 含有未提交数据(e、f); 场景 f 可能出现的情况为: 如果一台服务器在 Term2 时是 Leader,并且向它的日志中添加了一些数据条目,然后在数据提交前宕机了;接着该 Leader 很快重启后,又称为了任期 3 的 Leader,接着又向它的日志中添加了一些数据,然后在 Term2,Term3 数据条目提交前,又宕机了,之后一直处于宕机状态,直到有新的 Leader 产生。 当遇到这种一致性检查失败的情况时,Leader 通过强制 Follower 复制自己的日志来处理日志的不一致。这就意味着,在 Follower 上的冲突日志会被领导者的日志覆盖。 Leader 找到 Follower 与它日志一致的地方(Index=3),然后删除 Follower 在该位置之后的日志,接着把这之后的日志发送给 Follower: Leader 给每一个Follower 维护了一个 nextIndex,它表示 Leader 将要发送给该追随者的下一条日志条目的索引。当一个 Leader 开始掌权时,它会将 nextIndex 初始化为它的最新的日志条目索引数+1。如果一个 Follower 的日志和 Leader 的不一致,AppendEntries 一致性检查会在下一次 AppendEntries RPC 时返回失败。在失败之后,Leader 会将 nextIndex 递减然后重试 AppendEntries RPC。最终 nextIndex 会达到一个 Leader 和 Follower 日志一致的地方。这时,AppendEntries 会返回成功,Follower 中冲突的日志条目都被移除了,并且添加所缺少的上了 Leader 的日志条目。一旦 AppendEntries 返回成功,Follower 和 Leader 的日志就一致了,这样的状态会保持到该任期结束。 相关实现代码: 【plain】 func (rf *Raft) replicateOneRound(peer int) { rf.mu.RLock() if rf.state != StateLeader { rf.mu.RUnlock() return } prevLogIndex := rf.nextIndex[peer] - 1 if prevLogIndex < rf.getFirstLog().Index { // only snapshot can catch up request := rf.genInstallSnapshotRequest() rf.mu.RUnlock() response := new(InstallSnapshotResponse) if rf.sendInstallSnapshot(peer, request, response) { rf.mu.Lock() rf.handleInstallSnapshotResponse(peer, request, response) rf.mu.Unlock() } } else { // just entries can catch up request := rf.genAppendEntriesRequest(prevLogIndex) rf.mu.RUnlock() response := new(AppendEntriesResponse) if rf.sendAppendEntries(peer, request, response) { rf.mu.Lock() rf.handleAppendEntriesResponse(peer, request, response) rf.mu.Unlock() } } } func (rf *Raft) AppendEntries(request *AppendEntriesRequest, response *AppendEntriesResponse) { rf.mu.Lock() defer rf.mu.Unlock() defer rf.persist() defer DPrintf("{Node %v}'s state is {state %v,term %v,commitIndex %v,lastApplied %v,firstLog %v,lastLog %v} before processing AppendEntriesRequest %v and reply AppendEntriesResponse %v", rf.me, rf.state, rf.currentTerm, rf.commitIndex, rf.lastApplied, rf.getFirstLog(), rf.getLastLog(), request, response) if request.Term < rf.currentTerm { response.Term, response.Success = rf.currentTerm, false return } if request.Term > rf.currentTerm { rf.currentTerm, rf.votedFor = request.Term, -1 } rf.ChangeState(StateFollower) rf.electionTimer.Reset(RandomizedElectionTimeout()) if request.PrevLogIndex < rf.getFirstLog().Index { response.Term, response.Success = 0, false DPrintf("{Node %v} receives unexpected AppendEntriesRequest %v from {Node %v} because prevLogIndex %v < firstLogIndex %v", rf.me, request, request.LeaderId, request.PrevLogIndex, rf.getFirstLog().Index) return } if !rf.matchLog(request.PrevLogTerm, request.PrevLogIndex) { response.Term, response.Success = rf.currentTerm, false lastIndex := rf.getLastLog().Index if lastIndex < request.PrevLogIndex { response.ConflictTerm, response.ConflictIndex = -1, lastIndex+1 } else { firstIndex := rf.getFirstLog().Index response.ConflictTerm = rf.logs[request.PrevLogIndex-firstIndex].Term index := request.PrevLogIndex - 1 for index >= firstIndex && rf.logs[index-firstIndex].Term == response.ConflictTerm { index-- } response.ConflictIndex = index } return } firstIndex := rf.getFirstLog().Index for index, entry := range request.Entries { if entry.Index-firstIndex >= len(rf.logs) || rf.logs[entry.Index-firstIndex].Term != entry.Term { rf.logs = shrinkEntriesArray(append(rf.logs[:entry.Index-firstIndex], request.Entries[index:]...)) break } } rf.advanceCommitIndexForFollower(request.LeaderCommit) response.Term, response.Success = rf.currentTerm,True } 2.3.3 安全性 Leader 需要保证其存储全部已经提交的日志条目,保证日志条目只能从 Leader 流向 Follower,且 Leader 永远不会覆盖已经存在的日志条目。 每个 Candidate 发送 RequestVoteRPC 时,都会带上最后一个 Entry 的信息。所有节点收到投票信息时,会对该 Entry 进行比较,如果发现自己的更新,则拒绝投票给该 Candidate。 03 其他一致性算法 理解,首先 MCube 会依据模板缓存状态判断是否需要网络获取最新模板,当获取到模板后进行模板加载,加载阶段会将产物转换为视图树的结构,转换完成后将通过表达式引擎解析表达式并取得正确的值,通过事件解析引擎解析用户自定义事件并完成事件的绑定,完成解析赋值以及事件绑定后进行视图的渲染,最终将目标页面展示到屏幕。 3.1 Paxos 算法 早期的共识算法,由拜占庭将军问题的提出者 Leslie Lamport 所发明。谷歌的分布式锁服务 Chubby 就是以 Paxos 算法为基础。 3.2 ZAB 算法 Zookeeper 所使用的一致性算法,在流程上和 Raft 算法比较接近。 3.3 PBFT 算法 区块链技术所使用的共识算法之一,适用于私有链的共识。 04 总结 理解,首先 MCube 会依据模板缓存状态判断是否需要网络获取最新模板,当获取到模板后进行模板加载,加载阶段会将产物转换为视图树的结构,转换完成后将通过表达式引擎解析表达式并取得正确的值,通过事件解析引擎解析用户自定义事件并完成事件的绑定,完成解析赋值以及事件绑定后进行视图的渲染,最终将目标页面展示到屏幕。 Raft 算法是很广泛的强一致性、去中心化和高可用的分布式协议,是一种 leader-based 的共识算法。通过将共识问题拆分成主节点选举和主从日志同步,以及安全流程,来提高分布式系统的数据一致性、可靠性和容错性;首先选举主节点,然后主节点负责接收外部请求、数据复制、提交,保证系统中数据都是一致的。

优秀的个人博客,低调大师

每日一博 | 从历代 GC 算法角度刨析 ZGC

作者:京东科技 文涛 前言 本文所有介绍仅限于HotSpot虚拟机, 本文先介绍了垃圾回收的必要手段,基于这些手段讲解了历代垃圾回收算法是如何工作的, 每一种算法不会讲的特别详细,只为读者从算法角度理解工作原理,从而引出ZGC,方便读者循序渐进地了解。 GC是Garbage Collection的缩写,顾名思义垃圾回收机制,即当需要分配的内存空间不再使用的时候,JVM将调用垃圾回收机制来回收内存空间。 那么JVM的垃圾机制是如何工作的呢? 第一步识别出哪些空间不再使用(识别并标记出哪些对象已死); 第二步回收不再使用空间(清除已死对象 ) 判断对象是否已死 判断对象是否已死通常有两种方式 ,引用计数法和可达性分析法 引用计数法 给对象中添加一个引用计数器,每当有一个地方引用它时,计数器值就加1:当引用失效时,计数器值就减1;任何时刻计数器为0的对象就是不能再被使用的。 简单高效,但无法解决循环引用问题,a=b,b=a 引用计数法并没有在产品级的JVM中得到应用 可达性分析法 这个算法的基本思路就是通过一系列的称为“ GC Roots”的对象作为起始点,从这些节点开始向下搜索,搜索所走过的路径称为引用链( Reference Chain),当一个对象到 GC Roots没有任何引用链相连(用图论的话来说,就是从 GC Roots到这个对象不可达)时,则证明此对象是不可用的。  不过可达性算法中的对象并不是立即死亡的,对象拥有一次自我拯救的机会,对象被系统宣告死亡至少要经历两次标记过程,第一次是经过可达性分析之后没有与GC Roots相连的引用链,第二次是在由虚拟机自动建立的Finalize队列中判断是否需要执行finalize()方法。 HotSopt虚拟机采用该算法。 清除已死对象的方式 标记清除算法 先标记再清除 不足:1 效率问题,标记和清除效率都不高。2 空间问题,产生大量空间碎片 复制算法 内存分两块,A,B A用完了,将存活对象拷贝到B,A清理掉 代价:内存少了一半。 HotSopt虚拟机用此算法回收新生代。将新生代内存划分为8:1:1的Eden和Survivor解决复制算法内存使用率低的问题  标记整理算法 老年代使用,方式和标记清除类似,只是不直接清除,而是将后续对象向一端移动,并清理掉边界以外的内存。  分代收集算法 分代收集是一个算法方案,整合了以上算法的优点,一般是把Java堆分为新生代和老年代,在新生代中,使用复制算法老年代“标记一清理”或者“标记一整理” 历代垃圾收集器简介 通过上文我们了解了怎样识别垃圾,怎样清理垃圾,接下来,讲ZGC之前,我们回顾一下历代垃圾回收是怎样做的,主要是想给读者一种历史的视角,任何技术都不是凭空产生的,更多的是在前人成果之上进行优化整合 我们先看一个历代JDK垃圾收集器对比表格,以下表格着重说明或引出几个问题: 1 CMS从来未被当作默认GC,且已废弃 2 CMS的思想其实部分被ZGC吸收,CMS已死,但他的魂还在 3 JDK11、JDK17为长期迭代版本,项目中应优先使用这两个版本 版本 发布时间 默认收集器 事件 jdk1.3 2000-05-08 serial  jdk1.4 2004-02-06 ParNew  jdk1.5/5.0 2004-09-30 Parallel Scavenge/serial CMS登场 jdk1.6/6.0 2006-12-11 Parallel Scavenge/Parallel Old  dk1.7/7.0 2011-07-28 Parallel Scavenge/Parallel Old G1登场 jdk1.8/8.0 2014-03-18 Parallel Scavenge/Parallel Old  jdk1.9/9.0 2014-09-8 G1 CMS废弃 jdk10 2018-03-21 G1  jdk11 2018-09-25 G1 ZGC登场 jdk12 2019-3 G1 Shenandoah jdk13 2019-9 G1  jdk14 2020-3 G1 CMS移除 jdk15 2020-9-15 G1 ZGC、Shenandoah转正 jdk16 2021-3-16 G1  jdk17 2021-09-14 G1 ZGC分代 jdk18 2022-3-22 G1  jdk19 2022-9-22 G1  GC分类 我们经常在各种场景听到以下几种GC名词,Young GC、Old GC、Mixed GC、Full GC、Major GC、Minor GC,他们到底什么意思,本人进行了以下梳理 首先GC分两类,Partial GC(部分回收),Full GC Partial GC:并不收集整个GC堆的模式,以下全是Partial GC的子集 Young GC:只收集young gen的GC Old GC:只收集old gen的GC。只有CMS的concurrent collection是这个模式 Mixed GC:只有G1有这个模式,收集整个young gen以及部分old gen的GC。 Minor GC:只有G1有这个模式,收集整个young gen Full GC:收集整个堆,包括young gen、old gen、perm gen(如果存在的话)等所有部分的模式。 Major GC:通常是跟full GC是等价的 serial收集器 单线程收集器,“单线程”的意义并不仅仅说明它只会使用一个CPU或一条收集线程去完成垃圾收集工作,更重要的是在它进行垃圾收集时,必须暂停其他所有的工作线程,直到它收集结束。它依然是虚拟机运行在 Client模式下的默认新生代收集器。它也有着优于其他收集器的地方:简单而高效(与其他收集器的单线程比),对于限定单个CPU的环境来说, Serial I收集器由于没有线程交互的开销,专心做垃圾收集自然可以获得最高的单线程收集效率。 下图彩色部分说明了它的算法,简单粗暴 1 停止用户线程 2 单线程垃圾回收新生代 3 重启用户线程  ParNew收集器 Parnew收集器其实就是 Serial l收集器的多线程版本。它是许多运行在 Server模式下的虚拟机中首选的新生代收集器,其中有一个与性能无关但很重要的原因是,除了 Serial 收集器外,目前只有它能与CMS收集器配合工作。Pardew收集器在单CPU的环境中绝对不会有比 Serial收集器更好的效果。它默认开启的收集线程数与CPU的数量相同,在CPU非常多(臂如32个)的环境下,可以使用-XX: ParallelGCThreads参数来限制垃圾收集的线程数。 ParNew收集器追求降低GC时用户线程的停顿时间,适合交互式应用,良好的反应速度提升用户体验. 下图彩色部分说明了它的算法,同样简单粗暴 1 停止用户线程 2 多线程垃圾回收新生代 3 重启用户线程 Parallel Scavenge 收集器 Parallel Scavenge收集器是一个新生代收集器,它也是使用复制算法的收集器,又是并行的多线程收集器。算法的角度它和ParNew一样,在此就不画图解释了 Parallel Scavenge收集器的目标则是达到一个可控制的吞吐量( Throughput) 吞吐量是指用户线程运行时间占CPU总时间的比例 通过以下两种方式可达到目的: 1.在多CPU环境中使用多条GC线程,从而垃圾回收的时间减少,从而用户线程停顿的时间也减少; 2.实现GC线程与用户线程并发执行。 Serial Old收集器 Serial Old是 Serial 收集器的老年代版本,它同样是一个单线程收集器,使用“标记整理”算法。这个收集器的主要意义也是在于给 Client模式下的虚拟机使用。 如果在 Server模式下,那么它主要还有两大用途: 一种用途是在JDK1.5以及之前的版本中与 ParallelScavenge收集器搭配使用, 另一种用途就是作为CMS收集器的后备预案,在并发收集发生Concurrent Mode Failure时使用 下图彩色部分说明了它的算法,同样简单粗暴 1 停止用户线程 2 单线程垃圾回收老年代 3 重启用户线程 Parallel Old收集器 Paralle Old是 Parallel Scavenge收集器的老年代版本,一般它们搭配使用,追求CPU吞吐量,使用多线程和“标记一整理”算法。 下图彩色部分说明了它的算法,同样简单粗暴 1 停止用户线程 2 多线程垃圾回收老年代 3 重启用户线程 CMS收集器 以上5种垃圾回收原理不难理解,算法之所以如此简单个人理解在当时使用这种算法就够了,随着JAVA的攻城略地,有一种垃圾回收需求出现,即使用尽量短的回收停顿时间,以避免过久的影响用户线程,CMS登场了。 CMS( Concurrent Mark Sweep)收集器是一种以获取最短回收停顿时间为目标的收集器。 想要达到目的,就要分析GC时最占用时间的是什么操作,比较浪费时间的是标记已死对象、清除对象,那么如果可以和用户线程并发的进行,GC的停顿基本就限制在了标记所花费的时间。  如上图,CMS收集器是基于“标记一清除”法实现的,它的运作过程分为4个步骤 • 初始标记( EMS initial mark) stop the world • 并发标记( CMS concurrent mark) • 重新标记( CMS remark) stop the world • 并发清除( CMS concurrent sweep) 初始标记的作用是查找GC Roots集合的过程,这个过程处理对象相对较少,速度很快。(为什么要进行初始标记:枚举根结点。https://www.zhihu.com/question/502729840) 并发标记是实际标记所有对象是否已死的过程,比较耗时,所以采用并发的方式。 重新标记主要是处理并发标记期间所产生的新的垃圾。重新标记阶段不需要再重新标记所有对象,只对并发标记阶段改动过的对象做标记即可。 优点: 并发收集、低停顿 缺点: CMS收集器对CPU资源非常敏感。 CMS收集器无法处理浮动垃圾( Floating Garbage),可能出现“Concurrent ModeFailure”失败而导致另一次 Full GC的产生。 “标记一清除”法导致大量空间碎片产生,以至于老年代还有大量空间,却没有整块空间存储某对象。 Concurrent ModeFailure可能原因及方案 原因1:CMS触发太晚 方案:将-XX:CMSInitiatingOccupancyFraction=N调小 (达到百分比进行垃圾回收); 原因2:空间碎片太多 方案:开启空间碎片整理,并将空间碎片整理周期设置在合理范围; -XX:+UseCMSCompactAtFullCollection (空间碎片整理) -XX:CMSFullGCsBeforeCompaction=n 原因3:垃圾产生速度超过清理速度 晋升阈值过小; Survivor空间过小,导致溢出; Eden区过小,导致晋升速率提高;存在大对象; G1收集器 G1是一款面向服务端应用的垃圾收集器。下文会简单讲解一下它的“特点”和“内存分配与回收策略”,有基础或不感兴趣的同学直接跳到“G1垃圾回收流程” 特点 并行与并发 G1能充分利用多CPU、多核环境下的硬件优势,使用多个CPU(CPU或者CPU核心)来缩短Stop-The- World停顿的时间,部分其他收集器原本需要停顿Java线程执行的GC动作,G1收集器仍然可以通过并发的方式让Java程序继续执行。 分代收集 与其他收集器一样,分代概念在G1中依然得以保留。虽然G1可以不需要其他收集器配合就能独立管理整个GC堆,但它能够采用不同的方式去处理新创建的对象和已经存活了一段时间、熬过多次GC的旧对象以获取更好的收集效果。 空间整合 与CMS的“标记一清理”算法不同,G1从整体来看是基于“标记一整理”算法实现的收集器,从局部(两个 Region之间)上来看是基于“复制”算法实现的,但无论如何,这两种算法都意味着G1运作期间不会产生内存空间碎片,收集后能提供规整的可用内存。这种特性有利于程序长时间运行,分配大对象时不会因为无法找到连续内存空间而提前触发下一次GC。 可预测的停顿 这是G1相对于CMS的另一大优势,降低停顿时间是G1和CMS共同的关注点,但G1除了追求低停顿外,还能建立可预测的停顿时间模型,能让使用者明确指定在一个长度为M毫秒的时间片段内,消耗在垃圾收集上的时间不得超过N毫秒,这几乎已经是实时Java(RTSJ)的垃圾收集器的特征了。 在G1之前的其他收集器进行收集的范围都是整个新生代或者老年代,而G1不再是这样。使用G1收集器时,Java堆的内存布局就与其他收集器有很大差别,它将整个Java堆划分为多个大小相等的独立区域( Region),虽然还保留有新生代和老年代的概念,但新生代和老年代不再是物理隔离的了,它们都是一部分 Region(不需要连续)的集合 内存分配与回收策略 对象优先在Eden分配 大多数情况下,对象在新生代Eden区中分配。当Eden区没有足够空间进行分配时,虚拟机将发起一次 Minor[ˈmaɪnə(r)] GC 大对象直接进入老年代 所谓的大对象是指,需要大量连续内存空间的Java对象,最典型的大对象就是那种很长的字符串以及数组。大对象对虚拟机的内存分配来说就是一个坏消息(比遇到一个大对象更加坏的消息就是遇到一群“朝生夕灭”的“短命大对象”写程序的时候应当避免),经常出现大对象容易导致内存还有不少空间时就提前触发垃圾收集以获取足够的连续空间来“安置”它们。 长期存活的对象将进入老年代 虚拟机给每个对象定义了一个对象年龄(Age)计数器。如果对象在Eden出生并经过第一次 Minor GC后仍然存活,并且能被 Survivor容纳的话,将被移动到 Survivor空间中,并且对象年龄设为1。对象在 Survivor区中每“熬过”一次 Minor GC,年龄就增加1岁,当它的年龄增加到一定程度(默认15岁)会被晋升到老年代中。对象晋升老年代的年龄阈值,可以通过参数据-XX : MaxTenuringThreshold设置 动态对象年龄判定 为了能更好地适应不同程序的内存状况,虚拟机并不是水远地要求对象的年龄必须达到了 MaxTenuringThreshold才能晋升老年代,如果在 Survivor空间中相同年龄所有对象大小的总和大于 Survivor空间的一半,年龄大于或等于该年龄的对象就可以直接进入老年代,无须等到 MaxTenuringThreshold中要求的年龄。 空间分配担保 在发生 Minor GC之前,虚拟机会先检査老年代最大可用的连续空间是否大于新生代所有对象总空间,如果这个条件成立,那么 Minor GC可以确保是安全的。如果不成立,则虚拟机会查看 HandlePromotionFailure设置值是否允许担保失败。如果允许,那么会继续检查老年代最大可用的连续空间是否大于历次晋升到老年代对象的平均大小,如果大于,将尝试着进行一次 Minor GC,尽管这次 Minor GC是有风险的;如果小于,或者HandlePromotionFailure设置不允许冒险,那这时也要改为进行一次 Full GC. 为什么要担保: Minor GC后还有大量对象存活且空间不够存放新对象,就要直接在老年代存放 为什么是历次晋升到老年代对象的平均大小: 取平均值进行比较其实仍然是一种动态概率的手段,也就是说,如果某次 Minor GCd存活后的对象突增,远远高于平均值的话,依然会导致担保失败( HandlePromotionFailure)如果出现了 HandlePromotionFailure失败,那就只好在失败后重新发起一次 Full GC。虽然担保失败时绕的子是最大的,但大部分情况下都还是会将 HandlePromotionFailure开关打开,避免 Full GC过于频繁。 eden的大小范围默认是 =【-XX:G1NewSizePercent,-XX:G1MaxNewSizePercent】=【整堆5%,整堆60%】 humongous如果一个对象的大小已经超过Region大小的50%了,那么就会被放入大对象专门的Region中,这种Region我们叫humongous G1垃圾回收流程  网上对G1的回收阶段有不同的说法,参考Oracle JVM工程师的一个说法: 他把整个 G1 的垃圾回收阶段分成了这么三个,第一个叫 Minor GC,就是对新生代的垃圾收集,第二个阶段呢叫 Minor GC + Concurrent Mark,就是新生代的垃圾收集同时呢会执行一些并发的标记,这是第二个阶段,第三个阶段呢它叫 Mixed GC 混合收集,这三个阶段是一个循环的过程。刚开始是这个新生代的垃圾收集,经过一段时间,当老年代的内存超过一个阈值了,它会在新生代垃圾收集的同时进行并发的标记,等这个阶段完成了以后,它会进行一个混合收集,混合收集就是会对新生代、幸存区还有老年代都来进行一个规模较大的一次收集,等内存释放掉了,混合收集结束。这时候伊甸园的内存都被释放掉,它会再次进入新生代的一个垃圾收集过程,那我们先来看看这个新生代的收集 Minor GC。 Minor GC的回收过程(eden满了回收) 选定所有Eden Region放入CSet,使用多线程复制算法将CSet的存活对象复制到Survivor Region或者晋升到Old Region。 下图分7步演示了这个过程 1 初始状态,堆无占用 2 Eden Region满了进行标记 3 将存活对象复制到Survivor Region 4 清理Eden Region 5 Eden Region又满了进行再次标记,此时会连带Survivor Region一起标记 6 将存活对象复制到另一个Survivor Region 7 再次清理Eden Region和被标记过的Survivor Region  Minor GC结束后自动进行并发标记,为以后可能的Mixed GC做准备 Mixed GC的回收过程(专注垃圾最多的分区) 选定所有Eden Region和全局并发标记计算得到的收益较高的部分Old Region放入CSet,使用多线程复制算法将CSet的存活对象复制到Survivor Region或者晋升到Old Region。 当堆空间的占用率达到一定阈值后会触发Mixed GC(默认45%,由参数决定) Mixed GC它一定会回收年轻代,并会采集部分老年代的Region进行回收的,所以它是一个“混合”GC。 下图分3步演示了这个过程 1 并发标记所有Region 2 并发复制 3 并发清理   ZGC ZGC(Z Garbage Collector) 是一款性能比 G1 更加优秀的垃圾收集器。ZGC 第一次出现是在 JDK 11 中以实验性的特性引入,这也是 JDK 11 中最大的亮点。在 JDK 15 中 ZGC 不再是实验功能,可以正式投入生产使用了。 目标低延迟 • 保证最大停顿时间在几毫秒之内,不管你堆多大或者存活的对象有多少。 • 可以处理 8MB-16TB 的堆 通过以上历代垃圾回收器的讲解,我们大致了解到减少延迟的底层思想不外乎将stop the world进行极限压缩,将能并行的部分全部采用和用户线程并行的方式处理,然而ZGC更"过分"它甚至把一分部垃圾回收的工作交给了用户线程去做,那么它是怎么做到的呢?ZGC的标记和清理工作同CMS、G1大致差不多,仔细看下图的过程,和CMS特别像,这就是我在上文说的CMS其实并没有真正被抛弃,它的部分思想在ZGC 有发扬。  ZGC 的步骤大致可分为三大阶段分别是标记、转移、重定位。 标记:从根开始标记所有存活对象 转移:选择部分活跃对象转移到新的内存空间上 重定位:因为对象地址变了,所以之前指向老对象的指针都要换到新对象地址上。 并且这三个阶段都是并发的。 初始转移需要扫描 GC Roots 直接引用的对象并进行转移,这个过程需要 STW,STW 时间跟 GC Roots 成正比。 并发转移准备 :分析最有回收价值GC分页(无STW) 初始转移应对初始标记的数据 并发转移应对并发标记的数据 除了标记清理过程继承了CMS和G1的思想,ZGC要做了以下优化 并发清理(转移对象) 在 CMS 和 G1 中都用到了写屏障,而 ZGC 用到了读屏障。 写屏障是在对象引用赋值时候的 AOP,而读屏障是在读取引用时的 AOP。 比如 Object a = obj.foo;,这个过程就会触发读屏障。 也正是用了读屏障,ZGC 可以并发转移对象,而 G1 用的是写屏障,所以转移对象时候只能 STW。 简单的说就是 GC 线程转移对象之后,应用线程读取对象时,可以利用读屏障通过指针上的标志来判断对象是否被转移。 读屏障会对应用程序的性能有一定影响,据测试,对性能的最高影响达到 4%,但提高了 GC 并发能力,降低了 STW。这就是上面所说的ZGC“过分”地将部分垃圾回收工作交给用户线程的原因。 染色指针 染色指针其实就是从 64 位的指针中,拿几位来标识对象此时的情况,分别表示 Marked0、Marked1、Remapped、Finalizable。  0-41 这 42 位就是正常的地址,所以说 ZGC 最大支持 4TB (理论上可以16TB)的内存,因为就 42 位用来表示地址 也因此 ZGC 不支持 32 位指针,也不支持指针压缩。 其实对象只需要两个状态Marked,Remapped,对象被标记了,对象被重新映射了,为什么会有M0,M1,用来区分本次GC标记和上次GC标记 以下是标记转移算法说明: 1 在垃圾回收开始前:Remapped 2 标记过程: 标记线程访问 发现对象地址视图是 Remapped 这时候将指针标记为 M0 发现对象地址视图是 M0,则说明这个对象是标记开始之后新分配的或者已经标记过的对象,所以无需处理 应用线程 如果创建新对象,则将其地址视图置为 M0 3 标记阶段结束后 ZGC 会使用一个对象活跃表来存储这些对象地址,此时活跃的对象地址视图是 M0 4 并发转移阶段 转移线程: 转移成功后对象地址视图被置为 Remapped(也就是说 GC 线程如果访问到对象,此时对象地址视图是 M0,并且存在或活跃表中,则将其转移,并将地址视图置为 Remapped ) 如果在活跃表中,但是地址视图已经是 Remapped 说明已经被转移了,不做处理。 应用线程: 如果创建新对象,地址视图会设为 Remapped 5 下次标记使用M1 M1 标识本次垃圾回收中活跃的对象 M0 是上一次回收被标记的对象,但是没有被转移,且在本次回收中也没有被标记活跃的对象。 下图展示了Marked,Remapped的过程, 初始化时A,B,C三个对象处于Remapped状态 第一次GC,A被转移,B未被转移,C无引用将被回收 第二次GC,由于A被转移过了(Remapped状态),所以被标记M1,此时恰好B为不活跃对象,将被清理 第三次GC,A又被标记成M0  多重映射 Marked0、Marked1和Remapped三个视图 ZGC为了能高效、灵活地管理内存,实现了两级内存管理:虚拟内存和物理内存,并且实现了物理内存和虚拟内存的映射关系 在ZGC中这三个空间在同一时间点有且仅有一个空间有效,利用虚拟空间换时间,这三个空间的切换是由垃圾回收的不同阶段触发的,通过限定三个空间在同一时间点有且仅有一个空间有效高效的完成GC过程的并发操作  支持NUMA NUMA是非一致内存访问的缩写 (Non-Uniform Memory Access,NUMA) 早年如下图:SMP架构 (Symmetric Multi-Processor),因为任一个 CPU 对内存的访问速度是一致的,不用考虑不同内存地址之间的差异,所以也称一致内存访问(Uniform Memory Access, UMA )。这个核心越加越多,渐渐的总线和北桥就成为瓶颈,那不能够啊,于是就想了个办法。   把 CPU 和内存集成到一个单元上,这个就是非一致内存访问 (Non-Uniform Memory Access,NUMA)。  ZGC 对 NUMA 的支持是小分区分配时会优先从本地内存分配,如果本地内存不足则从远程内存分配。 ZGC优劣 综上分析,ZGC在战略上沿用了上几代GC的算法策略,采用并发标记,并发清理的思路,在战术上,通过染色指针、多重映射,读屏障等优化达到更理想的并发清理,通过支持NUMA达到了更快的内存操作。但ZGC同样不是银弹,它也有自身的优缺点,如下 优势: 1、一旦某个Region的存活对象被移走之后,这个Region立即就能够被释放和重用掉,而不必等待整个堆中所有指向该Region的引用都被修正后才能清理,这使得理论上只要还有一个空闲Region,ZGC就能完成收集。 2、颜色指针可以大幅减少在垃圾收集过程中内存屏障的使用数量,ZGC只使用了读屏障。 3、颜色指针具备强大的扩展性,它可以作为一种可扩展的存储结构用来记录更多与对象标记、重定位过程相关的数据,以便日后进一步提高性能。 劣势: 1、它能承受的对象分配速率不会太高 ZGC准备要对一个很大的堆做一次完整的并发收集。在这段时间里面,由于应用的对象分配速率很高,将创造大量的新对象,这些新对象很难进入当次收集的标记范围,通常就只能全部当作存活对象来看待——尽管其中绝大部分对象都是朝生夕灭的,这就产生了大量的浮动垃圾。如果这种高速分配持续维持的话,每一次完整的并发收集周期都会很长,回收到的内存空间持续小于期间并发产生的浮动垃圾所占的空间,堆中剩余可腾挪的空间就越来越小了。目前唯一的办法就是尽可能地增加堆容量大小,获得更多喘息的时间。 2、吞吐量低于G1 GC 一般来说,可能会下降5%-15%。对于堆越小,这个效应越明显,堆非常大的时候,比如100G,其他GC可能一次Major或Full GC要几十秒以上,但是对于ZGC不需要那么大暂停。这种细粒度的优化带来的副作用就是,把很多环节其他GC里的STW整体处理,拆碎了,放到了更大时间范围内里去跟业务线程并发执行,甚至会直接让业务线程帮忙做一些GC的操作,从而降低了业务线程的处理能力。 总结 综上,其实ZGC并不是一个凭空冒出的全新垃圾回收,它结合前几代GC的思想,同时在战术上做了优化以达到极限的STW,ZGC的优秀表现有可能会改变未来程序编写方式,站在垃圾收集器的角度,垃圾收集器特别喜欢不可变对象,原有编程方式鉴于内存、GC能力所限使用可变对象来复用对象而不是销毁重建,试想如果有了ZGC的强大回收能力的加持,是不是我们就可以无脑的使用不可变对象进行代码编写 参考: 《深入理解java虚拟机》 《JAVA性能权威指南》 JDK 发展至今的垃圾回收机制 全网最全JDK1~JDK15十一种JVM垃圾收集器的原理总结 为什么CMS需要初始标记? 一步一图带你理清G1垃圾回收流程 美团面试官问我:ZGC 的 Z 是什么意思? ZGC有什么缺点? ZGC 原理是什么,它为什么能做到低延时? 本文档示意图原型:https://www.processon.com/view/link/63771d355653bb3a840c4027

优秀的个人博客,低调大师

每日一博 | 一文带你入门图机器学习

本文主要涉及图机器学习的基础知识。 我们首先学习什么是图,为什么使用图,以及如何最佳地表示图。然后,我们简要介绍大家如何在图数据上学习,从神经网络以前的方法 (同时我们会探索图特征) 到现在广为人知的图神经网络 (Graph Neural Network,GNN)。最后,我们将一窥图数据上的 Transformers 世界。 什么是图? 本质上来讲,图描述了由关系互相链接起来的实体。 现实中有很多图的例子,包括社交网络 (如推特,长毛象,以及任何链接论文和作者的引用网络) 、分子、知识图谱 (如 UML 图,百科全书,以及那些页面之间有超链接的网站) 、被表示成句法树的句子、3D 网格等等。因此,可以毫不夸张地讲,图无处不在。 图 (或网络) 中的实体称为 节点 (或顶点) ,它们之间的连接称为 边 (或链接) 。举个例子,在社交网络中,节点是用户,而边是他 (她) 们之间的连接关系;在分子中,节点是原子,而边是它们之间的分子键。 可以存在不止一种类型的节点或边的图称为 异构图 (heterogeneous graph) (例子:引用网络的节点有论文和作者两种类型,含有多种关系类型的 XML 图的边是多类型的) 。异构图不能仅由其拓扑结构来表征,它需要额外的信息。本文主要讨论同构图 (homogeneous graph) 。 图还可以是 有向 (directed) 的 (如一个关注网络中,A 关注了 B,但 B 可以不关注 A) 或者是 无向 (undirected) 的 (如一个分子中,原子间的关系是双向的) 。边可以连接不同的节点,也可以自己连接自己 (自连边,self-edges) ,但不是所有的节点都必须有连接。 如果你想使用自己的数据,首先你必须考虑如何最佳地刻画它 (同构 / 异构,有向 / 无向等) 。 图有什么用途? 我们一起看看在图上我们可以做哪些任务吧。 在 图层面,主要的任务有: 图生成,可在药物发现任务中用于生成新的可能的药物分子, 图演化 (给定一个图,预测它会如何随时间演化) ,可在物理学中用于预测系统的演化, 图层面预测 (基于图的分类或回归任务) ,如预测分子毒性。 在 节点层面,通常用于预测节点属性。举个例子,Alphafold 使用节点属性预测方法,在给定分子总体图的条件下预测原子的 3D 坐标,并由此预测分子在 3D 空间中如何折叠,这是个比较难的生物化学问题。 在 边层面,我们可以做边属性预测或缺失边预测。边属性预测可用于在给定药物对 (pair) 的条件下预测药物的不良副作用。缺失边预测被用于在推荐系统中预测图中的两个节点是否相关。 另一种可能的工作是在 子图层面 的,可用于社区检测或子图属性预测。社交网络用社区检测确定人们之间如何连接。我们可以在行程系统 (如 Google Maps) 中发现子图属性预测的身影,它被用于预测到达时间。 完成这些任务有两种方式。 当你想要预测特定图的演化时,你工作在 直推 (transductive) 模式,直推模式中所有的训练、验证和推理都是基于同一张图。如果这是你的设置,要多加小心!在同一张图上创建训练 / 评估 / 测试集可不容易。 然而,很多任务其实是工作在不同的图上的 (不同的训练 / 评估 / 测试集划分) ,我们称之为 归纳 (inductive) 模式。 如何表示图? 常用的表示图以用于后续处理和操作的方法有 2 种: 表示成所有边的集合 (很有可能也会加上所有节点的集合用以补充) 。 或表示成所有节点间的邻接矩阵。邻接矩阵是一个 $node_size \times node_size$ 大小的方阵,它指明图上哪些节点间是直接相连的 (若 $n_i$ 和 $n_j$ 相连则 $A_{ij} = 1$,否则为 0) 。 注意:多数图的边连接并不稠密,因此它们的邻接矩阵是稀疏的,这个会让计算变得困难。 虽然这些表示看上去很熟悉,但可别被骗了! 图与机器学习中使用的典型对象大不相同,因为它们的拓扑结构比序列 (如文本或音频) 或有序网格 (如图像和视频) 复杂得多:即使它们可以被表示成链表或者矩阵,但它们并不能被当作有序对象来处理。 这究竟意味着什么呢?如果你有一个句子,你交换了这个句子的词序,你就创造了一个新句子。如果你有一张图像,然后你重排了这个图像的列,你就创造了一张新图像。 但图并不会如此。如果你重排了图的边列表或者邻接矩阵的列,图还是同一个图 (一个更正式的叫法是置换不变性 (permutation invariance) ) 。 基于机器学习的图表示 使用机器学习处理图的一般流程是:首先为你感兴趣的对象 (根据你的任务,可以是节点、边或是全图) 生成一个有意义的表示,然后使用它们训练一个目标任务的预测器。与其他模态数据一样,我们想要对这些对象的数学表示施加一些约束,使得相似的对象在数学上是相近的。然而,这种相似性在图机器学习上很难严格定义,举个例子,具有相同标签的两个节点和具有相同邻居的两个节点哪两个更相似? 注意:在随后的部分,我们将聚焦于如何生成节点的表示。一旦你有了节点层面的表示,就有可能获得边或图层面的信息。你可以通过把边所连接的两个节点的表示串联起来或者做一个点积来得到边层面的信息。至于图层面的信息,可以通过对图上所有节点的表示串联起来的张量做一个全局池化 (平均,求和等) 来获得。当然,这么做会平滑掉或丢失掉整图上的一些信息,使用迭代的分层池化可能更合理,或者增加一个连接到图上所有其他节点的虚拟节点,然后使用它的表示作为整图的表示。 神经网络以前的方法 只使用手工设计特征 在神经网络出现之前,图以及图中的感兴趣项可以被表示成特征的组合,这些特征组合是针对特定任务的。尽管现在存在 更复杂的特征生成方法,这些特征仍然被用于数据增强和 半监督学习。这时,你主要的工作是根据目标任务,找到最佳的用于后续网络训练的特征。 节点层面特征 可以提供关于其重要性 (该节点对于图有多重要?) 以及 / 或结构性 (节点周围的图的形状如何?) 信息,两者可以结合。 节点 中心性 (centrality) 度量图中节点的重要性。它可以递归计算,即不断对每个节点的邻节点的中心性求和直到收敛,也可以通过计算节点间的最短距离来获得,等等。节点的 度 (degree) 度量节点的直接邻居的数量。聚类系数 (clustering coefficient) 度量一个节点的邻节点之间相互连接的程度。图元度向量 (Graphlets degree vectors,GDV) 计算给定根节点的不同图元的数目,这里图元是指给定数目的连通节点可创建的所有迷你图 (如:3 个连通节点可以生成一个有两条边的线,或者一个 3 条边的三角形) 。 边层面特征带来了关于节点间连通性的更多细节信息,有效地补充了图的表示,有:两节点间的 最短距离 (shortest distance),它们的公共邻居 (common neighbours),以及它们的 卡兹指数 (Katz index) (表示两节点间从所有长度小于某个值的路径的数目,它可以由邻接矩阵直接算得) 。 图层面特征 包含了关于图相似性和规格的高层信息。总 图元数 尽管计算上很昂贵,但提供了关于子图形状的信息。核方法 通过不同的 “节点袋 (bag of nodes) ” (类似于词袋 (bag of words) ) 方法度量图之间的相似性。 基于游走的方法 基于游走的方法 使用在随机游走时从节点j访问节点i的可能性来定义相似矩阵;这些方法结合了局部和全局的信息。举个例子,Node2Vec模拟图中节点间的随机游走,把这些游走路径建模成跳字 (skip-gram) ,这与我们处理句子中的词很相似,然后计算嵌入。基于随机游走的方法也可被用于加速 Page Rank方法,帮助计算每个节点的重要性得分 (举个例子:如果重要性得分是基于每个节点与其他节点的连通度的话,我们可以用随机游走访问到每个节点的频率来模拟这个连通度) 。 然而,这些方法也有限制:它们不能得到新的节点的嵌入向量,不能很好地捕获节点间的结构相似性,也使用不了新加入的特征。 图神经网络 神经网络可泛化至未见数据。我们在上文已经提到了一些图表示的约束,那么一个好的神经网络应该有哪些特性呢? 它应该: 满足置换不变性: 等式:,这里 f 是神经网络,P 是置换函数,G 是图。 解释:置换后的图和原图经过同样的神经网络后,其表示应该是相同的。 满足置换等价性 公式:,同样 f 是神经网络,P 是置换函数,G 是图。 解释:先置换图再传给神经网络和对神经网络的输出图表示进行置换是等价的。 典型的神经网络,如循环神经网络 (RNN) 或卷积神经网络 (CNN) 并不是置换不变的。因此,图神经网络 (Graph Neural Network, GNN) 作为新的架构被引入来解决这一问题 (最初是作为状态机使用) 。 一个 GNN 由连续的层组成。一个 GNN 层通过 消息传递 (message passing) 过程把一个节点表示成其邻节点及其自身表示的组合 (聚合 (aggregation)) ,然后通常我们还会使用一个激活函数去增加一些非线性。 与其他模型相比:CNN 可以看作一个邻域 (即滑动窗口) 大小和顺序固定的 GNN,也就是说 CNN 不是置换等价的。一个没有位置嵌入 (positional embedding) 的 Transformer 模型可以被看作一个工作在全连接的输入图上的 GNN。 聚合与消息传递 多种方式可用于聚合邻节点的消息,举例来讲,有求和,取平均等。一些值得关注的工作有: 图卷积网络 对目标节点的所有邻节点的归一化表示取平均来做聚合 (大多数 GNN 其实是 GCN) ; 图注意力网络 会学习如何根据邻节点的重要性不同来加权聚合邻节点 (与 transformer 模型想法相似) ; GraphSAGE 先在不同的跳数上进行邻节点采样,然后基于采样的子图分多步用最大池化 (max pooling) 方法聚合信息; 图同构网络 先计算对邻节点的表示求和,然后再送入一个 MLP 来计算最终的聚合信息。 选择聚合方法:一些聚合技术 (尤其是均值池化和最大池化) 在遇到在邻节点上仅有些微差别的相似节点的情况下可能会失败 (举个例子:采用均值池化,一个节点有 4 个邻节点,分别表示为 1,1,-1,-1,取均值后变成 0;而另一个节点有 3 个邻节点,分别表示为 - 1,0,1,取均值后也是 0。两者就无法区分了。) 。 GNN 的形状和过平滑问题 每加一个新层,节点表示中就会包含越来越多的节点信息。 一个节点,在第一层,只会聚合它的直接邻节点的信息。到第二层,它们仍然只聚合直接邻节点信息,但这次,他们的直接邻节点的表示已经包含了它们各自的邻节点信息 (从第一层获得) 。经过 n 层后,所有节点的表示变成了它们距离为 n 的所有邻节点的聚合。如果全图的直径小于 n 的话,就是聚合了全图的信息! 如果你的网络层数过多,就有每个节点都聚合了全图所有节点信息的风险 (并且所有节点的表示都收敛至相同的值) ,这被称为过平滑问题 (the oversmoothing problem)。 这可以通过如下方式来解决: 在设计 GNN 的层数时,要首先分析图的直径和形状,层数不能过大,以确保每个节点不聚合全图的信息 增加层的复杂性 增加非消息传递层来处理消息 (如简单的 MLP 层) 增加跳跃连接 (skip-connections) 过平滑问题是图机器学习的重要研究领域,因为它阻止了 GNN 的变大,而在其他模态数据上 Transformers 之类的模型已经证明了把模型变大是有很好的效果的。 图 Transformers 没有位置嵌入 (positional encoding) 层的 Transformer 模型是置换不变的,再加上 Transformer 模型已被证明扩展性很好,因此最近大家开始看如何改造 Transformer 使之适应图数据 (综述) 。多数方法聚焦于如何最佳表示图,如找到最好的特征、最好的表示位置信息的方法以及如何改变注意力以适应这一新的数据。 这里我们收集了一些有意思的工作,截至本文写作时为止,这些工作在现有的最难的测试基准之一 斯坦福开放图测试基准 (Open Graph Benchmark, OGB) 上取得了最高水平或接近最高水平的结果: Graph Transformer for Graph-to-Sequence Learning (Cai and Lam, 2020) 介绍了一个图编码器,它把节点表示为它本身的嵌入和位置嵌入的级联,节点间关系表示为它们间的最短路径,然后用一个关系增强的自注意力机制把两者结合起来。 Rethinking Graph Transformers with Spectral Attention (Kreuzer et al, 2021) 介绍了谱注意力网络 (Spectral Attention Networks, SANs) 。它把节点特征和学习到的位置编码 (从拉普拉斯特征值和特征向量中计算得到) 结合起来,把这些作为注意力的键 (keys) 和查询 (queries) ,然后把边特征作为注意力的值 (values) 。 GRPE: Relative Positional Encoding for Graph Transformer (Park et al, 2021) 介绍了图相对位置编码 Transformer。它先在图层面的位置编码中结合节点信息,在边层面的位置编码中也结合节点信息,然后在注意力机制中进一步把两者结合起来。 Global Self-Attention as a Replacement for Graph Convolution (Hussain et al, 2021) 介绍了边增强 Transformer。该架构分别对节点和边进行嵌入,并通过一个修改过的注意力机制聚合它们。 Do Transformers Really Perform Badly for Graph Representation (Ying et al, 2021) 介绍了微软的 Graphormer, 该模型在面世时赢得了 OGB 第一名。这个架构使用节点特征作为注意力的查询 / 键 / 值 (Q/K/V) ,然后在注意力机制中把这些表示与中心性,空间和边编码信息通过求和的方式结合起来。 最新的工作是 Pure Transformers are Powerful Graph Learners (Kim et al, 2022),它引入了 TokenGT。这一方法把输入图表示为一个节点和边嵌入的序列 (并用正交节点标识 (orthonormal node identifiers) 和可训练的类型标识 (type identifiers) 增强它) ,而不使用位置嵌入,最后把这个序列输入给 Tranformer 模型。超级简单,但很聪明! 稍有不同的是,Recipe for a General, Powerful, Scalable Graph Transformer (Rampášek et al, 2022) 引入的不是某个模型,而是一个框架,称为 GraphGPS。它允许把消息传递网络和线性 (长程的) transformer 模型结合起来轻松地创建一个混合网络。这个框架还包含了不少工具,用于计算位置编码和结构编码 (节点、图、边层面的) 、特征增强、随机游走等等。 在图数据上使用 transformer 模型还是一个非常初生的领域,但是它看上去很有前途,因为它可以减轻 GNN 的一些限制,如扩展到更大 / 更稠密的图,抑或是增加模型尺寸而不必担心过平滑问题。 更进阶的资源 如果你想钻研得更深入,可以看看这些课程: 学院课程形式 斯坦福大学图机器学习 麦吉尔大学图表示学习 视频形式 几何深度学习课程 相关书籍 图表示学习*,汉密尔顿著 不错的处理图数据的库有 PyGeometric (用于图机器学习) 以及 NetworkX (用于更通用的图操作)。 如果你需要质量好的测试基准,你可以试试看: OGB, 开放图测试基准 (the Open Graph Benchmark) :一个可用于不同的任务和数据规模的参考图测试基准数据集。 Benchmarking GNNs: 用于测试图机器学习网络和他们的表现力的库以及数据集。相关论文特地从统计角度研究了哪些数据集是相关的,它们可被用于评估图的哪些特性,以及哪些图不应该再被用作测试基准。 长程图测试基准 (Long Range Graph Benchmark): 最新的 (2022 年 10 月份) 测试基准,主要关注长程的图信息。 Taxonomy of Benchmarks in Graph Representation Learning: 发表于 2022 年 Learning on Graphs 会议,分析并对现有的测试基准数据集进行了排序。 如果想要更多的数据集,可以看看: Paper with code 图任务排行榜: 公开数据集和测试基准的排行榜,请注意,不是所有本排行榜上的测试基准都仍然适宜。 TU 数据集: 公开可用的数据集的合辑,现在以类别和特征排序。大多数数据集可以用 PyG 加载,而且其中一些已经被集成进 PyG 的 Datsets。 SNAP 数据集 (Stanford Large Network Dataset Collection): MoleculeNet 数据集 关系数据集仓库 外部图像来源 缩略图中的 Emoji 表情来自于 Openmoji (CC-BY-SA 4.0),图元的图片来自于 Biological network comparison using graphlet degree distribution (Pržulj, 2007)。 英文原文: https://huggingface.co/blog/intro-graphml 译者: Matrix Yao (姚伟峰)

优秀的个人博客,低调大师

每日一博 | 委派模式 —— 从 SLF4J 说起

作者:vivo 互联网服务器团队- Xiong yangxin 将某个通用解决方案包装成成熟的工具包,是每一个技术建设工作者必须思考且必须解决的问题。本文从业内流行的既有工具包入手,解析实现思路,沉淀一般方法。为技术建设的初学者提供一些实践思路的参考。尤其是文中提倡的“去中心化”的协作模式,和“关键链路+开发接口”的开发模式,具有一定的实际落地意义。当然本文在行文中,不可避免存在一定主观偏见性,读者可酌情阅读。 一、前言 熟悉JAVA服务器开发的同学应该都使用过日志模块,并且大概率使用过"log4j-over-slf4j"和“slf4j-log4j”这两个包。那么这两个包的区别是什么?为什么会互相引用包含呢?这篇文章会解释下这几个概念的区别。 首先说一下SLF4J。 二、从SLF4J开始 SLF4J全称"Simple Logging Facade for Java (SLF4J)", 它诞生之初的目的,是为了针对不同的log解决方案,提供一套统一的接口适配标准,从而让业务代码无须关心使用到的第三方模块都使用了哪些log方案。 举个例子, Apache Dubbo和RabbitMQ使用到的日志模块便不相同。从某种意义上而言,SLF4J只是一个facade,类似于当年的ODBC(针对不同的数据库厂商而制定的统一接口标准, 下文会涉及到)。而这个facade对应的包名,是 “slf4j-api-xxx.xxx.xxx.jar”。所以,当你应用了"slf4j-api-xxx.jar"的包时,其实只是引入了一个日志接口标准,而并没有引入日志具体实现。 2.1、业内实现 SLF4J标准在应用层的核心类,就是两个: org.slf4j.Logger 和 org.slf4j.LoggerFactory。其中,自版本1.6.0后,如果并没有具体的实现,slf4j-api会默认提供一个啥也不干的Logger实现(org.slf4j.helpers.NOPLogger)。 在当前(本稿件于2022-03-01拟制)的市面上,既有的实现SLF4J的方案有以下几种: 整体层次如下图: 综上而言:以SLF4J-开头的jar包,一般指的是采用某种第三方框架实现的slf4j解决方案。 2.2 工作机制 那么整个SLF4J的工作机制是如何运作的呢,换句话说,系统是如何知道应该使用哪个实现方案的呢? 对于那种不需要适配器的原生实现方式,直接引入对应的包即可。 对于那种需要适配器的委托式实现方式,则需要通过另外的一个渠道来告知SLF4J应该使用哪个实现类: SPI机制。 举个例子,我们看一下slf4j-log4j的包结构: 我们先看pom文件,就包含两个依赖: <dependency><groupId>org.slf4j</groupId><artifactId>slf4j-api</artifactId></dependency><dependency><groupId>log4j</groupId><artifactId>log4j</artifactId></dependency> slf4j-log4j同时引入了slf4j-api和log4j。那么slf4j-log4j本身的作用不言而喻:使用LOG4J的功能,实现SLF4J的接口标准。 整体的接口/类关系路径如下图: 但是这仍然没有解决本章节开始提出的问题(程序怎么知道应该用哪个Logger)。 可以从源码入手:(slf4j/slf4j-log4j12 at master · qos-ch/slf4j · GitHub),我们看到了以下关键的文件: 也就是说:slf4j-log4j使用了java的SPI机制告知JVM在运行时调用具体哪一个实现类。由于SPI机制暂不属于本文章讨论范围,读者可以去官网获取信息。 读者可以去GitHub - qos-ch/slf4j: Simple Logging Facade for Java看其他的实现方式的适配器是如何工作的。 那么本章开始的问题答案便是: SLF4J制定一套日志打印流程,然后把核心类抽象出接口给外部去实现; 适配器使用第三方日志组件实现了这些核心类接口,并采用SPI机制,让JAVA运行时意识到核心接口的具体实现类。 而上述两点,构成了本文接下来要讲述的知识点:委派模式。 三、委派模式 从上文中,我们从SLF4J的案例,引出了"委派模式"这个概念,下面我们就重点讨论委派模式(delegation)。 接下来我们按照认知流程,依次从三个问题,解释委派模式: 为什么使用委派模式 什么是委派模式 如何使用委派模式 然后会在下一章,用业内的典型案例,分析委派模式的使用情况。 3.1 为什么采用委派模式? 我们回到SLF4J。为什么它会用委派模式呢?因为日志打印功能存在各种不同的实现方式。对于应用开发者而言,最好需要一个标准的打印流程,其他第三方组件可以在某些地方有些不同,但是核心流程是最好不要变。对于标准制定者 而言,他无法控制每一个第三方组件的所有细节,所以只能暴露出有限的自定制能力。 而我们放大到软件领域,或者在互联网开发领域,不同的开发者的协作模式,主要靠jar包应用:第三方开发一个工具包,放在中心仓库中(maven, gradle), 使用者从其他信息渠道(csdn, stackoverflow等等)根据问题定位到这个jar包,然后在代码工程中引用。理论上,如果这个第三方jar包很稳定(例如c3p0),那么该jar包的维护者就很少甚至几乎不会和使用者建立联系。如果某些中间件开发者觉得不满足自己公司/部门的需求,会根据该jar包再做一次自定义封装。 纵观上述整个过程,不难发现两点: 工具包开发者和使用者没有建立稳定的协同渠道 工具包开发者对自己成品的发展掌控很薄弱 那么如果有人想要建立一套标准呢?比如log标准,比如数据库连接标准,那么只能有几个大公司联盟,或者著名的开发团队联盟,制定一个标准,并实现其中核心链路部分。至于为什么不实现全部链路,原因也很简单:软件领域的协同本身就是弱中心化的 ,否则你不带别人玩,别人也不会采用你的标准(参考当年IBM推广的COBOL)。 综上而言:委派模式是基于当前软件领域的协作特性,采取的较好的软件结构模式。 所以啥时候采用委派模式呢? 存在设定某个标准并由中心化团队负责的必要 使用者有强烈的需求自定制某些局部实现 这里就举一个硬件领域的反例:快充标准。在2018年甚至更早,消费者就需要一个快充的功能。但是快充需要定制很多硬件才能实现,所以此时就具备了条件一,但是当时并没有任何一个团队或者公司能够掌控安卓手机硬件整个生态,无法共同推出一个中心化团队去负责,从而导致各个手机厂商的快充功能百花齐放:A公司的快充线,无法给B公司的手机快充。 3.2 什么是委派模式? 基于上述的讨论,委派模式的核心构成就显而易见了:核心链路,开放接口。 核心链路指的是:为了达到某个目的,特定的一组构件,按照特定的顺序,特定的协同标准,共同执行计算的逻辑。 开放接口指的是:给定特定的输入和输出,将实现细节交给外部的功能接口。 举个比较现实的例子:传统汽车。 几乎每一辆传统汽车,都按照三大件进行集成和协作:发动机,变速器,底盘。发动机做功, 通过变速器将动力传输给底盘(这么说并不标准,甚至在汽车工业的工人眼中,这种描述几乎是谬论,但是大致是这样)。也基于此,发动机的接口, 变速箱的接口,底盘的接口都已经固定,剩下的就各个厂商去实现了:三菱的发动机, 日产的发动机,爱信的变速箱,采埃孚的变速箱,伦福德的底盘,天合的底盘等等。甚至连轮胎的接口都制定好了:大陆的轮胎,普利司通的轮胎,固特异的轮胎。 不同的汽车厂商,选择不同公司的组件,集成出某个汽车型号。当然也有公司自己去实现某个标准:比如大众自己生产EA888发动机,PSA自己生产并调教的底盘并引以为傲。 如果大家觉得不够熟悉,那么可以举一个tomcat的例子。 经历过00年代的软件开发者,应该知道当时开发一个web应用是多么的困难:如何监听socket, 如何编码解码,如何处理并发,如何管理进程等等。但是有一点是共通的:每一个Web开发者都想要一个框架去管理整个http服务的协议层和内核层。于是出现了JBoss, WebSphere, Tomcat(笑到了最后)。 这些产品,都是指定了核心的链路:监听socket → 读数据包→ 封装成http报文→ 派发给处理池子→ 处理池的线程调用处理逻辑去处理→ 编码返回的报文→ 编组成tcp包→ 调用内核函数→ 发出数据。 基于这个核心链路,制定标准:业务处理逻辑的输入是什么,输出是什么,如何让web框架识别到业务处理模块。 Tomcat的方案就是web.xml。开发者只要遵从web.xml标准去实现servlet即可。也就是说,在整个http服务器链路中,Tomcat将特定的几个流程处理构件(listener, filter, interceptor, servlet)委派给了业务开发者去实现。 3.3 如何使用委派模式 在使用委派模式之前,先根据上文的模式匹配条件进行自我判断: 存在设定某个标准并由中心化团队负责的必要 使用者有强烈的需求自定制某些局部实现 如果并不符合条件一,那么就不需要考虑使用委派模式;如果符合条件一但是不符合条件二,那就先预留好接口,采用依赖注入的方式,自己开发接口实现类并注入到主流程中。这个做法在很多的第三方依赖包中能够看到,比如spring的BeanFactory, BeanAware等等,还有各个公司开发SSO时预留的一些hook和filter等等。 在确定使用委派模式后,第一件事就是“确定核心链路”,这一步最难,因为往往使用者都有某种期望,但是让他们具体描述出来,却又经常不够精准,甚至有时候后主次颠倒。笔者的建议是:直接让他们说出原始的需求/痛点,然后自己尝试给出方案,再对比他们的方案,进行沟通,并逐渐将两个方案统一。统一的过程也就是不断试探和确定的过程。 上述的过程是笔者自己的经验,仅当借鉴。 在确定核心流程后,再将流程中的一些需要自定制的功能抽象成接口暴露出去。接口的定义中,尽量减少对整个流程中其他类的调用依赖。 所以整体的流程分为三步:确认使用该模式;提取核心流程;抽象开放接口。 至于是采用SPI机制还是像TOMCAT一样使用XML配置识别,需要看具体情况,在此不做涉及。 四、 业内案例 4.1 JDBC JDBC的诞生很大程度上是借鉴了ODBC的思想,为JAVA设计了专用的数据库连接规范JDBC(JAVA Database Connectivity)。JDBC期望的目标是让Java开发人员在编写数据库应用程序时,可以有统一的接口,无须依赖特定数据库API,达到“ 一次开发,适用所有数据库”。虽然实际开发中,经常会因为使用了数据库特定的语法、数据类型或函数等而无法达到目标,但JDBC的标准还是大大简化了开发工作。 整体而言,JDBC的接入结构大致如下图: 但是实际上,在JDBC诞生之初,市面上并未有很多的厂家响应SUN公司(那时候SUN还并未被ORACLE收购), 于是SUN公司就使用了本文介绍的桥接模式,如下图: 也是说,形式上,出现了初步委派的结构形式。 下文会只针对单次委托的JDBC层级做分析。 按照上文所言,每一个委派结构,必然存在两个要素:核心路径和开放接口。我们从这两个维度开始分析JDBC。 JDBC的核心路径分为六步, 包含委托机制需要的两步(引入包,声明委托承接人),总共八步,如下: 引入JDBC实现包 注册JDBC Driver 和数据库建立连接 发起transaction(必要的话),创建statement 执行statement并读取返回,塞入ResultSet 处理ResultSet 关闭ResultSet, 关闭Statement 关闭Connection 纵观整个过程,核心的参与者为:Driver, Connection, Statement, ResultSet。transaction实际上是基于Connection的三个方法(setAutoCommit, commit, rollback)包装而成的会话层,理论上不属于标准层。 以mysql-connector-java为例,具体实现JDBC接口的情况如下: 通过Java自带的overriding机制,只要使用com.mysql.jdbc.Driver,那么其他组件的实现类便直接被应用实现。具体细节不做讨论。那么mysql-connector-java是如何告知JVM应该使用com.mysql.jdbc.Driver呢? 两种模式 明文模式——在业务代码中明文使用Class.forName("com.mysql.jdbc.Driver") SPA机制 其实上述的两种方法,核心就是初始化com.mysql.jdbc.Driver,执行以下类初始化逻辑。 try { DriverManager.registerDriver(new Driver());} catch (SQLException var1) { throw new RuntimeException("Can't register driver!");} 也就是说,JDBC通过DriveManager维护委托承接者的信息。读者如果有兴趣查看DriverManager的源码,会发现JDBC的另一种实现类发现方式。不过考虑行文长度,笔者在此不表。 4.2 Apach Dubbo Dubbo的核心路径大致如下(不考虑服务管理那一套): consumer调用→参数序列化→ 网络请求→接收请求→ 参数反序列化→ provider计算并返回→结果序列化→ 网络返回→consumer方接收→ 结果反序列化 (斜体代表consumer方的dubbo职责,下划线代表provider方的dubbo职责) Dubbo的可定制接口有很多,整体大量采用了“类SPI”机制,为整个RPC流程的很多环节,提供了自定制的注入机制。相较于传统的Java SPI, Dubbo SPI在封装性和实现类发现性上做了很多的扩展和自定制。 Dubbo SPI整体实现机制及工作机制不在本文范围,但为了行文方便,在此做一些必要说明。整体的Dubbo SPI机制可以分为三部分: @SPI注解——声明当前接口类为可扩展接口。 @Adaptive注解——声明当前接口类(或者当前接口类的当前方法)能根据特定条件(注解中的value),动态调用具体实现类实现方法。 @Activate注解——声明当前类/方法实现了某个可扩展接口(或者可扩展接口的某个具体方法的实现),并注明被激活的条件,以及所有的被激活实现类中的排序信息。 我们以Dubbo-Auth (dubbo/dubbo-plugin/dubbo-auth at 3.0 · apache/dubbo · GitHub)为例,从核心路径和开放接口两个维度进行分析。 Dubbo-Auth的实现逻辑,是基于Dubbo-filter的原理,也就是说:Dubbo-Auth本身就是Dubbo整体流程中的某一个环节的委派实现方。 Dubbo-Auth的核心入口(也就是核心路径的起始点), 是ProviderAuthFilter, 是org.apache.dubbo.auth.filter的具体实现, 也就是说: org.apache.dubbo.auth.filter是dubbo核心链路中对外暴露的一个开发接口(类定义上标注了@SPI)。 ProviderAuthFilter是实现了dubbo核心链路中对外暴露的开发接口Filter(ProviderAuthFilter实现类定义上标注了@Activate)。 ProviderAuthFilter的核心路径比较简单:获取Authenticator对象,使用Authenticator对象进行auth验证。 具体代码如下: @Activate(group = CommonConstants.PROVIDER, order = -10000)public class ProviderAuthFilter implements Filter { @Override public Result invoke(Invoker<?> invoker, Invocation invocation) throws RpcException { URL url = invoker.getUrl(); boolean shouldAuth = url.getParameter(Constants.SERVICE_AUTH, false); if (shouldAuth) { Authenticator authenticator = ExtensionLoader.getExtensionLoader(Authenticator.class) .getExtension(url.getParameter(Constants.AUTHENTICATOR, Constants.DEFAULT_AUTHENTICATOR)); try { authenticator.authenticate(invocation, url); } catch (Exception e) { return AsyncRpcResult.newDefaultAsyncResult(e, invocation); } } return invoker.invoke(invocation); }} 注意,上文代码中 url.getParameter(Constants.AUTHENTICATOR, Constants.DEFAULT_AUTHENTICATOR) 是dubbo spi 的Adaptive机制中的选择条件,读者可以深究,本文在此略过。 由于核心路径包含了Authenticator ,那么Authenticator 自然就很可能是对外暴露的开发接口了。也就是说,Authenticator 的声明类中,必然是注解了@SPI。 @SPI("accessKey")public interface Authenticator { /** * give a sign to request * * @param invocation * @param url */ void sign(Invocation invocation, URL url); /** * verify the signature of the request is valid or not * @param invocation * @param url * @throws RpcAuthenticationException when failed to authenticate current invocation */ void authenticate(Invocation invocation, URL url) throws RpcAuthenticationException;} 上述代码证明了笔者的猜想。 在Dubbo-Auth中,提供了一个默认的Authenticator :AccessKeyAuthenticator。在这个实现类中,核心路径被再次具体化: 获取accessKeyPai; 使用accessKeyPair, 计算签名; 对比请求中的签名和计算的签名是否相同。 在此核心路径中,由于引入了accessKeyPair概念,于是就引出一个环节:如何获取accessKeyPair, 针对此, dubbo-auth又定义了一个开放接口:AccessKeyStorage。 @SPIpublic interface AccessKeyStorage { /** * get AccessKeyPair of this request * * @param url * @param invocation * @return */ AccessKeyPair getAccessKey(URL url, Invocation invocation);} 4.3 LOG4J 最后一个案例,我们又回到了日志组件,而之所以介绍LOG4J, 是由于它使用了非常规的“反向委派”机制。 LOG4J借鉴了SLF4J的思想(或者LOG4J在前?SLF4J借鉴的LOG4J ?), 也采用了 接口标准+ 适配器+第三方方案的思路来实现委派。 那么显然,这里就有个问题:SLF4J确认了自己的核心路径,然后暴露出待实现接口,SLF4J-LOG4J在尝试实现SLF4J的待实现接口时,又使用了委托机制,把相关的路径细节外包了出去,从而形成了一个环。 所以说,如果我同时引入了"log4j-over-slf4j"和"slf4j-log4j",会造成stackoverflow。 这个问题非常典型, google一下就可能看到很多的案例,比如Analysis of stack overflow exception of log4j-over-slf4j and slf4j-log4j12 coexistence - actorsfit等等, 官方也给出了警告(SLF4J Error Codes)。 由于此文的关注点在委派模式,所以关于此问题并不详细讨论。而此案例的重点,是说明了一件事:委派模式的缺点,就是对于开放接口的实现逻辑不可控。如果第三方实现存在重大机制性隐患,会导致整体核心流程出现问题。 五、总结 综上所述, 委派模式的使用场景是: 存在设定某个标准并由中心化团队负责的必要; 使用者有强烈的需求自定制某些局部实现。 委派模式的核心点: 核心路径, 开放接口。 委派模式的隐藏机制:实现方式的注册/发现。 参考资料: SLF4J Manual Using log4j2 with slf4j: java.lang.StackOverflowError - Stack Overflow The Extension Mechanism > Creating and Using Extensions) (oracle.com)" linktype="text" imgurl="" tab="outerlink" data-linktype="2">Creating Extensible Applications (The Java™ Tutorials > The Extension Mechanism > Creating and Using Extensions) (oracle.com) slf4j/slf4j-log4j12 at master · qos-ch/slf4j · GitHub Delegation pattern - Wikipedia What is a JDBC driver? - IBM Documentation JDBC Database Access) (oracle.com)" linktype="text" imgurl="" tab="outerlink" data-linktype="2">Lesson: JDBC Basics (The Java™ Tutorials > JDBC Database Access) (oracle.com) GitHub - apache/dubbo: Apache Dubbo is a high-performance, java based, open source RPC framework. END 猜你喜欢 vivo 故障定位平台的探索与实践 源码级深度理解 Java SPI 规则引擎Drools在贷后催收业务中的应用 本文分享自微信公众号 - vivo互联网技术(vivoVMIC)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | 跳跃表数据结构与算法分析

作者:京东物流 纪卓志 目前市面上充斥着大量关于跳跃表结构与Redis的源码解析,但是经过长期观察后发现大都只是在停留在代码的表面,而没有系统性地介绍跳跃表的由来以及各种常量的由来。作为一种概率数据结构,理解各种常量的由来可以更好地进行变化并应用到高性能功能开发中。本文没有重复地以对现有优秀实现进行代码分析,而是通过对跳跃表进行了系统性地介绍与形式化分析,并给出了在特定场景下的跳跃表扩展方式,方便读者更好地理解跳跃表数据结构。 跳跃表[1,2,3]是一种用于在大多数应用程序中取代平衡树的概率数据结构。跳跃表拥有与平衡树相同的期望时间上界,并且更简单、更快、是用更少的空间。在查找与列表的线性操作上,比平衡树更快,并且更简单。 概率平衡也可以被用在基于树的数据结构[4]上,例如树堆(Treap)。与平衡二叉树相同,跳跃表也实现了以下两种操作 通过搜索引用[5],可以保证从任意元素开始,搜索到在列表中间隔为k的元素的任意期望时间是O(logk) 实现线性表的常规操作(例如_将元素插入到列表第k个元素后面_) 这几种操作在平衡树中也可以实现,但是在跳跃表中实现起来更简单而且非常的快,并且通常情况下很难在平衡树中直接实现(树的线索化可以实现与链表相同的效果,但是这使得实现变得更加复杂[6]) 预览 最简单的支持查找的数据结构可能就是链表。Figure.1是一个简单的链表。在链表中执行一次查找的时间正比于必须考查的节点个数,这个个数最多是N。 Figure.1 Linked List Figure.2表示一个链表,在该链表中,每个一个节点就有一个附加的指针指向它在表中的前两个位置上的节点。正因为这个前向指针,在最坏情况下最多考查⌈N/2⌉+1个节点。 Figure.2 Linked List with fingers to the 2nd forward elements Figure.3将这种想法扩展,每个序数是4的倍数的节点都有一个指针指向下一个序数为4的倍数的节点。只有⌈N/4⌉+2个节点被考查。 Figure.3 Linked List with fingers to the 4th forward elements 这种跳跃幅度的一般情况如Figure.4所示。每个2i节点就有一个指针指向下一个2i节点,前向指针的间隔最大为N/2。可以证明总的指针最大不会超过2N(见空间复杂度分析),但现在在一次查找中最多考查⌈logN⌉个节点。这意味着一次查找中总的时间消耗为O(logN),也就是说在这种数据结构中的查找基本等同于二分查找(binary search)。 Figure.4 Linked List with fingers to the 2ith forward elements 在这种数据结构中,每个元素都由一个节点表示。每个节点都有一个高度(height)或级别(level),表示节点所拥有的前向指针数量。每个节点的第i个前向指针指向下一个级别为i或更高的节点。 在前面描述的数据结构中,每个节点的级别都是与元素数量有关的,当插入或删除时需要对数据结构进行调整来满足这样的约束,这是很呆板且低效的。为此,可以_将每个2i节点就有一个指针指向下一个2i节点_的限制去掉,当新元素插入时为每个新节点分配一个随机的级别而不用考虑数据结构的元素数量。 Figure.5 Skip List 数据结构 到此为止,已经得到了所有让链表支持快速查找的充要条件,而这种形式的数据结构就是跳跃表。接下来将会使用更正规的方式来定义跳跃表 所有元素在跳跃表中都是由一个节点表示。 每个节点都有一个高度或级别,有时候也可以称之为阶(step),节点的级别是一个与元素总数无关的随机数。规定NULL的级别是∞。 每个级别为k的节点都有k个前向指针,且第i个前向指针指向下一个级别为i或更高的节点。 每个节点的级别都不会超过一个明确的常量MaxLevel。整个跳跃表的级别是所有节点的级别的最高值。如果跳跃表是空的,那么跳跃表的级别就是1。 存在一个头节点head,它的级别是MaxLevel,所有高于跳跃表的级别的前向指针都指向NULL。 稍后将会提到,节点的查找过程是在头节点从最高级别的指针开始,沿着这个级别一直走,直到找到大于正在寻找的节点的下一个节点(或者是NULL),在此过程中除了头节点外并没有使用到每个节点的级别,因此每个节点无需存储节点的级别。 在跳跃表中,级别为1的前向指针与原始的链表结构中next指针的作用完全相同,因此跳跃表支持所有链表支持的算法。 对应到高级语言中的结构定义如下所示(后续所有代码示例都将使用C语言描述) #define SKIP_LIST_KEY_TYPE int #define SKIP_LIST_VALUE_TYPE int #define SKIP_LIST_MAX_LEVEL 32 #define SKIP_LIST_P 0.5 struct Node { SKIP_LIST_KEY_TYPE key; SKIP_LIST_VALUE_TYPE value; struct Node *forwards[]; // flexible array member }; struct SkipList { struct Node *head; int level; }; struct Node *CreateNode(int level) { struct Node *node; assert(level > 0); node = malloc(sizeof(struct Node) + sizeof(struct Node *) * level); return node; } struct SkipList *CreateSkipList() { struct SkipList *list; struct Node *head; int i; list = malloc(sizeof(struct SkipList)); head = CreateNode(SKIP_LIST_MAX_LEVEL); for (i = 0; i < SKIP_LIST_MAX_LEVEL; i++) { head->forwards[i] = NULL; } list->head = head; list->level = 1; return list; } 从前面的预览章节中,不难看出MaxLevel的选值影响着跳跃表的查询性能,关于MaxLevel的选值将会在后续章节中进行介绍。在此先将MaxLevel定义为32,这对于232个元素的跳跃表是足够的。延续预览章节中的描述,跳跃表的概率被定义为0.5,关于这个值的选取问题将会在后续章节中进行详细介绍。 算法 搜索 在跳跃表中进行搜索的过程,是通过Z字形遍历所有没有超过要寻找的目标元素的前向指针来完成的。在当前级别没有可以移动的前向指针时,将会移动到下一级别进行搜索。直到在级别为1的时候且没有可以移动的前向指针时停止搜索,此时直接指向的节点(级别为1的前向指针)就是包含目标元素的节点(如果目标元素在列表中的话)。在Figure.6中展示了在跳跃表中搜索元素17的过程。 Figure.6 A search path to find element 17 in Skip List 整个过程的示例代码如下所示,因为高级语言中的数组下标从0开始,因此forwards[0]表示节点的级别为1的前向指针,依此类推 struct Node *SkipListSearch(struct SkipList *list, SKIP_LIST_KEY_TYPE target) { struct Node *current; int i; current = list->head; for (i = list->level - 1; i >= 0; i--) { while (current->forwards[i] && current->forwards[i]->key < target) { current = current->forwards[i]; } } current = current->forwards[0]; if (current->key == target) { return current; } else { return NULL; } } 插入和删除 在插入和删除节点的过程中,需要执行和搜索相同的逻辑。在搜索的基础上,需要维护一个名为update的向量,它维护的是搜索过程中跳跃表每个级别上遍历到的最右侧的值,表示插入或删除的节点的左侧直接直接指向它的节点,用于在插入或删除后调整节点所在所有级别的前向指针(与朴素的链表节点插入或删除的过程相同)。 当新插入节点的级别超过当前跳跃表的级别时,需要增加跳跃表的级别并将update向量中对应级别的节点修改为head节点。 Figure.7和Figure.8展示了在跳跃表中插入元素16的过程。首先,在Figure.7中执行与搜索相同的查询过程,在每个级别遍历到的最后一个元素在对应层级的前向指针被标记为灰色,表示稍后将会对齐进行调整。接下来在Figure.8中,在元素为13的节点后插入元素16,元素16对应的节点的级别是5,这比跳跃表当前级别要高,因此需要增加跳跃表的级别到5,并将head节点对应级别的前向指针标记为灰色。Figure.8中所有虚线部分都表示调整后的效果。 Figure.7 Search path for inserting element 16 Figure.8 Insert element 16 and adjust forward pointers struct Node *SkipListInsert(struct SkipList *list, SKIP_LIST_KEY_TYPE key, SKIP_LIST_VALUE_TYPE value) { struct Node *update[SKIP_LIST_MAX_LEVEL]; struct Node *current; int i; int level; current = list->head; for (i = list->level - 1; i >= 0; i--) { while (current->forwards[i] && current->forwards[i]->key < target) { current = current->forwards[i]; } update[i] = current; } current = current->forwards[0]; if (current->key == target) { current->value = value; return current; } level = SkipListRandomLevel(); if (level > list->level) { for (i = list->level; i < level; i++) { update[i] = list->header; } } current = CreateNode(level); current->key = key; current->value = value; for (i = 0; i < level; i++) { current->forwards[i] = update[i]->forwards[i]; update[i]->forwards[i] = current; } return current; } 在删除节点后,如果删除的节点是跳跃表中级别最大的节点,那么需要降低跳跃表的级别。 Figure.9和Figure.10展示了在跳跃表中删除元素19的过程。首先,在Figure.9中执行与搜索相同的查询过程,在每个级别遍历到的最后一个元素在对应层级的前向指针被标记为灰色,表示稍后将会对齐进行调整。接下来在Figure.10中,首先通过调整前向指针将元素19对应的节点从跳跃表中卸载,因为元素19对应的节点是级别最高的节点,因此将其从跳跃表中移除后需要调整跳跃表的级别。Figure.10中所有虚线部分都表示调整后的效果。 Figure.9 Search path for deleting element 19 Figure.10 Delete element 19 and adjust forward pointers struct Node *SkipListDelete(struct SkipList *list, SKIP_LIST_KEY_TYPE key) { struct Node *update[SKIP_LIST_MAX_LEVEL]; struct Node *current; int i; current = list->head; for (i = list->level - 1; i >= 0; i--) { while (current->forwards[i] && current->forwards[i]->key < key) { current = current->forwards[i]; } update[i] = current; } current = current->forwards[0]; if (current && current->key == key) { for (i = 0; i < list->level; i++) { if (update[i]->forwards[i] == current) { update[i]->forwards[i] = current->forwards[i]; } else { break; } } while (list->level > 1 && list->head->forwards[list->level - 1] == NULL) { list->level--; } } return current; } 生成随机级别 int SkipListRandomLevel() { int level; level = 1; while (random() < RAND_MAX * SKIP_LIST_P && level <= SKIP_LIST_MAX_LEVEL) { level++; } return level; } 以下表格为按上面算法执行232次后,所生成的随机级别的分布情况。 1 2 3 4 5 6 7 8 2147540777 1073690199 536842769 268443025 134218607 67116853 33563644 16774262 9 10 11 12 13 14 15 16 8387857 4193114 2098160 1049903 523316 262056 131455 65943 17 18 19 20 21 22 23 24 32611 16396 8227 4053 2046 1036 492 249 25 26 27 28 29 30 31 32 121 55 34 16 7 9 2 1 MaxLevel的选择 在Figure.4中曾给出过对于10个元素的跳跃表最理想的分布情况,其中5个节点的级别是1,3个节点的级别是2,1个节点的级别是3,1个节点的级别是4。 这引申出一个问题:既然相同元素数量下,跳跃表的级别不同会有不同的性能,那么跳跃表的级别为多少才合适? 分析 空间复杂度分析 前面提到过,分数p代表节点同时带有第i层前向指针和第i+1层前向指针的概率,而每个节点的级别最少是1,因此级别为i的前向指针数为npi−1。定义S(n)表示所有前向指针的总量,由等比数列求和公式可得 对S(n)求极限,有 易证,这是一个关于p的单调递增函数,因此p的值越大,跳跃表中前向指针的总数越多。因为1−p是已知的常数,所以说跳跃表的空间复杂度是O(n)。 时间复杂度分析 非形式化分析 形式化分析 延续_分数p代表节点同时带有第i层前向指针和第i+1层前向指针的概率_的定义,考虑反方向分析搜索路径。 搜索的路径总是小于必须执行的比较的次数的。首先需要考查从级别1(在搜索到元素前遍历的最后一个节点)爬升到级别L(n)所需要反向跟踪的指针数量。虽然在搜索时可以确定每个节点的级别都是已知且确定的,在这里仍认为只有当整个搜索路径都被反向追踪后才能被确定,并且在爬升到级别L(n)之前都不会接触到head节点。 在爬升过程中任何特定的点,都认为是在元素x的第i个前向指针,并且不知道元素x左侧所有元素的级别或元素x的级别,但是可以知道元素x的级别至少是i。元素x的级别大于i的概率是p,可以通过考虑视认为这个反向爬升的过程是一系列由成功的爬升到更高级别或失败地向左移动的随机独立实验。 在爬升到级别L(n)过程中,向左移动的次数等于在连续随机试验中第L(n)−1次成功前的失败的次数,这符合负二项分布。期望的向上移动次数一定是L(n)−1。因此可以得到无限列表中爬升到L(n)的代价C C=prob(L(n)−1)+NB(L(n)−1,p) 列表长度无限大是一个悲观的假设。当反向爬升的过程中接触到head节点时,可以直接向上爬升而不需要任何向左移动。因此可以得到n个元素列表中爬升到L(n)的代价C(n) C(n)≤probC=prob(L(n)−1)+NB(L(n)−1,p) 因此n个元素列表中爬升到L(n)的代价C(n)的数学期望和方差为 因为1/p是已知常数,因此跳跃表的搜索、插入和删除的时间复杂度都是O(logn)。 P的选择 Figure.11 Normalized search times 扩展 快速随机访问 #define SKIP_LIST_KEY_TYPE int #define SKIP_LIST_VALUE_TYPE int #define SKIP_LIST_MAX_LEVEL 32 #define SKIP_LIST_P 0.5 struct Node; // forward definition struct Forward { struct Node *forward; int span; } struct Node { SKIP_LIST_KEY_TYPE key; SKIP_LIST_VALUE_TYPE value; struct Forward forwards[]; // flexible array member }; struct SkipList { struct Node *head; int level; int length; }; struct Node *CreateNode(int level) { struct Node *node; assert(level > 0); node = malloc(sizeof(struct Node) + sizeof(struct Forward) * level); return node; } struct SkipList *CreateSkipList() { struct SkipList *list; struct Node *head; int i; list = malloc(sizeof(struct SkipList)); head = CreateNode(SKIP_LIST_MAX_LEVEL); for (i = 0; i < SKIP_LIST_MAX_LEVEL; i++) { head->forwards[i].forward = NULL; head->forwards[i].span = 0; } list->head = head; list->level = 1; return list; } 接下来需要修改插入和删除操作,来保证在跳跃表修改后跨度的数据完整性。 需要注意的是,在插入过程中需要使用indices记录在每个层级遍历到的最后一个元素的位置,这样通过做简单的减法操作就可以知道每个层级遍历到的最后一个元素到新插入节点的跨度。 struct Node *SkipListInsert(struct SkipList *list, SKIP_LIST_KEY_TYPE key, SKIP_LIST_VALUE_TYPE value) { struct Node *update[SKIP_LIST_MAX_LEVEL]; struct Node *current; int indices[SKIP_LIST_MAX_LEVEL]; int i; int level; current = list->head; for (i = list->level - 1; i >= 0; i--) { if (i == list->level - 1) { indices[i] = 0; } else { indices[i] = indices[i + 1]; } while (current->forwards[i].forward && current->forwards[i].forward->key < target) { indices[i] += current->forwards[i].span; current = current->forwards[i].forward; } update[i] = current; } current = current->forwards[0].forward; if (current->key == target) { current->value = value; return current; } level = SkipListRandomLevel(); if (level > list->level) { for (i = list->level; i < level; i++) { indices[i] = 0; update[i] = list->header; update[i]->forwards[i].span = list->length; } } current = CreateNode(level); current->key = key; current->value = value; for (i = 0; i < level; i++) { current->forwards[i].forward = update[i]->forwards[i].forward; update[i]->forwards[i].forward = current; current->forwards[i].span = update[i]->forwards[i].span - (indices[0] - indices[i]); update[i]->forwards[i].span = (indices[0] - indices[i]) + 1; } list.length++; return current; } struct Node *SkipListDelete(struct SkipList *list, SKIP_LIST_KEY_TYPE key) { struct Node *update[SKIP_LIST_MAX_LEVEL]; struct Node *current; int i; current = list->head; for (i = list->level - 1; i >= 0; i--) { while (current->forwards[i].forward && current->forwards[i].forward->key < key) { current = current->forwards[i].forward; } update[i] = current; } current = current->forwards[0].forward; if (current && current->key == key) { for (i = 0; i < list->level; i++) { if (update[i]->forwards[i].forward == current) { update[i]->forwards[i].forward = current->forwards[i]; update[i]->forwards[i].span += current->forwards[i].span - 1; } else { break; } } while (list->level > 1 && list->head->forwards[list->level - 1] == NULL) { list->level--; } } return current; } 当实现了快速随机访问之后,通过简单的指针操作即可实现区间查询功能。 参考文献 Pugh, W. (1989). A skip list cookbook. Tech. Rep. CS-TR-2286.1, Dept. of Computer Science, Univ. of Maryland, College Park, MD [July 1989] Pugh, W. (1989). Skip lists: A probabilistic alternative to balanced trees. Lecture Notes in Computer Science, 437–449. https://doi.org/10.1007/3-540-51542-9_36 Weiss, M. A. (1996).Data Structures and Algorithm Analysis in C (2nd Edition)(2nd ed.). Pearson. Aragon, Cecilia & Seidel, Raimund. (1989). Randomized Search Trees. 540-545. 10.1109/SFCS.1989.63531. Wikipedia contributors. (2022b, November 22).Finger search. Wikipedia. https://en.wikipedia.org/wiki/Finger_search Wikipedia contributors. (2022a, October 24).Threaded binary tree. Wikipedia. https://en.wikipedia.org/wiki/Threaded_binary_tree Wikipedia contributors. (2023, January 4).Negative binomial distribution. Wikipedia. https://en.wikipedia.org/wiki/Negative_binomial_distribution Redis contributors.Redis ordered set implementation. GitHub. https://github.com/redis/redis 后续工作 确定性跳跃表 无锁并发安全跳跃表 因文章展示完整性需要,所以部分公式内容采用截图上传,排版不当之处还望包涵。

优秀的个人博客,低调大师

每日一博 | 详解 Java 线程问题诊断工具 Thread Dump

摘要:Thread Dump是非常有用的诊断Java应用问题的工具。 本文分享自华为云社区《调试排错 - Java 线程分析之线程Dump分析》,作者:龙哥手记。 Thread Dump是非常有用的诊断Java应用问题的工具。每一个Java虚拟机都有及时生成所有线程在某一点状态的thread-dump的能力,虽然各个 Java虚拟机打印的thread dump略有不同,但是 大多都提供了当前活动线程的快照,及JVM中所有Java线程的堆栈跟踪信息,堆栈信息一般包含完整的类名及所执行的方法,如果可能的话还有源代码的行数。 Thread Dump特点 能在各种操作系统下使用; 能在各种Java应用服务器下使用; 能在生产环境下使用而不影响系统的性能; 能将问题直接定位到应用程序的代码行上; Thread Dump抓取 一般当服务器挂起,崩溃或者性能低下时,就需要抓取服务器的线程堆栈(Thread Dump)用于后续的分析。在实际运行中,往往一次 dump的信息,还不足以确认问题。为了反映线程状态的动态变化,需要接连多次做thread dump,每次间隔10-20s,建议至少产生三次 dump信息,如果每次 dump都指向同一个问题,我们才确定问题的典型性。 操作系统命令获取ThreadDump ps –ef | grep java kill -3 <pid> 注意: 一定要谨慎, 一步不慎就可能让服务器进程被杀死。kill -9 命令会杀死进程。 JVM 自带的工具获取线程堆栈 jps 或 ps –ef | grep java (获取PID) jstack [-l ] <pid> | tee -a jstack.log(获取ThreadDump) Thread Dump分析 Thread Dump信息 头部信息:时间,JVM信息 2011-11-02 19:05:06 Full thread dump Java HotSpot(TM) Server VM (16.3-b01 mixed mode): 线程INFO信息块: 1. "Timer-0" daemon prio=10 tid=0xac190c00 nid=0xaef in Object.wait() [0xae77d000] # 线程名称:Timer-0;线程类型:daemon;优先级: 10,默认是5; # JVM线程id:tid=0xac190c00,JVM内部线程的唯一标识(通过java.lang.Thread.getId()获取,通常用自增方式实现)。 # 对应系统线程id(NativeThread ID):nid=0xaef,和top命令查看的线程pid对应,不过一个是10进制,一个是16进制。(通过命令:top -H -p pid,可以查看该进程的所有线程信息) # 线程状态:in Object.wait(); # 起始栈地址:[0xae77d000],对象的内存地址,通过JVM内存查看工具,能够看出线程是在哪儿个对象上等待; 2. java.lang.Thread.State: TIMED_WAITING (on object monitor) 3. at java.lang.Object.wait(Native Method) 4. -waiting on <0xb3885f60> (a java.util.TaskQueue) # 继续wait 5. at java.util.TimerThread.mainLoop(Timer.java:509) 6. -locked <0xb3885f60> (a java.util.TaskQueue) # 已经locked 7. at java.util.TimerThread.run(Timer.java:462) Java thread statck trace:是上面2-7行的信息。到目前为止这是最重要的数据,Java stack trace提供了大部分信息来精确定位问题根源。 Java thread statck trace详解: 堆栈信息应该逆向解读:程序先执行的是第7行,然后是第6行,依次类推。 - locked <0xb3885f60> (a java.util.ArrayList) - waiting on <0xb3885f60> (a java.util.ArrayList) 也就是说对象先上锁,锁住对象0xb3885f60,然后释放该对象锁,进入waiting状态。为啥会出现这样的情况呢?看看下面的java代码示例,就会明白: synchronized(obj) { ......... obj.wait(); ......... } 如上,线程的执行过程,先用 synchronized 获得了这个对象的 Monitor(对应于 locked <0xb3885f60> )。当执行到 obj.wait(),线程即放弃了 Monitor的所有权,进入 “wait set”队列(对应于 waiting on <0xb3885f60> )。 在堆栈的第一行信息中,进一步标明了线程在代码级的状态,例如: java.lang.Thread.State: TIMED_WAITING (parking) 解释如下: |blocked| > This thread tried to enter asynchronized block, but the lock was taken by another thread. This thread isblocked until the lock gets released. |blocked (on thin lock)| > This is the same state asblocked, but the lock in question is a thin lock. |waiting| > This thread calledObject.wait() on an object. The thread will remain there until some otherthread sends a notification to that object. |sleeping| > This thread calledjava.lang.Thread.sleep(). |parked| > This thread calledjava.util.concurrent.locks.LockSupport.park(). |suspended| > The thread's execution wassuspended by java.lang.Thread.suspend() or a JVMTI agent call. Thread状态分析 线程的状态是一个很重要的东西,因此thread dump中会显示这些状态,通过对这些状态的分析,能够得出线程的运行状况,进而发现可能存在的问题。线程的状态在Thread.State这个枚举类型中定义: public enum State { /** * Thread state for a thread which has not yet started. */ NEW, /** * Thread state for a runnable thread. A thread in the runnable * state is executing in the Java virtual machine but it may * be waiting for other resources from the operating system * such as processor. */ RUNNABLE, /** * Thread state for a thread blocked waiting for a monitor lock. * A thread in the blocked state is waiting for a monitor lock * to enter a synchronized block/method or * reenter a synchronized block/method after calling * {@link Object#wait() Object.wait}. */ BLOCKED, /** * Thread state for a waiting thread. * A thread is in the waiting state due to calling one of the * following methods: * <ul> * <li>{@link Object#wait() Object.wait} with no timeout</li> * <li>{@link #join() Thread.join} with no timeout</li> * <li>{@link LockSupport#park() LockSupport.park}</li> * </ul> * * <p>A thread in the waiting state is waiting for another thread to * perform a particular action. * * For example, a thread that has called <tt>Object.wait()</tt> * on an object is waiting for another thread to call * <tt>Object.notify()</tt> or <tt>Object.notifyAll()</tt> on * that object. A thread that has called <tt>Thread.join()</tt> * is waiting for a specified thread to terminate. */ WAITING, /** * Thread state for a waiting thread with a specified waiting time. * A thread is in the timed waiting state due to calling one of * the following methods with a specified positive waiting time: * <ul> * <li>{@link #sleep Thread.sleep}</li> * <li>{@link Object#wait(long) Object.wait} with timeout</li> * <li>{@link #join(long) Thread.join} with timeout</li> * <li>{@link LockSupport#parkNanos LockSupport.parkNanos}</li> * <li>{@link LockSupport#parkUntil LockSupport.parkUntil}</li> * </ul> */ TIMED_WAITING, /** * Thread state for a terminated thread. * The thread has completed execution. */ TERMINATED; } NEW: 每一个线程,在堆内存中都有一个对应的Thread对象。Thread t = new Thread();当刚刚在堆内存中创建Thread对象,还没有调用t.start()方法之前,线程就处在NEW状态。在这个状态上,线程与普通的java对象没有什么区别,就仅仅是一个堆内存中的对象。 RUNNABLE: 该状态表示线程具备所有运行条件,在运行队列中准备操作系统的调度,或者正在运行。 这个状态的线程比较正常,但如果线程长时间停留在在这个状态就不正常了,这说明线程运行的时间很长(存在性能问题),或者是线程一直得不得执行的机会(存在线程饥饿的问题)。 BLOCKED: 线程正在等待获取java对象的监视器(也叫内置锁),即线程正在等待进入由synchronized保护的方法或者代码块。synchronized用来保证原子性,任意时刻最多只能由一个线程进入该临界区域,其他线程只能排队等待。 WAITING: 处在该线程的状态,正在等待某个事件的发生,只有特定的条件满足,才能获得执行机会。而产生这个特定的事件,通常都是另一个线程。也就是说,如果不发生特定的事件,那么处在该状态的线程一直等待,不能获取执行的机会。比如: A线程调用了obj对象的obj.wait()方法,如果没有线程调用obj.notify或obj.notifyAll,那么A线程就没有办法恢复运行; 如果A线程调用了LockSupport.park(),没有别的线程调用LockSupport.unpark(A),那么A没有办法恢复运行。 TIMED_WAITING: J.U.C中很多与线程相关类,都提供了限时版本和不限时版本的API。TIMED_WAITING意味着线程调用了限时版本的API,正在等待时间流逝。当等待时间过去后,线程一样可以恢复运行。如果线程进入了WAITING状态,一定要特定的事件发生才能恢复运行;而处在TIMED_WAITING的线程,如果特定的事件发生或者是时间流逝完毕,都会恢复运行。 TERMINATED: 线程执行完毕,执行完run方法正常返回,或者抛出了运行时异常而结束,线程都会停留在这个状态。这个时候线程只剩下Thread对象了,没有什么用了。 关键状态分析 Wait on condition:The thread is either sleeping or waiting to be notified by another thread. 该状态说明它在等待另一个条件的发生,来把自己唤醒,或者干脆它是调用了 sleep(n)。 此时线程状态大致为以下几种: java.lang.Thread.State: WAITING (parking):一直等那个条件发生; java.lang.Thread.State: TIMED_WAITING (parking或sleeping):定时的,那个条件不到来,也将定时唤醒自己。 Waiting for Monitor Entry 和 in Object.wait():The thread is waiting to get the lock for an object (some other thread may be holding the lock). This happens if two or more threads try to execute synchronized code. Note that the lock is always for an object and not for individual methods. 在多线程的JAVA程序中,实现线程之间的同步,就要说说 Monitor。Monitor是Java中用以实现线程之间的互斥与协作的主要手段,它可以看成是对象或者Class的锁。每一个对象都有,也仅有一个 Monitor。下面这个图,描述了线程和 Monitor之间关系,以及线程的状态转换图: 如上图,每个Monitor在某个时刻,只能被一个线程拥有,该线程就是 “ActiveThread”,而其它线程都是 “Waiting Thread”,分别在两个队列“Entry Set”和“Wait Set”里等候。在“Entry Set”中等待的线程状态是“Waiting for monitor entry”,而在“Wait Set”中等待的线程状态是“in Object.wait()”。 先看“Entry Set”里面的线程。我们称被 synchronized保护起来的代码段为临界区。当一个线程申请进入临界区时,它就进入了“Entry Set”队列。对应的 code就像: synchronized(obj) { ......... } 这时有两种可能性: 该 monitor不被其它线程拥有, Entry Set里面也没有其它等待线程。本线程即成为相应类或者对象的 Monitor的 Owner,执行临界区的代码。 该 monitor被其它线程拥有,本线程在 Entry Set队列中等待。 在第一种情况下,线程将处于 “Runnable”的状态,而第二种情况下,线程 DUMP会显示处于 “waiting for monitor entry”。如下: "Thread-0" prio=10 tid=0x08222eb0 nid=0x9 waiting for monitor entry [0xf927b000..0xf927bdb8] at testthread.WaitThread.run(WaitThread.java:39) - waiting to lock <0xef63bf08> (a java.lang.Object) - locked <0xef63beb8> (a java.util.ArrayList) at java.lang.Thread.run(Thread.java:595) 临界区的设置,是为了保证其内部的代码执行的原子性和完整性。但是因为临界区在任何时间只允许线程串行通过,这和我们多线程的程序的初衷是相反的。如果在多线程的程序中,大量使用 synchronized,或者不适当的使用了它,会造成大量线程在临界区的入口等待,造成系统的性能大幅下降。如果在线程 DUMP中发现了这个情况,应该审查源码,改进程序。 再看“Wait Set”里面的线程。当线程获得了 Monitor,进入了临界区之后,如果发现线程继续运行的条件没有满足,它则调用对象(一般就是被 synchronized 的对象)的 wait() 方法,放弃 Monitor,进入 “Wait Set”队列。只有当别的线程在该对象上调用了 notify() 或者notifyAll(),“Wait Set”队列中线程才得到机会去竞争,但是只有一个线程获得对象的Monitor,恢复到运行态。在 “Wait Set”中的线程, DUMP中表现为: in Object.wait()。如下: "Thread-1" prio=10 tid=0x08223250 nid=0xa in Object.wait() [0xef47a000..0xef47aa38] at java.lang.Object.wait(Native Method) - waiting on <0xef63beb8> (a java.util.ArrayList) at java.lang.Object.wait(Object.java:474) at testthread.MyWaitThread.run(MyWaitThread.java:40) - locked <0xef63beb8> (a java.util.ArrayList) at java.lang.Thread.run(Thread.java:595) 综上,一般CPU很忙时,则关注runnable的线程,CPU很闲时,则关注waiting for monitor entry的线程。 JDK 5.0 的 Lock 上面提到如果 synchronized和 monitor机制运用不当,可能会造成多线程程序的性能问题。在 JDK 5.0中,引入了 Lock机制,从而使开发者能更灵活的开发高性能的并发多线程程序,可以替代以往 JDK中的 synchronized和 Monitor的 机制。但是,要注意的是,因为 Lock类只是一个普通类,JVM无从得知 Lock对象的占用情况,所以在线程 DUMP中,也不会包含关于 Lock的信息, 关于死锁等问题,就不如用 synchronized的编程方式容易识别。 关键状态示例 显示BLOCKED状态 package jstack; public class BlockedState { private static Object object = new Object(); public static void main(String[] args) { Runnable task = new Runnable() { @Override public void run() { synchronized (object) { long begin = System.currentTimeMillis(); long end = System.currentTimeMillis(); // 让线程运行5分钟,会一直持有object的监视器 while ((end - begin) <= 5 * 60 * 1000) { } } } }; new Thread(task, "t1").start(); new Thread(task, "t2").start(); } } 先获取object的线程会执行5分钟,这5分钟内会一直持有object的监视器,另一个线程无法执行处在BLOCKED状态: Full thread dump Java HotSpot(TM) Server VM (20.12-b01 mixed mode): "DestroyJavaVM" prio=6 tid=0x00856c00 nid=0x1314 waiting on condition [0x00000000] java.lang.Thread.State: RUNNABLE "t2" prio=6 tid=0x27d7a800 nid=0x1350 waiting for monitor entry [0x2833f000] java.lang.Thread.State: BLOCKED (on object monitor) at jstack.BlockedState$1.run(BlockedState.java:17) - waiting to lock <0x1cfcdc00> (a java.lang.Object) at java.lang.Thread.run(Thread.java:662) "t1" prio=6 tid=0x27d79400 nid=0x1338 runnable [0x282ef000] java.lang.Thread.State: RUNNABLE at jstack.BlockedState$1.run(BlockedState.java:22) - locked <0x1cfcdc00> (a java.lang.Object) at java.lang.Thread.run(Thread.java:662) 通过thread dump可以看到:t2线程确实处在BLOCKED (on object monitor)。waiting for monitor entry 等待进入synchronized保护的区域。 显示WAITING状态 package jstack; public class WaitingState { private static Object object = new Object(); public static void main(String[] args) { Runnable task = new Runnable() { @Override public void run() { synchronized (object) { long begin = System.currentTimeMillis(); long end = System.currentTimeMillis(); // 让线程运行5分钟,会一直持有object的监视器 while ((end - begin) <= 5 * 60 * 1000) { try { // 进入等待的同时,会进入释放监视器 object.wait(); } catch (InterruptedException e) { e.printStackTrace(); } } } } }; new Thread(task, "t1").start(); new Thread(task, "t2").start(); } } Full thread dump Java HotSpot(TM) Server VM (20.12-b01 mixed mode): "DestroyJavaVM" prio=6 tid=0x00856c00 nid=0x1734 waiting on condition [0x00000000] java.lang.Thread.State: RUNNABLE "t2" prio=6 tid=0x27d7e000 nid=0x17f4 in Object.wait() [0x2833f000] java.lang.Thread.State: WAITING (on object monitor) at java.lang.Object.wait(Native Method) - waiting on <0x1cfcdc00> (a java.lang.Object) at java.lang.Object.wait(Object.java:485) at jstack.WaitingState$1.run(WaitingState.java:26) - locked <0x1cfcdc00> (a java.lang.Object) at java.lang.Thread.run(Thread.java:662) "t1" prio=6 tid=0x27d7d400 nid=0x17f0 in Object.wait() [0x282ef000] java.lang.Thread.State: WAITING (on object monitor) at java.lang.Object.wait(Native Method) - waiting on <0x1cfcdc00> (a java.lang.Object) at java.lang.Object.wait(Object.java:485) at jstack.WaitingState$1.run(WaitingState.java:26) - locked <0x1cfcdc00> (a java.lang.Object) at java.lang.Thread.run(Thread.java:662) 可以发现t1和t2都处在WAITING (on object monitor),进入等待状态的原因是调用了in Object.wait()。通过J.U.C包下的锁和条件队列,也是这个效果,大家可以自己实践下。 显示TIMED_WAITING状态 package jstack; import java.util.concurrent.TimeUnit; import java.util.concurrent.locks.Condition; import java.util.concurrent.locks.Lock; import java.util.concurrent.locks.ReentrantLock; public class TimedWaitingState { // java的显示锁,类似java对象内置的监视器 private static Lock lock = new ReentrantLock(); // 锁关联的条件队列(类似于object.wait) private static Condition condition = lock.newCondition(); public static void main(String[] args) { Runnable task = new Runnable() { @Override public void run() { // 加锁,进入临界区 lock.lock(); try { condition.await(5, TimeUnit.MINUTES); } catch (InterruptedException e) { e.printStackTrace(); } // 解锁,退出临界区 lock.unlock(); } }; new Thread(task, "t1").start(); new Thread(task, "t2").start(); } } Full thread dump Java HotSpot(TM) Server VM (20.12-b01 mixed mode): "DestroyJavaVM" prio=6 tid=0x00856c00 nid=0x169c waiting on condition [0x00000000] java.lang.Thread.State: RUNNABLE "t2" prio=6 tid=0x27d7d800 nid=0xc30 waiting on condition [0x2833f000] java.lang.Thread.State: TIMED_WAITING (parking) at sun.misc.Unsafe.park(Native Method) - parking to wait for <0x1cfce5b8> (a java.util.concurrent.locks.AbstractQueuedSynchronizer$ConditionObject) at java.util.concurrent.locks.LockSupport.parkNanos(LockSupport.java:196) at java.util.concurrent.locks.AbstractQueuedSynchronizer$ConditionObject.await(AbstractQueuedSynchronizer.java:2116) at jstack.TimedWaitingState$1.run(TimedWaitingState.java:28) at java.lang.Thread.run(Thread.java:662) "t1" prio=6 tid=0x280d0c00 nid=0x16e0 waiting on condition [0x282ef000] java.lang.Thread.State: TIMED_WAITING (parking) at sun.misc.Unsafe.park(Native Method) - parking to wait for <0x1cfce5b8> (a java.util.concurrent.locks.AbstractQueuedSynchronizer$ConditionObject) at java.util.concurrent.locks.LockSupport.parkNanos(LockSupport.java:196) at java.util.concurrent.locks.AbstractQueuedSynchronizer$ConditionObject.await(AbstractQueuedSynchronizer.java:2116) at jstack.TimedWaitingState$1.run(TimedWaitingState.java:28) at java.lang.Thread.run(Thread.java:662) 可以看到t1和t2线程都处在java.lang.Thread.State: TIMED_WAITING (parking),这个parking代表是调用的JUC下的工具类,而不是java默认的监视器。 案例分析 问题场景 CPU飙高,load高,响应很慢 一个请求过程中多次dump; 对比多次dump文件的runnable线程,如果执行的方法有比较大变化,说明比较正常。如果在执行同一个方法,就有一些问题了; 查找占用CPU最多的线程 使用命令:top -H -p pid(pid为被测系统的进程号),找到导致CPU高的线程ID,对应thread dump信息中线程的nid,只不过一个是十进制,一个是十六进制; 在thread dump中,根据top命令查找的线程id,查找对应的线程堆栈信息; CPU使用率不高但是响应很慢 进行dump,查看是否有很多thread struck在了i/o、数据库等地方,定位瓶颈原因; 请求无法响应 多次dump,对比是否所有的runnable线程都一直在执行相同的方法,如果是的,恭喜你,锁住了! 死锁 死锁经常表现为程序的停顿,或者不再响应用户的请求。从操作系统上观察,对应进程的CPU占用率为零,很快会从top或prstat的输出中消失。 比如在下面这个示例中,是个较为典型的死锁情况: "Thread-1" prio=5 tid=0x00acc490 nid=0xe50 waiting for monitor entry [0x02d3f000 ..0x02d3fd68] at deadlockthreads.TestThread.run(TestThread.java:31) - waiting to lock <0x22c19f18> (a java.lang.Object) - locked <0x22c19f20> (a java.lang.Object) "Thread-0" prio=5 tid=0x00accdb0 nid=0xdec waiting for monitor entry [0x02cff000 ..0x02cff9e8] at deadlockthreads.TestThread.run(TestThread.java:31) - waiting to lock <0x22c19f20> (a java.lang.Object) - locked <0x22c19f18> (a java.lang.Object) 在 JAVA 5中加强了对死锁的检测。线程 Dump中可以直接报告出 Java级别的死锁,如下所示: Found one Java-level deadlock: ============================= "Thread-1": waiting to lock monitor 0x0003f334 (object 0x22c19f18, a java.lang.Object), which is held by "Thread-0" "Thread-0": waiting to lock monitor 0x0003f314 (object 0x22c19f20, a java.lang.Object), which is held by "Thread-1" 热锁 热锁,也往往是导致系统性能瓶颈的主要因素。其表现特征为:由于多个线程对临界区,或者锁的竞争,可能出现: 频繁的线程的上下文切换:从操作系统对线程的调度来看,当线程在等待资源而阻塞的时候,操作系统会将之切换出来,放到等待的队列,当线程获得资源之后,调度算法会将这个线程切换进去,放到执行队列中。 大量的系统调用:因为线程的上下文切换,以及热锁的竞争,或者临界区的频繁的进出,都可能导致大量的系统调用。 大部分CPU开销用在“系统态”:线程上下文切换,和系统调用,都会导致 CPU在 “系统态 ”运行,换而言之,虽然系统很忙碌,但是CPU用在 “用户态 ”的比例较小,应用程序得不到充分的 CPU资源。 随着CPU数目的增多,系统的性能反而下降。因为CPU数目多,同时运行的线程就越多,可能就会造成更频繁的线程上下文切换和系统态的CPU开销,从而导致更糟糕的性能。 上面的描述,都是一个 scalability(可扩展性)很差的系统的表现。从整体的性能指标看,由于线程热锁的存在,程序的响应时间会变长,吞吐量会降低。 那么,怎么去了解 “热锁 ”出现在什么地方呢? 一个重要的方法是 结合操作系统的各种工具观察系统资源使用状况,以及收集Java线程的DUMP信息,看线程都阻塞在什么方法上,了解原因,才能找到对应的解决方法。 VM重要线程 JVM运行过程中产生的一些比较重要的线程罗列如下: 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

每日一博 | 一文详解 RocketMQ 的存储模型

摘要:RocketMQ 优异的性能表现,必然绕不开其优秀的存储模型。 本文分享自华为云社区《终于弄明白了 RocketMQ 的存储模型》,作者:勇哥java实战分享。 RocketMQ 优异的性能表现,必然绕不开其优秀的存储模型 。 1 整体概览 首先温习下 RocketMQ 架构。 整体架构中包含四种角色 : Producer :消息发布的角色,Producer 通过 MQ 的负载均衡模块选择相应的 Broker 集群队列进行消息投递,投递的过程支持快速失败并且低延迟。 Consumer :消息消费的角色,支持以 push 推,pull 拉两种模式对消息进行消费。 NameServer :名字服务是一个非常简单的 Topic 路由注册中心,其角色类似 Dubbo 中的 zookeeper ,支持 Broker 的动态注册与发现。 BrokerServer :Broker 主要负责消息的存储、投递和查询以及服务高可用保证 。 本文的重点在于分析 BrokerServer 的消息存储模型。我们先进入 broker 的文件存储目录 。 消息存储和下面三个文件关系非常紧密: 1.数据文件 commitlog 消息主体以及元数据的存储主体 ; 2.消费文件 consumequeue 消息消费队列,引入的目的主要是提高消息消费的性能 ; 3.索引文件 index 索引文件,提供了一种可以通过 key 或时间区间来查询消息。 RocketMQ 采用的是混合型的存储结构,Broker 单个实例下所有的队列共用一个数据文件(commitlog)来存储。 生产者发送消息至 Broker 端,然后 Broker 端使用同步或者异步的方式对消息刷盘持久化,保存至 commitlog 文件中。只要消息被刷盘持久化至磁盘文件 commitlog 中,那么生产者发送的消息就不会丢失。 Broker 端的后台服务线程会不停地分发请求并异步构建 consumequeue(消费文件)和 indexFile(索引文件)。 2 数据文件 RocketMQ 的消息数据都会写入到数据文件中, 我们称之为 commitlog 。 所有的消息都会顺序写入数据文件,当文件写满了,会写入下一个文件。 如上图所示,单个文件大小默认 1G , 文件名长度为 20 位,左边补零,剩余为起始偏移量,比如 00000000000000000000 代表了第一个文件,起始偏移量为 0 ,文件大小为1 G = 1073741824。 当第一个文件写满了,第二个文件为 00000000001073741824,起始偏移量为 1073741824,以此类推。 从上图中,我们可以看到消息是一条一条写入到文件,每条消息的格式是固定的。 这样设计有三点优势: 1、顺序写 磁盘的存取速度相对内存来讲并不快,一次磁盘 IO 的耗时主要取决于:寻道时间和盘片旋转时间,提高磁盘 IO 性能最有效的方法就是:减少随机 IO,增加顺序 IO 。 《 The Pathologies of Big Data 》这篇文章指出:内存随机读写的速度远远低于磁盘顺序读写的速度。磁盘顺序写入速度可以达到几百兆/s,而随机写入速度只有几百 KB /s,相差上千倍。 2、快速定位 因为消息是一条一条写入到 commitlog 文件 ,写入完成后,我们可以得到这条消息的物理偏移量。 每条消息的物理偏移量是唯一的, commitlog 文件名是递增的,可以根据消息的物理偏移量通过二分查找,定位消息位于那个文件中,并获取到消息实体数据。 3、通过消息 offsetMsgId 查询消息数据 消息 offsetMsgId 是由 Broker 服务端在写入消息时生成的 ,该消息包含两个部分: Broker 服务端 ip + port 8个字节; commitlog 物理偏移量 8个字节 。 我们可以通过消息 offsetMsgId ,定位到 Broker 的 ip 地址 + 端口 ,传递物理偏移量参数 ,即可定位该消息实体数据。 3 消费文件 在介绍 consumequeue 文件之前, 我们先温习下消息队列的传输模型-发布订阅模型, 这也是 RocketMQ 当前的传输模型。 发布订阅模型具有如下特点: 消费独立:相比队列模型的匿名消费方式,发布订阅模型中消费方都会具备的身份,一般叫做订阅组(订阅关系),不同订阅组之间相互独立不会相互影响。 一对多通信:基于独立身份的设计,同一个主题内的消息可以被多个订阅组处理,每个订阅组都可以拿到全量消息。因此发布订阅模型可以实现一对多通信。 因此,rocketmq 的文件设计必须满足发布订阅模型的需求。 那么仅仅 commitlog 文件是否可以满足需求吗 ? 假如有一个 consumerGroup 消费者,订阅主题 my-mac-topic ,因为 commitlog 包含所有的消息数据,查询该主题下的消息数据,需要遍历数据文件 commitlog , 这样的效率是极其低下的。 进入 rocketmq 存储目录,显示见下图: 消费文件按照主题存储,每个主题下有不同的队列,图中 my-mac-topic 有 16 个队列 ; 每个队列目录下 ,存储 consumequeue 文件,每个 consumequeue 文件也是顺序写入,数据格式见下图。 每个 consumequeue 包含 30 万个条目,每个条目大小是 20 个字节,每个文件的大小是 30 万 * 20 = 60万字节,每个文件大小约5.72M 。和 commitlog 文件类似,consumequeue 文件的名称也是以偏移量来命名的,可以通过消息的逻辑偏移量定位消息位于哪一个文件里。 消费文件按照主题-队列来保存 ,这种方式特别适配发布订阅模型。 消费者从 broker 获取订阅消息数据时,不用遍历整个 commitlog 文件,只需要根据逻辑偏移量从 consumequeue 文件查询消息偏移量 , 最后通过定位到 commitlog 文件, 获取真正的消息数据。 这样就可以简化消费查询逻辑,同时因为同一主题下,消费者可以订阅不同的队列或者 tag ,同时提高了系统的可扩展性。 4 索引文件 每个消息在业务层面的唯一标识码要设置到 keys 字段,方便将来定位消息丢失问题。服务器会为每个消息创建索引(哈希索引),应用可以通过 topic、key 来查询这条消息内容,以及消息被谁消费。 由于是哈希索引,请务必保证key尽可能唯一,这样可以避免潜在的哈希冲突。 //订单Id String orderId = "1234567890"; message.setKeys(orderId); 从开源的控制台中根据主题和 key 查询消息列表: 进入索引文件目录 ,如下图所以: 索引文件名 fileName 是以创建时的时间戳命名的,固定的单个 IndexFile 文件大小约为 400 M 。 IndexFile 的文件逻辑结构类似于 JDK 的 HashMap 的数组加链表结构。 索引文件主要由 Header、Slot Table (默认 500 万个条目)、Index Linked List(默认最多包含 2000万个条目)三部分组成 。 假如订单系统发送两条消息 A 和 B , 他们的 key 都是 “1234567890” ,我们依次存储消息 A , 消息 B 。 因为这两个消息的 key 的 hash 值相同,它们对应的哈希槽(深黄色)也会相同,哈希槽会保存的最新的消息 B 的索引条目序号 , 序号值是 4 ,也就是第二个深绿色条目。 而消息 B 的索引条目信息的最后 4 个字节会保存上一条消息对应的索引条目序号,索引序号值是 3 , 也就是消息 A 。 5 写到最后 Databases are specializing – the “one size fits all” approach no longer applies ------ MongoDB设计哲学 RocketMQ 存储模型设计得非常精巧,笔者觉得每种设计都有其底层思考,这里总结了三点 : 完美适配消息队列发布订阅模型 ; 数据文件,消费文件,索引文件各司其职 ,同时以数据文件为核心,异步构建消费文件 + 索引文件这种模式非常容易扩展到主从复制的架构; 充分考虑业务的查询场景,支持消息 key ,消息 offsetMsgId 查询消息数据。也支持消费者通过 tag 来订阅主题下的不同消息,提升了消费者的灵活性。 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

每日一博 | 浅谈权限系统在多利熊业务应用

作者 | 百度智能小程序团队 导读 本文首先引入多利熊业务介绍,引出多利熊业务建设权限系统的痛点,接着分别从权限系统模型、权限系统设计以及多利熊业务业务应用方面详细探讨了具体的方案和设计,最后对权限系统设计思考,对数据维度建设抛砖引玉,让大家一起思考解决方案。 全文5212字,预计阅读时间14分钟。 01 业务介绍 多利熊,是百度旗下的本地生活服务平台。多利熊旨在为用户提供特低价优惠的品质服务,基于百度的AI和双引擎能力,以改变市场格局之势迅速推进,为本地商家提供丰富的营销渠道,决心成为本地生活市场的重塑性力量。 多利熊覆盖餐饮、酒店、景区、休闲娱乐、丽人等众多品类。用户可以花更少的钱享受多利熊甄选的本地生活品质服务。成为多利熊分销达人,自购更省钱,分享直卖可赚取佣金,锁粉政策可让达人长期赚取用户自行下单佣金,发展下游达人组建团队更可赚取团队佣金。 多利熊架构是如何支撑起整个业务生态运转,如下图所示: 如图所示,多利熊整个业务架构分位三层。包括:生态场景层、平台支撑层、基础建设层。 多利熊生态场景:多利熊除了在百度的双引擎、百家号、私域中进行分发外,还扩展到了微信生态圈,建设了多利熊微信小程序,用于在微信生态的分发,通过微信群、微信分享、微信达人引流。除了自建外,也通过合作方式引入第三方服务商、自研商家、本地生活服务平台,从而打造多元化、多类型的本地生活服务生态圈。 多利熊平台支撑:多利熊建设了大量平台,包括:商户平台、运营平台、审核平台、小编平台、分发平台、干预平台、质量平台等等。通过丰富的平台,降低运营成本、提升商家接入效率,从而更好的支撑业务的高速发展,快速迭代。 多利熊基础建设:多利熊的基础建设层,通过集成小程序及百度中台的众多沉淀系统,迅速支撑业务快速迭代。包括:小程序自研的服务化治理方案:天路、天眼、BRCC;小程序沉淀的数据多维度分析报表和稳定性建设监控和治理手段;以及百度丰富的中台系统:交易中台、营销中台、互动中台、审核中台等等。 从图中可以看到,整个多利熊业务架构中,平台角色众多,权限系统面临非常多的挑战。 平台众多,各个平台的账号系统也会存在差异性。权限系统如何支持各平台的隔离设置,保证平台数据的合规性和安全性? 多个平台中存在众多业务角色、角色存在上下级关系,大家需要协同工作。权限系统如何支持高效的配置,保障多角色协同、高效、便利操作? 多个平台基于不同语言开发。权限系统如何保证接入的便捷性? 具体我们是如何建设,解决这些问题的呢?下面将详细介绍下。 02 权限系统介绍 2.1 权限系统模型 RBAC(role-based access control ):基于角色的权限访问控制。 RBAC是一种围绕角色和权限定义的访问控制机制,在RBAC中,权限与角色相关联,用户通过成为适当角色的成员而得到这些角色的权限。这就极大地简化了权限的管理。在一个组织中,角色是为了完成各种工作而创造,用户则依据它的责任和资格来被指派相应的角色,用户可以很容易地从一个角色被指派到另一个角色。角色可依新的需求和系统的合并而赋予新的权限,而权限也可根据需要而从某角色中回收。角色与角色的关系可以建立起来以囊括更广泛的客观情况。 RBAC四个核心组成部分: S(Subject):主体,一名使用者或自动代理人 R(Role):角色信息,被定义为一个授权等级的工作职位或职称 SE(Session):会话级别的身份权限表达,S,R或P之间的映射关系 P(Permissions):权限, 一种存取资源的方式 RBAC 定义了三个主要规则: 角色分配:只有当主体选择或分配了角色时,主体才能行使权限 角色授权:主体的活动角色必须为主体授权。使用上面的规则 1,此规则确保用户只能承担他们被授权的角色 权限授权:只有为主体的活动角色授权了权限,主体才能行使权限。对于规则 1 和 2,此规则确保用户只能行使他们被授权的权限 RBAC的四个模型: Flat RBAC:基本的 RBAC 模型,基本的概念是 用户被分配给角色,权限也被分配给角色,用户通过角色获取对应的权限 Hierarchical RBAC:角色被组织成分层结构,其中“较高”层级的角色从的“较低”层级的角色继承所有权限 Constrained RBAC:向角色添加职责分离 (SOD) 的实施 Symmetric RBAC:添加了权限角色审查的要求,类似于 Flat RBAC 中描述的用户角色审查 四种模型的等级和功能描述: Flat RBAC模型结构: Hierarchical RBAC模型结构: Constrained RBAC模型结构: 静态职责分离: 互斥角色:同一个用户在两个互斥角色中只能选择一个 基数约束:一个用户拥有的角色是有限的,一个角色拥有的许可也是有限的 先决条件约束:用户想要获得高级角色,首先必须拥有低级角色 动态职责分离: 会话和角色之间的约束,可以动态的约束用户拥有的角色,如一个用户可以拥有两个角色,但是运行时只能激活一个角色。 Symmetric RBAC模型结构: 2.2 权限系统设计 RBAC模型如何在我们的实际场景中选型和改造是一件深入思考的事情。首先我们要基于我们的业务场景圈定权限系统核心功能。 我们做的是本地服务tob业务,所以对于商家我们会有商家平台,除了商家的管理平台之外,我们还需要对于o端建设平台进行管理,以及我们开发同学的干预平台等,这些平台都需要权限管控。每个系统都有各自的页面,每个页面都有自己的功能实现,大到页面权限的管控,小到按钮的管控,在未来的业务发展中都是我们权限系统所需要考虑的。所以我们的权限管理相对来说任务也是比较繁重的。 针对我们以上的业务场景和需求形态,我们首先敲定了权限系统的核心职责: 页面菜单权限的管控 功能组权限管控 按钮功能权限管控 支持多业务线 我们基于Flat RBAC设计了如下的RBAC模型: 基于我们设计的RBAC模型,继续细节的考量 支持多业务线接入和业务线业务隔离 需要支持菜单权限、功能组权限、按钮权限的管控 首先考量业务线支持问题,对于这个事情我们使用了单独的表来表达产品线信息,在设计user,role 和 func 表,都需要与业务线信息表关联。 于是我们思考如何支持页面菜单权限、功能组权限和按钮权限的问题。 菜单权限、功能组权限和按钮权限都隶属于功能权限,于是我们使用一张表进行功能权限的表达,和前端页面的树形结构表达相映射,构造一个功能权限树,于是我们最终落地的ER图如下: 业务线 对于不同的系统,各自的用户体系、角色管理、权限管理都是有差异的,需要满足不同的系统的诉求,首先要做的是对各个系统的隔离。 我们设计了业务线信息的表,核心字段如下: 该表主要描述业务线的基础信息内容,用于更好的管理和配置。 业务线隔离的实质是用户表、角色表和权限表都需要指定业务线的prod_id,这样在BRAC模型的三个核心角色里都做到了业务线隔离,每个系统在使用自己的数据的时候都需要指定自己的prod_id。 用户 从业务角度分析来看,商家平台是对外面向商家登录的用户账号体系,对于o端来说,是面向我们运营同学,bd同学使用的场景,使用的内部账号体系,所以,我们这里就有这不同的用户登录体系。 我们面临着多种用户体系形态,所以,我们就兼容不同的用户体系设计,由此我们设计的用户表核心字段如下: prod_id、user_type 和 login_id 组成联合唯一建。 角色 FLAT BRAC模型的角色并没有涉及角色的继承关系,我们现在的业务没有涉及到这么复杂的角色关系,所以我们用最简单的方式来表达角色信息,从而减少对于角色身份的管理和维护。 角色的核心字段如下: prod_id 和 en_name组成联合唯一建。 权限 权限这块是我们思考最多的地方,我们希望可以通过统一的标准将前端页面的功能权限进行约定。 我们去了解前端使用的设计,无论是b端还是o端前端,都是我们自己的前端团队,他们讲使用统一的前端框架和风格进行设计,这样对于我们得权限系统来说就是最好的情况,我们首先需要面对的就是这样风格的权限管控。 首先看下我们b端的前端页面样式如下: 这里左侧为页面菜单栏,右侧为菜单栏对应的页面,里面就是涉及到的各个功能模块。 我们这里要处理的就是: 菜单栏的权限管控:菜单是否展示,菜单层级结构以及菜单设计的页面权限内容 页面权限:页面里涉及到的功能权限 功能组:页面中某些功能模块的功能权限 按钮:按钮的权限 于是我们准备改造权限表为树状结构如图所示: 基于这样的树状结构,我们就可以描述出前端的整个权限管控内容,权限的核心字段如下: 整体的核心设计就是这样,结合我们的微服务框架理念,我们整体的业务交互图如下: 现在我们权限系统已经在支持着多利熊B端平台和O端平台的权限管控,并正在支持小编平台,后续我们将继续服务更多平台的权限管控。 2.3 多利熊业务应用 基于上述权限系统的设计,使得多利熊业务在面对庞大的人员组织架构、复杂的业务系统时,也能够高效、灵活地实现权限的管理。 如下图的商务运营系统应用场景所示,该系统是面向内部多个团队开放的,每个团队都具有不同的职能,甚至团队内部也划分了不同的岗位。 针对该应用场景,系统权限的分配与管理主要包括以下的步骤: 1. 明确系统角色:如上图3.1所示,商务运营系统包括商家、商铺、订单等在内的多个平台。针对每个平台,需要确定好平台内需要哪些角色,不同角色在平台内承担着不同的任务。例如商户入驻系统包括了帮助商户入驻的角色、帮助商户管理成员的角色等。 2. 明确角色权限:针对角色承担的具体任务,其对应的系统可操作权限也是不同的,这就需要每一个角色分配具体的操作权限。例如帮助商户入驻的角色,可以有录入、查询、修改商家信息等接口与按钮的权限。 3. 明确团队架构:如上图3.2所示,审核管理项目需要有商务、运营、客服等多个团队,不同团队下还有相应的岗位来承担不同的任务。例如商务团队包括商务小编、商务管理员、商务负责人等岗位。 4. 为团队成员分配系统角色:为了将系统内的角色权限与团队内的组织架构进行结合,如上图3.3所示,管理人员可以通过角色配置的方式,来为岗位的人员赋予对应平台的权限。例如商务小编只有商品管理的角色,而商务可以同时有商品管理角色、商家入驻角色等,这样就实现了基于角色进行权限管理的实际应用。 03 权限系统思考 有了功能权限,我们进而应该思考另外一块领域,就是数据权限。 数据权限,就是有或者没有对某些数据的访问权限,具体表现形式就是当某用户有操作权限的时候,但不代表其对所有的数据都有查看或者管理权限。数据权限有两种表现形式:一种是行权限,另外一种是列权限。 所谓行权限,就是限制用户对某些行的访问权限,比如:只能对本人、本部门、本组织的数据进行访问;也可以是根据数据的范围进行限制,比如:合同额大小来限制用户对数据的访问。所谓列权限,就是限制用户对某些列的访问权限,比如:某些内容的摘要可以被查阅,但是详细内容就只有VIP用户才能查看。 通过数据权限,可以从物理层级限制用户对数据的行或列进行获取,这种方式比把所有数据拿到之后再根据用户权限来限制某些行或列有诸多好处。以列表数据权限为例,主要通过数据权限控制行数据,让不同的人有不同的查看数据规则;要实现数据权限,最重要的是需要抽象出数据规则。 但是光有数据规则是不够的,我们还需要把数据规则跟资源和用户进行绑定。这样资源就可以关联上了数据规则。 在设计上我们需要一个单独的数据规则管理功能,方便我们录入数据规则,然后在资源管理页面上就可以选择内置的数据规则进行资源与规则的绑定。 那么如何让不同的用户拥有不同的数据规则呢? 在RBAC模型中,用户是通过授予不同的角色来进行资源的管理,同理我们可以让角色在授予权限的时候关联上数据规则,这样最终在系统上就体现为不同的用户拥有不同的数据规则。 基于此,我们可以基本实现RBAC与数据规则的绑定;同时数据权限是一个实现相对比较复杂的功能,除了在RBAC模型基础上进行扩展,是否还有其他更合理的思路,留给大家进行思考。 ——END—— 参考资料: [1]https://csrc.nist.gov/CSRC/media/Publications/conference-paper/2000/07/26/the-nist-model-for-role-based-access-control-towards-a-unified-/documents/sandhu-ferraiolo-kuhn-00.pdf 推荐阅读: 分布式系统关键路径延迟分析实践 百度工程师教你玩转设计模式(装饰器模式) 百度工程师带你体验引擎中的nodejs 揭秘百度智能测试在测试定位领域实践 百度工程师带你探秘C++内存管理(ptmalloc篇) 为什么 OpenCV 计算的视频 FPS 是错的

优秀的个人博客,低调大师

每日一博 | 基于随机森林算法进行硬盘故障预测

摘要:本案例将带大家使用一份开源的S.M.A.R.T.数据集和机器学习中的随机森林算法,来训练一个硬盘故障预测模型,并测试效果。 本文分享自华为云社区《基于随机森林算法进行硬盘故障预测》,作者:HWCloudAI 。 实验目标 掌握使用机器学习方法训练模型的基本流程; 掌握使用pandas做数据分析的基本方法; 掌握使用scikit-learn进行随机森林模型的构建、训练、保存、加载、预测、统计准确率指标和查看混淆矩阵的方法; 案例内容介绍 随着互联网、云计算的发展,数据的存储需求与日倍增,大规模海量数据存储中心是必不可少的基础性设施。虽然新的存储介质例如SSD,已经很多方面拥有了比磁盘更好的性能,但就目前来讲,其高昂的花费仍然使大部分数据中心难以负担,因此,大型数据中心依然会采用传统的机械硬盘作为存储介质。 机械硬盘生命周期通常为3到5年,在2到3年后故障率明显升高,导致换盘量陡增。据统计,在服务器硬件故障中,硬盘故障占比达到48%+,是影响服务器运行可靠性的重要因素。早在上个世纪九十年代,人们就意识到数据的宝贵性远胜于硬盘自身价值,渴望有种技术能对硬盘故障进行预测并实现相对安全的数据保护,因此S.M.A.R.T.技术应运而生。 S.M.A.R.T.,全称为“Self-Monitoring Analysis and Reporting Technology”,即“自我监测、分析及报告技术”,是一种自动的硬盘状态检测与预警系统和规范。通过在硬盘硬件内的检测指令对硬盘的硬件如磁头、盘片、马达、电路的运行情况进行监控、记录并与厂商所设定的预设安全值进行比较,若监控情况将或已超出预设安全值的安全范围,就可以通过主机的监控硬件或软件自动向用户作出警告并进行轻微的自动修复,以提前保障硬盘数据的安全。除一些出厂时间极早的硬盘外,现在大部分硬盘均配备该项技术。关于该技术的更多介绍,请查看S.M.A.R.T.-百度百科。 虽然硬盘厂商采用了S.M.A.R.T.技术来监测硬盘的健康状态,但是大多数厂商都是基于设计规则制定的故障预测手段,预测效果非常差,不能满足日渐严格的提前预测硬盘故障的需求。因此,业界期望使用机器学习技术来构建硬盘故障预测的模型,更准确地提前感知硬盘故障,降低运维成本,提升业务体验。 本案例将带大家使用一份开源的S.M.A.R.T.数据集和机器学习中的随机森林算法,来训练一个硬盘故障预测模型,并测试效果。 关于随机森林算法的理论知识,可参考此视频。 注意事项 如果你是第一次使用 JupyterLab,请查看《ModelAtrs JupyterLab使用指导》了解使用方法; 如果你在使用 JupyterLab 过程中碰到报错,请参考《ModelAtrs JupyterLab常见问题解决办法》尝试解决问题。 实验步骤 1. 数据集介绍 本案例使用的数据集是来自于Backblaze公司的开源数据集,它是一家计算机备份和云存储服务提供商。自2013年以来,Backbreze每年都会公开发布他们的数据中心所使用硬盘的S.M.A.R.T.日志数据,有效地推动了使用机器学习技术进行硬盘故障预测的发展。 由于Backblaze公司发布的S.M.A.R.T.日志数据量较大,本案例为快速演示使用机器学习构建硬盘故障预测模型的过程,仅使用了该公司发布的2020年的数据,相关数据已经准备好,放在OBS中,运行如下代码即可下载这部分数据。 import os import moxing as mox if not os.path.exists('./dataset_2020'): mox.file.copy('obs://modelarts-labs-bj4-v2/course/ai_in_action/2021/machine_learning/hard_drive_disk_fail_prediction/datasets/dataset_2020.zip', './dataset_2020.zip') os.system('unzip dataset_2020.zip') if not os.path.exists('./dataset_2020'): raise Exception('错误!数据不存在!') !ls -lh ./dataset_2020 INFO:root:Using MoXing-v1.17.3- INFO:root:Using OBS-Python-SDK-3.20.7 total 102M -rw-r--r-- 1 ma-user ma-group 51M Mar 21 11:56 2020-12-08.csv -rw-r--r-- 1 ma-user ma-group 51M Mar 21 11:56 2020-12-09.csv -rw-r--r-- 1 ma-user ma-group 1.2M Mar 21 11:55 dataset_2020.csv -rw-r--r-- 1 ma-user ma-group 3.5K Mar 22 15:59 prepare_data.py 数据解释: 2020-12-08.csv:从backblaze公司发布的2020 Q4数据集中抽取出来的2020-12-08这天的S.M.A.R.T.日志数据 2020-12-09.csv:从backblaze公司发布的2020 Q4数据集中抽取出来的2020-12-09这天的S.M.A.R.T.日志数据 dataset_2020.csv:已经处理过的2020年全年S.M.A.R.T.日志数据,下文中“第2.6节 类别均衡度分析”会解释如何得到这部分数据 prepare_data.py: 运行该脚本,会下载2020年全年S.M.A.R.T.日志数据,并进行处理,得到dataset_2020.csv。运行该脚本需要20G的本地存储空间 2. 数据分析 使用机器学习构建任何模型之前,都需要先对数据集进行分析,了解数据集的规模、属性名、属性值、各类统计指标及空值情况。因为我们要先了解数据,才能用好数据。 2.1 读取csv文件 pandas是常用的python数据分析模块,我们先用它来加载数据集中的csv文件。以2020-12-08.csv为例,我们先加载该文件来分析S.M.A.R.T.日志数据的情况 import pandas as pd df_data = pd.read_csv("./dataset_2020/2020-12-08.csv") type(df_data) pandas.core.frame.DataFrame 2.2 查看单个csv文件数据的规模 print('单个csv文件数据的规模,行数:%d, 列数:%d' % (df_data.shape[0], df_data.shape[1])) 单个csv文件数据的规模,行数:162008, 列数:149 2.3 查看头5行数据 使用pandas加载csv后,得到的是一个DataFrame对象,可以理解为一个表格,调用该对象的head()函数,可以查看表格的头5行数据 df_data.head() <style scoped> .dataframe tbody tr th:only-of-type { vertical-align: middle; } .dataframe tbody tr th { vertical-align: top; } .dataframe thead th { text-align: right; } </style> 5 rows × 149 columns 如上所示是表格的头5行数据,表头是属性名,属性名下面是属性值,backblaze网站解释了属性值的含义,翻译为如下: 2.4 查看数据的统计指标 查看完表格的头5行数据,我们再调用DataFrame对象的describe()函数,计算表格数据的统计指标 df_data.describe() <style scoped> .dataframe tbody tr th:only-of-type { vertical-align: middle; } .dataframe tbody tr th { vertical-align: top; } .dataframe thead th { text-align: right; } </style> 8 rows × 146 columns 如上所示是表格数据的统计指标,describe()函数默认对数值类型的列进行统计分析,由于表格的前三列’date’、‘serial_number’、'model’是字符串类型,所以这三列没有统计指标。 各行统计指标的含义解释如下: count: 该列有多少个非空值 mean: 该列的均值 std: 该列数值的标准差 min: 该列数值的最小值 25%: 该列数值的25%中位值 50%: 该列数值的50%中位值 75%: 该列数值的75%中位值 max: 该列数值的最大值 2.5 查看数据空值情况 从上面的输出可以观察到,某些属性的count指标比较小,比如smart_2_raw的count数就比df_train的总行数要小很多,因此我们要再进一步看看各列属性的空值情况,执行如下代码可以查看空值情况 df_data.isnull().sum() date 0 serial_number 0 model 0 capacity_bytes 0 failure 0 smart_1_normalized 179 smart_1_raw 179 smart_2_normalized 103169 smart_2_raw 103169 smart_3_normalized 1261 smart_3_raw 1261 smart_4_normalized 1261 smart_4_raw 1261 smart_5_normalized 1221 smart_5_raw 1221 smart_7_normalized 1261 smart_7_raw 1261 smart_8_normalized 103169 smart_8_raw 103169 smart_9_normalized 179 smart_9_raw 179 smart_10_normalized 1261 smart_10_raw 1261 smart_11_normalized 161290 smart_11_raw 161290 smart_12_normalized 179 smart_12_raw 179 smart_13_normalized 161968 smart_13_raw 161968 smart_15_normalized 162008 ... smart_232_normalized 160966 smart_232_raw 160966 smart_233_normalized 160926 smart_233_raw 160926 smart_234_normalized 162008 smart_234_raw 162008 smart_235_normalized 160964 smart_235_raw 160964 smart_240_normalized 38968 smart_240_raw 38968 smart_241_normalized 56030 smart_241_raw 56030 smart_242_normalized 56032 smart_242_raw 56032 smart_245_normalized 161968 smart_245_raw 161968 smart_247_normalized 162006 smart_247_raw 162006 smart_248_normalized 162006 smart_248_raw 162006 smart_250_normalized 162008 smart_250_raw 162008 smart_251_normalized 162008 smart_251_raw 162008 smart_252_normalized 162008 smart_252_raw 162008 smart_254_normalized 161725 smart_254_raw 161725 smart_255_normalized 162008 smart_255_raw 162008 Length: 149, dtype: int64 这种显示方式不太方便查看,我们把可以空值的数量绘制成曲线图,看起来更直观 import numpy as np import matplotlib.pyplot as plt %matplotlib inline df_data_null_num = df_data.isnull().sum() x = list(range(len(df_data_null_num))) y = df_data_null_num.values plt.plot(x, y) plt.show() 从上面的结果可以看出,表格中的某些属性有大量的空值。 在机器学习领域中,数据集中存在空值是很常见的现象,引起空值的原因有很多种,比如一份用户画像中有很多个属性,但又不是所有用户都有对应的属性值,这时就产生了空值。或者某些数据因为传输超时,导致没有采集上来,也可能会出现空值。 2.6 类别均衡度分析 我们要实现的任务是“硬盘故障预测”,即预测某个硬盘在某个时间是正常还是损坏,这就是一个故障预测问题或异常检测问题,这类问题有个特点就是:正常样本非常多,故障样本非常少,两类样本的数量差异非常大。 比如,执行如下代码,可以看到df_data中硬盘正常的样本有16万个以上,故障的样本却只有8个,类别极度不均衡。 valid = df_data[df_data['failure'] == 0] failed = df_data[df_data['failure'] == 1] print("valid hdds:",len(valid)) print("failed hdds:",len(failed)) valid hdds: 162000 failed hdds: 8 由于大多数机器学习方法的学习过程都是基于统计学的思路来进行学习的,如果直接使用上面这样类别不均衡的数据进行训练,那么模型的能力可能会明显偏向于类别多的样本,类别少的样本就会被“淹没”掉了,在学习过程中发挥不了作用,因此我们需要平衡不同类别的数据。 为了获得更多的故障样本数据,我们可以从backblaze公司发布的2020年全年S.M.A.R.T.日志数据中将所有的故障样本都挑选出来,同时也随机挑出相同数量的正常样本,可以通过下面的代码来实现。 这段代码已被注释掉,如需运行,需要20G的本地存储空间。您也可以不必运行这段代码,因为本案例开头已经下载了dataset_2020.zip,这个压缩包中已经提供了dataset_2020.csv,该csv就是运行下面这段代码得到的文件 # if not os.path.exists('./dataset_2020/dataset_2020.csv'): # os.system('python ./dataset_2020/prepare_data.py') import gc del df_data # 删除 df_data 对象 gc.collect() # 回收内存 2655 2.7 加载类别均衡的数据集 dataset_2020.csv是已经经过类别均衡处理的硬盘S.M.A.R.T.日志数据,下面我们加载该文件,再确认一下类别均衡情况 df_data = pd.read_csv("./dataset_2020/dataset_2020.csv") valid = df_data[df_data['failure'] == 0] failed = df_data[df_data['failure'] == 1] print("valid hdds:", len(valid)) print("failed hdds:", len(failed)) valid hdds: 1497 failed hdds: 1497 可以看到,正常样本和故障样本都是1497个 3. 特征工程 准备好可用的训练集之后,接下来要做特征工程,通俗地讲,特性工程就是要选择表格中的哪些属性来构建机器学习模型。人工设计特征的好坏,很大程度上决定了机器学习模型效果的好坏,所以机器学习领域的研究人员需耗费大量精力在人工设计特征上,是一项比较耗时、耗力,且需要专家经验的工程。 3.1 SMART属性与硬盘故障的相关研究 (1)BackBlaze分析了其HDD故障和SMART属性之间的相关性,并发现了SMART 5、187、188、197、198与HDD故障的相关率最高,这些SMART属性还与扫描错误,重新分配计数和试用计数有关[1]; (2)El-Shimi等发现在随机森林模型中除了以上5个特征外,还有SMART 9、193、194、241、242这5个属性有最大权重[2]; (3)Pitakrat等人评估了21种用于预测硬盘故障的机器学习算法,发现在测试的21种机器学习算法中,随机森林算法在ROC曲线下有最大面积,而KNN分类器具有最高的F1值[3]; (4)Hughes等人也研究用于预测硬盘故障的机器学习方法,他们分析了SVM、朴素贝叶斯的表现,SVM实现了最高性能,检测率为50.6%,误报率为0%[4]; [1] Klein, Andy. “What SMART Hard Disk Errors Actually Tell Us.” Backblaze Blog Cloud Storage & Cloud Backup,6 Oct. 2016,www.backblaze.com/blog/what-smart-stats-indicate-hard-drive-failures/ [2] El-Shimi, Ahmed. “Predicting Storage Failures.” VAULT-Linux Storage and File Systems Conference.VAULT-Linux Storage and File Systems Conference, 22 Mar. 2017, Cambridge. [3] Pitakrat, Teerat, André van Hoorn, and Lars Grunske. “A comparison of machine learning algorithms for proactive hard disk drive failure detection.” Proceedings of the 4th international ACM Sigsoft symposium on Architecting critical systems. ACM, 2013. [4] Hughes, Gordon F., et al. “Improved disk-drive failure warnings.” IEEE Transactions on Reliability 51.3 (2002):350-357. 如上就是前人的一些研究成果,本案例计划采用随机森林模型,因此可以根据上面第2条研究成果,选择SMART 5, 9, 187, 188, 193, 194, 197, 198, 241, 242这些属性来作为特征,它们的含义分别是: SMART 5: 重映射扇区计数 SMART 9: 通电时间累计 SMART 187: 无法校正的错误 SMART 188: 指令超时计数 SMART 193: 磁头加载/卸载计数 SMART 194: 温度 SMART 197: 等待被映射的扇区数 SMART 198: 报告给操作系统的无法通过硬件ECC校正的错误 SMART 241: 逻辑块寻址模式写入总数 SMART 242: 逻辑块寻址模式读取总数 另外,由于不同硬盘厂商的不同型号硬盘记录SMART日志数据的标准可能不一样,所以我们最好将同一型号的硬盘数据挑出来作为训练数据,专门训练一个预测该型号硬盘是否故障的模型。如果需要预测多个不同型号的硬盘是否故障,则可能需要分别训练多个模型。 3.2 硬盘型号选择 执行下面的代码,看一下每种型号的硬盘数据量有多少 df_data.model.value_counts() ST12000NM0007 664 ST4000DM000 491 ST8000NM0055 320 ST12000NM0008 293 TOSHIBA MG07ACA14TA 212 ST8000DM002 195 HGST HMS5C4040BLE640 193 HGST HUH721212ALN604 153 TOSHIBA MQ01ABF050 99 ST12000NM001G 53 HGST HMS5C4040ALE640 50 ST500LM012 HN 40 TOSHIBA MQ01ABF050M 35 HGST HUH721212ALE600 34 ST10000NM0086 29 ST14000NM001G 23 HGST HUH721212ALE604 21 ST500LM030 15 HGST HUH728080ALE600 14 Seagate BarraCuda SSD ZA250CM10002 12 WDC WD5000LPVX 11 WDC WUH721414ALE6L4 10 ST6000DX000 9 TOSHIBA MD04ABA400V 3 Seagate SSD 2 ST8000DM004 2 ST18000NM000J 2 ST4000DM005 2 WDC WD5000LPCX 1 ST8000DM005 1 DELLBOSS VD 1 HGST HDS5C4040ALE630 1 TOSHIBA HDWF180 1 HGST HUS726040ALE610 1 ST16000NM001G 1 Name: model, dtype: int64 可以看到 ST12000NM0007 型号的硬盘数据量最多,因此我们把该型号硬盘的数据过滤出来 df_data_model = df_data[df_data['model'] == 'ST12000NM0007'] 3.3 特征选择 选取上文提到的10个属性作为特征 features_specified = [] features = [5, 9, 187, 188, 193, 194, 197, 198, 241, 242] for feature in features: features_specified += ["smart_{0}_raw".format(feature)] X_data = df_data_model[features_specified] Y_data = df_data_model['failure'] X_data.isnull().sum() smart_5_raw 1 smart_9_raw 1 smart_187_raw 1 smart_188_raw 1 smart_193_raw 1 smart_194_raw 1 smart_197_raw 1 smart_198_raw 1 smart_241_raw 1 smart_242_raw 1 dtype: int64 有空值存在,所以先要填充空值 X_data = X_data.fillna(0) print("valid hdds:", len(Y_data) - np.sum(Y_data.values)) print("failed hdds:", np.sum(Y_data.values)) valid hdds: 325 failed hdds: 339 3.4 划分训练集和测试集 使用sklearn的train_test_split即可划分训练集和测试集,test_size表示测试集的比例,一般取值为0.3、0.2或0.1 from sklearn.model_selection import train_test_split X_train, X_test, Y_train, Y_test = train_test_split(X_data, Y_data, test_size=0.2, random_state=0) 4. 开始训练 4.1 构建模型 准备好训练集和测试集之后,就可以开始构建模型了,构建模型的步骤非常简单,直接调用机器学习框架sklearn中的RandomForestClassifier即可 from sklearn.ensemble import RandomForestClassifier rfc = RandomForestClassifier() 随机森林算法的超参数有很多个,取不同的参数值构建模型会得到不同的训练效果,对于初学者,可以直接使用库中提供的默认参数值,在对随机森林算法的原理有一定的了解之后,可以尝试修改模型的参数来调整模型的训练效果。 4.2 数据拟合 模型训练的过程,也就是拟合训练数据的过程,实现也非常简单,调用fit函数即可开始训练 rfc.fit(X_train, Y_train) /home/ma-user/anaconda3/envs/XGBoost-Sklearn/lib/python3.6/site-packages/sklearn/ensemble/forest.py:248: FutureWarning: The default value of n_estimators will change from 10 in version 0.20 to 100 in 0.22. "10 in version 0.20 to 100 in 0.22.", FutureWarning) RandomForestClassifier(bootstrap=True, class_weight=None, criterion='gini', max_depth=None, max_features='auto', max_leaf_nodes=None, min_impurity_decrease=0.0, min_impurity_split=None, min_samples_leaf=1, min_samples_split=2, min_weight_fraction_leaf=0.0, n_estimators=10, n_jobs=None, oob_score=False, random_state=None, verbose=0, warm_start=False) 5 开始预测 调用predict函数即可开始预测 Y_pred = rfc.predict(X_test) 5.1 统计预测准确率 在机器学习中,分类问题的性能指标,常用的有四种:accuracy(精度)、precision(查准率)、recall(查全率)、F1-Score,四种指标越接近1,表示效果越好。sklearn库中有这四种指标的函数,直接调用即可。 关于四种指标的理论解释,可参考此视频 from sklearn.metrics import accuracy_score, precision_score, recall_score, f1_score print("Model used is: Random Forest classifier") acc = accuracy_score(Y_test, Y_pred) print("The accuracy is {}".format(acc)) prec = precision_score(Y_test, Y_pred) print("The precision is {}".format(prec)) rec = recall_score(Y_test, Y_pred) print("The recall is {}".format(rec)) f1 = f1_score(Y_test, Y_pred) print("The F1-Score is {}".format(f1)) Model used is: Random Forest classifier The accuracy is 0.8270676691729323 The precision is 0.8548387096774194 The recall is 0.7910447761194029 The F1-Score is 0.8217054263565892 每次进行随机森林模型的训练,会得到该模型不同的测试准确率指标,这是由于随机森林算法的训练过程具有一定的随机性导致的,是正常现象。但是同一模型、同一样本的预测结果是确定不变的。 5.2 模型保存、加载、再预测 模型保存 import pickle with open('hdd_failure_pred.pkl', 'wb') as fw: pickle.dump(rfc, fw) 模型加载 with open('hdd_failure_pred.pkl', 'rb') as fr: new_rfc = pickle.load(fr) 模型再预测 new_Y_pred = new_rfc.predict(X_test) new_prec = precision_score(Y_test, new_Y_pred) print("The precision is {}".format(new_prec)) The precision is 0.8548387096774194 5.3 查看混淆矩阵 要分析分类模型的效果如何,还可以使用混淆矩阵来查看,混淆矩阵的横轴表示预测结果的各个类别,纵轴表示真实标签的类别,矩阵方格中的值就代表对应横纵坐标重叠的测试样本数量。 import seaborn as sns import matplotlib.pyplot as plt from sklearn.metrics import confusion_matrix LABELS = ['Healthy', 'Failed'] conf_matrix = confusion_matrix(Y_test, Y_pred) plt.figure(figsize =(6, 6)) sns.heatmap(conf_matrix, xticklabels = LABELS, yticklabels = LABELS, annot = True, fmt ="d"); plt.title("Confusion matrix") plt.ylabel('True class') plt.xlabel('Predicted class') plt.show() 6. 改进模型的思路 如上内容是使用随机森林算法构建硬盘故障预测模型的过程演示,模型精度并不算高,有如下几个思路可以提升模型的精度: (1)本案例只使用了Backblaze公司2020年的数据,您可以尝试使用更多的训练数据; (2)本案例只使用了10个SMART属性作为特征,您可以尝试使用其他方法来构建特征; (3)本案例使用了随机森林算法来训练模型,您可以尝试使用其他的机器学习算法; 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

每日一博 | vivo 云原生容器探索和落地实践

作者:vivo 互联网容器团队- Pan Liangbiao 本文根据潘良彪老师在“2022 vivo开发者大会"现场演讲内容整理而成。公众号回复【2022 VDC】获取互联网技术分会场议题相关资料。 2018年起,vivo以容器作为基础底座,打造了一站式云原生机器学习平台。向上支撑了算法中台,为算法工程师提供数据管理、模型训练、模型管理、模型部署等能力,为广告、推荐和搜索等业务赋能,成功为算法实现了降本、提效,让云原生和容器价值初露锋芒。基于机器学习平台的试点成果,经过算法场景的试点实践和价值分析,对内部战略做了升级。确定基于云原生理念去构建行业一流的容器生态,实现规模化的降本提效目标。 本文会详细介绍vivo在容器集群高可用建设中的具体实践,包括在容器集群高可用建设、容器集群自动化运维、容器平台架构升级、容器平台能力增强、容器生态打通等层面的打磨和建设。目前,vivo容器产品能力矩阵逐渐趋于完善,并将围绕全面容器化、拥抱云原生和在离线混部三个方向继续发力。 云原生和容器,是当下比较火热的话题,其中 Kubernetes更是成为容器编排领域的事实标准。 国内外各企业在内部落地云原生和容器的过程中,基于自己的业务场景和发展阶段,会遇到各种问题和挑战,本文是vivo在云原生容器领域的探索和落地实践,希望能对读者有一些借鉴和帮助。 一、容器技术和云原生理念 首先是容器技术和云原生理念的介绍。 1.1 容器技术简介 容器技术不是一个新技术,从1979年unix系统的chroot诞生到现在,历经40多年的发展,共经过了四个阶段,分别是:技术萌芽期、技术迸发期、商用探索期和商用拓展期。 每个阶段,解决了不同的技术问题,分别是:环境隔离、软件分发和编排、商用服务形态、规模化和场景拓展。 相比于虚拟机,容器技术少了一层虚拟操作系统的损耗,因此它比虚拟机具有更好的性能表现。另外容器在系统资源、启动时间、集群规模、高可用策略等方面,也有非常明显的优势。 2020年CNCF中国云原生调查报告显示,接受调查的中国企业,有68%已经在生产环境使用容器技术。 从行业发展看,不管是云厂商还是各大科技公司,都在基于容器技术构建自己的新一代基础架构,推动企业数字创新。容器技术已经得到广泛的认可和普及。 1.2 云原生理念介绍 容器技术催生了云原生思潮,云原生生态推动了容器技术的发展。那么云原生的准确定义和含义是什么呢? 云原生其实没有标准定义,如果非要给他一个定义,行业有两种观点: 一个定义来自Pivotal 这家公司,它是云原生应用的提出者,是云原生的先驱者、探路者。Pivotal最新的官网对云原生的介绍有四个要点,分别是:DevOps、持续交付、微服务和容器。 另外一个定义来自CNCF,CNCF建立于2015年,它是一个开源组织,其存在的目的,是支持开源社区开发关键的云原生组件,包括 Kubernetes、Prometheus监控等。 它把云原生分为3种核心技术和2个核心理念: 3种核心技术:分别是容器、微服务、服务网格。 2个核心理念:分别指不可变基础设施和声明式API。 但是,不管是那一种定义,容器都是其基础,是云原生落地的核心技术手段。 1.3 云原生价值分析 任何技术和理念,都必须有实际的业务价值。从效率、成本、质量三个维度,来分析云原生和容器的技术价值,可总结如下: 效率:可实现持续交付部署快、镜像封装可移植、弹性计算秒扩容。 成本:可实现按需分配不浪费、统一调度高填充、混合部署少碎片。 质量:可实现运行状态可观测、故障发生可自愈、集群管理可运维。 二、vivo 容器技术探索与实践 新技术的引入带来新的价值,也必然会引入新的问题,接下来介绍vivo在容器技术上的探索和实践。 2.1 试点探索 在vivo的算法场景中,机器学习平台负责算法模型迭代,是互联网算法业务中核心的一环,早期的平台基于传统的架构,在效率、成本、性能和体验上均有一定的不足,无法满足算法业务快速增长的诉求。基于此,我们首先在算法场景进行容器的试点探索。从2018年开始,我们以容器作为基础底座,打造了vivo的一站式云原生机器学习平台,向上支撑了公司的算法中台,为算法工程师提供数据管理、模型训练、模型管理、模型部署等能力,为广告、推荐和搜索等业务赋能。 vivo的云原生机器学习平台具备如下5大优势: 场景全:业务端到端,覆盖推荐、广告、搜索多场景。 体验好:排队时间短,用户体验优,任务P99排队时长小于45分钟。 成本低:调度能力好,资源利用率高,CPU利用率均值大于45%。 效率高:网络规模大,训练跑得快,训练速度8.3亿样本每小时。 结果优:算法迭代稳定,训练成功率高,训练成功率大于95%。 vivo云原生机器学习平台,成功为算法实现了降本、提效,让云原生和容器价值初露锋芒。 2.2 价值挖掘 基于前面机器学习平台的试点成果,我们深入分析和挖掘容器和云原生的价值,结合vivo的情况,我们发现容器和云原生是企业大规模降本和提效的最佳方案。 1)在降本方面 当前我们内部服务器资源的利用率较低,以CPU利用率为例,当前vivo服务器整体利用率均值在25%左右,相比行业一流水平的40%~50%,还有不少的提升空间。 容器在资源隔离、统一调度和在离线混部等方面的优势,均是提升资源ROI的有效技术手段。 2)在提效方面 当前我们在中间件版本升级、机器迁移、测试环境管理、突发流量应对和全球化部署的环境一致性等方面均有业务痛点。 容器的快速交付、弹性自运维、微服务、服务网格等云原生技术和架构,则是提效的有力措施。 2.3 战略升级 经过算法场景的试点实践和价值分析,我们对内部战略做了升级, 确定基于云原生理念去构建行业一流的容器生态,实现规模化的降本提效目标。 为了更好匹配战略落地,拥抱云原生,我们还对内部技术架构重新规划和升级,新增引入统一流量接入平台、容器运维管理平台、统一名字服务、容器监控等平台和能力,支撑容器生态在公司内部的全面建设和推广。 2.4 面临挑战 2.4.1 集群挑战 要提供大规模的生产可用的容器服务,容器集群的可用性首先会面临诸多挑战。下面介绍vivo容器化,在生产集群建设过程中遇到的4个比较大的挑战。 集群规模快速增长:vivo集群服务器规模上万个宿主机节点,管理的集群数十个,单集群规模2千+,实例数10万+,对集群性能和机器管理挑战极大。 集群运维、运营和标准化:由于早期集群管理不规范,黑屏化操作和人为误操作等问题层出不穷,集群运维人员每天因为各种救火忙得焦头烂额。 集群容器监控架构和可观测性:随着集群规模快速增长,容器的监控组件面临极大压力,对容器监控的采集、存储和展示,提出更高的要求。 线上K8s版本升级迭代:面对Kubernetes版本的快速迭代,需要实现给飞行的飞机换引擎。 针对挑战,我们的应对方案分别是:高可用、可观测、标准化和自动化。其中容器监控和k8s版本无损升级的挑战,vivo公众号有详细技术方案的介绍,本文侧重介绍集群高可用和运维自动化两部分。 2.4.2 平台挑战 除了集群稳定性的挑战,平台也将面临各种挑战,由于容器平台和周边生态能力不完善,对业务存在较高的适配和迁移成本。总结起来我们遇到的挑战主要有4点: 容器IP的变化:k8s早期把业务都设计成无状态的,其原生实现是每次发布容器的IP都会变化,这对部分依赖固定IP的传统业务不太友好,业务改造成本较高。 周边生态的适配和兼容:包括发布系统、中间件微服务平台、内部开发框架和流量接入层等 用户使用习惯:vivo有比较成熟的发布平台,用户习惯按机房发布,习惯资源分配和发布分开操作。 价值输出:运维研发效率的提升不好量化,容器成本优势短期不好衡量。 上面这些挑战,推动我们要进行容器周边生态打通,同时通过增强容器平台产品能力,来适配各种业务场景,降低用户的迁移成本。 2.5 最佳实践 2.5.1 容器集群高可用建设 接下来,介绍vivo在容器集群高可用建设中的最佳实践,我们是从故障预防、故障发现和故障恢复,3个维度来构建容器集群可用性保障体系的。 1、在故障预防上,我们分别从流程工具、容灾能力和基础架构3个方面来进行建设: 流程工具:主要包含故障预案和故障演练,以及通过建设运维管理平台,来实现运维标准化、白屏化和自动化。 容灾能力:主要是构建业务跨故障域容灾能力,保障集群故障时,服务和业务流量能跨集群调度和快速一键迁移等。 基础架构:主要是通过屏蔽用户对底层集群的感知,一个机房多套集群,一个业务同时部署在多个集群上,避免单集群故障对业务造成影响。 2、在故障发现上,我们主要是通过,自建的监控大盘、日常集群巡检、核心组件监控、集群外拨测等措施,对故障及时发现和处理,降低对业务影响。 3、在故障恢复上,主要是基于前面的故障预案,快速恢复,及时止损,并做好故障的复盘,不断改进我们的故障预防和发现机制,沉淀宝贵经验。 另外,集群的可观测性是可用性保障的一个重要依据,我们通过建设自己的SLO面板,对集群状态实时地进行监控,只有对运营状况了如指掌,才能做到稳如泰山,沉着应对一切变化。 2.5.2 容器集群自动化运维 除了容器集群自身稳定性建设,在运维自动化方面,我们建设了容器多集群管理平台,实现集群配置标准化,核心运维场景白屏化,来提升运维效率。 我们的容器集群管理平台,是以云原生的方式来管理云原生,简单来说,就是基于k8s的operator机制,实现k8s on k8s。 当前,我们的平台已经能够实现多集群的统一纳管,集群部署也是自动化、标准化的,还实现了底层IAAS层打通,集群节点能全流程化、可视化的一键扩缩容,而集群巡检功能,可以帮助我们及时发现集群的问题和隐患。 通过平台进行日常运维和操作,不仅能提升效率,也具备审计能力,有操作和变更日志可追溯,便于问题定位。 2.5.3 容器平台架构升级 为适应业务容器化在内部的快速普及和推广,我们升级了vivo的容器平台架构。 新的架构分为4层,容器+k8s则作为基础的统一底座,向下对接公司IAAS层的基础设施,向上提供容器产品和平台能力,并通过开放API供上层调用和定制自己的上层逻辑。 API之上是容器支持的各种服务类型,包括在线服务、中间件服务、大数据计算、算法训练、实时计算等,最上面是为vivo互联网各个业务进行赋能。 基于这套容器平台架构,业务能实现资源隔离部署、快速交付和按需使用,同时也具备更好的弹性伸缩能力。对平台,我们可以统一资源的调度,实现资源的分时复用、在离线混部等,来提升资源的利用率。 2.5.4 容器平台能力增强 vivo内部容器化场景比较多样化,为了让业务能够安心、低成本的接入和使用容器的能力,在推广过程中,我们基于开源+自研做了容器的适配和原生能力的增强。 下面对6个产品能力增强进行简单的分享: 云原生工作负载增强:基于开源的openkruise,对原生deployment、statefulset等workload进行了增强,实现诸如原地升级、发布暂停、流式和配置优先级等扩展能力。 服务无损发布增强:基于内部框架和平台自主研发,实现HTTP、RPC等协议框架的流量无损发布。 容器镜像安全:基于开源的Harbor定制开发,实现容器镜像安全扫描和卡控能力。 容器镜像加速:基于开源dragonfly2定制扩展,让大规模集群镜像的分发性能提升80%以上。 IP固定能力增强:基于有状态服务和CNI进行自研,支撑黑白名单、有状态服务场景诉求,降低业务接入改造成本。 多集群管理能力增强:基于开源Karmada进行功能优化和扩展,提升业务容灾能力,支撑单集群横向扩展能力。 当然,在充分享受开源红利的同时,我们也持续地参与开源协同,回馈社区。在使用和自研的过程中,我们也把自己生产实践过程中发现的问题和积累的经验提交到社区,例如Dragonfly2、Karmada等。 2.5.5 容器CICD一体化 除了平台能力的增强,容器平台作为一个PaaS平台,需要和周边的生态打通,才能让业务更好的迁移和使用,其中最重要的就是发布系统的打通,也就是CICD平台。 几乎每个科技公司都会有自己的CICD,它是一个DevOps自动化的工具,可进行业务构建和编排部署的流水线。 vivo的CICD平台底层架构是基于JenKins+Spinnaker实现的,整个容器构建和部署流程如下: 首先,用户在CICD平台上创建好发布过程的流水线配置并保存。 其次,CI环节可实现和内部GitLab对接,拉取代码,基于jenkins进行代码编译和镜像构建,构建好的镜像经过安全扫描后,推送到开发环境的镜像仓库。 最后,在CD环节,CICD平台会调用容器平台提供的API,进行开发、测试、预发和生产环境的部署操作。 2.5.6 统一流量接入 接下来,介绍容器生态里,最重要的业务流量接入层的打通。 早期,vivo内部是基于Nginx,来实现的南北流量和东西流量的转发。在虚拟机和物理机场景能比较好的支撑,随着容器在内部全面的推广,传统的Nginx架构已不能适配。 主要体现在,容器场景业务实例数量,相比原来虚拟机和物理机成倍数增长,容器发布过程IP的频发变化和状态同步,都会对Nginx集群造成非常大的压力,在业务请求量非常大的情况下,接入层的配置文件刷新和加载,会造成业务的抖动,这是我们不能接受的。 基于这个背景,我们基于APISIX构建了云原生流量接入层,来适应全面容器化的需求。经过一年多的建设,当前我们的统一流量接入平台已经能够很好的支撑容器化的接入,同时具备更好的扩展能力。 2.6 实践成果 2.6.1 产品能力矩阵完善 经过多年的打磨和建设,vivo容器产品能力矩阵趋于完善,整个产品能力矩阵,分为4层: 基础服务层:包含3类服务,镜像管理、集群运维和集群监控。 能力层:包含6个核心能力,分别是集群调度、CAAS-API、容器配置、容器业务监控告警、容器日志和平台扩展能力。 平台层:包含2大平台能力,分别是CI和CD。 业务层:当前覆盖了vivo互联网所有业务场景。 2.6.2 业务接入成果凸显 接下来,会具体介绍下vivo容器推广情况。 目前容器在vivo内部主要覆盖4大场景,分别是:互联网在线业务、算法在线、大数据计算和AI算法训练等。接下来,会从接入规模和价值来简单介绍。 互联网在线服务:内部各个业务线均有大量服务运行在容器上,例如vivo商城、账号、浏览器、快应用、天气等,已经接入服务600+。 算法在线服务:当前接入500+服务,3000+服务器,涉及推广搜的各个业务线。 大数据计算服务:包含离线计算如Spark,实时计算如Flink、Olap等场景,当前接入集群20+。 AI算法训练:主要是提供GPU、CPU异构计算,业务场景如Tensorflow、mpi等场景,算力十几万核,以及若干GPU卡。 业务容器化后,给业务在降本提效上带来的效果非常明显,包括但不限于扩缩容效率、弹性伸缩能力、业务自愈能力、资源成本等方面。 2.7 实践总结 基于我们的探索和实践,可总结为技术价值、推广策略、平台建设和云原生突破4个维度的思考。 找价值:关注新技术,但不执着于技术本身,必须结合业务痛点和价值。 定策略:自下而上小范围试点探索,产生实际的业务价值,影响自上而下的战略调整。 建平台:当已经有比较完善的平台和能力时,要找到容器的切入点,进行融合共建,切忌推到重来;对于需要从0到1建设的新能力,需要果断的孵化创新。 求突破:在业务容器化过程中,为了快速容器化,我们做了许多的兼容和适配。为了更好的降本提效,未来,我们希望引导用户,实现从使用云原生,到用好云原生的突破。 总的来说,技术服务于业务,企业应基于自身现状,寻找合适的解决方案,并为业务创造价值。 三、vivo对云原生的未来展望 3.1 vivo基础架构发展 从过去看未来发展,回顾过去10年历程,vivo基础架构的发展经历了3个阶段: 阶段一:传统研发运维阶段,从2011到2018年,从早期的do分离研发模式,到基于openstack+kvm的虚拟化方案落地。 阶段二:应用架构互联网化阶段,从2018到2020年,容器化开始在vivo内部兴起。 阶段三:云原生基础架构演进阶段,从2021年到现在,云原生和容器将会在vivo内部有更多场景的应用和推广,如在离线混部等。 3.2 vivo云原生未来展望 回归事物本源思考,做正确的事,并把事情做正确。不盲从,有定力,基于价值,客观看待新技术发展,大胆假设、小心验证、实践出真知。 vivo云原生的未来,将会朝着3个方向发展,分别是全面容器化、拥抱云原生和在离线混部。 我们的愿景是:一次开发到处运行,通过自动运维实现极致效率和成本最优! 对开发人员:我们希望大家成为那只遨游海上的蓝色鲸鱼,驮着我们的业务应用,一次构建到处分发,灵活调度和运维。 对管理者:我们希望追求效率的同时,能够实现成本最优。 END 猜你喜欢 异构混排在vivo互联网的技术实践 云原生时代数据库运维体系演进 本文分享自微信公众号 - vivo互联网技术(vivoVMIC)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | 得物视频编辑工具优化全指南

一、背景介绍 随着4G网络的推广和网络带宽的提升,视频成为互联网用户主要的消费载体,用户通过短视频来分享和浏览信息。由此视频的编辑功能越来越重要、越来越普遍。视频编辑的App也如雨后春笋般涌现。 为更好地推动得物App社区业务的发展,得物也自研符合得物需求的视频编辑工具。我们致力于打造一个“更快、更强”的视频编辑工具。 二、视频编辑工具介绍 为了让大家更好地了解得物App的视频编辑工具,我们先简单介绍一下视频编辑工具的主要功能。 下面是得物App视频编辑工具的主要功能: 视频编辑工具的重点如下: 视频编辑工具需要操作的资源: 文字:包括普通的文字、特殊的艺术字、花字等等; 图片:包括静态图,如JPEG/PNG等等,也包括HEIC/GIF等动态图; 视频:包括各种各样的视频(各种编码和封装格式),主流的格式一般是MP4的封装格式、H264视频编码格式、AAC音频编码格式等等; 音频:包括各种各样的音频(各种编码和封装格式),当然视频当然也是包含音频轨道的。 视频编辑工具主要的操作方式: 操作图片、视频帧:我们知道视频是一帧一帧的图片组成的,所以操作视频帧和操作图片是一样的道理,我们通过添加一些特效在图片和视频帧上面,实现一些有趣的效果来吸引用户。 操作音频:主流的操作音频方式如倍速、调整音量、变调等等,都是现今短视频的主要玩法。 视频编辑工具最终生成的是一个新的视频,这个视频将特定的资源应用一些特效生成一个新的视频。 下面的流程图可以很方便地让大家了解视频编辑的工作流程。为了方便,我们输入一个视频,加上一些特效,生成一个新的视频。 从上面的流程可以看出来,原始视频A.mp4经过解封装分离出音频轨道和视频轨道,对它们解码之后,对音频数据应用音频特效、对视频帧数据应用视频特效,然后编码封装合成一个新的视频。当然解码和编码都是有一个队列控制的,流程图上标注了,没有深入展开,大家了解即可。 经过上面的介绍,大家对视频编辑工具有了大概得了解,其实衡量一个视频编辑工具做得好不好,主要从下面这几个方面着手: 内存占用情况 导出视频的速度如何 导出视频的清晰度如何 下面从这三方面详细展开给大家阐述得物App的视频编辑工具优化的心路历程。 三、内存优化 性能是所有程序好不好的首要指标,一个工具即使功能再强大,但是一点就崩溃,或者用着用着内存暴涨、应用卡死,估计这个应用不能称为一个优秀的应用,下面我们具体谈一谈视频编辑工具的优化检测方案。 优化内存从良好的编码习惯开始,尤其对音视频这种对内存需求非常高的应用而言。例如一个1080 * 1920的视频,解码出来原始数据一帧图片大小也是1080 * 1920,占用内存是1080 * 1920 * (8 * 3 ) / 8 = 5.93 MB,一个视频帧就占用这么大,1秒一般有30帧,那得占用177.9MB,如果不加控制,那不管多高性能的手机也经不住这样的折腾。希望下面的内存检测和优化方案可以给你带来一些帮助。 3.1 合理设计队列 上面我们在介绍视频编辑流程的视频谈到了解码队列和编码队列的概念。其实队列这个概念在音视频中使用非常频繁,正是因为内存的限制,所以才引入队列这个控制方式。大家可能还有点懵,但是看完下面的流程图,我相信你一定会豁然开朗。 我们仅选取解码的部分来分析一下队列的重要应用。 在视频编辑工具中有几个重要的队列: 解码过程中: Video Packet Queue:视频解码之前Packet存放的队列,一般建议的队列大小是100 Audio Packet Queue:音频解码之前Packet存放的队列,一般建议的队列大小是150 Video Frame Queue:视频解码之后Frame存放的队列,一般建议的队列大小是3 Audio Frame Queue:音频解码之后Frame存放的队列,一般建议的队列大小是8 编码过程中: Encode Video Packet Queue:视频编码之后Packet存放的队列,一般建议的大小是100 Encode Audio Packet Queue:音频编码之后的Packet存放的队列,一般建议的大小是150 按照上面的方式设计队列的大小,可以在保证功能正常的情况下最大程度的降低内存占用,提升用户体验。 3.2 排查内存泄漏 Android上排查内存泄漏的方式有很多,这里介绍两种: Asan检测 Profile检测 Asan全称是AddressSanitizer是一种基于编译器的快速检测的工具,用于检测原生代码中的内存错误问题,Asan可以解决如下四种核心问题: 堆栈和堆缓冲区上溢、下溢 释放之后堆重新使用问题 超过范围的堆栈使用情况 重复释放、错误释放问题 Asan的使用方式建议参考google官方文档,这儿就不多作介绍了: https://github.com/google/sanitizers/wiki/AddressSanitizer 关于Profile的使用,如果需要检测Native内存使用情况,需要满足API>=29,大家在使用的时候需要非常注意。 下面是我们在demo中应用Asan抓取的堆栈: 20042-20042/? A/DEBUG: *** *** *** *** *** *** *** *** *** *** *** *** *** *** *** *** 20042-20042/? A/DEBUG: Build fingerprint: 'samsung/t2qzcx/t2q:11/RP1A.200720.012/G9960ZCU2AUGE:user/release-keys' 20042-20042/? A/DEBUG: Revision: '13' 20042-20042/? A/DEBUG: ABI: 'arm64' 20042-20042/? A/DEBUG: Timestamp: 2021-09-17 00:32:31+0800 20042-20042/? A/DEBUG: pid: 19946, tid: 20011, name: AudioTrack >>> com.jeffmony.audioplayer <<< 20042-20042/? A/DEBUG: uid: 10350 20042-20042/? A/DEBUG: signal 6 (SIGABRT), code -1 (SI_QUEUE), fault addr -------- 2021-09-17 00:32:31.157 20042-20042/? A/DEBUG: Abort message: '================================================================= ==19946==ERROR: AddressSanitizer: heap-use-after-free on address 0x004ac1e41080 at pc 0x007157f69580 bp 0x00705c0bb350 sp 0x00705c0bab08 READ of size 1792 at 0x004ac1e41080 thread T32 (AudioTrack) #0 0x7157f6957c (/data/app/~~G094WKQQj7KZvdhvGYDLDA==/com.jeffmony.audioplayer-kcu1nmgzpBIQDRJDxCJDOQ==/lib/arm64/libclang_rt.asan-aarch64-android.so+0x9f57c) #1 0x706549c228 (/data/app/~~G094WKQQj7KZvdhvGYDLDA==/com.jeffmony.audioplayer-kcu1nmgzpBIQDRJDxCJDOQ==/lib/arm64/libltpaudio.so+0x14228) #2 0x706549bcd4 (/data/app/~~G094WKQQj7KZvdhvGYDLDA==/com.jeffmony.audioplayer-kcu1nmgzpBIQDRJDxCJDOQ==/lib/arm64/libltpaudio.so+0x13cd4) #3 0x70654994f0 (/data/app/~~G094WKQQj7KZvdhvGYDLDA==/com.jeffmony.audioplayer-kcu1nmgzpBIQDRJDxCJDOQ==/lib/arm64/libltpaudio.so+0x114f0) #4 0x70654a9cbc (/data/app/~~G094WKQQj7KZvdhvGYDLDA==/com.jeffmony.audioplayer-kcu1nmgzpBIQDRJDxCJDOQ==/lib/arm64/libltpaudio.so+0x21cbc) #5 0x70654a91d4 (/data/app/~~G094WKQQj7KZvdhvGYDLDA==/com.jeffmony.audioplayer-kcu1nmgzpBIQDRJDxCJDOQ==/lib/arm64/libltpaudio.so+0x211d4) #6 0x715af9d188 (/system/lib64/libwilhelm.so+0x1c188) #7 0x71570ea290 (/system/lib64/libaudioclient.so+0x8b290) #8 0x71570e9480 (/system/lib64/libaudioclient.so+0x8a480) #9 0x7156b664d4 (/system/lib64/libutils.so+0x154d4) #10 0x71593e9974 (/system/lib64/libandroid_runtime.so+0xa5974) #11 0x7156b65db0 (/system/lib64/libutils.so+0x14db0) #12 0x7156ace234 (/apex/com.android.runtime/lib64/bionic/libc.so+0xb6234) #13 0x7156a68e64 (/apex/com.android.runtime/lib64/bionic/libc.so+0x50e64) 0x004ac1e41080 is located 0 bytes inside of 1792-byte region [0x004ac1e41080,0x004ac1e41780) freed by thread T32 (AudioTrack) here: #0 0x7157f74c64 (/data/app/~~G094WKQQj7KZvdhvGYDLDA==/com.jeffmony.audioplayer-kcu1nmgzpBIQDRJDxCJDOQ==/lib/arm64/libclang_rt.asan-aarch64-android.so+0xaac64) #1 0x70654a6d2c (/data/app/~~G094WKQQj7KZvdhvGYDLDA==/com.jeffmony.audioplayer-kcu1nmgzpBIQDRJDxCJDOQ==/lib/arm64/libltpaudio.so+0x1ed2c) #2 0x70654a6af0 (/data/app/~~G094WKQQj7KZvdhvGYDLDA==/com.jeffmony.audioplayer-kcu1nmgzpBIQDRJDxCJDOQ==/lib/arm64/libltpaudio.so+0x1eaf0) #3 0x706549bf4c (/data/app/~~G094WKQQj7KZvdhvGYDLDA==/com.jeffmony.audioplayer-kcu1nmgzpBIQDRJDxCJDOQ==/lib/arm64/libltpaudio.so+0x13f4c) #4 0x706549bcd4 (/data/app/~~G094WKQQj7KZvdhvGYDLDA==/com.jeffmony.audioplayer-kcu1nmgzpBIQDRJDxCJDOQ==/lib/arm64/libltpaudio.so+0x13cd4) #5 0x70654994f0 (/data/app/~~G094WKQQj7KZvdhvGYDLDA==/com.jeffmony.audioplayer-kcu1nmgzpBIQDRJDxCJDOQ==/lib/arm64/libltpaudio.so+0x114f0) #6 0x70654a9cbc (/data/app/~~G094WKQQj7KZvdhvGYDLDA==/com.jeffmony.audioplayer-kcu1nmgzpBIQDRJDxCJDOQ==/lib/arm64/libltpaudio.so+0x21cbc) #7 0x70654a91d4 (/data/app/~~G094WKQQj7KZvdhvGYDLDA==/com.jeffmony.audioplayer-kcu1nmgzpBIQDRJDxCJDOQ==/lib/arm64/libltpaudio.so+0x211d4) #8 0x715af9d188 (/system/lib64/libwilhelm.so+0x1c188) #9 0x71570ea290 (/system/lib64/libaudioclient.so+0x8b290) 显示message是:heap-use-after-free on address 0x004ac1e41080 说明是使用了已经释放掉的内存了,再继续看,这个内存具体在什么地方被释放的?0x004ac1e41080 is located 0 bytes inside of 1792-byte region [0x004ac1e41080,0x004ac1e41780) Asan一个很大的优势就是可以追踪内存释放的路径,防止出现内存泄漏和野指针问题,特别是野指针,一旦出现特别难排查,简直是C++开发的噩梦,希望大家用好工具,同时培养良好的C++编码习惯。 3.3 优化线程 另一个影响内存的重要因素是线程,视频编辑工具涉及到的线程非常多,线程的使用得遵循一些基本的原则: 尽量少创建线程 尽量少使用pthread_mutex_t 本着功能隔绝原则使用线程 能同步就别异步 以编辑模块为例,这儿列一下我们使用到的所有线程: GL处理线程 视频解封装线程 视频中视频轨道解码线程 视频音频轨道解码线程 抽取缩略图线程 音频编码线程 视频编码线程 视频封装线程 如果插入了独立的音频文件,还需要添加两个额外的线程: 音乐文件播放线程 音乐文件解码线程 上面列出的是一个视频编辑工具能正常工作所必备的最少线程,如果你的视频编辑工具中多了什么线程,我们建议可以适当优化一下,毕竟少一个线程,可以少一分开销,而且少一分线程同步的工作。 我们在底层也按照Android的消息机制重写了一套C++层的消息分发SDK,这个我们后续会另外分享文章阐释我们定制的消息分发SDK,这儿点到为止。 四、提升导出视频的速度 我们使用视频编辑工具,最终是希望导出一个视频,如果这个导出的过程很慢,那肯定是无法忍受的,从上面的介绍我们已知视频的导出需要经过“解码——应用特效——编码”的过程,其中解码和编码这两个过程对速度的影响至关重要。因为解码和编码视频需要耗费大量的资源,目前主要有两种方式——“软解/编码”和“硬解/编码”。 如果你使用过FFmpeg或者其他使用CPU进行视频编解码的来处理视频的话,你可能已经遇到了处理速度慢的问题。这主要是因为软编码和软解码使用CPU进行运算,而CPU在处理视频上的速度远低于DSP芯片;简而言之“软解/编码”主要通过CPU来工作,通过CPU来主导大量的计算工作,是原始的处理方式,当然耗费的时间也比较长;“硬解/编码”是通过GPU来处理,GPU是专用的图形处理芯片,对视频的解码和编码有专门的优化,所以编码和解码的速度非常快。 Android上使用MediaCodec来实现“硬解/编码”,iOS上使用VideoToolBox来实现“硬解/编码”,这里着重介绍Android上编码解码的速度优化。 从上面的流程我们可以看出,编码在解码的后面,一个时长60s(30fps)的视频,需要解码1800帧,然后编码1800帧视频才能完整生成另外一个视频,这样串行的等待是耗时的主要原因。 这时候我们参考多线程方案,将一个60s的视频均分为两段,然后这两段视频同时进行解码操作,生成导出了两个30s的临时缓存视频文件,随后将这两个30s的视频合并为一个60s的B.mp4视频,最后删除临时缓存文件,这样我们只需要同时处理900帧的数据,理论上可以提升一倍的导出速度。 这就是并行导出,下面是得物App并行导出的基本流程。 首先我们要明确导出视频是需要消耗资源的,这个资源就是MediaCodec,最终是送入到GPU中处理,一个手机中的MediaCodec实例是有限的,正常情况下,一个手机可以提供的MediaCodec实例最多有16个,如果当前使用的MediaCodec实例超过16个,那么手机将无法正常工作。MediaCodec资源是手机中的所有App共同持有。所以并行分段的个数不是越多越好。 只有一段,需要两个MediaCodec(一个用来解码视频,一个用来编码视频),注意:音频的解码和编码可以不要用MediaCodec,毕竟音频的耗时少多了,不是瓶颈。 分成两段需要四个MediaCodec,分成三段需要六个MediaCodec,分成四段需要八个MediaCodec,以此类推。 下面是并行导出的测试结果: 两段并行速度提升50% ~ 70%,内存增加20%, 三段并行速度提升60% ~ 90%,内存增加80%;并行超过三段的话就无法明显提升速度了。我们比较建议并行两段,在一些性能很好的机型上并行三段。 如果有些同学对视频导出过程中文件操作还有疑问的,下面的示意图可以比较清楚地看出并行导出操作本地文件的过程: 并行导出的过程中,生成了两个临时文件 并行导出完成后,这两个临时文件合并为一个新的文件,两个临时生成的文件被删除了(节省用户宝贵的存储空间) 原始文件jeffmony_out.mp4并没有被删除/修改 Tips:目前我们在处理过程中生成的临时文件和最终的适配文件都会保存在/sdcard/Pictures/duapp/Compile/下,而在处理完成后的临时文件清理过程会触发在某些机型上的保护机制,建议后续调整到App的私有目录下。 当然还有其他的提升导出速度的建议,例如在视频帧特效处理的过程中,我们建议: 尽量采用FBO/EBO/ABO方式处理texture 纹理如果过大要进行压缩 严禁采用glFinish() 这些做法都是我们在视频编辑开发过程中的切实经验,希望能给大家带来一些帮助。 五、提升导出视频的清晰度 一个视频编辑功能是否足够优秀,其中的一个重要指标就是同等条件下导出的视频是否足够清楚,通常而言,衡量视频是否清晰的有两种方式: 主观标准:找一些用户观看不同的视频,根据用户的观感输出视频清晰度的对比结果,用户一般根据色彩、画面亮度、柔和度等来评估清晰度。 客观标准:利用算法计算视频画面质量分,目前比较推荐Netflix推出的开源库VMAF来计算视频帧的质量分。 实际上主观标准是比较准确的,但是可操作性比较差,特别是处理海量视频的时候,需要大量的人力,无法有效开展,因此日常工作中还是推荐客观标准进行海量计算,主观标准进行重点判断。具体的可以结合业务的重要程度来开展。 下面结合我们实际的工作给出具体提升视频清晰度的方式: 视频基础编码信息优化 Profile优化:Profile有三种Level,分别是Baseline、Main、High,其中Baseline Profile对应清晰度最低,Android 3.0之后的版本都支持的,Main Profile清晰度比Baseline Profile清晰度要好,但是从Android 7.0之后才支持,High Profile清晰度最高,也是从Android 7.0之后才支持。我们在设置Encoder Profile Level之前,需要判断一下当前是否支持。 Bitrate码率设置: 视频码率是视频数据传输时单位时间内传送的数据位数。单位是kbps,望文生义,码率越大,单位时间填充的数据就越多,视频质量就越高。但码率也不是设置的越大越好,超过必要限度,对视频画质的提升已不明显,建议采用合适的factor来调整码率。Bitrate = width * height * frameRate * factor,其中factor=0.15。 Bitrate Mode: 有三种通过的编码模式——VBR(可变码率)、CBR(固定码率)、ABR(平均码率),其中ABR是最好的方式,可以兼顾质量和视频大小。 B帧设置: 视频有I帧、P帧、B帧构成,其中I帧最大,P帧次之,B帧最小,我们在编码时尽量多设置B帧(在合理的范围内),并不会降低清晰度,但是可以大大降低视频的大小,这样我们就可以相应地调大码率,最终实现了提升清晰度的目标。 HEVC编码优化: 使用HEVC编码,可以保证在不增加文件大小的情况下,大大提升视频的清晰度。在相同的图像质量下,HEVC编码的视频比H.264编码的视频约减少40% 色彩调优 综合调整亮度、对比度、色温、饱和度、锐度等颜色参数,进而优化整体的视频画面,让视频画面看上去“更清晰”。 **超分算法 **: 采用ESRGAN算法,利用机器学习的优势对图片和视频进行去模糊、Resize、降噪、锐化等处理,重建图片,实现对图片的超分辨率处理。 特征提取:计算噪点 非线性映射:放大,模糊化噪点 图像重建:差分,平滑过度,去噪 下面是使用超分算法处理前后的对比图,可以很明显地看出右边的图更加清晰,少了很多噪点、图片更亮、过度更平滑。 如果大家想了解视频清晰度优化的技术细节,可以参考文章--视频清晰度优化指南 六、总结 本文开篇从介绍得物App的主要功能展开,提出了视频编辑工具优化的三个维度: 优化内存占用 提升视频导出速度 提升导出视频的清晰度 其中在“提升视频导出速度”时重点谈到了“并行导出”的技术方案,从最终的结果来看,视频导出速度的提升非常明显,同时也非常清楚地解释了“并行导出”过程中为什么生成临时文件?为什么有必要在导出完成之后删除临时文件?尽力给用户带来较好的体验。 最后在“提升导出视频的清晰度”中重点提到的超分算法应用效果提升明显,超分之后的视频帧相比原帧图更加清晰、噪点更少,而且细节部分更加真实。 后续我们还会结合AR特效输出更多有意义的技术分享,敬请期待。 *文 /JeffMony 关注得物技术,每周一三五晚18:30更新技术干货 要是觉得文章对你有帮助的话,欢迎评论转发点赞~

优秀的个人博客,低调大师

每日一博 | vivo 大数据日志采集 Agent 设计实践

作者:vivo 互联网存储技术团队- Qiu Sidi 在企业大数据体系建设过程中,数据采集是其中的首要环节。然而,当前行业内的相关开源数据采集组件,并无法满足企业大规模数据采集的需求与有效的数据采集治理,所以大部分企业都采用自研开发采集组件的方式。本文通过在vivo的日志采集服务的设计实践经验,为大家提供日志采集Agent在设计开发过程中的关键设计思路。 一、概述 在企业大数据体系的建设过程中,数据的处理一般包含4个步骤:采集、存储、计算和使用。其中,数据采集,是建设过程中的首要的环节,也是至关重要的环节,如果没有采集就没有数据,更谈不上后续的数据处理与使用。所以,我们看到的企业中的运营报表、决策报表、日志监控、审计日志等的数据来源都是基于数据采集。一般的,我们对数据采集的定义是,把各种分散的源头上的数据(可以包括企业产品的埋点的日志、服务器日志、数据库、IOT设备日志等)统一汇聚到大数据存储组件的过程(如下图所示)。其中,日志文件类型的采集场景,是各种数据采集类型中最常见的一种。接下来,将围绕该场景提出我们的设计实践方案。 通常,日志采集服务可以分为几个部分(业界常见的架构如下图所示):日志采集Agent组件(常见的开源采集Agent组件有Flume、Logstash、Scribe等)、采集传输与存储组件(如kafka、HDFS)、采集管理平台。Bees采集服务是vivo自研的日志采集服务,本文章是通过在Bees采集服务中的关键组件bees-agent的开发实践后,总结出一个通用的日志采集Agent设计中的核心技术点和一些关键思考点,希望对大家有用。 二、特性&能力 具备基本的日志文件的实时与离线采集能力 基于日志文件,无侵入式采集日志 具备自定义的过滤超大日志的能力 具备自定义的过滤采集、匹配采集、格式化的能力 具备自定义的限速采集的能力 具备秒级别的实时采集时效性 具备断点续传能力,升级和停止不丢数据 具备可视化的、中心化的采集任务管理平台 丰富的监控指标与告警(包括采集流量、时效性、完整性等) 低系统资源开销(包括磁盘、内存、CPU及网络等) 三、设计原则 简单优雅 健壮稳定 四、关键设计 目前业界流行的日志采集Agent组件,开源的有Flume、Logstash、Scribe、FileBeats、Fluentd等,自研的有阿里的Logtail。它们都有不错的性能与稳定性,如果想要快速上手,可以不妨使用它们。但是一般大企业会有个性化的采集需求,比如采集任务大规模管理、采集限速、采集过滤等,还有采集任务平台化、任务可视化的需求,为了满足上面这些需求我们自研了一个日志采集Agent。 在做一切的设计和开发之前,我们设定了采集Agent最基本的设计原则,即简单优雅、健壮稳定。 日志文件采集的一般流程会包括:文件的发现与监听、文件读取,日志内容的格式化、过滤、聚合与发送。当我们开始着手开始设计这样一个日志采集Agent时,会遇到不少关键的难点问题,比如:日志文件在哪里?如何发现日志文件新增?如何监听日志内容追加?如何识别一个文件?宕机重启怎么办?如何断点续传?等等问题,接下来,我们针对日志采集Agent设计过程中遇到的关键问题,为大家一一解答。(注:下文出现的文件路径与文件名都为演示样例非真实路径) 4.1 日志文件发现与监听 Agent要如何知道采集哪些日志文件呢? 最简单的设计,就是在Agent的本地配置文件中,把需要采集的日志文件路径都一一罗列进去,比如 /home/sample/logs/access1.log、/home/sample/logs/access2.log、/home/sample/logs/access3.log 等,这样Agent通过读取配置文件得到对应的日志文件列表,这样就能遍历文件列表读取日志信息。但是实际情况是,日志文件是动态生成的,像一般tomcat的业务日志,每个小时都会滚动生成一个新的的日志文件,日志名字通常会带上时间戳,命名类似 /data/sample/logs/ access.2021110820.log,所以采用直接配置固定的文件列表方式是行不通的。 所以,我们想到可以使用一个文件夹路径和日志文件名使用正则表达式或者通配符来表示(为了方便,下文统一使用通配符来表示)。机器上的日志一般固定存在某一个目录下,比如 /data/sample/logs/下,文件名由于某种规则是滚动产生的(比如时间戳),类似 access.2021110820.log、 access.2021110821.log、 access.2021110822.log,我们可以简单粗暴使用 access.*.log 的通配方法来匹配这一类的日志,当然实际情况可以根据你需要的匹配粒度去选择你的正则表达式。有了这个通配符方法,我们的Agent就能的匹配滚动产生的一批日志文件了。 如何持续发现和监听到新产生的日志文件呢? 由于新的日志文件会由其他应用程序(比如Nginx、Tomcat等)持续的按小时动态产生的,Agent如何使用通配符快速去发现这个新产生的文件呢? 最容易想到的,是使用轮询的设计方案,即是通过一个定时任务来检查对应目录下的日志文件是否有增加,但是这种简单的方案有个问题,就是如果轮询间隔时间太长,比如间隔设置为10s、5s,那么日志采集的时效性满足不了我们的需求;如果轮询间隔时间太短,比如500ms,大量的无效的轮询检查又会消耗许多CPU资源。幸好,Linux内核给我们提供一种高效的文件事件监听机制:Linux Inotify机制。该机制可监听任意文件的操作,比如文件创建、文件删除和文件内容变更,内核会给应用层一个对应的事件通知。Inotify这种的事件机制比轮询机制高效的多,也不存在CPU空跑浪费系统资源的情况。在java中,使用java.nio.file.WatchService,可以参考如下核心代码: /** * 订阅文件或目录的变更事件 */public synchronized BeesWatchKey watchDir(File dir, WatchEvent.Kind<?>... watchEvents) throws IOException { if (!dir.exists() && dir.isFile()) { throw new IllegalArgumentException("watchDir requires an exist directory, param: " + dir); } Path path = dir.toPath().toAbsolutePath(); BeesWatchKey beesWatchKey = registeredDirs.get(path); if (beesWatchKey == null) { beesWatchKey = new BeesWatchKey(subscriber, dir, this, watchEvents); registeredDirs.put(path, beesWatchKey); logger.info("successfully watch dir: {}", dir); } return beesWatchKey;} public synchronized BeesWatchKey watchDir(File dir) throws IOException { WatchEvent.Kind<?>[] events = { StandardWatchEventKinds.ENTRY_CREATE, StandardWatchEventKinds.ENTRY_DELETE, StandardWatchEventKinds.ENTRY_MODIFY }; return watchDir(dir, events);} 综合以上思考,日志文件的发现和日志内容变更的监听,我们使用的是"inotify机制为主+轮询机制兜底"、"通配符"的设计方案,如下图所示: 4.2日志文件的唯一标识 要设计日志文件的唯一标识,如果直接使用日志文件的名称是行不通的,日志文件名可能被频繁重复使用,比如,一些应用程序使用的日志框架在输出日志时,对于当前应用正在输出的日志命名是不带任何时间戳信息的,比如固定是 access.log,只有等到当前小时写入文件完毕时,才把文件重命名为 access.2021110820.log,此时新生产的日志文件命名也是 access.log,该文件名对于采集Agent来说是重复的,所以文件名是无法作为文件唯一标识。 我们想到使用Linux操作系统上的文件inode号作为文件标识符。Unix/Linux文件系统使用inode号来识别不同文件,即使移动文件或重命名文件,inode号是保持不变的,创建一个新文件,会给这个新文件分配一个新的不重复的inode号,这样就能与现有磁盘上的其他文件很好区分。我们使用 ls -i access.log 可以快速查看该文件的inode号,如下代码块所示: ls -i access.log62651787 access.log 一般来说,使用系统的inode号作为标识,已经能满足大多数的情况了,但是为了更严谨的考虑,还可以进一步升级方案。因为Linux 的inode号存在复用的情况,这里的"复用"要和"重复"区别一下,在一台机器上的所有文件不会同一时刻出现重复的两个inode号,但是当文件删除后,另一个新文件创建时,这个文件的inode号是可能复用之前删除文件的inode号的,代码逻辑处理不好,很可能造成日志文件漏采集,这一点是要注意的。为了规避这个问题,我们把文件的唯一标识设计为" 文件inode与文件签名组合",这里的文件签名使用的是该文件内容前128字节的Hash值,代码参考如下: public static String signFile(File file) throws IOException { String filepath = file.getAbsolutePath(); String sign = null; RandomAccessFile raf = new RandomAccessFile(filepath, "r"); if (raf.length() >= SIGN_SIZE) { byte[] tbyte = new byte[SIGN_SIZE]; raf.seek(0); raf.read(tbyte); sign = Hashing.sha256().hashBytes(tbyte).toString(); } return sign; } 关于inode再补充点小知识。Linux inode是会满的,inode的信息存储本身也会消耗一些硬盘空间,因为inode号只是inode内容中的一小部分,inode内容主要是包含文件的元数据信息:如文件的字节数、文件数据block的位置、文件的读写执行权限、文件的时间戳等,可以用stat命令,查看某个文件完整的inode信息(stat access.log)。因为这样的设计,操作系统是将硬盘分成两个区域的:一个是数据区,存放文件数据;另一个是inode区,存放inode所包含的信息。每个inode节点的大小,一般是128字节或256字节。查看每个硬盘分区的inode总数和已经使用的数量,可以使用df -i命令。由于每个文件都必须有一个inode,如果一个日志机器上,日志文件小而且数量太多,是有可能发生操作系统inode用完了即是inode区磁盘满了,但是我们使用的数据区硬盘还未存满的情况。这时,就无法在硬盘上创建新文件。所以在日志打印规范上是要避免产生大量的小日志文件的。 4.3 日志内容的读取 发现并且能有效监听日志文件后,我们应该如何去读取这个日志文件中实时追加的日志内容呢?日志内容的读取,我们期望从日志文件中把每一行的日志内容逐行读取出来,每一行以\n或者\r为分隔符。很显然,我们不能直接简单采用InputStreamReader去读取,因为Reader只能按照字符从头到尾读取整个日志文件,不适合读取实时追加日志内容的情况;最合适的选择应该是使用RandomAccessFile。RandomAccessFile它为代码开发者提供了一个可供设置的指针,通过指针开发者可以访问文件的随机位置,参考下图: 通过这种方式,当某一时刻出现线程读取到文件末尾时,只需要记录当前的位置,线程就进入等待状态,直到有新的日志内容写入后,线程又重新启动,启动后可以接着上次的尾部往下读取,代码参考如下。另外,在进程挂或者宕机恢复后,也会用到RandomAccessFile来从指定点位开始读取,不需要从整个文件头部重新读取。关于断点续传的能力后文会提到。 RandomAccessFile raf = new RandomAccessFile(file, "r");byte[] buffer;private void readFile() { if ((raf.length() - raf.getFilePointer()) < BUFFER_SIZE) { buffer = new byte[(int) (raf.length() - raf.getFilePointer())]; } else { buffer = new byte[BUFFER_SIZE]; } raf.read(buffer, 0, buffer.length);} 4.4 实现断点续传 机器宕机、Java进程OOM重启、Agent升级重启等这些是常有的事,那么如何在这些情况下保障采集数据的正确呢?这个问题主要考虑的是采集Agent断点续传的能力。一般的,我们在采集过程中需要记录当前的采集点位(采集点位,即RandomAccessFile中最后的指针指向的位置,一个整型数值),当Agent把对应缓冲区的数据成功发送到kafka后,此时可以先把最新点位的数值更新到内存,并且通过一个定时任务(默认是3s)持久化内存中的采集点位数值到本地的磁盘的点位文件中。这样,当出现进程停止,重新启动时,加载本次磁盘文件中的采集点位,并使用RandomAccessFile移动到对应的点位,实现了从上一次停止的点位继续往下采集的能力,Agent可以恢复到原有的状态,从而实现了断点续传,有效规避重复采集或者漏采集的风险。 Agent针对的每一个采集任务会有一个对应的点位文件,一个Agent如果有多个采集任务,将会对应多个点位文件。一个点位文件存储的内容格式为JSON数组(如下图所示)。其中file表示任务所采集的文件的名字,inode即文件的inode,pos即position的缩小,表示点位的数值; [ { "file": "/home/sample/logs/bees-agent.log", "inode": 2235528, "pos": 621, "sign": "cb8730c1d4a71adc4e5b48931db528e30a5b5c1e99a900ee13e1fe5f935664f1" }] 4.5实时数据发送 前面主要介绍了,日志文件的实时的发现、实时的日志内容变更监听、日志内容的读取等设计方案,接下来介绍Agent的数据发送。 最简单的模型是,Agent通过Kafka Client把数据直接发送到Kafka分布式消息中间件,这也是一种简洁可行的方案。实际上在Bees的采集链路架构中,在Agent与Kafka的数据链路中我们增加了一个"组件bees-bus“(如下图所示)。 bees-bus组件主要起到汇聚数据的作用,类似于Flume在采集链路中聚合的角色。Agent基于Netty开源框架实现NettyRpcClient与Bus之间通讯实现数据发送。网络传输部分展开讲内容较多,非本文章重点就此带过(具体可参考Flume NettyAvroRpcClient实现)。 这里稍微补充下,我们引入bees-bus的目的主要有以下几个: 收敛来自于Agent过多的网络连接数,避免所有Agent直连Kafka broker对其造成较大的压力; 数据汇聚到Bus后,Bus具备流量多路输出的能力,可以实现跨机房Kafka数据容灾; 在遇到流量陡增的情况下, 会导致topic分区所在broker机器磁盘IO繁忙进而导致数据反压到客户端, 由于kafka副本迁移比较耗时所以出现问题后恢复较慢,Bus可以起到一层缓冲层的作用。 4.6离线采集能力 除了上面常见的实时日志采集的场景外(一般是日志采集到kafka这类消息中间件),Bees采集还有一个离线日志采集的场景。所谓离线日志采集,一般是指把日志文件是采集到HDFS下(参考下图)。 这些日志数据是用于下游的Hive离线数仓建设、离线报表分析使用。该场景数据时效性没有那么强,一般是按天为单位使用数据(我们常说的T+1数据),所以日志数据采集无需像实时日志采集一样,实时的一行一行的采集。离线采集一般可以按照固定时间一个批次采集。我们默认是每隔一小时定时采集上个小时产生的一个完整的小时日志文件,比如在21点的05分,采集Agent则开始采集上个小时产生的日志文件(access.2021110820.log),该文件保存了20点内产生的完整的(20:00~20:59)日志内容。 实现离线的采集能力,我们的Agent通过集成HDFS Client的基本能力来实现,HDFS Client中使用 FSDataOutputStream 可以快速的完成一个文件PUT到HDFS的目录下。 尤其要关注的一点是,离线采集需要特别的增加了一个限流采集的能力。由于离线采集的特点是,在整点左右的时刻,所有的机器上的Agent会几乎同时全量开启采集,如果日志量大、采集速度过快,可能会造成该时刻公司网络带宽被快速占用飙升,超出全网带宽上限,进一步会影响其他业务的正常服务,引发故障;还有一个需要关注的就是离线采集整点时刻对机器磁盘资源的需求是很大,通过限流采集,可以有效削平对磁盘资源的整点峰值,避免影响其他服务。 4.7 日志文件清理策略 业务日志源源不断的产生落到机器的磁盘上,单个小时的日志文件大小,小的可能是几十MB,大的可以是几十GB,磁盘很有可能在几小时内被占满,导致新的日志无法写入造成日志丢失,另一方面可能导致更致命的问题,linux 操作系统报 “No space left on device 异常",引发其他进程的各种故障;所以机器上的日志文件需要有一个清理的策略。 我们采用的策略是,所有的机器都默认启动了一个shell的日志清理脚本,定期检查固定目录下的日志文件,规定日志文件的生命周期为6小时,一旦发现日志文件是6小时以前的文件,则会对其进行删除(执行 rm 命令)。 因为日志文件的删除,不是由日志采集Agent自身发起和执行的,那么可能出现”采集速度跟不上删除速度(采集落后6小时)“的情况。比如日志文件还在采集,但是删除脚本已经检测到该文件生命周期已达6小时准备对其进行删除;这种情况,我们只需要做好一点,保证采集Agent对该日志文件的读取句柄是正常打开的,这样的话,即使日志清理进程对该文件执行了rm操作(执行rm后只是将该文件从文件系统的目录结构上解除链接 unlink,实际文件还未从磁盘彻底删除),采集Agent持续打开的句柄,依然能正常采集完此文件;这种"采集速度跟不上删除速度"是不能长时间存在,也有磁盘满的风险,需要通过告警识别出来,根本上来说,需要通过负载均衡或者降低日志量的方法,来减少单机器日志长时间采集不过来的情况。 4.8 系统资源消耗与控制 Agent采集进程是随着业务进程一起部署在一个机器上的,共同使用业务机器的资源(CPU、内存、磁盘、网络),所以在设计时,要考虑控制好Agent采集进程对机器资源的消耗,同时要做好对Agent进程对机器资源消耗的监控。一方面保障业务有稳定的资源可以正常运行;另外可以保障Agent自身进程正常运作。通常我们可以采用以下方案: 1. 针对CPU的消耗控制。 我们可以较方便采用Linux系统层面的CPU隔离的方案来控制,比如TaskSet;通过TaskSet命令,我们可以在采集进程启动时,设定采集进程绑定在某个限定的CPU核心上面(进程绑核,即设定进程与CPU亲和性,设定以后Linux调度器就会让这个进程/线程只在所绑定的核上面去运行);这样的设定之后,可以保障采集进程与业务进程在CPU的使用上面互相不影响。 2. 针对内存的消耗控制。 由于采集Agent采用java语言开发基于JVM运行,所以我们可以通过JVM的堆参数配置即可控制;bees-agent一般默认配置512MB,理论上最低值可以是64MB,可以根据实际机器资源情况和采集日志文件大小来配置;事实上,Agent的内存占用相对稳定,内存消耗方面的风险较小。 3.针对磁盘的消耗控制。 由于采集Agent是一个IO密集型进程,所以磁盘IO的负载是我们需要重点保障好的;在系统层面没有成熟的磁盘IO的隔离方案,所以只能在应用层来实现。我们需要清楚进程所在磁盘的基准性能情况,然后在这个基础上,通过Agent自身的限速采集能力,设置采集进程的峰值的采集速率(比如:3MB/s、5MB/s);除此之外,还需要做好磁盘IO负载的基础监控与告警、采集Agent采集速率大小的监控与告警,通过这些监控告警与值班分析进一步保障磁盘IO资源。 4.针对网络的消耗控制。 这里说的网络,重点要关注是跨机房带宽上限。避免同一时刻,大批量的Agent日志采集导致跨机房的带宽到达了上限,引发业务故障。所以,针对网络带宽的使用也需要有监控与告警,相关监控数据上报到平台汇总计算,平台通过智能计算后给Agent下发一个合理的采集速率。 4.9 自身日志监控 为了更好的监控线上所有的Agent的情况,能够方便地查看这些Agent进程自身的log4j日志是很有必要的。为了达成这一目的,我们把Agent自身产生的日志采集设计成一个普通的日志采集任务,就是说,采集Agent进程自身,自己采集自己产生的日志,于是就可以把所有Agent的日志通过Agent采集汇聚到下游Kafka,再到Elasticsearch存储引擎,最后通过Kibana或其他的日志可视化平台可以查看。 4.10 平台化管理 目前的生产环境Agent实例数量已经好几万,采集任务数量有上万个。为了对这些分散的、数据量多的Agent进行有效的集中的运维和管理,我们设计了一个可视化的平台,管理平台具备以下Agent控制能力:Agent 的现网版本查看,Agent存活心跳管理,Agent采集任务下发、启动、停止管理,Agent采集限速管理等;需要注意的是,Agent与平台的通讯方式,我们设计采用简单的HTTP通讯方式,即Agent以定时心跳的方式(默认5分钟)向平台发起HTTP请求,HTTP请求体中会包含Agent自身信息,比如idc、ip、hostname、当前采集任务信息等,而HTTP返回体的内容里会包含平台向Agent下发的任务信息,比如哪个任务启动、哪个任务停止、任务的具体参数变更等。 五、与开源能力对比 bees-agent与flume-agent对比 内存需求大大降低。bees-agent 采用无 Channel 设计,大大节省内存开销,每个 Agent 启动 ,JVM 堆栈最低理论值可以设置为64MB; 实时性更好。bees-agent 采用Linux inotify事件机制,相比 Flume Agent 轮询机制,采集数据的时效性可以在1s以内; 日志文件的唯一标识,bees-agent 使用inode+文件签名,更准确,不会出现日志文件误采重采; 用户资源隔离。bees-agent 不同 Topic 的日志采集任务,采用不同的线程隔离采集,互相无影响; 真正的优雅退出。bees-agent 在正常采集过程中,随时使用平台的"停止命令"让 Agent 优雅退出,不会出现无法退出的尴尬情况,也能保证日志无任何丢失; 更丰富的指标数据。bees-agent 包括采集速率、采集总进度,还有 机器信息、JVM 堆情况、类数量、JVM GC次数等; 更丰富的定制化能力。bees-agent 具备关键字匹配采集能力、日志格式化能力、平台化管理的能力等; 六、总结 前文介绍了vivo日志采集Agent在设计过程中的一些核心技术点:包括日志文件的发现与监听、日志文件的唯一标识符设计、日志文件的实时采集与离线采集的架构设计、日志文件的清理策略、采集进程对系统资源的消耗控制、平台化管理的思路等,这些关键的设计思路覆盖了自研采集agent大部分的核心功能,同时也覆盖了其中的难点痛点,能让后续的开发环节更加畅通。当然,还有一些高阶的采集能力未涵盖本文介绍在内,比如"如何做好日志采集数据的完整性对账","数据库类型的场景的采集设计"等,大家可以继续探索解决方案。 从2019年起,vivo大数据业务的日志采集场景就是由Bees数据采集服务支撑。bees-agent在生产环境持续服务,至今已有3年多的稳定运行的记录,有数万个bees-agent实例正在运行,同时在线支撑数万个日志文件的采集,每天采集PB级别的日志量。实践证明,bees-agent的稳定行、健壮性、丰富的功能、性能与合理的资源情况,都符合最开始设计的预期,本文的设计思路的也一再被证实行之有效。 END 猜你喜欢 从0到1设计通用数据大屏搭建平台 探究Presto SQL引擎(4)-统计计数 vivo互联网机器学习平台的建设与实践 本文分享自微信公众号 - vivo互联网技术(vivoVMIC)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册