首页 文章 精选 留言 我的

精选列表

搜索[赛博朋克],共10000篇文章
优秀的个人博客,低调大师

每日一博 | 小程序编译器性能优化之路

作者 | 马可 导读 小程序编译器是百度开发者工具中的编译构建模块,用来将小程序代码转换成运行时代码。旧版编译器由于业务发展,存在编译慢、内存占用高的问题,我们对编译器做了一次大规模的重构,采用自研架构,做了多线程、代码缓存、sourcemap 等多项优化,在性能和内存占用上都有很大提升。全文介绍了新版编译器的设计思路和优化方法,以及一些能够用在通用打包工具里的技术点。 全文6629字,预计阅读时间17分钟。 01 前言 小程序编译器在小程序开发、预览、发布各个阶段都需要使用,因此编译器性能会直接影响到开发者开发效率,也会影响到开发者工具的使用体验。 由于旧版的编译器(基于 webpack4)在构建大型项目时会很慢,内存占用也高,一直被开发者吐槽。我们经过大量的调研和开发,最后采用完全自研架构做新编译,针对小程序项目构建做了大量优化,基本解决了旧编译存在的问题。 下图是部分项目构建时间对比: 新版编译器相对于旧版实现了 2~7 倍的性能提升,并且支持实时编译、热重载等特性,内存占用更少,构建产物更优。 下面从 框架选型、新编译器工作原理、性能和产物优化方法 等方面介绍新版编译器的成长之路。 02 框架选型 在进行新版编译器设计时,需要明确当前的痛点问题:性能,优先解决性能问题。其他新技术和新想法对编译器有帮助的也一起实施。 旧版编译器基于 webpack4 存在如下几个问题: 大型项目构建速度太慢。 dev 启动慢、增量编译慢,仅支持 loader 缓存,bundle 无缓存也比较慢。 基于 webpack4 做扩展开发,需要 patch 部分模块才能工作,维护困难。 部分 webpack bundle 过程无法针对小程序代码结构进行优化,存在无效构建。 新编译的设计目标: 更快的全量编译速度,消除 webpack 存在的无效构建过程。 支持全缓存,加快首次和增量编译速度。 支持实时编译,减少 dev 启动和二次编译时间。 支持多线程编译加速,支持页面热重载。 优化产物结构,减少产物体积。 2.1 主流构建工具 下面介绍的是我们调研过的主流前端构建工具,每个工具都有适用场景和优缺点。 在新版本编译器架构设计时,其他构建工具的设计理念和技术特点都值得参考。 Webpack 构建过程: Webpack 优点:功能完善、社区活跃、可配置性强、有很强的扩展性。 Webpack 缺点:配置复杂、构建速度慢,二次开发困难。 Parcel 构建过程: Parcel 优点:无需配置,构建速度快,原生支持多线程和全缓存,多线程之间共享数据通过 lmdb 进行,避免跨线程通信开销。 Parcel 缺点:生态小,自定义性有限,大量采用 Node 插件,兼容性也差一些。 Vite 构建过程: Vite 优点:配置较为简单,按需编译,启动快,dev 时有不错的体验。 Vite 缺点:生态小,dev 和 发布走两套构建流程。 其他小程序平台: 微信基于 gulp 和 C++ 模块做小程序构建,并且对 npm 模块做了预构建,在性能和开发体验上做的比较好。 支付宝基于 webpack 做小程序构建,并且使用了 esbuild 加速代码压缩。 抖音小程序使用自研编译器,构建流程比较简单。 2.2 新版编译器 在设计新编译框架时,借鉴了主流打包工具的工作流程,结合小程序代码特点,决定不做通用打包工具,重点优化小程序打包性能。 最终选择了自研编译器的方案,并做了大量优化工作,新版编译器优化点有如下几个方面: 1.支持多 Compiler 协同工作,将动态库开发等多类型项目构建解耦。 2.编译阶段全流程缓存,节省二次构建时间 90% 以上。 3.dev 开发默认采用按需编译,提升单页编译性能。 4.支持 babel 和 swc 多线程编译,提升全量编译速度 2 ~ 7 倍。 5.采用新版 sourcemap 协议,移除非必要解析合并,将 bundle 阶段耗时大幅缩减。 6.对 js、css、swan 模板编译均做了构建时标记优化,减少 bundle 合并耗时。 7.对于预览、发布阶段的 js 压缩和混淆,采用了 terser 和 esbuild 并行方案,esbuild 用于快速打出预览包,terser 可以保证压缩率用于发布包。 从结果看,新编译器从速度、资源占用和可维护性上相对于旧版都有显著的提升。 03 新版编译器工作原理 新编译器的处理流程和 parcel 比较类似,Compiler 控制处理流程,Processor 进行代码转换,基本流程如下: 其中几个重要的模块: CompileEntry 编译器为入口模块,包含 cli 通信、dev server 通信、命令调用等。 CompileManager 为编译管理器,用于依赖资源下载和管理以及多个 Compiler 协同构建。 Compiler 为编译器模块,用于将项目源码编译成运行时代码,项目构建时 Compiler 可能有多个。 Processor 为单元处理器,用于处理 代码转换、代码合并 等单个编译任务。 注:小程序 App 项目有 1 个Compiler,动态库和动态扩展项目 2 个Compiler。 3.1 Compiler 编译器 用于编译单个小程序项目,将开发者原始代码编译为可运行代码。 工作职能: 1.创建运行上下文,提供 config、fs 文件处理、watcher 监控、logger 等模块,给 Processor 使用。 2.全量编译、文件变更时二次编译;这里二次编译也是走一遍全量编译流程,不过大部分用的是缓存结果。 3.管理、调度、运行 Processor 处理单元。 4.维护 Processor 依赖关系和结果缓存。 特点: 1.实现全流程缓存,将每个 Processor 的输入参数、输出结果写入缓存,在有缓存情况下二次编译时长可减少 90% 。 2.支持按需编译,每次按需单页编译、增量编译、全量编译 都走同样的 Processor 处理流程。 3.通过 Proxy 机制自动计算缓存参数依赖,不用手动为每个 Processor 生成缓存 hash,相对于 webpack 或 parcel 减少 bug 产生。 4.仅维护 Processor 依赖关系,不维护 ModuleGraph,简化处理流程。 关于全流程缓存每家打包器都有自己的实现方案,基本原理是根据当前输入参数和依赖情况为处理单元生成一个唯一 hash,hash 一致则结果一致。 webpack 和 parcel 由于维护了 ModuleGraph,缓存的计算和重用会复杂一些。小程序编译器仅根据 Processor 入参和调用依赖进行计算。 3.2 Processor 单元处理器 Processor 有如下特性: 1.在输入参数一致的情况下,保证输出一致,输入和输出都必须可序列化为 json ,实现了 Processor 全缓存。 2.Processor 中的 uri 为构建 ID,在单次构建过程中 ID 一致则处理结果一致,例如处理 app.js 文件,uri 为:js:app.js,好处是可以统一 Processor 资源处理路径。 3.Processor 之间支持互相调用:processWith 调用并继续执行,processWithResult 调用并等待返回结果。 注意:这里的输入参数包含 uri、app config, contextFreeData。 几种常用的 Processor: 1.JS Processor 将 es6 代码转换成 es5 代码,这是最耗时的模块。 2.Swan Processor 将 swan 模板代码转换成 view 层 js 代码。 3.Css Processor 使用 postcss 处理 css 中的单位转换、依赖收集等工作。 4.Bundle Processor 将前面 transformer 处理结果按照 bundle 算法合并文件并输出结果。 Processor 工作流程: Processor 处理流程需要经过 transform -> bundle 的过程,在小程序里 js, css, swan 模板的 bundle 可以分开并行处理,这里和 webpack 的处理模式不一样,和 parcel 的 pipeline 类似。 3.3 性能和产物优化方法 3.3.1 多核心编译优化 由于 Node 中多线程模块初始化速度和通信效率比多进程好一些,新编译选择使用 多线程 做多核心优化。 多线程编译有 2 种方案选择: 方案1:基于 processor 做多线程调度,由于 processor 间支持相互调用,实际处理会很复杂且有通信成本。 旧的编译器做过基于webpack 的 workerthread-loader,性能提升有限(10%~15%)。 parcel 基于 lmdb 公共缓存消除线程间通信,保证读写效率,是一个比较好的解决方法。 方案2:仅对 js 转译做多线程调度,仅有一来一回 2 次通信成本。 使用 jest-worker 和 babel transform 做 js 多线程转译或者用 swc 多线程做 js 转译。 由于大部分构建时间在 js 转译这里(js 中有大量 node_modules 依赖,均需要转换),css 和 swan 模块转换耗时少。 最终选择方案2 仅做 js 多线程转译,处理流程简单且收益较好,整体提升如下: 使用 jest-worker 多线程 babel 转译,4 线程可提升 1 倍以上速度。 使用 swc 做 js 转译,4 线程提升 4 倍以上速度。 JS Processor 多线程处理: 其中: uri: 为处理器构建 ID contextFreeData: 单次构建中不可变数据,例如 app.json 中的配置项 context args:全局参数,例如优化实验开关、多线程开关等 在 js 转换处理时规定了 transformer 统一转换接口,基于接口实现了 babel 单线程、babel 多线程、swc 转换 3 种处理器,并且可随时做处理器切换。 对于不同的编译环境可以做到灵活设置: 1.开发者工具中开发者根据机器配置情况可以切换 多线程、swc 编译模式,提升效率。 2.云编译流水线默认开多线程编译提高性能。 3.webIDE 默认开单线程降低资源消耗。 3.3.2 SWC 编译优化 新编译器多线程模式相对于旧编译提升了 1 倍左右,在 dev 开发时一些大型项目页面首次编译还是有些慢,需要10秒以上,主要耗时在 js transform 这里。 swc 目前在 js 转译上基本成熟了,且大部分场景能提升 4 倍以上转译速度,因此增加了 swc 多线程转译支持,将大型项目页面首次编译控制在了 5 秒以内。 需要编写 2 个 swc 插件来适配 swc 转译: @swanide/swc-require-rename 将 require/import/export 中的模块提取路径信息,以便于后续在 js 中分析模块依赖关系。 @swanide/swc-web-debug 对 js 代码进行插桩处理,用来支持真机调试中的断点调试。 swc 编译带来的性能提升是巨大的,在使用中也发现了一些问题: 1.swc 存在内存泄露,在 dev 阶段如果全量编译次数过多,会导致内存占用很高,需手动重启编译器。 2.swc 插件支持的 api 较少,一部分 babel 容易实现的功能,在 swc 中很难处理。 3.swc 由于使用 rust 编写插件,插件在不同 @swc/core 版本间不能通用,需要为不同平台生成 swc 插件,在部署上会麻烦一些。 在实际使用中,对于一部分 swc 不能很好处理的场景,会降级到 babel 处理。 3.3.3 代码压缩和运行时缓存 在 dev 阶段,编译后的代码是没有经过压缩的,可以在模拟器中运行。在预览发布阶段由于限制了包体积,需要做代码压缩以减少产物体积。 可选的代码压缩工具有如下 3 个: 1.terser 压缩率高,产物体积小,速度最慢。 2.swc 压缩快,mangle 支持不完善,压缩率较差。 3.esbuild 压缩最快(比 terser 快了 10 倍以上),支持 mangle,代码压缩率不如 terser。 最后经过对比考虑,选择了如下压缩方案: 1.预览阶段由于不需要 sourcemap,移除 sourcemap,并使用 esbuild 做代码压缩,提高预览速度(对于自动预览场景有很大提升)。 2.发布阶段使用 terser 做多线程压缩,并保留 sourcemap。 运行时缓存 指的是构建过程的中间结果都在内存中做了缓存,包括 Processor 处理结果 和 代码压缩结果,在二次构建时可以节省大部分重新构建时间。由于缓存中保留的是字符串和 json 对象,相对于基于 webpack 的旧版编译器有 40% ~ 60% 的内存节省,在内存占用上处于可接受范围。 3.3.4 Swan 模板处理优化 旧的 swan 模板处理使用 swan-loader 进行模板转换,由于设计时没有处理好模板 import 作用域,导致 <template> 标签以及 filter 过滤器函数只能内联到页面代码中,如果模板中大量使用了 template 和 filter,最终生成的代码体积会非常大。 新编编译器纠正了 import 作用域关系,将编译产物中的 template 、 filter 生成模式由内联改为 require 引用,然后在 bundle 阶段做代码合并,使相同模块能够得到重用,算是填了一个大坑。 新编译器 swan 模板处理流程: 单个 swan 文件经过 Processor 处理后可能的产物有: component 组件模块,用于生成页面和自定义组件 template 模块 filter 过滤器函数、sjs 过滤器函数 transformed document 中间代码 将 swan 模板转换成不同类型的 js module,并维护依赖关系,便于后续的代码合并时更精细化的控制。 由于历史原因 import/include 中包含 sjs 或者 template 引用时不能直接生成 template 模块,需要在最后入口模板中生成。新编译也提供了 template静态编译选项,将严格限制 import 作用域,可直接生成 template 模块代码,对于 taro 生成的小程序项目可以节约 30% 左右的产物大小。 3.3.5 Sourcemap 优化 由于编译器需要支持 js 代码调试以及运行时 error 跟踪,在 dev 和发布阶段都需要生成 sourcemap。 在 webpack 中生成代码时需要对 sourcemap 进行合并计算,较大的项目 sourcemap 合并会占用很长时间,并且每次重新编译都要重新计算 sourcemap。 调研时发现浏览器 devtools 对 sourcemap 协议 的 index map 支持非常好, 新编译器基于 index map 协议做了 sourcemap 合并优化,由之前的多文件 sourcemap 合并计算,变成了计算生成 offset map 并拼接内容,这样 js bundle 耗时就由原来的 几秒到几十秒变为了固定 3 秒以内。 一个有意思的事情是 vscode 的 js-debugger 直到 22 年 6 月份才支持 index map 调试(index map 2011 年发布的),微软的动作稍微慢了一些。 3.3.6 后续工作 在新编译器开发完成之后的推广中,采用了渐进式推广方式: 第一阶段,开发者工具新旧编译器共存,dev、预览使用新编译器,发布使用旧编译器。 第二阶段,内部 pipeline 预览和发布全量使用新编译。 第三阶段,开发者工具全部切换到新编译器。 新版编译实际上线后还存在一些小的兼容性问题,需要尽量提前暴露问题才能做发布全量替换。 针对小程序项目,新编译做了大量的优化工作,部分优化工作还没有完成开发,包括: hmr 热重载:开发中,由于 运行时框架、开发者工具均需要做接口适配,需要较长时间调试才能达到预期。 tree-shaking 代码消除:对于 es6 模块在 transform 阶段可以做 tree-shaking 消减代码。 scope-hoisting 作用域提升:理论可行,需要验证代码缩减效果。 新版编译器由于需要完全兼容旧版编译器构建结果,在 bundle 打包场景还存在优化空间,我们在后续工作中配合运行时框架可以做更多打包产物优化。 04 总结 新版编译器采用自研打包方案,对比基于 webpack 的旧编译器实现了巨大的性能提升,彻底解决了编译慢、资源占用高的问题,相对友商的编译器也有不错的性能优势。 一些新编译引入的优化手段如 swc 转译、esbuild 压缩、sourcemap 优化 也能用在其他前端项目构建中,并起到加速效果。 在新编译器项目中每个同学都非常努力,贡献了很多奇妙的点子,遇到的大部分难题都有效解决了。我们会继续坚持性能和产物优化这两个方向,不断提升开发者体验和运行时效率。 ——END—— 推荐阅读 百度APP iOS端包体积50M优化实践(六)无用方法清理 基于异常上线场景的实时拦截与问题分发策略 极致优化 SSD 并行读调度 AI文本创作在百度App发文的实践 DeeTune:基于 eBPF 的百度网络框架设计与应用

优秀的个人博客,低调大师

每日一博 | 算法 AB 实验平台进化历程和挑战

1 AB平台简介 AB实验平台这几年在互联网公司得到了越来越广泛的应用,采用AB实验来评估产品和技术迭代效果也成为主流的业务新功能效果评估方式,数据驱动的文化在这几年得到了不少公司的广泛的认同,通过数据和指标来说明产品效果也得到了越来越多的公司的认可和应用。 AB实验在其中就是一种很常见的产品效果数据评估工具,在各大公司的产品迭代过程中也得到了越来越广泛的应用。 2 1.0时代 从无到有 在AB实验刚开始的时候,需要解决的问题很简单: 通过某种用户流量分组方式,将不同的用户划分到不同的流量组,在不同的流量组通过控制变量的方式应用不同的产品策略,随后观察两个组的产品效果差别。 这种非常朴素的实验思路就是最基本的AB实验的分流,需要注意的是在过程中需要保证控制变量和稳定的流量比例。 2.1 一个基本AB实验实例 一个基本的AB实验需要有以下要素: 1.实验目标和实验假设 a.实验目标决定到达到什么样的效果实验才算成功,举个例子,我希望付款率提升5%,这就是目标,其中的实验指标是付款率,做实验之前一定要有实验目标,没有实验目标没办法确定实验是否成功,实验目标包含指标和变化幅度两个要素。 b.实验假设是猜想通过控制哪些因素来达到实验目标,比如我们假设付款按钮的颜色会影响用户的付款意愿进而影响付款率,那这里的实验假设就是付款按钮颜色会影响用户付款意愿。 2.实验对象 (实验对象是可以用来应用策略的用户或者请求或者其他对象) a.实验对象并不是仅仅指用户,用户的每一次请求也可以单独做实验,甚至每一次用户请求的每一个曝光位置都可以看做一个实验流量,这个对象取决于具体的业务。 3.对照组和实验组 (AB实验的核心要求是控制变量做效果对照,所以至少有一个或多个对照组策略和实验组策略) a.对照组:一般是没有任何策略的组,代表了现在的实验效果。 b.实验组:一般是应用了新策略的组,代表了新策略的实验效果。 c.统计功效:在进行实验组和对照组的流量分配的时候要注意,因为我们的AB实验是从整体用户中取一部分进行实验,然后采用统计学方式进行效果评估,所以无论是实验组还是对照组样本量要满足最基本的统计功效,后续的实验才有意义,而统计功效无法在实验之后计算,需要我们在实验进行之前就做充足的调研。 2.2 算法的AB1.0主要功能 1.通过控制变量的方式进行AB分流实验,并通过离线的模拟分流规则提供用户实验分组信息,使得数据分析可以计算实验的指标报表。 2.打通基本的工程实验链路,可以让算法通过实验配置自主的控制实验流量和实验策略。 2.3 1.0 AB实验的策略生效流程 在早期的实验过程有以下链路: 1.通过配置中心配置约定好的AB实验配置信息,线上的服务通过配置中心的变更信息,实时变更实验配置,从下次分流开始应用新的分流策略,同时记录实验日志。 2.报表计算方式,将实验配置信息同步到ODPS,第二天用前一天的实验配置对昨天的用户进行重新分流计算,获得昨天的用户实验分流信息(之所以这样是因为实验变更是以天为单位,离线计算可以比较方面的支撑后续的实验分析)。 算法和普通业务的AB分流由于业务特性原因有较多的需求不同的地方,针对两者区别我们也进行了一些特殊的算法实验优化设计。具体如下: 早期的AB实验设计解决了基本的实验分流问题也提供了一套配套的实验指标和实验置信度计算方案,支撑了早期的简单业务可以通过AB实验的方式比较科学的观测算法模型效果。 3 2.0 时代 从有到全,支持复杂业务功能 3.1 新的业务需求 随着公司业务发展和各个系统迭代优化,用户对于基础的AB实验系统开始衍生出了一些新的,更细化更复杂的业务需求,用户也希望AB系统可以帮助支撑更高效的实验迭代。 1.流量饥渴,更丰富的流量需求:在1.0版本的AB实验中已经解决了基本的实验分流和配置的问题,但是由于一个场景中总用户流量有限,可能会有多种业务实验同时进行,实际实验运行时需要在同时运行的实验数量和每个实验的流量大小之间做一个取舍,业务高速发展时期经常会有用户希望提高同时运行的实验数量,同时保证每个实验有充足的流量,于是我们扩展了原来的实验流量分流模型设计,采用分层分域的正交的业务实验划分方式来支撑上述的流量需求。 2.更实时更准确的实验报表:在早期的实验中通过第二天的配置重算的方式得到前一天的用户实验分组数据,这种方法可以支撑非常巨大的用户和实验数量,但是时效性上比较难以保证。随着业务快速迭代,算法的实时实验效果监控的需求也逐渐增加,离线的实验报表计算反馈需要等到至少1天后才能观测,实验反馈周期太长。于是我们调整了实验分流和报表的计算链路,采用实时实验日志埋点通过flink等实时计算平台实时计算实验效果,这种做法可以实时捕捉实验流量的变化情况,对于验证实验分流效果有较大的效率提升。 3.复杂实验形式:联合实,多集群实验, 指定用户实验需求:随着算法工程链路的规范化,业务链路中的一些业务层之间开始进行联合调优实验,催生出了多参数跨层联合实验的需求,需要在分层实验的基础上支持联合参数的生效机制,这在一般的分层实验设计中是很难支撑的。随着工程链路稳定性项目的进展,大部分业务同时都具有多个不同集群,此时又需要AB系统也可以针对不同集群提供同场景不同实验配置的功能支撑。还有随着精细化运营的展开,越来越多的实验只针对更精准的特定用户群才能生效,这给原来的实验分流和实验分析都带来了不小的需求和挑战。 3.2 更大更通用的分流模型 为了满足更丰富的流量分配需求,我们设计了一套比较灵活通用的实验分流模型, 这套模型经过多个公司的业务验证,可以确保在未来较长的一段时间内,充分支撑我们所有业务的个各种AB实验分流需求。同时根据我们自己的业务发展需求,也支持了条件层,自定义分流机制等为更复杂业务设计的一些分流机制。 多层正交的实验流量模型 上述的分流模型将一个场景流量分为层和域两种嵌套结构,通过层来隔离不同业务配置,通过域来隔离不同用户群。用户在该模型进行分流的过程采用从外到内,从上到下的逐步命中,每一次进入一个业务层都会触发一次选桶逻辑,命中桶以后,读取桶上的配置,如果桶内还有层配置继续依次命中层,触发内部的选桶逻辑。 该模型可以支持如下主要特点: 1.分层分域,互相嵌套的流量设计,支持业务域分层的正交流量,每一层都是一个单独的业务,解决流量饥渴问题,同时支持自由的流量域划分,流量域和流量层可以互相嵌套,实现极其灵活的流量划分方式。 2.每一个流量层采用hash模板+流量槽,层内实验通过圈槽的形式决定实验在该层的流量比例,允许算法用户自定义实验分流的规则,支持根据用户的用户特征信息进行分流,同时支持灵活的跨层流量对齐机制。这种方式可以实现极为灵活的分流方式,支持各种对象和分流方式(比如用户分流,请求分流,设备分流,作者分流,按地区分流等)。 3.支持白名单,允许用户绕开分流机制,指定用户的固定实验链路,用于在线上进行特殊用户的实验验证。 4.支持条件层,允许符合某种条件的用户单独进行特定实验,比如只针对新用户进行的实验。 从该模型上线以来,2年多的时间内已经完美支撑了算法300多个场景的AB流量分配需求,经过了充分的业务验证,从分流层面解决了许多有特殊需求的分流业务遇到的问题。 具体层中的分流规则如下: 每一个流量层根据层中的分流配置信息和用户信息计算命中的流量槽,然后根据流量槽命中圈选了流量槽的实验,实验通过拥有的流量槽数量决定实验流量比例。 3.3标准实验的工程链路 通过AB实验的后台改造,我们重新思考并调整了整个实验链路的工程设计,在新的工程设计中,相对于上一个版本主要有以下几个方面需要改进: 1.采用实验分流日志而不是离线的实验配置来计算用户的实验分组信息。 a.实验日志可以捕获每一个时刻的用户的实验分流情况,可以较为敏感的捕捉到实验变更的情况。 b.实验日志可观测性强,用户配置完实验以后可以立刻通过日志观测实验的命中情况。 c.可以在日志中附加更多的实验环境相关信息,做更丰富的实验分析,可以简化离线的实验分组计算逻辑。 2.线上应用增加实验信息的具体埋点信息, 埋点分为两部分: a.一部分透传给客户端,其中包含用户命中的实验信息,称之为ACM埋点,客户端在用户进行点击曝光等操作时上报信息中回传服务端下发的ACM字段,这样我们可以通过神策上报的行为日志,清楚的知道每个实验曝光几次,被点击几次,可以及时得到实验的线上表现,这部分行为日志还可以帮助我们实时的计算实验策略效果报表。 b.另一部分作为应用的后台日志记录,记录了每一次请求中用户命中的实验相关信息,用于计算实验分组信息。 3.设计了AB实验的后台操作管理界面,不用再通过手动修改配置中心的配置来进行实验配置。并将实验发布,实验修改,实验配置回滚等功能做成具体的按钮功能,极大地提高了用户的实验操作使用体验。 4.拆分了实验参数和代码执行链路,抽象出了AB参数和代码链路运行方案两种概念,将AB变成一个弱依赖,降低实验参数配置错误对线上业务的影响。 Ps: 为什么要同时采用两种实验信息反馈链路,原因是第一种ACM上报的用户实验信息依赖于用户上报,如果用户遇到应用crash或者延迟上报,或者网络情况突然不好,我们没办法获得未上报的这部分信息,第二种很明显,没办法知道发放下来的带有实验信息的内容的后续反馈情况。两种链路都没办法完全的覆盖全部用户,只有互相配合才能完整的覆盖全量用户,至于为什么采用离线日志来做实验报表,ACM来做实时报表纯粹是工程效率方面的考虑。 ACM通用埋点标准 为了解决实验的实时效果观测问题, 我们需要想办法将后台的实验命中标识信息传递给客户端。考虑到其他业务场景也会有类似的埋点需求,为了埋点通用性考虑,我们规划了一个算法的埋点标准,主要想简化算法埋点流程和对算法的埋点信息进行统一的治理。 ACM埋点主要是通过算法与客户端约定一个固定的埋点内容字段ACM,后端算法在开发时候,通过提供的SDK工具,将需要埋点的信息和内容通过SDK采用特定的规范形成一串可识别的字符串内容,客户端同学对ACM这个约定好的字段进行事件(曝光,点击等)上报,后端就可以根据上报的用户行为日志通过实时计算工具快速的获得某个实验的后续用户反馈信息。 ACM埋点规范例子: 版本.业务域.内容资源类型.资源位.实验.自定义值 版本:标记本条ACM的遵循的规范版本,不同版本具有不同的解析规则,方便udf解析。 业务域:业务系统代称,尽量简短,比如 搜索srh。 内容资源类型:内容类型或资源,比如 user_10098, cspu_1020,spu_771等。 资源位:广告位,榜单位。 实验:资源本次采用的AB实验策略,多个实验用-隔开。 自定义值: 允许应用方进行扩展的字段,比如 chan_latest-pos_3 代表channel为latest,pos为3。 特殊要求:自定义字段中不能出现 ".","-","_"等字段,其他部分无此要求。 埋点示例: acm: 1.srh.spu_1009.sh.kka3b.10089-1929-100.channel_hot-position_2 acm: 2.srh.spu:1009.sh.kka3b.10089;1929;100.channel:hot;position:2 埋点场景: request维度,覆盖所有搜索和推荐场景 埋点动作: request维度 下面是一个带有acm信息的后端返回示例: { "code": 200, "data": { "total": 3730, "start": 0, "hits": 10, "searchId": "161113175619737242413163", "searchTime": 0.024447, "items":[ { "spuId":"xxx", "acm": "1.ms.prd-10092.v1ss.exp-1.kka.12", } ], "facet":[], "cache": false }, "requestId": "f2ca7c08693acd54", "cost": 0, "time": 1611131759 } 3.4 实时的实验指标监控 实时实验指标的计算流程 1.后台服务日志实验分流信息需要透传给客户端; 2.客户端用户行为及时上报; 3.行为日志被flink等实时计算平台及时处理; 4.制定明确且可计算的实时指标规范。 有了上面四个基础流程,就可以计算实时的实验反馈指标,但是要注意实时的指标计算往往只能反映一段时间的实验趋势变化,在部分复杂指标上很难实现精确的实验指标计算,所以一般用来观察实验指标变化趋势,不作为最终决策依据。 实时数据处理链路 打通了数据链路并且在用户的行为日志中包含了ACM埋点以后,算法就可以基于行为日志,通过flink等工具实时算计算用户的各种指标信息。 具体的监控链路流程如下图绿色链路所示: 具体实时实验监控效果 最终可以达到秒级的实验效果反馈,极大的加快了算法对实验策略的反馈效率,具体效果如下图,用户可以自己选择关注的实验信息对比不同实验在同一时间区间内的指标变化情况。可以非常迅速的得到线上的新实验的效果反馈信息,极大地缩短了算法对实验指标的策略调整反馈周期。 4 3.0 时代 从全到优,提升用户体验和实验效率 2.0 时代主要是从各种机制和功能方面尽量满足业务需要,业务功能满足以后,我们进行了业务与扩展,将算法的推荐业务场景也囊括进来,推荐业务接入以后,虽然在基本功能上也可以满足需求,但是推荐和搜索的业务特点还是有点不同,于是我们针对实验平台的实验操作用户体验和稳定性方面进行了较多的优化。 4.1 实验操作易用性的建设 业务场景铺开以后,使用的业务团队和人员也变得更为复杂,于是我们在针对特定场景的使用和业务人员使用习惯方面做了不少的功能改进和优化。根据我们收集的算法人员的参数配置,白名单配置,流量调整等功能使用痛点,我们进行了针对性的优化。 实验参数的易用性工具 实验参数配置是AB实验的最主要的功能,为了优化用户体验在实验参数使用方面的体验,我们收集了一些常见的用户在使用参数配置时候经常遇到的问题,并针对性做了功能和体验的优化。 场景1:随着业务发展,算法配置的业务层越来越多,由于约定的参数规范是同一层的可配置实验参数应该一致,同一个实验参数配置也应该出现在同一层,但是随着层数增多和部分参数使用不规范,估算某个实验参数的实际生效流量就变得很困难(参数有后覆盖前面的规则)。有可能出现你给a实验配置了 10%流量的 recallSize = 20 但是后续该参数被别人的同名参数覆盖导致实际参数生效流量不符合预期的情况。 参数流量着色分析 使用参数流量的着色分析可以清楚的知道某个实验参数都在哪些实验中有配置,这些实验如果同属于一个业务层则无流量覆盖,如果有些实验不属于同一个业务层,有可能出现参数覆盖的情况。流量着色就是通过程序,一键计算某个参数最终的流量结果分布情况,可以方便的看到某个参数最终的线上真实流量比例。 包含某参数配置的所有实验查询: 某参数的实际生效流量分布 场景2:实验参数越来越复杂,同一个参数往往有多个不同的版本需要同时观测实验的效果,这种时候可能由于时间久远或者实验变更频繁,或者参数过多,很多时候在进行实验观测和调整的时候需要确认实验中的参数配置信息,特地为这些需要对比参数的场景制作了便捷的实验参数对比的功能。 实验参数对比:可以比较清晰的对比同一个实验参数在同一层其他实验中分别是什么值,可以大幅度提高实验流量调整期间需要进行的实验信息核对工作效率。 实验布局的操作和展示优化 为了满足灵活的实验流量划分,我们设计了一套通用的实验流量模型,但是该流量模型的可视化方面一直是一个不小的难题,最基本的我们希望能直观的展示层与层,层与桶(用户域)之间的布局结构和用户流量的命中顺序关系。 我们进行了一些更能直观体现实验布局的探索,目前我们采用一个标准的树状结构来表示个实验分流模型。实验模型中的业务层和用户桶我们都会用图标进行区分,由于层桶结构可以嵌套多次,我们通过将结构关系进行拆分,将桶页面主视图和层页面主视图进行了分别设计。 层页面主视图:可以便捷的观察到当前层内的不同流量桶和子桶内的其他子业务层,主要是用于寻找自己的业务层位于某一个用户桶内,观察某些桶的流量比例和参数等。子业务层内的流量桶信息不予显示。 桶页面主视图:桶页面的主视图可以同时观察到该桶内的各个子业务层和业务层内部的子实验桶信息,可以用来直观的对照具体的实验命中链路从上往下核对实验命中路径。 界面显示如下(测试数据): 通过将层桶结构进行主要的功能拆分,可以在复杂场景的视图布局清晰度和易用性上达到一个比较好的平衡。 实验信息的完善 算法的实验在进行实验分析报表的时候往往需要对比多个指标综合观察实验效果,之前都是算法人员跟分析人工对齐某个实验什么时候开始什么时候结束,需要观察哪些指标等信息。为了方便后续自动化的进行实验效果分析,我们完善了实验的实验时长,核心指标,辅助指标等功能,方便用户进行实验的分析信息管理,后续通过自动化功能依赖这种信息可以实现实验报表指标流程的自动化计算。 4.2 服务稳定性的改进 1.动态白名单功能优化 白名单操作是一个使用频次较高的AB实验操作功能, 实验参数配置好以后往往需要通过白名单来小范围的验证策略效果。但是早期的白名单设计时候考虑到白名单会影响用户的分流,所以白名单信息和实验布局配置信息一起被用户感知,这也导致每一次的白名单变更都需要重新发布实验配置,给线上的配置稳定性造成了威胁。 解决方案: 基于白名单的设计和生效流程,我们尝试通过流程和配置格式改进优化,使得白名单的配置可以实时生效同时又不影响原来的实验配置,如下图所示: 动态白名单功能改动相当于将白名单的配置信息独立出来,在白名单有修改的时候独立加载,同时不触发配置信息本身的更新。但是考虑到兼容性问题,我们每次配置信息改动也会额外触发白名单的重新更新,描述配置更新相当于一次全量更新,配置和白名单都会更新。白名单更新相当于实时只更新新增的白名单信息。 2.并发操作Ark发布实验的优化 由于AB实验的配置下发方式是通过Ark配置中心提供的配置通知功能实现的,目前后台操作Ark进行配置发布的时候是通过http接口进行了,使用接口同时操作同一个Ark配置集的时候,大量操作容易产生并发,并发问题会导致Ark操作直接失败,这种情况极大地阻碍了实验配置发布过程的流畅性。 解决的办法有如下方案: 经过仔细评估和方案选择,我们决定方案2,3,4同步进行,最终完全解决了实验操作时候的并发问题。 4.3 实验效果分析的探索和优化 在过去2年的AB实验的实践和改进过程中,我们也十分注重实验效果方面的分析和问题归因,根据遇到的实际实验分析问题和情况,总结了一部分常见的实验分析相关经验文档,其中涉及实验流程标准化,实验指标选取,实验指标的统计功效分析,实验指标的p值和置信度分析,以及常见的实验中遇到的问题等。 常见的实验分析问题 我们总结了一些实验效果分析中常见的问题和可能的原因,可以帮助排查AB实验中遇到的常见问题。具体如下表: 实验中的辛普森悖论 辛普森悖论(英语:Simpson's paradox),是概率和统计中的一种现象,其中趋势出现在几组数据中,但当这些组被合并后趋势消失或反转。这个结果在社会科学和医学科学统计中经常遇到,当频率数据被不恰当地给出因果解释时尤其成问题。当干扰变量和因果关系在统计建模中得到适当处理时,这个悖论就可以得到解决。辛普森悖论已被用来说明统计误用可能产生的误导性结果。 落实到我们的AB实验中就是 如果一个实验A在一个较长的实验周期内每天指标都高于实验B,实验A的整体周期指标未必高于实验B。 本图想说明一个问题,如果一个实验周期跨很多天,每天观测实验效果的情况下,如果某个实验组用户数量(或者某个指标)长期每天稳定高于另一个实验组,不能说明分流不均匀。 第一天 因为刚刚重新分流,所以所有用户对实验来说都是新用户,a组 505万,b组 495万 ,1%的正常误差。 第二天 因为老用户要保持分流一致,组内用户=新用户+次留老用户, 新用户会重新分组,老用户沿用之前的分组,此时有两种情况: 情况1 (合理) 老用户按原来的分流, 新用户分流误差 1%。 情况2 (不合理) 老用户按原来的分流,新用户必须要保证误差 2%,才能逆转第二天的分组误差情况,但是此种情况下第二天的新老用户比例会严重不均匀,同时没办法保持分流策略的一致性,理论上不可能实现。 5 未来改进的方向 未来我们会希望借助数仓部门的AB平台的指标计算和可视化通用能力,希望可以逐步增强AB平台的数据可视化能力,在实验分流情况的可视化分析,实验的用户特征的分布可视化分析,实验的指标变化原因排查等方面与分析同学一起合作,提升AB实验的指标报表问题分析效率。 在AB实验平台本身的实验信息操作和性能,稳定性方面我们也有一些新的想法,希望将来可以打通开发环境,测试环境,生产环境,实现一个界面可以跨环境操作,降低算法同学使用不同环境AB需要在不同系统切换的问题,同时在将来还希望借助sidecard的形式增强AB实验的分流能力和分流稳定性,兼顾分流性能和分流平台功能迭代效率。 *文 / 开阳 本文属得物技术原创,更多精彩文章请看:得物技术官网 未经得物技术许可严禁转载,否则依法追究法律责任!

优秀的个人博客,低调大师

每日一博 | JVM 内存大对象监控和优化实践

作者: vivo 互联网服务器团队 - Liu Zhen、Ye Wenhao 服务器内存问题是影响应用程序性能和稳定性的重要因素之一,需要及时排查和优化。本文介绍了某核心服务内存问题排查与解决过程。首先在JVM与大对象优化上进行了有效的实践,其次在故障转移与大对象监控上提出了可靠的落地方案。最后,总结了内存优化需要考虑的其他问题。 一、问题描述 音乐业务中,core服务主要提供歌曲、歌手等元数据与用户资产查询。随着元数据与用户资产查询量的增长,一些JVM内存问题也逐渐显露,例如GC频繁、耗时长,在高峰期RPC调用超时等问题,导致业务核心功能受损。 图1 业务异常数量变化 二、分析与解决 通过对日志,机器CPU、内存等监控数据分析发现: YGC平均每分钟次数12次,峰值为24次,平均每次的耗时在327毫秒。FGC平均每10分钟0.08次,峰值1次,平均耗时30秒。可以看到GC问题较为突出。 在问题期间,机器的CPU并没有明显的变化,但是堆内存出现较大异常。图2,黄色圆圈处,内存使用急速上升,FGC变的频繁,释放的内存越来越少。 图2 老年代内存使用异常 因此,我们认为业务功能异常是机器的内存问题导致的,需要对服务的内存做一次专项优化。 步骤1 JVM优化 以下是默认的JVM参数: -Xms4096M-Xmx4096M-Xmn1024M-XX:MetaspaceSize=256M-Djava.security.egd=file:/dev/./urandom-XX:+HeapDumpOnOutOfMemoryError-XX:HeapDumpPath=/data/{runuser}/logs/other 如果不指定垃圾收集器,那么JDK 8默认采用的是Parallel Scavenge(新生代) +Parallel Old(老年代),这种组合在多核CPU上充分利用多线程并行的优势,提高垃圾回收的效率和吞吐量。但是,由于采用多线程并行方式,会造成一定的停顿时间,不适合对响应时间要求较高的应用程序。然而,core这类的服务特点是对象数量多,生命周期短。在系统特点上,吞吐量较低,要求时延低。因此,默认的JVM参数并不适合core服务。 根据业务的特点和多次对照实验,选择了如下参数进行JVM优化(4核8G的机器)。该参数将young区设为原来的1.5倍,减少了进入老年代的对象数量。将垃圾回收器换成ParNew+CMS,可以减少YGC的次数,降低停顿时间。此外还开启了CMSScavengeBeforeRemark,在CMS的重新标记阶段进行一次YGC,以减少重新标记的时间。 -Xms4096M-Xmx4096M-Xmn1536M-XX:MetaspaceSize=256M-XX:+UseConcMarkSweepGC-XX:+CMSScavengeBeforeRemark-Djava.security.egd=file:/dev/./urandom-XX:+HeapDumpOnOutOfMemoryError-XX:HeapDumpPath=/data/{runuser}/logs/other 图3 JVM优化前后的堆内存对比 优化后效果如图3,堆内存的使用明显降低,但是Dubbo超时仍然存在。 我们推断,在业务高峰期,该节点出现了大对象晋升到了老年代,导致内存使用迅速上升,并且大对象没有被及时回收。那如何找到这个大对象及其产生的原因呢?为了降低问题排查期间业务的损失,提出了临时的故障转移策略,尽量降低异常数量。 步骤2 故障转移策略 在api服务调用core服务出现异常时,将出现异常的机器ip上报给监控平台。然后利用监控平台的统计与告警能力,配置相应的告警规则与回调函数。当异常触发告警,通过配置的回调函数将告警ip传递给api服务,此时api服务可以将core服务下的该ip对应的机器视为“故障”,进而通过自定义的故障转移策略(实现Dubbo的AbstractLoadBalance抽象类,并且配置在项目),自动将该ip从提供者集群中剔除,从而达到不去调用问题机器。图 4 是整个措施的流程。在该措施上线前,每当有机器内存告警时,将会人工重启该机器。 图4 故障转移策略 步骤3 大对象优化 大对象占用了较多的内存,导致内存空间无法被有效利用,甚至造成OOM(Out Of Memory)异常。在优化过程中,先是查看了异常期间的线程信息,然后对堆内存进行了分析,最终确定了大对象身份以及产生的接口。 (1) Dump Stack 查看线程 从监控平台上Dump Stack文件,发现一定数量的如下线程调用。 Thread 5612: (state = IN_JAVA) - org.apache.dubbo.remoting.exchange.codec.ExchangeCodec.encodeResponse(org.apache.dubbo.remoting.Channel, org.apache.dubbo.remoting.buffer.ChannelBuffer, org.apache.dubbo.remoting.exchange.Response) @bci=11, line=282 (Compiled frame; information may be imprecise) - org.apache.dubbo.remoting.exchange.codec.ExchangeCodec.encode(org.apache.dubbo.remoting.Channel, org.apache.dubbo.remoting.buffer.ChannelBuffer, java.lang.Object) @bci=34, line=73 (Compiled frame) - org.apache.dubbo.rpc.protocol.dubbo.DubboCountCodec.encode(org.apache.dubbo.remoting.Channel, org.apache.dubbo.remoting.buffer.ChannelBuffer, java.lang.Object) @bci=7, line=40 (Compiled frame) - org.apache.dubbo.remoting.transport.netty4.NettyCodecAdapter$InternalEncoder.encode(io.netty.channel.ChannelHandlerContext, java.lang.Object, io.netty.buffer.ByteBuf) @bci=51, line=69 (Compiled frame) - io.netty.handler.codec.MessageToByteEncoder.write(io.netty.channel.ChannelHandlerContext, java.lang.Object, io.netty.channel.ChannelPromise) @bci=33, line=107 (Compiled frame) - io.netty.channel.AbstractChannelHandlerContext.invokeWrite0(java.lang.Object, io.netty.channel.ChannelPromise) @bci=10, line=717 (Compiled frame) - io.netty.channel.AbstractChannelHandlerContext.invokeWrite(java.lang.Object, io.netty.channel.ChannelPromise) @bci=10, line=709 (Compiled frame)... state = IN_JAVA 表示Java虚拟机正在执行Java程序。从线程调用信息可以看到,Dubbo正在调用Netty,将输出写入到缓冲区。此时的响应可能是一个大对象,因而在对响应进行编码、写缓冲区时,需要耗费较长的时间,导致抓取到的此类线程较多。另外耗时长,也即是大对象存活时间长,导致full gc 释放的内存越来越小,空闲的堆内存变小,这又会加剧full gc 次数。 这一系列的连锁反应与图2相吻合,那么接下来的任务就是找到这个大对象。 (2)Dump Heap 查看内存 对core服务的堆内存进行了多次查看,其中比较有代表性的一次快照的大对象列表如下, 图5 core服务的堆内存快照 整个Netty的taskQueue有258MB。并且从图中绿色方框处可以发现,单个的Response竟达到了9M,红色方框处,显示了调用方的服务名以及URI。 进一步排查,发现该接口会通过core服务查询大量信息,至此基本排查清楚了大对象的身份以及产生原因。 (3)优化结果 在对接口进行优化后,整个core服务也出现了非常明显的改进。YGC全天总次数降低了76.5%,高峰期累计耗时降低了75.5%。FGC三天才会发生一次,并且高峰期累计耗时降低了90.1%。 图6大对象优化后的core服务GC情况 尽管优化后,因内部异常导致获取核心业务失败的异常请求数显著减少,但是依然存在。为了找到最后这一点异常产生的原因,我们打算对core服务内存中的对象大小进行监控。 图7系统内部异常导致核心业务失败的异常请求数 步骤4 无侵入式内存对象监控 Debug Dubbo 源码的过程中,发现在网络层,Dubbo通过encodeResponse方法对响应进行编码并写入缓冲区,通过checkPayload方法去检查响应的大小,当超过payload时,会抛出ExceedPayloadLimitException异常。在外层对异常进行了捕获,重置buffer位置,而且如果是ExceedPayloadLimitException异常,重新发送一个空响应,这里需要注意,空响应没有原始的响应结果信息,源码如下。 //org.apache.dubbo.remoting.exchange.codec.ExchangeCodec#encodeResponseprotected void encodeResponse(Channel channel, ChannelBuffer buffer, Response res) throws IOException { //...省略部分代码 try { //1、检查响应大小是否超过 payload,如果超过,则抛出ExceedPayloadLimitException异常 checkPayload(channel, len); } catch (Throwable t) { //2、重置buffer buffer.writerIndex(savedWriteIndex); //3、捕获异常后,生成一个新的空响应 Response r = new Response(res.getId(), res.getVersion()); r.setStatus(Response.BAD_RESPONSE); //4、ExceedPayloadLimitException异常,将生成的空响应重新发送一遍 if (t instanceof ExceedPayloadLimitException) { r.setErrorMessage(t.getMessage()); channel.send(r); return; } }} //org.apache.dubbo.remoting.transport.AbstractCodec#checkPayloadprotected static void checkPayload(Channel channel, long size) throws IOException { int payload = getPayload(channel); boolean overPayload = isOverPayload(payload, size); if (overPayload) { ExceedPayloadLimitException e = new ExceedPayloadLimitException("Data length too large: " + size + ", max payload: " + payload + ", channel: " + channel); logger.error(e); throw e; }} 受此启发,自定义了编解码类(实现org.apache.dubbo.remoting.Codec2接口,并且配置在项目),去监控超出阈值的对象,并打印请求的详细信息,方便排查问题。在具体实现中,如果特意去计算每个对象的大小,那么势必是对服务性能造成影响。经过分析,采取了和checkPayload一样的方式,根据编码前后buffer的writerIndex位置去判断有没有超过设定的阈值。代码如下。 /** * 自定义dubbo编码类 **/public class MusicDubboCountCodec implements Codec2 { /** * 异常响应池:缓存超过payload大小的responseId */ private static Cache<Long, String> EXCEED_PAYLOAD_LIMIT_CACHE = Caffeine.newBuilder() // 缓存总条数 .maximumSize(100) // 过期时间 .expireAfterWrite(300, TimeUnit.SECONDS) // 将value设置为软引用,在OOM前直接淘汰 .softValues() .build(); @Override public void encode(Channel channel, ChannelBuffer buffer, Object message) throws IOException { //1、记录数据编码前的buffer位置 int writeBefore = null == buffer ? 0 : buffer.writerIndex(); //2、调用原始的编码方法 dubboCountCodec.encode(channel, buffer, message); //3、检查&记录超过payload的信息 checkOverPayload(message); //4、计算对象长度 int writeAfter = null == buffer ? 0 : buffer.writerIndex(); int length = writeAfter - writeBefore; //5、超过告警阈值,进行日志打印处理 warningLengthTooLong(length, message); } //校验response是否超过payload,超过了,缓存id private void checkOverPayload(Object message){ if(!(message instanceof Response)){ return; } Response response = (Response) message; //3.1、新的发送过程:通过状态码BAD_RESPONSE与错误信息识别出空响应,并记录响应id if(Response.BAD_RESPONSE == response.getStatus() && StrUtil.contains(response.getErrorMessage(), OVER_PAYLOAD_ERROR_MESSAGE)){ EXCEED_PAYLOAD_LIMIT_CACHE.put(response.getId(), response.getErrorMessage()); return; } //3.2、原先的发送过程:通过异常池识别出超过payload的响应,打印有用的信息 if(Response.OK == response.getStatus() && EXCEED_PAYLOAD_LIMIT_CACHE.getIfPresent(response.getId()) != null){ String responseMessage = getResponseMessage(response); log.warn("dubbo序列化对象大小超过payload,errorMsg is {},response is {}", EXCEED_PAYLOAD_LIMIT_CACHE.getIfPresent(response.getId()),responseMessage); } } } 在上文中提到,当捕获到超过payload的异常时,会重新生成空响应,导致失去了原始的响应结果,此时再去打印日志,是无法获取到调用方法和入参的,但是encodeResponse方法步骤4中,重新发送这个Response,给了我们机会去获取到想要的信息,因为重新发送意味着会再去走一遍自定义的编码类。 假设有一个超出payload的请求,执行到自定编码类encode方法的步骤2(Dubbo源码中的编码方法),在这里会调用encodeResponse方法重置buffer,发送新的空响应。 (1)当这个新的空响应再次进入自定义encode方法,执行 checkOverPayload方法的步骤3.1时,就会记录异常响应的id到本地缓存。由于在encodeResponse中buffer被重置,无法计算对象的大小,所以步骤4、5不会起到实际作用,就此结束新的发送过程。 (2)原先的发送过程回到步骤2 继续执行,到了步骤3.2 时,发现本地缓存的异常池中有当前的响应id,这时就可以打印调用信息了。 综上,对于大小在告警阈值和payload之间的对象,由于响应信息成功写入了buffer,可以直接进行大小判断,并且打印响应中的关键信息;对于超过payload的对象,在重新发送中记录异常响应id到本地,在原始发送过程中访问异常id池识别是否是异常响应,进行关键信息打印。 在监控措施上线后,通过日志很快速的发现了一部分产生大对象的接口,当前也正在根据接口特点做针对性优化。 三、总结 在对服务JVM内存进行调优时,要充分利用日志、监控工具、堆栈信息等,分析与定位问题。尽量降低问题排查期间的业务损失,引入对象监控手段也不能影响现有业务。除此之外,还可以在定时任务、代码重构、缓存等方面进行优化。优化服务内存不仅仅是JVM调参,而是一个全方面的持续过程。 END 猜你喜欢 vivo 容器集群监控系统优化之道 高效构建 vivo 企业级网络流量分析系统 HBase Compaction 原理与线上调优实践 本文分享自微信公众号 - vivo互联网技术(vivoVMIC)。 如有侵权,请联系 support@oschina.cn 删除。 本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | 消息队列 CKafka 跨洋数据同步性能优化

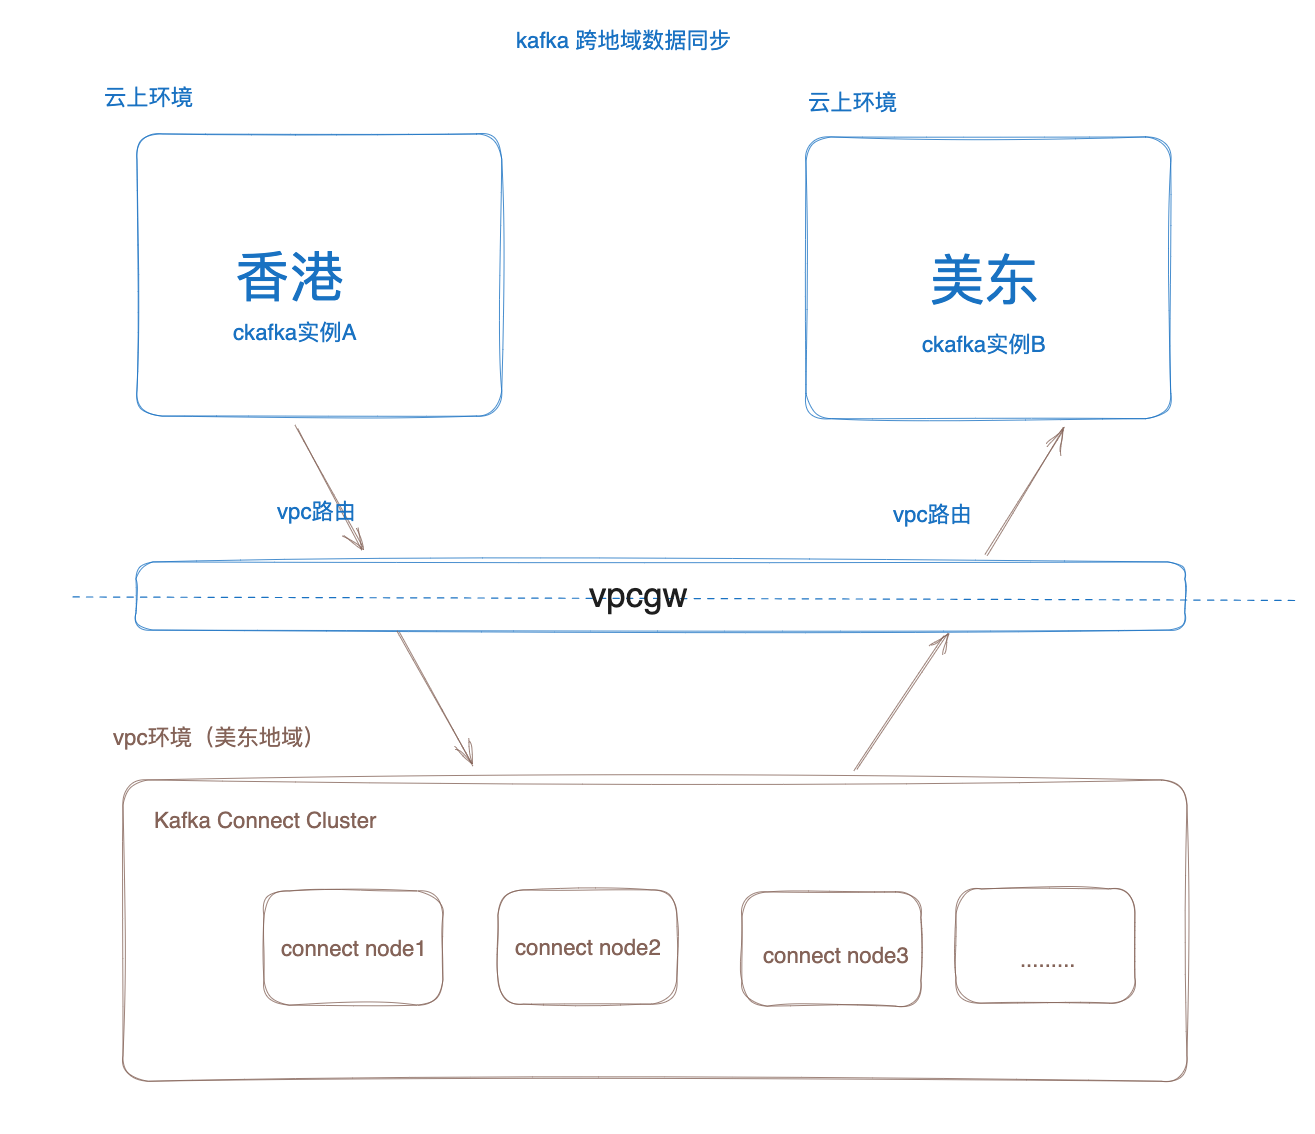
导语 本文主要介绍了 CKafka 在跨洋场景中遇到的一个地域间数据同步延时大的问题,跨地域延时问题比较典型,所以详细记录下来做个总结。 一. 背景 为了满足客户跨地域容灾、冷备的诉求,消息队列 CKafka 通过连接器功能,提供了跨地域数据同步的能力,支持跨地域秒级准实时数据同步。 整体的架构图: 如上图所示,CKafka 跨地域数据同步能力,底层基于 Kafka Connect 集群实现,并通过Vpcgw Privatelink 打通云上环境。 数据同步主要流程如下: 1. Connect 集群初始化 Connect Task,每个 Task 会新建多个 Worker ConsumerClient(具体多少取决于源实例的分区数)从源 CKafka 实例拉取数据。 2. Connect 集群从源实例拉取数据后,会启动 Producer 发送数据到目标 CKafka 实例。 在某个客户业务场景中,客户希望通过跨地域同步能力,把香港 CKafka 实例的数据同步到美东 CKafka 实例,在使用过程中引发了一个跨地域延时的诡异问题! 二. 问题现象 客户在使用跨地域同步能力的时候,发现数据从香港->美东同步数据的延时非常大,并且能明显的看到 Connect 作为 Consumer 去源实例(香港)消费拉取数据的消息堆积非常大。 消息堆积 根据过往的经验,我们国内地域的同步不会出现这么大的延时,为什么这次的跨地域会有这么大的延时呢? 三. 问题分析 消息堆积常见的原因 Kafka 在生产消费过程中,出现消息堆积常见的原因主要有以下几点: ● Broker 集群负载过高:包括 CPU 高、内存高、磁盘 IO 高导致消费吞吐慢。 ● 消费者处理能力不足:如果消费者的处理能力不足,无法及时消费消息,就会导致消息堆积。可以通过增加消费者的数量或者优化消费者的处理逻辑来解决该问题。 ● 消费者异常退出:如果消费者异常退出,就会导致消息无法及时消费,从而在 Broker 中积累大量未消费的消息。可以通过监控消费者的状态和健康状况,及时发现并处理异常情况。 ● 消费者提交偏移量失败:如果消费者提交偏移量失败,就会导致消息重复消费或者消息丢失,从而在 Broker 中积累大量未消费的消息。可以通过优化消费者的偏移量提交逻辑,或者使用 Kafka 的事务机制来保证偏移量的原子性和一致性。 ● 网络故障或者 Broker 故障:如果网络故障或者 Broker 故障,就会导致消息无法及时传输或者存储,从而在 Broker 中积累大量未消费的消息。可以通过优化网络的稳定性和可靠性,或者增加 Broker 的数量和容错能力来解决该问题。 ● 生产者发送消息速度过快:如果生产者发送消息速度过快,超过了消费者的处理能力,就会导致消息堆积。可以通过调整生产者的发送速度,或者增加消费者的数量来解决该问题。 基于以上原因,我们首先排查了 Connect 集群所有节点和源目标 CKafka 实例所有节点的负载,发现各项监控指标都很健康、集群负载很低,ConnectConsumer 消费能力也没有出现异常和性能瓶颈。 但是单次拉取消息的速率却很低,平均消费速度325KB/s,这个是不符合预期的。 (注:上图中的 bytes-consumed-rate 指标代表每秒消费的字节数) 既然集群负载没有问题,于是我们进行了更深层的排查分析: 第一阶段分析:排查网络速率 消息延时大,我们首先想到的就是网络问题,所以立刻着手压测网络。通过 Iperf3 、Wget 探测网络速率。 Iperf3 压测,速度在225Mbps 。 Wget 在 Connect 集群直连香港,下载速度在20MB/s。 这两个测试说明:在同样环境下,网络传输速率并不低,可以达到20MB/s。那既然网络带宽没问题,问题又会出在哪呢? 第二阶段分析:内核调参数 网络没有问题,那会不会是 Kafka 网络相关的应用程序参数、以及内核网络相关的参数设置的不合理呢? 1、我们首先进行了内核调参,跟网络相关的内核参数主要有: 系统默认值: net.core.rmem_max=212992 net.core.wmem_max=212992 net.core.rmem_default=212992 net.core.wmem_default=212992 net.ipv4.tcp_rmem="4096 87380 67108864" net.ipv4.tcp_wmem="4096 65536 67108864" --------------------------------------------------------- 调整内核参数: sysctl -w net.core.rmem_max=51200000 sysctl -w net.core.wmem_max=51200000 sysctl -w net.core.rmem_default=2097152 sysctl -w net.core.wmem_default=2097152 sysctl -w net.ipv4.tcp_rmem="40960 873800 671088640" sysctl -w net.ipv4.tcp_wmem="40960 655360 671088640" 调整TCP的拥塞算法为bbr: sysctl -w net.ipv4.tcp_congestion_control=bbr 整体内核参数的值我们都调大了(尽管我们认为系统内核默认值也不小),同时我们还调整了TCP 的拥塞算法。 这里解释一下为什么要调整 TCP 的拥塞算法。 (参考资料:[[译] [论文] BBR:基于拥塞(而非丢包)的拥塞控制(ACM, 2017)]([译] [论文] BBR:基于拥塞(而非丢包)的拥塞控制(ACM, 2017))) 因为这个延时发生在跨地域间且跨洋了,使用 BBR,可以获得显著的网络吞吐量的提升和延迟的降低。吞吐量的改善在远距离路径上尤为明显,比如跨太平洋的文件或者大数据的传输,尤其是在有轻微丢包的网络条件下。延迟的改善主要体现在最后一公里的路径上,而这一路径经常受到缓冲膨胀(Bufferbloat)的影响。所谓“缓冲膨胀”指的是网络设备或者系统不必要地设计了过大的缓冲区。当网络链路拥塞时,就会发生缓冲膨胀,从而导致数据包在这些超大缓冲区中长时间排队。在先进先出队列系统中,过大的缓冲区会导致更长的队列和更高的延迟,并且不会提高网络吞吐量。由于 BBR 并不会试图填满缓冲区,所以在避免缓冲区膨胀方面往往会有更好的表现。 经过内核参数调整后,验证发现延时并没有很大的改善。 2、在云产品技术服务专家大佬的提醒下,确认连接的 Receive Buffer 设置过小,调内核参数才没有生效,怀疑是应用层进行了设置。 于是我们调整了 Kafka 应用程序网络参数 Socket.Send.Buffer、Socket.Recevie.Buffer 的参数值: (1)把源目标 CKafka 实例 Broker 的 Socket.Send.Buffer.Bytes 参数从默认64KB调整为使用系统的 Socket Send Buffer。 Kafka 内核关于 Socket Send Buffer 的代码: 【Tips】: 在 Kafka 中,TCP 发送缓冲区的大小由应用程序和操作系统共同决定。应用程序可以通过设置 Socket.Send.Buffer.Bytes 参数来控制 TCP 发送缓冲区的大小,操作系统也可以通过设置 TCP/IP 协议栈的参数来控制 TCP 发送缓冲区的大小。 应用程序设置的 Socket.Send.Buffer.Bytes 参数会影响 TCP 发送缓冲区的大小,但是操作系统也会对 TCP 发送缓冲区的大小进行限制。如果应用程序设置的 Socket.Send.Buffer.Bytes 参数超过了操作系统的限制,那么 TCP 发送缓冲区的大小就会被限制在操作系统的限制范围内。如果应用程序设置的 Socket.Send.Buffer.Bytes=-1 ,那么 TCP 发送缓冲区的大小就会默认使用操作系统的 TCP 发送缓冲区的大小。需要注意的是,TCP 发送缓冲区的大小会影响网络的吞吐量和延迟时间。如果 TCP 发送缓冲区的大小过小,会导致网络的吞吐量和性能下降;如果 TCP 发送缓冲区的大小过大,会导致网络的延迟时间增加。因此,需要根据实际情况进行调整,以达到最优的性能和可靠性。 (2)把客户端 Connect Consumer 的 Receive.Buffer.Bytes 参数从默认64KB调整为使用系统的Socket Receive Buffer。把客户端 Max.Partition.Fetch.Bytes 这个分区最大拉取大小调整到了5MB。 调整后,我们迅速和客户协调时间重启集群,验证这个调参。调整完后的效果明显:单连接的平均速度从300KB/s提升到了2MB/s以上: 可以看到调大 Kafka 的 Socket 接收、发送参数后,效果确实很明显,同步数率上来了。当我们以为延时问题解决了的时候,问题又出现了! 第三阶段分析:深挖根因 上面第二阶段的 Kafka 调参应用到客户集群,观察一天后,客户反馈集群整体延时有所好转,但是部分分区延时还是很大。我们也观测到大概一半分区的同步速率依然很低。 (注:上图中的 Bytes-Consumed-Rate 指标 代表每秒消费的字节数) (1)为什么部分连接速度还是很低? 我们首先通过运营后台确定了消费速率低的 Partition 对应的 ConsumerGroupID,通过这个ConsumerGroupID 抓包定位对应的慢速 TCP 连接。 定位连接后,进行抓包分析: 从上可以看到 Server 发送一段数据之后,会暂停一段时间,大约一个 RTT 再继续发送。统计每个发送间隔之间的数据包的总大小,大概64KB。这基本能说明 TCP 的发送窗口被限制在64KB。但是,通过抓包其他速度正常的连接发现并没有这种限制。一般来说,TCP 发送窗口的实际大小是跟 Window Scale 有关的,这个只能在连接建立的时候确认。 【Tips】:TCP Window Scale, TCP 的窗口缩放因子。(参考资料:How to determine TCP initial window size and scaling option? Which factors affect the determination? - Red Hat Customer Portal) 在传统的 TCP 协议中,TCP 窗口大小的最大值只能达到 64KB,这限制了 TCP 协议的传输速度和效率。为了解决这个问题,TCP Window Scale 机制被引入到 TCP 协议中。 TCP 窗口大小 = (接收端窗口大小) * (2 ^ TCP Window Scale 选项的值) 需要注意的是,TCP Window Scale 机制需要在 TCP 三次握手连接建立时进行协商,以确定 TCP 窗口大小的扩展方式和参数。 为了抓取建连的情况,我们尝试重启单个 Partition 的消费任务,但是发现,只要一重启,消费的速度就能恢复,窗口的大小就不会出现瓶颈。 (2)为什么发送窗口被限制? 为了复现问题,我们模拟构造了客户的使用场景,进行了整体的场景复现。最终确认只有在任务全量重启的时候才会出现这个问题。 在任务重启过程中,我们进行了服务端的整体抓包。定位到了正常连接和异常连接,对比了建连的过程,最终确认了慢速的连接中 Window Scale 确实没有生效! 正常连接建连过程: 慢速连接建连过程: 从上图可以看出,慢速连接中,Server 在返回 Syn/Ack 包的时候,没有"WS=2",说明并没有开启 Window Scale 选项,进而导致整个连接的发送窗口被限制在了64KB,吞吐就上不去了。Client 返回最后一个 Ack 的时候,也明确显示了"no window scaling used"。 (3)为什么Window Scale 概率性不生效? 到这一步,我们就需要解释为什么 Server 端发送 Syn/Ack 的时候会概率性地不开 Window Scale 呢? 这里,计算组大佬给出了一个相似的 Case 提供我们学习:kubernetes - 深度复盘-重启 etcd 引发的异常 - 个人文章 - SegmentFault 思否 从中可以得到一个信息: 看起来是 SYN Cookie 生效的情况下,对方没有传递 Timestamp 选项过来(实际上,按照 SYN Cookie 的原理,发送给对端的回包中,会保存有编码进 Tsval 字段低 6 位的选项信息),就会调用 Tcp_Clear_Options, 清空窗口放大因子等选项。 我们从系统日志里面,我们也能观察到在任务整体重启的时候确实触发了 SYN Flood。 (4)为什么服务端没收到 Tsval (TCP 的 Timestamp Value) 呢? 上面有介绍过我们的数据同步时经过了公司内部的一个 VPCGW,我们分别在 Client 和 Server 上分别抓包,最终确认是 VPCGW 把 Client 发出的 Tsval 吞了。同时也跟 VPCGW 的研发同学确认,在 NAT 环境下,不转发 Timestamp 是预期行为,主要为了解决特殊情况下的丢包问题,NAT环境下tcp_timestamps问题_centos nat tcp_timestamps_清风徐来918的博客-CSDN博客。不过这个问题在新内核中,已经不存在,所以可以排期提供开放 Timestamp 的能力。 根因定位 一路分析深挖下来,至此,问题的根因就清晰了: Connect Consumer 批量启动,触发了大量新建 TCP 连接,短时间的大量新建连接触发了 SYN Cookie 保护检查逻辑。但是因为客户端没有发送 Timestamp 选项传过来,造成了服务端把窗口放大因子清除,最终造成连接的发送窗口最大64KB,在大延迟的场景下影响了传输性能。 四. 我们的解决方案 问题的根因找到了,解决方案就清晰明朗了。 ● 规避方案:我们调整了 Connect Woker 初始化的并发度,降低 TCP 初始化建连的速度,保证不会触发 SYN Cookie, 来保证后续数据同步的性能。 ● 最终方案:推动 VPCGW 打开 TCP Timestamp 的能力。 五. 总结 问题表面是跨地域数据同步请求慢的问题,但是一路深挖下来确实一个非常底层的网络问题。 这个问题的发生比较罕见,因为这个问题发生的条件比较复杂,主要是跨地域存在网络延时、同时大量的 TCP 建连、加上 VPCGW 路由传输过程中吃掉了 TCP Timestamp参数, 叠加起来导致了这个问题。 我们面对问题需要保持敬畏之心,深挖到底!

优秀的个人博客,低调大师

每日一博 | 得物 Android 包体积资源优化实践

包体积优化中,资源优化一般都是首要且容易有成效的优化方向。资源优化是通过优化APK中的资源项来优化包体积,本文我们会介绍得物App在资源优化上做的一些实践。 1. 插件优化 插件优化资源在得物App最新版本上收益12MB。插件优化的日志在包体积平台有具体的展示,也是为了提供一个资源问题追溯的能力。 1.1 插件环境配置 插件首先会初始化环境配置,如果机器上未安装运行环境则会去oss下载对应的可执行文件。 1.2 图片压缩 在开发阶段,开发同学首先会通过TinyPNG等工具主动对图片进行压缩,而对于三方库和一些业务遗漏处理的图片则会在打包的时候通过gradle插件进行压缩。 图片压缩插件使用 cwebp 对图片进行webp转换,使用 guetzli 对JPEG进行压缩,使用pngquant对PNG 进行压缩,使用 gifsicle 对gif进行压缩。在实施对过程中,对于 res 目录下的文件优先使用 webp 处理,对assets 目录下的文件则进行同格式压缩。下面先介绍下资源压缩插件的工作模式和原理。 1.2.1 Res图片压缩 第一步,找```language 到并遍历 ap_ 文件 ![103.png](https://cdn.poizon.com/ctoo/072011/103.png) ###### AAPT2这个工具在打包过程中主要做了下列工作: 把"assets"和"res/raw"目录下的所有资源进行打包(会根据不同的文件后缀选择压缩或不压缩),而"res/"目录下的其他资源进行编译或者其他处理(具体处理方式视文件后缀不同而不同,例如:".xml"会编译成二进制文件,".png"文件会进行优化等等)后才进行打包; 会对除了assets资源之外所有的资源赋予一个资源ID常量,并且会生成一个资源索引表resources.arsc; 编译AndroidManifest.xml成二进制的XML文件; 把上面3个步骤中生成结果保存在一个*.ap_文件,并把各个资源ID常量定义在一个 R.java\ R.txt中; - 第二步,解压 ap_ 文件,找到 res/drawable 、res/mipmap 、res/raw 目录下的图片进行压缩 ```fun compressImg(imgFile: File): Long { if (ImageUtil.isJPG(imgFile) || ImageUtil.isGIF(imgFile) || ImageUtil.isPNG(imgFile)) { val lastIndexOf = imgFile.path.lastIndexOf(".") if (lastIndexOf < 0) { println("compressImg ignore ${imgFile.path}") return 0 } val tempFilePath = "${imgFile.path.substring(0, lastIndexOf)}_temp${imgFile.path.substring(lastIndexOf)}" if (ImageUtil.isJPG(imgFile)) { Tools.cmd("guetzli", "--quality 85 ${imgFile.path} $tempFilePath") } else if (ImageUtil.isGIF(imgFile)) { Tools.cmd("gifsicle", "-O3 --lossy=25 ${imgFile.path} -o $tempFilePath") } else if (ImageUtil.isPNG(imgFile)) { Tools.cmd( "pngquant", "--skip-if-larger --speed 1 --nofs --strip --force --quality=75 ${imgFile.path} --output $tempFilePath" ) } val oldSize = imgFile.length() val tempFile = File(tempFilePath) val newSize = tempFile.length() return if (newSize in 1 until oldSize) { val imgFileName: String = imgFile.path if (imgFile.exists()) { imgFile.delete() } tempFile.renameTo(File(imgFileName)) oldSize - newSize } else { if (tempFile.exists()) { tempFile.delete() } 0L } } return 0 } 图片的压缩收益最大,且实施简单,风险最低,是资源优化的首选。 1.2.2 Assets图片压缩 Assets 图片压缩的处理方式与 res 下差不多,区别仅仅在于挂载的 task 与 压缩模式不同,Assets 下单资源由于是通过 AssetsManager 按照名称获取的,且使用场景不可控,无法明确感知业务使用对格式是否有要求的前提下,同格式压缩是相对稳妥的方案。 mergeAssets.doLast { task -> (task as MergeSourceSetFolders).outputDir.asFileTree.files.filter { val originalPath = it.absolutePath.replace(task.outputDir.get().toString() + "/", "") val filter = context.compressAssetsExtension.whiteList.contains(originalPath) if (filter) { println("Assets compress ignore:$originalPath") } !filter }.forEach { file -> val originalPath = file.absolutePath.replace(task.outputDir.get().toString() + "/", "") val reduceSize = CompressUtil.compressImg(file) if (reduceSize > 0) { assetsShrinkLength += reduceSize assetsList.add("$originalPath => reduce[${byteToSize(reduceSize)}]") } } println("assets optimized:${byteToSize(assetsShrinkLength)}") } 1.3 资源去重 相较于压缩,资源的去重需要对arsc文件格式有一点了解。为了便于理解,这里先对arsc二进制文件进行一点简单的介绍。 resource.arsc文件是Apk打包过程中的产生的一个资源索引文件,它是一个二进制文件,源码ResourceTypes.h 定义了其数据结构。通过学习resource.arsc文件结构,可以帮助我们深入了解apk包体积优化中使用到的 重复资源删除、资源文件名混淆 技术。关于 ARSC 文件的具体细节感兴趣的可以参考:https://huanle19891345.github.io/en/android/热修复字节码/tinker/源码分析/resource.arsc生成和结构/ 将apk使用AS 打开也能看到resource.arsc中存储的信息 说回到资源去重,去重打原理很简单,找到资源文件目录下相同的文件,然后删除掉重复的文件,最后到 arsc 中修改记录,将删除的文件索引名称进行替换。 由于删除重复资源在 arsc 中只是对常量池中路径替换,并没有删除 arsc 中的记录,也没有修改PackageChunk 中的常量池内容,也就是对应上图中的 Name 字段,故而重复资源的删除安全性比较高。 下面介绍下具体实施方案: 第一步遍历ap文件,通过 crc32 算法找出相同文件。之所以选择 crc32 是因为 gralde 的 entry file 自带 crc32 值,不需要进行额外计算,但是 crc32 是有冲突风险的,故而又对 crc32 的重复结果进行 md5 二次校验。 第二步则是对原始重复文件的删除 第三步修改 ResourceTableChunk 常量池内容,进行资源重定向 val groupResources = ZipFile(apFile).groupsResources() // 获取 val resourcesFile = File(unZipDir, "resources.arsc") val md5Map = HashMap<String, HashSet<ZipEntry>>() val newResouce = FileInputStream(resourcesFile).use { stream -> val resouce = ResourceFile.fromInputStream(stream) groupResources.asSequence() .filter { it.value.size > 1 } .map { entry -> entry.value.forEach { zipEntry -> if (whiteList.isEmpty() || !whiteList.contains(zipEntry.name)) { val file = File(unZipDir, zipEntry.name) MD5Util.computeMD5(file).takeIf { it.isNotEmpty() }?.let { val set = md5Map.getOrDefault(it, HashSet()) set.add(zipEntry) md5Map[it] = set } } } md5Map.values } .filter { it.size > 1 } .forEach { collection -> // 删除多余资源 collection.forEach { it -> val zips = it.toTypedArray() // 所有的重复资源都指定到这个第一个文件上 val coreResources = zips[0] for (index in 1 until zips.size) { // 重复的资源 val repeatZipFile = zips[index] result?.add("${repeatZipFile.name} => ${coreResources.name} reduce[${byteToSize(repeatZipFile.size)}]") // 删除解压的路径的重复文件 File(unZipDir, repeatZipFile.name).delete() // 将这些重复的资源都重定向到同一个文件上 resouce .chunks .filterIsInstance<ResourceTableChunk>() .forEach { chunk -> val stringPoolChunk = chunk.stringPool val index = stringPoolChunk.indexOf(repeatZipFile.name) if (index != -1) { // 进行剔除重复资源 stringPoolChunk.setString(index, coreResources.name) } } } } } resouce } 1.4 资源混淆 资源混淆则是在资源去重打基础上更进一步,与代码混淆的思路一致,用长路径替换短路径,一来减小文件名大小,二来降低arsc中常量池中二进制文件大小。 长路径替换短路径修改 ResourceTableChunk 即可,与重复资源处理如出一辙。 同时我们发现 PackageChunk 中常量池中字段还是原来的内容,但是并不影响apk的运行。因为通过 getDrawable(R.drawable.xxx)方式加载的资源在编译后对应的是 getDrawable(0x7f08xxxx)这种16进制的内容,其实就是与 arsc 中的 ID 对应,用不上 Name 字段。而通过 getResources().g val newResouce = FileInputStream(resourcesFile).use { inputStream -> val resouce = ResourceFile.fromInputStream(inputStream) resouce .chunks .filterIsInstance<ResourceTableChunk>() .forEach { chunk -> val stringPoolChunk = chunk.stringPool // 获取所有的路径 val strings = stringPoolChunk.getStrings() ?: return@forEach for (index in 0 until stringPoolChunk.stringCount) { val v = strings[index] if (v.startsWith("res")) { if (ignore(v, context.proguardResourcesExtension.whiteList)) { println("resProguard ignore $v ") // 把文件移到新的目录 val newPath = v.replaceFirst("res", whiteTempRes) val parent = File("$unZipDir${File.separator}$newPath").parentFile if (!parent.exists()) { parent.mkdirs() } keeps.add(newPath) // 移动文件 File("$unZipDir${File.separator}$v").renameTo(File("$unZipDir${File.separator}$newPath")) continue } // 判断是否有相同的 val newPath = if (mappings[v] == null) { val newPath = createProcessPath(v, builder) // 创建路径 val parent = File("$unZipDir${File.separator}$newPath").parentFile if (!parent.exists()) { parent.mkdirs() } // 移动文件 val isOk = File("$unZipDir${File.separator}$v").renameTo(File("$unZipDir${File.separator}$newPath")) if (isOk) { mappings[v] = newPath newPath } else { mappings[v] = v v } } else { mappings[v] } strings[index] = newPath!! } } val str2 = mappings.map { val startIndex = it.key.lastIndexOf("/") + 1 var endIndex = it.key.lastIndexOf(".") if (endIndex < 0) { endIndex = it.key.length } if (endIndex < startIndex) { it.key to it.value } else { // val vStartIndex = it.value.lastIndexOf("/") + 1 // var vEndIndex = it.value.lastIndexOf(".") // if (vEndIndex < 0) { // vEndIndex = it.value.length // } // val result = it.value.substring(vStartIndex, vEndIndex) // 使用相同的字符串,以减小体积 it.key.substring(startIndex, endIndex) to "du" } }.toMap() // 修改 arsc PackageChunk 字段 chunk.chunks.values.filterIsInstance<PackageChunk>() .flatMap { it.chunks.values } .filterIsInstance<StringPoolChunk>() .forEach { for (index in 0 until it.stringCount) { it.getStrings()?.forEachIndexed { index, s -> str2[s]?.let { result -> it.setString(index, result) } } } } // 将 mapping 映射成 指定格式文件,供给反混淆服务使用 val mMappingWriter: Writer = BufferedWriter(FileWriter(file, false)) val packageName = context.proguardResourcesExtension.packageName val pathMappings = mutableMapOf<String, String>() val idMappings = mutableMapOf<String, String>() mappings.filter { (t, u) -> t != u }.forEach { (t, u) -> result?.add(" $t => $u") compress[t]?.let { compress[u] = it compress.remove(t) } val pathKey = t.substring(0, t.lastIndexOf("/")) pathMappings[pathKey] = u.substring(0, u.lastIndexOf("/")) val typename = t.split("/")[1].split("-")[0] val path1 = t.substring(t.lastIndexOf("/") + 1, t.indexOf(".")) val path2 = u.substring(u.lastIndexOf("/") + 1, u.indexOf(".")) val path = "$packageName.R.$typename.$path1" val pathV = "$packageName.R.$typename.$path2" if (idMappings[path].isNullOrEmpty()) { idMappings[path] = pathV } } generalFileResMapping(mMappingWriter, pathMappings) generalResIDMapping(mMappingWriter, idMappings) } // 删除res下的文件 FileOperation.deleteDir(File("$unZipDir${File.separator}res")) // 将白名单的文件移回res keeps.forEach { val newPath = it.replaceFirst(whiteTempRes, "res") val parent = File("$unZipDir${File.separator}$newPath").parentFile if (!parent.exists()) { parent.mkdirs() } File("$unZipDir${File.separator}$it").renameTo(File("$unZipDir${File.separator}$newPath")) } // 收尾删除 res2 FileOperation.deleteDir(File("$unZipDir${File.separator}$whiteTempRes")) resouce } 白名单配置必不可少,保证反射调用资源不参与混淆 createProcessPath 用于将长路径修改为短路径 修改 PackageChunk 中的常量池,用于极致的包体裁剪,未压缩前减小包体300kb,arsc压缩后降低包体70kb 生成资源混淆mapping文件,提供给包体积服务进行资源名称还原使用 资源混淆的落地过程必须要谨慎,对存量代码,在得物app中我们先通过字节码扫描找出所有反射调用资源的地方,配置keep文件。对于后续业务开发中新增的反射调用则通过测试流程及早发现问题。 1.5 ARSC压缩 Arsc 压缩降低的体积非常可观,压缩后的arsc 700kb,未压缩的约 7MB。实施起来通过 7zip对 arsc文件压缩即可。 但是 Target Sdk 在30以上 arsc 压缩被禁了。压缩 resources.arsc 虽然能带来包体上的收益,但也有弊端,它将带来内存和运行速度上的劣势。不压缩的resources.arsc系统可以使用mmap来节约内存的使用(一个app的资源至少被3个进程所持有:自己, launcher, system),而压缩的resources.arsc会存在于每个进程中。 2. 资源下发 Apk 中的存量大资源在打包后包体积平台检测出来,针对问题资源排期处理。动态下发和无用删除则是处理存量资源的常用手段,同时通过 CI 前置管控新增资源过大的情况。 资源下发的主体主要是 so 文件和图片,对下发的资源的管控则需可以通过平台化管理。堵不如疏,能下发的资源就下发是包体优化的一大利器。 下发的资源通过动态资源管理平台进行处理 3. 无用资源删除 无用资源的检测结合bytex的 resCheck 编译期 与 matrix-apk-canary smail 扫描的结果,将业务可以处理的部分在平台上展示,版本迭代过程中边迭代边治理,能够有效防止无用资源的持续恶化。 4. 总结 本文主要介绍了得物APP资源优化做了的一些动作,其中对资源优化插件的工作模式进行了重点介绍。当然,对于资源依旧有不少手段可以完善,比如提供高效简单的 9 图下发方案,包体积平台增加图片相似度检测能力、把一些次级的资源通过插件包下发都是之后可以尝试的地方。 ::: hljs-center *文/Jay ::: 本文属得物技术原创,更多精彩文章请看:得物技术官网 未经得物技术许可严禁转载,否则依法追究法律责任!

优秀的个人博客,低调大师

每日一博 | 前端文件上传的几种交互造轮子

背景 前端文件上传本来是一个常规交互操作,没什么特殊性可言,但是最近在做文件上传,需要实现截图粘贴上传,去找了下有没有什么好用的组件,网上提供的方法有,但是没找完整的组件来支持cv上传,经过了解发现可以用剪贴板功能让自己的cv实现文件上传,于是自己就整合了目前几种文件上传的交互方式,码了一个支持cv的vue3文件上传组件(造个轮子)。 介绍 作为一个完整的组件内容还是挺多的,这里主要介绍下上传交互中一些主要功能,包括上传的几种交互方式, 上传进度的获取,上传类型的限制,默认上传请求和自定义上传请求。 以下代码都是非完整代码,大家用于参考实现过程,可以通过以下代码修改来完成自己想要的交互功能。 几种交互 1,点击选择上传 点击选择是最常见的上传交互,之前原生上传控件,样式修改比较麻烦,为了修改上传样式,我们可以把该控件设置隐藏,用其他元素通过从click交互, 来触发该文件选择控件。在选择文件控件上绑定onchange事件,该控件在change后获取到文件,然后调用上传方法,实现如下: <div class="uploader-content" @click="handleClick"> <input ref="inputRef" class="uploader-target" :name="name" :multiple="multiple" :accept="accept" type="file" @change="handleChange" /> </div> <script setup> const inputRef = shallowRef(null) const handleClick = () => { inputRef.value.value = '' inputRef.value?.click() } const handleChange = (e) => { const files = e.target.files if (!files) return // 获取到文件后调用附件上传方法 uploadFiles(files) } </script> <style lang='less' scoped> .uploader-target { display: none; } </style> 2,拖动上传 拖拽文件上传,首先在页面上建立一个拖放区域,在拖放区域上绑定拖放事件,监听拖放事件drop内容中datTransfer中是包含files,如果存在files,获取files然后调用上传附件方法。 拖放区域可以通过事件dragover来检查拖放文件是否进入拖放区域来设置拖放区域悬浮样式,通过dragleave来检查离开拖放区取消悬浮样式。 进行交互提示 实现如下: <div class="uploader-drag" v-if="props.uploadMode == 'drag'" :class="['dragger', dragover ? 'dragover' : '']" @drop.prevent="onDrop" @dragover.prevent="onDragover" @dragleave.prevent="dragover = false"> <div class="dragicon-box"> <span>+</span> </div> </div> <script setup> const dragover = ref(false) const onDrop = (e) => { const files = Array.from(e.dataTransfer?.files) dragover.value = false uploadFiles(files); } const onDragover = () => { dragover.value = true } </script> 3,复制上传(复制检测区域设置) 复制上传的交互步骤 •将文件保存到剪贴板: 执行键盘快捷键或者使用鼠标复制 •将鼠标移动到可粘贴区: 判断是否移动到可粘贴区,来确定是否在执行粘贴后上传,否则整个页面都会作为粘贴区, •执行粘贴操作:执行键盘粘贴快捷键(ctrl+v) 粘贴区绑定paste事件,在触发paste事件前将鼠标移到粘贴区,复制会被检查不在粘贴区,阻止上传操作,实现如下: <div class="uploader-paste" v-if="props.uploadMode == 'paste'" :class="['dragger', dragover ? '' : '']" @mouseover.stop="clipboardover = true" @mouseleave.stop="clipboardover = false" @drop.prevent="onDrop" @dragover.prevent="onDragover" @dragleave.prevent="dragover = false" @paste="pasteFun" > <!--默认插槽内容--> <template v-if="$slots.default == null"> <div class="dragicon-box"> <span>+</span> </div> </template> <slot /> </div> <script setup> const clipboardover = ref(false) const pasteFun = (e) => { if(!clipboardover.value) return const clipboardFile = e.clipboardData.files; uploadFiles(clipboardFile) } </script> 上传模式 根据以上三种交互,大家可自由组合上传形式,比如点击和拖拽,拖拽和粘贴组合等等,我这边目前按点击,拖拽,粘贴叠加组合,设置为: •点击上传,click •拖拽上传 drag(包括点击上传和拖拽上传) •粘贴上传 paste (包括点击,拖拽和复制上传) 通过传参 uploadeMode设置 (click, drag, paste) 组件设置: <div class="uploader-content" @click="handleClick"> <input ref="inputRef" class="uploader-target" :name="name" :multiple="multiple" :accept="props.accept" type="file" @change="handleChange" v-if="props.uploadMode != 'click'" /> <!-- click --> <div class="uploader-click" v-if="props.uploadMode == 'click'"> <slot /> <input ref="inputRef" class="uploader-target" :name="name" :multiple="multiple" :accept="accept" type="file" @change="handleChange" @click.stop /> </div> <!-- drag --> <div class="uploader-drag" v-if="props.uploadMode == 'drag'" :class="['dragger', dragover ? 'dragover' : '']" @drop.prevent="onDrop" @dragover.prevent="onDragover" @dragleave.prevent="dragover = false"> <template v-if="$slots.default == null"> <div class="dragicon-box"> <span>+</span> </div> </template> <slot /> </div> <!-- copy --> <div class="uploader-paste" v-if="props.uploadMode == 'paste'" :class="['dragger', dragover ? '' : '']" @mouseover.stop="clipboardover = true" @mouseleave.stop="clipboardover = false" @drop.prevent="onDrop" @dragover.prevent="onDragover" @dragleave.prevent="dragover = false" @paste="pasteFun" > <template v-if="$slots.default == null"> <div class="dragicon-box"> <span>+</span> </div> </template> <slot /> </div> </div> </template> 组件应用 <Upload action="https://jsonplaceholder.typicode.com/posts/" uploadMode="click"> <div>点击上传</div> </Upload> <script lang="ts"> import Upload from '@/components/uploader'; </script> 文件限制 文件限制包括是否多文件上传限制multiple, 上传数量limit限制,上传类型accept限制,这些设置参考了element-plus上传组件,在其基础上做了简化。实现如下 multiple 和 accept 首先需要在点击控件上绑定,以便于在点击选择上传时就能够过滤对应文件,拖拽上传和粘贴上传,无法通过input[type=file] 组件控制需要在上传方法中判断过滤,(以粘贴上传为例) 组件实现 <div class="uploader-content" @click="handleClick"> <input ref="inputRef" class="uploader-target" :name="name" :multiple="multiple" :accept="props.accept" type="file" @change="handleChange" v-if="props.uploadMode != 'click'" @click.stop /> <div class="uploader-paste" v-if="props.uploadMode == 'paste'" :class="['dragger', dragover ? '' : '']" @mouseover.stop="clipboardover = true" @mouseleave.stop="clipboardover = false" @drop.prevent="onDrop" @dragover.prevent="onDragover" @dragleave.prevent="dragover = false" @paste="pasteFun" > <template v-if="$slots.default == null"> <div class="dragicon-box"> <span>+</span> </div> </template> <slot /> </div> </div> <script setup> import { shallowRef, ref } from 'vue'; const inputRef = shallowRef(null) // 上传文件 const uploadFiles = (files) => { if (files.length === 0) return const { limit, multiple, accept } = props // 是否多文件限制,主要用于拖拽和粘贴上传中 if (!multiple) { files = Array.from(files).slice(0, 1) } // 文件数量 if (limit && files.length > limit) { /*具体大家需要的逻辑可自行定义*/ return } // 文件类型限制 if (accept) { files = filesFiltered(Array.from(files), accept) } //在文件符合条件后执行上传方法 } // 文件过滤 const filesFiltered = (files, accept) => { return files.filter((file) => { const { type, name } = file const extension = name.includes('.') ? `.${name.split('.').pop()}` : '' const baseType = type.replace(//.*$/, '') return accept .split(',') .map((type) => type.trim()) .filter((type) => type) .some((acceptedType) => { if (acceptedType.startsWith('.')) { return extension === acceptedType } if (//*$/.test(acceptedType)) { return baseType === acceptedType.replace(//*$/, '') } if (/^[^/]+/[^/]+$/.test(acceptedType)) { type === acceptedType } return false }) }) } </script> 上传进度设置 获取文件上传进度,使用ajax中的progress 事件监听机制,回传数据loaded进度,和ttotal进行计算,获取到计算的百分比通过process插槽线上在界面上。 具体实现如下: 组件实现 文件限制后执行组件上传,默认情况下走内置的上传方法,如果做了自定义,上传进度也需要自己实现(自己实现过程可以参考内置方法中的实现) // 上传方法调用 ajaxUpload({...props, file}) // 上传方法实现 ajaxUpload = (options) => { const xhr = new XMLHttpRequest() const action = option.action console.log(xhr, xhr.upload) if (xhr.upload) { // 建立progress监听 xhr.upload.addEventListener('progress', (evt:any) => { const progressEvt = evt progressEvt.percent = evt.total > 0 ? (evt.loaded / evt.total) * 100 : 0 // 回传进度数据 option.onProgress(progressEvt) }) } } 同样文件上传成功,异常等方法也可以通过监听load并且判断 xhr.status 来实现, xhr.addEventListener('load', () => { if (xhr.status < 200 || xhr.status >= 300) { return option.onError(getError(action, option, xhr)) } option.onSuccess(getBody(xhr)) }) 组件使用 •配置获取进度数据回调函数 onProgress •配置接收回传的进度数据进行赋值 •配置进度条插槽显示进度数据 <Upload action="https://jsonplaceholder.typicode.com/posts/" :limit="3" uploadMode="click" :onProgress="progress"> <div class="button">点击上传</div> <template v-slot:progress> <!-自定义的进度条样式,大家可以根据自己的想象,自行设置进度条样式--> <div class="progress-box"> <div class="progress"> <span class="line" :style="{'width': progressval + '%'}"></span> </div> <span class="val">{{progressval}} %</span> </div> </template> </Upload> <script setup> import {ref} from 'vue' import Upload from '@/components/uploader'; const progressval = ref(0) const progress = (evt)=>{ progressval.value = evt.percent.toFixed(2) }, // 上传成功 const uploadSucess = (e)=>{ console.log('sucess', e) } // 上传异常 const uploadError= (e)=> { console.log('sucess', e) } </script> 自定义上传请求 默认情况下,不需要自定义上传请求,组件内置了上传请求,如果个人有需求可以自定义上传请求,子定义上传请求,是在文件限制流程后,检查是否有自定义请求方法,如果存在就将文件传入自定义请求方法。 组件实现: // 上传文件 const uploadFiles = (files) => { if (files.length === 0) return const { limit, multiple, accept, httpRequest } = props // 是否多文件限制,主要用于拖拽和粘贴上传中 if (!multiple) { files = Array.from(files).slice(0, 1) } // 文件数量 if (limit && files.length > limit) { /*具体大家需要的逻辑可自行定义*/ return } // 文件类型限制 if (accept) { files = filesFiltered(Array.from(files), accept) } //在文件符合条件后执行上传方法 // 自定义上传方法调用 if(httpRequest) { return httpRequest(files) } } 组件应用: 注意点: 通过自定义上传方法实现时,在原来组件上的属性action无效 <Upload :limit="3" uploadMode="click" :onProgress="progress" :onSuccess="uploadSucess" :onError="uploadError" :httpRequest="httpRequest"> <div class="button">点击上传</div> <template v-slot:progress> <div class="progress-box"> <div class="progress"> <span class="line" :style="{'width': progressval + '%'}"></span> </div> <span class="val">{{progressval}} %</span> </div> </template> </Upload> <script setup> const httpRequest = (files)=> { // 获取到文件 ,自定已上传方法 } </script> 总结 通过以上可以实现一个支持多种交互方式的文件上传组件,同时也将element-plus中文件上传的流程做了一个学习,因为该组件的实现过程就是参考了element-plus的实现,在element-plus上传的基础上添加了粘贴上传交互, 该组件的实现重在交互方式,各个样式风格通过插槽自定义。 作者:京东物流 刘海鼎 来源:京东云开发者社区

优秀的个人博客,低调大师

每日一博 | 一种接口依赖关系分层方案

1、背景 到店商详迭代过程中,需要提供的对外能力越来越多,如预约日历、附近门店、为你推荐等。这其中不可避免会出现多个上层能力依赖同一个底层接口的场景。最初采用的方案是对外API入口进来后获取对应的能力,并发调用多项能力,由能力层调用对应的数据链路,进行业务处理。然而,随着接入功能的增多,这种情况导致了底层数据服务的重复调用,如商品配置信息,在一次API调用过程中重复调了3次,当流量增大或能力项愈多时,对底层服务的压力会成倍增加。 正值618大促,各方接口的调用都会大幅度增加。通过梳理接口依赖关系来减少重复调用,对本系统而言,降低了调用数据接口时的线程占用次数,可以有效降级CPU。对调用方来说,减少了调用次数,可减少调用方的资源消耗,保障底层服务的稳定性。 原始调用方式: 2、优化 基于上述问题,采用底层接口依赖分层调用的方案。梳理接口依赖关系,逐层向上调用,注入数据,如此将同一接口的调用抽取到某层,仅调用一次,即可在整条链路使用。 改进调用方式: 只要分层后即可在每层采用多线程并发的方式调用,因为同一层级中的接口无先后依赖关系。 3、如何分层? 接下来,如何梳理接口层级关系就至关重要。 接口梳理分层流程如下: 第一步:构建层级结构 首先获取到能力层依赖项并遍历,然后调用生成数据节点方法。方法流程如下:构建当前节点,检测循环依赖(存在循环依赖会导致栈溢出),获取并遍历节点依赖项,递归生成子节点,存放子节点。 第二步:节点平铺 定义Map维护平铺结构,调用平铺方法。方法流程如下:遍历层级结构,判断当前节点是否已存在map中,存在时与原节点比较将层级大的节点放入(去除重复项),不存在时直接放入即可。然后处理子节点,递归调用平铺方法,处理所有节点。 第三步:分层(分组排序) 流处理平铺结构,处理层级分组,存储在TreeMap中维护自然排序。对应key中的数据节点Set<DataNode>需用多线程并发调用,以保证链路调用时间 1 首先,定义数据结构用于维护调用链路 Q1:为什么需要定义祖先节点? A1:为了判断接口是否存在循环依赖。如果接口存在循环依赖而不检测将导致调用栈溢出,故而在调用过程中要避免并检测循环依赖。在遍历子节点过程中,如果发现当前节点的祖先已经包含当前子节点,说明依赖关系出现了环路,即循环依赖,此时抛异常终止后续流程避免栈溢出。 public class DataNode { /** * 节点名称 */ private String name; /** * 节点层级 */ private int level; /** * 祖先节点 */ private List<String> ancestors; /** * 子节点 */ private List<DataNode> children; } 2 获取能力层的接口依赖,并生成对应的数据节点 Q1:生成节点时如何维护层级? A1:从能力层依赖开始,层级从1递加。每获取一次底层依赖,底层依赖所生成的节点层级即父节点层级+1。 /** * 构建层级结构 * * @param handlers 接口依赖 * @return 数据节点集 */ private List<DataNode> buildLevel(Set<String> handlers) { List<DataNode> result = Lists.newArrayList(); for (String next : handlers) { DataNode dataNode = generateNode(next, 1, null, null); result.add(dataNode); } return result; } /** * 生成数据节点 * * @param name 节点名称 * @param level 节点层级 * @param ancestors 祖先节点(除父辈) * @param parent 父节点 * @return DataNode 数据节点 */ private DataNode generateNode(String name, int level, List<String> ancestors, String parent) { AbstractInfraHandler abstractInfraHandler = abstractInfraHandlerMap.get(name); Set<String> infraDependencyHandlerNames = abstractInfraHandler.getInfraDependencyHandlerNames(); // 根节点 DataNode dataNode = new DataNode(name); dataNode.setLevel(level); dataNode.putAncestor(ancestors, parent); if (CollectionUtils.isNotEmpty(dataNode.getAncestors()) && dataNode.getAncestors().contains(name)) { throw new IllegalStateException("依赖关系中存在循环依赖,请检查以下handler:" + JsonUtil.toJsonString(dataNode.getAncestors())); } if (CollectionUtils.isNotEmpty(infraDependencyHandlerNames)) { // 存在子节点,子节点层级+1 for (String next : infraDependencyHandlerNames) { DataNode child = generateNode(next, level + 1, dataNode.getAncestors(), name); dataNode.putChild(child); } } return dataNode; } 层级结构如下: 3 数据节点平铺(遍历出所有后代节点) Q1:如何处理接口依赖过程中的重复项? A1:遍历所有的子节点,将所有子节点平铺到一层,平铺时如果节点已经存在,比较层级,保留层级大的即可(层级大说明依赖位于更底层,调用时要优先调用)。 /** * 层级结构平铺 * * @param dataNodes 数据节点 * @param dataNodeMap 平铺结构 */ private void flatteningNodes(List<DataNode> dataNodes, Map<String, DataNode> dataNodeMap) { if (CollectionUtils.isNotEmpty(dataNodes)) { for (DataNode dataNode : dataNodes) { DataNode dataNode1 = dataNodeMap.get(dataNode.getName()); if (Objects.nonNull(dataNode1)) { // 存入层级大的即可,避免重复 if (dataNode1.getLevel() < dataNode.getLevel()) { dataNodeMap.put(dataNode.getName(), dataNode); } } else { dataNodeMap.put(dataNode.getName(), dataNode); } // 处理子节点 flatteningNodes(dataNode.getChildren(), dataNodeMap); } } } 平铺结构如下: 4 分层(分组排序) Q1:如何分层? A1:节点平铺后已经去重,此时借助TreeMap的自然排序特性将节点按照层级分组即可。 /** * @param dataNodeMap 平铺结构 * @return 分层结构 */ private TreeMap<Integer, Set<DataNode>> processLevel(Map<String, DataNode> dataNodeMap) { return dataNodeMap.values().stream().collect(Collectors.groupingBy(DataNode::getLevel, TreeMap::new, Collectors.toSet())) } 分层如下: 1.根据分层TreeMap的key倒序即为调用的层级顺序 对应key中的数据节点Set<DataNode>需用多线程并发调用,以保证链路调用时间 4、分层级调用 梳理出调用关系并分层后,使用并发编排工具调用即可。这里梳理的层级关系,level越大,表示越优先调用。 这里以京东内部并发编排框架为例,说明调用流程: /** * 构建编排流程 * * @param infraDependencyHandlers 依赖接口 * @param workerExecutor 并发线程 * @return 执行数据 */ public Sirector<InfraContext> buildSirector(Set<String> infraDependencyHandlers, ThreadPoolExecutor workerExecutor) { Sirector<InfraContext> sirector = new Sirector<>(workerExecutor); long start = System.currentTimeMillis(); // 依赖顺序与执行顺序相反 TreeMap<Integer, Set<DataNode>> levelNodes; TreeMap<Integer, Set<DataNode>> cacheLevelNodes = localCacheManager.getValue("buildSirector"); if (Objects.nonNull(cacheLevelNodes)) { levelNodes = cacheLevelNodes; } else { levelNodes = getLevelNodes(infraDependencyHandlers); ExecutorUtil.executeVoid(asyncTpExecutor, () -> localCacheManager.putValue("buildSirector", levelNodes)); } log.info("buildSirector 梳理依赖关系耗时:{}", System.currentTimeMillis() - start); // 最底层接口执行 Integer firstLevel = levelNodes.lastKey(); EventHandler[] beginHandlers = levelNodes.get(firstLevel).stream().map(node -> abstractInfraHandlerMap.get(node.getName())).toArray(EventHandler[]::new); EventHandlerGroup group = sirector.begin(beginHandlers); Integer lastLevel = levelNodes.firstKey(); for (int i = firstLevel - 1; i >= lastLevel; i--) { EventHandler[] thenHandlers = levelNodes.get(i).stream().map(node -> abstractInfraHandlerMap.get(node.getName())).toArray(EventHandler[]::new); group.then(thenHandlers); } return sirector; } 5、 个人思考 作为接入内部RPC、Http接口实现业务处理的项目,在使用过程中要关注调用链路上的资源复用,尤其长链路的调用,要深入考虑内存资源的利用以及对底层服务的压力。 要关注对外服务接口与底层数据接口的响应时差,分析调用逻辑与流程是否合理,是否存在优化项。 多线程并发调用多个平行数据接口时,如何使得各个线程的耗时方差尽可能小? 作者:京东零售 王江波 来源:京东云开发者社区

优秀的个人博客,低调大师

每日一博 | “事后达尔文”—— 游戏业务效果评估方法实践

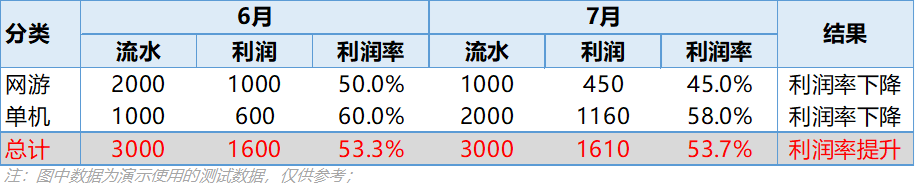
作者:vivo 互联网数据分析团队 Luo Yandong、Zhang Lingchao 本文介绍了互联网业务数据效果评估的几种常见问题及方法,并基于分层抽样的逻辑优化出一套可应用于解决用户不均匀的“事后达尔文"分析法,可适用于无法AB测试或人群不均匀的AB测试等场景下的效果评估中,本文会基于实际应用案例,来给大家仔细阐述相关方法模型的思考过程,实现原理,应用结果,希望能够帮助大家,如果能对大家在各自领域中的业务效果评估有所助益的话,那就更棒了! 一、引言 游戏业务作为公司重点的创收团队,为了更好的达成营收结果,需要不定期地开展各类运营活动来促进玩家付费转化、提升玩家付费水平,这就要求我们游戏数据分析师采取科学有效的分析模型,准确洞察分析各类运营策略的价值与收益,及时控制风险与优化后续运营方案。 而在实际的分析工作中,我们通常会碰到各种各样的业务及数据上的问题,逼迫我们不断迭代优化分析模型,产出更优价值更科学有效的结论建议。 如下案例,就是我们曾经碰到的一个典型问题——算是“辛普森悖论”[1]在游戏业务的一个实际体现:受不同月份游戏业务用户付费分布不均匀变化的影响,业务效果评估重要指标利润率(利润/流水),在整体和分游戏类型的场景下的数据表现完全互斥。 近三年来,我们持续地开展业务效果评估,在发现并解决问题的过程中不断总结经验及数据结论,最终优化迭代出“事后达尔文”分析方法论,从而有效解决游戏业务中效果评估的各项困难。 本文将从游戏业务效果评估的诸多问题出发,阐述分析方法的发展历程及数据逻辑原理,以及在游戏业务中具体的解决方案实践,来完整介绍“事后达尔文”的思考过程与应用落地,并展望更多应用场景。 二、游戏业务效果评估常见问题一览 游戏业务效果评估中常见的问题有如下这些难点: 游戏业务受节假日自然因素影响大,如何剔除?比如十一、春节期间玩家自发的付费增长同活动影响的关系? 部分活动存在参与门槛,如何保障研究人群的一致性?比如返利活动中需消费达标才能获取礼券的参与门槛,未参与玩家天然付费能力弱一档的问题。 整体与局部的效果差异的问题,如何解读?比如引言中网游单机利润率下降但整体利润率提升的问题。 vivo的游戏营销类活动,一直致力于公平公正,绝对禁止杀熟,因此都需保持统一折扣力度,无法实现AB测试,如何持续优化迭代? 游戏业务中营销活动往往能冲刺短时间的付费增长,但是后期受玩家实际收入能力影响存在回落的风险,如何有效论证活动的长期正向价值?比如双11期间开展的电商活动,明显影响了前一个月及后一个月的用户正常消费水平。 以上诸多难点问题,都衍生于业务的实际运行过程中,需要我们分析师基于一套切实可行的方法论进行解决。 三、效果评估分析方法的发展 3.1 什么是效果评估 业务团队为了提升相关指标,如流水、利润等,而开展的如满减,返利,打折,促销等活动,在一段时间内让玩家、用户更多的参与、消费,来提升对应的指标。 而我们分析师就需要及时的研究清楚,这些业务动作带来了怎样的实质性的业务提升,以及如何形成更多优化空间,这就是效果评估的核心内容与价值。 3.2 效果评估方法的发展阶段 判断业务效果,我们通常会细分很多指标,比如参与率、投入产出比、流水、利润等。但我们最关心的往往是指标增量,这是一个相对概念,核心就在于如何对比。为此,行业内通用的分析方法有如下几种: 时序比对法: 通过观察活动前后的增长变化,如本周末开展的活动,那我们看本周末的流水去比对上周末的流水,来判断活动的增量; 自然过滤法: 受节假日等季节因素影响,本周和上周会有自然变化因素,为了过滤自然因素影响,我们将活动参与人群与未参与人群拆解开,将自然时间变化计算为未参与人群的本周流水比对上周流水的数值,最终按活动增量减去自然变化情况来作为最终增量; AB测试: 基于均匀分层情况下的严格AB测试实验,部分游戏/门店开展活动,部分不开展,以不开展活动的部分增长作为自然增长,这样也可以计算出最终的增量。 但是存在如下风险: ①无法保证用户均匀分布; ②活动开展较复杂,且存在客诉风险,玩家不易接受,且损失部分活动增量,不利于目标达成。 事后达尔文: 集合方法2、3的各自优势,我们将参与活动人群/未参与人群,基于均匀分层的逻辑,按上周末arpu等指标拆解分层,保障对比对象的相对公平,计算各分层内参与人群的增长-自然增长(同分层未参与人群的增长),最终汇总整体结果。 如下示例: 3.3 各方法的优劣对比及适用场景说明 注:“事后达尔文”由数据分析团队成员于2019年研究出相关分析方法,并于2020年整理并取名为“事后达尔文”。 四、“事后达尔文”的分析方法论 在介绍数据方案设计前,先介绍一下“事后达尔文”的分析思路和方法论,帮助大家更好地理解本文。 4.1 确认研究对象 研究对象分两部分——人群和指标。 (1)人群 包含参与活动的人群、未参与活动的人群。参与活动的人群受到活动、季节因素的综合影响;未参与活动的人群主要受季节因素的自然变化影响,如十一前和十一期间的自然付费增长。 (2)研究指标 我们一般选择核心关注的如人均流水ARPU、人均礼券(游戏业务活动核心目标)。其他场景亦可按核心关注指标开展研究,如产品测试场景的点击率等。 4.2 分人群时间对比 基于我们的研究人群(参与活动与未参与活动的人群),在活动前、活动期的研究指标(流水、利润)表现情况,如下图: 其中: C1=A*(A4-A3*(B4/B3)); C2=A*(A2-A1*(B2/B1)); 因通常情况下,主动参与我们活动的玩家会有更积极主动的活跃、付费等行为特征,导致玩家A、B人群并不符合均匀分布的特征,故B玩家人群的自然季节因素变化无法完全代表A玩家人群的自然变化,最终导致无法完全科学合理的体现出活动玩法对A人群的增量。 4.3 人群均匀分层对比 我们为保障玩家人群B的自然变化能反映A玩家人群的水平,在核心研究的指标逻辑下,将A、B玩家人群做均匀的拆分,参考游戏业务活动中,按照活动前人均付费水平拆分(其他场景也可基于其核心指标拆分,如点击率分发效率等)。 其中: C1=A*(A4-A3*(B4/B3)); C2=A*(A2-A1*(B2/B1)); C=sum(C1:Cn);D=sum(D1:Dn); 为保障以上分析结果真的均匀,我们会对每一分组做相应的验证,如上初始人群差异,若人群差异绝对值>=5%,则判断置信度不足,对应分组人群活动影响不单独做评估。 4.4 结果评估 基于以上分层逻辑后,我们即可得到对应置信分组下,参与人群的指标变化率,未参与人群的指标变化率,二者相减即得到活动策略影响的增量变化(可正可负),汇总之后,即可得到整体增量变化,即为整体的活动影响。 特别说明: 通常情况下,置信度不足的分组人群,如果相关人群/流水比重过大,无法忽略影响的话(如超过10%),则会按照置信分组的总增量变化率来作为该分组的增量测算,此处仅供参考; 参与活动人群规模较未参与差距过于悬殊,如<1:10的情况下,可考虑对B人群以抽样的方式来实现以上的效果。 五、实际分析案例 5.1 某年端午活动数据效果分析 5.1.1 背景信息: 端午期间开展了充值不同档位可领取不同礼品的活动,如100元档、1000元档、4000元档等。(非实际案例) 5.1.2 前置分析: 主动参与的玩家,有较强的充值能力和欲望,对应效果研究需排除过滤这种充值能力上的差异; 活动面向全体玩家,无法开展ABtest,也不一定适宜差异化策略; 游戏充值玩家存在活动期大幅拉收,活动后消费降级的风险,所以整体研究中需考虑活动中+活动后的总体增量情况; 有活动曝光的用户内部仍有较大差异,未参与活动(即未领奖)用户表明这些用户对本次礼包活动没有兴趣,本身付费倾向较低,而参与活动用户则有较强付费意愿。 5.1.3 分析结果: 整体有无曝光对比:从整体看,有活动曝光用户的付费提升显著高于无曝光用户,且在低付费档位的提升效应更为显著; 有曝光用户内部对比:有活动曝光但无领奖用户本身为游戏的低付费意愿用户,因此后向付费甚至不及无曝光用户,而活动对参与的用户有明显的付费刺激作用。 5.2 某年游戏预约版本效果分析 5.2.1 背景信息: (1)受国家版号政策的紧缩,游戏业务的稳定增长体现在老游戏的持续迭代上,而其拉新、回流、留存的节点,都围绕在重大版本更新节点上。所以我们有产品通过版本更新功能,提前将游戏新的玩法/内容/活动传递给用户,以提升游戏节点表现。 (2)我们vivo的版本预约已做了有段时间,但始终没有一个较为严谨的实验对比和数据分析,验证做这件事为平台带来的增量价值。故我们使用“事后达尔文”的分析方法对其展开了相应研究。 版本页面样式参考如下: 5.2.2 前置分析思考: 预约与非预约用户,除了在预约行为上存在差异,还存在版本信息感知上的差异,主要体现在活跃频次上,需要逐步进行对比分析; 中心灰度放量提供了是否感知版本信息的两类人群对比,但灰度本身对用户的中心版本、手机性能和中心使用行为有要求,导致灰度用户在游戏内的活跃付费天然优于非灰度用户。 5.2.3 分析结果: 版本信息感知价值:提前感知版本信息的用户在版本更新后向付费有提升,总体付费约高于无版本预约感知用户6%,且在高活跃天频下付费与无感知用户拉开差距; 主动预约行为的价值:版本更新后预约用户付费相比仅感知无预约用户,其提升更为明显。 六、总结和展望 对于游戏业务效果评估中面临的各类问题,我们借鉴过往经验,经过不断尝试和探索,基于用户分层的逻辑,拆解用户,将保持同一核心特征的用户放在一个水平线上进行对比,开发出“事后达尔文”的解决方案,并在解决游戏业务效果评估中取得长期较好效果。我们近期也有在推动大数据将相关的分析方法模型,结合游戏业务用户运营的实际特点,进行模型线上化,届时将更加快速便捷的完成活动策略的效果评估,给到业务方更及时有效的支持。 本文希望能让大家更了解游戏业务分析工作的实践情况,能对大家不同业务的分析评估工作有一些直观的参考价值。当然,方案中的具体模型细节、风险排查等无法完完全全的写出,也由衷欢迎感兴趣的朋友们和笔者一起探讨交流,谢谢大家! 参考文献: 赵焕光、章勤琼、王迪著《真理相遇统计》 END 猜你喜欢 用户行为分析模型实践(三)——H5通用分析模型 Kafka实时数据即席查询应用与实践 Hive 和 Spark 分区策略剖析 本文分享自微信公众号 - vivo互联网技术(vivoVMIC)。 如有侵权,请联系 support@oschina.cn 删除。 本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | MySQL 8.0.29 instant DDL 数据腐化问题分析

前言 Instant add or drop column的主线逻辑 表定义的列顺序与row 存储列顺序阐述 引入row版本的必要性 数据腐化问题 原因分析 Bug重现与解析 MySQL8.0.30修复方案 前言 DDL 相对于数据库的 DML 之类的其他操作,相对来说是比较耗时、相对重型的操作; 因此对业务的影比较严重。MySQL 从5.6版本开始一直在持续改进其DDL性能:引入了 online DDL,inplace DDL,instant DDL 等实用性极强的功能, DDL 目前对业务的影响持续降低。 MySQL 8.0.29 引入了 instant add/drop column 功能,支持在任意位置添加 column, drop column 也不需要表数据的任何形式的移动, 只需要修改表的元数据就可以完成 add/drop column,所以 instant add/drop column 的操作是轻型操作,速度快,资源需求量少。 ALTER table drop column a, ALGORITHM=INSTANT; 8.0.29 引入了新的alter 算法 INSTANT。 但是这个新功能目前很不稳定,导致的问题比较多; 而且通常都比较严重: 数据损坏,或者数据库无法启动等。 本文是分析其中的一个问题: 对表进行 instant drop 后,进行 update ,之后数据库停机,而后数据库无法启动。 为分析这个问题, 我们会从 instant add/drop column 在 Innodb 的实现原理与细节方面来阐述这个数据腐化bug的具体原因。 Instant add or drop column的主线逻辑 因为这个功能的WorkLog无法从官方获取,所以无法得到准确的设计出发点,通过阅读相关代码,得出要实现这个功能,必须要处理以下关键点: 因为要支持在任意位置添加/删除列,同时不会更改表数据文件,所以表的逻辑定义与row的实际存储形式需要映射关系,不再是所见即所得的一一对应的关系。即为了实现这样功能: 表中列的定义顺序与表中行数据(row)的存储顺序是不同的。 同时对同一个table可以做多次instant DDL, 所以需要引入版本机制,在表的数据文件中,不同row对应的表定义可能是不同的,需要在row中记住表定义的version。 以上可以认为是该功能的设计原则与实现的主线逻辑。 表定义的列顺序与row 存储列顺序阐述 在引入这个功能之前, create table 时列定义的顺序与列在 InnoDB 中存储的顺序是一致的。(这里我们不用考虑 InnoDB 添加系统隐藏列) Instant add/drop column 要实现的亮点功能是在表定义的任意位置添加或者减少 column,同时做这样的操作的时候,能够做到不需要重构表数据。 我们称 column 在表定义中出现的顺序为逻辑顺序; 而 column 在行数据的存储顺序为物理顺序。 要做到修改表定义,而不重构表数据,就必须将逻辑顺序与物理顺序解耦: 不能再像MySQL 8.0.29之前的版本那样,逻辑顺序与物理顺序是完全一致的;而从8.0.29开始通过表的元数据保存了逻辑顺序与物理顺序的映射关系。这种映射关系的构建与维护构成了 instant add/drop column 的基础. 如下图简单阐述了逻辑/物理顺序的关系。 引入row版本的必要性 对于同一张表,Instant add/drop DDL可以执行多次;每一次执行后,逻辑/物理顺序的映射关系就发生变化;同时 instant add/drop DDL 并不需要做表数据的重构操作;因此可以得出经过多次 instant add/drop DDL,InnoDB存储的行数据与表定义存在多种逻辑/物理顺序映射关系:比如说,在 ibd 文件中,前十行数据对应原始的表定义,接下来的十行可能对应着 instant add column 后的数据,再接下来的十行,可能对应着 instant drop column 后的数据。 为了管理这种形式的逻辑/物理,在 InnoDB 中,为每一行实际存储的数据引入了版本号的概念:每个版本号对应着一个逻辑/物理映射关系。 为存储这个版本信息,InnoDB 中,row 的信息头记录的格式有稍微的变化: 如上图所示,在row的extra中存储了其对应的版本号, 同时在 row header 中有标志位指示出了是否存在版本号信息。 根据版本号获取相应的映射关系,就可以正确的解析行数据。 目前版本号最大支持到64, instant add/drop column 到达这个限制后报错;其后如果还需要 instant add/drop column DDL 操作,可能需要做一次能够触发 table rebuild 操作才可以。 数据腐化问题 由 instant add/drop column 引入了多个数据腐化问题,其中一个问题可以从: [PS-8292] MySQL 8.0.29 fails to perform crash recovery - Percona JIRA(https://jira.percona.com/browse/PS-8292) 查看。 这个问题简单来说:在对表进行 instant drop 后,进行update操作,之后MySQL server 重启,在启动阶段恢复之前的 update 操作会引发 assert 崩溃(debug版本的情况下)。 从代码上看,这个bug可能会造成数据的静默错误(数据完全错乱而且不报任何错误),而不仅仅是崩溃这一种现象。 通过对core文件的简单分析,造成该问题的大概原因如下: 在通过redo做恢复的时候,字段的逻辑顺序与物理存储顺序之间的映射关系不对(错位)导致的。在恢复期间可能会找不到对应的字段,或者更新了错误的字段。 原因分析 从原始的问题看,这个是发生在 InnoDB 启动恢复阶段。这一阶段离不开 redo log的参与。前面介绍 instant add/drop 设计要点的时候,那些列出的要点,可以认为是在在 DDL 期间的工作以及编码的基本逻辑;那么在完成 instant DDL 时候, 在 DML 的时候也需要将必要的信息写入 redo log 才能做到 recovery。 为支持 instant add/drop column,redo log 记录的格式发生了变化,因为代码bug,导致在解析 redo log 做恢复的时候,得到的字段信息错误,导致数据腐化。 问题表现出来可能是: 恢复始终无法执行,数据库无法启动;还可能是恢复到错误的数据,数据库能够启动。 因为 redo log 的种类较多,信息也比较繁杂,这里我们只关注问题本身中出现的 update 相关的 redo log ,进而较多的关注 update redo log 与该问题相关的字段信息。 下图简要的阐述了 update redo log 相关内容: 到这里,可以看到 在MySQL 8.0.29中,update redo log 引入了 instant column 的物理逻辑顺序。 下面从 InnoDB 的恢复流程跟踪问题发生的原因,其中主要需要关注的是恢复过程中的表(索引)定义。 应用 redo log 是在数据库启动阶段最开始就执行,此时数据字典无法打开,获取不到待恢复表的定义信息 但是此时需要表的定义信息去解析 redo log 中的相关数据 此时就会根据redo log中记录的长度信息,以及记录长度的顺序构建临时的表定义,此时仅仅是为了恢复,并不需要精确的表定义,此时只需要知道field的长度和位置即可。 同时如果 redo log 中如果有instant DDL 的信息,那么也会用这些信息去修改临时构建的表定义:这是问题发生的初始错误的地方。 恢复过程中,构建出的临时表实际上表中列的逻辑顺序,这是符合正常运行的需求的。 但是实际上8.0.29中字段长度的记录顺序是按字段(列)的物理存储顺序写入的。 如果带有 instant DDL 的信息,那么修改表定义时就会按物理顺序去修改逻辑顺序的表定义,这样会修改到非预期的字段,导致错误发生! Bug重现与解析 CREATE TABLE `tb1` ( `col1` VARCHAR(10) NOT NULL, `col2` char(13), `col3` varchar(11), PRIMARY KEY (`col1`) ) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_0900_ai_ci; INSERT INTO tb1 VALUES ('4000','50','100'); --echo # the FIRST INSTANT ALTER ALTER TABLE tb1 DROP COLUMN col2, LOCK=DEFAULT; INSERT INTO tb1 VALUES( '4545', '52' ); UPDATE tb1 SET col3 = '46' WHERE col1 = '4545'; --echo # crash and restart 1 --source include/kill_and_restart_mysqld.inc CHECK TABLE tb1; DROP TABLE tb1; 以上MySQL MTR 测例可以重现 InnoDB 启动恢复期间始终 core 的问题。我们从这个例子出发,结合上面解释的 instant drop DDL 代码行为看看问题是如何一步步发生的。 首先说明一下,在测例运行期间逻辑顺序与物理顺序的变化。 如下图所示稍微展示了 table 的逻辑定于与 InnoDB row 存储的以下细节。这里注意的是 被 dropped column 仍然会以隐藏列的形式存在于表定于中:因为 drop 之前存在的 row 还是需要这样信息解析字段。 结合 redo log 的恢复过程看看问题发生的第一现场。这里针对这个测例摘取相关 redo log 的部分信息: 2.1 按照字段长度列表(8.0.29中是物理顺序写入的列表)创建的专门用于恢复的表,类似于: create table dummy_table (d1:10, d2:13, d3:11) 2.2 按照 instant 字段信息修改 dummy 表:按照 physical pos=1 去修改后,结果类似于:create table dummy_table (d1:10, d2:13[dropped], d3:11) 2.3 期望的正确的表应该类似于:create table dummy_table(d1:10, d3:11, d2:13[dropped]); 2.4 Redo log中的Field_no=1, 去恢复时期望用到的是 #2.3 的表,但是过程中创建的是#2.2中错误的表,这样当Field_no=1去恢复数据时,会错误的发现对应的field(column)已经dropped, 导致core! MySQL8.0.30修复方案 知道了问题发生的原因,修复起来就比较简单了: MySQL 8.0.30的代码修复方案 Redo log中字段的长度列表,按照字段的逻辑顺序写入,不再按存储顺序写入。 在 redo log 的 instant column 信息中也包含了字段的逻辑位置。 Redo log 的记录本身的版本设置为 1 ,与8.0.29的版本为 0 ,做出差别。 8.0.30的修复代码本身也是不能正确解析8.0.29产生的 redo log ,只是根据版本号检测出8.0.29 redo log,进而报错防止数据进一步恶化。实际上8.0.29的 redo log ,在 instant DDL 后,是不可能正确解析的,因为没有逻辑/物理的映射关系。 修复的逻辑比较简单: Redo log中字段的长度列表,按照字段的逻辑顺序写入: 保证在恢复阶段构建的临时表是按正确的逻辑定义顺序构建的。 在redo log 的 instant column 信息中也包含字段的逻辑位置: 保证在更新临时表的字段时,按照逻辑顺序,不会出现错误更新的情况。 下面是MySQL 8.0.30 update redo log 相关字段信息: 从上图可以看出,MySQL 8.0.30 redo log 中已经不存储物理位置相关的信息了,全部是逻辑位置相关的信息;这样就和MySQL 8.0.29 redo log 这种有问题的记录方式是昙花一现了。 附带的这个测例可以重现数据的静默错误(恢复过程没问题, 但是数据实际上错了) CREATE TABLE `tb2` ( `c1` char(4) NOT NULL, `c2` char(4), `c3` char(4), PRIMARY KEY (`c1`) ) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_0900_ai_ci; begin; INSERT INTO tb2 VALUES ('1000','2000','3000'); commit; --echo # the FIRST INSTANT ALTER ALTER TABLE tb2 add COLUMN c4 char(4) after c1, LOCK=DEFAULT; INSERT INTO tb2 VALUES ('1001','4001', '2001', '3001'); SELECT * FROM tb2; UPDATE tb2 set c4='4002' WHERE c1='1001'; --echo # crash and restart 1 --source include/kill_and_restart_mysqld.inc select * from tb2; CHECK TABLE tb2; 需要把这个测例放到innodb test case suite中。 Enjoy GreatSQL :) 关于 GreatSQL GreatSQL是由万里数据库维护的MySQL分支,专注于提升MGR可靠性及性能,支持InnoDB并行查询特性,是适用于金融级应用的MySQL分支版本。 相关链接: GreatSQL社区 Gitee GitHub Bilibili GreatSQL社区: 社区有奖建议反馈: https://greatsql.cn/thread-54-1-1.html 社区博客有奖征稿详情: https://greatsql.cn/thread-100-1-1.html 社区2022年度勋章获奖名单: https://greatsql.cn/thread-184-1-1.html (对文章有疑问或者有独到见解都可以去社区官网提出或分享哦~) 技术交流群: 微信&QQ群: QQ群:533341697 微信群:添加GreatSQL社区助手(微信号:wanlidbc )好友,待社区助手拉您进群。

优秀的个人博客,低调大师

每日一博 | Iframe 在 Vue 中的状态保持技术

引言 Iframe是一个历史悠久的HTML元素,根据MDN WEB DOCS官方介绍,Iframe定义为HTML内联框架元素,表示嵌套的Browsing Context,它能够将另一个HTML页面嵌入到当前页面中。Iframe可以廉价实现跨应用级的页面共享,并且具有使用简单、高兼容性、内容隔离等优点,因此以Iframe为核心形成了前端平台架构领域第1代技术。 众所周知,当Iframe在DOM中初始渲染时,会自动加载其指向的资源链接Url,并重置内部的状态。在一个典型的平台应用中,一个父应用主页面要挂载多个窗口(每一个窗口对应一个Iframe),那么如何在切换窗口时,实现每一个窗口中的状态(包括输入状态、锚点信息等)不丢失,也即“状态保持”呢? 如果采用父子应用通信来记录窗口状态,那么改造成本是非常巨大的。答案是利用Iframe的CSS Display特性,切换窗口时,非激活状态的窗口并不消失,仅是Display状态变更为none,激活状态窗口的Display状态变更为非none。在Display状态切换时,Iframe不会重新加载。在Vue应用中,一行v-show指令即可替我们实现这一需求。 竞争机制 上述的状态保持模型存在一个性能缺陷,即父应用主页面实际上要提前摆放多个Iframe窗口。即使是这些不可见的窗口,也会发出资源request请求。大量的并发请求,会导致页面性能下降。(值得一提的是,Chrome最新版本已经支持了Iframe的滚动懒加载策略,但是在此场景下,并不能改善并发请求的问题。)因此,我们需要引入资源池和竞争机制来管理多个Iframe。 引入一个容量为N的Iframe资源池来管理多开窗口,当资源池未满时,新激活的窗口可以直接插入至资源池中;当资源池已满时,资源池按照竞争策略,淘汰若干池中的窗口并丢弃,然后插入新激活的窗口至资源池中。通过调整容量N,可以限制父应用主页面上多开窗口的数量,从而限制并发请求数量,实现资源管控的目的。 Vue Patch原理探索 日前遇到了一个基于Vue应用的Iframe状态保持问题,在上述模型下,资源池不仅保存窗口对象,而且记录了每个窗口的点击激活时间。资源池使用以下竞争淘汰策略:对窗口激活时间进行先后次序排序,激活时间排序次序较前的窗口优先被淘汰。当资源池满时,会偶发池中窗口状态不能保持的问题。 在Vue中,组件是一个可复用的Vue实例,Vue 会尽可能高效地渲染元素,通常会复用已有元素而不是从头开始渲染。组件状态是否正确保持,依赖关键属性key。基于此,首先排查了Iframe组件的key属性。事实上,Iframe组件已经正确分配了唯一的Uid,此种情况可以排除。 既然不是组件复用的问题,那么在Vue内部的Diff Patch机制到底是如何运行的呢?让我们看一下Vue 2.0的源代码: /** * 页面首次渲染和后续更新的入口位置,也是 patch 的入口位置 */ Vue.prototype._update = function (vnode: VNode, hydrating?: boolean) { if (!prevVnode) { // 老 VNode 不存在,表示首次渲染,即初始化页面时走这里 …… } else { // 响应式数据更新时,即更新页面时走这里 vm.$el = vm.__patch__(prevVnode, vnode) } } (1)在update生命周期下,主要执行了vm.__patch__方法。 /** * vm.__patch__ * 1、新节点不存在,老节点存在,调用 destroy,销毁老节点 * 2、如果 oldVnode 是真实元素,则表示首次渲染,创建新节点,并插入 body,然后移除老节点 * 3、如果 oldVnode 不是真实元素,则表示更新阶段,执行 patchVnode */ function patch(oldVnode, vnode, hydrating, removeOnly) { …… // 1、新节点不存在,老节点存在,调用 destroy,销毁老节点 if (isUndef(oldVnode)) { …… // 2、老节点不存在,执行创建新节点 } else { // 判断 oldVnode 是否为真实元素 const isRealElement = isDef(oldVnode.nodeType) if (!isRealElement && sameVnode(oldVnode, vnode)) { // 3、不是真实元素,但是老节点和新节点是同一个节点,则是更新阶段,执行 patch 更新节点 patchVnode(oldVnode, vnode, insertedVnodeQueue, null, null, removeOnly) } else { ……// 是真实元素,则表示初次渲染 } } invokeInsertHook(vnode, insertedVnodeQueue, isInitialPatch) return vnode.elm } (2)在__patch__方法内部,触发patchVnode方法。 function patchVnode (oldVnode, vnode, insertedVnodeQueue, removeOnly) { …… if (isUndef(vnode.text)) {// 新节点不为文本节点 if (isDef(oldCh) && isDef(ch)) {// 新旧节点的子节点都存在,执行diff递归 if (oldCh !== ch) updateChildren(elm, oldCh, ch, insertedVnodeQueue, removeOnly) } else { …… } } else { …… } } (3)在patchVnode方法内部,触发updateChildren方法。 /** * diff 过程: * diff 优化:做了四种假设,假设新老节点开头结尾有相同节点的情况,一旦命中假设,就避免了一次循环,以提高执行效率 * 如果不幸没有命中假设,则执行遍历,从老节点中找到新开始节点 * 找到相同节点,则执行 patchVnode,然后将老节点移动到正确的位置 * 如果老节点先于新节点遍历结束,则剩余的新节点执行新增节点操作 * 如果新节点先于老节点遍历结束,则剩余的老节点执行删除操作,移除这些老节点 */ function updateChildren(parentElm, oldCh, newCh, insertedVnodeQueue, removeOnly) { // 老节点的开始索引 let oldStartIdx = 0 // 新节点的开始索引 let newStartIdx = 0 // 老节点的结束索引 let oldEndIdx = oldCh.length - 1 // 第一个老节点 let oldStartVnode = oldCh[0] // 最后一个老节点 let oldEndVnode = oldCh[oldEndIdx] // 新节点的结束索引 let newEndIdx = newCh.length - 1 // 第一个新节点 let newStartVnode = newCh[0] // 最后一个新节点 let newEndVnode = newCh[newEndIdx] let oldKeyToIdx, idxInOld, vnodeToMove, refElm // 遍历新老两组节点,只要有一组遍历完(开始索引超过结束索引)则跳出循环 while (oldStartIdx <= oldEndIdx && newStartIdx <= newEndIdx) { if (isUndef(oldStartVnode)) { // 如果节点被移动,在当前索引上可能不存在,检测这种情况,如果节点不存在则调整索引 oldStartVnode = oldCh[++oldStartIdx] // Vnode has been moved left } else if (isUndef(oldEndVnode)) { oldEndVnode = oldCh[--oldEndIdx] } else if (sameVnode(oldStartVnode, newStartVnode)) { // 老开始节点和新开始节点是同一个节点,执行 patch patchVnode(oldStartVnode, newStartVnode, insertedVnodeQueue, newCh, newStartIdx) // patch 结束后老开始和新开始的索引分别加 1 oldStartVnode = oldCh[++oldStartIdx] newStartVnode = newCh[++newStartIdx] } else if (sameVnode(oldEndVnode, newEndVnode)) { // 老结束和新结束是同一个节点,执行 patch patchVnode(oldEndVnode, newEndVnode, insertedVnodeQueue, newCh, newEndIdx) // patch 结束后老结束和新结束的索引分别减 1 oldEndVnode = oldCh[--oldEndIdx] newEndVnode = newCh[--newEndIdx] } else if (sameVnode(oldStartVnode, newEndVnode)) { // Vnode moved right // 老开始和新结束是同一个节点,执行 patch …… } else if (sameVnode(oldEndVnode, newStartVnode)) { // Vnode moved left // 老结束和新开始是同一个节点,执行 patch …… } else { // 如果上面的四种假设都不成立,则通过遍历找到新开始节点在老节点中的位置索引 …… // 在老节点中找到新开始节点了 if (sameVnode(vnodeToMove, newStartVnode)) { // 如果这两个节点是同一个,则执行 patch patchVnode(vnodeToMove, newStartVnode, insertedVnodeQueue, newCh, newStartIdx) // patch 结束后将该老节点置为 undefined oldCh[idxInOld] = undefined canMove && nodeOps.insertBefore(parentElm, vnodeToMove.elm, oldStartVnode.elm) } else { // 最后这种情况是,找到节点了,但是发现两个节点不是同一个节点,则视为新元素,执行创建 …… } // 老节点向后移动一个 newStartVnode = newCh[++newStartIdx] } } // 走到这里,说明老姐节点或者新节点被遍历完了,执行剩余节点的处理 …… } (4)咱们终于来到了主角updateChildren。在updateChildren内部实现中,使用了2套指针分别指向新旧Vnode头尾,并向中间聚拢递归,以实现新旧数据对比刷新。 在前述资源池模型下,当查找到新旧Iframe组件时,会执行如下逻辑: if (sameVnode(vnodeToMove, newStartVnode)) { // 如果这两个节点是同一个,则执行 patch patchVnode(vnodeToMove, newStartVnode, insertedVnodeQueue, newCh, newStartIdx) // patch 结束后将该老节点置为 undefined oldCh[idxInOld] = undefined canMove && nodeOps.insertBefore(parentElm, vnodeToMove.elm, oldStartVnode.elm) } 看来出现问题的罪魁祸首是执行了nodeOps.insertBefore。在WEB的运行环境下实际上执行的是DOM的insertBefore API。那么我们移步来看看在DOM环境下,Iframe究竟是采取了何种刷新策略。 Iframe的状态刷新机制 为了更清晰地看到DOM节点的变化情况,我们可以引入MutationObserver在最新版Chrome中来观测DOM根节点。 首先设置容器节点下有两个子节点:<span/>和<iframe/>,分别执行以下方案并记录结果: 对比方案A:使用insertBefore在iframe节点前再插入一个新的span节点 对比方案B:使用insertBefore在iframe节点后再插入一个新的span节点 对比方案C:使用insertBefore交换span和iframe节点 对比方案D:使用insertBefore原地操作iframe自身 其结果如下: 方案名称 Iframe是否刷新 DOM节点变化 A 否 新增一个子节点span B 否 新增一个子节点span C 是 先移除一个iframe,再插入一个iframe D 是 先移除一个iframe,再插入一个iframe 实验结果显示,对Iframe执行insertBefore时,实际上DOM会依次执行移除、新增节点操作,导致Iframe状态刷新。 在Vuejs Issues #9473中提到了类似的问题,一种解决方案是在Vue Patch时优先对非Iframe类型元素进行DOM操作,但是目前这个优化策略尚未被采用,在Vue 3.0版本中也依然存在这个问题。 那么在资源池模型下,如何才能保证Iframe不执行insertBefore呢?重新回到Vue Patch机制下,我们发现,只有新旧Iframe在新旧Vnode列表中的相对位置保持不变时,才会只执行patchVnode方法,而不会触发insertBefore方法。 因此,采取的最终解决方案是,更改淘汰机制,将排序操作改为搜索操作,保证了多开窗口在Vue中的状态保持。 作者:京东零售 陈震 内容来源:京东云开发者社区

优秀的个人博客,低调大师

每日一博 | 应用现代化中的弹性伸缩

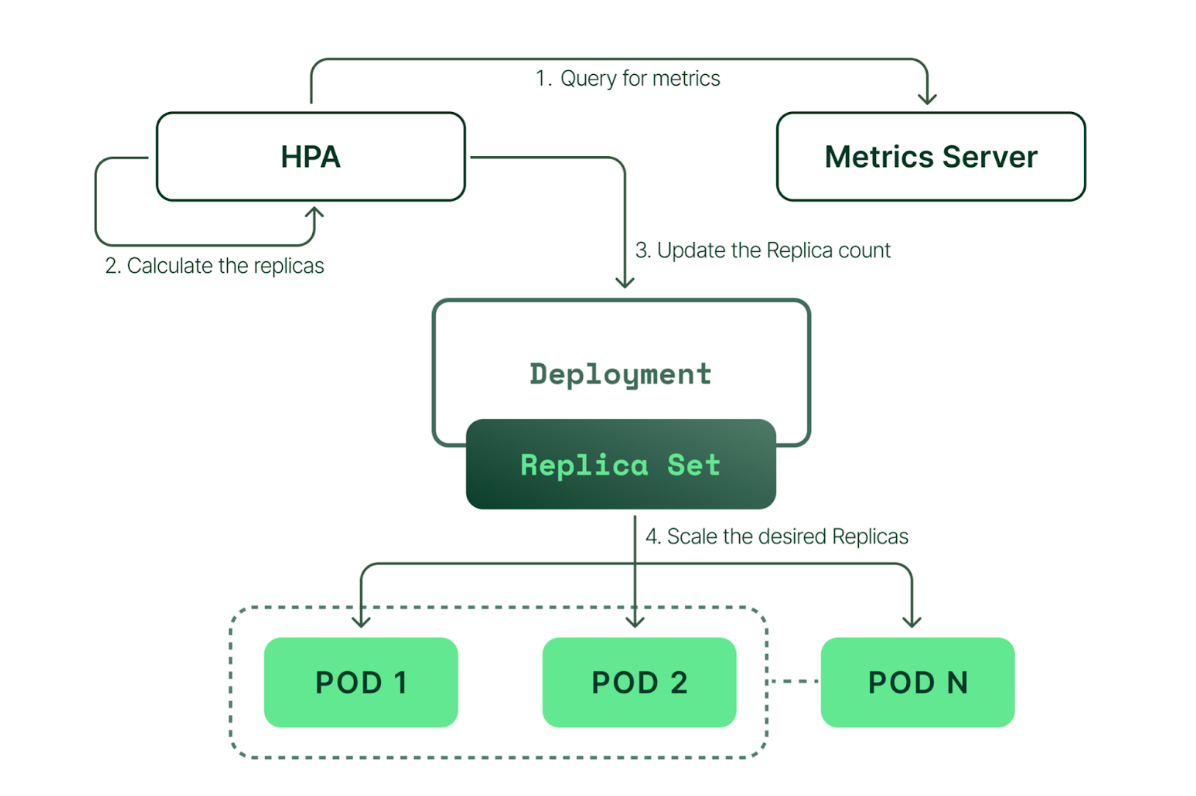
作者:马伟,青云科技容器顾问,云原生爱好者,目前专注于云原生技术,云原生领域技术栈涉及 Kubernetes、KubeSphere、KubeKey 等。 2019 年,我在给很多企业部署虚拟化,介绍虚拟网络和虚拟存储。 2023 年,这些企业都已经上了云原生了。对于高流量的 Web 应用程序,实时数据分析,大规模数据处理、移动应用程序等业务,容器比虚拟机更适合,因为它轻量级,快速响应,可轻松移植,并具有很强的弹性伸缩能力。 为什么需要弹性伸缩呢? 峰值负载应对:促销活动、节假日购物季或突发事件根据需求快速扩展资源,保证应用可用性和性能。 提高资源利用率:根据实际资源负载动态调整资源规模,避免基础设施资源浪费,降低 TCO。 应对故障和容错:多实例部署和快速替换,提高业务连续性和可用性。 跟随需求变化:匹配前端的业务需求及压力,快速调整规模,提高事件应对能力,满足需求和期望。 Horizontal Pod Autoscaling Kubernetes 自身提供一种弹性伸缩的机制,包括 Vertical Pod Autoscaler (VPA)和 Horizontal Pod Autoscaler (HPA)。HPA 根据 CPU 、内存利用率增加或减少副本控制器的 pod 数量,它是一个扩缩资源规模的功能特性。 HPA 依赖 Metrics-Server 捕获 CPU、内存数据来提供资源使用测量数据,也可以根据自定义指标(如 Prometheus)进行扩缩。 由上图看出,HPA 持续监控 Metrics-Server 的指标情况,然后计算所需的副本数动态调整资源副本,实现设置目标资源值的水平伸缩。 但也有一定局限性: 无外部指标支持。如不同的事件源,不同的中间件/应用程序等,业务端的应用程序变化及依赖是多样的,不只是基于 CPU 和内存扩展。 无法 1->0。应用程序总有 0 负载的时候,此时不能不运行工作负载吗? 所以就有了Kubernetes-based Event-Driven Autoscaling(KEDA)! KEDA KEDA 基于事件驱动进行自动伸缩。什么是事件驱动?我理解是对系统上的各种事件做出反应并采取相应行动(伸缩)。那么 KEDA 就是一个 HPA+多种触发器。只要触发器收到某个事件被触发,KEDA 就可以使用 HPA 进行自动伸缩了,并且,KEDA 可以 1-0,0-1! 架构 KEDA 自身有几个组件: Agent: KEDA 激活和停止 Kubernetes 工作负载(keda-operator 主要功能) Metrics: KEDA 作为一个 Kubernetes 指标服务器,向 Horizontal Pod Autoscaler 提供丰富的事件数据,从源头上消费事件。(keda-operator-metrics-apiserver 主要作用)。 Admission Webhooks: 自动验证资源变化,以防止错误配置。 Event sources: KEDA 更改 pod 数量的外部事件/触发源。如 Prometheus、Kafka。 Scalers: 监视事件源,获取指标并根据事件触发伸缩。 Metrics adapter:从 Scalers 获取指标并发送给 HPA。 Controller: 根据 Adapter 提供的指标进行操作,调谐到 ScaledObject 中指定的资源状态。Scaler 根据 ScaledObject 中设置的事件源持续监视事件,发生任何触发事件时将指标传递给 Metrics Adapter。Metrics Adapter 调整指标并提供给 Controller 组件,Controller 根据 ScaledObject 中设置的缩放规则扩大或缩小 Deployment。 总的来说,KEDA 设置一个 ScaledObject,定义一个事件触发器,可以是来自消息队列的消息、主题订阅的消息、存储队列的消息、事件网关的事件或自定义的触发器。基于这些事件来自动调整应用程序的副本数量或处理程序的资源配置,以根据实际负载情况实现弹性伸缩。 CRD ScaledObjects:代表事件源(如 Rabbit MQ)和 Kubernetes。 Deployment、StatefulSet 或任何定义 / 规模子资源的自定义资源之间的所需映射。 ScaledJobs:事件源和 Kubernetes Jobs 之间的映射。根据事件触发调整 Job 规模。 TriggerAuthentications:触发器的认证参数。 ClusterTriggerAuthentications:集群维度认证。 部署 KEDA helm repo add kedacore https://kedacore.github.io/charts helm repo update kubectl create namespace keda helm install keda kedacore/keda --namespace keda kubectl apply -f https://github.com/kedacore/keda/releases/download/v2.10.1/keda-2.10.1.yaml root@node-1:/# kubectl get all -n keda NAME READY STATUS RESTARTS AGE pod/keda-metrics-apiserver-7d89dbcb54-v22nl 1/1 Running 0 44s pod/keda-operator-5bb9b49d7c-kh6wt 0/1 Running 0 44s NAME TYPE CLUSTER-IP EXTERNAL-IP PORT(S) AGE service/keda-metrics-apiserver ClusterIP 10.233.44.19 <none> 443/TCP,80/TCP 45s NAME READY UP-TO-DATE AVAILABLE AGE deployment.apps/keda-metrics-apiserver 1/1 1 1 45s deployment.apps/keda-operator 0/1 1 0 45s NAME DESIRED CURRENT READY AGE replicaset.apps/keda-metrics-apiserver-7d89dbcb54 1 1 1 45s replicaset.apps/keda-operator-5bb9b49d7c 1 1 0 45s root@node-1:/# kubectl get all -n keda NAME READY STATUS RESTARTS AGE pod/keda-metrics-apiserver-7d89dbcb54-v22nl 1/1 Running 0 4m8s pod/keda-operator-5bb9b49d7c-kh6wt 1/1 Running 0 4m8s NAME TYPE CLUSTER-IP EXTERNAL-IP PORT(S) AGE service/keda-metrics-apiserver ClusterIP 10.233.44.19 <none> 443/TCP,80/TCP 4m9s NAME READY UP-TO-DATE AVAILABLE AGE deployment.apps/keda-metrics-apiserver 1/1 1 1 4m9s deployment.apps/keda-operator 1/1 1 1 4m9s NAME DESIRED CURRENT READY AGE replicaset.apps/keda-metrics-apiserver-7d89dbcb54 1 1 1 4m9s replicaset.apps/keda-operator-5bb9b49d7c # kubectl get crd | grep keda clustertriggerauthentications.keda.sh 2023-05-11T09:26:06Z scaledjobs.keda.sh 2023-05-11T09:26:07Z scaledobjects.keda.sh 2023-05-11T09:26:07Z triggerauthentications.keda.sh 2023-05-11T09:26:07Z KubeSphere 部署 KEDA kubectl edit cc -n kubesphere-system (kubesphere 3.4+) spec: ··· autoscaling: enabled: true ··· 扩展工作负载 CRD ScaledObject 资源定义,详情参数请看 :https://keda.sh/docs/2.10/concepts/scaling-deployments/。 apiVersion: keda.sh/v1alpha1 kind: ScaledObject metadata: name: {scaled-object-name} spec: scaleTargetRef: apiVersion: {api-version-of-target-resource} # Optional. Default: apps/v1 kind: {kind-of-target-resource} # Optional. Default: Deployment name: {name-of-target-resource} # Mandatory. Must be in the same namespace as the ScaledObject envSourceContainerName: {container-name} # Optional. Default: .spec.template.spec.containers[0] pollingInterval: 30 # Optional. Default: 30 seconds cooldownPeriod: 300 # Optional. Default: 300 seconds idleReplicaCount: 0 # Optional. Default: ignored, must be less than minReplicaCount minReplicaCount: 1 # Optional. Default: 0 maxReplicaCount: 100 # Optional. Default: 100 fallback: # Optional. Section to specify fallback options failureThreshold: 3 # Mandatory if fallback section is included replicas: 6 # Mandatory if fallback section is included advanced: # Optional. Section to specify advanced options restoreToOriginalReplicaCount: true/false # Optional. Default: false horizontalPodAutoscalerConfig: # Optional. Section to specify HPA related options name: {name-of-hpa-resource} # Optional. Default: keda-hpa-{scaled-object-name} behavior: # Optional. Use to modify HPA's scaling behavior scaleDown: stabilizationWindowSeconds: 300 policies: - type: Percent value: 100 periodSeconds: 15 triggers: # {list of triggers to activate scaling of the target resource} 查看 KEDA Mterics Server 暴露的指标 kubectl get --raw "/apis/external.metrics.k8s.io/v1beta1" Demo KEDA 目前支持 53 种 Scalers,如 Kafka,Elasticsearch,MySQL,RabbitMQ,Prometheus 等等。 此处演示一个 Prometheus 和 Kafka 的例子。 Prometheus & KEDA 部署一个 Web 应用,使用 Prometheus 监控 Web 应用 http 请求指标。 为寻求演示效果,此处部署了一个有点击,互动的 Demo APP,地址如下:https://github.com/livewyer-ops/keda-demo/blob/v1.0.0/examples/keda/。 部署成功后通过 NodePort 访问: 进入 KubeSphere 项目,新建一个自定义伸缩: 设置最小副本数为 1,最大副本数为 10,轮询间隔 5 秒,等待时间为 1 分钟: KubeSphere 支持 Cron、Prometheus,和自定义触发器: 触发器设置 Prometheus,设置请求为 30s 内的增长率总和,当阈值大于 3 时事件驱动触发缩放: 设置一些其他设置,如资源删除后是否恢复指本来的副本数,以及扩缩策略设置: 现在并发访问 Web App: 可以在自定义监控看到监控指标的变化: Web App 的副本数开始横向扩展: 最终扩展到 ScaledObject 中定义的 10 个副本: 在访问停止后,可以看到监控指标的数值在慢慢变小: Deployment 开始缩容: Kafka & KEDA KEDA 使用 Kafka 事件源演示的整体拓扑如下: Kafka 使用 Demo 代码:https://github.com/ChamilaLiyanage/kafka-keda-example.git。 部署 Kafka 打开 KubeSphere 应用商店,查看 DMP 数据库中心: 选择 Kafka,进行安装: 安装好 Kafka 后,创建一个测试的 Kafka Topic,Topic 分区设置为 5,副本设置为 1: 创建 Kafka Producer 服务: 向主题发送订单: 创建 Consumer 服务: 发送新订单看 Consumer 服务是否消费: 现在可以来做自动伸缩了,创建一个 ScaledObject,设置最小副本数为 0,最大为 10,轮询间隔为 5s,Kafka LagThreshold 为 10: apiVersion: keda.k8s.io/v1alpha1 kind: ScaledObject metadata: name: kafka-scaledobject namespace: default labels: deploymentName: kafka-consumer-deployment # Required Name of the deployment we want to scale. spec: scaleTargetRef: deploymentName: kafka-consumer-deployment # Required Name of the deployment we want to scale. pollingInterval: 5 minReplicaCount: 0 #Optional Default 0 maxReplicaCount: 10 #Optional Default 100 triggers: - type: kafka metadata: # Required BootstrapeServers: radondb-kafka-kafka-external-bootstrap.demo:9092 # Kafka bootstrap server host and port consumerGroup: order-shipper # Make sure that this consumer group name is the same one as the one that is consuming topics topic: test lagThreshold: "10" # Optional. How much the stream is lagging on the current consumer group 创建自定义伸缩: 现在,让我们向队列提交大约 100,000 条订单消息,看看自动缩放的实际效果。你会看到随着队列中多余消息的增长,将会产生更多的 kafka-consumer pod。 NAMESPACE NAME REFERENCE TARGETS MINPODS MAXPODS REPLICAS AGE demo keda-hpa-kafka-consumer Deployment/kafka-consumer 5/10 (avg) 1 10 1 2m35s 此处我们看到最大到 5 个副本,没有到 10 个副本,因为默认最大副本数不会超过 Kafka 主题分区数量,上面设置了分区为 5,可以激活 allowIdleConsumers: true 来禁用这个默认行为。 重新编辑自定义伸缩后,最大副本变化成 10: 在无消息消费时,副本变化为 0: 结尾 到这里本篇就结束了,对此有需求或感兴趣的小伙伴可以操练起来了。 本文由博客一文多发平台 OpenWrite 发布!

优秀的个人博客,低调大师

每日一博 | 云原生背景下如何配置 JVM 内存

背景 前段时间业务研发反馈说是他的应用内存使用率很高,导致频繁的重启,让我排查下是怎么回事; 在这之前我也没怎么在意过这个问题,正好这次排查分析的过程做一个记录。 首先我查看了监控面板里的 Pod 监控: 发现确实是快满了,而此时去查看应用的 JVM 占用情况却只有30%左右;说明并不是应用内存满了导致 JVM 的 OOM,而是 Pod 的内存满了,导致 Pod 的内存溢出,从而被 k8s 杀掉了。 而 k8s 为了维持应用的副本数量就得重启一个 Pod,所以看起来就是应用运行一段时间后就被重启。 而这个应用配置的是 JVM 8G,容器申请的内存是16G,所以 Pod 的内存占用看起来也就 50% 左右。 容器的原理 在解决这个问题之前还是先简单了解下容器的运行原理,因为在 k8s 中所有的应用都是运行在容器中的,而容器本质上也是运行在宿主机上的一个个经常而已。 但我们使用 Docker 的时候会感觉每个容器启动的应用之间互不干扰,从文件系统、网络、CPU、内存这些都能完全隔离开来,就像两个运行在不同的服务器中的应用。 其实这一点也不是啥黑科技,Linux 早就支持 2.6.x 的版本就已经支持 namespace 隔离了,使用 namespace 可以将两个进程完全隔离。 仅仅将资源隔离还不够,还需要限制对资源的使用,比如 CPU、内存、磁盘、带宽这些也得做限制;这点也可以使用 cgroups 进行配置。 它可以限制某个进程的资源,比如宿主机是 4 核 CPU,8G 内存,为了保护其他容器,必须给这个容器配置使用上限:1核 CPU,2G内存。 这张图就很清晰的表示了 namespace 和 cgroups 在容器技术中的作用,简单来说就是: namespace 负责隔离 cgroups 负责限制 在 k8s 中也有对应的提现: resources: requests: memory: 1024Mi cpu: 0.1 limits: memory: 1024Mi cpu: 4 这个资源清单表示该应用至少需要为一个容器分配一个 0.1 核和 1024M 的资源,CPU 的最高上限为 4 个核心。 不同的OOM 回到本次的问题,可以确认是容器发生了 OOM 从而导致被 k8s 重启,这也是我们配置 limits 的作用。 k8s 内存溢出导致容器退出会出现 exit code 137 的一个 event 日志。 因为该应用的 JVM 内存配置和容器的配置大小是一样的,都是8GB,但 Java 应用还有一些非 JVM 管理的内存,比如堆外内存之类的,这样很容易就导致容器内存大小超过了限制的 8G 了,也就导致了容器内存溢出。 云原生背景的优化 因为这个应用本身使用的内存不多,所以建议将堆内存限制到 4GB,这样就避免了容器内存超限,从而解决了问题。 当然之后我们也会在应用配置栏里加上建议:推荐 JVM 的配置小于容器限制的 2/3,预留一些内存。 其实本质上还是开发模式没有转变过来,以传统的 Java 应用开发模式甚至都不会去了解容器的内存大小,因为以前大家的应用都是部署在一个内存较大的虚拟机上,所以感知不到容器内存的限制。 从而误以为将两者画了等号,这一点可能在 Java 应用中尤为明显,毕竟多了一个 JVM;甚至在老版本的 JDK 中如果没有设置堆内存大小,无法感知到容器的内存限制,从而自动生成的 Xmx 大于了容器的内存大小,以致于 OOM。

优秀的个人博客,低调大师

每日一博 | 解析内存中的高性能图结构

在进行各种图处理、图计算、图查询的时候,内存或是硬盘中如何存储图结构是一个影响性能的关键因素。本文主要分析了几种常见的内存图结构,及其时间、空间复杂度,希望对你有所启发。 通常来说,对于图结构的几种常见的基础操作: 插入一个点 插入一个边 删除一个边 删除一个点的全部邻边 找到一个点的全部邻边 找到一个点的另一个邻点 全图扫描 获取一个点的入度或者出度 这些图相关的操作,除了要关心时间复杂度之外,需要考虑空间占用的问题。 对于大多数实时读写型的系统,增删改查的性能问题会比较重要,它们比较关注上面 1-6 的操作;对于部分密集计算的系统,对批量读取的性能会比较重视,侧重上面 5-8 的操作。 不过遗憾的是,无论是常规的图查询,还是进阶的图计算,根据 RUM 猜想[1],读快、写快、又省空间这样”既要又要也要”的好事是不存在的。 下面,我们介绍几个数据结构并给出少量的定量分析。 我们先从三个典型的方案(邻接矩阵、压缩稀疏矩阵和邻接表)说起,再介绍几种近几年的研究的变种结构 PCSR、VCSR、CSR++。 邻接矩阵 Adjacency Matrix 用矩阵来表示图结构是大学里数据结构课程中都学过的知识,也是一种非常直观的办法。 点 i 与点 j 之间有一条边,等价对应于矩阵上 $M_{ij}$ 为 1。当然,这里的点 ID 是需要连续排列无空洞。 用矩阵来表示图结构有明显的好处,可以复用大量线性代数的研究成果:比如图上模式匹配类的问题等价于矩阵的相乘。 下面是一个模式匹配问题,它的大体意思是在全图上寻找这样一种图结构: Match (src)-[friend * 2..4]->(fof) WHERE src.age > 30 RETURN fof 对于这样一个问题可以直接对应右边的矩阵操作: 比如,2 跳遍历等价于矩阵 F 自乘;2 - 4 跳遍历分别等价于 F^2、F^3、F^4;取属性等价于乘以一个过滤矩阵。 更进一步,由于矩阵操作是天生可以分块并行加速,这在性能上有极大的优势。 下面,我们对邻接矩阵操作进行一个简单的定量分析 操作 时间复杂度 备注 插入一个点 O(n^2) 对于矩阵来说,增加一个点意味着整个矩阵的维度增加,通常需要另外开辟一块空间 插入一个边 O(1) 增加一个边只是将对应的位置置 1 删除一个边 O(1) 置0 删除一个点的全部邻边 O(n) 对于某个点所有出边的删除对应某一行的置0。入边对应某一列,可以批量操作 找到一个点的全部邻边 O(n) 找到一个点的给定邻点 O(1) 全图扫描 O(n^2) 其中,n=|V|,m=|E|。 优化上,批量操作(CPU Cache/SSD block)可以线性增加性能,例如 O(n) 可以降低到 O(n/B),但不影响定量分析。 由于绝大多数图结构是极其稀疏的,因此简单用邻接矩阵来表示图结构,其内存会有夸张的浪费。更为严重的是,当有多种边类型时,每种边类型各需要一个邻接矩阵。这使得裸用矩阵在实际情况中只能处理很小数据量的场景。当然,对于现代服务器动辄几百 G 的内存,如果只有几亿点边的数据量,像是 twitter2010,这并不会是很严重的问题。但大多数情况下,条件允许的话,大家还是希望找到一些更加经济的结构。 压缩稀疏矩阵 CSR/CSC 压缩稀疏矩阵是一种非常流行和紧凑的图结构表示方式,大多数图计算系统都采用 CSR。 这里简单介绍一下 CSR 的结构: 对于点 IDx,取邻居 ID 就是 F[N[x]] 到 F[N[x+1]-1]。 例如,查找点 ID2 的邻居,对应为 F[N[2]] 到 F[N[2+1]-1],对应到上图也即 1 6 8。查找点 ID7 的邻居,对应为 F[N[7]] 到 F[N[7+1]-1],也就是 2 和 4。 另外,CSR 记录的仅是出边的信息,如果要考虑入边就使用 CSC,其原理是类似的。 操作 时间复杂度 备注 插入一个点 O(1) 在点矢量尾部增加 插入一个边 <u,v> O(m+n) 边矢量,从 u 对应的邻居开始,都向后移动一位;点矢量,从 u 对应位置开始每个值加 1 删除一个边 O(m+n) 插入边的逆过程 删除一个点 v 的全部邻边 O(m+n) 边矢量移动 deg(v) 位,点矢量 u 对应位置置 0 找到一个点的全部邻边 O(deg(v)) 找到一个点的给定邻点 O(log(deg(v))) deg(v) 内的排序查找 全图扫描 O(m+n) CSR 的空间占用是 O(|V|+|E|),在空间节省和顺序查找上是极其高效的。但在大量插入时,压缩稀疏矩阵和邻接矩阵一样,需要重新开辟空间,效率很低。所以,它适合于计算密集场景但不适合增改频繁的场景。 CSR 还有一个显著的优点是可以快速获取每个点的出入度,只要计算 N[x+1]-N[x],这在判断一些点是否为超级节点时很方便。如果不是稀疏矩阵的话,通常会用另外一个单独的结构来记录出入度。 此外,CSR 不容易实现并发修改,其每次插入都需要对两个矢量进行位移,这并不高效。 这里推荐两个相关的开源项目,可以进一步了解下 CSR 的使用: https://github.com/DrTimothyAldenDavis/GraphBLAS https://github.com/GraphBLAS/LAGraph 邻接链表 Adjacency List 和基于矩阵的方式不同,邻接链表 AL 空间上有优势,但对于边的读写上会略微慢一点(指针在内存中不能连续移动)。AL 的做法是把邻边(出边)用 list 或者有序 list 的方式串连起来。由此延伸的一个变种是邻边从 list 改为 array。 操作 时间复杂度 备注 插入一个点 O(1) 尾插入 插入一个边 <u,v> O(log(deg(u))) 有序 list 删除一个边 O(log(deg(u))) 删除一个点 v 的全部邻边 O(1) 找到一个点的全部邻边 O(deg(u)) 找到一个点的给定邻点 O(log(deg(u))) 全图扫描 O(n+m) AL 相比 CSR 通常不能直接获得点的出入度,可以通过可以单独维护一个字段实现该功能。 此外,邻接表并不需要 ID 连续排布,对于频繁增删点的场景特别友好。AL 对于并发修改的支持也更友好,天然在点级别有并行度。当然,对于超级节点,直接用 list 的方式,还是会有些性能的问题要考虑;优化上可能会进一步改造成 Blocked list 的方式,可以带来更好的数据局部性和细颗粒度。 由于 ID 不用严格连续排布,AL 的一个常见变种就是 Tree。 Tree 在这种结构中,一个点和其所有的邻边被建模成了 key-value,key 是点 ID,value 是所有邻边的编码。Key 通过 Tree 的方式组织在一起。这里的树可以是 B-Tree 等各变种 Tree。虽然本文没有讨论图属性,但 value 中也是可以存放 value。 操作 时间复杂度 备注 插入一个点 O(log(n)) 插入一个边 <u,v> O(deg(u) log(n)) 删除一个边 O(deg(u) log(n)) 删除一个点 v 的全部邻边 O(log(n)) 找到一个点的全部邻边 O(deg(u) log(n)) 找到一个点的给定邻点 O(log(n deg(u)) 全图扫描 O(n+m) 为了控制访问颗粒度,每个叶子通常会被限定为固定的大小(页)。这就是在数据库类系统里面最常见的办法 B-tree。为了增改方便,也可以把每页的 in-place update 改成 Copy-On-Write 的方式;一个典型的代表就是 LLAMA[2],但这种多版本的读取通常会需要更多的空间,并且当有大量累积修改时,需要定期的多版本合并以降低跨快照读。某种程度上,它和 LSM-Tree 的思路有些接近。 基于 CSR 的变种 PCSR 和 VCSR 由于 CSR 在空间和读性能上有很大的优势,但在插入时的耗时和空间上都很弱,因此本节几个变种的主要目的都是为了改善其弱项,大体思路都是分块和 buffer。 在 CSR 的边矢量进行增删时可以注意到,主要耗时是在对于矢量的元素位移上。因此,一个直观的思路是预留一些插入空白位,在删除时也不立刻回收这些空白。 而分块思想,是指将一些局部数据放在同一个分块内,例如 Tree 中每个 page 就是一种分块的方式。与此对应的是,buffer 空白之间的连续区域。 PCSR PCSR [3]的基本思想是:对于点矢量,其元素从一个值改为对应边矢量中对应邻边位置的 <起点,终点>。而对于边矢量,在这些分块所对应边界放置哨兵 sentinel,上图中的 S,上图的 “-“ 对应预留插入位置留空。 事实上,原文中,对于边矢量,其本质是实现为一个 B-Tree,本文先简化成一个 Array。 操作 时间复杂度 备注 插入一个点 O(1) 直接在点矢量和边矢量的尾插入 插入一个边 <u,v> O(log(deg(u)) 边矢量对应分片的二分+空位查找 删除一个边 O(log(deg(u)) 删除一个点v的全部邻边 O(1) 边矢量对应分片置空,点矢量对应 ID 位置置空 找到一个点的全部邻边 O(deg(u)) 找到一个点的给定邻点 O(log(deg(u)) 全图扫描 O(n+m) 可以看到,PCSR 的预留位置多少都是需要重平衡,不能过多也不能不足。特别是大批量增删时,对预留位置的处理会是一个较重的操作。 此外,如果把 PMA 的 B-Tree 以及需要 rebalance 的本质考虑进去,其和前述 Tree 方式的区别并不是很大。 VCSR VCSR[4]主要是对 PCSR 的一个改进,其朴素思想是 PCSR 的留空是均匀的,而大多数图结构的出入度,是存在 20-80 这样的幂率特征,而 PCSR 的一个主要痛点是频繁的 rebalance。VCSR 的做法是为每个分块预留空间正比于其分块内的点的数量,即:边矢量中,一个分块内,如果点的数量多,就多预留一些空位。在直觉上,点数量多时,其分块对应的边插入会更多一些,这样可以减少 rebalance 的频率。 此外,VCSR 还有些版本号之类的优化。 CSR++ 事实上,CSR++[5]在设计上其实更接近一种 AL/Tree 的变种,而不是 CSR。它主要有三个方面的优化: 第一,对于 Vertex Array 再分段,将一个大的 Array 拆成多段,这样可以有更细的读写颗粒度。通过 段 ID + 点 ID 来定位每个点和其邻边。 第二,Vertex Array 中每个元素,除了记录点 ID 之外,对于邻边数量很少的点,直接把邻居 ID 也对齐地塞 inline 进去。 对于大多数的点,其邻边就不需要单独的 Edge Array 来存储了。 可以看到这种方式在图比较稀疏的时候,对于 CPU Cache 扫描是很友好的。 第三,对于每个点的邻边,采用copy-on-write、标记删除等常见的优化办法,构建成类似 std::vector 结构。 小结 最后,由于在图查询、图存储和图计算不同场景下,对于图结构的读写扫描和生命周期都有些不同的要求,不同的数据结构也有不同的优劣。 当然,本文只是讨论了图结构可以放在内存中的情况。当不得不把部分数据放在硬盘上时,问题就完全不同了。当然本文也没有讨论不同 CPU 对于不同距离内存的性能差异 NUMA,或者跨进程通信带来的影响。 延伸阅读 最后,我们来了解下在图计算/图算法上的图操作。 图算法中的图操作 在图计算中,存在多种图结构算法,可能会涉及多种基础操作。 中心性 Centrality Algorithms,一种衡量一个节点在整个网络图中所在中心程度的算法,包括:度中心性、接近中心性、介数中心性等,会涉及“找到一个点的全部邻边”、“找到一个点的另一个邻点”、“全图扫描”的操作组合。 度中心性通过节点的度数,即关联的边数来刻画节点的受欢迎程度,这将会要求找到一个点的所有邻边。 接近中心性,通过计算每个节点到全图其他所有节点的路径和来刻画节点与其他所有节点的关系密切程度,这将会要求进行全图扫描,查找点和图中所有点的路径信息。 介数中心性,则用于衡量一个顶点出现在其他任意两个顶点对之间最短路径上的次数,从而来刻画节点的重要性,这将会要求进行全图扫描,找到一个点和它的邻点及路径信息 PageRank,又称网页排名、谷歌左侧排名,是一种由搜索引擎根据网页之间相互的超链接计算的技术作为网页排名的要素之一的排名方法。它以 Google 公司创办人拉里·佩奇 Larry Page 之姓来命名。Google 用它来体现网页的相关性和重要性,在搜索引擎优化操作中是经常被用来评估网页优化的成效因素之一。一般来说,PageRank 的值越高,表示其被很多其他网页链接到,说明它的重要性很高;而如果一个 PageRank 很高的网页链接到其他网页,被链接的网页的 PageRank值也会随之提高。PageRank 的计算过程如下: 假设由 4 个网页组成的集合:A、B、C、D,每个页面的初始 PageRank 值相同,为了满足概率值为 0-1 之间,假设这个值为 0.25。 如果所有页面都只链接至 A,如下图,则 A 点的值将是 B、C、D 的 PageRank 值的和。 倘若是下图这种图结构: B 链接到 C,D 链接到 B 和 C,A 点的值计算的方式如下: 这里的 2、1、3,分别是 B 点对外链接的 2 条边,C 点对外链接的 1 条边,D 点对外链接的 3 条边。 换句话说,算法将根据每个页面连出总数平分该页面的 PR 值,并将其加到其所指向的页面: 最后,所有这些 PR 值被换算成百分比形式再乘上一个修正系数。 由于“没有向外链接的网页”传递出去的 PR 值会是0,这时候如果递归的话,会导致指向它的页面的 PR 值的计算结果同样为零,所以 PageRank 会赋给每个页面一个最小值。 因此,一个页面的 PR 值直接取决于指向它的的页面。如果在最初给每个网页一个随机且非零的 PR 值,经过重复计算,这些页面的 PR 值会趋向于某个定值,也就是处于收敛的状态,即最终结果。 简单来说,大多数迭代图计算模型都是基于“找到一个点的全部邻边”、“找到一个点的另一个邻点”操作。 AIGC 小课堂 在 AIGC 小课堂部分,我们会用 NebulaGraph 接入的 aibot 来讲解下文中的部分概念。你如果对 chatgpt 或者是 aibot 有兴趣,可以来 https://discuss.nebula-graph.com.cn/ 向 aibot 提出你的要求。 参考文献 Athanassoulis, M., Kester, M. S., Maas, L. M., et al. (2016). Designing Access Methods: The RUM Conjecture. In EDBT (pp. 461-466). Macko, P., Marathe, V. J., Margo, D. W., et al. (2015). Llama: Efficient Graph Analytics Using Large Multiversioned Arrays. In 2015 IEEE 31st International Conference on Data Engineering (pp. 363-374). IEEE. Wheatman, B., & Xu, H. (2018). Packed Compressed Sparse Row: A Dynamic Graph Representation. In 2018 IEEE High Performance Extreme Computing Conference (HPEC) (pp. 1-7). IEEE. Islam, A. A. R., Dai, D., & Cheng, D. (2022). VCSR: Mutable CSR Graph Format Using Vertex-Centric Packed Memory Array. In 2022 22nd IEEE International Symposium on Cluster, Cloud and Internet Computing (CCGrid) (pp. 71-80). IEEE. Firmli, S., Trigonakis, V., Lozi, J. P., et al. (2020). CSR++: A Fast, Scalable, Update-Friendly Graph Data Structure. In 24th International Conference on Principles of Distributed Systems (OPODIS'20).

优秀的个人博客,低调大师

每日一博 | 基于公共信箱的全量消息实现

作者 | 百度消息中台团队 导读 消息中台为百度App以及厂内百度系产品提供即时通讯的能力,提供包括私聊、群聊、聊天室、直播弹幕等用户沟通场景,并帮助业务通过消息推送触达用户。百度App存在需要以『低用户打扰』的形式触达全量用户的场景,而现有基于用户『私有信箱』通知拆分的机制,很难低成本、高时效的满足该场景诉求。基于上述问题,本文介绍了现有消息系统的主要组成,对比多种实现方案的差异,提出以『公有信箱』通知读扩散的方式,低成本、高时效的实现全量用户通知推送。 全文5515字,预计阅读时间14分钟。 01 全量消息提出背景 百度App存在需要触达全量用户的诉求,比如:2022年12月7日解除疫情管控结束后,将经过筛选的官方政策解读、专题汇总、知识科普、实用工具类介绍等信息,通过官方号『百度小助手』下发触达到百度App用户,来有效体现人文关怀,提高用户粘性。 1.1 全量消息诉求 在以消息服务进行全量触达(即全量消息)时,期望能够满足: 在触达范围上,希望尽量扩大用户触达范围,包括百度App月活用户、以及非月活用户但是近期新注册或登录的用户(根据2022年12月对外公开数据,百度App月活6亿+用户);在时效上,一次全量触达,希望短时间内完成(比如小时级、甚至分钟级),抢占时效性;在用户打扰方面,消息触达不能给用户带来较大的打扰,每次消息下发,只触达一次,不能重复打扰用户,但是需要保留回访入口,满足用户二次查看的诉求。 1.2现有技术痛点 我们现有IM(即时通讯)服务中,每个IM用户对应一个用户信箱。基于现有服务,如果想完成全量用户的消息触达,需要把消息推送到每个用户的信箱。完成6亿+的消息写入(假定每条占用存储4KB,每秒写入2W条消息),在消息写入时效性,以及存储资源消耗上,都是很难接受的。且现有的基于用户私有信箱的方案,在同时支持多条全量消息的场景下,扩展性也较差。 基于上述背景和技术痛点,我们抽象基于公共信箱的全量消息实现:在特定业务场景下通过消息服务,低成本、高时效的给全量用户推送内容一致的通知消息。 02 现有消息系统介绍 在介绍基于公共信箱(信箱的实现方式,该信箱为IM用户公有)的全量消息实现之前,先介绍一下目前消息系统的现状,包括消息系统的组成、通知拉取模式、用户信箱等。 2.1 消息系统组成 从普通用户的直观体验上看,一个IM系统可以包括如下几个元素:用户主体、用户账号、账号关系、聊天会话、聊天消息。『用户主体』具有『用户账号』,『用户主体』具有头像、昵称等用户属性,『用户主体』通过『用户账号』登录IM系统,进行聊天;账号之间的关注、屏蔽、免打扰等构成『用户关系』;通过用户之间的互动环节可以产生『聊天消息』;聊天记录构成了一个『聊天会话』。 从集成消息服务的业务方角度看,一个IM系统可以包括消息客户端(消息客户端UI组件、消息SDK)和消息服务端。IM消息可以作为一种服务,嵌入到各业务系统中,为业务系统提供『实时交互』能力。业务通过集成IM服务,提升其用户体验。如下为一个集成了IM SDK的业务架构图。业务App集成IM SDK,通过IM SDK与IM Server交互,完成用户上行通讯能力。业务App Server通过与IM Server交互,完成通知下行触达用户。 从使用场景来看,消息包括『私信消息』(包括用户上下行消息)、『通知消息』(业务方给用户推送的下行消息)、『群聊』、『聊天室』、『直播间弹幕』等。 2.2 消息的通知拉取模式 IM消息系统,采用通知拉取(notify-pull) 模式来感知新消息、拉取新消息。IM SDK登录时,与IM 服务端建立长连接(LCS, Long Connect Service),用户有新的消息时,通过长连接下发notify,实时通知用户的IM SDK。实时notify不写用户信箱,因为noitfy不是消息,而可以理解为提醒在线用户有新消息的信号,IM SDK根据这个信号,来服务端拉取消息。业务方server或者其他用户给该用户发送消息后,经过IM业务处理模块,把消息写入接收者信箱,IM Server会根据用户的登录和路由信息,给消息接收者(私信场景下也包括『消息发送者』,用于消息的多端同步)发送新消息notify,接收到notify的IM设备,通过IM SDK来IM Server端拉取 **(pull)**消息。 2.3用户信箱介绍 为了暂存尚未拉取到IM SDK本地的离线消息,需要对消息进行服务端存储,而消息的离线存储通过消息信箱服务完成。目前IM用户消息信箱主要包括用户私有信箱、群公共信箱(非下文提到的用户公共信箱)、直播间弹幕mcast等。用户信箱通过『消息所属应用』+『IM标识用户的唯一ID』来标识。就一条消息而言,消息参与者有『消息发送者』和『消息接收者』,消息收发双方的信箱都是相互独立的(假设发送方删除了自己信箱的某一条消息,不会影响消息接受者信箱的消息)。对于有查看历史消息诉求的一方来说,消息需要入该方的信箱:比如用户之间的私信(点对点聊天)消息需要入发送者和接收者的信箱,而对于全量通知场景,消息不需要存储发送者信箱,而只需要存接收者的信箱。而用户的信箱排序,是基于信箱Timeline,即消息在信箱内部基于时间线存储,每条消息对应一个unix 微秒时间戳(如第一条消息1679757323320865),用户进行信箱拉取时,基于时间范围正序或者逆序拉取,如下为信箱timeline的示例: △信箱timeline 用户信箱中的每一条消息记录都包含『消息ID』、『消息用户标识』、『消息通用属性』、『消息业务属性』四个主要部分。消息ID为unix微秒时间戳,不需要全局唯一,只需要特定用户信箱范围内唯一即可。消息用户标识包括from_uid、to_uid、contacter。消息通用属性包括create_time、expire、is_read。消息业务属性包括category、type、priority、business_type、app_id、msgkey、content等。如下为一条消息记录示例: △消息记录示例 03 全消息实现 3.1 全量消息推送方案分析 目前消息推送机制中,主要支持:单播(消息推送方式,每次给一个用户推送一条消息)、批量单播(每次给小范围用户推送消息,比如30个)、广播(基于关注关系的推送,如给全量粉丝推送),上述三种消息推送机制推送的消息,均需要存储服务端的用户私有信箱。为了完成百度App 6亿+月活用户(月活数据来源:2022年12月百度App公开月活数据, https://baijiahao.baidu.com/s?id=1758522783976467912&wfr=spider&for=pc )的消息推送,有几种可选的方案。 3.1.1 全流程从通知入口推送 ①该种方式下,需要获取全量的月活用户列表,经过IM Server推送入口,给每一个用户推送疫情相关通知。该通知写入到用户信箱,若用户在线,在实时拉取该通知;若用户离线,再下次登录IM服务时,拉取离线通知。该种方案下,推送行为会覆盖IM的全流程,推送的通知会进入每个月活用户的私有信箱,服务压力大。其中增量用户不会收到通知推送(这里增量用户指的是不在月活用户列表的用户)。 3.1.2 跳过通知入口直接写信箱 ②跳过IM消息推送流程中的中间环节,直接把通知消息写入用户信箱。由于跳过了中间流程,直接写入信箱,通知写入速度主要取决于信箱底层存储的压力承受情况。该种方案下,同①方案一样,无法给用户发送实时通知,依赖用户IM SDK的主动消息拉取(断链后重新登录/新消息提醒拉取),无法给增量用户发送通知。该方案由于跳过中间环节直接写信箱,风险较大,无法直接提供给业务方使用,不建议如此操作。 3.1.3 公有信箱实现机制 ③公有信箱机制,把通知消息写入『公共信箱』,在用户消息拉取时,合并『用户私信信箱』+『公共信箱』的消息。 3.1.4 三种方案比较 方案①②都是写扩散方式,基于现有『用户私有信箱』的机制,把通知消息写入每个接收通知的用户私有信箱。方案②与方案①的差别主要是跳过了消息中间流程,可以避免因为中间环节负载瓶颈导致整体消息写入速度过低。方案③是读扩散方式,消息不用再写入接收通知的用户私有信箱,而只需要在公共信箱存储一份,在用户拉取消息时,实时拉取公共信箱的消息。方案③中可以采用内存缓存方案,解决对公共信箱的读压力。本质上来说,方案③与方案①②相比,是用读成本(CPU)换写成本(存储)。 3.2 基于公有信箱的全量消息实现 基于上述方案③的思路,我们进行基于公有信箱的全量消息设计与实现。该种方案中,包含两个主要流程:『全量消息的管理』和『用户私有+公有信箱的拉取』。 3.2.1 全量消息的管理 全量消息管理主要分为运营O端操作平台(复用运营消息平台),以及全量消息处理服务(复用IM服务的连接层、逻辑处理层、信箱代理、信箱处理)。运营O端平台为运营同学提供可视化界面,可以对全量消息进行编辑、预发布、发布、修改、停止、撤回等操作;接入层对接运营O端,进行参数校验、转发IM后端逻辑处理模块;逻辑处理层进行全量消息的创建、修改、停止、删除、撤回等逻辑操作;信箱代理层复用IM服务的信箱CRUD操作;信箱存储层公共信箱的底层存储。 △全量消息管理流程 3.2.1 用户信箱拉取 用户通过IM SDK,以长连接的方式,在逻辑处理层进行消息拉拉取。在用户拉取信箱消息时,需要对『用户个人信箱』和『公有信箱』进行合并。由于每次用户信箱拉取,都需要进行信箱的合并拉取。 公共信箱内存缓存机制 百度App的IM用户,在IM SDK登录时需要拉取信箱中的消息。每次消息拉取时,需要检查公共信箱中是否有消息。因此,公共信箱需要能抗住日常和峰值流量(拉取峰值为4.7Wqps)。为了防止流量击穿,流量打到底层的持久化公共信箱MYSQL存储,我们设计了基于内存的公共信箱缓存机制。同时公共信箱内容变化时,也要实时(或者在能容忍的范围内做到准实时)变更内存缓存信箱中的消息,我们采用Bthread定期轮询持久化公共信箱,更新内存公共信箱,轮询间隔可配置(比如设置1秒)。 分级发布机制 同时,在逻辑层实现白名单机制,支持全量消息在『预发布』状态下,仅对白名单用户可见,从而达到分级验证的效果。白名单的用户列表通过逻辑处理成的配置加载,也支持通过CURL请求动态修改白名单的配置。 3.3 基于公有信箱的全量消息实现需要解决的问题 以公有信箱的方案实现全量消息,需要解决如下问题: 04 全量消息公共信箱实现的优缺点 以公共信箱的方式,实现全量消息分发,具有:**『分发速度快』、『资源成本低』**的特点。 公共信箱的方式也存在一定的局限性: 1、不适用于个性化要求高的场景:由于消息在公共信箱只存储一份,下发消息内容固定,无法很大程度下,下发个性化消息(当然也不是一定无法下发个性化的消息,可以通过在公共信箱存储消息模板,根据拉取消息的用户ID获取个性化信息,在消息拉取时,临时拼装消息,这样就增大了消息拉取时的代价)。 2、不适用于实时消息提醒场景: ①从业务场景上看,全量消息优先级低,不需要在全量生效的瞬间让用户感知; ②从实现上看,全量消息实时消息提醒成本高(因为实时消息提醒Notify,需要以类似单播的形式实时通知用户。和单播的区别是,Notify不用触达离线用户,也就是不用写用户信箱,只需实时触达在线用户); ③从系统压力看,全量在线用户均收到实时新消息提醒,会带来信箱拉取请求的瞬时流量(手百IM SDK长连接峰值在线1550W,假定新消息提醒在瞬间下发,同时在线用户信箱拉取请求,会把db打挂的)。 05 全量消息的应用 全量消息目前已经在百度App得到应用,包括:重大通知的下发,百度App功能更新介绍通知,消息的撤回,后续将推广到其他的矩阵App的全量通知推送场景。 22年Q4宣布疫情解封时,利用全量消息推送,低成本、高时效的完成3条『疫情解封专项』全量消息下发。 备注:三次全量消息下发,到达数据在2亿+,该值小于月活的6亿+,主要因为几个原因: ①本次全量消息有效期仅3天左右,全量消息有效期内登录IM SDK的用户才有机会拉到全量消息; ②本次下发使用了新的消息展示模板,所以限制了拉取全量消息的百度App版本,只有高版本百度App可以拉到; ③本次全量消息,限制了仅有百度App登录用户拉取。 06 展望 前文介绍了现有消息系统,通过公有信箱低成本、高分发速度完成全量消息下发的设计、实现与应用。在全量消息应用方面,除了业务上的使用,后续也可以用于广播消息、批量单播消息的撤回。比如由于误操作发送了广播消息,用户已经把广播消息拉到了端,并持久化到端,这是可以『以全量消息的方式,下发删除指令』,删除已经缓存到端的垃圾消息。 希望,通过消息系统持续不断优化,为更多的业务提供低成本、高稳定性的即时通讯能力。 ——END—— 推荐阅读: 百度APP iOS端包体积50M优化实践(二) 图片优化 浅论分布式训练中的recompute机制 剖析多利熊业务如何基于分布式架构实践稳定性建设 百度工程师的软件质量与测试随笔 百度APP iOS端包体积50M优化实践(一)总览 基于FFmpeg和Wasm的Web端视频截帧方案

优秀的个人博客,低调大师

每日一博 | Node 工程的依赖包管理方式

作者:京东零售 陈震 在前端工程化中,JavaScript 依赖包管理是非常重要的一环。依赖包通常是项目所依赖的第三方库、工具和框架等资源,它们能够帮助我们减少重复开发、提高效率并且确保项目可以正确的运行。 目前比较常见的前端包管理器有 npm 和 Yarn,npm 是 Node.js 自带的包管理器,它可以安装、共享和分发 node.js 模块。最近pnpm也挺火的,通过并行下载和安装依赖项,在执行安装、更新、删除等操作时也更快。 但无论使用哪个包管理器,都要通过 package.json 文件的版本控制功能,保证在不同开发环境中的一致性。那么,package.json是如何进行依赖包管理的呢?我们来一起深入了解一下package.json的配置方式。 一、分类管理 根据package.json规范,依赖包被大致分为以下几种:dependencies、devDependencies、optionalDependencies、peerDependencies和bundledDependencies总共5种。dependencies和devDependencies这两项是我们使用较为频繁的。 1、dependencies 工程在生产环境下也需要使用的依赖,例如react、antd等,使用npm安装插件时,会默认写入dependencies,也可以使用-P或--save-prod后缀。 2、devDependencies 工程只有开发环境需要,生产环境不需要的依赖,例如eslint、babel等,使用-D或--save-dev来写入devDependencies。 3、optionalDependencies 顾名思义,依赖是可选的,它们只有在运行时需要使用某些功能时才会被引入。通常用于实现某些可选的功能或优化。例如,一个包可能依赖于某个库来实现某种高级功能,但是这个库在某些环境下不存在或不可用。在这种情况下,可以将该库声明为可选依赖项,并在代码中检查该依赖项是否存在,然后根据情况来决定是否使用该高级功能。使用这个功能的工程比较少,使用-O或--save-optional来写入optionalDependencies。 4、peerDependencies 工程需要和这个依赖配套使用,一般用于解决插件依赖的核心库的版本和主项目依赖的核心库的版本不一致的问题,常见于开发配套插件。例如vuex@4.1.0声明了: "peerDependencies": { "vue": "^3.2.0" } 表明vuex@4.1.0需要和vue@^ 3.2.0一起安装和使用,否则可能会出现异常。使用-O或--save-optional来写入optionalDependencies。 5、bundledDependencies 工程依赖于某些特定的依赖项,并且希望在运行时不必再次下载它们,则可以使用该选项。npm pack会将这些依赖一同放入生成的包中,并且在npm install时本工程,这些依赖项也会被一同安装。使用-B或--save-bundle来写入bundledDependencies。 看到这里你可能会有点疑问,为什么npm没有提供类似--save-peer的指令来写入peerDependencies呢?原因是peerDependencies暗示本工程将会被其他主模块使用,但是主模块本身并不需要在项目代码中显式使用。因此官方没有支持这一指令。 二、版本管理 一般情况下,以上依赖配置(除了bundledDependencies)都需要指定依赖的版本号,版本号遵循semver语义化版本规范(Semantic Versioning)命名规则,可以用下图表示,如2.1.0、3.1.4-beta.2等。 当发生不兼容的 API 修改时,更新major位 当做了向下兼容的功能性新增时,更新minor位 当做了向下兼容的问题修正时,更新patch位 可选的-tags即先行版本号,可以作为发布正式版之前的版本,格式是在修订版本号后面加上一个连接号(-),再加上一连串以点(.)分割的标识符,标识符可以由英文、数字和连接号([0-9A-Za-z-])组成。 在 npm 的依赖的规则中,还有~、>、<、=、>=、<=、-、||、x、X、*等符号来描述适用的版本范围; ^ :表示只锁定major,不小于指定版本号的版本范围。例如^1.1.0,代表>=1.1.0 <2.0.0的版本范围。 ~ :表示锁定major和minor,不小于指定版本号的版本号。例如~1.1.0,代表>=1.1.0 <1.2.0的版本范围。 x、X、*:表示通配符。例如1.1.x,也代表>=1.1.0 <1.2.0的版本范围。 默认情况下,若指定了一个版本范围,npm会在范围内安装最新版本的依赖。当使用 npm install XX 时,会安装当前最新版本,并在版本号前默认加上 ^ 符号。因此在安装运行老项目时,很容易出现安装依赖后,项目启动报错的情况,原因就是某些依赖没有做到很好的向下兼容,导致重新安装的版本太高造成兼容性错误,此时需要定位错误依赖并回退版本。 三、npm install加载机制 npm install核心流程大致分为以下5步: 1、npm 向 registry 查询依赖压缩包的网址。 2、下载压缩包,存放在cache目录,供下次安装时使用。 3、解压压缩包到当前项目的node_modules目录。 4、把所有安装的包信息写入package-lock.json,供下次安装时使用。 5、继续处理依赖的依赖。 install的过程速度也和每一个步骤息息相关: (1)共享工程package-lock.json,可以避免向registry查询的步骤,并且保证不同环境下安装包的一致性。 (2)使用下载速度快的registry镜像(例如jd镜像)。 (3)预先进行依赖关系分析构建依赖关系,然后最后再并行下载(例如yarn)。 希望以上的介绍能够帮助你更好的理解npm的依赖管理。

优秀的个人博客,低调大师

每日一博 | 音视频通讯 QoS 技术及其演进

利用多种算法和策略进行网络传输控制,最大限度满足弱网场景下的音视频用户体验。 良逸|技术作者 01 什么是QoS?音视频通讯QoS是哪一类? QoS(Quality of Service)是服务质量的缩写,指一个网络能够利用各种基础技术,为指定的网络通信提供更好的服务能力,是网络的一种安全机制,是用来解决网络延迟和阻塞等问题的一种技术,包括流分类、流量监管、流量整形、接口限速、拥塞管理、拥塞避免等。通常QoS提供以下三种服务模型:Best-Effort service(尽力而为服务模型),Integrated service(综合服务模型,简称Int-Serv),Differentiated service(区分服务模型,简称Diff-Serv)。 上面的这些描述,都指的是传统的、原始的QoS的定义和技术栈,其来源于早期互联网的网络传输设备间的质量保证体系。而本文要讨论的QoS,是在一个完全不同层次的质量保证体系,我们先看一下这两个层次QoS的关系。 视频会议公司Polycom的H323白皮书QoE and QoS-IP Video Conferencing里提到,QoS分为两类,一类是基于网络的服务质量(Network-Based QoS)NQoS,一类是基于应用的服务质量(Application-Based QoS)AQoS。 下图展示了两种QoS不同的作用使用场景和不同的质量保障层次。 NQoS是网络传输设备间的基础通信质量保障能力,是这类通讯设备间特有的一组质量保障协议,这些设备有路由器、交换机、网关等。而AQoS则是应用程序内部,根据应用对应的终端设备类型、业务场景、数据流类型所实现的,在不同网络状态下尽力而为地保障用户体验的能力。 虽然NQoS和AQoS都会对最终用户的体验有决定性影响,但如果将应用场景限定在音视频通讯领域,则AQoS这种基于应用的QoS就极为重要了,因为NQoS作为互联网的基础设施的一部分,为兼顾各种使用场景,更多的是一种「普适」的传输质量保障技术,很难对特定领域做太多的针对性优化,所以本文重点讨论的音视频通讯QoS其实是一类基于应用的AQoS,是针对音视频通讯领域的相关应用程序的传输质量保障技术。 02 音视频通讯QOS背景 个人理解,音视频通讯QoS是「利用多种算法和策略进行网络传输控制,最大限度满足弱网场景下的音视频用户体验的能力」,如下图所示: 数据从音视频媒体生产环节,经过各种弱网网络条件的中间传输环节,到音视频媒体的消费环节,形成最终的用户体验。QoS通过各种策略和算法,对端到端全链路进行控制,最终让用户能够获得最佳体验。 03 音视频通讯QoS面临的挑战 网络场景 各种网络条件非常复杂:网络的种类和组合多样,特别是在最后一公里,有双绞线、同轴电缆、光纤、WIFI、4G、5G等;即使同样的网络链接,又会随着不同的场景产生变化,比如4G,5G,WIFI这种无线信号,会随着位置的变化信号强弱也飘忽不定,会出现4G、5G、WIFI信号的切换。即使是有线网络,也会因为链路上多种App共用、多个用户共用,出现竞争拥塞等问题。 业务场景 各种音视频通讯业务场景多样,例如,点播、直播(RTMP/RTS)、会议、互动娱乐、在线教育、IOT、云游戏、云渲染、云桌面、远程医疗等等。不同的业务场景,又有不同的体验需求,例如,直播场景注重流畅的体验,而对音视频互动时效性,要求并不是太高;会议场景则对沟通交流的实时性要求会比较高,而对音视频画质的要求没有那么高;但对云游戏等场景,则要求极低的延时,同时要保证极高的清晰度。 用户体验 如下图所示,音视频通讯场景,用户体验主要从清晰度、流畅性、实时性三个方面来衡量。 清晰度,是用户感受到的视频画面清晰还是模糊,一般情况下分辨率越高越清晰,越清晰的画面包含的信息量就越多,传输时占用的流量就多; 流畅性,是用户感受到的视频画面运动起来的时候是顺畅还是卡顿,一般情况每秒钟看到的画面数量越多越流畅,同样每秒画面数量越多,传输时占用的流量也越多; 实时性,是音视频信息从其发生到被远端用户感受到所需要的时间,时间越短实时性越好,实时性越好对传输速度的要求就越高。 前面说过,不同的业务场景对清晰度、流畅性、实时性三者的要求有着不同的侧重,然而随着音视频通讯业务场景的不断发展,越来越多极低延时和可沉浸的场景不断涌现,用户对音视频体验,可以说是既要又要还要,而且要求越来越高,留给技术人辗转腾挪的空间越来越小。在这种趋势下,对音视频传输QOS的技术要求也变得越来越高。 从底层协议来看,基于TCP传输的音视频通讯,例如直播、点播等,一般都延时比较大,而且因为数据都封装在TCP协议内部,依靠TCP本身的抗弱网机制来保证可靠性,应用层很难有机会参与其中的控制和优化,只适用于延时容忍度较大的场景。对于延时容忍度较小的场景,基本都是基于UDP的,大家都知道UDP传输的特征就是可靠性差,需要应用层通过各种抗弱网技术手段来保证数据传输的可靠性,QoS技术就有了大显身手的机会。 本文主要讨论基于UDP传输的,最具挑战性、技术最复杂的音视频短延时通讯QoS技术,包括实时音视频通讯RTC场景和低延时直播RTS场景。 04 弱网的分类 假如我们的传输网络非常的完美,有足够大的带宽、有足够低的延时、有足够高的保障,那我们就能很容易地实现像真人一样的面对面交流,我们也不需要QoS技术,不需要编解码,只要把音视频采集下来,再瞬间传送到对端播放出来就可以了,人与人的远程互动将变得十分美好。 然而,现实离这种美好相去甚远,现代的音视频通讯是建立在互联网的基础设施之上的一类应用,这让互联网的传输质量,变成了音视频通讯传输质量不可能突破的天花板。众所周知,互联网的传输是复杂的、昂贵的、不可靠的、不稳定的,没有办法搞清楚所有的传输环节的状况,我们需要对这些问题进行抽象分类,以便于更好地针对不同的场景进行有效应对,竭尽所能的保证用户的音视频体验不受太大的影响。 我们一般把网络传输质量不符合预期的场景叫弱网场景,弱网分成拥塞、丢包、延时、抖动、乱序、误码等。拥塞,是可用带宽不足的表现,如同高速堵车;丢包,是数据在传输过程中丢了,不知去向,如同快递丢失包裹;延 时,一般是中转太多或者拥塞排队导致时效性变差,如同转机或堵车;抖动,是数据传输间隔忽大忽小,如果不做处理,可能会导致音视频忽快忽慢;乱序,是后发先至,先发出去的数据比后发出去的数据到的还晚,如果不处理,可能会导致音视频的回放;误码,是传输过程中数据错误,由于传输层会有校验、修正、重传,所以应用层一般都无感知、无需特别处理。 上图用管道灌水比较形象的把几种弱网场景做了说明:左边是流量生产侧,右边是流量消费侧,管道的长度是链路的基本延时;管道传输过程中会产生一些错误和丢包;当管道由宽变窄而且流量超过管道的宽度,就会产生带宽拥塞;当拥塞产生时会出现流量排队的情况,部分流量会被放到缓存队列,相应地产生队列延时;当缓存队列满了之后,会产生队列溢出,溢出的流量就对应了溢出丢包;链路数据传输过程中会有一些波动和信号干扰,导致数据的传输速率不是恒定的,最后收到的数据变得忽快忽慢,我们将其归类为链路抖动。现实中,这些不同的弱网类型往往是混合在一起同时出现,对其做不同的分类,可以方便我们从技术上对其各个击破。 05 音视频通讯QoS技术体系 QoS技术分类 音视频通讯QoS技术和策略就是为了对抗上述弱网场景而诞生的,其目的就是尽最大可能消除因为网络变差给用户带来的体验衰退,所以对应上面讲的不同弱网场景的分类,用到的QoS技术也被分成了几大类:拥塞控制、信源控制、抗丢包、抗抖动,每一类技术都包含很多的不同的技术点和技术细节,后面再来展开。 拥塞控制,是网络状况探测和数据发送方式的决策中心,是整个发送侧QoS技术的核心,是传输控制的大脑; 信源控制,是在拥塞控制的决策下,控制音视频信源产生的方式,控制信源的码率,来适应探测出来的网络状况,实现抗拥塞的目的; 抗丢包,是在网络有丢包的场景下,对信源数据增加冗余信息,达到部分信息被丢失的场景,也能够完整地恢复出原有数据; 抗抖动,是在网络延时有波动、数据时快时慢、时有时无的情况下,增加一部分延时,对数据进行缓冲,让用户体验更流畅,不至于卡顿; 上面也说明了不同类的QoS技术对应可以解决不同的用户体验问题,可以看出都是围绕流畅性、清晰度、实时性这三点来改善的。拥塞控制是总指挥,很多时候对整个链路的体验起决定性作用,信源控制可以提升流畅性和清晰度方面的体验,抗丢包和抗抖动可以提升流畅性和实时性方面的体验。 QoS在音视频通讯流程中的位置 我们知道音视频通讯是端到端的全链路通讯,其涉及的技术领域非常广泛,跨度非常大、非常复杂。比如,客户端侧就包含了市面上能见到的Windows、MacOS、iOS、Andorid四个平台的所有终端的适配、兼容、互通,甚至要跟浏览器进行互联互通,同一个平台每款不同的设备也存在较大的差异,很多时候需要单独的适配。还有音频3A(AEC、AGC、ANS)、音频编解码(Opus、AAC)、视频编解码(H264、H265、AV1)等任何一个领域展开都是非常复杂的技术栈。而云端的各种服务器也是实现互联互通不可缺少的环节,包括信令服务器、媒体服务器、混流、转码、录制、节点部署、调度选路、负载均衡等等,每个节点、每种服务都是复杂的存在。 在如此复杂的音视频通讯技术链路中,QoS技术也只是其中的一个比较窄的领域,但也是不可或缺的,对线上的音视频通讯的可用性有着决定性意义。QoS技术看起来也是音视频通讯领域为数不多的全链路的技术,它端到端、全链路控制着媒体传输、媒体编解码的各个环节,以至于从事QoS技术的相关工程师需要对客户端和服务器的全链路的技术都要有一定的了解,需要从全局的视角来看整个音视频通讯。 下图是对音视频实时通讯链路功能的一个抽象,用媒体发送和媒体接收的P2P模式,省略了复杂的服务器传输部分,方便大家的理解。 音视频通讯的基本流程:首先是推流客户端,从终端设备的音视频采集模块采集的音视频数据是未经过压缩的原始数据,按帧(frame)存储的、尺寸较大的媒体数据,是没有办法直接在网络上传输的,需要先进行压缩,就到了编码部分,用到了音视频的编码器,编码完成之后,数据依然很大,需要进行切片,然后经过RTP对切片后的数据做封装,封装完之后,从发送队列发送到网络上,经过服务器的一系列透传或处理,到达拉流客户端,拉流端收到网络发送过来的RTP数据包之后,要先进行RTP包的完整性判断,判断编码后的数据帧切片数据是否都已经被收到,之后再解RTP封装,恢复编码后的端数据帧,并送给解码器进行解码,解码完的数据送到渲染模块,用户就看到和听到了推流端的画面和声音。 上图左边是媒体发送侧的处理流程:音视频采集模块、前处理模块、编码模块、RTP封装模块、发送队列、网络数据发送。右边是媒体接收侧的处理流程:网络数据接收、RTP包解析模块、接收队列管理、解码模块、后处理模块、渲染模块。中间的左边蓝色的框内功能是发送侧QoS相关的功能,右边的蓝色框内的功能是接收侧QoS相关的功能。另外,从RTCP协议本身的定位看,它就是对基于UDP的媒体RTP数据进行控制的协议,所以也可以看成QoS控制的一部分。 从上图还可以看出两个特点,第一,QoS功能跟很多其它模块都相关,这是因为QoS技术是全链路控制的技术,需要触达的模块比较多;第二,发送侧的QoS功能明显比接收侧的QoS功能多,这是因为目前很多都是发送侧带宽估计和拥塞控制,因为这样会更接近信息产生的源头,从源头解决问题的效率更高,防患于未然。接收侧的技术往往是比较被动的,是出了问题之后的最后补救,亡羊补牢。 QoS技术体系 讲完QoS技术的分类和QoS技术在音视频通讯技术中的位置,接下来我们聚焦在QoS技术领域内部,从客户端和服务器媒体链路来看QoS技术体系和其中比较大的技术点,如下图所示。左下角的推流客户端侧,用到了信源控制、拥塞控制、抗丢包技术;中上部的媒体转发服务器SFU,用到了信源控制、拥塞控制、抗丢包技术;右下角的拉流客户端侧,用到了抗丢包、抗抖动技术。下面简要串一下相关的技术点的大概流程和意义。 l 音视频推流客户端 所有媒体RTP数据包发送的时候,会在RTP的扩展头中增加一个统一的序列号,可以认为每个数据包有一个唯一的编号,这样所有发出去的数据都有了对应的序列号、发送时刻、包大小三个信息。在接收端收到这些RTP数据包之后,会把每个收到的序列号以及收到的此序列号的接收时刻信息,按照TransportFeedback(twcc)报文定义的格式封装到RTCP包中,反馈到推流端。参考:《WebRTC研究:Transport-cc之RTP及RTCP》,推流端根据这些反馈信息,就能估算出当前网络传输的状况,包括丢包、延时、带宽三个方面的信息。这些估算的算法,就是带宽估计算法(也叫拥塞控制算法),上图提到了比较常用的两种,一个是GCC(google congestion control),一个是BBR(Bottleneck Bandwidth and Round-trip Time),两个都是谷歌推出的拥塞控制算法。 为什么不单纯叫带宽估计算法呢?这些估计算法一般都会跟平滑发送PacedSender配对使用,很少出现只估计不控制的情况,平滑发送控制策略也是估计算法架构设计中的一部分,为了让发送的码流尽量是比较平顺的,防止忽高忽低的波动,以免对链路造成冲击,带来不必要的拥塞。 基于这些拥塞控制算法的设计,很多时候为了相对准确的探测到足够大的可用带宽,在原始的音视频数据不足以填满期望的带宽到时候,比如视频画面静止不动、音频静音的场景,就需要发送一些Padding数据来临时填充带宽,这些Padding数据有时是用重复发送原始包的方式,有时就干脆发一堆垃圾数据,目的只是用来填充带宽,收到之后也会将其丢掉。 经过估计算法的估算,得到网络的可用带宽、传输延时、丢包率信息之后,就可以将这几个信息广播到各个需要的模块,例如带宽分配模块。在带宽分配模块中,会按照一定的优先级和分配策略,将可用的带宽,分给每一条音视频流,而且在有丢包的场景,需要同时为每条音视频流分配对应的冗余信息带宽。 分配完带宽资源之后,就到了信源控制部分,音视频流的码控模块会根据各自的码流特征、编解码能力、技术手段进行各自的控制,例如基础的音频码率、帧长、视频的码率、帧率、分辨率、QP等基本控制,同时也有一些编码相关的特定技术点的控制,例如音频DTX(Opus编码器不连续传输-->降低带宽占用)、视频simulcast(同时推送多流-->满足不同订阅场景降低带宽)、视频SVC(可分层视频编码-->实现动态抽帧能力降低拥塞)、视频LTR(长期参考帧-->降低重传带宽)、视频屏幕共享SCC(屏幕内容编码-->降低屏幕共享场景带宽)等等。 在网络有丢包的场景下,我们要储备抗丢包的技术手段。抗丢包手段一般有两种: 一种是丢包重传,收流端发现数据丢包了,不再连续的时候,主动通过NACK报文(RTCP报文的一种)发送重传请求到推流端,而推流端则需要随时缓存之前发过的数据,以满足丢包之后的重传需求,对丢失的数据进行补发。这是一种滞后性的补救措施,所以相对比较节省带宽,但是会增加延时; 另一种是发送数据的时候,同时发送一部分冗余信息,一旦传输过程中出现丢包,则可以靠这部分冗余信息,恢复部分或全部的原有数据。这是一种预防性的技术手段,因为冗余和原始数据同时发送,所以可以即刻进行丢包恢复,不存在延时问题,但因为有冗余信息存在,所以会占用更多的带宽。这里增加冗余信息的方式有2种,一种是RED封装,用在数据包比较小的音频传输场景;另一种是FEC编码封装,用在数据包比较大的视频或音频场景,目前有很多种FEC编码方式可用,这方面算法的研究也比较多。 l 媒体转发处理服务器SFU 到了媒体转发服务器,其一方面作为收流侧对应推流侧客户端,另一方面媒体服务器会作为发送侧对应拉流客户端。收流侧基本只提供抗丢包能力,和拉流侧的抗丢包能力配合使用就形成了全链路的分段抗丢包能力,分段意味着上行和下行分开来做抗丢包,互不影响,好处是可以简化设计,同时对不同的下行弱网和非弱网用户,可以提供按需服务,有比较强的自适应能力。收流侧和拉流侧的抗丢包跟上面说的客户端的抗丢包一样,也包含丢包请求、重传,对应RED编解封装,对应FEC编解码、编解封装的功能,这部分功能相对比较固定,在跟客户端推流侧进行SDP媒体能力协商之后,就确定了哪些功能可以开或者是关。 服务器的发送侧功能,跟客户端推流侧一样也比较复杂,包含拥塞控制GCC、BBR、平滑发送、Padding等拥塞控制算法以及带宽分配,服务器上的这些算法跟客户端推流侧的算法基本的框架结构和基本功能都是一样的,只是算法的参数配置、使用的策略,都跟客户端是不一样的,因为服务器侧的信源控制力跟客户端推流侧的信源控制力,是完全没法比的,不可同日耳语。同时,服务器需要顾及很多的推流端和很多的拉流端,更需要平衡各种关系,众口难调是服务器面临的主要矛盾。 服务器的这种地位也衍生出了一些特定的技术手段,比如视频的抽帧(抽掉一些不影响解码的帧数据来降带宽)、视频切流(主动切换到带宽和清晰度较低的流上来降低带宽)、视频按需推流(根据实际的订阅关系准许推流端直推需要的流来降低带宽)、音视频带宽反馈(特定场景可以将拉流测信息反馈给推流侧让其提供更准确的码控服务)、音频AudioRanking(多人会议场景将不说话人的声音过滤掉来降低带宽)等等。服务器相关的更详细的技术点描述,可以参考《阿里云 GRTN QoS 体系 — 构建实时音视频产品最佳体验》。 l 音视频拉流客户端 最后到了音视频拉流客户端,这里的抗丢包功能除了上面说的丢包重传、RED、FEC,又多出了两个,一个是关键帧请求,一个是长期参考帧LTR请求,这两个视频帧请求目的都是为了恢复视频帧的参考链,以便能够重新开始视频解码。 关键帧请求是需要视频重新开始编码,让收到关键帧的任意客户端都可以解码,使视频帧的参考链重新开始。长期参考帧则是在确认已经收到一个长期参考帧的情况下,不必再从关键帧开始编码,只要发送一个长期参考帧就可以恢复参考链,即用发送长期参考帧的方式替代发送关键帧。这样做的好处主要是降低重传带宽,但同时增加了复杂性,因为服务器需要确认每个拉流客户端,都收到了某个特定的长期参考帧,在拉流客户端数量较多的场景,这个条件比较难以满足。可以参考《阿里云 RTC QoS 弱网对抗之 LTR 及其硬件解码支持》。 另外拉流客户端比其它部分多了抗抖动的功能,主要思想是增加一个数据缓冲的buffer,增加了一部分延时。就像一个水库一样,雨季的时候蓄水,将快速流入的水储存起来,旱季的时候放水,将之前存储起来的水慢慢放出来,确保自始至终有水流出。 音频和视频的数据流有各自不同的特征,对应音频的抖动缓存机制和视频的抖动缓冲机制也是不一样的,目前用的较多的都是WebRTC里面的音视频抖动控制机制,视频是基于卡尔曼滤波器的JitterBuffer,音频是NetEQ,具体的算法都非常复杂,这里就不展开了,有兴趣的同学可以参考《WebRTC视频JitterBuffer详解》和我之前的一篇白话文《白话解读 WebRTC 音频 NetEQ 及优化实践》。 音视频的拉流侧或播放侧一般都会有音视频同步(又叫唇音同步lip sync)的需求,否则会出现只闻其声不见其人,或只看到闪电听不见雷声的情况。WebRTC原有的音视频同步机制非常的复杂,我之前也有过介绍《WebRTC 音视频同步原理与实现》,而且在NetEQ及优化实践中也提到了一种简单的替代方案,这里也不展开。 06 音视频通讯QoS技术的演进 上面粗略地讲述了音视频通讯QoS用到的技术体系,任何技术都是需要一定的软件架构来承载和实现的,音视频通讯领域的QoS技术也是随着音视频通讯的软件架构演进而不断升级的。对于实时音视频通讯RTC的演进历史,可以参考《历经5代跨越25年的RTC架构演化史》。这里面提到「谷歌在2011年开源了WebRTC,作为RTC技术领域的里程碑事件,大大降低了RTC开发的门槛,催生了后来移动互联网RTC应用的大时代」。 WebRTC以前 在WebRTC面世以前,因为门槛较高,音视频通讯基本都是几大头部玩家的之间的游戏,例如Polycom、华为、思科、微软、BT、Vidyo等,各家都有自己的私有架构,都在闭关修炼。他们用到的QoS技术也都是各自的武功秘籍,只能从一些公开的文章或者协议标准的提交中窥探一二。2012年当我在Polycom看到WebRTC开源的消息时,还完全没有觉得是什么了不起的事情,Polycom当时有着一众音视频技术的科学家,支持各种编解码技术,是行业里的绝对头部,没想到几年光景下来就泯然于众了。 WebRTC以后 在WebRTC面世以后,音视频通讯领域第一次将其技术栈较全面的暴露在了阳光下,人人都可以基于上面做自己的实验、优化、演进,吸引了大量开发者、初创企业、互联网巨头的参与,不管是技术小白,还是行业专家,都不自觉的、主动或被动地卷入了WebRTC重新定义的音视频通讯行业。因为WebRTC本身也是一个比较优秀的架构,其QoS技术和带来的通讯效果都是不错的,所以很多企业也都放弃了原有的私有架构,转而在WebRTC的基础之上适配自己的业务逻辑,增加自己业务场景特有的QoS算法优化。 然而,WebRTC本身定位源于P2P的互联网浏览器间的通讯,其重点在客户端侧的架构与实现,而伴随云上音视频通讯业务场景的发展,媒体转发服务器变成了两个客户端之间不可缺少的一环。支持WebRTC协议的媒体服务器也有多种,例如janus、mediasoup、srs、licode、kurento、jitsi等,可以参考《十大必知开源WebRTC服务器》。但很多媒体转发服务器SFU都只是实现了转发功能,对链路控制的QoS技术支持非常的薄弱,有的甚至聊胜于无,而且由于服务器代码架构跟WebRTC的端侧代码架构差异巨大,导致迁移原有WebRTC的QoS算法,也变得非常困难。 QoS技术算法优化阶段 大概在2021年疫情前半段以前,互联网逐渐走到巅峰,大家都是业务高涨、快速迭代,各家都是拿来主义,直接把WebRTC编译通过之后,就集成到自己的SDK里面去了,先把业务做起来,再慢慢调优QoS算法,只要能满足高涨的业务需求,不会考虑架构是否复杂、实现是否优雅。这个阶段都是基于WebRTC的QoS算法优化,各类技术文章层出不穷,基本上覆盖了上面QoS技术体系中提到的各个技术点,网上90%以上关于QoS优化的文章都是这一类单点算法的优化和算法的深度解析。大家的技术水平很快被拉到了同一个起跑线上,对新入坑的音视频技术同学非常友好,只要愿意学很快就能上手。 这种QoS单点技术的优化升级,是提升QoS性能的核心手段,是最终提升用户体验的立足点,将会一直持续下去。但是这些单点算法优化也有瓶颈,一旦到达现有基础科学研究的天花板,想再提高就很难了,因为需要基础理论研究的突破为前提,这个投入产出不是一般商业公司愿意承担的,也不是一般的算法技术人员能够突破的,所以大部分的国内的公司和技术人员都选择了知难而退,也是大环境使然。 当然,大家也不用担心算法技术人员就无用武之地了,毕竟很多技术还没有到达基础科学的天花板,我们还有一些时间;毕竟我们最擅长的就是拿来主义,搞不了脑力,就搞体力,短期提高不了技术的高度,那我们可以从技术的广度入手,只要能挖掘足够多的用户场景,我们就可以针对特定的场景,进行量体裁衣,通过缝缝补补,就可以让各种场景都有一个比较好的体验,这也是一种价值体现罢。不止是QoS技术,我们的很多科学技术领域,每每说到这个层面总是让人心酸,也是没有办法的事情,希望有一天这种局面能有改观。 QoS技术架构升级阶段 随着疫情进入后半段,互联网热潮不再,IOT、云渲染、云游戏等新场景的出现,大家逐渐慢了下来,重新开始思考WebRTC这套框架是否是适合自己业务的,有没有更好的解法。对WebRTC源代码有一些了解或者参与过相关编译的同学都应该知道,WebRTC是非常庞大的一个实现,包含引用的第三方库的话,源文件数量接近20万个,这种数量级的代码给环境部署、编译配置、工程引用都带来了很大的麻烦,以至于网上有人把编译WebRTC做成了一门生意,按次收费。很少有公司能拿WebRTC直接使用,都是需要找专门的同学,做环境的配置、代码的裁剪等一系列对业务没啥价值的事情,费力不讨好。 QoS技术作为WebRTC中最有价值的技术之一,则被深度捆绑在整个代码框架里面,如果不做伤筋动骨的改造,很难直接被用在非WebRTC的代码框架中。下图是简单梳理的WebRTC中跟QoS相关的媒体处理部分流程,熟悉WebRTC代码的同学应该可以比较清楚地知道图里面每个模块的意义和作用,这里就不展开介绍了。其中红色的部分是QoS相关的模块,我们可以看出,整个流程相互耦合在一起,没有办法单独将QoS功能抽取出来。 同时,对于IOT、云游戏、云渲染等场景,由于有自己特有的采集渲染、编解码功能,不能使用WebRTC的整个框架,而只需要媒体传输、QoS控制能力,所以不得不对WebRTC做裁剪,对QoS算法进行剥离。这种业务需求推动了,对原有WebRTC架构的思考和升级,推动了QoS技术的架构演进。 这种架构的升级演进具体如何来做?我认为,首先要从音视频通讯技术链路和功能模块的抽象来入手,抽象到一定高度,就看清了事物的本质,看清了本质,就能比较容易看清各个模块之间的关系,然后才能物以类聚进行解耦。下图是对QoS推拉流功能和处理流程的抽象。 经过上面的抽象之后,我们就能比较清楚地定义出QoS功能的边界,能够进一步将QoS内部的各个功能进行重新设计实现,最终可能会变成下图分层解耦、功能模块化的样子。有了这种架构的QoS模块,就可以非常方便地迁移到各种不同的场景,甚至可以迁移到媒体转发服务器SFU上面去,实现QoS能力的快速复用,一次优化多点受益,加速新场景的商业化速度。例如,央视三星堆奇幻之旅的项目中的QoS部分,就是使用了演进后的QoS模块功能,《三星堆大型沉浸式数字交互空间最佳实践》。 从音视频通讯软件演进的形态来看,最终的结果可能是又回到了WebRTC开源之前的状态,各家有各自的私有软件架构,各家又回到了自己的QoS技术优化的小圈子,看起来绕了一圈又回到了起点,只是每家都吸收了WebRTC的精华。 本文从更宏观、更宽泛的角度介绍了QoS的概念和分类,从音视频通讯QoS领域的常用技术到架构的演进过程做了简单汇总。随着音视频通讯新场景的不断涌现,更实时,更高清变得越来越重要,相关技术也会往这个方向倾斜,同时基于大数据分析的QoS相关技术应用将会逐渐渗透。

优秀的个人博客,低调大师

每日一博 | 解构内核源码 eBPF 样例编译过程

作者:闻茂泉 他山之石 了解和掌握纯c语言的ebpf编译和使用,有助于我们加深对于eBPF技术原理的进一步掌握,也有助于开发符合自己业务需求的高性能的ebpf程序。目前常见和主流的纯c语言的ebpf编译使用方法,主要是两种。一种是内核源码中原生提供的编译方式。另外一种是libbpf-bootstrap项目中提供的skeleton编译方式。libbpf-bootstrap方式和社区5.x以上内核结合的比较好,以后再做介绍,今天我们选择基于4.18内核的基于内核源码的原生编译方式做介绍。 在国内学习ebpf技术,就不得不提到《Linux内核观测技术BPF》书籍译者狄卫华老师。狄老师还有一个网站《深入浅出 eBPF》。在网站里,他专门用一篇文章介绍了基于内核源码方式编译ebpf的方式,文章内容叫《【BPF入门系列-3】BPF 环境搭建》 网址:https://www.ebpf.top/post/ebpf_c_env/ 我们今天将参考这篇文章内容,对基于内核源码方式的纯c语言的ebpf编译方式做进一步分析。 获取内核源码 目前主流的服务器的操作系统环境还是以8u + 4.18内核为主。因此,本文以4.18版本内核为主要分析对象。我们提供如下操作系统环境的获取建议: 获取操作系统环境 如果你自己有centos8u兼容环境操作系统,则可以使用已有的环境。如果没有,可以通过阿里云官网购买阿里云主机,选择选择centos8或者anolis8操作系统环境。 $ cat /etc/centos-release CentOS Linux release 8.5.2111 $ uname -r 4.18.0-348.7.1.el8_5.x86_64 获取开源的内核源码 可以使用wget,从aliyun官网镜像,获取开源的4.18内核源码。 $ cd /tmp/$ wget https://mirrors.aliyun.com/linux-kernel/v4.x/linux-4.18. tar.gz$ tar -zxvf linux-4.18.tar.gz$ cd linux-4.18 下载内核源码一定要确保内核版本与操作系统的一致。原因是ebpf会用到VERSION、PATCHLEVEL和SUBLEVEL这3个宏的值与内核做内核版本校验。如果版本传的不对,ebpf校验会失败。 $ cat Makefile | grep -P '^VERSION|^PATCHLEVEL|^SUBLEVEL' VERSION = 4 PATCHLEVEL = 18 SUBLEVEL = 0 初始化基础环境 需要安装ebpf编译时依赖的llvm和clang等rpm包。此外内核编译还需要依赖openssl-devel等rpm包。 $ sudo yum install bison flex openssl-devel $ sudo yum install clang llvm elfutils-libelf-devel 具体每个实验机器的环境可能略有差别,需要根据自己的情况做细节调整。 编译内核源码中ebpf程序样例 编译环境初始化 狄老师的文章中这里执行的是make scripts,在内核源码编译时此步骤前通常还需要执行make prepare。而make init正好包含这两步make prepare && make scripts。因此,我们将命令按照如下方式优化,基本能够一遍跑过: $ cd /tmp/linux-4.18 $ make oldconfig && make init # make oldconfig && make prepare && make scripts $ make headers_install 编译内核源码样例 终于执行到了内核源码中提供的ebpf程序样例的编译。 $ make M=samples/bpf 执行样例程序 我们可以通过对样例程序的执行,对编译效果进行验证。结果显示执行成功,狄老师文章中的步骤验证通过,有点小激动。 $ sudo ./samples/bpf/trace_output recv 1766352 events per sec 内核源码的ebpf编译关键过程提取 接下去就是本文最重点的部分,对ebpf编译过程的分析。我们主要分分析headers_install和对samples/bpf目录的make这2个步骤。 头文件安装 make headers_install 重新获取一个干净的内核源码,再次执行上面的编译步骤。这次我们对编译过程增加一些观察步骤。 $ cd /tmp/ $ rm -fr /tmp/linux-4.18 $ tar -zxvf linux-4.18.tar.gz $ cd /tmp/linux-4.18 $ make oldconfig && make init $ ls usr/include/ ls: cannot access usr/include/: No such file or directory # 此时include目录不存在 $ make headers_install $ ls usr/include/ -R | grep -v -P ':$' | grep -v -P '^$' | wc -l931 # 此时include目录下有931个文件 $ diff -rs usr/include/ /usr/include/|grep -P '^Files .+ and .+ are identical$'|wc -l677 这说明内核源码目录下,headers_install步骤生成的usr/include/目录下功能900多个文件,其中大多数(677个)文件都能在操作系统环境的/usr/include/下找到完全一摸一样的同名文件,并且内容也完全相同。 $ rpm -ql kernel-headers | wc -l 964 $ rpm -ql kernel-headers | head /usr/include/asm /usr/include/asm-generic /usr/include/asm-generic/bpf_perf_event.h 而操作系统环境的/usr/include/目录正好是kernel-headers包的安装目录。所以编译过程中headers_install步骤就是在内核源码目录生成了kernel-headers包作用一样的内容。 eBPF样例编译 make M=samples/bpf ebpf样例的编译过程,我们做一下改进,通过SHELL选项打开shell的调试选项。具体命令如下: $ make M=samples/bpf --debug=v,m SHELL="bash -x" > make.log 2>&1 通过分析make.log,再结合其他一些黑科技,可以大概找出内核源码样例中trace_output命令的编译脉络。其中用户态编译脉络如下。为了表述上更加突出主题,此处只显示编译命令的关键信息,下一节会给出完整编译命令。 $ gcc -g -fPIC -c -o libbpf.o libbpf.c $ gcc -g -fPIC -c -o bpf.o bpf.c $ gcc -g -fPIC -c -o btf.o btf.c $ gcc -g -fPIC -c -o nlattr.o nlattr.c $ ld -r -o libbpf-in.o libbpf.o bpf.o nlattr.o btf.o $ ar rcs libbpf.a libbpf-in.o $ gcc -O2 -std=gnu89 -c -o bpf_load.o bpf_load.c $ gcc -O2 -std=gnu89 -c -o trace_output_user.o trace_output_user.c $ gcc -O2 -std=gnu89 -c -o trace_helpers.o trace_helpers.c $ gcc -o trace_output bpf_load.o trace_output_user.o trace_helpers.o libbpf.a -lelf -lrt 其中内核态编译脉络如下: $ clang -O2 -emit-llvm -c trace_output_kern.c -o - $ llc -march=bpf -filetype=obj -o trace_output_kern.o 其中前一行最后的横线-表示 这里是输出给shell管道,所以这两行实际是可以通过shell管道拼接成一个命令来执行的。 手工编译内核源码中的eBPF样例分析 通过上一节对关键步骤make M=samples/bpf的实践,我们已经可以编译出内核源码中提供的ebpf样例。但这还不够我们充分地理解这个编译过程,我们将这编译过程继续拆解一下,拆解成可以一步步执行的那种,为了方便大家理解,我将这个过程分解为 A-H 6大手工步骤,里面还会包含一些细分的小步骤: $ cd /tmp/ $ rm -fr /tmp/linux-4.18$ tar -zxvf linux-4.18.tar.gz $ cd /tmp/linux-4.18 $ make oldconfig && make init $ make headers_install $ cd tools/lib/bpf/ 手工步骤A过程解析 手工步骤A1: $ # gcc -g -fPIC -c -o libbpf.o libbpf.c $ gcc -g -DHAVE_LIBELF_MMAP_SUPPORT -DCOMPAT_NEED_REALLOCARRAY -fPIC -I. -I/tmp/linux-4.18/tools/include -I/tmp/linux-4.18/tools/arch/x86/include/uapi -I/tmp/linux-4.18/tools/include/uapi -I/tmp/linux-4.18/tools/perf -D"BUILD_STR(s)=#s" -c -o libbpf.o libbpf.c 手工步骤A2: $ # gcc -g -fPIC -c -o bpf.o bpf.c $ gcc -g -DHAVE_LIBELF_MMAP_SUPPORT -DCOMPAT_NEED_REALLOCARRAY -fPIC -I. -I/tmp/linux-4.18/tools/include -I/tmp/linux-4.18/tools/arch/x86/include/uapi -I/tmp/linux-4.18/tools/include/uapi -I/tmp/linux-4.18/tools/perf -D"BUILD_STR(s)=#s" -c -o bpf.o bpf.c 手工步骤A3: $ # gcc -g -fPIC -c -o btf.o btf.c $ gcc -g -DHAVE_LIBELF_MMAP_SUPPORT -DCOMPAT_NEED_REALLOCARRAY -fPIC -I. -I/tmp/linux-4.18/tools/include -I/tmp/linux-4.18/tools/arch/x86/include/uapi -I/tmp/linux-4.18/tools/include/uapi -I/tmp/linux-4.18/tools/perf -D"BUILD_STR(s)=#s" -c -o btf.o btf.c 手工步骤A4: $ # gcc -g -fPIC -c -o nlattr.o nlattr.c $ gcc -g -DHAVE_LIBELF_MMAP_SUPPORT -DCOMPAT_NEED_REALLOCARRAY -fPIC -I. -I/tmp/linux-4.18/tools/include -I/tmp/linux-4.18/tools/arch/x86/include/uapi -I/tmp/linux-4.18/tools/include/uapi -I/tmp/linux-4.18/tools/perf -D"BUILD_STR(s)=#s" -c -o nlattr.o nlattr.c 针对手工步骤A1到A4的关键编译选项做一些介绍。 -fPIC,告诉编译器输出位置无关目标,为后面生成共享库埋下伏笔。 -I. 表示需要包含当前目录下的头文件。 -I/tmp/linux-4.18/tools/include -I/tmp/linux-4.18/tools/arch/x86/include/uapi -I/tmp/linux-4.18/tools/include/uapi -I/tmp/linux-4.18/tools/perf,这4个头文件,是用户态ebpf程序所依赖tool目录下的头文件位置。 手工步骤B过程解析 $ ld -r -o libbpf-in.o libbpf.o bpf.o nlattr.o btf.o 手工步骤B是将步骤A中产生4个.o文件进行链接。 手工步骤C过程解析 $ ar rcs libbpf.a libbpf-in.o 手工步骤C是从链接后的文件中提取静态库文件。 手工步骤D/E/F过程解析 手工步骤D: $ # gcc -O2 -std=gnu89 -c -o bpf_load.o bpf_load.c $ gcc -O2 -fomit-frame-pointer -std=gnu89 -I./usr/include -I./tools/lib/ -I./tools/testing/selftests/bpf/ -I./tools/lib/ -I./tools/include -I./tools/perf -I./usr/include -Wno-unused-variable -c -o samples/bpf/bpf_load.o samples/bpf/bpf_load.c 手工步骤E: $ # gcc -O2 -std=gnu89 -c -o trace_output_user.o trace_output_user.c $ gcc -O2 -fomit-frame-pointer -std=gnu89 -I./usr/include -I./tools/lib/ -I./tools/testing/selftests/bpf/ -I./tools/lib/ -I./tools/include -I./tools/perf -I./tools/lib/bpf/ -c -o samples/bpf/trace_output_user.o samples/bpf/trace_output_user.c 手工步骤F: $ # gcc -O2 -std=gnu89 -c -o trace_helpers.o trace_helpers.c $ gcc -O2 -fomit-frame-pointer -std=gnu89 -I./usr/include -I./tools/lib/ -I./tools/testing/selftests/bpf/ -I./tools/lib/ -I./tools/include -I./tools/perf -I./tools/lib/bpf/ -c -o samples/bpf/../../tools/testing/selftests/bpf/trace_helpers.o samples/bpf/../../tools/testing/selftests/bpf/trace_helpers.c 针对手工步骤E的关键编译选项做一些介绍。手工步骤D和手工步骤F与此类似。 O2 和 -std=gnu89 是两个核心选项。 include选项,一共有6个,我们将其分为3组。第一组是-I./usr/include ,这表示包含等同于kernel-headers的内容。● 第二组是-I./tools/lib/, -I./tools/include,-I./tools/perf,-I./tools/lib/bpf/● 第三组是-I./tools/testing/selftests/bpf/。之所以把这一组单独独立出来,是因为它和样例代码处于同样的路径。 手工步骤G过程解析 $ # gcc -o trace_output bpf_load.o trace_output_user.o trace_helpers.o libbpf.a -lelf -lrt $ gcc -o samples/bpf/trace_output samples/bpf/bpf_load.o samples/bpf/trace_output_user.o samples/bpf/../../tools/testing/selftests/bpf/trace_helpers.o /tmp/linux-4.18/samples/bpf/../../tools/lib/bpf/libbpf.a -lelf -lrt 针对手工步骤G的关键编译选项做一些介绍。 -lelf -lrt链接两个类库 libbpf.a表示以静态链接库的方式链接libbpf的类库。● 最关键的是,没有添加-static选项,没有添加-static选项,没有添加-static选项,重要的事情说三遍。 手工步骤H过程解析 $ clang -nostdinc -isystem /usr/lib/gcc/x86_64-redhat-linux/8/include -I./arch/x86/include -I./arch/x86/include/generated -I./include -I./arch/x86/include/uapi -I./arch/x86/include/generated/uapi -I./include/uapi -I./include/generated/uapi -include ./include/linux/kconfig.h -Isamples/bpf -I./tools/testing/selftests/bpf/ -D__KERNEL__ -D__BPF_TRACING__ -D__TARGET_ARCH_x86 -O2 -emit-llvm -c samples/bpf/trace_output_kern.c -o - | llc -march=bpf -filetype=obj -o samples/bpf/trace_output_kern.o 针对手工步骤H的关键编译选项做一些介绍。 -nostdinc -isystem /usr/lib/gcc/x86_64-redhat-linux/8/include,这2个选项是一组。nostdinc表示屏蔽掉系统默认的include环境,替换成当前gcc编译器自带的include头文件环境。 -I./arch/x86/include,-I./arch/x86/include/generated,-I./include,-I./arch/x86/include/uapi,-I./arch/x86/include/generated/uapi,-I./include/uapi,-I./include/generated/uapi。这7个头文件很关键,是内核态ebpf程序所依赖的绝大多数头文件的位置。● -include ./include/linux/kconfig.h,这个头文件也很关键,是让上面7个头文件生效的前提条件。● -I samples/bpf 和 -I ./tools/testing/selftests/bpf/,这2个头文件是和ebpf样例所处位置相同,单独独立出来看。● llc是llvm的连接器。内核是将clang的编译和llc的链接独立成两步完成,在llc步骤才指定-march=bpf。对编译结果进行验证,完美验证通过,第二次有点小激动。 $ sudo ./samples/bpf/trace_outputrecv 1760674 events per sec 关键步骤抽取不是最终目的,根本目的是能让我们实现脱离内核源码进行独立的纯C语言编译。我们将在后续的文章中进一步阐述。 关于4.9版本内核 按照内核的原生步骤,对4.9内核进行一次编译,我们会发现对应手工步骤E的这一步,编译代码有点不一样,具体代码如下。 $ gcc -o samples/bpf/trace_output samples/bpf/bpf_load.o samples/bpf/libbpf.o samples/bpf/trace_output_user.o -lelf -lrt 其中没有了对libbpf.a静态库的链接,但却多了一个libbpf.o文件的链接。 $ cd /tmp/linux-4.9/ $ find . -name libbpf.c ./samples/bpf/libbpf.c ./tools/lib/bpf/libbpf.c 查询内核源码,可以发现,在4.9内核下,有2个libbpf.c文件,分别处于./tools/lib/bpf/目录和./samples/bpf/目录。而内核ebpf样例暂时使用的还是老的./samples/bpf/libbpf.c文件。 进一步探索 本文为eBPF动手实践系列的第一篇,我们实现了基于内核源码框架的一步一步的纯C语言编译,下一篇我们会对这个编译过程继续深入探索,实现脱离内核源码后的纯C语言编译。 欢迎有想法或者有问题的同学,加群交流eBPF技术以及工程实践。 SREWorks数智运维工程群(钉钉群号:35853026) 附录: eBPF手工纯C编译完整命令清单 cd /tmp/rm -fr /tmp/linux-4.18tar -zxvf linux-4.18.tar.gz cd /tmp/linux-4.18make oldconfig && make initmake headers_installcd tools/lib/bpf/ # 步骤A1# gcc -g -fPIC -c -o libbpf.o libbpf.cgcc -g -DHAVE_LIBELF_MMAP_SUPPORT -DCOMPAT_NEED_REALLOCARRAY -fPIC -I. -I/tmp/linux-4.18/tools/include -I/tmp/linux-4.18/tools/arch/x86/include/uapi -I/tmp/linux-4.18/tools/include/uapi -I/tmp/linux-4.18/tools/perf -D"BUILD_STR(s)=#s" -c -o libbpf.o libbpf.c # 步骤A2# gcc -g -fPIC -c -o bpf.o bpf.cgcc -g -DHAVE_LIBELF_MMAP_SUPPORT -DCOMPAT_NEED_REALLOCARRAY -fPIC -I. -I/tmp/linux-4.18/tools/include -I/tmp/linux-4.18/tools/arch/x86/include/uapi -I/tmp/linux-4.18/tools/include/uapi -I/tmp/linux-4.18/tools/perf -D"BUILD_STR(s)=#s" -c -o bpf.o bpf.c # 步骤A3# gcc -g -fPIC -c -o btf.o btf.cgcc -g -DHAVE_LIBELF_MMAP_SUPPORT -DCOMPAT_NEED_REALLOCARRAY -fPIC -I. -I/tmp/linux-4.18/tools/include -I/tmp/linux-4.18/tools/arch/x86/include/uapi -I/tmp/linux-4.18/tools/include/uapi -I/tmp/linux-4.18/tools/perf -D"BUILD_STR(s)=#s" -c -o btf.o btf.c # 步骤A4# gcc -g -fPIC -c -o nlattr.o nlattr.cgcc -g -DHAVE_LIBELF_MMAP_SUPPORT -DCOMPAT_NEED_REALLOCARRAY -fPIC -I. -I/tmp/linux-4.18/tools/include -I/tmp/linux-4.18/tools/arch/x86/include/uapi -I/tmp/linux-4.18/tools/include/uapi -I/tmp/linux-4.18/tools/perf -D"BUILD_STR(s)=#s" -c -o nlattr.o nlattr.c # 步骤Bld -r -o libbpf-in.o libbpf.o bpf.o nlattr.o btf.o # 步骤Car rcs libbpf.a libbpf-in.o cd /tmp/linux-4.18/ # 步骤D# gcc -O2 -std=gnu89 -c -o bpf_load.o bpf_load.cgcc -O2 -fomit-frame-pointer -std=gnu89 -I./usr/include -I./tools/lib/ -I./tools/testing/selftests/bpf/ -I./tools/lib/ -I./tools/include -I./tools/perf -I./usr/include -Wno-unused-variable -c -o samples/bpf/bpf_load.o samples/bpf/bpf_load.c # 步骤E# gcc -O2 -std=gnu89 -c -o trace_output_user.o trace_output_user.cgcc -O2 -fomit-frame-pointer -std=gnu89 -I./usr/include -I./tools/lib/ -I./tools/testing/selftests/bpf/ -I./tools/lib/ -I./tools/include -I./tools/perf -I./tools/lib/bpf/ -c -o samples/bpf/trace_output_user.o samples/bpf/trace_output_user.c # 步骤F# gcc -O2 -std=gnu89 -c -o trace_helpers.o trace_helpers.cgcc -O2 -fomit-frame-pointer -std=gnu89 -I./usr/include -I./tools/lib/ -I./tools/testing/selftests/bpf/ -I./tools/lib/ -I./tools/include -I./tools/perf -I./tools/lib/bpf/ -c -o samples/bpf/../../tools/testing/selftests/bpf/trace_helpers.o samples/bpf/../../tools/testing/selftests/bpf/trace_helpers.c # 步骤G# gcc -o trace_output bpf_load.o trace_output_user.o trace_helpers.o libbpf.a -lelf -lrtgcc -o samples/bpf/trace_output samples/bpf/bpf_load.o samples/bpf/trace_output_user.o samples/bpf/../../tools/testing/selftests/bpf/trace_helpers.o /tmp/linux-4.18/samples/bpf/../../tools/lib/bpf/libbpf.a -lelf -lrt # 步骤Hclang -nostdinc -isystem /usr/lib/gcc/x86_64-redhat-linux/8/include -I./arch/x86/include -I./arch/x86/include/generated -I./include -I./arch/x86/include/uapi -I./arch/x86/include/generated/uapi -I./include/uapi -I./include/generated/uapi -include ./include/linux/kconfig.h -Isamples/bpf -I./tools/testing/selftests/bpf/ -D__KERNEL__ -D__BPF_TRACING__ -D__TARGET_ARCH_x86 -O2 -emit-llvm -c samples/bpf/trace_output_kern.c -o - | llc -march=bpf -filetype=obj -o samples/bpf/trace_output_kern.o

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册